


KARL: Knowledge Agents via Reinforcement Learning 요약 설명
05 Mar 2026 | Paper Review Search Agents Reinforcement Learning Synthetic Data Test-Time Scaling목차
- 요약
- 1 Introduction
- 2 KARLBench
- 3 Agent Harness
- 4 Training a Knowledge Agent via Reinforcement Learning (KARL)
- 5 Scaling KARL via Test-time Compute
- 6 Agent Infrastructure
- 7.1 Evaluation and Training Set
- 7.2 Training Data Synthesis
- 7.3 Training Experiments
- 7.4 Test-Time Compute Experiments
- 8.1 Quantitative Behavioral Analysis
- 8.2 Qualitative Case Studies
- 9 Conclusion
- 부록
- 짧은 생각
이번 글에서는 KARL: Knowledge Agents via Reinforcement Learning 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 5일(Arxiv)
- Chang, Jonathan D., Drozdov, Andrew, Toshniwal, Shubham, Oertell, Owen, Trott, Alexander, Portes, Jacob, Gupta, Abhay, Koppol, Pallavi, Baheti, Ashutosh, Kulinski, Sean, et al.
- Databricks AI Research
- 논문 링크
요약
- KARL: Knowledge Agents via Reinforcement Learning은 폐쇄형 문서 집합에 근거한 추론을 연구한다. 6가지 검색 유형을 다루는 KARLBench를 제안하고, 문서에 근거한 합성 과제와 반복적인 대규모 배치 off-policy 강화학습으로 GLM 4.5 Air를 사후 학습한다.
- KARL은 BrowseComp-Plus와 TREC-Biogen에서 검색 질의, 답변 생성, 문맥 압축을 함께 학습하며, 나머지 4개 과제는 RL 학습에서 제외한다. 추가 test-time compute 없이 KARLBench 점수가 기본 모델의 52.6에서 58.9로 오른다. 병렬 rollout 10개를 사용하면 Claude Opus 4.6과 같은 67.5에 도달하고, 20개를 사용하면 68.1에 도달한다.
- 압축 모델 교체 실험과 검색 상태별 궤적 분석은 성능 향상이 검색뿐 아니라 문맥 관리와 근거 활용의 개선에서도 비롯되었음을 뒷받침한다. 다만 결과는 벡터 검색만 사용하는 harness에 한정된다. 수치 추론 실패, 정보를 잘못 보존한 압축, LLM 기반 채점, 일관되지 않은 필터링 설명 때문에 더 넓은 기업 환경에서 신뢰성이 확보되었다고 보기는 어렵다.
1 Introduction
근거 기반 추론에는 기업의 비공개 지식처럼 모델 파라미터에 없는 정보가 필요하다. 논문은 특정 검색 벤치마크에서 성공했다고 해서 제약 충족, 보고서 합성, 수치 추론, 전수 검색, 절차 설명 능력까지 입증되지는 않는다고 주장한다. KARLBench와 이질적인 과제를 활용한 RL 학습은 이러한 평가와 학습의 공백을 다룬다.
- 시스템은 에이전트 기반 과제 합성, OAPL 사후 학습, 공통 검색 harness, 추론 시점의 병렬 연산을 결합한다.
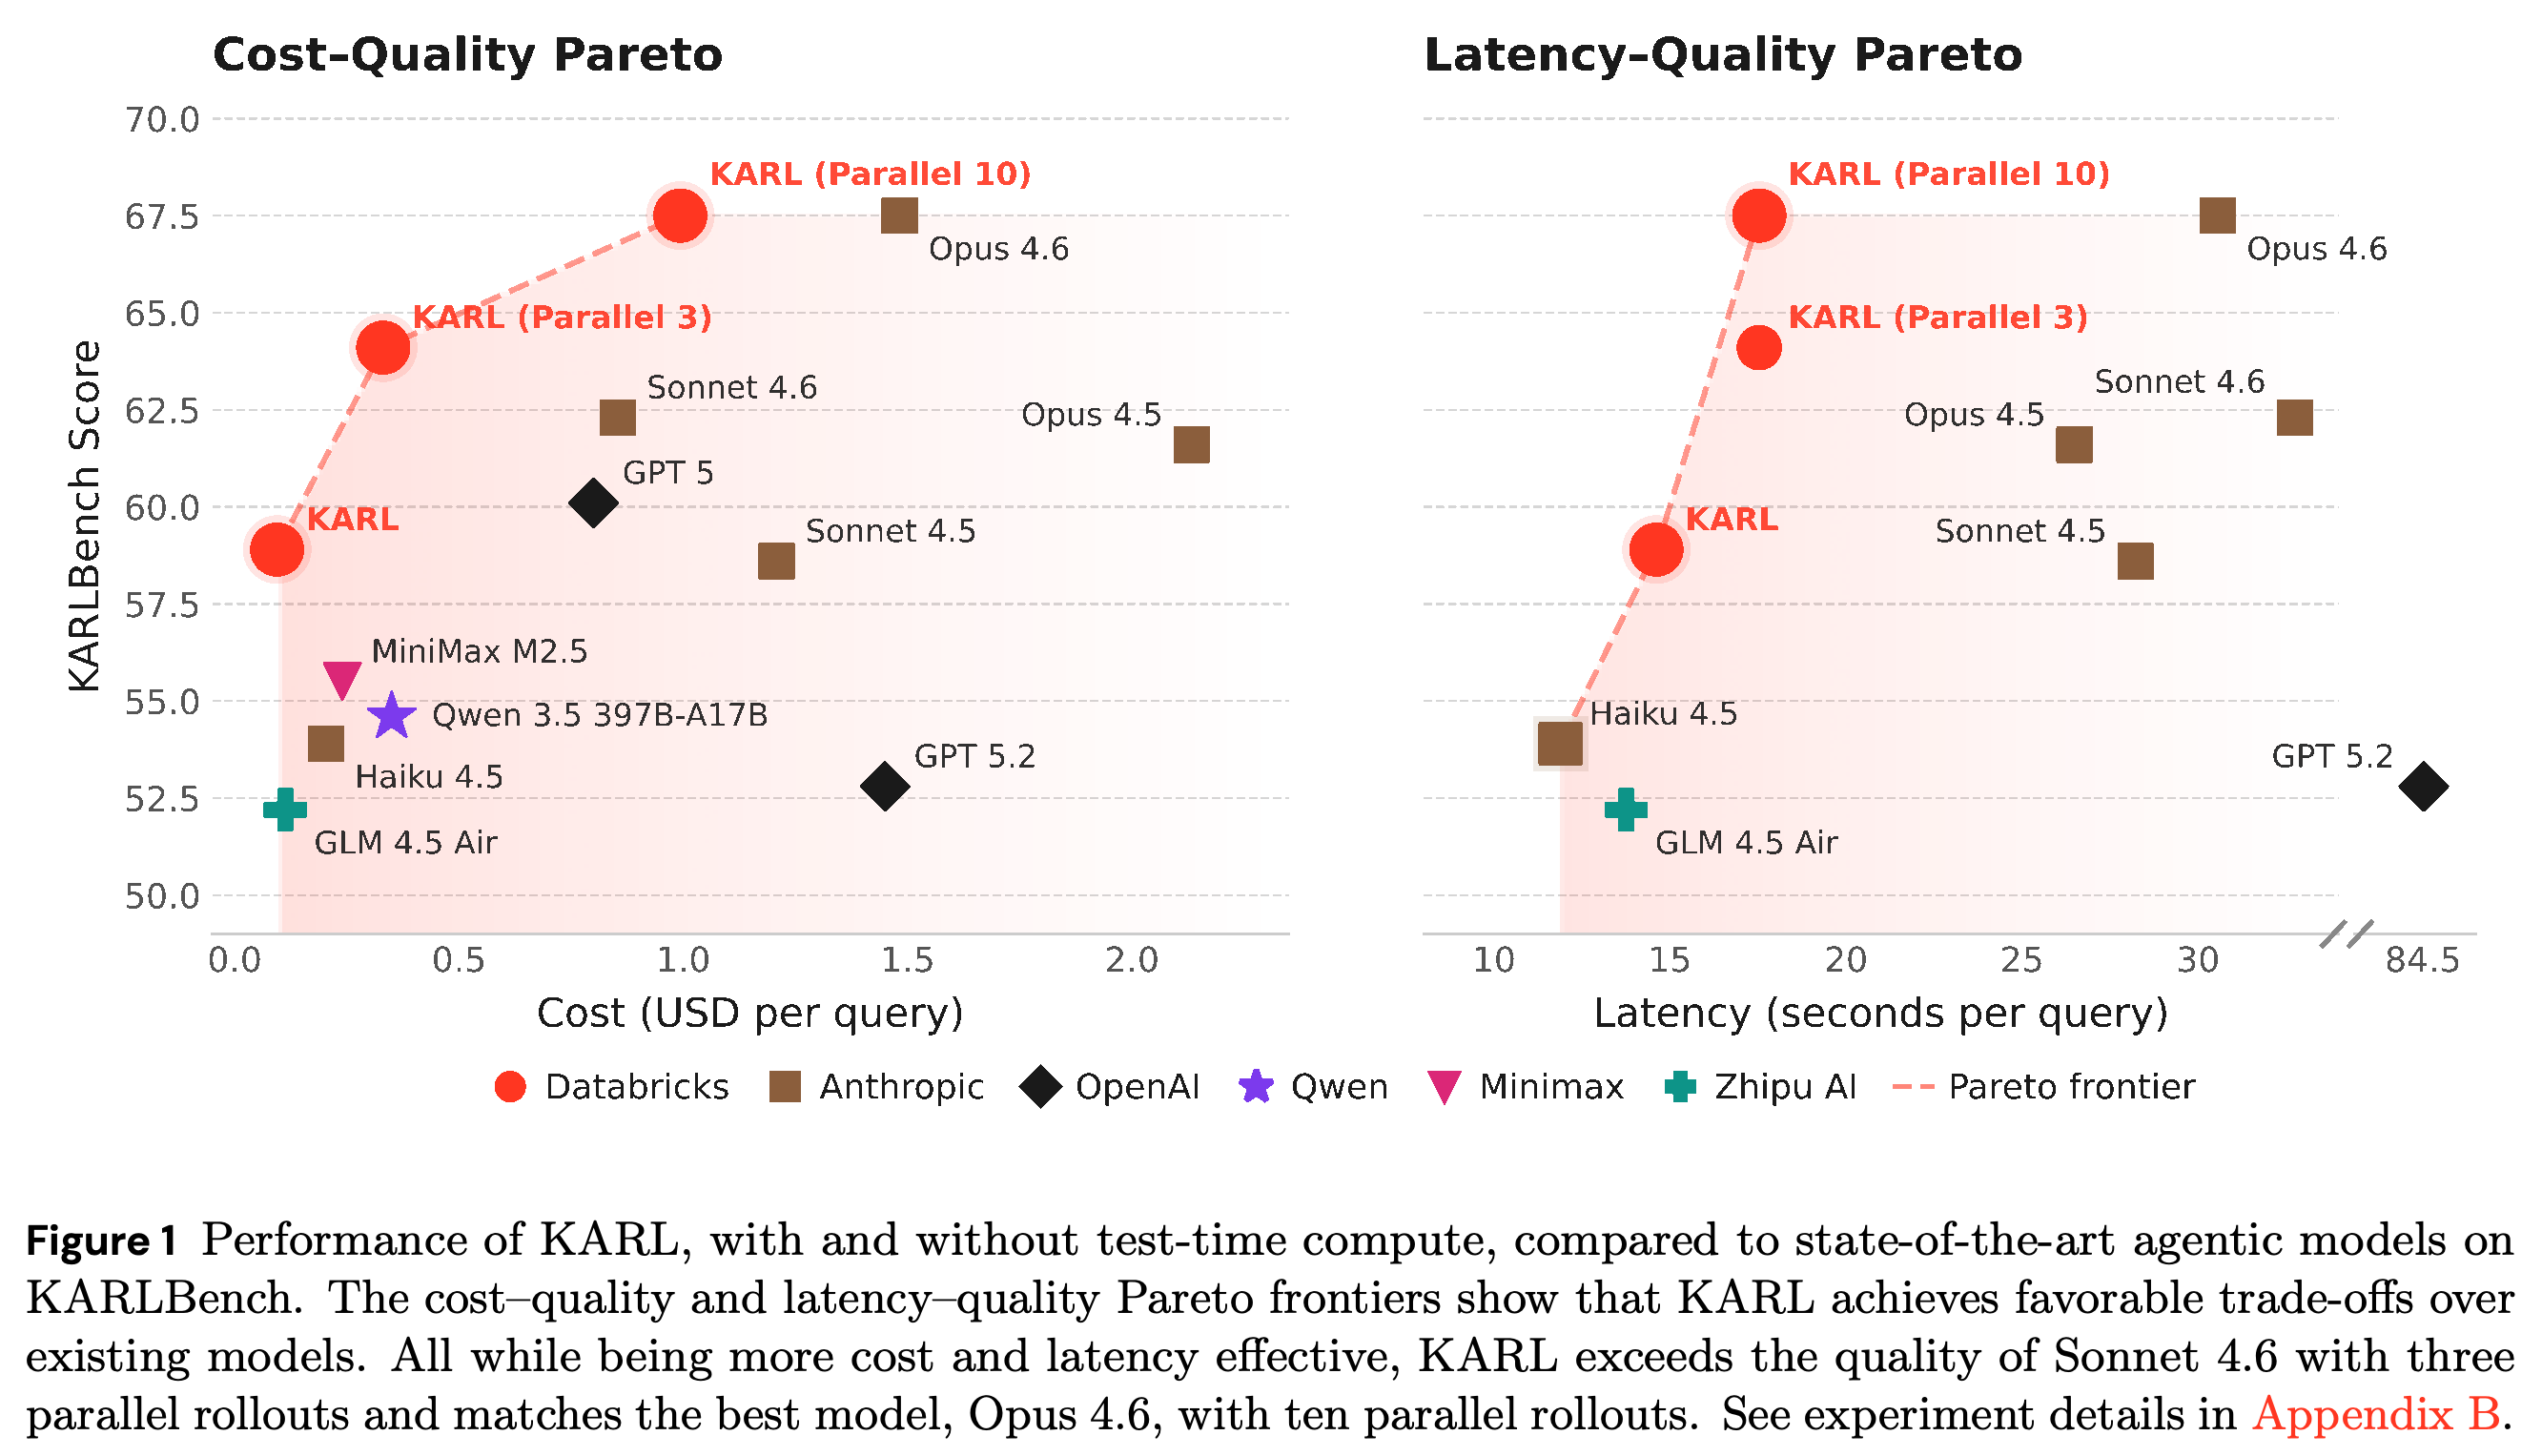
- Figure 1은 논문에서 사용한 추론 설정, 토큰 가격, 지연 시간 측정 절차에 따른 비용·품질 및 지연 시간·품질의 절충 관계를 요약한다.
병렬 rollout 3개는 Sonnet 4.6의 전체 점수를 넘고, 10개는 보고된 프로토콜에서 Opus 4.6과 같은 점수를 얻는다. 품질을 고려했을 때 유리한 위치는 토큰 가격과 지연 시간 정의에 따라 달라진다. 이 그래프는 KARL이 기본 모델보다 항상 빠르거나 저렴하다는 것을 보여주지 않는다.
2 KARLBench
KARLBench는 구조적으로 다른 6가지 근거 기반 추론 능력을 각각 평가한다. 에이전트가 벡터 검색만 사용하도록 제한해 검색 인터페이스를 통제하고, 더 폭넓은 도구 조율의 영향을 배제한 채 근거 획득과 통합을 살펴본다. 다만 OfficeQA 같은 벤치마크에 필요한 더 폭넓은 도구 조율은 평가하지 않는다.
2.1 Tasks Overview
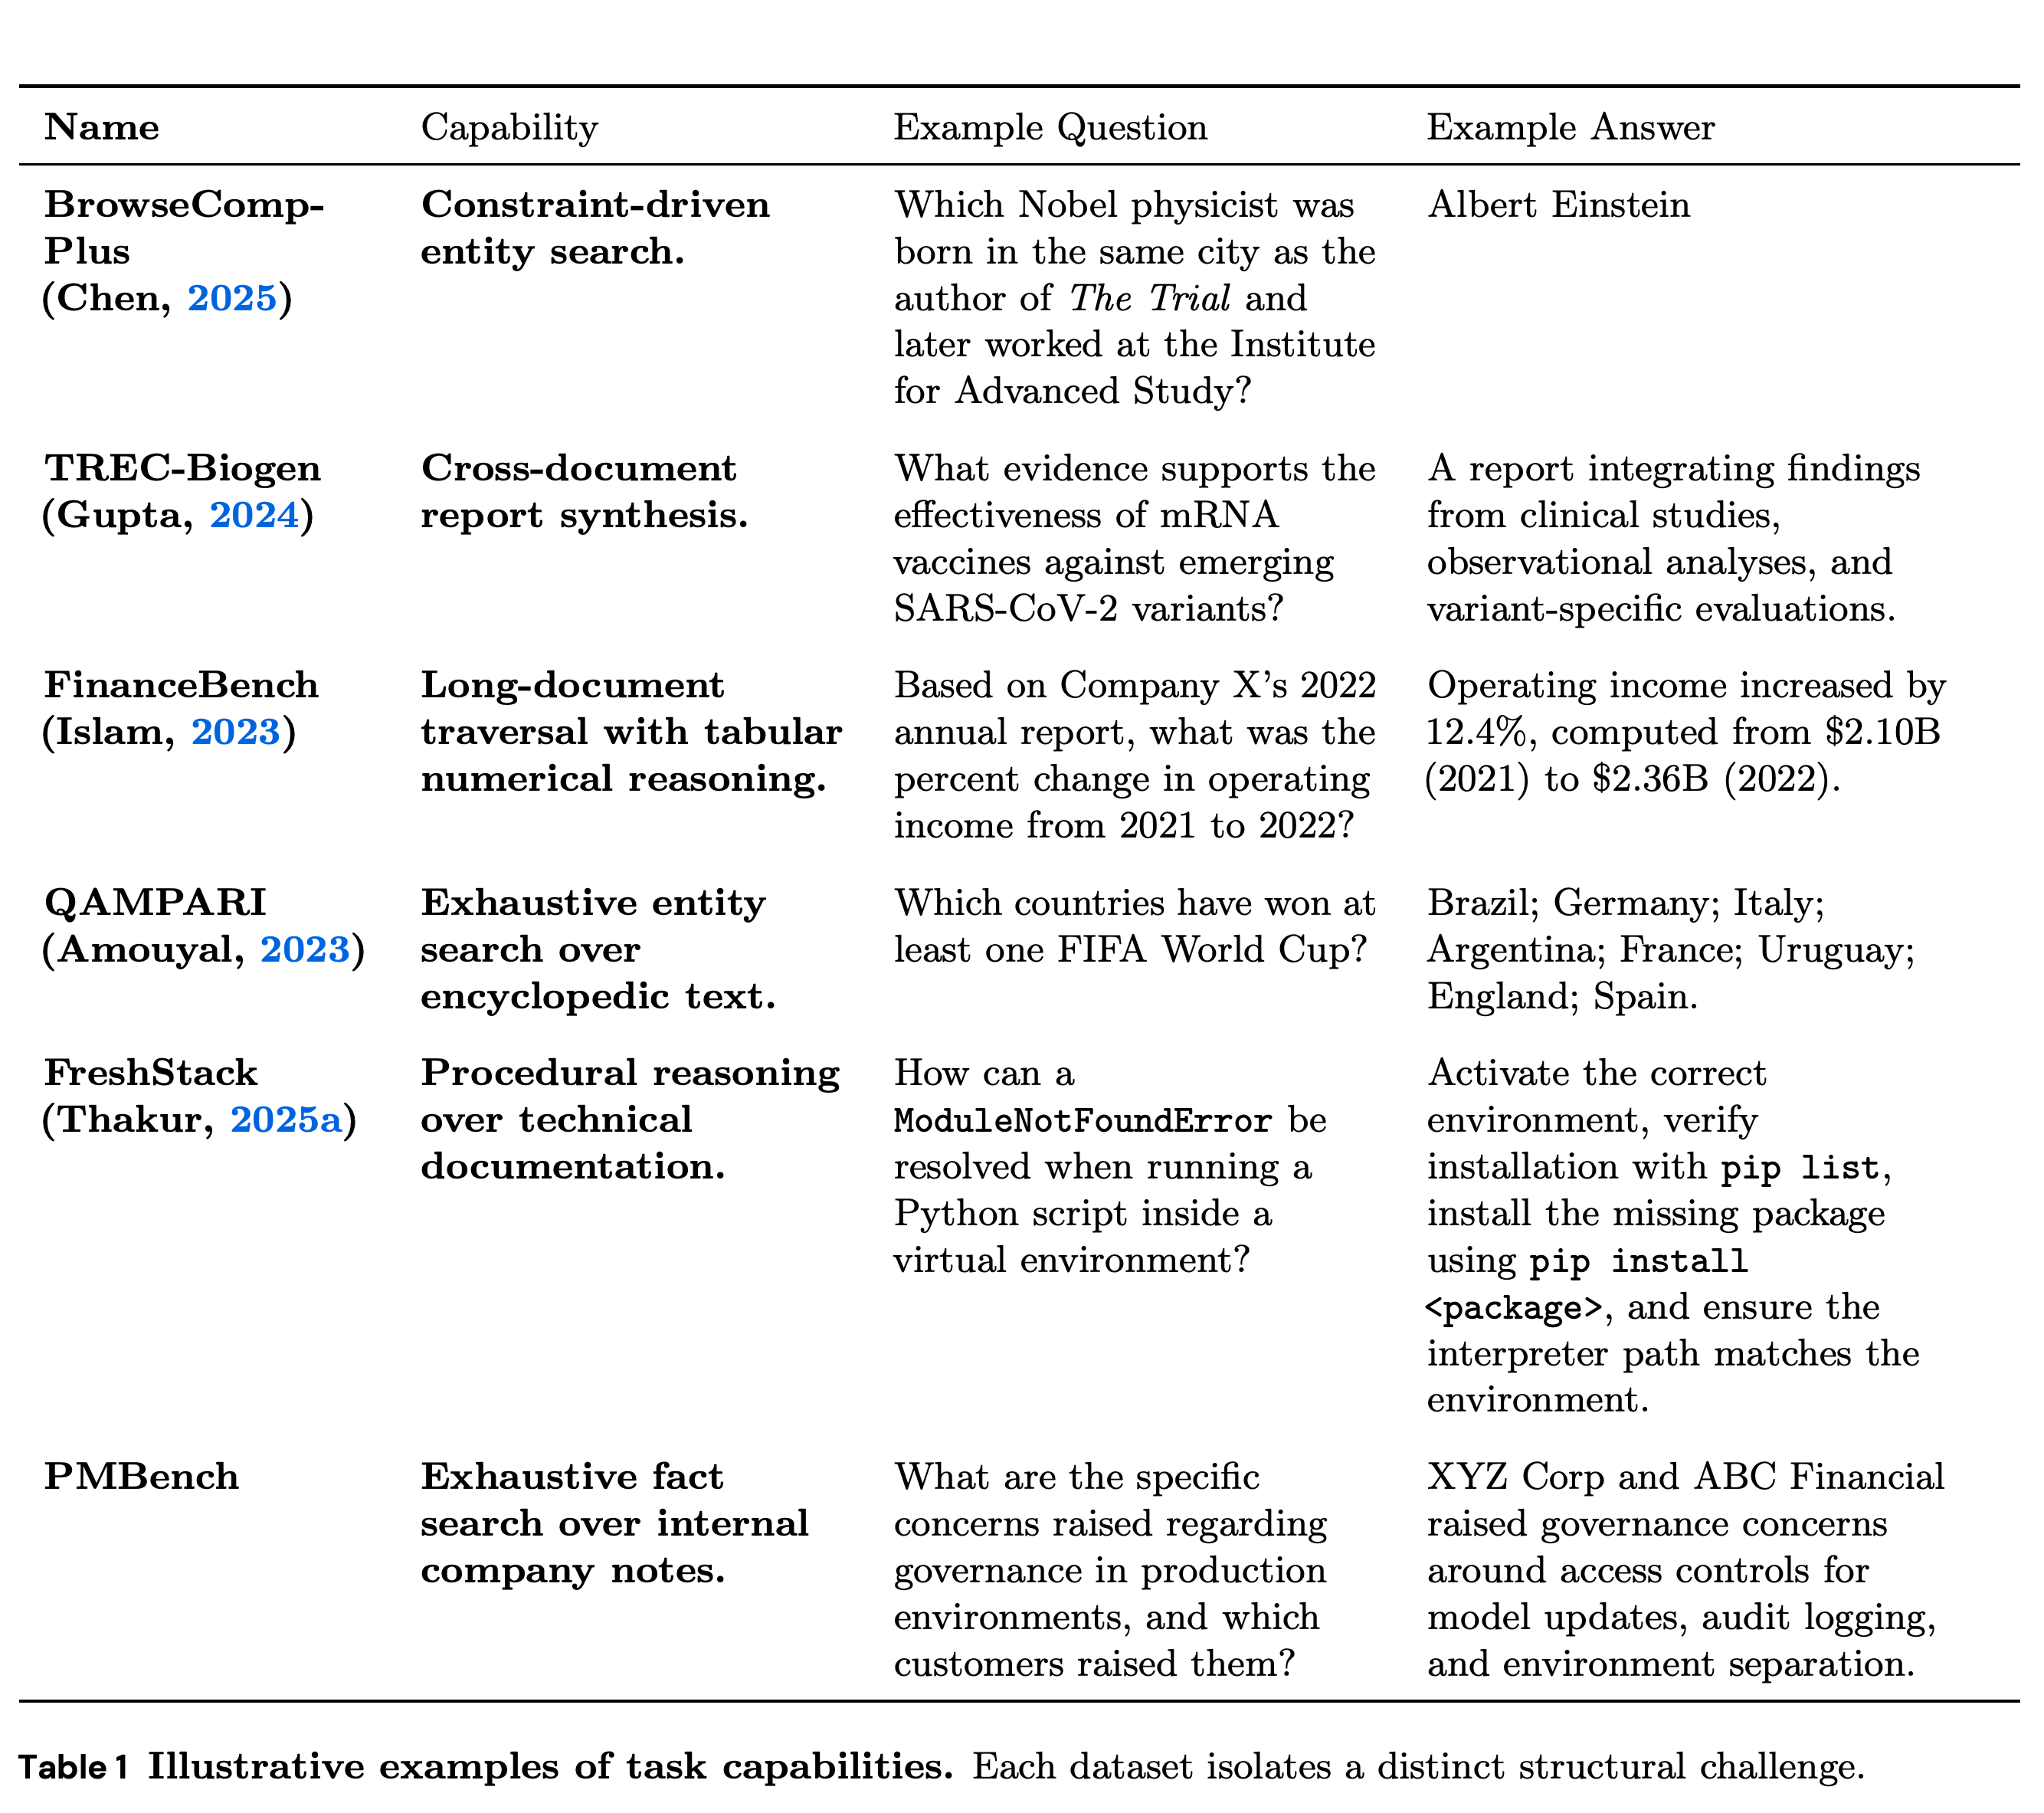
BrowseComp-Plus는 제약에 맞는 개체 검색을, TREC-Biogen은 여러 문서를 종합한 생의학 보고서 작성을, FinanceBench는 긴 문서 탐색과 표 기반 수치 추론을 평가한다. QAMPARI는 개체를 빠짐없이 검색해야 하며, FreshStack은 기술 문서와 소스 코드에 대한 절차적 추론을, PMBench는 사내 메모에 흩어진 사실의 종합을 요구한다.
- Table 1은 측정된 모델 성능이 아니라 과제 형식을 보여준다.
- 정답 1개를 찾는 과제와 여러 근거 사실을 모으는 과제의 차이가 깊이 있는 검색과 폭넓은 검색을 함께 학습하는 동기가 된다.
예시들은 단일 개체 식별과 여러 사실을 종합한 보고, 수치 계산, 전수 열거, 기술 절차, 기업 메모 종합을 구분한다. 검증된 답변 품질이나 측정된 벤치마크 성능이 아니라 과제의 다양성을 보여준다.
2.2 Corpus Construction
코퍼스를 구성할 때는 가능한 한 원래 분할을 유지하고, 데이터셋별 재분할, 의미적 정보 추가, 메타데이터 보강, 후속 성능에 따른 chunk 크기 조정을 피한다. BrowseComp-Plus는 문서마다 처음 512 tokens를 색인하고, FinanceBench는 페이지를, FreshStack은 제공된 최대 2048 tokens의 chunk를, TREC-Biogen은 초록을 사용한다.
- QAMPARI는 정답 개체가 적어도 1개 포함된 문장 단위 chunk를 색인하며, 총 256,680개 chunk를 사용한다. 따라서 제한 없는 백과사전 코퍼스가 아니라 범위를 좁힌 전수 검색 환경이다.
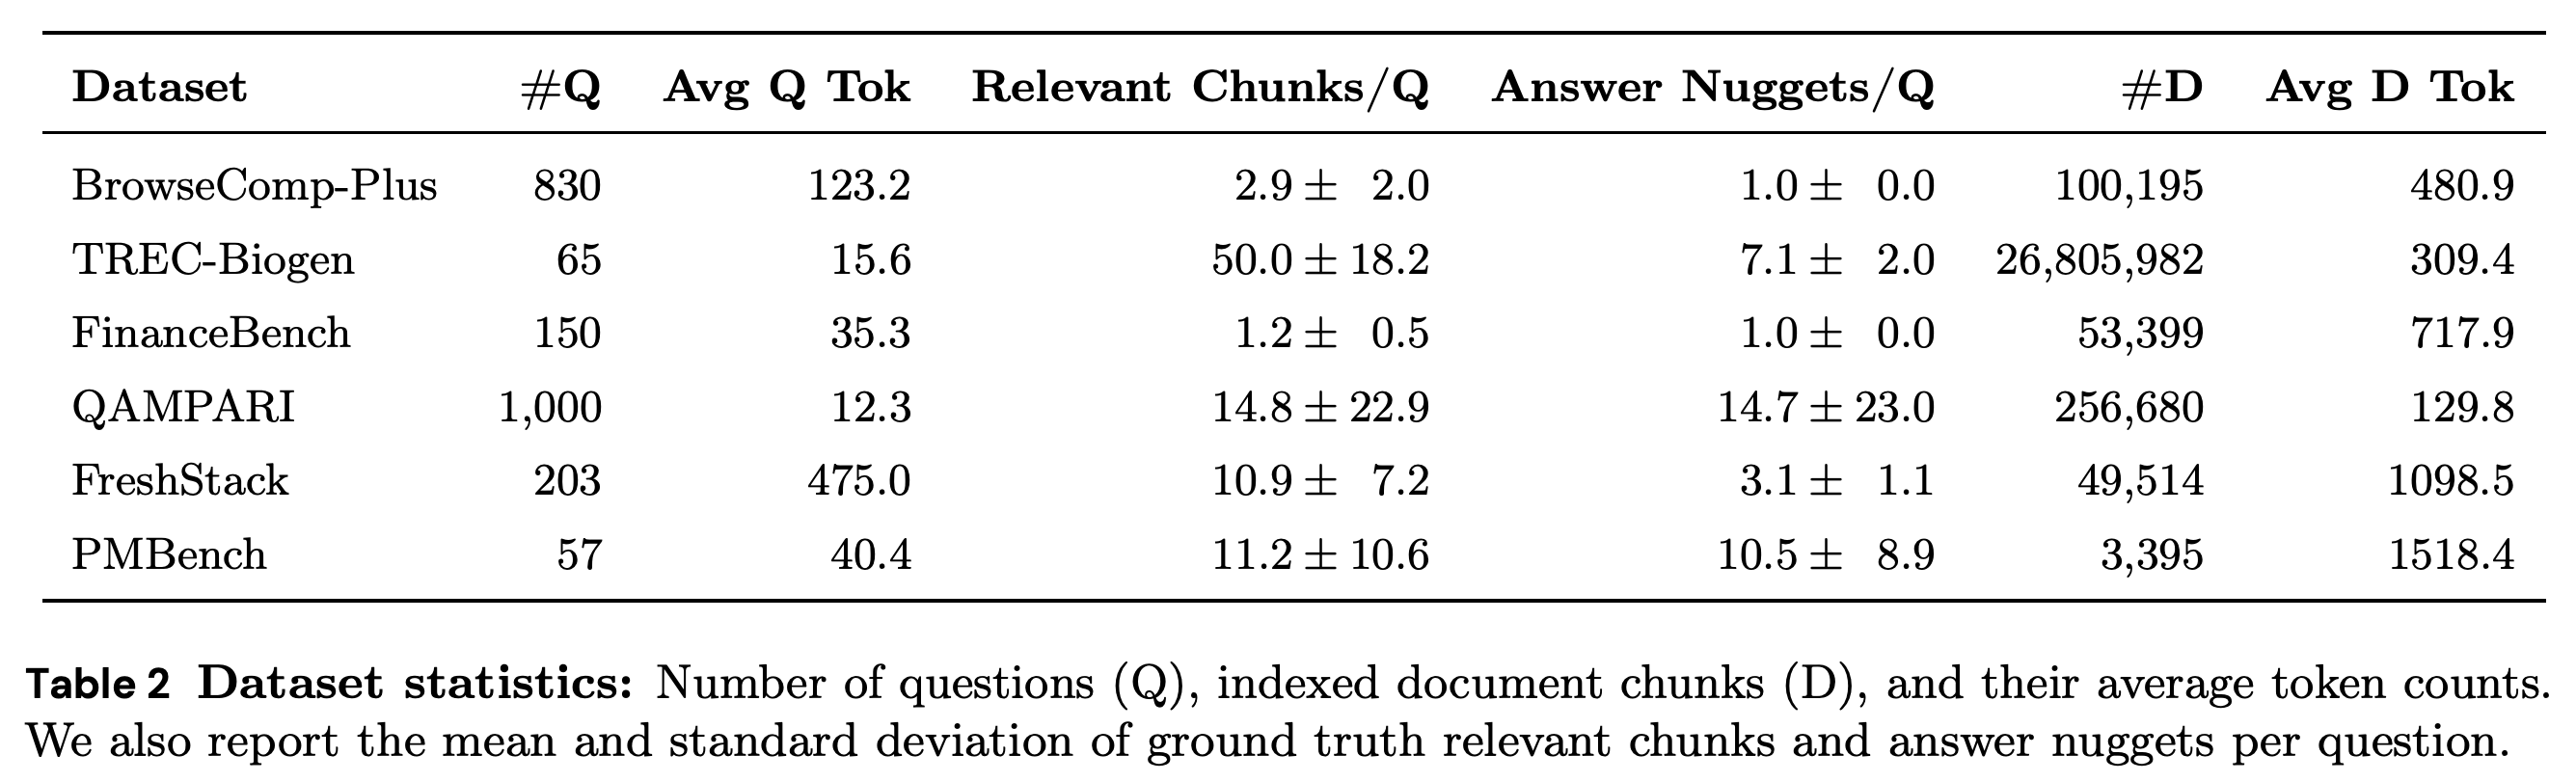
- PMBench는 문서마다 처음 2048 tokens를 색인한다. Table 2에 제시된 코퍼스 규모는 PMBench의 3,395개 chunk부터 TREC-Biogen의 26,805,982개 초록까지 다양하다.
- BrowseComp-Plus의 처음 512 tokens에는 정답 근거의 86.5%가 포함된다. 따라서 추가 문서 탐색 도구가 없으면 주석으로 지정된 근거를 확보할 수 있는 범위가 제한된다. 폐쇄형 코퍼스는 실시간 웹 콘텐츠와 검색 엔진에서 발생하는 변동도 피한다.
2.3 Evaluation
모든 과제는 nugget 단위의 충족도를 기준으로 평가한다. QAMPARI의 개체는 각각 별도 nugget이 되고, FreshStack과 PMBench의 참조 답변은 고정된 사실로 분해된다. TREC-Biogen의 참조 답변은 각각 독립적으로 분해한 뒤 통합한다. BrowseComp-Plus와 FinanceBench는 각각 올바른 nugget 1개를 요구한다.
- Table 2에는 BrowseComp-Plus 830개, TREC-Biogen 65개, FinanceBench 150개, QAMPARI 1,000개, FreshStack 203개, PMBench 57개 질문이 보고된다. 이후 실험에서는 보정된 BrowseComp-Plus 부분집합을 사용한다.
- 평가 모델은 답변이 참조 사실을 뒷받침하는지, 부분적으로 뒷받침하는지, 뒷받침하지 않는지를 판단한다. 이는 참조 사실의 충족도를 측정하며, 추가 주장이나 인용의 타당성을 별도로 종합 점검하는 평가는 아니다.
코퍼스 크기, chunk 길이, 필요한 답변 수는 크게 다르다. TREC-Biogen에는 색인된 초록 26,805,982개가 있고, PMBench에는 chunk 3,395개가 있다. QAMPARI와 PMBench는 많은 답변 nugget을 요구하므로, 단일 사실의 정확도만으로 모든 과제를 설명하기 어렵다.
3 Agent Harness
에이전트는 벡터 검색 질의를 반복해서 보내고, 근거가 충분하다고 판단하면 답변을 생성한다. 누적된 상호작용 기록이 임계값에 도달하면 자체 모델로 압축한다. 압축 결과도 검색 질의와 답변처럼 최종 성과에 따른 RL 학습을 받는다.
- 검색 결과 수는 검색으로 가져오는 토큰 예산을 비슷하게 맞추도록 정하며, k = 20을 상한으로 둔다. BrowseComp-Plus는 Qwen3-8B 임베딩을, PMBench는 GTE-large를 사용한다. TREC-Biogen, QAMPARI, FinanceBench는 Qwen3-0.6B와 k = 20을, FreshStack은 Qwen3-0.6B와 k = 10을 사용한다.
- 압축은 요약 데이터로 별도 사전 학습하지 않는다. 일반 harness 설명은 토큰 수를 기준으로 압축을 시작하지만, BrowseComp-Plus 합성 설정은 150K characters를 기준으로 명시한다.
4 Training a Knowledge Agent via Reinforcement Learning (KARL)
KARL 학습은 근거 기반 과제와 궤적을 에이전트로 합성하는 과정, OAPL을 이용한 off-policy RL, 상호 보완적인 검색 행동을 함께 최적화하는 다중 과제 학습을 결합한다. 반복 사이에 합성 모델과 풀이 모델을 갱신하므로, 이후의 오프라인 데이터는 최신 정책이 생성한다.
4.1 Agentic Synthesis
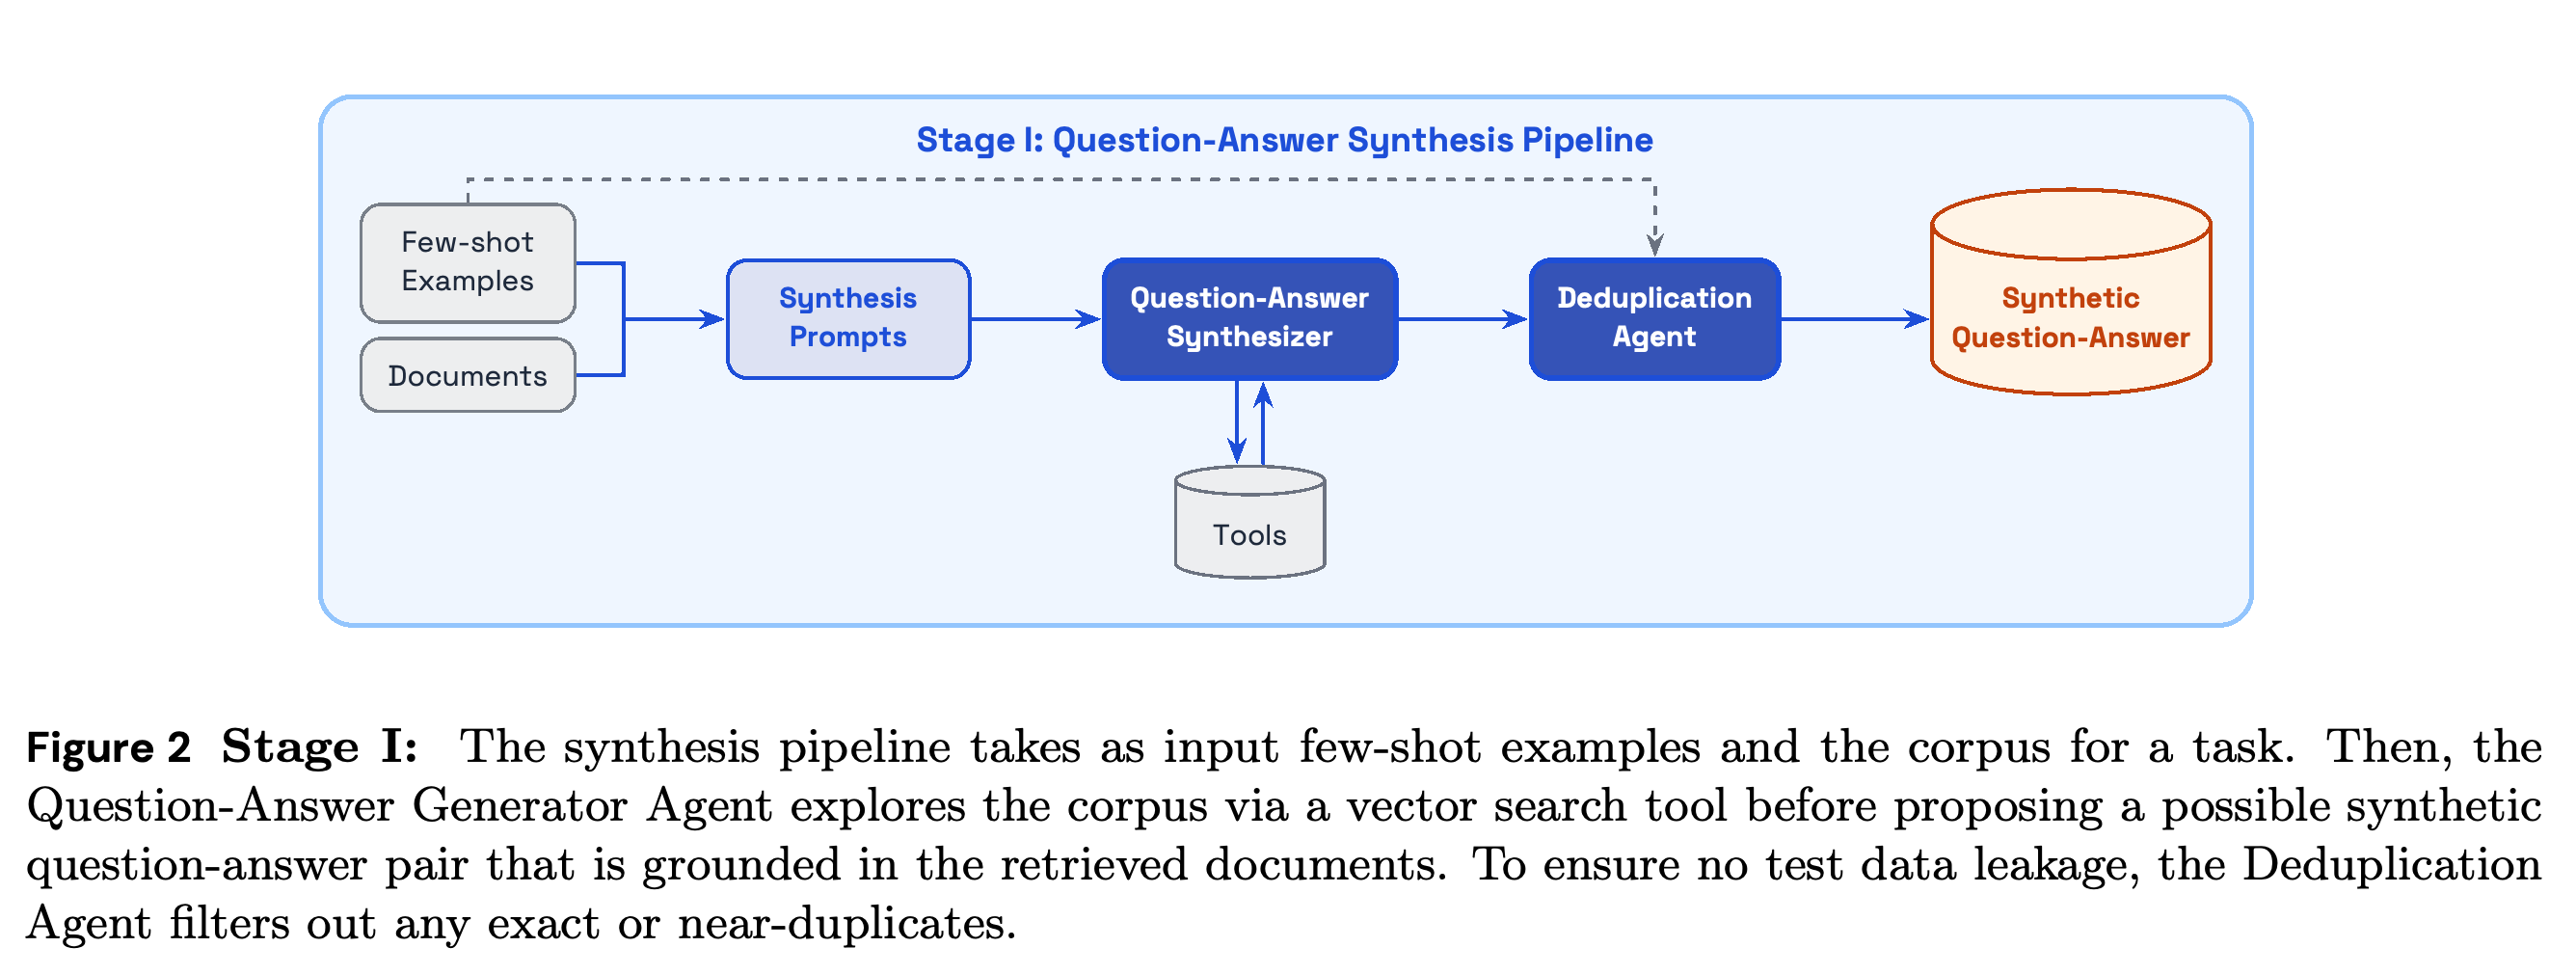
Stage I에서는 few-shot 예시와 코퍼스 탐색으로 검색 문서에 근거한 질문·답변 쌍을 합성한 뒤, 정확히 일치하거나 의미가 같은 중복을 제거한다. Stage II에서는 독립적인 풀이를 생성하고 모든 시도가 성공하거나 실패한 질문을 제거한다. 또한 모호한 질문이나 잘못된 참조 답변을 판별하는 품질 평가 모델을 제안한다.
- Figure 2는 도구를 통한 코퍼스 탐색과 고정된 문서 집합을 입력으로 사용하는 합성을 구분한다.
- Figure 3은 성공과 실패가 섞인 rollout 그룹을 남겨, 그룹 단위 advantage 추정에 필요한 결과 차이를 확보한다.
- 일반 파이프라인 설명은 품질 필터링을 표준 단계로 제시하지만, Appendix D.3은 문서화된 다중 과제 학습 실행에서 BrowseComp-Plus Iter. 1에만 사용했다고 보고한다.
합성 모델은 도구로 코퍼스를 탐색한 뒤 근거 기반 과제를 제안하고, 중복 제거 에이전트는 seed 예시와의 중복을 검사한다. 이는 정확히 일치하거나 의미가 같은 중복을 줄일 수 있지만, 도식만으로 평가 데이터 누출이 전혀 없다고 입증할 수는 없다.
4.2 Post-training via Off-Policy RL
Optimal Advantage-based Policy Optimization with Lagged Inference policy (OAPL)은 정책과 참조 정책의 로그 확률 비율을 KL 정규화 RL이 정의하는 최적 advantage에 맞춰 회귀한다. 최소제곱 목적함수는 min_π ∑_x ∑_{i=1}^G (β ln[π(y_i|x)/π_ref(y_i|x)] − [r(x,y_i) − V̂⋆(x)])²이며, V̂⋆(x) = β ln[(1/G)∑_{i=1}^G exp(r(x,y_i)/β)]이다.
- 최적 정책은 π⋆(y|x) ∝ π_ref(y|x) exp(r(x,y)/β)이다. 가치 추정 논증은 참조 정책이 프롬프트를 해결할 확률에 하한이 있다고 가정한다. 실제로는 β1이 가치 추정치의 평활도를, β2가 로그 비율 항의 정규화 강도를 제어한다.
- 모델이 생성한 토큰만 rollout 로그 확률 계산에 포함하며, 프롬프트와 도구 출력은 마스킹한다. 압축 경계에서 긴 궤적을 구간으로 나누며, 기록을 입력으로 받아 요약을 생성하는 별도 학습 쌍도 포함한다.
- 각 구간은 전체 궤적의 결과 보상과 최초 프롬프트의 가치 추정치를 그대로 받는다. 반복 사이에 참조 정책을 교체하고 오프라인 데이터를 다시 생성하며, 실험에서는 최대 3회 반복한다.
- 저자들은 importance weight clipping, off-policy 데이터 삭제, router replay 없이 대규모 MoE를 안정적으로 학습했다고 보고한다. 오프라인 rollout을 재사용하면 여러 갱신과 하이퍼파라미터 실험에 생성 비용을 분산할 수 있다. 다만 논문에는 이 효율성 이점을 정량화하는 동일 조건의 온라인 GRPO 비교 실험이 없다.
4.3 Multi-task RL Post Training
다중 과제 RL은 BrowseComp-Plus의 깊이 있는 검색과 TREC-Biogen의 폭넓은 검색을 결합하고, 전체 학습 토큰에서 각 과제가 차지하는 비중을 대략 균등하게 맞춘다. 대안으로는 RL 전문가를 각각 학습한 뒤, 이들의 궤적을 supervised fine-tuning으로 GLM 4.5 Air에 증류한다.
- 일반화는 합성에 사용한 2개 도메인의 성능과 함께, KARL의 RL 학습에서 제외한 4개 과제에서 평가한다.
- 이후 비교는 RL이 증류보다 더 잘 일반화한다는 주장의 범위를 제한한다. 단일 rollout에서는 SFT의 OOD 점수가 더 높지만, 실험한 parallel thinking 예산에서는 KARL의 OOD 점수가 더 높다.
5 Scaling KARL via Test-time Compute
논문은 실제 경과 시간을 고려해 순차적 추론을 늘리는 대신 병렬 연산으로 test-time compute를 확장한다. 과제에 독립적인 parallel thinking과, 학습된 성공 예측기가 필요한 과제별 Value-Guided Search (VGS)를 비교한다.
5.1 Parallel Thinking TTC
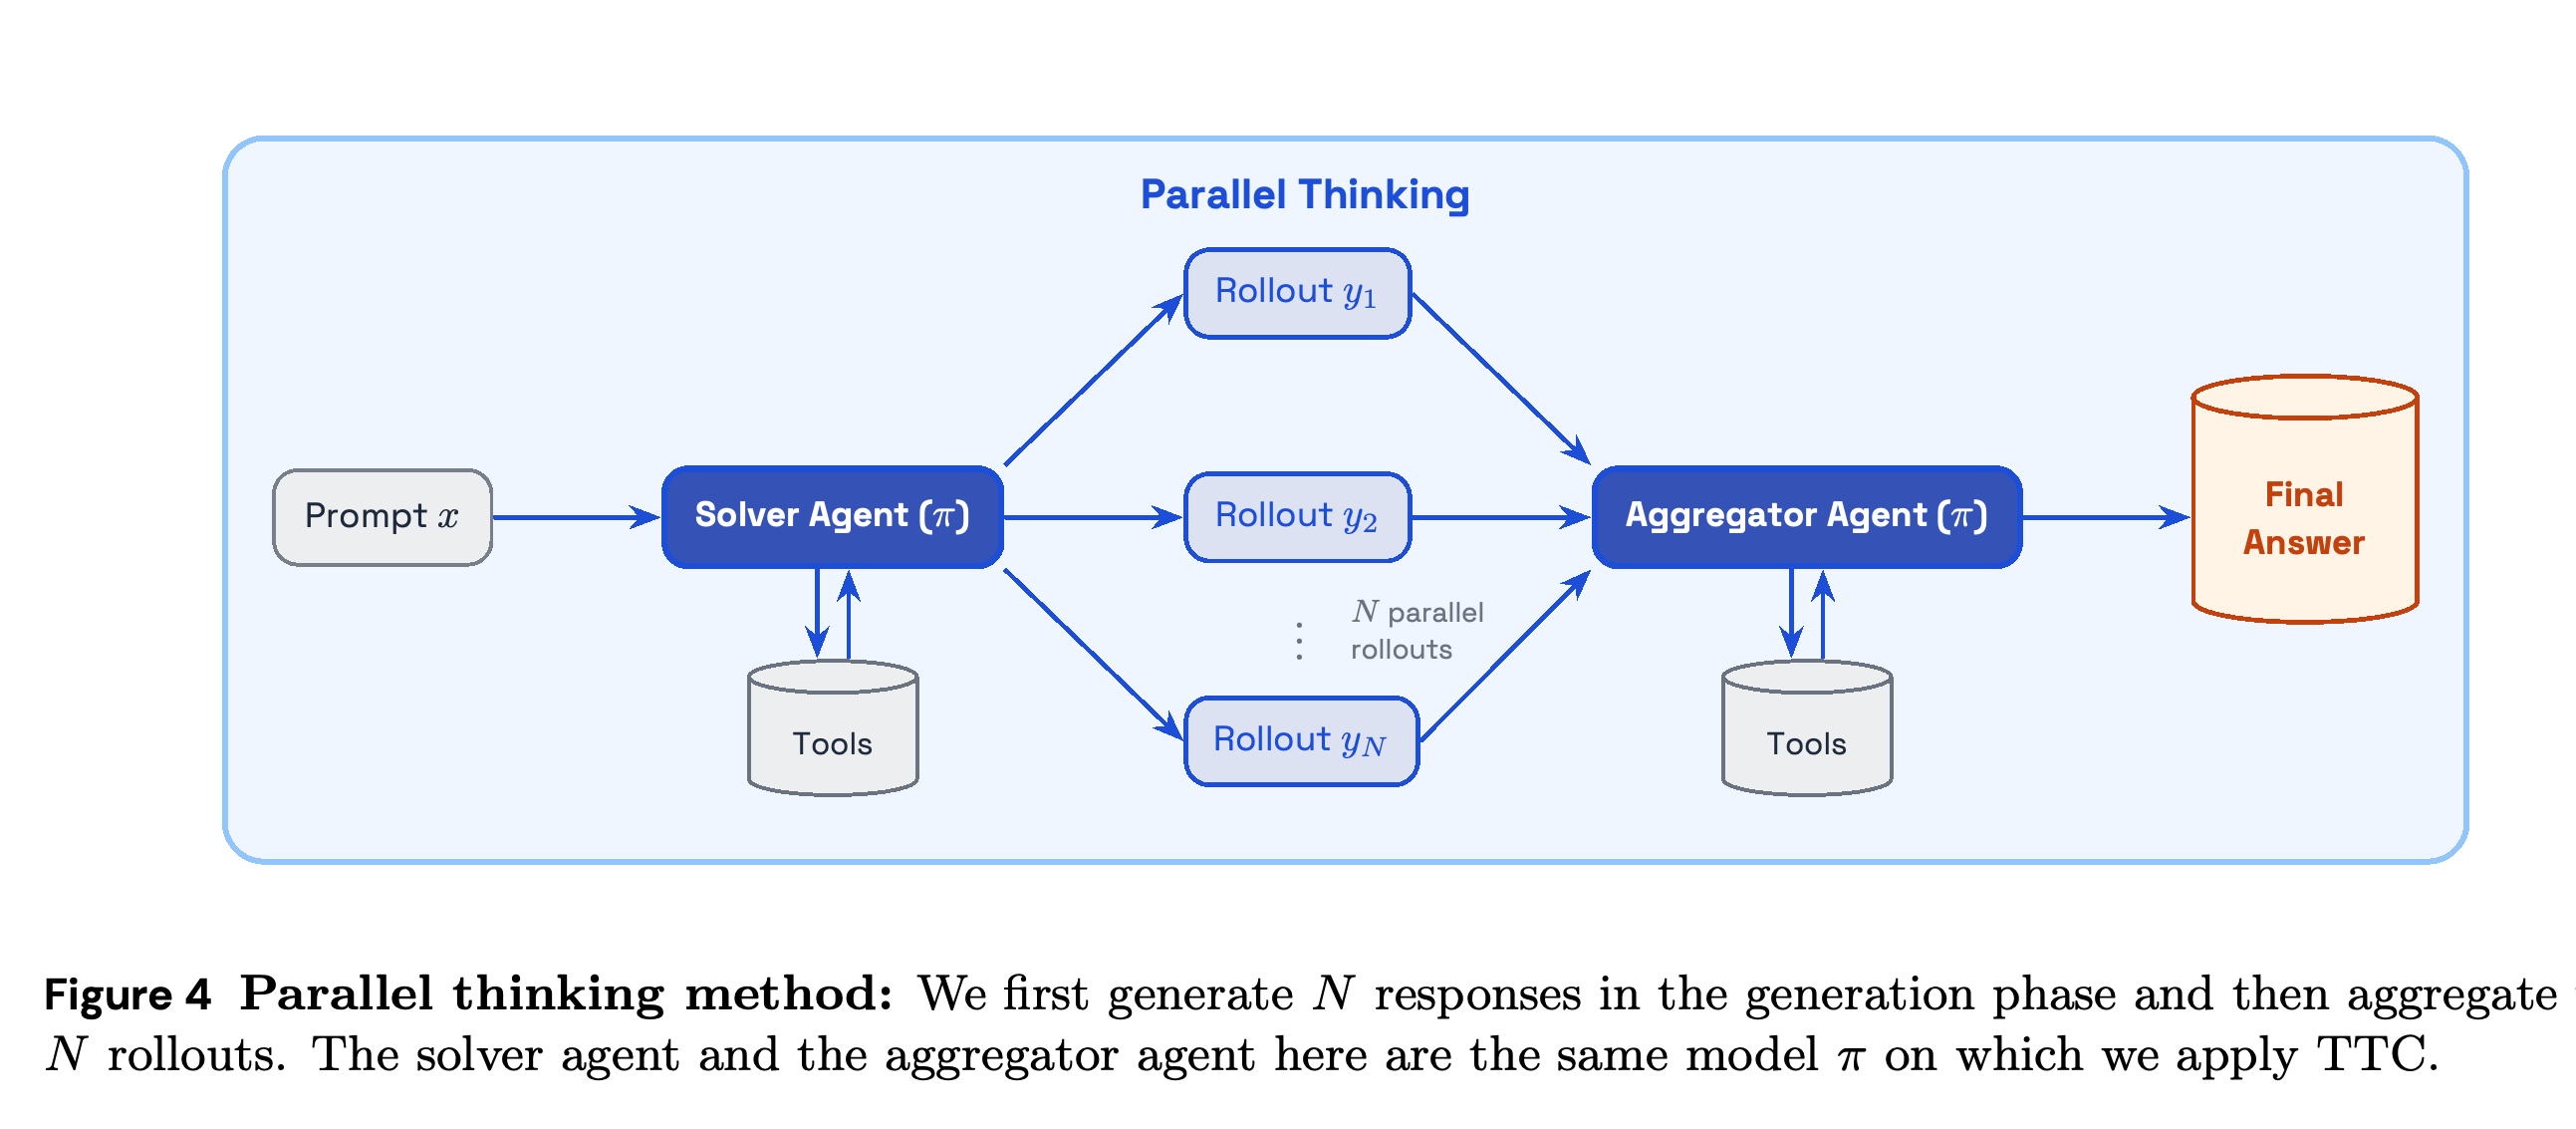
Parallel thinking은 독립적인 궤적 N개를 생성하고, 각 궤적의 최종 답변을 같은 모델에 전달해 통합한다. 풀이 모델과 통합 모델 모두 도구를 사용할 수 있으므로, 통합 모델은 후보를 고르기만 하는 것이 아니라 추가 근거를 검색하고 답변을 종합할 수 있다.
- Figure 4는 병렬 풀이 생성과 최종 통합을 구분한다. 전체 기록 대신 최종 답변을 전달해 통합 모델의 문맥 크기를 제한한다.
- PMBench에서 rollout 5개를 사용했을 때, 통합 모델은 23.7%의 경우 가장 좋은 개별 후보보다 높은 점수를 얻는다. 이는 상호 보완적인 사실을 결합할 수 있음을 보여준다.
풀이 궤적을 동시에 생성한 뒤, 같은 정책을 사용하는 통합 모델이 도구를 활용해 답변을 종합한다. 통합 모델은 후보 답변을 받고 다시 검색할 수 있으므로, 가장 빈번한 답변을 고르기만 하는 대신 상호 보완적인 내용을 결합할 수 있다.
5.2 Reward-based TTC via Value-Guided Search
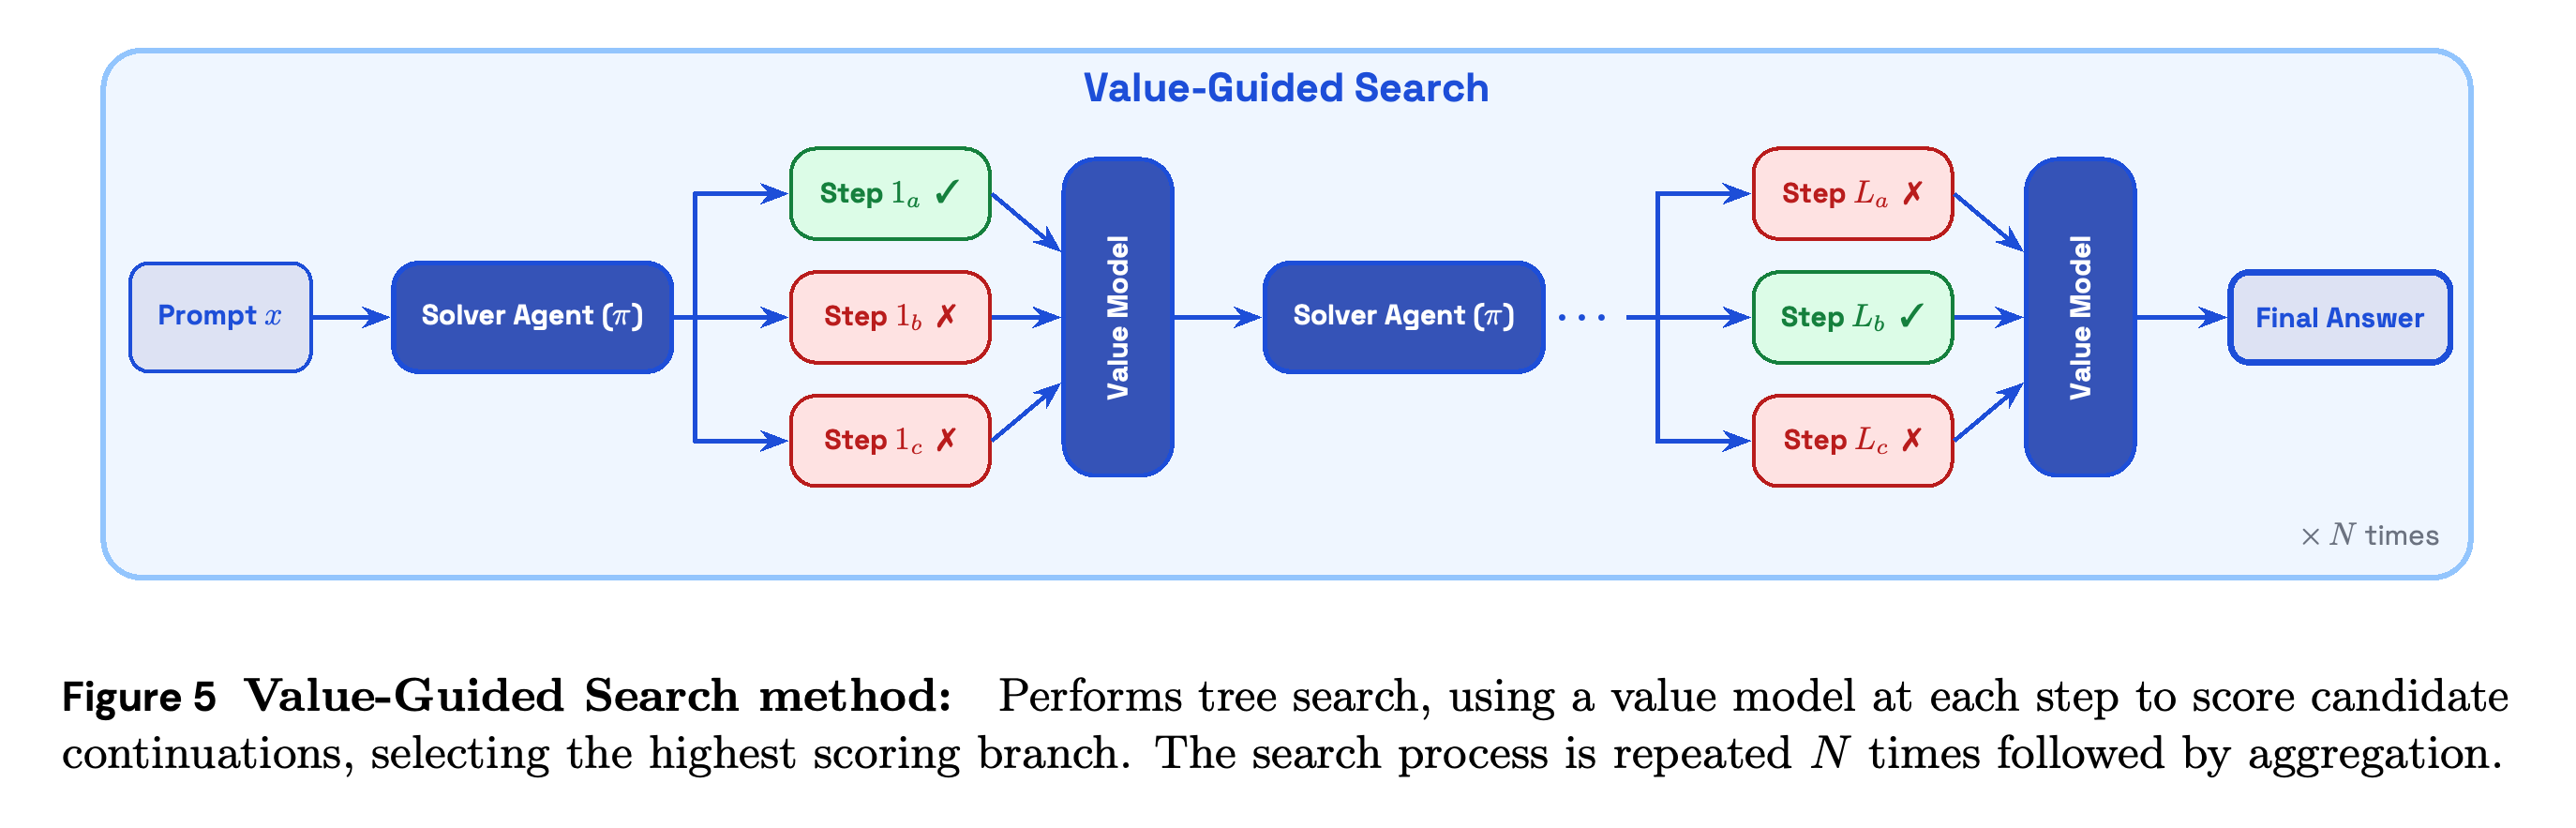
VGS는 부분 궤적으로부터 최종적인 이진 성공 여부를 예측하도록 토큰 단위 가치 모델을 학습한다. 교차 엔트로피 손실을 사용하며, 마스크로 정책이 생성한 토큰만 학습에 포함한다. 실험에서는 Qwen3-4B-Thinking-2507을 가치 모델로 사용한다.
- 질의, 요약, 답변을 포함한 모든 assistant 단계에서 정책이 후보 k개를 생성하고, 예측 성공 확률이 가장 높은 후보에서 계속 진행한다.
- Figure 5는 이 선택 반복을 보여준다. 실험에서는 k = 2로 고정하고 검색 과정 N개를 병렬 실행한 뒤, majority voting, weighted majority voting, Best-of-N을 비교한다.
- 투표는 답변을 이산적인 동치 클래스로 나눌 수 있어야 하므로, 자유 형식 보고서에 직접 적용하기 어렵다. Best-of-N은 대신 점수가 가장 높은 개별 답변을 선택한다.
별도 가치 모델이 매 assistant 단계에서 이어질 후보를 선택한다. 도식은 후보 3개를 그리지만, 실험은 단계당 2개를 사용하고 최종 통합 전에 이 과정을 N회 반복한다.
6 Agent Infrastructure
인프라는 대량의 오프라인 궤적 수집과 합성·평가·추론 전반의 공통 에이전트 환경을 지원한다. 주요 구성 요소는 내장형 벡터 검색과 내부 rollout 프레임워크인 aroll이다.
6.1 Scaling Vector Search
코퍼스는 오프라인에서 임베딩하고 색인한 뒤 공유 저장소에 캐시한다. 각 worker는 이를 프로세스 내부의 열 지향 벡터 데이터베이스에 적재한다. 클라이언트·서버 간 네트워크 I/O를 없애 오프라인 생성 중 호스트당 초당 500개 질의를 넘는 처리량을 달성했다고 보고한다.
6.2 Agent Harness Implementation
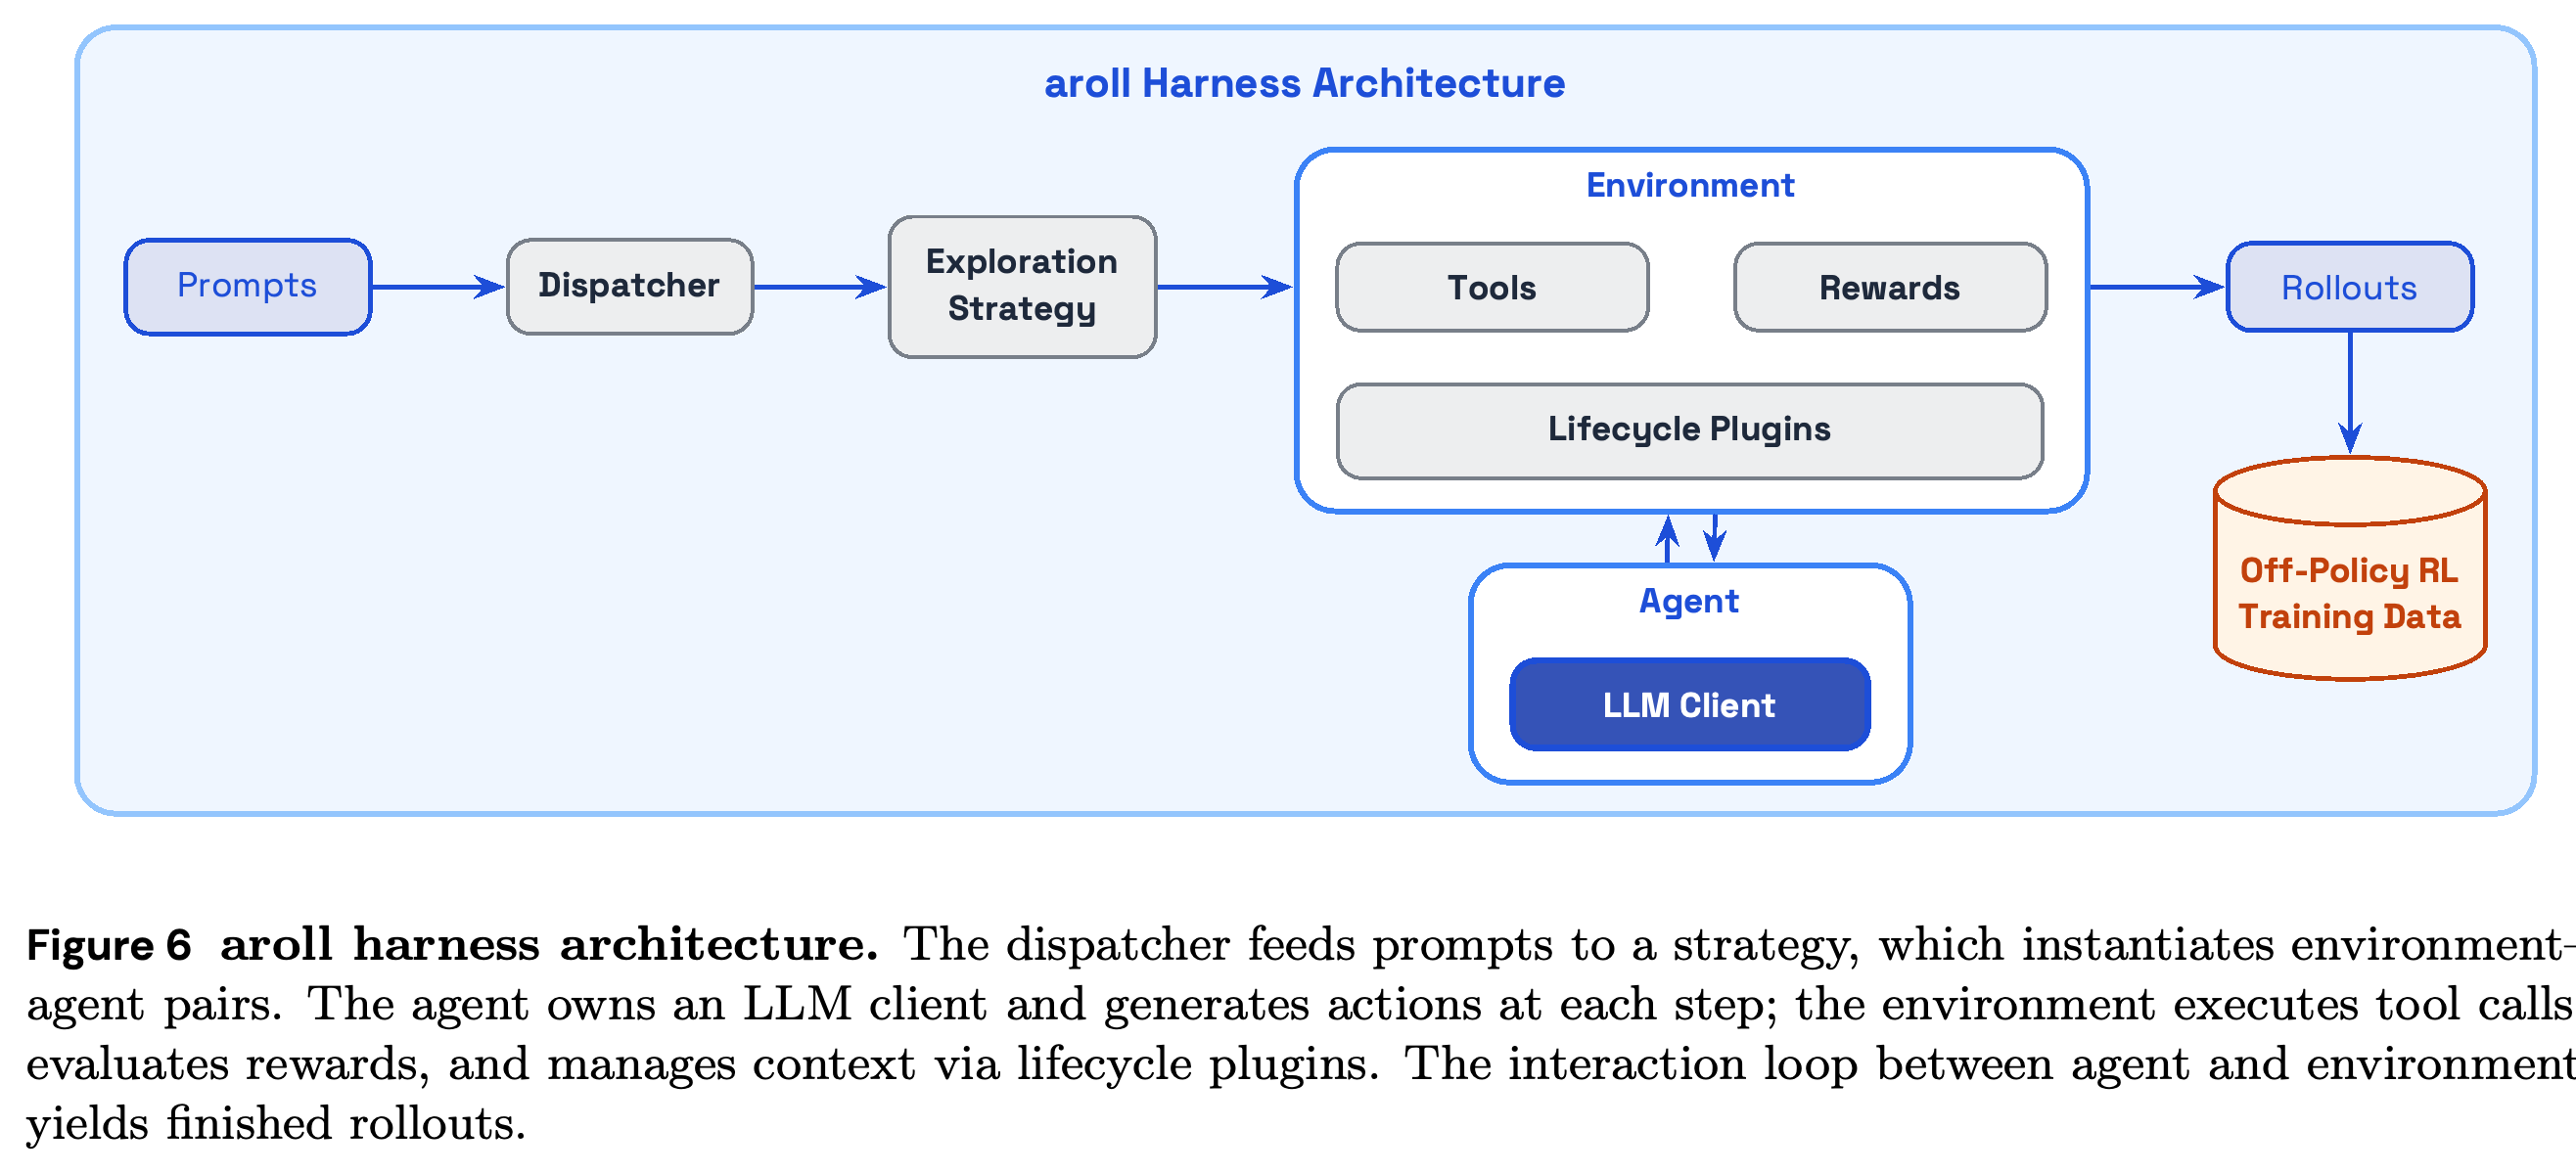
aroll은 프롬프트 분배, 탐색 전략, 환경 실행, 에이전트 생성, 도구, 조합 가능한 보상을 분리한다. Lifecycle plugin은 핵심 상호작용 루프를 바꾸지 않고 압축, 단계 예산, 도구 사용 제한을 구현한다.
- Figure 6은 환경·에이전트 쌍이 off-policy 학습에 사용할 완성된 rollout을 생성하는 모습을 보여준다.
- Parallel thinking은 전략 계층을, VGS는 에이전트 계층을, 압축은 plugin 설정을 변경한다. 공통 인터페이스는 데이터 수집과 서비스 제공 사이의 harness 차이를 줄이지만, 가능한 모든 분포 이동의 원인을 제거하지는 않는다.
공통 인터페이스를 통해 조율, 생성, 도구 실행, 보상, lifecycle 로직을 분리한다. 따라서 rollout 실행 파이프라인을 재사용하면서 parallel thinking, VGS, 압축을 서로 다른 계층에서 변경할 수 있다.
7.1 Evaluation and Training Set
실험은 데이터 합성, 사후 학습, test-time scaling, KARLBench 전반의 전이를 다룬다. RL 학습에는 BrowseComp-Plus와 TREC-Biogen을 사용하고, FreshStack, FinanceBench, QAMPARI, PMBench는 제외한다. BrowseComp-Plus 평가는 원래 830개 중 보정된 230개 질문을 사용하며, 나머지 600개는 합성의 seed로 사용한다.
- 저자들은 보정된 부분집합과 전체 BrowseComp-Plus 데이터셋 사이의 점수 차이가 ±1이라고 보고한다.
- BrowseComp-Plus는 seed 예시와 평가 질문을 분리한다. 반면 TREC-Biogen은 평가 집합에서 seed 예시를 가져오고, 중복 제거로 동등한 합성 질문을 없앤다.
7.2 Training Data Synthesis
각 RL 반복에서 현재 정책은 질문·답변 합성 모델과 풀이 모델 역할을 모두 맡으며, GLM 4.5 Air에서 시작한다. 남겨진 각 과제에는 풀이 시도 8개를 연결해 난이도를 필터링하고 그룹 단위 off-policy advantage를 추정한다.
7.2.1 TREC-Biogen Data Synthesis.
TREC-Biogen 합성은 seed 예시 4개를 샘플링하고 k = 20으로 최대 50단계 탐색한 뒤, nugget으로 나눈 답변과 인용을 포함하는 질문 8개를 제안한다. 정확히 일치하는 중복을 제거한 다음 Qwen3-8B-Embedding으로 유사 항목을 검색하고 gpt-4o-mini로 의역 여부를 판단한다.
- 각 과제는 동일한 최대 50단계 조건으로 풀이 rollout 8개를 생성한다. Pass-rate 필터링은 다중 과제 반복 2회에서 nugget 점수를 각각 0.6과 0.7로 이진화하고, TREC-Biogen 전문가 반복 3회에서는 각각 0.6, 0.75, 0.9로 이진화한다.
- 본문은 각 평가 질문에 대해 상위 20개 합성 질문을 검색한다고 설명하지만, Figure 32는 각 합성 질문에 대해 상위 20개 검증 질문을 검색한다고 설명한다. 후보 목록을 잘라내는 경우 이 방향들은 동등하지 않다.
- 이 절은 gpt-5-mini가 품질 필터링을 수행한다고 서술하지만, Appendix D.3은 TREC-Biogen에 Quality Filter를 적용하지 않았다고 명시한다. PDF는 실제 사용 여부를 일관되게 설명하지 않는다.
7.2.2 BrowseComp-Plus Data Synthesis
BrowseComp-Plus 합성은 seed 문서 10개와 600개 질문으로 이루어진 검증 집합의 예시 4개에서 시작한다. k = 5로 최대 60단계 탐색한 뒤 후보 과제 8개를 제안한다. 문서를 seed로 제공하면 문서 탐색 범위가 25% 늘어난다고 보고한다.
- 본문은 검증 답변과 정확히 일치하는 항목을 제거한 뒤, Qwen3-0.6B-Embedding과 gpt-4o-mini 판단을 사용해 각 검증 질문과 유사한 합성 질문 상위 10개를 검색한다고 설명한다. 반면 Figure 33은 각 생성 쌍에 대해 답변 기반으로 검증 예시를 검색한다고 설명해, 검색에 사용하는 표현과 검색 방향이 불명확하다.
- 풀이 생성은 시도 8개, k = 20, 최대 200단계, 150K characters에서의 문맥 압축을 사용한다. 모두 정답이거나 모두 오답인 그룹은 버린다.
- 본문은 gpt-4o-mini 품질 필터링을 일반적으로 설명하지만, Appendix D.3은 Iter. 1에만 사용하고 Iter. 2에는 사용하지 않았다고 명시한다.
7.3 Training Experiments
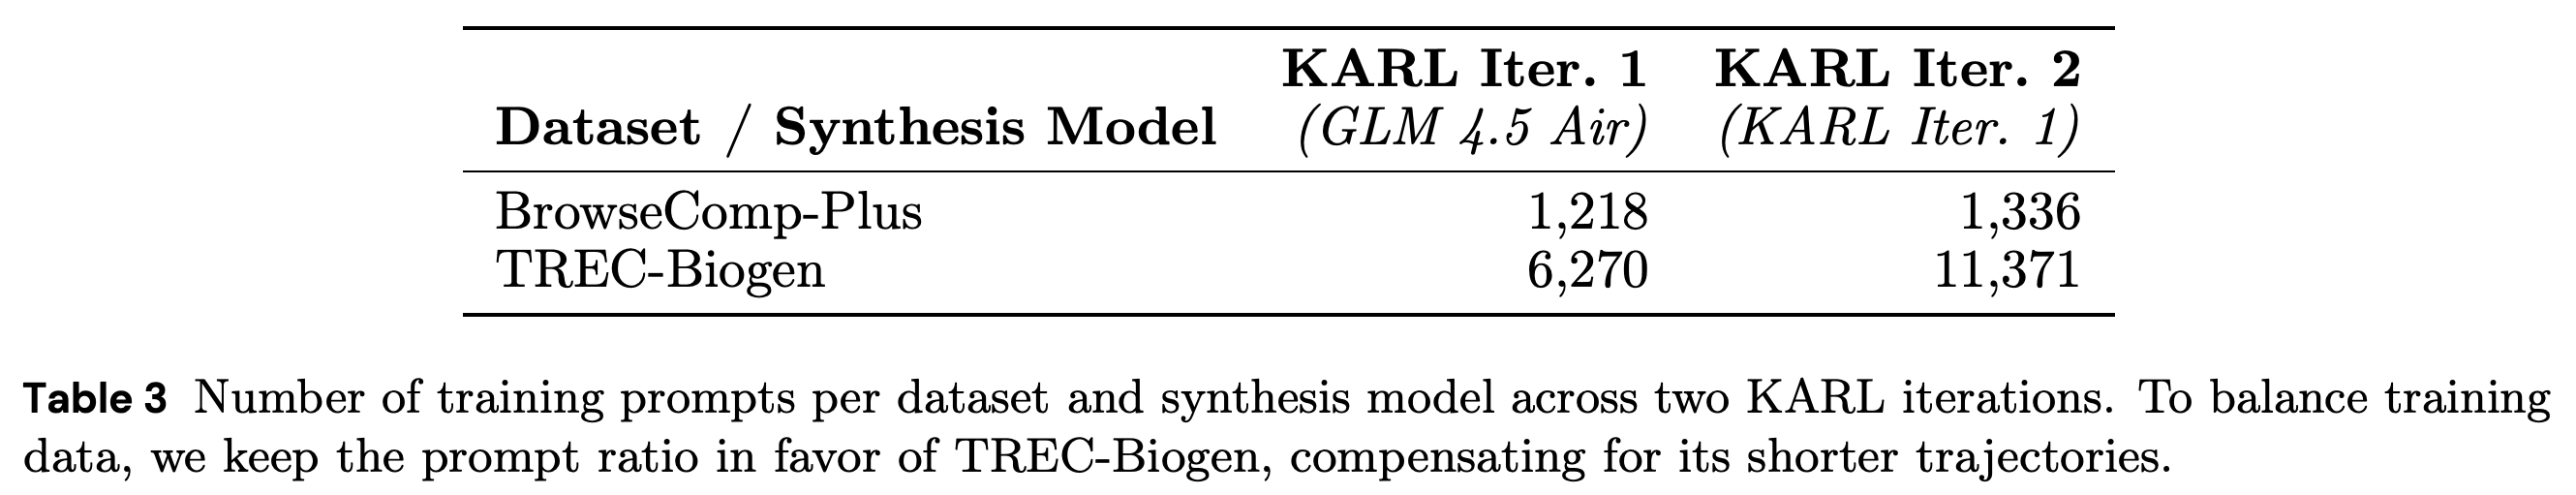
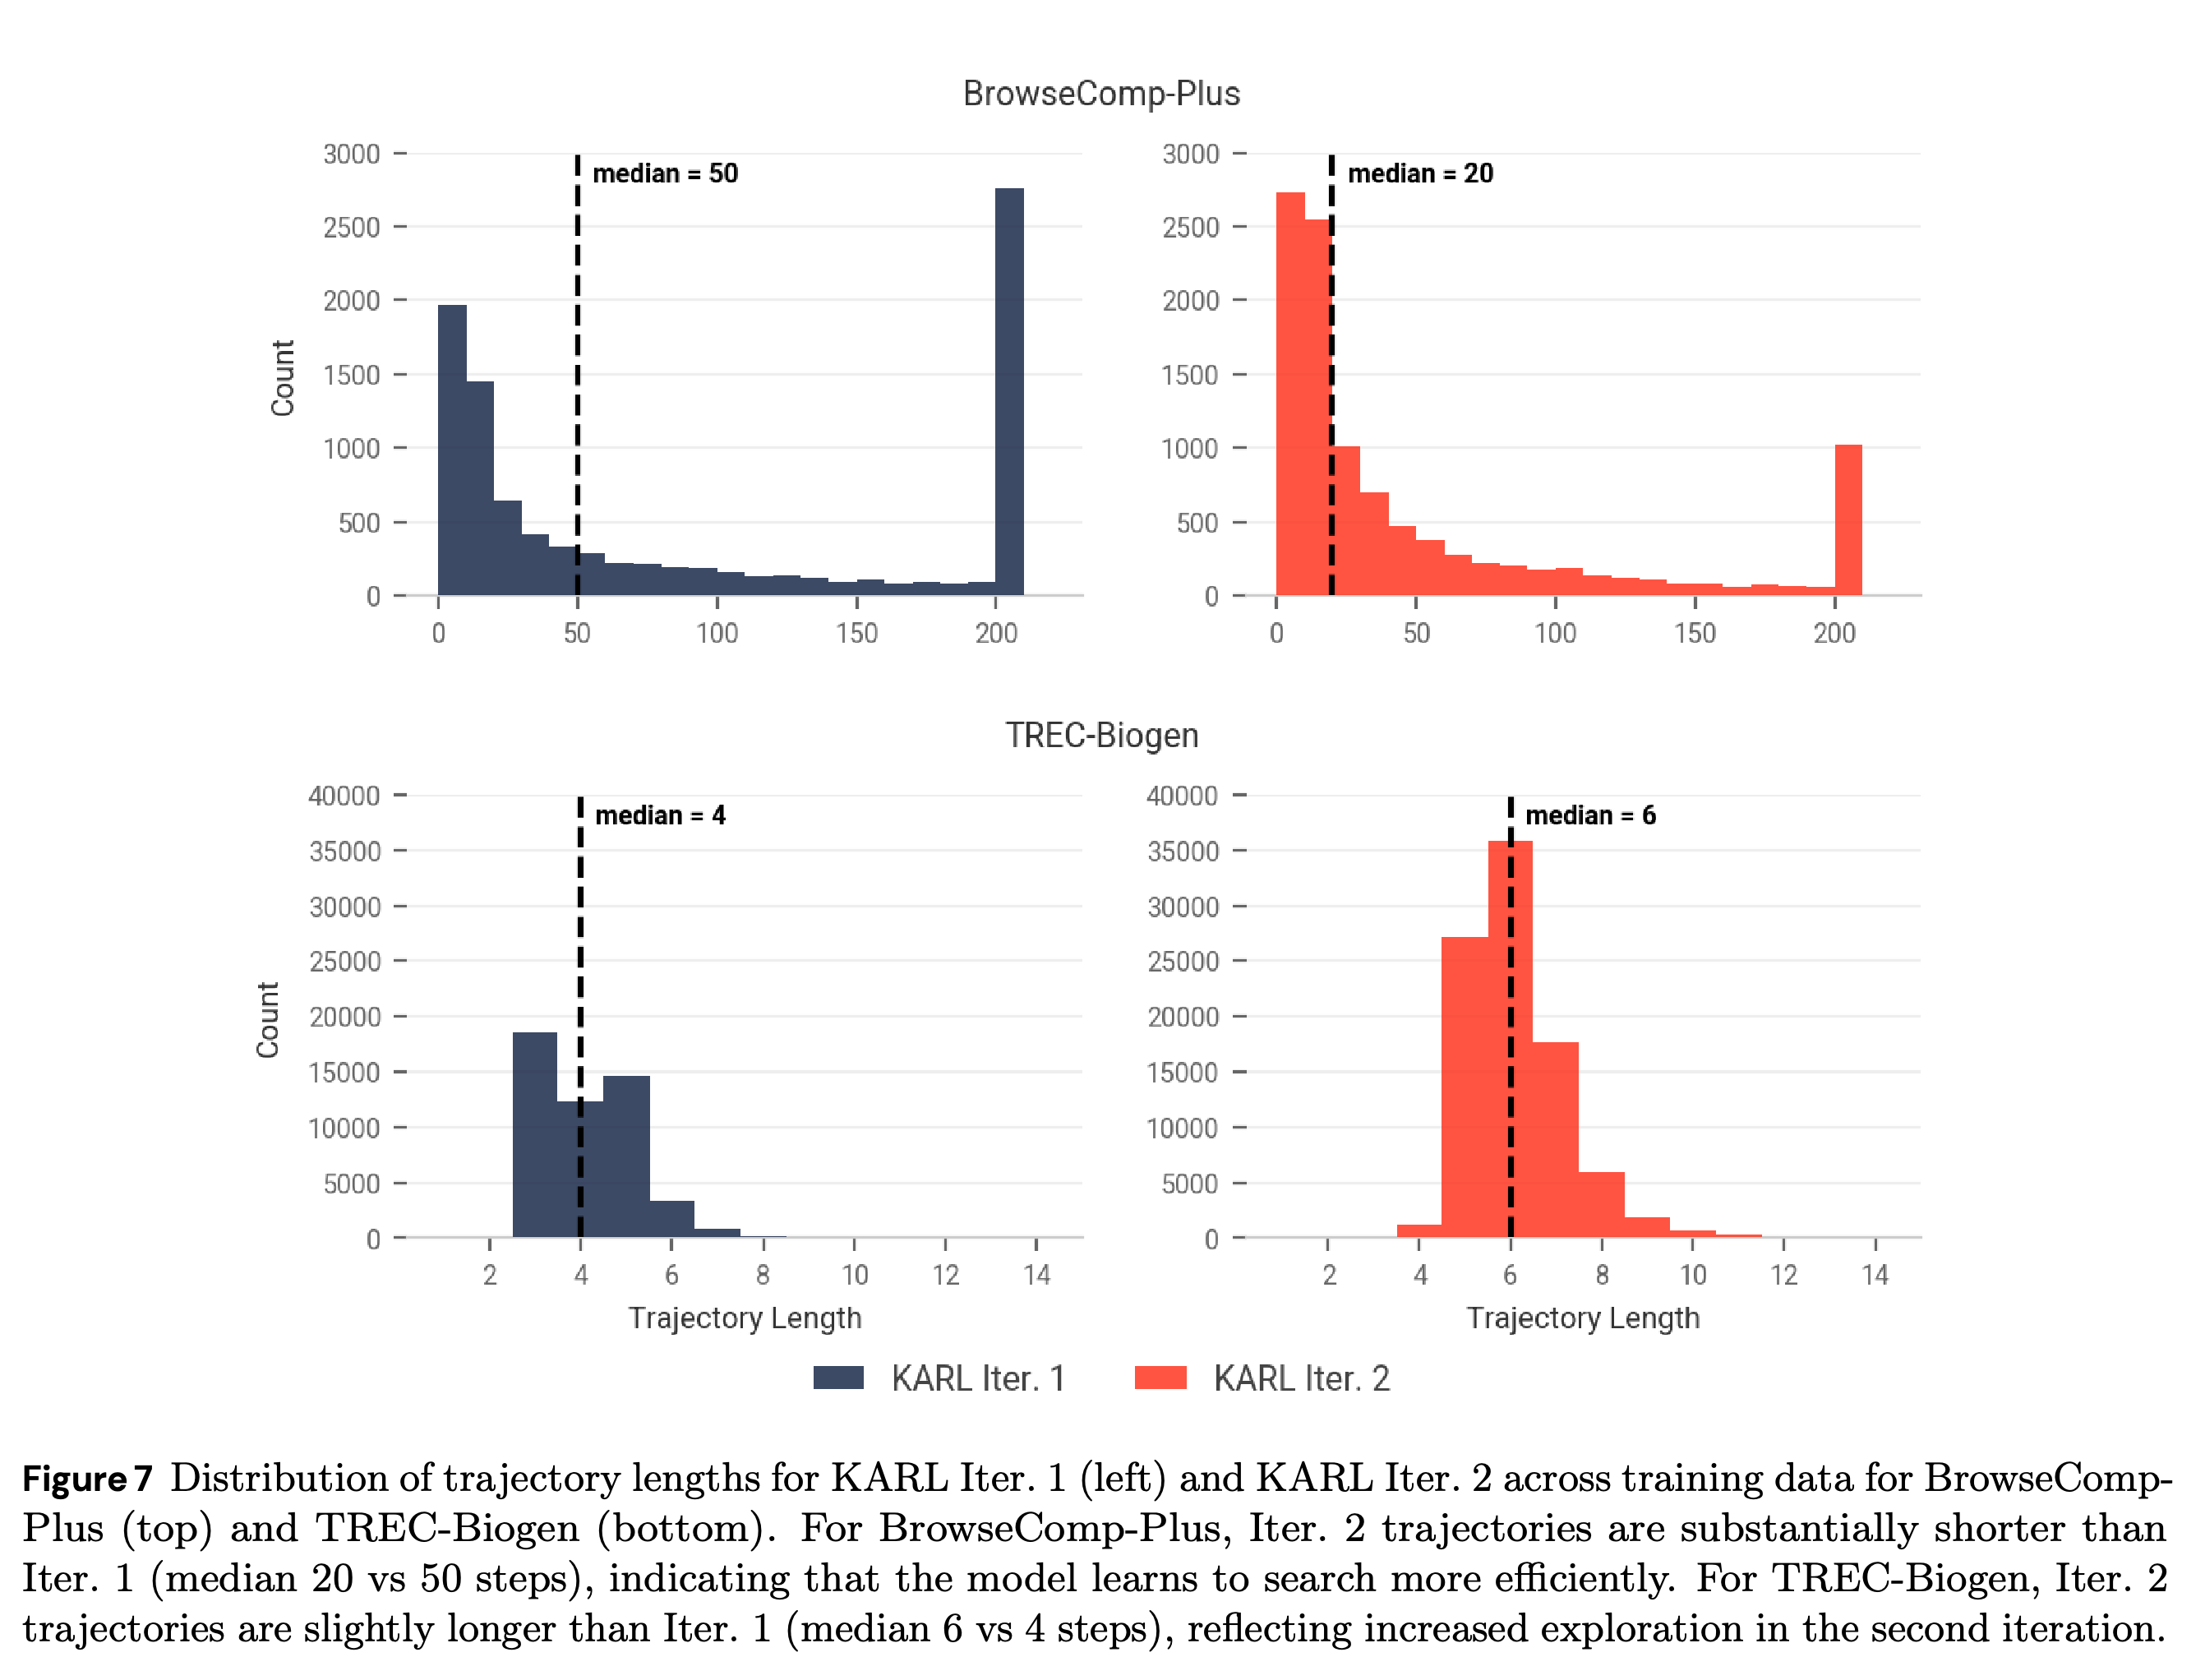
별도 설명이 없으면 KARL은 다중 과제 OAPL을 2회 반복한 GLM 4.5 Air를 뜻한다. Table 3은 Iter. 1에서 BrowseComp-Plus 프롬프트 1,218개와 TREC-Biogen 프롬프트 6,270개를, Iter. 2에서는 각각 1,336개와 11,371개를 보고한다.
- TREC-Biogen은 궤적이 더 짧으므로, 학습 토큰 비중을 맞추기 위해 더 많은 프롬프트를 사용한다.
- Figure 7에서 BrowseComp-Plus 궤적 길이의 중앙값은 50단계에서 20단계로 줄고, TREC-Biogen은 4단계에서 6단계로 늘어난다. BrowseComp-Plus 분포에서는 200단계 예산 한계에 몰린 부분이 줄지만 여전히 보인다.
- 이는 같은 질문 집합의 궤적을 짝지어 비교한 결과가 아니라 다시 생성한 학습 데이터의 분포다. 따라서 합성과 필터링의 변화도 비교 결과에 영향을 준다.
TREC-Biogen은 궤적이 더 짧으므로, 학습 토큰 비중을 맞추기 위해 더 많은 프롬프트를 제공한다. 표의 수치는 최초 합성 후보 전체가 아니라 최종적으로 남긴 학습 프롬프트 수다.
BrowseComp-Plus의 길이 중앙값은 50단계에서 20단계로 줄고, TREC-Biogen은 4단계에서 6단계로 늘어난다. 이후 BrowseComp-Plus 분포에도 예산 한계에 몰린 부분이 남아 있다. 학습 질문을 다시 생성하므로 분포에는 정책 변화와 데이터 파이프라인 변화가 모두 반영된다.
7.3.1 Main Results
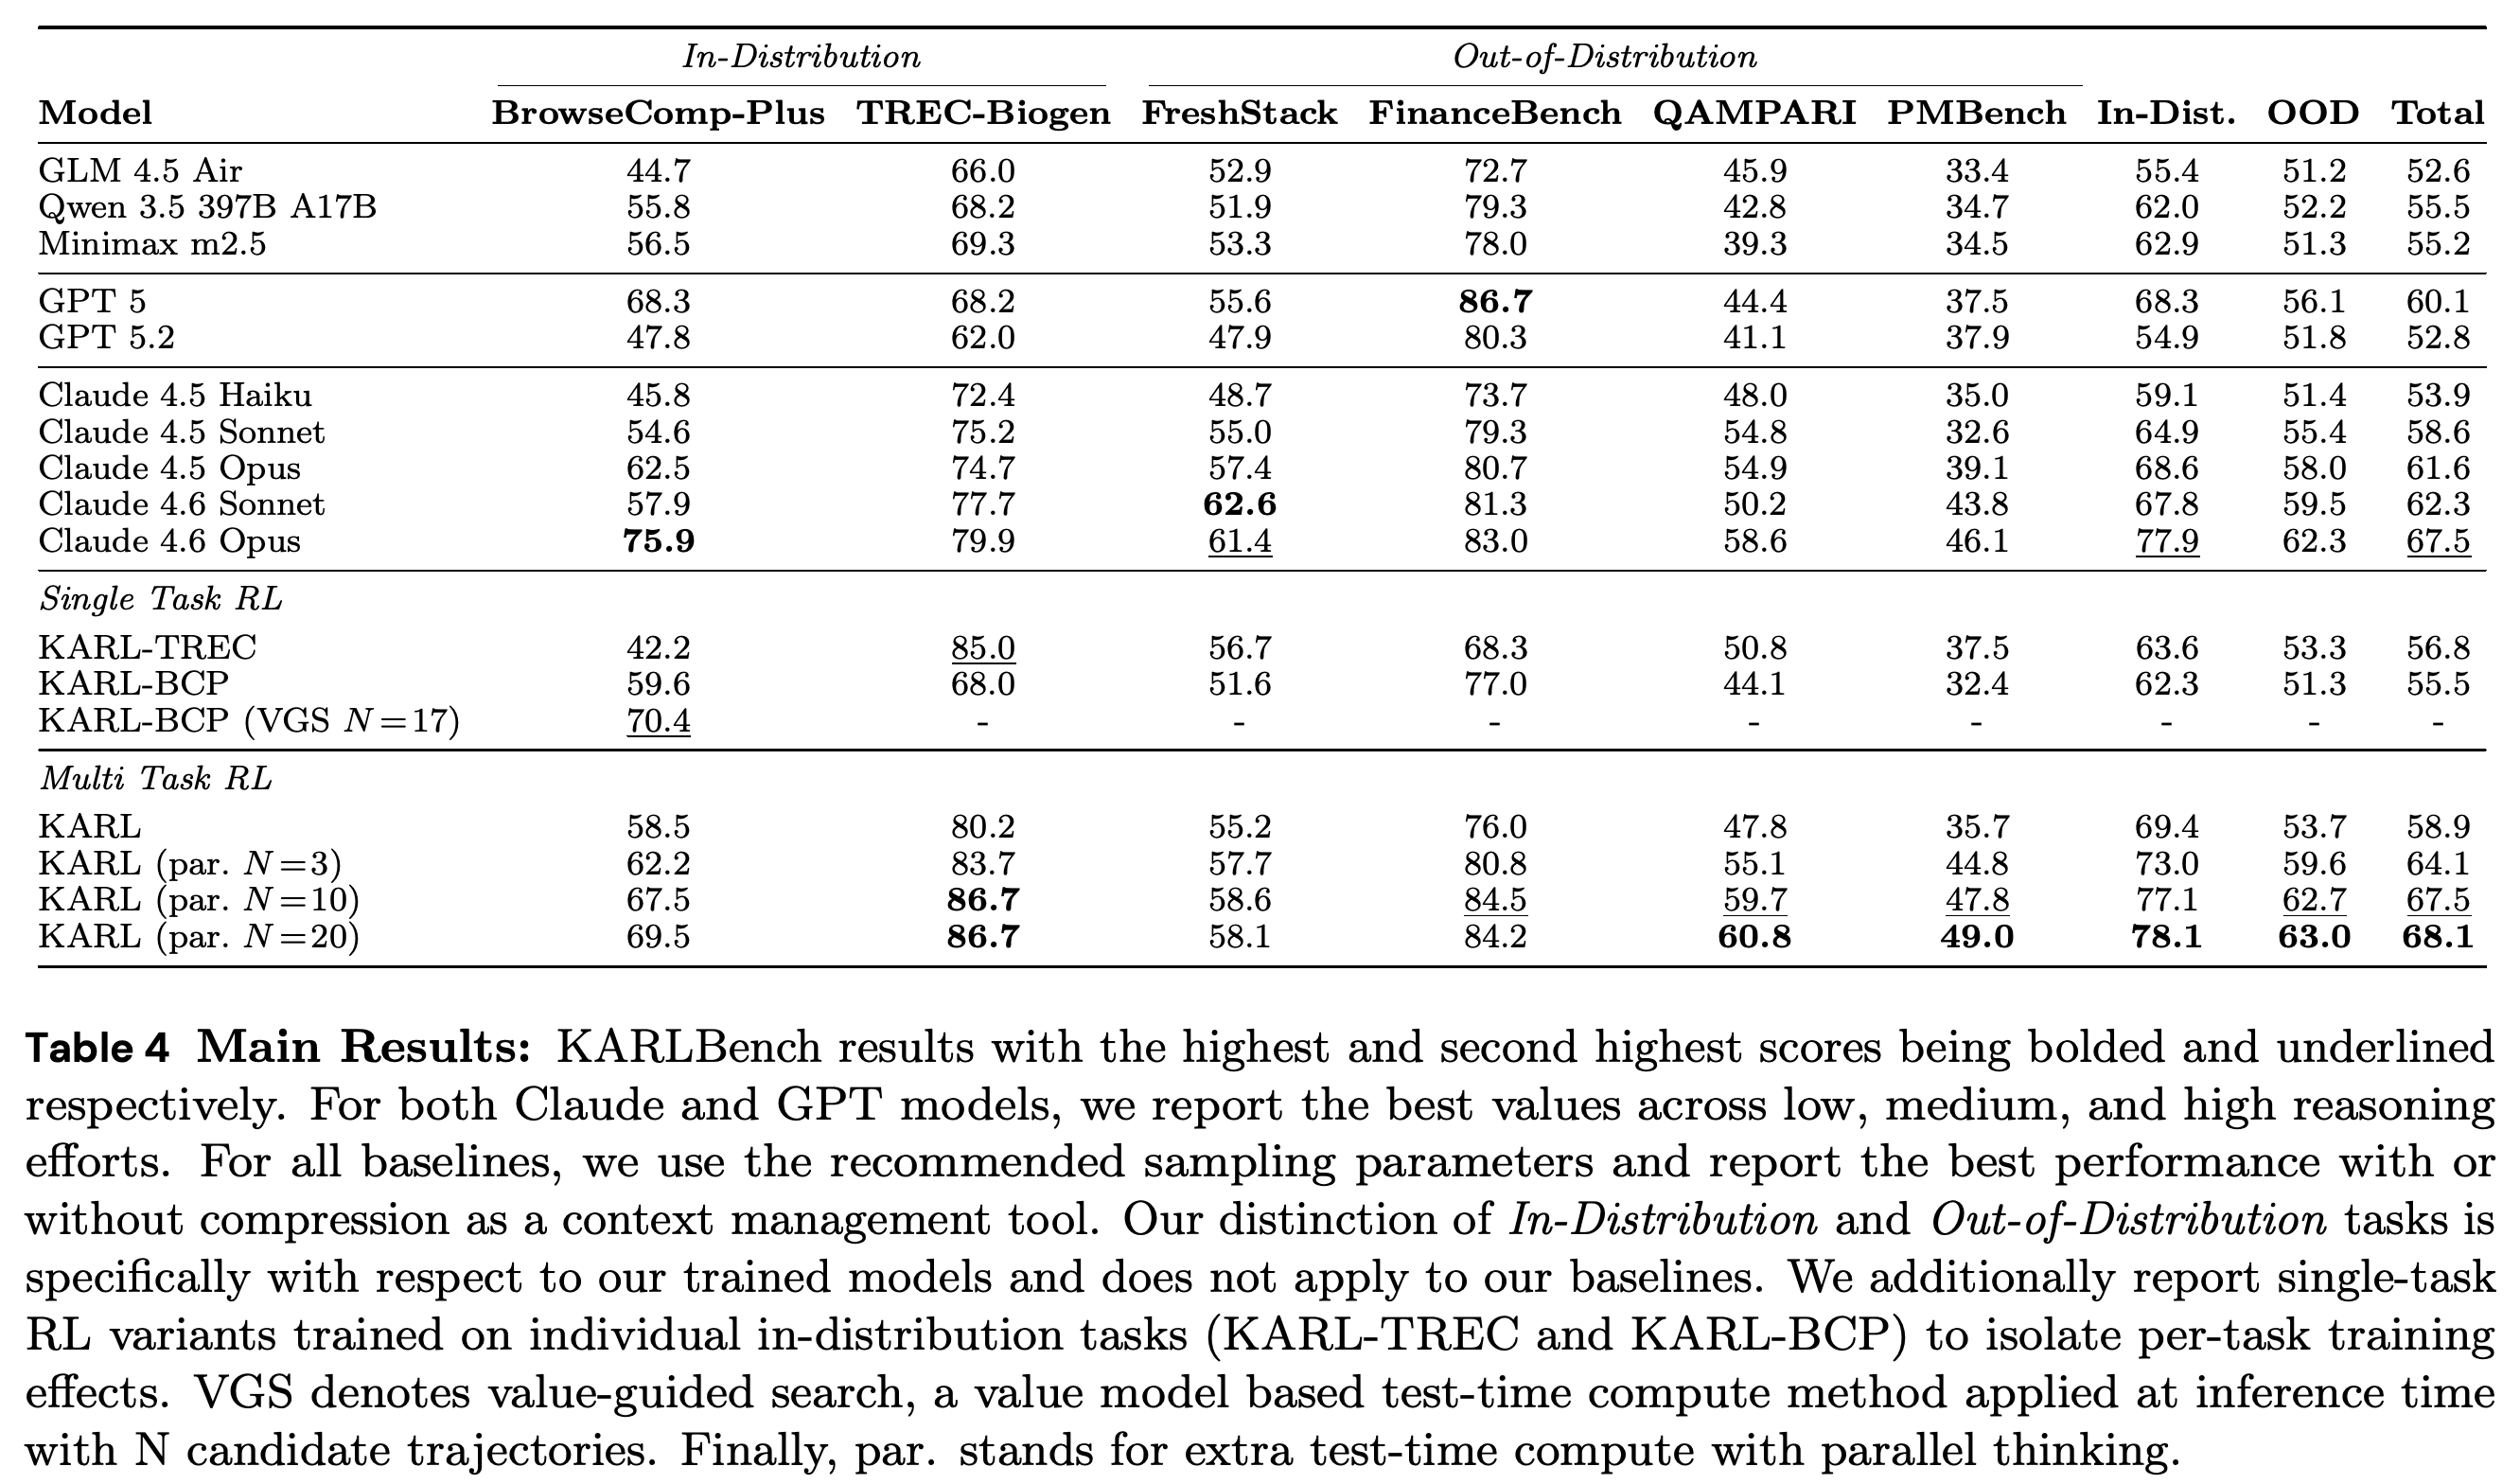
Table 4에서 KARL의 전체 점수는 58.9이며, GLM 4.5 Air는 52.6, Claude 4.5 Sonnet은 58.6이다. Parallel thinking을 사용하면 KARL은 N = 3에서 64.1, N = 10에서 67.5, N = 20에서 68.1에 도달한다. Claude 4.6 Opus의 점수는 67.5이다.
- KARL의 단일 rollout 점수는 BrowseComp-Plus 58.5, TREC-Biogen 80.2, FreshStack 55.2, FinanceBench 76.0, QAMPARI 47.8, PMBench 35.7이다.
- N = 10에서 각 점수는 67.5, 86.7, 58.6, 84.5, 59.7, 47.8이며, OOD 평균은 62.7로 Claude 4.6 Opus의 62.3과 비교된다. 전체 점수가 같다고 해서 각 과제의 성능도 같다는 뜻은 아니다.
- 단일 과제 전문가는 TREC-Biogen에서 85.0, BrowseComp-Plus에서 59.6에 도달한다. KARL-TREC는 BrowseComp-Plus에서 42.2로 떨어지지만, KARL-BCP는 TREC-Biogen에서 기본 모델의 66.0보다 높은 68.0을 얻는다. 따라서 전이가 모두 없는 것이 아니라 전이 양상이 비대칭적이다.
- Claude와 GPT 결과는 low, medium, high 중 가장 좋은 reasoning effort를 선택하며, baseline도 더 좋은 압축 설정을 선택한다. OOD는 KARL의 RL 학습에서 제외되었다는 뜻이지, baseline의 사전 학습에서도 제외되었다는 뜻은 아니다.
표는 baseline 모델, 단일 과제 전문가, 다중 과제 KARL, 추론 시점 확장을 구분한다. KARL의 전체 점수 58.9는 병렬 rollout 10개에서 67.5, 20개에서 68.1로 오른다. 다만 모든 개별 과제에서 선두는 아니며, OOD 표기는 구체적으로 KARL 학습에 대한 것이다.
7.3.2 Cost and Latency
논문은 parallel thinking을 사용하지 않을 때 KARL의 질의당 비용이 $0.10 미만이라고 보고한다. 병렬 궤적 10개로 전체 품질을 맞추면 Claude Opus 4.6보다 질의 비용이 약 33% 낮고, 같은 품질 조건에서 지연 시간은 약 47% 낮다고 보고한다.
- 비용은 프롬프트당 생성 4회의 입력·출력 토큰 기록과 artificialanalysis.ai의 가격으로 추정한다. 전체 인프라 지출이나 학습 비용을 측정한 값은 아니다.
- 오픈 모델은 8 GPU H200 노드에서 vLLM으로 서비스한다. 주 지연 시간 지표는 첫 답변 토큰까지 걸린 시간이며, 예산을 소진하거나 문맥이 잘린 궤적에는 전체 end-to-end 시간을 대신 사용한다.
- Appendix B는 벤치마크마다 프롬프트 5개를 샘플링하고, 프롬프트마다 warm-up 궤적 3개 이후 측정 궤적 30개를 수집한다. 동시성 1에서 3개 split에 걸쳐 측정한다. 지연 시간 그림은 과제별 차이와 평가 평균의 신뢰구간을 포함한다.
- Appendix Figures 21–22에서 평균 유효 지연 시간은 KARL 14,615 ms, GLM 4.5 Air 13,758 ms이다. 따라서 KARL은 품질을 고려하면 지연 시간이 유리하지만, 기본 모델보다 항상 빠른 것은 아니다. Figure 1 역시 기본 모델보다 비용이 낮다는 본문의 주장을 명확히 뒷받침하지는 않는다.
7.3.3 Multi-Expert Distillation vs. Multi-Task RL
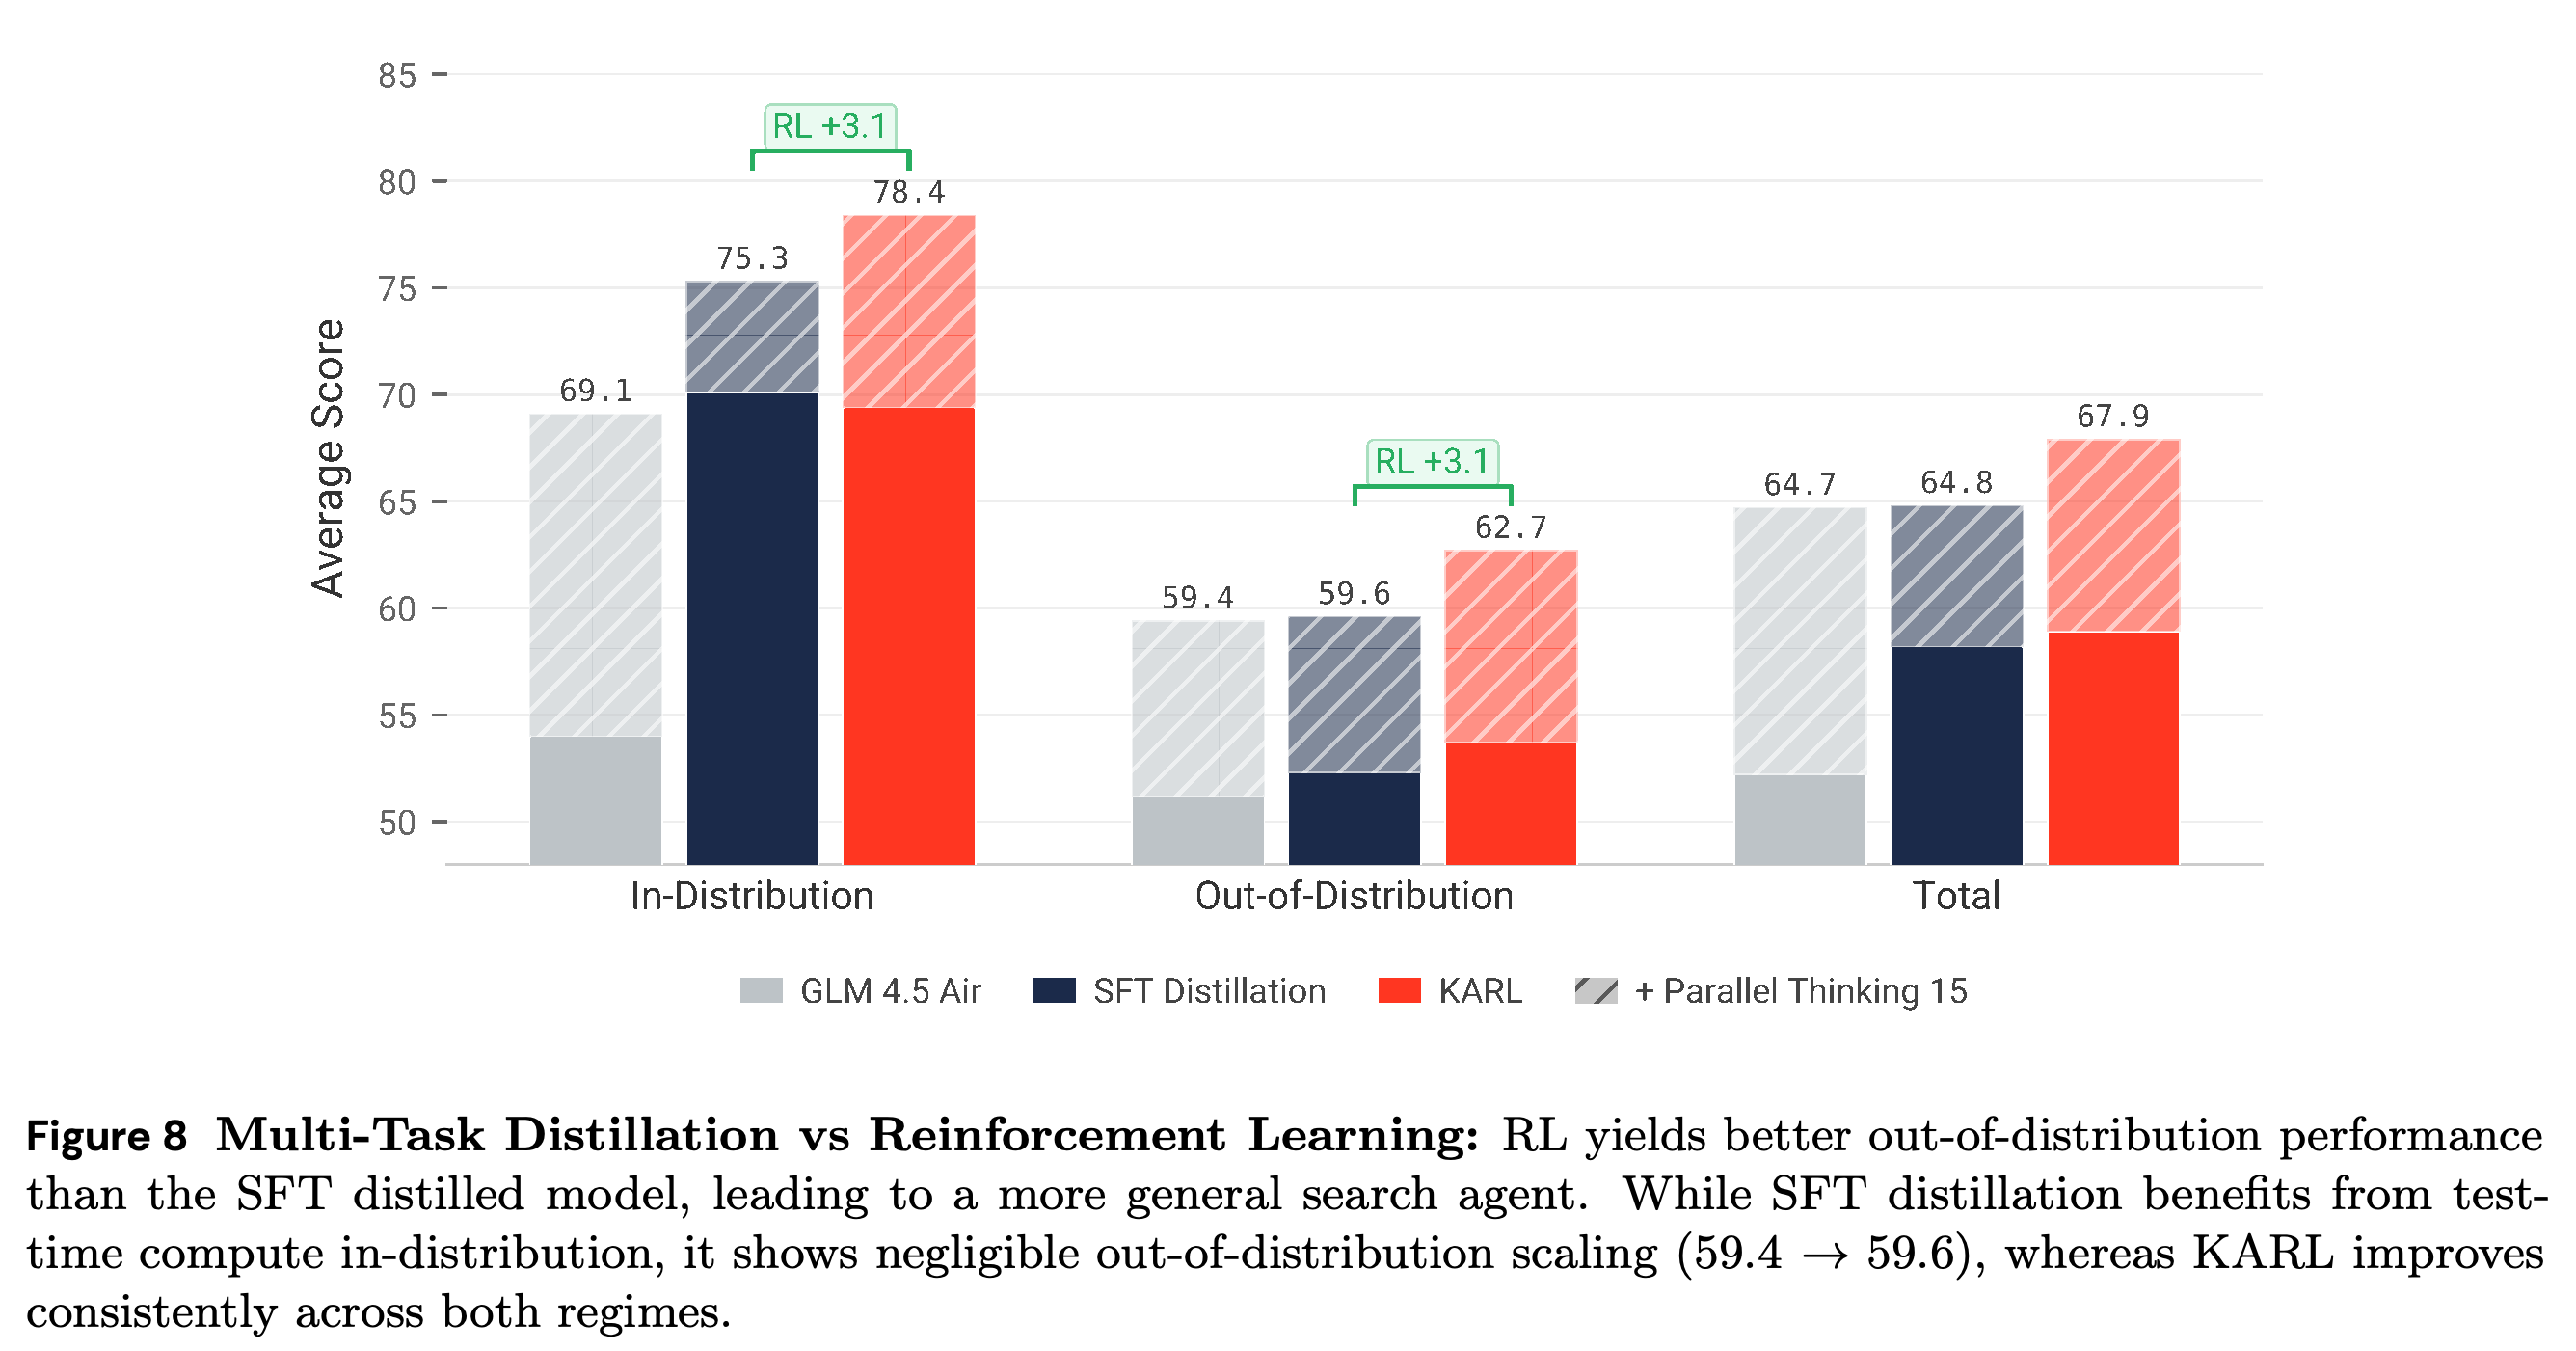
SFT 대안은 프롬프트당 전문가 rollout 8~16개를 GLM 4.5 Air에 증류한다. Figure 8에서 SFT의 OOD 성능은 parallel thinking 없이 59.4, 병렬 궤적 15개에서 59.6이다. KARL은 같은 병렬 예산에서 62.7에 도달한다.
- Parallel thinking이 없으면 SFT의 전체 점수 64.7과 OOD 점수 59.4가 KARL의 58.9와 53.7보다 높다. 이 근거는 RL의 병렬 확장 특성을 지지하지만, 증류보다 무조건 우월하다는 주장을 지지하지는 않는다.
- 병렬 설정에서 KARL은 in-distribution 78.4와 전체 67.9를 얻고, SFT는 75.3과 64.8을 얻는다. KARL의 OOD 우위는 3.1점이다.
- Figure 8에 보고된 SFT 전체 점수 64.7은 in-distribution 평균 69.1과 OOD 평균 59.4에서 계산되는 6개 과제 평균과 일치하지 않는다. PDF는 이 집계 차이를 설명하지 않는다.
SFT는 단일 rollout에서 OOD 성능이 더 높지만, parallel thinking을 사용해도 59.4에서 59.6으로만 바뀐다. KARL은 같은 설정에서 62.7에 도달해 RL의 확장 이점을 뒷받침한다. 표시된 SFT 전체 점수 64.7은 in-distribution과 OOD 평균에서 계산되는 6개 과제 평균과 일치하지 않는다.
7.3.4 Multi-Iteration Training
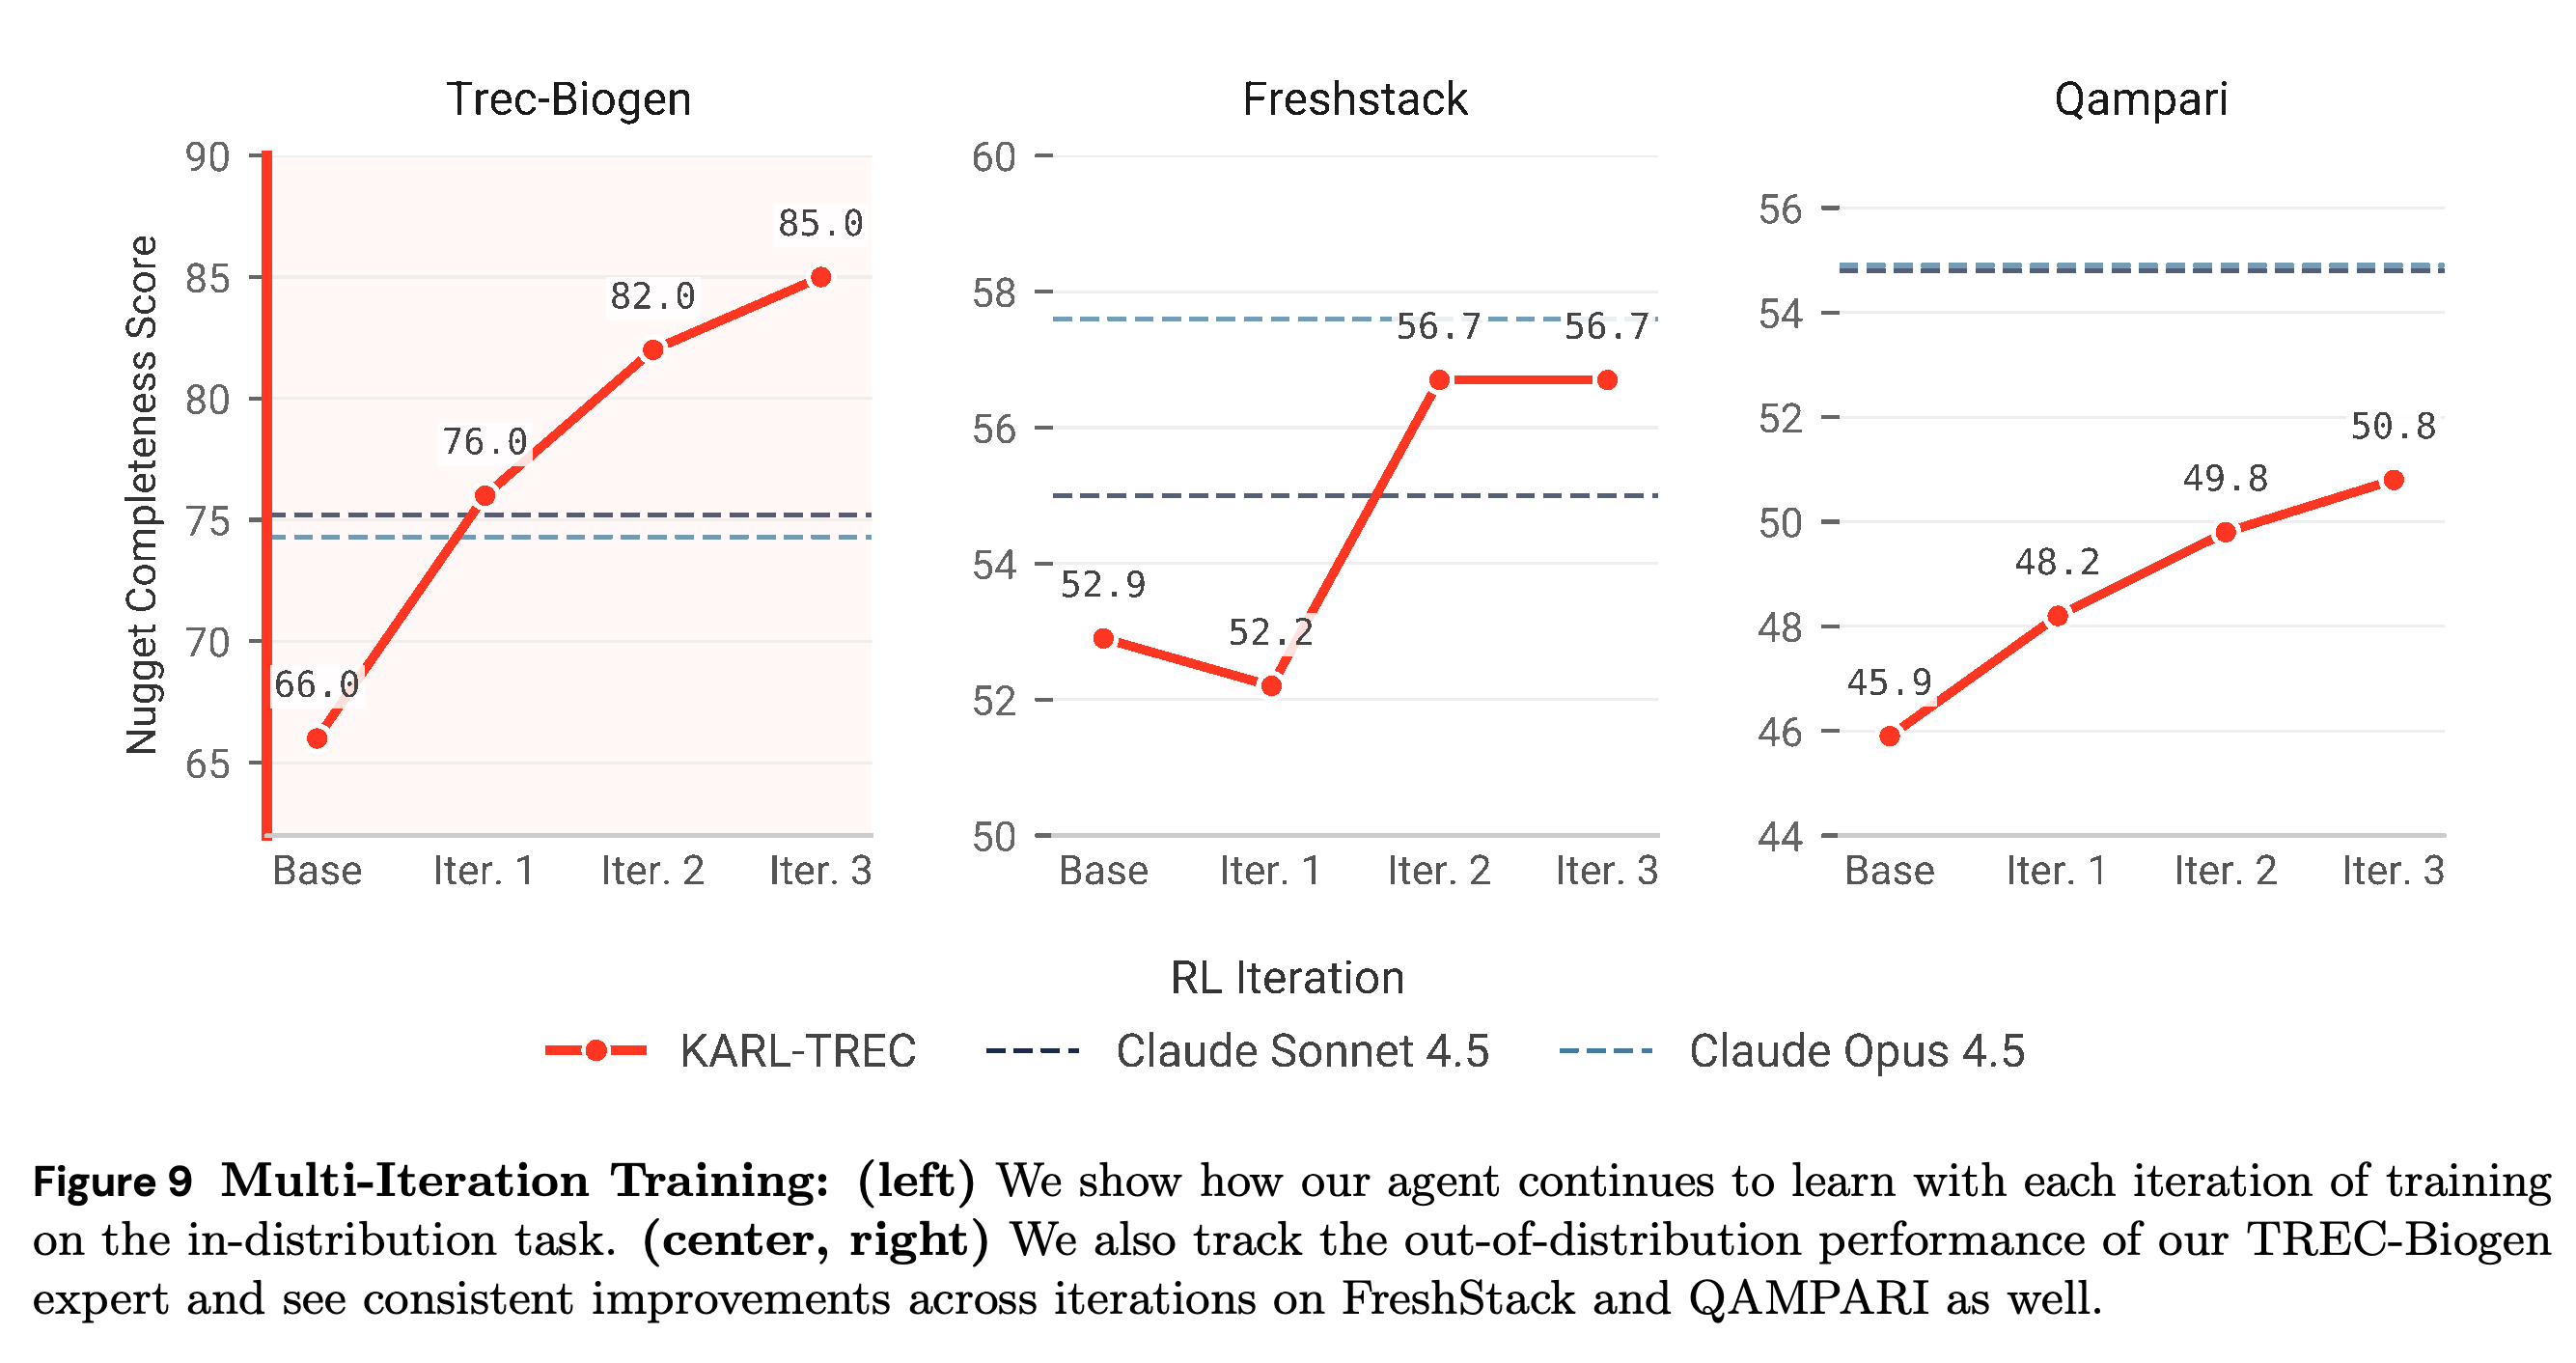
KARL-TREC는 반복적 오프라인 학습의 3-iteration case를 제공한다. Figure 9에서 기본 모델부터 Iter. 3까지의 TREC-Biogen 점수는 66.0, 76.0, 82.0, 85.0이다.
- QAMPARI는 45.9에서 48.2, 49.8, 50.8로 오른다. FreshStack은 처음에 52.9에서 52.2로 떨어진 뒤 Iter. 2에서 56.7에 도달하고 Iter. 3에서도 유지된다.
- 결과는 학습에서 제외한 일부 과제로의 전이를 보여주지만, 모든 과제에서 단조롭게 개선되거나 실험한 반복 횟수 이후에도 계속 향상된다는 뜻은 아니다.
TREC-Biogen과 QAMPARI는 매 반복에서 개선된다. FreshStack은 처음에 52.9에서 52.2로 떨어진 뒤 56.7에서 정체되므로, 이 곡선은 모든 과제에서 단조롭게 개선되는 전이를 뒷받침하지 않는다.
7.3.5 RL Generalizes beyond Sharpening
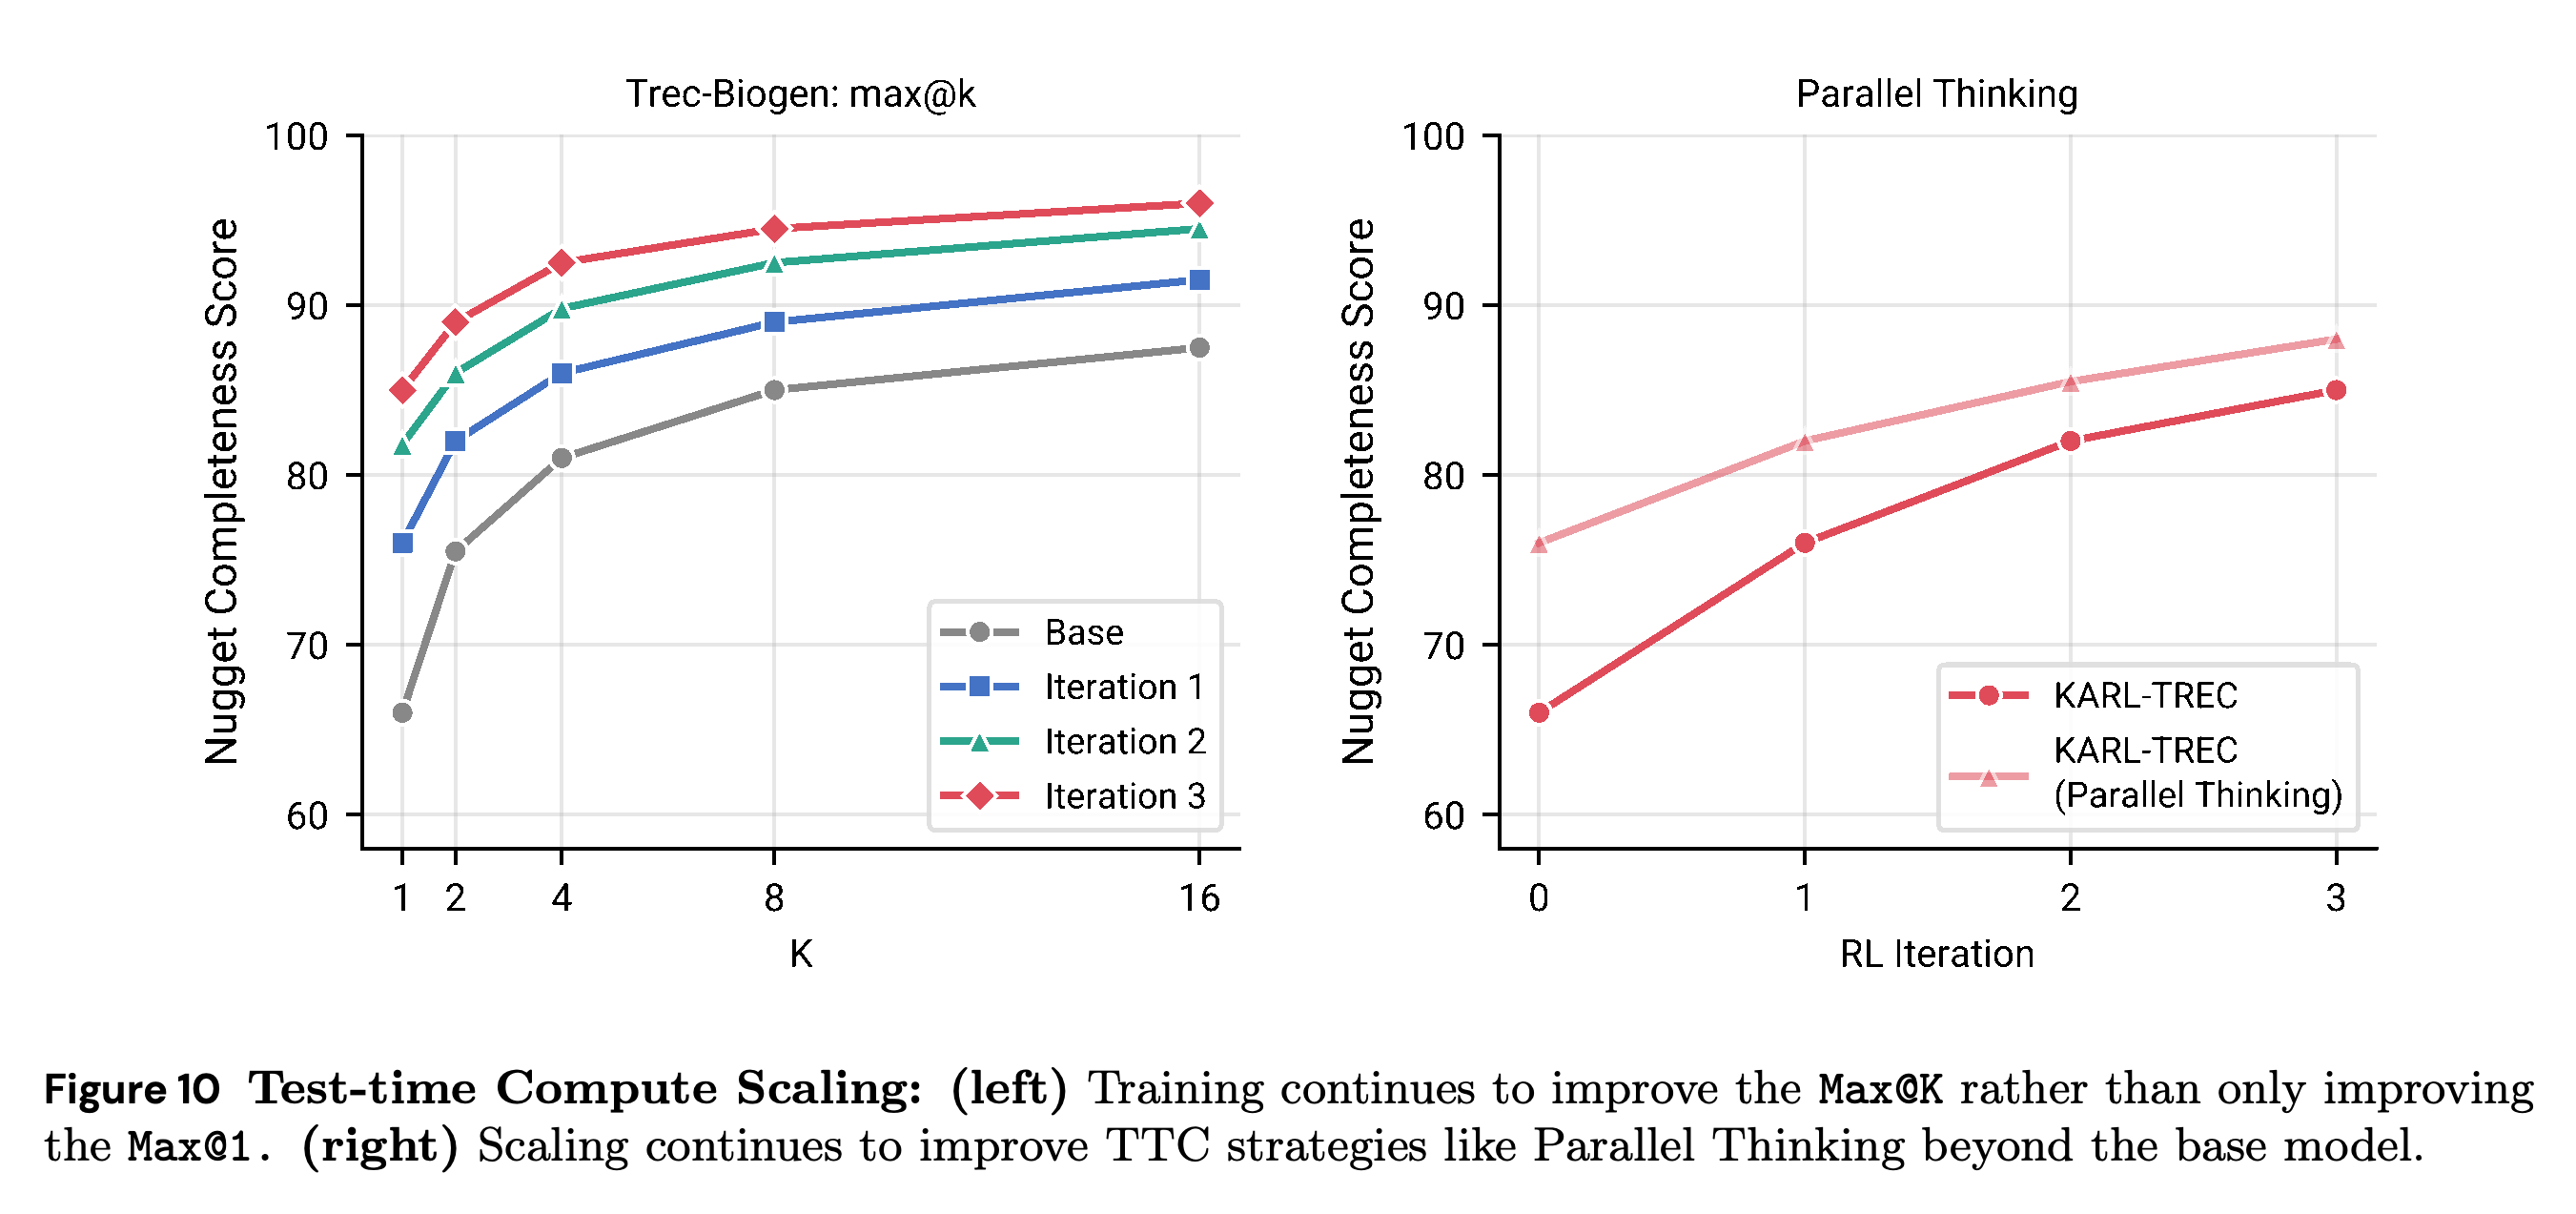
Figure 10은 RL 반복이 진행될수록 k = 1, 2, 4, 8, 16에서 TREC-Biogen max@k가 개선되는 모습을 보여준다. 3회 반복 후 max@1은 기본 모델의 max@8과 대략 같고, max@2는 기본 모델의 max@16보다 높다. 이는 실험한 샘플링 예산에서 관측된 해결 범위가 넓어졌음을 뒷받침한다.
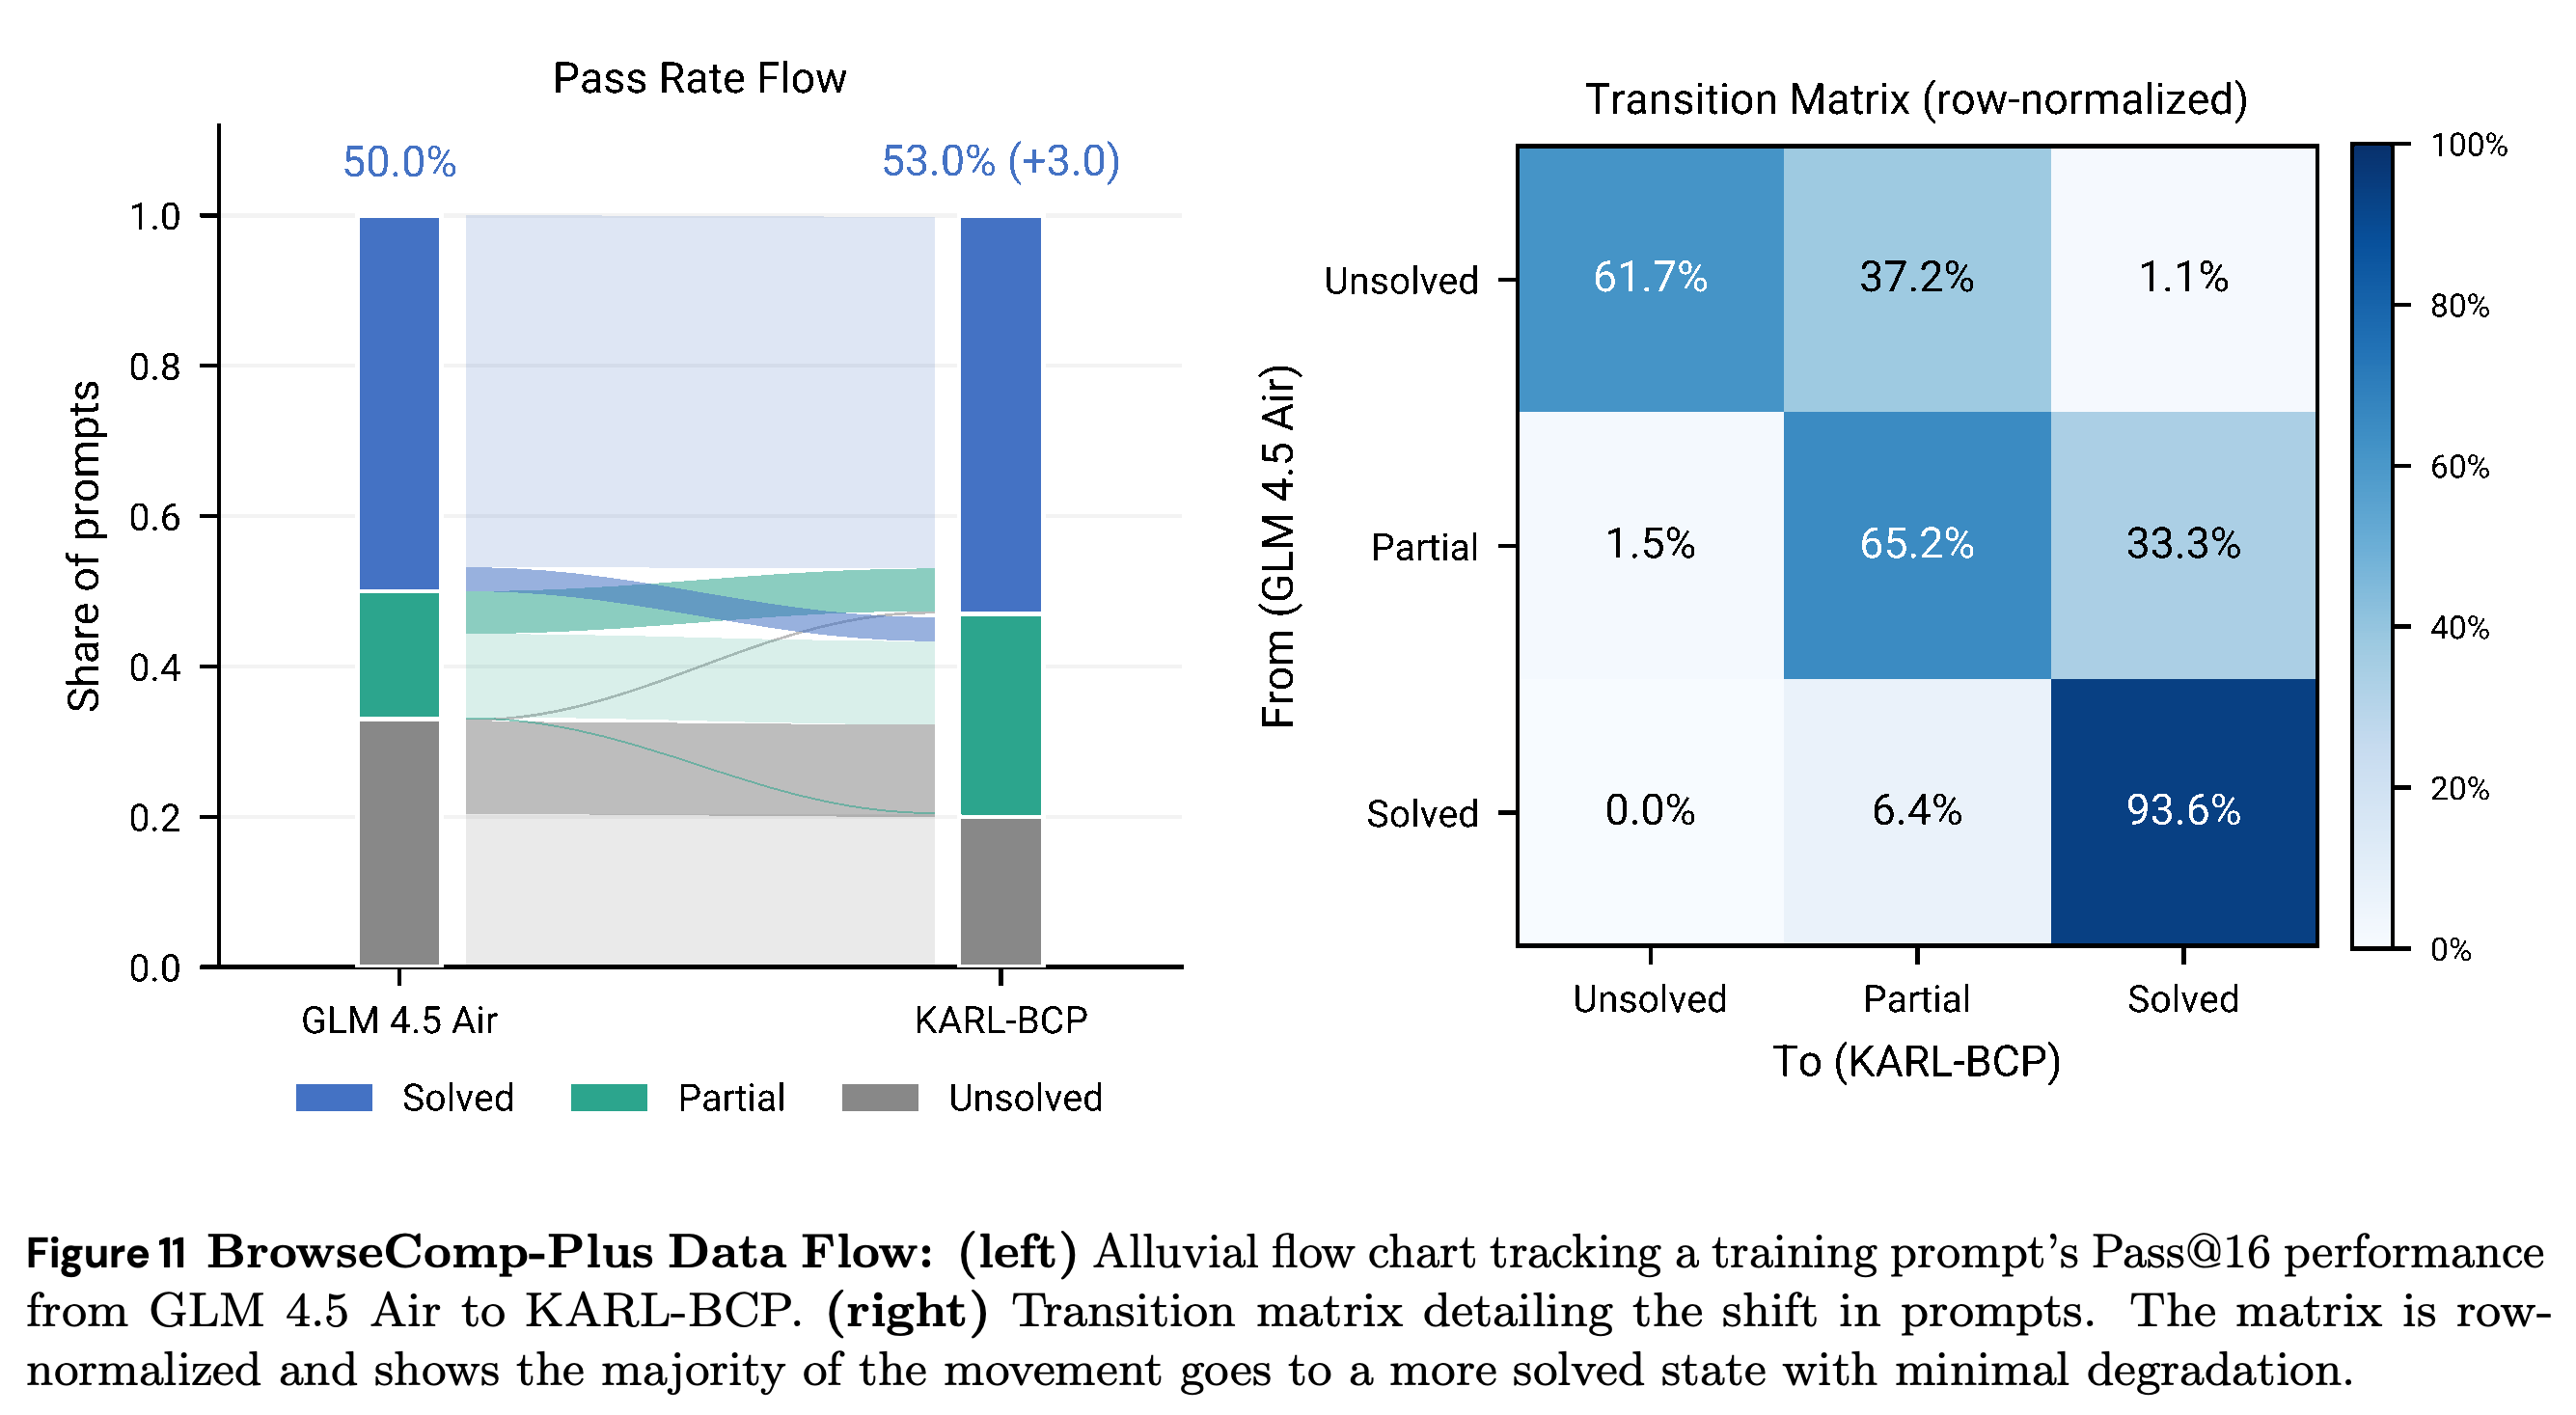
- Figure 11은 합성 BrowseComp-Plus 프롬프트를 16회 시도의 성공 범주로 추적한다. Partial 프롬프트의 33.3%가 Solved로, Unsolved 프롬프트의 37.2%가 Partial로 바뀐다.
- Solved 프롬프트 중 Partial로 바뀐 비율은 6.4%뿐이며, Unsolved로 바뀐 비율은 0.0%다. 논문은 Solved와 Unsolved 그룹을 최적화에서 제외했다고 설명하므로, 이들의 변화는 직접 학습한 프롬프트를 넘어선 전이의 근거가 된다.
- 유한한 샘플에서 실패했다고 해서 기본 정책의 정답 생성 확률이 0임이 입증되지는 않는다. 이 결과만으로 모든 형태의 distribution sharpening과 확실히 구분된다고 할 수는 없다.
max@k 곡선은 실험한 모든 샘플링 예산에서 상승하고, 병렬 통합도 학습에 따라 개선된다. 이는 샘플에서 얻은 최대 nugget 충족 점수의 향상이지, 기본 정책에서 정답 응답의 생성 확률이 0이었다는 증거가 아니다.
행 단위로 정규화한 행렬에서 이전 Unsolved 프롬프트의 37.2%가 Partial로, Partial 프롬프트의 33.3%가 Solved로 바뀐다. 최적화에서 제외한 그룹의 개선은 전이를 뒷받침하지만, 유한한 16회 시도로 정한 범주는 여전히 샘플링에 의존한다.
7.3.6 Training Ablations: Search Environment Generalization
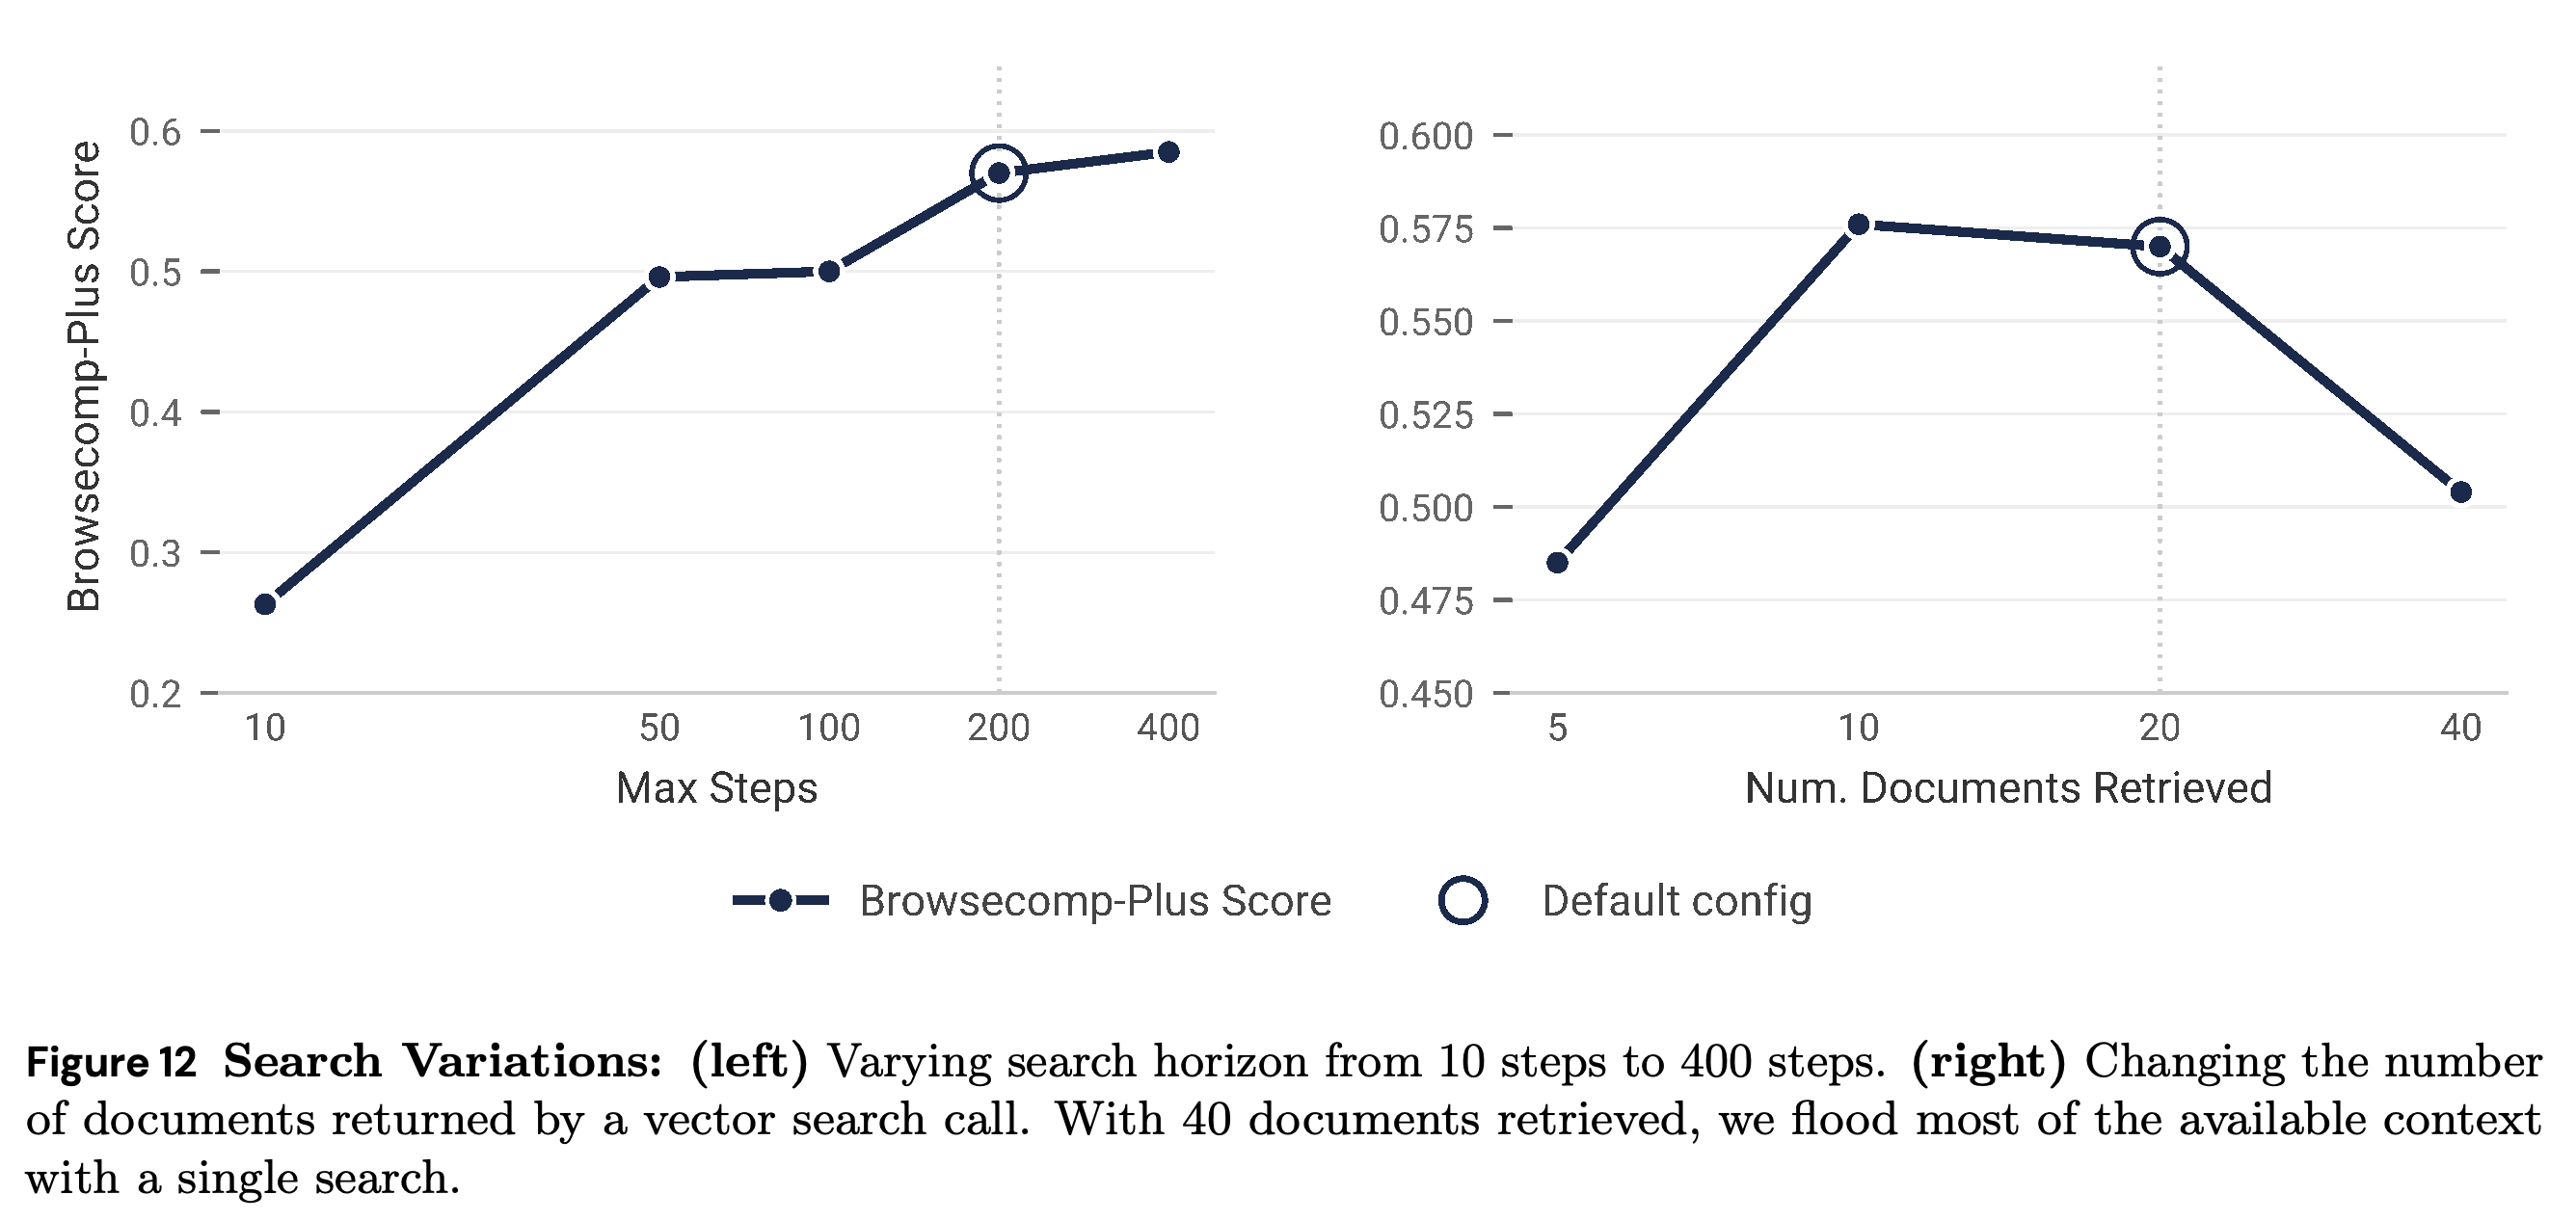
KARL-BCP 성능은 단계 예산이 10에서 200으로 늘어날 때 개선되고, 이후 400까지는 대체로 정체된다. Figure 12에서 검색 문서 수가 10~20개일 때는 성능이 비슷하지만, 40개일 때는 떨어진다. 저자들은 검색 결과가 다단계 추론에 필요한 문맥 공간을 차지하기 때문이라고 설명한다.
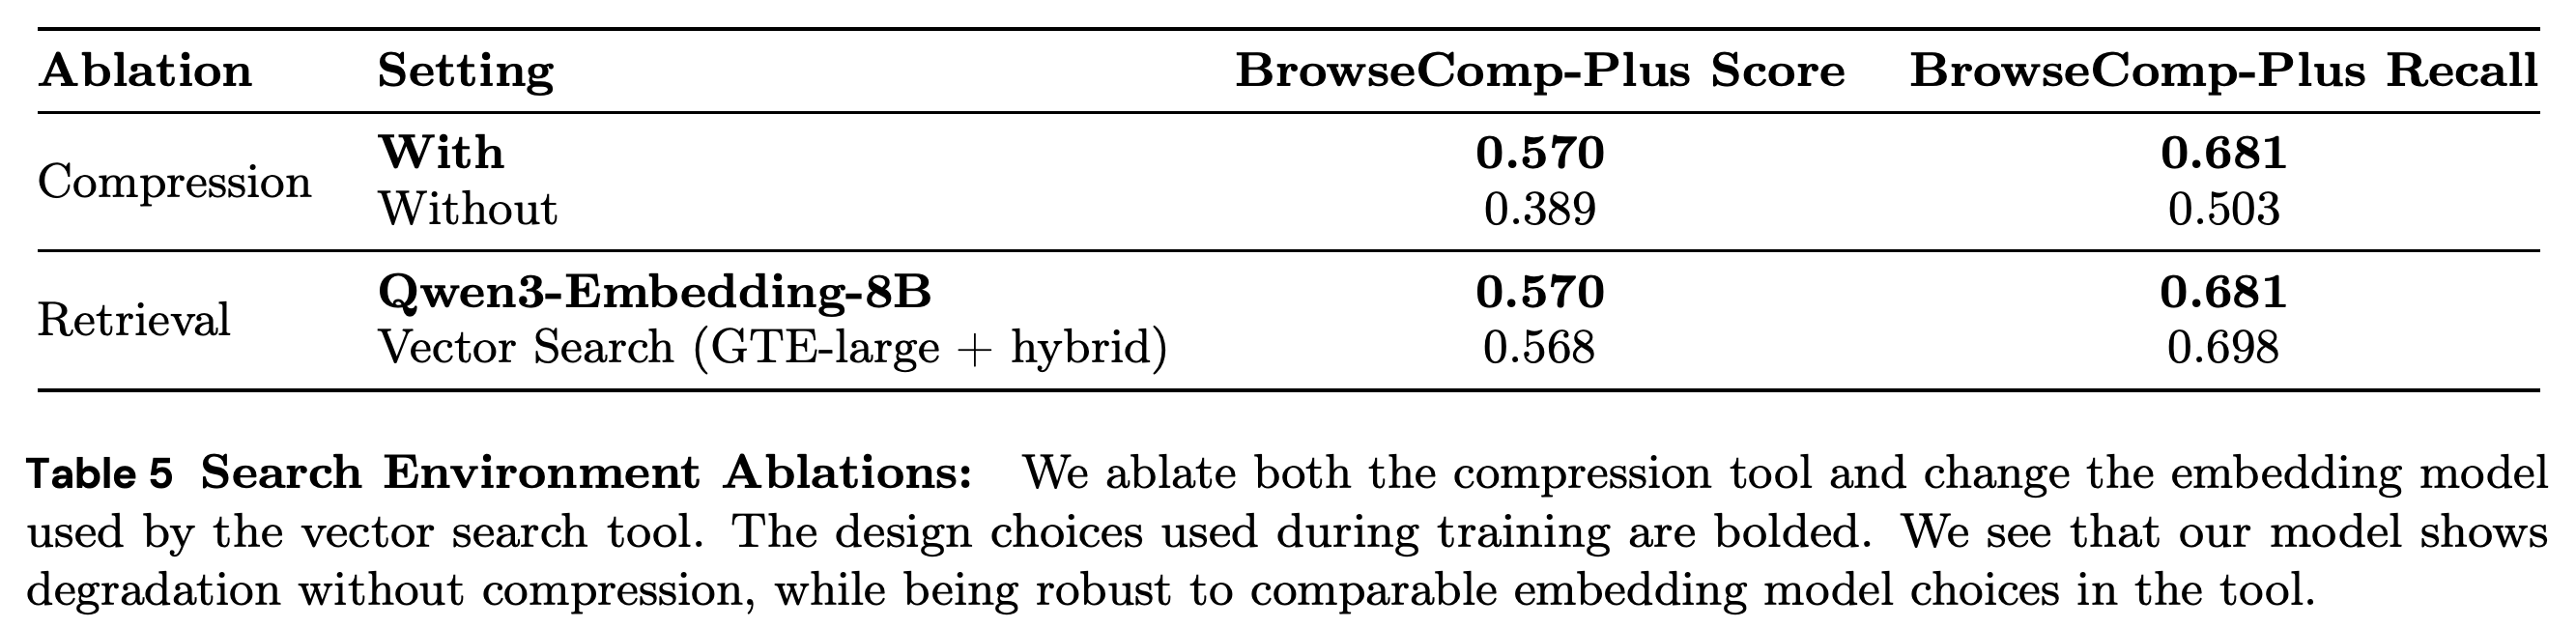
- Table 5에서 압축을 제거하면 정확도는 0.570에서 0.389로, recall은 0.681에서 0.503으로 떨어진다. Qwen3-Embedding-8B를 GTE-large와 hybrid retrieval로 교체하면 정확도는 0.568로 유지되고 recall은 0.698이다.
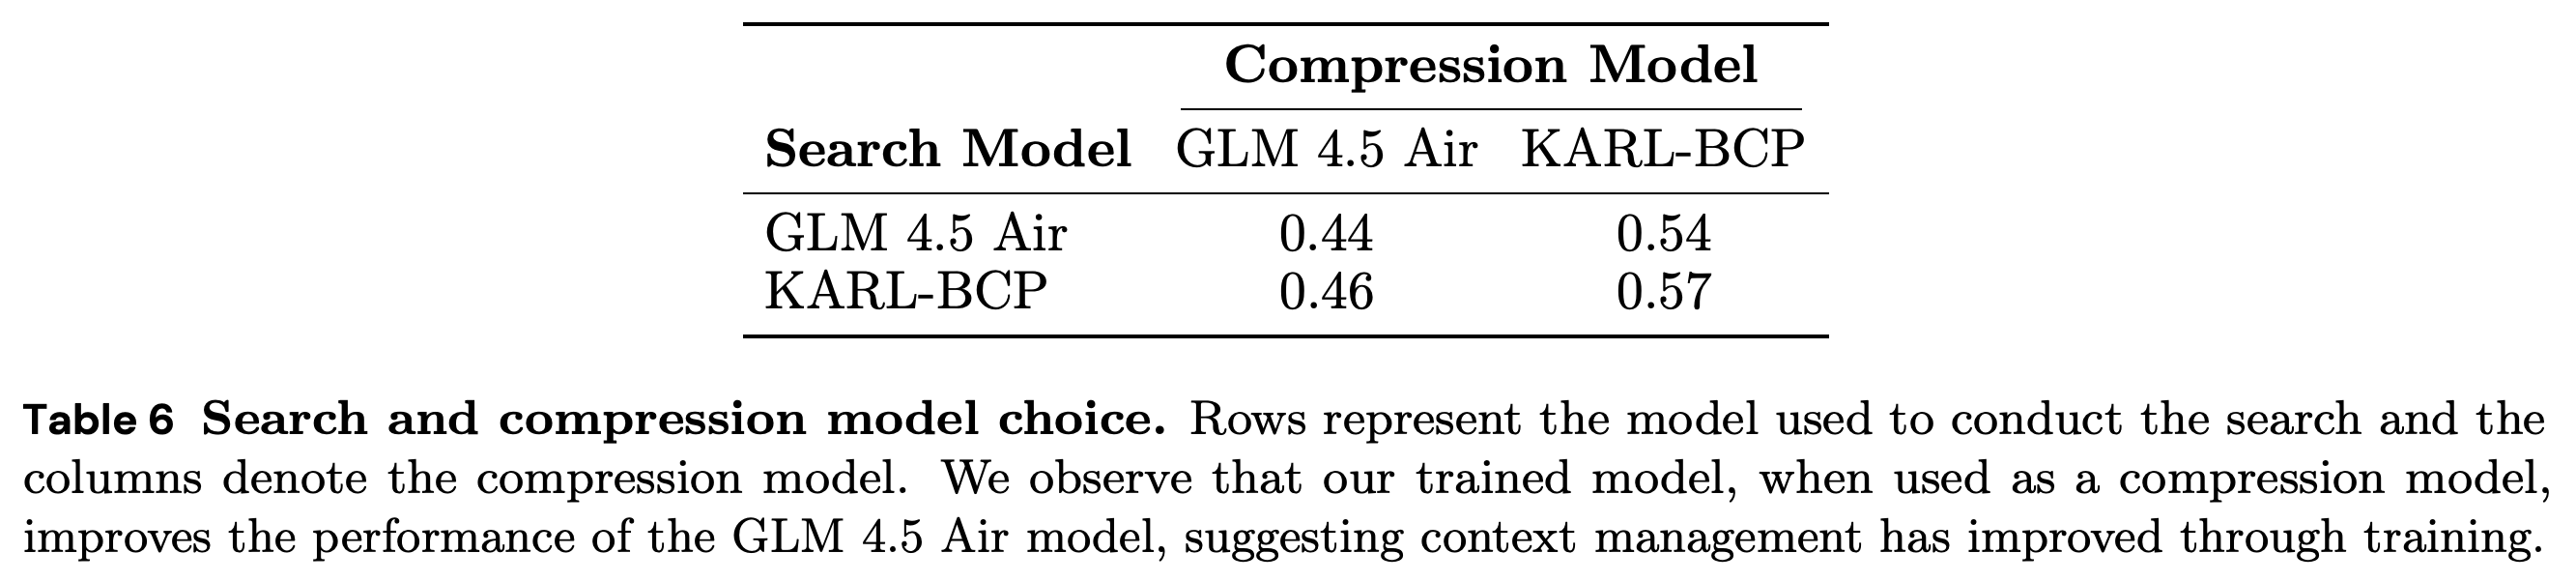
- Table 6은 검색과 압축의 역할을 분리한다. 기본 압축 모델을 KARL-BCP로 교체하면 기본 검색 모델의 정확도는 0.44에서 0.54로, KARL-BCP-search의 정확도는 0.46에서 0.57로 오른다.
- 역할 교차 실험은 압축 개선이 과제 성공에 기여함을 분리해서 보여준다. 비슷한 검색기로 교체한 단일 실험은 제한적인 환경 강건성을 뒷받침하지만, 검색기와 무관한 성능을 입증하지는 않는다.
압축을 제거하면 정확도와 주석 문서 recall이 모두 낮아진다. 비슷한 GTE-large hybrid 검색기로 교체하면 정확도가 유지된다. 이는 해당 교체에 대한 강건성을 보여줄 뿐, 임의의 검색 시스템에 대한 강건성을 보여주지는 않는다.
검색 예산을 약 200단계까지 늘리면 성능이 개선되지만, 400단계까지의 추가 이득은 제한적이다. 호출마다 문서 40개를 검색하면 10개나 20개보다 성능이 낮다. 이는 즉시 확보하는 근거의 양과 다단계 추론 공간 사이의 절충 관계와 부합한다.
검색 모델을 고정해 압축 모델의 기여를 분리한다. KARL-BCP 압축은 기본 검색 모델과 학습된 검색 모델 모두의 정확도를 높인다. 압축 모델만 바꿔 얻은 이득은 학습된 문맥 관리가 최종 과제 성공에 기여한다는 직접적인 근거다.
7.4 Test-Time Compute Experiments
Test-time 실험은 Majority Voting (MV), Weighted Majority Voting (WMV), Best-of-N (BoN), 생성형 통합을 구분한다. MV는 답변마다 같은 표를 주고, WMV는 학습된 점수로 표에 가중치를 주며, BoN은 점수가 가장 높은 후보를 반환한다. 생성형 통합은 상호 보완적인 내용을 결합해 새로운 답변을 만들 수 있다.
- MV와 WMV에는 이산적인 답변 동치 클래스가 필요하다. 후보 답변을 자연스럽게 묶기 어려운 자유 형식 응답에는 생성형 통합을 사용한다.
7.4.1 Parallel Thinking
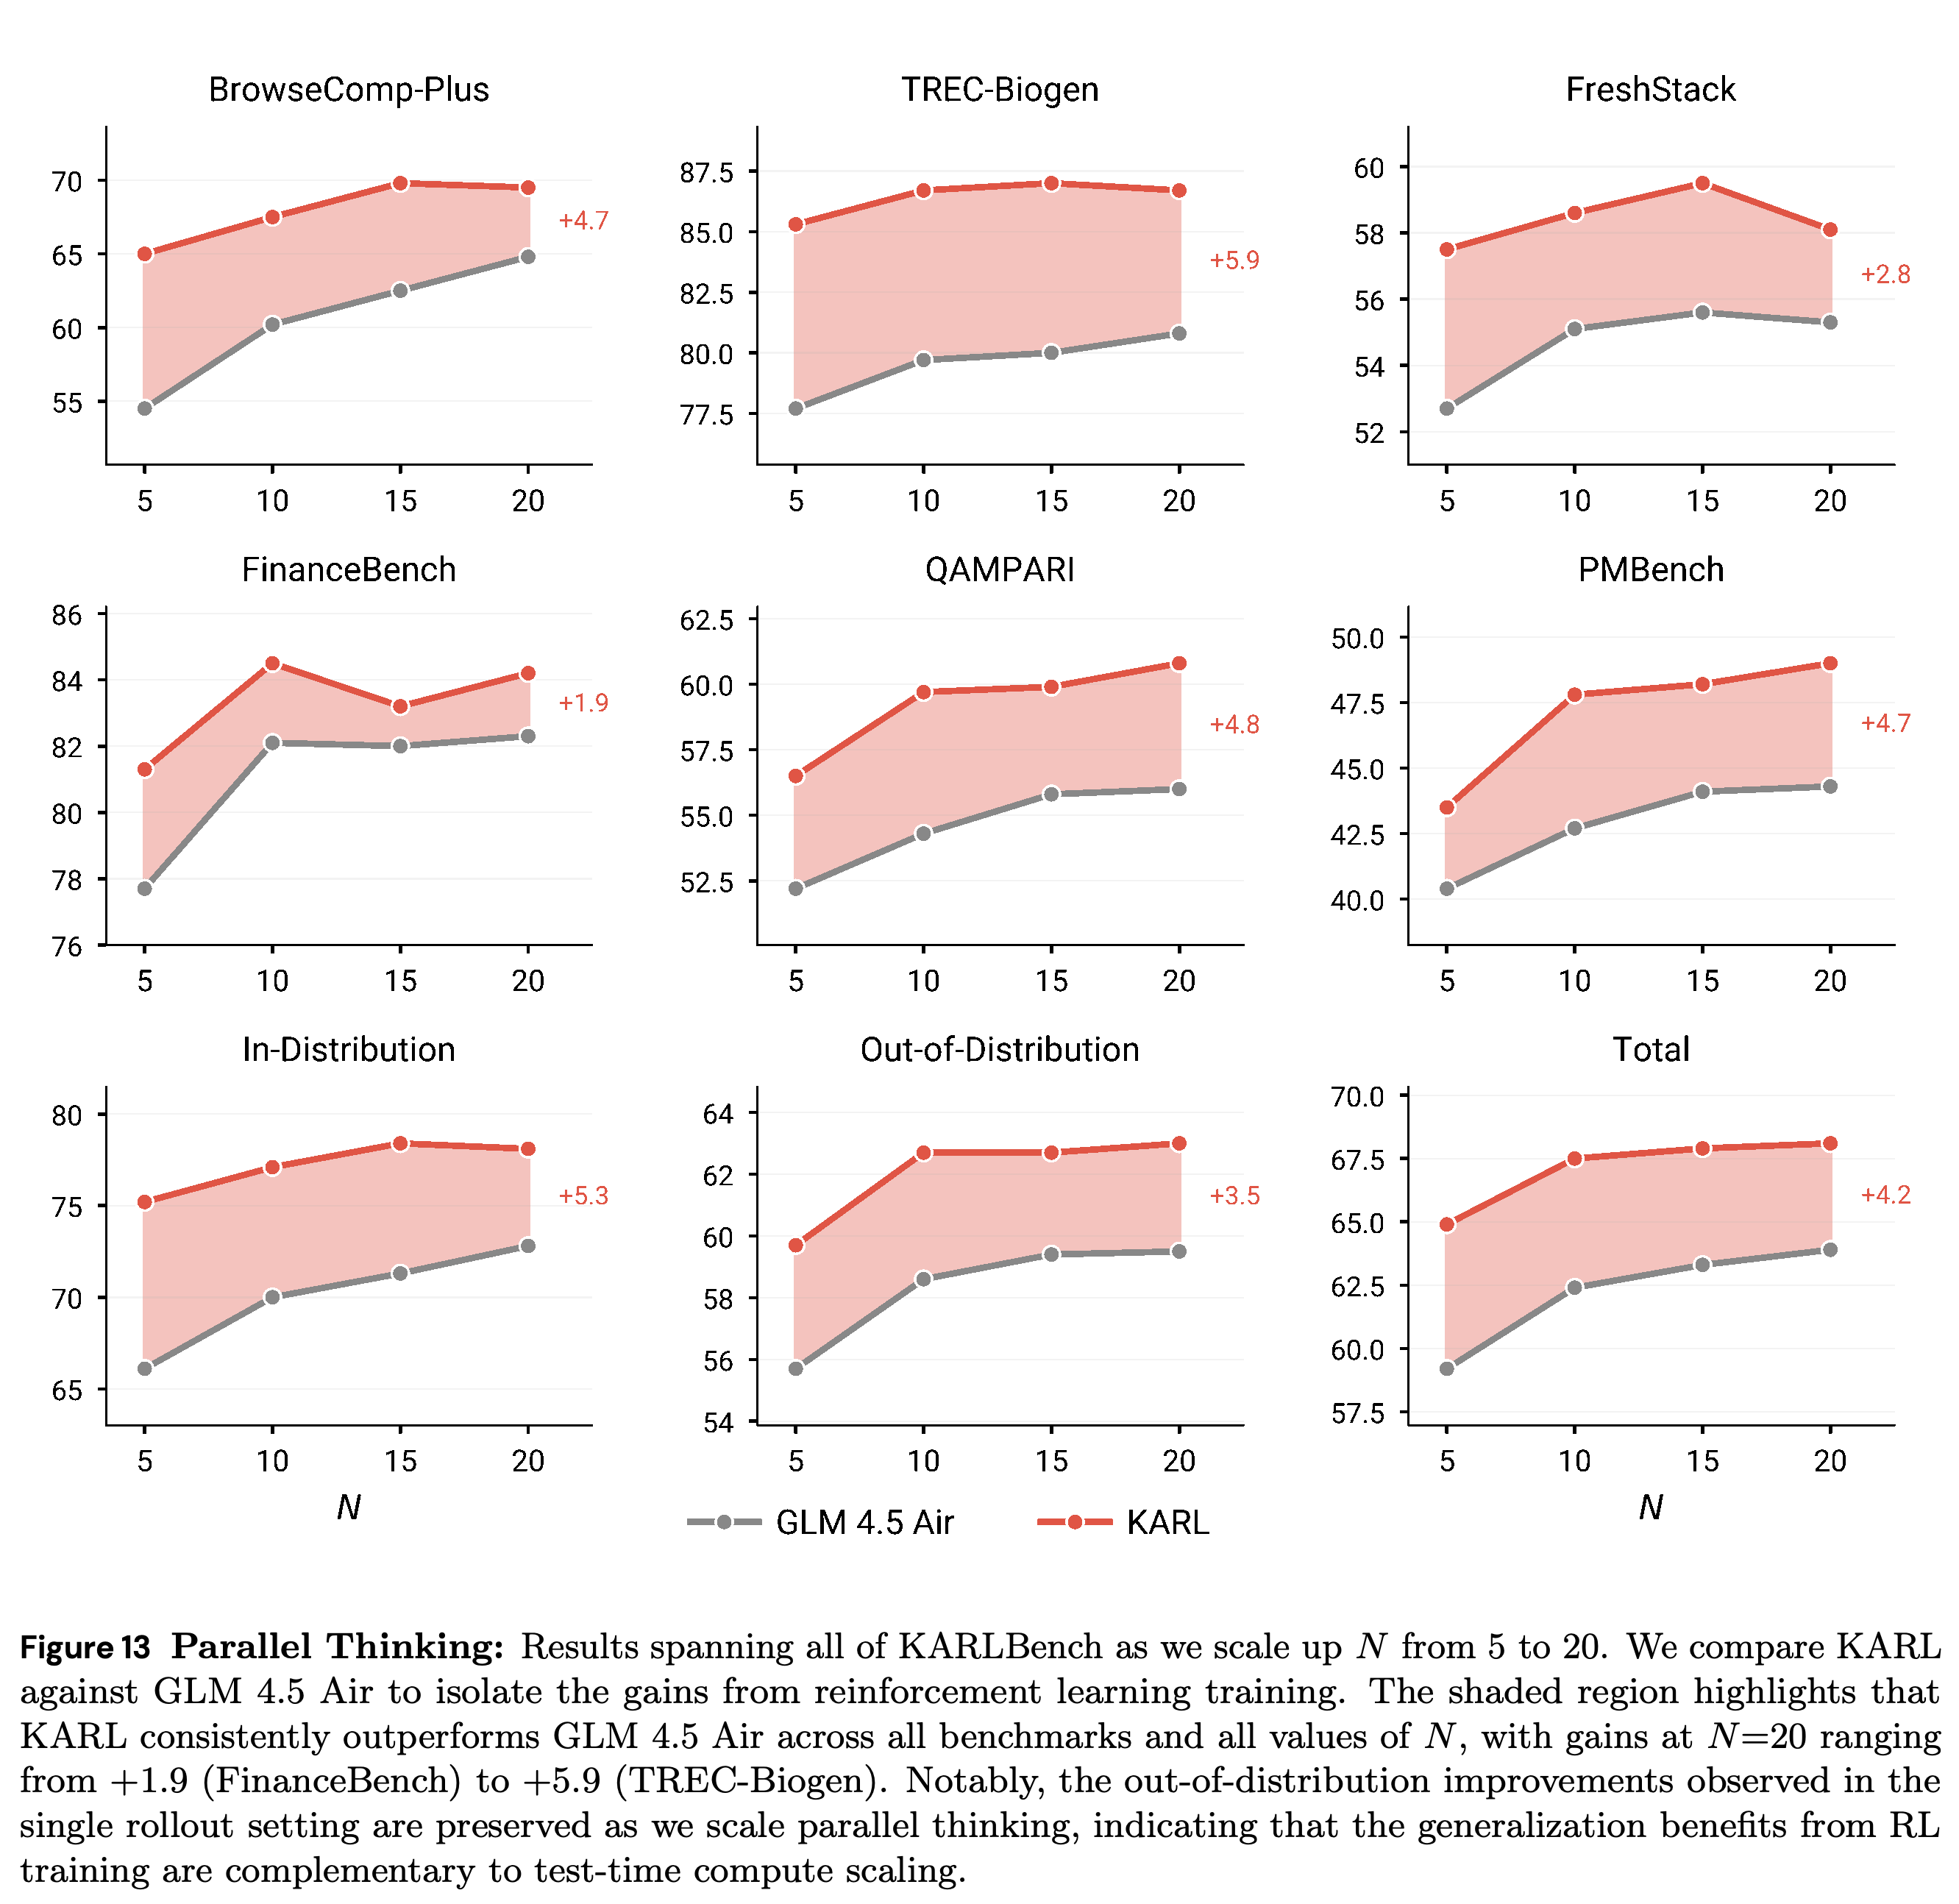
Figure 13은 parallel thinking을 N = 5에서 N = 20으로 늘리면서 KARL과 GLM 4.5 Air를 비교한다. KARL은 6개 과제의 모든 실험 예산에서 앞서며, N = 20에서 전체 점수 차이는 +4.2이다.
- N = 20개일 때 과제별 우위는 FinanceBench의 +1.9부터 TREC-Biogen의 +5.9까지다. N = 15 이후에는 이득이 줄고 일부 과제 곡선은 하락하므로, 확장이 항상 단조롭게 성능을 높이지는 않는다.
- 저자들은 후보 품질의 포화와 통합 모델의 문맥 증가를 원인으로 제안하지만, 이 메커니즘들을 독립적으로 검증하지는 않는다.
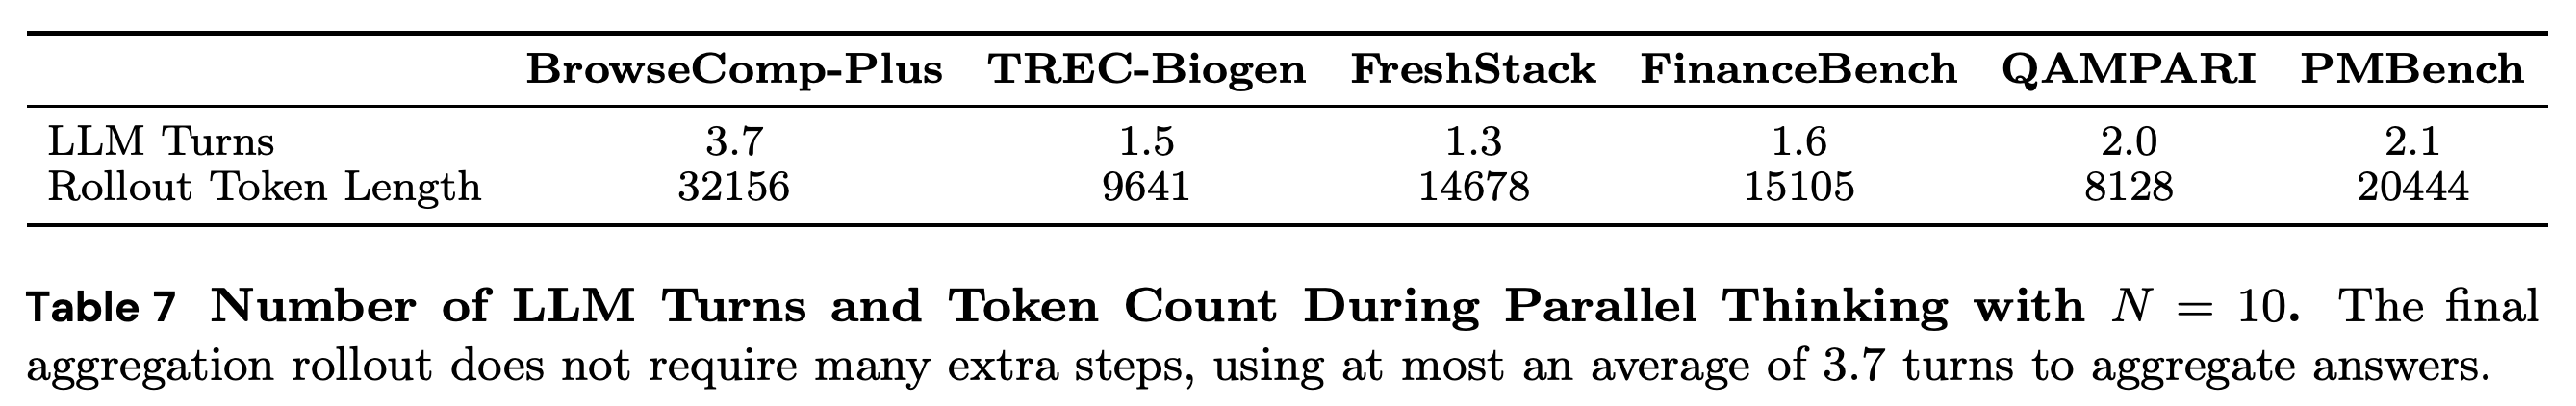
- Table 7에서 N = 10의 평균 통합 LLM turn 수는 BrowseComp-Plus, TREC-Biogen, FreshStack, FinanceBench, QAMPARI, PMBench 순으로 3.7, 1.5, 1.3, 1.6, 2.0, 2.1이다. 보고된 통합 rollout 토큰 길이는 각각 32156, 9641, 14678, 15105, 8128, 20444이다.
KARL은 6개 과제의 모든 실험 병렬 예산에서 GLM 4.5 Air보다 높다. 예산이 커지면 여러 과제 곡선이 평평해지거나 하락한다. 따라서 RL과 parallel thinking은 상호 보완적일 수 있지만, 단조로운 확장 효과를 보장하지는 않는다.
통합에 추가되는 LLM turn은 적으며, BrowseComp-Plus가 평균 3.7로 가장 높다. 보고된 토큰 길이는 여전히 크고 과제마다 다르므로, turn 수가 적다고 통합 비용이 무시할 만하다고 해석해서는 안 된다.
7.4.2 Value-Guided Search (VGS)
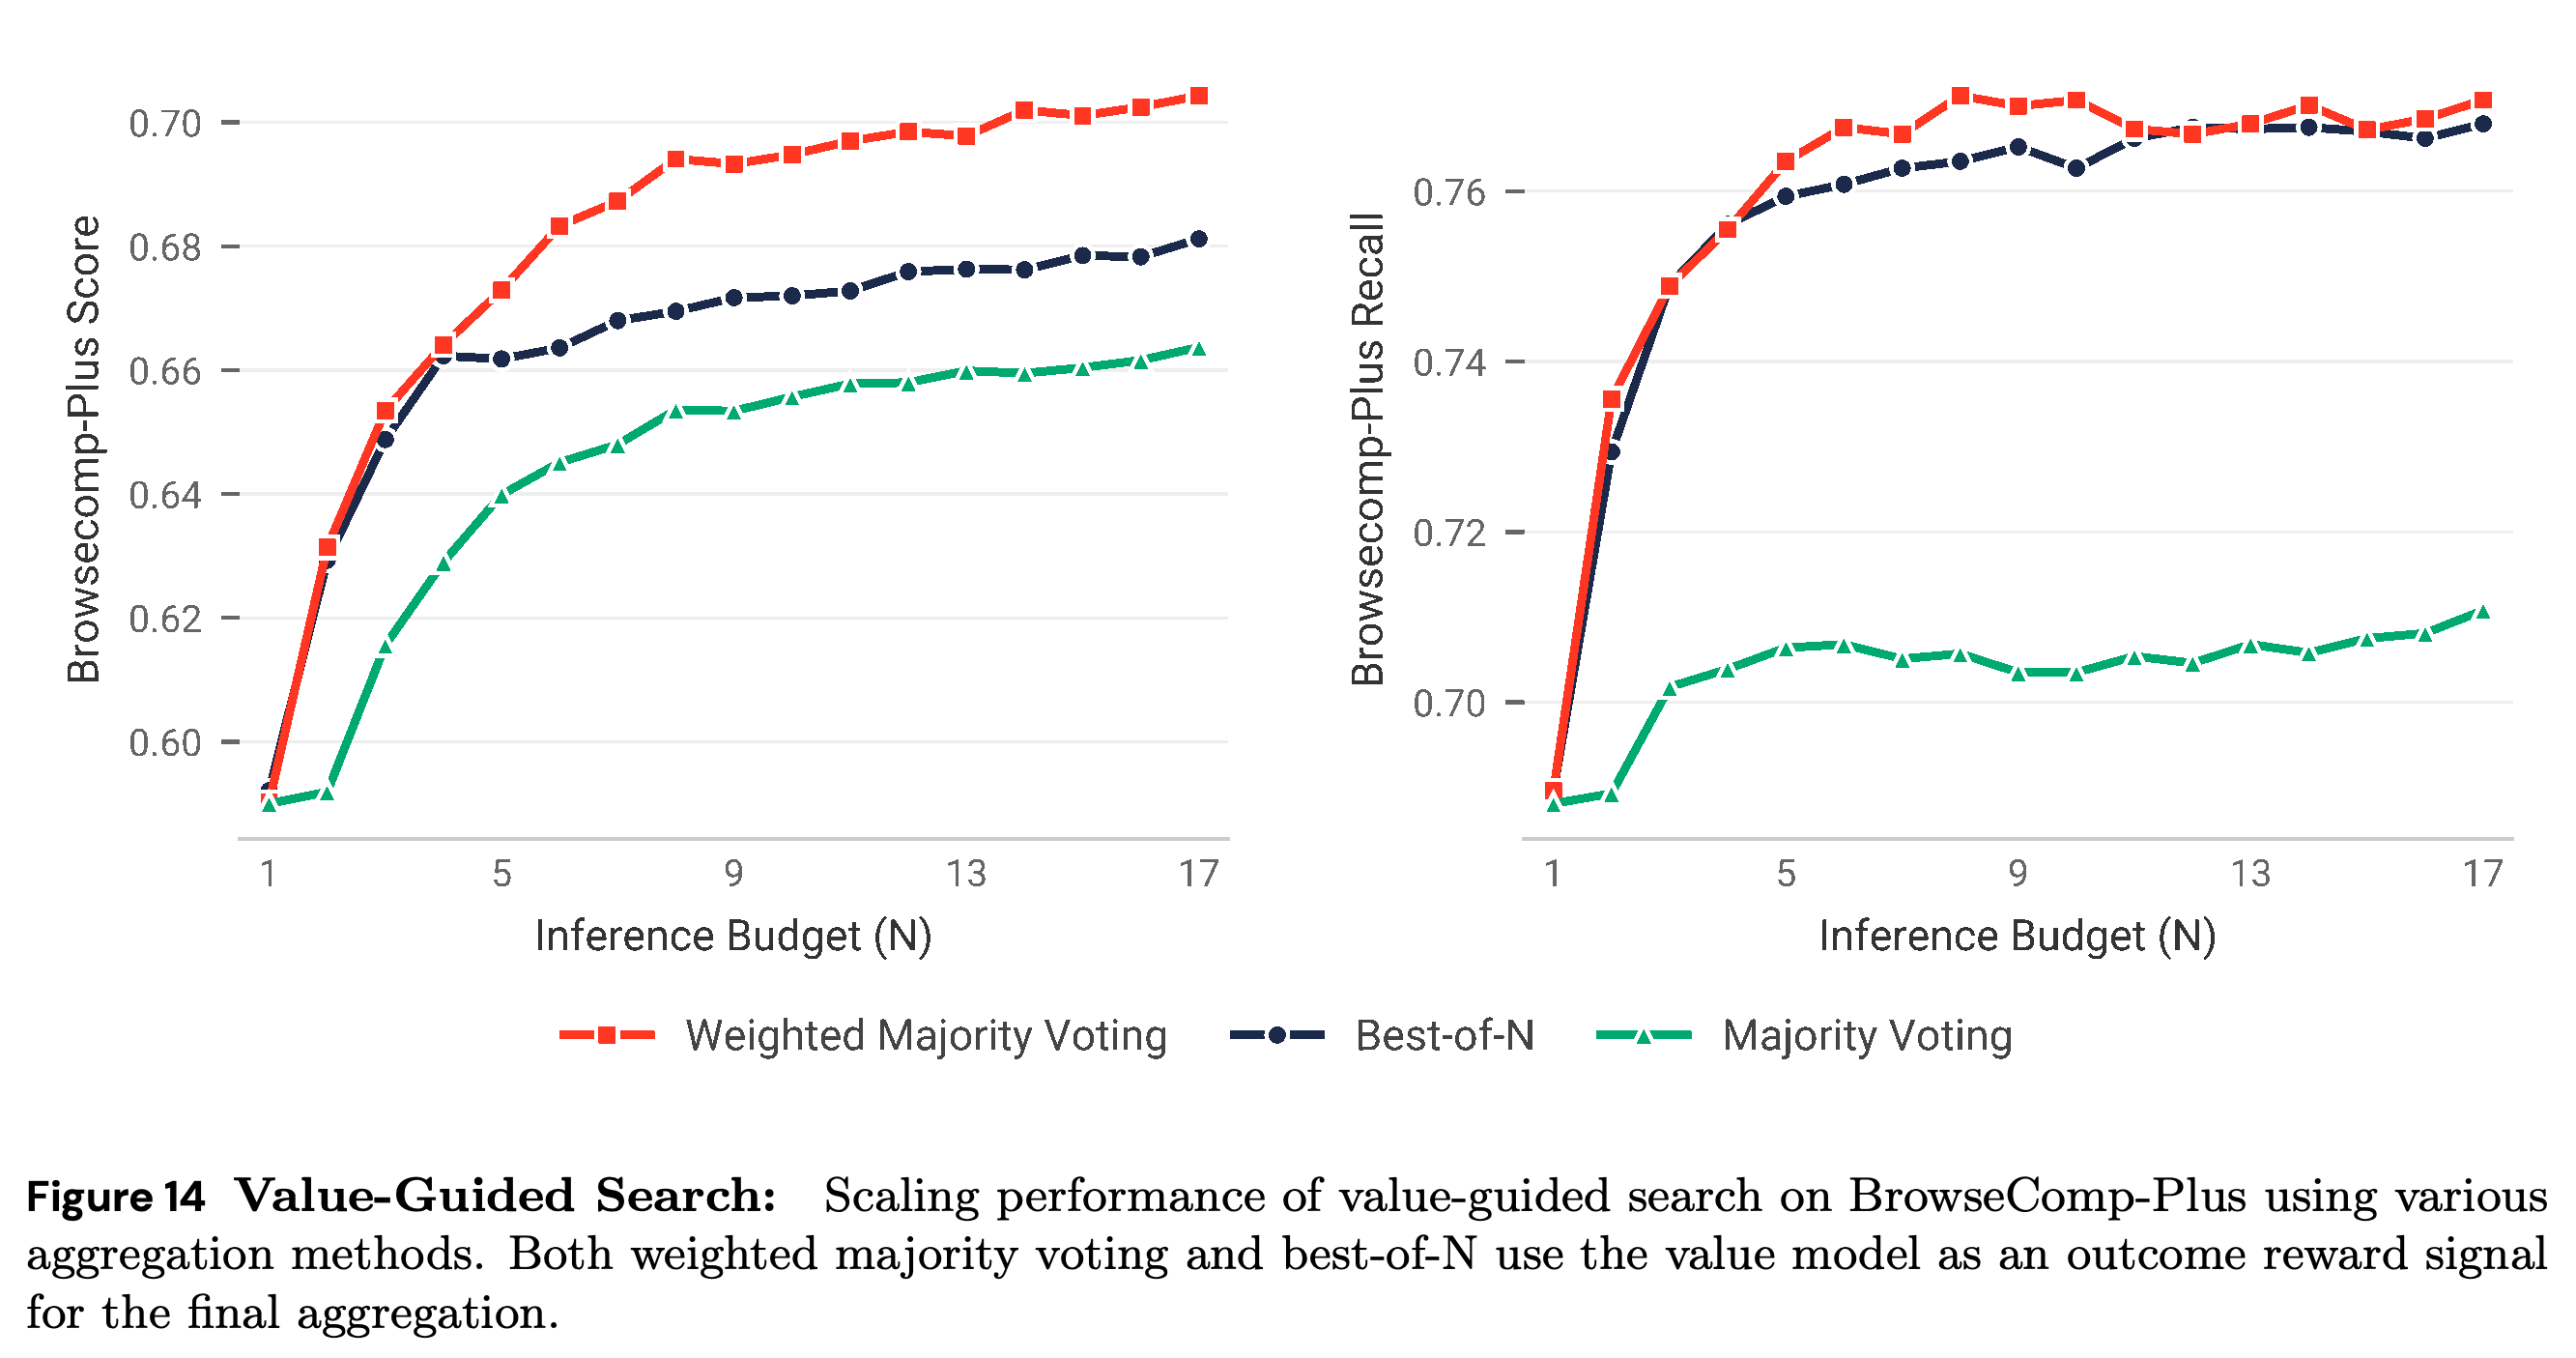
VGS는 KARL-BCP에서 분기 크기 2로 평가하며, 병렬 검색 과정의 수를 늘린다. Figure 14에서는 WMV가 가장 높은 답변 정확도를 보이며, N = 17에서 BrowseComp-Plus 점수 70.4에 도달한다.
- 가치 모델은 recall이 아니라 답변 성공 여부로 학습했지만, WMV와 BoN이 선택한 출력은 가중치 없는 MV보다 문서 recall도 높다. 다만 이 비교는 다른 조건이 동일한 VGS 없는 정책과 대비해 단계별 VGS의 효과를 분리한 것이 아니다.
- 결과는 BrowseComp-Plus 전문가와 과제별 가치 모델을 사용한다. 이 가치 모델이 KARLBench의 6가지 유형 모두에 전이되는지는 평가하지 않는다.
Weighted majority voting은 N = 17에서 70.4로 가장 높은 답변 정확도를 얻는다. 가치 모델을 답변 성공 여부로 학습했음에도 WMV와 BoN은 가중치 없는 MV보다 문서 recall이 높은 출력을 선택한다. 비교한 모든 전략은 VGS 실험 안에서 실행된다.
8.1 Quantitative Behavioral Analysis
논문은 정량적인 궤적 측정과 정성적 사례 연구로 RL의 영향을 살펴본다. 정량 분석은 합성 데이터와 평가 질문에서 궤적 길이, 검색 다양성, 검색 상태, 답변 정확도를 근거 획득과 중단 행동의 변화에 연결한다.
8.1.1 Quantitative Analysis on Synthetic Data
Figure 15에서 KARL-BCP는 합성 궤적을 Unsolved, Partial, Solved 그룹 모두에서 단축한다. 평균 길이는 각각 163.8에서 159.6단계로, 134.4에서 113.1단계로, 51.1에서 36.3단계로 바뀐다. 가장 큰 감소는 학습에서 제외한, 이미 Solved인 질문에서 나타난다.
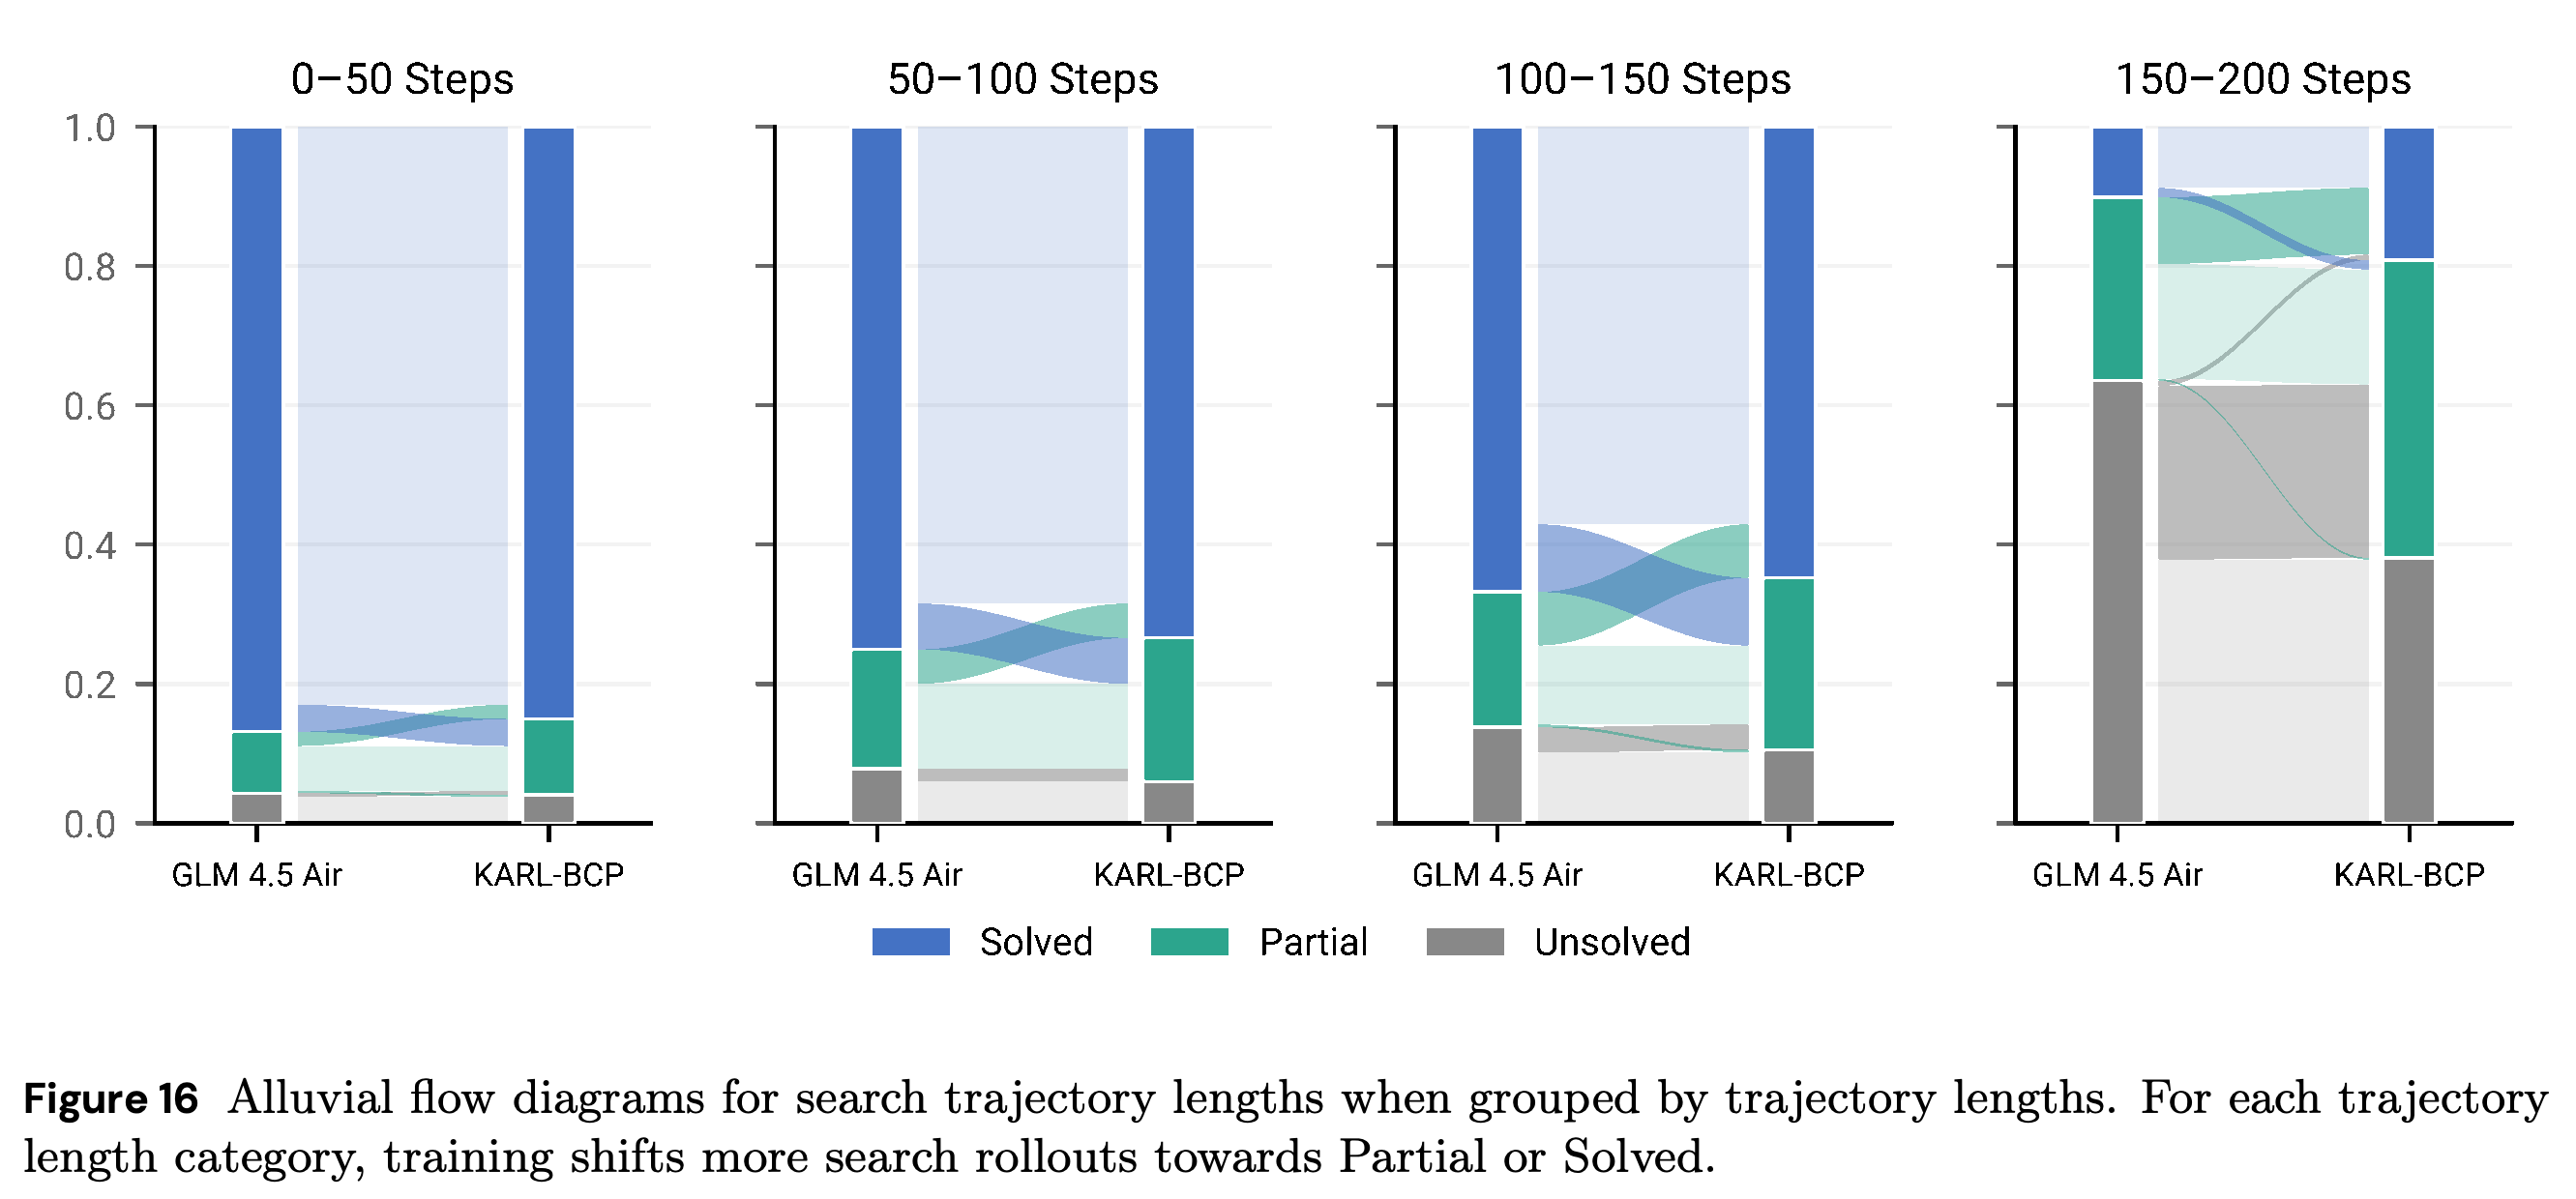
- Figure 16은 기본 모델의 16회 시도 평균 길이를 기준으로 프롬프트를 0–50, 50–100, 100–150, 150–200단계 구간으로 나눈다.
- 가장 긴 구간에서 미해결 비율이 가장 높다. 논문은 이 구간에서 이전에 미해결이던 질문의 20% 넘게 부분 해결로 바뀌고, 부분 해결 질문의 약 10%가 완전 해결로 바뀐다고 보고한다.
- 짧은 궤적이 본질적으로 더 좋은 것은 아니다. 이후 수치 추론 실패 사례는 조기 중단도 검색 길이를 줄일 수 있음을 보여준다.
모든 성공 범주에서 평균 궤적이 짧아지며, 최적화에서 제외한 이미 Solved인 프롬프트에서 감소 폭이 가장 크다. Unsolved 프롬프트의 훨씬 작은 감소만으로는 추론 개선이나 성공적인 종료를 알 수 없다.
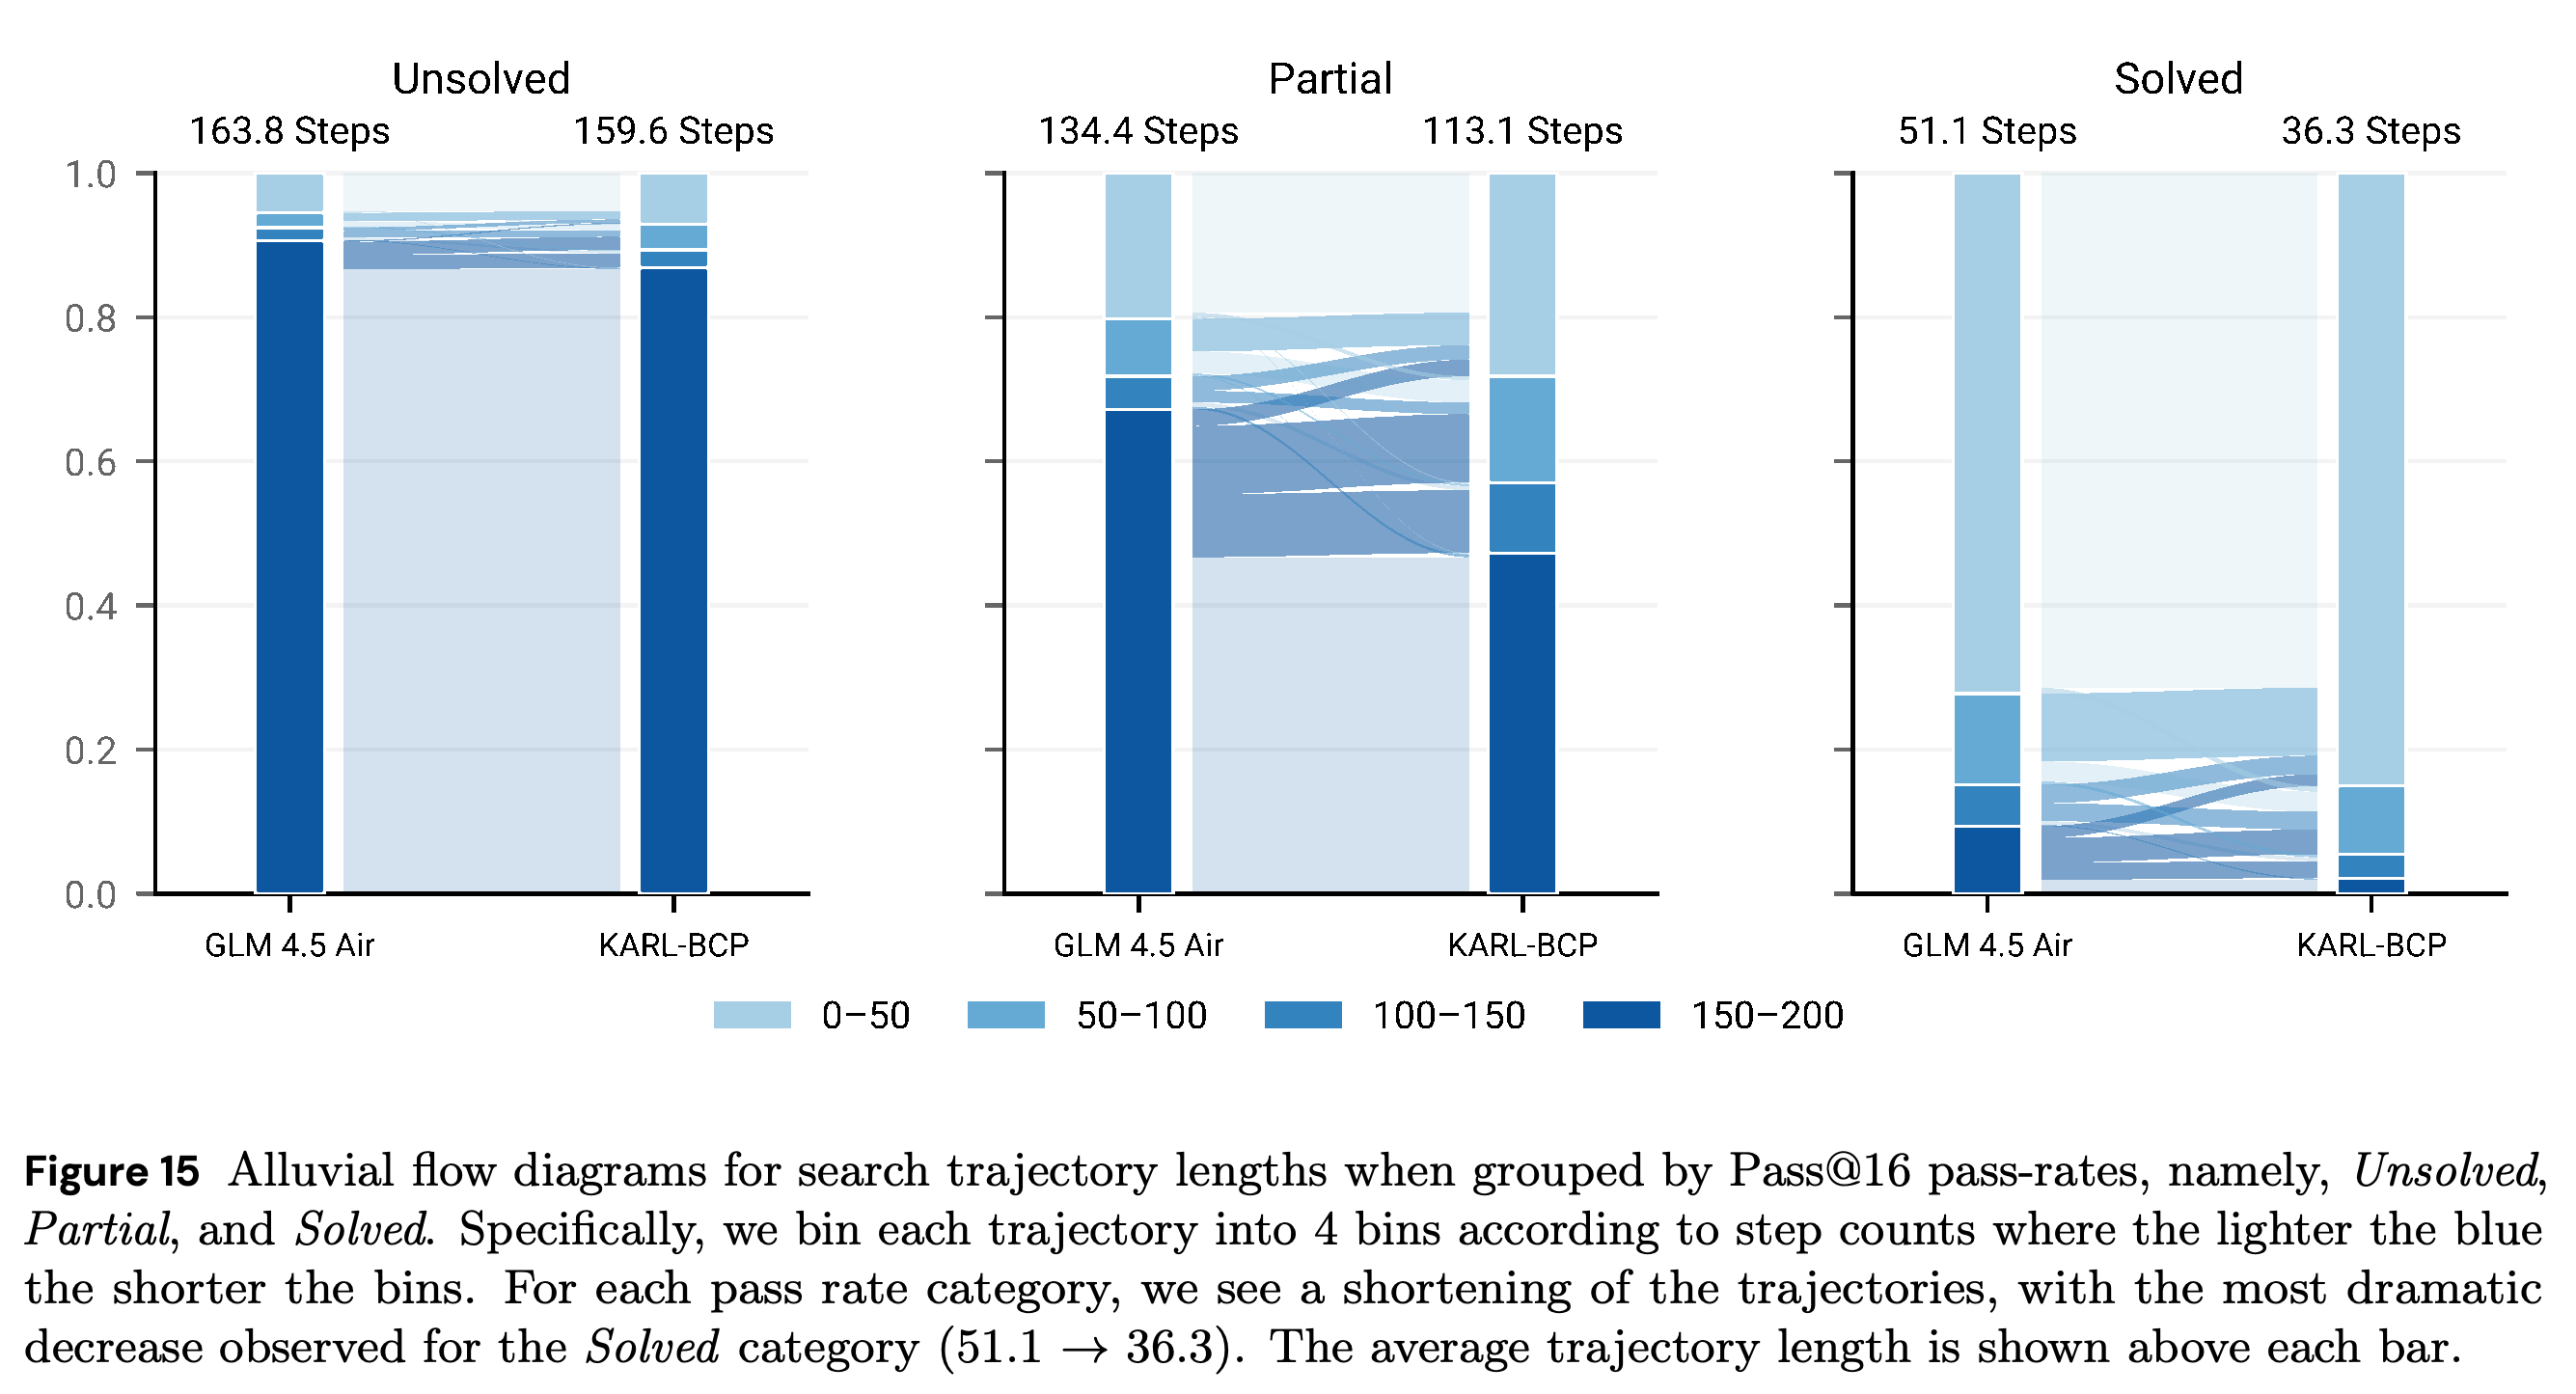
기본 모델의 궤적이 가장 긴 질문들은 미해결 비율이 가장 높고, 학습 후 부분 성공으로 크게 이동한다. 기본 모델의 궤적 길이로 묶으면 이 변화를 어려운 검색 사례와 연결할 수 있지만, 원인을 독립적으로 식별할 수는 없다.
8.1.2 Quantitative Analysis on Evaluation Sets
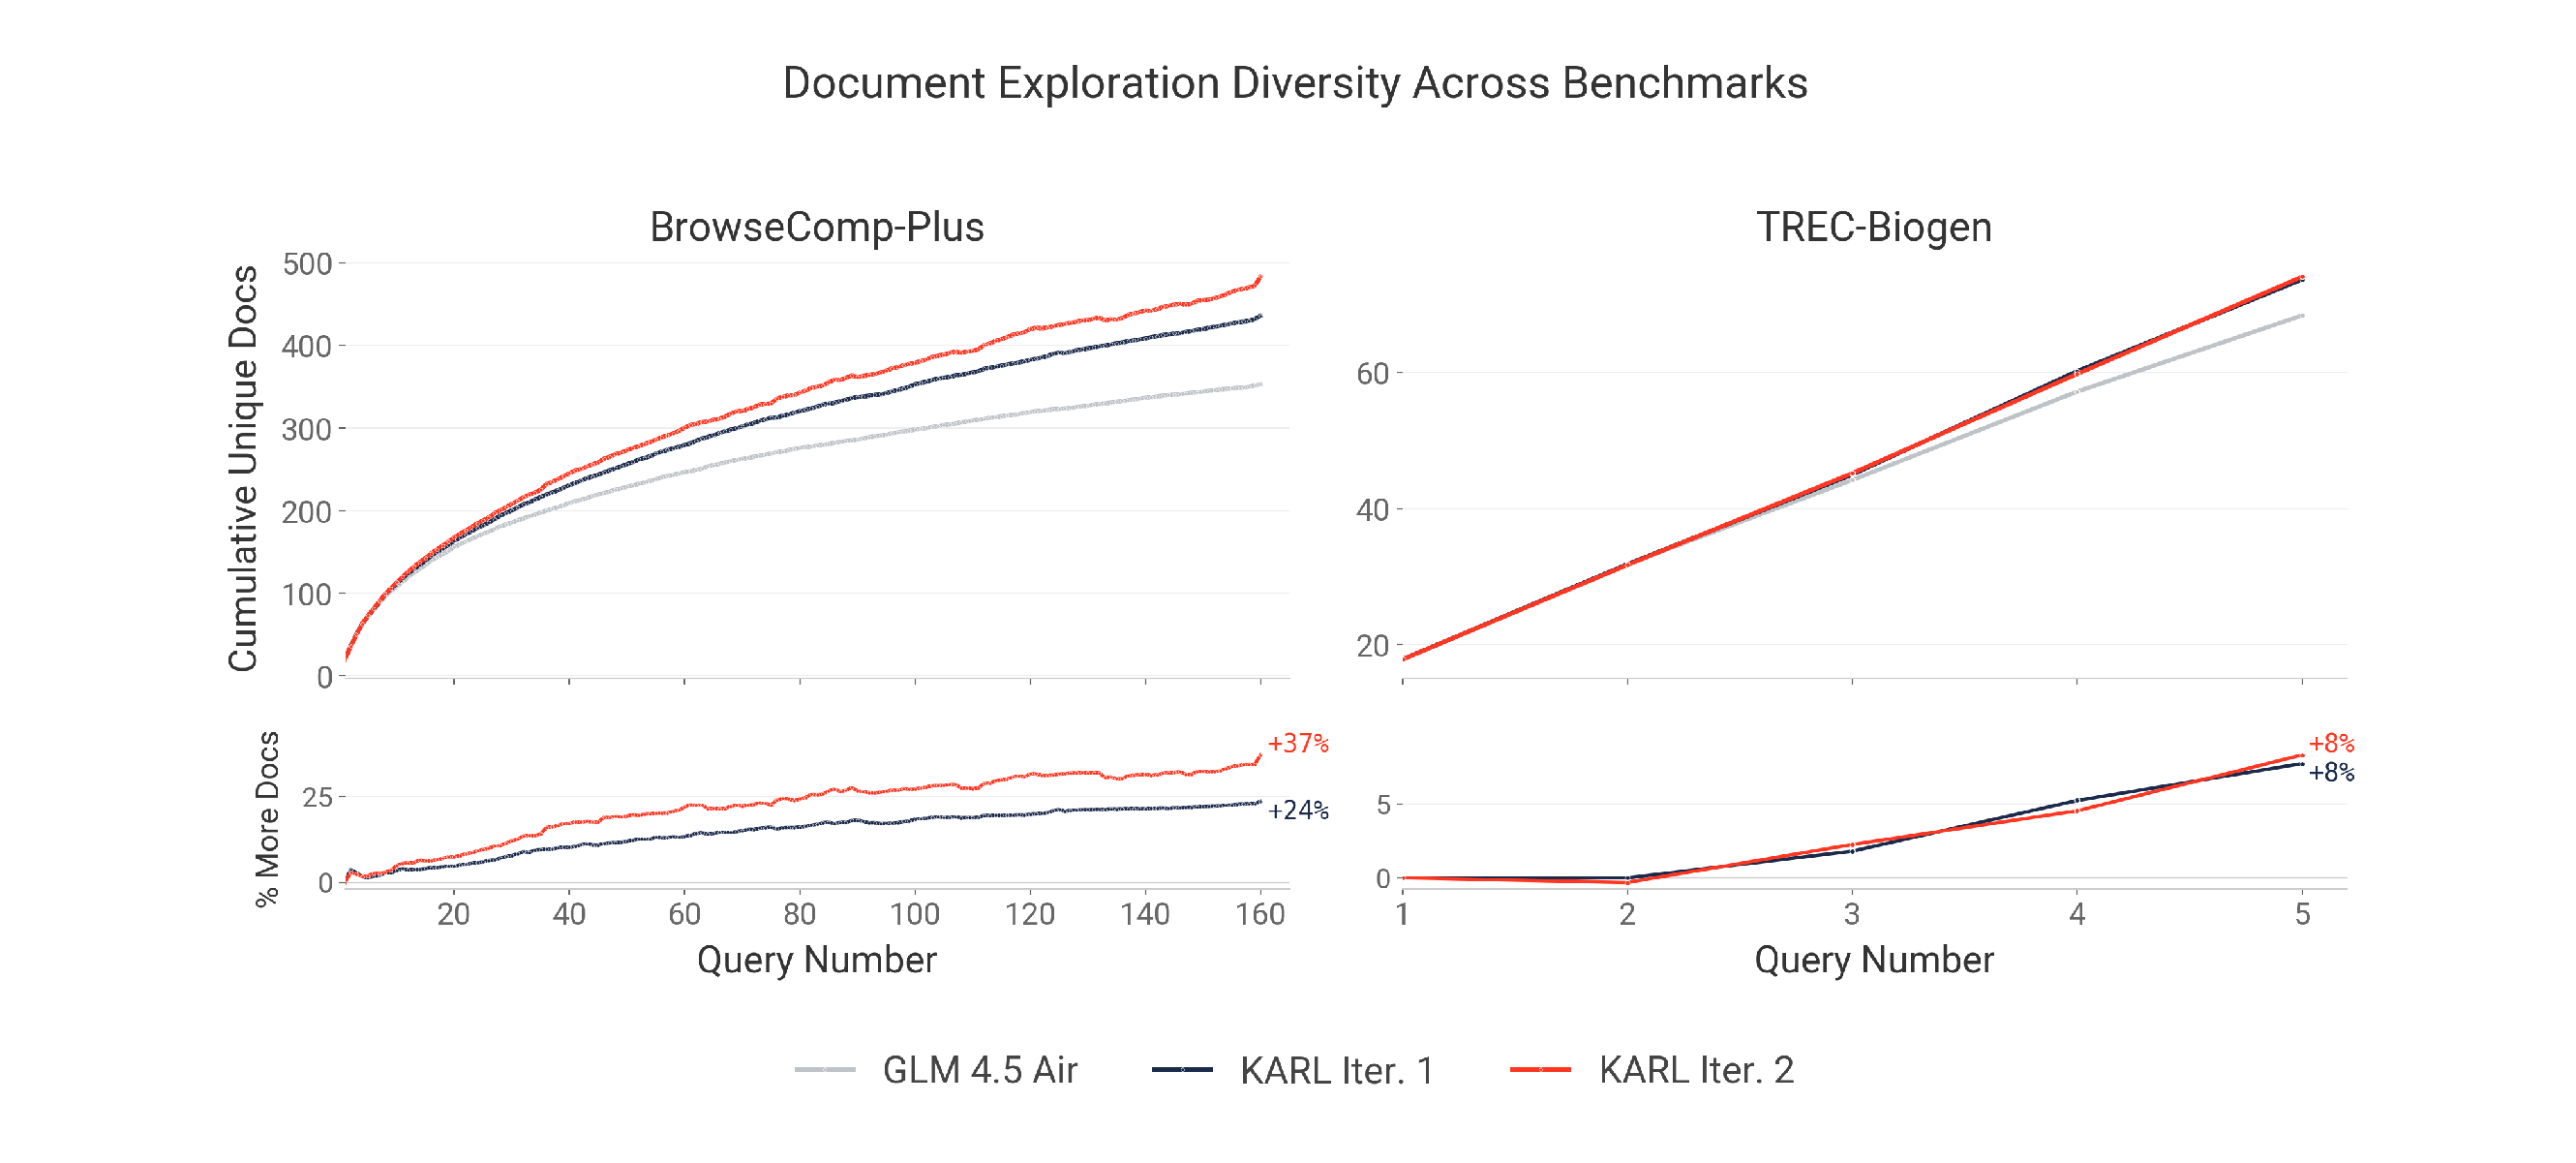
평가 집합 분석은 GLM 4.5 Air와 KARL의 2개 반복 모델에 대해 질문당 rollout 2개를 사용한다. Figure 17에서 2회 반복 후 고유 검색 문서 수는 BrowseComp-Plus에서 37%, TREC-Biogen에서 8% 늘어난다. 질의 수는 각각 160개와 5개로 제한한다.
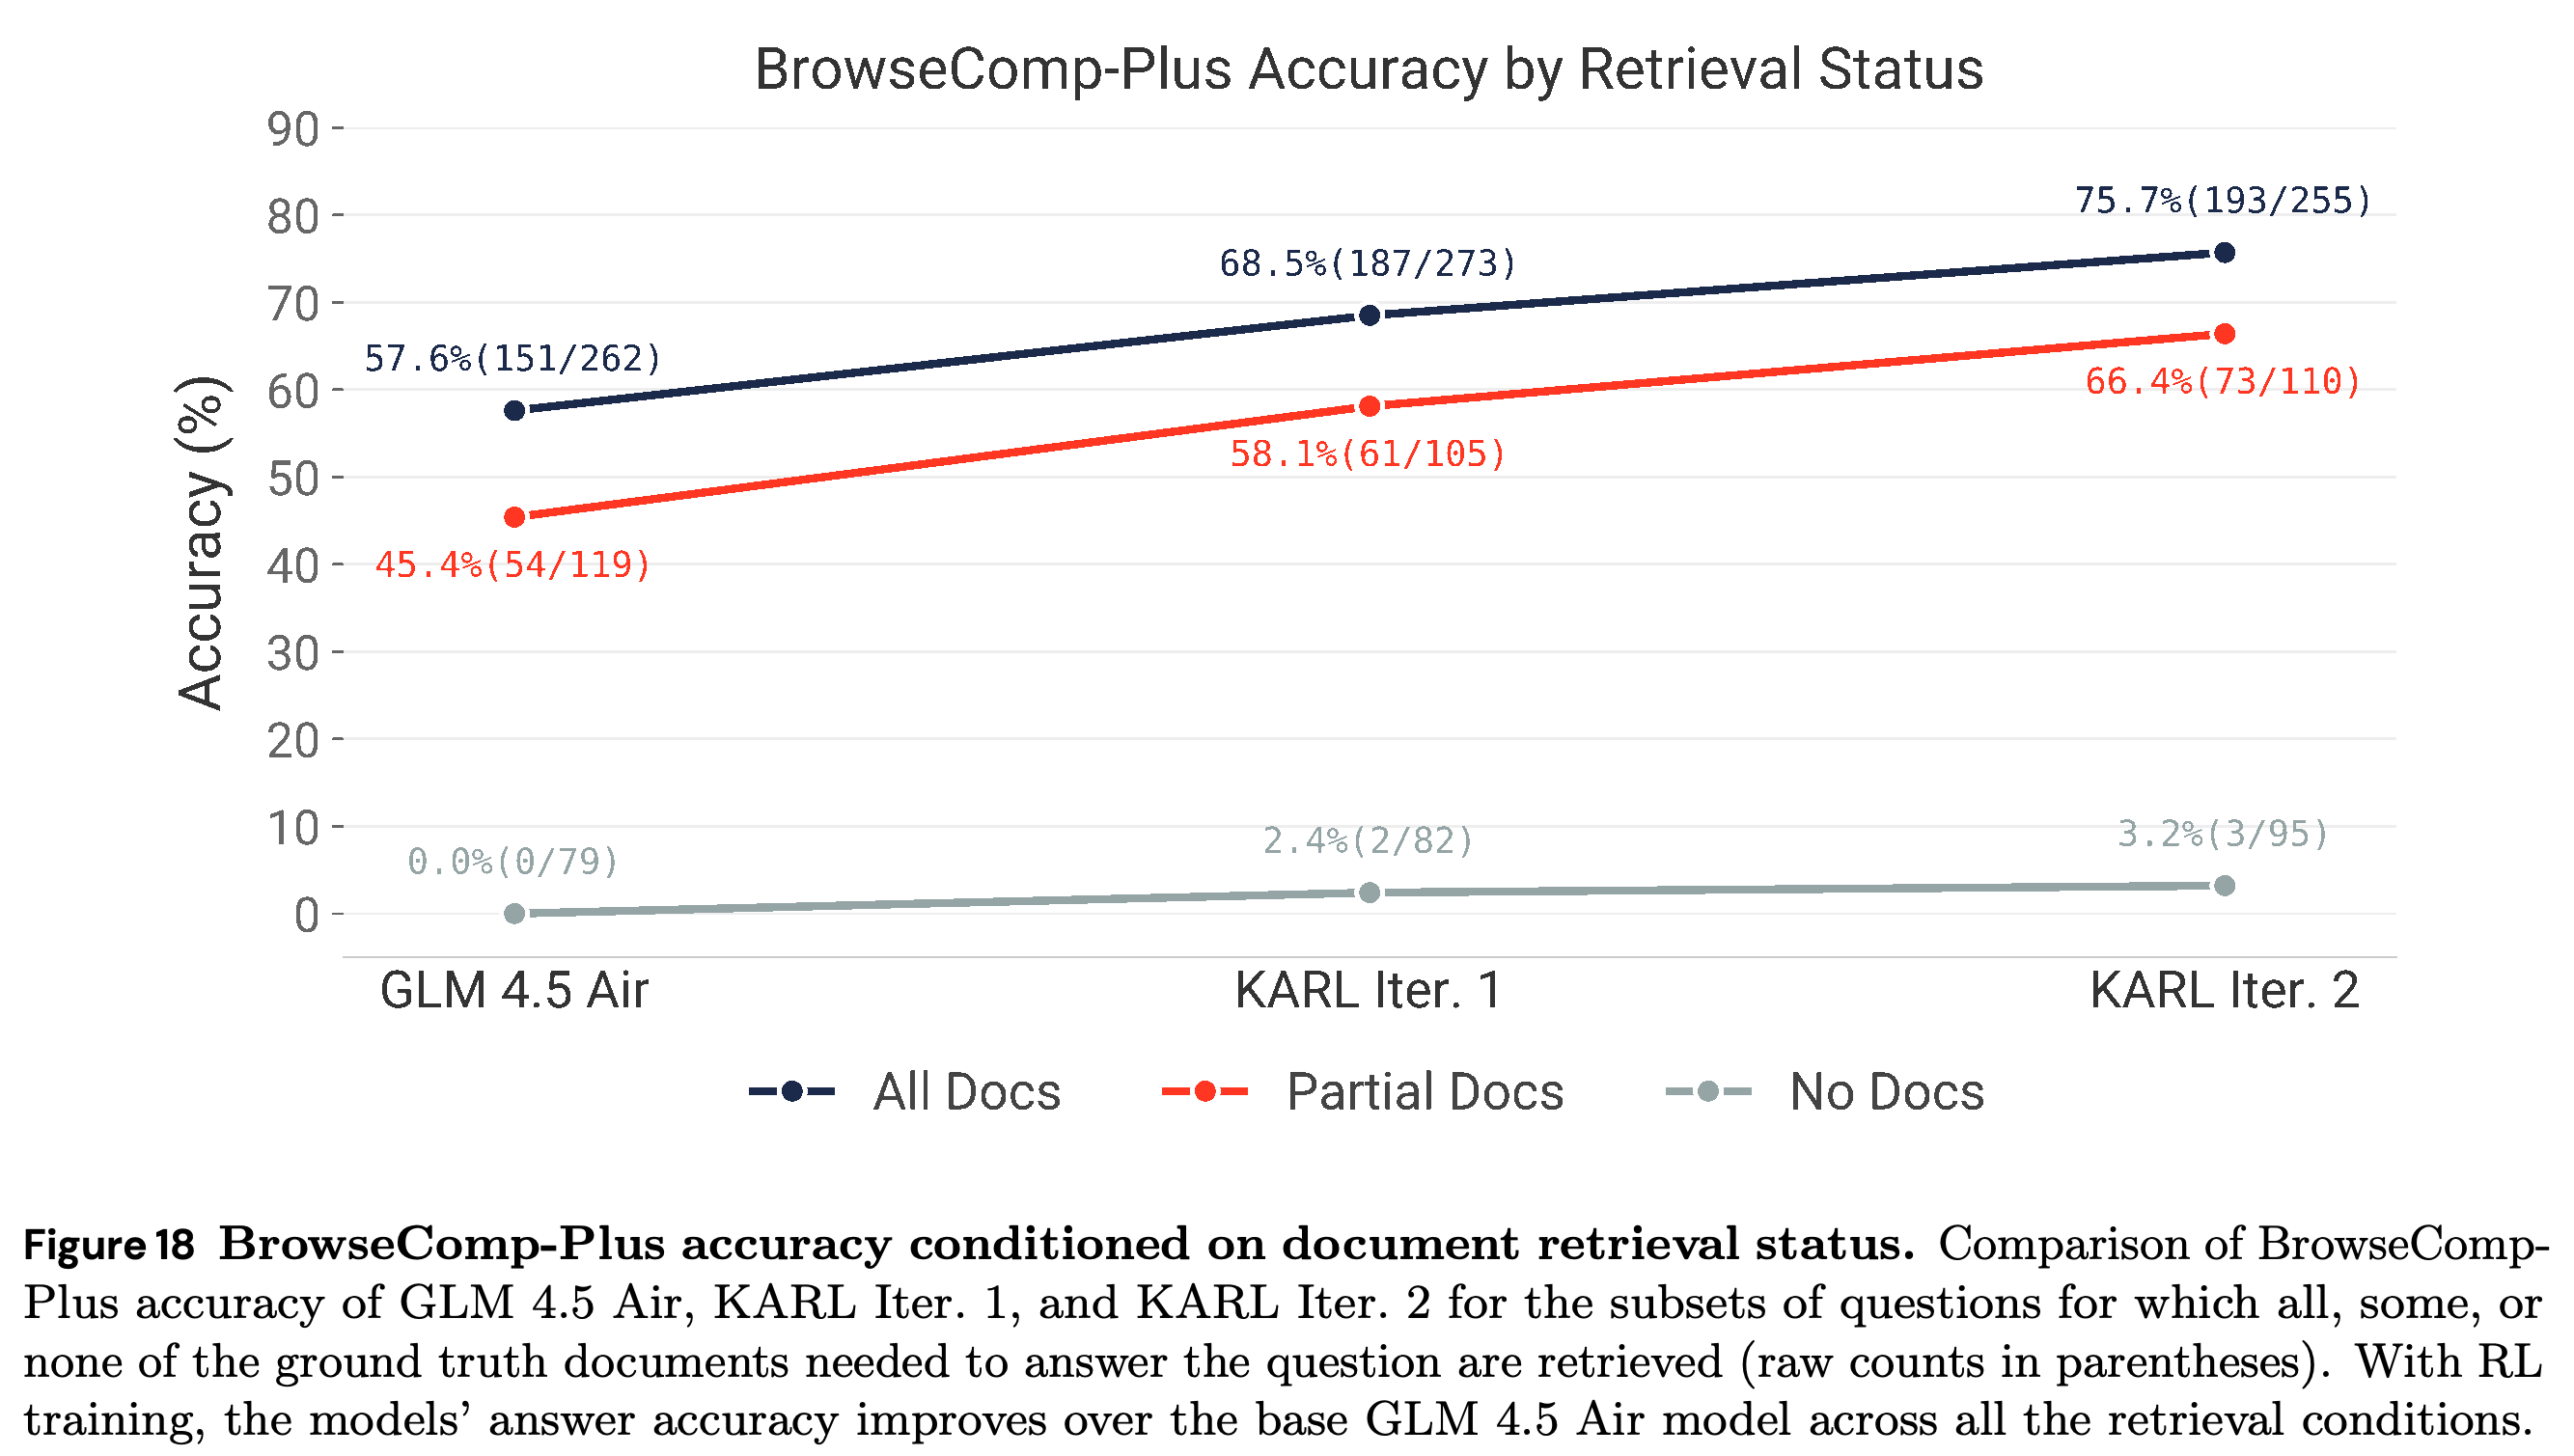
- Figure 18에서 주석 문서를 모두 검색한 경우의 정확도는 57.6%에서 68.5%, 75.7%로 오르고, 부분 검색의 정확도는 45.4%에서 58.1%, 66.4%로 오른다. 모델마다 이 그룹에 속한 rollout이 다르므로, 동일 사례를 통제한 비교는 아니다.
- 주석에 지정된 정답 문서 없이 성공한 낮은 비율인 0.0%, 2.4%, 3.2%는 수동 검토 결과 주석에 빠진 관련 출처 때문으로 설명된다. 따라서 반드시 근거 없는 답변을 뜻하지는 않는다.
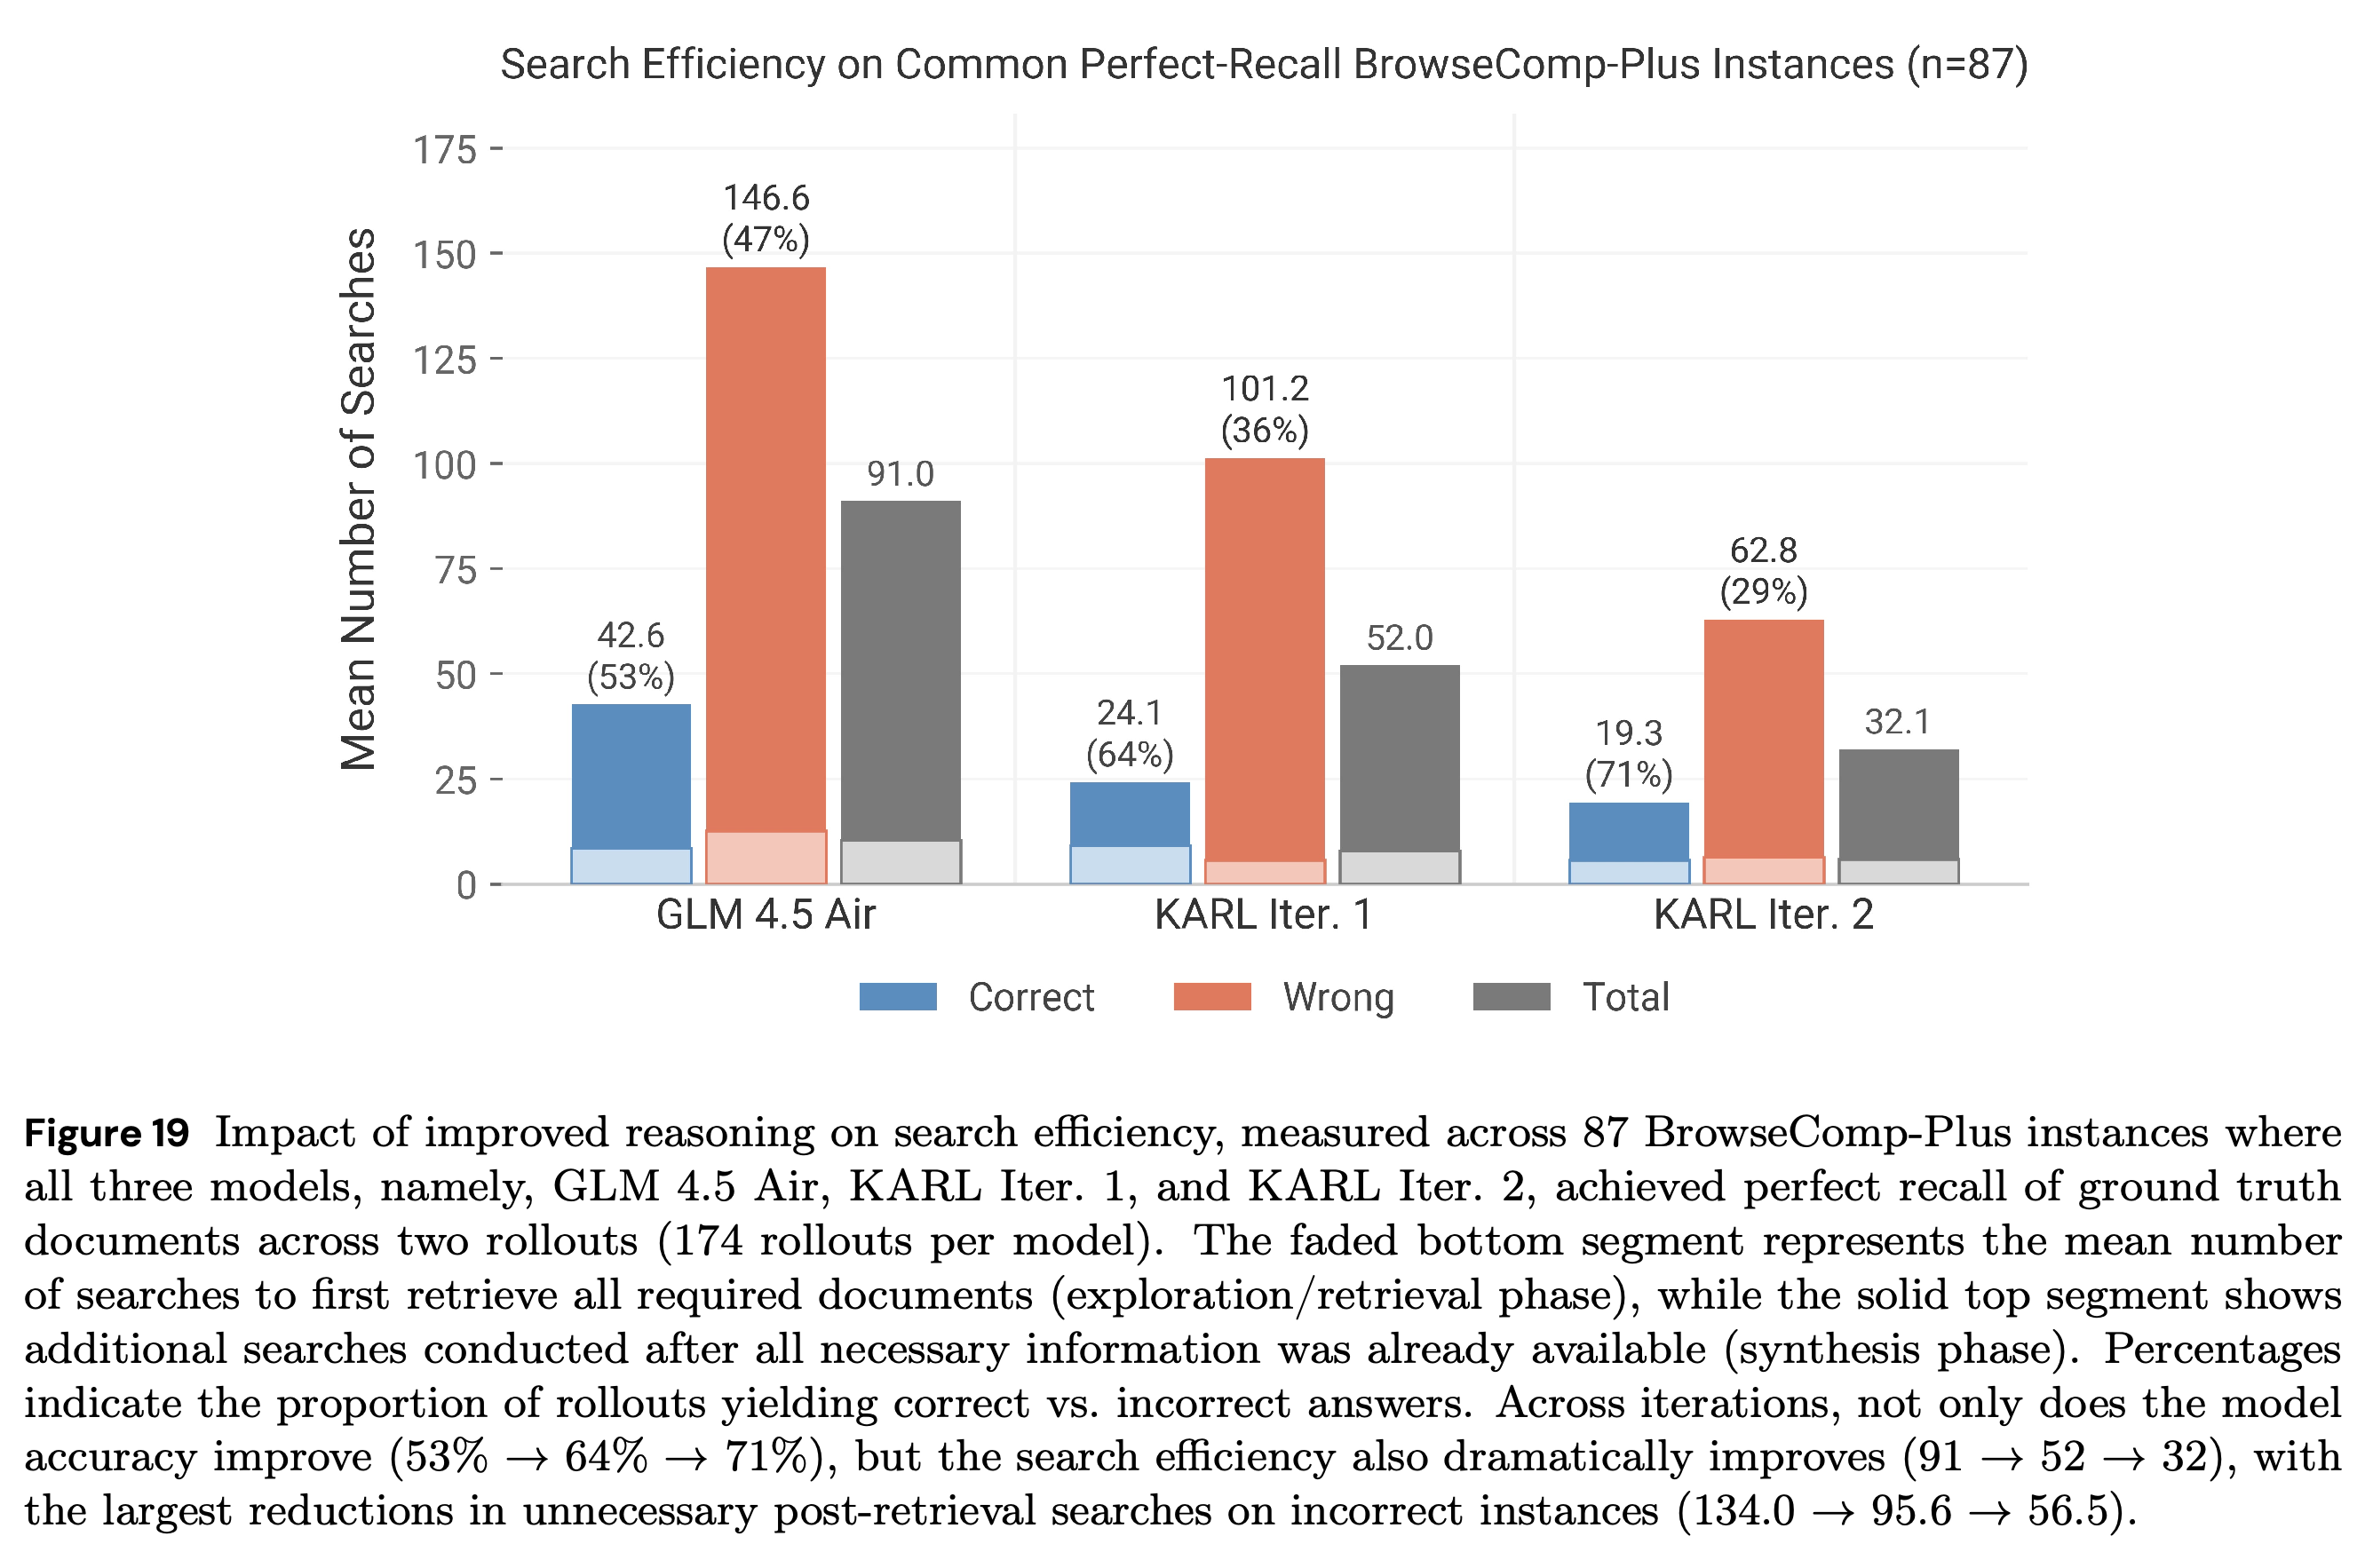
- Figure 19는 모든 모델의 rollout 2개 모두에서 정답 문서 recall이 완전한 87개 질문만 비교하며, 모델당 rollout은 174개다. 평균 검색 수가 91.0에서 52.0, 32.1로 줄어드는 동안 정확도는 53%에서 64%, 71%로 오른다. 검색 감소는 주로 주석 근거를 이미 확보한 이후에 발생한다.
KARL은 비슷한 질의 순번에서 더 많은 고유 문서를 검색하며, 특히 BrowseComp-Plus에서 차이가 크다. 다양성은 직접 보상하지 않았다. 곡선은 검색 행동의 변화를 보여주지만, 다양성만으로 정확도가 개선되었다고 입증하지는 않는다.
주석 문서의 전체 검색, 부분 검색, 미검색 그룹 모두에서 정확도가 오른다. 모델마다 그룹에 속한 rollout이 달라 이 비교는 동일 사례를 통제한 분석이 아니라 관측 결과를 기술한 비교다. 수동 검토는 정답 문서를 검색하지 않고 성공한 소수 사례를 불완전한 주석으로 설명한다.
모든 모델의 rollout 2개에서 주석 문서 recall이 완전한 87개 질문에서 평균 검색 수는 91.0에서 52.0, 32.1로 줄고, 정확도는 53%에서 64%, 71%로 오른다. 검색 감소의 대부분은 완전 recall 이후에 발생한다. 이는 선택된 부분집합에서 근거 활용과 답변 확정이 개선되었음을 뒷받침한다.
8.2 Qualitative Case Studies
정성 연구는 끈기 있는 탐색, 검색 후 해석, 검증, 부분 근거만으로 답변을 확정하는 행동, 조기 중단을 살펴본다. 이 사례들은 집계 결과의 변화와 부합하는 메커니즘을 보여주지만, 선택된 예시만으로 벤치마크 전반에서 얼마나 자주 나타나는지 알 수는 없다.
8.2.1 Comparison with Baselines
BrowseComp-Plus Query ID 280에서 KARL은 155단계에 Sol Campbell을 답하지만, Sonnet 4.5는 25단계에서 중단하고 GLM 4.5 Air는 200단계 예산까지 소진한 뒤 실패한다. Query ID 61에서 KARL은 첫 책의 장르가 시임을 7단계 만에 알아내지만, Sonnet은 소설 장르라고 가정하고 GLM은 잘못된 후보를 선택한다.
- 이 사례들은 생산적인 장기 탐색과 답에 도달하지 못하는 검색을 구분하고, 근거 해석과 단순 검색을 구분한다.
- 축구 관련 답변은 모든 제약의 검증을 기록하지 않으며, 창립일 조건도 대략적으로 처리한다. 따라서 최종 답변이 맞았다는 사실이 모든 제약을 확인했다는 증거는 아니다.
8.2.2 Behavioral Impact on Efficiency
KARL에도 중복 검증이 남아 있다. Query ID 472에서는 검색 7회째에 Saturna를 찾지만 19회째까지 계속한다. Query ID 257에서는 검증하지 않은 제약이 있는데도 KARL이 57단계 또는 7단계 후 Sasquatch Books를 답하는 반면, GLM 4.5 Air는 검색 예산을 소진한다.
- 이 사례들은 고정된 중단 임계값이나 모든 제약의 검증 의무보다는 유연한 답변 확정 정책을 뒷받침한다.
- Query ID 1185는 짧은 기록을 효율성 개선과 동일시할 수 없다는 반례다. KARL은 관련 크리켓 데이터를 검색하지만 33+11+31+2+0 = 77 같은 계산을 수행하는 대신 검색 13회 후 포기한다.
- 이 실패는 검색 중심 학습이 검색 후 수치 계산을 안정적으로 해결하지 못함을 보여준다. 논문은 명시적 산술 및 표 추론 보상을 추가하자고 제안하지만, 이 확장을 평가하지는 않는다.
8.2.3 Behavioral Profiles
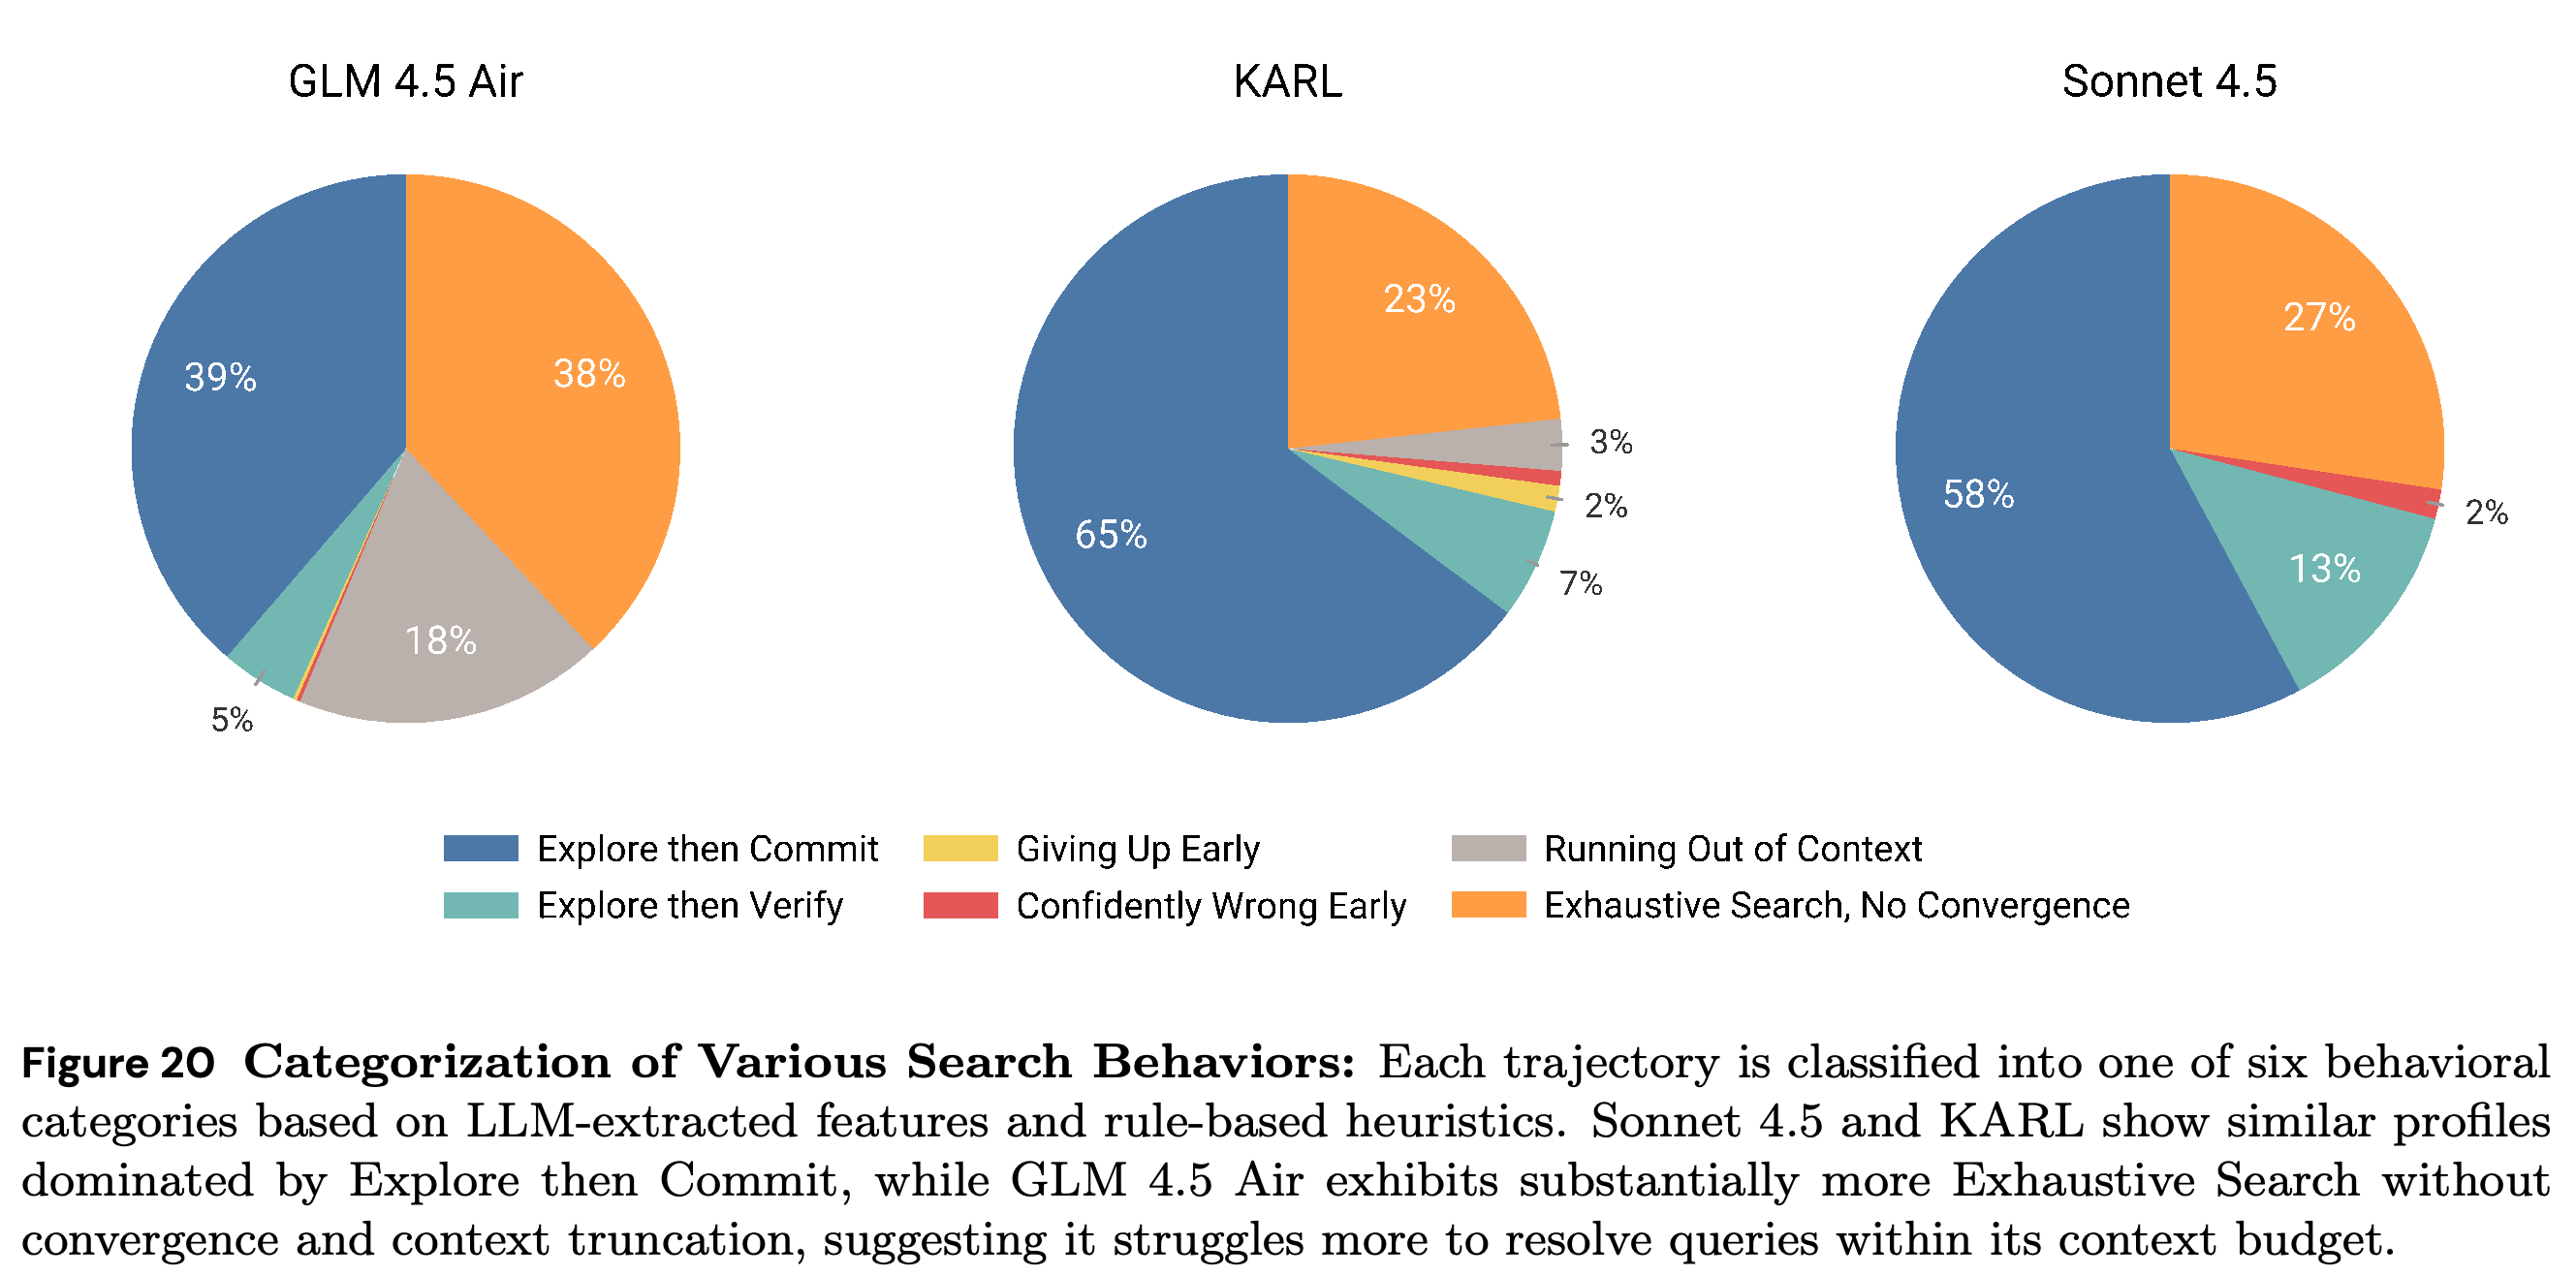
행동 범주 6개는 Explore then Commit, Explore then Verify, Giving Up Early, Confidently Wrong Early, Running Out of Context, Exhaustive Search, No Convergence다. Figure 20에서 Explore then Commit은 GLM 4.5 Air의 39%에서 KARL의 65%로 늘어나며, Sonnet 4.5는 58%다.
- Exhaustive Search, No Convergence는 38%에서 23%로, Running Out of Context는 18%에서 3%로 줄어든다. 이는 검색 예산 안에서 답에 도달하는 경우가 늘어났다는 해석과 부합한다.
- 저자들은 Giving Up Early가 늘었음을 지적하고, 짧은 기록과 정답 사이의 허위 연관을 학습했을 가능성을 제시한다. 다만 이 설명을 실험으로 분리해 검증하지는 않는다.
- Appendix F는 수동 라벨링한 기록 30개로 분류기를 보정하고, 규칙이 생성한 라벨과 사람의 판단이 약 75% 일치한다고 보고한다. 행동 비율은 분류기에 기반한 근사 측정치다.
KARL은 Explore then Commit의 비중이 커지고, 문맥 소진과 답에 도달하지 못하는 전수 검색은 줄어든다. 이 비율은 전체를 수동 주석한 결과가 아니라, 사람과의 일치율이 약 75%로 보고된 휴리스틱·LLM 보조 분류기에서 나온다.
9 Conclusion
논문은 폐쇄형 코퍼스 프로토콜에서 근거 기반 합성 과제, 이질적인 off-policy RL, 상호 보완적인 test-time scaling이 효과적인 검색 에이전트를 만든다고 결론짓는다. 구조화된 검색, 코드 실행, 호출 가능한 하위 에이전트, 계층적 메모리는 제안된 확장이지, 현재의 벡터 검색 전용 시스템에서 평가한 능력이 아니다.
부록
- A Authors는 Databricks AI Research 보고서의 개별 기여자와 연락처를 나열한다. 기여자를 명시하는 부분이며, 추가 방법론이나 실험 결과를 제공하지 않는다.
- B Cost and Latency Experiment Details는 reasoning effort와 압축 설정 선택, 토큰 가격 계산, 8 GPU H200 추론, warm-up, 샘플링, 첫 답변 토큰 기준의 지연 시간 측정 절차를 설명한다. Figures 21–25의 평균 유효 지연 시간은 GLM 4.5 Air 13,758 ms, KARL 14,615 ms, Sonnet 4.6 32,753 ms, Opus 4.6 30,566 ms, GPT 5.2 82,748 ms이다. 과제별 차이가 크며, end-to-end 측정도 별도로 제시한다. Figure 24는 Opus rollout을 FinanceBench의 572개를 포함해 총 2,822개로 기록한다. 다른 모델은 총 2,700개, 과제당 450개로 제시되며, PDF는 이 차이를 설명하지 않는다.
- C Dataset Details and Examples는 TREC-Biogen의 유전자 치료 보고서 합성, BrowseComp-Plus의 텔레비전 에피소드 식별, FinanceBench의 자본 지출 조회, QAMPARI의 James B. Longacre 디자인 열거, Freshstack의 LangChain JSON 로딩 절차에 대한 KARL 답변을 제시한다. C.2는 보정된 BrowseComp-Plus query ID 230개도 나열한다. 생성 예시는 답변 형식을 보여줄 뿐, 모든 의료·소프트웨어 주장을 독립적으로 검증하지는 않는다. C.6 PMBench (Internal Benchmark)는 약 2년 동안 작성된 고객 대화 문서 약 3,000개에 대한 수동 검증 질문 57개를 설명한다. 실제 product manager의 질의나 월별 요약에서 질문을 선별하고 연결된 메모로 검증하며, nugget 기반 부분 점수로 평가한다.
- D Prompts는 D.1 평가 모델의 support, partial_support, not_support 라벨과 D.2의 중복 제거, 풀이, 품질 필터 템플릿을 제공한다. 풀이 템플릿은 문서 인용을 포함한 설명, 정확한 답변, 신뢰도를 요청한다. D.3 Data Synthesis Statistics는 BrowseComp-Plus의 수율을 Iter. 1에서 8.8%, Iter. 2에서 16.2%로 보고하지만, Iter. 2에서는 품질 필터링을 생략한다. 또한 TREC-Biogen에는 Quality Filter를 사용하지 않았다고 명시해 본문의 합성 설명과 충돌한다. D.4는 의미적 중복을, D.5는 잘못된 생의학 nugget, 지시 대상이 모호한 수상 비교, 잘못된 기업 참조 답변을 예시로 보여준다. 품질 필터의 효과를 측정한 필터링 ablation은 없다.
- E Qualitative Case Studies는 E.1의 끈기 있는 검색, E.2의 장르 추론, E.3의 중복 검증, E.4의 미검증 제약이 남은 상태에서의 답변 확정, E.5의 수치 추론 조기 중단을 자세히 다룬다. E.6에서 비외상성 손 골절에 대한 KARL의 최고 응답은 특정 원인을 겨냥한 후속 검색을 통해 참조 nugget 9/9를 충족하며, 기본 모델의 최고 응답은 5/9를 충족한다. E.7에서는 PMBench 통합 모델이 각각 완전히 뒷받침하는 nugget이 최대 3/9인 응답 5개를 결합해 5/9를 뒷받침하는 답변을 만든다. 여기에는 상호 보완적인 부분 정보로 구성한 nugget 1개가 포함된다.
- F Categorizing Search Behavior는 잘림, 불확실성, 제안된 답변, 검증 검색 등의 특징에 우선순위를 적용하는 규칙 분류기를 정의한다. 특징은 LLM 판단과 문자열 매칭으로 추출한다. 추가 LLM 판단은 신뢰도가 ≥95%이거나 일치하는 규칙이 없을 때 규칙 결과를 덮어쓸 수 있다. 수동 라벨링한 rollout 30개로 보정한 뒤, 모델마다 BrowseComp-Plus 질문 230개 각각에 대해 궤적 2개를 분류한다. 저자들은 판단이 애매한 기록을 수동 검토하며, 사람 주석과 규칙 기반 라벨의 일치율이 약 75%라고 보고한다.
- G Details about Compression Behavior와 G.1 Compression Statistics는 rollout 2개에 걸쳐 평균을 낸 BrowseComp-Plus 질문당 압축 횟수의 중앙값이 6회, 평균이 10.2회라고 보고한다. 230개 질문 중 47개에는 20회 이상의 압축이 필요하다. G.2는 약 100배 축소한 사례 2개를 대비한다. G.2.1 Successful Compression: Author Identification은 112,946 characters를 1,134 characters로 줄이면서 정답 제목 Baby에 필요한 발견을 보존한다. G.2.2 Harmful Compression: ICC Hall of Fame Puzzle은 108,881 characters를 1,131 characters로 줄이지만, 진행 중이던 연도 차이 추론을 누락하고 2009를 확정된 값으로 취급해 정답 2010을 가리키는 반대 근거를 놓친다.
- H Evaluation Infrastructure는 스트리밍 출력, 도구 호출, 인용, 선택적 블라인드 선호 투표, 메모, 공유 가능한 실행을 지원하는 aroll 기반 비교 앱을 설명한다. 별도 trace viewer는 정성적 검토 대상을 추리고 탐색·검증 행동을 비교하도록 돕는다. 부록은 검토 도구를 보여주지만, 벤치마크 순위를 검증하는 통제된 사람 선호 평가 결과는 보고하지 않는다.
짧은 생각
가장 구체적인 근거는 문맥 관리와 확보한 근거가 충분한지 판단하는 능력에 관한 것이다. 모델 간 압축 교체 실험과 모든 모델이 정답 문서를 빠짐없이 검색한 공통 질문에 대한 분석은 전체 순위표보다 이러한 기여를 더 직접적으로 뒷받침한다. RL-versus-SFT 결과는 추론 시점 확장에 관한 근거로 가장 설득력이 있다. Parallel thinking이 없으면 SFT가 더 높은 점수에서 시작하지만, 실험한 병렬 예산에서는 RL의 점수가 더 높다. max@k 개선은 관측된 해결 범위가 넓어졌음을 뒷받침하지만, 기본 정책이 해당 풀이를 생성할 수 없었다는 사실을 입증하지는 않는다.
주요 결과는 벡터 검색 harness, 보정된 평가 부분집합, 토큰 기반 비용 모델의 범위 안에서 해석해야 한다. 상충하는 필터링·중복 제거 설명, 불완전한 문서 주석, 분류기 잡음, 실제로 관찰된 산술·압축 실패 때문에 재현성과 신뢰성에 관한 중요한 문제가 남아 있다. TREC-Biogen과 PMBench 평가 집합이 작고 벤치마크 품질 점수의 불확실성 추정치가 없어, 작은 순위 차이를 통계적으로 해석하기 어렵다. 지연 시간의 불확실성은 별도로 보고한다. 동일 조건의 온라인 RL 비교나 전체 학습 비용 집계가 없어, OAPL이 주장하는 샘플·연산 효율성을 분리해 확인할 수 없다. 실제 배포에서는 참조 nugget 충족도에 더해 근거 없는 추가 주장, 인용의 타당성, 제시된 절차를 실제로 실행했을 때의 정확성을 점검해야 한다.