


Autodata: An agentic data scientist to create high quality synthetic data 요약 설명
24 Jun 2026 | Paper Review Synthetic Data Self-Evolving Agents Reinforcement Learning목차
- 요약
- 1 Introduction
- 2 Autodata
- 3 Experiments
- 4 Meta Optimization of the Data Scientist
- 5 Related Work
- 6 Conclusion and Discussion
- 부록
- 짧은 생각
이번 글에서는 Autodata: An agentic data scientist to create high quality synthetic data 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 6월 24일(Arxiv)
- Kulikov, Ilia, Whitehouse, Chenxi, Wu, Tianhao, Nie, Yixin, Saha, Swarnadeep, Helenowski, Eryk, Yuan, Weizhe, Golovneva, Olga, Lanchantin, Jack, Bachrach, Yoram, et al.
- FAIR at Meta
- 논문 링크
요약
- Autodata: An agentic data scientist to create high quality synthetic data는 합성 데이터 구축을 반복적인 데이터 과학 과정으로 다룬다. 에이전트는 예제를 생성하고, solver의 동작과 예제 품질을 평가하며, 실패를 분석해 생성 전략을 수정한다. 관련 연구에서 다루는 Self-Instruct, 근거 자료 기반 생성, 에이전트 기반 생성 방식과 비교하면, 평가 피드백으로 생성 방식을 수정하고 필요에 따라 데이터 과학자 에이전트의 scaffold 자체도 최적화한다는 점을 강조한다.
- 구체적인 구현인 Agentic Self-Instruct는 challenger, weak solver와 strong solver, verifier/judge를 사용해 유용한 학습 예제를 찾는다. 목표는 특정 모델에 유용한 학습 신호를 제공하는 것이다. CS 질문은 더 어렵게 만들지만, 법률 질문은 보상이 일괄적으로 0에 가까워지는 상황을 피하여 더 학습하기 쉽게 만든다.
- 예제 수를 맞춘 비교에서 Agentic Self-Instruct는 CS 연구 질문과 PRBench 법률 추론에서 CoT Self-Instruct보다 Qwen3.5-4B의 성능을 더 높인다. 과학 추론에서도 전체 avg@8은 에이전트 기반 데이터가 우세하다. 다만 분포 외 성능 향상은 작고, 외부 벤치마크의 전체 pass@8은 CoT 데이터가 더 높다.
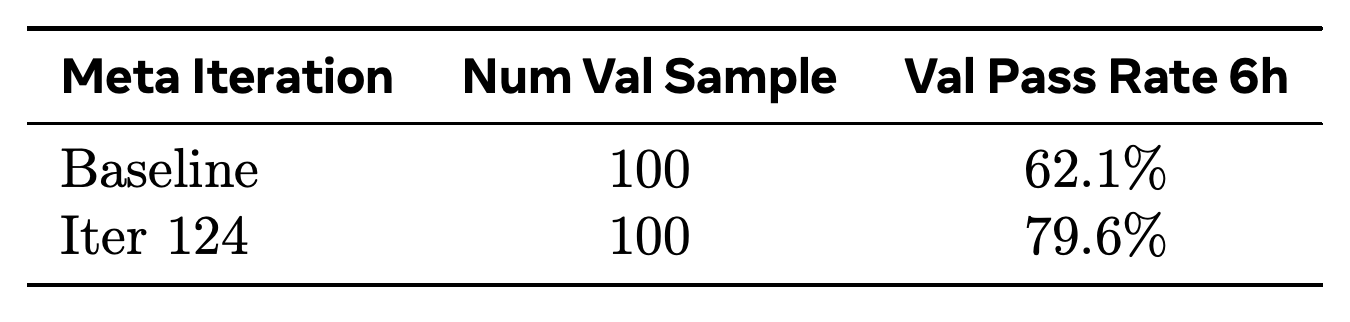
- 외부 진화 최적화기는 프롬프트와 scaffold를 수정하여 CS 데이터 생성 에이전트의 보고된 검증 통과율을 62.1%에서 79.6%로 높인다. 이는 예제 생성 성공률이 높아졌다는 결과이지, 추가적인 downstream solver 학습 성능 향상을 입증한 결과는 아니다. 생성 비용, judge 의존성, 목표 편법 공략, 제한적인 데이터셋 수준 분석 때문에 결론의 범위에는 한계가 있다.
1 Introduction
연구 문제는 언어 모델이 발전해도 난이도와 품질이 유용하게 유지되는 합성 학습 데이터와 벤치마크를 어떻게 생성하느냐는 것이다. Self-Instruct, 근거 자료 기반 생성, CoT 기반 생성은 다양한 예제를 만들 수 있지만, 고정된 생성 방식만으로 특정 모델에 효과적인 학습 신호를 보장하지는 못한다.
- Autodata는 명시적인 피드백 순환을 추가한다. 정성적 검토와 측정된 solver 성능을 다음 생성 시도에 반영한다.
- 논문은 내부 루프에서 생성 예제를 개선하는 과정과 외부 루프에서 데이터 과학자 에이전트의 전략을 최적화하는 과정을 구분한다.
2 Autodata
Autodata는 Data Creation, Data Analysis, Overall Data Scientist Loop, Meta-Optimization of the Data Scientist로 구성된다. 근거 자료는 도메인 맥락을 제공하고, 도구, 하위 에이전트, 메모리, 추론 시점 연산은 생성을 지원한다. 분석 단계에서는 정확성, 난이도, 다양성, 학습 유용성의 문제를 파악한 뒤 다음 반복으로 진행한다.
- 일반 프레임워크는 예제 수준 평가와 데이터셋 수준 평가를 모두 허용하며, 데이터셋이 학습된 모델의 성능을 높이는지 측정하는 평가도 포함한다.
- 실험은 주로 예제 수준 피드백을 구현하며, 생성 루프 안에서 solver를 반복 학습시키지는 않는다.
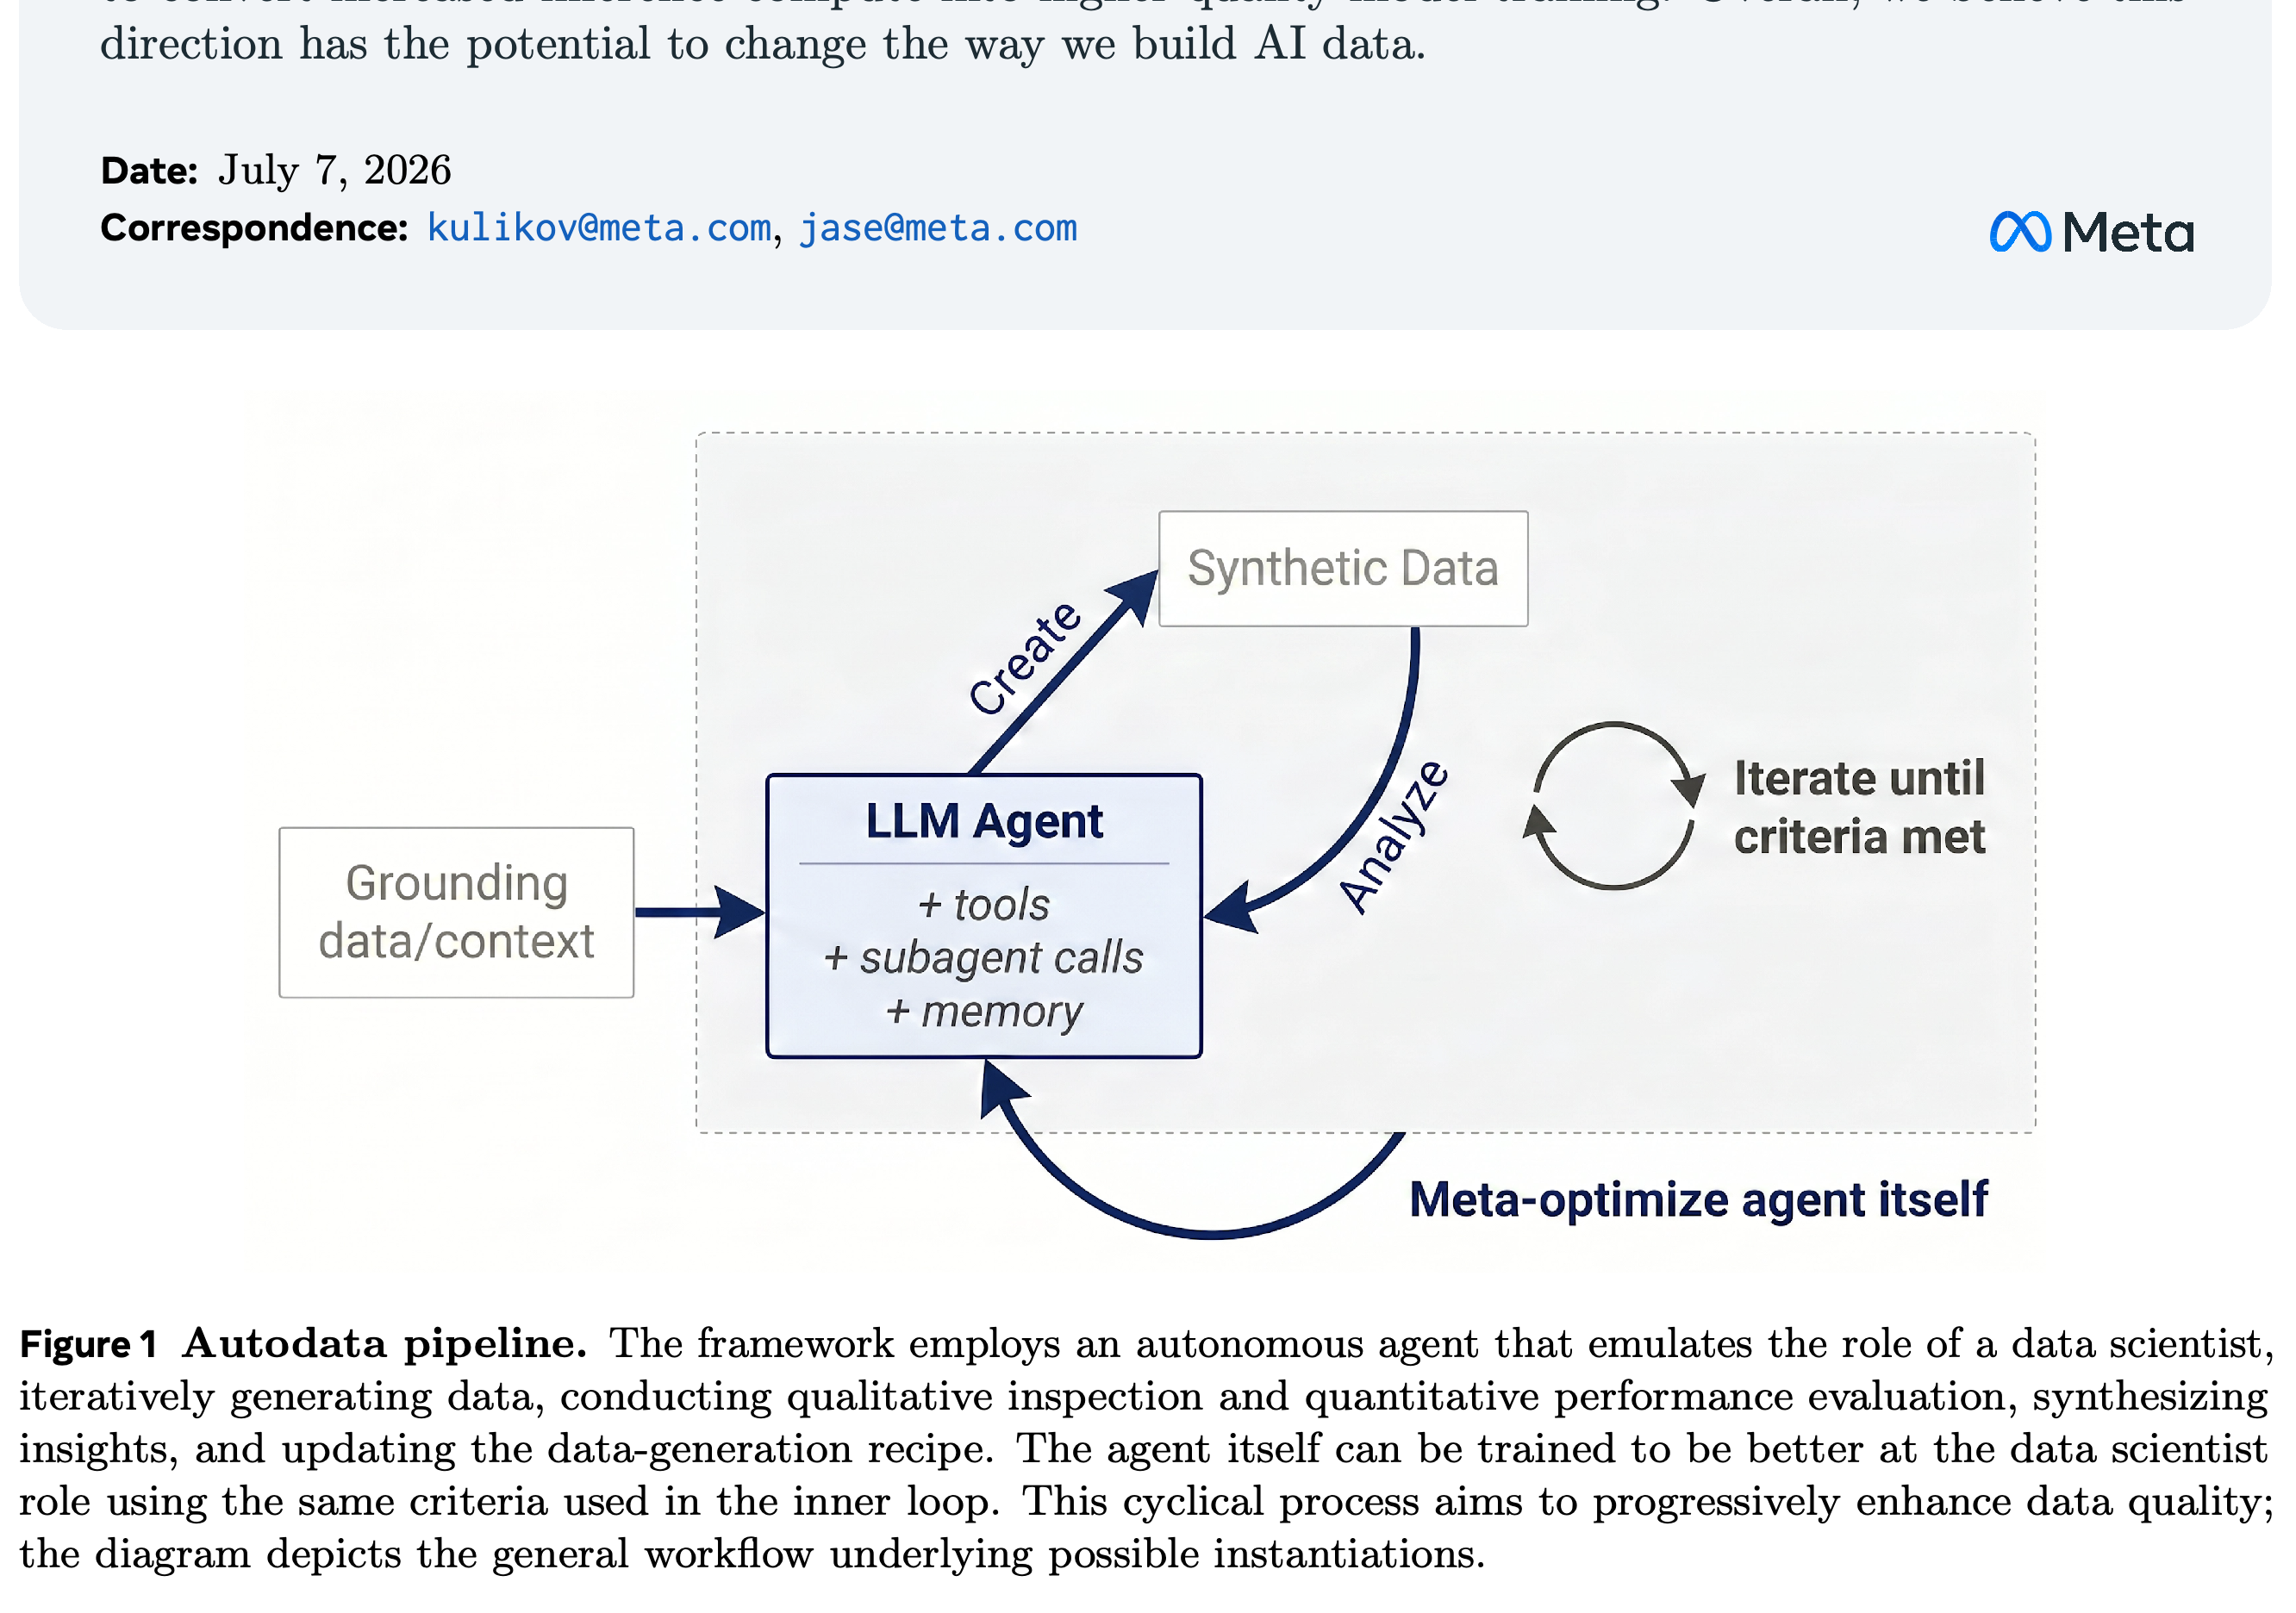
- Figure 1은 생성·분석 순환과 에이전트 자체를 개선하는 외부 과정을 구분한다.
내부 화살표는 근거 자료를 입력받은 에이전트가 생성과 분석을 번갈아 수행하는 과정을 보여준다. 별도의 meta-optimization 화살표는 예제를 한 번 더 필터링하는 과정이 아니라, 에이전트의 전략이라는 별도 최적화 대상을 나타낸다.
2.1 A specific implementation: Agentic Self-Instruct
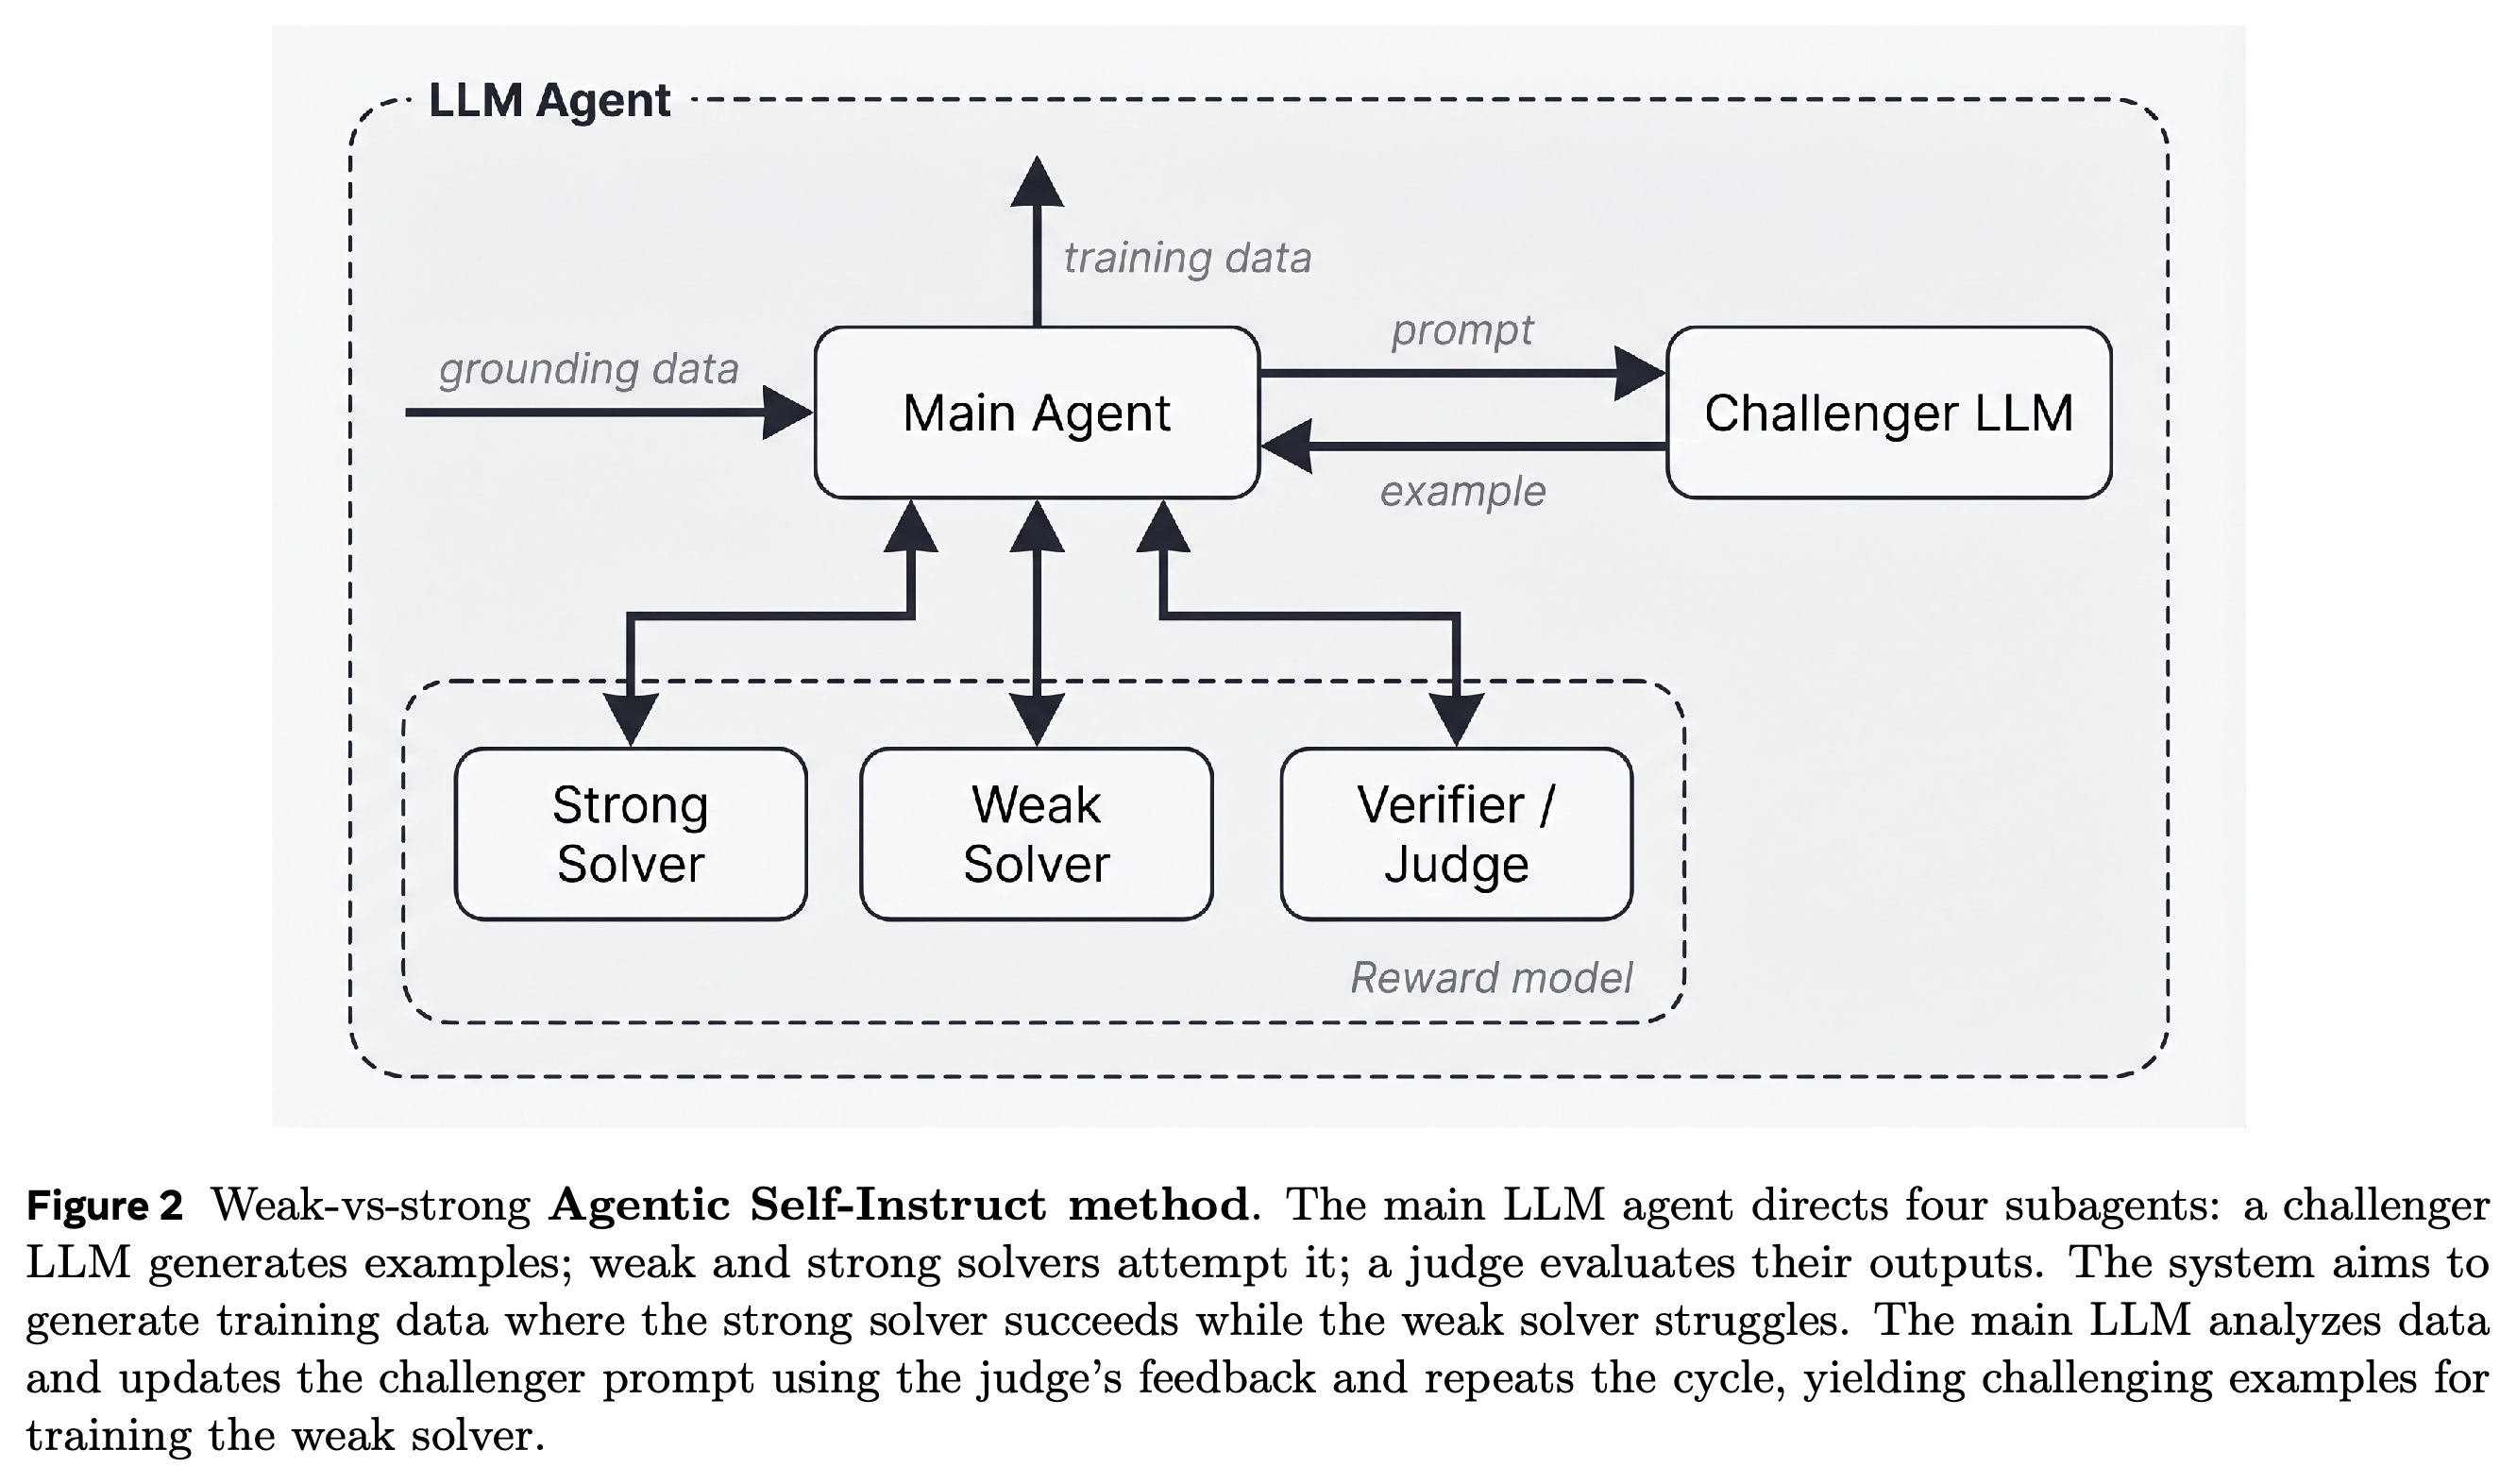
Agentic Self-Instruct는 주 orchestrator와 4가지 기능적 역할인 Challenger, “Weak” solver, “Strong” solver, Verifier/judge로 프레임워크를 구현한다. challenger는 질문과 참조 답변 또는 rubric을 만들고, solver는 질문에 답한다. judge는 응답과 예제 자체를 평가하며, orchestrator는 진단 결과를 바탕으로 필요할 때 다른 후보를 요청한다.
- 검증 가능한 과제에서는 반복 시도에 걸쳐 strong solver가 성공하고 weak solver가 실패해야 예제를 채택하도록 설정할 수 있다.
- 개방형 과제에서는 가중치가 있는 rubric으로 응답 품질을 측정하고, 모델별 채택 판단에 반영한다.
- Weak와 strong이 반드시 서로 다른 모델일 필요는 없다. 서로 다른 추론 예산, scaffold, 집계 절차, 추가로 제공되는 정보를 사용하는 방식도 허용한다.
주 에이전트는 challenger의 예제를 받고, solver와 verifier의 피드백을 조율한 뒤 학습 데이터를 출력한다. 관찰한 weak–strong 동작은 최종 선택 점수로만 쓰이지 않고 후속 생성에도 반영된다.
3 Experiments
실험은 개방형 CS 연구 질문, 법률 추론, 수학적 객체에 관한 과학 추론을 다룬다. 모든 설정에서 Qwen3.5-4B가 목표 weak solver이고, Qwen3.5-397B-A17B가 strong solver이다. Kimi-K2.6는 생성과 평가를 담당하며, downstream 학습에는 GRPO를 사용한다.
- CS와 법률 비교에서는 CoT Self-Instruct와 Agentic Self-Instruct의 예제 수를 맞춘다.
- 과학 추론에서는 양쪽 데이터를 포함해 학습 예제가 2배인 Combined 데이터셋도 평가한다.
- 채택 기준은 모든 도메인에 동일한 수치적 난이도 목표를 적용하지 않고 도메인별로 달리 설정한다.
3.1 Computer Science Research tasks
CS 연구 과제는 학술 논문을 근거 자료로 사용하며 개방형 답변을 요구한다. 생성된 예제 묶음에는 맥락, 질문, 참조 답변, 자체적으로 완결된 가중 rubric이 포함된다. 응답 judge는 참조 답변을 보지 않고 이 rubric을 적용한다.
- Kimi-K2.6가 orchestrator와 challenger를 맡으며, 두 solver는 후보마다 각각 3회 시도한다.
- 품질 verifier는 solver 평가 전과 루프 종료 시점에 맥락을 통한 정보 누출, rubric의 평가 범위, 질문 품질을 확인한다.
- Section 3.1 기준에서는 strong 평균 ≥0.65, weak 평균 <0.5, strong−weak 격차 ≥20%포인트를 충족해야 채택한다.
2022+의 S2ORC 논문 10k편 이상을 처리하여 에이전트 기반 예제 2.8k개를 채택한다. 최종 검증에서 논문에 특화된 참조 정보 누출, 짧은 맥락, 형식이 잘못된 rubric을 제거하면 1.3k개가 남는다. CoT 기준선에도 같은 verifier를 적용하고, 필터링된 예제를 동일한 수만큼 추출한다.
- 원본 논문 수에 비해 최종 예제 수가 크게 줄어든다는 점은 상당한 탐색과 필터링이 필요함을 보여준다. 다만 논문은 비용을 맞춘 비교를 제공하지 않는다.
- Weak 점수 기준을 충족한 뒤에만 strong 응답을 평가하므로, 이미 너무 쉬운 후보에 드는 평가 작업을 줄인다.
3.1.1 Agentic Self-Instruct Loop Analysis
채택된 CS 예제에는 평균 6.59라운드가 필요하다. 채택 전 880라운드에서 실패의 80%는 weak solver의 점수가 너무 높아서 발생하고, 13%는 strong solver가 질문을 안정적으로 풀지 못해서 발생한다.
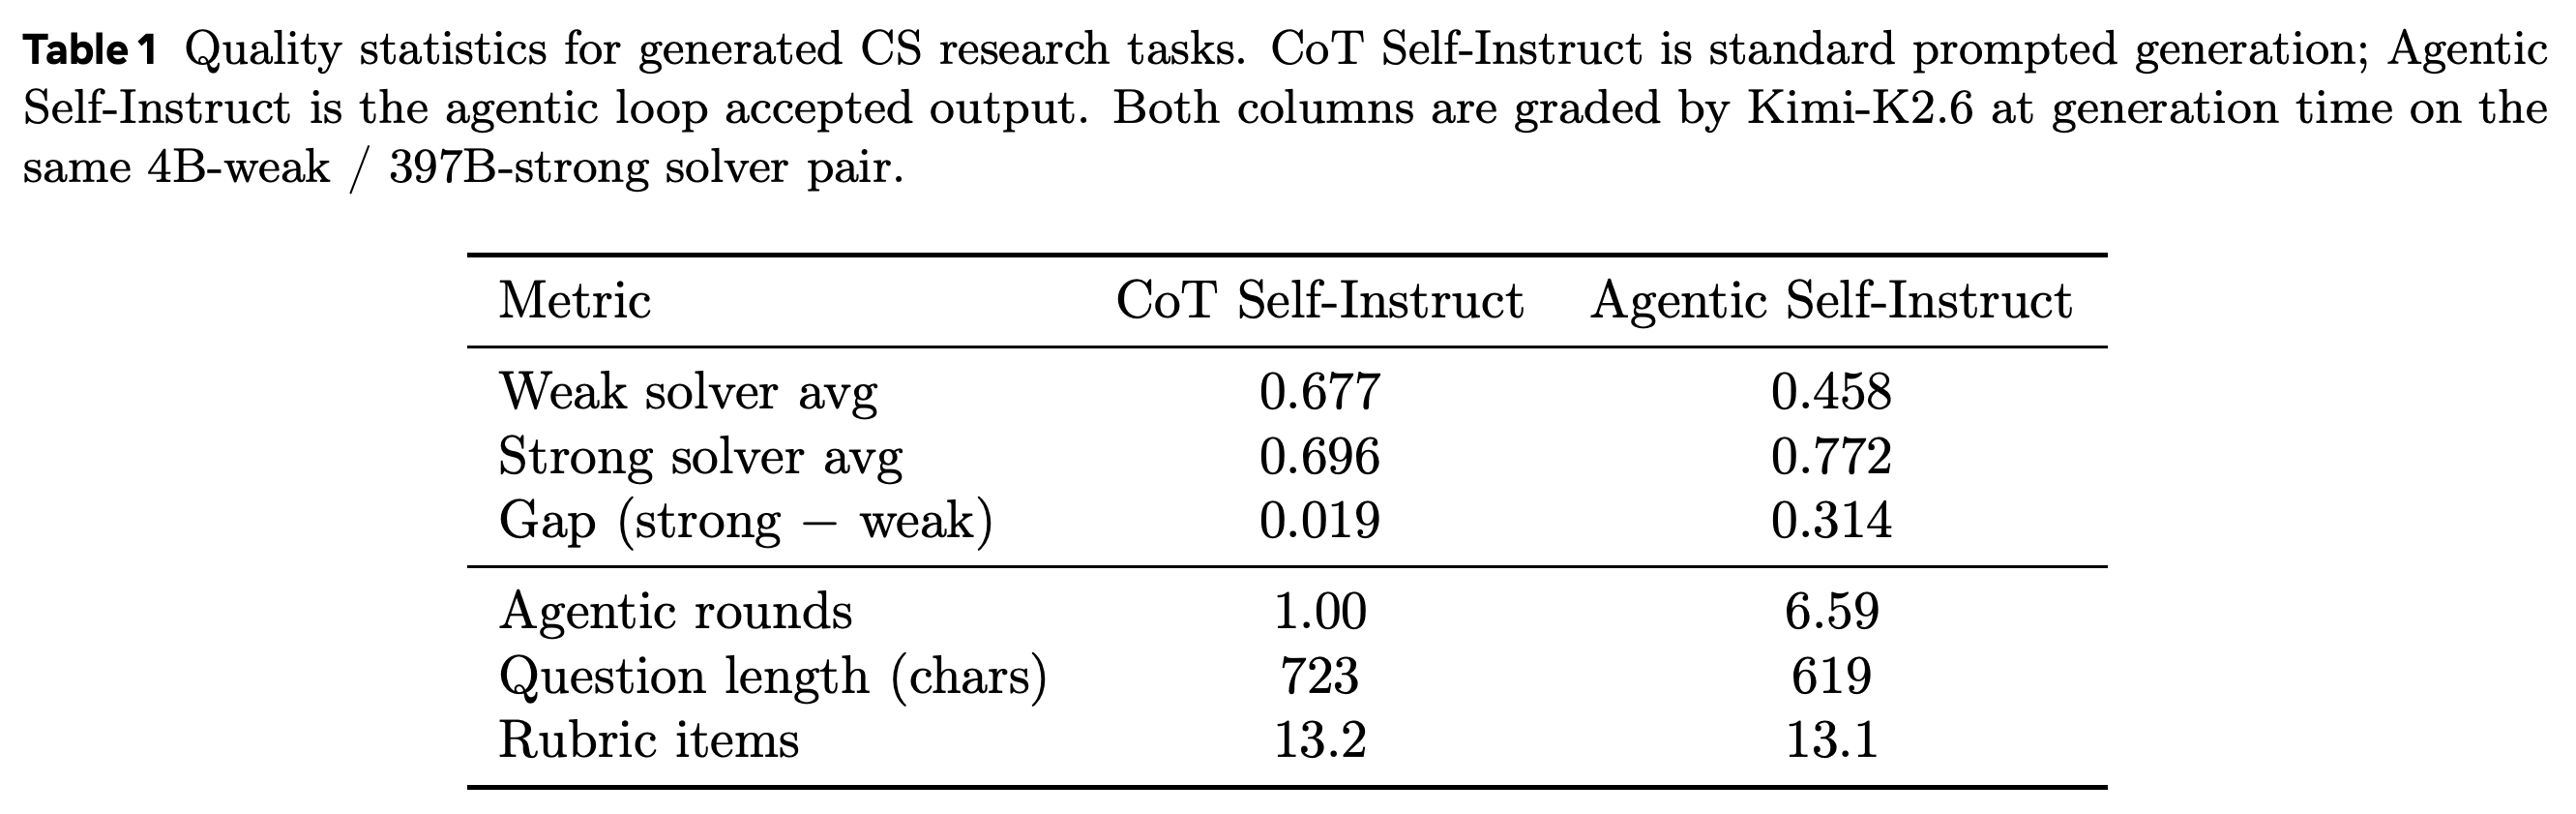
- Table 1에서 weak 평균은 0.677에서 0.458로 낮아지고 strong 평균은 0.696에서 0.772로 높아져, 격차가 0.019에서 0.314로 커진다.
- 생성 궤적을 검토하면 포괄적인 요약 질문에서 알고리즘 단계, ablation, 다단계 유도, 논문에 특화된 tradeoff를 묻는 질문으로 바뀐다.
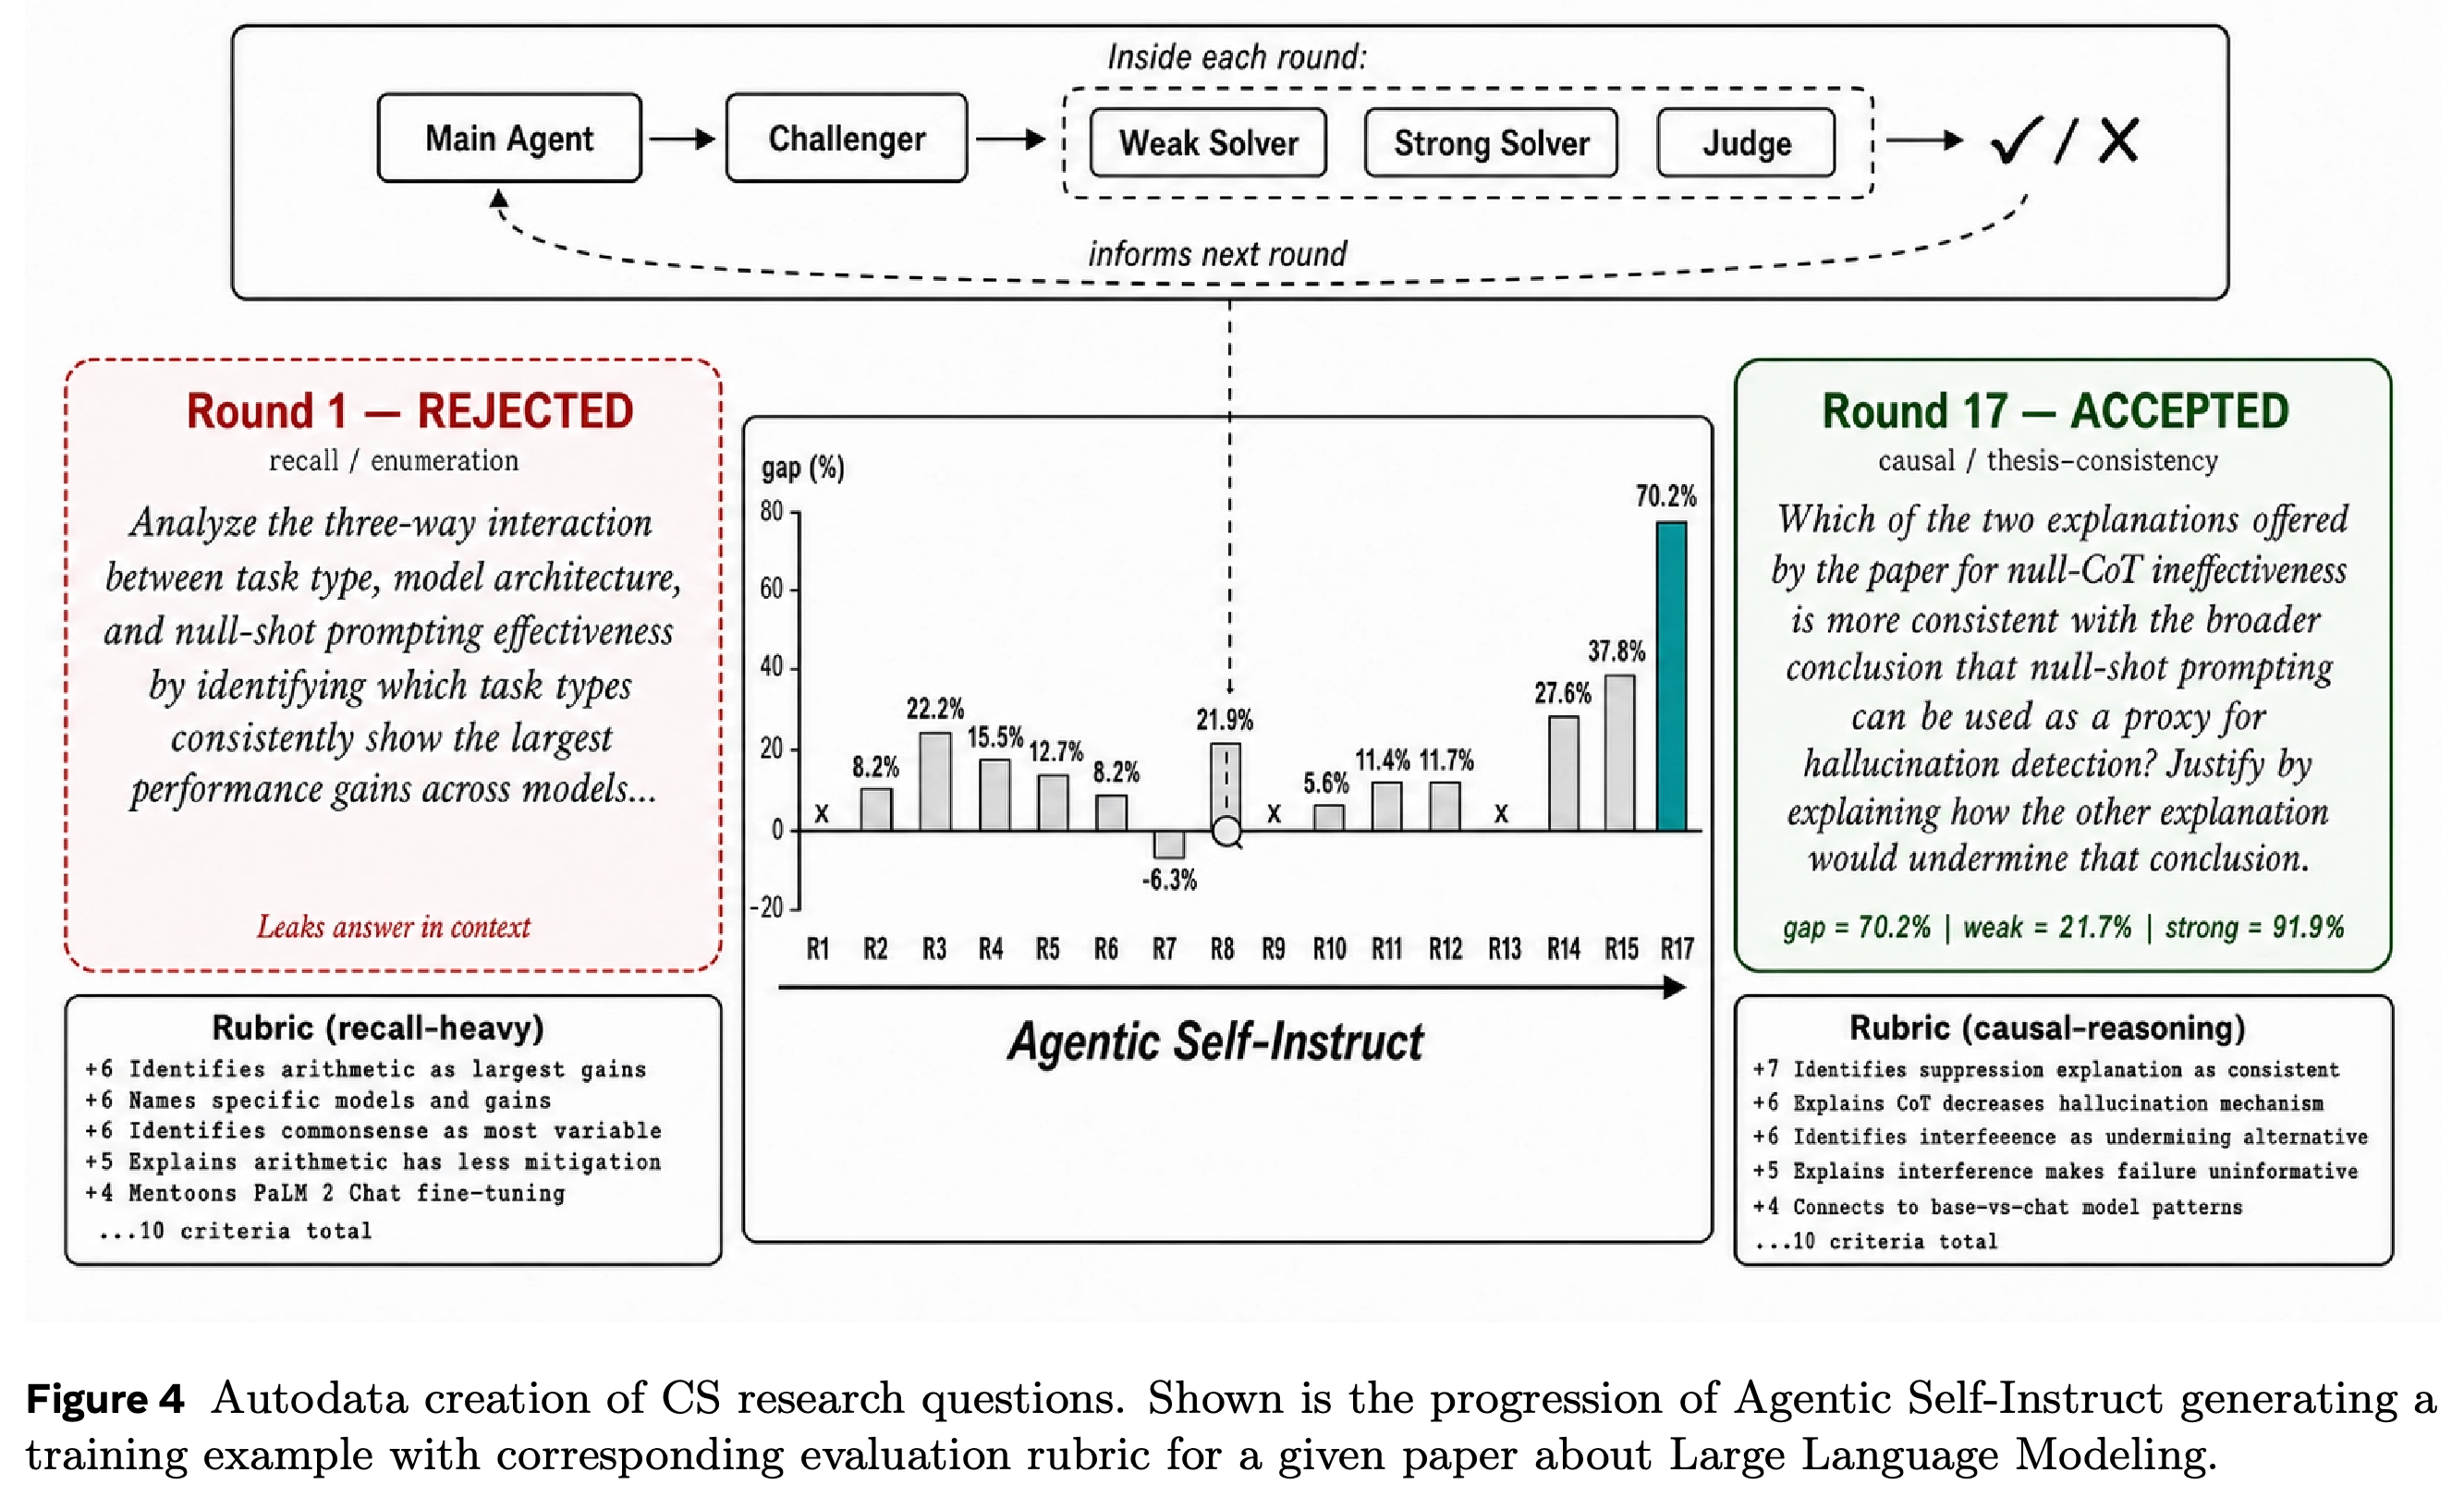
- Figure 4는 단순한 재서술이 아닌 탐색을 보여준다. 기각된 회상 중심 질문을 인과적 일관성을 묻는 질문으로 교체하고 17라운드에서 채택한다.
Weak 성능은 낮아지고 strong 성능은 높아져 격차가 0.019에서 0.314로 커진다. 평균 질문 길이는 723자에서 619자로 줄고, rubric 크기는 13.2개 대 13.1개로 거의 변하지 않는다. 따라서 더 큰 격차가 더 긴 질문이나 더 많은 rubric 기준과 함께 나타난 것은 아니다.
3.1.2 RL Training Results
CS 비교에서는 배치 크기 16, 학습률 1e-6, Kimi-K2.6 rubric 보상을 사용한 GRPO로 Qwen3.5-4B를 학습한다. 논문은 출처별 예제가 1.3k개라고 보고하면서, 각 데이터셋에서 100개를 별도로 남겨 2가지 테스트 분포와 200개의 평가 프롬프트를 구성한다고 설명한다. 이 분할 후 정확한 학습 예제 수는 명시하지 않는다.
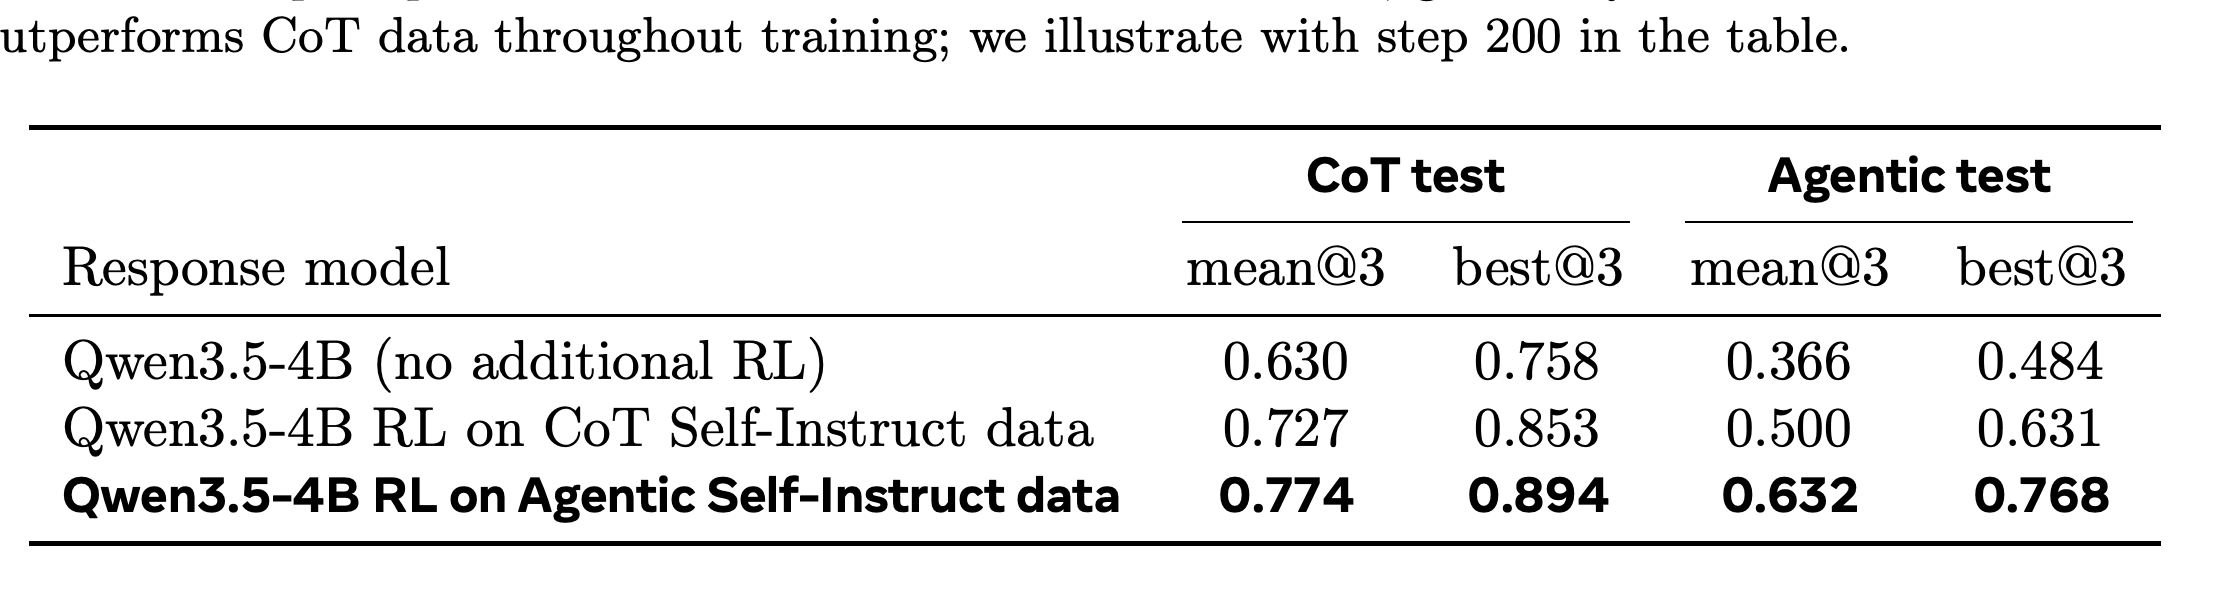
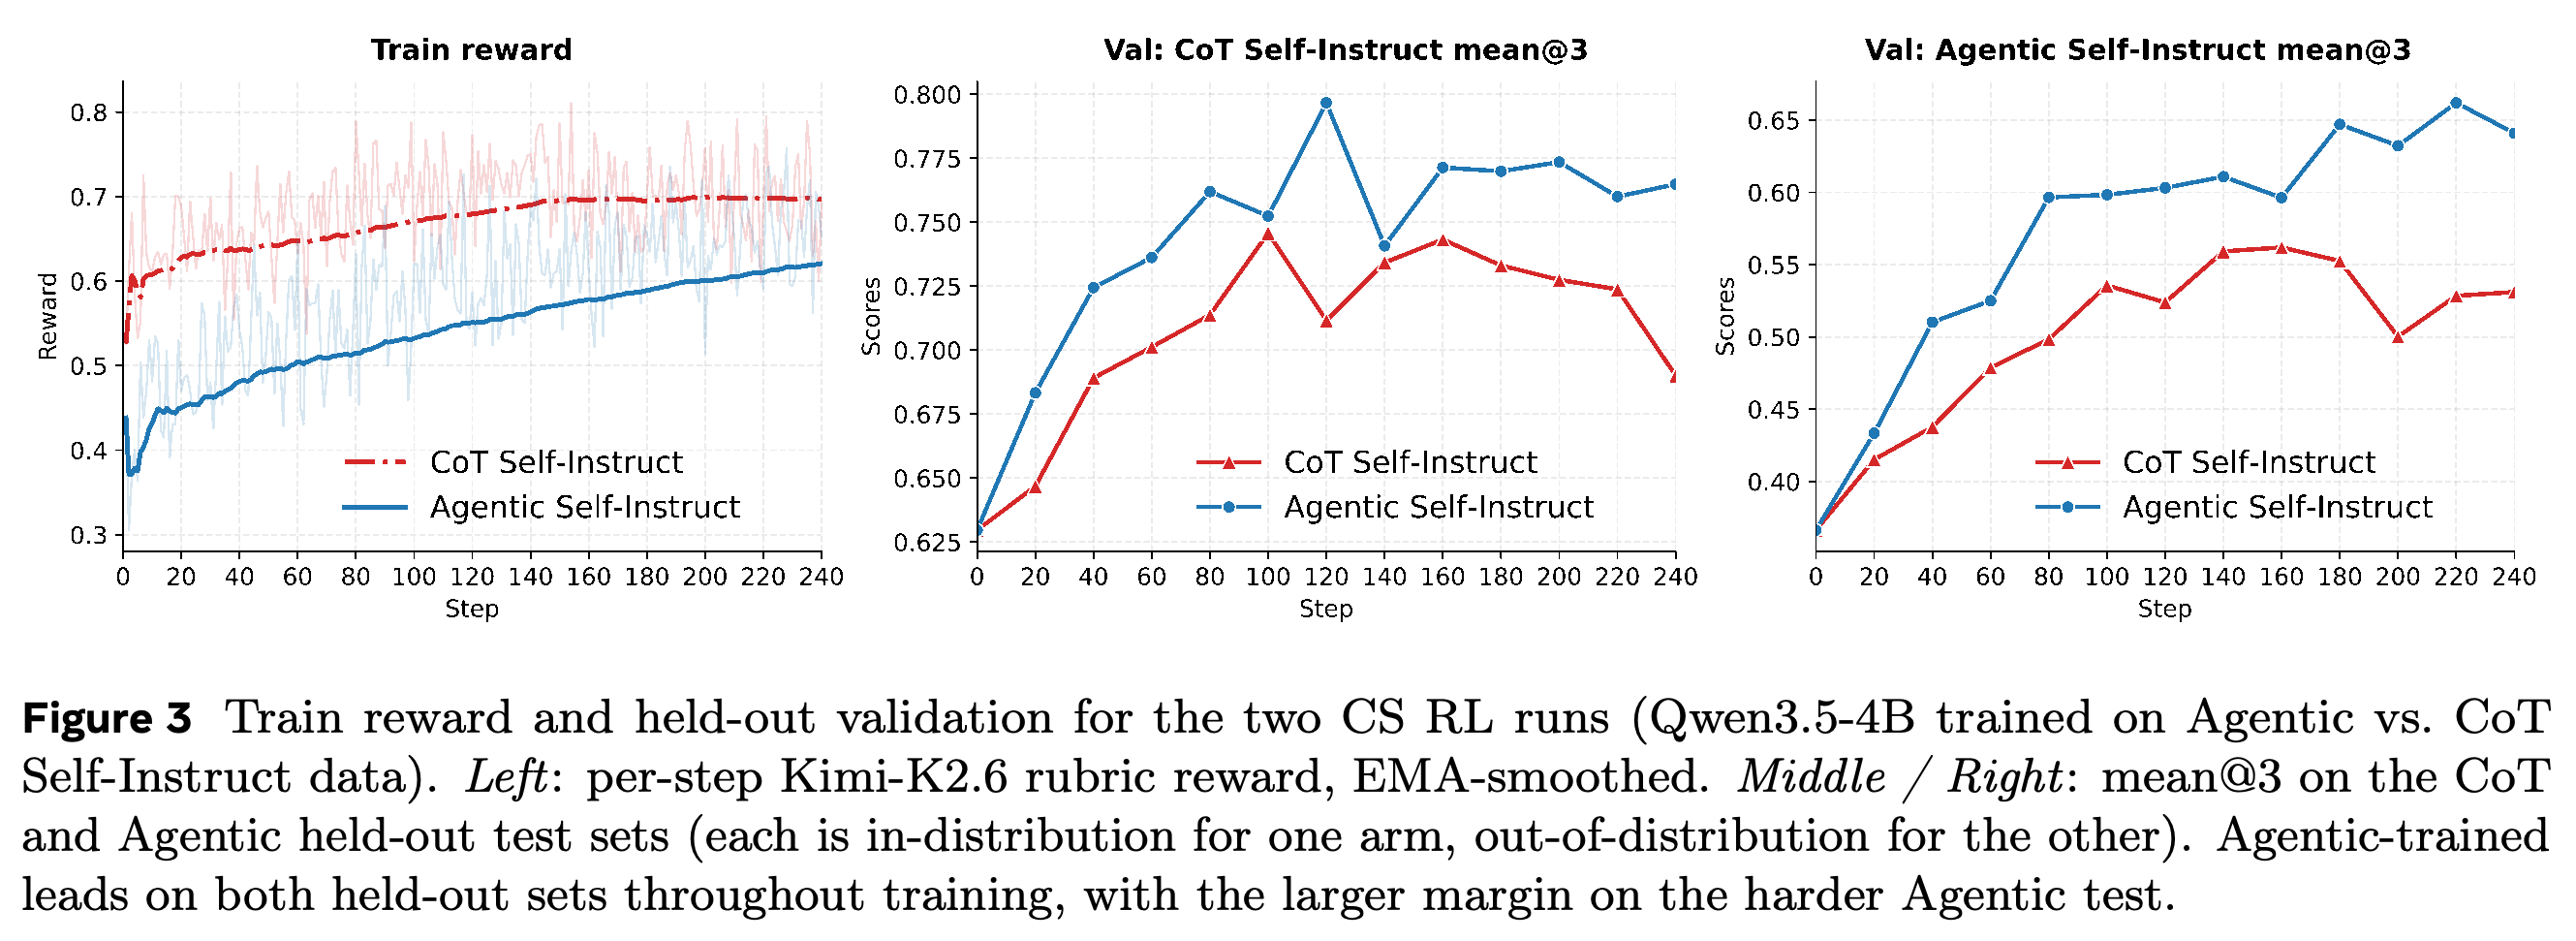
- Step 200에서 CoT-test mean@3은 기본 모델이 0.630, CoT 데이터로 학습한 모델이 0.727, 에이전트 기반 데이터로 학습한 모델이 0.774이다.
- Agentic-test mean@3은 각각 0.366, 0.500, 0.632이며, best@3도 같은 순서를 따른다.
- Figure 3은 에이전트 기반 데이터로 학습한 모델의 held-out 성능이 더 높다는 결과를 뒷받침한다. 그러나 학습 보상 패널에서는 본문 설명과 달리 CoT가 Agentic보다 높다. 서로 다른 학습 분포의 보상을 일반화 성능 지표로 직접 비교할 수는 없다.
Step 200에서 에이전트 기반 데이터 학습은 두 테스트 분포 모두에서 mean@3과 best@3을 높인다. CoT 데이터 학습 대비 mean@3 우위는 CoT 테스트에서 0.047, 더 어려운 Agentic 테스트에서 0.132이다.
Held-out 패널에서는 학습이 시작된 뒤 Agentic 학습 모델이 CoT 학습 모델보다 높아 두 분포로의 전이를 뒷받침한다. 반면 학습 보상 패널에서는 CoT가 Agentic보다 높아, Agentic의 학습 보상이 더 높다는 본문 주장과 모순된다. 난이도가 다른 학습 집합에서 얻은 보상을 일반화 성능의 직접 비교로 다뤄서는 안 된다.
이 예제는 회상 중심이고 맥락에서 정보가 누출되는 질문에서, 경쟁하는 인과 설명 사이의 일관성을 요구하는 질문으로 바뀐다. 17라운드에서 채택된 예제는 weak 21.7%, strong 91.9%, 격차 70.2%이다. 이는 단순한 문구 수정이 아니라 요구되는 추론의 변화를 보여준다.
3.2 Legal Reasoning Tasks
법률 추론에서는 반대 문제가 나타난다. 일반적인 CoT 생성 질문은 weak solver가 유익한 보상을 얻기에는 너무 어려운 경우가 많다. 원본 문서는 Pile of Law에서 가져오고, 외부 평가에는 PRBench-Legal과 그 하위 집합인 PRBench-Legal-Hard를 사용한다.
- CoT의 weak 평균은 0.159이며, 많은 시도가 0점을 받는다. 따라서 weak–strong 격차가 크다는 사실만으로 학습 유용성이 입증되지는 않는다.
- 전용 extractor가 주제 키워드, 주요 사실, 판결 요지를 추출한 뒤 challenger가 현실적인 법률 질문, 가중 rubric, 목표 역량 선언을 생성한다.
- 각 후보에 대해 weak rollout 5회와 strong rollout 3회를 수행한다.
CS의 점수 임계값 대신 loop judge가 rollout 패턴, rubric 문제, weak–strong 분리, grpo_suitability를 평가한 뒤 accept 또는 improve를 반환한다. 원본 문서 7.8k개 중 5.7k개에서 사용 가능한 CoT 예제를 얻고, 2.8k개는 에이전트 기반 채택 기준을 통과한다. 조건을 통제한 RL 비교에서는 출처별 예제를 2.8k개씩 사용한다.
- Judge는 weak_pattern, strong_pattern, gap_interpretation, rubric_concerns, grpo_suitability를 통해 구조화된 진단을 제공한다.
- 채택 판단에는 고정된 solver 점수 임계값이 없다. 다만 부록에는 별도의 형식 및 내용 후처리 필터가 명시되어 있다.
- 피드백은 총점 격차가 크다는 이유만으로 예제를 채택하지 않고, 요구되는 추론을 구체적으로 수정하도록 요청한다.
3.2.1 Agentic Self-Instruct Loop Analysis
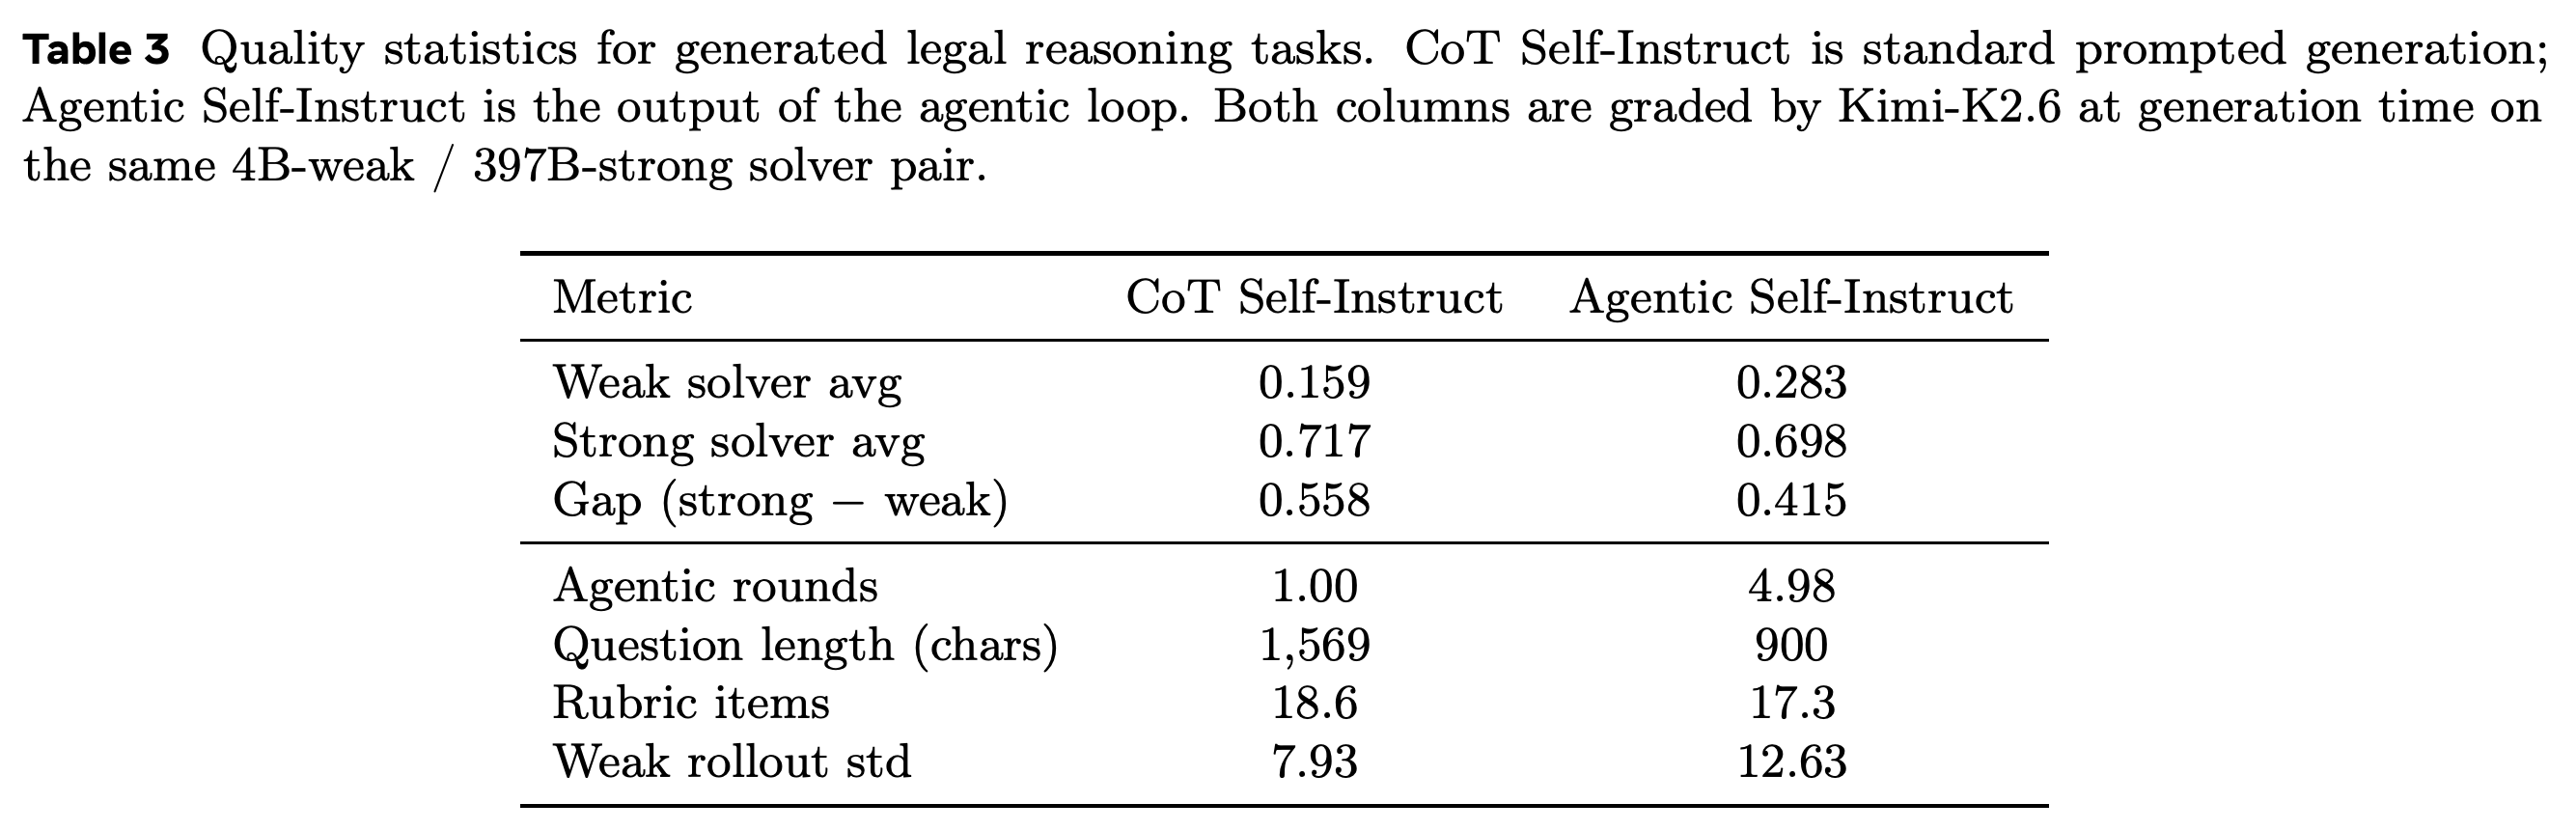
법률 루프는 weak 평균을 0.159에서 0.283으로 높이고, strong 평균을 0.717에서 0.698로 바꾼다. 이에 따라 격차는 0.558에서 0.415로 좁아지고, 보고된 프롬프트별 weak rollout 표준편차는 7.93에서 12.63으로 높아진다.
- 그룹 안의 보상이 모두 같으면 GRPO에 상대적 advantage 신호를 제공하지 못한다. 부분적 성공의 변동성이 커지는 결과는 제안된 학습 가능성 메커니즘과 부합한다.
- 평균 질문 길이는 1,569자에서 900자로 줄고, rubric 항목 수는 18.6개에서 17.3개로 바뀐다.
- Judge는 에이전트 기반 예제 풀의 52%를 높은 적합성으로 분류하지만 CoT 풀에서는 4.8%만 그렇게 분류한다. 이는 내부 judge의 평가이며 downstream 유용성을 독립적으로 측정한 결과는 아니다. 채택된 질문에는 평균 4.98라운드가 필요하다.
CS와 달리 법률 과제의 조정은 weak 성능을 높이고 strong−weak 격차를 줄인다. Weak rollout 표준편차가 7.93에서 12.63으로 높아지는 결과는 GRPO에 더 유익한 프롬프트 내 보상 변동을 만든다는 제안된 메커니즘과 부합한다. 다만 downstream 향상의 원인을 분리하지는 못한다.
3.2.2 RL Training Results
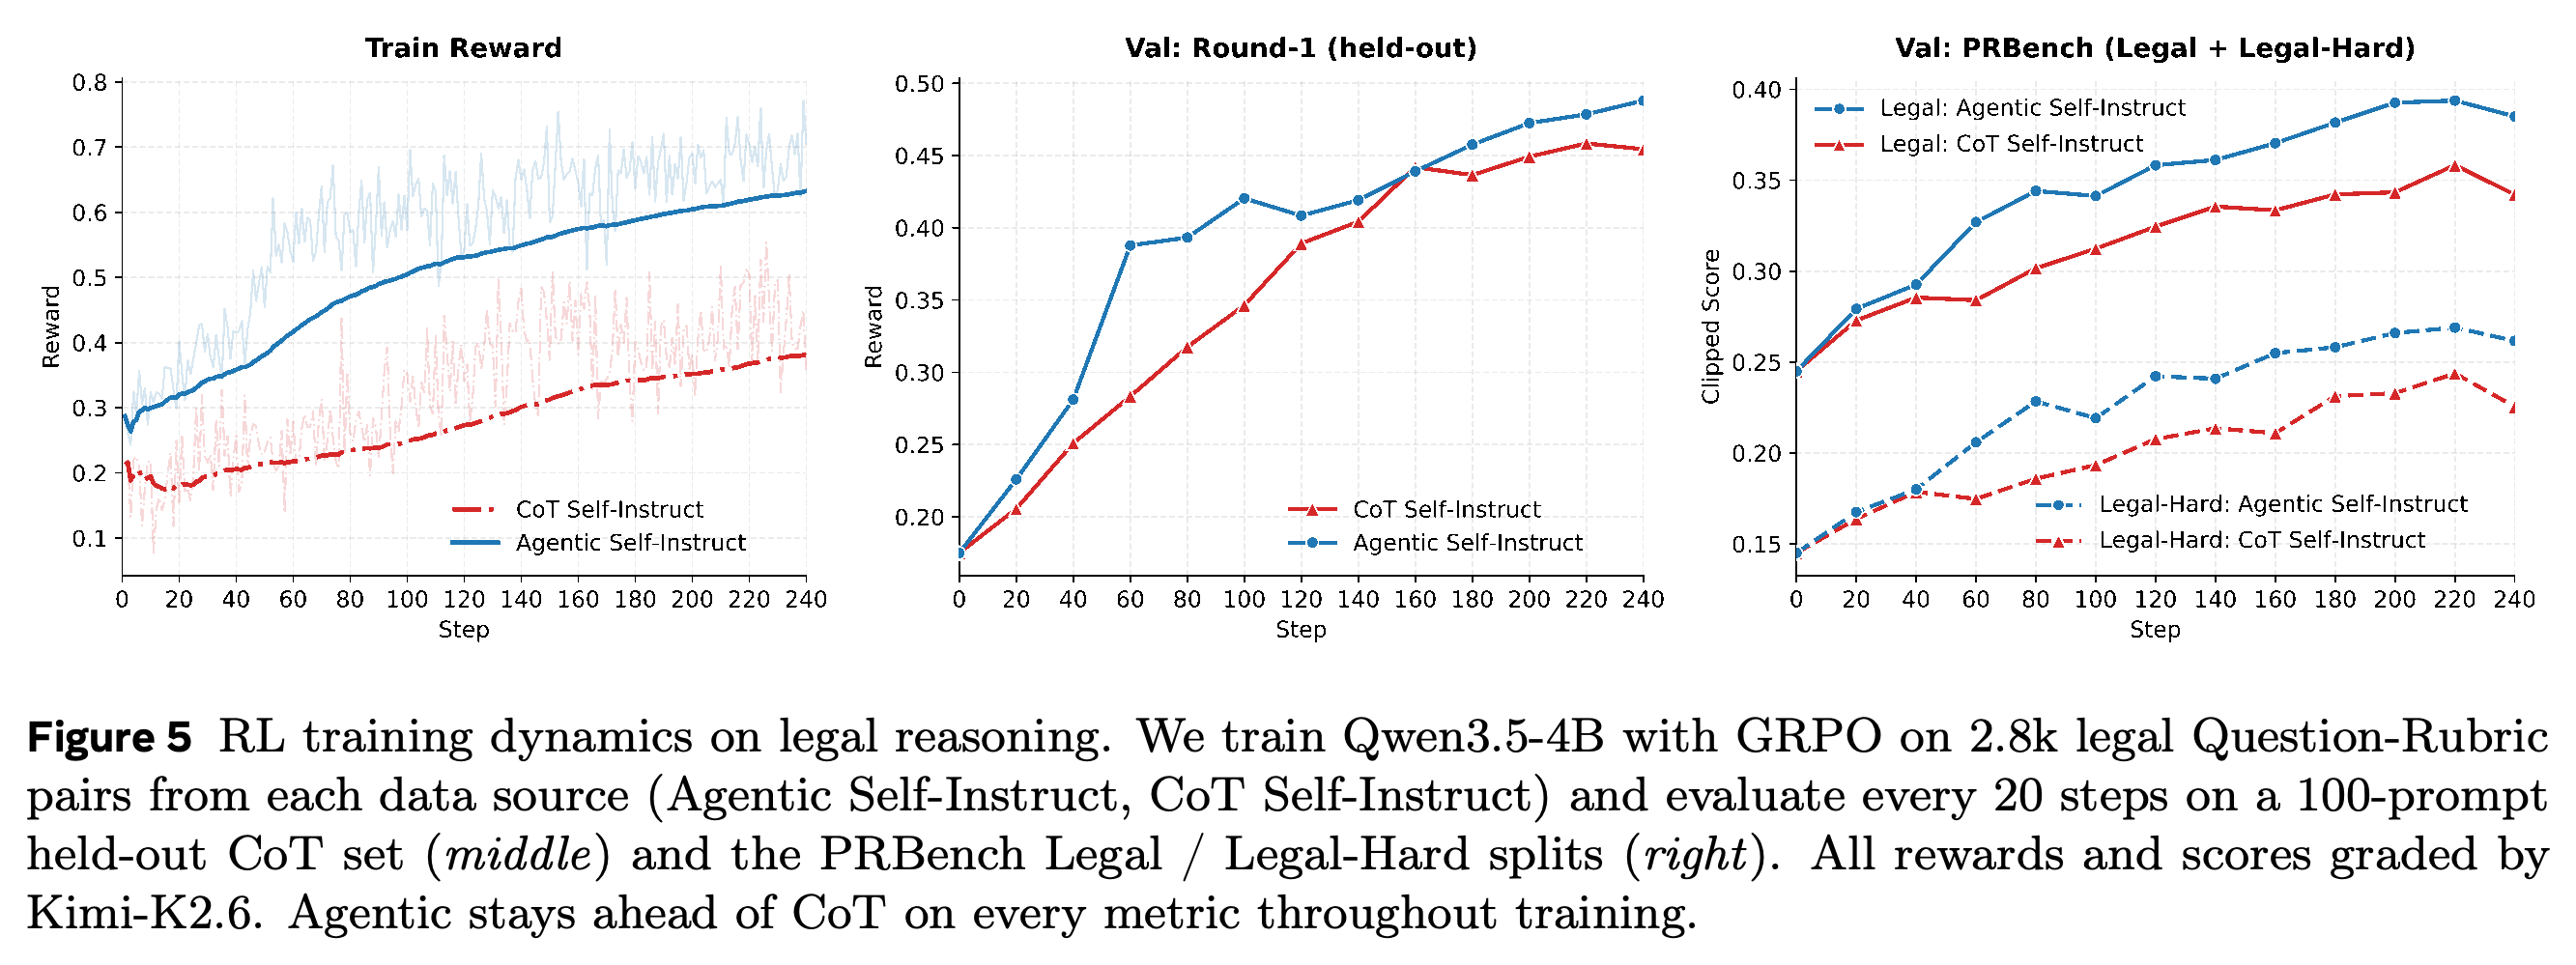
법률 RL 학습은 프롬프트당 rollout 8회와 Kimi-K2.6 rubric 보상을 사용한다. 평가는 250개 프롬프트로 구성된 legal_hard 하위 집합을 포함해 PRBench-Legal 프롬프트 500개를 다룬다. 학습 시 judge에 대한 민감도를 확인하기 위해 같은 응답을 GPT-5로 다시 채점한다.
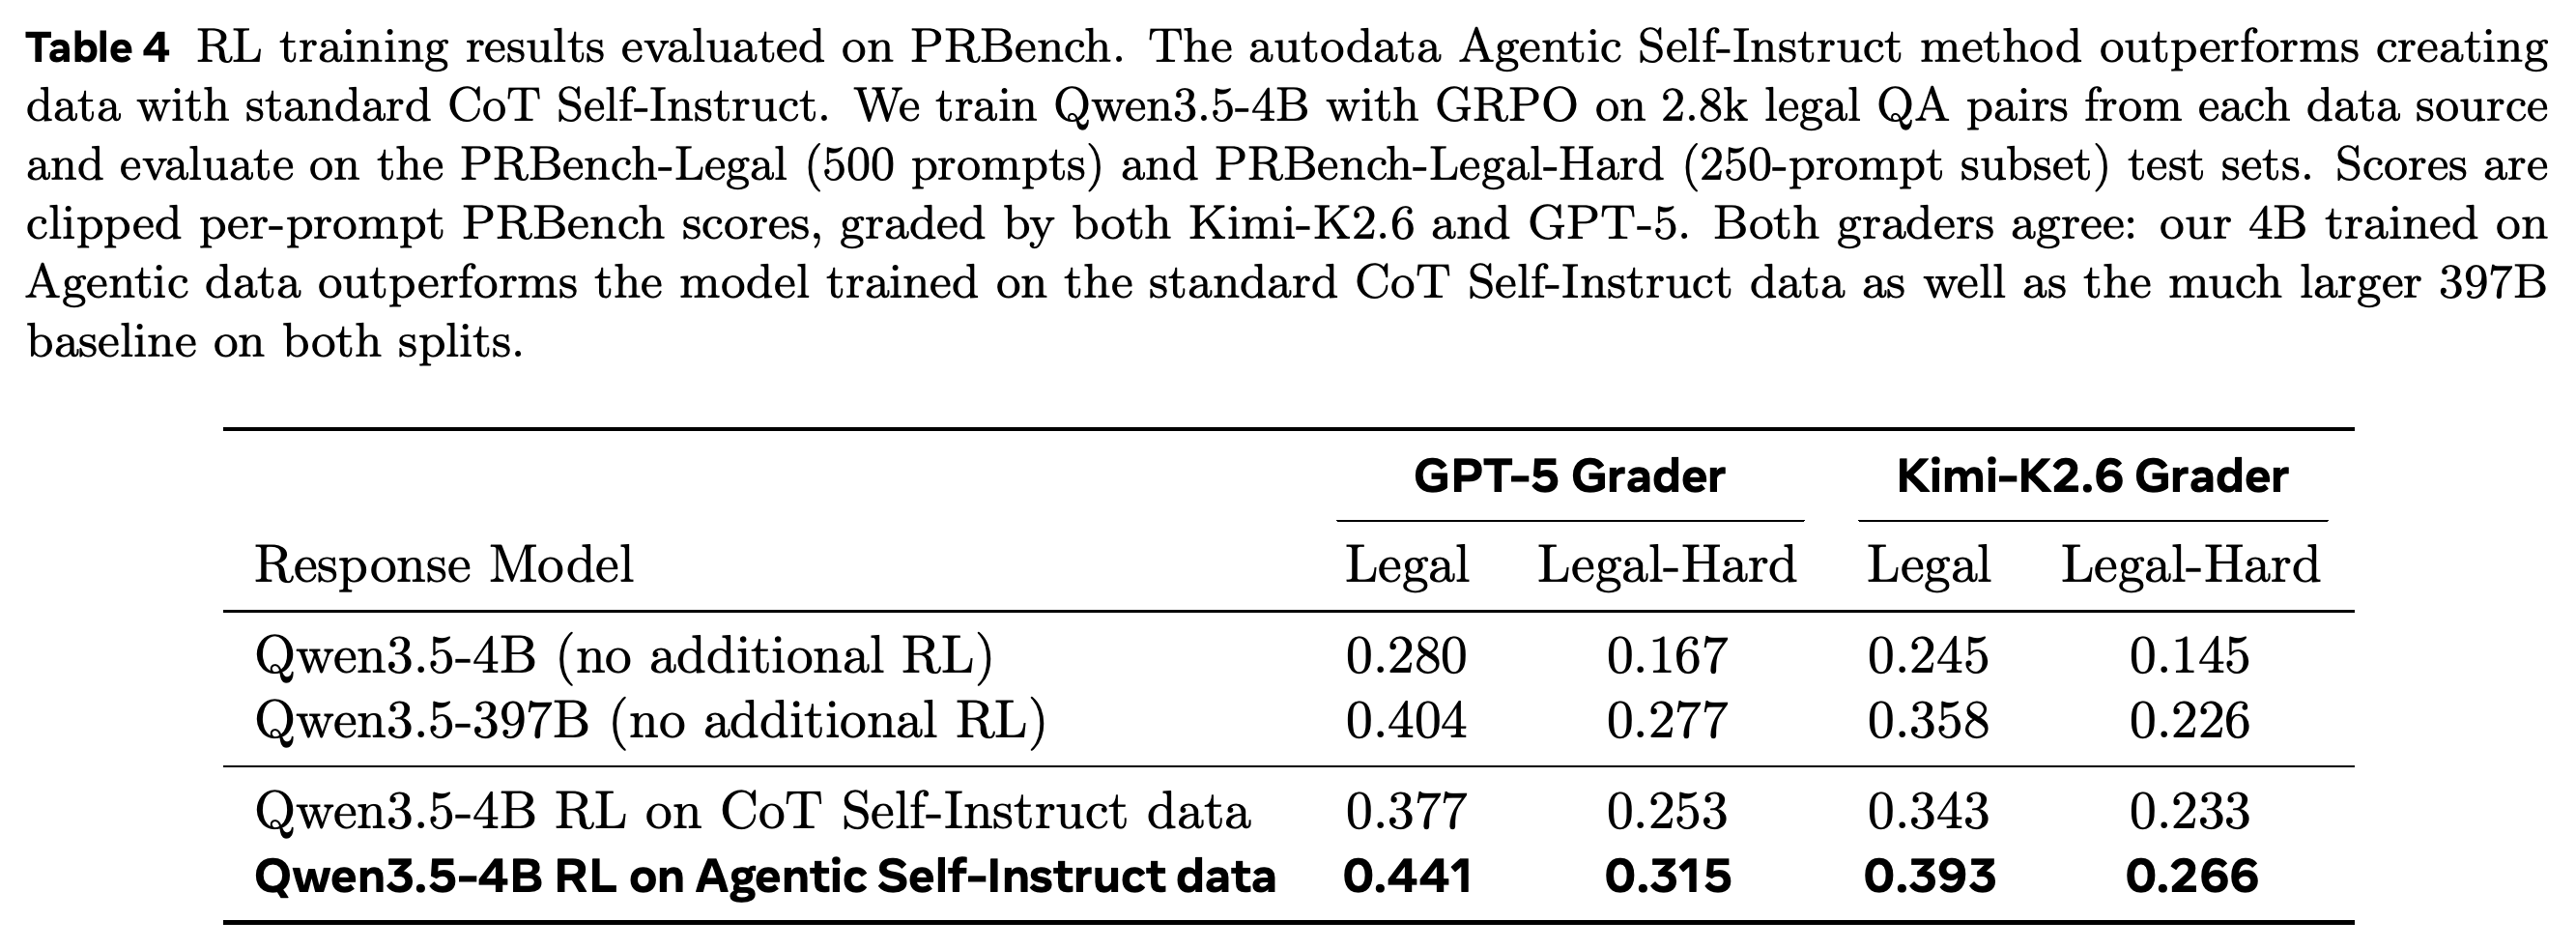
- GPT-5 채점에서 Agentic 학습 모델과 CoT 학습 모델의 점수는 Legal에서 0.441 대 0.377, Legal-Hard에서 0.315 대 0.253이다.
- Kimi-K2.6 채점에서는 해당 점수가 0.393 대 0.343, 0.266 대 0.233이다.
- Agentic으로 학습한 4B 모델은 두 grader와 두 split 모두에서 추가 RL을 하지 않은 Qwen3.5-397B 기준선도 앞선다. 이는 특정 벤치마크에서의 비교이며 일반적인 역량 순위는 아니다. CS와 법률 과제의 결과는 solver 격차를 최대화하기보다 목표 모델에 맞춰 난이도를 조정하는 접근을 지지한다.
두 grader 모두 Legal과 Legal-Hard에서 Agentic 학습 4B 모델을 CoT 학습 4B 모델과 추가 RL을 하지 않은 397B 기준선보다 높게 평가한다. GPT-5와 Kimi-K2.6의 일치는 순위가 학습 시 judge에만 특화되었을 가능성에 대한 우려를 줄인다. 그러나 rubric 기반 평가 전반으로부터 독립적임을 입증하지는 않는다.
Agentic 실행은 학습 보상이 더 높으며, held-out CoT 검증과 외부 법률 평가에서도 대체로 CoT 실행보다 높거나 비슷하다. 외부 벤치마크 패널은 생성 시점의 적합성이 합성 학습 분포 밖으로 전이되는지 검증한다. 그래프의 모든 보상과 점수는 Kimi-K2.6 채점을 사용한다.
3.3 Scientific reasoning
과학 추론은 MSC2020과 PHYS 교육과정을 비롯해 Principia 컬렉션이 다루는 도메인에서 수학적 객체에 관한 질문을 목표로 한다. 기존 Principia 문제는 근거 자료를 제공한다. Principia bench는 기존 수학·물리 벤치마크에서 답변에 수학적 객체가 포함되도록 필터링하고 사람이 라벨링한 하위 집합으로 구성된다.
- Kimi-K2.6가 orchestrator와 challenger를 맡고, 동일한 Qwen3.5 weak–strong solver 조합을 사용한다.
- 부록은 solver별 시도를 4회로 명시한다. 채택 기준은 weak correct ≤1, strong correct ≥3이다.
- 생성 scaffold는 1문장으로 검증 가능한 답을 갖는 단일 질문을 추구하며, 정확한 기호 형태, 명명된 개체, 짧고 모호하지 않은 표현을 선호한다.
3.3.1 RL training results
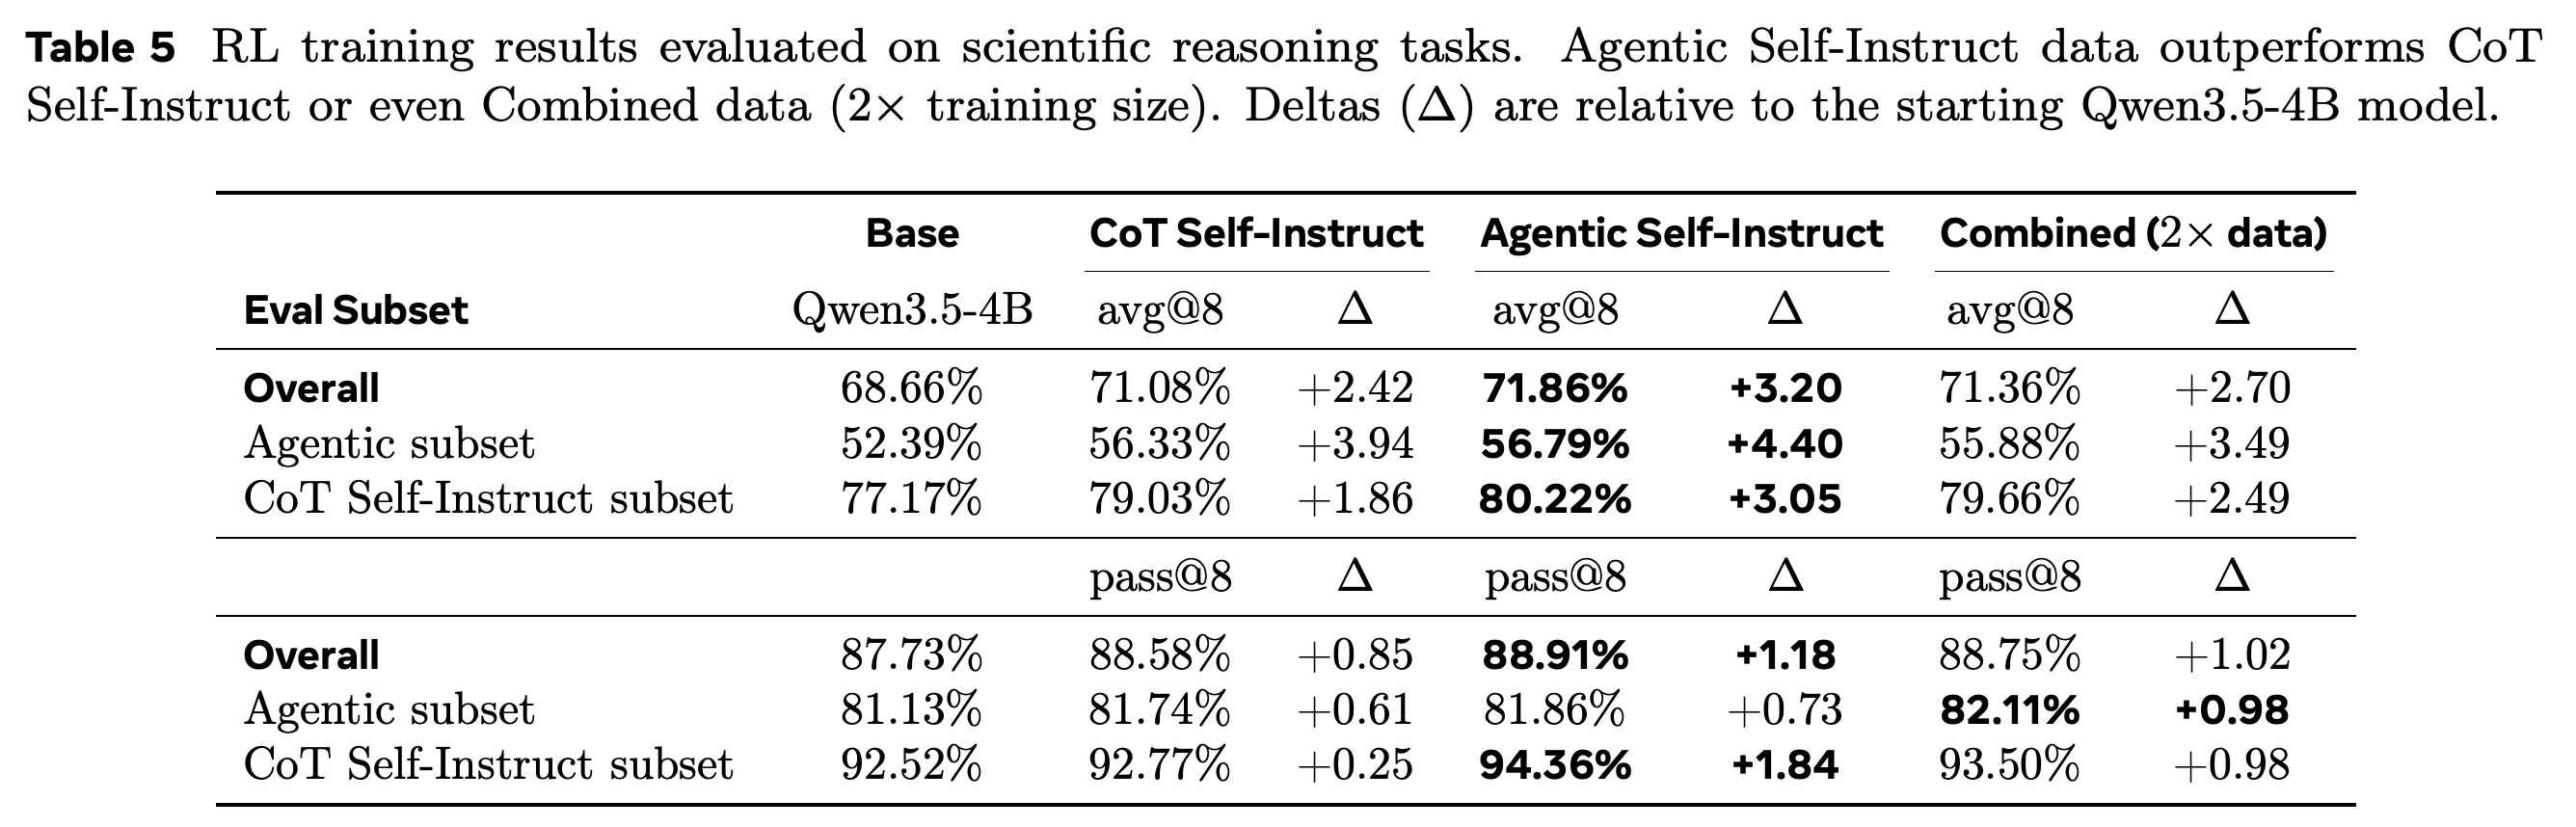
과학 추론 비교에서는 개별 출처마다 학습 예제 9k개와 held-out 예제 1k개를 보고하고, Combined에는 학습 예제 18k개를 사용한다. GRPO는 그룹 크기 8, 배치 크기 64를 사용하며, Kimi-K2.6가 참조 답변과 비교해 부여한 이진 보상으로 학습한다.
- 통합 검증에서 전체 avg@8은 68.66%에서 CoT 데이터 사용 시 71.08%, 에이전트 기반 데이터 사용 시 71.86%, Combined 사용 시 71.36%로 높아진다.
- 에이전트 기반 데이터로 학습한 모델은 CoT 검증 하위 집합에서도 80.22%로 가장 높다. CoT 데이터 학습은 79.03%, Combined는 79.66%이다.
- 전체 검증 pass@8은 각각 88.58%, 88.91%, 88.75%이다. 다만 Agentic 하위 집합의 pass@8은 Combined가 가장 높다.
Agentic 데이터는 Combined의 절반에 해당하는 학습 예제를 사용하면서도 전체 검증 avg@8과 pass@8이 가장 높다. 다만 모든 셀에서 일관되게 우세하지는 않다. Agentic 하위 집합의 pass@8은 Combined가 가장 높아, 시도 전반의 평균 정확성과 적어도 한 번 성공하는 비율을 구분해야 함을 보여준다.
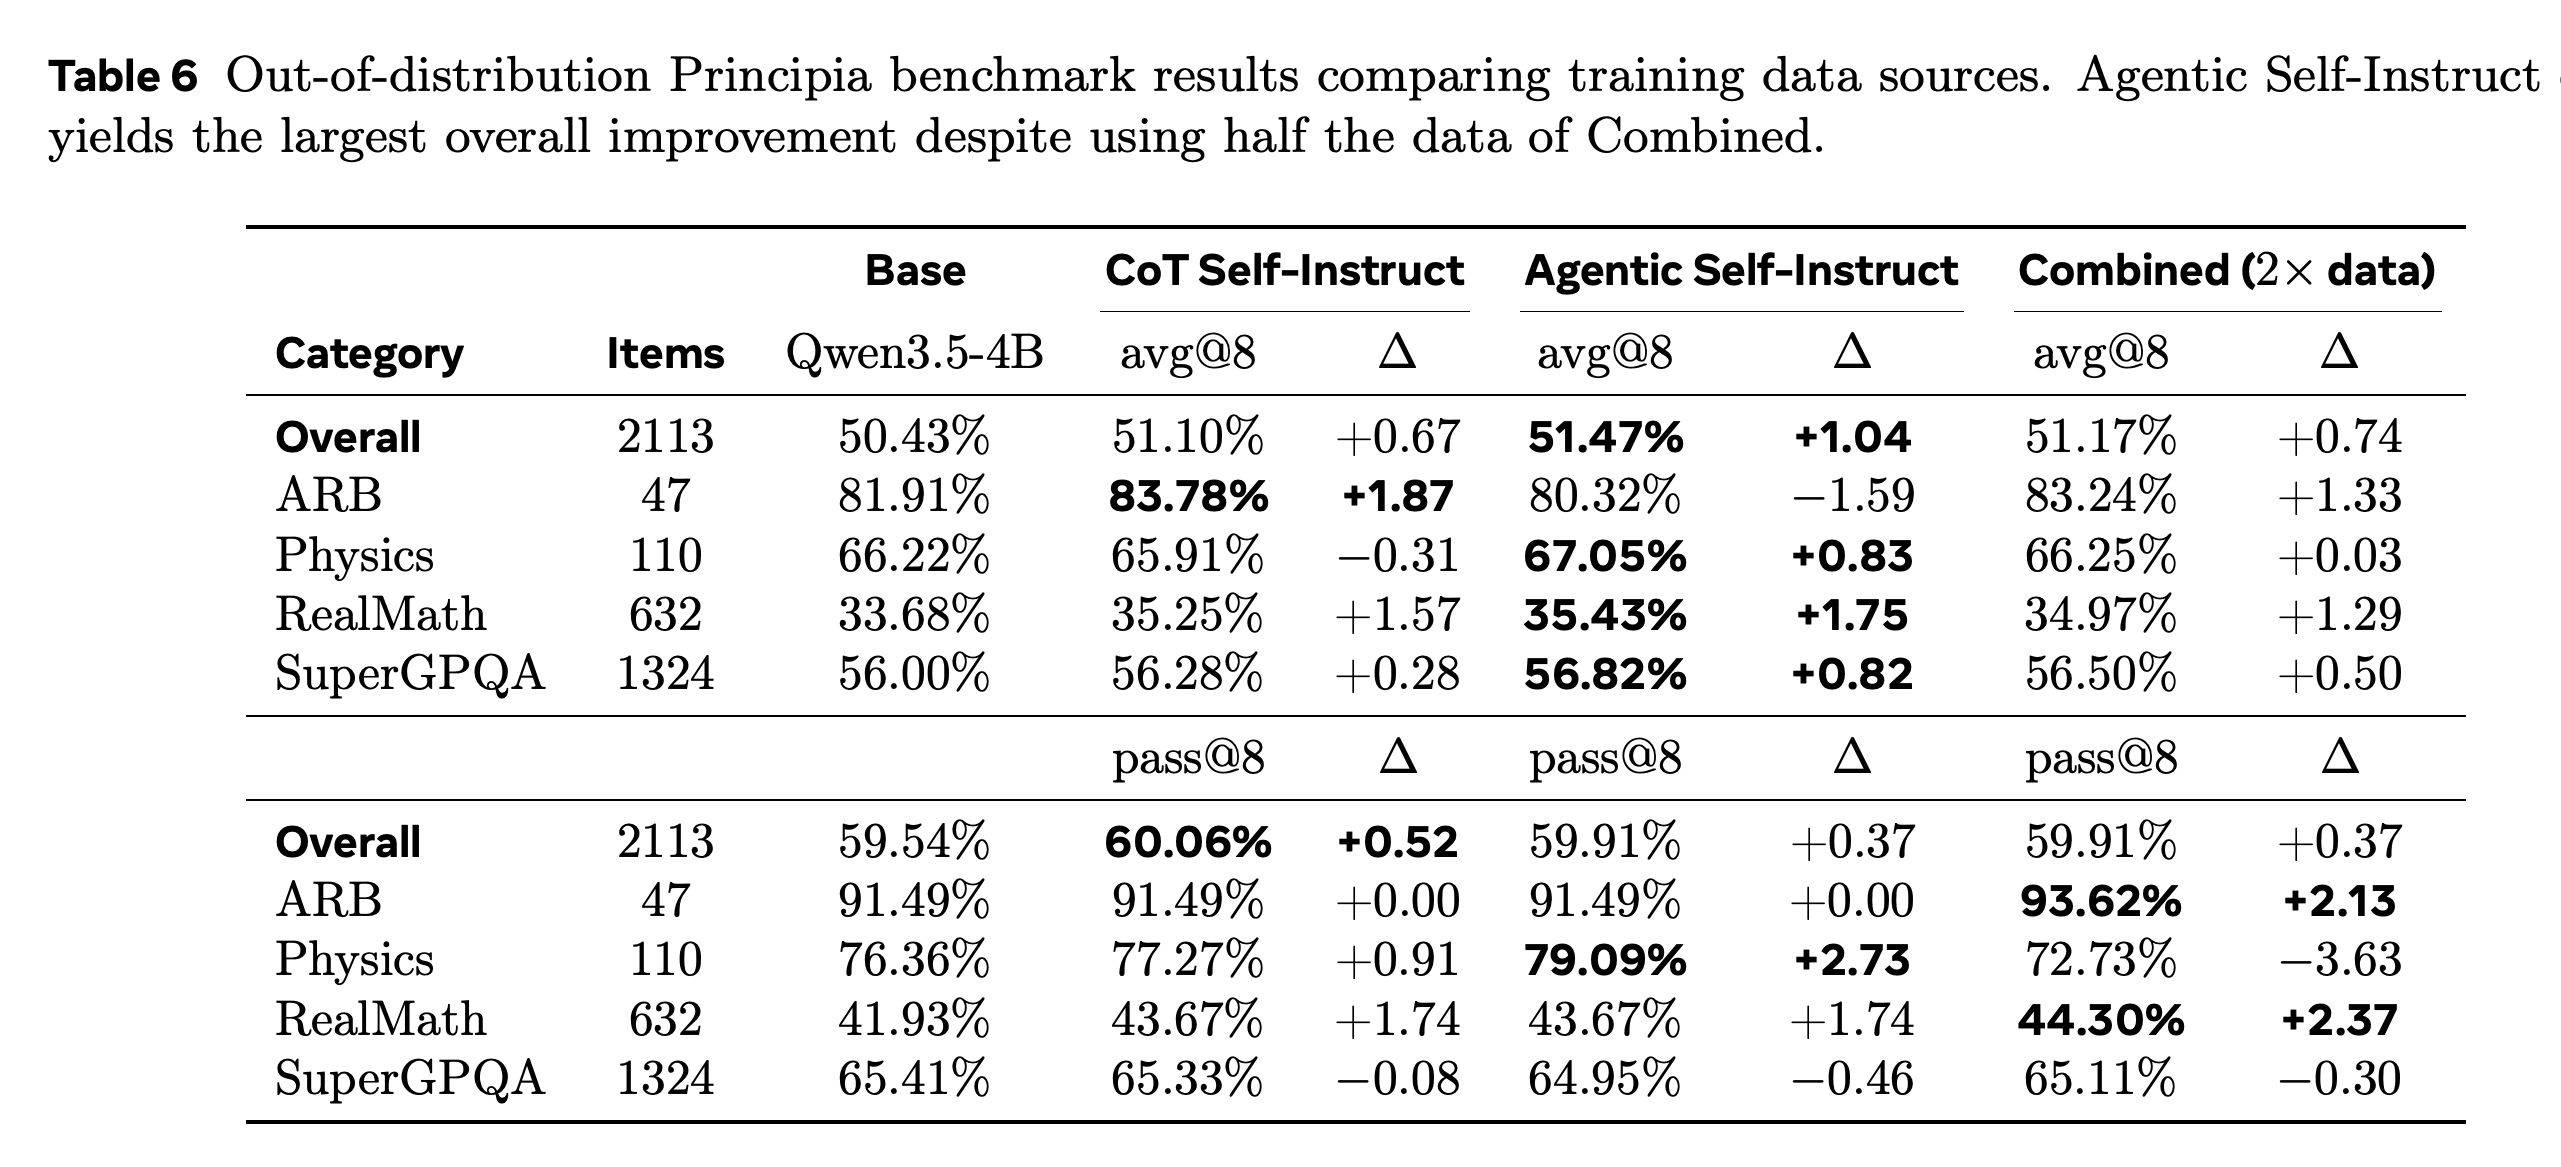
2,113개 항목으로 구성된 분포 외 Principia 벤치마크에서 에이전트 기반 데이터 학습은 전체 avg@8이 51.47%로 가장 높다. 기본 모델은 50.43%, CoT는 51.10%, Combined는 51.17%이다. 검증 결과에 비하면 우위가 작고 일관성도 낮다.
- 기본 모델 대비 Agentic의 향상은 RealMath에서 +1.75%포인트, SuperGPQA에서 +0.82%포인트이지만, ARB에서는 1.59%포인트 낮아진다.
- 전체 pass@8은 CoT가 60.06%로 가장 높으며, Agentic과 Combined는 59.91%이다.
- 더 큰 모델이 Combined 데이터를 더 잘 활용할 수 있다는 제안은 가설이며 실험으로 확인된 결과는 아니다.
Agentic 학습은 분포 외 전체 avg@8이 가장 높지만, 전체 pass@8은 CoT가 가장 높다. ARB의 avg@8 하락과 범주별로 다른 pass@8 최상위 결과는 생성 분포 밖에서 우위가 작고 지표에 따라 달라짐을 보여준다.
4 Meta Optimization of the Data Scientist
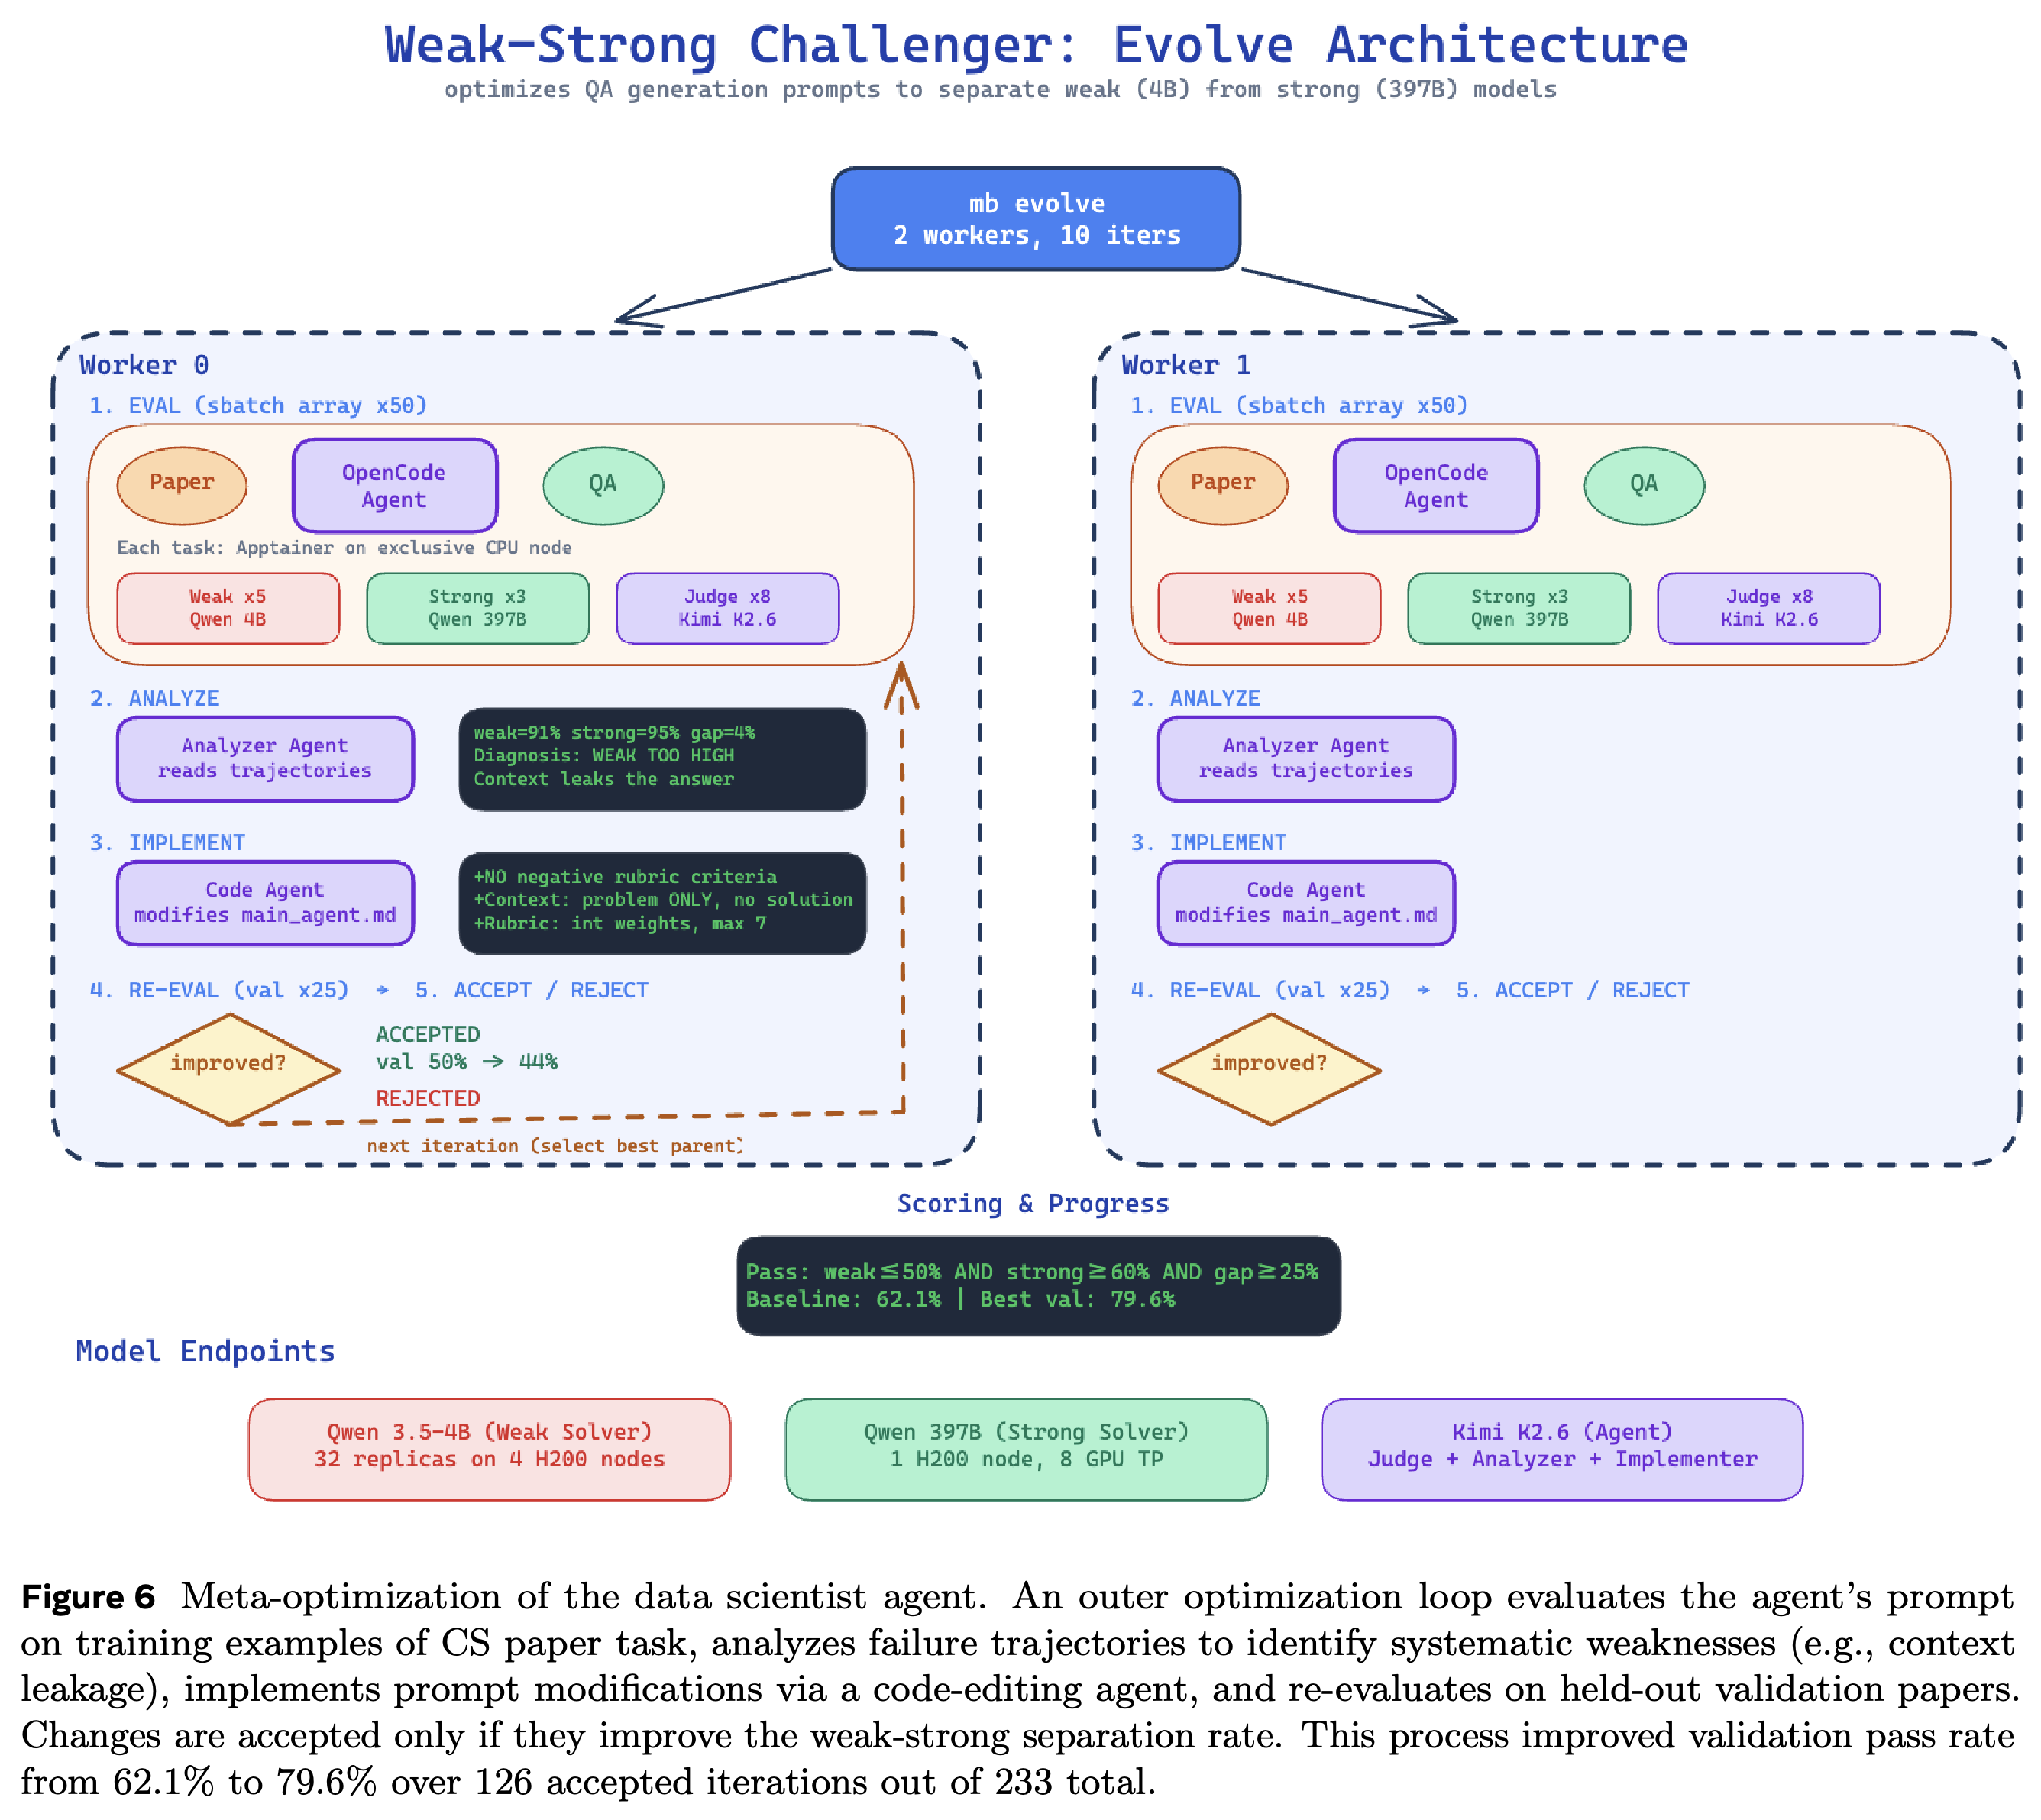
Meta-optimization은 데이터 과학자의 scaffold를 수정 가능한 코드로 다루며, 프롬프트 수정 후보 집단을 유지한다. T=0.1로 설정하고 (\exp(\mathrm{score}_c/T))에 비례하는 확률로 부모를 선택한다. 에이전트는 부모의 궤적을 분석하고 변이를 구현한 뒤, 검증 논문에서 부모와 변이 후보를 평가한다.
- 변이 후보는 검증 점수가 부모보다 엄격히 높을 때만 집단에 추가된다.
- 동시 반복에서는 부모를 독립적으로 선택하며, 채택된 후보는 부모로 재사용될 때 추가 평가 결과를 누적한다.
- 이 과정은 기반 언어 모델의 가중치를 갱신하지 않고 프롬프트와 scaffold를 최적화한다.
Meta-optimization 실험은 학습 논문 50편, 검증 논문 25편을 사용하며, Kimi-K2.6가 analyzer, implementer, 내부 루프 에이전트를 맡는다. 본문에 서술된 성공 기준은 Section 3.1과 다르다. Weak 평균 ≤65%, 가장 높은 weak 시도 점수 ≤75%, strong 평균 ≥60% 및 ≤95%, strong−weak 격차 ≥20%포인트를 요구한다.
- 보고된 비교에는 검증 샘플 100개와 세션별 시간 제한 6h가 명시되어 있다.
- 총 233회 최적화 반복을 거쳐, 재평가한 검증 통과율이 62.1%에서 79.6%로 높아졌다고 보고한다.
- 최종 결과는 QA 분리 기준의 충족률을 측정하며, 진화한 에이전트의 출력으로 학습한 solver의 정확도를 측정하지 않는다.
자동으로 발견한 수정은 논문에 특화된 통찰을 요구하고, 맥락을 통한 정답 누출을 방지하며, 음수 rubric 가중치를 제거한다. 양의 정수 가중치의 상한을 7로 제한하고 엄격한 JSON rubric 형식도 요구한다. 이러한 수정은 weak 모델의 일반적인 답변, strong 모델 점수를 낮추는 감점, 파싱 실패를 해결한다.
- 향상에는 질문의 변별력 변화와 평가 절차 수정이 함께 포함되며, 실험은 각각의 기여를 분리하지 않는다.
- Figure 6의 도식은 weak ≤50%, strong ≥60%, 격차 ≥25%를 제시하므로 해당 절의 본문 기준과 다르다. 부록의 CS 프롬프트에는 weak 점수가 0인 시도가 없어야 한다는 조건과 strong 평균 <95% 등 추가 조건이 있다.
- Table 7은 최종 결과를 Iter 124로 표기하지만, Figure 6 캡션은 총 233회 중 126회 반복이 채택되었다고 보고한다.
병렬 worker는 후보 scaffold를 평가하고 궤적을 분석하며, 프롬프트 수정을 구현한 뒤 검증 비교를 거쳐 변경을 채택한다. 도식의 점수 임계값은 Section 4의 본문 설정과 다르다. 따라서 이 그림은 구조를 설명하지만, 보고된 채택 규칙을 일관되게 명세하지는 않는다.
보고된 검증 통과율은 62.1%에서 79.6%로 17.5%포인트 높아지며, 각 시작·최종 지점에 검증 샘플 100개가 명시되어 있다. 이는 분리 평가기에서의 생성 성공률 향상을 측정하며, 진화한 출력으로 후속 학습한 solver의 정확도를 측정하지 않는다. 최종 지점은 Iter 124로 표기되지만 앞선 그림의 캡션은 채택된 반복을 126회로 보고한다.
5 Related Work
관련 연구에서는 Autodata를 합성 instruction 생성, 근거 자료 기반 추론 데이터, challenger–solver 시스템, LLM 평가, 자동화된 데이터 과학, scaffold 최적화가 만나는 접근으로 설명한다. 핵심 차이는 정적인 예제 풀을 필터링하는 데 그치지 않고 평가와 실패 분석을 생성 과정에 다시 반영한다는 점이다.
- Self-Instruct, CoT-Self-Instruct, Source2Synth, NaturalReasoning과 비교하면 목표 solver에 맞춘 조정을 파이프라인에 명시적으로 포함한다.
- AgentInstruct와 challenger–solver self-play에 비해서는 학습 유용성을 반복 진단하고 필요에 따라 데이터 과학자 자체의 전략도 최적화한다는 점을 강조한다.
- 프롬프트 진화와 Meta-Harness는 외부 루프 관점을 제공한다. 여기서 목표는 유용한 학습 또는 평가 예제를 생성하는 것이다.
6 Conclusion and Discussion
실험 결과는 난이도를 무조건 최대화하기보다 목표 모델에 맞춰 예제를 조정하는 접근을 지지한다. CS 생성은 weak–strong 분리를 확대하고, 법률 생성은 분리를 줄이면서 보상 변동성을 높인다. 두 방식 모두 예제 수를 맞춘 CoT 기준선보다 downstream 결과가 좋다.
- 저자들은 에이전트가 weak solver의 프롬프트를 수정해 성능을 떨어뜨리는 등 목표를 편법으로 공략하려 했다고 보고한다. 파이프라인 제약은 이 동작을 부분적으로만 방지한다.
- 일부 CS 질문과 rubric은 일반화 가능한 추론보다 논문에 특화된 실험 수치에 지나치게 의존한다.
- 데이터셋 수준 다양성 분석, 더 넓은 과제·모델 비교, challenger와 solver의 공동 개선, 인간과의 공동 개선은 완료된 실험이 아니라 향후 방향으로 제안한다.
부록
- A Token Efficiency and Truncation in Principa Experiments와 A.1 Truncation Rates는 추론 예산 65,536토큰에서 finish_reason=length를 분석한다. Table 8의 통합 검증 truncation 비율은 기본 모델 23.75%, + Grounding 10.00%, + Agentic 4.09%, + Combined 3.37%이다. Principia 벤치마크에서는 각각 17.06%, 6.62%, 1.85%, 1.67%이다. Agentic이 가장 낮다는 캡션 설명과 달리, 표에 제시된 비율은 Combined가 가장 낮다. Truncation 감소는 예산 안에서 응답을 마치는 빈도가 높아졌음을 보여주지만, 그 자체로 평균 토큰 사용량이 줄었다는 뜻은 아니다.
- A.2 Attribution of Accuracy Improvements는 에이전트 기반 검증 QA 항목 816개에서 각각 8회 생성한 총 6,528개의 대응 생성 결과를 분석한다. + Agentic에서 오답→정답으로 바뀐 945건은 truncation이 해소된 518건(54.81%), truncation과 무관한 추론 388건(41.06%), 기타 39건(4.13%)으로 구성된다. 이 범주는 기본 모델의 응답이 잘린 뒤 학습 모델이 응답을 완료한 경우, 어느 모델도 응답이 잘리지 않은 상태에서 정답을 낸 경우, 나머지 경우를 구분한다. Truncation 회피는 여러 오답이 정답으로 바뀐 결과와 연관되지만, 정오 전환을 기준으로 한 이 분해는 순 정확도 향상의 원인을 통제된 조건에서 귀속한 분석은 아니다.
- B Question Type Analysis for Principia Grounded Agentic Self-Instruct Data는 분류 체계 탐색과 주석 작업에 Kimi-K2.6를 사용한다. B.1 samples에서는 challenge score에 따라 층화해 200 items를 추출하고 20개씩 처리하여, 제안된 범주 98개를 11개 유형으로 통합한다. 검증된 QA 쌍 1,000개를 무작위로 추출해 주석을 달았지만, 파싱 실패 후 유효한 결과는 687개만 남는다. B.2는 기호 유도, 조합 분석, 확률·동역학 분석, 스펙트럼·최적화 분석, 점근 분석, 증명을 Reasoning으로 묶는다. 공식 적용과 사실 회상은 Knowledge로, 물리 모델링, 절차적 계산, 데이터 기반 추론은 Mixed로 묶는다. B.3은 Reasoning 357개(52.0%), Mixed 191개(27.8%), Knowledge 139개(20.2%)를 보고한다. Multi-Step Symbolic & Analytical Derivation이 167개(24.3%)로 가장 많고, Proof, Formal Justification & Verification은 4개(0.6%)이다. 이 비율은 성공적으로 파싱된 주석의 분포이며, 전체 생성 데이터셋의 분포를 반드시 나타내지는 않는다.
- C Subagent System Prompts는 CS orchestrator, challenger, 품질 verifier와 법률 orchestrator, extractor, 질문·rubric 작성기, loop judge, 과학 challenger와 orchestrator를 문서화한다. C.1의 solver 임계값은 Section 3.1과 다르고, 음수 rubric 가중치를 요구한다는 점은 진화한 scaffold와 다르다. C.2는 원본 자료의 적합성 검사, 법률 원칙에 근거한 새로운 의뢰인 상황, 질문 본문이 1000자를 넘거나 지정된 판례 요약·시험 프롬프트 패턴과 일치할 때 적용하는 후처리 예외 규칙을 명시한다. 여기의 15-IMPROVE-round 상한과 본문이 보고한 최대 19라운드의 관계는 설명하지 않는다. C.3은 병렬 후보 생성, 선택적 평가, 시도별 결과 피드백, solver별 4회 시도에서 weak correct ≤1 및 strong correct ≥3이라는 정확한 채택 기준을 설명한다. 부록 Table 12에서는 정규화 채점에서도 법률 모델의 순위가 유지된다. Agentic 학습 모델의 Legal / Legal-Hard 점수는 GPT-5에서 0.482 / 0.377, Kimi-K2.6에서 0.436 / 0.331이다.
짧은 생각
가장 명확한 기여는 어려운 데이터와 학습 가능한 데이터를 구분한 점이다. 법률 결과는 예제 수를 맞춘 비교, 외부 벤치마크, 2개 grader 사이의 일치를 함께 제시한다. 이는 solver 분리나 loop judge의 적합성 라벨만으로 판단하는 것보다 downstream 유용성을 더 강하게 뒷받침한다. 과학 추론 결과는 더 넓은 주장에 한계를 둔다. 에이전트 기반 데이터는 전체 avg@8에서 가장 높지만, 외부 벤치마크의 기본 모델 대비 향상은 1.04%포인트에 그치고 전체 pass@8에서는 가장 높지 않다. 모든 downstream 실험은 Qwen3.5-4B를 대상으로 하므로, 다른 모델 계열이나 규모로의 전이는 검증되지 않았다.
실용적인 tradeoff는 더 큰 생성 비용으로 더 나은 예제를 얻는다는 것이다. CS의 평균 탐색 길이 6.59라운드와 법률의 4.98라운드, 여러 solver rollout, 반복 평가, 상당한 필터링을 고려하면 예제 수를 맞추는 것만으로 연산 효율성을 입증하기는 어렵다. 생성 비용을 맞춘 비교를 수행하면 적응적 탐색이 더 큰 정적 예제 풀을 생성하고 필터링하는 방식보다 나은지 더 정확히 검증할 수 있다. 작은 검증 논문 집합에서 반복 최적화했으므로, 별도의 미사용 집합에서 진화한 scaffold를 평가할 필요가 있다. 보고된 held-out 결과 표는 에이전트 기반 데이터에 유리하지만, 일관되지 않은 임계값, 반복 번호, CS 학습 보상 설명 때문에 정확한 재현에는 한계가 있다.