


SkillOS: Learning Skill Curation for Self-Evolving Agents 요약 설명
07 May 2026 | Paper Review Agentic Skills Self-Evolving Agents Reinforcement Learning목차
이번 글에서는 SkillOS: Learning Skill Curation for Self-Evolving Agents 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 5월 7일(Arxiv)
- Ouyang, Siru, Yan, Jun, Chen, Yanfei, Han, Rujun, Wang, Zifeng, Mishra, Bhavana Dalvi, Meng, Rui, Li, Chun-Liang, Jiao, Yizhu, Zha, Kaiwen, et al.
- University of Illinois Urbana-Champaign, Google Cloud AI Research, Massachusetts Institute of Technology
- 논문 링크
요약
- SkillOS: Learning Skill Curation for Self-Evolving Agents는 에이전트가 과거의 작업 수행 경험을 재사용 가능한 절차적 지식으로 바꾸는 방법을 연구한다. 고정된 Agent Executor와 학습 가능한 Skill Curator를 분리하고, 큐레이터가 외부 SkillRepo에 Markdown 스킬을 삽입·수정·삭제하도록 한다.
- 큐레이터는 서로 관련된 작업 스트림에서 GRPO로 학습한다. 앞선 실행 궤적에서 추출한 스킬을 이후 작업 결과로 평가할 수 있다. 복합 보상은 judge가 판정한 후속 작업 성공, 유효한 함수 호출, 콘텐츠 품질 평가, 저장소 압축을 결합한다.
- Qwen3-8B를 실행기로 사용하면 SkillOS는 보고된 ALFWorld 성공률을 메모리가 없을 때의 47.9%에서 61.2%로 높이고, 평균 행동 수를 21.1에서 18.9로 줄인다. 학습한 8B 큐레이터는 학습 중 사용하지 않은 더 큰 실행기의 성능도 개선한다. 다만 도메인 간 전이가 항상 효과적이지는 않으며, 행동 수 감소만으로 전체 시스템 비용이 낮아졌다고 볼 수는 없다.
1. Introduction
스트리밍 에이전트는 미래 작업을 보기 전에 현재 작업을 해결해야 한다. 그러나 매번 독립적으로 실행하면 이후 의사결정에 도움이 될 경험을 버리게 된다. 논문은 단순한 저장이나 검색이 아니라 스킬 큐레이션을 핵심 문제로 제시한다. 스킬 큐레이션은 유용한 교훈을 추출하고, 기존 절차를 수정하며, 효용이 낮은 지식을 제거하는 과정이다.
- 수동으로 저장소를 구축하려면 전문가의 노력이 필요하다. 고정된 프롬프트와 휴리스틱 기반 관리 방식은 실행기가 후속 작업에서 필요로 하는 내용을 직접 최적화하지 않는다.
- 기존 RL 접근법은 스킬 사용이나 짧은 스트림에 대한 적응을 학습하는 경우가 많다. SkillOS는 관련된 미래 작업으로 큐레이션을 평가하고, 지연된 결과 피드백을 중간 보상으로 보완한다.
2. Related Work
Memory for Self-Evolving Agents에서는 원시 실행 궤적과 질의–응답 예시 같은 사례 기반 메모리와, 워크플로·추출한 통찰·재사용 가능한 스킬 같은 전략 기반 메모리를 구분한다. SkillOS는 모듈형 스킬 방식을 따르지만, 각 스킬을 스크립트와 보조 자료가 담긴 폴더가 아니라 1개의 Markdown 파일로 단순화한다.
- Learning Memory and Skill Curation with RL에서는 컨텍스트 관리, 메모리 검색, 스킬 활용, 스킬 큐레이션을 서로 다른 최적화 대상으로 구분한다.
- SkillRL과 D2Skill은 외부에서 큐레이션한 스킬을 사용하도록 모델을 학습한다. ARISE는 휴리스틱으로 스킬을 관리하면서 검색과 실행을 학습한다.
- SkillOS는 큐레이션 자체를 학습 대상으로 삼는다. 관련 작업 스트림을 통해 스킬을 삽입한 직후의 전이뿐 아니라 수정과 삭제도 학습할 기회를 제공한다.
3. Methodology
방법론은 스트리밍 추론을 위한 모듈형 실행–큐레이션 루프와 큐레이터를 학습하는 RL 절차를 결합한다. 실행기의 파라미터는 고정한다. 추론 중에는 외부 저장소가 바뀌고, 학습 중에는 저장소를 관리하는 큐레이터의 정책이 바뀐다.
3.1. Streaming Skill Curation with Multi-Agent Modular Design
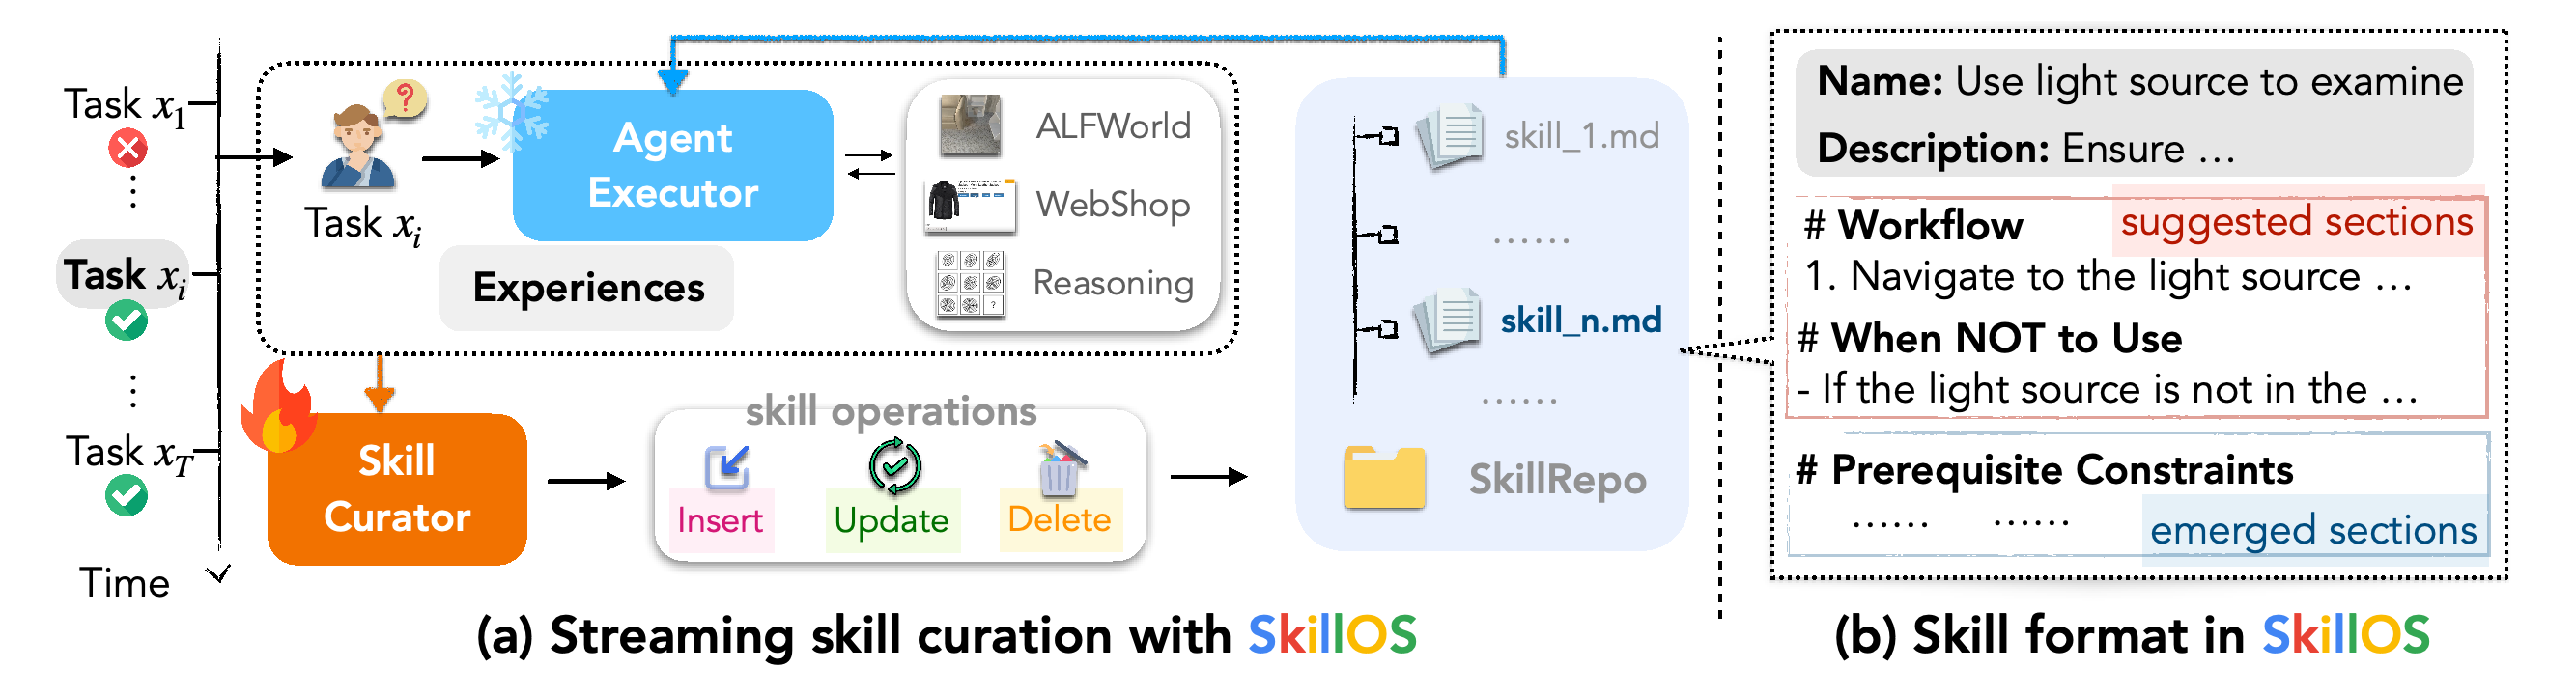
새 작업이 들어오면 BM25가 SkillRepo에서 관련 스킬을 검색한다. 고정된 실행기는 작업, 현재 관측, 검색한 내용을 바탕으로 행동한다. 실행 후 큐레이터는 실행 궤적, 자체 판정한 정답 신호, 관련 스킬을 받아 구조화된 insert_skill, update_skill, delete_skill 연산을 생성한다.
- 각 스킬은 name과 description을 포함한 YAML frontmatter로 시작한다. 이후 Markdown 지침에 워크플로, 제약 조건, 재사용 가능한 휴리스틱을 담는다.
- 연산을 적용하면 후속 작업에 사용할 SkillRepo가 갱신된다. 실행기의 가중치를 바꾸지 않고도 절차적 메모리를 통해 적응할 수 있다.
- 부록의 함수 시그니처는 new_skill_insert, skill_update, skill_delete를 사용하지만, 본문에서는 연산을 insert_skill, update_skill, delete_skill로 명명한다.
도식은 외부 저장소에서 적응이 일어남을 보여준다. 실행기 가중치는 고정된 상태에서 경험이 큐레이터로 전달되고 저장된 스킬이 바뀐다. Markdown 예시는 권장 섹션과 학습 중 새로 생길 수 있는 추가 구조를 구분한다.
3.2. Learning Skill Curation with RL
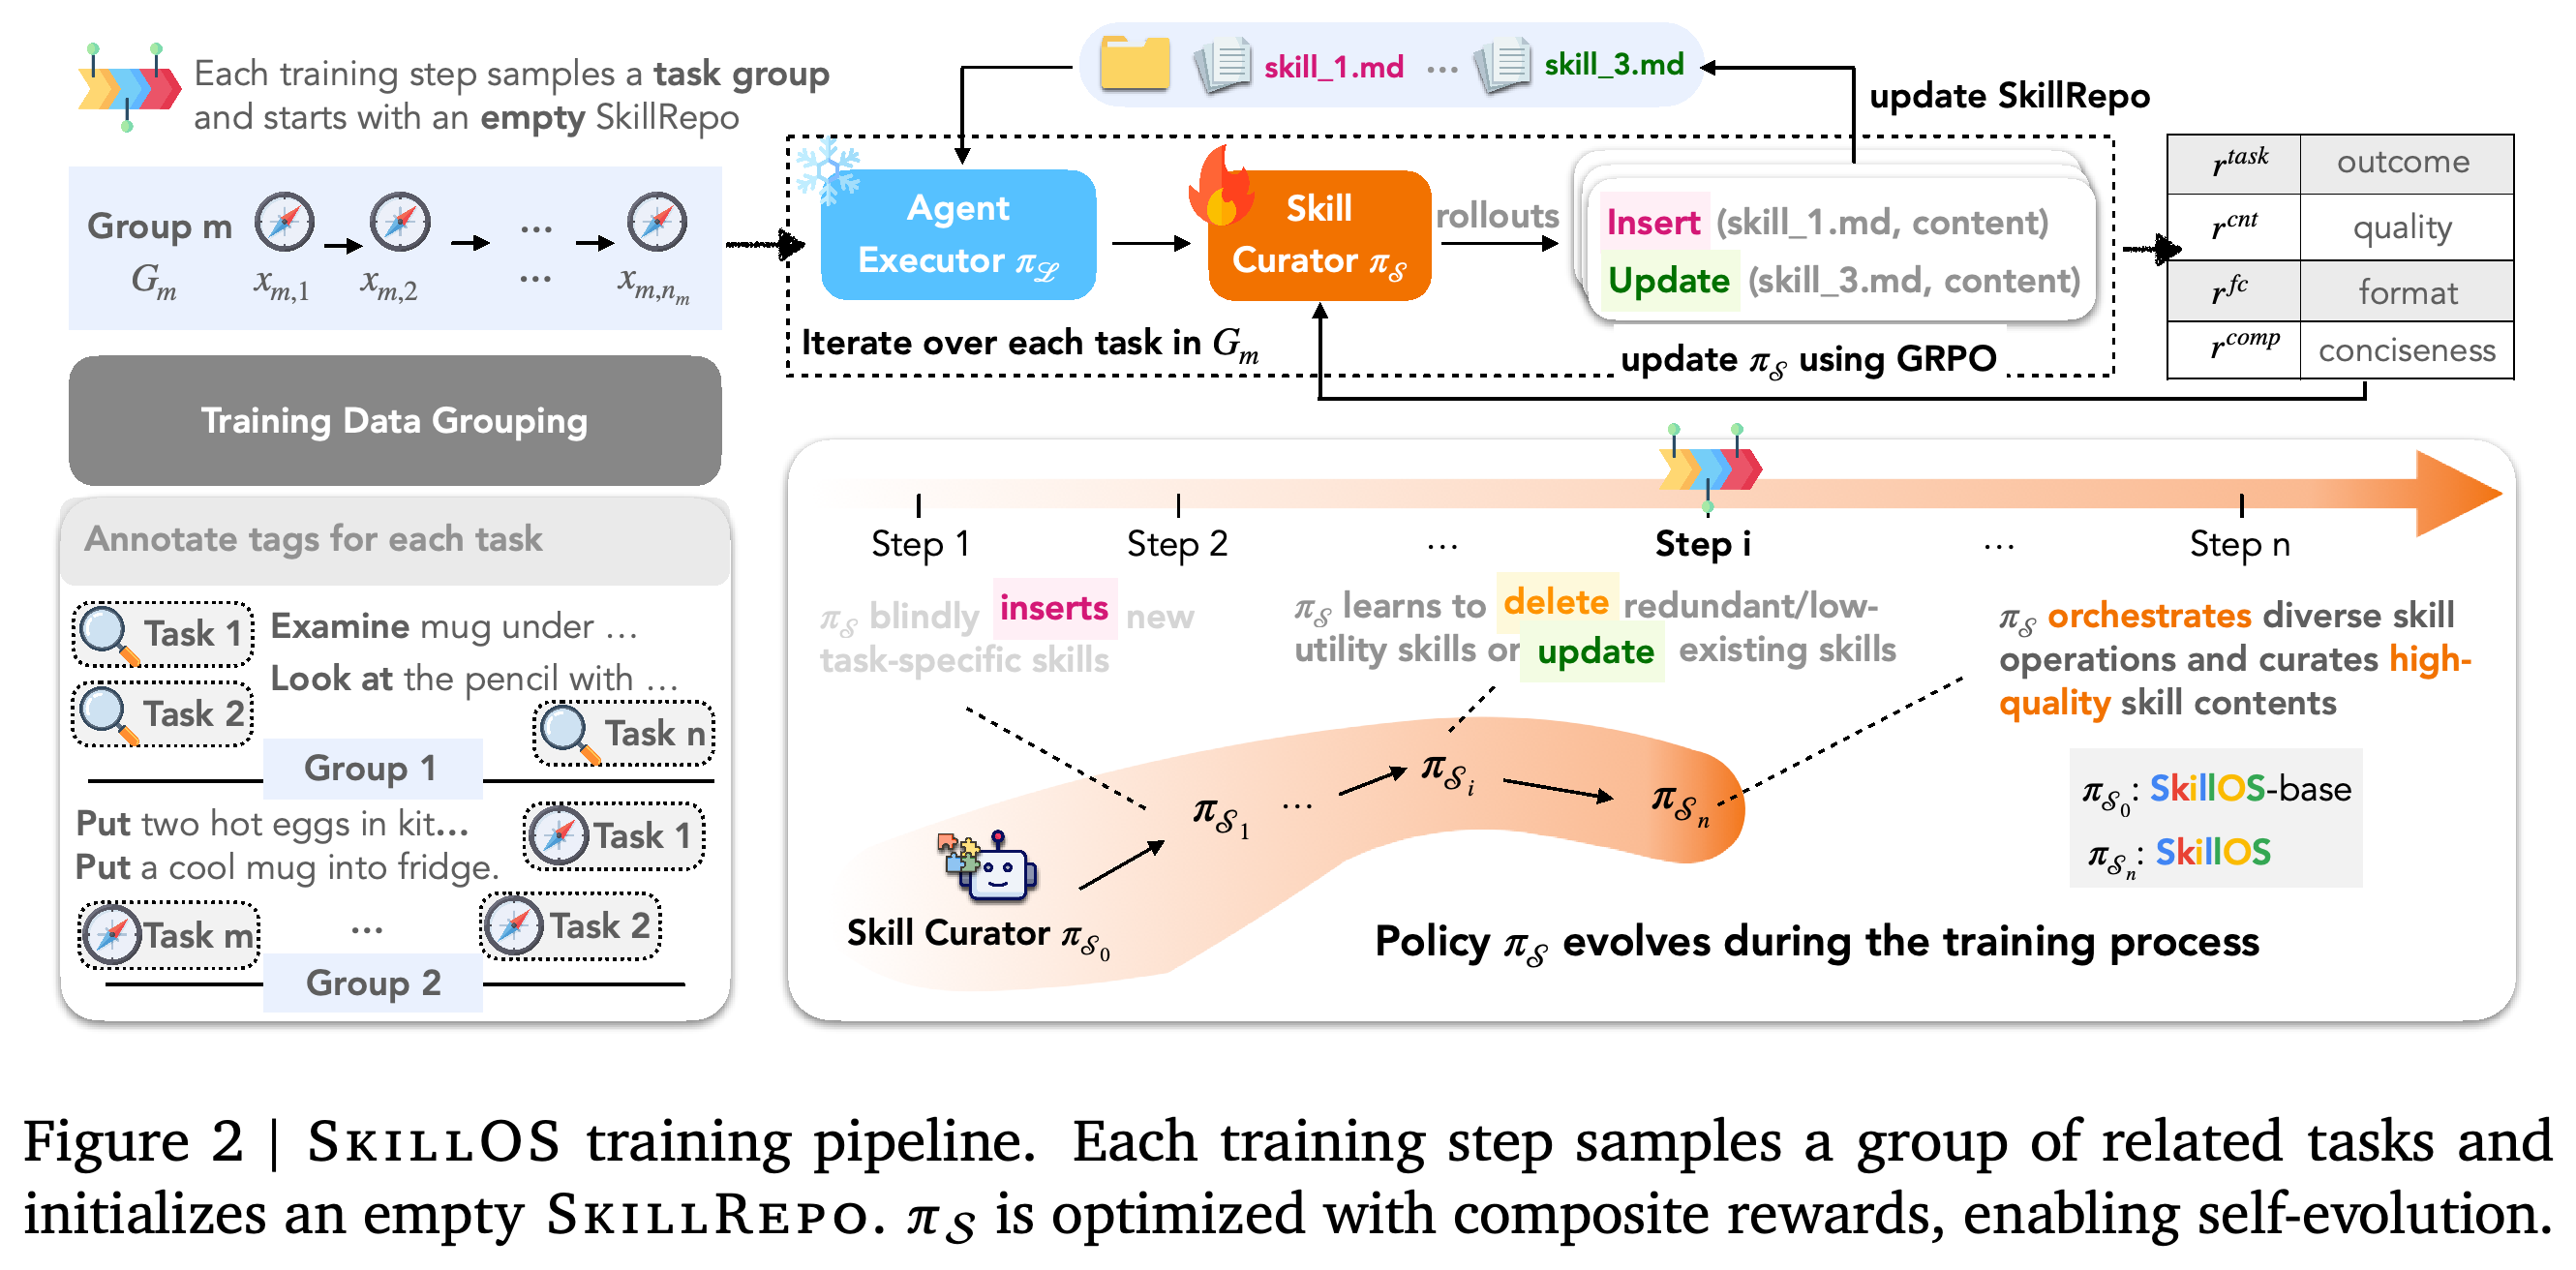
3.2.1. Training Instance Construction에서는 스킬이 서로 관련된 작업들을 순차적으로 묶어 학습 인스턴스를 구성한다. 각 rollout은 빈 SkillRepo에서 시작한다. 앞선 작업의 실행 궤적으로 저장소를 갱신하고, 이후 작업으로 갱신 내용이 유용한지 평가한다.
- 추론 문제에는 Gemini-2.5-Pro가 주제, 역량, 개념, 전략, 함정을 주석으로 부여한다. 이후 의미적 유사도와 의존성 필터로 그룹을 구성한다.
- ALFWorld와 WebShop 실험에서는 추론 문제에 사용하는 전체 주석 파이프라인 대신 기본 작업 유형 주석을 사용한다.
- 그룹 구성은 메모리를 1번 갱신한 직후의 전이만 평가하는 대신, 스킬을 반복해서 재사용하고 개선할 기회를 만든다.
3.2.2. Training Loop and Policy Optimization에서는 복합 보상 r = r^task + λ_f r^fc + λ_u r^cnt + λ_c r^comp를 사용한다. 계수는 λ_f = 1.0, λ_u = 0.1, λ_c = 0.05다.
- 작업 결과 보상은 작업 2부터 |G|까지의 성공률을 평균한다. 첫 작업은 큐레이터가 저장소를 갱신하기 전에 실행되므로 제외한다. 정답 신호는 최종 벤치마크 채점 절차가 아니라, 고정된 실행기 백본을 사용하는 LLM judge로 얻는다.
- 함수 호출 보상은 유효하고 성공적으로 실행된 연산의 비율을 평균한다. 콘텐츠 품질 보상은 생성된 스킬이 의미 있고 재사용 가능한지를 Qwen3-32B로 평가한다.
-
압축 보상은 (1-\frac{ \mathcal{S}_i }{ \chi_i })를 평균한다. 분자는 갱신 후 저장소의 토큰 길이이고, 분모는 큐레이터 입력 컨텍스트의 토큰 길이다. 이 보상은 실행 궤적 전체를 메모리에 복사하는 행동을 억제한다.
학습 시 각 작업 그룹에서 완전한 큐레이션 rollout을 여러 개 샘플링한다. 각 rollout에서는 저장소와 실행기 궤적이 독립적으로 변화한다. GRPO는 각 rollout의 보상에서 샘플링한 rollout들의 평균 보상을 뺀 값을 advantage로 사용하고, 클리핑된 중요도 비율 목적함수를 적용한다.
- 동일한 시퀀스 수준 advantage를 생성된 모든 큐레이션 토큰에 균일하게 부여한다. 따라서 보조 보상은 감독 신호를 추가하지만, 개별 연산에 대한 인과적 기여도는 제공하지 않는다.
- 본문은 탐색을 장려하기 위해 KL 항을 제거한다고 설명하지만, Table 4에는 KL 손실 계수가 0.001로 기재되어 있다.
각 rollout은 빈 저장소에서 시작해 관련 작업 그룹을 처리하므로, 앞선 수정이 이후 실행에 영향을 줄 수 있다. 4개 보상 신호가 큐레이터에 감독 신호를 제공한다. 아래 도식은 더 다양한 관리 연산으로 발전하려는 의도를 나타내며, 모든 연산을 숙달했다는 측정 근거는 아니다.
4. Experiments
실험은 멀티턴 상호작용과 싱글턴 추론을 다루고, 이어서 실행기 백본과 작업 도메인 간 전이를 평가한다. 작업 성능과 실행기의 행동 효율을 구분해 평가한다.
4.1. Setup
에이전트 평가는 ALFWorld의 가사 작업과 WebShop의 쇼핑 지시를 사용한다. 추론 평가는 AIME24, AIME25, GPQA-Diamond를 사용한다. 추론 학습에는 DeepMath-103k에서 샘플링한 33,000개 문제를 사용하고, 에이전트 학습에는 각 벤치마크의 학습 분할을 사용한다.
- 큐레이터와 고정된 학습용 실행기는 모두 Qwen3-8B다. GRPO는 학습률 1 × 10⁻⁶, 배치 크기 32, 그룹당 샘플링한 rollout 8개를 사용한다.
- 학습은 H100 GPU 16개에서 verl로 수행한다. ALFWorld는 약 3일, 추론은 약 2.5일, WebShop은 약 5일이 걸린다.
- 추론 시 상위 5개 스킬을 검색하고, 에이전트 작업에는 30턴을 허용하며, 최근 상호작용 3단계를 유지한다. 에이전트 실행에는 ReAct를, 추론에는 CoT를 사용한다.
- 비교 대상은 No Memory, ReasoningBank, MemP, 학습하지 않은 SkillOS-base, Gemini-2.5-Pro 기반 SkillOS-gemini다. 보고된 평균과 표준편차는 3회 실행에서 얻는다.
4.2. Main Results
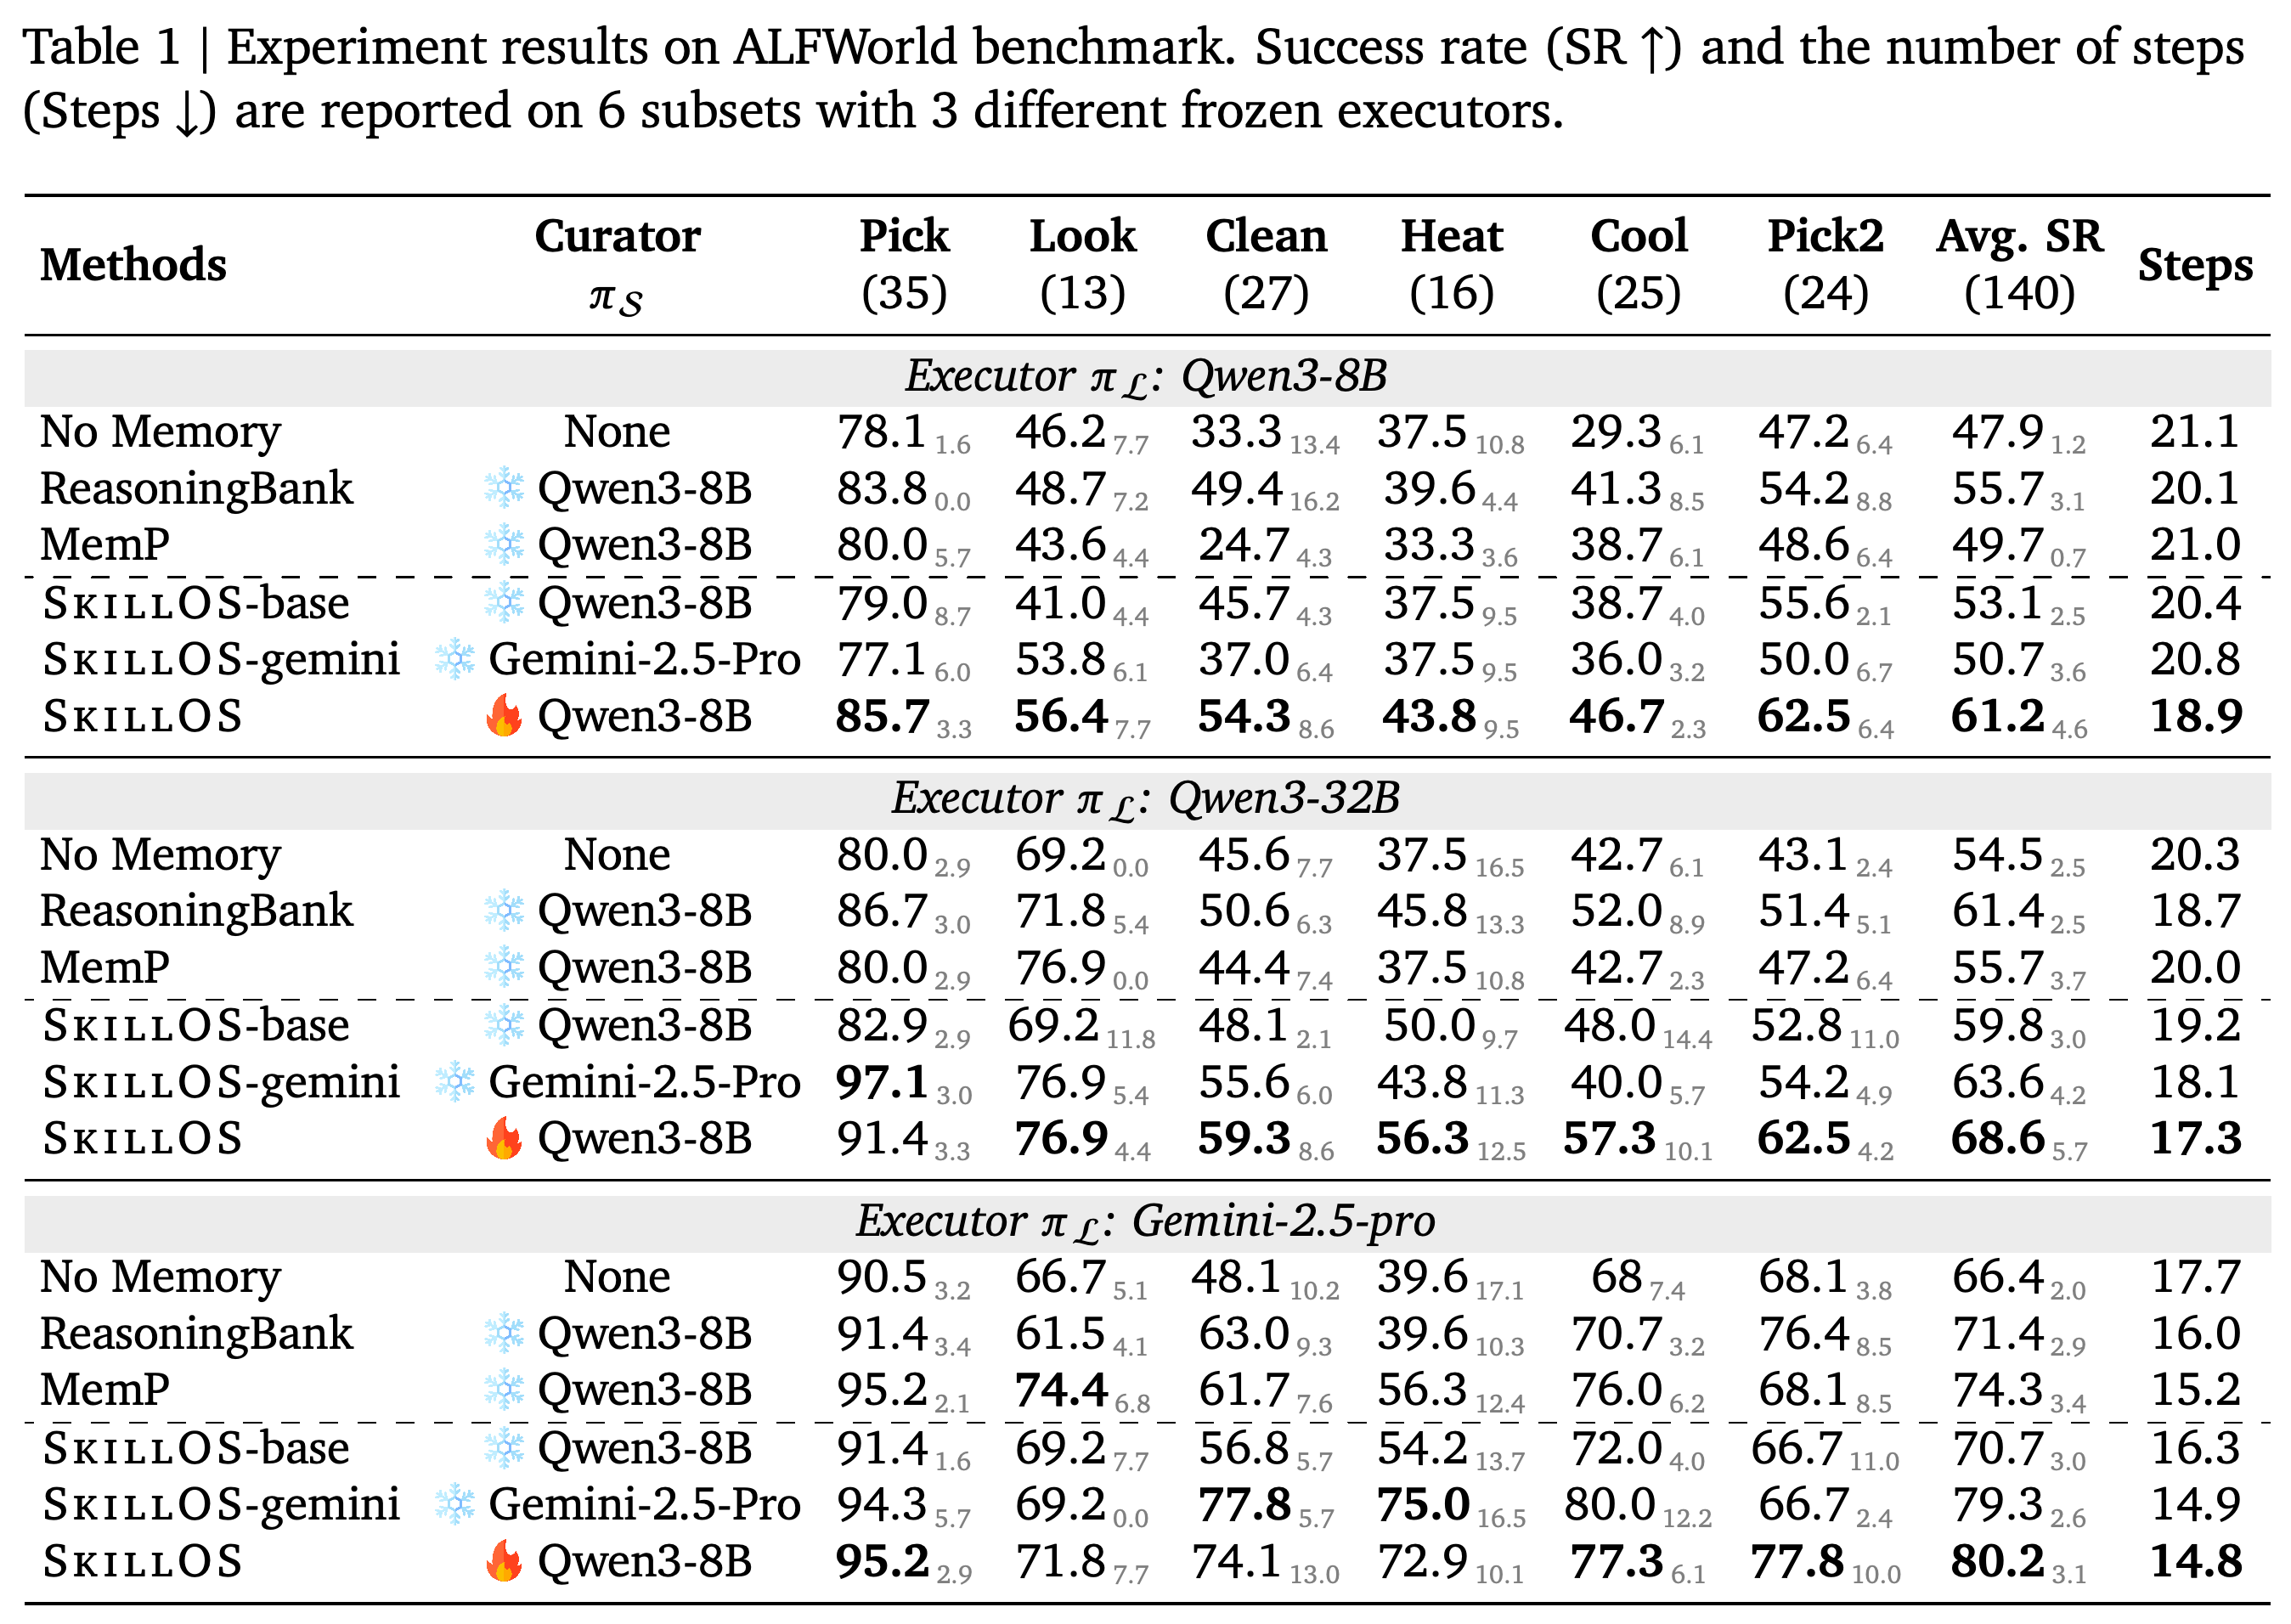
ALFWorld에서 학습한 큐레이터는 주요 실행기 3개 모두에서 가장 높은 평균 성공률을 기록한다. Qwen3-8B에서는 61.2 ± 4.6%, Qwen3-32B에서는 68.6 ± 5.7%, Gemini-2.5-Pro에서는 80.2 ± 3.1%다. 각 실행기의 SkillOS-base 결과는 53.1%, 59.8%, 70.7%다. 동일한 저장소 인터페이스에서 큐레이터 학습이 효과적임을 뒷받침한다.
- Qwen3-8B에서 ReasoningBank는 성공률 55.7%, 행동 수 20.1을 기록한다. SkillOS는 61.2%, 행동 수 18.9를 기록한다.
- SkillOS-gemini는 실행기 3개에서 각각 50.7%, 63.6%, 79.3%를 기록한다. 학습한 8B 큐레이터는 종합 지표에서 직접 Gemini-2.5-Pro로 큐레이션하는 방식보다 높지만, 모든 실행기 블록의 모든 작업 하위 집합에서 우세하지는 않다.
- 여러 설정에서 실행 간 변동이 상당히 크다. 논문은 유의성 검정을 보고하지 않는다.
실행기 블록 3개 모두에서 SkillOS가 가장 높은 평균 ALFWorld 성공률과 가장 적은 행동 수를 기록한다. 범주별 결과를 보면 이러한 종합적 우세가 모든 하위 집합의 우세를 뜻하지는 않는다. 여러 설정에서 실행 간 변동도 상당히 크다.
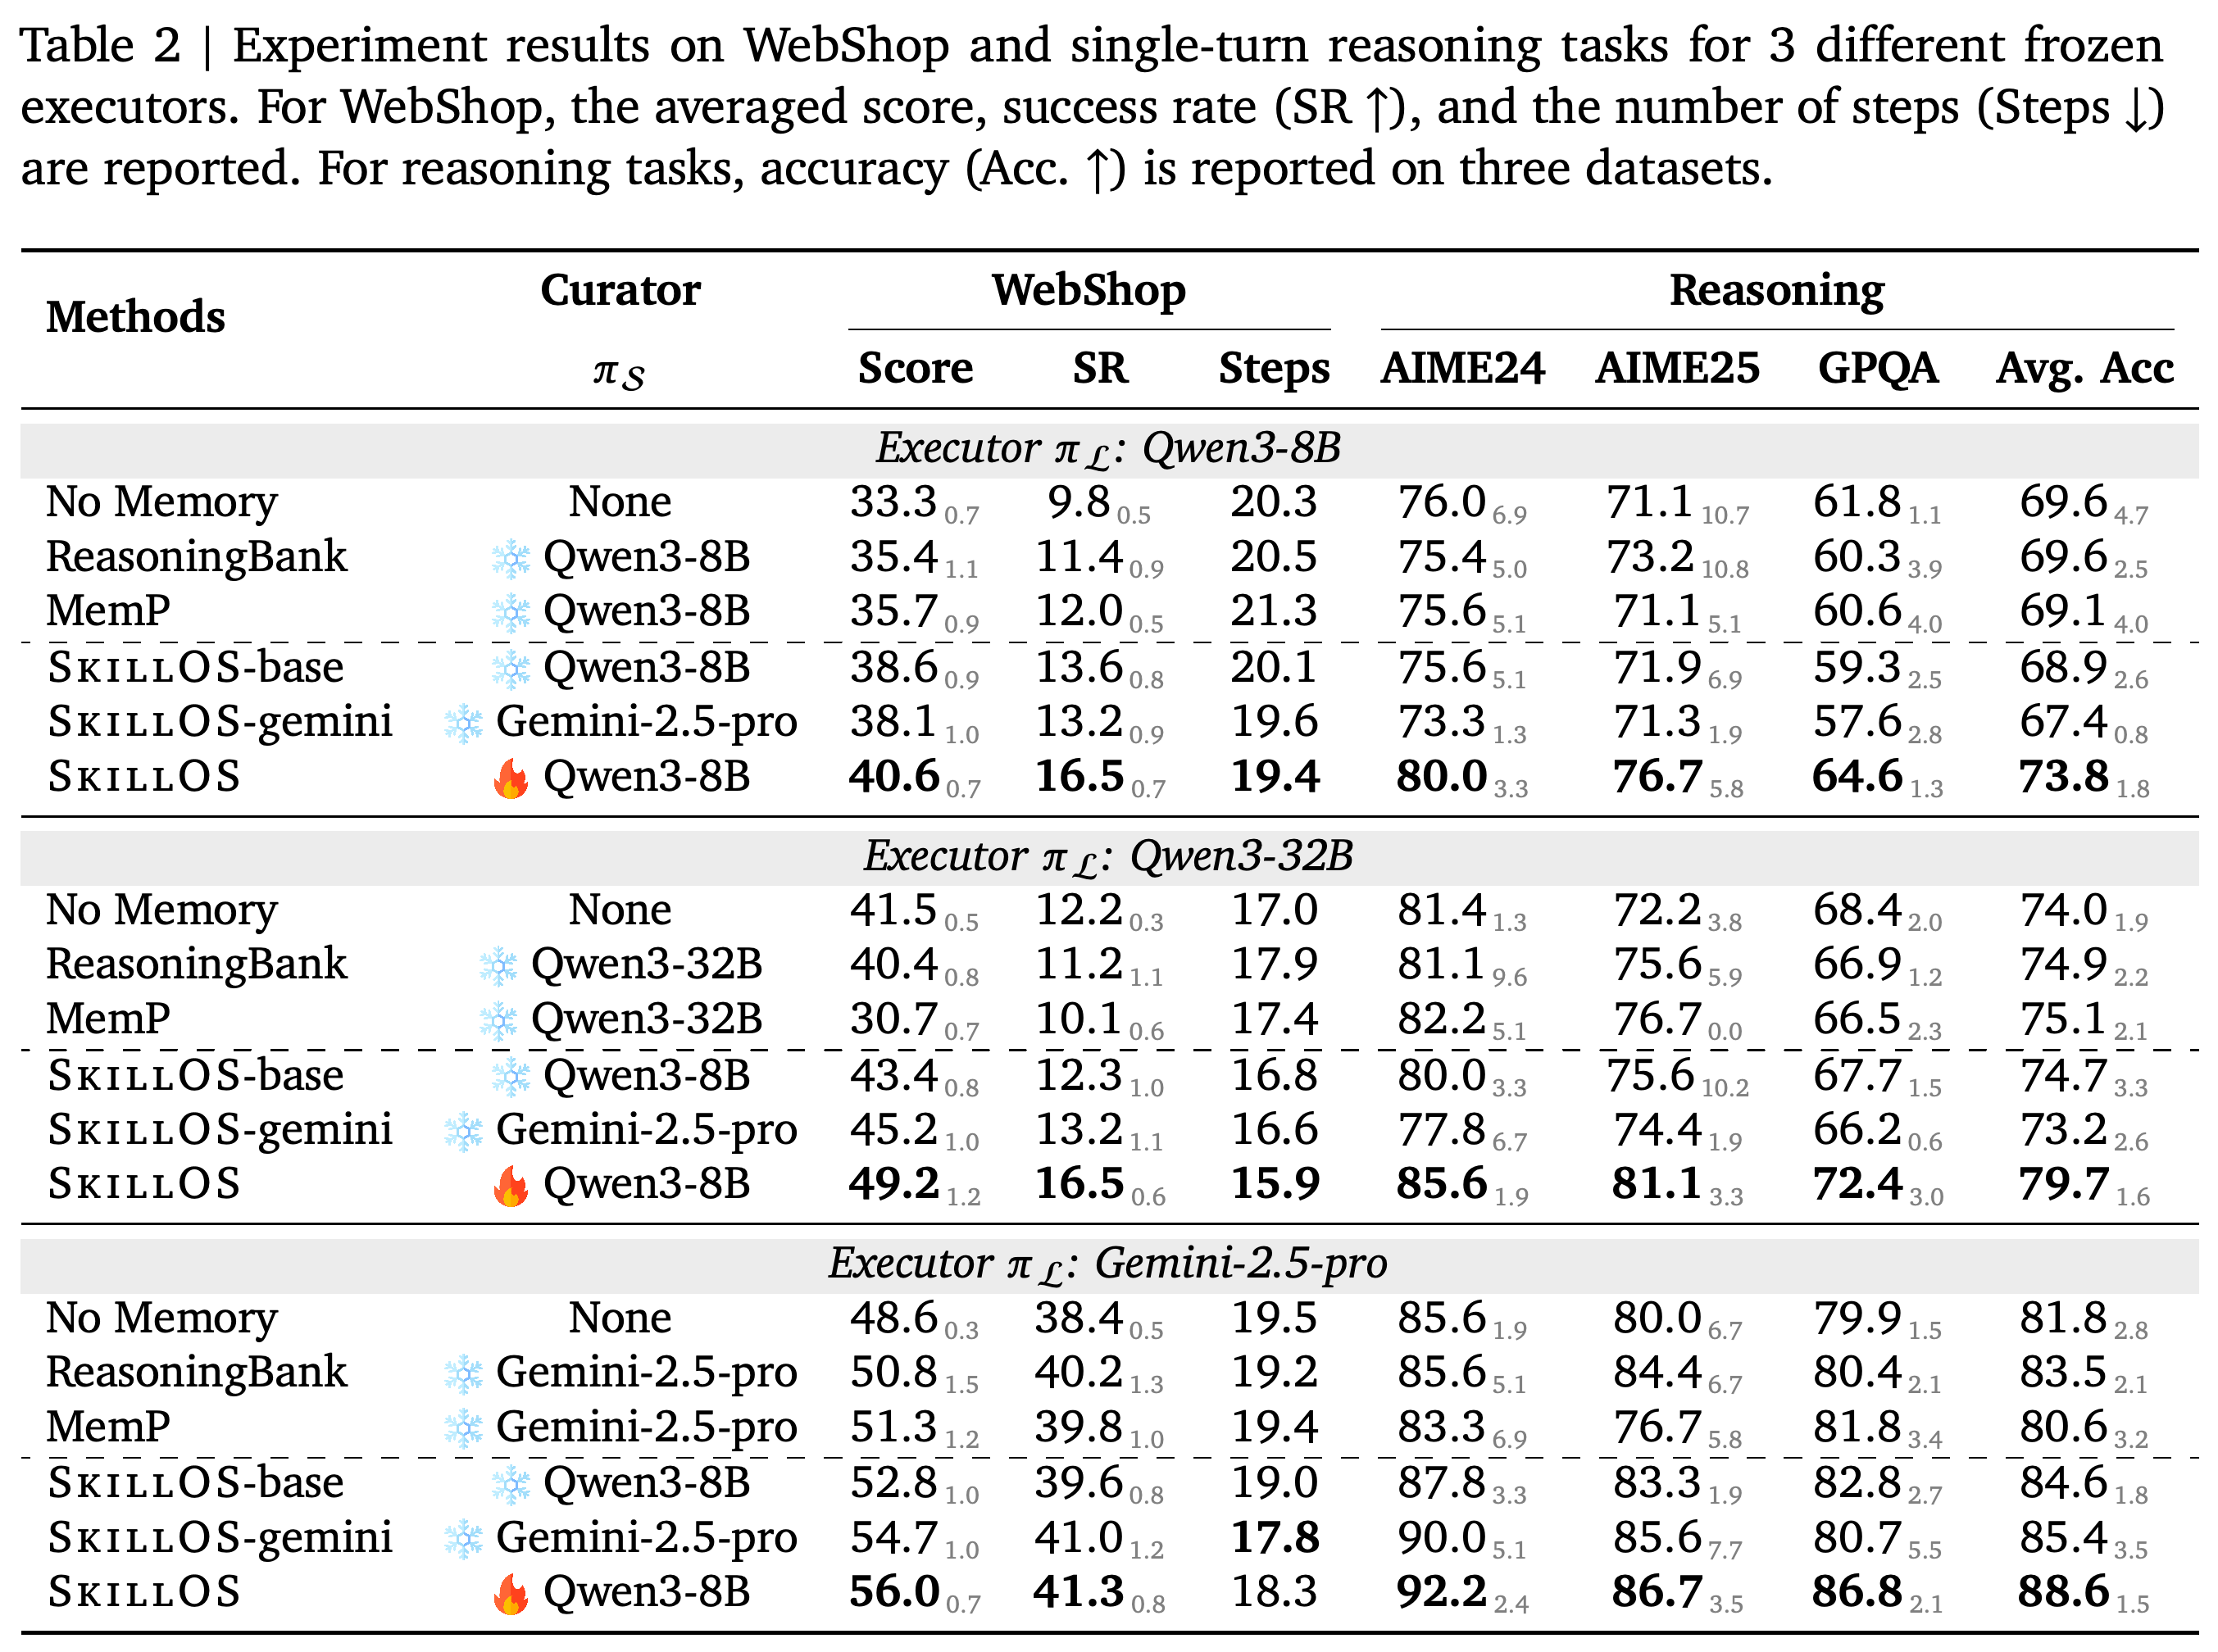
WebShop에서 SkillOS는 Qwen3-8B, Qwen3-32B, Gemini-2.5-Pro를 사용할 때 각각 점수 40.6, 49.2, 56.0을 기록한다. 성공률은 16.5%, 16.5%, 41.3%다. AIME24, AIME25, GPQA-Diamond의 평균 추론 정확도는 No Memory의 69.6%, 74.0%, 81.8%에서 73.8%, 79.7%, 88.6%로 높아진다.
- Gemini-2.5-Pro를 실행기로 사용하면 SkillOS는 AIME24에서 92.2%, AIME25에서 86.7%, GPQA-Diamond에서 86.8%를 달성한다.
- 학습하지 않은 메모리 설정이나 휴리스틱 기반 메모리 설정 중 일부는 No Memory보다 성능이 낮다. 경험을 보존하는 것만으로 개선을 보장하지는 않는다.
- 베이스라인 큐레이터의 백본은 표마다 다르다. ALFWorld에서는 모든 실행기 블록의 ReasoningBank와 MemP에 Qwen3-8B를 사용하지만, WebShop과 추론에서는 해당 실행기의 백본을 사용한다.
ALFWorld의 행동 수는 실행기 3개에서 No Memory 대비 각각 21.1에서 18.9로, 20.3에서 17.3으로, 17.7에서 14.8로 줄어든다. WebShop에서도 No Memory보다 적은 행동을 사용한다. 다만 Gemini-2.5-Pro 실행기에서는 SkillOS-gemini가 행동 수 17.8로, SkillOS의 18.3보다 효율적이다.
- 저자들은 에이전트 작업에서 개선 폭이 더 큰 이유가 재사용 가능한 행동 순서, 탐색, 복구 절차, 환경 제약에 있다고 추측한다. 반면 추론 스킬은 더 추상적인 분해와 검증 전략을 담는다.
- 정성적 예시는 이 설명을 보여주지만, 해당 메커니즘을 실험적으로 분리해 검증하지는 않는다.
- 실험 설정은 추론 토큰 수를 효율 지표로 제시하지만, Table 2는 토큰 수 대신 추론 정확도를 보고한다. 행동 수 비교에는 큐레이터 추론, 판정, 학습 비용이 포함되지 않는다.
학습한 큐레이터는 실행기 3개 모두에서 WebShop 성능과 평균 추론 정확도를 높인다. 행동 효율은 항상 가장 높지는 않다. Gemini-2.5-Pro의 WebShop 블록에서 SkillOS-gemini의 행동 수는 17.8이고, SkillOS는 18.3이다. 추론 토큰 효율은 이 표에서 보고하지 않는다.
4.3. Generalization of SkillOS
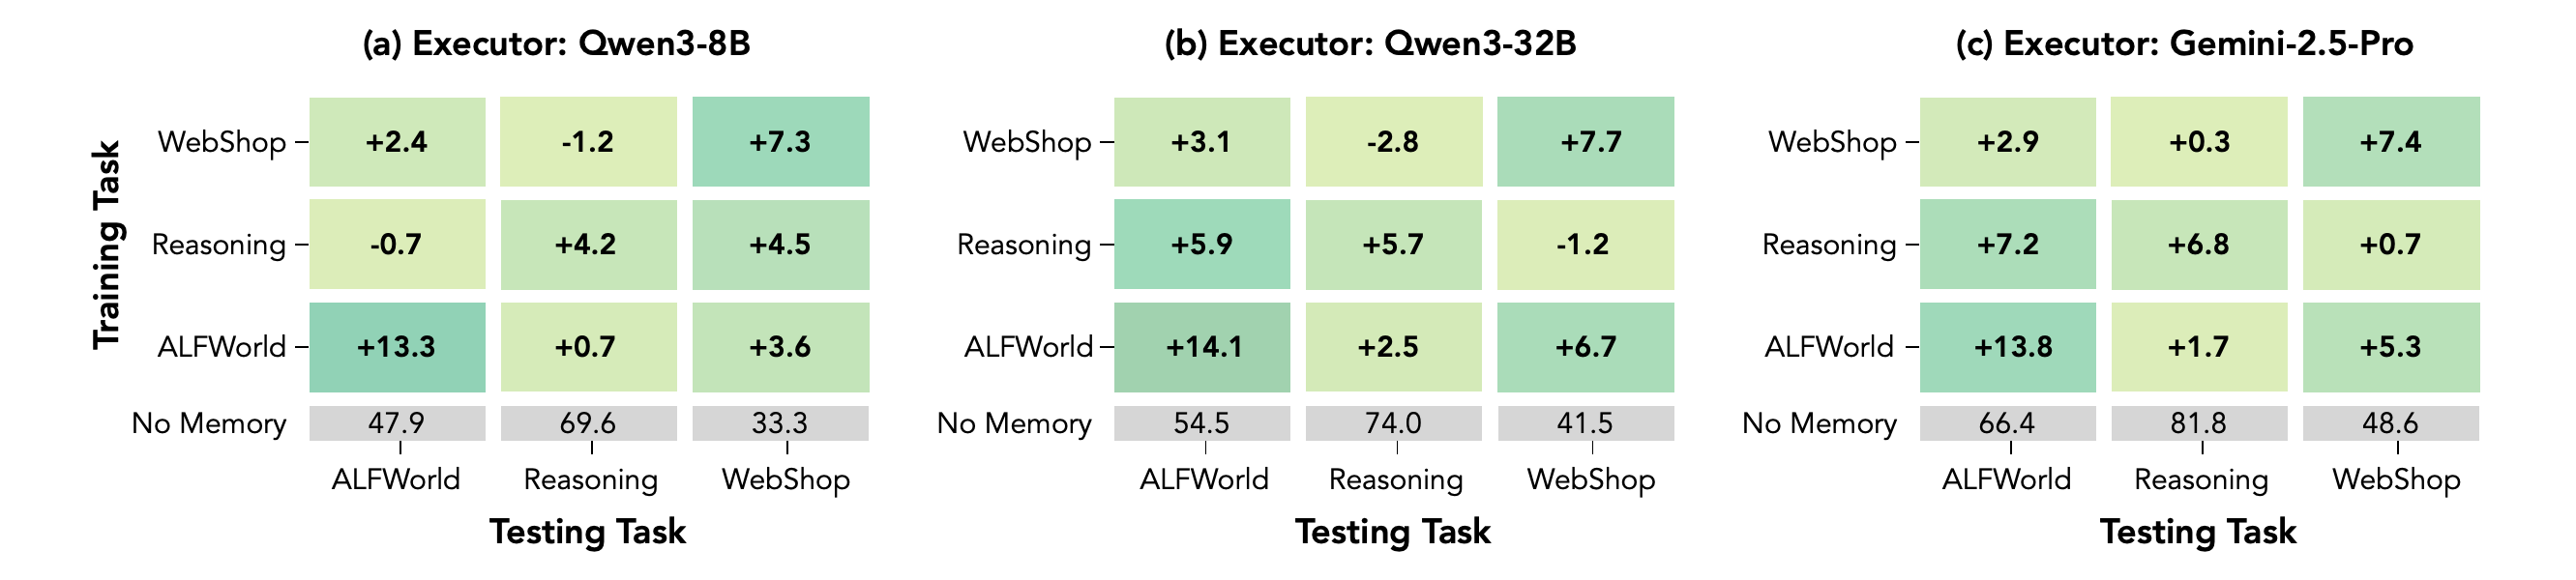
Qwen3-8B 실행기와 함께 학습한 큐레이터는 Qwen3-32B와 Gemini-2.5-Pro 실행기를 재학습하지 않고도 전이된다. ALFWorld에서 Gemini-2.5-Pro의 성공률을 메모리가 없을 때의 66.4%에서 80.2%로 높여, 더 강한 백본에도 유용하게 전이됨을 보여준다.
- 저자들은 직접 Gemini-2.5-Pro로 큐레이션했을 때, 특히 작은 실행기에서 결과가 더 낮은 현상을 큐레이터–실행기 불일치 가능성으로 해석한다.
- 실험은 이 불일치를 독립적으로 측정하거나, 생성된 스킬 콘텐츠의 다른 차이와 분리하지 않는다.
도메인 간 실험은 소스 도메인의 고정된 스킬 모음만 옮기는 것이 아니라, 학습한 큐레이터를 전이한다. 대부분의 조합은 No Memory보다 성능이 높지만, 히트맵에는 음수 항목도 있다. 따라서 전이가 항상 이롭지는 않다.
- Gemini-2.5-Pro에서는 추론으로 학습한 큐레이터가 ALFWorld를 7.2포인트, WebShop 점수를 0.7 높인다. 반면 Qwen3-32B에서는 추론에서 WebShop으로 전이하면 점수가 1.2 낮아진다.
- WebShop에서 추론으로 전이하면 Qwen3-8B, Qwen3-32B, Gemini-2.5-Pro의 정확도가 각각 −1.2, −2.8, +0.3포인트 변한다.
- 캡션은 이 변화를 상대적 개선이라고 부르지만, 표시된 값은 백분율로 정규화한 증가율이 아니라 베이스라인 지표와의 절대 차이다.
행은 큐레이터의 학습 도메인, 열은 평가 도메인을 나타낸다. 대각선 밖의 변화는 대부분 양수지만, Qwen3-32B의 WebShop에서 추론으로의 전이가 −2.8인 사례처럼 음수 항목도 있다. 학습한 큐레이션이 모든 조합에서 유익하게 전이되지는 않는다.
5. Analysis
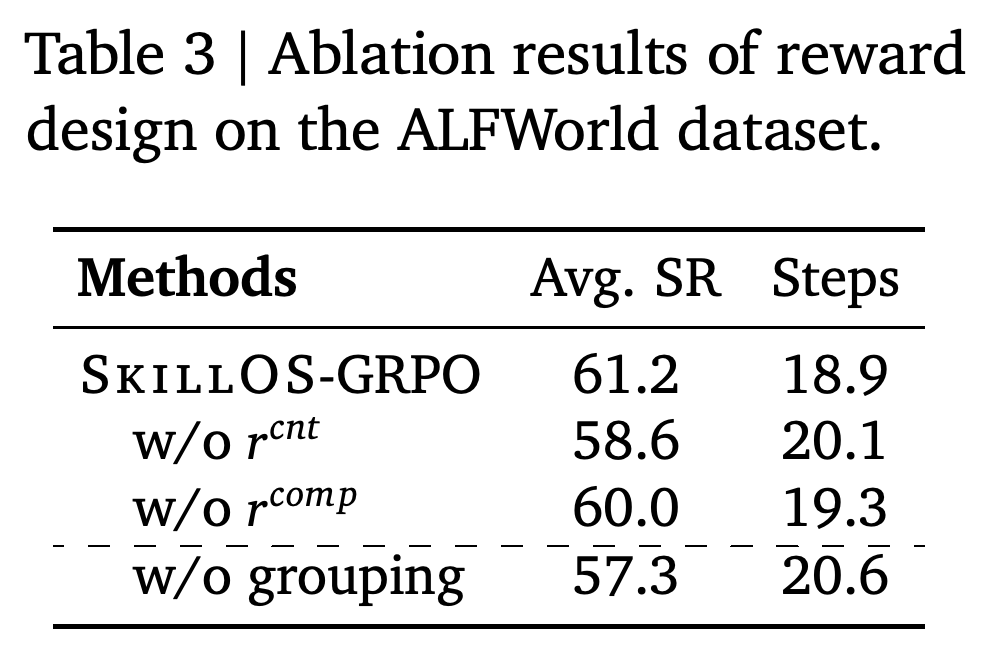
ALFWorld 절제 실험은 큐레이터와 실행기에 모두 Qwen3-8B를 사용한다. 콘텐츠 품질 보상을 제거하면 성공률이 61.2%에서 58.6%로 낮아지고, 압축 보상을 제거하면 60.0%로 낮아진다. 그룹화한 스트림을 무작위 시퀀스로 바꾸면 57.3%로 낮아진다.
- 평균 행동 수도 18.9에서 각각 20.1, 19.3, 20.6으로 늘어난다.
- 이 절제 실험 중 그룹화를 제거했을 때 성능 저하가 가장 크다. 관련된 미래 작업을 큐레이션의 감독 신호로 사용하는 방식을 뒷받침한다.
- Table 3은 작업 결과 보상이나 함수 호출 보상을 제거한 실험을 다루지 않으며, 절제 설정의 표준편차도 제공하지 않는다.
작업 그룹화를 제거하면 테스트한 절제 설정 중 성공률이 가장 크게 떨어져 61.2에서 57.3이 된다. 콘텐츠 품질 보상이나 압축 보상을 제거해도 성공률이 낮아지고 행동 수가 늘어난다. 이는 해당 설계 선택을 뒷받침하지만, 모든 보상 요소의 기여를 입증하지는 않는다.
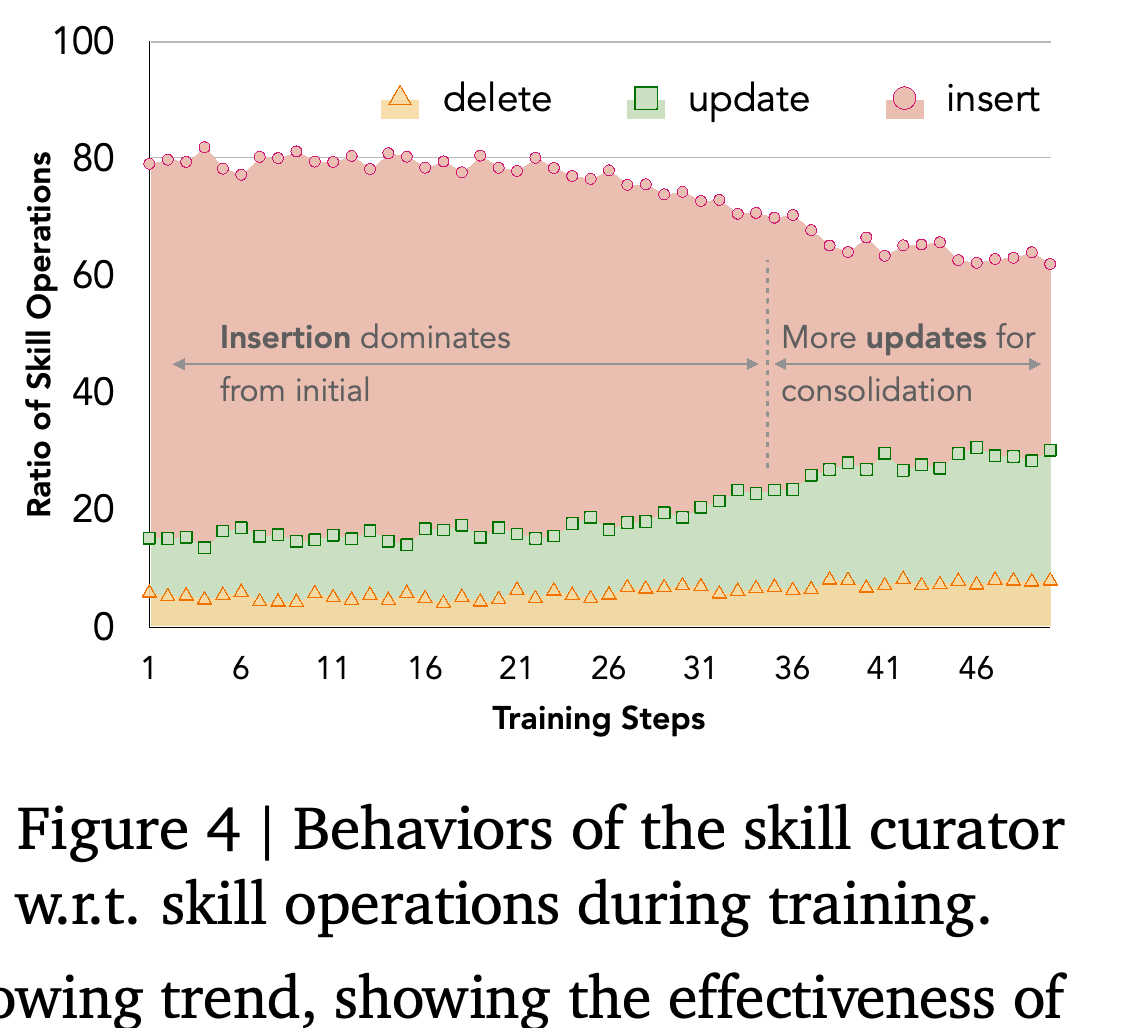
학습이 진행되면서 연산 분포는 삽입 위주에서 수정이 더 잦은 방향으로 바뀐다. 삭제 비율은 계속 낮게 유지된다. 따라서 기존 스킬을 통합하고 개선하는 행동이 가장 뚜렷한 변화다.
- 연산 빈도는 관리 행동의 변화를 보여주지만, 개별 수정이나 삭제가 미래 결과를 개선하는지는 입증하지 않는다.
- 삭제 비율이 낮아 장기 큐레이션의 주요 역량으로 삭제를 학습했다는 근거는 제한적이다.
학습이 진행되면서 삽입은 줄고 수정은 더 잦아져, 기존 항목을 개선하는 방향으로 행동이 바뀐다. 삭제는 계속 드물다. 따라서 이 그래프는 광범위한 망각을 학습했다는 근거보다 기존 스킬 통합의 근거를 더 강하게 제공한다.
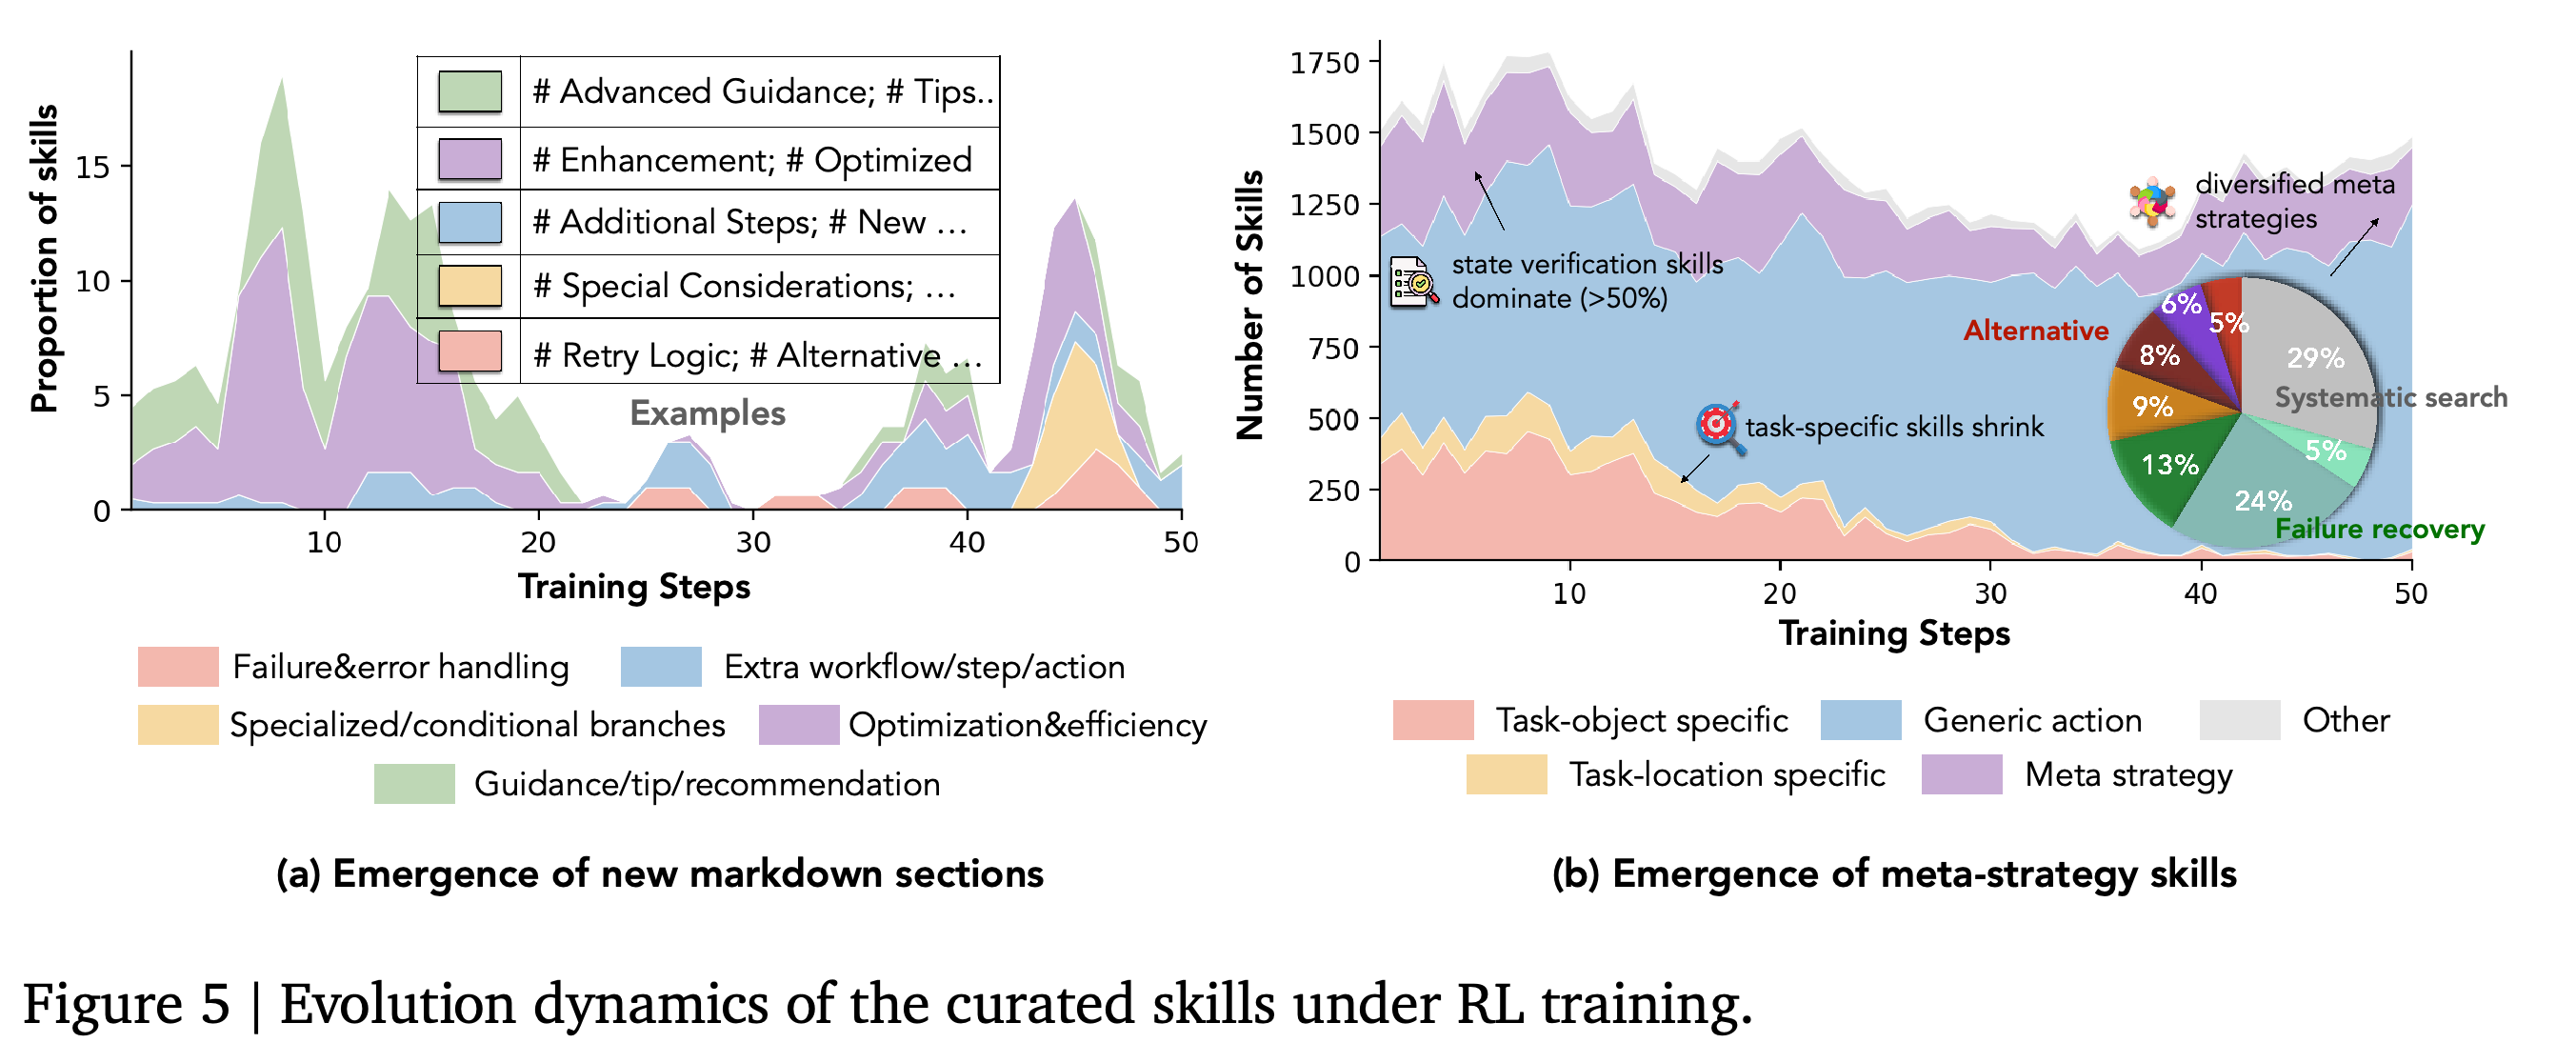
저장소 분석은 새로운 Markdown 섹션과 스킬 범주의 변화를 추적한다. 초기에 추가되는 섹션은 일반적인 지침에 집중하고, 후기에는 실패 처리와 조건부 분기가 더 자주 포함된다. 작업별 스킬은 줄어들고, 저장소에는 검증·탐색·복구·조정을 위한 더 폭넓은 전략이 담긴다.
- 이 관찰은 학습이 저장된 절차의 양뿐 아니라 구조도 바꾼다는 점을 시사한다.
- Figure 5에서는 초기에도 상태 검증 스킬이 지배적이다. 따라서 범주 변화 추세를 좁은 작업별 스킬만 있던 저장소가 확장되는 과정으로 단순화해서는 안 된다.
- 이 분석은 관찰한 변화를 서술한다. 새로 생긴 특정 섹션이나 메타 스킬이 후속 작업에 기여하는 정도를 분리해 검증하지 않는다.
왼쪽 패널은 새로 도입된 섹션 유형을 포함하는 스킬의 비율을 추적한다. 후기에는 조건부 분기와 실패 처리 등이 추가된다. 오른쪽 패널은 범주별 개수를 추적하며, 작업별 콘텐츠가 줄고 전략이 다양해짐을 보여준다. 초기부터 상태 검증이 지배적이라는 점을 고려하면, 본문처럼 작업별 스킬에서 메타 스킬로 바뀌는 단순한 과정으로 설명하기는 어렵다.
ALFWorld에서 SkillOS는 SkillOS-base 대비 명시적 스킬 사용률을 87.9%에서 100.0%로, 스킬을 사용한 사례의 성공률을 53.6%에서 61.2%로, 저장소 커버리지를 72.9%에서 88.6%로 높인다. 사례당 평균 사용 스킬 수는 2.24에서 1.95로 줄어든다.
- 저장소 커버리지가 넓어지는 동시에 사례당 사용 스킬 수가 줄어드는 결과는 더 선별적인 사용과 부합한다.
- 이 통계는 스킬 사용과 성공 사이의 연관성을 보여준다. 검색한 개별 스킬을 제거하거나 교체해 결과의 인과적 원인을 규명하지는 않는다.
6. Conclusion
결론은 실행기의 결과를 바탕으로 학습하는 모듈형 큐레이션을 핵심 기여로 제시한다. 작은 큐레이터를 학습해 변화하는 절차적 저장소로 고정된 실행기를 개선한다. 그룹화한 스트림과 복합 보상은 이 정책의 감독 신호를 제공하며, 평가한 벤치마크와 여러 실행기 백본에서 효과를 보인다.
부록
- A. Prompts는 시스템 템플릿을 설명한다. A.1. Prompt for Skill Curator는 작업, 기존 스킬, 실행 궤적, 결과를 제공하고, name과 description을 frontmatter에 담은 원자적이고 재사용 가능한 Markdown 스킬을 요청한다. A.2. Prompt for Agent Executor는 에이전트 작업에 검색한 스킬과 최근 상호작용 컨텍스트를 제공하고, 추론 작업에는 문제와 검색한 스킬을 제공한다. 두 작업 유형 모두 단계별 추론을 명시적으로 지시한다.
- A.3. Prompt Used During Training은 Qwen3-32B 콘텐츠 judge에 추상화 수준, 재사용성, 실행 가능성, 실행 궤적에 대한 충실도를 평가하도록 요청한다. A.4. Prompt for LLM-as-a-Judge to Obtain Correctness Signals는 해당 고정 실행기로 실행 궤적이나 풀이를 평가한다. WebShop judge는 score >= 0.5를 성공으로 정의하지만, 최종 벤치마크의 성공 판정은 환경 보상이 정확히 1이어야 한다.
- B. Implementation Details와 B.1. Hyperparameters는 최대 프롬프트 길이와 응답 길이를 각각 16,384와 4,096, temperature를 1.0으로 명시한다. 학습 스텝은 ALFWorld, WebShop, 추론에 각각 60, 50, 100이다. 작업 스트림의 그룹 크기는 각 에이전트 벤치마크에서 10, 추론에서는 Random(5,12)이며, GRPO rollout 그룹 크기 8과는 다르다. Table 4에는 본문 설명과 모순되는 KL 계수 0.001도 기재되어 있다.
- B.2. Grouping Training Instances는 B.2.1. Stage 1: Latent Attribute Annotation을 통해 추론 문제를 주제, 스킬, 개념, 휴리스틱 전략, 함정의 5개 차원으로 기술한다. Gemini-2.5-Pro는 구조화된 디코딩으로 표준화된 짧은 구절을 생성한다. B.2.2. Stage 2: Group Construction은 all-MiniLM-L6-v2와 soft-Jaccard 유사도로 이 구절들을 매칭한다. 이후 공통 개념과 스킬, 공통 전략 또는 함정, 비중복성, 새로운 개념 또는 스킬, 감소하지 않는 난이도를 요구한다.
- 그룹 구성 파이프라인은 코사인 임계값 0.60, 매칭된 개념 쌍 최소 1개와 스킬 쌍 최소 1개, 주제 soft-Jaccard 최댓값 0.65, 전체 유사도 범위 0.30~0.85를 사용한다. 개념, 스킬, 전략, 함정, 주제의 차원별 가중치는 (5, 4, 3, 1, 2)다. 커리큘럼 확률은 (0.80, 0.20, 0.00)이고, easy→hard 난이도 차이는 [0.5, 3.0], 동일 모드의 최대 난이도 차이는 0.3이다. 후보는 최대 2,000개로 제한한 의존성 구절 역색인에서 가져오거나, 대체 후보 풀 200개에서 가져온다. 조건을 만족하는 후속 작업은 가중 유사도에 가중치 1.0의 난이도 보너스를 더해 순위를 정한다. 가중치는 학습에서 제외한 소스 작업 200개에 대해 샘플링한 작업 쌍을 검토해 조정했다.
- B.3. Experiment Setup은 B.3.1. Datasets, B.3.2. Baselines, B.3.3. Evaluation Metrics를 상세히 설명한다. ALFWorld는 학습 작업 3,553개와 valid_seen 평가 작업 140개를 사용한다. WebShop은 학습 지시 10,587개와 테스트 지시 500개를 사용한다. AIME24와 AIME25는 각각 문제 30개, GPQA-Diamond는 198개를 포함한다. 베이스라인은 메모리 없이 독립적으로 실행하는 방식, ReasoningBank의 추출된 통찰, MemP의 휴리스틱 절차적 메모리 관리, 동일한 SkillOS 인터페이스에서 학습하지 않은 Qwen3-8B 큐레이터나 직접 Gemini-2.5-Pro로 큐레이션하는 방식을 포괄한다.
- 추론 전처리는 주석이 부여된 약 33,000개 문제에서 시작하며, 최종적으로 그룹화한 학습 인스턴스 20,000개를 보고한다. 평가는 에이전트 작업의 환경 성공 여부, 부분 일치 기반 WebShop 점수, 성공 및 실패 에피소드 전체의 평균 행동 수, https://github.com/huggingface/Math-Verify를 통한 AIME 수학적 동치 검증, GPQA의 선택지 완전 일치를 사용한다. 부록은 ALFWorld Avg. SR을 6개 범주의 매크로 평균으로 정의하지만, 표에 표시된 값은 작업 수로 가중한 평균에 해당한다. 예를 들어 Qwen3-8B No Memory의 범주별 성공률을 비가중 평균하면 보고된 47.9%가 아니라 약 45.3%다.
- C. Additional Analyses에는 C.1. Results on Gemini-3.1-Flash-Lite가 포함된다. SkillOS는 ALFWorld 성공률 73.1 ± 2.7%, 행동 수 15.5를 기록한다. ReasoningBank는 66.0 ± 2.7%, 행동 수 17.6이고, No Memory는 61.2 ± 2.3%, 행동 수 18.5다. C.2. Case Studies는 다른 스킬을 참조하는 실패 복구, 선행 조건을 포함한 대안적 수학 풀이 경로, SkillOS-base보다 구체적인 경우의 수 계산 지침을 보여준다. 메모리 없는 에이전트가 30-step 예산을 소진한 반면, SkillOS가 desklamp 아래에서 CD를 성공적으로 검사하는 사례도 제시한다.
- D. Limitations는 의도적으로 단순화한 3가지 선택을 제시한다. 키워드 기반 BM25 검색, 실행 가능한 보조 자료나 명시적 계층이 없는 단일 파일의 선언적 Markdown 스킬, 고정된 실행기다. 이 선택은 큐레이션을 분리해 연구할 수 있게 하지만, 검색 품질, 더 풍부한 스킬 표현, 큐레이터–실행기의 공동 적응은 미해결 과제로 남긴다.
- E. Future Research Directions는 경험 메모리에 대한 에이전트 기반 검색, 계층적·조합적 스킬, 에이전트 간 공유 메모리를 제안한다. 공유 메모리에서는 갱신 충돌과 어려운 기여도 할당 문제가 발생한다. F. Use of LLMs는 글의 명확성과 가독성을 개선하는 데 LLM이 도움을 주었으며, 아이디어·방법론·실험·분석·최종 글쓰기 결정의 책임은 저자들에게 있다고 밝힌다.
짧은 생각
동일한 구조와 메모리 인터페이스를 사용하는 SkillOS-base와의 비교, 그리고 그룹화한 스트림의 절제 실험이 학습 절차에 대한 가장 명확한 근거다. 이 비교는 성능 향상을 외부 메모리나 더 큰 큐레이터만의 효과로 보기보다, 큐레이션 정책 학습의 효과로 해석하도록 뒷받침한다.
장기 확장성과 정밀한 기여도 할당에 대한 근거는 덜 명확하다. 학습 스트림은 에이전트 작업 10개 또는 추론 작업 5–12개로 구성되고, 삭제는 드물며, 모든 큐레이션 토큰이 1개의 rollout advantage를 공유한다. 음의 전이 결과, 보고되지 않은 종단 간 비용, 작은 추론 평가 세트, 일관되지 않은 KL 및 ALFWorld 평균 설명은 효율적이고 견고한 평생 자기 진화를 일관되게 달성한다는 주장을 제한한다.