


Experiential Reinforcement Learning 요약 설명
15 Feb 2026 | Paper Review Reinforcement Learning Self-Reflection Self-Distillation목차
- 요약
- 1 Introduction
- 2 Experiential Reinforcement Learning (ERL)
- 3 Experiment
- 4 Result and Discussion
- 5 Related Work
- 6 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Experiential Reinforcement Learning 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 2월 15일(Arxiv)
- Shi, Taiwei, Chen, Sihao, Jiang, Bowen, Song, Linxin, Yang, Longqi, Zhao, Jieyu.
- University of Southern California, Microsoft, University of Pennsylvania
- 논문 링크
요약
- Experiential Reinforcement Learning (ERL)은 경험, 성찰, 내재화 과정을 반복하며 언어 모델 에이전트를 학습한다. 최초 시도가 최적의 결과를 얻지 못하면 모델은 피드백을 바탕으로 지침을 생성하고 과제를 다시 시도한다. 이후 양의 보상을 받은 재시도를 선택적 자기 증류로 내재화한다.
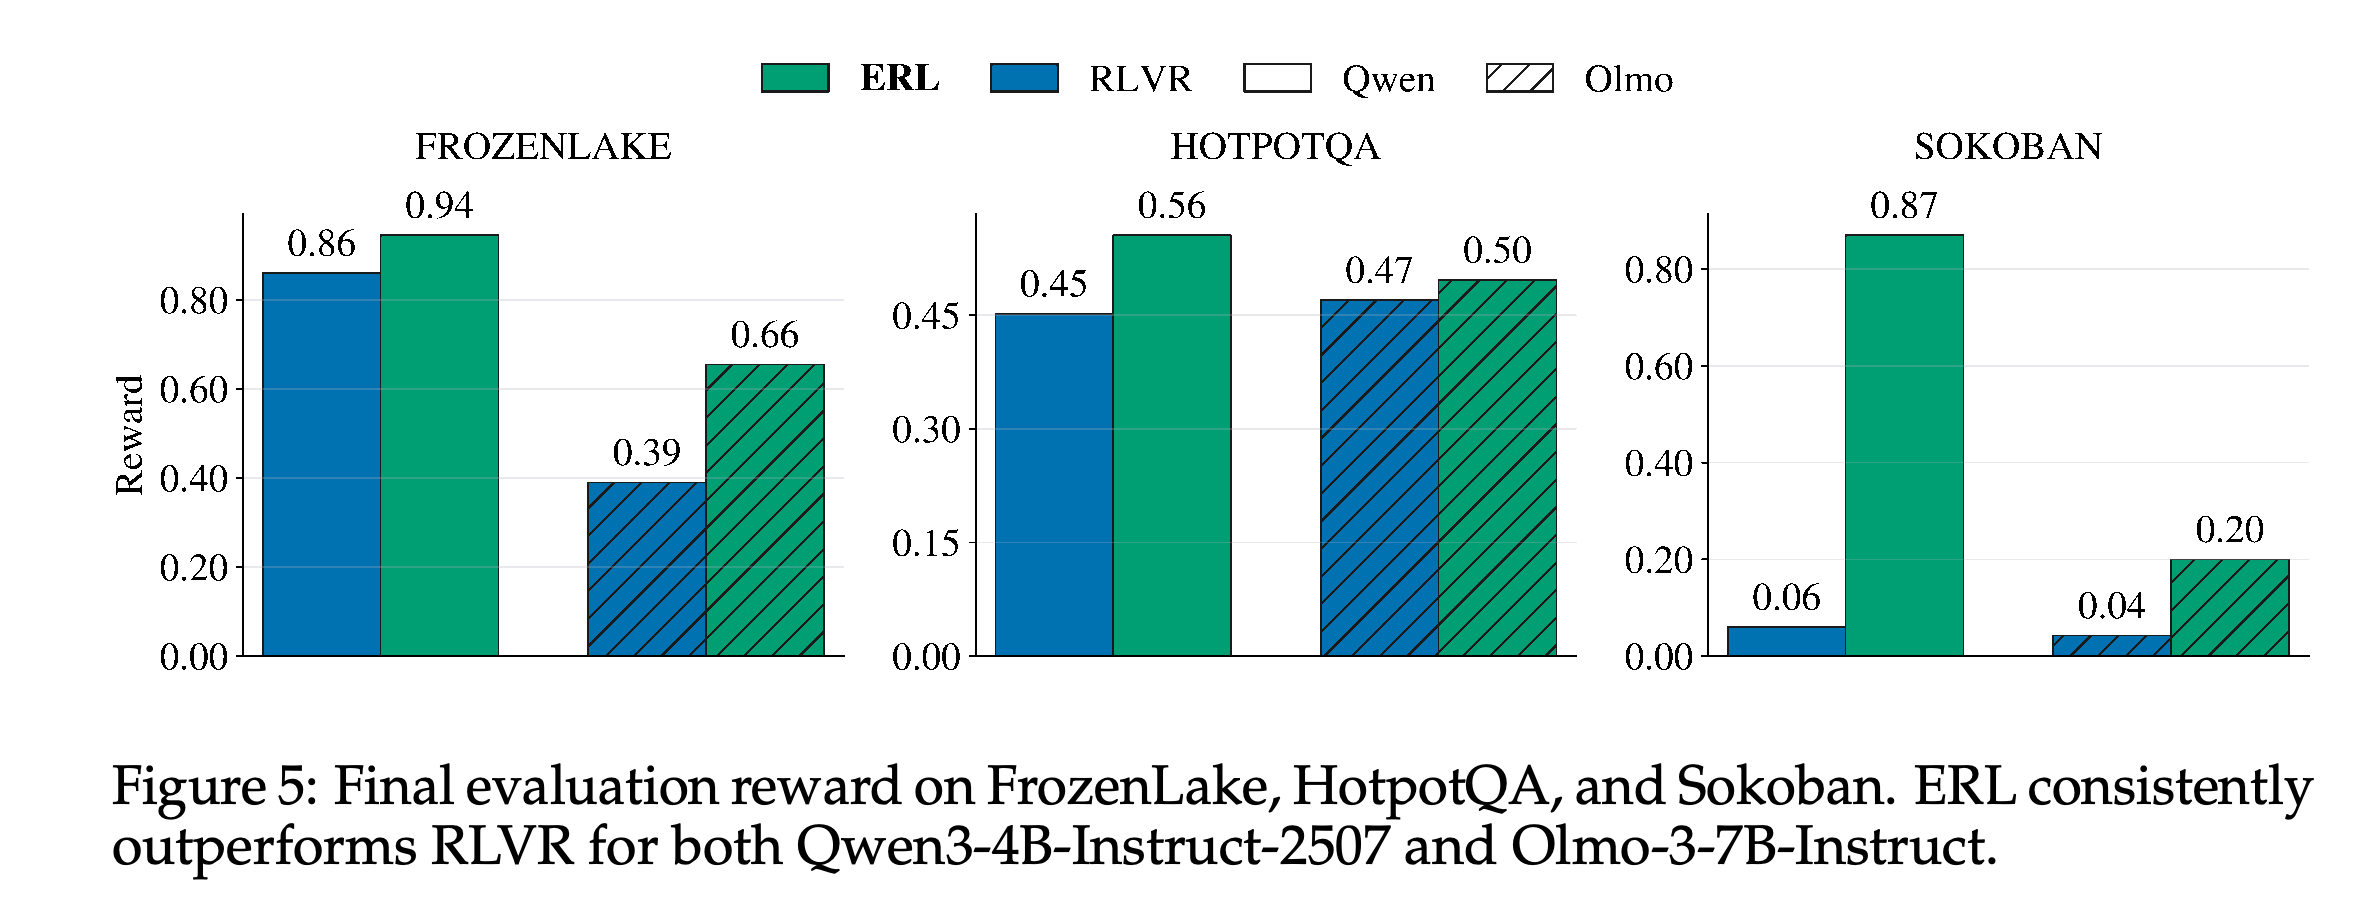
- ERL은 3개 과제와 2개 백본을 조합한 6개 설정 모두에서 GRPO 기반 RLVR보다 높은 최종 평가 보상을 얻는다. 절대 증가폭이 가장 큰 설정은 Qwen3-4B-Instruct-2507의 Sokoban으로, 보상이 0.06에서 0.87로 높아진다. HotpotQA의 증가폭은 더 작으며, Qwen은 0.45에서 0.56으로, Olmo는 0.47에서 0.50으로 높아진다.
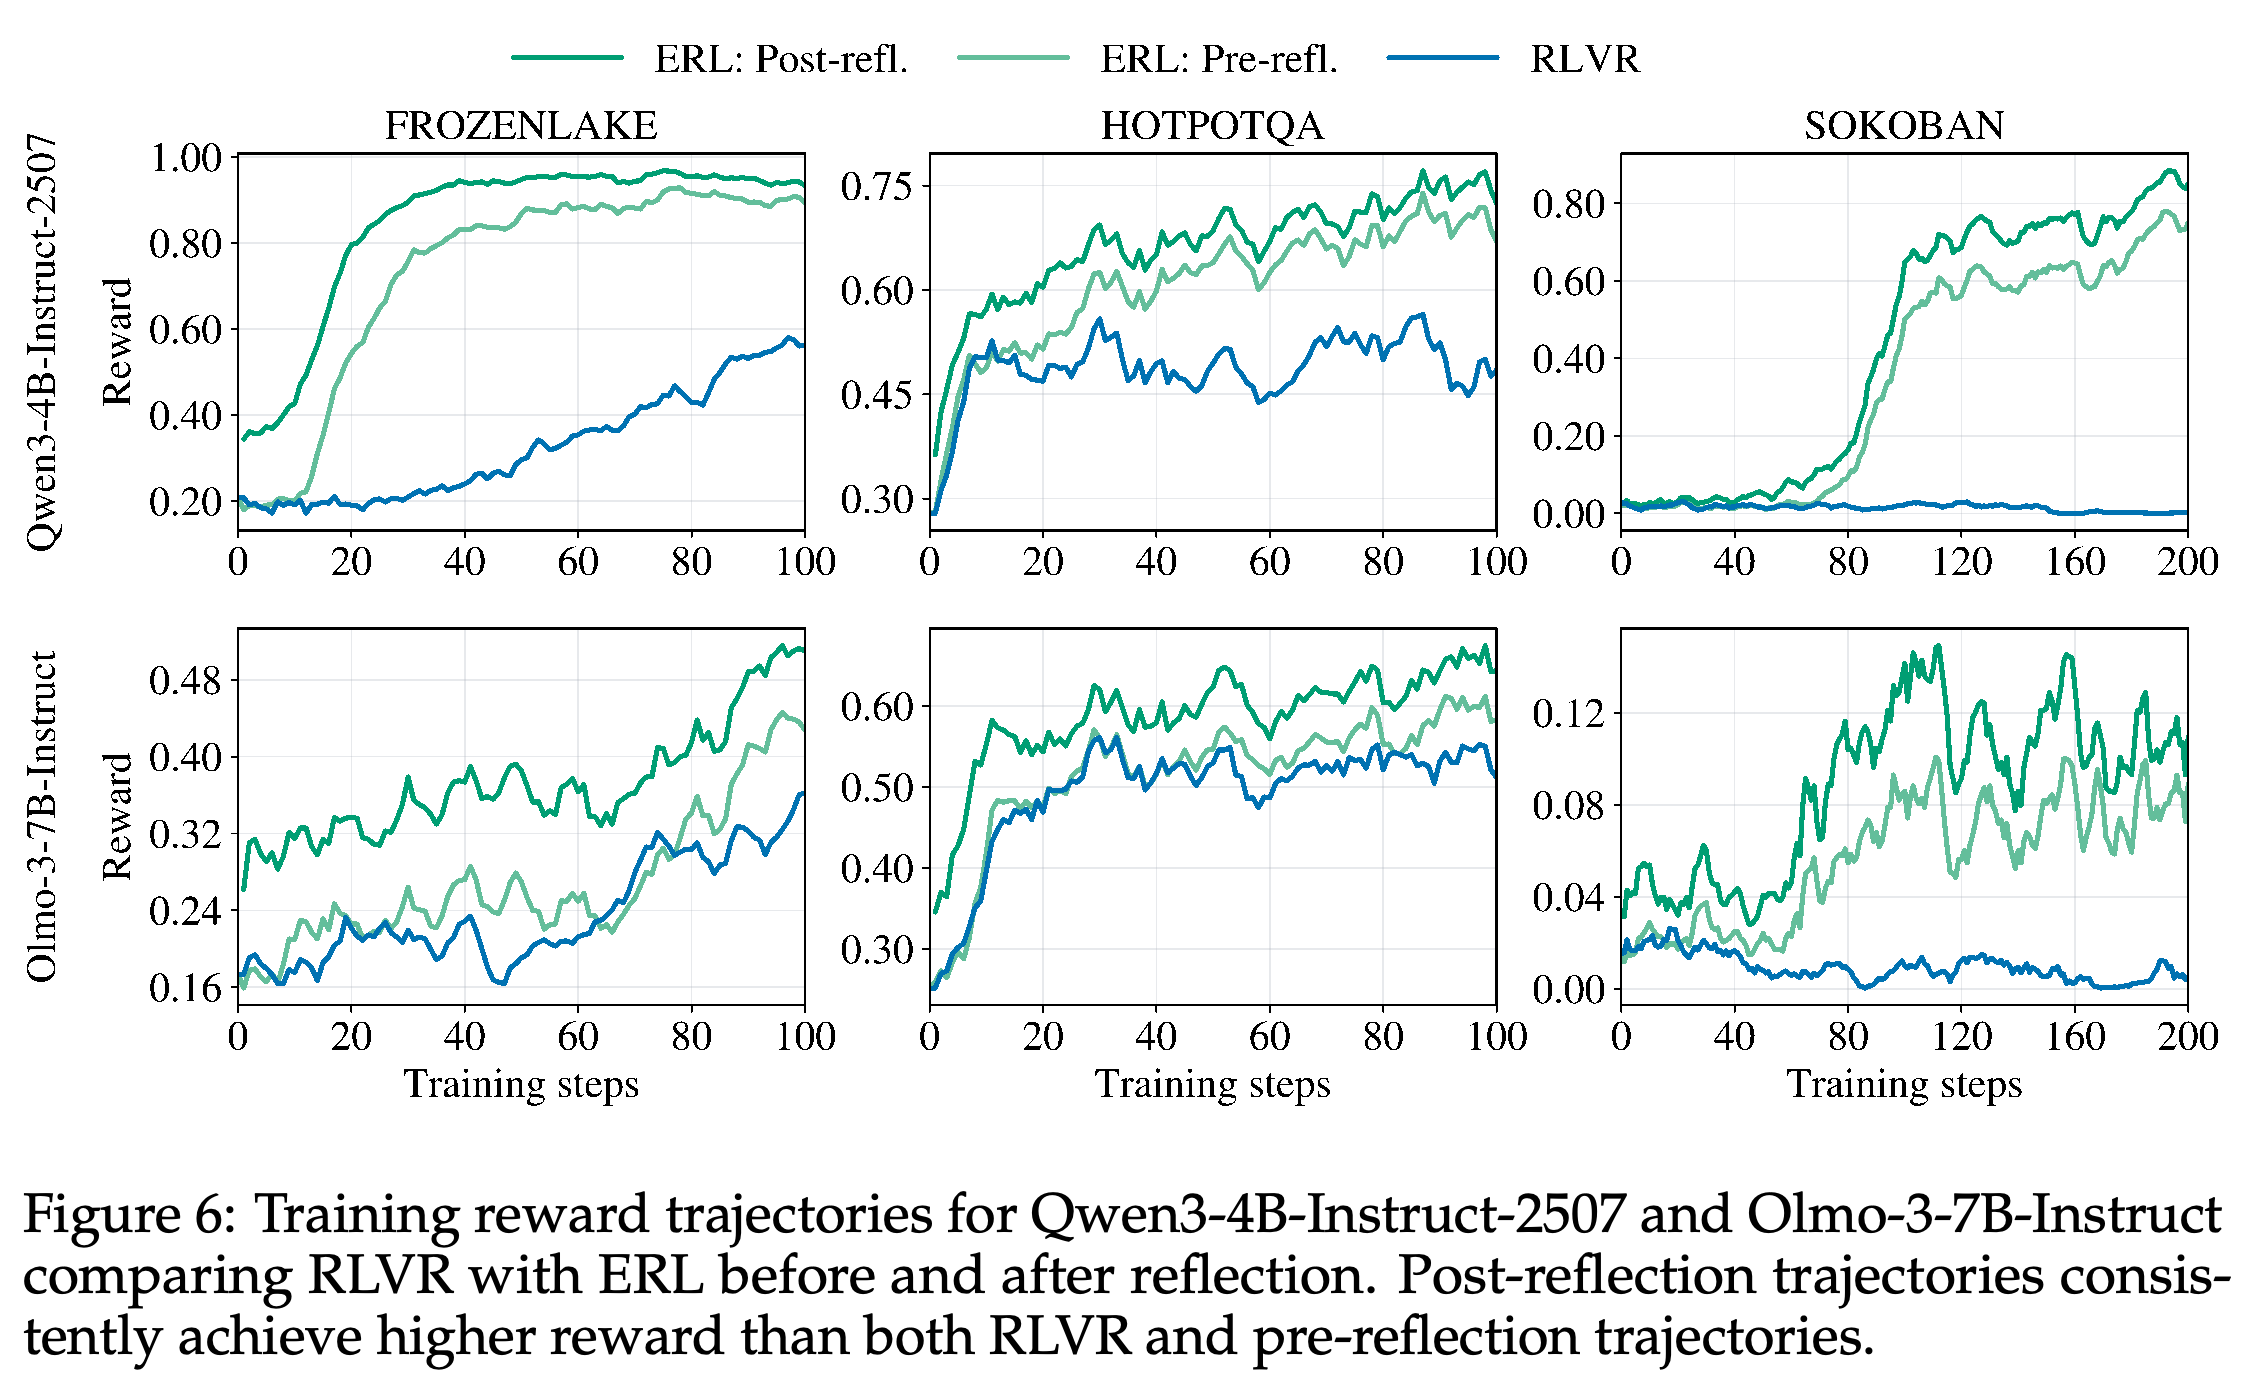
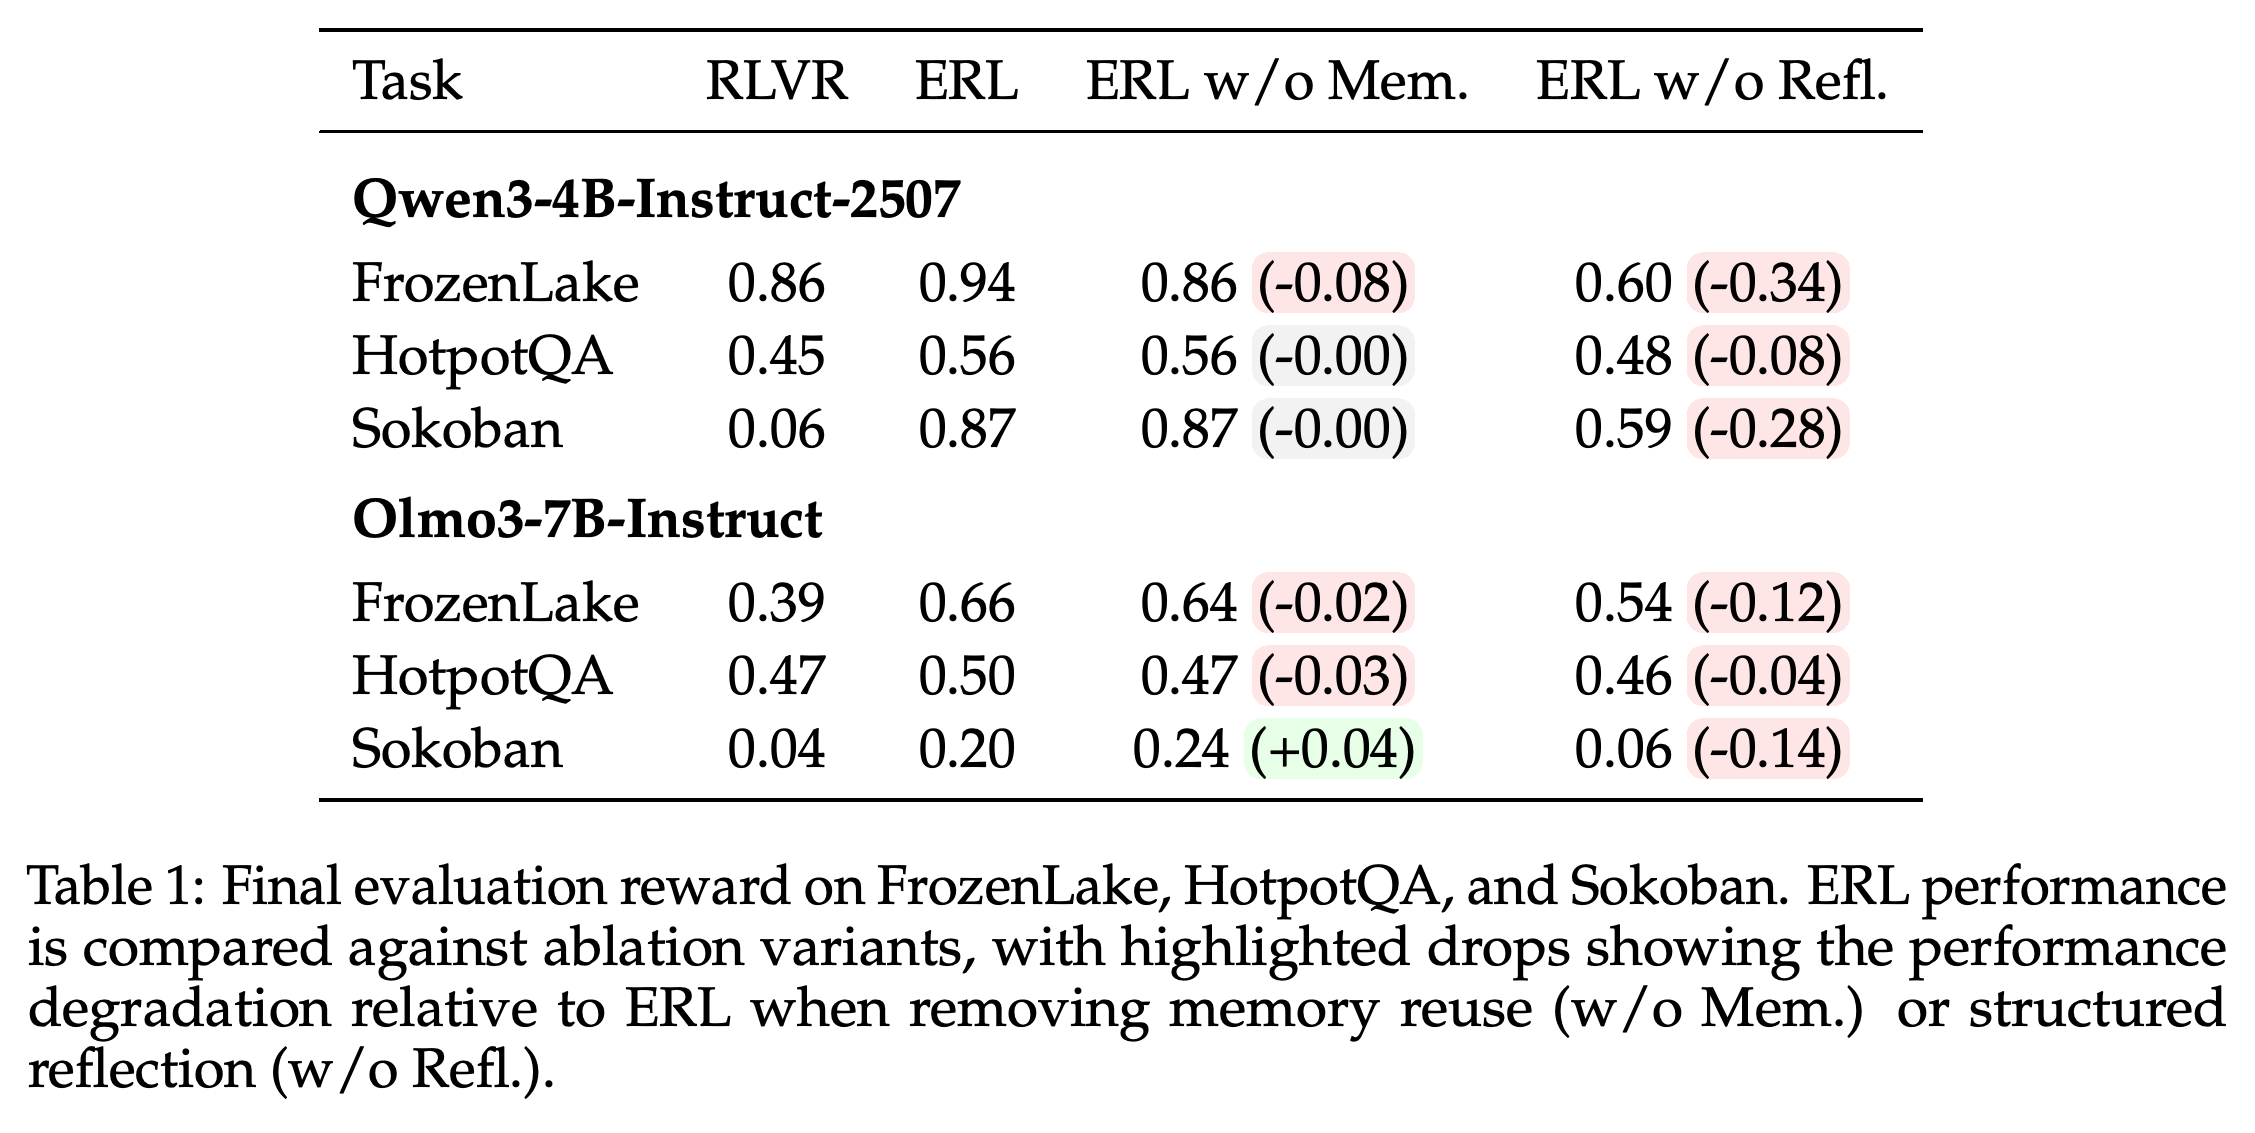
- 학습 중에는 성찰을 조건으로 수행한 재시도가 대체로 최초 시도보다 좋은 성과를 낸다. 구조화된 성찰을 제거하면 모든 평가 설정에서 최종 보상이 낮아진다. 메모리의 효과는 일관되지 않다. 일부 결과는 개선하고 일부는 바꾸지 않으며, Olmo의 Sokoban 보상은 메모리를 사용하지 않는 변형보다 낮아진다.
- 배포 시에는 학습 때 사용한 성찰 단계나 이전 시도의 피드백이 필요하지 않다. 실험은 2개 백본과 3개 과제를 다루며, 행동 한도가 8회인 결정론적 제어 에피소드도 포함한다. 다만 시드별 불확실성은 보고하지 않는다. PDF에는 롤아웃 할당과 메모리 임계값에 관한 불일치도 해결되지 않은 채 남아 있다.
1 Introduction
희소한 최종 보상은 어떤 궤적이 실패했는지 알려 주지만, 에이전트가 결정을 어떻게 수정해야 하는지는 알려 주지 않는다. ERL은 행동 수정 전체를 스칼라 보상 최적화에 맡기지 않고, 수정 방향을 추론하는 과정을 명시적인 학습 출력으로 만든다.
- 이 방법은 결과를 관찰하고, 실패를 성찰하며, 행동을 수정하고, 성공적인 수정을 내재화하는 경험 학습에서 출발한다.
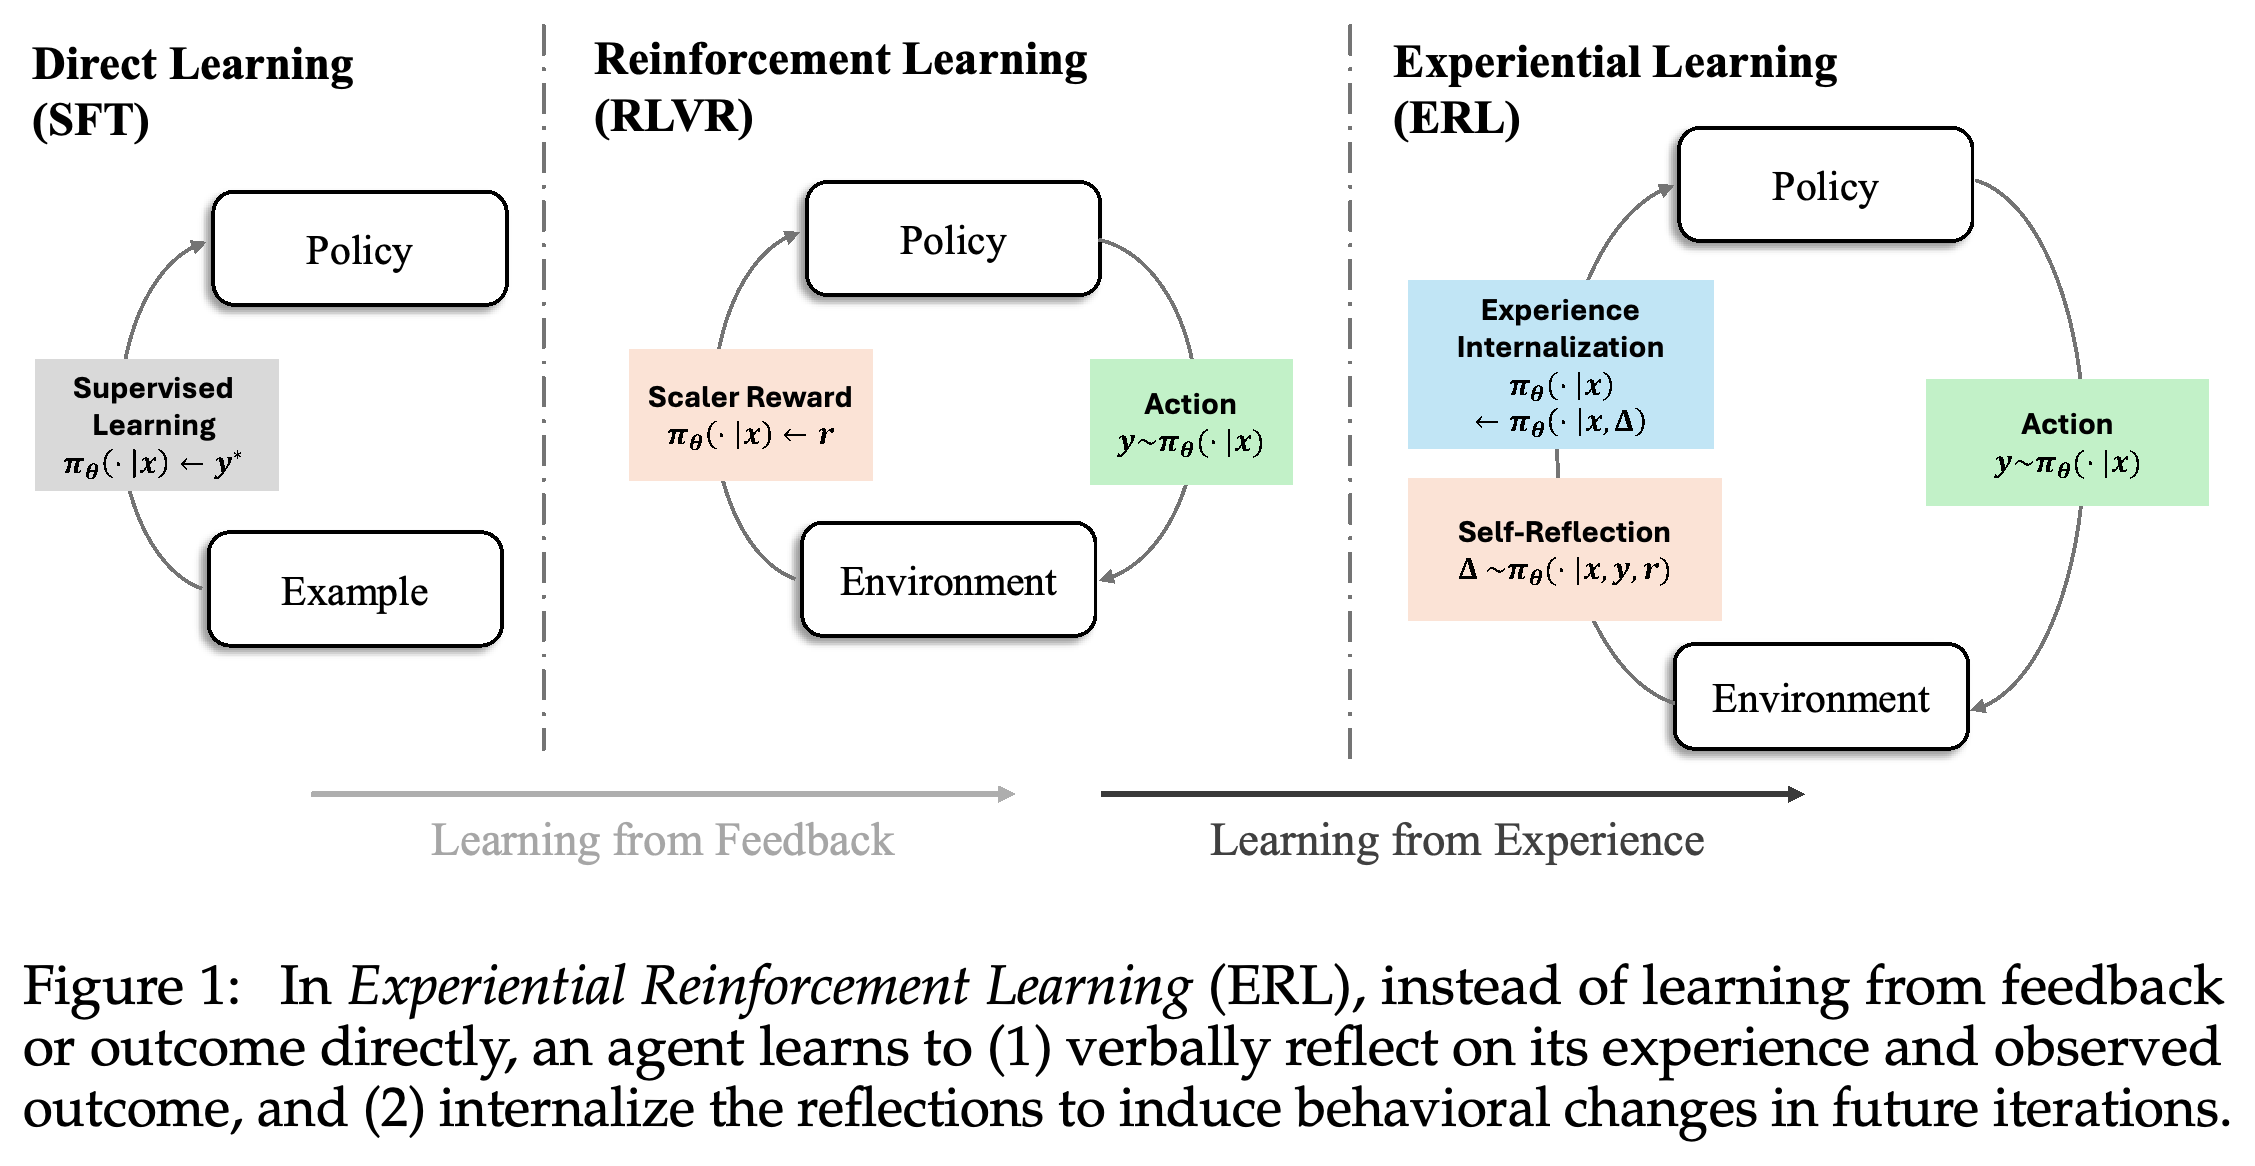
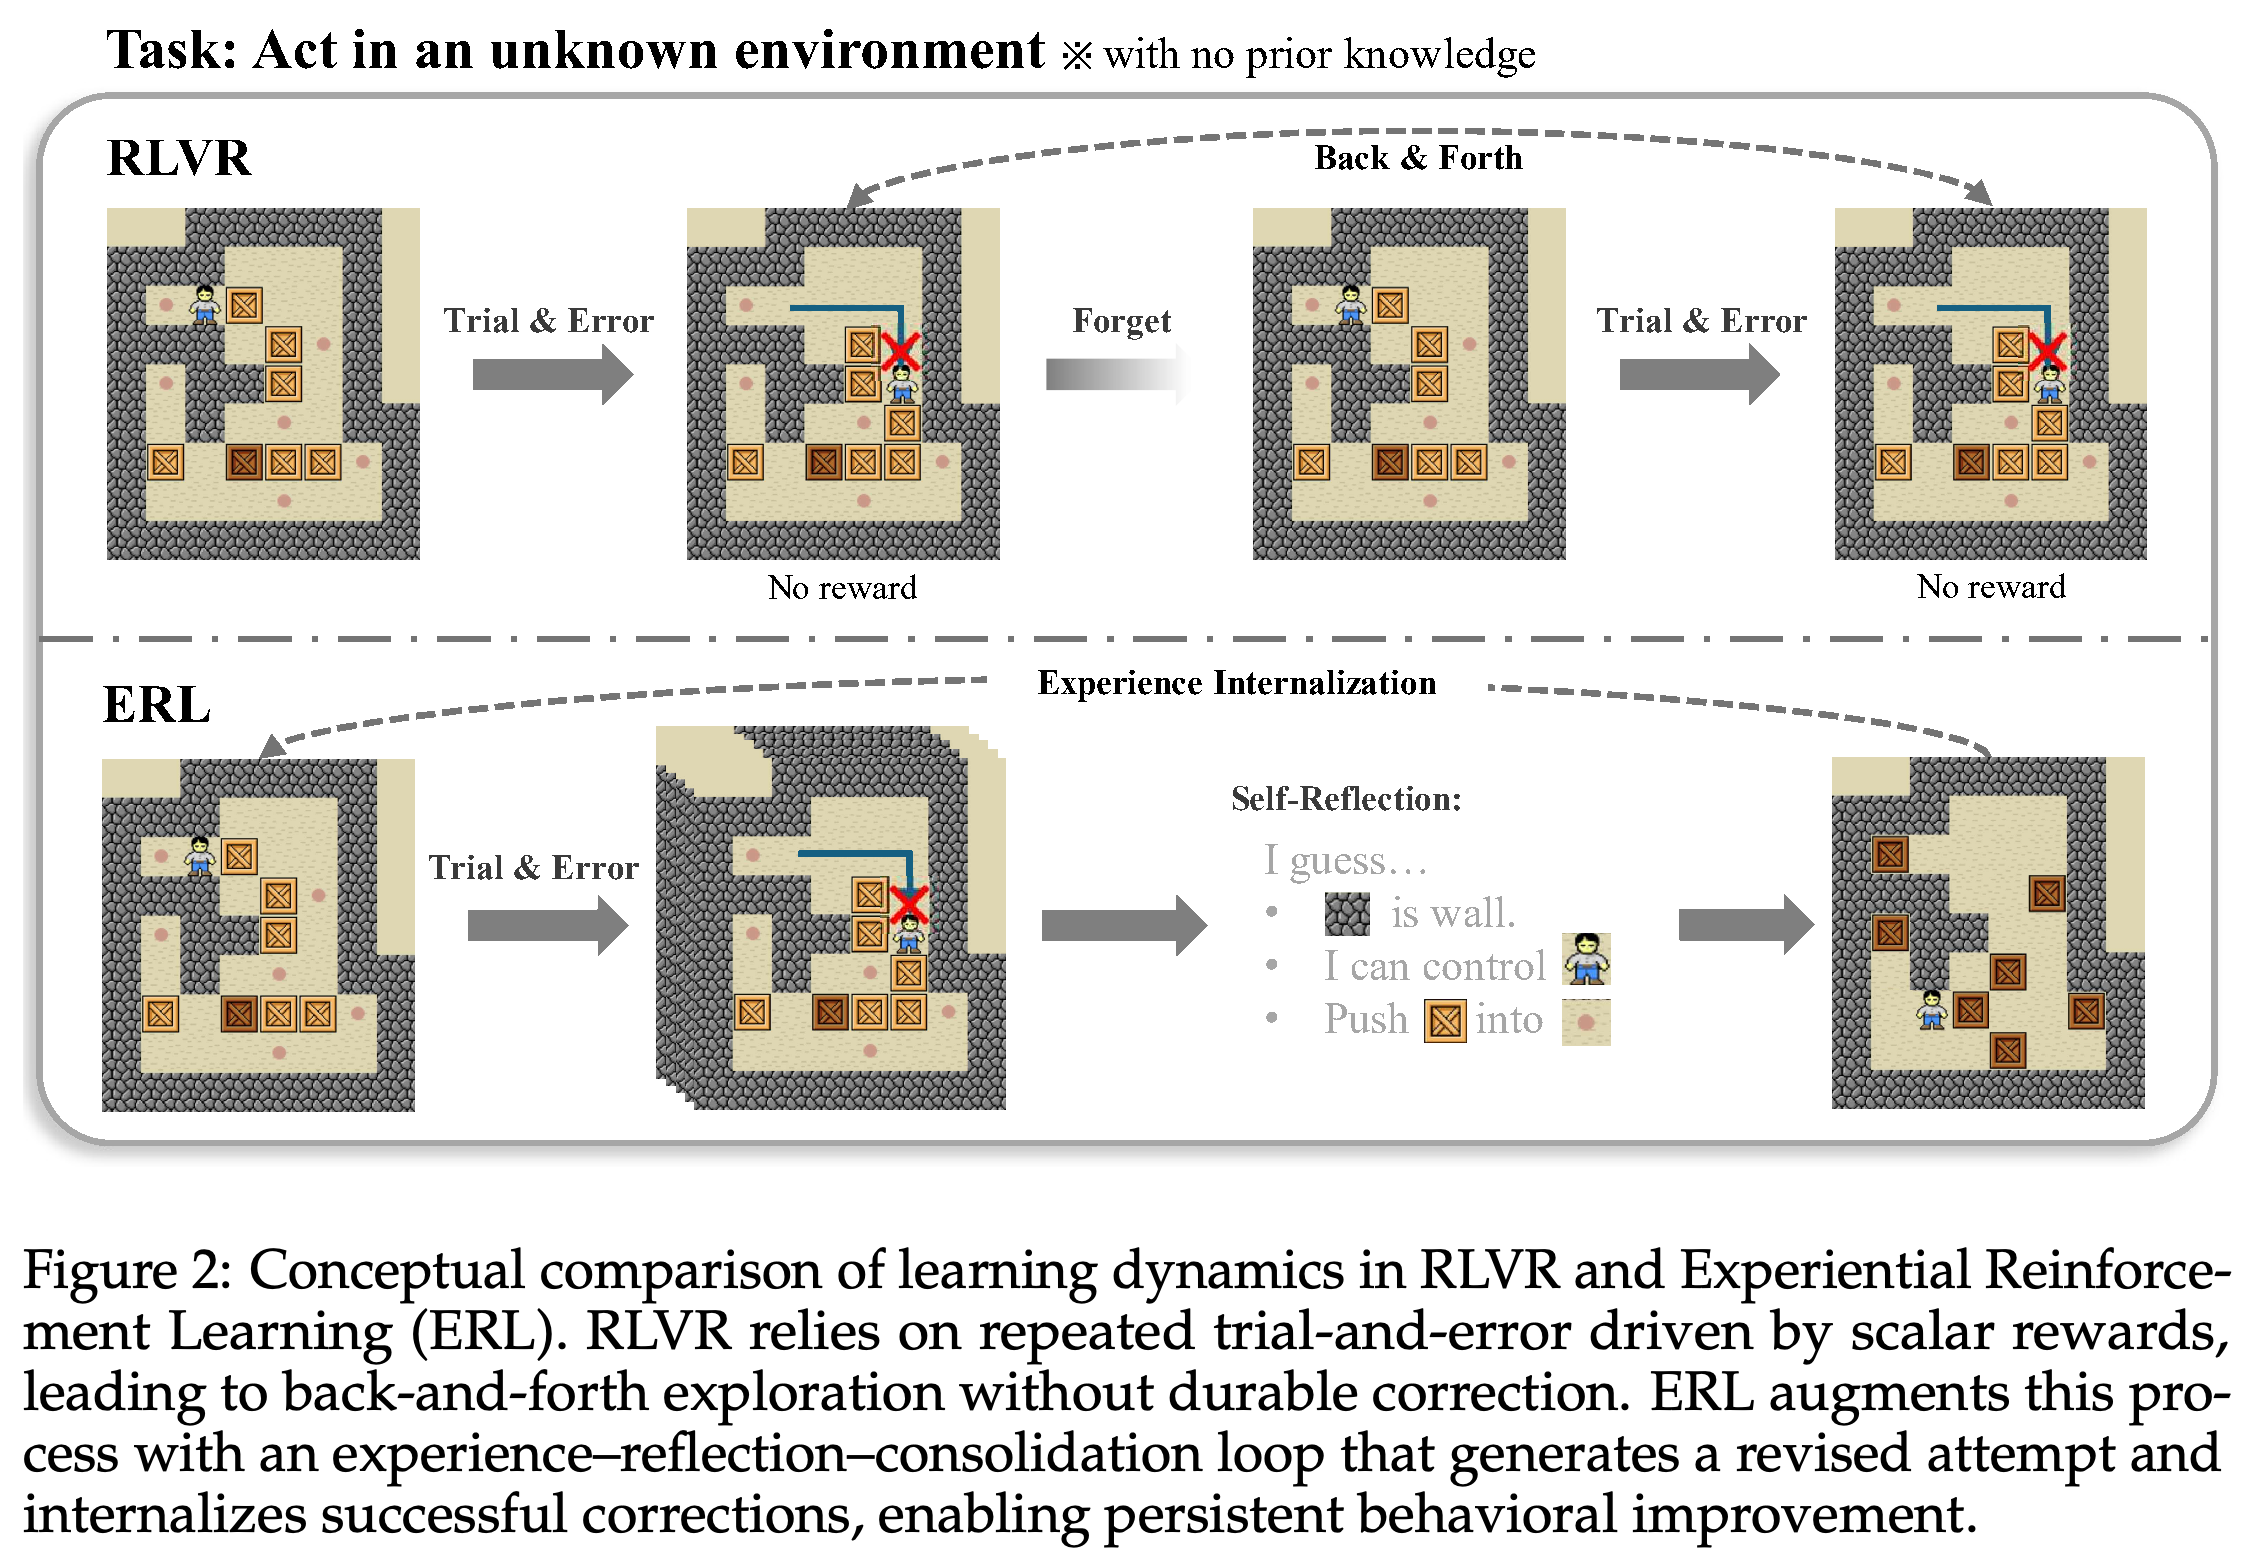
- Figure 1과 Figure 2는 모방, 보상 기반 시행착오, 성찰 기반 학습을 구분한다. 이 그림들은 개념을 설명할 뿐, RLVR이 실패한 시도를 반드시 잊는다는 근거는 아니다.
- 논문이 제시하는 기여는 명시적인 학습 루프, 성찰 없이 작동하는 정책으로의 내재화, 제어 및 도구 활용 추론 과제에서의 실증적 개선이다.
3개 패널은 예시 모방, 스칼라 보상 최적화, 성찰 후 내재화를 구분한다. ERL이 추가한 경로는 성찰을 조건으로 한 행동을 원래 맥락을 입력으로 사용하는 정책에 전달한다. 이 도식은 의도한 작동 방식을 설명하며, 효과를 측정한 결과는 아니다.
ERL 행은 Sokoban과 유사한 실패 이후 벽, 조작 가능한 대상, 밀기 동작에 대한 가설을 제시하고, 여러 시도에 걸쳐 이를 내재화하는 과정을 보여 준다. RLVR 행의 반복적인 실패는 동기를 설명하는 도식이며, 상자가 1개인 실험에서 측정한 궤적은 아니다.
2 Experiential Reinforcement Learning (ERL)
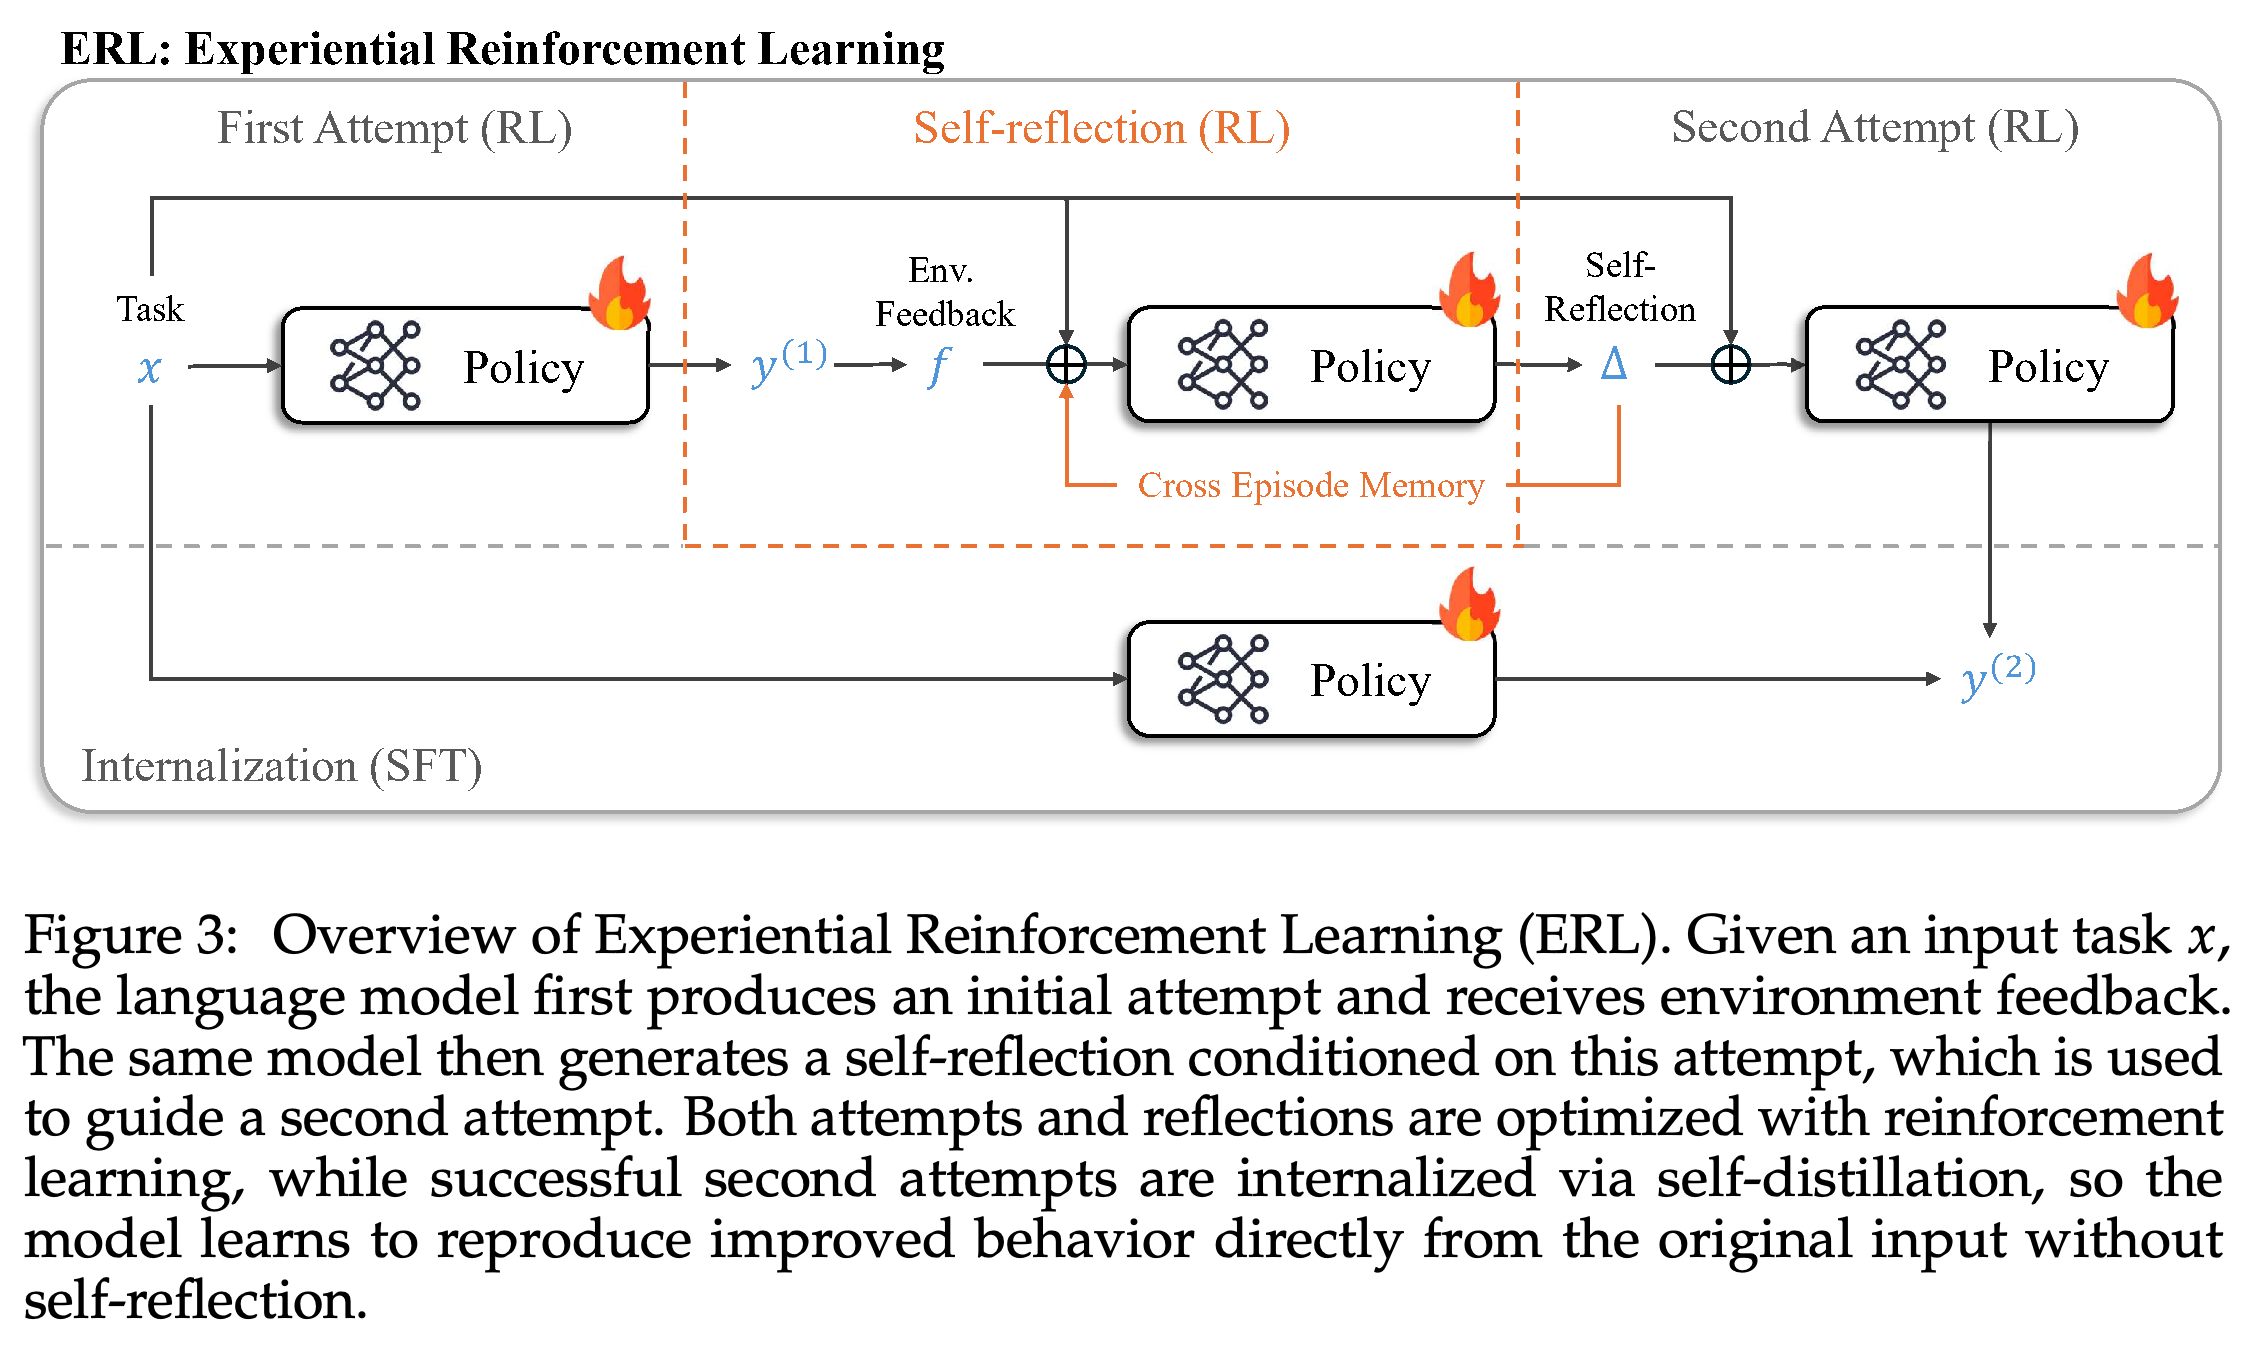
과제 x가 주어지면 정책은 πθ(· | x)에서 y^(1)을 샘플링하고, 텍스트 피드백 f^(1)과 보상 r^(1)을 받는다. 성찰 조건이 충족되면 같은 모델이 과제, 최초 궤적, 피드백, 보상, 메모리 m을 조건으로 Δ를 생성한다. 이후 πθ(· | x, Δ)에서 y^(2)를 샘플링한다.
- 성찰에는 2번째 시도의 보상인 r̃ = r^(2)를 부여한다. 이를 통해 성찰의 최적화를 후속 과제 성과와 연결한다.
- 에피소드 간 메모리는 성찰을 생성할 때 이전의 수정 지침을 제공한다. 구현에서는 검색 기반 메모리 대신 일반 텍스트로 된 시스템 프롬프트 지침을 사용한다.
- Figure 3은 시도와 성찰에 대한 보상 기반 학습을 지도학습을 통한 내재화와 구분한다. Algorithm 1은 간략한 버전이며, Appendix A는 실험에 사용한 조건부 성찰 버전을 제시한다.
위쪽 경로는 같은 정책으로 최초 시도, 성찰, 수정된 시도를 수행하고 강화학습으로 학습한다. 아래쪽 경로는 성찰 없이 원래 입력에서 수정된 출력을 학습한다. 이를 통해 학습 시 맥락으로 제공하는 지침과 매개변수 수준의 내재화를 구분한다.
정책 목적함수는 Lpolicy(θ) = −E[A log πθ(y | x, ·)]이다. 여기서 y는 최초 시도, 성찰, 수정된 시도 중 하나이며, A는 해당 출력에 부여된 보상으로 추정한다. 내재화에는 Ldistill(θ) = −E[I(r^(2) > 0) log πθ(y^(2) | x)]를 사용하며, 조건 입력에서 성찰을 제거한다.
- 보상이 이진 값인 제어 과제에서는 증류 필터가 성공한 재시도를 선택한다. HotpotQA에서는 양의 보상을 받은 부분 정답 재시도도 허용한다.
- 이 필터는 2번째 시도가 최초 시도보다 개선되었는지를 요구하지 않는다. 명시된 조건은 2번째 시도의 보상이 양수라는 것이다.
- 배포 정책은 먼저 성찰을 생성하지 않고도 원래 과제 맥락에서 수정된 행동을 재현하도록 학습한다.
2.1 Comparison to Standard RLVR
표준 RLVR은 피드백을 조건으로 성찰하고 재시도하는 명시적 단계 없이 결과 보상을 최적화한다. ERL은 보상 기반 정책 최적화를 유지하면서 학습 궤적에 성찰과 재시도를 추가한다. 이후 양의 보상을 받은 재시도를 원래 맥락을 입력으로 사용하는 정책에 증류한다.
- 환경 보상은 여전히 시도에 학습 신호를 제공하고 성찰의 보상을 결정한다. 언어로 표현한 성찰이 검증 가능한 과제 평가를 대체하지는 않는다.
- 메모리는 학습 맥락에서 지침을 재사용한다. 반면 내재화는 모델 매개변수를 갱신하므로, 배포 시 해당 지침에 의존하지 않는다.
3 Experiment
실험은 Frozen Lake, Sokoban, HotpotQA에서 ERL과 표준 RLVR을 비교한다. 2개 백본을 각 학습 방식으로 학습하여 6개 과제–모델 조합을 비교한다.
3.1 Task
Frozen Lake와 Sokoban은 목표를 달성하면 최종 보상 +1을, 그렇지 않으면 0을 제공한다. 명시적인 게임 규칙과 기호 정의는 제공하지 않는다. 따라서 에이전트는 격자 관측, 가능한 행동, 텍스트 상태 전이 피드백을 통해 환경의 동작을 추론해야 한다.
- 2개 제어 과제 모두 결정론적 상태 전이를 사용하며, 행동 한도는 8이다. Sokoban 인스턴스는 단일 상자와 단일 목표로 구성하며, 이동 수가 8 이하인 해법을 BFS로 찾은 경우만 채택한다.
- 각 제어 과제는 절차적으로 생성한 학습 인스턴스 10,000개와 같은 방식으로 생성하되 학습 데이터와 겹치지 않는 평가 인스턴스 100개를 사용한다.
- 다만 최초 프롬프트는 상태 분석, 전략적 가치 평가, 후보 행동 2개의 결과 예측으로 구성된 추론 절차를 제공한다. 따라서 게임 규칙을 제공하지 않는다고 해서 추론 지침까지 모두 제공하지 않는 것은 아니다.
HotpotQA는 Search-R1을 따라 도구를 활용하는 멀티홉 질의응답 과제로 구성한다. 에이전트는 Wikipedia 근거를 검색하고 최종 답변을 \boxed{} 안에 넣는다. 에피소드당 상호작용은 최대 5턴까지 허용한다.
- 정확히 일치하는 답변에는 보상 1.0을 부여한다. 그렇지 않으면 토큰 수준 F1이 F1 ≥ 0.3을 만족할 때 해당 F1을 보상으로 사용하고, 임계값 미만이면 0을 부여한다.
- 이 점수 방식은 이진 보상을 사용하는 제어 과제와 달리 일부 오답에도 부분 점수를 부여한다.
- 환경 설정에는 HotpotQA의 학습 및 평가 샘플 수가 보고되어 있지 않다.
3.2 Models and Baselines
백본은 Olmo-3-7B-Instruct와 Qwen3-4B-Instruct-2507이며, ERL과 RLVR 모두 GRPO를 사용한다. 클리핑, KL 정규화, 중요도 샘플링으로 최적화를 안정화한다. 내재화에 사용하는 학습 대상 출력도 원래 맥락을 입력으로 사용하는 정책에 대해 off-policy이므로, 저자들은 내재화 과정에도 이 기법들을 적용한다.
- Section 3.2는 RLVR에 과제당 롤아웃 10개를 할당하고, ERL에는 시도당 그 절반을 할당한다고 설명하므로 5개를 뜻한다. 반면 Appendix C는 ERL의 각 시도에 프롬프트당 샘플 4개를 사용한다고 명시한다.
- 이 할당은 성찰 단계를 포함하더라도 연산량을 맞추려는 목적이다. 하지만 PDF에는 이 불일치를 해소할 토큰 수준의 연산량 산정이 없다.
- 모든 실행은 H100 8개가 장착된 단일 노드에서 rLLM 학습 스택을 사용한다.
4 Result and Discussion
결과는 최종 평가 보상, 실제 경과 시간에 따른 검증 보상, 성찰 전후의 학습 보상을 구분한다. Table 1과 Figures 4–6은 최종 정책 성능, 관측된 학습 속도, 재시도를 통한 즉각적인 개선을 다룬다.
- 별도 설명이 없으면 곡선에는 최근 5개 지점의 이동 평균을 사용한다.
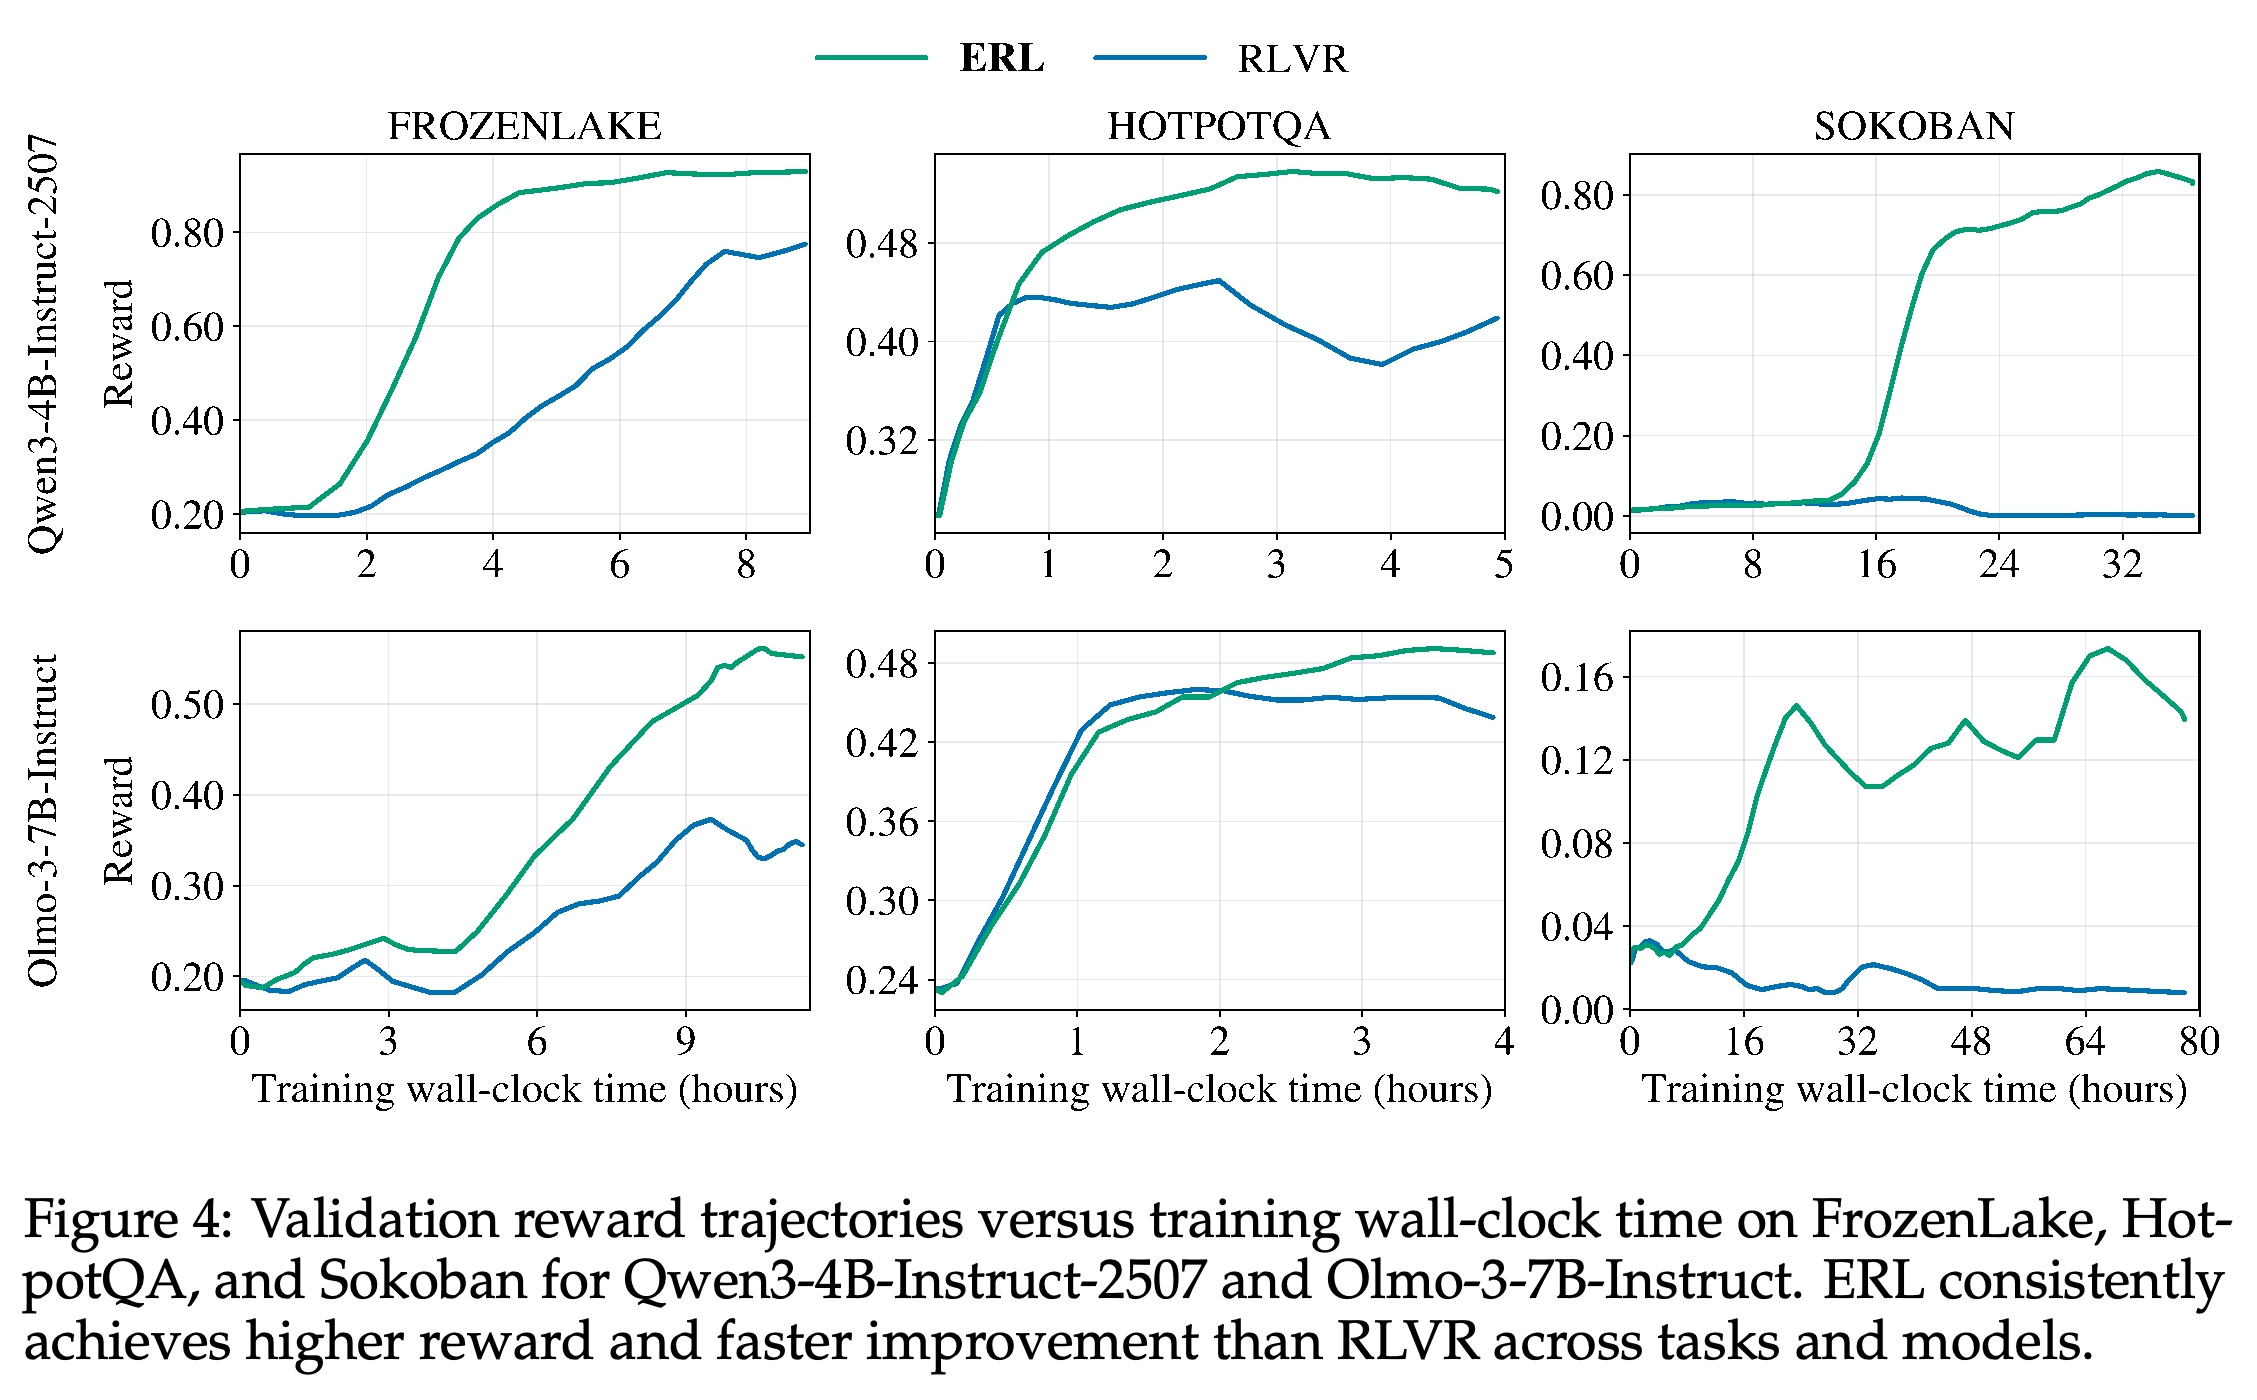
- Figure 4는 특히 제어 과제에서 전반적으로 실제 경과 시간 기준의 이점을 보여 준다. 다만 ERL이 모든 시점에서 앞서는 것은 아니다.
- 보고된 표와 그림에는 신뢰구간이나 독립적인 학습 시드 간 변동성이 없다.
시간 단위로 표시한 실제 학습 경과 시간은 갱신 횟수만으로는 알 수 없는 실용적인 학습 속도 차이를 보여 준다. 제어 과제 패널에서는 학습 후반의 격차가 크며, 특히 Qwen의 Sokoban에서 두드러진다. HotpotQA의 차이는 더 작고, Olmo의 RLVR 곡선은 초기에 앞서다가 ERL에 추월당한다.
4.1 Performance Across Tasks
Qwen3-4B-Instruct-2507의 RLVR → ERL 보상은 FrozenLake에서 0.86 → 0.94, HotpotQA에서 0.45 → 0.56, Sokoban에서 0.06 → 0.87이다. Olmo-3-7B-Instruct의 해당 보상은 각각 0.39 → 0.66, 0.47 → 0.50, 0.04 → 0.20이다.
- 서론에서 제시한 최대 +81%, +27%, +11%의 개선은 상대적인 증가율이 아니라 각각 0.81, 0.27, 0.11의 절대 보상 차이를 뜻한다.
- 저자들은 제어 과제에서 개선폭이 더 큰 이유를 알려지지 않은 환경 동작의 추론과 누적 오류의 수정에서 찾는다. 하지만 과제 난도와 보상 밀도를 독립적으로 조작하지 않았으므로, 이는 해석에 머문다.
- 논의에서는 장기 계획을 강조하지만, 설정된 제어 에피소드는 행동을 8회만 허용한다. 또한 2개 백본에서 개선되었다고 해서 아키텍처와 무관한 이점이 입증되는 것은 아니다.
ERL은 6개 과제–모델 비교 모두에서 최종 보상이 더 높다. 다만 효과 크기는 크게 다르다. Qwen의 Sokoban 개선폭은 0.81인 반면 Olmo의 HotpotQA 개선폭은 0.03이다. 막대에는 불확실성 구간이 표시되어 있지 않다.
4.2 Learning Efficiency and Optimization Dynamics
Figure 4에서 ERL은 전반적으로 더 빠르게 개선되고 학습 후반의 검증 보상도 더 높다. 차이가 가장 큰 과제는 Sokoban이다. Qwen의 ERL 보상은 급격히 상승하는 반면 RLVR은 0에 가까운 수준에 머문다.
- 저자들은 피드백을 조건으로 한 수정이 최종 보상의 전파에만 의존하지 않고 탐색을 더 유용한 궤적으로 유도한다고 해석한다.
- HotpotQA에서는 차이가 더 작다. Olmo의 RLVR 곡선은 초기에 앞서지만 이후 ERL이 추월한다.
- 실제 경과 시간에 따른 곡선은 관측된 학습 속도 차이를 보여 준다. 하지만 성찰, 증류, 메모리, 롤아웃 할당을 각각 분리하여 원인으로 검증하지는 않는다.
4.3 Mechanistic Role of Reflection
Figure 6에서 성찰 후 학습 보상은 두 백본과 3개 과제 모두에서 대체로 성찰 전 보상보다 높다. 이 차이가 지속된다는 점은 피드백을 바탕으로 생성한 지침이 에피소드 내 재시도를 개선한다는 해석과 부합한다.
- 성찰 전 보상도 학습 중에 개선된다. 이는 이점이 재시도에만 한정되지 않고 최초 시도의 행동도 좋아진다는 것을 보여 준다.
- 재시도는 최초 시도에 없던 정보를 받으므로, 이 비교만으로는 구조화된 성찰과 일반적인 맥락 재사용의 효과를 구분할 수 없다. 성찰을 제거한 절제 실험이 더 적절한 대조군을 제공한다.
성찰 후 학습 보상은 대체로 성찰 전 보상보다 높다. 이는 피드백을 조건으로 한 재시도가 즉각적인 이점을 준다는 해석과 부합한다. 성찰 전 곡선의 상승도 최초 시도의 행동이 개선됨을 보여 준다. 하지만 이 그래프는 내재화의 효과를 다른 ERL 구성 요소와 분리하지 않는다.
4.4 Ablation Study: Memory and Reflection Mechanisms
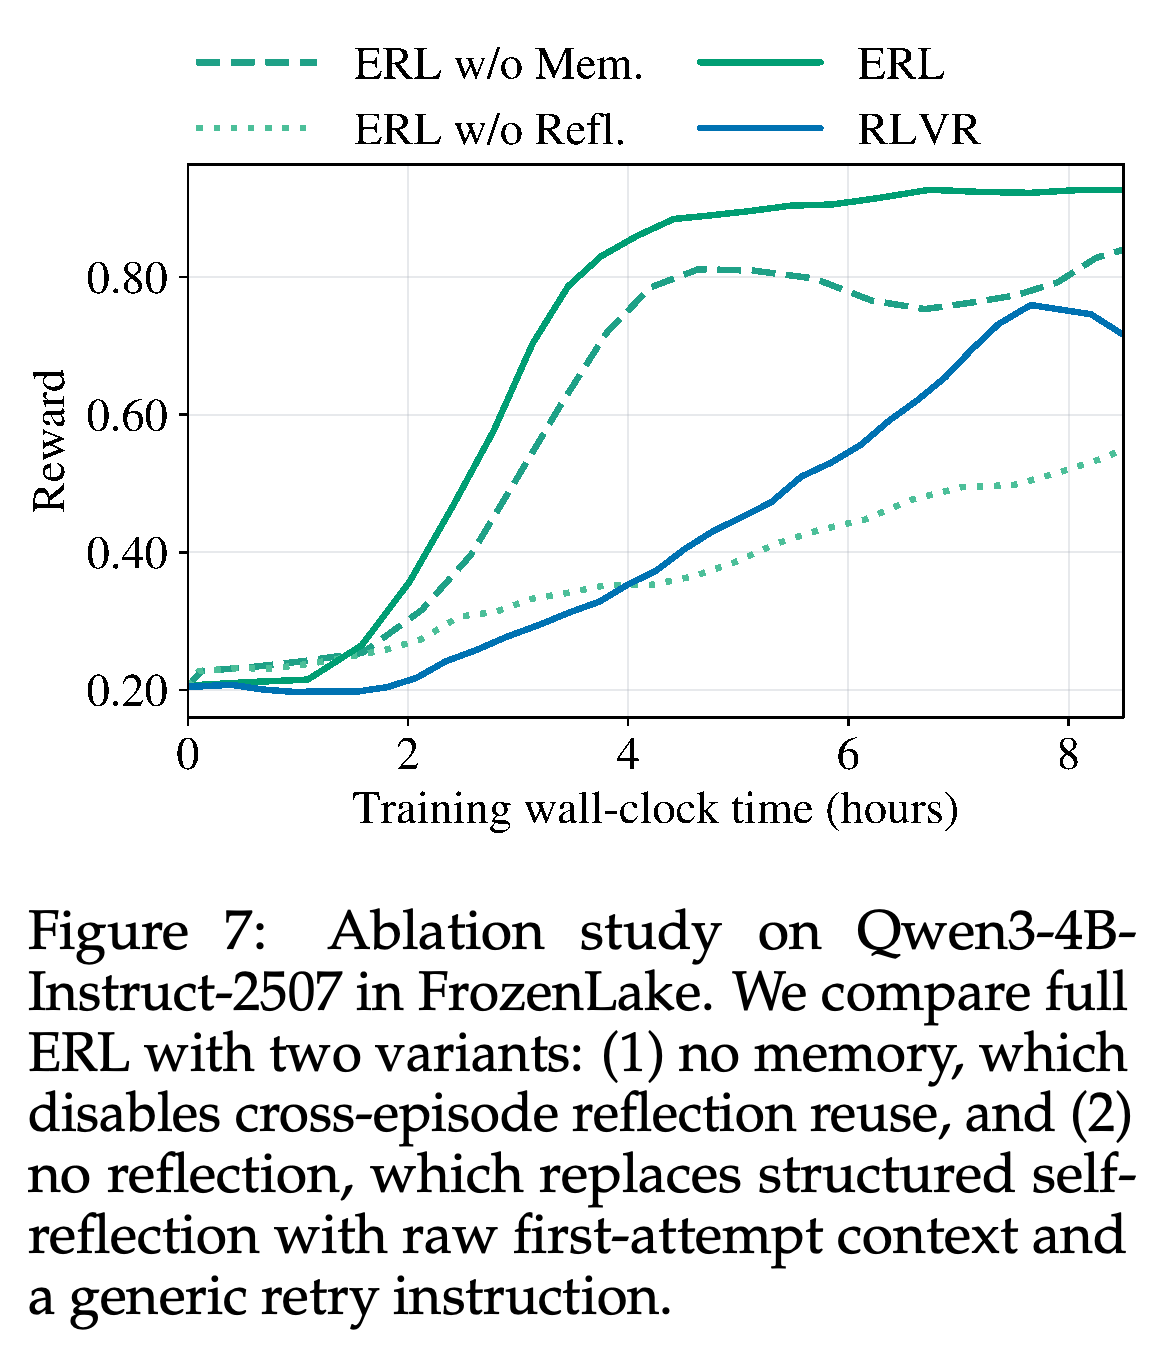
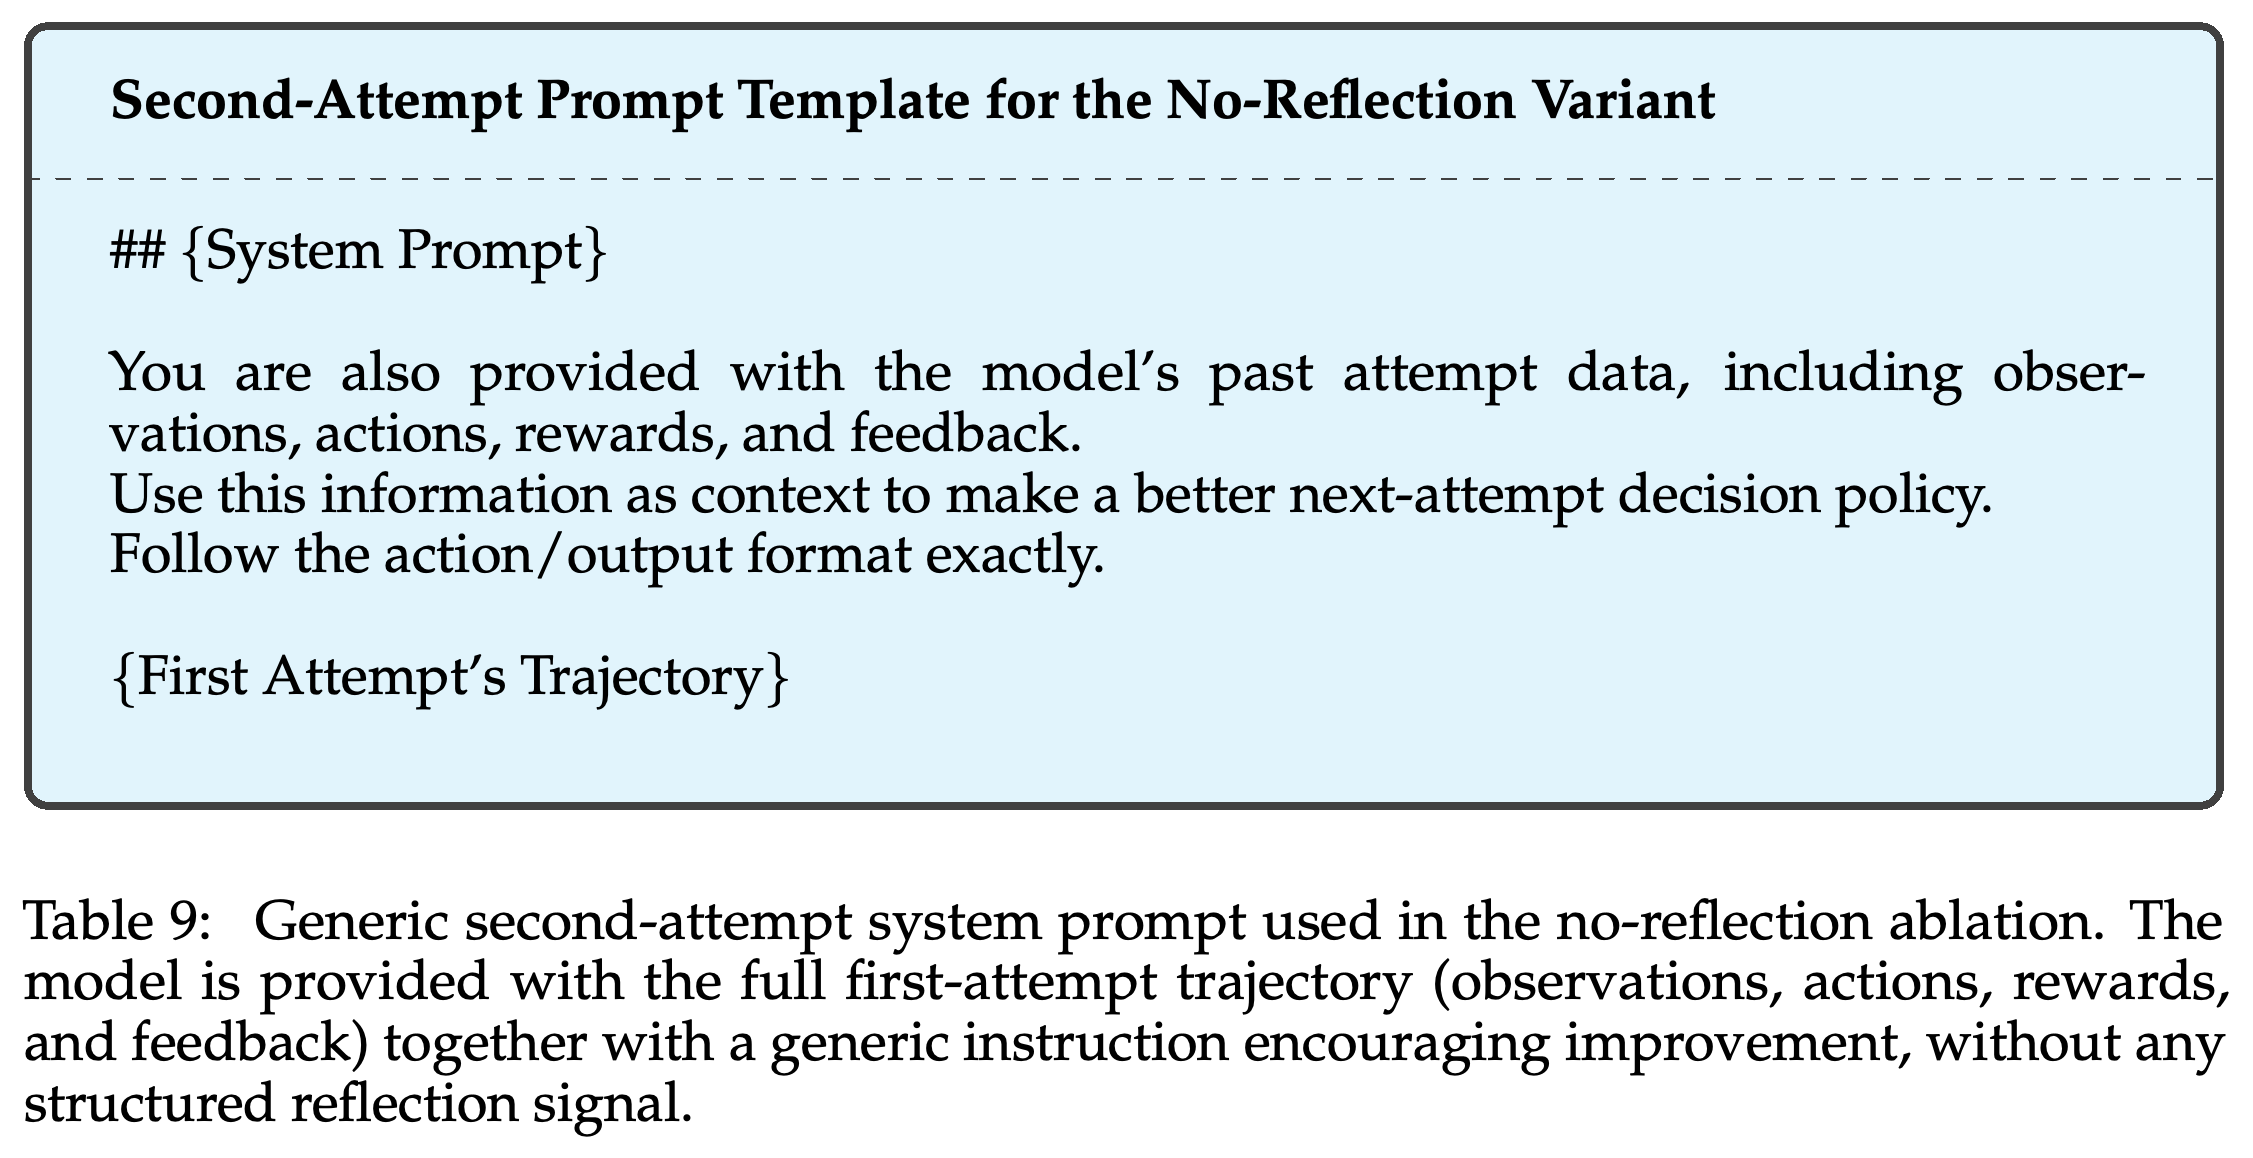
메모리를 제거한 절제 실험은 성찰과 재시도를 유지하되 에피소드 간 재사용을 비활성화한다. 성찰을 제거한 절제 실험은 2회의 시도를 유지하고, 생성된 성찰 지침 대신 최초 궤적 전체와 일반적인 개선 지시를 제공한다. 이 지시는 Table 9에 제시되어 있다.
- Qwen에서 성찰을 제거하면 보상이 FrozenLake에서는 0.94에서 0.60으로, HotpotQA에서는 0.56에서 0.48로, Sokoban에서는 0.87에서 0.59로 낮아진다.
- Olmo에서 성찰을 제거하면 해당 보상이 각각 0.66에서 0.54로, 0.50에서 0.46으로, 0.20에서 0.06으로 낮아진다.
- Figure 7에서 Qwen의 FrozenLake 결과는 메모리를 제거하면 개선 속도가 느려지고, 성찰을 제거하면 곡선이 상당히 낮아진다.
메모리의 이점은 구조화된 성찰보다 일관성이 낮다. 메모리를 제거하면 FrozenLake, HotpotQA, Sokoban에서 Qwen의 보상은 각각 0.86, 0.56, 0.87이 되고, Olmo의 보상은 각각 0.64, 0.47, 0.24가 된다.
- Olmo의 Sokoban 보상은 메모리를 제거하면 0.20에서 0.24로 높아진다. 따라서 이 결과에서 메모리 재사용이 최종 성능에 항상 유리하다고 볼 수는 없다.
- 저자들은 초기에 부정확한 성찰이 남아 이후의 회복을 방해할 수 있다고 설명하지만, 성찰의 정확도나 오류 전파를 측정하지는 않는다. 또한 저자들이 언급하는 확률적 환경은 실험에 설정된 결정론적 제어 과제에 해당하지 않는다.
- 내재화만 제거한 절제 실험은 보고되지 않았다. 따라서 배포 정책의 개선을 선택적 증류만의 효과로 볼 수는 없다.
구조화된 성찰을 제거하면 모든 설정에서 보상이 낮아진다. 반면 메모리를 제거한 효과는 더 작고 일관되지 않다. Olmo의 Sokoban 결과는 메모리가 없을 때 0.24로, 전체 ERL의 0.20보다 높다. 이는 메모리가 최종 성능을 항상 개선하지는 않음을 보여 준다.
Qwen의 FrozenLake에서 전체 ERL은 각 절제 변형보다 더 빠르게 개선되고 더 높은 검증 보상에서 정체 구간에 도달한다. 메모리를 제거해도 개선 효과는 상당 부분 유지되지만 진행이 늦어진다. 일반적인 궤적 기반 재시도의 곡선은 더 낮으며, 이 패널에서는 최종적으로 RLVR보다 낮은 수준에 머문다.
재시도에는 최초 시도의 관측, 행동, 보상, 피드백을 제공하지만 생성된 성찰은 제공하지 않는다. 이는 독립적인 2번째 샘플보다 이전 경험의 재사용을 더 직접적으로 통제한다. 다만 전체 ERL과 비교하면 경험을 표현하는 방식이 달라진다.
5 Related Work
관련 연구에서는 ERL을 RLHF, 검증 가능한 보상을 이용한 추론, 도구 활용 에이전트, hindsight experience replay, 자체 생성한 상호작용 기록을 통한 학습과 연결한다. 방법론적으로 가장 가까운 비교 대상은 추론 시점의 성찰과 피드백을 조건으로 한 교사–학생 증류이다.
- Self-Refine과 Reflexion 같은 추론 시점의 방법은 대체로 배포 시에도 비평이나 메모리를 유지한다. 반면 ERL은 수정된 행동을 모델 매개변수에 반영하는 것을 목표로 한다.
- 동시기에 진행된 자기 증류 및 텍스트 피드백 연구도 피드백을 조건으로 한 행동을 배포 정책으로 전달한다. ERL은 시도–재시도 궤적 안에서 보상으로 학습한 성찰, 선택적 내재화, 에피소드 간 메모리를 강조한다.
6 Conclusion
결론은 명시적인 성찰과 선택적 내재화를 환경 피드백을 배포 가능한 행동 변화로 전환하는 방법으로 제시한다. 실험에서는 추론 시 성찰을 요구하지 않으면서도 평가한 설정에서 더 높은 최종 보상과 전반적인 실제 경과 시간 기준의 학습 이점을 보인다.
- 지속적인 적응은 향후 방향으로 제안한다. 실험에서는 평생 학습, 검색 기반 메모리, 크게 다른 환경으로의 전이를 검증하지 않는다.
부록
- A Full Algorithm and Gated Reflection에서는 Algorithm 2가 최초 시도로 정책을 갱신하고, r^(1) < τ일 때만 성찰을 실행한다. 이때 τ = 1이다. 저자들은 성공한 시도를 성찰하면 인스턴스에 특화된 보상 해킹을 유도하고, 성찰을 조건으로 한 궤적이 초기 최적화를 지배할 수 있었다고 정성적으로 보고한다. 다만 성찰 실행 조건에 대한 정량적인 절제 실험은 제공하지 않는다.
- Algorithms 1과 2의 메모리 저장 조건은 r^(2) > τ이다. τ = 1이고 문서에 명시된 보상의 상한이 1.0이므로, 이 엄격한 부등식은 충족될 수 없다. 따라서 의사코드와 보고된 메모리 실험 사이에는 해결되지 않은 불일치가 남아 있다.
- Appendix A는 메모리를 누적되는 검색 데이터베이스가 아니라, 직접 덮어써서 갱신하는 일반 텍스트 시스템 프롬프트 지침으로 설명한다. 검색 기반 갱신과 on-policy 증류는 평가한 구성 요소가 아니라 향후 확장으로 제안한다. 본문은 후자를 reverse KL이라고 부르지만, 제시된 KL 수식에서는 성찰을 조건으로 한 정책이 배포 정책보다 앞에 놓인다. on-policy 증류에 대해서는 이 글을 참조하라.
- B Envrionment Configuration Details의 B.1 Frozen Lake에서는 격자 크기 n을 [2, 9]에서 균등하게 샘플링하고, 얼어 있는 타일의 확률 p를 [0.6, 0.85)에서 샘플링한다. 시작점과 목표점은 서로 다르며, 생성 과정은 유효한 경로를 보장한다. 상태 전이는 결정론적이다. 기호는 A = 에이전트 위치, B = 목표 타일, C = 구멍, D = 안전한 얼음 타일로 정의한다.
- B.2 Sokoban에서는 n을 [6, 8]에서 균등하게 샘플링한다. 경계에는 벽을 두고, 내부에는 상자 1개와 목표 1개를 겹치지 않게 배치한다. BFS는 8회 이하의 이동으로 해결할 수 있는 배치만 채택한다. 행동은 {Up, Down, Left, Right}이며, 유효하지 않은 이동은 상태를 바꾸지 않는다. 행동 횟수는 8회로 제한한다.
- B.3 HotpotQA의 검색에는 PeterJinGo/wiki-18-corpus Wikipedia 코퍼스, PeterJinGo/wiki-18-e5-index 밀집 인덱스, intfloat/e5-base-v2 임베딩, 다중 GPU를 지원하는 FAISS를 사용한다. 도구는 query와 top_k 매개변수를 받는 local_search이다. 추출한 \boxed{} 답변은 소문자 변환과 공백 정규화를 거친 뒤 채점한다.
- C Training Configuration Details에 따르면 학습은 H100 8개에서 rLLM, GRPO, vLLM, FlashAttention, hybrid engine training, gradient checkpointing, remove-padding을 사용한다. 학습률은 1e-6이며, 학습 배치와 actor 미니배치 크기는 모두 64이다. 프롬프트와 응답의 최대 길이는 각각 8,196토큰이고, GPU당 actor 최대 토큰 길이는 24,000이다. Actor의 매개변수 및 옵티마이저 오프로딩과 참조 모델의 매개변수 오프로딩을 활성화한다.
- 학습 롤아웃은 temperature 0.7, GPU 메모리 사용률 0.85, 비동기 생성, tensor model parallel size 1을 사용한다. 검증은 프롬프트당 샘플 4개와 temperature 0.7, top-p 0.8, top-k 20을 사용한다. KL 손실 계수와 고정 KL 제어 계수는 모두 0.001이며, actor 클리핑 비율의 상한은 0.28이고 엔트로피 계수는 0이다.
- Appendix C는 RLVR에 프롬프트당 샘플 10개, ERL에 시도당 샘플 4개를 사용한다고 명시한다. 평가는 5회 반복마다 수행하고, 수렴하면 수동으로 조기 종료한다. Rejection sampling과 단계별 advantage 추정은 비활성화한다. Tables 2–9는 최초 프롬프트, 성찰 프롬프트, 예시 과제, 성찰을 제거한 일반 재시도 템플릿을 제공한다.
짧은 생각
성찰을 제거한 절제 실험은 명시적인 성찰 지침의 가치를 가장 분명하게 보여 준다. 성찰 지침은 이전 궤적과 일반적인 재시도 지시를 제공하는 방식보다 좋은 성과를 낸다. 배포 정책의 결과도 별도로 중요하다. 추론 시 학습 때의 성찰 루프가 필요하지 않기 때문이다.
실험 범위는 더 넓은 결론을 내리는 데 한계가 있다. 백본 2개, 제어 과제당 평가용 격자 배치 100개, 행동 한도가 8회인 결정론적 에피소드, 시드별 불확실성의 부재만으로는 다양한 아키텍처, 긴 계획 구간, 분포 밖 환경 동작에 대한 강건성을 입증할 수 없다.
재현성을 확보하려면 엄격한 메모리 임계값과 롤아웃 5개 대 4개의 불일치를 해결해야 한다. 연산량 산정, 독립 실행 간 변동성, 내재화만 제거하는 절제 실험이 있으면 각 구성 요소의 기여를 더 정확히 구분할 수 있다.