


Learning beyond Teacher: Generalized On-Policy Distillation with Reward Extrapolation 요약 설명
12 Feb 2026 | Paper Review On-Policy Distillation Reward Extrapolation Reinforcement Learning목차
- 요약
- 1 Introduction
- 2 Related Work
- 3 Methodology
- 4.1 Experiments with Same-Sized Student and Teacher
- 4.2 Experiments in the Strong-to-Weak Distillation Setting
- 5 Conclusion and Discussion
- 부록
- 짧은 생각
이번 글에서는 Learning beyond Teacher: Generalized On-Policy Distillation with Reward Extrapolation 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 2월 12일(Arxiv)
- Yang, Wenkai, Liu, Weijie, Xie, Ruobing, Yang, Kai, Yang, Saiyong, Lin, Yankai.
- Gaoling School of Artificial Intelligence, Renmin University of China, LLM Department, Tencent
- 논문 링크
- Github
요약
- 이 논문은 on-policy distillation(OPD)을 KL 제약이 있는 강화학습으로 재정식화한다. 보상은 teacher 확률을 reference 확률로 나눈 로그 확률비이며, 토큰별로 분해할 수 있다. Generalized On-Policy Distillation(G-OPD)은 보상 배율 λ와 선택 가능한 reference 모델을 도입한다. λ = 1에서는 표준 OPD가 된다.
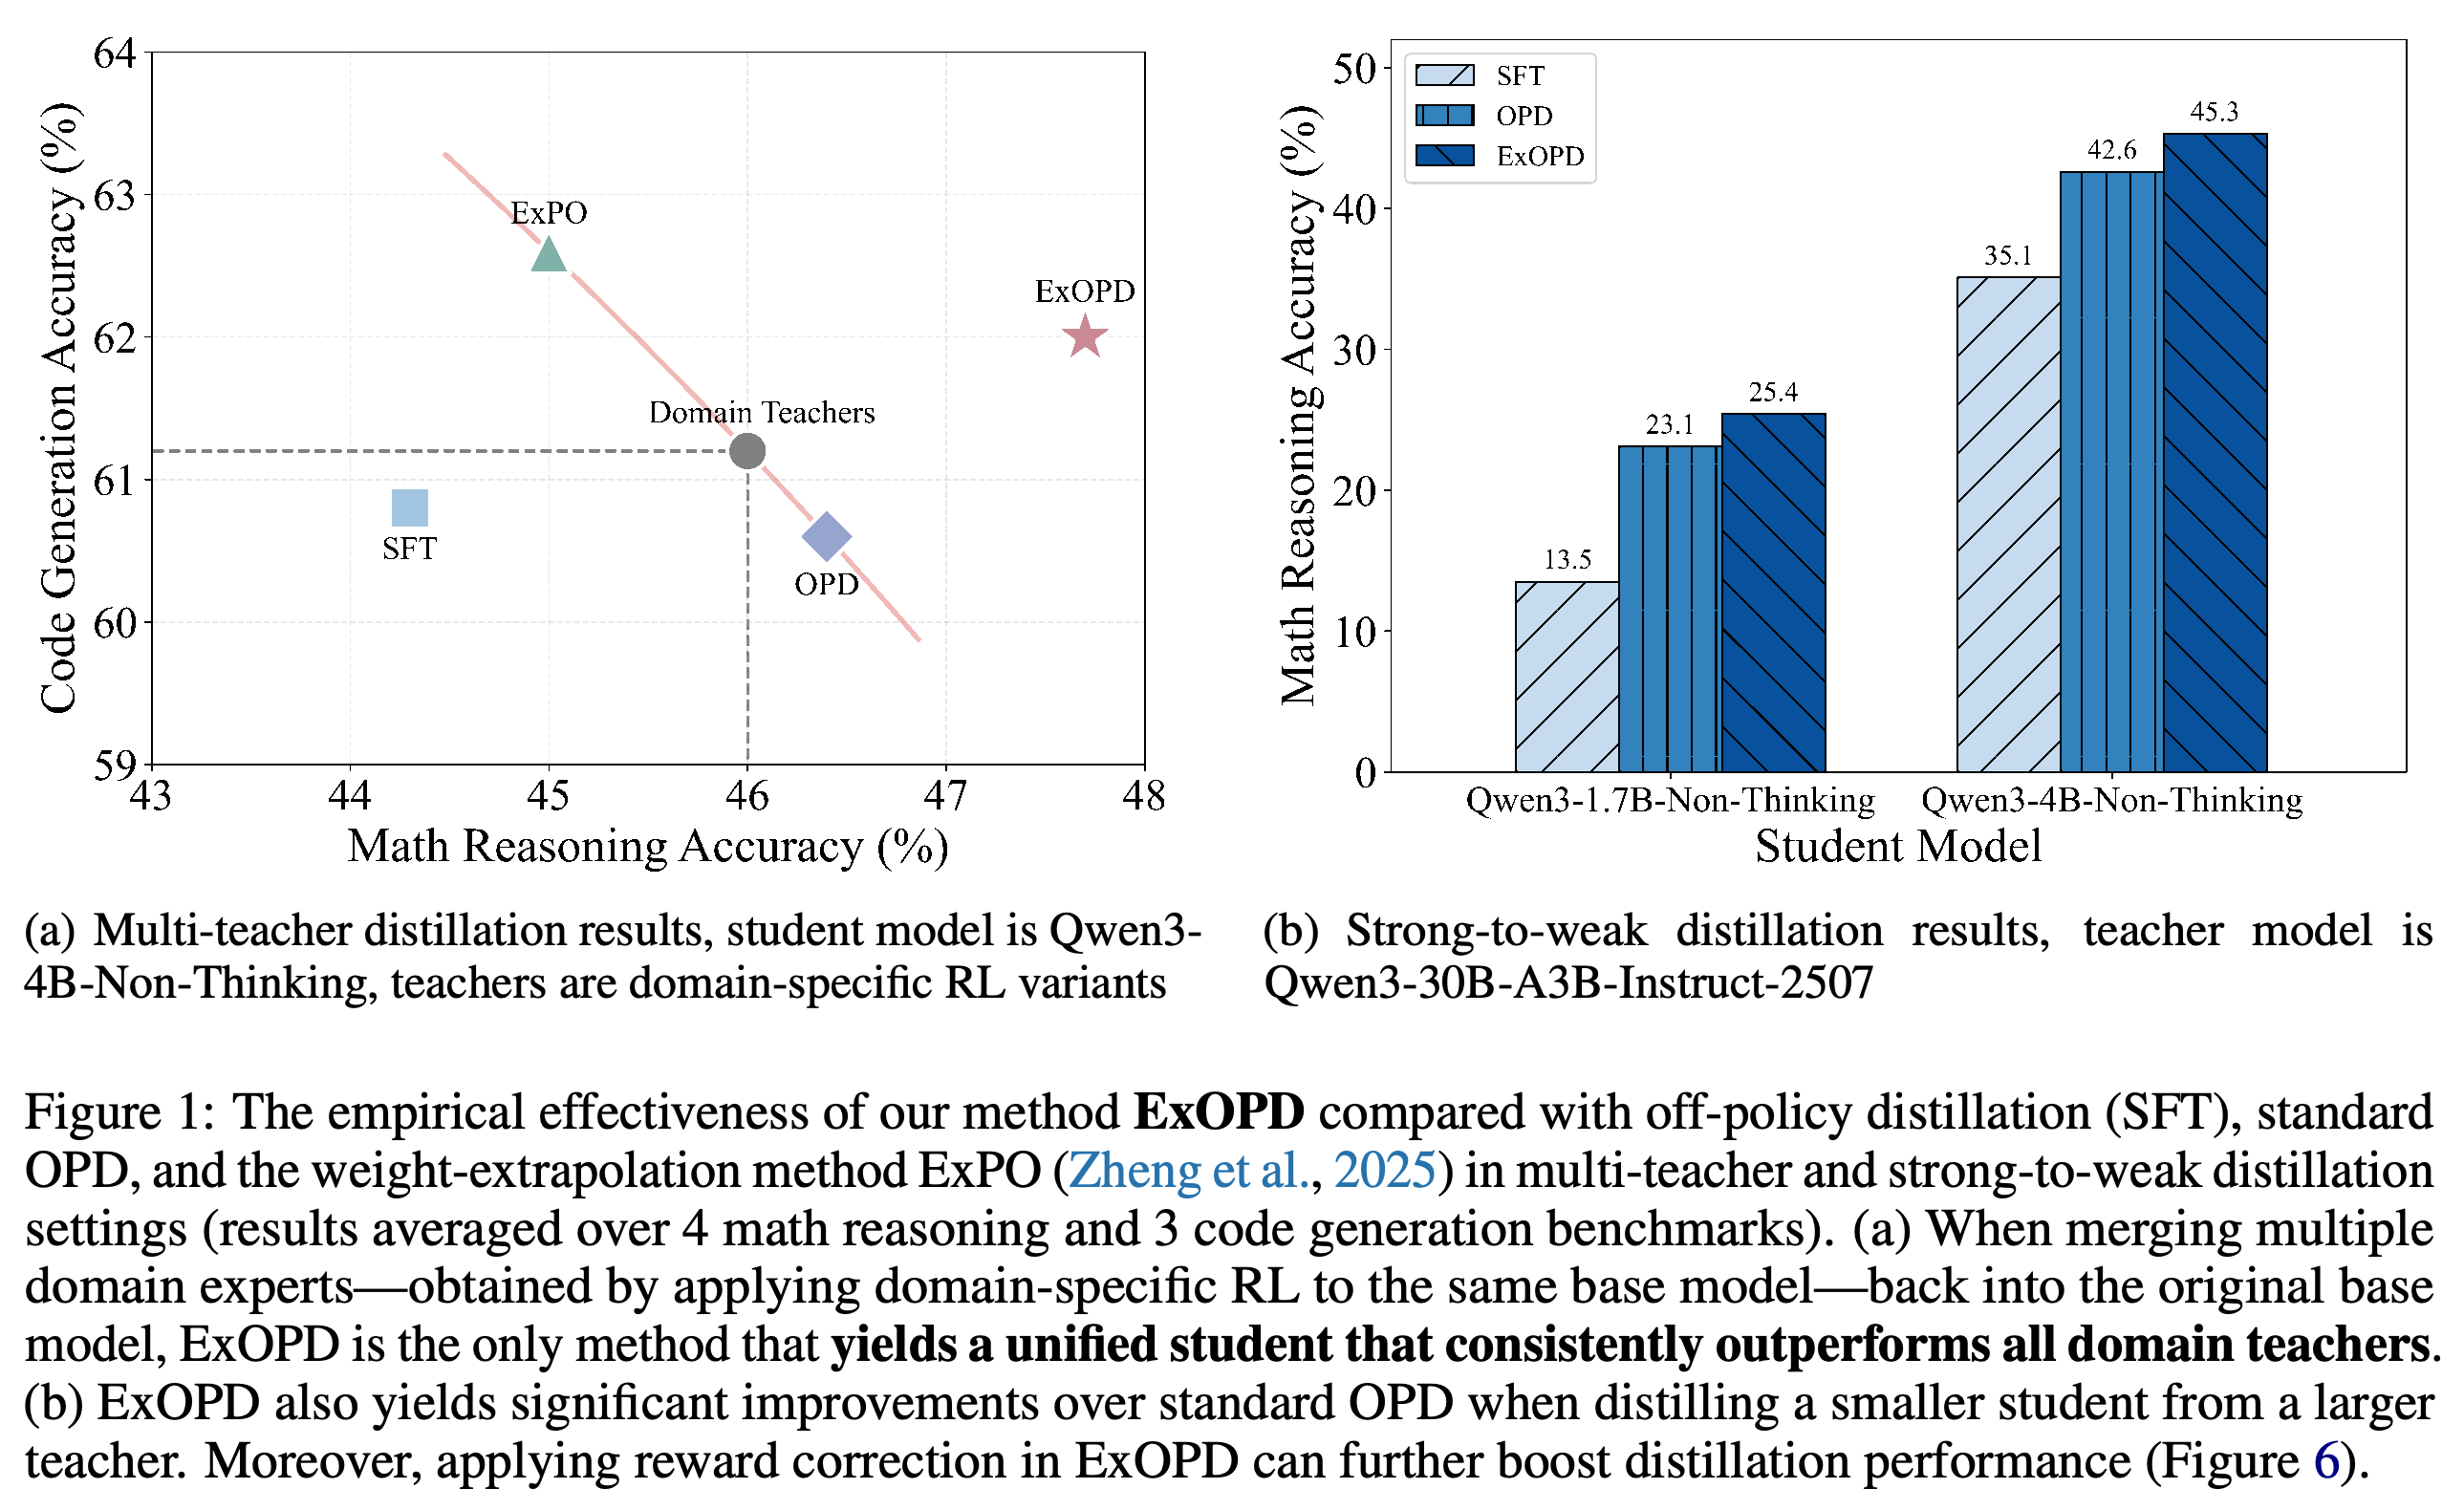
- ExOPD라고 부르는 reward extrapolation은 λ > 1을 사용해 KL 정규화에 대한 암묵적 보상의 상대적 가중치를 높인다. 주요 multi-teacher 실험에서 λ = 1.25를 적용한 통합 Qwen3-4B-Non-Thinking student는 7개 벤치마크 모두에서 해당 수학·코드 domain teacher를 능가한다. 평균 정확도는 각각 47.7%와 62.0%다.
- ExOPD는 Qwen3-30B-A3B-Instruct-2507에서 1.7B 및 4B student로 수학 능력을 증류할 때도 성능을 높인다. 별도의 4B-to-1.7B 실험에서는 teacher의 RL 이전 모델을 reference로 사용하면 성능이 더 높아진다. Extrapolation에는 reference 모델 연산이 필요하며, 대체로 응답이 길어진다. 지나친 extrapolation은 정확도를 떨어뜨릴 수 있고, 서로 다른 모델 계열 간 전이는 검증하지 않았다.
Multi-teacher 패널에서 ExOPD는 각 domain teacher의 평균보다 높다. 반면 ExPO는 수학 정확도가 낮고 코드 정확도가 높다. Strong-to-weak 패널은 각 student 크기에서 OPD 대비 개선을 보여주지만, 어느 student도 더 큰 teacher를 능가했다는 근거는 아니다.
1 Introduction
OPD는 student가 생성한 trajectory에 teacher의 예측으로 학습 신호를 제공한다. 이를 통해 teacher가 생성한 학습 데이터와 student의 추론 행동 사이의 불일치를 줄인다. 이 논문은 OPD와 RL의 관계, 목적함수를 바꾸어 teacher 모방보다 나은 성능을 얻을 수 있는지, reference 선택이 용량이 다른 모델 간 전이에 어떤 영향을 주는지를 살펴본다.
- 첫 번째 설정은 공통 base 모델에서 도메인별 RL로 만든 변형 모델들을 다시 해당 base 모델로 통합한다.
- 두 번째 설정은 더 큰 teacher의 능력을 더 작은 student로 전이한다.
- 공개 구현은 https://github.com/RUCBM/G-OPD 에서 확인할 수 있다.
2 Related Work
관련 연구는 학습 trajectory를 생성하는 정책에 따라 증류 방법을 구분한다. G-OPD는 새로운 teacher 생성 방식이나 black-box 증류 기법을 제안하지 않는다. 대신 student가 생성한 trajectory에 teacher가 학습 신호를 제공하는 방식을 기반으로 한다.
Off-Policy Distillation.
Off-policy distillation은 teacher가 생성한 trajectory로 학습한다. KL divergence로 student의 logits를 teacher에 맞추거나, teacher가 샘플링한 토큰에 supervised fine-tuning(SFT)을 적용한다. SFT는 teacher의 전체 출력 분포를 요구하지 않지만, student의 현재 정책에서 샘플링한 trajectory에 직접 학습 신호를 제공하지는 않는다.
On-Policy Distillation.
OPD는 student에서 trajectory를 샘플링하고 토큰 분포를 teacher에 맞추어 조밀한 on-policy 학습 신호를 제공한다. 인용된 연구들은 서로 다른 모델 계열 간 전이, black-box teacher 접근, 맥락 정보의 self-distillation도 다룬다. 이들은 관련 연구 방향이며, 이 논문에서 평가한 설정은 아니다.
3 Methodology
이 방법은 reverse-KL 증류와 KL 정규화를 적용한 보상 최대화가 목적함수 수준에서 동등하다는 점에서 출발한다. 이후 보상과 정규화 사이의 가중치 비율, 암묵적 보상을 정의하는 reference 분포를 바꾼다.
3.1 Preliminaries
기초 설명에서는 teacher에서 샘플링하는 지식 증류, student에서 샘플링하는 KL 제약 RL, student에서 샘플링하는 reverse-KL OPD를 비교한다. 지식 증류는 teacher에서 student로 향하는 forward KL을 통해 student 분포를 teacher에 맞춘다. 반면 OPD는 student에서 teacher로 향하는 reverse KL을 최소화한다.
- RL 목적함수는 응답 보상의 기댓값에서 reference 정책과의 KL divergence에 β를 곱한 값을 뺀다. 이 KL 항은 분포 변화를 제한한다.
- 보상은 학습된 선호도 모델이나 결정론적 결과 검증기에서 얻을 수 있다. 논문은 흔히 쓰는 종료 시점 보상과 OPD의 토큰별 학습 신호를 대비한다.
- Teacher의 전체 출력 분포를 얻을 수 없거나 계산 비용이 높다면, teacher가 생성한 데이터로 수행하는 SFT가 실용적인 off-policy 대안이다.
정확한 OPD gradient에는 현재 토큰부터 응답 끝까지 student와 teacher 사이의 로그 확률 차이를 누적한 값이 포함된다. 실용적인 근사는 할인율 0을 사용하며 현재 토큰의 차이만 남긴다.
- 따라서 이 국소 업데이트는 시퀀스 수준 reverse-KL gradient의 근사이며, 해당 목적함수의 정확한 gradient는 아니다.
- Appendix A는 앞선 토큰의 항들이 기댓값에서 사라지는 이유를 보이고, 현재 토큰부터 응답 끝까지 남은 항들의 합을 유도한다.
3.2 Generalized On-Policy Distillation
Reference 정책을 도입하면 표준 OPD를 암묵적 보상 log[π*(y|x)/πref(y|x)]와 πref에 대한 KL 페널티로 분해할 수 있다. 이때 각 항의 가중치는 같다. G-OPD는 목적함수 JG-OPD(θ) = maxθ E[λ log(π*(y|x)/πref(y|x)) − DKL(πθ ∥ πref)]로 이 균형을 바꾼다.
- λ = 1에서는 reference에 의존하는 항들이 상쇄되므로 reference 선택과 관계없이 표준 OPD가 된다.
- λ ≠ 1에서는 reference가 목적함수에 영향을 주며, reference의 로그 확률을 계산해야 한다.
- 기본적으로 πref는 student의 초기 정책이다. 양수 λ에 대해 보상을 재조정하면 λ는 KL 계수의 역수에 대응한다.
Equation (12)는 제안한 목표 분포의 변화를 log πθ(y|x) = λ log π*(y|x) + (1 − λ) log πref(y|x)로 표현한다. 논문은 0 < λ < 1을 reward interpolation, λ > 1을 reward extrapolation으로 해석한다. 후자는 teacher에 맞추는 수준을 넘어 reference에서 teacher로의 분포 변화를 추가로 반영한다.
- 저자들은 interpolation이 reference와 표준 OPD 사이의 행동을 만들며, 응답 길이도 그 중간에 놓일 것이라고 추측한다.
- Extrapolation은 대리 보상을 강화하므로 그 편향도 증폭할 수 있다. 과제 정확도 향상을 보장하지는 않는다.
- 인쇄된 Equation (12)에는 입력에 의존하는 정규화 항이 빠져 있으므로, 정규화하지 않은 로그 정책 관계로 읽어야 한다.
공통 base에서 파생된 domain expert에서는 그 base를 πref로 선택하면 도메인별 RL이 유발한 분포 변화를 분리할 수 있다. Strong-to-weak 전이의 reward correction은 student base reference를 teacher의 RL 이전 base로 바꾼다. 이를 통해 teacher의 post-training 변화와 teacher·student base 모델 사이의 차이를 분리한다.
- Equation (13)은 G-OPD를 teacher 방향의 reverse-KL 정규화와 λ − 1로 가중한 추가 암묵적 보상으로 다시 표현한다.
- Reward correction에는 teacher의 RL 이전 체크포인트가 필요하다. 이 reference가 student보다 크면 연산량도 증가한다.
- Equation (14)에 인쇄된 토큰 계수의 부호는 Equation (11)의 최대화 목적함수를 위한 상승 방향 advantage가 아니라, 목적함수의 음수를 손실로 삼았을 때의 gradient 부호다.
4.1 Experiments with Same-Sized Student and Teacher
실험은 먼저 같은 크기의 single-teacher 증류에서 λ를 바꾸고, 이어 수학·코드 teacher를 통합한 뒤, 마지막으로 strong-to-weak 전이를 평가한다. 같은 크기 설정에서는 Qwen3-4B-Non-Thinking을 초기 student이자 domain teacher들의 공통 기반 모델로 사용한다.
4.1.1 Experimental Settings
수학 학습에는 난이도가 6 이상인 DeepMath 샘플 57K를, 코드 학습에는 Eurus-RL-Code 샘플 25K를 사용한다. 별도의 GRPO 학습으로 Qwen3-4B-Non-Thinking-RL-Math와 Qwen3-4B-Non-Thinking-RL-Code를 만든다. 수학 정답을 맞히거나 코드의 모든 단위 테스트를 통과하면 보상 1.0을, 그렇지 않으면 0.0을 부여한다.
- 주요 수학·코드 teacher는 각각 500, 300 optimization step으로 학습한다. 각 모델은 batch size 128, rollout n = 8, learning rate 1 × 10⁻⁶, KL 계수 0.0을 사용한다.
- RL의 최대 응답 길이는 수학에서 16,384, 코드에서 8192다.
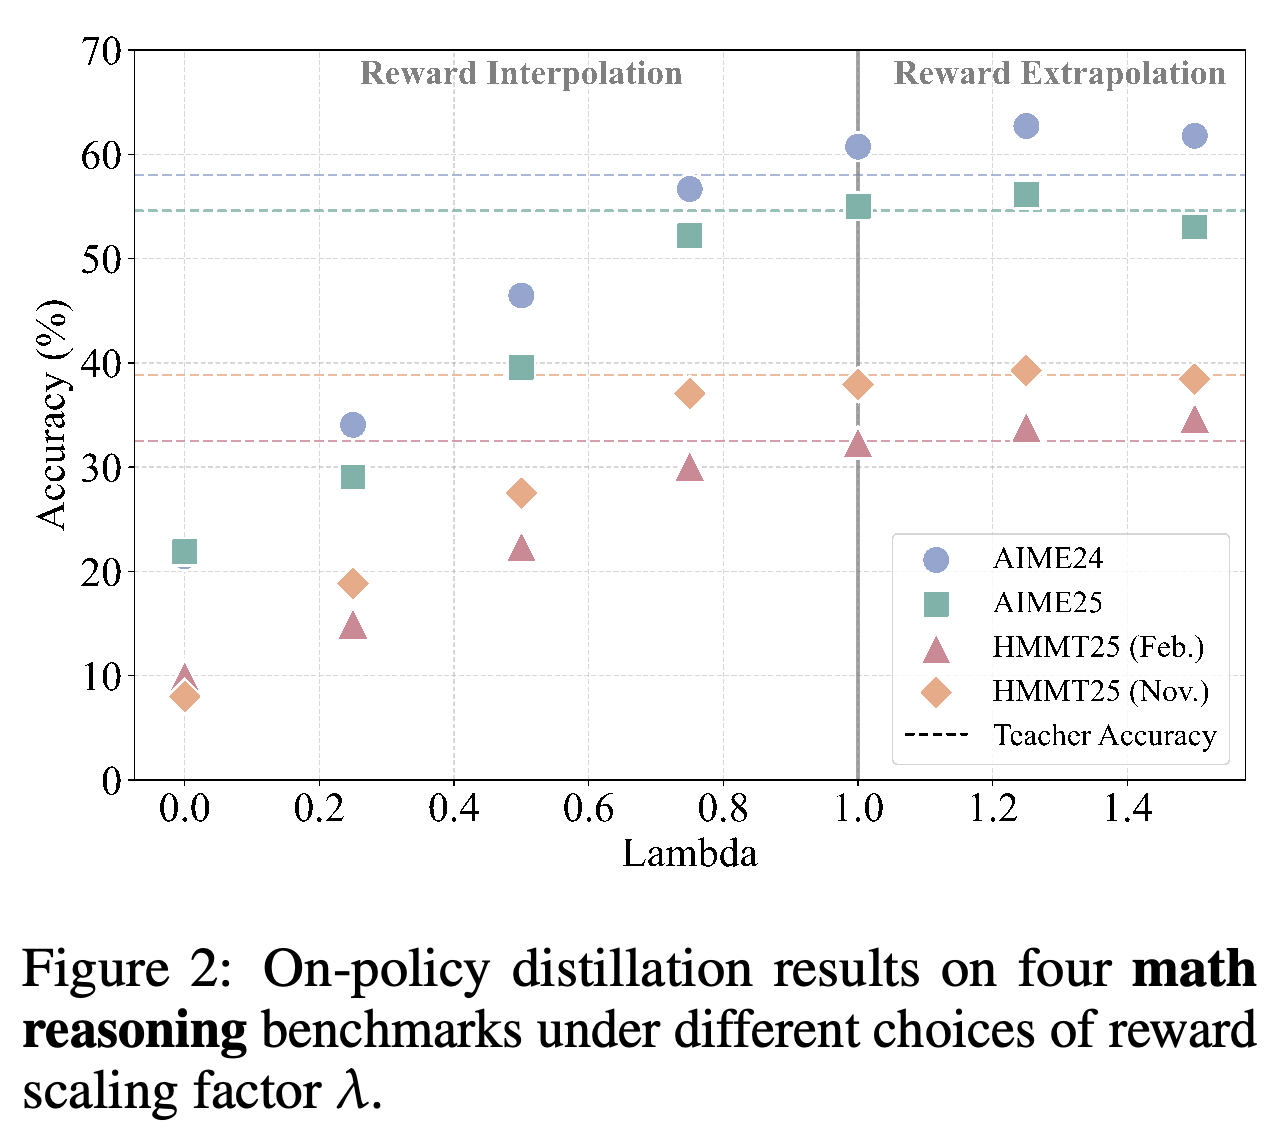
- 증류는 같은 데이터셋을 사용하며, 원래 student를 reference로 고정한 채 λ ∈ {0.0, 0.25, 0.5, 0.75, 1.0, 1.25, 1.5}를 평가한다. λ = 0.0은 초기 모델을 나타낸다.
- G-OPD는 batch size 1024, rollout n = 1, learning rate 1 × 10⁻⁵, 최대 응답 길이 16,384를 사용한다. GRPO와 G-OPD는 verl과 토큰별 rollout correction을 사용한다.
수학 teacher는 GRPO 500 step, prompt당 rollout 8개, 최대 응답 길이 16,384를 사용한다. KL 계수는 0.0이다. 따라서 실제 teacher 학습 설정은 이론 설명에서 사용하는 일반적인 KL 제약 정식화와 다르다.
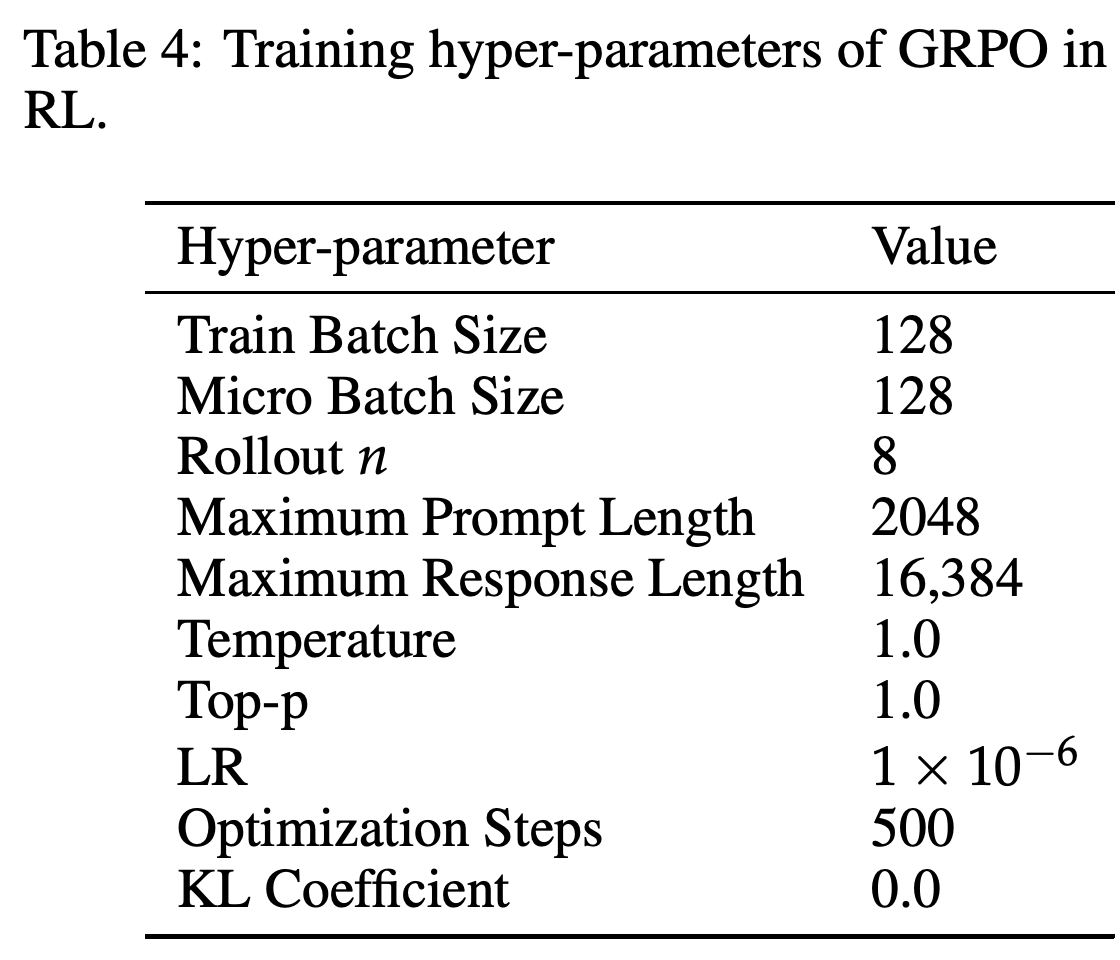
G-OPD는 batch size 1024, prompt당 rollout 1개, learning rate 1 × 10⁻⁵를 사용한다. 이는 GRPO 설정과 다르므로, 증류 step이 적다는 사실만으로 연산량이 그에 비례해 적다고 볼 수는 없다.
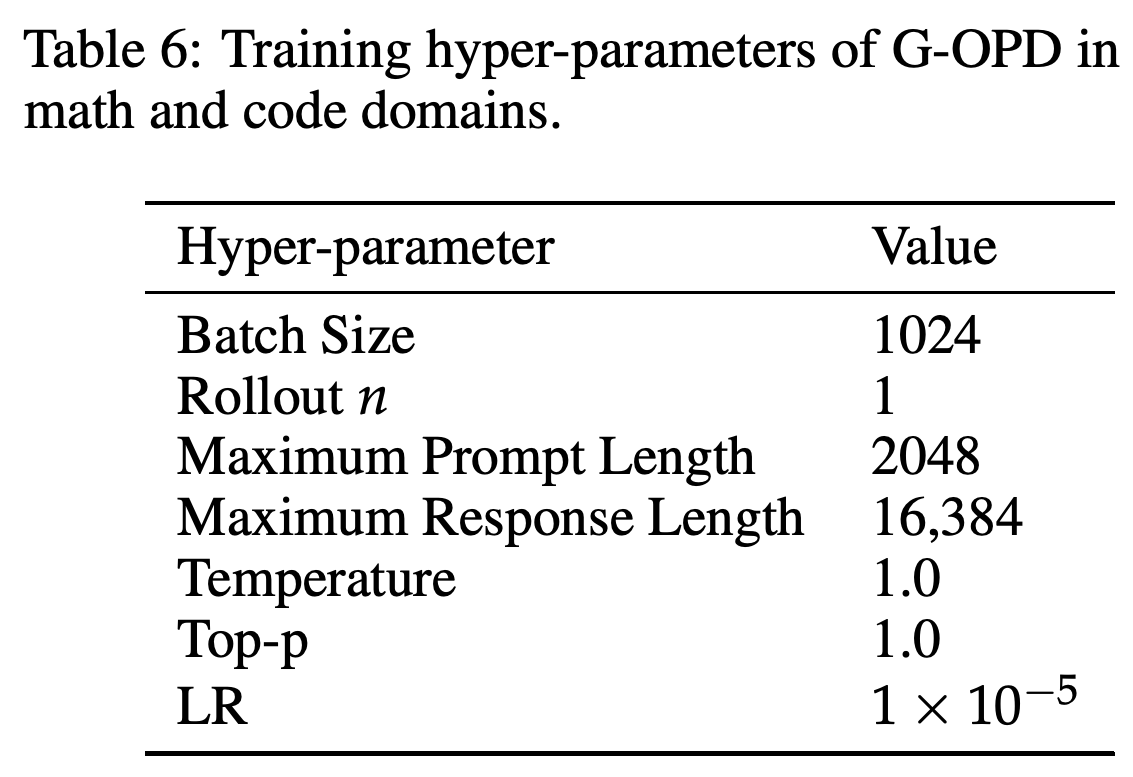
수학은 AIME24, AIME25, HMMT25 (February), HMMT25 (November)에서 평가한다. 코드는 HumanEval+, MBPP+, LiveCodeBench v6의 February 2025∼May 2025 구간에서 평가한다. 평가에서는 temperature 1.0, top-p 1.0, 최대 생성 길이 16,384를 사용한다. 수학 문제당 풀이 32개, 코드 문제당 풀이 4개를 샘플링한 뒤 평균 정확도를 보고한다.
- 수학 답안 검증에는 Math-Verify를 사용한다. https://github.com/huggingface/Math-Verify 에서 확인할 수 있다.
- 평가 지표는 샘플링한 풀이의 정답 여부를 평균한 값이다. best-of-32 또는 best-of-4 성공률이 아니다.
4.1.2 Results of Single-Teacher Distillation
λ를 바꾼 실험에서 표준 OPD는 teacher의 정확도와 응답 길이를 대략 재현하며, interpolation은 행동을 base 모델 쪽으로 이동시킨다. λ = 1.25에서 single-teacher ExOPD는 모든 벤치마크에서 주요 teacher를 능가한다. 수학 평균 정확도는 ExOPD 48.0%, teacher 46.0%, OPD 46.5%다. 코드 평균 정확도는 각각 62.1%, 61.2%, 60.8%다.
- Figures 2와 3은 벤치마크별 interpolation 및 extrapolation 추세를 보여준다.
- 선택한 배율은 주요 결과 7개를 모두 개선하지만, 더 큰 λ가 정확도를 일관되게 높이지는 않는다.
λ가 1에 가까워질수록 수학 정확도는 대체로 teacher 성능에 가까워진다. λ = 1.25는 주요 수학 결과 4개를 모두 개선하지만, 추가 extrapolation이 언제나 유리하지는 않다.
코드 결과는 λ = 1.25에서 유리하지만, λ = 1.5에서는 벤치마크마다 다른 양상을 보인다. 더 큰 배율에서 HumanEval+ 성능이 하락하므로 보상 가중치를 높인다고 정확도가 반드시 향상되지는 않는다.
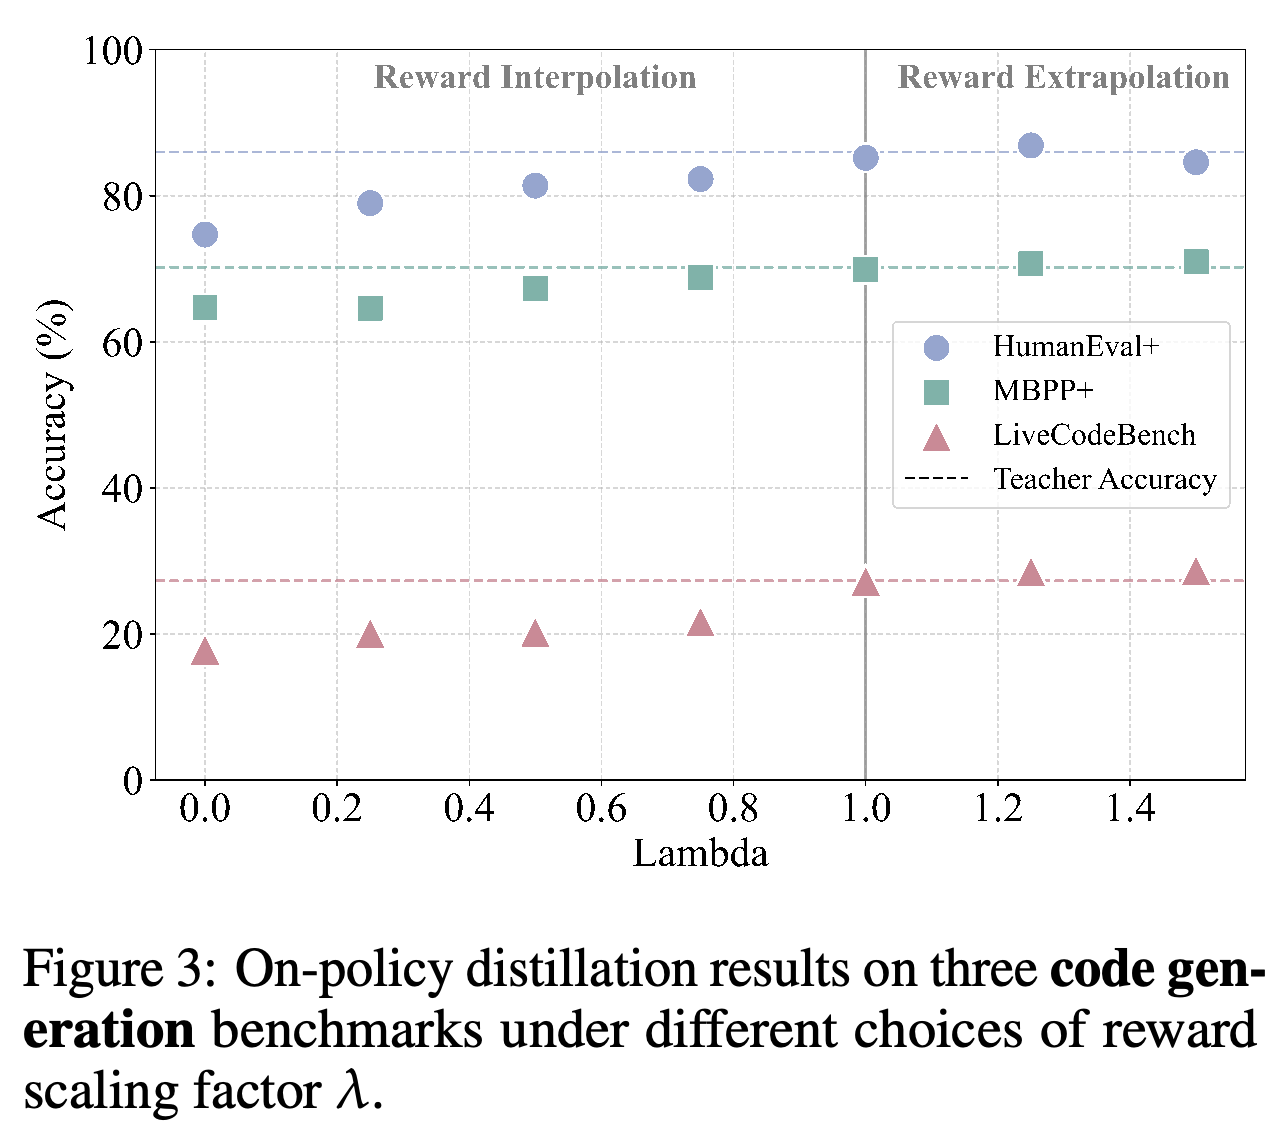
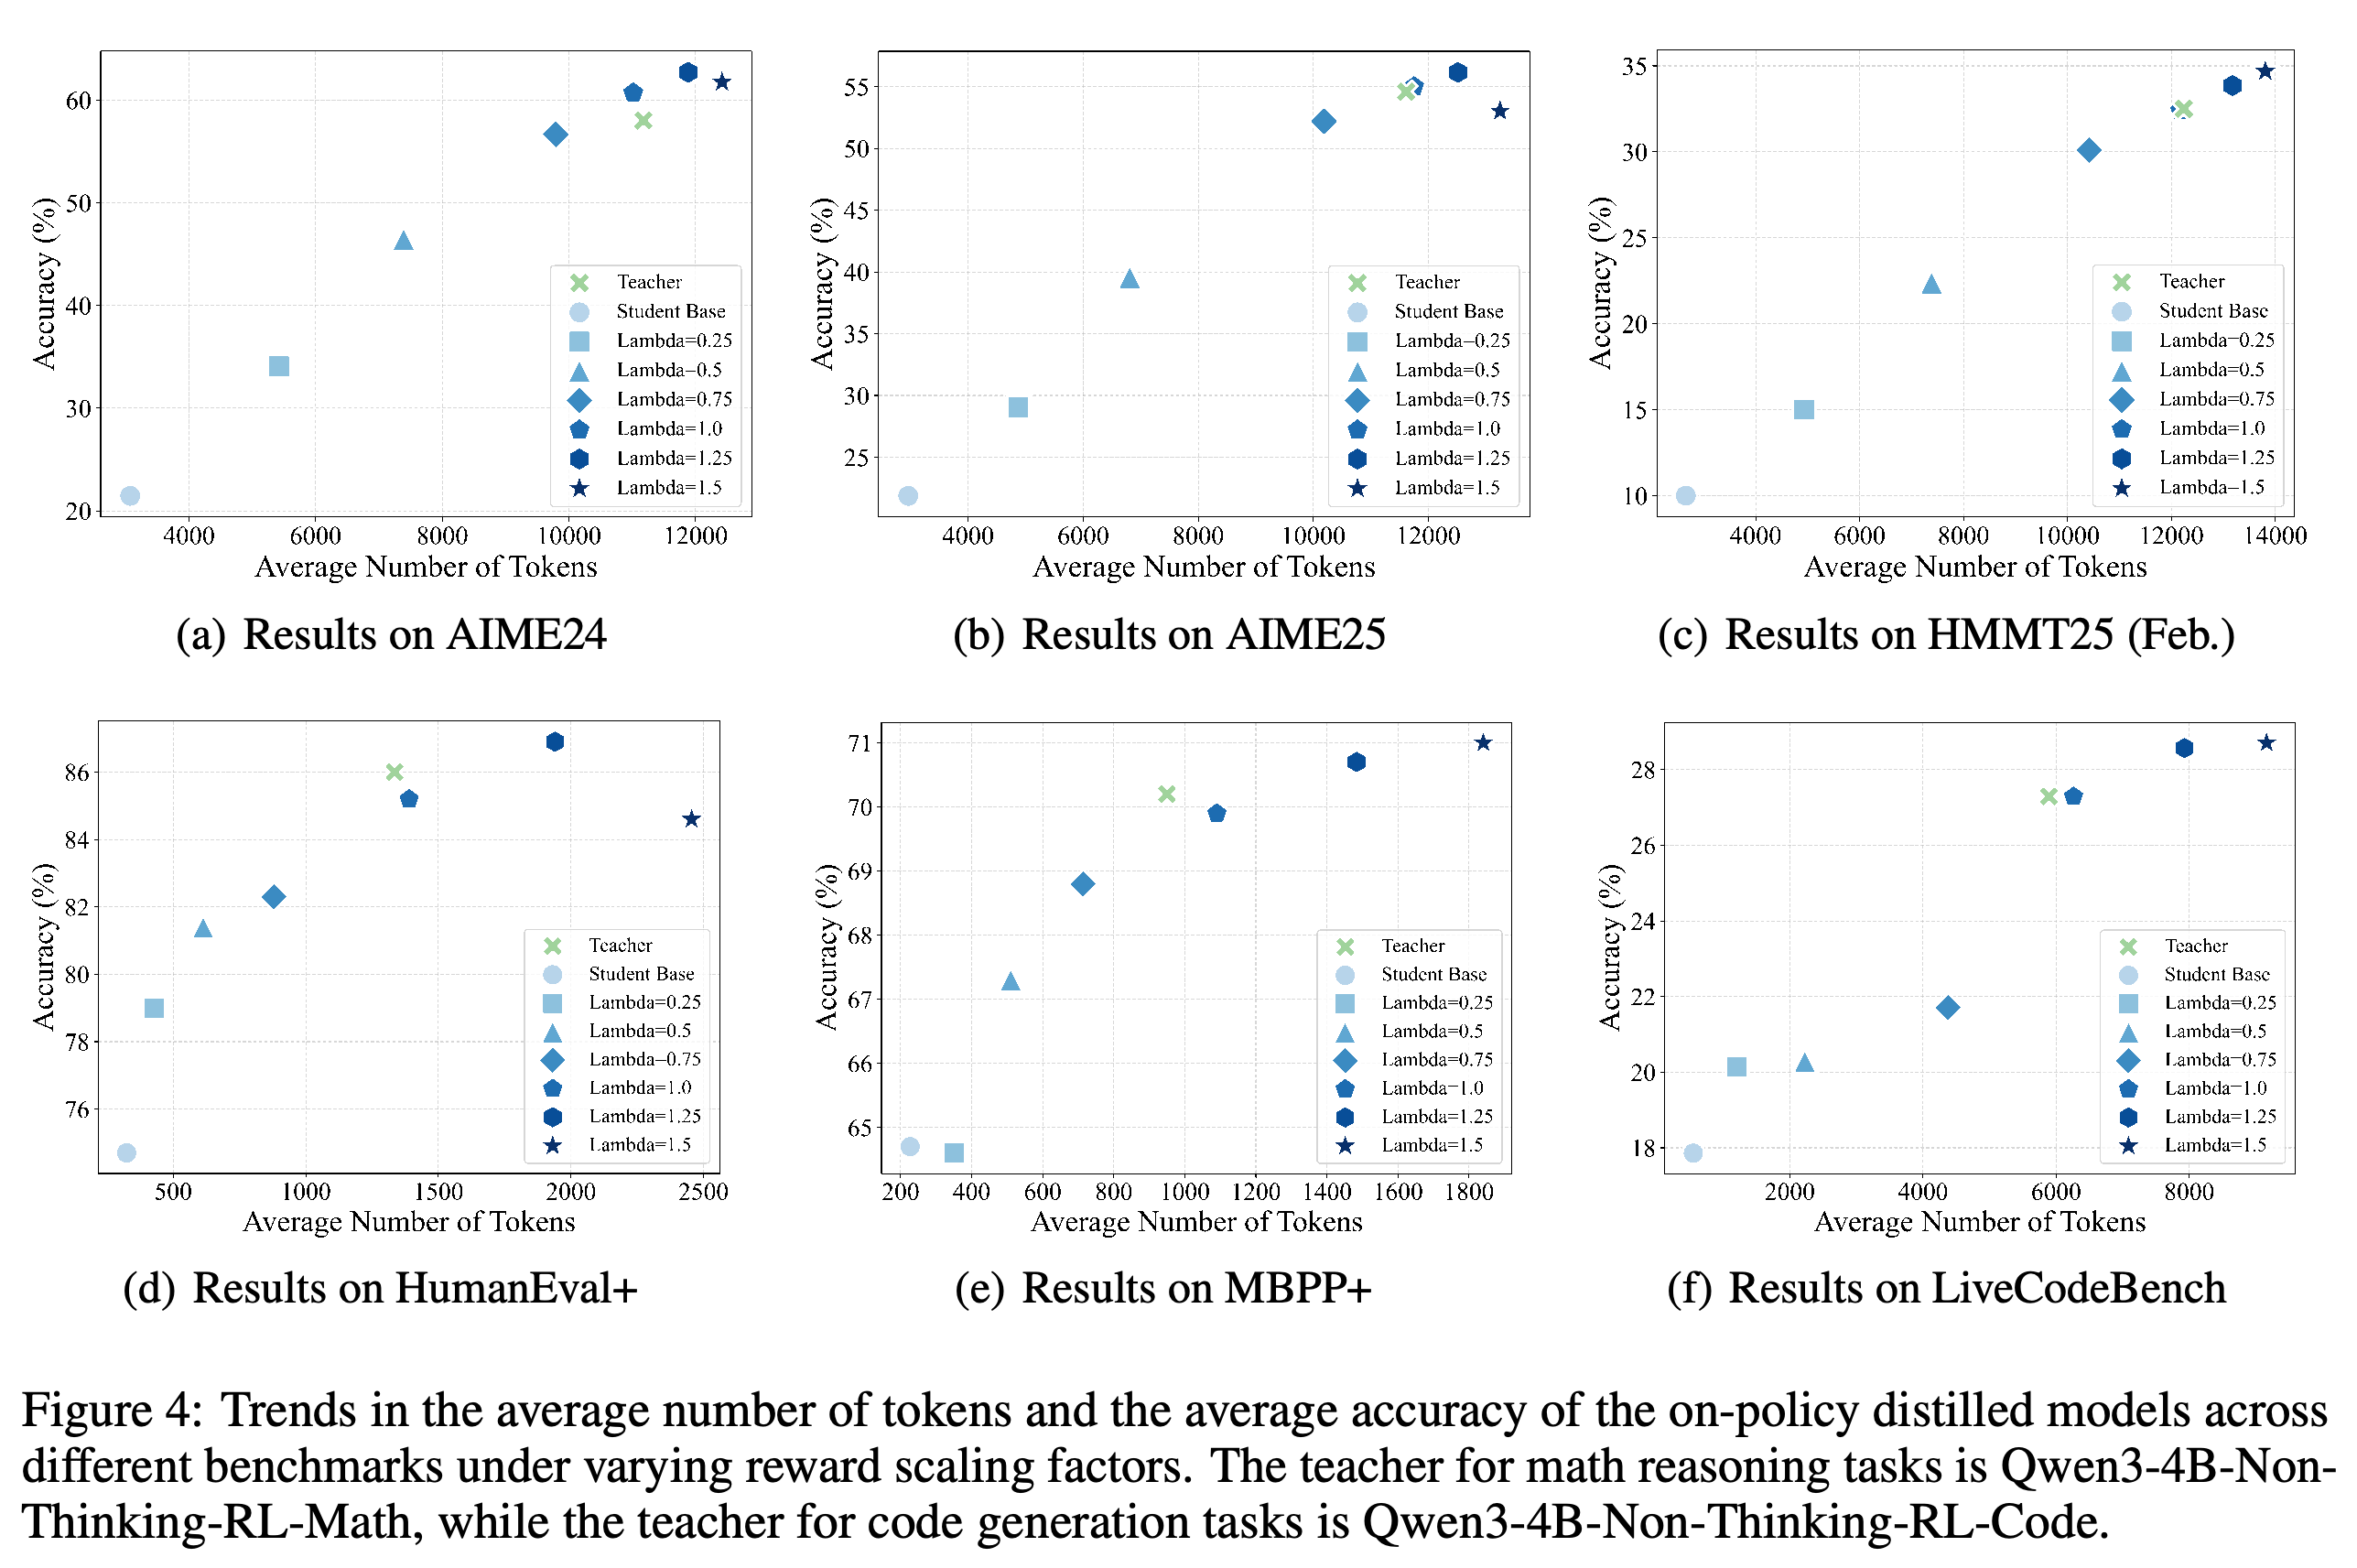
Figure 4는 보상 가중치를 높이면 대체로 응답이 길어진다는 점을 보여준다. λ = 1.5에서는 응답 길이가 계속 늘어나는데도 일부 벤치마크의 정확도가 떨어진다. 저자들은 암묵적 보상 해킹과 길이 편향을 가능한 원인으로 제시하지만, 이 메커니즘을 직접 검증하지는 않았다.
- 출력이 길어지면 추론 비용도 늘어난다. 실험은 생성 토큰 예산을 고정한 상태에서 정확도를 비교하지 않았다.
보상 가중치를 높이면 student의 출력이 대체로 길어진다. λ = 1.5의 일부 지점은 오른쪽으로 더 이동하면서 정확도는 떨어진다. 이는 extrapolation이 성능 향상 없이 생성 비용을 늘릴 수 있음을 보여준다.
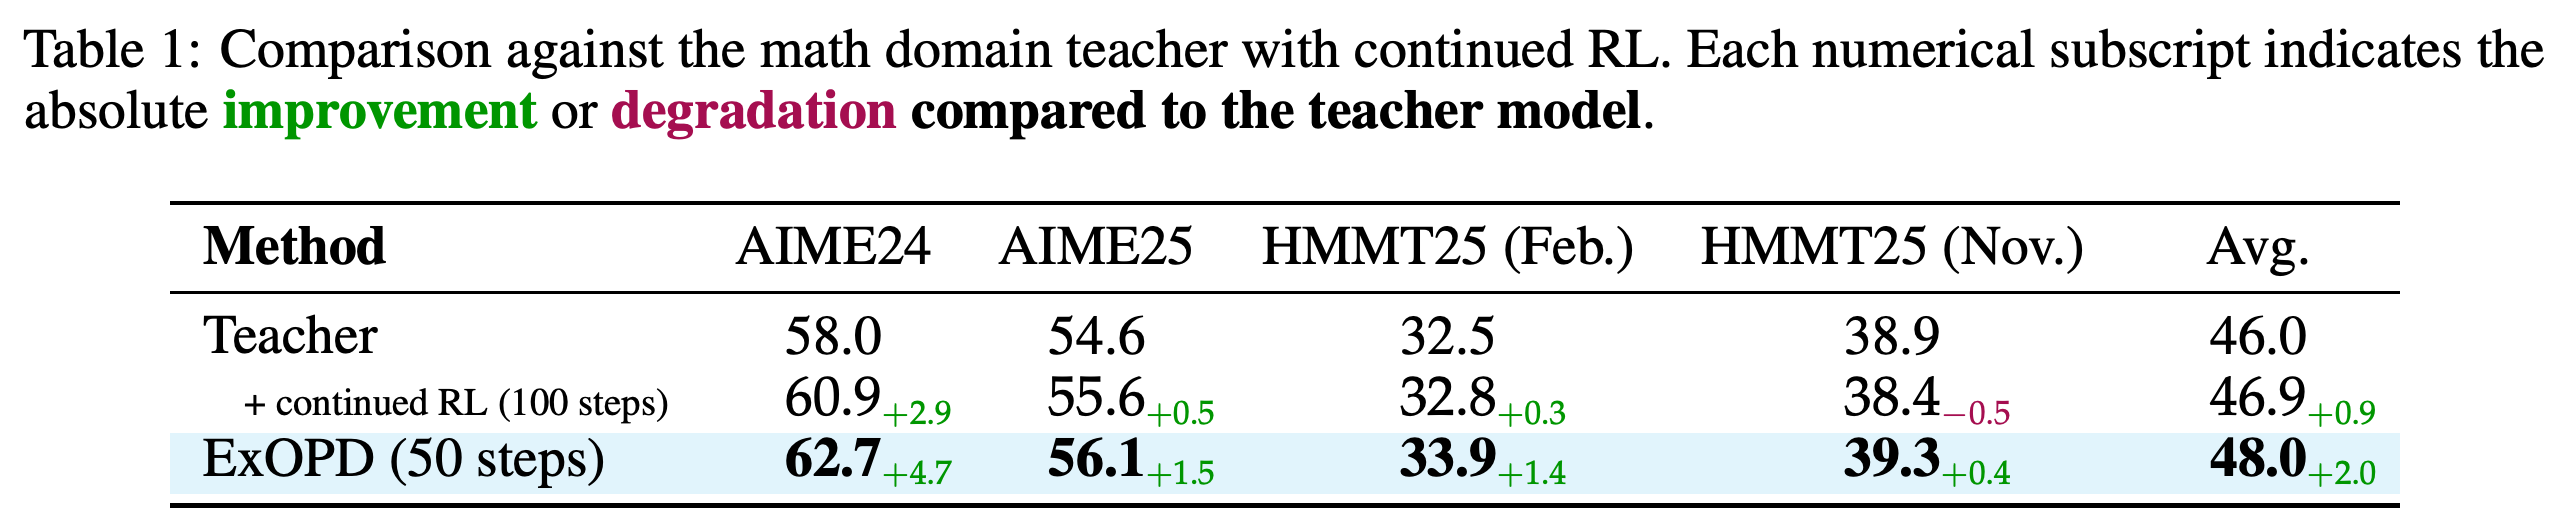
추가 RL 실험은 ExOPD의 이점이 단순히 teacher 학습 부족에서 비롯되는지 검토한다. 수학 RL을 100 step 더 수행하면 평균 정확도가 46.0%에서 46.9%로 높아지는 반면, ExOPD는 50 step으로 48.0%에 도달한다. Appendix C에서는 RL을 1200 step 수행한 teacher도 평가한다. ExOPD는 도메인 평균에서 여전히 더 높은 성능을 보이지만, 이 강한 teacher를 모든 수학 벤치마크에서 능가하지는 않는다.
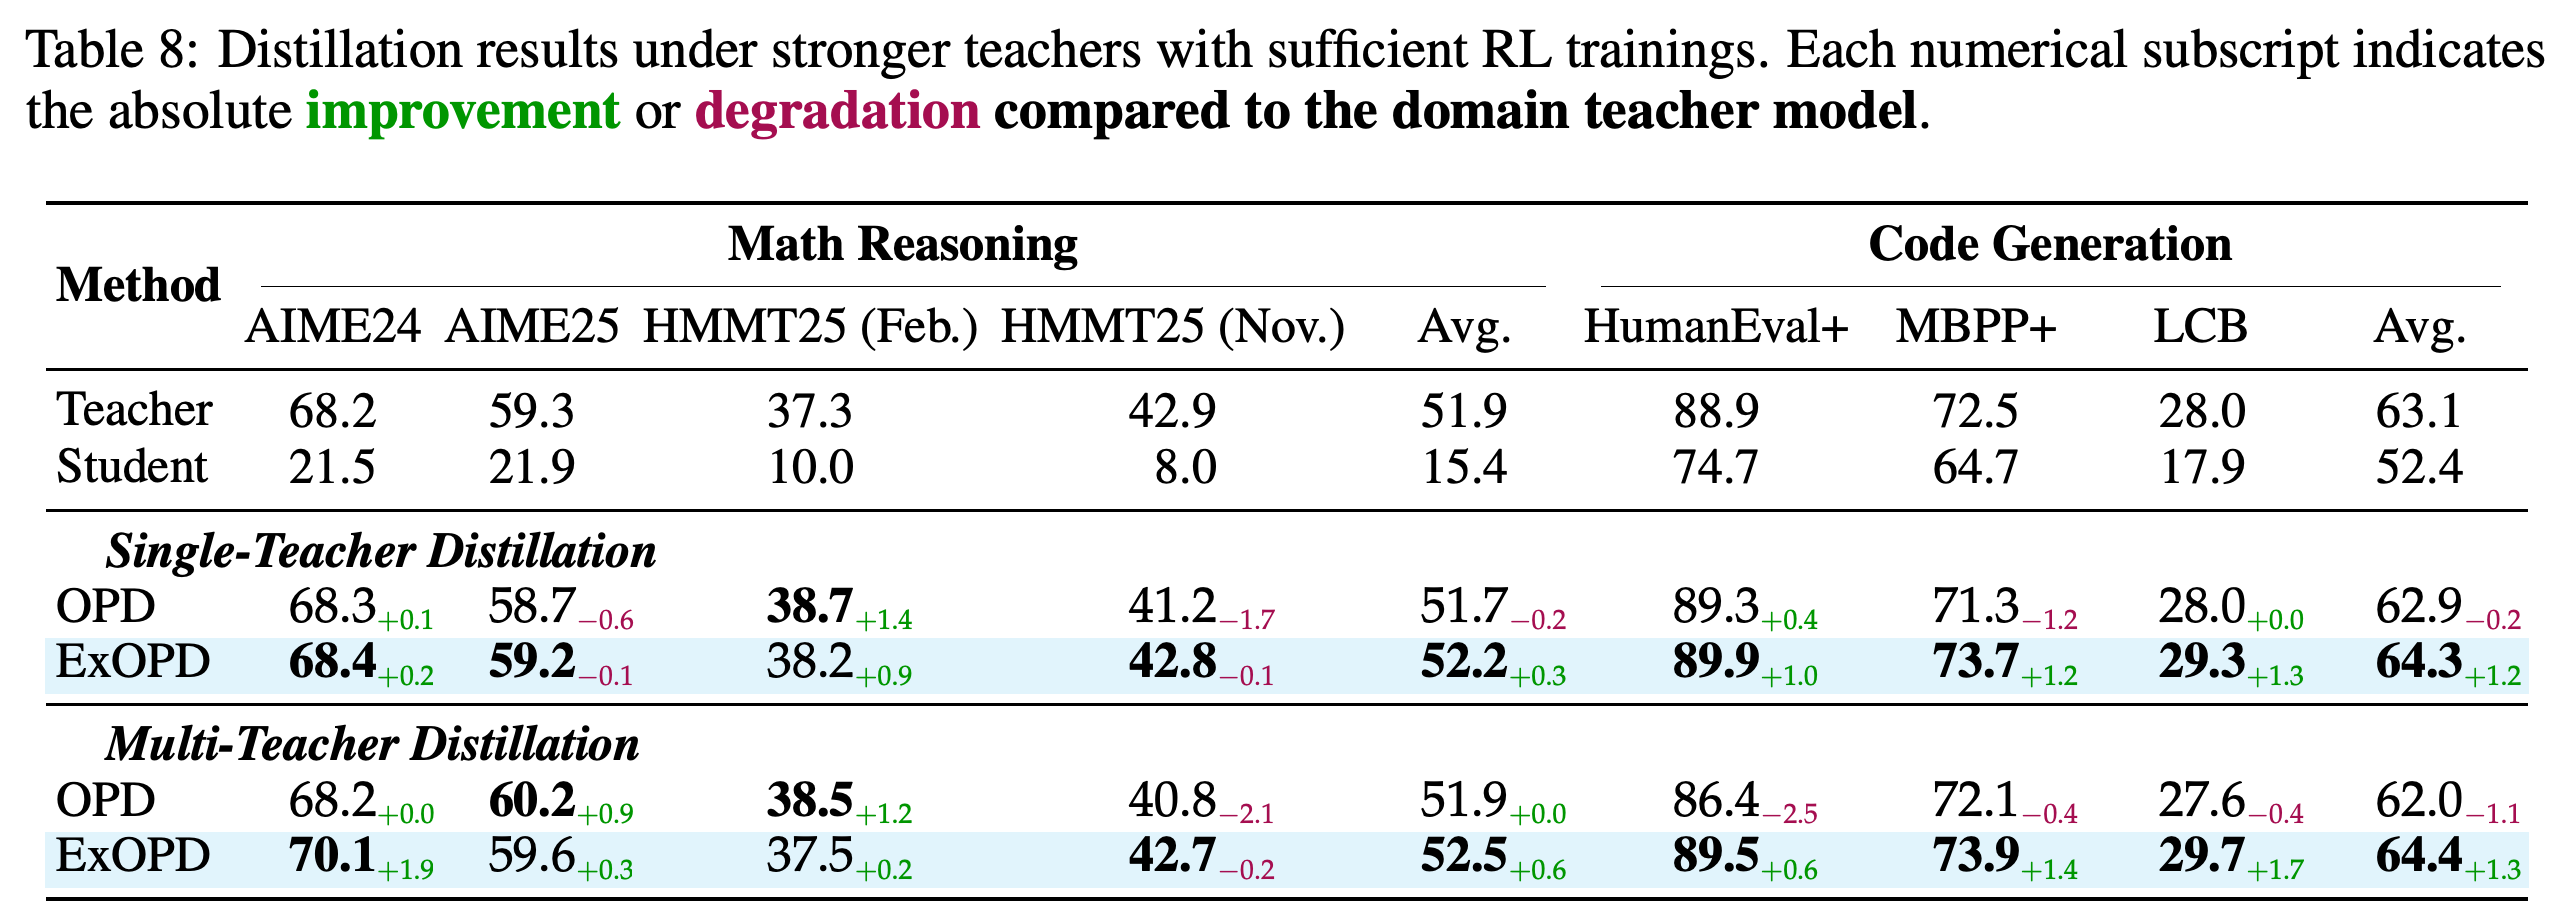
- 1200-step teacher를 사용한 single-teacher ExOPD의 평균은 수학 52.2%, 코드 64.3%다. Teacher 평균은 각각 51.9%와 63.1%다.
- Multi-teacher ExOPD의 평균은 52.5%와 64.4%다. 다만 HMMT25 (November)에서는 42.7%로 수학 teacher의 42.9%보다 낮다.
- RL과 증류는 rollout 수와 모델 연산이 다르므로, optimization step 수만으로 학습 비용이 같다고 볼 수 없다.
Teacher의 수학 평균 정확도는 RL을 100 step 추가한 뒤 46.9%로 높아지고, ExOPD는 50 step으로 48.0%에 도달한다. 이는 teacher 학습이 부족했기 때문이라는 설명을 약화한다. 다만 학습 절차가 다르므로 step 수만으로 비용을 충분히 비교할 수는 없다.
1200-step teacher를 사용해도 ExOPD는 각 설정에서 OPD보다 높은 도메인 평균을 유지한다. 다만 벤치마크별 예외는 남는다. Multi-teacher ExOPD는 HMMT25 (November)에서 42.7%로 teacher의 42.9%보다 낮고, AIME25와 HMMT25 (February)에서는 OPD보다 낮다.
4.1.3 Results of Multi-Teacher Distillation
Multi-teacher 실험은 설정별 추가 튜닝 없이 λ = 1.25로 고정한다. OPD와 ExOPD에서는 수학 데이터를 다운샘플링해 코드 샘플 수에 맞춘다. SFT는 trajectory 수를 맞춘 teacher 생성 trajectory를 사용한다. ExPO는 domain teacher의 가중치를 평균한 뒤, {0.25, 0.5}에서 선택한 α로 student를 기준으로 가중치를 외삽한다.
- OPD와 ExOPD는 각 학습 도메인에 해당하는 teacher에서 학습 신호를 받는다.
- 같은 크기 설정의 G-OPD는 50 optimization step을 수행한다.
- SFT는 해당 증류의 step 수에 맞추며, batch size 1024, 최대 시퀀스 길이 32,768, warm-up ratio 0.05, learning rate 1 × 10⁻⁵를 사용한다.
SFT는 G-OPD와 같은 batch size와 learning rate를 사용하며, 최대 시퀀스 길이는 32,768, warm-up ratio는 0.05다. 함께 제시된 본문은 trajectory 수와 optimization step 수도 맞추지만, 각 방법의 전체 연산 비용이 같다고 하지는 않는다.
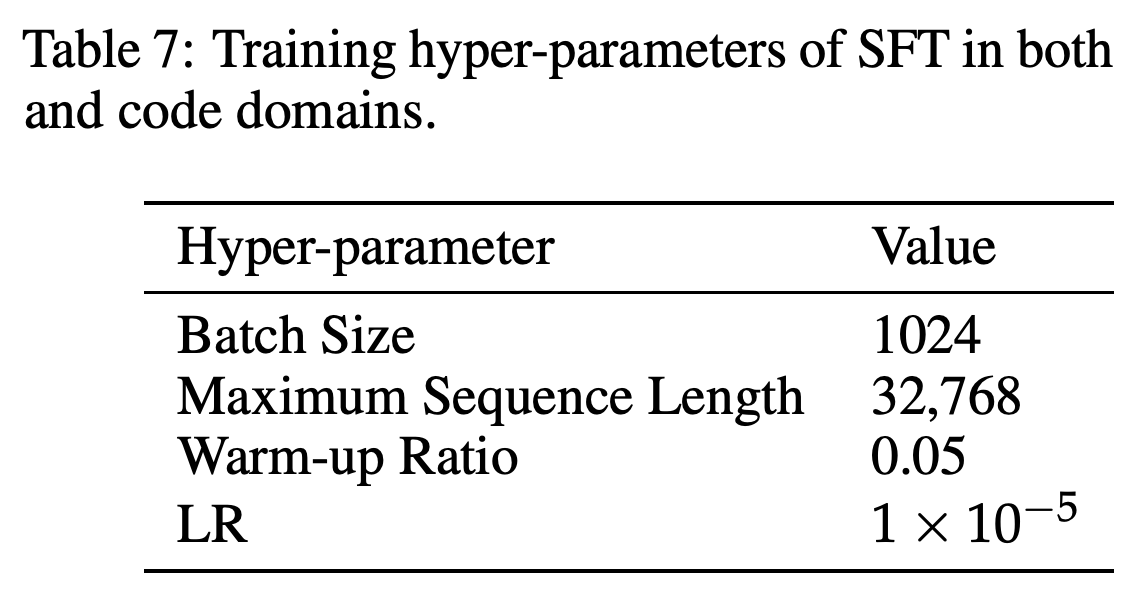
Table 2에서 multi-teacher ExOPD의 평균 정확도는 수학 47.7%, 코드 62.0%다. 이는 OPD의 46.4%, 60.6%와 domain teacher의 46.0%, 61.2%를 능가한다. 이 주요 실험에서 모든 벤치마크의 해당 teacher를 능가한 방법은 ExOPD뿐이다. 다만 코드 평균은 ExPO가 62.6%로 더 높다.
- SFT의 평균은 수학 44.3%, 코드 60.8%로, 각 도메인의 teacher 평균보다 낮다.
- ExPO의 수학 평균은 45.0%다. 따라서 높은 코드 평균만으로 모든 영역에서 전이가 더 우수하다고 볼 수는 없다.
ExOPD는 single-teacher와 multi-teacher 증류 모두에서 모든 벤치마크의 해당 주요 domain teacher를 능가한다. 하지만 multi-teacher 코드 평균은 ExPO가 가장 높다. 따라서 일관되게 teacher를 능가하는 것과 모든 지표에서 모든 baseline보다 높은 성능을 내는 것은 다르다.
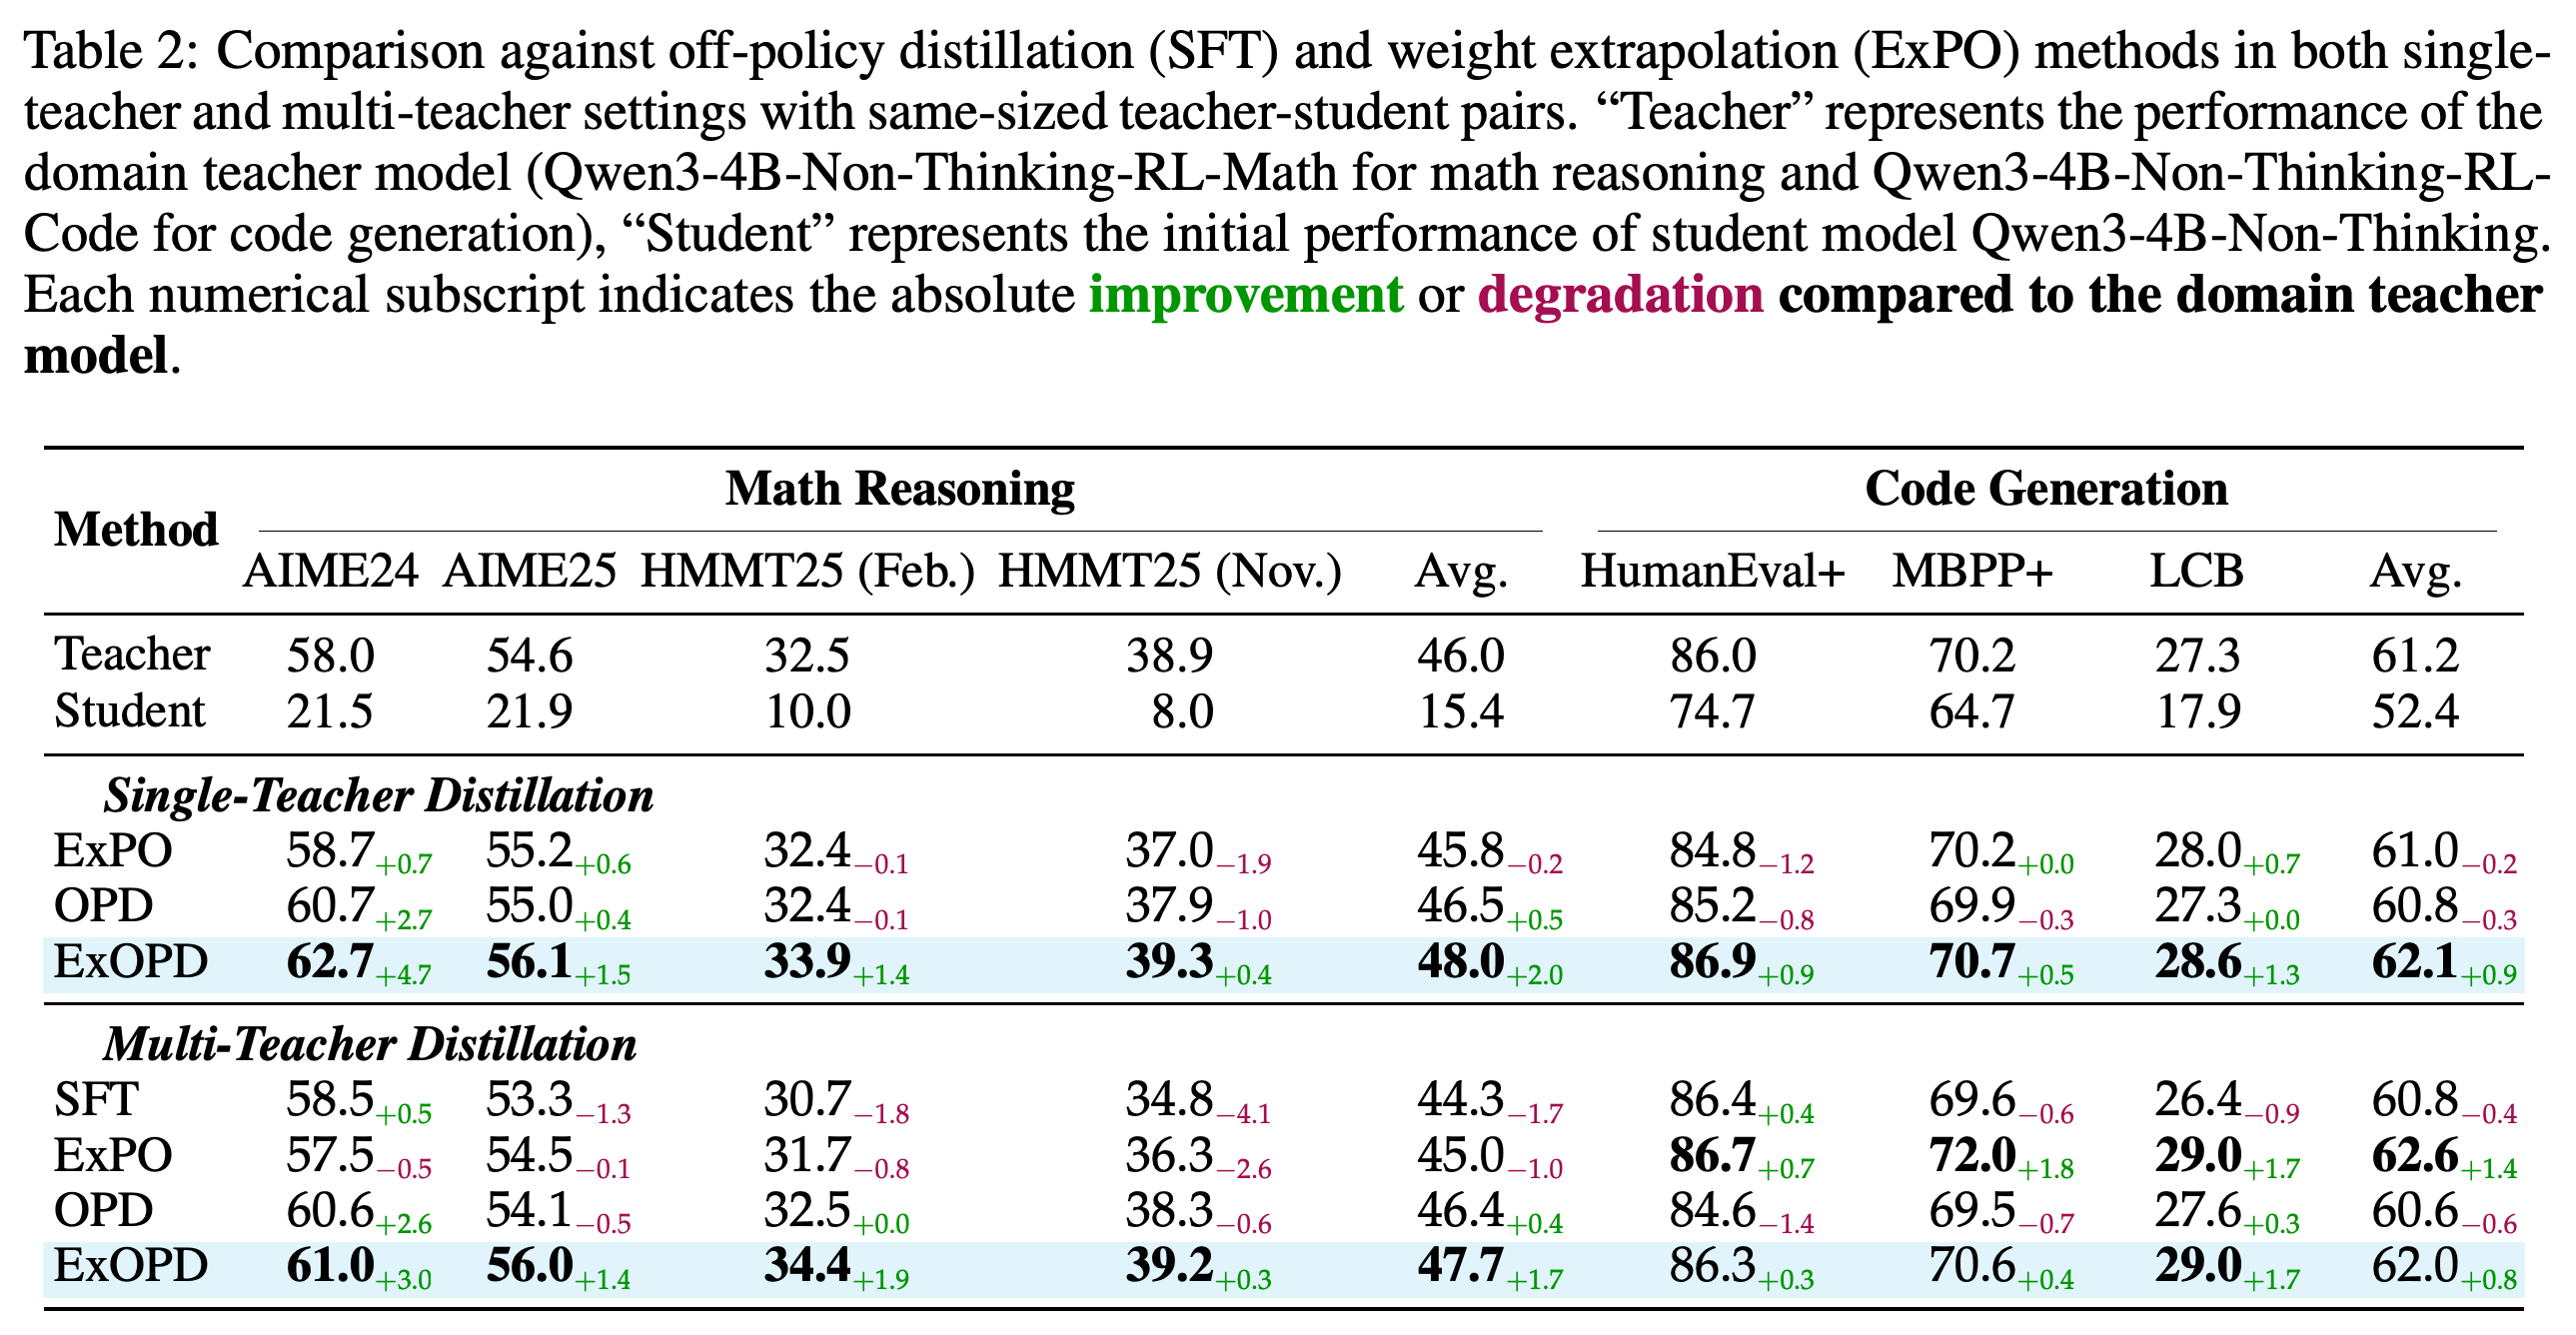
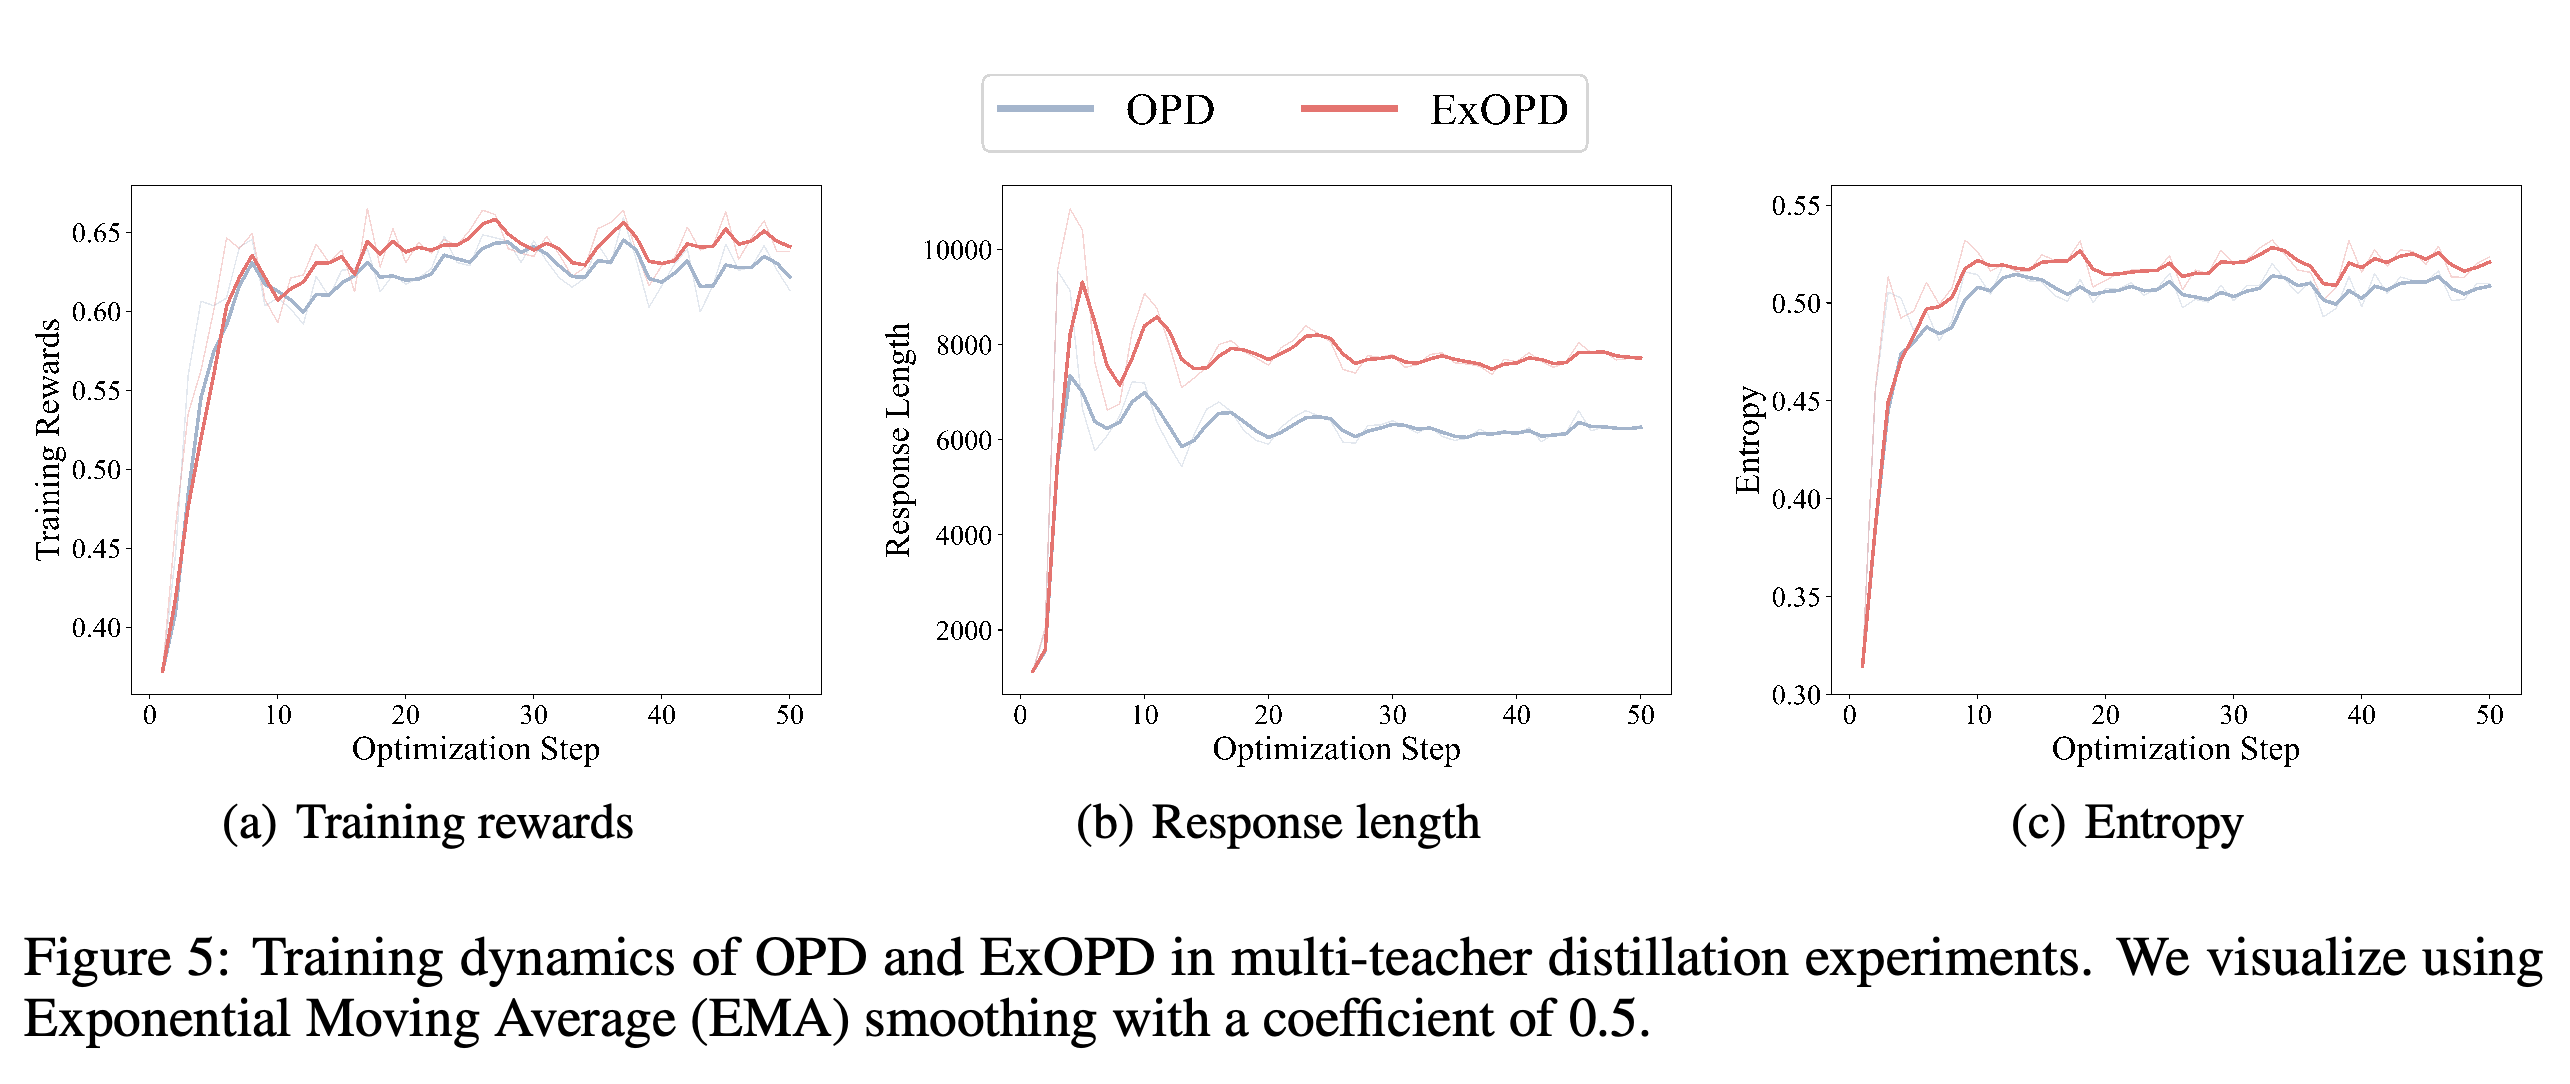
Figure 5에서 ExOPD는 OPD보다 학습 보상이 다소 높고, 응답이 길며, 응답 엔트로피도 높다. 곡선에는 계수 0.5의 Exponential Moving Average 평활화를 적용한다. 긴 응답이 다양성을 높인다는 저자들의 설명은 함께 나타난 추세에 대한 해석이다.
ExOPD와 OPD는 비슷한 학습 보상 범위로 수렴하지만, ExOPD가 대체로 다소 높다. 응답 길이에서는 차이가 더 뚜렷하고 엔트로피도 더 높다. 이는 평가에서 관찰한 더 긴 출력과 일치한다.
4.2 Experiments in the Strong-to-Weak Distillation Setting
Strong-to-weak 증류는 teacher가 student 자체의 RL 변형이 아니라 student보다 큰 모델일 때 extrapolation을 평가한다. 기본 설정에는 teacher와 student base가 필요하고, reward correction에는 teacher의 RL 이전 체크포인트가 추가로 필요하다.
4.2.1 Experimental Settings
주요 strong-to-weak 실험은 같은 수학 학습 데이터와 수학 벤치마크 4개를 사용해 Qwen3-30B-A3B-Instruct-2507을 Qwen3-1.7B-Non-Thinking과 Qwen3-4B-Non-Thinking으로 증류한다. ExOPD는 λ = 1.25와 student base reference를 사용하며, 증류를 100 step 수행한다. 표준 OPD 및 SFT와 비교한다.
- 저자들은 30B teacher의 RL 이전 체크포인트에 접근할 수 없어, 해당 teacher에 대한 reward correction을 평가하지 않았다.
- 대신 reward-correction 실험은 RL 이전 base에 접근할 수 있는 저자들의 4B domain teacher를 사용한다.
4.2.2 Results of Strong-to-Weak Distillation
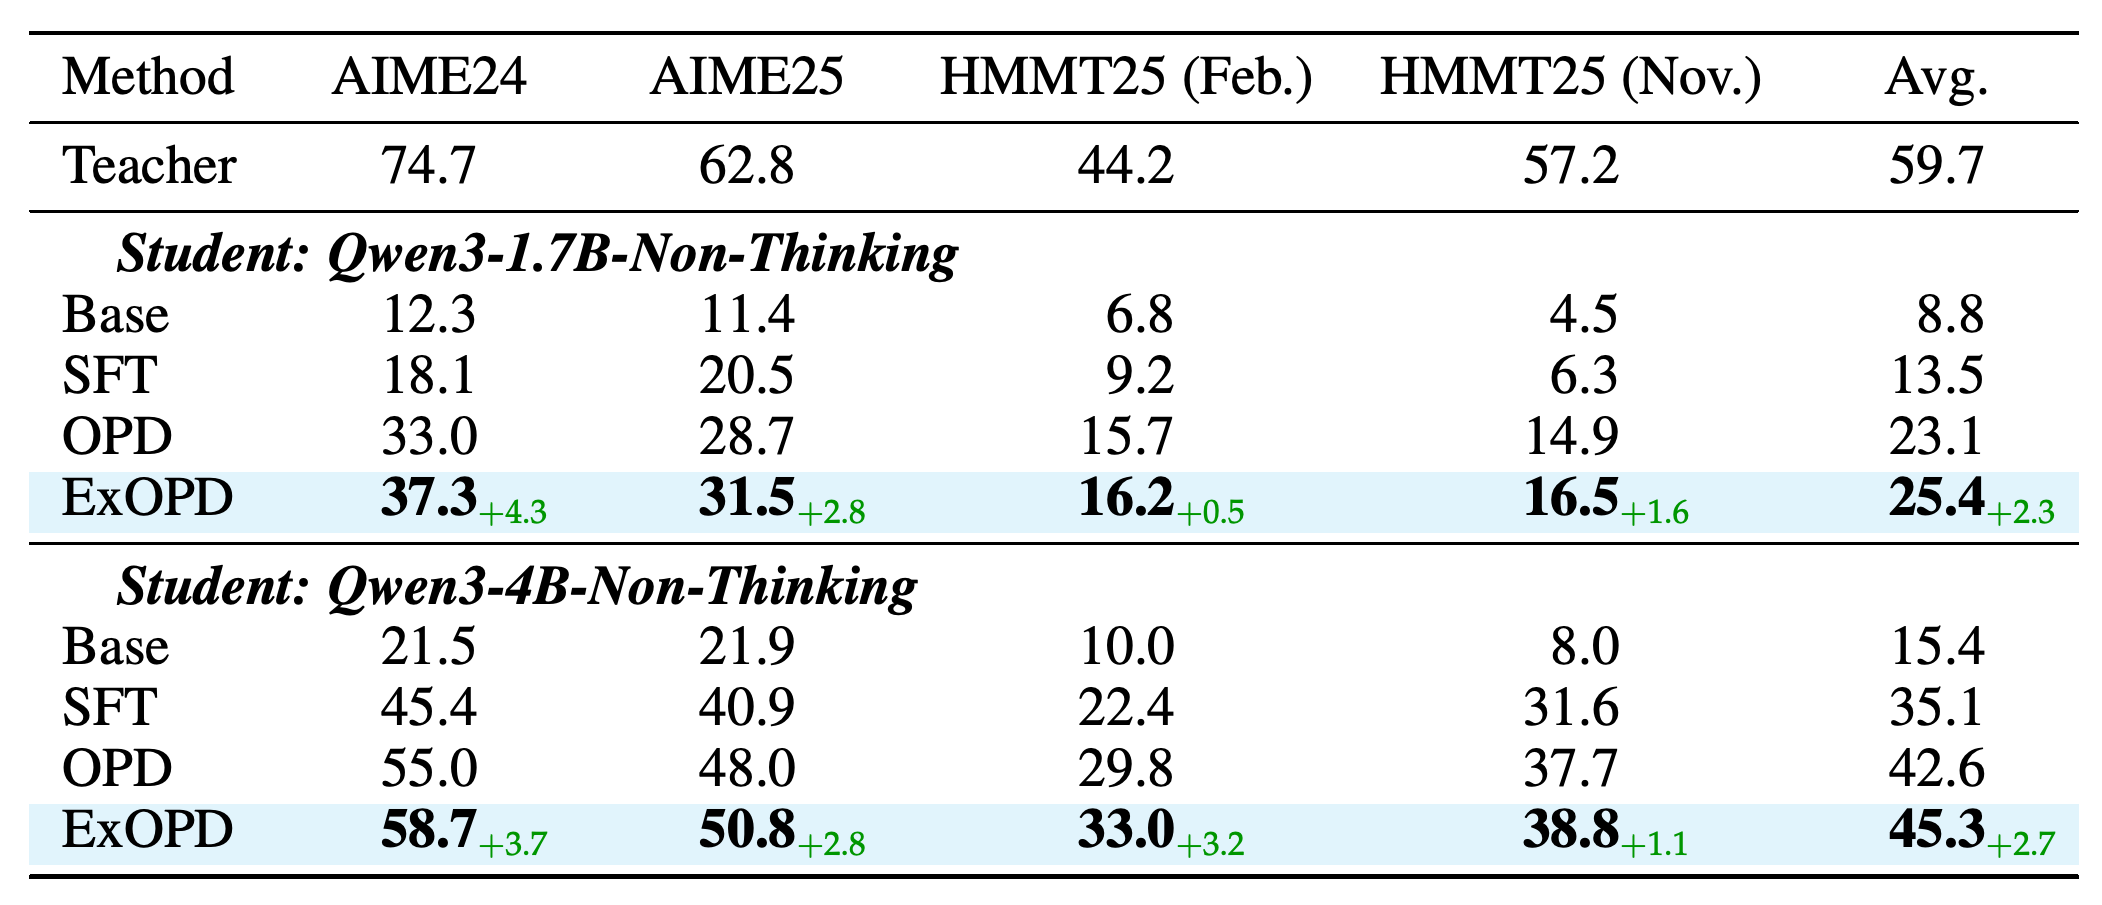
1.7B student에서 ExOPD는 평균 수학 정확도를 OPD의 23.1%에서 25.4%로 높인다. SFT는 13.5%, base 모델은 8.8%다. 4B student의 해당 평균은 각각 45.3%, 42.6%, 35.1%, 15.4%다. ExOPD는 각 student에서 수학 벤치마크 4개 전체에 걸쳐 OPD보다 성능이 높다.
- OPD 대비 평균 개선 폭은 1.7B student에서 2.3 percentage points, 4B student에서 2.7 percentage points다.
- 각 student의 평균은 teacher 평균인 59.7%보다 낮다. 따라서 이 결과는 더 큰 teacher를 능가한 것이 아니라 전이 성능을 개선한 것이다.
- 논문은 신뢰구간이나 반복 학습에 따른 변동성 없이 점 추정치를 보고한다.
ExOPD는 각 student의 모든 수학 벤치마크에서 OPD보다 성능이 높으며, 평균을 각각 2.3, 2.7 percentage points 개선한다. Teacher 평균인 59.7%는 각 student보다 여전히 높다. 따라서 teacher를 능가한 결과는 다른 실험 설정에 한정된다.
4.2.3 Reward Correction in Strong-to-Weak Distillation
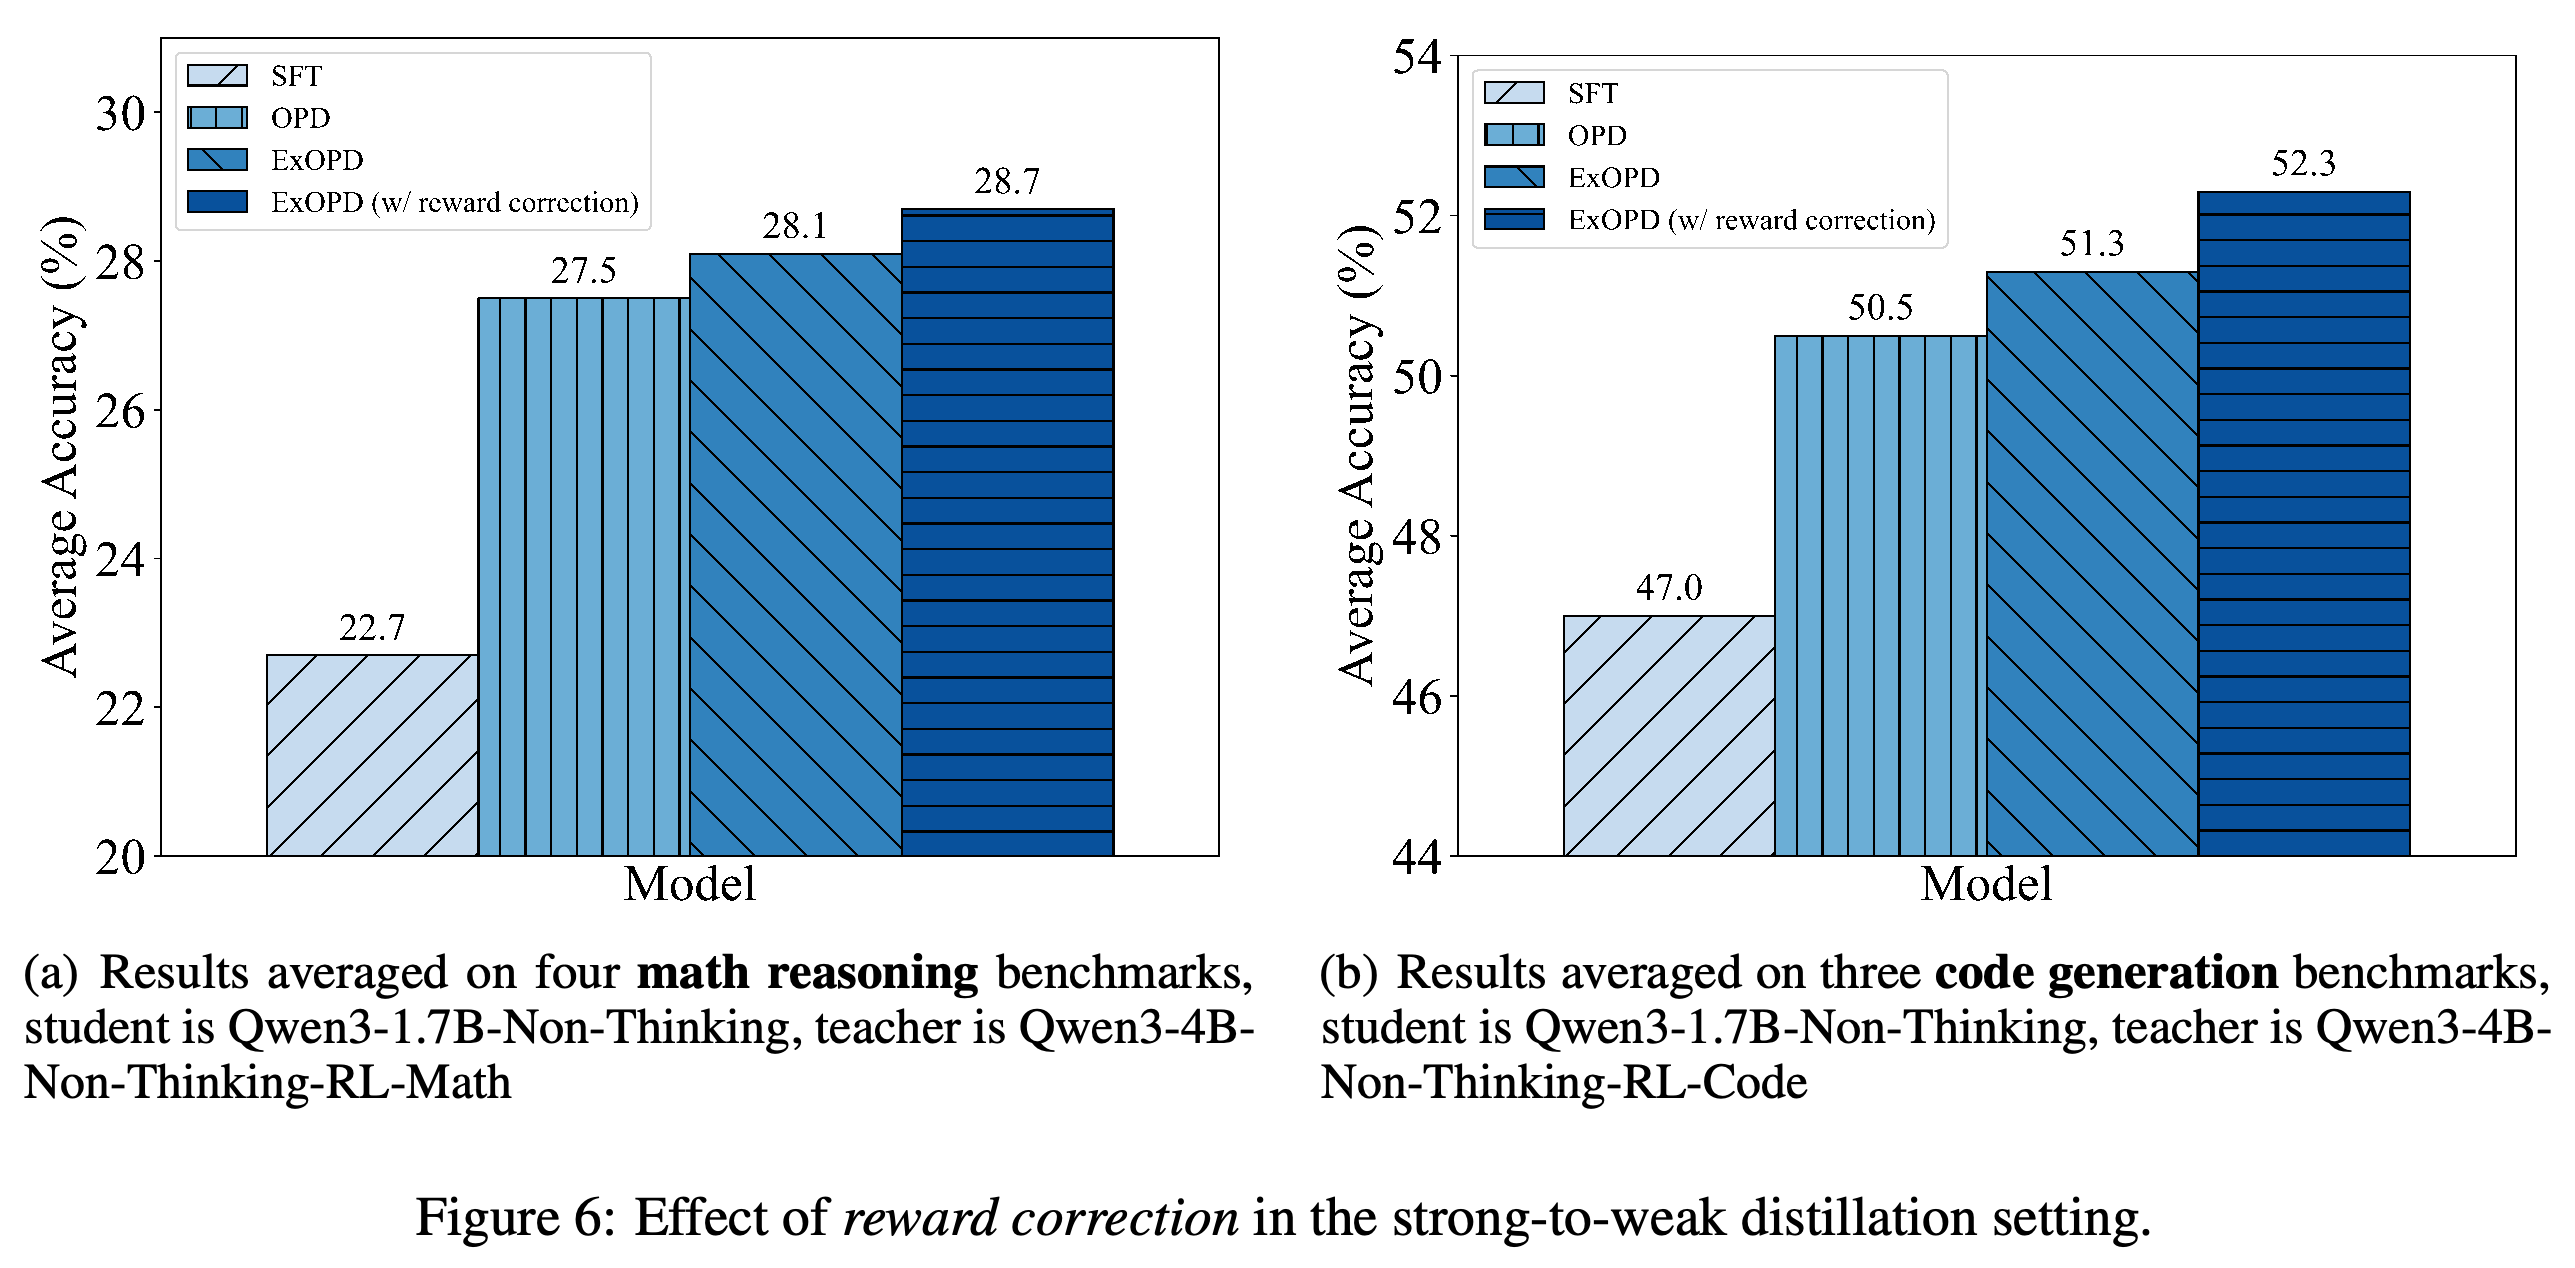
Reward correction은 Qwen3-1.7B-Non-Thinking을 student로, 4B 수학 또는 코드 RL 변형을 teacher로, Qwen3-4B-Non-Thinking을 보정된 reference로 사용한다. 평균 수학 정확도는 기본 ExOPD의 28.1%에서 보정 후 28.7%로 높아진다. 평균 코드 정확도는 51.3%에서 52.3%로 높아진다.
- 해당 OPD 평균은 수학 27.5%, 코드 50.5%다. SFT는 22.7%와 47.0%다.
- 이 비교는 통제된 4B-to-1.7B 설정에서 제안한 reference 선택을 뒷받침하지만, 보상 신호의 정확도를 직접 측정하지는 않는다.
- 보정에는 추가 체크포인트가 필요하며, 기본 ExOPD보다 큰 reference에서 로그 확률을 계산해야 한다.
Student base reference를 teacher base 체크포인트로 바꾸면 ExOPD가 수학에서 0.6 percentage points, 코드에서 1.0 percentage point 개선된다. 이 비교는 접근 가능한 4B domain teacher를 사용하며, 주요 strong-to-weak 실험의 30B teacher를 사용하지 않는다.
5 Conclusion and Discussion
결론은 보상 가중치와 reference 선택으로 평가한 설정에서 OPD를 teacher 모방 이상으로 개선할 수 있다고 정리한다. 더 큰 규모의 모델, 더 폭넓은 domain teacher 구성, 서로 다른 모델 계열에 대한 검증은 후속 연구로 남긴다.
부록
- A Detailed Math Derivations는 score-function identity로 reverse-KL OPD gradient를 유도한다. 직접적인 score 항의 기댓값은 0이며, 현재 행동 이전 위치의 로그 확률 차이도 기댓값에서 사라진다. 따라서 할인율 0 근사를 적용하기 전에는 현재 토큰부터 응답 끝까지 합산한 gradient가 남는다. 부록은 이에 대응하는 국소 G-OPD gradient도 제시한다.
- B Detailed Training Settings는 GRPO, G-OPD, SFT의 하이퍼파라미터를 제공한다. G-OPD는 같은 크기 모델 간에는 50 step, strong-to-weak 전이에는 100 step을 사용한다. 저자들은 추가 증류가 과적합으로 일반화 성능을 떨어뜨릴 수 있다고 보고한다. 또한 prompt-count × rollout-n의 곱을 고정하면 prompt batch가 클수록 더 매끄럽게 수렴한다고 보고한다.
- C Results of Distillation from Domain Teachers with Sufficient RL Trainings는 RL을 1200 step 수행한 teacher로 같은 크기 모델 간 실험을 반복한다. Table 8에서 ExOPD는 각 증류 설정에서 OPD보다 도메인 평균이 높다. 다만 벤치마크별로 teacher를 능가하지 못하거나 OPD보다 낮은 예외도 있다.
- D Prompt Templates는 Training and Evaluation Prompt Template for Math Reasoning과 Training and Evaluation Prompt Template for Code Generation을 제공한다. 수학 템플릿은 단계별 추론과 \boxed{} 안의 최종 답을 요청한다. 코드 템플릿은 추론 후 마지막 코드 블록에 Python 코드를 작성하도록 요청하며, 입력 자리표시자로 {question}을 사용한다.
짧은 생각
핵심 실증적 기여는 설정별 추가 튜닝 없이 λ = 1.25가 평가한 같은 크기 및 strong-to-weak 설정 전반에서 표준 OPD를 개선한다는 점이다. 1200-step teacher 대조 실험은 이 결과를 뒷받침한다. 동시에 모든 벤치마크에서 teacher를 능가한다고 표현하면 지나치게 넓은 주장이라는 점도 보여준다.
목적함수 수준의 해석은 유용한 설계 근거를 제공한다. 다만 재현할 때는 국소 gradient 근사와 Equations (12), (14)의 정규화 및 부호 문제에 주의해야 한다. 응답 길이 증가, 보고되지 않은 통계적 불확실성, 정량화하지 않은 reference 모델의 추가 비용 때문에 연산량을 맞춘 조건에서의 효과는 아직 확인되지 않았다.