


LLM-as-a-Coach: Experiential Learning for Non-Verifiable Tasks 요약 설명
20 Jul 2026 | Paper Review Reinforcement Learning On-Policy Distillation LLM EvaluationContents
이번 글에서는 LLM-as-a-Coach: Experiential Learning for Non-Verifiable Tasks 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 20일(Arxiv), arXiv
- Ye, Tianzhu, Dong, Li, Chen, Guanheng, Zhu, He, Wu, Xun, Huang, Shaohan, Wei, Furu.
- Microsoft Research, Tsinghua University, Peking University
- 논문 링크
요약
- 이 논문은 루브릭 기반 LLM 평가가 흔히 스칼라 보상으로 축소되는 검증 불가능한 개방형 작업의 사후 학습을 다룬다. 저자들은 피드백 모델을 전이 가능한 경험 지식을 추출하는 LLM-as-a-Coach로 전환하고, 이를 on-policy context distillation으로 내재화하는 Experiential Learning(EL)을 제안한다.
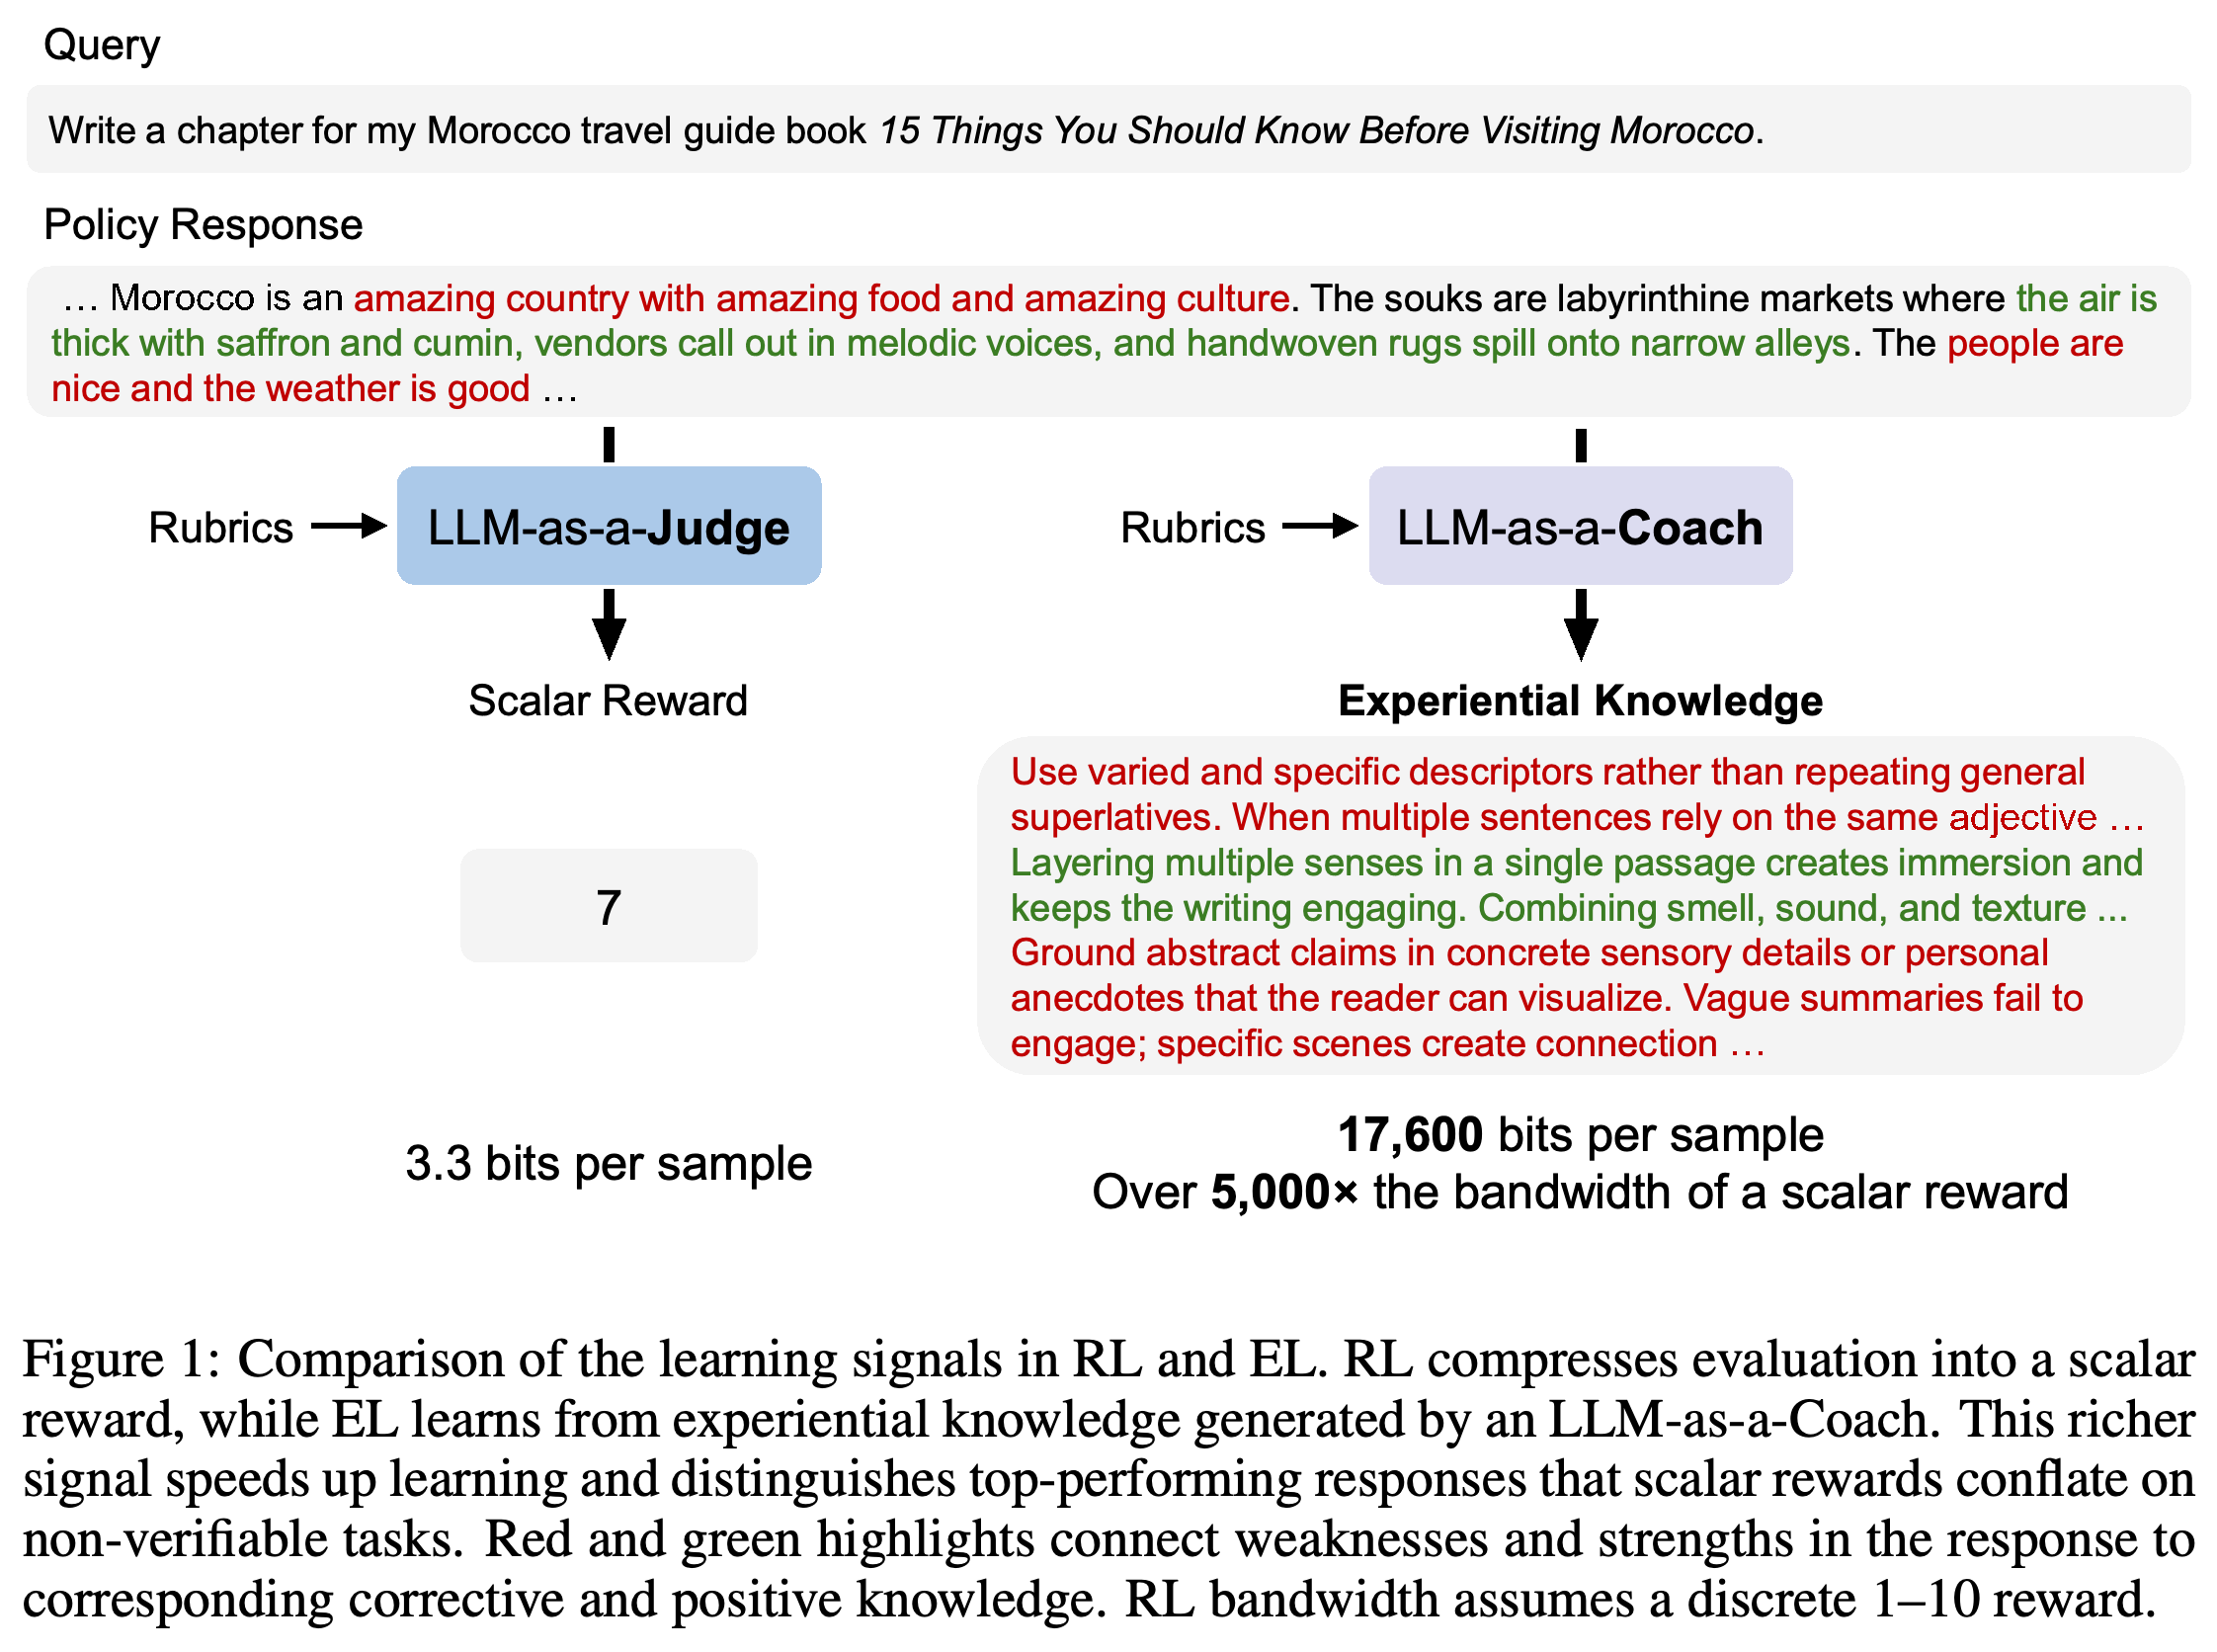
여행 가이드 응답은 단일 점수 7과 구체성, 감각적 세부 묘사, 근거 제시에 관한 coach의 조언이 어떻게 다른지를 보여준다. 제시된 3.3-bit 대 17,600-bit 비교는 논문이 가정한 이산 점수와 텍스트 채널 조건에서의 상한 대역폭 예시다.
1 Introduction
자동으로 정오를 확인할 수 있을 때 RL은 효과적이지만, 개방형 응답은 사실성, 관련성, 완전성, 구성, 문체 등 여러 차원에서 평가해야 한다. 저자들은 스칼라 보상이 평가자의 서면 분석을 버리고 같은 점수를 받은 응답을 구별하지 못하게 하며, 특히 보상 척도 상단에서 이 문제가 두드러진다고 주장한다.
2 Method
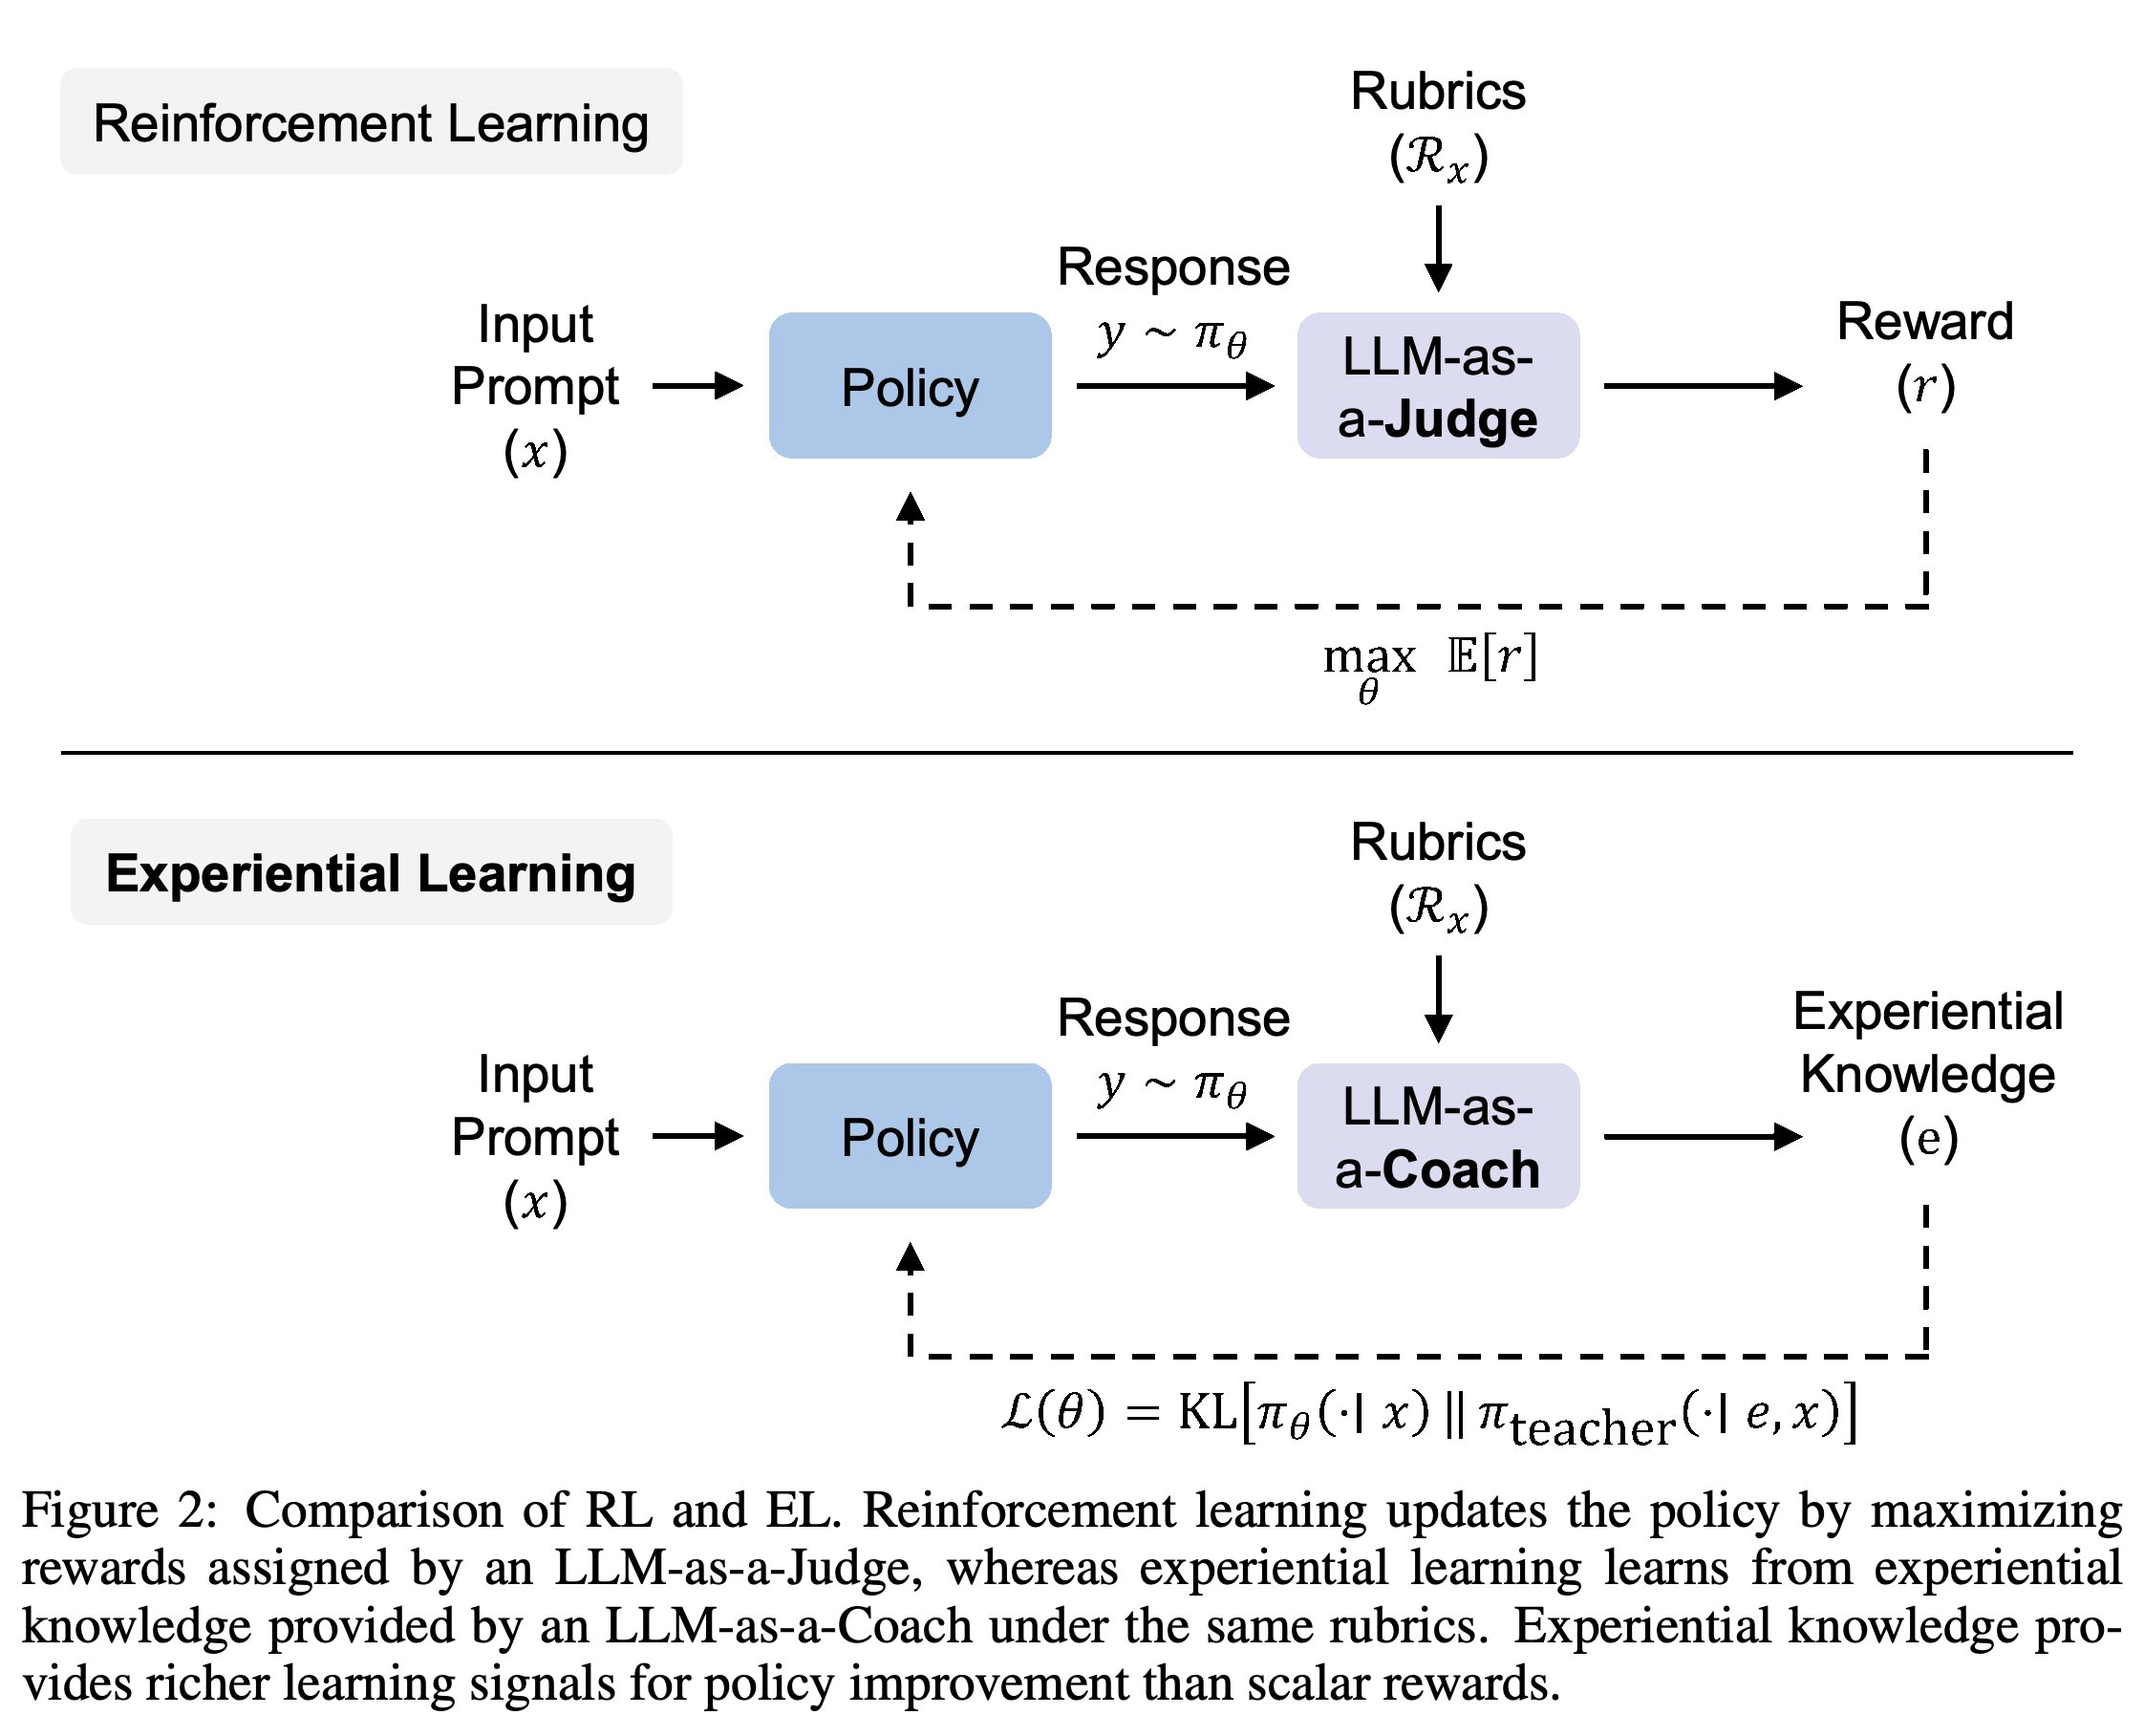
EL은 프롬프트와 루브릭 쌍 (x, Rx)으로 정책 πθ를 학습한다. 각 on-policy 응답에 대해 피드백 모델이 재사용 가능한 경험 지식을 생성하고, 이 지식은 정책에 조밀한 토큰 수준 감독을 제공하는 teacher를 조건화한다.
2.1 Preliminaries: RL with an LLM-as-a-Judge
RL 기준선은 피드백 모델 M을 LLM-as-a-Judge로 사용하며, y ∼ πθ(·|x)에 대해 r = Extract_Reward(M(x, y, Rx))를 추출하고 GRPO로 기대 보상을 최대화한다. judge가 상세한 분석을 생성할 수 있어도 최적화에는 시퀀스 수준의 스칼라 점수만 전달된다. LLM-as-a-Judge에 대해서는 이 글을 참조하라.
2.2 Experiential Learning with an LLM-as-a-Coach
EL에서 coach는 각 rollout으로부터 경험 지식 e = Extract_Knowledge(M(x, y, Rx))를 추출한다. 정책은 자신의 궤적을 따라 πteacher(·|e, x)에 대한 토큰 수준 reverse KL을 최소화한다. 이 과정은 coach의 텍스트 지침을 문맥 조건부 목표 분포로 바꾸고, 추론 시 문맥이 없어도 이를 정책 가중치에 흡수한다.
도식은 업데이트 경로를 대조한다. RL은 judge가 제공한 보상을 최대화하는 반면, EL은 coach가 생성한 경험 지식으로 teacher를 조건화하고 reverse-KL 목적을 최소화한다. 두 접근법 모두 프롬프트, 정책 rollout, 루브릭에서 시작한다.
2.3 From Judge to Coach
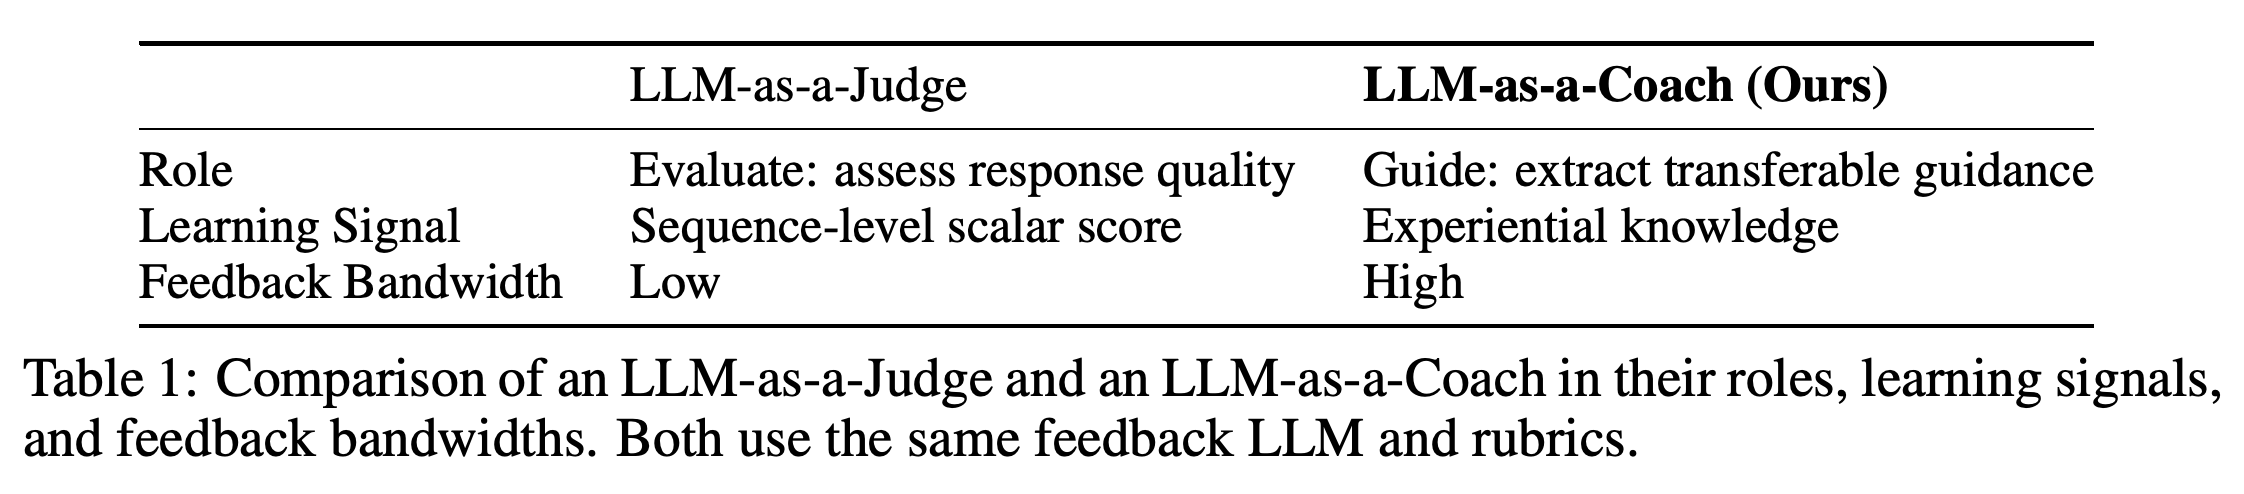
judge와 coach는 같은 피드백 모델과 프롬프트별 루브릭을 사용할 수 있지만, 서로 다른 학습 신호를 제공한다. judge는 스칼라 평가를 제공하는 반면 coach는 유사한 미래 응답을 개선하기 위한 전이 가능한 지침을 제공한다. 이 차이는 피드백 LLM의 고유 역량 차이가 아니라 최적화기가 받는 인터페이스의 차이다.
표는 EL의 개념적 변화를 분리해 보여준다. 두 인터페이스 모두 같은 LLM과 루브릭을 사용하지만, judge는 스칼라 점수로 평가하고 coach는 더 높은 것으로 제시된 피드백 대역폭을 갖는 전이 가능한 지침을 제공한다.
2.4 Feedback-Bandwidth Intuition
피드백 대역폭 비교는 활용 가능한 정보를 측정한 결과가 아니라 직관으로 제시된다. 이산적인 1–10 보상은 샘플당 최대 log2(10) ≈ 3.3 표현 비트를 가지는 반면, 150,000-token 어휘에서 1024-token 문맥은 이론적으로 약 17,600 비트의 상한을 가진다. 자연어의 중복성과 불완전한 추출은 유효 감독량을 크게 줄일 수 있다.
3 Experiments
실험은 EL을 Rubric-as-Reward RL과 held-out WildChat-IF 및 4개의 보지 못한 개방형 벤치마크에서 비교한다. 연구는 Qwen3-8B와 OLMo-3-7B-Instruct 정책을 사용하며, 초기 동결 정책 체크포인트 또는 GPT-4o를 피드백 모델로 사용한다. 또한 teacher 업데이트, 대체 teacher 문맥, 통제된 피드백 양자화 분석도 검토한다.
3.1 Setup
학습에는 GPT-4o-generated 루브릭을 갖춘 7,500개의 WildChat-IF 프롬프트를 사용한다. 두 방법 모두 256개 프롬프트 배치, 프롬프트당 8개 응답, 학습률 1e-6, temperature 1, 3 epochs를 사용한다. 평가는 held-out WildChat-IF 프롬프트 250개와 AlpacaEval v2.0, WildBench, ArenaHard v2.0, CreativeWritingV3를 사용하고 GPT-4o를 평가자로 쓰며, 저자들은 더 강한 proprietary evaluator를 사용한 일관성 점검도 보고한다.
3.2 Main Results
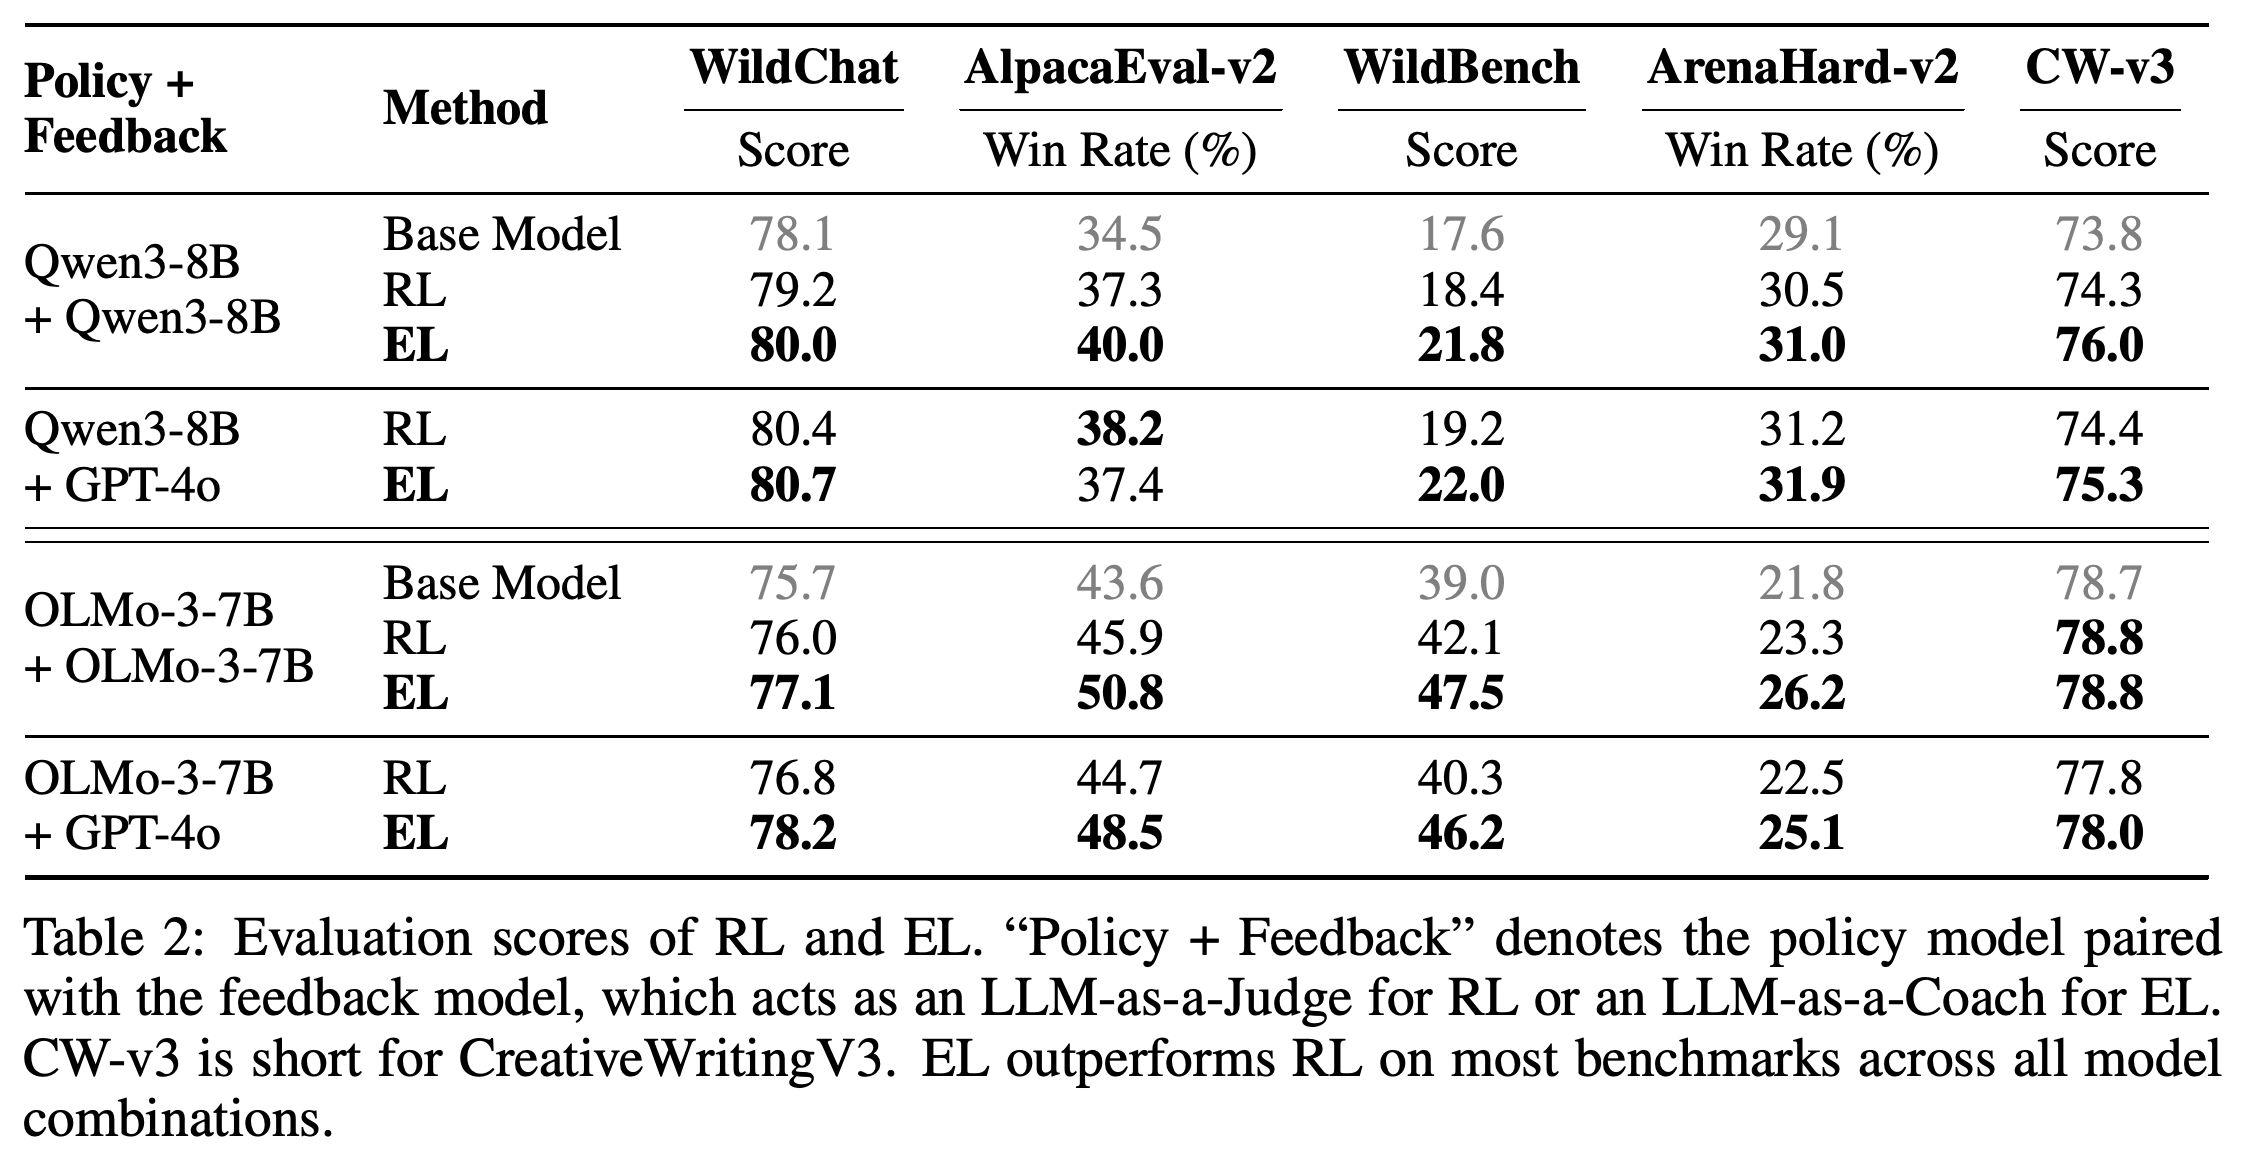
EL은 정책과 피드백 모델 조합 전반에서 보고된 벤치마크 대부분에서 RL을 능가한다. Qwen3-8B와 Qwen3-8B 피드백 조합에서 EL은 WildChat 80.0, AlpacaEval-v2 승률 40.0%, WildBench 21.8, ArenaHard-v2 승률 31.0%, CreativeWritingV3 76.0을 기록하며, RL의 79.2, 37.3%, 18.4, 30.5%, 74.3보다 높다. GPT-4o 피드백에서는 EL이 AlpacaEval-v2에서 더 낮지만 WildBench, ArenaHard-v2, CreativeWritingV3에서는 더 높다.
Qwen3-8B와 OLMo-3-7B 정책 및 2가지 피드백 모델 선택 전반에서 EL은 일반적으로 RL보다 held-out WildChat과 보지 못한 벤치마크 지표를 개선한다. 표는 Qwen3-8B와 GPT-4o 피드백의 AlpacaEval-v2처럼 EL의 37.4% 승률이 RL의 38.2%보다 낮은 예외도 보여준다.
3.3 Experiential Learning Generalizes Better
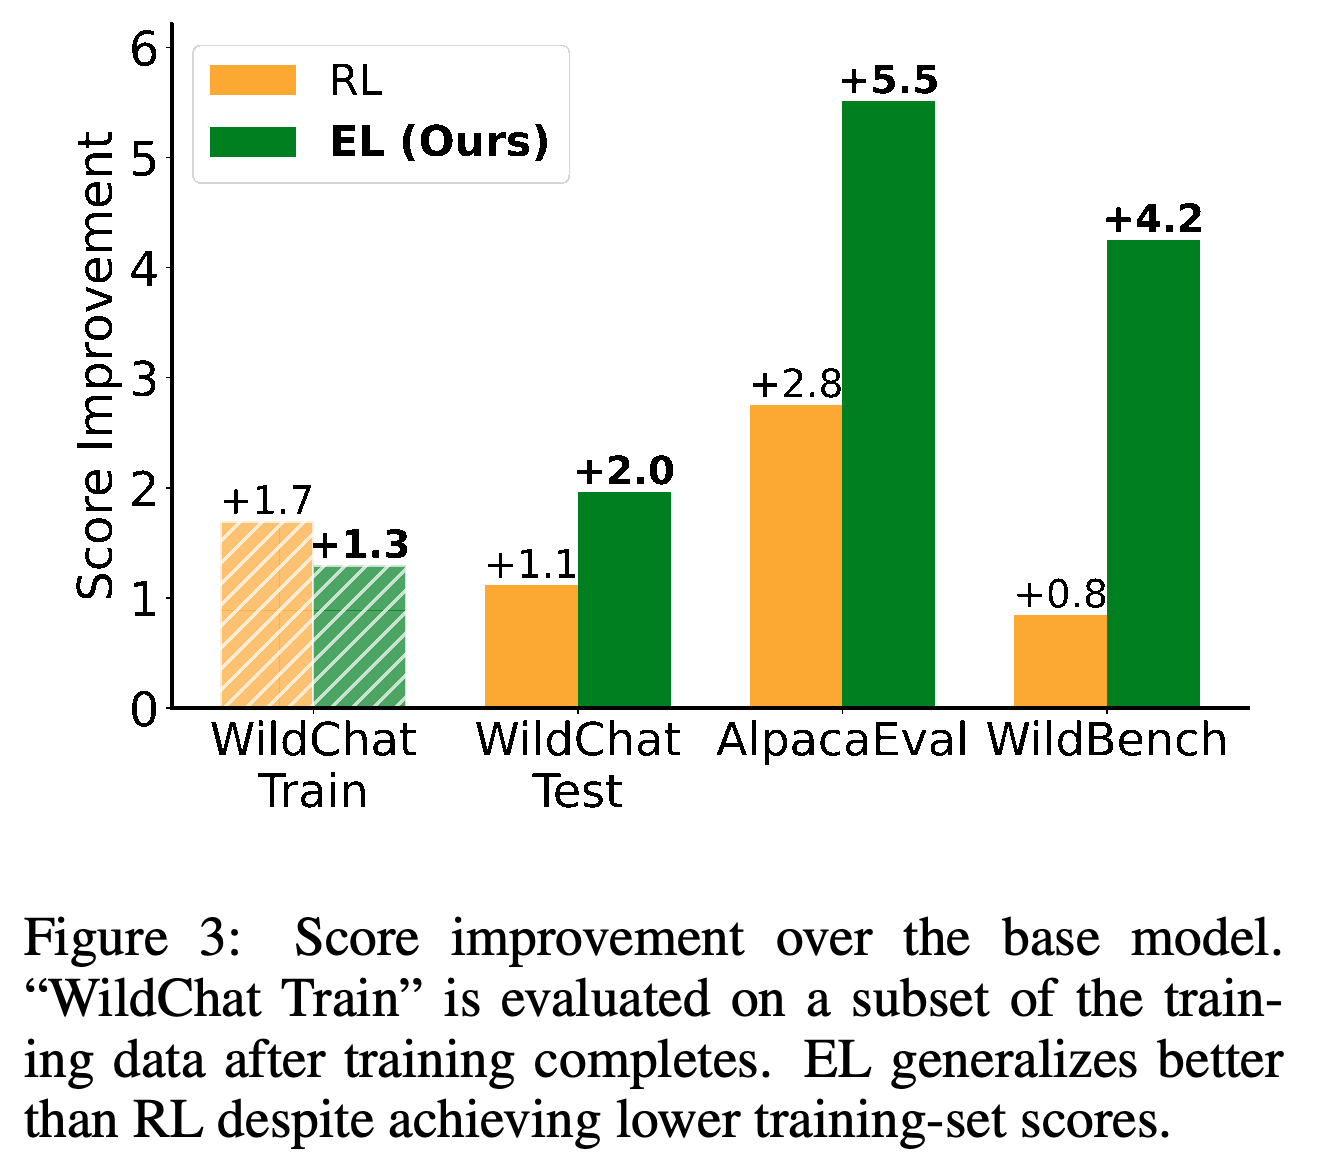
1,000-example WildChat 학습 부분집합에서 RL은 EL보다 더 크게 향상한다(+1.7 대 +1.3). 반면 EL은 WildChat test(+2.0 대 +1.1), AlpacaEval(+5.5 대 +2.8), WildBench(+4.2 대 +0.8)에서 더 크게 향상한다. 논문은 스칼라 보상 최적화가 전이되지 않는 방식으로 학습 보상을 높이는 패턴을 선호할 수 있는 반면, 경험 지침은 더 효과적으로 전이된다고 가설을 제시한다.
막대는 RL이 더 큰 학습 세트 향상을 보이는 반면, EL은 WildChat test, AlpacaEval, WildBench에서 더 큰 향상을 보임을 나타낸다. 이는 학습 분포를 넘어선 더 강한 전이에 관한 논문의 직접적인 실증 근거다.
3.4 Ablations
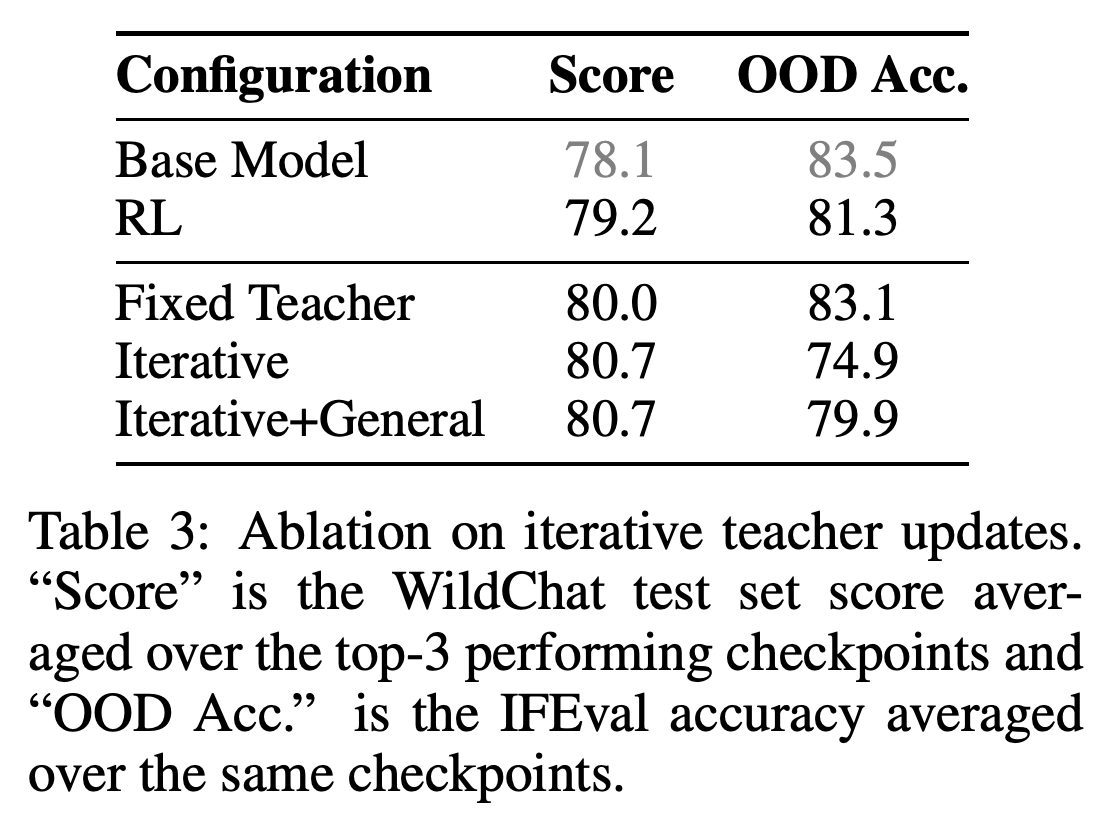
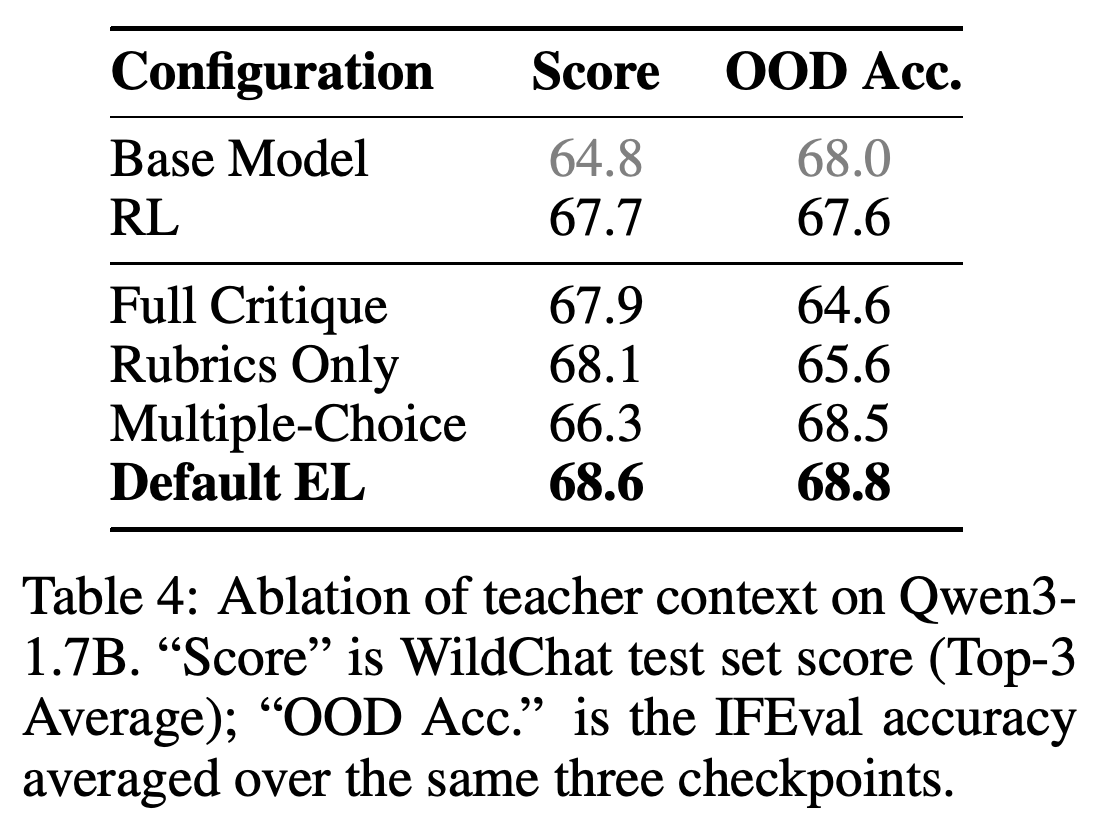
반복적인 teacher 업데이트는 Qwen3-8B의 WildChat 점수를 고정 teacher 사용 시 80.0에서 80.7로 높이지만, IFEval 정확도는 83.1에서 74.9로 낮춘다. Tulu3 일반 프롬프트를 1:0.25 비율로 섞으면 80.7 점수를 유지하면서 IFEval을 79.9로 회복한다. 또한 추출된 경험 지식은 Qwen3-1.7B 실험에서 보고된 WildChat 점수와 OOD 정확도 모두에서 Full Critique, Rubrics Only, Multiple-Choice teacher 문맥을 능가한다.
teacher 반복은 보고된 WildChat 점수를 높이지만 IFEval OOD instruction-following 정확도를 크게 떨어뜨린다. 일반 프롬프트 on-policy distillation을 추가하면 보고된 WildChat 점수를 유지하면서 이 역량을 부분적으로 회복한다.
추출된 경험 지식은 이 Qwen3-1.7B 실험에서 가장 높은 WildChat 점수 68.6과 가장 높은 보고 OOD 정확도 68.8을 달성한다. Full Critique와 Rubrics Only는 작업 점수를 높이지만 OOD 정확도를 낮추고, 저대역폭 Multiple-Choice 문맥은 OOD 정확도를 유지하지만 작업 향상은 더 작다.
3.5 Analysis
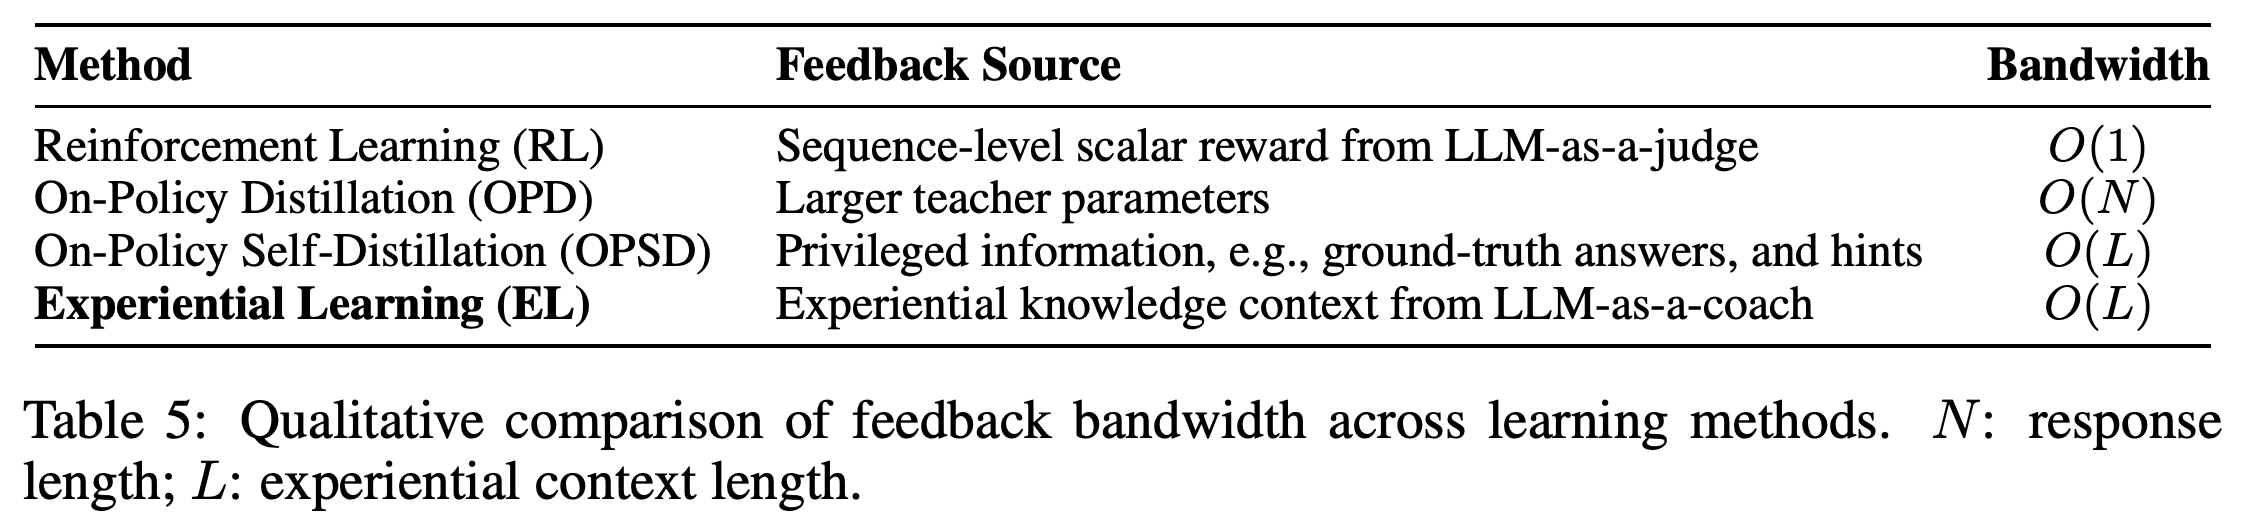
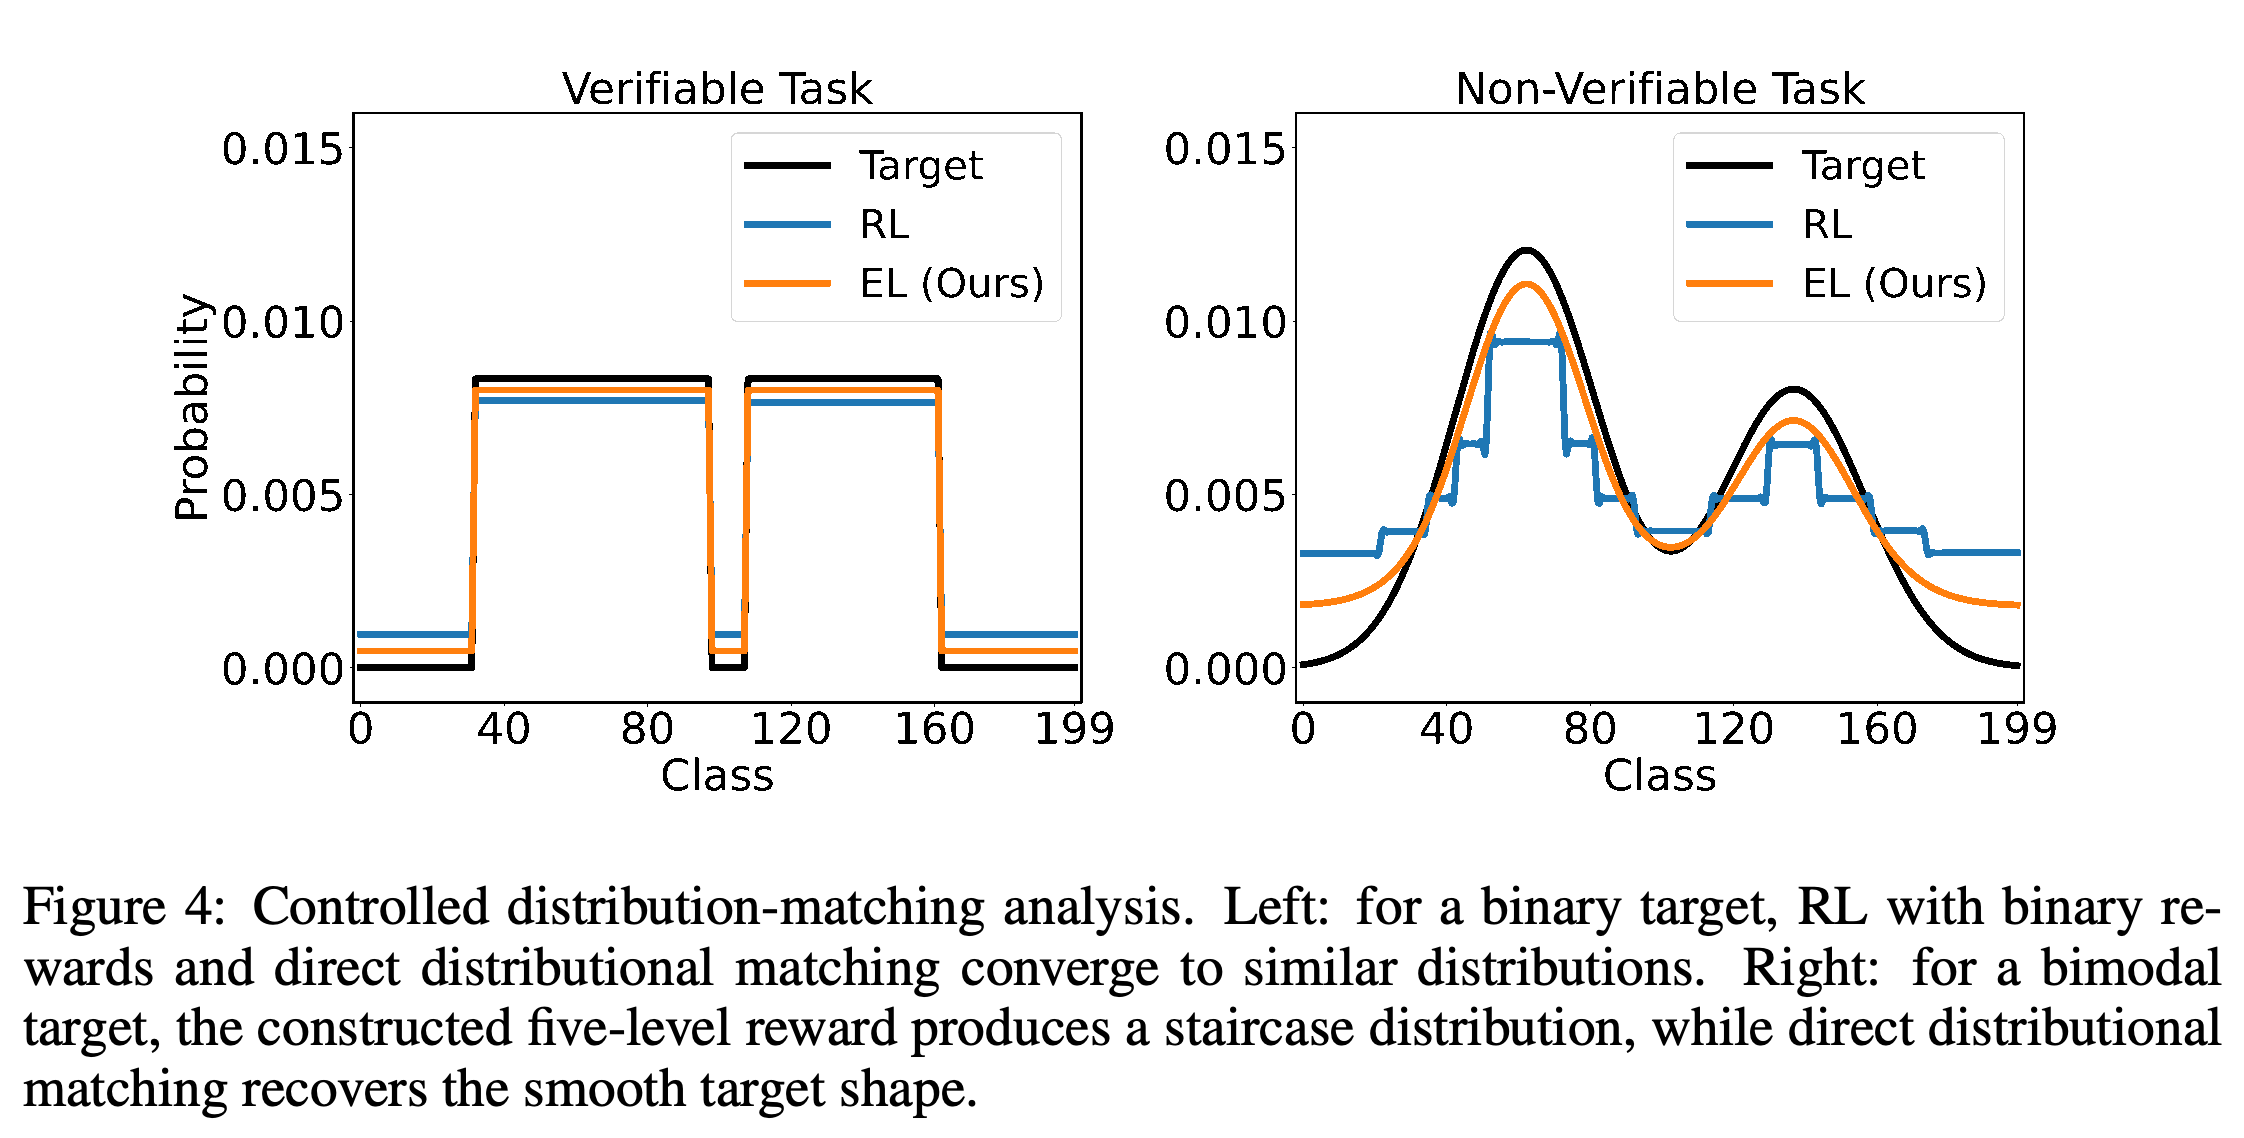
분석은 EL의 외부 텍스트 피드백 채널을 O(L)로, RL의 스칼라 신호를 O(1)로 규정하며, 더 강한 teacher의 파라미터에서 O(N) 정보를 얻을 수 있는 일반적인 on-policy distillation과 구분한다. V = 200인 toy 분포 정합 설정에서 이진 보상은 이진 목표를 직접 reverse-KL 정합과 유사하게 근사한다. 반면 5개 양자화 보상 수준은 이봉 목표를 계단 형태로 근사하지만, 직접 분포 정합은 이를 더 매끄럽게 복원한다.
표는 RL을 O(1) 스칼라 피드백, 일반적인 on-policy distillation을 더 큰 teacher에서 오는 O(N) 피드백, EL을 coach가 생성한 경험 문맥의 O(L) 피드백으로 분류한다. 이는 정성적 비교이며, 정보 출처와 스케일링 표기를 함께 구분한다.
구성한 이진 목표에서는 RL과 직접 분포 정합이 유사한 곡선을 만든다. 5개 보상 수준으로 양자화한 이봉 목표에서는 RL이 평탄 구간을 형성하지만 직접 분포 정합은 매끄러운 목표를 따른다. 논문은 이를 양자화에 관한 직관으로만 제시한다.
4 Discussion
EL은 평가자와 정책 사이의 피드백 압축으로 발생하는 reward hacking을 완화하려는 방법이지, 편향되거나 보정이 잘못된 피드백 모델에서 비롯하는 오류를 해결하려는 방법은 아니다. EL은 스칼라 보상 최대화 대신 문맥 조건부 teacher를 향한 분포 정합을 수행한다. 논문은 추가 teacher forward pass와 토큰 수준 distillation 비용이 해당 설정에서 공유 rollout 및 피드백 생성 비용에 비해 작다고 보고한다.
5 Related Work
이 연구는 EL을 learning from experience, textual feedback, context distillation, on-policy distillation, on-policy self-distillation과 연결한다. 구체적으로 루브릭 기반 응답 평가에서 전이 가능한 지식을 추출하고, 이를 검증 불가능한 작업에서 on-policy distillation을 위한 외부 문맥으로 사용한다.
6 Conclusion
논문은 경험 지식이 보고된 개방형 작업에서 스칼라 루브릭 보상보다 풍부한 사후 학습 신호를 제공하며, 대부분의 비교에서 held-out 및 보지 못한 벤치마크 결과가 더 강하다고 결론짓는다. 다만 근거는 LLM 기반 평가, 선택한 모델과 벤치마크에 한정되며, 대역폭 주장은 유효 감독량의 측정치가 아니라 이론적 직관이라고 명시한다.
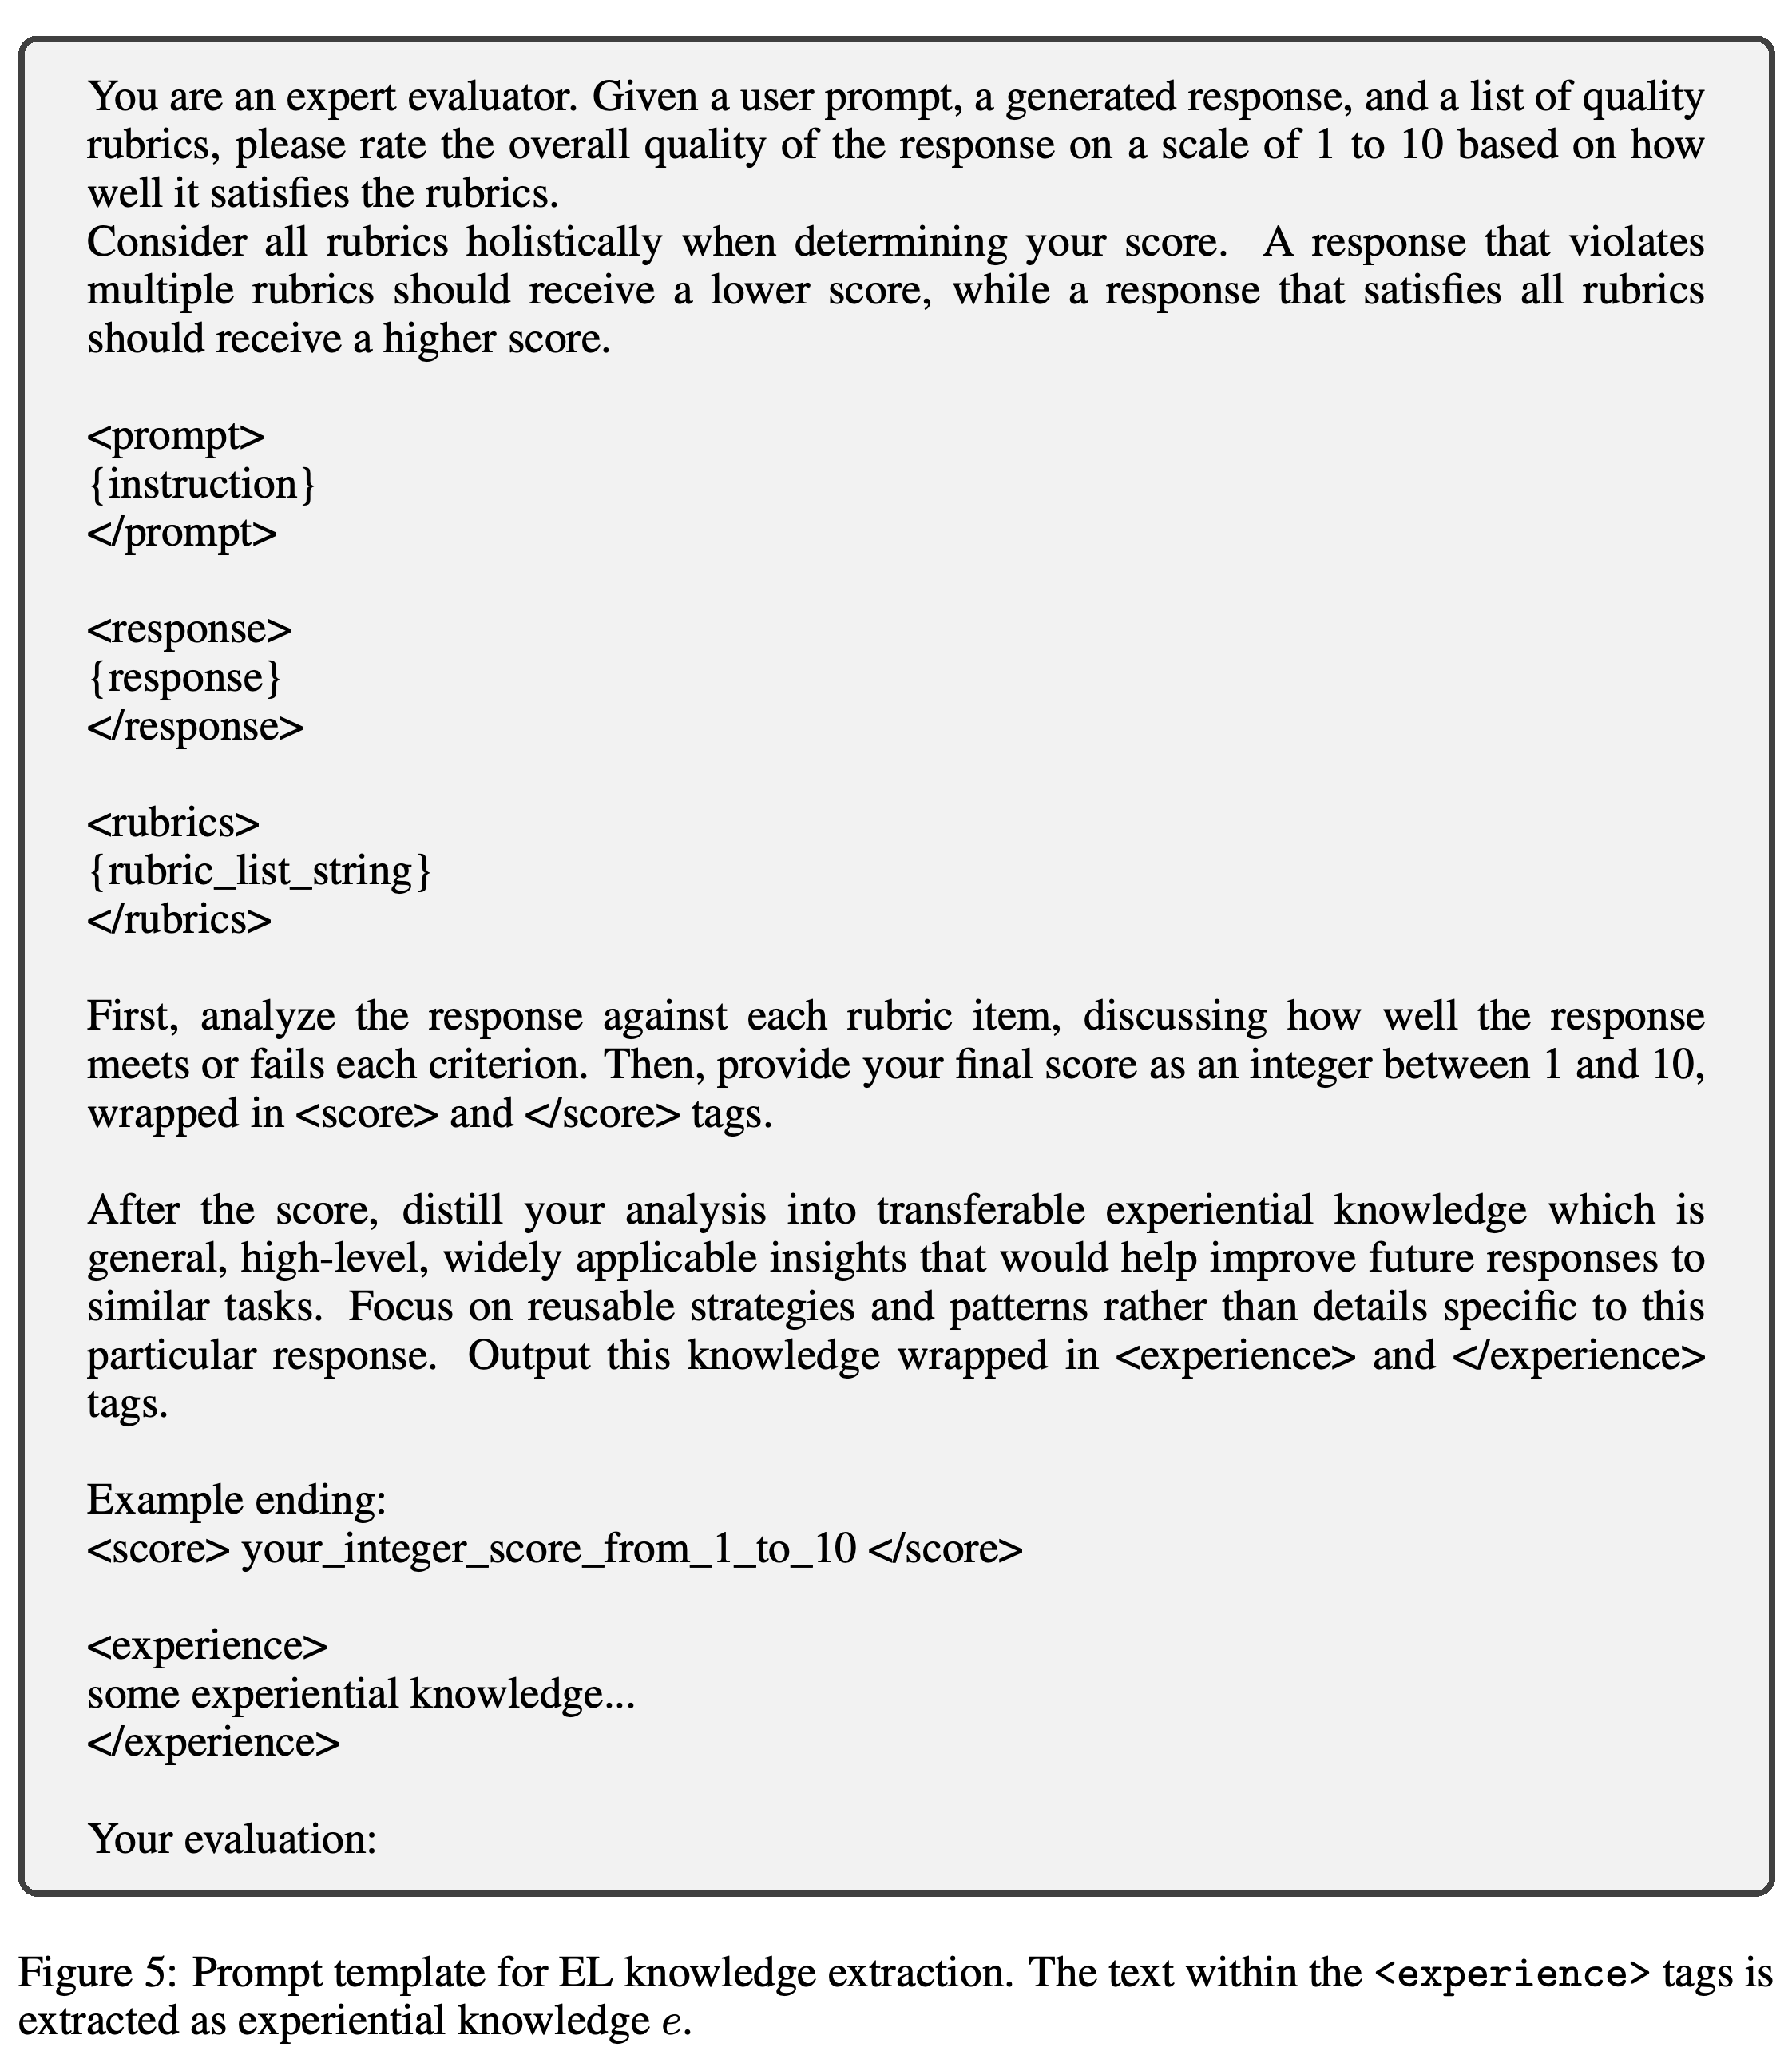
템플릿은 coach에게 루브릭을 평가하고, 점수를 부여하고, <experience> 태그 안에 일반적이고 재사용 가능한 전략을 추출하도록 지시한다. EL은 점수를 학습 신호로 사용하지 않고 이 마지막 필드를 e로 추출한다.
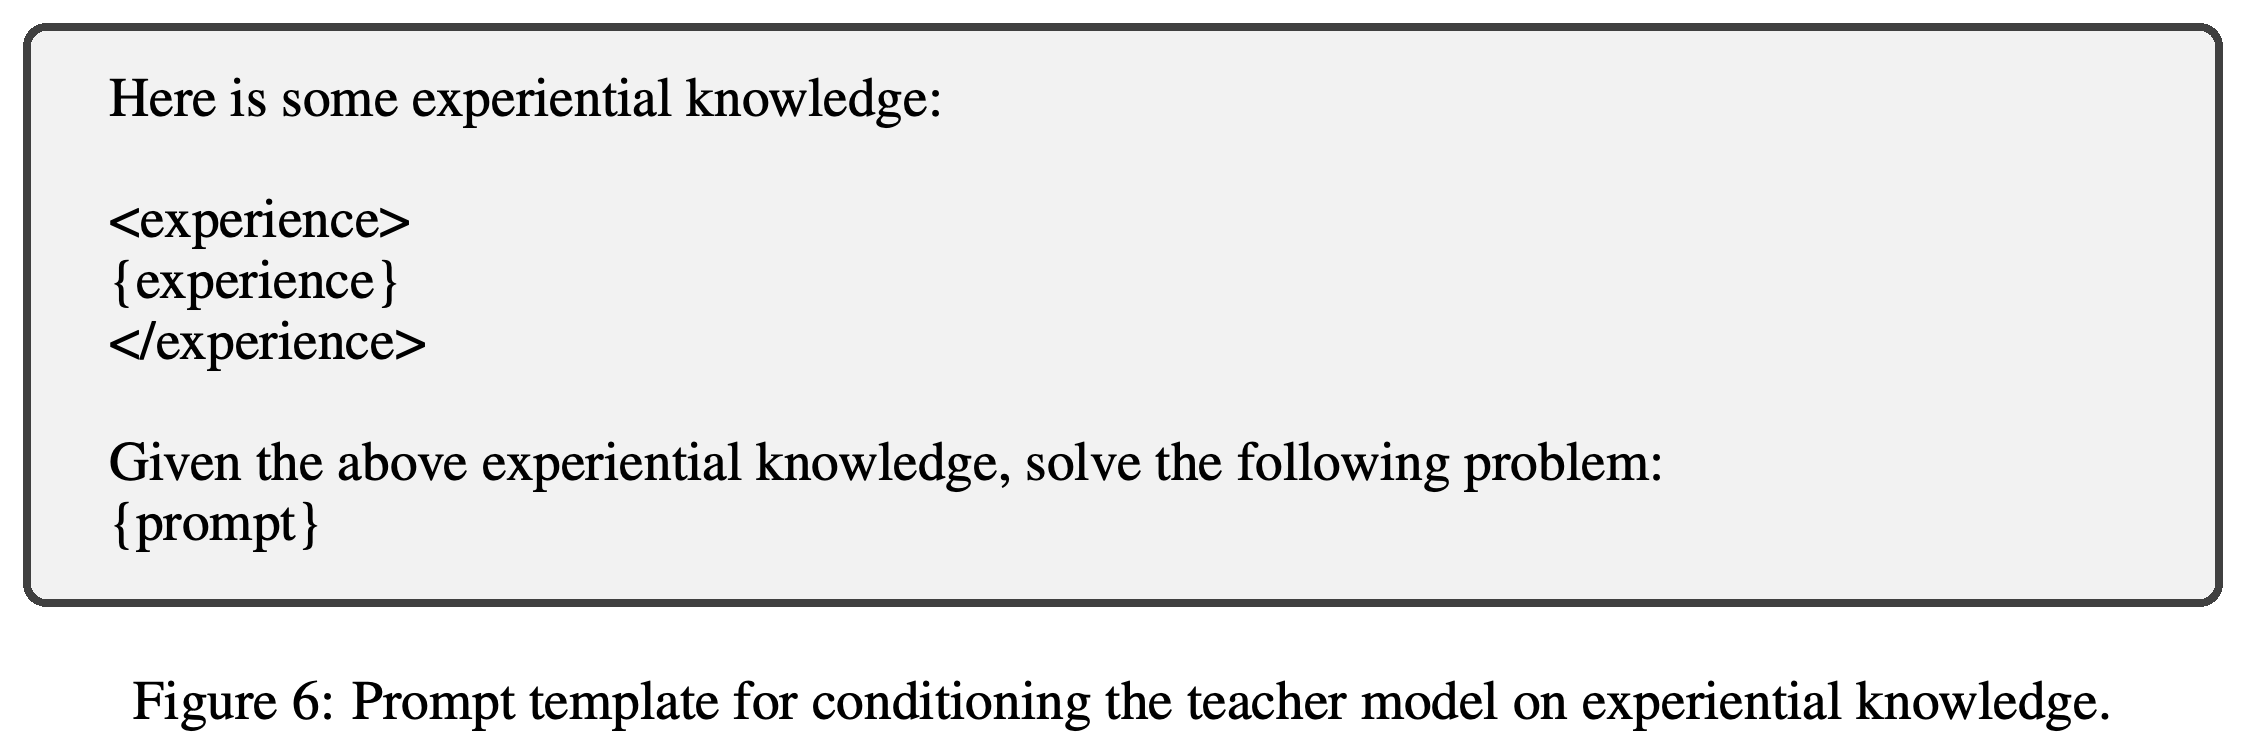
이 템플릿은 추출된 경험을 앞에 붙이고 teacher에게 원래 프롬프트를 풀도록 요청한다. 이는 EL의 reverse-KL 목적에 사용되는 teacher 분포를 만드는 문맥 조건화를 구현한다.
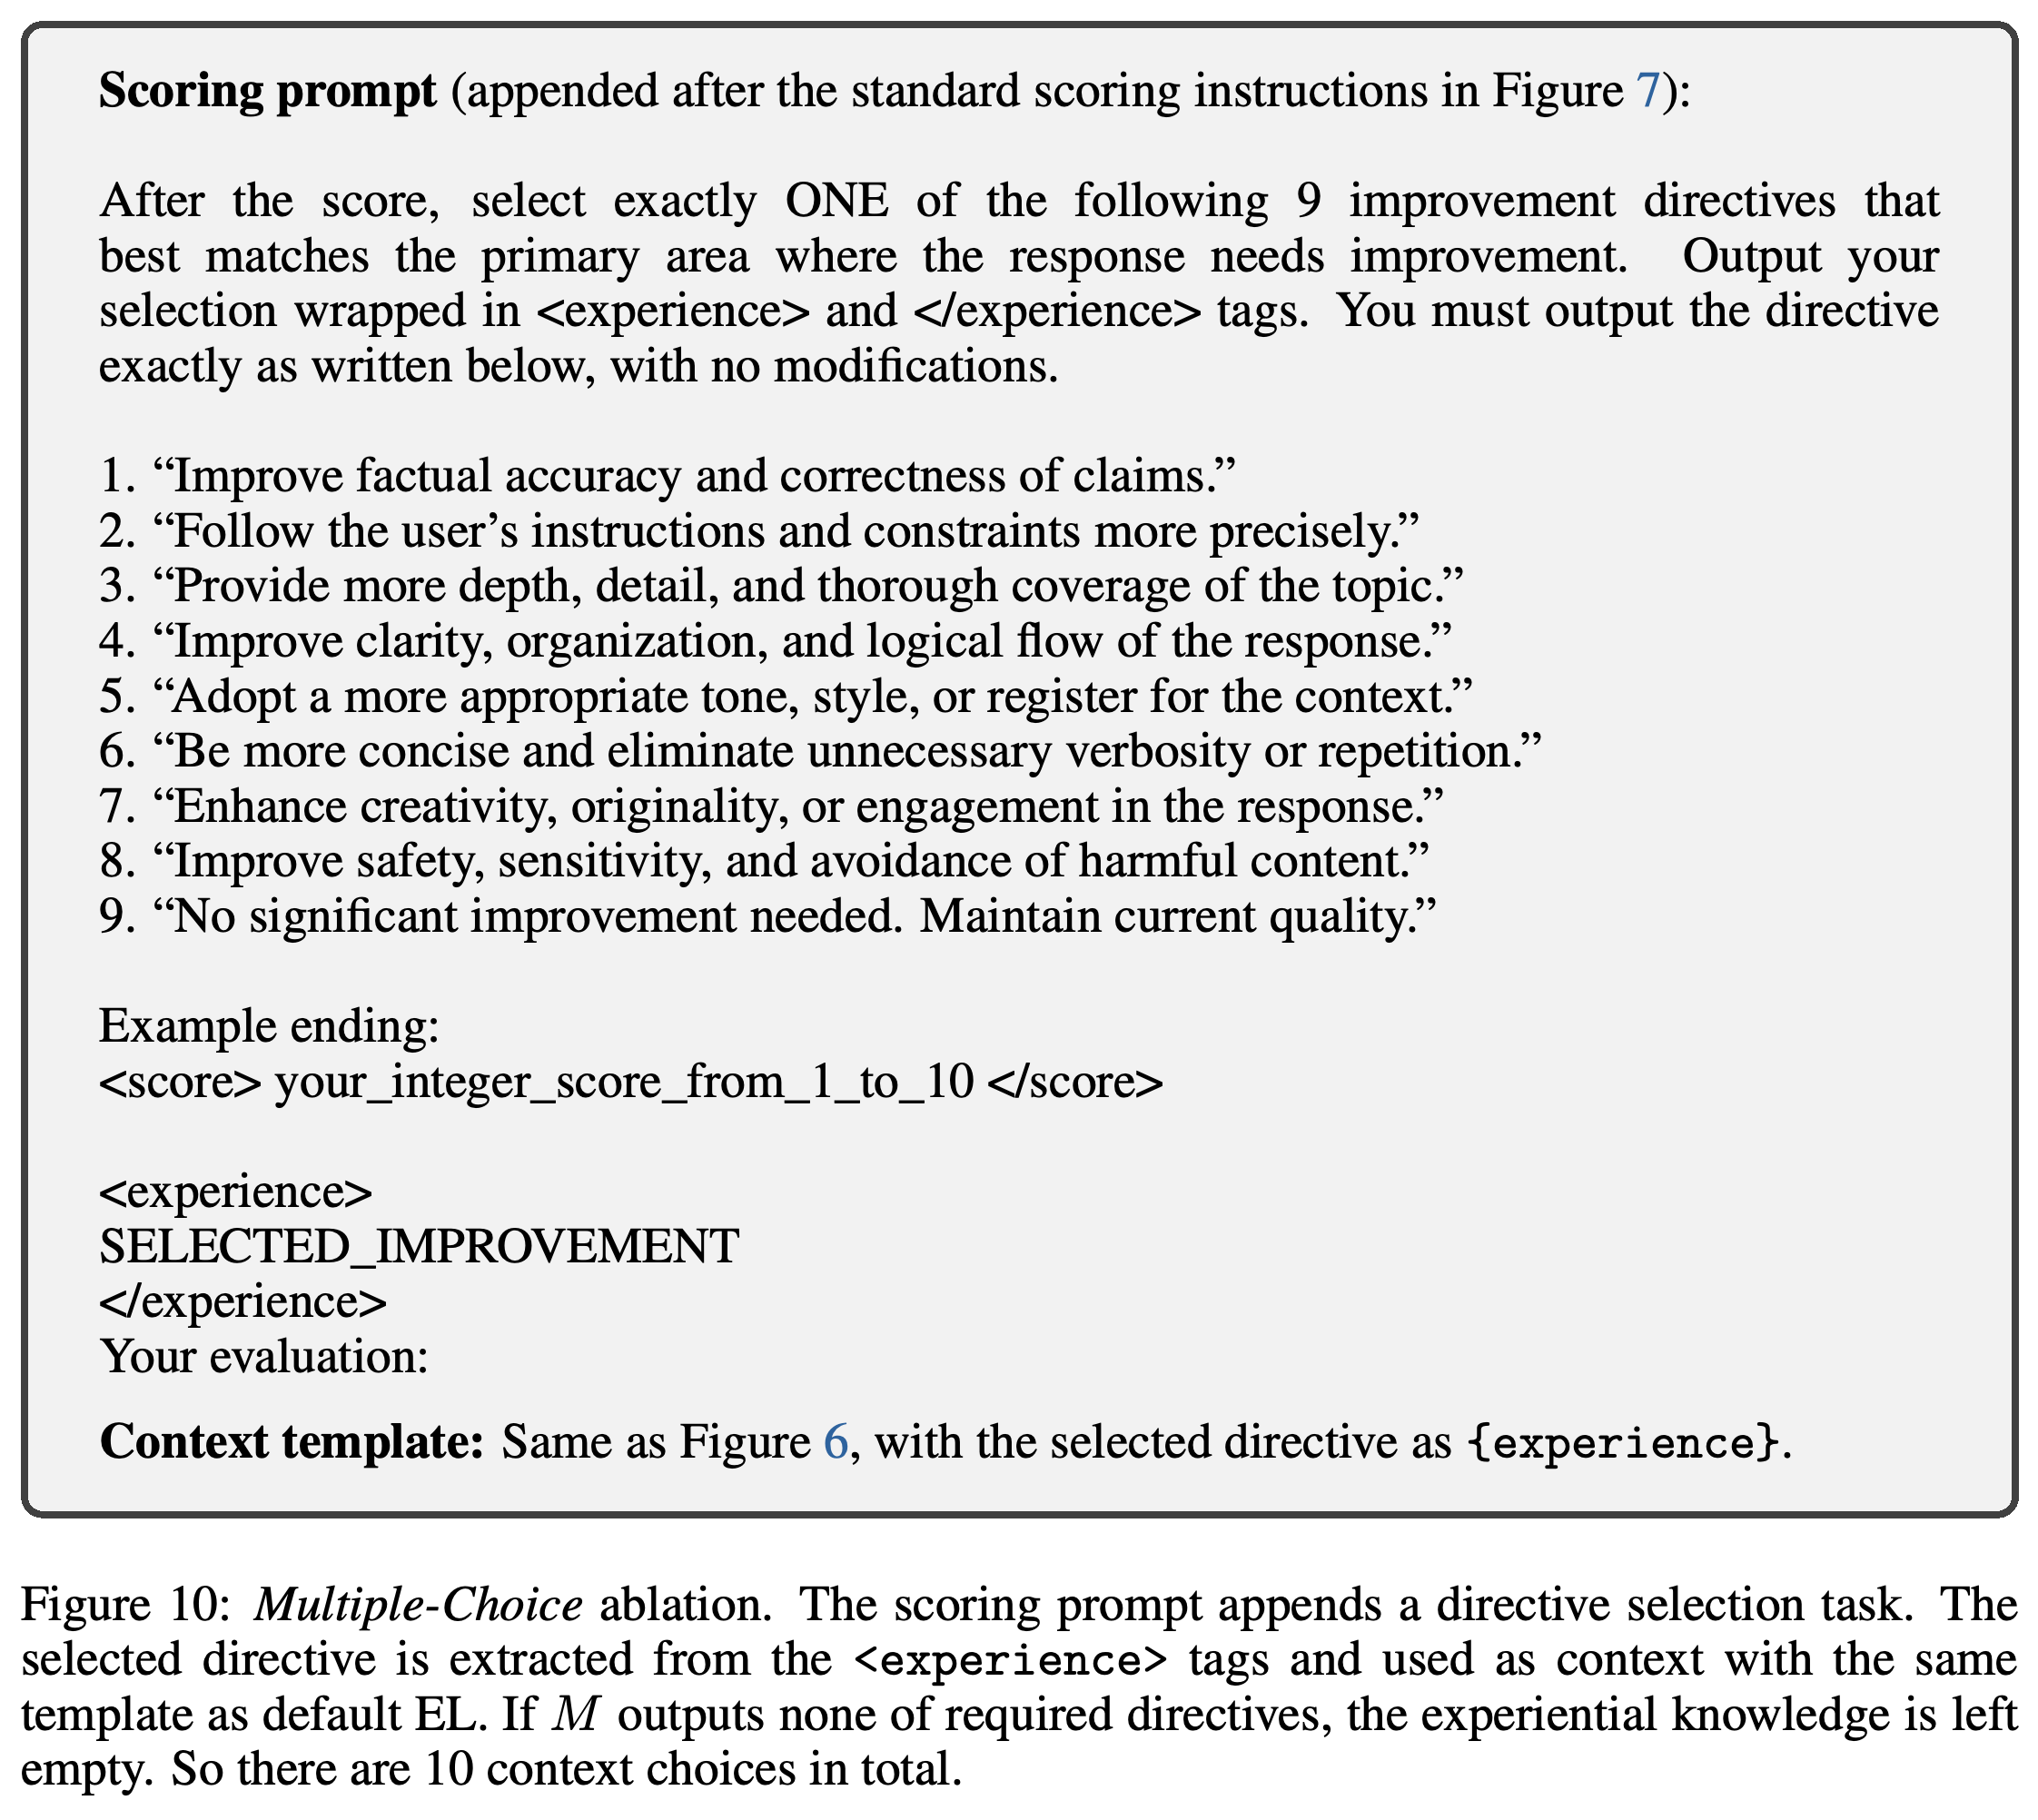
Multiple-Choice ablation은 피드백을 9개의 사전 정의된 개선 지침 중 1개와 빈 fallback으로 제한하여 가능한 문맥 10개를 만든다. 논문은 이를 1–10 점수와 동일한 log2(10) 최대 용량을 갖는 저대역폭 비교로 사용한다.
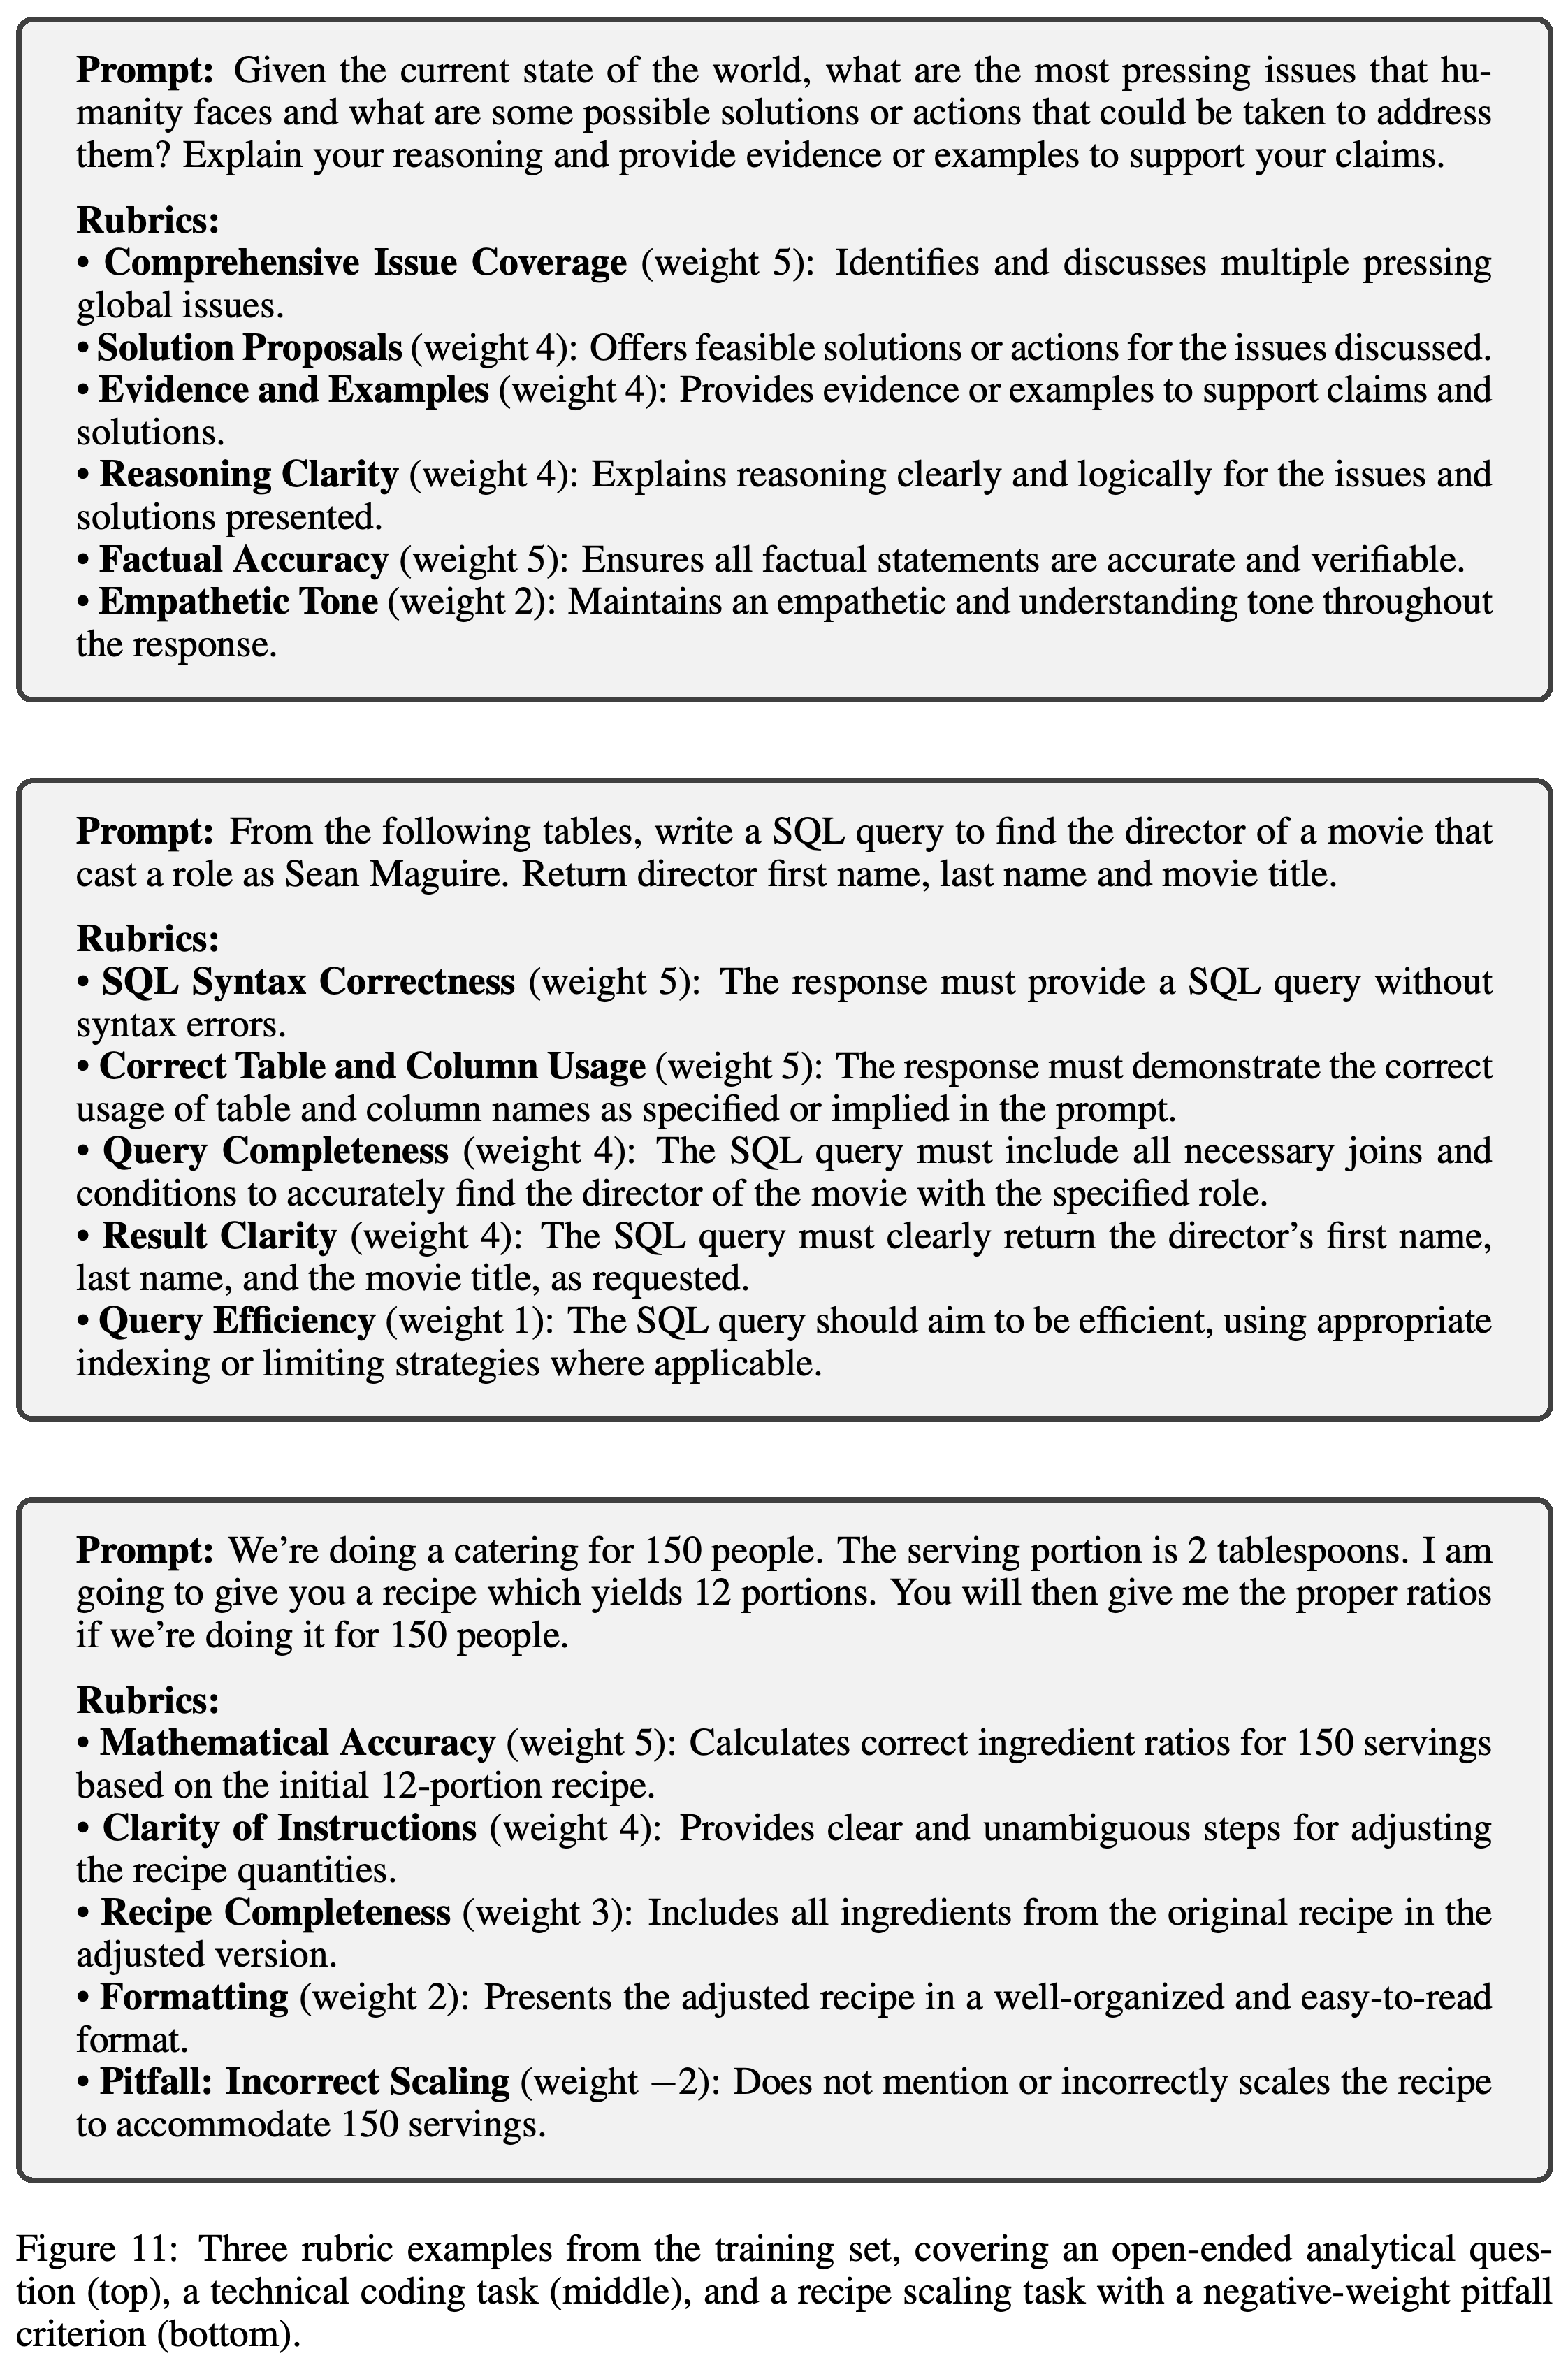
3개 예시는 광범위한 분석 응답, SQL 쿼리 작성, 레시피 비율 조정을 위한 학습 루브릭을 보여준다. 각 루브릭에는 명명된 기준과 가중치가 있으며, 레시피 예시에는 음의 가중치를 갖는 함정 기준도 포함된다.
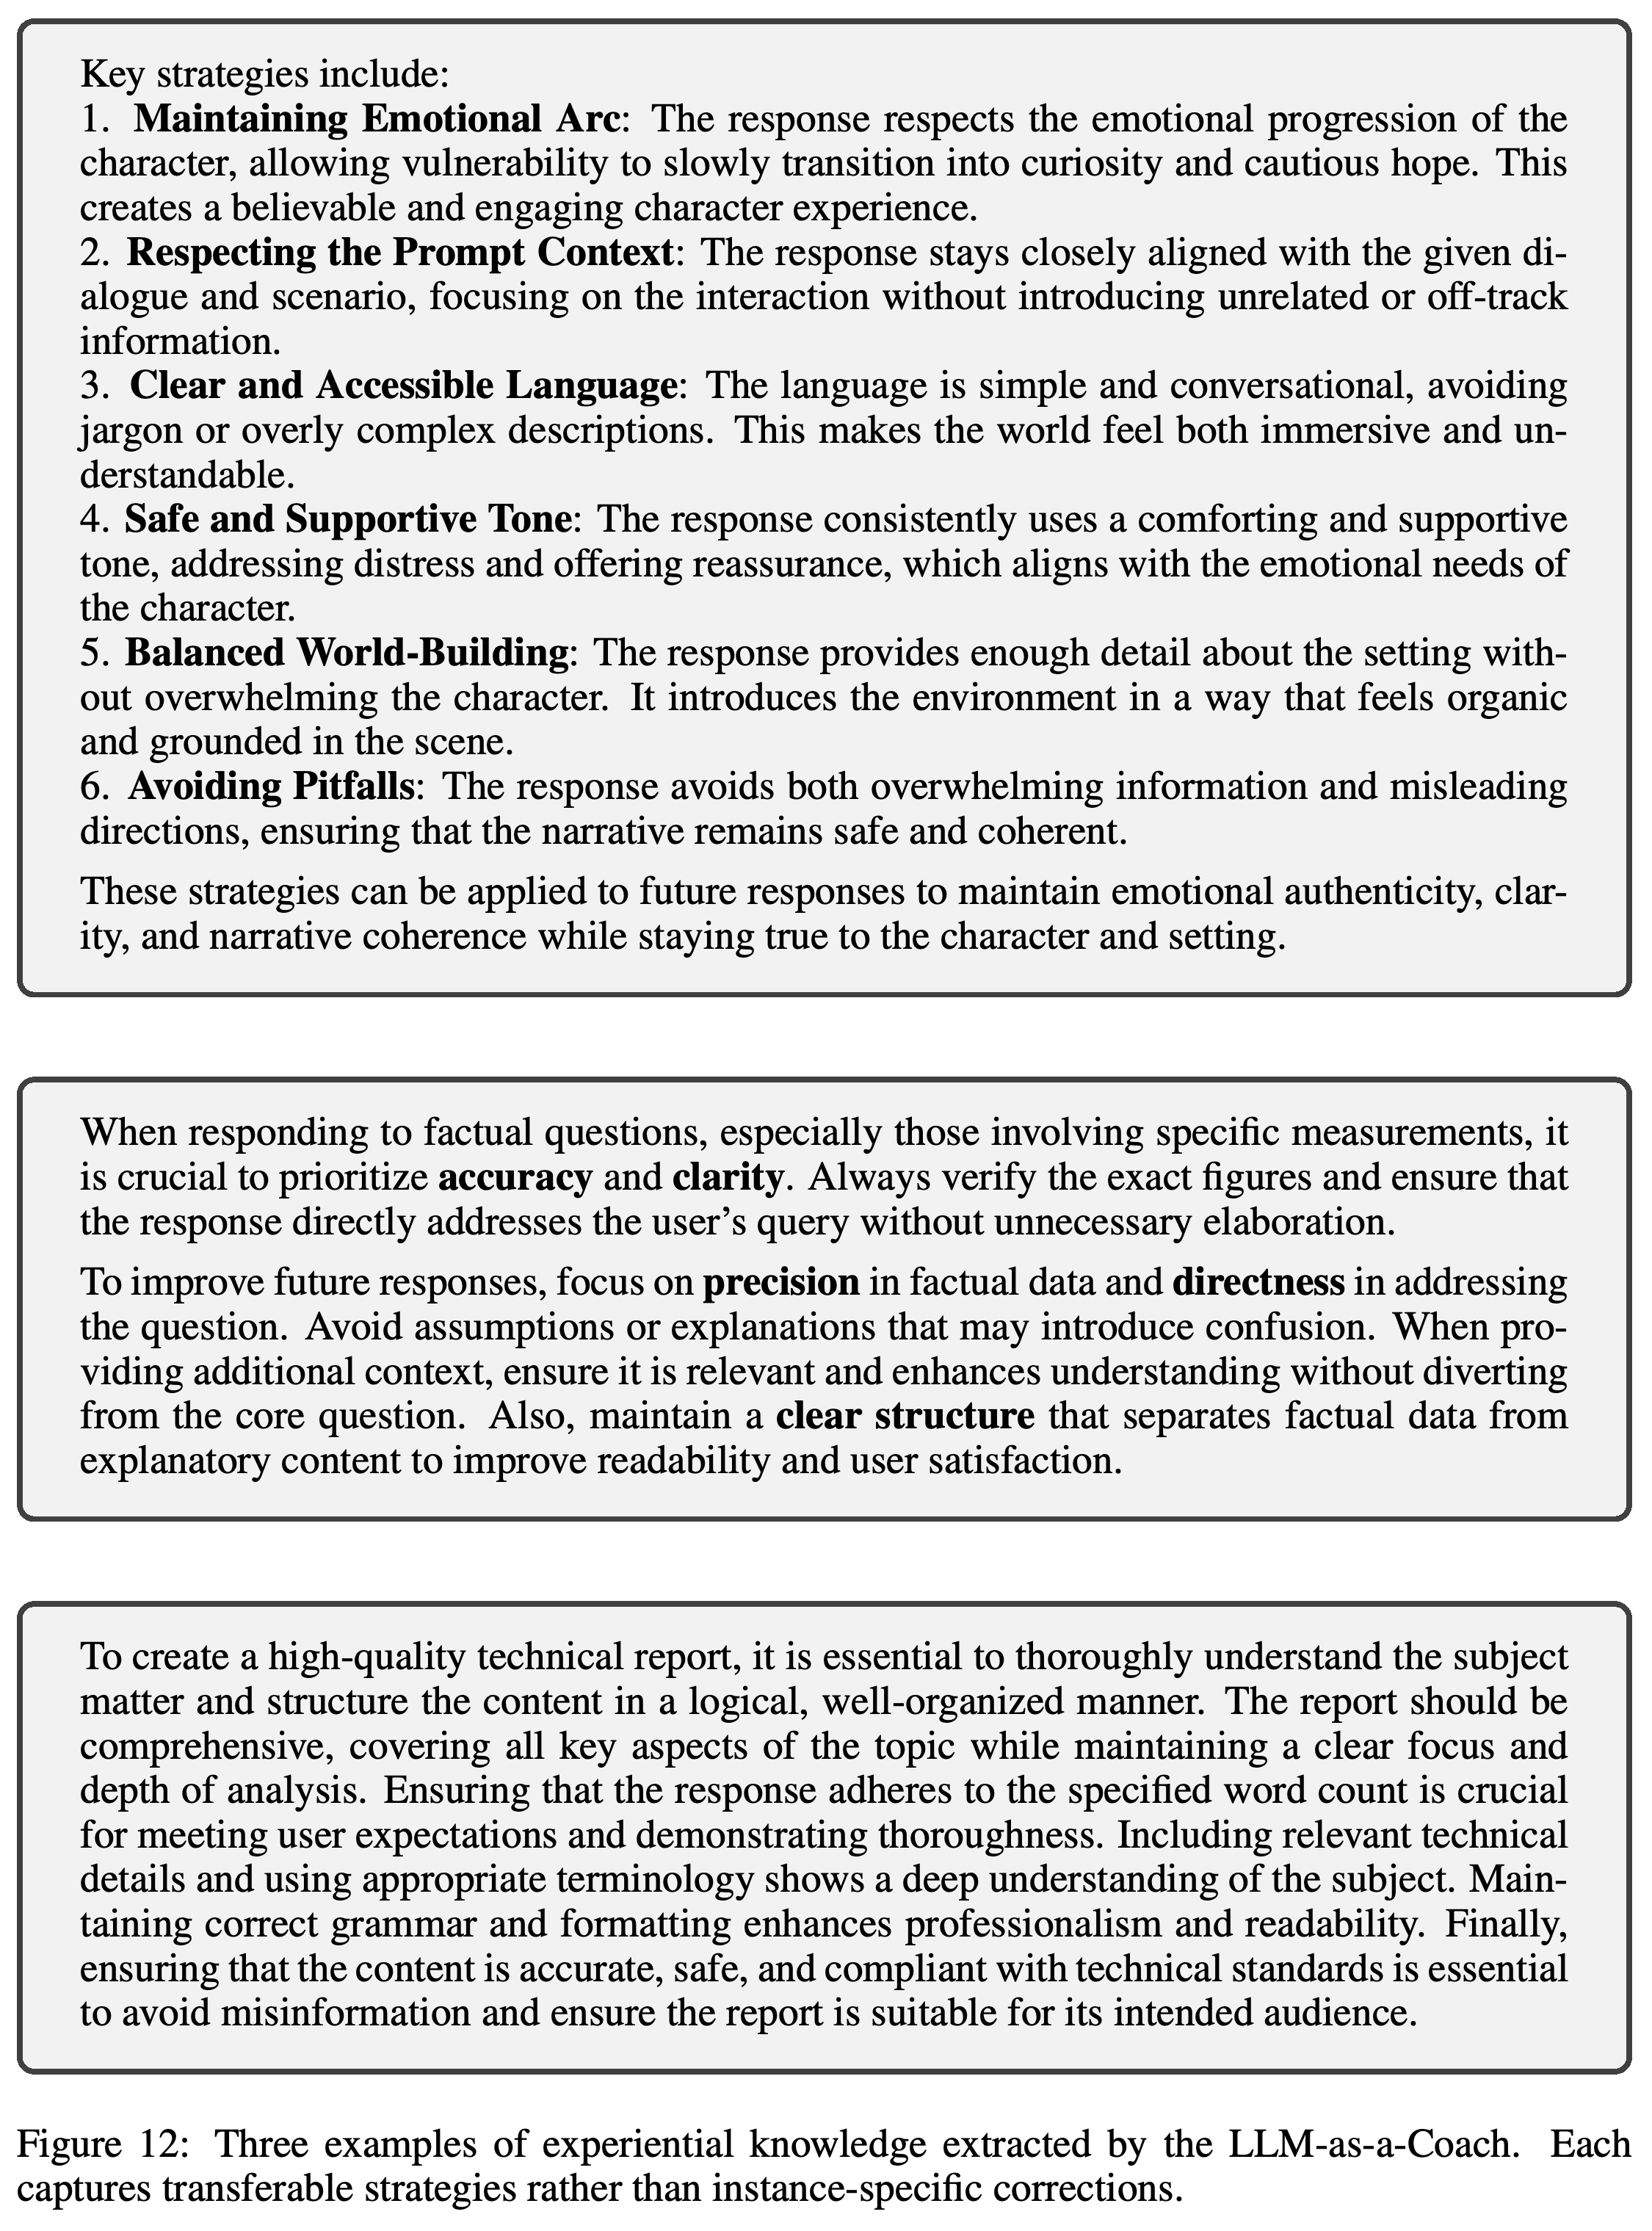
예시는 감정적 흐름 유지, 사실 정밀성 우선, 기술 보고서 구조화처럼 단일 응답을 넘어 추상화한 전략을 강조한다. 이는 경험 지식을 사례별 피드백이 아니라 전이 가능한 지식으로 정의한 방식을 보여준다.
부록
- 부록은 EL 지식 추출 및 teacher 조건화 프롬프트, RL 채점 프롬프트, teacher 문맥 ablation 템플릿, GPT-4o-generated 루브릭 예시, 추출된 경험 예시, 종단 간 EL 예시를 제공한다. 기본 coach 프롬프트는 루브릭 분석, 1–10 점수, <experience> 태그로 감싼 재사용 가능한 고수준 전략을 요청하며, EL은 추출된 경험으로 teacher를 조건화한다.
짧은 생각
RL과 EL이 같은 루브릭을 사용하고 같은 피드백 모델도 사용할 수 있으므로, 핵심 비교는 학습 인터페이스의 효과를 분리한다는 점에서 통제되어 있다. 그러나 일반화와 reward hacking에 관한 해석은 시사적일 뿐 결정적이지는 않다. 대부분의 결과가 GPT-4o 평가에 의존하며, 양자화 실험도 모든 스칼라 보상 방법에 관한 시뮬레이션이나 증명이 아니라 toy 구성이라고 명시되어 있다.