


Likelihood-Based Reward Designs for General LLM Reasoning 요약 설명
03 Feb 2026 | Paper Review Reward Design Reinforcement Learning Reasoning목차
이번 글에서는 Likelihood-Based Reward Designs for General LLM Reasoning 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 2월 3일(Arxiv)
- Kwiatkowski, Ariel, Butt, Natasha, Labiad, Ismail, Kempe, Julia, Ollivier, Yann.
- Meta FAIR, University of Amsterdam, New York University
- 논문 링크
요약
- Likelihood-Based Reward Designs for General LLM Reasoning은 chain-of-thought(CoT) 추론을 학습할 때 참조 답변의 우도로 과제별 검증기를 대체할 수 있는지 연구한다. 답변 전체 확률 보상과 로그 확률 보상을 비교하며, 토큰 평균과 그룹 단위 변형도 포함한다.
- 실험에서는 MATH, DeepScaleR, Alpaca, NuminaProof에서 Llama-3.2-3B-Instruct와 Qwen-2.5-3B-Instruct를 사용한다. 로그 확률 보상은 greedy decoding에서 경쟁력 있는 수학 정확도를 달성하고, Base RL이나 답변 전체 확률 보상보다 참조 답변의 perplexity를 크게 낮춘다. 다만 T = 1로 답변을 샘플링하면 성공률은 대체로 더 낮다.
- 긴 답변 데이터셋에서 로그 확률 방법은 참조 답변 우도와 perplexity가 supervised fine-tuning(SFT)에 근접하지만, 답변 전체 확률 보상은 이에 준하는 개선을 보이지 못한다. 이 결과가 긴 답변에서 추론 능력이 향상되었음을 입증하지는 않는다. 학습된 CoTs가 매우 짧아져서 학습 과정이 사실상 SFT와 비슷해지기 때문이다.
- 최소 길이 페널티, KL 정규화, warm-start 학습은 더 긴 CoTs를 유지할 수 있지만, 보고된 연산 예산 안에서는 SFT보다 유리하다는 점을 입증하지 못한다. 실험 결과는 로그 확률이 실험한 여러 도메인에서 참조 기반 학습 신호로 쓰일 수 있음을 뒷받침한다. 그러나 검증 불가능한 과제에서 유용한 명시적 추론을 학습하는 해결책임을 보여 주지는 않는다.
1 Introduction
일반적인 추론 RL은 CoT 토큰을 행동으로 취급하고, 정답 검증기로 최종 답변에 보상을 부여한다. 이 방식은 짧은 수학 답변이나 실행 가능한 코드에 자연스럽게 적용되지만, 긴 증명이나 개방형 응답에는 신뢰할 수 있는 과제별 검증 수단이 없는 경우가 많다.
- 신뢰할 수 있는 이진 검증기가 없더라도 참조 응답은 확보할 수 있다.
- 논문은 참조 응답에서 얻은 확률과 로그 우도 신호를 연구하며, 특히 로그 확률 보상과 사전학습의 관계에 주목한다.
Our Approach and Contributions.
논문의 기여는 2개 모델 계열을 대상으로 짧은 답변과 긴 답변 환경에서 우도 기반 보상을 체계적으로 비교한 데 있다. 답변 성공률, 참조 답변 우도, perplexity, CoT 길이를 함께 추적하여 예측 성능과 명시적 추론 과정의 발달을 구분한다.
- 로그 확률 변형은 4개 데이터셋 모두에서 참조 우도를 개선한다. 답변 전체 확률 보상은 NuminaProof에서 효과가 없고 Alpaca에서는 일관된 효과를 보이지 않는다.
- 우도 기반 보상은 보상을 계산하기 위해 최종 답변을 샘플링할 필요가 없다. 다만 CoT를 생성하고 참조 응답의 점수를 계산하는 과정은 여전히 필요하다.
- CoT 길이 분석은 우도 최적화에 성공하더라도 명시적 추론은 대부분 사라질 수 있음을 보여 준다.
Related Work.
논문은 참조 기반 보상을 모델의 확신도, 엔트로피, 다양성에 기반한 내재적 보상 및 LLM-as-a-judge 감독과 구분한다. 가장 밀접한 비교 대상은 참조 답변 확률을 서로 다른 방식으로 집계하는 VeriFree, JEPO, RLPR, NOVER다.
- VeriFree (Zhou et al., 2025)는 답변 전체 확률을 사용한다. JEPO (Tang et al., 2025)는 개별 CoT의 로그 확률을 평균하는 대신, 그룹 평균 답변 확률에 로그를 취한다.
- RLPR (Yu et al., 2025)는 개별 토큰 확률의 평균을 사용할 근거를 제시한다. NOVER (Liu et al., 2025)는 토큰별 perplexity의 기하평균을 사용한다.
- Reinforcement-pretraining (Dong et al., 2025)과 LongForm (Gurung & Lapata, 2025)은 후속 텍스트를 이용하는 관련 학습 방법을 제시한다. 이 방법들과 NOVER는 보고된 실험 비교에서 별도 알고리즘으로 다루지 않는다.
2 Method
이 방법은 샘플링한 추론 과정과 그 추론 과정을 평가하는 데 쓰는 참조 답변을 분리한다. 따라서 주석으로 제공된 CoTs 없이도 같은 보상 구성 방식으로 짧은 정답과 긴 참조 후속 텍스트의 점수를 계산할 수 있다.
Context: Chain-of-thought fine-tuning via Reinforcement Learning.
프롬프트 p에 대해 정책 πθ는 CoT z를 생성한 뒤 답변 a를 생성한다. 일반적인 목적함수는 Jθ = E[p ∼ D] E[z ∼ πθ(z|p), a ∼ πθ(a|p,z)] [R(z,a)]이며, RLOO, GRPO, PPO와 같은 Reinforce 계열 알고리즘으로 최적화할 수 있다.
- RLOO는 같은 프롬프트에서 독립적으로 샘플링한 추론 과정들의 평균 보상을 빼서 advantage를 추정한다. 평균을 계산할 때 현재 추론 과정은 제외한다.
- 보상 선택에 따라 학습이 답변의 정확한 일치를 강조할지, 참조 후속 텍스트의 우도를 강조할지가 달라진다.
RL fine-tuning with probability-based rewards.
참조 답변 a⋆가 주어지면 기본 보상은 R(z,a) = log πθ(a⋆|p,z)다. 참조 답변을 teacher forcing으로 입력하여 1회의 transformer 순전파로 계산할 수 있으며, 샘플링한 최종 답변에는 의존하지 않는다.
- 평균 로그 확률은 이 보상을 참조 답변의 토큰 수로 나눈다. 이에 따라 답변 길이가 다른 예시들의 상대적 가중치가 달라진다.
- VeriFree는 대신 정확히 일치할 때 부여하는 이진 보상의 조건부 기댓값인 πθ(a⋆|p,z)를 사용한다.
- 긴 답변에서는 참조 시퀀스 전체와 일치할 확률이 극히 작을 수 있다. 로그를 취하면 시퀀스 간 차이가 거의 구분할 수 없는 0에 가까운 보상으로 압축되는 문제를 피할 수 있다.
보상이 현재 정책 파라미터에 의존하므로, 목적함수의 기울기에는 CoT의 policy-gradient 항과 참조 답변 우도의 직접적인 기울기가 모두 포함된다. 구체적으로 ∇Jθ = E[log πθ(a⋆|p,z) ∇log πθ(z|p) + ∇log πθ(a⋆|p,z)]이므로, 이 학습은 고정된 외부 평가기에 대한 RL만 수행하는 것이 아니다.
- 첫 번째 항은 참조 응답의 확률을 높이는 추론 과정을 강화한다.
- 두 번째 항은 샘플링한 추론 과정을 조건으로 하는 SFT와 유사하다. 추론 과정이 대부분 사라지면 학습은 답변을 직접 학습하는 SFT에 가까워진다.
Algorithms and rewards tested.
비교 대상은 CoT 없는 SFT, Base RL, Probability (VeriFree), Average prob (AvgProb), Log-prob, Average log-prob (AvgLogprob), JEPO다. JEPO를 제외한 RL의 advantage는 프롬프트별 leave-one-out 평균 보상을 baseline으로 사용한다.
- SFT는 프롬프트에서 참조 답변을 직접 예측한다. Base RL은 추론과 답변을 모두 생성한 뒤 검증기를 적용한다.
- AvgProb는 참조 토큰의 조건부 확률을 평균하고, AvgLogprob는 그 로그 확률을 평균한다.
- JEPO는 R(z1,…,zG) = log[(1/G) Σi πθ(a⋆|p,zi)]를 사용하고, 현재 샘플을 제외한 대응 추정값을 뺀다. 더 큰 그룹은 효율적으로 구현하기 어려워서 실험에서는 G = 4를 사용한다.
Success metrics.
평가는 greedy decoding의 답변 성공률과 T = 1 답변 샘플링의 성공률을 구분하고, 참조 답변 우도도 측정한다. CoT를 주변화한 답변 확률은 πCoT(a⋆|p) = Ez∼π(z|p)[π(a⋆|p,z)]이므로, 우도를 평가할 때 생성된 추론 과정의 분포를 고려해야 한다.
- 확률적 성공률에 대해서는 방법 절에서 CoT를 샘플링하고 조건부 참조 답변 확률을 계산하여 정확한 일치 성공률의 기댓값을 추정한다고 설명한다. 반면 greedy 성공률은 결정적으로 디코딩한 답변을 평가한다.
- 토큰별 로그 확률은 답변 로그 확률의 합을 전체 토큰 수로 나눈다. 답변별 로그 확률은 각 답변을 길이로 정규화한 뒤 평균한다. Perplexity는 답변별 로그 확률에 음수를 취한 값의 지수다.
- 평균 CoT 길이에는 형식 지정 토큰도 포함되므로, 길이가 0이 아닌 짧은 추론 과정에 실질적인 추론이 들어 있다고 볼 수는 없다.
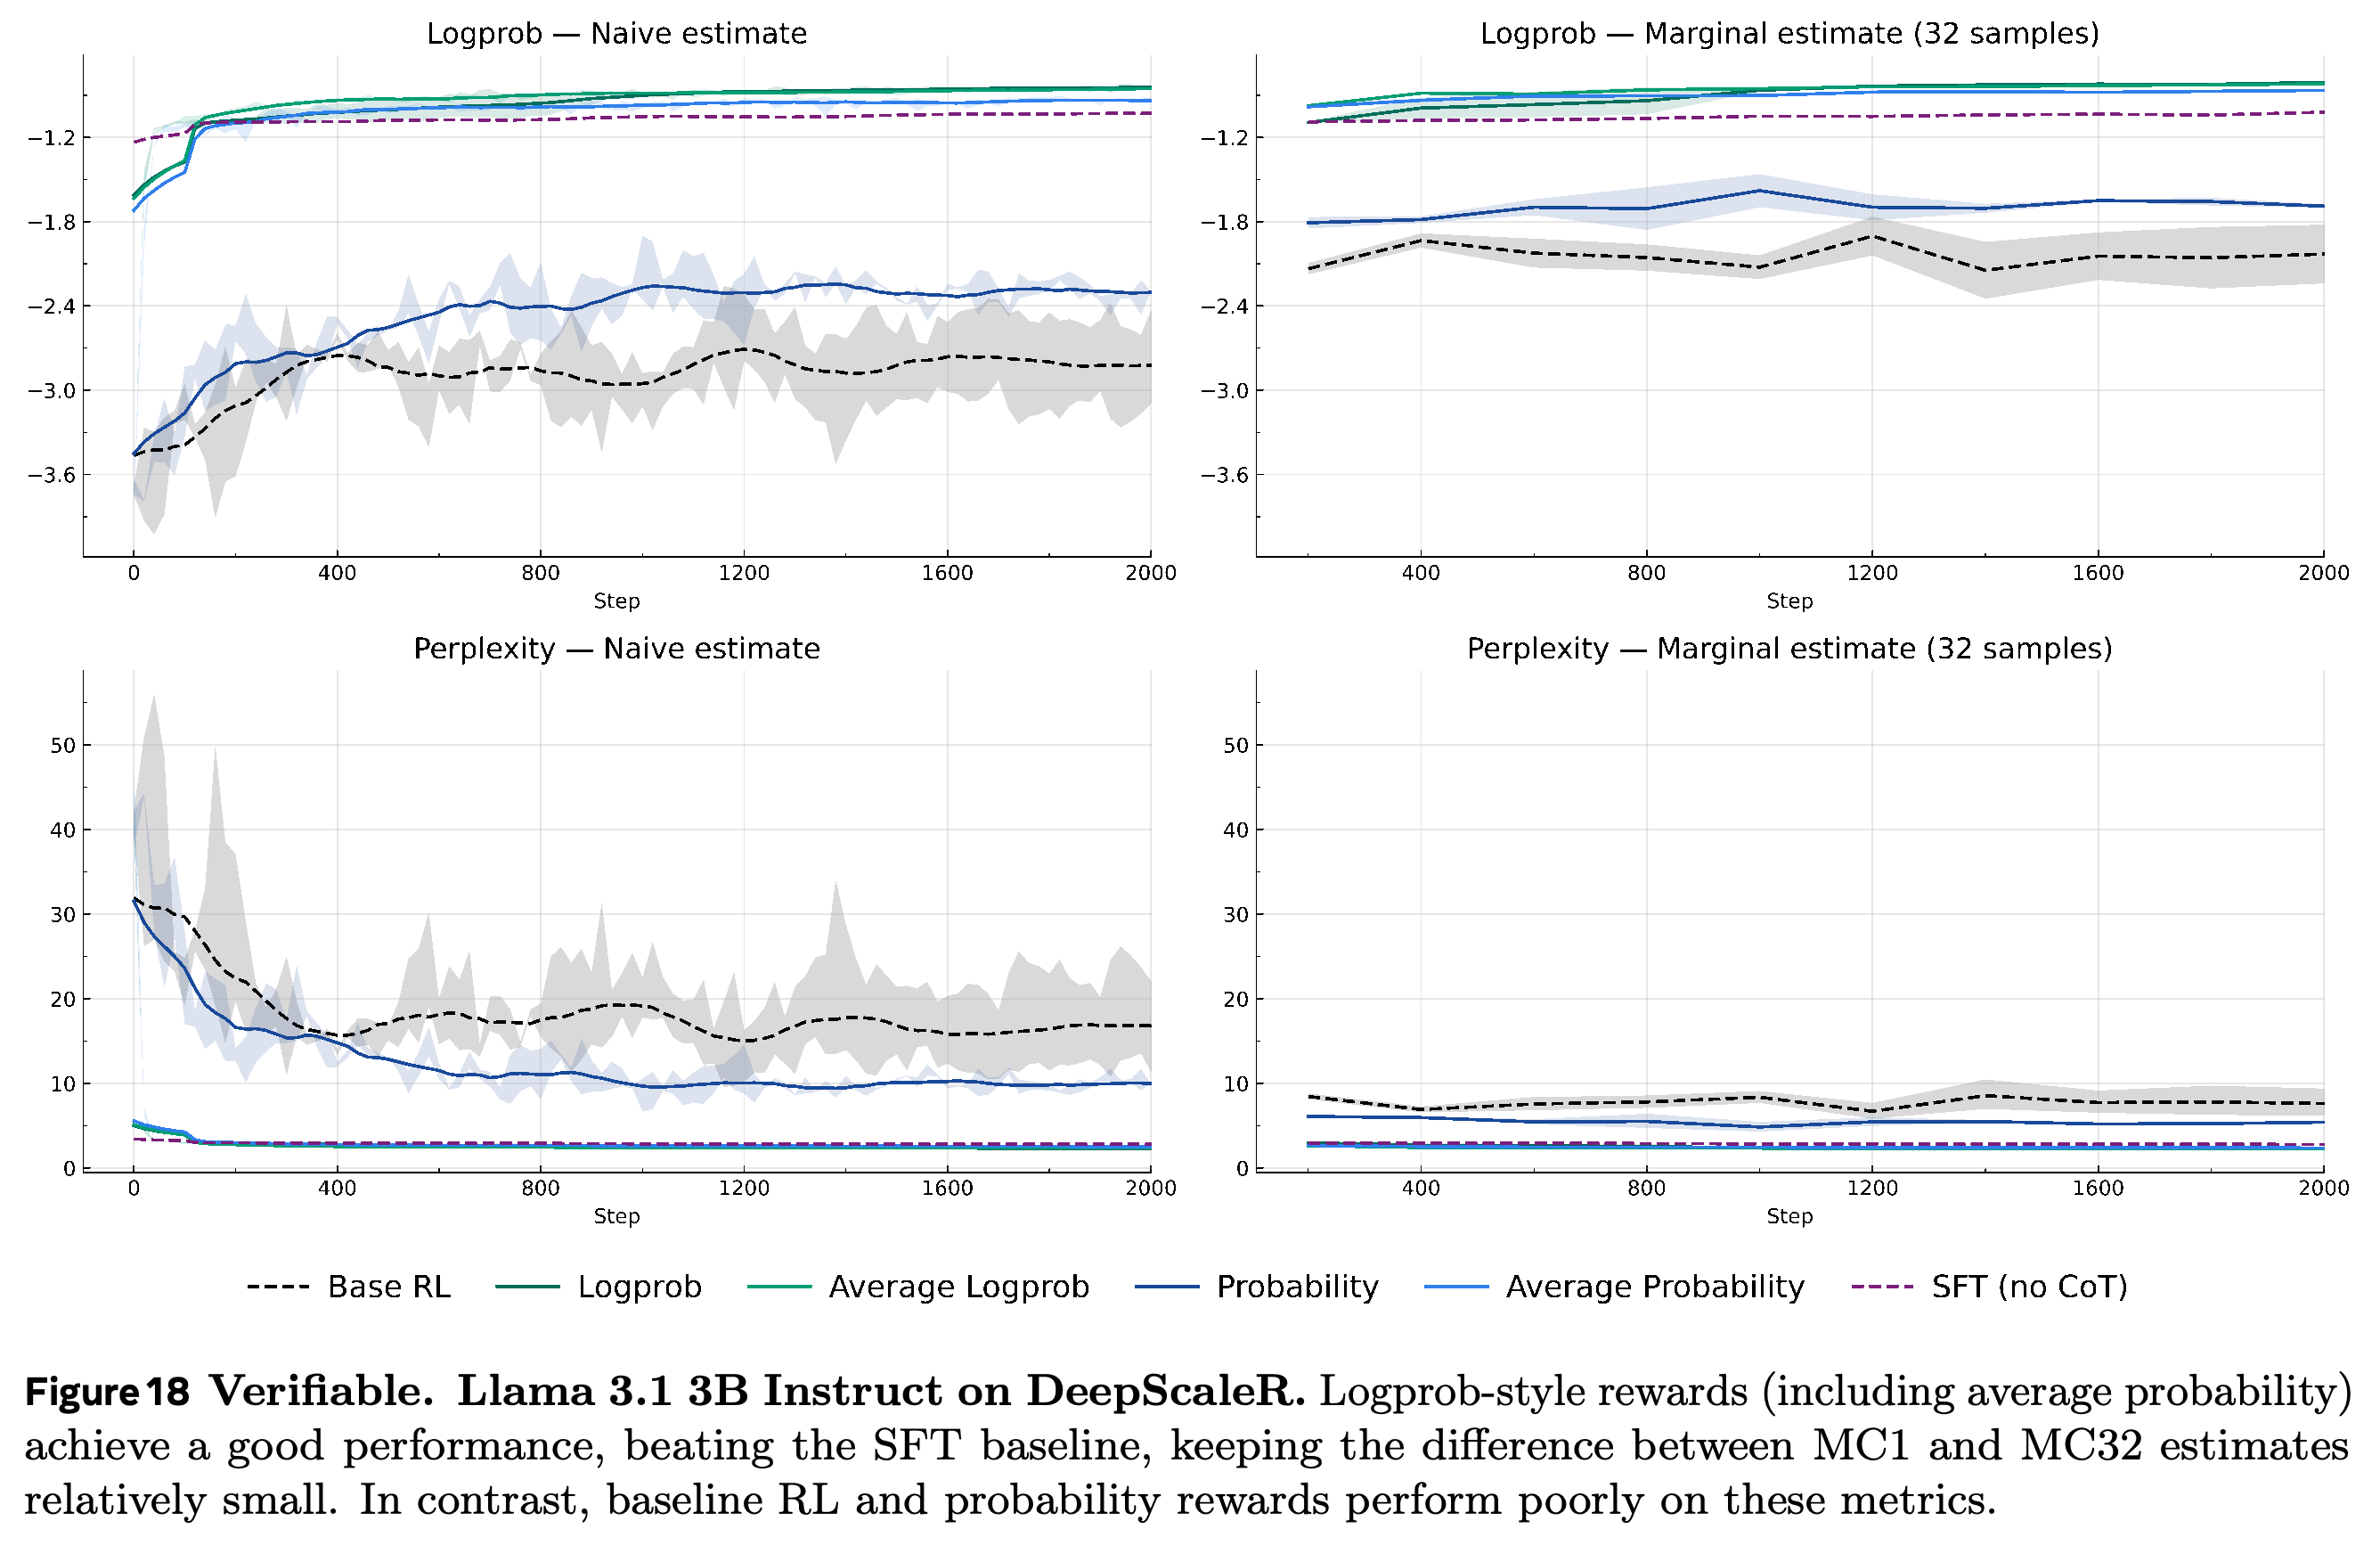
논문은 logprob-MC1과, 더 낮은 빈도로 측정한 logprob-MC32를 사용하여 주변 로그 우도를 추정한다. N개 CoTs를 샘플링하여 답변 확률을 평균한 뒤 로그를 취한다. 로그의 오목성 때문에 이 추정량은 기댓값 수준에서 하향 편향된다. 다만 모든 실제 샘플에서 반드시 과소 추정되는 것은 아니다. 이 차이는 CoT 모델과 SFT를 비교할 때 중요하다.
- 그림 18과 19는 DeepScaleR의 Base RL과 답변 전체 확률 학습에서 MC1–MC32 차이가 크다는 점을 보여 준다.
- 로그 확률 방법은 추정값 간 차이가 더 작으며, 이 비교에서는 MC32에서도 우도 우위가 유지된다.
- 그림 18은 모델을 Llama 3.1 3B Instruct로 표기하지만, 실험 설정에서는 Llama-3.2-3B-Instruct를 명시한다.
32개 추론 과정의 확률을 평균하면 특히 Base RL과 Probability의 주변 우도 추정값이 높아진다. 그러나 로그 확률 방법보다 우도가 낮다는 점은 바뀌지 않는다. 캡션의 Llama 3.1 표기는 실험 설정에서 명시한 Llama-3.2 모델과 다르며, PDF만으로는 이 불일치를 해소할 수 없다.
3 Experimental Results
실험은 검증기 없는 보상이 짧은 수학 답변의 성공률을 유지하는지, 긴 참조 답변의 예측을 개선하는지 확인한다. CoT 길이도 측정하여 예측 성능의 개선이 지속적인 명시적 추론을 동반하는지 평가한다.
3.1 Setup: Datasets, Models, and Protocol
모델은 Llama-3.2-3B-Instruct와 Qwen-2.5-3B-Instruct의 2개다. MATH는 무작위로 10%를 검증용으로 분리한 뒤 약 7,000개 학습 문제를 포함하며, 공식 테스트 분할로 평가한다. DeepScaleR는 무작위로 10%를 검증용으로 분리한 뒤 약 39,000개 학습 문제를 포함하며, 분리한 검증 데이터로 평가한다.
- Alpaca (cleaned)는 무작위 예시 1,000개를 검증용으로 분리하고 약 50,000개를 학습 샘플로 남긴다.
- NuminaProof는 NuminaMath-1.5에서 정리–증명 항목을 추출하고, 하이퍼링크가 포함된 예시를 제거하며, 풀이를 정리한다. 검증 예시 1,000개를 분리한 뒤 약 50,000개를 학습 샘플로 남긴다.
- 수학 학습에서는 중간 풀이를 버리고 최종 답변만 유지하므로, 데이터셋의 풀이로 생성된 CoT를 지도 학습하지 않는다.
실험 설정은 SFT, Base RL, Probability, Log-prob, AvgLogprob, AvgProb, JEPO를 비교한다. 검증 가능한 과제에서는 G = 4와 G = 32를 사용하되 JEPO는 G = 4로 제한하며, KL 계수는 0.001이다. 검증 불가능한 과제의 주요 결과는 KL 정규화 없이 G = 4를 사용한다. 검증 가능한 과제의 결과 표는 2개 seed의 평균을 제시한다.
- 학습은 8개 프로세스에서 동기식 RLOO를 사용한다. AdamW의 학습률은 10−5이며, cosine schedule, 20회의 warm-up step, 1.0의 전역 gradient clipping을 적용한다.
- 각 배치는 질문 8개와 질문별 G개 CoTs로 구성된다. 기본 최대 생성 길이는 T = 1024 토큰이며, 생성에는 <think>와 <answer> 형식을 사용한다.
- 구현된 Base RL 보상은 파싱한 답변이 맞으면 100, 틀렸지만 형식이 올바르면 10, 파싱할 수 없으면 0이다. 개념적으로 설명한 0/1 보상과는 다르다. 수학 학습과 평가는 의미적 동등성 검증이 아니라 답변의 정확한 일치를 사용한다.
3.2 Results on Verifiable Domains
G = 32에서 우도 기반 보상은 Base RL과 대체로 비슷한 greedy 수학 성공률을 달성한다. MATH의 Llama에서 Log-prob는 43.30 ± 0.10을 기록하고 Base RL은 42.74 ± 0.66을 기록한다. DeepScaleR에서는 각각 32.40 ± 1.02와 28.55 ± 0.14를 기록한다.
- MATH의 Qwen에서 Log-prob는 56.84 ± 0.21을 기록하고 Base RL은 55.85 ± 0.46을 기록한다.
- DeepScaleR의 Qwen에서는 Log-prob가 37.92 ± 0.11로 Base RL의 38.30 ± 2.40보다 약간 낮다. 따라서 이 표는 모든 우도 기반 변형이 모든 모델–데이터셋 조합을 개선한다는 주장을 문자 그대로 뒷받침하지는 않는다.
- CoT 없는 SFT의 greedy 수학 성공률은 훨씬 낮으며, 이 4개 설정에서 9.88부터 18.32까지다.
4개 모델–데이터셋 블록은 greedy 성공률, 확률적 성공률, 참조 우도를 구분한다. MATH의 Qwen에서 Log-prob는 greedy 성공률 56.84 ± 0.21과 perplexity 1.55 ± 0.03을 기록하고, Base RL은 55.85 ± 0.46과 8.25 ± 0.80을 기록한다. 반면 T = 1 샘플링에서는 Base RL이 55.36 ± 0.17로 Log-prob의 44.18 ± 0.42보다 높다. Qwen의 DeepScaleR에서도 Log-prob의 greedy 성공률이 Base RL보다 약간 낮으므로, 전반적으로 우월하다고 단정할 수는 없다.
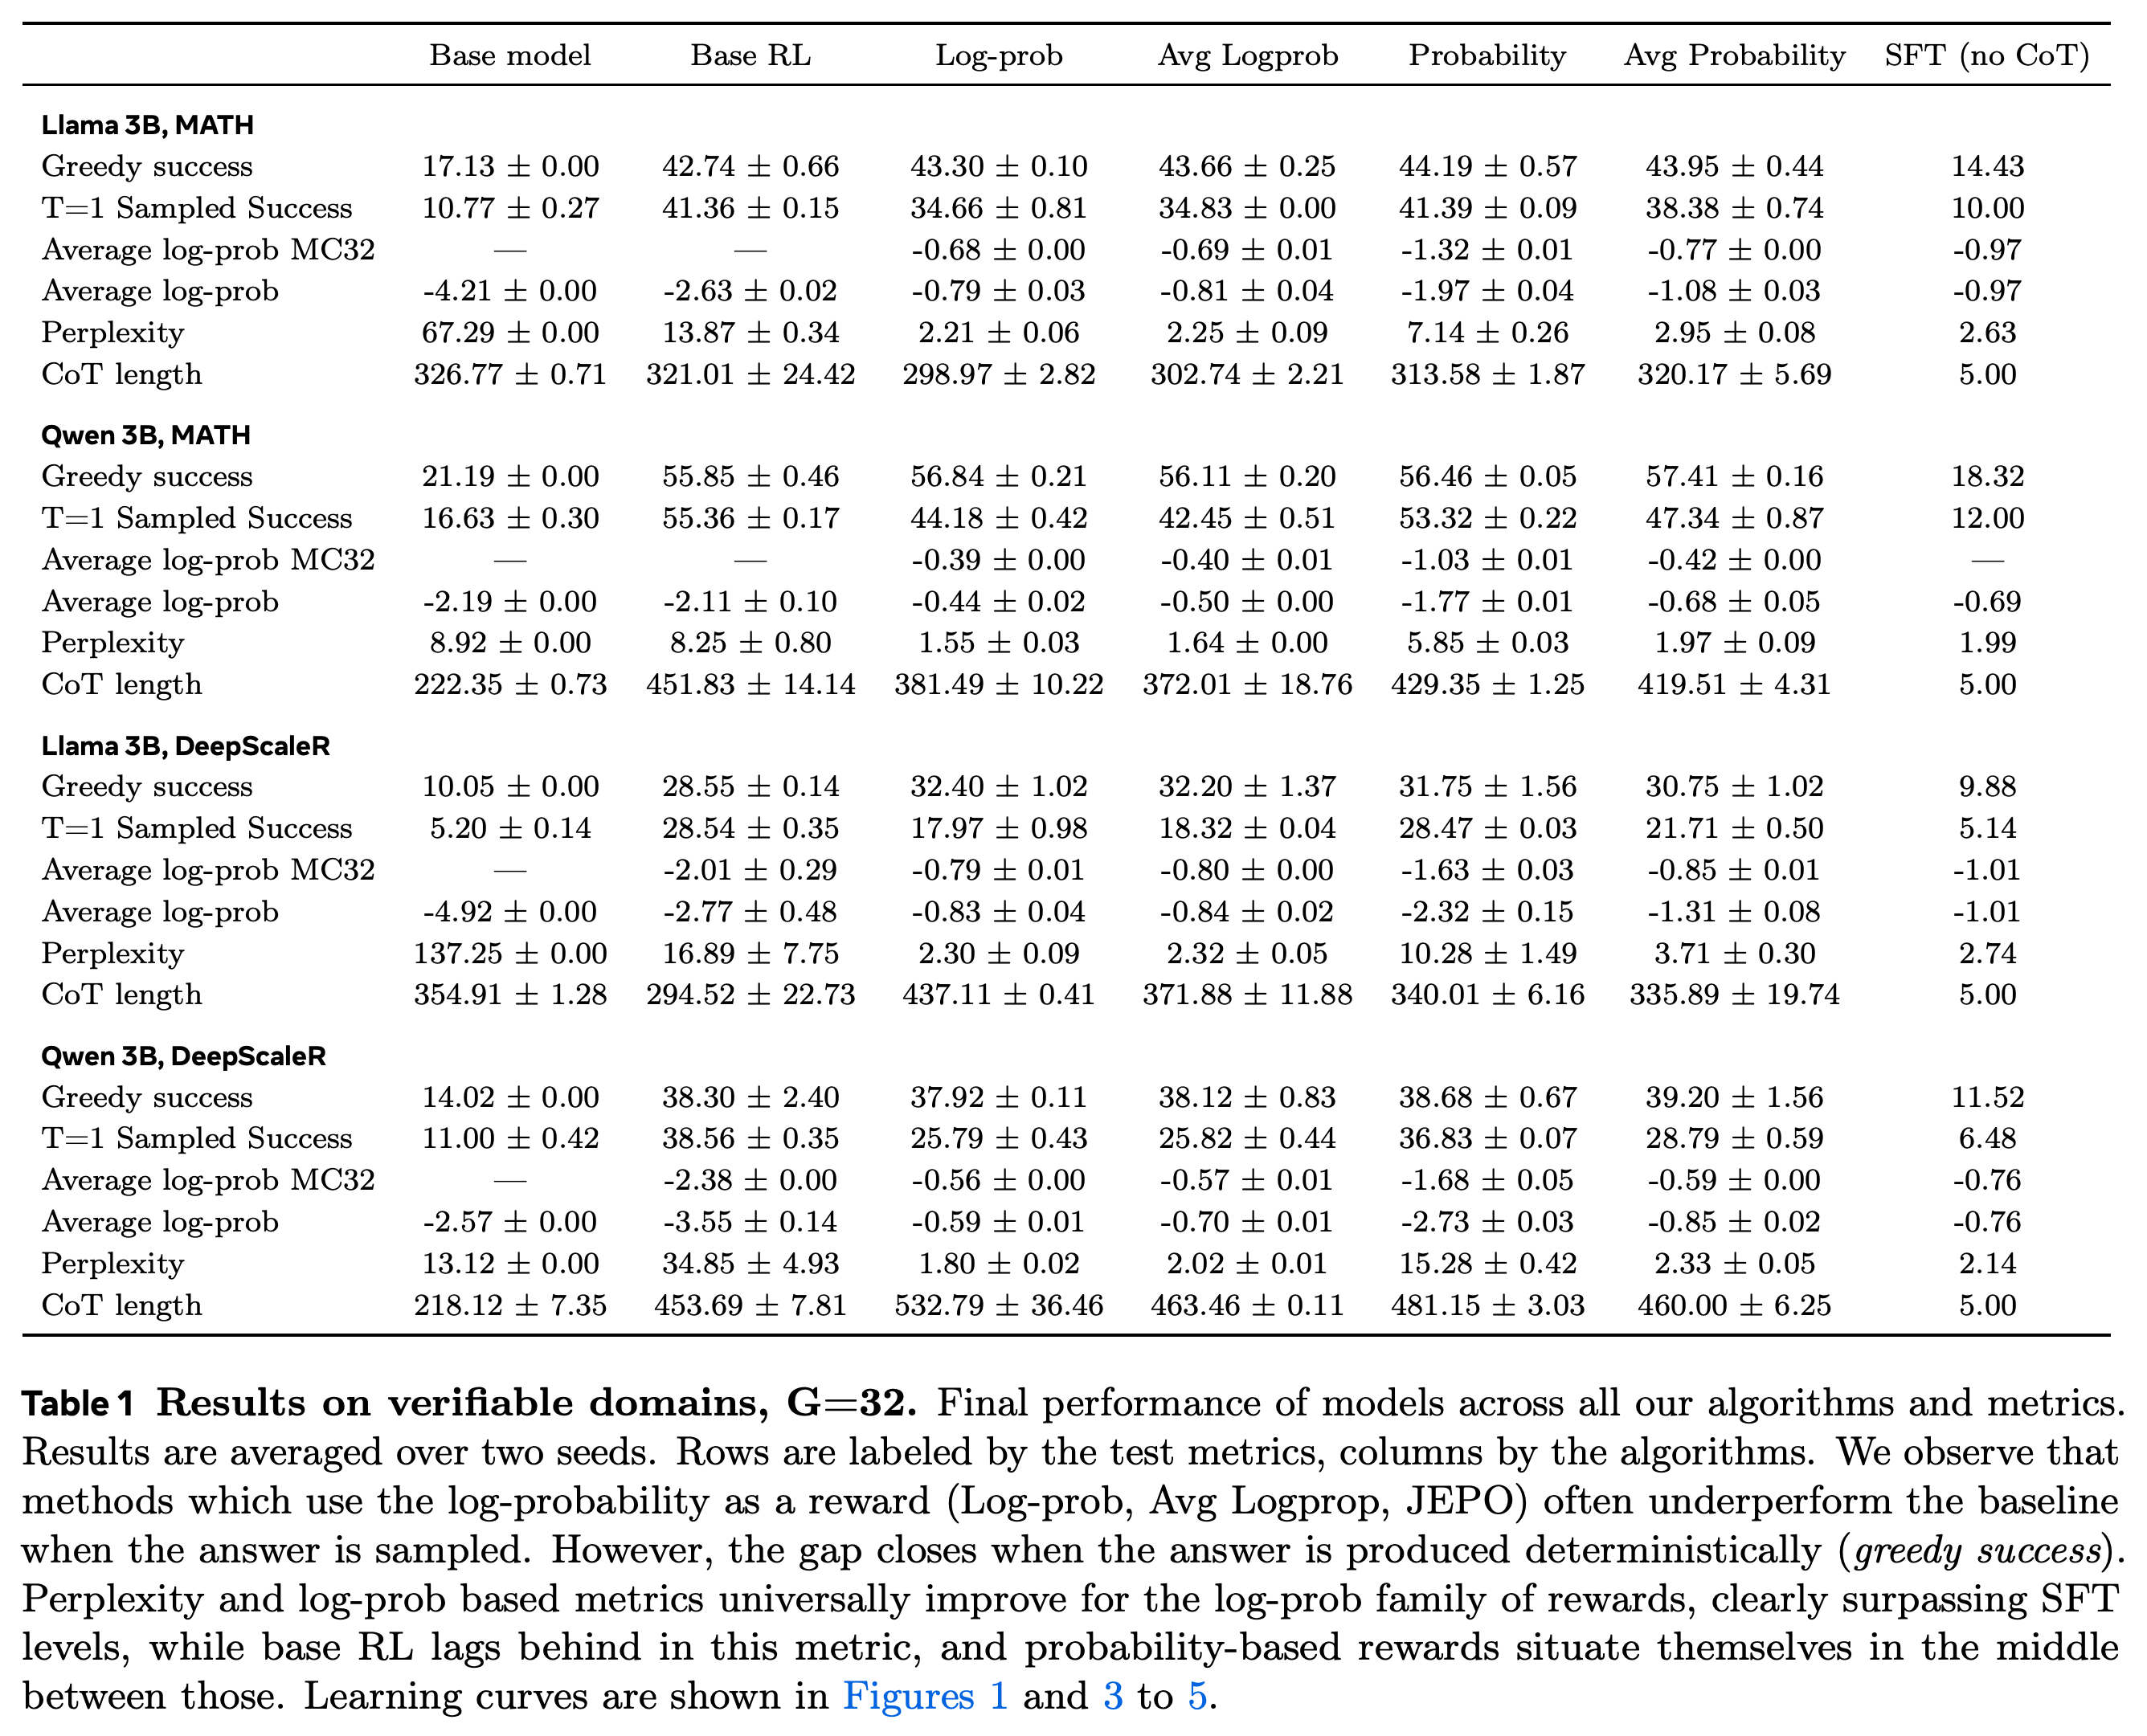
T = 1 답변 샘플링에서는 순위가 달라진다. MATH의 Qwen에서 Log-prob는 greedy 성공률이 조금 더 높지만, 샘플링 성공률은 44.18 ± 0.42로 Base RL의 55.36 ± 0.17보다 낮다. Perplexity는 Log-prob가 1.55 ± 0.03, Base RL이 8.25 ± 0.80, SFT가 1.99다.
- MATH의 Llama에서 Log-prob의 perplexity는 2.21 ± 0.06이다. Base RL은 13.87 ± 0.34, Probability는 7.14 ± 0.26, SFT는 2.63이다.
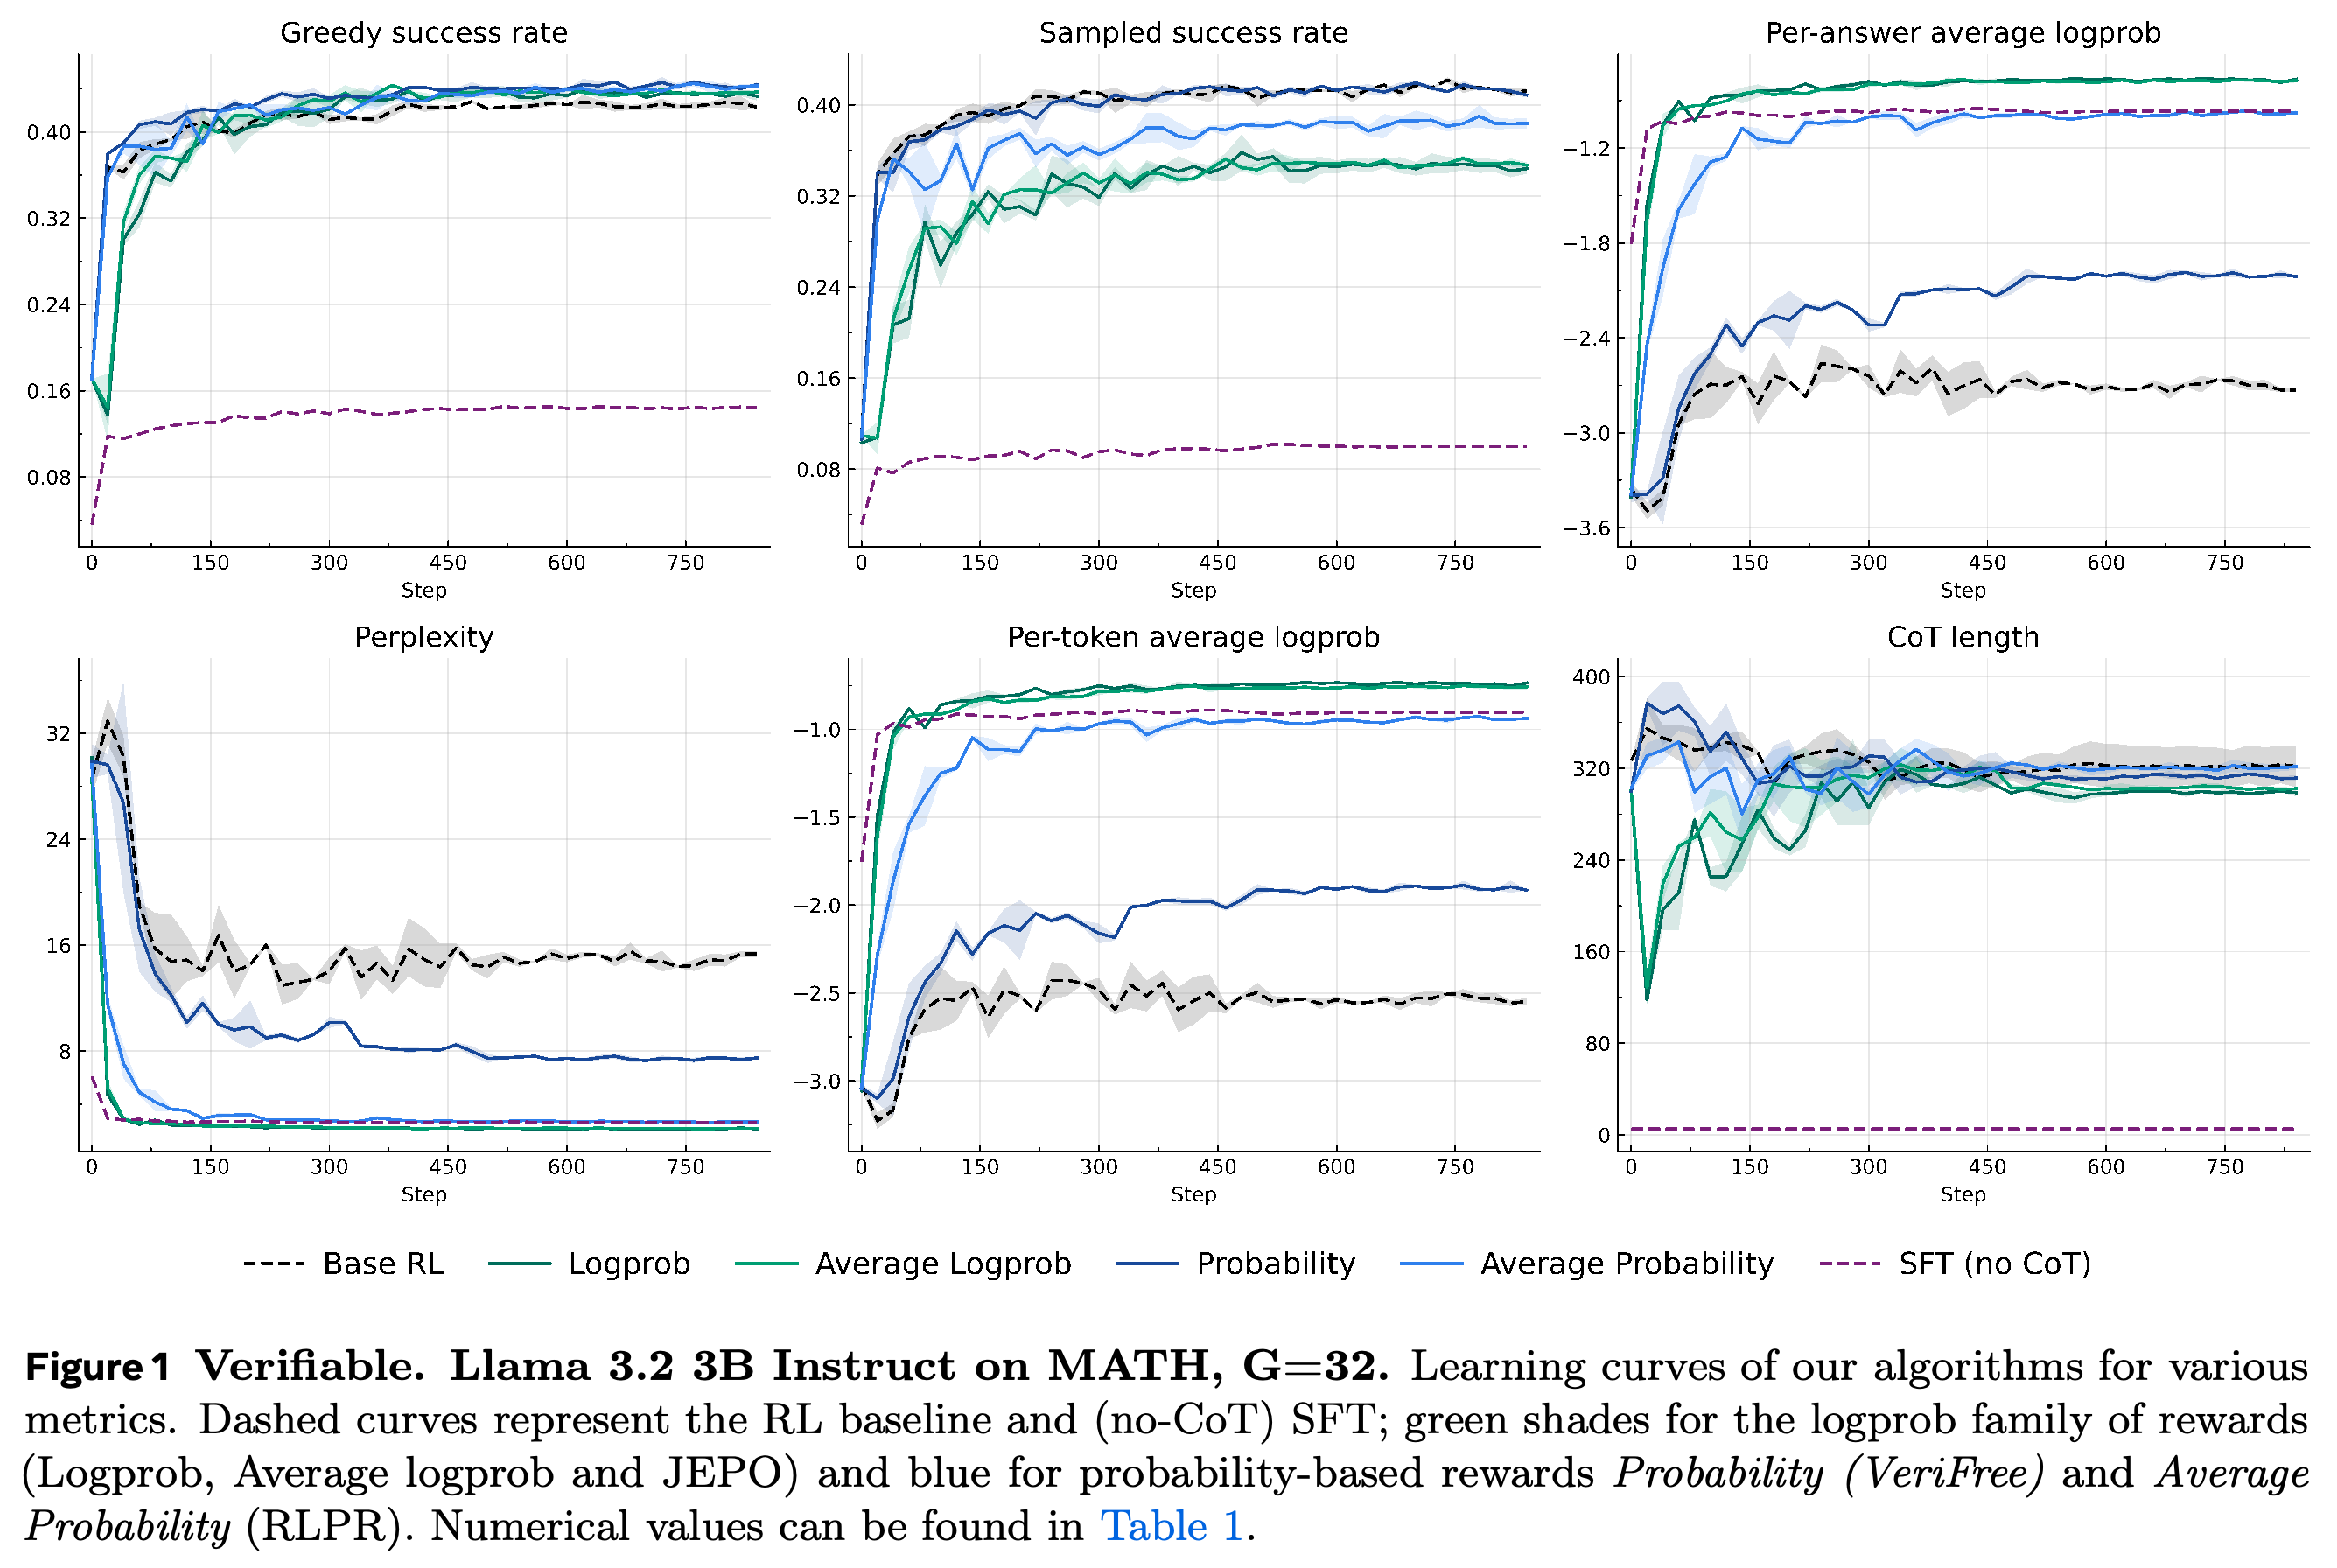
- 그림 1은 RL 변형들의 최종 greedy 성공률이 비슷하고 로그 확률 보상의 우도가 더 높다는 점을 보여 준다. CoT 길이는 초기에 감소했다가 회복한다.
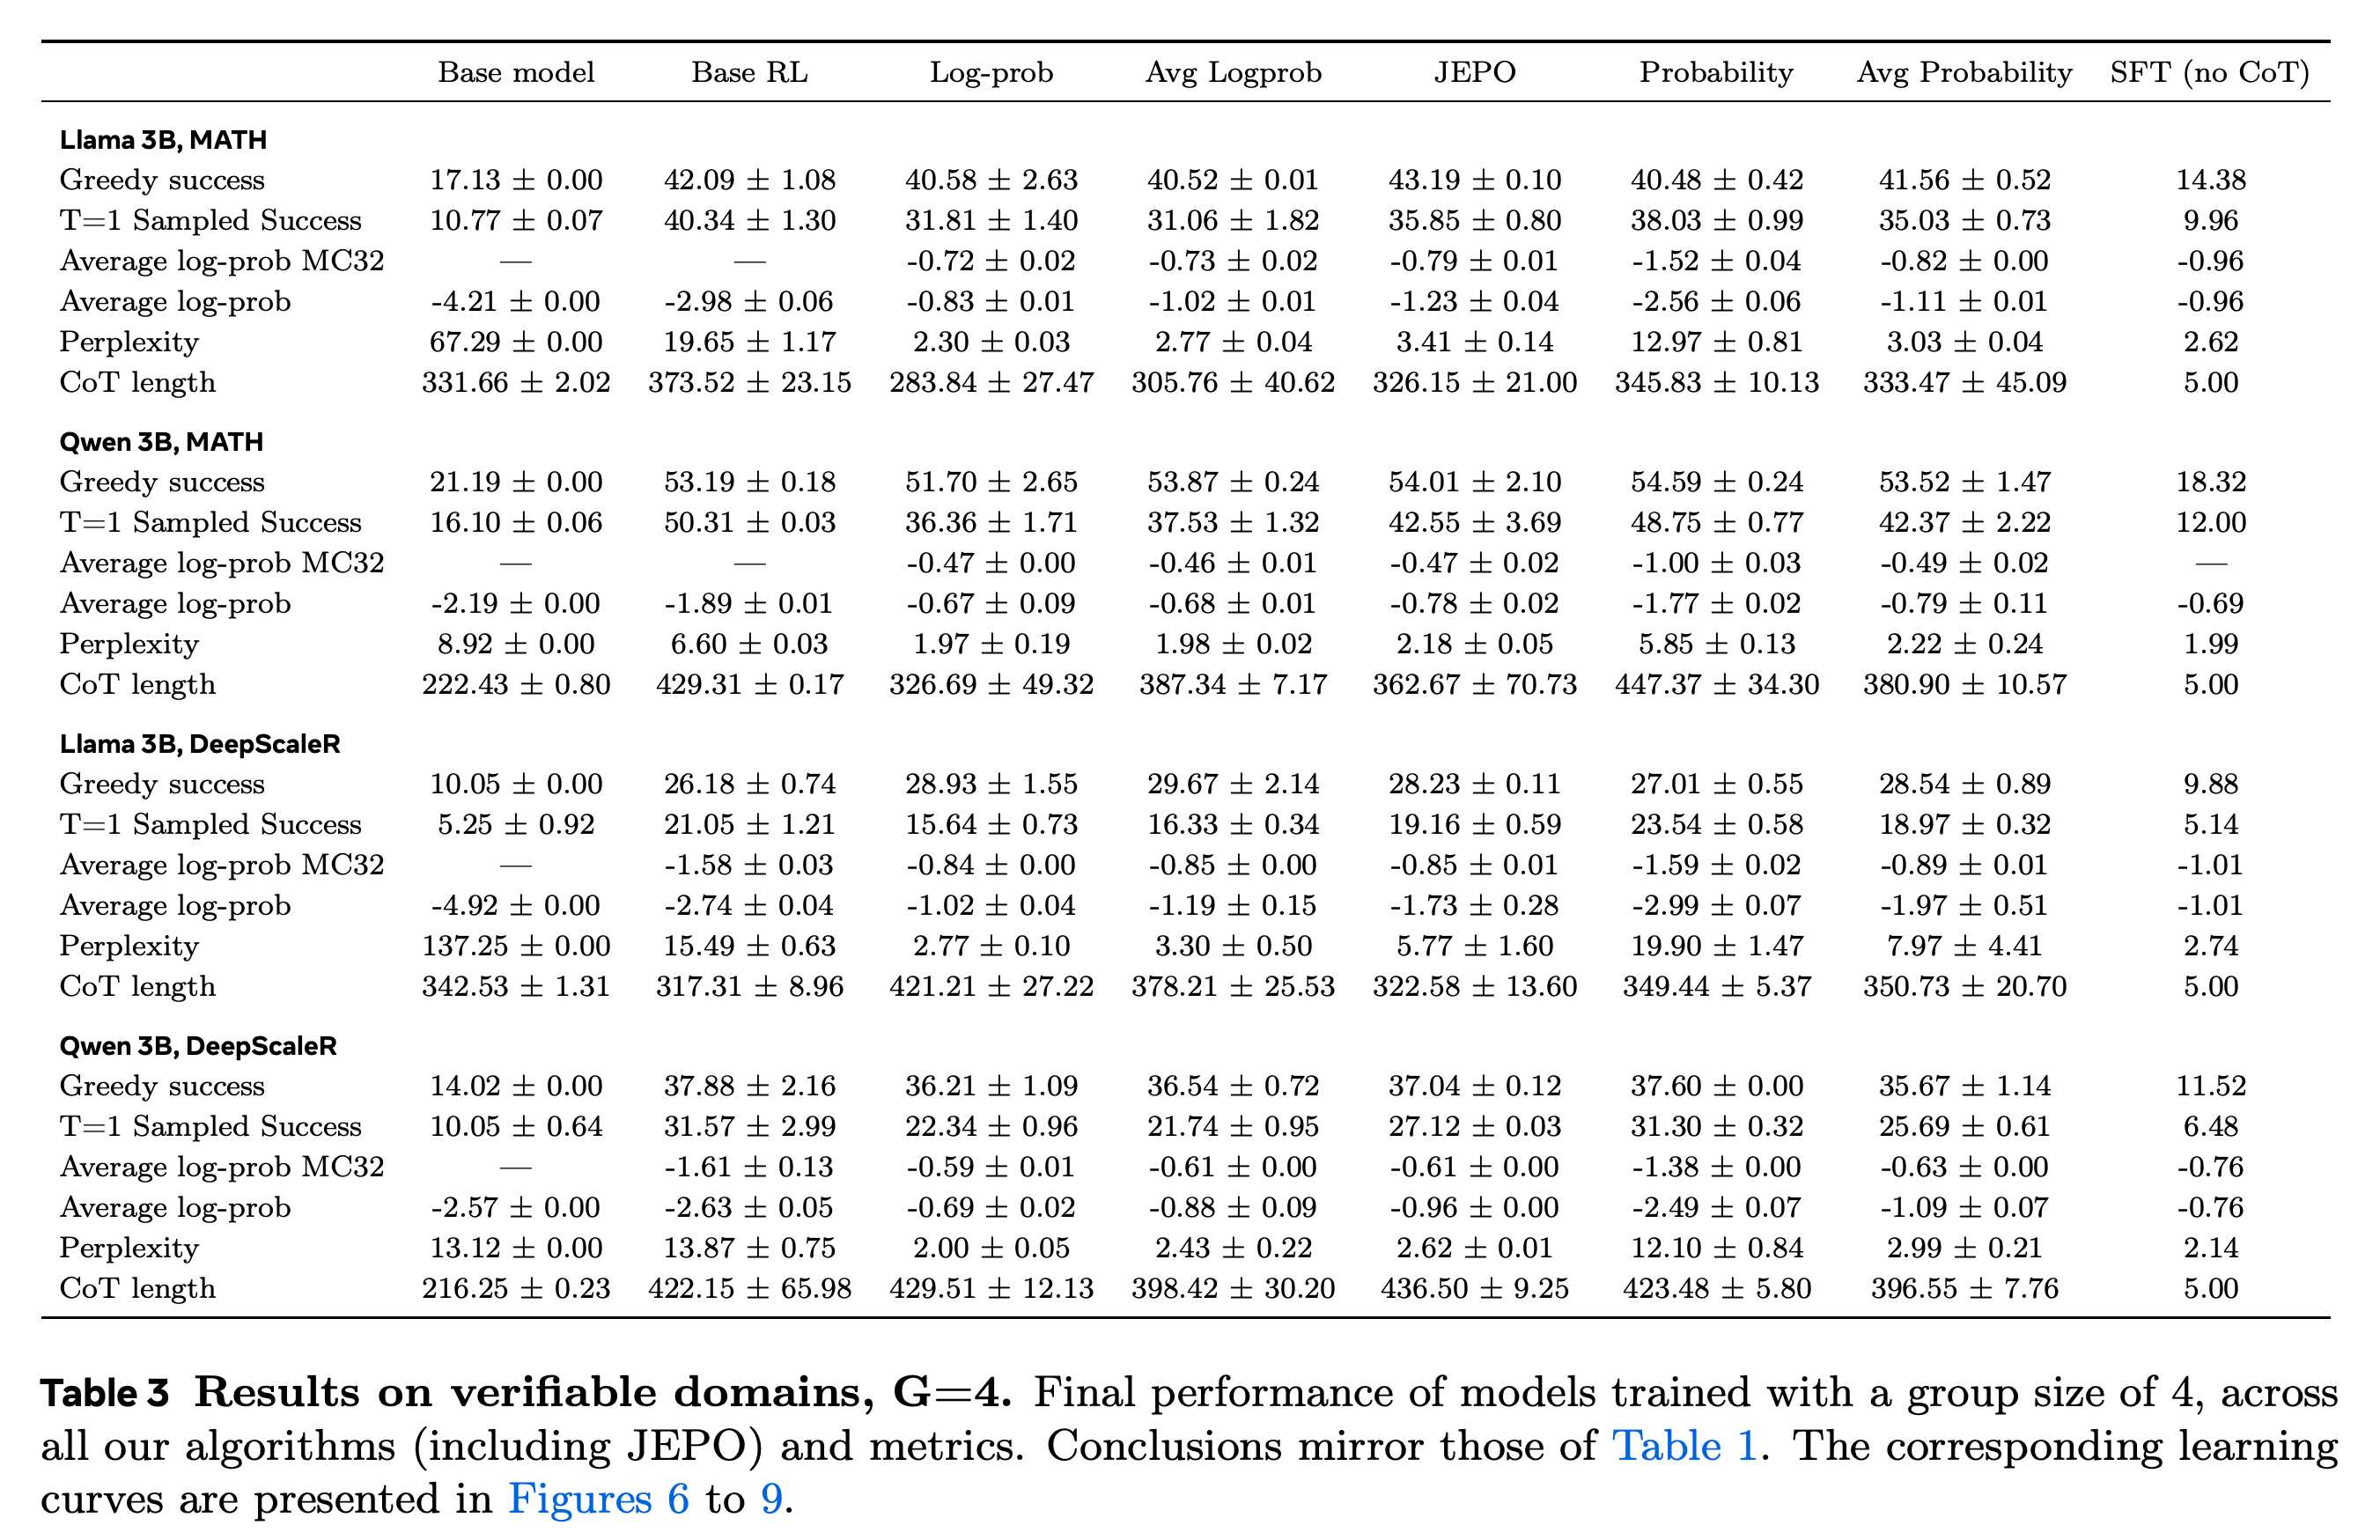
- G = 4의 표 3에서 JEPO는 단순한 Log-prob보다 일관된 greedy 성공률 우위를 보이지 않는다. 우도 순위도 MC1과 MC32 중 무엇을 사용하느냐에 따라 달라진다.
- 저자들은 우도 결과를 로그 확률 학습에서 답변 확률이 덜 집중된다는 근거로 해석하지만, 별도의 calibration 지표는 보고하지 않는다.
곡선은 RL 변형들의 최종 greedy 성공률이 비슷하지만 로그 확률 학습의 참조 우도가 더 높다는 점을 보여 준다. 로그 확률 학습의 CoT 길이는 초기에 급격히 줄어든 뒤 회복한다. 이는 긴 답변 실험에서 추론 과정이 지속적으로 사라지는 현상과 다르다.
더 작은 그룹의 비교에는 JEPO가 추가되지만, 단순한 Log-prob보다 일관된 greedy 성공률 우위는 나타나지 않는다. MATH의 Llama에서 JEPO는 43.19 ± 0.10으로 Log-prob의 40.58 ± 2.63보다 높다. 그러나 DeepScaleR에서는 JEPO가 28.23 ± 0.11로 Log-prob의 28.93 ± 1.55보다 낮다. 우도를 비교할 때도 MC1과 MC32를 구분해야 하며, 특히 JEPO에서 중요하다.
3.3 Results on Non-verifiable Domains
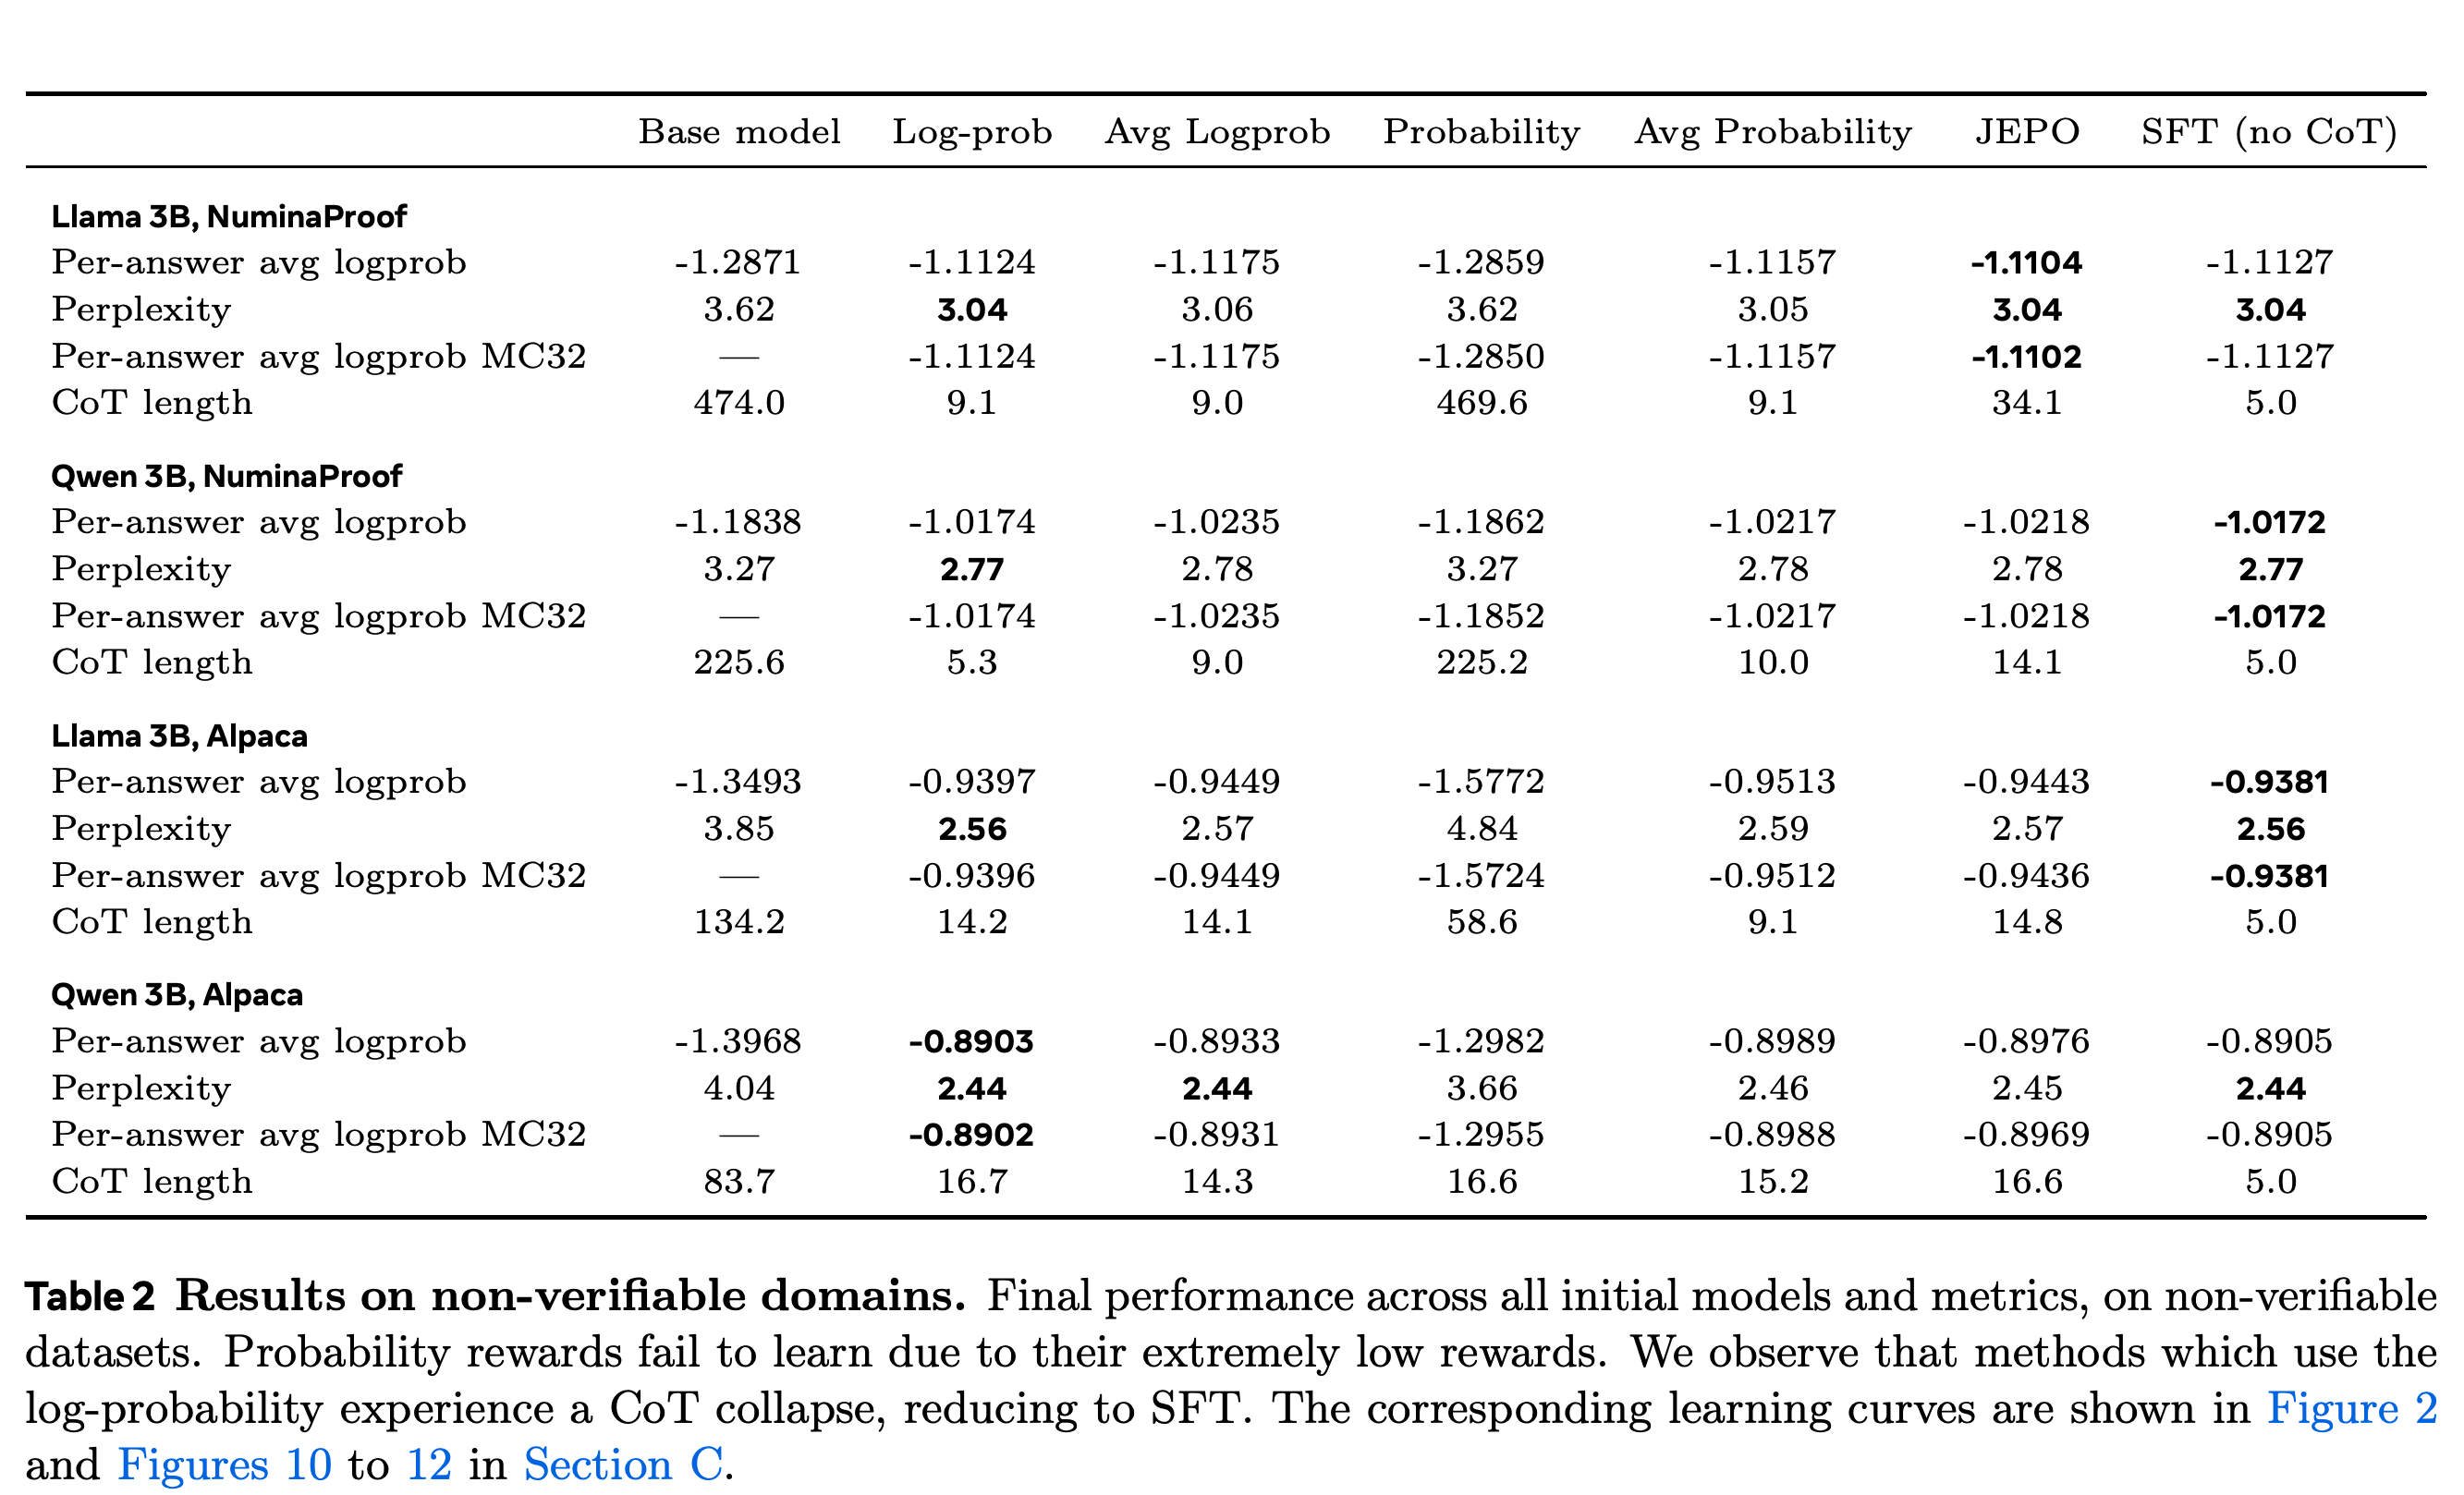
NuminaProof와 Alpaca에서 Log-prob, AvgLogprob, JEPO는 참조 답변 우도와 perplexity가 SFT에 근접한다. NuminaProof의 Qwen에서 Log-prob의 답변별 평균 로그 확률은 −1.0174이고 perplexity는 2.77이다. SFT는 −1.0172와 2.77이며, Probability는 −1.1862와 3.27에 머문다.
- Alpaca의 Llama에서 Log-prob와 SFT의 perplexity는 모두 2.56이다. Probability는 4.84로 기본 모델의 3.85보다 나쁘다. Qwen의 Alpaca 결과에는 예외가 있다. Probability는 4.04에서 3.66으로 개선되지만, SFT의 2.44보다는 여전히 상당히 높다.
- AvgProb는 대체로 로그 확률 계열에 근접하지만, 논문은 그 학습에 잡음이 더 많다고 설명한다. 따라서 토큰 평균 확률 보상과 답변 전체 확률 보상이 같은 방식으로 실패한다고 봐서는 안 된다.
- 이 결과는 제공된 참조 답변의 예측을 측정한다. 독립적으로 검증한 증명의 정확성이나 사람이 평가한 응답 품질을 측정하지는 않는다.
로그 확률 방법은 매우 짧은 추론 과정을 생성하면서 긴 답변 우도가 SFT와 거의 같아진다. Qwen의 NuminaProof 결과는 이 차이를 명확히 보여 준다. Log-prob와 SFT의 perplexity는 모두 2.77이고 CoT 길이는 각각 5.3과 5.0인 반면, Probability는 225.2 토큰과 perplexity 3.27을 유지한다. Qwen의 Alpaca에서 Probability는 기본 모델보다 소폭 개선되지만 SFT에 준하는 성능은 보이지 않는다.
3.4 Length of the Chain-of-Though During Training
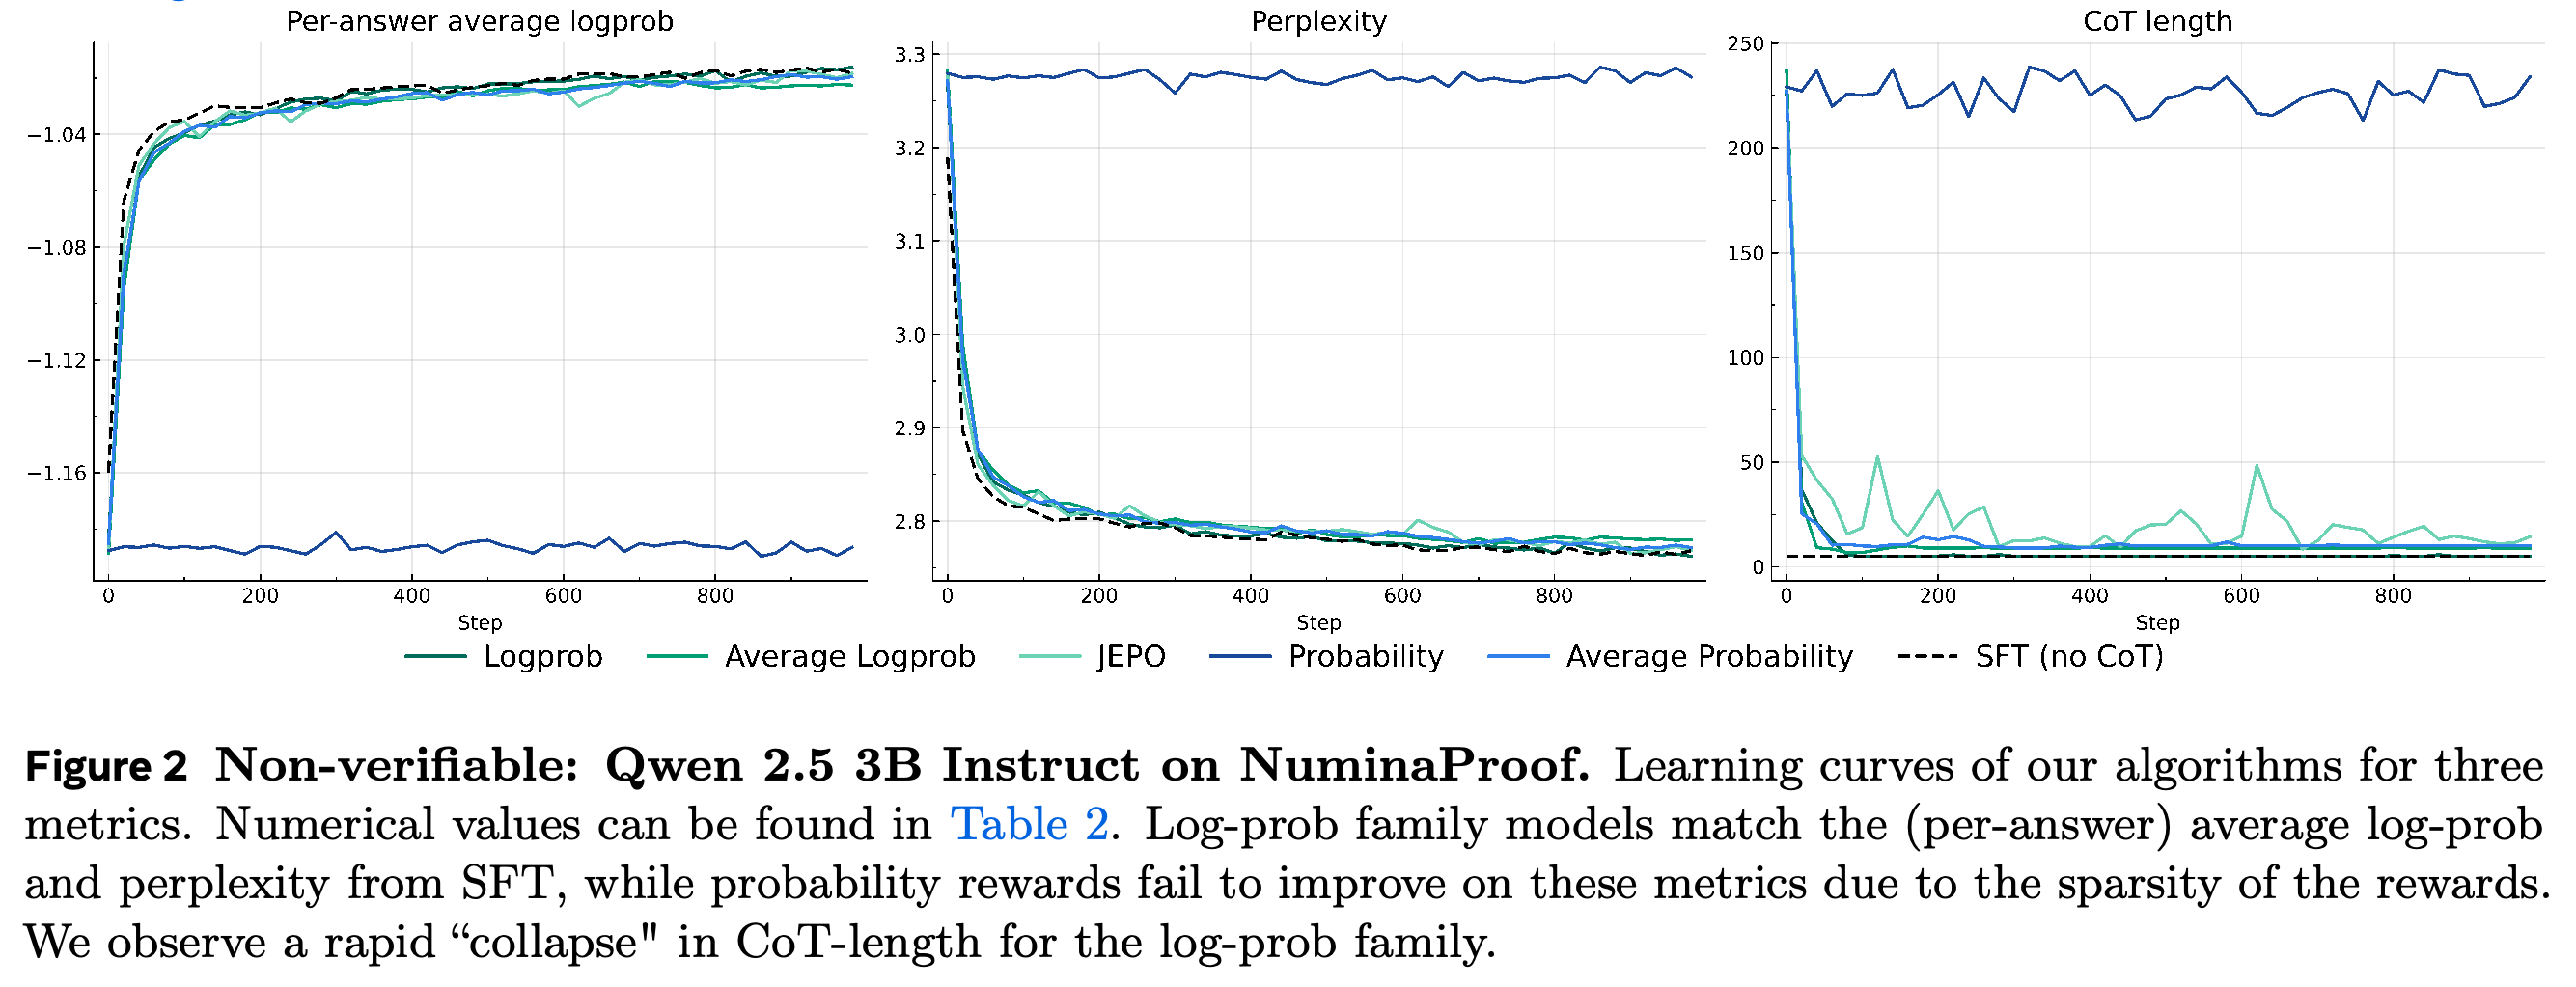
로그 확률 학습은 검증 가능 여부와 관계없이 처음에는 CoTs를 줄이지만, 추론 과정의 길이는 검증 가능한 실험에서만 회복한다. Qwen의 NuminaProof에서 Log-prob는 평균 CoT 길이를 225.6에서 5.3 토큰으로 줄인다. CoT 없는 SFT의 형식 지정 토큰은 5.0개다. Probability는 perplexity를 개선하지 못한 채 225.2 토큰을 유지한다.
- 그림 2는 NuminaProof에서 참조 우도의 개선과 명시적 추론의 급격한 소멸이 함께 나타남을 보여 준다.
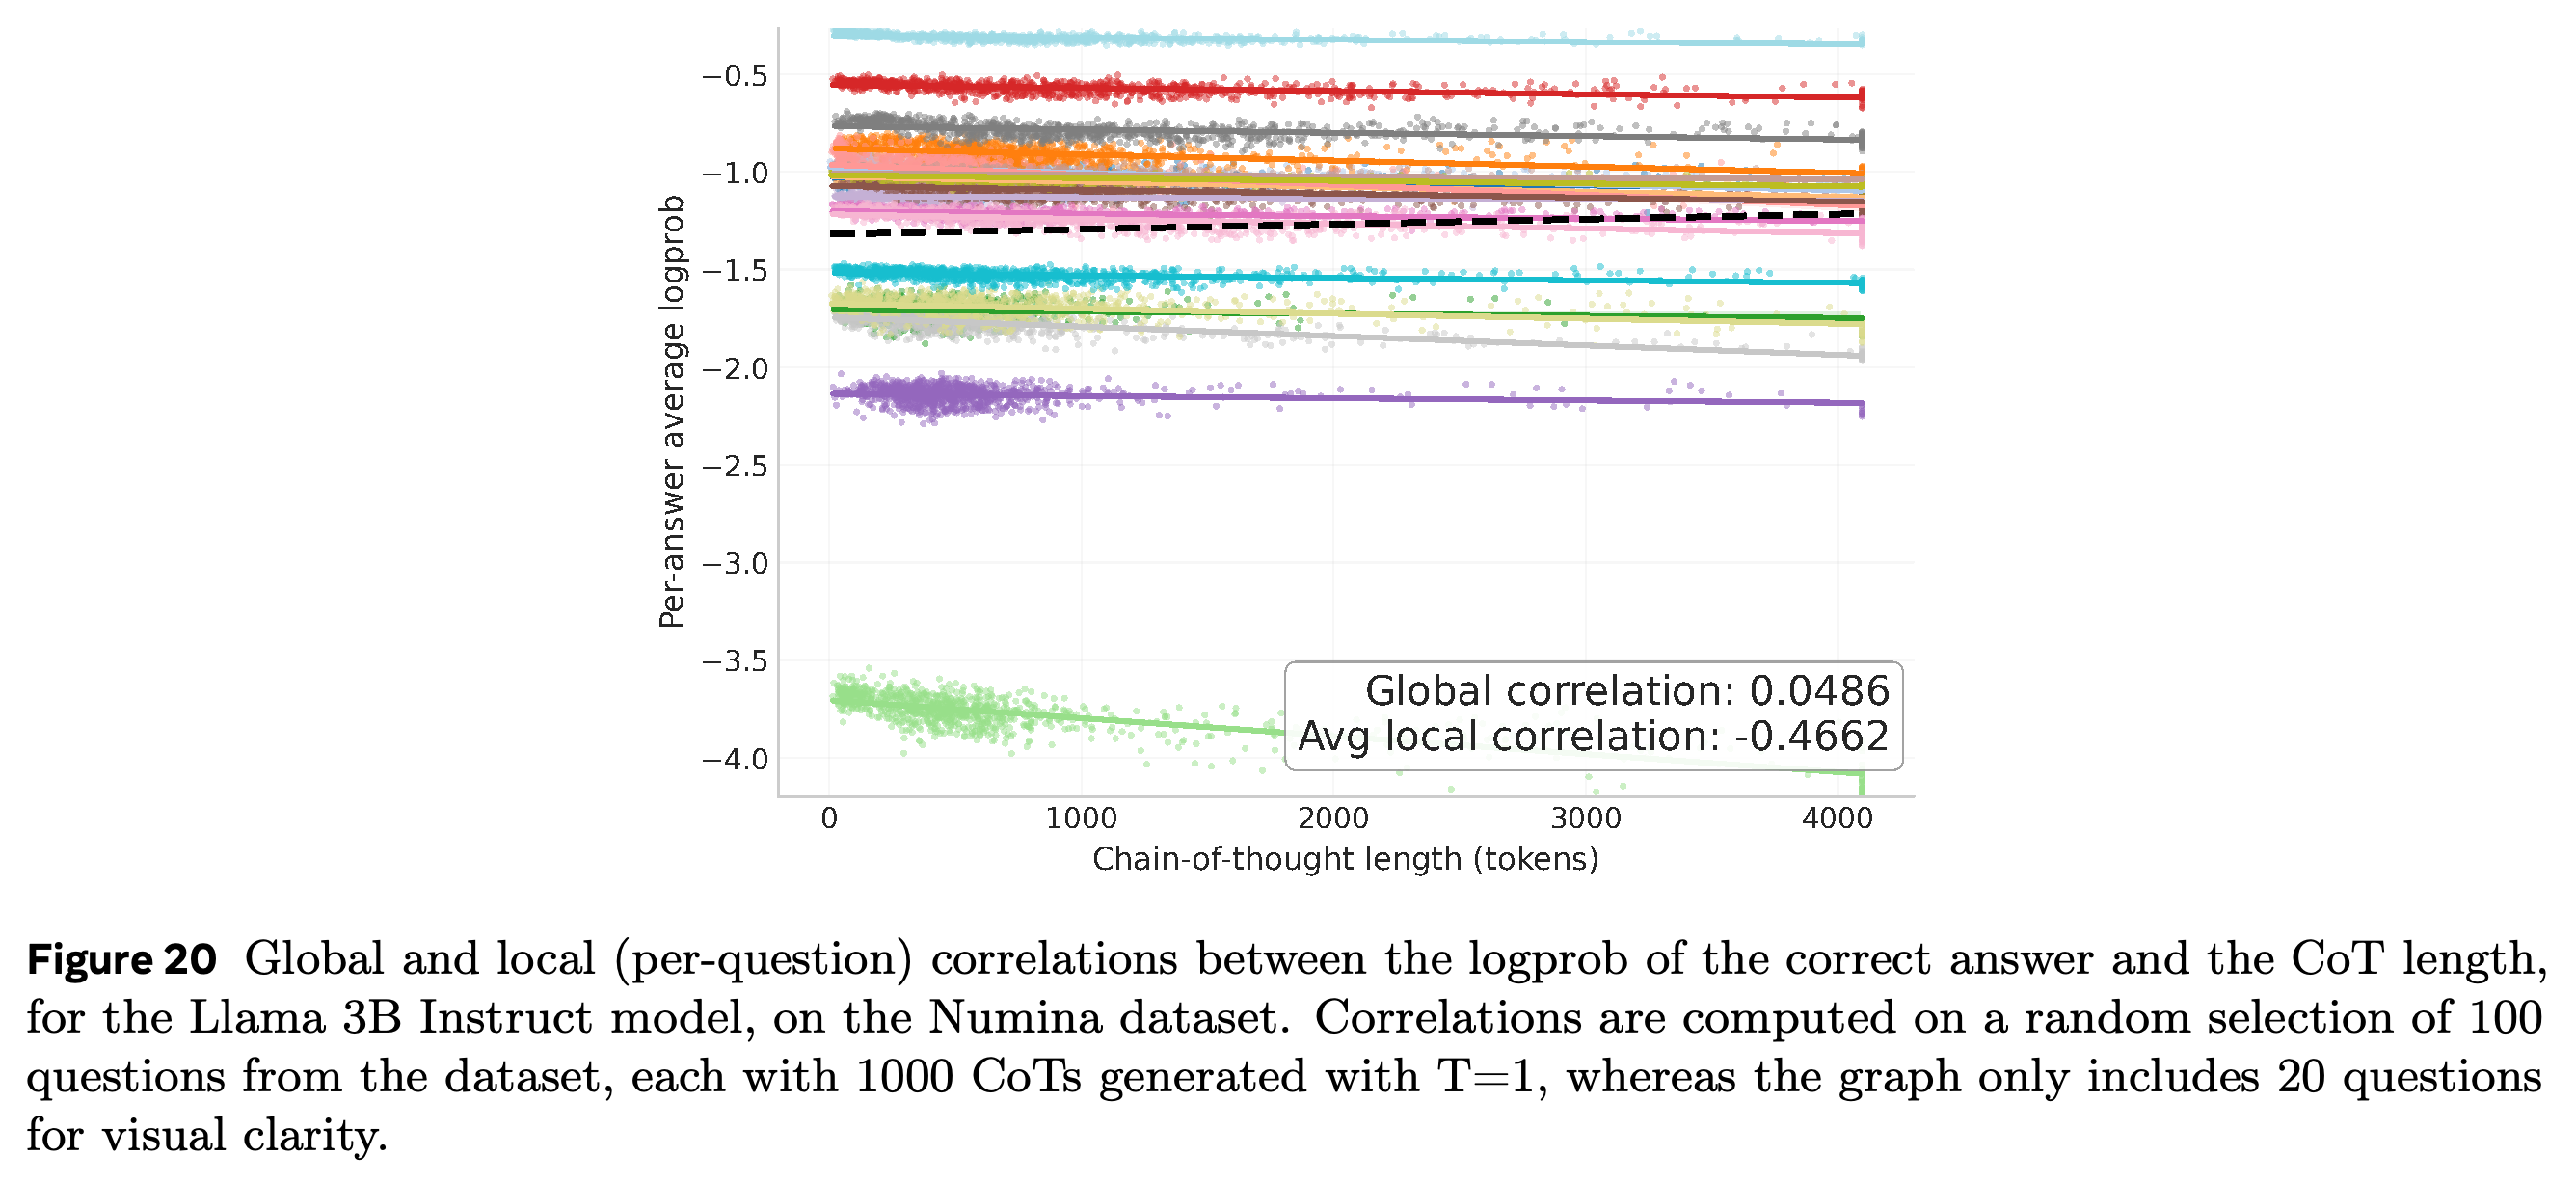
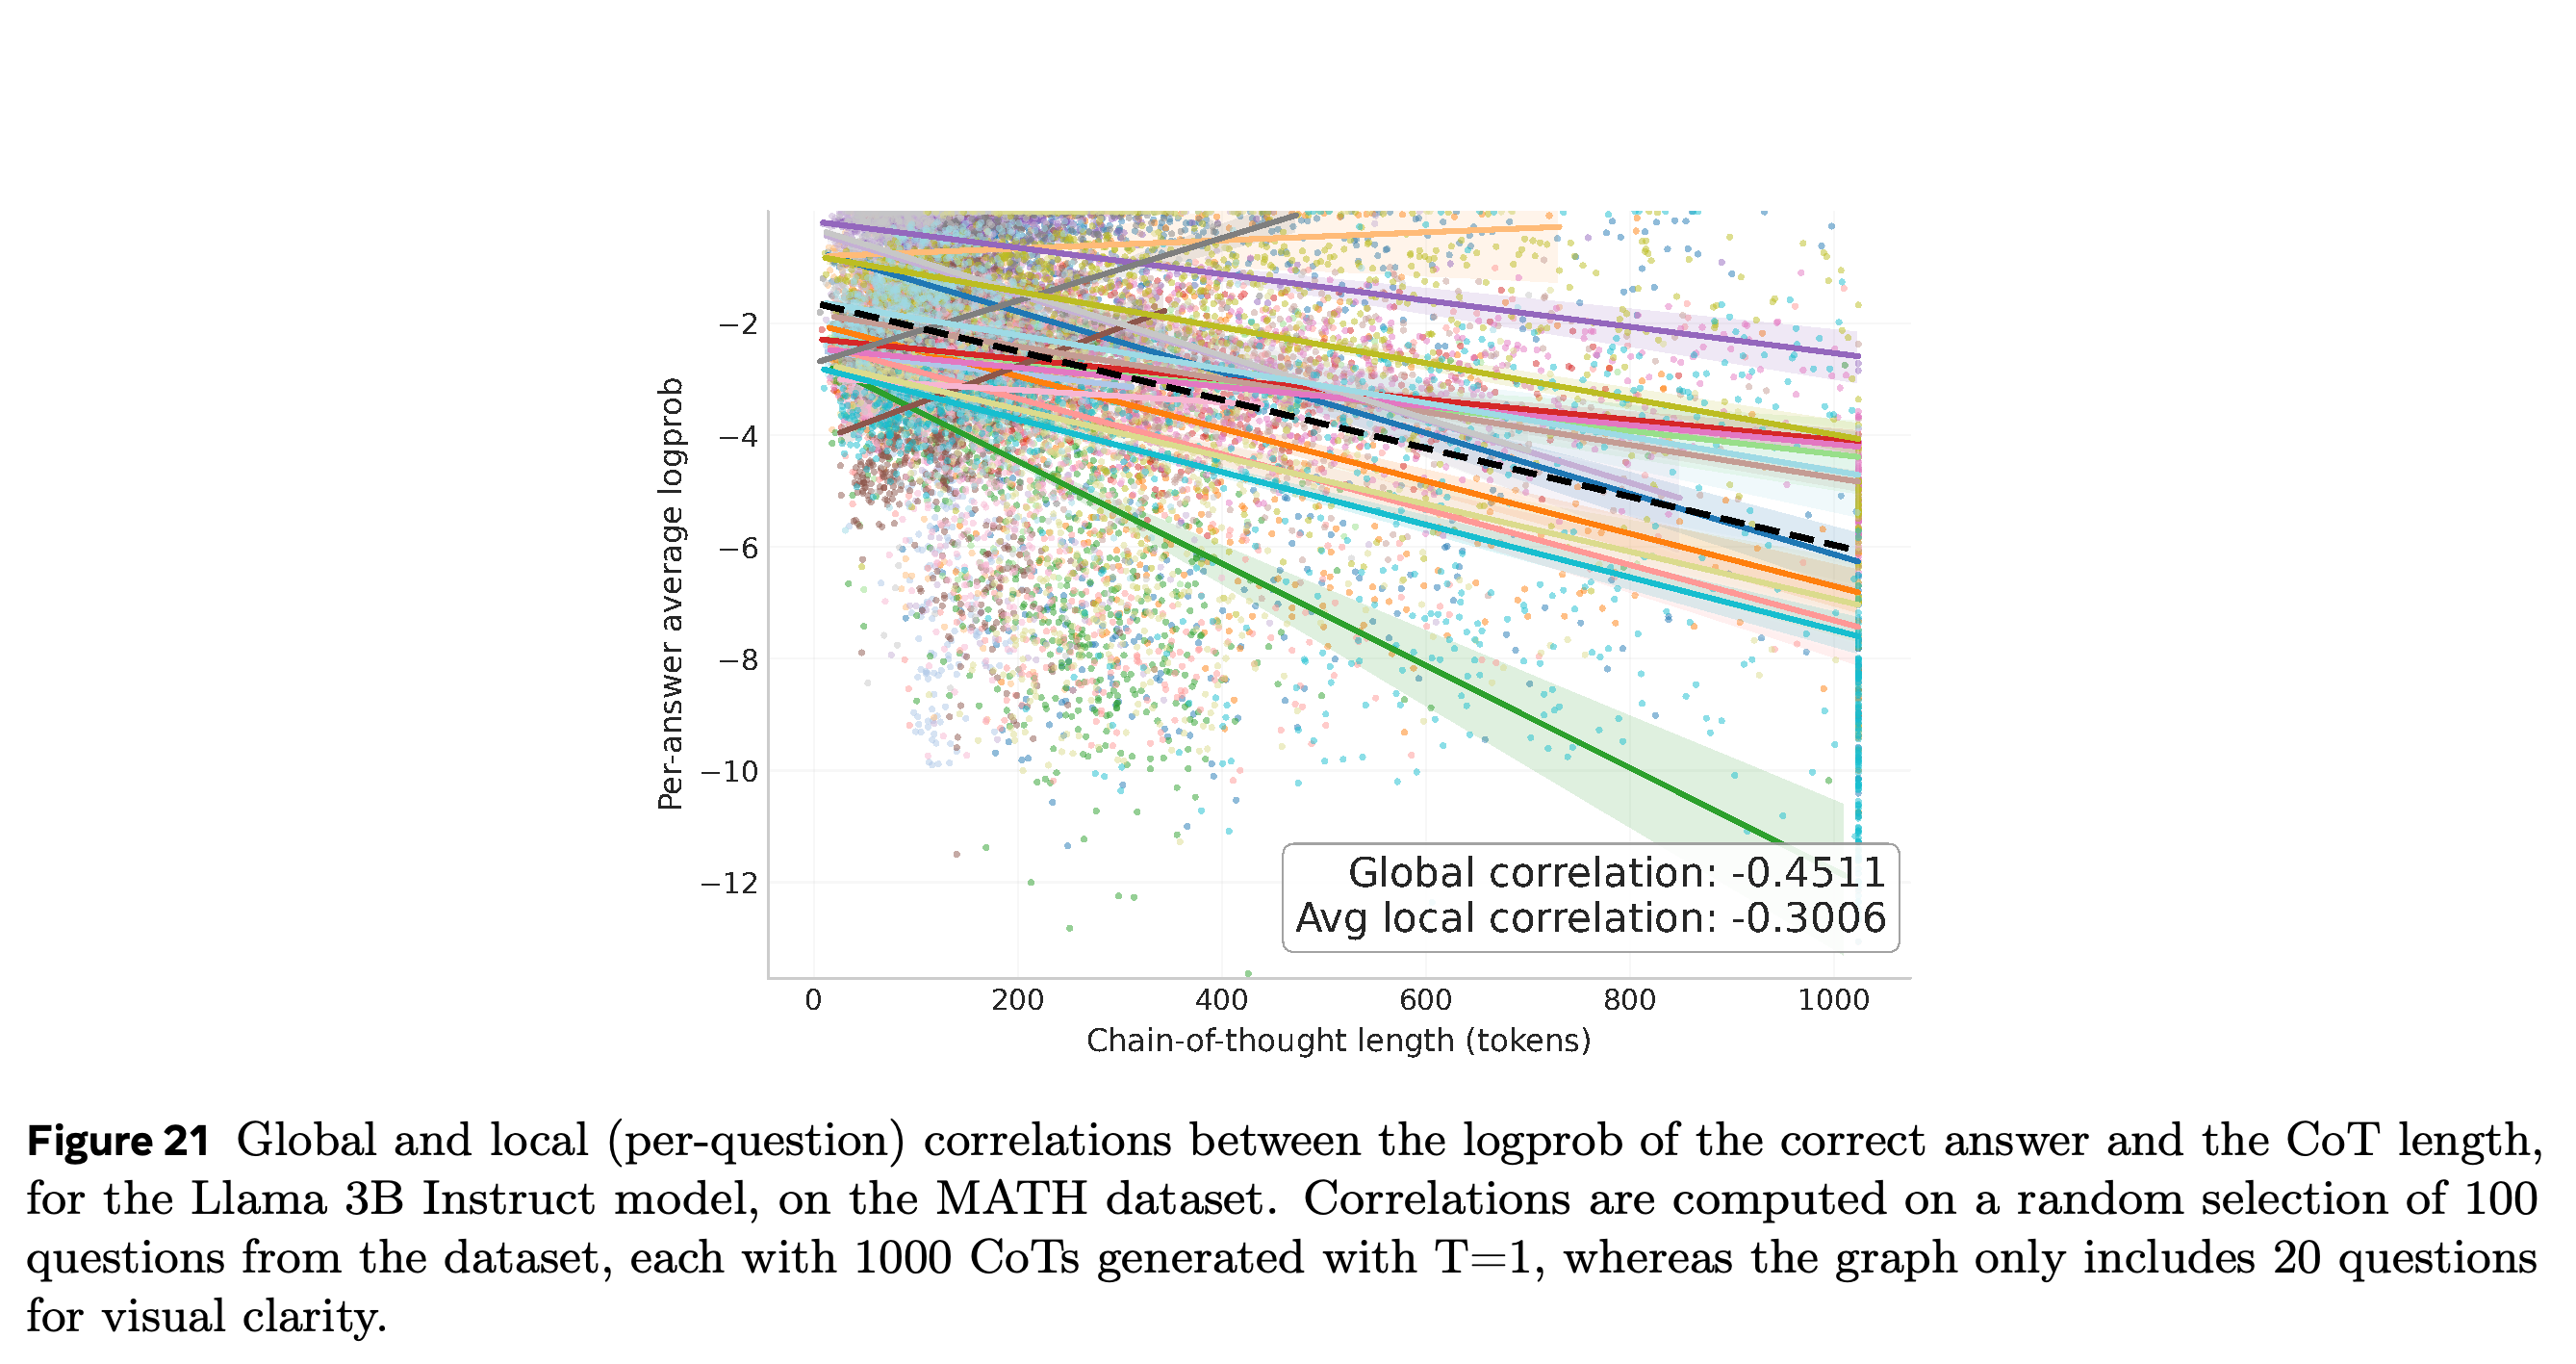
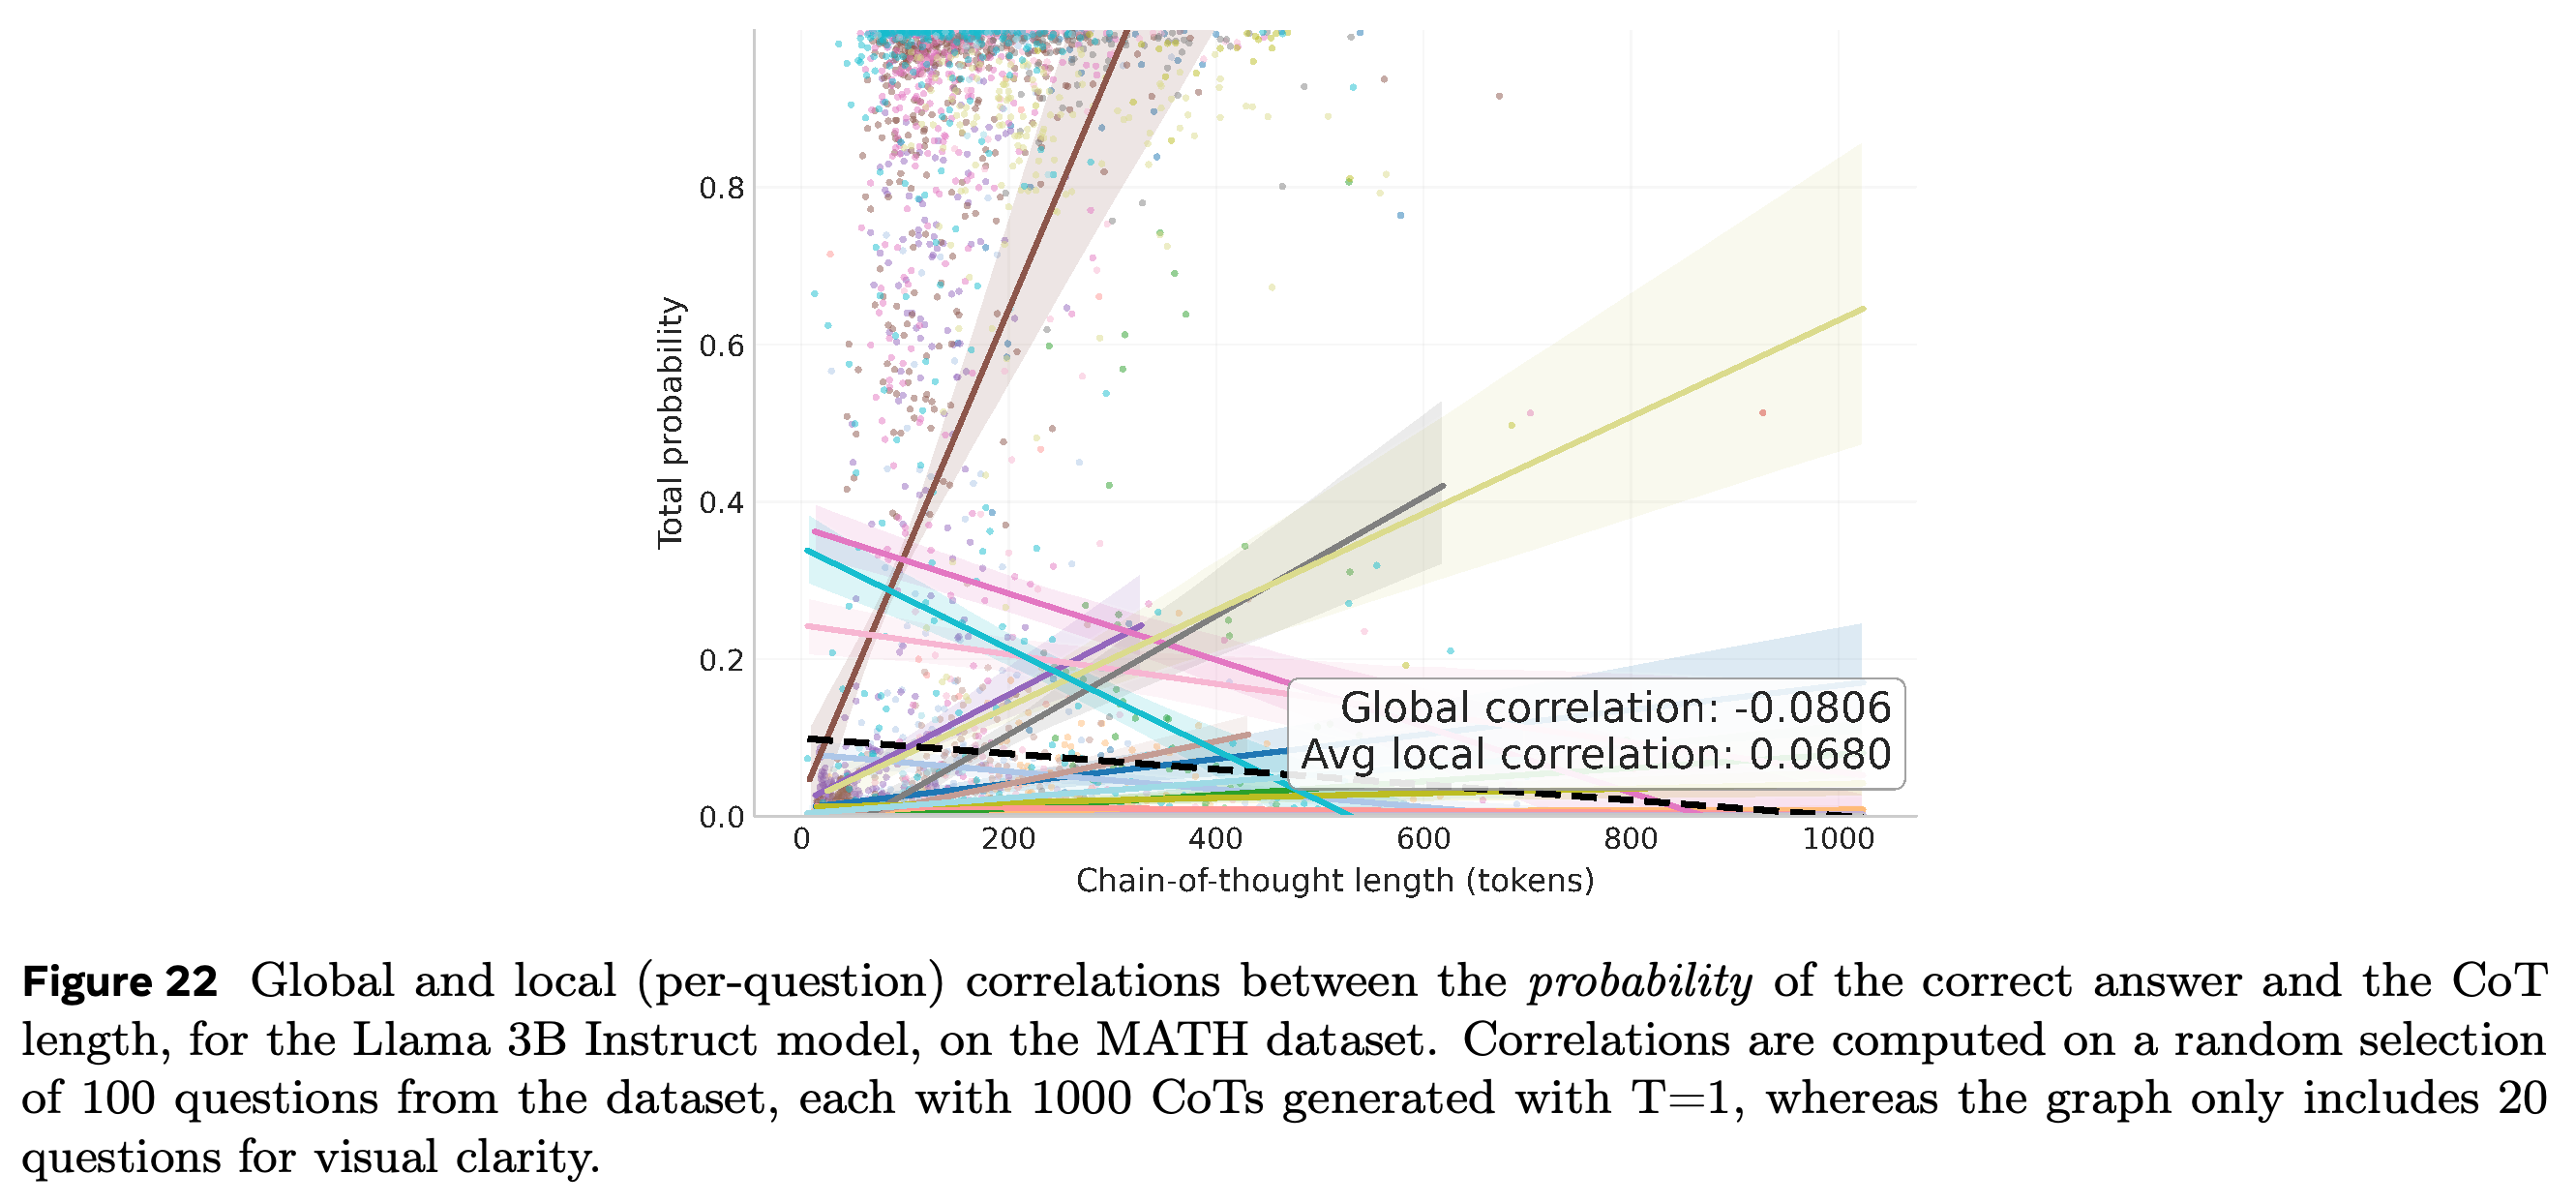
- 그림 20–22는 T = 1에서 무작위 질문 100개와 질문별 CoTs 1000개를 사용하여 전체를 합친 상관관계와 질문별 상관관계를 비교한다. 표시된 질문은 20개뿐이다.
- Numina에서 로그 확률과 CoT 길이의 전역 상관계수는 0.0486이지만, 평균 국소 상관계수는 −0.4662다. MATH의 대응 값은 −0.4511과 −0.3006이다.
- 반면 MATH의 답변 전체 확률은 전역 상관계수가 −0.0806이고 평균 국소 상관계수가 0.0680이다. RLOO의 advantage는 같은 질문의 추론 과정들을 비교하므로 국소 상관관계가 중요하다.
Qwen의 NuminaProof에서 참조 우도 개선은 급격한 CoT 단축 및 SFT에 가까운 수준으로의 수렴과 함께 나타난다. 답변 전체 확률을 사용하는 Probability는 긴 추론 과정을 유지하지만 우도는 초기 수준에 머문다. 이는 추론 과정의 길이만으로 예측 성능에 도움이 된다고 판단할 수 없음을 보여 준다.
Numina에서 전체를 합친 상관계수는 0.0486으로 약한 양수지만, 질문 내 상관계수의 평균은 −0.4662로 음수다. RLOO는 같은 프롬프트 안에서 추론 과정들을 비교하므로, 국소 관계는 추론 과정을 짧게 만드는 압력이 있다는 해석과 일치한다. 전체 통계량은 거의 관계가 없음을 시사하지만, 질문별로 비교하면 이러한 음의 관계가 나타난다.
MATH에서는 전체를 합친 상관계수 −0.4511과 질문 내 상관계수의 평균 −0.3006이 모두 음수다. 이는 로그 확률 보상에서 초기에 추론 과정이 짧아지는 현상과 일치하지만, 이후 수학 학습 중 길이가 회복하는 이유는 설명하지 못한다.
답변 전체 확률과 CoT 길이의 평균 국소 상관계수는 0.0680이고, 전체를 합친 상관계수는 −0.0806이다. 많은 추론 과정에 0에 가까운 확률이 부여되어, 로그 확률 척도에서는 드러나는 보상 차이가 압축된다. 약한 양의 국소 상관관계는 Probability 학습에서 같은 초기 단축 패턴이 나타나지 않는 현상과 일치한다.
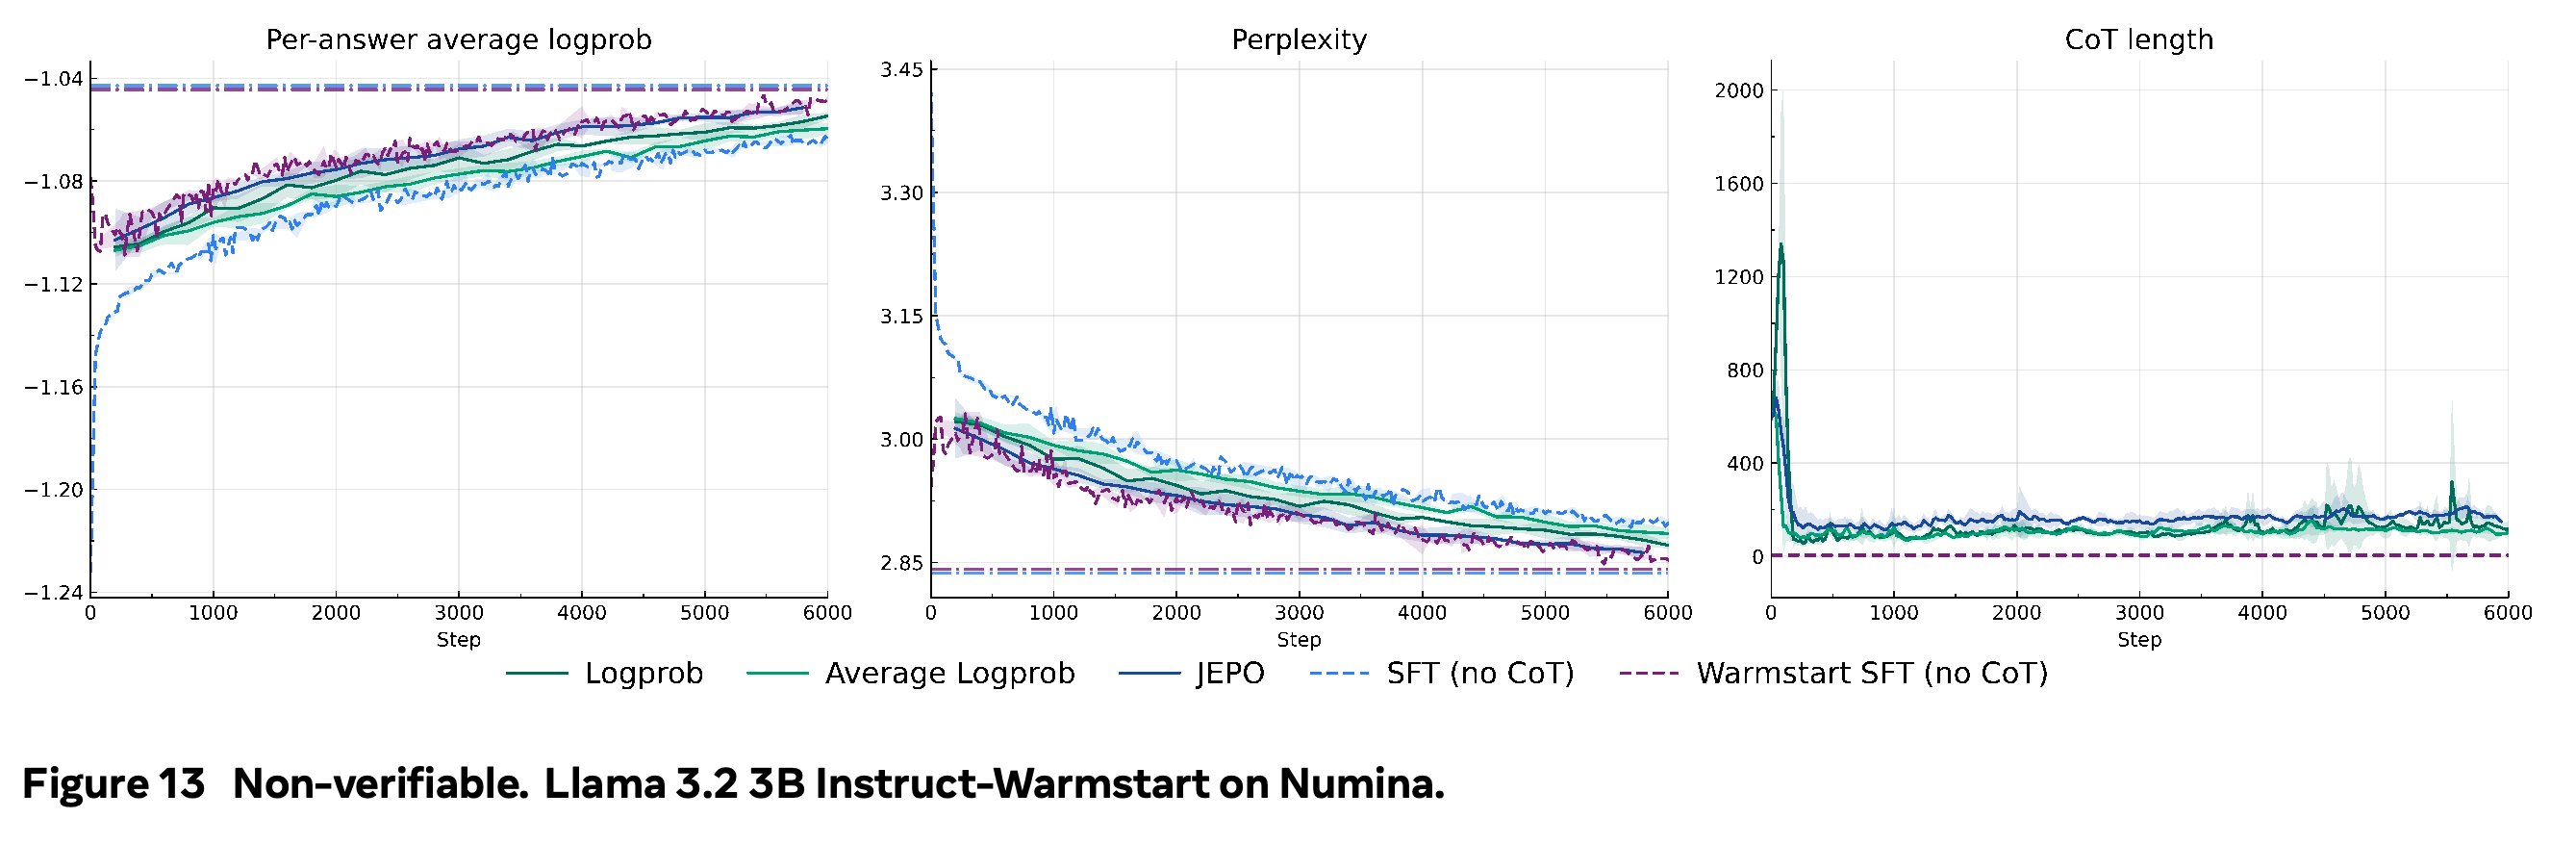
저자들은 더 강한 KL 정규화, 임계 길이보다 짧은 추론 과정에 대한 페널티, SFT warm start를 실험한다. SFT warm start는 고정된 생성 CoTs 뒤에서 참조 답변을 학습하며 CoT의 기울기는 마스킹한다. 이 방법들은 더 긴 추론 과정을 유지하지만, 최종 참조 답변 성능이 SFT보다 낫다는 점은 입증하지 못한다.
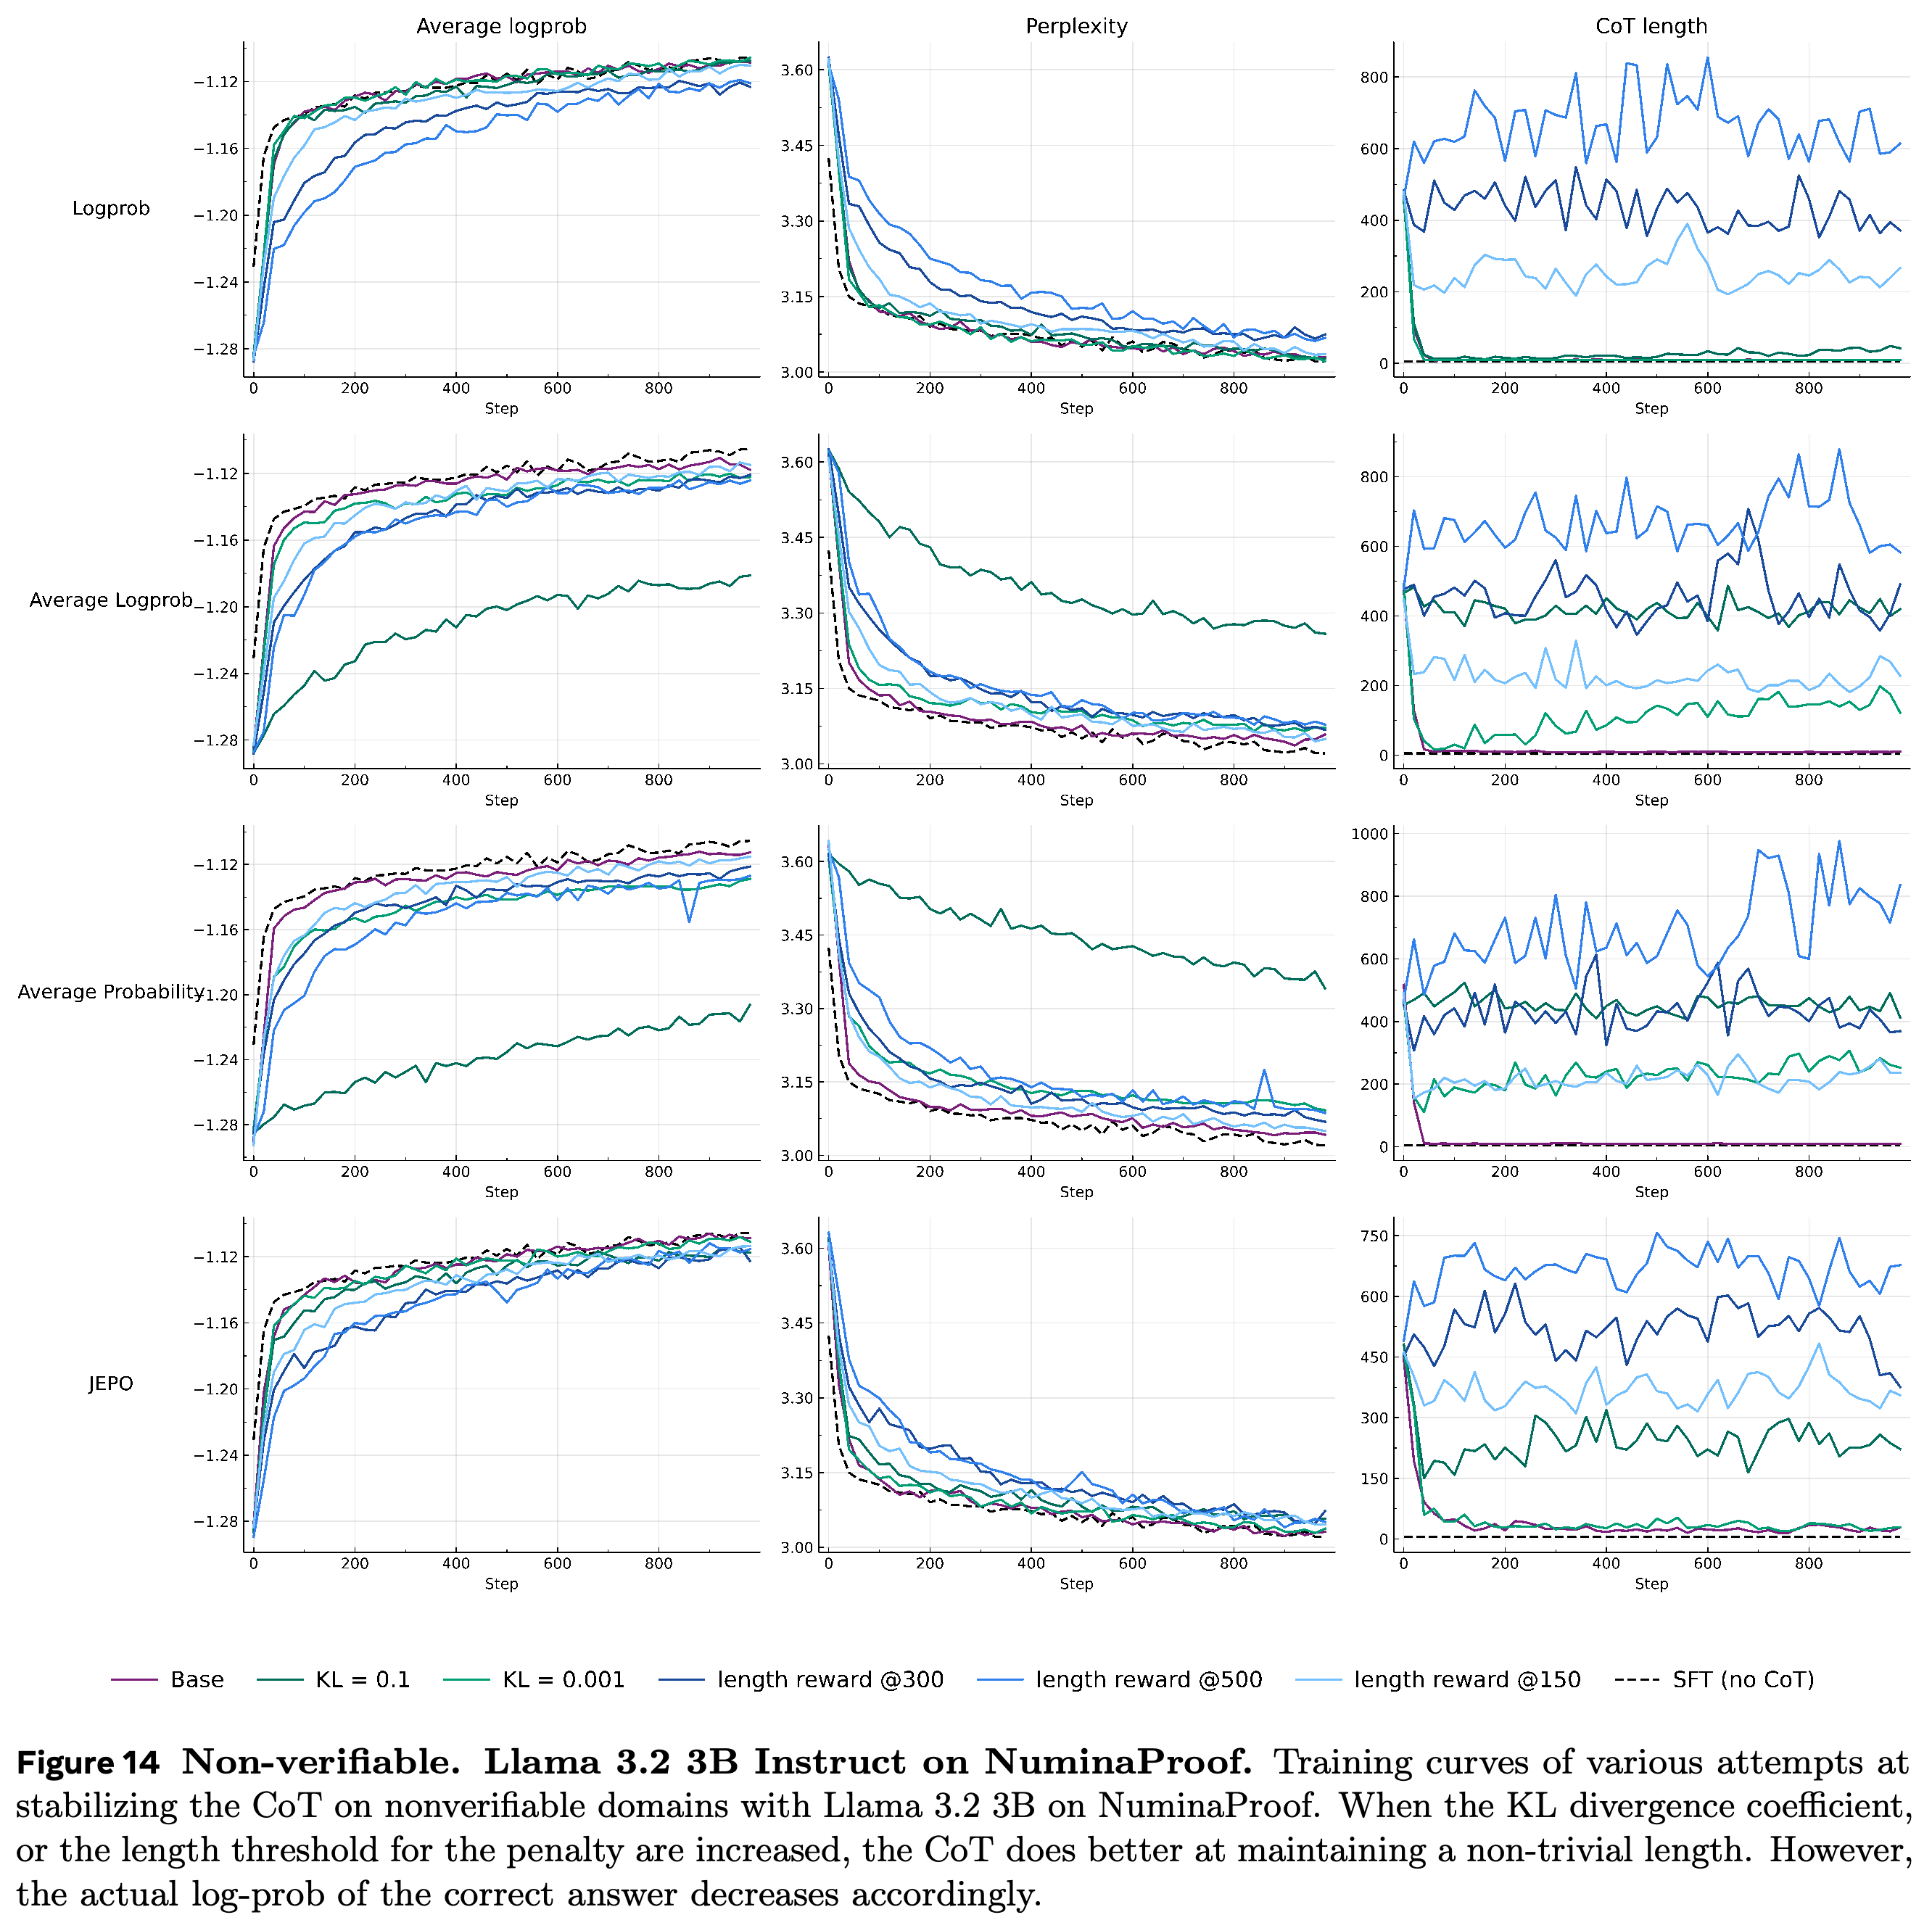
- 그림 14는 Llama의 NuminaProof에서 길이와 성능의 절충 관계를 보여 준다. 상당한 길이의 CoTs를 유지하는 방법들은 대체로 우도 개선을 늦추거나 저해한다.
- 그림 13에서는 warm start를 적용한 CoTs가 약 5 토큰이 아니라 100–200 토큰 부근에서 안정화된다. 그러나 perplexity는 연산량을 맞춘 SFT baseline보다 낮아지지 않는다.
- Tang et al. (2025)은 더 큰 배치와 더 낮은 학습률로 JEPO를 약 한 차수 더 오래 학습한다. 따라서 이 논문의 긴 답변 결과는 실험한 학습 예산에 한정된다.
Warm-start 학습은 추론 과정이 사라지는 현상을 부분적으로 막아 길이를 100–200 토큰 부근에서 안정화한다. 그럼에도 우도와 perplexity 곡선은 연산량을 맞춘 SFT 기준 수준을 넘어서지 못한다. 따라서 명시적 추론 과정을 유지하는 것만으로 긴 답변 성능의 이점이 생기지는 않는다.
행은 보상 계열을 비교하고 열은 예측 품질과 추론 과정 길이를 추적한다. 길이 페널티는 상당한 길이의 CoTs를 유지하지만 대체로 우도 개선을 늦춘다. 더 강한 KL도 여러 보상 계열에서 예측 품질을 저하시킨다. 이 그래프는 추론 과정을 기계적으로 유지하는 것과 그 추론 과정을 유용하게 만드는 것을 구분한다.
논의에서는 검증 불가능한 도메인에서 CoTs가 성능을 개선하지 못하는 이유를 살펴본다. 논문은 다음 설명을 제안하지만 결론을 내리지는 못한다. 긴 행동 시퀀스에서 credit assignment가 어렵다는 설명과, 긴 답변에서는 별도의 명시적 CoT 없이도 내부 추론이 가능하다는 설명이다.
- Credit assignment의 어려움은 회복이 지연되는 현상을 설명할 수 있다. 그러나 검증 가능한 과제의 Probability 학습에서는 같은 초기 감소가 나타나지 않는 이유나 길이 페널티가 도움이 되지 않는 이유는 설명하지 못한다.
- 내부 추론은 관련 문헌에서 도출한 가설이며, 이 실험에서 측정한 메커니즘은 아니다.
- 음의 국소 상관관계는 초기에 추론 과정을 짧게 만드는 압력이 있음을 뒷받침한다. 그러나 이후 유용한 긴 CoTs가 나타나지 않는 이유는 밝혀 주지 못한다.
4 Conclusion
결론은 로그 확률 보상을 짧고 검증 가능한 답변과 길고 검증 불가능한 후속 텍스트에 공통으로 적용할 수 있는 참조 기반 목적함수로 제시한다. 실험한 설정에서는 경쟁력 있는 greedy 수학 성공률과 개선된 perplexity를 함께 달성하며, 긴 답변의 우도는 SFT 수준을 유지한다. 긴 답변 과제에서 유익한 명시적 CoTs를 학습하는 문제는 여전히 해결되지 않았다.
부록
- A Losses and Advantages for the Rewards Considered는 파라미터에 의존하는 보상의 기울기를 유도한다. Lemma 1은 score-function 항과 보상의 직접 미분을 분리하고, 샘플링한 추론 과정과 독립적인 baseline을 빼도 기울기의 기댓값이 바뀌지 않음을 보여 준다. Stop-gradient 연산자는 이에 대응하는 샘플 기반 대리 목적함수를 구현한다.
- B Experimental details는 optimizer, 병렬 실행, 배치 구성, 답변 추출, 데이터셋 필터링, prompting을 명시한다. Full Details on the Datasets.는 검증 분할과 수학 풀이 제거 과정을 설명한다. Prompting and formatting.는 DeepSeek-R1 스타일 태그, 기본 1024 토큰 제한, 우도 계산을 위한 <answer 위치에서의 절단, 구현된 100/10/0 Base RL 보상을 명시한다.
- C Additional Experimental Results는 C.1 Verifiable Domains와 C.2 Non-verifiable Domains를 포함한다. 그림 3–9와 표 3은 모델과 그룹 크기별 수학 비교를 확장하고, 그림 10–12는 긴 답변 비교를 확장한다. 이 결과는 디코딩 방식에 따라 달라지는 수학 성능의 절충 관계와, CoTs가 짧아지면서 긴 답변 우도가 SFT에 근접하는 현상을 보여 준다.
-
D Attempted regularization methods는 (R_l(z)=r\cdot\min{ z -l_0,0})을 추가하며, 임계값은 100, 150, 300, 500 토큰이다. 계수 (r=\frac{\Delta R}{\Delta L})은 처음 40 학습 step에서 나타난 보상 증가와 길이 감소를 기준으로 보정한다. 그림 14–17은 이 페널티와 KL 계수 0.001 및 0.1을 살펴본다. Warm start.는 고정된 생성 CoTs 뒤에서 답변만 학습하는 SFT를 설명한다. 이 방식은 길이를 부분적으로 안정화하지만, 연산량을 맞춘 SFT를 능가하지는 못한다. - E Impact of the Marginal Log-Probability Estimate는 MC1과 MC32 우도 추정값의 차이를 살펴본다. 그림 18과 19는 DeepScaleR에서 Base RL과 Probability의 추정값 차이가 로그 확률 방법보다 크다는 점을 보여 준다. 더 많은 추론 과정의 확률을 평균해도 이들의 우도 성능은 더 낮다.
- F Correlation Analysis는 전체를 합친 Pearson 상관계수와 질문 내 상관계수의 평균을 구분한다. 그림 20–22는 이 통계량들의 부호가 다를 수 있음을 보여 준다. 로그 확률과 CoT 길이 사이의 음의 국소 관계는 그룹 상대적 RL에서 초기에 길이를 줄이는 압력이 있다는 해석과 일치한다.
짧은 생각
표 1은 이 목적함수들을 비교할 때 greedy 정확도만으로는 충분하지 않은 이유를 보여 준다. 수학 정확도가 비슷하더라도 참조 우도와 확률적 성공률은 크게 다를 수 있다. MC32 비교가 보고된 설정에서는 그 결과가 우도에 관한 발견을 더 뒷받침한다.
여기서 일반적 적용 가능성이란 참조 기반 목적함수의 적용 가능성을 뜻하며, 일반 추론 능력의 향상을 입증했다는 뜻은 아니다. 근거는 instruction tuning을 거친 3B 모델 2개, 데이터셋 4개, 보고된 학습 예산에서 나온다. 긴 답변 평가는 SFT 대비 이점을 입증하지 않으며, 증명의 정확성을 독립적으로 평가하지도 않는다.
수학 비교를 해석할 때는 Base RL의 형식 보상과 답변의 정확한 일치 기준을 고려해야 한다. 상관관계 연구는 초기 CoT 단축과 일치하는 근거를 제공하지만, 긴 답변에서 추론 과정이 지속적으로 사라지는 원인은 여전히 밝혀지지 않았다.