


D-OPSD: On-Policy Self-Distillation for Continuously Tuning Step-Distilled Diffusion Models 요약 설명
06 May 2026 | Paper Review On-Policy Distillation Self-Distillation Text-to-Image Generation목차
- 요약
- 1 Introduction
- 2 Method
- 3 Experiment
- 4 Discussion on Limitations and Future Works
- 5 Related Work
- 6 Conclusion
- 부록
- 짧은 생각
이번 글에서는 D-OPSD: On-Policy Self-Distillation for Continuously Tuning Step-Distilled Diffusion Models 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 5월 6일(Arxiv), Tech Report (D-OPSD)
- Jiang, Dengyang, Jin, Xin, Liu, Dongyang, Wang, Zanyi, Zheng, Mingzhe, Du, Ruoyi, Yang, Xiangpeng, Wu, Qilong, Li, Zhen, Gao, Peng, et al.
- The Hong Kong University of Science and Technology, Z-Image Team, Alibaba Group, University of California, San Diego, The Chinese University of Hong Kong
- 논문 링크
- Github
- Project Page
요약
- D-OPSD는 step-distilled 이미지 생성 모델을 지도 학습으로 적응시키면서 few-step 생성 품질을 유지하는 문제를 다룬다. 표준 flow-matching 미세 조정은 모델의 샘플러가 실제로 방문하는 상태가 아니라 타깃 이미지에 노이즈를 더한 상태로 학습하므로, 학습과 추론 사이에 불일치가 생긴다.
- D-OPSD는 텍스트 조건부 student 궤적을 생성하고, 같은 상태에서 평가한 EMA teacher의 속도에 student의 속도를 맞춘다. Teacher는 수정된 멀티모달 인코더를 통해 이미지–텍스트 조건을 받는다. 따라서 student가 샘플링한 상태를 대체하거나 외부 보상 함수를 사용하지 않고도, 학습 쌍에 포함된 이미지로 학습 신호를 제공할 수 있다.
- Z-Image-Turbo 6B와 FLUX.2-klein 4B를 사용한 실험은 소규모 데이터셋을 이용한 LoRA 맞춤화와 애니메이션 이미지 25K개를 이용한 전체 미세 조정을 다룬다. D-OPSD는 비교한 베이스라인보다 few-step 품질과 적응 성능이 좋다. 다만 일반 능력 벤치마크 성능은 기본 모델보다 낮아지고, 학습 반복마다 비용이 더 들며, 멀티모달 조건을 받은 teacher가 타깃 개념을 포착하지 못하면 적응에 실패할 수 있다.
1 Introduction
핵심 문제는 student의 few-step rollout 상태를 대체하지 않으면서 타깃 이미지 정보를 도입하는 방법이다. Online RL은 on-policy 최적화를 제공하지만, 맞춤화 데이터가 소수의 이미지–텍스트 쌍뿐일 때는 적절한 보상을 설계하기 어렵다.
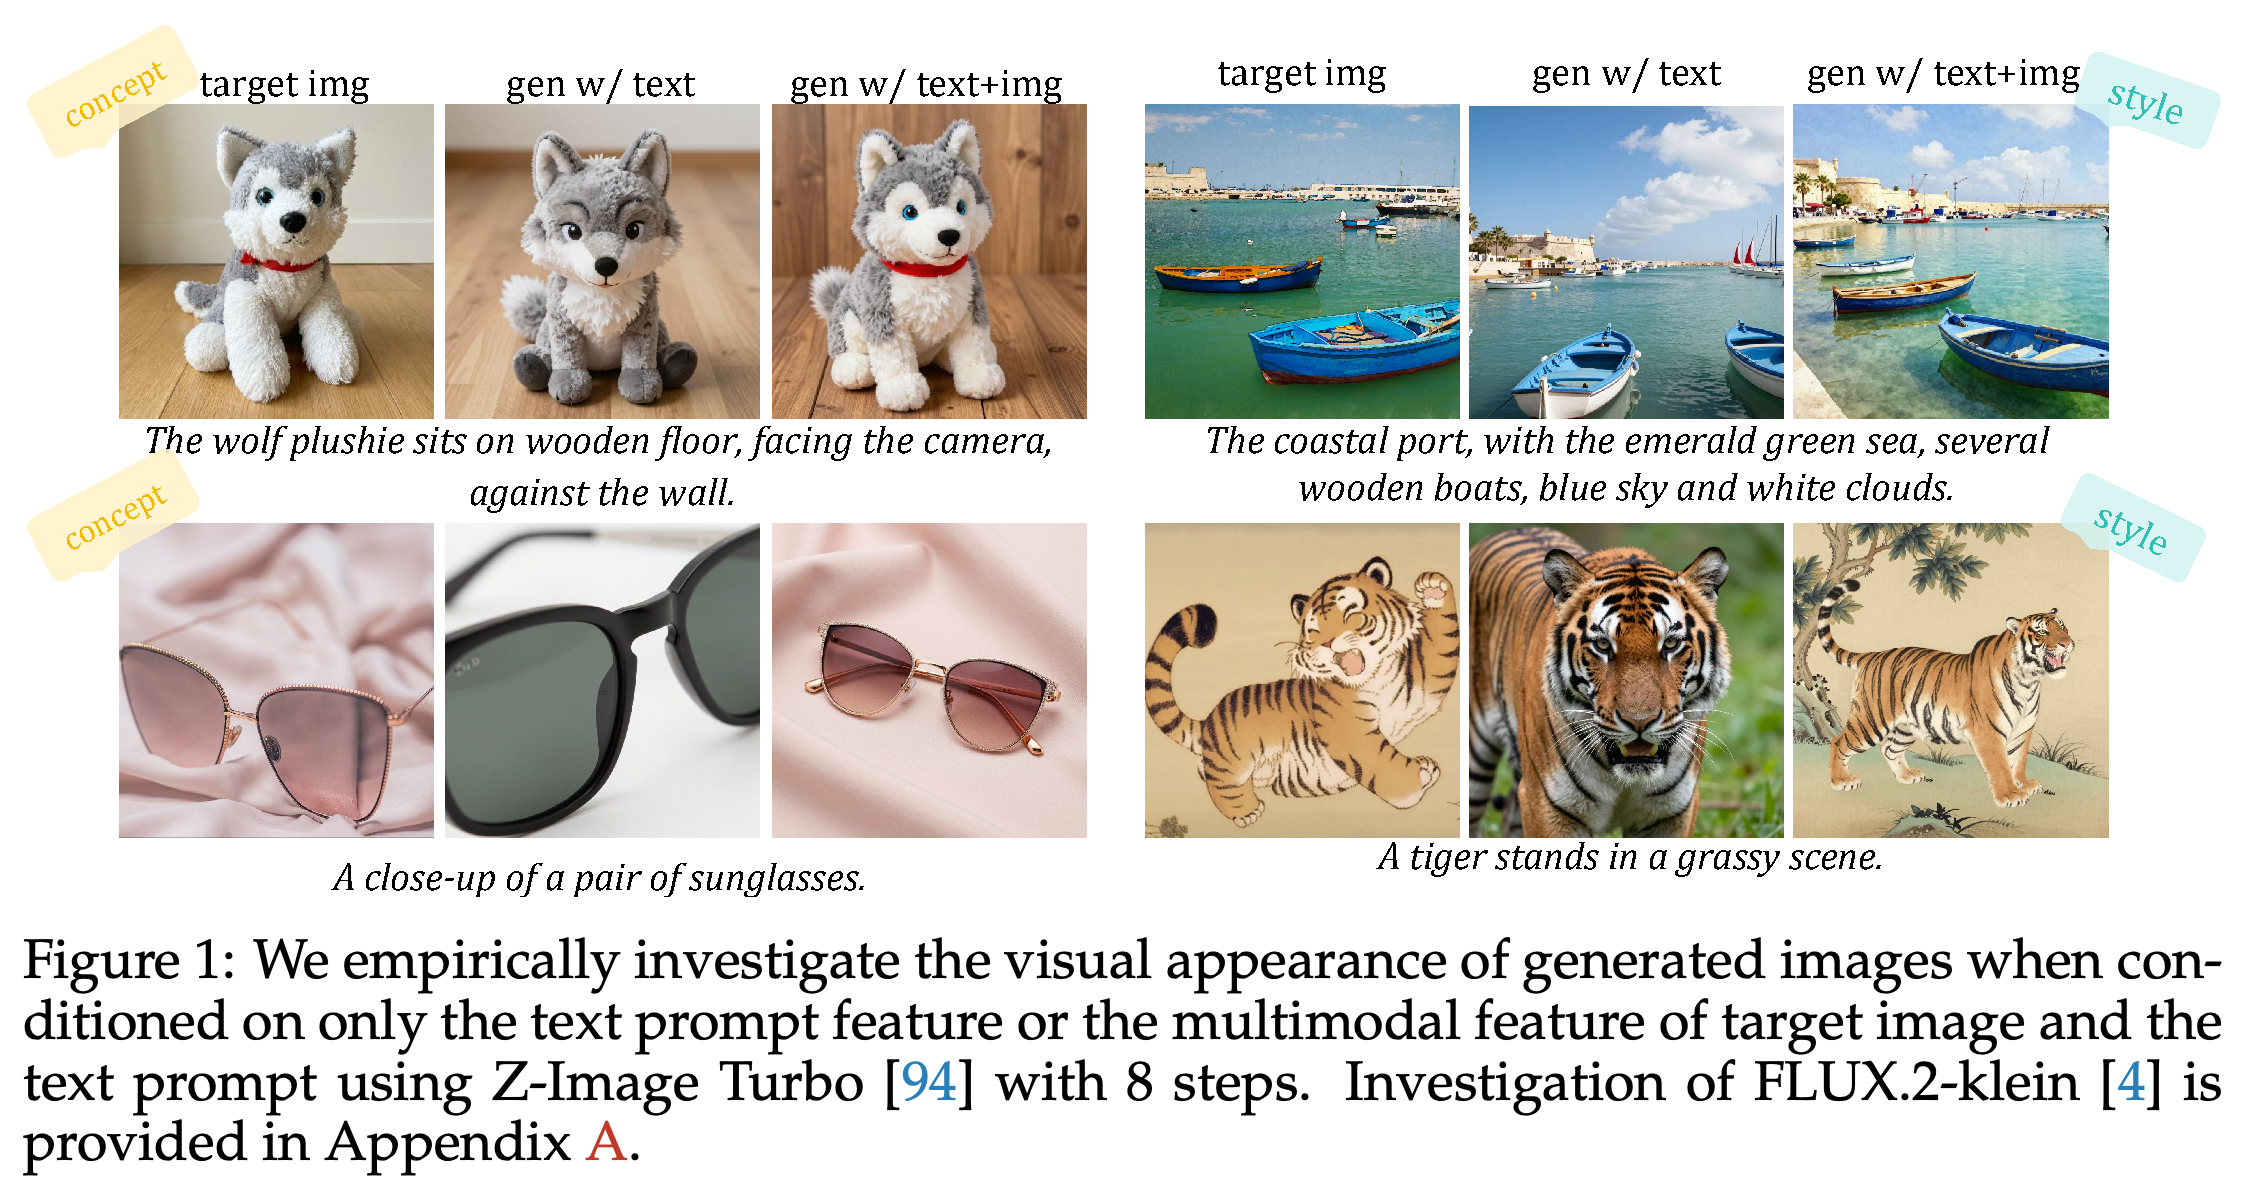
- Figure 1은 8 steps로 샘플링한 Z-Image-Turbo가 텍스트 전용 특징 대신 이미지–텍스트 특징을 조건으로 받으면 참조 개념과 스타일의 일부 특성을 유지할 수 있음을 보여준다.
- 논문은 이러한 조건부 생성 특성을 활용해 언어 모델의 on-policy self-distillation을 diffusion 모델로 확장한다.
- 프로젝트 URL은 https://vvvvvjdy.github.io/d-opsd이며, 제공된 PDF에는 보고서가 arXiv:2605.05204v3로 표기되어 있다.
늑대 봉제 인형과 선글라스 예시는 텍스트 전용 프롬프트가 참조 대상의 구체적인 외형을 지정하지 못함을 보여준다. 참조 이미지 특징을 추가하면 출력이 해당 외형에 가까워지며, 항구와 호랑이 예시는 스타일 특성의 전달을 보여준다. 이 선택된 예시들은 더 풍부한 맥락을 사용하는 teacher의 필요성을 뒷받침한다.
2 Method
이 방법은 학습 신호와 샘플링을 분리한다. 타깃 이미지는 teacher의 조건 정보를 풍부하게 하고, student는 원래의 text-to-image 경로로 샘플링한다. 양쪽 분기는 student가 생성한 상태에서 속도를 예측하며, 정렬 손실의 그래디언트는 student에만 전달된다.
2.1 Background
Vanilla SFT는 타깃 이미지에 노이즈를 더해 구성한 상태에서 정답 flow-matching 속도를 회귀한다. 반면 D-OPSD는 현재 student의 궤적에서 최적화에 사용할 상태와 학습 신호로 사용할 예측을 모두 정의하여 few-step 추론과의 불일치를 줄인다.
- 이 연구는 diffusion 모델을 처음부터 학습하는 것이 아니라, 이미 step-distilled된 생성 모델을 적응시키는 데 초점을 둔다.
- Online RL도 생성된 궤적을 사용하지만, D-OPSD는 보상 기반 학습 신호를 멀티모달 조건부 self-distillation으로 대체한다.
2.2 D-OPSD
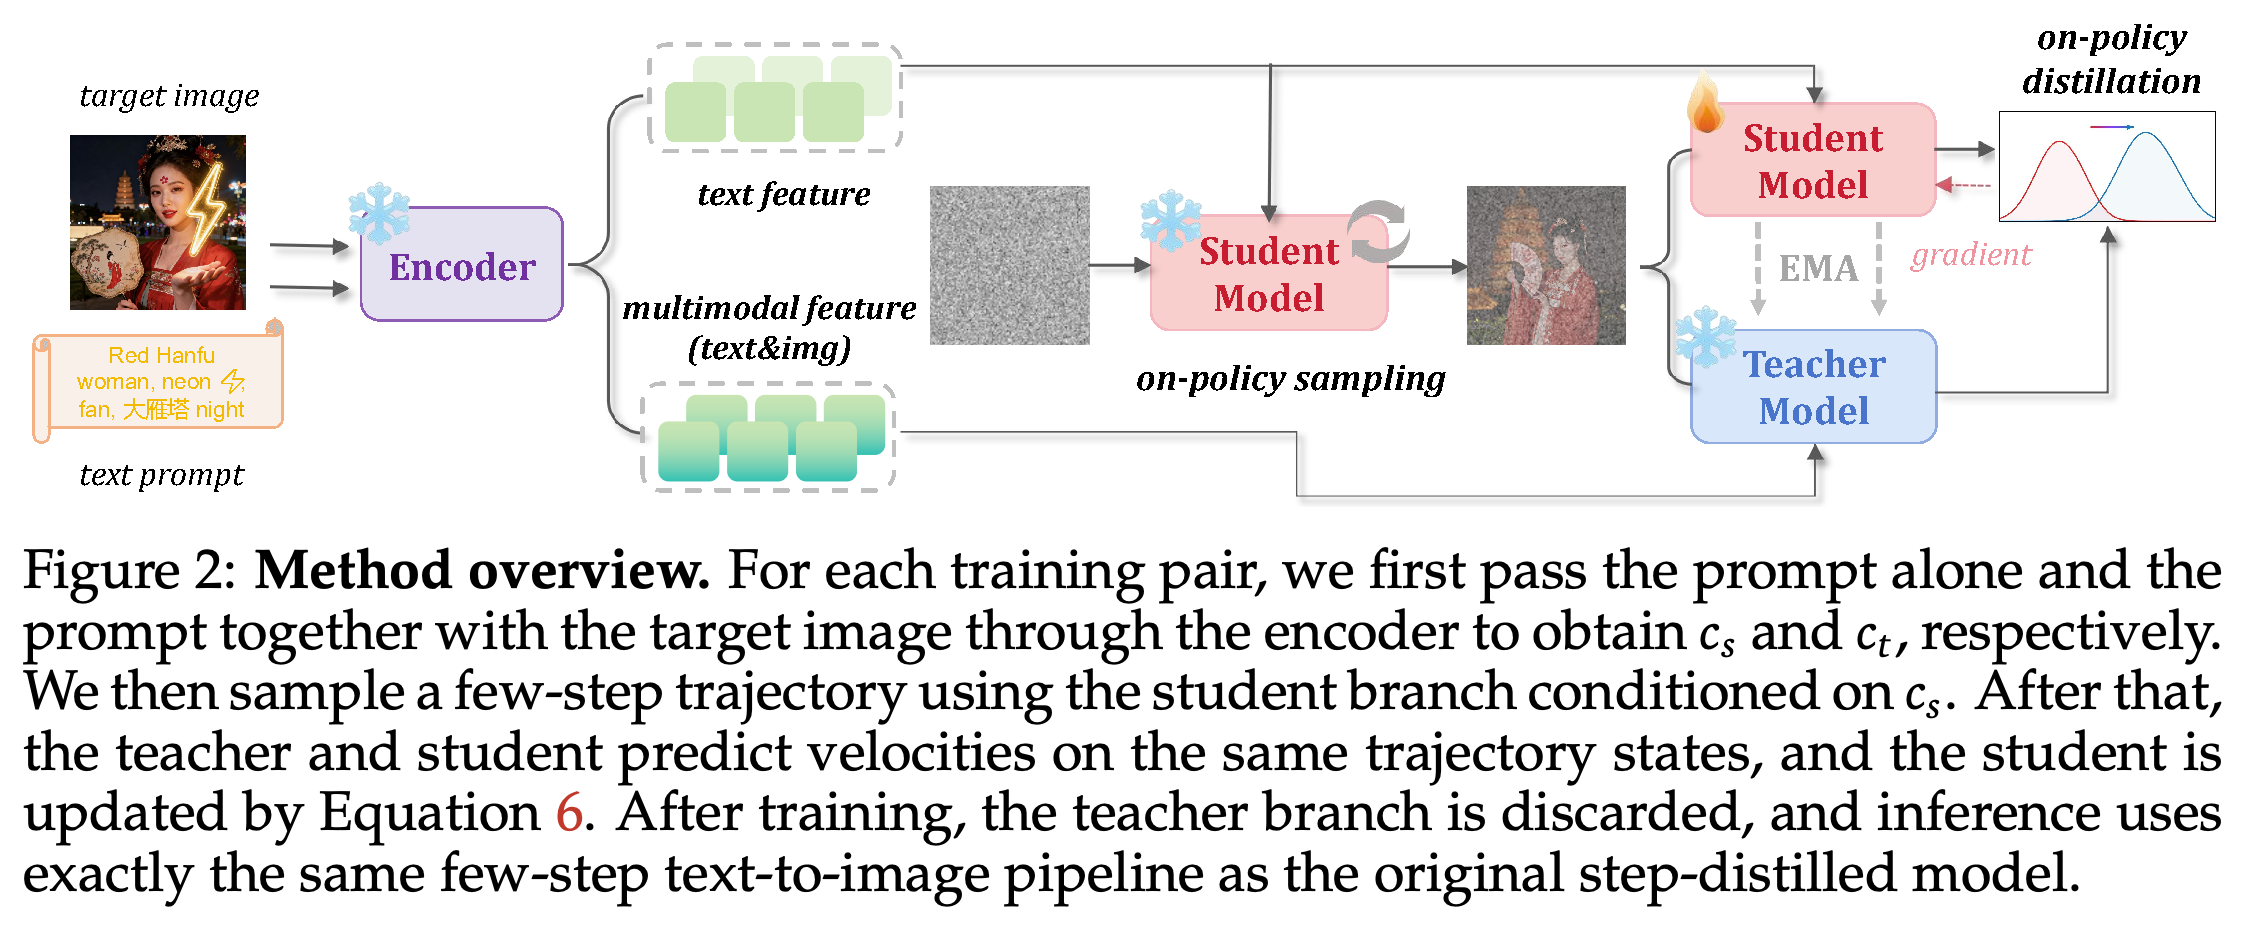
D-OPSD는 각 학습 쌍 ((x_0,y))에 대해 조건 cs = ftext(y)와 ct = fmm(y, x0)를 구성한다. Student는 프롬프트만 보고, teacher는 프롬프트와 타깃 이미지를 함께 인코딩한 특징을 본다. Figure 2는 이러한 분리를 요약한다.
- 타깃 이미지는 student 샘플을 대신하는 노이즈 잠재 상태가 아니라 조건 표현을 통해 입력된다.
- Teacher의 diffusion 가중치는 같은 기본 모델에서 가져오며 EMA로 유지한다. 멀티모달 인코더 구성은 Appendix D에서 자세히 설명한다.
모델은 ODE (\frac{dx_t}{dt}=v_\theta(x_t,t,c))를 정의하고, 스케줄 1 = t_K > t_{K−1} > … > t_0 = 0을 사용한다. Student는 Gaussian noise에서 출발해 추론에 사용하는 것과 같은 few-step solver를 따르며, teacher와 student의 속도는 공유된 각 궤적 상태에서 평가한다.
- 학습 시 별도의 denoising 과정을 정하지 않고, 4 또는 8 steps와 같은 원래 샘플링 예산을 사용한다.
- Teacher는 student rollout이 방문하는 상태를 결정하지 않는다.
Equation 6은 L_D-OPSD = E_(x0,y)[(1/K) Σ_(k=1)^K ||u_k^s − sg(u_k^t)||_2^2]를 최소화하며, sg는 stop-gradient를 뜻한다. 이는 on-policy 상태에서 속도를 평균제곱오차로 정렬하는 목적 함수이며, 토큰 수준 KL divergence나 명시적인 분포 매칭 목적 함수는 아니다.
- 논문은 속도 정렬을 통해 student의 조건부 생성 동역학을 더 풍부한 맥락을 받은 teacher의 동역학에 가깝게 만든다고 해석한다.
- 이 해석은 언어 모델 OPSD와의 유사성을 뒷받침하지만, 보고서는 속도 MSE와 전체 이미지 분포 사이의 divergence가 형식적으로 동등함을 입증하지 않는다.
Algorithm 1은 양쪽 diffusion 분기를 기본 모델로 초기화하고, 미니배치와 Gaussian 시작 상태를 샘플링한 뒤, few-step 스케줄에 걸쳐 정렬 손실을 누적한다. 이어서 student를 업데이트하고 EMA로 teacher를 업데이트한다. 샘플링 상태 사이의 전이에서는 그래디언트를 차단하며, teacher 예측에도 그래디언트를 전달하지 않는다.
- 학습 후에는 teacher 분기를 제거하므로, 배포 시에는 원래의 텍스트 전용 조건 파이프라인과 샘플링 예산을 유지한다.
- Few-step 생성 품질의 유지는 실험 결과이며, 최적화가 생성 동역학을 바꾸지 않는다는 수학적 보장은 아니다.
도식은 텍스트 조건부 샘플링과 이미지–텍스트 teacher 조건을 분리한다. 양쪽 예측 분기는 student가 생성한 상태를 입력받고, 그래디언트는 student를 업데이트하며 EMA는 teacher를 업데이트한다. 참조 이미지는 rollout 상태를 대체하지 않고 학습 신호에 영향을 준다.
3 Experiment
실험은 2가지 적응 설정을 평가한다. 하나는 LoRA로 개별 대상이나 스타일을 학습하는 설정이고, 다른 하나는 전체 미세 조정으로 모델을 애니메이션 도메인에 적응시키는 설정이다. 평가는 타깃 이미지 유사도, 새로운 프롬프트로의 일반화, few-step 이미지 품질, 일반적인 프롬프트 수행 능력의 유지를 구분한다.
3.1 Experimental Setup
기본 모델은 Z-Image-Turbo 6B와 FLUX.2-klein 4B이며, 주요 비교에서는 각 모델의 원래 추론 설정을 사용한다. LoRA 베이스라인에는 Vanilla SFT, SFT + LoRA on distilled, Dreambooth, PSO가 포함된다. 전체 미세 조정 베이스라인에는 Vanilla SFT와 PSO가 포함된다.
- 소규모 데이터 설정에서는 DreamBooth 데이터와 추가 스타일 예시를 사용한다. Table 1은 개념 클래스 30개와 스타일 클래스 10개에 걸쳐 평균을 계산한다.
- 전체 미세 조정에는 고품질 애니메이션 이미지 25K개로 구성된 내부 데이터셋을 사용한다.
- 원래 foundation model의 정확한 distillation 절차는 공개되어 있지 않으므로, Appendix C에서는 이를 재현하는 대신 오픈소스 DMD를 이용한 2단계 대안을 평가한다.
DINO-D와 LPIPS-D는 타깃 이미지와의 유사도를 측정한다. VLM-J와 CLIP-S는 새로운 프롬프트에서 개념·스타일 일관성과 프롬프트 정렬을 평가한다. Quality-S와 Aesthetic-S는 평가에만 사용하는 내부 VLM 기반 보상 모델로 계산하며, GenEval과 DPG는 일반 능력이 얼마나 유지되는지 평가한다.
- DINO-D는 DINOv3-ViT-S-plus, LPIPS-D는 VGG, VLM-J는 Qwen3-VL-8B-Instruct, CLIP-S는 DFN-CLIP-H를 사용한다. CLIP-S를 계산할 때는 DreamBooth의 특수 토큰 [V]를 원래 클래스 이름으로 대체한다.
- 전체 미세 조정의 FID와 관련 이미지 지표는 학습 예시에서 무작위로 뽑은 2K개와 해당 프롬프트로 생성한 이미지를 사용한다. 따라서 별도로 분리한 타깃 도메인 데이터에서 측정한 결과는 아니다.
- GenEval과 DPG는 Prompt-Enhanced 변형이 아니라 원래 벤치마크 프롬프트를 사용한다.
3.2 Main Results
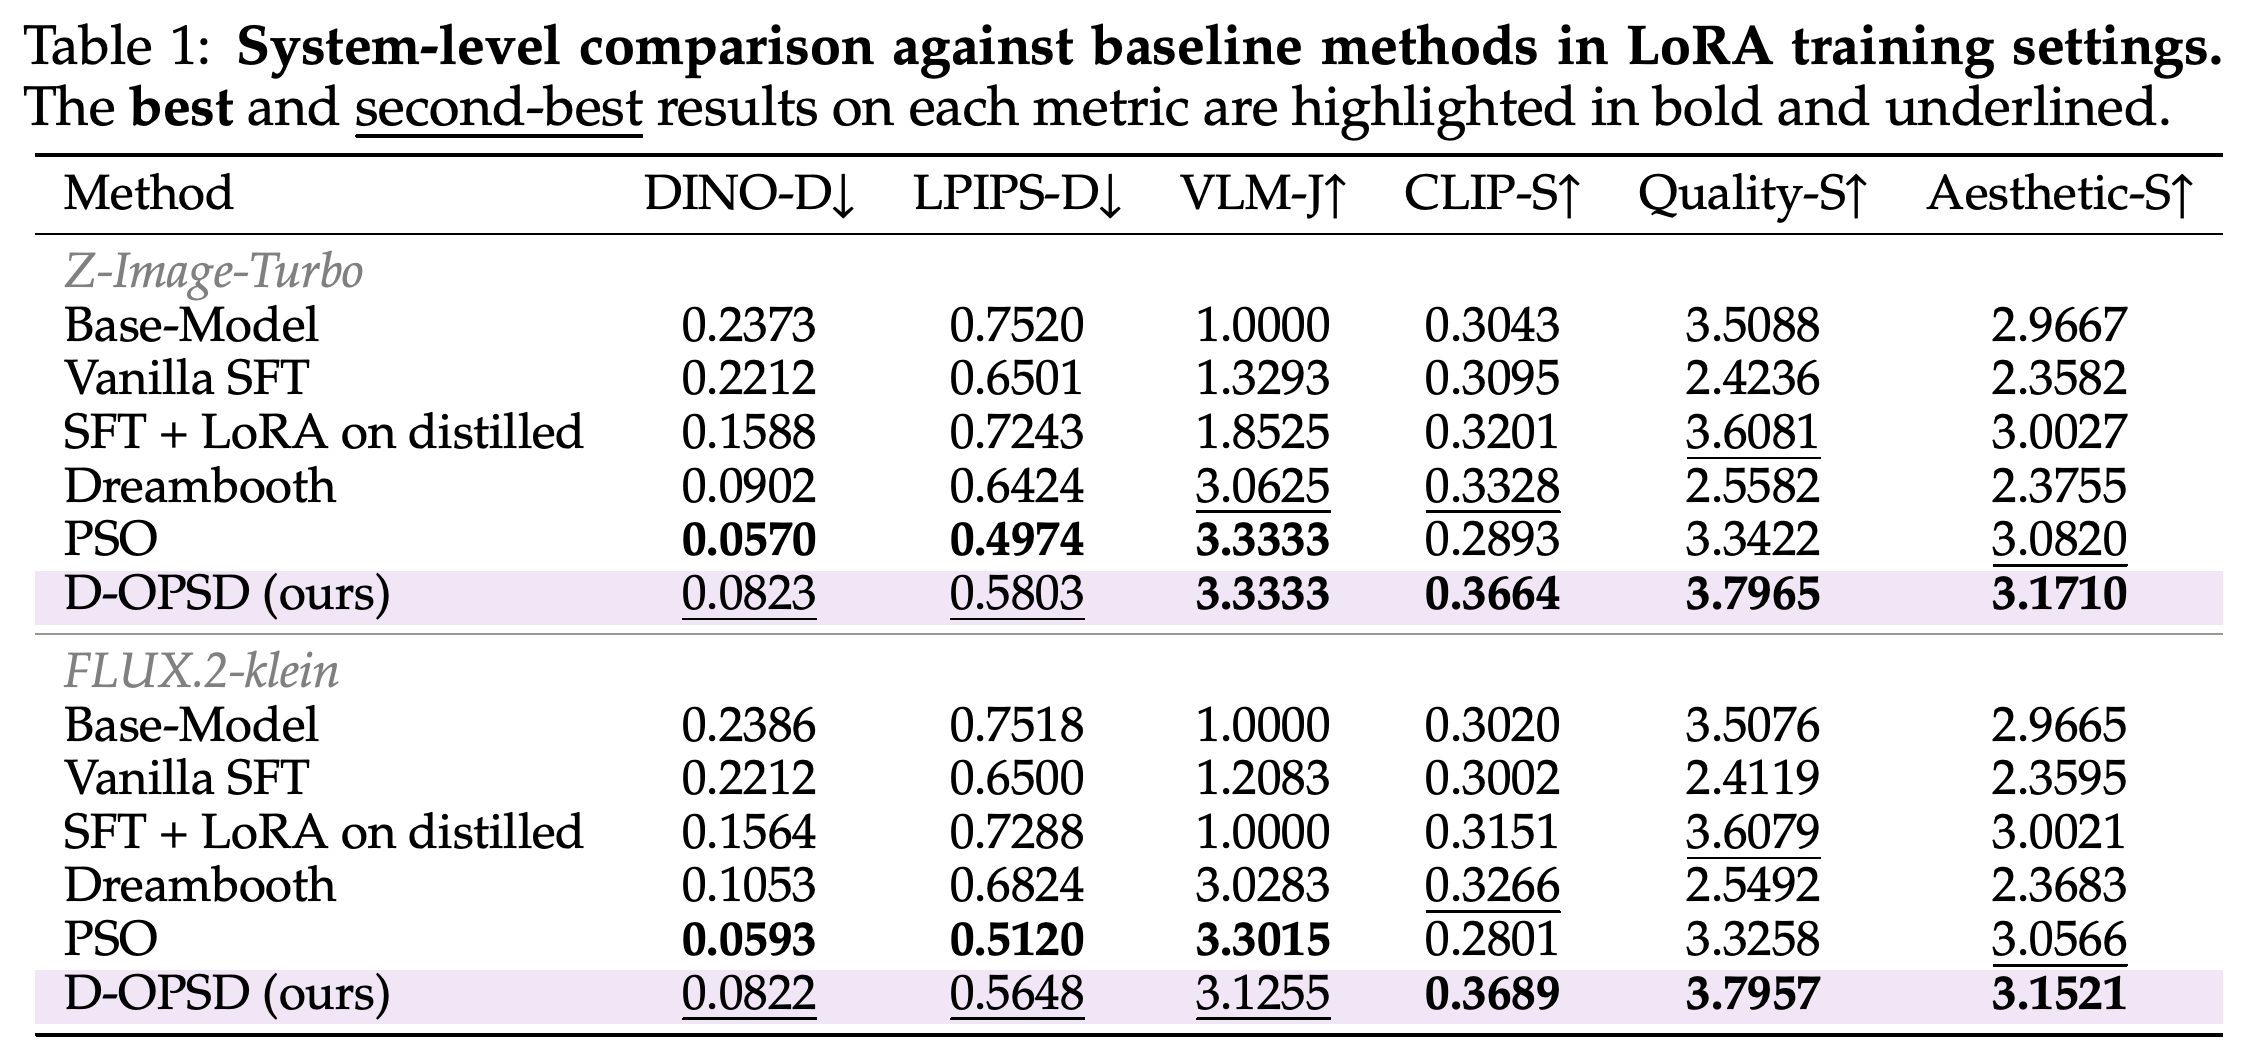
LoRA 맞춤화에서 D-OPSD는 Table 1의 기본 모델 2개 모두에서 가장 높은 CLIP-S, Quality-S, Aesthetic-S를 기록한다. Z-Image-Turbo의 CLIP-S와 Quality-S는 각각 0.3664와 3.7965이며, PSO는 0.2893과 3.3422, Vanilla SFT는 0.3095와 2.4236이다.
- PSO는 기본 모델 2개 모두에서 D-OPSD보다 DINO-D와 LPIPS-D가 낮으므로, D-OPSD가 모든 타깃 유사도 지표에서 앞서는 것은 아니다.
- FLUX.2-klein에서는 PSO의 VLM-J도 3.3015로 D-OPSD의 3.1255보다 높다. Z-Image-Turbo에서는 PSO와 D-OPSD 모두 3.3333이다.
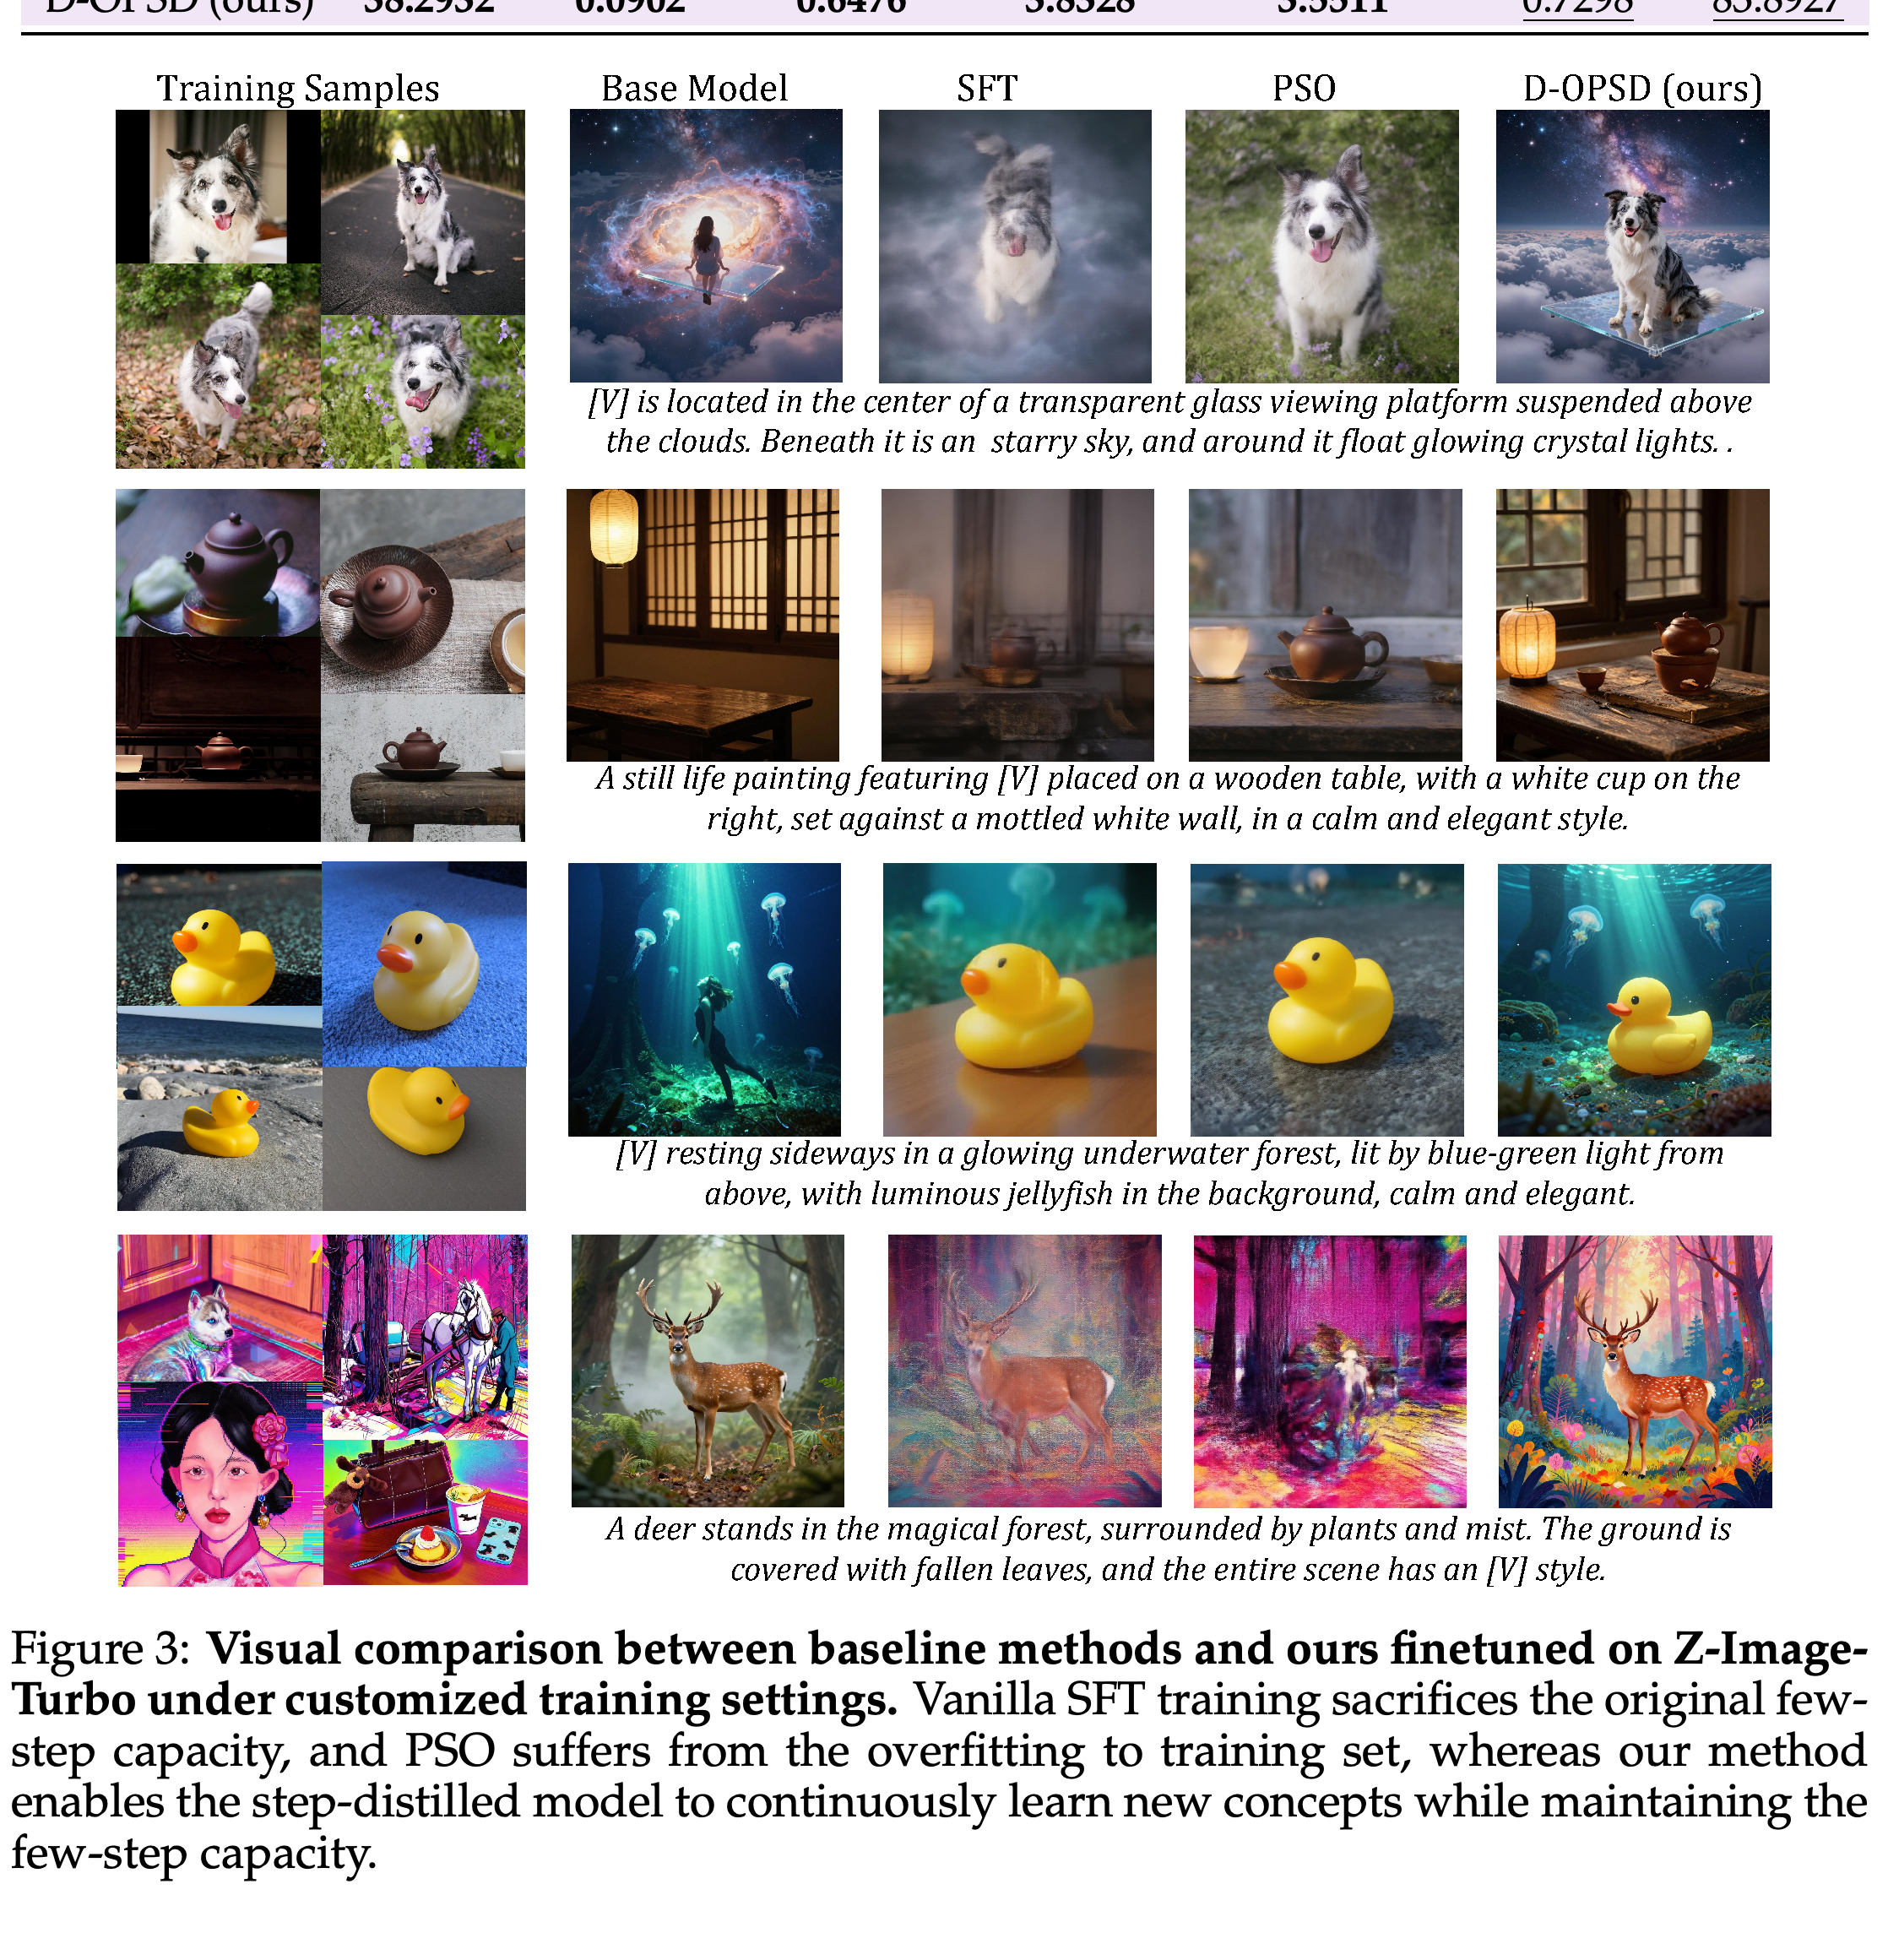
- Figure 3에서 D-OPSD는 학습한 대상을 요청된 새로운 장면과 결합한다. 반면 제시된 PSO 출력은 학습 이미지의 구도에 더 가깝고, SFT 출력은 선명도가 낮다.
D-OPSD는 기본 모델 2개 모두에서 CLIP-S, Quality-S, Aesthetic-S가 가장 높다. 그러나 PSO는 DINO-D와 LPIPS-D가 더 낮고, FLUX.2-klein에서 VLM-J가 더 높다. 결과는 모든 지표에서의 우위가 아니라 참조 학습, 새로운 프롬프트 수행, few-step 품질 사이의 균형을 뒷받침한다.
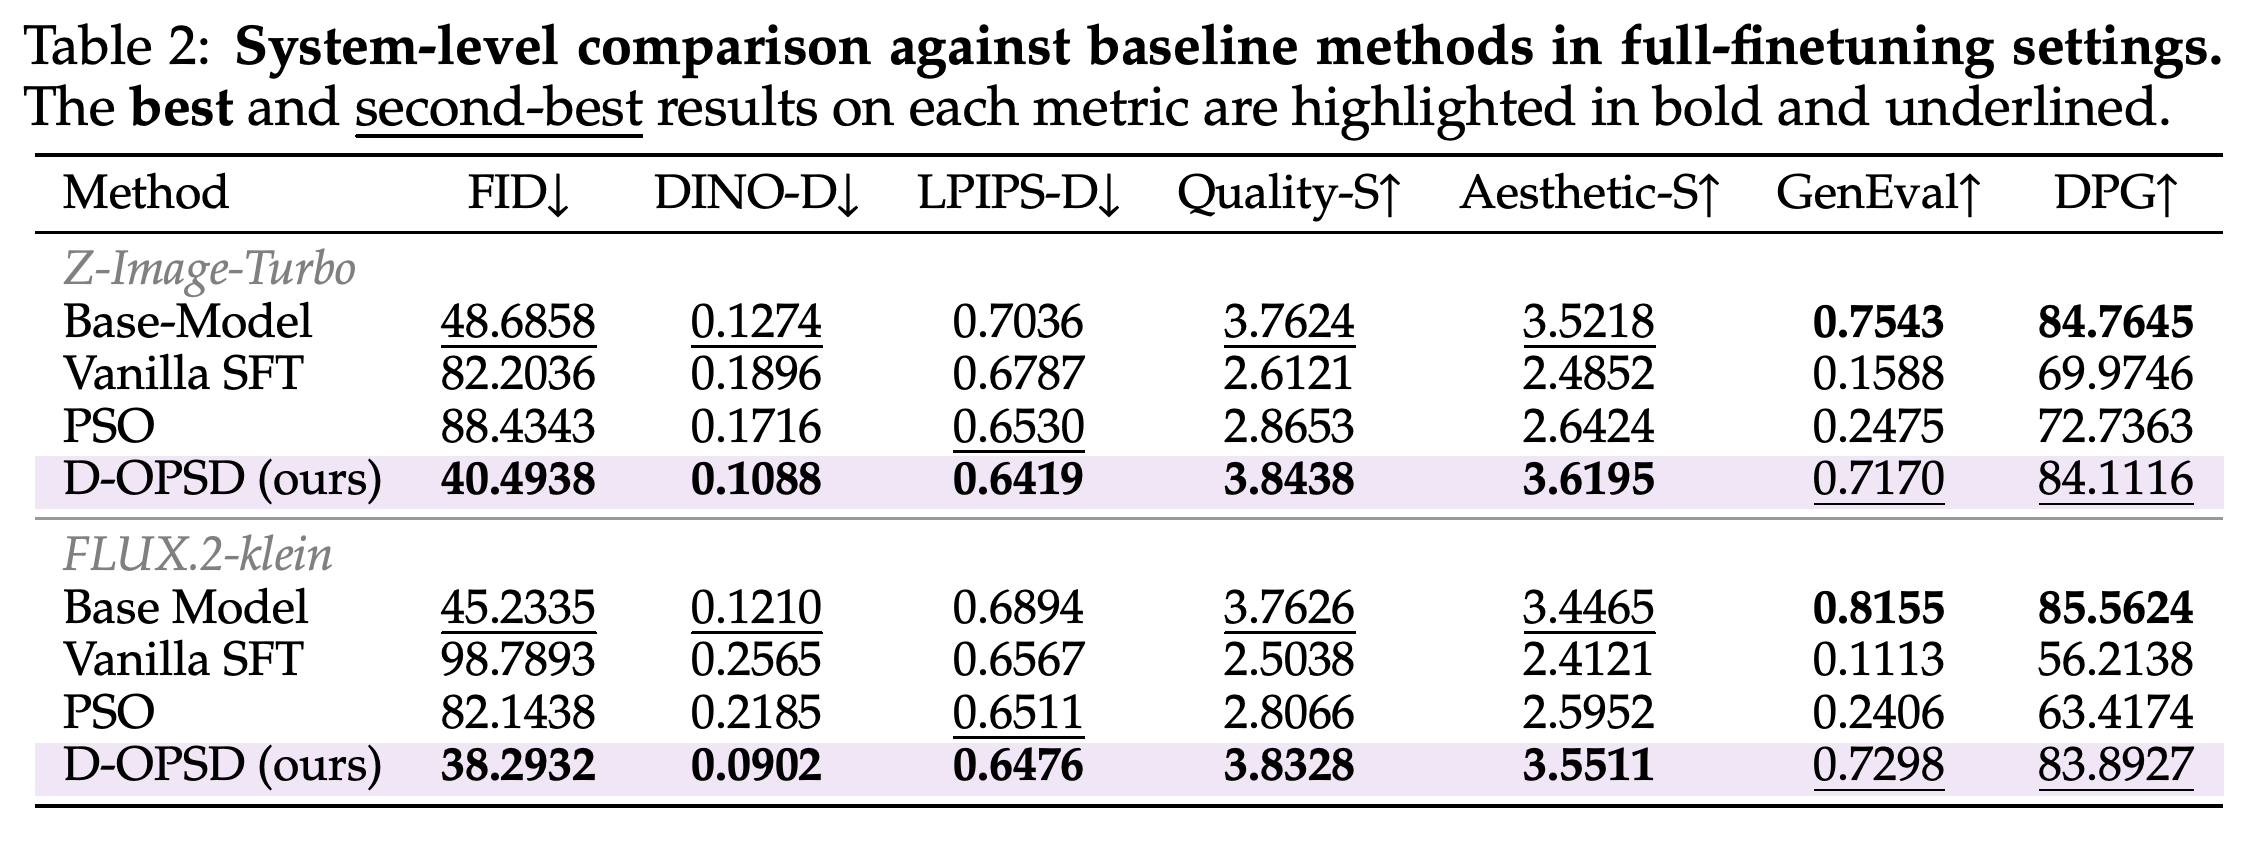
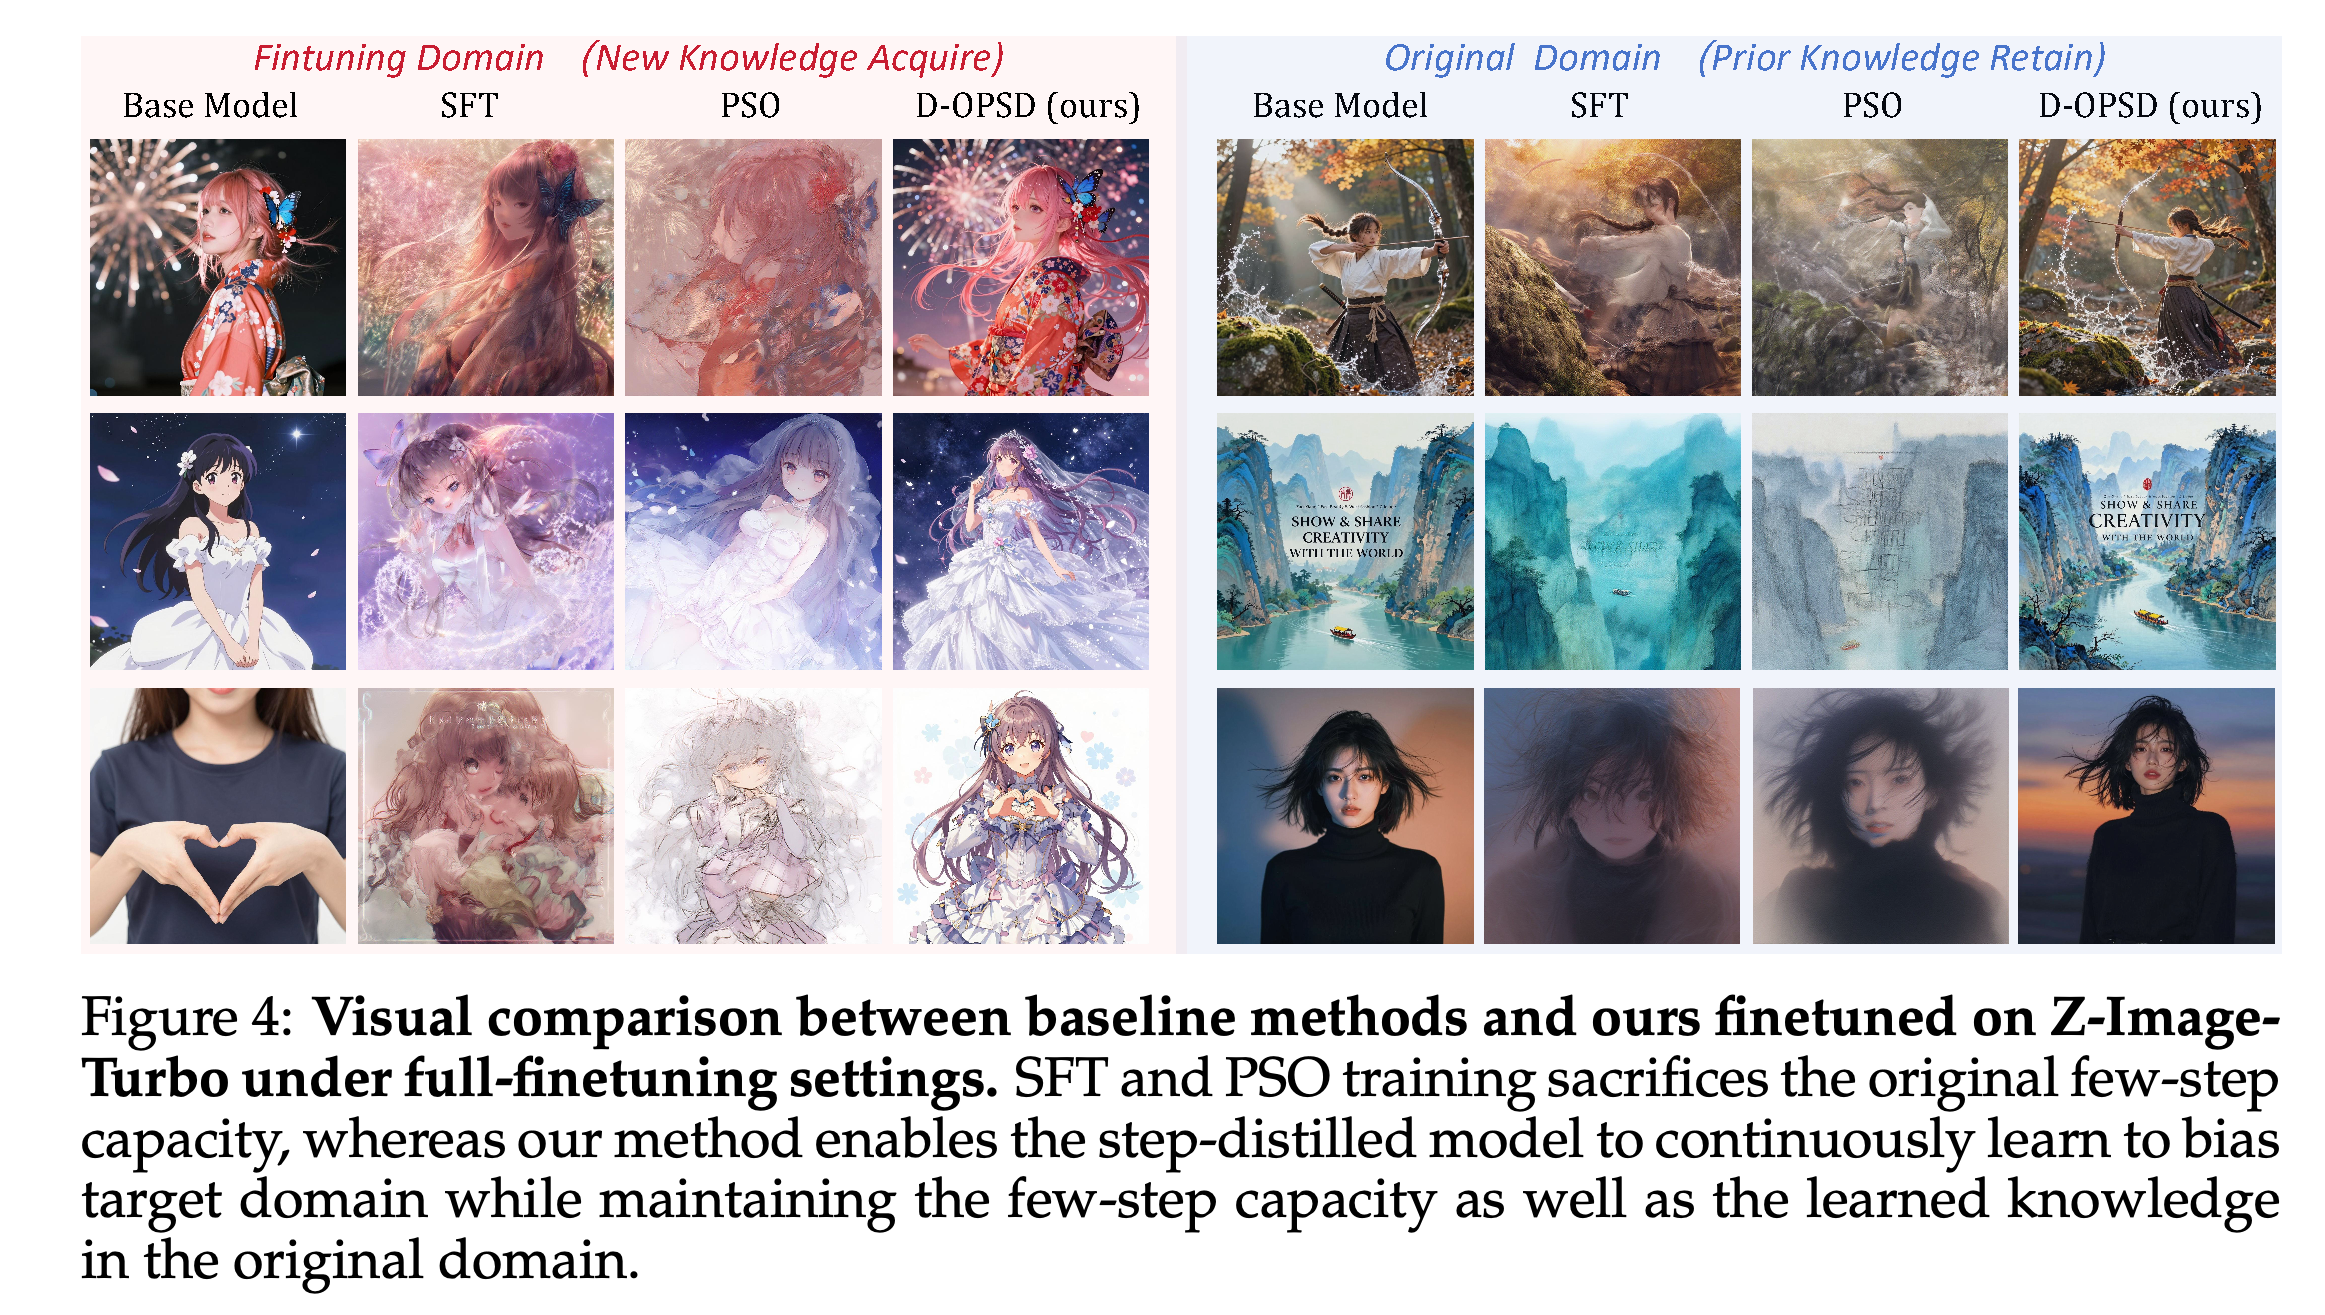
전체 미세 조정에서 D-OPSD는 Z-Image-Turbo의 FID를 48.6858에서 40.4938로, FLUX.2-klein의 FID를 45.2335에서 38.2932로 낮춘다. 또한 각 기본 모델과 비교한 적응 베이스라인보다 DINO-D, LPIPS-D, Quality-S, Aesthetic-S가 개선된다.
- 일반 능력이 완전히 유지되지는 않는다. Z-Image-Turbo의 GenEval은 0.7543에서 0.7170으로, DPG는 84.7645에서 84.1116으로 변한다.
- FLUX.2-klein의 GenEval은 0.8155에서 0.7298로, DPG는 85.5624에서 83.8927로 변한다.
- Figure 4의 선택된 예시에서는 SFT나 PSO보다 타깃 도메인과 원래 도메인 모두에서 더 선명한 출력이 나타난다. 저자들은 벤치마크 성능 하락을 도메인 적응의 상충 관계로 설명하지만, 실험은 이 설명을 독립적으로 검증하지 않는다.
D-OPSD는 기본 모델 2개 모두보다 타깃 도메인 FID와 이미지 품질 점수를 개선하며, SFT나 PSO보다 GenEval과 DPG를 기본 성능에 훨씬 가깝게 유지한다. 다만 GenEval과 DPG 값은 여전히 기본 모델보다 낮으므로, 벤치마크 능력이 완전히 유지되지는 않는다.
개, 주전자, 고무 오리, 스타일 예시는 맞춤화 이미지와 다른 프롬프트를 평가한다. 이 예시에서 D-OPSD는 학습한 외형을 요청된 새로운 환경과 결합한다. 반면 PSO는 학습 이미지와 비슷한 구도를 유지하는 경우가 많고, SFT는 덜 뚜렷한 출력을 생성한다. 이 비교는 참조 유사도만으로 지시 수행의 일반화를 측정할 수 없는 이유를 보여준다.
왼쪽 패널은 애니메이션 도메인 적응을 보여주고, 오른쪽 패널은 원래 도메인의 생성을 확인한다. 양쪽 패널에서 D-OPSD 출력은 제시된 SFT와 PSO 출력보다 구조와 세부 묘사가 더 선명하다. 이는 정량적 품질 비교를 뒷받침하지만, 모든 프롬프트에서 품질이 유지됨을 입증하지는 않는다.
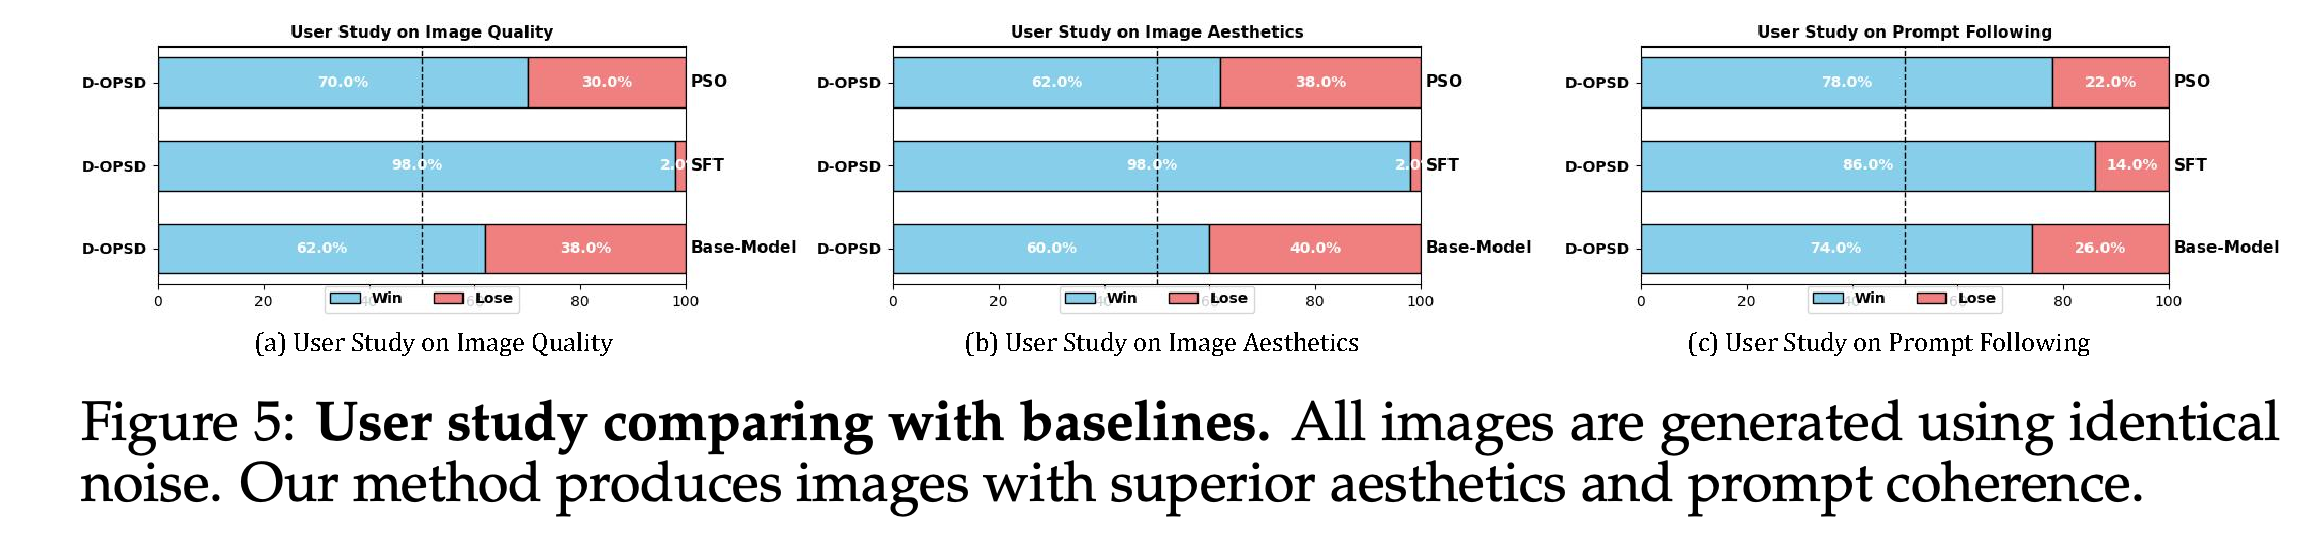
사용자 연구는 LoRA 프롬프트 50개와 전체 미세 조정 프롬프트 50개를 합쳐 진행한다. 동일한 노이즈로 생성한 출력 쌍을 무작위 순서로 제시한다. Figure 5는 품질, 미적 완성도, 프롬프트 수행에서 PSO, Vanilla SFT, 기본 모델보다 D-OPSD를 선호한 비율을 보고한다.
- 기본 모델과 비교했을 때 D-OPSD의 선호 비율은 이미지 품질에서 62.0%, 미적 완성도에서 60.0%, 프롬프트 수행에서 74.0%다.
- 맞춤화 설정에서는 참조 이미지나 스타일 예시를 제공한다.
- 보고서는 평가자 수를 명시하지 않으며, 선호 비율의 불확실성 구간도 제공하지 않는다.
선호 비율 막대는 평가한 3개 차원과 비교 대상 3개 모두에서 D-OPSD가 우세함을 보여준다. 기본 모델과 비교한 선호 비율은 품질 62.0%, 미적 완성도 60.0%, 프롬프트 수행 74.0%다. 이 연구는 맞춤화와 전체 미세 조정 설정을 따로 보고하지 않고 프롬프트를 합쳐 집계한다.
3.3 Ablation Study
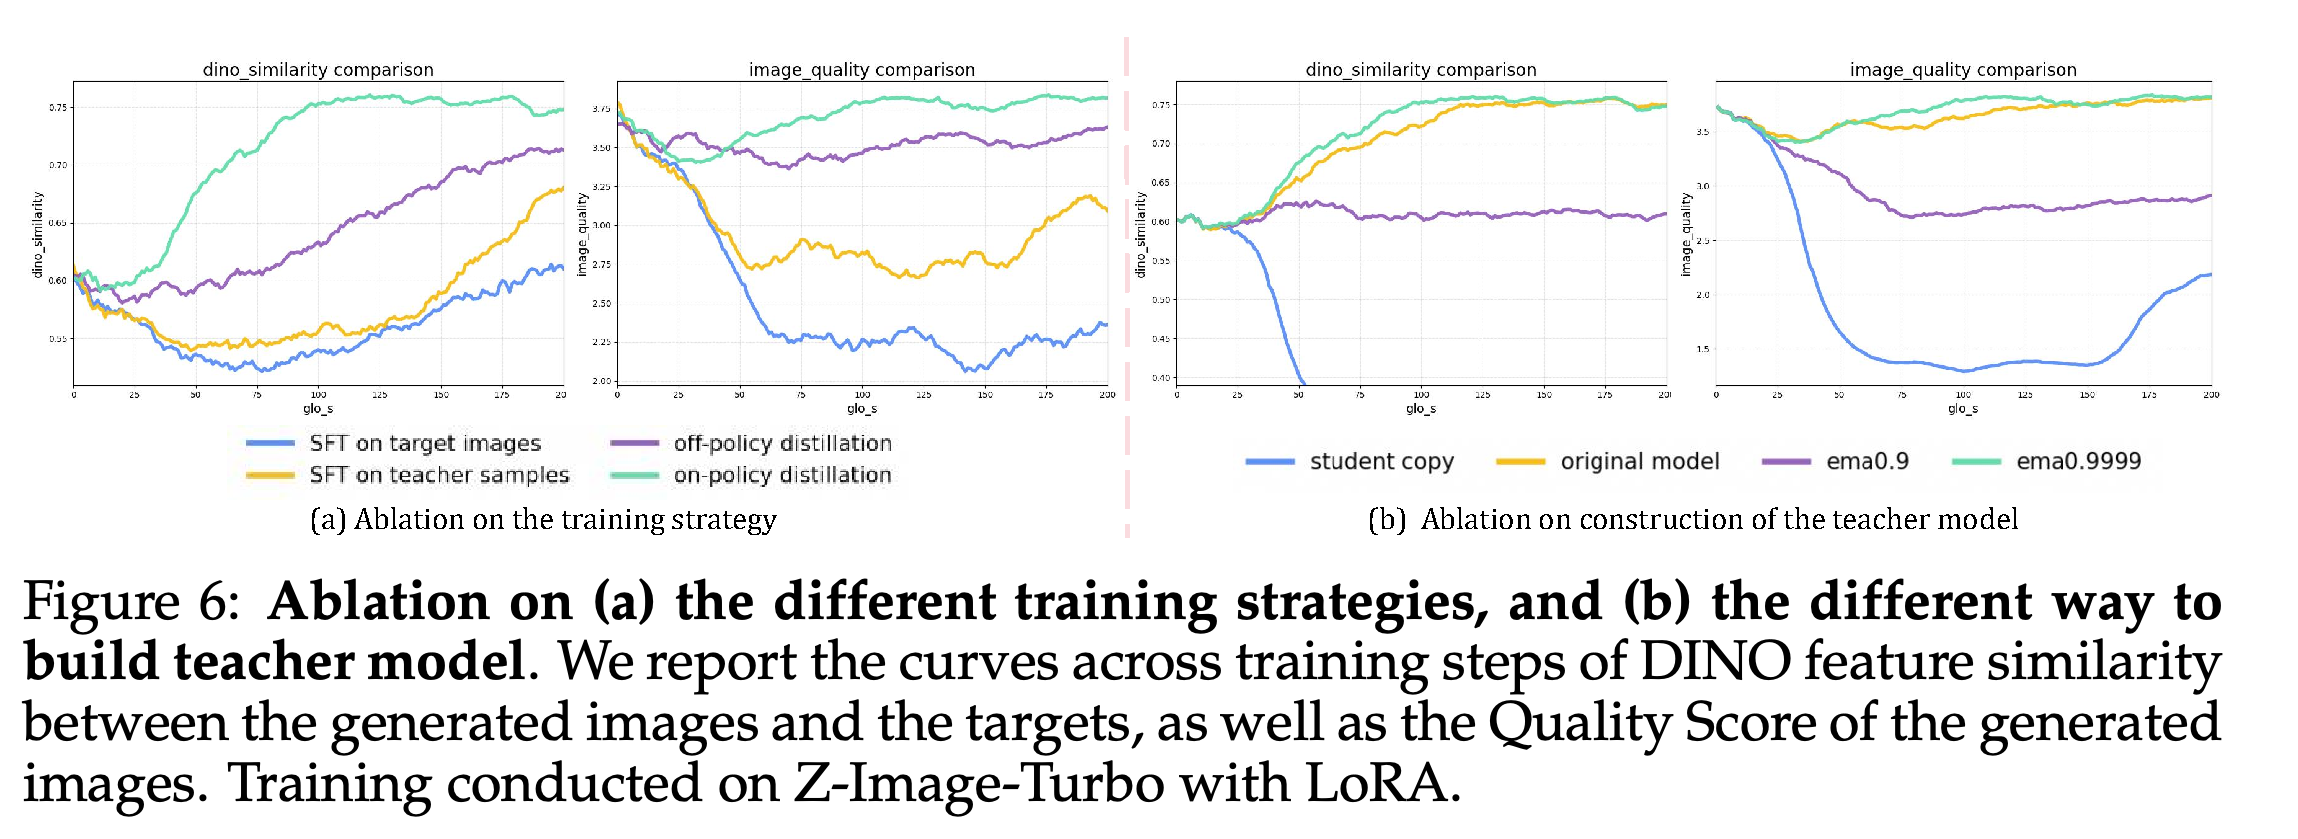
학습 전략 ablation 실험은 타깃 이미지로 수행하는 SFT, teacher 생성 이미지로 수행하는 SFT, 고정 데이터셋을 이용한 off-policy distillation, D-OPSD의 on-policy distillation을 비교한다. Z-Image-Turbo LoRA 학습으로 얻은 Figure 6(a)에서 on-policy 방식은 DINO 유사도를 더 빠르게 높이면서 제시된 방식 중 가장 높은 Quality Score를 유지한다.
- 타깃 이미지를 teacher 샘플로 대체하는 것만으로는 현재 student 궤적에서 distillation을 수행하는 이점을 재현하지 못한다.
- Off-policy distillation은 SFT보다 품질 저하를 완화하지만, 제시된 곡선에서 수렴 속도가 더 느리고 on-policy 방식보다 성능이 낮다.
Teacher 구성은 학습 안정성에 영향을 준다. 고정된 기본 모델 teacher는 작동하지만, student 복사본을 그대로 사용하면 학습이 붕괴한다. Figure 6(b)에서는 momentum 0.9999의 EMA teacher가 가장 좋은 결과를 보인다.
- 그림에는 EMA momentum 0.9도 포함되며, 높은 momentum의 teacher보다 성능이 낮다.
- 저자들은 느린 EMA 업데이트가 student의 개선을 따라가면서 변동하는 정렬 타깃을 평활화한다고 설명한다. 이는 관찰된 곡선에 대한 해석이다.
학습 전략 곡선에서 on-policy distillation은 제시된 대안보다 높은 이미지 품질을 유지하면서 DINO 유사도를 더 빠르게 높인다. Teacher 곡선에서는 student 복사본을 직접 사용할 때 학습이 붕괴하고, EMA momentum 0.9에서는 성능이 더 낮으며, 고정 teacher 또는 EMA momentum 0.9999에서는 안정적으로 개선된다. 따라서 이 LoRA 실험에서는 teacher 업데이트 동역학이 중요하다.
4 Discussion on Limitations and Future Works
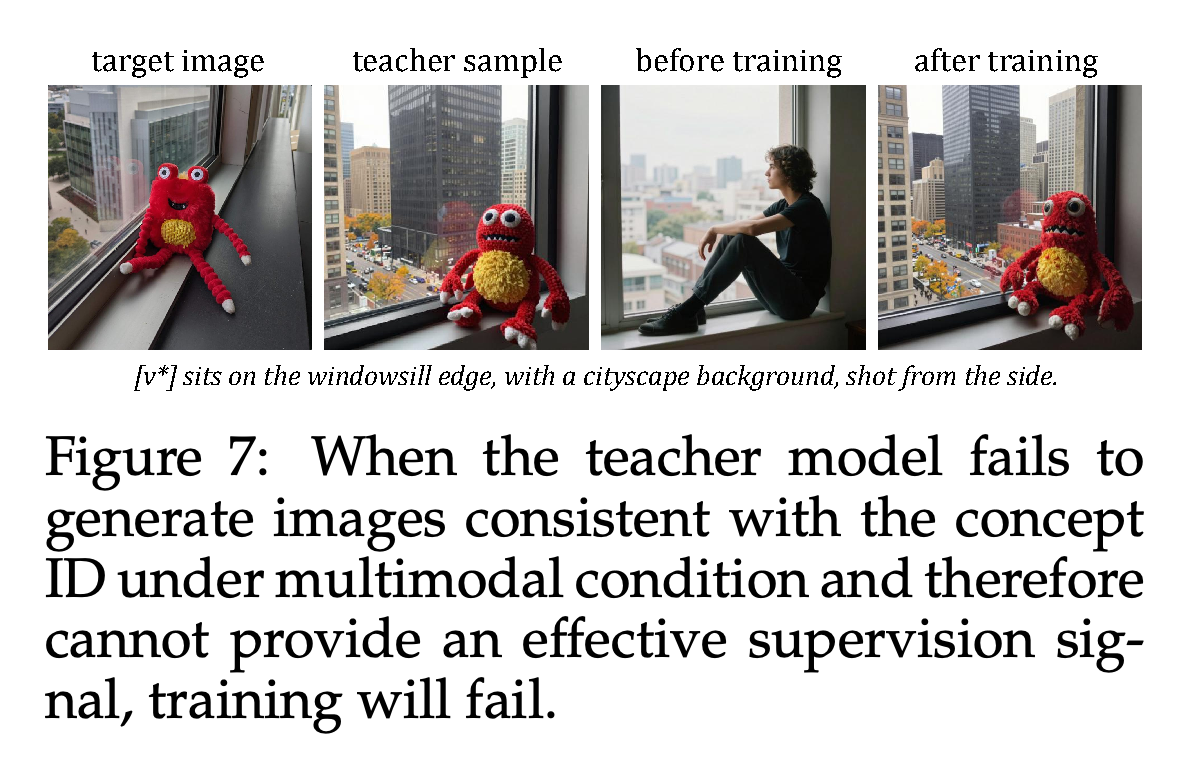
D-OPSD는 student rollout과 teacher 추론이 필요하므로, Vanilla SFT보다 학습 반복당 FLOPs가 약 4배이고 학습 시간은 약 2배다. 또한 멀티모달 조건을 받은 teacher가 타깃에 특화된 유용한 학습 신호를 제공해야 성공할 수 있다.
- Figure 7에서는 teacher가 참조 장난감의 고유한 외형을 정확히 포착하지 못한다. 학습 후 student는 teacher의 잘못된 외형을 따른다.
- 보고된 자원 효율성의 이점은 별도의 re-distillation 단계를 피한다는 뜻이며, 개별 학습 반복이 SFT보다 저렴하다는 뜻은 아니다.
멀티모달 teacher가 참조 장난감의 외형을 바꾸며, 적응된 student도 이 불일치를 이어받는다. 이 예시는 teacher가 부정확한 개념 학습 신호를 제공하면 student가 생성한 상태에서 정렬하더라도 참조 대상의 고유한 외형을 복원할 수 없음을 보여준다.
향후 연구 방향으로는 이미지 편집이나 비디오 생성 모델을 통한 더 풍부한 teacher 조건 정보, 추가 학습 제약, multi-expert on-policy distillation을 제안한다. 이는 연구 제안이며, 보고된 실험에서 입증한 능력은 아니다.
5 Related Work
논문은 step distillation과 on-policy self-distillation을 연결한다. 기존 step-distillation 방법은 궤적을 압축하거나 분포를 맞춰 추론을 가속한다. 언어 모델 OPSD는 더 풍부한 맥락을 사용해 현재 정책의 샘플에 대한 학습 신호를 자체적으로 생성한다.
- D-OPSD는 이미 distillation된 이미지 생성 모델을 적응시키며, 다단계 모델을 처음 압축하는 절차를 제안하는 것은 아니다.
- Diffusion에 맞춘 구성에서는 이산 토큰 분포 정렬을 student가 생성한 상태에서 수행하는 조건부 속도 정렬로 대체한다.
6 Conclusion
보고된 결과는 외부 보상 설계나 별도의 re-distillation 단계 없이, 멀티모달 맥락을 이용한 self-distillation으로 평가 대상 few-step diffusion 모델을 단일 단계에서 지도 학습으로 적응시킬 수 있음을 뒷받침한다. D-OPSD는 비교한 SFT와 PSO 베이스라인보다 few-step 이미지 품질과 일반 벤치마크 성능을 더 잘 유지하지만, 일반 능력 손실과 teacher에 따른 실패는 여전히 나타난다.
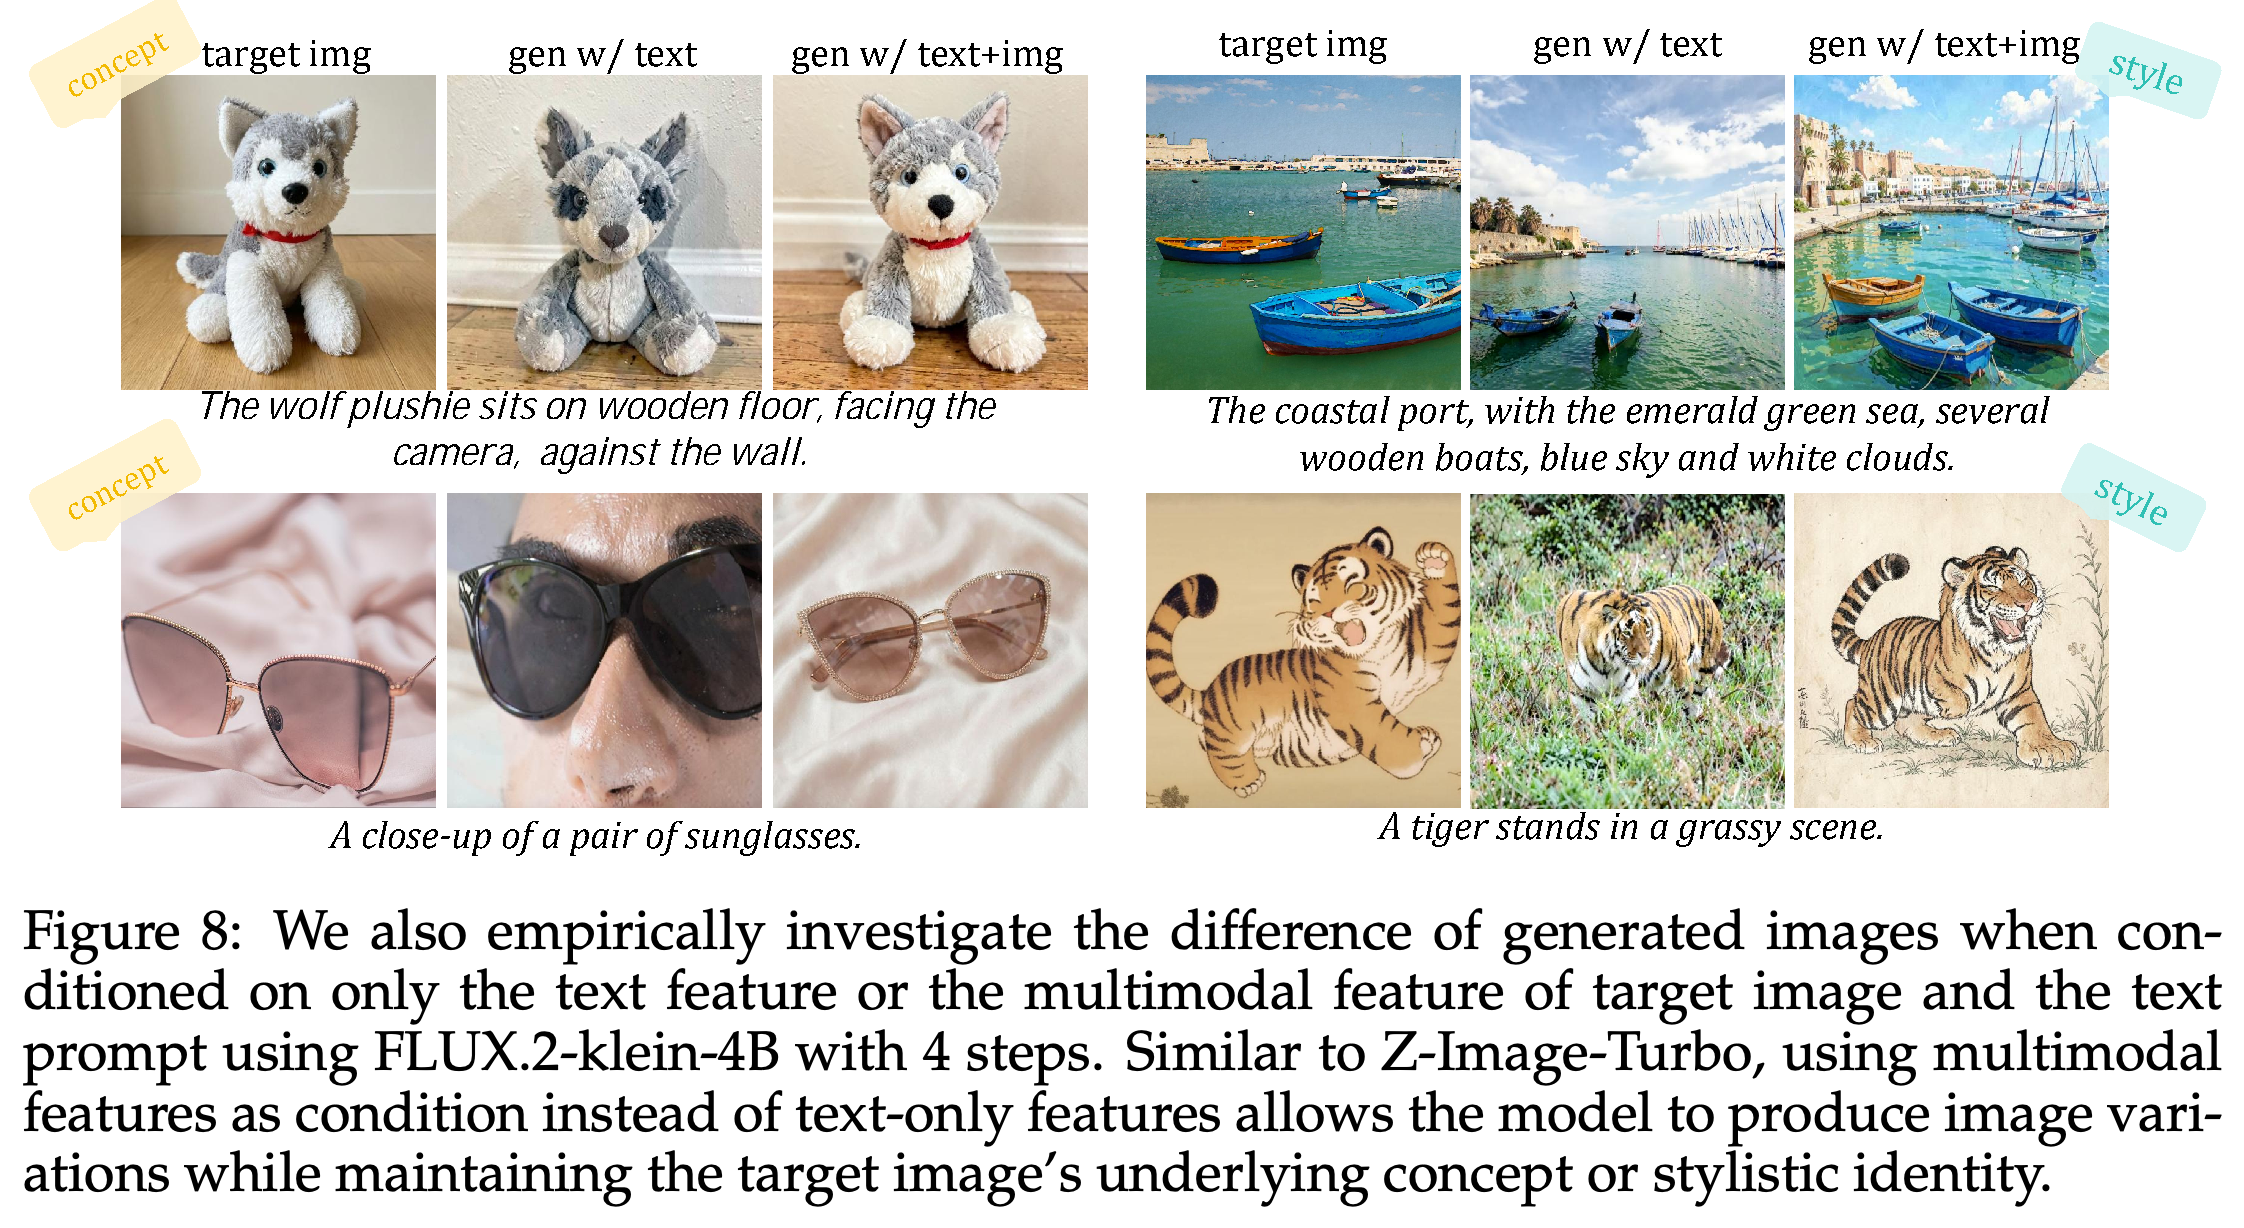
FLUX.2-klein에서도 Z-Image-Turbo에 D-OPSD를 적용하는 근거가 된 정성적 조건부 생성 특성이 나타난다. 선택된 예시에서 이미지–텍스트 특징은 텍스트 전용 특징보다 특정 대상의 외형과 참조 스타일을 더 잘 유지한다. 이는 평가한 2번째 모델로 관찰 범위를 확장한 결과이며, 모든 LLM/VLM 조건부 생성 모델에 해당하는 것은 아니다.
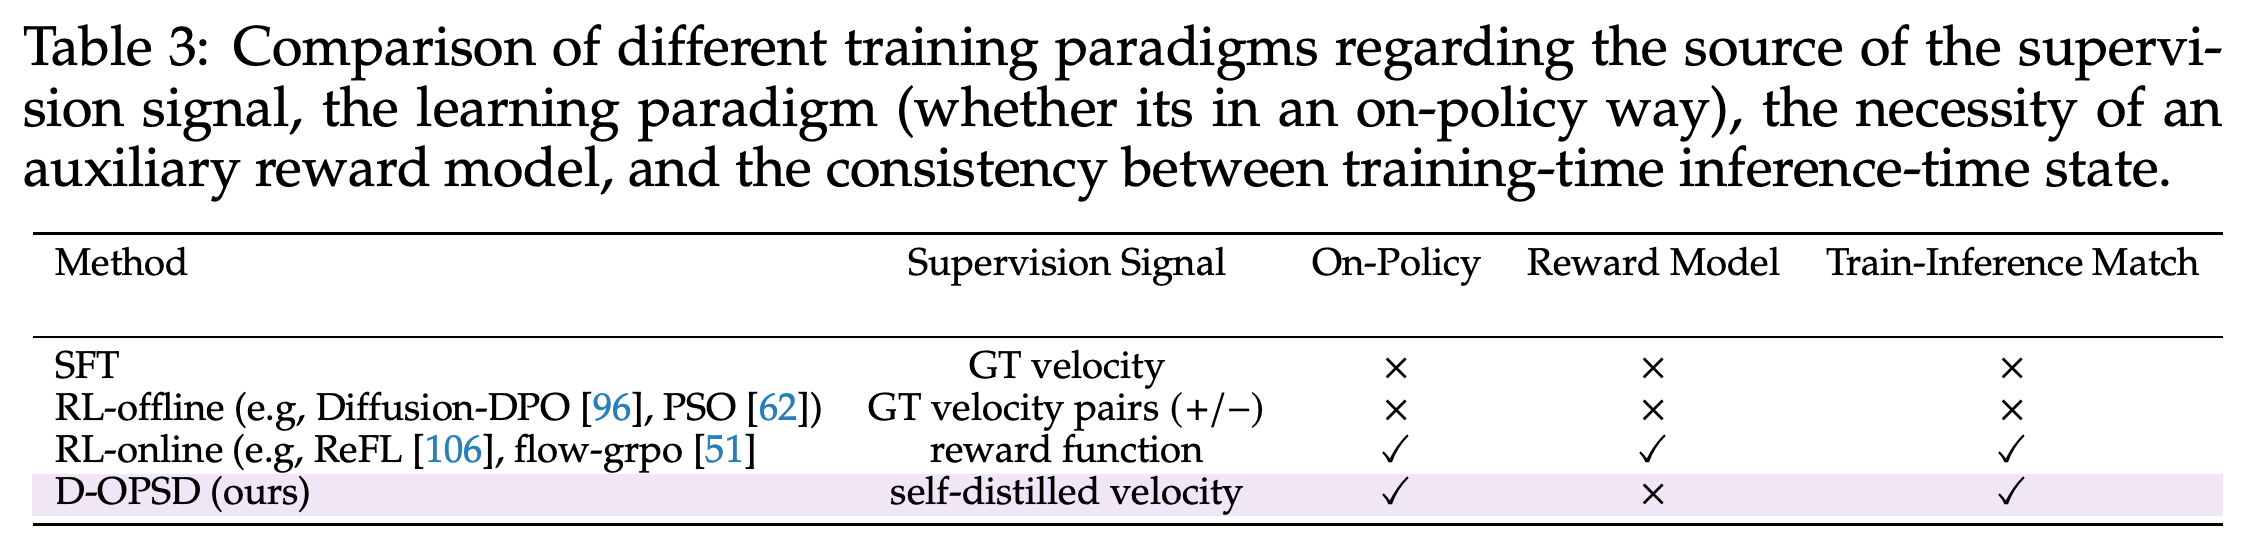
D-OPSD와 나열된 online RL 방식은 on-policy이며 학습과 추론이 일관적인 것으로 표시된다. 하지만 이 선택지 중 보상이 필요하지 않은 방식은 D-OPSD뿐이다. SFT와 나열된 offline preference 방법은 타깃 이미지와 관련된 상태에서 정답 속도 학습 신호를 사용한다. 표의 항목은 정량적 성능이 아니라 각 방식의 구성을 설명한다.
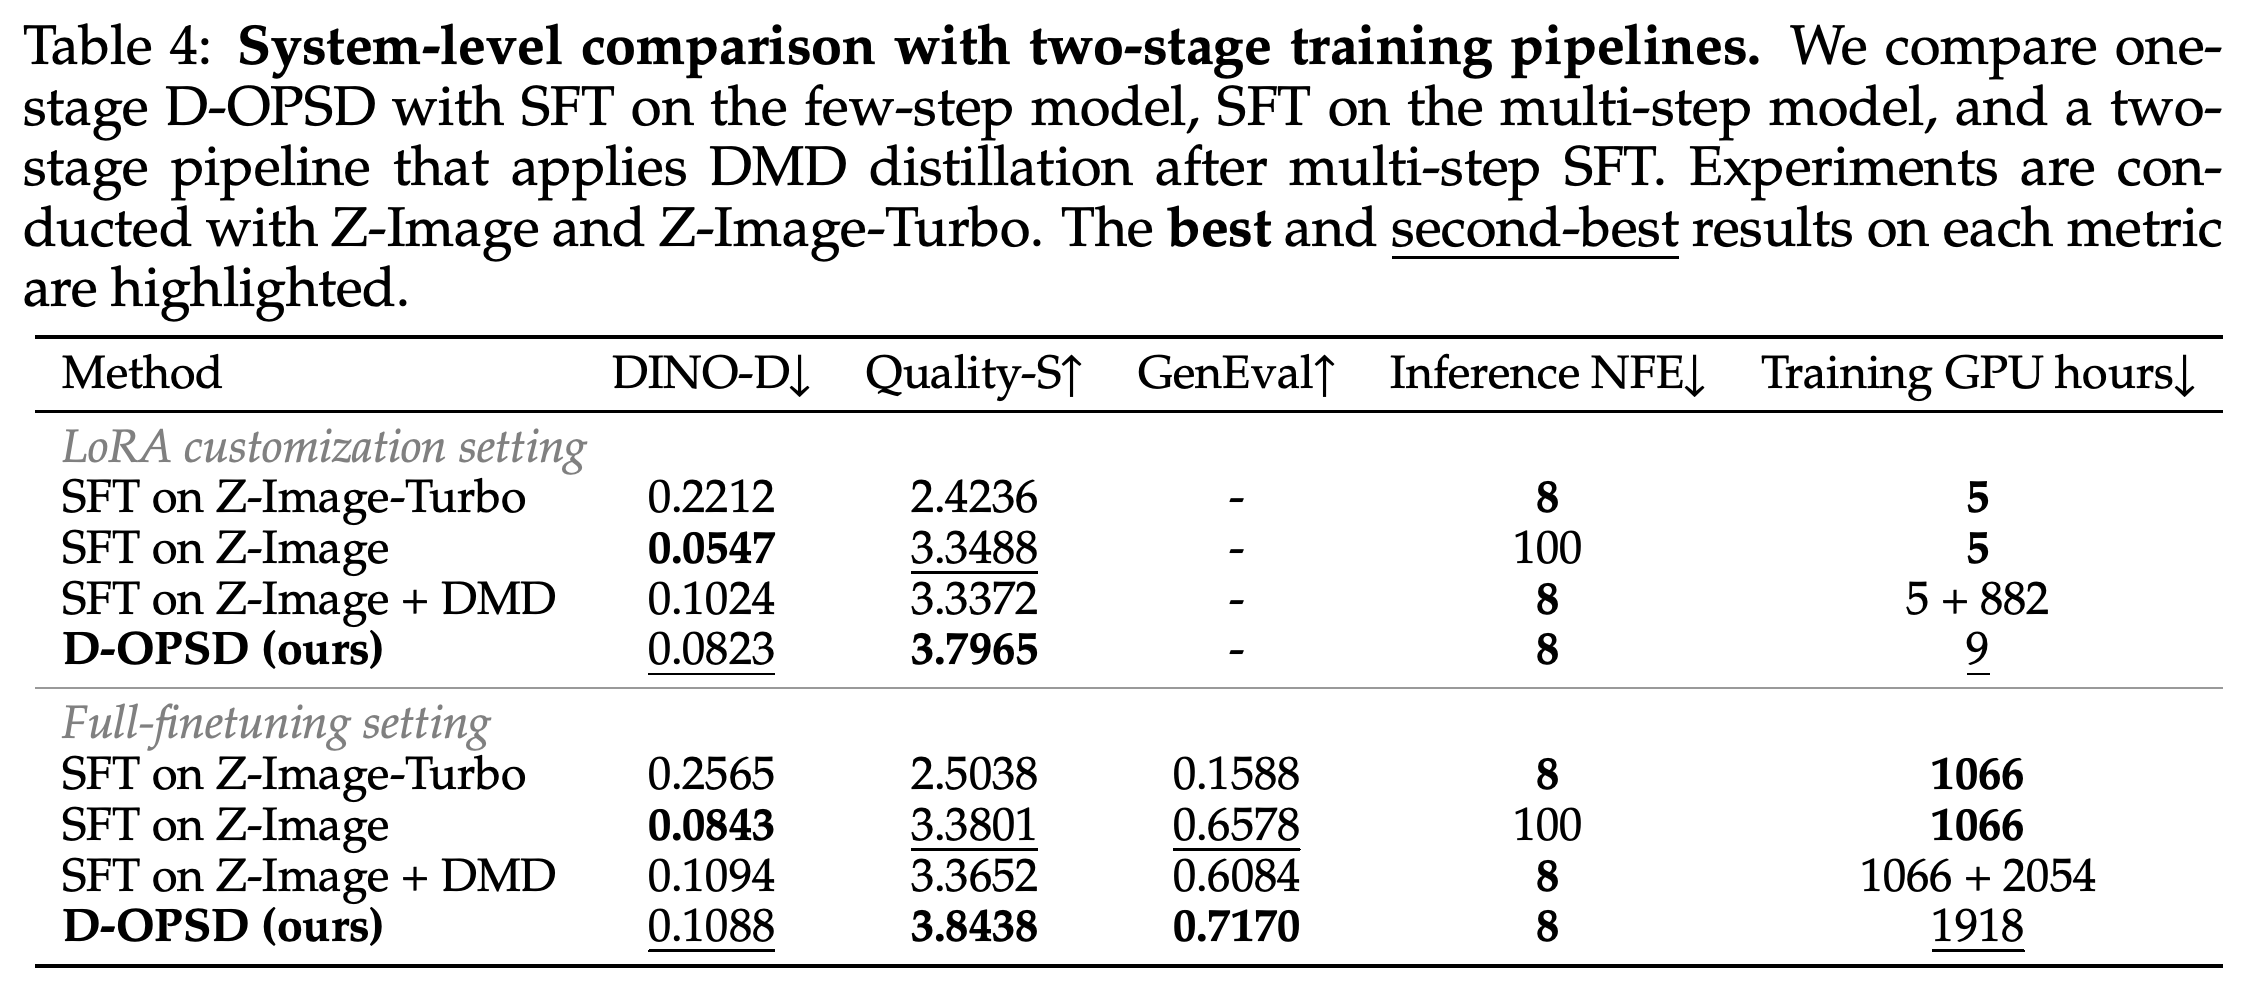
다단계 SFT는 DINO-D가 가장 낮지만, 추론에 100 NFEs가 필요하다. DMD는 상당한 GPU-hour 추가 비용으로 8-NFE 예산을 복원한다. 반면 D-OPSD는 8 NFEs를 유지하면서 비교한 2단계 파이프라인보다 Quality-S가 높고, 전체 미세 조정에서는 GenEval도 높다. 이 결과는 사용한 오픈소스 DMD 구현에 한정된다. 일부 전체 미세 조정 SFT 항목은 Table 2의 Z-Image-Turbo 항목과도 다르다.
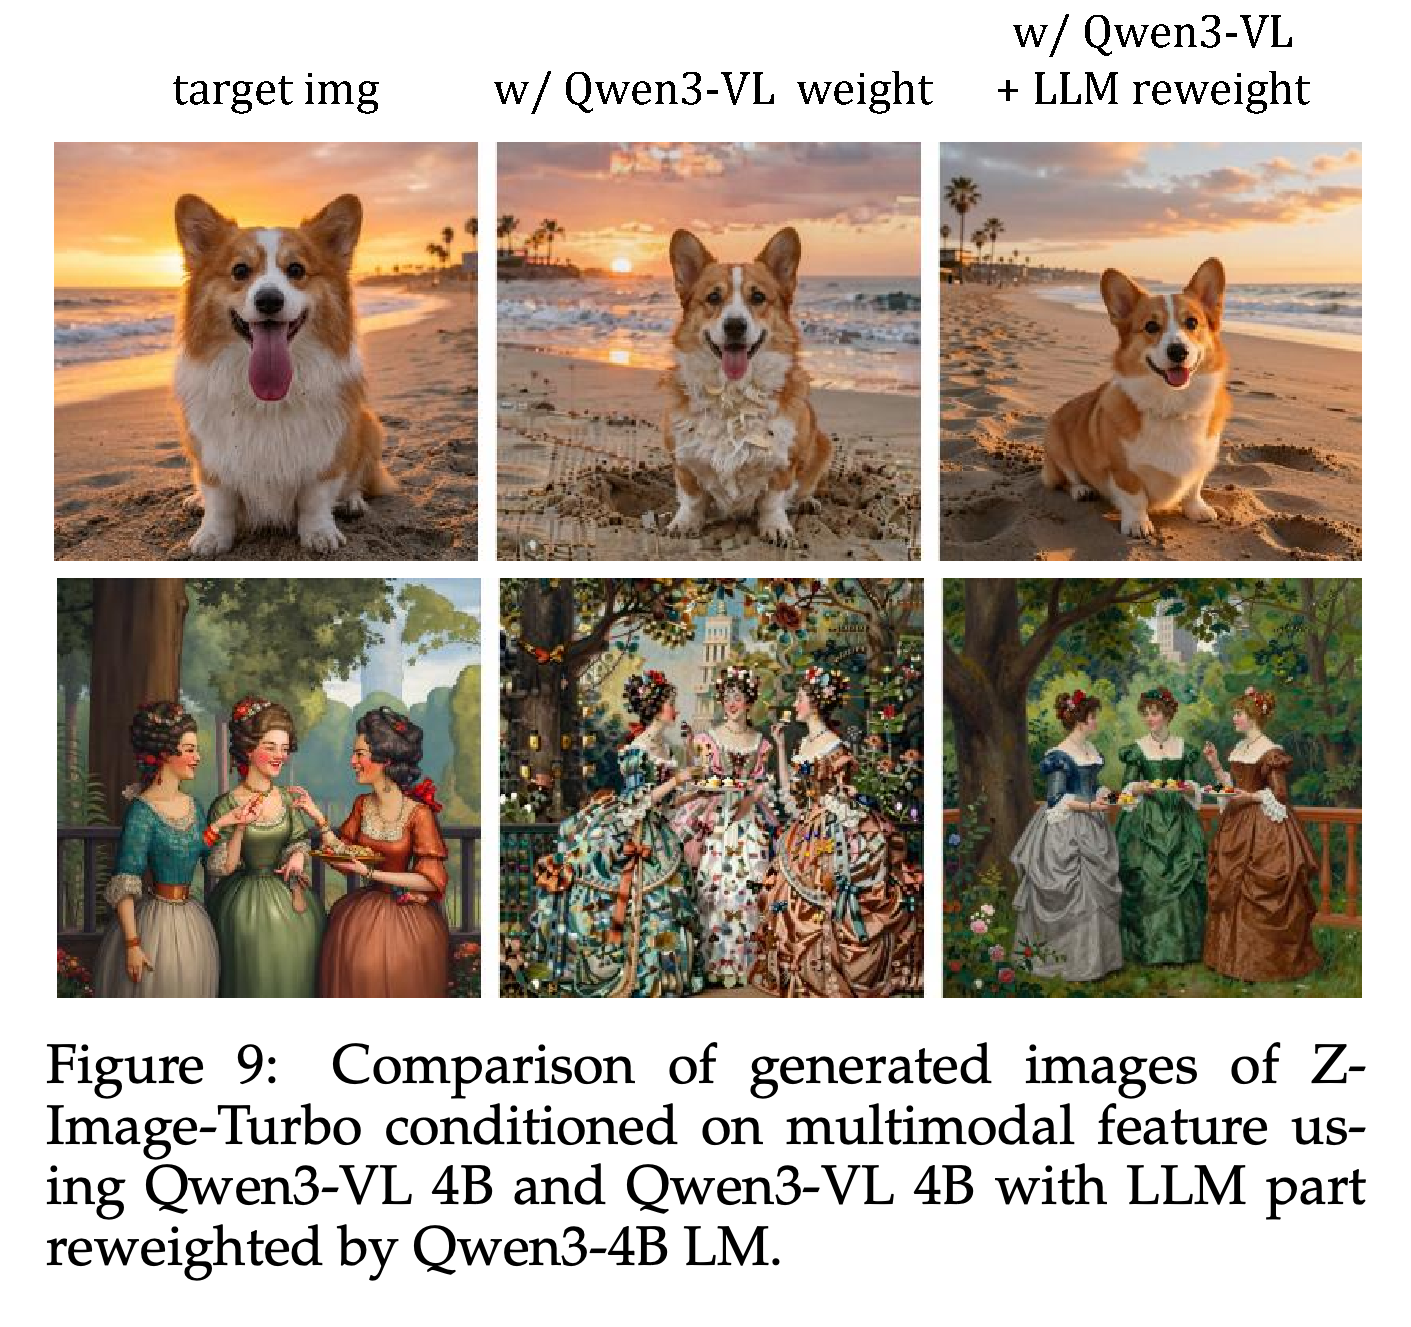
Qwen3-VL 조건을 직접 사용하면 개와 그림 예시에서 과도한 세부 묘사와 눈에 띄는 아티팩트가 발생한다. 언어 모델 가중치를 Qwen3-4B 가중치로 대체하면 이미지 조건부 생성을 유지하면서 이러한 현상이 줄어든다. 이는 teacher 인코더에 적용한 특징 호환성 조정을 보여준다.
부록
- A Investigation of FLUX.2-klein: Figure 8은 FLUX.2-klein-4B를 4 steps로 사용해 텍스트 전용 조건과 이미지–텍스트 조건을 다시 비교한다. 참조 이미지를 조건으로 받은 생성 결과는 대상의 외형이나 스타일의 일부 특성을 유지한다. 이는 Z-Image-Turbo를 넘어 같은 정성적 특성을 관찰한 결과이지만, 모든 인코더 구조에서 보편적으로 성립함을 입증하지는 않는다.
- B Discussion and Comparison of Different Training Paradigms: Table 3은 학습 신호의 출처, on-policy 학습 여부, 보상 필요 여부, 학습과 추론의 일관성을 구분한다. D-OPSD는 현재 student 상태에서 self-distillation으로 얻은 속도를 사용한다. 비교한 online RL 방법도 현재 정책의 샘플을 사용하지만 보상이 필요하다. 반면 SFT와 논의한 offline preference 방법은 타깃 이미지에서 유도된 상태와 정답 속도 학습 신호를 사용한다.
- C Comparison with Two-stage Training Pipeline: Table 4는 직접 적응과, Z-Image SFT 후 오픈소스 DMD로 다시 8 NFEs로 distillation하는 방식을 비교한다. LoRA 맞춤화에서 D-OPSD와 SFT + DMD의 학습 비용은 각각 9와 5 + 882 H800 GPU hours이며, Quality-S는 각각 3.7965와 3.3372다. 전체 미세 조정에서는 학습 비용이 각각 1918과 1066 + 2054 GPU hours이며, Quality-S는 각각 3.8438과 3.3652다. 이 비교는 공개되지 않은 원래 foundation model의 distillation 절차를 재현하지 않는다.
- D Implementation Details.: 양쪽 student 모두 Qwen3-4B 텍스트 인코딩을 유지한다. 멀티모달 teacher 인코딩에 Qwen3-VL-4B를 그대로 사용하면 고주파 아티팩트와 과도한 샤프닝이 발생한다. 따라서 구현에서는 Figure 9와 같이 ViT와 Connector 가중치는 유지하고 LLM 구성 요소의 가중치를 Qwen3-4B 가중치로 대체한다.
- LoRA training on small customized dataset: 기본 모델 2개 모두 rank 64, alpha 128, 전체 배치 크기 4, EMA momentum 0.9999를 사용하며, 단일 H800 GPU에서 1K iterations 동안 학습한다. 학습률은 Z-Image-Turbo가 4e-5, FLUX.2-klein이 1e-5다. Backbone 가중치를 공유하면서 LoRA 가중치에 EMA를 적용한다.
- Full finetuning on larger scale dataset: 전체 배치 크기 256과 EMA momentum 0.9999를 사용해 diffusion-transformer backbone의 모든 파라미터를 업데이트한다. 기본 모델 2개 모두 32 H800 GPUs에서 10K iterations 동안 학습하며, 학습률은 Z-Image-Turbo가 3e-5, FLUX.2-klein이 8e-6이다.
- E More Details of Evaluation: LoRA의 타깃 유사도 지표에는 캡션을 바꿔 표현한 프롬프트를 사용한다. 개념·스타일 일반화에는 새로운 프롬프트 4개 그룹과 1부터 4까지의 VLM-J 척도를 사용한다. 전체 미세 조정 이미지 지표에는 학습 데이터에서 샘플링한 예시 2K개를 사용한다. 품질과 미적 완성도 평가기는 학습 중 최적화하지 않는 내부 VLM 기반 보상 모델이다. 사용자 연구는 2가지 적응 설정의 프롬프트 100개에 걸쳐 선호 비율을 집계한다.
- F More Related Works: 부록은 text-to-image diffusion, knowledge distillation과 self-distillation, DreamBooth, textual inversion, LoRA를 비롯한 적응 기법을 검토한다. 다단계 모델용으로 개발된 표준 적응 방법은 이미 distillation된 생성 모델의 원래 few-step 동작을 유지하는 데 명시적으로 초점을 두지 않는다는 점에서 D-OPSD와 구별된다.
짧은 생각
고정된 추론 예산에서의 비교와 학습 전략 ablation 실험이 이 방법을 가장 명확하게 뒷받침한다. 품질 개선은 단순히 대체 학습 타깃을 생성하는 것이 아니라, student가 생성한 상태에서 distillation을 수행하는 것과 관련된다. LoRA 결과는 참조 이미지 매칭과 새로운 장면의 지시 수행도 구분한다. PSO는 일부 유사도 지표에서 앞서지만 CLIP-S는 더 낮다.
이 근거를 continual learning의 일반적인 해결책으로 보기에는 범위가 좁다. 실험은 개별 맞춤화와 애니메이션 도메인 적응을 다루며, 연속된 과제들을 차례로 학습하는 설정은 다루지 않는다. 비공개 학습 데이터와 품질 평가기, 학습 데이터 기반 도메인 지표, 불확실성 추정의 부재, teacher 실패 사례는 재현성과 지식 유지에 관한 폭넓은 주장을 제한한다.