


A ConvNet for the 2020s 요약 설명
10 Jan 2022 | Paper Review CNN Model Architecture Image Classification목차
이번 글에서는 A ConvNet for the 2020s 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 1월 10일(Arxiv)
- Liu, Zhuang, Mao, Hanzi, Wu, Chao-Yuan, Feichtenhofer, Christoph, Darrell, Trevor, Xie, Saining.
- Facebook AI Research (FAIR), UC Berkeley
- 논문 2판 (2022년 3월 2일 개정, 이 글은 개정판을 기준으로 작성했다)
요약
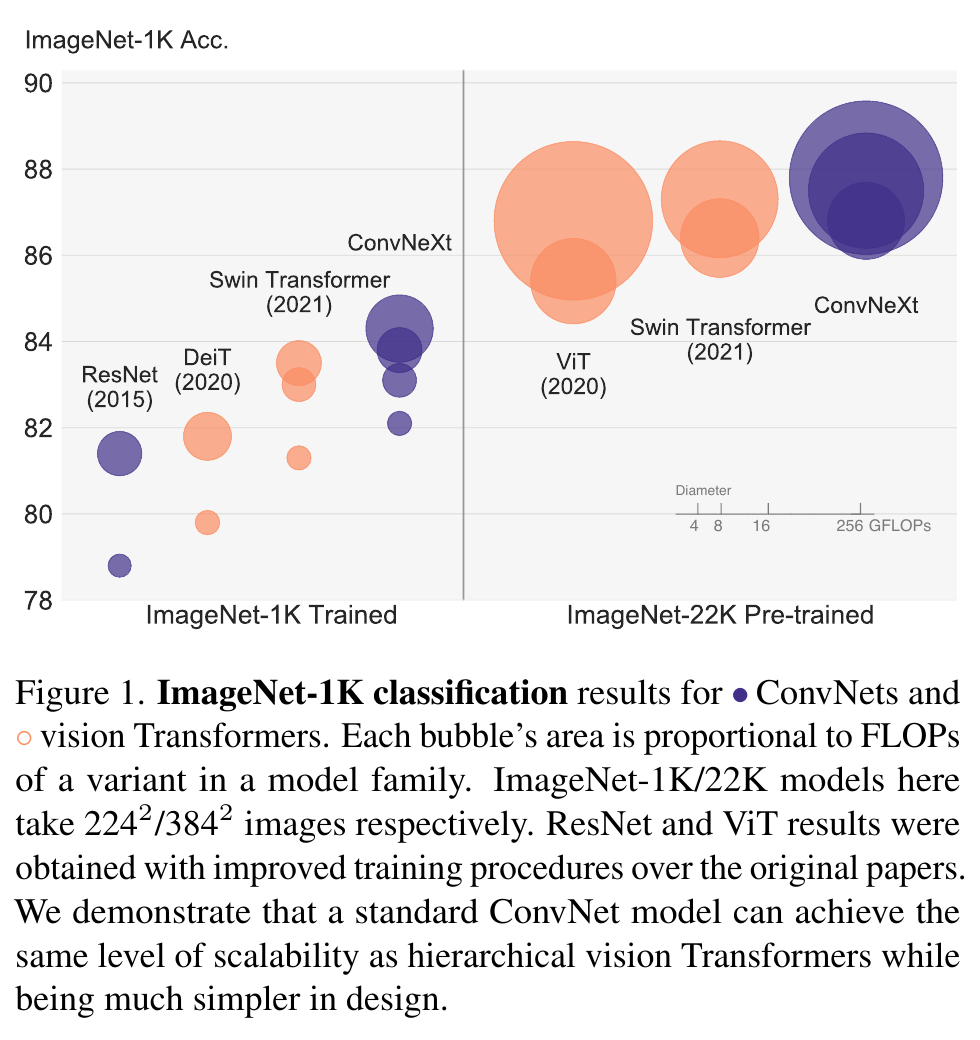
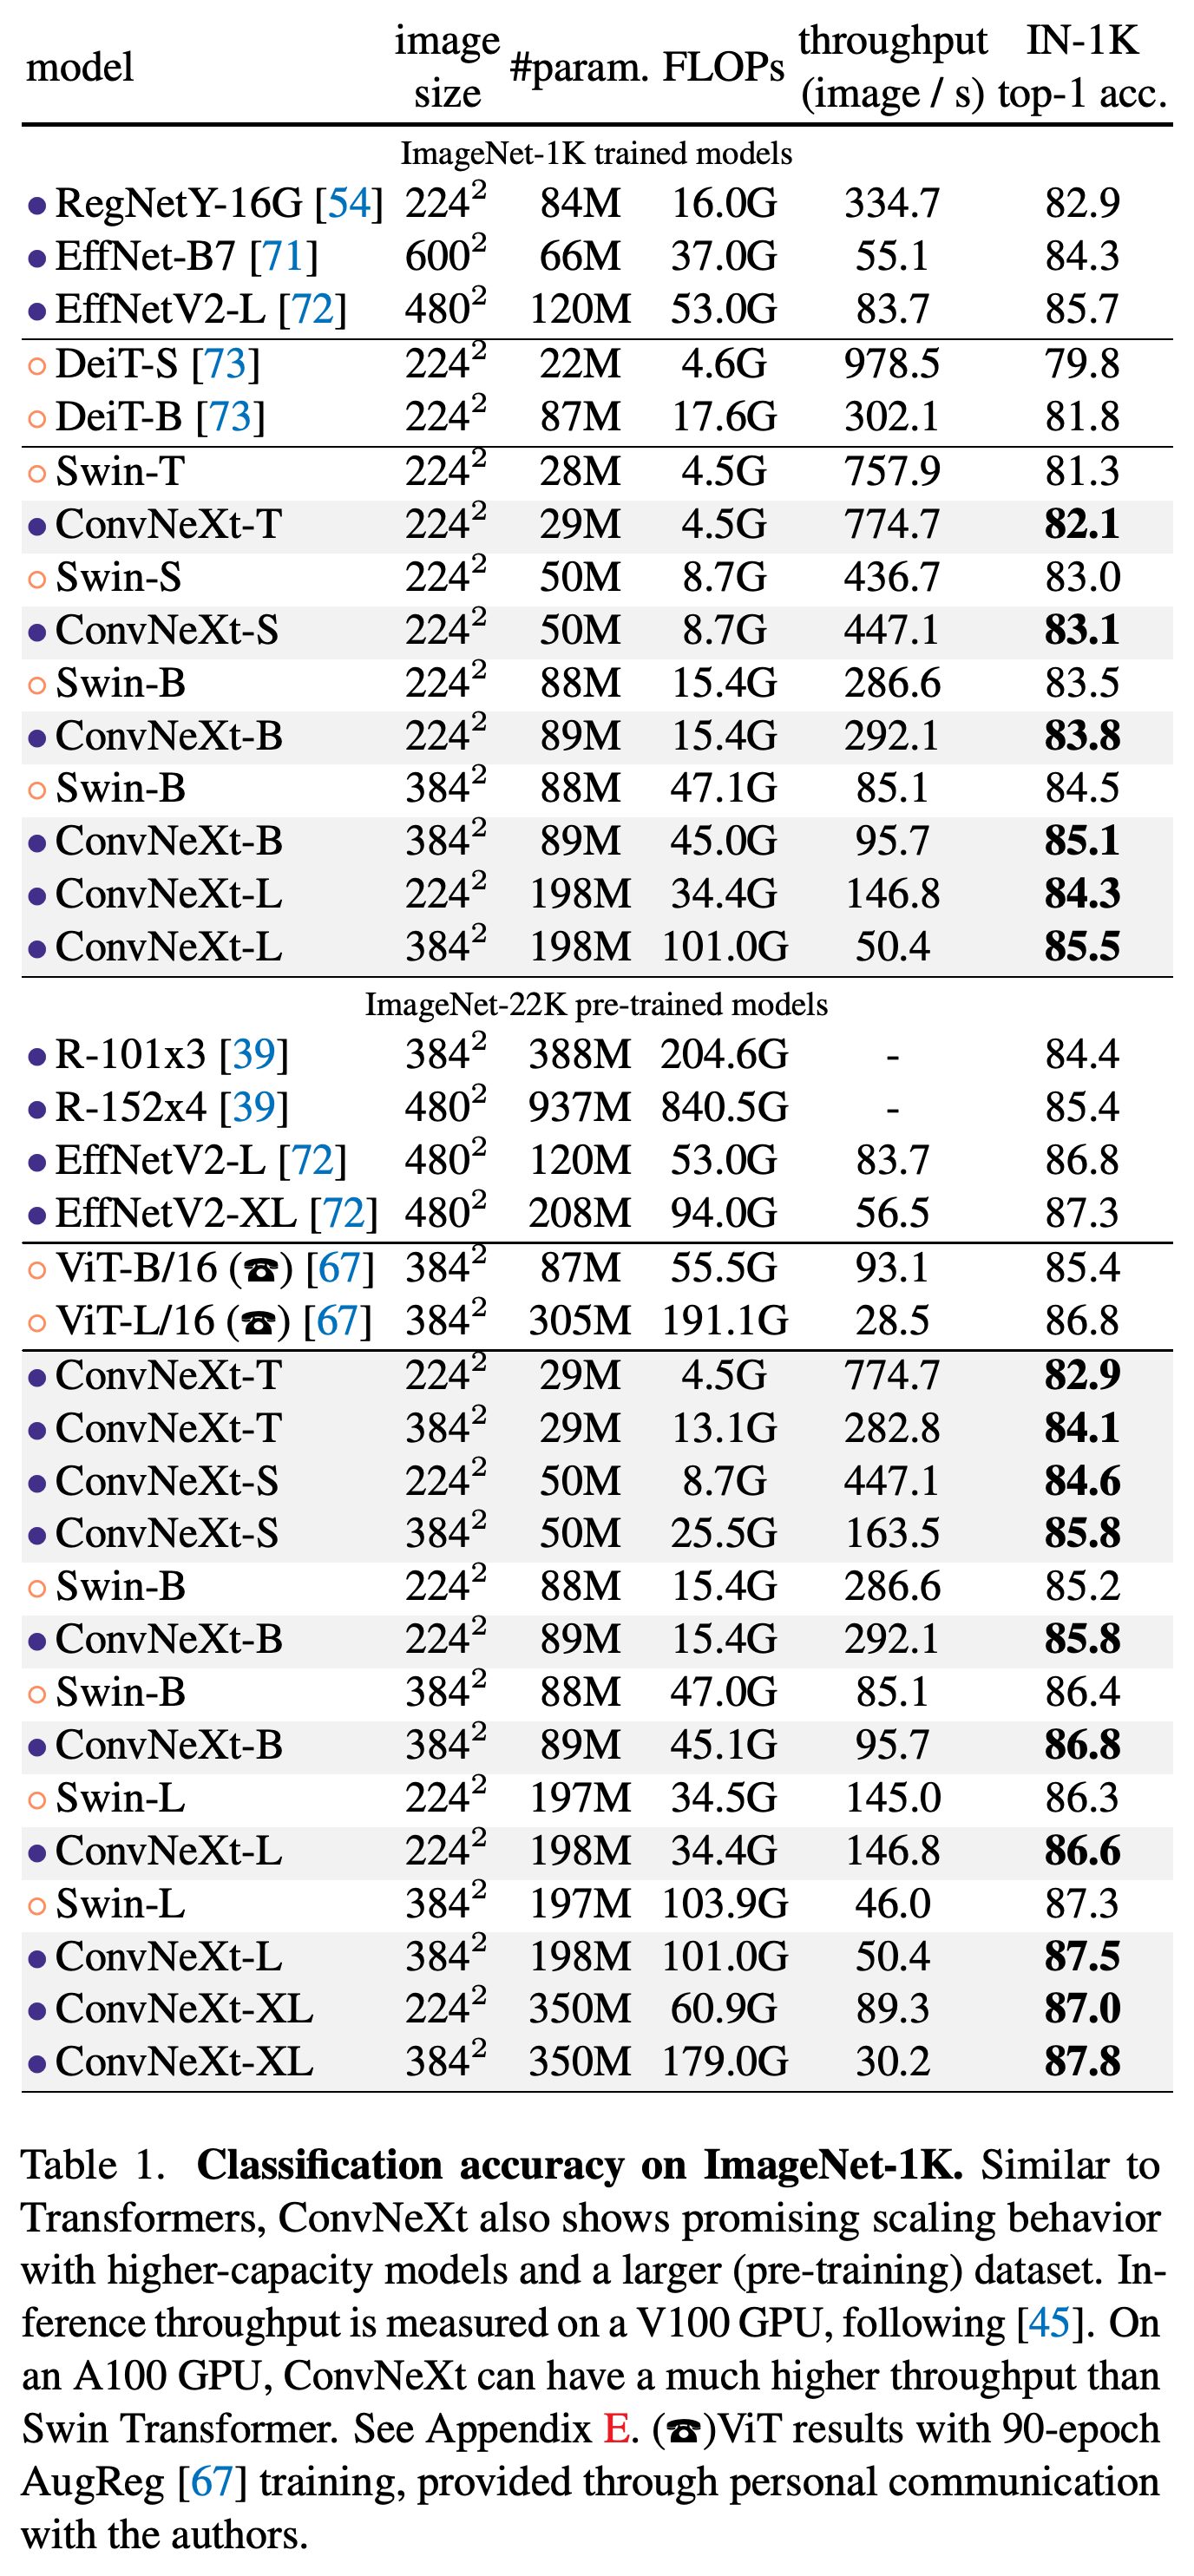
- 이 논문은 학습된 지역 필터로 이미지를 처리하는 convolutional neural networks(ConvNets)를 현대화하여 시각 인식에서 vision Transformer와 대등한 성능을 낼 수 있는지 살펴본다. ImageNet-1K로 학습한 ConvNeXt-B는 384×384 해상도에서 top-1 정확도 85.1%를 기록해 비슷한 크기의 Swin-B가 기록한 84.5%를 넘었다. V100 GPU에서 처리 속도는 각각 초당 이미지 95.7개와 85.1개다.
- 저자들은 ResNet의 학습 방식과 아키텍처를 단계적으로 바꾸어 ConvNeXt를 만들었다. ConvNeXt는 attention 없이 채널별 공간 convolution, 더 큰 필터, 단순화한 블록을 사용한다. ImageNet-22K로 사전 학습한 ConvNeXt-XL은 ImageNet-1K에서 top-1 정확도 87.8%를 기록했으며, ConvNeXt는 논문에서 보고한 COCO와 ADE20K 평가에서도 비교 대상인 Swin 모델과 대등하거나 더 좋은 성능을 보였다. ResNet에 대해서는 CNN 기본 모델(ImageNet Challenge - AlexNet, ZFNet, VGG, GoogLeNet, ResNet, InceptionNet) 글을 참조하라.
1. Introduction
Vision Transformer는 attention으로 이미지 패치를 처리하지만, 고해상도에서는 전역 attention의 비용이 커진다. 이 논문은 학습 방식과 아키텍처의 차이가 지역 윈도와 여러 특징 맵 해상도를 사용하는 Swin 같은 계층형 Transformer와의 비교에 영향을 주는지 살펴본다.
그래프에 표시된 연산량 범위에서 ConvNeXt 계열은 계층형 Transformer와 비슷한 정확도에 도달한다. 원의 면적은 FLOPs를 나타내며, 그림의 2개 영역은 사전 학습과 이미지 해상도 조건이 서로 다르다.
2. Modernizing a ConvNet: a Roadmap
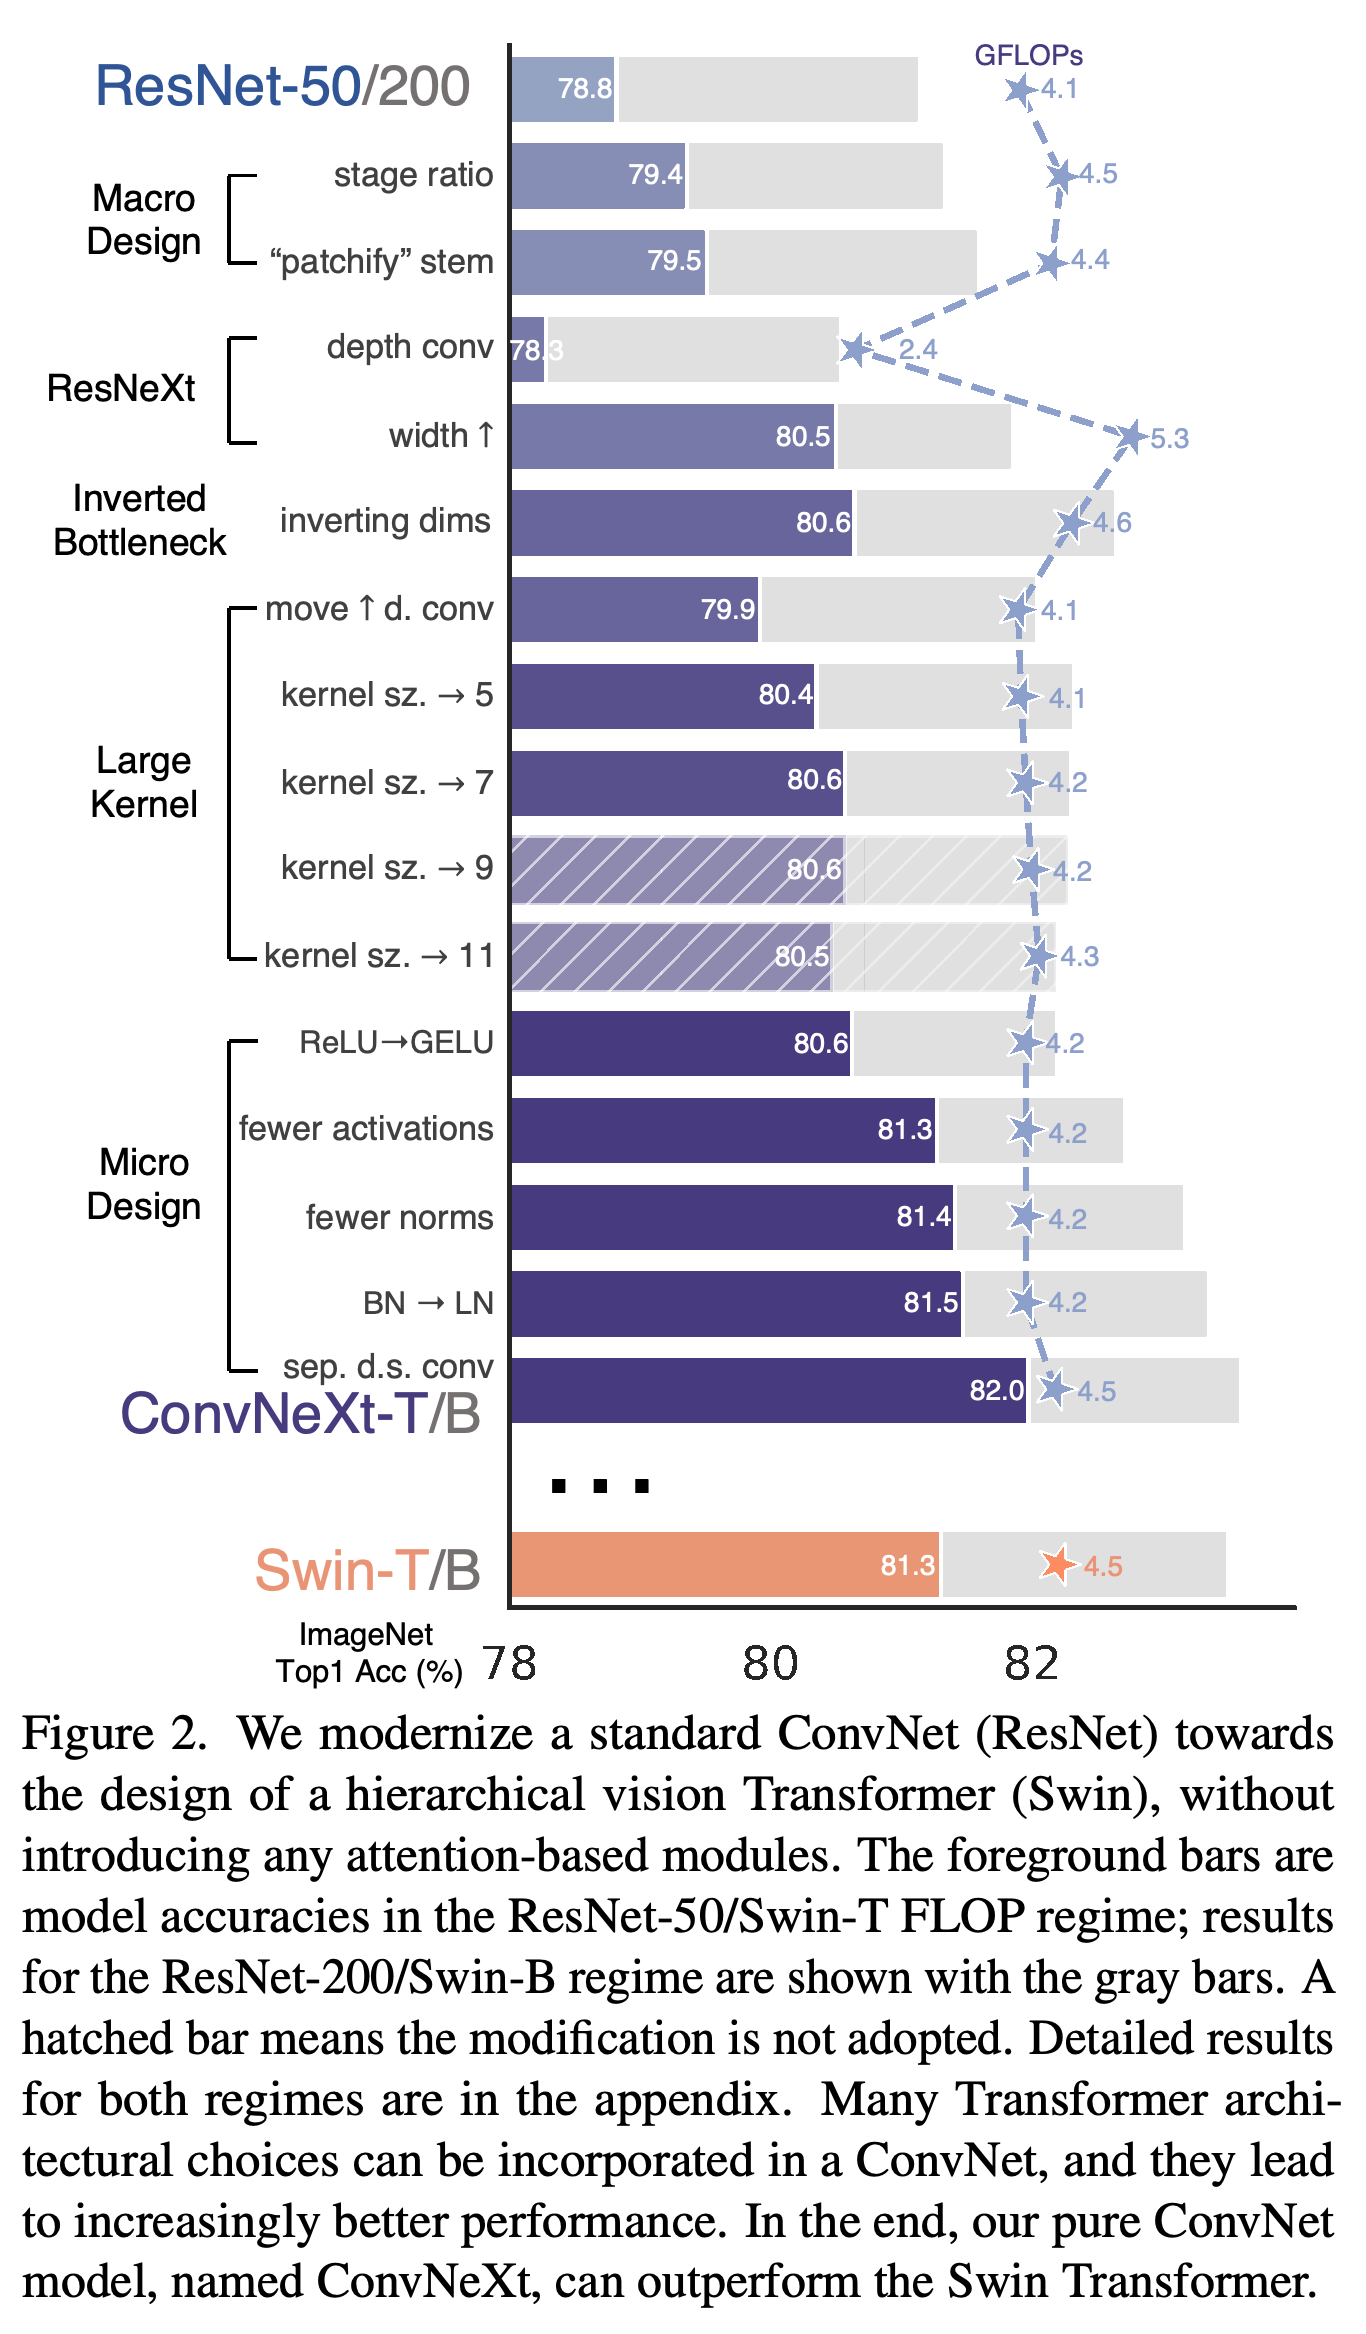
현대화 과정은 각각 약 4.5G와 15.0G의 부동소수점 연산량(FLOPs)을 사용하는 ResNet-50과 ResNet-200에서 시작한다. 저자들은 아키텍처를 단계적으로 변경하는 동안 학습 설정을 고정하고 연산량을 대략 비슷하게 유지했지만, 중간 모델들의 FLOPs에는 차이가 있다.
단계별 결과에는 성능 향상과 일시적인 성능 저하가 모두 나타난다. Depthwise convolution을 적용하고 이를 앞쪽으로 옮기면 정확도가 떨어지지만, 채널 수와 커널을 변경하면 정확도가 회복된다. 최종 모델은 이 비교에서 Swin-T를 앞선다.
2.1. Training Techniques
300 에포크 학습 방식에 AdamW 옵티마이저, 이미지 증강, 정규화 기법을 사용한다. 이를 통해 ResNet-50의 정확도는 76.1%에서 78.8%로 높아진다. 이후 ResNet-50-regime 결과는 세 무작위 시드에 대한 평균이다.
2.2. Macro Design
4개 stage의 블록 수를 (3, 4, 6, 3)에서 (3, 3, 9, 3)으로 바꾸면 정확도가 78.8%에서 79.4%로 높아진다. 네트워크의 초기 이미지 처리 계층인 stem을 겹치지 않는 4×4, stride-4 convolution으로 교체하면 정확도가 79.5%로 높아진다.
2.3. ResNeXt-ify
Depthwise convolution은 각 채널에 공간 필터를 별도로 적용하여 공간 혼합과 1×1 convolution이 수행하는 채널 혼합을 분리한다. 이 교체로 정확도와 연산량이 감소한 뒤 초기 채널 수를 64에서 96으로 늘리면 5.3G FLOPs에서 정확도 80.5%를 얻는다. Depthwise convolution에 대해서는 MobileNetV2 논문 설명(MobileNetsV2 - Inverted Residuals and Linear Bottlenecks 리뷰) 글을 참조하라.
2.4. Inverted Bottleneck
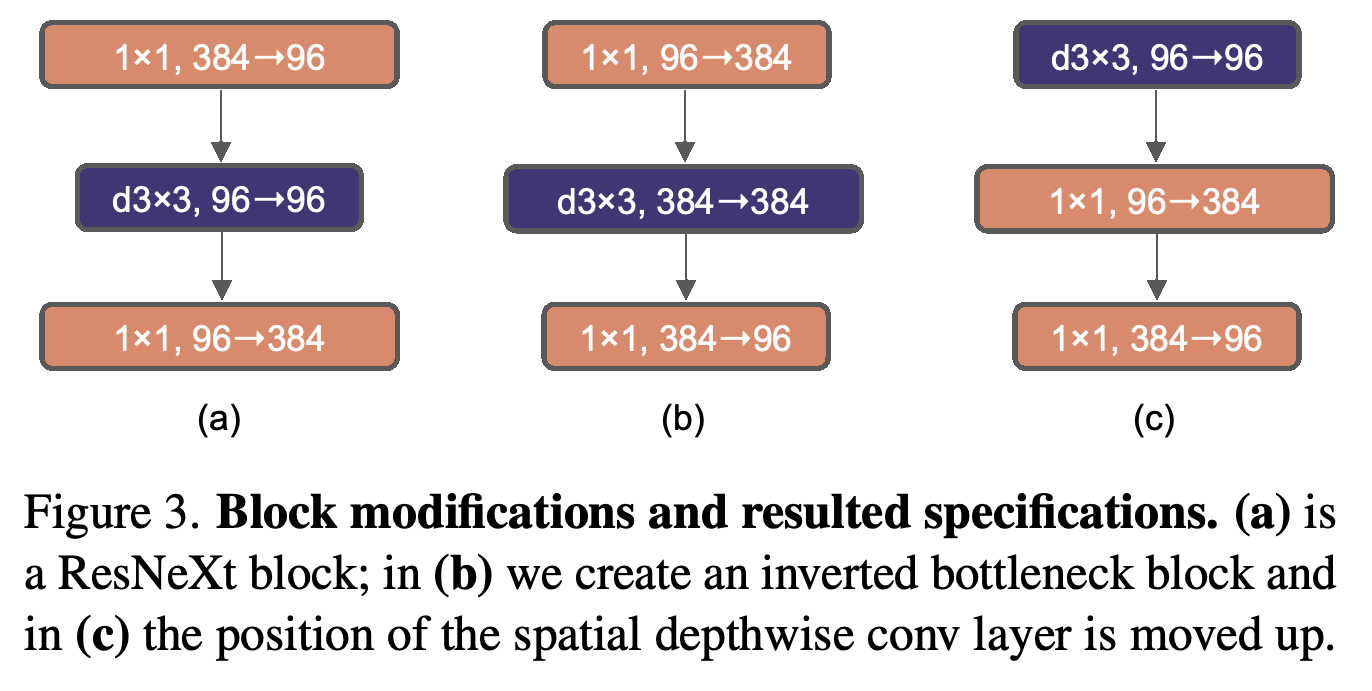
Inverted bottleneck은 블록의 은닉 채널 차원을 입력 차원의 4 times로 확장한 뒤 다시 축소한다. 이 변경으로 정확도는 80.5%에서 80.6%로 높아지고 전체 연산량은 4.6G FLOPs로 줄어든다. 더 큰 규모에서는 정확도가 81.9%에서 82.6%로 높아진다.
그림은 공간 convolution이 일반적인 bottleneck의 좁은 중간 부분에서 확장된 중간 부분으로 이동한 뒤, 다시 확장 단계 앞으로 이동하는 과정을 보여준다. 이로써 공간 연산이 적용되는 채널 수가 줄어든다.
2.5. Large Kernel Sizes
Depthwise convolution을 채널 확장 앞으로 옮기면 연산량은 줄지만 정확도가 일시적으로 79.9%까지 떨어진다. 공간 필터인 커널을 3×3에서 7×7로 키우면 FLOPs를 거의 유지하면서 정확도가 80.6%로 회복된다. 실험한 규모에서는 7×7보다 더 크게 늘려도 성능이 향상되지 않았다.
2.6. Micro Design
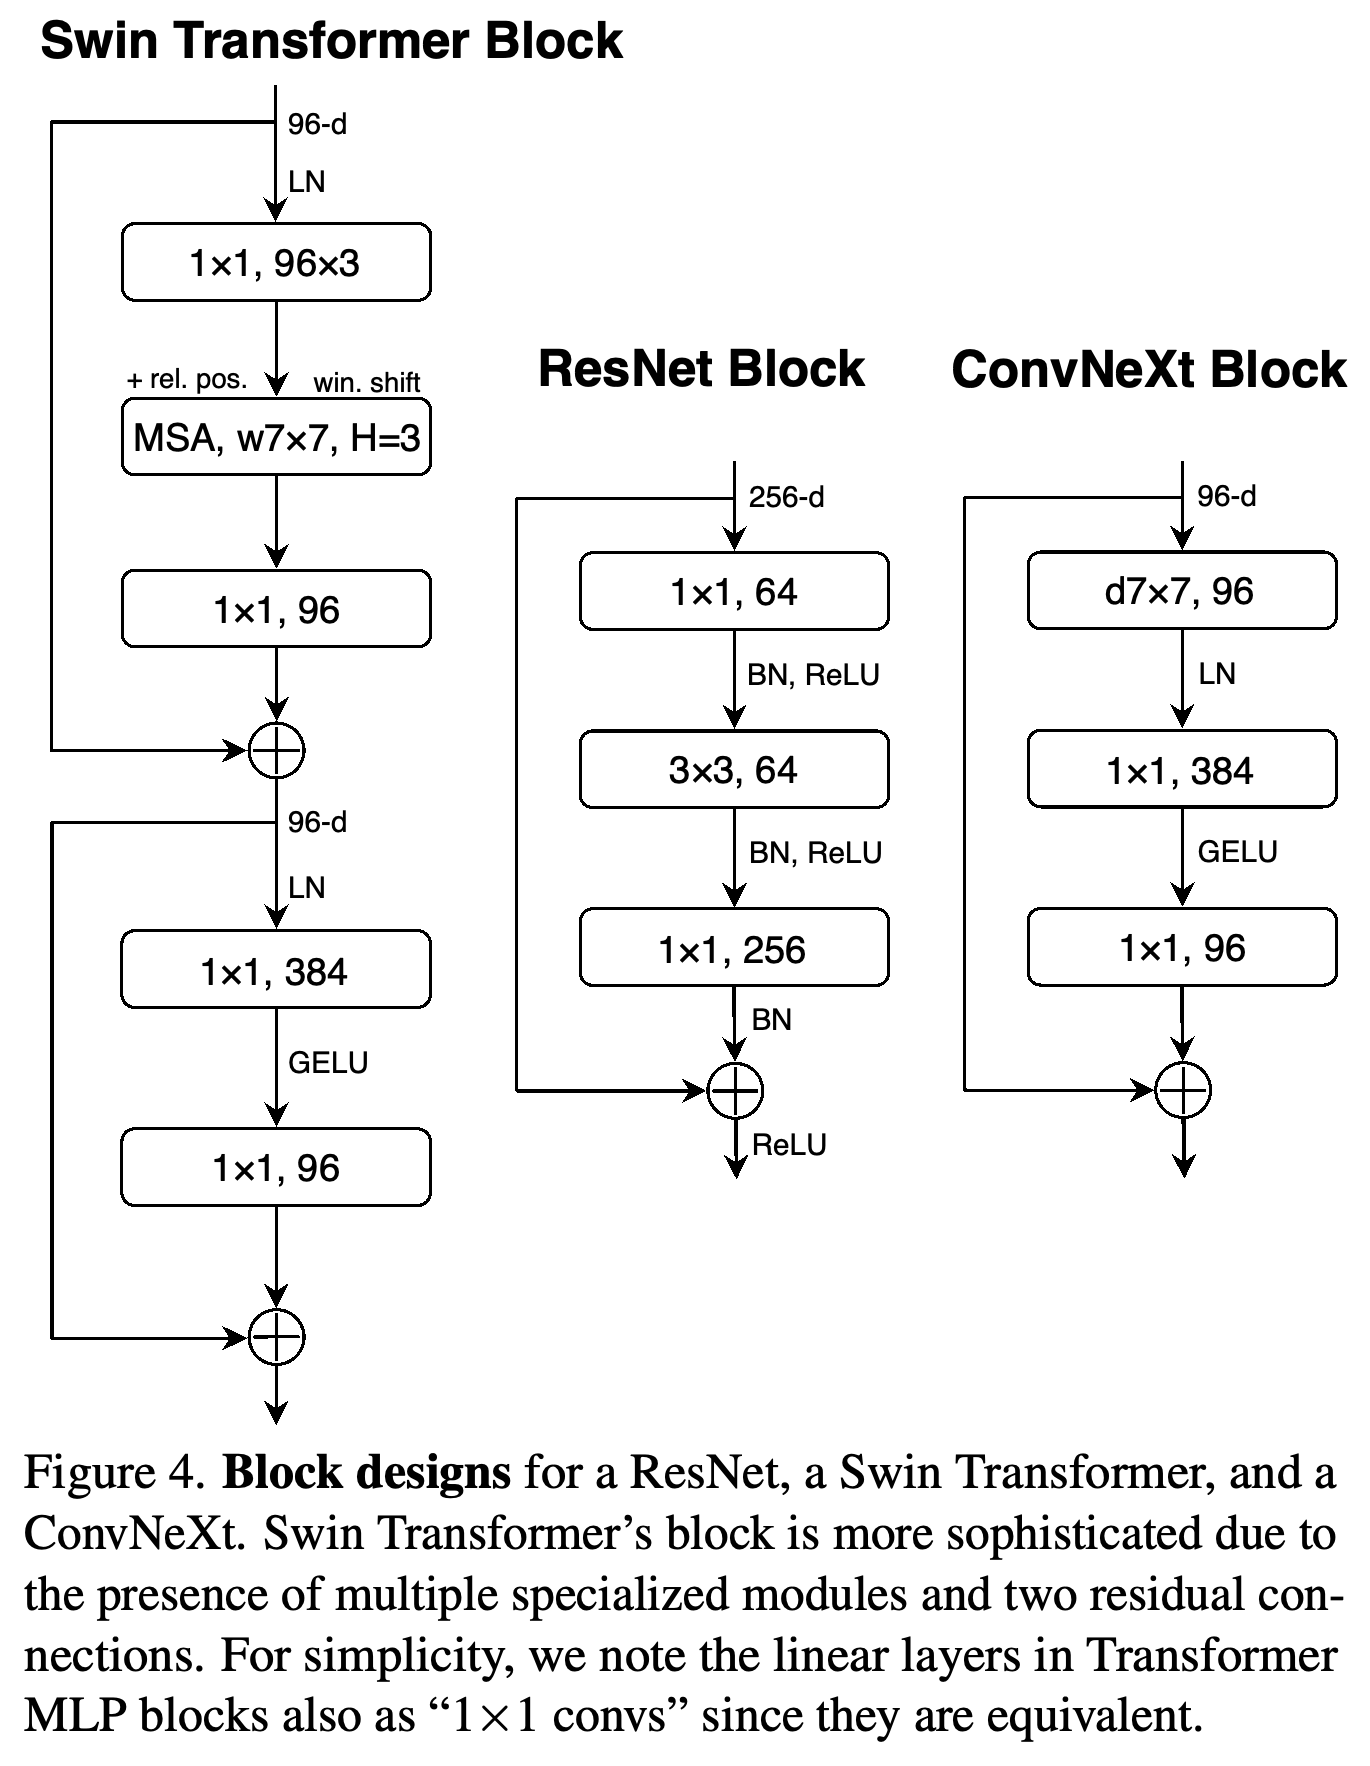
Rectified linear unit(ReLU)을 더 매끄러운 Gaussian error linear unit(GELU) 활성화 함수로 교체해도 정확도는 80.6%로 유지되지만, 블록마다 활성화 함수를 1개만 남기면 81.3%로 높아진다. 정규화 계층을 제거하고 BatchNorm을 LayerNorm으로 교체하면 81.5%에 도달한다. 해상도가 바뀌는 지점에 정규화를 포함한 별도의 다운샘플링 convolution을 사용하면 학습이 안정화되고 정확도가 82.0%가 된다. 현대화 비교에서 Swin-T의 정확도는 81.3%다.
ConvNeXt의 잔차 블록은 depthwise 공간 convolution 1개, pointwise 채널 투영 2개, 정규화 1개, 활성화 함수 1개를 결합한다. 그림에 나타난 Swin 블록에는 잔차 연결 2개와 특수한 attention 연산이 있다.
3. Empirical Evaluations on ImageNet
ConvNeXt-T/S/B/L은 Swin-T/S/B/L과 비슷한 연산 복잡도로 구성하며, ConvNeXt-XL로 추가적인 규모 확장을 실험한다. 모델 변형마다 stage별 채널과 블록 수가 다르며, 새로운 stage마다 채널 수가 2배가 된다.
3.1. Settings
ImageNet-1K에는 클래스 1,000개와 학습 이미지 1.2M개가 있고, ImageNet-22K에는 클래스 21,841개와 이미지 약 14M개가 있다. ImageNet-1K 학습에는 300 에포크, 배치 크기 4096, 학습률 4e-3을 사용한다. ImageNet-22K에서 90 에포크 동안 사전 학습한 뒤 ImageNet-1K에서 학습률 5e-5와 배치 크기 512로 30 에포크 동안 미세 조정한다.
3.2. Results
ImageNet-1K로 학습한 뒤 224×224 해상도에서 ConvNeXt-T는 82.1%, Swin-T는 81.3%를 기록하며, 2개 모델의 연산량은 모두 4.5G FLOPs다. ImageNet-22K 사전 학습 후 384×384 해상도에서 ConvNeXt-L은 87.5%, Swin-L은 87.3%를 기록하고, 더 큰 ConvNeXt-XL은 87.8%에 도달한다.
384×384 B models인 ImageNet-1K-trained 모델을 비교하여 정확도와 V100 처리량을 확인할 수 있다. 표의 아래쪽에는 더 큰 데이터로 사전 학습한 결과가 나온다.
3.3. Isotropic ConvNeXt vs. ViT
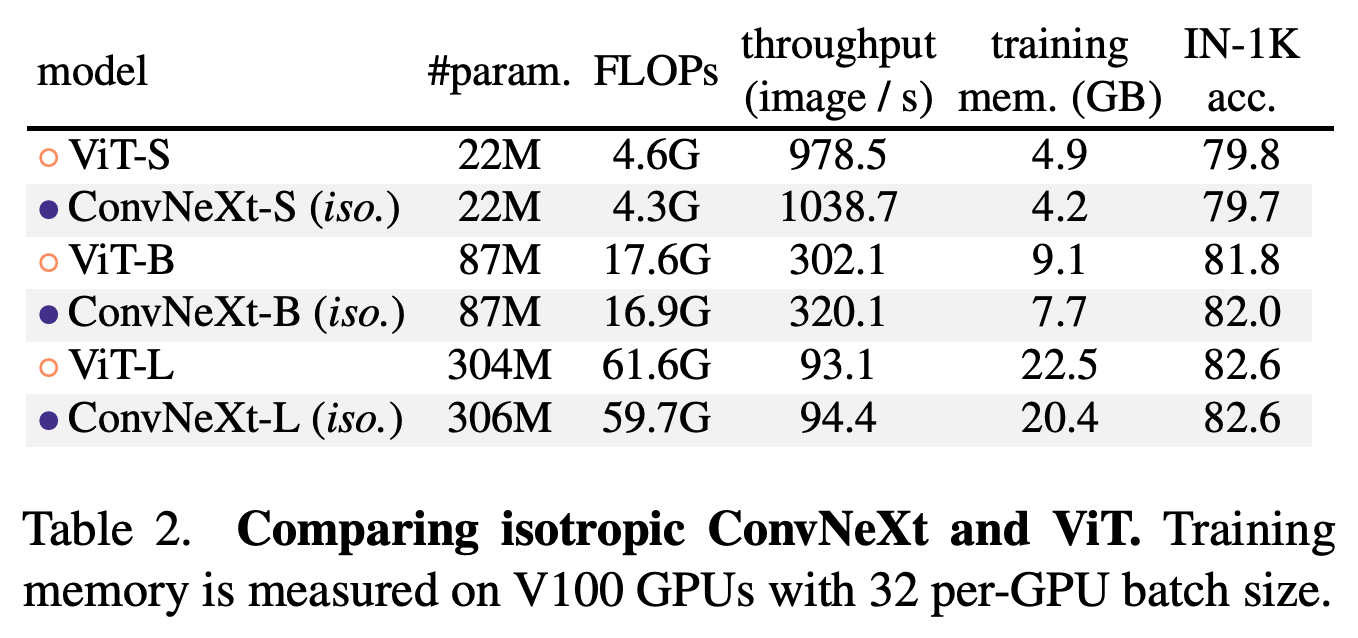
등방성 아키텍처는 모든 깊이에서 특징 맵의 해상도를 동일하게 유지한다. 224×224 해상도에서 등방성 ConvNeXt-S/B/L은 각각 79.7%/82.0%/82.6%를 기록한다. 파라미터 수와 FLOPs가 비슷한 vision Transformer(ViT) S/B/L 모델의 성능은 각각 79.8%/81.8%/82.6%다.
등방성 모델을 비교한 3개 결과에서 정확도 차이는 최대 0.2%포인트다. 명시된 V100 배치 조건에서 ConvNeXt는 각 크기마다 보고된 학습 메모리 사용량이 더 낮다.
4. Empirical Evaluation on Downstream Tasks
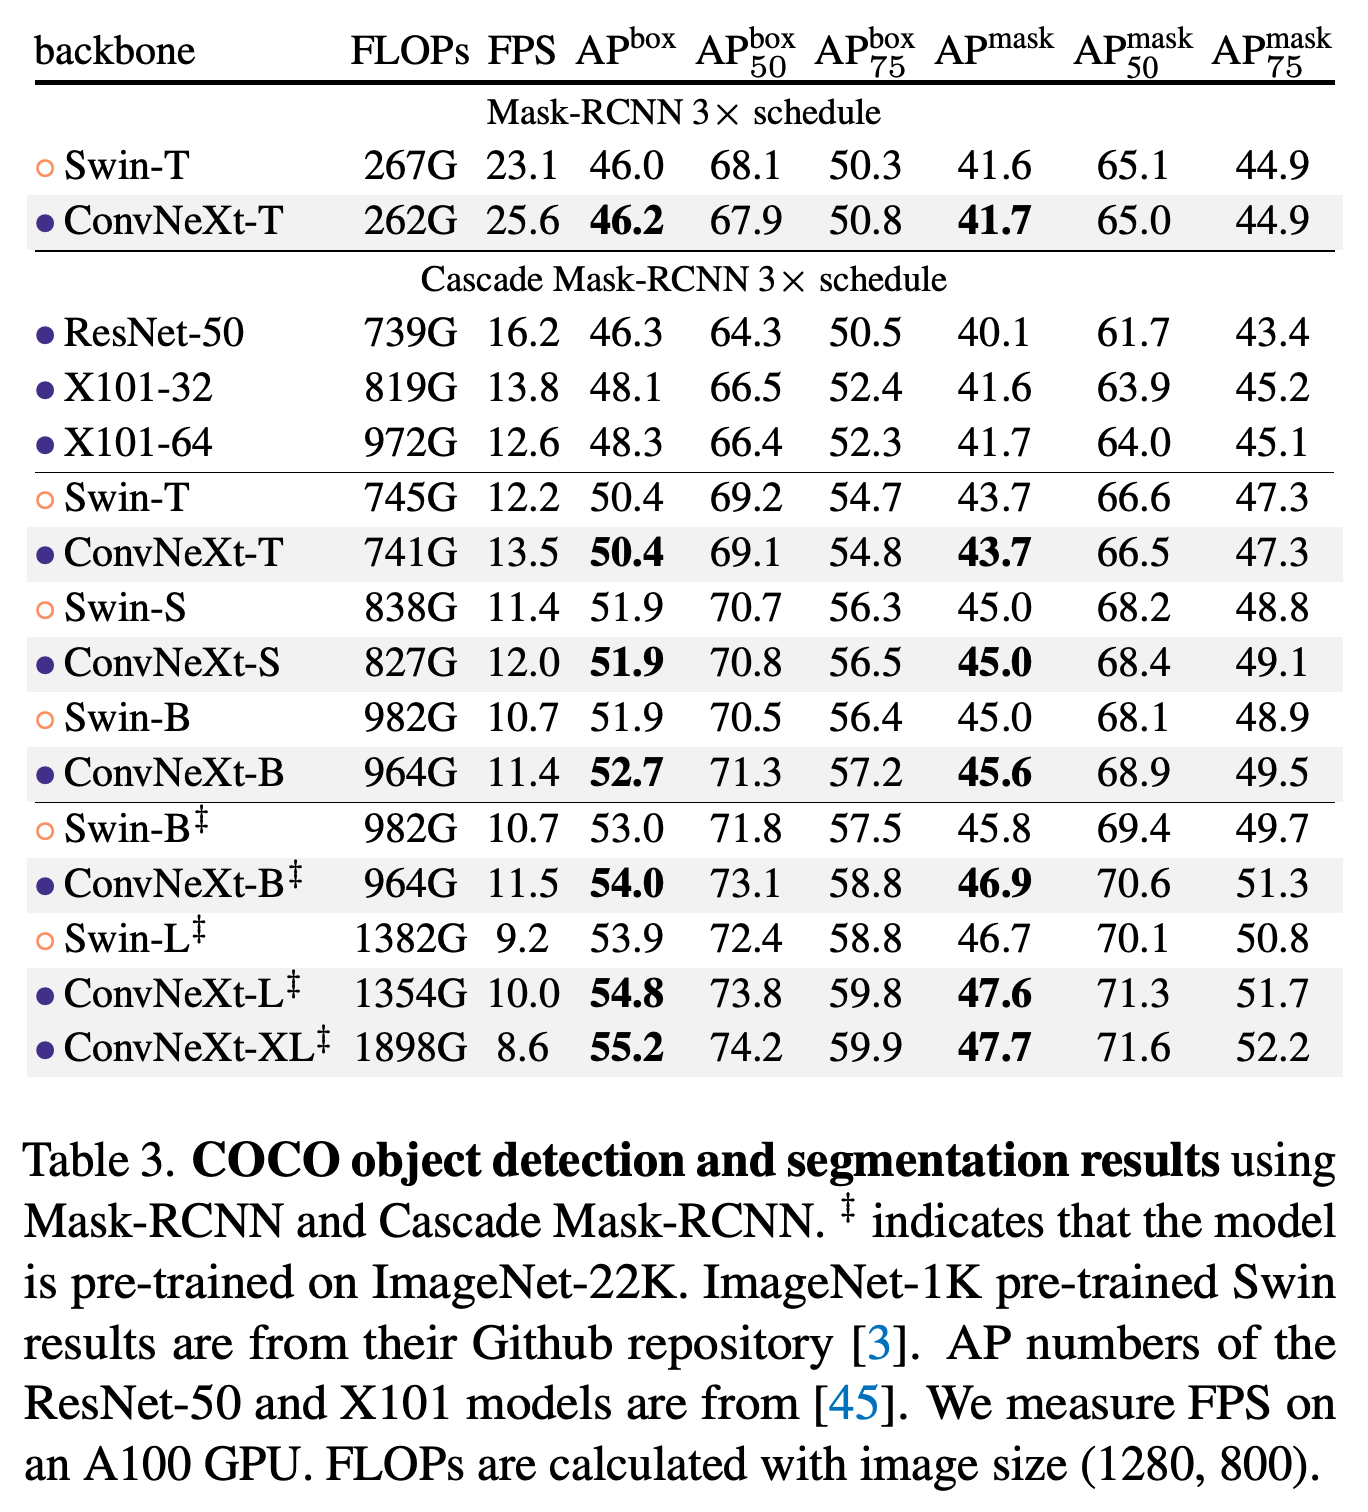
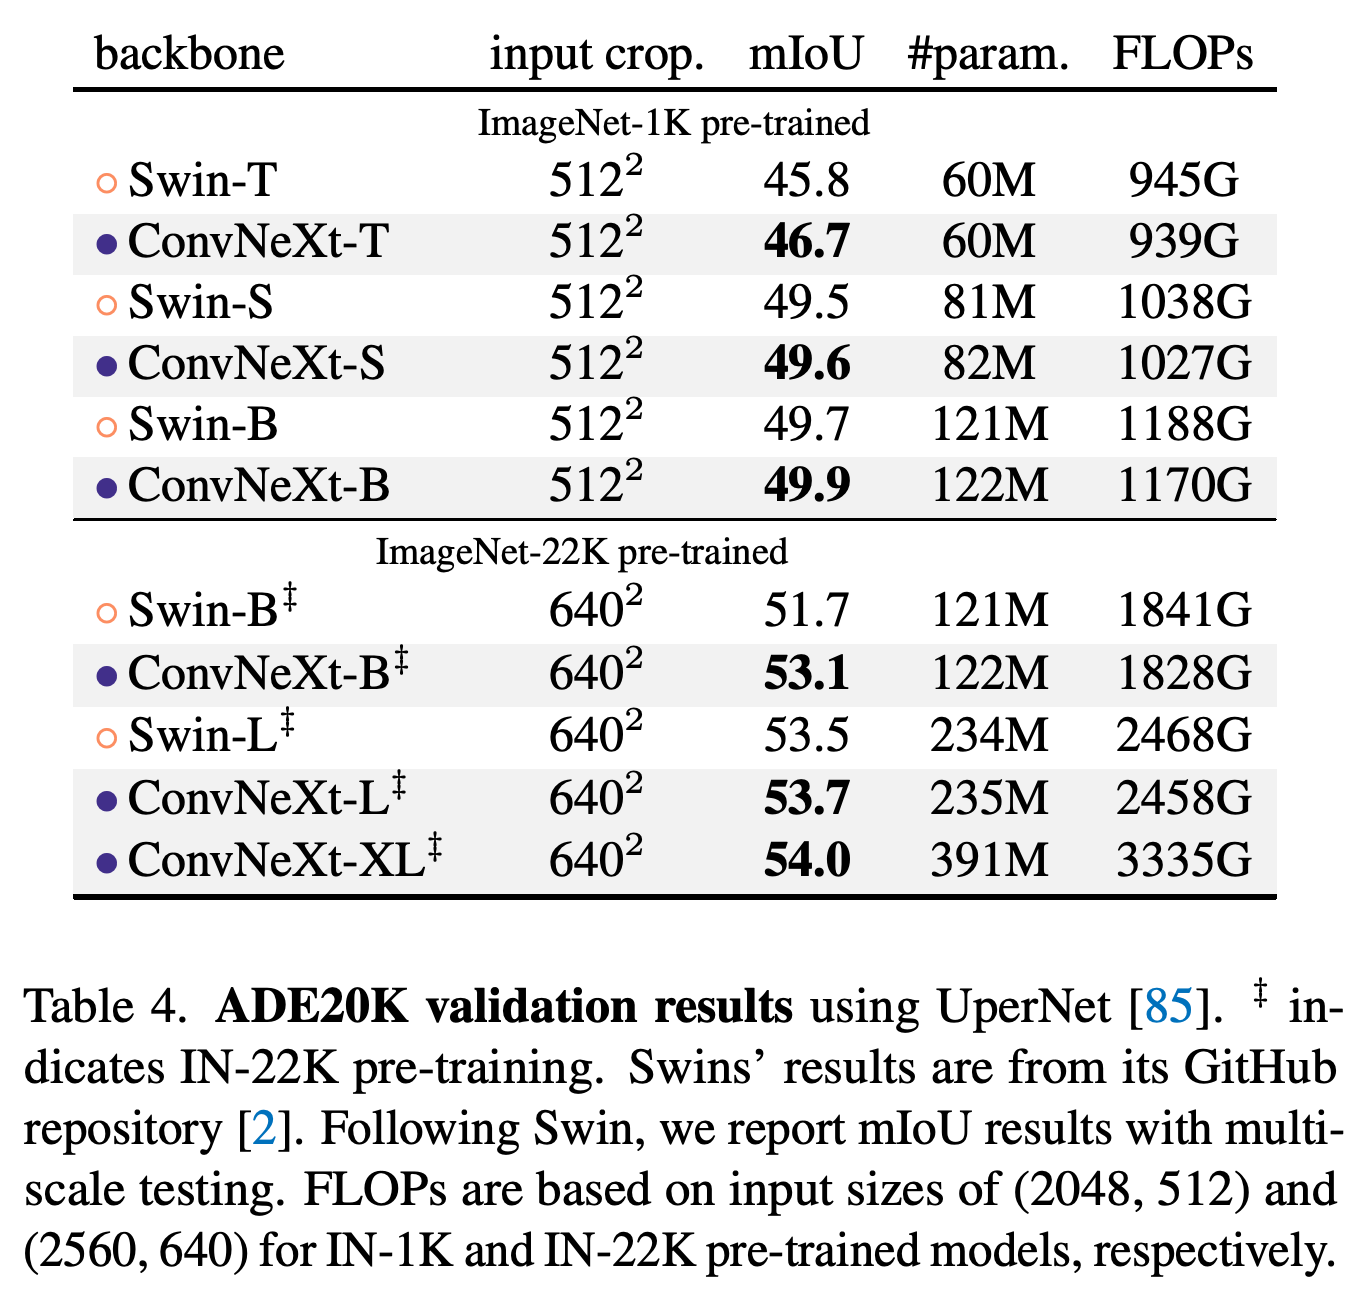
COCO에서 객체 탐지는 객체의 위치를 찾고 인스턴스 분할은 각 객체의 마스크를 예측한다. ImageNet-22K 사전 학습과 Cascade Mask R-CNN을 사용한 ConvNeXt-B는 박스 average precision(AP) 54.0과 마스크 AP 46.9를 기록했고, Swin-B는 각각 53.0과 45.8을 기록했다. 각 픽셀에 클래스를 할당하는 ADE20K 의미 분할에서는 동일한 사전 학습을 사용한 ConvNeXt-B의 mean intersection over union(mIoU)이 53.1이고 Swin-B는 51.7이다. UperNet은 배치 크기 16으로 160K 반복 학습한 뒤 여러 스케일에서 평가한다.
표는 탐지 점수와 마스크 점수를 구분하며, 성능 향상이 모델 크기와 탐지기에 따라 달라짐을 보여준다. T와 S의 Cascade 결과는 주요 박스 및 마스크 AP에서 Swin과 같고, 사전 학습한 B 모델 비교에서는 ConvNeXt가 우세하다.
ImageNet-22K 사전 학습과 640×640 크롭을 사용했을 때 ConvNeXt-B의 mIoU는 Swin-B보다 1.4점 높고, L 모델 간 차이는 0.2점이다.
5. Related Work
논문은 ConvNeXt를 convolution과 attention을 결합한 모델 및 최근 convolution 기반 접근법과 함께 살펴본다. 여기에는 Swin의 attention을 depthwise convolution으로 대체한 연구도 포함된다 [25]. 표준 ResNet을 현대화하는 과정을 제시한 것이 이 논문의 기여이며, 저자들은 개별 설계 선택이 이전에도 연구되었다고 밝힌다.
6. Conclusions
저자들은 기존에 연구된 구성 요소로 조합한 순수 ConvNet이 논문에서 보고한 벤치마크에서 계층형 vision Transformer와 경쟁할 수 있다고 결론짓는다. 코드는 https://github.com/facebookresearch/ConvNeXt 에서 공개되어 있다.
부록
- A. Experimental Settings는 학습, 미세 조정, 다운스트림 작업의 하이퍼파라미터를 명시한다. 현대화 실험에서는 모델 가중치의 평균인 exponential moving average(EMA)를 사용하지 않으며, 다운스트림 실험은 사전 학습의 최종 가중치로 초기화한다. 미세 조정도 일반적으로 EMA 가중치가 아닌 최종 가중치에서 시작하지만, ImageNet-1K-pre-trained ConvNeXt-L은 과적합 때문에 예외로 둔다.
- B. Robustness Evaluation에 따르면 ImageNet-22K-pre-trained ConvNeXt-XL은 특수 모듈이나 추가 미세 조정 없이 ImageNet-A, ImageNet-R, ImageNet-Sketch에서 각각 69.3%, 68.2%, 55.0%를 기록한다. C. Modernizing ResNets: detailed results와 D. Detailed Architectures는 현대화 실험의 양쪽 연산 규모와 stage별 명세를 제시한다. ResNet-50 결과에는 세 시드의 표준편차가 포함된다.
- E. Benchmarking on A100 GPUs는 TensorFloat32와 channel-last 메모리 레이아웃을 사용할 때 ConvNeXt의 처리량이 비슷한 Swin 모델보다 최대 49% 높다고 보고한다. F. Limitations는 평가한 시각 작업이 모든 응용 분야를 포괄하지 않으며 멀티모달 상호작용에 cross-attention이 유용할 수 있다고 설명한다. G. Societal Impact는 컴퓨팅 수요, 탄소 배출, 데이터셋에 존재할 수 있는 편향을 논의한다.
짧은 생각
학습 방식을 개선한 베이스라인 덕분에 아키텍처 비교를 더 유의미하게 해석할 수 있다. ResNet-50은 아키텍처를 바꾸기 전에 정확도가 2.7%포인트 높아졌으며, 이후 변경 중 일부는 중간 단계에서 효과가 작거나 부정적이었다. 이 과정은 변경 순서에 영향을 받으므로, 단계별 결과만으로 각 구성 요소를 단독으로 적용하거나 다른 작업에 적용했을 때도 같은 효과가 나타난다고 볼 수는 없다.