


Toward Training at ImageNet Scale with Differential Privacy 요약 설명
28 Jan 2022 | Paper Review Differential Privacy Image Classification Transfer Learning목차
- 요약
- 1 Introduction
- 2 Background
- 3 Effective Training Settings for DP
- 3.1 Obs. 1: Choice of model matters
- 3.2 Obs. 2: More epochs is better than lower noise
- 3.3 Obs. 3: Hyperparameter tuning makes a big difference
- 3.4 Obs. 4: Large batch size improves the privacy-utility tradeoff
- 3.5 Obs. 5: Transfer learning from public data significantly boosts accuracy
- 3.6 Combining everything together
- 4 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Toward Training at ImageNet Scale with Differential Privacy 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 1월 28일(arXiv, v2 수정일 2022년 2월 9일)
- Kurakin, Alexey, Song, Shuang, Chien, Steve, Geambasu, Roxana, Terzis, Andreas, Thakurta, Abhradeep.
- Google Research, Columbia University
- 논문 링크
요약
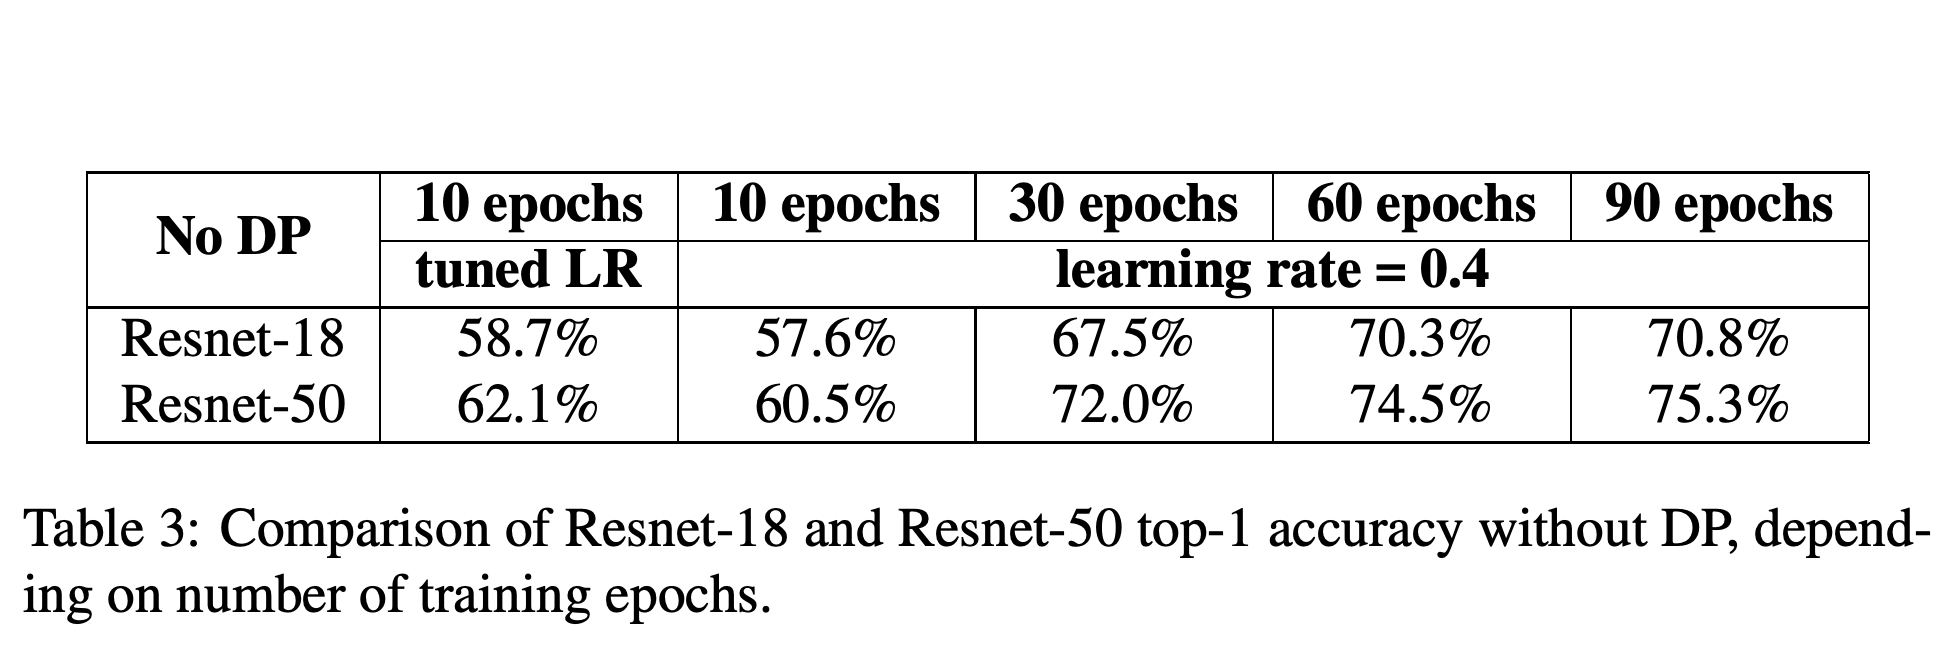
- 이 논문은 학습 데이터의 개별 사례가 모델 출력에 드러나는 정도를 제한하는 차등 프라이버시(DP)를 적용해 ImageNet 분류를 연구한다. Places365로 사전 학습한 Resnet-18은 ε = 10, δ = 10⁻⁶에서 top-1 정확도 47.9%를 달성한다. 같은 ε에서 단순한 DP 학습은 몇 퍼센트에 그친다. 논문에서 보고한 DP를 적용하지 않은 90 epoch 학습의 정확도는 Resnet-18이 70.8%, Resnet-50이 75.3%다.
- 저자들은 차등 프라이버시 확률적 경사 하강법, 큰 배치, 모델과 하이퍼파라미터 선택, 공개 데이터 사전 학습을 결합한다. JAX 구현은 프라이버스를 보장하는 학습에 필요한 사례별 그래디언트의 계산 비용을 줄인다.
1 Introduction
모델은 특정 사례가 학습에 사용됐는지 판별하는 membership inference나 민감한 데이터의 복원을 통해 학습 사례를 노출할 수 있다. 저자들은 정확도 저하와 계산 오버헤드를 ImageNet에 DP를 적용하는 장애물로 제시하고, 코드를 https://github.com/google-research/dp-imagenet에 공개한다.
2 Background
배경에서는 프라이버시 보장과 차등 프라이버시 최적화 알고리즘을 소개하고, 사례별 연산에 드는 비용을 살펴본다.
2.1 Privacy Notions and DP-SGD
항목 1개만 다른 데이터셋에 대해 (ε, δ)-DP는 한 데이터셋에서 특정 출력이 나올 확률의 상한을 다른 데이터셋에서의 확률에 e^ε를 곱하고 δ를 더한 값으로 정한다. ε와 δ는 프라이버시 보장 수준을 지정한다. 차등 프라이버시 확률적 경사 하강법(DP-SGD)은 각 사례의 그래디언트가 ℓ₂ norm C를 넘지 않도록 클리핑하고, 클리핑한 그래디언트를 합산한 뒤 표준편차가 σC인 가우시안 노이즈를 더한다. 샘플링과 합성에 따라 최종 프라이버시 경계가 결정된다.
2.2 Automatically Fast DP Training with JAX
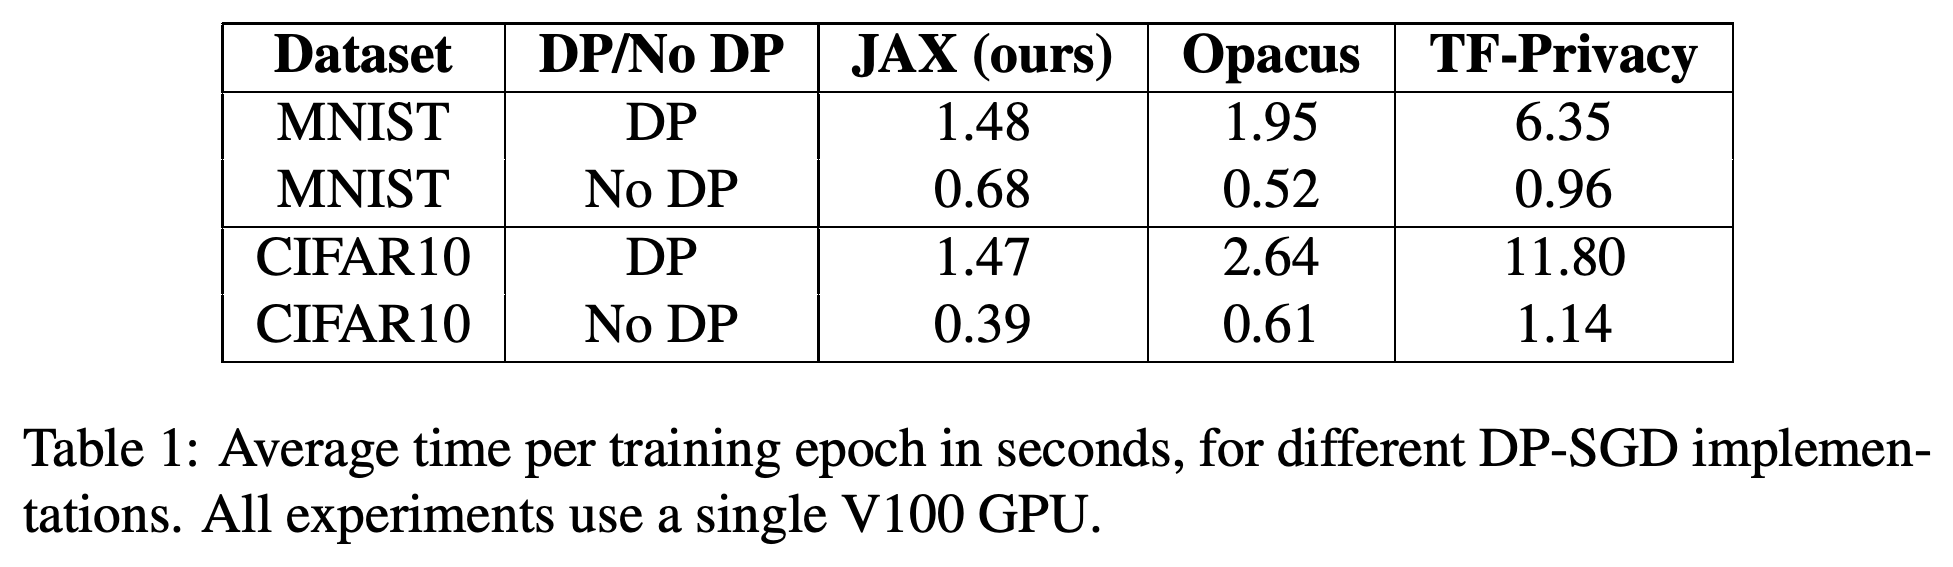
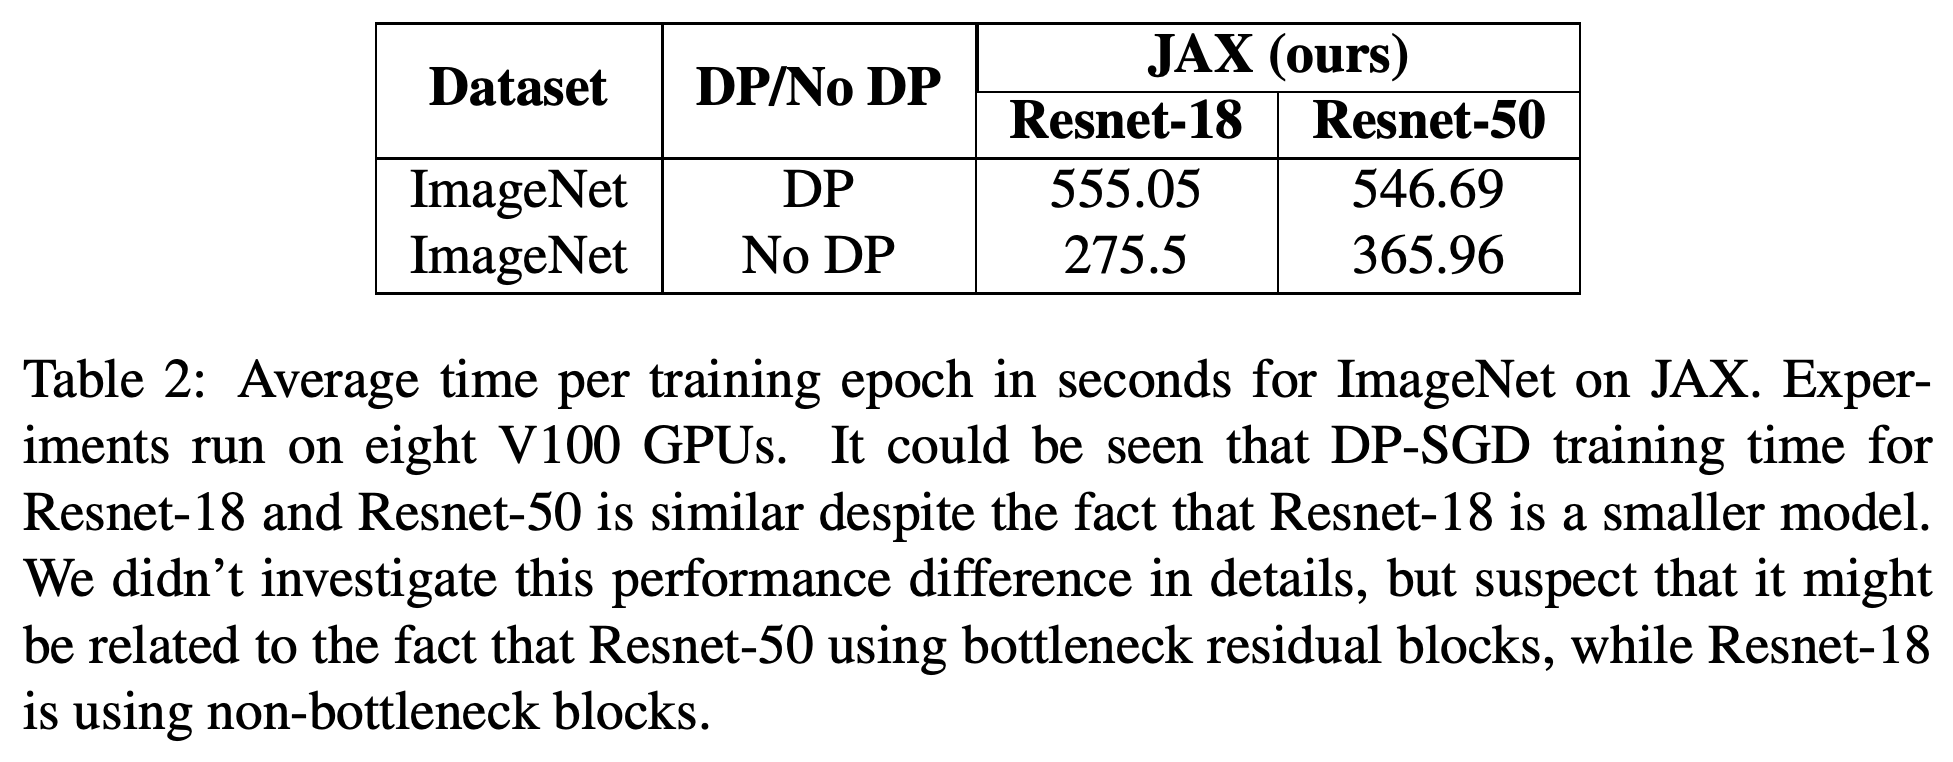
계산 라이브러리인 JAX는 자동 벡터화와 just-in-time 컴파일을 이용해 사례별 그래디언트 계산을 병렬화한다. V100 GPU 1개에서 DP를 적용한 CIFAR-10 학습의 epoch당 시간은 JAX가 1.47초, Opacus가 2.64초, TF-Privacy가 11.80초였다. V100 GPU 8개에서 ImageNet Resnet-18의 epoch당 학습 시간은 DP를 적용했을 때 555.05초, 적용하지 않았을 때 275.5초였다.
소형 합성곱 네트워크를 사용하는 두 벤치마크 모두에서 JAX의 프라이버스 적용 epoch 시간이 가장 짧지만, 프라이버스를 적용하지 않은 MNIST 학습 시간은 Opacus보다 길다.
측정한 하드웨어에서 프라이버스를 적용한 ImageNet 학습의 epoch당 시간은 적용하지 않은 경우보다 Resnet-18에서 대략 두 배, Resnet-50에서 약 1.5배 길다.
3 Effective Training Settings for DP
실험에서는 기존에 알려진 기법을 결합하고 ImageNet에서 아키텍처 선택, 학습 기간, 튜닝, 배치 크기, 공개 데이터 사전 학습을 평가한다. 저자들은 이를 전체 탐색이 아닌 초기 관찰 결과로 제시한다.
3.1 Obs. 1: Choice of model matters
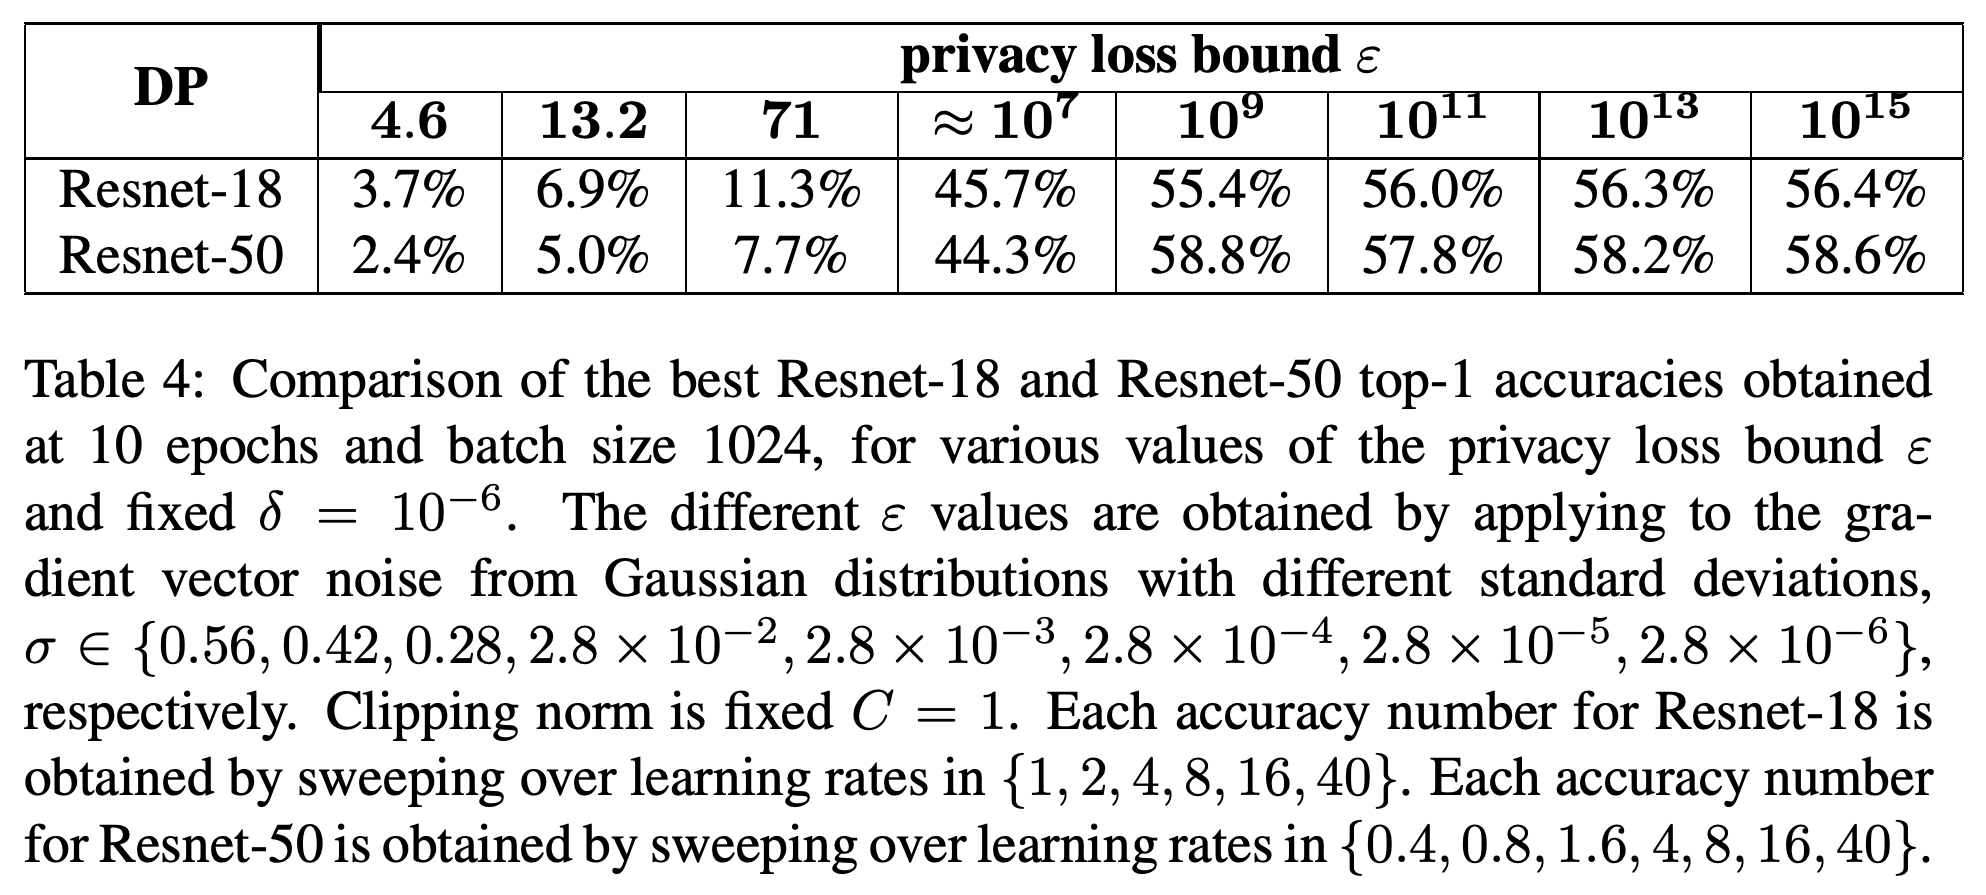
저자들은 DP-SGD 분석을 위해 사례 간 정보를 사용하는 batch normalization을 group normalization으로 대체한다. 10 epoch, 배치 크기 1024, ε = 4.6, δ = 10⁻⁶에서 Resnet-18의 top-1 정확도는 3.7%, Resnet-50은 2.4%다. DP를 적용하지 않으면 보고된 설정에서 더 큰 모델이 우수하다.
Resnet-50은 표에 나온 프라이버스를 적용하지 않은 모든 학습 기간에서 Resnet-18보다 우수하며, 이는 프라이버스 적용 실험의 비교 기준이 된다.
ε가 4.6, 13.2, 71일 때는 Resnet-18이 앞서지만, ε가 매우 커지면 Resnet-50이 다시 우위를 차지한다.
3.2 Obs. 2: More epochs is better than lower noise
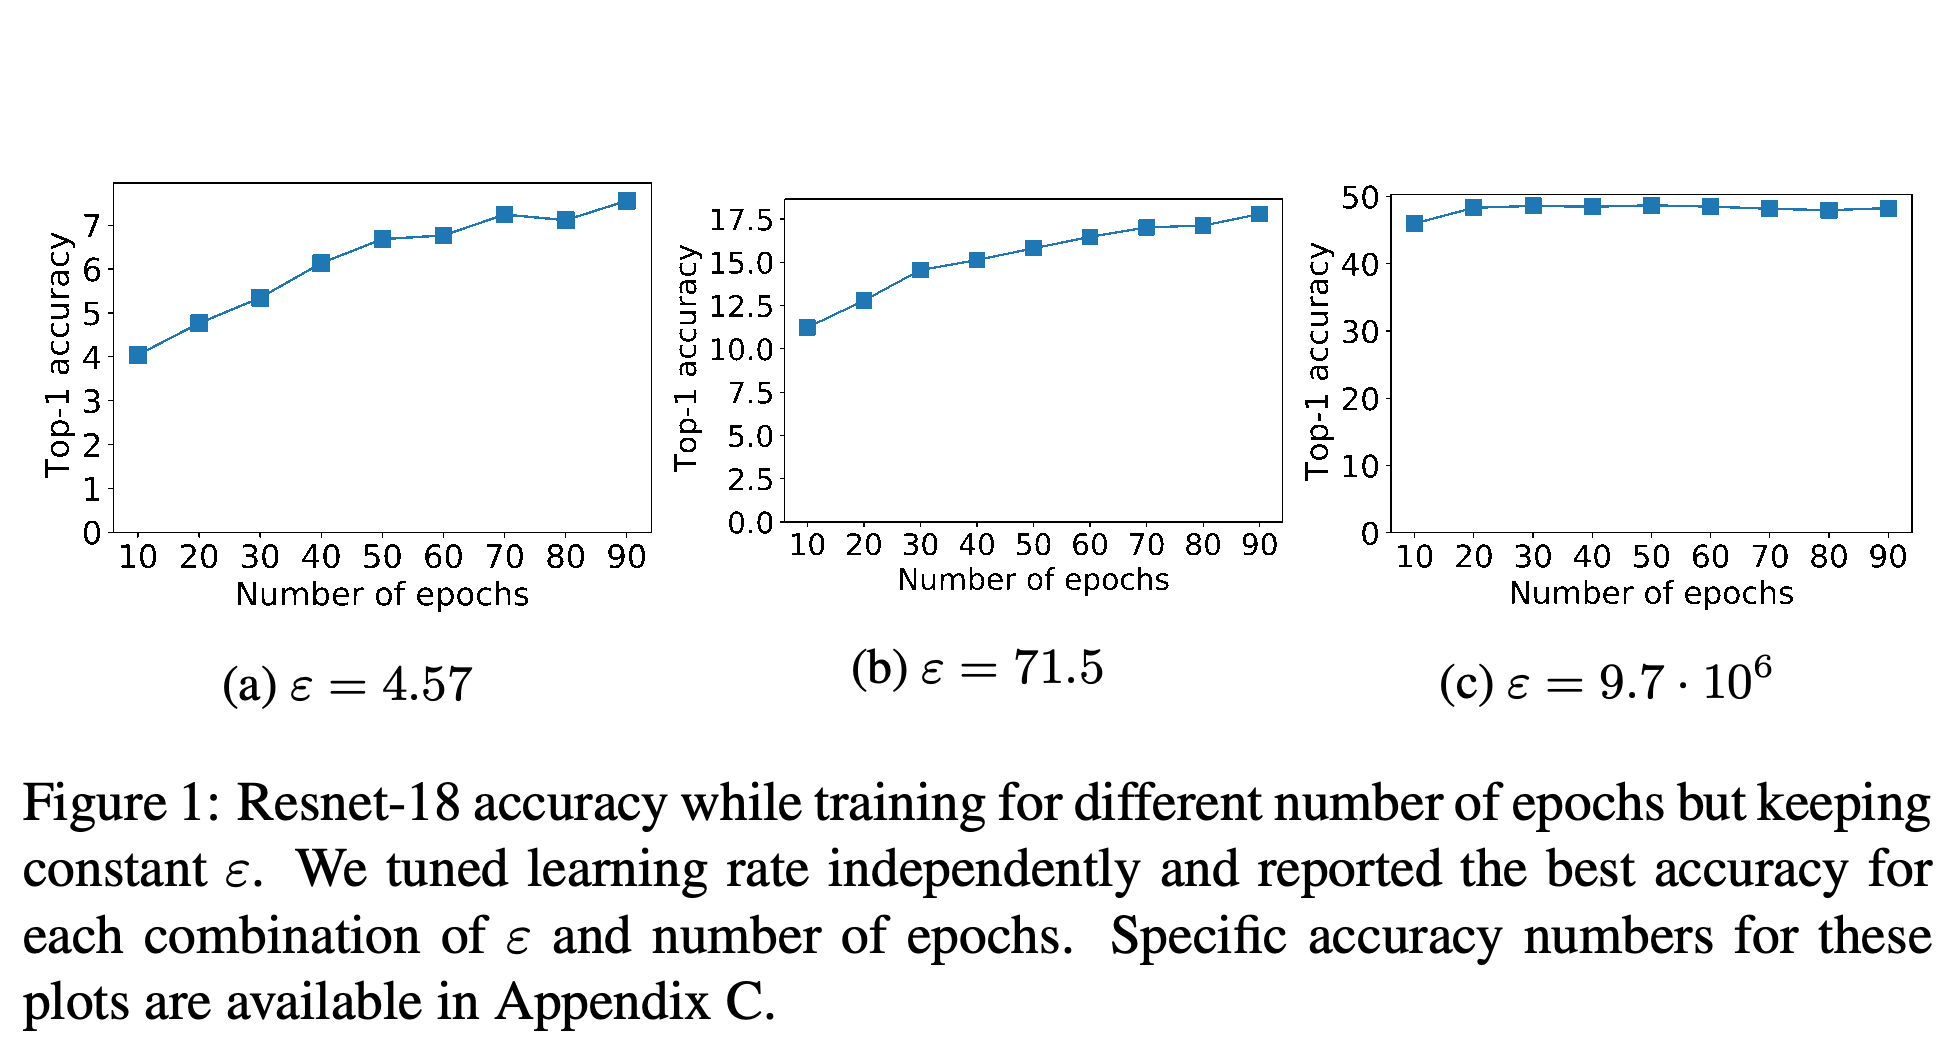
보고된 실험에서는 프라이버시 경계를 고정했을 때 노이즈를 그에 맞게 늘리면서 더 오래 학습하면, 노이즈가 적고 epoch 수도 적은 학습보다 정확도가 높아진다. ε = 4.57에서 Resnet-18의 정확도는 10 epoch의 3.6%에서 90 epoch의 7.6%로 상승한다. ε = 9.7 × 10⁶인 곡선은 훨씬 일찍 거의 평평해진다.
더 작은 프라이버시 경계 2개에서는 학습 기간이 길어질수록 정확도가 상승하지만, ε가 매우 큰 곡선은 초기 epoch 이후 거의 평평해진다.
3.3 Obs. 3: Hyperparameter tuning makes a big difference
저자들은 클리핑 norm과 학습률을 함께 튜닝할 것을 권한다. 먼저 프라이버스를 적용하지 않은 학습의 학습률을 찾고, 노이즈가 없는 상태에서 클리핑 임곗값을 정한 다음, 프라이버시 예산에 맞는 노이즈를 선택하고 학습률을 탐색한다. 임곗값 아래에서는 C를 k배 줄이고 학습률을 k배 늘리면 비슷한 정확도를 유지할 수 있지만, 극단적인 설정은 불안정할 수 있다. 제안된 튜닝 절차 자체는 프라이버시를 보장하지 않는다.
3.4 Obs. 4: Large batch size improves the privacy-utility tradeoff
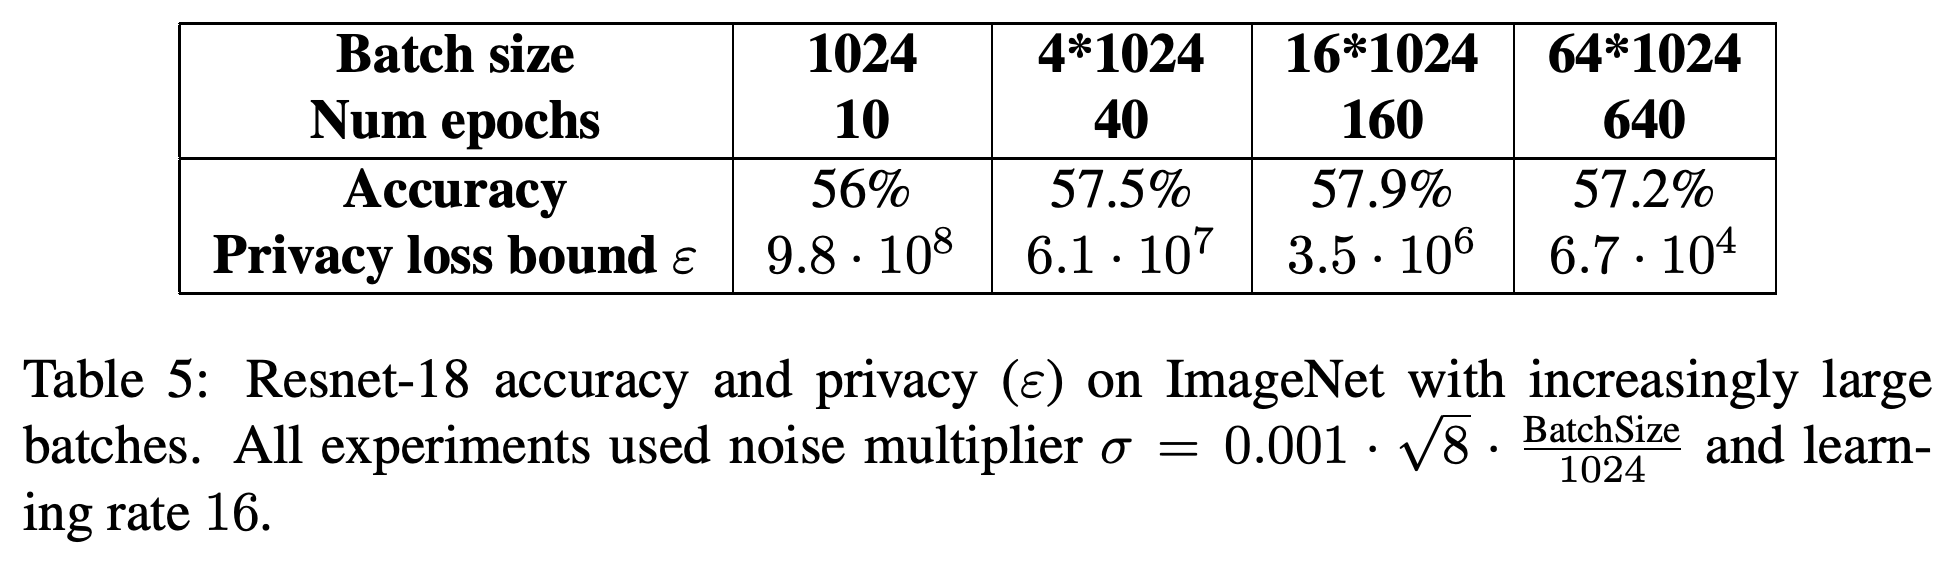
업데이트 전에 그래디언트를 누적하는 가상 단계를 사용하면 큰 배치를 모사할 수 있다. 배치 크기 16 × 1024와 10 epoch에서 ε = 2.2 × 10⁵일 때 정확도는 5.8%다. 배치 크기 1024 × 1024와 640 epoch에서는 ε가 약 72일 때 정확도가 6.2%로, 낮은 정확도에서의 트레이드오프를 보여준다.
배치 크기와 epoch 수를 함께 늘리면 정확도가 56–58% 부근으로 유지되는 동안 보고된 ε가 감소한다. 다만 저자들에 따르면 표에 나온 프라이버시 경계는 모두 의미 있는 프라이버시를 제공하기에는 너무 크다.
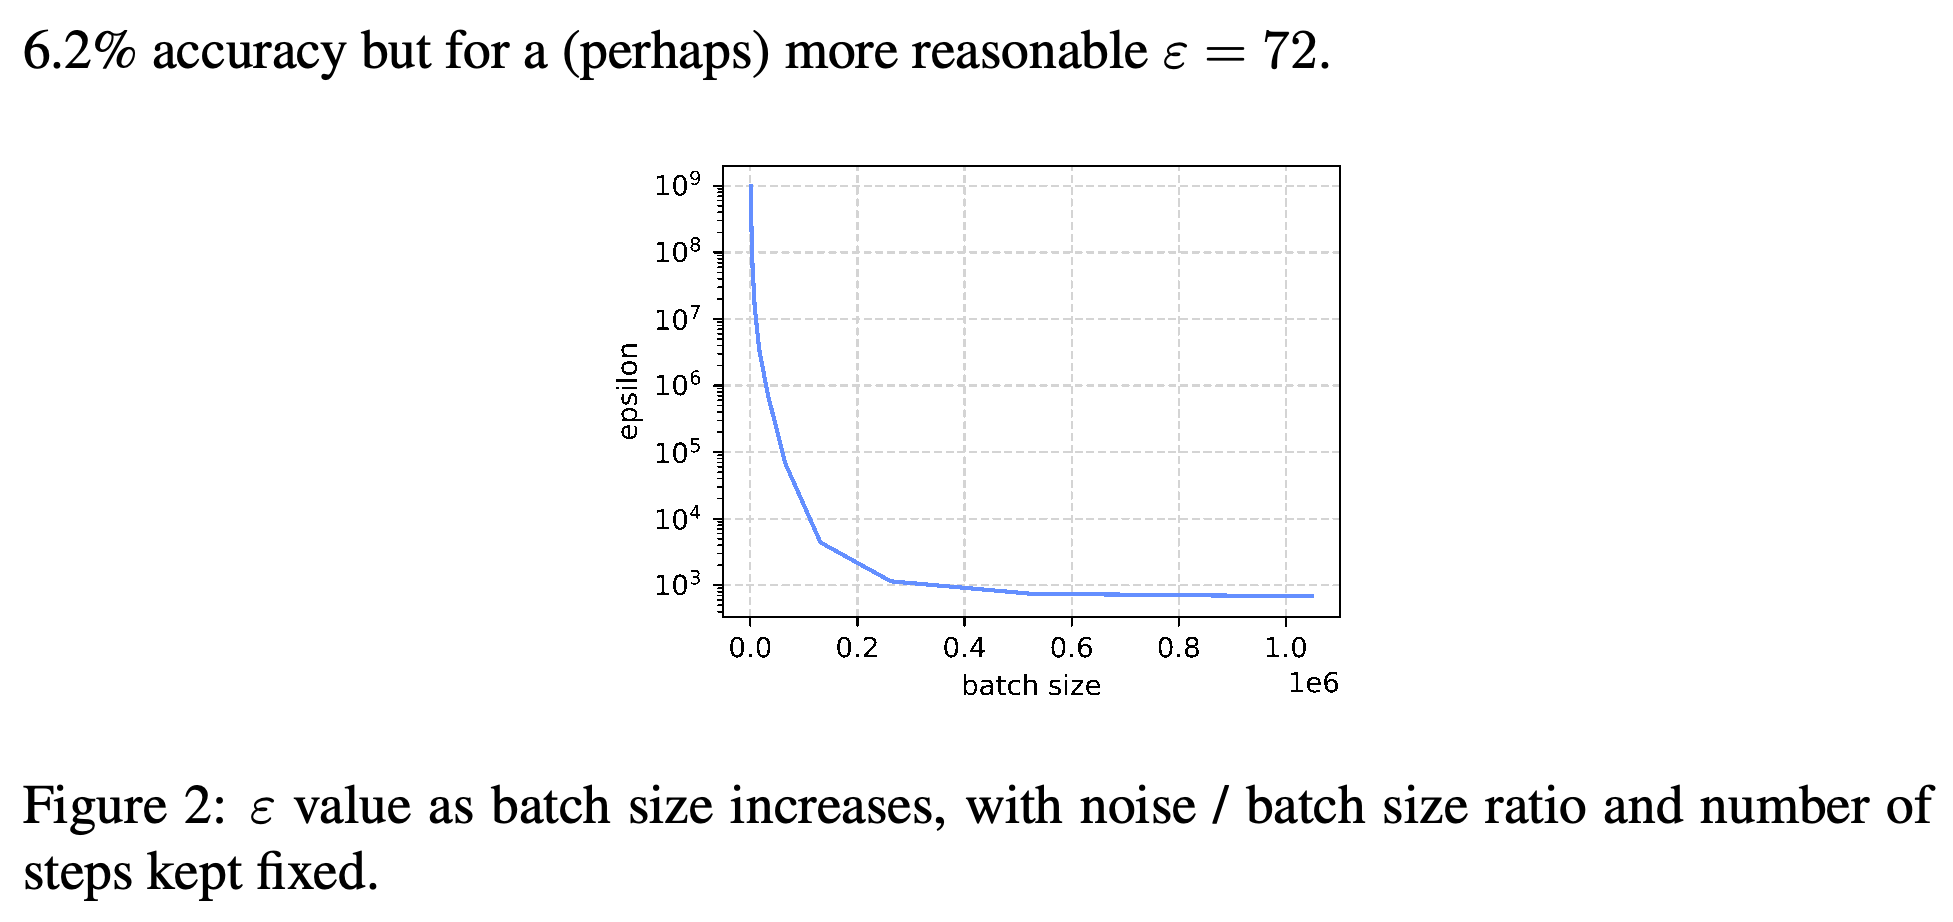
노이즈와 배치 크기의 비율 및 업데이트 횟수를 고정하면 배치 크기가 커질수록 그래프의 프라이버시 경계가 급격히 낮아진다.
3.5 Obs. 5: Transfer learning from public data significantly boosts accuracy
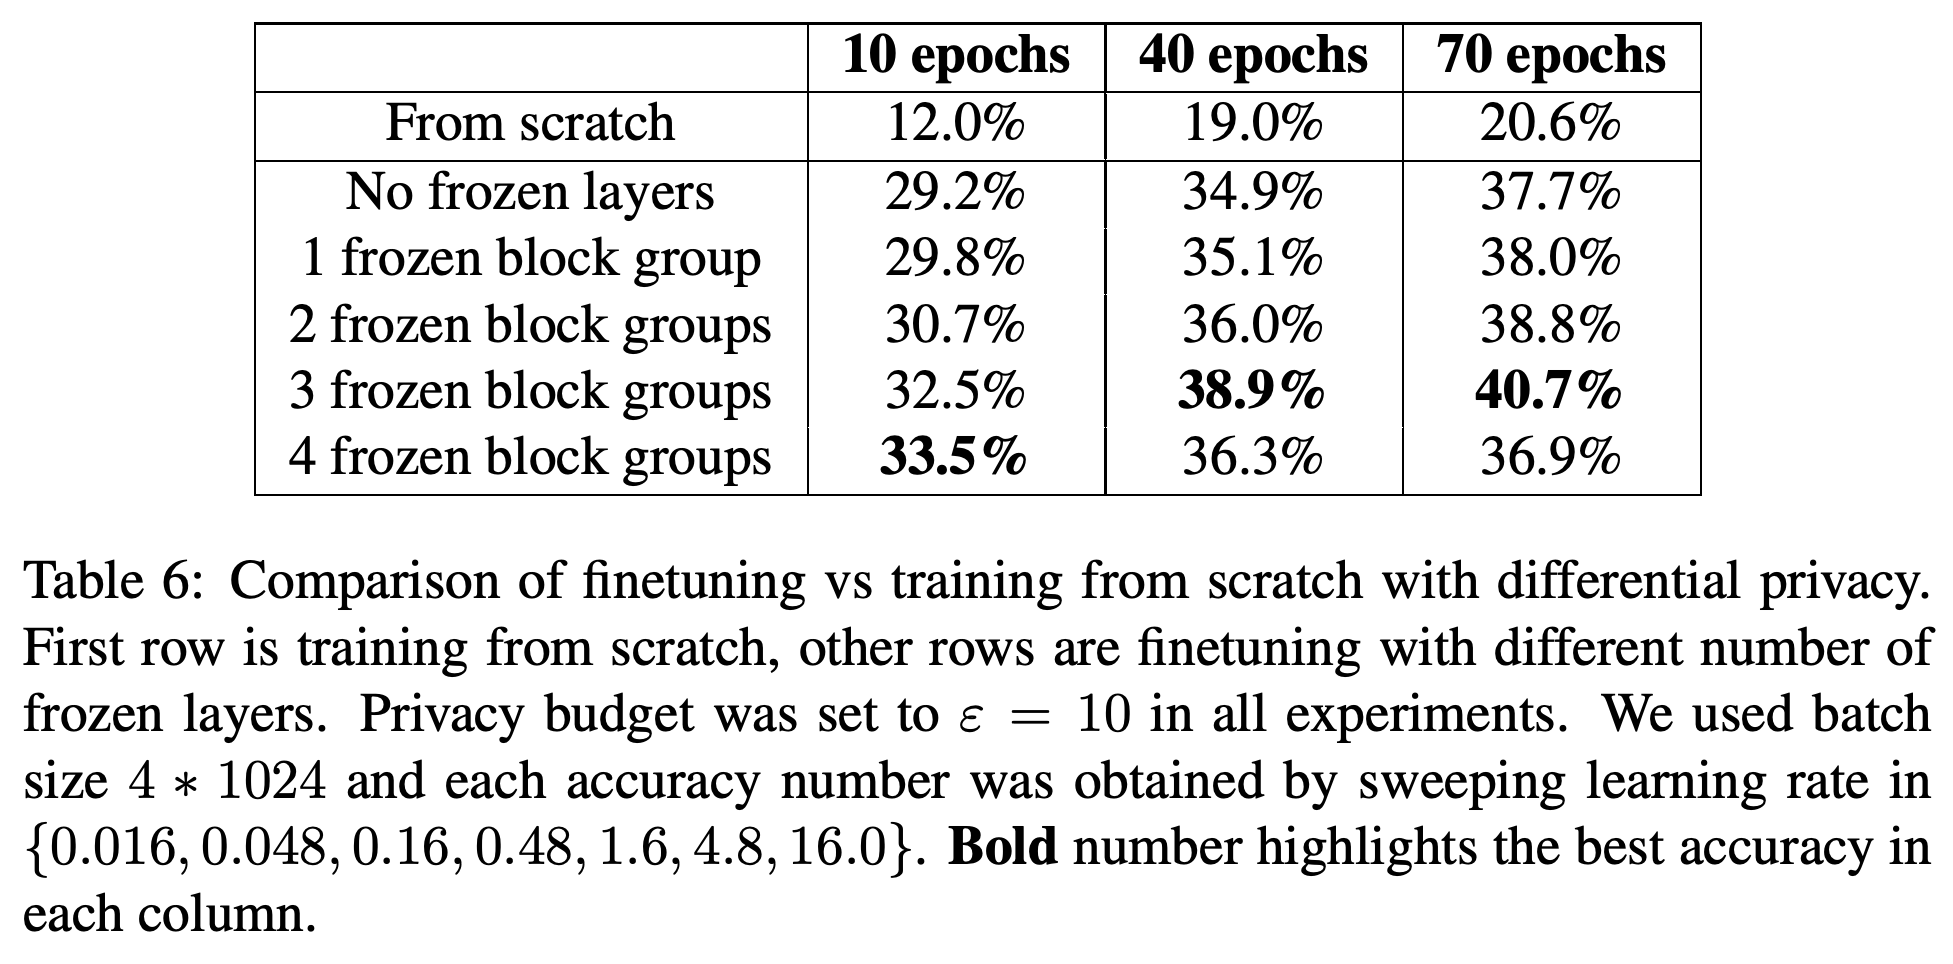
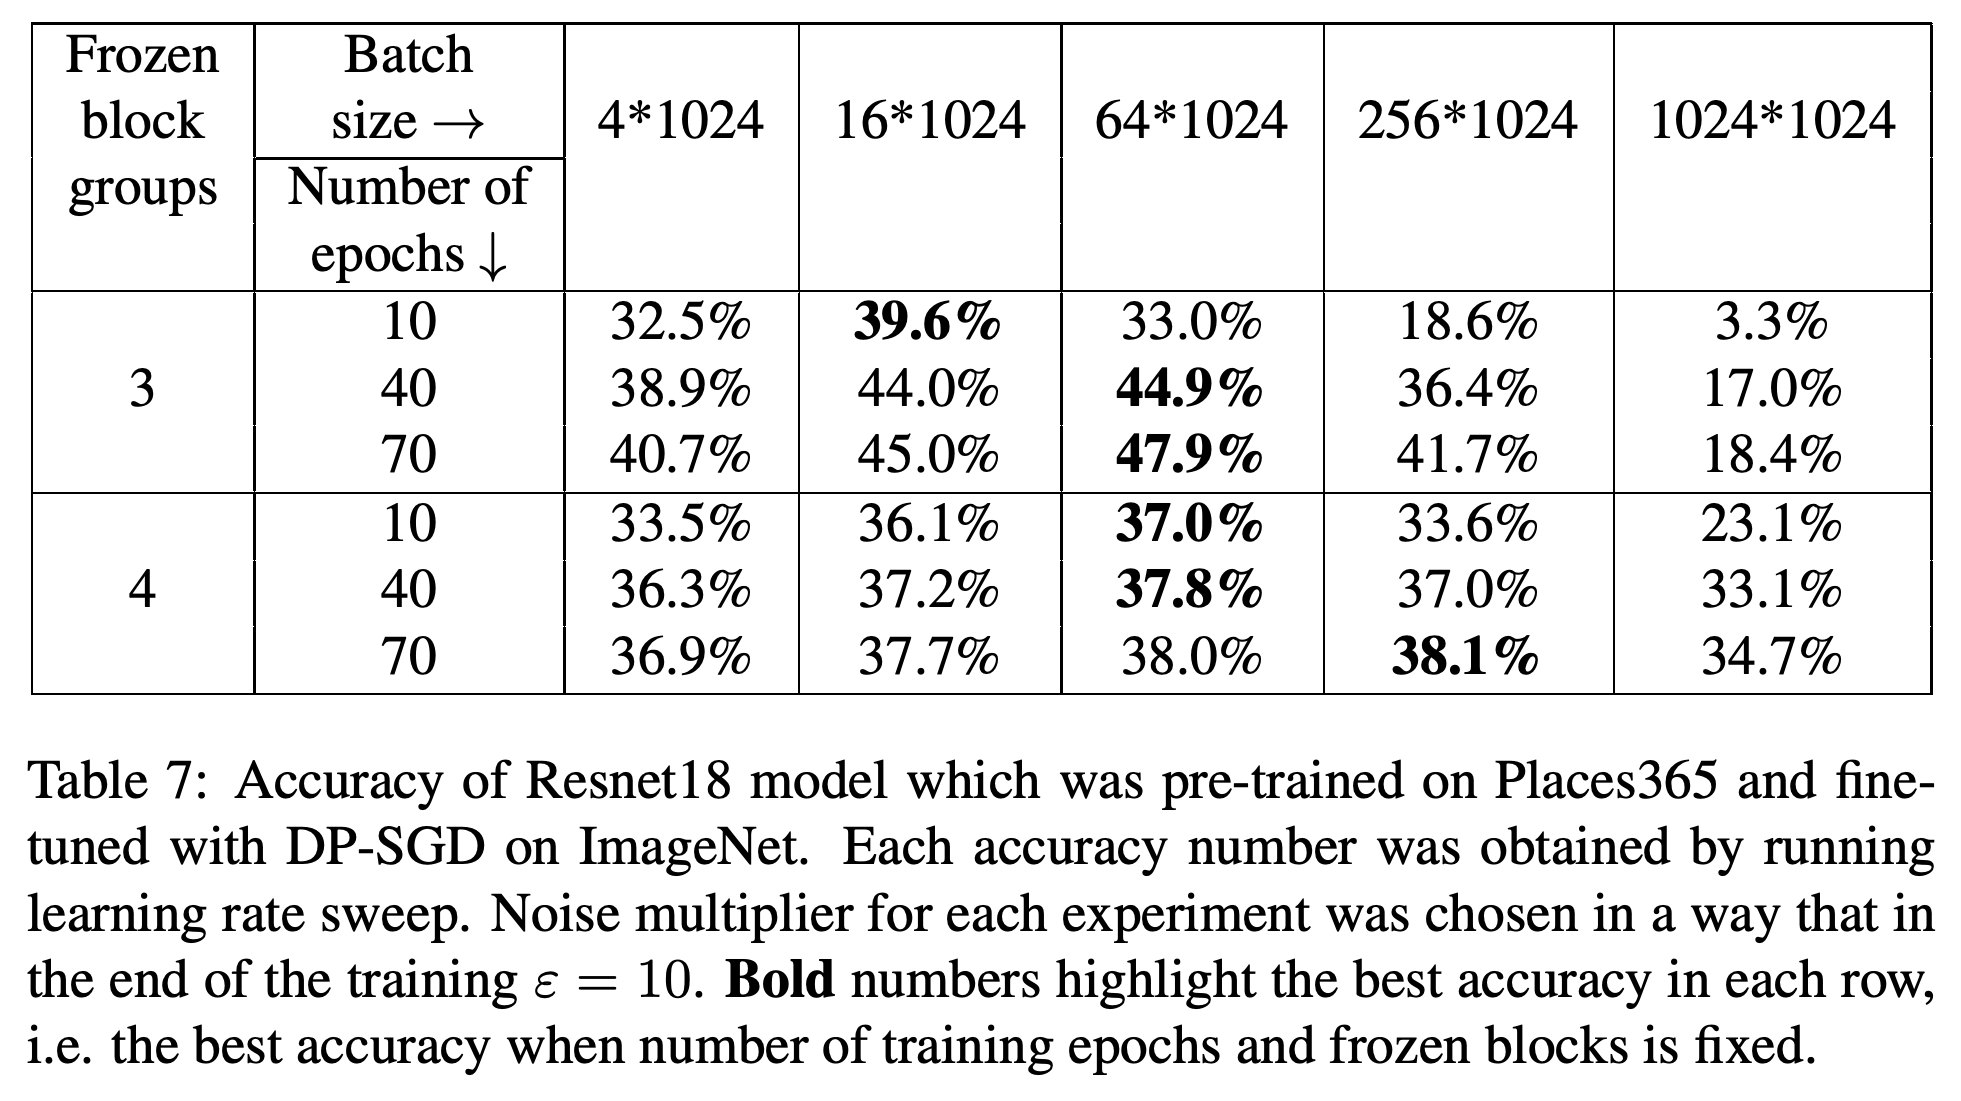
Places365는 365개 레이블에 걸친 공개 장면 이미지 180만 장을 제공한다. 저자들은 Resnet-18을 사전 학습하고 마지막 계층을 1,000개 클래스를 분류하는 ImageNet 계층으로 교체한 뒤 프라이버스를 보장하며 미세 조정한다. ε = 10, 배치 크기 4 × 1024, 70 epoch에서 처음부터 학습하면 정확도가 20.6%이고, 사전 학습 후 블록 그룹 세 개를 고정하면 40.7%다. 실험한 미세 조정에서는 배치가 지나치게 커지면 성능이 저하된다.
보고된 모든 결과에서 사전 학습이 처음부터 학습한 경우보다 정확도를 높인다. 70 epoch에서는 그룹 3개를 고정한 결과가 이 비교에서 가장 좋다.
관찰된 최고 정확도는 그룹 3개를 고정하고 70 epoch, 배치 크기 64 × 1024로 학습했을 때의 47.9%다. 실험한 학습 기간에서 가장 큰 배치는 더 낮은 성능을 보인다.
3.6 Combining everything together
가장 좋은 실행에서는 블록 그룹 3개를 고정하고 배치 크기 64 × 1024로 70 epoch 동안 미세 조정한다. 1 epoch warmup과 최댓값 7.68의 코사인 학습률 감쇠, Nesterov momentum 0.9, weight decay 10⁻⁴, 클리핑 norm C = 1을 사용하고, ε = 10에 맞춰 노이즈를 선택한다.
4 Conclusion
결합한 설정은 보고된 프라이버시 매개변수에서 ImageNet 정확도 47.9%의 베이스라인을 수립하지만, 프라이버스를 적용하지 않은 학습과는 여전히 정확도 차이가 크다. 성능 향상은 DP-SGD에 여러 학습 선택을 결합한 결과다.
부록
- A Resnet training without DP와 B Resnet training with DP-SGD는 옵티마이저와 하드웨어 설정을 설명한다. DP 구현은 8개 복제본에 독립적인 노이즈를 더한다. 최종 프라이버시 경계를 계산하는 데 사용하는 Rényi differential privacy 회계는 특히 ε가 클 때 ε를 과대평가할 수 있다.
- C Experiments with fixed epsilon and different number of epochs는 이진 탐색으로 노이즈 배율을 찾고 기초 정확도 값을 보고한다. D Hyperparameter tuning for DP-SGD는 클리핑과 학습률 탐색을 제시하며, 계산 예산 때문에 대부분 10 epoch로 제한한다.
- E Details of large batch training sweep은 배치와 epoch 조합을 보고한다. F Pre-training on Places365 dataset은 80 epoch 후 정확도 54.96%를 보고한다. G DP-SGD finetuning experiments는 고정된 블록 그룹을 정의하고 프라이버스를 적용한 미세 조정과 적용하지 않은 미세 조정을 비교한다.
- H Experiments on CIFAR-10은 배치 크기 500과 노이즈 수준 3가지에서 simpleVGG 합성곱 아키텍처를 100 epoch 동안 시험한다. 노이즈가 커질수록 더 단순한 모델이 좋은 성능을 낼 수 있다. I Values of ε at different δ는 정확도가 약 48%인 동일한 실행에서 δ를 줄이면 ε가 높아짐을 보여준다.
짧은 생각
ε = 10에서 보고된 비교에 따르면, 같은 배치 크기와 epoch 수에서 사전 학습 후 미세 조정한 결과가 처음부터 학습한 결과를 크게 앞선다. 프라이버스를 적용하지 않은 하이퍼파라미터 튜닝, 공개 사전 학습 데이터에 대한 의존, 남아 있는 정확도 차이를 고려해 결과를 해석해야 한다. Table 3은 90 epoch에서 Resnet-18의 정확도를 70.8%, Resnet-50의 정확도를 75.3%로 보고하므로, 초록에서 동일한 네트워크를 기준으로 약 75%라고 비교한 내용은 주의해서 해석해야 한다.