


A3: Android Agent Arena for Mobile GUI Agents with Essential-State Procedural Evaluation 요약 설명
02 Jan 2025 | Paper Review Agent Evaluation Mobile GUI Agents Reward Modeling목차
이번 글에서는 A3: Android Agent Arena for Mobile GUI Agents with Essential-State Procedural Evaluation 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 1월 2일(Arxiv)
- Chai, Yuxiang, Tang, Shunye, Xiao, Han, Lin, Weifeng, Li, Hanhao, Zhang, Jiayu, Liu, Liang, Zhao, Pengxiang, Liu, Guangyi, Wang, Guozhi, et al.
- MMLab @ CUHK, Nankai University, EE @ CUHK, vivo AI Lab, SJTU
- 논문 링크
- Github
- Project Page
요약
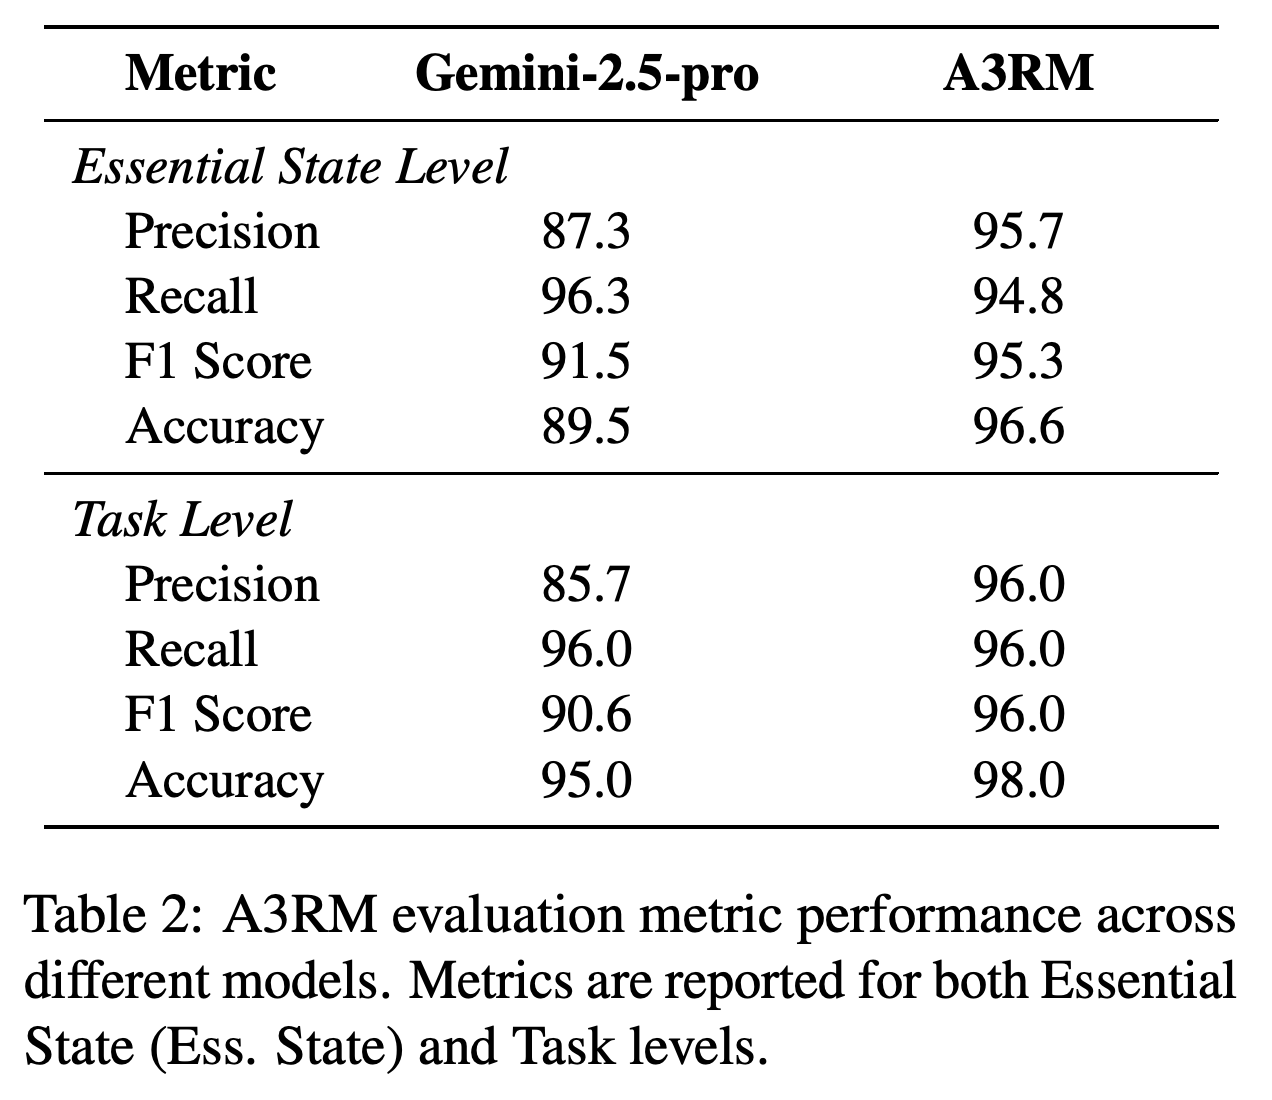
- 화면 상호작용으로 앱을 조작하는 모바일 그래픽 사용자 인터페이스(GUI) 에이전트를 평가하려면 온라인 콘텐츠가 바뀌는 상황에서도 부분적인 진척과 완료 여부를 파악해야 한다. 논문에서 과제 달성 여부를 평가하도록 특화한 Android Agent Arena Reward Model(A3RM)은 학습에 사용하지 않은 Android Agent Arena(A3) 테스트 세트에서 과제 수준 평가 정확도 98.0%를 기록하며, Gemini-2.5-pro는 95.0%를 기록한다. 성공으로 예측한 사례 중 실제 성공 사례의 비율인 과제 수준 정밀도는 각각 96.0%와 85.7%다.
- A3는 20개 범주의 앱 20개에 걸친 과제 100개를 포함한다. 각 과제의 성공 조건은 완료에 필요한 관찰 가능한 의미적 중간 목표인 essential state로 나눈다. 시각적 증거와 텍스트 증거를 처리하는 멀티모달 대규모 언어 모델(MLLM)이 앱 내부를 살펴보지 않고 연속된 스크린샷 윈도우에서 이 중간 목표의 달성 여부를 확인한다.
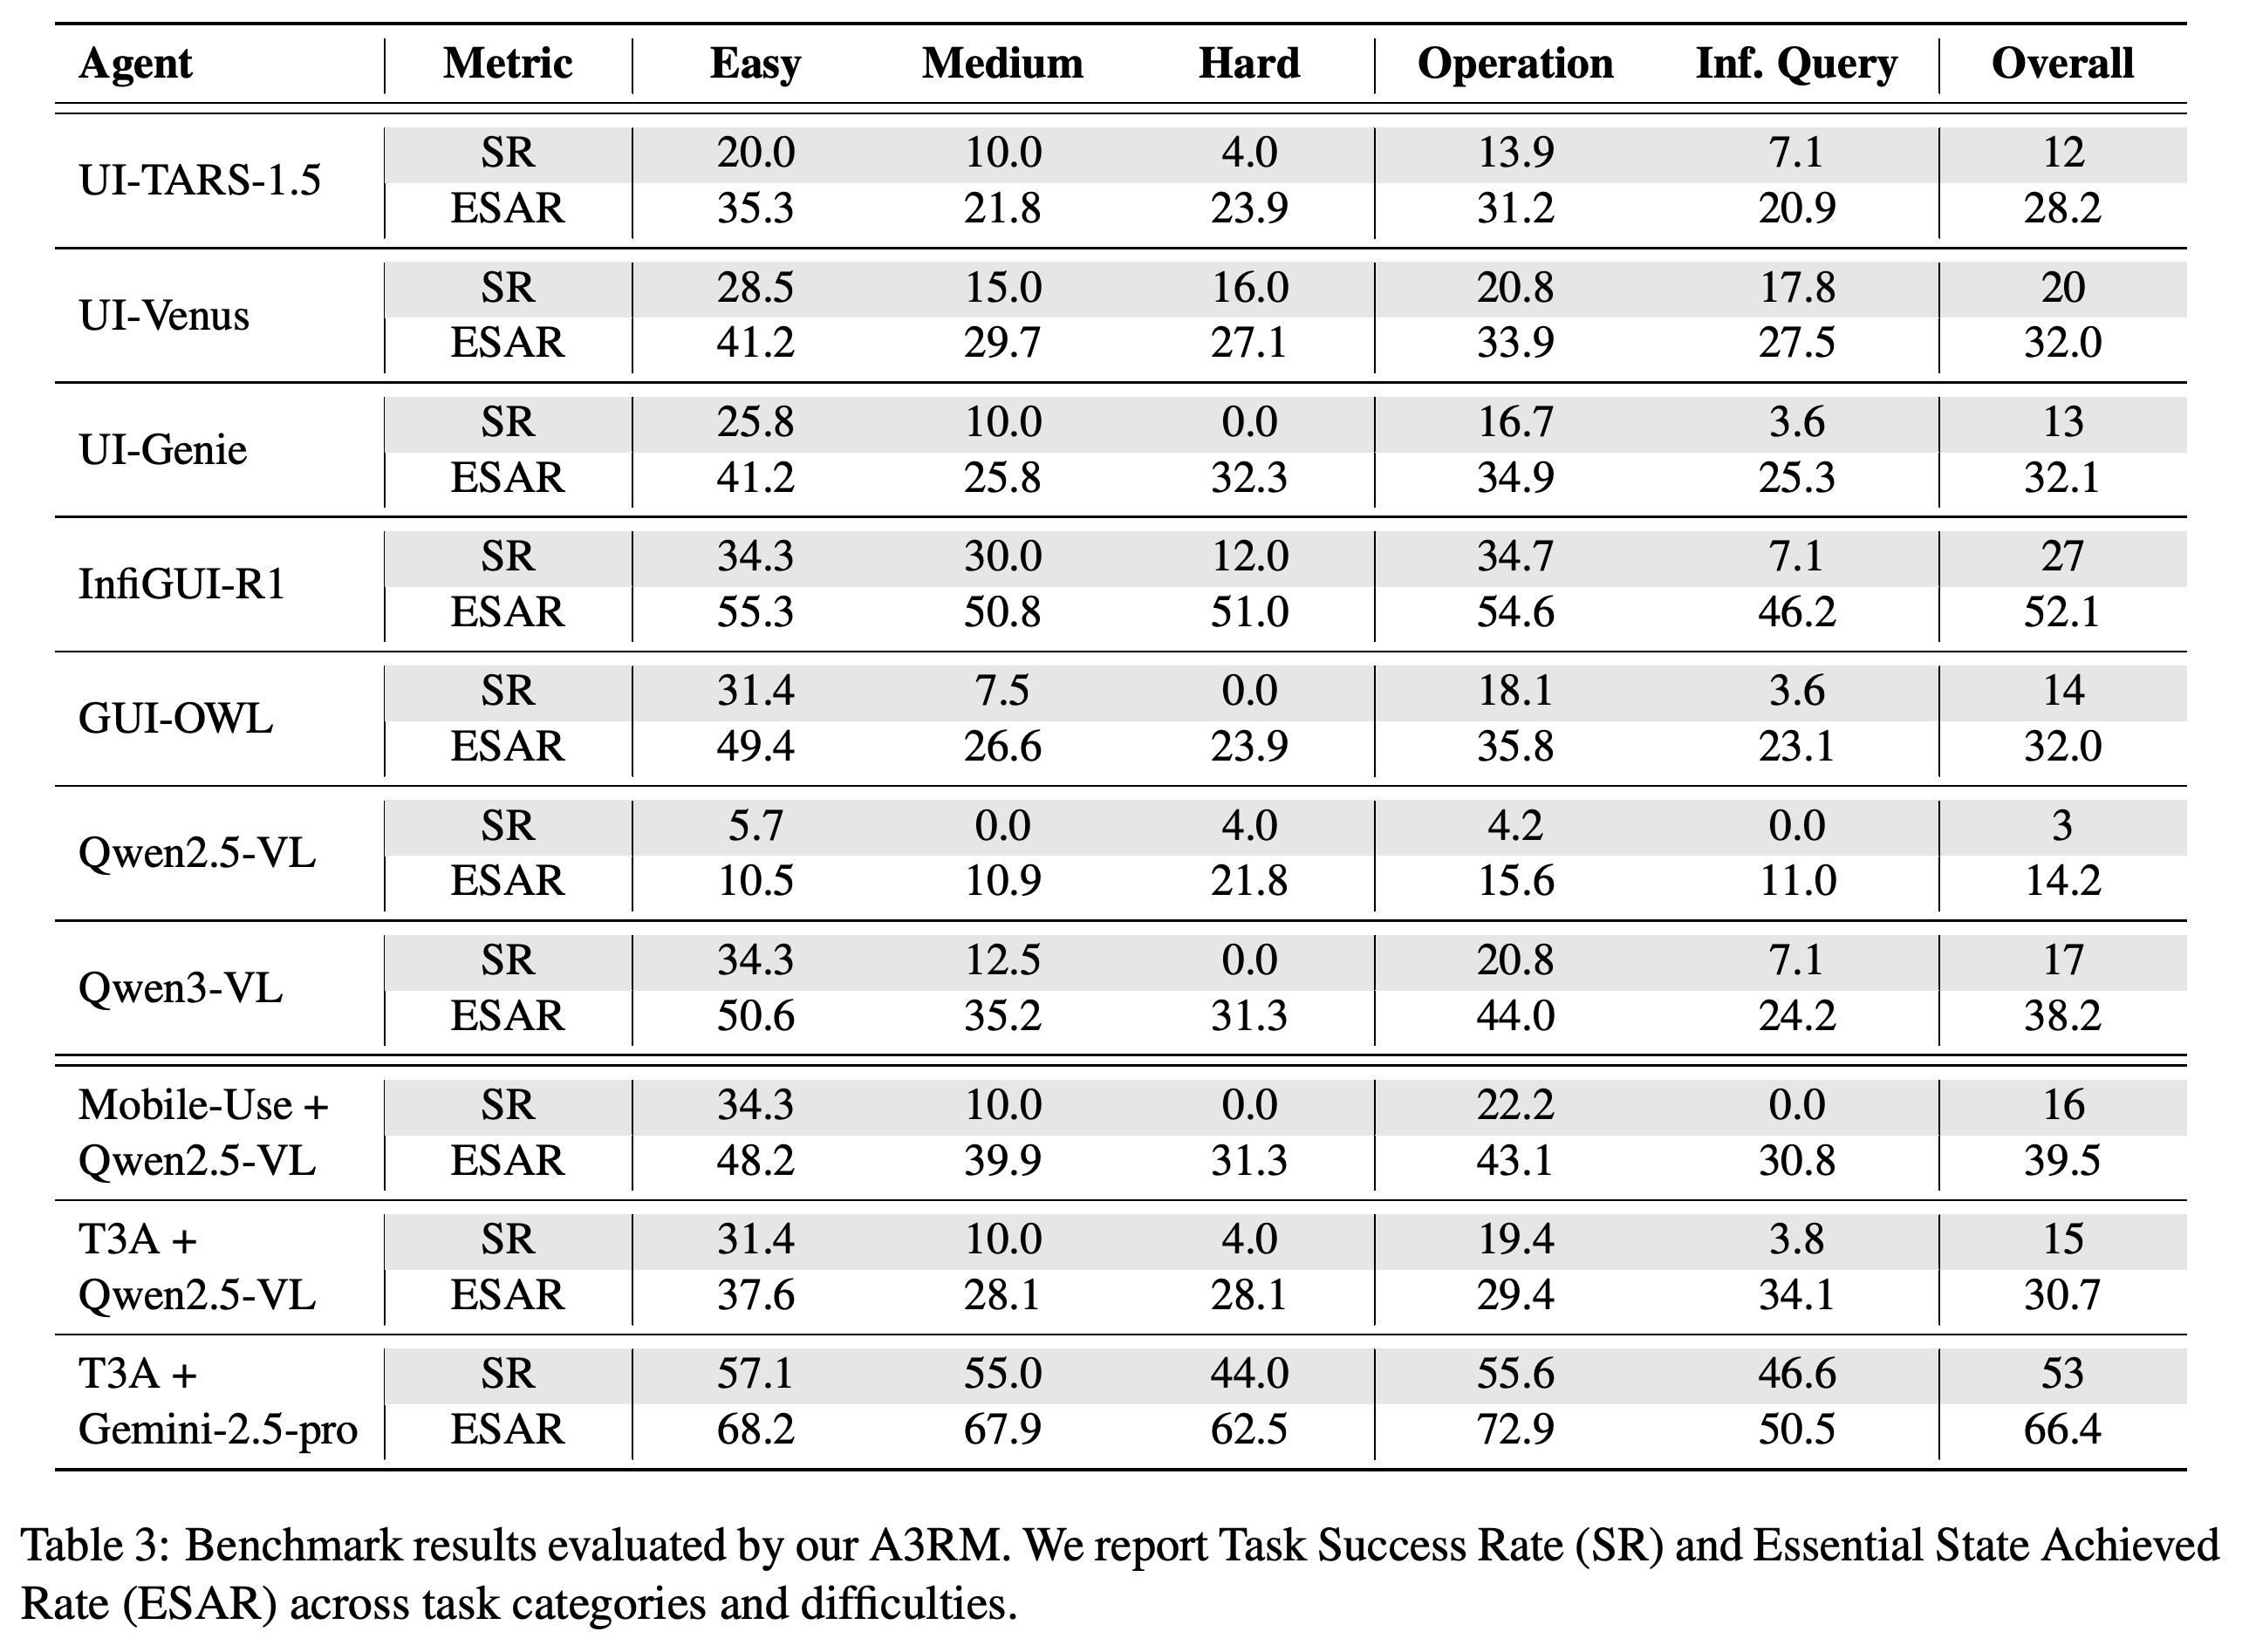
- A3RM으로 평가하면 Gemini-2.5-pro를 사용하는 T3A 에이전트 프레임워크는 과제의 53.0%를 완료한다. 평가한 오픈소스 단일 모델 에이전트 중 성능이 가장 높은 InfiGUI-R1은 27.0%를 완료한다. 이 결과는 에이전트의 실행 성능이며, 앞서 제시한 평가 모델의 정확도와는 별개다. 평가 범위는 Android와 자동 초기화가 가능한 앱으로 제한되며, 학습한 평가 모델도 오류를 낼 수 있다.
1 Introduction
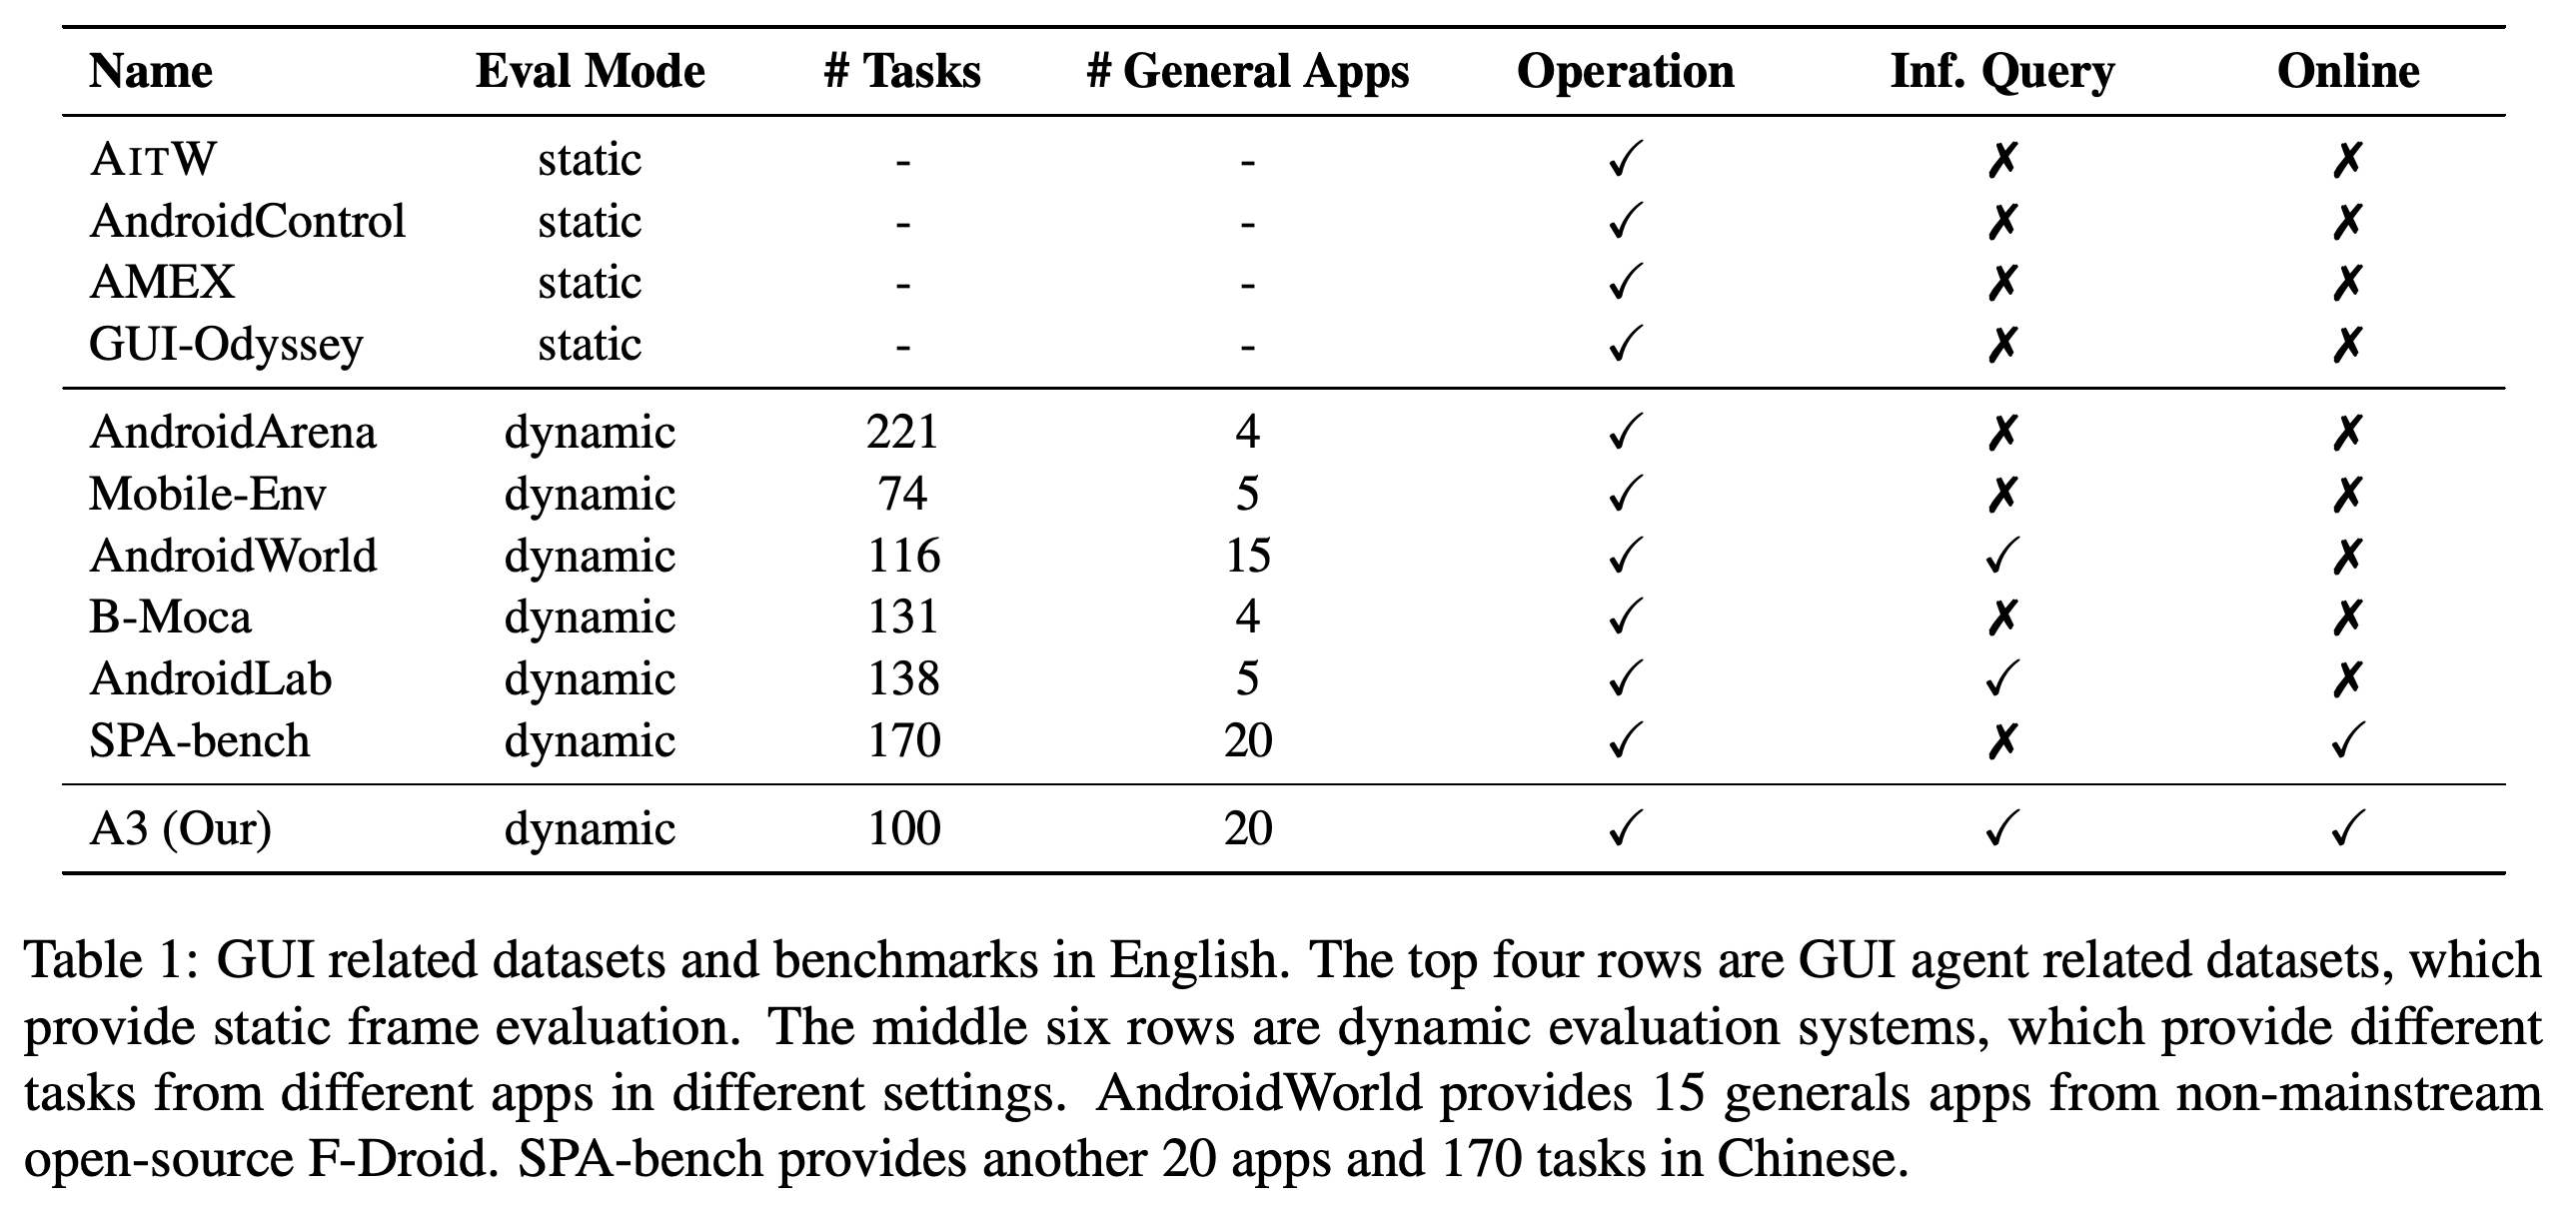
정적인 스크린샷 벤치마크는 개별 행동의 예측을 측정하지만, 누적되는 오류와 서로 다른 유효한 상호작용 경로를 포착하지 못한다. 상호작용형 벤치마크는 실제 환경을 더 잘 반영하지만, 내부 상태를 노출하도록 코드를 수정한 오픈소스 앱에 의존하므로 많은 독점 서비스를 포함하지 못한다. A3는 온라인 과제, 의미적 진척 평가, 상호작용 도구 모음으로 이 공백을 보완한다.
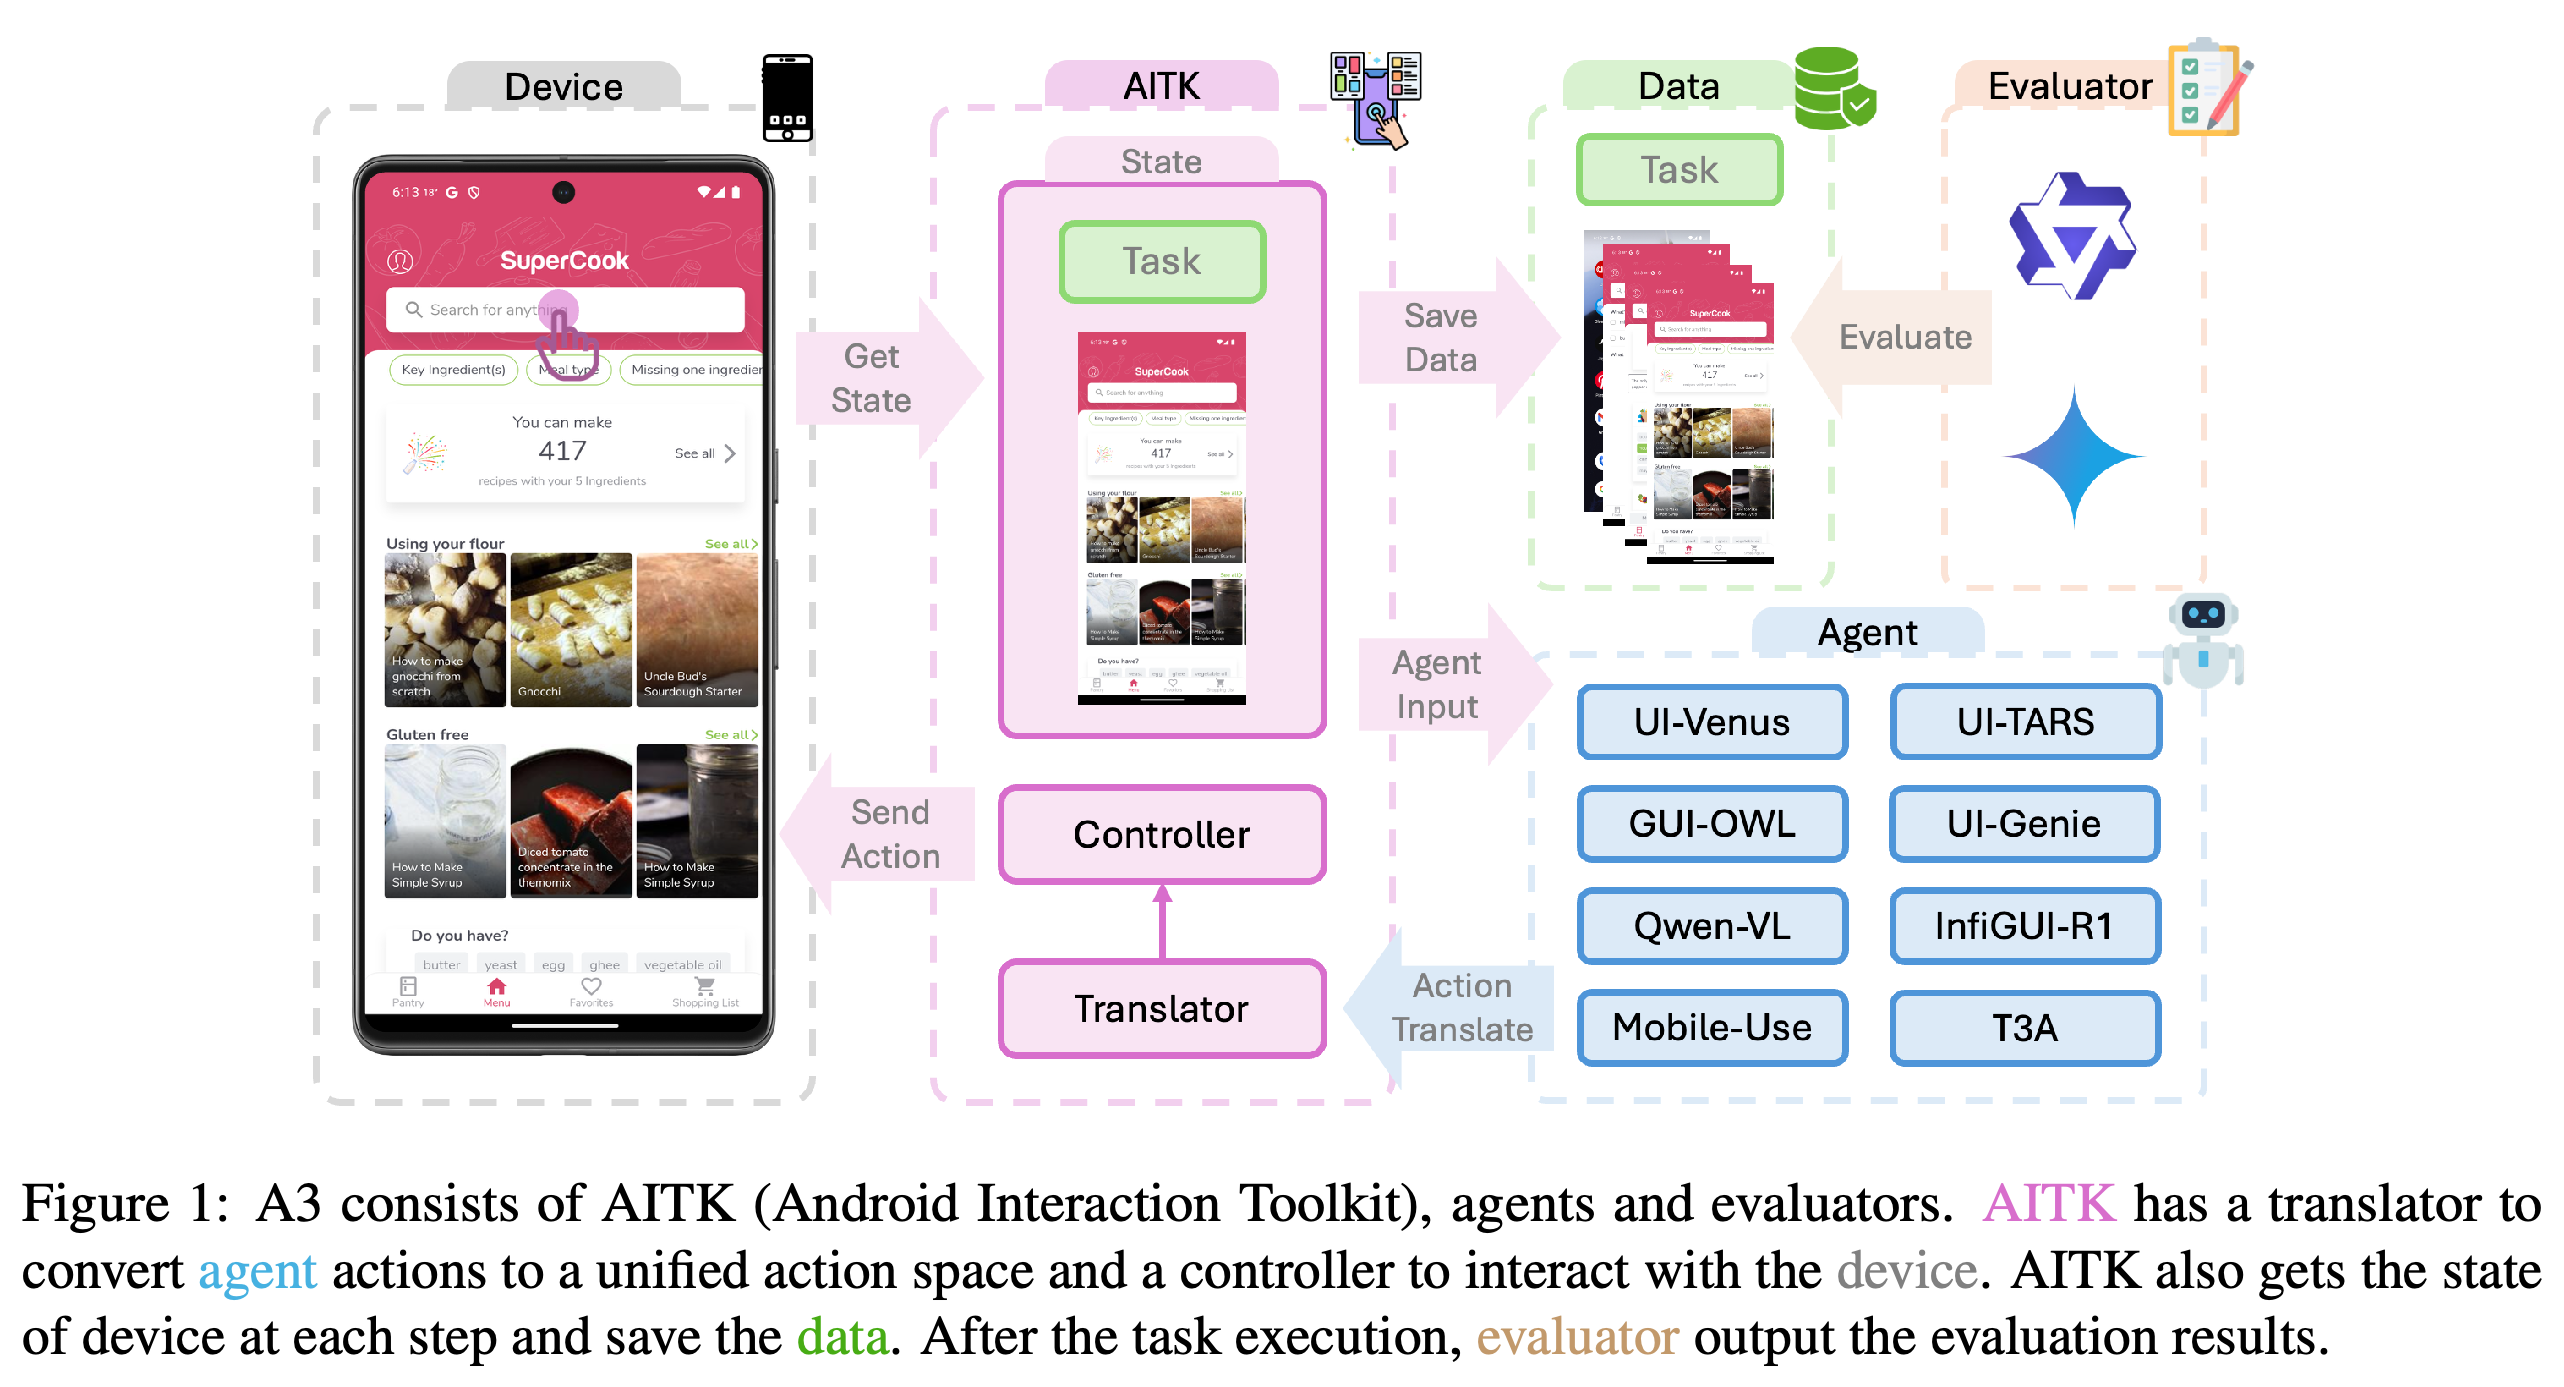
이 구조는 기기 제어를 에이전트 구현 및 후속 평가와 분리한다. 따라서 기록된 상호작용을 생성한 에이전트와 독립적으로 평가할 수 있다.
2 Related Work
관련 연구에서는 에이전트 구조와 벤치마크 평가 방법을 검토한다. 하위 절 2개는 에이전트가 인터페이스를 제어하는 방식과 과제 달성 여부를 평가하는 방식을 구분해 다룬다.
2.1 GUI Agents
논문은 미세 조정한 MLLM으로 직접 계획하고 행동하는 단일 모델 에이전트와, 인터페이스 인식, 인터페이스 계층 구조, 다중 에이전트 계획, 단축 경로 안내 등을 추가한 프레임워크를 구분한다. 인터페이스 계층 구조는 화면 요소와 요소 간 관계를 표현한다. A3는 단일 모델 에이전트와 프레임워크라는 2가지 유형을 모두 평가한다.
2.2 GUI Agent Benchmarks
기존 정적 벤치마크는 예측한 화면 요소나 좌표가 정답과 일치하는지 확인하고, 동적 벤치마크는 상호작용 환경에서 과제를 실행한다. 논문은 제한된 앱 범위, 불안정한 초기화, 미리 정한 정답과의 대조, 내부 상태의 정확한 일치 여부 확인이 변화하는 온라인 서비스의 평가를 제한한다고 주장한다. Table 1은 A3가 온라인 앱에서 상태를 바꾸는 조작과 정보 질의를 모두 지원한다는 점을 보여준다.
제시된 비교에서 A3는 동적 실행, 온라인 앱, 조작, 정보 질의를 함께 지원한다. 과제 100개는 비교 대상인 여러 동적 벤치마크보다 적으므로, 과제 수만으로 평가 범위가 더 넓다고 볼 수는 없다.
3 Android Agent Arena (A3)
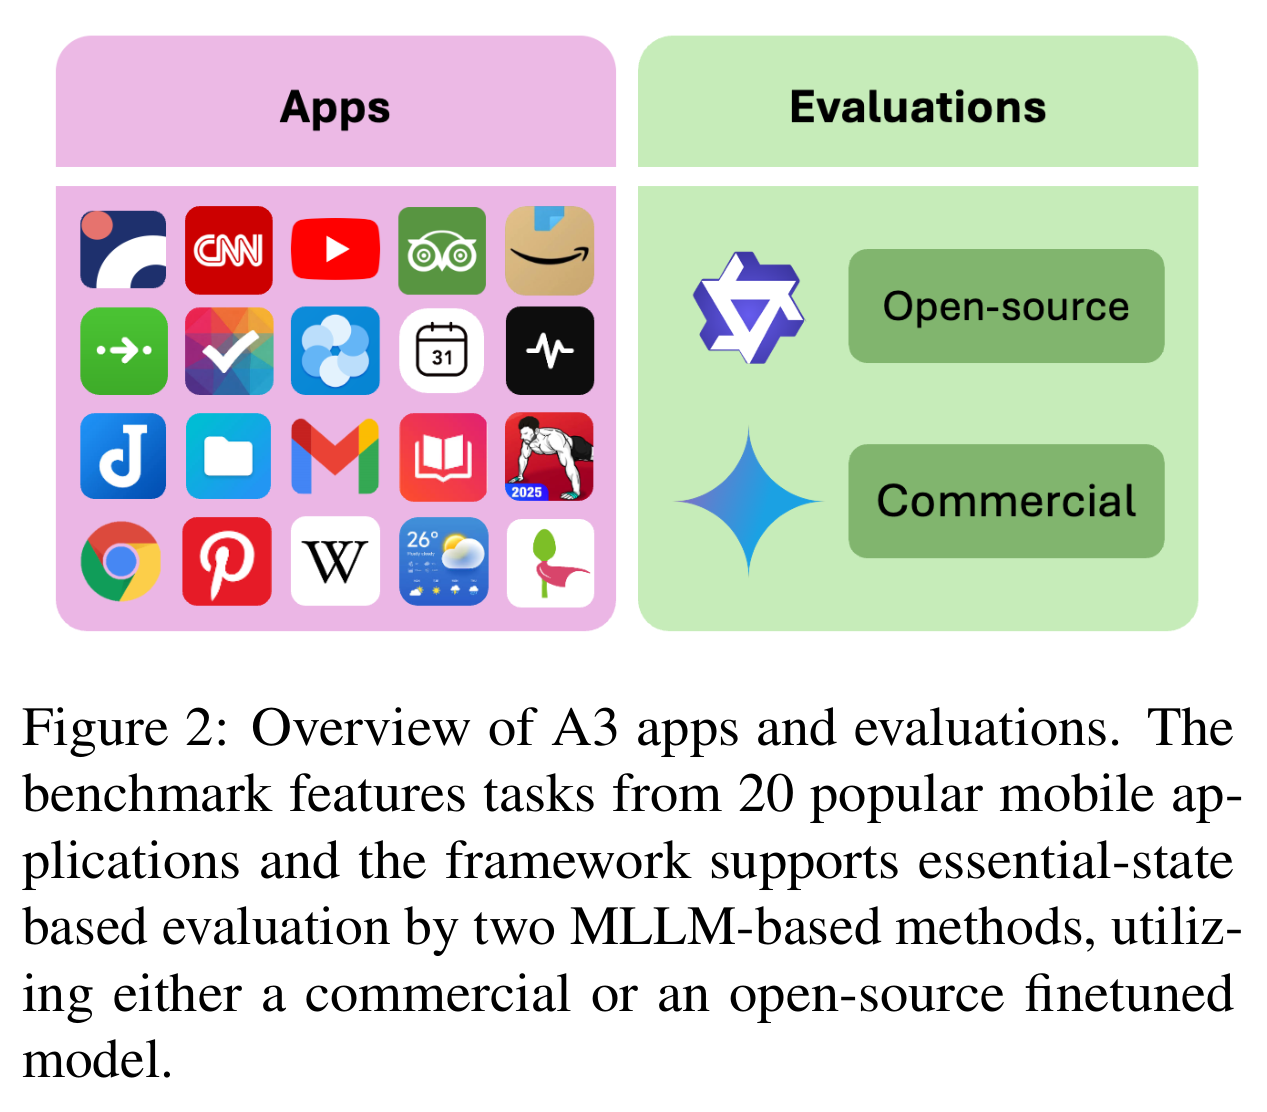
A3는 선정한 앱과 과제, essential state 평가, 모델 기반 판정, 소프트웨어 파이프라인을 결합한다. 독점 앱의 코드에 접근하지 않고도 시각적으로 관찰할 수 있는 과제 결과를 평가한다.
3.1 Apps & Tasks
저자들은 강제 로그인이 적고 자동 초기화가 안정적으로 가능한 앱을 우선하여 Google Play Store의 20개 범주에서 앱을 하나씩 선정한다. 선정한 앱의 평균 다운로드 수는 앱당 115 million회다. 과제 100개는 상태를 바꾸는 행동이 필요한 Operation과, 여기에 더해 질문에 답할 정보를 추출해야 하는 Information Query로 구성된다.
- 난도는 인간 전문가에게 필요한 단계 수 N에 따라 나눈다. Easy는 N < 7, Medium은 7 ≤ N ≤ 11, Hard는 N > 11이다.
- 과제는 Amazon의 쇼핑, CNN의 뉴스 검색처럼 각 앱의 핵심 기능을 따른다. 초기화 가능 여부에 따라 벤치마크에 포함할 작업 절차가 제한된다.
앱 모음에 평가 모델 선택지 2개를 제공한다. 동일한 벤치마크 프레임워크에서 상용 모델의 판정과 로컬 배포가 가능한 특화 모델의 판정을 모두 지원한다.
3.2 Essential-State Evaluation
essential state는 특정 화면 요소의 식별자나 픽셀 위치 대신, 검색어를 검색하거나 첫 번째 결과를 선택하는 것처럼 달성해야 할 의미적 결과를 지정한다. Essential-State Achieved Rate(ESAR)는 필요한 중간 목표 중 달성한 비율이며, ESAR = N_AES/N_TES로 정의한다. 여기서 N_AES는 달성한 essential state의 수이고, N_TES는 필요한 전체 essential state의 수다. 과제에 성공하려면 해당 과제의 모든 essential state를 달성해야 한다.
- 작업자 2명이 서로 다른 전략으로 각 과제를 독립적으로 완료한 뒤, 중간 목표를 함께 제안하고 독립적인 사람의 검토를 받는다.
- 중간 목표는 시각적으로 확인할 수 있어야 하고, 반드시 달성해야 하는 결과여야 하며, 전체 목표를 달성하면 과제 논리를 충분히 포괄해야 한다. 이를 정의하려면 수작업이 필요하다. 저자들은 핵심 과제 목표가 바뀌지 않는 동안에는 이 정의가 유효하다고 주장한다.
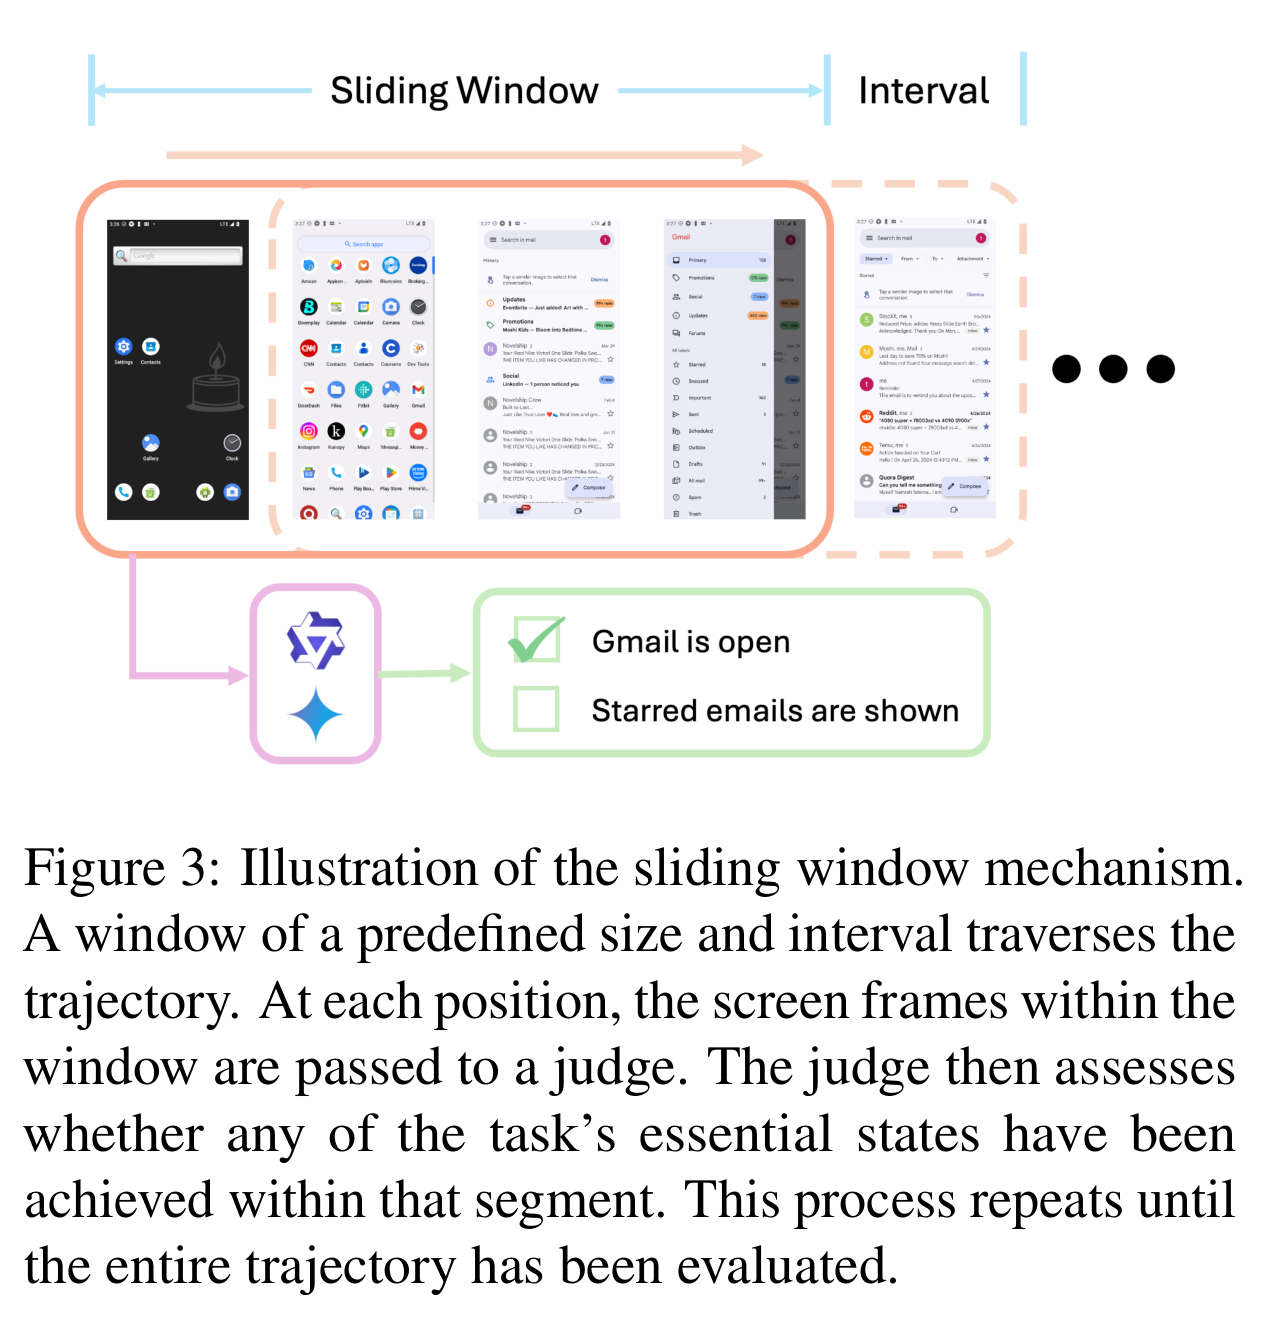
- 슬라이딩 윈도우는 연속된 스크린샷으로 구성된 구간을 이동시키는 방식이다. 기록된 상호작용 시퀀스인 궤적을 순회하면서 평가 모델이 각 윈도우에서 어떤 중간 목표가 달성되었는지 확인한다.
겹치는 스크린샷 구간은 해당 구간의 상태 변화를 확인할 증거를 제공한다. Gmail 예시는 앱 열기와 별표 표시된 메시지 보기를 별도 달성 항목으로 처리하므로, 전체 과제를 끝내기 전에도 진척을 기록할 수 있다.
3.3 MLLM-Based Judgment
독점 앱이 제공하는 인터페이스 계층 구조가 일관되지 않을 수 있고, 첫 번째 상품 선택과 같은 결과에는 의미 해석이 필요하므로 평가 모델은 시각 및 언어 이해 능력을 사용한다. 논문은 중간 목표 검증과 전체 궤적을 한 번에 판정하는 방식을 비교하며, 후자의 정확도가 기존 연구에서 약 80%였다고 인용한다. 이 수치는 A3 안에서 조건을 통제해 비교한 결과가 아니다.
- Gemini-2.5-pro를 상용 평가 모델로 사용한다. 정확도와 유료 평가 호출 수의 균형을 맞추기 위해 윈도우 크기와 윈도우 사이에 전진하는 단계 수인 간격을 조정한다.
- A3RM은 로컬에서 essential state를 검증할 수 있도록 Qwen3-VL-8B를 미세 조정한 모델이다. 로컬 배포는 호출별 서비스 요금을 없애지만, 추론에 필요한 연산은 여전히 수행해야 한다.
3.4 A3 Pipeline Suite
Android Interaction Toolkit인 AITK는 기기 상호작용, 과제 실행, 사람 또는 에이전트의 궤적 수집을 관리한다. 변환기가 에이전트 출력을 공통으로 지원하는 기기 행동 집합인 통합 행동 공간으로 변환하면 컨트롤러가 이를 실행한다. 에이전트와 독립적인 평가 모듈이 기록된 궤적을 처리한다. 저장소 URL은 https://github.com/YuxiangChai/AITK 이다.
4 Experiments
실험은 평가 모델의 판정이 주석으로 표시한 결과와 얼마나 일치하는지, 에이전트가 과제 100개로 구성된 벤치마크에서 어떤 성능을 보이는지 측정한다. 이는 과제 달성 여부를 판정하는 능력과 과제를 성공적으로 실행하는 능력을 각각 측정한다.
4.1 A3 Reward Model (A3RM)
A3RM은 크기 2, 간격 1의 스크린샷 윈도우를 사용한다. 학습 데이터는 양성 표본 981개와 음성 표본 7260개를 포함한 전문가 궤적 표본 8241개로 구성하며, 에이전트 궤적에서 얻은 음성 표본 1083개를 추가한다. 성공한 인간 시연은 벤치마크 과제당 평균 3개다. essential state를 달성한 전이를 양성 표본으로 표시하고, 나머지 전문가 전이를 음성 표본으로 사용한다.
- 저자들은 dynamic sampling policy optimization(DAPO)을 강화학습 알고리즘으로 명시하며, 보상 피드백으로 모델을 갱신하는 데 사용한다. 클래스 불균형에 대응하기 위해 학습 데이터를 한 차례 순회하는 각 에포크에서 양성 표본을 4배로 과표집한다.
- 학습에 사용하지 않은 A3 테스트 세트에서 A3RM의 essential state 정밀도는 95.7%, 재현율은 94.8%, F1 점수는 95.3%, 정확도는 96.6%다. Gemini-2.5-pro는 각각 87.3%, 96.3%, 91.5%, 89.5%를 기록한다. 재현율은 실제 달성 사례 중 탐지한 비율이고, F1은 정밀도와 재현율을 결합하며, 정확도는 전체 판정 중 올바른 판정의 비율이다.
- 과제 수준에서 A3RM의 정밀도는 96.0%, 재현율은 96.0%, F1은 96.0%, 정확도는 98.0%다. essential state 재현율은 Gemini보다 약간 낮다. 논문은 A3RM이 A3 과제 분포에 특화된 모델이라고 명시한다.
A3RM은 Gemini-2.5-pro보다 essential state 정밀도가 8.4%p, 과제 정밀도가 10.3점 높다. essential state 재현율은 96.3%에서 94.8%로 낮아지므로, 모든 지표가 개선된 것은 아니다.
4.2 A3 Benchmark
벤치마크는 공식 공개 프롬프트와 추론 설정을 사용해 단일 모델 에이전트 7개와 에이전트 프레임워크 2개의 구성 3개를 평가한다. A3RM으로 평가하면 완료한 과제의 비율인 과제 성공률(Success Rate, SR)은 T3A + Gemini-2.5-pro가 53.0%로 가장 높다. 단일 모델 에이전트 중에서는 InfiGUI-R1이 27.0%로 가장 높다.
- Qwen2.5-VL의 SR은 단독 사용 시 3.0%, Mobile-Use와 결합하면 16.0%, T3A와 결합하면 15.0%다. T3A를 유지한 채 Qwen2.5-VL을 Gemini-2.5-pro로 교체하면 SR이 53.0%로 높아진다. 이는 프레임워크와 기반 모델 모두 측정 성능에 영향을 준다는 점을 보여준다.
- Qwen3-VL은 프레임워크 없이 SR 17.0%를 달성한다. Hard 과제에서 UI-Genie, GUI-OWL, Qwen3-VL, Mobile-Use + Qwen2.5-VL은 각각 0.0%를 기록하고, T3A + Gemini-2.5-pro는 44.0%를 기록한다.
- 평가한 모든 구성에서 ESAR이 SR보다 높다. InfiGUI-R1은 ESAR 52.1%, SR 27.0%를 기록하고, T3A + Gemini-2.5-pro는 각각 66.4%와 53.0%를 기록한다. 이 차이는 완전한 성공에 이르지 못해도 일부 목표를 달성했음을 보여준다. 별도의 사례 연구에서는 행동 반복과 완료 인식 실패를 확인한다.
모든 구성에서 ESAR이 SR보다 높아, 완료한 과제 외에도 부분적인 진척이 있음을 보여준다. T3A + Gemini-2.5-pro가 전체 성능에서 앞서지만, A3RM 평가의 성공률은 53%이므로 과제의 47%는 완료하지 못한다.
5 Conclusion
논문은 온라인 Android 벤치마크와, 완전한 성공 여부뿐 아니라 중간 목표 달성도 기록하는 시각적 평가 방법을 제시한다. 평가한 에이전트는 과제를 끝내지 못해도 진척을 보이는 경우가 많다. 특화된 평가 모델은 학습에 사용하지 않은 A3 테스트 세트에서 Gemini-2.5-pro보다 높은 정확도와 정밀도를 보인다.
Limitations
A3는 Android만 다룬다. 저자들은 가상화와 프로그래밍 방식의 제어에 대한 제약 때문에 iOS를 지원하지 못했다고 설명한다. 인증과 계정 초기화 제약으로 인스턴트 메시징 같은 범주도 제외된다. A3RM은 기록된 상호작용으로 뒷받침되지 않는 성공을 보고하는 환각 오류를 낼 수 있다.
부록
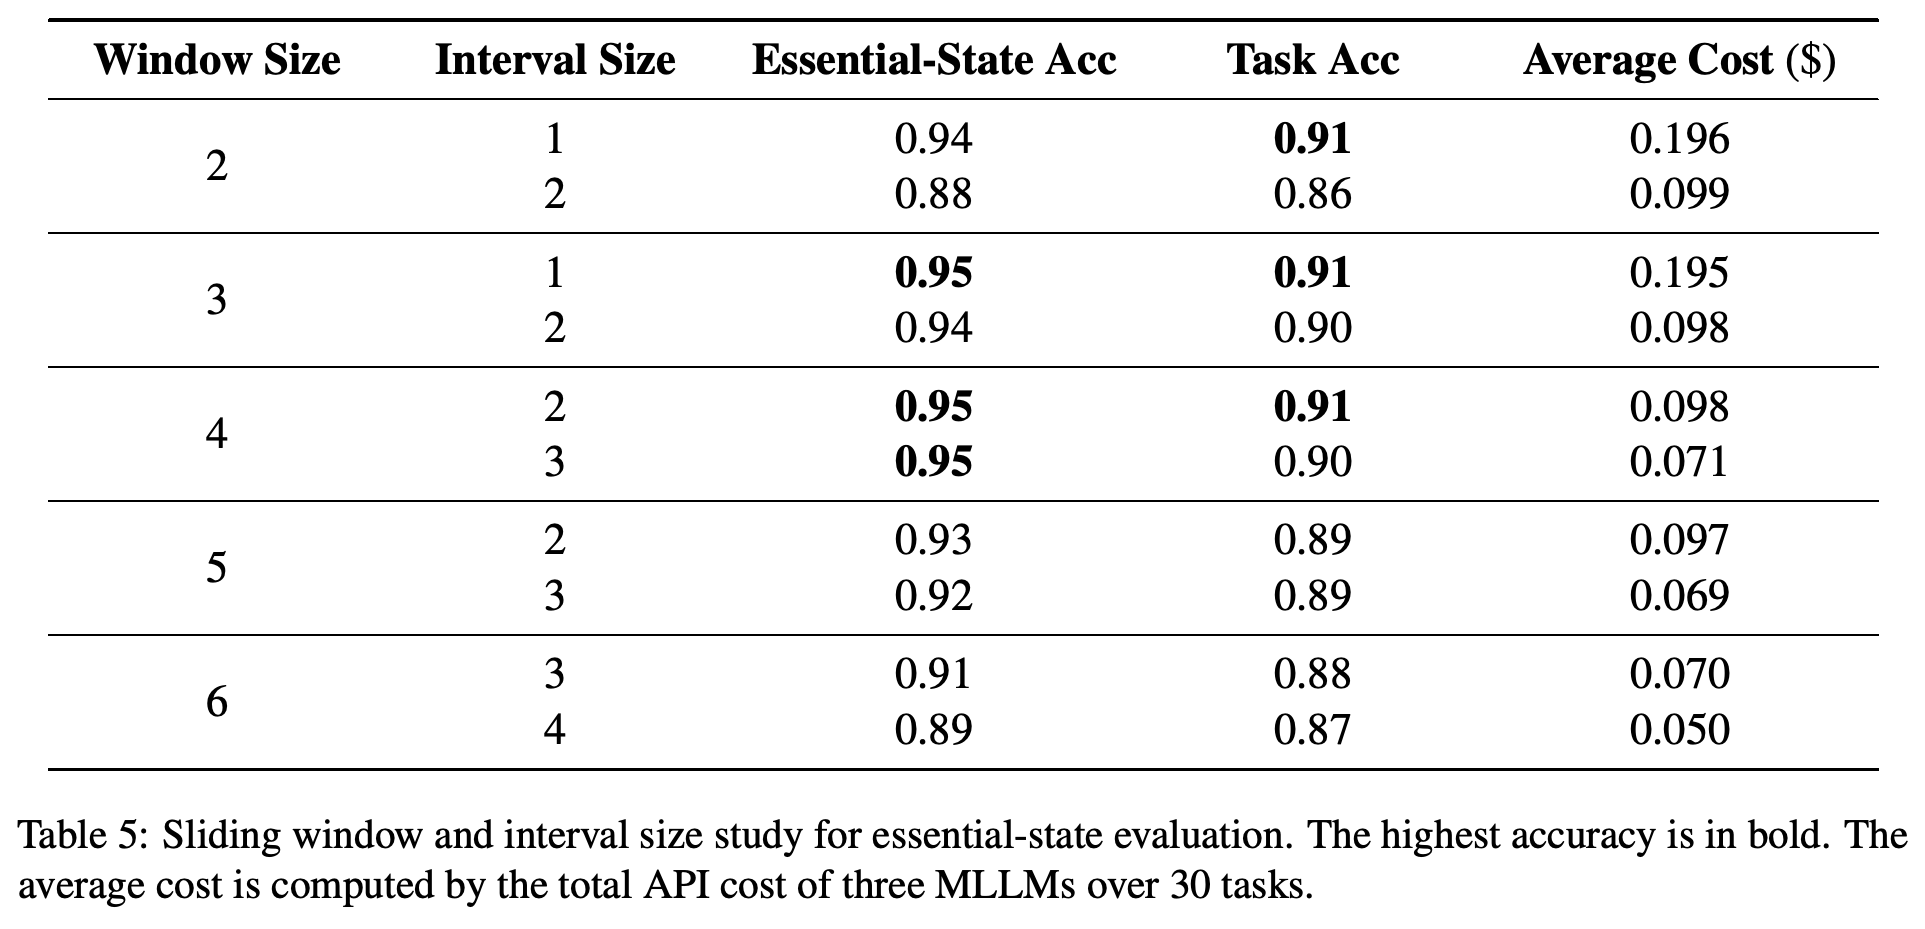
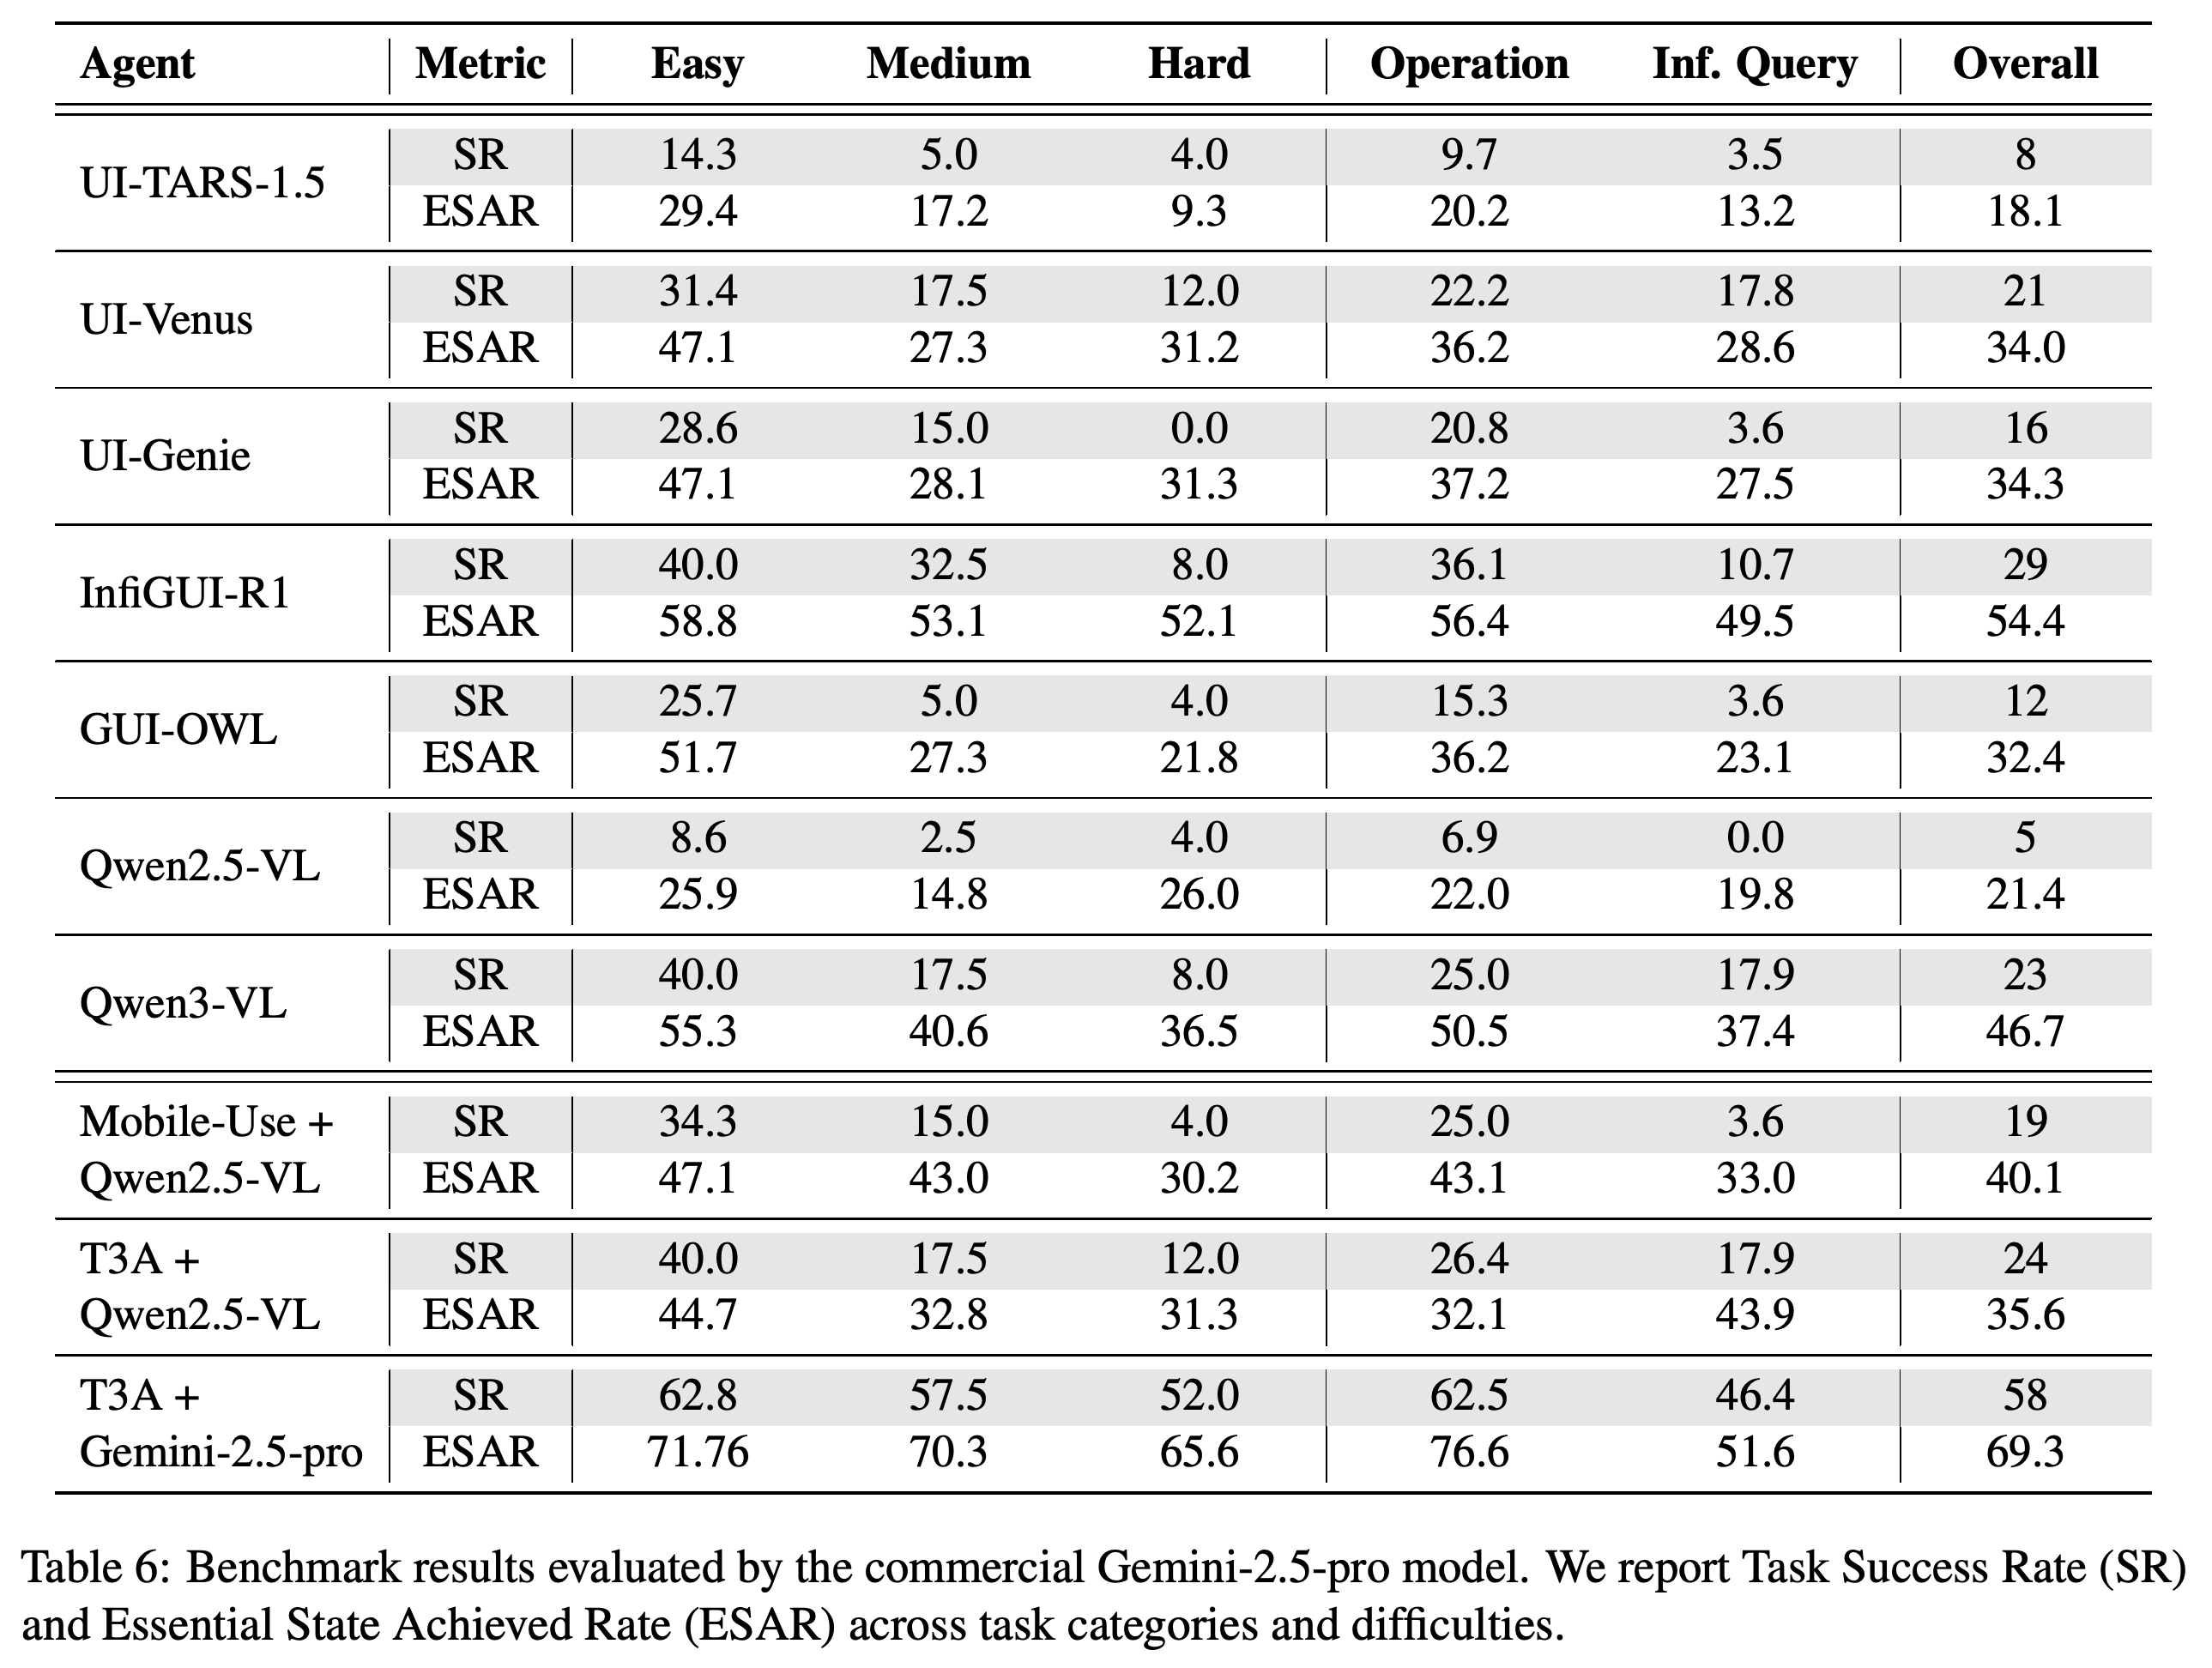
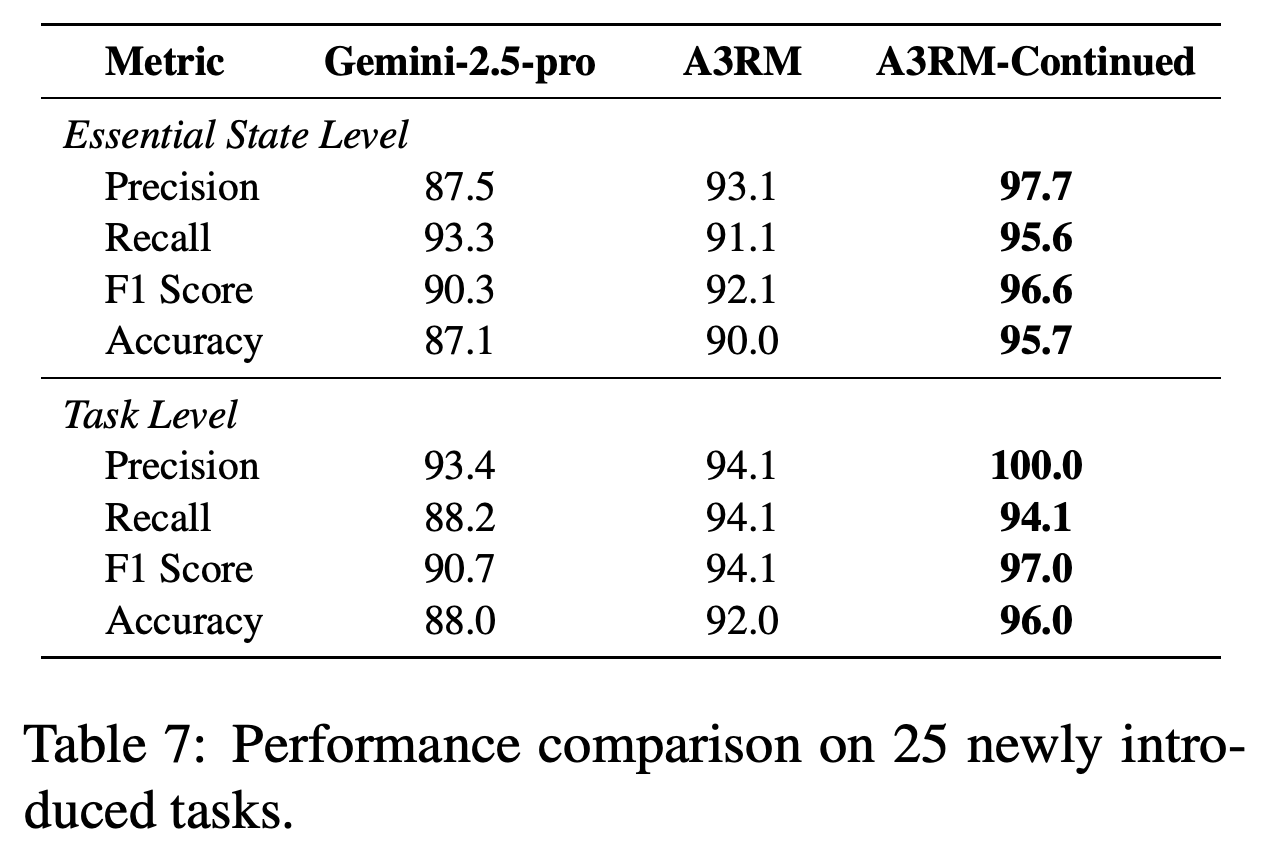
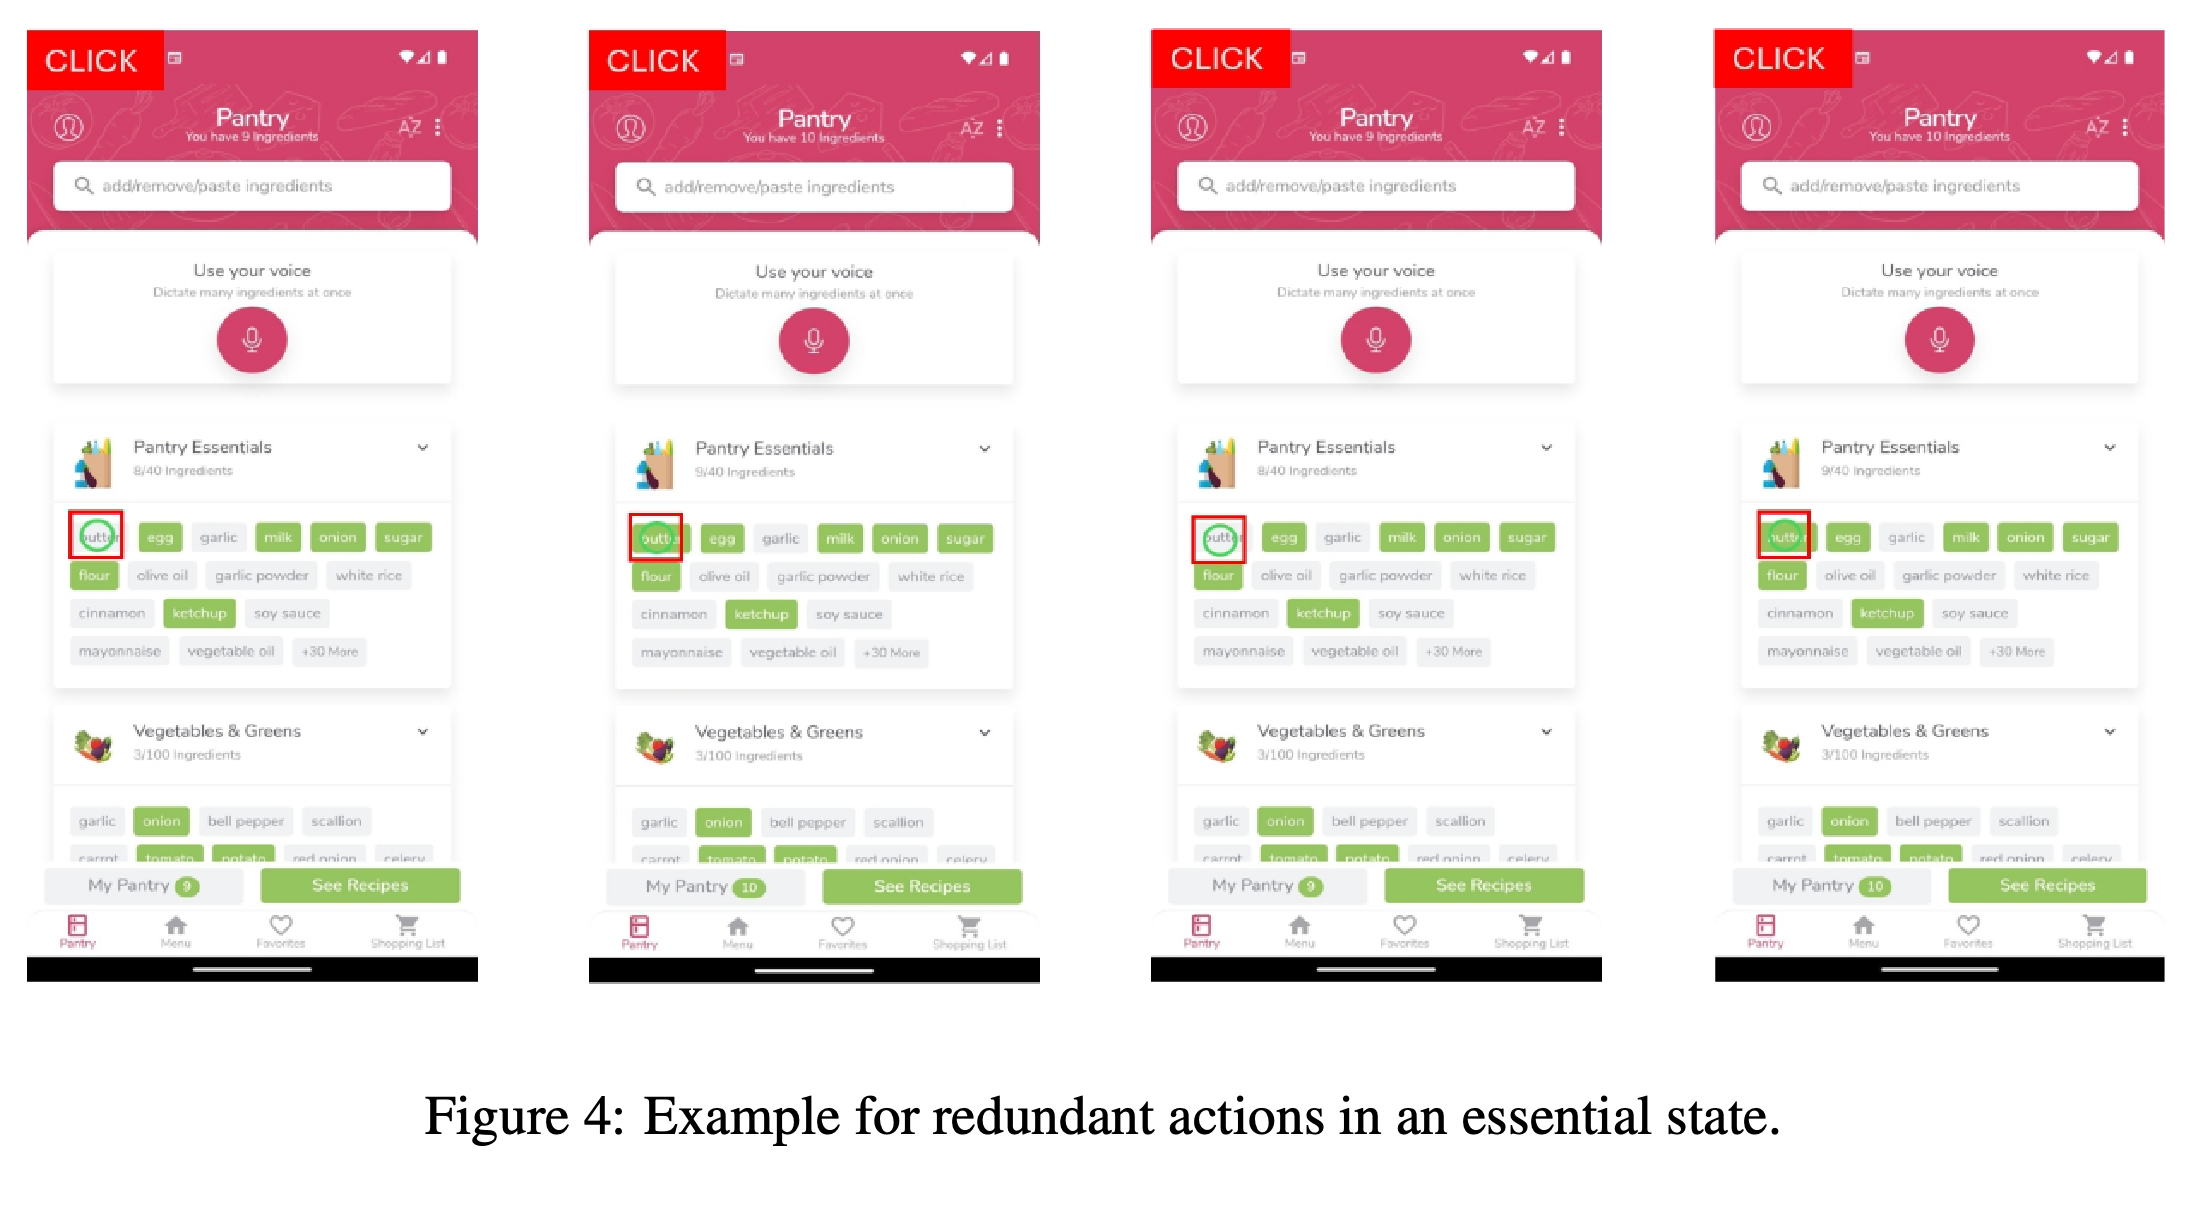
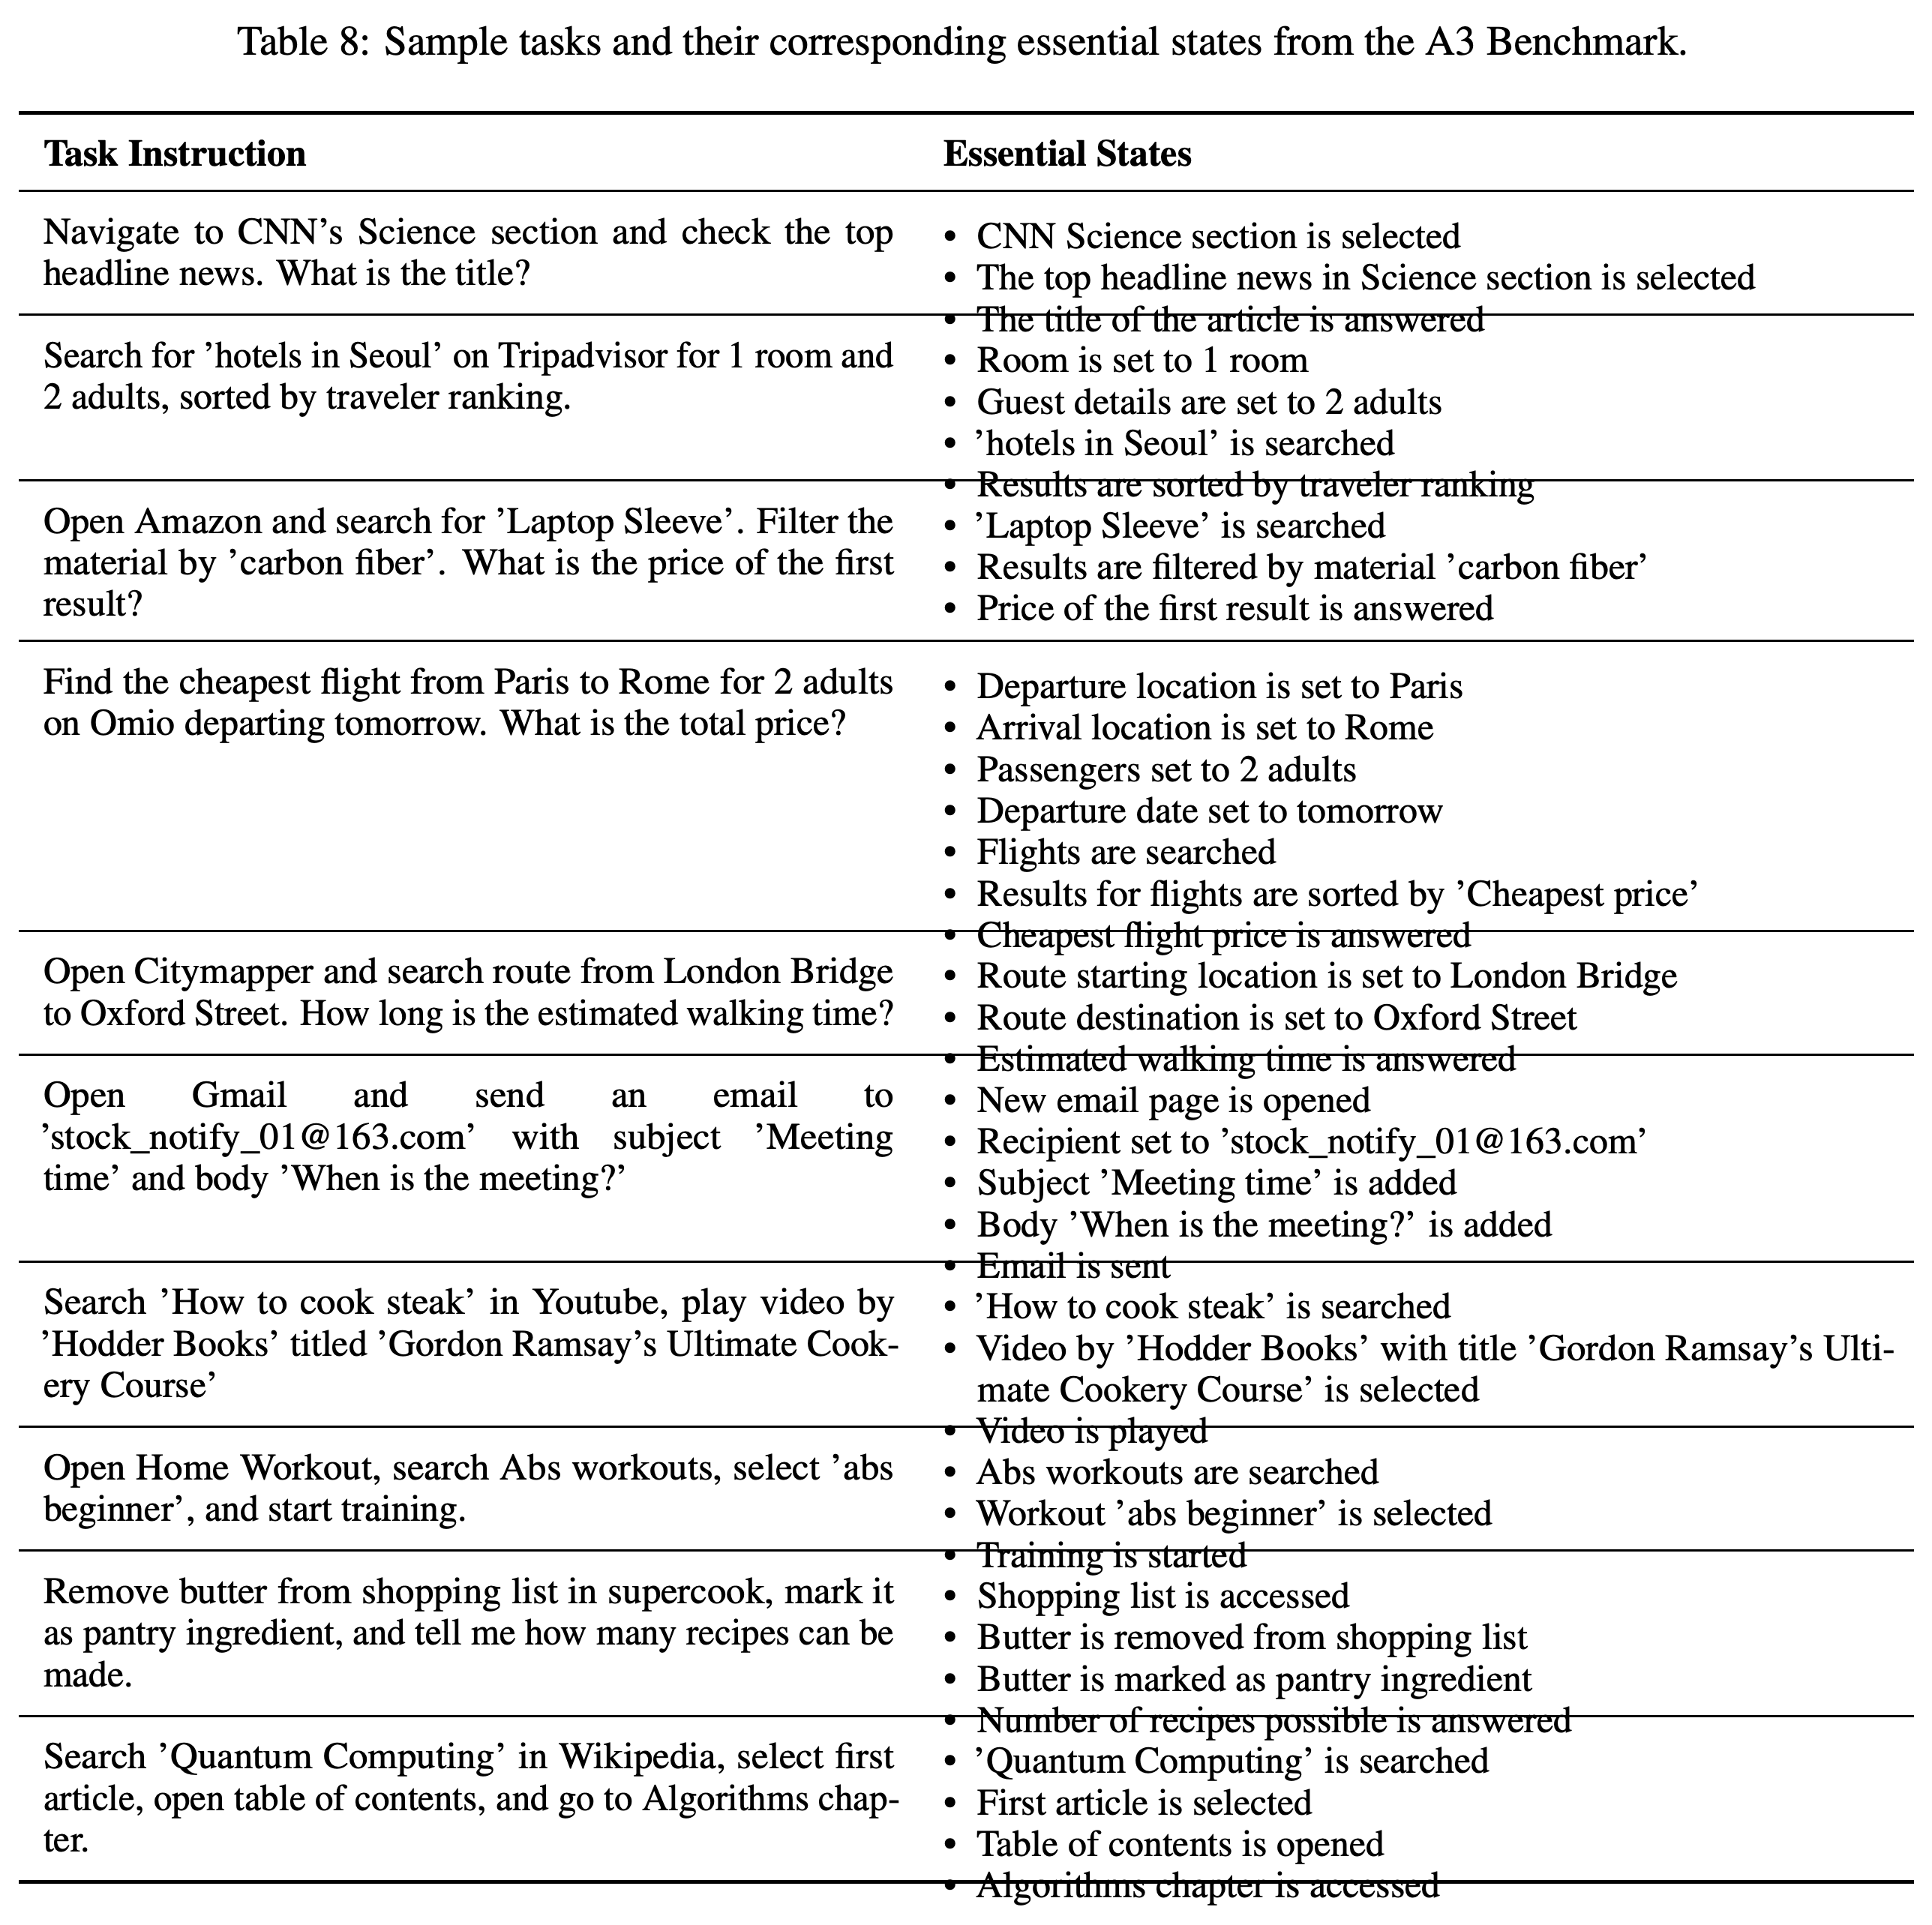
- A Appendix는 앱 목록, 과제 예시, 평가 모델 연구, 실패 사례, 구현 정보를 제공한다. A.1 App List와 A.2 Tasks & Essential States는 앱과 범주의 대응 관계 20개를 기록하고, 과제를 분해한 예시 10개를 제시한다. 예시에는 CNN의 Science 헤드라인을 선택하고 제목을 답하는 과제, Amazon 검색 결과에 소재 필터를 적용하는 과제, Omio 항공편 검색을 설정한 뒤 최저가를 보고하는 과제가 포함된다. A.3 Sliding Window and Interval Study는 윈도우 크기 2–6을 시험한다. 크기 4, 간격 2는 essential state 정확도 0.95와 0.91 task accuracy를 달성하며, 보고된 평균 비용은 $0.098이다. 크기 2, 간격 1의 비용은 $0.196이다. 캡션은 30 tasks에 three MLLMs를 사용한 총 서비스 비용을 기준으로 평균 비용을 정의한다. 저자들은 윈도우가 커지면 스크린샷의 가독성이 낮아지고, 작은 윈도우가 겹치지 않으면 행동과 그 결과가 서로 다른 윈도우로 분리되어 정확도가 낮아진다고 설명한다. A.4 Gemini Evaluation에서 T3A + Gemini-2.5-pro의 SR은 58.0%, InfiGUI-R1의 SR은 29.0%다. A3RM으로 평가한 값은 각각 53.0%와 27.0%다. 저자들은 전반적으로 높은 점수를 Gemini의 낙관적인 판정으로 해석하며, 이는 Table 2의 낮은 정밀도와도 일관된다. 다만 모든 결과가 같은 방향으로 바뀌지는 않는다. UI-TARS-1.5는 Gemini 평가에서 8.0%, A3RM 평가에서 12.0%를 기록하고, GUI-OWL은 각각 12.0%와 14.0%를 기록한다. A.5.1 General Agent Issues와 A.5.2 Dynamic Online Apps Specialty를 포함한 A.5 Case Study는 불필요한 행동 반복, 종료 실패, 시각적 요소의 잘못된 식별, 부정확한 클릭 좌표를 확인한다. 온라인 환경에 특유한 어려움으로는 순위가 매겨진 유사한 결과, 광고와 스폰서 콘텐츠, 중첩된 필터 메뉴가 있는 복잡한 인터페이스가 있다. 이는 정성적 관찰이며 오류 발생 빈도는 보고하지 않는다. A.6 Generalization Analysis는 원래 학습 분포 밖에서 새로 도입한 과제 25개를 평가한다. 추가 학습을 하지 않은 A3RM은 essential state 정확도 90.0%, 과제 정확도 92.0%를 기록하며, Gemini-2.5-pro는 각각 87.1%와 88.0%를 기록한다. 그러나 essential state 재현율은 91.1%로 Gemini의 93.3%보다 낮아, 모든 지표에서 우수하다는 본문 주장과 모순된다. 새 과제의 데이터로 추가 학습한 A3RM-Continued는 정확도 95.7%와 96.0%를 달성하므로, 이 개선에는 새 과제에 대한 적응 효과가 포함된다. A.7 Risks & License는 온라인 앱에서 잘못된 행동이 콘텐츠에 영향을 줄 수 있으며, 일부 앱은 로그인이 필요하다고 설명한다. GUI-OWL과 UI-Genie에는 MIT 라이선스가, UI-TARS, UI-Venus, InfiGUI-R1, Qwen2.5/3-VL에는 Apache 라이선스가 적용된다고 기재한다. A.8 Training Details는 L40s (48G)에서 600 GPU-hour를 사용했다고 보고한다. 학습 코드베이스로 EasyR1을, 강화학습 알고리즘으로 DAPO를 사용한다. A.9 AI Declaration은 Gemini가 논문 작성을 도왔으며 평가 방법 중 하나로도 사용되었다고 밝힌다.
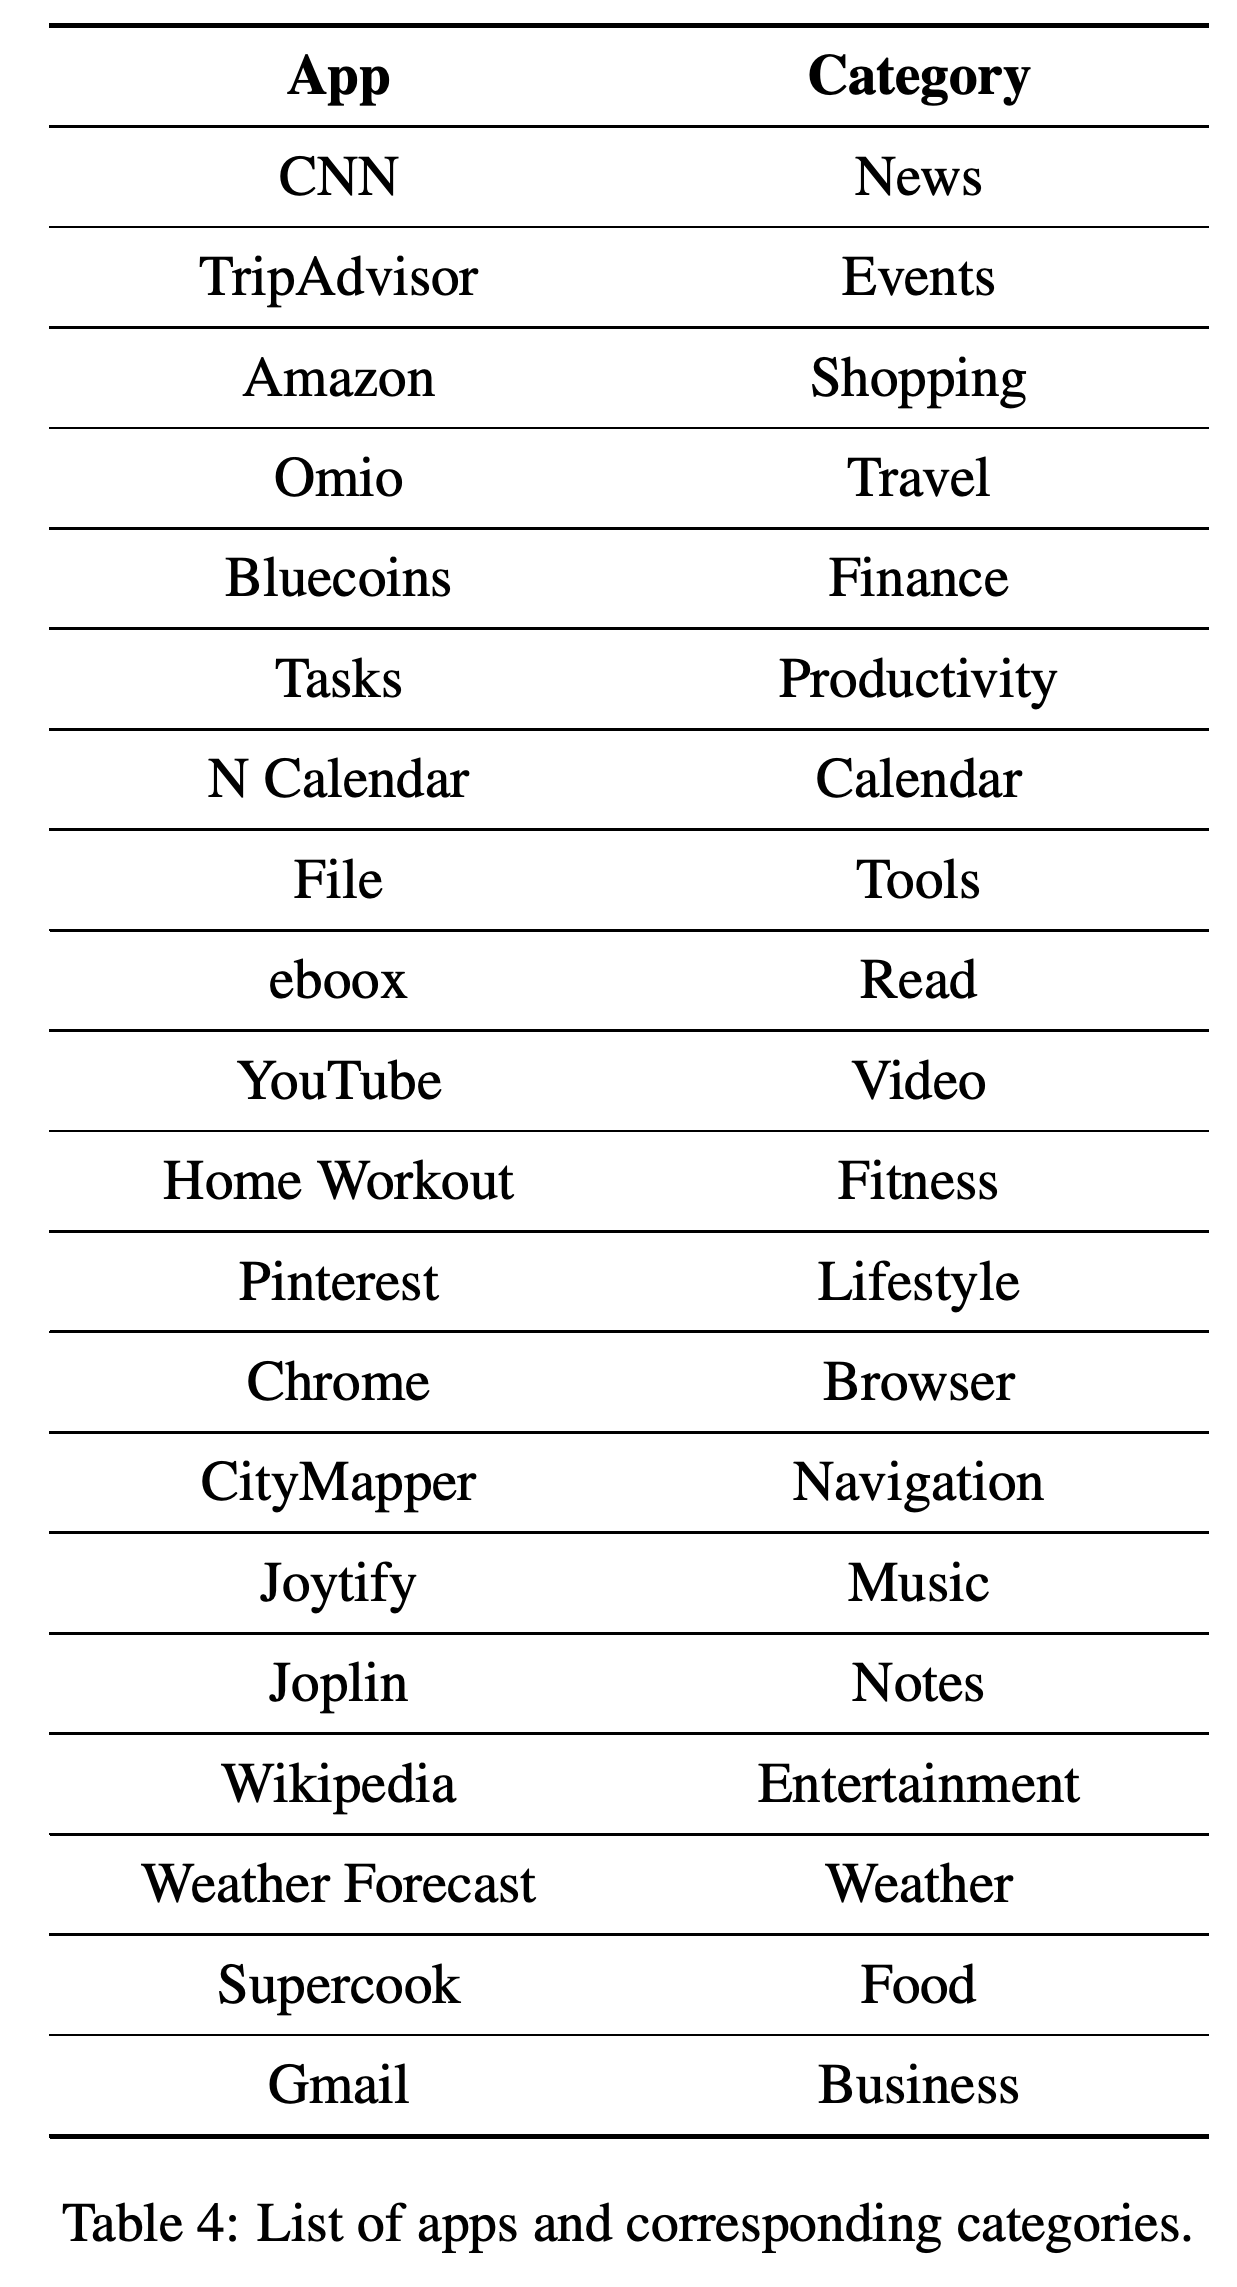
목록은 범주마다 선정한 앱을 제시하며 뉴스, 쇼핑, 내비게이션, 이메일, 로컬 유틸리티를 포함한다. 벤치마크가 다루는 범위를 명시하지만, 선정한 앱이 해당 범주의 모든 작업 절차를 대표한다는 근거는 제공하지 않는다.
윈도우 크기 4, 간격 2는 보고된 비용 계산 기준으로 $0.098에서 essential state 정확도 0.95와 과제 정확도 0.91을 기록하며, 각 정확도는 모두 최고값에 도달한다. 더 저렴한 설정도 있다. 크기 6, 간격 4는 $0.050 task 비용으로 더 저렴하지만 과제 정확도는 0.87로 낮아진다.
Gemini 평가에서도 T3A + Gemini-2.5-pro가 전체 성능에서 가장 높고 InfiGUI-R1이 단일 모델 에이전트 중 가장 높지만, 절대 점수는 달라진다. UI-TARS-1.5와 GUI-OWL의 성공률은 A3RM 평가보다 낮아, 평가 모델의 차이가 모든 점수를 일률적으로 높이지는 않음을 보여준다.
새 과제 25개에서 추가 학습을 하지 않은 A3RM은 Gemini보다 정확도가 높지만 essential state 재현율은 낮다. A3RM-Continued는 해당 과제의 추가 데이터를 사용하므로, 더 높은 성능에는 적응 효과가 포함되며 변경하지 않은 모델의 전이 능력만을 측정한 결과는 아니다.
이 시퀀스는 버터 항목의 처리가 완료되었음을 안정적으로 인식하지 못하고 같은 재료를 반복해서 조작하는 모습을 보여준다. 불필요한 행동 반복의 예시지만, 벤치마크 전체에서 이 실패가 얼마나 자주 발생하는지는 보여주지 않는다.
과제 분해 예시는 고정된 정답과 대조하는 대신 현재 콘텐츠를 선택하거나 헤드라인과 가격 같은 현재 정보를 보고하도록 요구한다. 또한 어떤 달성 항목을 완료 조건으로 인정할지 정하기 위해 과제별 수작업 정의가 필요하다는 점을 보여준다.
짧은 생각
의미적 중간 목표와 실행 가능한 온라인 앱 벤치마크를 결합하면 독점 소스 코드에 접근하지 않고도 부분적인 진척을 측정할 수 있다. Table 2는 평가 모델의 정밀도 향상을 뒷받침한다. Table 3은 완전한 성공 여부와 함께 중간 목표 달성을 보고할 때 얻는 추가 정보를 보여준다. 과제 25개를 추가한 실험은 전이에 대한 제한적인 근거를 제공한다. 재현율이 낮아지는 점과 A3RM-Continued에 사용한 추가 학습은 일반화 주장의 범위를 제한한다. ESAR–SR 차이만으로는 과제 실패 원인을 알 수 없다. 정성적 예시는 진척 추적 문제와, 의도한 행동을 잘못된 화면 대상에 연결하는 시각적 그라운딩 오류를 보여주지만 각 원인의 상대적 기여도는 정량화하지 않는다. 에이전트 점수는 평가 모델에 따라 달라지고, 앱 선정은 초기화 가능 여부에 따라 달라진다. 이러한 조건은 결과를 모바일 에이전트의 전반적인 신뢰성으로 일반화할 수 있는 범위를 제한한다.