


2025년 8월 AI 논문 동향
31 Aug 2025 | Paper Review Monthly Papers Efficient Generation Agentic Reasoning Long-Context Modeling목차
이달의 트렌드
2025년 8월의 주제는 긴 생성 과정에서 정보와 연산을 관리하는 방법이며, 선정된 세 논문은 실행 피드백, 이전 영상 내용의 선택적 참조, 간결한 음성 표현으로 추론과 긴 출력을 지원한다. rStar2-Agent는 Python으로 중간 결과를 검증하며 수학 추론을 학습한다. Mixture of Contexts는 국소 문맥을 유지하면서 관련된 이전 영상 구간을 검색한다. VibeVoice는 음성을 간결한 연속형 특징 벡터로 인코딩하여 일관된 목소리로 긴 대화를 생성하도록 한다. 1, 2, 3
각 설계는 서로 다른 형태의 유용한 문맥을 보존한다. rStar2-Agent는 추론과 도구 상호작용의 전체 시퀀스인 궤적 중 정답을 내고 실행 오류와 형식 오류가 적은 궤적을 우선 선택해 학습한다. Mixture of Contexts는 캡션과 현재 shot에 반드시 접근하도록 하면서 이전 내용을 선택적으로 검색한다. Shot은 컷 사이에 이어지는 연속 영상 구간이다. VibeVoice는 오디오 특성을 나타내는 음향 특징과 대본 관련 내용을 나타내는 의미 특징을 모두 이후 예측에 다시 사용한다. 이 방법들은 서로 다른 실패 양상을 다루므로, 결과는 분야별 설계 선택의 근거가 된다. 공통된 성능 순위를 제시하는 비교는 아니다.
효율성을 뒷받침하는 근거는 논문마다 다르다. Mixture of Contexts는 64초 장면에서 측정한 종단 간 속도가 2.2× 향상되었다고 보고하지만, 짧은 영상에서는 산술 연산량이 줄어도 전체 생성 과정이 느려진다. rStar2-Agent는 일부 비교 모델보다 짧은 응답을 보고하지만, 학습 비교에는 추가 후보 생성과 궤적 선택의 효과가 함께 포함된다. VibeVoice는 음성 토큰 생성률을 낮추지만 실행 시간 비교나 90분 생성 전반의 품질에 대한 체계적인 평가를 제공하지 않는다. 실제 설계를 판단할 때는 생성 길이, 산술 연산 절감량, 측정된 지연 시간을 구분해야 한다.
2025년 8월의 주요 논문
1. rStar2-Agent: Agentic Reasoning Technical Report
- https://arxiv.org/abs/2508.20722
- rStar2-Agent: Agentic Reasoning Technical Report 요약 설명
- rStar2-Agent는 같은 질문에 대한 응답들의 보상을 비교하고 오류가 적은 성공 궤적을 우선 선택하는 보상 기반 학습 방법인 Group Relative Policy Optimization with Resampling on Correct(GRPO-RoC)를 사용한다. 질문마다 후보 32개를 생성하고 업데이트에 사용할 16개를 선택한다. 정답 응답 중 도구 오류와 형식 오류가 적은 응답을 우선 선택하되, 보상은 최종 답의 정답 여부만으로 결정한다. 선별한 수학 문제 42K개를 사용하며 AMD MI300X GPU 64개에서 1주 이내에 강화학습 510스텝을 수행한다.
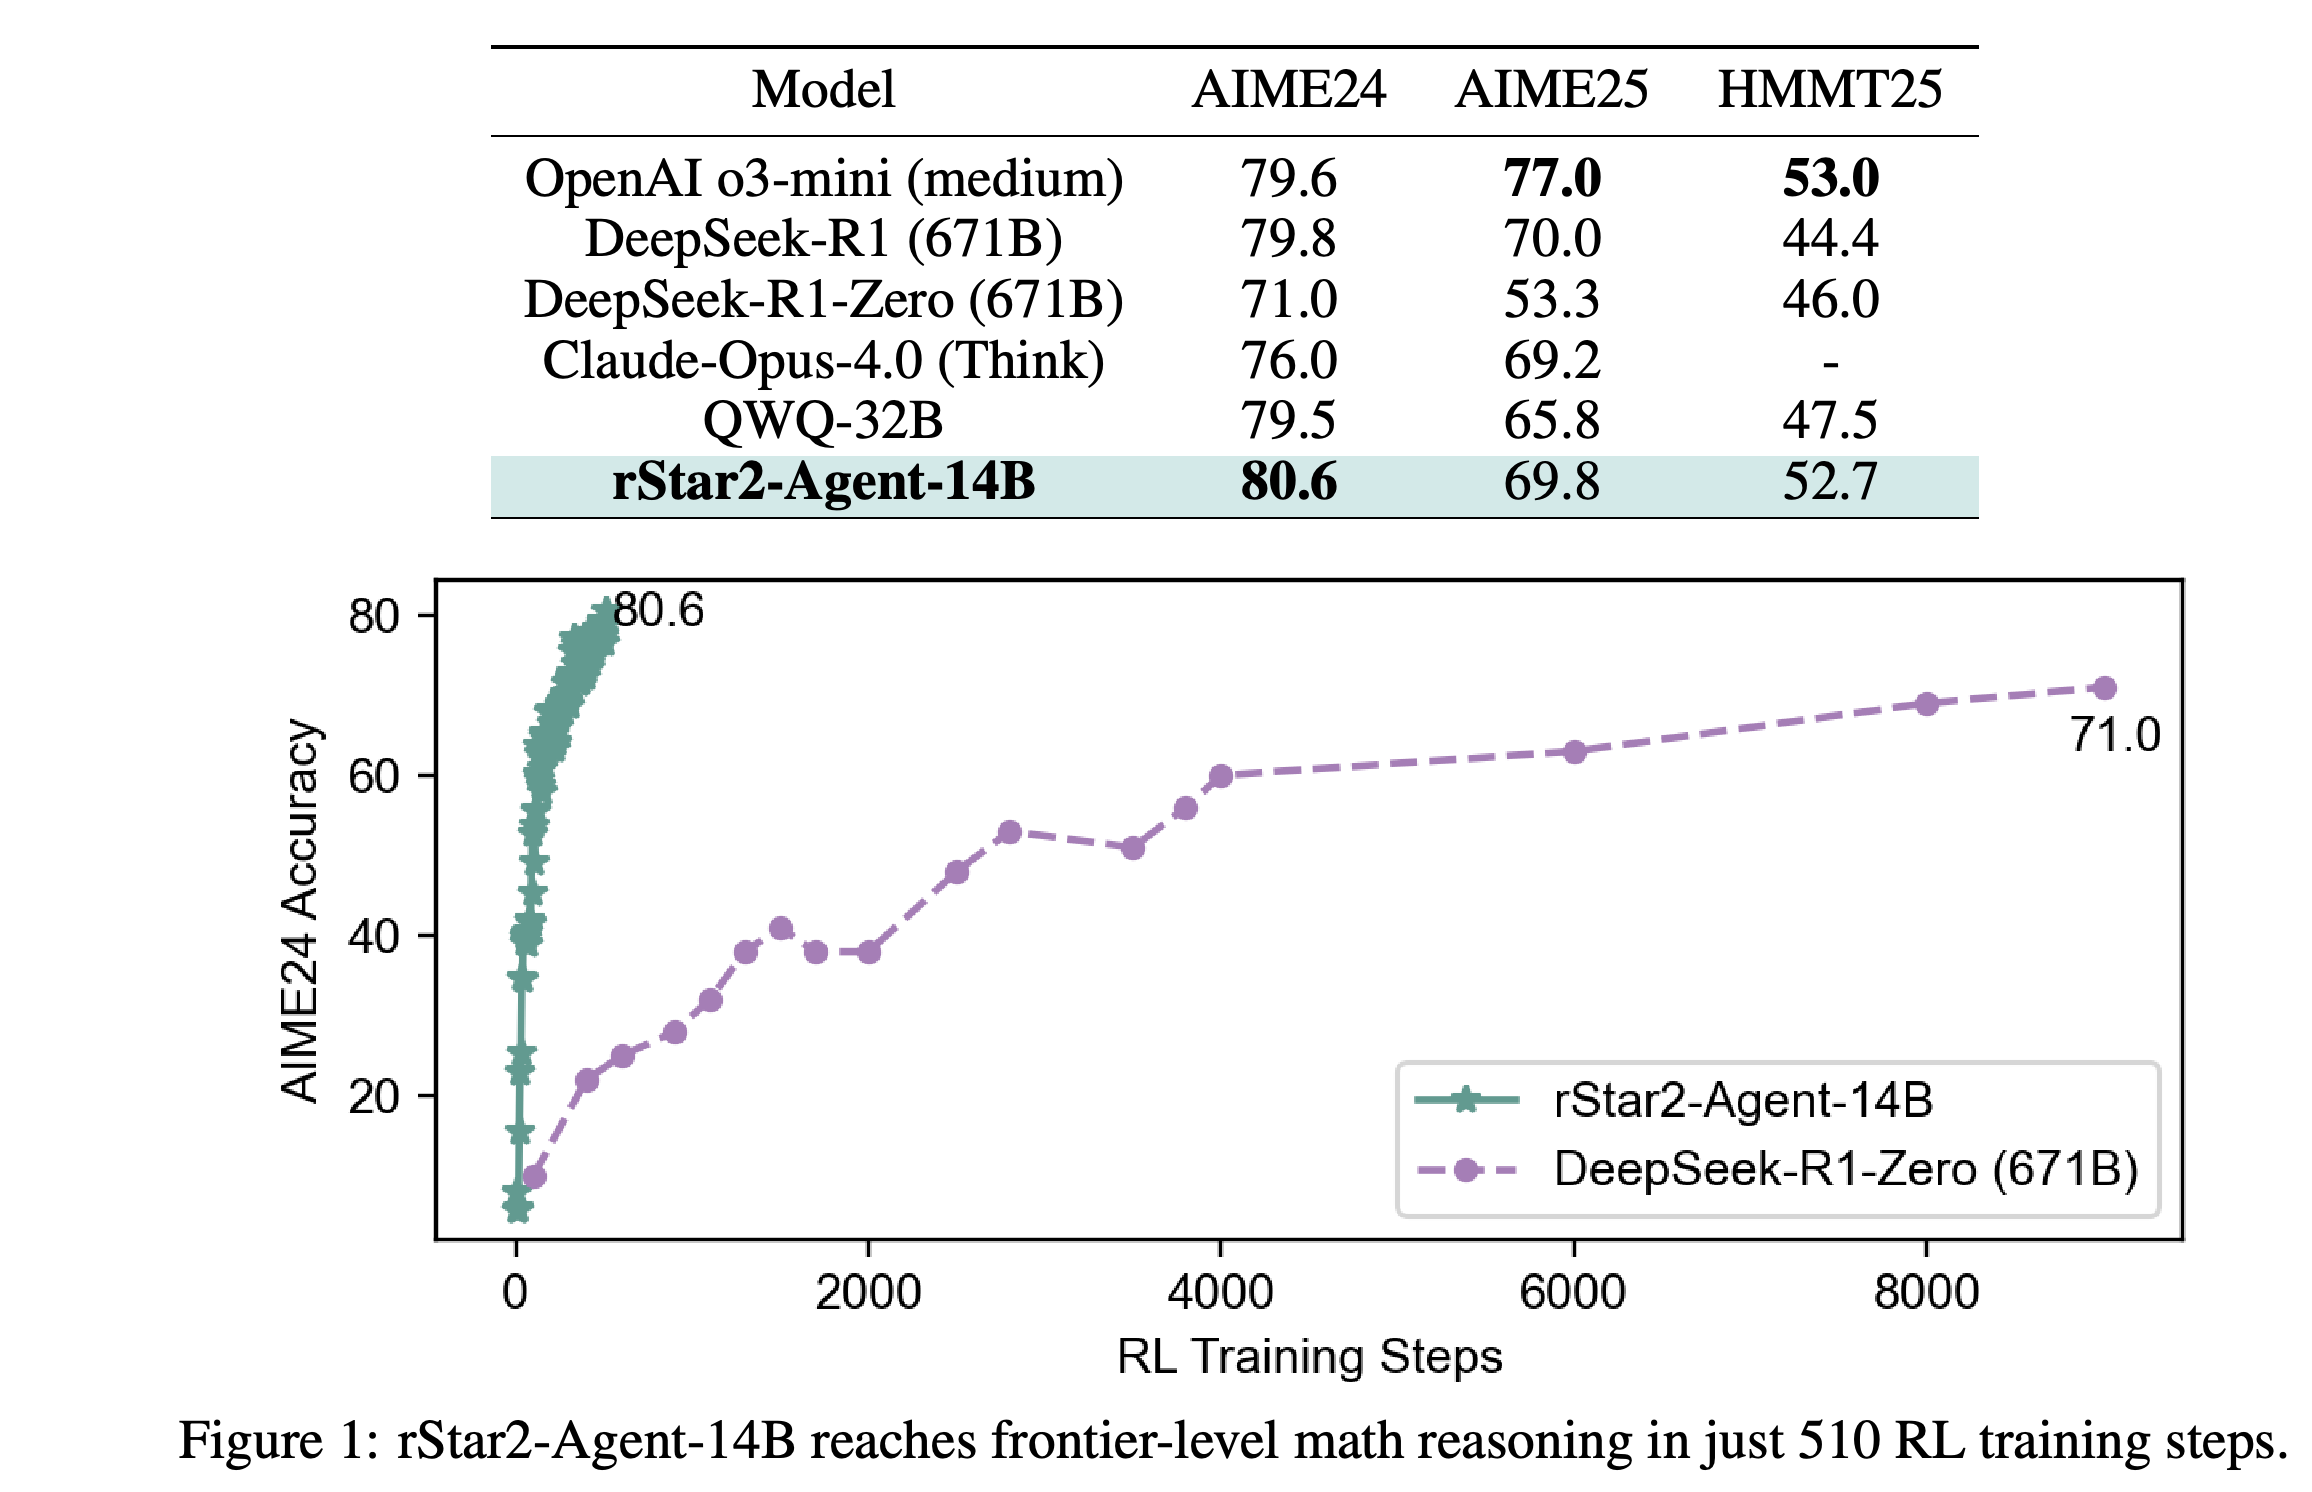
- 14B 파라미터 모델은 경시 수학 벤치마크 AIME24와 AIME25에서 각각 80.6%와 69.8%를 기록하며, DeepSeek-R1(671B)은 각각 79.8%와 70.0%를 기록한다. 이는 질문마다 샘플 16개로 단일 응답의 정답률을 추정한 평균 pass@1 점수다. 평가에서는 모델이 처리하는 텍스트 단위인 토큰을 최대 30K개, 상호작용을 최대 30턴까지 허용한다. 과학 질의응답 벤치마크 GPQA-Diamond 점수는 시범 예제로 학습하는 지도 미세조정 이후 42.1%에서 수학 강화학습 이후 60.9%로 높아진다.
- 보고된 평균 응답 길이는 AIME24에서 9339.7토큰, AIME25에서 10943.4토큰이며, DeepSeek-R1-Zero는 각각 14246.8토큰과 17132.9토큰이다. 재샘플링 실험에서는 정확도가 높아지고 학습 응답이 짧아지지만, 후보 32개를 생성하는 방법과 16개를 생성하는 기준 방법을 비교하므로 동일 연산량에서의 이점은 확인되지 않는다. 일반 도구 사용과 지시 이행 점수는 지도 미세조정 체크포인트보다 소폭 낮아진다. 보고된 14B 실험에서는 510스텝 이후 학습을 계속하면 정책과 보상이 붕괴하며, 원인은 확인되지 않았다.
개요는 벤치마크 점수와 AIME24 학습 곡선을 함께 제시한다. rStar2-Agent-14B는 510 RL 스텝에서 80.6에 도달하며 표시된 DeepSeek-R1-Zero (671B) 곡선은 훨씬 많은 스텝 이후 71.0에서 끝난다. 모델 크기와 학습 방식이 달라 통제된 연산량 비교로 볼 수 없다.
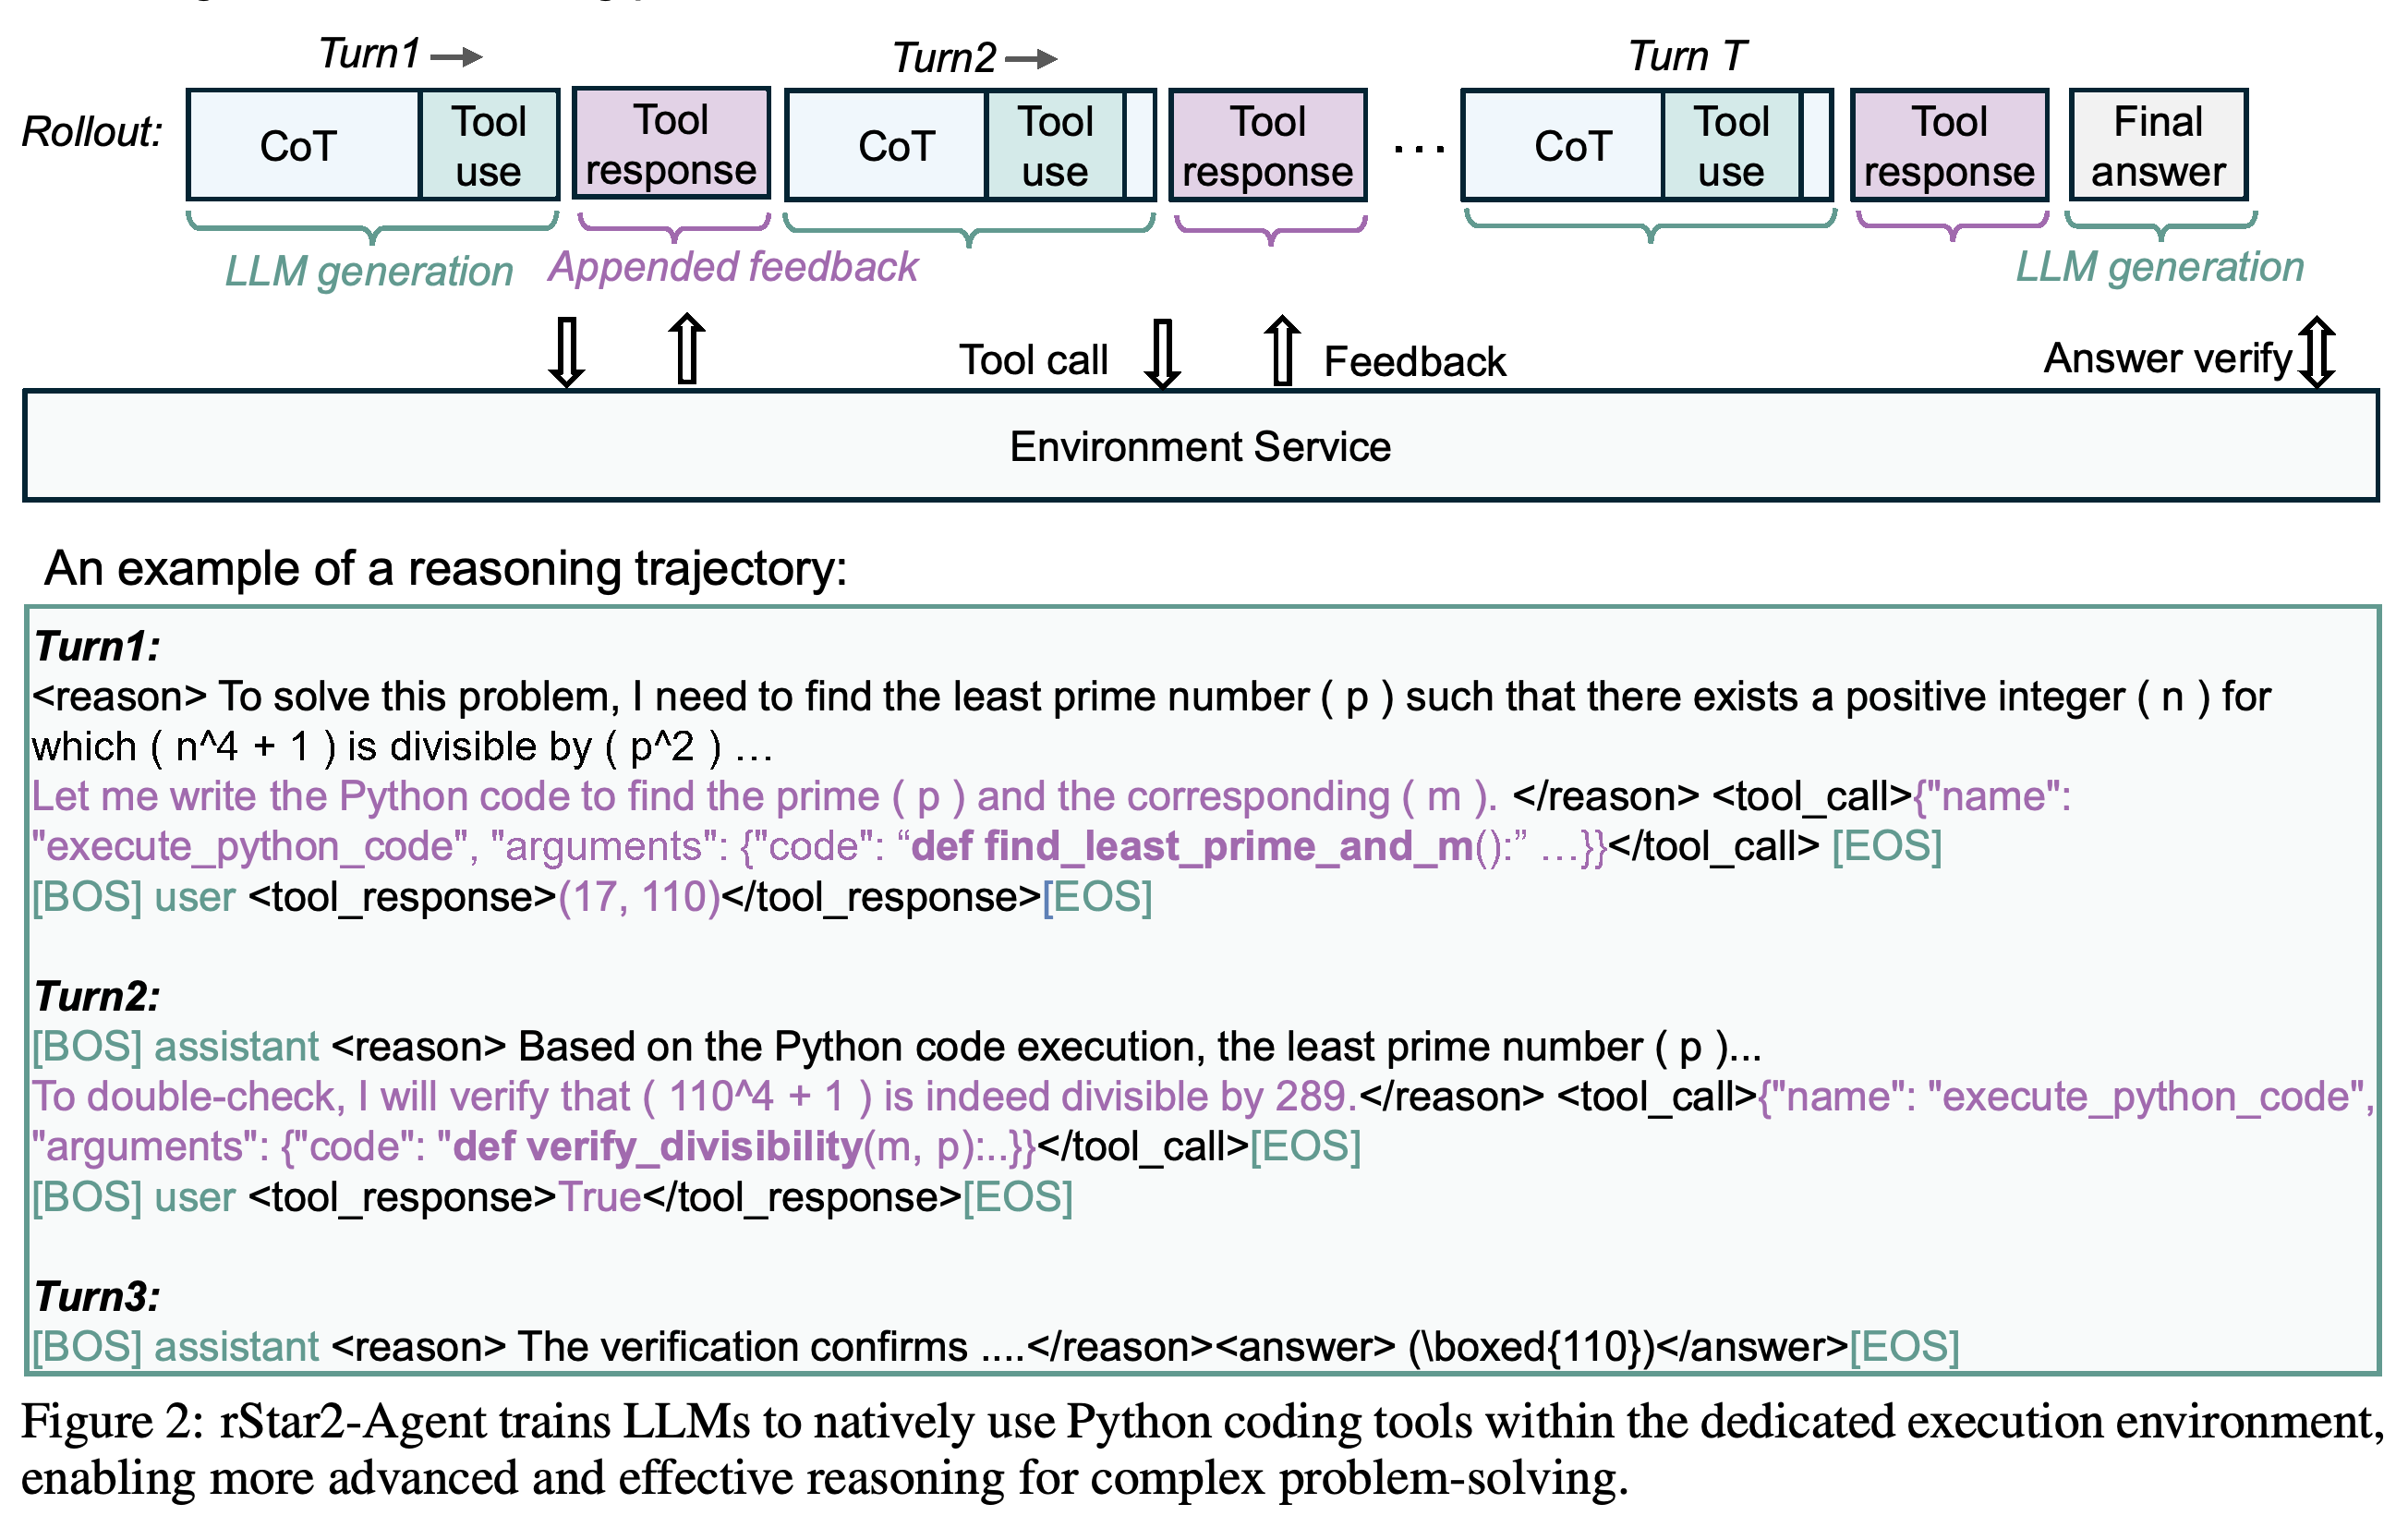
실행 피드백은 모델의 다음 턴에 포함된다. 예제에서는 (17, 110)을 구한 뒤 별도의 Python 호출로 나누어떨어지는지 확인하고 110을 반환한다. 이는 제출 전에 중간 계산을 검증하는 과정을 보여준다.
2. Mixture of Contexts for Long Video Generation
- https://arxiv.org/abs/2508.21058
- Mixture of Contexts for Long Video Generation 요약 설명
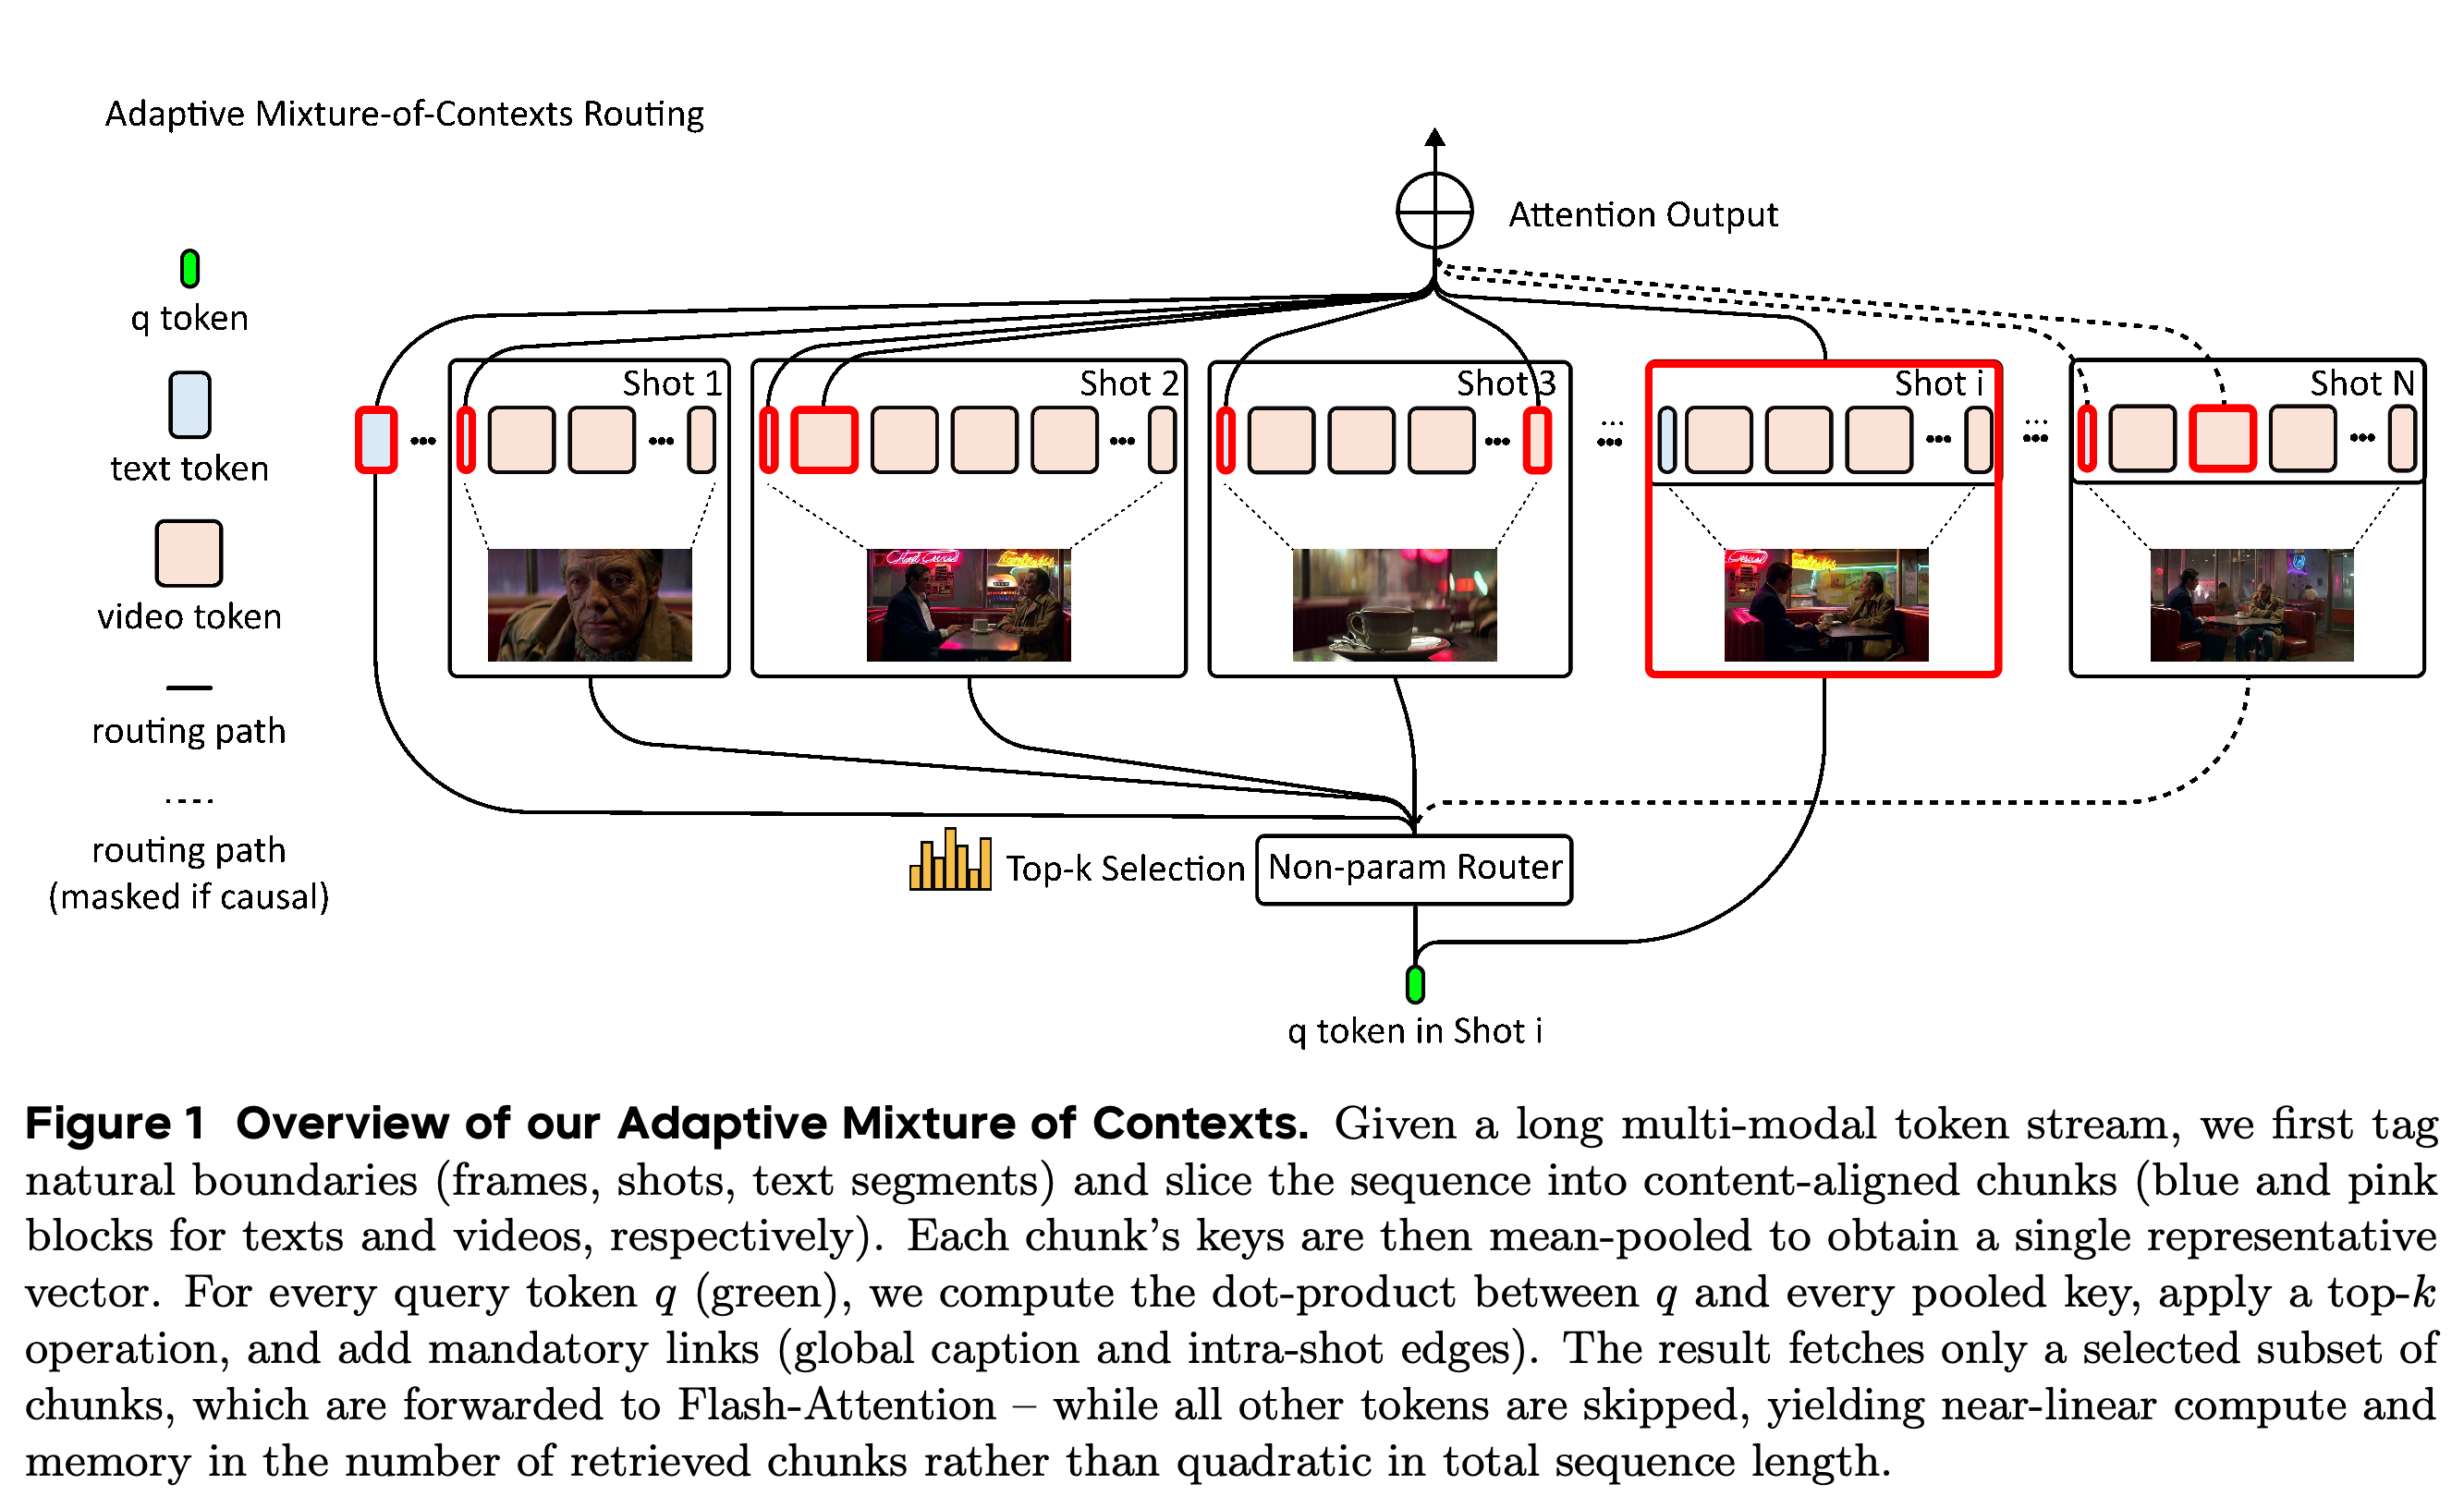
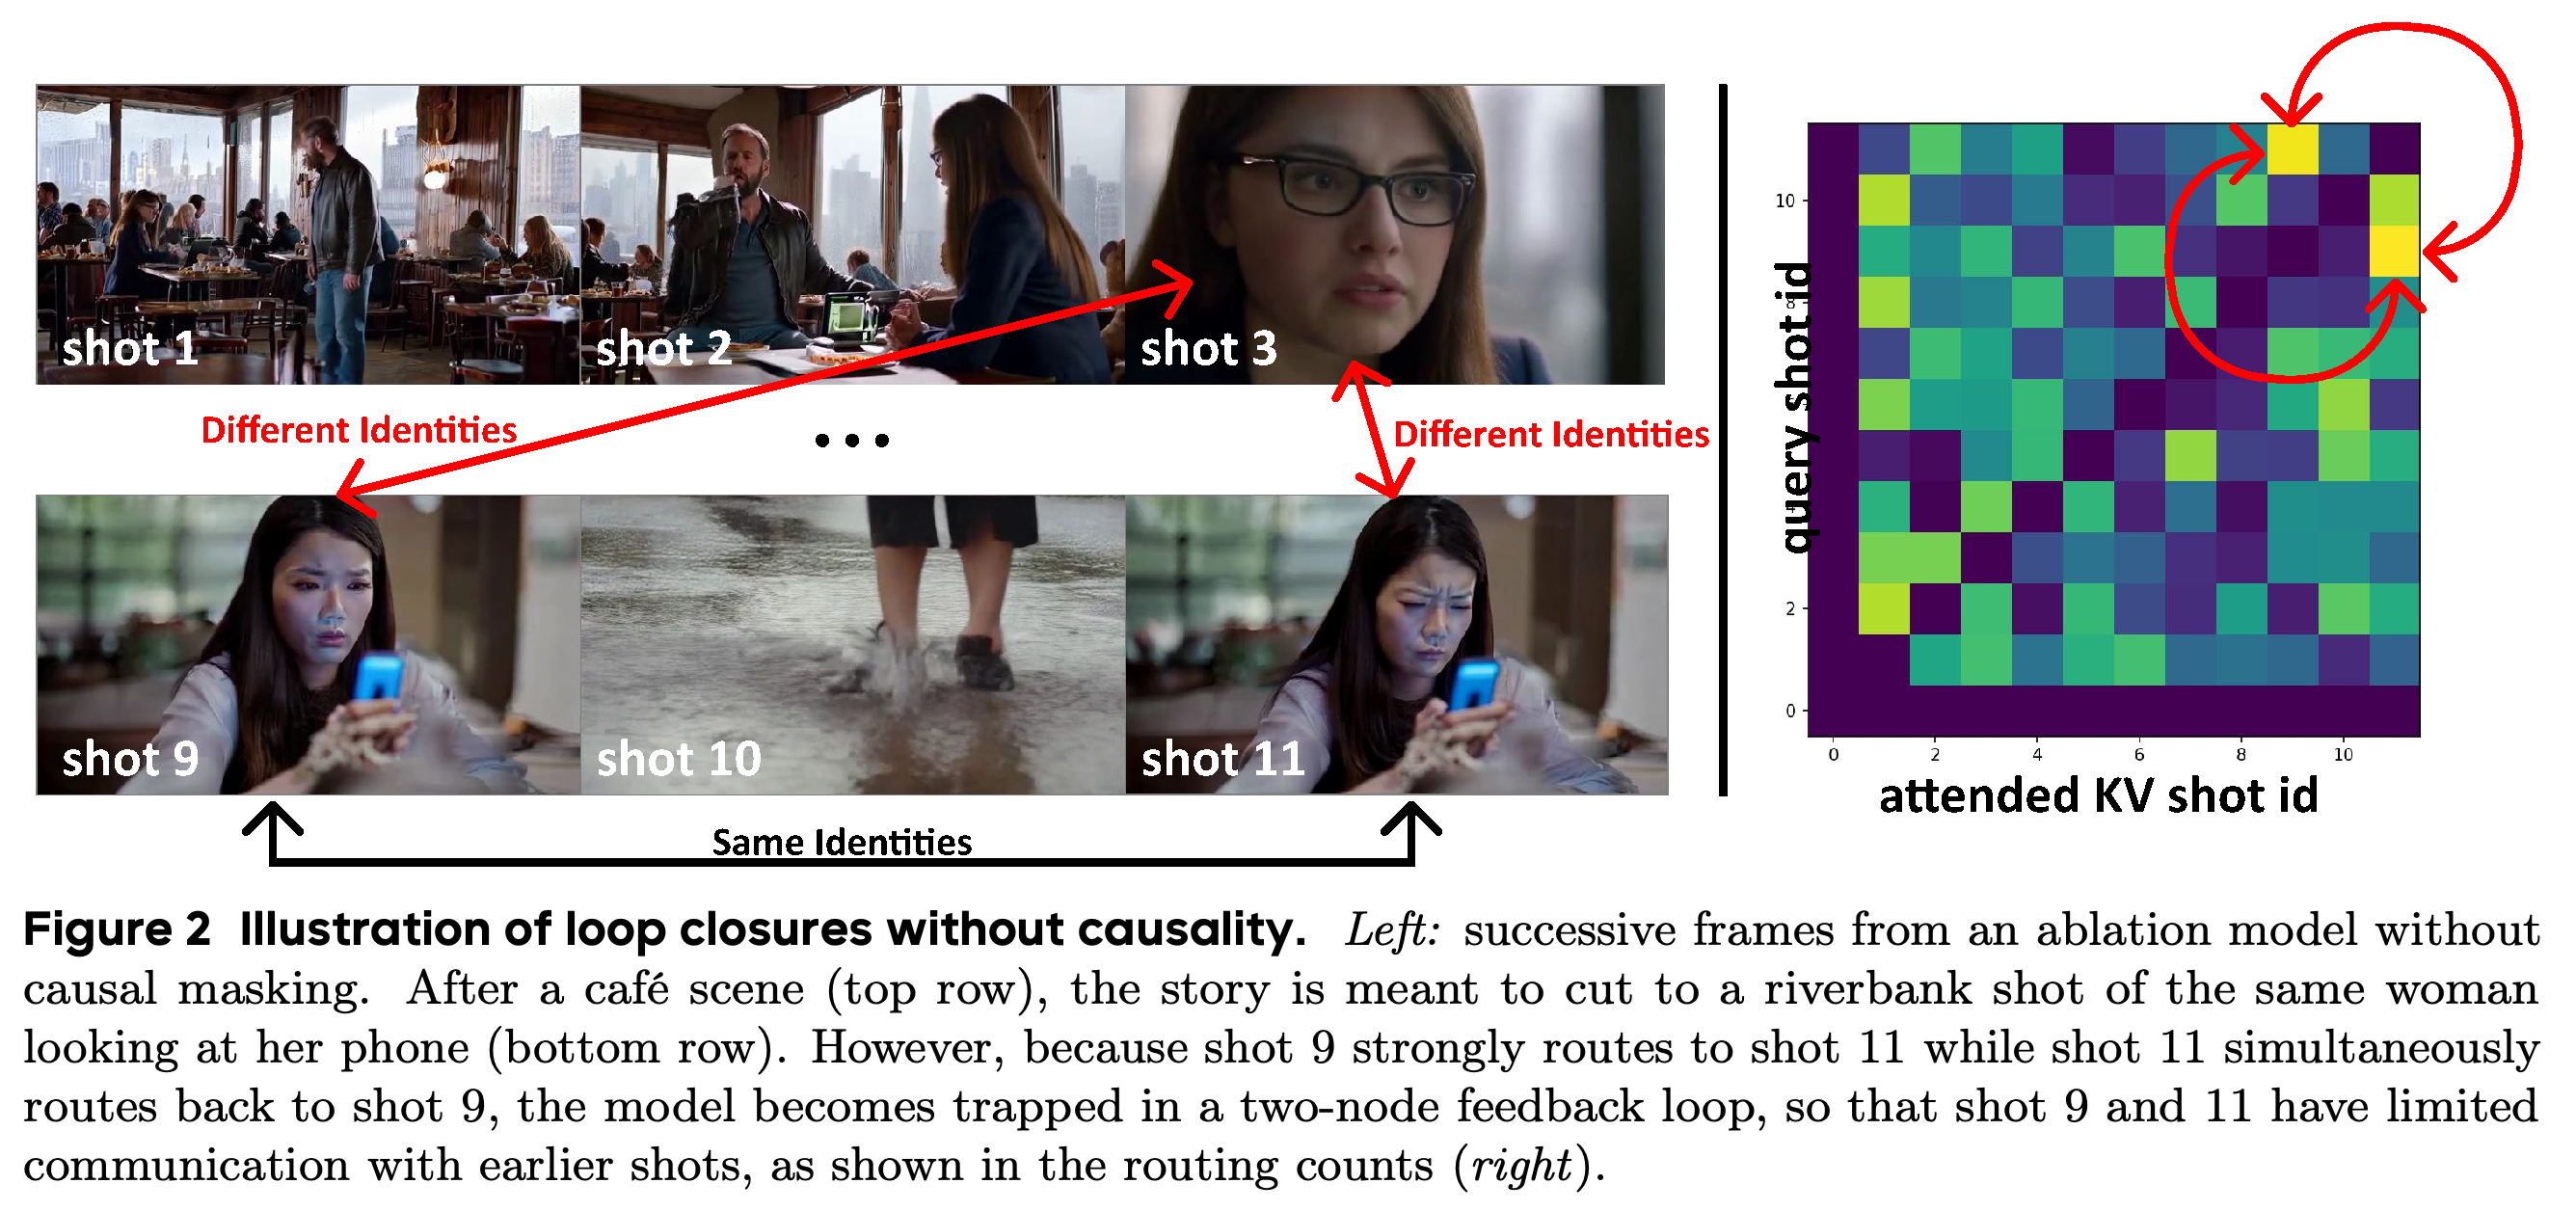
- Mixture of Contexts(MoC)는 모든 토큰 특징 쌍을 비교하는 dense attention을 프레임, shot, 캡션 경계에 맞춰 나눈 토큰 묶음인 chunk의 검색으로 대체한다. 관련 문맥을 찾는 query 특징은 평균화한 매칭 특징으로 점수가 가장 높은 chunk를 선택한 뒤 해당 chunk의 원래 토큰에 attention을 적용한다. 캡션과 현재 shot에 대한 연결은 반드시 유지한다. 선택적 검색은 이전 chunk로 제한하여, 서로를 참조하는 경로 때문에 과거의 인물 정체성 정보에 접근하지 못하는 현상을 방지한다.
- 장면 단위 context window를 사용하는 생성 모델인 dense Long-Context Tuning(LCT)과 비교하면, MoC는 토큰 쌍 상호작용을 생략하는 비율인 attention sparsity 85%에서 종단 간 속도 2.2× 향상을 보고한다. 비교 조건은 480p, 초당 12프레임, shot 8개로 구성된 64초 장면이며 약 180K토큰에 해당한다. 영상 품질을 평가하는 VBench 지표 6개 중 5개가 개선된다. 움직임의 양을 측정하는 Dynamic Degree는 0.4583에서 0.5625로 높아지지만, 프레임의 기술적 품질을 측정하는 Image Quality는 0.5140에서 0.5003으로 낮아진다.
- 실행 시간의 이점은 시퀀스 길이에 따라 달라진다. 짧은 single-shot 생성에서는 특징을 집계하는 pooling과 토큰 수집의 부가 비용이 attention 절감분보다 커서 실행이 느려진다. 주요 긴 영상 비교는 LCT에 한정되며 평가 샘플 수나 불확실성 구간을 보고하지 않는다. 산술 연산량을 나타내는 attention 부동소수점 연산 수는 1.7 × 10^13에서 2.3 × 10^12로 감소했다고 보고한다. 다만 예시 계산이 제시한 공식 및 입력값과 맞지 않으므로, 측정된 속도 향상과 별개로 연산량 추정치를 해명해야 한다.
도식은 선택적 검색과 필수 연결을 구분한다. Query는 pooled chunk의 점수를 계산하고 선택한 영상 토큰을 검색하면서 caption과 현재 shot에 대한 접근을 유지한다. 점선 경로는 causal masking으로 제거되는 연결을 나타낸다. Sparse context 선택이 국소 attention을 유지하면서 선택적 검색을 이전 context로 제한하는 방식을 보여준다.
강변 shot끼리는 여성의 외모가 일치하지만 이전 카페 장면의 정체성과는 일치하지 않는다. Heatmap에서 shot 9와 11 사이의 강한 상호 routing은 선택적 경로가 피드백 쌍을 형성할 때 국소적 일치와 과거 정보 회상의 실패가 함께 나타날 수 있음을 보여준다.
3. VibeVoice Technical Report
- https://arxiv.org/abs/2508.19205
- VibeVoice Technical Report 요약 설명
- VibeVoice는 오디오를 간결한 특징 벡터로 바꾸는 인코더인 연속형 음성 토크나이저와, 반복적인 노이즈 제거로 벡터를 차례로 생성하는 next-token diffusion을 결합한다. 음향 토크나이저는 24 kHz 오디오를 초당 7.5프레임으로 줄인다. 사전 학습된 언어 모델은 음성 프롬프트와 화자 표시가 있는 대본을 처리하며, 생성된 음향 특징과 의미 특징을 다시 문맥에 포함한다. 보고서는 64K-token context window에서 최대 4명의 화자가 참여하는 최대 90분 길이의 음성을 생성할 수 있다고 설명한다.
- 총 약 1시간 분량의 대화 대본 8개를 평가자 24명이 평가한 결과, VIBEVOICE-7B는 보고된 평균 청취자 평가 점수 중 가장 높은 3.76을 기록한다. 대본을 음성으로 합성하는 text-to-speech 시스템인 Gemini 2.5 Pro Preview TTS는 3.66을 기록한다. Gemini는 다른 시스템에 적용한 음성 프롬프트 제어를 지원하지 않아 기본 목소리를 사용한다. 시험한 음성 인식기 모두에서 VIBEVOICE-1.5B는 7B 모델보다 전사 오류가 적지만, 7B 모델은 청취자 평가 점수와 측정된 화자 유사도가 더 높다.
- 음향 토크나이저는 비교한 재구성 시스템 중 품질 지표 2개에서 가장 높은 점수를 기록하지만, 객관적 명료도에서는 여러 비교 시스템보다 낮다. 초당 7.5토큰이라는 생성률은 표에 제시된 초당 600토큰의 Encodec 구성보다 80배 낮다. 이 비율만으로 저장 공간이나 실행 시간도 같은 비율로 절감된다고 판단할 수는 없다. 짧은 발화의 결과는 지표에 따라 엇갈리며, 보고서는 구성 요소의 기여를 분리하는 통제된 ablation 실험이나 체계적인 90분 안정성 평가를 제공하지 않는다. 지원 언어는 영어와 중국어이며 중첩 발화, 배경 소음, 음악, 음향 효과를 명시적으로 생성하지 않는다.
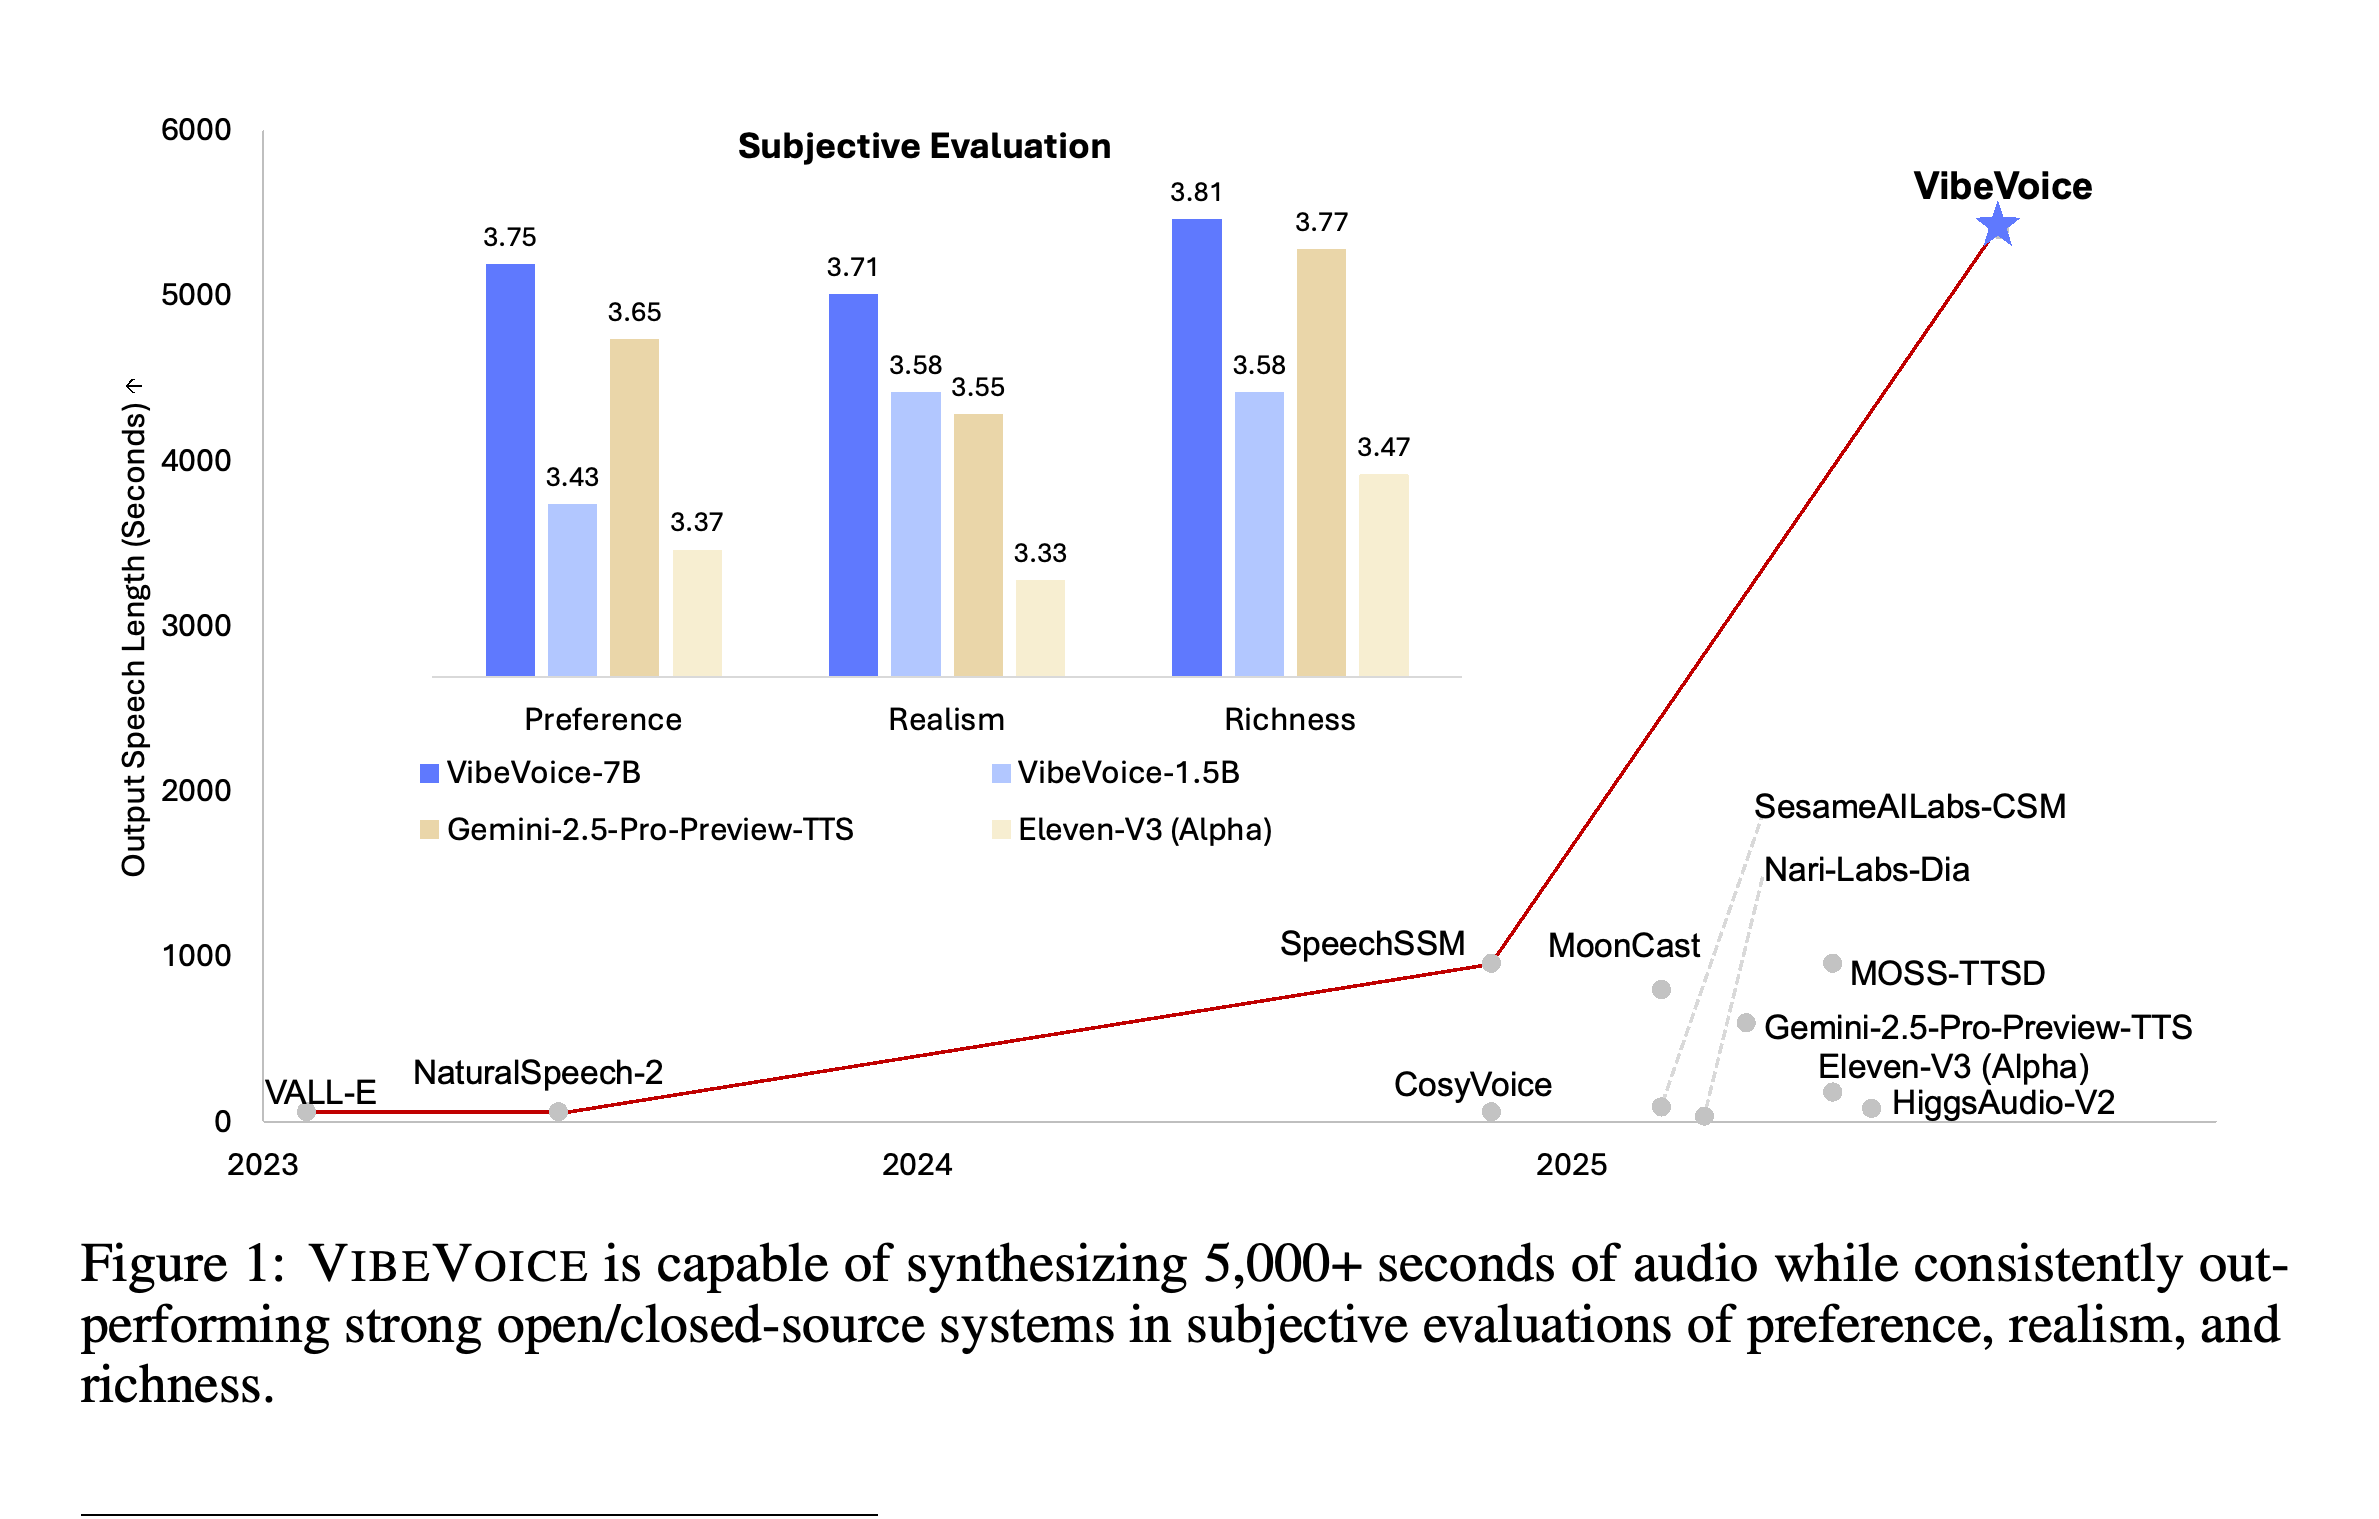
이 그래프는 VIBEVOICE의 생성 길이를 5,000초 초과로 표시하고 이러한 생성 능력 주장과 일부 청취자 평가 점수를 함께 제시한다. 삽입 그래프에서는 7B 모델의 점수가 더 높지만 일부 값이 Table 1과 조금 다르므로 상세 평가에는 Table 1을 사용한다. 생성 길이 비교와 청취자 평가는 서로 별개의 근거다. 이 그림은 통제된 90분 테스트 전체에 걸친 품질을 입증하지 않는다.
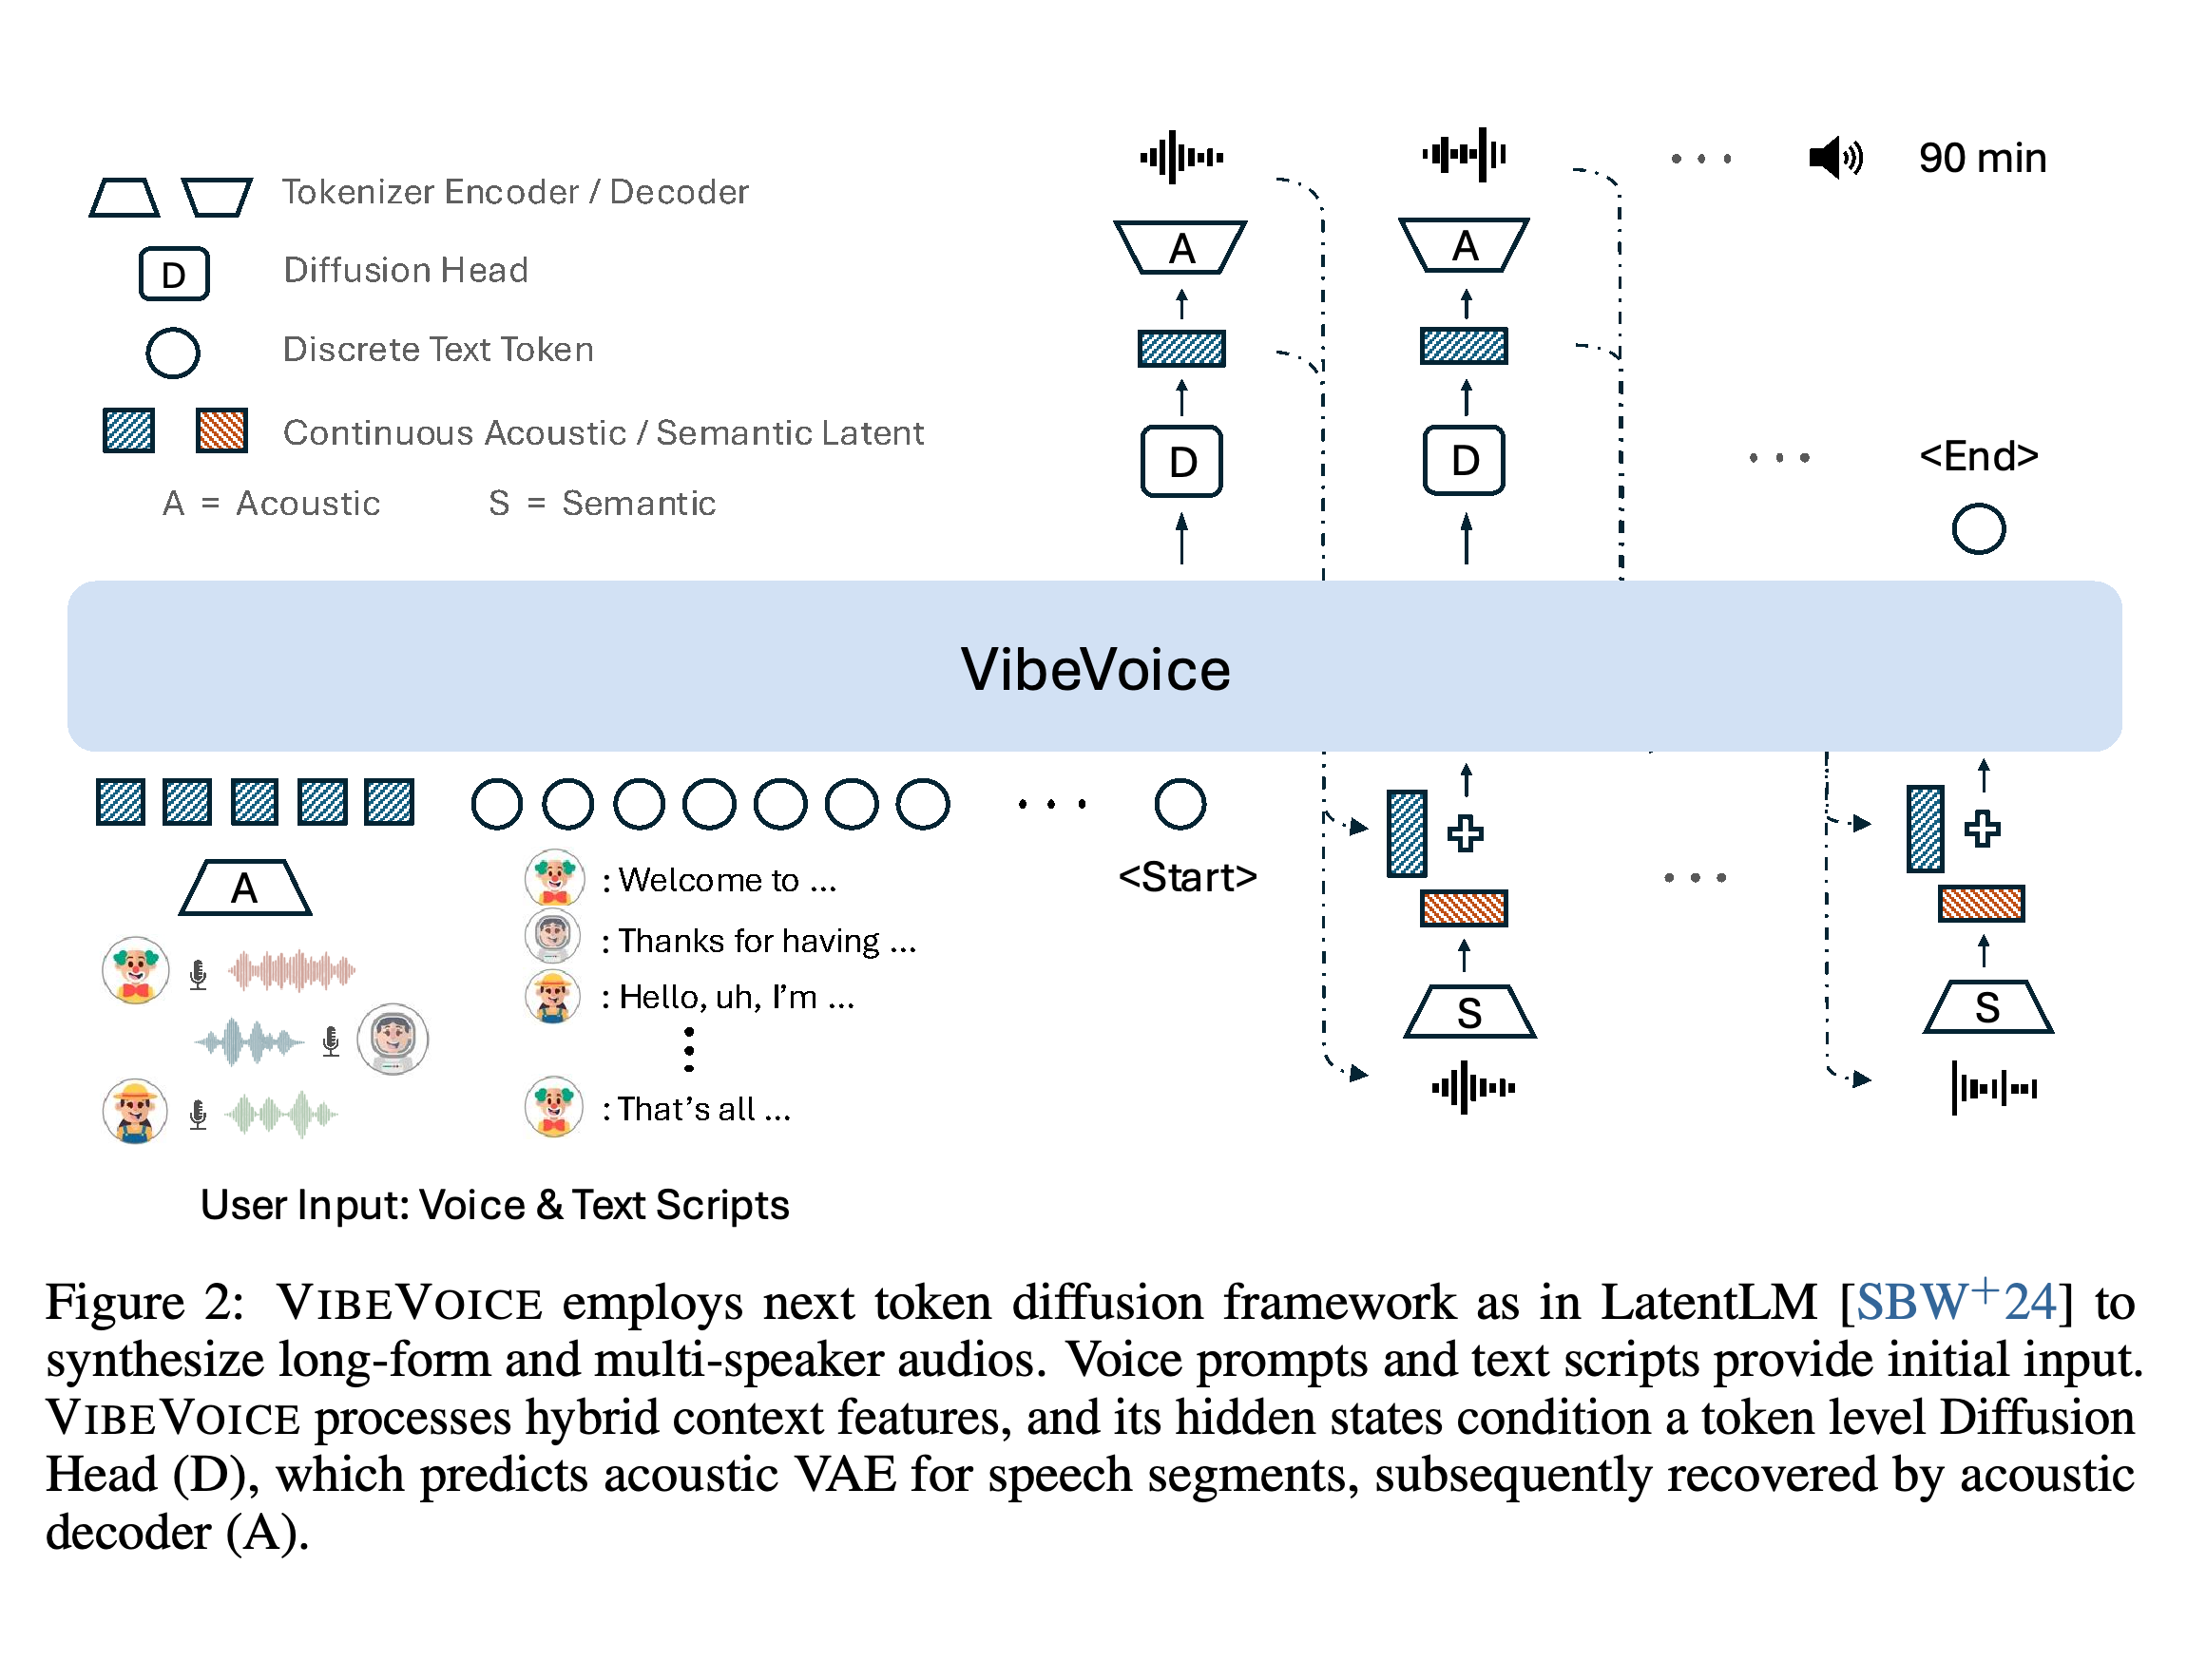
음성 프롬프트와 화자 표시가 있는 텍스트로 시퀀스 모델을 초기화한다. 모델의 은닉 상태는 diffusion head가 음향 특징을 생성할 때 조건으로 사용된다. 음향 디코더는 특징을 음성으로 변환한다. 생성된 음성의 음향 및 의미 인코딩 결과는 이후 예측을 위해 다시 컨텍스트에 포함된다.
출처
[1] rStar2-Agent: Agentic Reasoning Technical Report
[2] Mixture of Contexts for Long Video Generation
[3] VibeVoice Technical Report
선정한 논문은 2025년 8월에 처음 제출됐다. 이 회고 리뷰에서 확인한 PDF 버전은 rStar2-Agent v1, Mixture of Contexts v3, VibeVoice v1이다.