


2026년 5월 AI 논문 동향
31 May 2026 | Paper Review Monthly Papers Persistent Memory Skill Curation Scientific Agents목차
이달의 트렌드
2026년 5월에 선정한 세 논문은 지속 상태를 통한 적응을 다룬다. δ-mem, SkillOS, AutoScientists는 모두 이전 상호작용이나 실험에서 얻은 정보를 이후 의사결정에 활용한다. 각 방법이 저장하는 경험의 형태는 다르다. δ-mem은 학습한 key–value 관계를 작은 행렬에 담는 연관 메모리를 유지한다. SkillOS는 Markdown 파일에 저장한 재사용 가능한 지침인 절차적 스킬을 편집한다. AutoScientists는 실험 결과, 기각한 연구 방향, 현재까지 채택된 최선의 프로그램인 champion을 공유한다. 이 설계들은 축적한 경험을 표현하고 수정하는 방식을 시스템의 핵심 요소로 다룬다. 1, 2, 3 절차적 스킬에 대해서는 2025년 12월 AI 논문 동향 글을 참조하라.
이 연구들은 축적한 지식과 이를 사용하는 모델이나 에이전트도 분리한다. δ-mem은 사전 학습된 언어 모델인 backbone을 동결한 채 메모리 인터페이스를 학습하며, 추론 중에는 메모리 내용이 바뀐다. SkillOS는 작업을 해결하는 에이전트인 실행기를 동결하고, 실행기가 사용할 외부 저장소를 관리하도록 큐레이터를 학습한다. AutoScientists는 공유 실험 기록으로 연속된 에이전트 세션을 조율하고, 진전이 정체되면 팀을 재편한다. 이 방법들에서 적응은 어떤 정보를 보존하는지뿐 아니라 저장한 정보가 이후 연산에 어떻게 영향을 주는지에도 달려 있다.
효율성 결과는 방법마다 다르게 해석해야 한다. δ-mem은 학습 가능한 인터페이스가 작지만, 토큰 단위 디코딩은 더 느리다. SkillOS는 실행기의 행동 수를 줄이지만, 이 수치에는 큐레이션, 판정, 학습 비용이 포함되지 않는다. AutoScientists는 하드웨어와 시간 예산을 맞춘 조건에서 실험 탐색을 개선하지만, 언어 모델 호출에는 더 많은 비용을 쓴다. 이 근거들은 평가한 설정에서 경험을 유용하게 재사용할 수 있음을 뒷받침한다. 총운영비가 낮아지거나 모든 과제에서 행동이 일관되게 개선된다는 점까지 입증하지는 않는다.
2026년 5월의 주요 논문
1. $\delta$-mem: Efficient Online Memory for Large Language Models
- https://arxiv.org/abs/2605.12357
- $\delta$-mem: Efficient Online Memory for Large Language Models 요약 설명
- δ-mem: Efficient Online Memory for Large Language Models는 동결된 full-attention Transformer에 지속적으로 유지되는 행렬을 추가하며, 사용 가능한 토큰에 대한 backbone의 attention은 유지한다. 각 위치에서 이전 메모리를 읽고 attention의 query와 output을 보정한 뒤 새 정보를 기록한다. 게이트를 적용한 delta rule은 망각을 조절하면서 기존 상태가 잘못 예측하는 연관 관계를 보정한다.
- 쓰기 단위에 따라 메모리 동작이 달라진다. Token-State Write(TSW)는 매 토큰 뒤에 상태를 갱신하고, Sequence-State Write(SSW)는 메시지의 평균 은닉 표현으로 메시지당 1회 갱신하며, Multi-State Write(MSW)는 병렬 하위 상태를 유지한다. rank r = 8에서 단일 상태 변형은 삽입 계층마다 8 × 8 행렬을 사용하며, 학습 가능한 파라미터는 4.87M이다. MSW는 이러한 하위 상태 4개와 학습 가능한 파라미터 19.47M을 사용한다. 이 파라미터 수는 실행 중 메모리 상태를 저장하는 공간과 구별된다.
- Qwen3-4B-Instruct에서 TSW는 보고된 5개 벤치마크 평균을 46.79에서 51.66으로 높인다. 이 평균은 HotpotQA의 완전 일치 점수를 반영하며, 서로 다른 벤치마크 지표를 종합한다. 가장 좋은 변형을 기준으로 종합 점수는 Qwen3-8B에서 47.20에서 50.86으로, SmolLM3-3B에서 26.08에서 36.96으로 높아진다. 다만 가장 좋은 쓰기 전략은 backbone마다 다르다.
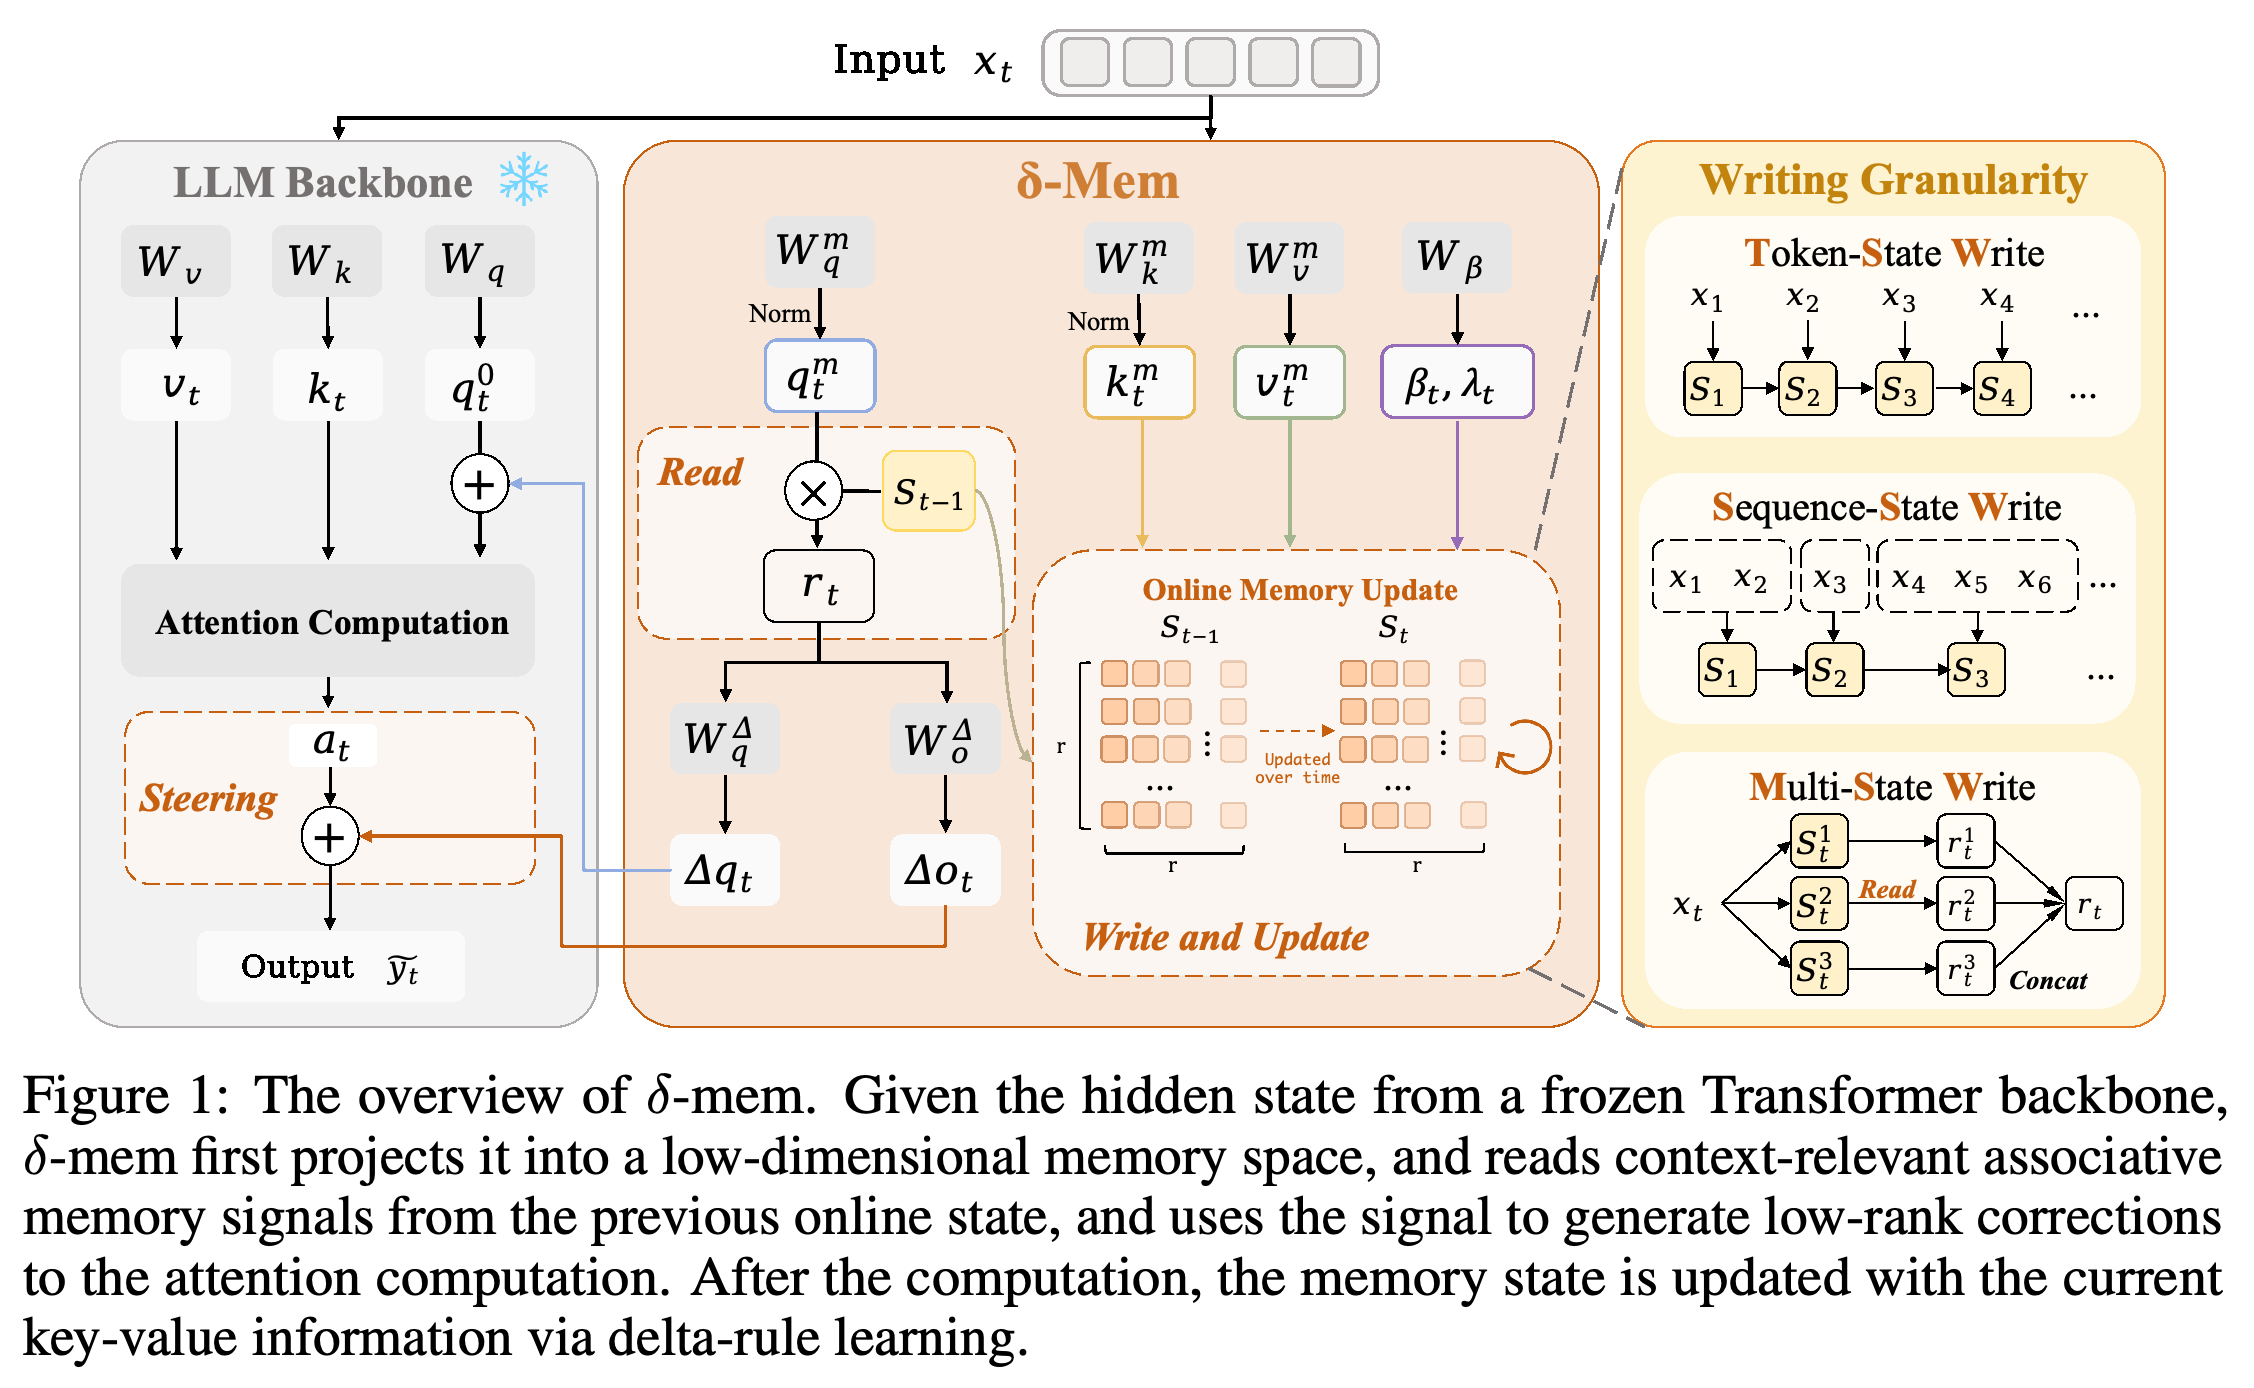
연관 상태 읽기, low-rank attention steering, delta-rule 쓰기와 3가지 쓰기 전략으로 구성된 δ-mem 구조
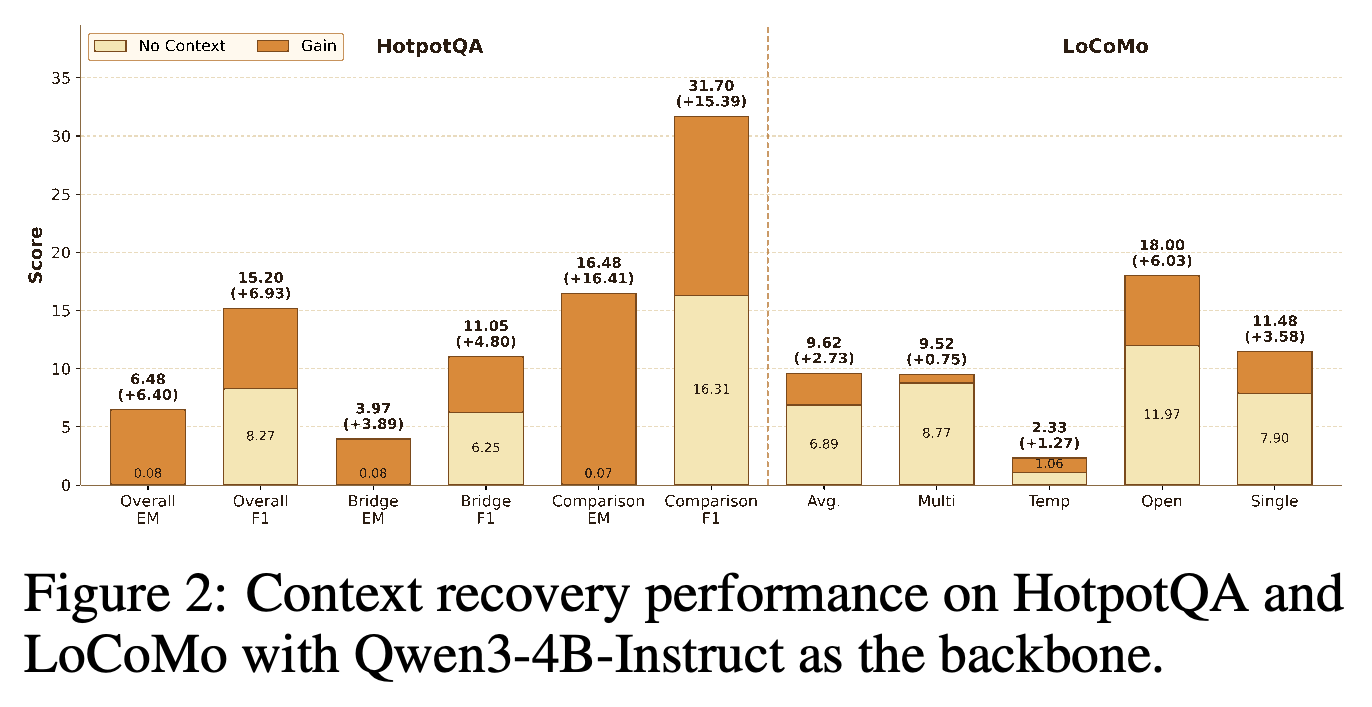
HotpotQA와 LoCoMo의 문맥 없는 baseline 점수 및 압축 메모리 상태에 따른 개선
2. SkillOS: Learning Skill Curation for Self-Evolving Agents
- https://arxiv.org/abs/2605.06614
- SkillOS: Learning Skill Curation for Self-Evolving Agents 요약 설명
- SkillOS: Learning Skill Curation for Self-Evolving Agents는 작업 실행과 메모리 관리를 분리한다. 동결된 실행기는 키워드 기반 검색 방법인 BM25로 관련 Markdown 스킬을 검색한다. 실행 후에는 학습 가능한 큐레이터가 실행 궤적과 자체 판정한 정답 신호를 바탕으로 스킬을 삽입, 수정, 삭제하여 후속 작업에서 사용할 저장소를 바꾼다.
- 큐레이터 학습에서는 관련 작업을 그룹으로 처리하여 앞선 저장소 편집을 이후 작업 결과로 평가한다. 강화 학습 보상은 후속 작업 성공, 유효한 저장소 연산, 판정된 콘텐츠 품질, 압축을 결합한다. 가사 작업 벤치마크인 ALFWorld에서 관련 작업 그룹을 무작위 작업 시퀀스로 바꾸면 성공률이 61.2%에서 57.3%로 낮아진다. 이는 보고된 그룹화 및 보조 보상 제거 실험 중 가장 큰 하락이다. 강화 학습에 대해서는 Reinforcement Learning for Reasoning in Small LLMs: What Works and What Doesn’t 요약 설명 글을 참조하라.
- Qwen3-8B를 실행기로 사용하면 보고된 ALFWorld 성공률은 메모리가 없을 때의 47.9%에서 61.2 ± 4.6%로 높아지고, 평균 행동 수는 21.1에서 18.9로 줄어든다. 학습한 큐레이터는 학습하지 않은 SkillOS-base의 53.1%도 넘어선다. 이는 동일한 저장소 인터페이스에서 큐레이션 학습이 유용함을 뒷받침한다. 학습 중 사용하지 않은 Gemini-2.5-Pro를 실행기로 사용하면 성공률은 메모리가 없을 때의 66.4%에서 80.2 ± 3.1%로 높아진다. 보고된 평균과 표준편차는 3회 실행에서 얻은 값이다.
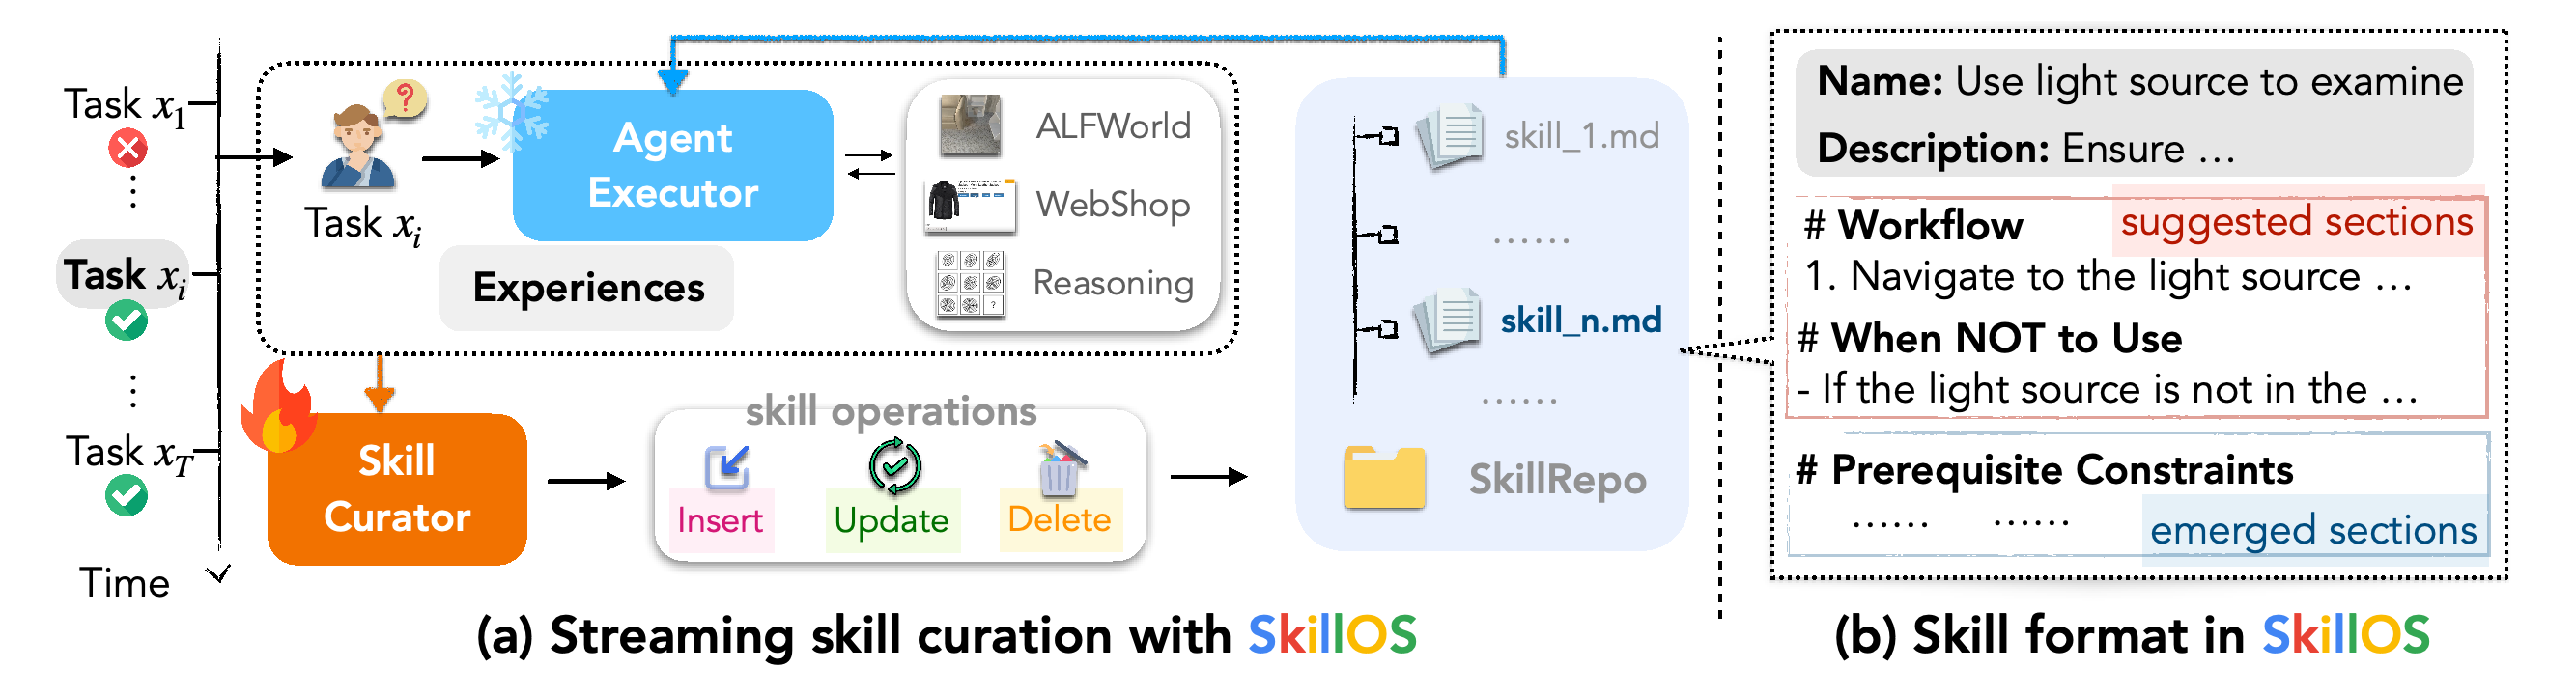
SkillOS의 스트리밍 실행–큐레이션 루프와 Markdown 스킬 표현
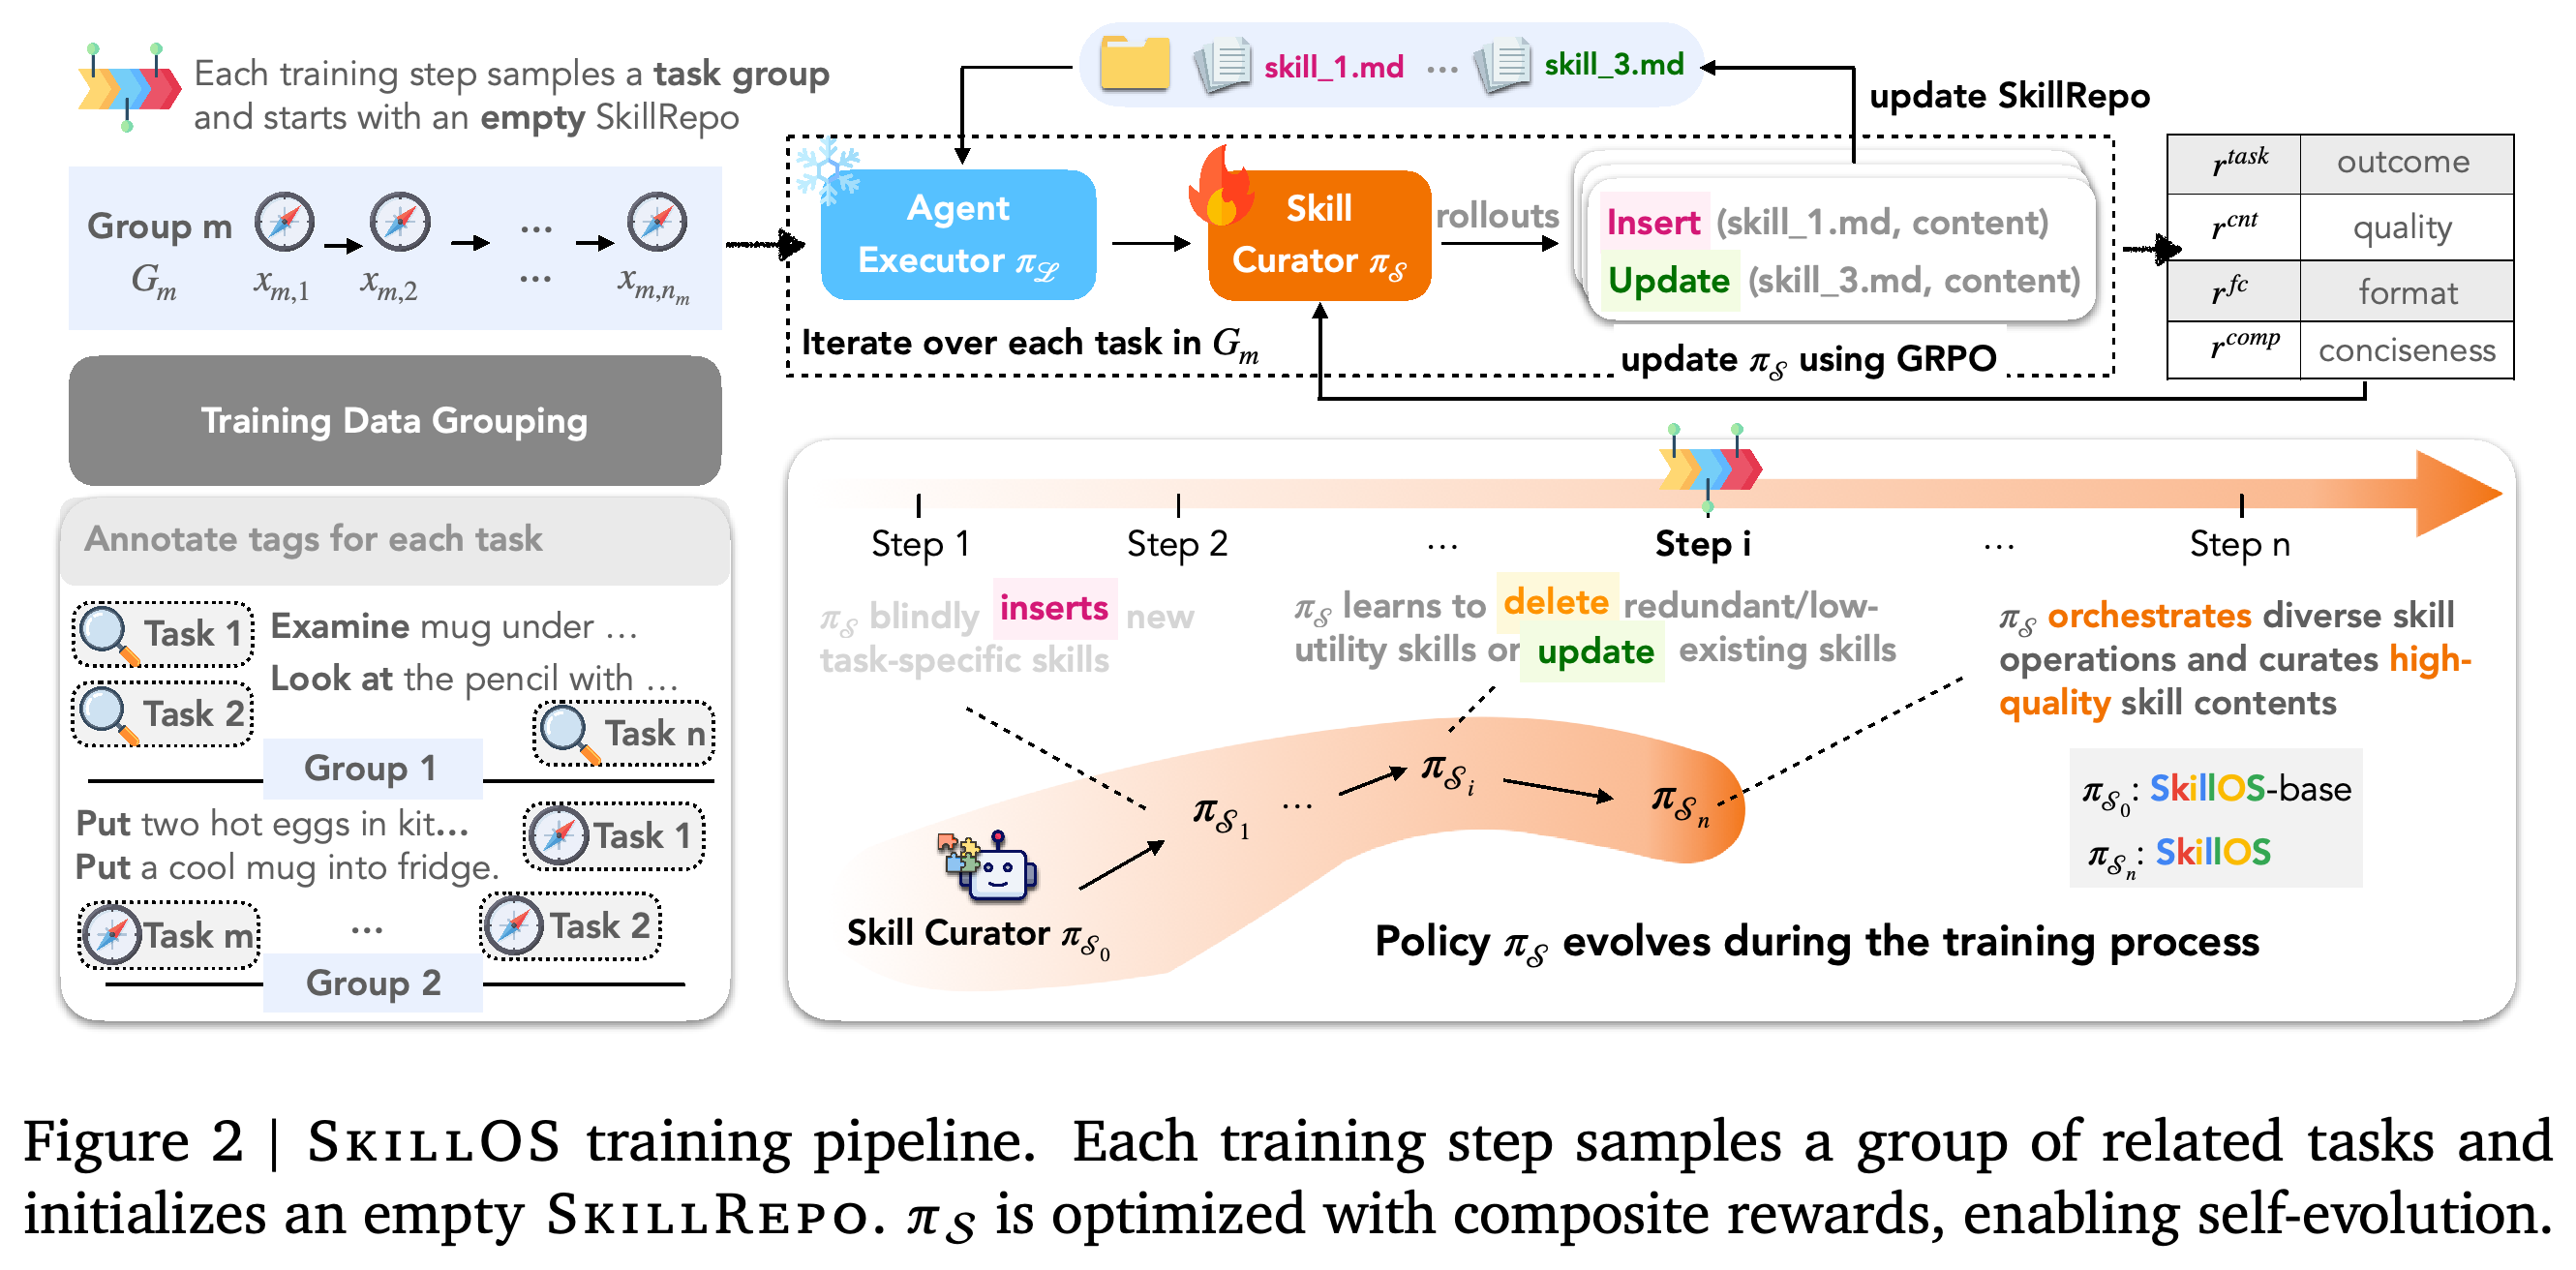
저장소 변화와 복합 보상 최적화를 포함한 그룹화 작업 학습 파이프라인
3. AutoScientists: Self-Organizing Agent Teams for Long-Running Scientific Experimentation
- https://arxiv.org/abs/2605.28655
- AutoScientists: Self-Organizing Agent Teams for Long-Running Scientific Experimentation 요약 설명
- AutoScientists: Self-Organizing Agent Teams for Long-Running Scientific Experimentation은 중앙 계획 에이전트 없이 계산 연구를 조율한다. Analyst는 제안을 비평하고 대기열에 넣으며, experiment 에이전트는 공유 champion을 수정하고 평가한다. 지속적으로 유지되는 로그와 실패 방향 기록은 세션 사이에 실험 근거를 전달한다. 연구 방향이 바뀌면 토론을 재개해 팀을 병합, 분할, 종료할 수 있다.
- 생의학 머신러닝 과제 24개로 구성된 BioML-Bench에서 평균 리더보드 백분위는 74.40%, 표준오차는 6.20%다. Autoresearch의 평균 66.07%, 표준오차 7.38%와 비교하면 8.33 백분위 포인트 높다. AutoScientists, Autoresearch, 재실행한 Biomni에는 H100 GPU 1개, CPU 16개, 메모리 48 GB를 제공하며, 비영상 과제당 4시간, 영상 과제당 16시간을 허용한다. 기존에 발표된 다른 비영상 기준 모델은 CPU만 사용하는 별도 프로토콜을 따른다.
- GPT nanochat 학습 최적화에서 AutoScientists는 낮을수록 좋은 예측 손실 지표인 검증 bits-per-byte 약 0.978에 34회 실험으로 도달하며, Autoresearch는 65회가 필요했다고 보고한다. 각 실험에서는 H100 1개로 5분 동안 학습한다. 두 시스템이 값이 0.9777인 동일한 개선된 champion과 동일한 기각 방향 기록에서 시작하면, AutoScientists는 93회 실험에서 갱신 7건을 채택해 0.9730에 도달한다. Autoresearch는 100회 실험에서 갱신을 채택하지 못한다. 이 비교는 실험 탐색 효율을 측정하며, 실제 소요 시간의 단축을 입증하지는 않는다.
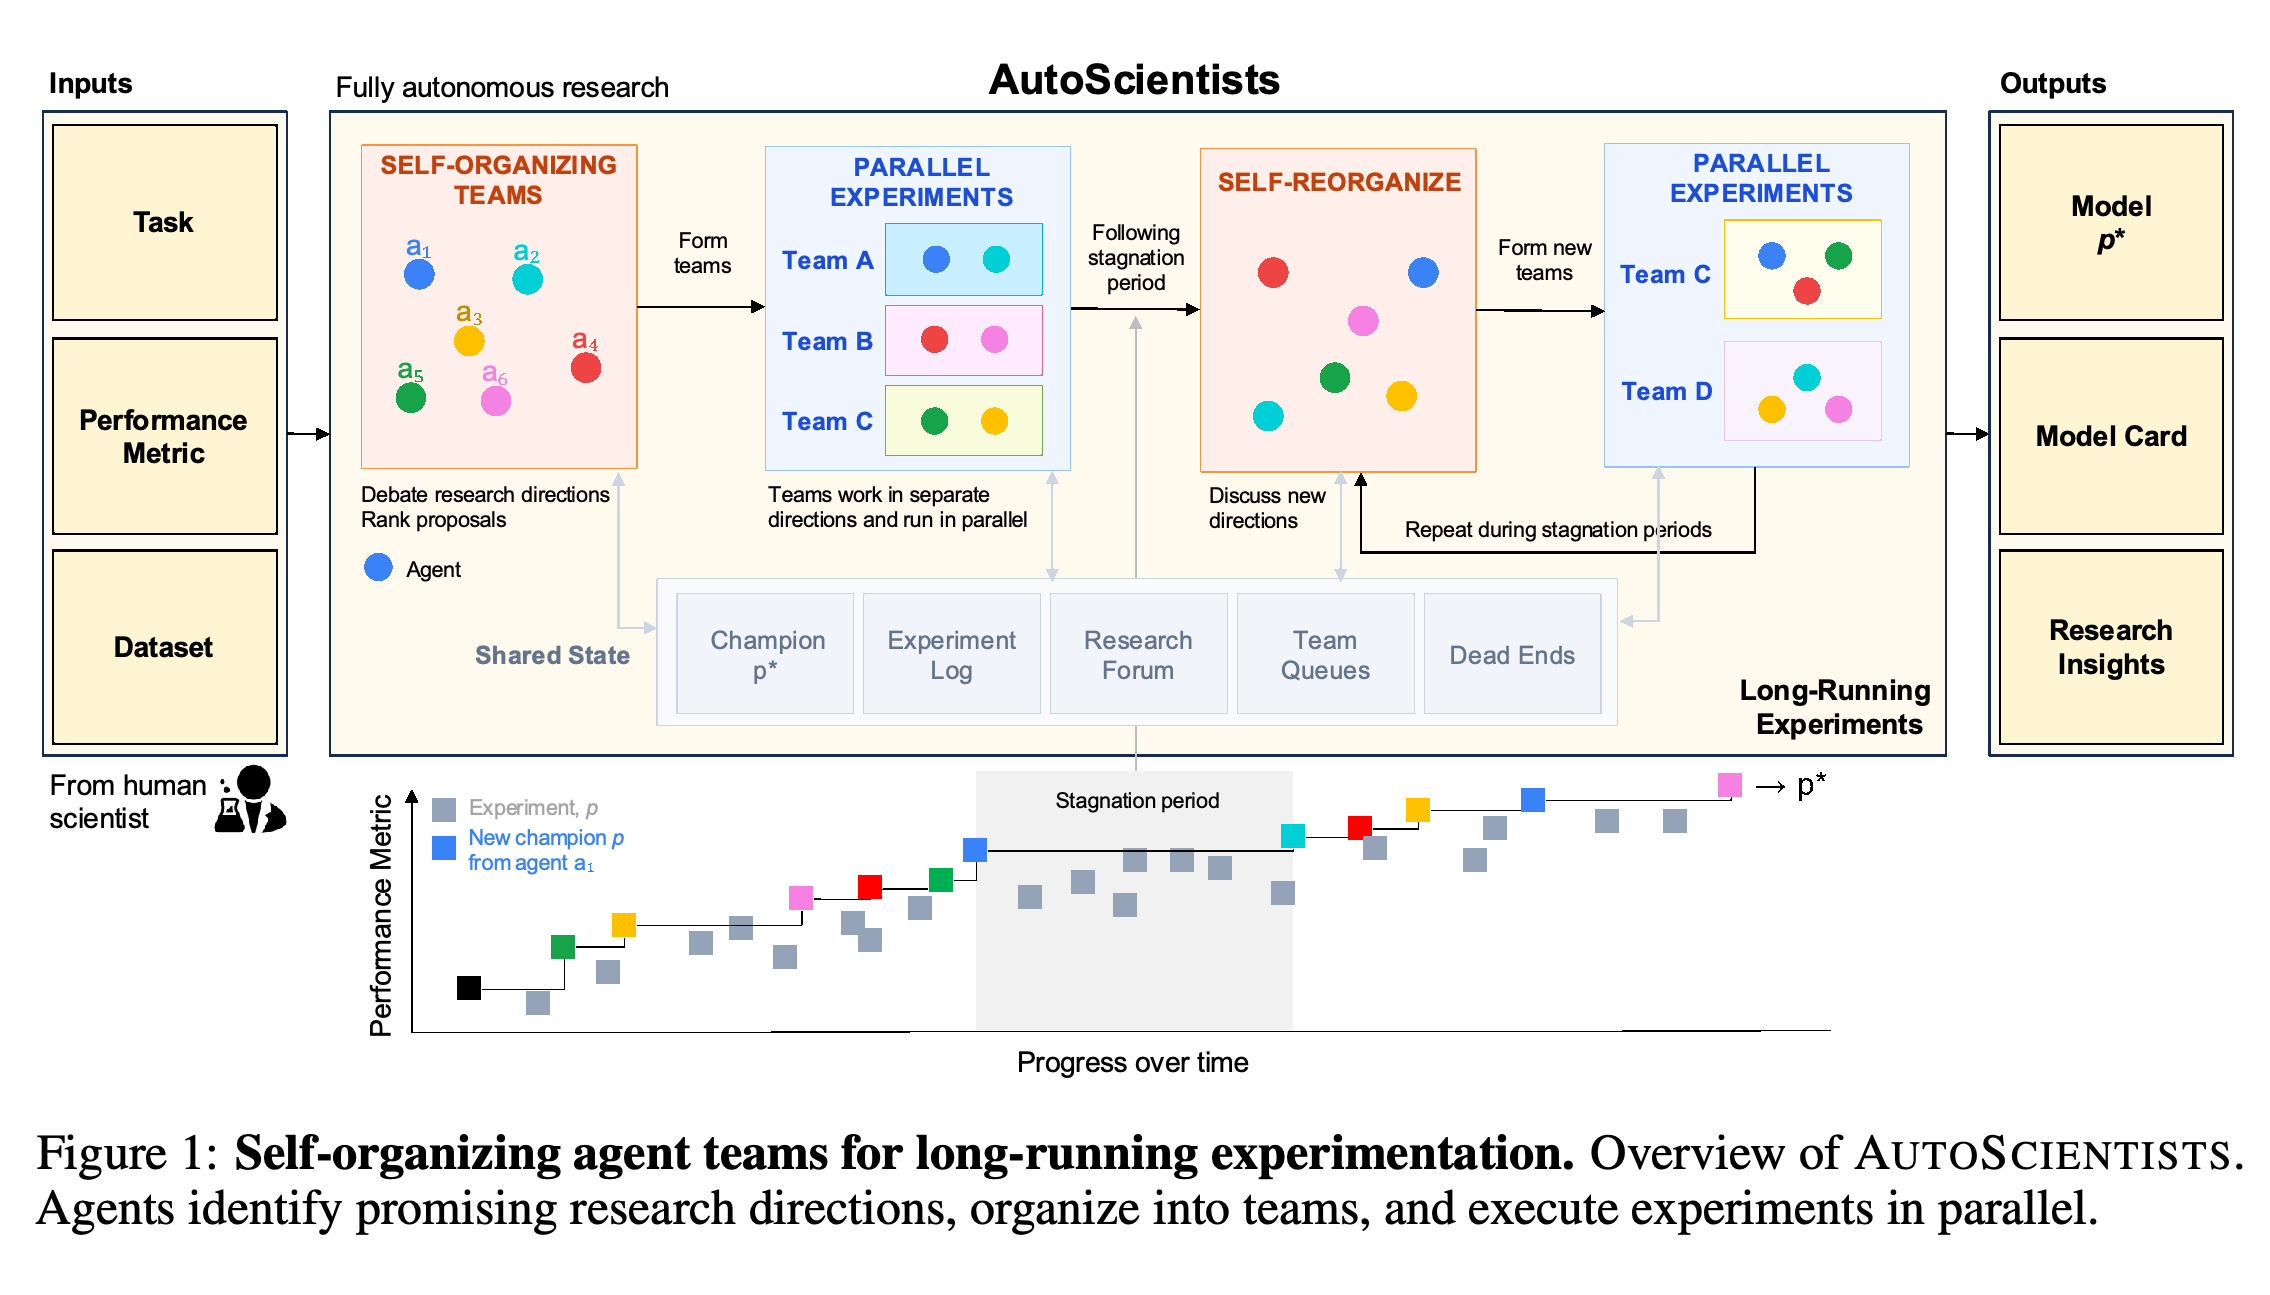
정체 시 팀 재편과 champion 모델, 모델 카드, 연구 통찰 산출을 포함한 자기 조직화 연구팀의 공유 상태 기반 조율
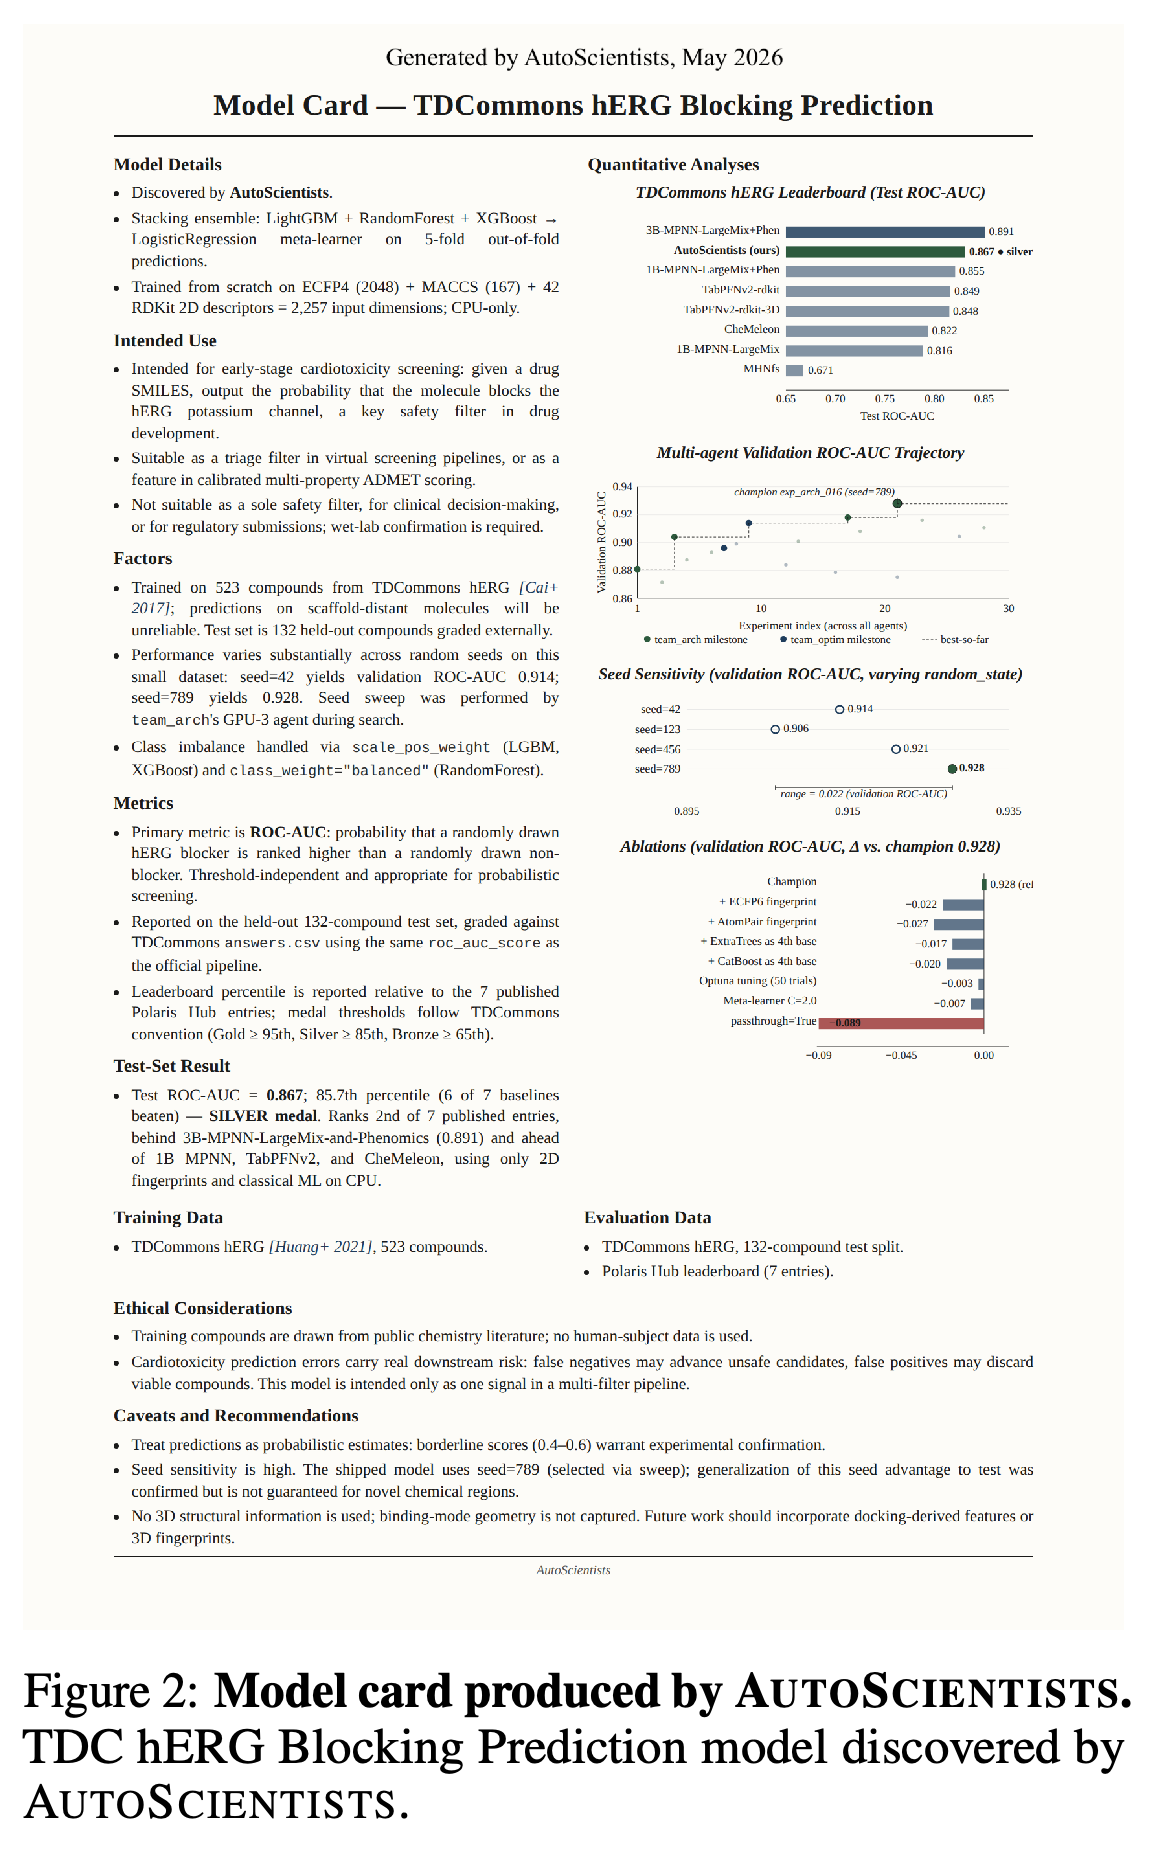
평가 결과와 문서화한 한계를 포함한 TDCommons hERG 차단 예측기의 생성 모델 카드
출처
[1] $\delta$-mem: Efficient Online Memory for Large Language Models
[2] SkillOS: Learning Skill Curation for Self-Evolving Agents
[3] AutoScientists: Self-Organizing Agent Teams for Long-Running Scientific Experimentation