


ATLAS: Learning to Optimally Memorize the Context at Test Time 요약 설명
29 May 2025 | Paper Review Long Context Associative Memory Recurrent Neural Networks목차
이 글은 Ali Behrouz, Zeman Li, Praneeth Kacham, Majid Daliri, Yuan Deng, Peilin Zhong, Meisam Razaviyayn, Vahab Mirrokni의 ATLAS: Learning to Optimally Memorize the Context at Test Time을 나중에 검토한 정리이다. 기준 원문은 2025년 5월 29일 공개된 arXiv v1이다.
이번 글에서는 ATLAS: Learning to Optimally Memorize the Context at Test Time 논문의 핵심을 정리한다.
- 2025년 5월 29일(arXiv)
- Behrouz, Ali, Li, Zeman, Kacham, Praneeth, Daliri, Majid, Deng, Yuan, Zhong, Peilin, Razaviyayn, Meisam, Mirrokni, Vahab.
- 논문 링크
요약
- ATLAS는 문맥에 따라 바뀌는 메모리를 작은 모델로 보고 시퀀스를 처리하면서 갱신한다. 최근의 키와 값 쌍, 더 풍부한 키 표현, Muon에서 착안한 최적화 규칙을 결합한다. 저자들은 언어 모델링과 검색 과제에서 여러 순환 메모리 기준 모델보다 좋은 결과를 보고한다. 다만 일부 회상 측정에서는 전체 어텐션 Transformer가 더 강하다. 결과는 논문에 기재된 실험 조건에서 해석해야 한다.
- 여기서 추론 시 기억은 현재 입력을 이용해 문맥별 메모리 상태를 갱신하는 뜻이다. 공유 모델의 가중치를 영구적으로 재학습하는 것과 구별된다. 메모리는 한 시퀀스 안에서 정보를 전달한다.
1. Introduction
전체 어텐션은 이전 토큰에 직접 접근할 수 있지만 시퀀스가 길어질수록 비용이 커진다. 고정 크기의 순환 상태는 모든 토큰을 그대로 보관하지 않아도 되지만 정보를 압축하고 덮어쓰면서 손실이 생길 수 있다. 논문은 메모리 표현력과 갱신 방식을 함께 개선해 기억과 검색 성능을 높이고자 한다.
2. Preliminaries
2.1 Backgrounds
각 토큰에서 키, 값, 쿼리를 만든다고 가정한다. 메모리는 키로부터 해당 값을 예측하도록 갱신되며, 이후 쿼리로 저장된 정보를 읽는다. 선형 메모리의 상태는 행렬이다. 예측값과 실제 값의 차이로 계산한 손실이 이 행렬의 갱신에 쓰인다. 투영과 다른 모델 파라미터는 학습 과정에서 익히고 메모리 상태는 문맥을 처리하면서 바뀐다. 메모리가 표현할 수 있는 함수와 주어진 정보로 갱신하는 방식은 서로 다른 설계 요소이다.
3. Learning to Memorize the Context at Test Time
3.1 Associative Memory with Super Linear Capacity
제곱 오차로 학습하는 선형 메모리에서 저자들은 독립적인 키와 값 연관을 얼마나 저장할 수 있는지 분석한다. 제시된 독립성과 모델 가정 아래 상한은 키 차원 \(d_k\)에 대해 \(O(d_k)\)로 표현된다. 차수 p의 다항식 특징 맵을 쓰는 분석에서는 \(O(d_k^p)\) 상한을 얻는다. 이는 논문의 가정 아래 얻은 상한이며 임의의 실제 입력에서 그만큼 저장된다는 보장은 아니다. 특징 확장은 표현력과 계산량 사이의 선택에도 영향을 준다.
3.2 Long-term Memory with Context Memorization
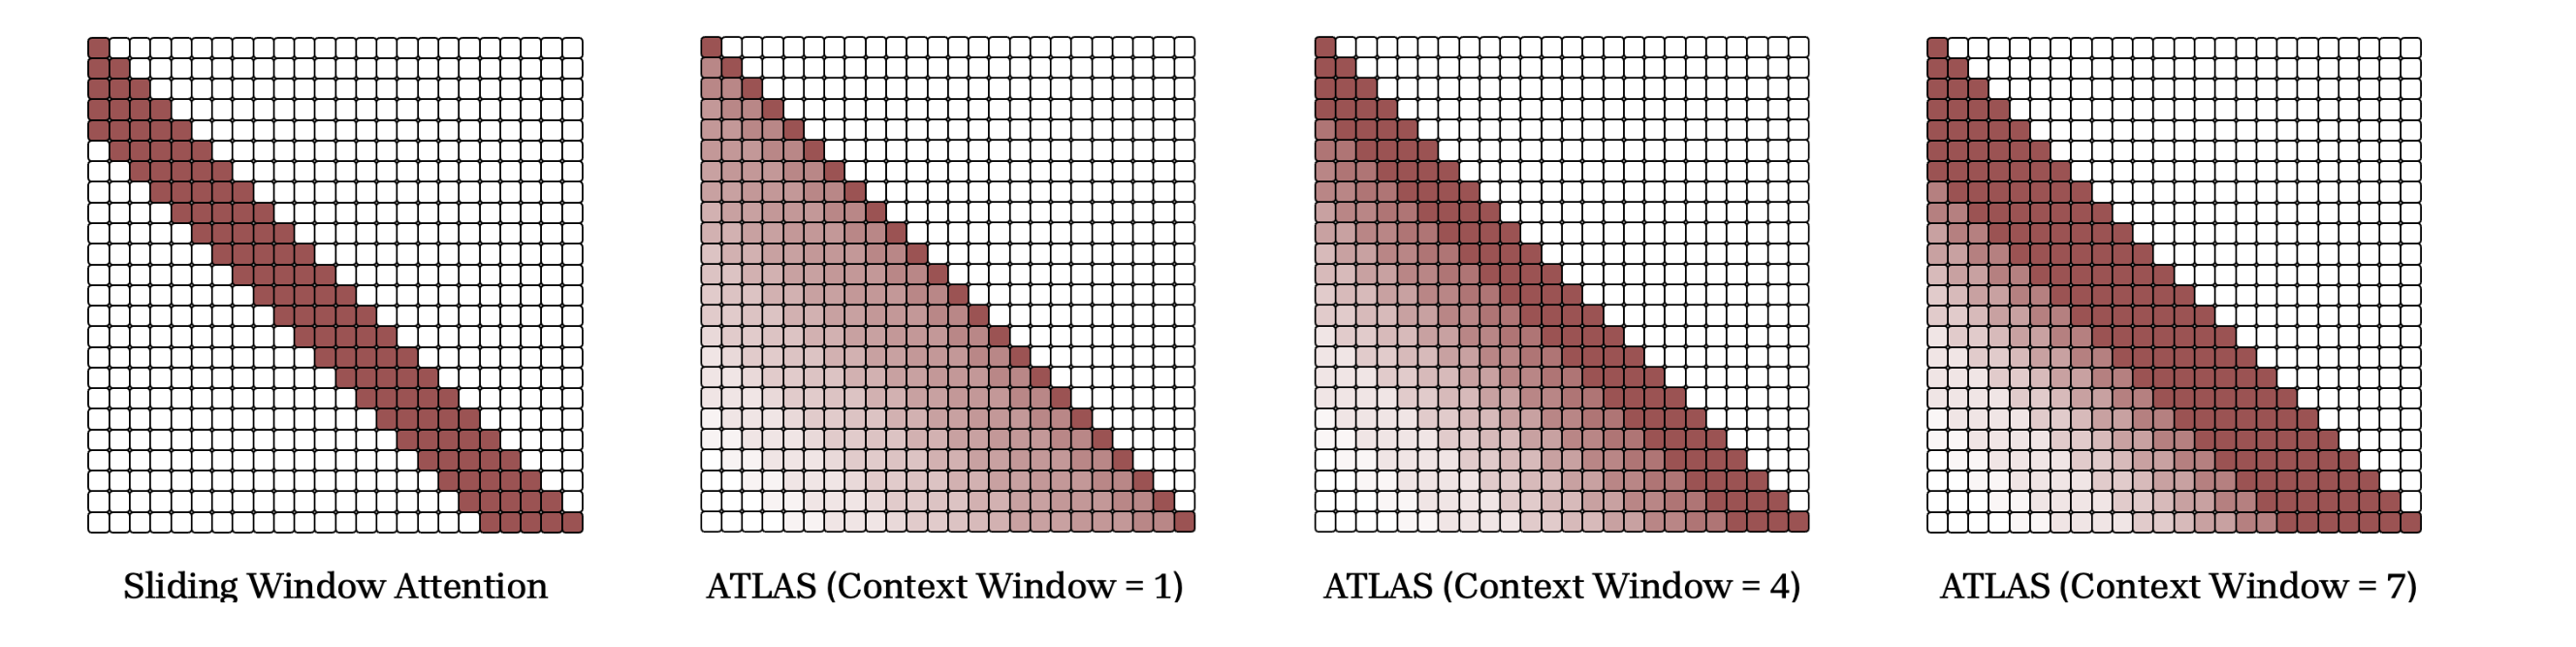
토큰 하나를 이용한 갱신은 현재의 연관만 맞춘다. Omega 목적 함수는 최근 윈도에 있는 여러 연관의 손실을 입력에 따라 가중해 합친다. 윈도 크기가 하나면 단일 연관 갱신이 된다. OmegaNet은 이 목적 함수에 다항식 키와 쿼리 표현을 결합한다. 갱신에 사용하는 최근 윈도와 순환 상태에 남을 수 있는 과거 정보는 서로 다르다.
그림 2의 첫 패널은 슬라이딩 윈도 어텐션이다. 나머지 패널은 문맥 윈도가 각각 1, 4, 7인 ATLAS를 나타낸다. 이 도식은 의존 관계를 비교하며 정확도 측정 결과는 아니다.
첫 패널은 슬라이딩 윈도 어텐션이며 나머지는 표시된 윈도 크기에 따른 ATLAS 의존 관계다.
3.3 Parallelizing Omega Rule
저자들은 이전 청크 경계의 메모리 상태를 기준으로 갱신을 계산하고 인과적 윈도 마스크를 쓰는 청크별 공식을 제시한다. 청크 내부 계산은 병렬화할 수 있지만 청크 사이의 메모리 상태는 여전히 순환한다. 특정 근사와 학습 방식에 관한 결과이며 순차 의존성이 사라지거나 실제 서비스 속도가 반드시 빨라진다는 증명은 아니다.
4. DeepTransformers: Transformers with Deep Memory
4.1 Online and Local Context Optimization of Memory
논문은 어텐션을 가중 회귀의 관점에서 설명한다. 쿼리가 연관들의 가중치를 정하고, 그에 맞춘 매핑이 출력을 생성한다는 관점이다. 여기서 Deep Transformers와 지수 특징 공간에 Omega 목적 함수를 적용하는 Dot 모델을 제안한다.
4.2 Memory Capacity and Exponential Kernels
논문이 다루는 특수한 경우는 비정규화 Transformer에 대응한다. 이 조건을 생략하고 모든 실용적인 소프트맥스 어텐션을 고정 비용의 순환 메모리로 바꿀 수 있다고 해석할 수는 없다.
4.3 Deep Omega Transformer (Dot): Transformers with Omega learning rule
Dot은 지수 특징 구성과 Omega 목적 함수를 결합한다.
5. Atlas: A Locally Optimal Memory with High Capacity
ATLAS는 메모리에 Muon에서 착안한 갱신을 적용한다. Newton–Schulz 반복으로 모멘텀을 근사적으로 준직교화하며, 저자들은 이를 2차 최적화와 관련된 근사로 설명한다. 논문의 분석은 국소적으로 최적인 갱신을 다루며 학습된 언어 모델 전체의 전역 최적성을 보장하지는 않는다. 복잡한 갱신에는 추가 계산이 필요할 수도 있다.
5.1 Parallel Training
앞서 설명한 청크별 학습에서도 청크 사이의 순환은 유지된다.
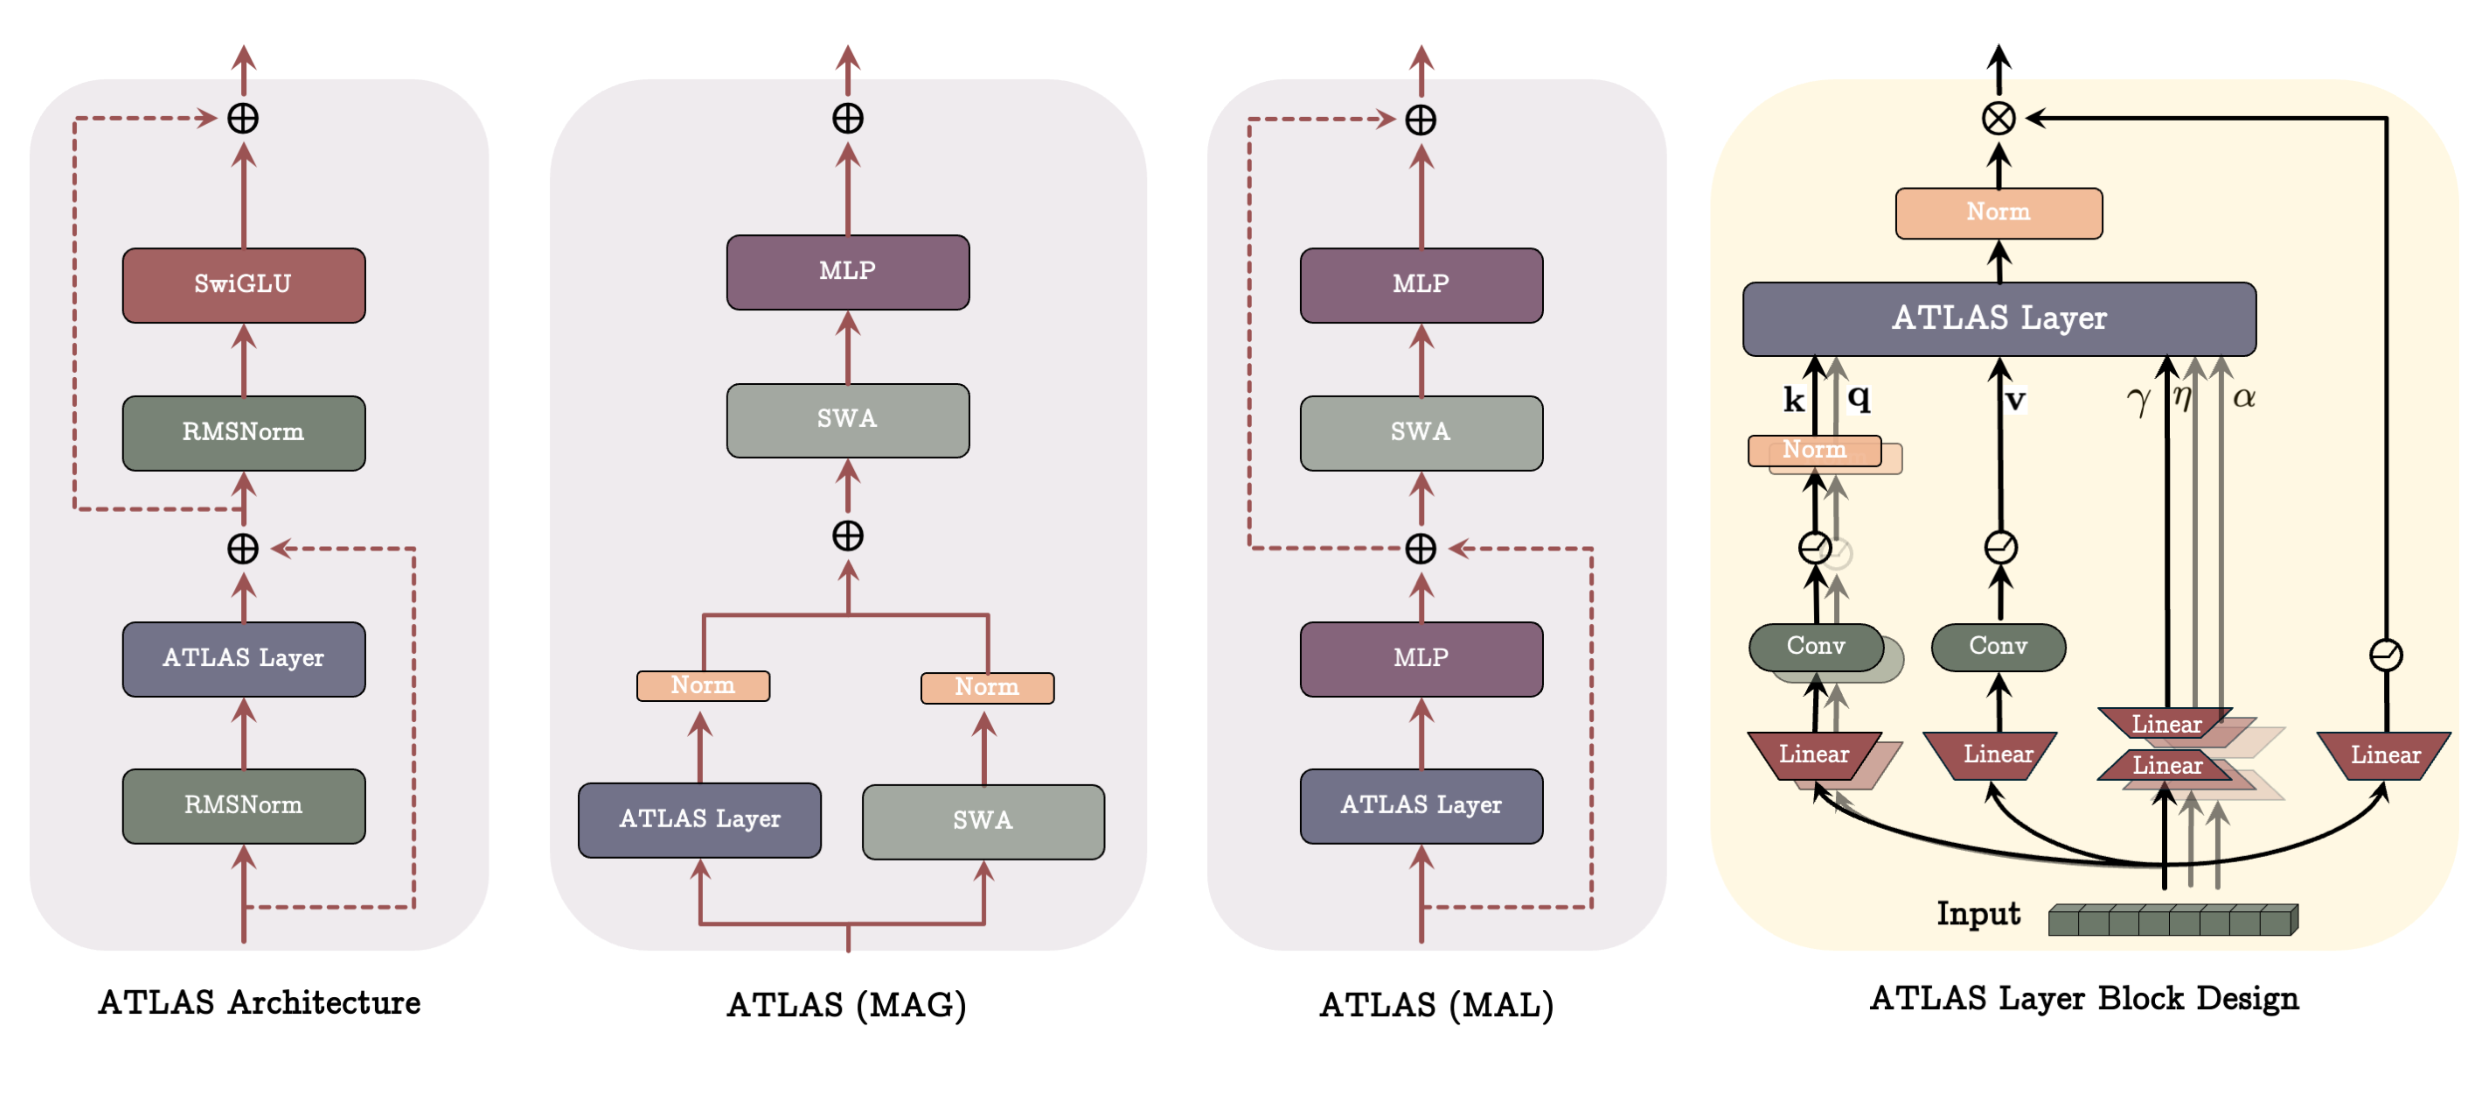
기본 메모리는 잔차 연결이 있는 2층 MLP이다. ATLAS++는 게이트가 있는 MLP를 사용하며, 논문은 메모리와 국소 어텐션을 결합한 혼합 구조도 평가한다. 수치를 비교할 때 각 변형 모델을 구분해야 한다.
그림 3은 왼쪽부터 ATLAS 구조, ATLAS MAG, ATLAS MAL, ATLAS 레이어 블록을 보여 준다. 도식의 구성 요소와 본문에서 설명하는 기본 잔차 메모리 및 게이트형 ATLAS++ 변형은 구분해 읽어야 한다.
왼쪽 세 패널은 ATLAS, MAG, MAL을 구분하고 오른쪽 패널은 ATLAS 레이어를 펼쳐 보인다.
6. Experiments
6.1 Language Modeling and Common-Sense Reasoning
논문은 낮을수록 좋은 퍼플렉서티와 높을수록 좋은 정확도를 보고한다. 표 2에서 30B 토큰으로 학습한 760M ATLAS의 WikiText 퍼플렉서티는 18.92, 평균 추론 정확도는 52.77이다. OmegaNet은 각각 19.16과 52.56, Transformer++는 25.21과 48.69이다. 100B 토큰으로 학습한 1.3B ATLAS는 14.97과 57.62, ATLAS++는 14.40과 58.03을 기록한다. 개별 데이터셋과 변형 모델에 따라 결과가 다르므로 모든 지표에서 ATLAS가 앞선다고 말할 수는 없다.
같은 모델 크기와 토큰 예산에서 비교해야 하며 퍼플렉서티와 정확도의 유리한 방향은 서로 다르다.
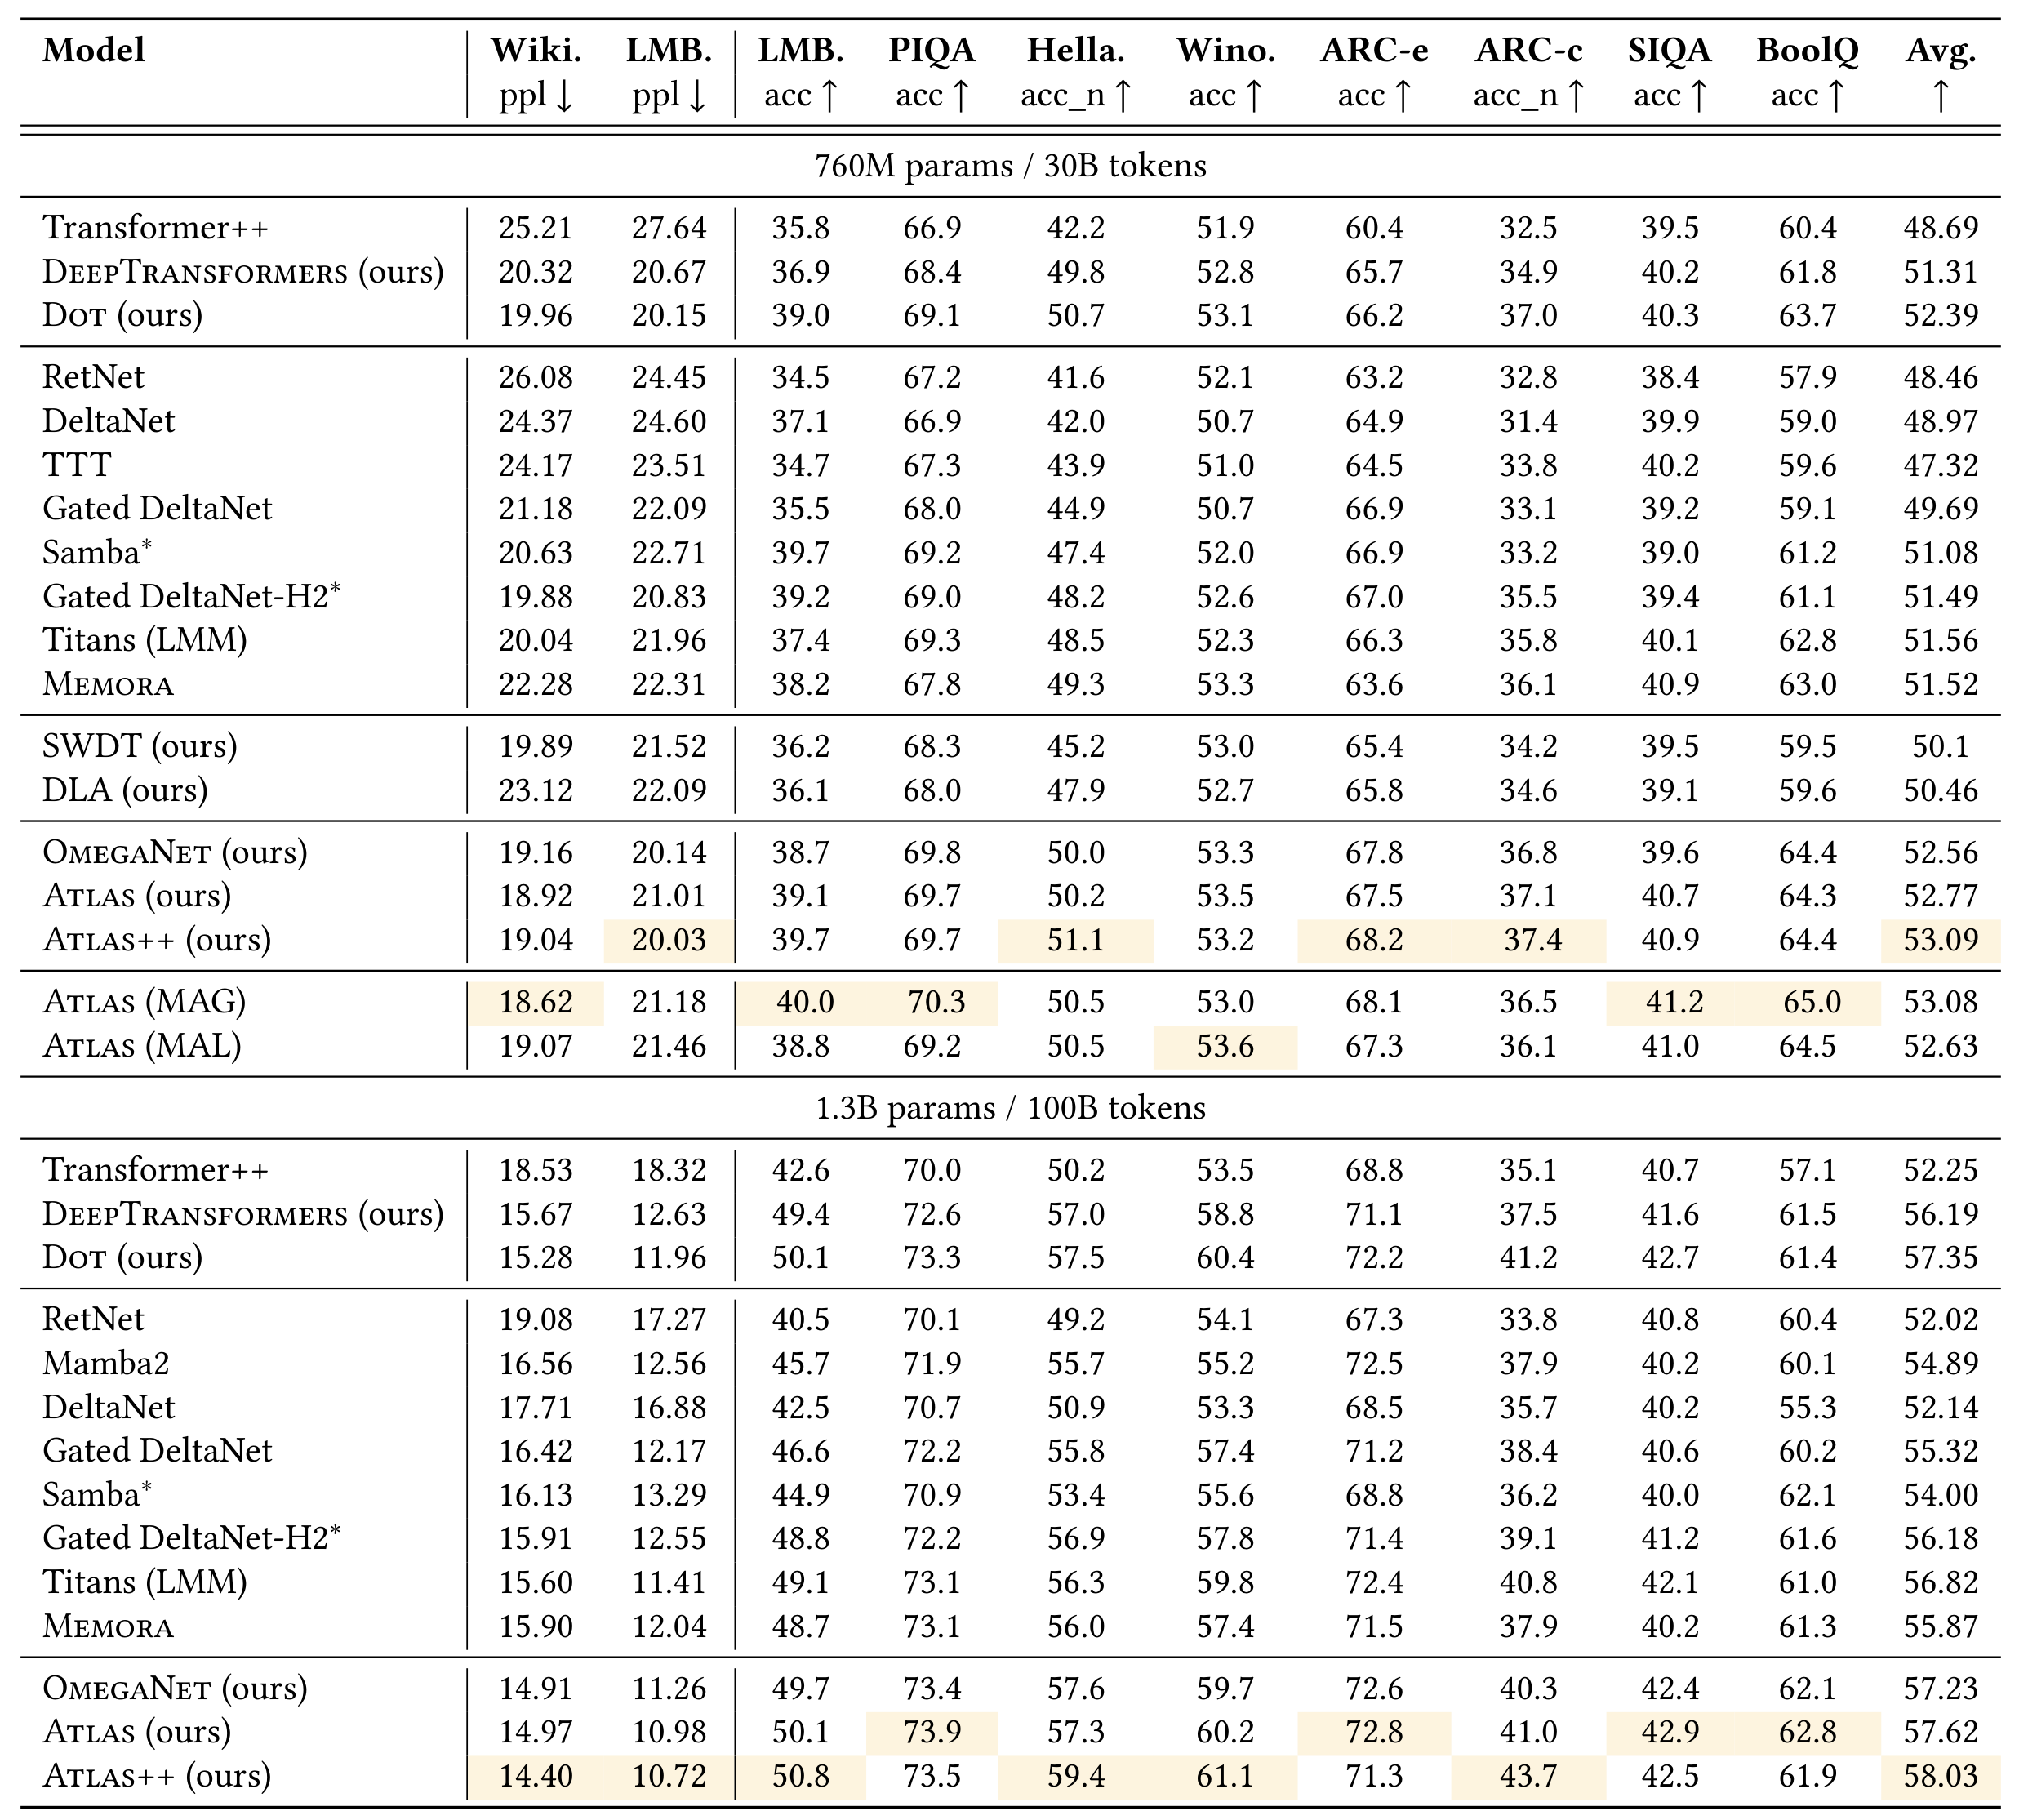
PDF 14쪽의 실험 설정은 모델 크기를 340M, 400M, 790M, 1.3B로 나열하지만 30쪽 표 7은 170M, 340M, 760M, 1.3B로 나열한다. 특히 본문은 790M이라고 쓰지만 15쪽 표 2의 결과에는 760M이라는 표기가 붙어 있다. 이 불일치는 확인되지 않았으며 오타라고 단정할 수 없다. 위 비교는 실제 학습 구성이 별도로 확인됐다는 뜻이 아니라 보고된 결과에 붙은 표 2의 표기를 따라 760M을 사용했다. 6.1절은 ATLAS와 OmegaNet이 두 지표에서 가장 좋은 비혼합 모델이라고 설명하지만, 표 2의 1.3B WikiText 퍼플렉서티는 OmegaNet 14.91, ATLAS 14.97로 OmegaNet이 더 좋다. 여기서는 표의 수치를 기준으로 비교했다.
6.2 Long Context: Needle In a Haystack
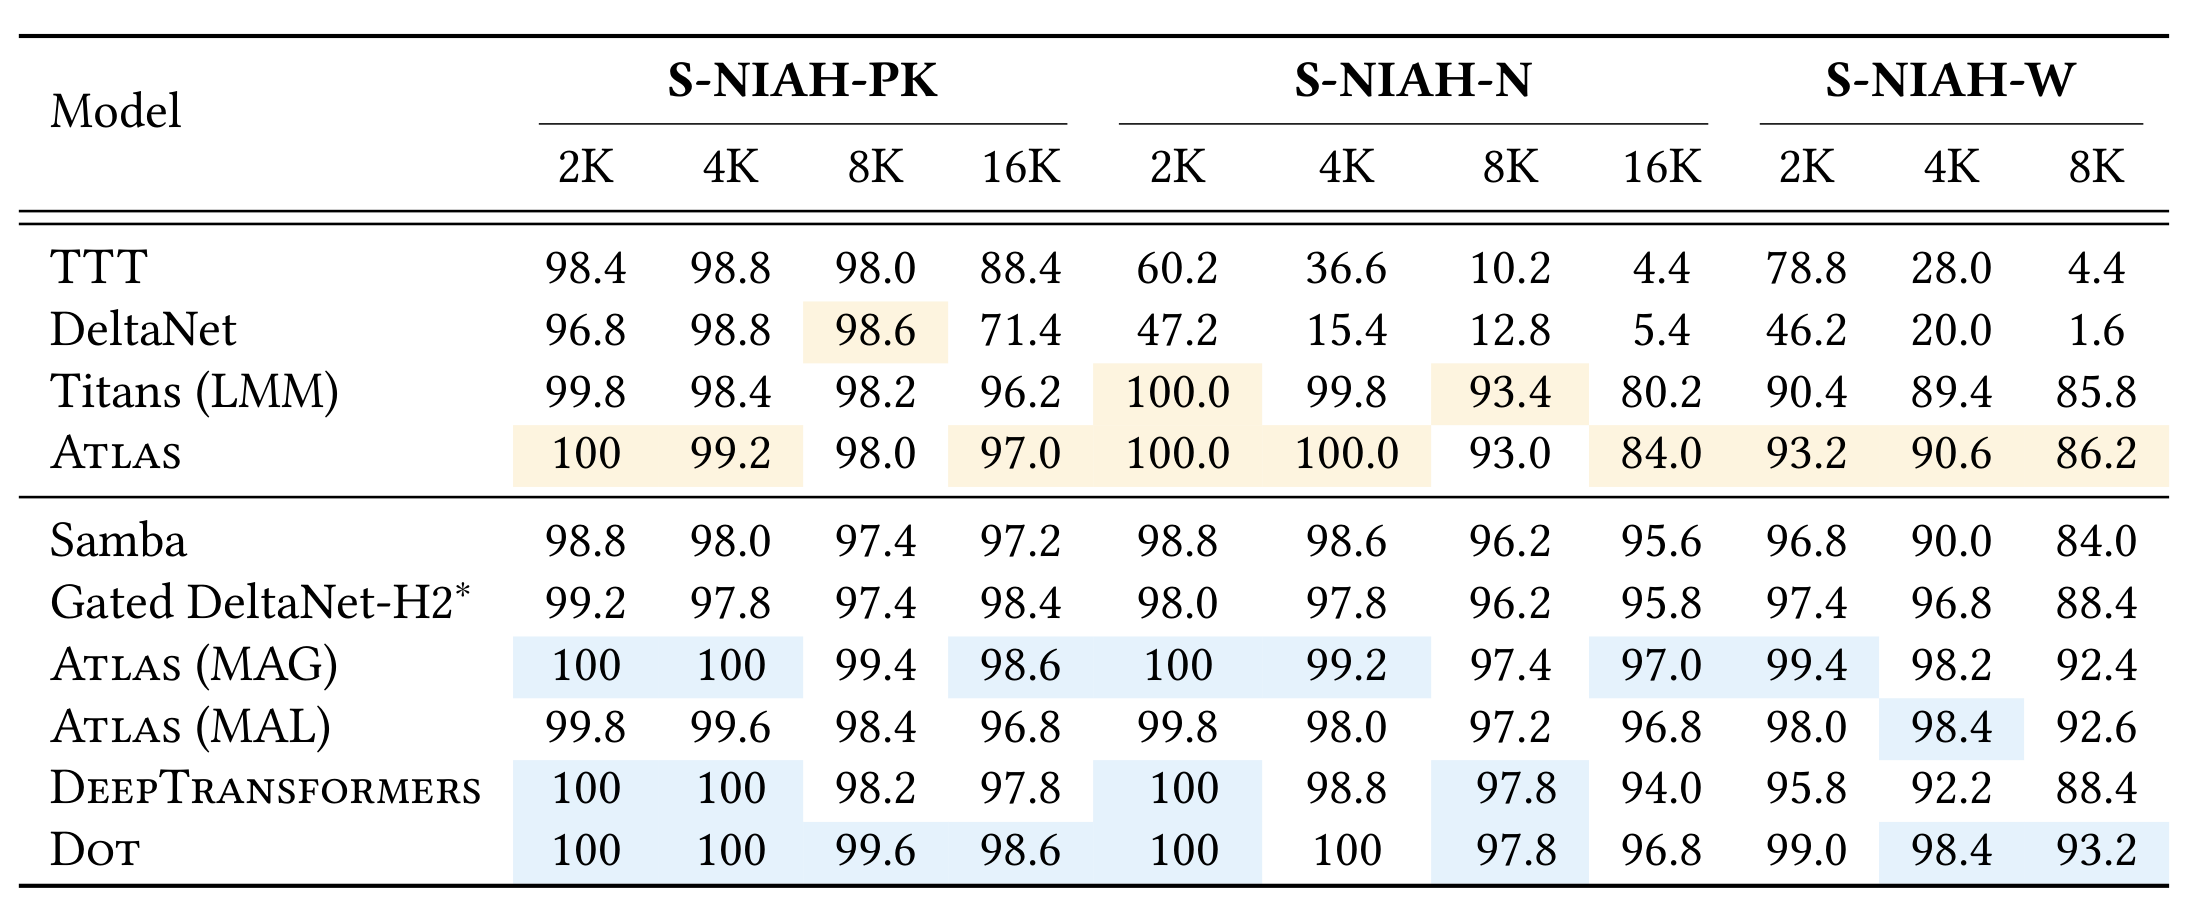
표 3의 RULER S-NIAH-N 16K 평가에서 ATLAS는 84.0, Titans는 80.2, ATLAS MAG는 97.0을 기록한다. 학습 문맥은 4K이므로 더 긴 입력에 대한 평가이다. 합성 검색 과제 하나의 결과를 문서 이해 전반의 성능으로 일반화할 수는 없다.
16K 열은 합성 벤치마크에서 4K 학습 문맥을 넘어선 검색을 평가한다.
6.3 Long Context: BABILong Benchmark
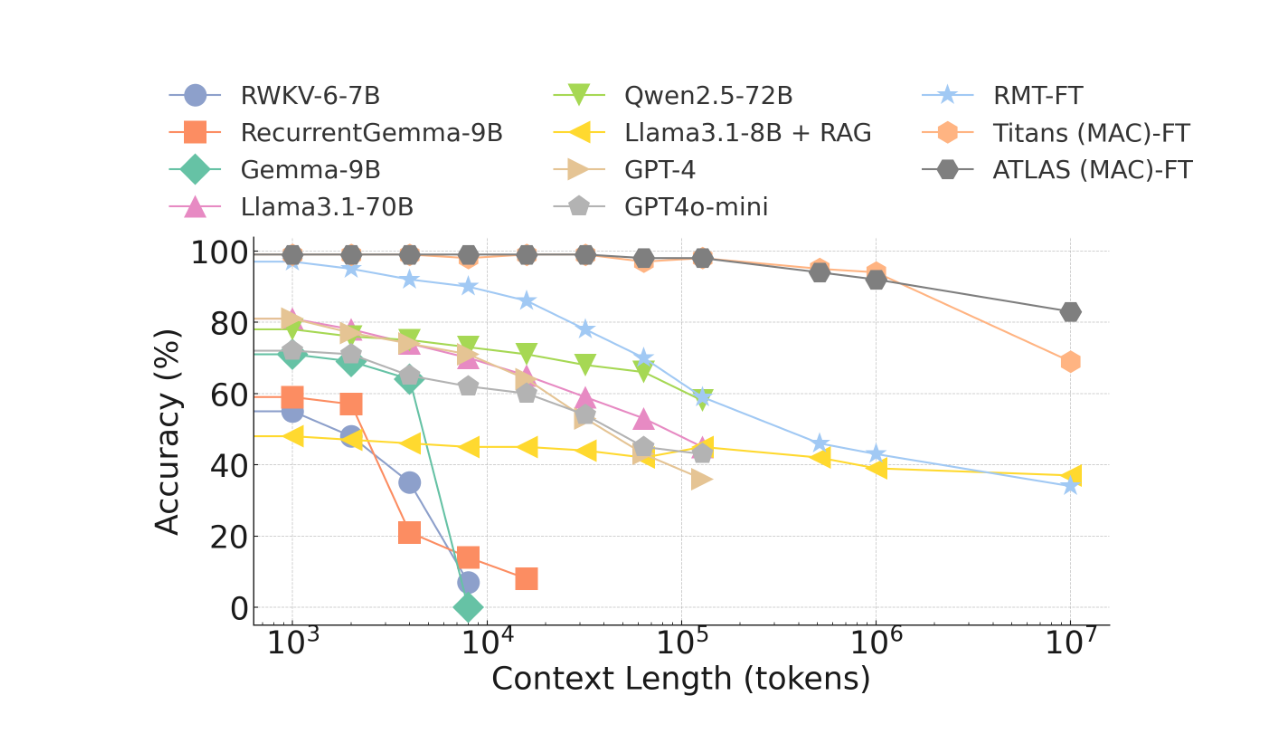
BABILong 실험에서 평가된 ATLAS 혼합 모델은 10M 토큰에서 80%가 넘는 정확도를 보인다. 이 그래프는 해당 벤치마크에 대한 파인튜닝과 지속 메모리 토큰을 사용하지 않는 MAC 구조라는 조건을 포함한다. 제로샷 성능이나 모든 긴 문맥 작업의 정확도로 해석하면 안 된다.
이 곡선에는 벤치마크 파인튜닝과 명시된 MAC 구조가 적용되어 있어 제로샷 정확도를 확정하지 못한다.
6.4 Learnability Experiments
합성 학습 가능성 실험은 메모리 구조와 확장 크기를 다섯 매핑에서 비교한다. 저랭크 선형 매핑, MLP 매핑, 어텐션 뒤의 MLP, 어텐션 출력을 입력으로 받는 MLP, 슬라이딩 윈도 어텐션 뒤의 MLP다. 어텐션 출력을 입력으로 받는 설정의 입력은 상관되어 있으며 기본 MLP 설정의 독립 표본 입력과 다르다. 저자들은 이 실험에서 상관된 입력을 쓰는 설정이 기본 MLP 설정보다 매핑을 더 빨리 학습했다고 보고한다. 다만 무작위로 초기화된 벡터를 쓰는 어텐션은 실제 학습된 언어 모델 어텐션의 모든 구조를 재현하지 않는다.
6.5 Additional Experiments: In-context Recall, MAD Synthetic Benchmark, and Associative Recall
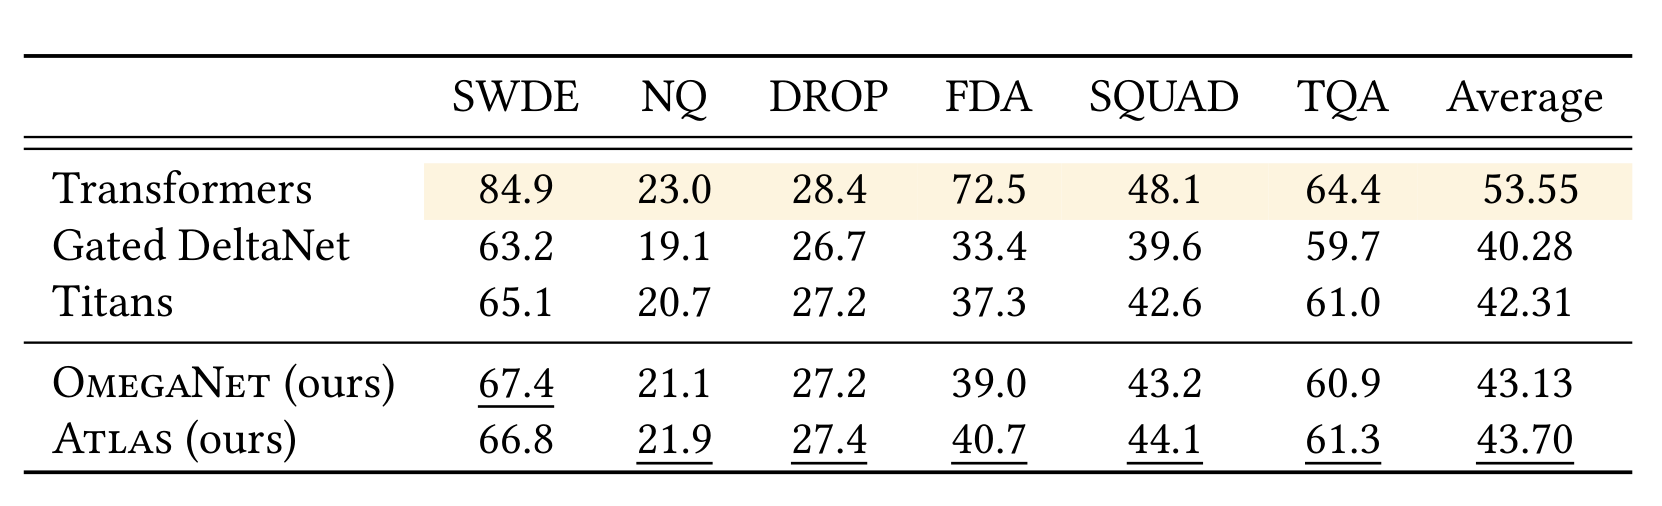
표 4의 MAD 평균은 ATLAS 79.50, OmegaNet 78.98, Titans 76.44, Transformer 75.46이다. 개별 과제에는 동점과 서로 다른 방향의 차이가 있다. 별도의 문맥 내 회상 평가인 표 5에서는 ATLAS가 43.70, OmegaNet이 43.13인 반면 전체 Transformer는 53.55이다. 이 실험에서는 순환 메모리가 직접 어텐션을 모든 회상 과제에서 대체하지 못한다는 점도 드러난다.
이 회상 과제의 평균 점수에서는 전체 Transformer가 순환 기준 모델보다 높다.
6.6 Ablation Study and Scaling Patterns
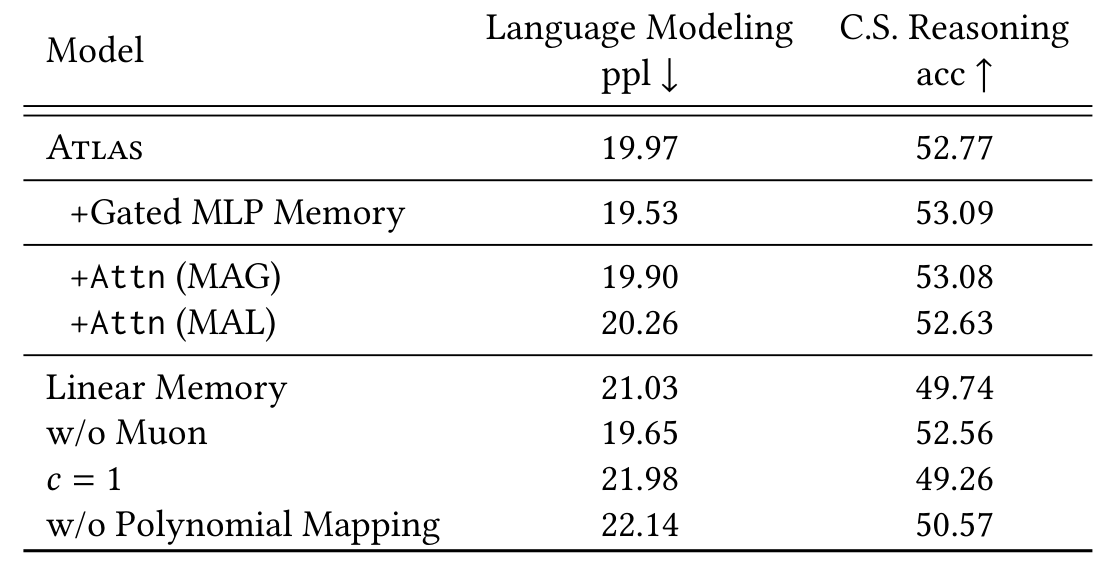
표 6에서 Omega 윈도를 하나로 줄이면 퍼플렉서티가 19.97에서 21.98로, 평균 정확도는 52.77에서 49.26으로 바뀐다. 다항식 특징을 제거하면 각각 22.14와 50.57이다. Muon을 제거한 경우는 19.65와 52.56으로, 퍼플렉서티는 오히려 좋아지고 평균 정확도는 조금 떨어진다. 이는 모든 구성 요소가 긍정적으로 기여한다는 표의 캡션과 충돌한다. 표의 수치는 지표에 따른 상충 관계를 보여 준다.
이 설정에서 Muon을 제거하면 보고된 퍼플렉서티와 평균 추론 정확도가 모두 조금 낮아진다.
확장 실험과 다중 쿼리 연관 회상 그래프는 시험한 설정에 관한 추가 근거이다. 퍼플렉서티나 FLOP 그래프만으로 실제 서비스 지연 시간이나 최대 메모리 사용량을 확정할 수는 없다.
7. Conclusion
ATLAS는 순환 상태를 학습된 연관 메모리로 보고 표현력과 갱신 방식을 함께 분석한다. 최근 윈도를 이용한 목적 함수와 더 풍부한 메모리는 여러 평가에서 개선과 연결된다. 결과는 구조, 데이터, 지표와 학습 설정에 좌우된다. 보고된 평균 회상 점수에서는 전체 어텐션이 앞서며, 파인튜닝한 10M 토큰 실험은 일반적인 제로샷 성능의 근거가 아니다.
부록에는 관련 연구, 메타러닝 공식, 용량 분석, 구조와 실험 설정이 담겨 있다. 용량 결과의 가정과 앞서 언급한 모델 크기 표기의 불일치는 재현 전에 확인할 부분이다.
부록
- A Additional Related Work: 저자들은 선형 순환망, 입력 의존 갱신, 델타 규칙, 깊은 신경 메모리 등과 제안 모델의 관계를 설명한다. 이 부록은 설계 계열의 맥락을 제공하며 새로운 통제 비교 실험은 아니다.
- B Miras Framework: Miras는 시퀀스 모델을 연관 메모리, 어텐션 편향, 유지 메커니즘과 메모리 학습 규칙으로 표현한다. 서로 다른 구조를 공통 언어로 비교하기 위한 틀이다.
- C Supporting Proofs: 보조 증명은 명시된 모델과 데이터 가정에서 용량을 분석한다. 다항식 맵의 결과는 특징 공간의 차원을 세어 정확히 맞출 수 있는 독립 연관의 수를 제한하며, 실제 입력에서의 용량을 보장하는 결과는 아니다.
- D Detailed Formulations of All Architectures: 깊은 선형 어텐션, 슬라이딩 윈도 선형 어텐션, OmegaNet, Atlas의 공식을 자세히 제시한다. 키, 쿼리, 값 투영을 공유하더라도 목적 함수와 순환 규칙은 서로 다르다.
- E Experimental Details: FineWeb 학습, 구조 설정과 기준 모델의 출처를 설명한다. 표 7의 모델 구성과 토큰 수 목록은 본문 실험 설정의 크기 서술과 다르다.
- F Additional Experimental Results: 표 8에는 340M 설정을 포함한 작은 규모의 언어 모델링과 추론 결과가 제시된다. 이 비교만으로 본문의 모델 크기 목록 불일치가 해소되지는 않는다.
짧은 생각
메모리가 표현할 수 있는 정보와 갱신 과정에서 실제로 보존되는 정보를 구분한 점이 유용하다. 전체 어텐션과의 회상 격차와 Muon 제거 시 엇갈린 지표를 보면, 실제 적용할 작업에서 정확도와 자원 비용을 함께 평가할 필요가 있다.