


End-to-end Algorithm Synthesis with Recurrent Networks: Logical Extrapolation Without Overthinking 요약 설명
11 Feb 2022 | Paper Review Neural Algorithm Execution Recurrent Neural Networks Out-of-Distribution Generalization목차
이번 글에서는 End-to-end Algorithm Synthesis with Recurrent Networks: Logical Extrapolation Without Overthinking 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 2월 11일(Arxiv), 36th Conference on Neural Information Processing Systems (NeurIPS 2022)
- Bansal, Arpit, Schwarzschild, Avi, Borgnia, Eitan, Emam, Zeyad, Huang, Furong, Goldblum, Micah, Goldstein, Tom.
- University of Maryland, University of Chicago, New York University
- 논문 링크 (v3, 2022년 10월 14일 수정)
요약
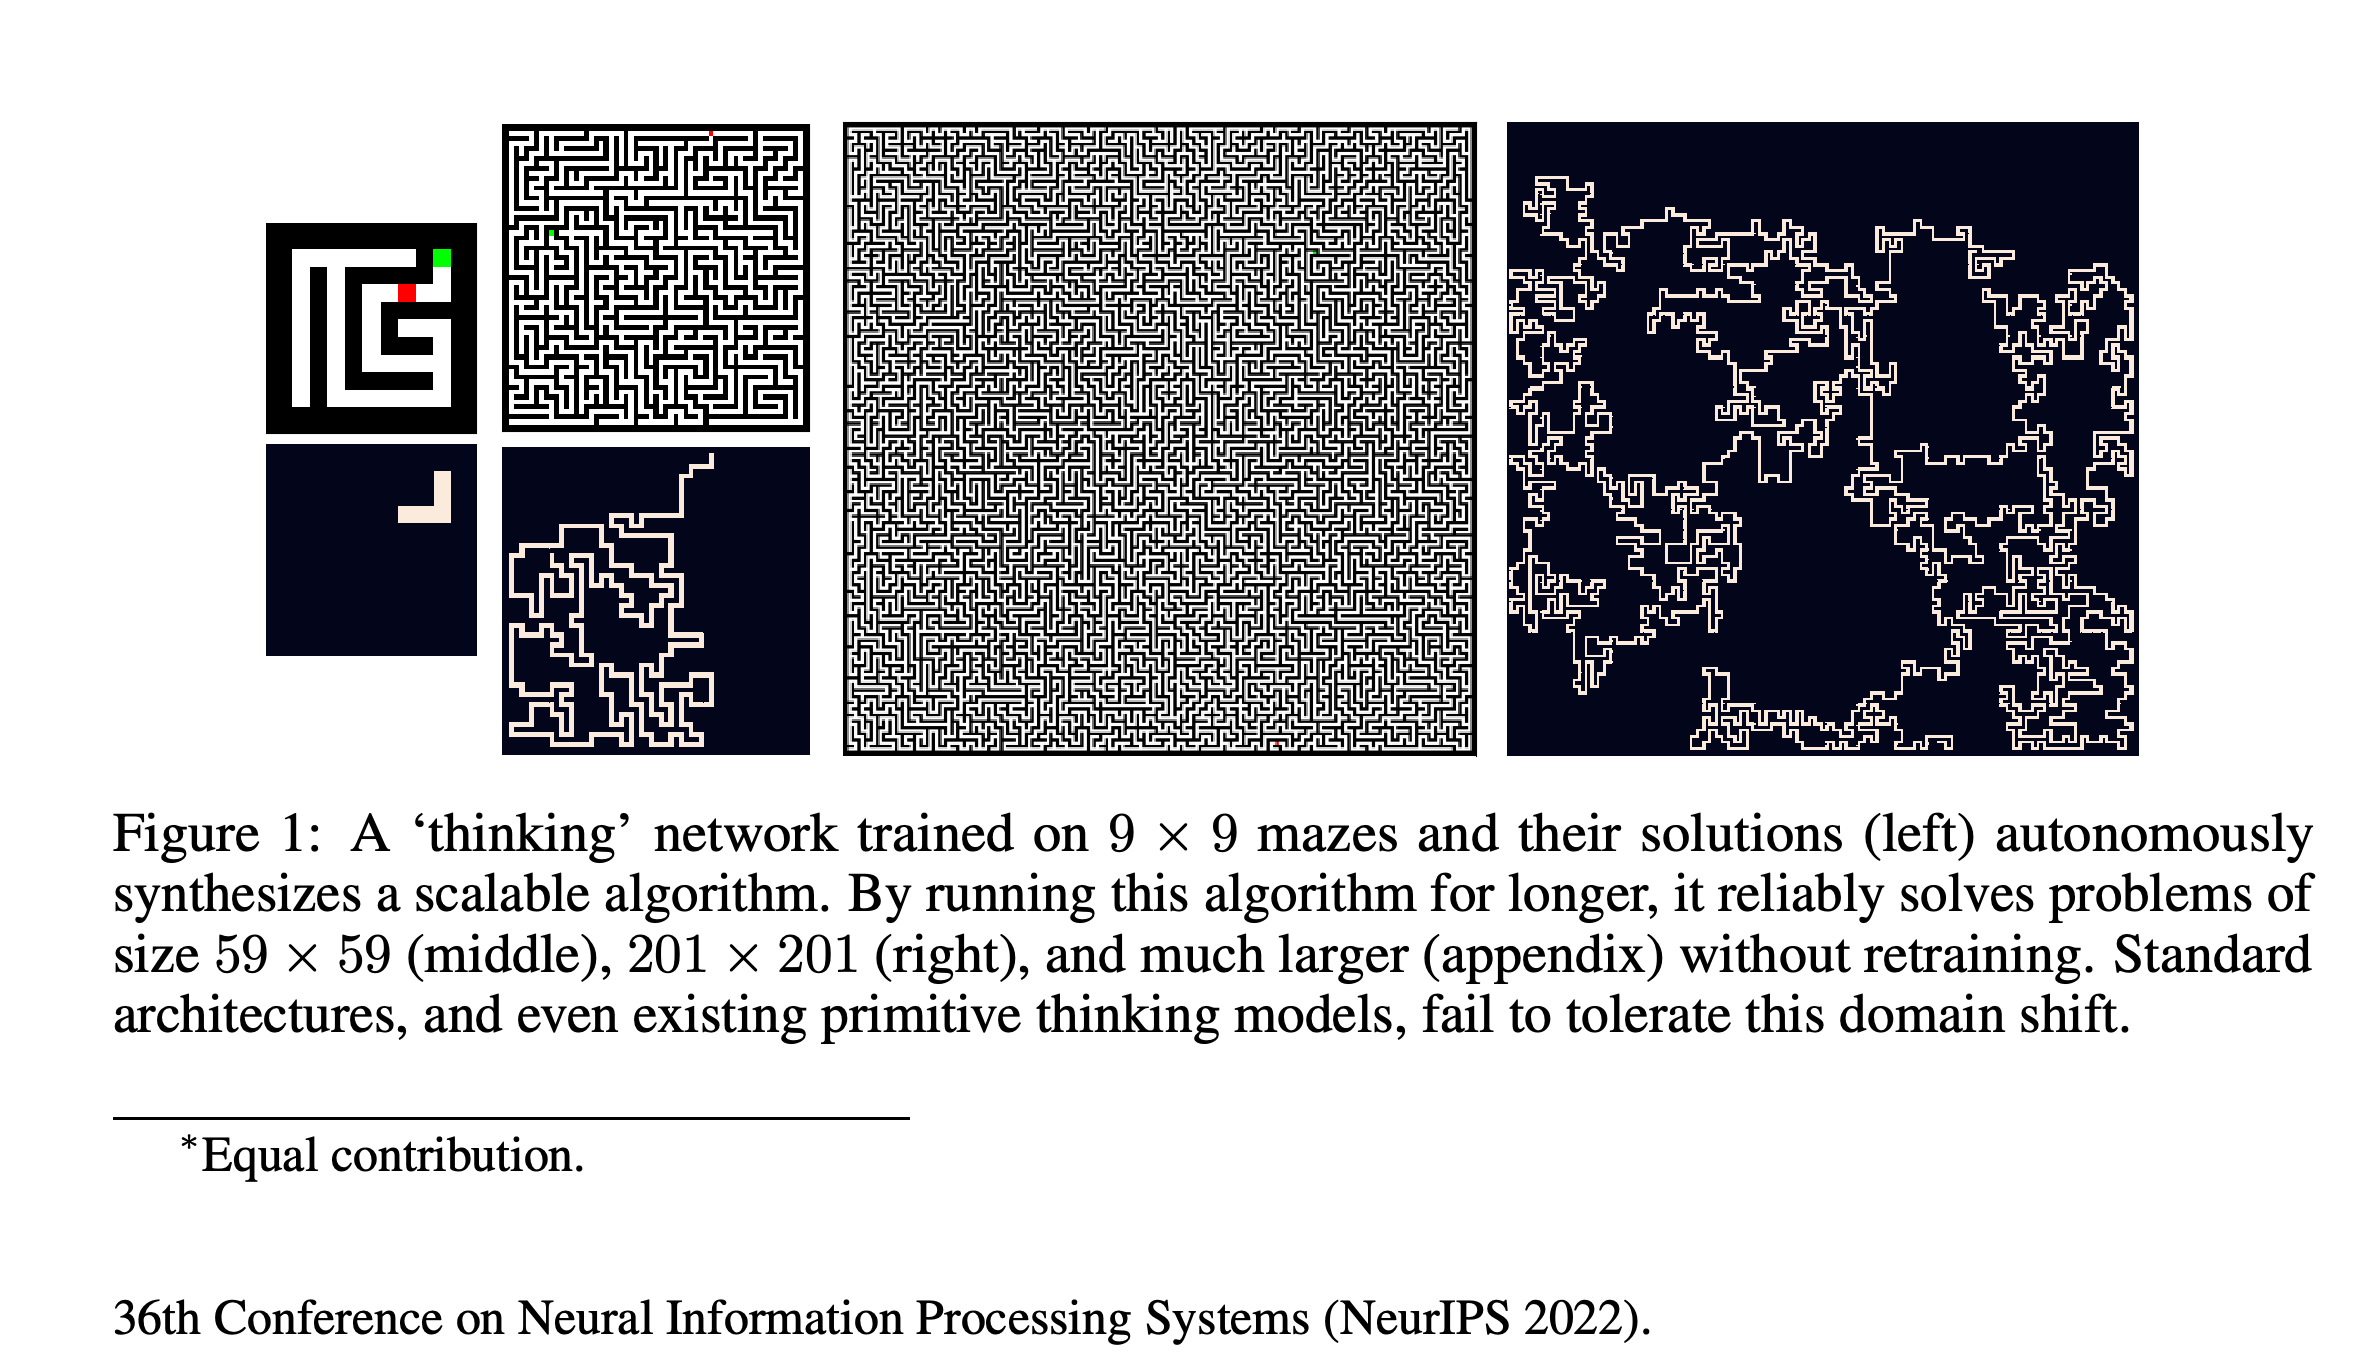
- 이 논문은 작은 추론 문제로 학습한 신경망이 계산을 계속하더라도 답이 악화되지 않으면서 훨씬 큰 문제를 풀 수 있는지 살펴본다. 9 × 9 미로로 학습한 뒤 input recall과 progressive loss를 적용한 순환 모델은 59 × 59 미로에서 최고 정확도 97.30%를 기록했다. 표준 순환 모델과 feed-forward 베이스라인의 정확도는 0%였다.
- Input recall은 매 반복마다 원래 문제를 공유 순환 블록에 제공하고, progressive loss는 무작위로 선택한 중간 상태를 개선하도록 블록을 학습한다. 32-bit 문자열로 학습한 뒤 512-bit prefix sum, 즉 modulo 2 누적합에서 두 방법을 결합한 모델은 최고 정확도 97.12%를 기록했으며 표준 순환 베이스라인은 0%를 기록했다.
- 실험에서는 체스 퍼즐에서 안정성이 개선되고 교란 이후에도 복구되는 모습을 보였다. 다만 근거는 3개 벤치마크 분야에 한정되며 보편적인 수렴을 입증하지는 않는다. 보고된 평균에서는 학습 정확도 99%에 도달하지 못한 실행을 제외했으며, 여기에는 체스 실행의 약 절반이 포함된다.
1 Introduction
알고리즘 외삽은 쉬운 학습 예제에서 배운 절차로 더 어려운 테스트 문제를 푸는 것이다. Deep Thinking (DT) 네트워크는 테스트 시 순환 블록을 추가로 반복하지만, 학습 범위를 넘어 반복하면 출력이 악화될 수 있다. 논문은 이 실패를 overthinking이라고 부른다 [22].
작은 미로로 학습한 모델이 순환 계산을 늘려 훨씬 큰 입력에 적용되는 모습을 예제로 보여준다.
2 Related work
논문은 알고리즘 학습, 적응형 계산, 논리적 외삽과 관련하여 제안 방법을 설명한다. 이 방법은 개별 알고리즘 단계에 대한 감독 없이 완전한 해법을 학습하는 가중치 공유 thinking network를 바탕으로 한다 [22]. 저자들은 주로 학습 분포에서 평가된 기존 적응형 모델과 이를 구분한다.
3 Methods
DT 네트워크는 p로 입력 x를 임베딩하고, 공유 순환 블록 r을 m회 적용한 뒤 h로 결과 특징을 출력에 매핑한다: f(x;m) = h(r^m(p(x))). 구현에는 4층 잔차 순환 블록을 사용하며, 테스트 시 m을 늘려 계산량을 확대한다.
3.1 Recall architectures
DT-Recall은 매 순환 반복에서 블록의 중간 표현인 feature map에 원래 입력을 연결하고, convolution으로 특징의 형태를 복원한다. 이 구조는 변화하는 특징이 정보를 잃더라도 네트워크가 문제에 직접 접근할 수 있게 한다. convolution에 대해서는 A ConvNet for the 2020s 요약 설명 글을 참조하라.
3.2 Promoting forward progress through optimization
Progressive training은 {0, …, m−1}에서 n을, {1, …, m−n}에서 k를 각각 균일하게 샘플링한다. 처음 n회 반복은 gradient 없이 계산하고, 이어서 k회 더 반복한 결과로 학습한다. 목적 함수는 progressive loss와 전체 m회 반복의 loss를 가중치 α로 결합해 중간 상태에서도 유용한 갱신이 이루어지도록 한다.
3.3 Datasets
easy-to-hard-data 벤치마크 [21]에는 각 출력 비트가 입력 접두사의 패리티인 modulo 2 prefix sum, 최적 경로 미로 풀이, 최선의 수를 찾는 체스 퍼즐이 포함된다. 학습에는 32-bit 문자열, 9 × 9 미로, 가장 쉬운 체스 퍼즐 600K개를 사용한다. 체스의 주요 그래프는 퍼즐 600K–700K를 평가하며, 더 어려운 집합도 테스트한다. 논문 3.3절은 테스트 범위를 700K–1.1M으로 설명하지만, Figure 5와 Table 5는 600K–700K를 사용한다.
4 Extreme extrapolation
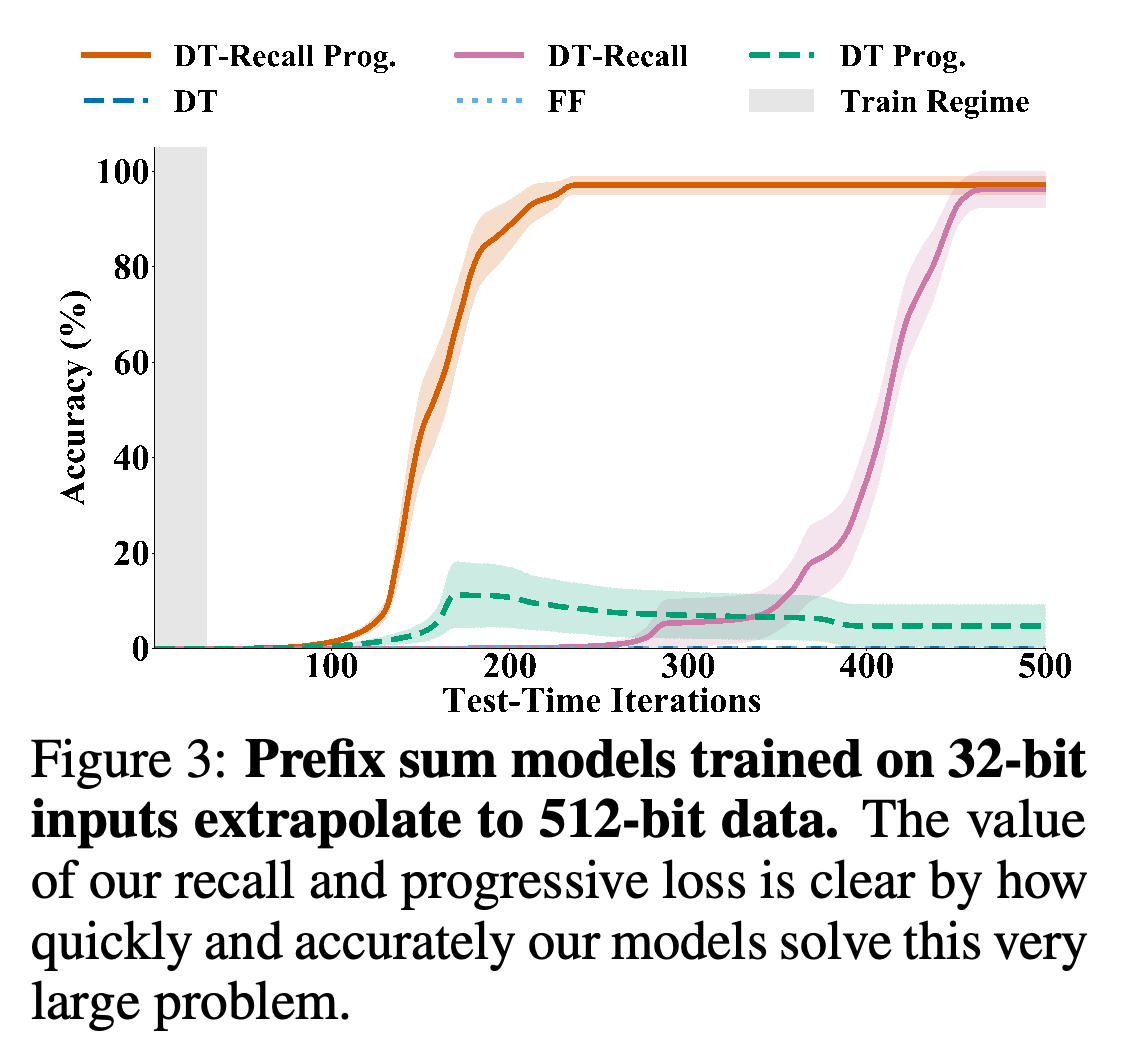
모델은 학습 중 최대 30회 순환하며, 표준 DT 및 유효 깊이가 같은 feed-forward 네트워크와 비교한다. 512-bit 문자열에서 recall과 progressive loss를 결합한 모델은 237회 반복 후 최고 정확도 97.12 ± 1.88%를 기록했다. Recall만 적용한 모델은 466회 반복 후 96.19 ± 3.73%, 표준 DT는 0%를 기록했다. 표준 DT 베이스라인에는 최대 신뢰도 종료 규칙을 적용했다.
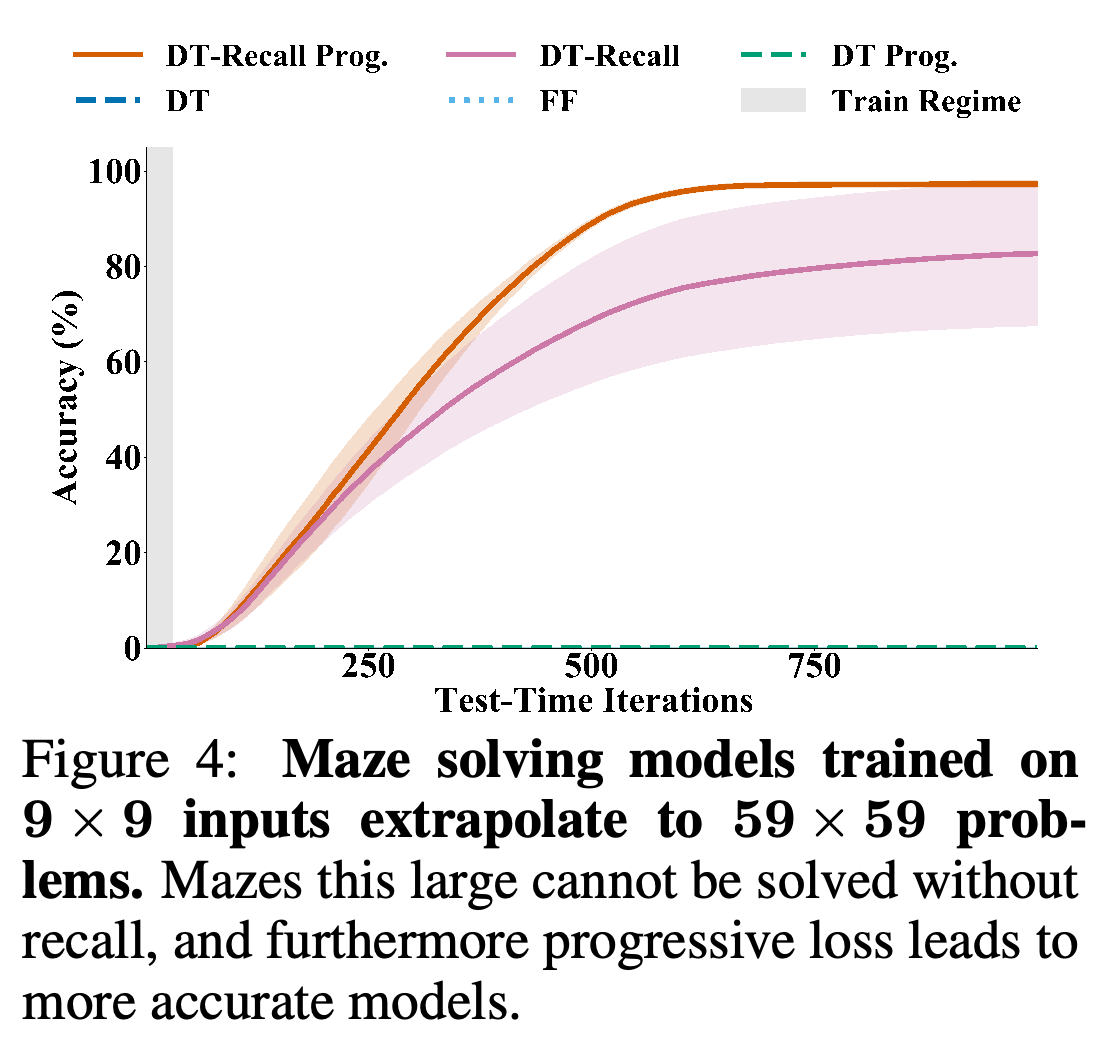
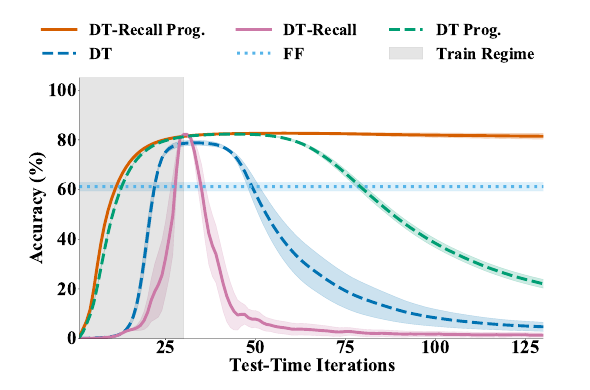
59 × 59 미로에서 recall과 progressive loss를 결합한 모델은 최고 정확도 97.30 ± 0.68%를 기록했다. Recall만 적용한 모델은 82.72 ± 15.14%였고, recall이 없는 순환 모델 변형 2개와 feed-forward 베이스라인은 모두 0%였다. 결합 모델은 테스트한 201 × 201 미로 100개 중 74개를 정확히 풀었다. 체스 퍼즐 600K–700K에서 결합 모델의 최고 정확도는 82.69 ± 0.27%로, 표준 DT의 78.81 ± 1.04%보다 높았다.
512-bit 입력에서 progressive training을 적용한 recall 모델은 recall만 적용한 모델보다 훨씬 빨리 높은 정확도에 도달하며, recall이 없는 모델의 정확도는 훨씬 낮다.
5 The overthinking problem
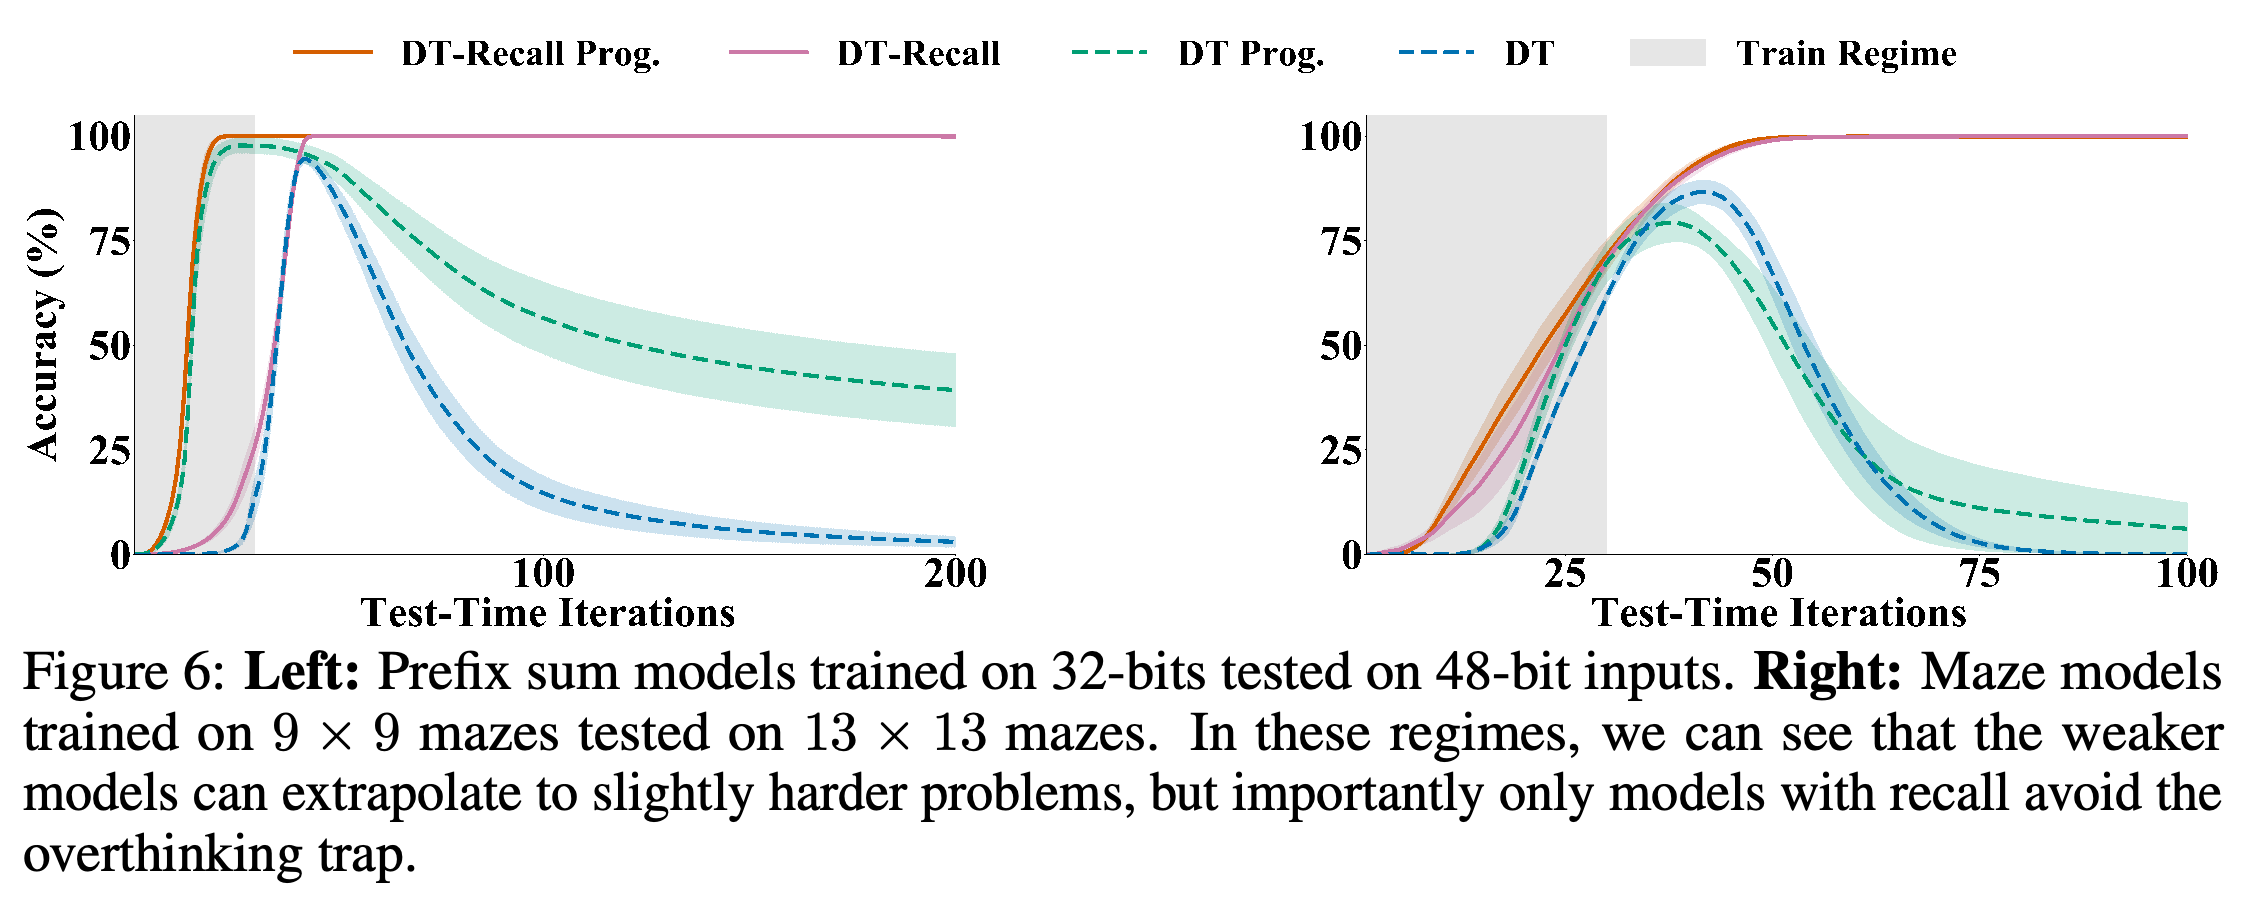
48-bit prefix sum과 13 × 13 미로에서 recall이 없는 모델은 처음에는 개선되지만 반복이 계속되면 정확도가 떨어진다. Recall 모델은 이 테스트에서 안정성을 유지했다. 체스 실험에서는 많은 반복에 걸쳐 정확도를 유지하려면 progressive loss도 필요했다.
59 × 59 미로에서 recall 곡선 2개는 recall이 없는 모델보다 성능이 높으며, progressive loss를 적용한 곡선은 더 높은 수준에서 안정된다.
결합 모델은 반복 횟수가 늘어나도 체스 정확도를 유지하지만, 다른 순환 모델 변형의 정확도는 결국 감소한다.
5.1 Manipulating feature maps
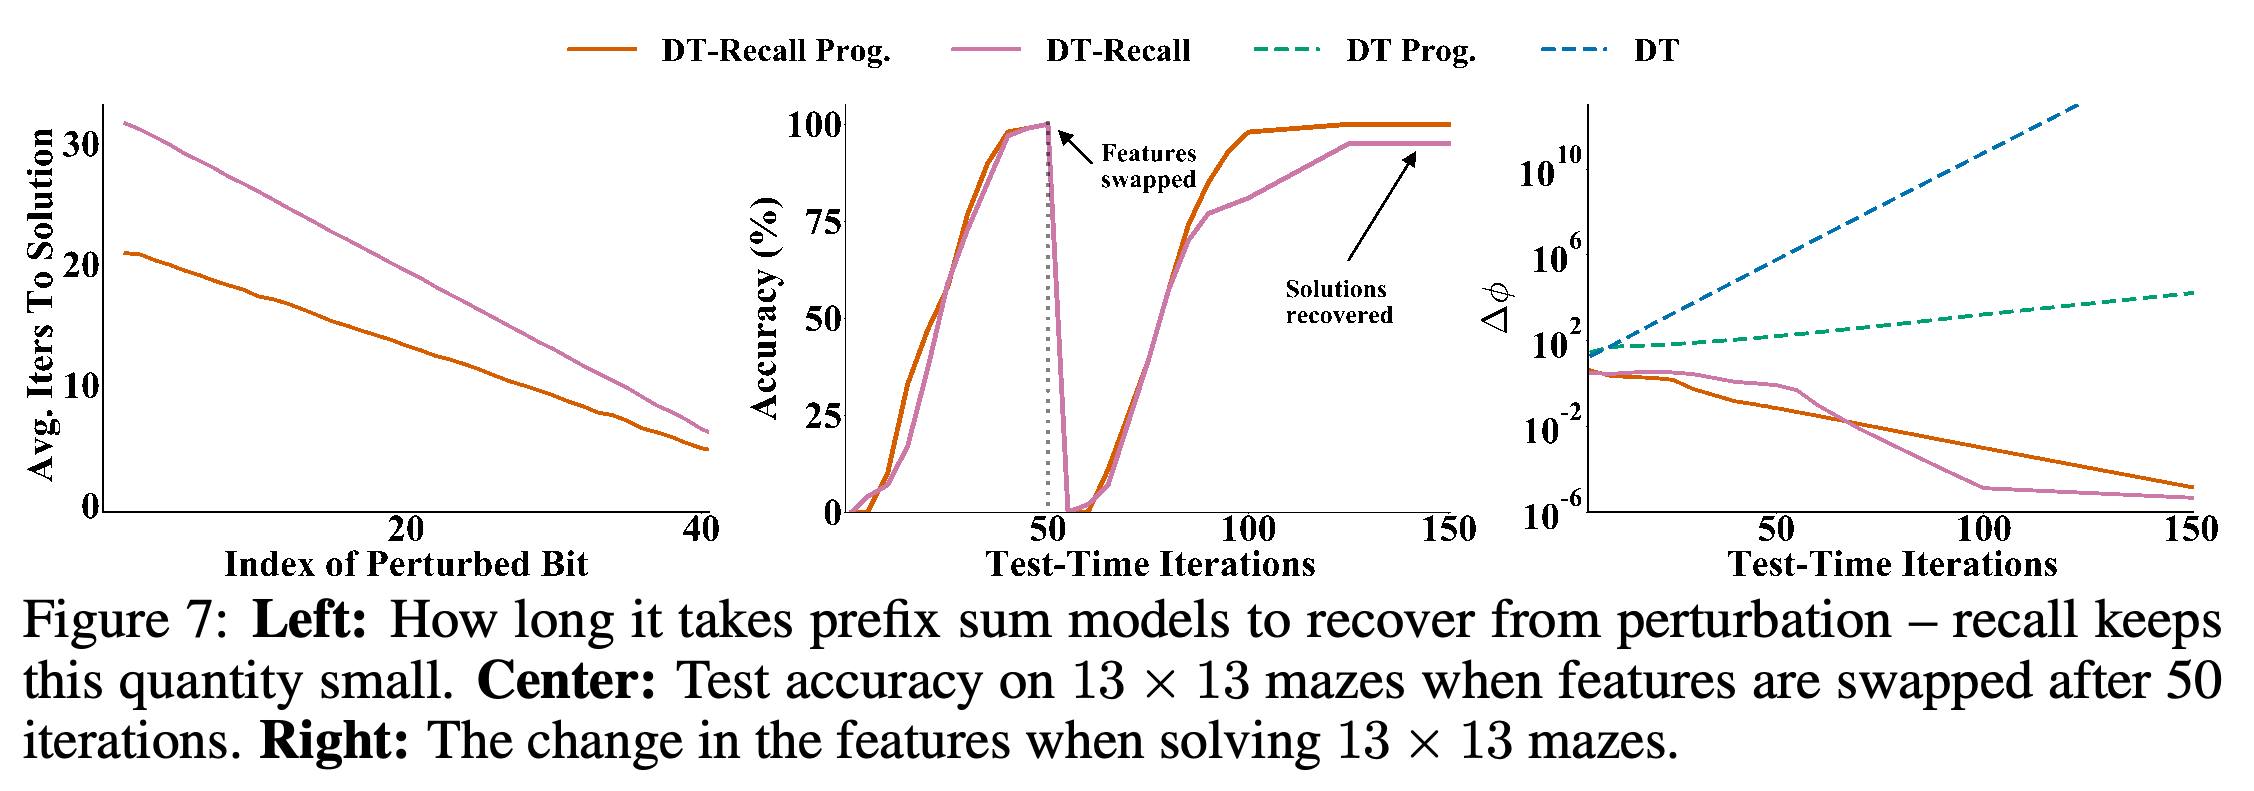
한 번 반복한 후 미로 특징에 평균이 0이고 표준편차가 단위 크기인 Gaussian noise를 추가해도 recall 모델은 13 × 13 미로를 풀었지만, recall이 없는 모델은 실패했다. 50차 반복 후 특징을 모두 영으로 바꾸면 recall 모델은 표현을 다시 생성하고 미로를 다시 풀었다.
Recall이 없는 모델의 점선 곡선은 과제 2개 모두에서 최고점에 도달한 뒤 하락하지만, recall 곡선은 높은 정확도를 유지한다.
5.2 Manipulating inputs
이미 풀린 48-bit prefix-sum 입력에서 비트를 하나 반전하면 recall 모델은 해답을 복구했으며, 뒤쪽 비트일수록 복구 시간이 짧아졌다. 50차 반복 후 다른 미로의 특징으로 교체한 경우에도 recall 모델은 입력으로 계속 제공된 미로의 해답을 복구했다.
5.3 Converging to a fixed point
저자들은 연속된 feature map 사이의 차이에 대한 유클리드 노름을 측정했다. 제시된 미로 실험에서 이 차이는 recall 모델에서는 감소하고 recall이 없는 모델에서는 증가했다. 이는 수렴과 일치하는 경험적 근거이지만 수렴을 증명하지는 않는다.
6 Conclusion
저자들은 recall과 progressive training이 easy-to-hard 일반화를 개선하고 관찰된 overthinking을 줄인다고 결론 내린다. 또한 연구 결과가 테스트한 분야에 한정된다고 명시하고 다른 환경에서 평가할 것을 제안한다.
각 패널은 비트 반전 후 복구, 미로 특징 교체 후 복구, recall 모델에서 특징 변화량의 감소를 보여준다.
부록
- A.1–A.4는 아키텍처, 자원, loss, 하이퍼파라미터를 설명한다. 모델 너비는 prefix sum에서 400, 미로에서 128, 체스에서 512이며, 학습에는 Nvidia GeForce RTX 2080Ti GPU를 사용한다. Prefix sum은 GPU 1개로 1시간 미만에, 미로는 GPU 1개로 최대 8시간에, 체스는 GPU 4개로 24–48시간에 학습한다. 학습 데이터의 20%는 검증용으로 따로 둔다. Loss는 위치와 예제에 걸친 이진 분류 loss의 평균이며, α가 progressive 항의 가중치를 조절한다.
- A.5–A.8은 확장 실험과 분포 내 실험 결과, hard-to-easy 테스트, 교란 연구를 다룬다. 학습 정확도가 99% 미만인 실행은 보고된 평균에서 제외한다. 더 어려운 체스 실험 결과에서는 일반화 성능의 한계가 나타나며, recall이 없는 모델은 더 쉬운 24-bit 입력에서도 overthinking을 보인다. 부록은 학습과 같은 난이도의 문제에 대한 검증과 특징 교란 이후의 복구도 보고한다.
- A.9와 A.10은 201 × 201 및 801 × 801 미로 예제를 보여준다. 논문에서 801 × 801 예제의 반복 횟수는 일치하지 않는다. Section 4에는 20,000회라고 적혀 있지만 해당 그림의 캡션에는 10,000회라고 적혀 있다.
짧은 생각
Ablation 결과는 2가지 변경이 서로 다른 역할을 한다는 점을 뒷받침한다. Recall은 큰 미로로의 외삽을 가능하게 하고, progressive loss는 정확도를 높이며 512-bit prefix-sum 문제를 더 빨리 풀게 한다. 수렴하지 않아 제외된 실행과 제한된 과제 집합을 고려해 성능 향상을 해석해야 하며, feature map 측정은 관찰된 안정성을 보여줄 뿐 수렴을 보장하지는 않는다.