


Neural Approximation of Graph Topological Features 요약 설명
28 Jan 2022 | Paper Review Persistent Homology Graph Neural Networks Neural Algorithm Execution목차
이번 글에서는 Neural Approximation of Graph Topological Features 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 1월 28일(Arxiv), 36th Conference on Neural Information Processing Systems (NeurIPS 2022)
- Yan, Zuoyu, Ma, Tengfei, Gao, Liangcai, Tang, Zhi, Wang, Yusu, Chen, Chao.
- Wangxuan Institute of Computer Technology, Peking University, IBM T. J. Watson Research Center, Halıcıoğlu Data Science Institute, University of California, Department of Biomedical Informatics, Stony Brook University
- 논문 링크 (검토 원문: v4 (2022-11-15))
요약
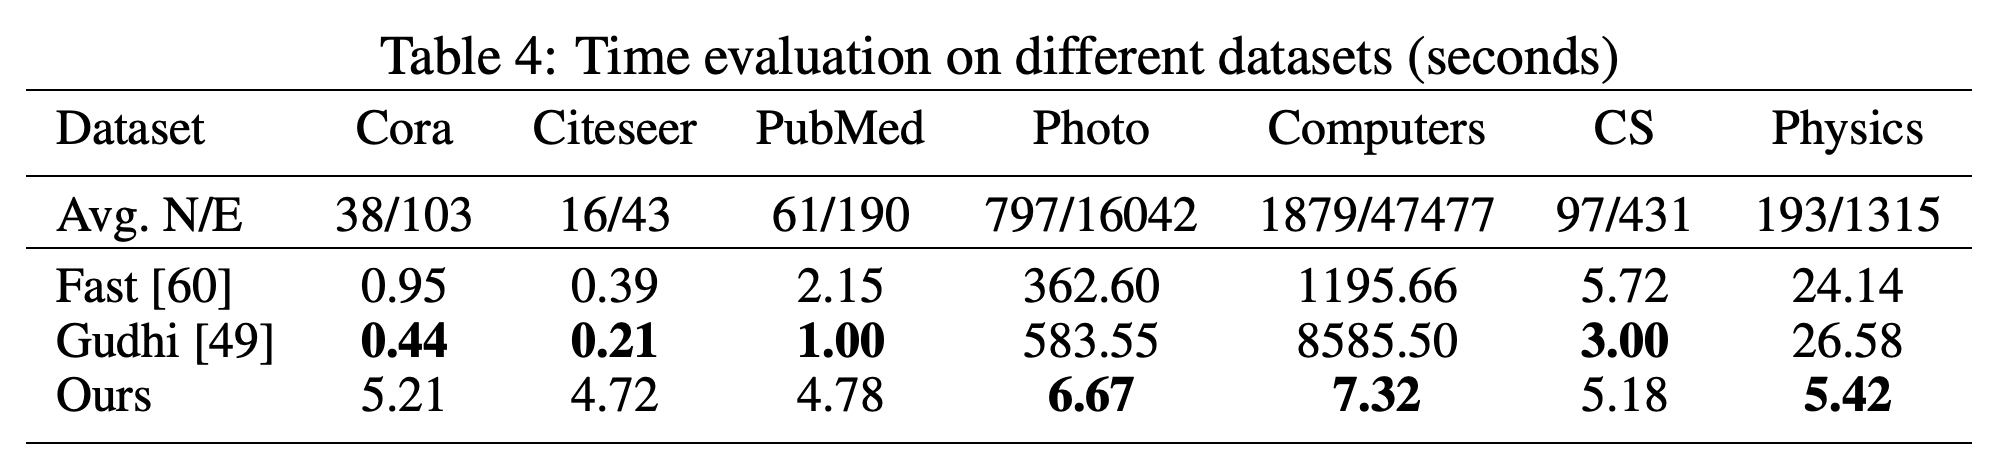
- 연결 요소와 루프를 포착하는 그래프 요약을 계산하는 과정은 크고 밀도가 높은 그래프에서 학습의 병목이 될 수 있다. Computers의 2-hop 이웃 그래프 1,000개에서 제안한 신경망 근사 방법은 7.32초가 걸렸고, 정확한 알고리즘인 Fast는 1195.66초가 걸렸다. 예측한 요약을 사용한 다운스트림 점수는 정확한 요약을 사용한 점수와 비슷했다.
- 이 방법은 임계값이 변할 때 그래프 구조가 나타나고 사라지는 시점을 기록한 점 집합인 extended persistence diagram(EPD)을 예측한다. EPD 계산을 엣지별 예측 문제로 바꾸고, 연결 요소를 관리하는 Union-Find 알고리즘의 일부를 모방하도록 그래프 신경망을 학습한다.
- 이웃 그래프 데이터셋 5개에서 제안한 Persistence Diagram Graph Neural Network(PDGNN)는 실험한 베이스라인보다 낮은 근사 오차를 기록했다. 작은 Cora와 Citeseer 이웃 그래프에서는 정확한 알고리즘이 더 빨랐으며, 일부 특이한 diagram은 여전히 근사하기 어려웠다.
1 Introduction
Persistent homology는 여러 임계값에 걸친 그래프 위상을 요약하지만, 다수의 지역 이웃 그래프에 대한 EPD 계산이 학습 파이프라인에서 큰 비중을 차지할 수 있다. 행렬 축소와 매칭 기반 거리를 이용해 크기가 가변적인 점 집합을 지도 학습하는 과정이 주요 과제다.
2 Background: Extended Persistent Homology
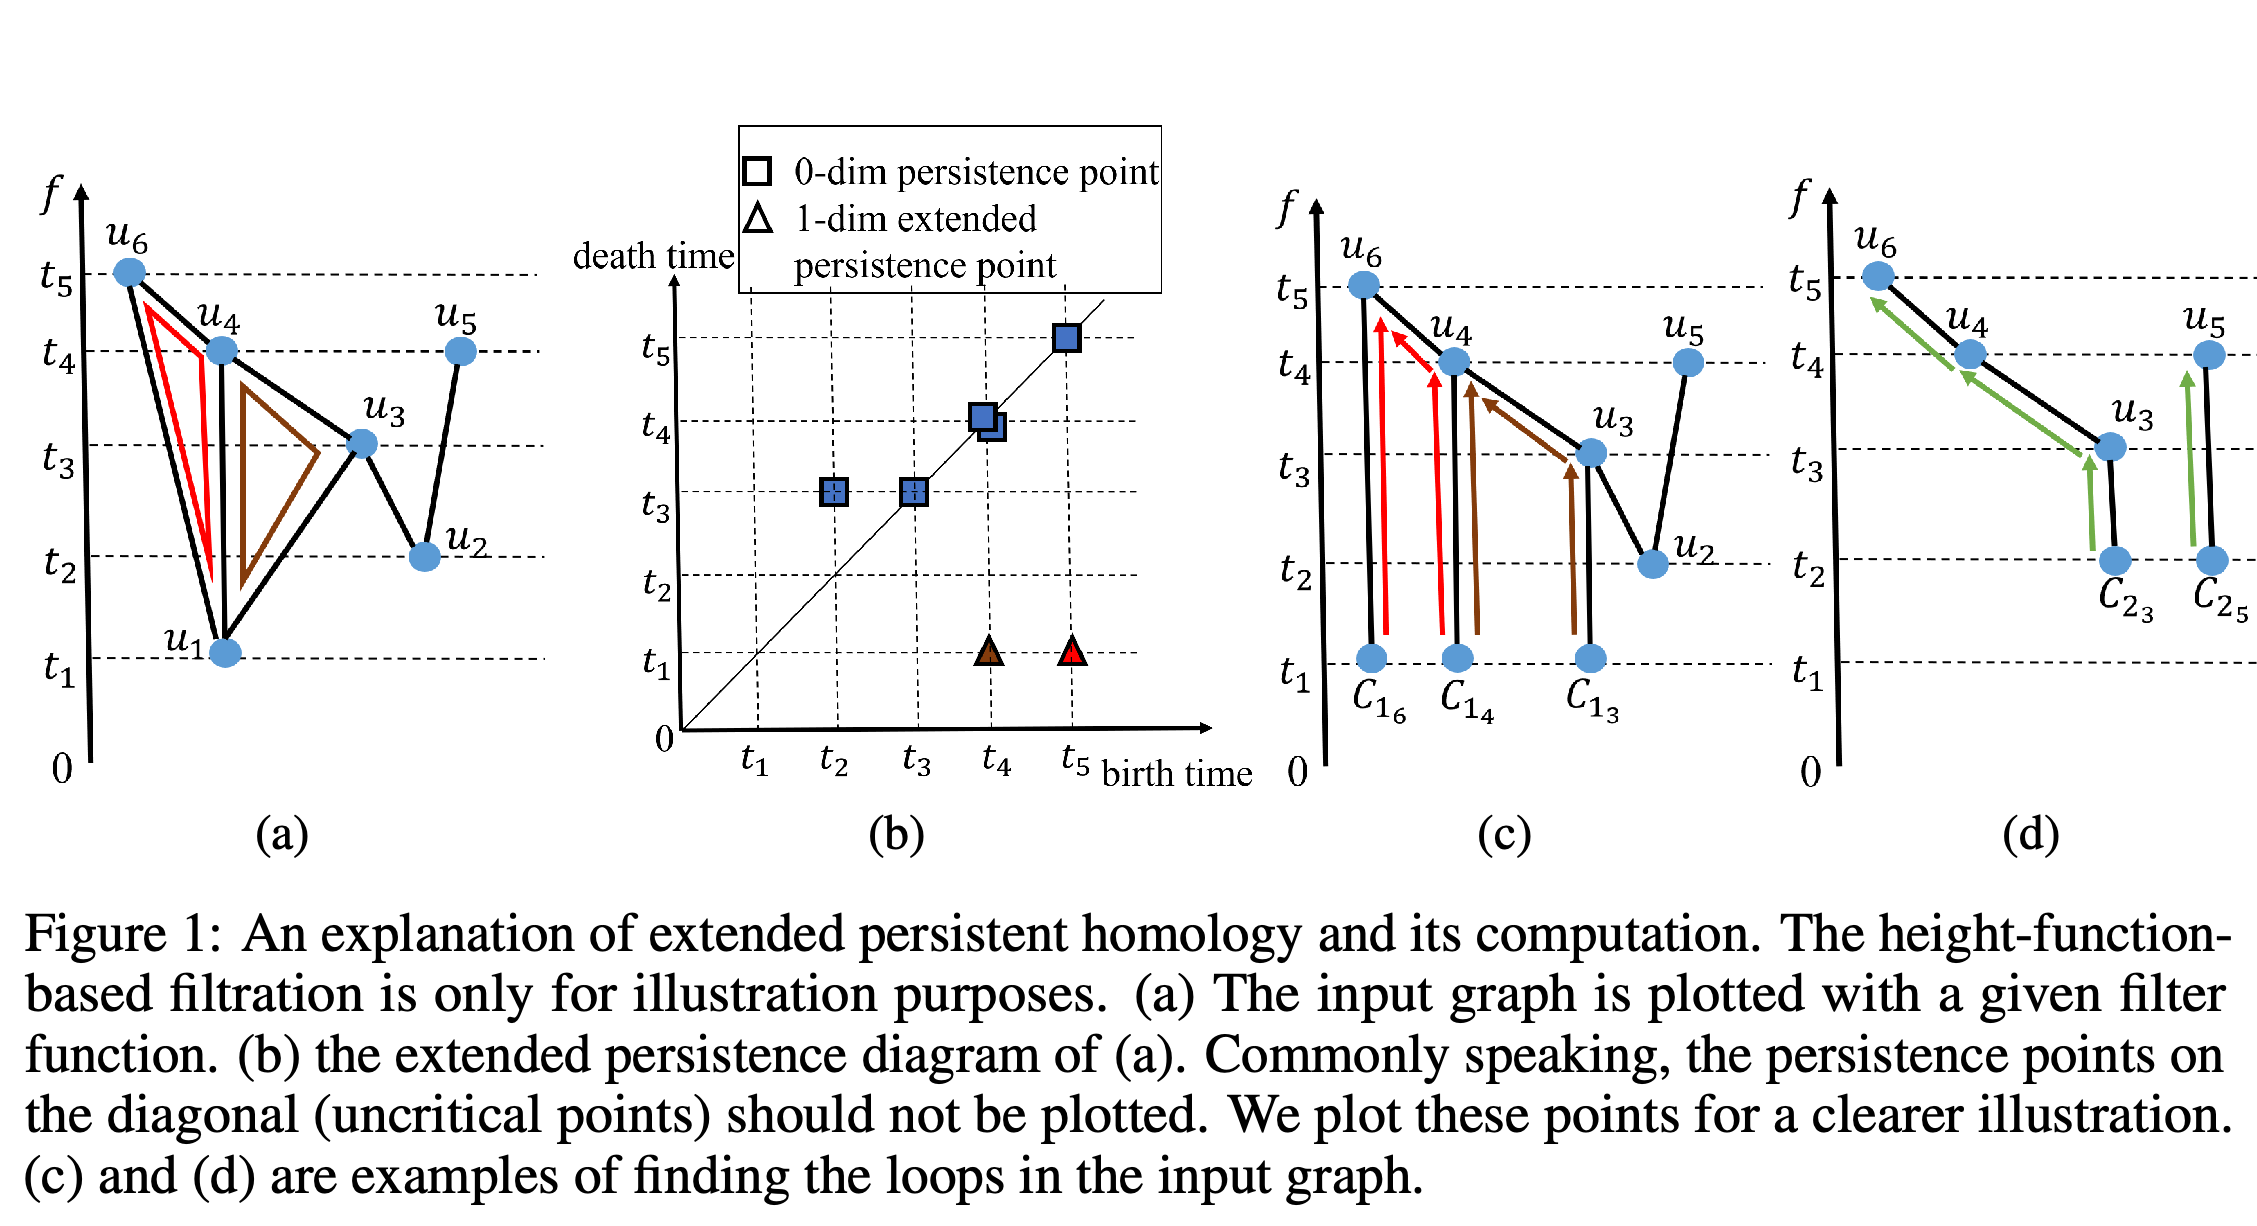
필터 함수는 그래프 요소에 스칼라 값을 부여하고, filtration은 임계값 순서에 따라 요소를 추가하거나 제거한다. Persistence diagram은 각 특징이 생성되고 소멸하는 값을 기록한다. Extended persistence는 일반적인 persistence에서 유한한 소멸값을 갖지 않는 독립적인 루프도 포착한다.
- 논문은 연결 요소를 나타내는 일반 0D diagram과 루프를 나타내는 1D extended diagram의 합집합을 근사하며, 전역 최솟값과 최댓값은 별도로 구한다.
이 예시는 필터를 적용한 그래프에서 연결 요소와 루프가 변화하는 사건을 diagram의 점과 연결한다. 분리된 연결 요소의 예시는 루프의 짝을 찾는 과정을 보여준다.
3 Algorithm Revision: Decomposing EPD into Edge-Wise Paring Predictions
Diagram의 각 점은 정점과 엣지 또는 엣지와 엣지의 짝짓기에 대응하므로, 계산을 엣지별 예측으로 표현할 수 있다. 저자들은 정확한 계산을 Union-Find 서브루틴으로 분해하고, Theorem 3.1에서 Algorithm 2가 표준 알고리즘과 같은 1D EPD를 생성함을 증명한다.
- 각 정점에서 upper-edge splitting은 해당 정점에 연결된 더 높은 값의 엣지를 별도 연결 요소에 배치하며, 이후 연결 요소가 합쳐지는 과정에서 루프의 persistence point를 찾는다.
4 A Graph Neural Network for EPD Approximation
이 프레임워크는 엣지별 예측과 PDGNN을 결합한다. PDGNN의 집계와 메시지 전달은 분해된 Union-Find 계산에 맞춰 설계됐다. 집계에 대해서는 Graph Isomorphism Network (GIN) 설명 글을 참조하라.
4.1 EPD computation as a edge-wise prediction problem
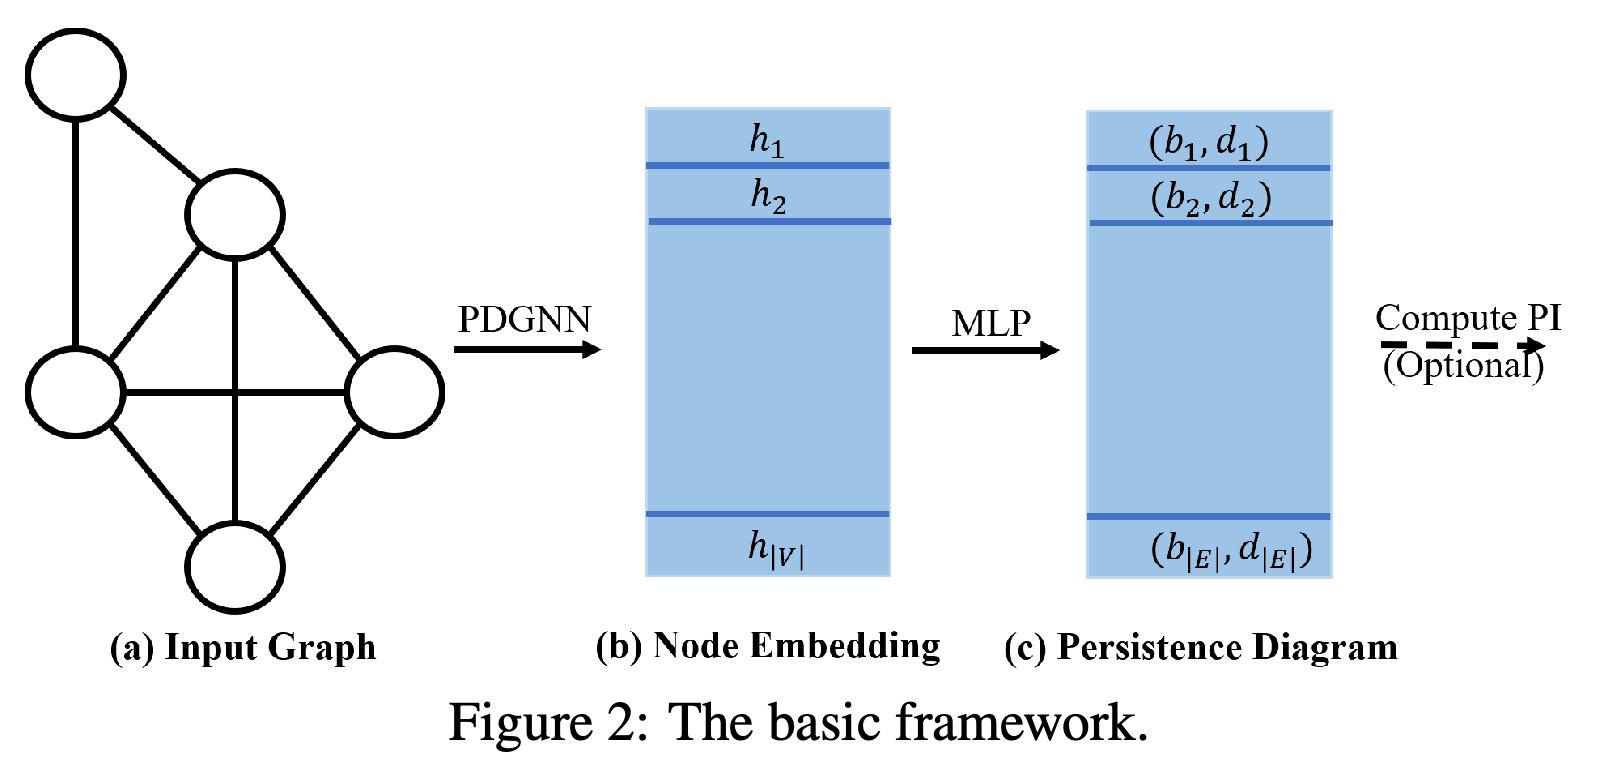
PDGNN은 필터 값으로 초기화한 노드를 임베딩하고, 다층 퍼셉트론은 각 엣지의 양 끝점 임베딩을 이어 붙인 값을 2개 좌표로 구성된 persistence point로 변환한다. 구현에서는 크기가 제한된 노드 특징을 사용해 그래프 크기에 비례하는 특징 없이 병렬 서브루틴을 근사한다.
입력 그래프에서 노드 임베딩을 생성한 뒤 엣지 수준의 예측으로 persistence point를 생성한다. 이 점들은 필요에 따라 persistence image로 변환할 수 있다.
4.2 PDGNN
PDGNN은 연결 요소의 루트를 찾는 과정을 모델링하기 위해 합계 집계와 최솟값 집계를 이어 붙인다. 엣지 연산을 모델링할 때는 메시지에 끝점 특징과 attention으로 구한 엣지 가중치를 사용한다. 학습에는 예측 diagram과 정답 diagram의 점을 매칭하는 거리인 2-Wasserstein 거리를 사용하며, 매칭 제약은 부록에 설명돼 있다.
5 Experiments
실험에서는 인용, Amazon 쇼핑, 공저자 그래프에서 1-hop 또는 2-hop 이웃 그래프를 추출하고 필터 4개를 사용한다. 필터는 그래프 측도인 Ollivier-Ricci curvature 기반 거리, 온도 10과 0.1에서의 heat kernel signature, 노드 차수다. 논문은 근사 성능, 노드 분류, 링크 예측, 계산 시간을 평가하며 코드는 https://github.com/pkuyzy/TLC-GNN 에 제시돼 있다.
5.1 Approximation Quality
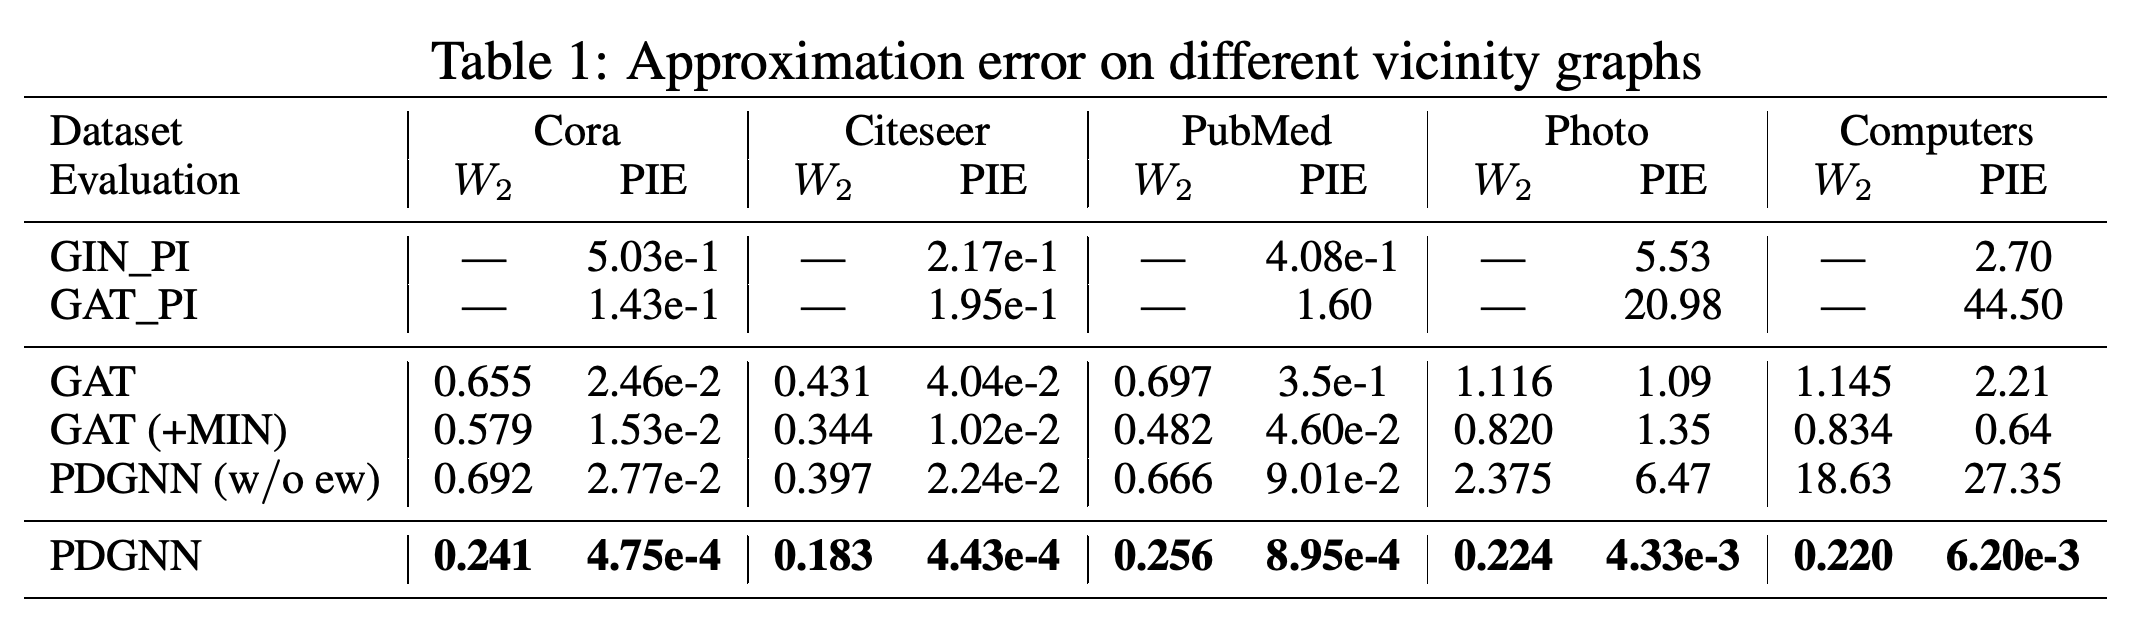
이웃 그래프를 학습과 테스트에 80%/20%로 무작위 분할한다. 평가 지표는 평균 2-Wasserstein 거리와 벡터화한 diagram 사이의 제곱 오차인 persistence image 오차다. Cora에서 PDGNN은 각각 0.241과 4.75e-4를 기록했고, 최솟값 집계를 추가한 graph attention network인 GAT (+MIN)은 0.579와 1.53e-2를 기록했다. 엣지 가중치를 제거해도 오차가 증가한다.
PDGNN은 데이터셋 5개 모두에서 보고된 Wasserstein 오차와 persistence image 오차가 가장 낮다. 엣지 가중치를 제거하면 특히 Computers에서 결과가 크게 나빠진다.
5.2 Downstream Tasks
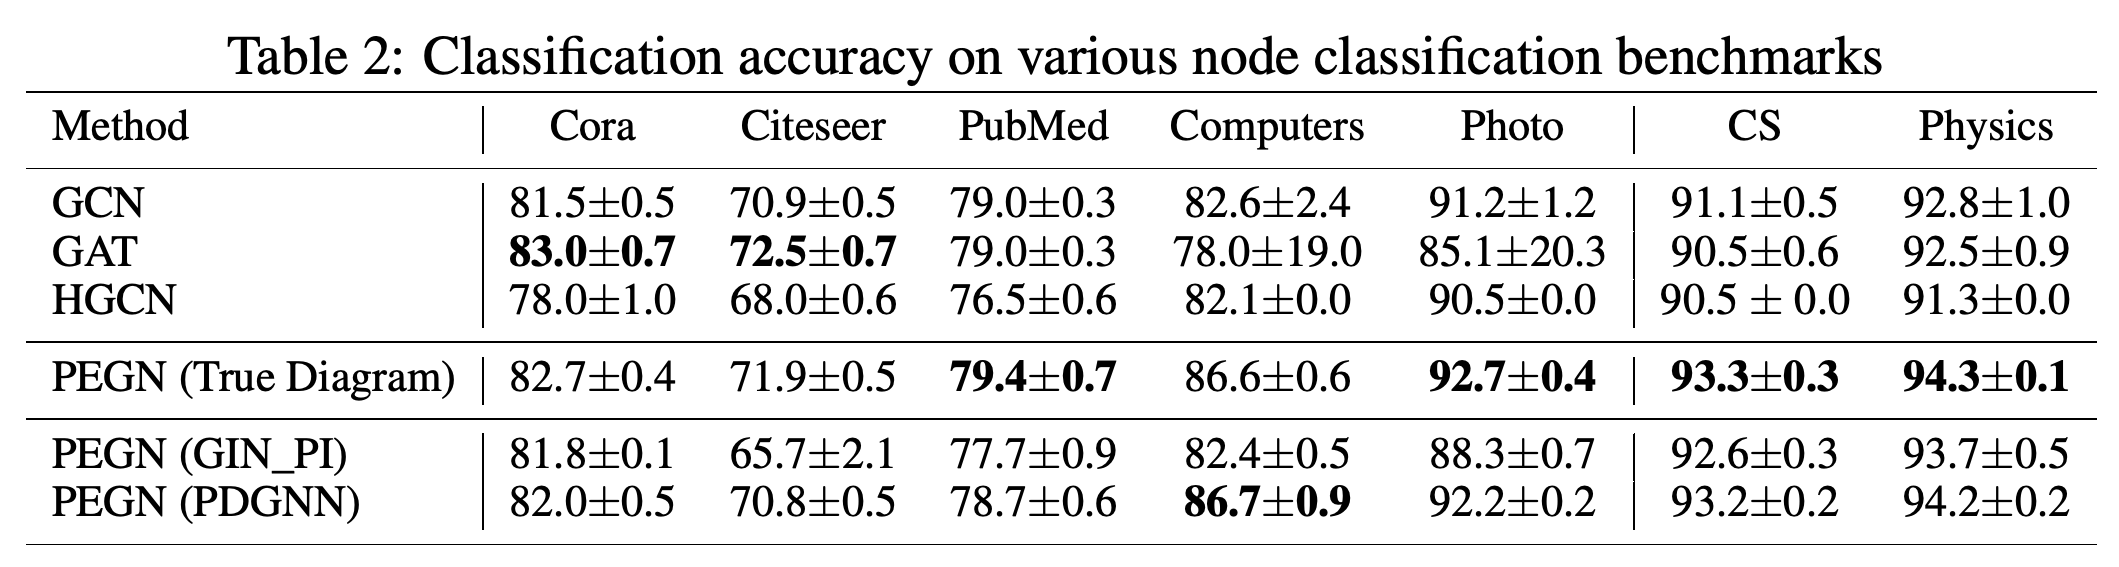
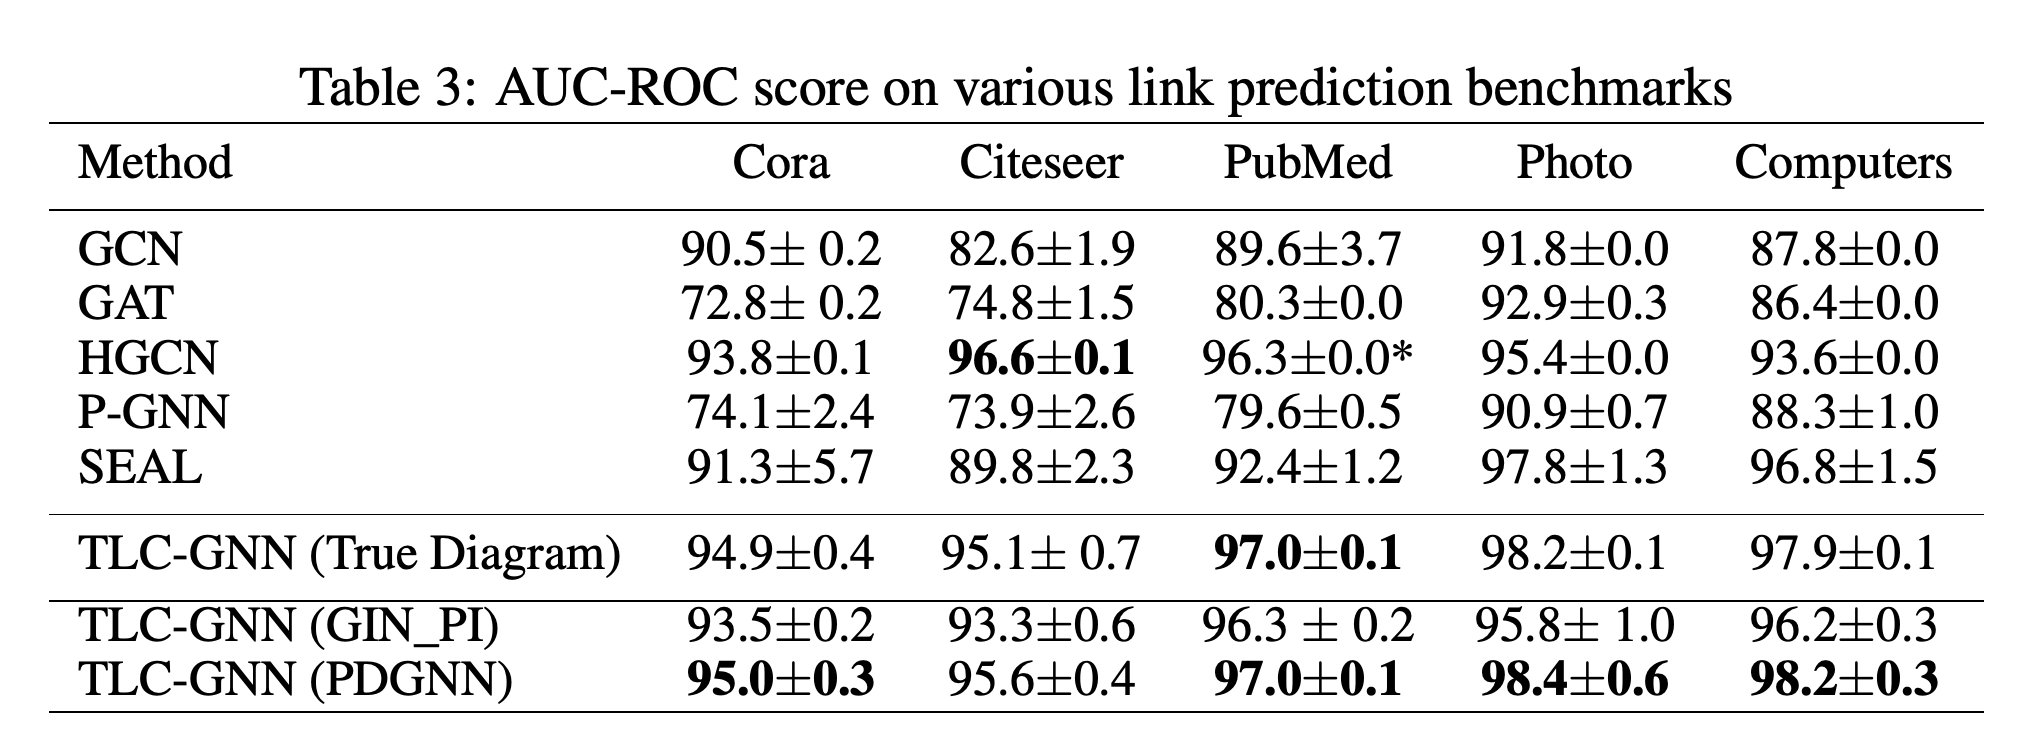
노드 분류에서는 클래스당 노드 20개로 학습하고 검증 노드 500개와 테스트 노드 1,000개를 사용한다. 링크 예측에서는 엣지를 85/5/10%로 분할하고 존재하지 않는 엣지를 음성 사례로 표본 추출한다. 10회 실행에서 Computers의 persistence 강화 그래프 신경망 PEGN은 PDGNN을 사용해 86.7±0.9, 실제 diagram을 사용해 86.6±0.6을 기록했다. Persistence 기반 링크 예측 모델 TLC-GNN의 수신자 동작 특성 곡선 아래 면적은 각각 98.2±0.3과 97.9±0.1이었다.
실제 diagram을 PDGNN의 예측으로 대체해도 벤치마크 7개에서 노드 분류 정확도가 비슷하게 유지되지만, 수치가 완전히 같지는 않다.
PDGNN의 예측을 사용하는 TLC-GNN은 링크 예측 데이터셋 5개에서 실제 diagram을 사용할 때와 비슷한 점수를 얻는다.
5.3 Algorithm Efficiency
시간 측정 실험에서는 처음 1,000개 노드의 2-hop 이웃 그래프를 추출하고 Ollivier-Ricci 기반 필터를 사용한다. Photo에서 PDGNN은 6.67초, Fast는 362.60초가 걸렸다. 반면 Cora에서는 PDGNN이 5.21초, Gudhi가 0.44초가 걸려 속도상 이점은 작업에 따라 달랐다.
신경망 방법은 가장 작은 이웃 그래프에서 더 느리지만, 이웃 그래프당 노드와 엣지가 훨씬 많은 Photo와 Computers에서는 상당히 빠르다.
6 Conclusion
저자들은 알고리즘을 반영한 신경망 근사 방법이 실험한 다운스트림 작업에서 유용한 위상 정보를 유지하고 큰 그래프의 계산 시간을 줄인다고 결론짓는다. 전이 실험에서는 Photo로 사전 학습한 모델을 다른 그래프 데이터셋에도 적용한다.
부록
- 보충 자료는 persistent homology 학습, 신경망을 이용한 알고리즘 실행, 더 빠른 정확한 계산을 검토한다. 또한 정확한 분해의 정당성을 증명하고, 0D diagram을 위한 순차 Union-Find 알고리즘을 제시한다. 순차 1D 계산의 시간 복잡도는 O(|V||E|α(|E|))이며, α는 역 Ackermann 함수다. 이 증명은 학습된 모델의 정확성을 보장하지 않는다.
- 데이터셋은 인용 네트워크, Amazon 쇼핑 그래프, 공저자 그래프를 포함한다. 보충 자료에 따르면 벤치마크 자료는 MIT 라이선스로 제공된다. 설정에는 4층 그래프 신경망, 2층 다층 퍼셉트론, 학습률 0.002와 가중치 감쇠 0.01을 적용한 Adam, 배치 크기 10, 20 epoch가 포함된다. 학습 중에는 붕괴를 방지하기 위해 예측한 점을 대각선이 아닌 정답 점과 강제로 매칭하며, 평가에는 일반적인 매칭을 사용한다.
- Photo로 사전 학습하고 1 epoch 동안 미세 조정했을 때 PubMed의 diagram 오차는 0.360이었고, 표준 설정에서는 0.344였다. 학습 표본 실험에서는 표본이 많을수록 diagram 오차가 낮아지는 경향을 보였고 노드 분류 점수는 비교적 비슷하게 유지됐다. 전체 그래프 실험에서는 비용 때문에 Ollivier-Ricci 필터를 제외했다. 또 다른 예시는 직접 예측한 persistence image가 정답과 비슷한 제곱 오차를 보여도 공간 분포는 다를 수 있음을 보여준다.
- 추가 실험은 큰 희소 그래프와 다른 필터도 다룬다. 합성 데이터의 시간 측정 실험에서는 노드 100개와 엣지 820개 또는 766개 부근에서 해당 실험에 한정된 속도 역전 지점이 나타났다. 저자들은 드문 diagram 분포는 근사 성능이 낮을 수 있고 위상 정보만으로는 유용한 의미 정보를 놓칠 수 있다고 지적한다. 체크리스트에는 학습 세부 사항과 오차 막대가 제공됐으며 채택 시 코드를 공개할 예정이라고 명시돼 있다. 본문에는 별도로 코드 URL이 제시돼 있다.
짧은 생각
Diagram 수준의 제거 실험과 다운스트림 비교는 상호 보완적인 근거를 제공한다. 전체 모델은 근사 오차를 줄이면서 정확한 diagram을 사용했을 때와 비슷한 작업 점수를 유지한다. 시간 측정 결과는 작은 그래프에서의 속도 저하와 제한적으로 실험한 전이 및 필터 설정을 함께 고려해 해석해야 한다.