


Physical Design using Differentiable Learned Simulators 요약 설명
01 Feb 2022 | Paper Review Inverse Design Graph Neural Networks Differentiable Simulation목차
이번 글에서는 Physical Design using Differentiable Learned Simulators 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 2월 1일(Arxiv)
- Allen, Kelsey R., Lopez-Guevara, Tatiana, Stachenfeld, Kimberly, Sanchez-Gonzalez, Alvaro, Battaglia, Peter, Hamrick, Jessica, Pfaff, Tobias.
- DeepMind, UK
- 논문 링크 (검토 원문: v1 (2022-02-01))
요약
- 이 논문은 원하는 동작을 구현하도록 물체의 형태를 선택하는 역설계 문제를 다룬다. 기준 물리 시뮬레이터로 설계를 평가했을 때, 학습된 시뮬레이터를 통한 경사 기반 최적화는 유체 과제에서 샘플링 기반 최적화보다 높은 성능을 보였고, 날개 단면에서는 전문 솔버와 비슷한 항력을 얻었다.
- 저자들은 물리 시스템을 연결된 노드로 표현하는 그래프 신경망을 학습해 물리 상태를 예측하고, 시뮬레이션 궤적을 통해 역전파하여 설계를 갱신한다. 동일한 기본 아키텍처는 과제별 시뮬레이터 추가 학습 없이 최대 625개의 설계 변수와 최대 300단계의 유체 궤적을 처리한다.
- 롤아웃 길이 실험에서는 약 225단계를 넘어서면 설계 품질이 저하되었다. 도구가 유체와 접촉하지 않아 기울기가 0이 되면 최적화가 중단될 수도 있다. 날개 단면의 시간 비교에는 학습된 모델과 전문 솔버에 서로 다른 하드웨어를 사용했다.
1. Introduction
기존 물리 시뮬레이터는 느리거나 특정 분야에 특화되어 있거나 기울기를 제공하지 못할 수 있다. 학습된 시뮬레이터는 예측 오차가 누적되고 학습 데이터와 다른 상태를 만날 수 있다. 이 논문은 사전 학습된 그래프 기반 시뮬레이터가 긴 궤적에 걸친 고차원 설계 최적화에 충분한 정확도와 매끄러움을 갖추었는지 검증한다.
2. Background
기존에 학습된 생성기와 점수 함수는 역설계를 가속할 수 있지만, 일반화 성능이 제한되면 학습 사례에 가까운 구성으로 설계가 제한되거나 모델을 추가 개선해야 할 수 있다. 저자들은 최종 설계 목표와 독립적으로 물리 동역학을 학습한다.
3. Problem Formulation
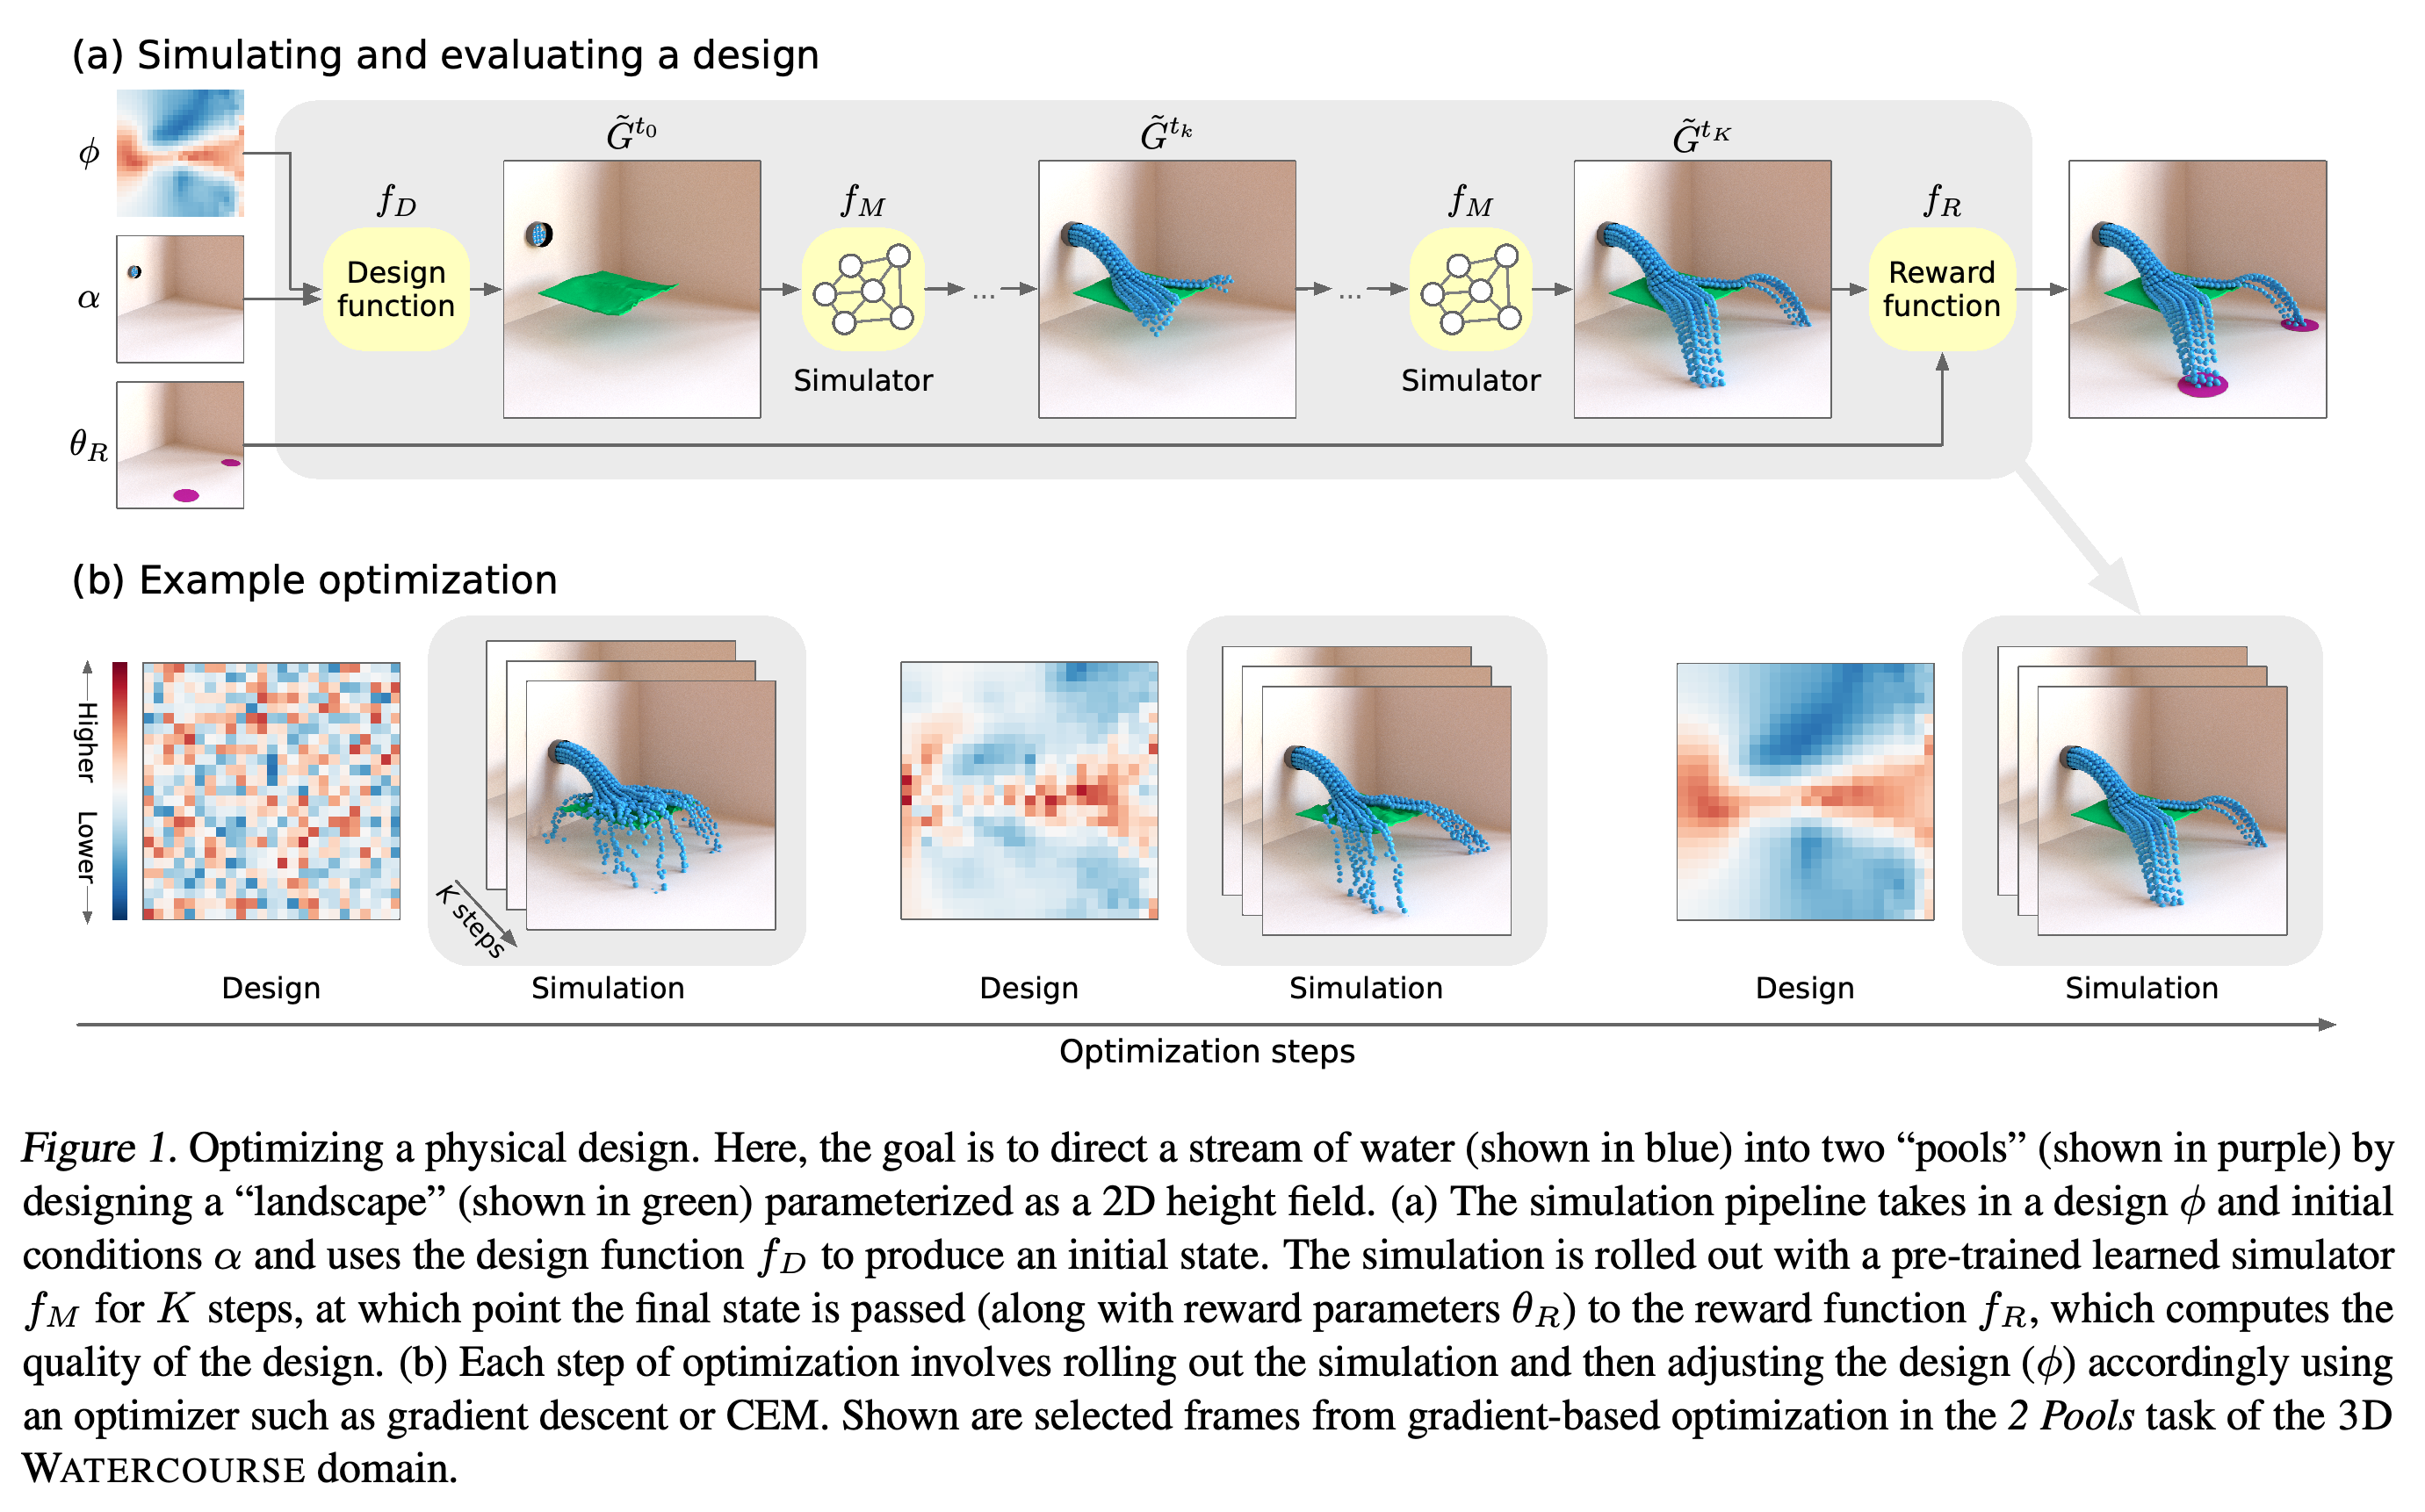
논문에서 반복적으로 사용하는 예시는 물을 2개의 수조로 보내는 지형을 설계한다. 미분 가능한 설계 함수가 초기 장면을 만들고, 시뮬레이터가 상태를 진행하며, 보상 함수가 결과를 평가하고, 최적화기가 지형을 조정한다.
이 파이프라인은 매개변수화된 지형을 학습된 시뮬레이터의 롤아웃과 최종 보상에 연결한다. 설계를 반복하면서 물줄기를 나누는 수로가 형성된다.
3.1. Learned simulators
MeshGraphNets는 물리 시뮬레이션을 위해 노드와 엣지의 표현을 갱신하는 메시지 전달 그래프 신경망이다 (Pfaff et al., 2021). 날개 단면 메시를 정점과 엣지로 표현하고, 유체 입자는 근접도에 따른 엣지로 연결하며, 3D WATERCOURSE는 하이브리드 그래프로 표현한다. 반복된 예측은 시뮬레이션 상태의 궤적인 롤아웃을 이룬다.
3.2. Optimizing design parameters
Adam은 학습된 모델의 보상을 전체 롤아웃과 설계 함수를 통해 미분하여 설계 변수를 갱신한다. 설계 후보군을 샘플링하고 갱신하는 기울기 없는 최적화기인 cross-entropy method (CEM)는 학습된 시뮬레이터를 쓰는 CEM-M과 기준 시뮬레이터를 쓰는 CEM-S 베이스라인을 제공한다. 학습된 시뮬레이터를 이용한 경사 하강법은 GD-M이라고 부른다.
- 별도 언급이 없으면 학습된 모델로 찾은 설계를 포함해 최종 설계를 기준 시뮬레이터로 평가한다.
- CEM은 최적화 단계마다 시뮬레이터를 20–40회 평가하지만, Adam은 단계마다 후보 1개를 평가한다. 기준 시뮬레이터는 미분할 수 없어 직접적인 GD-S 베이스라인을 사용할 수 없다.
4. Design Tasks
실험은 서로 다른 기준 시뮬레이터를 사용하는 3개 영역을 다루며, 이 시뮬레이터로 학습 데이터를 생성하고 설계를 평가한다. 과제에는 유체를 유도하는 도구, 물길을 바꾸는 지형, 공기역학적 형상 최적화가 포함된다.
4.1. 2D FLUID TOOLS
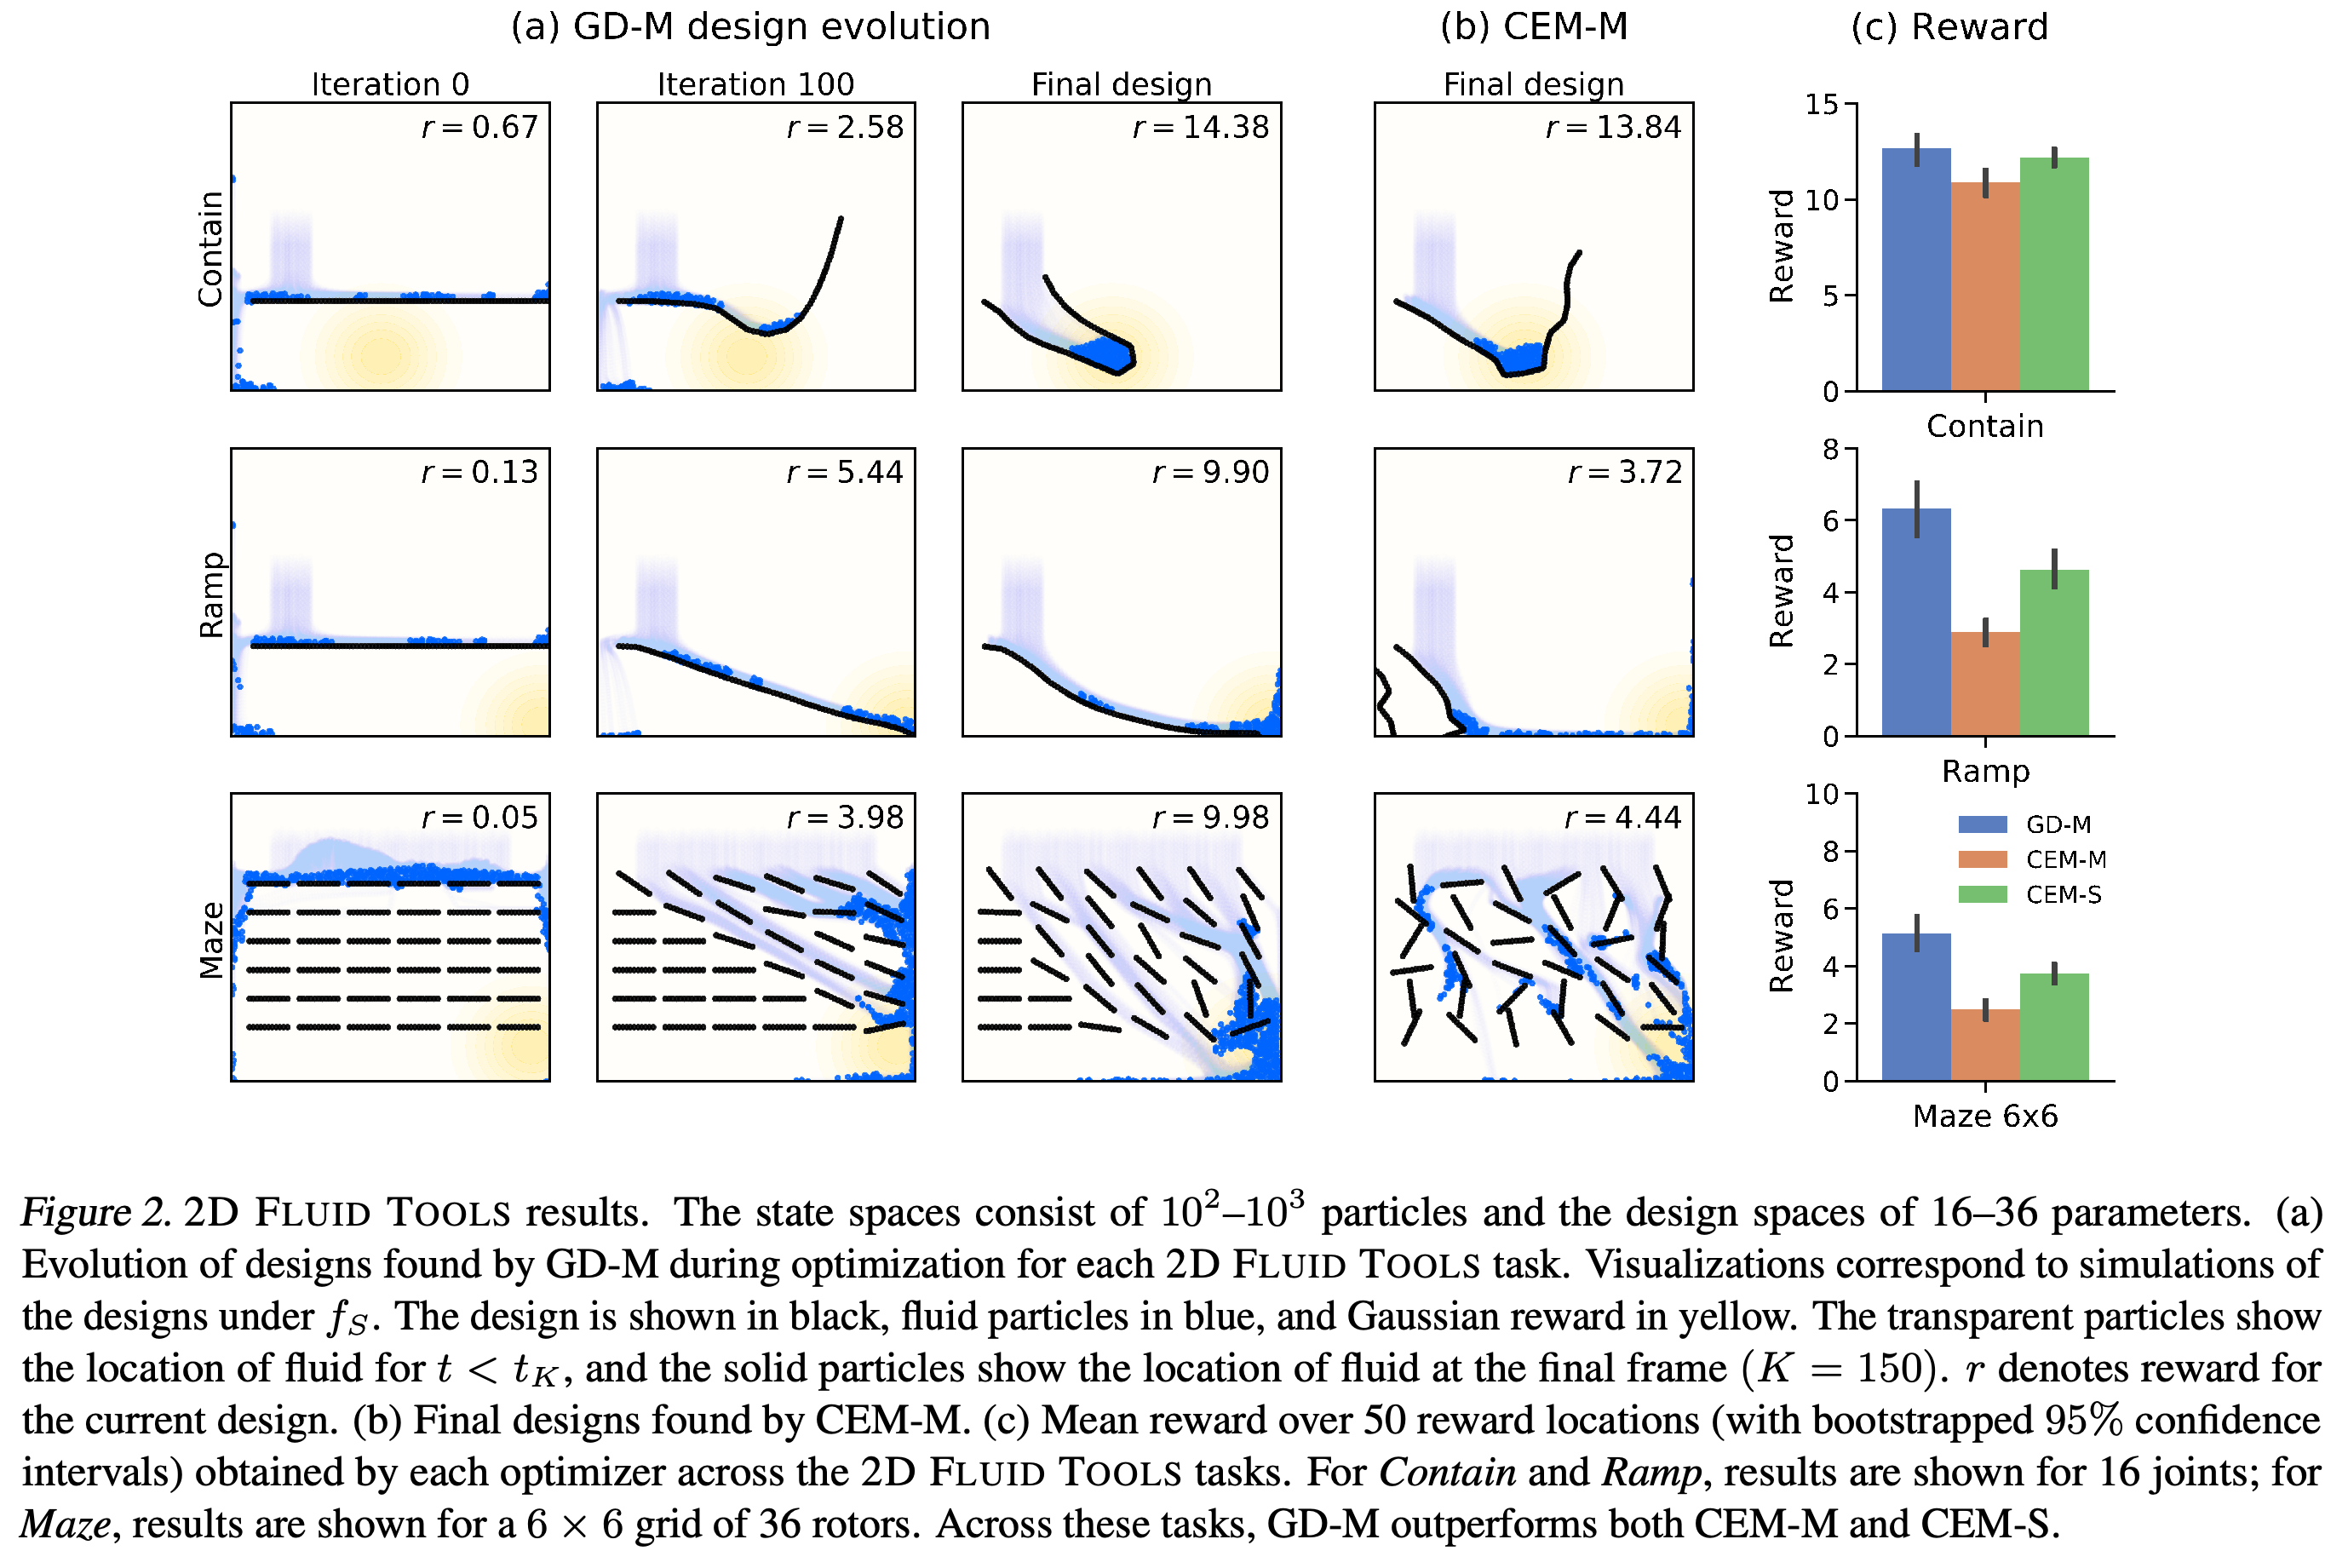
2D FLUID TOOLS에서 Contain과 Ramp는 여러 구간으로 이루어진 도구의 관절 각도를 최적화하고, Maze는 여러 도구의 회전을 최적화해 유체를 목표로 유도한다. 과제에는 설계 변수 4–48개, 유체 입자 10²–10³개, 최대 300단계의 시뮬레이션을 사용한다. 학습 장면에는 직선 구간 1–4개만 포함된다 (Sanchez-Gonzalez et al., 2020).
4.2. 3D WATERCOURSE
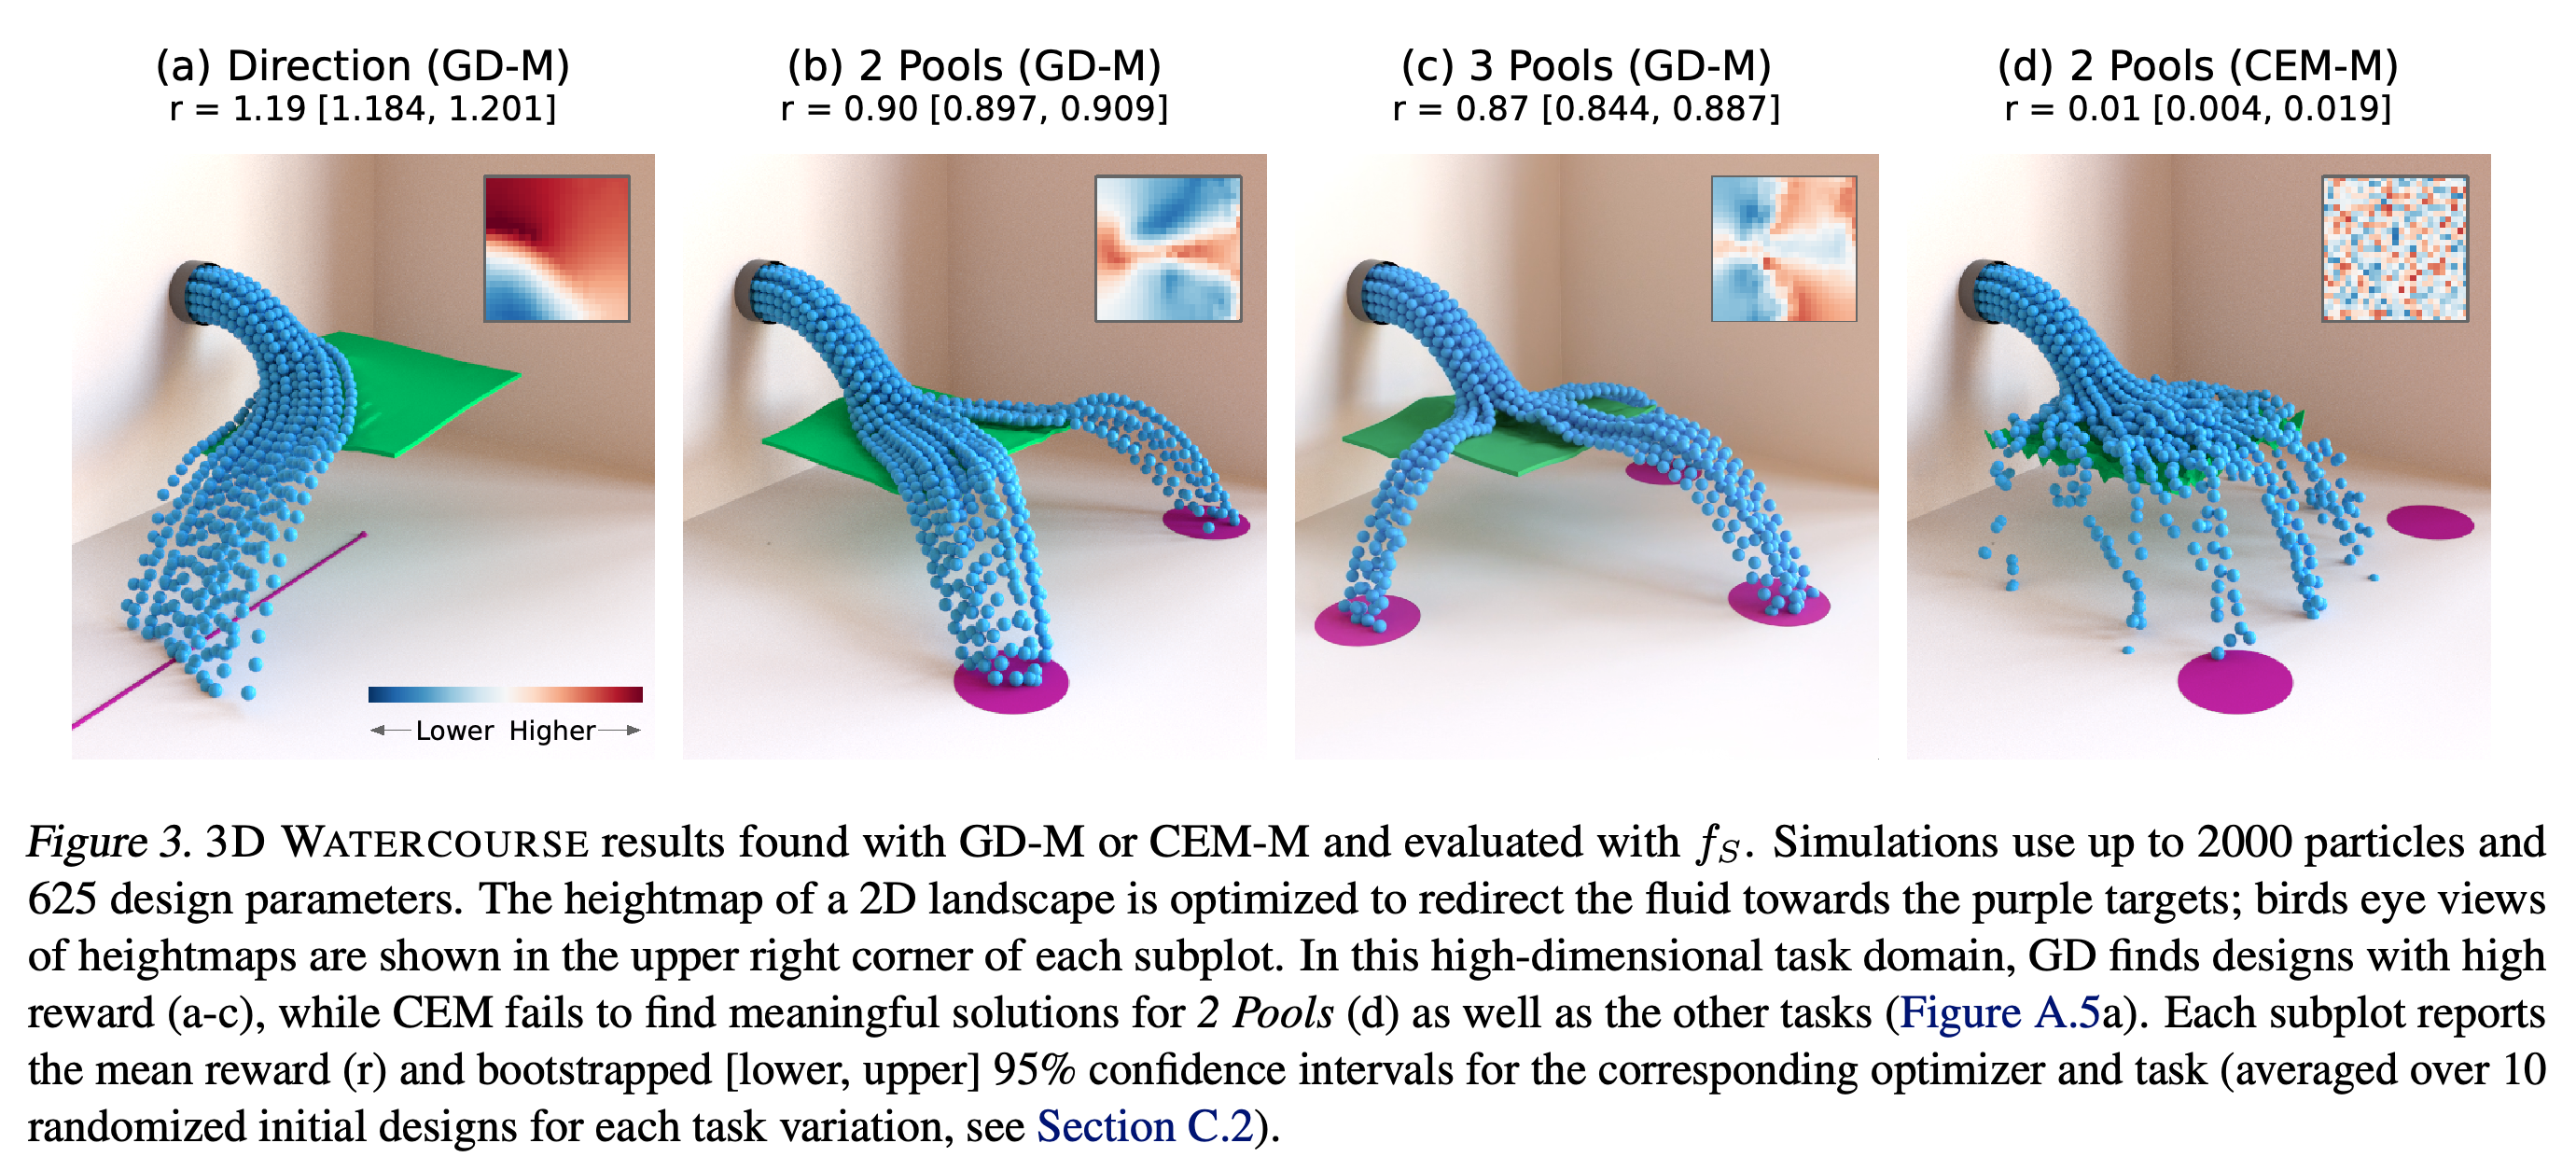
3D WATERCOURSE에서는 25 × 25 높이맵으로 물줄기 아래 지형의 변수 625개를 지정한다. Direction은 물줄기의 방향을 바꾸고, 2 Pools와 3 Pools는 물줄기를 목표 지점으로 나눈다. 시뮬레이션은 50단계 동안 진행되며 본문은 최대 2048개의 입자를 사용했다고 보고한다.
4.3. AIRFOIL
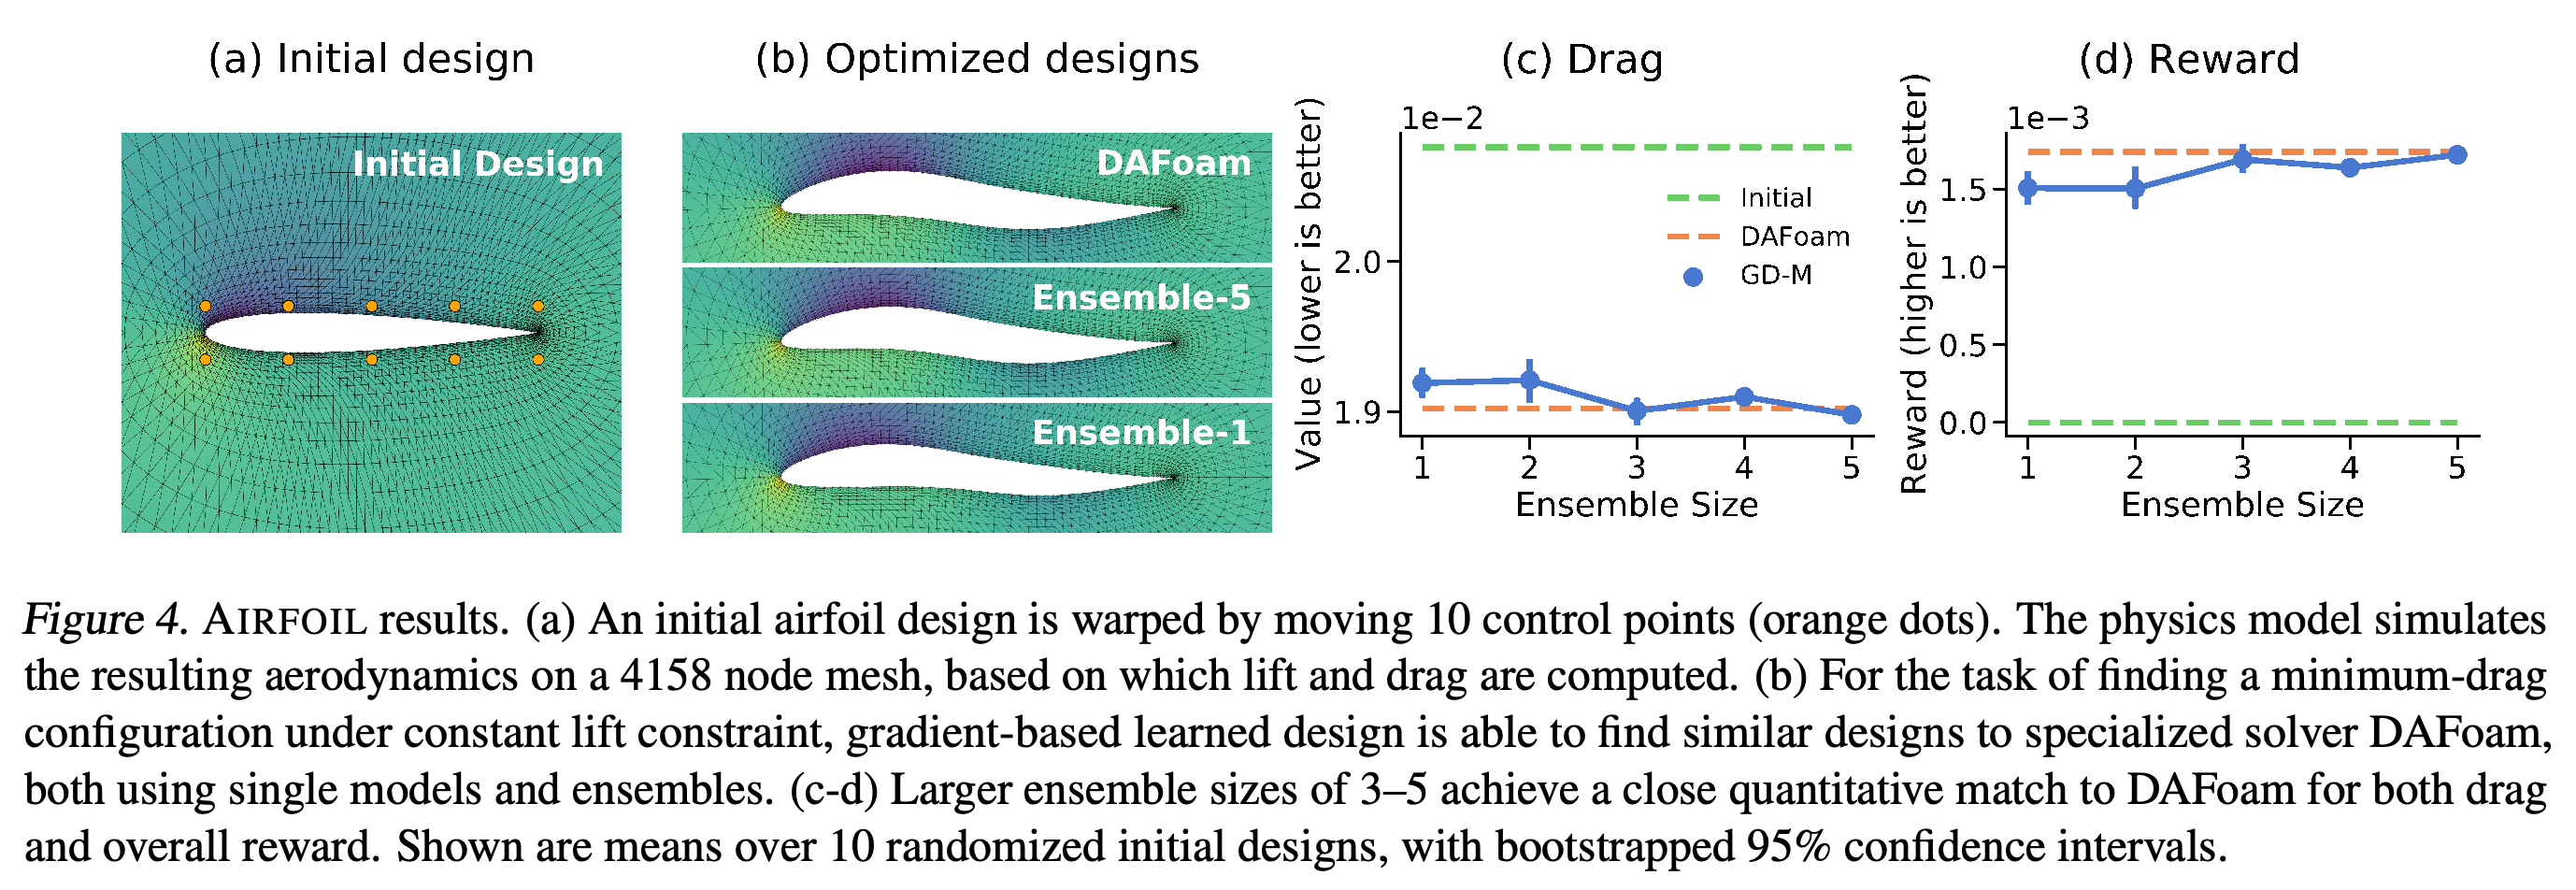
AIRFOIL은 양력과 형태를 제한하면서 2차원 날개 단면의 항력을 최소화한다. 제어점 10개가 단면을 변형하고, OpenFOAM 유체 솔버가 4158개 노드로 이루어진 메시에서 공기 흐름을 평가한다.
4.4. Model learning and optimization
각 영역은 동일한 기본 그래프 네트워크 아키텍처를 사용한다. 유체 영역 2개에는 동일한 하이퍼파라미터를 적용하고 정상 상태 날개 단면 과제에는 약간의 변경을 적용한다. 모델은 과제와 무관한 데이터로 다음 단계를 예측하도록 학습한 뒤 추가 미세 조정 없이 설계 최적화에 사용한다.
5. Results
저자들은 최적화된 설계를 기준 시뮬레이터로 평가하고 https://sites.google.com/view/optimizing-designs 에 예시를 제공한다. 실험에서는 전반적인 성능, 롤아웃 안정성, 일반화, 앙상블, 확장성, 최적화 비용을 살펴본다.
5.1. Overall results
그림에 제시된 2D FLUID TOOLS 과제에서 GD-M은 CEM-M보다 평균 보상이 16.1–118.9%, CEM-S보다 3.9–37.5% 높았다. 3D WATERCOURSE에서 CEM-M의 성능은 GD-M보다 30–85배 낮았다. AIRFOIL에서 GD-M의 항력 계수는 앙상블 크기에 따라 0.01898–0.01919였고, 전문 공기역학 솔버인 DAFoam은 0.01902였다 (He et al., 2020).
기준 시뮬레이션에서 GD-M은 용기, 경사로, 깔때기를 형성한다. 보상 막대는 목표 위치 50곳의 결과를 요약하며, 제시된 구성에서 GD-M이 CEM 베이스라인 2개보다 앞선다.
학습된 시뮬레이터의 기울기로 얻은 설계는 물의 방향을 바꾸거나 물줄기를 나누는 표면을 만든다. 반면 그림의 CEM-M 2 Pools 설계에서는 대부분의 물이 목표 지점에 도달하지 못한다. 보고된 보상은 과제 변형마다 무작위 초기 설계 10개의 평균이다.
최적화된 날개 단면은 DAFoam의 해와 비슷하다. 모델 3–5개로 구성된 앙상블은 무작위 초기 설계 10개에 걸쳐 항력과 보상을 DAFoam의 값에 가깝게 만든다.
5.2. Model stability & gradient quality
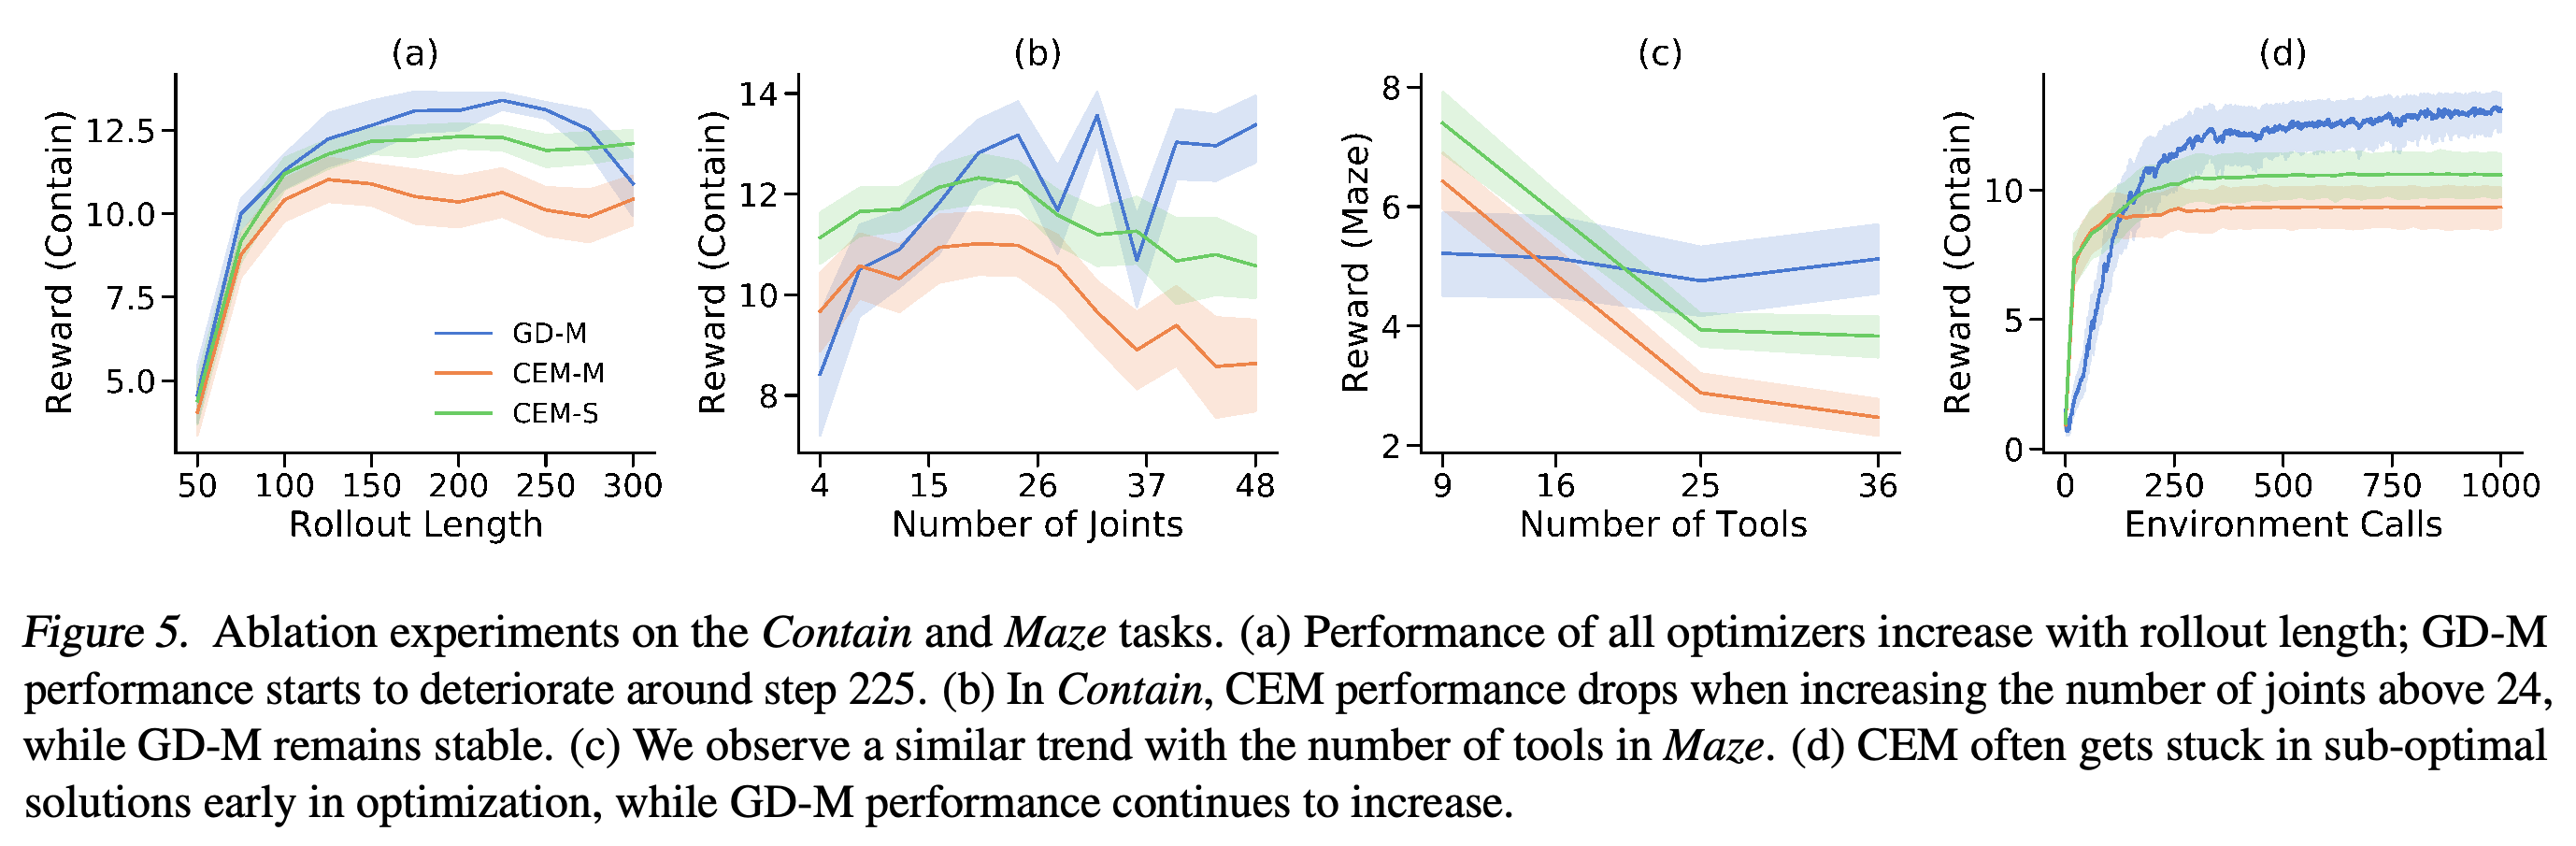
Contain의 롤아웃 길이 절제 실험에서 GD-M의 설계 품질은 약 225단계까지 상승한 뒤 저하된다. 시험한 길이 전반에서 GD-M은 CEM-M보다 평균 18.1%, CEM-S보다 4.4% 높았다. 저자들은 학습 노이즈가 안정성과 기울기의 매끄러움에 도움이 된다고 가정하지만, 이 메커니즘을 입증하지는 않았다.
5.3. Generalization
유체 모델은 직선 구간 1–4개만 포함된 장면으로 학습했지만 효과적인 곡선 및 다중 장애물 설계를 찾는다. 저자들은 학습된 국소 충돌 규칙이 이러한 전이에 기여한다고 가정한다. 기준 솔버에서도 입자가 장애물 사이에 끼일 수 있어 Maze의 비교가 복잡해진다.
5.4. Improving accuracy with ensembles
AIRFOIL에서 저자들은 서로 다른 데이터 분할로 학습한 모델들의 기울기를 평균한다. 모델 5개의 항력 계수는 0.01898이고 모델 1개는 0.01919, DAFoam은 0.01902다. 회귀 분석에서는 앙상블 크기가 클수록 항력이 낮고 보상이 높았다.
5.5. Scalability to larger design spaces
관절 48개를 사용한 Contain에서 GD-M은 CEM-M보다 154.9%, CEM-S보다 126.5% 높았다. 관절 36개를 사용한 Maze에서는 각각 207.4%와 133.7%의 개선을 보고했다. 설계 차원이 커질수록 샘플링 베이스라인의 성능은 저하되지만 GD-M은 비교적 효과적이다.
절제 실험에서 GD-M의 보상은 롤아웃 약 225단계에서 최고에 도달하고, 관절이나 도구의 수가 늘어나도 성능을 유지한다. 반면 CEM의 성능은 설계 공간이 커지면 저하된다.
5.6. Model speed and sample efficiency
AIRFOIL 최적화는 A100 GPU 1개에서 학습된 모델 1개를 사용하면 21초, 5개를 사용하면 62초가 걸렸다. DAFoam은 8-core 워크스테이션에서 1021초가 걸렸으며, GD-M은 최적화 단계를 10배 더 많이 사용했다. 비교에 사용한 하드웨어는 서로 다르다. 2D FLUID TOOLS에서 기울기 계산 비용은 순전파 평가의 약 3배지만, CEM은 단계마다 20–40회 평가한다.
6. Discussion
이 연구는 3개 영역과 7개 과제에서 사전 학습된 시뮬레이터가 경사 기반 물리 설계를 지원할 수 있음을 보인다. 기울기가 0인 영역에서는 경사 하강법이 실패할 수 있으며, 크기가 가변적이거나 조합적인 설계 공간은 이 방법으로 최적화하기 어렵다.
부록
- A. 최적화기 하이퍼파라미터: 저자들은 주요 최적화 설정을 탐색하고 CEM 샘플 크기로 2D FLUID TOOLS에서는 20개, 3D WATERCOURSE에서는 40개를 선택한다. Adam의 학습률은 0.005 또는 0.01이며, 2D 과제에서는 기울기를 10으로 클리핑한다. 최적화는 2D에서 1000단계, 3D와 AIRFOIL에서 200단계 동안 진행한다.
- B. 모델 아키텍처와 학습: Encode-Process-Decode 네트워크는 프로세서 블록 10개와 너비가 128인 2층 노드 및 엣지 다층 퍼셉트론을 갖는다. Adam, 배치 크기 2, 학습 노이즈를 사용해 최대 1000만 단계까지 학습한다. Gradient checkpointing은 중간 활성값을 다시 계산해 긴 롤아웃의 메모리 사용량을 줄인다 (Chen et al., 2016).
- C. 과제 영역: 2D 유체 모델은 WaterRamps 궤적 1000개로 학습하고, 3D 모델은 장애물 평면을 무작위로 설정한 궤적 1000개로 학습한다. AIRFOIL은 무작위 메시 10000개, 마하 0.1의 유입류, 받음각 5.1°를 사용한다. 정상 상태 예측에는 모델 단계 1개를 사용한다.
- D. 추가 결과: 3D WATERCOURSE에서는 학습된 모델과 기준 시뮬레이터의 보상이 비슷하지만, Maze에서는 차이가 더 크다. Maze에서 평가에 사용하는 material point method (MPM) 솔버는 입자가 달라붙는 병목을 만들 수 있다. 관절 각도를 절대 각도로 바꾸면 CEM 성능은 크게 떨어지지만 GD-M 보상은 비슷하게 유지된다. 도구의 평행 이동을 추가하면 도구가 유체와 접촉하지 않게 되어 기울기가 0이 될 수 있다. 추가 그림은 롤아웃 길이, 설계 크기, 무작위 시드에 따른 해를 보여준다.
짧은 생각
기준 시뮬레이터로 방법들을 평가한 결과, 이 과제들에서는 경사 기반 탐색의 이점이 학습된 모델의 오차보다 클 수 있음을 보여준다. 근거는 시뮬레이션에 기반하며, Maze의 솔버 인공물과 날개 단면 시간 비교에 사용된 서로 다른 하드웨어는 물리적 정확도와 속도를 더 넓게 해석하는 데 제약이 된다.