


Compute Trends Across Three Eras of Machine Learning 요약 설명
11 Feb 2022 | Paper Review Compute Trends Scaling Laws목차
이번 글에서는 Compute Trends Across Three Eras of Machine Learning 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 2월 11일(Arxiv)
- Sevilla, Jaime, Heim, Lennart, Ho, Anson, Besiroglu, Tamay, Hobbhahn, Marius, Villalobos, Pablo.
- University of Aberdeen, Centre for the Governance of AI, University of St Andrews, Massachusetts Institute of Technology, University of Tübingen, Complutense University of Madrid
- 논문 링크 (v2, 2022년 3월 9일 수정)
요약
- 이 논문은 주목할 만한 머신러닝 시스템을 학습하는 데 필요한 연산량이 시간에 따라 어떻게 변했는지 살펴본다. 논문의 역사적 데이터셋에서 학습 연산량은 2010년 이전에는 약 20개월마다, 2010년 이후에는 약 6개월마다 배증했다.
- 저자들은 2015년 말부터 기존 추세보다 학습 연산량이 10~100배 큰 별도의 대규모 추세가 나타났을 가능성도 제시한다. 이 추세의 추정 배증 시간은 9.9개월이다. 다만 데이터를 살펴본 뒤 분류 기준을 정했고 대규모 표본도 작으므로 이 구분은 잠정적이다.
1 Introduction
저자들은 데이터와 알고리즘 발전을 비롯한 머신러닝 발전의 한 측면을 측정할 수 있는 대리 지표로 연산량을 본다. 주요 시스템 123개를 선별하고 학습 연산량을 기록했다. 데이터셋, 그림, 대화형 시각화는 각각 https://ml-progress.com/data, https://github.com/ML-Progress/Compute-Trends, https://ml-progress.com/visualization에서 확인할 수 있다.
2 Related work
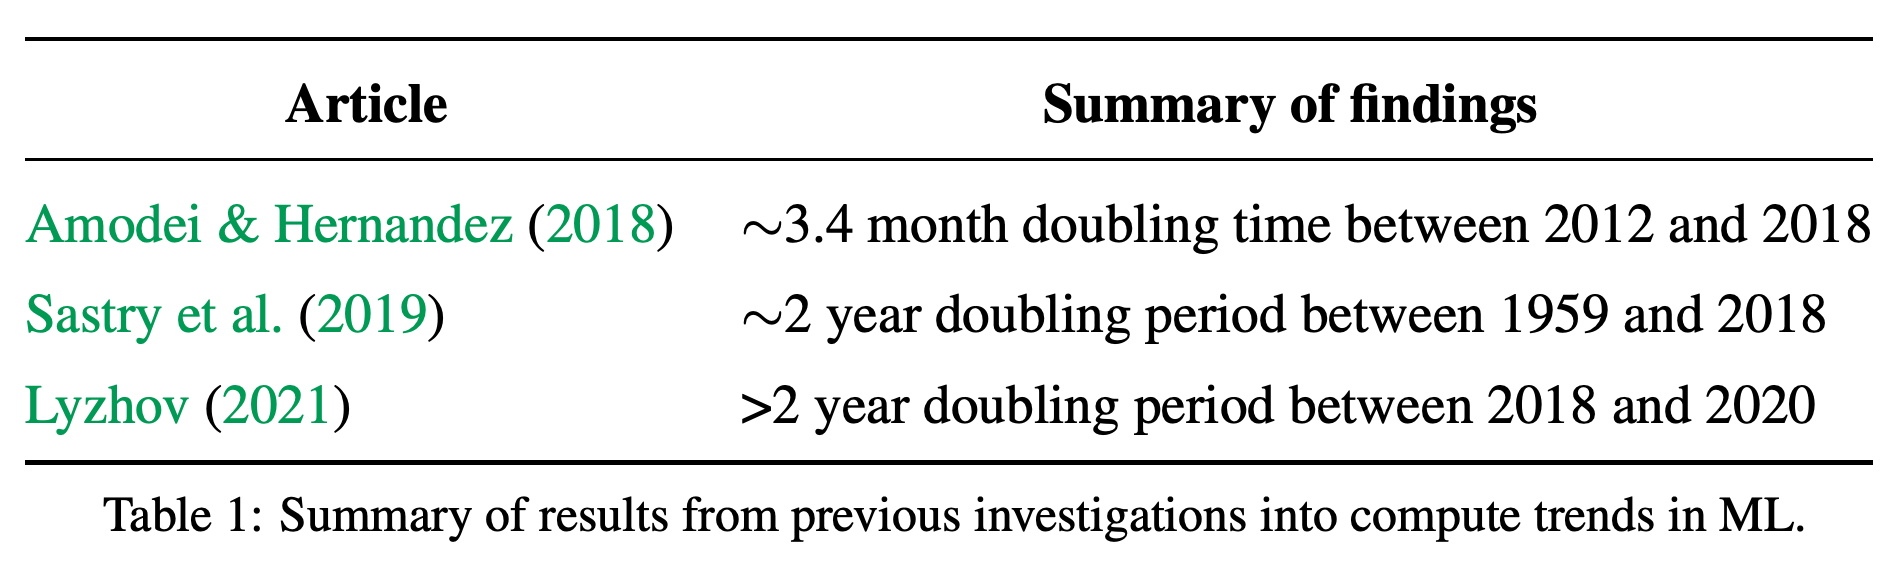
Amodei & Hernandez (2018)는 2012년부터 2018년까지 시스템 15개를 분석해 배증 시간이 3.4개월이라고 보고했다. Sastry et al. (2019)은 1959–2012년의 배증 시간을 약 2년으로 추정했다. 이 논문의 Table 1에는 Sastry의 기간이 1959–2018년으로 표시돼 있다. Lyzhov (2021)는 2018년 이후 증가가 정체됐다고 주장했다. 이 논문은 데이터셋을 2022년까지 확장하고 일반 규모와 대규모 추세를 따로 살펴본다.
기존 추정치는 관측 기간과 표본에서 큰 차이를 보이며, 이 논문이 역사적 추세를 다시 살펴본 배경을 보여준다.
3 Trends
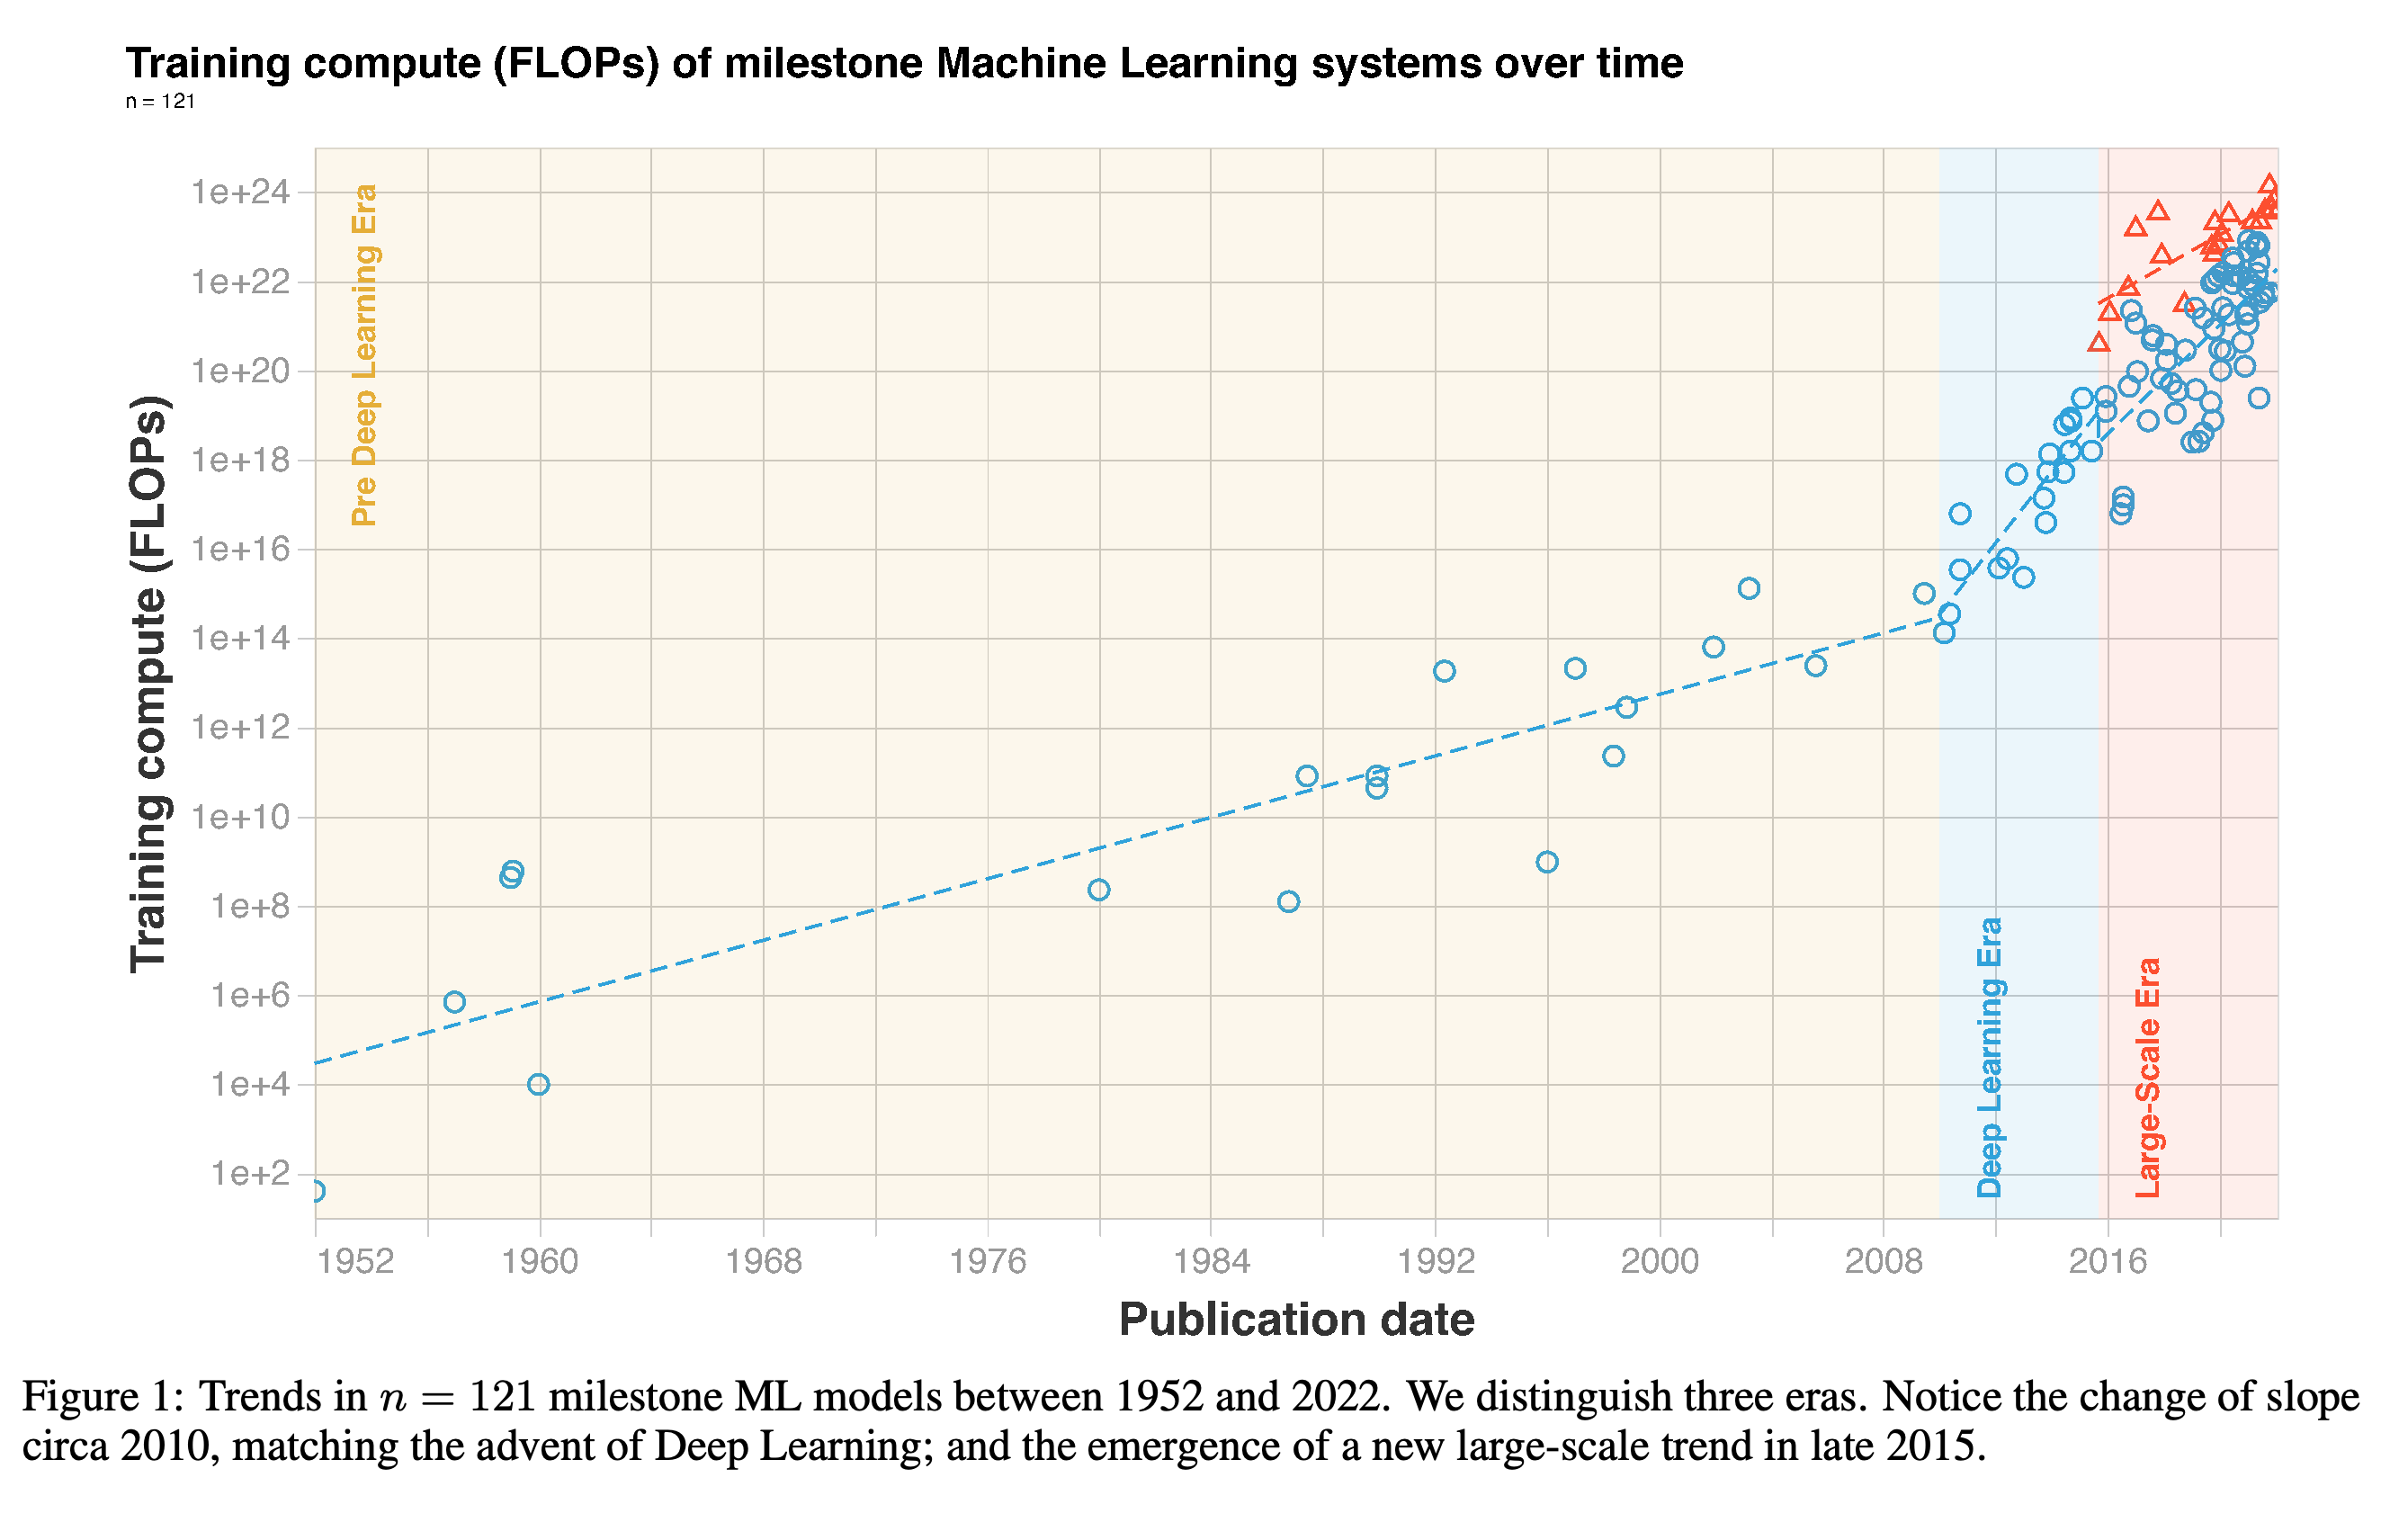
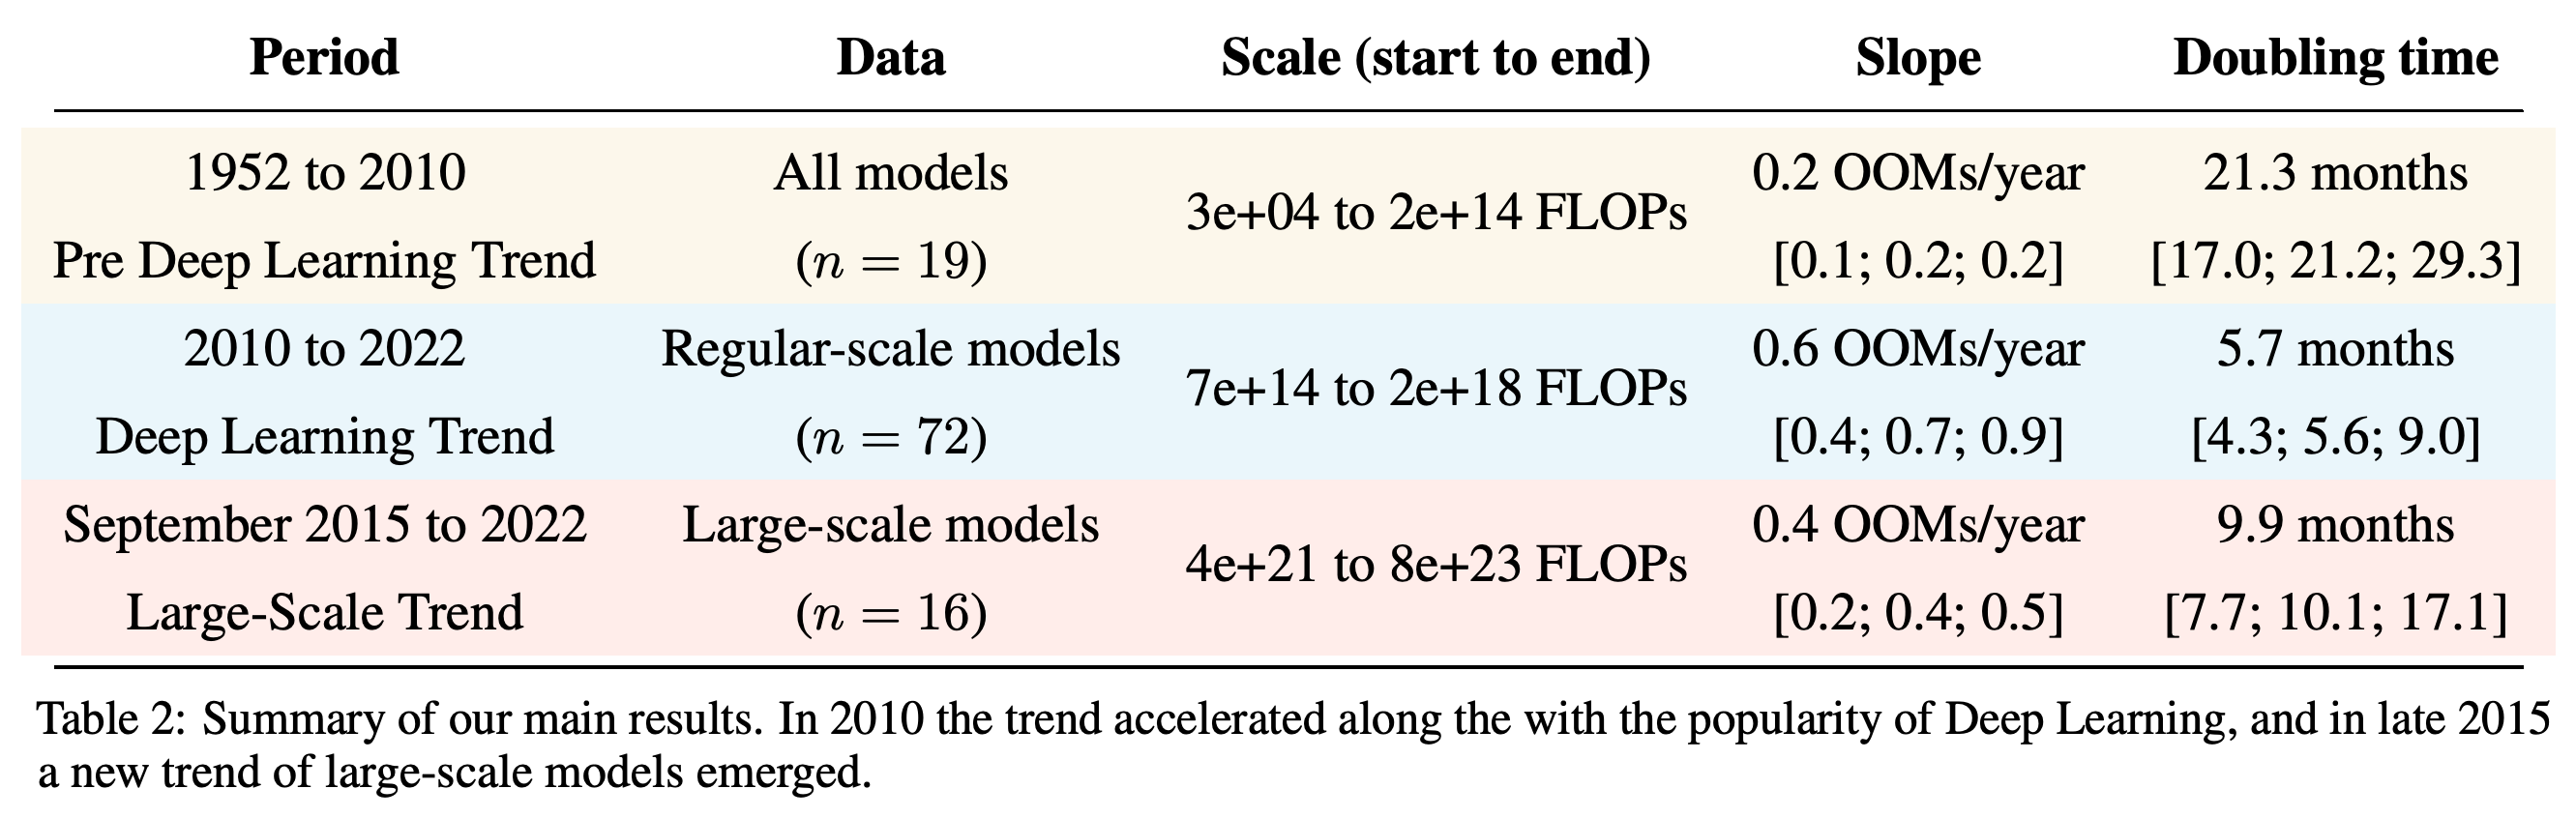
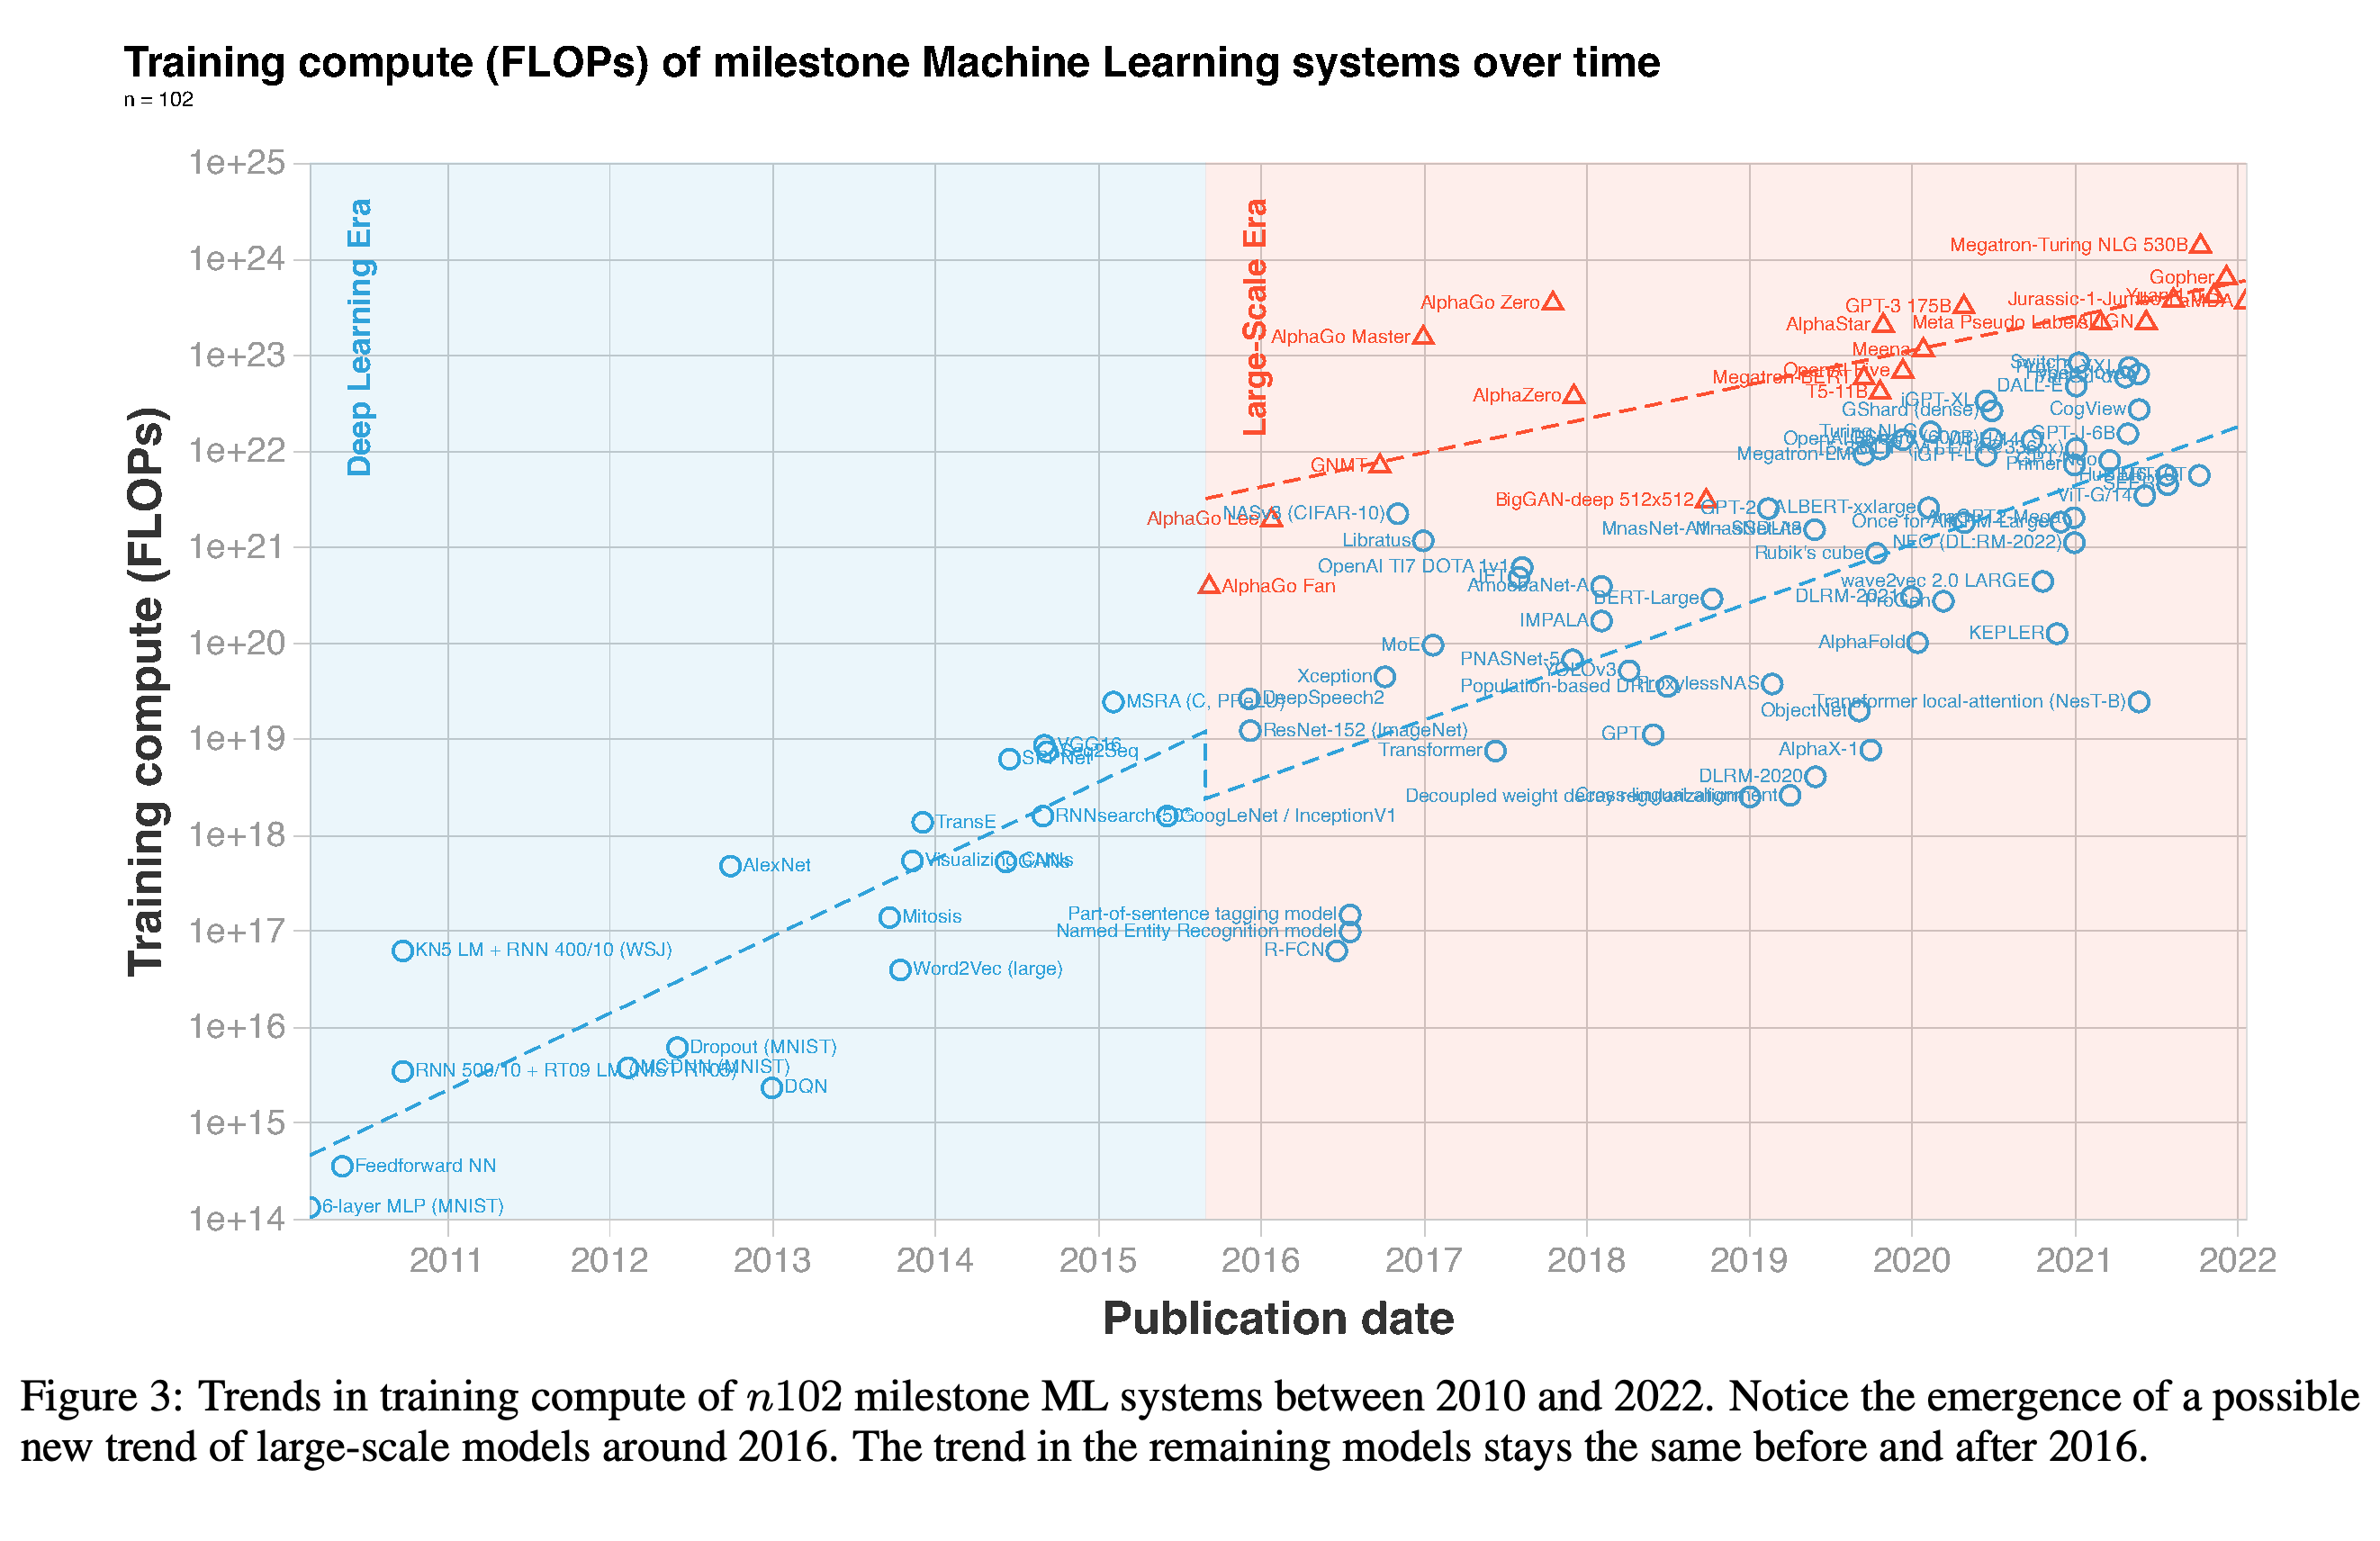
저자들은 학습 연산량의 로그값에 직선을 맞추는 로그 선형 추세를 3개 기간에 걸쳐 추정했다. Table 2에서 연산량이 2배가 되는 데 걸리는 시간은 1952–2010년 21.3개월(모델 19개), 2010–2022년 일반 규모 모델 5.7개월(모델 72개), 2015년 9월부터 2022년까지 대규모 모델 9.9개월(모델 16개)이다.
로그 척도의 세로축에서 2010년 무렵 증가 기울기가 가팔라지고, 2015년 말부터 연산량이 특히 큰 시스템들이 등장하는 모습을 확인할 수 있다.
추세를 추정한 3개 그룹은 표본 크기와 배증 시간이 서로 다르며, 대규모 그룹은 일반 규모 그룹보다 훨씬 작다.
3.1 The transition to Deep Learning
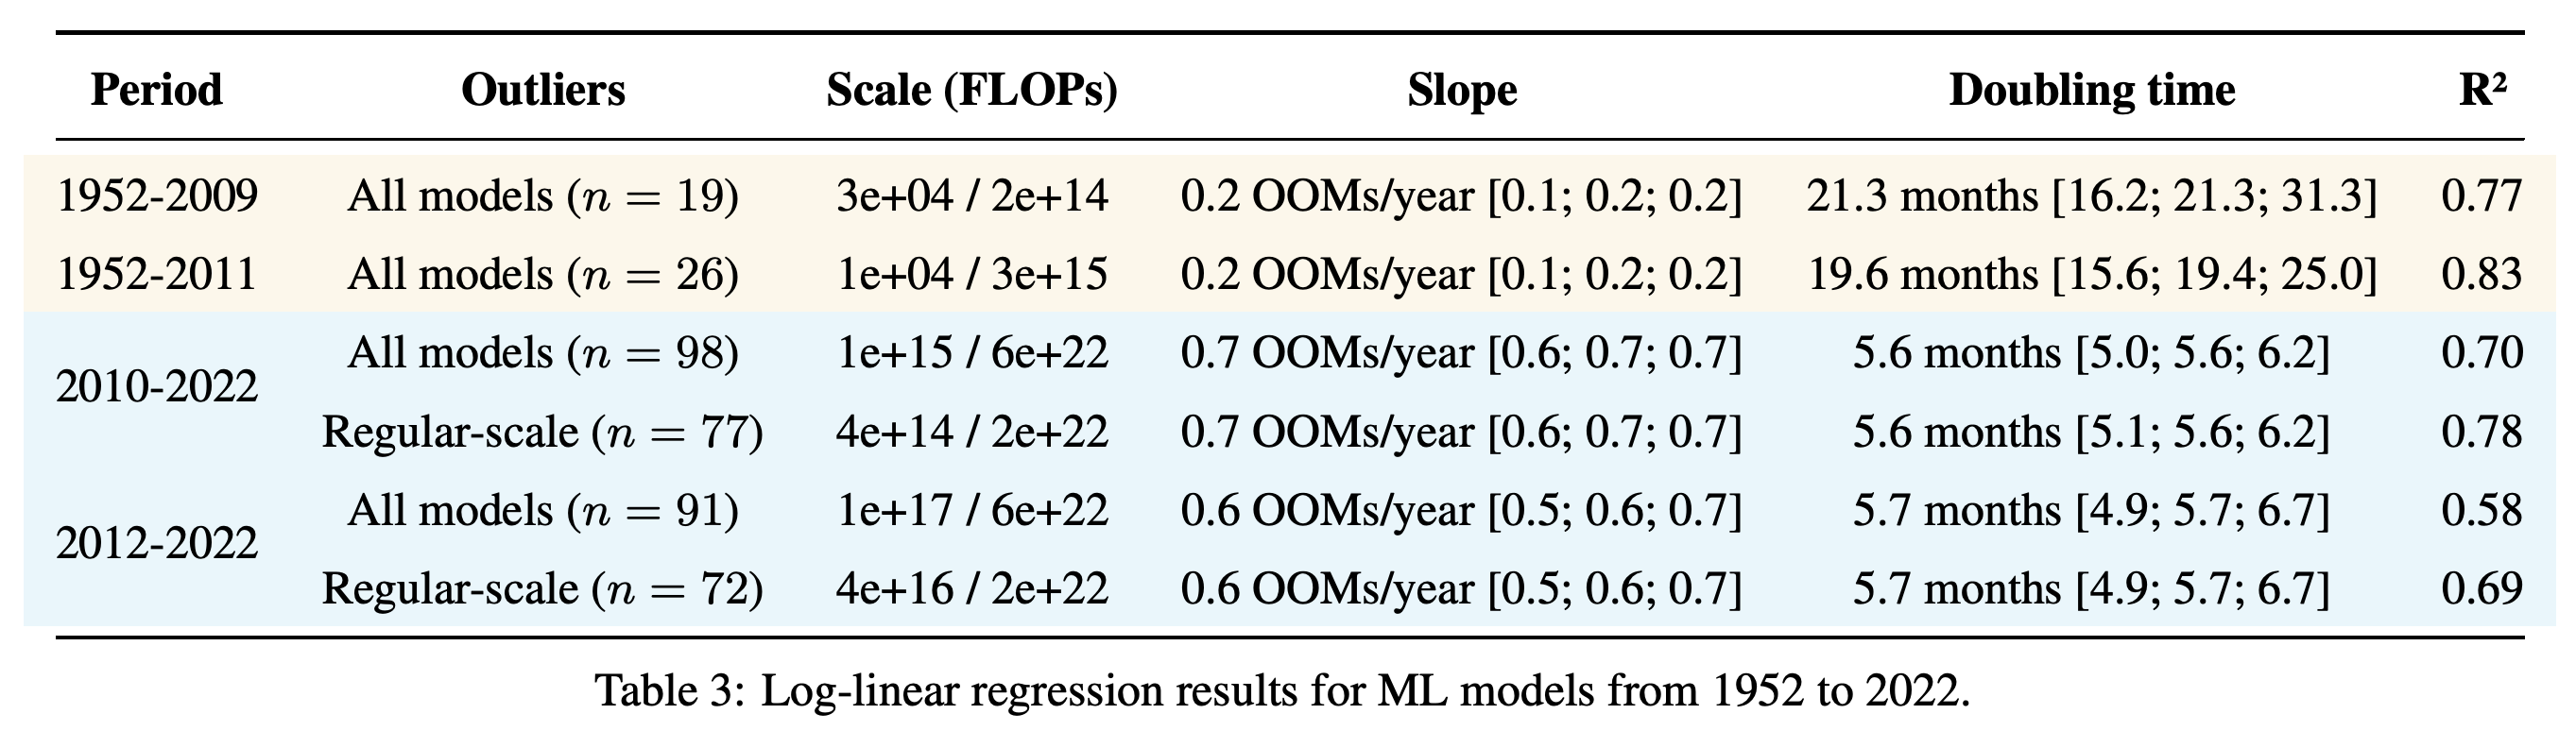
2010년 이전 추세는 트랜지스터 밀도가 약 2년마다 2배가 된다는 Moore’s law와 대체로 일치한다. Deep Learning Era의 시작을 2010년과 2012년 중 어느 해로 잡아도 추정 배증 시간은 거의 달라지지 않는다. Table 3에서 각 시작 연도 이후 전체 모델의 배증 시간은 각각 5.6개월과 5.7개월이다.
같은 역사적 관측치를 대규모 그룹으로 따로 구분하지 않고 제시해 2010년 무렵의 기울기 변화를 강조한다.
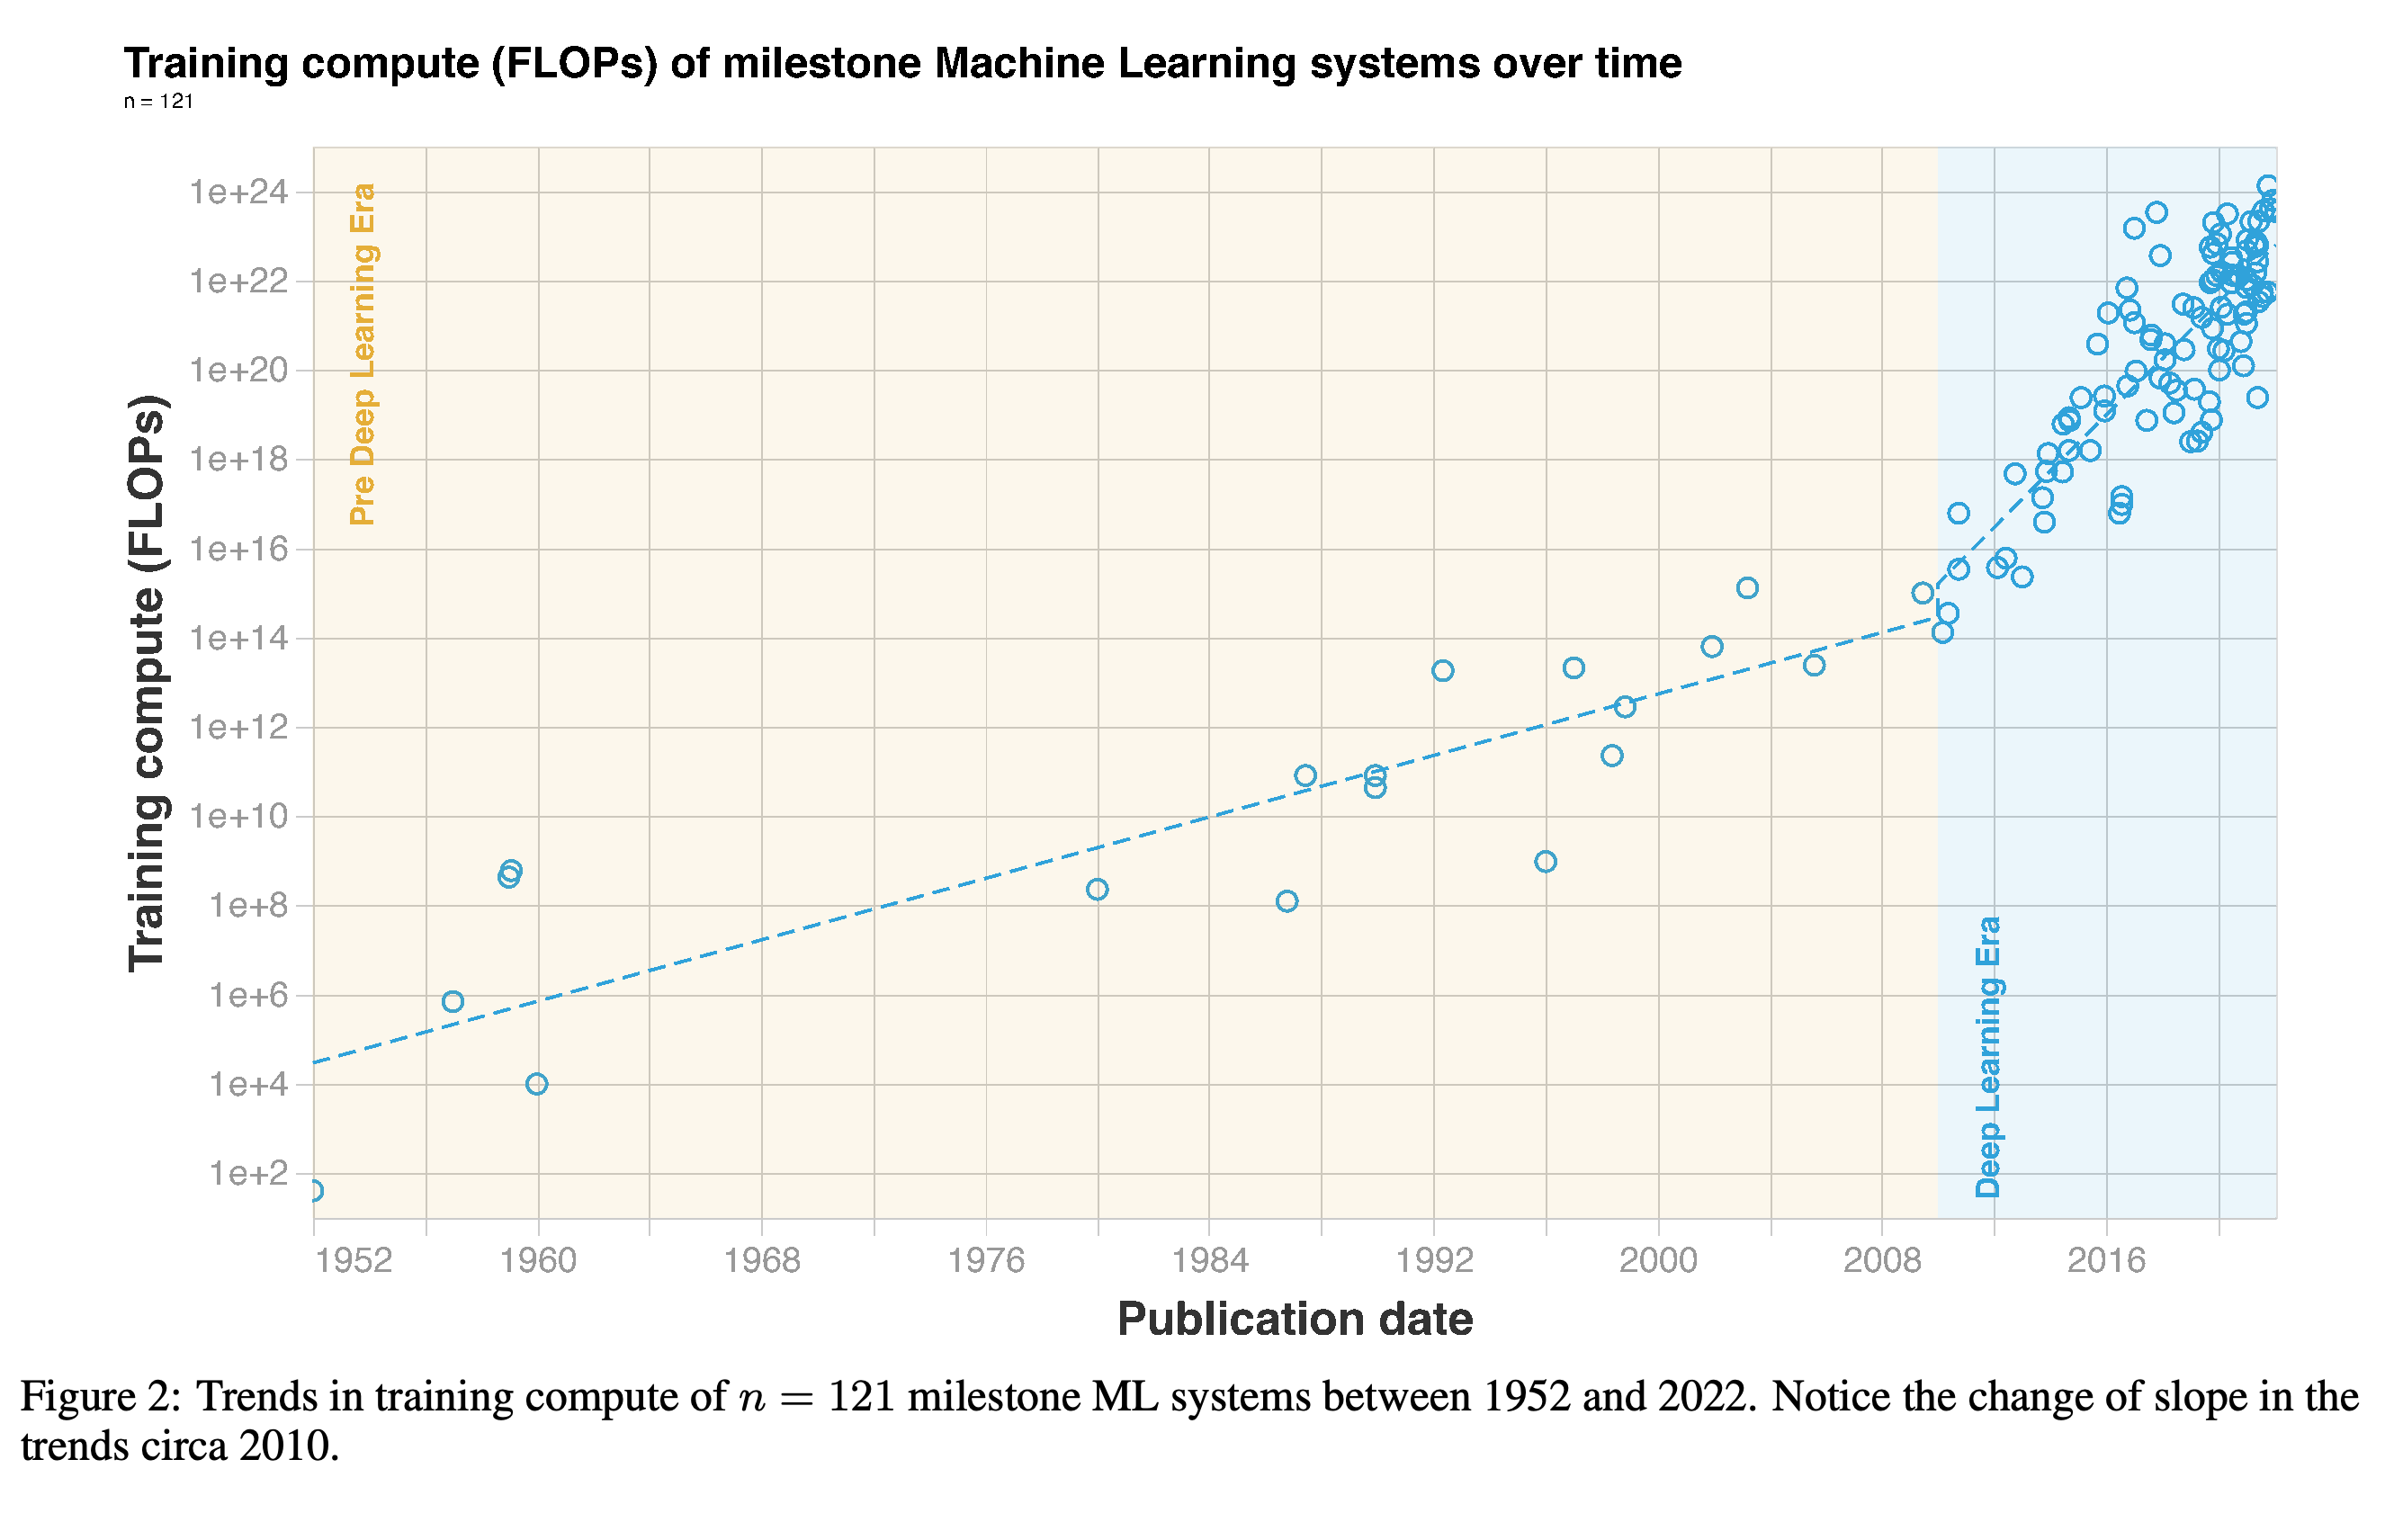
시작 연도를 2010년에서 2012년으로 바꾸거나 대규모 모델을 제외해도 이후 기간의 점추정치는 비슷하게 유지된다.
3.2 Trends in the Large-Scale era
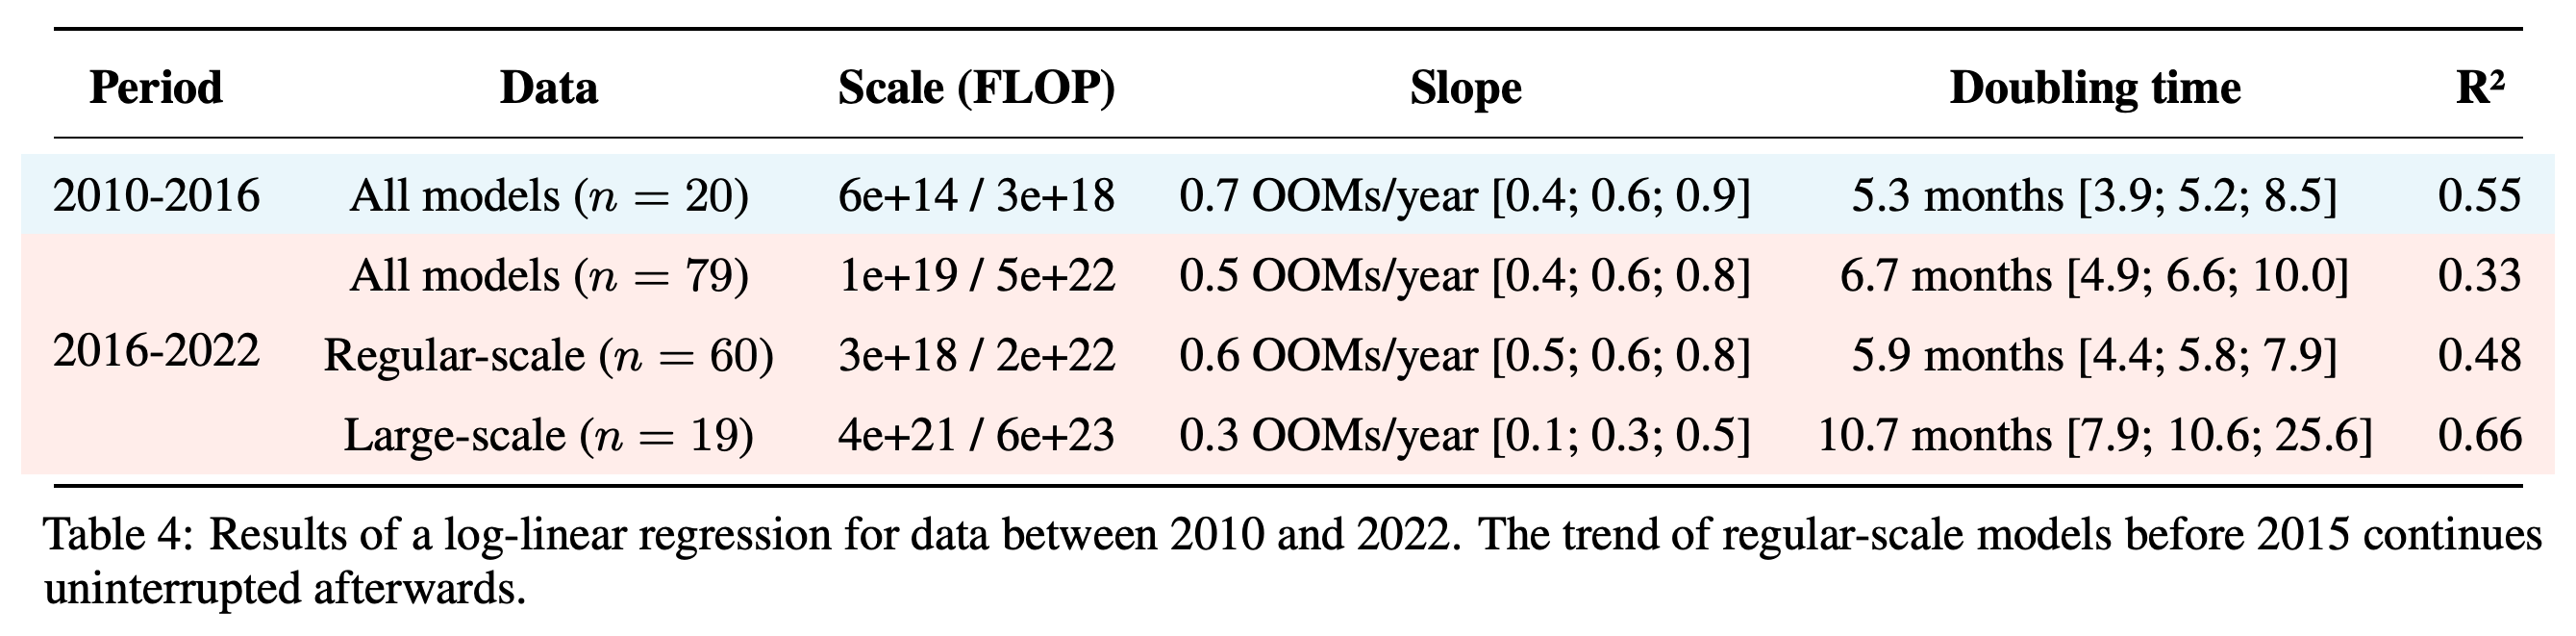
제안된 대규모 추세는 2015년 말 AlphaGo부터 시작하며, 일반 규모 모델은 2016년 전후로 대략 같은 속도로 계속 증가한다. Table 4에서 2016–2022년의 배증 시간은 일반 규모 모델 60개에서 5.9개월, 대규모 모델 19개에서 10.7개월로 추정된다. 저자들은 이 속도 차이가 잡음일 수 있다고 지적한다.
2016년 무렵부터 고연산량 모델이 지속되는 일반 규모 추세보다 위에 나타나며, 이는 저자들이 잠정적으로 추세 2개를 구분하는 근거가 된다.
2016년 이후 일반 규모 모델의 추정치는 2010–2016년 전체 모델의 추정치와 비슷하며, 대규모 모델의 추정 구간은 더 넓다.
4 Conclusion
저자들은 이 역사를 딥러닝 이전의 느린 증가, 2010년 무렵의 빠른 증가, 2015년 말부터 나타났을 가능성이 있는 고연산량 분기로 해석한다. 대규모 시스템이 별도 범주를 이루는지는 불확실하며, 이 논문에서는 데이터셋 크기의 추세를 분석하지 않았다.
부록
- A Methods: 주요 시스템으로 선정하려면 학습 요소, 실험 결과, 당시 최고 성능의 개선을 모두 갖추고 주목도를 나타내는 기준도 최소 1개 충족해야 한다. 2020년 이후 모델의 선정은 더 주관적이다. 누락된 학습 연산량은 순전파 연산량이나 그래픽 처리 장치 사용 시간 등의 정보로 추정하며, 최종 학습 실행만 계산한다.
- A Methods: 신뢰구간은 재표본 추출 방식인 부트스트랩 표본 1,000개를 사용해 구한다. 각 연산량 추정치에는 1/2에서 2 사이의 로그 균등 계수를 곱해 변화를 준다. 저연산량 이상치와 대규모 모델은 시각적으로 살펴본 뒤 정한 임계값으로 선정한다. 본문은 1.5년 비교 기간을 설명하지만 Table 5에는 2년으로 적혀 있다.
- B Analyzing record-setting models: 이전의 모든 학습 연산량 기록을 넘어선 모델은 초기에 느린 증가 추세를 보이고 2010년 이후에는 더 빠르게 증가한다. 2015년 이후 추정치는 AlphaGo Zero와 AlphaGo Master에 민감하게 반응하며, 이는 개별 기록이 미치는 영향을 보여준다.
- C Trends in different domains: 2009–2022년의 추정 배증 시간은 비전 분야 6.0개월, 언어 분야 4.8개월, 기타 분야 6.8개월이다. 게임 분야는 표본이 적고 분산돼 있어 일관된 추세가 나타나지 않는다.
- D When did the Deep Learning Era start?: 저자들은 AlexNet이 등장한 2012년 이전에 경쟁력 있는 심층 신경망과 그래픽 처리 장치를 이용한 학습이 있었고 음성 인식 분야에도 딥러닝이 도입됐다는 이유로 2010년을 선택했다. 다만 이 시작 연도에는 이견이 있을 수 있다고 인정한다.
- E Comparison to Amodei & Hernandez’s analysis: 더 짧은 관측 기간이나 대규모 모델의 분리는 기존 3.4개월 추정치와의 차이를 설명할 수 있다. 저자들은 추세 2개를 구분하는 해석을 선호하지만, 2017년 이후 증가 속도가 둔화된 단일 추세로 보는 해석도 제시한다.
- F Are large-scale models a different category?: 저자들은 비용이 특히 많이 드는 대표 프로젝트가 별도 범주를 이룬다는 가설을 제시한다. 그러나 이를 입증할 내부 지출과 수익 데이터는 확보하지 못했다. 선정 임계값을 바꿔도 추정 증가율의 변화는 비교적 작다.
- G Causes of the possible slowdown of training budget in large-scale models between 2016 and 2022: 가능한 설명으로 칩 부족, 인프라 엔지니어링의 어려움, 예산 한계, 공개되지 않은 모델을 제시한다. 이는 가설이며 검증된 인과관계는 아니다.
- H Limitations: 연산량 추정치에 계산 오류가 있을 수 있고 표본이 작다. 또한 학술적으로 발표됐거나 영어로 작성됐거나 주관적으로 주목할 만하다고 판단된 시스템이 선정되기 쉽다. 저자들은 추정 방법을 비교한 결과를 바탕으로 대부분의 추정치가 실제 값과 약 2배 이내의 차이를 보일 것으로 예상한다.
짧은 생각
이 역사적 비교는 기간 경계를 다르게 설정한 결과와 모델 선정에 따른 민감도를 함께 제시한다. 배증 시간은 선정된 주요 학습 실행에 관한 수치이므로, 모든 머신러닝 작업의 증가율이나 연산량만으로 성능 향상이 발생했다는 근거로 해석할 수 없다.