


Densing Law of LLMs 요약 설명
05 Dec 2024 | Paper Review Scaling Laws LLM Evaluation Efficient Inference목차
이번 글에서는 Densing Law of LLMs 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 5일(Arxiv)
- Xiao, Chaojun, Cai, Jie, Zhao, Weilin, Zeng, Guoyang, Lin, Biyuan, Zhou, Jie, Zheng, Zhi, Han, Xu, Liu, Zhiyuan, Sun, Maosong.
- Tsinghua University, ModelBest Inc.
- 논문 링크
요약
- 파라미터 수가 다른 대규모 언어 모델(LLM)을 비교하려면 과제 성능과 모델 크기라는 2가지 항목을 함께 고려하는 지표가 필요하다. 저자들은 후속 지시 튜닝이나 선호 학습 없이 평가한 오픈소스 사전학습 베이스 모델 29개를 분석한다. 선택한 기준 설정과 다섯 벤치마크로 평가했을 때, 최대 역량 밀도는 약 석 달마다 배증한다. 역량 밀도는 대상 모델과 같은 성능을 내는 데 필요한 기준 모델의 파라미터 수를 대상 모델의 실제 파라미터 수로 나눈 값이다.
- 먼저 파라미터 수와 학습 데이터 크기로 조건부 정답 손실을 추정하는 관계식을 적합한다. 조건부 정답 손실은 과제 입력이 주어졌을 때 모델이 정답을 얼마나 잘 예측하는지 측정한다. 이어서 손실과 벤치마크 성능의 관계식을 적합한다. 기준 학습량을 1 trillion 토큰으로 고정하고 이 관계식들을 역산하면, 목표 점수에 도달하는 데 필요한 기준 모델의 크기인 유효 파라미터 수를 구할 수 있다. 본문 분석에서는 최대 밀도의 성장률을 하루당 A ≈ 0.0073, 밀도가 2배가 되는 시간을 약 95일로 보고한다. 회귀 적합도를 나타내는 값은 R² = 0.912다.
- 이 연구는 선택한 기준에 따라 벤치마크 성능과 파라미터 효율을 비교하는 방법을 제시하고, 과거에 관찰한 최대 밀도의 추이를 실증적으로 분석한다. 다만 학습 중 테스트 데이터와 유사한 데이터에 노출되는 벤치마크 오염, 제한된 과제 범위, 후속 학습과 가변적인 추론 연산량의 제외 때문에 해석에 제약이 있다. 관찰한 추세가 모델 교체 주기를 보장하지는 않으며, 배포 비용을 직접 측정하지도 않는다.
Highlights
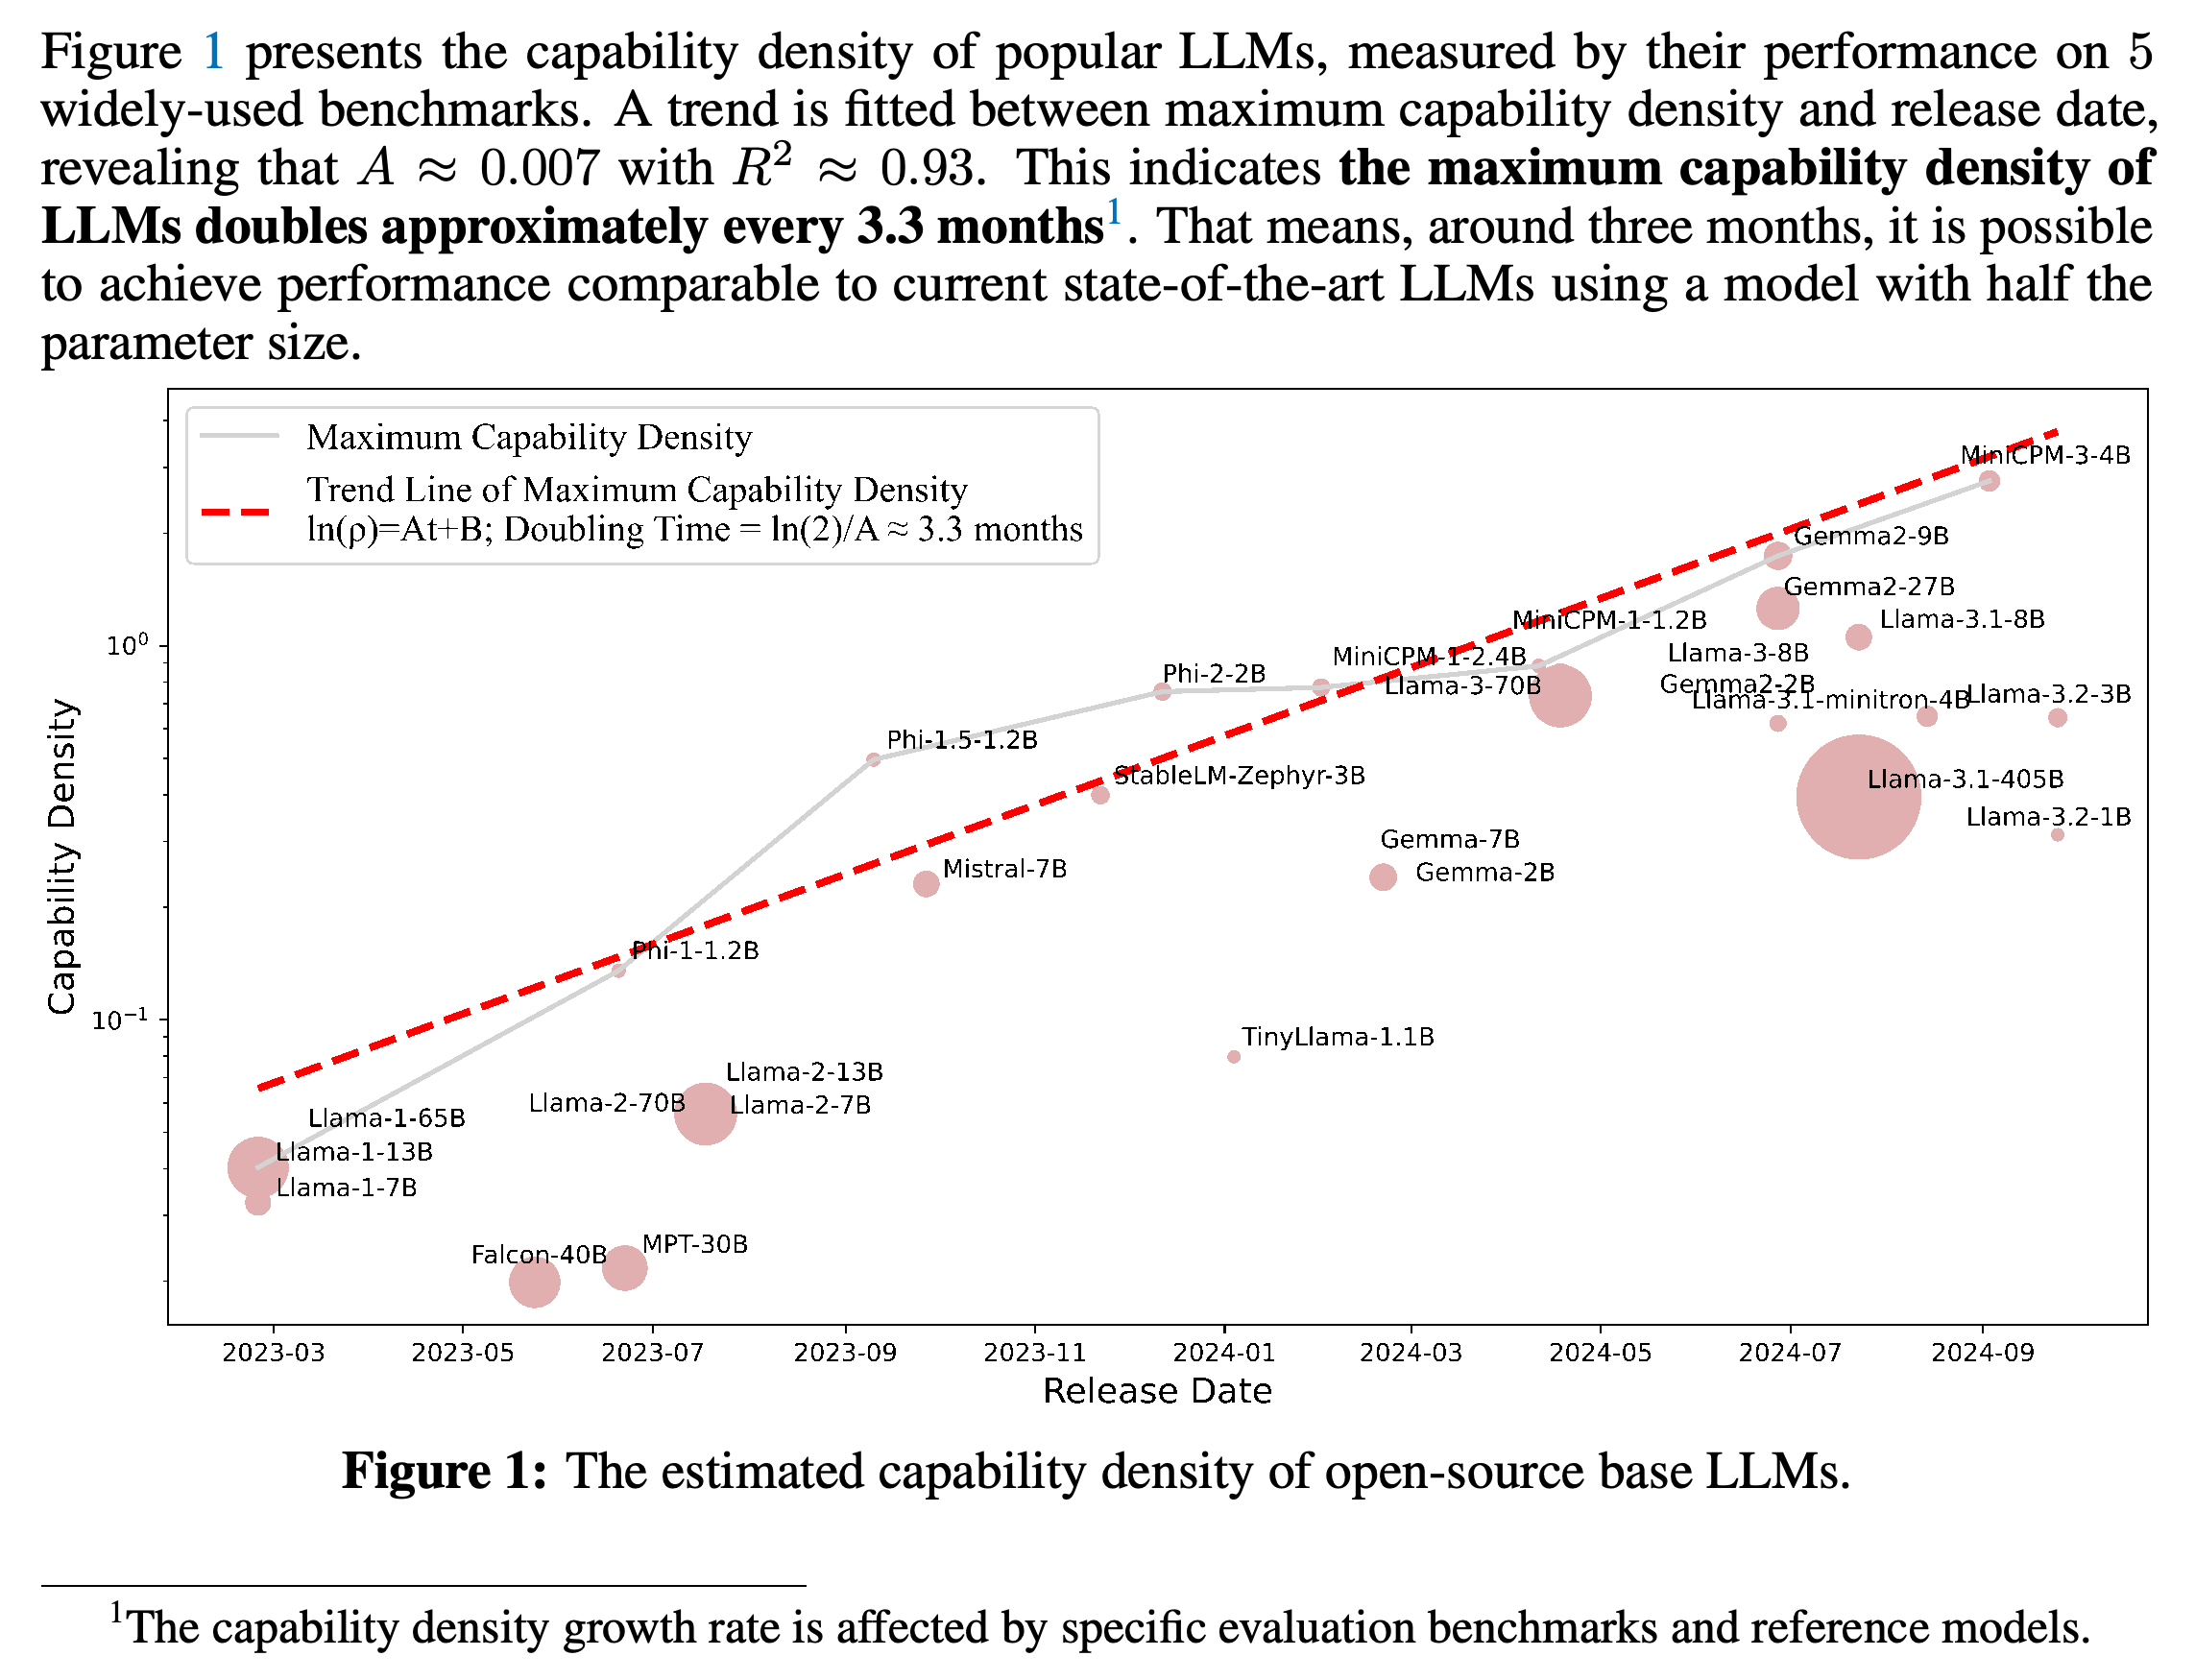
Highlights에서는 동일한 성능을 달성하는 데 필요한 기준 모델의 최소 파라미터 수를 사용해 상대적 역량 밀도를 정의한다. Densing Law는 \(\ln(\rho_{\max})=At+B\)로 표현한다. 여기서 ρ_max는 시점 t의 최대 밀도이며, A와 B는 적합으로 구한 계수다. A ≈ 0.007, R² ≈ 0.93이며, 밀도가 2배가 되는 데 약 3.3개월이 걸린다고 보고한다. 각주에는 성장률이 평가 벤치마크와 기준 모델에 따라 달라진다고 명시한다.
모델이 잇따라 공개되면서 밀도의 상단 경계는 높아지지만, 많은 개별 모델은 그 아래에 머문다. 이는 지수함수 적합의 대상이 관찰된 최대 밀도임을 보여 준다. Llama-3.1-405B는 높은 절대 성능에도 불구하고 최대 밀도의 경계 아래에 위치한다.
1 Introduction
서론에서는 파라미터와 데이터 규모의 증가를 성능 향상과 연결한다. 모델 출력을 생성하는 연산인 추론에는 비용이 들기 때문에, 스마트폰 배포와 같은 응용에서 소형 모델을 개발할 동기가 생긴다. 추론 과정이 담긴 출력이 길어질수록 이러한 수요도 커진다. 모델 규모와 성능 또는 손실 사이에 적합한 관계식인 스케일링 법칙을 바탕으로, 기준 모델을 통해 성능과 파라미터 효율을 비교하는 방법을 제안한다.
1.1 Key Findings
핵심 발견은 오픈소스 사전학습 베이스 모델 29개에서 관찰한 최대 밀도의 추이에 관한 것이다. 구체적으로 저자들은 2024년 2월 1일에 공개된 MiniCPM-1-2.4B가 2023년 9월 27일에 공개된 Mistral-7B와 같거나 더 높은 성능을 낸다고 보고한다. 공개 시점은 넉 달 뒤이며, 파라미터 수는 약 35%에 불과하다.
- 저자들은 5가지 시사점을 논의한다. 동일한 성능에서의 추론 비용 감소, 알고리즘과 하드웨어 발전의 결합, ChatGPT 공개 이후의 밀도 증가 가속, 압축에 따른 밀도 감소 가능성, 밀도를 우선하는 학습이다.
- 가지치기(pruning)는 모델 구성 요소를 제거하며, 증류(distillation)는 더 큰 모델을 활용해 작은 모델을 학습한다. 논문의 압축 사례 비교에서는 이러한 방법이 역량 밀도를 일관되게 높이지는 않는다.
2 Density for Large Language Models
Density for Large Language Models에서는 유효 파라미터 수와 실제 파라미터 수의 비율을 정식화한다. 이를 구하려면 선택한 기준 학습 설정에서 파라미터 수가 다운스트림 성능, 즉 평가 과제의 점수로 어떻게 이어지는지 추정해야 한다.
2.1 Overall Framework and Definition
파라미터 수가 N_M이고 점수가 S_M인 대상 모델 M에 대해, 기준 관계식 S = f(N)은 유효 크기를 N̂(S_M) = f⁻¹(S_M)로 정의한다. 역량 밀도는 ρ(M) = N̂(S_M)/N_M이다. 따라서 밀도가 1보다 크면 기준 설정에서 대상 모델과 같은 성능을 내는 데 더 많은 파라미터가 필요하다는 뜻이다.
- 저자들은 f를 파라미터에서 손실을 추정하는 단계와 손실에서 성능을 추정하는 단계로 나눈다. 전자의 관계는 작은 기준 모델로 구하고, 후자의 관계는 더 충분히 학습한 모델로 구한다. 작은 규모의 스케일링 실험에서는 과제 점수가 무작위 추측 수준에 그치는 경우가 많기 때문이다.
2.2 Loss Estimation
Loss Estimation에서는 조건부 정답 손실 L = −log P(answer | instruction)을 \(\mathcal{L}=aN^{-\alpha}+bD^{-\beta}\)로 모델링한다. N은 파라미터 수, D는 학습 토큰 수이며, a, α, b, β는 적합으로 구한 계수다. 이는 전체 입출력 시퀀스의 가능도가 아니라 과제 입력이 주어졌을 때 정답의 가능도를 측정한다.
- 객관식 과제에서는 질문과 모든 선택지를 입력에 포함하며, 분석에 이어 정답 레이블을 제시하는 출력에 대해 손실을 계산한다. 복잡한 문제에서는 추론 단계와 정답을 평가 대상 출력에 포함한다.
- 이러한 유형의 과제에서는 대부분의 데이터셋이 추론 단계를 제공하지 않으므로, GPT-4o로 모든 테스트 사례의 추론 단계를 생성한다. 생성한 설명은 손실 추정 절차의 일부로 사용한다.
2.3 Performance Estimation
Performance Estimation에서는 조건부 손실과 과제 점수 사이에 시그모이드, 즉 S자형 관계인 S = c/[1 + e^(−γ(L − l))] + d를 적합한다. 적합으로 구한 계수 c, γ, l, d는 곡선의 척도, 전이 구간, 점수의 상한과 하한을 결정한다.
- 충분히 학습한 오픈소스 모델을 사용해, 손실 추정에 사용한 작은 모델보다 넓은 성능 범위를 관찰한다. 저자들은 벤치마크 점수의 범위가 제한되어 있다는 점, 손실이 높을 때 성능이 무작위 추측 수준이라는 점, 손실이 낮을 때 성능이 상한에 가까워진다는 점을 근거로 시그모이드를 선택한다.
2.4 Density
Density에서는 기준 학습 데이터를 D = D₀ = 1T tokens로 고정하고 적합한 함수 2개를 역산한다. 여기서 1T는 1 trillion을 뜻한다. 이렇게 구한 유효 파라미터 수는 해당 토큰 예산으로 학습해 대상 점수에 도달할 기준 모델의 크기다. 대상 모델 자체의 학습량을 나타내지는 않는다.
- 식 (4)는 L̂(S_M) = l − (1/γ) ln[c/(S_M − d) − 1]과 N̂(S_M) = [(L̂(S_M) − bD₀^(−β))/a]^(−1/α)를 제시한다. 이 유효 크기를 실제 크기로 나누면 밀도가 된다.
- 파라미터 수가 같을 때 더 높은 성능을 내는 모델은 적합한 기준 관계식에서 더 높은 밀도를 얻는다.
3 Density Evolution
Density Evolution에서는 시간에 따른 모델 공개 이력에 이 지표를 적용한다. 하위 절에서는 평가 절차를 정하고, 손실에서 성능을 추정하는 방법을 점검한 뒤, 과거 최대 밀도의 추세를 적합한다.
3.1 Evaluation Settings
벤치마크 5개는 영어 지식 중심 과제를 위한 MMLU, 어려운 논리 추론을 위한 BBH, 수학 추론을 위한 MATH, 코딩을 위한 HumanEval과 MBPP다. 평가 조건은 각각 5-shot, 3-shot, 4-shot, 0-shot, 3-shot이며, shot 수는 프롬프트에 포함한 시연 예시의 수다. BBH, MATH, MBPP에는 중간 추론 단계를 제공하는 chain-of-thought prompting을 사용한다.
- 작은 기준 모델은 MiniCPM-3-4B의 학습 말뭉치를 사용한다. 학습률 스케줄은 준비 단계, 일정 학습률 유지 단계, 감쇠 단계로 구성한다.
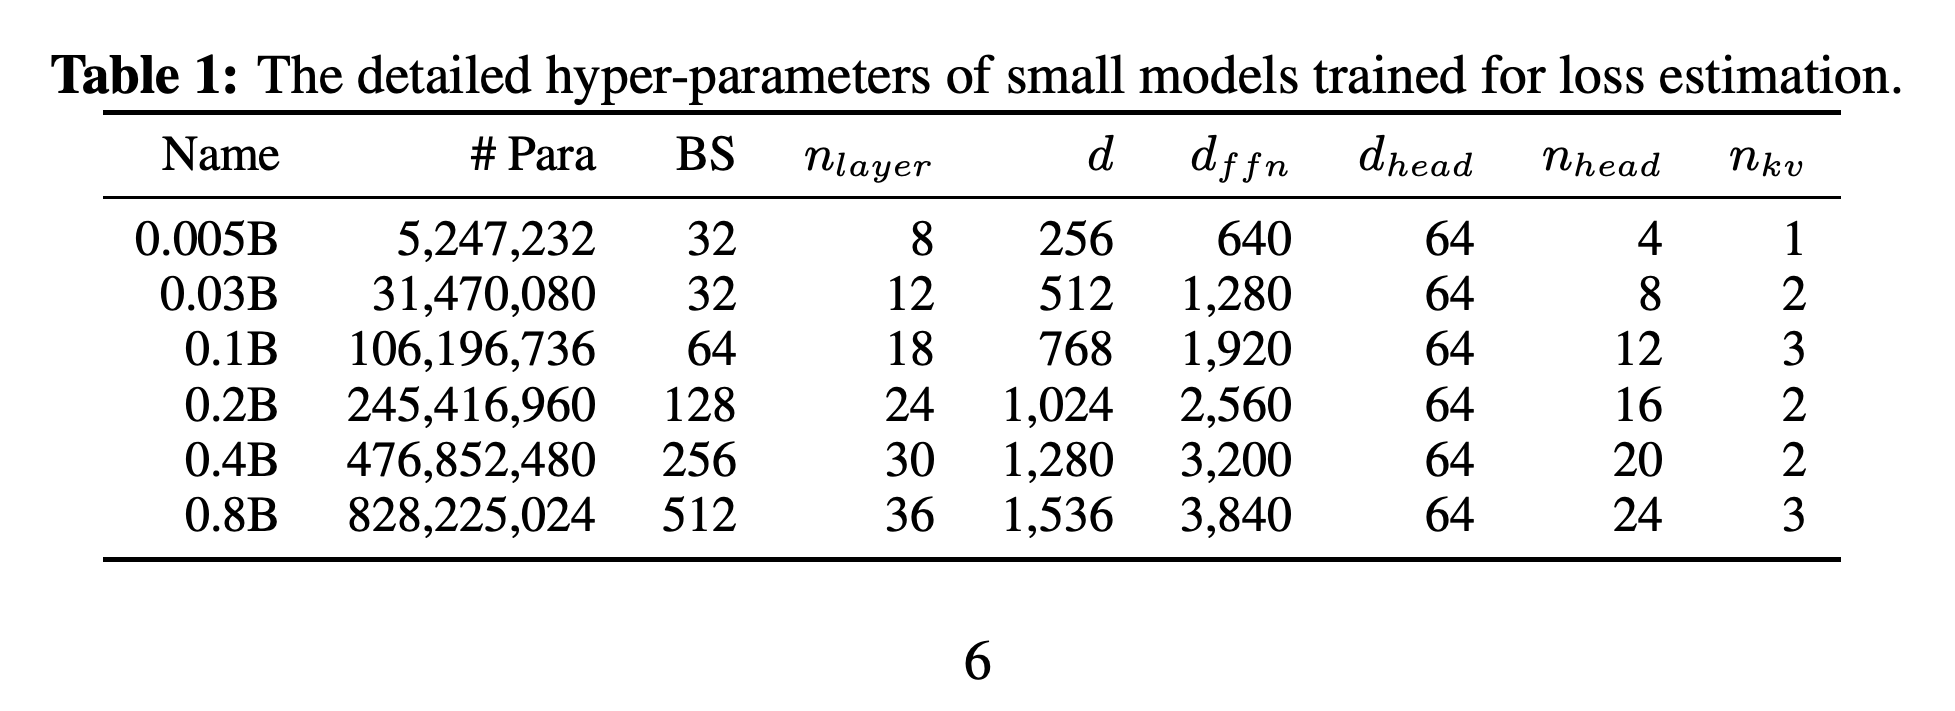
- Table 1에는 파라미터 수가 5,247,232에서 828,225,024에 이르는 기준 모델 6개가 제시되어 있다. 학습량은 {10, 15, 20, 30, 40, 60} × N 토큰이며, N은 파라미터 수다.
- 손실과 성능의 관계를 적합할 때는 파라미터 수가 0.5 billion에서 수백억에 이르는 MiniCPM-3 모델과 중간 학습 체크포인트를 사용한다. 이 모델들은 기준 모델과 어휘집, 즉 모델이 사용할 수 있는 토큰 집합을 공유한다.
- 시간에 따른 분석에서는 모델 기술 보고서의 점수를 우선 사용한다. 분석 대상은 후속 지도 미세조정, 즉 레이블이 있는 예시를 이용한 학습이나 선호 학습을 거치지 않은 사전학습 베이스 모델이다. 저자들은 사전학습 중에도 벤치마크와 유사한 데이터가 포함될 수 있음을 인정한다.
손실 추정용 모델 6개의 파라미터 수는 5,247,232에서 828,225,024까지이며, 손실 스케일링을 적합하는 데 필요한 소형 모델 관측값을 제공한다. 깊이는 8층에서 36층으로, 은닉 차원은 256에서 1,536으로 증가한다. 따라서 기준 모델 계열에서는 파라미터 수와 함께 아키텍처의 차원도 달라진다.
3.2 Loss and Performance Estimation Results
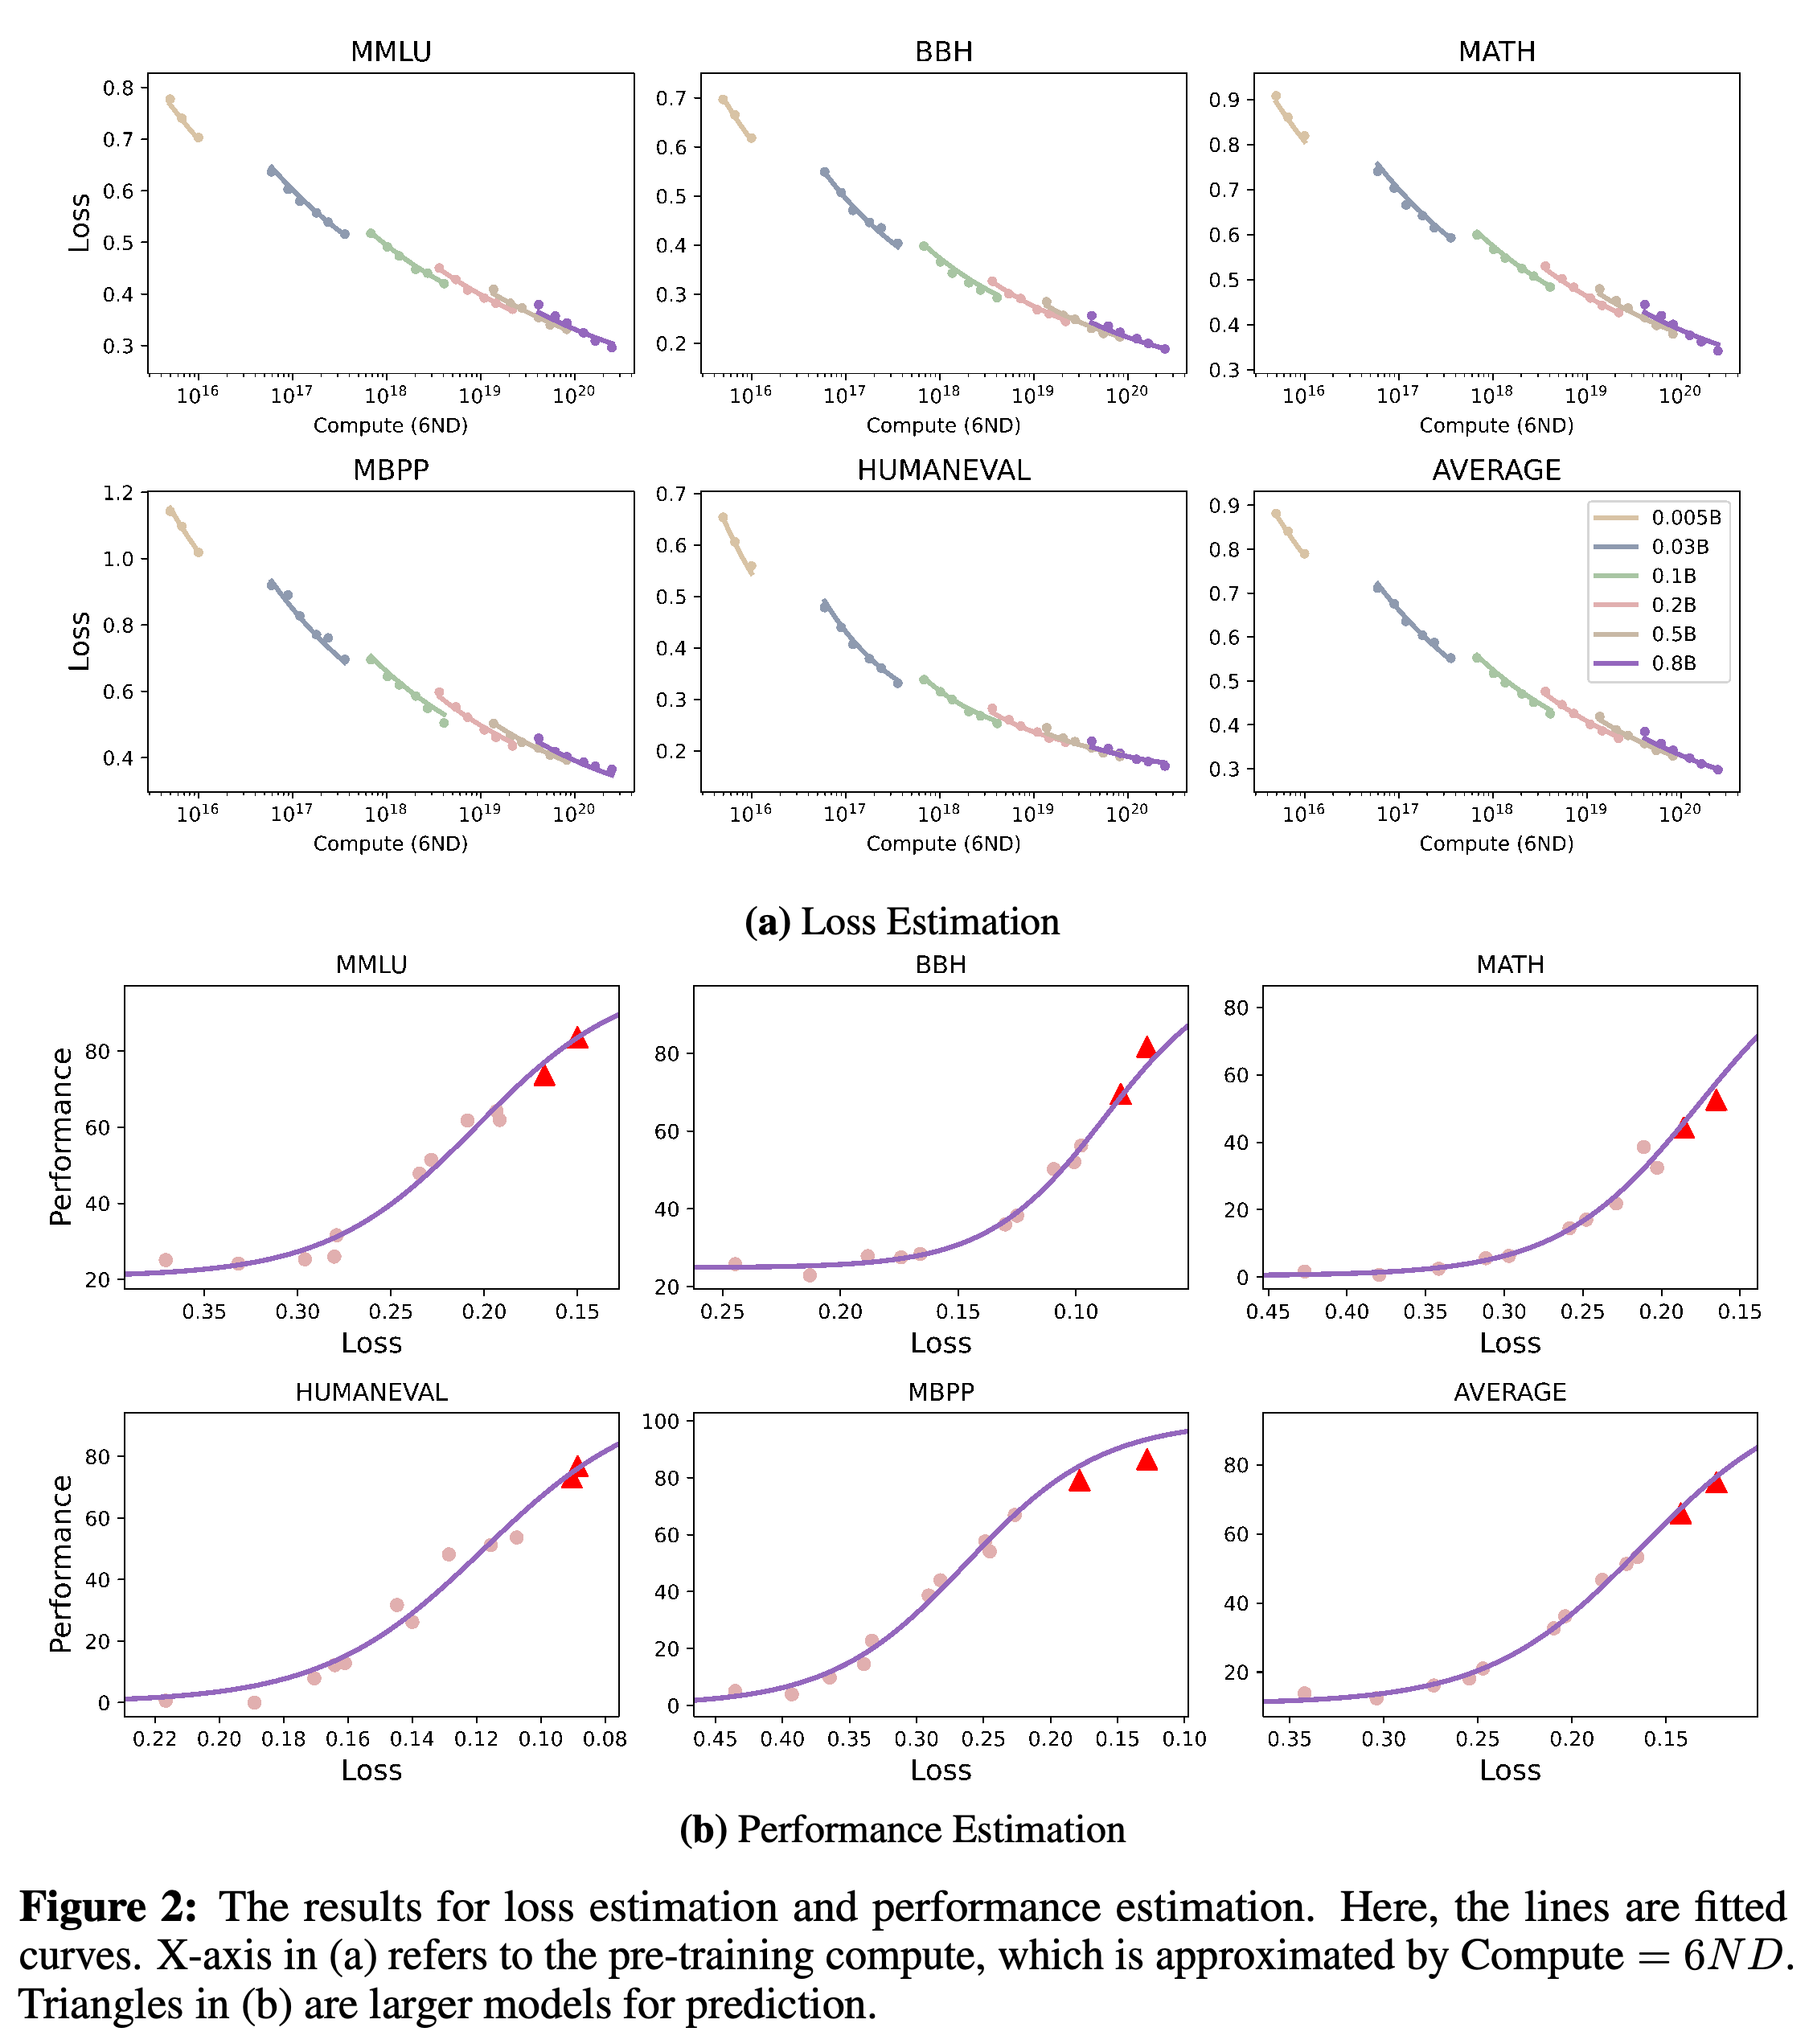
Figure 2에서는 사전학습 연산량이 증가할수록 조건부 손실이 줄어들고, 손실과 과제 성능 사이에는 S자형 관계가 나타난다. 적합 범위를 벗어난 예측을 시험하기 위해, 저자들은 파라미터 수가 4B 미만인 모델로 손실과 성능의 관계를 적합하고 수백억 규모의 모델 2개를 예측용으로 남겨 둔다.
- 적합에서 제외한 관측점은 대체로 적합 곡선을 따른다. 이는 평가한 모델 계열 안에서 추정 결과를 시각적으로 점검하는 근거가 된다. 이 절에서는 수치로 계산한 예측 오차나 불확실성 구간을 보고하지 않는다.
- 본문에서는 다운스트림 과제 3개를 언급하지만, Figure 2에는 선택한 벤치마크 5개와 그 평균이 모두 표시되어 있다.
위쪽 패널은 모델 크기와 학습량에 따라 손실이 감소하는 모습을 보여 준다. 연산량은 6ND로 근사하며, N은 파라미터 수, D는 학습 토큰 수다. 아래쪽 패널은 시그모이드 적합 곡선과 관측 점수를 비교한다. 빨간 삼각형은 파라미터 수가 4B 미만인 적합 범위를 벗어난 예측을 위해 남겨 둔 대형 모델 2개를 나타낸다. 수치로 계산한 예측 오차는 제공하지 않는다.
3.3 Densing Law
Densing Law에서는 관찰한 모델 밀도의 상단 경계를 \(\ln(\rho_{\max})=A\cdot t+B\)로 적합한다. t는 Llama-1 공개 이후 경과한 일수다. 본문에서는 A ≈ 0.0073, ln(2)/A ≈ 95일, R² = 0.912로 보고한다. Highlights에서는 약 3.3개월과 R² ≈ 0.93을 보고한다.
- 저자들은 Llama-1의 밀도가 0.1 미만이며, Gemma-2-9B와 MiniCPM-3-4B 같은 최근 모델은 약 3에 도달한다고 서술한다. 다만 Figure 1에서 Gemma-2-9B는 그보다 낮게 표시되어 있다. 저자들은 밀도 증가를 더 크고 더 잘 정제된 학습 데이터셋과 연결하며, Llama-1의 1.4 trillion 토큰과 Llama-3의 15 trillion 토큰을 예로 든다.
- Llama-3.1-405B는 벤치마크의 절대 성능이 높아도 밀도가 가장 높지는 않을 수 있음을 보여 준다. 적합한 법칙은 모든 모델 각각의 변화가 아니라, 공개된 모델들에서 관찰한 최대 밀도를 설명한다.
3.4 Corollaries of Densing Law
Corollaries of Densing Law에서는 시사점 5가지를 전개하며, 그중 여러 항목에 대해 관측 자료를 비교한다. 여기에는 과거 응용 프로그래밍 인터페이스(API) 가격, ChatGPT 공개 전후의 MMLU만을 사용한 비교, 압축 모델과 더 큰 원본 모델의 밀도 비교가 포함된다.
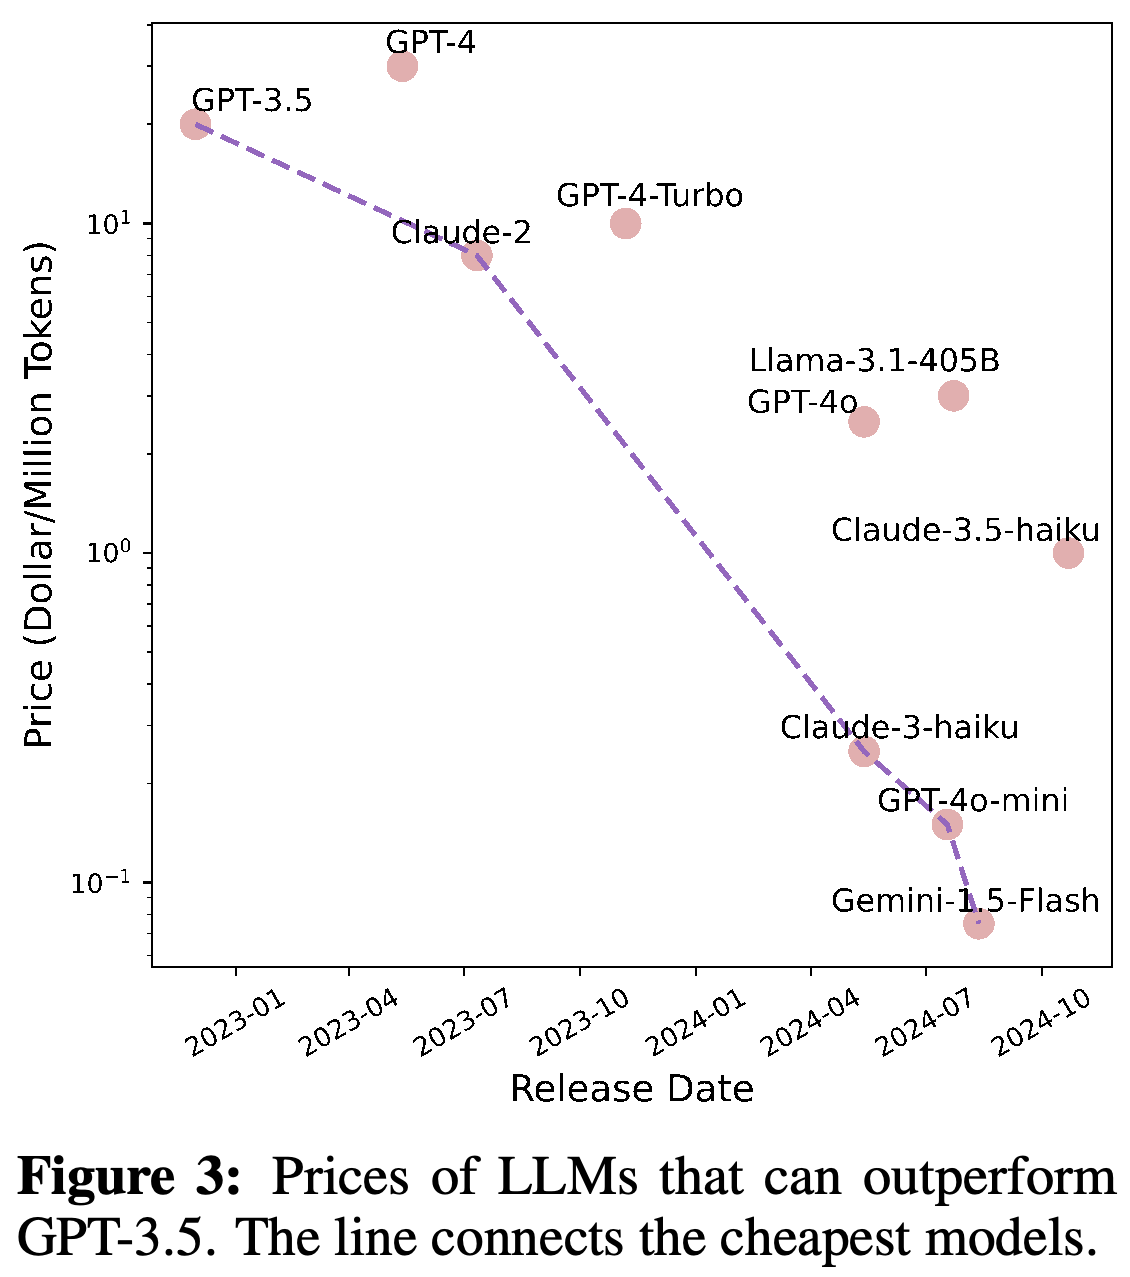
- Inference Costs Decrease Exponentially에서는 2022 12월 GPT-3.5의 100만 토큰당 $20과 2024 8월 Gemini-1.5-Flash의 $0.075를 비교한다. 가격 감소 배율은 266.7이며, 가격이 절반으로 줄어드는 데 약 2.6개월이 걸렸다고 보고한다. 가격 하락의 원인으로 소형 모델과 추론 인프라 개선이라는 2가지 요인을 함께 제시한다.
- Densing Law Meets Moore’s Law에서 Moore’s Law는 칩 구성 요소의 밀도가 증가하는 현상을 뜻한다. 저자들은 모델 밀도 증가에, 같은 가격의 칩 연산량이 2.1년마다 2배가 된다는 인용 자료를 결합한다. 이를 통해 최대 유효 모델 크기가 88일마다 2배가 된다고 추산한다. 이는 도출한 시사점이며 배포 실험의 결과는 아니다.
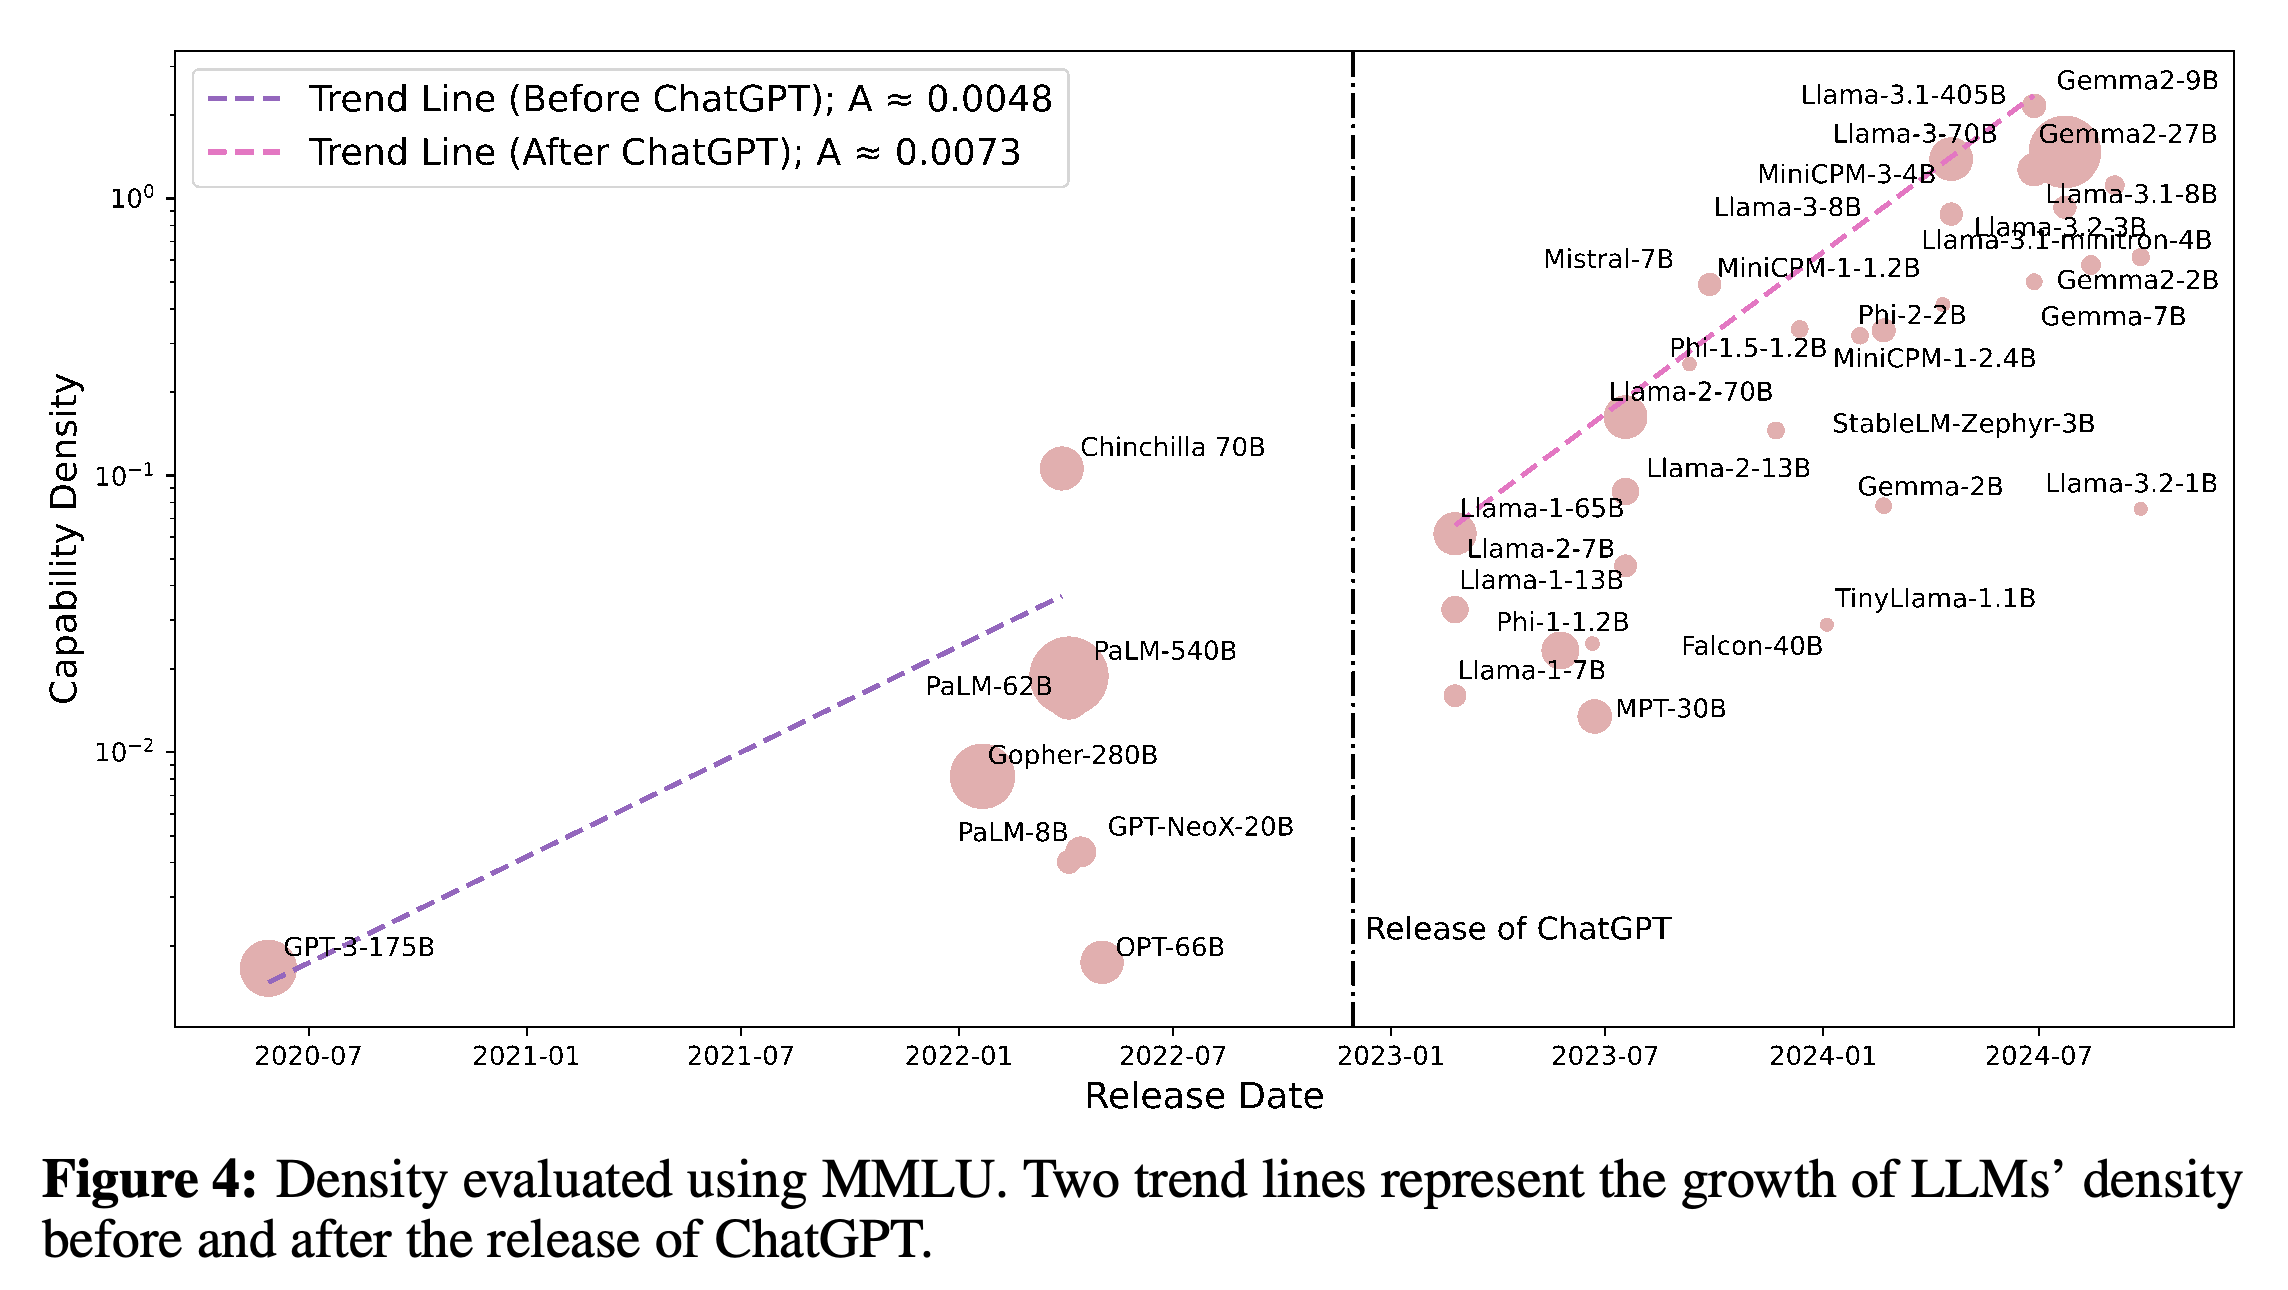
- Density Growth Accelerated after ChatGPT’s Release에서는 MMLU 기반 추세의 기울기가 ChatGPT 이전 A ≈ 0.0048에서 이후 A ≈ 0.0073으로 증가했으며, 성장 속도가 약 50% 빨라졌다고 서술한다. 투자와 오픈소스 모델의 접근성 향상을 가능한 설명으로 제안하지만, 이 비교가 인과관계를 입증하지는 않는다.
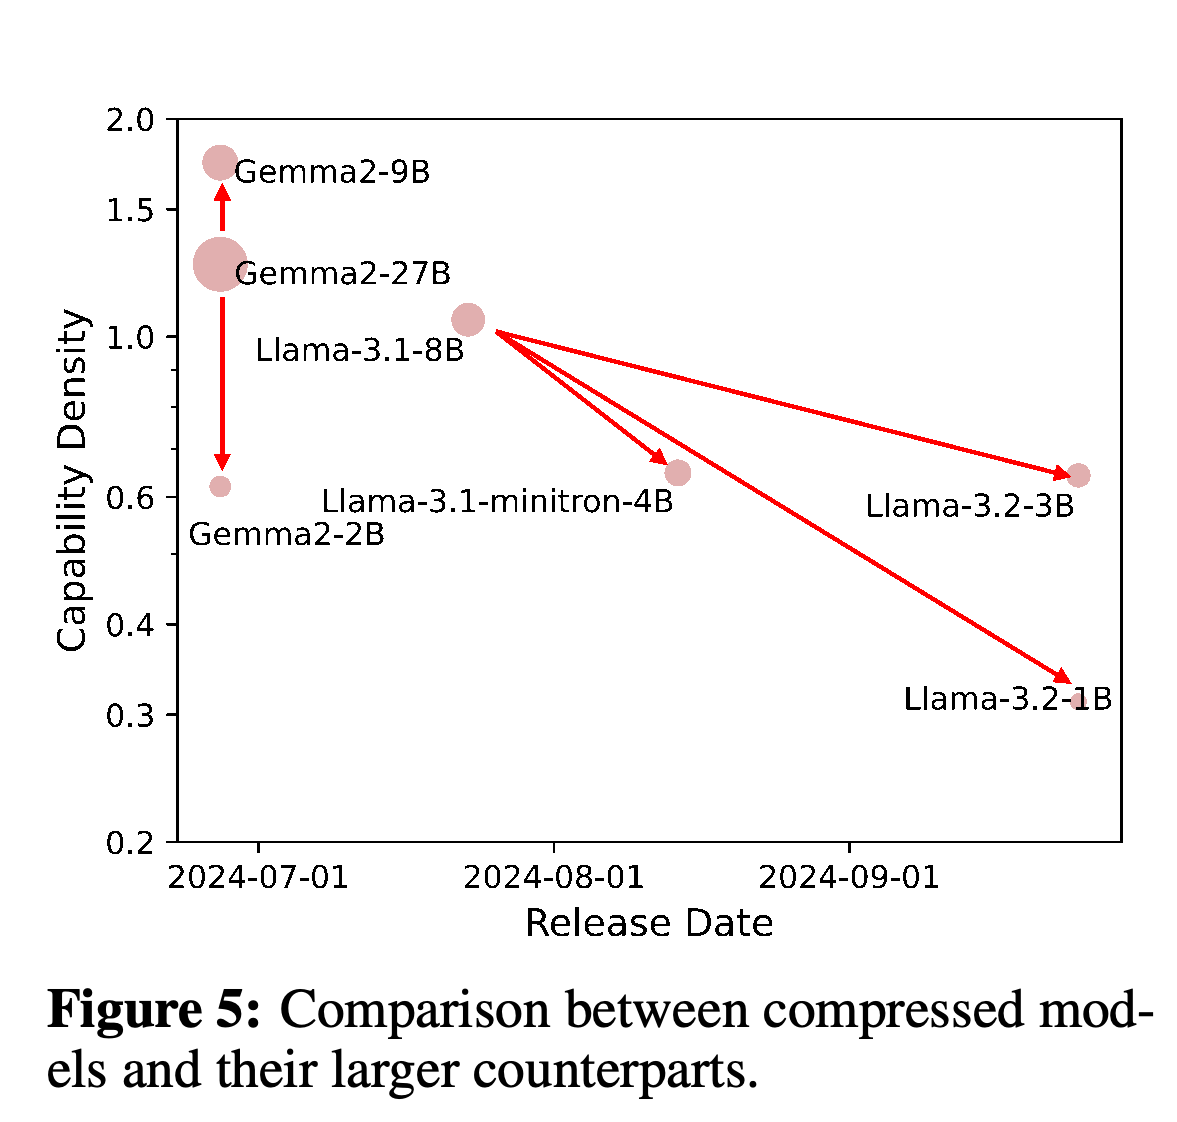
- Efficient Compression ≠ Density Improvement에서는 표시된 압축 모델 중 Gemma-2-9B만 더 큰 원본 모델보다 밀도가 높다. Gemma-2-2B, Llama-3.1-minitron-4B, Llama-3.2-3B/1B는 각각의 원본 모델보다 밀도가 낮다. 압축 단계의 학습 부족을 가능한 설명으로 제시한다.
- Towards Density-Optimal Training - Green Scaling Law에서는 학습 비용과 짧은 모델 수명을 고려하면서 파라미터당 성능을 높여야 한다고 주장한다. 논문은 새로운 밀도 최적 학습 알고리즘을 구현하거나 평가하지 않는다.
최저가 모델들을 연결한 경계는 뚜렷하게 하락하지만, 다른 모델의 가격은 그보다 높게 유지된다. 이는 GPT-3.5보다 성능이 높다고 설명된 모델들에서 최저 공시 가격이 하락했음을 보여 준다. 가격에는 서빙 인프라와 상업적 결정도 반영되며, 밀도 지표는 이러한 요인을 측정하지 않는다.
MMLU만 사용해 이전 모델들까지 비교 범위를 넓히면, 적합한 기울기는 ChatGPT 이전 약 0.0048, 이후 0.0073이다. 이후 구간의 더 가파른 선은 보고된 시간적 연관성을 뒷받침하지만, ChatGPT 공개 시점을 기준으로 관측값을 나누는 것만으로 가속의 원인을 입증할 수는 없다.
Gemma-2-9B는 Gemma-2-27B보다 밀도가 높지만, Gemma-2-2B와 그림에 제시된 압축 Llama 모델은 더 큰 원본 모델보다 밀도가 낮다. 이 비교 사례들은 파라미터 수가 감소하는 비율보다 유효 파라미터 수가 감소하는 비율이 더 클 수 있음을 보여 준다.
4 Discussion
Discussion에서는 모델 역량을 포괄적으로 측정할 수 없으므로, 밀도가 선택한 기준과 벤치마크 구성에 상대적인 값임을 강조한다. 또한 특정 학습 설정 안의 스케일링 관계와, 잇따라 공개된 모델들의 역사적 추세를 나타내는 Densing Law를 구분한다.
- 학습 데이터가 충분한 조건에서 저자들은 손실의 스케일링을 L = AN^(−α)로 논의하며, 데이터, 알고리즘, 아키텍처의 개선이 α를 높일 수 있다고 제안한다. 과거 모델을 분석한 결과에서는 α의 변화를 추정하거나 각 요인의 기여를 분리하지 않는다.
- 저자들은 지속적인 투자를 근거로 지수적 성장이 이어질 것으로 기대하지만, 그 지속 기간은 확인되지 않았다. 자율적으로 연구하는 모델이 밀도 증가를 가속할 수 있다는 추가 제안도 추측에 해당한다.
- 기존 벤치마크의 변별력이 낮아짐에 따라 평가 데이터셋을 갱신해야 한다고 논의한다.
5 Limitations and Future Directions
Limitations and Future Directions에서는 벤치마크의 평가 범위와 공정성을 핵심 한계로 제시한다. 좁은 과제 구성으로는 변화하는 역량을 놓칠 수 있고, 오염이나 벤치마크를 겨냥한 최적화는 점수를 부풀릴 수 있다. 저자들은 새로 구성한 평가 데이터셋, 여러 유형의 데이터를 처리하는 멀티모달 모델로의 확장, 추론 연산량에 기반한 밀도 지표를 제안한다.
- 제안한 Inference Densing Law는 유효 추론 FLOPs와 실제 추론 FLOPs의 비율을 비교 지표로 삼는다. FLOPs는 부동소수점 연산 횟수를 뜻한다. 이를 통해 파라미터 수만으로는 반영하지 못하는 추가 추론 연산을 고려할 수 있다.
- 멀티모달 밀도와 추론 연산량 밀도는 향후 연구 방향으로 남아 있다. 보고한 경험 법칙은 선택한 프롬프팅 조건에서 평가한 언어 모델의 베이스 체크포인트에 관한 것이다.
6 Conclusion
결론에서는 크기가 다른 모델의 학습 품질을 비교하는 방법으로 역량 밀도를 다시 제시한다. 또한 2023년 이후 공개된 오픈소스 베이스 모델에서 약 3개월마다 밀도가 2배가 되는 추세를 요약한다. 현재 성능을 절반의 파라미터로 달성한다는 전망은 선택한 기준과 벤치마크 조건에서 관찰한 최대 밀도 추세를 외삽한 것이다.
부록
- 제공된 16페이지 PDF에는 부록이 없으며, 13–16페이지에는 References가 실려 있다.
짧은 생각
과제 성능을 동등한 기준 모델의 크기로 표현하면, 정확도를 파라미터 수로 바로 나누는 것보다 비교 기준이 명확해진다. Figure 2는 추정기의 적합 범위를 벗어난 예측을 제한적으로 점검한다. 다만 논문은 최대 밀도 성장률의 불확실성을 분석하지 않으며, Highlights와 본문의 적합 통계도 서로 다르다. 약 3개월마다 밀도가 2배가 된다는 결과는 이 평가 설정에서 관찰한 과거의 추세다. 기준 선택, 오염된 점수, 벤치마크 평가 범위의 변화에 따라 밀도 추정값이 달라질 수 있다. API 가격 비교와 압축 사례는 선택한 모델에 관한 관찰을 뒷받침한다. 배포 비용이나 압축 효과에 관한 일반적인 주장을 하려면 하드웨어, 서빙 구현, 추론 길이를 추가로 측정해야 한다.