


Detecting Twenty-thousand Classes using Image-level Supervision 요약 설명
07 Jan 2022 | Paper Review Open-Vocabulary Object Detection Weak Supervision Image-Level Supervision목차
이번 글에서는 Detecting Twenty-thousand Classes using Image-level Supervision 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 1월 7일(Arxiv)
- Zhou, Xingyi, Girdhar, Rohit, Joulin, Armand, Krähenbühl, Philipp, Misra, Ishan.
- Meta AI, The University of Texas at Austin
- 논문 3판 (2022년 7월 29일 개정, 이 글은 개정판을 기준으로 작성했다)
요약
- 객체 탐지기는 비용이 많이 드는 bounding box 주석이 있는 범주의 수에 제약을 받는다. 학습에 box label을 사용하지 않은 클래스를 평가하는 open-vocabulary LVIS에서 Detic은 box 감독학습 베이스라인보다 mask mean average precision(mAP)을 전체 클래스에서 2.4점, novel 클래스에서 8.3점 높였다. Mask mAP는 개별 객체 마스크의 평균 정밀도를 클래스와 겹침 기준별로 평균한 지표다.
- Detic은 box label이 있는 이미지와 이미지 수준 클래스 label이 있는 이미지를 함께 학습하고, 후자의 label을 가장 큰 후보 영역에 적용한다. ImageNet의 전체 21K 클래스를 사용하면 미세조정 없이 Objects365와 OpenImages에 전이되지만, 대상 데이터셋의 box label로 학습한 모델보다는 성능이 낮다.
1 Introduction
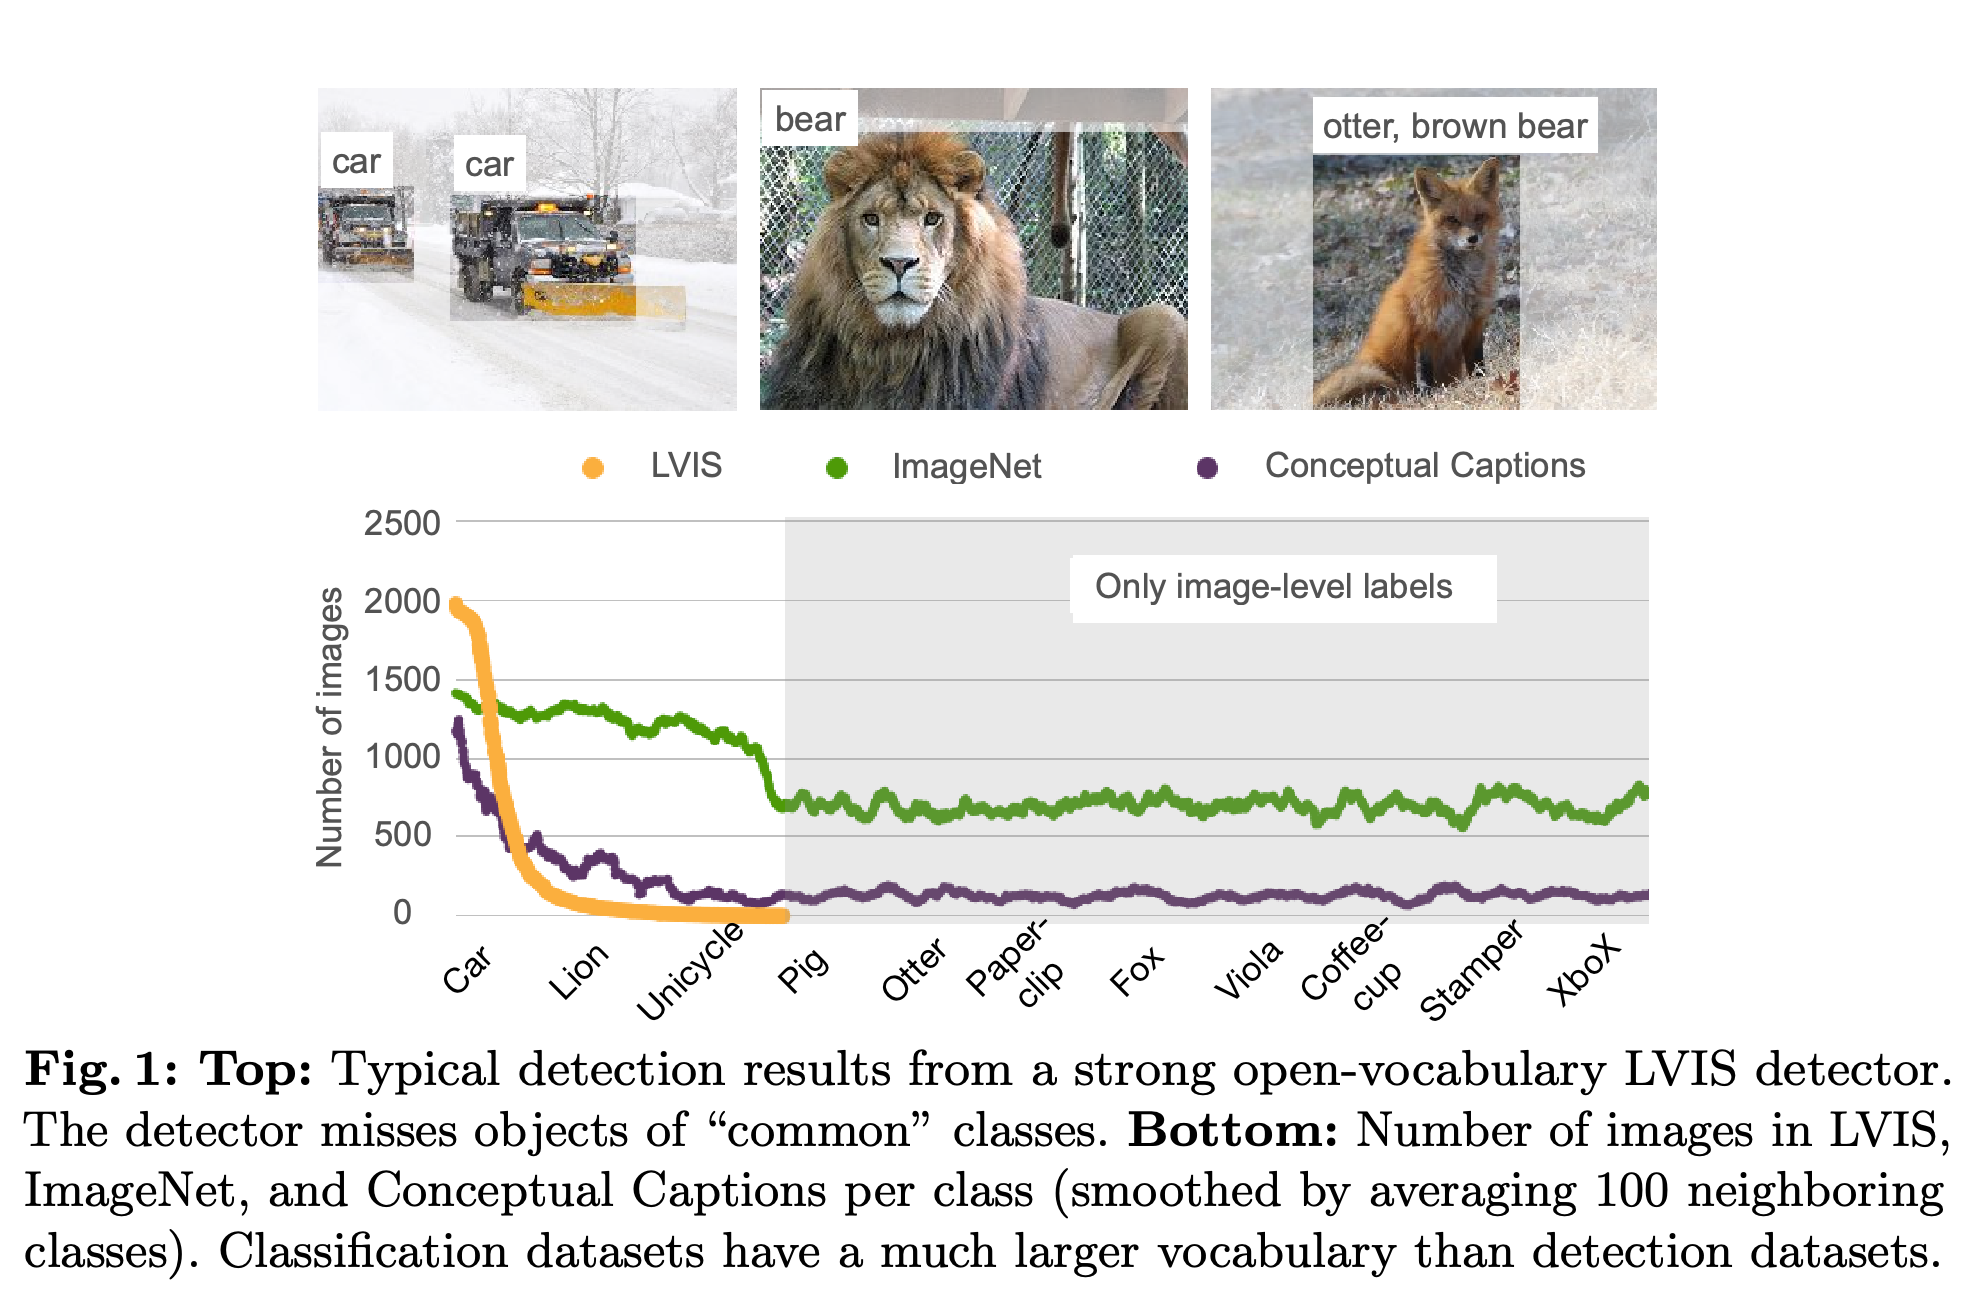
객체 탐지는 객체의 box를 찾는 localization과 객체의 이름을 정하는 classification을 결합한다. Detic은 이 작업을 분리한다. 후보 객체 box를 생성하는 region proposal network가 box label이 있는 학습 데이터에 없는 클래스도 상당수 찾아낼 수 있으므로, classification 데이터로 탐지기의 어휘를 확장할 수 있다.
예시는 흔한 객체를 놓치거나 잘못 분류한 사례를 보여준다. 클래스별 빈도 곡선은 이미지 분류 데이터가 탐지 주석보다 더 넓은 어휘를 제공할 수 있는 이유를 보여준다.
2 Related Work
Weakly supervised object detection은 이미지 수준 label을 사용하며, semi-supervised 방식은 box label도 사용한다. 기존 방법은 예측한 클래스 점수를 이용해 이미지 label을 후보 box에 할당하는 경우가 많다. Detic은 고정된 방식으로 label을 할당하고 이미지 label이 있는 데이터로 함께 학습한다.
3 Preliminaries
탐지 학습 데이터에는 box와 클래스가 있고, 분류 데이터에는 이미지 수준 클래스가 있다. 각 데이터셋과 테스트에 사용되는 클래스 목록은 서로 다를 수 있다. 이 논문은 open-vocabulary detection을 위해 비전-언어 모델 CLIP에서 얻은 고정된 클래스 이름 임베딩을 분류기 가중치로 사용한다 [17, 42]. CLIP에 대해서는 CLIP 논문 리뷰(Learning Transferable Visual Models From Natural Language Supervision) 글을 참조하라.
4 Detic: Detector with Image Classes
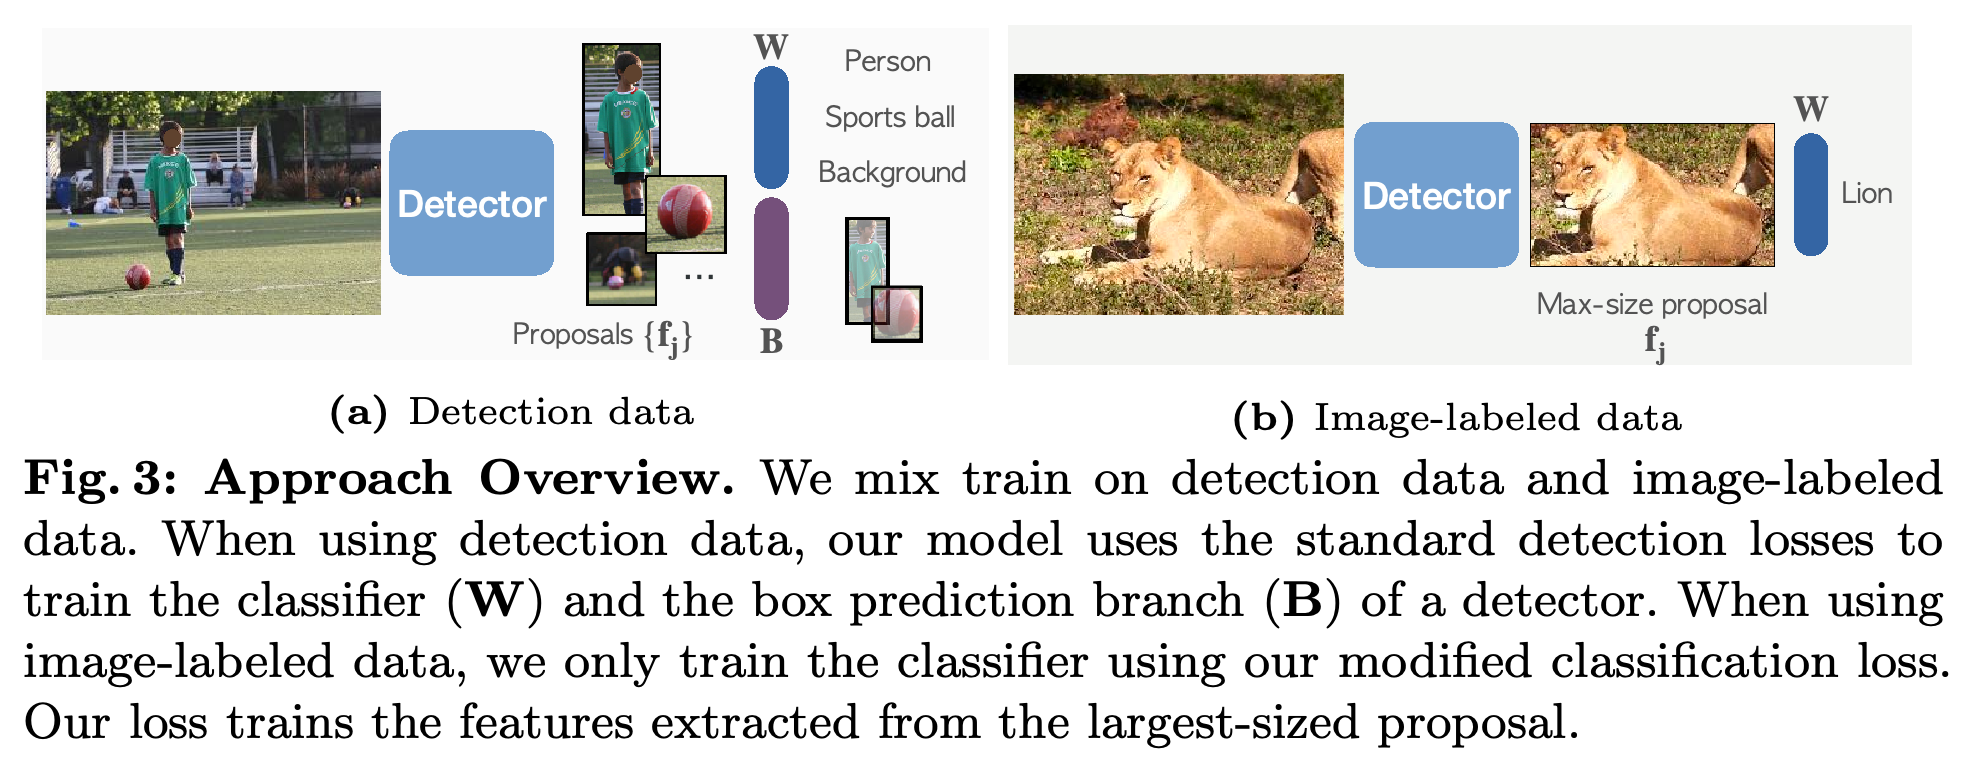
Detic은 box label이 있는 이미지에 표준 proposal, box regression, classification 손실을 적용한다. 이미지 label이 있는 이미지에는 가장 큰 proposal box의 특징에 binary cross-entropy 분류 손실을 적용한다. 분류 매개변수는 데이터셋 간에 공유하고 이 손실의 가중치는 λ = 0.1로 설정한다. 전체 이미지와 objectness가 가장 높은 proposal도 대안으로 사용할 수 있다.
학습 경로 2개는 localization 손실에 box label이 필요한 반면, 이미지 label은 가장 큰 후보 영역을 통해 분류기를 업데이트한다는 점을 보여준다.
5 Experiments
LVIS에는 클래스 1,203개와 이미지 100K개가 있다. Open-vocabulary 분할에서는 희소 클래스 337개의 주석을 제거하고 base 클래스 866개를 유지한다. 대부분의 실험에는 LVIS 클래스 997개를 포함하는 이미지 1.2M개의 ImageNet 부분집합 IN-L이나, 클래스 992개를 포함하도록 이미지 1.5M개를 선별한 캡션 데이터셋 Conceptual Captions(CC)를 사용한다. LVIS 결과는 mask mAP로 평가한다.
5.1 Implementation details
주요 베이스라인은 ResNet50 백본을 사용하는 CenterNet2 탐지기, ImageNet-21K 사전학습, CLIP 분류기, 640×640 탐지 입력과 약 48 LVIS epoch에 해당하는 4× 학습 스케줄을 사용한다. 공동 학습에서는 탐지와 분류 미니배치를 1:1 비율로 샘플링하고, 이미지 label이 있는 입력에 320×320 크기를 사용하며, 수렴한 베이스라인을 4× 스케줄만큼 추가 미세조정한다.
5.2 Prediction-based vs non-prediction-based methods
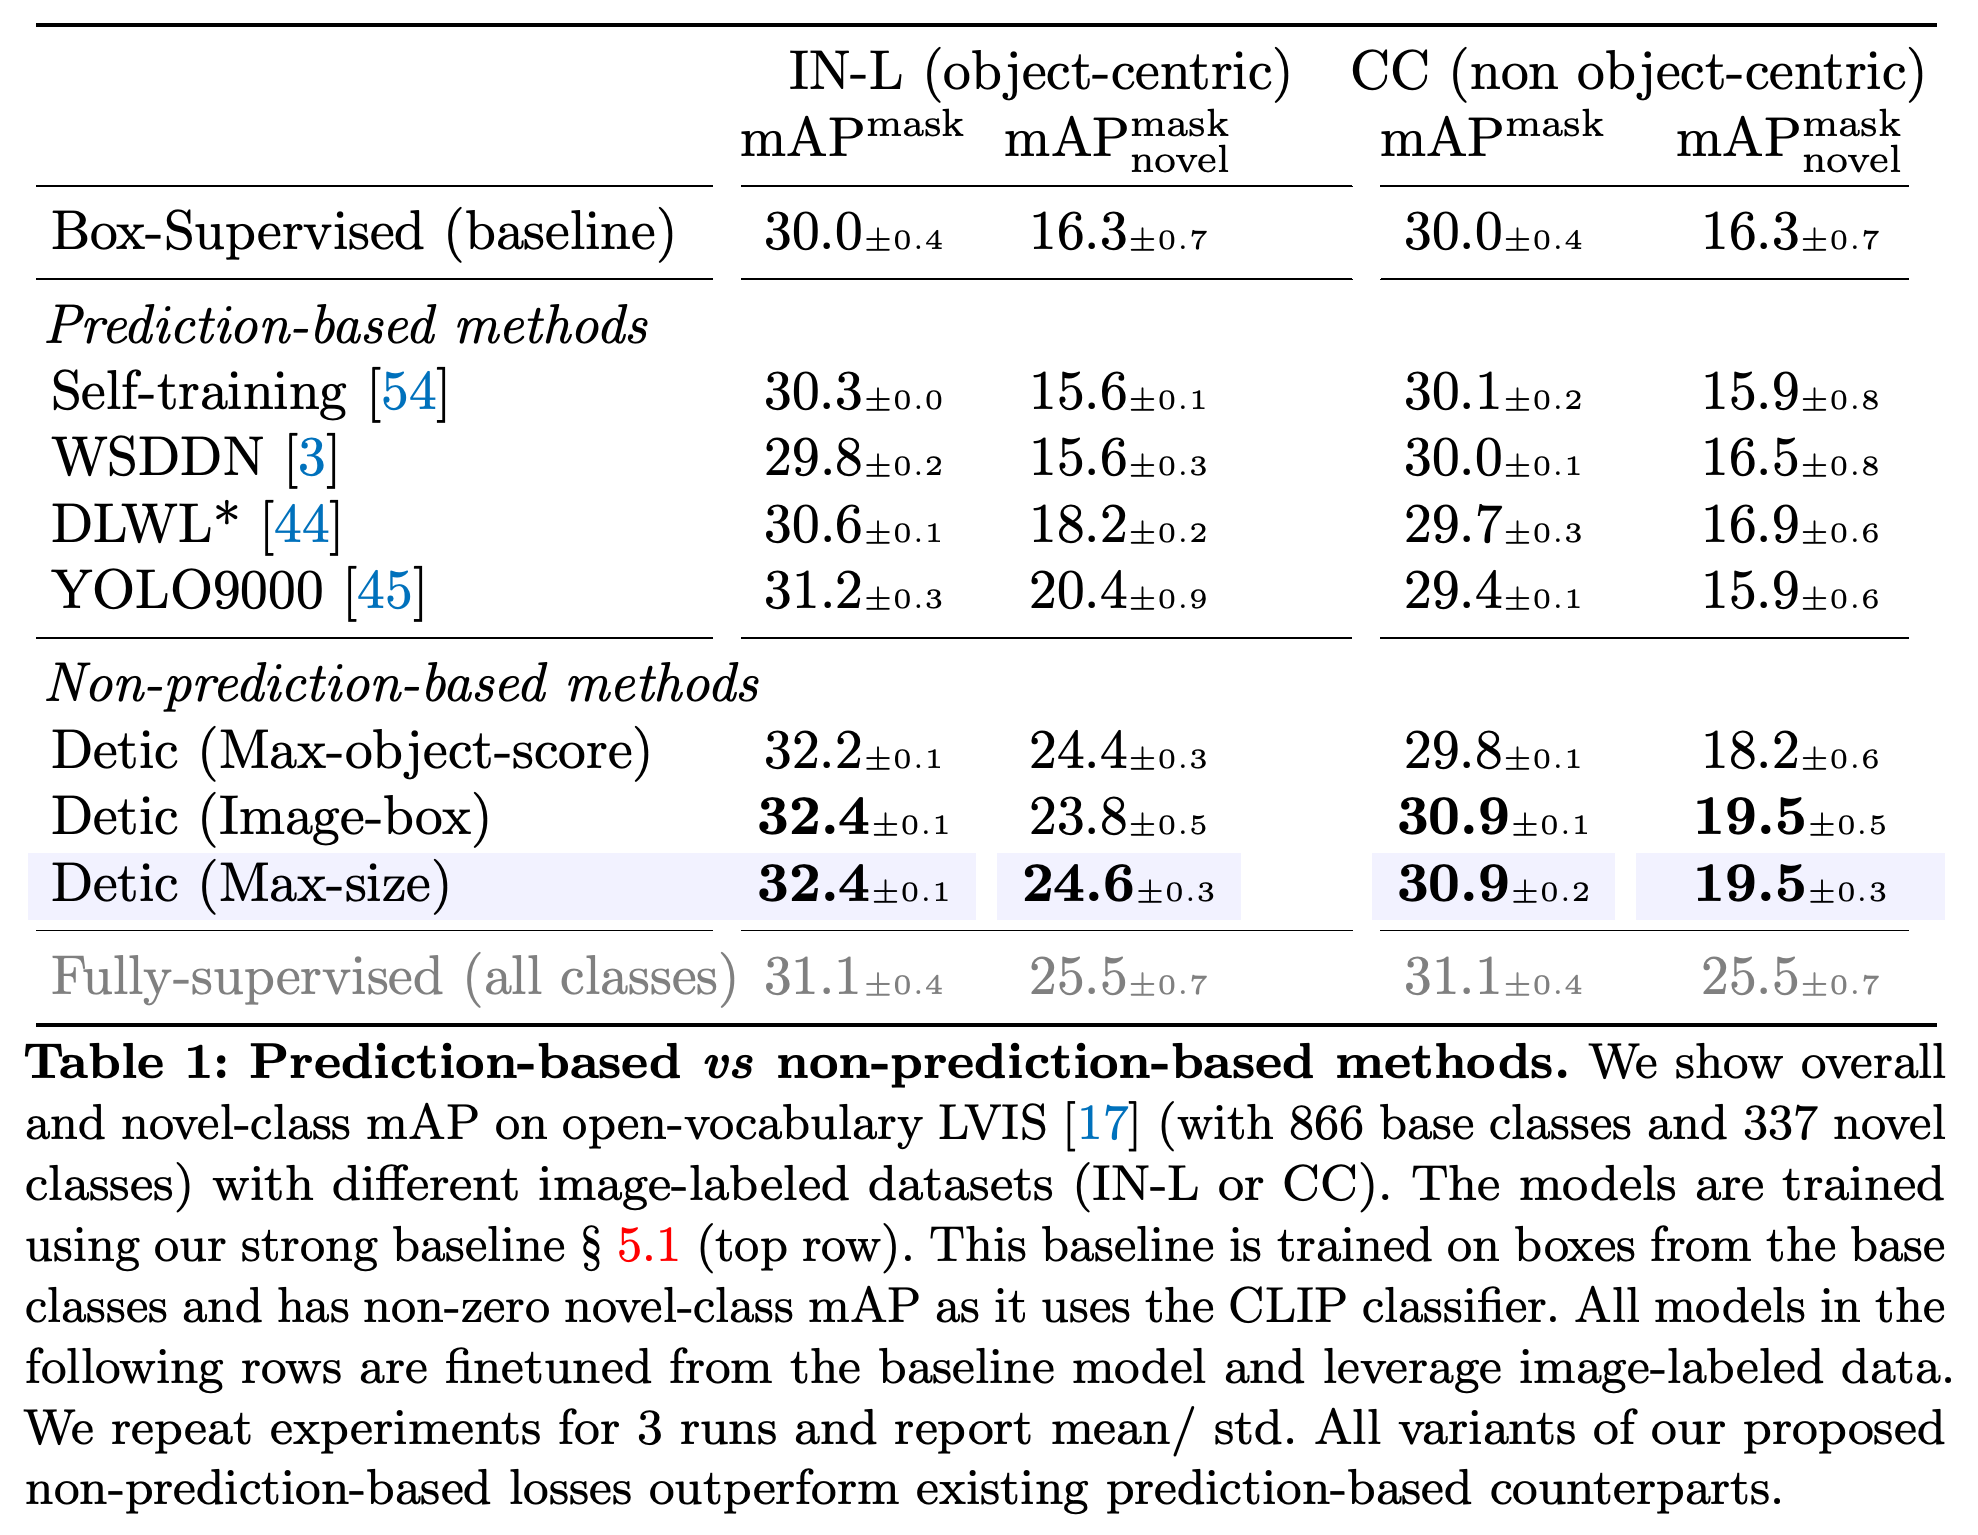
Open-vocabulary LVIS에서 3회 실행한 결과, max-size는 IN-L을 사용할 때 전체 mask mAP 32.4, novel mask mAP 24.6을 기록했다. 가장 성능이 좋은 prediction-based 대안은 각각 31.2와 20.4를 기록했다. CC를 사용하면 max-size는 30.9와 19.5를 기록했고, novel 클래스 성능이 가장 좋은 prediction-based 방법은 29.7과 16.9를 기록했다.
3회 실행한 비교에서 IN-L을 사용한 max-size는 베이스라인보다 novel 클래스 성능이 8.3점 높았지만, 해당 클래스에서 모든 클래스의 box로 감독학습한 모델보다는 약간 낮았다.
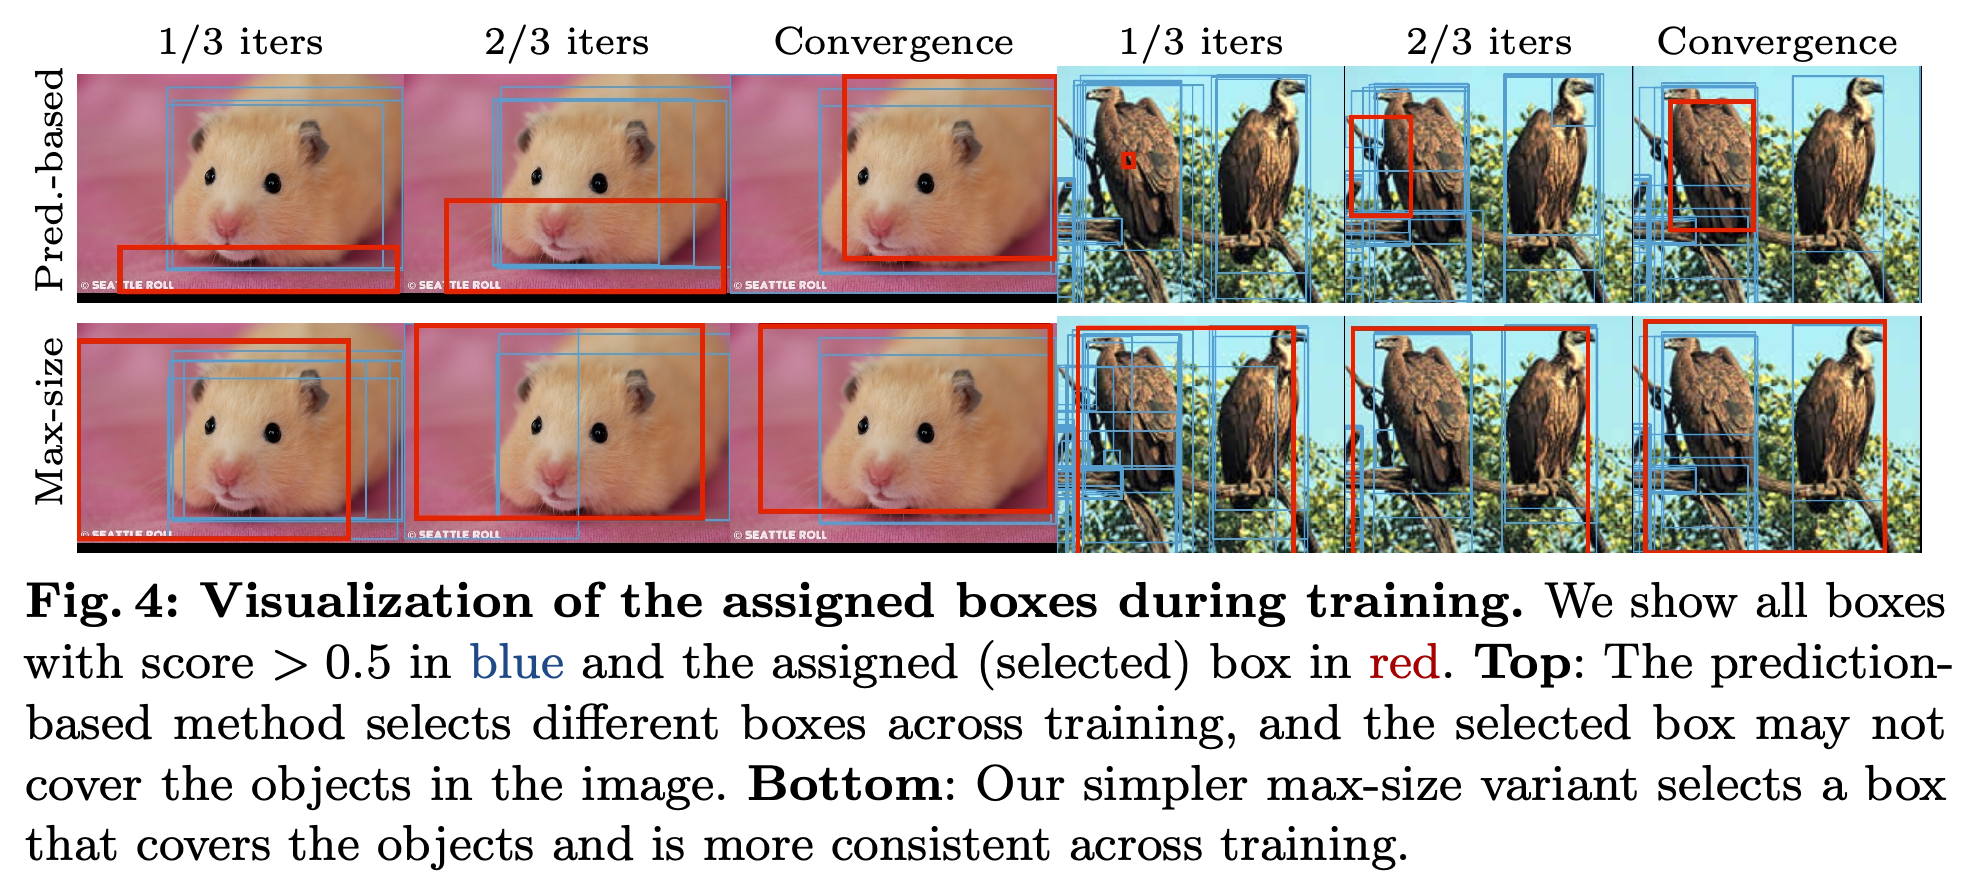
주석이 있는 IN-L 부분집합에서 가장 큰 proposal의 포함률은 92.8%, prediction-based 할당의 포함률은 69.0%였다. 포함률은 정답 box 면적의 절반보다 큰 부분이 할당된 proposal과 겹치는 객체의 비율이다. 다만 선택된 영역이 객체보다 너무 넓거나 작은 객체를 놓칠 수 있으며, 포함률만으로 최종 성능을 완전히 설명할 수는 없다.
학습 중 여러 시점에서 선택된 box를 보면 max-size box가 예측으로 선택한 box보다 안정적으로 유지되며, 제안한 할당 방식의 특성을 보여준다.
5.3 Comparison with a fully-supervised detector
IN-L을 사용한 Detic은 novel 클래스의 box label 없이 전체 mask mAP 32.4, novel mask mAP 24.6을 기록했다. 모든 클래스의 box label로 학습한 탐지기는 각각 31.1과 25.5를 기록했다. 이 비교에서 Detic의 novel 클래스 성능은 완전 감독학습보다 0.9점 낮다.
5.4 Comparison with the state-of-the-art
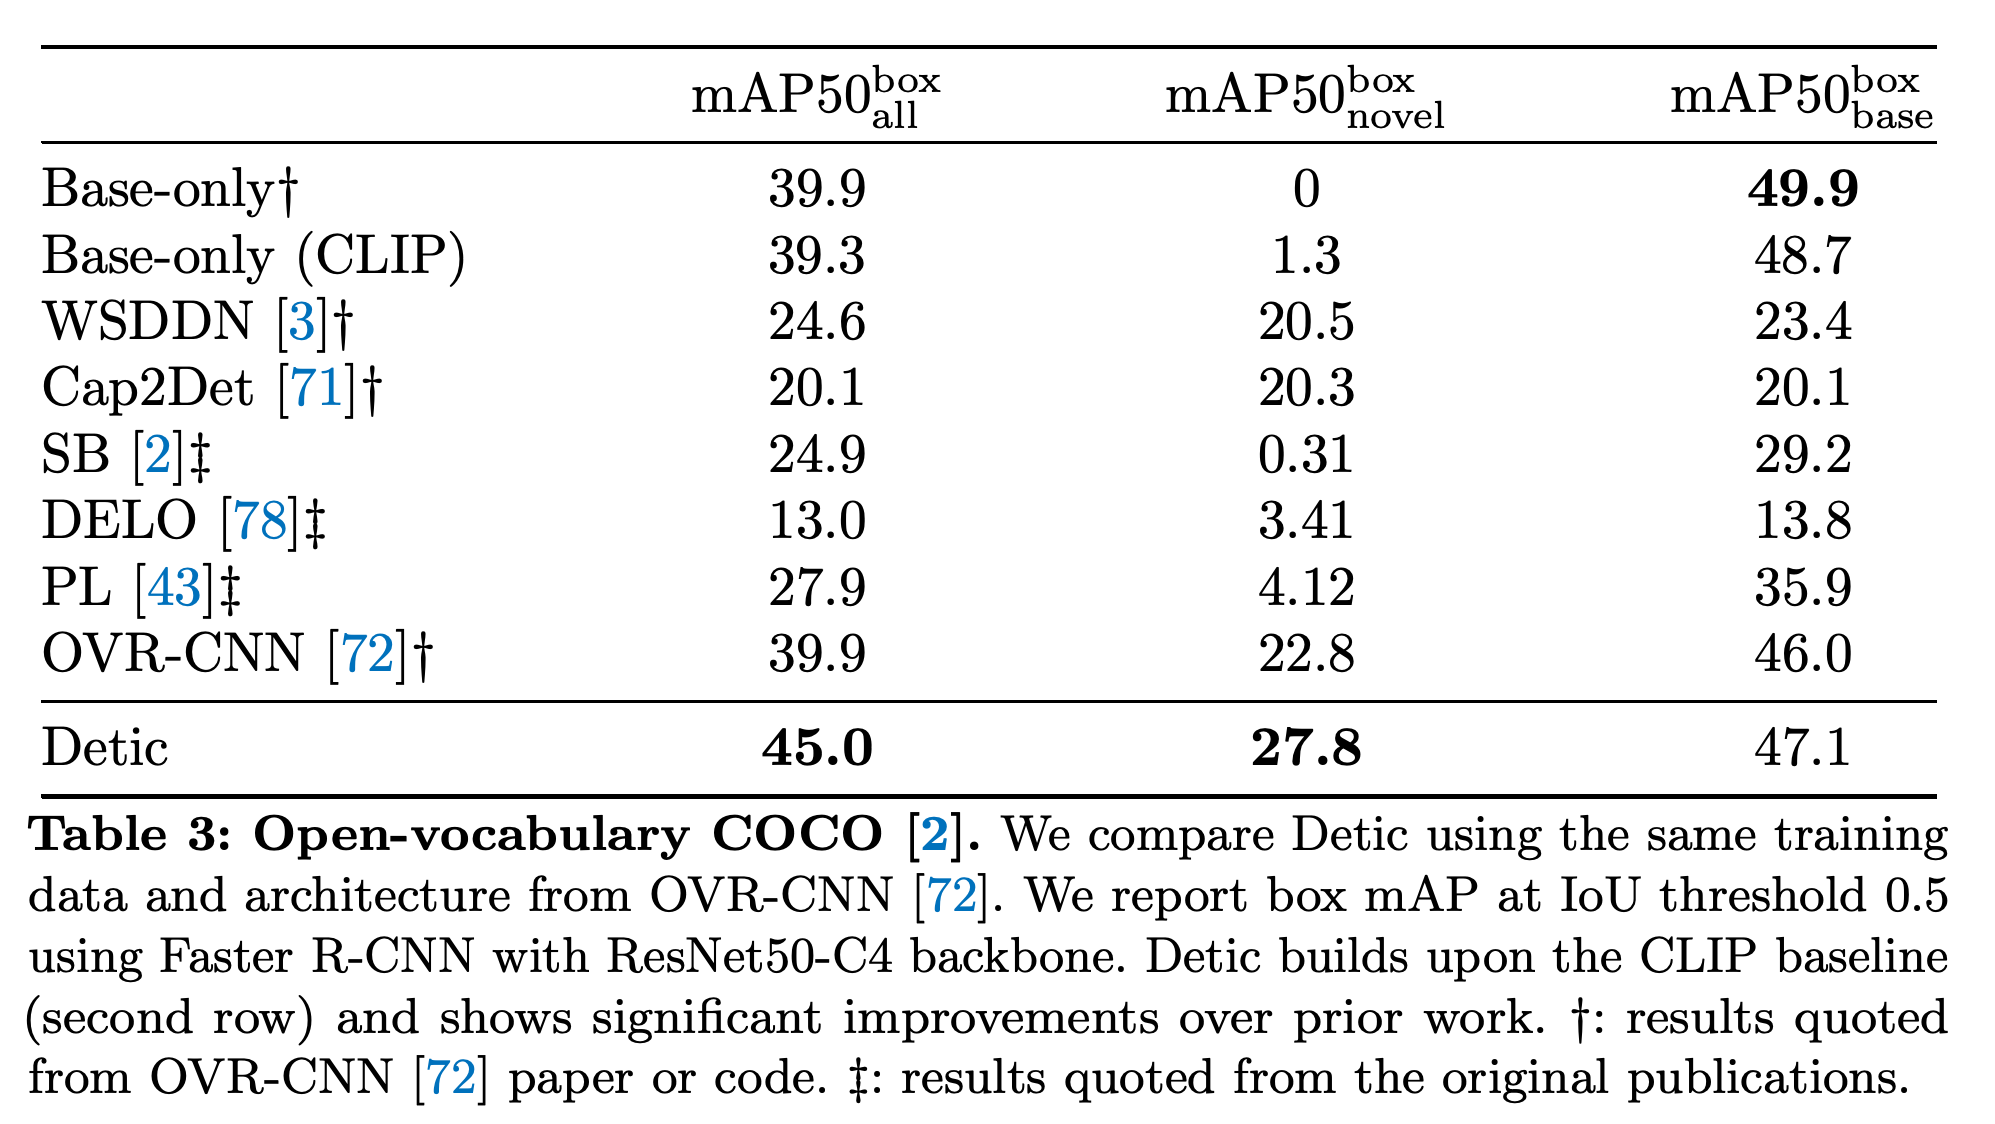
ViLD의 Mask R-CNN-ResNet50 설정에서 Detic은 전체 mask mAP 26.8, novel mask mAP 17.8을 기록했고, ViLD-ensemble은 각각 25.5와 16.6을 기록했다 [17]. Open-vocabulary COCO에서 OVR-CNN의 아키텍처와 데이터를 사용한 Detic은 intersection-over-union 임계값 0.5에서 전체 box mAP 45.0, novel box mAP 27.8을 기록했고, OVR-CNN은 각각 39.9와 22.8을 기록했다 [72]. Intersection over union은 예측 box와 정답 box가 겹치는 정도를 측정한다.
Detic은 OVR-CNN과 같은 아키텍처와 학습 데이터를 사용해 novel 클래스 box mAP50을 22.8에서 27.8로 높였다.
5.5 Detecting 21K classes across datasets without finetuning
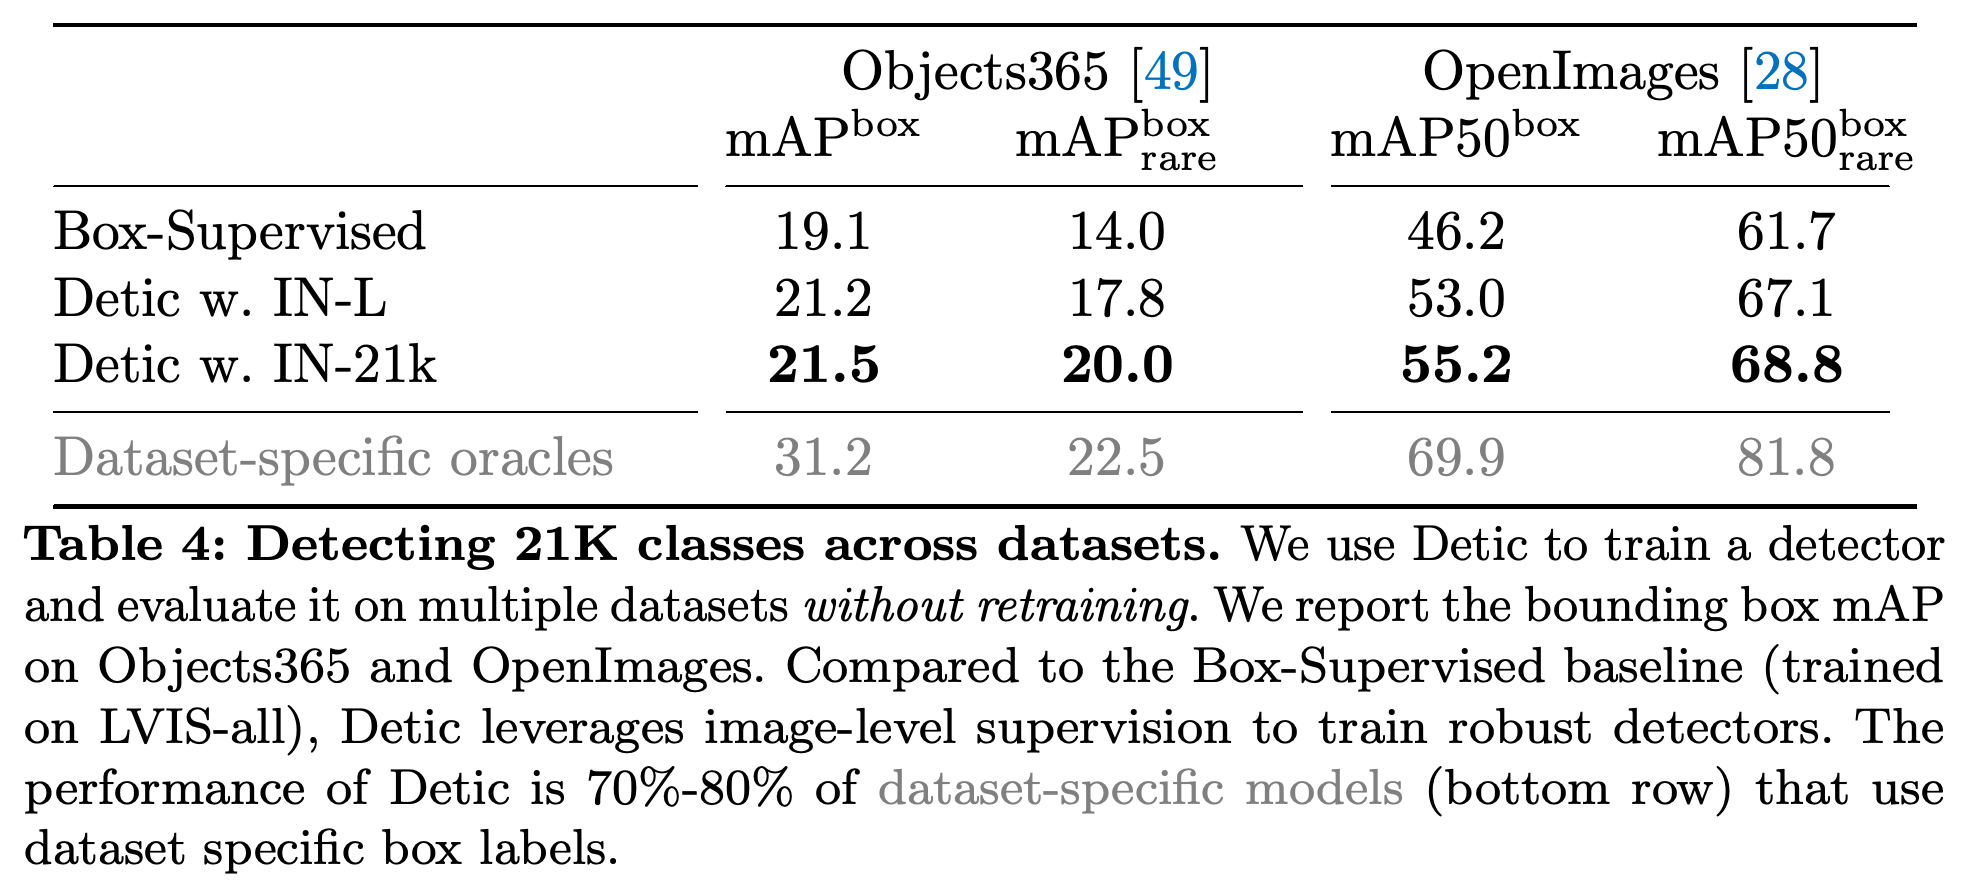
21K 클래스 Swin-B 모델은 classification 손실을 계산할 때 반복마다 클래스 50개를 샘플링한다. 대상 데이터셋에서 미세조정하지 않은 상태로 Objects365에서 box mAP 21.5, OpenImages에서 box mAP50 55.2를 기록했다. Box 감독학습 베이스라인은 각각 19.1과 46.2를, 데이터셋별 oracle은 31.2와 69.9를 기록했다.
전체 ImageNet-21K 감독학습은 더 작은 IN-L 부분집합보다 전이 성능을 높이지만, 대상 데이터셋 oracle 모델 2개의 성능에는 미치지 못한다.
5.6 Ablation studies
Detic은 실험한 모든 분류기의 성능을 개선했다. 학습된 분류기에서는 novel mask mAP가 0에서 17.4로 올랐고, CLIP은 24.9를 기록했다. 이미지 수준 공동 학습은 ImageNet-1K 사전학습에서 novel mAP를 8.1점, ImageNet-21K 사전학습에서 8.5점 높였다.
5.7 The standard LVIS benchmark
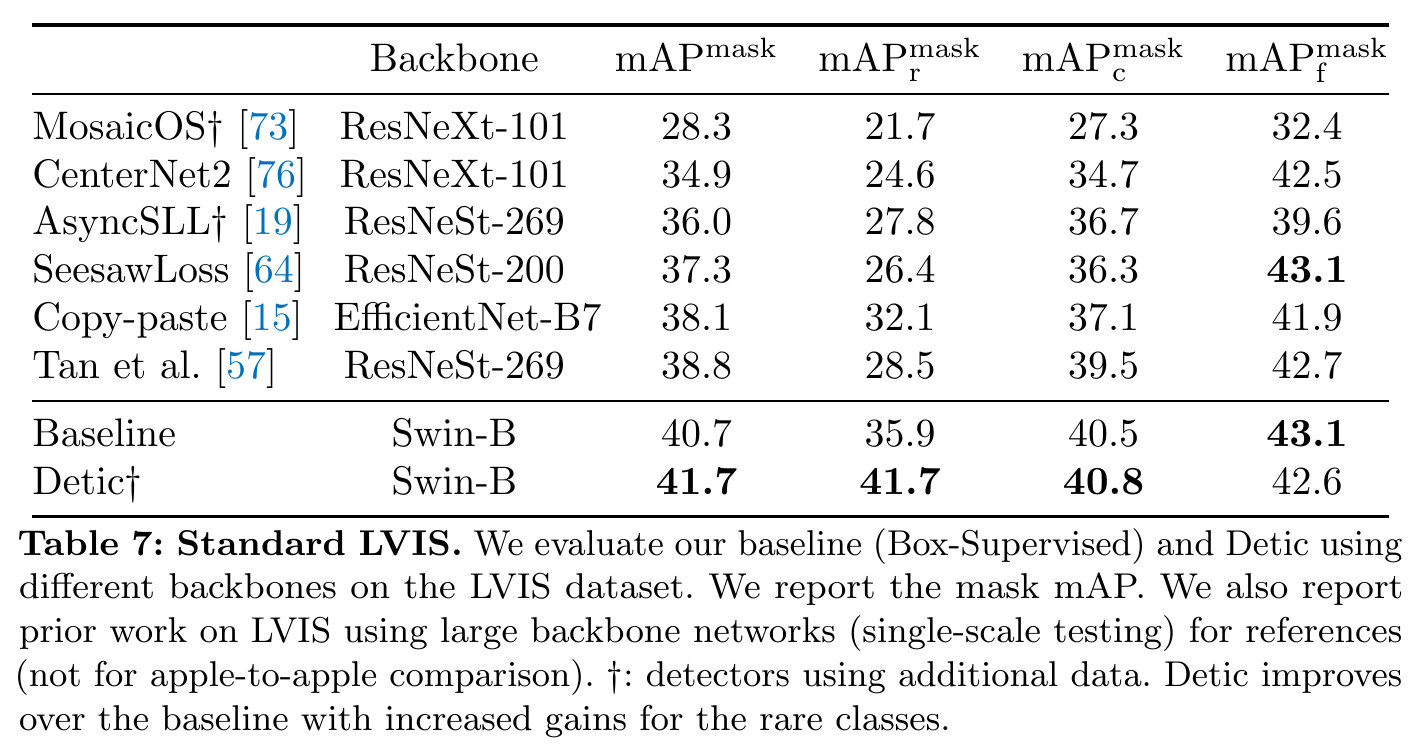
모든 클래스의 box와 mask label에 IN-L 이미지 label을 추가한 표준 LVIS 실험에서 Swin-B Detic 모델은 전체 및 희소 클래스 mask mAP 모두 41.7을 기록했다. 동일한 조건의 베이스라인은 전체 40.7, 희소 클래스 35.9를 기록했다. 빈도가 높은 클래스의 mAP는 43.1에서 42.6으로 낮아졌다.
동일한 조건의 Swin-B 비교에서 전체 성능 향상은 희소 클래스에 집중되며, 빈도가 높은 클래스의 성능은 소폭 하락한다.
6 Limitations and Conclusions
이 방법은 모든 이미지 label을 같은 영역에 할당하며 데이터셋 전체의 통계를 사용하지 않는다. 저자들은 극단적인 도메인에서 open-vocabulary 일반화가 보장되지 않는다고도 밝힌다.
부록
- A Region proposal quality: Proposal 1,000개와 intersection-over-union 0.5에서 희소 클래스 재현율은 해당 클래스의 학습 주석이 없을 때 78.5, 있을 때 79.7이다.
- B Direct captions supervision: 이미지 label 손실과 캡션 손실을 결합하면 LVIS에서 novel mask mAP 21.3, COCO에서 novel box mAP50 27.8을 기록해 각 손실을 단독으로 사용한 결과를 넘는다.
- C LVIS baseline details: Federated Loss, CenterNet2, 데이터 증강, CLIP 분류와 ImageNet-21K 사전학습은 31.5 mask mAP baseline에 기여했으며, detectron2 베이스라인은 22.4를 기록했다.
- D Resolution change for classification data: 이미지 입력 크기를 640에서 320으로 줄이면 IN-L 결과가 약 1점 개선되지만 CC에는 영향이 거의 없다.
- E Prediction-based losses implementation details: 비교 대상에는 가중 proposal 점수, 가장 높은 예측 클래스 점수, 원래의 bootstrapping 단계를 제외한 단순화된 군집 손실인 DLWL*가 포함된다 [3, 44, 45].
- F More comparison between prediction-based and non-prediction-based methods: 더 좋은 백본과 희소 클래스 주석을 사용하면 max-size의 성능 우위가 줄어든다. 포함률과 할당의 일관성만으로는 최종 정확도를 예측할 수 없다.
- G ViLD baseline details: 재현한 Mask R-CNN-ResNet50-FPN 설정에서는 1024×1024 크기로 처음부터 학습한 뒤 ImageNet 데이터를 사용해 max-size 손실로 미세조정한다.
- H Open-vocabulary COCO benchmark details: 이 분할은 base 클래스 48개와 novel 클래스 17개를 사용한다. 평가에는 모든 COCO 검증 이미지를 포함하며, 동일한 조건의 Faster R-CNN 설정은 800×1333 입력을 사용한다.
- I Compare to MosaicOS [73]: MosaicOS의 베이스라인 설정에서 학습된 분류기를 사용하는 Detic은 전체 mask mAP 25.1, 희소 클래스 mask mAP 18.6을 기록했다. MosaicOS는 각각 24.5와 18.3을 기록했다.
- J Generalization to Deformable-DETR.: 가장 큰 예측 query에 이미지 수준 감독학습을 적용하면 box mAP가 31.7에서 32.5로, 희소 클래스 box mAP가 21.4에서 26.2로 오른다.
- K Improvements breakdown to classes: 성능 향상은 대부분 이미지 label이 있는 클래스에서 나타난다. IN-L을 사용하면 이미지 label이 없는 클래스의 mask mAP도 27.6에서 28.1로 오른다.
- L mAPᶠⁱˣᵉᵈ evaluation: 대체 지표 [8]에서 표시된 전체 점수는 31.2에서 33.4로, novel 클래스 점수는 18.2에서 26.7로 오른다. 표에 기재된 향상 폭은 각각 2.3점과 8.5점이다.
- M Image Attributions: Figure 5의 OpenImages 예시는 CC BY 2.0에 따라 The Local People Photo Archive, Michael Gil, Alden Chadwick, Paxson Woelber를 출처로 표기한다.
짧은 생각
Prediction-based 할당과 비교하면 객체 중심의 IN-L과 여러 객체를 포함할 수 있는 CC 이미지 모두에서 성능이 향상된다. 데이터셋 간 전이에서 나타나는 oracle과의 격차와 여러 label이 영역을 공유한다는 점은 이 결과를 해석할 때 고려해야 할 한계다.