


GAIA: a benchmark for General AI Assistants 요약 설명
21 Nov 2023 | Paper Review Agent Evaluation Benchmark Tool Use목차
이번 글에서는 GAIA: a benchmark for General AI Assistants 논문의 핵심 포인트만 간단히 정리한다.
- 2023년 11월 21일(Arxiv)
- Mialon, Grégoire, Fourrier, Clémentine, Swift, Craig, Wolf, Thomas, LeCun, Yann, Scialom, Thomas.
- FAIR, Meta, HuggingFace, AutoGPT, GenAI, Meta
- 논문 링크
요약
- GAIA는 추론, 웹 탐색, 파일 처리와 그 밖의 도구 사용이 필요한 실제 질문으로 범용 AI assistant를 평가한다. 검증에 참여한 사람 어노테이터는 유효한 질문 전체에서 92%를 기록했고, 사람이 각 작업에 맞게 선택한 plugin을 사용하는 GPT-4는 15%를 기록했다.
- 이 benchmark는 사람이 설계한 질문 466개로 구성되며, 유형에 따라 정규화한 뒤 정답과 거의 일치하는지 비교해 짧은 답변을 채점한다. 어노테이션이 포함된 개발자용 질문 166개를 공개하고, 리더보드용 질문 300개의 정답은 공개하지 않는다.
- Plugin을 사용한 GPT-4는 Level 1, 2, 3에서 각각 30.3%, 9.7%, 0%를 기록했다. 사람이 plugin을 선택하고 사용 가능한 plugin도 바뀌므로 이 비교를 재현하기 어렵다.
1 Introduction
저자들은 전문 시험과 자유 형식 생성이 신뢰할 만한 평가를 어렵게 만든다고 주장한다. GAIA는 사람에게 개념적으로 단순하지만 검증 가능한 사실을 답하려면 일련의 행동이 필요할 수 있는 질문을 다룬다.
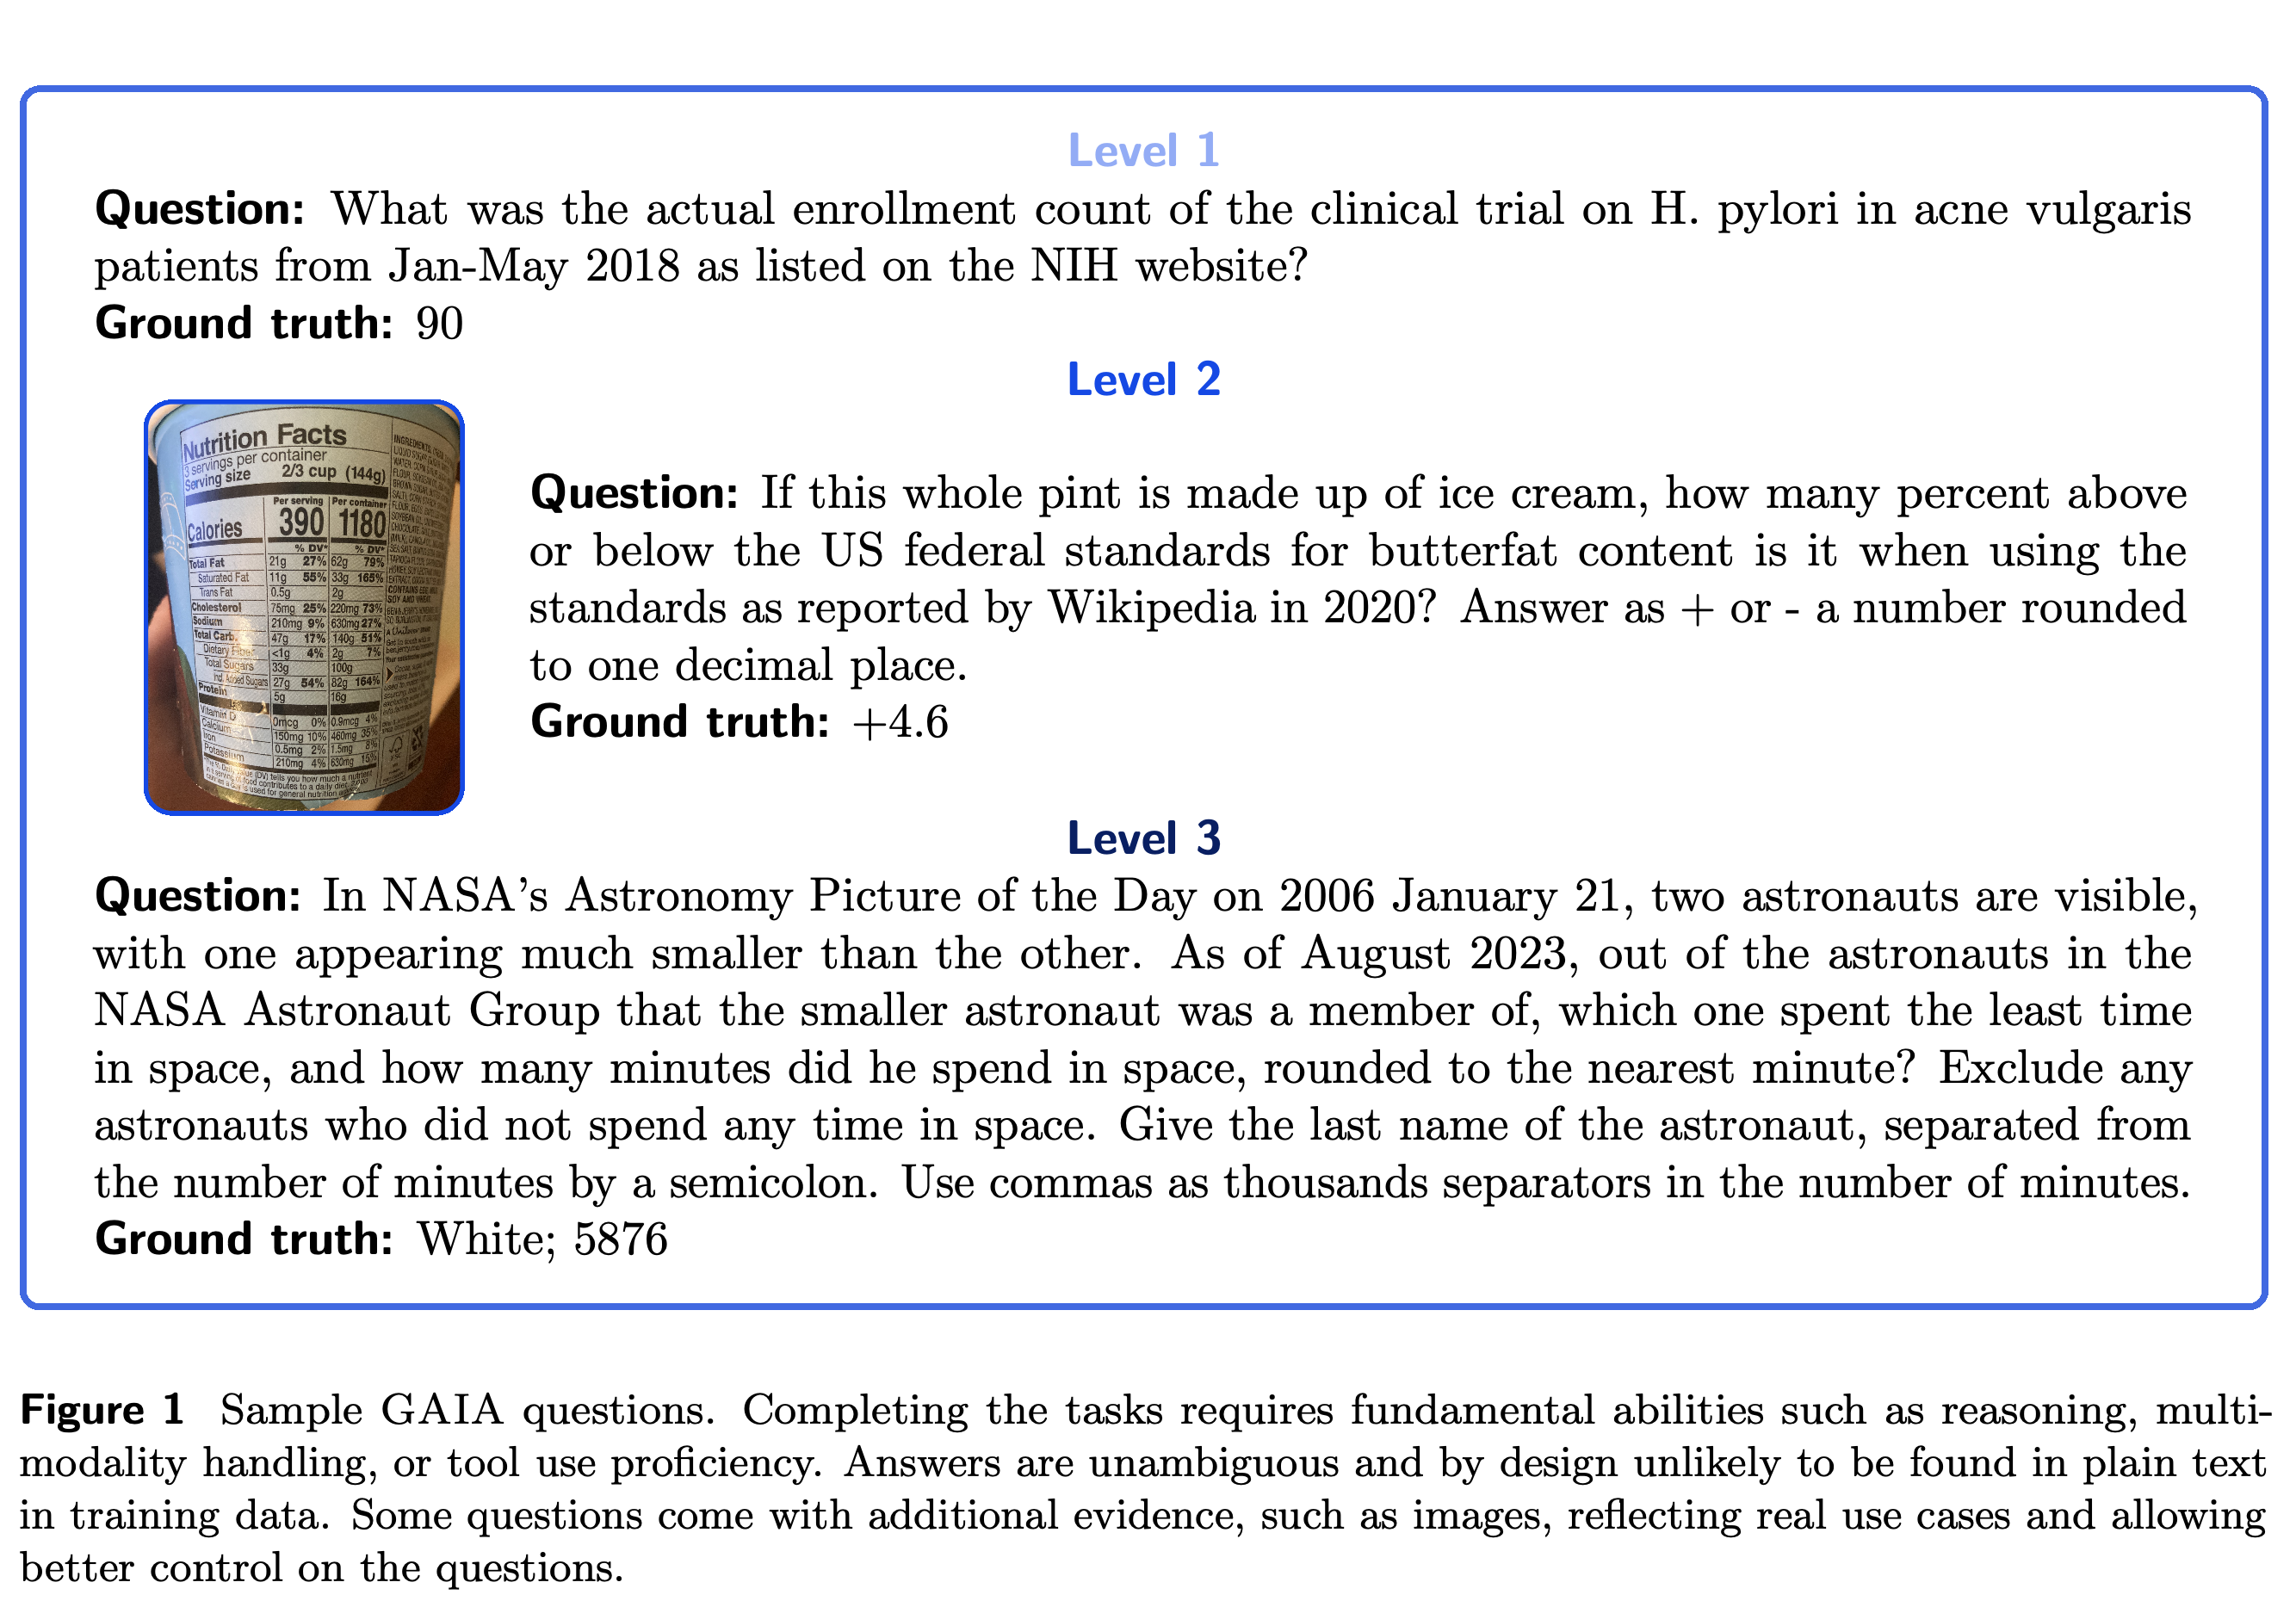
예시는 임상시험 등록 인원 조회부터 이미지에 기반한 계산과 우주비행사에 관한 정보 결합으로 이어진다. 짧은 답변을 얻기 위해서도 여러 검색 또는 추론 단계가 필요할 수 있다.
2 Related work
기존 assistant 평가는 폐쇄된 환경, 특정 애플리케이션 프로그래밍 인터페이스(API), 또는 미리 정해진 풀이 경로를 사용하는 경우가 많다. GAIA는 도구를 지정하지 않고 개방된 환경과의 상호작용을 포함한다. 논문은 OpenAGI를 당시 모델의 능력에 초점을 맞춘 관련 다단계 benchmark로 소개한다.
3 GAIA
GAIA는 benchmark와 함께 확장을 지원하도록 설계한 질문 작성 및 검증 과정을 제시한다.
3.1 A convenient yet challenging benchmark for general AI assistants
텍스트 질문 466개는 개인적인 작업, 과학, 일반 지식을 다루며, 일부에는 이미지나 스프레드시트 같은 파일이 포함된다. 질문은 assistant에게 작업 예시를 제공하지 않는 zero-shot 평가를 위해 설계됐으며, 간결한 정답 1개를 요구한다.
설계 과정에서는 실제 작업, 해석 가능한 풀이, 암기에 대한 저항성, 사용 편의성을 중시했다. 정답이 사전 학습 데이터에 일반 텍스트로 등장하지 않도록 의도했지만, 저자들은 데이터 오염 가능성이 남아 있다고 인정한다.
3.2 Evaluation
Prefix prompt로 답변 형식을 지정하고, 채점 함수는 답변 유형에 따라 정규화한 뒤 최종 답변과 기준 정답을 비교한다. 답변은 대개 숫자, 짧은 문자열, 쉼표로 구분된 목록이며, benchmark는 추론 경로를 자동으로 채점하지 않는다.
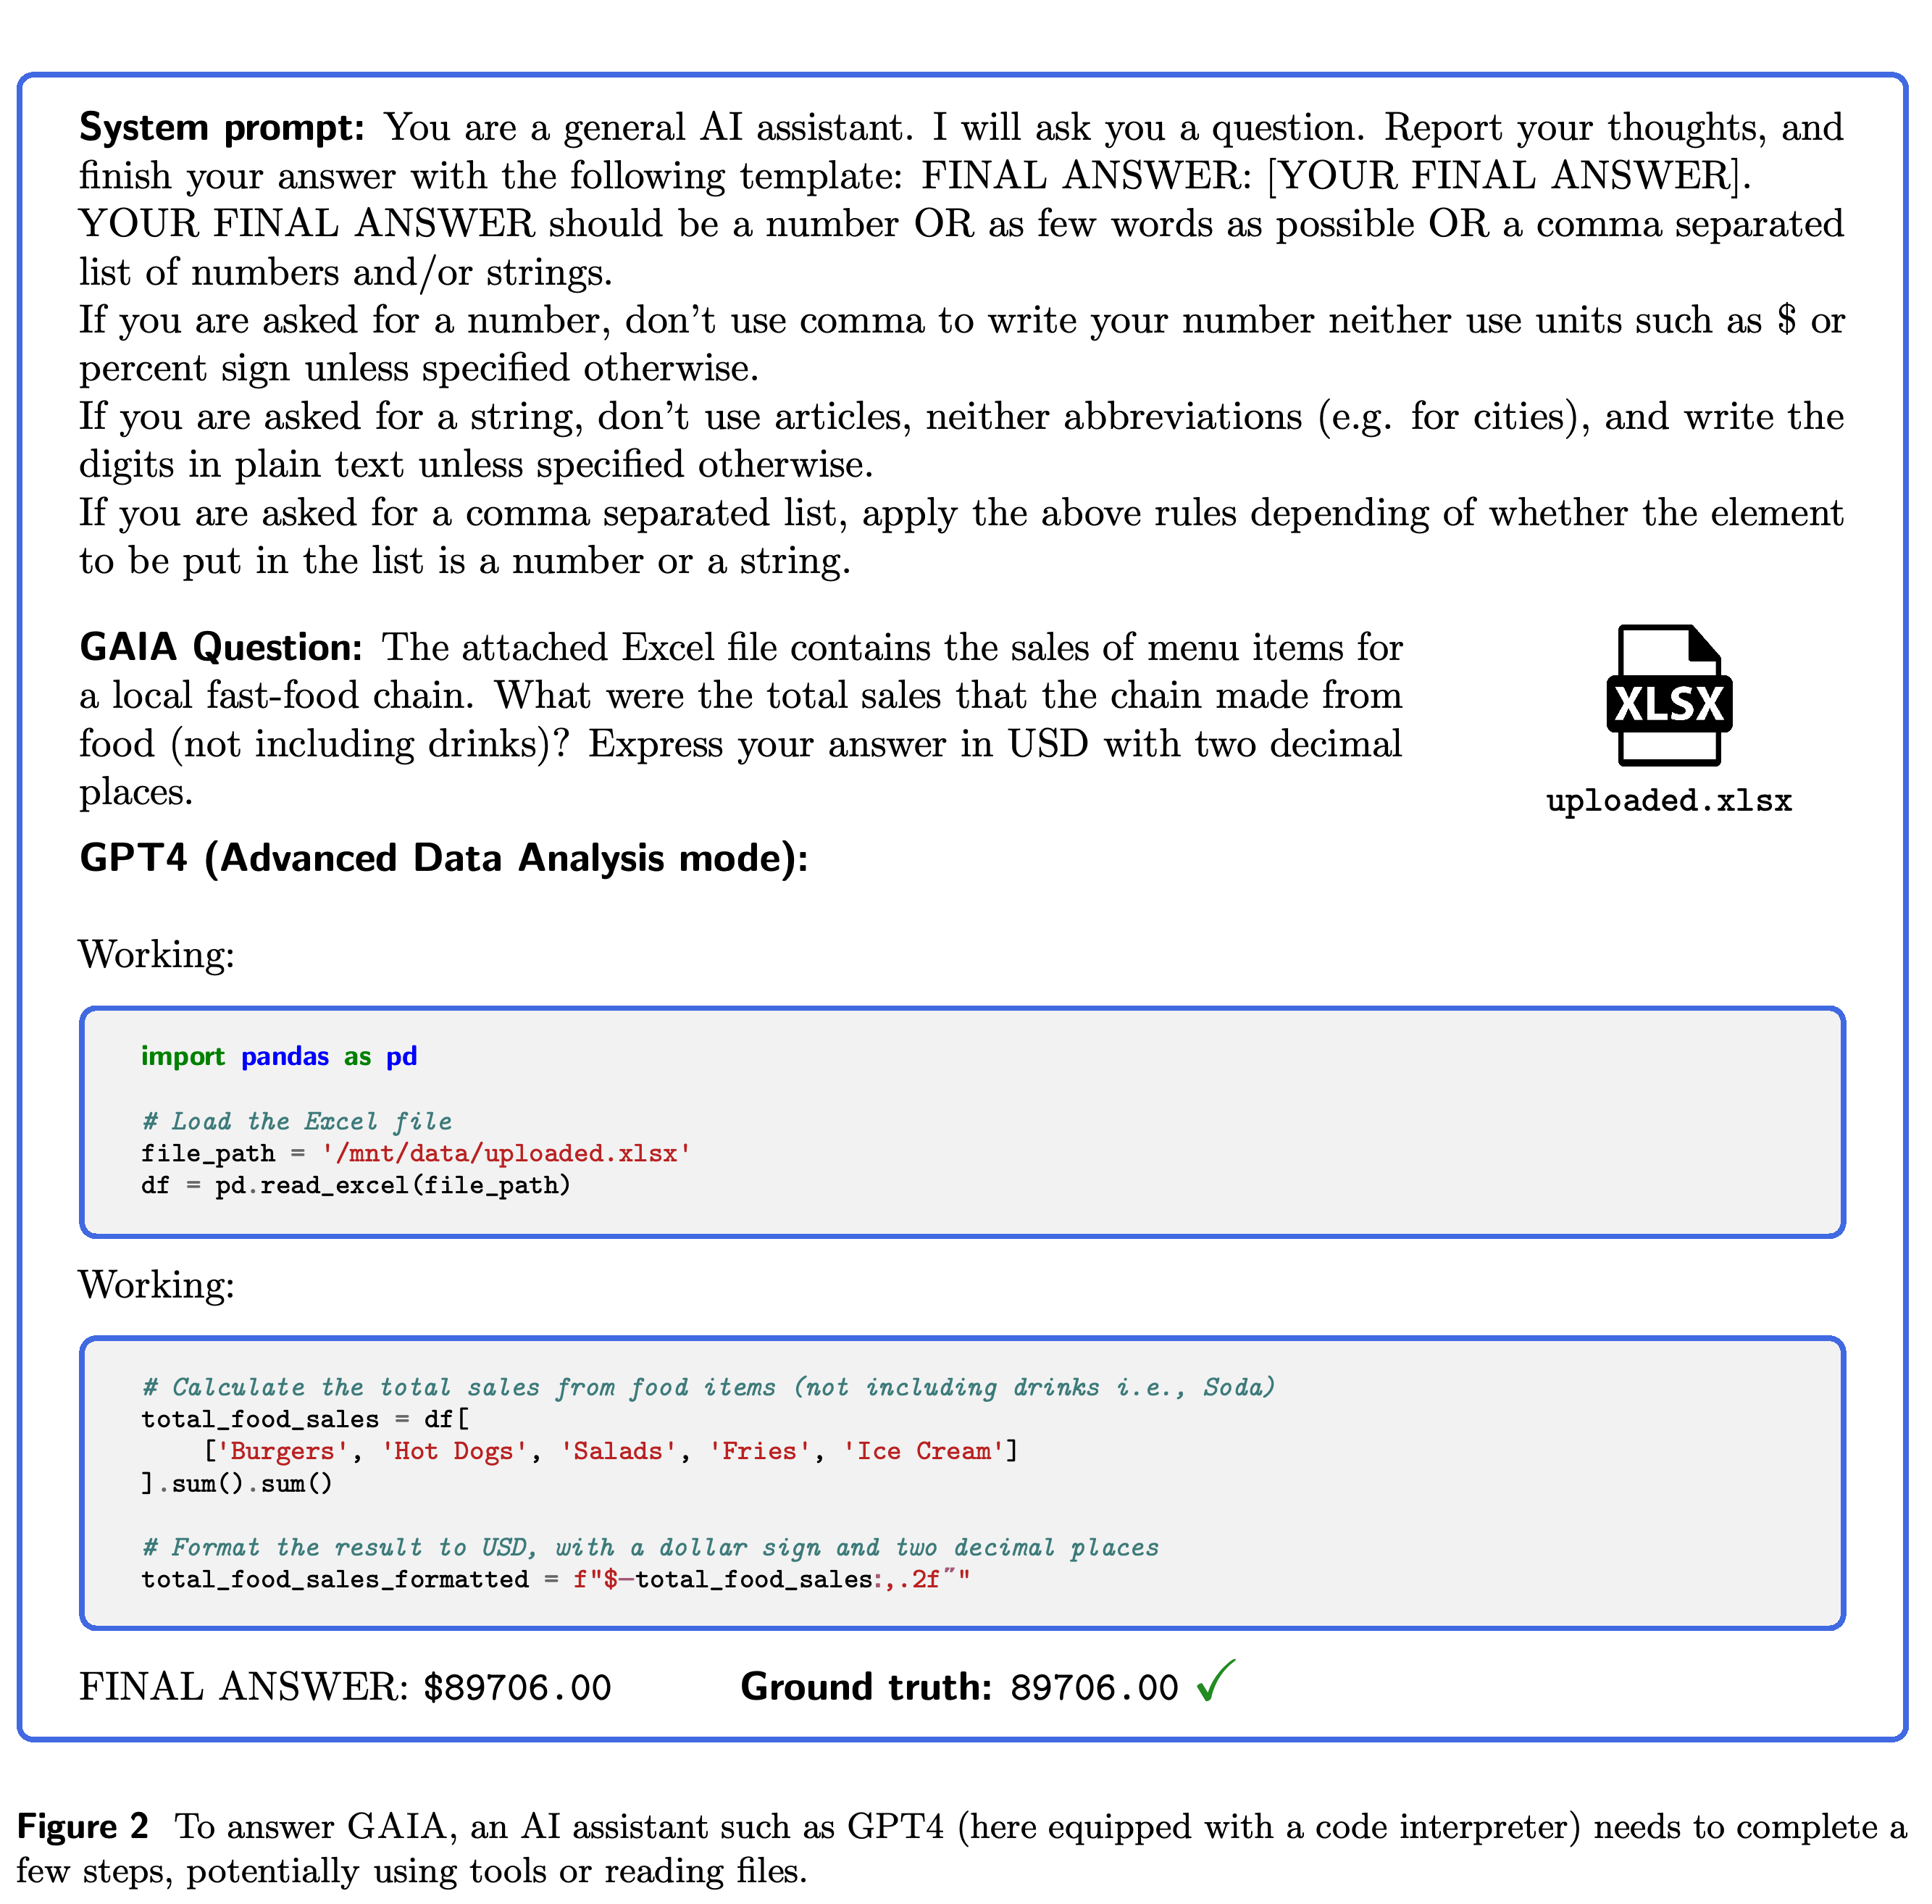
GPT-4가 첨부된 스프레드시트를 읽고 식품 항목 열을 합산해 89706.00을 구한다. 파일 접근과 코드 실행을 통해 검증 가능한 최종 답변을 얻는 과정을 보여준다.
3.3 Composition of GAIA
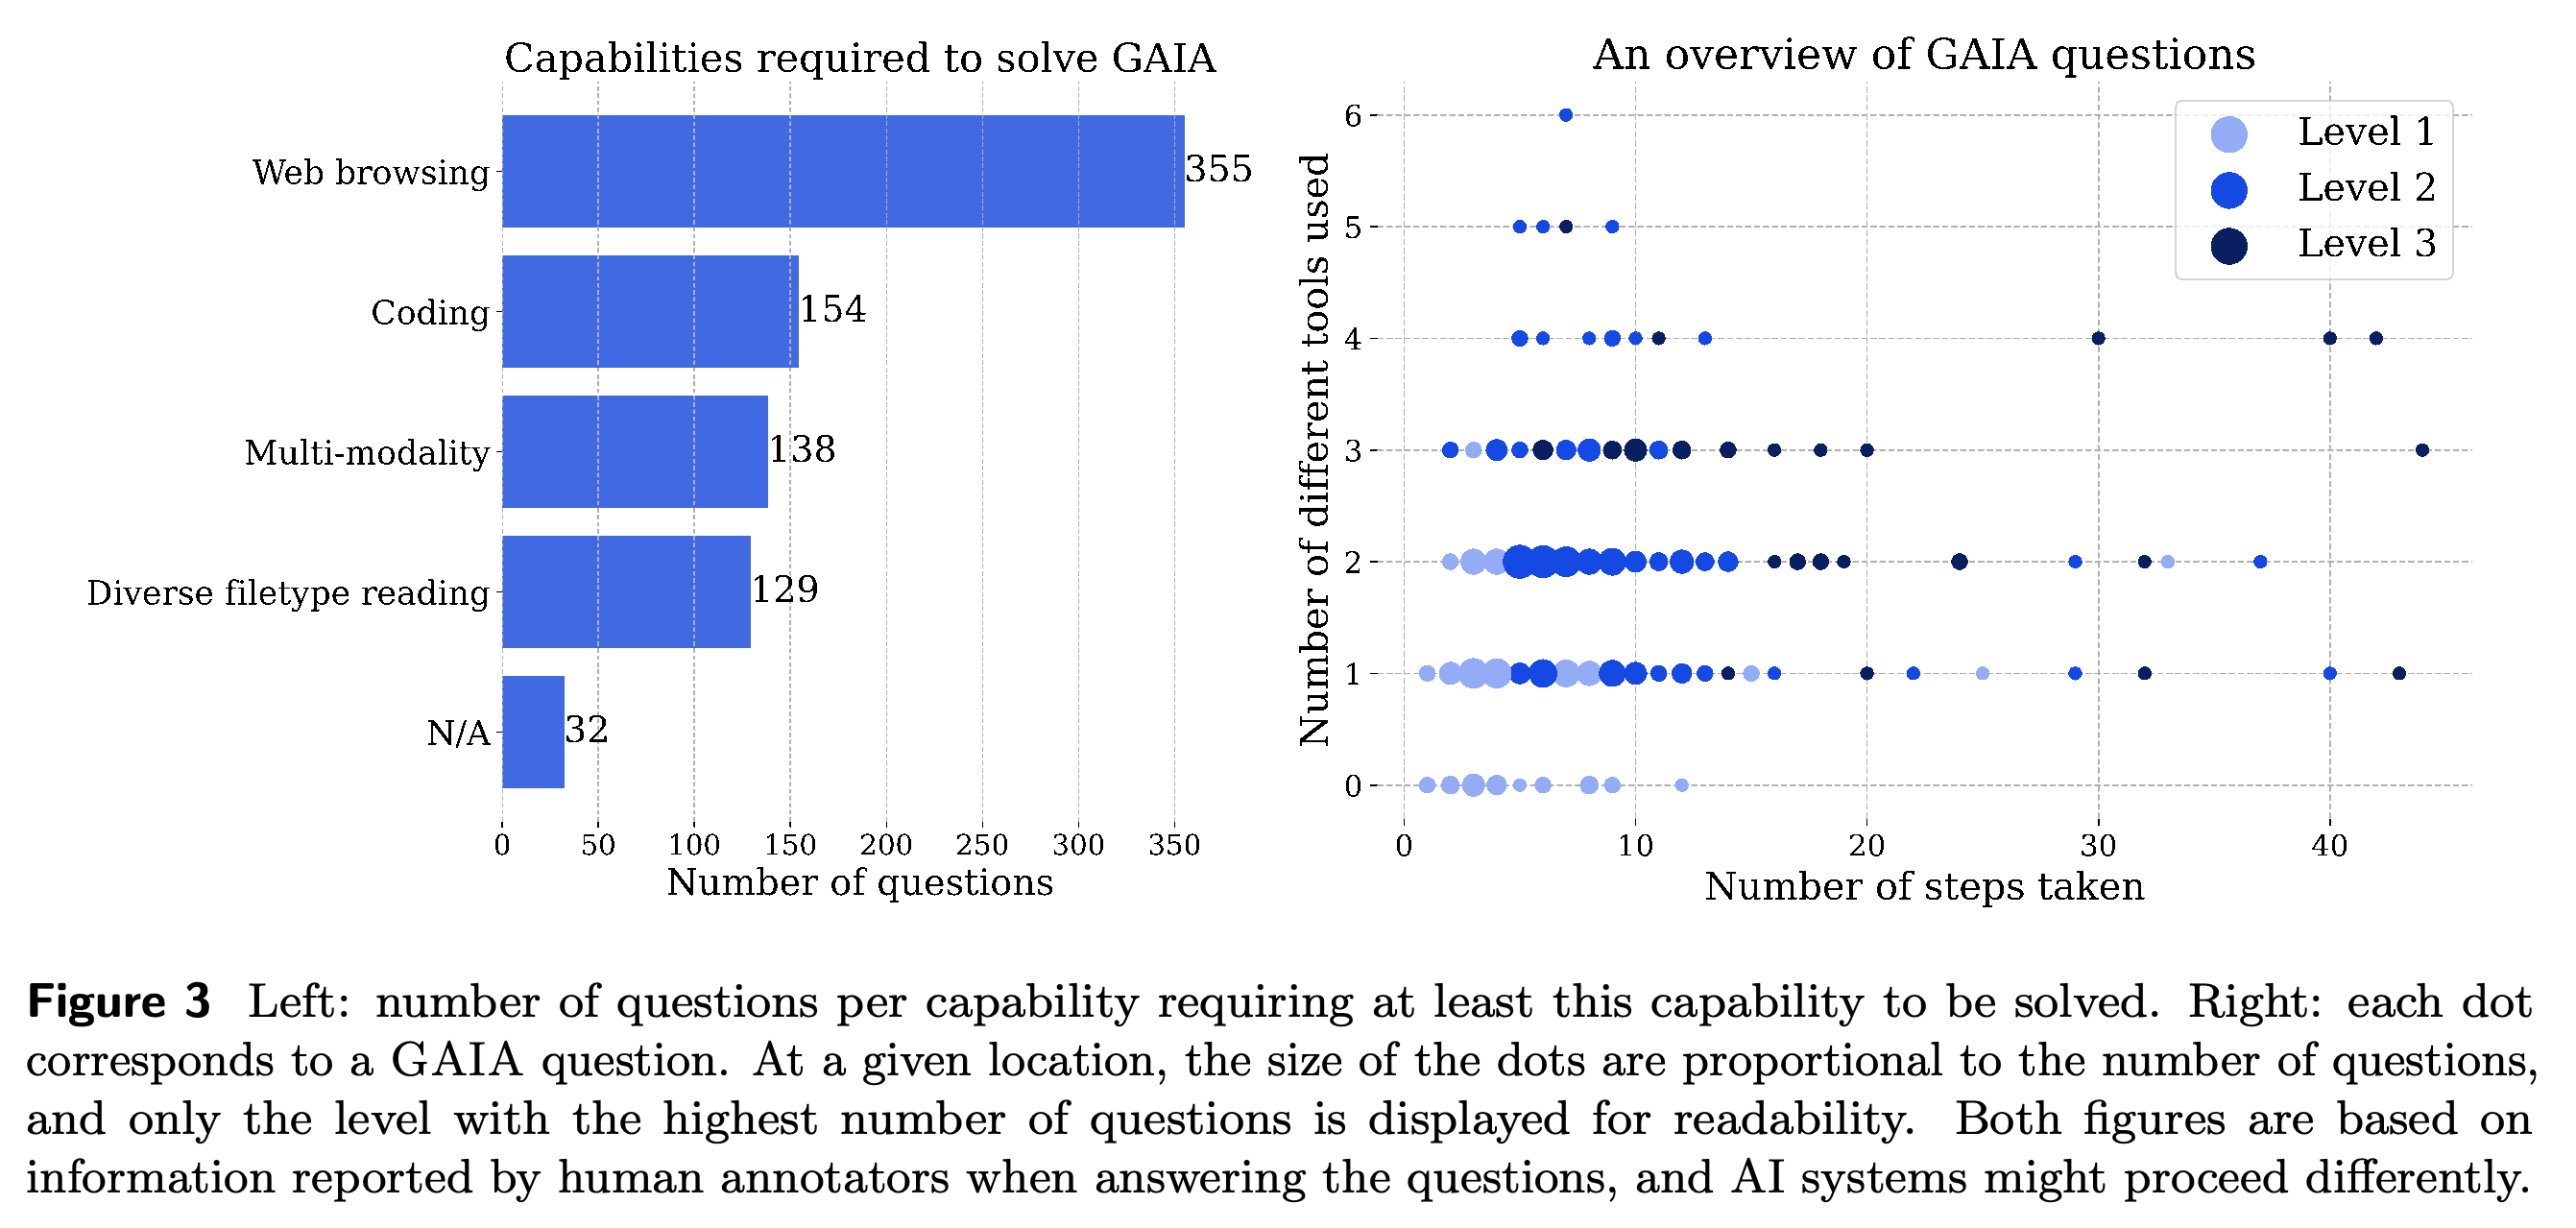
어노테이터의 풀이 경로를 기준으로 질문 355개에는 웹 탐색이, 154개에는 코딩이, 138개에는 멀티모달 처리 또는 텍스트 외 데이터 처리가, 129개에는 다양한 파일 형식 읽기가 포함된다. 이 범주들은 서로 겹칠 수 있다. 시스템은 같은 질문을 서로 다른 능력을 활용해 풀 수도 있다.
저자들은 Level 1을 도구를 사용하지 않거나 최대 1개를 사용하고 단계가 5개 이하인 수준, Level 2를 도구를 조합해 약 5–10단계를 거치는 수준, Level 3을 도구에 제한 없이 긴 행동 과정을 거칠 수 있는 수준으로 대략 정의한다. 이는 사람의 어노테이션을 바탕으로 한 대략적인 기준이며 엄격한 제약은 아니다. 질문 466개 중 각 수준에 해당하는 질문은 각각 146개, 245개, 75개다.
웹 탐색은 가장 자주 어노테이션된 능력이며, 단계 수와 도구 수는 수준별로 서로 겹친다. 그래프에 표시된 경로는 사람 어노테이터의 풀이를 나타내므로 모델의 풀이와 일치하지 않을 수 있다.
3.4 Building and extending GAIA
질문 작성자는 정답, 단계, 도구, 시간을 기록하고 추가 어노테이터 2명이 각 질문에 독립적으로 답한다. 답이 일치하지 않으면 필요에 따라 질문을 수정하거나 제거한다. 작성된 질문 중 68%가 초기 유효성 기준을 충족했으며, 작성과 검증, 필요한 경우 수정까지 질문당 어노테이터 작업 시간으로 약 2시간이 걸렸다.
웹 자료는 변경되거나 사라질 수 있으므로 질문에 자료의 버전을 명시하고 오래 유지될 만한 근거를 우선할 수 있다. 저자들은 관련 웹사이트에 대한 접근이 robots.txt로 제한되는지도 확인한다.
4 LLMs results on GAIA
평가는 GPT-4, GPT-4 Turbo, GPT-4를 백엔드로 사용하는 AutoGPT, plugin을 사용하는 GPT-4, 사람 어노테이터, 검색 결과 첫 페이지에 기반한 베이스라인을 비교한다. API에 직접 접근할 수 있는 경우 저자들은 모델을 3회 실행하고 평균을 보고했다.
사람은 Level 1–3에서 각각 93.9%, 91.8%, 87.3%를 기록했고, plugin을 사용한 GPT-4는 30.3%, 9.7%, 0%를 기록했다. AutoGPT는 14.4%, 0.4%, 0%를 기록했으며, Level 1과 2에서 평균 답변 시간은 각각 7.6분과 11.7분이었다.
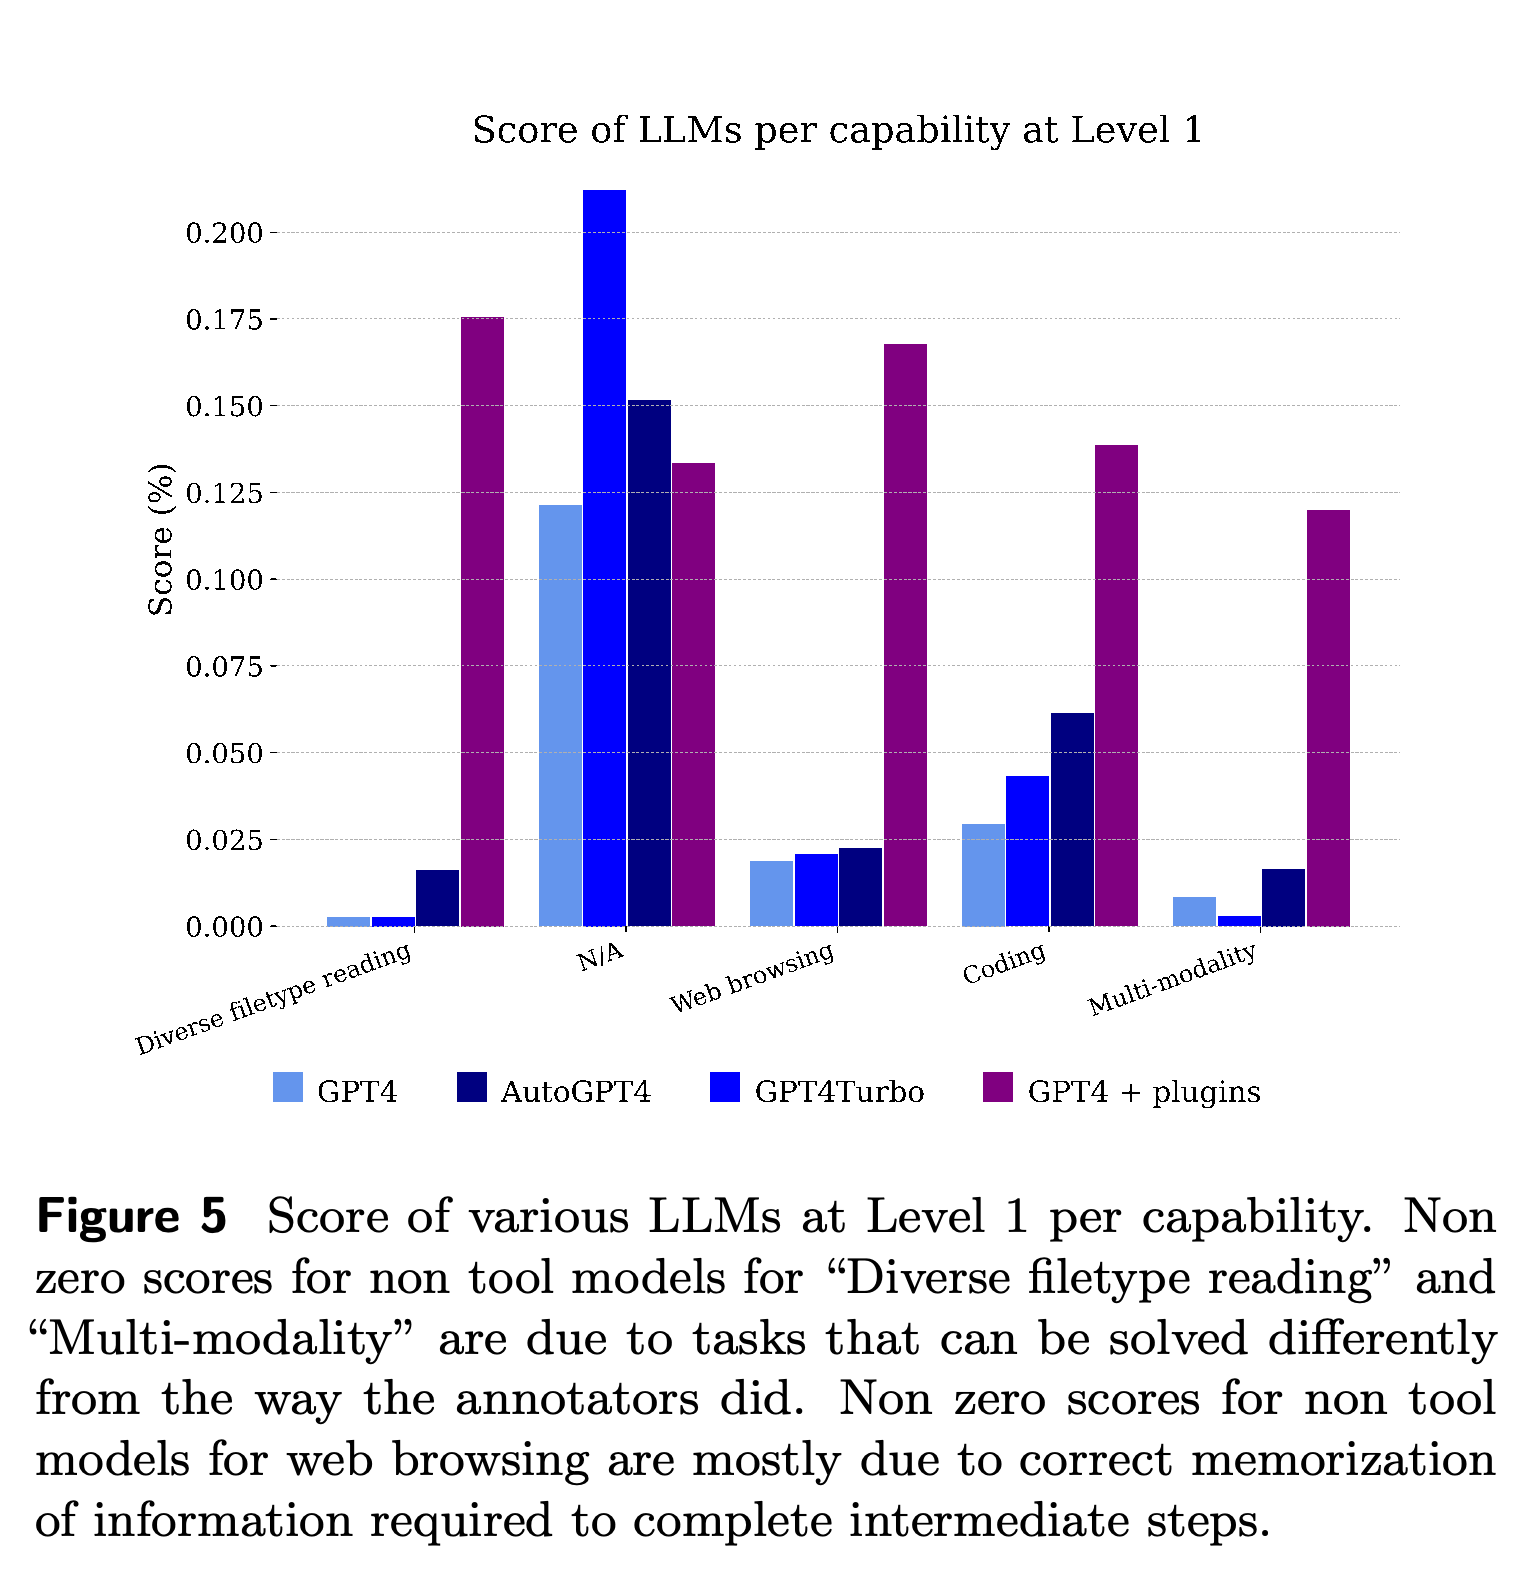
Level 1에서 plugin을 사용하는 설정은 어노테이션된 여러 능력 범주에서 더 높은 점수를 기록한다. 도구를 사용하지 않는 모델도 다른 풀이 경로나 암기한 중간 정보를 활용해 일부 질문에 답할 수 있다.
Plugin 결과는 사람이 적합한 도구를 골라 제공한 조건에서 얻은 오라클 방식의 추정치다. 사람은 각 작업에 대해 코드 실행과 파일 읽기가 가능한 Advanced Data Analysis 모드 또는 최대 3개의 plugin을 선택했으며, 사용 가능한 plugin은 바뀌었다. API 시간 추정치는 특정 1개 시점에 질문 20개의 평균을 구한 것으로, GPT-4와 GPT-4 Turbo의 속도를 비교하기 위한 수치가 아니다.
5 Discussion
저자들은 웹 자료가 사라지거나 학습 데이터 오염이 증가하면 benchmark를 갱신할 것을 제안한다. GAIA는 assistant 시스템 전체를 평가하므로 최종 답변이 틀렸다는 사실만으로는 웹 탐색, 시각 처리 또는 다른 구성 요소 중 어디에서 실패했는지 알 수 없다.
6 Limitations
최종 답변만 채점하므로 추론 과정과 도구 호출은 평가하지 않으며, 논문은 세밀한 분석에 필요한 도구 호출 기록도 제한적이라고 보고한다. 검증 후에도 모호함이 남을 수 있고, 유일한 정답을 얻기 위해 상세하게 작성한 질문은 충분히 구체적이지 않은 실제 사용자 요청과 거리가 생길 수 있다.
모든 질문이 표준 영어로 작성됐고 상당수가 영어 웹페이지에 의존하므로, 이 benchmark만으로는 다른 언어와 방언 또는 영어가 아닌 웹에서 assistant가 유용한지 입증할 수 없다.
부록
- A Extended related work는 단일 agent prompting, 다중 agent 협업, 도구를 활용하는 assistant, 도구 라이브러리를 살펴본다. B Datacard는 어노테이터들이 US에 있었으며 질문, 답변, 메타데이터를 일반적으로 쓰이는 영어로 작성했다고 보고한다.
- C Extended description of GAIA는 어노테이터가 사용한 도구를 바탕으로 능력 범주를 정의하고 범주들이 서로 겹친다고 설명한다. 답변 시간은 도구 수보다 단계 수와 더 뚜렷한 상관관계를 보인다고도 보고한다. 제시된 첨부 파일 중 가장 흔한 형식은 xlsx(29개), png(18개), pdf(15개)다.
- D Extended description of our question design framework는 자료에 근거하고 어노테이터 2명이 독립적으로 확인하는 짧고 안정적이며 모호하지 않은 정답을 규정한다. 새로 작성한 질문 623개 중 검증자 2명 모두 기존 정답과 일치한 경우는 55%, 1명만 일치한 경우는 27%, 아무도 일치하지 않은 경우는 18%였다. 어노테이터의 오류로 답이 불일치한 경우도 허용하는 유효성 기준은 68%가 충족했다.
- D.1 Extended evaluation은 상세한 베이스라인 점수와 예시를 제시한다. GPT-4는 웹 탐색을 통해 표본의 위치를 묻는 질문에 Saint Petersburg를 찾아내지만, Rubik’s cube 예시에서는 틀린 답을 낸다. 이 기록들은 전체 성능이 아닌 개별 성공과 실패를 보여준다.
짧은 생각
GAIA는 간결한 답변을 사용해 assistant를 실용적으로 시험할 수 있으며, 수준별 결과는 보고된 2023년 설정에서 성능 차이가 크다는 사실을 보여준다. 점수는 사람이 선택한 plugin, 변화하는 웹 자료, 영어에 한정된 범위, 과정 수준의 채점이 없다는 점을 함께 고려해 해석해야 한다.