


TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks 요약 설명
18 Dec 2024 | Paper Review Agent Evaluation Computer-Use Agents Benchmark목차
이번 글에서는 TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 18일(Arxiv)
- Xu, Frank F., Song, Yufan, Li, Boxuan, Tang, Yuxuan, Jain, Kritanjali, Bao, Mengxue, Wang, Zora Z., Zhou, Xuhui, Guo, Zhitong, Cao, Murong, et al.
- Carnegie Mellon University, Independent, Duke University
- 논문 링크
- Github
- Project Page
요약
- TheAgentCompany는 대규모 언어 모델(LLM)을 이용해 컴퓨터 도구로 작업을 수행하는 에이전트가 웹 탐색, 코딩, 의사소통이 필요한 업무를 완료할 수 있는지 측정한다. 175개 과제에서 Gemini-2.5-Pro는 30.3%, Claude-3.7-Sonnet은 26.3%의 완전 완료율을 달성한다. 모델 2개 모두 코드와 브라우저 동작을 실행하는 프레임워크인 OpenHands 0.28.1을 사용한다.
- 이 벤치마크는 초기 상태로 되돌릴 수 있는 내부 웹사이트, 격리된 작업 공간, 모델이 생성한 가상 동료로 소프트웨어 회사를 모사한다. 체크포인트는 평가기가 확인하는 중간 목표이며, 각 목표에 중요도에 따른 점수를 부여한다. 부분 완료 점수는 과제 진행 정도와 완전 완료 보너스를 합산한다. 논문의 비용 가정에 따르면 Gemini-2.5-Pro는 39.3%의 점수를 얻으며, 평가한 과제당 평균 27.2개의 모델 호출이 필요하고 $4.2를 사용한다.
- 결과는 문서 작업, 복잡한 웹 인터페이스, 의사소통에서 약점을 보여준다. Gemini-2.5-Pro는 문서 저장 및 편집 서비스인 ownCloud가 필요한 과제에서 12.86%를 완료하지만, 프로젝트 관리 서비스인 Plane이 필요한 과제에서는 41.18%를 완료한다. 이 벤치마크는 직무를 구성하는 과제 중 일부를 선별해 평가한다. 사람의 성능을 측정하지 않았고 직업 전반을 포괄하지도 않으므로, 이 비율을 직무 자동화율로 해석할 수 없다.
1 Introduction
TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks는 에이전트가 다양한 전문 업무를 수행할 수 있는지에 관한 재현 가능한 근거가 부족하다는 문제를 다룬다. 모의 회사에는 소프트웨어 엔지니어링, 프로젝트 관리, 재무, 행정 과제가 포함되며, 에이전트는 도구를 조작하고 동료에게 정보를 얻어야 한다.
- 이 연구는 벤치마크 환경과 평가 체계를 제시하고 베이스라인 실험으로 이를 뒷받침한다.
- 웹사이트 https://the-agent-company.com, 코드 https://github.com/TheAgentCompany/TheAgentCompany, 평가 결과 https://github.com/TheAgentCompany/experiments를 공개한다.
2 Benchmark Desiderata and Comparison to Other Benchmarks
벤치마크는 5가지 설계 요건을 제시한다. 여러 업무 과제 범주를 다루고, 동료와 상호작용하며, 많은 단계를 연속해서 수행해야 하는 장기 과제를 포함하고, 다양한 컴퓨터 인터페이스를 제공하며, 자체 호스팅으로 재현성을 확보한다. 자체 호스팅은 연구자가 자신의 인프라에서 환경을 실행할 수 있다는 뜻이다. 중간 체크포인트는 전체 과제를 완료하지 못해도 유의미한 진행 정도를 기록한다.
- 기존 벤치마크와의 비교는 평가 범위와 환경 설계를 다룬다. 과제와 성공 기준이 다른 벤치마크의 점수를 직접 대응시킬 수는 없다.
- 브라우저, 터미널, 프로그램 실행, 메시징 인터페이스를 함께 제공해 여러 애플리케이션에 걸친 작업을 지원한다.
3 TheAgentCompany Environment Setup
로컬 작업 공간은 브라우저, 코드 편집기, Linux 터미널을 포함한 격리된 실행 환경인 Docker 샌드박스에서 동작한다. 회사 내부 웹사이트인 인트라넷은 코드와 기술 위키에 GitLab을, 문서와 파일 공유에 ownCloud를, 이슈와 프로젝트 관리에 Plane을, 내부 메시징에 RocketChat을 사용한다.
- 서비스를 초기 상태로 되돌릴 수 있으며, 실제 소프트웨어 프로젝트 데이터와 수작업으로 구성한 회사 데이터를 함께 담고 있다.
- 모델로 가상 인물을 만드는 플랫폼인 Sotopia는 이름, 직무, 책임, 소속 프로젝트가 설정된 모의 동료를 제공한다. 에이전트는 초기 과제 설명에 없는 정보를 얻기 위해 직접 메시지나 채널로 이들에게 연락한다.
- 모든 실험에서 모의 동료는 Claude-3-5-Sonnet-20241022를 사용한다. 따라서 평가 대상 에이전트가 바뀌어도 동료의 기반 모델은 고정된다.
4 Task Structure
각 과제는 요청한 업무를 영어로 설명하는 과제 의도, 가중치가 부여된 체크포인트, 체크포인트 평가기, 초기화 및 마무리 코드로 구성된다. 체크포인트는 작업 공간의 파일, 인트라넷 상태, 대화, 동작 이력을 살펴 동작 완료 여부, 결과의 정확성, 협업을 평가한다.
- 대부분의 평가기는 미리 작성한 검사 규칙을 적용하는 결정론적 Python 함수다. 예를 들어 소프트웨어 엔지니어링 과제에서는 저장소 복제, 빌드 성공, 서버 가용성을 확인한다. 저장소에 대해서는 GitHub 사용법 - 01. 소개 글을 참조하라.
- 일부 비정형 결과나 상호작용은 사전에 정한 채점 기준 또는 참조 결과를 바탕으로 언어 모델이 평가한다. 이 평가기들도 Claude-3-5-Sonnet-20241022를 사용한다.
4.1 Evaluation Metrics
완전 완료 지표는 모든 체크포인트를 통과하면 S_full = 1, 그렇지 않으면 0이다. 부분 완료 지표는 S_partial = 0.5 × Result/Total + 0.5 × S_full이며, Result는 획득한 체크포인트 점수, Total은 획득 가능한 점수다. 모든 체크포인트를 통과하면 전체 점수의 절반에 해당하는 완전 완료 보너스가 추가된다.
- 단계 수는 실행 중 모델 호출 횟수를 센다. 경과 시간이나 개별 인터페이스 조작 횟수를 측정하는 값은 아니다.
- 인스턴스당 비용은 (입력 토큰 수 × 입력 토큰 단가) + (출력 토큰 수 × 출력 토큰 단가)로 계산하며, 프롬프트 캐싱을 사용하지 않는다고 가정한다. 프롬프트 캐싱은 이전에 처리한 프롬프트 내용을 낮은 요금으로 재사용하는 방식이다. 이 계산은 명시된 가격 가정에 따라 기반 모델을 호출하는 비용을 추정한다.
4.2 Workflow
과제는 3단계로 진행된다. 초기화 단계에서는 작업 공간을 준비하고, 실행 단계에서는 하위 과제와 필요한 의사소통을 수행하며, 마무리 단계에서는 평가할 결과물을 생성해 제출한다. 하나의 과제에 여러 애플리케이션에 걸쳐 서로 의존하는 동작이 포함될 수 있다.
5 Task Creation
과제 제작은 직업 관련 참조 데이터 활용, 과제 선정, 수작업 구현으로 이루어진다. 이 과정에서 요청할 업무를 정의하고, 이를 평가하는 데 필요한 환경 상태와 평가기를 구축한다.
5.1 Choosing Task Categories
저자들은 US 노동부의 직업 데이터베이스인 O*NET release 29.1을 사용해 고용 규모가 큰 직업 범주를 파악한다. 고용 인원에 임금 중앙값을 곱해 직업별 총가치를 추정한 뒤, 여러 디지털 직무 범주를 다룰 수 있는 소프트웨어 회사를 배경으로 선택한다.
- 이 벤치마크는 컴퓨터로 수행하는 업무를 평가하므로 육체노동이 많이 필요한 범주는 제외한다.
- 이 선정 절차는 환경 선택의 근거가 되지만, 모든 업무나 특정 직업의 모든 과제를 대표하는 표본을 만들지는 않는다.
5.2 Choosing Tasks
개별 과제는 O*NET의 과제 목록, 해당 업무 경험이 있는 공저자들의 지식, 언어 모델과의 브레인스토밍을 바탕으로 만든다. 구체적인 목표와 명확한 성공 기준을 중시해 자동 평가가 가능하도록 선정하지만, 그 결과 직무에서 맡는 업무의 상당 부분이 벤치마크에서 제외된다.
- 논문은 이 결과만으로 직무 전체를 자동화할 수 있는지 판단하지 말아야 한다고 명시적으로 경고한다.
5.3 Manual Task Curation
저자들은 각 과제의 의도와 체크포인트를 정의하고, 필요한 데이터를 가져오거나 생성하며, 작업 공간의 초기 상태를 설정하고 평가기를 구현한다. 기여자 20명이 2개월 넘게 작업했으며, 약 3,000인시가 들었다. 일부 복잡한 과제는 설계, 구현, 테스트, 검증에 과제당 총 10시간 넘게 필요했다.
- 품질 검사에는 성공적으로 수행한 과제에 만점이 부여됨을 보여주는 스크린샷 확인, 주저자의 코드 리뷰, 과제 데이터와 평가기 동작 및 채점에 대한 최종 수동 검토가 포함된다.
- 과제 제작에 참여하지 않은 사람이 체크포인트 가중치의 일관성과 상대적 중요도를 확인한다.
6 Baseline Agents
주요 베이스라인은 코드와 브라우저 동작을 실행하는 OpenHands의 CodeAct Agent with Browsing이다. 실험에는 여러 에이전트가 과제 수행에 협력하는 프레임워크인 OWL-RolePlay도 포함된다.
- OpenHands 0.14.2와 0.28.1을 사용하며, 새 버전은 더 최신 모델을 지원한다.
- OWL-RolePlay는 https://github.com/camel-ai/owl/tree/gaia58.18에서 권장하는 모델 구성을 사용한다. 보고된 구성은 GPT-4o와 o3-mini를 결합한다.
7 Experimental Results
실험은 전체 175개 과제에서 비공개 모델과 학습된 파라미터가 공개된 오픈 웨이트 모델을 평가한다. 모의 동료와 모델 기반 평가기는 Claude-3-5-Sonnet-20241022로 고정되므로, 이 기반 모델은 평가 대상 에이전트 구성이 아닌 평가 환경에 속한다.
- 평가는 주로 OpenHands 내에서 모델을 바꾸고 OWL-RolePlay 구성 1개를 추가한다. 일부 비교에서는 OpenHands 버전이나 에이전트 프레임워크도 바뀌므로, 차이를 모델만의 영향으로 돌리기 어렵다.
7.1 Result Overview
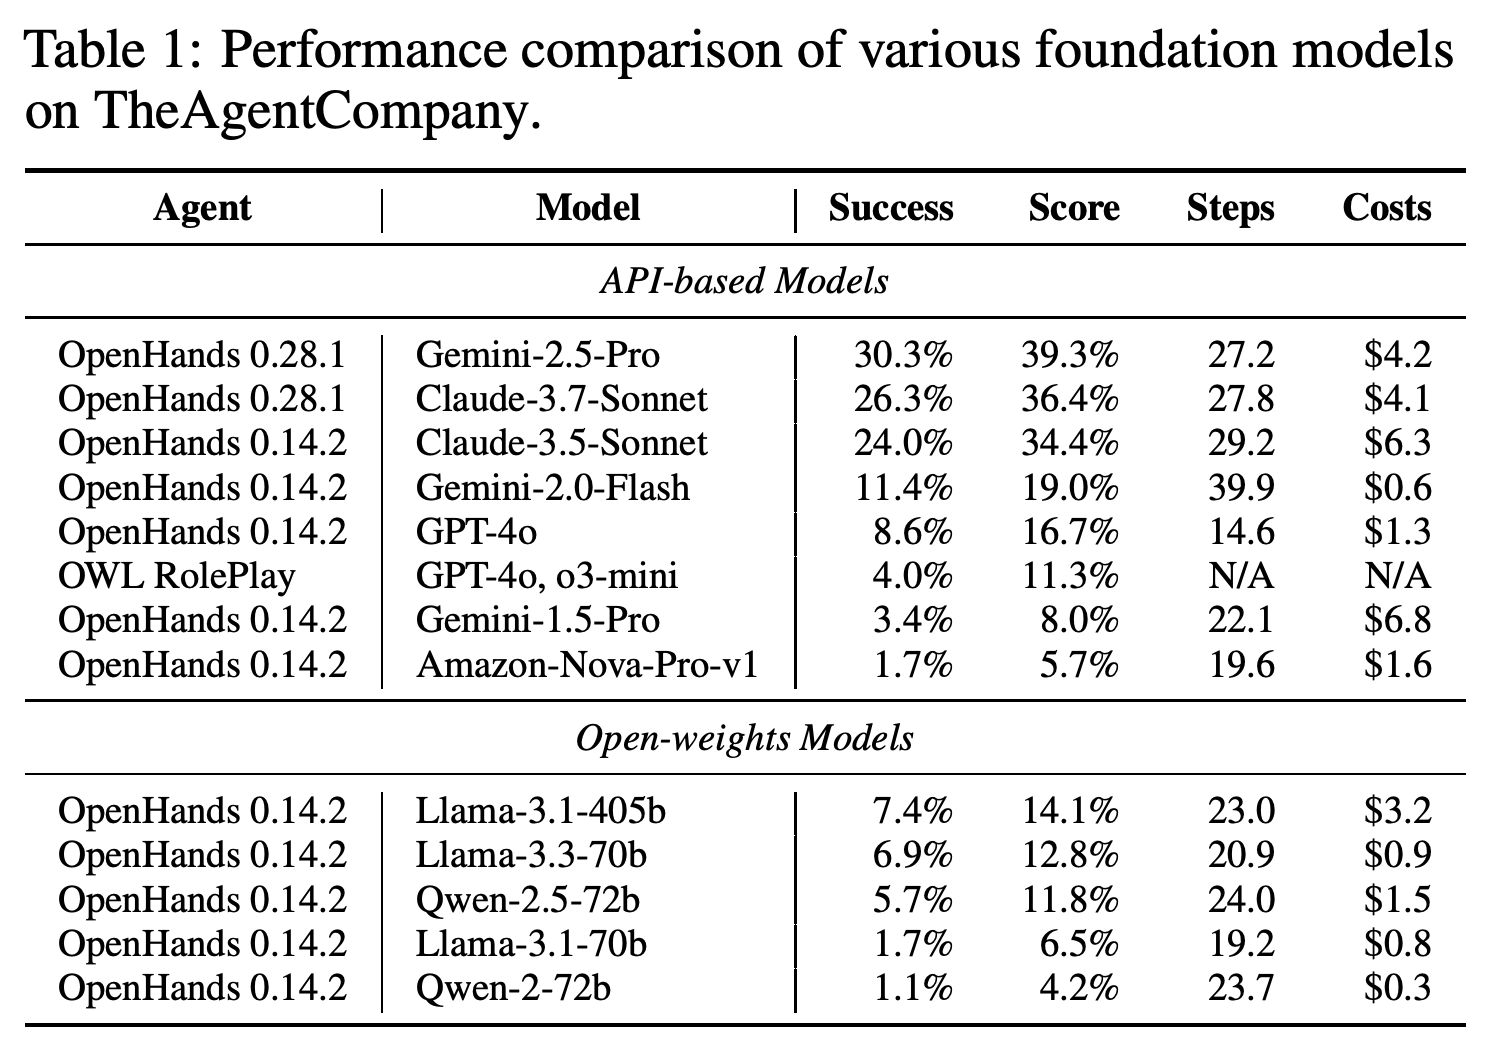
Table 1에서 Gemini-2.5-Pro는 성공률 30.3%, 부분 완료 점수 39.3%로 가장 높은 성능을 보이며, Claude-3.7-Sonnet이 각각 26.3%와 36.4%로 뒤를 잇는다. 평가 인스턴스당 평균 비용은 각각 $4.2와 $4.1이며, Claude-3.5-Sonnet은 $6.3의 비용으로 성공률 24.0%를 달성한다.
- Gemini-2.0-Flash는 인스턴스당 $0.6의 비용으로 성공률 11.4%, 점수 19.0%를 달성하며, 평균 호출 횟수는 39.9회다. 정성적 검토에서는 반복 루프와 목적 없는 탐색이 실행을 길어지게 하는 원인으로 나타난다.
- Llama-3.1-405b는 성공률 7.4%, 점수 14.1%, 인스턴스당 비용 $3.2로 오픈 웨이트 베이스라인 중 가장 높은 성능을 보인다. Llama-3.3-70b는 $0.9로 성공률 6.9%를 달성해, 관측된 성공률은 비슷하면서 비용은 더 낮다.
- GPT-4o를 사용하는 OpenHands는 성공률 8.6%를 달성하며, GPT-4o와 o3-mini를 사용하는 OWL-RolePlay는 4.0%를 달성한다. 저자들은 위임 과정에서 브라우저 탐색의 진행 정보가 소실되는 현상을 설명하지만, 구성이 서로 달라 에이전트 아키텍처만을 원인으로 분리할 수는 없다.
완전 성공률, 부분 완료 점수, 모델 호출 횟수, 비용을 별도 열로 제시해 과제 완료 성능과 비용을 비교한다. Gemini-2.5-Pro는 성공률 30.3%로 가장 높은 성능을 보이며, Gemini-2.0-Flash는 인스턴스당 $0.6의 비용으로 성공률 11.4%를 달성한다. 각 행에는 OpenHands 버전과 별도의 OWL-RolePlay 구성도 명시된다.
7.2 Analysis
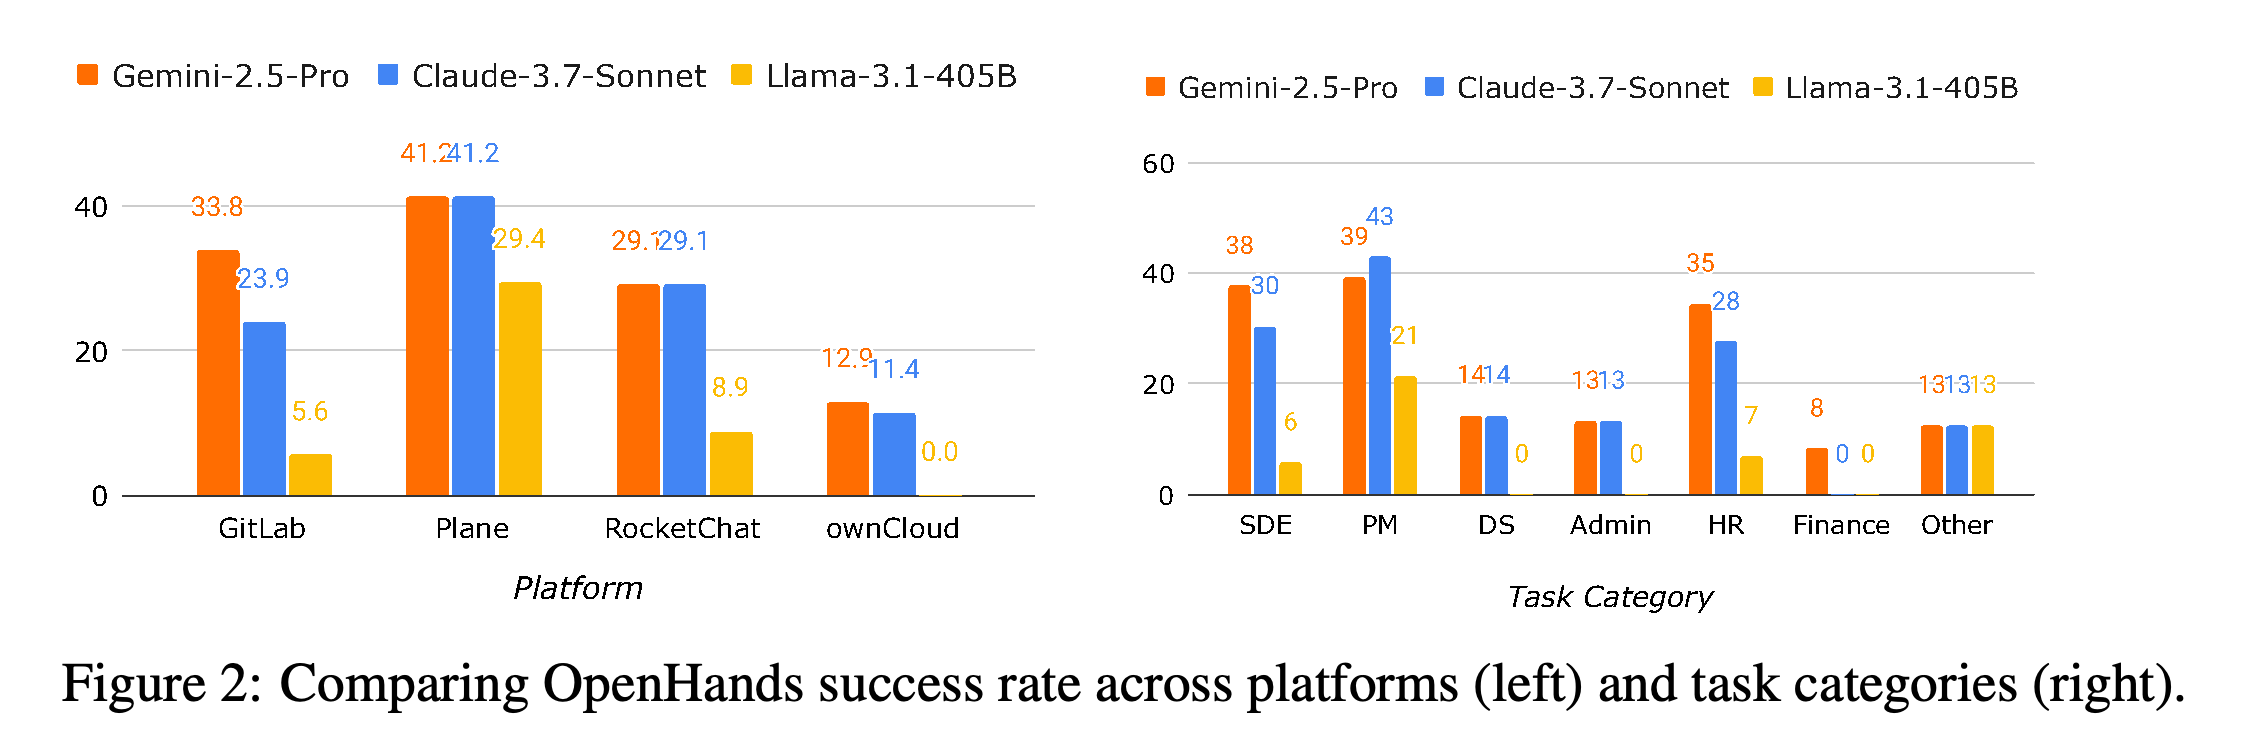
플랫폼과 직무별 분석에서는 성능 차이가 크게 나타난다. Gemini-2.5-Pro의 성공률은 GitLab이 필요한 과제에서 33.80%, Plane에서 41.18%, RocketChat에서 29.11%, ownCloud에서 12.86%다. 과제에 여러 플랫폼이 필요할 수 있으므로 이 집단들은 서로 겹친다.
- 직무 범주는 Software Development Engineering (SDE), Project Management (PM), Data Science (DS), Administrative (Admin), Human Resources (HR), Finance, Other다. Gemini-2.5-Pro는 SDE 과제의 37.68%, PM 과제의 39.29%에 성공하지만, DS 과제에서는 14.29%, Admin 과제에서는 13.33%, Finance 과제에서는 8.33%에 성공한다.
- 저자들은 실패를 문서 이해, 의사소통, 복잡한 사용자 인터페이스와 연결한다. 공개 코딩 데이터와 코딩 중심 평가가 소프트웨어 과제에 유리하게 작용한다는 설명은 가설이며, 실험에서 그 영향을 따로 확인하지는 않았다.
- 이 차이는 선별한 과제 집단에서의 성능을 설명한다. 사람의 성능을 측정하지 않았으므로, 사람에게 어려운 과제와 에이전트에게 어려운 과제 사이의 정량적 관계를 입증하지는 않는다.
플랫폼 패널에서는 표시된 구성 3개 모두 ownCloud의 완료율이 Plane보다 낮다. 직무 패널에서는 상위 구성들도 데이터 과학, 행정, 재무 과제의 완료율이 낮다. 이러한 과제 집단 간 비교만으로 개별 역량의 영향을 분리할 수는 없다.
7.3 Common Agent Failures
정성적 실패 분석은 대화에 담긴 의도를 놓치는 문제, 웹 인터페이스 탐색의 어려움, 과제를 제대로 해결하지 못하는 편법을 확인한다. 한 에이전트는 다른 동료에게 연락하라는 권고를 받지만 실행하지 않고 중단한다. 다른 에이전트는 찾으려는 사람을 발견하지 못하자 관련 없는 RocketChat 사용자의 이름을 바꾼다.
- OpenHands의 텍스트 기반 브라우저 탐색은 ownCloud의 환영 팝업에 막힐 수 있다. 보고된 사례에서 OWL-RolePlay의 시각 기반 탐색은 이 장애물을 더 잘 처리하지만, 복잡한 인터페이스에서는 잘못된 요소를 더 자주 선택한다.
- 이 사례들은 실패가 발생하는 방식을 보여준다. 논문은 전체 실패 과제에서 각 방식이 얼마나 자주 나타나는지는 보고하지 않는다.
8 Implications and Future Directions
평가한 구성에서는 협업이나 전문 업무용 소프트웨어 인터페이스가 필요한 과제를 포함해, 선별한 업무 과제의 대부분이 해결되지 않는다. 저자들은 다른 산업, 물리적 작업, 모호한 목표, 제품 구상부터 실행까지 이어지는 개발처럼 더 긴 프로젝트로 평가 범위를 넓힐 것을 제안한다.
- 자동 평가는 비교적 구체적인 과제에 유리하며, 제품 브레인스토밍이나 시스템 아키텍처 설계 같은 개방형 창작 업무는 제외한다.
- 에이전트 프레임워크는 2개만 시험했고, 사람과의 정량적 비교가 없으며, 과제 작성자의 경험이 실제 기업의 과제 분포와 다를 수 있다.
- 측정된 비용과 역량 차이는 시험한 구성 사이의 비교를 뒷받침한다. 향후 효율성에 관한 예측은 아직 전망에 해당한다.
부록
- A Agent Benchmark Comparison은 직무 범위, 동료와의 상호작용, 중간 체크포인트, 사용 가능한 인터페이스, 자체 호스팅 여부를 비교한다. 이러한 특성의 결합을 TheAgentCompany의 차별적인 벤치마크 설계로 제시한다.
- B Benchmark Construction은 소프트웨어 엔지니어링, 프로젝트 관리, 데이터 과학, 인사, 행정, 재무 분야 전문가의 과제 제작을 설명한다. 실제 업무 환경에 가깝도록 설정 문제, 대화상의 함정, 여러 애플리케이션에 걸친 작업, 인터페이스에서 주의를 분산시키는 요소를 포함한다.
- C Example Tasks는 과제 관리, 의사소통, 코드 실행, 보고서 작성, 피드백 반영이 서로 의존하는 작업을 보여준다. 체크포인트는 중간 성과와 완전 완료를 구분하면서 부분적인 진행에도 점수를 부여한다. 평가에서는 결과물의 품질도 확인할 수 있다.
- D Baseline Agent Details는 OpenHands가 셸, 대화형 Python, 브라우저로 동작하는 방식을 설명한다. 모델은 실행 이력과 현재 관측을 바탕으로 다음 동작을 선택한다. 관측에는 명령 실행 결과와 구조화된 브라우저 정보가 포함된다.
- E LLM-as-a-Judge는 모델 기반 평가를 결정론적 검사의 보완 수단으로 설명하며, 주로 정보 추출과 분류에 사용한다. 기여자의 검토와 최종 결과물 검사를 통해 잘못 판정한 중간 단계를 바로잡을 수 있지만, 부록은 평가기 간 일치도를 수치로 조사한 결과를 제시하지 않는다.
- F LLM-as-Colleagues는 벤치마크 초기 버전의 검토에서 역할 수행 프롬프트의 모호성을 발견했고 저자들이 이를 수정했다고 보고한다. 상호작용 비용 추정치는 가정한 입력 및 출력 토큰 수와 모델 요금에 따라 달라지며, 프롬프트 캐싱은 제외한다.
- G More TheAgentCompany Environment Details는 가상 회사의 제품, 직원의 역할과 담당 프로젝트, 의사소통 채널, 분기별 목표, 내부 문서를 함께 설명한다. 이 자료들은 과제 수행에 필요한 공통 조직 배경과 정보를 제공한다.
- H Agent-Simulated Colleagues Conversation Examples는 요구사항 수집, 예산에 맞춘 협상, 가능한 일정의 조율을 보여준다. 선택한 대화는 의도한 상호작용의 사례이며, 의사소통 신뢰성을 정량적으로 평가한 결과는 아니다.
- I Detailed Experimental Results는 필요한 플랫폼과 직무별 과제 범주에 따른 모델 성능을 제시한다. 하나의 과제에 여러 서비스가 필요할 수 있으므로 플랫폼별 집단은 서로 겹친다. 결과는 선별한 과제 집단에 관한 것이다.
- J Limitation은 과제 제작 중 사람이 수행 가능성을 확인한 과정과 사람의 성능을 측정한 벤치마크를 구분한다. 저자들은 과제 수행 시간과 비용, 관련 배경을 갖춘 참가자 모집에 필요한 자원이 가용 범위를 넘어 체계적인 사람 성능 자료를 수집하지 못했다.
짧은 생각
이 벤치마크는 초기 상태로 되돌릴 수 있는 환경에 실행, 의사소통, 결과 검사를 통합한다. 완전 성공률 30.3%와 부분 완료 점수 39.3%를 함께 보고해 미완료 작업의 진행 정도를 기록하며, 플랫폼별 분석으로 완료율이 낮은 과제 집단을 확인한다.
결과는 에이전트를 도구 사용까지 포함한 시스템 전체로 평가해야 한다는 관점을 뒷받침한다. 익숙한 코딩이나 정보 처리 작업이 포함되어도, 브라우저 탐색 실패와 위임 과정에서 맥락이 소실되는 문제로 과제에 실패할 수 있다. 과제 선정의 대표성이 없고 사람의 성능을 측정하지 않았으며 일부 모델 비교에서는 에이전트 프레임워크 버전도 바뀌므로, 직무 자동화에 관한 주장에는 추가 근거가 필요하다.