


Gemini Embedding: Generalizable Embeddings from Gemini 요약 설명
10 Mar 2025 | Paper Review Text Embeddings Multilingual Learning Contrastive Learning Synthetic Data목차
이번 글에서는 Gemini Embedding: Generalizable Embeddings from Gemini 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 3월 10일(Arxiv)
- Lee, Jinhyuk, Chen, Feiyang, Dua, Sahil, Cer, Daniel, Shanbhogue, Madhuri, Naim, Iftekhar, Ábrego, Gustavo Hernández, Li, Zhe, Chen, Kaifeng, Vera, Henrique Schechter, et al.
- Gemini Embedding Team, Google
- 논문 링크
- Project Page
요약
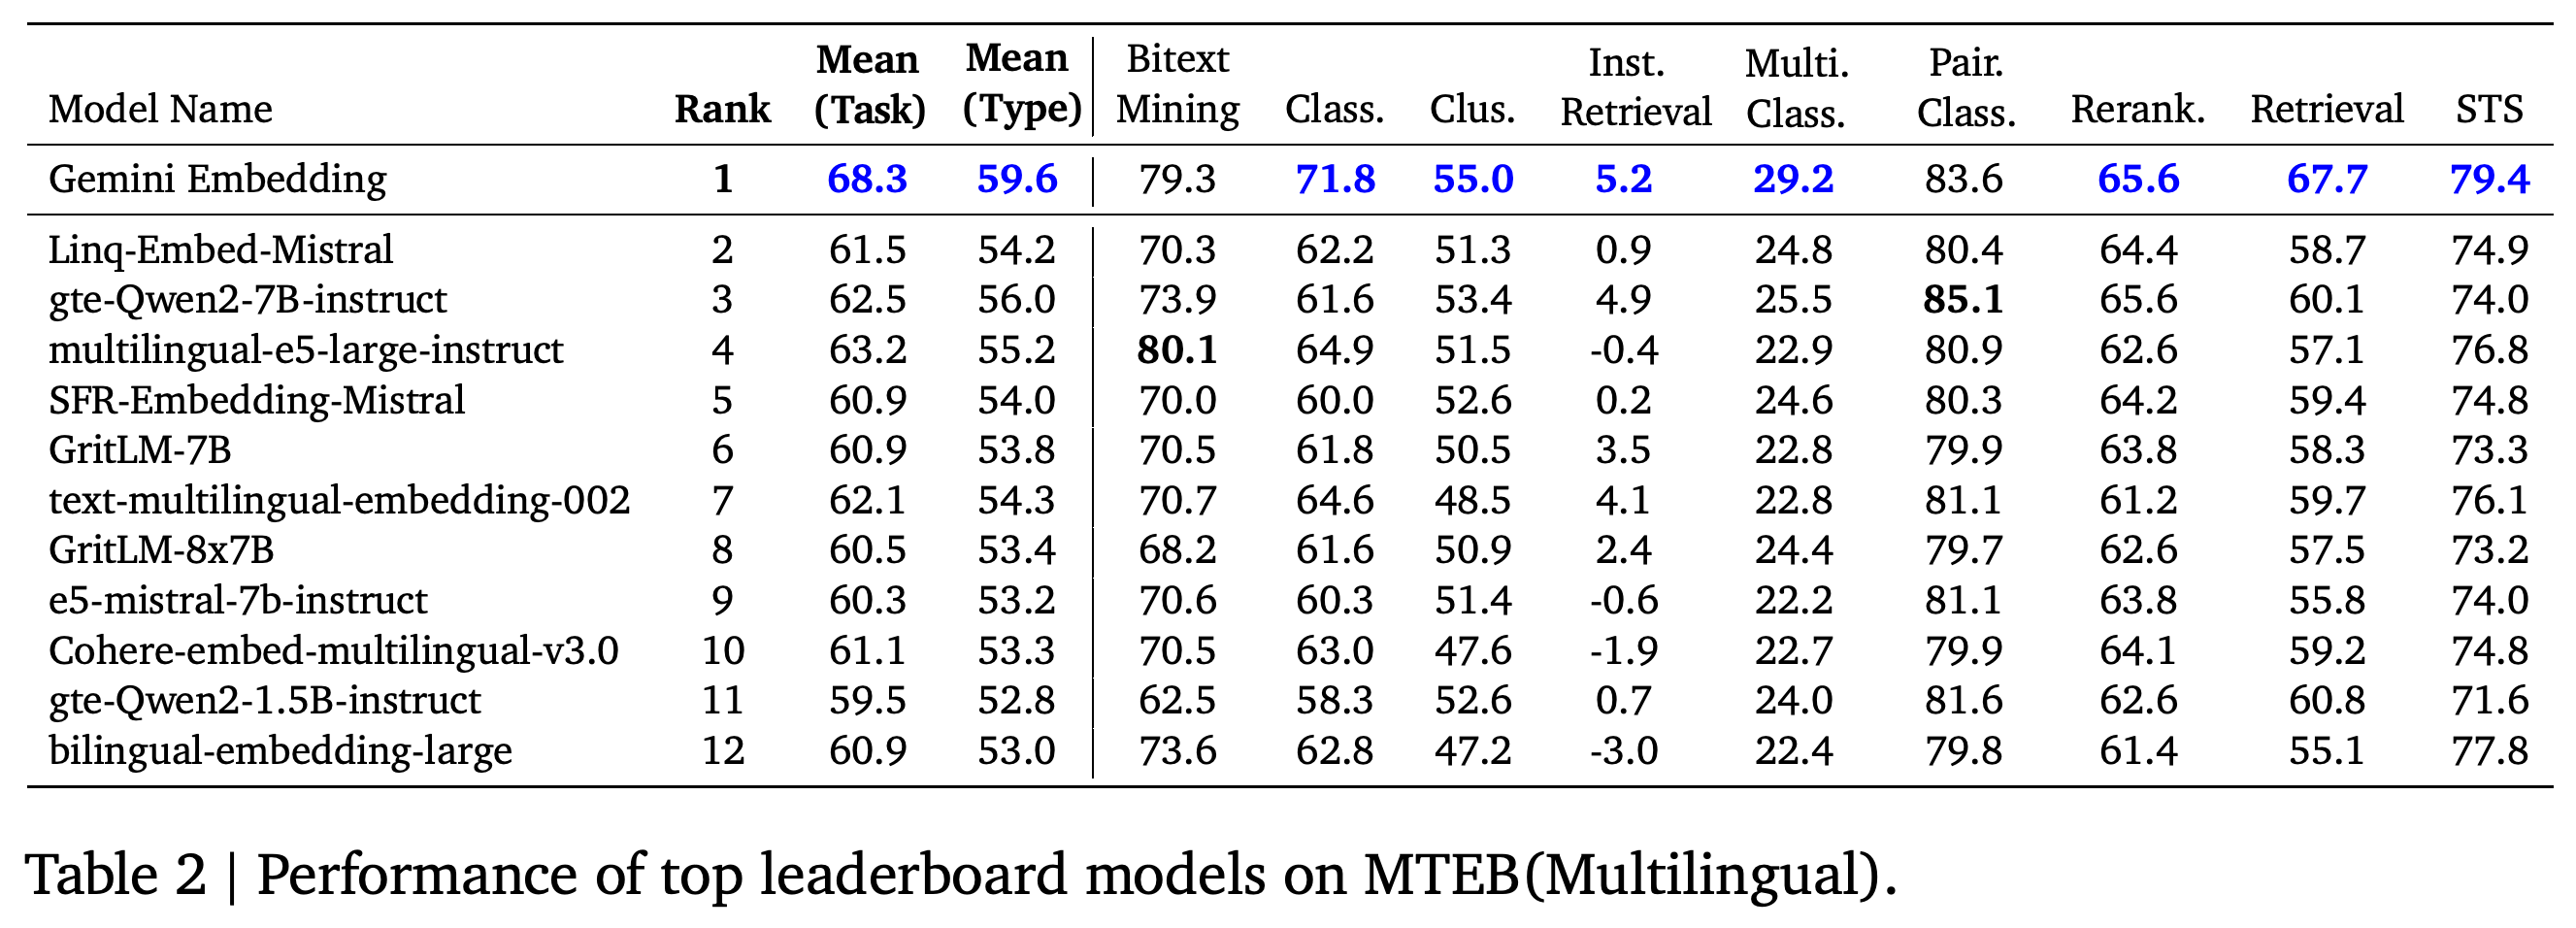
- 이 논문은 텍스트를 재사용 가능한 수치 벡터로 변환하는 텍스트 임베딩 모델 1개를 여러 언어, 코드, 태스크에 적용하는 방법을 다룬다. Gemini Embedding은 Massive Multilingual Text Embedding Benchmark(MMTEB)에서 MTEB(Multilingual)로 표기한 March 10th, 2025 다국어 평가에서 태스크 평균 68.32를 기록한다. 이는 보고된 경쟁 모델 중 태스크 평균이 가장 높은 multilingual-e5-large-instruct의 63.23을 웃도는 점수이며, 공개 리더보드에서 1위를 차지한다.
- 모델은 사전 학습된 대규모 언어 모델인 Gemini로 초기화하며, 일치하는 질의와 타깃 쌍을 일치하지 않는 쌍과 구별하는 대조 학습, Gemini를 활용한 데이터 생성과 필터링을 결합한다. 학습은 텍스트 생성 모델을 벡터 인코더로 먼저 적응시키는 pre-finetuning, 태스크별 fine-tuning, 선택한 모델 저장 상태인 체크포인트의 파라미터를 평균하는 Model Soup 순서로 진행한다. 전체 벡터는 3,072차원이며, 학습 과정에서 앞부분의 768차원과 1,536차원도 사용할 수 있도록 한다. 대조 학습에 대해서는 Contrastive Learning, SimCLR 논문 설명(SimCLRv1, SimCLRv2) 글을 참조하라.
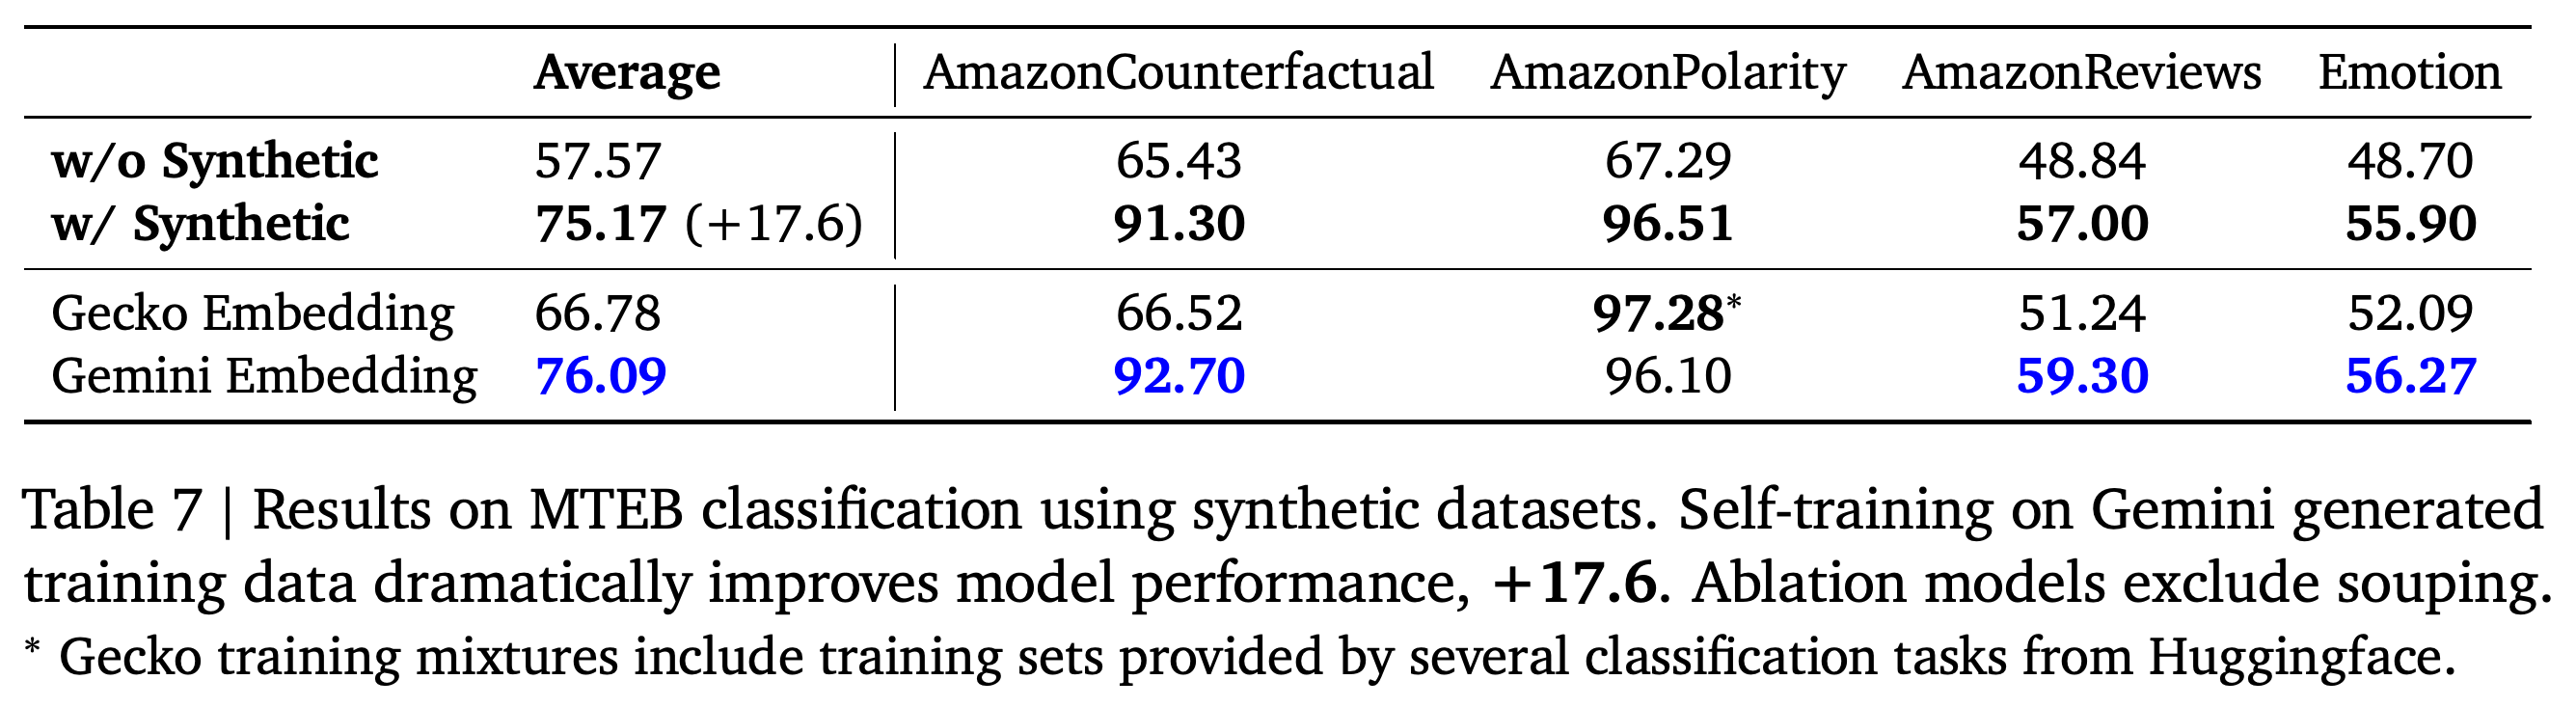
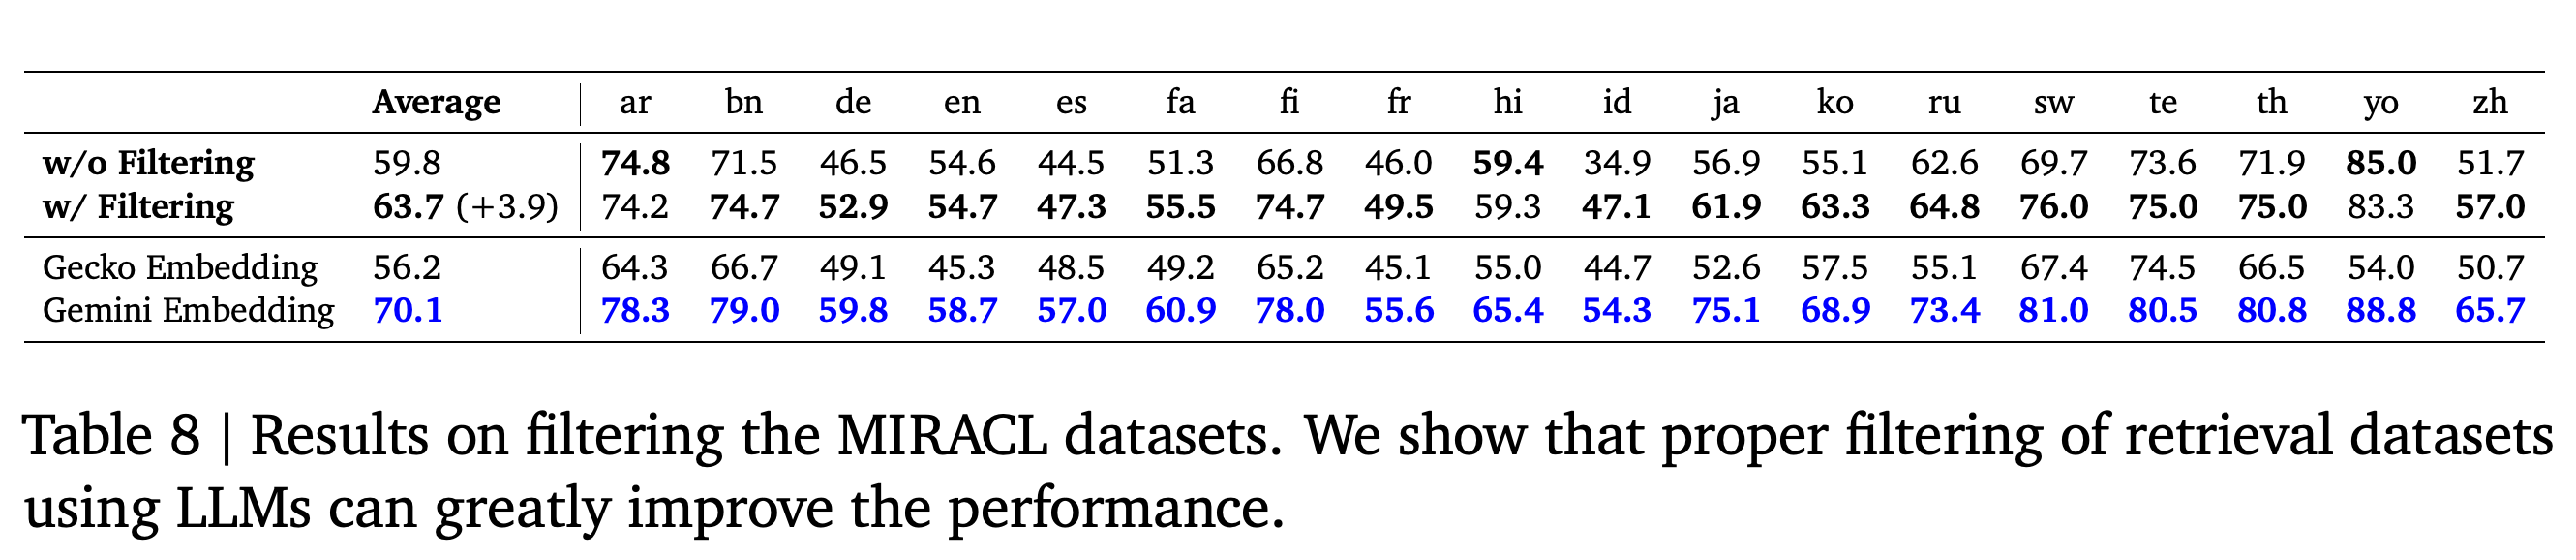
- 합성 분류 데이터는 4개 태스크의 평균을 57.57에서 75.17로 높이며, 다국어 검색 데이터 필터링은 평균을 59.8에서 63.7로 높인다. 학습 데이터 혼합 비교에서는 상충 관계가 나타난다. 다국어 검색 데이터만으로 fine-tuning한 모델은 벤치마크에서 충분히 다루지 않는 언어의 질의로 영어 구절을 검색하는 XTREME-UP에서 더 높은 성능을 보이지만, 최종 모델은 더 폭넓은 태스크 모음에서 우수하다. 논문은 모델 크기, 학습 연산량, 학습 설정 일부를 공개하지 않는다.
1. Introduction
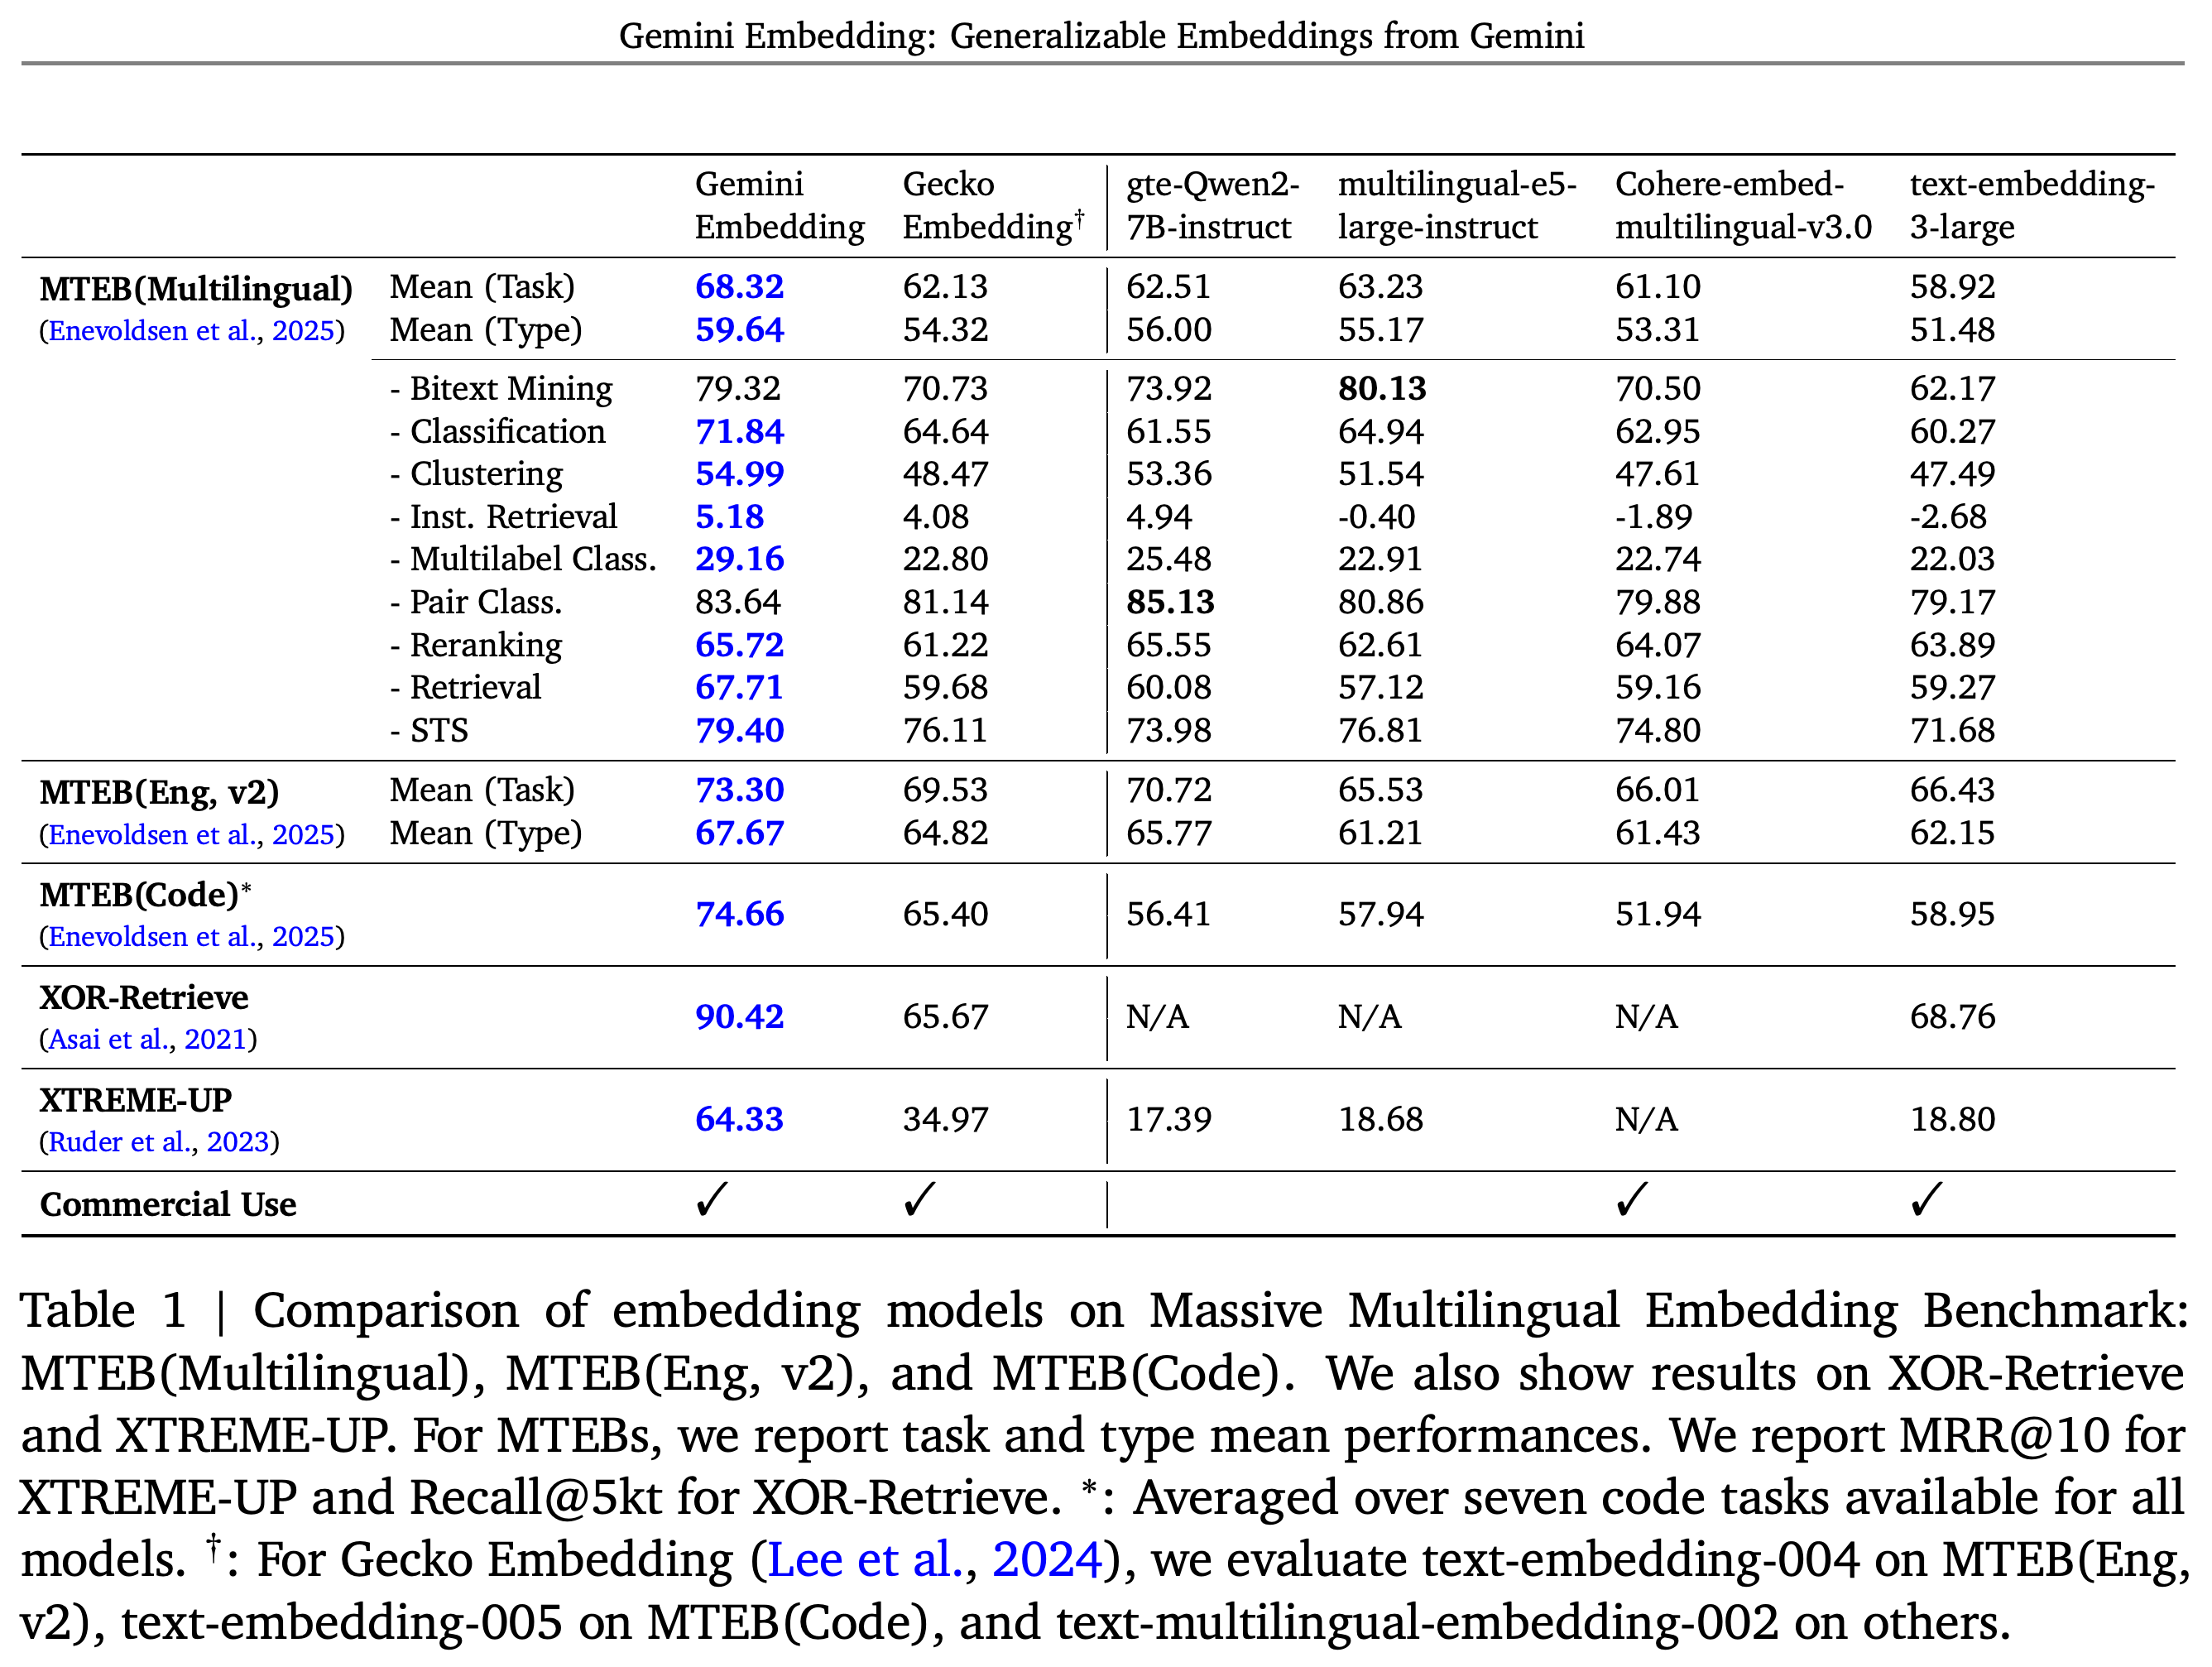
목표는 미리 계산한 뒤 재사용할 수 있는 표현을 만드는 것이다. 이 표현은 관련 구절을 찾는 검색, 레이블을 부여하는 분류, 관련 텍스트를 묶는 군집화, 유사도 점수 계산에 활용한다. Gemini는 초기 모델 파라미터를 제공하고, 예제 생성과 관련 또는 비관련 구절 평가 등 학습 데이터 구성에도 쓰인다. Table 1은 다국어, 영어, 코드 평가와 질의 및 구절의 언어가 서로 다른 교차 언어 검색 결과를 요약한다.
- 주요 평가 체계인 MMTEB는 250+개 언어를 다룬다. 태스크 범주에 동일한 가중치를 부여하는 다국어 태스크 유형 평균에서 Gemini Embedding은 59.64를 기록하며, gte-Qwen2-7B-instruct의 56.00보다 3.64점 높다.
- 논문은 모델 접근 경로로 https://ai.google.dev/gemini-api/docs/embeddings 를 제시하며, March 10th, 2025 비교에 사용한 공개 리더보드로 https://huggingface.co/spaces/mteb/leaderboard 를 명시한다.
Gemini Embedding은 보고된 다국어, 영어, 코드, 교차 언어 종합 비교에서 가장 높은 성능을 보이지만, 개별 다국어 범주에는 예외가 있다. 코드 점수에는 공통 태스크 7개를 사용한다. Gecko 열은 영어에 text-embedding-004, 코드에 text-embedding-005, 나머지 벤치마크에 text-multilingual-embedding-002를 사용하므로 행에 따라 서로 다른 모델을 나타낸다.
2. Related Work
관련 연구는 대규모 언어 모델(LLM)의 2가지 활용법을 뒷받침한다. 임베딩 학습 데이터를 생성하는 방법과 사전 학습된 모델 파라미터를 임베딩 모델에 맞게 적응시키는 방법이다. 초기 문장 인코더는 여러 태스크에서 재사용할 수 있는 표현을 확립했으며, 후속 연구는 더 큰 언어 모델을 출발점으로 삼았다. 논문은 도메인 내 데이터를 대량으로 학습할 때 발생하는 벤치마크별 과적합을 문제로 지적한다. 이는 성능 향상이 학습 도메인 밖으로 전이되지 않는 현상이다.
- 기존 합성 질의 연구는 질의 생성에 사용한 구절이 반드시 최적의 양성 타깃은 아니라는 점을 보여준다. 양성 타깃은 학습에서 관련성이 있다고 간주하는 구절이다.
- 인용 문헌에는 질의, 양성 타깃, hard negative로 이루어진 다국어 삼중항을 생성하는 연구가 포함된다. Hard negative는 관련 구절과 의미상 유사하지만 질의에 답하지 못하는 타깃이다.
3. Gemini Embedding
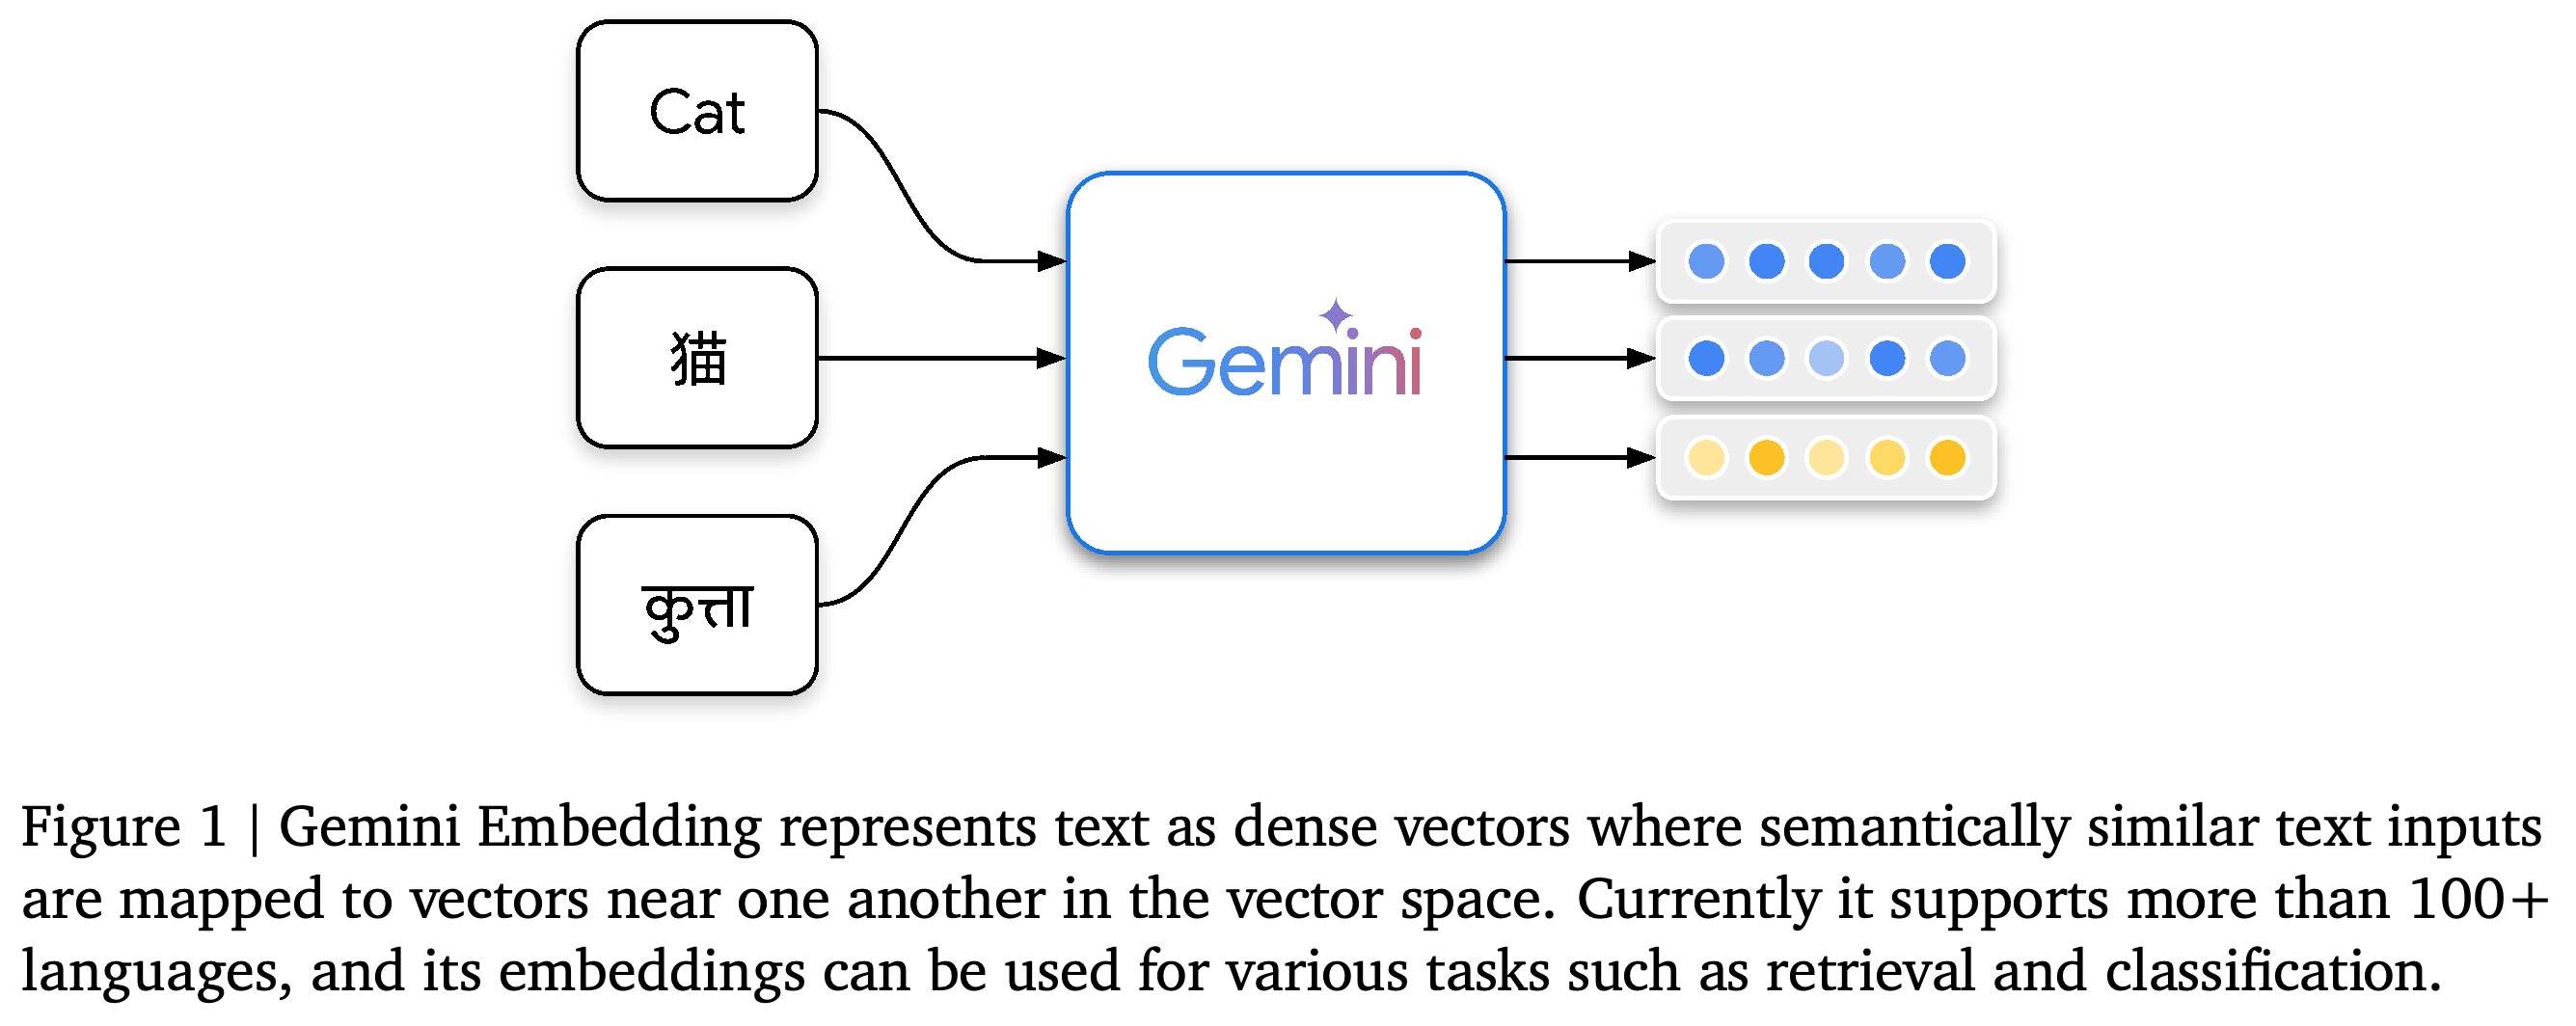
Gemini Embedding은 Gemini를 다국어 텍스트와 코드를 위한 공통 인코더로 적응시킨다. 인코더는 입력을 벡터로 변환하는 모델이다. 이 방법은 문맥을 반영한 토큰 표현을 만드는 transformer, 토큰 표현을 결합하는 시퀀스 풀링, 출력 벡터 공간으로의 투영, 대조 학습을 결합한다. Figure 1은 다국어 입력 사이에 형성하려는 의미 관계를 보여준다.
도식은 고양이를 뜻하는 영어와 중국어 단어를 유사한 벡터로, 개를 뜻하는 힌디어 단어를 다른 벡터로 표현한다. 측정한 벡터 거리를 보고하지는 않으며, 언어 간에 형성하려는 공통 의미 공간을 보여준다.
3.1. Model Architecture
Gemini로 초기화한 transformer는 양방향 어텐션을 사용하므로 각 토큰 표현에 2개 방향의 문맥을 반영할 수 있다. 평균 풀링으로 입력 시퀀스 전체의 토큰 표현을 평균한 뒤, 무작위로 초기화한 선형 투영으로 출력 임베딩 차원에 매핑한다. 논문은 이 적응 방식을 설명하지만 정확한 Gemini 체크포인트나 파라미터 수는 밝히지 않는다.
3.2. Training Objective
학습에는 양성 타깃과 음성 타깃을 구별하는 손실인 noise-contrastive estimation(NCE)을 사용하며, 배치 내 다른 예제에서 음성 타깃을 가져온다. 질의 앞에는 “question answering”이나 “fact checking” 같은 태스크 문자열을 붙이고, 타깃은 이 문자열 없이 인코딩한다. 생성된 표현의 점수는 벡터 내적을 정규화한 코사인 유사도로 계산한다.
- 각 예제는 질의, 양성 타깃, 선택적인 hard negative로 구성한다. 마스크는 질의나 양성 타깃이 반복되는 비교를 제외하며, 이는 분류 예제가 레이블을 공유할 때 중요하다.
- Hard negative를 제공하지 않으면 분모에서 명시적인 hard-negative 항을 제외한다. 질의끼리 또는 타깃끼리 비교하는 same-tower negative도 제외한다. 저자들은 이를 포함하면 대부분의 태스크에서 성능이 낮아진다고 보고하며, 관련 있는 쌍을 불일치로 잘못 취급하는 false negative가 원인일 가능성을 제시한다.
- 서로 겹치는 벡터 앞부분에 손실을 적용해 학습하는 Matryoshka Representation Learning(MRL)을 통해 전체 3,072차원 임베딩에서 앞부분의 768차원과 1,536차원을 사용할 수 있다.
3.3. Recipe
Pre-finetuning은 잡음이 포함될 수 있는 대량의 질의와 타깃 쌍, 큰 배치, 명시적인 hard-negative 항이 없는 손실을 사용한다. 이를 통해 토큰을 순서대로 생성하는 자기회귀 생성 모델인 Gemini를 인코더로 적응시킨다. 이후 fine-tuning에는 태스크별 질의, 타깃, hard negative 삼중항과 예제 수가 1024개 미만인 배치 등 더 작은 배치를 사용한다. 배치마다 데이터셋 1개를 사용해 경쟁하는 타깃이 같은 태스크에서 나오도록 한다.
- Pre-finetuning은 데이터셋이 더 크기 때문에 fine-tuning보다 훨씬 많은 스텝을 수행한다. 정확한 배치 크기와 스텝 수는 공개하지 않는다.
- 그리드 탐색에서 학습 하이퍼파라미터와 데이터셋 포함 여부를 바꿔 후보 체크포인트를 얻는다. Model Soup는 같은 학습 실행이나 서로 다른 실행에서 얻은 체크포인트의 파라미터를 평균하며, 가중 평균도 사용한다. 체크포인트는 의도적인 데이터 구성 변화와 수동 실험을 통해 선택한다.
- 논문은 구성 요소의 효과를 분리해 비교하는 정량적 ablation을 Model Soup에 대해 별도로 보고하지 않는다.
4. Datasets
학습 데이터 혼합은 다국어 임베딩 태스크와 질의에 관련된 코드를 찾는 코드 검색을 포괄한다. Gemini는 합성 예제 생성, 저품질 예제 제거, 학습에 사용할 어려운 비관련 타깃을 고르는 hard-negative mining을 통해 데이터 품질을 높인다.
4.1. Training Data Mixture
Pre-finetuning에는 10억 규모의 웹 코퍼스에서 추출한 제목과 구절의 양성 쌍을 사용한다. Fine-tuning에는 선별한 학술 데이터셋과 합성 데이터셋을 사용해 태스크 다양성, 언어 다양성, 코딩 능력을 각각 강조하는 3가지 데이터 혼합을 준비한다.
- 저자들은 기존 Massive Text Embedding Benchmark(MTEB)의 도메인 내 데이터셋 다수를 제외한다. 해당 데이터셋 자체의 테스트 분할에서만 성능이 개선되는 현상을 관찰했기 때문이다. 저자들은 이를 학습 데이터와 평가 데이터가 정보를 공유하는 train–test leakage 또는 데이터셋 편향과 연관 짓는다.
- 데이터 혼합 비율은 개별 데이터셋이 수렴하는 데 필요한 학습 스텝을 초기값으로 삼아 세밀한 그리드 탐색으로 선택한다. 전체 데이터셋 목록, 혼합 가중치, 선택한 학습 스케줄은 제공하지 않는다.
4.2. Improving Data Quality with Gemini
검색에서는 Gemini가 웹 구절에 대한 질의를 생성하고, 자동 품질 평가자로서 비현실적인 질의 등의 예제를 제거한다. 분류에서는 생성한 사용자, 제품, 영화 정보를 조건으로 삼는 다단계 프롬프트를 통해 영어 반사실, 감성, 리뷰 분류 예제를 생성한다. 다양성을 높이기 위해 길게 생성한 목록의 뒤쪽 항목을 샘플링한다.
- 프롬프트에 예제를 제공하는 few-shot prompting을 검색 데이터 생성과 데이터 품질 평가에 활용한다. Gemini는 사람이 주석을 단 검색 예제에서도 양성 또는 음성 타깃이 잘못된 사례를 걸러낸다.
- Hard-negative mining은 hard negative 없이 학습한 임베딩 모델로 시작하며, 각 질의에 대해 상위 k개 이웃 구절을 검색한다. Gemini는 관련성 수준을 부여하는 graded classification과 구절이 주어졌을 때 질의가 나올 가능성을 평가하는 query likelihood로 후보 점수를 계산한다.
- 후보 순위를 결합하는 방법인 Reciprocal Rank Fusion(RRF)으로 2가지 평가를 결합한다. 저자들은 검색된 이웃 집합 안에서 Gemini 점수가 가장 낮은 구절을 hard negative로 선택한다.
5. Evaluation
평가는 모델 1개와 공통 임베딩 공간이 태스크 유형, 도메인, 언어, 질의와 구절의 언어 조합 전반에서 작동하는지 검증한다. MMTEB 평가에 다른 언어의 질의로 영어 구절을 검색하는 벤치마크 2개인 XOR-Retrieve와 XTREME-UP을 결합한다.
5.1. Benchmarks and Tasks
논문은 개별 MMTEB 평가 태스크가 164개라고 보고하면서, 별도로 MTEB(Multilingual)에 132개, MTEB(Eng, v2)에 41개, MTEB(Code)에 12개 태스크가 있다고 제시한다. 이 모음별 태스크 수를 합하면 185개이지만, 논문은 이 수치와 앞서 밝힌 총 164개의 관계를 설명하지 않는다. 평가 체계는 250+개 언어와 10개 태스크 유형을 다룬다.
- 태스크 유형은 언어 간 대응 텍스트를 찾는 Bitext Mining, Classification, Clustering, 지시에 따라 구절을 찾는 Instruction Retrieval, 여러 레이블을 부여하는 Multilabel Classification, 텍스트 쌍에 레이블을 부여하는 Pair Classification, 후보 결과의 순서를 조정하는 Reranking, Retrieval, 텍스트 간 유사도를 평가하는 semantic textual similarity(STS), Summarization이다.
- XOR-Retrieve는 7개 언어의 질의와 영어 구절을 연결하며, XTREME-UP은 벤치마크에서 충분히 다루지 않는 언어 20개의 질의를 사용한다.
- 태스크 평균은 각 태스크에 동일한 가중치를 부여하고, 태스크 유형 평균은 각 태스크 유형에 동일한 가중치를 부여한다. 논문은 공식 리더보드 순위 지표로 Borda rank를 사용하며, XTREME-UP에는 상위 10개 결과 안에서의 평균 역순위인 MRR@10을 보고한다. XOR-Retrieve의 재현율은 Recall@5kt로 보고하지만, 논문에서 이 검색 범위 표기를 정의하지 않는다.
5.2. Overall Performance
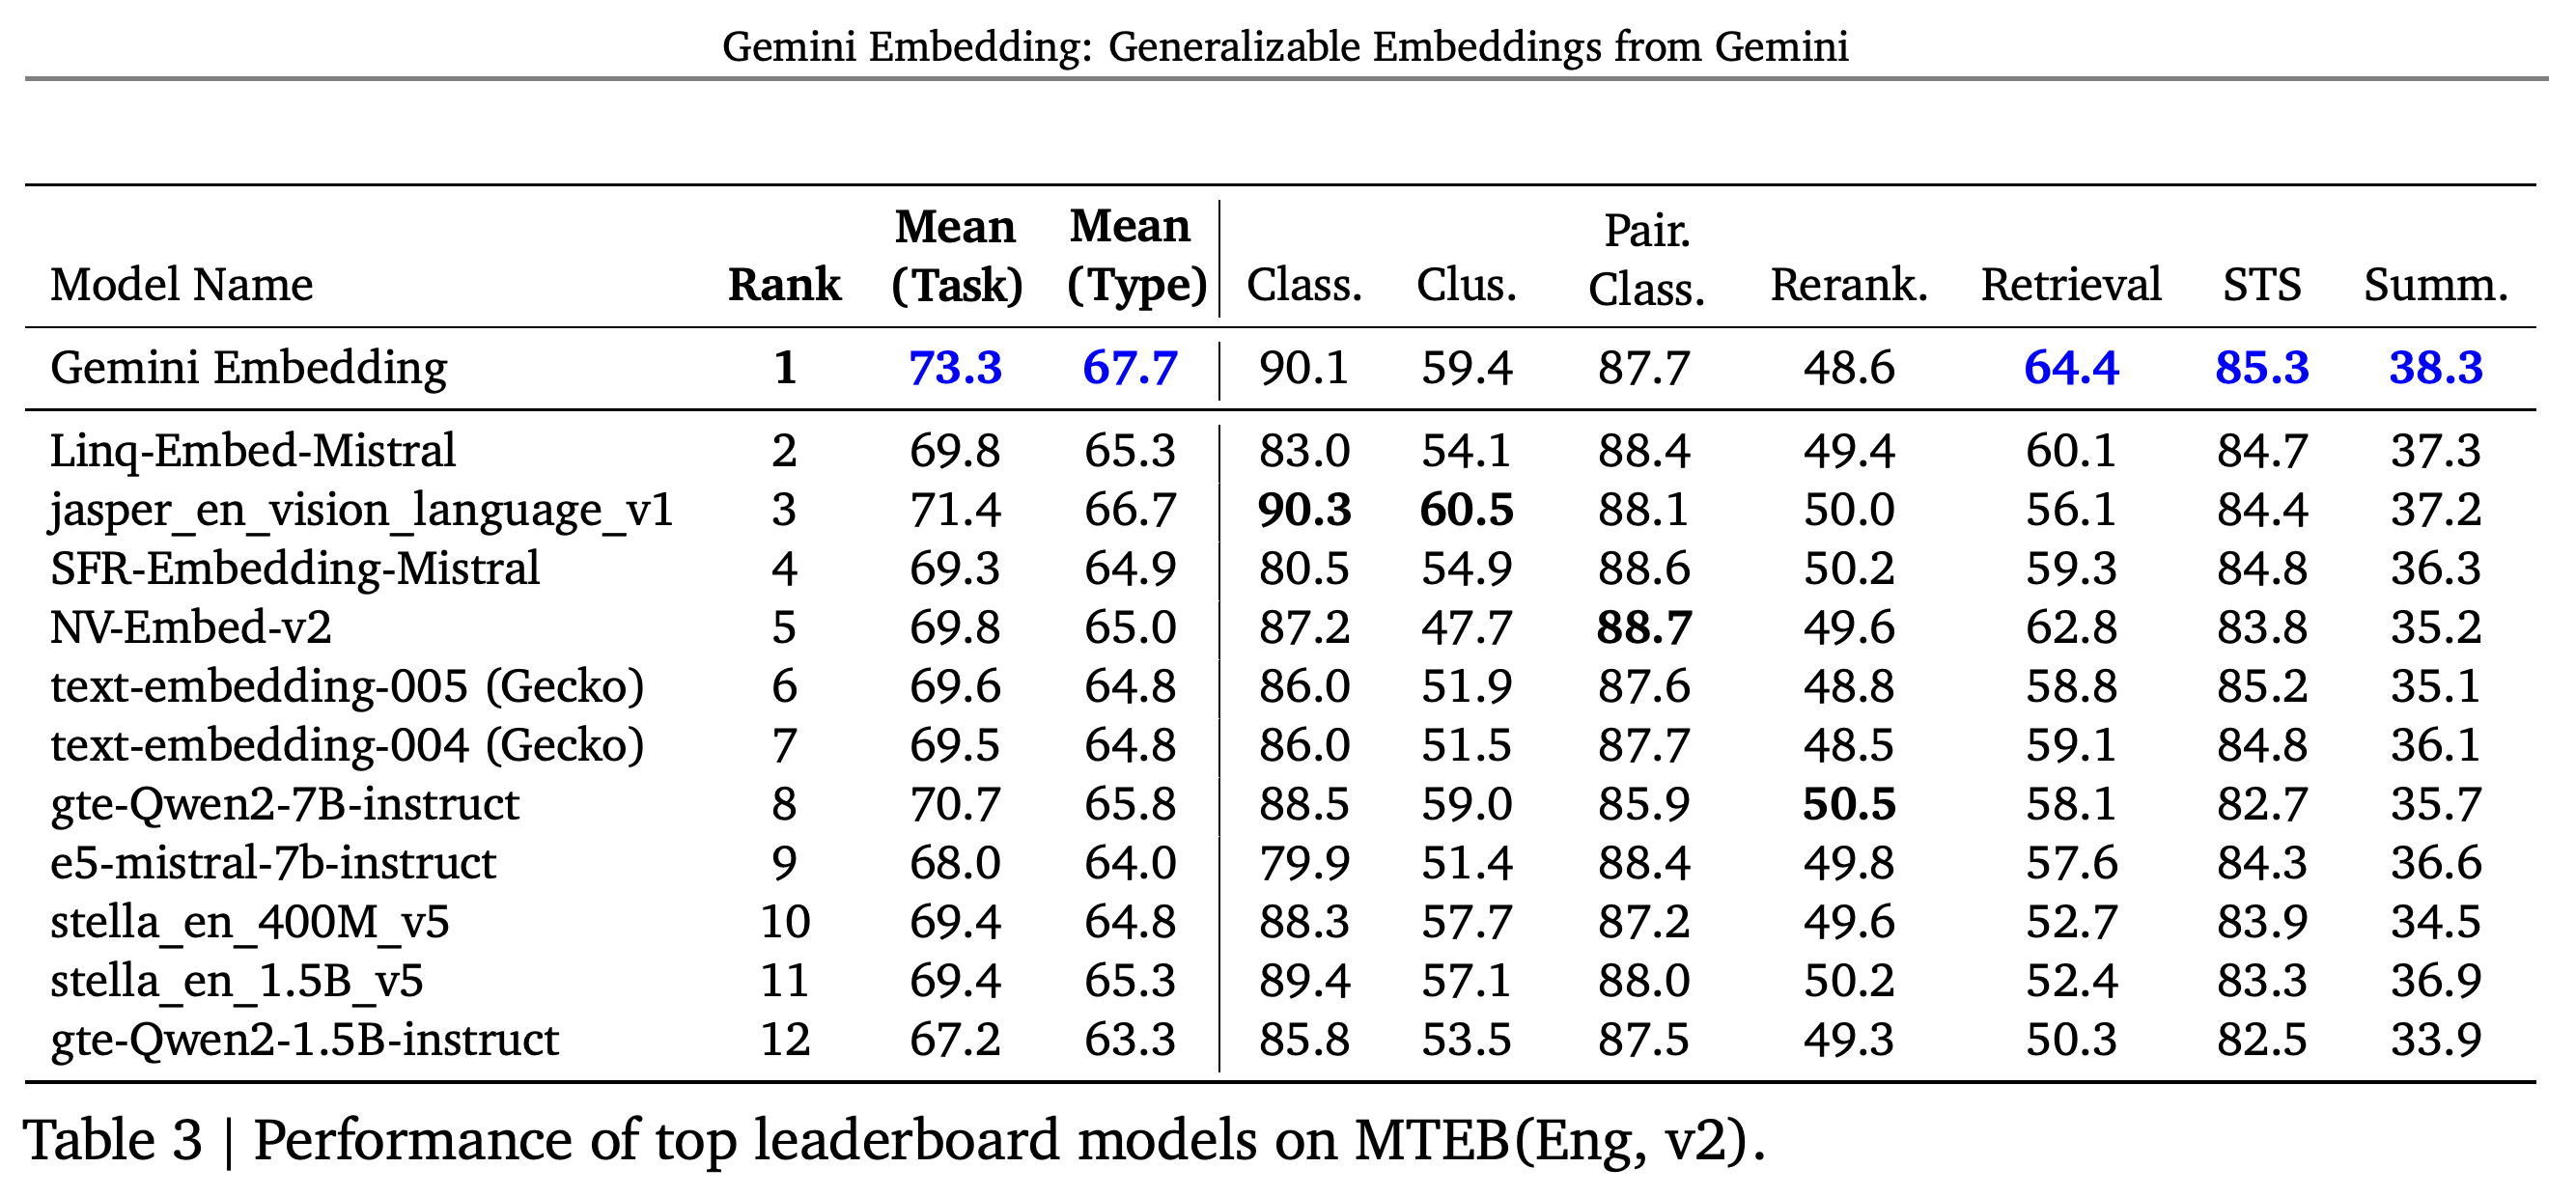
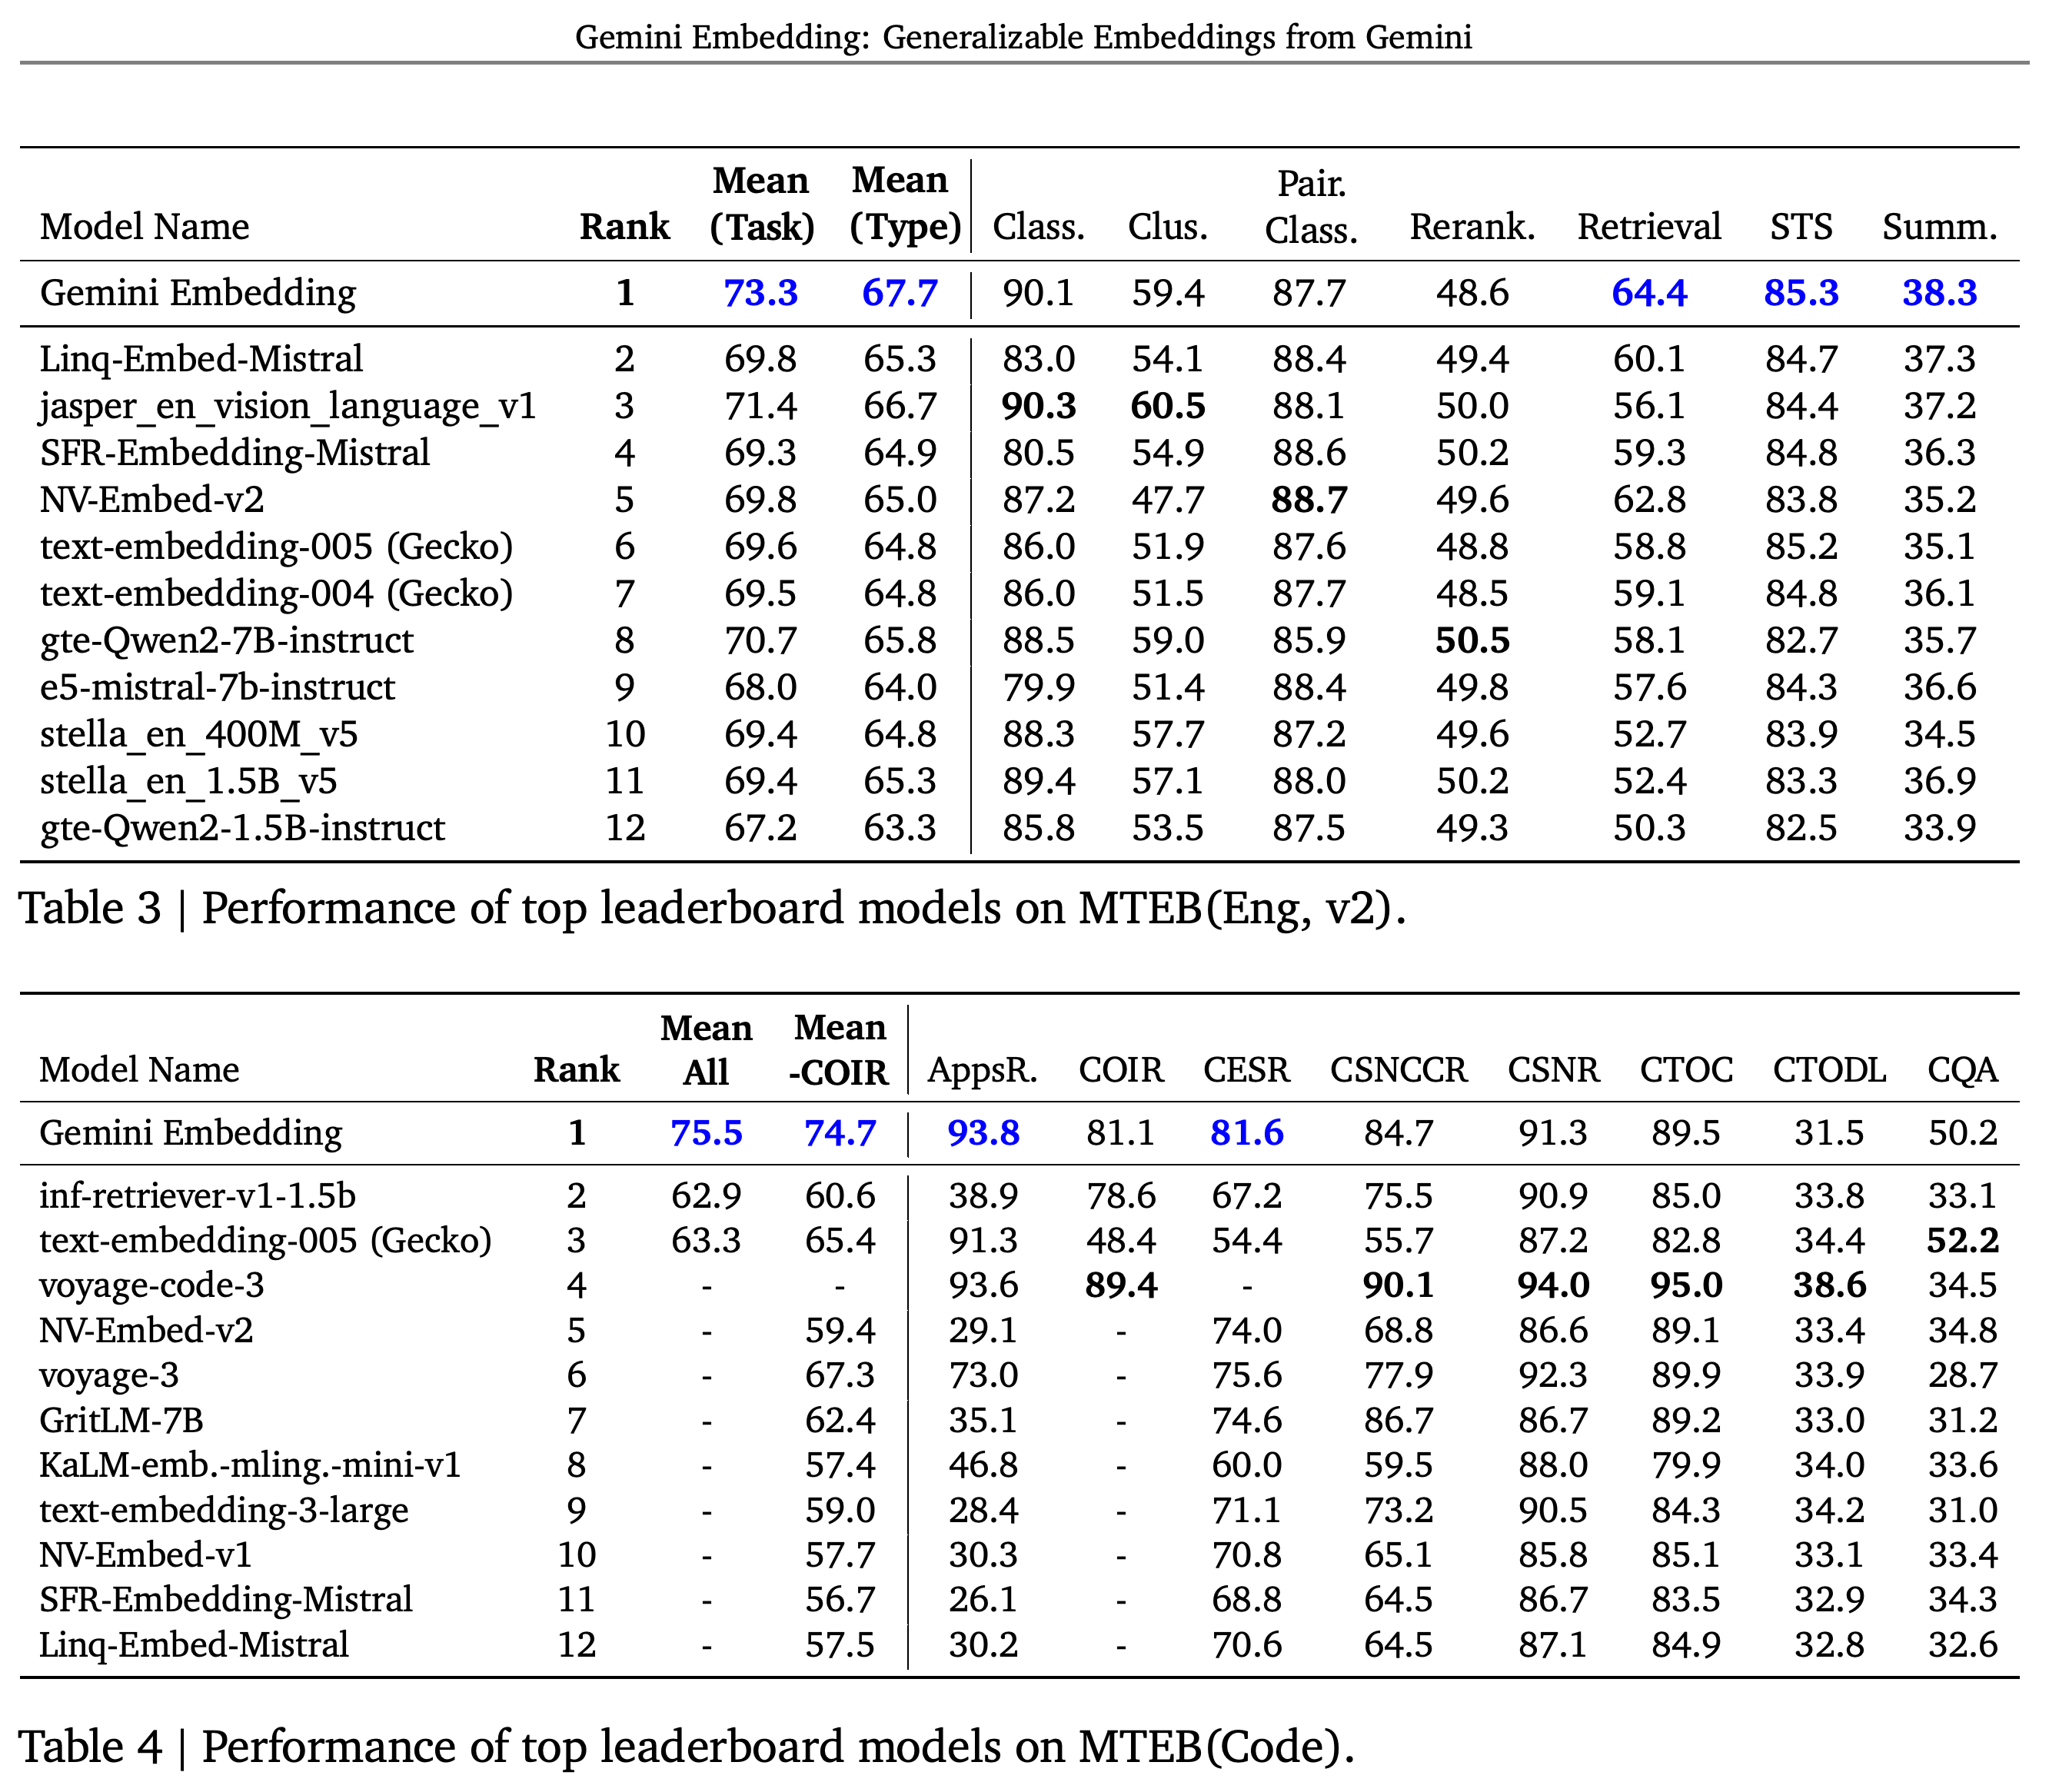
Gemini Embedding은 논문에 제시한 March 10th, 2025 다국어, 영어, 코드 리더보드에서 1위를 기록한다. Table 1은 다국어 태스크 평균과 태스크 유형 평균을 각각 68.32와 59.64, 영어 평균을 각각 73.30과 67.67로 보고하며, 코드 태스크 7개의 평균은 74.66으로 제시한다. Tables 2–4는 태스크 유형별 결과와 코드 태스크별 결과를 제공한다.
- 다국어 성능이 모든 범주에서 가장 높은 것은 아니다. Bitext Mining에서는 multilingual-e5-large-instruct가 80.13으로 Gemini Embedding의 79.32보다 높고, Pair Classification에서는 gte-Qwen2-7B-instruct가 85.13으로 Gemini Embedding의 83.64보다 높다.
- 영어 리더보드는 73.3 task mean과 태스크 유형 평균 67.7을 보고한다. Gemini Embedding은 표시된 Retrieval, STS, Summarization 열에서 가장 높은 점수를 기록하지만, 나머지 여러 범주에서는 다른 모델의 점수가 더 높다.
- 코드 리더보드는 8개 태스크를 다루며 CodeFeedbackMT, CodeFeedbackST, StackOverflowQA, SyntheticText2SQL을 제외한다. Gemini Embedding은 전체 8개에서 75.5를 기록하고, 여러 경쟁 모델이 제출하지 않은 코드 검색 태스크인 COIRCodeSearchNetRetrieval을 제외하면 74.7을 기록한다. voyage-code-3는 여러 개별 태스크에서 가장 높은 점수를 기록하지만 전체 평균은 없다.
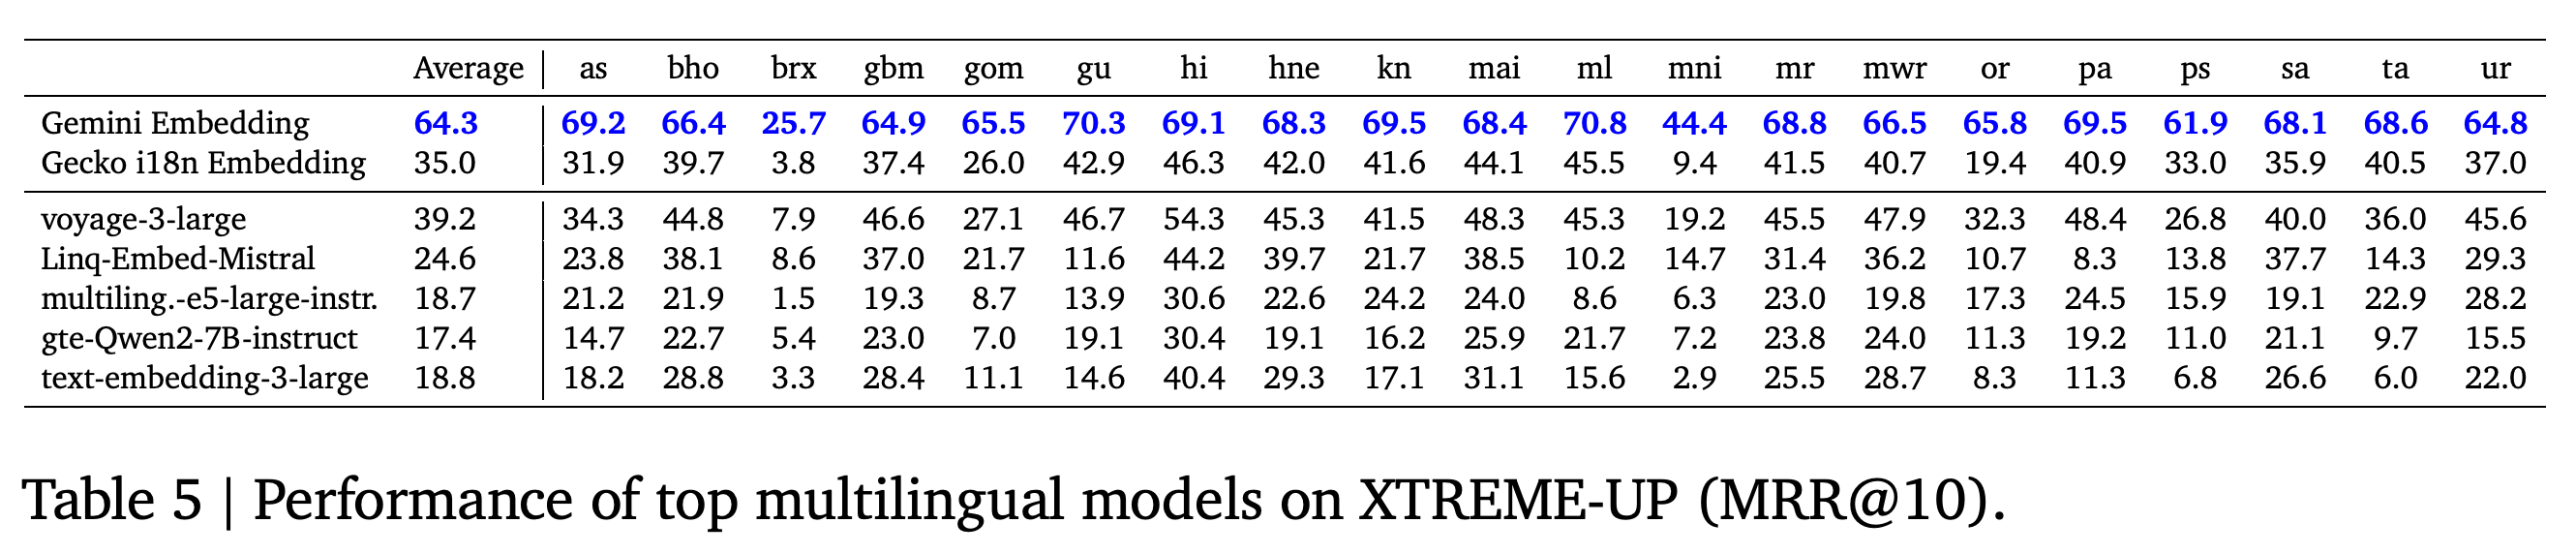
- XOR-Retrieve에서는 Recall@5kt 90.42를 기록하며, text-embedding-3-large는 68.76, Gecko는 65.67을 기록한다. XTREME-UP에서는 MRR@10 64.33을 기록한다. Table 5에 표시된 Gemini 외 모델 중 가장 높은 평균은 voyage-3-large의 39.2이다.
Gemini Embedding은 68.3 task mean과 태스크 유형 평균 59.6으로 선두를 기록한다. 종합 점수는 가장 높지만 Bitext Mining과 Pair Classification 점수는 각 범주에서 가장 높은 경쟁 모델보다 낮다. 따라서 선두라는 순위가 모든 태스크 유형에서 최고 점수를 뜻하지는 않는다.
Gemini Embedding은 종합 1위를 기록하며, 표시된 Retrieval, STS, Summarization 열에서 가장 높은 점수를 얻는다. Classification, Clustering, Pair Classification, Reranking에서는 다른 모델의 점수가 더 높아, 종합 성능에서 앞서더라도 태스크 유형별 결과는 다르다.
Gemini Embedding은 코드 태스크 8개의 평균으로 75.5를 기록하고, COIRCodeSearchNetRetrieval을 제외한 평균으로 74.7을 기록한다. 경쟁 모델의 미제출 결과 때문에 전체 종합 비교에는 제약이 있다. voyage-code-3는 전체 평균이 없지만 여러 개별 열에서 가장 높은 점수를 기록한다.
Gemini Embedding은 표시된 XTREME-UP의 모든 언어 열에서 가장 높은 점수를 기록하며, 평균 MRR@10은 64.3으로 voyage-3-large의 39.2보다 높다. 모델 자체의 결과도 brx에서는 25.7, ml에서는 70.8을 기록하는 등 언어별 편차가 크다.
5.3. Qualitative Examples
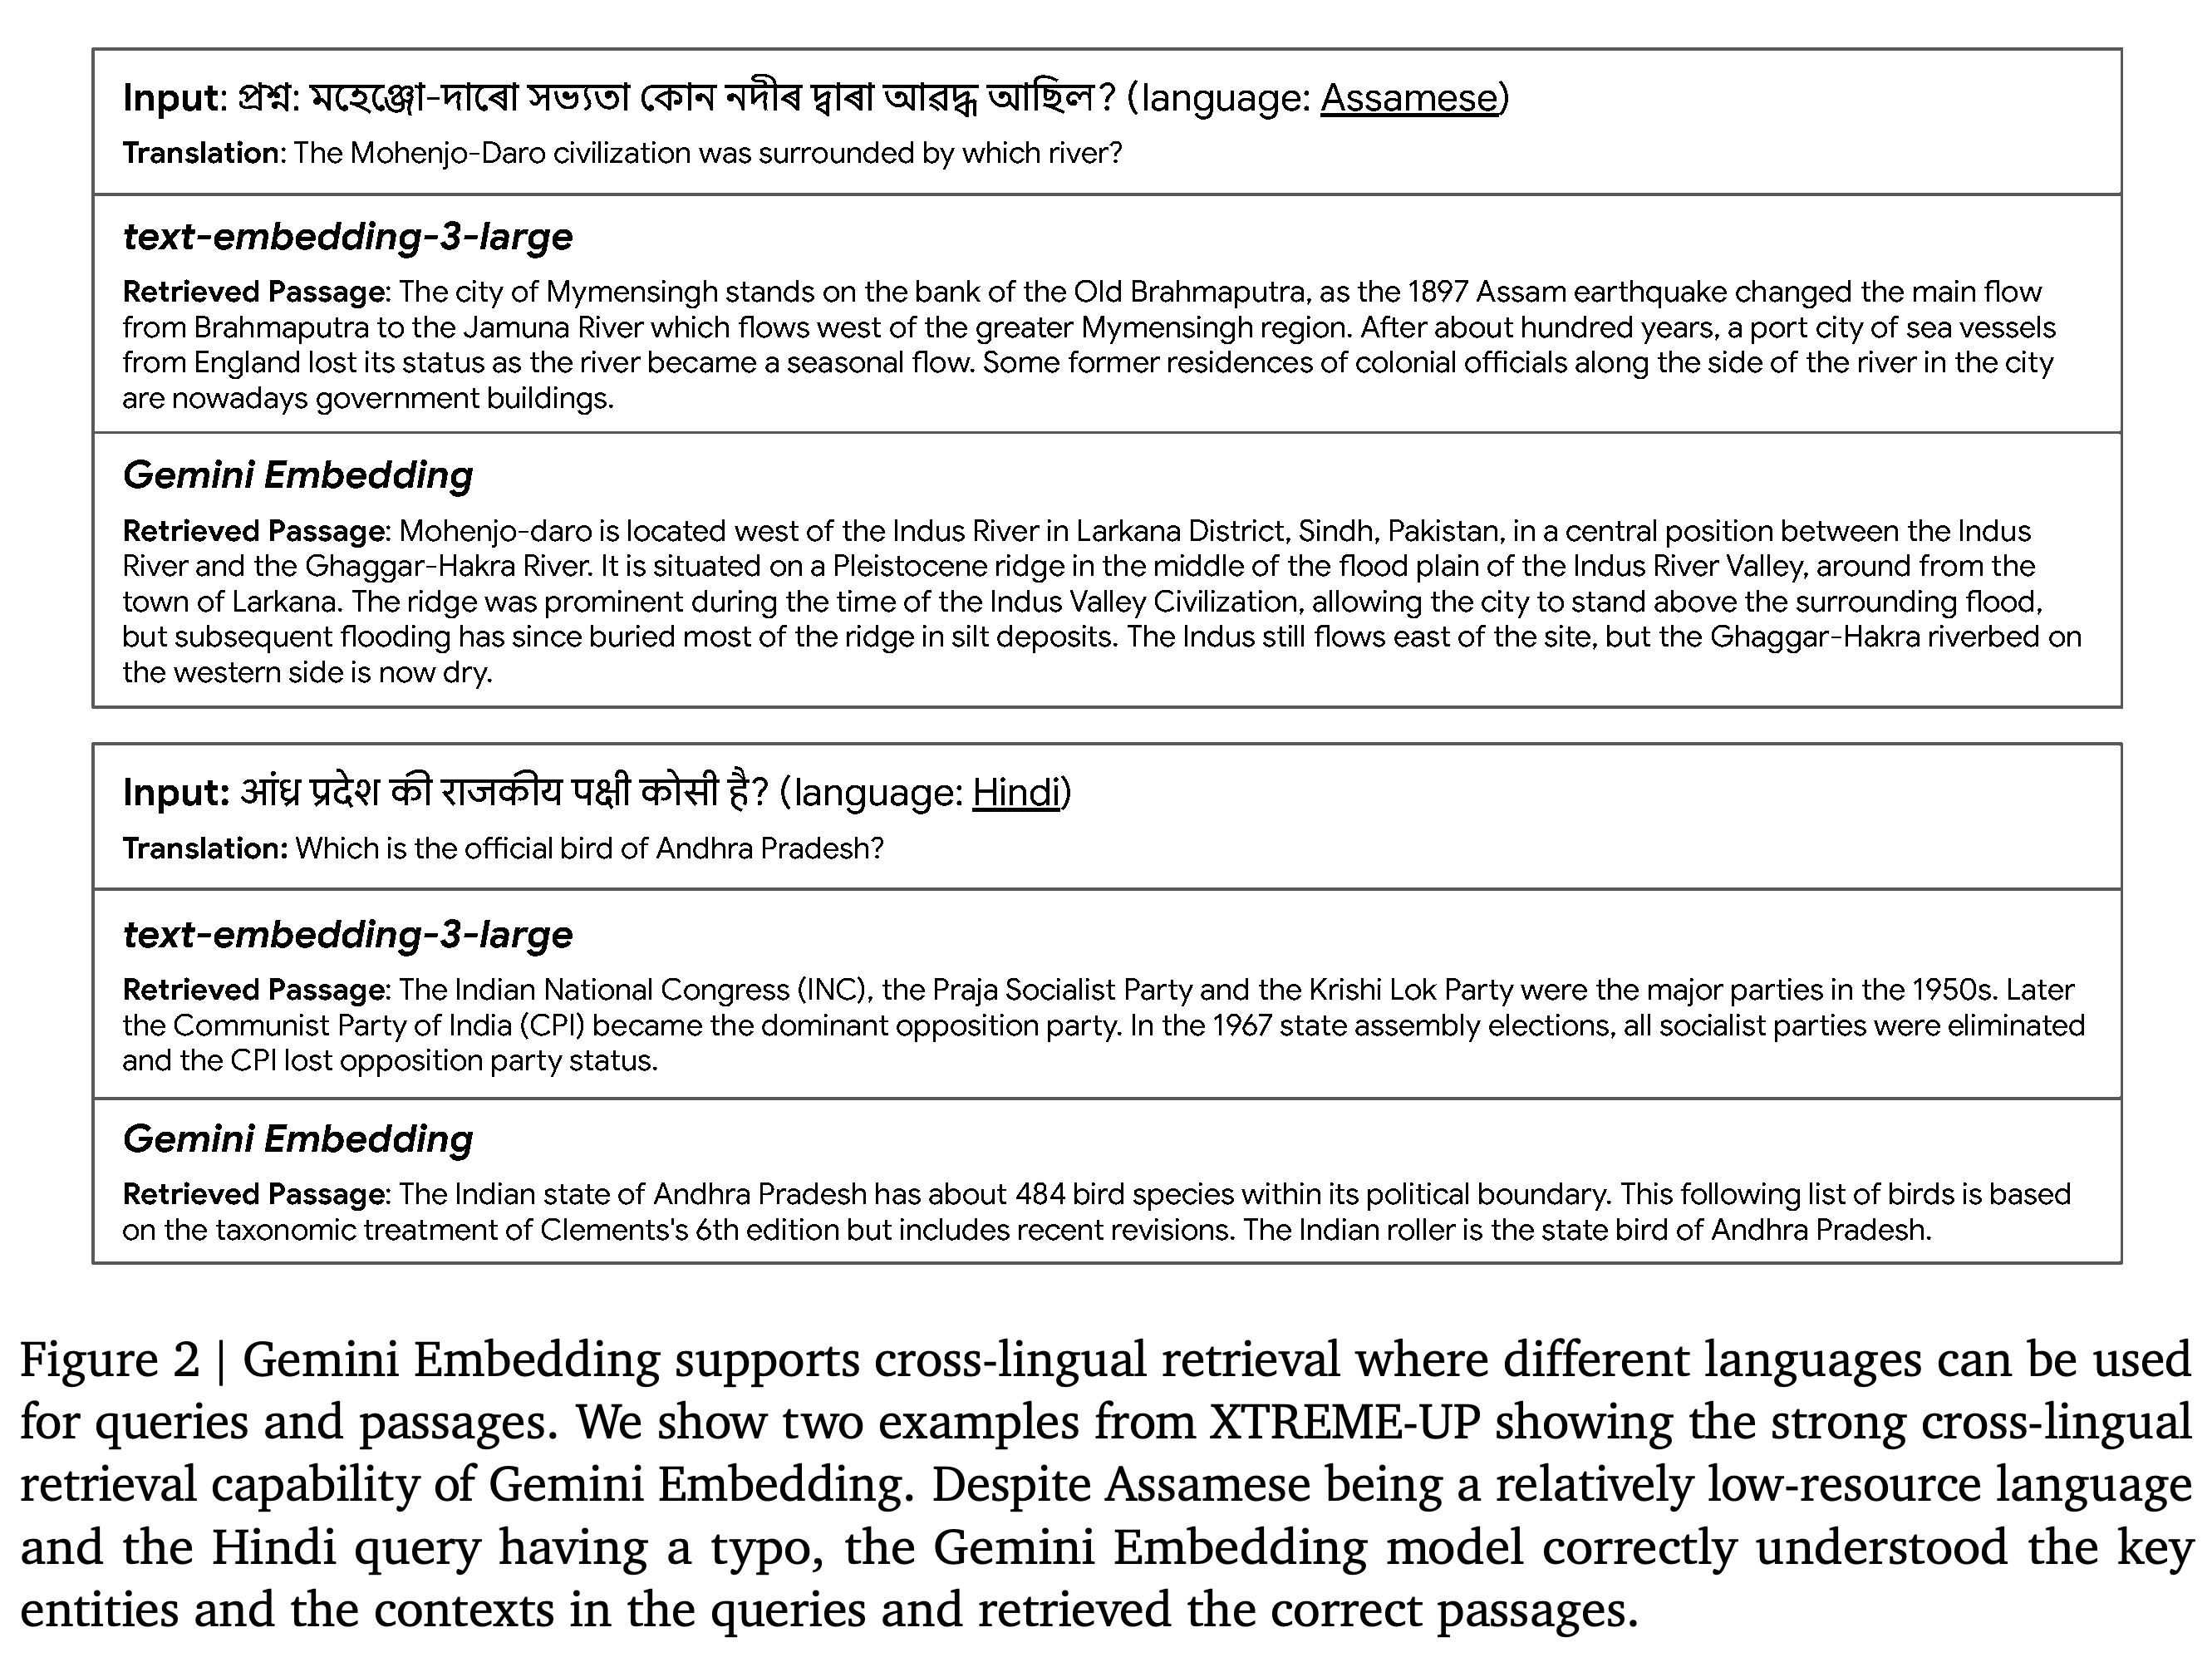
Figure 2는 아삼어와 힌디어 질의를 번역 없이 직접 인코딩하고 코사인 유사도로 영어 구절을 검색하는 사례를 제시한다. Gemini Embedding은 모헨조다로의 강 주변 입지와 안드라프라데시주의 상징 새인 인도파랑새에 관한 구절을 검색하지만, text-embedding-3-large는 관련 없는 구절을 검색한다. 선별된 이 사례들은 오타가 포함된 힌디어 질의를 비롯해 언어를 넘어 개체와 문맥을 연결하는 모습을 보여주지만, 일반적인 강건성 비율을 측정하지는 않는다.
Gemini Embedding은 모헨조다로에 관한 아삼어 질문과 안드라프라데시주의 상징 새에 관한 힌디어 질문에 답하는 영어 구절을 검색한다. 비교 모델이 검색한 구절은 관련 없는 주제를 다룬다. 이 2개 사례는 오타가 포함된 질의에서도 검색에 성공한 모습을 보여주지만, 일반적인 오타 강건성 비율을 입증하지는 않는다.
6. Ablation Study
Ablation 연구는 학습 단계, fine-tuning 데이터 혼합, 합성 분류 데이터, 검색 데이터 필터링, hard negative 개수를 살펴본다. Ablation 모델에서 Model Soup를 명시적으로 제외하므로(Tables 6 and 7 explicitly exclude Model Soup), 이 구성 요소별 비교는 최종 결합 모델과의 비교와 차이가 있다.
6.1. Does Gemini Embedding Generalize to Multilingual Tasks?
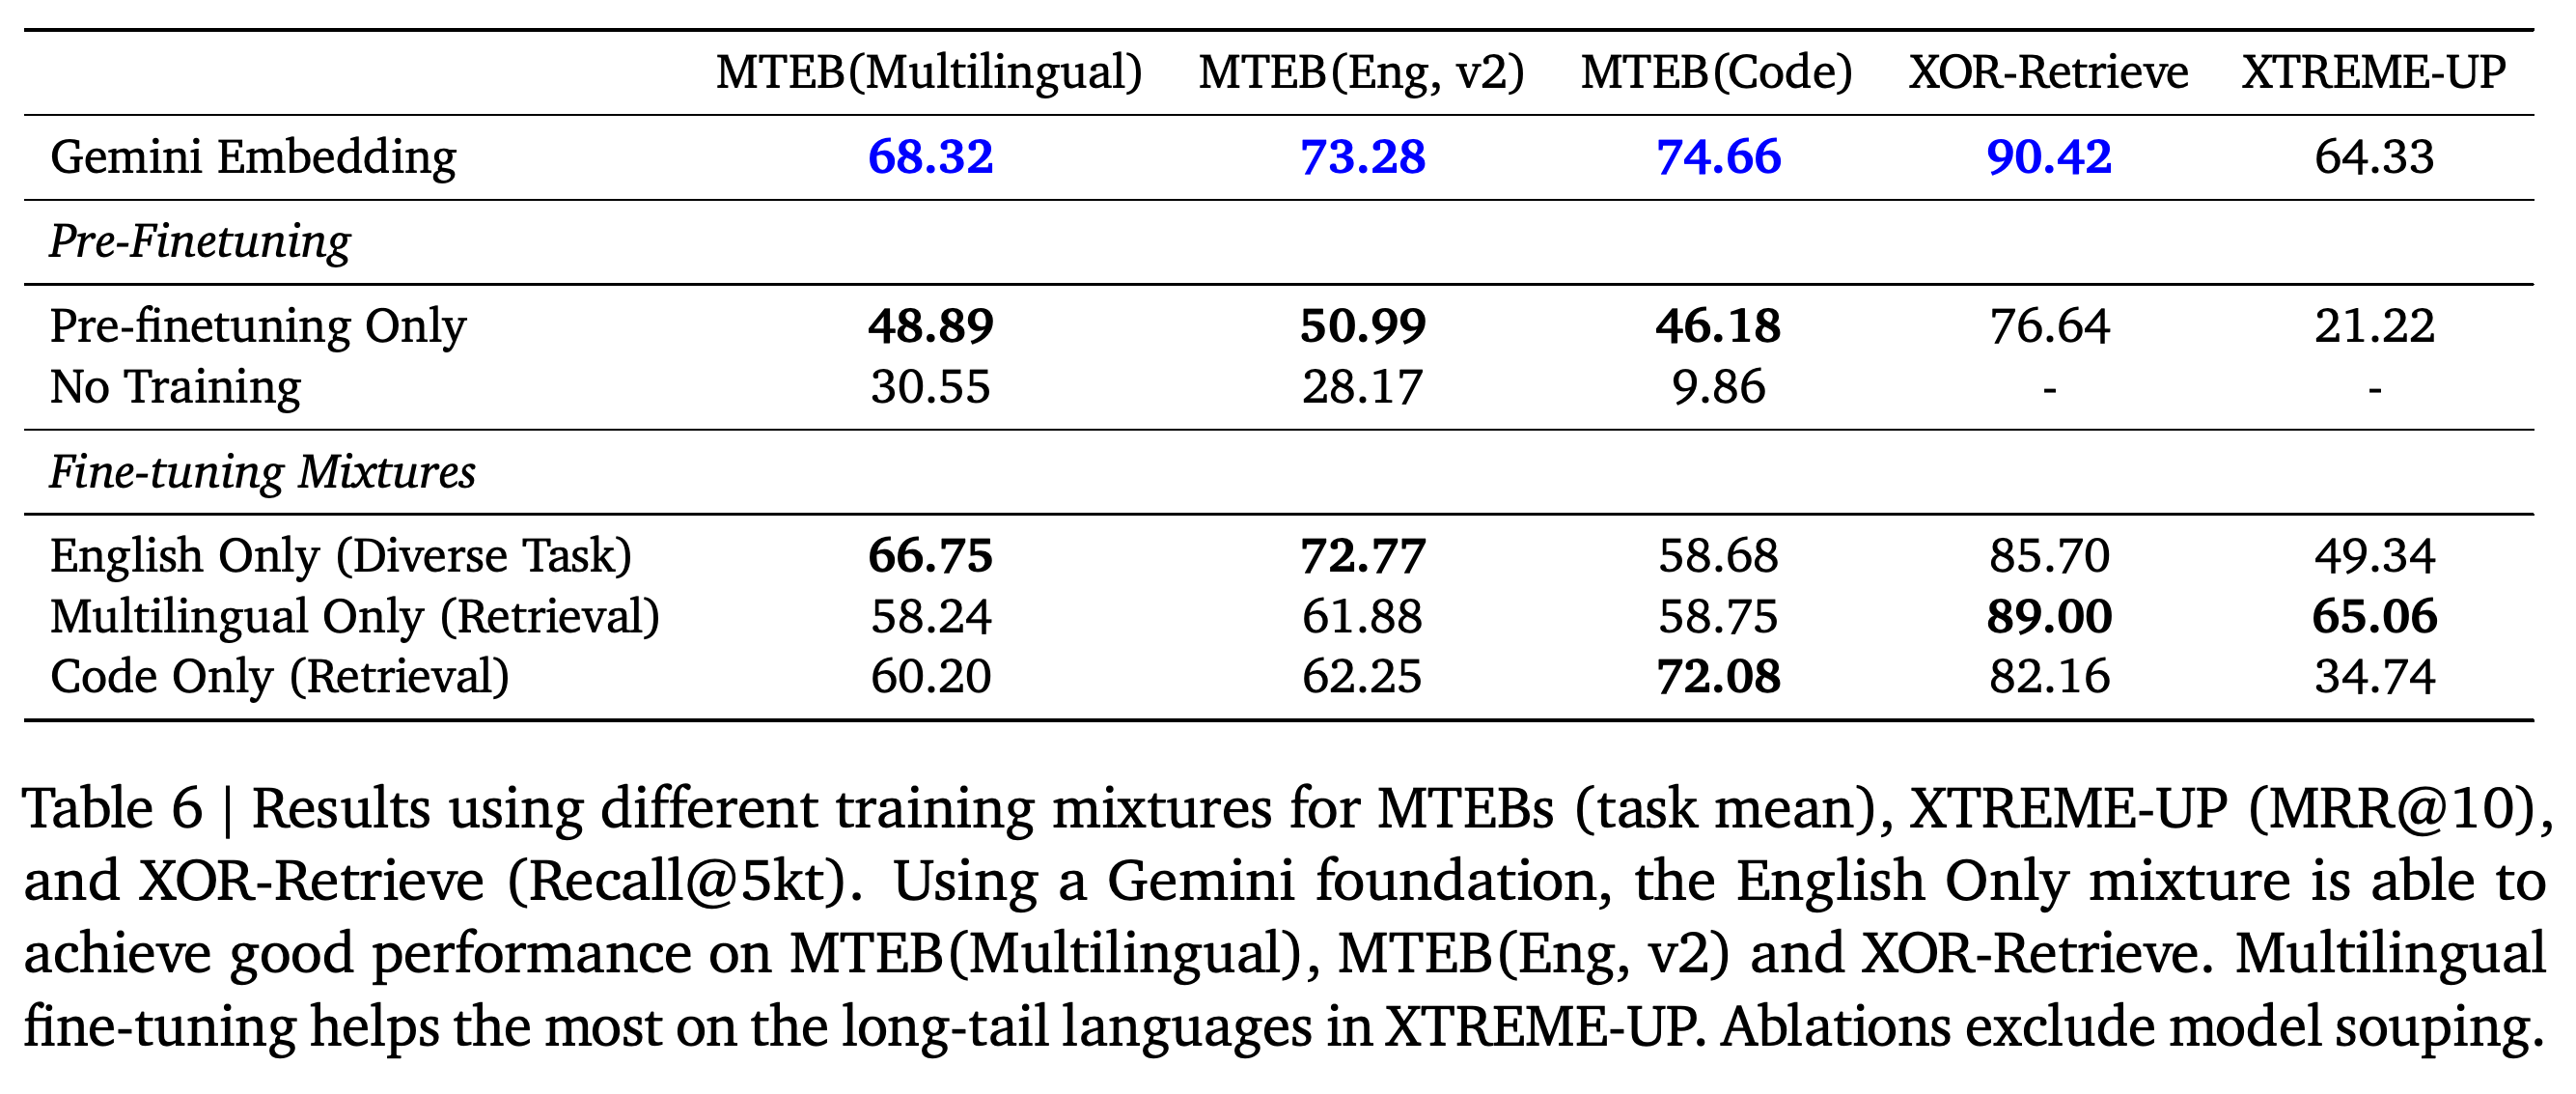
Pre-finetuning은 다국어 태스크 평균을 임베딩 전용 학습이 없는 상태의 30.55에서 48.89로 높이고, 영어 평균을 28.17에서 50.99로, 코드 평균을 9.86에서 46.18로 높인다. 이후 영어로만 구성한 다양한 태스크로 fine-tuning하면 MTEB(Multilingual)에서 66.75, MTEB(Eng, v2)에서 72.77, XTREME-UP에서 49.34를 기록한다. 이는 Gemini 초기화와 pre-finetuning 이후 fine-tuning에 사용하지 않은 언어로 성능이 전이됨을 뒷받침한다. 모델의 전체 학습 이력에서 영어만 사용했다는 뜻은 아니다.
- 다국어 검색 데이터만으로 fine-tuning하면 MTEB(Multilingual)에서 58.24를 기록해 다양한 영어 태스크로 fine-tuning한 모델보다 낮지만, XTREME-UP에서는 65.06으로 최종 모델의 64.33보다 높다. 따라서 데이터 혼합에 따라 폭넓은 태스크 성능과 교차 언어 검색 성능 사이의 상충 관계가 달라진다.
- 코드 검색 데이터만으로 fine-tuning하면 MTEB(Code)에서 72.08을 기록한다. 영어 데이터만으로 fine-tuning하면 58.68, 다국어 데이터만으로 fine-tuning하면 58.75를 기록한다.
- 저자들은 이 결과를 폭넓은 임베딩 성능에는 언어 다양성보다 태스크 다양성이 더 중요하다는 근거로 해석한다. 다만 비교한 데이터 혼합은 태스크 구성과 언어 구성이라는 2가지 요소가 모두 다르므로, 이 실험은 각 요인의 효과를 독립적으로 분리하지 못한다.
Pre-finetuning은 보고된 임베딩 벤치마크 평균 3개를 모두 적응 전 모델보다 높인다. 다양한 영어 태스크를 사용한 fine-tuning은 다국어 태스크로 전이되며, 다국어 검색 데이터만 사용한 fine-tuning은 표에서 가장 높은 XTREME-UP 점수를 기록한다. 이 비교는 Gemini 초기화와 pre-finetuning 이후의 fine-tuning 데이터 혼합을 대상으로 한다.
6.2. How Does Gemini Improve Data Quality?
합성 분류 데이터로 학습하면 AmazonCounterfactual, AmazonPolarity, AmazonReviews, Emotion의 평균이 57.57에서 75.17로 17.6점 상승한다. 저자들은 프롬프트에 원본 데이터셋의 예제를 넣지 않고 이 데이터셋들을 생성했다고 밝히며, 이를 zero-shot 합성 생성이라고 부른다. 18개 언어를 다루는 검색 데이터셋 MIRACL을 필터링하면 평균이 59.8에서 63.7로 높아진다.
- 합성 데이터를 사용하면 분류 태스크 4개가 모두 개선되지만 향상 폭은 다르다. AmazonCounterfactual은 65.43에서 91.30으로, Emotion은 48.70에서 55.90으로 높아진다.
- 필터링은 평균을 높이지만 아랍어는 74.8에서 74.2로, 힌디어는 59.4에서 59.3으로, 요루바어는 85.0에서 83.3으로 낮아진다.
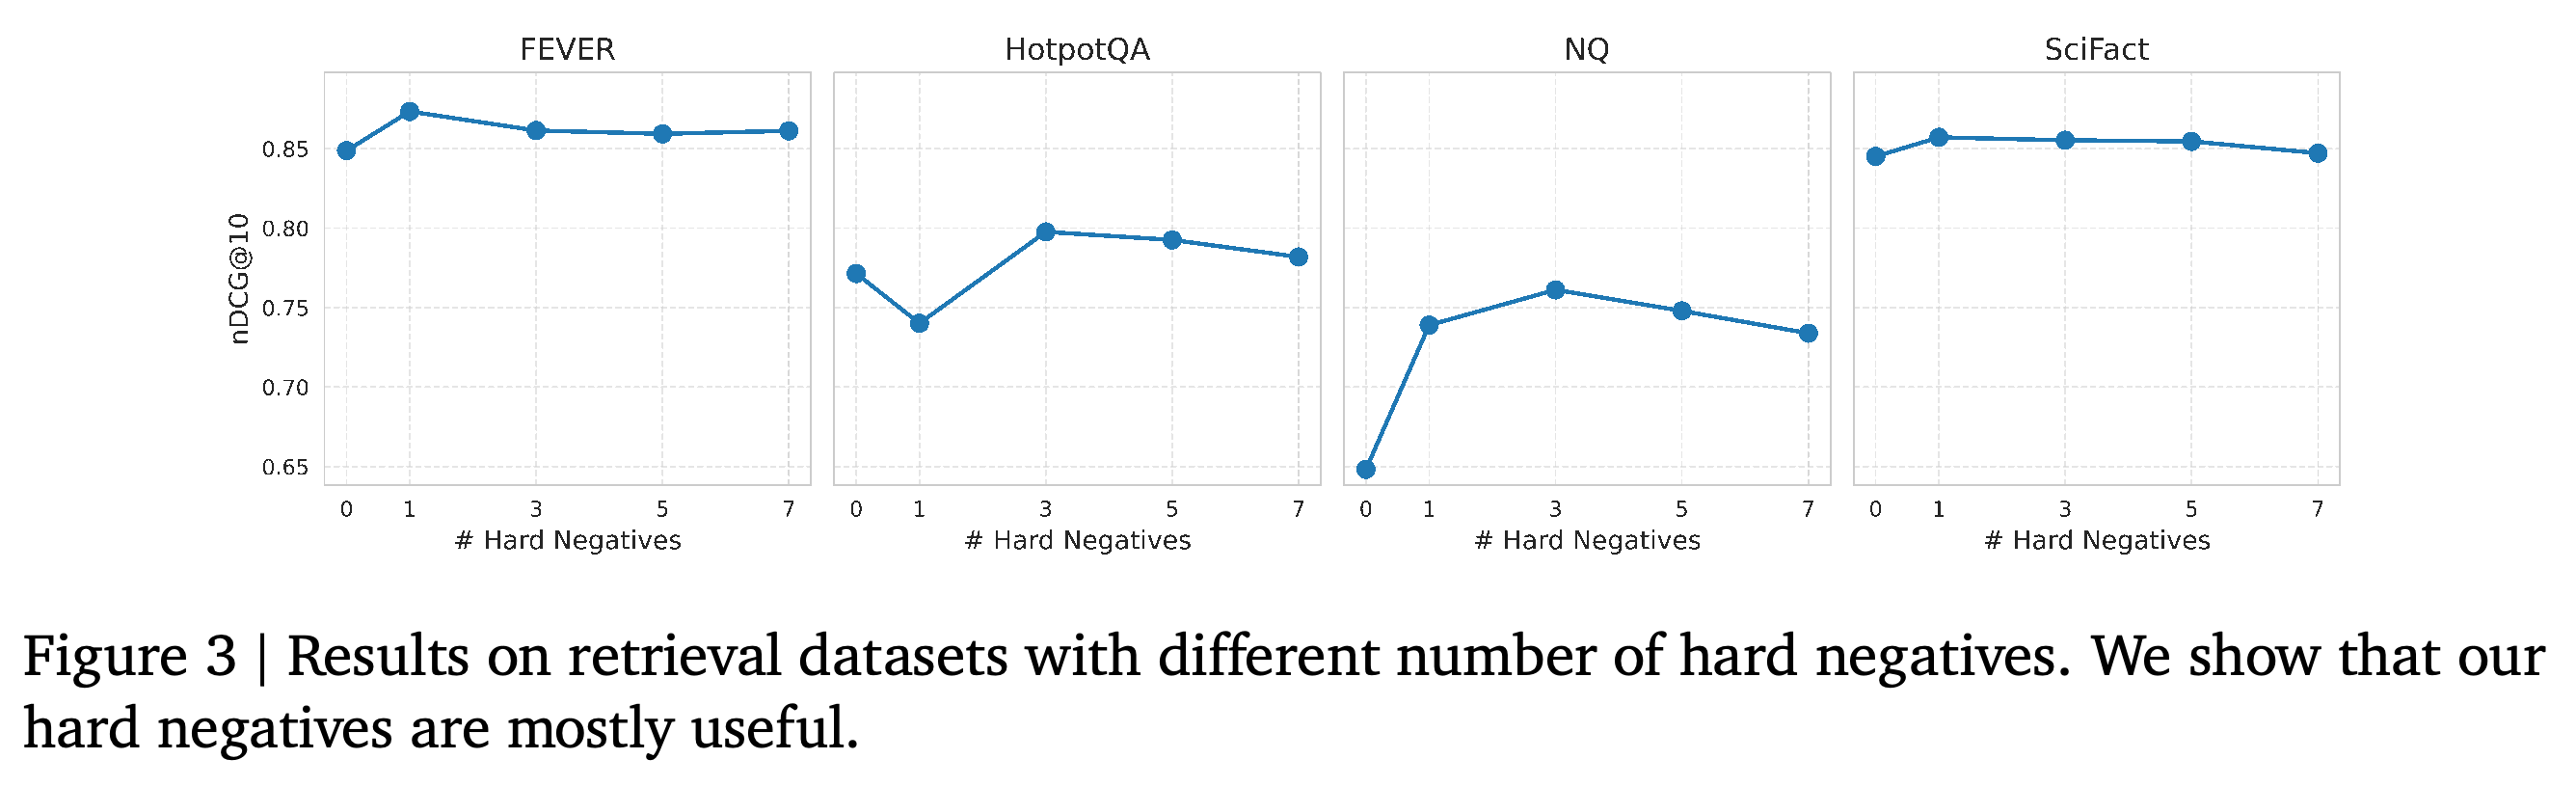
- Figure 3은 검색 데이터셋 4개인 FEVER, HotpotQA, NQ, SciFact에서 hard negative 개수를 0, 1, 3, 5, 7로 바꾼 결과를 보여준다. 표시한 지표는 순위 품질을 측정하는 nDCG@10이며, 순위 10까지의 정규화된 할인 누적 이득을 뜻한다. 대체로 적당한 개수는 도움이 되지만, hard negative 1개를 사용하면 HotpotQA 성능이 낮아지고 개수를 더 늘리면 최적 설정보다 성능이 떨어지는 경우가 많다.
- 저자들은 hard negative가 지나치게 많을 때 성능이 저하되는 원인을 과적합으로 설명하며, 향후 연구로 정규화와 샘플링 개선을 제안한다. 제어 가능한 합성 생성이 편향을 줄일 수 있다는 제안은 직접적인 편향 평가로 검증하지 않는다.
합성 예제를 추가하면 분류 태스크 4개가 모두 개선되며, 평균이 17.6점 상승한다. Gecko는 제공된 분류 학습 세트를 사용한다는 주석이 있으므로, 합성 데이터 ablation과 도메인 내 학습을 비교할 때 이 조건을 고려해야 한다.
필터링은 MIRACL 평균을 3.9점 높이며, 표시된 언어 대부분에서 성능을 개선하지만 아랍어, 힌디어, 요루바어에서는 성능이 낮아진다. 최종 Gemini Embedding 행은 70.1을 기록하지만 더 폭넓은 학습 방법을 반영하므로, 필터링만의 효과를 분리하지는 않는다.
최적의 hard negative 개수는 데이터셋에 따라 다르다. FEVER와 SciFact는 1개 부근에서, HotpotQA와 NQ는 3개 부근에서 최고 성능을 보인다. 개수를 더 늘리면 성능이 낮아지는 경우가 많고, HotpotQA는 음성 예제 1개를 사용할 때 처음부터 성능이 떨어진다. 이 곡선은 데이터셋마다 실험을 통해 개수를 선택해야 함을 뒷받침한다.
7. Future Work
향후 연구로 공통 임베딩 공간을 이미지, 비디오, 오디오 입력까지 확장하는 방향을 제안한다. 저자들은 서로 다른 입력 유형을 포함하는 멀티모달 태스크를 구성하는 작업과 단일 모달리티 및 멀티모달 성능의 균형을 맞추는 학습 방법을 연구 방향으로 제시한다. 이 텍스트 임베딩 논문에서는 이러한 확장을 평가하지 않는다.
8. Conclusion
논문은 Gemini 초기화와 Gemini를 활용한 학습 데이터로 다국어 텍스트, 영어, 코드 태스크에 재사용할 수 있는 표현 모델 1개를 만들 수 있다고 결론짓는다. 벤치마크 결과는 폭넓은 임베딩 품질을 뒷받침하며, 벡터를 미리 계산하고 캐싱하는 방식은 지연 시간에 민감한 환경에 배포하기 위한 수단으로 제시한다. 논문은 지연 시간, 처리량, 추론 비용을 정량화하지 않는다.
부록
-
- Full Results는 Table 9에 다국어 태스크별 점수, Table 10에 영어 및 코드 점수, Table 11에 언어별 교차 언어 검색 점수를 제공한다. 다국어 결과에는 Robust04InstructionRetrieval의 −2.41, TempReasonL1의 2.96, HagridRetrieval의 99.31이 포함된다. XTREME-UP 점수에는 brx의 25.66과 ml의 70.82가 포함된다. 태스크 지표가 서로 다르면 점수를 직접 비교할 수 없지만, 벤치마크 내부의 세부 결과는 종합 평균에 드러나지 않는 편차를 보여준다.
-
- Contributions and Acknowledgments는 Core Contributors, Contributors, Leadership을 구분한다. Jinhyuk Lee, Feiyang Chen, Sahil Dua, Daniel Cer, Madhuri Shanbhogue는 동등 기여자로 표시한다. Leadership에는 Zach Gleicher, Karan Gill, Zhe Dong, Mojtaba Seyedhosseini, Yunhsuan Sung, Raphael Hoffmann, Tom Duerig를 기재한다. Contributors 목록에서는 추가 팀원들의 기여를 인정하며, 마지막 페이지에서는 다른 협력자들에게도 감사를 표한다.
짧은 생각
가장 유용한 근거는 폭넓은 벤치마크 평가와 pre-finetuning, 합성 분류 예제, 검색 데이터 필터링의 효과를 측정한 ablation을 함께 제시한 점이다. 데이터 혼합 비교는 최종 모델이 더 폭넓은 성능을 얻는 대신 다국어 검색 데이터만으로 fine-tuning한 모델보다 XTREME-UP 점수가 낮다는 점도 보여준다. 공개하지 않은 모델 크기, 불완전한 학습 명세, 수동 체크포인트 선택, 지연 시간과 연산량 측정의 부재는 재현과 배포 평가를 제한한다. 또한 논문은 태스크 수의 불일치를 해소하지 않으며, 최종 영어 점수도 Table 6에서는 73.28, Table 1에서는 73.30으로 다르게 제시한다.