


NeoBERT: A Next-Generation BERT 요약 설명
26 Feb 2025 | Paper Review BERT Text Embeddings Contrastive Learning목차
이번 글에서는 NeoBERT: A Next-Generation BERT 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 2월 26일(Arxiv)
- Breton, Lola Le, Fournier, Quentin, Mezouar, Mariam El, Morris, John X., Chandar, Sarath.
- Chandar Research Lab, Mila – Quebec AI Institute, Polytechnique Montréal, Cornell University, Royal Military College of Canada, Canada CIFAR AI Chair
- 논문 링크
- Github
- Project Page
요약
- NeoBERT는 양방향 텍스트 인코더의 발전이 더뎠다는 문제를 다룬다. 양방향 텍스트 인코더는 토큰 양쪽의 문맥을 활용해 분류, 군집화, 검색에 사용할 표현을 생성하는 모델이다. 동일한 2,000 steps의 미세조정 절차를 거친 뒤, 250M-parameter 모델은 영어 Massive Text Embedding Benchmark(MTEB)에서 51.3을 기록한다. 이 비교에서 가장 성능이 높은 베이스라인인 BERT large는 49.1을 기록한다.
- NeoBERT는 28개 층과 768차원으로 구성된 아키텍처에 RefinedWeb과 masked language modeling을 결합한다. RefinedWeb은 필터링과 중복 제거를 거친 웹 코퍼스이며, masked language modeling은 가려진 토큰을 예측하는 학습 목표다. 2단계 사전학습으로 학습 문맥을 1,024토큰에서 4,096토큰으로 확장하며, 패딩을 포함한 이론적 총학습량은 2.1T토큰이다.
- NeoBERT는 언어 이해 과제 벤치마크인 GLUE에서 89.0점을 기록하고, Contextual Document Embeddings(CDE) 학습 후에는 MTEB에서 66.60점을 기록한다. CDE는 관련 예제를 묶고 코퍼스 문맥을 조건으로 표현을 생성하는 방법이다. 일부 설계 선택을 바꾸는 통제 실험에서는 데이터와 모델 규모를 늘릴 때 성능이 향상된다. 최종 학습 방식에 유지된 변경 사항 2개는 초기 실험에서 성능을 낮추며, 대규모 학습에서 이점이 있으리라는 가설은 검증되지 않았다.
1 Introduction
논문은 인코더 사전학습의 개선과 다운스트림 미세조정의 개선을 구분한다. 기존 임베딩 시스템은 기반 사전학습 인코더인 백본을 개선할 때 대조 학습을 사용하는 경우가 많다. 대조 학습은 관련 텍스트의 표현을 가깝게 하고 무관한 텍스트의 표현을 멀어지게 한다. NeoBERT는 백본을 갱신하고 공통 미세조정 절차로 모델을 비교한다. 대조 학습에 대해서는 Contrastive Learning, SimCLR 논문 설명(SimCLRv1, SimCLRv2) 글을 참조하라.
- BERT base와 같은 768차원 은닉 크기를 갖춘 재사용 가능한 인코더를 제공하여, 해당 표현 크기를 사용하는 구성 요소와 호환되도록 하는 것이 목표다.
- 저자들은 사전학습 모델 10개로 순차적인 설계 변경을 검증하고, 문맥 확장과 초당 처리 토큰 수로 측정하는 추론 처리량을 별도로 평가한다.
2 Related work
관련 연구는 BERT와 RoBERTa의 사전학습에서 점차 특화된 임베딩 미세조정으로 발전한다. SimCSE는 학습 중 활성값을 무작위로 억제하는 dropout을 적용해 같은 텍스트를 2번 처리하여 양성 쌍을 만든다. GTE는 여러 대조 학습 단계를 사용하고, jina-embeddings는 과제별 저랭크 파라미터 갱신 방식인 Low-Rank Adaptation(LoRA)을 사용한다.
- CDE는 관련 예제를 배치로 묶고 코퍼스 문맥을 조건으로 표현을 생성하여 임베딩 성능을 높이는 또 다른 방법이다.
- NomicBERT와 NeoBERT 개발 시기에 함께 개발된 ModernBERT는 인코더 아키텍처와 학습 방식을 현대화한다. NeoBERT는 이들과 다른 아키텍처, 데이터, 학습 방식의 조합을 평가한다.
3 NeoBERT
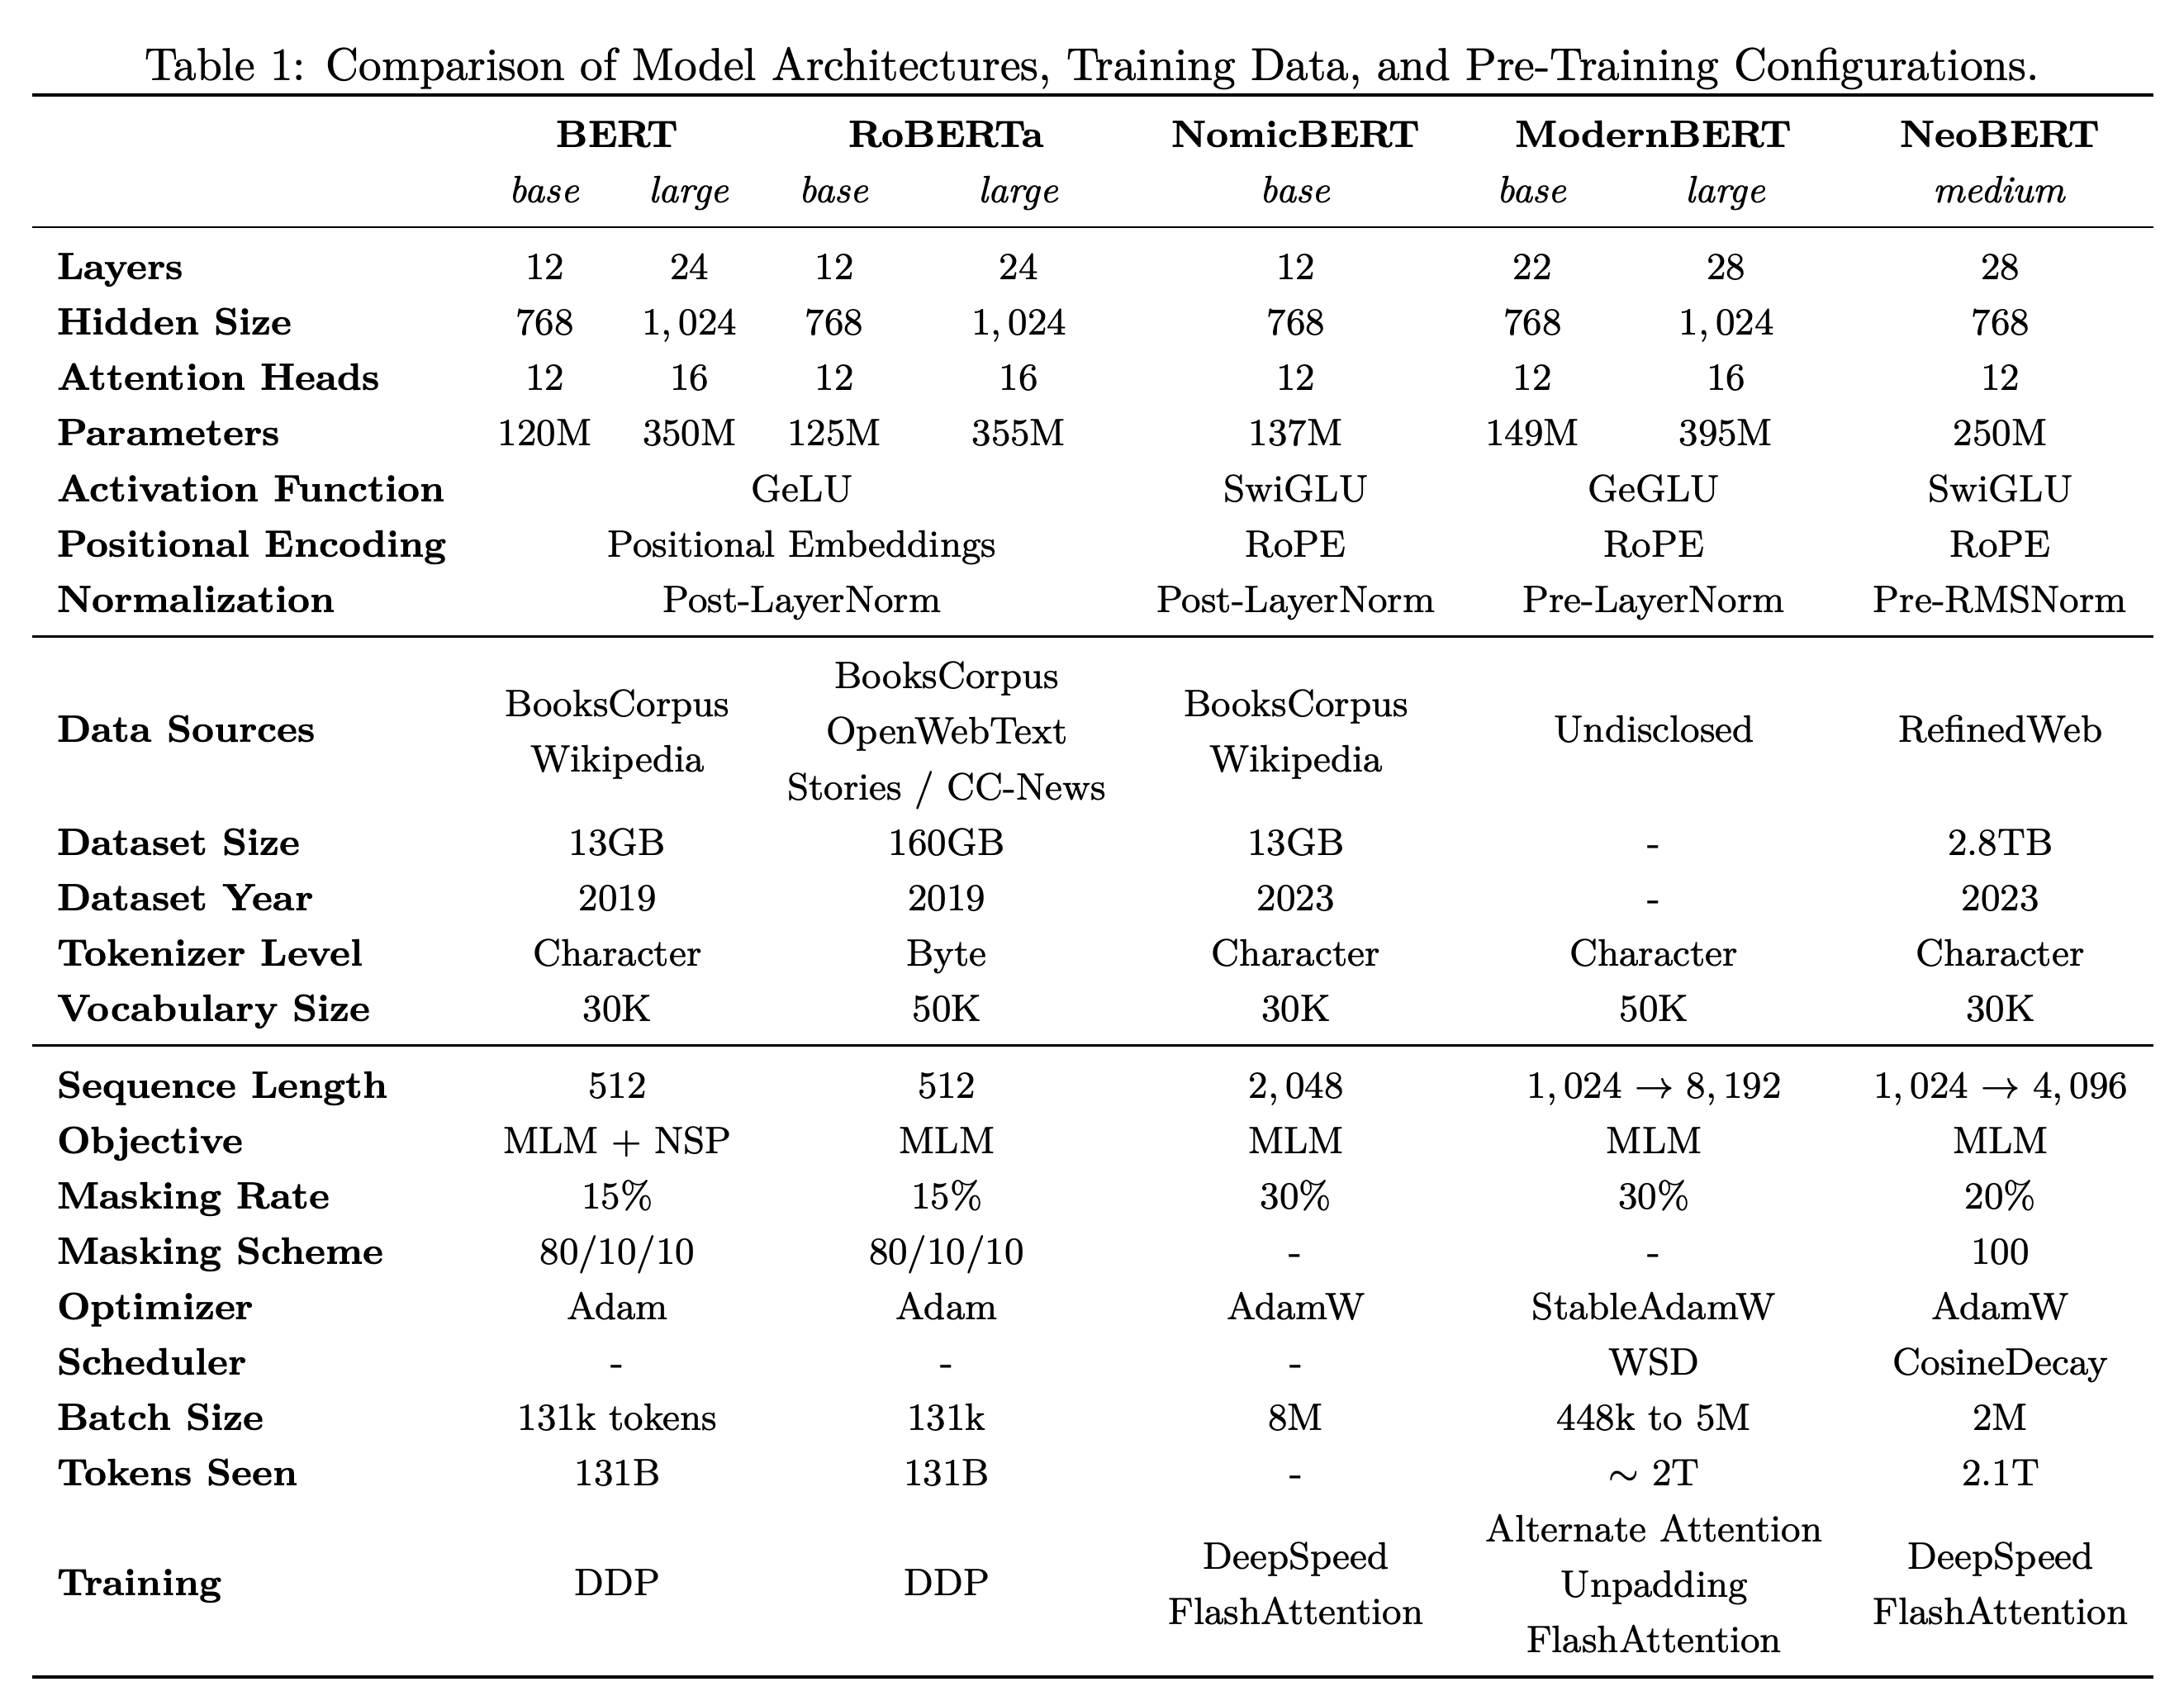
NeoBERT는 28개 층, 은닉 크기 768, attention head 12개를 갖춘 250M-parameter 인코더다. Attention head는 각 층에서 attention을 병렬로 계산하는 구성 요소다. 표 1은 NeoBERT를 기존 base 인코더와 large 인코더 사이에 배치하고 아키텍처, 데이터, 학습 목표, 문맥 길이, 학습 설정을 비교한다.
NeoBERT는 base 인코더의 768차원 인터페이스를 유지하면서 깊이와 파라미터 수를 늘린다. 학습한 문맥 길이는 ModernBERT가 8,192토큰으로 NeoBERT의 4,096토큰보다 길다. 따라서 이 표는 NeoBERT의 기본 문맥 길이가 가장 길다는 주장을 뒷받침하지 않는다.
3.1 Architecture
아키텍처는 BERT base의 너비 768을 유지하면서 깊이를 28개 층으로 늘린다. Attention에 상대적 위치 정보를 반영하는 Rotary Position Embeddings(RoPE)가 절대 위치 임베딩을 대체한다. 모델은 더 긴 문맥에 적응시키는 방법인 Yet Another RoPE Extension(YaRN)과도 호환된다.
- Pre-Layer Normalization은 잔차 분기 내부에 정규화를 배치한다. NeoBERT는 기존 LayerNorm보다 필요한 통계량이 1개 적은 Root Mean Square Layer Normalization(RMSNorm)을 사용한다.
- 게이트 활성화 함수인 SwiGLU가 Gaussian Error Linear Unit(GELU) 활성화 함수를 대체한다. SwiGLU에 가중치 행렬이 추가되므로 파라미터 수를 맞추기 위해 feed-forward 은닉 유닛 수에 2/3을 곱한다.
3.2 Data
RefinedWeb은 600B토큰을 포함한다. 저자들은 규모와 다양성을 강조하면서도 엄격한 고품질 기준을 적용하지 않았다는 점을 인정한다.
- 첫 단계에서는 최대 길이 1,024토큰으로 1M스텝 학습을 1회 수행하여 NeoBERT1024를 만든다. 다음 단계에서는 최대 길이 4,096토큰으로 50k스텝을 추가 학습하여 NeoBERT4096을 만든다.
- 2단계에서는 원본 코퍼스, 길이가 1,024토큰을 초과하는 시퀀스의 부분집합, 길이가 2,048토큰을 초과하는 시퀀스의 부분집합에서 각각 20%, 40%, 40%의 확률로 배치를 추출한다.
3.3 Pre-Training
사전학습에는 masked language modeling만 사용하며, 토큰의 20%를 선택하고 선택한 토큰을 모두 마스크로 대체한다. 이론적 배치 크기 2M토큰으로 1,050,000 steps 동안 학습하면 총 2.1T토큰이 된다. 이 수치는 패딩을 포함하므로 실제로 처리한 텍스트 토큰 수를 뜻하지 않는다.
- 가중치 감쇠를 분리한 옵티마이저인 AdamW는 β1 = 0.9, β2 = 0.95, ε = 10−8, 가중치 감쇠 0.1, 노름 1.0의 그래디언트 클리핑을 사용한다. 2,000 steps의 워밍업으로 학습률을 6 × 10⁻⁴까지 높인 뒤 코사인 형태로 최댓값의 10%까지 낮춘다. 이후 짧은 문맥 학습의 마지막 100k스텝과 긴 문맥 학습의 50k스텝에서는 학습률을 일정하게 유지한다.
- DeepSpeed와 분산 학습 메모리 최적화 기법인 ZeRO는 가속기 간에 중복 저장되는 상태를 줄인다. xFormers는 융합 연산자를 제공하며, FlashAttention은 전체 attention 행렬을 저장하지 않고 정확한 attention을 계산한다. 차원은 64의 배수로 설정하고 편향은 제거한다.
4 Effect of Design Choices
설계 변경 실험은 pre-layer normalization을 적용하고 다음 문장 예측 목표를 제거한 BERT base 유사 모델 M0에서 시작한다. 다음 문장 예측은 2개 문장이 연속하는지 예측하는 과제다. 모델은 무작위 시드와 데이터로더 상태를 통제하여 1M스텝 동안 학습한다. 초기 GLUE 탐색에서는 배치 크기 {16, 32}와 학습률 {1e−5, 2e−5, 3e−5}를 사용한다.
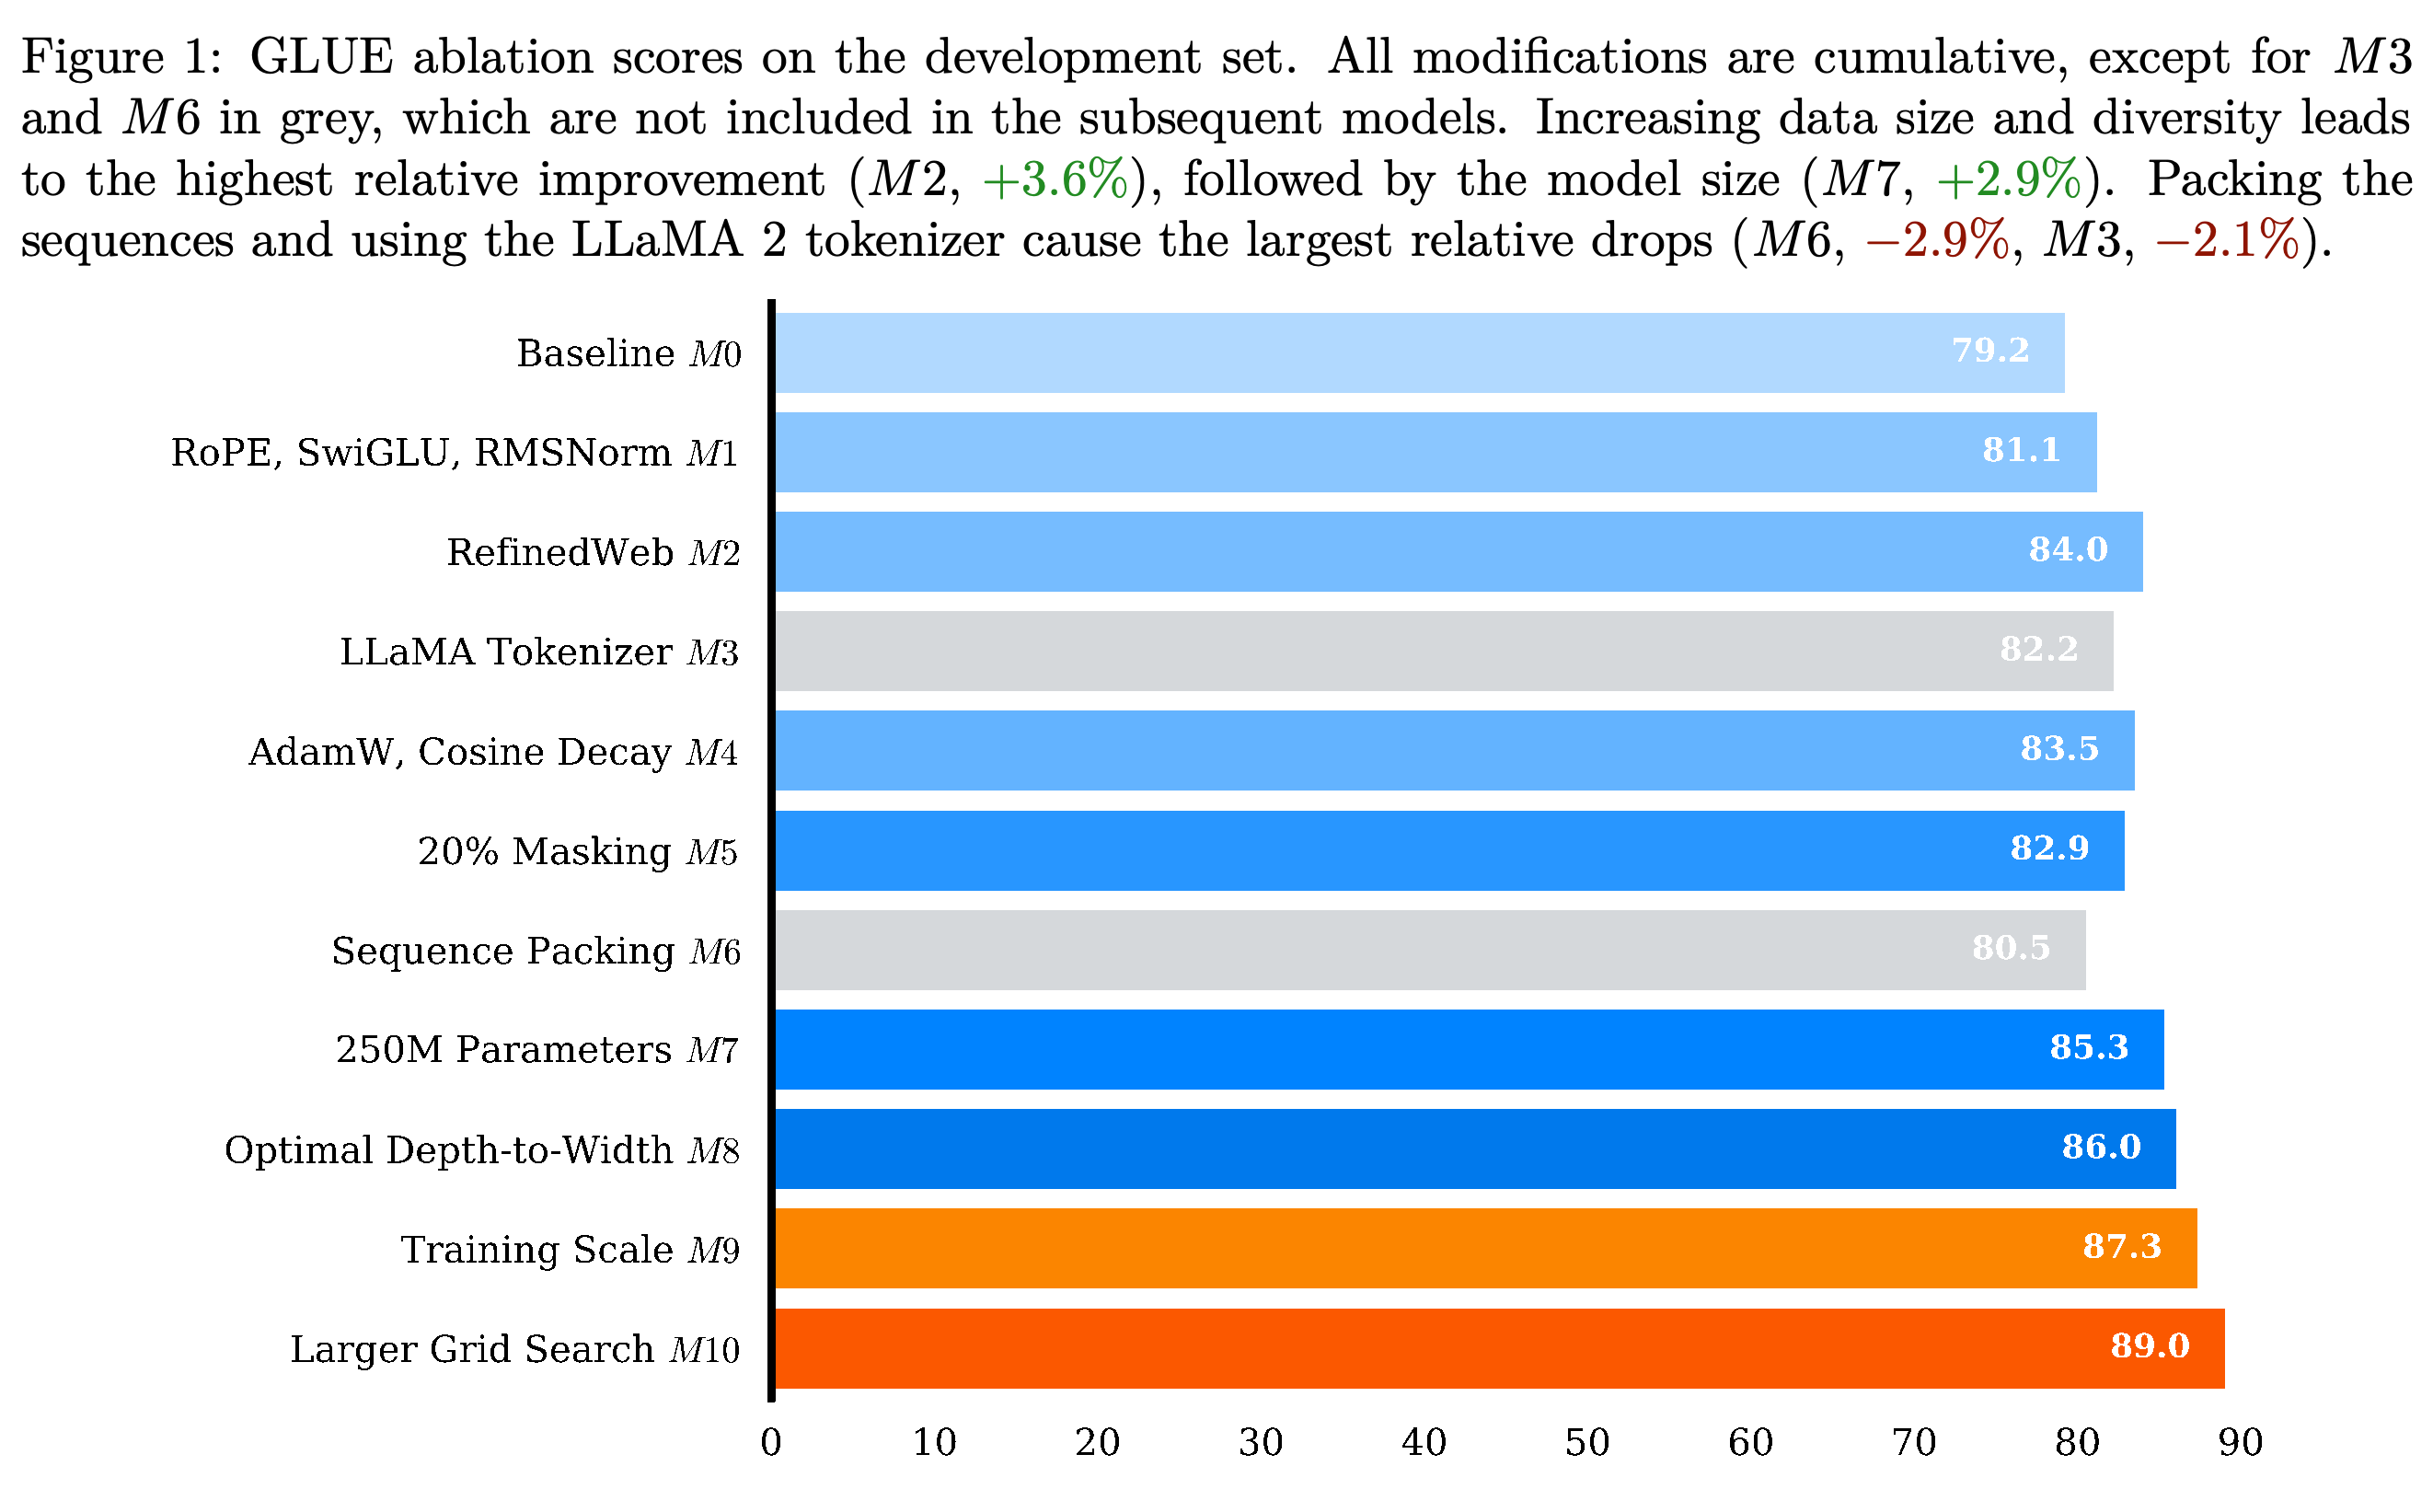
- 아키텍처 변경을 묶어 적용하면 점수가 79.2에서 81.1로 오르고, RefinedWeb을 적용하면 84.0으로 오른다. 모델 규모를 120M에서 250M으로 늘리면 82.9에서 85.3으로 오른다. 같은 파라미터를 너비 1056의 16개 층에서 너비 768의 28개 층으로 재배분하면 86.0으로 오른다.
- 텍스트를 토큰으로 나누는 방식을 바꾼 LLaMA 토크나이저 실험 M3는 82.2점을 기록한다. 예제 사이의 경계를 넘어서는 attention을 차단하지 않고 예제를 이어 붙이는 시퀀스 패킹 실험 M6는 80.5점을 기록한다. 변경 사항 2개 모두 이후 모델에서 제외한다.
- AdamW와 코사인 감쇠의 조합, 마스킹 비율을 20%로 바꾸는 변경은 각각 −0.5%, −0.7%의 상대적 성능 저하를 보이지만 최종 학습 방식에 유지한다. 대규모 학습에서 이점이 있으리라는 주장은 가설이며, 저자들은 계산 비용 때문에 이를 검증하지 못했다.
이 실험 순서는 모델 규모 확대와 이후의 깊이 및 너비 재배분을 분리하여, 파라미터 수가 거의 같은 조건에서 비교할 수 있게 한다. 일부 행에서는 아키텍처, 최적화, 학습 규모 등 여러 요인을 함께 바꾸므로 개별 구성 요소의 기여를 파악하는 데 한계가 있다.
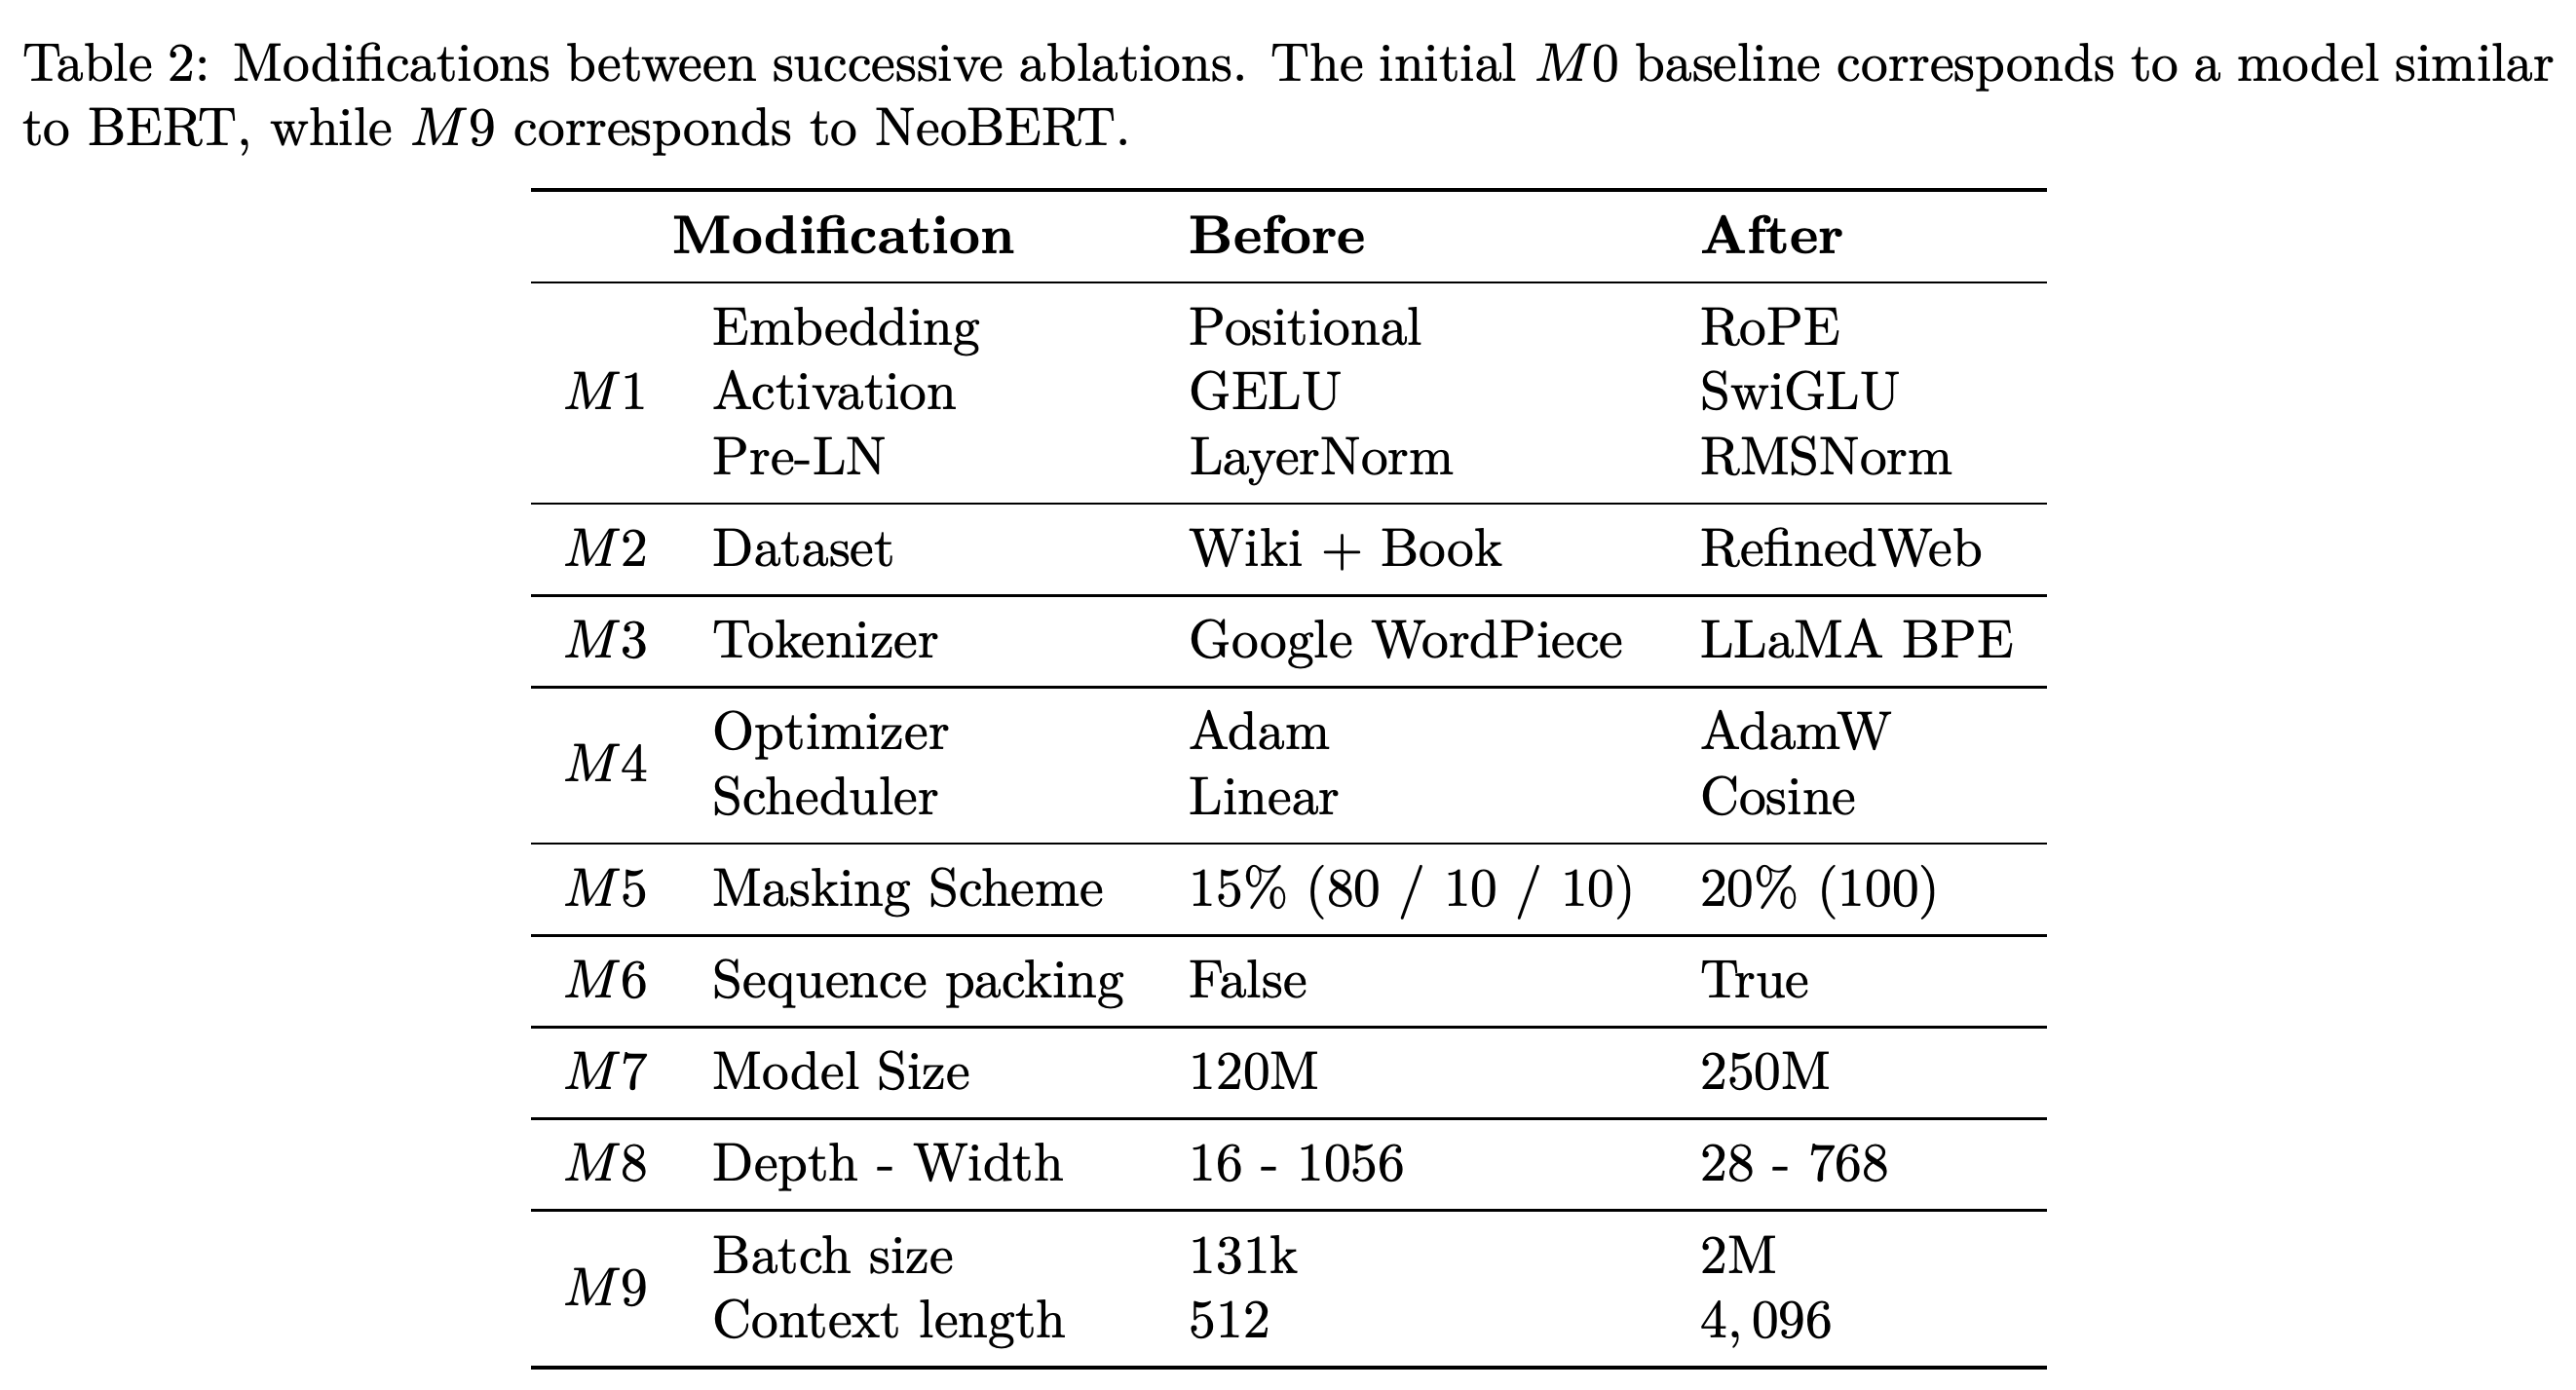
학습 규모를 바꾸면 87.3점을 기록하고, 다운스트림 하이퍼파라미터 탐색 범위를 넓히면 89.0점을 기록한다. 따라서 최종 성능 향상에는 백본 변경뿐 아니라 미세조정 설정 선택도 포함된다. 누적 실험은 모든 구성 요소와 상호작용의 효과를 개별적으로 분리하지 못한다.
RefinedWeb 적용과 모델 규모 확대에서 가장 큰 성능 향상이 나타나며, 회색으로 표시한 토크나이저와 패킹 실험은 이후 모델에서 제외한다. 마지막 87.3점에서 89.0점으로의 상승은 미세조정 탐색 범위를 넓힌 결과다.
5 Experiments
실험에서는 GLUE로 기존 언어 이해 성능을 비교하고, MTEB로 더 폭넓은 임베딩 성능을 평가한다. 긴 시퀀스 모델링과 합성 입력에서의 추론 처리량은 별도 실험으로 측정한다.
5.1 GLUE
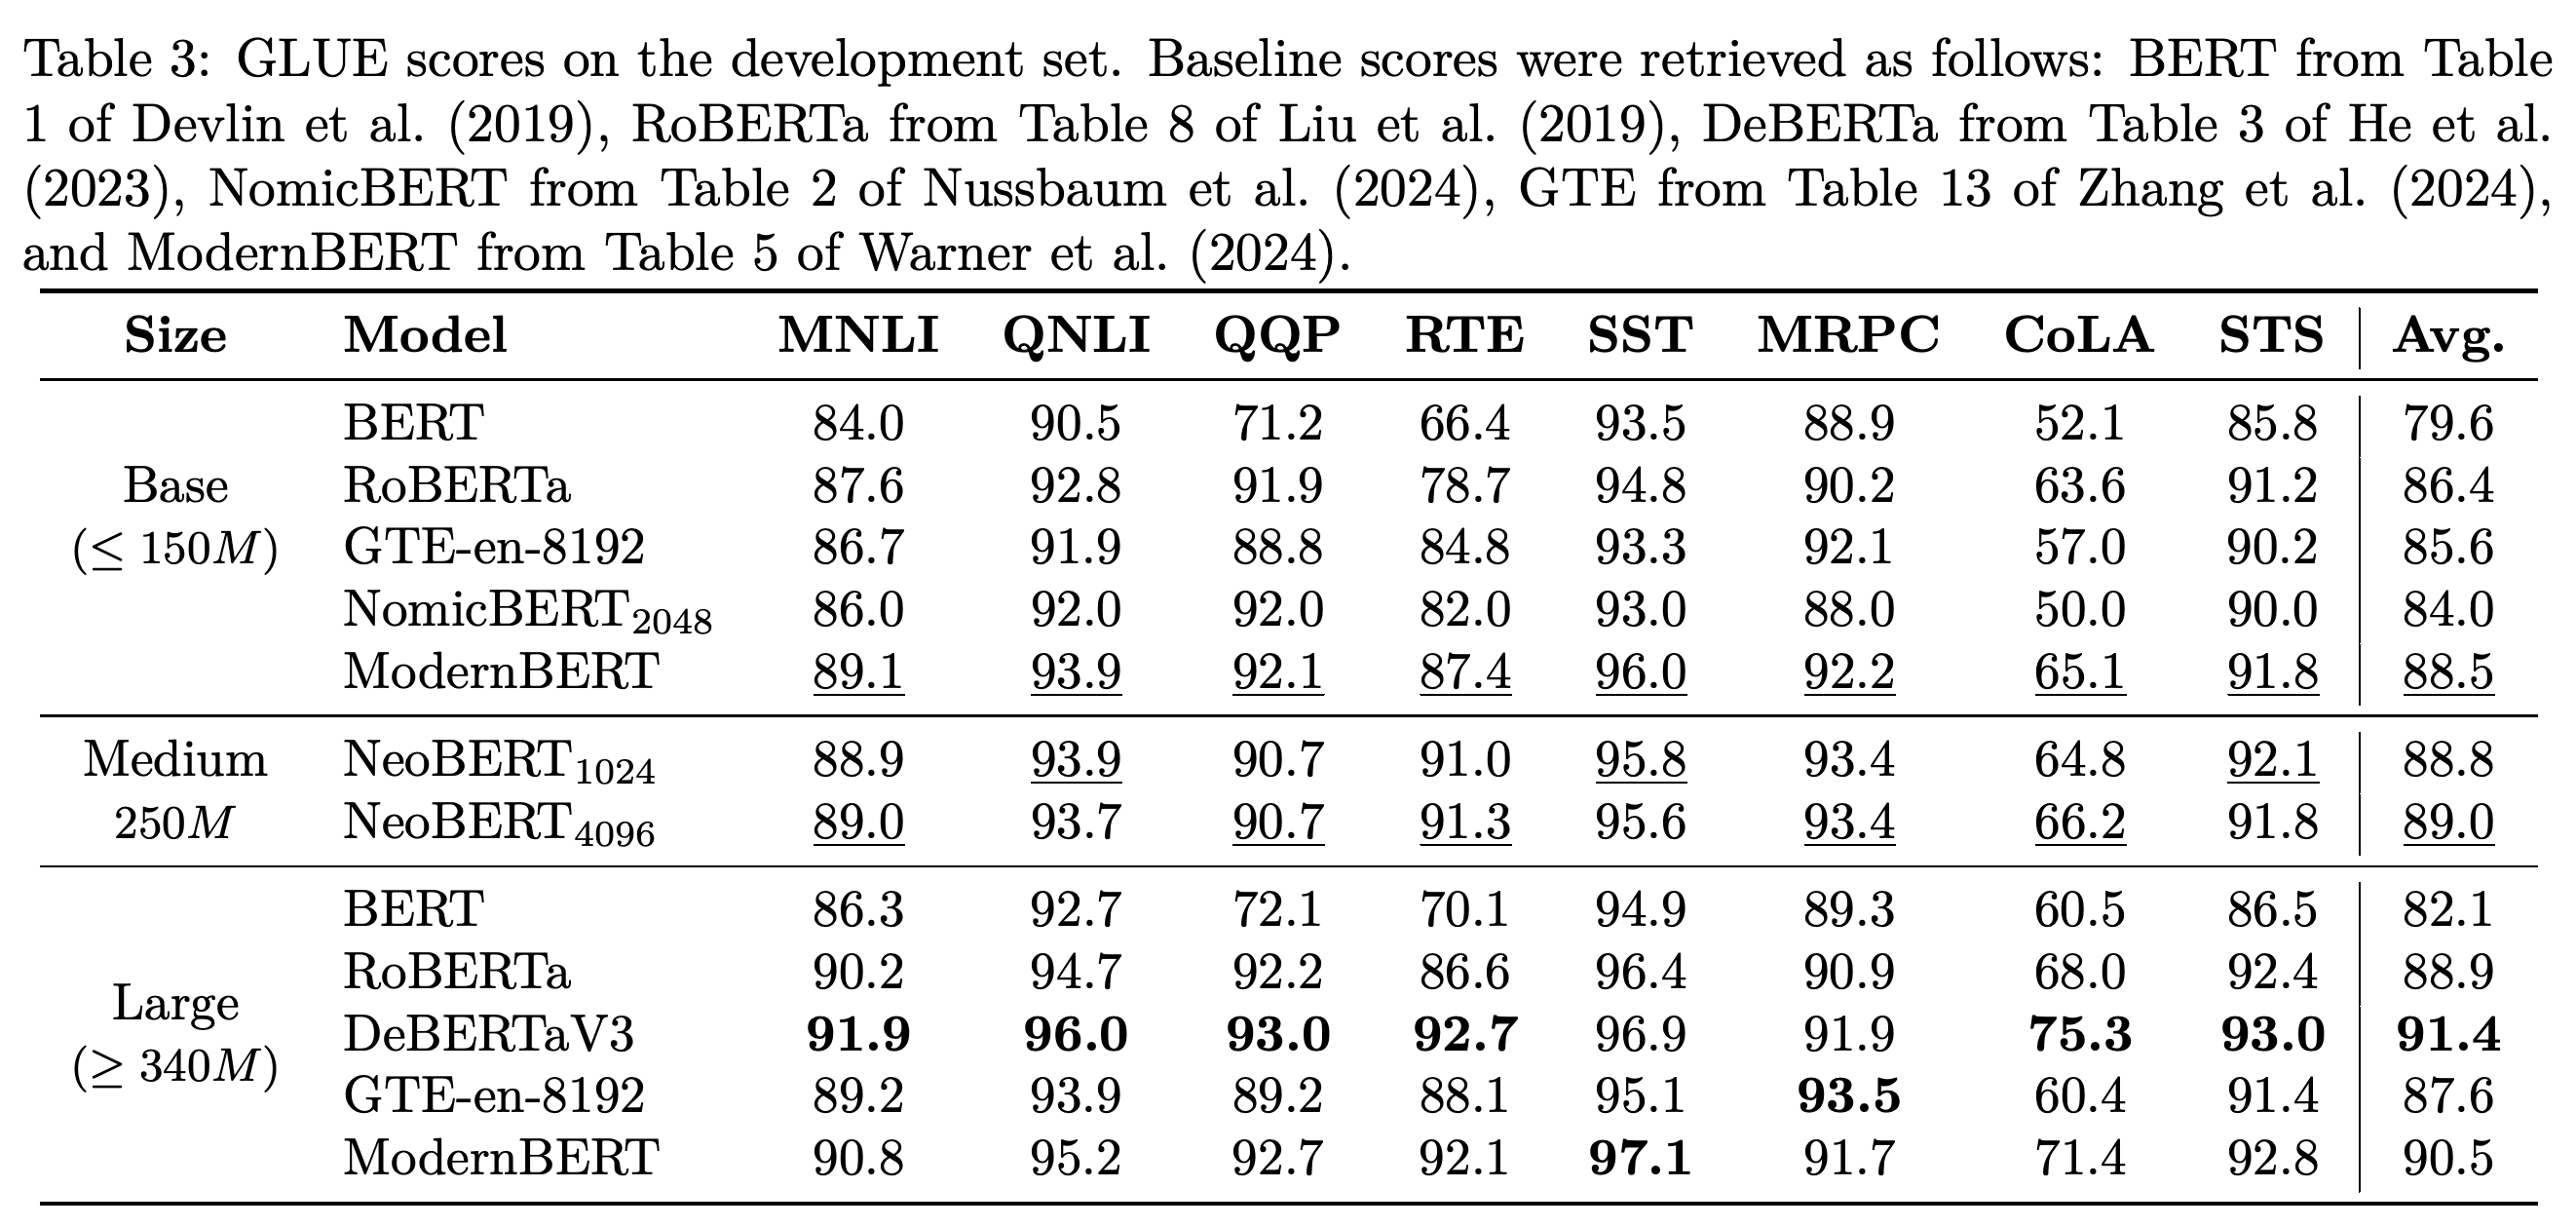
NeoBERT1024와 NeoBERT4096은 GLUE 개발 세트 평균 88.8점과 89.0점을 기록한다. NeoBERT4096은 88.9점인 RoBERTa large와 비슷하지만, 90.5점인 ModernBERT large와 91.4점인 DeBERTaV3 large에는 미치지 못한다.
- 표 3의 베이스라인 점수는 기존 출판물에서 가져왔으므로, 이 비교에는 MTEB 실험의 공통 미세조정 프로토콜을 적용하지 않았다.
- 부록 C는 학습 분할을 이용한 미세조정, 검증 결과에 따른 선택, 최상의 Multi-Genre Natural Language Inference(MNLI) 체크포인트를 관련 과제로 전이하는 절차를 명시한다. MNLI 체크포인트는 문장 간 관계를 판단하도록 학습한 모델이다. 보고된 결과는 별도 테스트 세트에 제출한 점수가 아니라 개발 세트 점수다.
NeoBERT4096은 파라미터가 더 적으면서도 평균 89.0점으로 RoBERTa large의 88.9점과 비슷하다. ModernBERT large와 DeBERTaV3 large는 여전히 더 높은 점수를 기록하며, 베이스라인 결과는 서로 다른 출판물에서 가져왔다.
5.2 MTEB
MTEB의 영어 부분집합은 7개 과제 유형에 걸친 56개 데이터셋으로 구성된다. 마스킹된 토큰을 예측하는 사전학습은 문장 수준 표현을 직접 최적화하지 않으므로, 저자들은 모든 백본에 공통 임베딩 미세조정 절차를 적용한 뒤 비교한다.
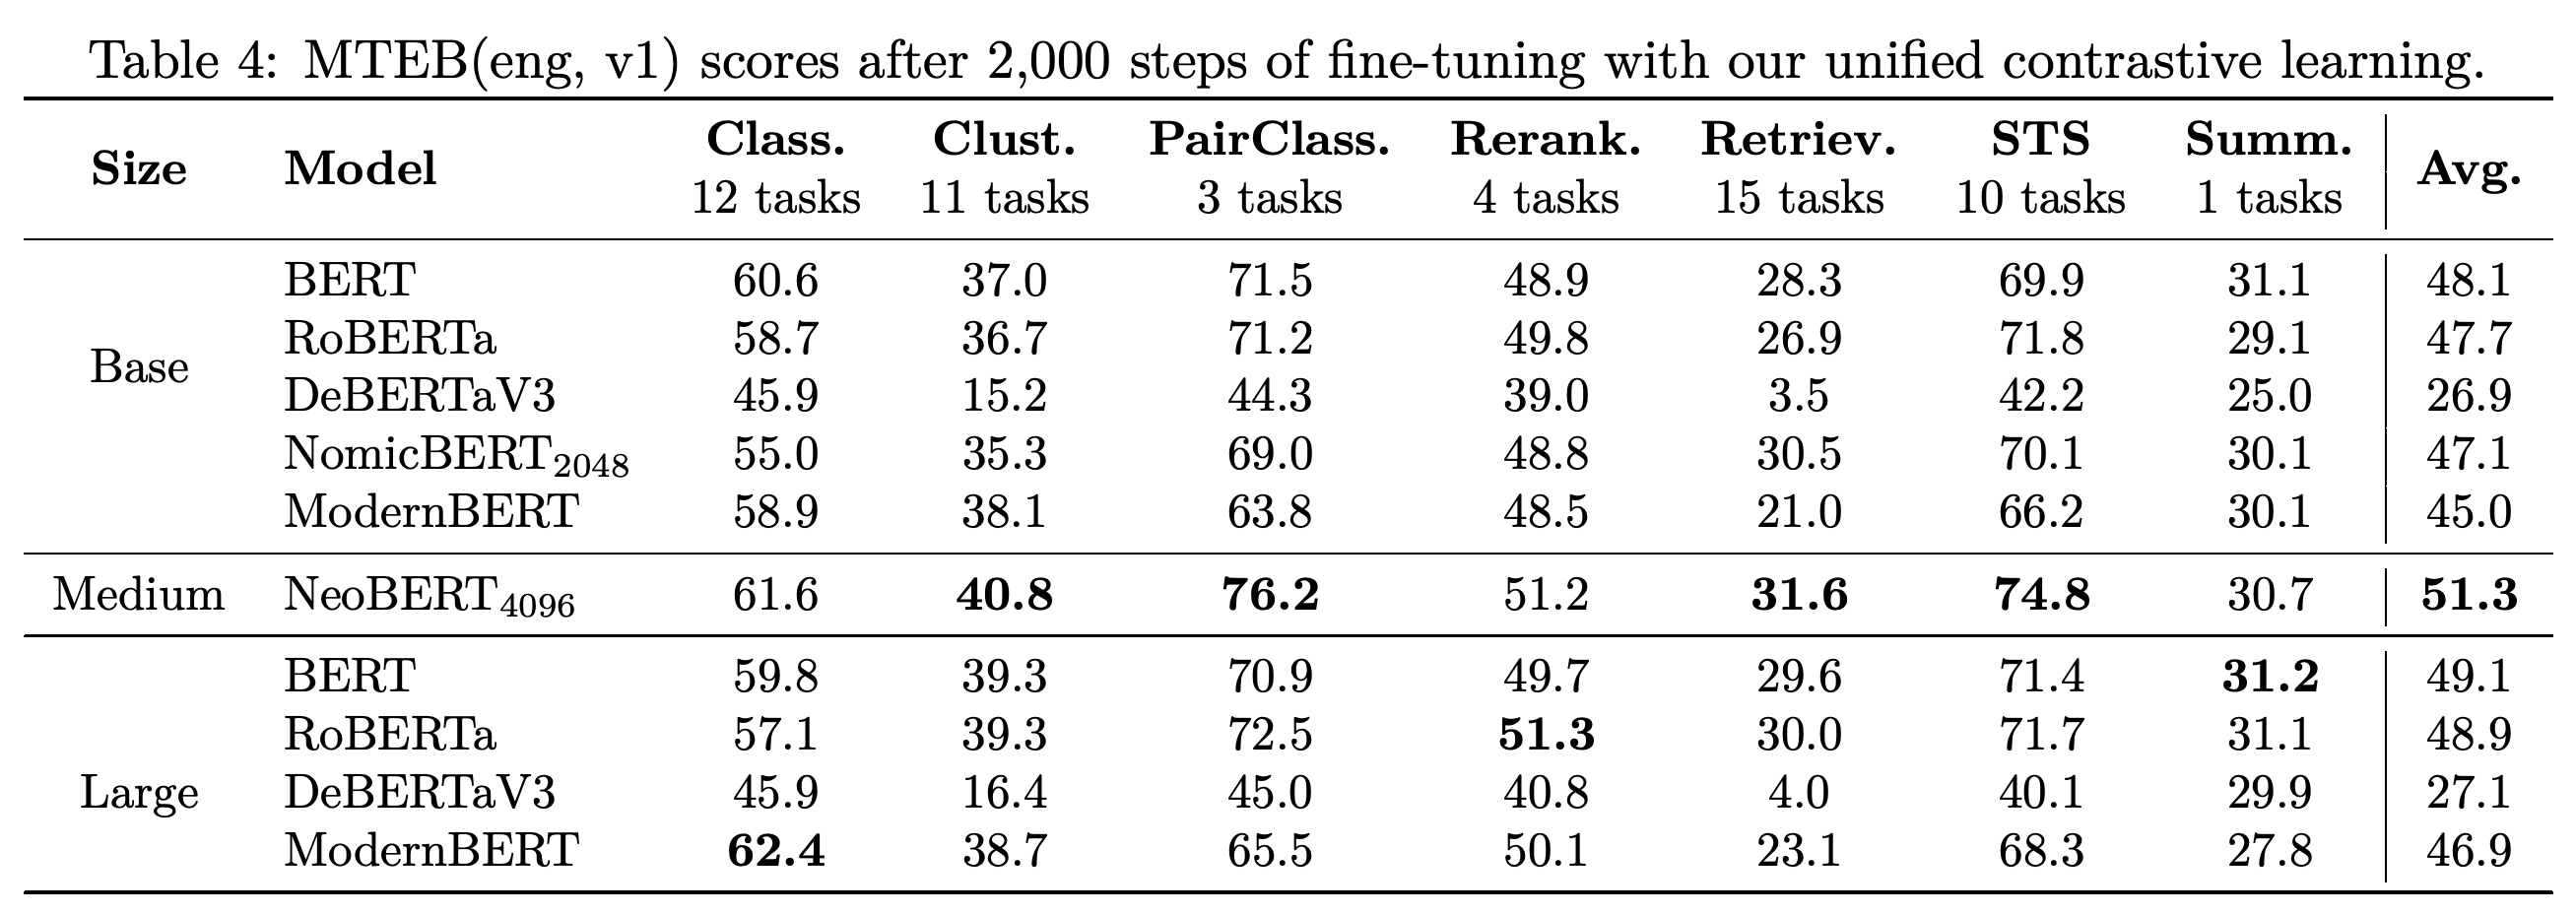
5.2.1 Unified Contrastive Learning은 총 9,000,000개 문서를 포함한 공개 데이터셋에서 추출한 양성 질의-문서 쌍, 선택적으로 사용하는 hard negative, 같은 과제로 구성된 배치 내부의 음성 예제를 사용한다. 배치 내부 음성 예제는 같은 과제와 학습 배치에 속하지만 서로 대응하지 않는 예제다. Hard negative는 비교 대상 예제와 유사하지만 대응하지 않는 문서다. 모든 모델에 과제별 지시문과 온도 파라미터로 조정한 데이터셋 샘플링을 공통으로 적용한다.
- 2,000 steps 후 NeoBERT4096의 평균은 51.3이며, BERT large는 49.1, RoBERTa large는 48.9, NomicBERT2048은 47.1, ModernBERT large는 46.9다.
- 논문은 2위 모델 대비 +4.5%의 상대적 향상을 보고한다. NeoBERT는 전체 비교에서 군집화, 쌍 분류, 검색, semantic textual similarity(STS)에서 가장 높은 점수를 기록한다. STS는 문장 의미의 유사성을 측정한다.
- 이 실험에서는 2,000 steps를 넘어 학습해도 향상이 미미하다. 이 비교는 공통 적응 절차에서의 성능을 보여주며, 각 백본이 달성할 수 있는 최대 성능을 입증하지는 않는다.
공통 2,000 steps 절차에서 NeoBERT는 전체 평균 51.3으로 가장 높고, BERT large가 49.1로 그다음이다. NeoBERT는 7개 범주 중 4개 범주에서 앞선다. 분류에서는 ModernBERT large, 재순위화에서는 RoBERTa large, 요약에서는 BERT large가 앞선다.
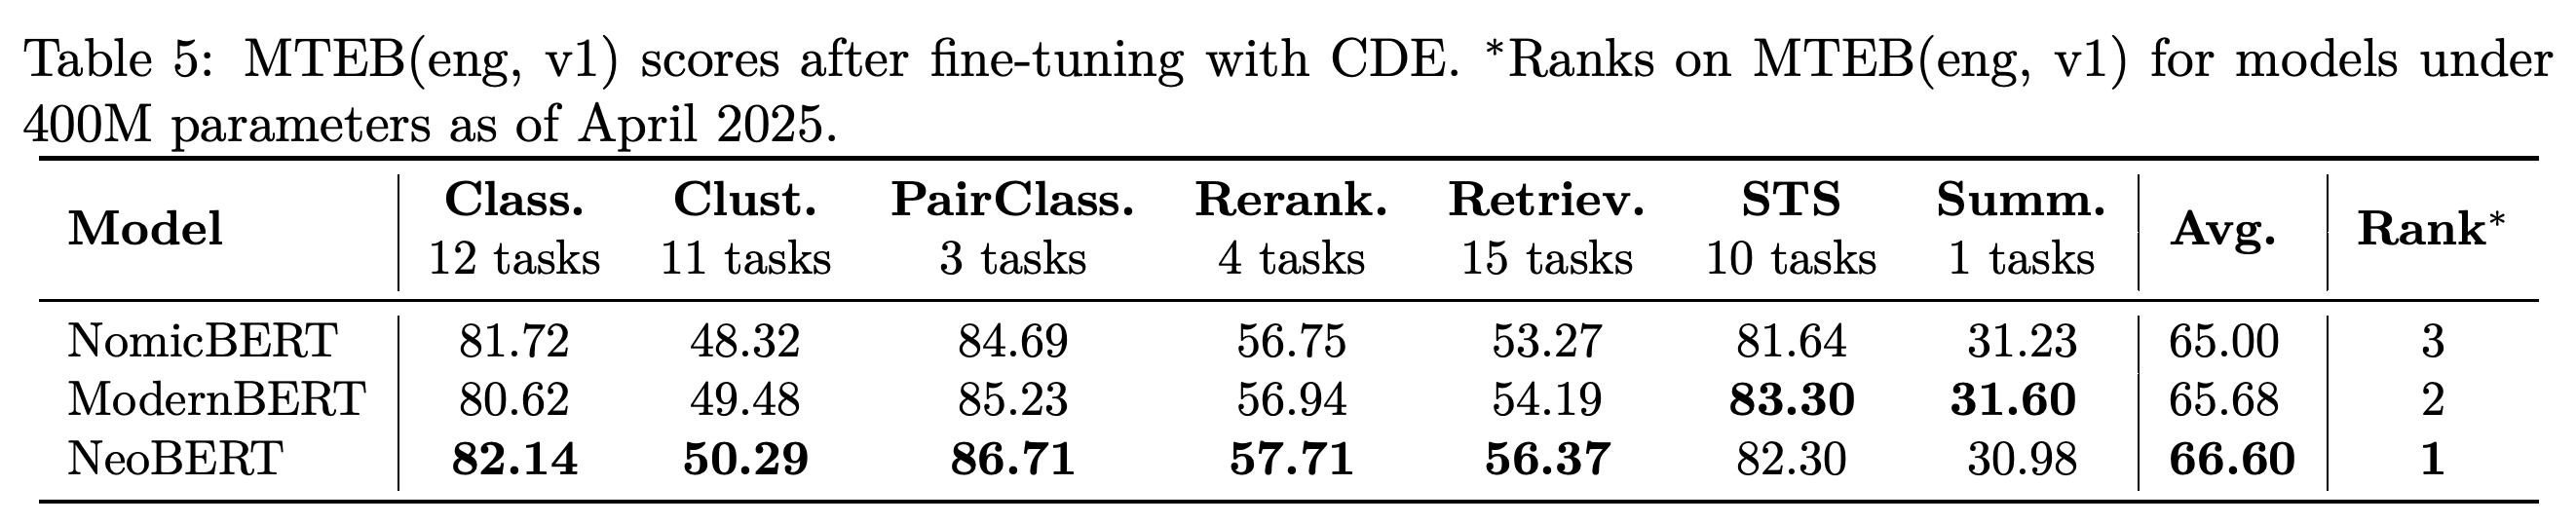
5.2.2 Contextual Document Embeddings에서는 계산 비용이 더 큰 CDE 절차를 NeoBERT에 적용한다. MTEB 평균은 NeoBERT가 66.60점, ModernBERT가 65.68점, NomicBERT가 65.00점이다. 표 5는 2025년 4월 기준 파라미터 수가 400M 미만인 모델 중 1위를 보고한다.
- NeoBERT는 이 모델 3개 중 분류, 군집화, 쌍 분류, 재순위화, 검색에서 가장 높은 성능을 보인다. 재순위화는 관련성에 따라 후보 문서의 순서를 다시 정하는 과제다.
- ModernBERT는 STS에서 83.30 대 82.30, 요약에서 31.60 대 30.98로 더 높은 성능을 유지한다. 66.60은 공통 프로토콜의 51.3과 상당히 다른 학습 방식에서 얻은 결과다.
CDE 학습에서 NeoBERT의 평균은 ModernBERT보다 0.92점, NomicBERT보다 1.60점 높다. NeoBERT는 5개 범주에서 앞서고, STS와 요약에서는 ModernBERT가 가장 높은 점수를 유지한다. 파라미터 수가 400M 미만인 모델의 순위는 2025년 4월 기준이다.
5.3 Sequence Length
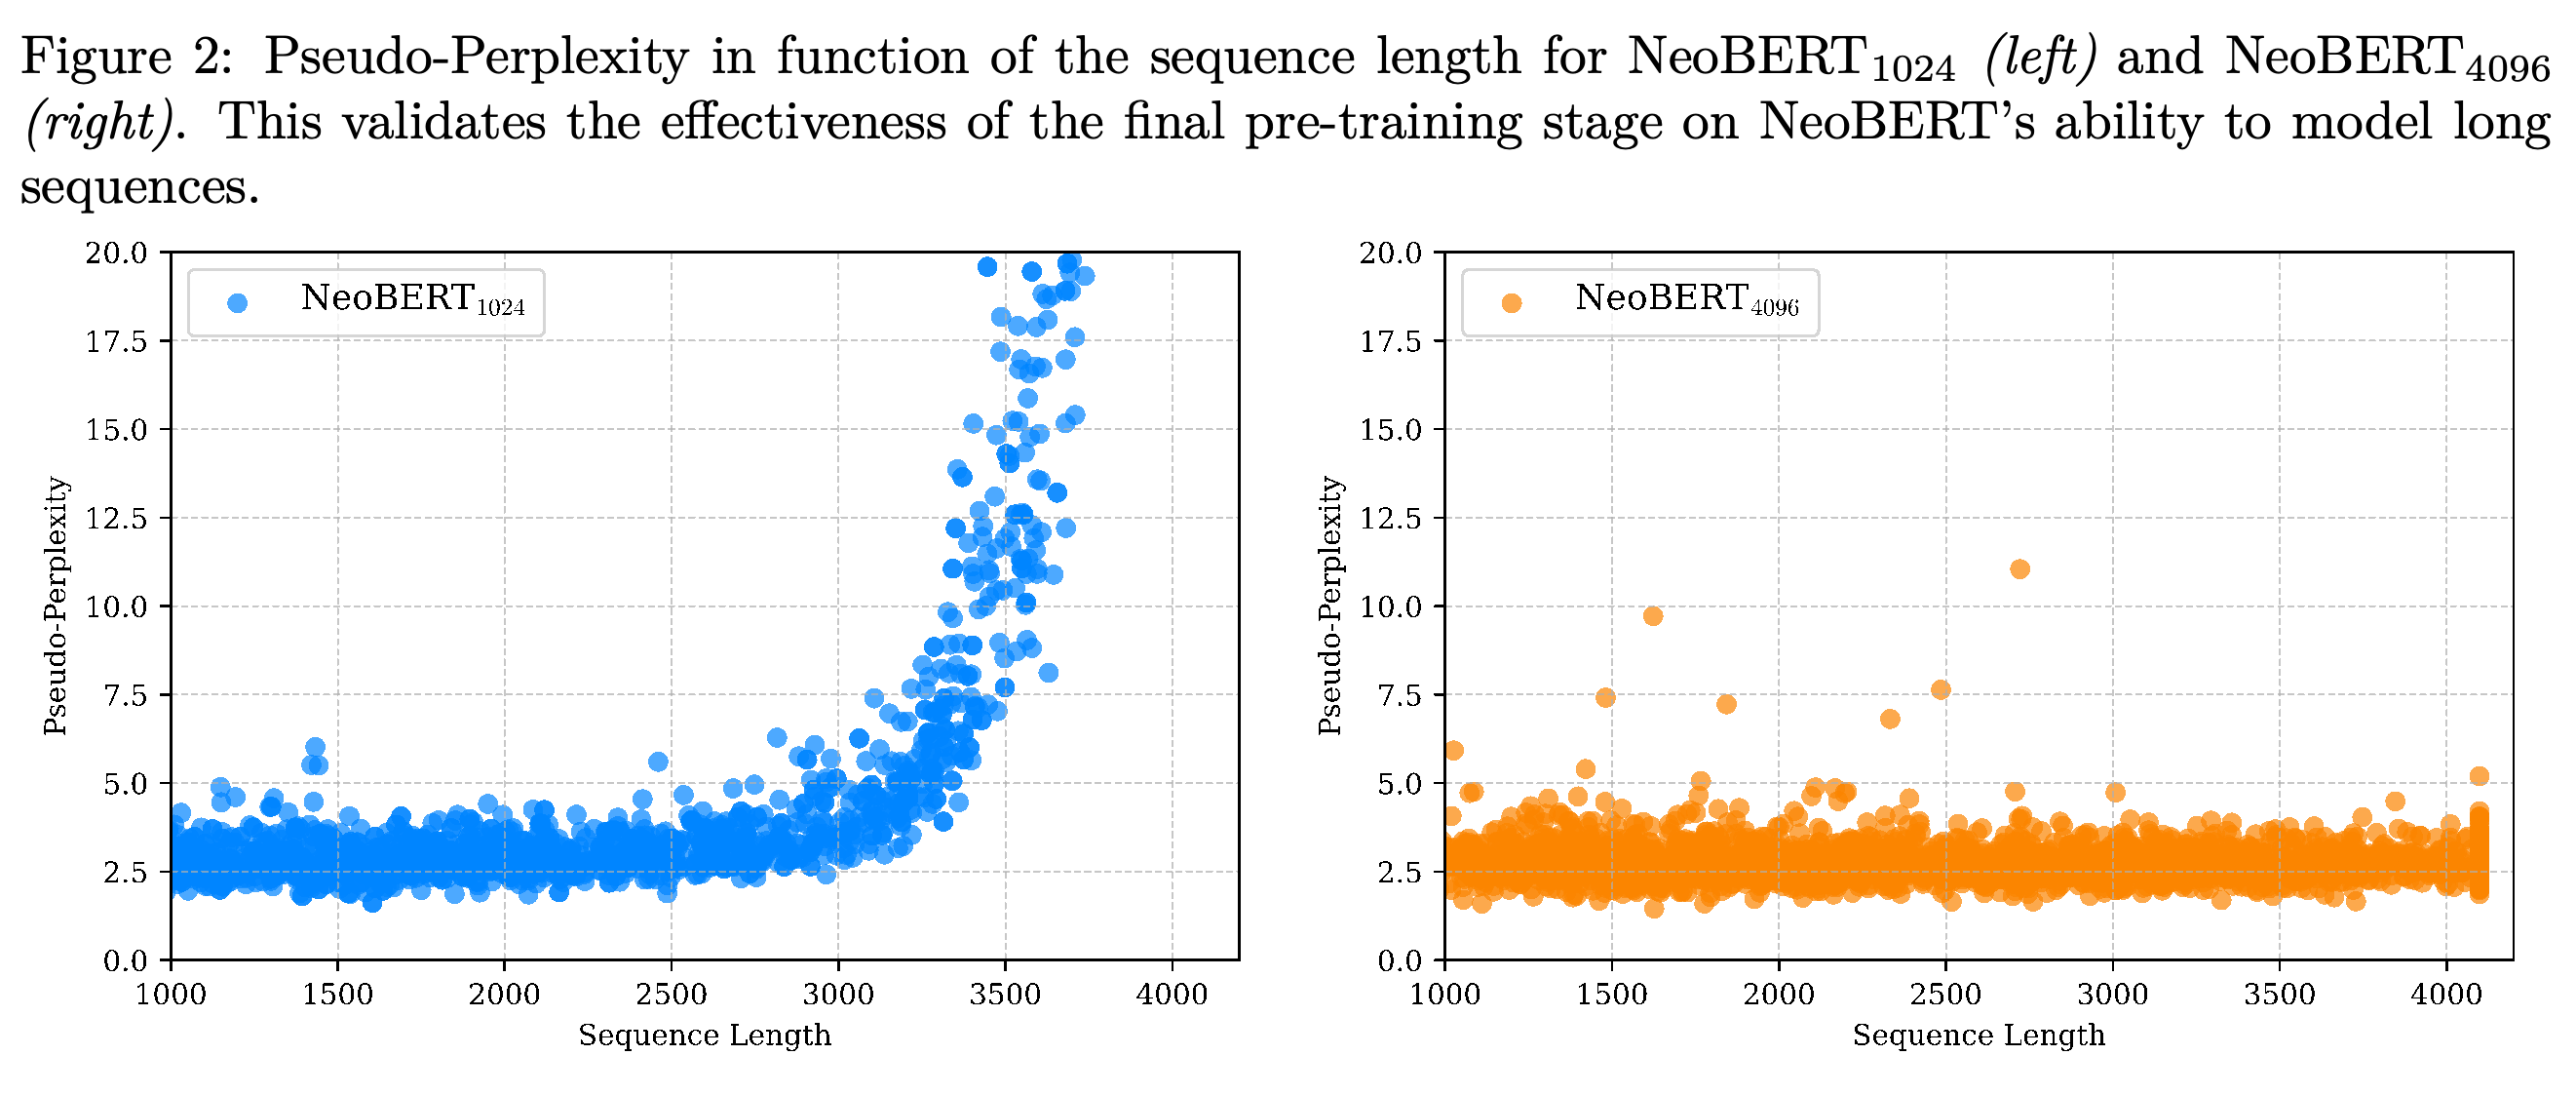
문맥 실험은 긴 영어 Wikipedia 시퀀스 2,467개를 추출하고 각 토큰을 독립적으로 마스킹하여 pseudo-perplexity를 계산한다. Pseudo-perplexity는 마스킹된 토큰의 평균 교차 엔트로피에 지수 함수를 적용한 값이다. NeoBERT1024는 약 3,000토큰까지 낮은 pseudo-perplexity를 유지하다가 급격히 상승하지만, NeoBERT4096은 확장된 학습 길이 범위 전반에서 낮은 pseudo-perplexity를 유지한다.
- 그림 2는 긴 문맥을 사용한 추가 50k스텝 학습의 효과를 뒷받침한다.
- 이 실험은 Wikipedia에서 마스킹된 토큰을 모델링하는 능력을 평가하며, 긴 문서의 검색 정확도나 추론 능력을 직접 측정하지 않는다.
NeoBERT1024의 pseudo-perplexity는 약 3,000토큰을 넘으면 급격히 상승하지만, NeoBERT4096은 4,096토큰까지 비교적 안정적이다. 이 결과는 Wikipedia에서 마스킹된 토큰을 모델링할 때 긴 문맥 학습 단계가 효과적임을 뒷받침한다. 다운스트림 장문 처리 성능을 직접 입증하지는 않는다.
5.4 Efficiency
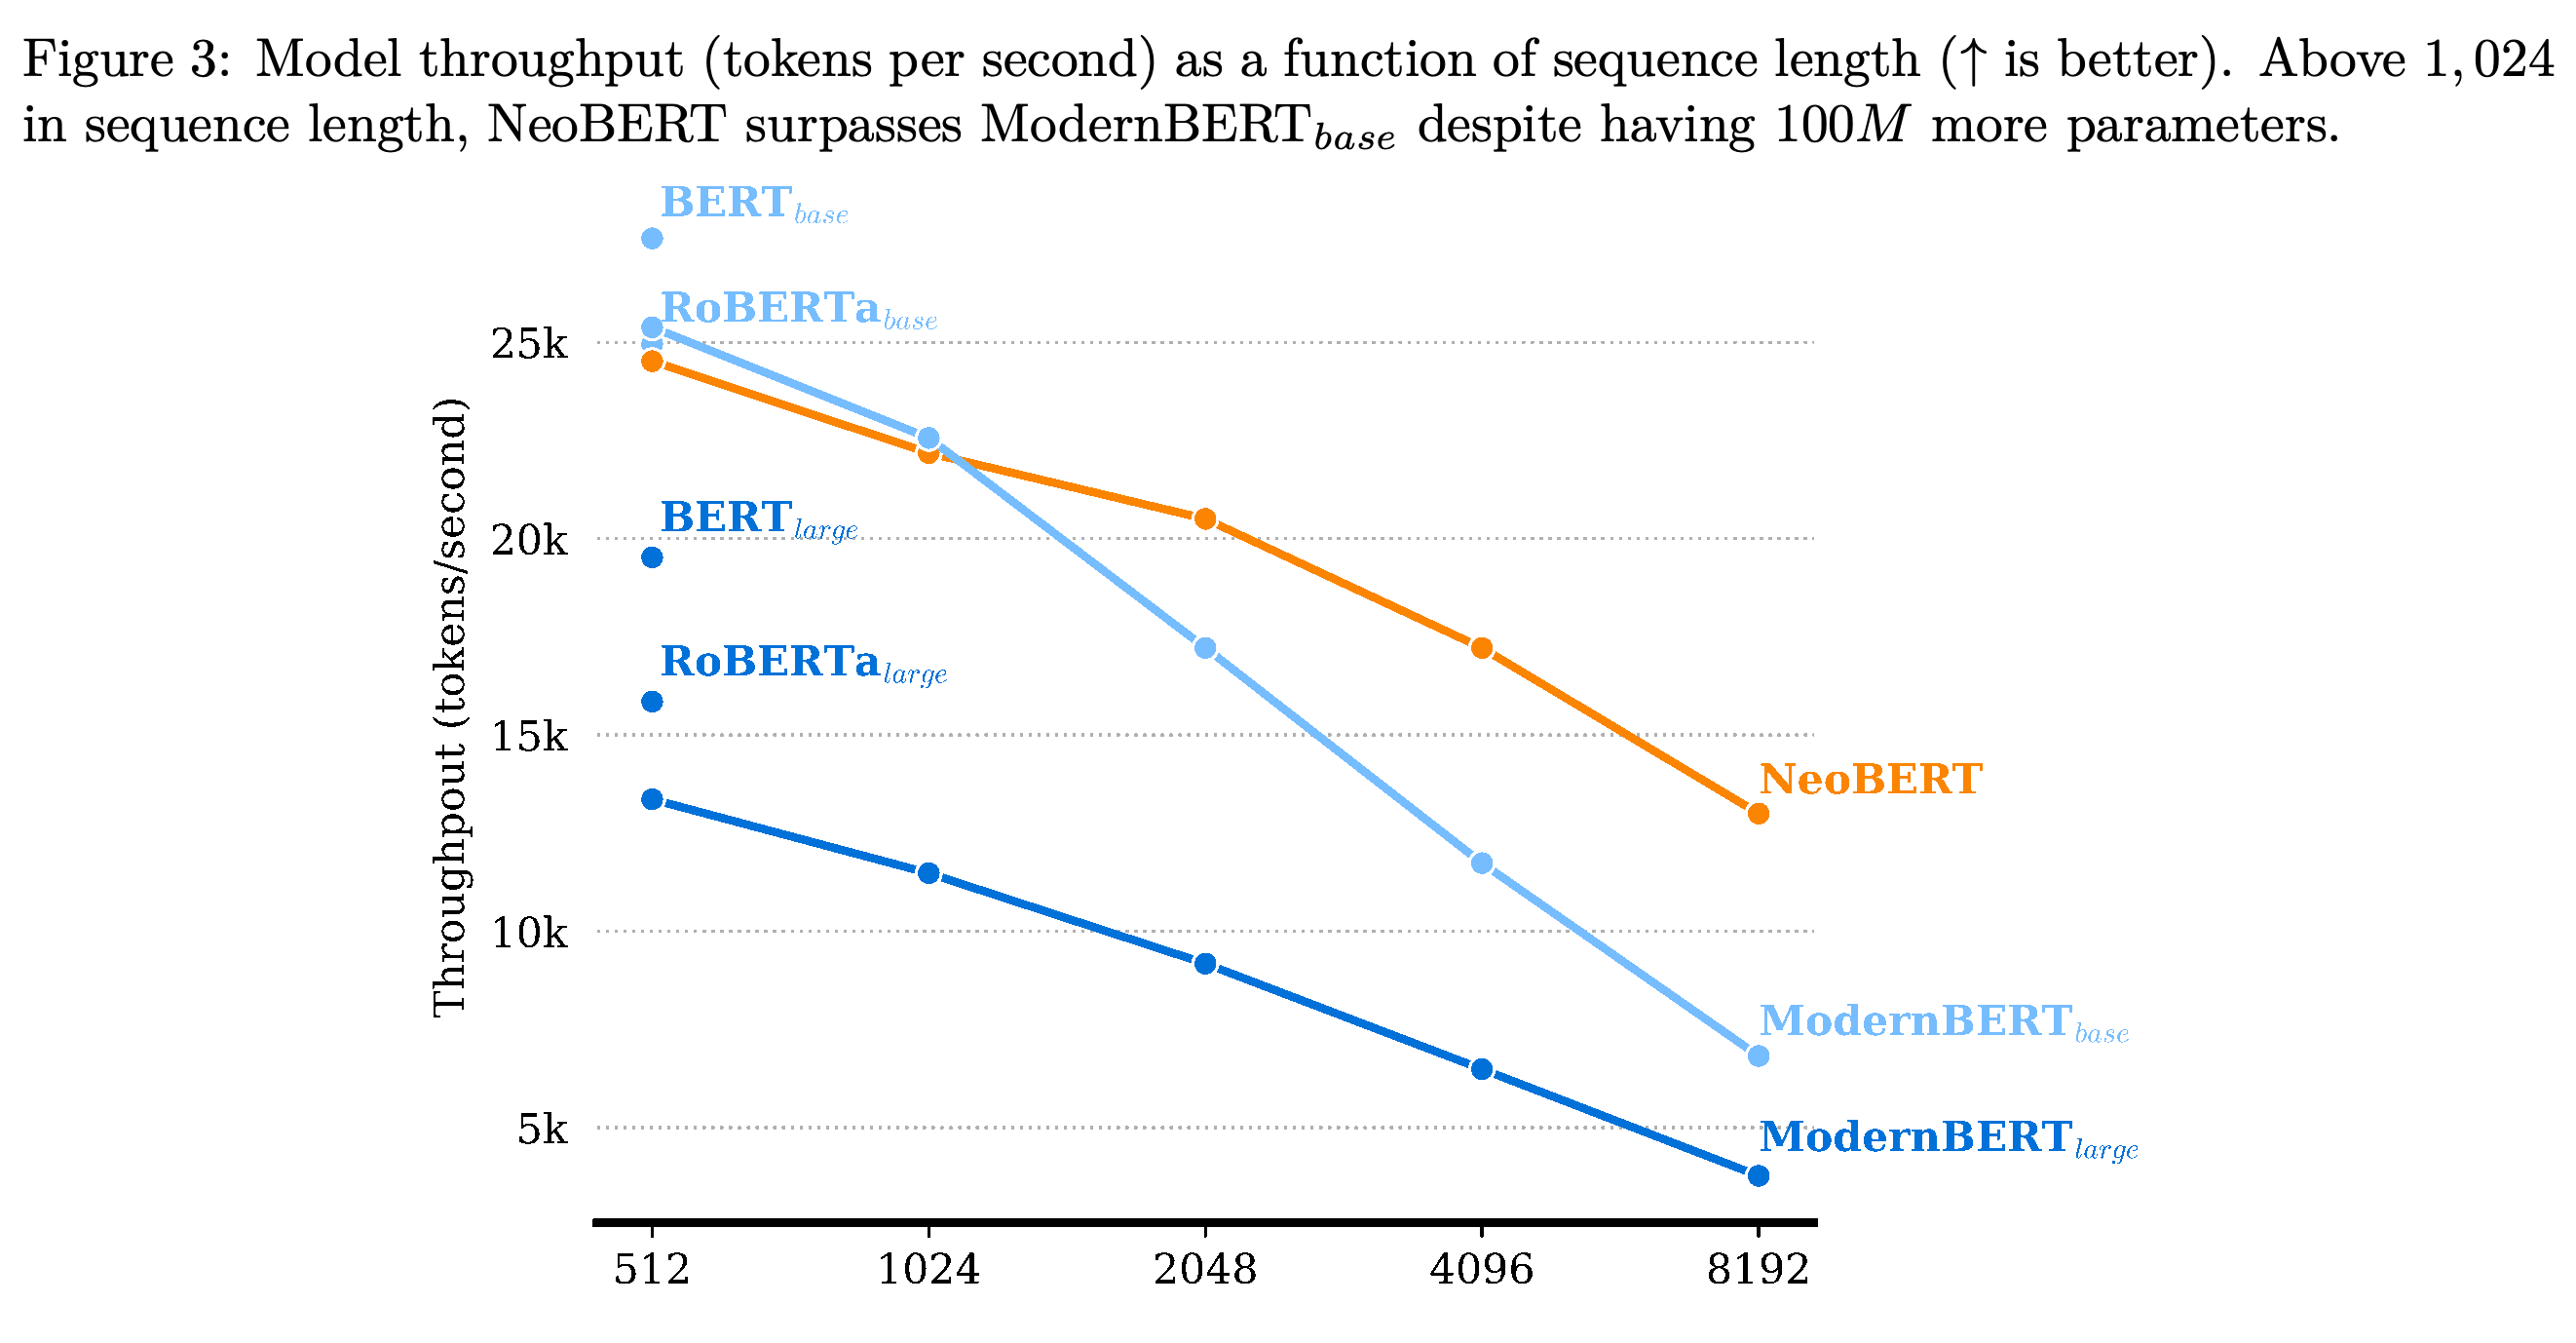
효율성은 길이 {512, 1024, 2048, 4096, 8192}의 합성 시퀀스로 측정하며, 배치 크기를 1에서 512까지 또는 메모리가 소진될 때까지 늘린다. 각 설정은 A100 가속기 1개에서 추론 100스텝을 실행하며, 저자들은 모델과 시퀀스 길이별로 가장 높은 처리량을 보고한다.
- 4,096토큰에서 처리량은 NeoBERT가 17.2 ± 1.2, ModernBERT base가 11.7 ± 0.8이며, 단위는 초당 1,000토큰이다. 본문은 46.7%의 속도 향상을 보고한다.
- 512토큰에서 처리량은 BERT base가 27.6 ± 3.6으로 NeoBERT의 24.5 ± 1.4보다 높으며, 단위는 초당 1,000토큰이다. 처리량의 우위는 시퀀스 길이와 최적화한 배치 크기에 따라 달라진다.
- 8,192토큰에서의 처리량 측정은 해당 길이로 추론을 실행할 수 있음을 보여준다. 해당 길이에서 모델링 품질이 신뢰할 만하다는 근거는 아니다.
A100 1개를 사용한 실험에서 NeoBERT의 처리량은 시퀀스가 길어질 때 ModernBERT보다 완만하게 감소한다. ModernBERT base 대비 우위는 1,024토큰을 넘을 때 나타나며, 512토큰에서는 BERT base가 더 빠르다. 각 설정은 시험한 배치 크기 중 처리량이 가장 높은 값을 사용한다.
6 Discussion
논의에서는 인코더 순위가 평가와 적응 방식에 크게 좌우된다고 주장한다. GLUE는 제한된 과제를 다루고 과적합에 취약하다. MTEB 리더보드 성능은 비용이 큰 미세조정 절차에 좌우될 수 있어 사전학습 백본 자체의 기여를 파악하기 어렵다.
- DeBERTaV3가 GLUE에서는 높은 점수를 기록하지만 이 논문의 공통 MTEB 프로토콜에서는 낮은 성능을 보인다는 점은 평가 간 불일치를 보여준다.
- 저자들은 표준화되고 비용 부담이 적은 미세조정 프로토콜과 개선된 zero-shot 평가를 제안한다. Zero-shot 평가는 과제별 모델 적응 없이 수행하는 평가다.
7 Conclusion
결론은 NeoBERT를 공개된 인코더 백본으로 제시한다. 보고된 설정에서 경쟁력 있는 언어 이해 성능, 공통 미세조정 후의 높은 임베딩 성능, 향상된 긴 시퀀스 처리량을 보인다. 코드, 모델 체크포인트, 데이터, 학습 스크립트는 https://huggingface.co/chandar-lab/NeoBERT 및 https://github.com/chandar-lab/NeoBERT 에서 제공한다.
Broader Impact Statement
NeoBERT는 사전학습 코퍼스의 편향과 한계를 물려받는다. 설계 변경 실험에서 가장 큰 향상이 데이터셋 변경에서 나타났으므로, 저자들은 추가 개선을 위해 더 최신이거나 규모가 크거나 다양한 데이터로 재학습해야 할 것으로 예상한다. 실험이 재학습의 필요성을 입증한 것은 아니다.
부록
- A Training details는 H100 가속기를 사용한 1,050,000 steps의 학습과 6,000 GPU시간을 보고한다. 가속기 수와 첫 단계의 그래디언트 누적 스텝 수는 모두 8이다. 첫 단계는 로컬 배치 크기 32와 최대 길이 1,024를 사용한다. 그래디언트 누적은 옵티마이저를 갱신하기 전에 그래디언트를 합치는 방식이다. 다음 단계는 길이를 4,096으로 늘리면서 이론적 배치 크기 2M-token을 유지한다.
- B Ablations와 B.1 Baseline은 M0와 BERT base의 차이가 pre-layer normalization과 다음 문장 예측 제거임을 명시한다. B.2 Tokenizers는 알고리즘, 학습 코퍼스, 대소문자 구분, 문자 처리의 차이를 다루지만 각각의 기여를 분리하지 않는다. 또한 토크나이저 변경에 따른 하락을 2.9%로 보고하여, 본문과 그림 1의 −2.1%와 일치하지 않는다.
- C GLUE는 미세조정을 10에포크 동안 수행하고, min(500, len(dataloader) // 10)스텝마다 검증하며, 15회 평가 동안 개선이 없으면 조기 종료한다고 설명한다. 문장 추론 평가인 Winograd Natural Language Inference(WNLI)는 제외하고, 함께 보고하는 지표는 평균을 낸다. 표 6은 부록 본문보다 넓은 탐색 공간을 제시한다. 배치 크기는 {2, 4, 8, 16, 32}, 학습률은 {5e−6, 6e−6, 8e−6, 1e−5, 2e−5, 3e−5}, 가중치 감쇠는 {1e−2, 1e−5}다.
- D MTEB의 D.1 Evaluation of pre-trained models에서 zero-shot BERT base는 37.4점으로 BERT large의 36.3점과 RoBERTa large의 36.0점보다 높다. D.2 Contrastive learning은 표현 벡터 간 방향의 일치 정도를 측정하는 코사인 유사도, 손실에서 유사도 배율을 조절하는 온도 τ = 0.07, 데이터셋 크기의 제곱근에 비례하는 데이터셋 샘플링, 미세조정 2,000스텝, 16비트 부동소수점 값을 사용하는 float16 평가를 명시한다. D.3 Task instructions는 표 7–9에 학습과 평가 지시문을 제공한다.
- E Context Length에서는 NeoBERT4096이 6,000토큰 부근까지 비교적 낮은 Wikipedia pseudo-perplexity를 유지하지만, 그보다 길어지면 크게 악화된다는 점을 확인한다. F Efficiency는 전체 처리량 표를 제공한다. 8,192토큰에서 처리량은 NeoBERT가 13.0 ± 0.2, ModernBERT base가 6.8 ± 0.2이며, 단위는 초당 1,000토큰이다.
- G Contextual Document Embeddings와 G.1 Method는 예제를 군집화하여 관련 배치를 구성하고 백본 2개를 사용하는 방법을 설명한다. 한 백본은 문맥 문서를 인코딩하고, 다른 백본은 그 인코딩을 조건으로 질의나 문서의 표현을 생성한다. 백본 2개 모두 2단계 그래디언트 캐싱 절차로 종단 간 학습한다. 이 절차는 중간 그래디언트를 캐시하여 문맥을 활용하는 아키텍처의 학습을 지원한다.
- G.2 Data and hyperparameters는 에포크당 노이즈가 있는 질의-문서 쌍 235M을 사용한 뒤 고품질 예제 1.5M을 사용하며, 단계마다 3 epochs 동안 학습한다. Adam은 1,000스텝의 워밍업으로 학습률을 5e−5까지 높인 뒤 선형으로 0까지 낮춘다. 배치와 클러스터 크기는 512이며, 가속기 사이에서 음성 예제를 공유하지 않는다. 문서당 길이가 512인 문맥 문서 512개를 사용해 후속 단계의 입력 길이 1024토큰을 구성한다. G.3 Results는 66.60을 보고하며, ModernBERT보다 낮은 STS 점수가 사전학습 데이터 구성 때문일 수 있다고 제안한다. 논문은 이 가설을 검증하지 않는다.
짧은 생각
NeoBERT는 공통 적응 프로토콜과 계산 비용이 더 큰 CDE 절차 2개 모두에서 MTEB 평균을 높인다. 설계 변경 실험은 데이터셋 교체, 모델 규모 확대, 깊이와 너비 간 파라미터 재배분의 효과를 뒷받침한다. 다만 여러 변경을 묶어 적용했으므로 개별 구성 요소의 효과는 규명되지 않았다.
실험 결과는 긴 입력을 포함한 영어 표현 생성 작업에서 NeoBERT를 평가해 볼 근거를 제공한다. 모델 선택은 여전히 과제에 따라 달라진다. GLUE에서는 더 큰 모델이 앞서고, 일부 임베딩 범주에서는 다른 인코더가 앞선다. 처리량 비교에는 합성 입력과 모델별로 따로 최적화한 배치 크기를 사용한다.