


Generative Recursive Reasoning 요약 설명
19 May 2026 | Paper Review Latent Reasoning Test-Time Scaling Variational Inference목차
이번 글에서는 Generative Recursive Reasoning 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 5월 19일(Arxiv), 40th Conference on Neural Information Processing Systems (NeurIPS 2026)
- Baek, Junyeob, Jo, Mingyu, Kim, Minsu, Ren, Mengye, Bengio, Yoshua, Ahn, Sungjin.
- KAIST, Mila – Québec AI Institute, New York University, Université de Montréal
- 논문 링크
- Project Page
요약
- Generative Recursive Reasoning은 작은 신경망이 내부 상태를 반복적으로 개선하면서 대안적인 해를 탐색하는 방법을 다룬다. 내부 추론 경로를 샘플링하는 Generative Recursive reAsoning Models (GRAM)는 최소한의 단서가 주어진 9×9 퍼즐 벤치마크 Sudoku-Extreme에서 병렬 경로 20개와 개선 반복 16회로 정확도 96.1%를 달성한다. 결정론적 재귀 베이스라인 TRM은 거의 같은 연산량으로 320회 반복해 92.1%를 달성한다.
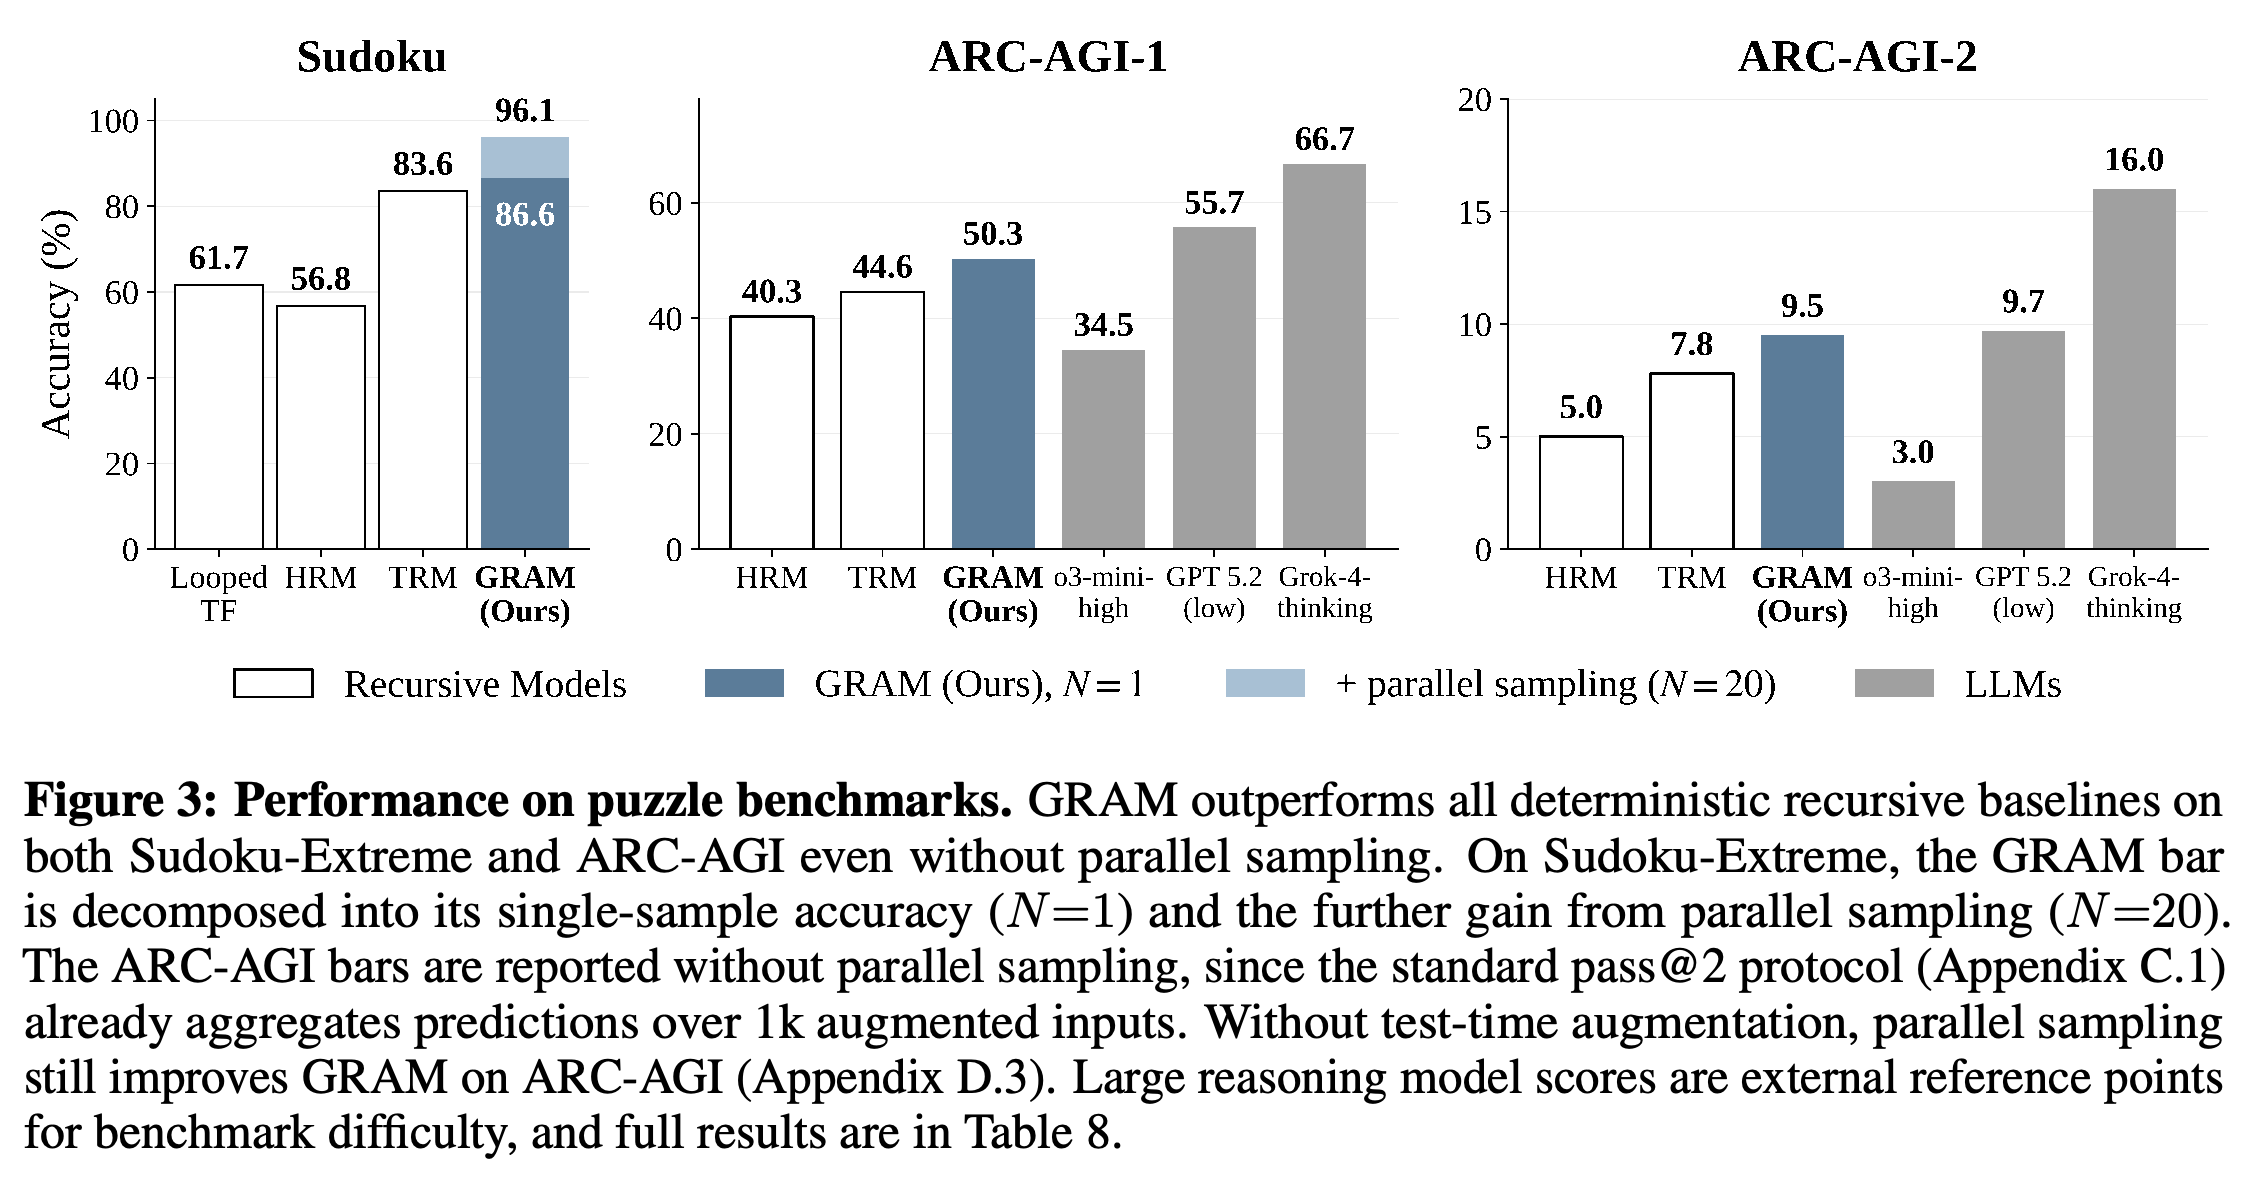
- GRAM은 결정론적 상태 갱신마다 학습된 가우시안 섭동을 더한다. 이 섭동은 상태에 따라 평균과 분산이 달라지는 무작위 잡음이다. 학습에는 내부 경로에 대한 직접 계산이 어려운 추론을 근사하는 변분 추론을 사용한다. 단일 경로에서도 TRM보다 성능이 높다. Sudoku-Extreme에서는 86.6% 대 83.6%, ARC-AGI-1에서는 50.3% 대 44.6%, ARC-AGI-2에서는 9.5% 대 7.8%를 기록한다. ARC-AGI는 소수의 예시로 추상적인 시각 변환을 추론하는 능력을 평가한다. 이 결과는 변환된 입력 1,000개의 예측을 투표로 집계하고 답안 2개 제출을 허용한 조건에서 얻었다.
- GRAM은 퀸이 서로 공격하지 않도록 배치하는 N-Queens에서도 샘플 20개로 평가한 보드 크기 2개 모두에서 정확도 100.0%를 달성한다. 빈 입력에서 생성한 Sudoku 샘플 100K개 중 99.05%가 유효하다. 실험 근거는 통제된 퍼즐과 픽셀을 이진화한 손글씨 숫자에 한정된다. 순차적 학습과 전체 학습 목적함수에 대한 편향된 근사는 이 접근법의 제약이다.
1 Introduction
Recursive Reasoning Models (RRMs)는 공유 매개변수로 유지되는 내부 상태를 반복 갱신하는 신경망이다. 출력 시퀀스를 늘리거나 매개변수 수를 늘리지 않고도 연산량을 늘릴 수 있다. 기존 결정론적 모델은 입력과 초기 상태가 고정되면 같은 경로를 따르므로, 반복 실행으로 대안적인 해를 탐색하는 능력이 제한된다.
- GRAM은 내부 상태의 연속인 추론 궤적을 확률변수로 취급한다. 이에 따라 재귀 깊이를 늘리는 방법에 병렬 궤적 샘플링을 추가한다.
- 논문은 구조화된 추론, 유효한 해가 여러 개인 과제, 유의미한 입력 없이 출력을 만드는 무조건부 생성을 평가한다. 작은 순환 모델 베이스라인으로 아키텍처를 비교하며, 범용 대규모 언어 모델 결과는 외부 참고 자료로 사용한다.
- 논문에서 제공한 프로젝트 URL은 https://ahn-ml.github.io/gram-website/이다.
도식은 여러 유효한 출력을 제안한 연산 방식과 연결한다. 입력과 초기 상태가 고정되면 결정론적 반복 실행은 같은 경로를 따르지만, 샘플링한 경로는 서로 다른 완성 해에 도달할 수 있다. 이는 의도한 메커니즘을 보여 주는 개념도이며, 측정된 커버리지를 제시하지는 않는다.
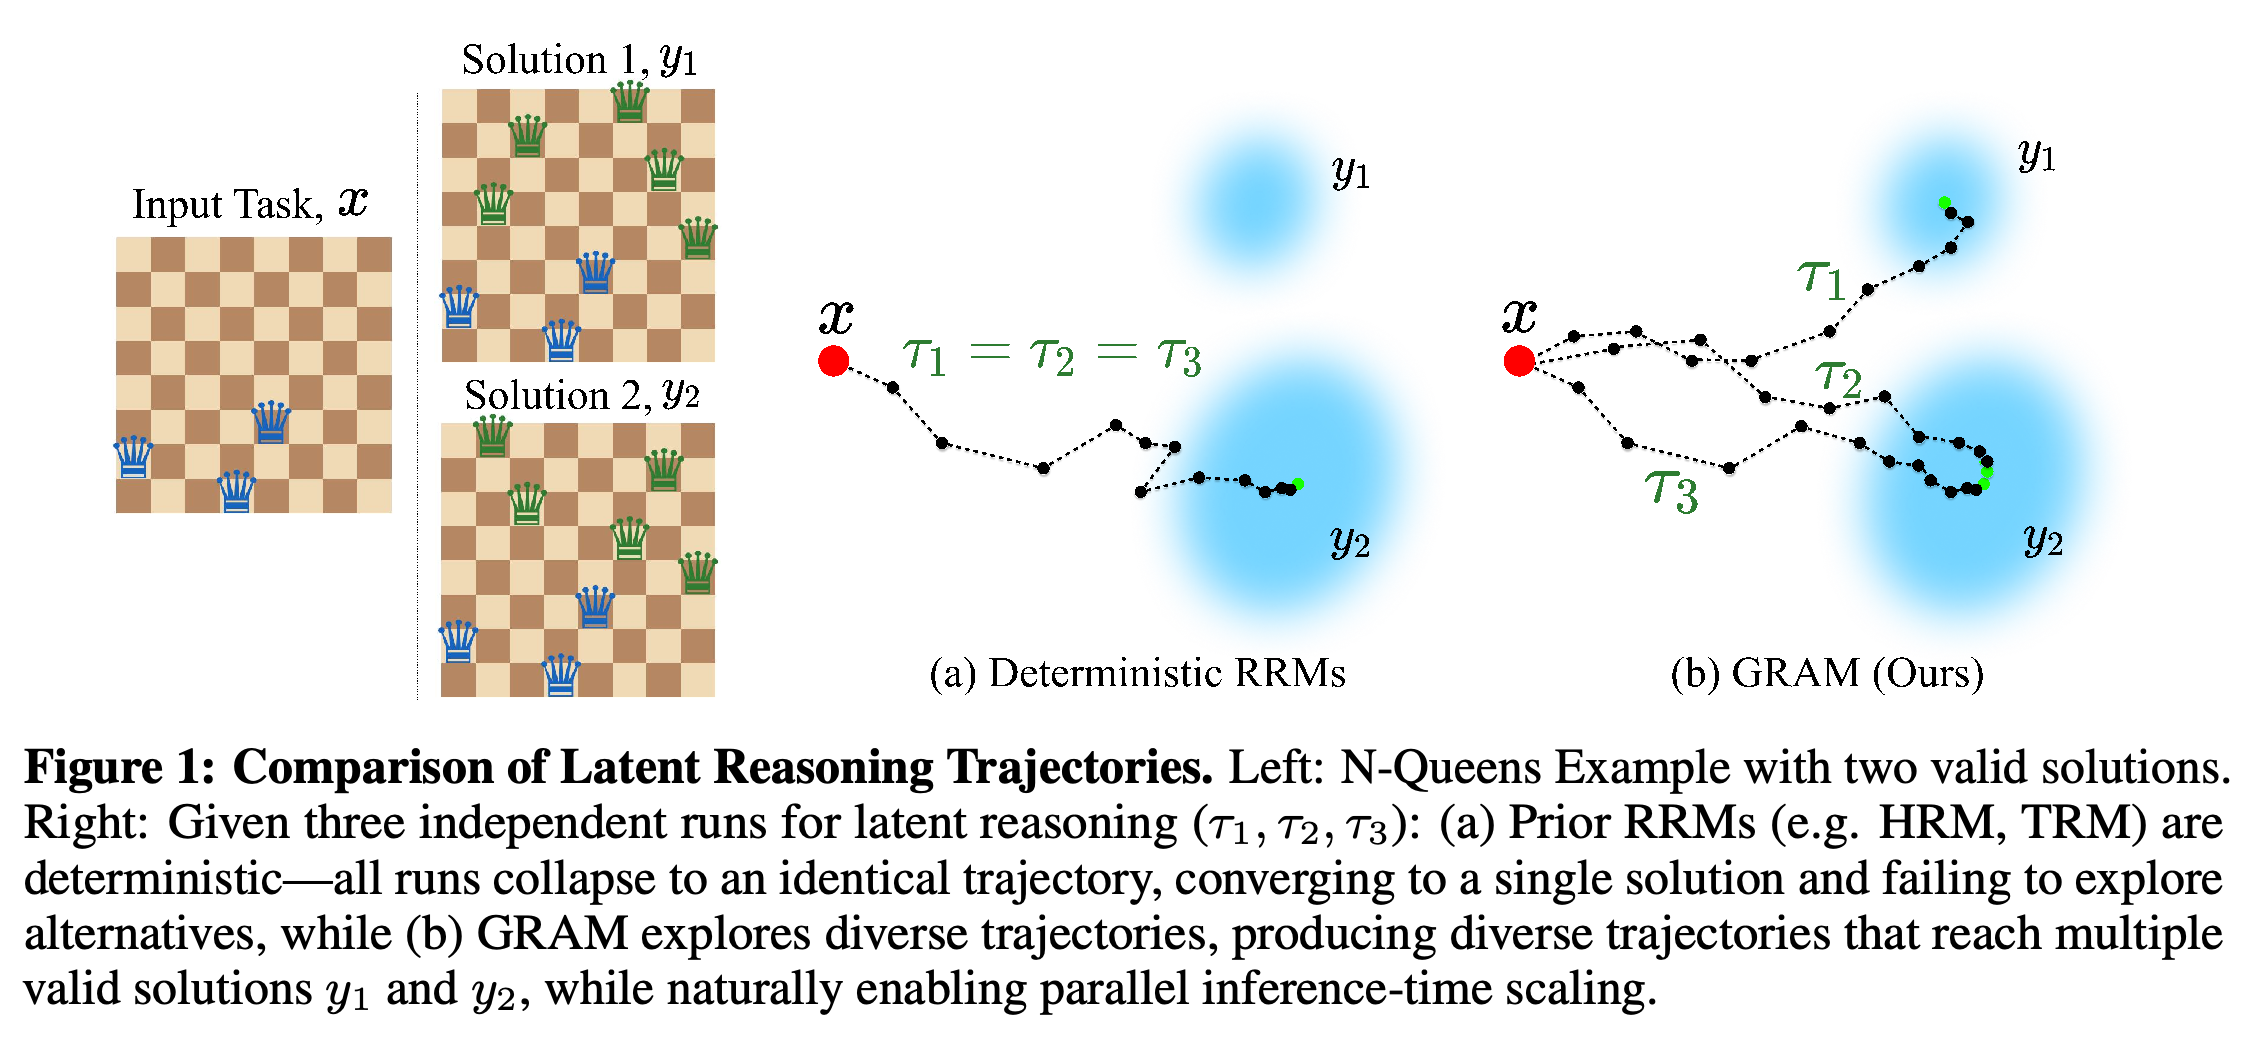
2 Generative Recursive Reasoning Models
GRAM은 재귀 추론을 잠재변수 생성 과정으로 정의한다. 관측되지 않는 내부 궤적이 출력 분포를 결정한다. 방법은 확률적 상태 전이 아키텍처, 학습 절차, 재귀 깊이와 병렬 경로에 연산량을 배분하는 추론 절차로 구성된다.
2.1 Architecture
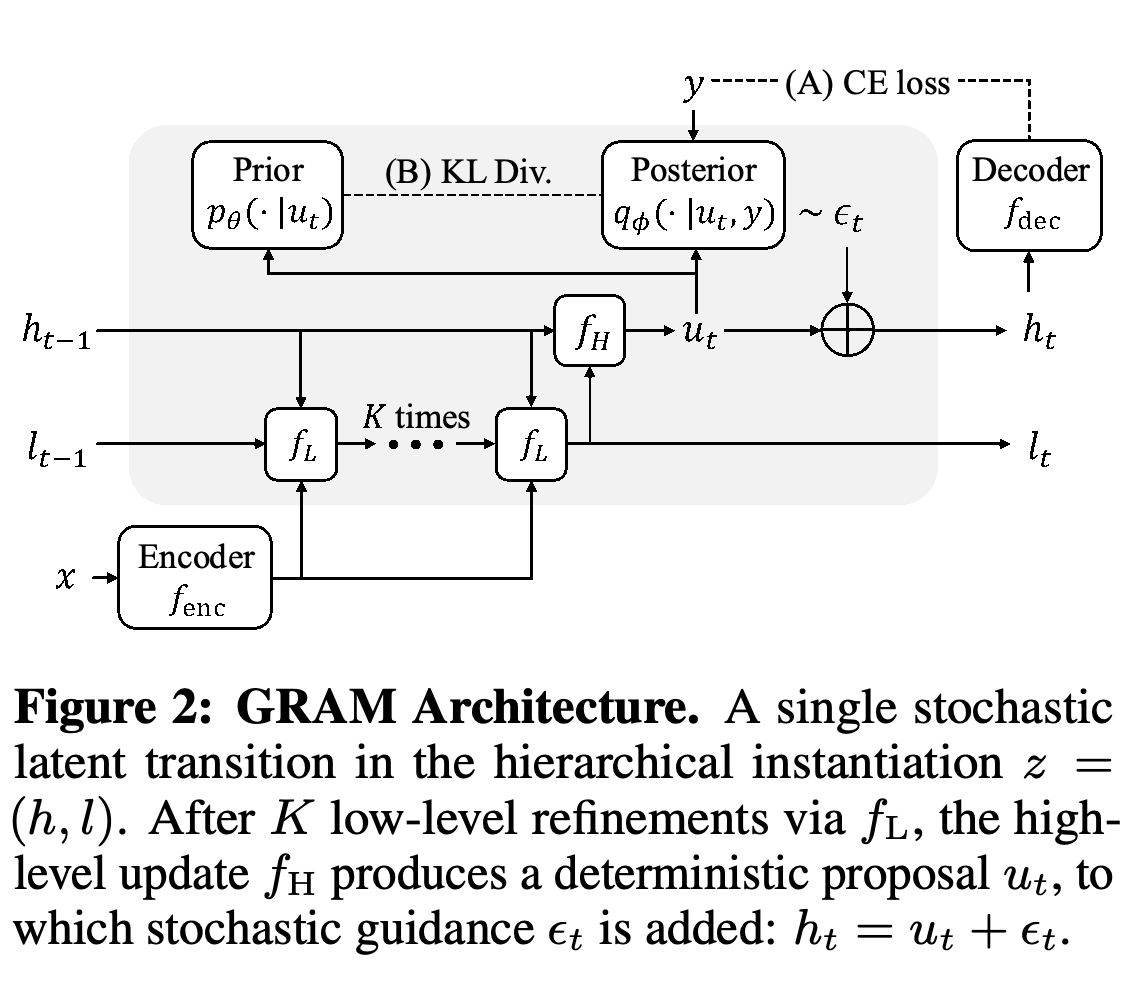
인코더는 입력의 수치 표현인 입력 임베딩을 1회 계산한 뒤 재귀 과정에서 재사용한다. 고정된 상태에서 시작해 각 전이는 결정론적 갱신 후보를 계산하고 학습 가능한 확률적 가이던스를 더한다. 수식은 \(\epsilon_t\sim\mathcal{N}\!\left(\mu_\theta(u_t),\sigma_\theta^2(u_t)I\right),\qquad z_t=u_t+\epsilon_t\)로 표현한다.
- 여기서 u_t는 갱신 후보, ε_t는 섭동, z_t는 갱신된 상태다. 학습된 평균은 섭동의 방향을, 분산은 탐색 정도를 조절한다.
- 계층적 구현에서는 z = (h, l)이다. 상위 상태 h는 더 느린 추상적 연산을 담당하고, 하위 상태 l은 상위 상태를 갱신하기 전에 K회의 결정론적 개선을 거친다. 가이던스는 상위 상태 갱신에만 더하며, 내부 상태를 출력으로 변환하는 디코더는 h를 읽는다.
- 지도 단계에는 T개의 전이가 포함되며, 디코딩과 학습 목적함수 적용으로 끝난다. 각 단계의 마지막 상태는 총 N_sup개의 지도 단계 중 다음 단계의 초기 상태가 된다. 조건을 비워 두면 무조건부 생성이 가능하다.
도식은 결정론적 상위 수준 갱신 후보 뒤에 확률적 가이던스를 배치하고, 목표 출력을 조건으로 하는 학습 사후분포와 추론 사전분포를 구분한다. 손실 연결은 예측 오류 목적함수인 출력 교차 엔트로피와 전이 분포 2개를 맞추는 KL 페널티를 보여 준다.
2.2 Training
조건부 모델은 궤적에 대해 적분해 출력 확률을 구한다. 수식은 p_θ(y | x) = ∫ p_θ(y | τ, x)p_θ(τ | x)dτ이며, x는 입력, y는 목표 출력, τ는 내부 궤적이다. 학습에서는 목표 출력을 관측하는 근사 궤적 분포인 변분 사후분포 q_ϕ(τ | x, y)에서 샘플링한다. 추론에서는 목표 출력에 접근하지 않는 학습된 사전분포 p_θ(τ | x)에서 샘플링한다.
- 로그 우도의 계산 가능한 하한인 evidence lower bound (ELBO)는 출력 재구성 항과 Kullback–Leibler (KL) 발산을 결합한다. KL 발산은 사후 전이와 사전 전이의 차이에 부과하는 페널티다. 섭동 분포를 예측하는 사전 헤드와 사후 헤드는 아키텍처가 같고 가중치는 별개다.
- 전체 궤적 목적함수에는 모든 전이의 KL 항이 포함된다. 실제 학습에서는 연속적인 개선 단계마다 목적함수를 적용하는 deep supervision을 사용하며, 각 지도 단계의 마지막 전이를 통해서만 기울기를 전파한다.
- 이에 따라 전체 ELBO를 대신하는 편향된 대리 목적함수를 얻으며, 이 근사는 메모리를 효율적으로 사용한다. 앞선 상태는 기울기 계산에서 분리하며, 보조 헤드는 연산을 언제 중단할지 학습한다.
2.3 Inference-Time Scaling
추론 연산량은 재귀 전이 수인 깊이와 독립적으로 샘플링한 궤적 수 N인 너비를 통해 확장한다. 각 궤적은 학습된 사전분포를 사용해 후보 예측을 만든다. 다수결 투표는 별도의 선택기 학습 없이 가장 자주 나온 전체 예측을 선택한다.
- 너비를 늘리면 순차적 재귀 길이를 유지하면서 연산량을 늘릴 수 있다. 독립적인 경로는 배치로 함께 실행할 수 있다.
- Appendix A.4는 선택적으로 사용할 수 있는 학습된 후보 선택기를 설명하지만, 보고된 실험은 다수결 투표를 사용한다.
3 Related Work
관련 연구는 내부 표현에서 중간 연산을 수행하는 잠재 추론을 순환 아키텍처와 확률적 상태 공간 모델에 연결한다. 확률적 상태 공간 모델은 숨은 상태의 확률적 변화를 기술한다. GRAM은 이러한 확률적 전이를 시간에 따른 관측 모델링 대신 추론 연산에 사용한다.
- Recurrent Transformer는 개선 단계마다 신경망 매개변수를 재사용한다. GRAM은 경로에 대한 분포를 도입해 이 연산을 확장한다.
- 확률적 순환 모델은 변분 모델링의 틀을 제공한다. GRAM은 이를 재귀 추론, 병렬 탐색, 생성에 적용한다.
4 Experiments
실험은 단일 샘플 성능인 N=1과 궤적 20개를 샘플링한 성능인 N=20을 구분한다. 단일 샘플 평가는 여러 추론 경로 중 선택하는 과정을 제외하며, 다중 샘플 평가는 탐색과 투표가 주는 추가 이점을 측정한다.
- 과제는 Sudoku-Extreme과 ARC-AGI, 해가 여러 개인 N-Queens와 Graph Coloring, 무조건부 Sudoku 생성과 손글씨 숫자 데이터셋의 픽셀을 이진화한 binarized MNIST 생성을 포함한다.
- 베이스라인은 순전파 1회의 직접 예측, 결정론적 재귀 연산, 생성 샘플링을 포함한다. 실험은 통제된 과제에서 제안한 연산 방식을 검증한다.
4.1 Challenging Puzzle Tasks
Sudoku-Extreme에서 GRAM은 지도 단계 16개로 샘플 1개를 사용했을 때 정확도 86.6±2.2%, 샘플 20개를 사용했을 때 정확도 96.1±0.9%를 기록한다. TRM은 16단계에서 83.6±1.3%를 기록한다. ARC-AGI-1과 ARC-AGI-2에서 GRAM은 각각 50.3±2.3%와 9.5±2.5%를 달성하며, TRM의 보고된 점수는 44.6%와 7.8%다.
- Sudoku 재귀 베이스라인은 공식 코드와 설정으로 재현하고 시드 3개, 즉 독립적인 학습 실행의 평균을 구한다. Table 8은 ARC-AGI 베이스라인 점수가 원 논문에서 가져온 값임을 명시한다.
- ARC-AGI는 제출한 예측 2개 중 하나라도 맞으면 해결한 것으로 세는 pass@2를 사용한다. 회전, 반사, 색상 순열로 만든 입력 1,000개의 예측을 집계하며, 변환된 입력마다 GRAM 궤적을 1개 사용한다.
- 공유 Transformer 블록을 반복 적용하는 베이스라인 Looped Transformer는 추정 학습 비용 때문에 ARC-AGI에서 제외한다. 외부 대규모 추론 모델 점수는 평가 조건이 다르다.
GRAM은 벤치마크 3개 모두에서 단일 궤적으로 그림에 제시된 결정론적 재귀 베이스라인보다 높은 성능을 보인다. Sudoku의 추가 구간은 샘플 20개로 얻은 이득을 나타낸다. ARC-AGI는 이미 변환된 입력의 예측을 집계하며, 외부 언어 모델의 막대는 평가 조건이 다르다.
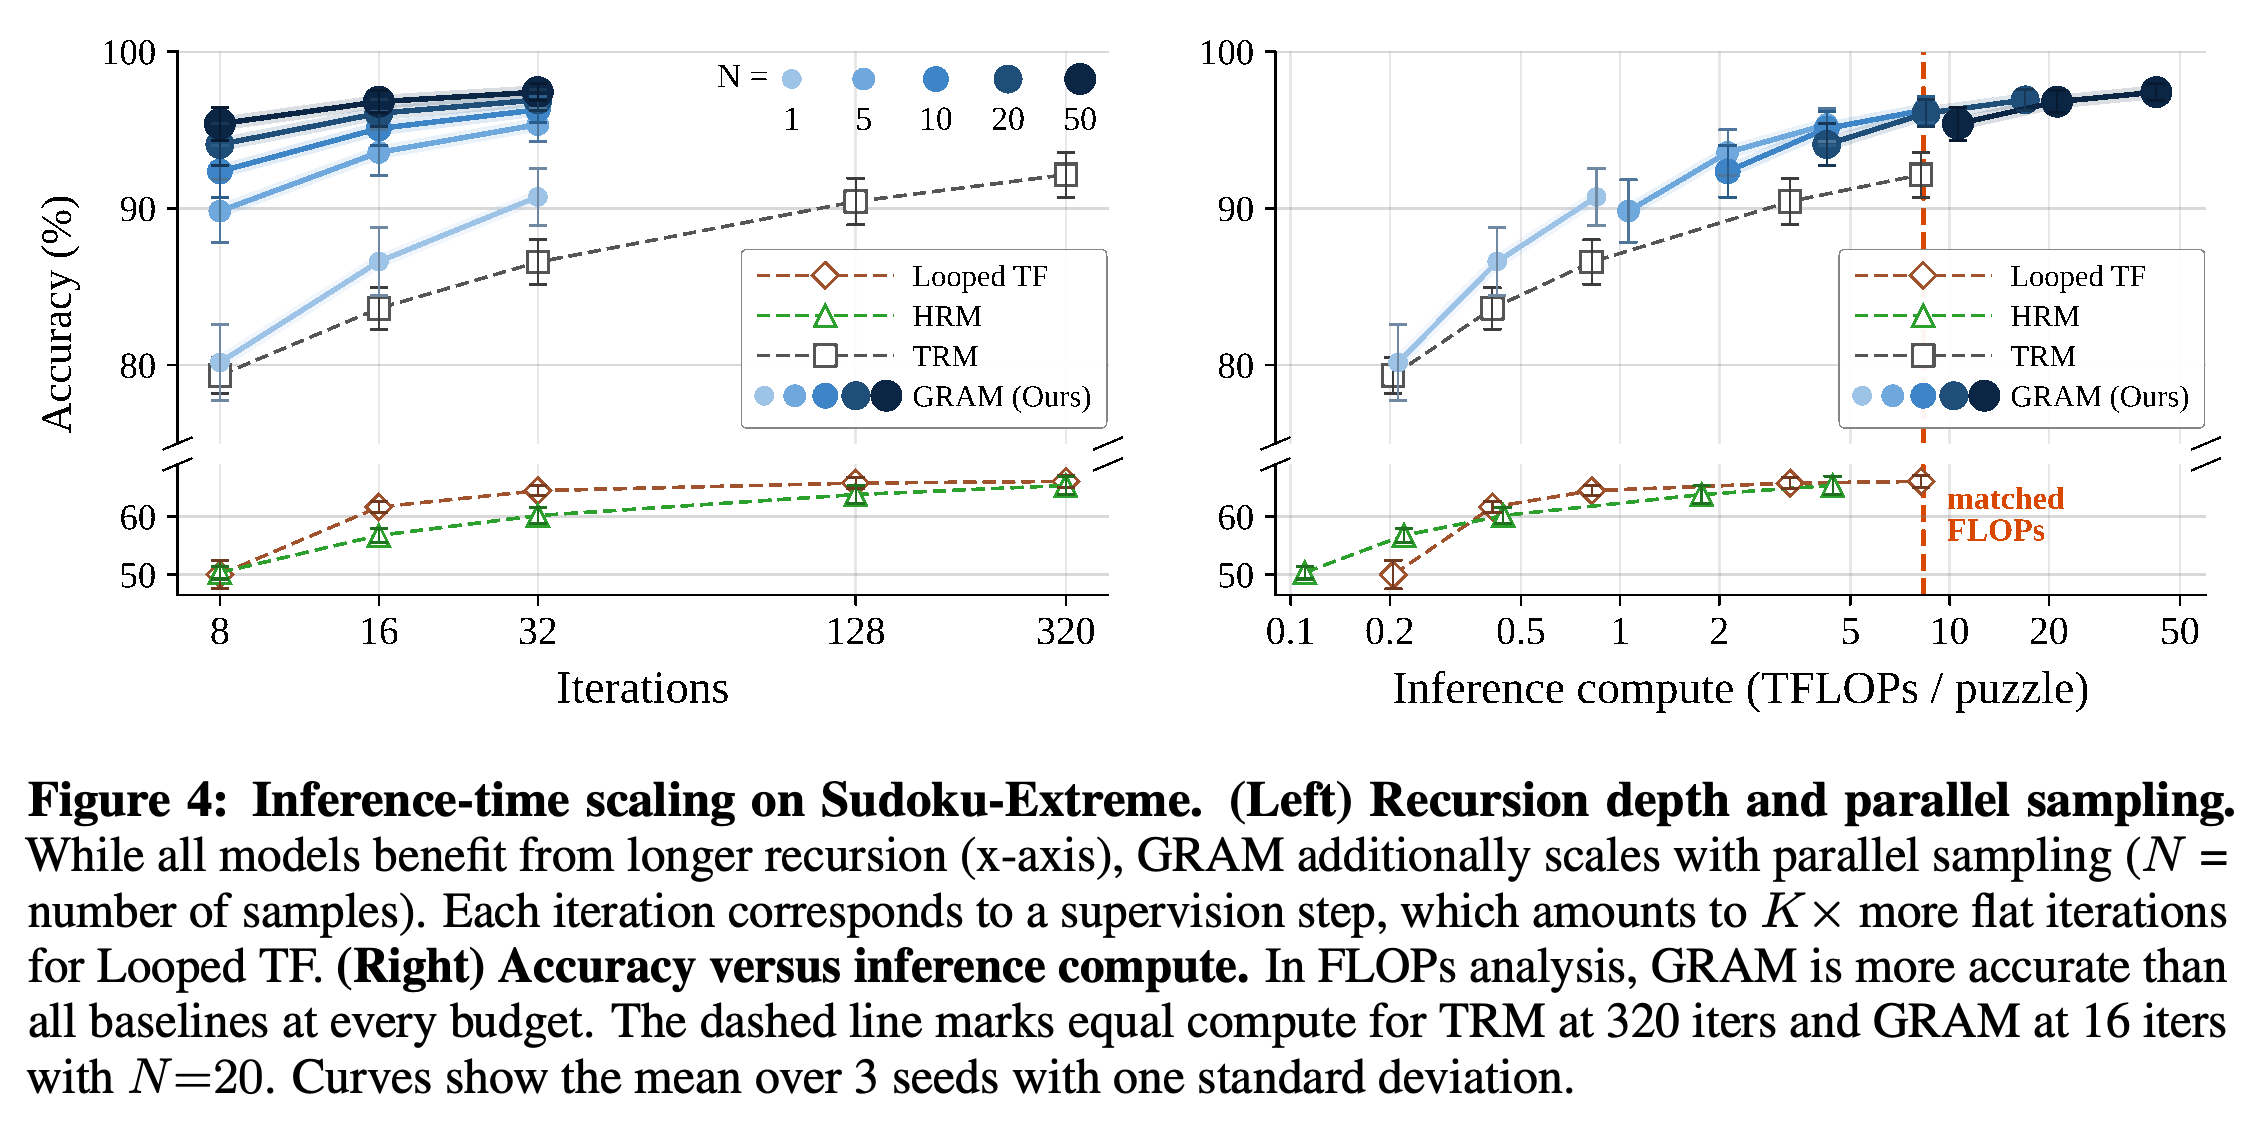
Sudoku 반복을 16회로 두고 GRAM 샘플 수를 1개에서 5개, 20개로 늘리면 정확도는 86.6%에서 93.6%, 96.1%로 높아진다. 각 반복은 지도 단계 1개다. 거의 같은 연산량 조건에서 GRAM은 샘플 20개로 퍼즐당 8.48 TFLOPs, 즉 조 단위 부동소수점 연산을 사용하며 지연 시간은 184 ms다. TRM은 순차 반복 320회로 8.19 TFLOPs를 사용하며 지연 시간은 2,755 ms다.
- 지연 시간 실험은 동일한 하드웨어에서 퍼즐 1개를 처리하며, GRAM의 병렬 샘플을 배치로 묶는다.
- Table 10의 더 정밀한 정확도는 96.06%와 92.15%다. 연산량이 +3.5%인 조건에서 정확도는 +3.9%포인트 높고 처리 속도는 15.0배 빠르다.
- 이 지연 시간 측정은 보고된 단일 요청 배치 처리 조건에 해당한다. 여러 요청으로 처리 용량을 포화시킨 서빙은 평가하지 않는다.
왼쪽 패널은 재귀를 더 길게 수행할 때와 샘플링 경로를 늘릴 때의 이득을 구분하고, 오른쪽 패널은 그 연산 비용을 비교한다. 거의 같은 연산량의 설정에서는 GRAM의 병렬 탐색이 유리하다. 곡선은 시드 3개의 평균과 표준편차를 보고한다.
4.2 Multi-solution Puzzle Tasks
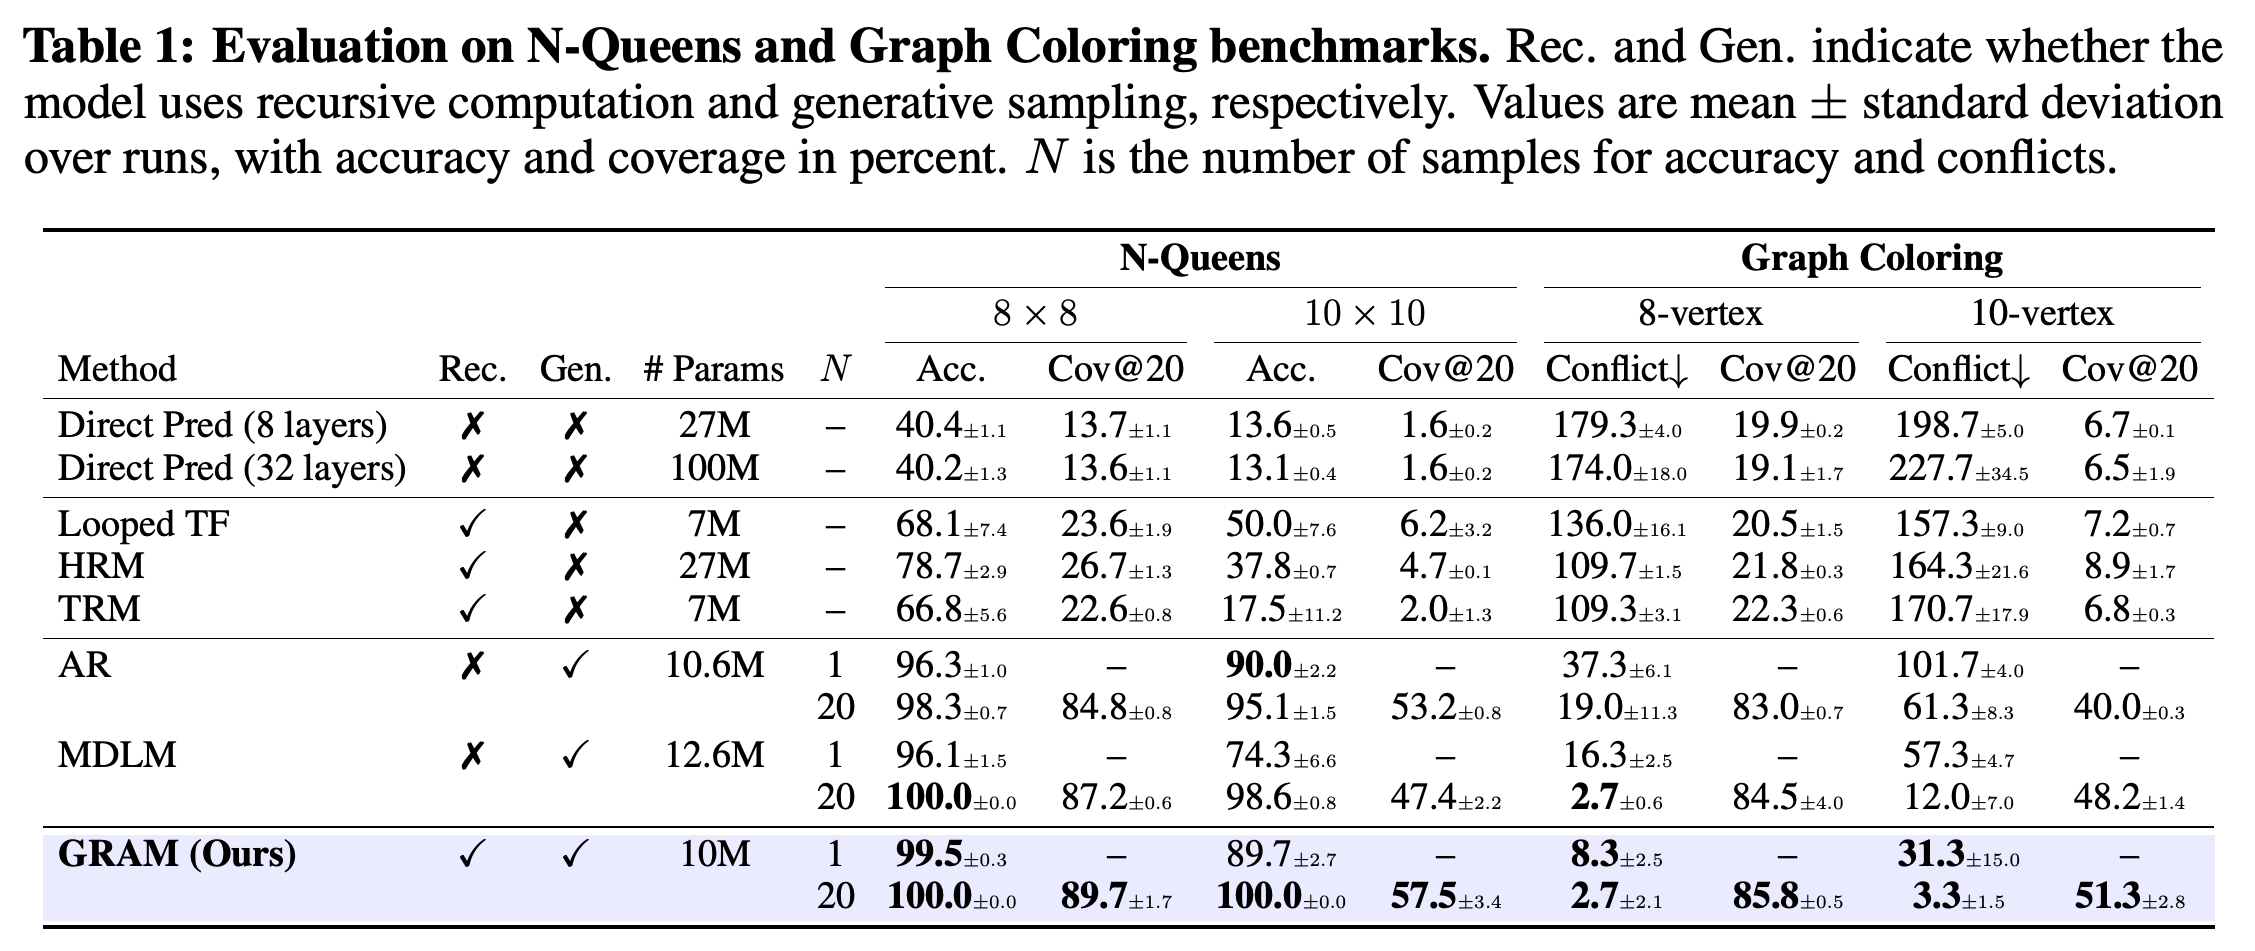
N-Queens는 퀸이 같은 행, 열, 대각선을 공유하지 않도록 보드를 완성하는 과제다. Graph Coloring은 인접한 정점의 색이 다르도록 색을 배정한다. 실험은 8×8 및 10×10 보드와 정점 수가 8 또는 10인 그래프를 사용한다. N-Queens에서는 유효한 출력의 정확도를, Graph Coloring에서는 충돌하는 간선 수를 보고한다. 커버리지는 샘플 20개로 찾은 유효한 해의 비율이다.
- 8×8 N-Queens에서 단일 샘플 GRAM은 정확도 99.5±0.3%를 달성하며, 결정론적 재귀 베이스라인의 최고 정확도는 78.7%다. 샘플 20개를 사용하면 GRAM은 보드 크기 2개 모두에서 100.0%를 달성하고, 커버리지는 각각 89.7±1.7%와 57.5±3.4%다.
- 생성 모델 비교에는 토큰을 순차적으로 예측하는 autoregressive Transformer와 마스킹된 토큰을 반복적으로 채우는 masked diffusion language model인 MDLM이 포함된다. GRAM은 과제 4개 모두에서 커버리지가 가장 높다. 단일 샘플 10×10 N-Queens 정확도는 autoregressive 베이스라인이 90.0%로 GRAM의 89.7%보다 약간 높다.
- 정점 10개인 Graph Coloring에서 샘플 20개를 사용한 GRAM의 충돌 수는 3.3±1.5, 커버리지는 51.3±2.8%다. MDLM은 각각 12.0±7.0과 48.2±1.4%를 기록한다. 정점 8개인 그래프에서는 모델 2개 모두 평균 충돌 값이 2.7이다.
표는 유효한 답을 생성하는 능력과 대안적인 해를 찾는 능력을 구분한다. GRAM은 설정 4개 모두에서 보고된 커버리지가 가장 높다. 다만 autoregressive 베이스라인은 단일 샘플 10×10 N-Queens 정확도가 약간 높으며, 샘플 20개에서 MDLM은 정점 8개인 그래프의 평균 충돌 값이 GRAM과 같다.
4.3 Exploring GRAM as an Unconditional Generator
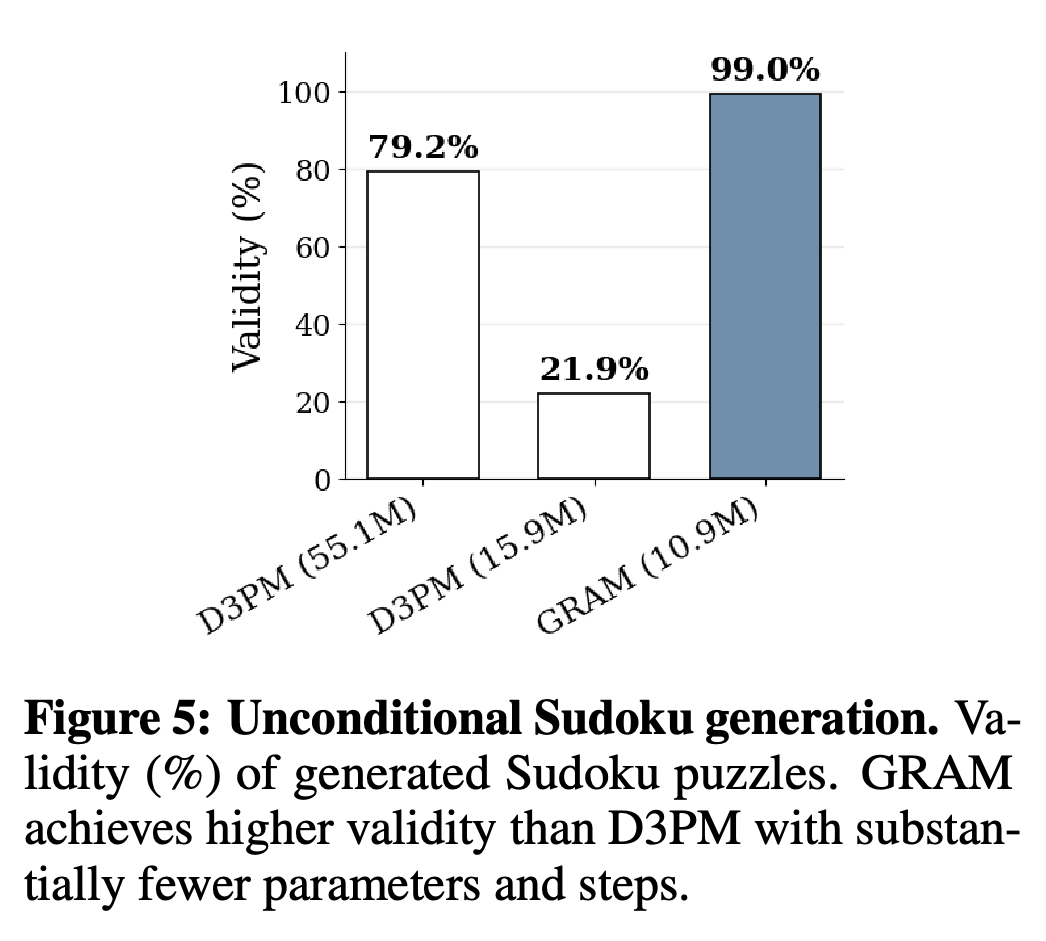
GRAM은 조건을 비워 두면 학습된 사전분포에서 완전한 출력을 생성한다. Sudoku 생성에서는 매개변수 10.9M과 추론 단계 16개를 사용해 샘플 100K개 중 99.05%가 유효한 보드를 생성한다. 이산 상태에서 잡음을 제거하는 확산 모델인 55.1M-parameter D3PM은 1,000단계에서 79.18%를 기록한다. 보드가 정확히 일치하는지 비교하면 유효한 보드 사이에 중복이 없다.
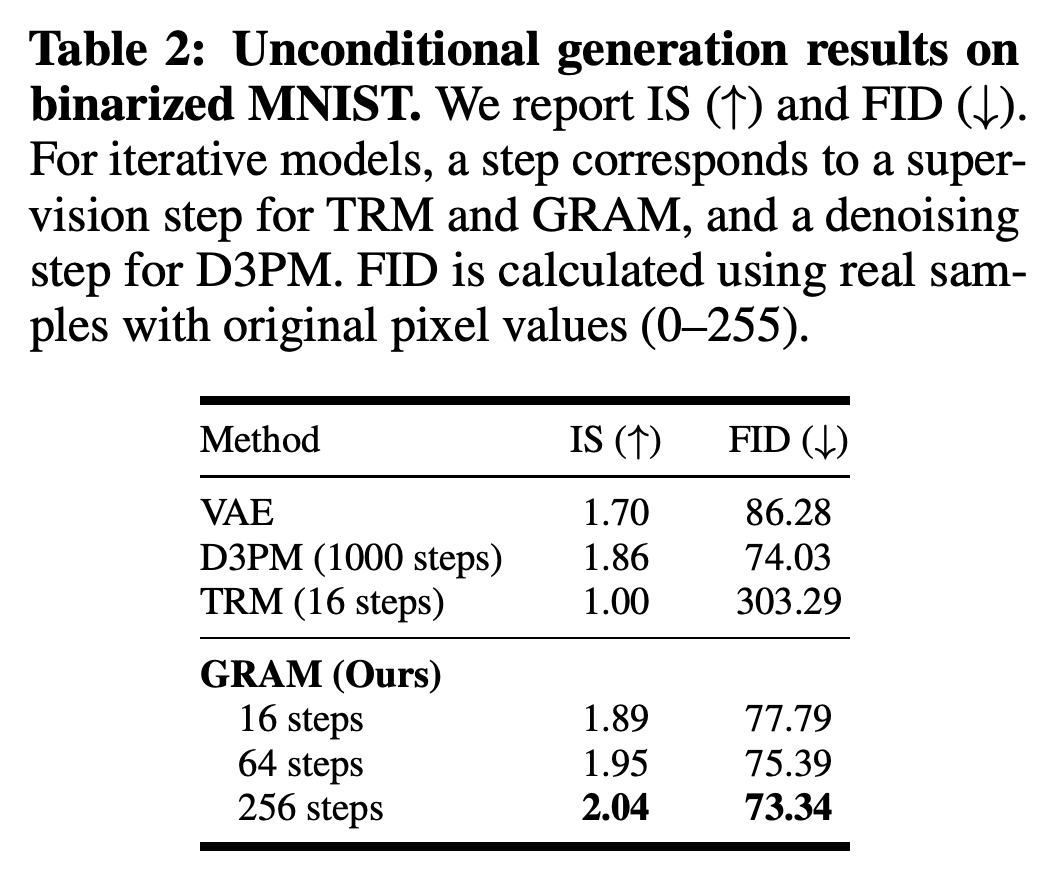
- Binarized MNIST에서 GRAM의 추론 단계를 16개에서 256개로 늘리면, 값이 클수록 좋은 이미지 생성 지표 Inception Score (IS)는 1.89에서 2.04로 높아진다. 값이 작을수록 좋은 이미지 분포 차이 지표 Fréchet Inception Distance (FID)는 77.79에서 73.34로 낮아진다. 논문은 원래 픽셀 값이 0–255인 실제 이미지를 기준으로 FID를 계산한다.
- 256단계의 GRAM은 1,000단계 D3PM의 IS 1.86과 FID 74.03보다 좋은 결과를 낸다. 16단계에서는 D3PM보다 IS가 좋고 FID는 나쁘며, 잠재변수 인코더와 디코더를 사용하는 베이스라인인 variational autoencoder (VAE)보다는 지표 2개 모두 좋다.
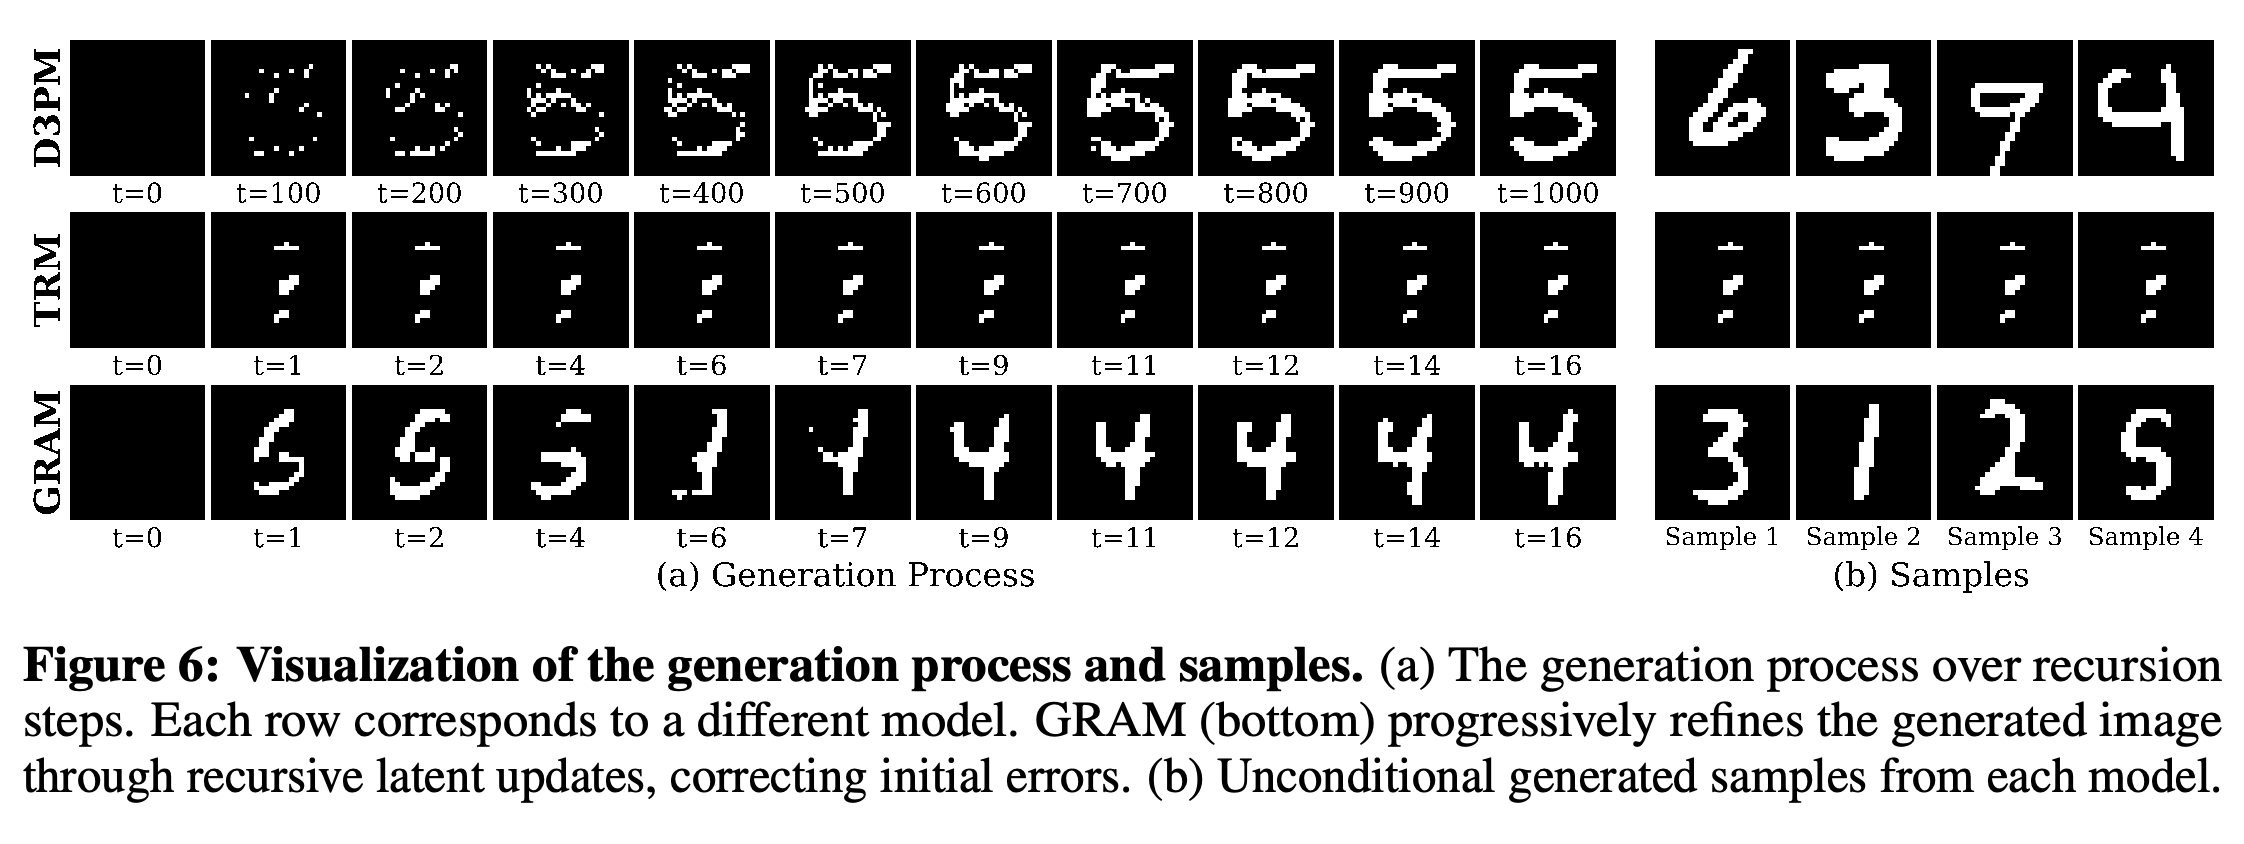
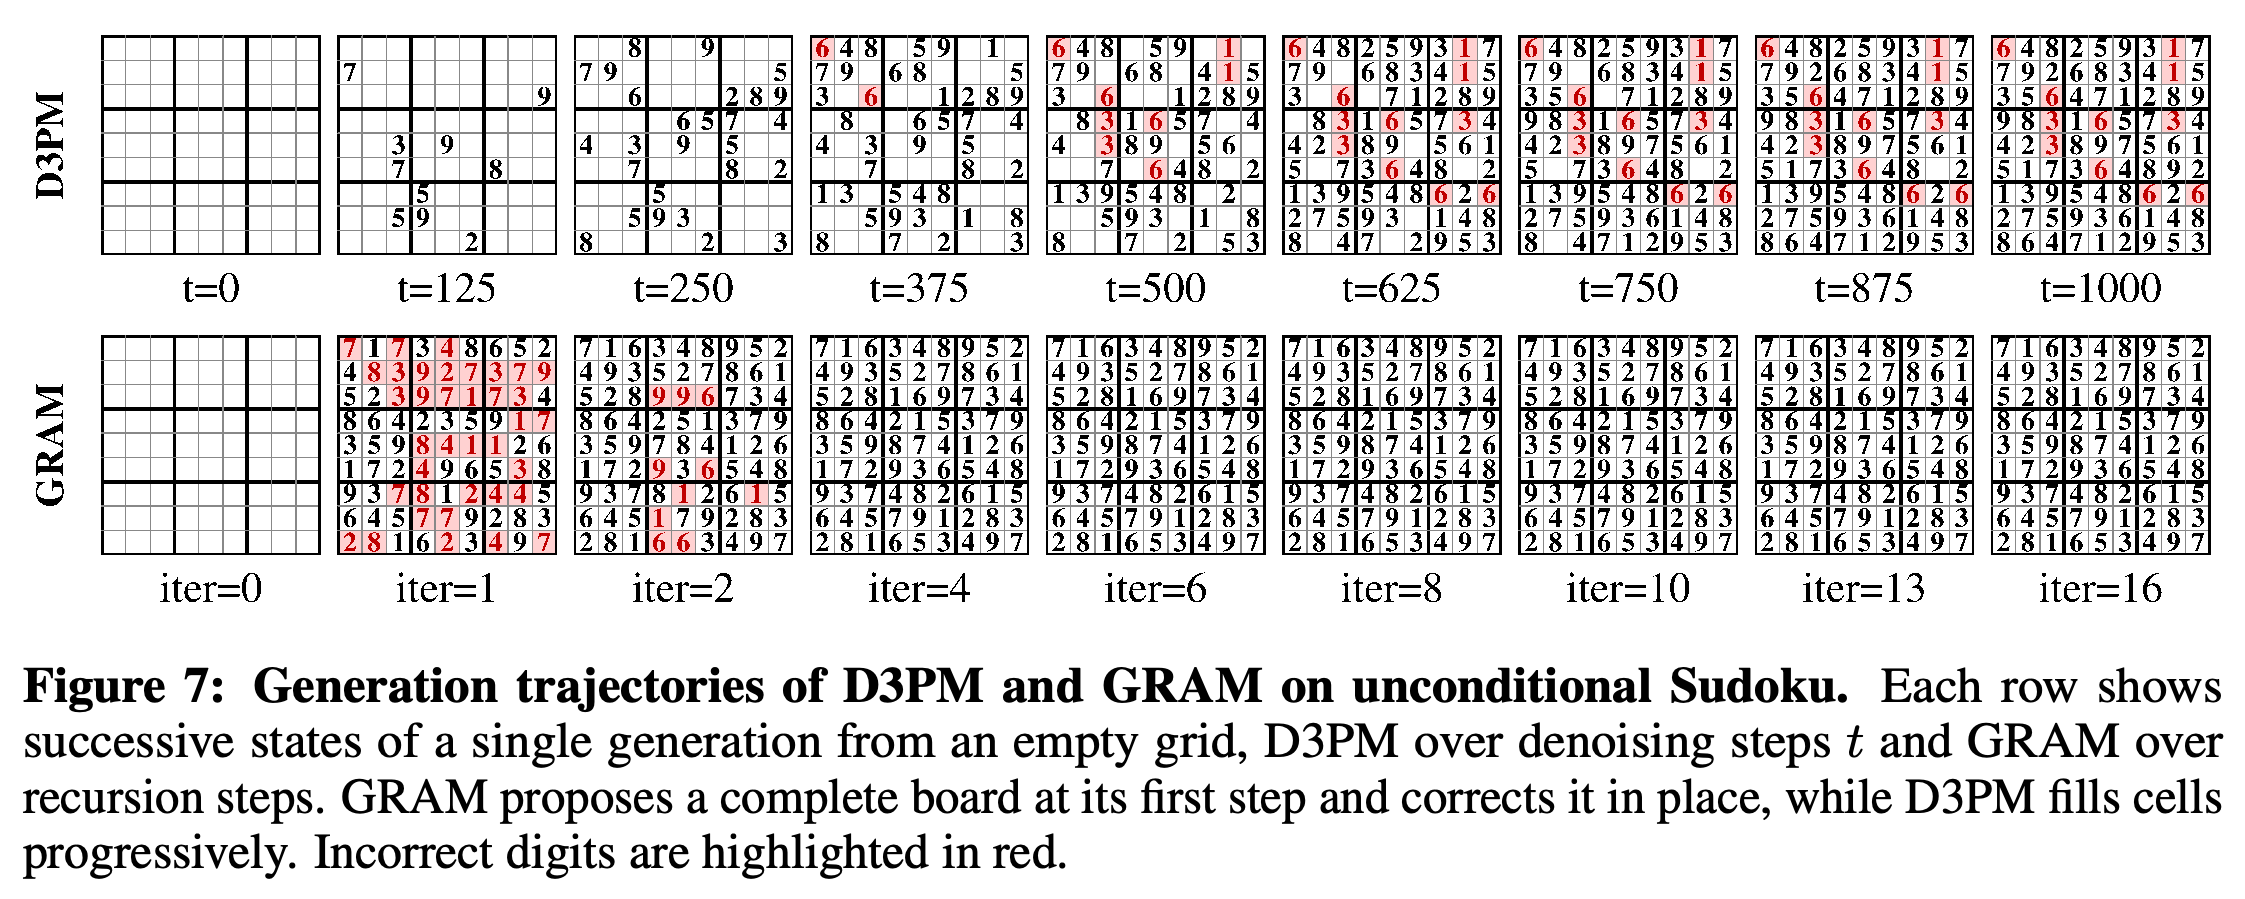
- TRM은 거의 일정한 숫자 출력을 생성하며, IS는 1.00, FID는 303.29다. Figures 6과 7은 GRAM이 재귀적 개선 과정에서 초기에 잘못 생성한 부분을 포함해 완전한 후보를 수정하는 모습을 보여 준다.
- GRAM은 지도 단계 16개로 학습한다. 추론 단계를 추가하면 보고된 MNIST 지표 2개 모두 좋아지지만, 지도 단계와 확산 모델의 잡음 제거 단계는 수행하는 연산이 다르다.
GRAM의 추론 단계를 학습 깊이보다 늘리면 숫자 생성 지표 2개 모두 좋아진다. 256단계에서 GRAM은 지표 2개 모두 D3PM보다 좋지만, 16단계에서는 FID가 여전히 나쁘다. 모델마다 단계의 의미가 다르므로 단계 수를 연산량과 동일시할 수 없다.
유효 보드 비율은 매개변수 수가 더 적은 GRAM이 높다. 그림의 값은 반올림된 수치이며, 상세 결과는 GRAM 99.05%, 더 큰 D3PM 베이스라인 79.18%다.
예시는 GRAM이 순환 갱신을 통해 처음에 모호했던 숫자를 수정하는 모습을 보여 준다. 결정론적 TRM은 샘플마다 거의 같은 출력을 만든다. 선택된 궤적은 정량적 생성 결과와 일치하는 동작을 보여 준다.
4.4 Ablation Study
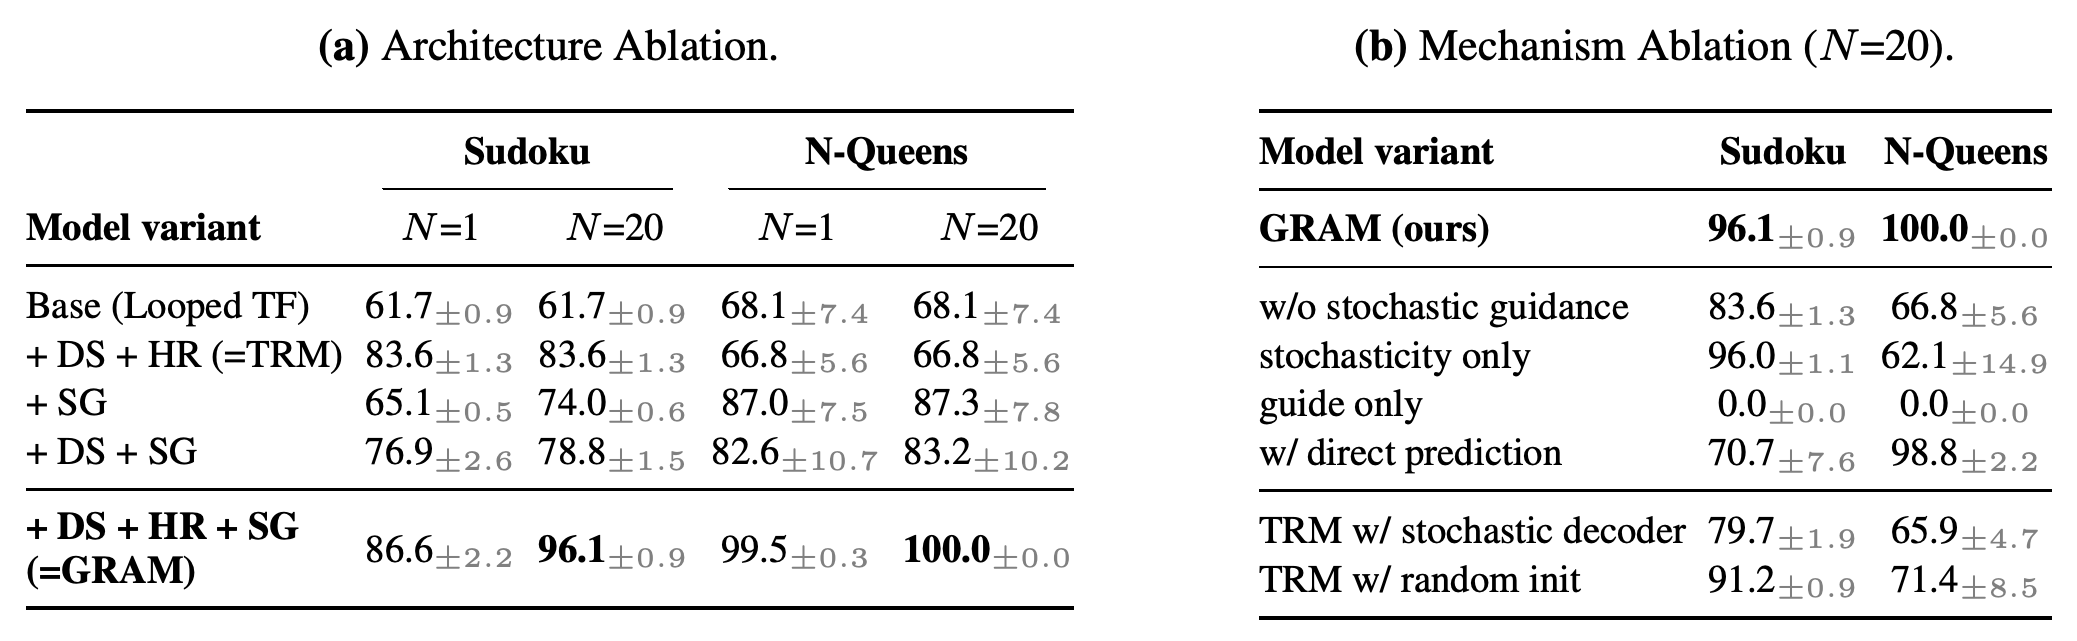
구성요소를 선택적으로 추가하거나 제거해 비교하는 아키텍처 제거 실험은 Looped Transformer 베이스라인에 deep supervision, 계층적 재귀, 확률적 가이던스를 추가한다. 가이던스는 비계층적 베이스라인의 성능을 높인다. 모든 요소를 결합하면 샘플 20개에서 Sudoku 정확도 96.1%, 8×8 N-Queens 정확도 100.0%를 달성한다.
- 확률성을 유지한 채 학습된 평균을 제거하면 Sudoku 성능은 96.0%로 유지되지만 N-Queens 정확도는 62.1%로 낮아진다. 이 제거 실험에서 학습된 평균을 유지한 채 확률성을 제거하면 과제 2개 모두 0.0%를 기록한다.
- 잔차 섭동을 더하는 대신 다음 상태를 직접 샘플링하면 Sudoku에서 70.7%, N-Queens에서 98.8%를 기록한다. 잔차 설계는 이 과제 2개에서 더 일관된 성능을 보인다.
- TRM의 초기 상태를 무작위화하면 샘플 20개에서 Sudoku 정확도 91.2%, N-Queens 정확도 71.4%를 달성한다. 이는 GRAM의 96.1%와 100.0%보다 낮다. 디코더 출력을 샘플링하는 방식도 GRAM에 미치지 못하며, 이는 실험한 무작위화 전략보다 학습된 확률적 전이가 유리하다는 해석을 뒷받침한다.
아키텍처 비교는 중간 단계의 지도, 계층 구조, 확률적 가이던스의 결합을 뒷받침한다. 가이던스 평균을 제거하면 Sudoku 성능은 대체로 유지되지만 N-Queens 성능은 크게 낮아진다. 평균을 유지한 채 확률성을 제거하면 실험한 설정 2개 모두에서 실패한다.
GRAM은 초기에 전체 보드를 제안한 뒤 충돌하는 값을 수정하며, D3PM은 셀을 점진적으로 채운다. 이 예시는 서로 다른 개선 방식을 보여 준다. 유효한 출력을 얼마나 안정적으로 생성하는지 비교하는 근거는 전체 유효성 실험에서 제공한다.
5 Conclusions and Limitations
논문은 확률적 재귀가 조건부 추론, 다중 해 발견, 무조건부 생성을 지원하며, 너비를 추론 연산량 확장의 선택지로 추가한다고 결론짓는다. 명시한 확장 제약은 deep supervision의 순차적 특성이다. 이 특성은 Transformer보다 학습 효율을 낮추고 더 큰 파운데이션 모델로의 확장을 어렵게 한다.
- 실험은 통제된 과제에서 이러한 특성을 확인한다. 일반적인 언어 추론과 파운데이션 모델 규모의 학습은 평가하지 않는다.
- 구현된 기울기 갱신은 전체 궤적 수준 변분 목적함수를 절단한 대리 목적함수를 최적화한다.
Broader Impacts
저자들은 불확실성과 다중 해가 중요한 제약 만족 및 과학적 문제 해결을 가능한 응용 분야로 제시한다. 그럴듯하지만 유효하지 않은 출력을 검증된 해로 취급하는 위험과 다중 샘플 추론의 연산 및 에너지 비용도 지적한다. 실제 배포에는 검증, 신뢰도가 정확성을 반영하는지 확인하는 불확실성 보정, 분야별 안전장치가 필요하다고 본다.
부록
- A Additional Method Details와 A.1 Algorithms는 같은 전이 함수를 사용하는 학습 및 추론 의사코드를 제시한다. 학습에서는 목표 출력을 조건으로 하는 사후분포에서 가이던스를 샘플링하고, 지도 단계 후 매개변수를 갱신하며, 다음 단계로 전달하는 상태를 기울기 계산에서 분리한다. 추론에서는 사전분포에서 샘플링하고, 고정 깊이 비교를 위해 조기 중단을 비활성화하며, 다수결 투표로 선택한다. A.2 Empirical Validation of the Surrogate Objective는 Sudoku-Extreme과 8×8 N-Queens의 학습 중 실제로 사용하는 대리 목적함수와 전체 궤적 ELBO를 비교한다. 목적함수 2개 모두 전반적으로 개선되어 이 실험에서 대리 목적함수가 유용함을 뒷받침한다. 전체 ELBO는 모든 전이의 KL 항을 누적하지만 대리 목적함수는 각 지도 단계의 마지막 전이 KL만 포함하므로 수치는 다르다. A.3 Adaptive Computation Time은 중단하거나 계속할 때의 가치를 추정하는 보조 헤드를 통해 중단 시점을 학습하는 방법을 설명한다. 공개 구현은 더 단순한 조건 σ(q_halt)>0.5를 사용한다. 여기서 σ는 중단 점수를 0과 1 사이의 값으로 변환하는 시그모이드 함수다. A.4 Latent Process Reward Model (LPRM)은 최종 출력의 정답 여부를 예측하는 선택적 가치 헤드를 설명한다. 이 헤드는 가장 높은 점수의 후보를 고르는 best-of-N 선택에 사용할 수 있지만, 보고된 실험은 다수결 투표를 사용한다.
- B.1 Architecture Details를 포함한 B Training and Architecture Details는 공유 재귀 신경망, 별도의 사전 및 사후 가이던스 헤드, 퍼즐 임베딩 토큰 16개, 은닉 차원 512, Transformer 백본의 어텐션 헤드 8개를 명시한다. 각 지도 단계는 T=3개의 전이를 포함하며, 하위 수준 개선 횟수는 Sudoku-Extreme에서 K=6, 다른 과제에서 K=4다. 초기 상태는 1회 샘플링해 체크포인트에 저장한다. Sudoku는 TRM을 따라 다른 재귀 코어 블록을 사용하며, binarized MNIST는 이미지의 국소 영역을 시퀀스 표현으로 변환하는 합성곱 패치 인코더를 사용한다. B.2 Training Details는 가중치 감쇠를 분리한 적응형 옵티마이저 AdamW를 사용한다고 보고한다. 설정은 학습률 10⁻⁴, 가중치 감쇠 1.0, 전역 배치 크기 768, 모델 매개변수를 평활화하는 지수 이동 평균 감쇠율 0.999, KL 균형 계수 0.8, 지도 단계 16개다. KL 가중치는 Sudoku에서 0.1, ARC-AGI-1/2에서 0.04/0.1, N-Queens 8×8/10×10에서 0.07/0.045, 노드 8/10개의 Graph Coloring에서 0.5/0.45, binarized MNIST에서 0.015다. Table 7은 NVIDIA RTX 4090 GPU에서의 학습을 보고하며, ARC-AGI는 GPU 8개로 5일간 학습한다. 무조건부 Sudoku를 위해 B.2 Training Details는 단서 패턴을 버린 완성된 학습 해 50K개를 사용한다. 데이터 증강 없이 200에포크를 학습하며, KL 가중치는 0.05, 추론 단계는 16개다. D3PM 크기 2개 모두 동일하게 가공한 데이터셋으로 학습한다. Binarized MNIST 모델의 매개변수 수는 VAE 15.81M, D3PM 18.07M, GRAM 15.82M, TRM 10.90M으로, 비슷하지만 같지는 않다.
- C Additional Details of Experiment Setup과 C.1 Challenging Puzzle Tasks는 ARC-AGI의 변환된 입력 1,000개, 역변환, 투표, pass@2 평가를 명시한다. Looped Transformer의 전체 ARC-AGI 학습은 약 97일, 즉 ≈776 GPU-days로 추정되며, 이 때문에 비교에서 제외한다. 이 추정은 측정한 단계별 시간을 전체 학습 예산으로 외삽한 값이다. 부록은 이 베이스라인에 deep supervision과 적응적 중단이 없다는 점도 학습 비용의 원인으로 지적한다. C.2 Multi-solution Puzzle Tasks는 8×8 해에서 k∈{5,6,7}개의 퀸을, 10×10 해에서 k∈{7,8,9}개의 퀸을 제거해 N-Queens 입력을 만든다. 동일한 부분 보드가 학습 세트와 테스트 세트에 함께 나타나지 않도록 고유한 입력 구성별로 묶어 85:15로 분할한다. 이에 따라 8×8은 학습/테스트 사례 7,224/1,240개, 10×10은 108,234/18,466개가 된다. 평균 목표 해 개수는 각각 1.65와 2.93이며, 데이터 증강이나 재균형화는 적용하지 않는다. Graph Coloring을 위해 C.2는 필요한 최소 색상 수인 채색수가 정확히 3인 생성 그래프만 남긴다. 색상이 처음 등장한 순서로 레이블을 다시 붙여 해를 정규화한다. 정점 8개에서는 학습 사례 7,002개와 테스트 사례 255개, 정점 10개에서는 학습 사례 13,465개와 테스트 사례 192개를 보고한다. 평균 학습 목표 해 개수는 각각 3.40과 8.73이다. 제공된 데이터셋 URL은 https://huggingface.co/datasets/CUN-bjy/graph-coloring이다.
- D Additional Experimental Results와 D.1 Additional Results on Challenging Puzzle Benchmarks는 전체 비교 표를 제공한다. 재귀 모델의 ARC-AGI 점수는 공개 평가 세트를, 외부 대규모 추론 모델 점수는 일부 비공개 평가 세트를 사용하므로 표의 행들을 통제된 조건의 순위로 볼 수 없다. 보고된 설정에서 직접 예측은 Sudoku-Extreme과 ARC-AGI-2 모두에서 0%를 기록한다. 이는 해당 비교에서 재귀의 유용성을 뒷받침하지만, 가능한 모든 단일 순전파 아키텍처가 실패함을 입증하지는 않는다. D.2 Computational Cost of Inference-Time Scaling은 torch.utils.flop_counter로 연산량을 세고, 퍼즐 1개를 처리하는 조건에서 지연 시간을 측정한다. 반복당 연산량은 GRAM이 0.0265 TFLOPs, TRM이 0.0256 TFLOPs다. Tables 10–12는 연산량을 맞춘 결과, 목표 정확도 달성에 필요한 연산량 추정치, 깊이와 너비를 바꾼 결과를 제공한다. 정확도 85%, 88%, 90%에서 보고한 1.6배, 2.6배, 3.7배의 연산량 절감은 측정 지점 사이의 로그 선형 보간을 사용한다. D.3 Scaling with Parallel Sampling on ARC-AGI Challenge는 내부 샘플링의 효과를 분리하기 위해 평가 입력을 변환하는 테스트 시점 증강을 제거한다. 실험한 KL 가중치 전반에서 샘플을 늘리면 대체로 성능이 좋아지지만, 정체 구간과 작은 변동도 나타난다. 증강 수준 Aug=50에서는 추가 샘플링의 이점이 작다. 이는 증강과 샘플링이 모두 투표용 예측을 제공할 때 추가 이득이 줄어듦을 보여 준다. D.4 Analysis of Model Performance by Number of Valid Solutions는 유효한 완성 해의 수에 따라 N-Queens 입력을 묶는다. GRAM의 단일 샘플 8×8 정확도는 그래프에 표시된 그룹 전반에서 100%에 가깝게 유지되지만, 결정론적 베이스라인은 성능이 낮아진다. 샘플링 경로를 늘리면 보드 크기 2개 모두에서 커버리지가 높아진다. 그래도 가능한 해의 수가 늘수록 커버리지는 낮아지므로, 정확하게 푼다는 사실이 모든 해를 찾는다는 뜻은 아니다. D.5 Additional Generated Samples는 GRAM의 숫자 생성 궤적 8개와 VAE 샘플을 보여 주며, 처음에 모호했던 출력이 수정되는 모습을 제시한다. D.6 Additional Results on Unconditional Sudoku Generation은 샘플 100K개에서 GRAM의 유효 보드 비율이 99.05%, D3PM-Big가 79.18%, D3PM-Small이 21.88%라고 보고한다. 보드가 정확히 일치하는지 비교하면 유효한 보드 사이에 중복이 없다. 이는 이 평가에서 동일한 유효 출력이 반복되지 않았음을 뜻하지만, 유효한 보드 전체에서 균일하게 샘플링한다는 사실을 입증하지는 않는다. D.7 Stochasticity and Guidance Ablation without Parallel Sampling은 메커니즘 비교를 N=1과 N=20으로 확장해 단일 경로의 동작과 샘플링 이득을 구분한다. D.8 Placement of the Stochastic Transition에서는 하위 수준에 1회 주입하는 방식이 N-Queens 정확도 99.2±0.6%, 커버리지 90.2±0.4%를 달성해 기본 상위 수준 주입과 비슷한 결과를 낸다. 반면 하위 수준 개선마다 주입하면 실험한 KL 변형 2개 모두 0.0%를 기록한다. 저자들은 반복적으로 주어지는 목표 정보가 과적합을 일으킨 탓으로 해석하지만, 실험은 이 설명을 별도로 분리해 검증하지 않는다. D.9 Reinforcement Learning Fine-Tuning of GRAM은 사전 학습된 나머지 매개변수를 고정하고, 정책 기울기 학습 방법인 proximal policy optimization으로 확률적 전이 사전분포만 갱신한다. 이진 유효성 보상, 최대 궤적 단계 16개, 갱신 1,000회, 궤적 512개로 구성한 배치, 문제당 궤적 8개를 사용한다. 10×10 N-Queens에서 단일 샘플 정확도는 89.7%에서 99.1%로, 샘플 20개의 커버리지는 57.5%에서 61.8%로 높아진다. 샘플 20개의 다수결 투표 정확도는 100.0%를 유지한다. D.10 Visualizing Latent Recursion Process는 선형 차원 축소 방법인 주성분 분석으로 상위 상태를 2차원에 투영하고, 공간 인덱싱 구조인 K-D tree로 손실 지형을 보간한다. 그림은 같은 Sudoku 입력에 대한 TRM 경로 1개와 GRAM 경로 50개를 보여 주며, 궤적의 다양성과 서로 다른 도착점을 나타낸다. 투영하고 보간한 지형은 정성적 근거이며, 전체 고차원 기하 구조를 직접 측정한 결과는 아니다.
- Licenses는 외부 데이터셋과 참조 구현의 보고된 이용 조건 및 출처 링크를 나열한다. 논문은 ARC-AGI와 여러 베이스라인 저장소에 Apache License 2.0, TRM과 Looped Transformer에 MIT License, MNIST에 Creative Commons Attribution-Share Alike 3.0을 명시한다. 저자들이 합성한 N-Queens와 Graph Coloring 사례는 저자들이 생성한 자산으로 구분한다.
짧은 생각
단일 경로의 성능 향상, 다중 해 커버리지, 거의 같은 연산량의 Sudoku 비교는 학습된 확률적 재귀의 이점을 함께 뒷받침한다. 무작위 초기화와 디코더 샘플링 제거 실험은 더 단순한 무작위성 도입 방법을 비교함으로써 이 해석을 강화한다.
지연 시간 결과는 병렬 배치 처리에 의존하며, 나머지 실험 근거도 통제된 과제에 한정된다. 순차적 학습, 절단된 목적함수, 광범위한 ARC-AGI 증강에서 줄어드는 샘플링 이득, 불완전한 해 커버리지가 실험으로 확인된 방법의 실용적 한계다.