


Training Large Language Models to Reason in a Continuous Latent Space 요약 설명
09 Dec 2024 | Paper Review Latent Reasoning Curriculum Learning Test-Time Scaling목차
이번 글에서는 Training Large Language Models to Reason in a Continuous Latent Space 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 9일(Arxiv)
- Hao, Shibo, Sukhbaatar, Sainbayar, Su, DiJia, Li, Xian, Hu, Zhiting, Weston, Jason, Tian, Yuandong.
- FAIR at Meta, UC San Diego
- 논문 링크
요약
- 대규모 언어 모델(LLM)은 보통 중간 추론을 텍스트로 표현한다. 이 과정에서 자연스러운 문장을 만드는 데 연산을 쓰고, 잘못된 추론 경로를 너무 일찍 선택할 수 있다. Chain of Continuous Thought의 약자인 Coconut은 내부 상태 벡터를 다음 추론 단계에 직접 입력한다. 논문의 GPT-2 실험 설정에서 Coconut은 탐색이 필요한 논리 추론 벤치마크 ProsQA에서 97.0±0.3%의 정확도를 달성한다. 중간 추론을 언어로 생성하는 chain-of-thought(CoT)의 정확도는 77.5±1.9%다.
- Coconut은 텍스트 추론 단계를 continuous thought로 점차 대체하는 학습 커리큘럼을 사용한다. Continuous thought는 모델의 마지막 은닉 상태, 즉 내부 상태 벡터다. 이를 다음 위치에서 모델에 제공하는 벡터인 입력 임베딩으로 재사용한다. 초등학교 수학 벤치마크 GSM8k에서 정확도는 34.1±1.5%로, 중간 추론을 사용하지 않을 때의 16.5±0.5%보다 높지만 텍스트 CoT의 42.9±0.2%에는 미치지 못한다.
- 중간 상태를 디코딩하는 분석은 Coconut의 동작이 너비 우선 탐색(BFS)과 유사하다는 해석을 뒷받침한다. BFS는 더 깊이 진행하기 전에 같은 깊이의 대안들을 탐색한다. 다만 근거는 과제에 따라 다르다. 합성 논리 과제에서는 커리큘럼을 사용하는 베이스라인도 높은 성능을 보이며, 커리큘럼 없이 학습하면 직접 답하는 방식보다 나아지지 않는다. 더 큰 모델을 사용한 실험에서는 성능 향상 폭도 작다.
1 Introduction
Training Large Language Models to Reason in a Continuous Latent Space는 모든 중간 추론 상태를 생성 텍스트의 단위인 이산 토큰으로 변환해야 하는지 묻는다. 저자들은 생성 토큰마다 거의 같은 양의 연산을 배분하는 방식이 추론에 필요한 난도의 차이를 제대로 반영하지 못한다고 주장한다. 많은 토큰은 자연스러운 문장을 유지하는 데 쓰이지만, 일부 토큰에는 상당한 계획이 필요하기 때문이다.
- Coconut은 중간 추론에서 은닉 상태를 이산 토큰으로 변환하는 과정을 생략하고, 질문과 답변에는 언어를 사용한다.
- 인용된 신경과학 연구는 언어와 추론을 분리하는 접근의 동기가 되지만, 논문의 실험 근거는 기계 추론 벤치마크에서 나온다.
- 제공된 버전은 arXiv:2412.06769v4이며, 마지막 갱신일은 2026년 8월 25일이다. 코드는 https://github.com/facebookresearch/coconut 에서 제공한다.
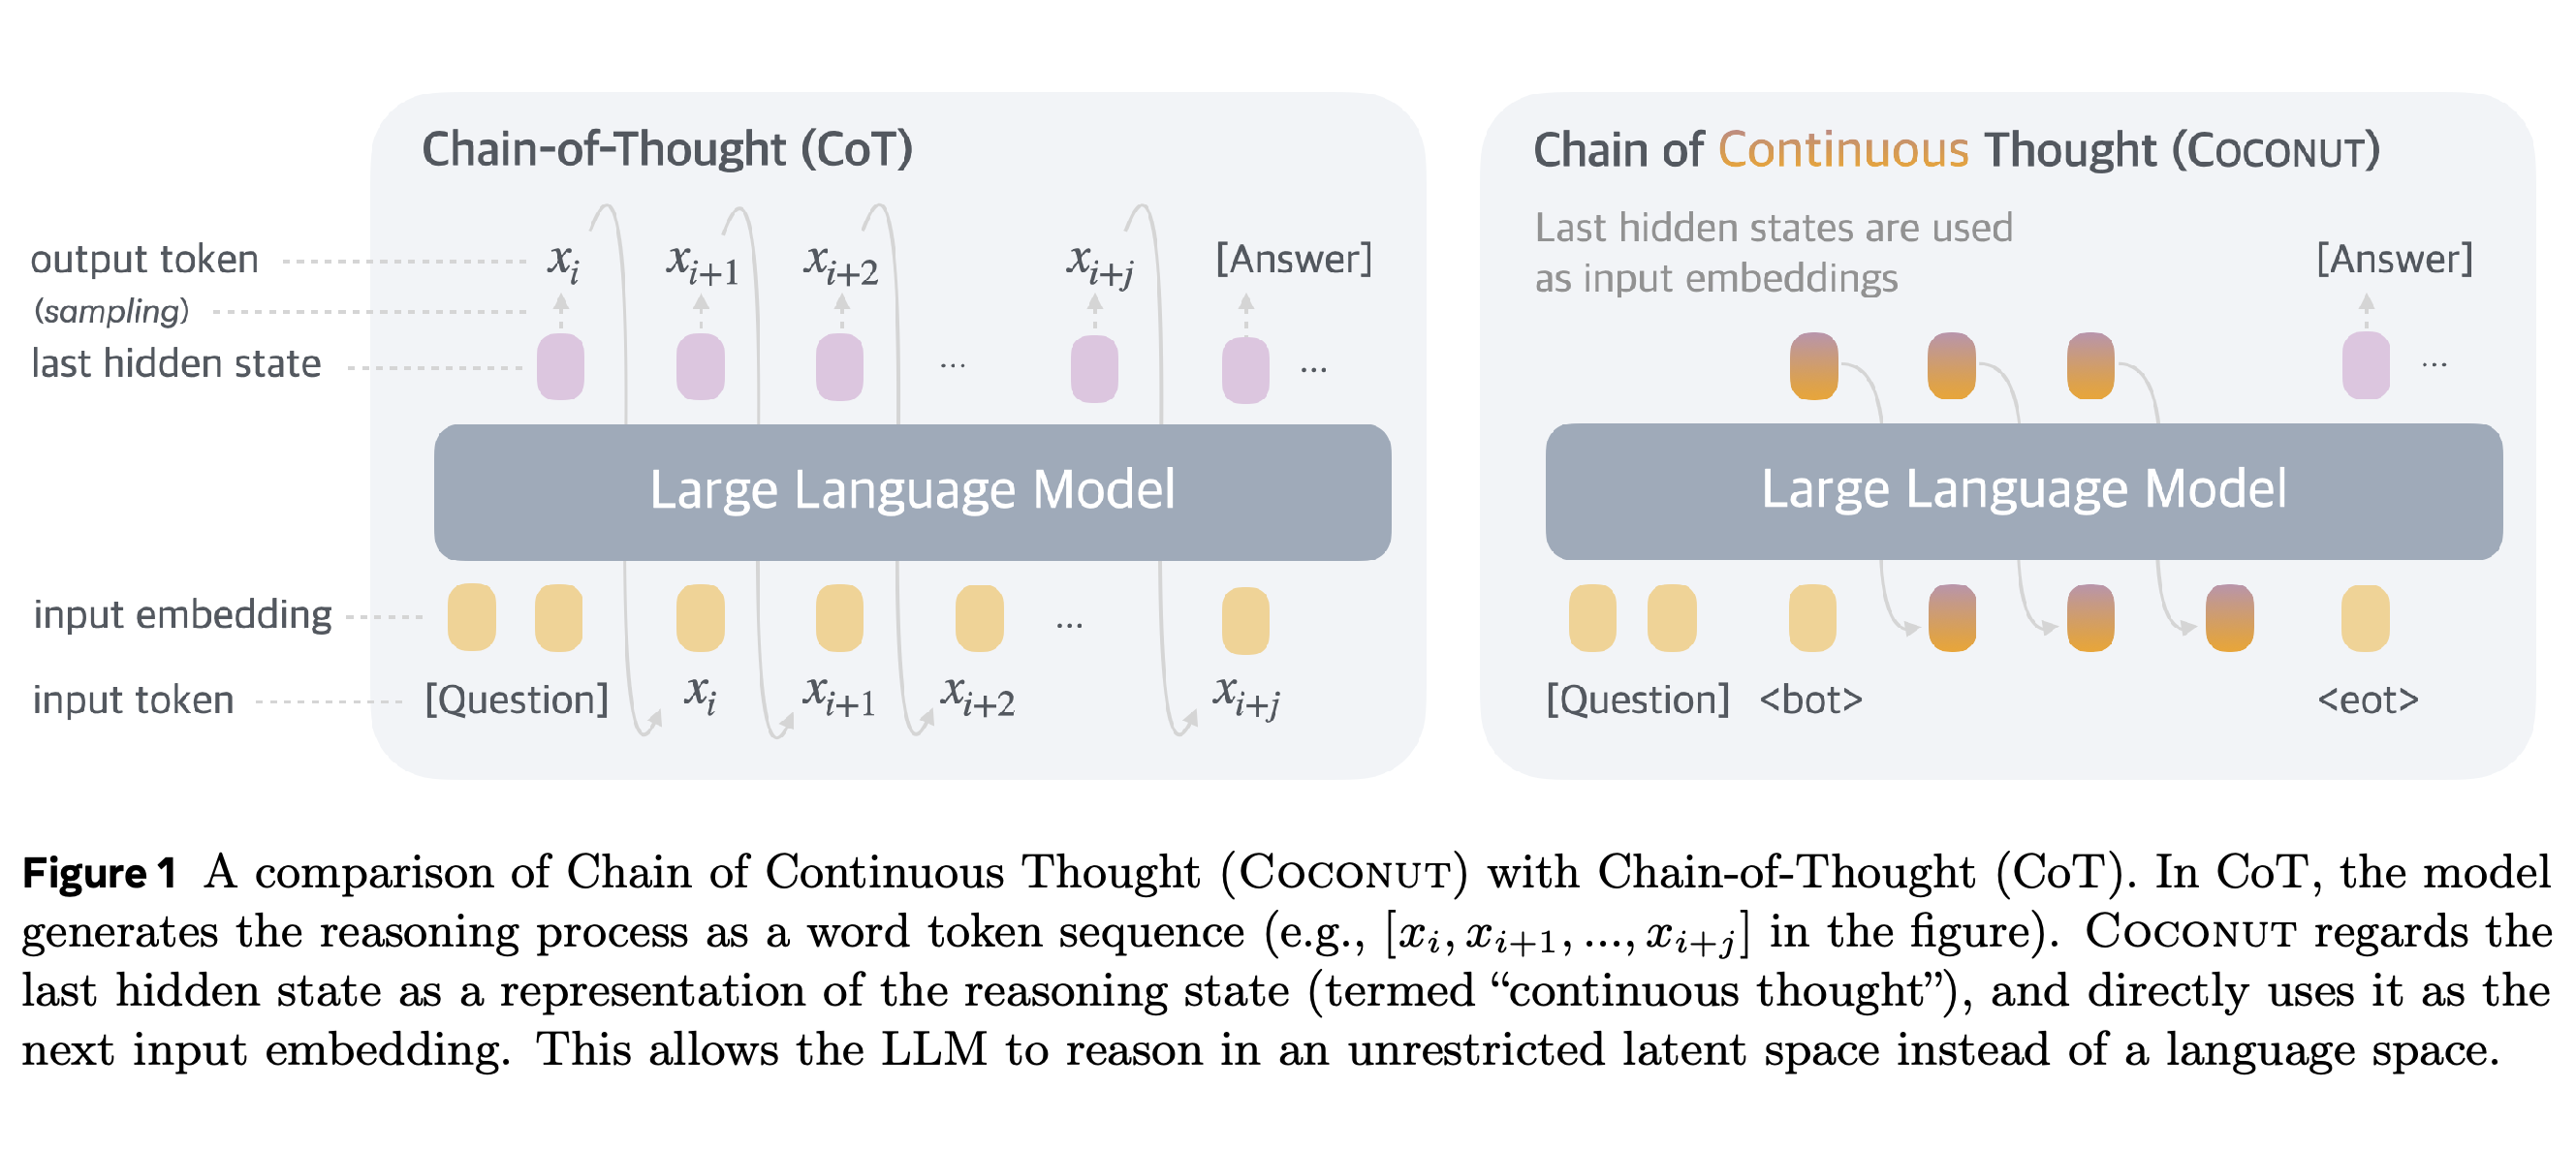
피드백 화살표는 핵심적인 연산 변화를 보여준다. CoT는 토큰 선택과 임베딩 조회를 거치지만, Coconut은 은닉 벡터를 다음 위치에 직접 전달한다. 잠재 구간이 끝나면 언어 생성을 재개한다.
2 Related Work
논문은 생성된 추론을 언어 모델의 기반 구조인 transformer에 다시 입력하면 실질적인 연산 깊이가 늘어난다는 연구와 Coconut을 연결한다. 명시적 탐색, 은닉 상태를 통한 추론, 추가 연산 토큰, 학습 중 텍스트 추론을 점차 제거하는 방법도 검토한다.
- Pause token은 추론 단계를 표현하지 않으면서 답변 전에 연산을 수행하도록 추가하는 입력 토큰이다.
- iCoT는 앞부분의 추론 토큰을 점차 제거해 모델이 답을 직접 예측하게 함으로써 CoT를 내재화하는 커리큘럼 기반 방법이다.
- Coconut은 추론을 제거하는 커리큘럼과 연속적인 은닉 상태의 반복 사용을 결합한다. 제공된 개정본은 여러 추론 경로를 함께 표현하는 중첩에 관한 후속 이론 연구도 다룬다.
3 Coconut: Chain of Continuous Thought
Coconut은 일반적인 언어 생성 모드와 잠재 모드를 번갈아 사용한다. 잠재 모드에서는 이전 위치의 마지막 은닉 상태가 다음 입력 임베딩이 된다. 특수 토큰 <bot>과 <eot>은 잠재 추론의 시작과 끝을 표시한다. 재사용하는 은닉 상태는 크기를 조절하는 모델의 마지막 정규화 층을 이미 통과한 상태다.
- 일반 언어 모드에서는 은닉 상태를 토큰 확률로 변환하는 출력 헤드를 적용해 다음 토큰을 선택한다. 잠재 모드에서는 토큰을 선택하지 않고 은닉 벡터를 재사용한다.
- 분석을 위해 출력 헤드로 잠재 상태를 디코딩할 수는 있지만, 해당 상태에서 언어를 생성하는 과정은 잠재 추론 단계에 포함되지 않는다.
- 반복해서 사용하는 상태가 연속적이므로 학습 중 잠재 연산의 연쇄를 따라 기울기가 전파될 수 있다.
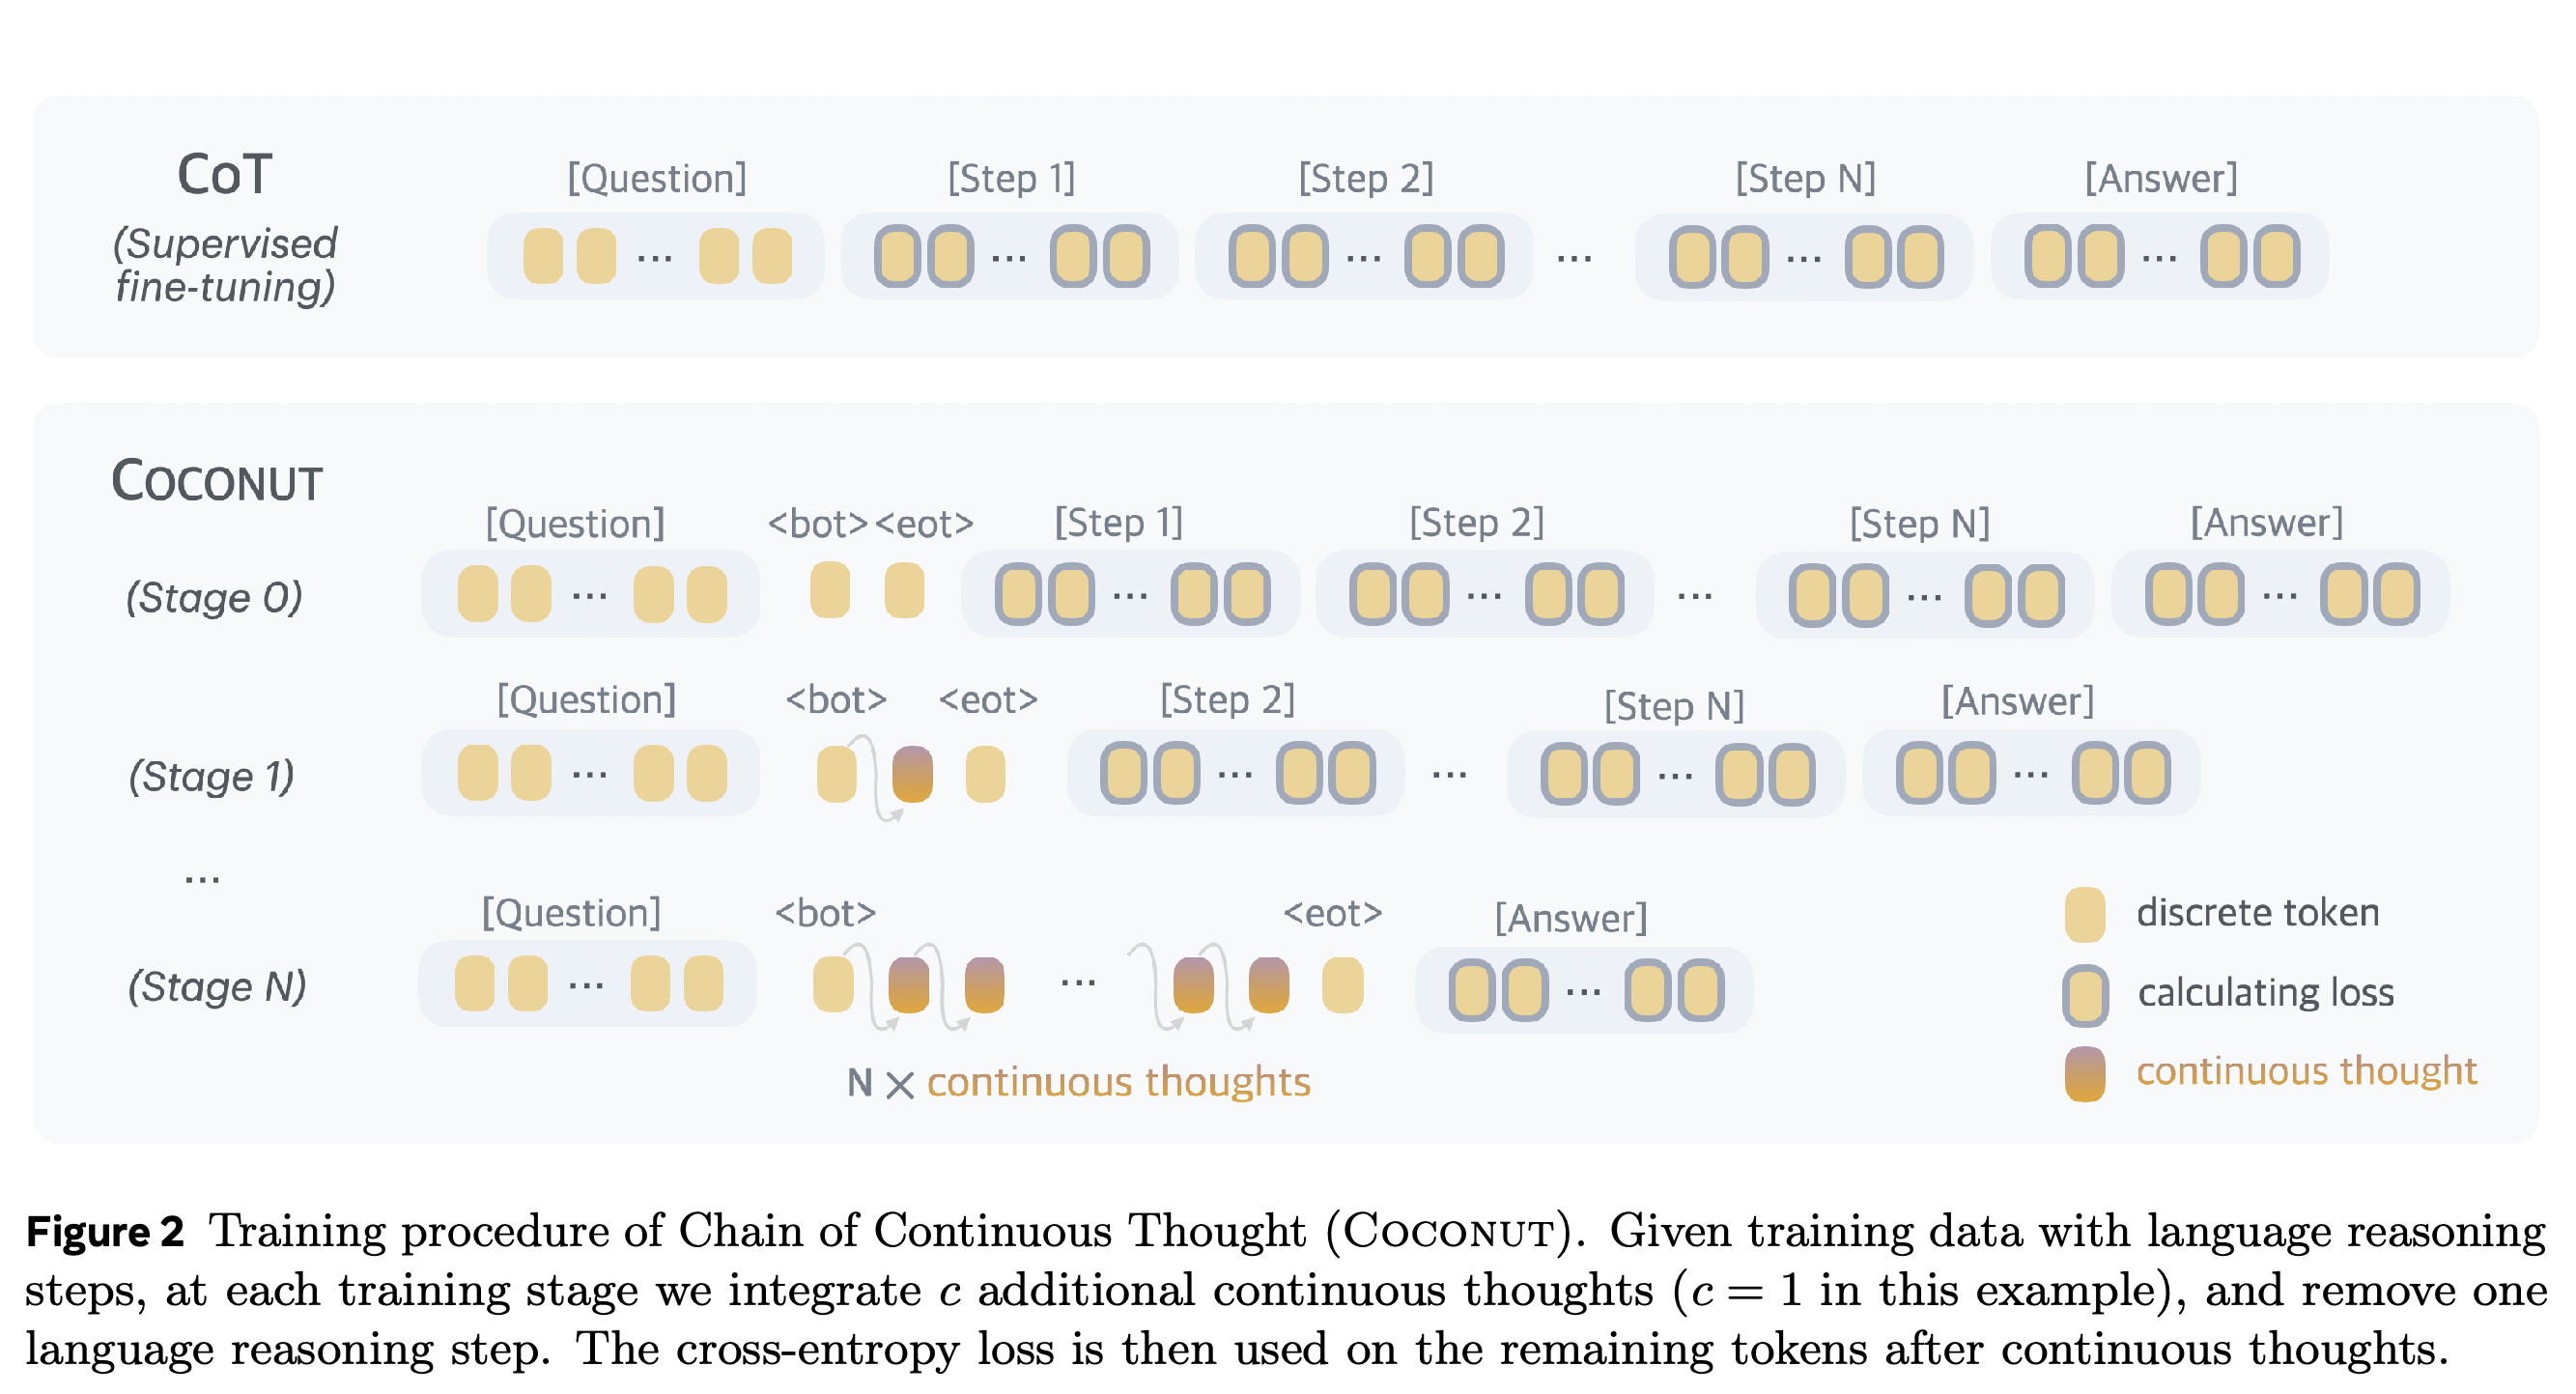
학습 단계 k에서는 앞부분의 텍스트 추론 k개 단계를 \(k\times c\)개의 continuous thought로 대체한다. c는 언어 추론 1개 단계를 잠재 단계 몇 개로 대체할지 정한다. 단계가 바뀔 때마다 옵티마이저 상태를 초기화하며, 예측 손실은 질문과 잠재 사고를 제외하고 남은 추론 텍스트와 답변에 적용한다.
- 이 목적함수는 잠재 상태가 이후 예측에 도움이 되도록 학습한다. 제거한 추론 텍스트를 복원하거나 압축하도록 명시적으로 요구하지는 않는다. 추론 사슬의 텍스트 단계가 k개보다 적으면 모두 제거한다.
- 잠재 사고 n개로 학습하려면 n+1회의 순전파가 필요하다. 앞서 계산한 attention key와 value를 저장하는 key-value(KV) 캐시로 중복 연산을 피하지만, 순전파는 여전히 순차적으로 수행한다.
- 추론에서는 보통 잠재 단계 수를 수동으로 고정한다. 저자들은 잠재 추론의 종료 여부를 판단하는 이진 분류기도 시험해 비슷한 성능을 보고했지만, 상세한 정량 비교는 제시하지 않는다.
단계적으로 대체하면 이후의 텍스트 추론과 답변이 앞선 연속 상태에 학습 신호를 제공한다. 이 도식은 최종적으로 답변만 출력하더라도 학습에는 추론 사슬 데이터가 필요한 이유도 보여준다.
4 Continuous Space Enables Latent Tree Search
잠재 트리 탐색 실험은 Proof with Search Question-Answering의 약자인 ProsQA를 사용한다. 방해가 되는 논리 분기들을 탐색하며 계획을 세울 때 잠재 추론이 유리한지 개념 증명 수준에서 살펴본다. 저자들은 같은 학습 모델이 잠재 모드를 끝내는 시점만 바꿔, 모델 가중치를 변경하지 않고 완전한 텍스트 추론, 혼합 추론, 완전한 잠재 추론을 비교한다.
4.1 Experimental Setup
ProsQA는 순환이 없는 방향 그래프인 방향성 비순환 그래프(DAG)를 논리 명제로 제시하고, 특정 개체에서 2개 개념 중 어느 개념에 도달할 수 있는지 묻는다. GPT-2 실험은 학습률 \(1\times10^{-4}\), 유효 배치 크기 128을 사용한다. 초기 단계 이후 대체 단계 6개를 진행하고 각 단계를 5 에포크씩 학습한 뒤, 총 50 에포크가 될 때까지 마지막 단계를 이어간다.
- 추론에서는 continuous thought 수를 \(k\in\{0,1,2,3,4,5,6\}\)으로 바꾼다. 이 잠재 사고들을 거친 뒤에는 남은 추론을 언어로 생성한다.
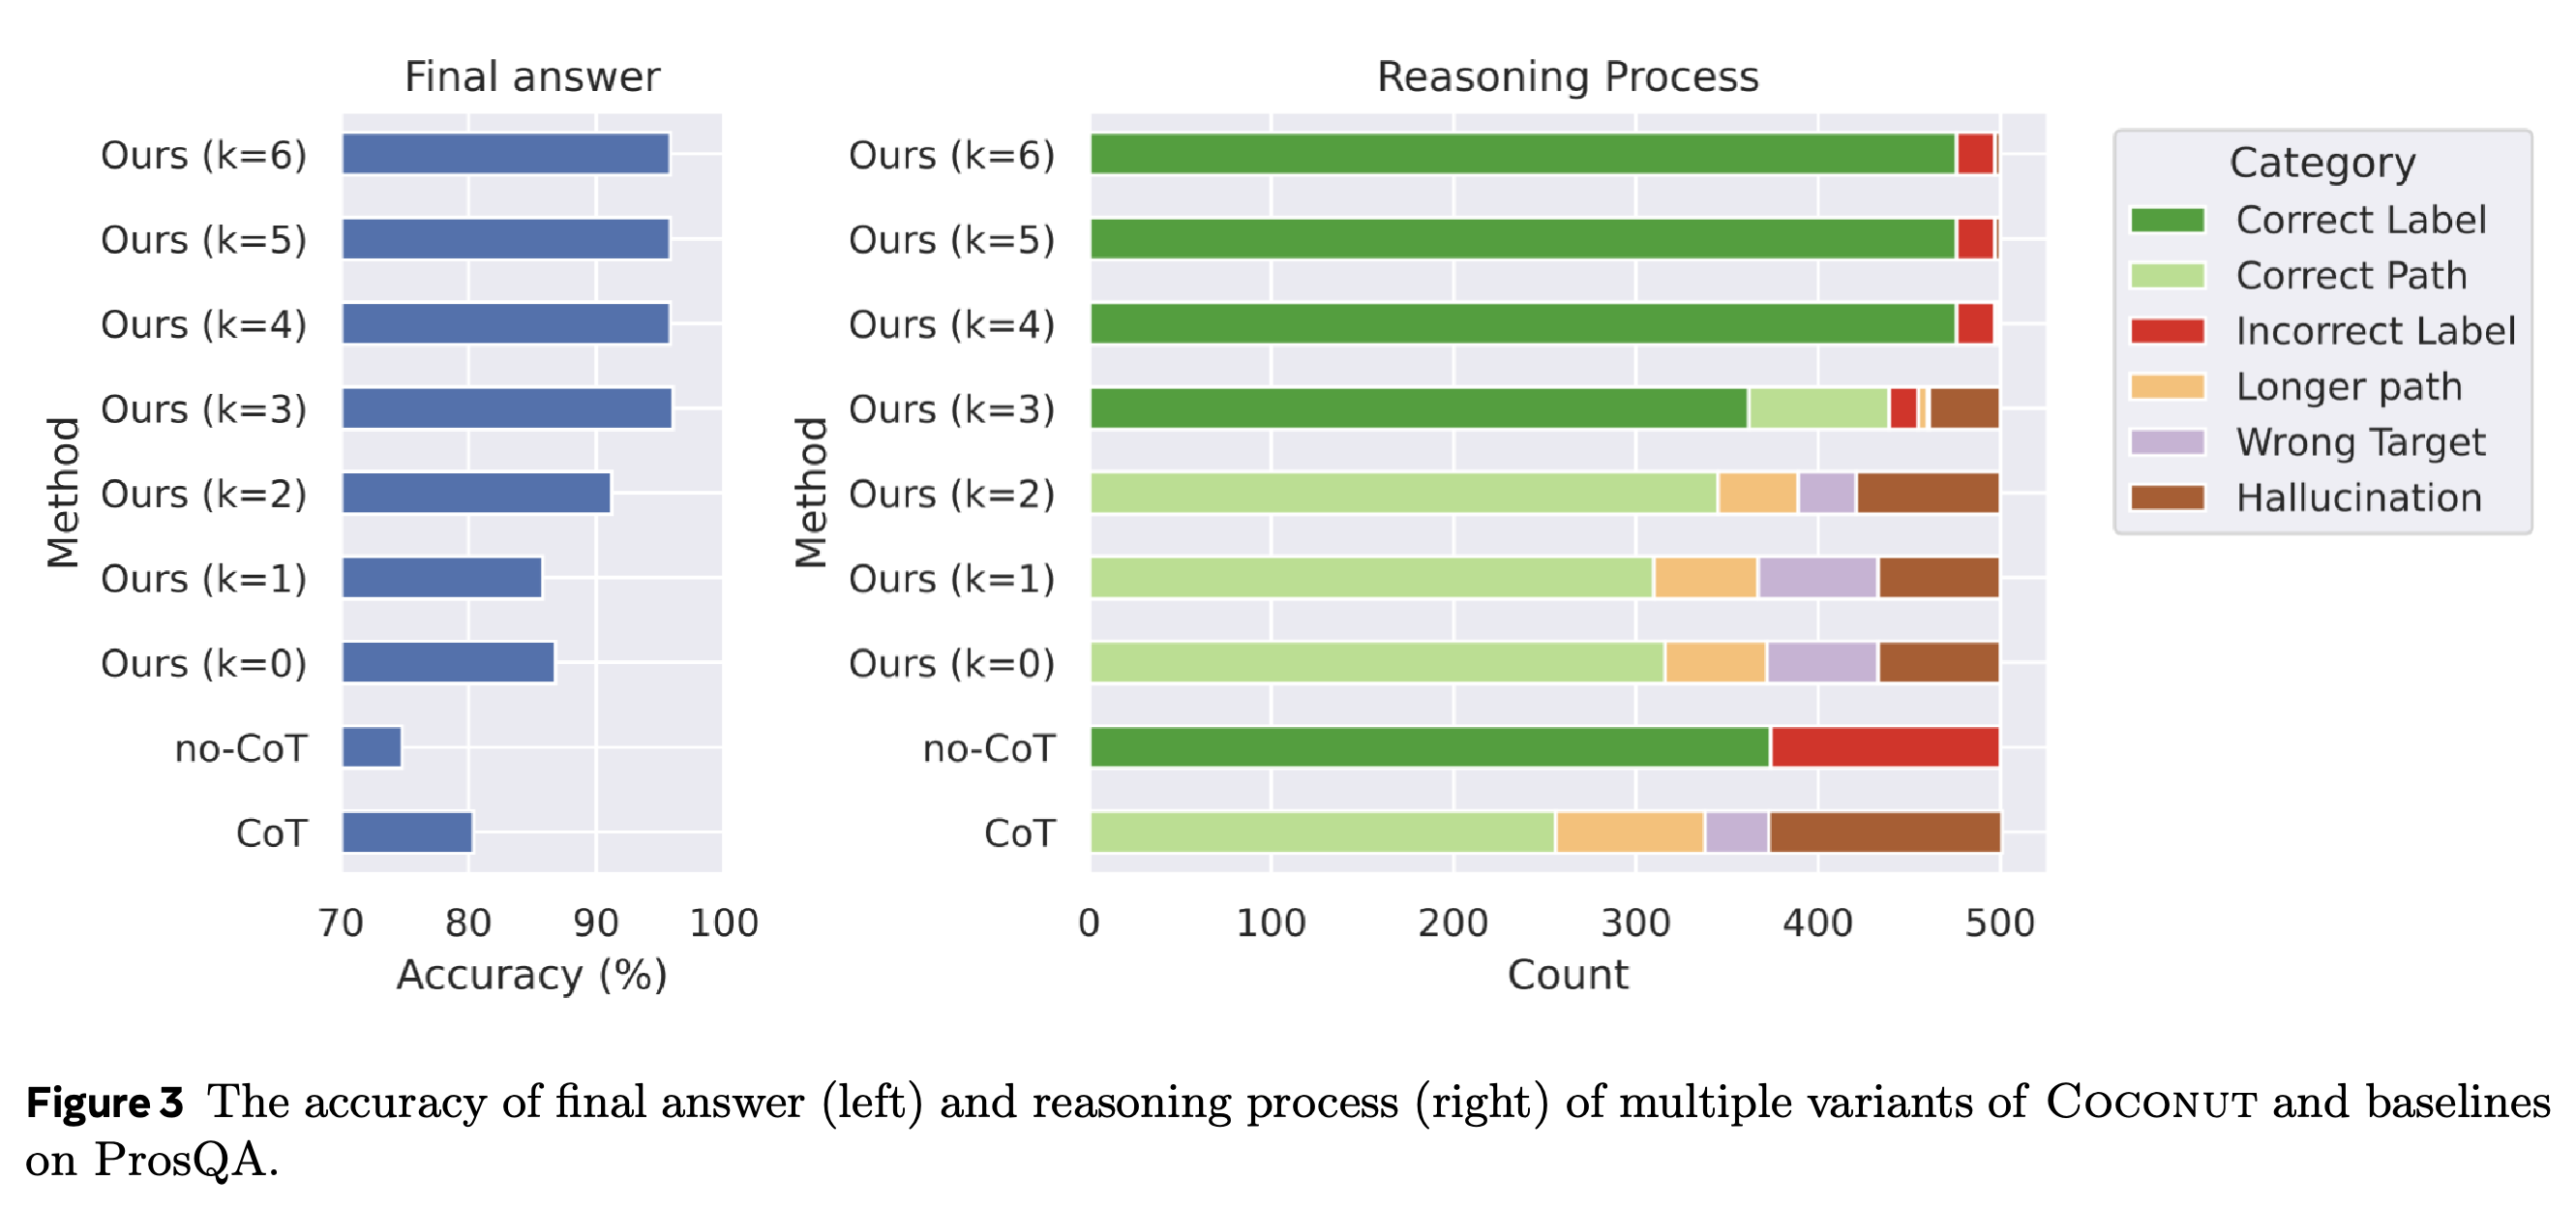
- 최종 답변 정확도와 추론 품질은 따로 평가한다. Correct Path는 답으로 이어지는 최단 유효 경로, Longer Path는 유효하지만 더 긴 경로, Hallucination은 존재하지 않는 간선이나 끊어진 경로, Wrong Target은 무관한 목적지로 이어지는 유효 경로를 뜻한다. 답변만 있는 출력은 Correct Label 또는 Incorrect Label로 분류한다.
- 경로의 일부만 언어로 표현된 경우, Correct Path는 관찰된 뒷부분에 앞선 설명을 보충해 유효한 경로를 완성할 수 있다는 뜻이다. 숨겨진 추론을 직접 관찰하는 대신 출력이 유효한 경로와 양립하는지 평가한다.
4.2 Overall Results
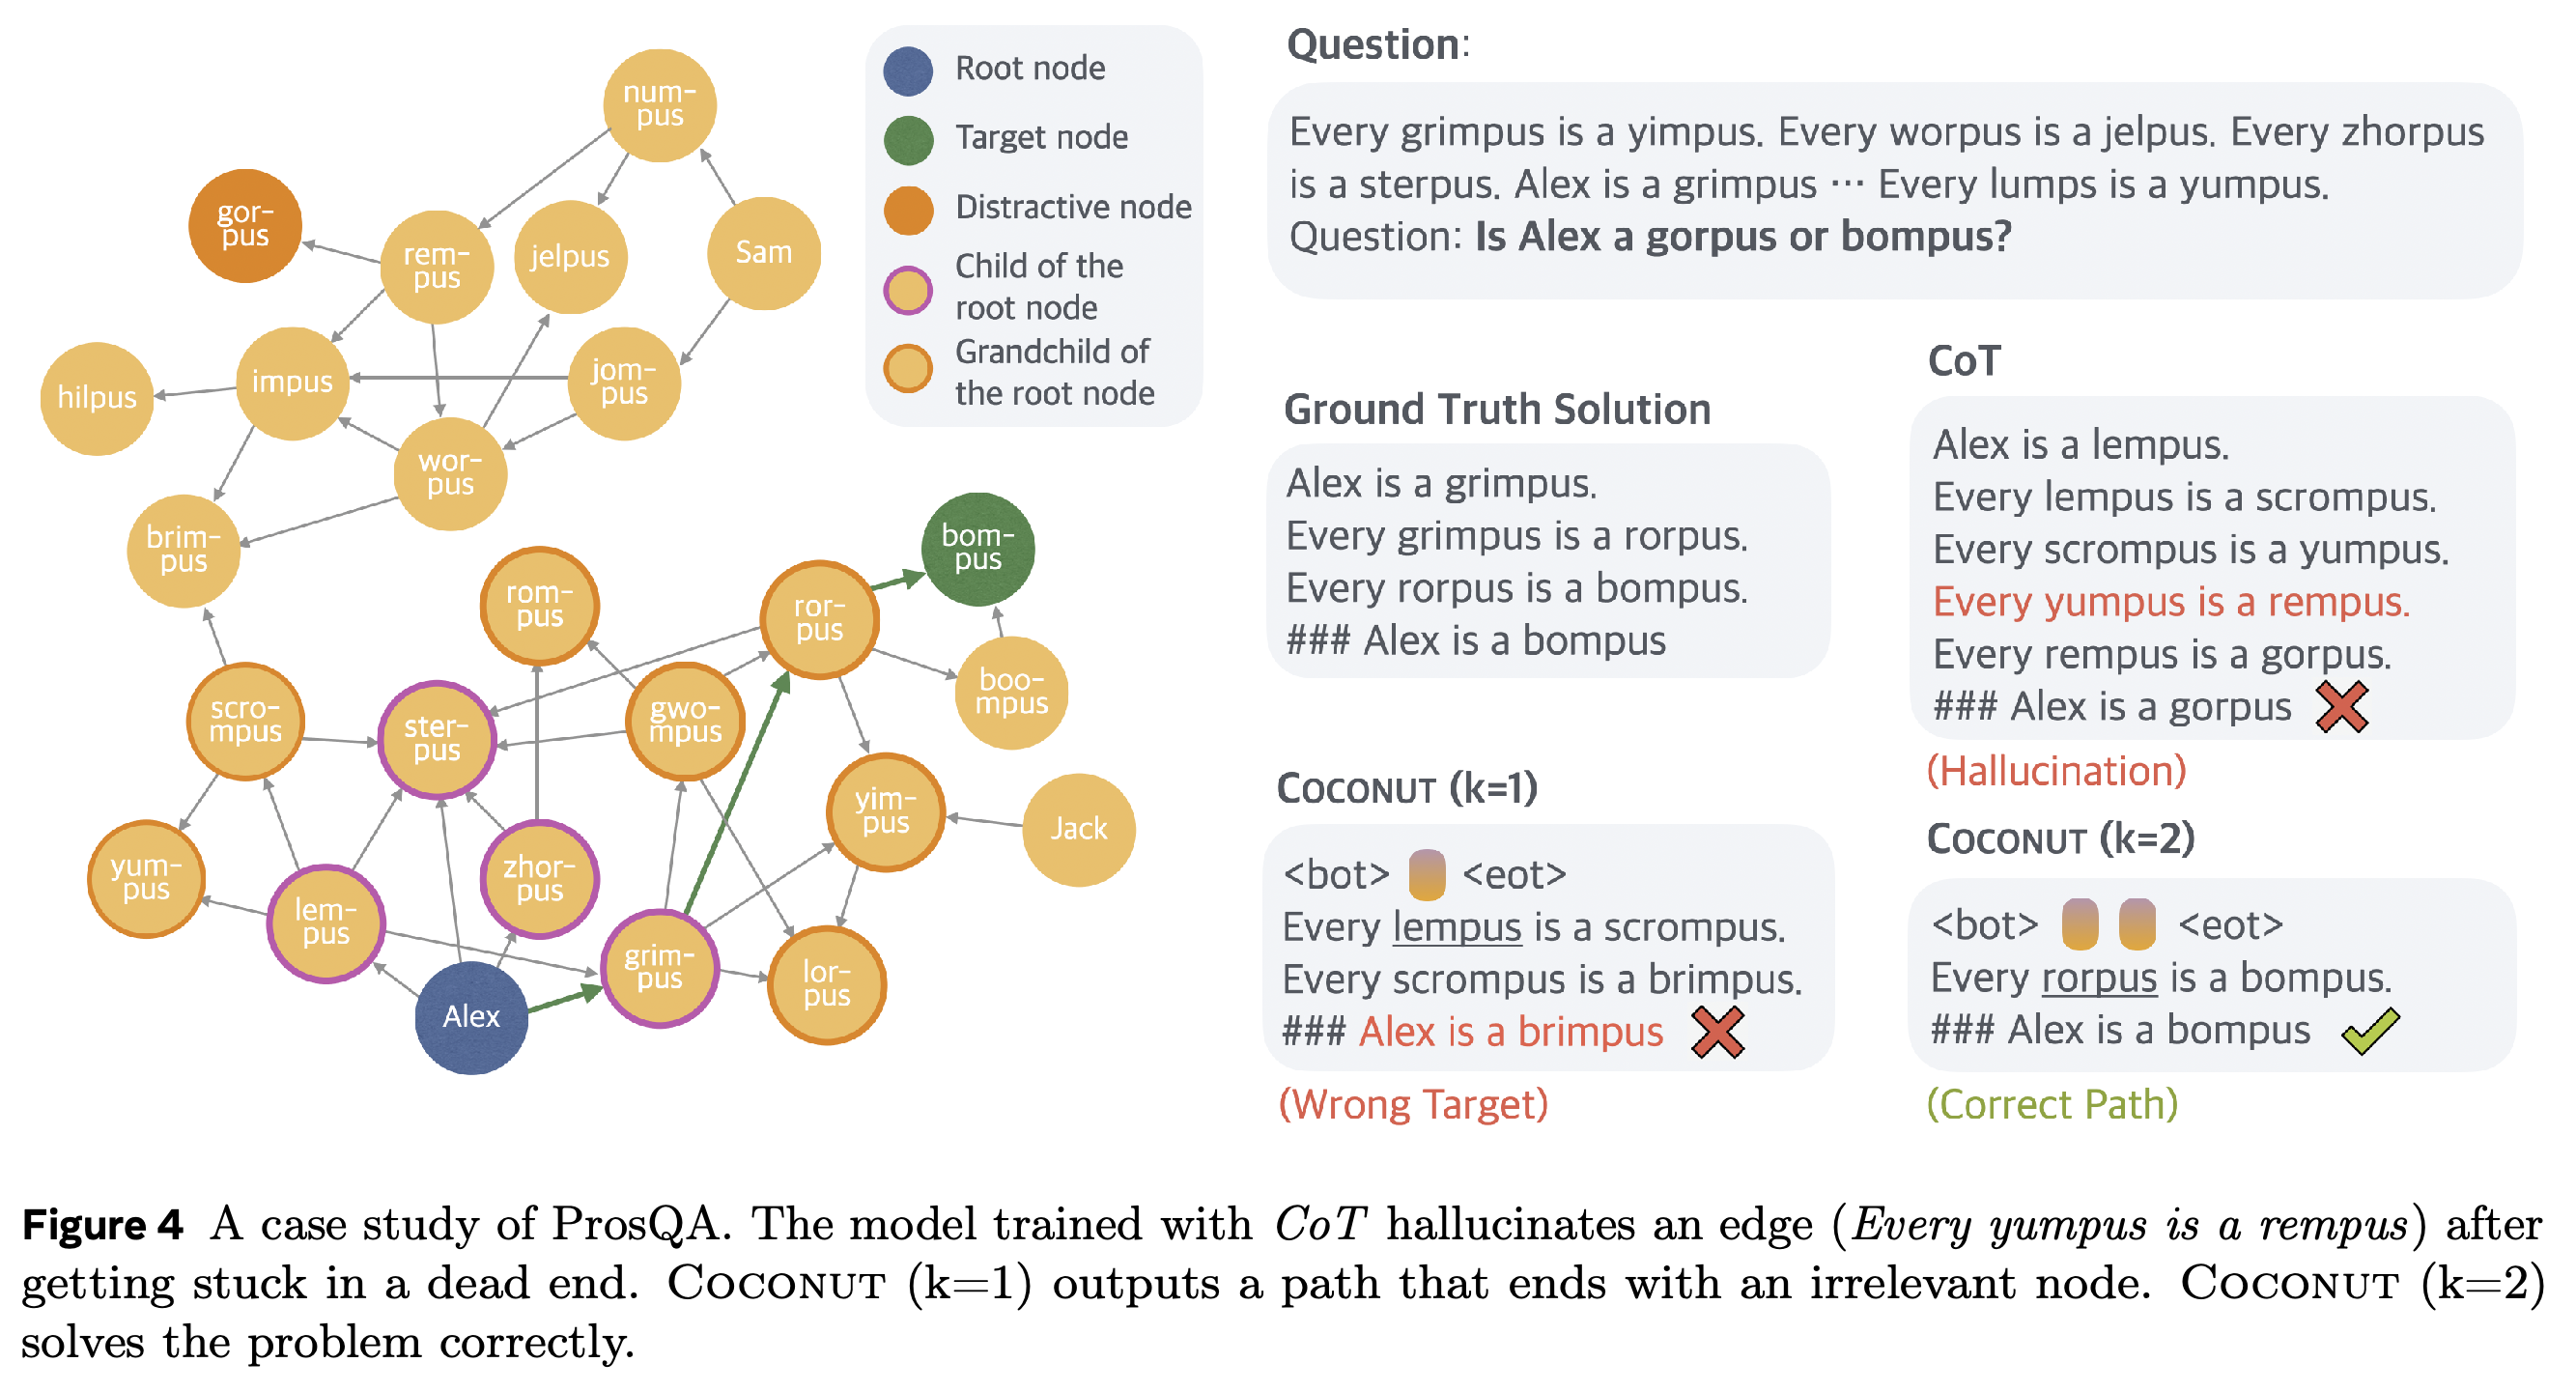
Figure 3에서는 Coconut이 여러 continuous thought를 사용하면 ProsQA 답변 정확도가 높아지고, 유효하지 않은 간선과 잘못된 목적지를 포함한 출력이 줄어든다. Figure 4의 사례는 저자들이 제안한 설명을 보여준다. 텍스트 CoT는 막다른 경로를 선택한 뒤 간선을 지어내고, 잠재 사고 1개를 사용해도 무관한 목적지로 향하지만, 잠재 사고 2개를 사용하면 올바른 후속 추론을 생성한다.
- 인접한 모든 k 값에서 정확도가 단조롭게 증가하지는 않는다. 짧은 잠재 추론 구간을 여러 잠재 단계로 늘릴 때 가장 뚜렷하게 개선된다.
- k가 커지면 답변만 포함한 출력이 많아진다. 이러한 출력의 Correct Label 분류는 명시적인 증명을 검증하지 않는다.
앞부분의 잠재 추론 구간이 길어지면 전반적으로 답변 정확도가 높아지고, 유효하지 않거나 무관한 후속 텍스트 추론이 줄어든다. 잠재 길이가 클 때 Correct Label이 많은 것은 생성된 증명을 검증한 결과가 아니라 답변만 평가한 결과다.
같은 그래프에서 서로 다른 결과 3개가 나타난다. 텍스트 CoT는 근거 없는 간선을 지어내고, continuous thought 1개는 무관한 종점으로 이어지며, continuous thought 2개는 올바른 목표로 이어지는 유효한 경로 뒷부분을 생성한다. 이 사례는 분기 선택을 미루는 이점에 관한 설명을 보여준다.
4.3 Interpreting the Latent Reasoning as Tree Search
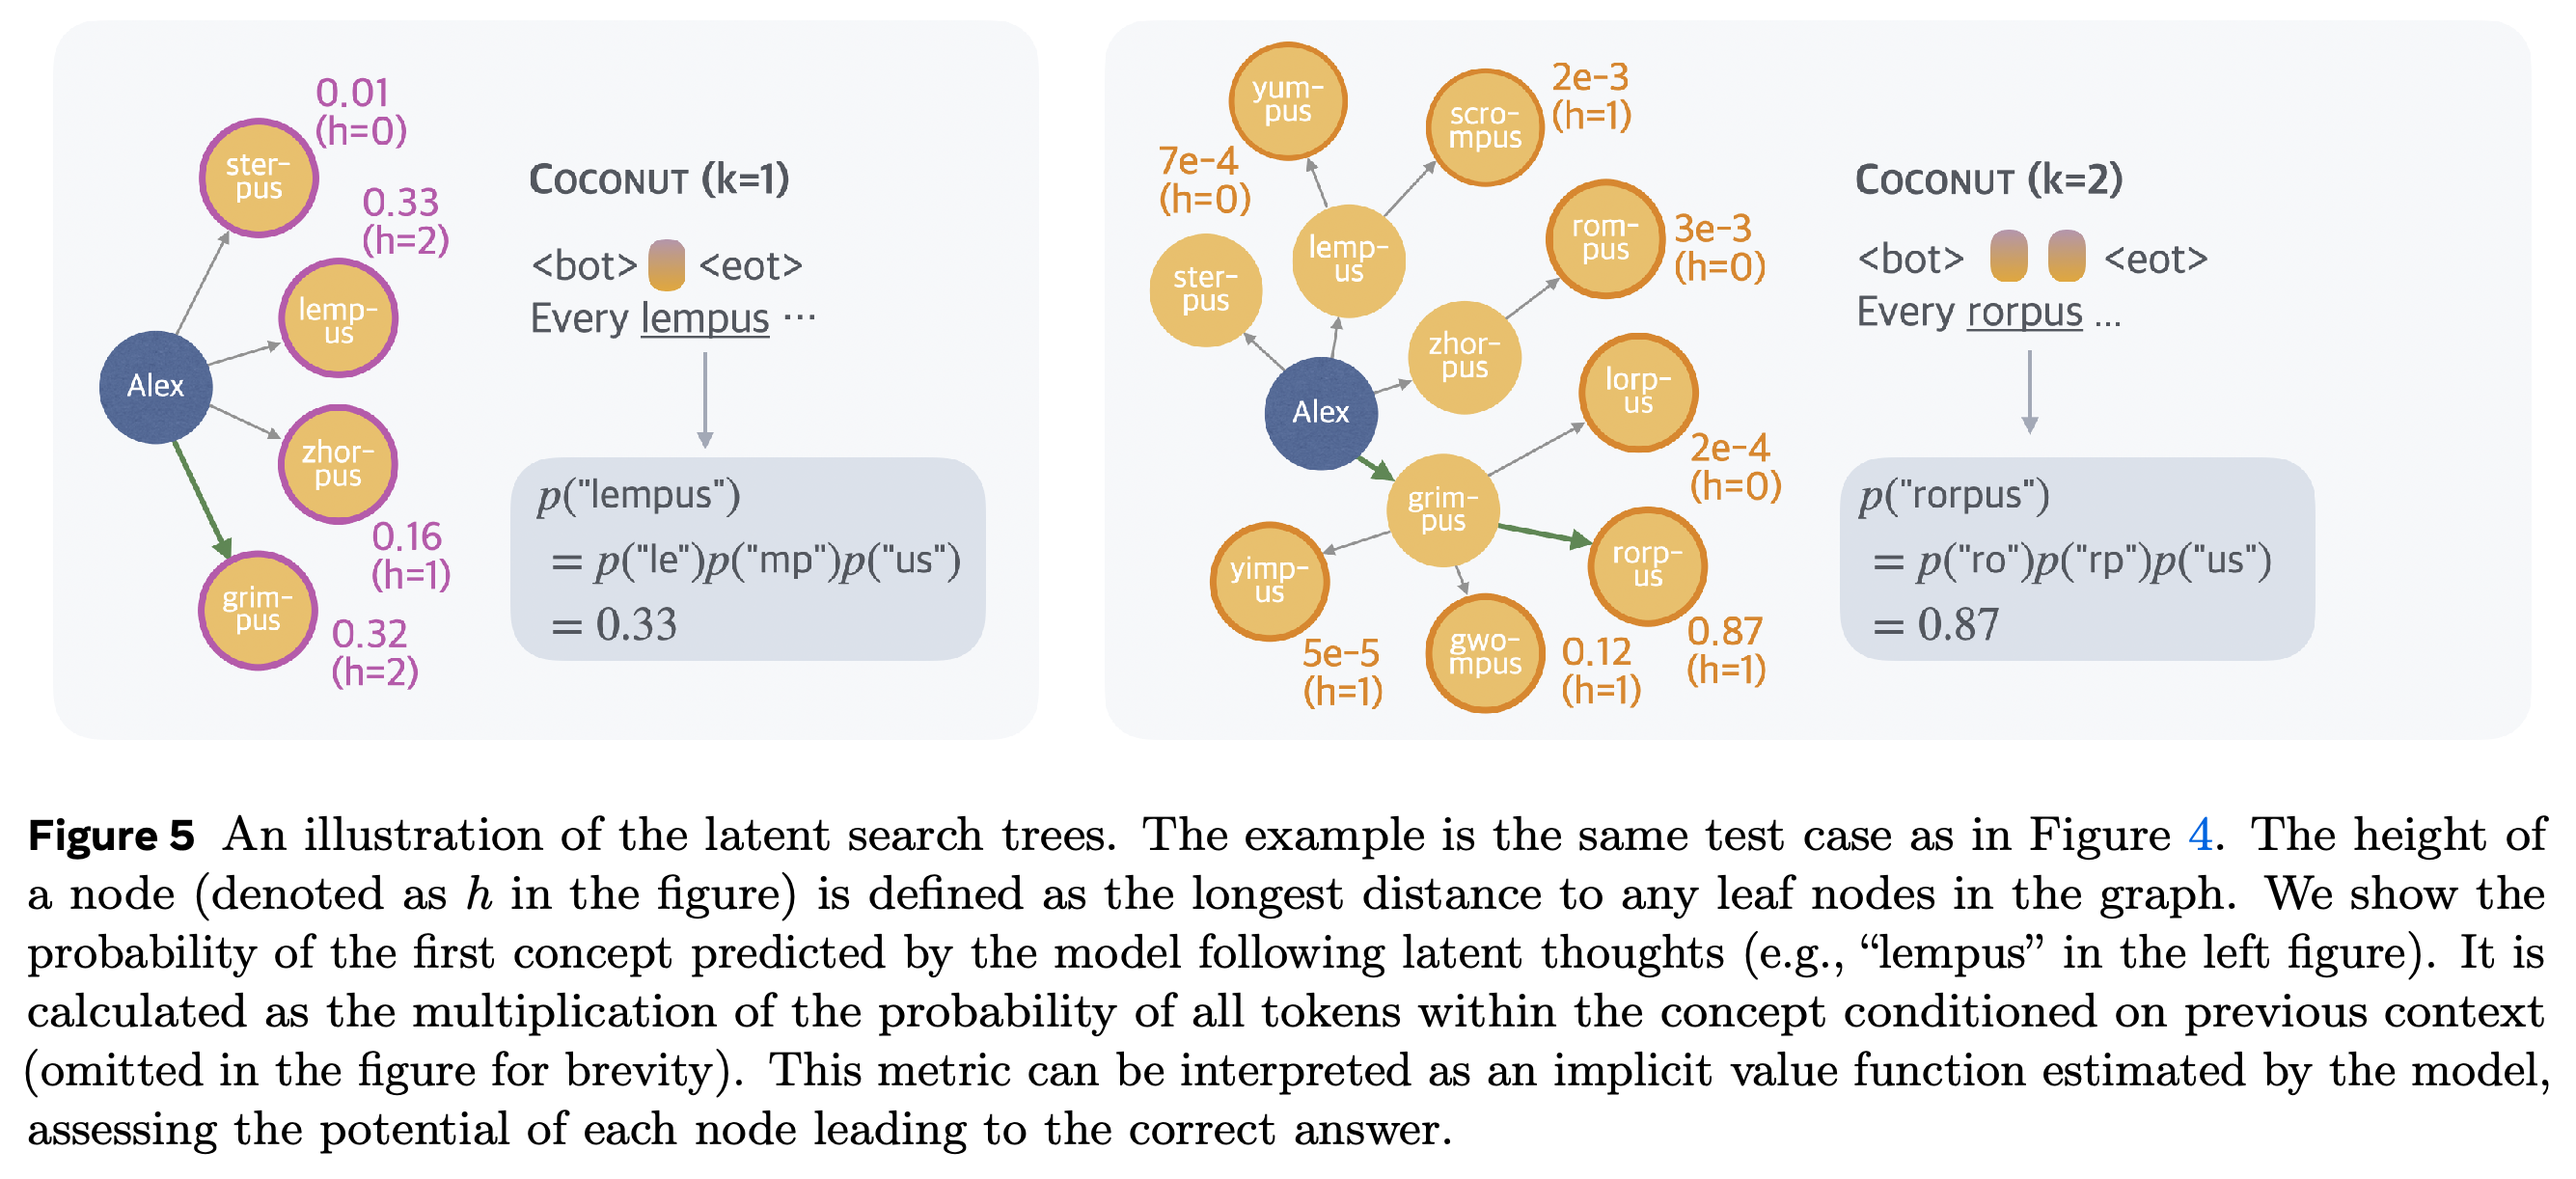
저자들은 중간 잠재 상태에서 언어 모드로 강제 복귀시킨 뒤, 다음 개념 후보의 확률을 측정한다. 제시된 예시에서는 처음에 “lempus”의 확률이 0.33으로 가장 높지만, 다음 잠재 단계에서는 다른 “grimpus” 분기에서 이어지는 “rorpus”의 확률이 0.87로 가장 높다.
- 개념 점수는 해당 개념을 구성하는 토큰들의 조건부 확률을 곱한 값이다. 논문은 이 점수를 목표에 도달하는 데 해당 개념이 얼마나 유용한지 추정하는 암묵적 가치 함수로 해석한다.
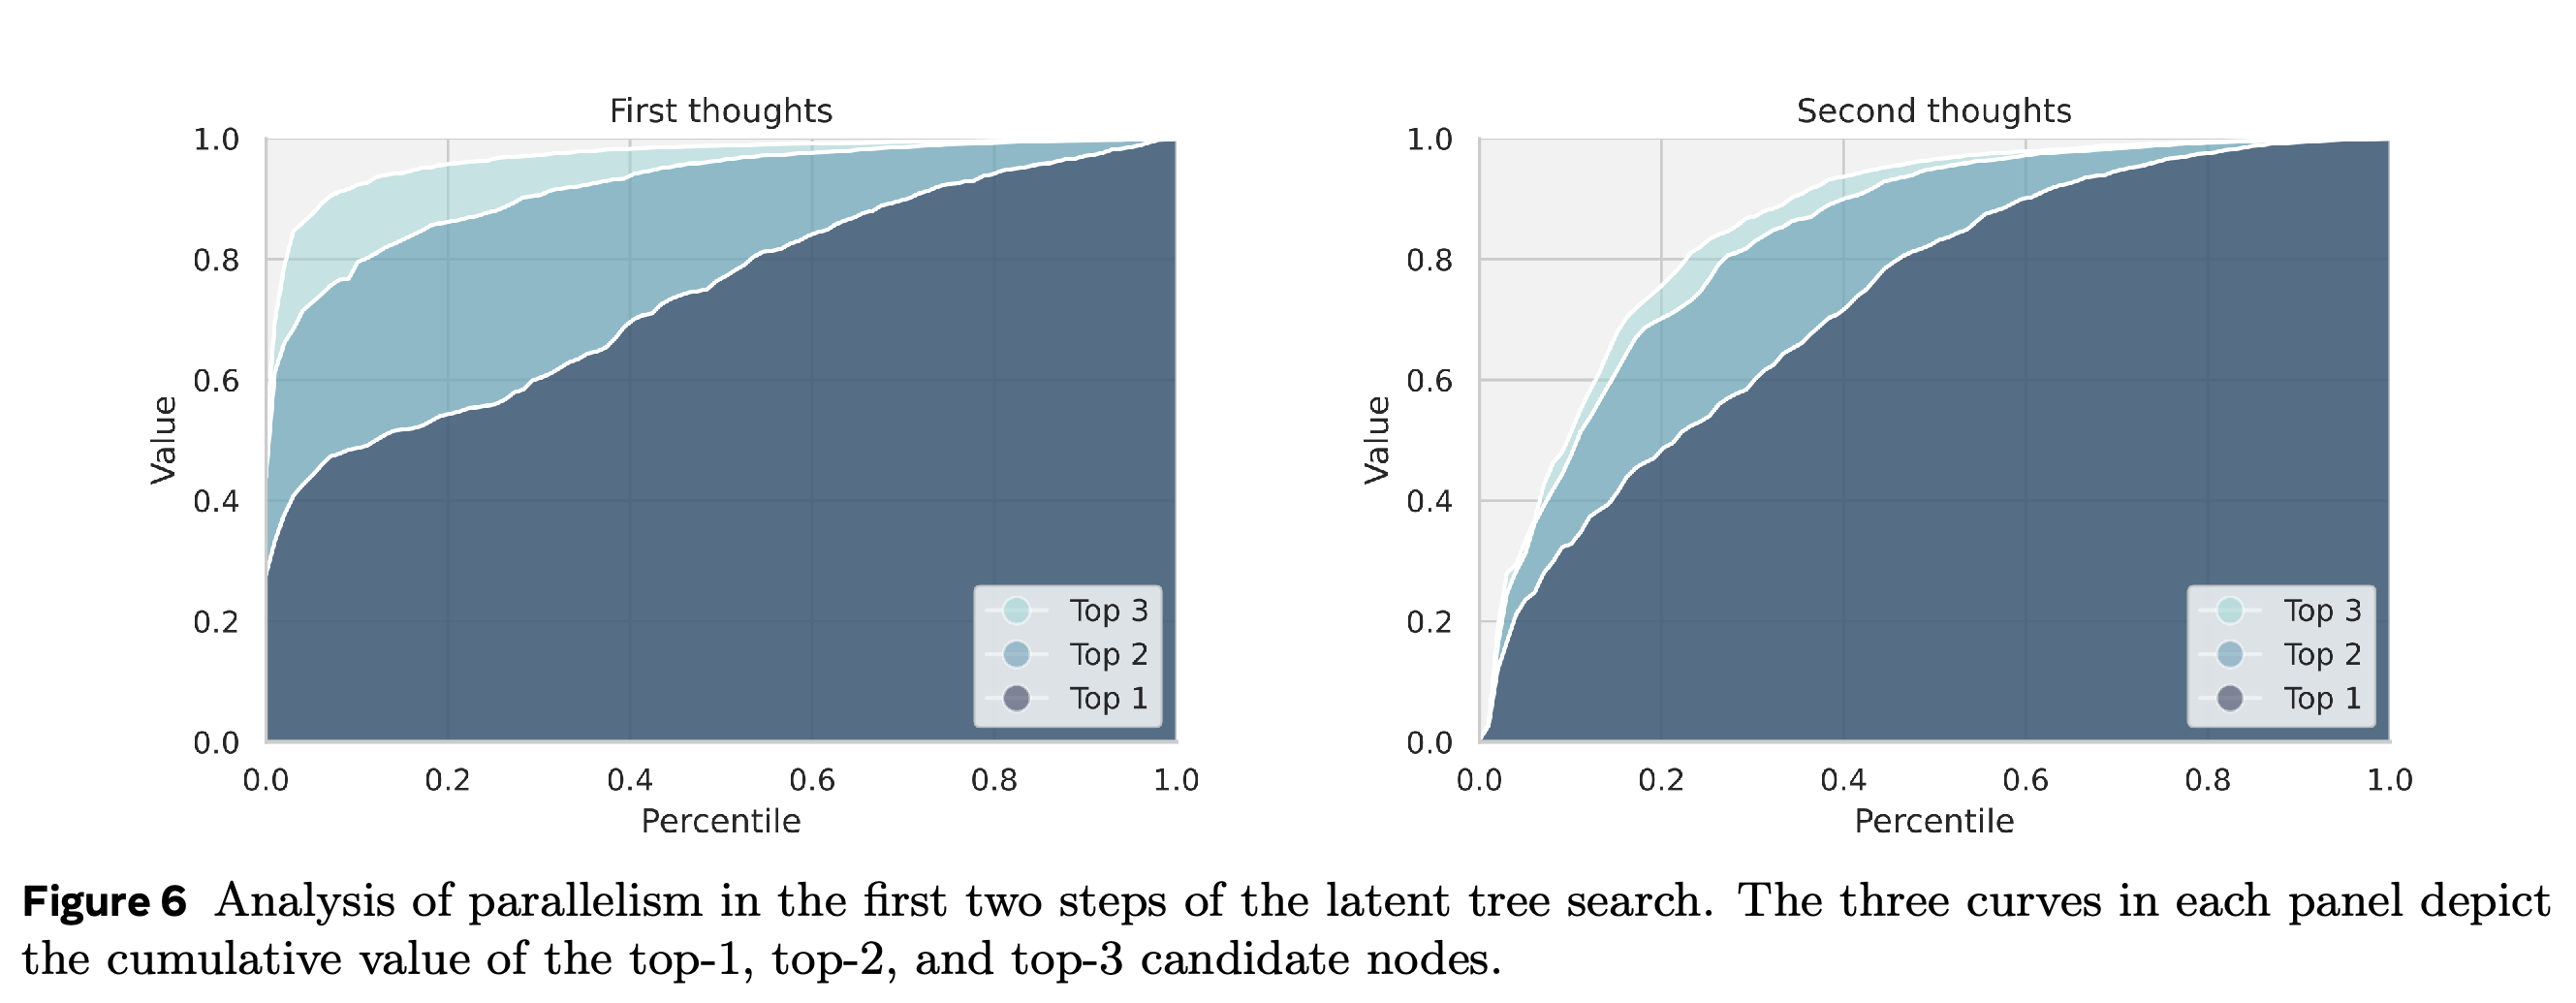
- 테스트 세트 전체에서 첫 번째 잠재 단계는 여러 후보에 상당한 확률을 배분하고, 잠재 추론 2단계에서는 선두 후보에 확률이 더 집중된다.
- 이 관찰은 선택을 미루는 BFS 유사 동작이라는 해석을 뒷받침한다. 내부 탐색 과정 전체를 직접 열거한 결과는 아니다.
잠재 단계를 추가하면 다음 개념의 최고 확률 후보가 0.33의 “lempus”에서 0.87의 “rorpus”로 바뀐다. “rorpus”는 처음에 다른 분기에 속했던 개념이다. 이 변화는 처음에 가장 유력했던 후보 외의 대안도 유지된다는 해석을 뒷받침한다.
잠재 추론 1단계에서 top-1과 누적 top-2/top-3 값의 간격이 큰 것은 확률이 여러 대안에 분산되어 있음을 나타낸다. 잠재 추론 2단계에서 간격이 작아지는 현상은 잠재 추론이 진행될수록 모델이 후보를 더 선별한다는 해석을 뒷받침한다.
4.4 Why is Latent Space Better for Planning?
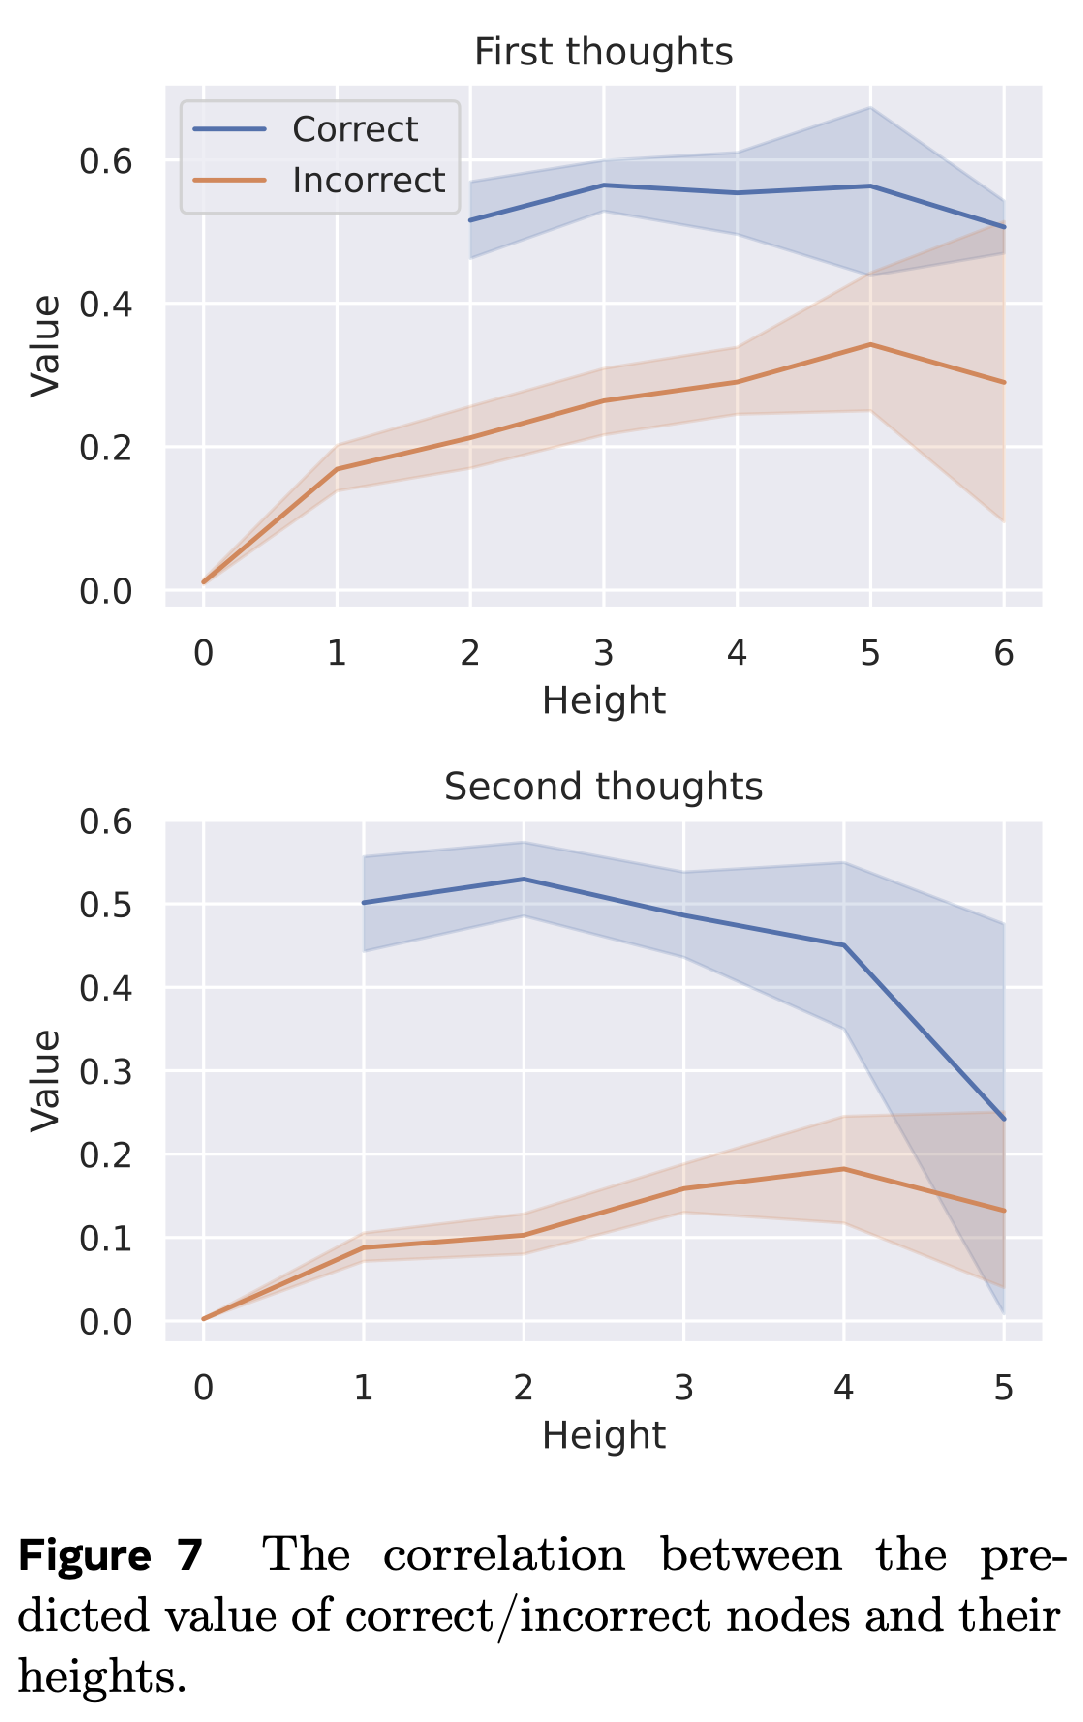
계획에 관한 가설은 초기 후보 노드가 최종 결과에서 멀리 떨어져 있어 평가하기 어렵다는 것이다. Figure 7은 후보 점수와 리프까지의 거리를 나타내는 노드 높이의 관계를 살펴본다. 리프에 가까울수록 올바른 후보와 잘못된 후보의 점수가 더 뚜렷하게 구분되며, 이는 이산적인 선택을 미루는 이점에 관한 설명을 뒷받침한다.
- 이는 제안한 설명을 뒷받침하는 상관관계 근거다. 선택을 미루는 동작이 정확도 향상의 원인인지 분리해서 확인한 개입 실험은 아니다.
- 원문의 높이 정의는 일관되지 않는다. Figure 5는 리프까지의 최장 거리를 사용하지만 Section 4.4는 최단 거리를 사용한다. 본문은 분석에 어느 정의를 사용했는지 명확히 밝히지 않는다.
리프 노드에 가까울수록 올바른 후보와 잘못된 후보의 점수가 더 뚜렷하게 구분된다. 이는 최종 결과에 가까울수록 선택을 평가하기 쉽다는 가설과 부합한다. 다만 논문의 노드 높이 정의가 일관되지 않아 해석에 한계가 있다.
5 Empirical Results with Coconut
더 폭넓은 평가에서는 수학과 합성 논리 추론 데이터셋 2개에서 연속적인 추론을 시험한다. 최종 답변 정확도, 추론 길이, 커리큘럼 의존성, 테스트 시점의 연산 확장을 살펴본다. 여기서 테스트 시점의 연산 확장은 연속 단계를 추가해 더 많은 연산을 배분했을 때의 효과를 뜻한다.
5.1 Experimental Setup
GSM8k에서는 합성 수학 데이터로 학습하며 c=2를 사용한다. 초기 단계는 6 에포크, 이후 각 단계는 3 에포크씩 학습한다. 3개 단계에 걸쳐 추론을 점차 대체한 뒤, 추가 단계에서 continuous thought 6개를 유지하면서 남은 텍스트 추론을 모두 제거한다.
- 합성 논리 연역 벤치마크 ProntoQA와 ProsQA는 c=1을 사용하며, 초기 단계 이후 대체 단계 6개를 각 5 에포크씩 학습한다.
- 모든 학습 일정은 총 50 에포크가 될 때까지 마지막 단계를 이어간다. 검증 정확도로 체크포인트를 선택하고, 추론에서는 마지막 학습 단계의 잠재 길이를 사용한다. 모든 실험은 다음 토큰 중 확률이 가장 높은 것을 선택하는 greedy decoding을 사용한다.
- 주요 평가는 GPT-2를 사용하며, 더 큰 모델의 별도 결과는 Appendix C.2에 제시한다.
5.2 Baselines and Variants of Coconut
베이스라인은 텍스트 CoT, 질문과 답변 쌍만으로 학습한 No-CoT, 추론 토큰을 점차 제거하는 iCoT, 추론 사슬에 대한 지도 없이 추가 연산 토큰으로 학습한 Pause Token이다. Coconut 변형 3개를 통해 커리큘럼과 연속 상태의 기여를 구분한다.
- w/o curriculum은 중간 커리큘럼 단계를 제거하고 처음부터 완전한 잠재 추론으로 학습한다.
- w/o thought는 Coconut의 커리큘럼을 유지하지만 continuous thought를 추가하지 않는다. 학습 일정은 iCoT가 아닌 Coconut을 따른다.
- pause as thought는 같은 커리큘럼을 유지하면서 연속 상태를 <pause> 토큰으로 대체한다. 추론을 제거하는 커리큘럼이 없는 Pause Token 베이스라인과는 다르다.
5.3 Results and Discussion
Table 1에서 Coconut의 GSM8k 정확도는 34.1±1.5%, 추론 토큰 수는 8.2개이며, CoT는 42.9±0.2%와 25.0개다. ProntoQA에서 Coconut은 9.0개 토큰으로 99.8±0.2%를 달성하고, CoT는 92.5개 토큰으로 98.8±0.8%를 달성한다. ProsQA에서는 Coconut이 14.2개 토큰으로 97.0±0.3%를, CoT가 49.4개 토큰으로 77.5±1.9%를 달성한다.
- 보고된 Coconut의 추론 길이에는 continuous thought 위치도 포함되므로 생성된 텍스트만 센 값은 아니다. GSM8k 정확도는 No-CoT의 16.5±0.5%와 인용된 iCoT 수학 결과 30.0%보다 높지만, 표에서 수학 정확도가 가장 높은 방법은 여전히 텍스트 CoT다.
- ProsQA에서 iCoT는 8.2개 토큰으로 98.2±0.3%를 달성해 정확도와 간결성 모두에서 Coconut을 앞선다. 따라서 논리 추론 결과만으로 Coconut이 평가한 방법 중 가장 우수하다고 할 수는 없다.
- ± 수치는 원문 표기를 유지한다. 주변 실험 설명은 해당 수치의 통계적 정의를 명시하지 않는다.
표는 결과 3가지를 구분해 보여준다. Coconut은 수학에서 직접 답하는 방식보다 성능이 높고, 과제 3개 모두에서 보고된 추론 위치 수가 텍스트 CoT보다 적으며, 효과적인 학습에 커리큘럼이 필요하다. 한편 ProsQA에서는 iCoT가 Coconut보다 우수하므로 전반적인 우월성을 주장하기에는 한계가 있다.
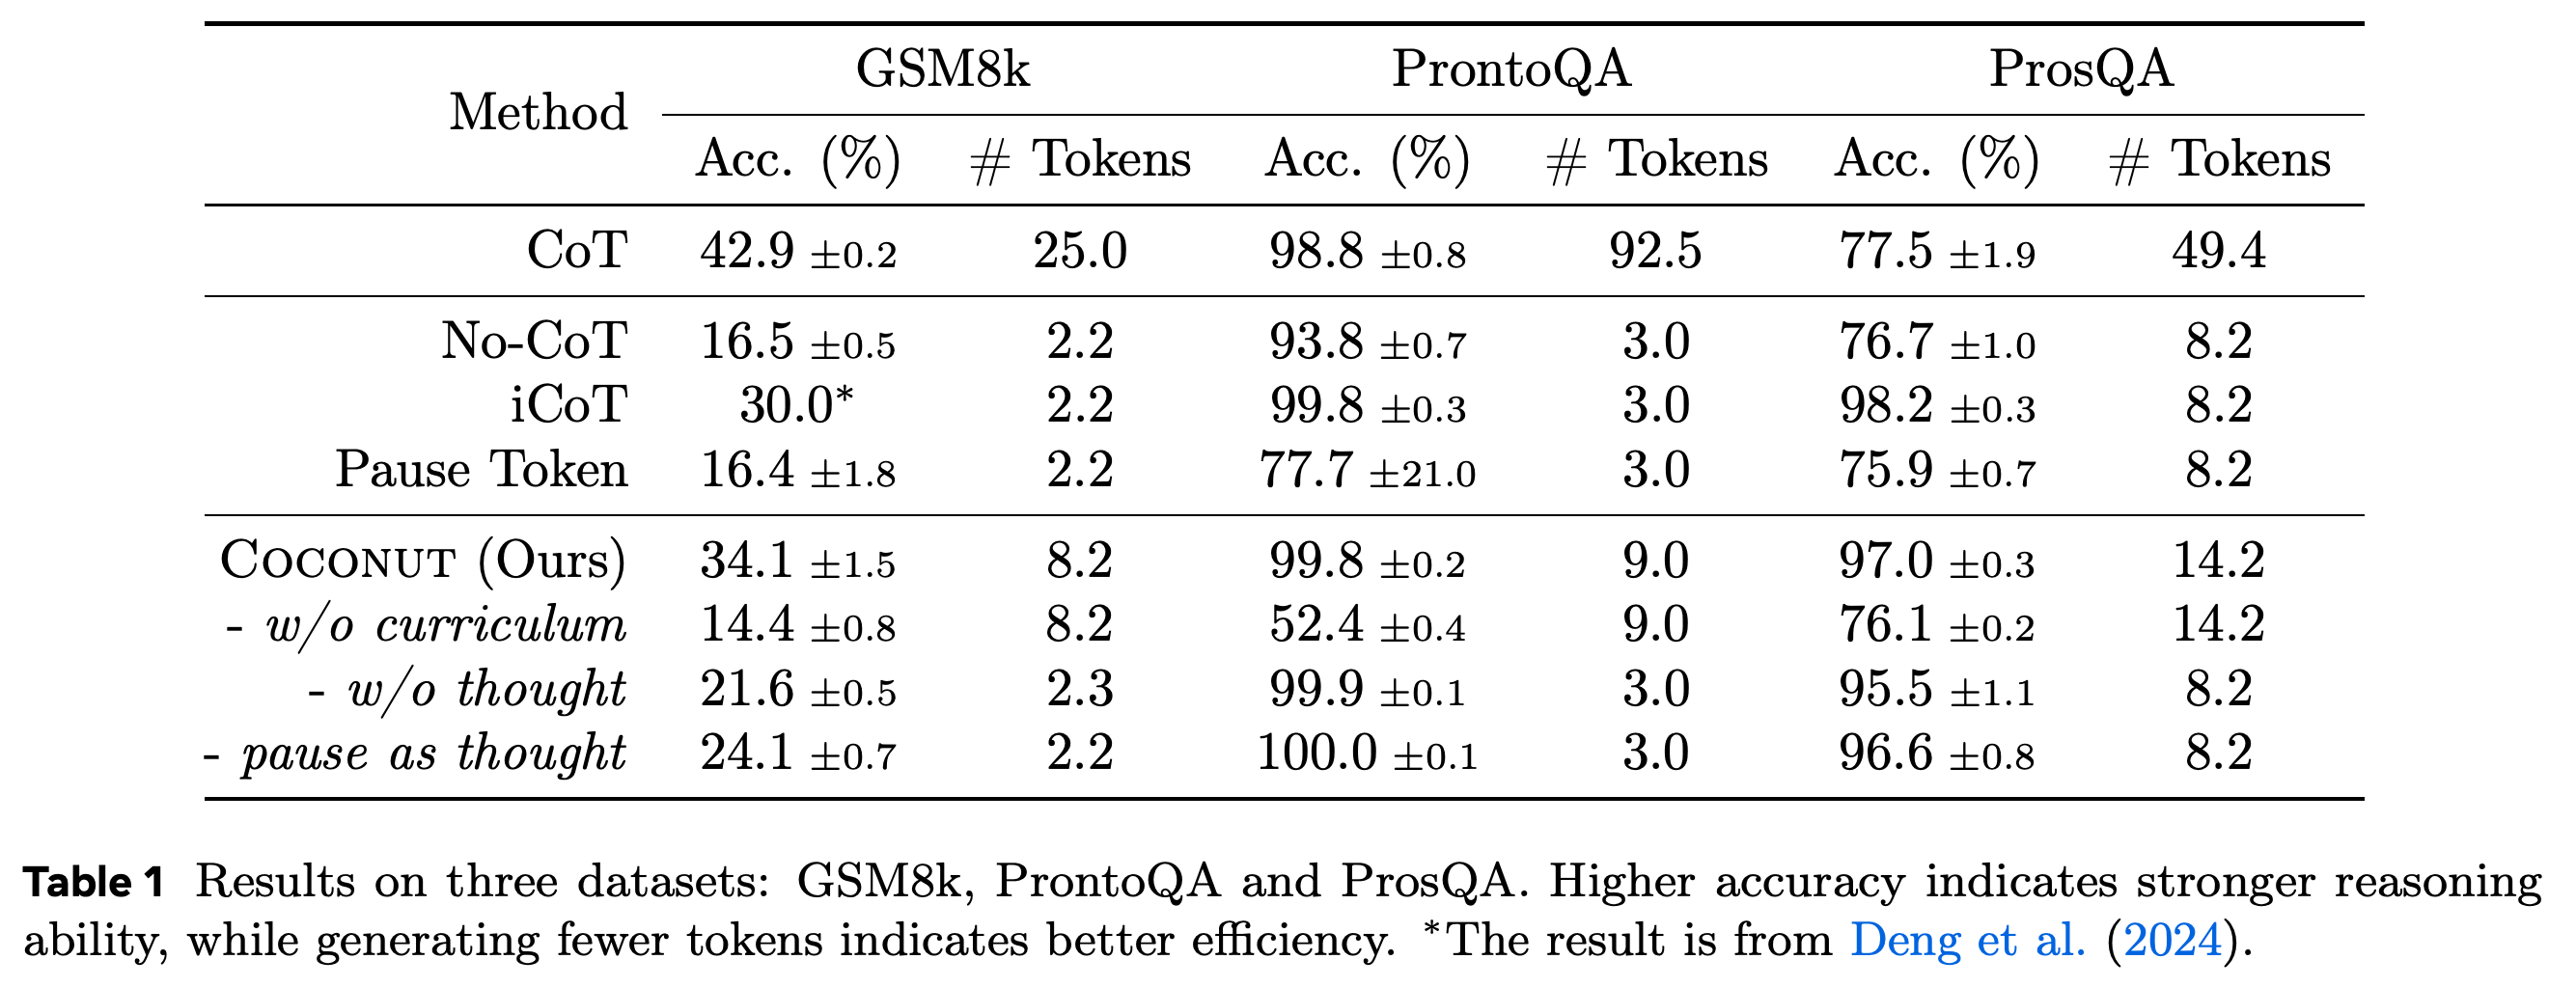
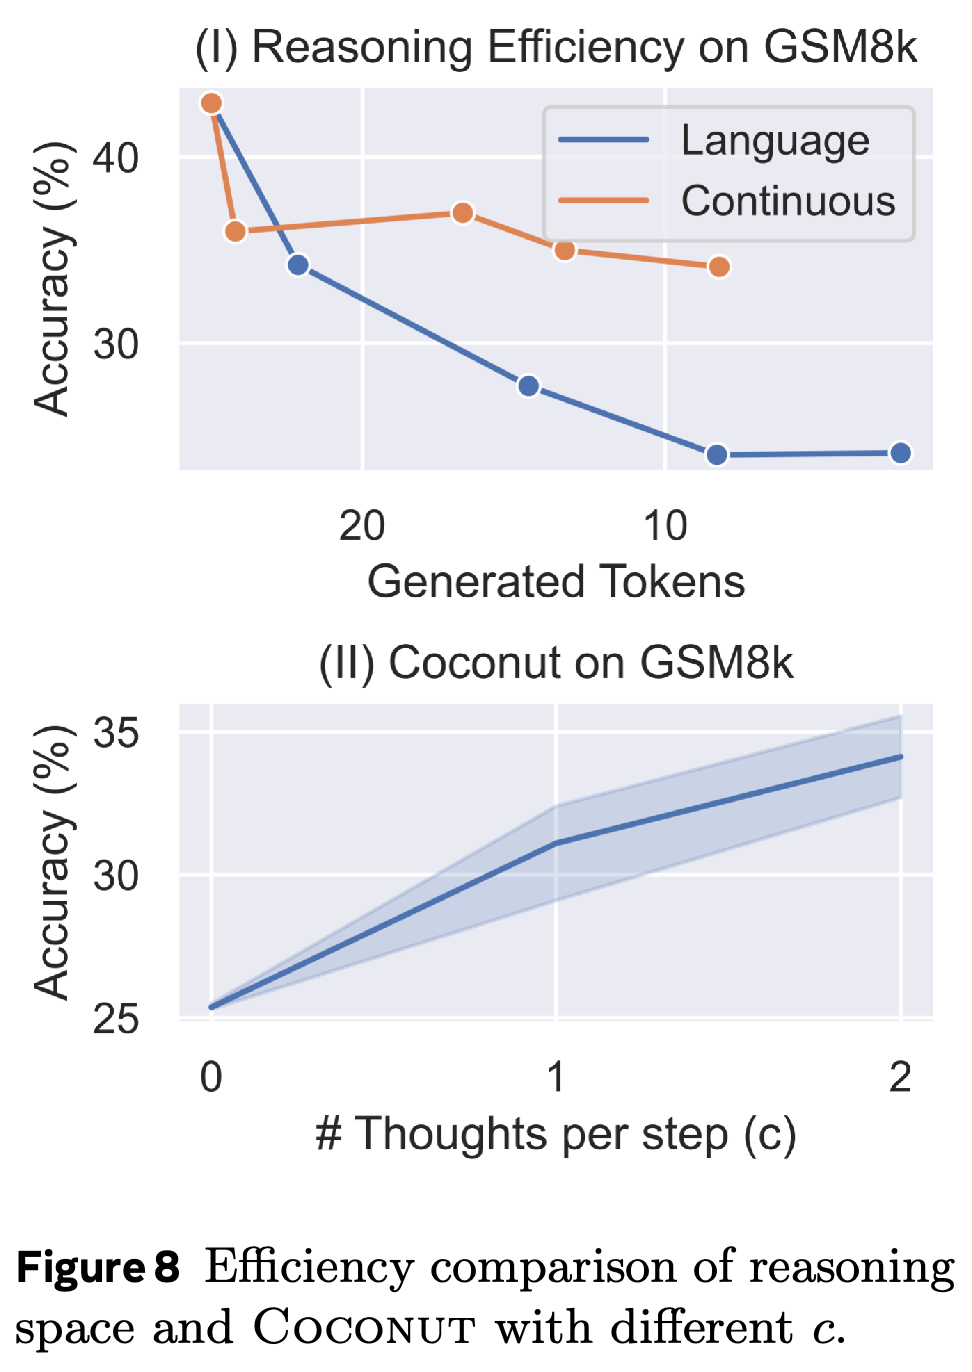
실험 조건에서는 커리큘럼이 필수적이다. 이를 제거하면 Coconut의 정확도는 GSM8k에서 14.4±0.8%, ProntoQA에서 52.4±0.4%, ProsQA에서 76.1±0.2%로 낮아진다. c를 0에서 1, 2로 늘리면 수학 성능이 개선된다. Figure 8에서는 텍스트 단계를 단순히 제거하는 것보다 continuous thought로 대체할 때 정확도가 더 잘 유지된다.
- GSM8k에서 w/o thought는 21.6±0.5%, pause as thought는 24.1±0.7%를 기록하며, 이 변형 2개 모두 완전한 Coconut보다 낮다. 이 비교는 커리큘럼만의 효과 외에도 연속 상태 피드백이 기여한다는 근거가 된다.
- 같은 변형들이 합성 논리 과제에서는 높은 성능을 보이므로, 해당 과제들은 연속 상태 피드백의 필요성을 뒷받침하는 근거가 상대적으로 약하다.
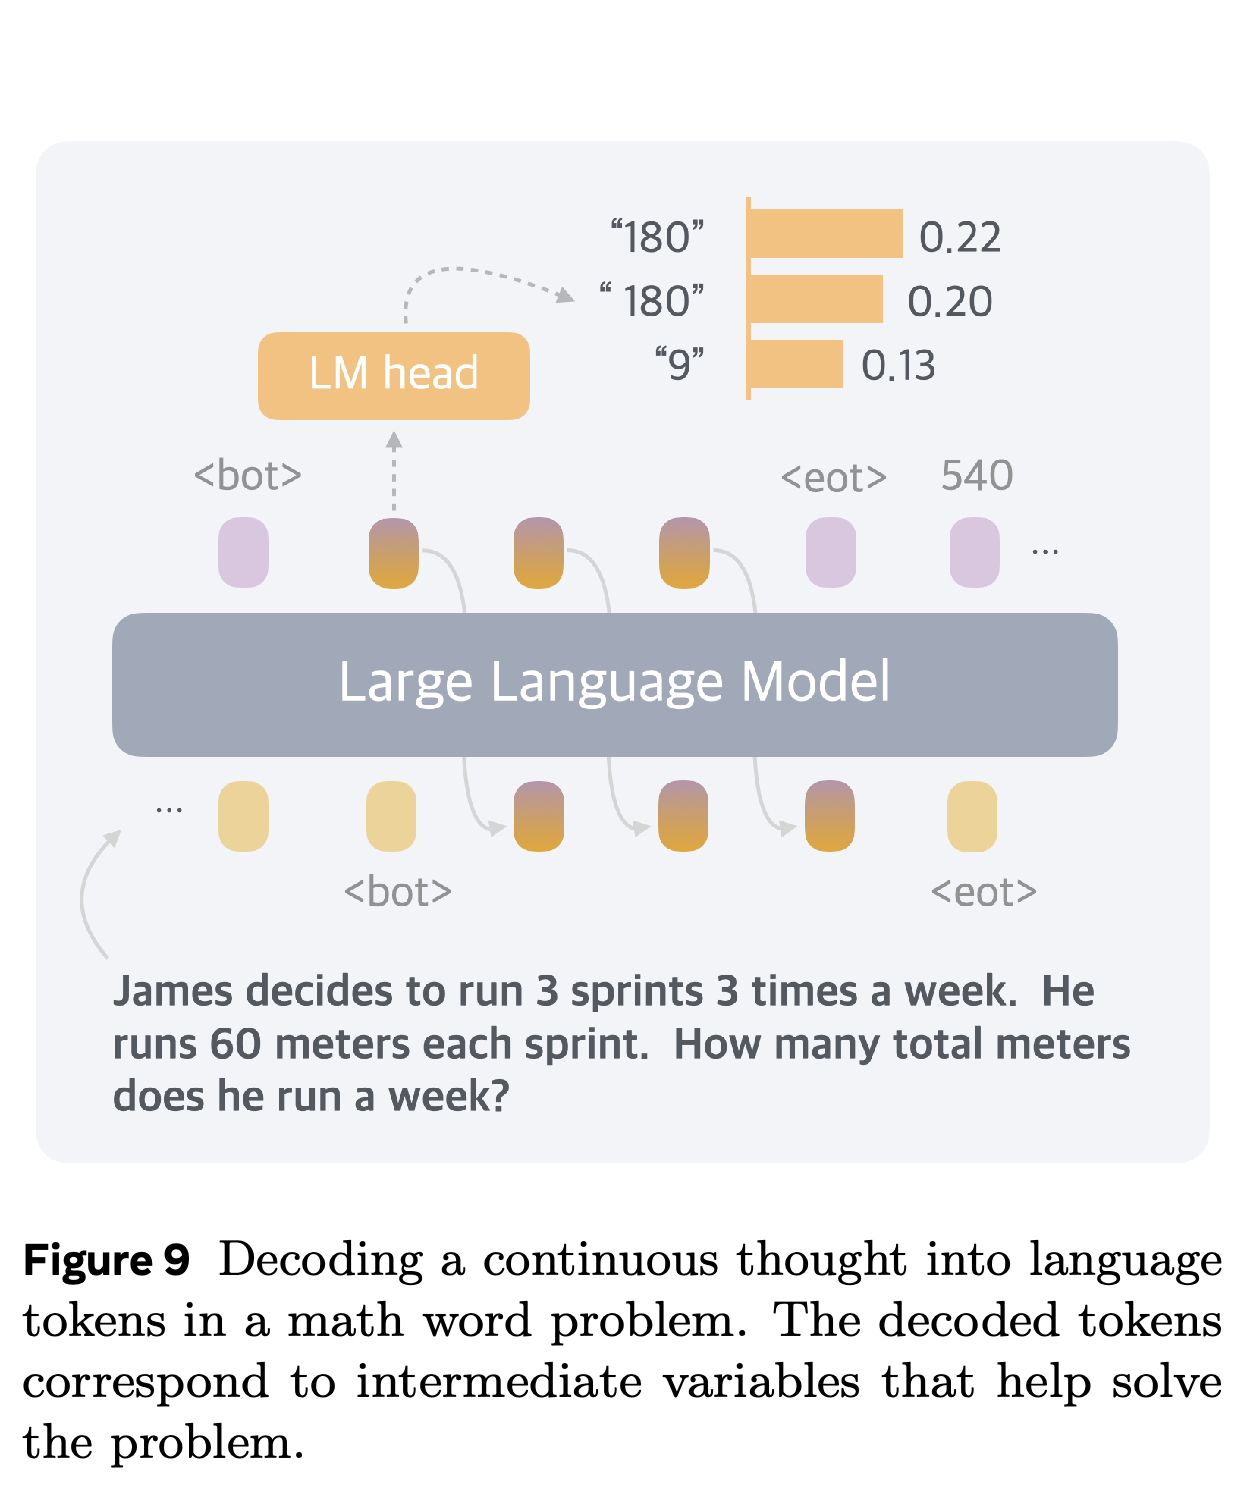
- Figure 9는 수학 문제의 중간 상태를 “180”과 “9”를 포함한 그럴듯한 수치로 디코딩한다. 이는 잠재 상태의 의미를 일반적으로 검증한 결과가 아니라 예시를 통한 분석이다.
위쪽 패널은 비슷하게 짧아진 추론 길이에서 텍스트 추론을 제거하는 것보다 연속 상태로 대체할 때 수학 정확도가 더 잘 유지됨을 보여준다. 아래쪽 패널은 c=0, 1, 2에서 성능이 개선됨을 보여준다. Appendix C.1에 따르면 이 추세는 c=3까지 일관되게 이어지지 않는다.
첫 번째 연속 상태에 언어 모델 출력 헤드를 적용하면 “180”과 “9”를 포함해 계산과 관련된 숫자에 확률이 배분된다. 이는 중간 상태의 수치 정보를 해석할 수 있는 예시를 제공하지만, 모든 잠재 상태의 의미를 직접 읽을 수 있음을 입증하지는 않는다.
6 Conclusion
결론은 연속적인 은닉 상태 피드백을 명시적인 언어 토큰을 넘어 추론하는 방법으로 제시하고, 관찰된 대안 경로 관련 동작을 잠재 탐색으로 해석한다. 이 접근을 사전학습으로 확장하고 일반화 성능을 개선하는 것은 향후 연구 방향으로 제안하며, 실험이 이러한 성과를 입증한 것은 아니다.
부록
- A Datasets는 산술과 논리 문제의 형식, 합성 ProsQA 그래프 생성 절차, 데이터셋 통계와 분할을 설명한다. 위치 편향을 줄이기 위해 답변 선택지 순서를 무작위로 섞는다.
- B Clock-Time Reasoning Efficiency Metric은 Nvidia A100 GPU에서 배치 크기 1로 측정한 평균 지연 시간을 보고한다. 해당 하드웨어와 구현에서는 Coconut이 CoT보다 빠르며, 이 비교의 범위는 측정 조건에 한정된다.
- C More Discussion은 continuous thought를 더 추가하면 GSM8k 성능이 낮아지고 학습이 불안정해질 수 있다고 보고한다. 더 큰 모델의 실험에서는 향상 폭이 크지 않았고 텍스트 CoT와 비교하지 않았다. 언어 중심 사전학습은 잠재 공간 적응이 어려운 이유에 대한 가능한 설명으로 제시된다.
짧은 생각
핵심 기여는 연속적인 은닉 상태 피드백과, 중간 연산이 처음에 가장 유력했던 언어 분기 외의 대안도 유지할 수 있음을 보여주는 분석이다. 수학 실험은 해당 설정에서 정확도와 추론 길이 사이의 유용한 절충을 뒷받침한다. 다만 높은 iCoT 성능, 커리큘럼 의존성, 순차적인 학습 비용, 제한적인 대형 모델 비교를 고려하면 더 넓은 범위에서 우월하다고 주장하기는 어렵다.