


JuStRank: Benchmarking LLM Judges for System Ranking 요약 설명
12 Dec 2024 | Paper Review LLM-as-a-Judge LLM Evaluation Benchmark목차
이번 글에서는 JuStRank: Benchmarking LLM Judges for System Ranking 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 12일(Arxiv)
- Gera, Ariel, Boni, Odellia, Perlitz, Yotam, Bar-Haim, Roy, Eden, Lilach, Yehudai, Asaf.
- IBM Research
- 논문 링크
- 검토한 원문: arXiv:2412.09569v2, 2025-06-10.
요약
- JuStRank는 생성된 응답을 평가하는 대규모 언어 모델(LLM) 판정자가 해당 응답을 생성한 시스템의 순위를 신뢰성 있게 매길 수 있는지 살펴본다. 인간 평가에서 도출한 Chatbot Arena 순위와 비교했을 때, Qwen2.5-72B-Instruct에 품질을 5개 라벨로 평가하는 Likert와 다른 시스템보다 응답 점수가 높은 비율을 평균하는 Win-Rate 집계를 적용하면 순위 일치도 지표인 Kendall’s Tau가 0.827이다. 응답 품질 점수를 부여하는 8B-parameter 보상 모델 URM-LLaMa-3.1-8B에 시스템별 응답 점수를 평균하는 Mean 집계를 적용한 결과는 0.823이다. Chatbot Arena에 대해서는 Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (LLM-as-a-Judge) 요약 설명 글을 참조하라.
- 이 벤치마크는 Arena Hard v0.1의 지시문 500개와 시스템 63개의 응답으로 판정 방식 48개를 평가하고 약 1.5M개의 점수를 생성한다. 판정 방식은 응답 점수를 산출하는 구체적인 구현을 뜻한다. 평균적으로 0–100점을 부여하는 Numeric과 Likert가 고정된 기준 응답과 비교하는 Anchor, yes/no 토큰 확률로 점수를 산출하는 TokenProbs보다 우수하다. 개별 응답 비교 벤치마크인 RewardBench의 성능은 시스템 순위 평가 성능을 일관되게 예측하지 못한다.
- 분석에서는 강한 시스템과 약한 시스템 사이의 차이를 확대하는 경향인 단호함(decisiveness)과, 특정 시스템을 지속적으로 과대평가하거나 과소평가하는 시스템별 편향을 구분한다. 순위 품질은 단호함과 양의 상관관계를, 편향과 음의 상관관계를 보인다. 다만 이 결과를 해석할 때는 별도로 구성된 자동 평가 데이터셋과 인간 기준 데이터셋이 유사하다는 가정을 고려해야 한다.
1 Introduction
모델을 선택하거나 학습 및 추론 방법을 평가할 때 LLM 판정자를 활용하는 사례가 늘고 있지만, 판정자 검증은 대개 개별 응답에 대한 판단을 측정한다. JuStRank는 이러한 판단을 집계했을 때 인간 평가에 기반한 시스템 순위를 재현하는지 평가한다.
- 이 연구는 약 1.5M개의 판정 점수를 https://huggingface.co/datasets/ibm-research/justrank_judge_scores 에 공개한다.
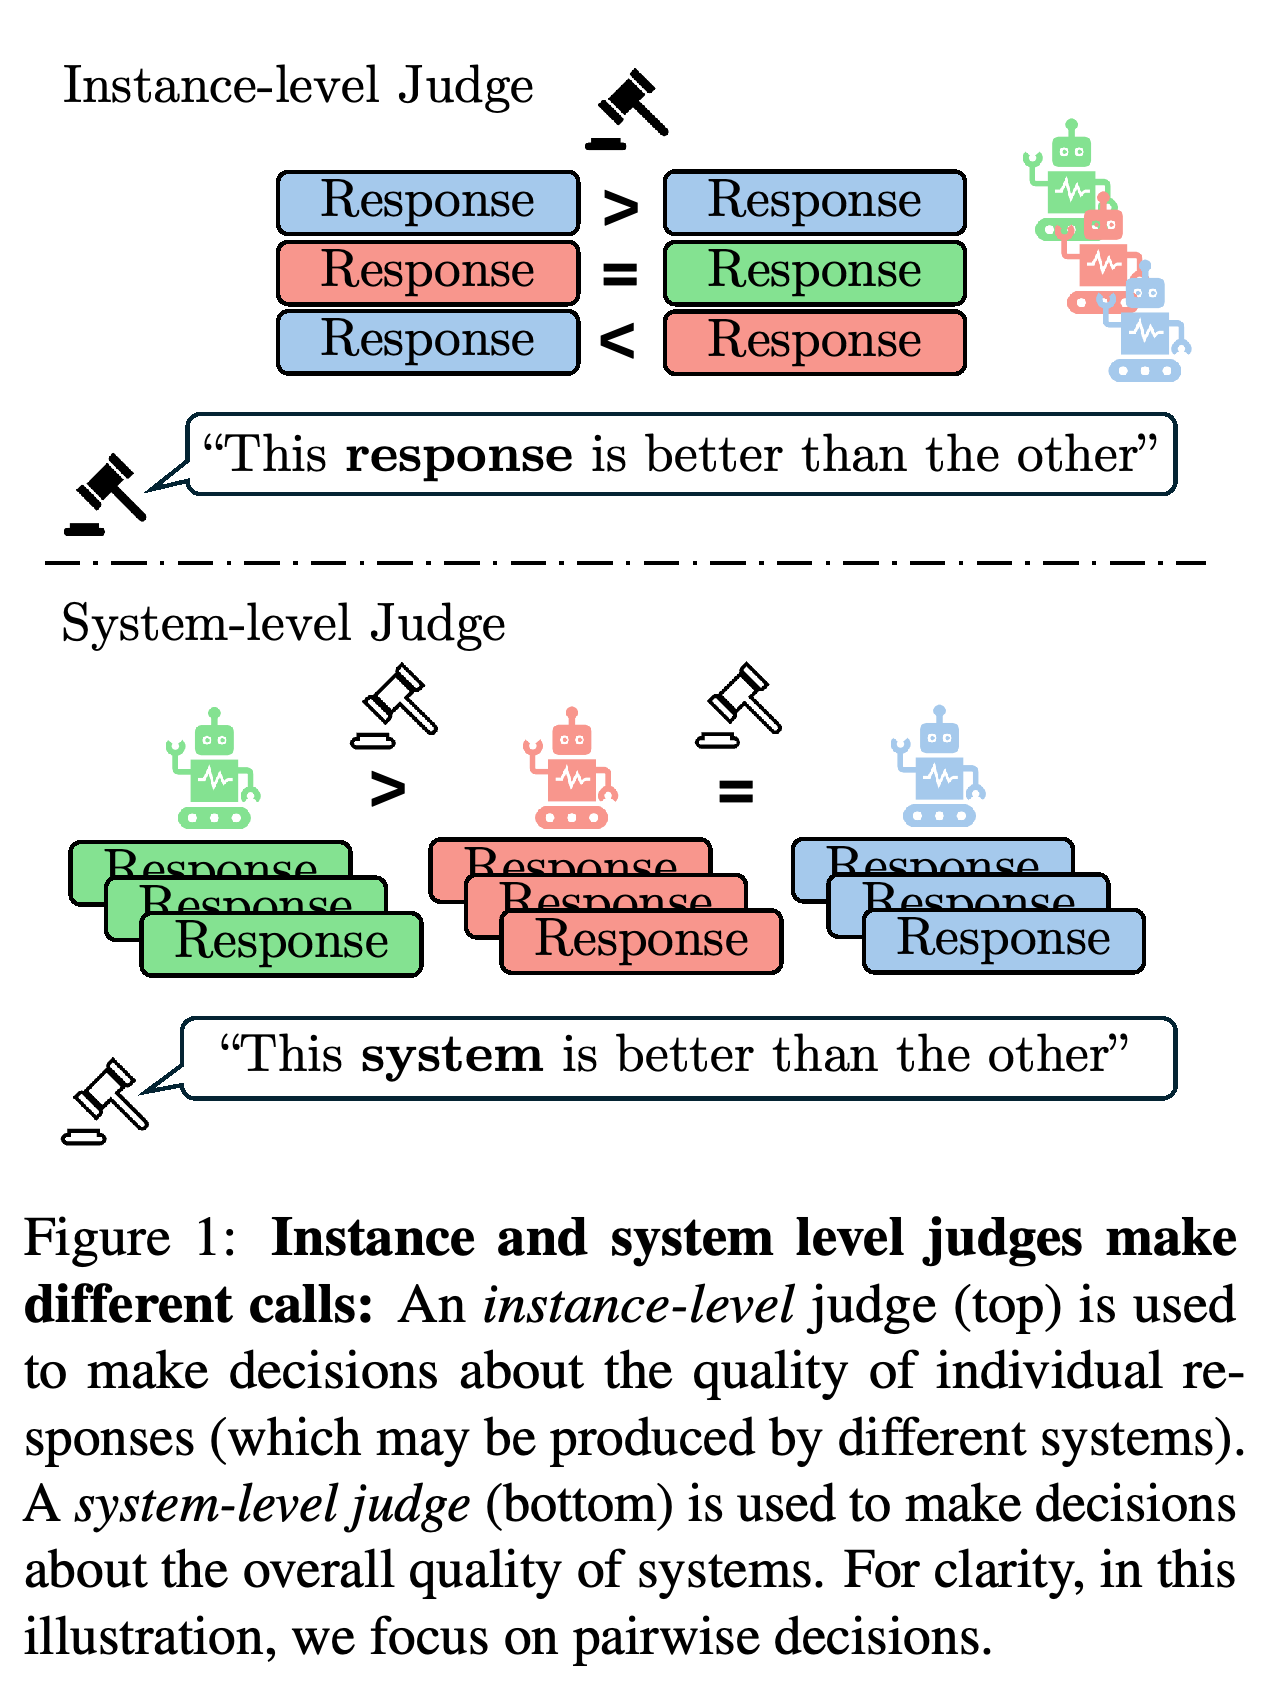
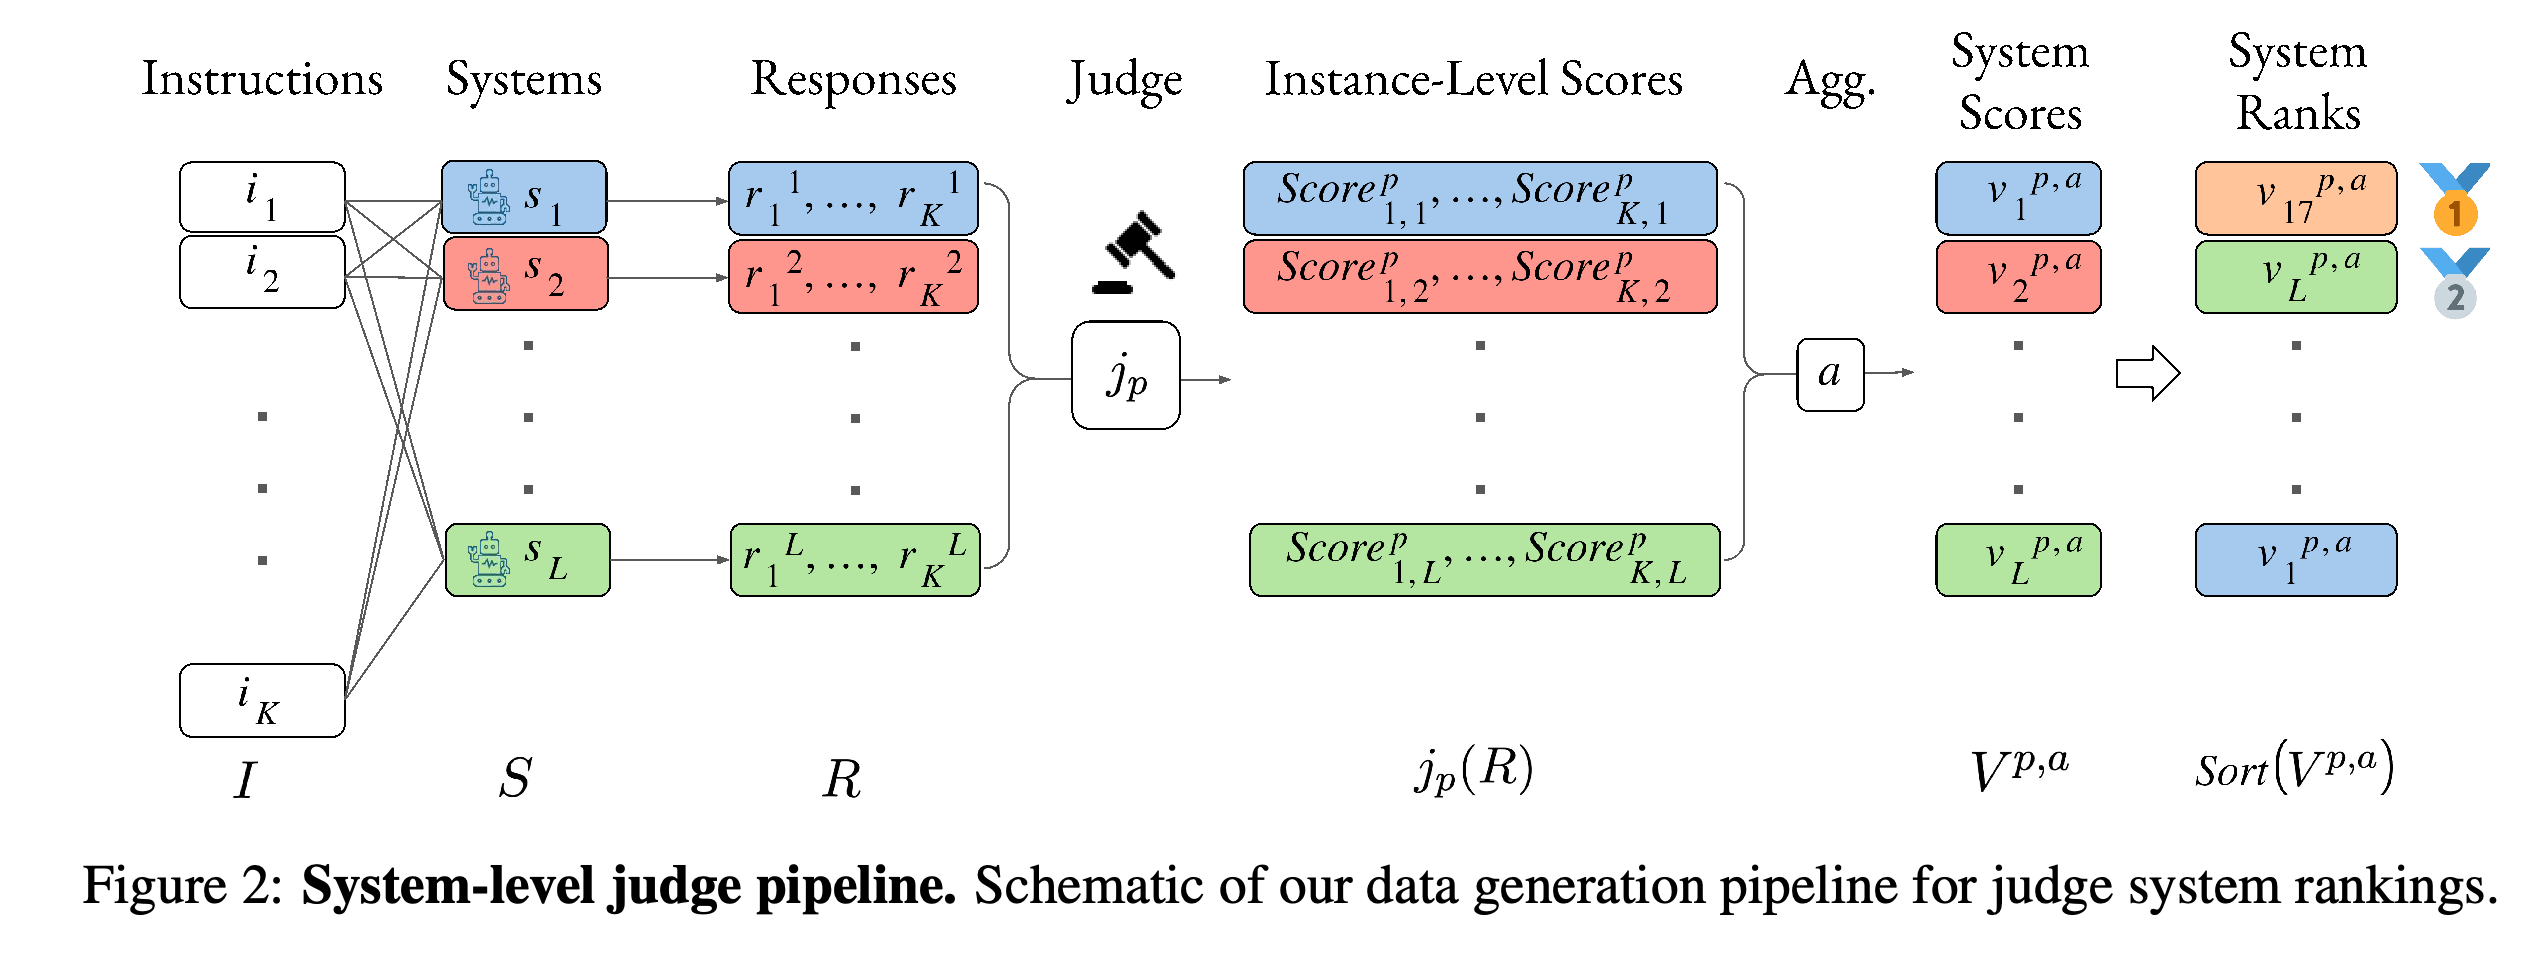
- Figure 1은 응답 수준의 선호와 시스템 수준의 선호를 구분하고, Figure 2는 응답 점수가 시스템 순위로 변환되는 과정을 보여준다.
평가자는 개별 출력 사이에서 선택하는 결정과 다수의 출력을 생성하는 시스템 사이에서 선택하는 결정이라는 2가지 의사결정을 지원할 수 있다. 이 차이는 응답 정확도만으로 시스템 순위 평가의 신뢰성을 입증하기에 부족한 이유를 설명한다.
2 The Gap in Judge Benchmarking
개별 응답 정확도는 오류를 집계하지만, 그 오류가 응답을 생성한 시스템들에 어떻게 분포하는지는 설명하지 못한다. 판정자는 전체 오류가 비교적 적어도 특정 1개 시스템을 일관되게 선호해 순위를 왜곡할 수 있다. 반대로 개별 응답에 대한 판단이 불완전해도 이를 집계하면 정확한 순위를 얻을 수 있다.
- 따라서 판정자는 실제 시스템 선택 과제에 맞춰 검증하고, 시스템별 오류 양상을 살펴볼 필요가 있다.
3 Task Formulation
L개 시스템이 동일한 K개 지시문에 각각 응답하고, 각 판정자는 지시문과 응답의 쌍을 스칼라 품질 점수로 변환한다. 집계 방법은 이렇게 얻은 K-by-L 점수 행렬을 시스템당 1개 점수로 변환한다. 이 점수를 정렬해 순위를 구하고, 인간 평가에서 도출한 기준 순위와의 상관관계로 판정자 성능을 측정한다.
- 시스템은 평가 대상 모델이나 파이프라인이며, 판정자는 그 응답에 점수를 부여하거나 응답을 비교한다. 생성형 LLM은 어느 역할이든 수행할 수 있다.
이 파이프라인은 집계를 판정자 구성의 명시적인 요소로 다룬다. 판정자가 공통 응답 집합에 점수를 부여하고, 이를 시스템당 1개 점수로 요약한 뒤 정렬하므로, 실험에서 점수 부여 방식과 집계를 별도로 바꿀 수 있다.
4 Experimental setup
실험은 응답 수집, 판정 생성, 점수 집계, 인간 평가에서 도출한 기준과의 비교로 나뉜다. 전용 보상 모델과 함께, 프롬프트를 통해 4가지 방식으로 응답을 판정하는 생성형 LLM을 평가한다.
4.1 System Responses Data
Arena Hard v0.1은 어려운 지시문 500개와 2024년 9월 기준 시스템 63개의 응답을 제공하며, 지시문과 응답의 쌍은 총 약 32K개다. 각 시스템이 동일한 지시문 집합에 응답하므로 판정자는 시스템 간 응답 점수를 비교할 수 있다.
4.2 Generating Judgments
판정 방식 48개는 보상 모델 8개와, 생성형 LLM 10개에 점수 부여 방식 4개를 적용한 프롬프트 기반 판정자 40개로 구성된다. 판정 방식 48개를 모두 사용해 지시문 500개에 대한 시스템 63개의 응답을 평가하면 약 1.5M개의 개별 점수가 나온다.
- 4.2.1 Reward Models: 모델 8개는 ArmoRM-Llama3-8B-v0.1, Eurus-RM-7b, InternLM2-7b-reward, InternLM2-20b-reward, Skywork-Reward-Llama-3.1-8B-v0.2, Llama-3-OffsetBias-RM-8B, GRM-Llama3.2-3B-ft, URM-LLaMa-3.1-8B다.
- 4.2.2 LLM Judge Realizations: 생성형 판정자는 Llama-3.1-405B-Instruct, Llama-3.1-70B-Instruct, Llama-3.1-8B-Instruct, Llama-3-70B-Instruct, Mixtral-8x22B-Instruct-v0.1, Mixtral-8x7B-Instruct-v0.1, Mistral-Large-Instruct-2407, Qwen2.5-72B-Instruct, GPT-4o, GPT-4o-mini다.
Numeric은 0에서 100 사이의 절대 품질 점수를 요청한다. Likert는 [Very Bad, Bad, Mediocre, Good, Very Good]이라는 라벨 5개 중 하나를 요청하고 이를 1에서 5까지의 점수로 변환한다. TokenProbs는 응답이 좋은지 질문하고, 첫 생성 토큰의 yes와 no 확률에서 0.0과 1.0 사이의 점수를 도출한다.
- TokenProbs는 첫 생성 토큰에 대해 반환된 상위 로그 확률을 사용하며, yes에 해당하는 확률의 합을 yes와 no에 해당하는 확률의 합으로 나눈다.
Anchor는 각 시스템의 응답을 고정된 기준 시스템인 GPT-4-0314의 응답과 비교한다. 선호 결과 5개를 [−2, +2] 범위의 점수로 변환하며, 0은 동점, +1 / +2는 평가 대상 응답을 약하게/강하게 선호한다는 뜻이다.
- 고정된 기준 응답을 사용하면 모든 시스템을 다른 모든 시스템과 직접 비교할 필요가 없다.
4.3 Aggregations
이 연구는 Win-rate, Mean, Median, Bradley-Terry(BT) 집계로 순위를 구성한다. BT는 쌍별 비교 결과로 시스템의 강도를 추정하는 모델이다. Mean은 평균을, Median은 중앙값을 사용해 각 시스템의 응답 점수를 요약한다. Win-rate와 BT는 시스템 간 응답 점수를 비교한다.
- 이산적인 점수를 사용하면 여러 시스템의 중앙값이 같아져 Median 집계로 시스템을 구분하지 못할 수 있다.
- 응답 점수에 동점이 없는 보상 모델에서는 BT와 Win-rate 집계가 유사한 순위를 생성한다.
4.4 Gold Ranking - Chatbot Arena Battles
기준 순위는 Chatbot Arena의 English Hard Prompts 부분집합에서 시스템 응답 2개를 비교한 인간 선호 대결로부터 구한다. Arena Hard가 이 부분집합의 지시문 분포에 맞춰 설계되었기 때문에 해당 부분집합을 선택했다. 공통 시스템에 대해 자동 평가 순위와 기준 순위 사이의 Kendall’s Tau로 판정자 품질을 측정한다.
- 인간 기준과 자동 판정은 별도의 데이터셋에서 나오므로, 비교는 동일한 응답에 대한 판단이 아니라 분포의 유사성에 의존한다. 데이터셋 간 공통 시스템은 59개다.
5 JuStRank - Judge Performance Results
가장 높은 점수를 얻은 구성은 Likert와 Win-Rate 집계를 사용한 Qwen2.5-72B-Instruct로, 점수는 0.827이다. 그다음은 Mean을 사용한 URM-LLaMa-3.1-8B의 0.823과 Anchor 및 Mean을 사용한 GPT-4o-2024-11-20의 0.822다. 이 결과는 이 실험 환경에서 8B-parameter 보상 모델도 상위 생성형 판정자에 견줄 만한 순위 일치도를 달성할 수 있음을 보여준다.
- Table 1은 각 판정 모델의 최적 판정 방식과 집계를 보고하며, 이 3개 결과를 0.83, 0.82, 0.82로 반올림해 표시한다. Table 2는 소수점 이하 3자리 값을 제공한다.
- 인간 기준과의 일치도가 같아도 순위가 같다는 뜻은 아니다. 판정자마다 서로 다른 시스템 쌍에서 판단이 엇갈릴 수 있다.
표에 표시된 정밀도에서 Qwen2.5-72B-Instruct가 0.83으로 가장 높고, URM-LLaMa-3.1-8B와 GPT-4o는 모두 0.82를 기록한다. 각 행은 해당 모델의 최적 판정 방식과 집계를 제시하므로, 표는 모델별로 따로 선택한 구성을 비교한다.
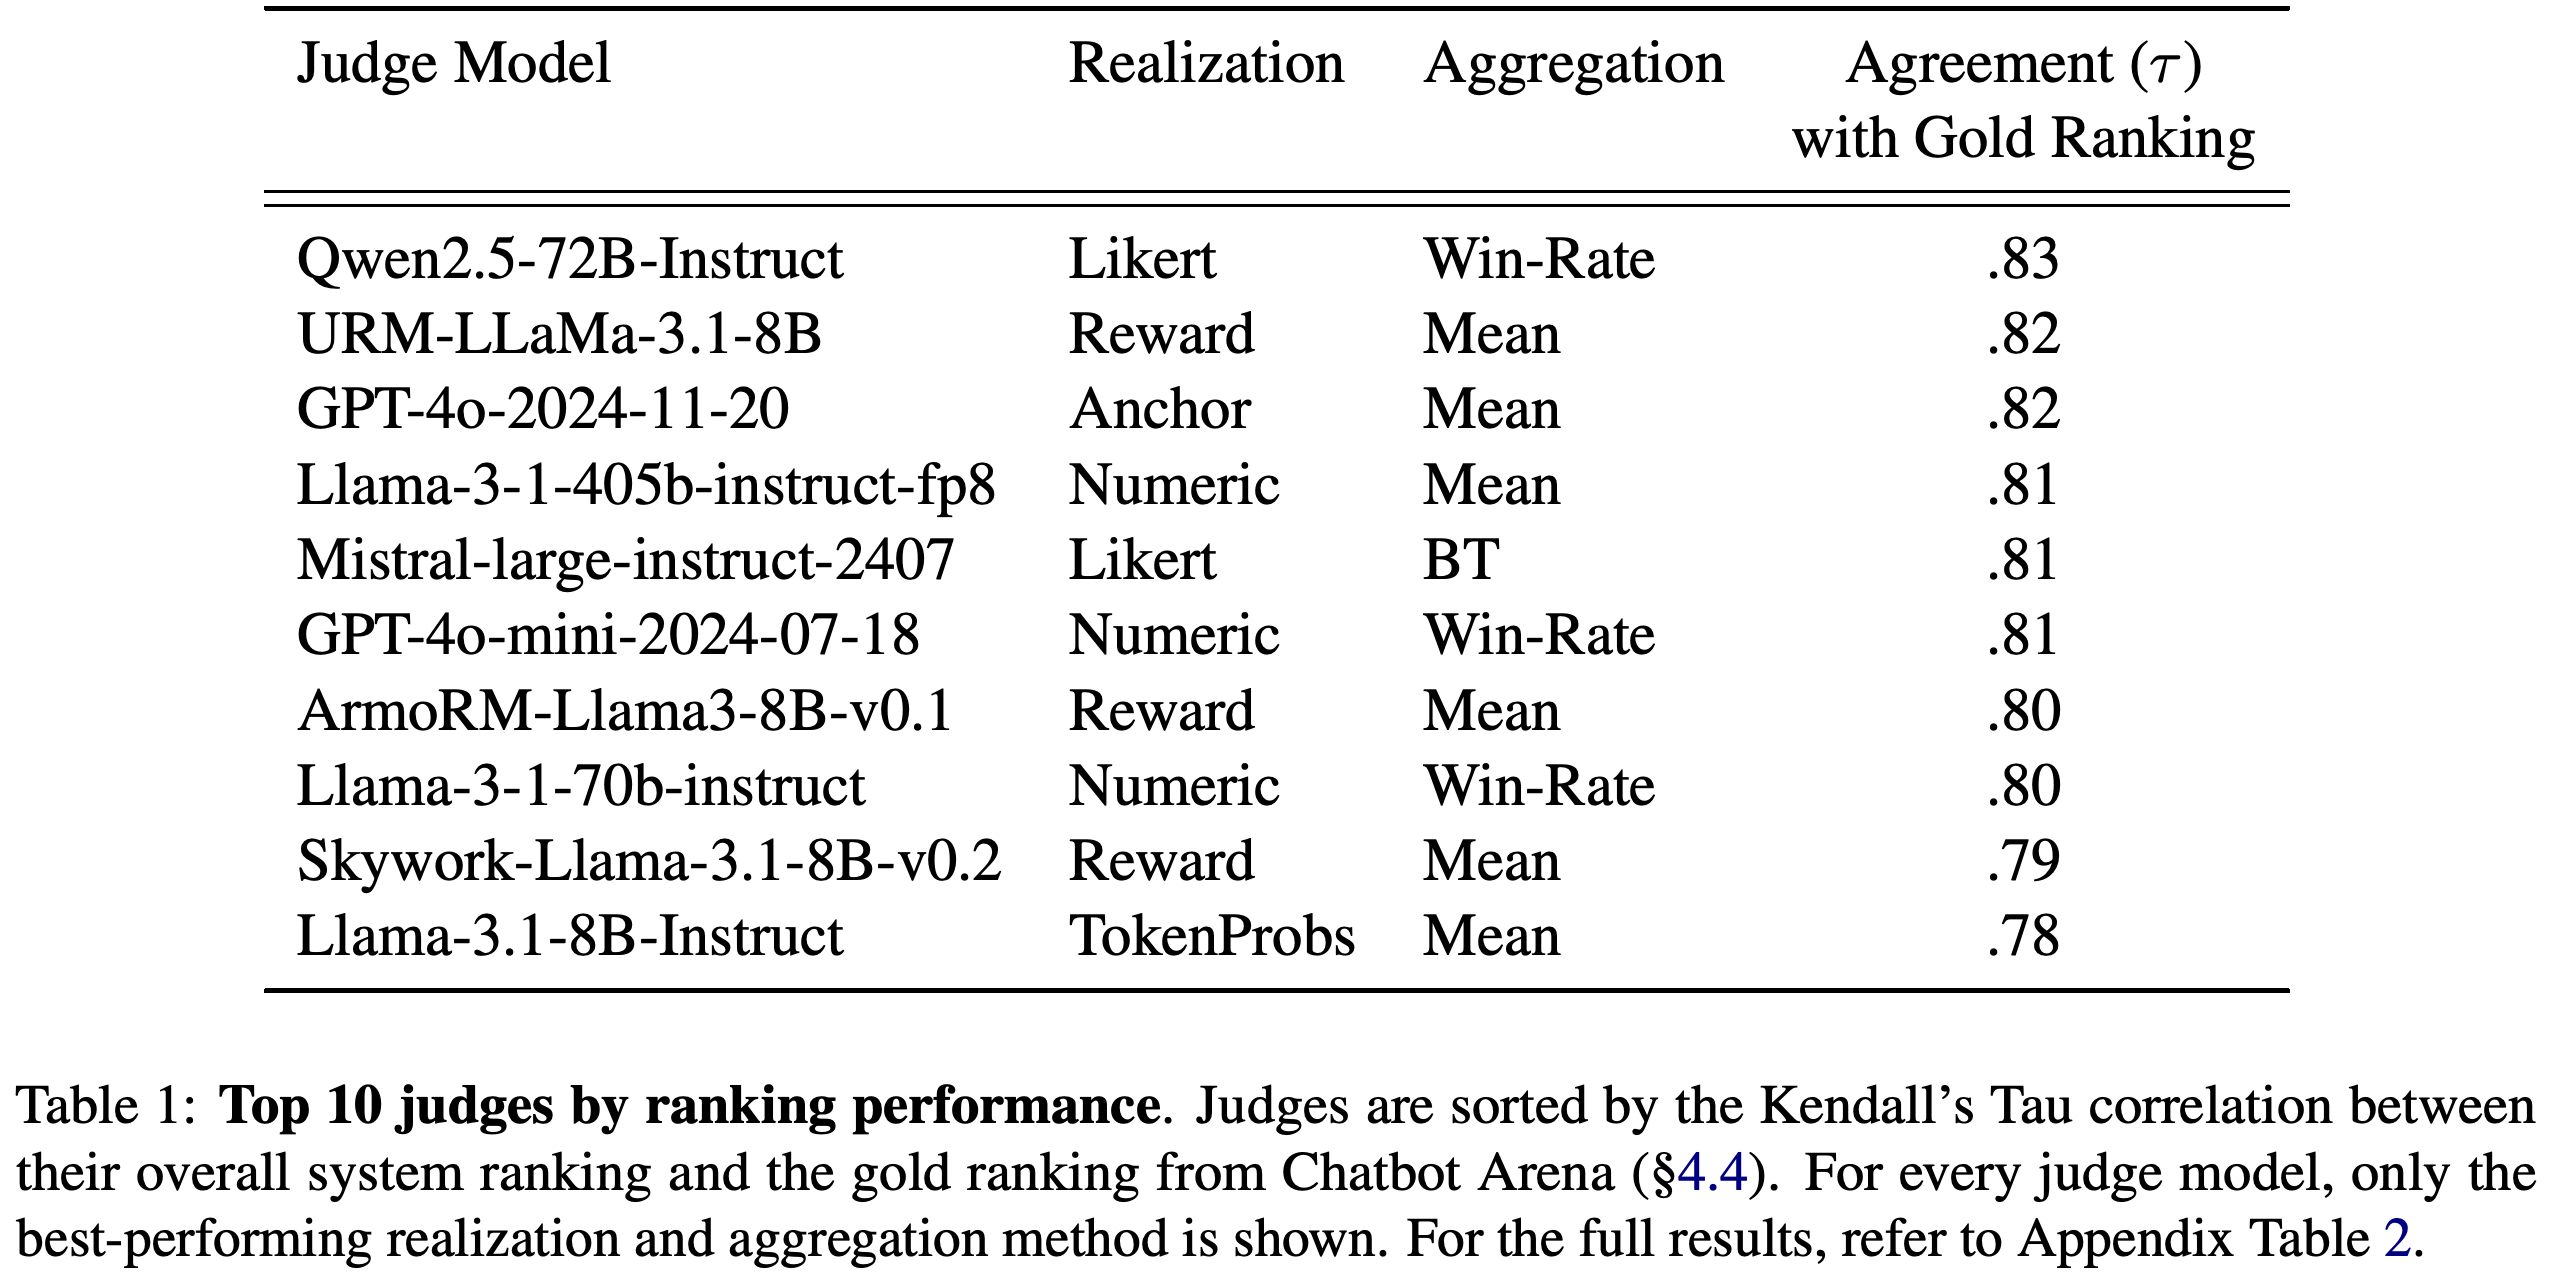
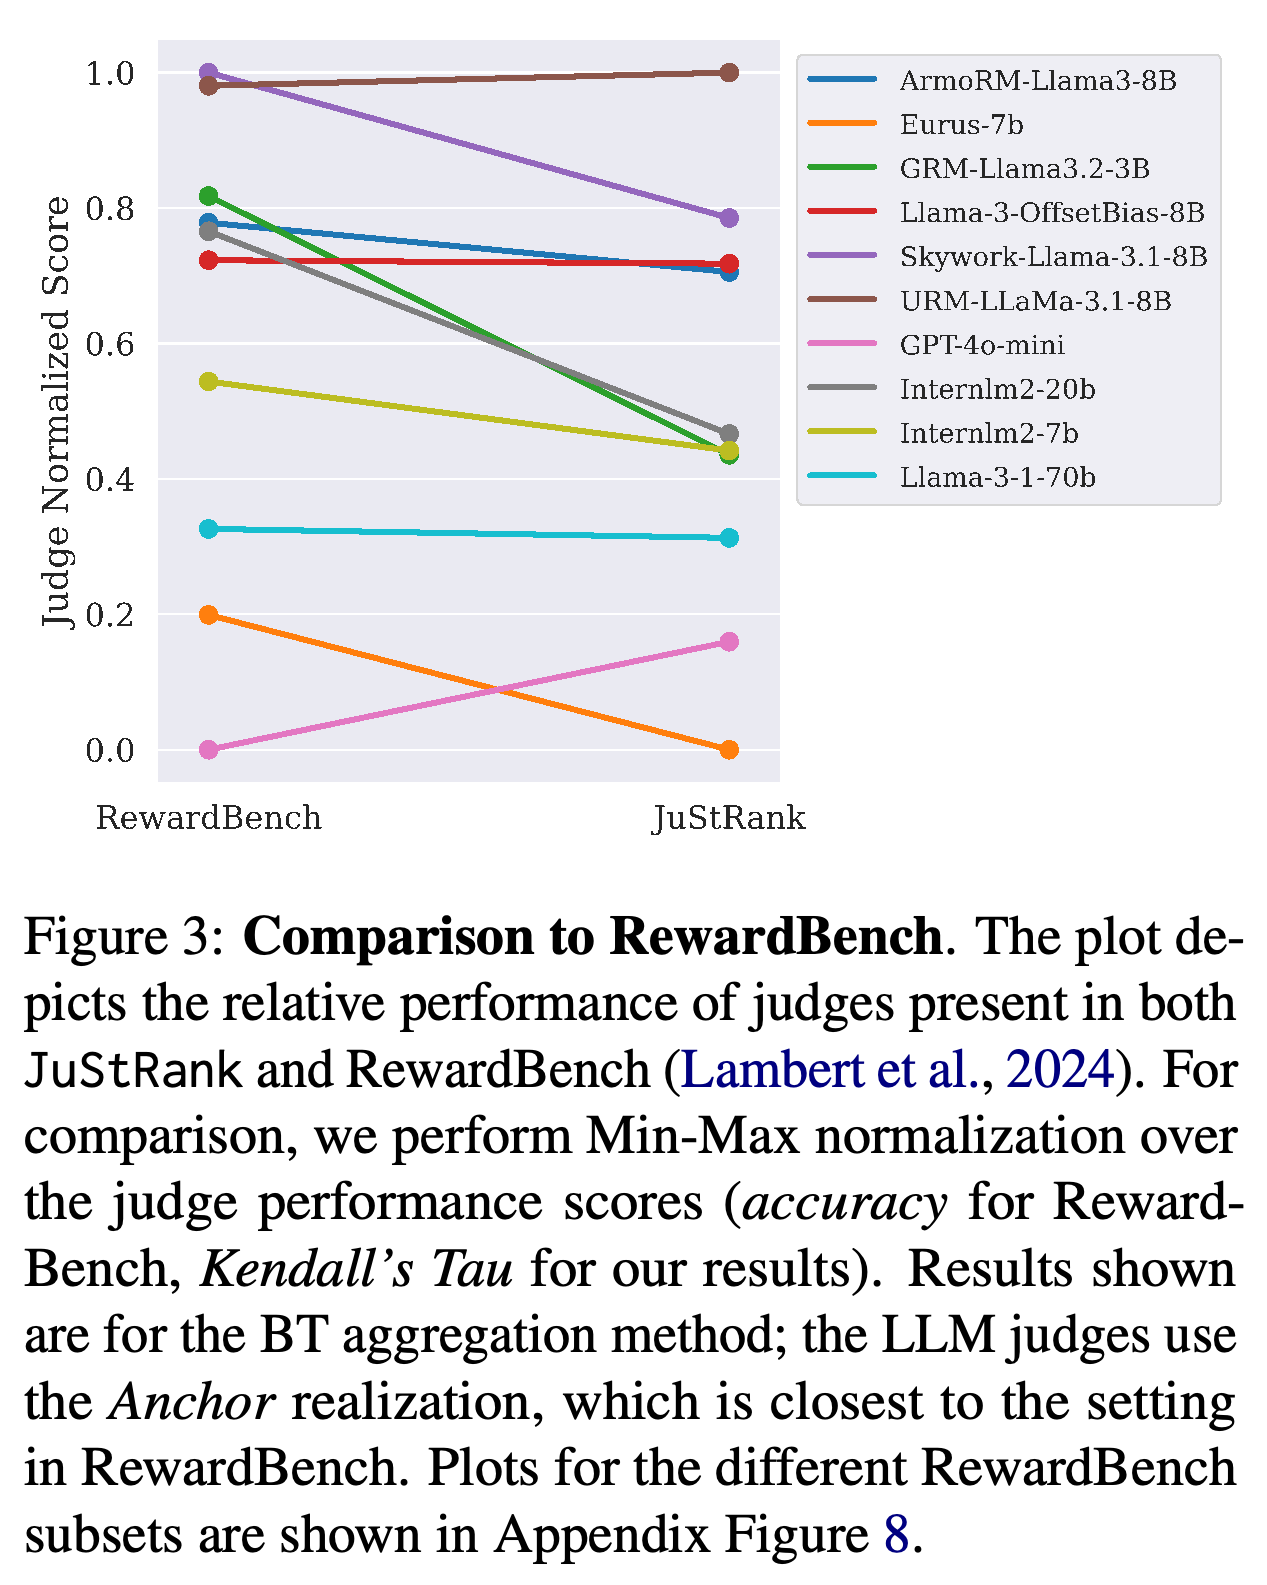
Figure 3은 RewardBench에서의 상대적 성능이 JuStRank에서의 상대적 성능을 일관되게 예측하지 못한다는 점을 보여준다. 저자들은 비교 프롬프트의 차이와 최신 보상 모델이 RewardBench에 맞춰 조정되었을 가능성도 추가 설명으로 제시한다.
- 그래프는 BT 집계를 사용하고 생성형 판정자에는 Anchor를 적용한다. RewardBench 정확도와 JuStRank 순위 상관관계에는 각 벤치마크에서 관측된 점수를 [0, 1]로 변환하는 Min-Max 정규화를 각각 적용한다.
선이 교차하는 모습은 응답 수준 평가와 시스템 순위 평가 사이에서 판정자의 상대적 성능이 달라짐을 보여준다. 별도의 Min-Max 정규화로 상대적 위치를 비교할 수 있지만, 세로축의 차이가 공통된 원래 지표에서의 차이를 나타내지는 않는다.
5.1 Effects of LLM Realizations
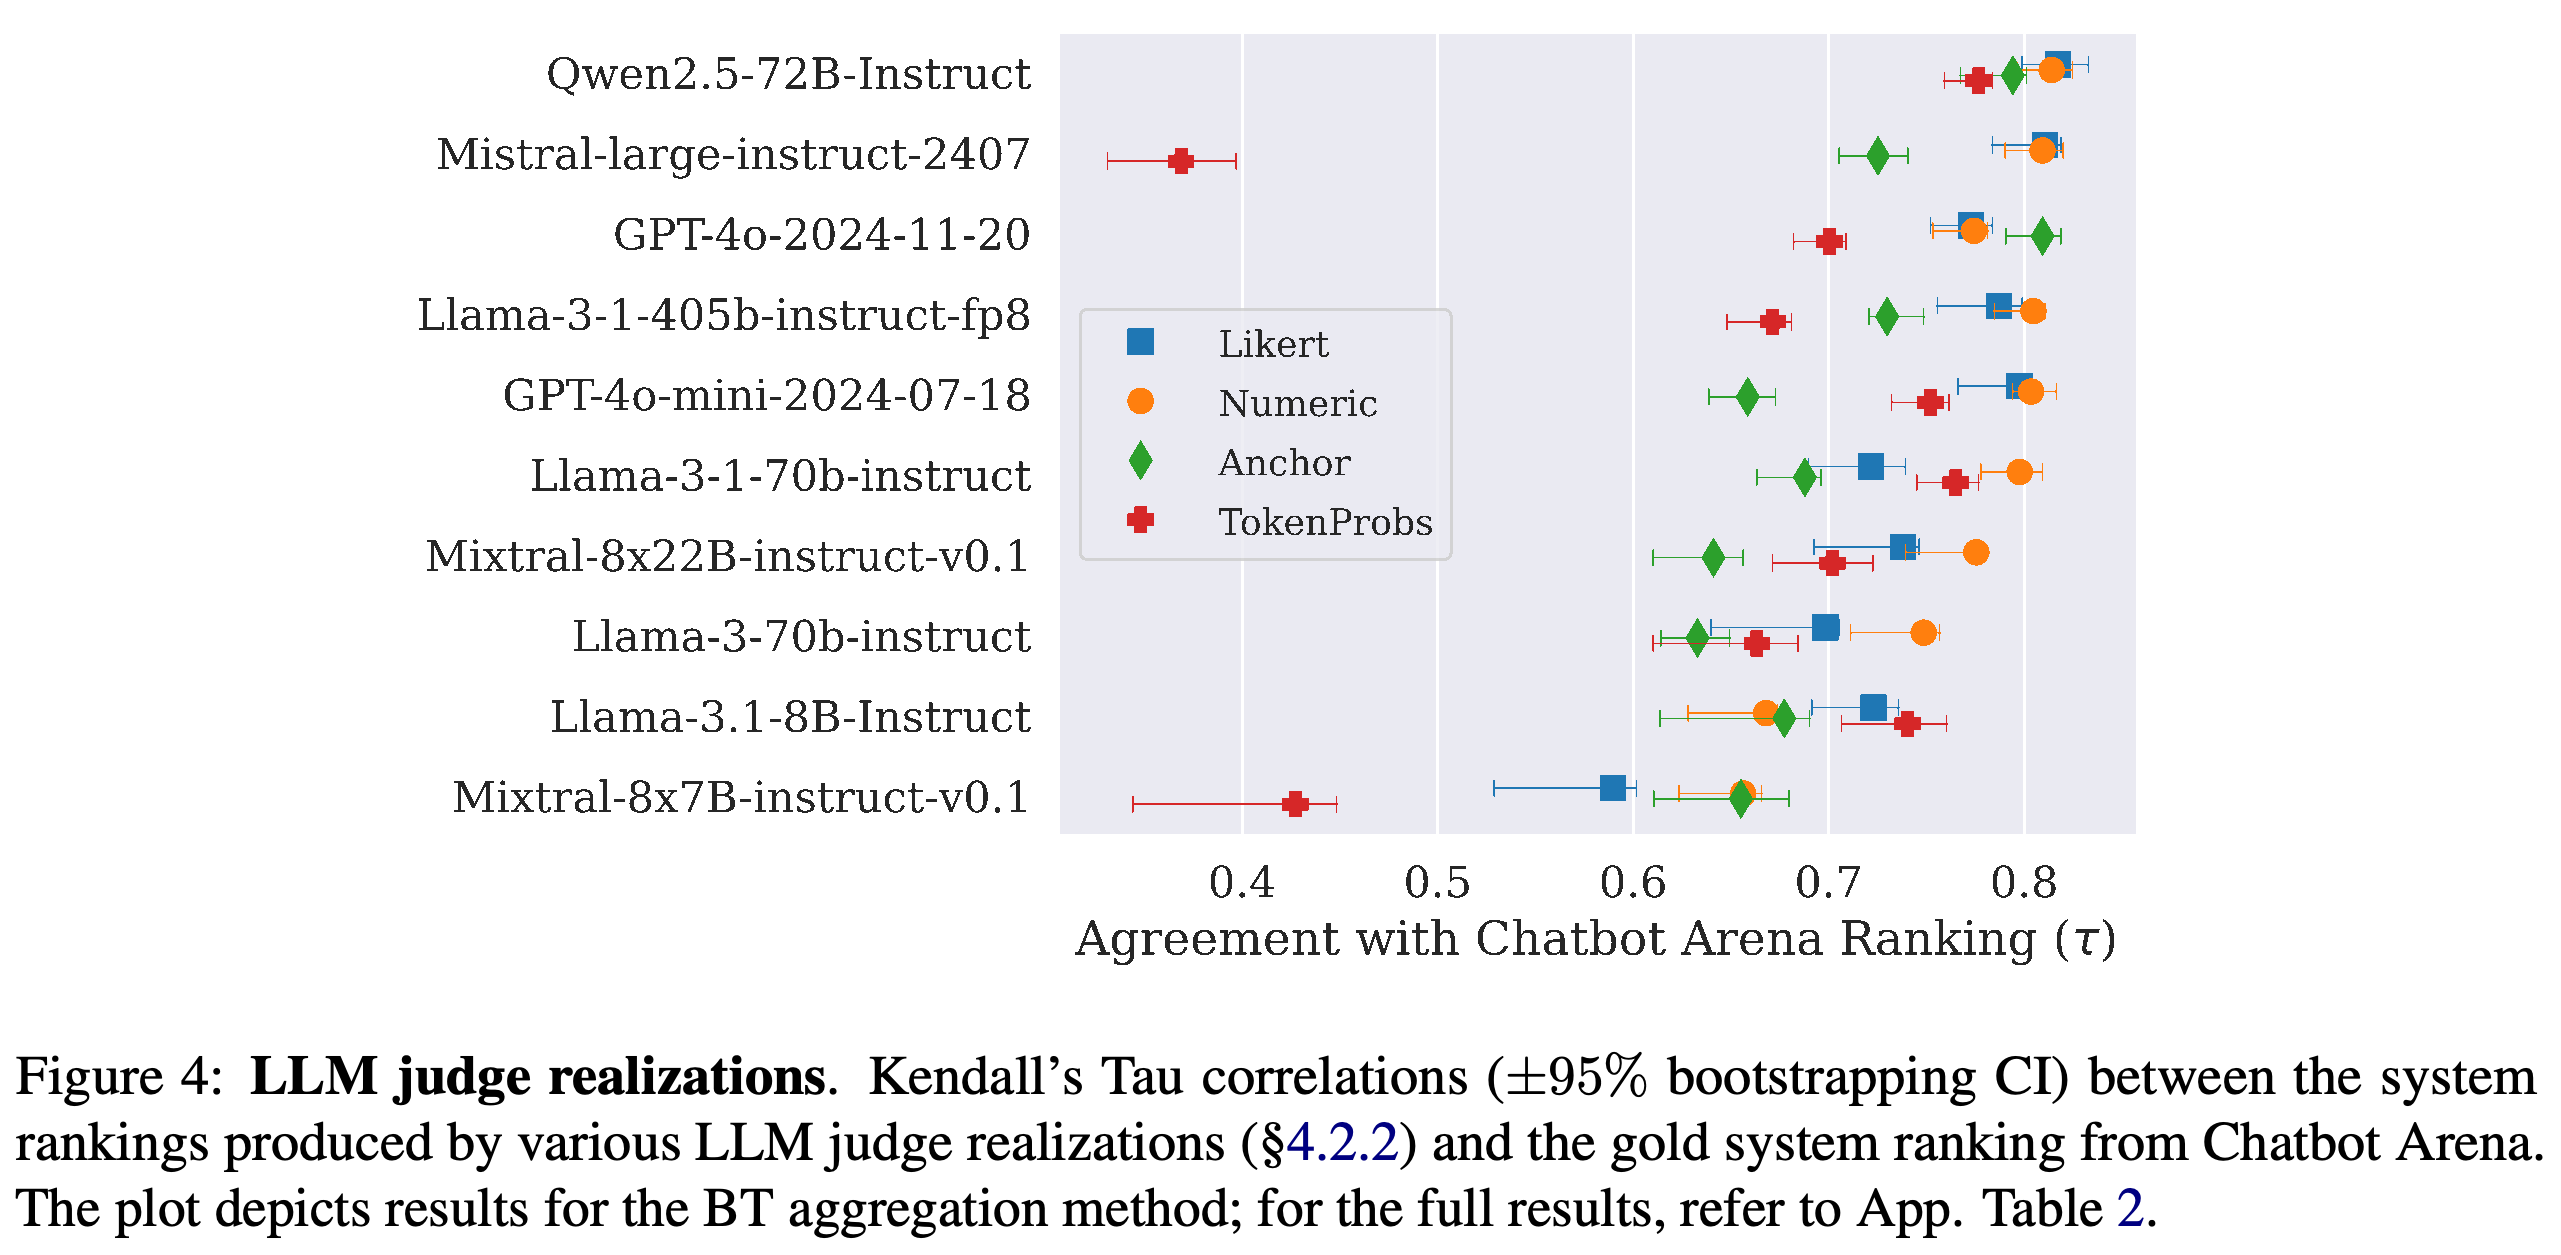
Figure 4는 같은 LLM이라도 점수 부여 방식에 따라 순위 일치도가 크게 달라짐을 보여준다. 전반적으로 Numeric과 Likert의 성능이 가장 좋고, Anchor는 GPT-4o를 제외하면 대체로 성능이 낮다. 논문의 통계 분석에서도 Numeric과 Likert 2개 방식 모두 Anchor와 TokenProbs보다 유의하게 우수하다.
- 각 판정 방식은 고유한 점수 분포도 보인다. Numeric과 Likert의 점수는 특정 값에 집중되고, TokenProbs는 0이나 1에 매우 가까운 값을 자주 생성한다.
- 그림은 BT 집계와 재표집으로 불확실성을 추정하는 95% 부트스트랩 신뢰구간을 사용한다.
모델과 BT 집계를 고정해도 점수 부여 방식을 바꾸면 큰 차이가 발생한다. Mistral-large-instruct-2407은 Numeric과 Likert에서 높은 성능을 보이지만 TokenProbs에서는 성능이 낮다. GPT-4o는 Anchor에서 가장 좋은 성능을 보이는 대표적인 사례다.
6 Judge Behavior
행동 분석은 점수 집계 이전의 시스템 쌍별 승률을 살펴본다. 판정자의 승률은 동점이 아닌 지시문 중 1개 시스템이 상대 시스템보다 높은 응답 점수를 받은 비율이다. 인간 대결과의 비교에는 공통 시스템 59개와 시스템 쌍 968개를 사용한다.
- 이 행동 분석의 승률에서는 동점을 제외한다. 반면 Win-rate 집계는 모든 지시문과 다른 시스템에 걸쳐 응답 점수가 상대보다 높은 비율을 평균한다.
6.1 Some Judges are Particularly Decisive
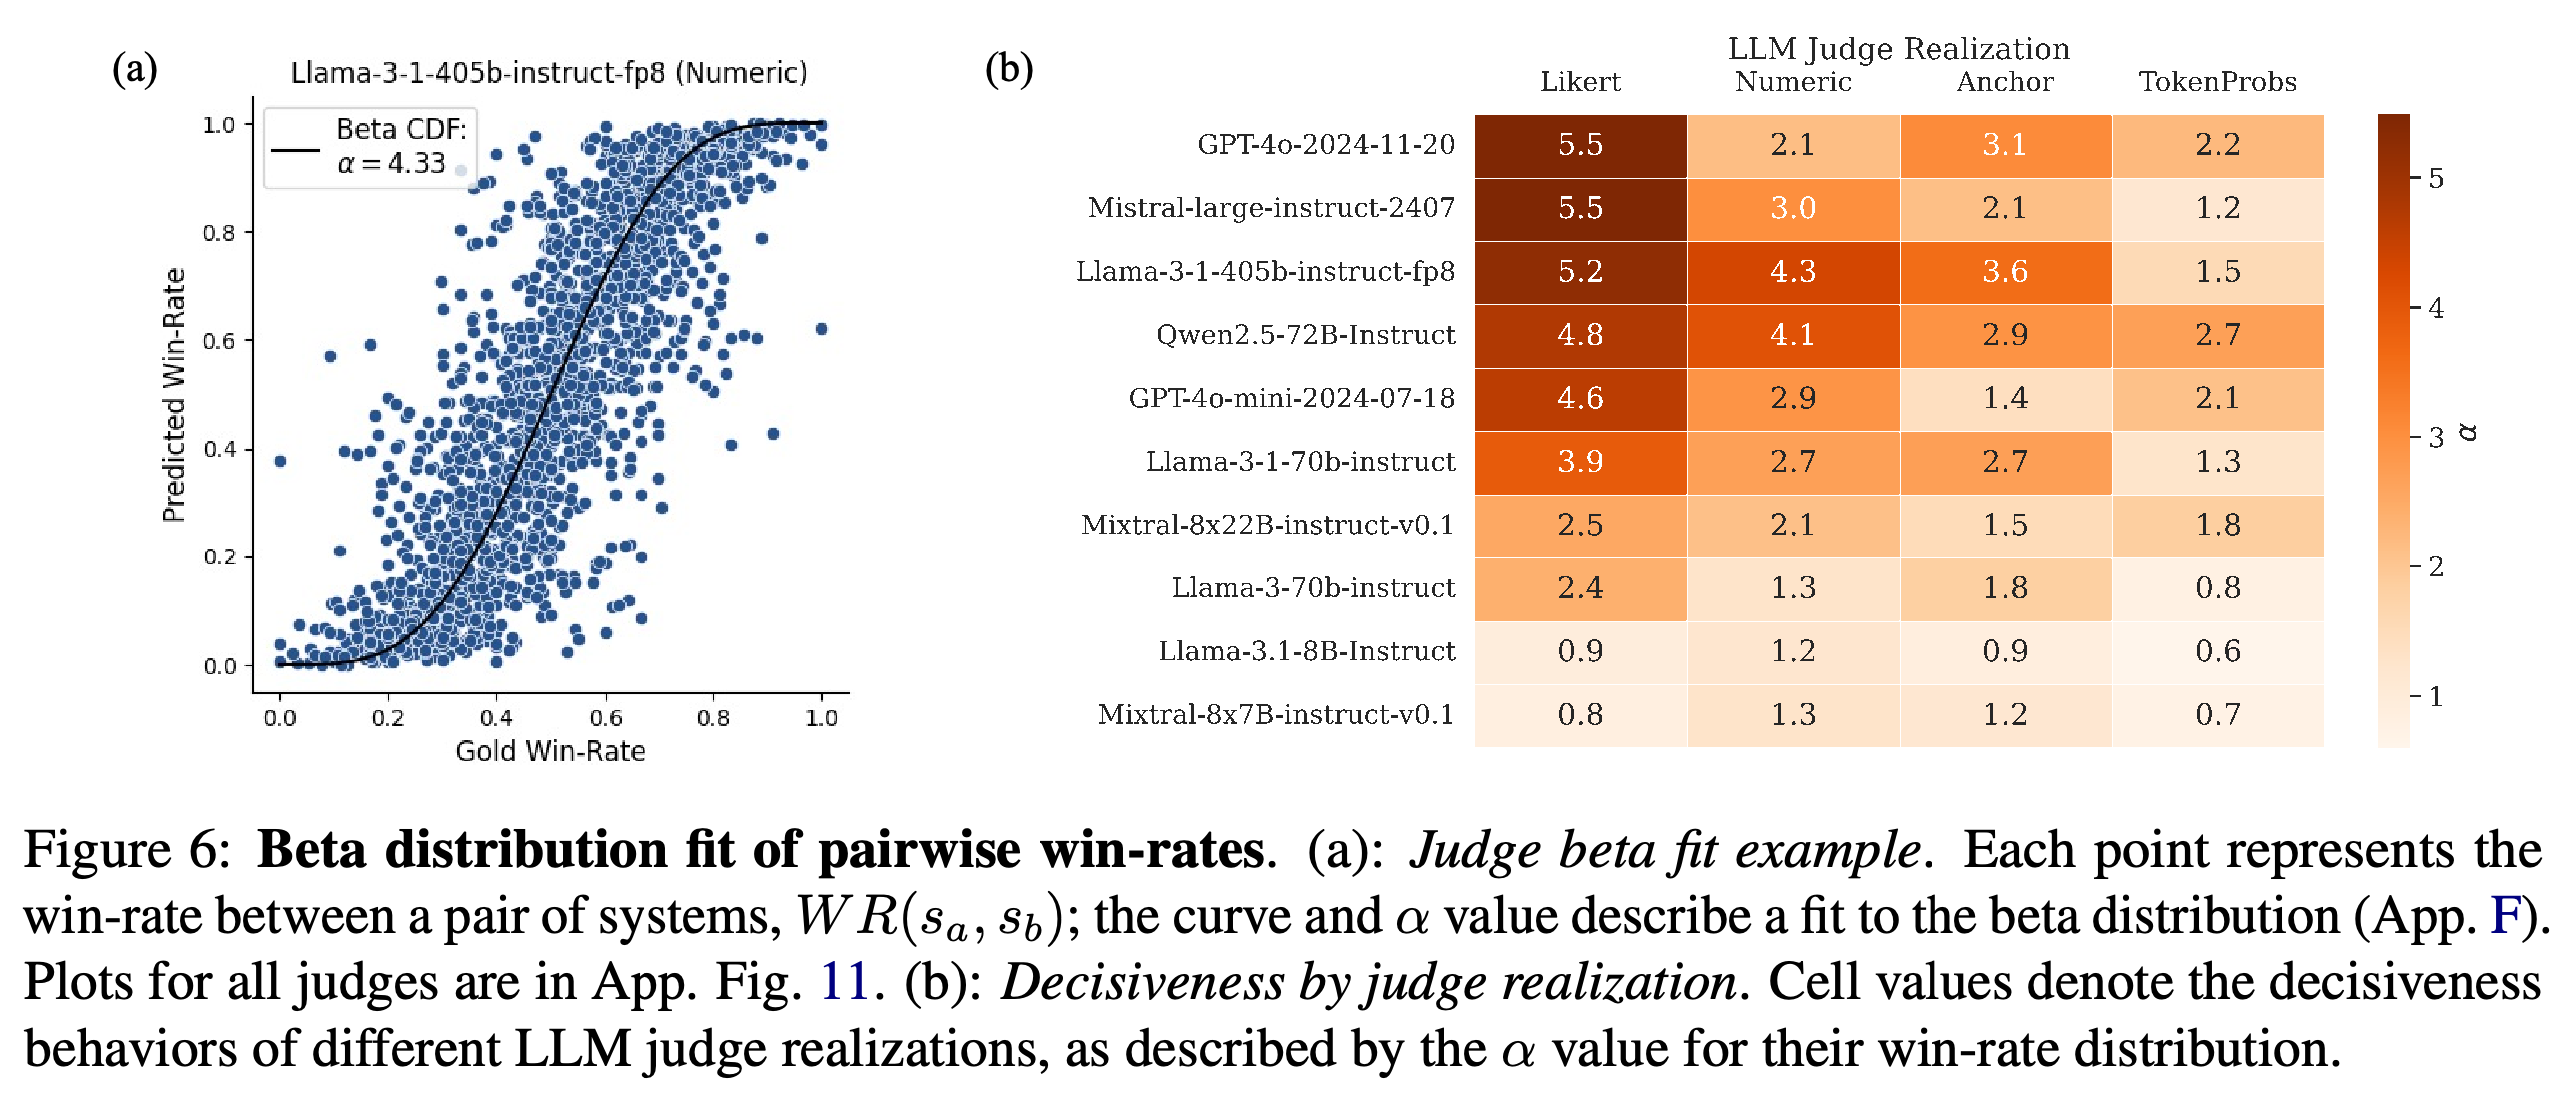
일부 판정자는 인간보다 극단적인 시스템 쌍별 승률을 산출한다. Figure 5에서 Likert를 사용한 Llama-405B는 인간 승률이 약 0.8인 쌍에 대해 0.9를 넘는 승률을 자주 예측한다. 논문은 형상 모수가 같은 대칭 베타 누적분포함수로 이 관계를 모델링하며, 이 곡선은 인간 승률을 판정자의 예측 승률로 변환한다.
- 적합시킨 형상 모수 alpha는 단호함을 측정한다. alpha가 1이면 항등 관계이고, 1보다 크면 선호가 더 극단적이며, 1보다 작으면 선호가 덜 단호하다.
- Figure 6에서 Likert는 대체로 TokenProbs보다 높은 단호함을 보이지만, 모델에 따른 차이도 크다.
산점도는 승리하는 시스템에 대한 일치와 수치적인 승률에 대한 일치를 구분한다. Llama-405B Likert 예시는 극단적인 예측 쪽으로 휘어지며, 판정자가 선호 차이를 과장하면서도 많은 승자 판단을 유지할 수 있음을 보여준다.
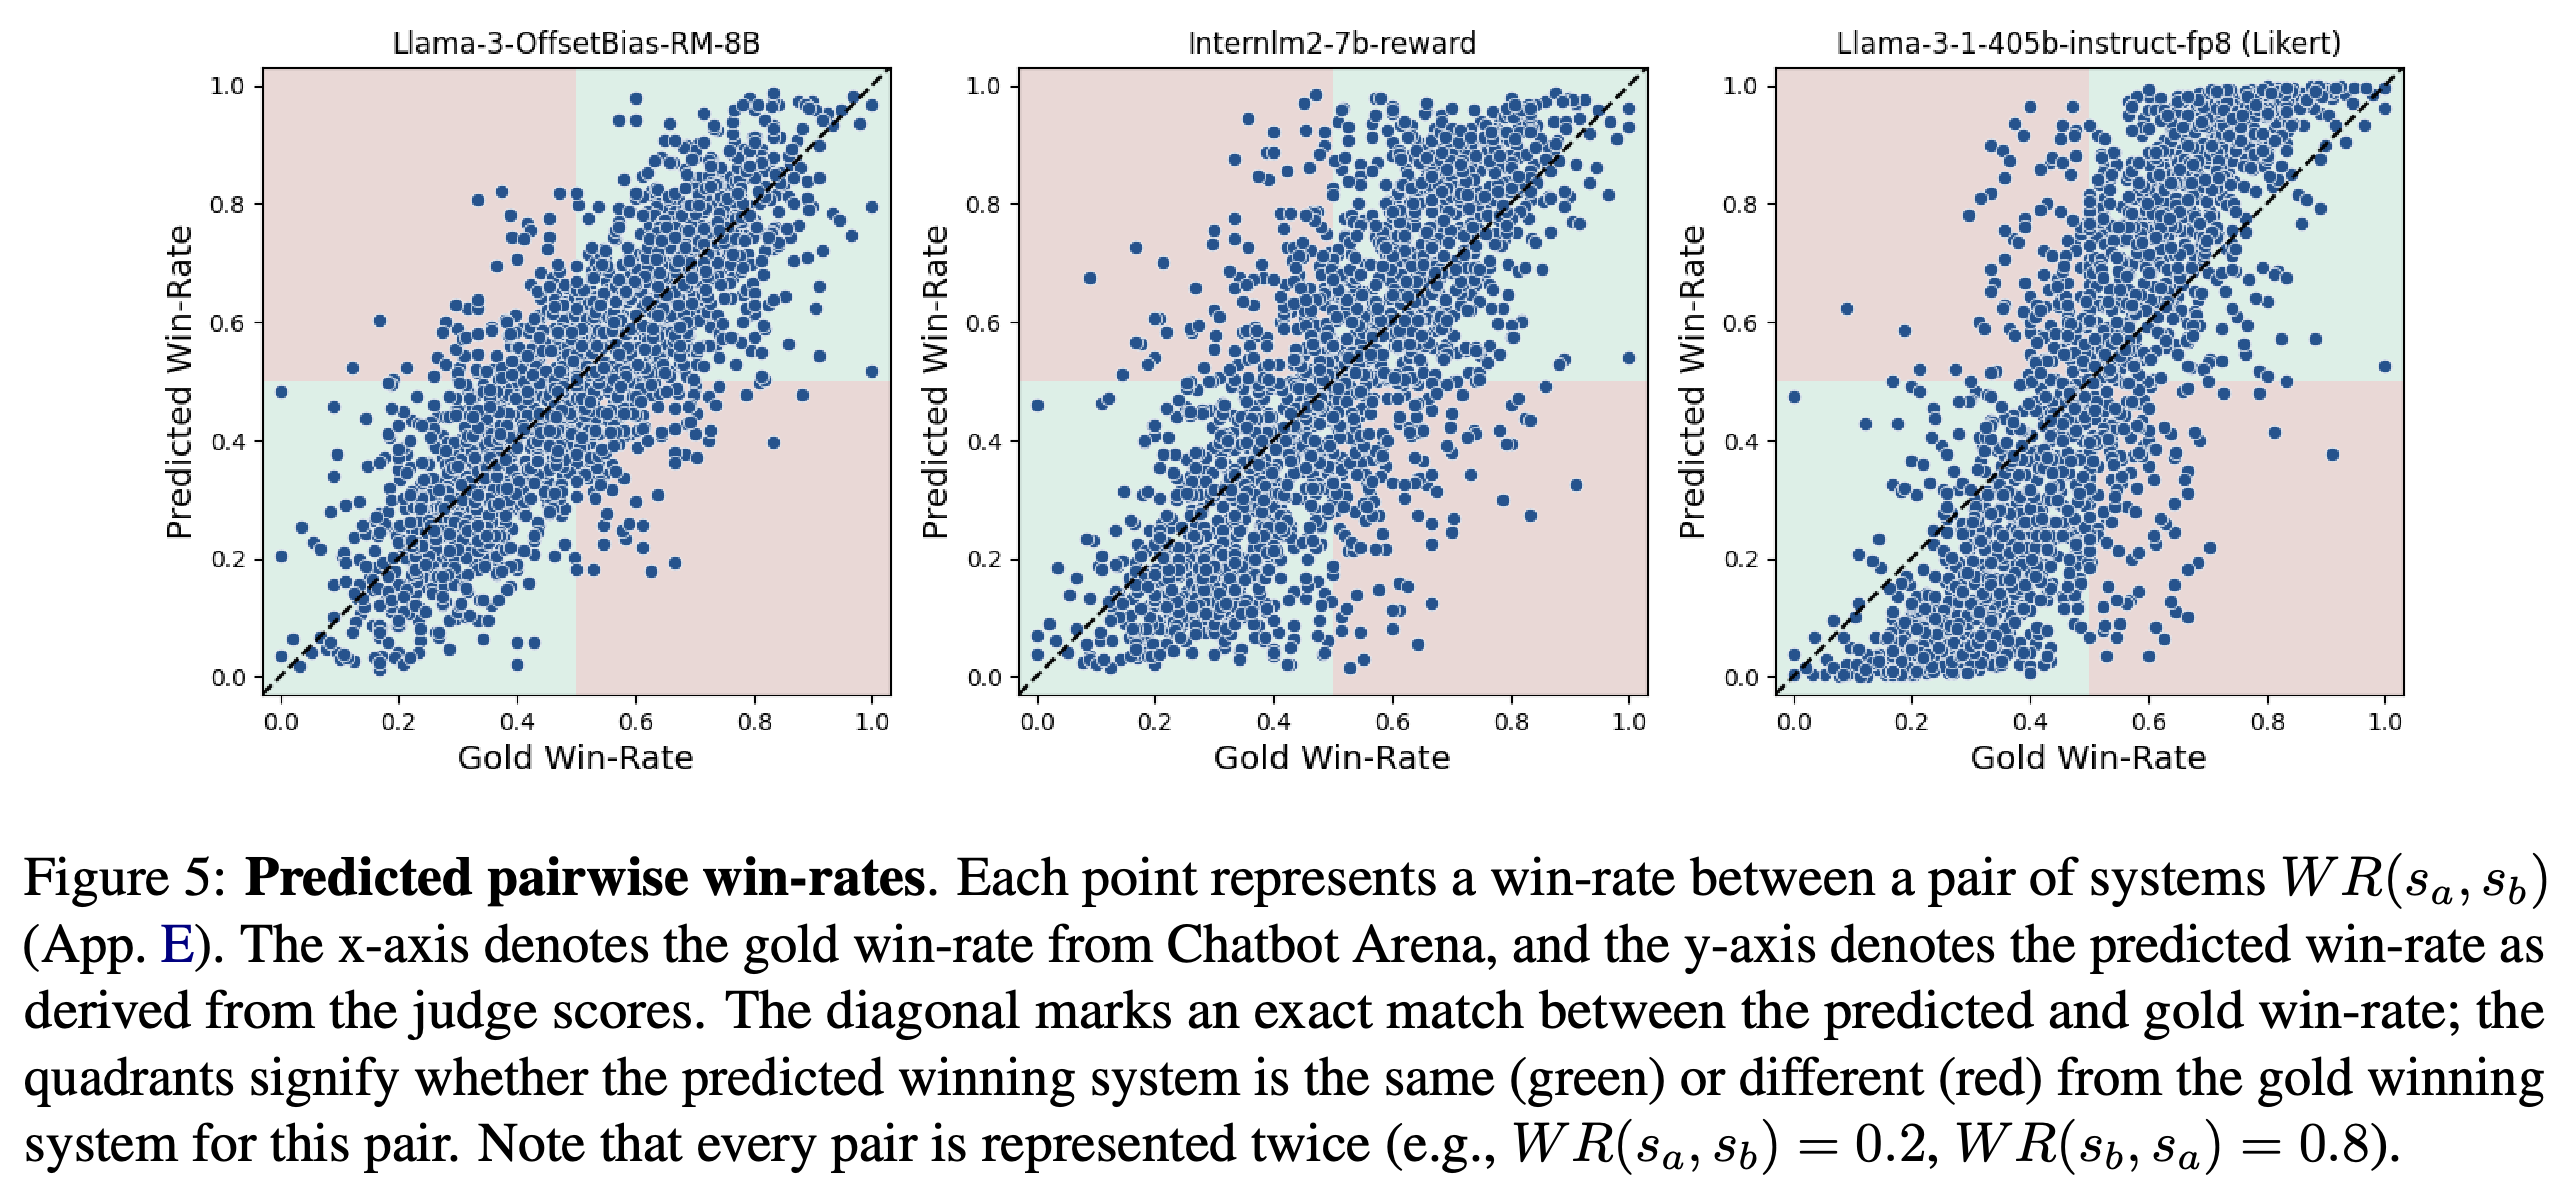
저자들은 이 양상의 가능한 원인으로 2가지를 제시한다. 인간 평가자 간 의견 차이가 집계된 인간 선호를 완만하게 만들 수 있고, 판정자가 강한 시스템의 응답을 선호하는 휴리스틱을 사용할 수도 있다. 실험은 어느 설명이 더 지배적인지 밝히지 않는다. 더 적은 응답으로 시스템을 뚜렷하게 구분할 수 있다는 이점은 선행 연구가 뒷받침하는 해석이며, 이 연구에서 표본 효율성을 직접 실험한 결과는 아니다.
예시 곡선은 적합시킨 alpha 값 4.33으로 Llama-405B Numeric이 선호 차이를 확대하는 양상을 요약한다. 히트맵은 단호함이 모델과 점수 부여 방식이라는 2개 요소에 모두 영향을 받음을 보여준다. Likert는 가장 높은 값을 자주 보이며, 여러 TokenProbs 구성은 1보다 낮다.
6.2 Bias Towards Specific Systems
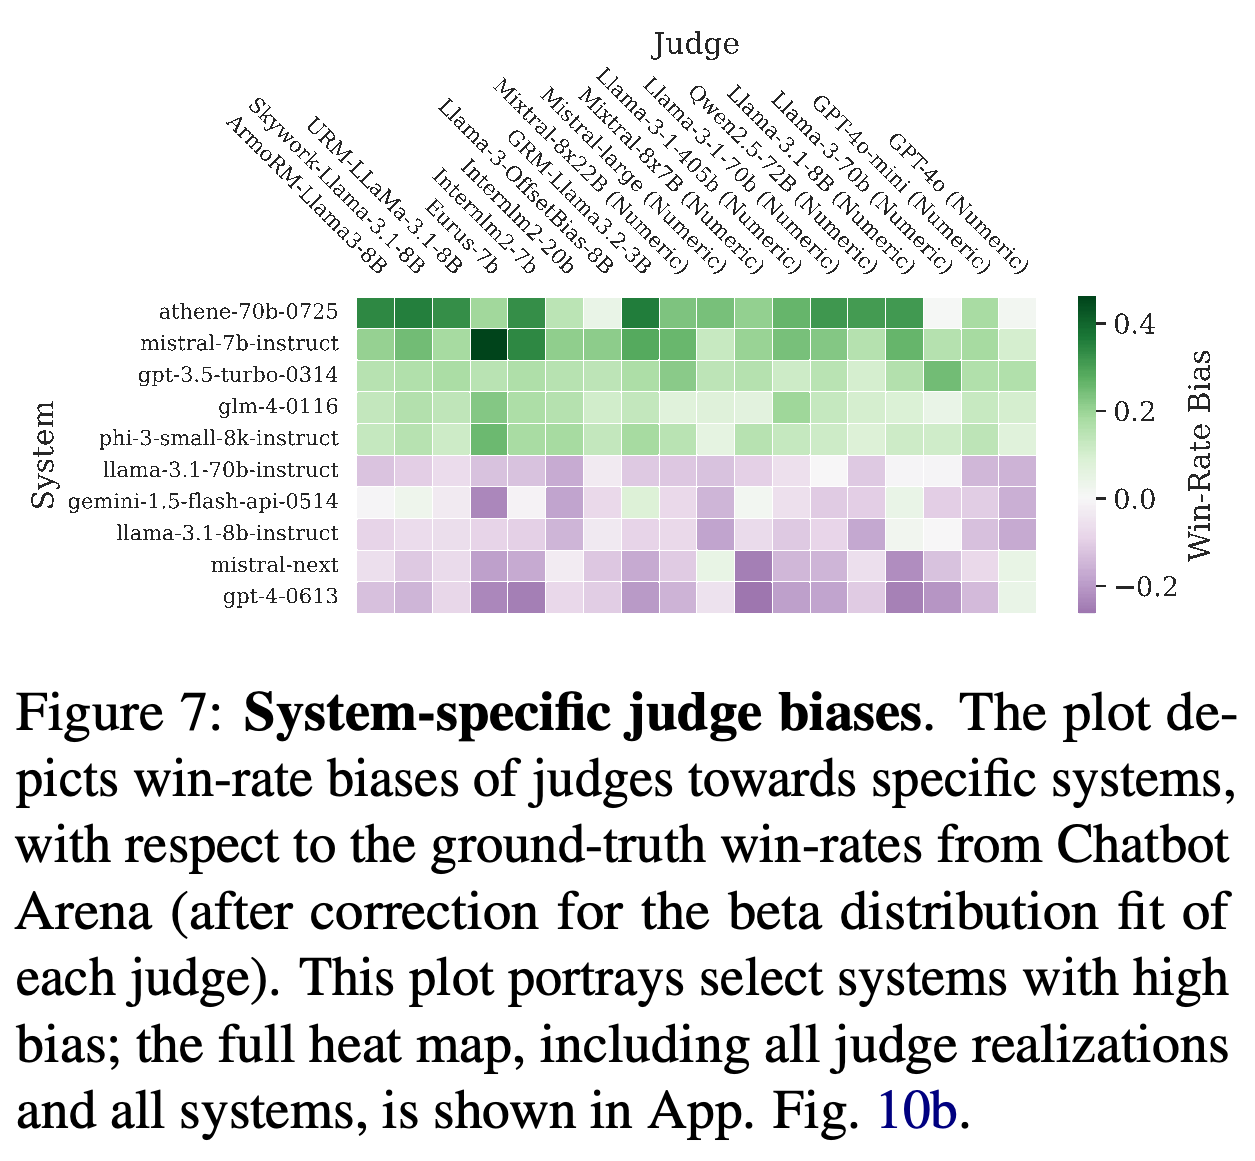
시스템별 편향은 특정 시스템이 실제로 대결한 상대들에 대해, 판정자가 예측한 승률과 인간 기준 승률 사이의 차이를 평균한 값이다. 저자들은 이 효과를 전반적인 단호함과 분리하기 위해, 원래 인간 기준값을 각 판정자에 맞춰 적합시킨 베타 곡선의 예측값으로 대체한 뒤 보정 편향을 계산한다.
- Figure 7은 여러 판정자가 Athene-70B에 지속적인 양의 편향을 보이며, 이를 1위에 자주 배치한다는 점을 보여준다.
- GPT-4-0613의 인간 기준 순위는 27th지만 판정자들이 부여한 순위의 중앙값은 38위다.
- 판정자와 기반 LLM을 공유하는 시스템을 선호하는 자기 편향은 일부 구성에서 나타나지만, 판정 방식 전반에서 일관되지는 않다.
비슷한 색의 가로 띠는 단호함을 보정한 뒤에도 여러 판정자가 특정 시스템을 일관되게 과대평가하거나 과소평가함을 드러낸다. Athene-70B의 양의 편향을 나타내는 띠와 GPT-4-0613의 음의 편향을 나타내는 띠는 전체 순위 일치도만으로 설명할 수 없는 공통적인 시스템별 편향을 보여준다.
6.3 Characterizing Judge Behaviors
전체적인 편향 성향은 시스템별 보정 편향의 표준편차로 측정한다. 선형 연관성을 측정하는 Pearson 상관계수는 순위 품질과 단호함 사이에서 0.55이고, 순위 품질과 편향 성향 사이에서는 −0.56이다. 단호함과 보정 편향 성향 사이의 상관계수는 −0.07이다.
- 이러한 연관성은 판정자의 상호 보완적인 특성을 설명하지만, 단호함을 높이면 순위가 개선된다는 인과관계를 입증하지는 않는다.
7 Related Work
논문은 기존 자연어 생성 분야의 시스템 수준 평가와 최근 LLM 판정자 벤치마크를 연결한다. RewardBench와 미묘한 오류가 있는 어려운 응답 쌍을 다루는 JudgeBench는 개별 응답 비교를 평가한다. Arena Hard와 자동 시스템 비교 벤치마크인 AlpacaEval은 특정 리더보드 구성을 외부 순위와 비교해 검증한다.
- JuStRank는 여러 판정 모델과 판정 방식을 시스템 순위 평가자로 비교하고, 단호함과 시스템별 편향을 분석한다.
- 질의응답 데이터셋 TriviaQA에서 수행한 과제별 시스템 수준 판정자 평가는 범위가 더 좁은 선례다. JuStRank는 더 큰 규모의 범용 시스템 및 지시문 집합을 연구한다.
8 Discussion
판정자를 선택할 때는 모델, 점수 부여 프롬프트, 절대 평가 또는 비교 평가, 집계 방법을 함께 고려해야 하며, 이러한 선택 사이에는 상호작용이 있다. 실험 결과는 전체 평가 구성을 실제 시스템 순위 평가 과제에 맞춰 검증하고, 판정자가 평가할 응답을 생성하는 시스템의 분포도 고려할 필요가 있음을 뒷받침한다.
- 저자들은 강한 시스템과 약한 시스템을 구분하는 데 도움이 될 수 있는 효과와, 특정 시스템의 순위를 왜곡하는 잔여 편향을 구분한다.
- 공개된 점수는 시스템 순위 평가 전용 판정자, 여러 평가자를 결합하는 판정자 앙상블, 대안적인 집계 방법을 추가로 연구하는 데 활용할 수 있다. 이는 제안된 연구 방향이다.
9 Conclusion
JuStRank는 판정자의 응답 점수를 집계하고, 그 결과로 얻은 시스템 순위를 인간 평가에서 도출한 순위와 비교해 판정자를 벤치마킹한다. 실험한 환경에서는 판정자 크기만으로 순위 품질이 결정되지 않으며, 일부 전용 보상 모델은 상위 LLM 판정자와 비슷한 성능을 보인다. 단호함과 시스템별 편향은 전체 순위 일치도만으로 드러나지 않는 행동 특성을 설명한다.
Limitations
인간 기준 데이터셋은 대결에 사용한 지시문과 응답을 공개하지 않으므로, 자동 판정에는 Arena Hard를 대신 사용한다. 따라서 이 비교는 동일한 예시에 대한 인간 판단과 자동 판단을 직접 측정하지 않고, Arena Hard와 English Hard Prompts가 충분히 유사하다고 가정한다.
- 결과는 실험에 사용한 프롬프트와 추론 구현에 한정된다. 다른 표현이나 애플리케이션 프로그래밍 인터페이스(API)의 동작은 판정자 출력을 바꿀 수 있다.
- 집계된 인간 선호에는 유용성, 안전성, 문체, 일관성 등 주관적인 차원이 함께 반영된다.
- 기준 순위는 주로 응답별 품질 차이의 크기보다 승리 빈도로 품질을 정의한다.
- 실험은 전문 분야, 개별 과제, 영어 이외의 언어에서의 성능을 입증하지 않는다.
부록
- A Judge Score Distributions는 판정 방식에 따라 점수 범위, 특정 값에 대한 집중, 동점 양상이 달라짐을 보여준다. Anchor 분포는 판정자 행동뿐 아니라 기준 시스템에도 영향을 받는다.
- B Aggregation Methods는 Mean, Median, Win-rate, Bradley-Terry 집계를 설명한다. 이산 점수의 동점 때문에 Median이 시스템을 구분하는 데 적합하지 않을 수 있다.
- C Chatbot Arena Data는 공개 데이터의 중복 제거, English Hard Prompts를 이용한 인간 기준 순위 구성, 행동 분석을 위한 공통 시스템의 비동점 대결 선별을 설명한다.
- D Statistical Analysis of Judge Performance는 보고된 분석에서 판정자 모델, 판정 방식, 이들의 상호작용에 따른 효과를 확인했지만 집계의 효과는 유의하지 않았다고 보고한다. 사후 비교에서는 Numeric과 Likert가 Anchor와 TokenProbs보다 우수했다.
- E Pairwise Win-Rates는 승자를 올바르게 식별하는 능력과 승리 폭을 정확히 추정하는 능력을 구분한다. 단호한 판정자는 승리 폭을 과장하면서도 승자를 잘 식별할 수 있다.
- F Beta Distribution Fit은 인간 승률과 판정자 승률의 관계에 대칭 베타 누적분포함수를 적합하고, 가중 절대오차를 사용하는 방법을 설명한다.
- G LLM Judge Prompts는 실험에 사용한 Numeric, Likert, TokenProbs, Anchor의 정확한 점수 부여 템플릿을 제공한다.
짧은 생각
이 벤치마크는 집계된 평가를 바탕으로 시스템을 선택하는 일반적인 엔지니어링 의사결정을 다룬다. URM-LLaMa-3.1-8B의 0.823이라는 결과와 동일 모델에서도 점수 부여 방식에 따라 나타나는 큰 성능 차이는 전체 판정 구성을 검증할 구체적인 근거가 된다. 모델 크기나 개별 응답 리더보드만으로는 판정자를 선택하기 어렵다.
행동 특성을 나누어 분석하면 판정자가 선호 차이를 과장하면서도 많은 승자 판단을 유지하는 현상과, 시스템별 잔여 편향이 순위를 왜곡하는 현상을 이해하는 데 도움이 된다. 이 해석은 인간 데이터셋과 자동 평가 데이터셋이 별도로 구성되었다는 조건을 전제로 하며, 보고된 상관관계가 더 단호한 판정자의 보편적인 이점을 입증하지는 않는다.