


LaMDA: Language Models for Dialog Applications 요약 설명
20 Jan 2022 | Paper Review Language Models Supervised Fine-Tuning Tool Use LLM Safety목차
이번 글에서는 LaMDA: Language Models for Dialog Applications 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 1월 20일(Arxiv)
- Thoppilan, Romal, De Freitas, Daniel, Hall, Jamie, Shazeer, Noam, Kulshreshtha, Apoorv, Cheng, Heng-Tze, Jin, Alicia, Bos, Taylor, Baker, Leslie, Du, Yu, et al.
- 논문 링크
- 검토한 원문: arXiv v3, 2022-02-10.
요약
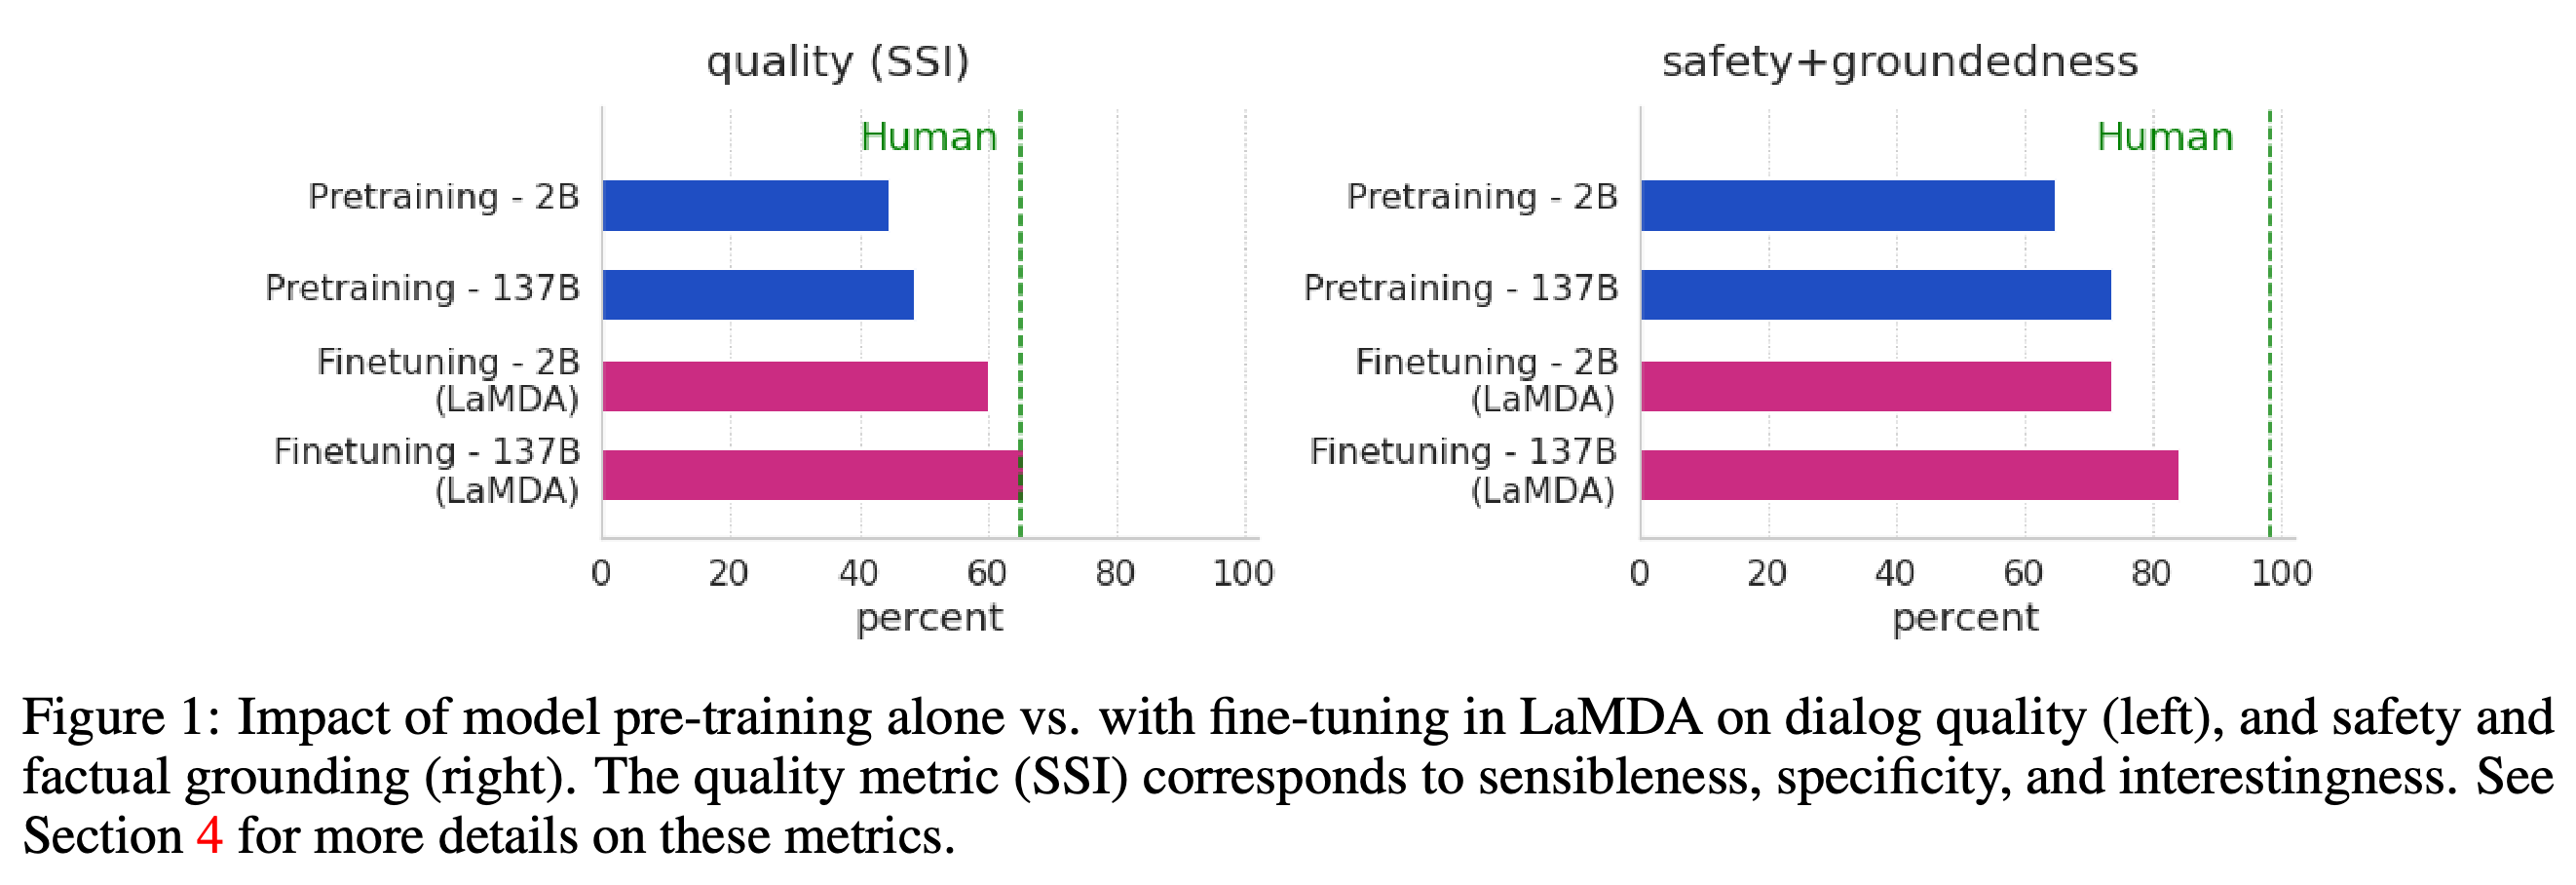
- LaMDA는 유용하고 안전하며 근거를 갖춘 개방형 대화 응답을 생성하기 어려운 문제를 다룬다. 텍스트 예측으로만 학습한 137B-parameter 모델과 비교하면, fine-tuning한 137B LaMDA의 안전성은 88%에서 95.2%로 높아졌다. 외부 세계에 관한 주장을 담은 응답 중 알려진 출처가 뒷받침하는 응답의 비율인 groundedness는 57.9%에서 73.2%로 높아졌다.
- 저자들은 사람이 주석을 단 품질 및 안전성 평가와 외부 도구에 질의하고 응답을 수정하도록 하는 학습을 결합한다. 완성된 모델은 일부 품질 지표에서 측정된 크라우드워커 기준에 근접하지만, 안전성과 groundedness에서는 그 기준에 미치지 못한다.
- Fine-tuning과 평가 데이터셋은 영어로만 구성된다. 논문은 근거 없는 주장, 편향된 행동, 복잡한 추론에서의 실패를 기록한다. 안전성 목표는 미국 상황을 기준으로 수립되어 모든 잠재적 피해를 포착하지는 못한다.
1 Introduction
LaMDA, Language Models for Dialog Applications는 파라미터가 2B부터 137B까지인 모델을 연구한다. 단일 모델이 후보 응답을 생성하고 안전성을 기준으로 걸러내며, 외부 지식을 활용하고 품질에 따라 응답의 순위를 매긴다.
표시된 모델 크기 2가지 모두에서 fine-tuning은 종합 품질 점수와 안전성 및 groundedness 점수를 높인다. 후자는 여전히 사람의 기준보다 낮다.
2 Related work
논문은 대화 모델의 규모 확장과 사람의 평가를 대화 모델, 안전성 필터링, 검색에 관한 선행 연구와 연결한다. 이 논문의 grounding 절차는 도구의 결과를 사용해 생성된 응답을 수정한다. 인용된 검색 증강 대화 방식은 생성 전에 검색한 정보를 입력 맥락에 추가한다 [45].
3 LaMDA pre-training
LaMDA는 공개 대화와 웹 문서에서 수집한 1.56T 단어를 사용해 다음 토큰을 예측하도록 사전 학습한 decoder-only Transformer다. 가장 큰 모델은 64개 층과 137B 비임베딩 파라미터를 갖추고 있으며, 배치당 256K 토큰을 사용해 1024개 TPU-v3 칩에서 약 57.7일 동안 학습했다.
- 코퍼스에는 2.97B 문서, 1.12B 대화, 13.39B 대화 발화가 포함되며, 90% 초과가 영어다.
- 사전 학습된 모델은 top-k sampling으로 응답 16개를 샘플링하고 로그 우도와 길이를 기준으로 1개를 선택한다. 이 방식은 각 토큰의 선택지를 순위가 가장 높은 k개로 제한하며, k = 40을 사용한다.
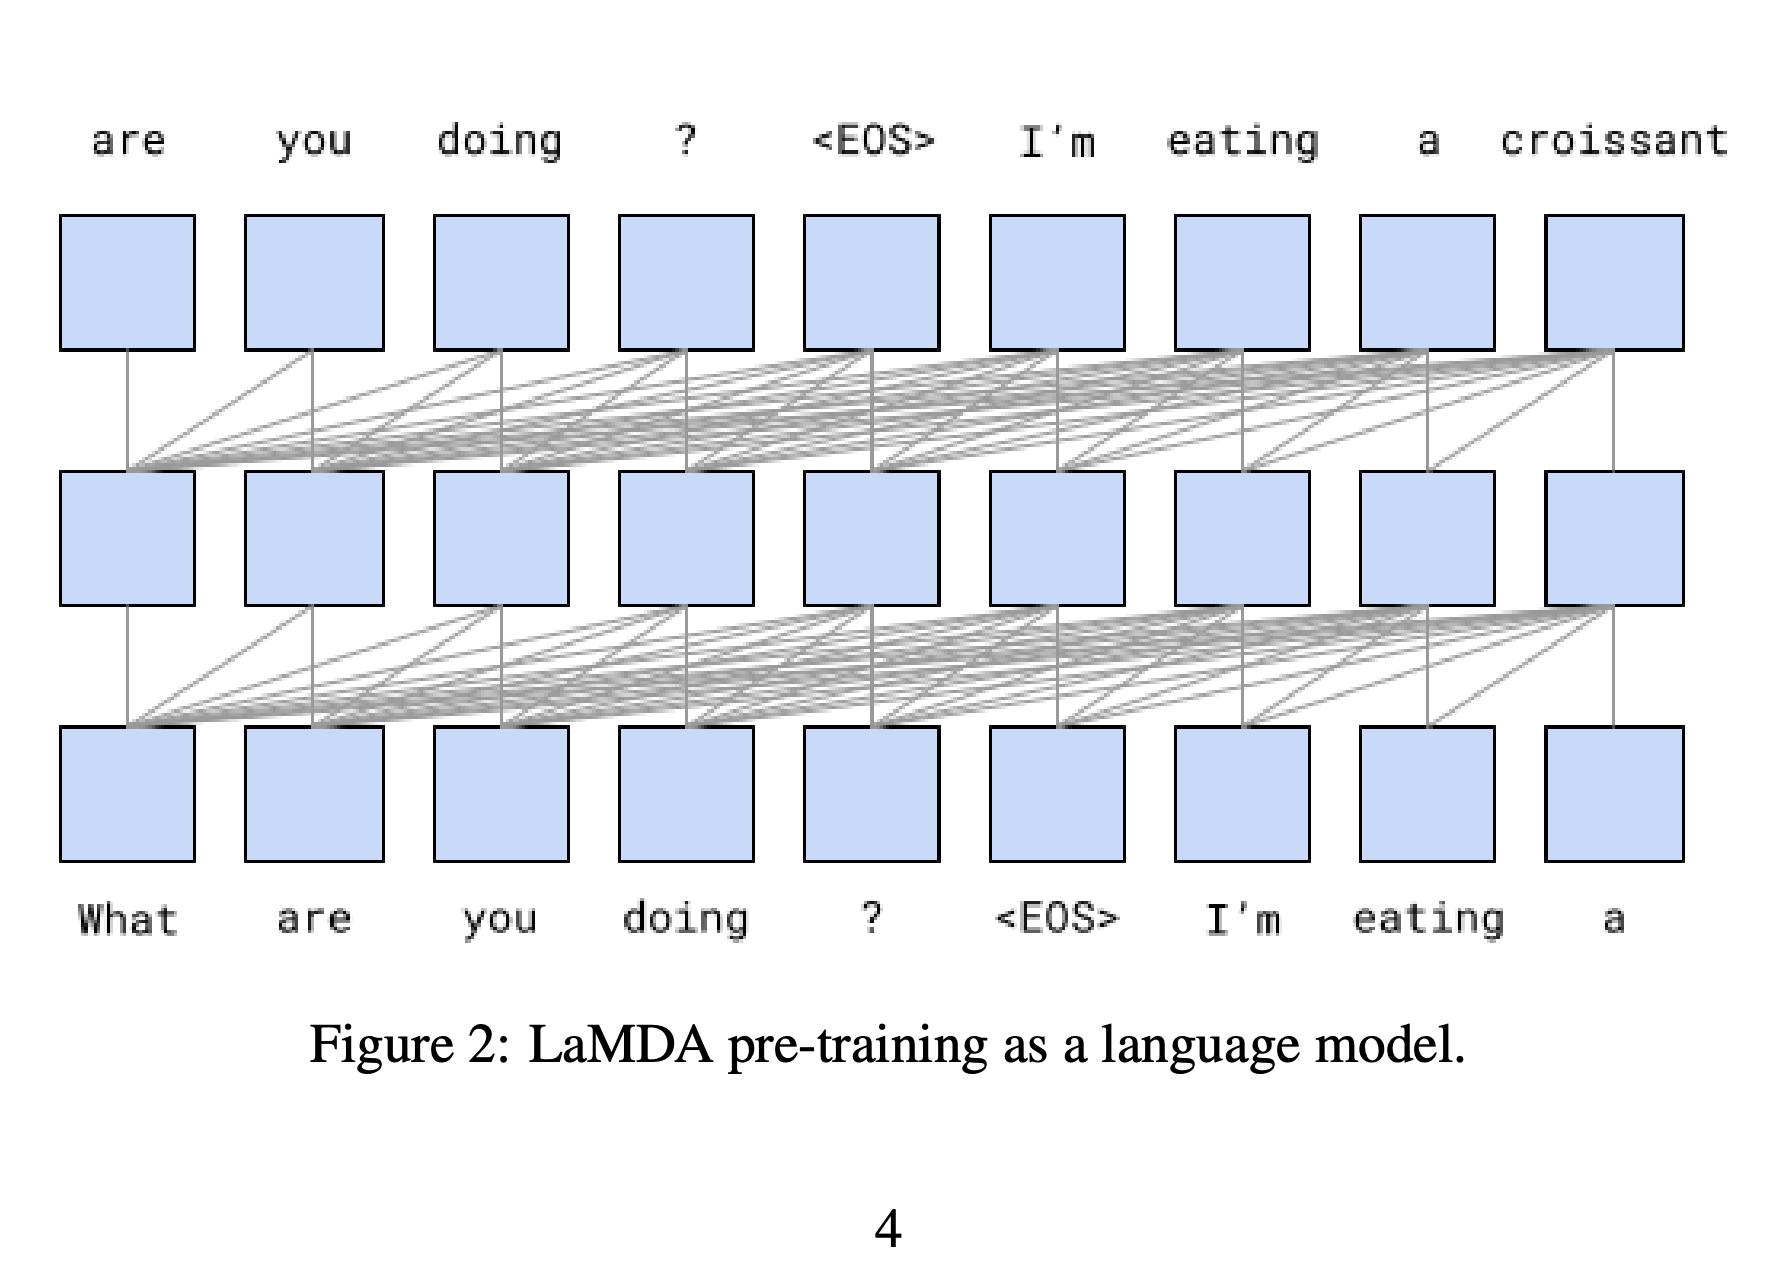
한 칸씩 이동한 입력과 목표 시퀀스는 <EOS>로 표시된 대화 경계를 가로지르는 다음 토큰 예측을 보여준다.
4 Metrics
평가는 일반적인 대화 속성과 애플리케이션별 행동을 구분하고 크라우드워커의 판단을 활용한다. 별도 지표를 사용하면 종합 지표에 가려질 수 있는 약점을 파악할 수 있다.
4.1 Foundation metrics: Quality, Safety and Groundedness
품질은 응답이 맥락에 맞는지, 맥락에 특화되어 있는지, 관심이나 호기심을 끄는지를 나타내는 sensibleness, specificity, interestingness의 평균인 SSI로 측정한다. 안전성은 예시로 제시된 목표를 준수하는 정도를 측정한다. Groundedness는 외부 세계에 관한 주장을 담은 응답 중 출처가 뒷받침하는 응답의 비율을 측정하며, informativeness는 모든 응답을 분모로 사용한다.
- Citation accuracy는 외부 세계에 관한 명시적 주장을 담은 응답 중 출처 URL을 포함한 응답의 비율을 측정하며, 널리 알려진 사실은 제외한다.
4.2 Role-specific metrics: Helpfulness and Role consistency
Helpfulness는 독립적인 조사를 통해 정확하다고 판단되고 사용자에게 유용한 정보를 요구한다. Role consistency는 응답이 이전 대화 내용과 일치하는지가 아니라 주어진 애플리케이션 역할에 부합하는지를 평가한다.
5 LaMDA fine-tuning and evaluation data
품질 평가는 1,477개 Mini-Turing Benchmark 대화 [17]와 평가자 5명의 다수결을 사용한다. 안전성 평가는 별도로 확보한 1,166개 대화의 1,458개 턴과 평가자 3명의 다수결을 사용한다. Groundedness 평가는 784개 대화 턴과 평가자 3명을 사용하며, 모든 fine-tuning 및 평가 데이터는 영어다.
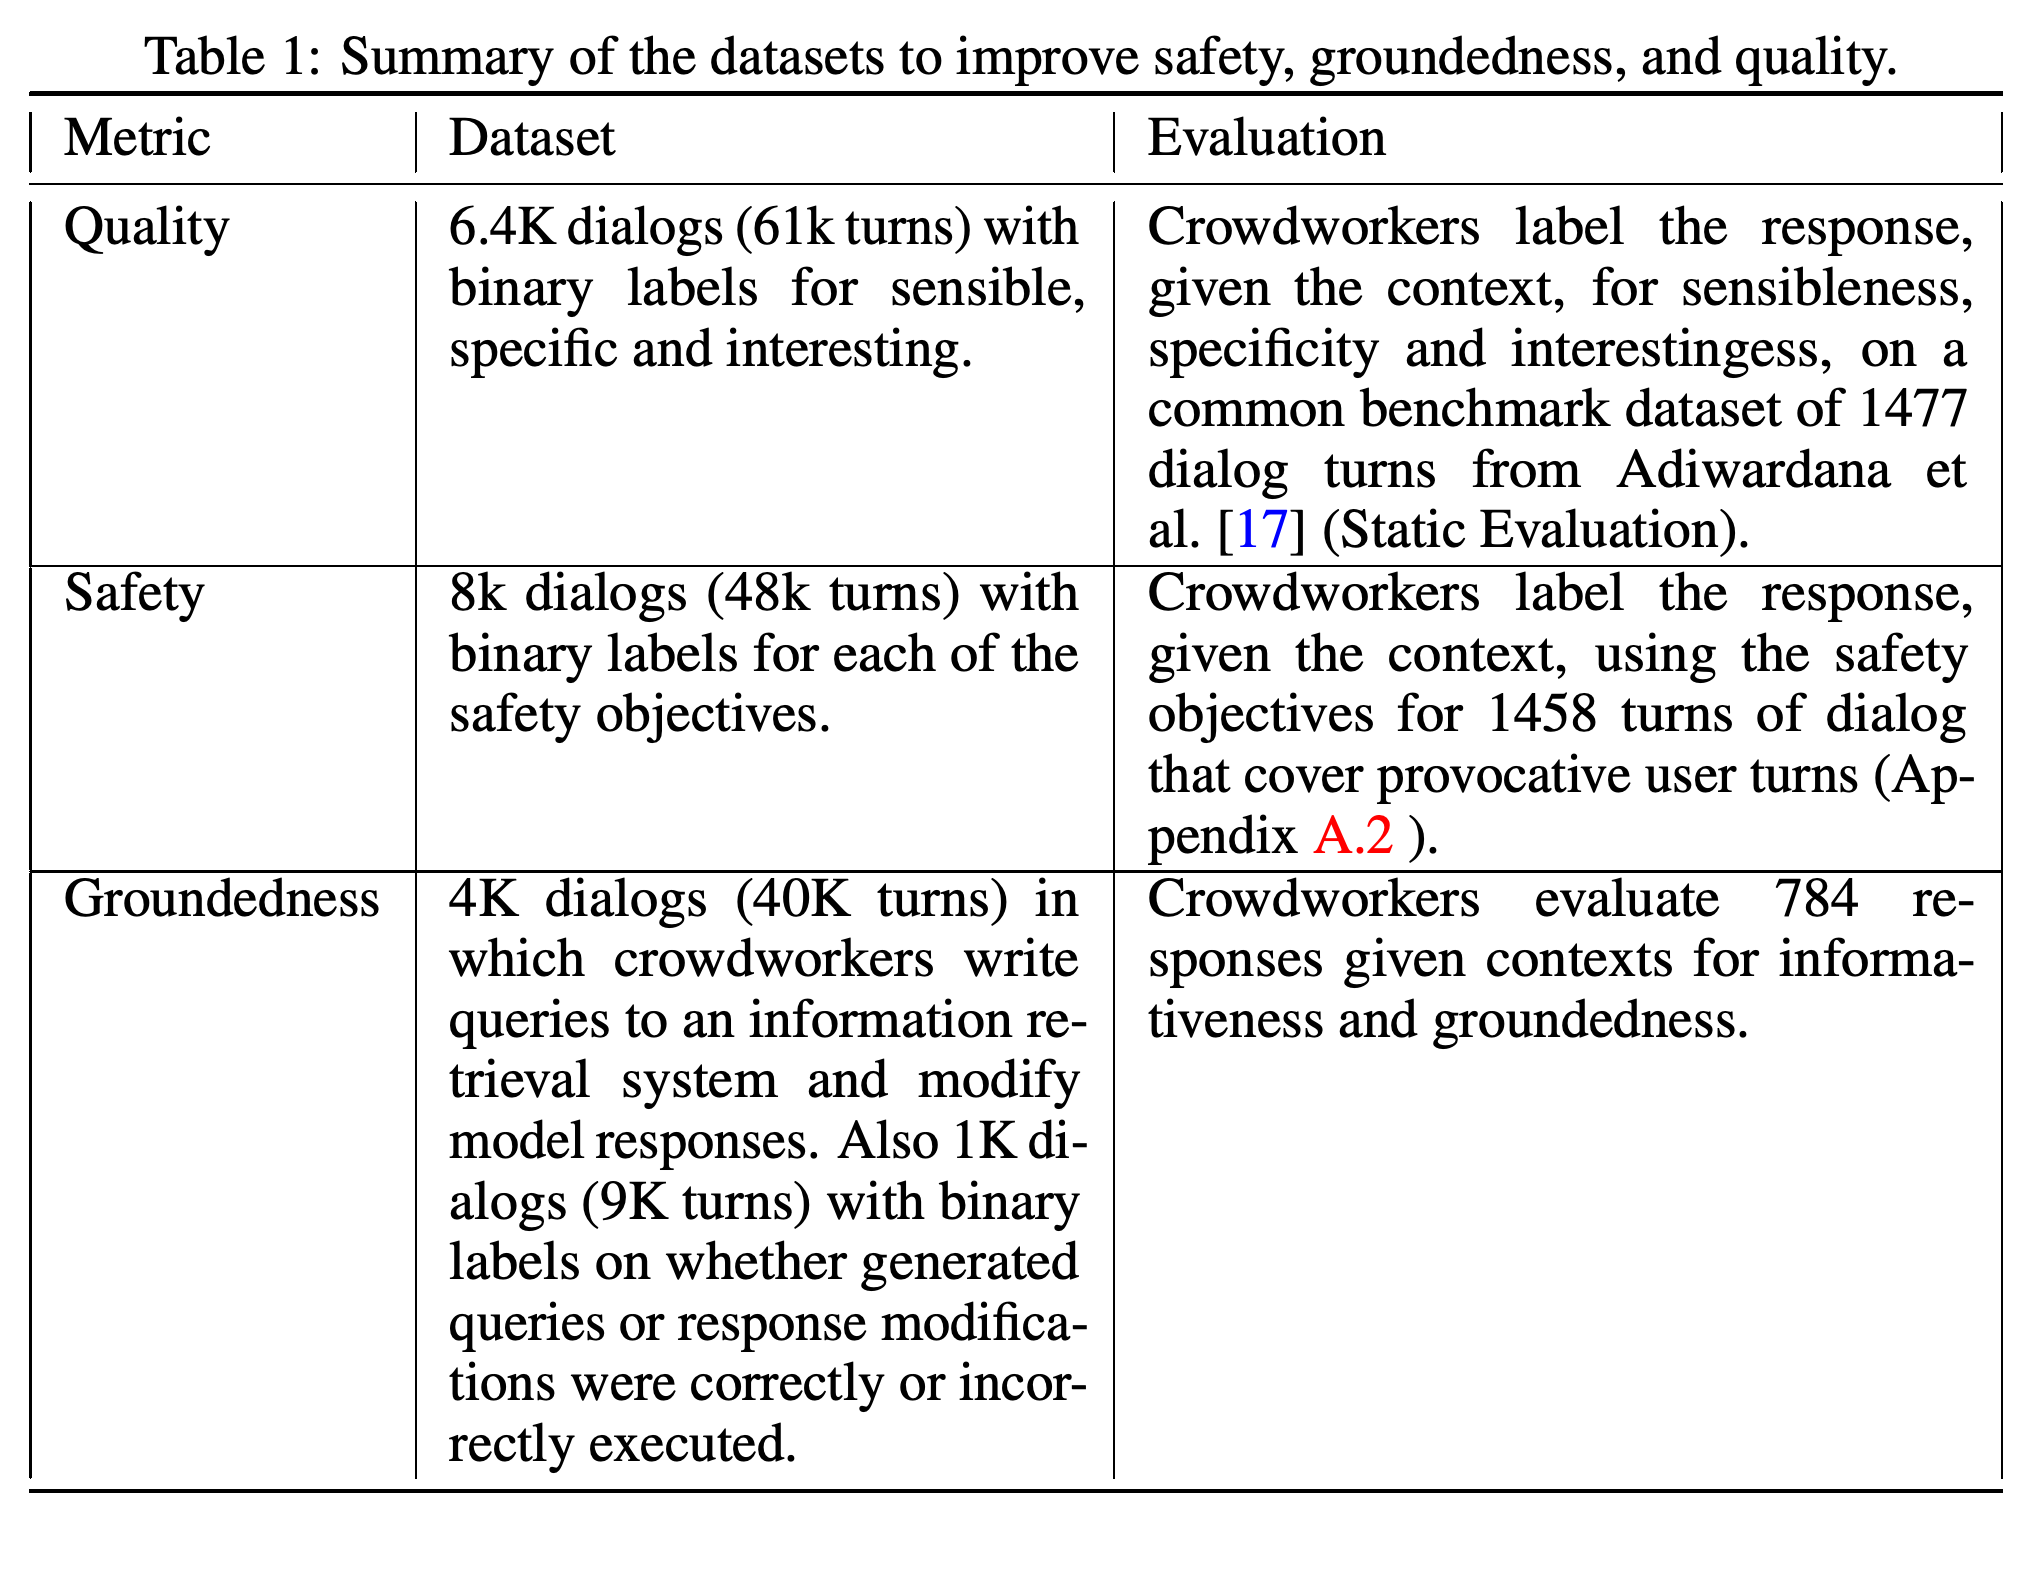
- 본문은 품질 데이터가 대화 6,400개와 121K 턴으로 구성된다고 보고하지만, Table 1에는 61K 턴이 기재되어 있다. 안전성 데이터는 8K 대화와 48K 턴, grounding 데이터는 4K 대화와 40K 턴으로 구성된다.
6 LaMDA fine-tuning
Fine-tuning은 응답을 생성하는 생성 과제와 응답의 속성을 예측하는 판별 과제를 결합한다. 2가지 과제는 모두 토큰 시퀀스로 표현되며 같은 decoder-only 모델이 처리한다.
6.1 Discriminative and generative fine-tuning for Quality (SSI) and Safety
모델은 안전성 임계값 미만의 후보를 걸러내고, 남은 후보의 순위를 3 * P(sensible) + P(specific) + P(interesting)으로 매긴다. 분류기는 사전 학습 대화 2.5M 턴도 필터링하여 생성형 fine-tuning에 사용할 800K 턴을 선별한다.
6.2 Fine-tuning to learn to call an external information retrieval system
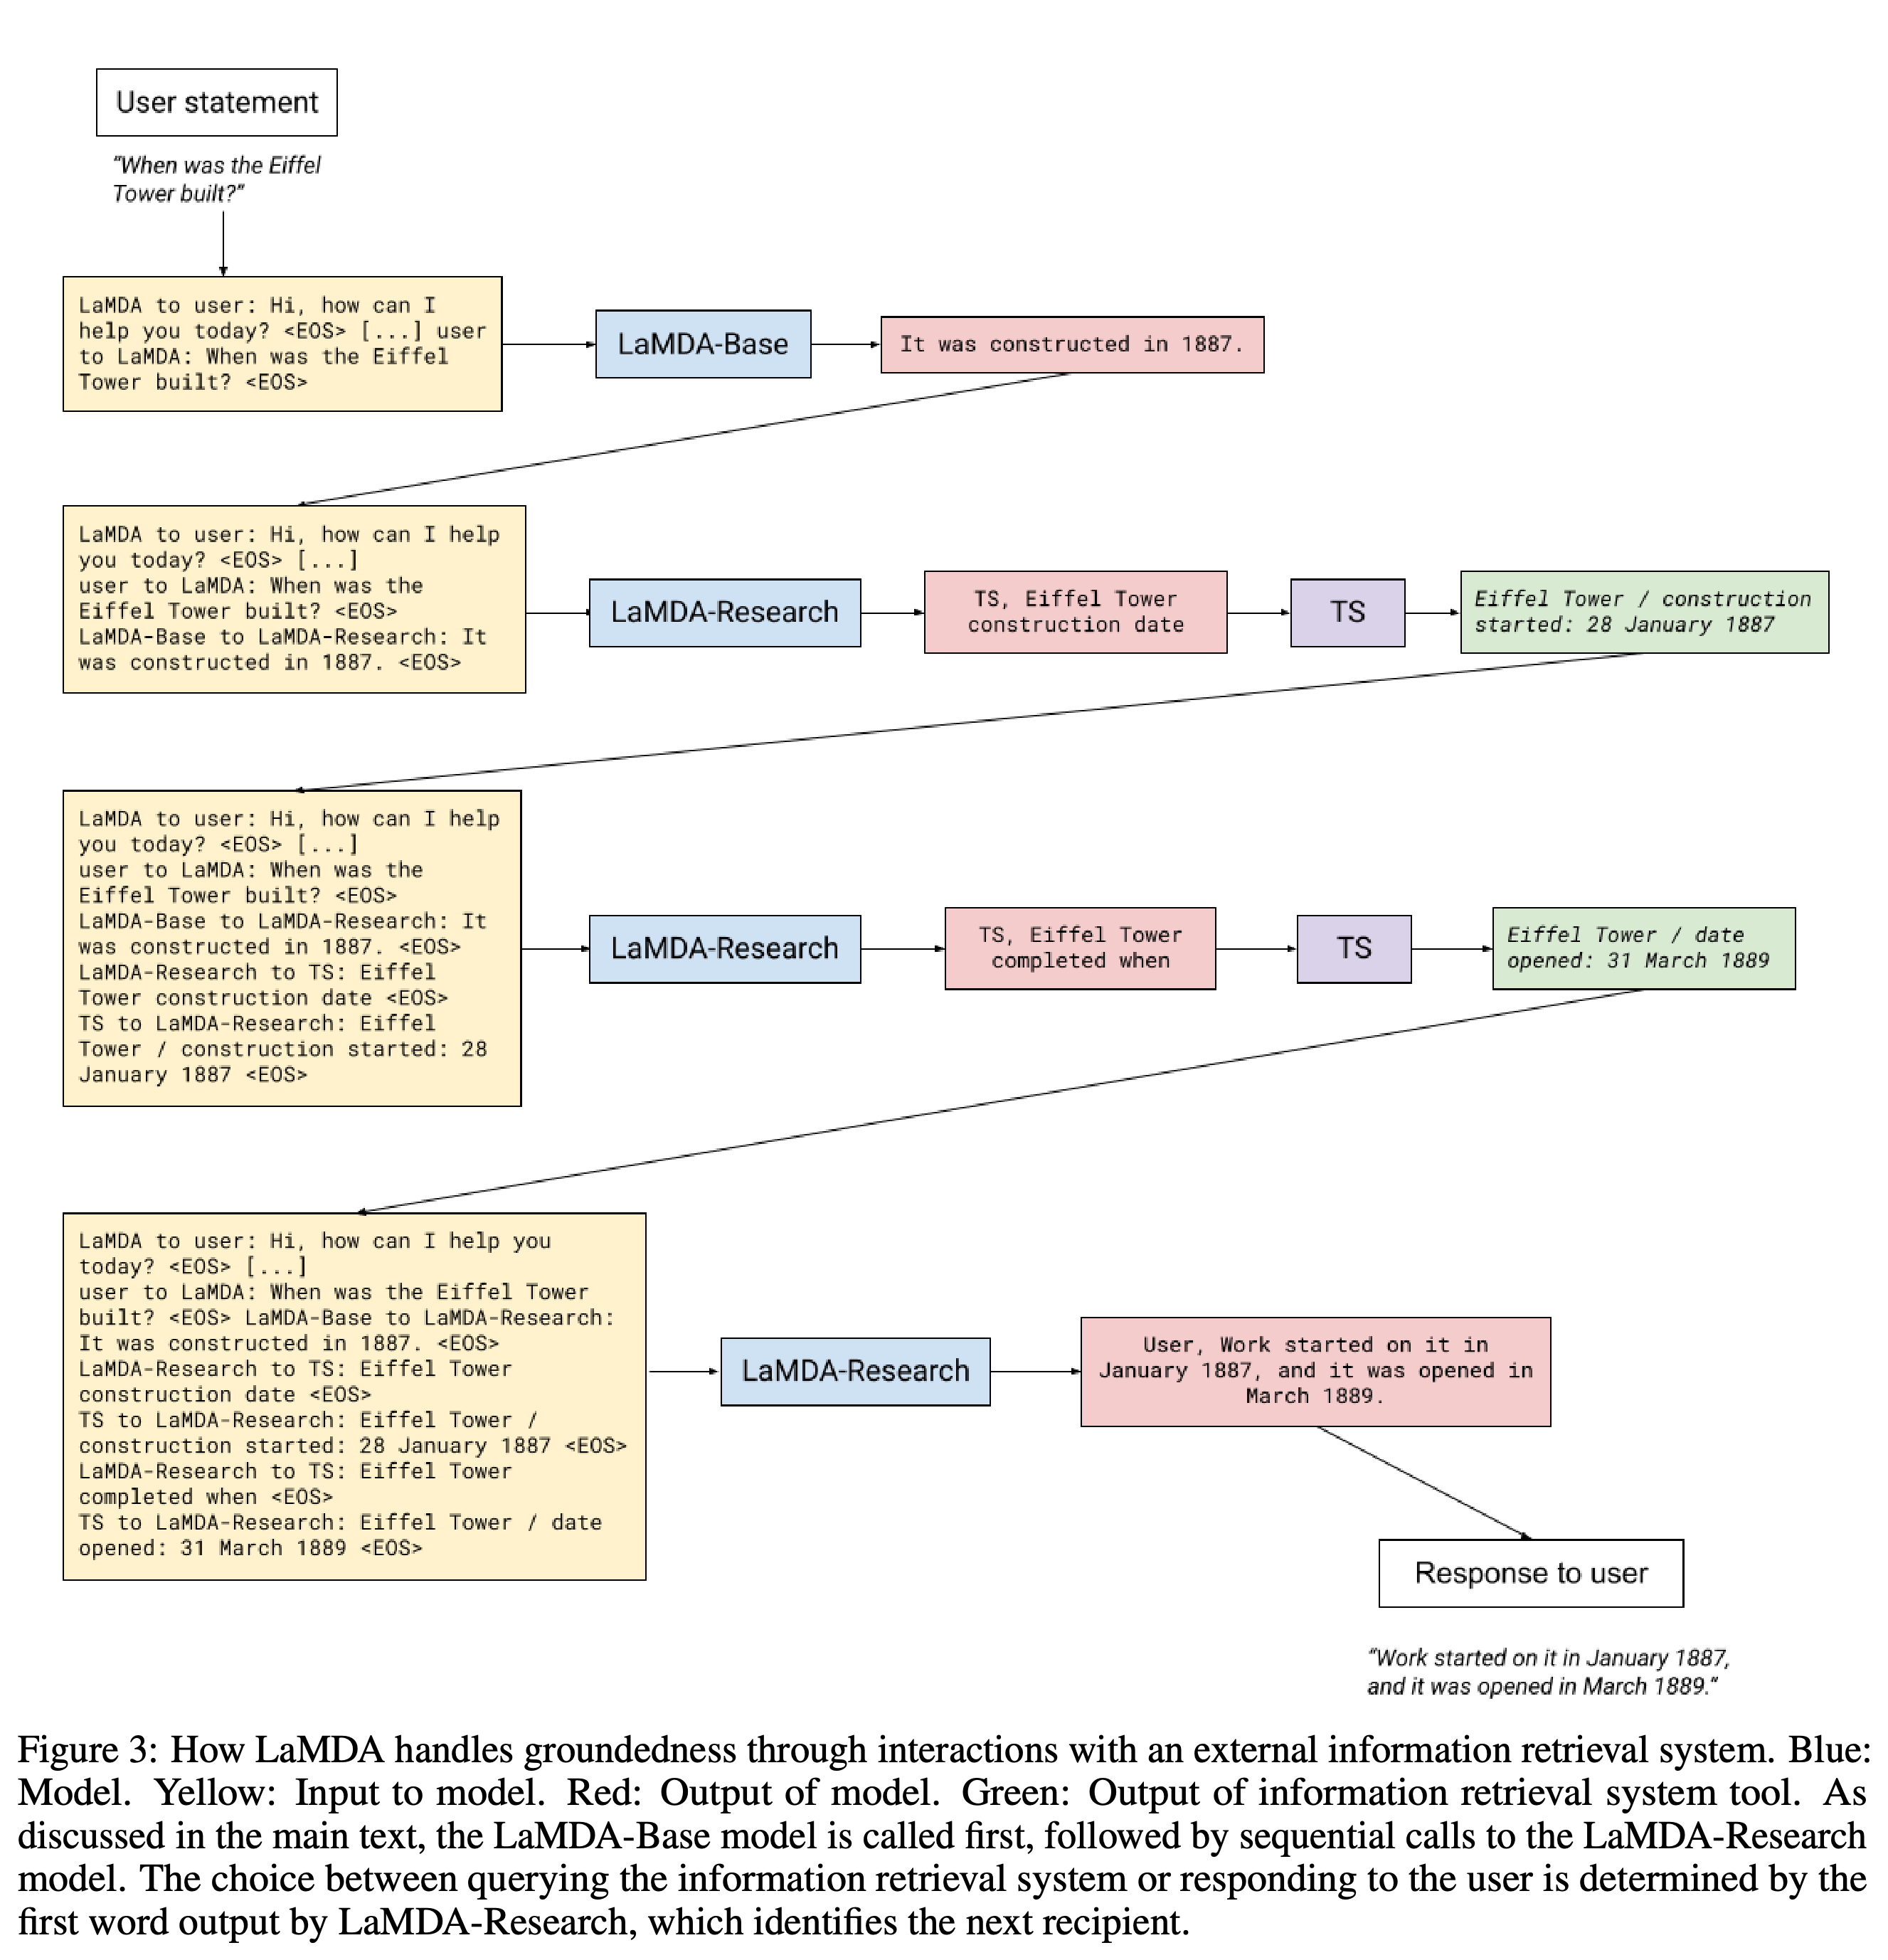
Toolset(TS)은 정보 검색, 계산기, 번역기를 결합한다. LaMDA는 주석이 달린 생성형 40K 턴과 판별형 9K 턴을 사용해 질의를 보내고 반환된 스니펫을 읽은 뒤, 추가 질의를 보내거나 사용자에게 수정된 응답을 생성하도록 학습한다.
- 그림에 제시된 검색 과정에서는 처음 생성된 문자열이 출력을 TS 또는 사용자에게 전달하도록 지정하며, 추론 시 설정한 최댓값이 질의 횟수를 제한한다.
Eiffel Tower 예시는 초안 작성 후 도구에 2번 질의하여 최종 응답에서 착공 시점과 개장 날짜를 구분하는 과정을 보여준다.
7 Results on foundation metrics
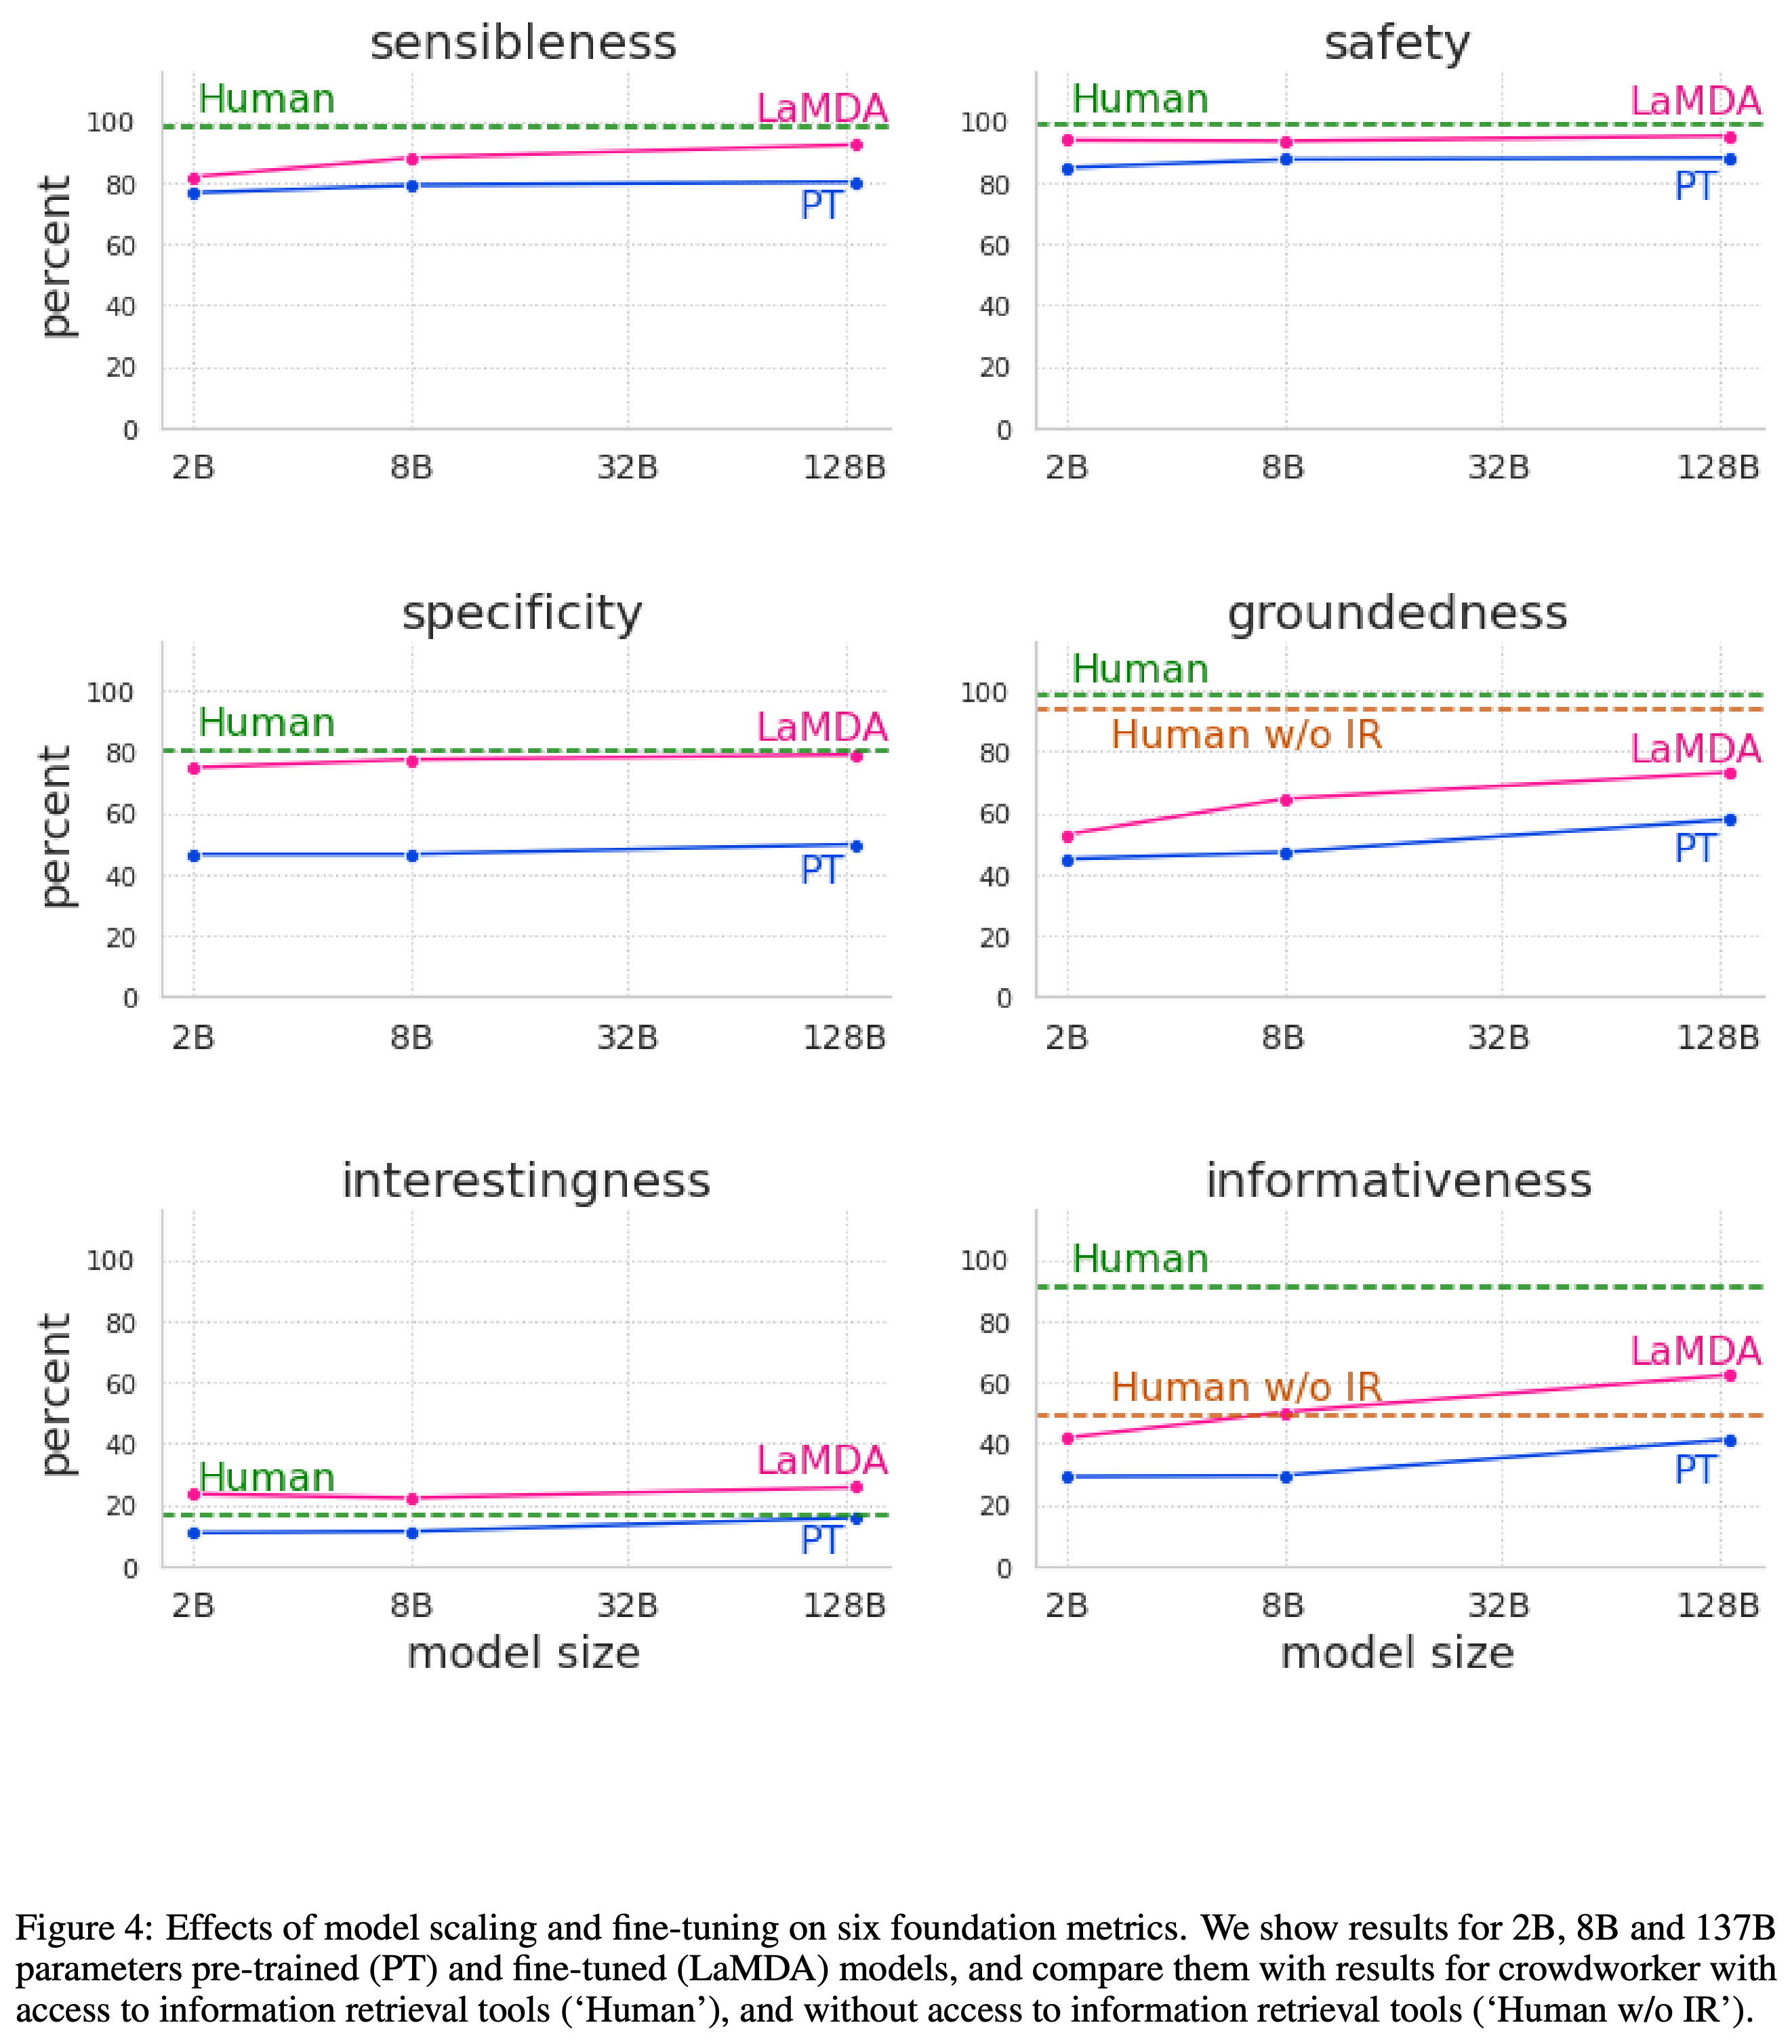
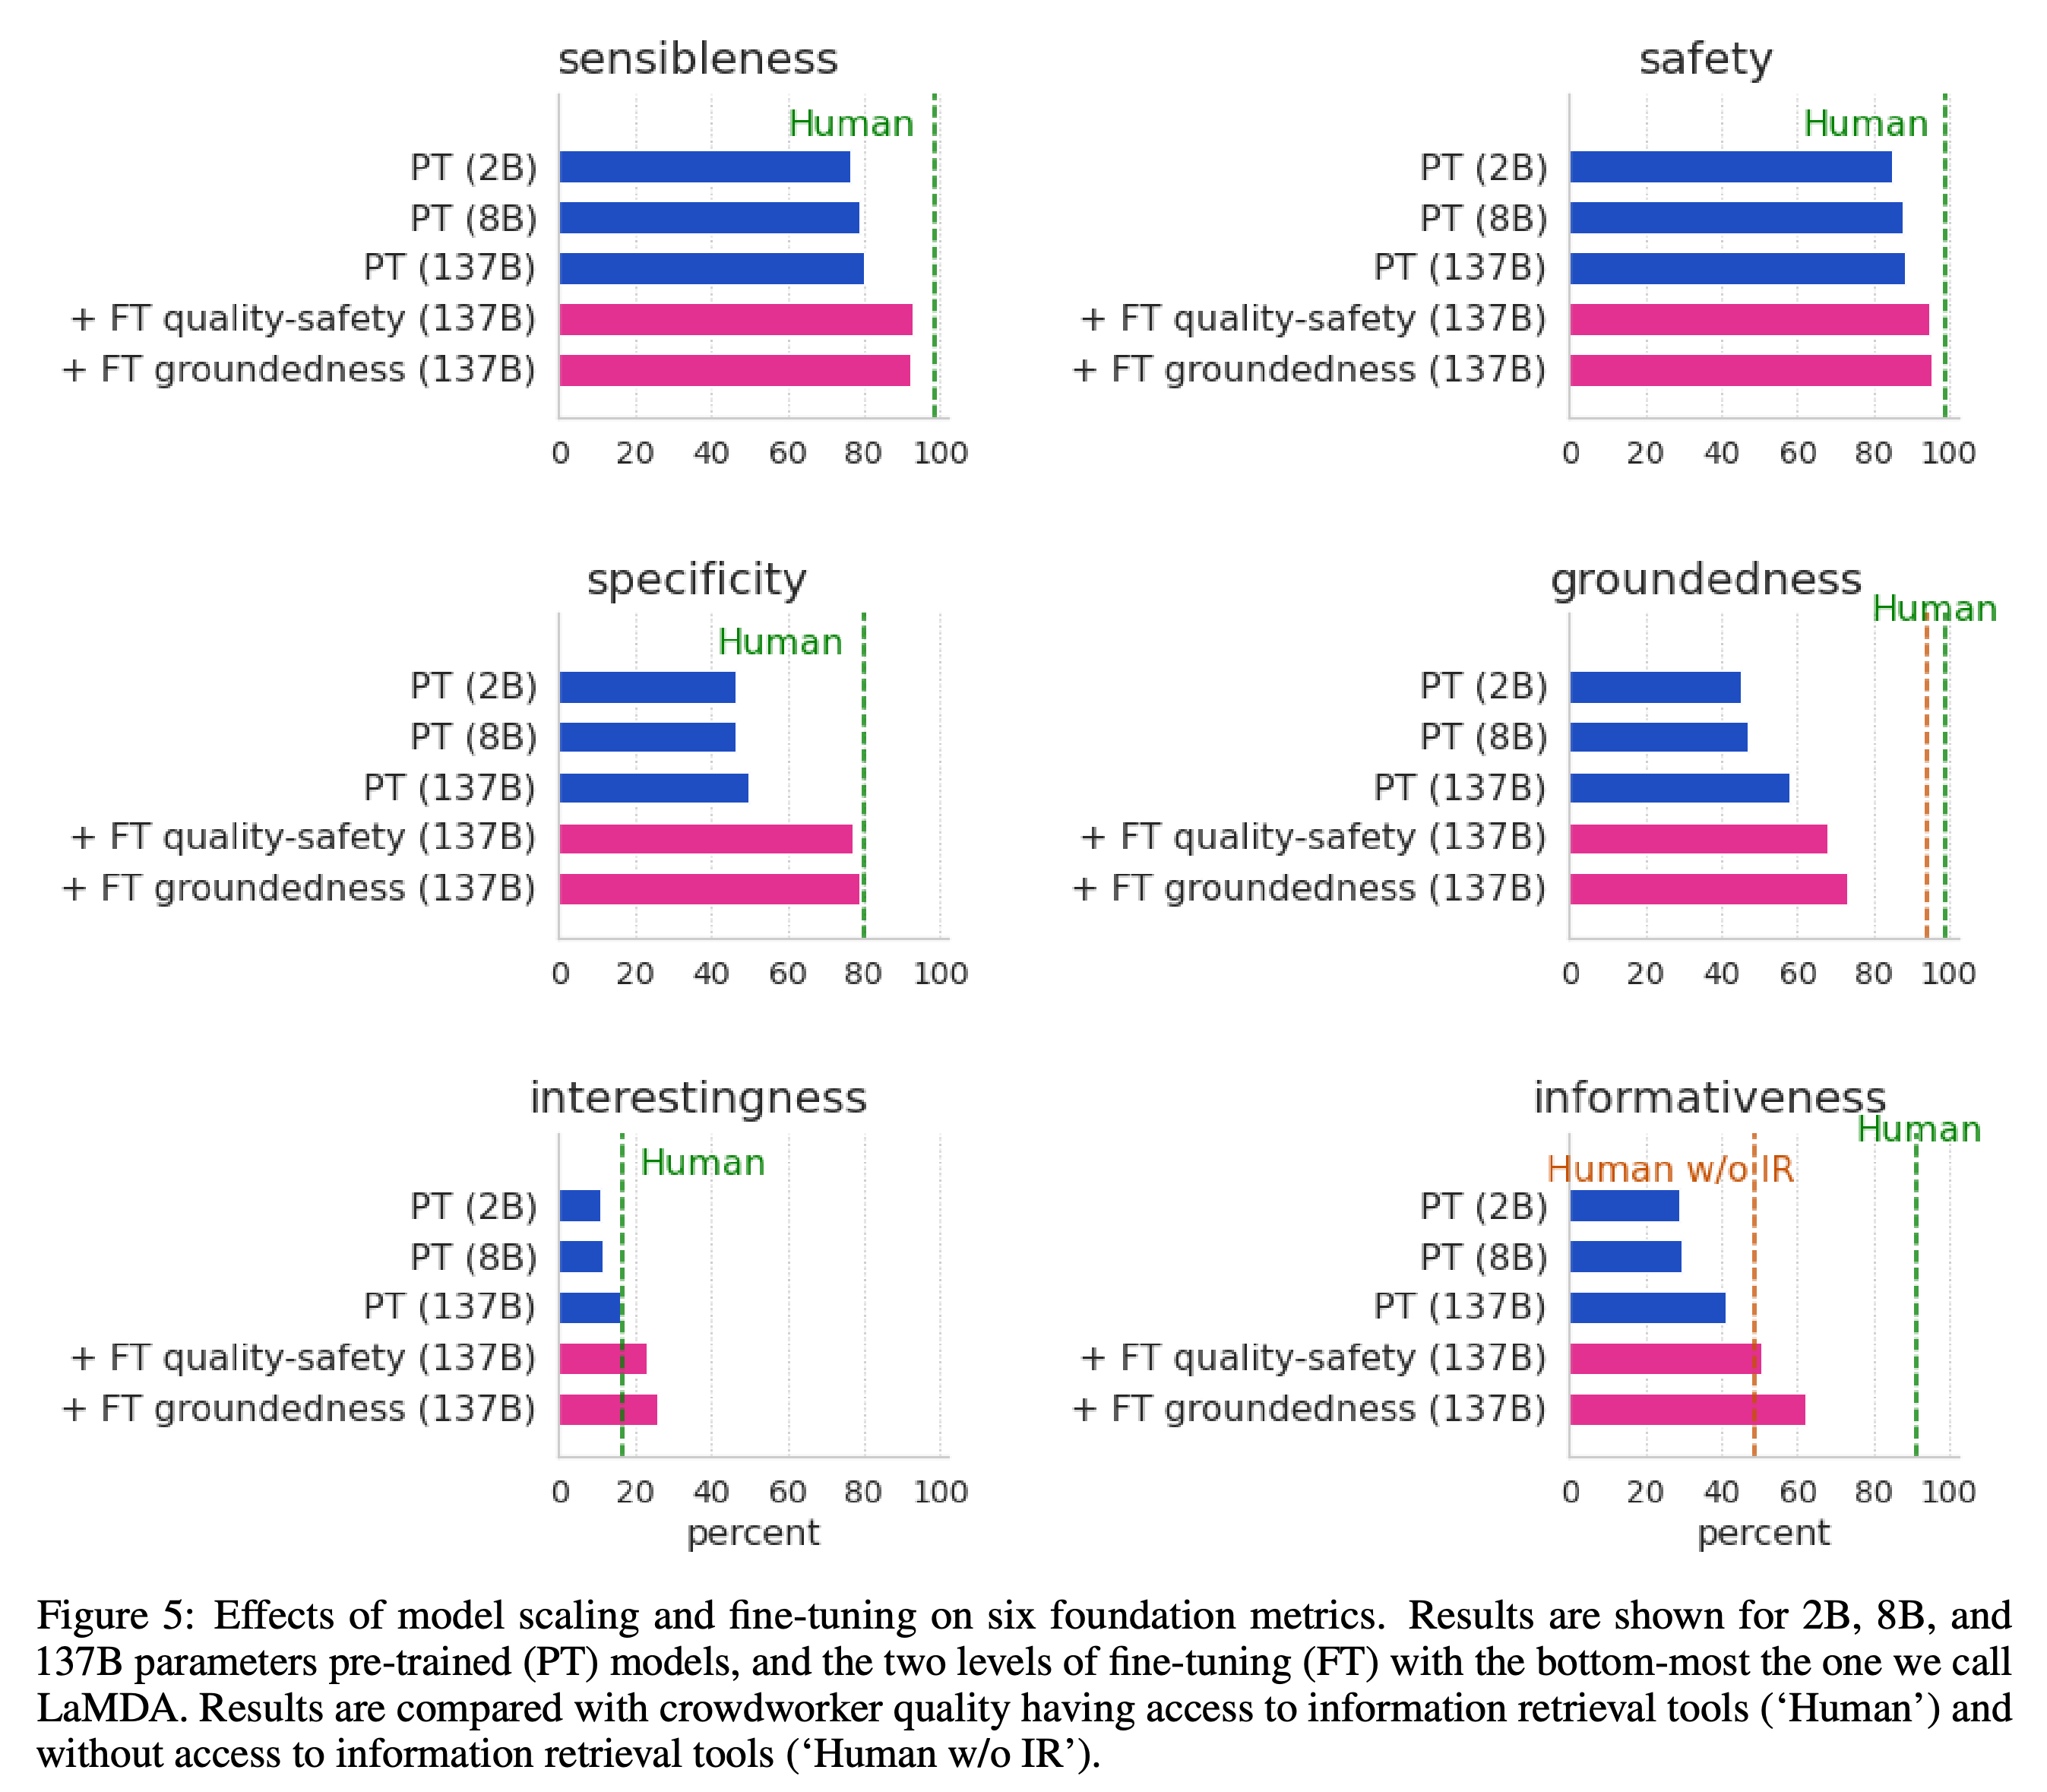
137B 파라미터 모델에서 사전 학습만 적용하면 sensibleness는 80.2%, 안전성은 88%, groundedness는 57.9%다. 전체 LaMDA는 각각 92.3%, 95.2%, 73.2%를 기록하고 citation accuracy는 65%다. 품질 및 안전성 fine-tuning만 적용하면 groundedness가 67.9%에 도달하며, grounding 단계를 추가하면 73.2%로 더 높아진다.
- Fine-tuning한 모델은 측정된 크라우드워커의 interestingness 점수를 넘지만, 저자들은 크라우드워커가 고품질 응답을 작성하도록 충분히 훈련받거나 보상을 받지 않았다고 주의를 당부한다.
- 모델은 groundedness와 informativeness에서 검색 기능을 이용할 수 있는 크라우드워커보다 낮은 성능을 보인다.
표는 각 학습 데이터 수집분을 별도의 사람 평가 세트와 연결하여 품질, 안전성, groundedness가 서로 다른 맥락에서 평가됨을 보여준다.
2B, 8B, 137B 모델 모두에서 fine-tuning은 그래프에 표시된 6개 지표를 개선한다. 검색 기능을 이용할 수 있는 사람의 기준은 groundedness와 informativeness에서 여전히 상당히 높다.
단계별 비교에 따르면 품질 및 안전성 튜닝이 큰 성능 향상을 이끌며, grounding 단계를 추가하면 groundedness와 informativeness가 더 높아진다.
8 Domain grounding
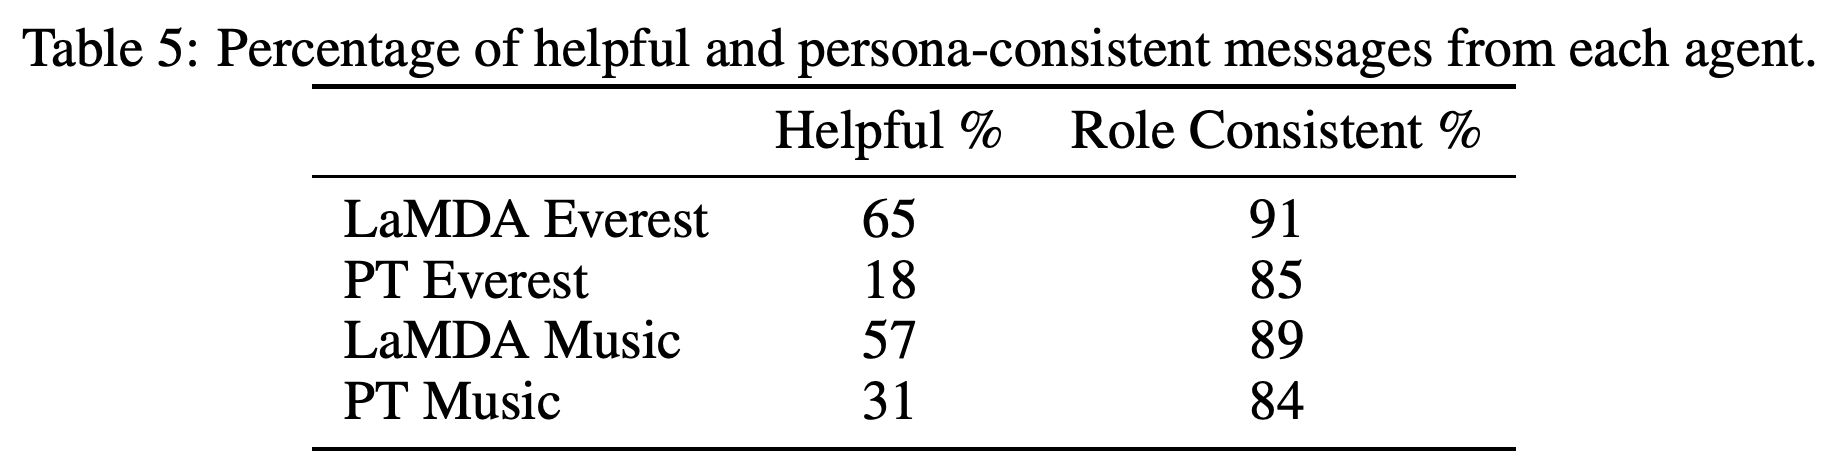
저자들은 Mount Everest 교육 페르소나와 음악 추천 에이전트를 평가하면서 사전 학습 모델과 fine-tuning 모델에 동일한 역할별 사전 조건화, 즉 역할에 맞는 초기 대화 턴 몇 개를 제공한다. 600개 대화 턴에서 helpfulness는 Everest의 경우 65% 대 18%, Music의 경우 57% 대 31%이며, role consistency는 84%에서 91% 사이다.
- LaMDA Everest 응답 중 약 30%에는 알려진 출처로 뒷받침할 수 없는 사실이 포함된다. LaMDA Music은 응답의 약 9%에서 추천을 빠뜨리고 약 7%에서 작동하지 않는 링크를 제공한다.
2개 애플리케이션 모두에서 fine-tuning은 role consistency보다 helpfulness를 더 크게 개선하며, 모든 모델의 role consistency는 80%를 넘는다.
9 Discussion and limitations
사람이 주석을 단 fine-tuning 데이터는 사전 학습 데이터의 0.001% 미만이지만, 주관적 판단을 수집하는 작업은 비용이 많이 들고 복잡하다. 저자들은 평가자 간 의견 불일치의 패턴을 분석하지 않았으며, 모델은 여전히 출처를 잘못 전달하거나 사용자에 관한 정보를 지어내고 복잡한 추론에 실패할 수 있다.
9.1 Examining bias
개별 응답이 명시된 안전성 목표를 충족하더라도, 전체 출력에는 특정 집단을 전문직에서 체계적으로 적게 표현하는 등의 재현 편향이 나타날 수 있다. 논문은 애플리케이션과 사회문화적 맥락에서 이러한 영향을 평가해야 한다고 강조한다.
9.2 Adversarial data collection
적대적 데이터 수집에서는 참가자에게 안전성 목표를 위반하는 응답을 유도하도록 요청한다. 저자들은 참가자가 드문 실패보다 흔한 문제를 더 쉽게 발견하는 경향이 있어 발생 빈도가 낮은 위험을 포괄하는 데 한계가 있다고 보고한다.
9.3 Safety as a concept and a metric
안전성 점수는 여러 목표를 통합하고 거친 레이블을 사용하므로 심각도의 차이가 가려지고 목표별 가중치를 따로 적용할 수 없다. 또한 나중에 나타나는 피해를 놓치며, 미국을 기준으로 한 목표가 보편적이라고 가정할 수 없다.
9.4 Appropriateness as a concept and a metric
저자들은 안전성과 예의 및 격식을 포함하는 사회적 적절성을 구분한다. 어떤 표현은 안전하더라도 특정 문화적 상황에서 불편할 수 있으므로, 적절성은 맥락에 맞춰 평가해야 한다.
9.5 Cultural responsiveness
안전성 판단은 사회문화적 맥락에 따라 달라지지만, 이 연구의 데이터와 평가자는 일부 집단을 충분히 대표하지 못한다. 저자들은 참여형 fine-tuning을 통해 관련 공동체가 데이터 수집과 선별에 참여하도록 제안한다.
9.6 Impersonation and anthropomorphization
사람과 유사한 대화는 사용자가 시스템에 인격을 부여하거나 시스템을 사람으로 오인하게 만들 수 있다. 논문은 기만, 조작, 개인 사칭을 가능한 오용 위험으로 지목한다.
9.7 Future work
향후 연구 과제로는 안전성 목표와 레이블이 달린 데이터 확대, 크라우드워커 모집과 평가 개선, 애플리케이션별 절충 관계 연구가 제안된다. 저자들은 애플리케이션에 따라 추론 시 판별기의 임계값을 조정하는 방안도 제시한다.
10 Energy and Carbon Footprint Estimate of LaMDA
저자들은 가장 큰 모델의 사전 학습에 451 MWh가 들었고, 모든 모델의 사전 학습과 fine-tuning에서 약 26 tCO2e가 배출되었다고 추정한다. 추정에는 데이터 센터의 전력 사용 효율 1.10과 kWh당 0.056 kg CO2e의 에너지 믹스를 사용한다. 논문은 GPT-3와 비교한 탄소 배출량 차이의 상당 부분을 에너지 믹스에 기인한다고 설명한다 [108].
11 Conclusion
연구 결과, 주석을 활용한 fine-tuning과 외부 정보 검색은 모델 규모 확대만으로 얻는 수준보다 대화 지표를 개선한다. 동일한 역할 사전 조건화에서 사전 학습 모델과 fine-tuning 모델 2가지 모두 응답 5개 중 4개 초과에서 역할을 유지하며, fine-tuning한 애플리케이션의 helpfulness가 더 높다.
부록
- Appendix A는 피해, 불공정한 편향, 허위 정보를 다루는 예시 안전성 목표를 정의한다. A.2는 자연스러운 대화, 민감한 주제의 대화, 적대적 대화를 생성하고 이후 발화마다 미국 크라우드워커 3명이 주석을 다는 과정을 설명한다. A.3은 25–34세의 과다 대표를 비롯한 인구통계학적 한계를 지적한다.
- A.4는 주석이 달린 발화 48,348개를 보고하며, 그중 41,810개는 안전하다고 분류되었다. B는 품질과 groundedness 평가 지침을 제공한다. C.1과 C.2는 PALMS [87]의 프롬프트를 포함한 안전성 응답을 비교한다. C.3은 grounding 응답을 비교하고, C.4는 근거를 갖춘 대화를 보여주며, C.5는 할당된 역할을 설명하고, C.6은 코딩과 추론 오류를 포함한 개방형 예시를 제공한다.
- D는 모델 하이퍼파라미터를 보고한다. E는 공개 포럼 대화 50%와 C4 데이터 [11], 코드 문서, 영어 Wikipedia 각각 12.5%를 포함하는 Infiniset의 구성을 제시한다. F는 각 모델과 처리 방식에 따른 foundation metric의 수치 결과를 제공한다.
짧은 생각
동일한 137B 기반 모델을 단계별로 비교하면 groundedness는 57.9%에서 품질 및 안전성 튜닝 후 67.9%로, grounding 튜닝 후 73.2%로 높아진다. 영어만 사용한 평가와 미국에 특화된 안전성 목표 때문에 다른 언어와 문화적 맥락에서의 성능은 검증되지 않았다.