


LLM360: Towards Fully Transparent Open-Source LLMs 요약 설명
11 Dec 2023 | Paper Review LLM Pretraining Research Reproducibility Code Generation목차
이번 글에서는 LLM360: Towards Fully Transparent Open-Source LLMs 논문의 핵심 포인트만 간단히 정리한다.
- 2023년 12월 11일(Arxiv)
- Liu, Zhengzhong, Qiao, Aurick, Neiswanger, Willie, Wang, Hongyi, Tan, Bowen, Tao, Tianhua, Li, Junbo, Wang, Yuqi, Sun, Suqi, Pangarkar, Omkar, et al.
- Petuum, MBZUAI, USC, CMU, UIUC, UCSD
- 논문 링크
- Github
요약
- LLM360은 학습 데이터, 코드, 중간 상태가 공개되지 않아 대규모 텍스트로 학습한 대규모 언어 모델(LLM)을 재현하고 연구하기 어려운 문제를 다룬다. 초기 공개에는 약 7B 규모의 모델 2개와 학습 산출물이 포함된다. 언어 과제 평균과 코드 과제 평균에 같은 가중치를 주는 논문의 평가에서 CRYSTALCODER는 41.65로 CodeLlama-7B의 39.94를 앞선다.
- 이 프레임워크는 모델의 초기 학습 과정인 사전학습 전반에서 데이터와 학습 순서, 구현과 설정, 체크포인트, 지표를 연결한다. 체크포인트는 저장된 모델 상태를 뜻한다. AMBER는 체크포인트 360개를 공개했으며, CRYSTALCODER는 143개를 공개했다. CRYSTALCODER는 영어와 코드를 사용하는 3단계 학습에서 총 약 13820억 토큰을 처리한다. 토큰은 모델이 처리하는 텍스트 단위다.
- 공개된 산출물은 AMBER 체크포인트 전반의 벤치마크 성능 추적과 학습 데이터의 후속 구간을 정확히 재현하는지 분석하는 연구를 지원한다. 다만 AMBER는 학습 알고리즘이 누적한 이력인 옵티마이저 상태를 저장하지 않았고 초기 체크포인트도 낮은 정밀도로 저장해 학습 상태를 정확히 복구하는 데 한계가 있다. 보고된 벤치마크 4개의 평균도 45.20점으로 LLaMA-7B의 49.69점보다 낮다.
1 Introduction
서론은 불완전한 공개에 따른 문제 3가지를 제시한다. Data Provenance는 학습 데이터의 출처와 구성을, Reproducibility는 보고된 학습과 평가를 반복할 수 있는 능력을, Open Collaboration은 중간 학습 산출물에 접근해 수행하는 공동 연구를 뜻한다. 데이터가 비공개이면 편향과 벤치마크 누출, 즉 학습 데이터와 평가 데이터의 중복을 조사하기 어렵다. 코드와 체크포인트가 없으면 연구자는 비용이 큰 학습을 반복해야 한다. LLM360은 정확한 사전학습 데이터, 모델과 학습 설정, 저장된 체크포인트, 수집한 평가 결과를 공개하자고 제안한다.
2 Related Work
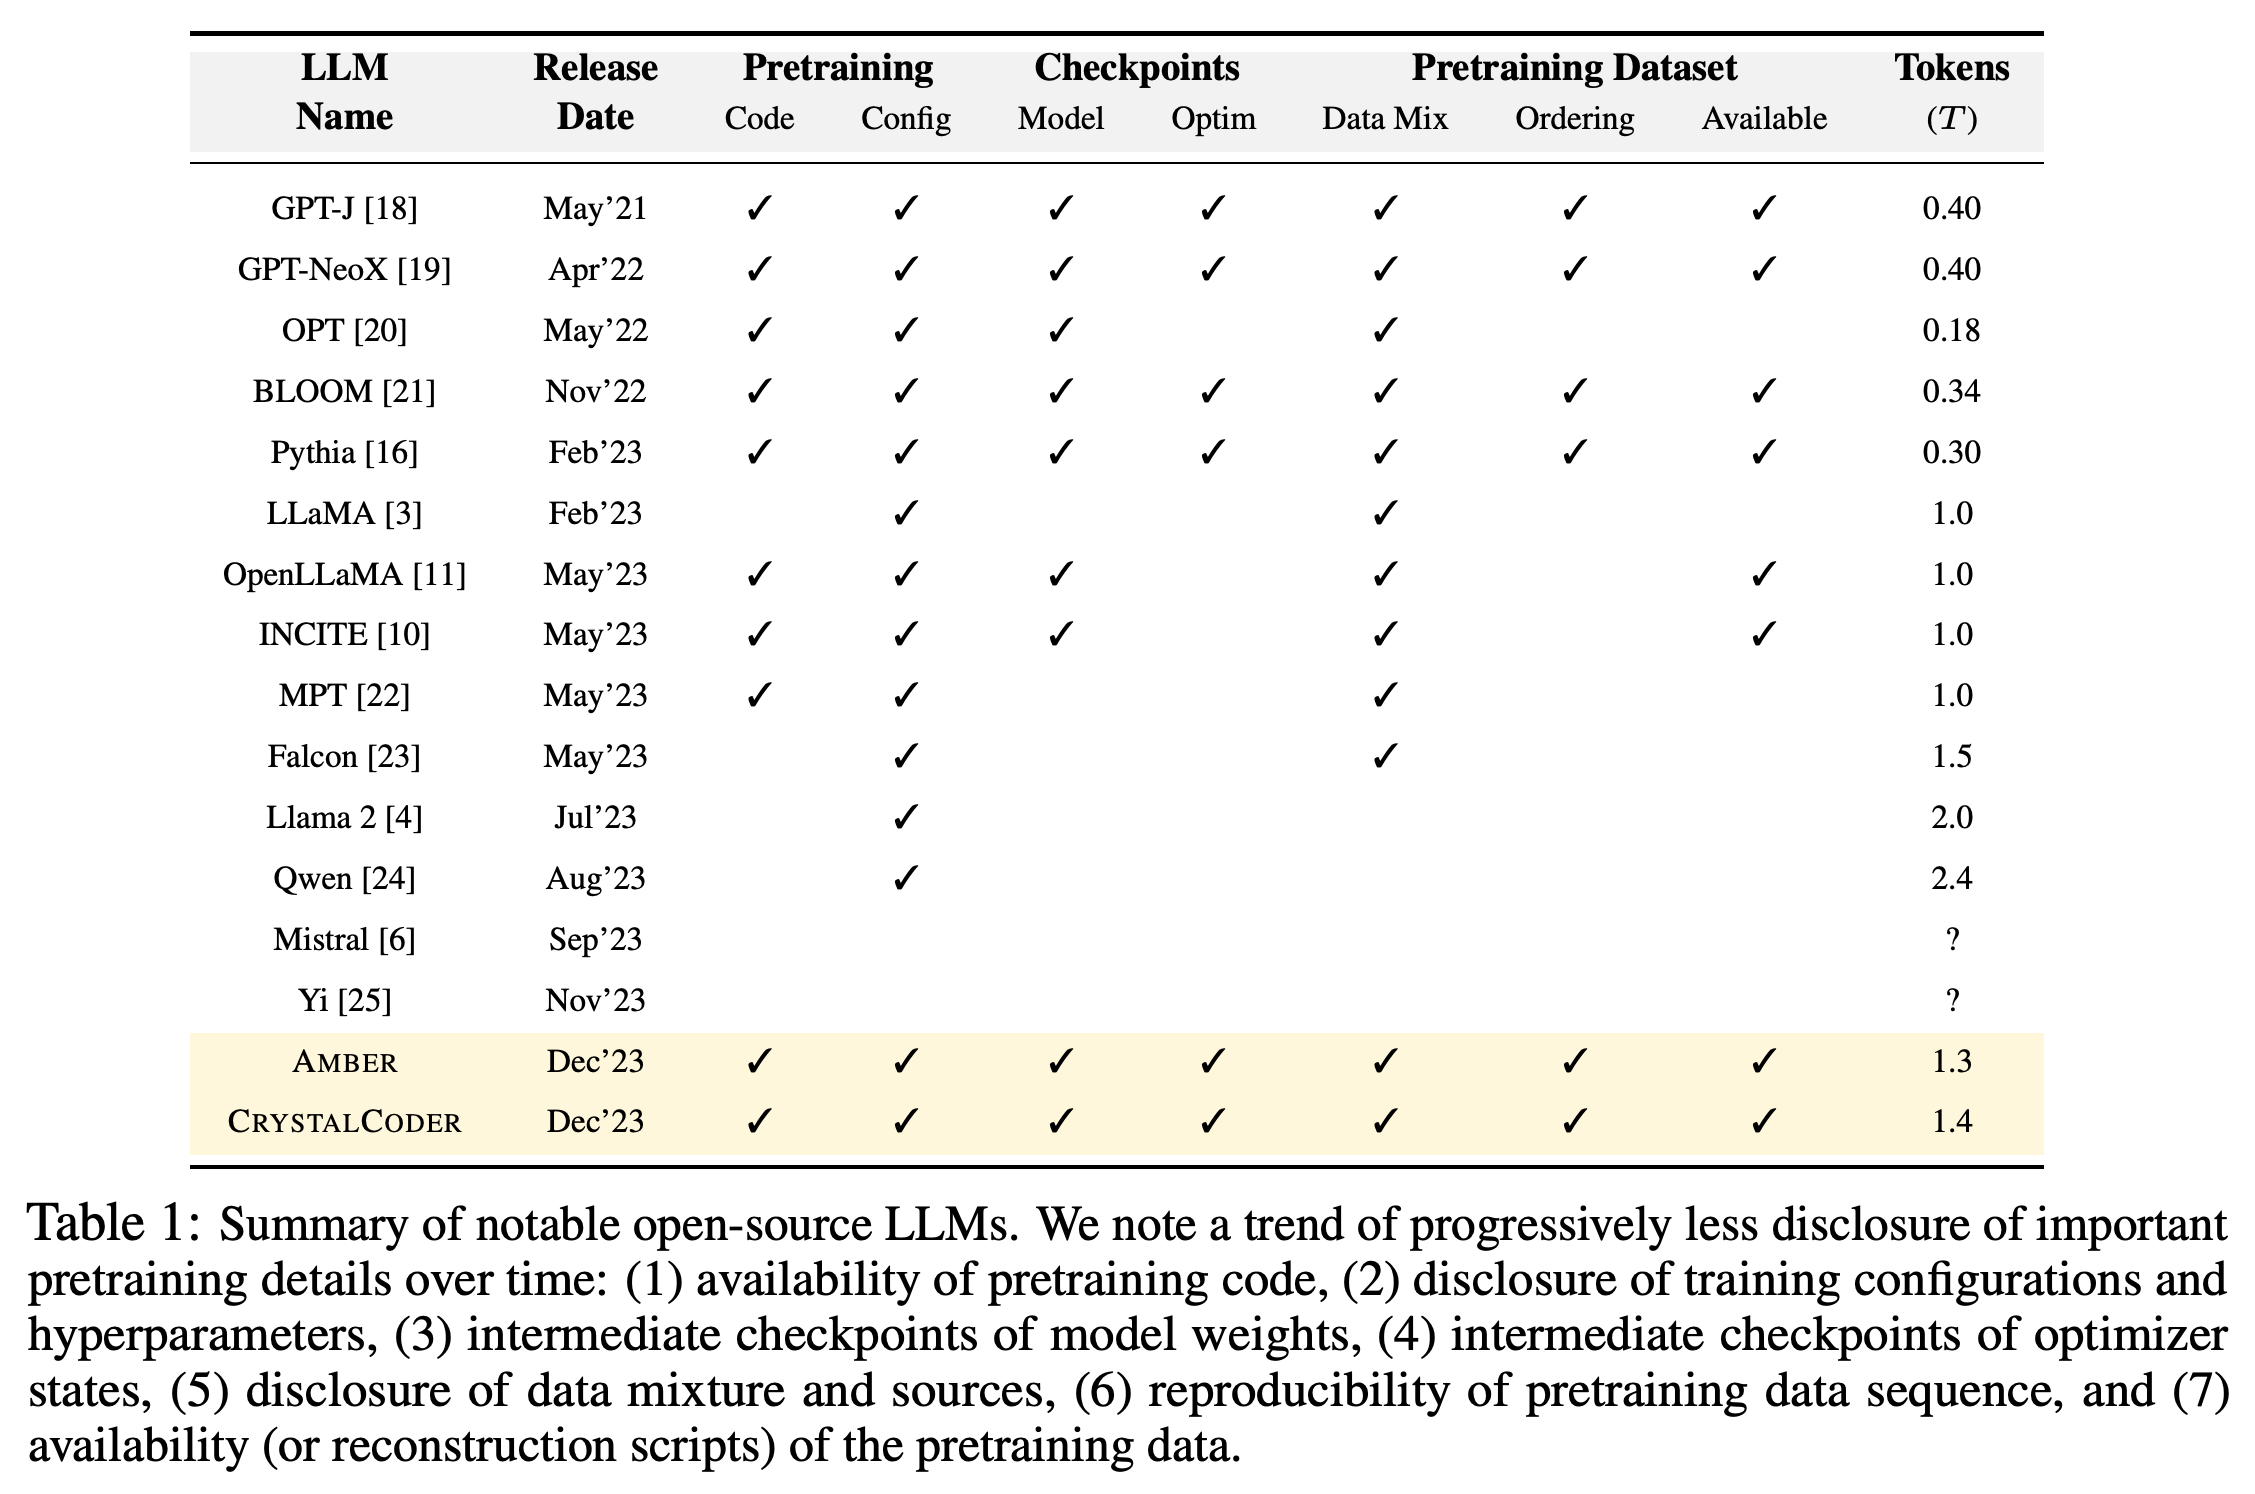
가장 가까운 선행 연구인 Pythia는 학습 양상과 스케일링을 연구할 수 있도록 파라미터 규모가 70 million에서 12B에 이르는 모델에 체크포인트 154개를 제공한다. LLM360은 이 접근을 1조 토큰 규모의 학습과 단계별 언어, 코드 혼합 학습으로 확장한다. 저자들은 AMBER가 공개 벤치마크에서 Pythia-12B를 앞선다고 서술하지만, 이 절에는 수치 비교가 없다. Table 1은 산출물을 일곱 범주로 나눠 공개 여부를 비교한다. 그러나 AMBER의 옵티마이저 체크포인트 공개 표시는 해당 상태를 저장하지 않았다는 Section 4.1.5의 설명과 모순된다.
이 비교는 공개성을 산출물 범주 7개로 나눠 학습을 조사하는 데 필요한 자료를 어떤 모델이 공개했는지 보여준다. AMBER와 CRYSTALCODER에는 모든 항목에 공개 표시가 있지만, AMBER의 옵티마이저 상태 공개 표시는 Section 4.1.5의 설명과 모순된다.
3 The LLM360 Framework
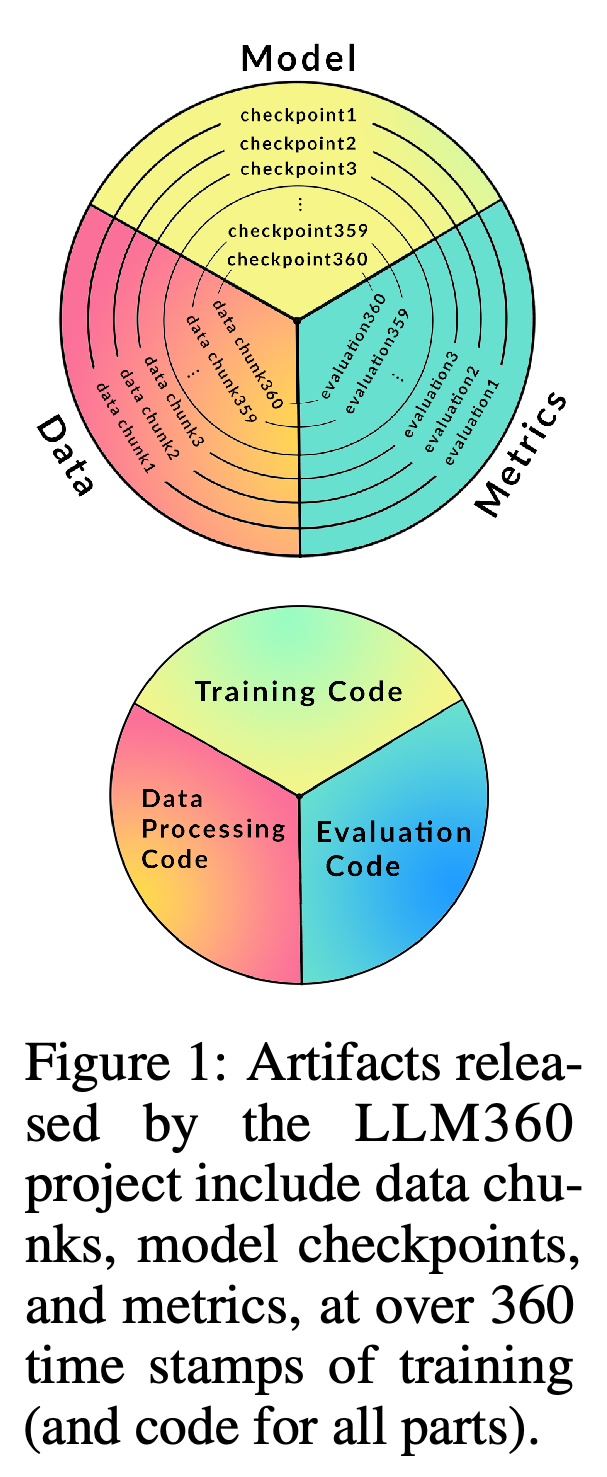
LLM360 Framework는 서로 연결된 공개 구성 요소 4가지를 명시한다. Training Dataset and Data Processing Code, Training Code, Hyperparameters, and Configurations, Model Checkpoints, Metrics다. 이 프레임워크는 모델 가중치와 해당하는 옵티마이저 이력을 공개하고, 시스템 활용률, 학습 손실, 기울기 노름, 다운스트림 평가를 데이터 청크와 체크포인트에 맞춰 제공할 것을 권장한다. 여기서 손실은 학습 목적함수를 측정한 값이며, 기울기 노름은 모델 파라미터 갱신에 사용하는 기울기의 크기를 요약한다.
- 저자들은 데이터, 모델 연산, 연속된 모델 단계를 장치에 분산하는 data-model-pipeline 병렬화를 조정하면 Nvidia A100 클러스터에서 PyTorch FSDP보다 처리량이 최대 15% 높아진다고 보고한다. FSDP는 상태를 완전히 분할하는 데이터 병렬 학습 방식이다. 보고서에는 상세한 처리량 비교가 없다.
- 저자들은 모델의 위치 표현인 rotary positional embeddings(RoPE)에 사용하는 역주파수 행렬을 32비트 부동소수점 정밀도인 FP32로 유지해야 한다고도 보고한다.
- 학습 지표는 https://wandb.ai/llm360/projects 에, 분석 코드는 https://github.com/llm360/analysis360 에 연결되어 있다.
이 도식은 학습 전반의 모델 체크포인트, 데이터 청크, 지표를 대응시키고 이를 지원하는 코드를 함께 묶는다. 이 대응 관계로 특정 체크포인트를 분석할 수 있다. 도식에 나타난 개수가 각 공개 모델의 실제 체크포인트 수를 뜻하지는 않는다.
4.1 Amber
초기 모델 공개에서는 범용 영어 모델 AMBER와 추가 학습으로 조정한 변형 모델 AMBERCHAT, AMBERSAFE를 소개한다. 보고서는 AMBER를 7B 모델로 부르지만, 아키텍처 표에는 6.7B 파라미터로 명시되어 있다.
영어 모델과 미세조정 변형 모델을 소개하는 부분에 호박 삽화를 배치해 AMBER를 나타낸다.
4.1.1 Details on Data Preparation and Model Architectures
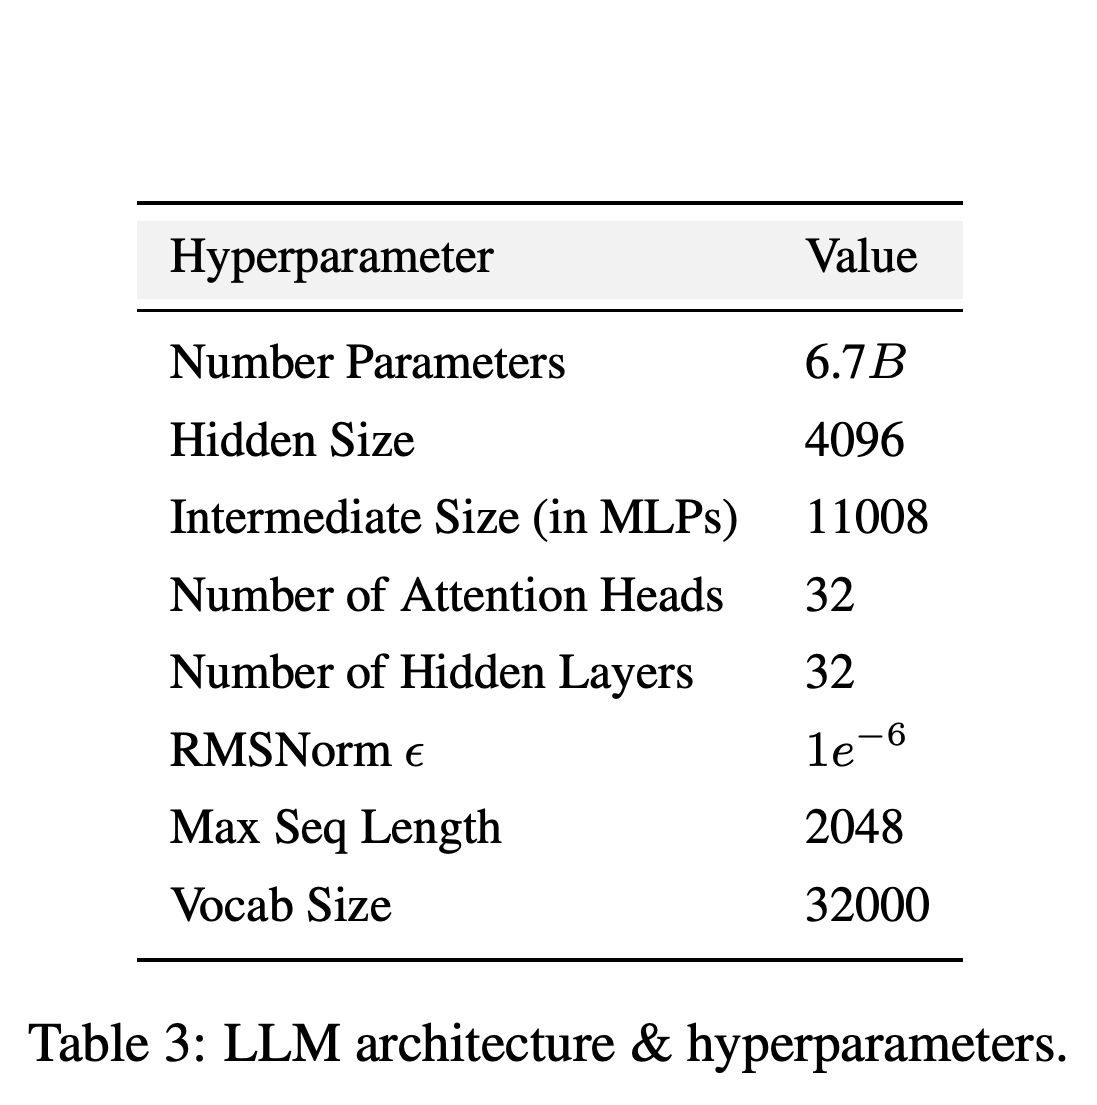
AMBER는 C4를 포함한 RedPajama-v1 데이터와 RefinedWeb, StarCoder를 추가 정제, 필터링, 서브샘플링 없이 결합한다. 보고된 12591.3억 토큰을 전체적으로 섞은 뒤 같은 크기의 청크 360개로 나눈다. LLaMA-7B 아키텍처를 사용하며, 레이어 32개, 어텐션 헤드 32개, 은닉 크기 4096, 중간 크기 11008, 최대 시퀀스 길이 2048, 어휘 크기 32000으로 구성된다.
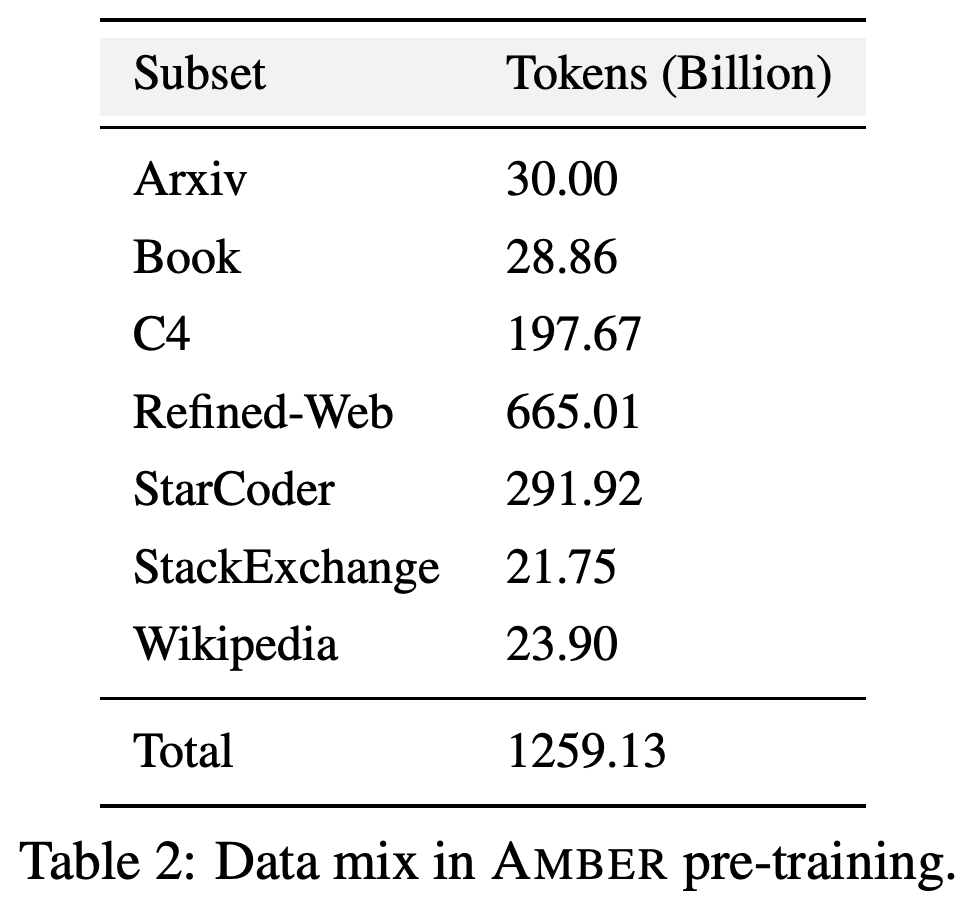
- Table 2에는 Arxiv 30.00B, Book 28.86B, C4 197.67B, Refined-Web 665.01B, StarCoder 291.92B, StackExchange 21.75B, Wikipedia 23.90B 토큰이 나열되어 있다. B는 1,000,000,000을 뜻한다. Refined-Web이 가장 큰 비중을 차지한다.
- 모델 파라미터를 갱신하는 알고리즘인 AdamW 옵티마이저는 β1 = 0.9, β2 = 0.95를 사용한다. 학습률은 코사인 스케줄에 따라 3e−4에서 3e−5로 줄이며, 가중치 감쇠는 0.1, 기울기 클리핑 임계값은 1.0, 워밍업은 2,000스텝으로 설정한다.
- 배치 크기는 224 × 10으로 계산한 2,240이며, LLaMA의 2,048과 다르다. Table 3은 아키텍처의 정규화 연산인 RMSNorm에 ε = 1e−6을 사용한다고 명시한다.
Refined-Web은 665.01 billion 토큰을 제공하고 StarCoder의 기여량은 291.92 billion이다. 이들은 보고된 혼합 데이터(1259.13, 단위: billion-token)에서 가장 큰 비중을 차지하는 두 출처다. 이 수치는 AMBER 학습에 사용한 데이터 구성을 명시한다.
설정은 AMBER의 파라미터 수를 6.7B로 명시하며, 깊이, 너비, 어텐션 헤드, 문맥 길이, 어휘 크기를 제시한다. 이를 통해 LLaMA-7B와 아키텍처를 비교할 수 있으며, 주변 절에는 학습 데이터와 실행 방식의 차이가 기록되어 있다.
4.1.2 Details on the Pre-training Infrastructure
AMBER는 노드마다 80GB A100 그래픽 처리 장치 네 개를 갖춘 DGX A100 노드 56개에서 총 장치 224개로 학습한다. 장치 간에는 장치당 NVLink 연결 네 개를, 노드 간에는 포트 두 개를 사용하는 200 Gb/sec InfiniBand 연결을 사용한다. 보고된 처리량은 초당 약 582.4k 토큰이다. PyTorch Lightning 기반의 lit-llama 구현은 혼합 정밀도를 사용한다. 활성화와 기울기에는 16비트 부동소수점 형식인 BF16을, 모델 가중치에는 FP32를 사용한다.
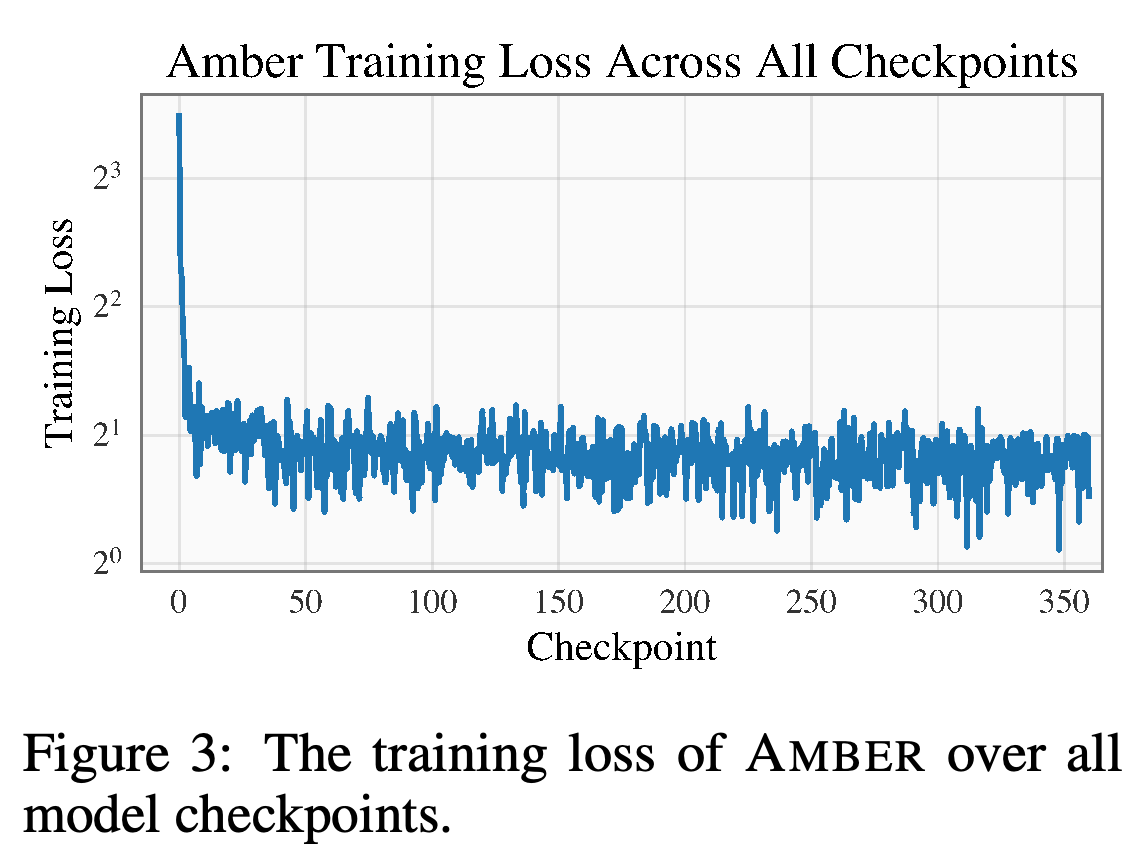
- Figure 3에서는 학습 손실이 초기에 급격히 줄어든 뒤 체크포인트마다 변동하면서 완만하게 감소한다. 수치 연산 실패와 체크포인트 문제는 Section 4.1.5에 별도로 기록되어 있다.
- 구현은 https://github.com/Lightning-AI/lit-llama 에 연결되어 있다.
학습 손실은 초기화 직후 급격히 감소한 뒤 변동을 보이며 점차 완만하게 개선된다. 이 곡선은 체크포인트 전반의 최적화 진행을 요약한다. 학습 과정을 해석할 때는 별도로 보고된 청크 건너뛰기와 체크포인트 문제를 함께 고려해야 한다.
4.1.3 Finetuned AMBER models
이 절은 AMBERCHAT을 WizardLM이 사용한 진화형 지시 데이터로 미세조정했다고 설명한다. FastChat 학습 프레임워크와 FSDP를 사용해 80GB A100 장치 여덟 개에서 3에포크 동안 학습한다. 에포크는 데이터를 순회하는 횟수를 뜻한다. 학습률은 2 × 10⁻⁵, 기울기 누적 횟수는 16, 워밍업 비율은 0.04다. 기울기 누적은 여러 스텝의 기울기를 모은 뒤 파라미터를 갱신하는 방식이다. AMBERSAFE는 ShareGPT 90K로 학습한 뒤, 안전성 정렬에 사용하는 인간 선호 데이터셋 SafeRLHF에서 추가로 최적화한다. 이때 β = 0.1, 기울기 누적 네 스텝, 학습률 5 × 10⁻⁷을 사용한다.
- 보고서는 정렬 절차를 “Direct Parameter Optimization (DPO)”이라고 부르지만, 인용한 참고문헌 [39]의 제목은 “Direct preference optimization: Your language model is secretly a reward model”이다. AMBERSAFE에는 이 선호 기반 최적화 절차를 사용한다.
- ShareGPT 90K 각주는 최종 체크포인트 대신 체크포인트 355를 기반으로 사용했다고 명시한다. Section 4.1.4도 ShareGPT 90K를 사용한 AMBERCHAT 실험을 설명하므로, WizardLM 데이터를 사용한 학습 방법과 어떤 관계인지는 불분명하다.
4.1.4 Results and Analysis
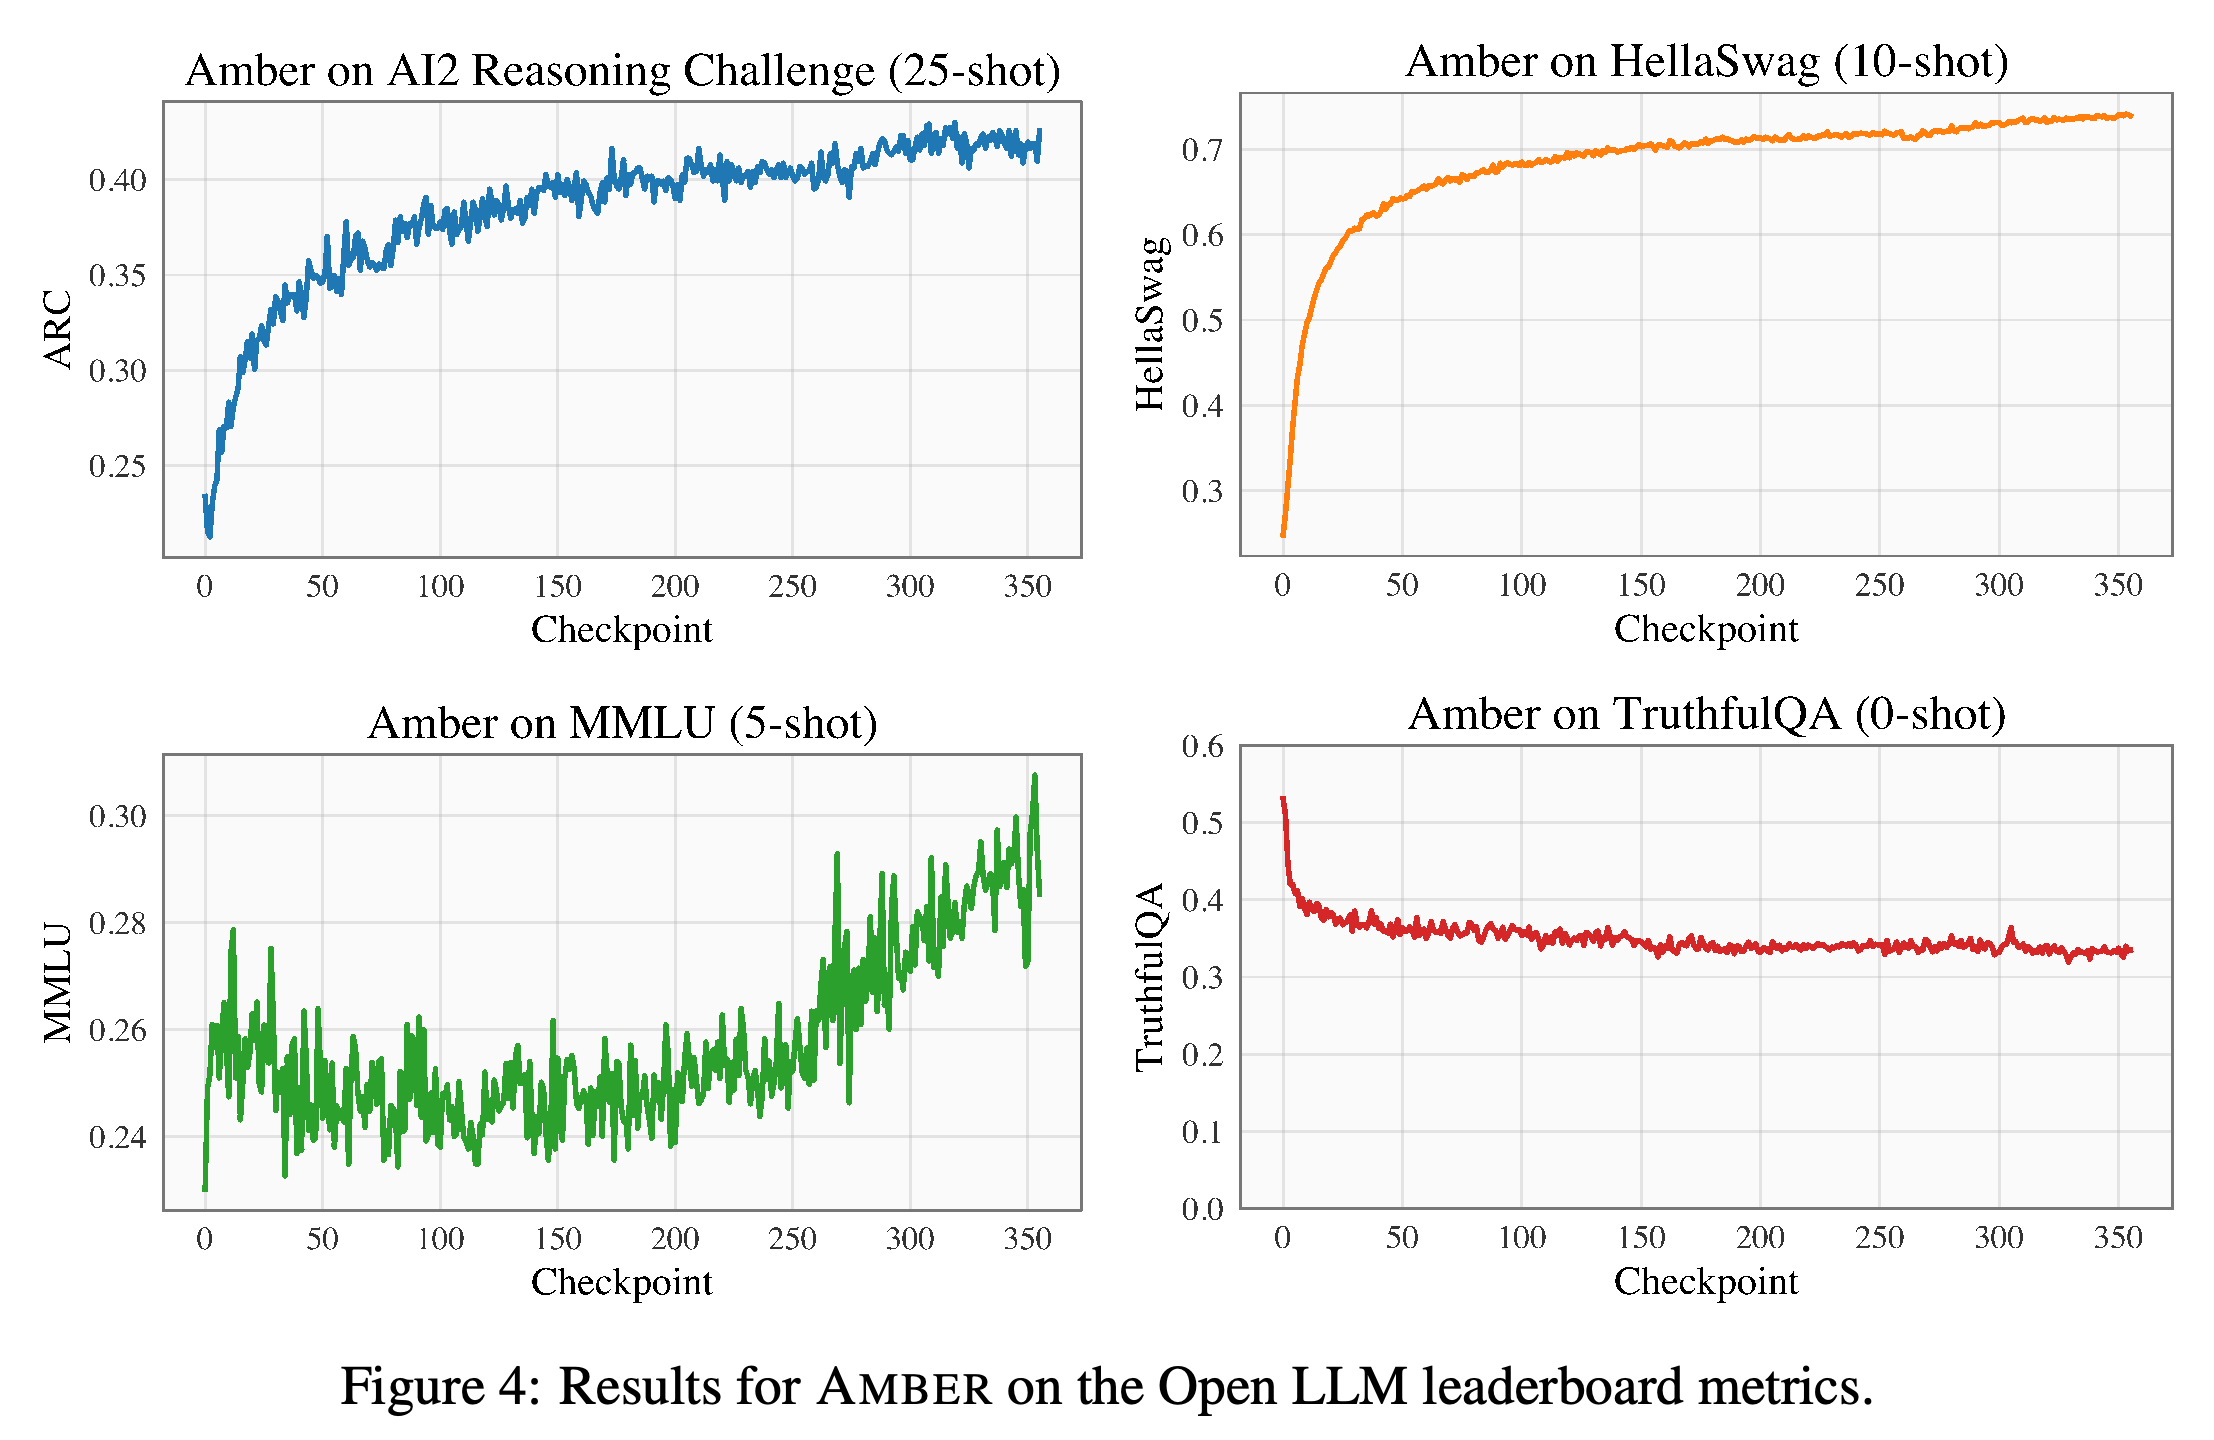
AMBER 체크포인트 360개 전체를 Open LLM Leaderboard의 벤치마크 4개로 평가한다. ARC는 AI2 Reasoning Challenge이며, HellaSwag와 MMLU는 이 평가 모음에 포함된 언어 평가 데이터셋 2개다. TruthfulQA는 진실성을 평가한다. Figure 4는 ARC 25-shot, HellaSwag 10-shot, MMLU 5-shot, TruthfulQA 0-shot을 명시한다. shot 수는 평가에 제공하는 예시 수를 뜻한다. ARC와 HellaSwag는 전반적으로 향상되고, MMLU는 초기에 하락한 뒤 회복하며, TruthfulQA는 사전학습이 진행될수록 하락한다.
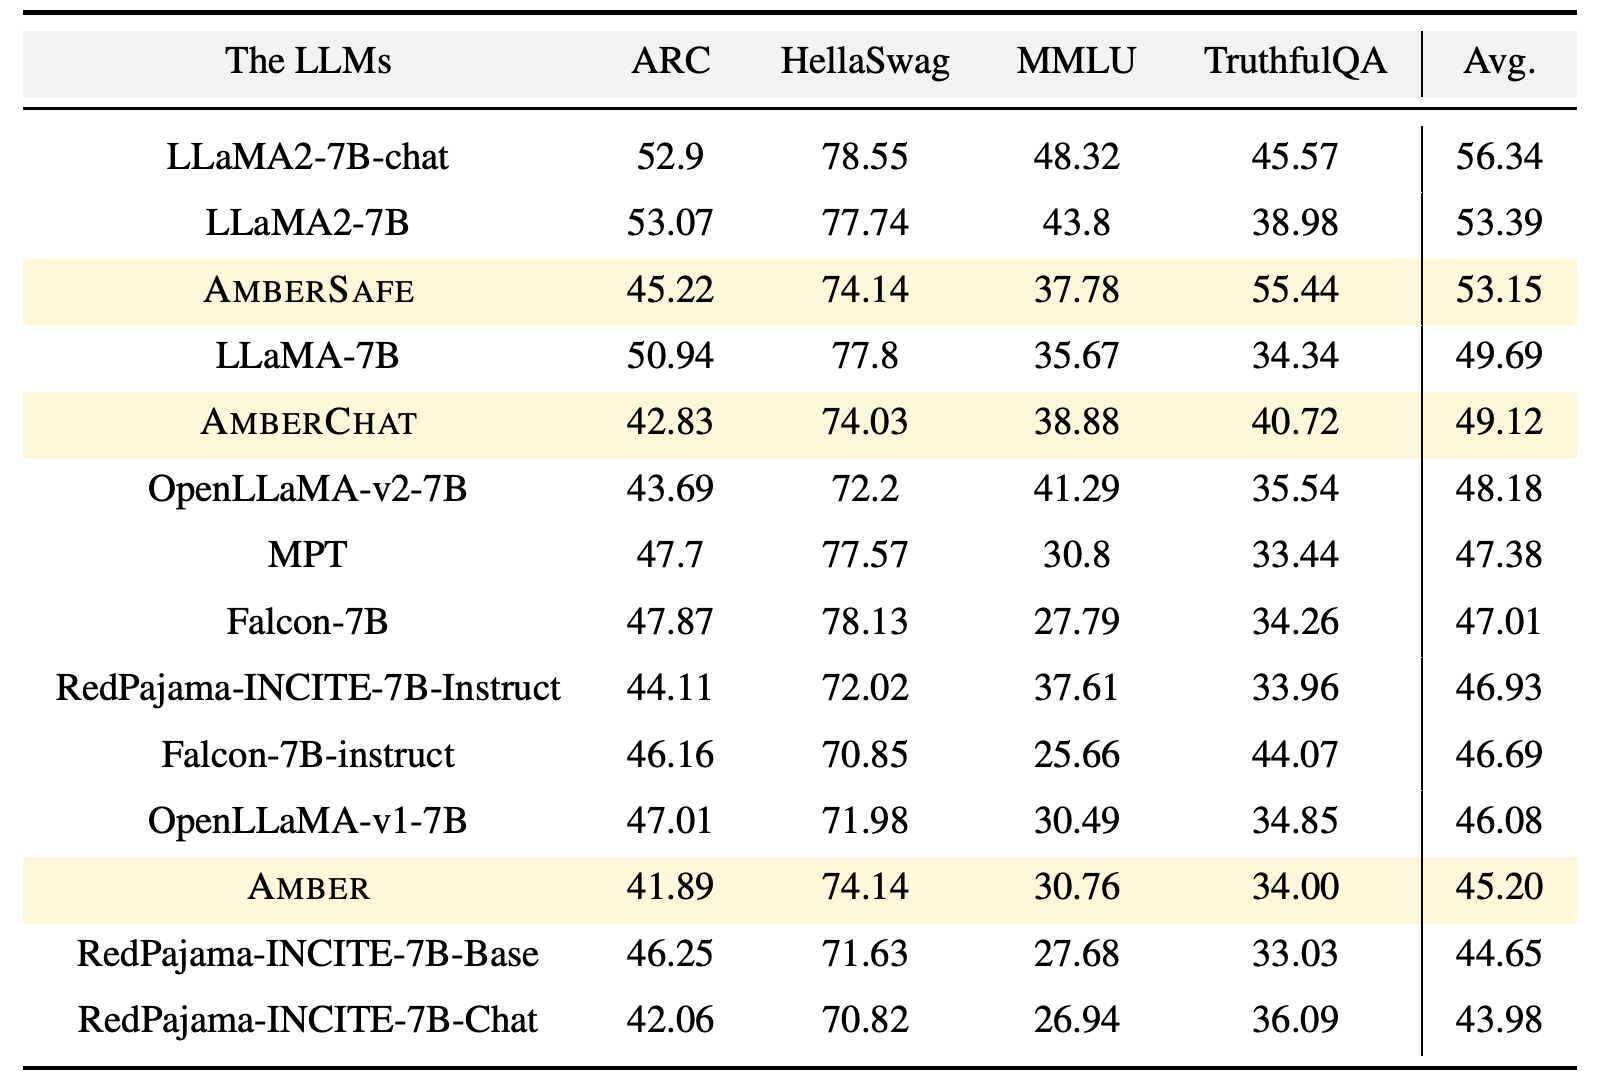
- Table 4에서 AMBER는 ARC 41.89점, HellaSwag 74.14점, MMLU 30.76점, TruthfulQA 34.00점으로 평균 45.20점을 기록한다. 평균은 RedPajama-INCITE-7B-Base의 44.65점보다 높지만, OpenLLaMA-v2-7B의 48.18점과 LLaMA-7B의 49.69점보다 낮다.
- AMBERCHAT의 평균은 49.12점이고 AMBERSAFE의 평균은 53.15점이다. AMBERSAFE의 TruthfulQA 점수는 55.44점으로 AMBER의 34.00점보다 높다. 다만 이 평가들은 안전성을 포괄적으로 측정하지 않는다.
- 저자들은 ARC와 HellaSwag 점수가 단조 증가한다고 설명한다. 그래프의 체크포인트에는 국소적인 변동이 있어, 전반적인 상승 추세로 해석할 수 있다.
ARC와 HellaSwag는 전반적으로 상승하고, MMLU는 초기에 하락한 뒤 개선되며, TruthfulQA는 하락한다. 평가 조건은 각각 25-shot, 10-shot, 5-shot, 0-shot이다.
AMBER의 평균 45.20점은 LLaMA-7B의 49.69점보다 낮으며, AMBERCHAT과 AMBERSAFE는 각각 49.12점과 53.15점에 도달한다. AMBERSAFE의 TruthfulQA 55.44점은 표에서 가장 높지만, 이 벤치마크는 안전성을 포괄적으로 측정하지 않는다.
4.1.5 Issues Encountered During Pre-training
AMBER는 데이터 청크 360개 중 4개에서 숫자로 표현되지 않는 손실값인 NaN 손실이 발생했다. 해당 청크를 건너뛰었으며, 학습 후반으로 옮겨도 같은 실패가 발생했다. 저자들은 처음 4개 청크를 반복해 학습률 스케줄을 완료했다. 또한 옵티마이저 상태를 저장하지 않아 학습 재개 시 AdamW 이력을 다시 초기화해야 했으며, 학습 가중치는 FP32로 유지하면서 체크포인트는 BF16으로 저장한 초기 버그도 공개했다.
- 저자들은 옵티마이저 이력 누락이 불안정성에 영향을 주었을 수 있고, 초기 체크포인트의 정밀도가 정확도를 낮췄을 수 있다고 제안한다. 어느 설명도 통제 실험으로 효과를 분리해 검증하지 않았다.
- 저장된 가중치는 분석과 추가 학습에 사용할 수 있지만, 옵티마이저 이력 누락과 초기 체크포인트의 낮은 정밀도로 인해 원래 학습 상태를 복원하는 데 한계가 있다.
4.2 CRYSTALCODER
CRYSTALCODER는 세 단계에 걸쳐 영어와 코드를 결합하며 총 약 1382B 토큰을 학습한다. 먼저 SlimPajama의 절반에서 약 345B 토큰을 학습한다. 다음으로 나머지 절반과 StarCoder의 2에포크에서 약 927B 토큰을 학습한다. 마지막으로 Python과 웹 관련 코드 100B 토큰, 10B SlimPajama 토큰을 학습한다. LLaMA-7B-like 아키텍처에 maximal update parameterization(muP)을 도입하며, 이는 참고문헌 [44]에서 하이퍼파라미터 전이와 연관된 파라미터화 방식이다. 은닉 차원의 처음 25%에 RoPE를 적용하고, 시퀀스 길이 2048과 하드웨어에서 효율적으로 지원하는 정규화 연산 LayerNorm을 사용한다. 보고서는 32032를 “embedding dimension”이라고 표현한다. 학습에는 Cerebras Condor Galaxy 1(CG-1)을 사용한다. 이는 4 exaFLOPS, 즉 초당 부동소수점 연산량 4 × 10^18, 코어 5400만 개를 갖춘 64-node system이다.
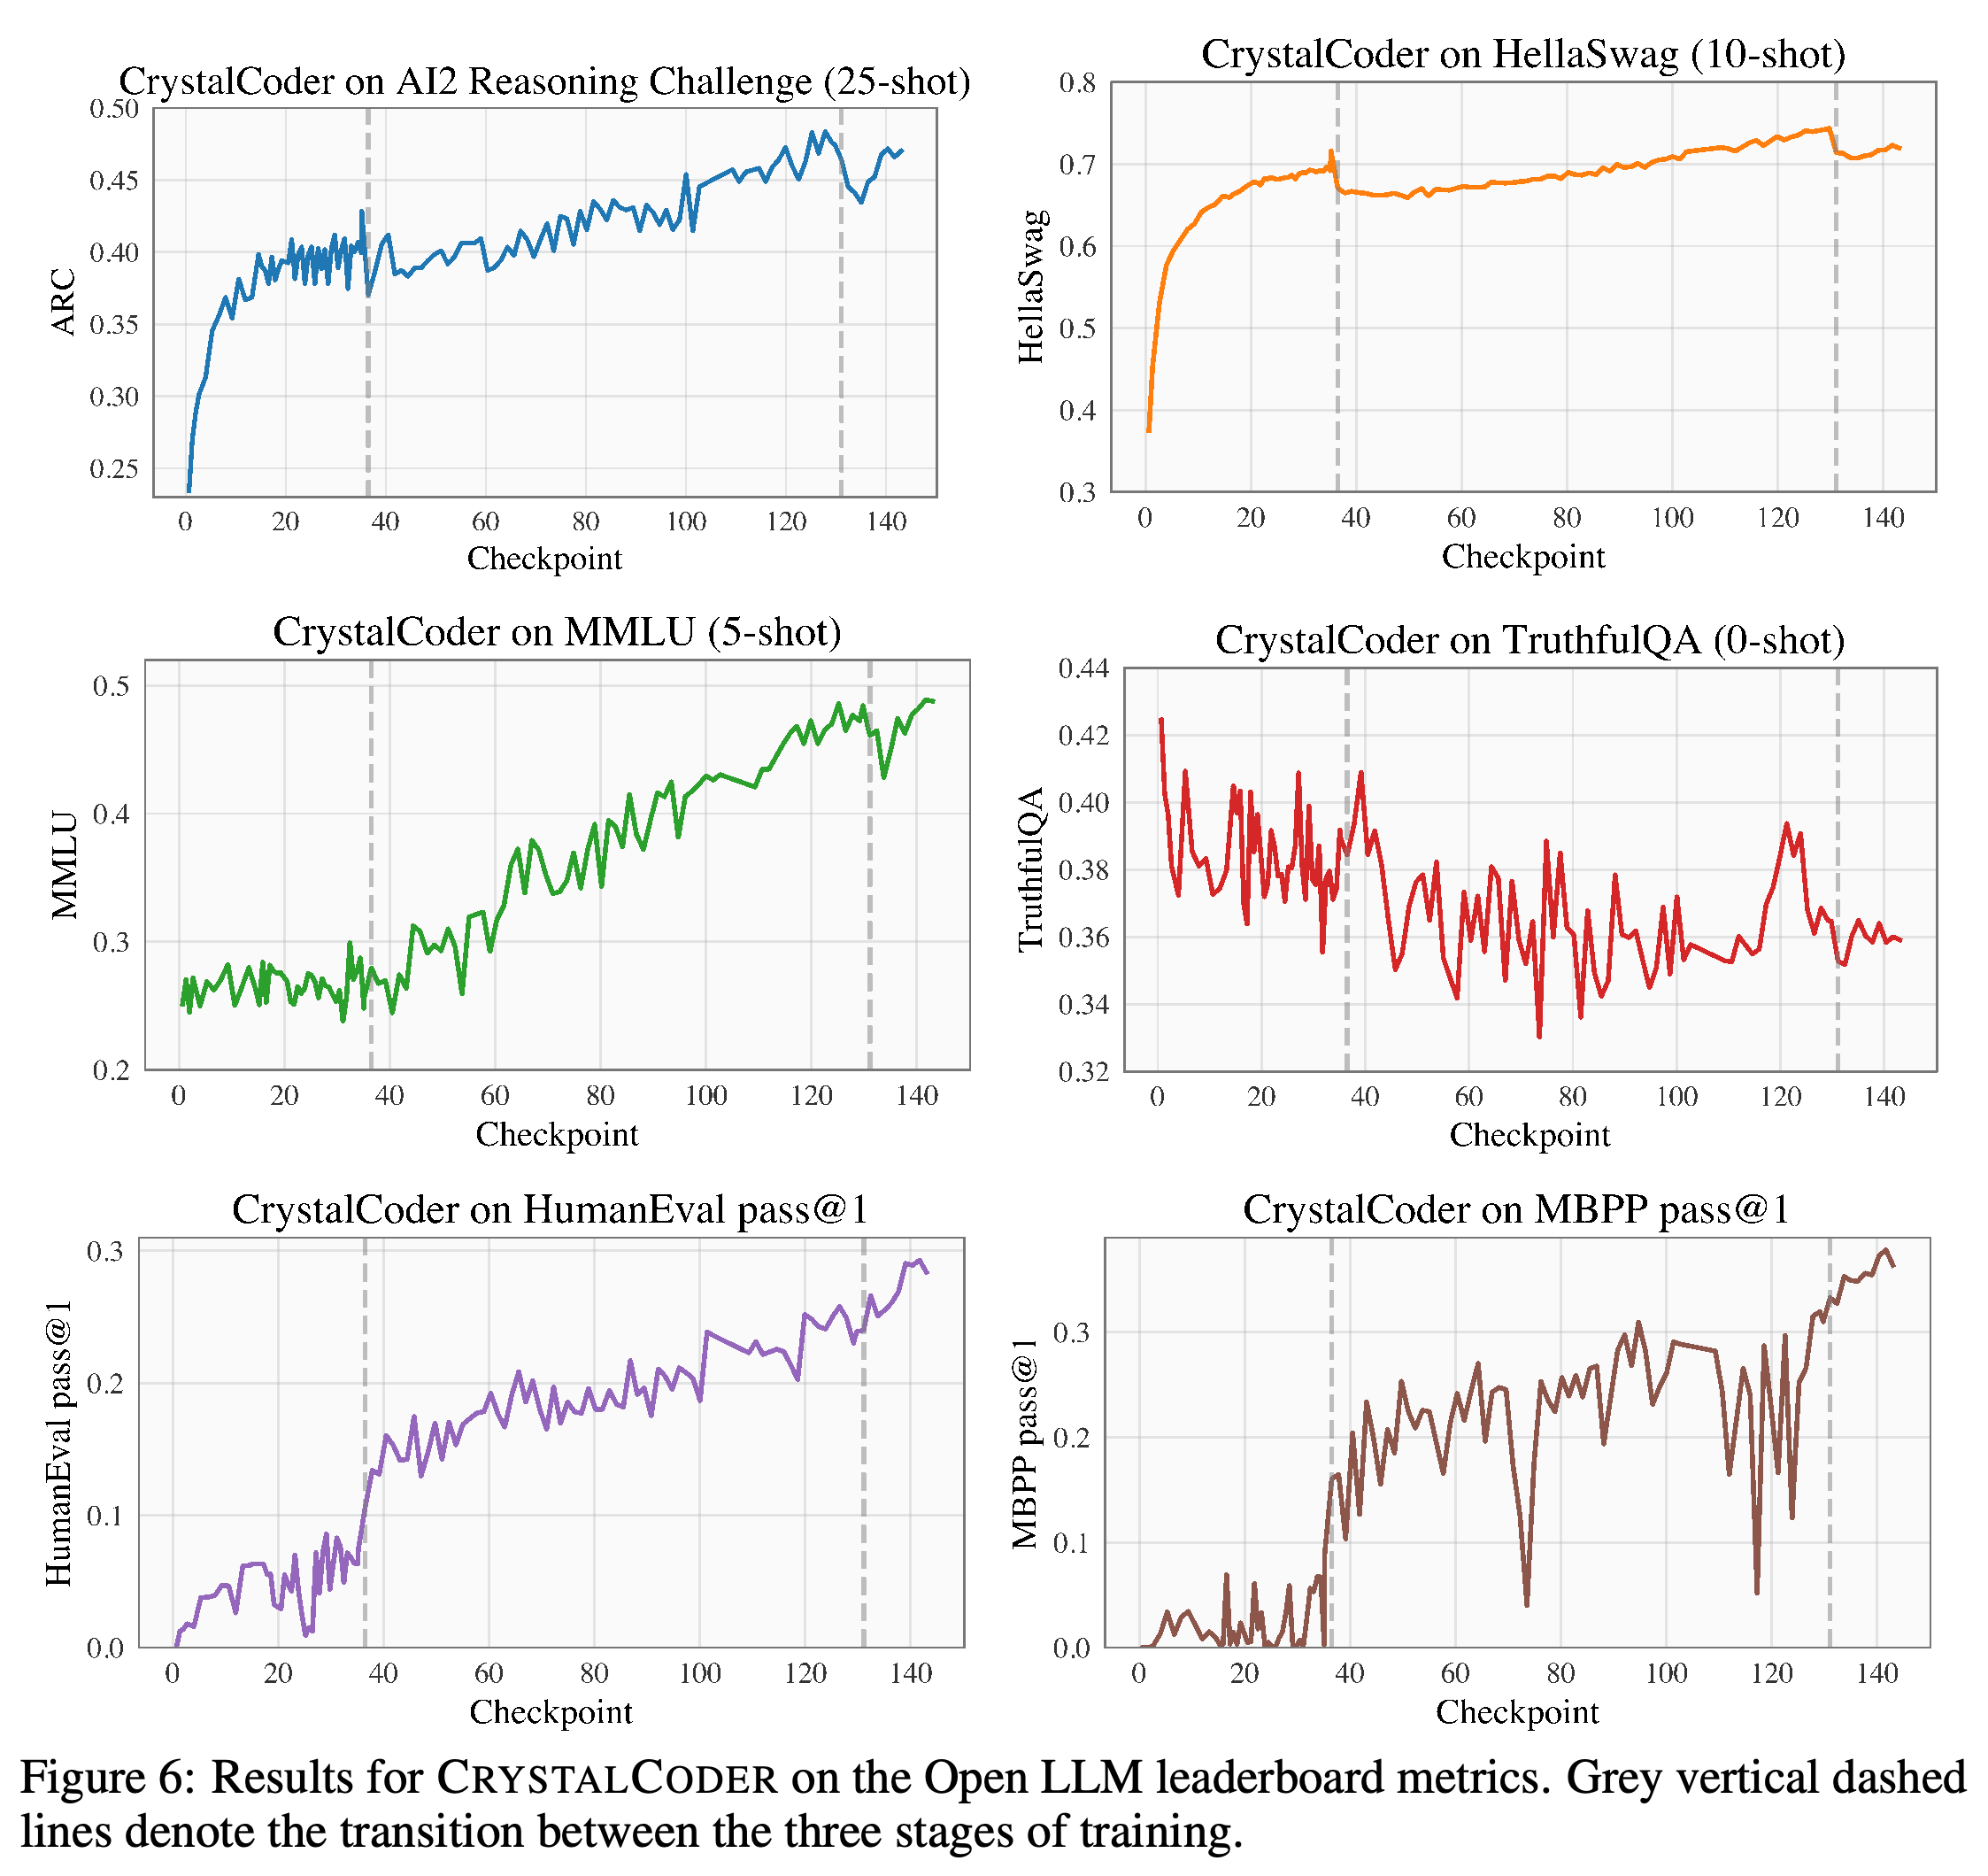
- Figure 6은 언어 벤치마크 4개와 코드 생성 벤치마크 2개인 HumanEval, MBPP의 성능을 추적한다. 코드 평가는 단일 시도 성공 지표인 pass@1을 사용한다. 단계 전환 시점에 벤치마크 추세도 달라지며, 코드가 학습에 포함된 뒤 코드 점수가 뚜렷하게 향상된다.
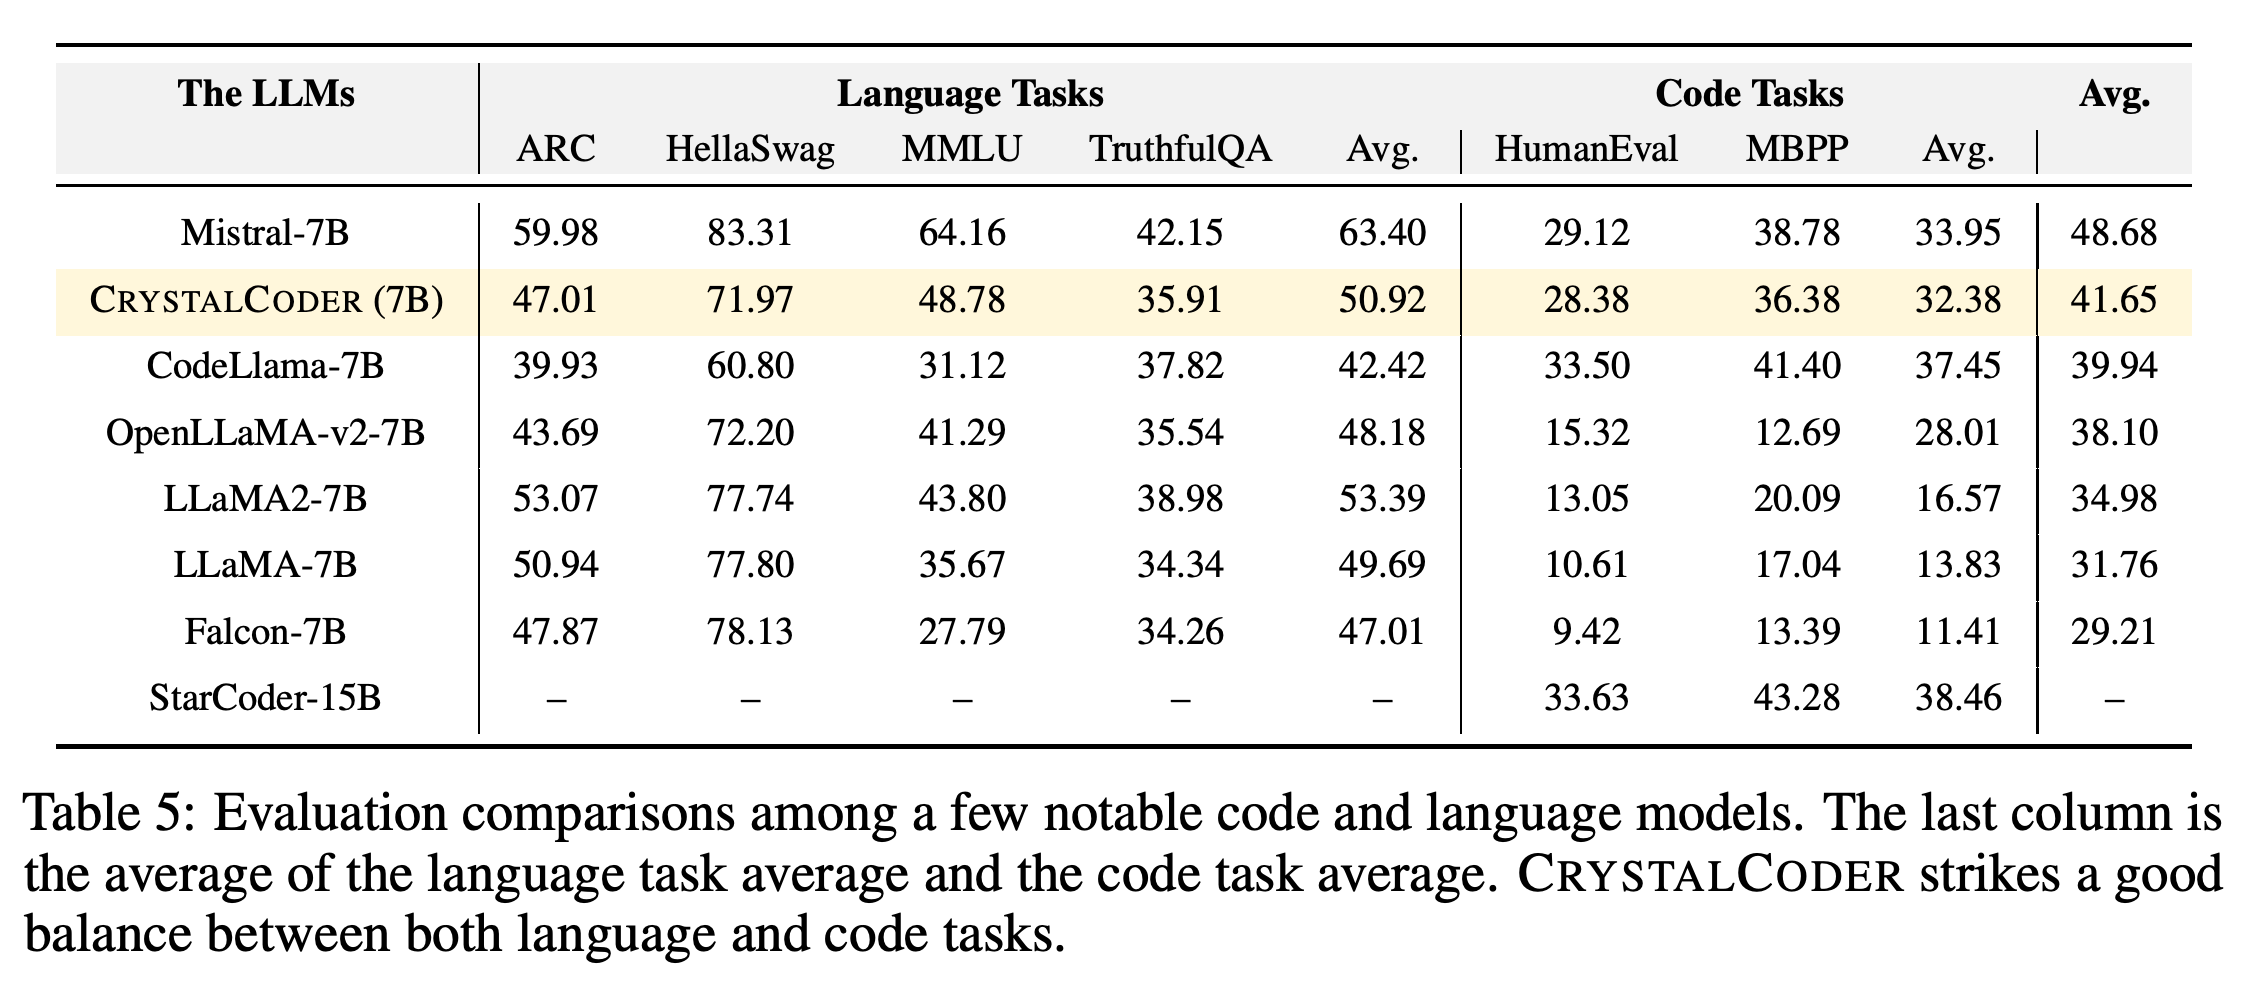
- Table 5에서 CRYSTALCODER의 언어 과제 평균은 50.92점, 코드 과제 평균은 32.38점이다. 같은 가중치를 적용한 전체 점수는 41.65점이다. CodeLlama-7B는 각각 42.42점, 37.45점, 39.94점이다. CRYSTALCODER는 언어 평균이 더 높고 코드 평균은 더 낮다.
- Mistral-7B의 전체 점수는 48.68점이며, 나열된 개별 벤치마크 모두에서 CRYSTALCODER를 앞선다. CRYSTALCODER의 전체 점수는 표에 나온 여러 베이스라인보다 높지만 비교 모델 중 최고는 아니다.
영어와 코드를 혼합한 학습 데이터를 설명하는 부분에 결정 삽화를 배치해 CRYSTALCODER를 나타낸다.
점선은 학습 단계 3개 사이의 전환 지점 2개를 표시한다. 코드 벤치마크 점수는 첫 전환 이후 크게 상승한다. HellaSwag는 단계 경계에서 하락하고 MMLU는 학습 후반에 크게 개선된다. 이러한 변화는 학습 데이터 혼합이 바뀌는 시점과 일치하지만, 인과적 효과를 분리해 보여주지는 않는다.
CRYSTALCODER의 50.92 language average와 32.38 코드 평균으로 계산한 전체 점수는 41.65다. CodeLlama-7B는 39.94, Mistral-7B는 48.68이다. 전체 점수는 과제 그룹 2개에 같은 가중치를 준다. OpenLLaMA-v2-7B의 보고된 코드 평균은 표에 기재된 두 코드 점수와 일치하지 않는다.
4.3 ANALYSIS360
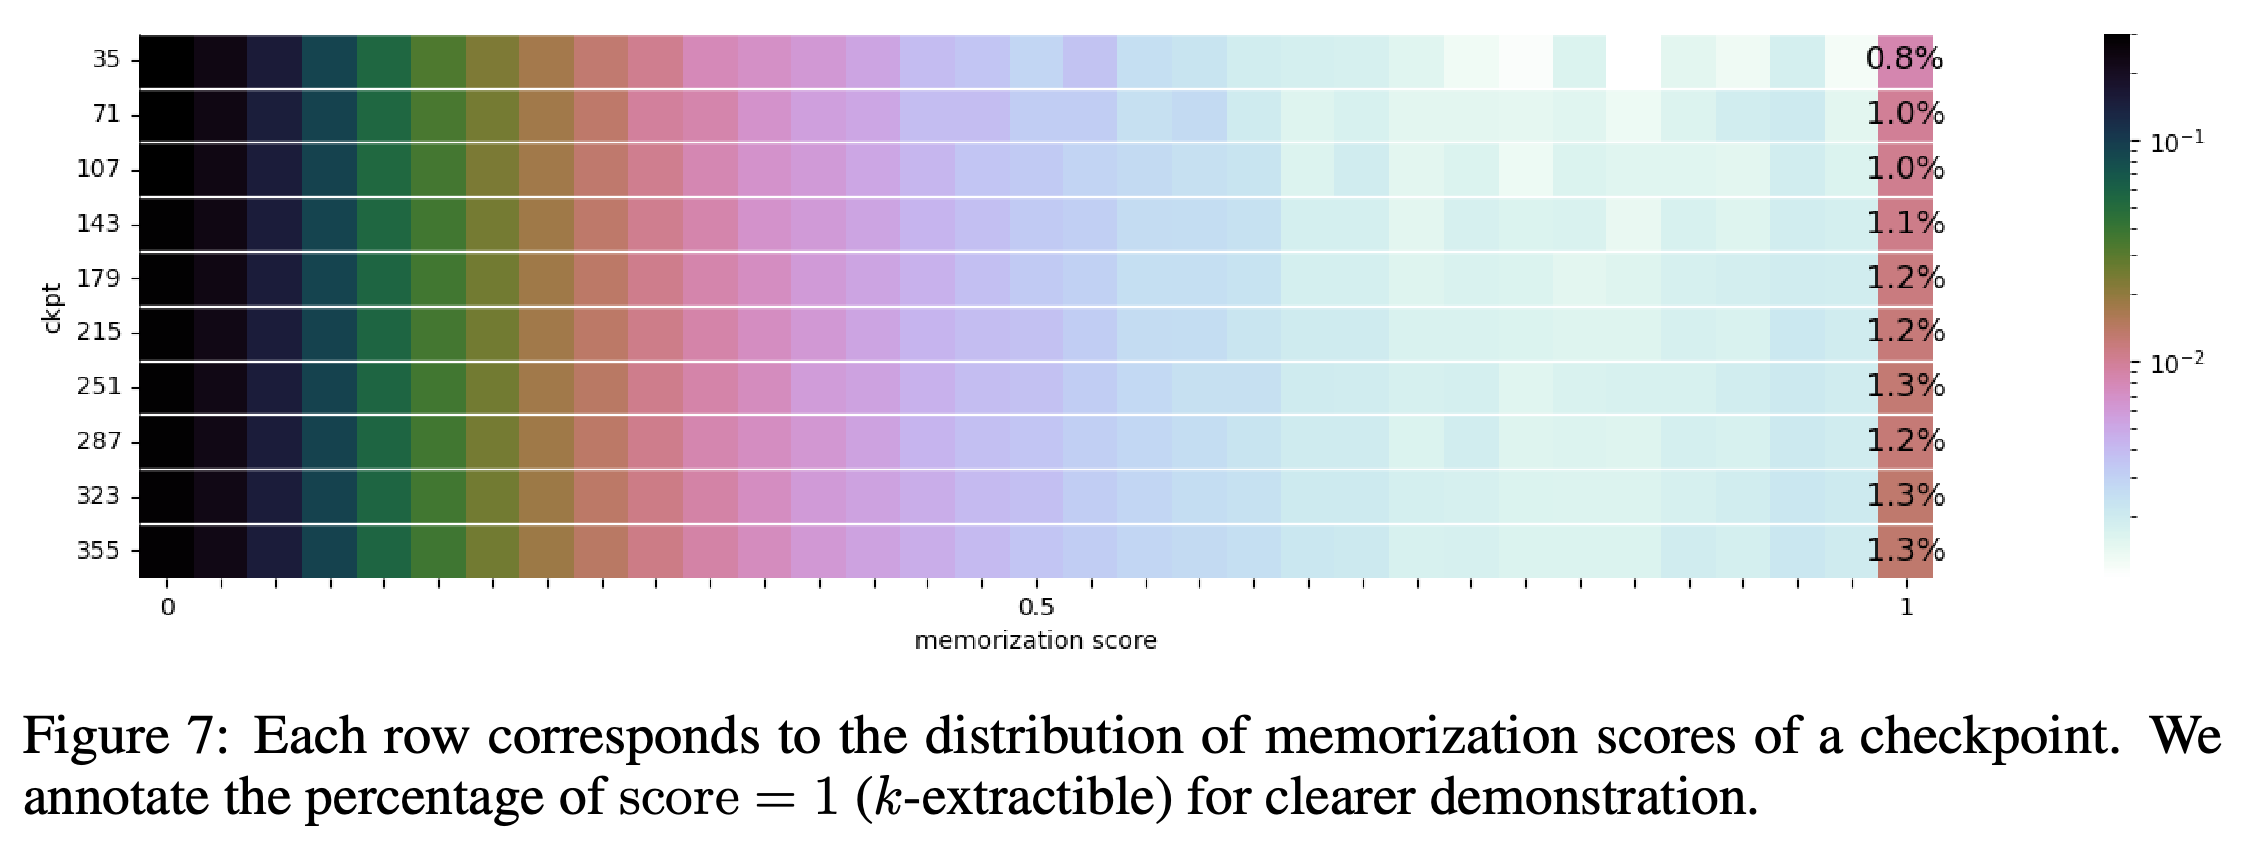
ANALYSIS360은 학습 시퀀스의 앞부분을 입력해 후속 구간을 생성할 때의 토큰 정확도로 암기를 측정하며, 체크포인트를 활용한 연구를 보여준다. 실험은 데이터 청크 360개에서 각각 시퀀스 1000개를 표본으로 뽑아 처음 64개 토큰을 사용한다. 이 중 32개 토큰을 프롬프트로 주고 후속 토큰 32개를 생성한다. 점수가 1이면 해당 시퀀스를 32-extractible로 분류하며, 이는 후속 구간을 정확히 재현했다는 뜻이다.
- 점수는 \(\operatorname{score}(k,l)=\frac{1}{l}\sum_{i=1}^{l}\mathbf{1}[S_{k+i}=G_{k+i}]\)로 계산한다. S는 학습 시퀀스이고 G는 생성한 후속 구간이며, 실험에서는 k = l = 32로 설정한다.
- Figure 7은 선택한 체크포인트 10개를 평가하며, 각 체크포인트에서 이미 학습한 청크만 사용한다. 표시된 완전 일치 비율은 중간에 변동하면서 체크포인트 35의 0.8%에서 체크포인트 355의 1.3%로 상승한다.
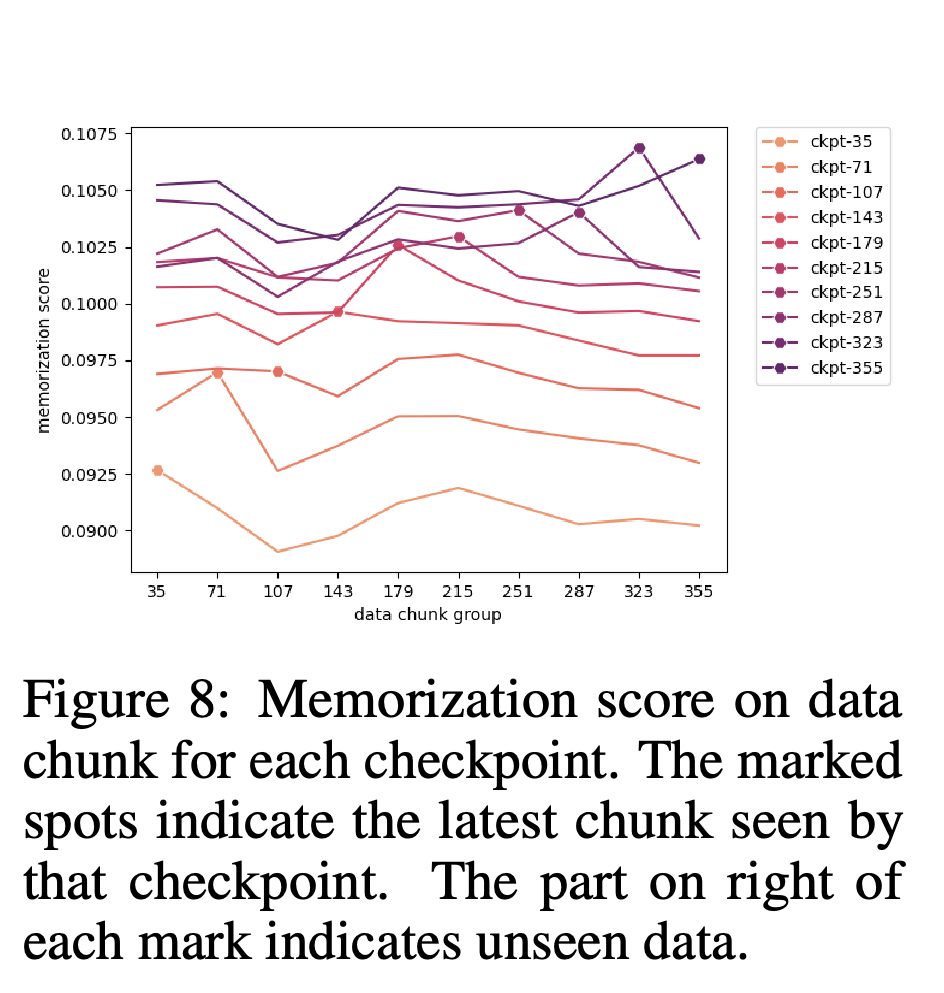
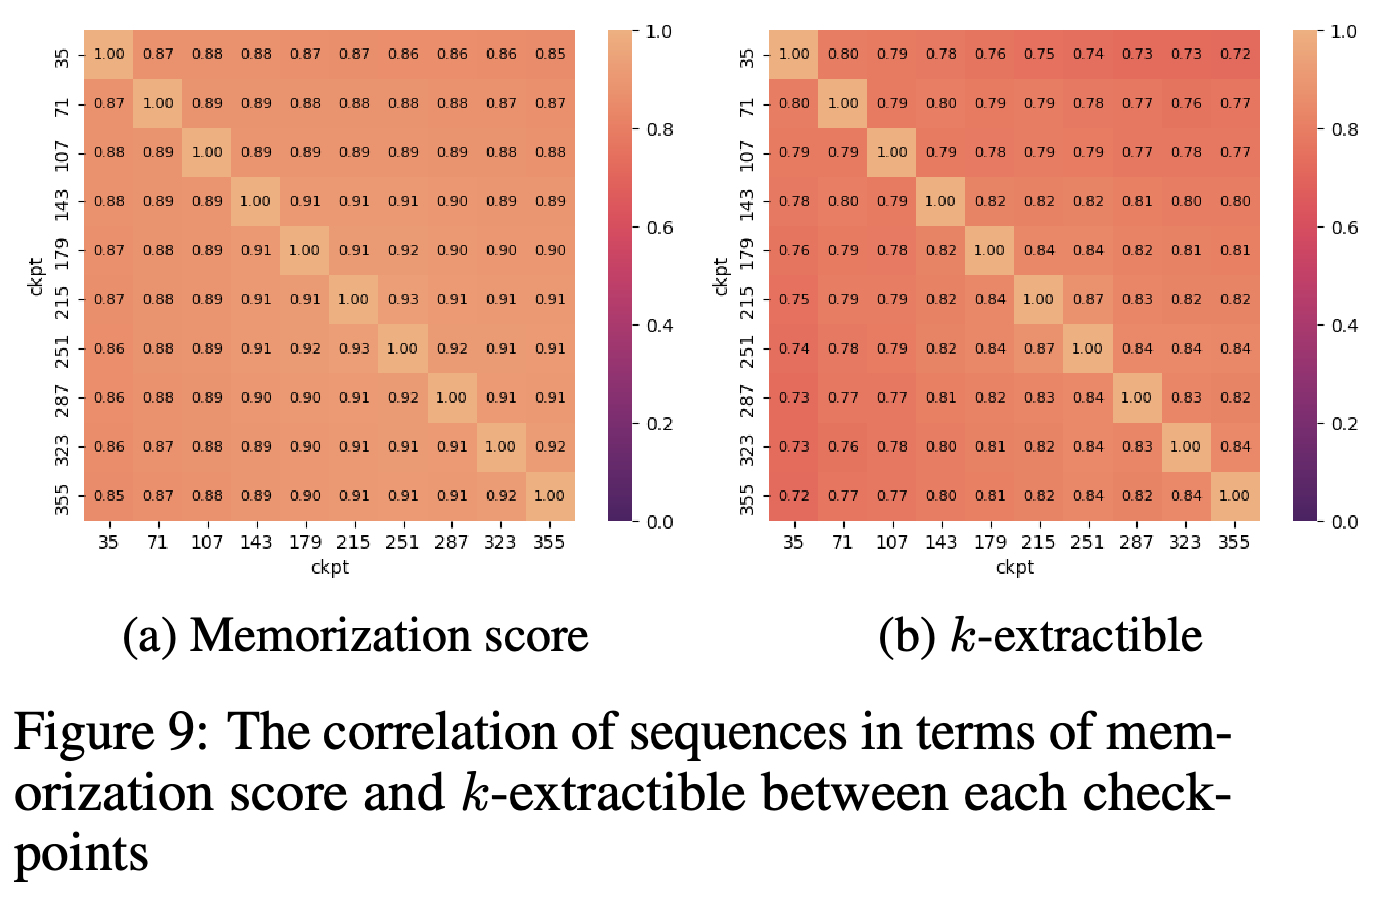
- Figure 8에서는 최근에 본 데이터를 더 강하게 암기하며, 특정 청크 그룹의 암기 점수는 초기에 감소한 뒤 나중에 증가한다. Figure 9에서는 토큰 수준 암기 점수와 정확한 추출 모두에서 체크포인트 간 상관관계가 강하게 나타난다.
분포는 선택한 각 체크포인트에서 이미 학습한 청크를 사용하며, 후속 토큰 32개가 정확히 일치하는 경우를 강조한다. 표시된 비율은 중간에 변동하면서 처음과 마지막으로 제시된 체크포인트 사이에서 0.8%에서 1.3%로 증가한다.
표식은 각 체크포인트가 마지막으로 학습한 청크 그룹을 나타내며, 오른쪽 점들은 아직 보지 않은 데이터에 해당한다. 곡선은 최근 데이터를 더 강하게 암기하고, 이전에 학습한 데이터의 암기 점수가 초기에 감소한 뒤 나중에 증가한다는 저자들의 관찰을 뒷받침한다.
행렬 2개는 시퀀스별 토큰 정확도와 정확한 추출에서 체크포인트 간 상관관계가 강함을 보여준다. 어떤 시퀀스를 암기하는지가 지속되는 양상을 나타내지만, 그 원인은 밝히지 않는다.
5 Summary and Take-home Messages
핵심 메시지는 수치 안정성, 하드웨어에 따른 병렬화 방식, 데이터 정제, 혼합 비율, 학습 순서의 중요성이다. AMBER는 LLaMA와 하이퍼파라미터가 유사하지만 성능 차이가 있어 데이터와 구현의 차이를 조사할 필요가 있다. 다만 이 보고서는 각각의 영향을 분리하지 않는다. 제안하는 활용법에는 중간 체크포인트에서 데이터 혼합을 바꿔 학습을 분기하는 방법, 도메인 특화 모델 개발, 부분적으로 학습된 가중치가 필요한 학습 방법의 초기화가 있다.
- 저자들은 배포 전에 정확한 데이터와 편향 분석을 검토하고, 재현 가능한 학습 기록으로 보호 장치를 연구하자고 제안한다. 보고서는 이러한 활용이 배포 위험을 줄인다는 결과를 입증하지 않는다.
- 조정한 하이브리드 병렬화의 처리량 이점은 특히 노드 내부 대역폭이 제한된 환경에서 유용하다고 설명한다.
6 Conclusion and Future Work
결론은 LLM360을 AMBER와 CRYSTALCODER로 구현한 공개 프레임워크로 제시한다. 공개 대상에는 학습 코드, 설정, 중간 가중치, 데이터 순서, 처리 코드, 분석이 포함된다. 옵티마이저 상태를 공개한다는 서술은 Section 4.1.5에 기록된 AMBER의 누락과 모순된다. 더 상세한 모델 평가, 더 큰 모델, 최적 데이터 혼합 연구는 향후 과제로 제시한다.
부록
- 제공된 15페이지 보고서에는 부록이 없으며, 결론과 감사의 글 뒤에 References가 이어진다. 구현과 분석 링크로 https://github.com/llm360 과 https://github.com/LLM360/Analysis360 을 제공하며, 프로젝트는 https://www.llm360.ai/ 에 연결되어 있다.
짧은 생각
데이터 청크, 중간 가중치, 평가 결과의 대응 관계 덕분에 Figures 4와 7–9의 학습 및 암기 분석이 가능하다. 다만 AMBER의 옵티마이저 이력 누락과 초기 체크포인트의 낮은 정밀도는 정확한 학습 재현을 제한한다. 통제된 절제 실험도 없어 성능 차이의 원인은 밝혀지지 않았다. Table 5에는 산술적 불일치도 있다. OpenLLaMA-v2-7B에 기재된 HumanEval 15.32점과 MBPP 12.69점의 평균은 14.005점으로, 보고된 코드 평균 28.01점과 다르다. 따라서 해당 행의 종합 점수를 비교할 때 주의가 필요하다.