Paper2Code: Automating Code Generation from Scientific Papers in Machine Learning 요약 설명
24 Apr 2025 | Paper Review Code Generation Large Language Models Research Reproducibility목차
원문 버전. 이 논문은 최초 공개일인 2025년 4월 24일에 따라 2025-W17로 분류됐다. 이 글은 그 후 공개된 arXiv:2504.17192v5를 살펴보는 회고 설명이다. v5는 2026년 2월 27일자이며 ICLR 2026에 발표됐다. 이 버전의 실험과 부록이 최초 공개본에도 있었다고 단정할 수 없다.
Minju Seo, Jinheon Baek, Seongyun Lee, Sung Ju Hwang은 연구 논문에서 여러 파일로 구성된 머신러닝 저장소를 생성하는 방법을 연구한다. 제안한 프레임워크의 이름은 PaperCoder다. 논문, 코드.
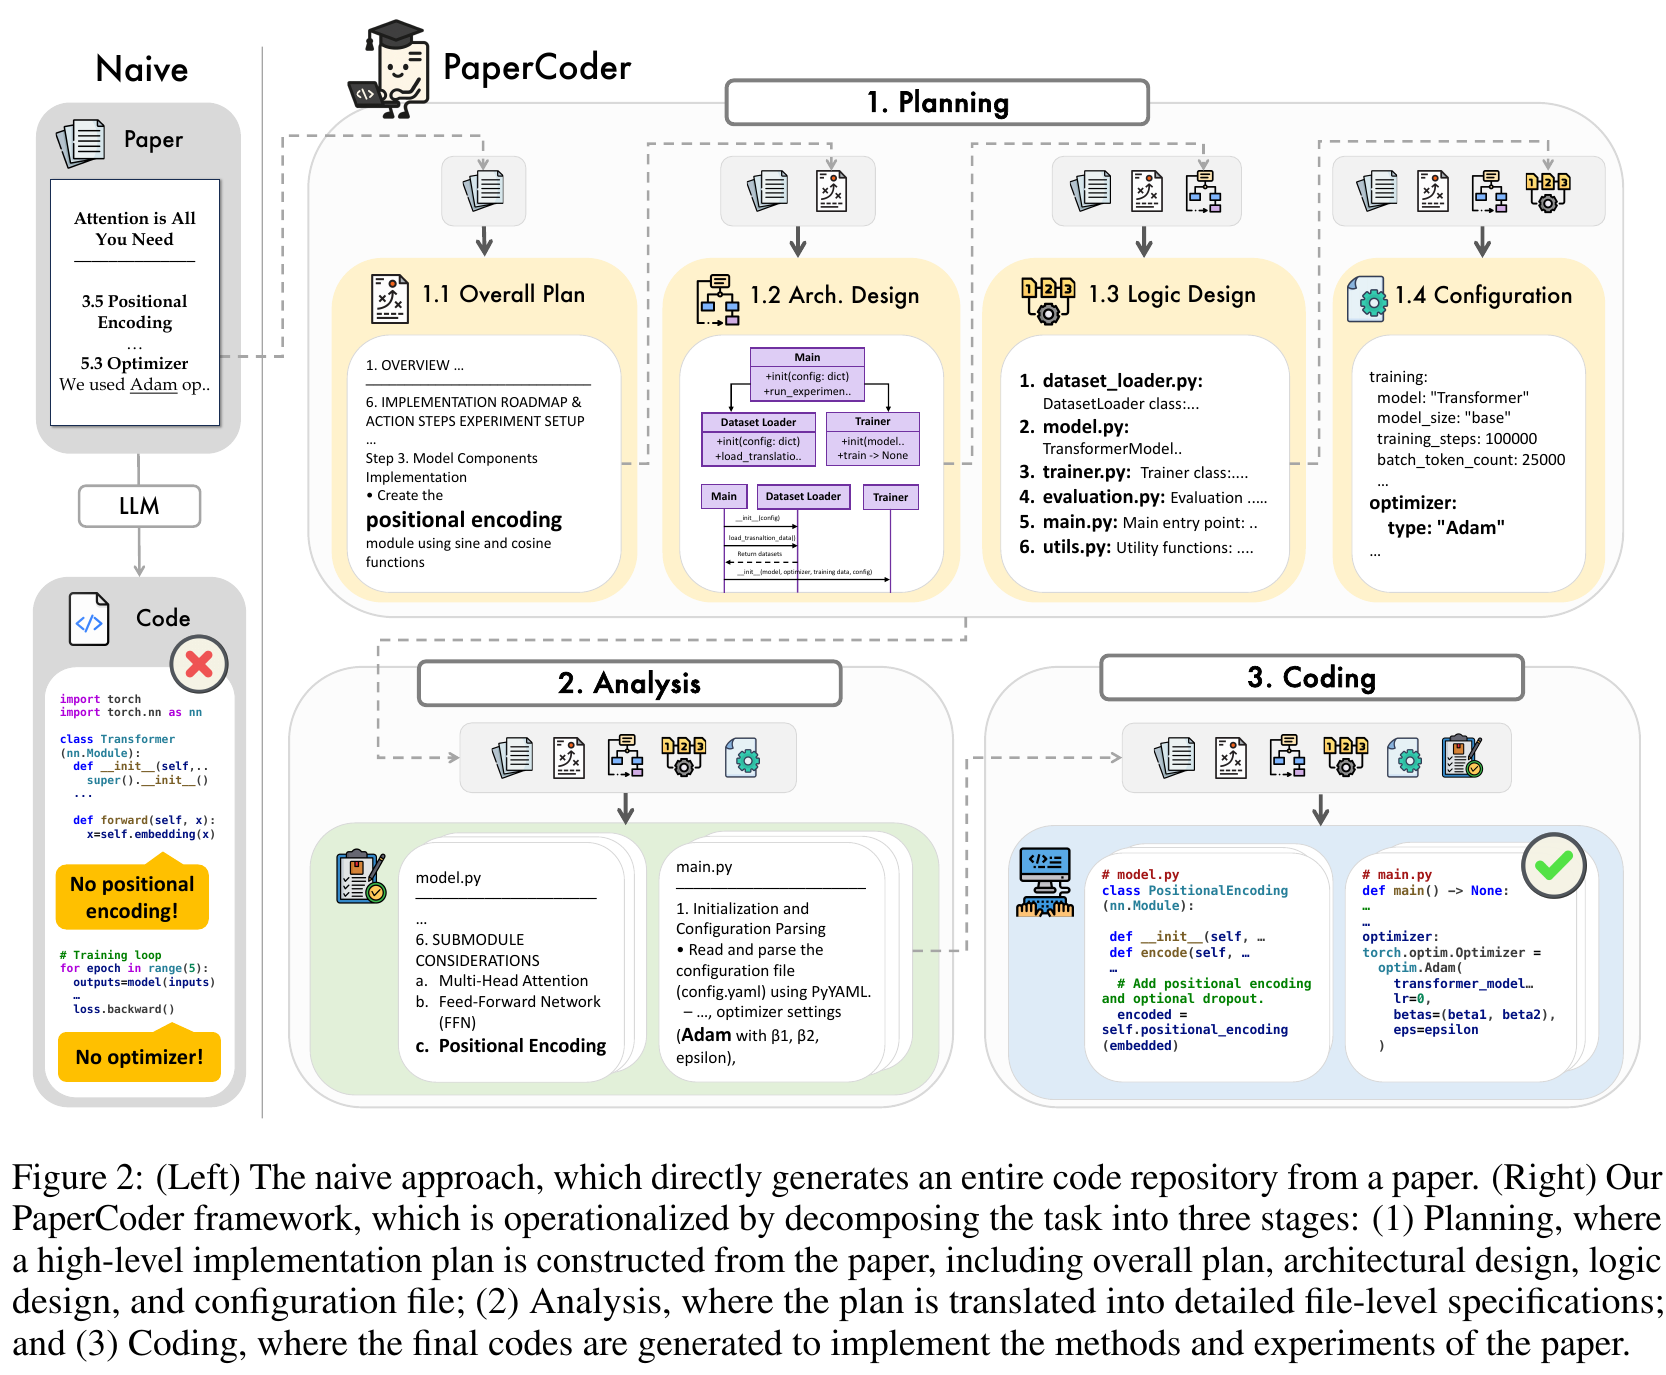
출처 및 라이선스. 이 글은 Minju Seo, Jinheon Baek, Seongyun Lee, Sung Ju Hwang의 Paper2Code: Automating Code Generation from Scientific Papers in Machine Learning, arXiv:2504.17192v5를 요약한다. arXiv 레코드에는 이 논문의 라이선스가 CC BY 4.0으로 표시되어 있다. 아래 이미지는 해당 버전 PDF에서 자른 그림과 표다: 그림 2 (PDF 4쪽), 표 1 (PDF 7쪽), 표 2 (PDF 7쪽) 및 그림 5 (PDF 9쪽).
요약
- PaperCoder는 저장소 구조와 실행 순서를 계획하고, 파일별 구현을 분석한 다음, 의존 관계에 따라 파일을 순차 생성한다. [3–5쪽]
- Paper2CodeBench는 ICLR, ICML, NeurIPS 2024에서 각각 30편씩 선정한 논문 90편으로 구성된다. 저자들은 참조 코드 유무에 따른 모델 평가와 더 작은 규모의 인간 평가를 사용했다. [5–7쪽]
- ICML 부분집합에서 전체 파이프라인의 참조 기반 점수는 5점 만점에 3.72였고, 논문 전체를 한 번에 입력하는 기준 방법은 3.28이었다. 이는 연구에서 모델이 매긴 점수이며 저장소가 논문을 재현한다는 보장은 아니다. [7–8쪽]
- 저자들은 저장소 다섯 개의 재현성 사례 연구에서 네 개가 결과를 적어도 부분적으로 재현했다고 보고했다. 그림 5의 방법 구현 범위는 도표에 86%, 본문에는 80%로 적혀 있어 원문 내부의 불일치가 남아 있다. [9–10쪽]
1. Introduction
연구 논문에는 구현 코드가 없거나 실행에 필요한 세부 조건이 빠지는 경우가 있다. 저자들은 ICLR, ICML, NeurIPS 2024 채택 논문에서 코드 공개율의 평균이 19.5%라고 보고한다. 이 연구는 저자 코드나 부분 구현에 의존하지 않고 논문에서 저장소를 생성하는 문제를 다룬다. [1–2쪽]
이 작업에는 함수 하나를 생성하는 것 이상의 조정이 필요하다. 여러 파일에 역할을 나누고 파일 사이를 연결하면서 논문에 적힌 방법과 실험을 구현해야 한다. 저자들은 생성 결과의 구조뿐 아니라 일부 구현의 실행 가능성과 결과 재현도 살펴봤다. [2–3, 9–10쪽]
2. Related Work
관련 연구는 코드 생성 언어 모델, 여러 에이전트를 활용한 저장소 생성, 과학 연구를 돕는 언어 모델을 다룬다. PaperCoder는 수정할 기존 저장소 대신 논문 전체를 입력으로 사용한다. 저자들은 코드 생성 절차를 제안하는 이 연구와 논문 재현을 평가하는 PaperBench도 구분한다. [2–3쪽]
3. Method
3.1 Repository-Level Code Generation from Machine Learning Papers
입력은 머신러닝 논문이고 출력은 논문의 내용을 함께 구현하는 여러 파일로 구성된 저장소다. 파일 간 의존성이 있으므로 나중에 생성하는 파일이 앞에서 만든 구성 요소를 사용할 수 있도록 순서를 정해야 한다. 저자들은 논문 전체를 한 번에 코드로 바꾸는 대신 중간 산출물을 통해 이 조정을 수행한다. [3쪽]
3.2 PaperCoder: LLM-Powered Multi-Agent Framework for Paper-to-Code
PaperCoder는 계획, 분석, 코딩의 세 단계로 생성 과정을 나눈다. 각 단계에는 전문화된 언어 모델 에이전트가 참여하고 산출물을 다음 단계로 전달한다. 계획 에이전트는 저장소 설계를 만들고, 분석 에이전트는 계획된 파일별 명세를 작성하며, 코딩 에이전트는 의존 순서에 따라 파일을 생성한다. 코드를 작성하기 전에 파일 역할과 의존성을 명시하려는 구성이지만, 이 구조만으로 구현의 정확성이 검증되는 것은 아니다. [3–5쪽]
3.2.1 Planning
계획 단계는 전체 계획, 아키텍처 설계, 실행 로직 설계, 설정을 차례로 만든다. 아키텍처에는 파일 목록과 클래스, 시퀀스 다이어그램이 포함된다. 로직 설계는 구성 요소의 상호작용을 설명하고 의존 관계를 고려해 구현 순서를 정한다. [3–4쪽]
3.2.2 Analysis
분석 단계는 계획된 파일을 각각 살펴본다. 논문과 계획을 바탕으로 함수, 입력과 출력, 의존성, 알고리즘 제약을 포함하는 구현 명세를 만든다. 이 명세는 이후 생성에 쓰이는 중간 지침이므로 논문의 누락이나 잘못된 해석이 코드까지 이어질 수 있다. [5쪽]
3.2.3 Coding
코딩 단계는 계획된 순서에 따라 파일을 하나씩 생성한다. 이때 계획과 분석 결과, 앞에서 생성한 관련 파일을 함께 사용한다. 나중 파일을 의존 대상과 일관되게 만들려는 방식이지만, 이런 구조만으로 프로그램이 올바르게 실행된다고 보장할 수는 없다. [5쪽]
PaperCoder는 저장소 생성을 계획, 파일별 분석, 순차 코딩으로 나누며 그림은 이를 한 번에 생성하는 예와 비교한다.
4. Experiment
4.1 Experimental Setup
Paper2CodeBench는 ICLR, ICML, NeurIPS 2024 논문을 각 30편씩 포함해 총 90편으로 구성된다. 저자들은 인간 평가에 논문 21편을 사용했고, PaperBench Code-Dev에서는 ICML 2024 논문 20편을 사용했다. 비교 대상에는 ChatDev, MetaGPT, 초록만 이용하는 생성, 논문 전체를 한 번에 입력하는 생성, PaperCoder의 소거 실험이 포함된다. 별도 설명이 없는 한 생성과 평가에 사용하는 기본 모델은 o3-mini-high다. [5–7쪽]
저자 코드가 있는 경우에는 참조 기반으로, 그렇지 않은 경우에는 참조 없이 평가한다. 모델이 매기는 저장소 점수는 5점 척도이며, 인간 평가와 논문 저자의 평가도 비교한다. 이 점수는 정해진 기준에서 생성 결과를 평가한 것이므로 과학적 결과가 완전히 재현됐다는 뜻은 아니다. [5–8쪽]
4.2 Experimental Results and Analysis
표 1에서 PaperCoder의 참조 기반 점수는 ICLR, ICML, NeurIPS 부분집합에 대해 각각 3.68, 3.72, 3.83이었다. 논문 전체를 한 번에 입력한 기준 방법은 각각 3.08, 3.28, 3.22였다. 참조 없는 점수는 PaperCoder가 4.73, 4.73, 4.77, 기준 방법이 4.15, 4.30, 4.08이었다. 저자들은 저자 저장소와의 참조 없는 비교에서 통계적으로 유의한 차이가 없다고 보고하면서, 그 오라클 설정은 직접 비교할 수 없다고 명시했다. 참조 기반 오라클 점수는 제공되지 않았다. [7쪽]
PaperCoder는 세 학회 부분집합에서 제시된 생성 기준 방법보다 높은 점수를 받았으며 오라클은 저자 저장소를 뜻한다.
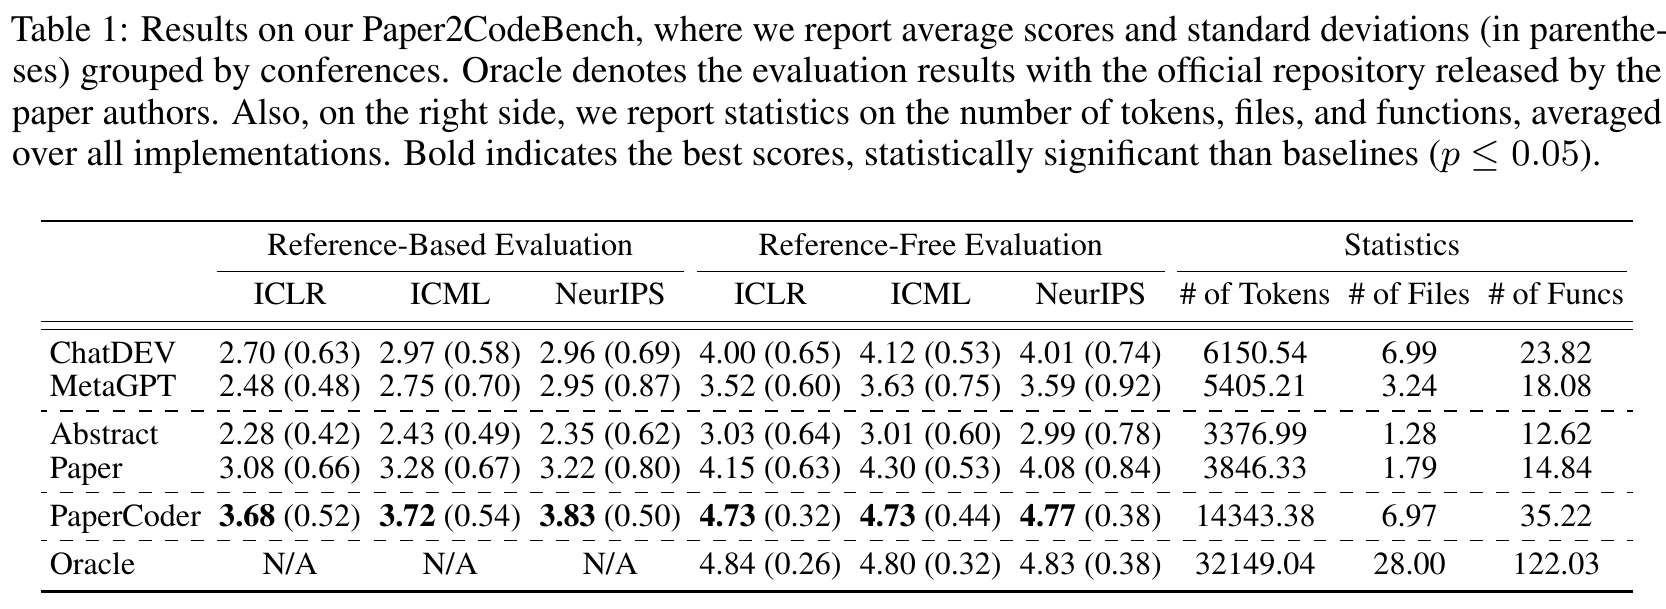
참조 기반 점수와 참조 없는 점수의 피어슨 상관계수는 0.79로 보고됐다. 인간 판단과의 상관계수는 GPT-4o에서 각각 0.74와 0.71, o3-mini-high에서 각각 0.78과 0.73이었다. 평가자 간 Cohen의 카파는 0.79였다. 이 상관관계는 해당 평가에서의 일치를 보여주지만 모델 평가의 한계를 없애지는 않는다. [7–8쪽]
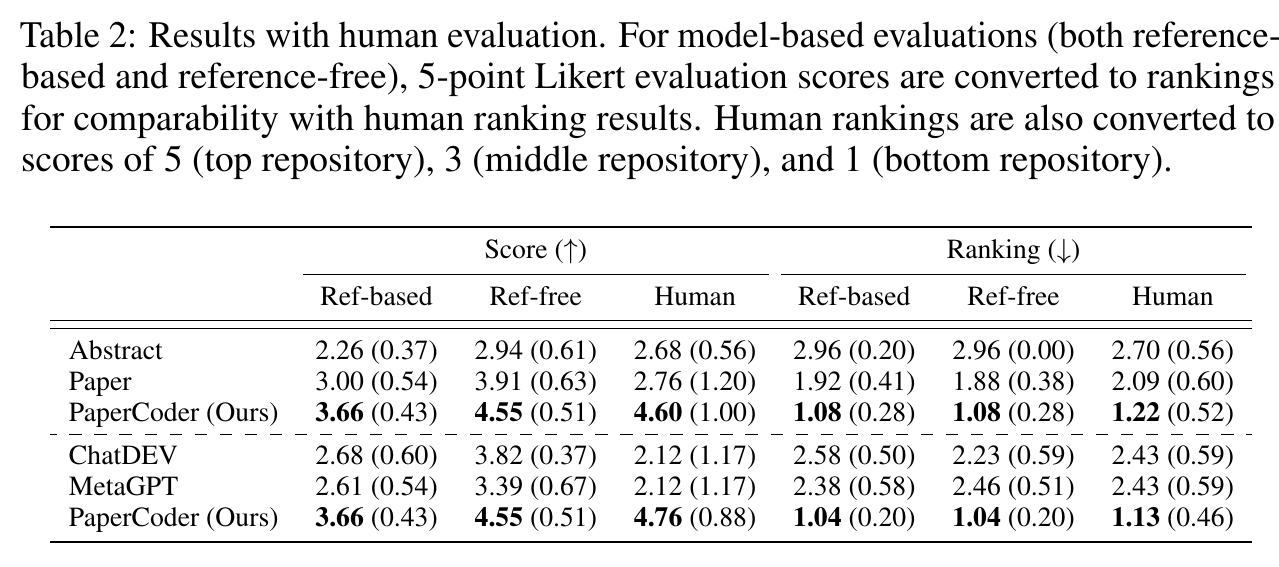
인간 비교에서 평가자의 92%는 가장 높은 순위를 받은 PaperCoder 저장소가 처음부터 시작하는 것보다 원래 연구를 재현하기 쉽게 할 것이라는 데 동의했다. 저자들은 또 평가자 25건의 선택 중 22건이 PaperCoder 저장소를 선호했다고 보고하며, 서론에서는 이 결과를 기준 방법과 비교해 88%가 가장 높은 평가를 받았다고 요약한다. 이 수치는 연구의 표본과 질문에 한정되며 생성된 모든 저장소의 성공률을 측정한 것은 아니다. [2, 7–9쪽]
제시된 표본에서 인간 평가와 모델 평가를 점수와 순위로 비교한다.
PaperBench Code-Dev의 표 3에서 PaperCoder의 재현 점수는 o3-mini-high 사용 시 45.14 ± 0.3, Claude 3.5 Sonnet 사용 시 51.14 ± 1.4였다. 같은 순서로 BasicAgent는 5.1 ± 0.8과 35.4 ± 0.8, IterativeAgent는 16.4 ± 1.4와 27.5 ± 1.6이었다. [8쪽]
표 6은 ICML 부분집합에서 파이프라인 구성 요소를 비교한다. 전체 단계를 사용한 점수는 참조 기반 3.72, 참조 없음 4.73으로, 기준 방법의 3.28과 4.30보다 높았다. 아키텍처 설계만 추가했을 때 점수가 낮아졌다가 로직 설계를 더한 뒤 회복됐으며, 저자들은 파일 순서와 의존성을 명시한 효과로 해석한다. 이 결과는 해당 실험의 소거 비교이며 모든 논문에 각 구성 요소가 도움이 된다는 증명은 아니다. [8쪽]
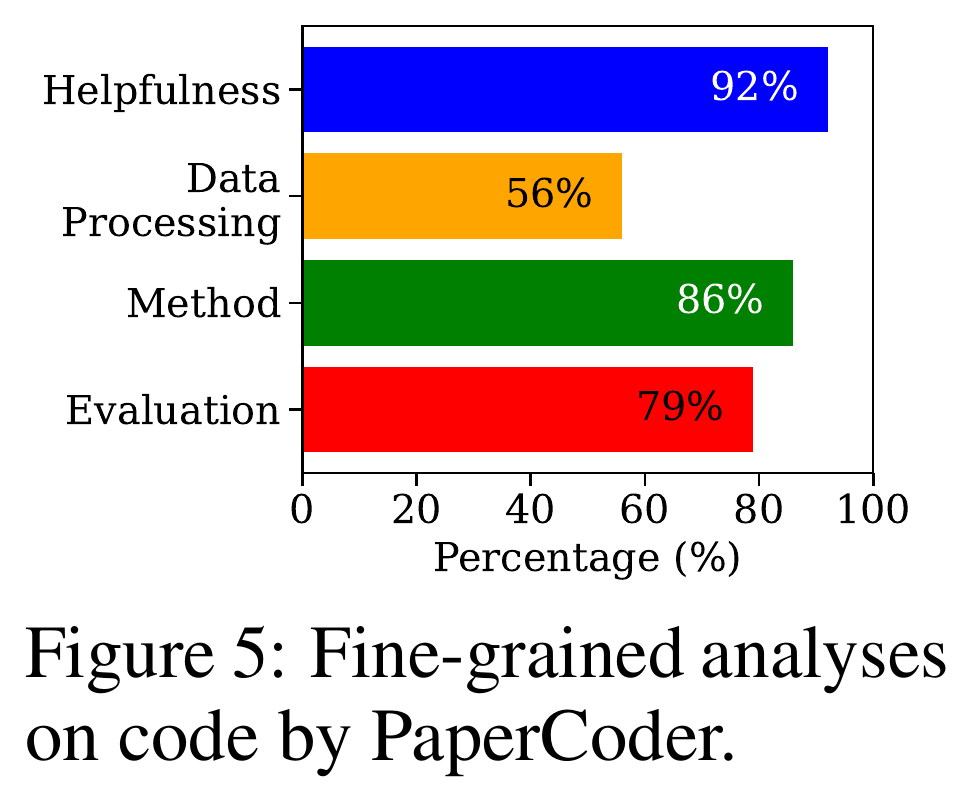
그림 5의 도표는 데이터 처리 구현 범위를 56%, 방법을 86%, 평가를 79%로 표시한다. 주변 본문은 방법 구현 범위를 80%라고 적는다. 원문이 두 값을 일치시키지 않으므로 이 차이는 미해결 상태로 둔다. 저자들은 데이터 형식, 전처리, 로딩 지침이 충분히 명시되지 않은 점을 데이터 처리 오류의 원인으로 지목한다. [9쪽]
도표는 방법 구현 범위를 86%로 표시하지만 주변 본문은 80%라고 적으며 원문은 이 차이를 해소하지 않는다.
4.3 Additional Analysis on Reproduction from Implemented Code Repository
저자들은 수동으로 실행한 저장소 다섯 개에서 실행에 성공하기 위해 코드 줄의 평균 0.81%를 수정했다고 보고한다. 표본이 작고 수동 디버깅, 데이터와 하이퍼파라미터 조정이 포함되므로 이 비율을 모든 생성 저장소에 일반화하기는 어렵다. [9–10, 18쪽]
같은 저장소 다섯 개의 재현성 사례 연구에서는 네 개가 결과를 적어도 부분적으로 재현했고, 한 개는 손실 함수 설계 때문에 실패했다. 논문 10편으로 구성된 PaperBench 재현 표본의 표 8에서 PaperCoder는 28.46, IterativeAgent는 11.22, BasicAgent는 2.60을 기록했다. 저자들은 하드웨어 제약으로 하이퍼파라미터를 바꾸고 드물게 부분 표본을 사용했다고 밝힌다. [9–10, 18쪽]
5. Conclusion
PaperCoder는 저장소 생성 과정을 명시적인 설계와 구현 단계로 나누자고 제안한다. 보고된 비교는 평가한 조건에서 단계별 파이프라인의 점수가 개선됐음을 보여주며, 사례 연구는 더 제한된 범위에서 결과 재현을 살펴본다. 다른 논문들에서도 생성 코드가 얼마나 자주 실행되고 결과를 재현할지는 남은 질문이다. [9–10쪽]
Ethics Statement
저자들은 보안상 이유로 구현 코드를 의도적으로 공개하지 않는 논문도 있다고 지적한다. 예를 들어 jailbreak나 취약점 악용을 다룬 논문에서 텍스트로 코드를 복원하는 시스템이 민감한 구현을 재현할 가능성이 있다. 저자들은 실제 서비스에서 유해 콘텐츠 필터, 보호 프롬프트와 안전한 실행 환경 같은 보호 장치를 제안하지만, 이런 조치가 위험을 없앤다고 입증하지는 않는다. [10쪽]
Appendix
부록은 실험 설계, 추가 분석, 한계, 프롬프트와 계획 산출물의 예시를 제공한다. 부록 C는 시각 자료 입력, 실행 환경 구성, 완전한 실행과 재현을 남은 과제로 제시한다. 서로 다른 모델 계열을 이용한 평가 검사는 논문 30편을 사용했으며, 저자들은 모델이 벤치마크 논문을 간접적으로 접했을 가능성을 완전히 배제할 수 없다고 밝힌다. [18–21, 28–59쪽]
Additional Experimental Results and Analysis
o3-mini-high를 기본 모델로 사용한 논문 30편의 부분집합에서 방법론 절을 제거하자 평균 참조 기반 점수가 4.26에서 3.75로 떨어졌다. 저자들은 이를 상세한 방법 설명이 충실한 코드 생성에 도움이 된다는 근거로 해석한다. 이 소거 실험은 해당 부분집합의 결과이며 모든 논문에 적용되는 추정치는 아니다. [20쪽, 표 12]
저자들은 벤치마크 논문 90편을 o4-mini-high로 분류한 뒤 범주별 평균 참조 기반 점수를 계산했다. 점수 범위는 3.38–4.21이었다. 이론과 해석 가능성 분야는 각각 4.21과 3.97로 높았고, 강화학습과 제어, 데이터셋 중심 논문은 각각 3.38로 낮았다. 모델을 이용한 범주 분류와 평가 점수에 의존하므로 차이를 일반화할 때 한계가 있다. [21쪽]
보고된 실행 오류는 의존성 누락, import 오류와 모듈 누락이 가장 흔했다. 별도의 논문 30편 실험에서 환경 요구사항을 추론하고 수정하도록 프롬프트를 추가한 뒤에는 의존성 관련 실패가 관찰되지 않았다. 이것이 완전한 실행 가능성을 입증하는 것은 아니다. 저자들은 또 보고된 자동 수리 실험에서 o4-mini-high와 GPT-5가 문제를 해결했으며 대부분 적은 반복으로 끝났다고 적는다. 오류 범주는 GPT-5.1로 분류했다. 이 결과는 평가한 사례의 관찰이며 생성 코드가 항상 수리된다는 보장은 아니다. [20쪽, 표 13; 22쪽, 표 14]
무작위로 선택한 논문 30편에서 Gemini-Flash 2.5와 o3-mini-high의 평가 사이 Spearman 상관계수는 0.73이었다. 저자들은 주된 모델의 지식 기준 시점이 2023년 10월로 2024년 벤치마크 논문보다 앞선다고 설명하면서도 간접 노출 가능성을 배제하지 못한다고 밝힌다. 모델 계열 간 일치와 시점 차이는 우려 일부를 줄이지만 모델 평가에 편향이 없거나 데이터 오염이 없었다는 증명은 아니다. [21쪽]
짧은 생각
파일 구조를 설계하는 단계와 파일을 구현하는 단계를 나누면 잘못된 계획, 불완전한 파일 명세, 오류가 있는 코드를 따로 살펴볼 수 있다. 다만 주요 증거는 언어 모델 평가에 크게 의존하고 실행 및 재현 사례도 적다.