


Marco-o1: Towards Open Reasoning Models for Open-Ended Solutions 요약 설명
21 Nov 2024 | Paper Review Reasoning Monte Carlo Tree Search Supervised Fine-Tuning목차
이번 글에서는 Marco-o1: Towards Open Reasoning Models for Open-Ended Solutions 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 11월 21일(Arxiv)
- Zhao, Yu, Yin, Huifeng, Zeng, Bo, Wang, Hao, Shi, Tianqi, Lyu, Chenyang, Wang, Longyue, Luo, Weihua, Zhang, Kaifu.
- MarcoPolo Team, Alibaba International Digital Commerce
- 논문 링크
- Github
요약
- Marco-o1은 구어체 번역처럼 정답 기준이 불명확한 문제를 언어 모델이 어떻게 해결할 수 있는지 탐구한다. 중간 추론 단계를 요청하는 Chain-of-Thought(CoT) 프롬프트를 적용한 Qwen2-7B-Instruct와 비교하면, 추론 단계 전체를 단위로 탐색할 때 영어 MGSM 수학 문장제 정확도가 84.00%에서 90.40%로 높아진다. 32토큰 단위로 탐색하면 중국어 정확도가 76.80%에서 82.40%로 높아진다. 토큰은 모델이 생성하는 텍스트 단위다.
- 이 방법은 주어진 예제로 모델 가중치 전체를 갱신하는 전체 파라미터 지도 미세 조정과, 트리에서 여러 추론 경로를 탐색하는 Monte Carlo Tree Search(MCTS)를 결합한다. 학습에는 예제 60,266개를 사용한다. 추론, 즉 답변 생성 과정에서는 추론 단계 전체와 64토큰 또는 32토큰으로 구성된 더 작은 행동을 비교하며, 토큰 확률에서 구한 신뢰도로 완성된 경로에 점수를 매긴다.
- 탐색은 수학 정확도를 높이지만, 가장 좋은 행동 크기는 언어에 따라 다르다. 개방형 번역의 근거는 예시 3개에 한정된다. 탐색의 무작위성, 보고되지 않은 연산 예산, 이전 추론을 재검토하도록 요청하는 reflection에 관한 제한적인 보고 때문에 결과를 폭넓게 일반화하기는 어렵다.
1. Introduction
이 논문은 OpenAI의 o1에서 영감을 받아, 긴 추론을 수행하도록 설계된 언어 모델인 대규모 추론 모델이 표준 정답과 쉽게 수치화할 수 있는 보상이 있는 과제를 넘어 일반화할 수 있는지 묻는다. 주요 기여는 CoT 미세 조정, 신뢰도 기반 MCTS, 행동 크기 조절, 프롬프트를 통한 reflection, 번역 사례 연구를 결합한 데 있다. 저자들은 이 모델이 o1-like 특성을 갖춘 개발 중인 모델이며, 완성된 o1 모델보다 성능이 낮다고 명시한다.
- 프로젝트 홈페이지는 https://github.com/AIDC-AI/Marco-o1 이다.
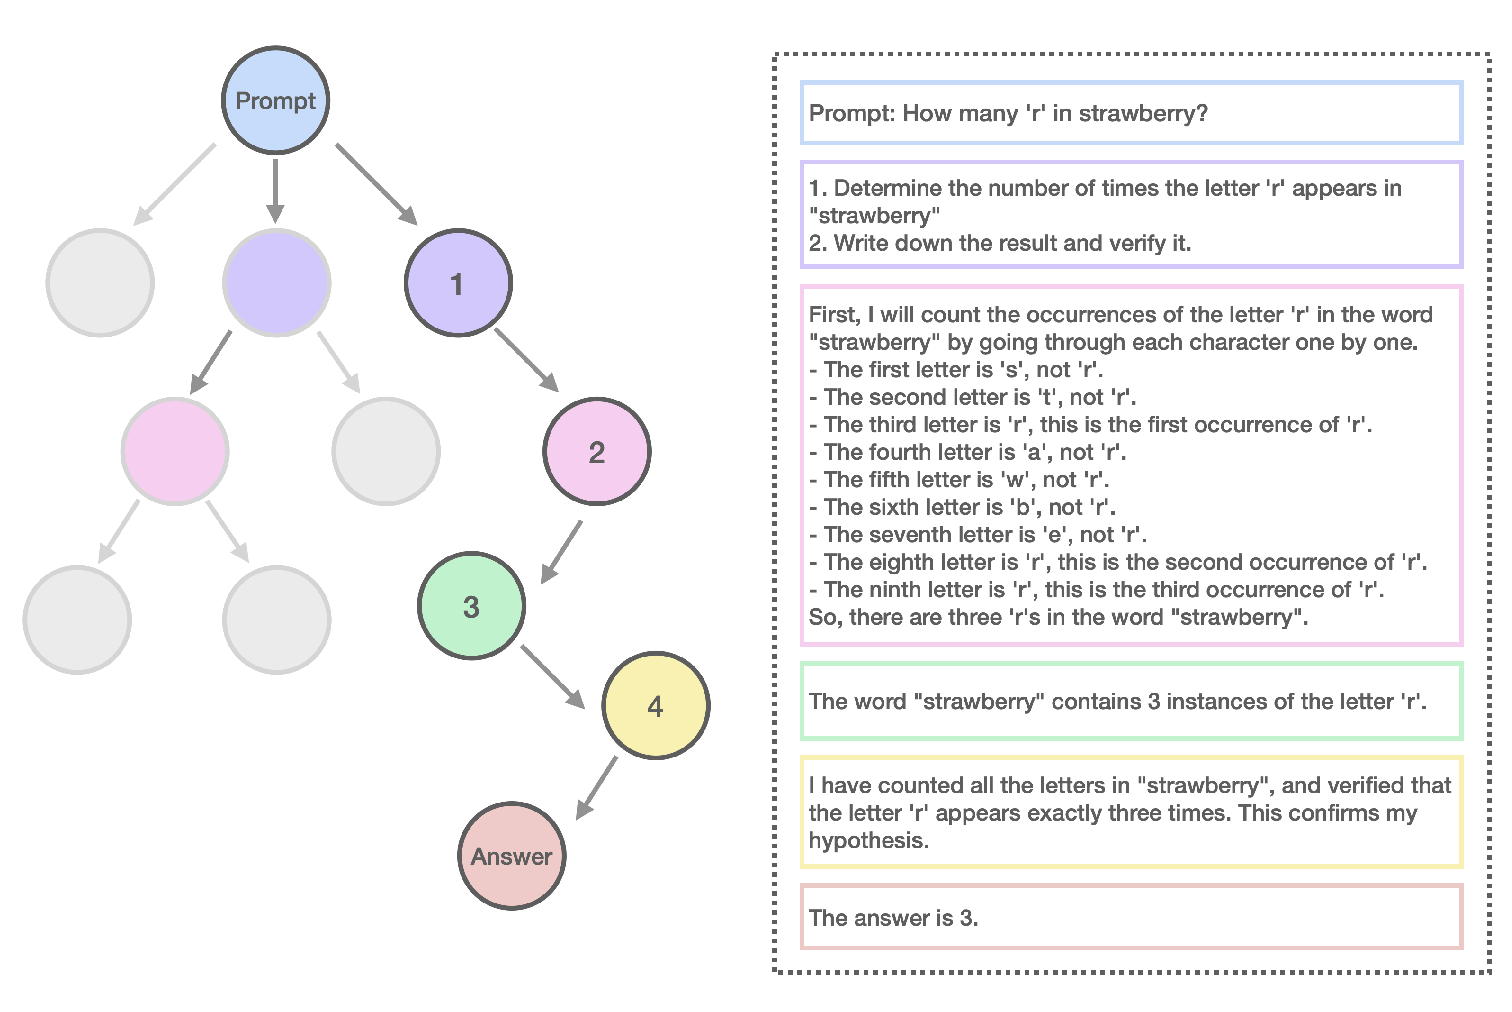
- Figure 1은 strawberry에서 “r”의 개수를 세는 질문에 대한 정답을 보여 준다. 제시된 추론에는 마지막 “y”가 빠져 있다. 명백한 단계를 생략해도 된다는 자신감이 반영되었다는 저자들의 설명은 가설로 남아 있다.
- 서론은 영어에서 +6.17%, 중국어에서 +5.60%의 향상을 보고한다. 반면 Table 2에서 계산한 Qwen2-7B-Instruct 대비 절대 향상 폭은 각각 6.40%포인트와 5.60%포인트다. 영어 수치의 불일치는 해소되지 않았다.
강조된 경로는 “strawberry”에 “r”이 3개 있다는 정답에 도달한다. 그러나 글자를 나열한 설명은 마지막 “y” 전에 끝난다. 이는 최종 답변이 맞더라도 설명은 불완전할 수 있음을 보여 준다. 이 그림은 생략이 발생한 이유를 입증하지 않는다.
2. Marco Reasoning Datasets
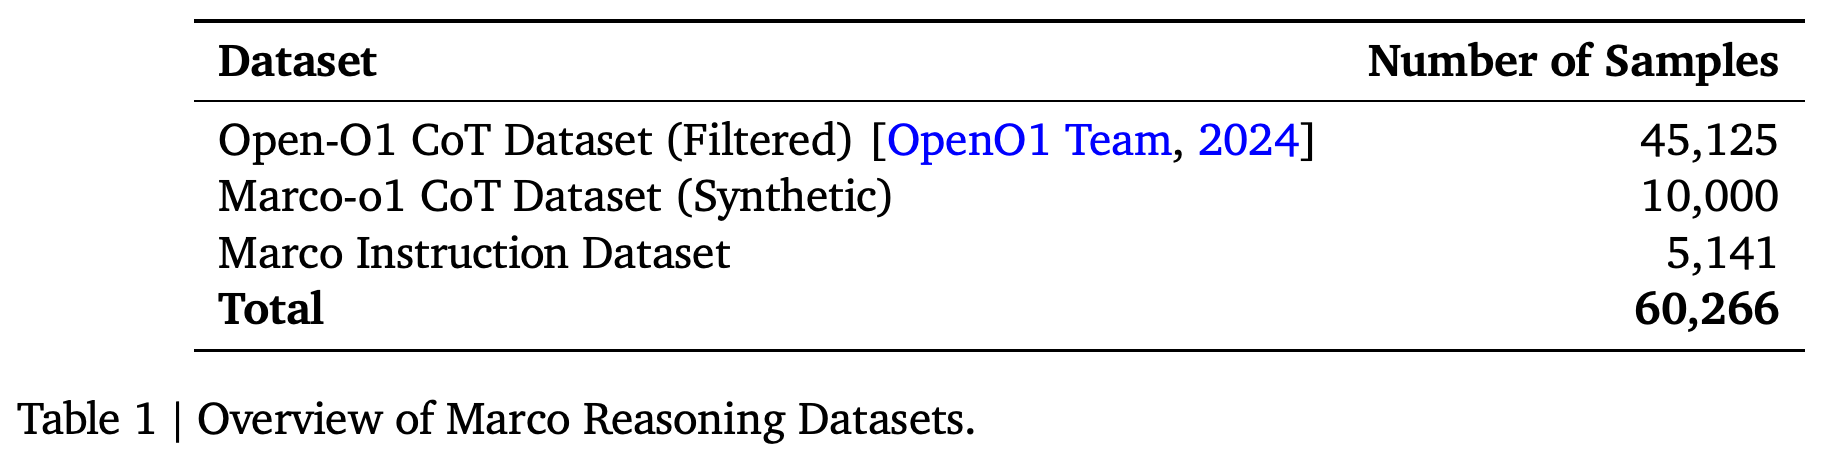
Marco-o1-CoT는 총 60,266개 샘플로 구성된 데이터셋 3개로 학습한다. Open-O1 CoT Dataset (Filtered)에서 45,125개, Marco-o1 CoT Dataset (Synthetic)에서 10,000개, Marco Instruction Dataset에서 5,141개를 사용한다. 첫 번째 데이터셋은 필터링한 추론 패턴을, 두 번째 데이터셋은 MCTS로 생성한 추론 경로를 제공한다. 세 번째 데이터셋은 지시 이행 능력을 유지하기 위한 것이다.
- Open-O1에는 휴리스틱 필터링과 품질 필터링을 적용했다고 설명하지만, 재현할 수 있는 구체적인 필터링 규칙은 제시하지 않는다.
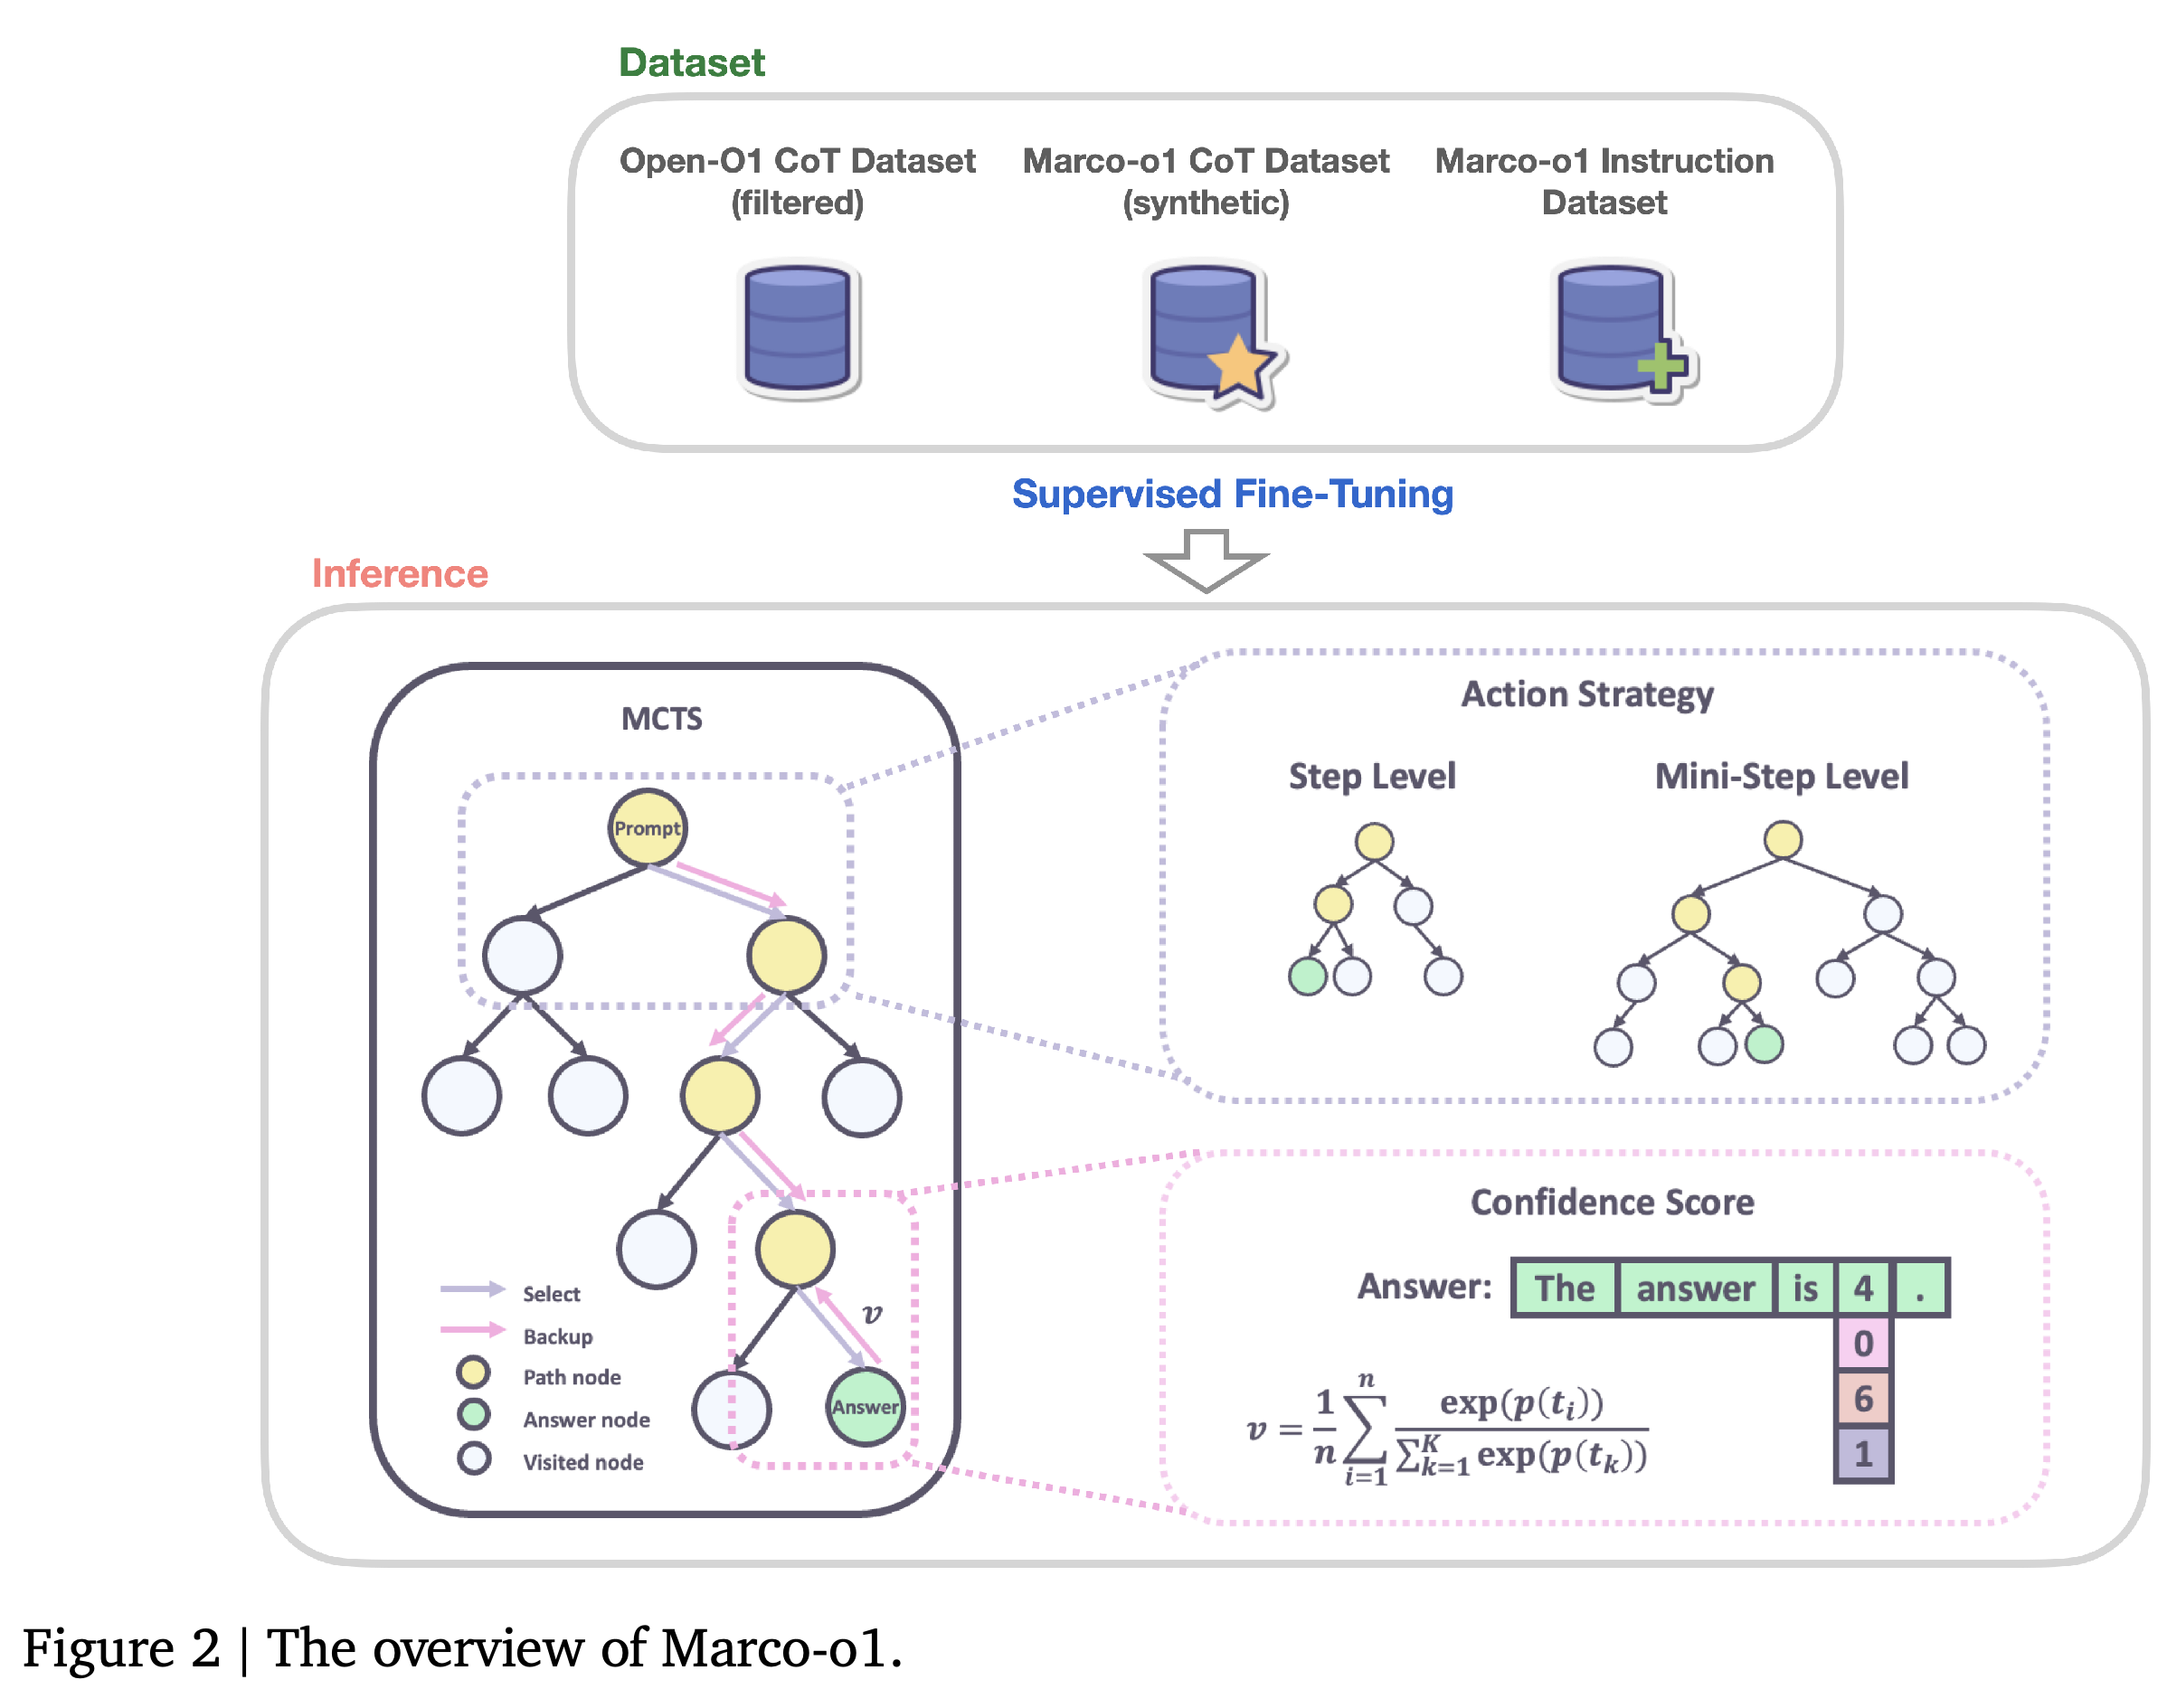
- Figure 2는 지도 학습과 추론 시점의 탐색을 구분한다. 또한 각 행동으로 생성하는 후속 텍스트의 크기와 신뢰도 점수가 탐색 절차에 어떻게 사용되는지 보여 준다.
학습 데이터는 필터링한 Open-O1 예제 45,125개, 합성 Marco-o1 추론 예제 10,000개, 지시 예제 5,141개로 구성되며, 총 60,266개다. 필터링한 외부 데이터셋이 학습 샘플의 대부분을 차지하므로, 모델은 자체 합성 추론만이 아니라 혼합 데이터로 학습한다.
이 도식은 데이터셋을 이용한 지도 미세 조정과 추론 시점의 트리 탐색을 구분한다. 탐색을 설명하는 영역 2개는 연구 대상인 메커니즘을 보여 준다. 하나는 추론 단계 전체와 mini-step 행동의 비교이고, 다른 하나는 토큰 신뢰도에서 구한 rollout 값이다.
3. Solution Space Expansion via MCTS
각 MCTS 노드는 추론 상태를 나타내며, 각 행동은 모델이 생성한 후속 텍스트다. 최종 답변까지 생성을 이어 가는 rollout에는 신뢰도 기반 값을 부여한다. 이 값은 경로 선택과 트리의 상위 노드로 값을 전파하는 백업에 사용된다.
- 논문에 제시된 토큰 신뢰도 식은 \(c_i = \frac{\exp(p(t_i))}{\sum_{k=1}^{5}\exp(p(t_k))}\) 이다. 여기서 p(t_i)는 생성된 토큰 확률의 로그값이며, 분모에는 해당 위치에서 예측 확률이 가장 높은 토큰 5개를 사용한다.
- rollout 값은 \(v = \frac{1}{n}\sum_{i=1}^{n}c_i\) 이며, n은 rollout의 토큰 수다. 이는 모델 신뢰도에 기반한 대리 지표다. 논문은 이 값이 답변의 정확성을 신뢰할 만하게 측정한다는 근거를 제시하지 않는다.
- 본문은 생성된 토큰과 “상위 대안 토큰 5개”를 언급하지만, 제시된 식의 분모에는 항이 5개다. 이 표현만으로는 후보 집합을 정확히 어떻게 구성하는지 알기 어렵다.
4. Reasoning Action Strategy
추론 행동 전략은 탐색이 분기할 수 있는 위치를 바꾸고, 완료된 사고 과정을 재검토하도록 요청하는 프롬프트를 추가한다. 행동 선택은 탐색의 세밀함을 조절하며, reflection은 모델에 자신의 추론을 다시 평가하도록 요청한다.
4.1. Action Selection
“Step as Action”은 각 분기에서 추론 단계 전체를 생성하고, “Mini-step as Action”은 32토큰 또는 64토큰의 후속 텍스트를 생성한다. 행동이 작을수록 더 세밀하게 분기할 수 있지만, 논문은 토큰 단위 탐색의 장애물로 연산 비용과 보상 설계의 어려움을 지적한다.
- 실험은 모든 조건에서 우수한 행동 크기를 입증하지 않는다. 영어에서는 추론 단계 전체를 단위로 탐색할 때 가장 좋은 성능을 보이고, 중국어에서는 32토큰 mini-step이 가장 좋은 성능을 보인다.
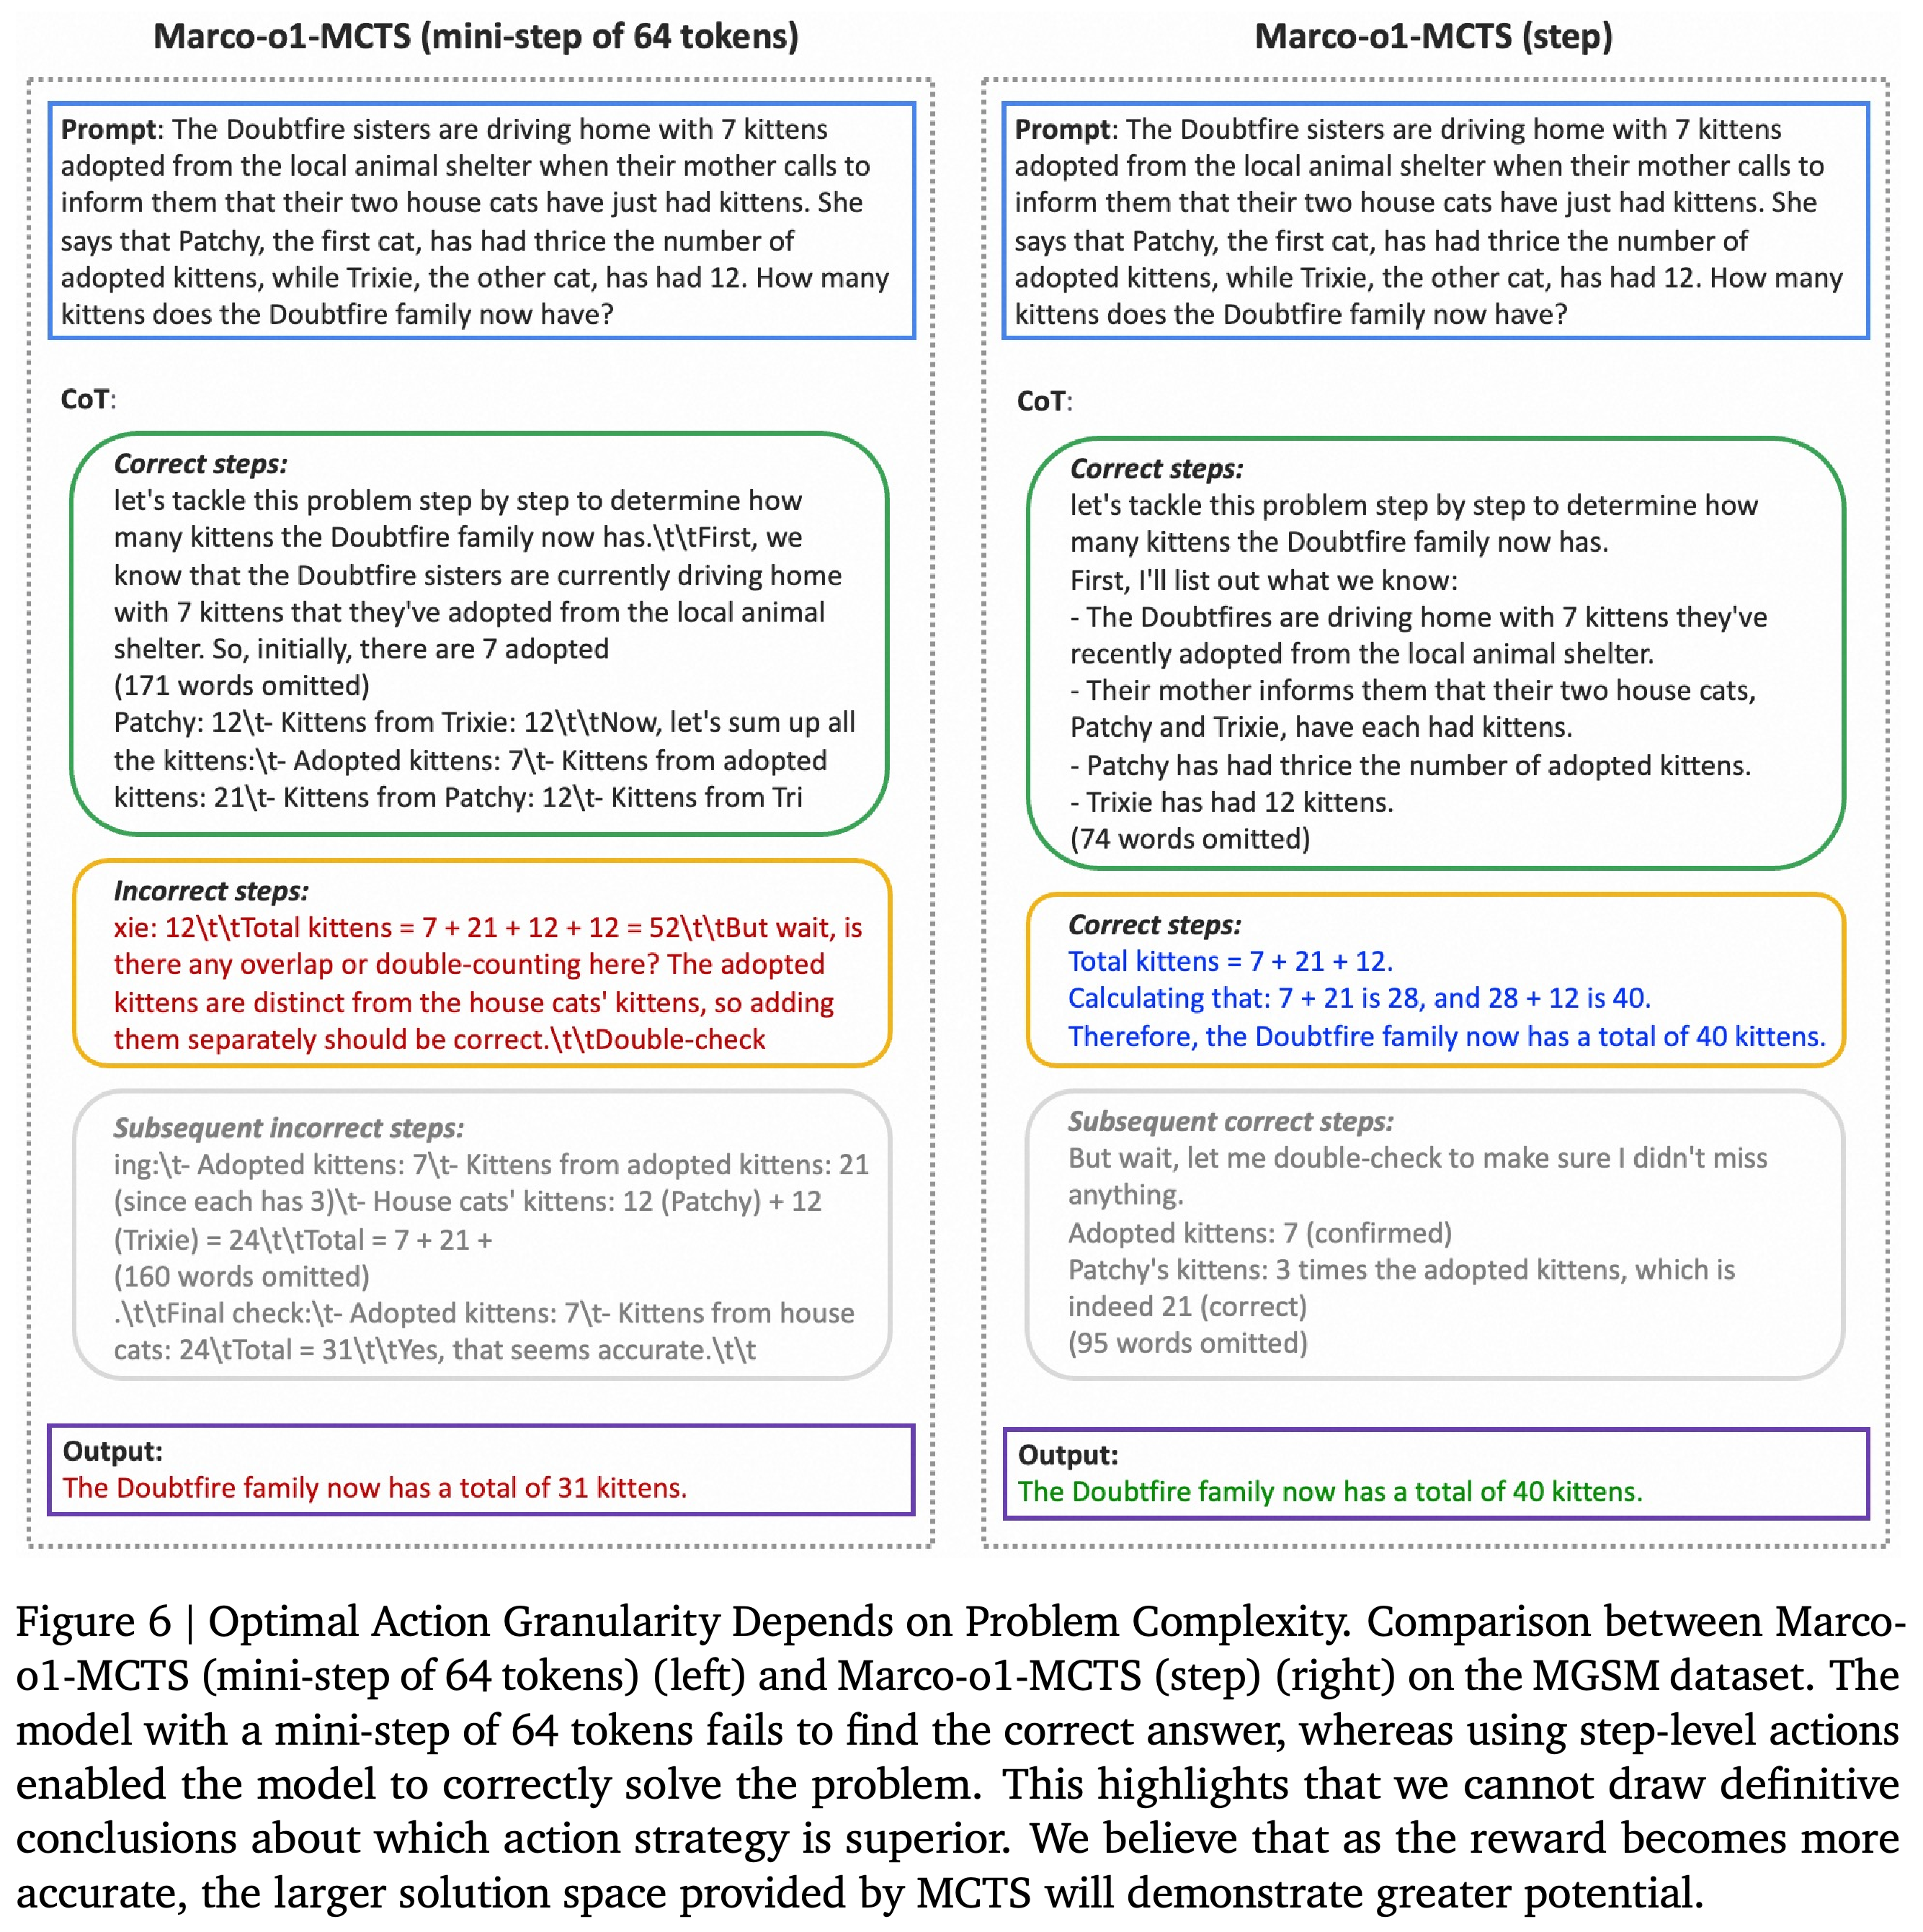
- Figures 5와 6은 더 세밀한 탐색에서 상반된 결과를 보여 준다. 이 예시들은 작은 행동이 개별 문제에서 도움이 될 수도 있고 실패할 수도 있음을 보여 주지만, 어떤 조건에서 특정 행동 크기가 더 좋은지는 밝히지 않는다.
4.2. Reflection after Thinking
Reflection은 각 사고 과정의 끝에 “Wait! Maybe I made some mistakes! I need to rethink from scratch.”라는 문구를 그대로 추가한다. 저자들은 처음에 오답을 낸 어려운 문제 중 약 절반이 reflection 이후 정답으로 바뀐다고 보고한다.
- 논문은 이 문제 집합의 크기와 선정 기준, 통제된 비교 결과 표, reflection의 기여를 분리해 확인하는 별도의 제거 실험을 제공하지 않는다. 따라서 보고된 정답 회복률을 해석하는 데 필요한 실험 정보가 부족하다.
5. Experiments
실험은 수학 추론을 정량적으로 평가하고 구어체 번역을 정성적으로 평가한다. 정량 비교에서는 기본 모델, 미세 조정한 모델, 탐색 설정 3개를 살펴본다. 번역 절에서는 선별한 출력을 Google Translate와 함께 제시한다.
5.1. Setup
Qwen2-7B-Instruct를 전체 파라미터 미세 조정하여 Marco-o1-CoT를 만든다. 이 모델은 추론 단계 전체, 64토큰 mini-step, 32토큰 mini-step이라는 MCTS 설정 3개 모두에 사용된다. 영어(En)와 중국어(Zh) MGSM 하위 집합에서 평가할 때는 모든 모델에 CoT 프롬프트를 제공한다.
- 기본 모델 URL은 https://huggingface.co/Qwen/Qwen2-7B-Instruct 이다.
- 논문은 학습 하이퍼파라미터, 탐색 rollout 예산, 세부 샘플링 설정, 추론 지연 시간, 불확실성 추정치를 보고하지 않는다. 이 정보가 없어 재현과 동일한 연산 비용에서의 비교가 제한된다.
5.2. Main Results
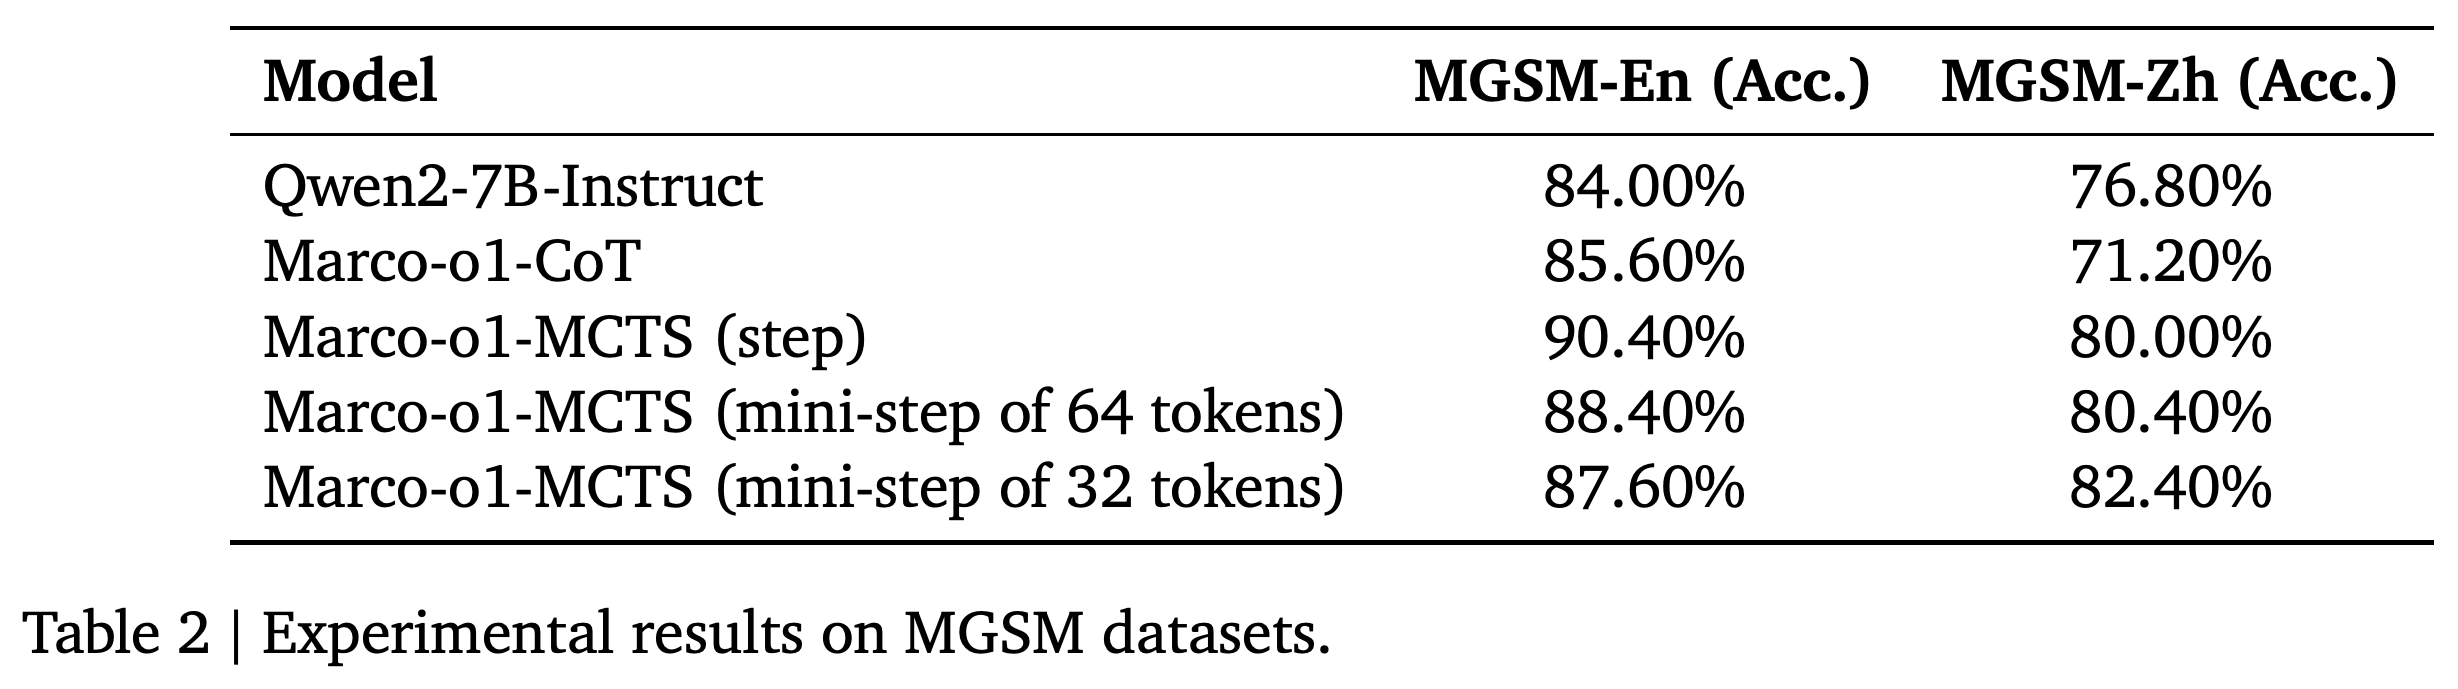
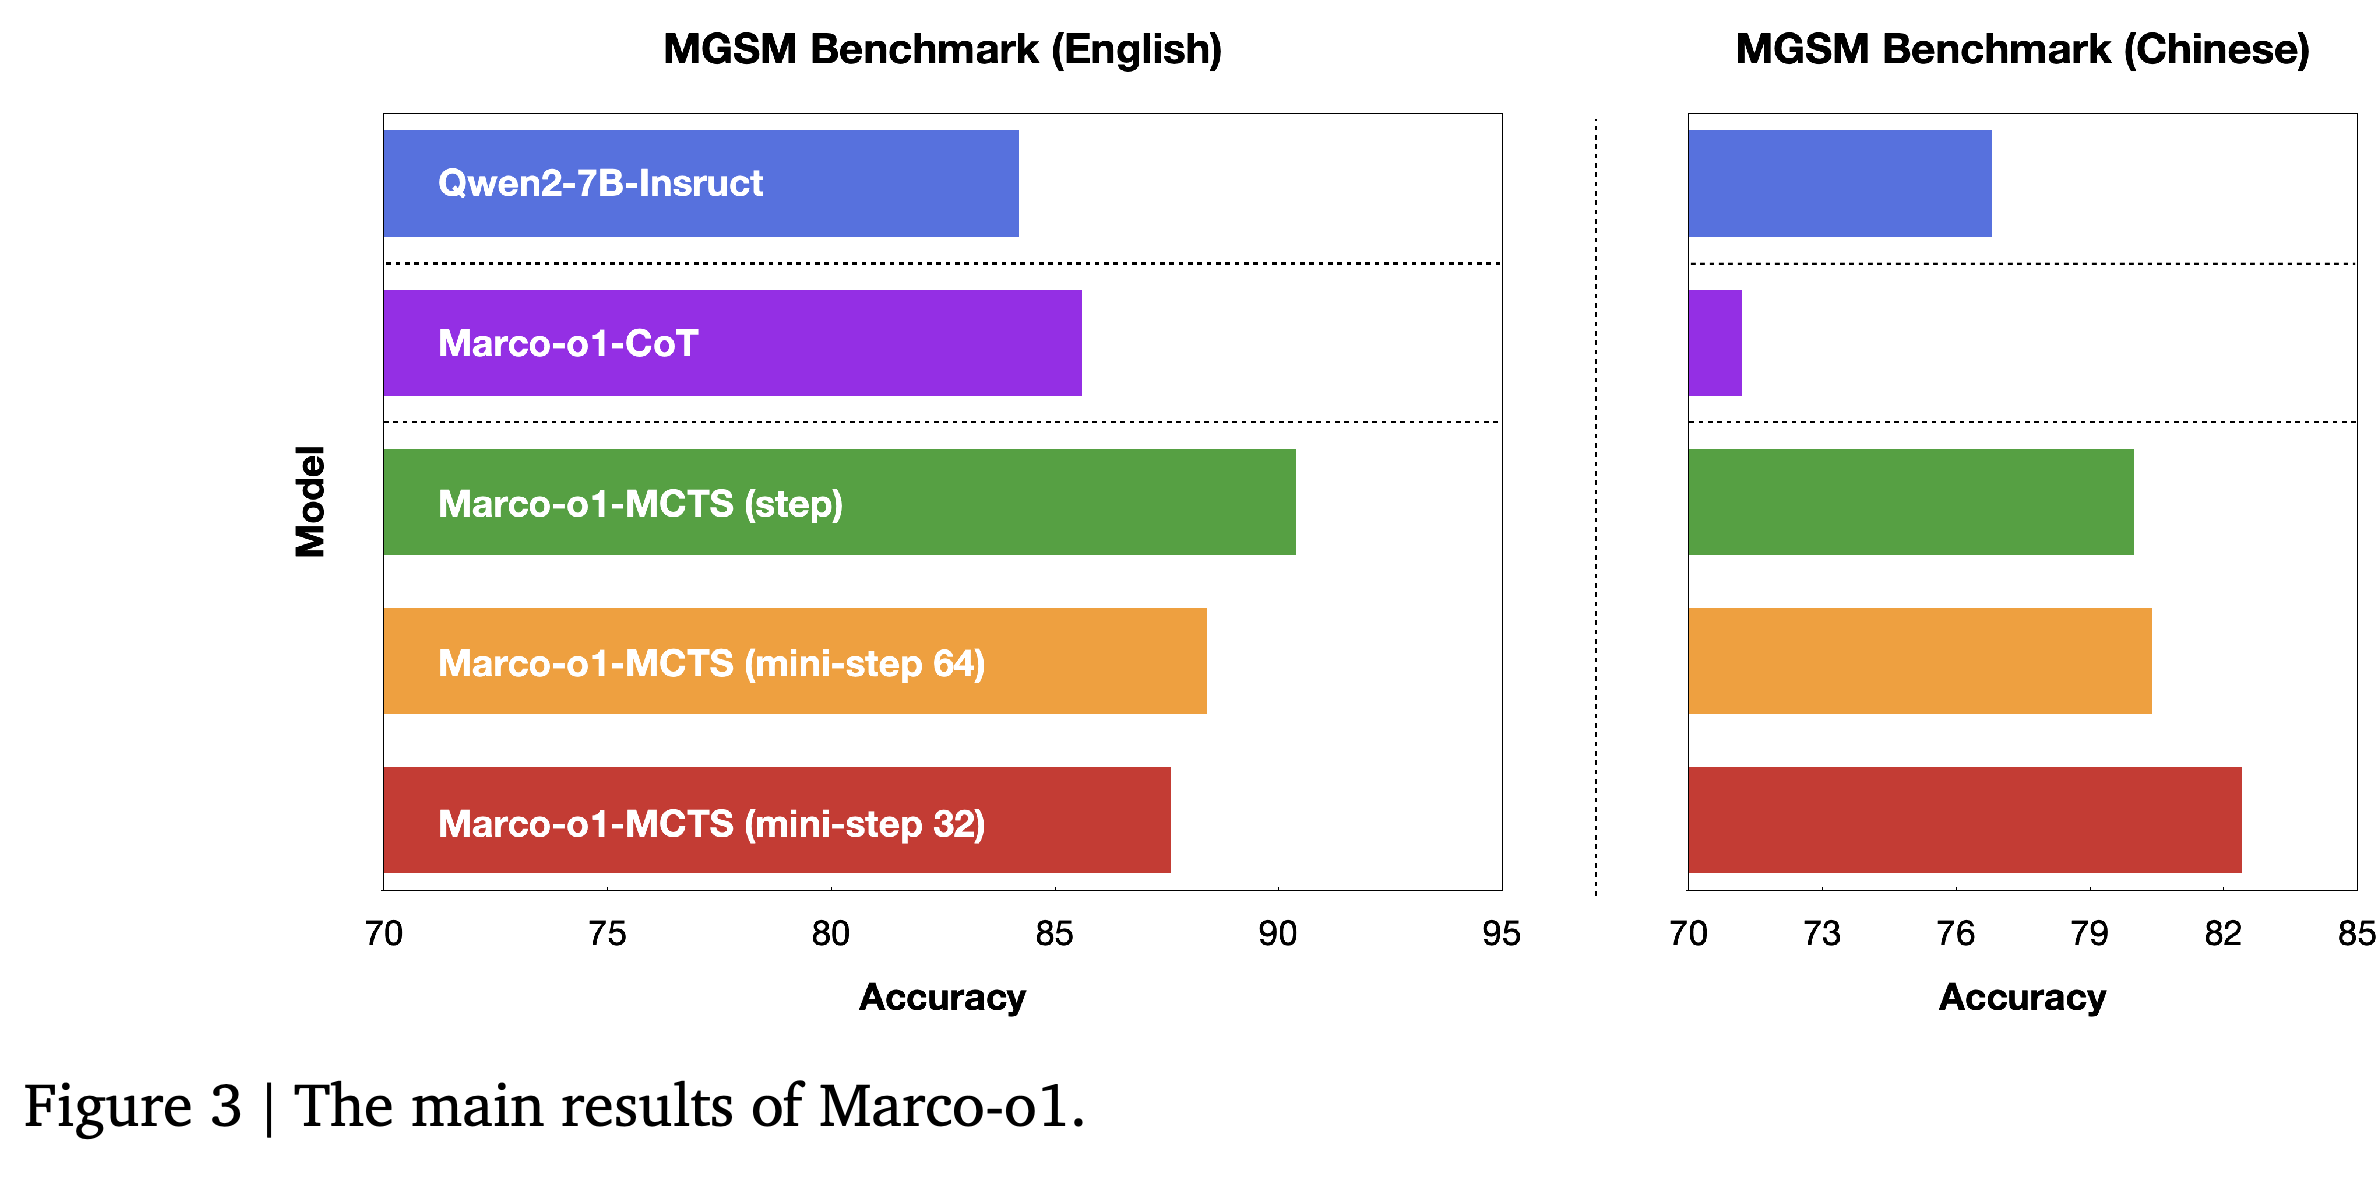
Table 2에서 영어/중국어 정확도는 Qwen2-7B-Instruct가 84.00%/76.80%, Marco-o1-CoT가 85.60%/71.20%, 추론 단계 전체를 사용하는 MCTS가 90.40%/80.00%, 64토큰 mini-step MCTS가 88.40%/80.40%, 32토큰 mini-step MCTS가 87.60%/82.40%다. 모든 탐색 설정은 영어와 중국어 2개 언어에서 모두 Marco-o1-CoT보다 정확도가 높다. 미세 조정만 적용하면 영어 정확도는 높아지고 중국어 정확도는 낮아진다.
- 저자들은 미세 조정 후 중국어 성능이 낮아진 원인으로 영어 CoT 학습 데이터를 지목하지만, 다국어 데이터의 영향을 통제한 제거 실험은 제공하지 않는다.
- Figure 3은 언어에 따라 달라지는 탐색 설정의 순위를 시각화한다. 저자들은 신뢰도 기반 보상에 상당한 무작위성이 있음을 인정하며, 특정 행동 전략이 일반적으로 더 우수하다고 판단하지 않는다.
추론 단계 전체를 단위로 탐색하면 영어에서 가장 높은 정확도인 90.40%를 기록하며, 32토큰 mini-step 탐색은 중국어에서 가장 높은 정확도인 82.40%를 기록한다. 미세 조정만 적용하면 영어 정확도는 84.00%에서 85.60%로 바뀌고, 중국어 정확도는 76.80%에서 71.20%로 바뀐다. 이는 미세 조정의 이점이 언어에 따라 동일하게 나타나지 않음을 보여 준다.
영어 패널에서는 추론 단계 전체를 사용하는 탐색이 가장 높은 순위를 차지한다. 중국어 패널에서는 32토큰 mini-step이 가장 높고, Marco-o1-CoT는 기본 모델보다 낮다. 가로축 2개 모두 70에서 시작하므로, 막대 길이는 0에서 시작하는 정확도 축보다 차이를 시각적으로 크게 나타낸다.
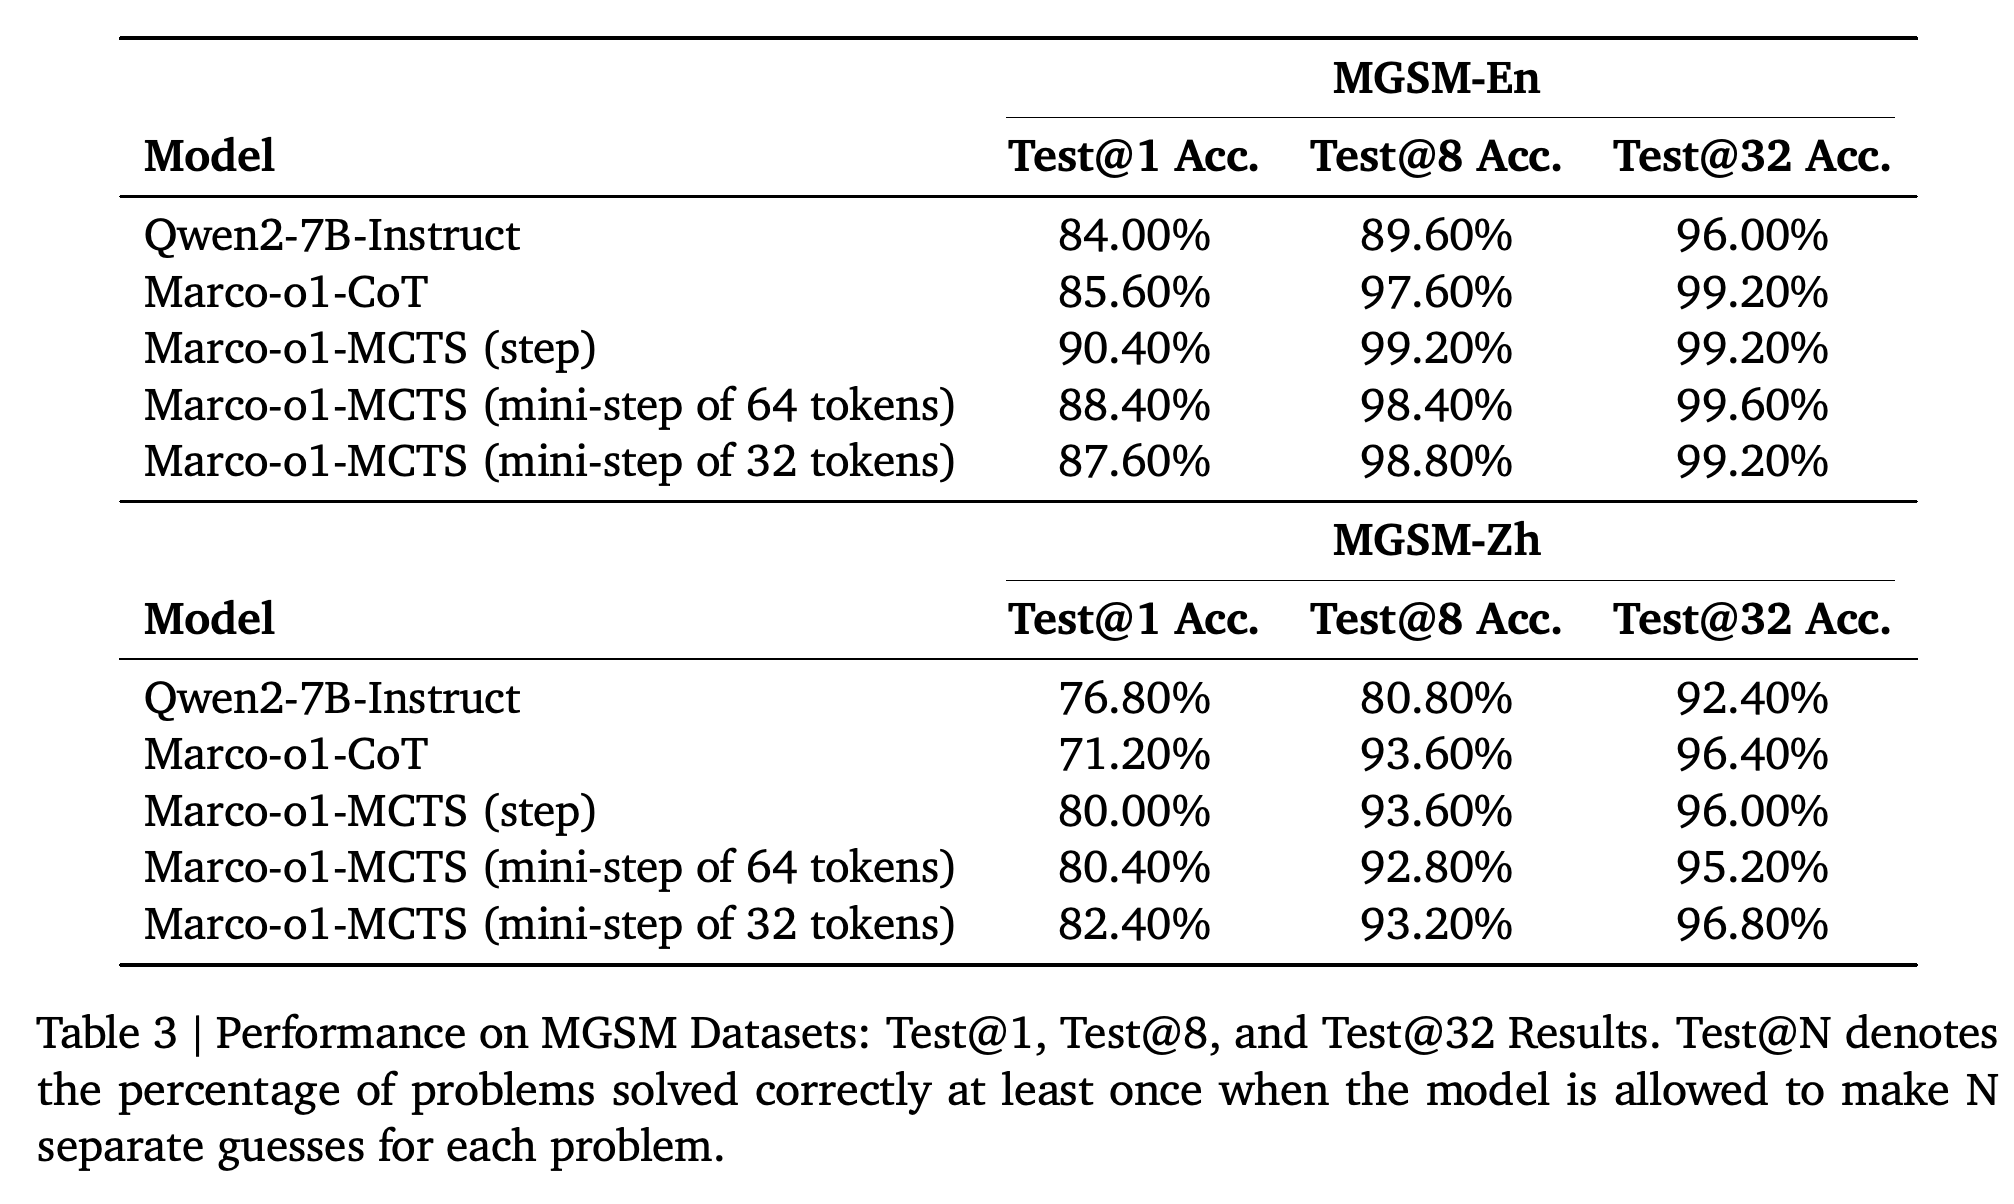
Test@N은 별도로 생성한 답변 N개 중 정답이 적어도 1번 나온 문제의 비율이며, Test@1, Test@8, Test@32에서 평가한다. 영어에서 추론 단계 전체를 사용하는 MCTS는 90.40%/99.20%/99.20%를 기록하며, Marco-o1-CoT는 85.60%/97.60%/99.20%를 기록한다. 중국어에서 32토큰 mini-step MCTS는 82.40%/93.20%/96.80%를 기록하며, Marco-o1-CoT는 71.20%/93.60%/96.40%를 기록한다.
- 영어 Test@32의 최고 성적은 64토큰 mini-step의 99.60%이며, 기본 모델은 96.00%다. 중국어 Test@32의 최고 성적은 32토큰 mini-step의 96.80%이며, 기본 모델은 92.40%다.
- 탐색의 이점은 답변 수가 더 많은 조건보다 Test@1에서 뚜렷하다. 탐색 기반 답변을 생성하는 데에도 여러 후속 텍스트가 사용될 수 있으므로, 이 결과는 동일한 추론 연산량에서의 우위를 입증하지 않는다.
- Test@N은 생성한 답변 중 정답이 있는지를 측정한다. 정답 여부에 관한 정보 없이 시스템이 해당 답변을 선택할 수 있음을 보여 주지는 않는다.
생성하는 답변 수를 늘리면 모든 설정에서 해결률이 높아진다. 영어에서 Marco-o1-CoT와 추론 단계 전체를 사용하는 MCTS 2개 모두 Test@32에서 99.20%에 도달한다. 중국어에서 Marco-o1-CoT는 Test@8에서 93.60%를 기록해 추론 단계 전체를 사용하는 탐색과 같고, mini-step 변형 2개보다 높다. 따라서 탐색이 답변 수가 많은 모든 비교에서 우세한 것은 아니다.
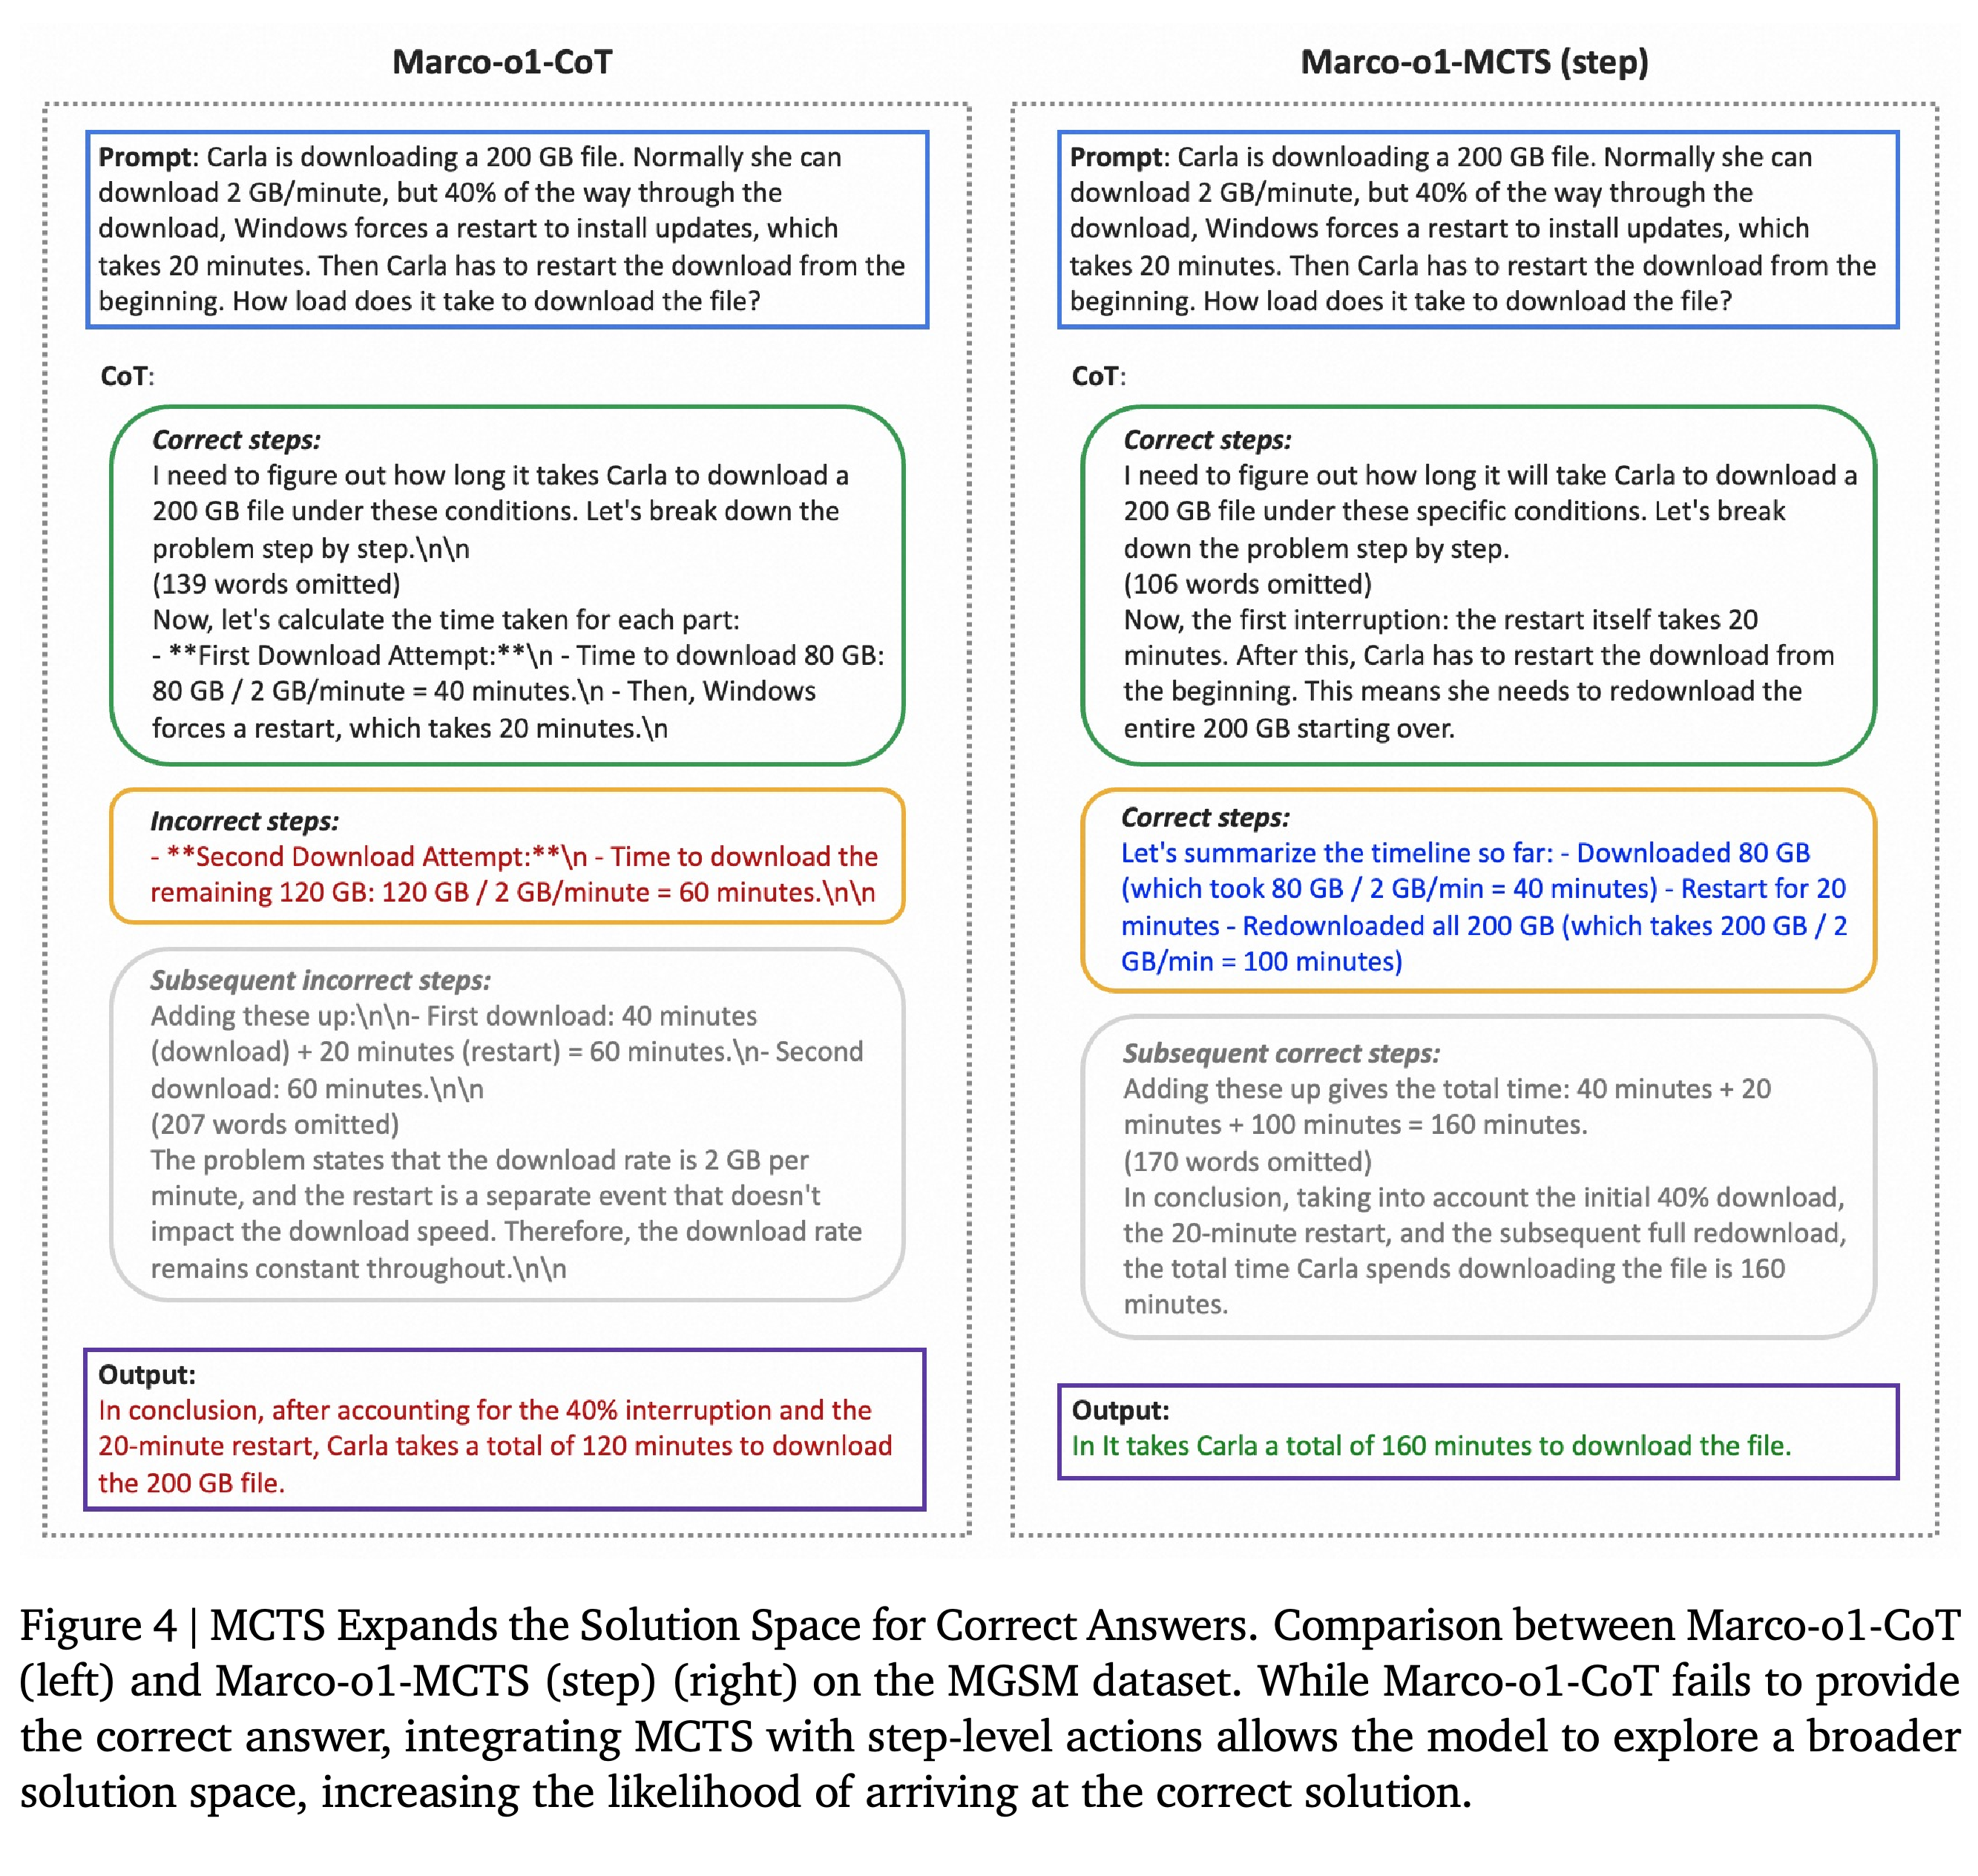
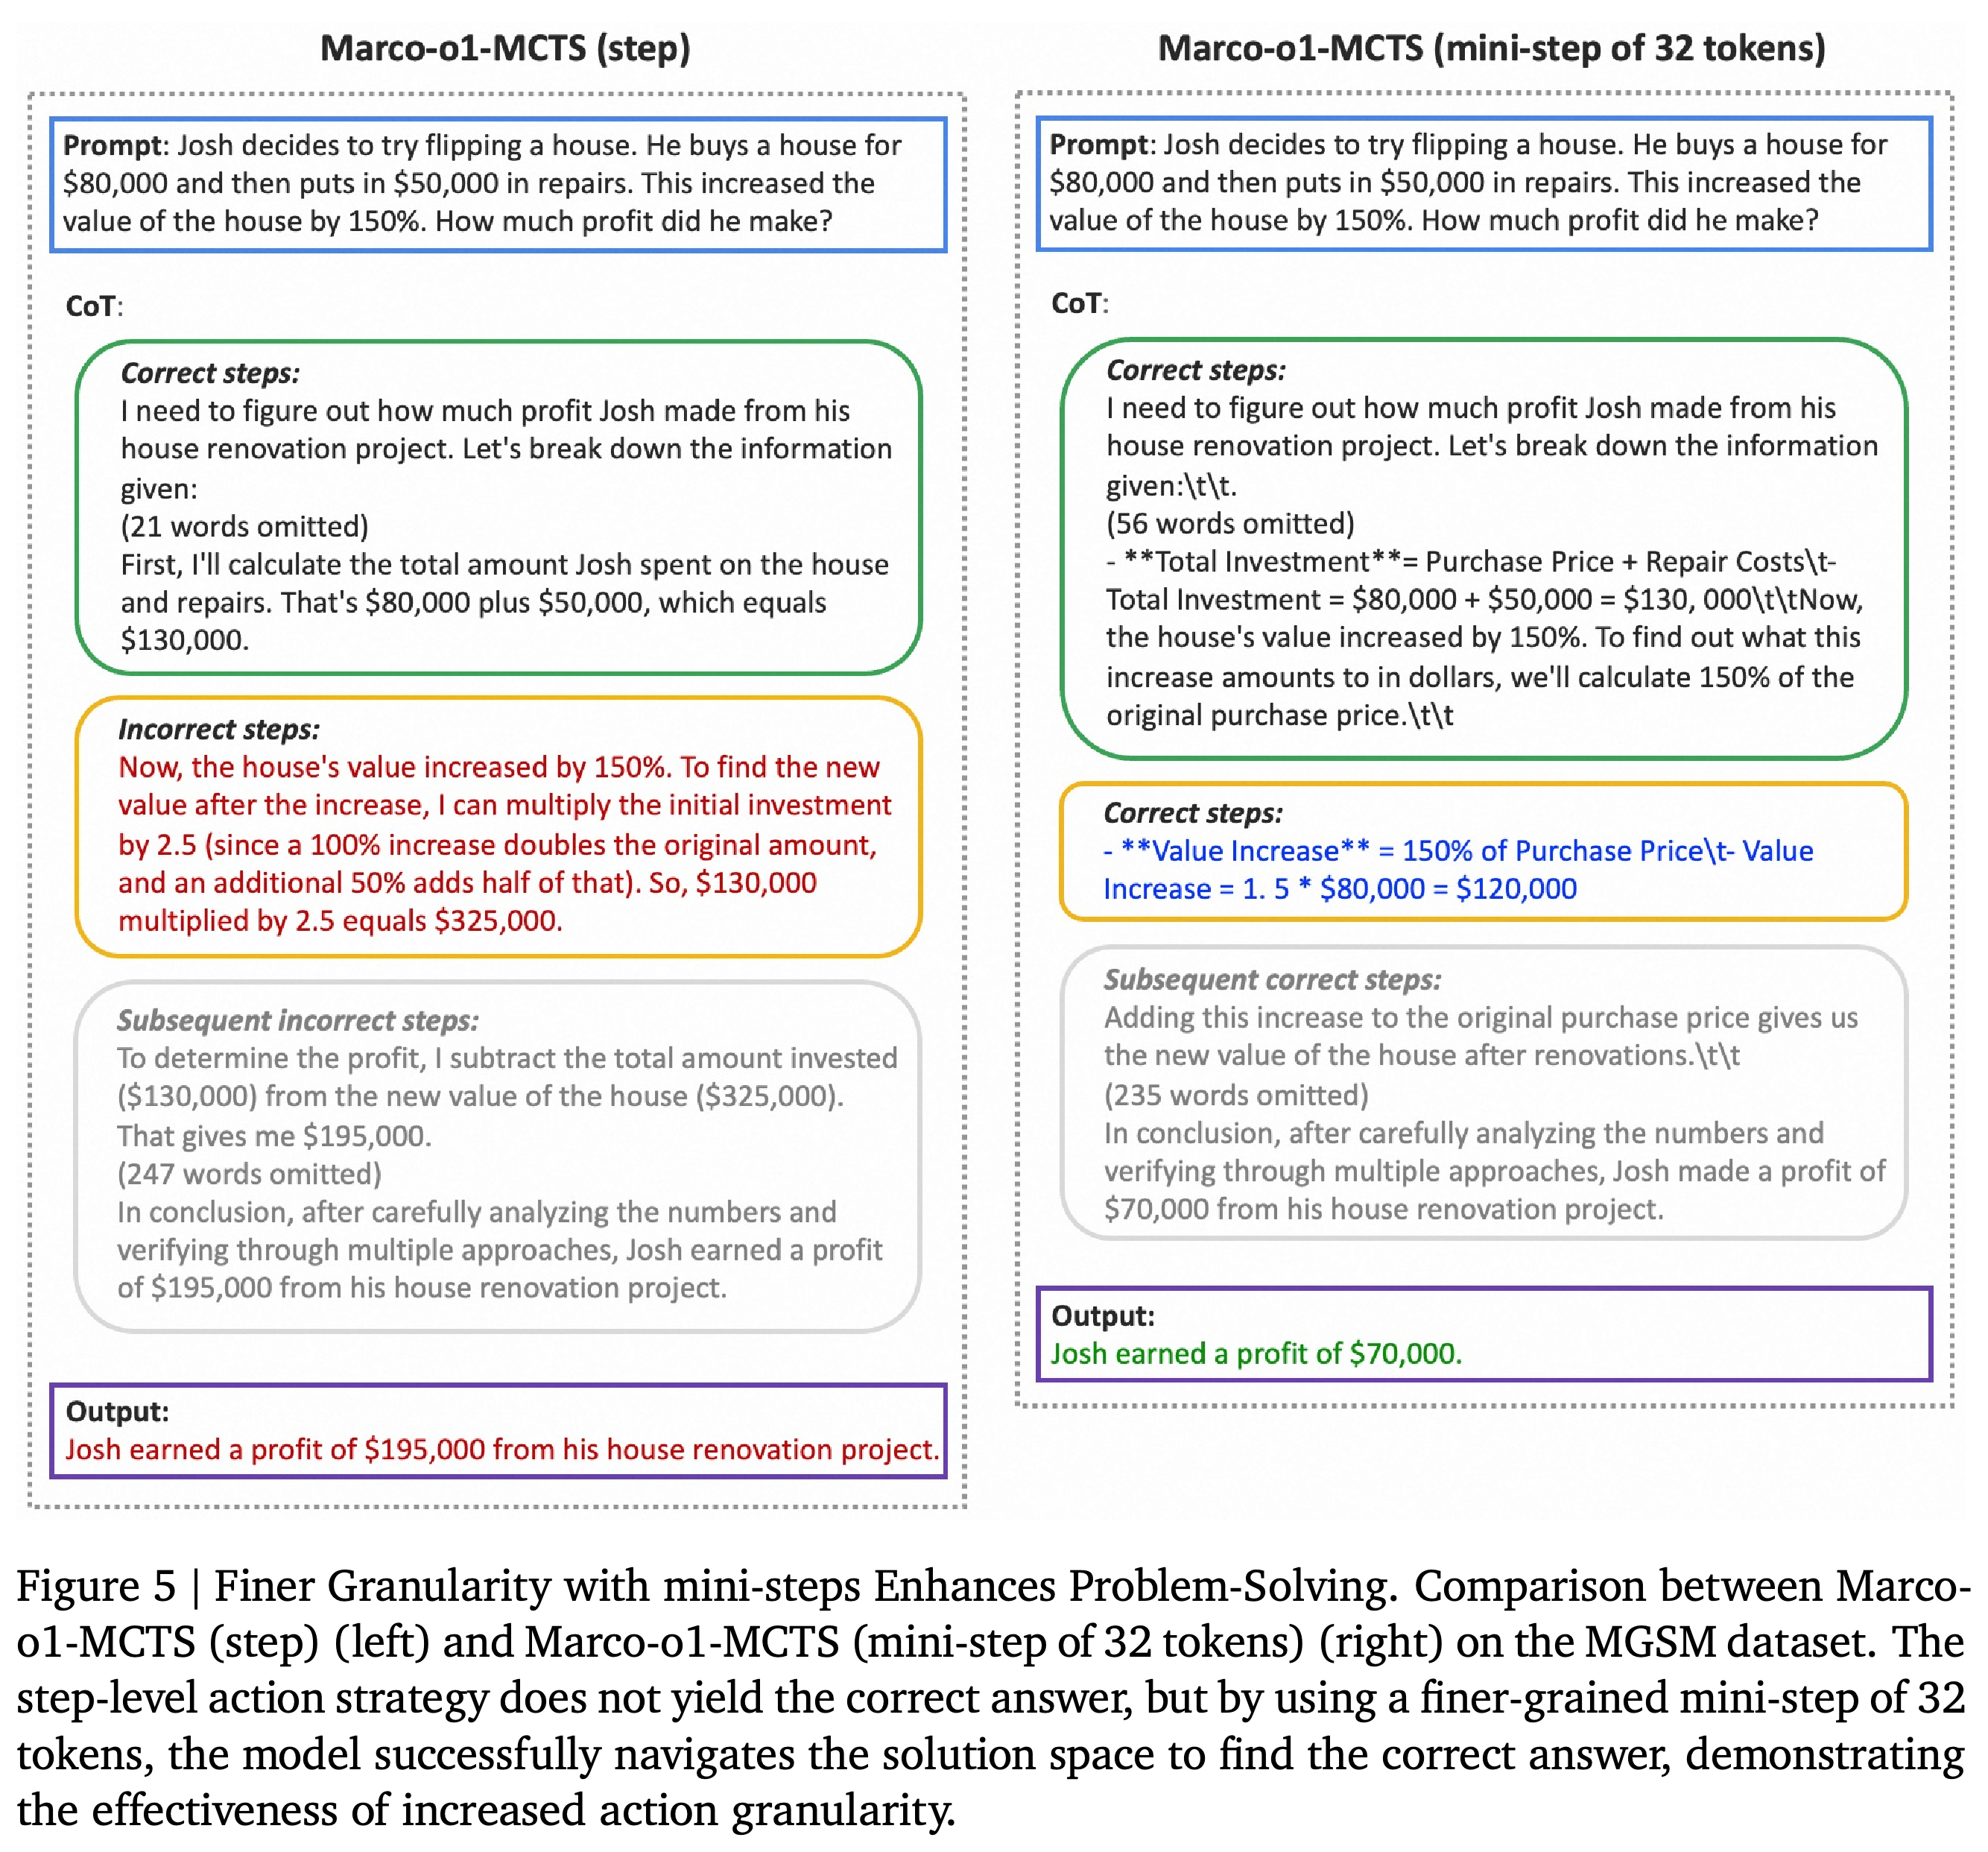
수학 사례 연구는 다른 경로를 탐색하여 특정 오류를 바로잡는 과정을 보여 주며, 작은 행동도 실패할 수 있음을 보여 준다. Figure 4는 잘못된 다운로드 시간인 120분과 정답인 160분을 비교한다. Figure 5는 잘못 계산한 주택 개조 수익 $195,000과 정답 $70,000을 비교한다. Figure 6은 잘못 센 새끼 고양이 수 31마리와 정답 40마리를 비교한다.
- Figure 4에서 추론 단계 전체를 사용하는 MCTS는 시스템 재시작에 20분을 쓴 뒤 남은 120 GB만 내려받는 것이 아니라, 전체 200 GB 다운로드를 다시 시작해야 한다는 점을 반영한다.
- Figure 5에서 32토큰 mini-step은 구매 가격 $80,000에 150% 증가율을 적용한 뒤, 총투자액 $130,000을 뺀다.
- Figure 6에서 추론 단계 전체를 사용하는 MCTS는 입양한 새끼 고양이 7마리, Patchy가 낳은 21마리, Trixie가 낳은 12마리를 올바르게 더한다. 반면 64토큰 mini-step 출력은 계산이 일관되지 않는다.
미세 조정한 모델은 다시 시작한 다운로드에서 남은 120 GB만 내려받으면 된다고 잘못 판단한다. 추론 단계 전체를 사용하는 탐색은 중단 전 40분, 재시작에 필요한 20분, 전체 200 GB를 다시 내려받는 100분을 반영하여 160분을 구한다.
추론 단계 전체를 사용하는 탐색은 구매비와 수리비를 합한 $130,000에 150% 증가율을 적용하여 수익을 $195,000으로 잘못 계산한다. 32토큰 mini-step 응답은 구매 가격 $80,000에 증가율을 적용하여 주택 가치 $200,000과 수익 $70,000을 구한다.
64토큰 mini-step 응답은 중간 합계가 일관되지 않으며 최종적으로 새끼 고양이가 31마리라고 답한다. 추론 단계 전체를 사용하는 탐색은 7 + 21 + 12 = 40을 올바르게 계산한다. 이는 행동을 더 세밀하게 나누면 언제나 정확성이 높아진다는 일반적인 주장에 대한 반례다.
5.3. Case Study on Translation Tasks
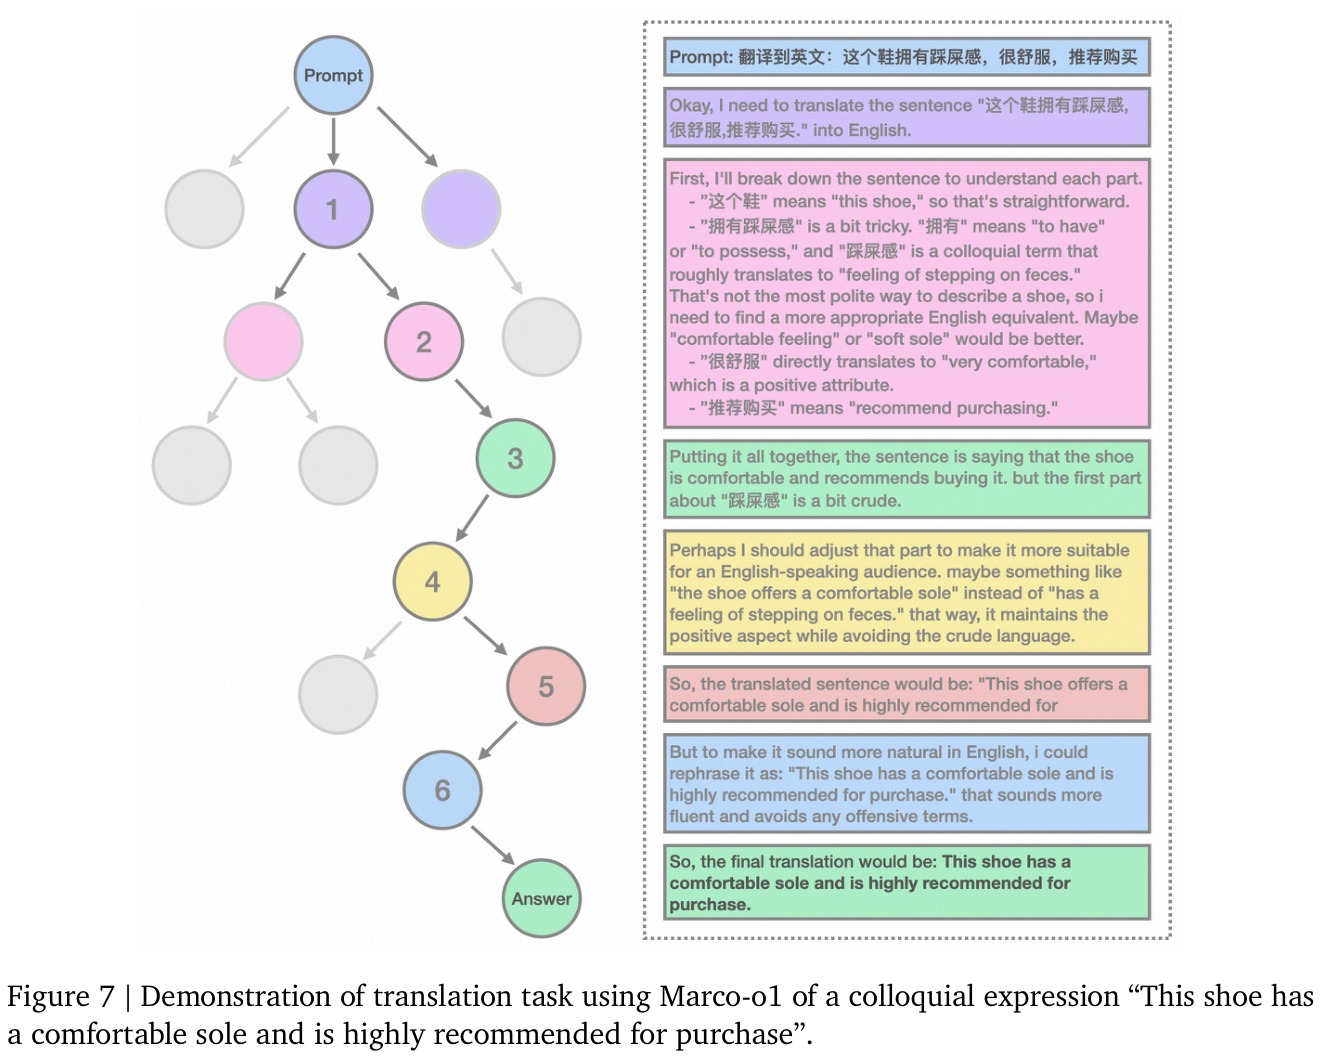
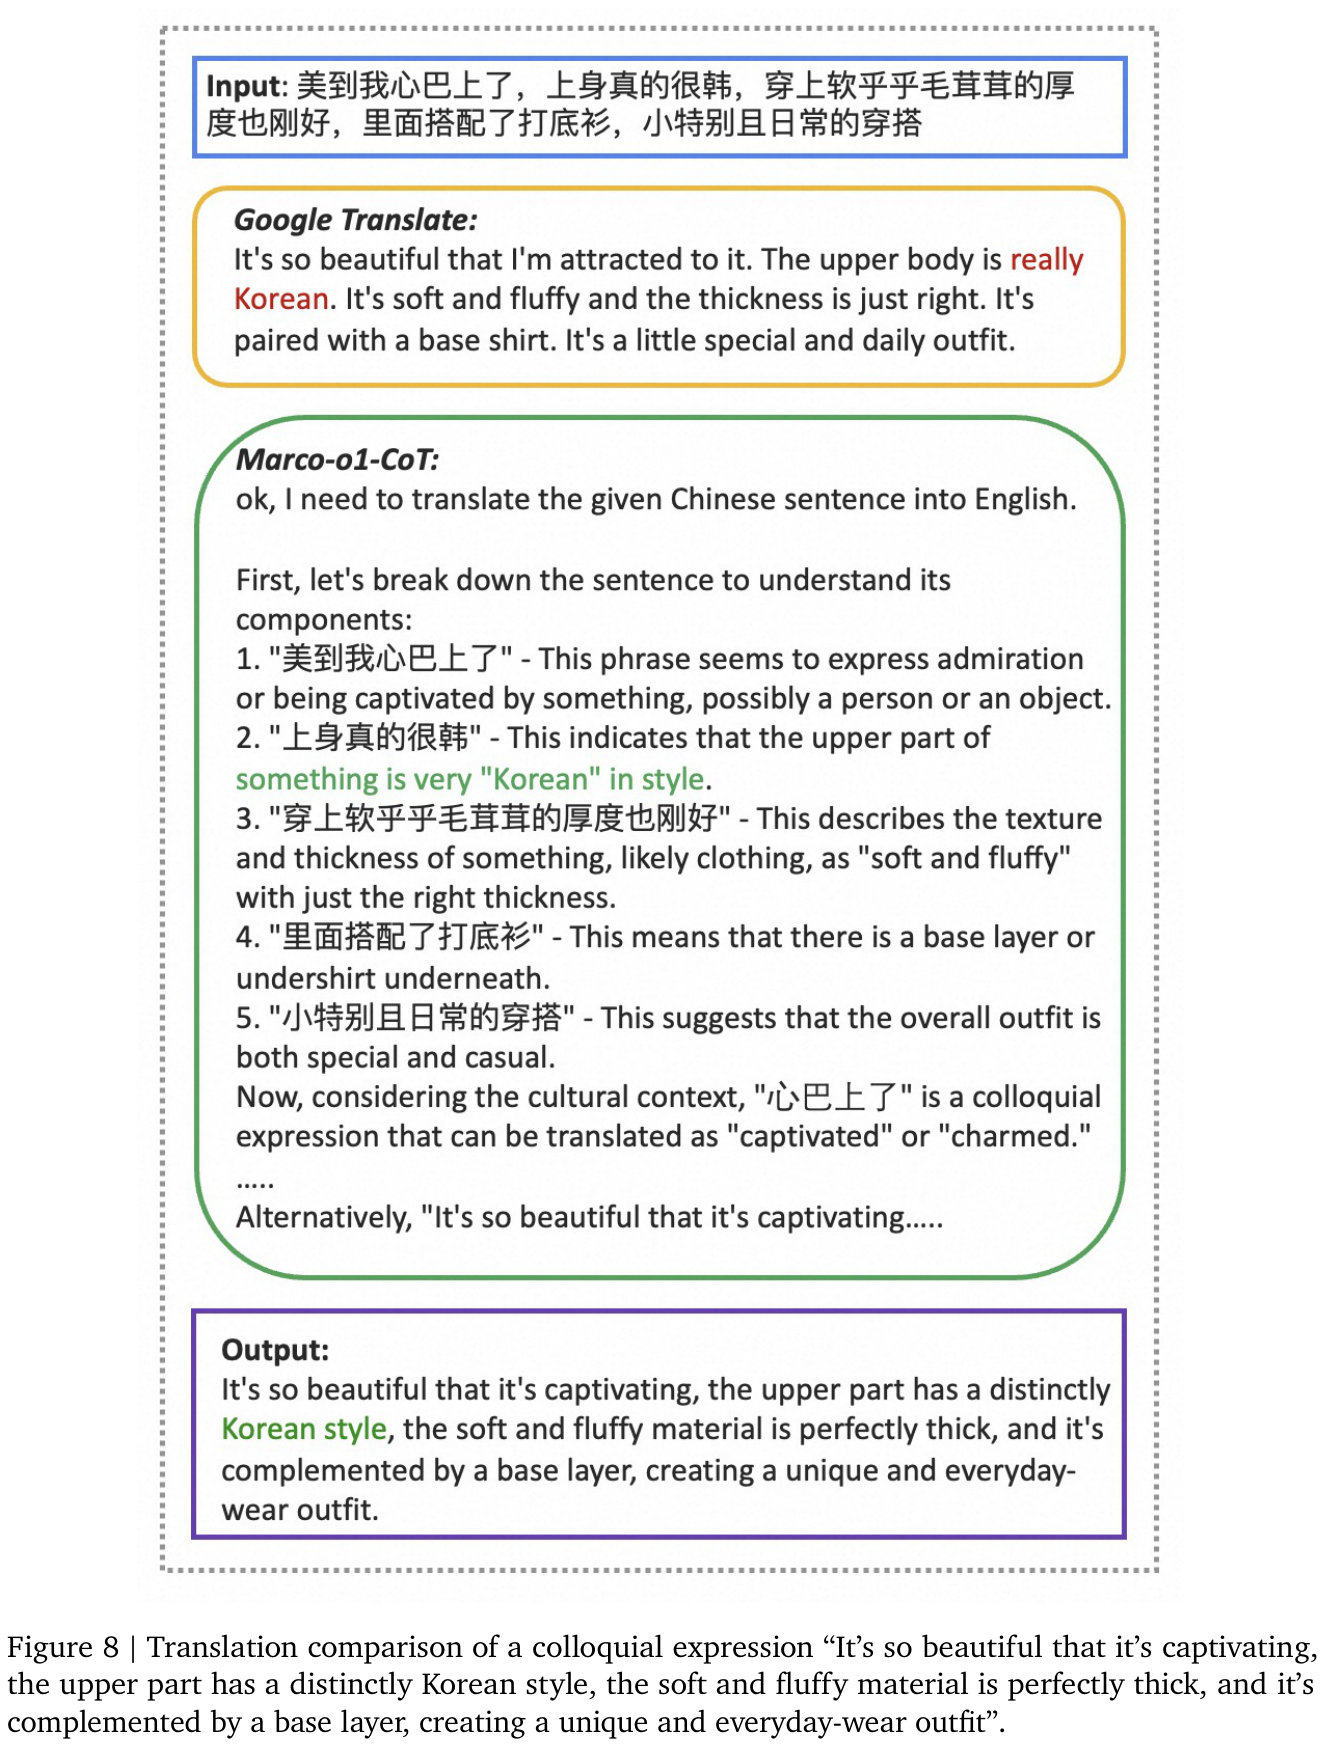
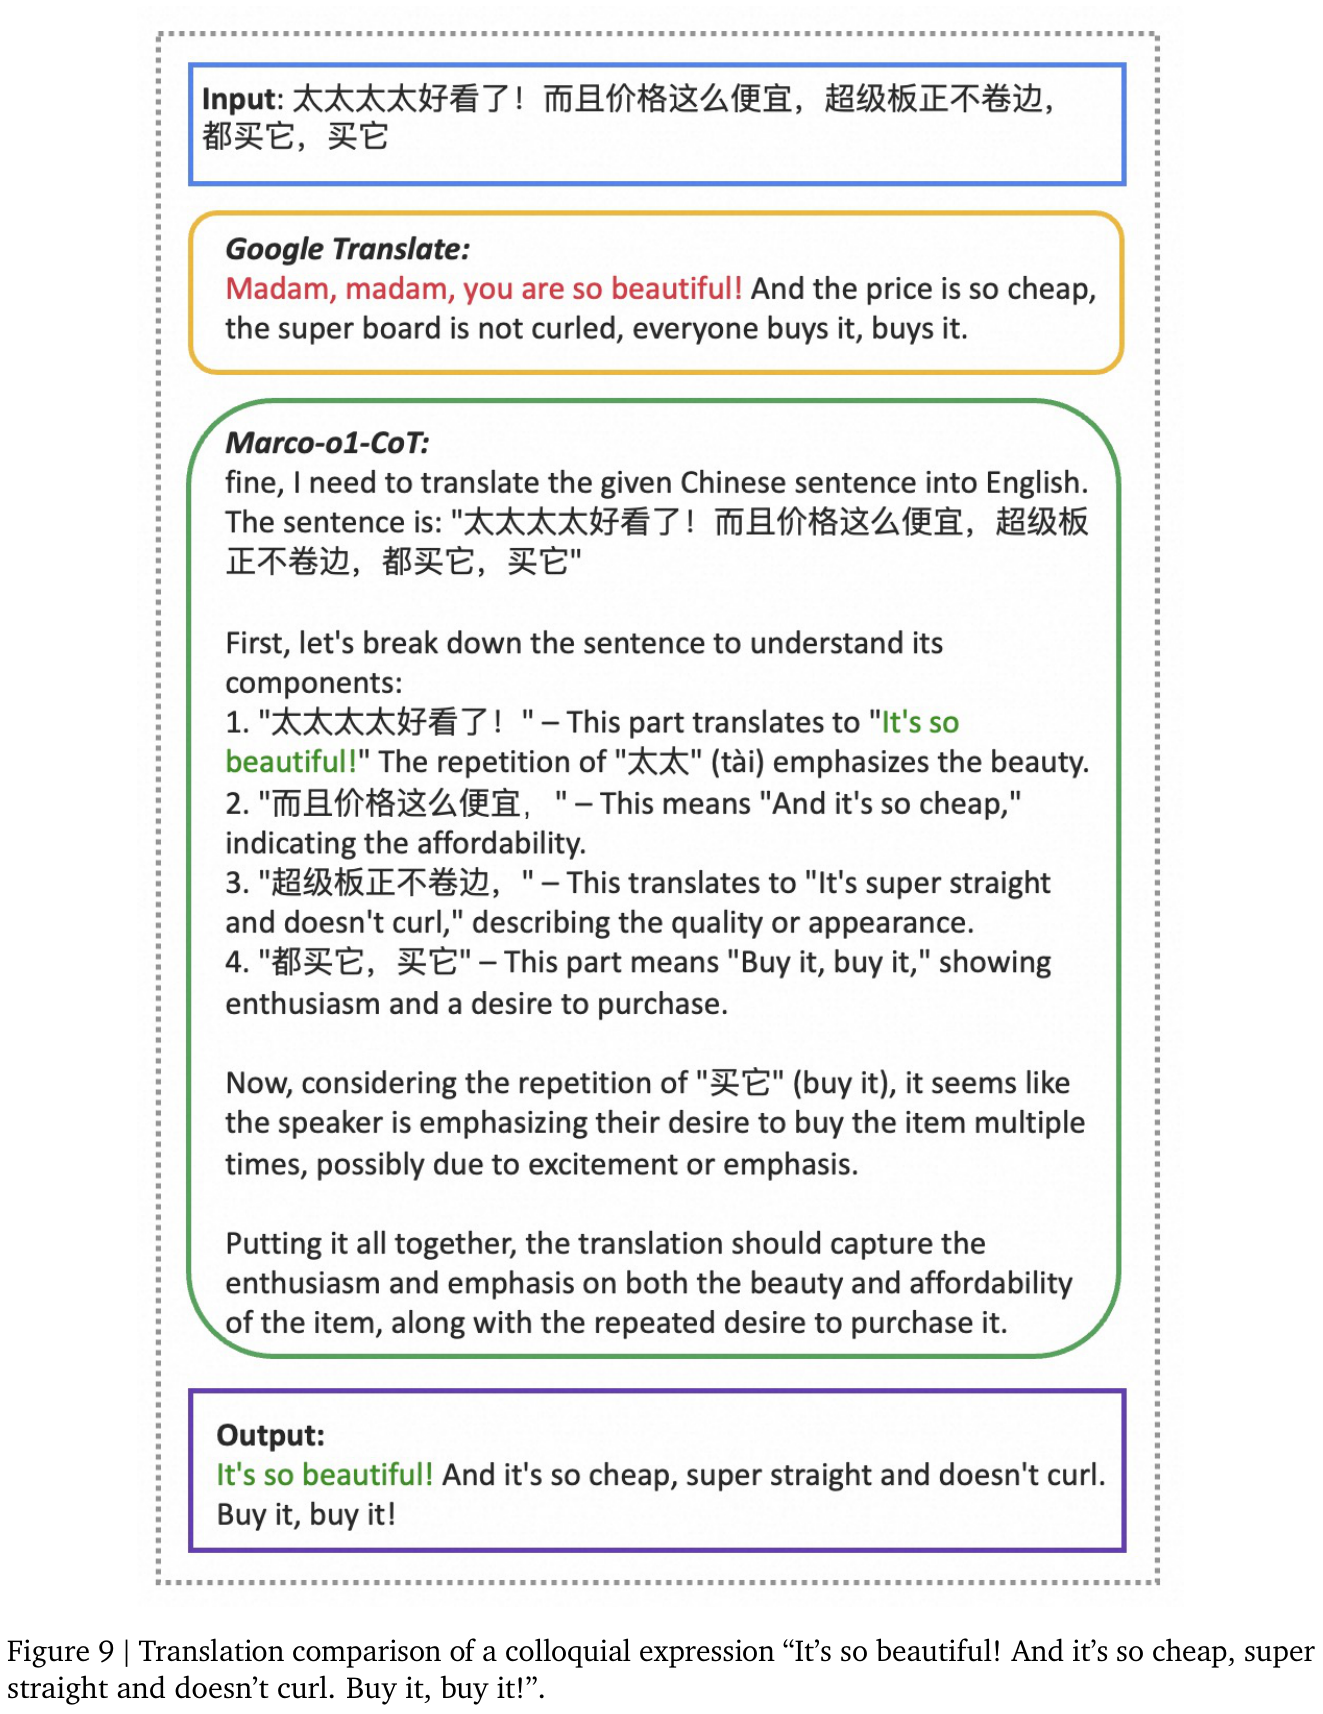
중국어를 영어로 번역하는 사례 3개는 구어체의 의미를 추론하는 과정을 보여 준다. Figure 7은 직역하면 “배설물을 밟는다”는 신발 묘사를 밑창이 편안하다는 뜻으로 해석한다. Figure 8은 의류 묘사를 한국 스타일이라는 뜻으로 해석한다. Figure 9는 반복된 “太”를 “madam”이라는 단어가 아니라 강조로 이해한다.
- Figures 8과 9는 모델 출력을 Marco-o1-CoT로 명시하고 Google Translate와 비교한다. 따라서 번역 품질에 대한 MCTS의 기여를 분리해 보여 주지는 않는다.
- 이 예시들은 특정 문맥 해석이 개선되었음을 뒷받침한다. 체계적인 번역 벤치마크, 종합 지표, 블라인드 인간 평가, 연산량 확장 실험은 보고하지 않으므로, 개방형 번역 전반에서의 우위는 입증되지 않았다.
제시된 추론은 배설물과 관련된 직역 표현을 편안함을 어색하게 묘사한 말로 파악하고, “This shoe has a comfortable sole and is highly recommended for purchase.”로 수정한다. 이 사례 1개는 문맥에 맞게 표현을 바꾸는 과정을 보여 주지만, 종합적인 번역 평가는 제공하지 않는다.
Google Translate는 의류 표현을 “The upper body is really Korean”으로 번역한다. Marco-o1-CoT는 “the upper part has a distinctly Korean style”로 번역하여 한국 스타일을 뜻한다는 점을 명확하게 드러낸다. 이 비교는 특정 문맥 해석이 개선되었음을 뒷받침한다.
Google Translate는 반복된 “太”를 “Madam, madam”으로 해석한다. Marco-o1-CoT는 반복을 강조로 처리하여 “It’s so beautiful!”을 출력한다. 이 예시는 해당 모호성을 바로잡은 사례를 보여 주지만, 평균적인 번역 품질에 관한 근거는 제공하지 않는다.
6. Conclusions and Future Work
저자들은 CoT 미세 조정과 MCTS가 추론을 개선할 수 있으며, 행동 크기가 탐색하는 경로에 영향을 준다고 결론짓는다. 탐색 보상을 개선하기 위해 최종 결과에 점수를 매기는 Outcome Reward Modeling(ORM)과 중간 추론에 점수를 매기는 Process Reward Modeling(PRM)을 제안한다. 보상에 따라 학습하는 강화 학습도 향후 과제로 제시한다.
- 이러한 보상 모델과 강화 학습 제안은 보고된 시스템에서 평가한 구성 요소가 아니다. 기대하는 이점은 향후 연구에 관한 주장으로 남아 있다.
부록
- PDF에는 부록이라는 제목이 명시된 절이 없다. Figures 4–9는 참고문헌 뒤를 포함한 후반 페이지에 배치되어 있지만, 본문 실험의 근거로 논의된다.
짧은 생각
가장 뚜렷한 결과는 평가한 언어 2개 모두에서 탐색이 Marco-o1-CoT보다 일관되게 좋은 성능을 보인다는 점이다. 행동 크기에 따라 정확도 순위는 달라진다. 개방형 추론의 근거는 선별한 번역 사례로 제한된다. 연산 예산, 불확실성 추정치, 통제된 reflection 결과가 보고되지 않아 효율성, 안정성, 구성 요소별 기여는 여전히 불명확하다.