


No More Adam: Learning Rate Scaling at Initialization is All You Need 요약 설명
16 Dec 2024 | Paper Review Adaptive Optimization Learning Rate Scaling Memory-Efficient Training목차
이번 글에서는 No More Adam: Learning Rate Scaling at Initialization is All You Need 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 16일(Arxiv)
- Xu, Minghao, Xiang, Lichuan, Cai, Xu, Wen, Hongkai.
- Department of Computer Science, University of Warwick, Coventry, UK, Collov Labs
- 논문 링크
- Github
요약
- AdamW는 기울기 이력을 바탕으로 파라미터 업데이트의 크기를 조정하는 옵티마이저다. 파라미터마다 기울기 제곱의 이력을 유지하므로 메모리와 연산 비용이 크다. 이미지를 패치 단위로 처리하는 Vision Transformer인 ViT-S/16을 사용한 ImageNet-1K 이미지 분류 탐색에서 SGD-SaI의 top-1 정확도는 72.92%, AdamW는 73.04%다. 별도로 수행한 옵티마이저 프로파일링에서 SGD-SaI의 옵티마이저 상태 메모리는 AdamW의 약 절반이다.
- SGD-SaI는 이전 기울기를 활용해 업데이트를 평활화하는 모멘텀 확률적 경사 하강법(SGDM)에 Scaling at Initialization(SaI)을 결합한다. SaI는 첫 배치로 파라미터 블록별 학습률 배율을 정한 뒤 고정한다. 기울기 신호 대 잡음비(g-SNR)는 블록의 기울기 노름을 기울기 표준편차로 나누되 수치 안정화를 적용한 값이다. 이 표준편차는 블록 내부 기울기 원소들의 변동을 측정한다.
- GPT-2-Small 사전 학습에서 SGD-SaI의 학습 손실과 검증 손실은 각각 2.98과 3.09다. AdamW와 파라미터 블록 내부에서 적응형 배율을 공유하는 Adam-mini는 베이스라인 2개 모두 학습 손실이 3.11, 검증 손실이 3.12다. 옵티마이저 업데이트 시간은 SGD-SaI가 9.31 ms, AdamW가 13.42 ms, Adam-mini가 27.21 ms다. 이 수치는 전체 학습 반복이 아니라 옵티마이저 업데이트에 걸리는 시간을 측정한 결과다.
- 실험에는 학습한 합성곱 필터로 이미지를 처리하는 합성곱 신경망(CNN)과 저랭크 파라미터 업데이트로 모델을 미세 조정하는 low-rank adaptation(LoRA)도 포함된다. 대규모 모델에 대한 근거는 프로파일링에 한정되며, 초기 수렴은 Adam 계열 베이스라인보다 느리다. 이미지 생성기를 사용한 확산 모델 비교는 정량 평가 없이 정성적 예시만 제시한다.
1. Introduction
논문은 Adam이 유용한 이유 중 하나로 local gain을 제시한다. local gain은 기울기 패턴이 다른 파라미터들의 학습률을 조정하는 배율이다. 기울기와 기울기 제곱의 이동 평균인 1차, 2차 모멘트 텐서를 유지하는 비용은 모델이 커질수록 증가한다. SGD-SaI는 2차 모멘트를 유지하지 않고도 초기 기울기 측정으로 유용한 고정 배율을 얻을 수 있는지 살펴본다.
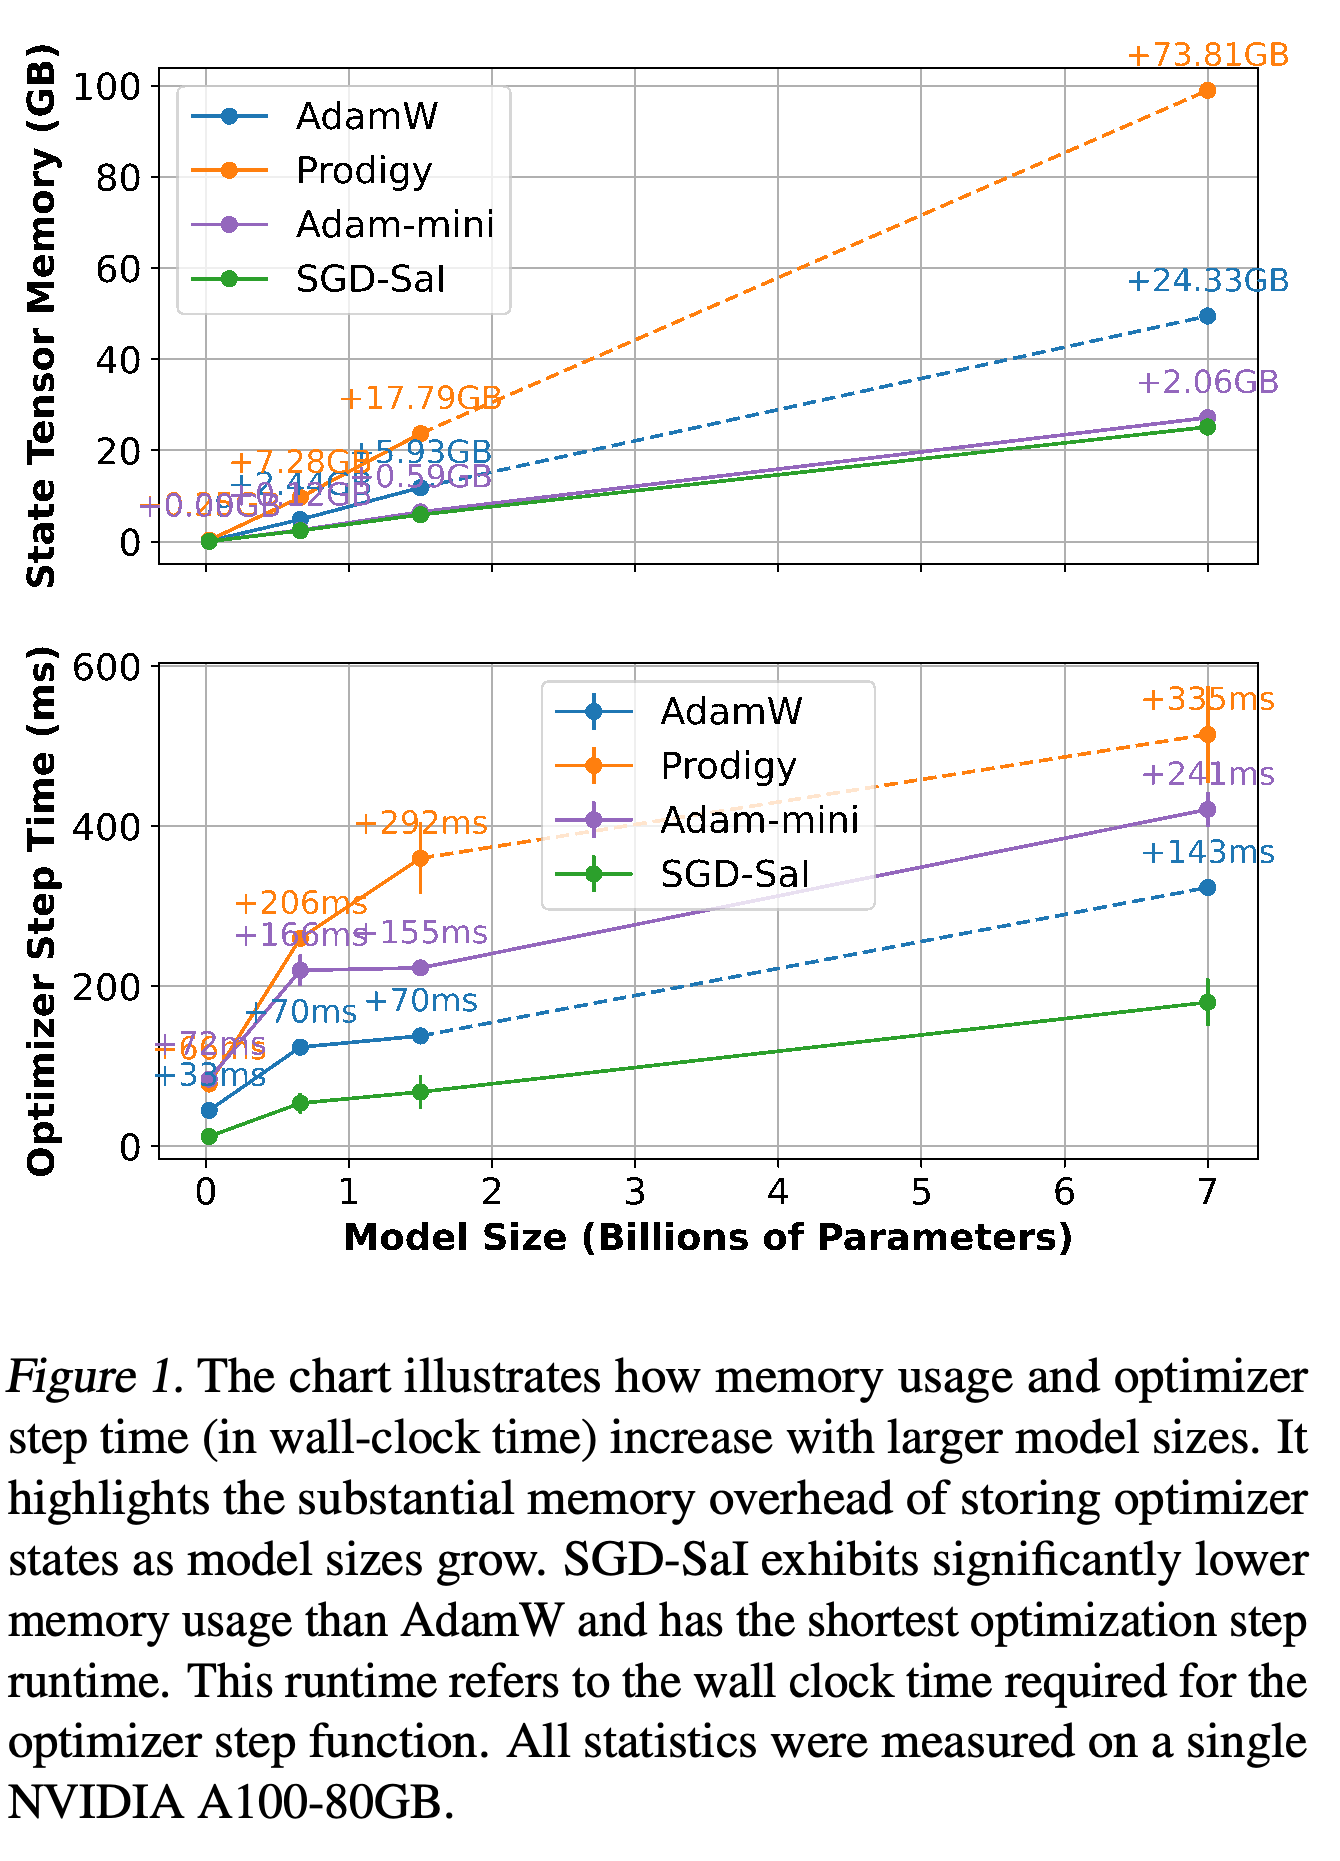
- Figure 1은 NVIDIA A100-80GB 1개에서 옵티마이저 상태 메모리와 옵티마이저 스텝 시간을 측정하며, 전체 학습 속도를 측정하지는 않는다.
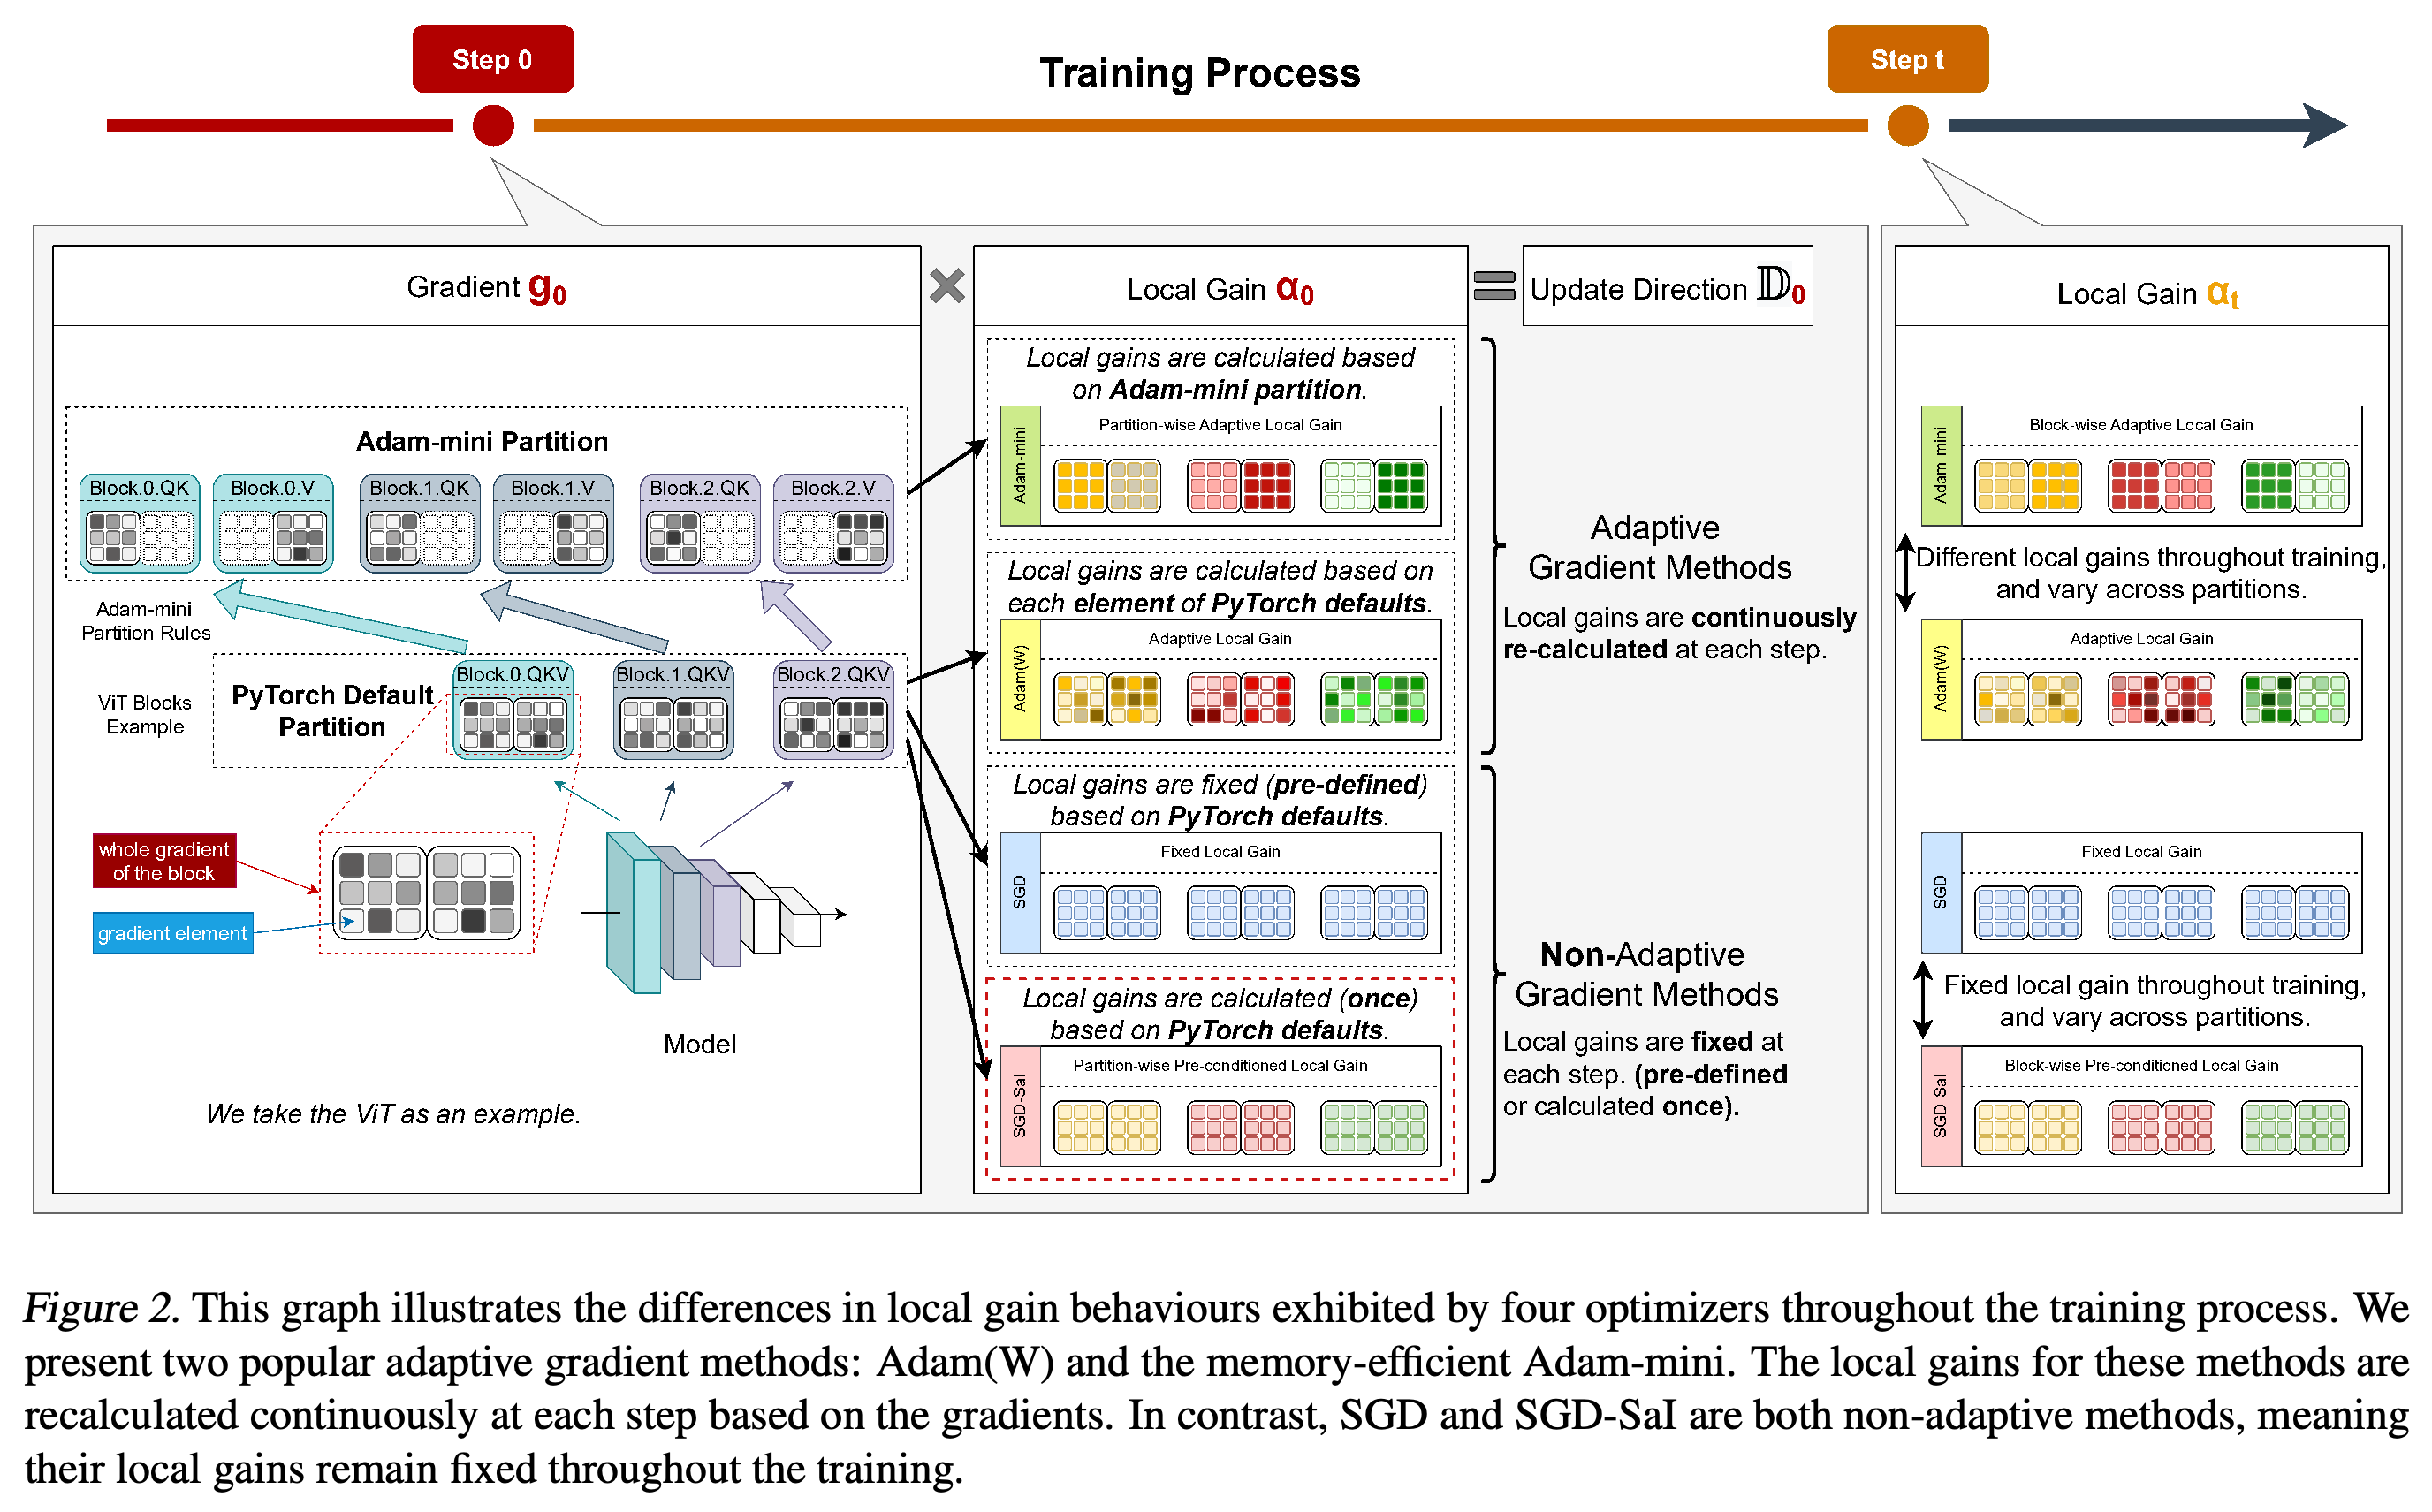
- Figure 2는 Adam과 AdamW를 뜻하는 Adam(W)의 원소별 적응형 배율, Adam-mini의 분할별 적응형 배율, SGD의 균일한 배율, SGD-SaI의 블록별 고정 배율을 구분한다.
모델이 커질수록 옵티마이저 상태 비용이 증가하며, SGD-SaI의 측정 비용은 도표에 제시한 적응형 옵티마이저보다 낮다. 실행 시간 축은 옵티마이저 스텝을 측정하므로 이 도표만으로 전체 학습의 가속을 입증할 수는 없다.
SGD-SaI는 기본 파라미터 블록마다 서로 다른 배율을 1회 부여한다. Adam(W)와 Adam-mini는 배율을 반복해서 계산한다. 도식은 Adam-mini가 사용하는 더 세밀한 분할도 보여준다.
2. Related Work
관련 연구에서는 적응형 옵티마이저, 메모리 절감 방법, 초기화 시점의 기울기 측정을 연결한다. Adafactor는 차원 간에 2차 모멘트 정보를 공유하고, 저비트 옵티마이저는 저장 상태를 압축하며, Adam-mini는 선택한 블록 내부에서 2차 모멘트를 공유한다. SGD-SaI는 동적으로 갱신하는 2차 모멘트를 제거한다.
- 학습 전에 희소 네트워크를 선택하는 Pruning at Initialization과 적은 비용의 측정으로 학습 전 아키텍처를 평가하는 zero-cost neural architecture search는 초기 기울기 구조를 활용하는 동기가 된다.
- 이러한 연관성은 방법의 동기를 제공하지만, 첫 배치의 통계량이 학습 내내 적절하다는 점을 독립적으로 입증하지는 않는다.
3. Problem Setting
파라미터 벡터는 d개의 원소로 이루어지며, 아키텍처에 따라 B개의 블록으로 나뉜다. 최적화는 전역 학습률과 업데이트 방향을 곱한 값을 파라미터에서 빼는 방식으로 진행한다. 모멘텀 SGD는 기울기의 이동 평균을 사용한다. Adam은 기울기 제곱의 이동 평균도 유지하며, 초기화로 인한 편향을 보정한 값을 사용해 업데이트 크기를 조정한다.
- 목표는 전체 2차 모멘트 텐서를 저장하거나 갱신하지 않고 2차 모멘트에 의존하는 local gain을 대체하는 것이다.
- 이 구분은 옵티마이저 상태에 관한 것이다. 파라미터와 같은 크기의 상태 텐서 1개를 제거해도 전체 학습 메모리가 절반으로 줄어들지는 않는다. 전체 학습 메모리에는 파라미터, 기울기, 모델의 중간 활성값도 포함된다.
4. Methods
제안 방법은 블록별 기울기 통계량을 정의하고, 파라미터 유형과 학습 스텝에 따른 분포를 살펴본 뒤, 초기화 시점에 정규화한 블록별 배율을 고정한다. 분석한 모델에서 관측한 안정성과 작은 파라미터 업데이트에 관한 국소적 논거를 근거로 제시한다.
4.1. Memory Efficient Local Gain: g-SNR
블록 i의 기울기 노름은 G_norm^(i) = sqrt(sum_j (g_j^(i))²), 블록 내부 분산은 G_var^(i) = (1/d_i) sum_j (g_j^(i) − ḡ^(i))²로 정의한다. 여기서 d_i는 원소 수이며, ḡ^(i)는 원소들의 평균이다. ε을 수치 안정화를 위한 작은 상수로 두고 G_snr^(i) = G_norm^(i)/sqrt(G_var^(i) + ε)을 계산한다. 각 블록의 값을 전체 블록 중 최대 g-SNR로 나누어 정규화하면 0과 1 사이의 배율을 얻는다.
- 블록에 적용하는 실효 학습률은 전역 학습률에 이 정규화된 통계량을 곱한 값이다.
- 분산은 파라미터 블록 내부의 기울기 원소들을 대상으로 계산한다. 이 식은 독립적으로 추출한 배치 사이의 확률적 기울기 분산을 직접 추정하지 않는다.
- 블록마다 배율을 1개씩 저장하므로 블록 수에 비례하는 O(B) 저장 공간이 필요하다. 유지하는 모멘텀 텐서에는 여전히 파라미터 수에 비례하는 O(d) 저장 공간이 필요하다.
4.2. Statistics Analysis for g-SNR
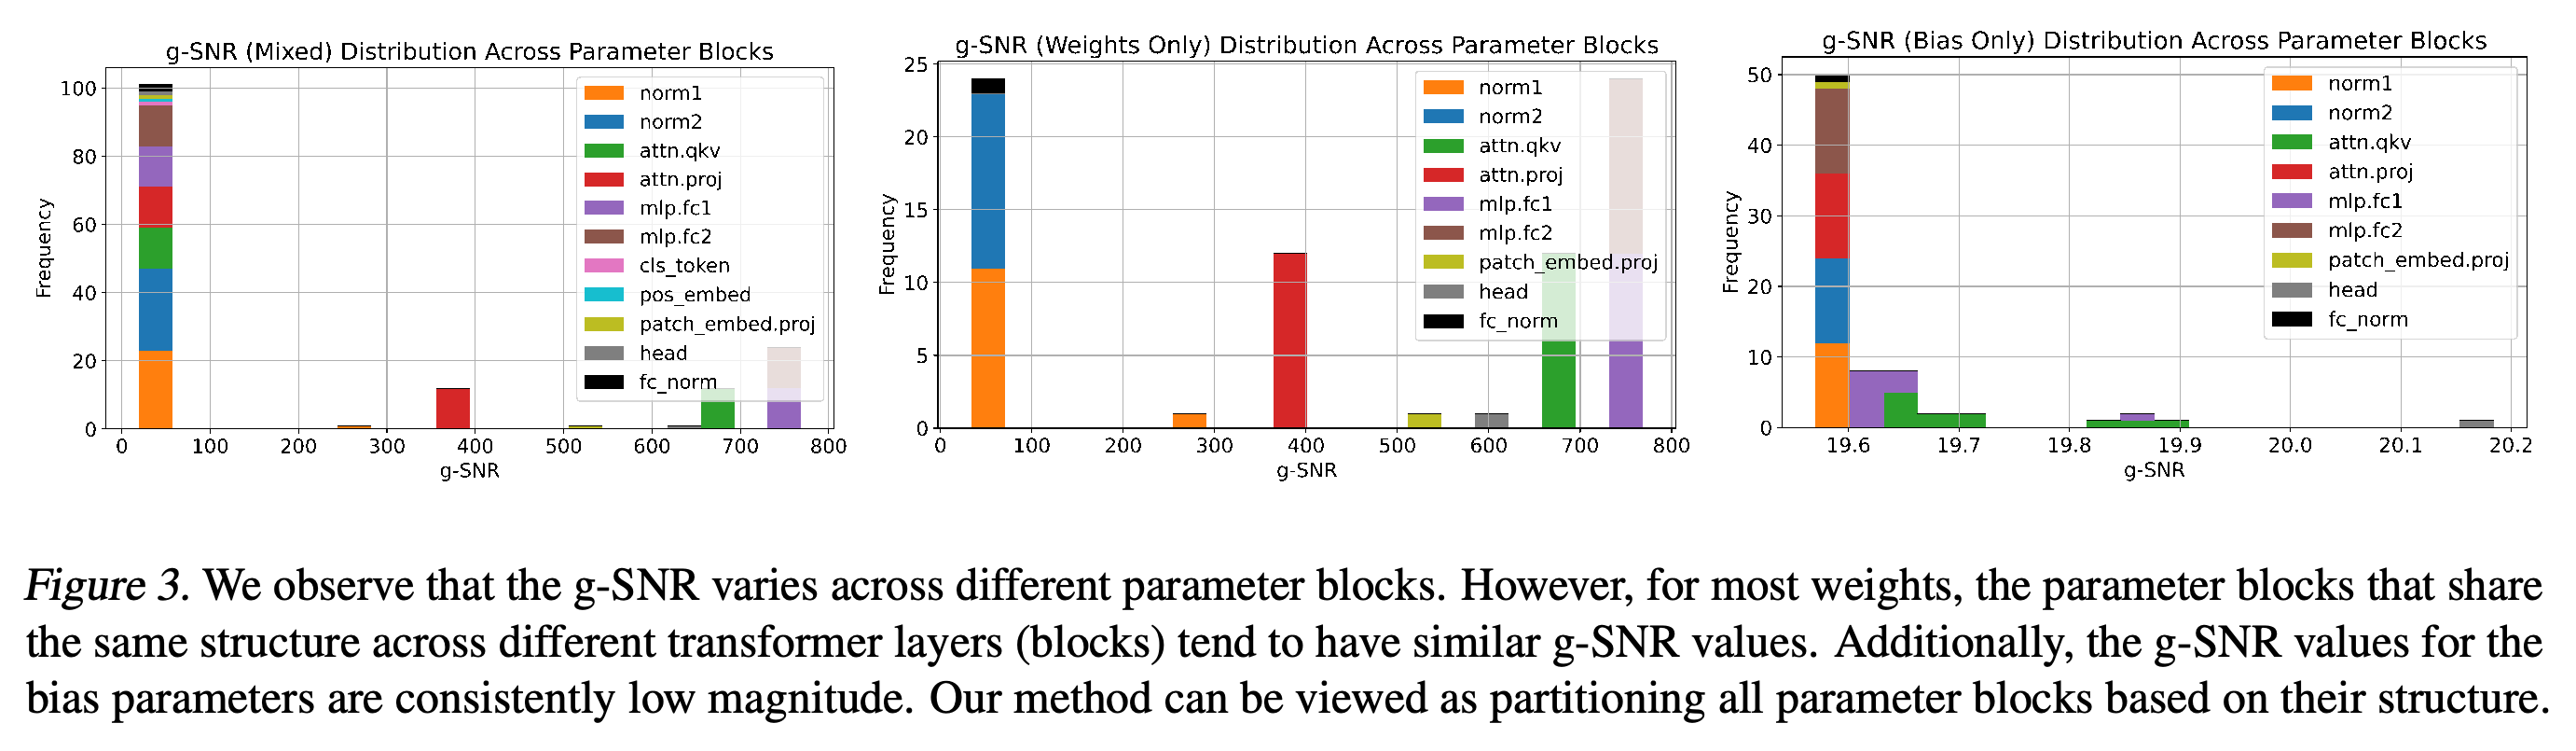
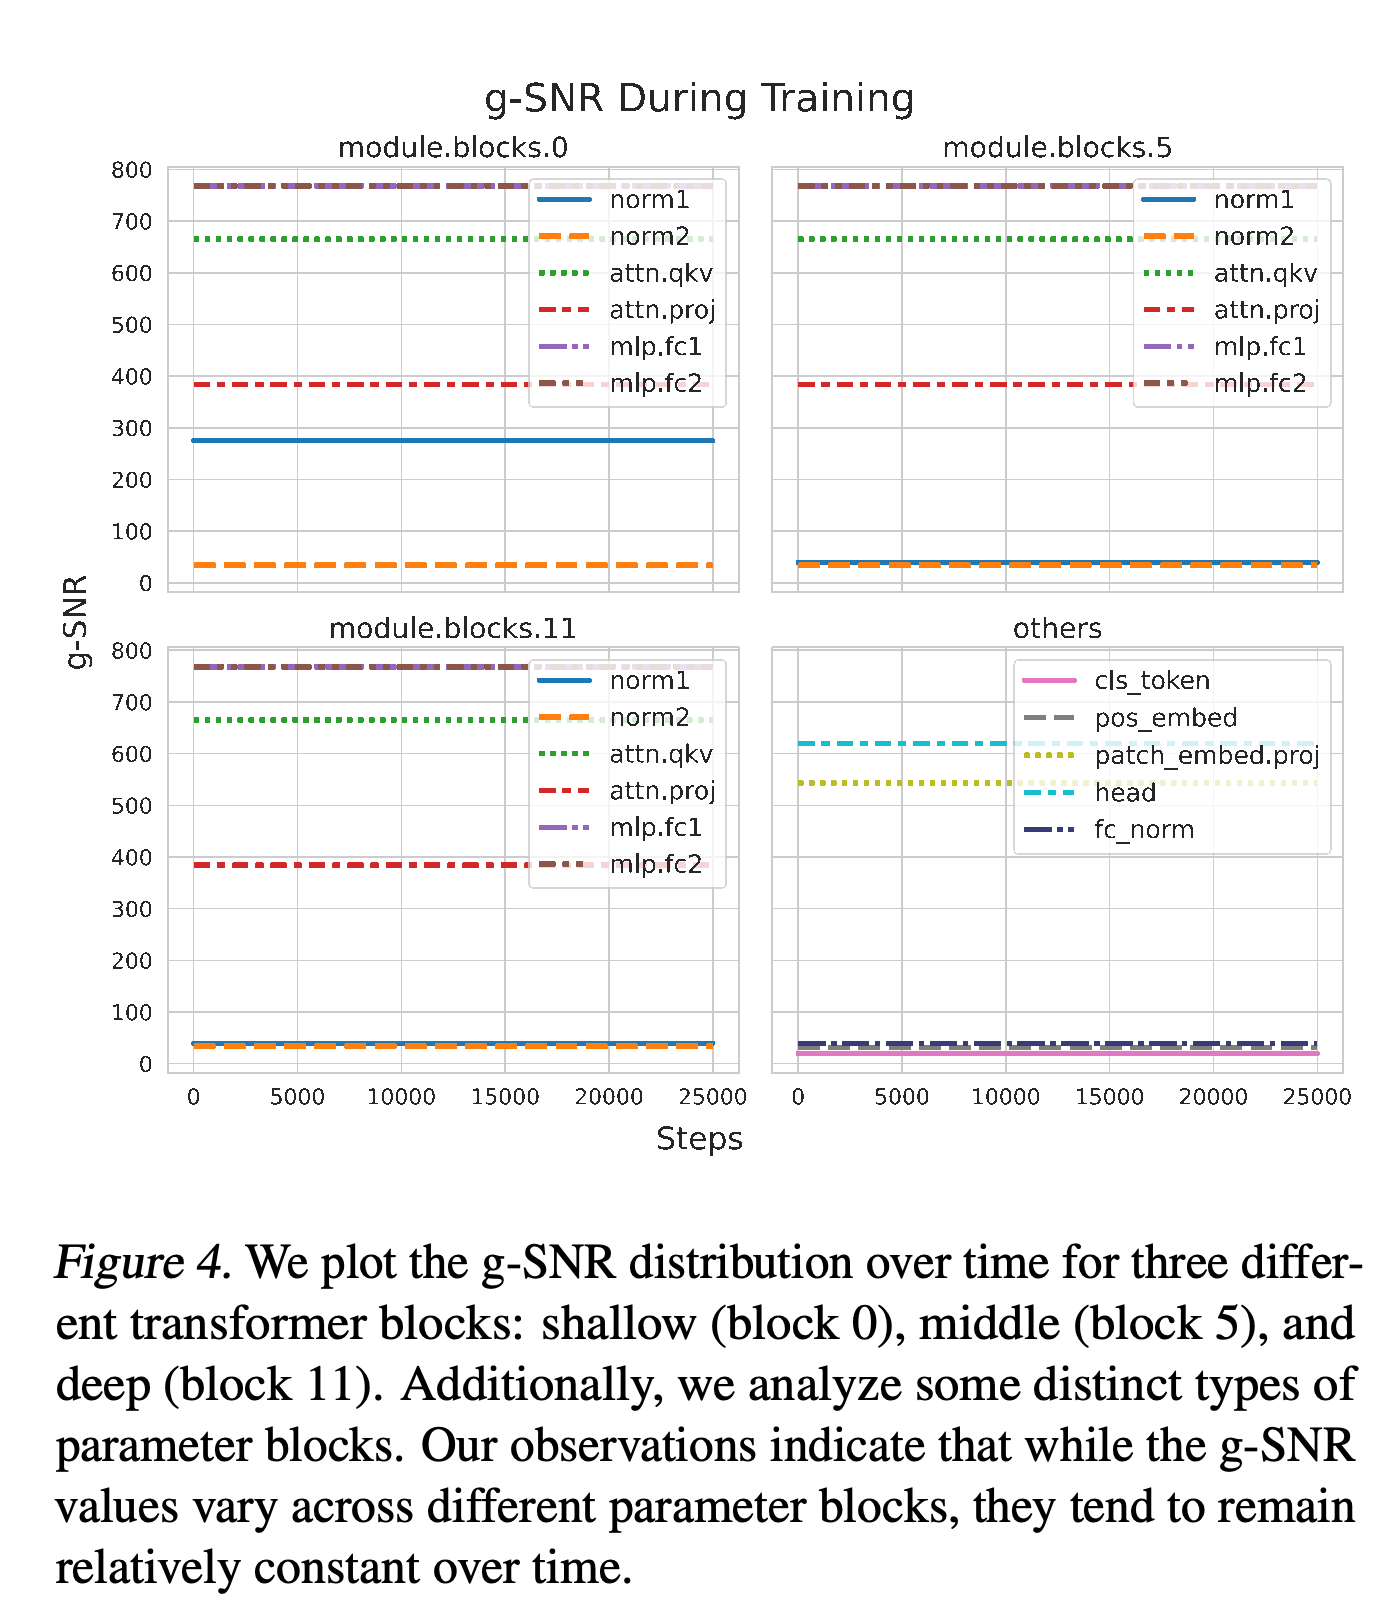
ImageNet-1K로 학습한 ViT-S/16에서 파라미터 유형별 g-SNR 값이 다르며, 도표에 나타난 학습 구간에서는 값이 비교적 안정적이다. 서로 다른 레이어에서도 구조가 비슷하면 대체로 값이 비슷하고, 편향 파라미터는 일관되게 낮은 값을 보인다.
- Figure 3은 파라미터 유형별 분포를 보여준다. Figure 4는 얕은 블록, 중간 블록, 깊은 블록과 이 블록들에 속하지 않는 몇몇 파라미터의 변화를 추적한다.
- 함께 제시한 1차 Taylor 논거는 기울기 변화의 국소 근사다. 파라미터 업데이트가 충분히 작다고 가정해 기울기와 그 통계량의 변화도 작을 것이라는 근거를 제시한다. 임의의 학습 경로에서 첫 배치의 배율이 적절함을 보장하는 전역 경계를 제공하지는 않는다.
- 첫 블록의 첫 정규화 레이어에 속하는 norm1 가중치는, 대응하는 레이어 구조에서 대체로 값이 비슷하다는 관측의 예외로 보고한다.
가중치 블록들의 g-SNR은 뚜렷하게 다른 범위에 걸쳐 분포하지만, 편향 값은 낮고 좁은 범위에 모인다. 이는 분석한 모델에서 블록별 배율을 고려할 근거가 되지만, 그 배율이 최적임을 보여주지는 않는다.
추적한 통계량은 파라미터 유형별로 거의 일정하게 유지되지만 유형 사이에는 차이가 있다. 이러한 변화 양상은 초기화 시점의 배율을 고정하는 경험적 근거가 된다.
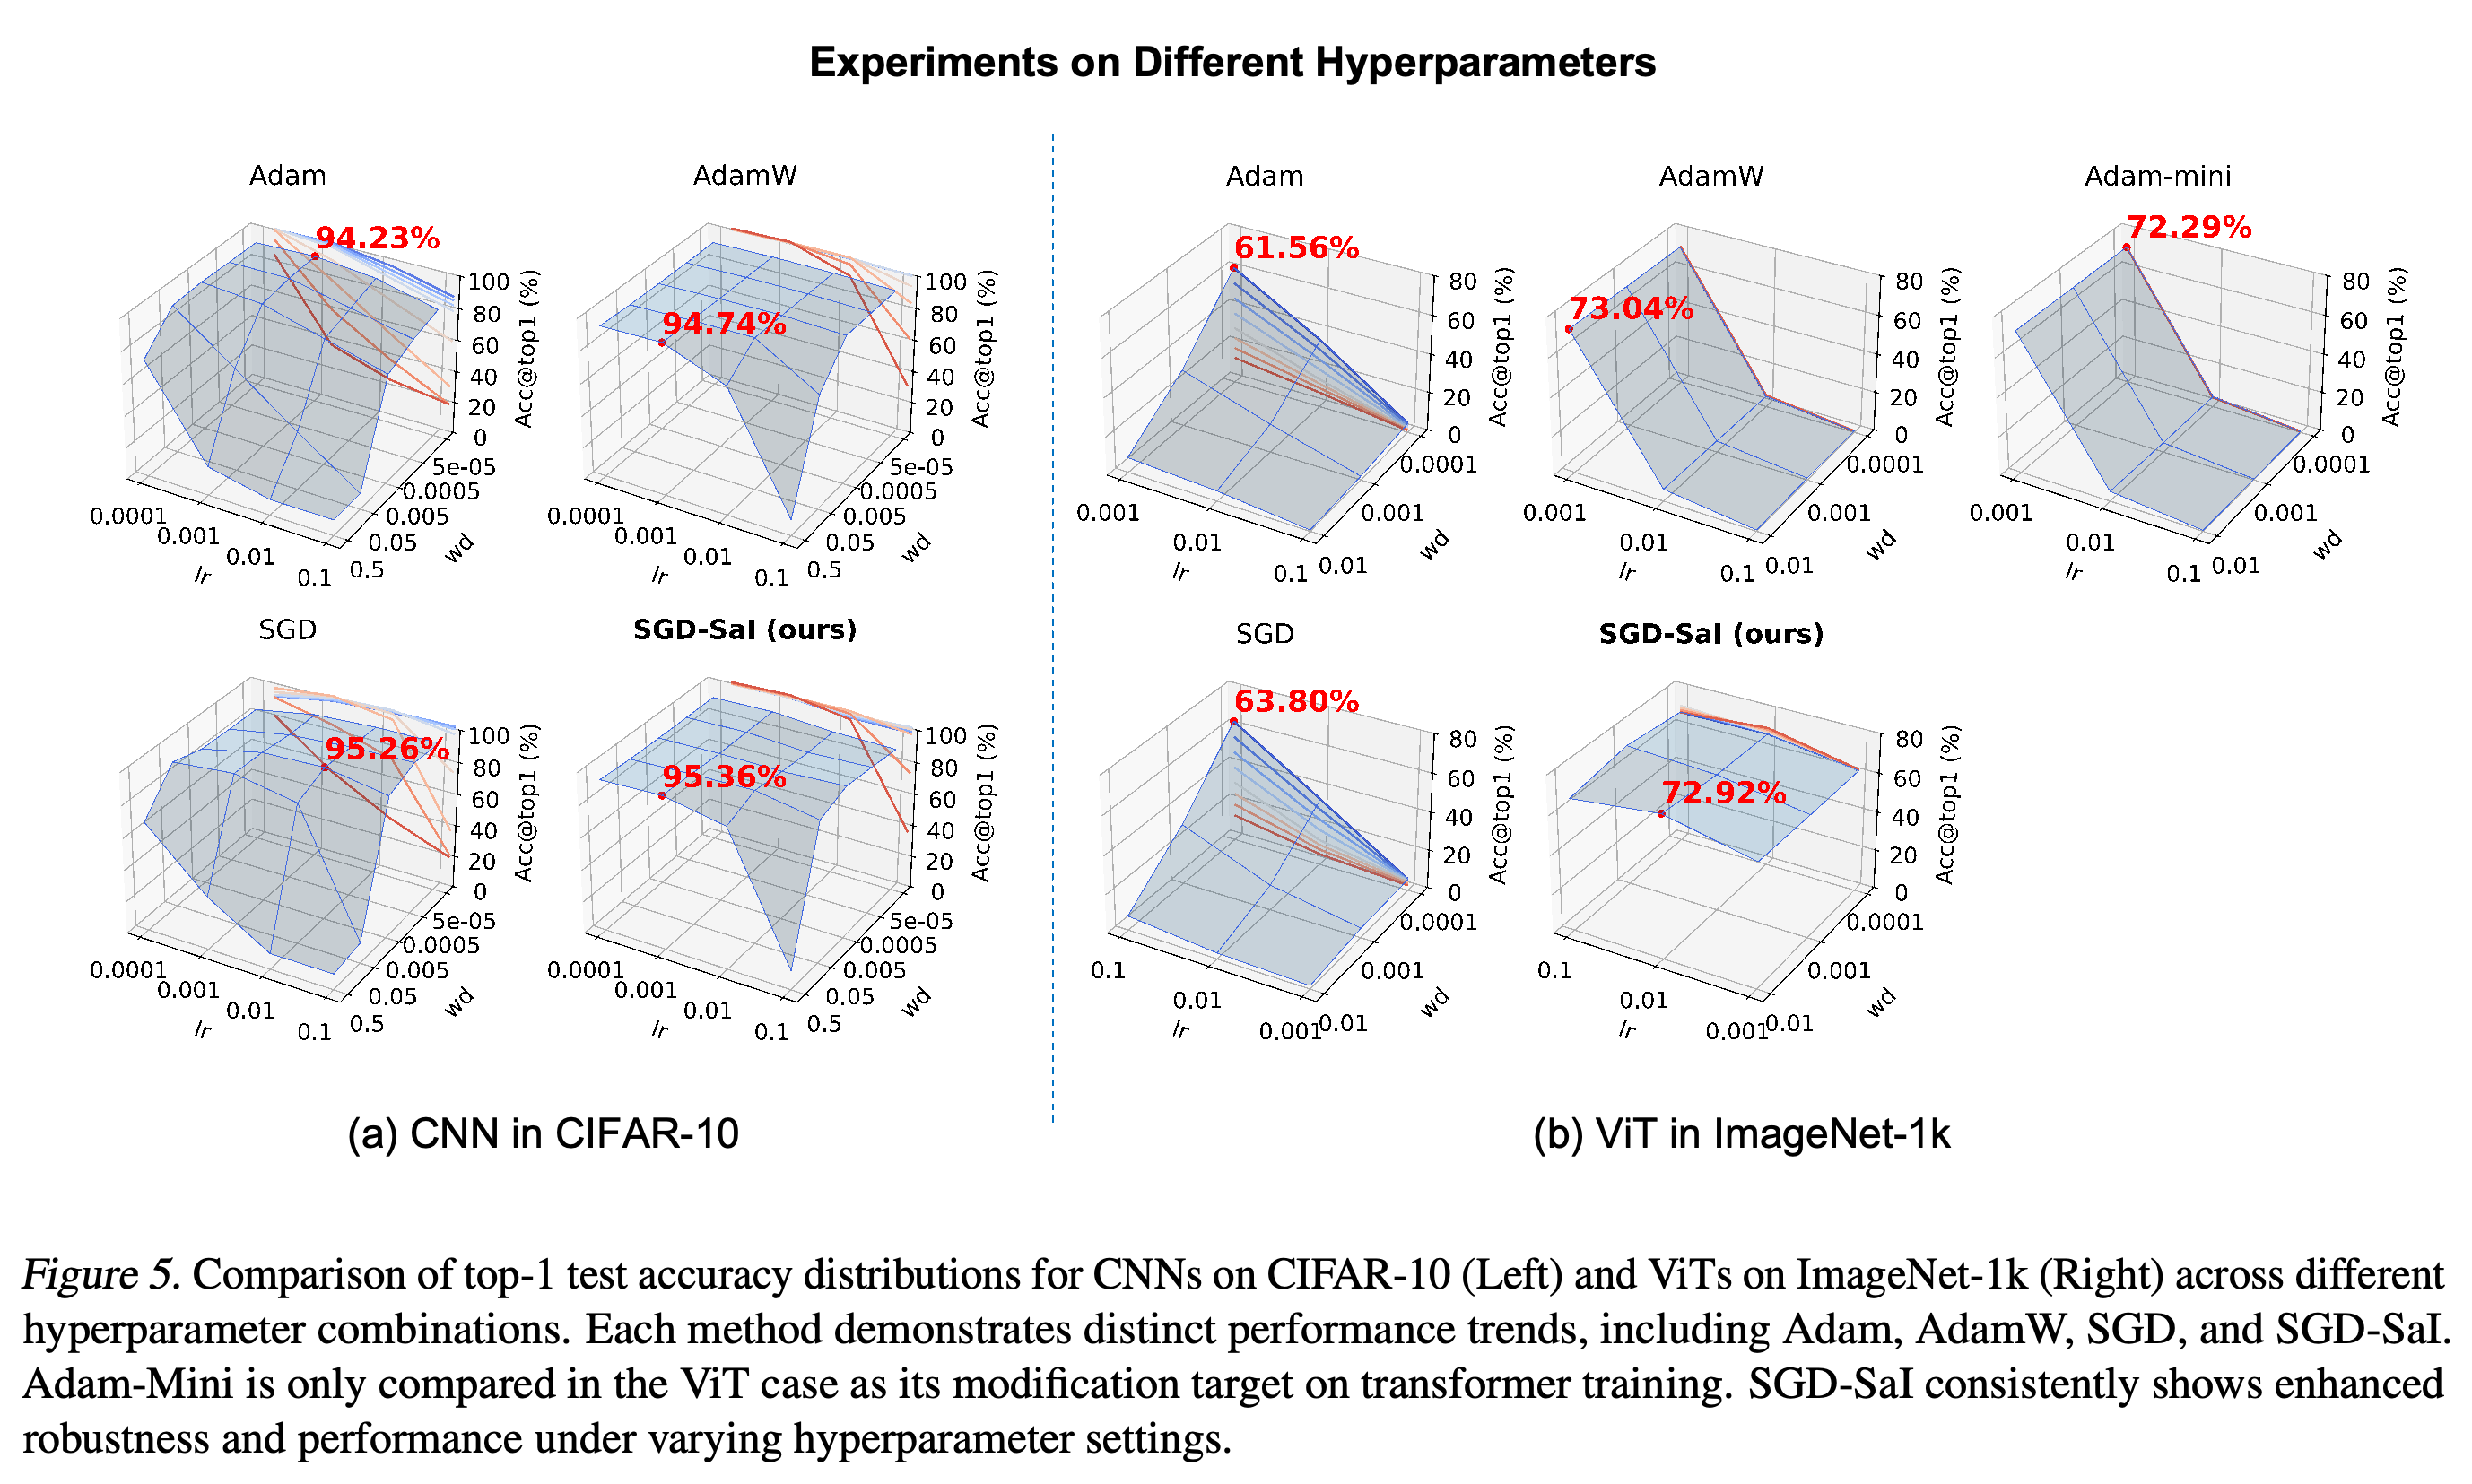
정확도 곡면에서 SGD-SaI는 선택한 학습률과 가중치 감쇠 그리드의 더 넓은 영역에서 유용한 성능을 유지한다. ResNet18의 최고 정확도는 SGDM보다 조금 높지만, ViT의 최고 정확도는 AdamW보다 조금 낮다.
4.3. Proposed Methods Detail: SGD-SaI
SGD-SaI는 초기 배치에서 g-SNR을 계산하고 정규화한 배율을 저장한 뒤, 나머지 학습 과정의 모멘텀 업데이트에 적용한다. PyTorch의 기본 파라미터 분할과 분리형 가중치 감쇠를 사용한다. 가중치 감쇠는 파라미터에 직접 정규화를 적용하므로 감쇠 항이 기울기 통계량에 들어가지 않는다.
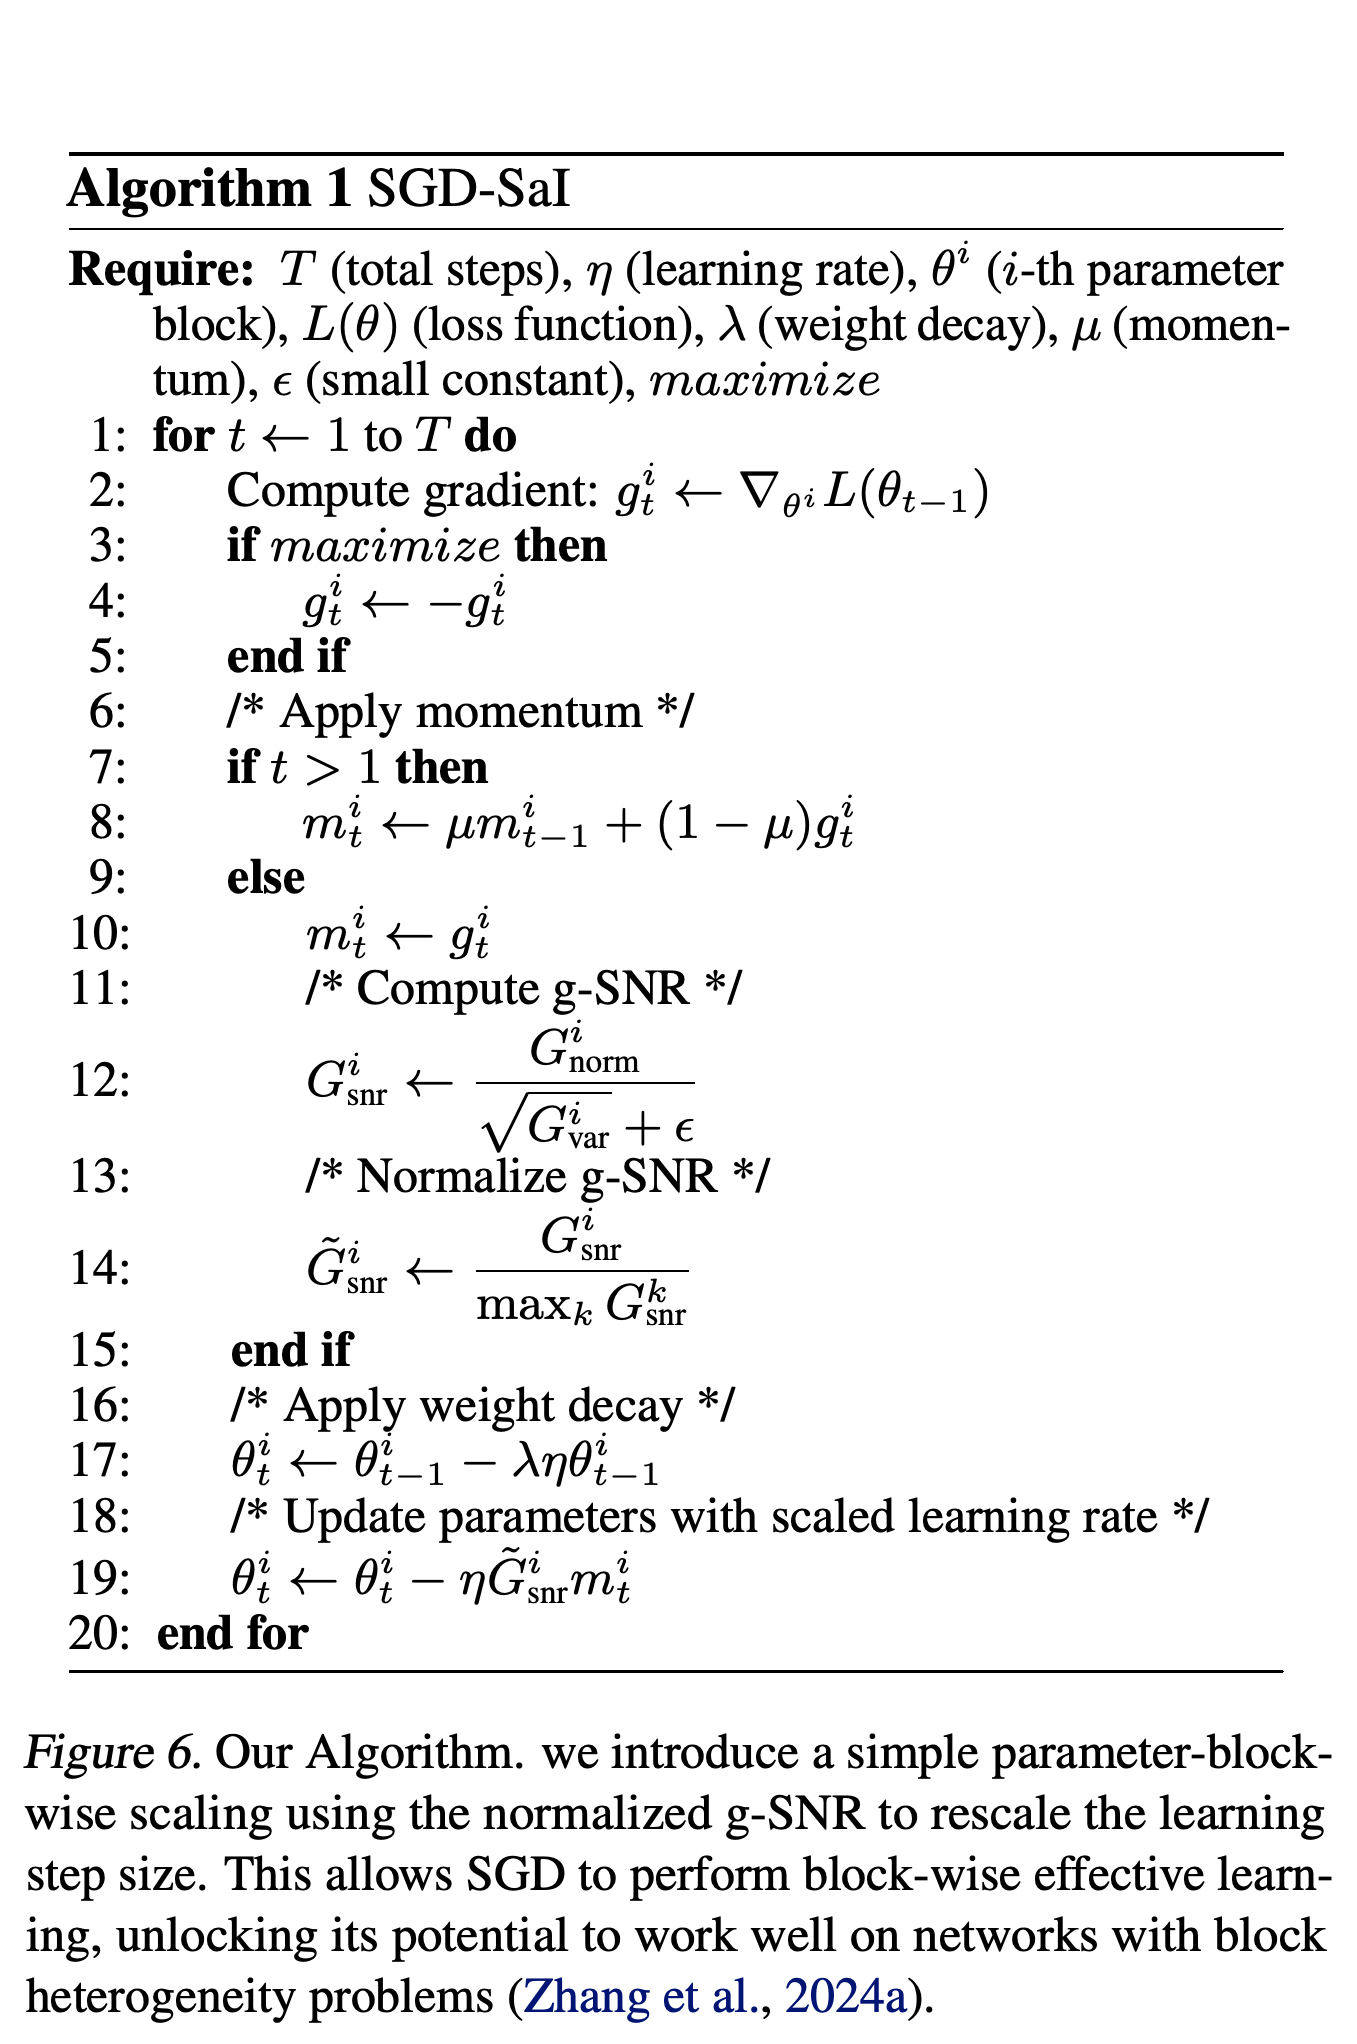
- Algorithm 1은 첫 기울기로 모멘텀을 초기화한 뒤, 이후 스텝에서 m_t^(i) = μm_(t−1)^(i) + (1−μ)g_t^(i)를 사용한다. 여기서 μ는 모멘텀 계수다.
- 업데이트는 먼저 가중치 감쇠를 적용한 뒤, 전역 학습률, 저장한 정규화 g-SNR, 모멘텀을 곱한 값을 뺀다.
- 알고리즘은 Figure 6에 제시한다. Section 4.3의 Algorithm 6이라는 참조는 실제 제시된 SGD-SaI 알고리즘과 일치하지 않는다.
제시된 Algorithm 1은 첫 스텝 분기 안에서 g-SNR을 계산하고 이후에는 계산한 배율을 재사용한다. 가중치 감쇠는 배율을 적용한 모멘텀 업데이트와 별도로 수행한다.
5. Experiments
평가는 대규모 언어 모델(LLM) 사전 학습, 이미지 분류 사전 학습, 제한된 파라미터 집합을 갱신하는 파라미터 효율적 미세 조정(PEFT), 합성곱 신경망을 이용한 이미지 분류를 다룬다. 대규모 모델의 효율 측정에서는 모델 품질 실험과 별도로 옵티마이저 상태 메모리와 옵티마이저 스텝 시간을 보고한다.
- 전체 사전 학습 비교에서는 텍스트 말뭉치인 OpenWebText로 GPT-2-Small을 학습하고, ImageNet-1K로 ViT-S/16을 학습한다.
- 더 큰 GPT-2와 Llama-2 모델은 전체 사전 학습 없이 프로파일링만 수행한다.
- 미세 조정에는 자연어 생성 데이터셋인 E2E로 학습한 GPT-2와 시각적 개념을 학습하는 확산 이미지 생성기를 포함한다.
5.1. LLM Pre-train
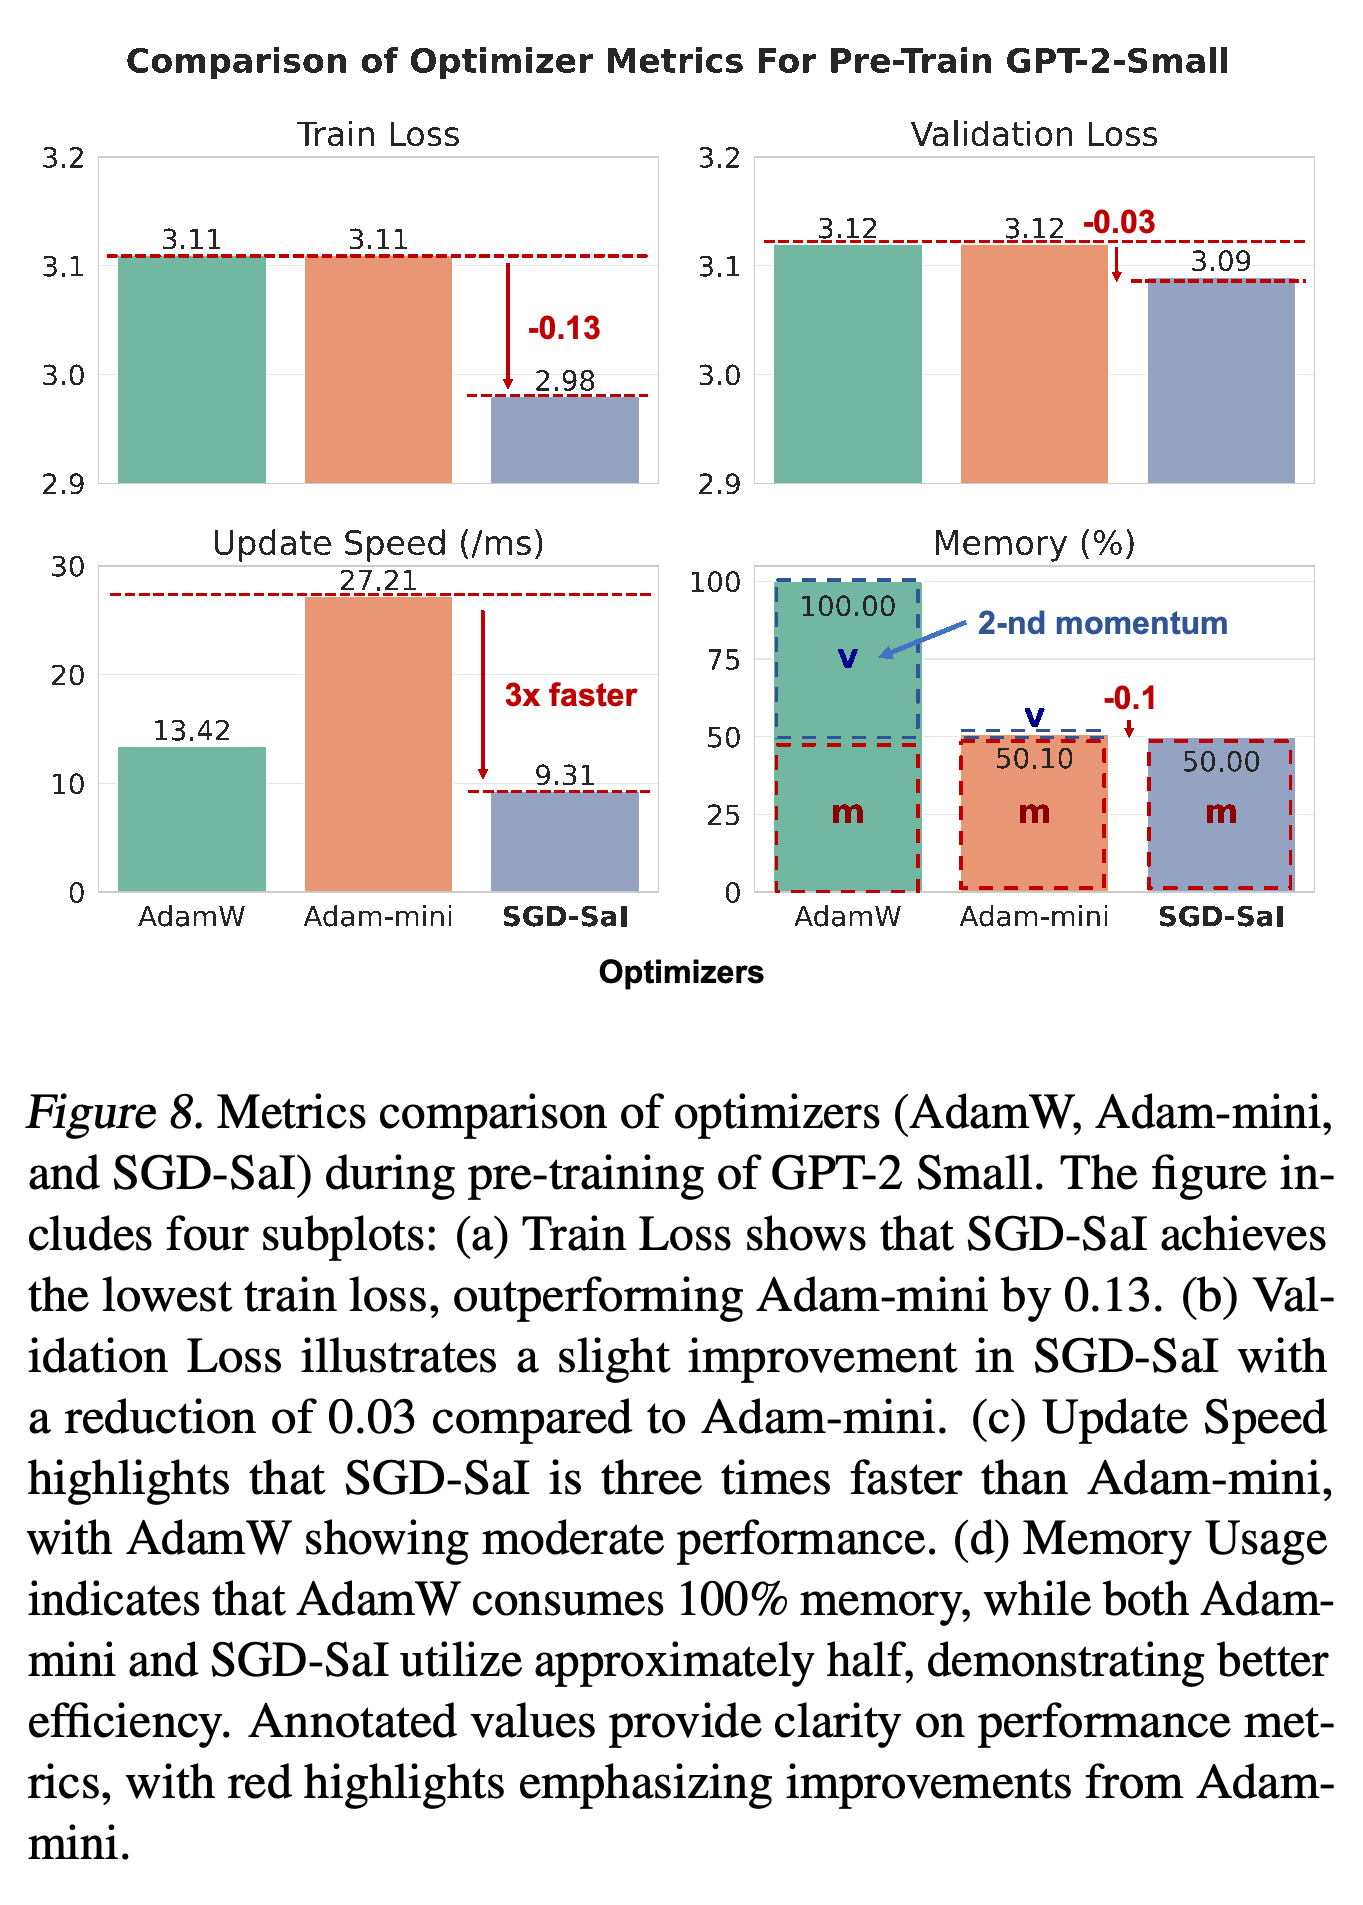
GPT-2-Small은 125M 파라미터 모델이다. 인용한 Adam-mini 연구의 설정을 사용해 OpenWebText에서 사전 학습하며 AdamW, Adam-mini와 비교한다. Figure 8에서 SGD-SaI는 초기 수렴이 느리지만 최종 학습 손실과 검증 손실이 더 낮고, 옵티마이저 상태 메모리는 AdamW의 약 절반이다.
- 학습 손실은 SGD-SaI가 2.98, 베이스라인 2개가 모두 3.11이며, 검증 손실은 각각 3.09와 3.12다.
- 옵티마이저 업데이트 시간은 SGD-SaI가 9.31 ms, AdamW가 13.42 ms, Adam-mini가 27.21 ms다.
- 이 절은 GPT-2-Small 손실 비교의 전체 학습 설정이나 불확실성 추정치를 제공하지 않는다.
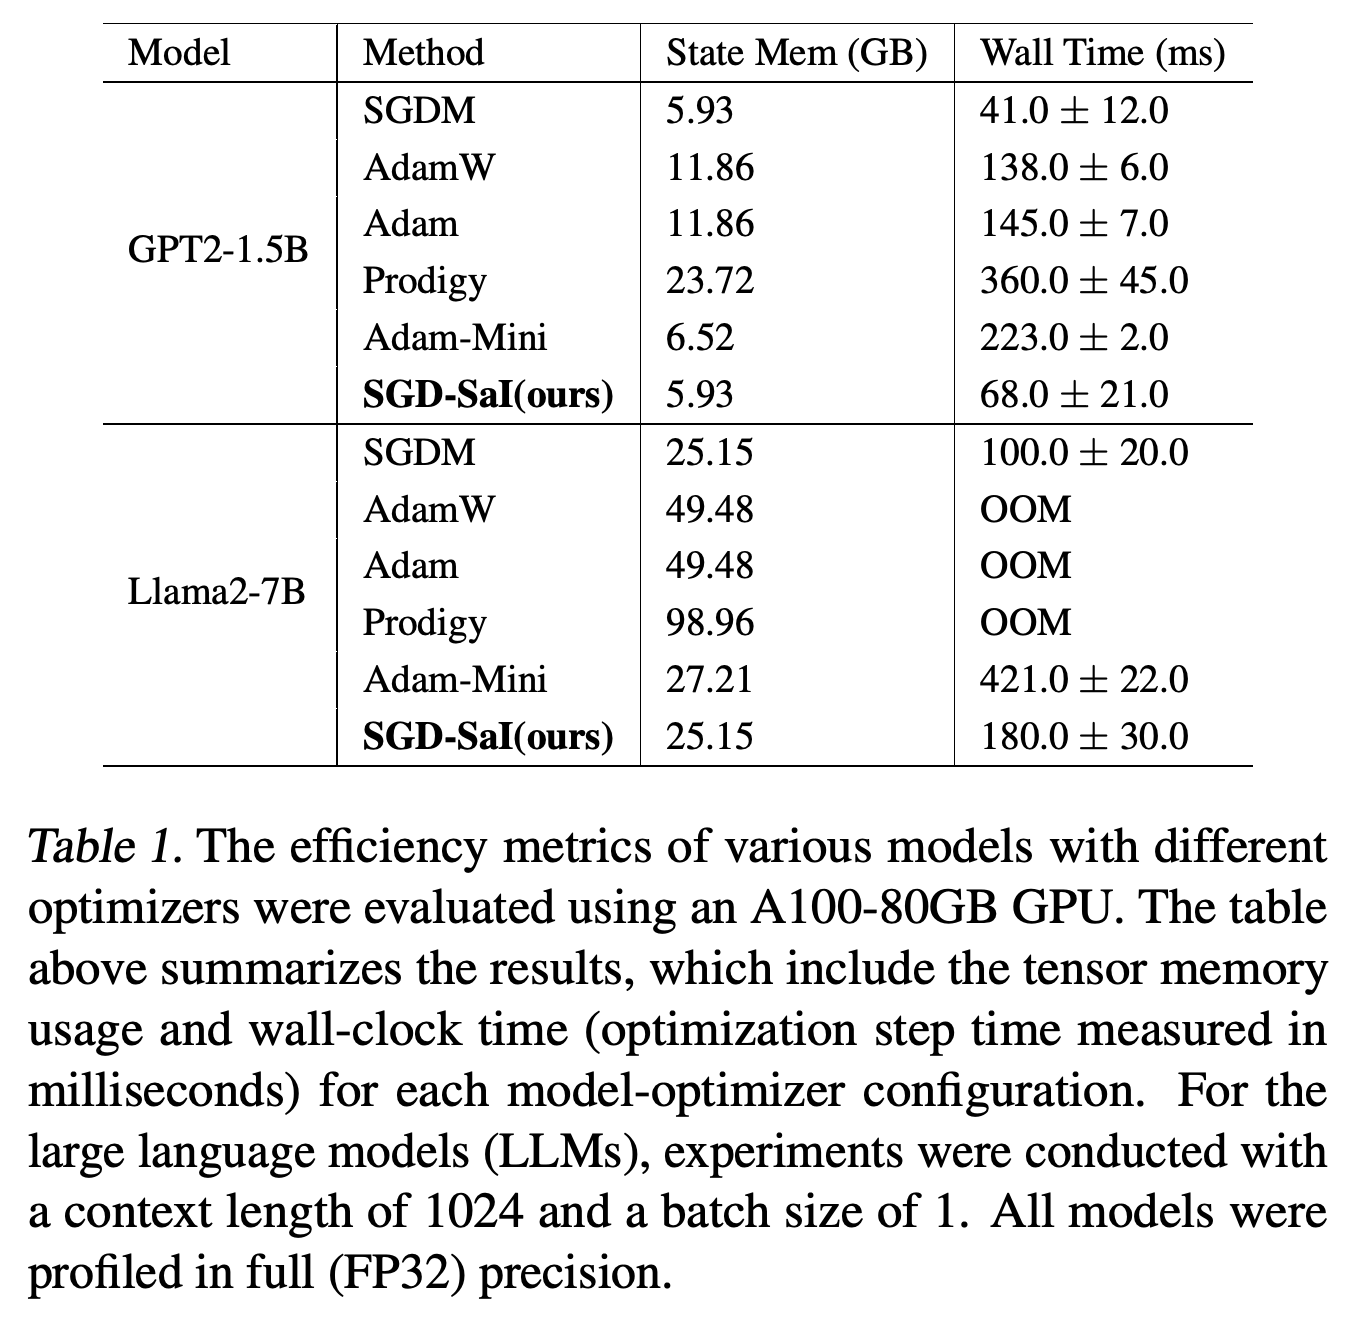
Table 1은 NVIDIA A100-80GB 1개에서 문맥 길이 1024, 배치 크기 1로 GPT2-1.5B와 Llama2-7B를 프로파일링한다. 정밀도는 32비트 부동소수점 값을 사용하는 FP32다. GPT2-1.5B의 옵티마이저 상태 메모리는 SGD-SaI가 5.93 GB, AdamW가 11.86 GB이며, 옵티마이저 스텝 시간은 각각 68.0 ± 21.0 ms와 138.0 ± 6.0 ms다.
- Llama2-7B에서 SGD-SaI는 25.15 GB와 180.0 ± 30.0 ms, Adam-mini는 27.21 GB와 421.0 ± 22.0 ms를 보고한다.
- AdamW, Adam, 스텝 크기를 자동으로 조정하는 Adam 변형인 Prodigy는 Llama2-7B 설정에서 메모리 부족 오류가 발생한다.
- 초록은 Llama2-7B에서 AdamW 대비 25.15 GB를 절감한다고 주장한다. 하지만 Table 1의 49.48 GB와 25.15 GB 차이는 24.33 GB이며, 이는 Figure 1과 일치한다.
5.2. ViT Pre-train
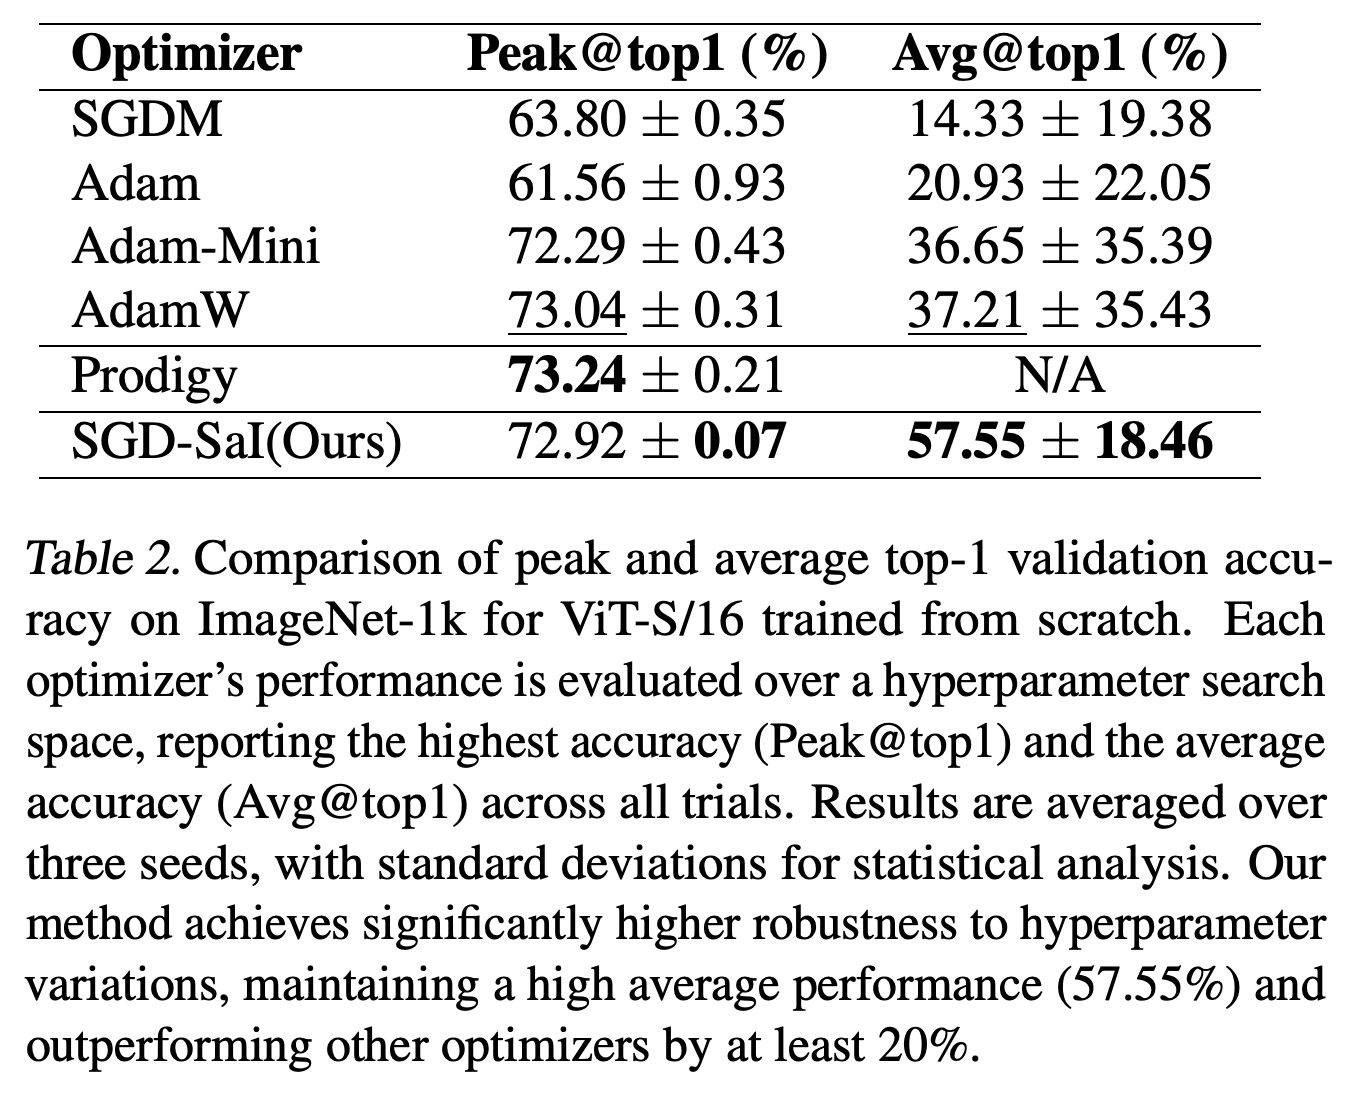
ImageNet-1K의 ViT-S/16에 대해 Table 2는 최고 top-1 검증 정확도를 시드 3개에 걸쳐 평균한 값을 보고한다. 이 정확도는 가장 높은 점수를 받은 예측이 정답인 사례의 비율이다. SGD-SaI는 72.92 ± 0.07%, SGDM은 63.80 ± 0.35%, AdamW는 73.04 ± 0.31%, Adam-mini는 72.29 ± 0.43%, Prodigy는 73.24 ± 0.21%다. SGD-SaI는 AdamW보다 그리드 평균 정확도가 높지만, 최고 정확도는 AdamW가 조금 더 높다.
- 보고한 하이퍼파라미터 실험의 평균 정확도는 SGD-SaI가 57.55 ± 18.46%, AdamW가 37.21 ± 35.43%, Adam-mini가 36.65 ± 35.39%다. 이 그리드 평균 결과는 설정에 따른 민감도를 나타내며, 최적 설정에서의 시드별 변동과 구분해야 한다.
- 그리드는 학습률 {0.1, 0.01, 0.001, 0.0001}과 가중치 감쇠 {0.01, 0.001, 0.0001}을 사용한다. 그리드 평균 성능은 이 선택에 따라 달라진다.
- 논문은 Prodigy의 하이퍼파라미터를 변경하면 수렴에 실패한다고 보고하며, 이를 그리드 평균 비교에서 제외한다.
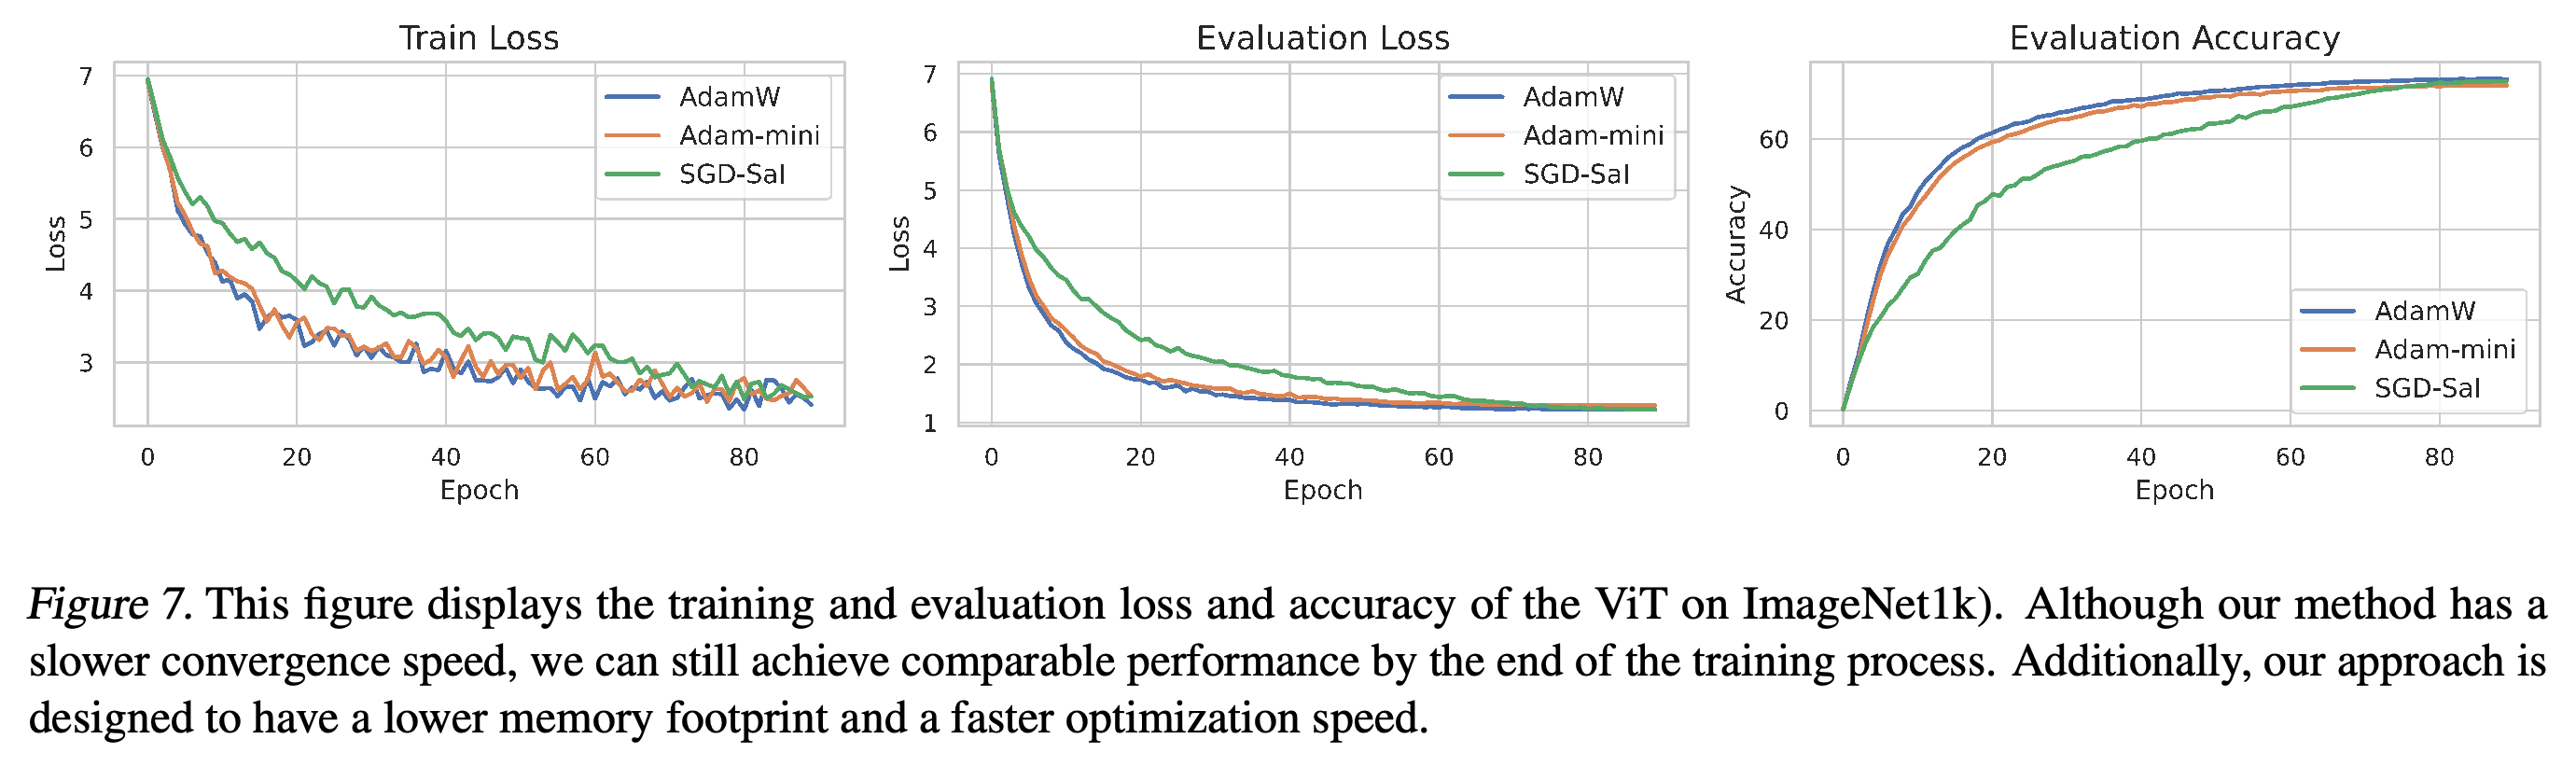
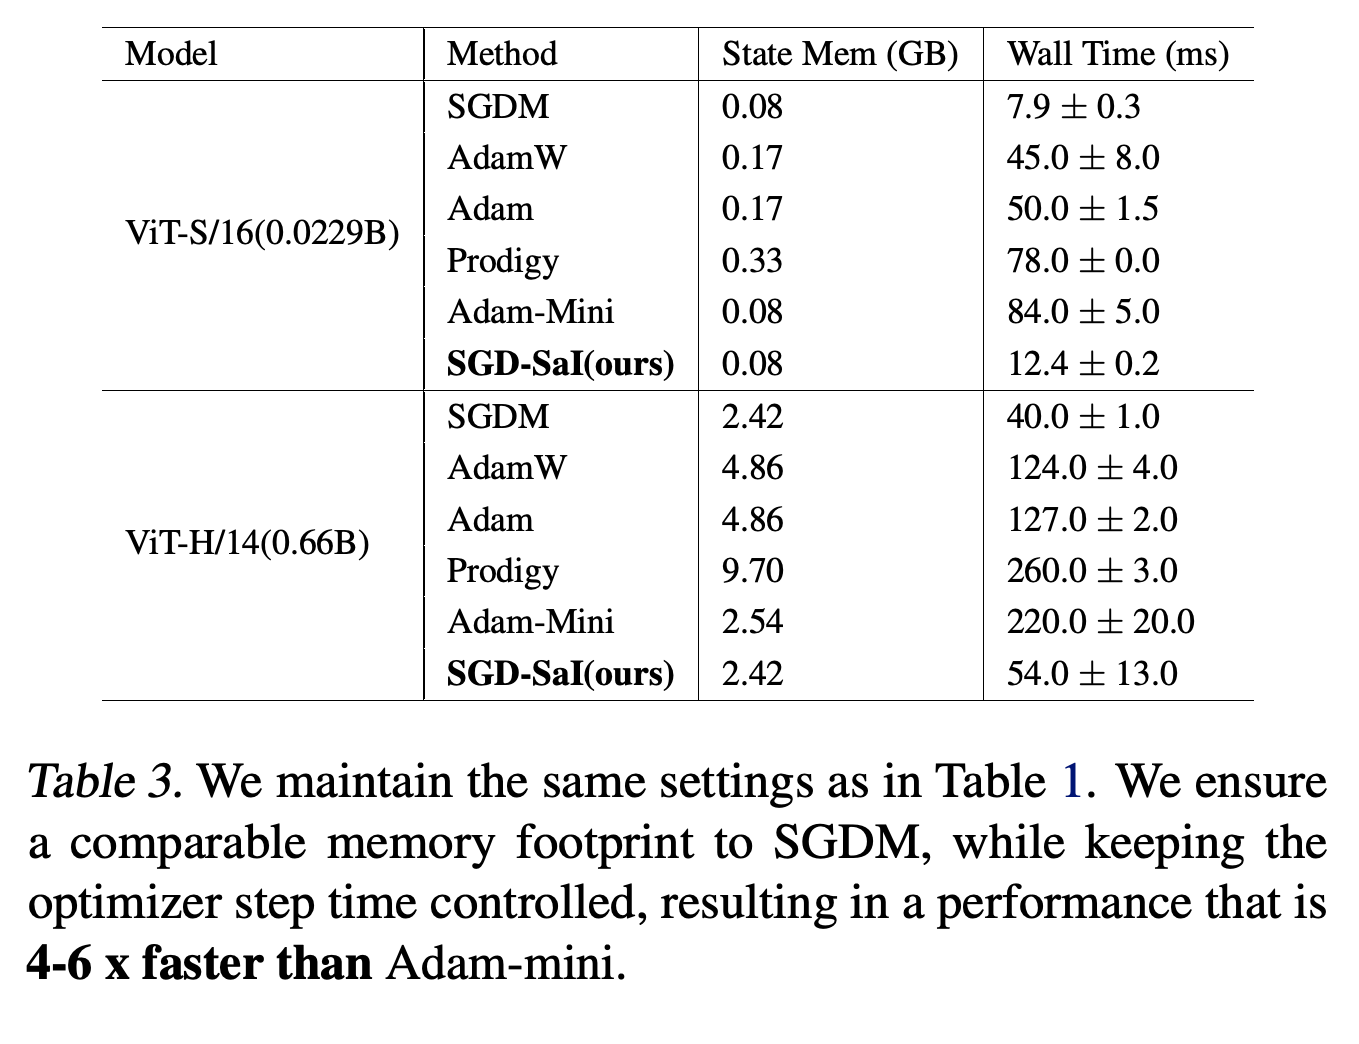
Figure 7에서 SGD-SaI는 초기 수렴이 느리지만 최종 이미지 분류 성능은 비슷하다. Table 3은 옵티마이저 효율을 별도로 측정한다. ViT-H/14에서 SGD-SaI의 상태 메모리는 2.42 GB, 옵티마이저 스텝 시간은 54.0 ± 13.0 ms이며, AdamW는 각각 4.86 GB와 124.0 ± 4.0 ms다.
- ViT-S/16에서 SGD-SaI는 0.08 GB와 12.4 ± 0.2 ms, AdamW는 0.17 GB와 45.0 ± 8.0 ms를 보고한다.
- 이 측정에서 SGDM은 더 빠르며, ViT-S/16에서는 7.9 ± 0.3 ms, ViT-H/14에서는 40.0 ± 1.0 ms다.
- 클러스터의 입출력과 네트워크 영향으로 비교가 복잡해지므로 전체 학습 시간의 개선은 보고하지 않는다.
SGD-SaI는 학습 초기에 더 느리게 개선되며, 학습이 끝날 무렵 베이스라인에 근접한다. 이 곡선은 옵티마이저 스텝이 빠르다는 사실만으로 목표 정확도까지 걸리는 시간을 판단할 수 없는 이유를 보여준다.
SGD-SaI는 제시된 결과 중 최종 손실이 가장 낮고, 업데이트 시간은 9.31 ms, 정규화된 옵티마이저 상태 메모리는 50.00%다. 약 3배의 속도 비교는 Adam-mini의 옵티마이저 업데이트에 해당한다.
표는 옵티마이저 상태 메모리를 기록하고, 문맥 길이 1024와 배치 크기 1의 FP32 프로파일링에서 메모리가 부족한 설정을 표시한다. Llama2-7B 항목에서 AdamW와 SGD-SaI의 상태 메모리 차이는 24.33 GB이며, 초록에 명시한 절감량과 다르다.
SGD-SaI는 보고된 그리드 평균 정확도가 가장 높고, 최적 설정에서 시드별 변동이 가장 작다. AdamW와 Prodigy는 최고 정확도가 조금 더 높다. 그리드 평균 통계와 최적 설정 통계는 서로 다른 변동 요인을 나타낸다.
SGD-SaI의 상태 메모리 사용량은 SGDM과 거의 같으며, 적응형 베이스라인보다 업데이트가 빠르다. 프로파일링한 ViT 크기 2개 모두에서 SGDM 자체는 SGD-SaI보다 더 빠르다.
5.3. Parameter Efficient Fine Tuning: PEFT
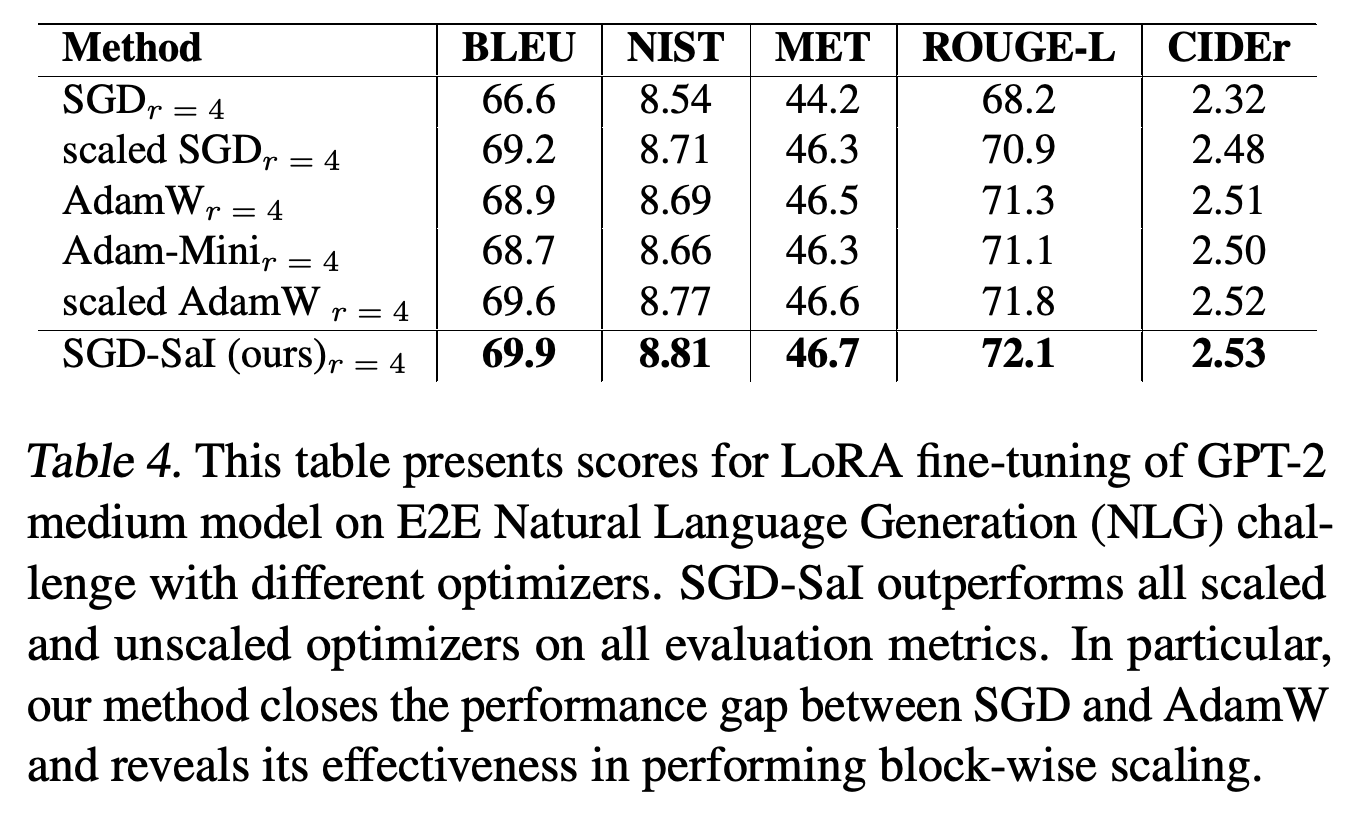
5.3.1. LLMS PARAMETER EFFICIENT FINE-TUNING에서는 LoRA 랭크 4, 학습률 1e−3, 가중치 감쇠 1e−2로 GPT-2 medium을 E2E에서 미세 조정한다. Table 4에서 SGD-SaI는 보고된 지표 전반에서 가장 높은 점수를 기록한다. BLEU와 NIST는 단어 시퀀스의 일치에 기반한 지표다. MET는 텍스트 생성 평가 지표인 METEOR를 표에서 지칭하는 이름이다. ROUGE-L은 시퀀스 중첩을 측정하며, CIDEr는 합의에 기반한 텍스트 생성 지표다.
- SGD-SaI의 점수는 69.9 BLEU, 8.81 NIST, 46.7 MET, 72.1 ROUGE-L, 2.53 CIDEr다.
- 제시한 scaled-AdamW 베이스라인 중 가장 우수한 결과는 같은 순서로 69.6, 8.77, 46.6, 71.8, 2.52다. 배율을 적용한 베이스라인은 Zhang & Pilanci (2024)의 사전 조건화 방법으로 LoRA 파라미터 행렬 2개의 학습률을 조정한다.
- 수치상 개선 폭은 작으며, Table 4는 결과의 재현성을 판단할 불확실성 추정치를 제공하지 않는다.
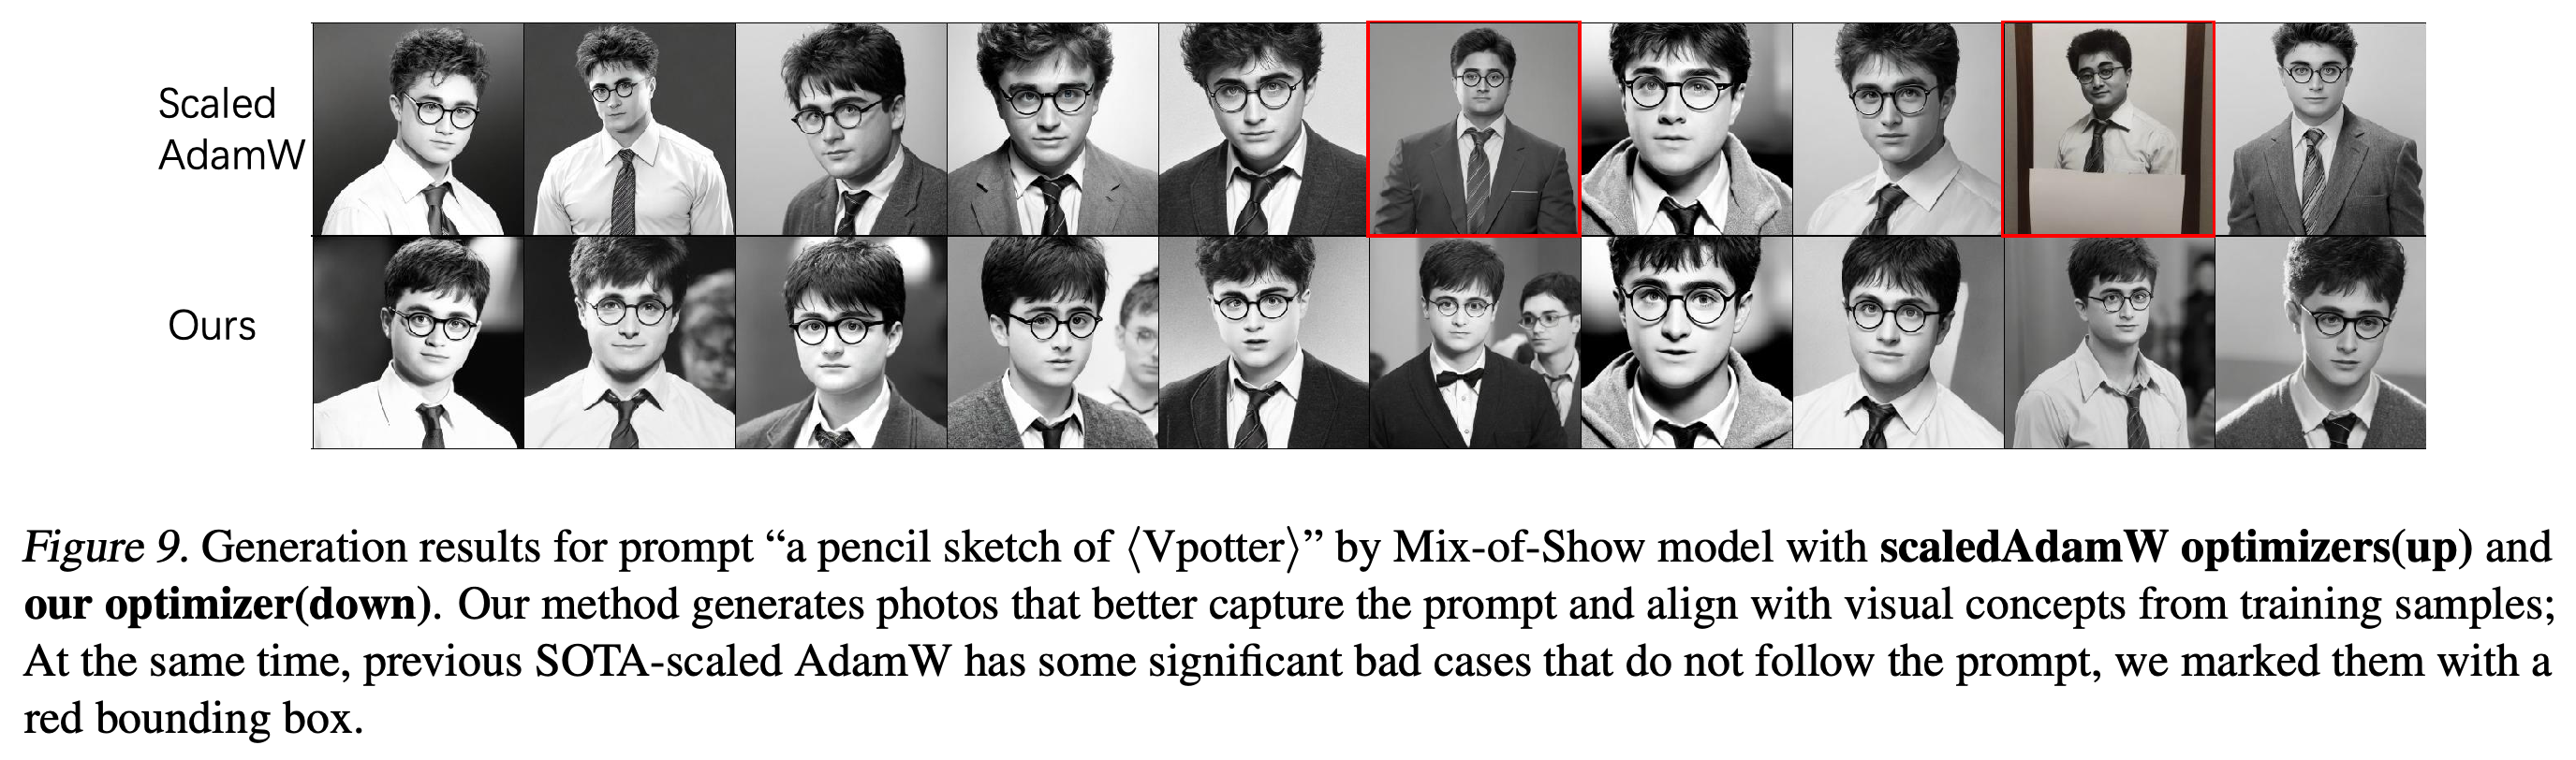
5.3.2. DMS PARAMETER EFFICIENT FINE-TUNING에서는 Mix-of-Show의 개념 맞춤화 설정을 사용해 확산 이미지 생성 모델 ChilloutMix에 LoRA를 적용한다. 학습률 0.1에서 SGD-SaI와 scaled-AdamW를 비교한다. Figure 9는 “a pencil sketch of ⟨Vpotter⟩”의 생성 예시를 보여주며, 저자들은 scaled-AdamW 행에서 실패 사례를 표시한다.
- 평가는 제시된 샘플에 기반한 정성 평가다.
- 이 비교에서는 이미지 품질이나 개념 충실도를 측정하는 정량 지표 또는 반복 평가 결과를 보고하지 않는다.
SGD-SaI는 보고한 생성 지표 5개 모두에서 가장 높은 점수를 기록하지만, scaled-AdamW와의 차이는 작다. 표에는 불확실성 추정치가 없다.
제시된 샘플은 SGD-SaI가 목표 개념을 더 일관되게 포착한다는 저자들의 정성적 주장을 보여준다. 선택한 예시와 표시된 베이스라인 실패 사례만으로 전체 생성 품질이나 프롬프트 충실도를 정량화할 수는 없다.
5.4. Convolutional Neural Network(CNN)
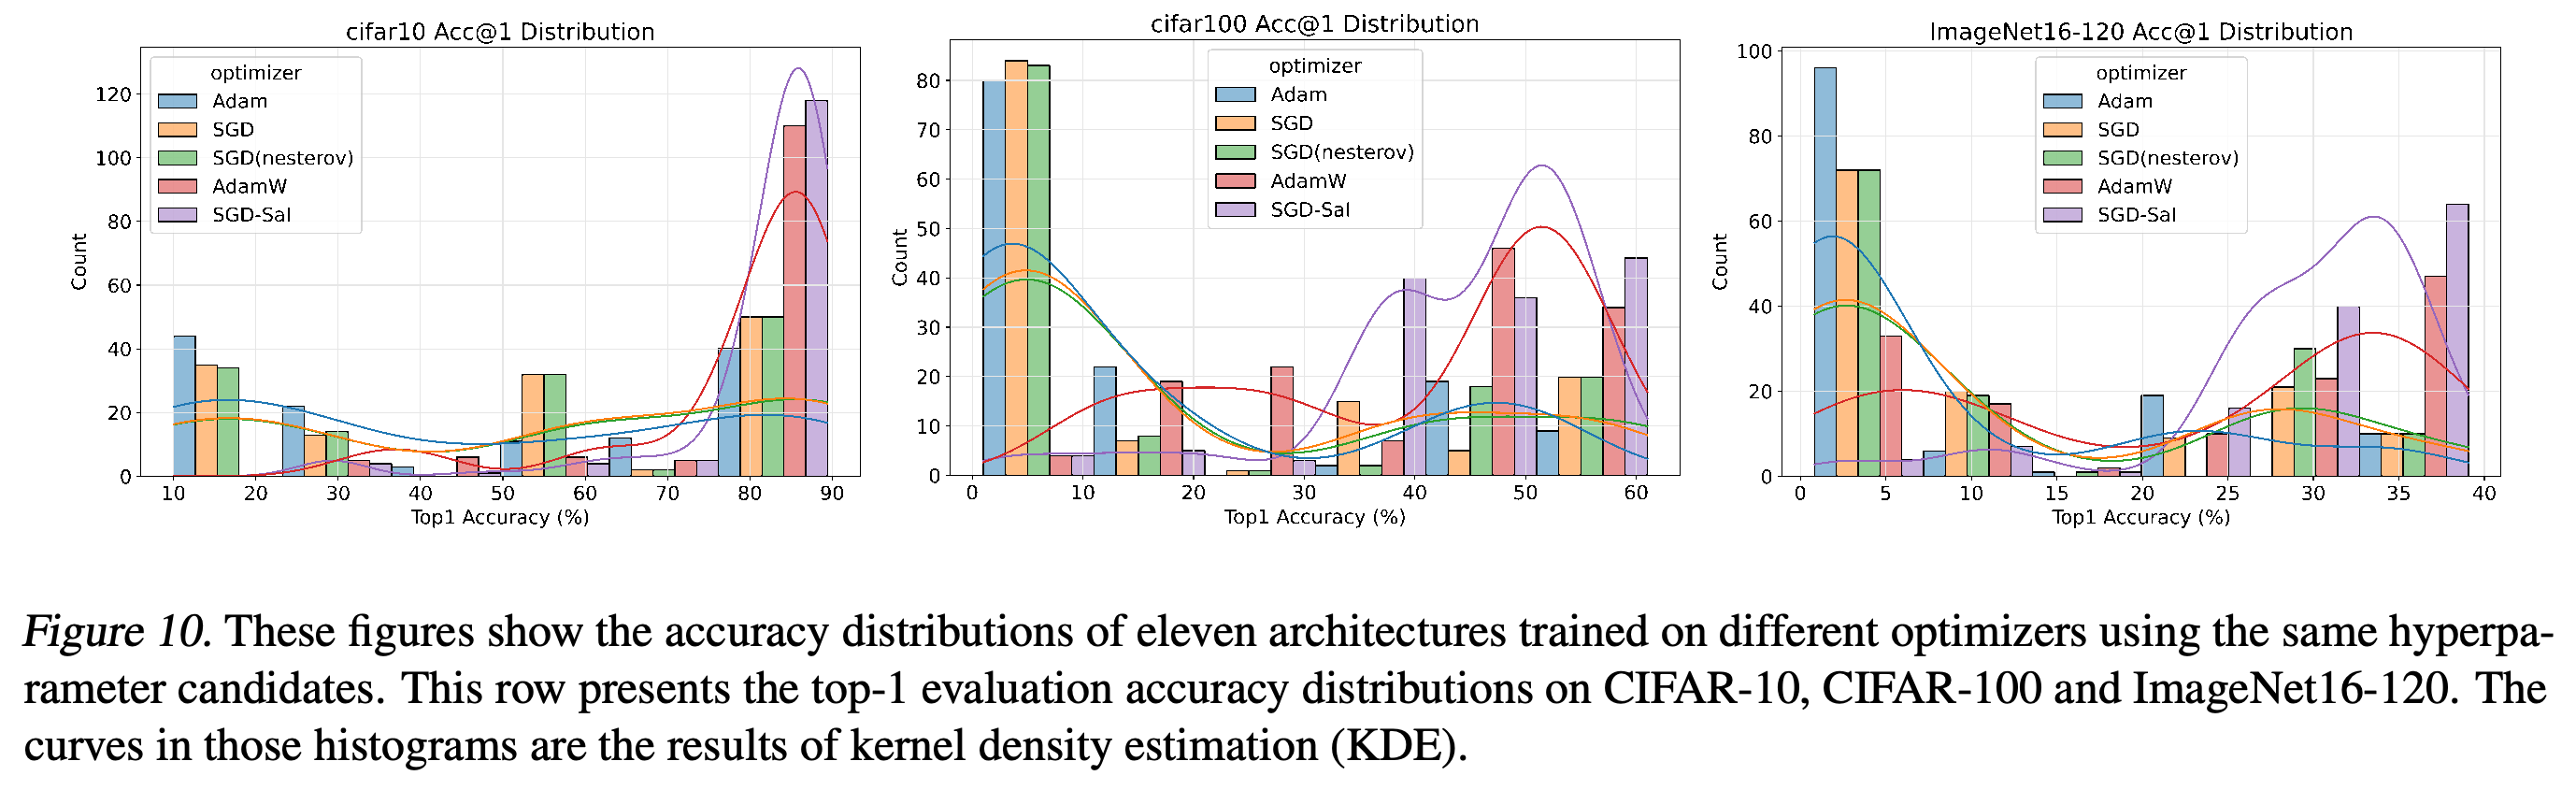
CIFAR-10의 ResNet18에서 SGD-SaI의 최고 테스트 정확도는 95.36%이며, SGDM은 95.26%, AdamW는 94.74%, Adam은 94.23%다. 추가 실험에서는 신경망 아키텍처 벤치마크인 NATS-Bench에서 가져온 아키텍처 11개를 CIFAR-10, CIFAR-100, ImageNet16-120으로 평가한다. 옵티마이저마다 동일한 하이퍼파라미터 후보를 사용한다.
- Figure 5는 ResNet18과 ViT-S/16에서 학습률과 가중치 감쇠에 따른 민감도를 보여준다.
- Figure 10은 선택한 아키텍처와 하이퍼파라미터 설정에서 SGD-SaI가 더 유리한 정확도 분포를 보인다는 결과를 제시한다.
- NATS-Bench 실험은 시드 777을 사용한다. 검증 정확도 top-10에 속하는 아키텍처 10개와 bottom-1에 속하는 아키텍처 1개를 선택한다. 따라서 도표의 분포는 제한 없이 추출한 아키텍처 표본이 아니라 이 선택된 집합을 나타낸다.
히스토그램에서 SGD-SaI의 실험 결과는 데이터셋 3개에 걸쳐 더 높은 정확도 쪽에 많이 분포한다. 매끄러운 곡선은 해당 실험 결과로 분포를 추정한 것이다. 이 결과는 선택한 아키텍처 11개, 하이퍼파라미터 후보, 보고된 NATS-Bench 시드 1개에 적용된다.
6. Conclusion
결론에서는 초기화 시점에 정한 블록별 배율을 고정하면 모멘텀 SGD의 작은 옵티마이저 상태 메모리를 유지하면서 경쟁력 있는 최종 성능을 얻을 수 있다고 제시한다. ViT-S/16 탐색 결과, GPT-2-Small 손실, 별도로 수행한 옵티마이저 프로파일링은 실험한 설정 안에서 이 주장을 뒷받침한다. AdamW를 보편적으로 대체할 수 있음을 입증하지는 않는다.
7. Limitation
저자들은 제한된 연산 자원과 느린 초기 수렴을 주요 한계로 제시한다. Llama-2-7B를 포함한 대규모 모델의 전체 사전 학습은 검증하지 않았다. 따라서 해당 규모에서 메모리 용량 내에 실행할 수 있고 옵티마이저 스텝이 빠르다는 사실만으로 수렴 품질이나 목표 손실까지 걸리는 시간을 확인할 수는 없다.
부록
- A. More Experiments Details는 ViT와 CNN의 하이퍼파라미터 탐색과 학습 절차를 설명한다. Nesterov를 적용한 모멘텀 SGD와 적용하지 않은 베이스라인, 선택한 NATS-Bench 아키텍처, 확장한 ResNet18 탐색을 다룬다. CNN 비교는 데이터 증강을 통제하고 전체 학습을 수행한다. NATS-Bench 비교는 보고된 시드 1개를 사용하지만, 확장한 ResNet18 탐색은 여러 시드로 반복한다. 보고된 강건성 결과는 이러한 선택의 범위 안에서 해석해야 한다.
- B. Optimizer Analysis는 모멘텀 SGD가 저장하는 모멘텀, Adam(W)의 모멘트 텐서 2개, 임베딩에 대한 원소별 처리를 유지하는 Adam-mini의 블록별 2차 모멘트, Prodigy의 파라미터 크기 추가 상태를 비교한다. 이 분석은 전체 학습 메모리가 아닌 옵티마이저 상태 저장 공간의 하한을 다룬다.
- C. Profiling Results on ”g-SNR Calculation” Stage는 서로 다른 GPU에서 1회 발생하는 초기화 비용을 옵티마이저 스텝 시간과 별도로 측정한다. 캡션의 포괄적인 주장과 달리 일부 계산 시간은 보고된 옵티마이저 스텝 1회의 시간보다 길다. 이 계산은 1회만 수행하며, 이 측정만으로 전체 학습 속도를 입증할 수는 없다.
- D. Algorithm Overview는 아키텍처에 따라 달라지는 블록별 배율을 첫 옵티마이저 업데이트 전에 계산하고 학습 내내 고정한다고 설명한다. local gain의 반복 계산을 제거하는 효과와, 메모리 사용을 줄여 더 큰 배치를 지원함으로써 얻을 수 있는 처리량 개선을 구분한다.
짧은 생각
이 방법은 고정된 블록별 배율만으로 적응형 최적화의 이점을 얼마나 얻을 수 있는지 검증하는 간단한 베이스라인을 제공한다. ViT-S/16에서 SGDM의 63.80%를 72.92%로 개선한 결과는 이 실험 안에서 상당한 차이다. 다만 AdamW와 Prodigy의 최고 정확도는 조금 더 높다.
후속 연구에서는 초기화 배치와 옵티마이저 구현을 바꾸면서 대규모 모델의 전체 학습에서 목표 검증 손실까지 걸리는 시간을 측정하면 도움이 될 것이다. 현재 실험은 이 질문들을 해결하지 못했다. 대규모 모델은 전체 학습 없이 프로파일링만 수행했고, 초기 배율의 안정성은 주로 ViT-S/16에서 분석했으며, 옵티마이저 스텝 속도는 느린 초기 수렴과 별도로 측정했다.