


Open Problems in Mechanistic Interpretability 요약 설명
27 Jan 2025 | Paper Review Mechanistic Interpretability Sparse Dictionary Learning목차
- 요약
- 1 Introduction
- 2 Open problems in mechanistic interpretability methods and foundations
- 2.1 Reverse engineering: Identifying the roles of network components
- 2.2 Concept-based interpretability: Identifying components for given roles
- 2.3 Proceduralizing mechanistic interpretability into circuit discovery pipelines: A case study
- 2.4 Automating steps in mechanistic interpretability research
- 3 Open problems in applications of mechanistic interpretability
- 3.1 Axes of mechanistic interpretability progress.
- 3.2 Using mechanistic interpretability for better monitoring and auditing of AI systems for potentially unsafe cognition
- 3.3 Using mechanistic interpretability for better predictions about AI systems
- 3.4 Using mechanistic interpretability to improve our ability to perform inference, improve training, and make better use of learned mechanisms
- 3.5 Using mechanistic interpretability for ‘microscope AI’
- 3.6 Mechanistic interpretability on a broader range of models and model families
- 3.7 Human computer interaction with model internals
- 4 Open socio-technical problems in mechanistic interpretability
- 5 Conclusion
- Author Contributions
- 부록
- 짧은 생각
이번 글에서는 Open Problems in Mechanistic Interpretability 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 1월 27일(Arxiv)
- Sharkey, Lee, Chughtai, Bilal, Batson, Joshua, Lindsey, Jack, Wu, Jeff, Bushnaq, Lucius, Goldowsky-Dill, Nicholas, Heimersheim, Stefan, Ortega, Alejandro, Bloom, Joseph, et al.
- Apollo Research, Anthropic, Decode Research, Eleuther AI, FAR AI, Google DeepMind, Leap Laboratories, Harvard University, King’s College London and Imperial College London, MATS, MIT, METR, Northeastern University, Pr(AI)²r group, Tel Aviv University, Timaeus, University of Melbourne, Goodfire
- 논문 링크
요약
- Mechanistic interpretability는 신경망이 학습 예시를 넘어 일반화할 수 있게 하는 내부 연산을 설명하려는 분야다. 이 리뷰는 현재 방법들이 부분적인 통찰을 제공하지만, 해석 가능성이 필요하지 않은 관련 대안과 비교한 평가에서 일관된 실용성을 입증하지 못했다고 평가한다. 새로운 통제 비교 실험을 보고하는 대신 기존 연구를 종합한다.
- 리뷰는 방법론 연구를 신경망 분해, 구성 요소의 기능 설명, 설명의 검증으로 나눈다. Sparse dictionary learning(SDL)은 내부 수치 상태인 은닉 활성화를 학습된 사전 요소로 표현하며, 한 번에 소수의 요소만 활성화한다. 리뷰는 SDL을 특히 면밀히 검토한다. 재구성 오차, 불확실한 가정, 학습 데이터 의존성 때문에 SDL 구성 요소만으로 연산에 관해 확인할 수 있는 내용이 제한되기 때문이다.
- 응용 분야에는 인공지능(AI) 시스템 모니터링, 행동 제어, 실패와 능력 예측, 학습과 추론 개선, 과학 지식 추출이 포함된다. 저자들은 인과적 설명을 더 엄격히 검증하고 실용 과제에서 공정하게 비교해야 한다고 주장한다. 또한 선택적 투명성이 안전에 대한 잘못된 확신을 줄 수 있다고 경고한다.
1 Introduction
신경망은 개발자가 능력을 구현하는 메커니즘을 이해하지 못해도 학습을 통해 능력을 얻는다. 서론은 이해를 조작적으로 정의한다. 내부 메커니즘에 관한 지식으로 행동을 정확히 예측하거나 유용한 개입을 수행할 수 있어야 한다는 것이다. 더 정밀한 제어나 신경망 설계 개선이 그 예다.
- 과학적 동기에는 인공 인지에 대한 이해와 단백질 구조 예측, 의학 등의 분야에서 모델이 학습한 패턴을 찾아내는 일이 포함된다.
- 이러한 이점을 안정적으로 실현하는 일은 여전히 미해결 연구 목표다.
1.1 The focus of this review: Open problems and the future of mechanistic interpretability
리뷰는 현재 방법론과 우선적으로 해결해야 할 미해결 문제를 살펴본다. “1.1.1 Why ‘mechanistic’ interpretability?”에서는 해석 가능한 모델 설계, 개별 결정에 대한 설명, 일반적인 문제군에서 공유되는 메커니즘에 대한 설명을 구분한다.
- 이 논문에서 mechanistic interpretability는 구체적으로 신경망의 일반화를 뒷받침하는 메커니즘을 연구하는 분야를 뜻한다.
- 일반화가 공유된 연산에서 비롯된다는 가설이 연구의 출발점이다. 이 가설에 따르면 반복적으로 나타나는 내부 과정은 유용한 연구 대상이 된다.
1.2 Types of open problems
미해결 문제는 방법과 기반 이론, 응용, 기술 연구를 둘러싼 사회적 맥락에 걸쳐 있다. 목표에는 위험한 내부 과정 탐지, 행동 수정, 낯선 상황의 행동이나 능력 발달 예측, 연산 개선, 학습된 지식 추출이 포함된다.
- 저자들은 기존 도구의 활용을 넓히는 동시에 방법론도 개선해야 한다고 주장한다.
- 응용에 따라 필요한 이해의 종류와 수준이 다르므로, 이후에는 여러 축을 따라 진전을 분석한다.
2 Open problems in mechanistic interpretability methods and foundations
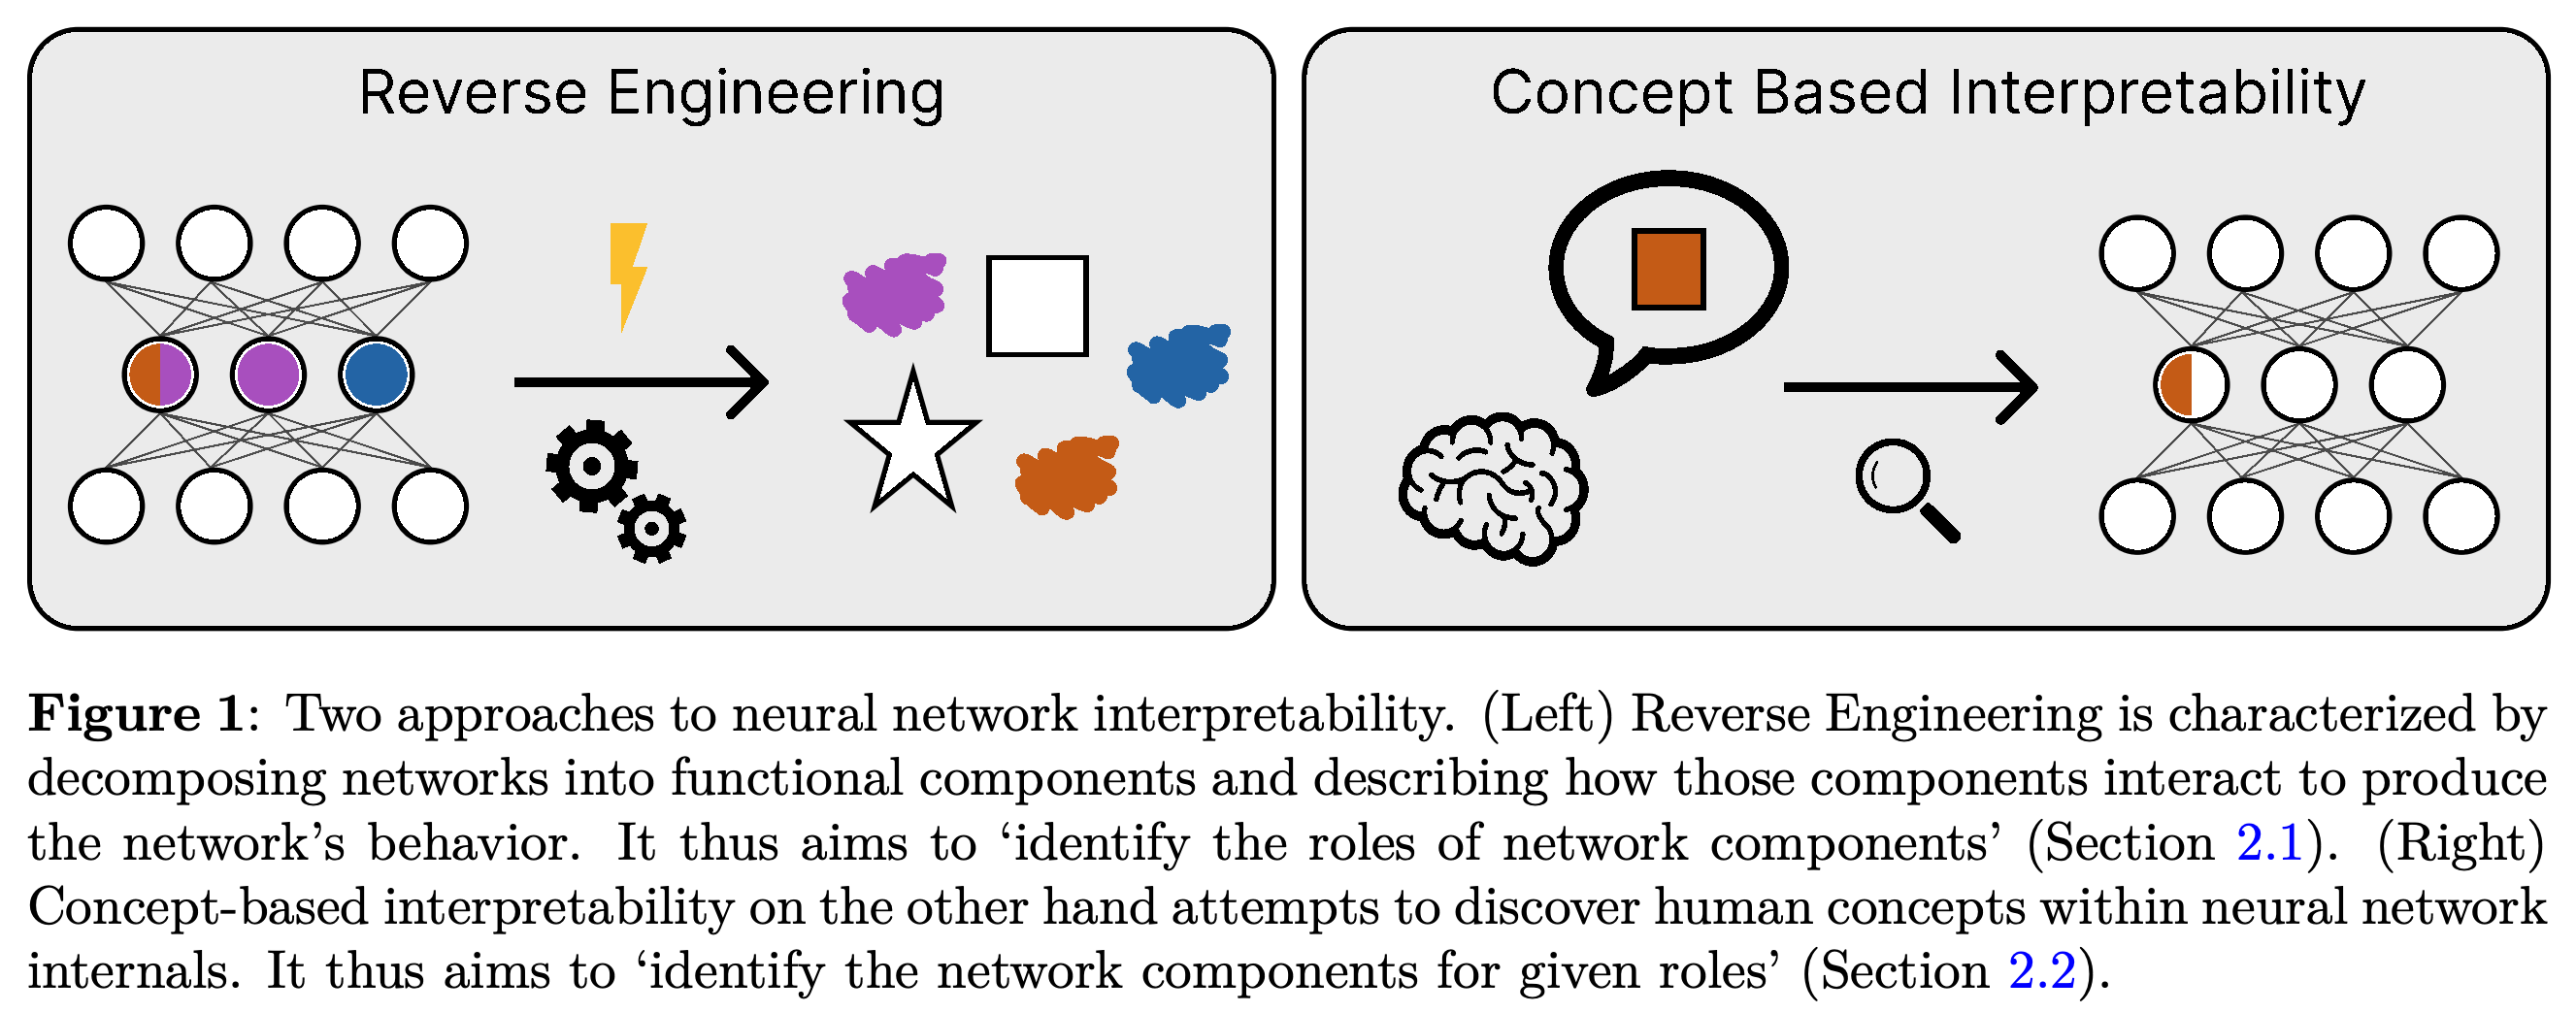
방법론 논의는 신경망을 내부 활성화를 변환하여 출력을 만드는 학습된 알고리즘으로 본다. 신경망 구성 요소에서 시작해 역할을 조사하는 역공학과, 제안된 개념에서 시작해 대응하는 구성 요소를 찾는 개념 기반 해석을 구분한다.
- Figure 1은 이러한 2가지 출발점을 보여준다.
- 도구들을 신뢰할 수 있는 연구 절차로 결합하는 일과 그 절차를 자동화하는 일은 별개의 과제이며, 접근법 2가지 모두에 영향을 미친다.
각 패널은 출발점에 따라 조사 방식이 어떻게 달라지는지 보여준다. 역공학은 분해한 신경망 구성 요소의 기능을 찾으며, 여기에는 낯선 기능도 포함된다. 개념 기반 분석은 연구자가 미리 지정한 개념에 대응하는 구성 요소를 찾는다.
2.1 Reverse engineering: Identifying the roles of network components
사람과 모델이 비슷한 과제 성능을 보인다고 해서 비슷한 방식으로 연산하는 것은 아니므로 역공학이 필요하다. 예를 들어 이미지 모델은 질감이나 데이터셋의 우연한 단서에 의존하기도 한다. 또한 소형 transformer가 문제를 주파수로 표현하는 Fourier transform 전략으로 모듈러 덧셈을 푼 사례가 있다. Transformer는 위치 간 정보를 attention으로 결합하는 신경망 구조다.
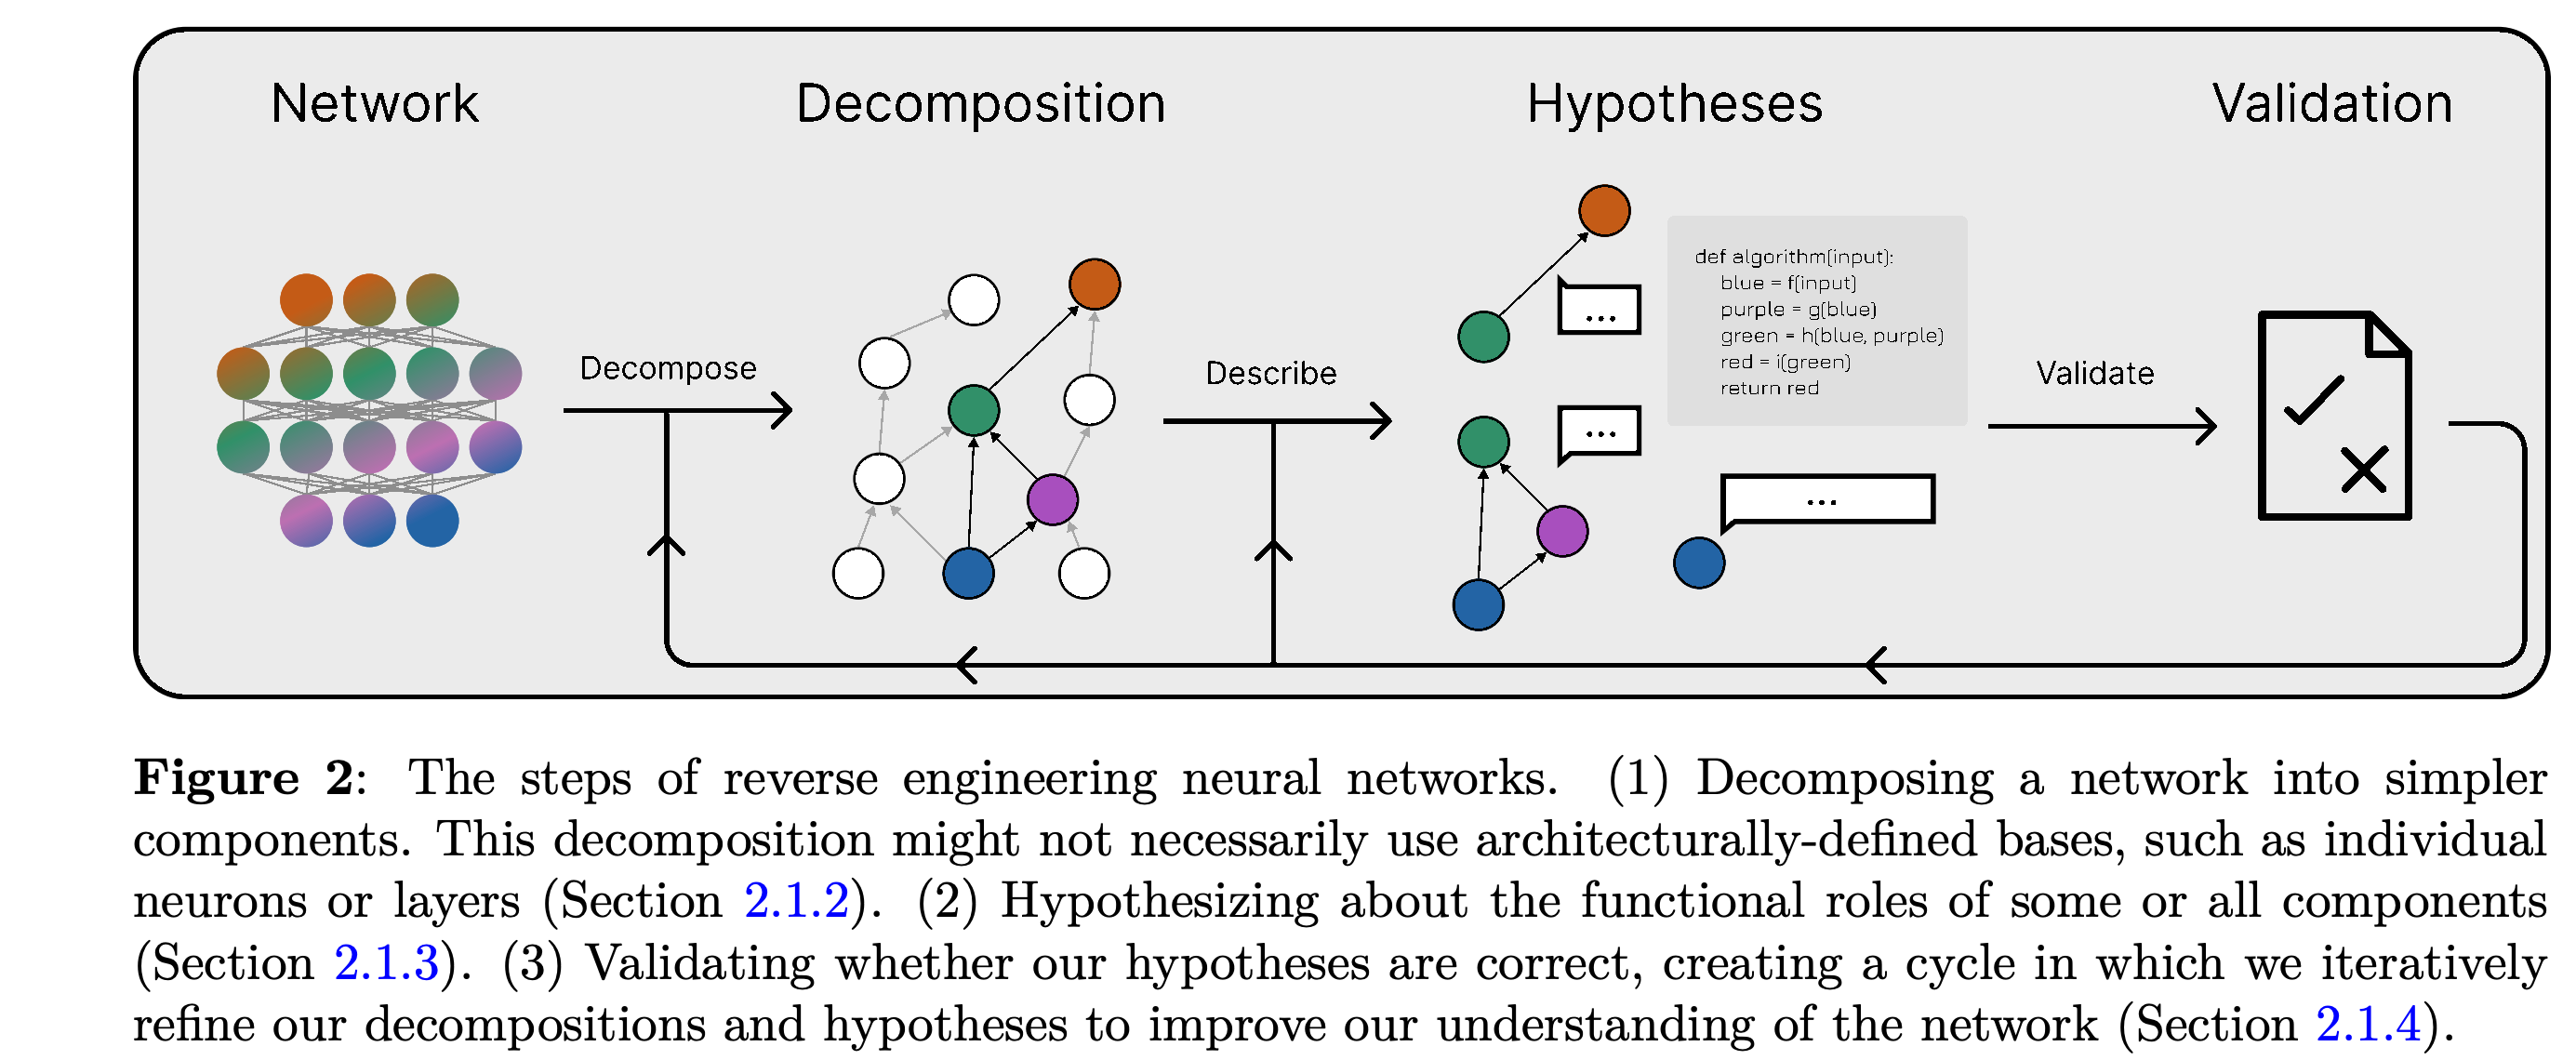
- 작업 절차는 더 단순한 부분으로 분해하기, 구성 요소의 기능과 상호작용에 관한 가설 세우기, 검증하기의 3단계로 이루어진다.
- Figure 2는 수정 과정을 명시한다. 검증에 실패하면 분해 방식이나 기능 가설을 바꿔야 한다.
되돌아가는 화살표는 검증이 반복 과정의 일부임을 보여준다. 예측에 실패하면 분해가 부적절하거나 기능 설명이 틀렸을 수 있다. 따라서 구성 요소의 역할을 이해했다고 판단하기 전에 이를 수정해야 한다.
모델 구조상의 단위가 기능 단위와 정확히 대응하지는 않는다. 뉴런과 attention head는 여러 종류의 특징에 반응하는 다의성을 보일 수 있다. Attention head는 transformer에서 정보를 선택하고 결합하는 병렬 구성 요소다. 표현이 여러 층에 걸쳐 분포할 수도 있다.
- Principal Component Analysis, Singular Value Decomposition, non-negative matrix factorization은 저차원 표현이나 분해된 표현을 통해 은닉 활성화의 패턴을 찾지만, 이 구조가 연산 구조와 일치한다는 보장은 없다.
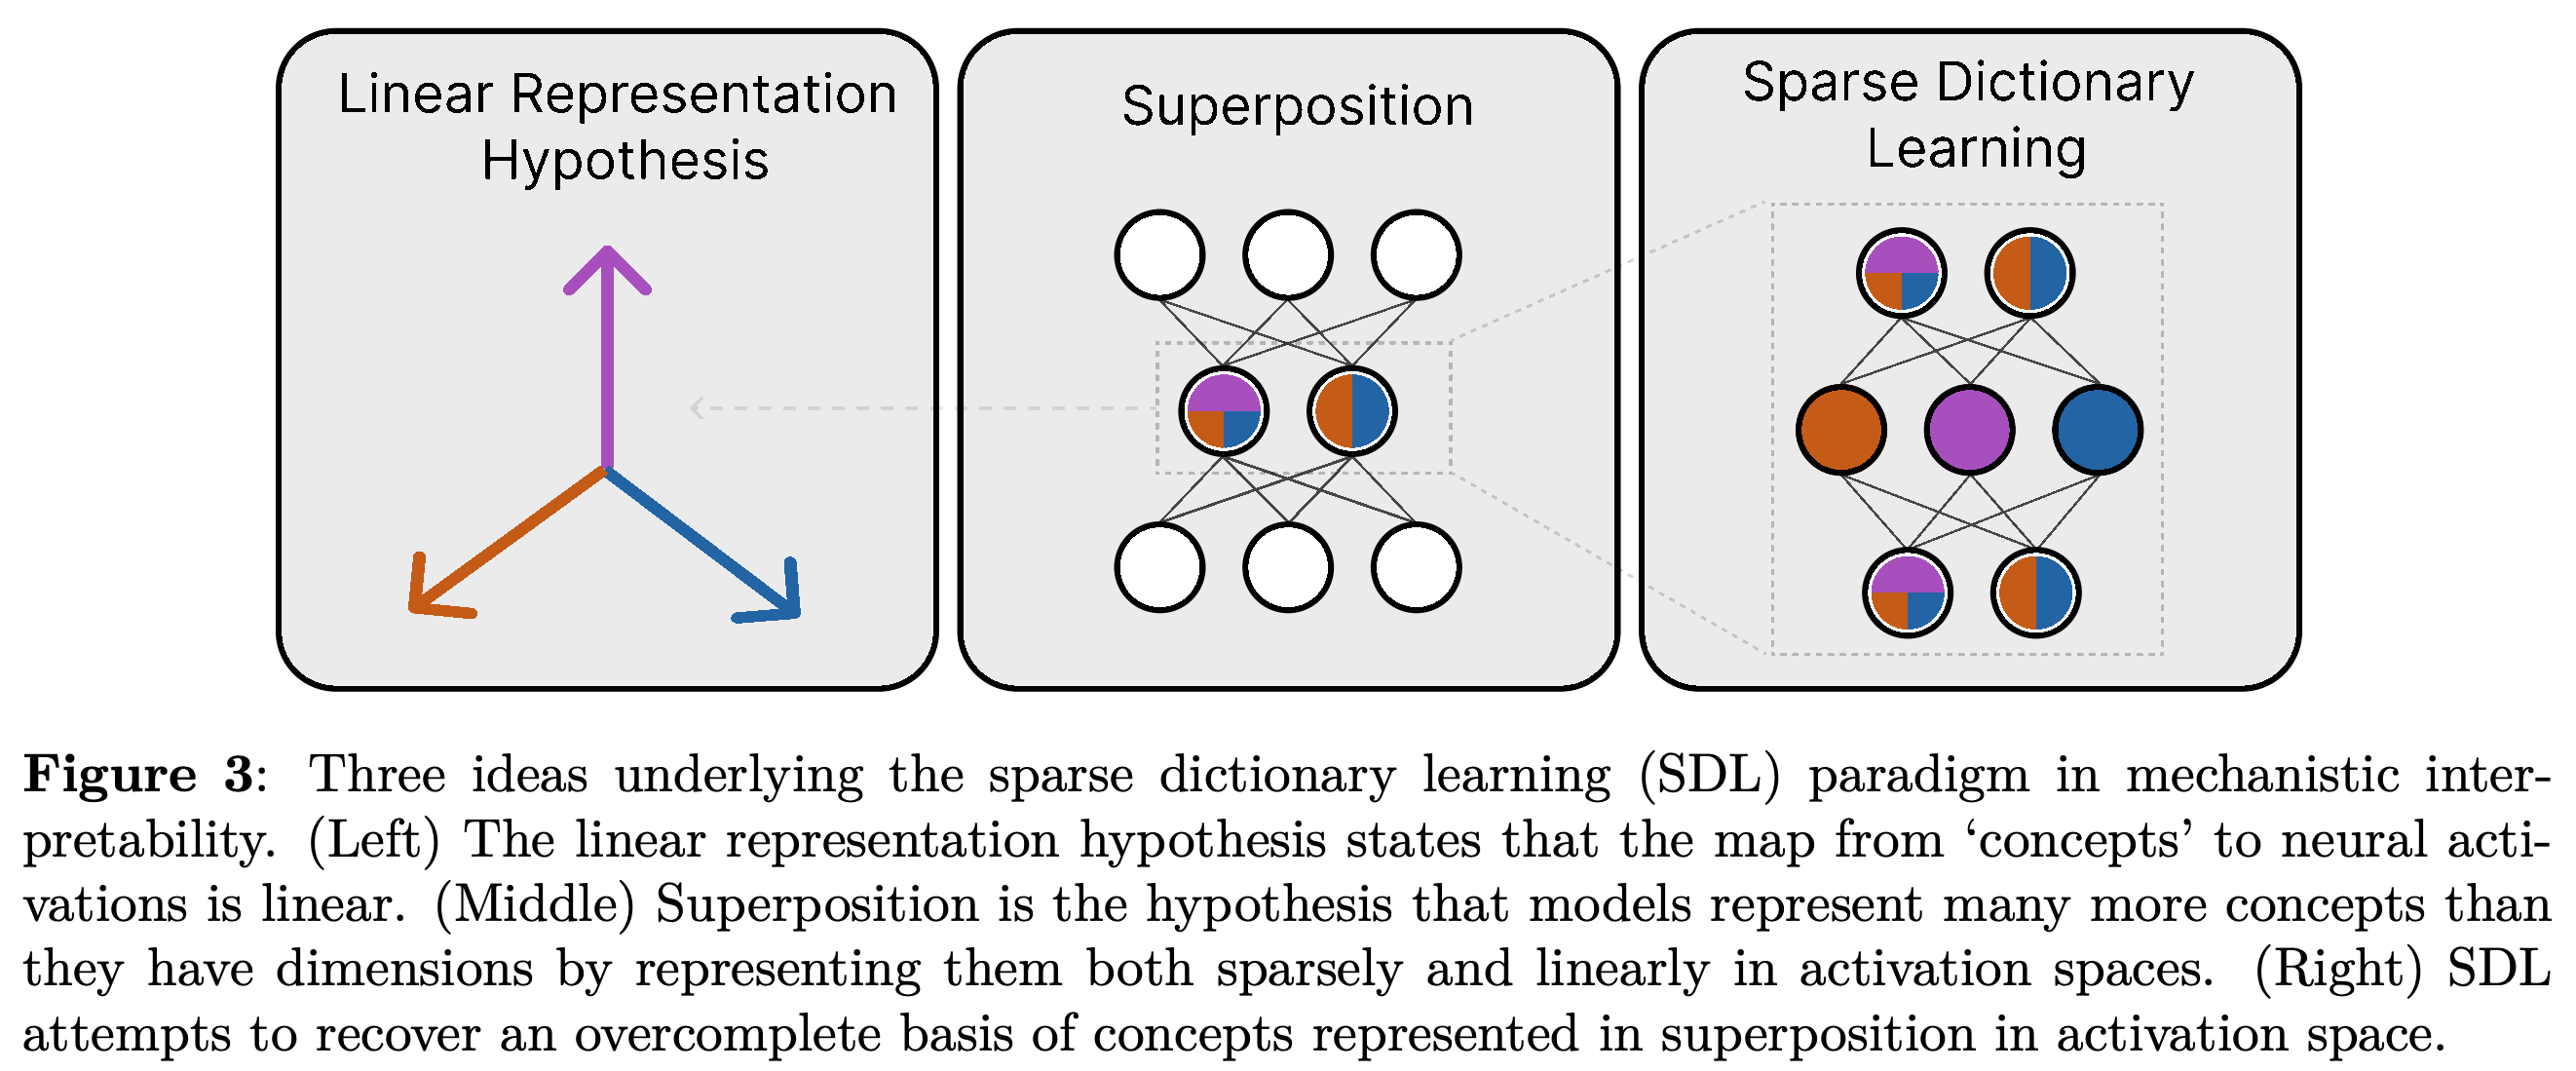
- Superposition 가설은 희소하게 활성화되는 특징의 수가 활성화 차원 수보다 많을 수 있다고 제안한다. 일반적인 차원 축소로는 차원 수보다 많은 방향을 복원할 수 없다.
SDL은 활성화 차원 수보다 많은 학습 방향을 가진 과완비 사전을 복원하려 한다. Sparse Autoencoders(SAEs)는 희소한 내부 코드로 활성화를 재구성하도록 학습하는 인코더-디코더 신경망으로, SDL의 구현 방식이다. Transcoder는 다음 층의 활성화를 재구성하며, crosscoder는 여러 층의 활성화를 재구성할 수 있다.
- Latent는 학습된 사전 요소이며, 그 활성화는 재구성에 대한 기여도를 나타낸다.
- Figure 3은 이 접근법을 선형 표현 가설과 연결한다. 이 가설에서는 개념을 벡터로 표현하고, 벡터의 덧셈과 스케일 조정으로 개념의 조합과 강도를 표현한다. 논문은 일부 개념에 관한 약한 주장과 모든 개념에 관한 강한 주장을 구분한다. 인용된 연구는 일부 모델에서 강한 주장이 성립하지 않음을 보인다.
그림은 선형 개념 표현, 제한된 활성화 공간의 희소한 공유, 활성화 차원 수보다 많은 사전 요소의 복원을 연결한다. 이러한 아이디어는 SDL의 연구 동기와 그 해석이 의존하는 가정을 함께 보여준다.
재구성 대체 검증은 원래 모델의 활성화를 사전으로 재구성한 값으로 바꾸고 성능 변화를 측정하여 SDL을 검증한다. 리뷰에 따르면 GPT-4에 latent 16 million개를 가진 사전을 삽입했을 때, 언어 모델링 손실은 GPT-4 사전 학습 연산량의 10%만 사용한 모델과 동등했다. 별도의 GPT-2 small 연구에서는 과제별 데이터로 SAE를 학습했을 때 성능이 10%, 전체 분포의 데이터로 학습했을 때는 40% 하락했다.
- 이 수치들은 조건이 서로 다른 인용 연구에서 나온 결과다. GPT-4 비교는 예측 손실에 관한 것이며, 활성화를 대체한 모델을 학습하거나 실행하는 데 사용한 연산량에 관한 비교가 아니다.
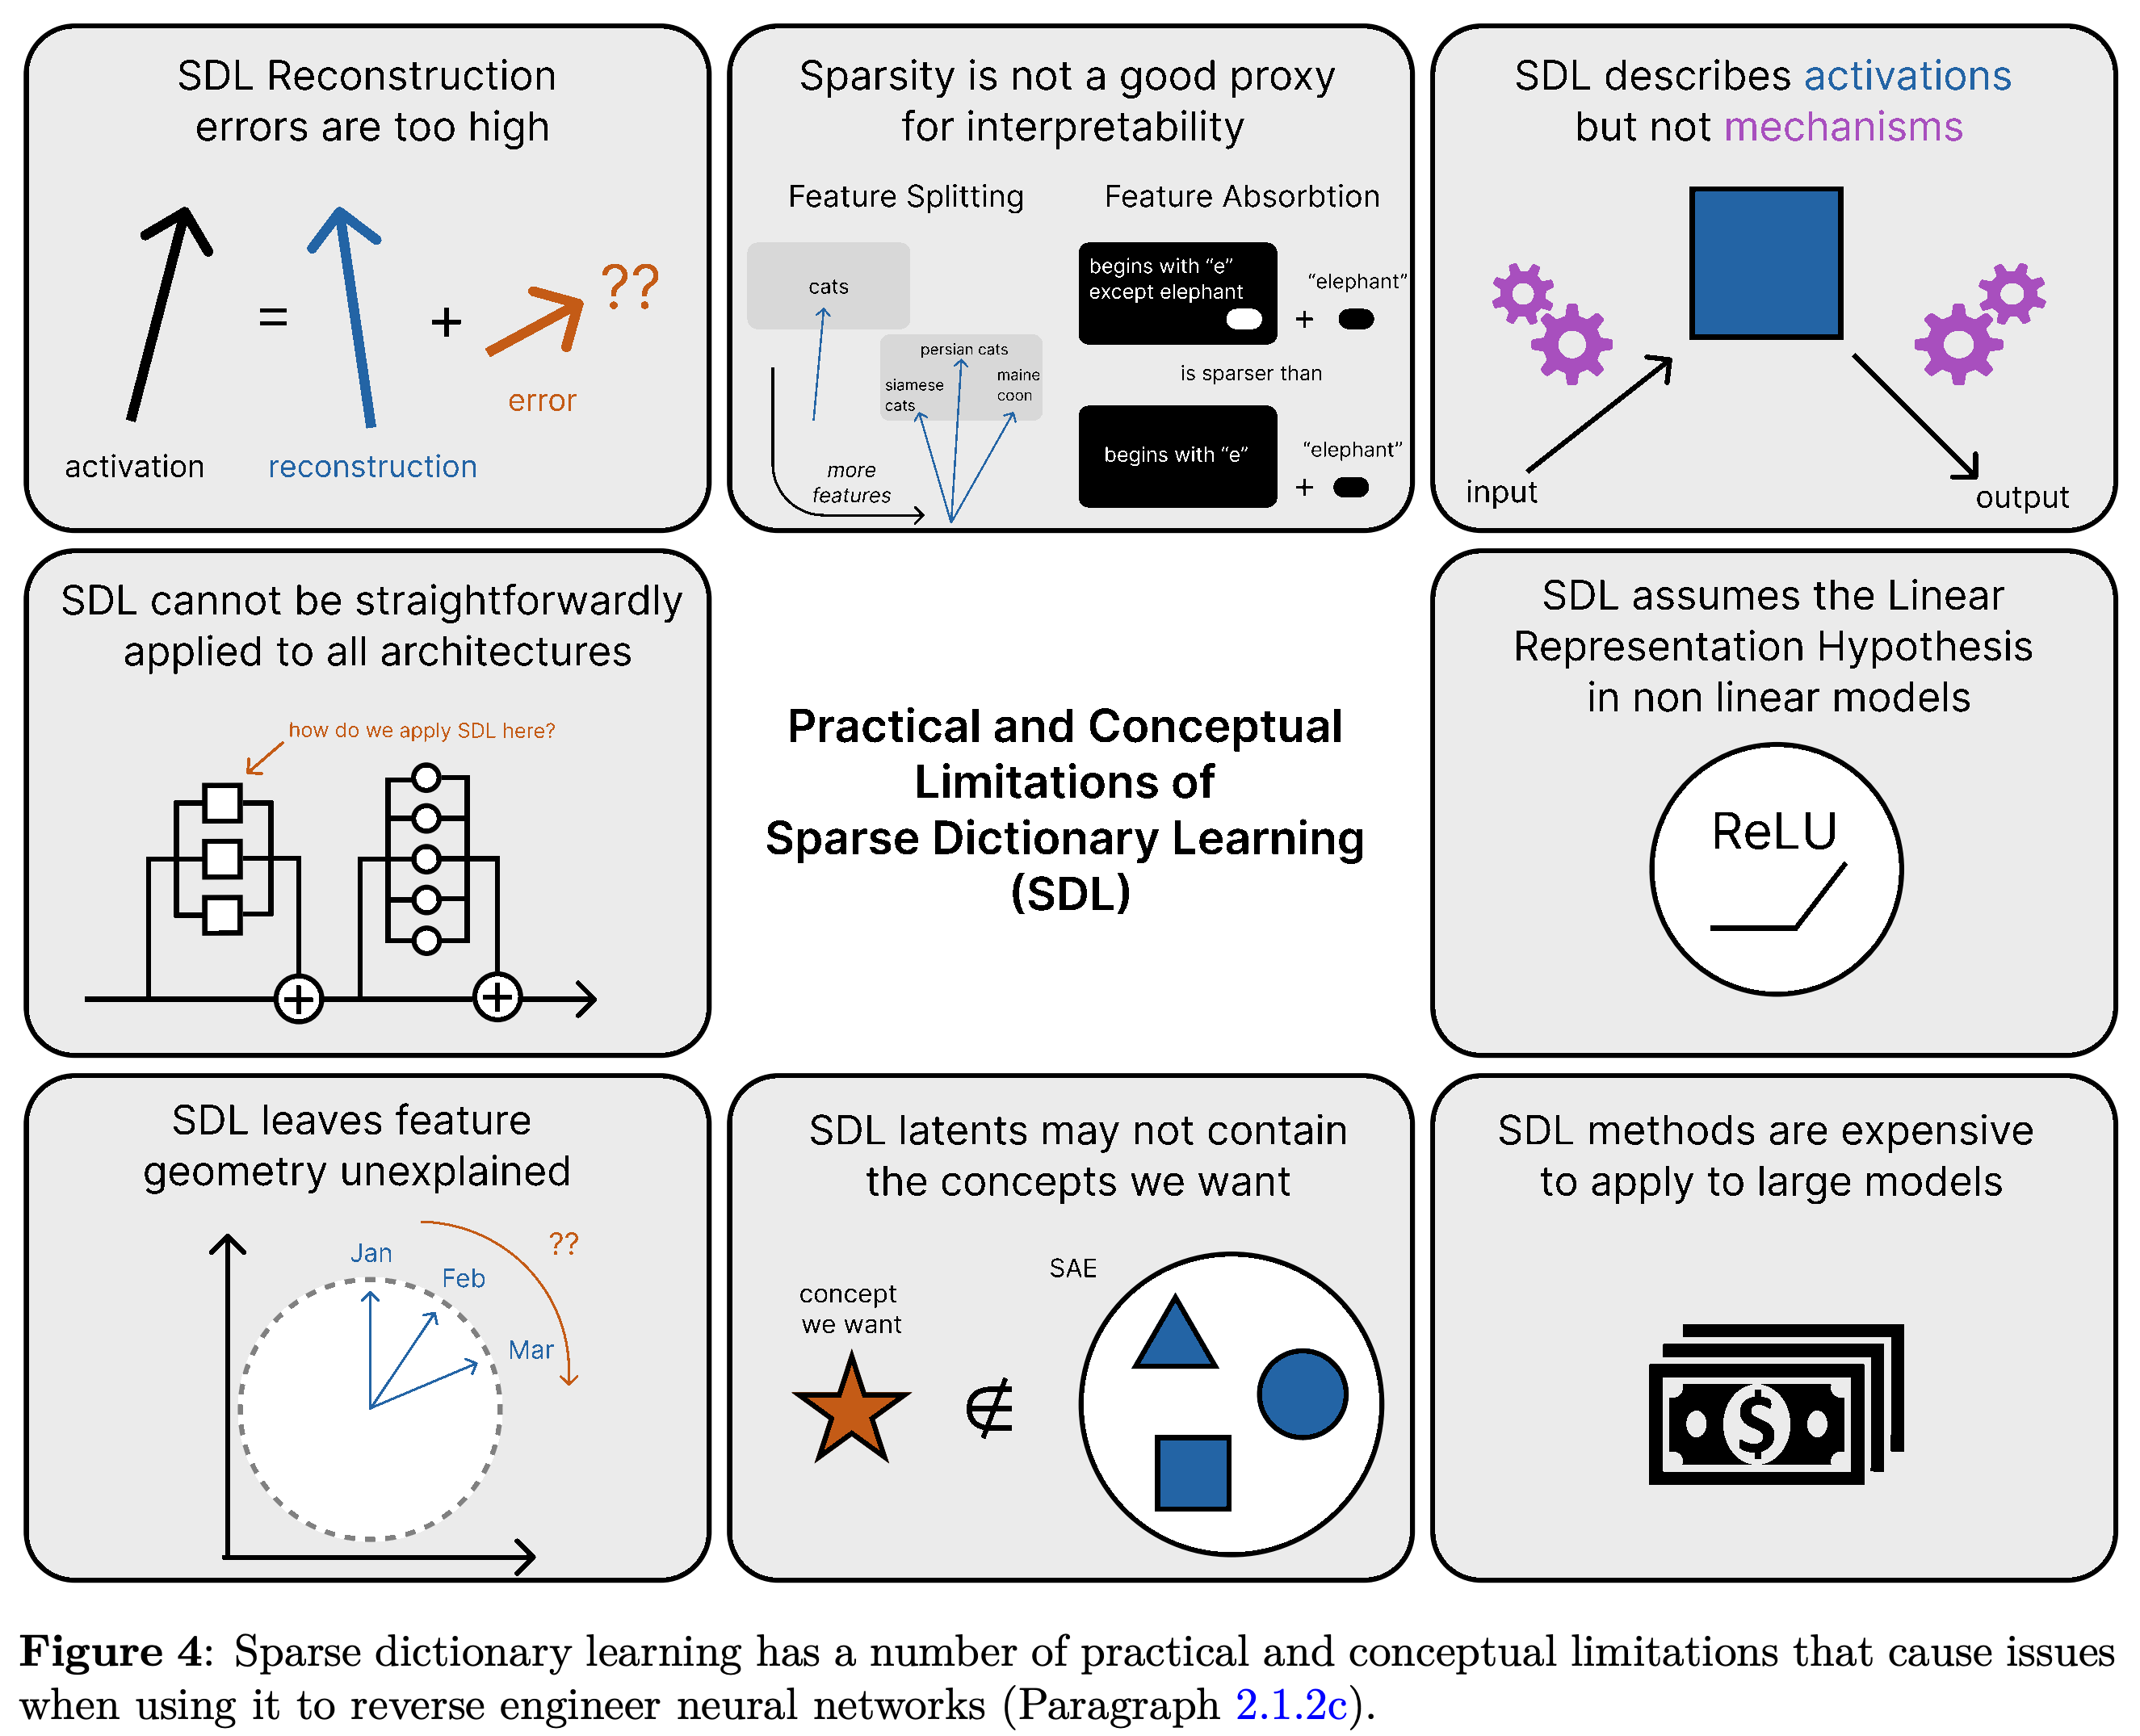
- 그 밖의 한계로는 계산 비용, 특징 방향 간 기하학적 관계에 대한 미해결 문제, 여러 head와 층에 걸친 표현을 다루기 어렵다는 점, 희소성이 해석 가능성과 일관되게 대응하지 않는다는 점이 있다. Figure 4는 이러한 한계를 모아 보여준다.
- SDL은 신경망 파라미터가 구현하는 메커니즘을 직접 설명하는 대신 활성화 방향을 찾는다. 학습되는 개념은 학습 데이터에도 의존한다. 인용된 연구에서 사전 학습 데이터로 학습한 SAE에는 대체로 유용한 거부 관련 latent가 없었지만, 채팅 형식 데이터로 학습한 SAE에는 있었다.
주변 패널은 재구성 품질만으로 메커니즘을 이해했다고 판단할 수 없는 이유를 보여준다. 재구성이 개선되어도 어떤 개념을 복원했는지, 개념 간 기하학적 관계가 중요한지, 신경망이 활성화를 어떻게 변환하는지는 여전히 해결되지 않을 수 있다.
이론적 문제는 재구성 개선에 그치지 않는다. 이 분야에는 합의된 특징의 형식적 정의나 표준적인 분해 단위가 없다. 리뷰는 특징의 기하학, superposition 상태의 연산, 인과적 기반, 일반화 이론과의 연결을 연구하자고 제안한다.
- 내재적 해석 가능성은 모델을 설계하거나 학습할 때 해석하기 쉬운 구조를 유도하는 것을 뜻한다. 이산 코드, 희소 활성화나 가중치, 모듈성, 수학적으로 다루기 쉬운 구조 등이 사용된다.
- 논문은 해석 가능한 활성화를 직접 유도하려는 많은 시도가 경쟁력 있는 성능을 유지하지 못했고 superposition도 제거하지 못했다고 지적한다.
- 모델 자체를 분해하기 쉽게 설계했더라도 구성 요소의 기능 설명과 검증은 여전히 필요하다.
구성 요소를 설명할 때는 무엇이 활성화를 일으키고, 그 활성화가 이후에 무엇을 바꾸는지 밝혀야 한다. 구성 요소를 강하게 활성화하는 예시와 특징 합성은 가설을 세우는 데 도움이 된다. 특징 합성은 제약 조건 아래에서 구성 요소의 활성화를 최대화하는 입력을 생성한다. 그러나 데이터셋 편향과 사람의 기대 때문에 설득력 있어 보이지만 잘못된 해석이 나올 수 있다.
- Attribution 방법은 상류 변수가 하류 값에 미치는 영향을 추정한다. 기울기 근사는 비선형 효과를 놓칠 수 있고, 교란은 모델을 학습 분포 밖에서 작동하게 할 수 있다.
- Logit lens는 중간 표현에 모델의 출력 매핑을 적용해 어휘 예측으로 변환한다. 이를 통해 직접적인 출력 효과를 볼 수 있지만, 이후 층을 거쳐 나타나는 효과는 놓친다.
- 인과적 개입은 순전파 중 내부 값을 바꾸고 변화를 관찰한다. Activation patching은 활성화를 교체하며, path patching은 특정 연결의 영향을 분리해 조사한다. Figure 5는 상류 원인을 중간 효과 및 최종 효과와 구분한다.
- Patchscopes는 활성화를 다른 순전파로 옮긴다. 이때 문맥은 언어 모델이 해당 활성화에 담긴 정보를 드러내도록 유도한다. 모델이 생성한 추론 단계인 chain-of-thought를 읽는 것은 내부를 직접 조사하는 방법이 아니며, 인용된 연구들은 이러한 단계가 실제 연산을 충실히 설명하지 않을 수 있음을 보인다.
파란 구성 요소는 상류 원인과 하류 효과 사이에 놓이며, 중간 구성 요소는 입력 및 출력과 구분된다. 이를 통해 구성 요소를 활성화하는 원인을 찾는 일과 그 활성화가 신경망의 다른 부분에서 무엇을 바꾸는지 예측하는 일이라는 2가지 설명 과제를 구분한다.
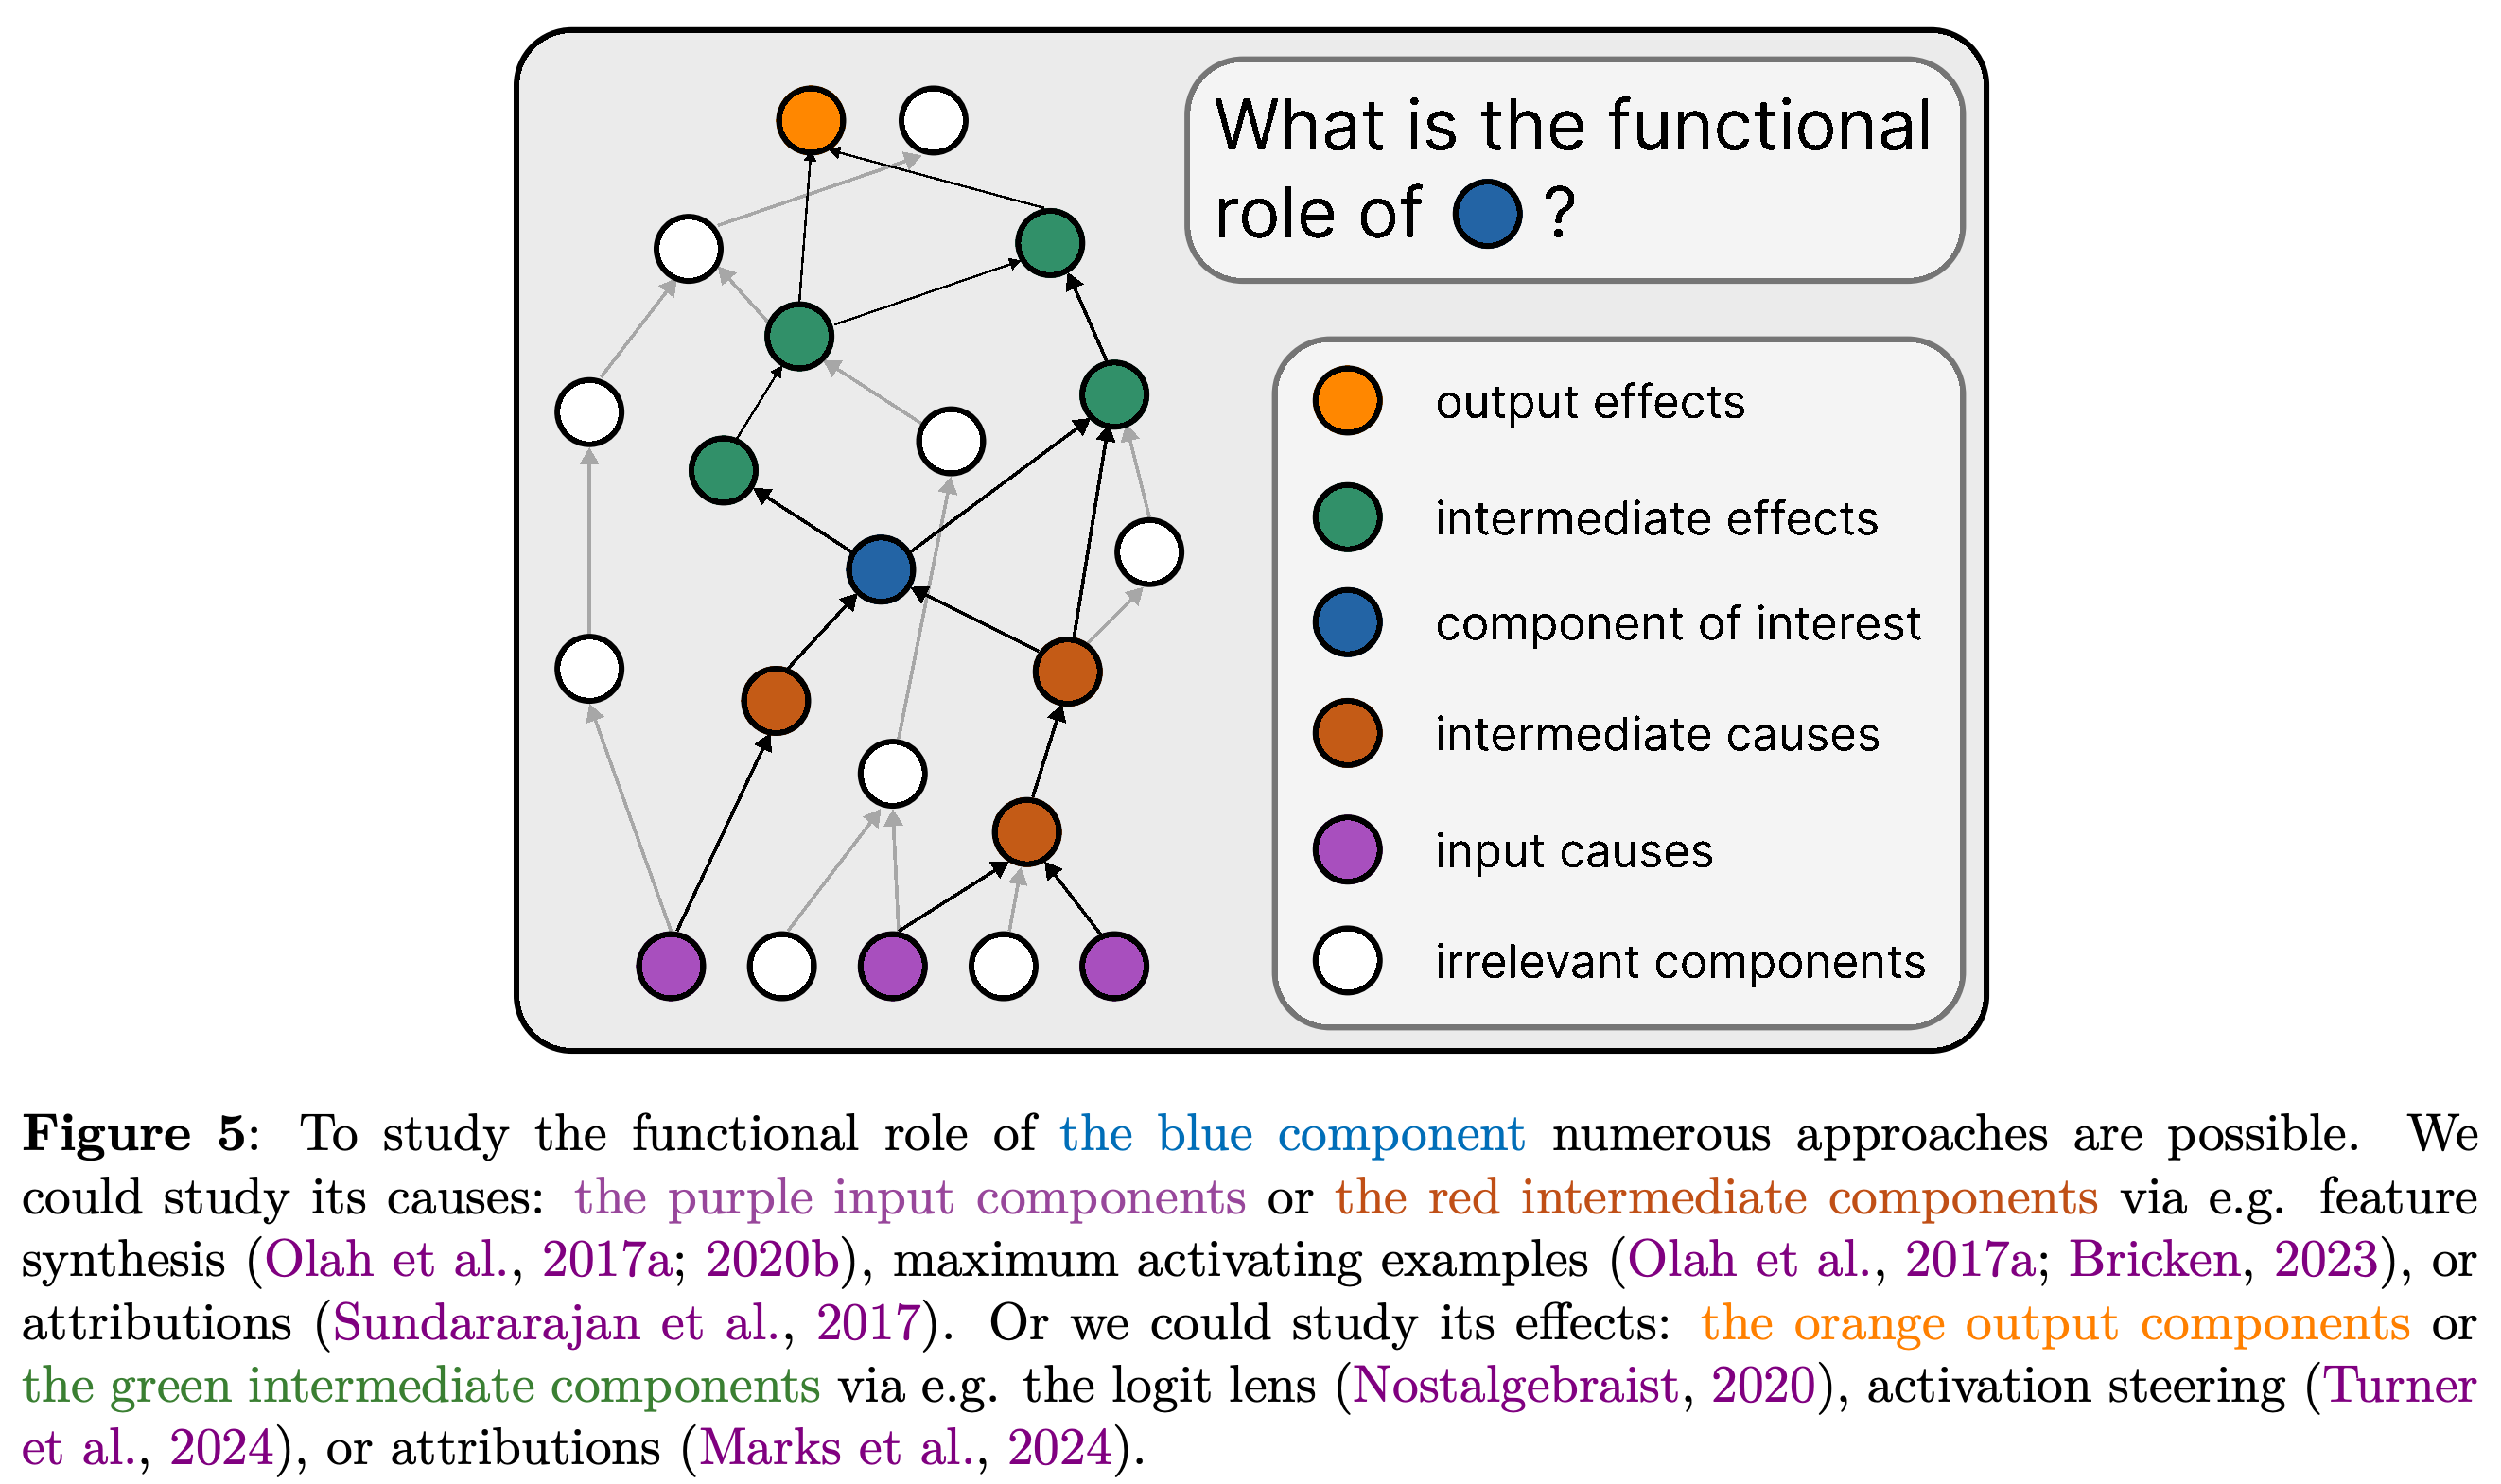
검증에서는 기능 가설이 활성화, 개입, 실패, 유용한 행동 변화를 정확히 예측하는지 확인한다. 리뷰는 수작업으로 만든 대체 구성 요소, 연산을 알고 있는 신경망, 관련 공학 베이스라인과의 비교 등 여러 검증 방법을 권장한다.
- “모델 생물”은 누적 실험과 교차 검증을 지원하도록 광범위하게 연구한 참조 신경망이다. 공개 학습 데이터, 재현 가능한 학습, 낮은 비용, 폭넓은 대표성, 서로 다른 random seed로 학습한 인스턴스가 바람직한 특성으로 제시된다.
- 작은 참조 모델은 다루기 쉽지만, 실제 안전 문제에 일반화되지 않는 방법을 장려할 수 있다.
- 벤치마크에는 프로그램을 신경망 가중치로 컴파일하거나, 알려진 설명을 따르도록 학습 절차를 설계하는 방법을 사용할 수 있다. 그럴듯한 설명과 일부 기존 지표도 오해를 부를 수 있으므로 예측 검증과 실용적 검증은 여전히 필요하다.
2.2 Concept-based interpretability: Identifying components for given roles
개념 기반 probe는 다른 모델의 은닉 활성화에서 지정된 개념을 예측하도록 학습한 분류기다. Probe에는 신중하게 정의한 레이블이 필요하며, 찾아낸 활성화가 출력에 인과적 영향을 주지 않아도 상관관계를 포착할 수 있다.
- Contrast-Consistent Search는 확률적 일관성을 통해 긍정 명제와 부정 명제에 대응하는 활성화 축을 찾지만, 적절히 구성된 대조 예시가 여전히 필요하다. 일반적인 probe도 레이블을 붙일 만큼 명확히 정의된 개념에만 적용할 수 있다.
- 관심 개념을 변화시키는 반사실적 데이터와 개입으로 인과적 관련성을 검증할 수 있다. Concept erasure는 표현에서 개념 정보를 제거했을 때의 효과를 검증한다. 이러한 방법에는 더 특화된 데이터가 필요하며, 허위 상관관계를 찾으려면 낯선 분포에서 평가해야 한다.
- Concept bottleneck model은 학습 중 지정된 개념을 반영하므로, 해당 개념을 할당받은 구성 요소가 인과적 관련성을 가질 가능성을 높인다. 신경망이 지정된 인과 구조를 사용하도록 학습할 수도 있지만, 유용한 개념이나 구조를 모두 사전에 지정하기는 여전히 어렵다.
2.3 Proceduralizing mechanistic interpretability into circuit discovery pipelines: A case study
Circuit discovery는 상호작용하는 모델 구성 요소에서 과제와 관련된 부분 그래프, 즉 circuit을 찾는다. 일반적인 절차에서는 과제를 정의하고, 구성 요소를 선택하고, 개입으로 관련 노드와 연결을 찾고, 설명과 검증을 반복한 뒤 최종 검증을 수행한다.
- 충실도는 전체 신경망의 행동과 얼마나 일치하는지 측정하고, 최소성은 불필요하게 포함된 구성 요소를 확인하며, 완전성은 중요한 구성 요소가 빠졌는지 확인한다.
- 사람이 정의한 과제는 개별 예시 간의 큰 차이를 가릴 수 있으며, 측정된 충실도는 개입 구현 방식에 따라 달라질 수 있다.
- 확장 가능한 기울기 근사, 개입을 보상하는 백업 연산, 과제 성능을 억제하는 부정적 행동, 유난히 단순한 과제를 선택하는 관행은 모두 현재 절차의 한계다.
2.4 Automating steps in mechanistic interpretability research
자동 해석은 구성 요소를 강하게 활성화하는 예시로부터 설명을 생성하고, 활성화 패턴을 예측하여 그 설명을 검증할 수 있다. 과제 관련 연산 부분 그래프를 찾는 Automated Circuit DisCovery(ACDC)는 작업 절차의 다른 부분을 자동화한다.
- 부분 그래프를 찾았다고 해서 구성 요소의 기능이 자동으로 설명되지는 않는다.
- 저자들은 현재 절차를 완전히 자동화해도 방법론적 약점이 그대로 남으므로, 아직 만족스러운 설명을 얻을 수 없다고 주장한다.
- 제안된 개선 방안에는 테스트 입력 생성, 더 엄격한 통계 검정, 특징의 효과와 상호작용에 대한 설명이 포함된다.
3 Open problems in applications of mechanistic interpretability
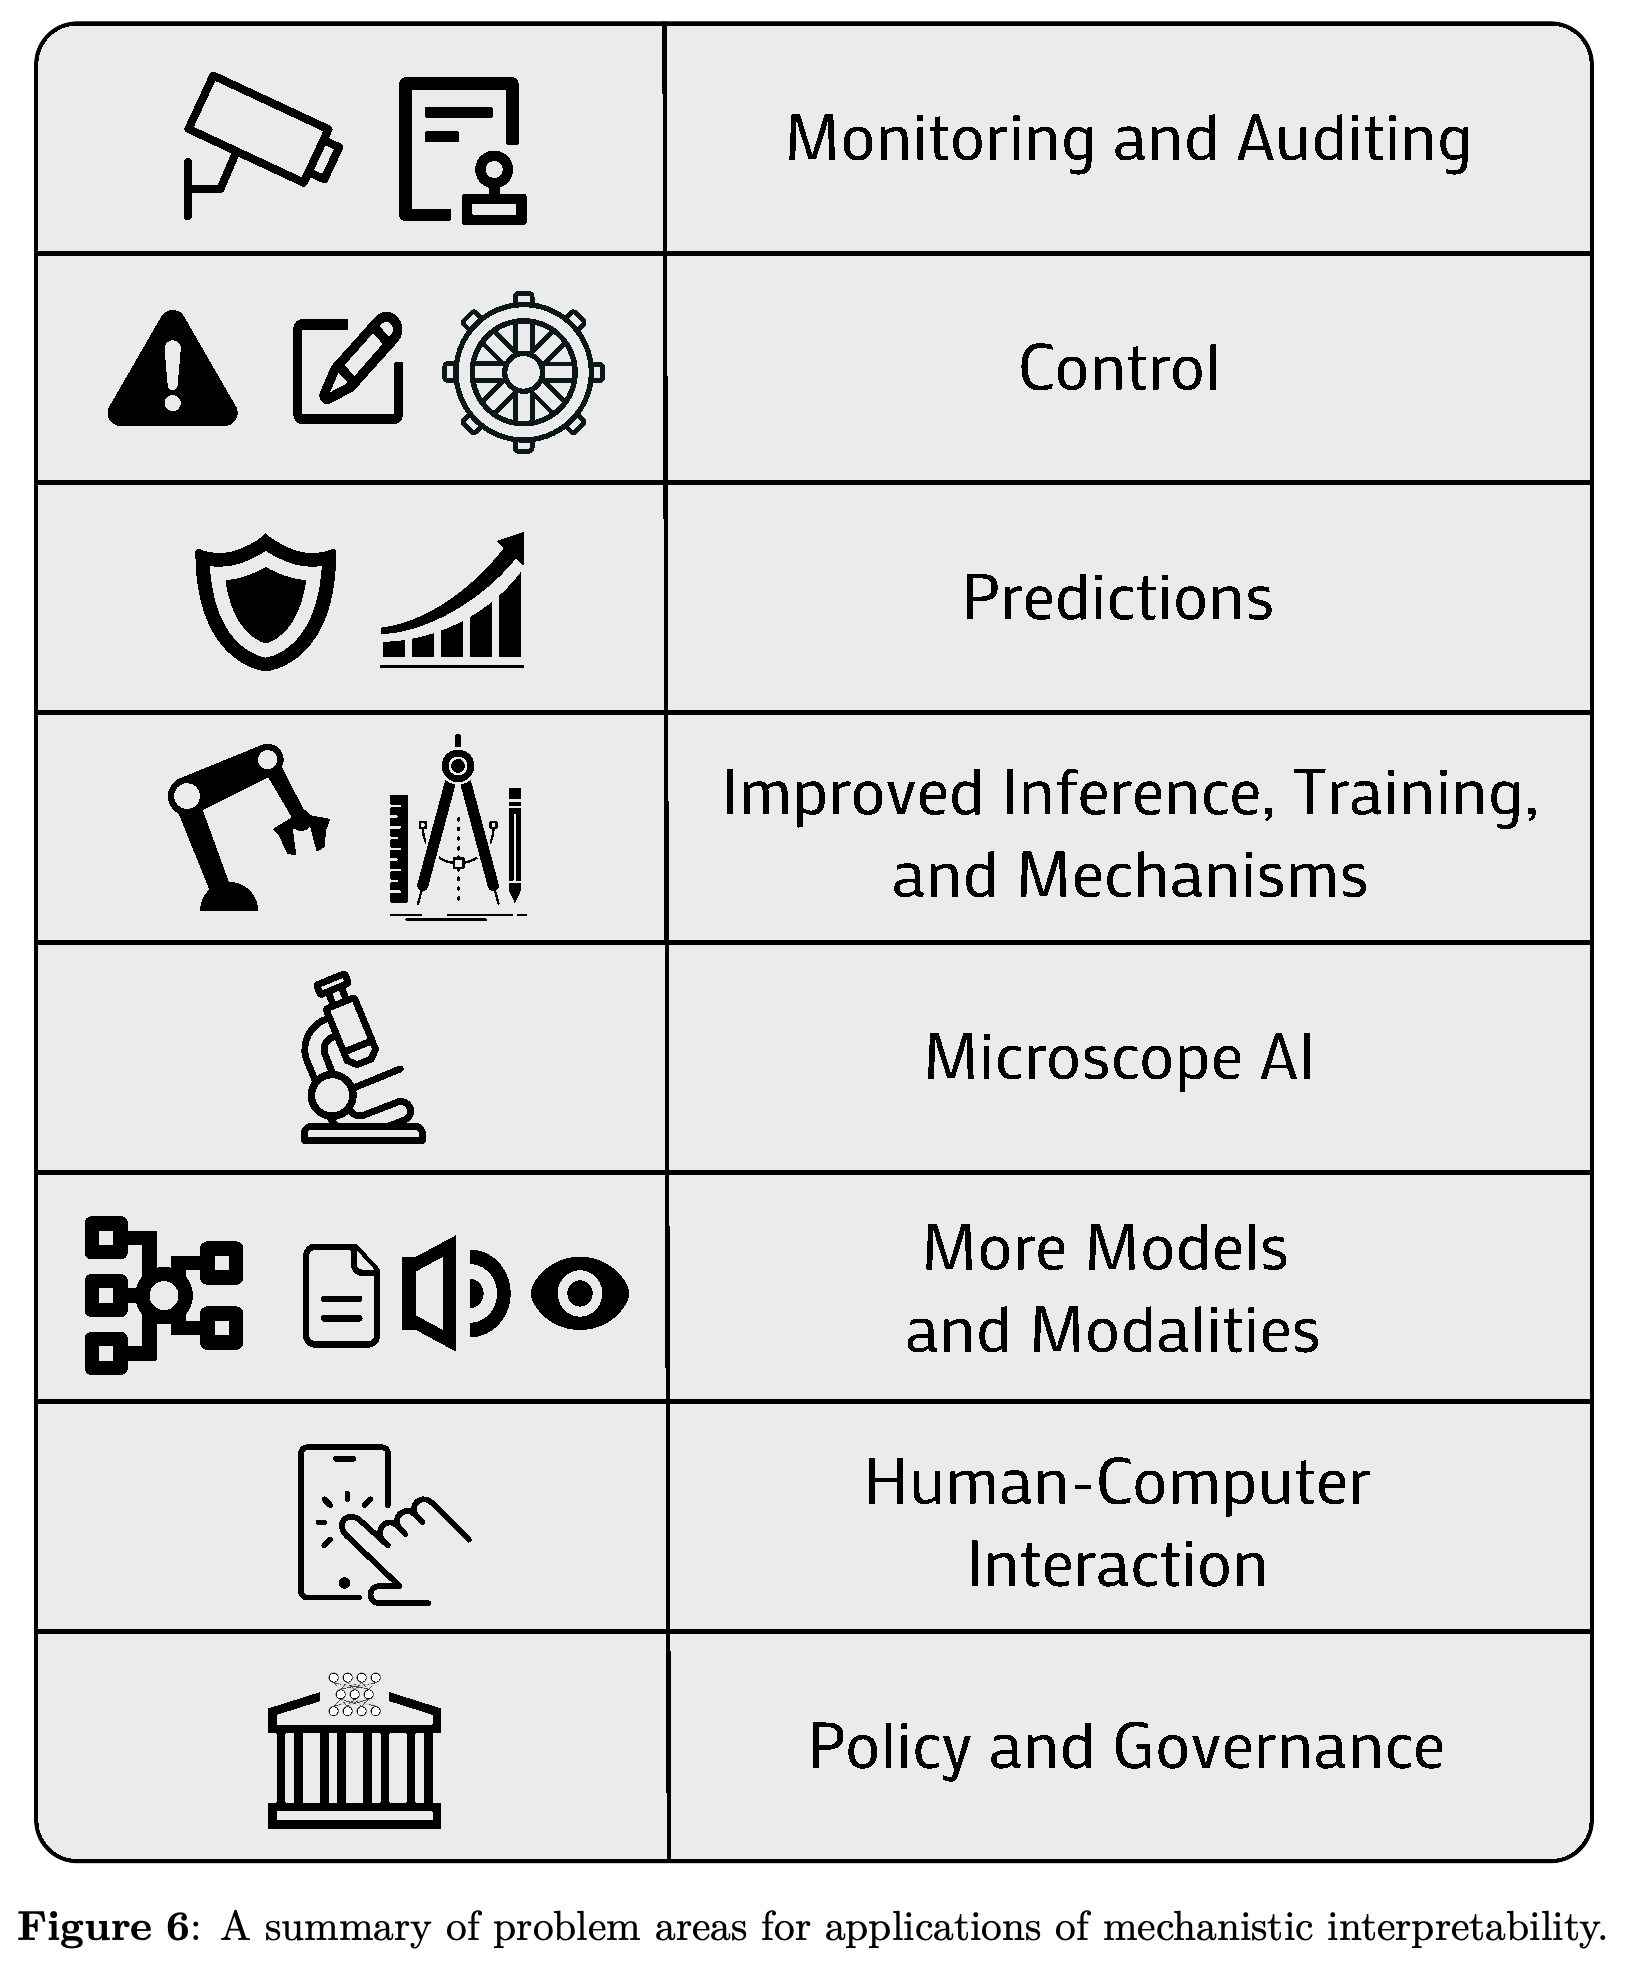
응용 논의는 구체적인 과학 및 공학 목표에 어떤 기술적 발전이 필요한지 묻는다. Figure 6은 모니터링, 제어, 예측, 연산 개선, 과학적 발견, 더 넓은 모델 범위, 인터페이스, 거버넌스를 정리한다.
- 분야마다 요구 사항이 다르므로, 해석 가능성의 한 측면이 개선되더라도 모든 응용이 똑같이 발전하는 것은 아니다.
- 리뷰는 내부 분석이 기존 행동 평가에서 찾지 못한 문제를 드러낼 가능성도 예상한다.
8개 행은 응용 분야를 정리한 것이며 성능 결과를 나타내지는 않는다. 모니터링, 제어, 과학적 발견, 인터페이스, 거버넌스 등 해석 가능성을 평가할 때 고려해야 할 다양한 목표를 보여준다.
3.1 Axes of mechanistic interpretability progress.
논문은 분해 방법의 발전과 구성 요소에 대한 설명이 깊어지는 일을 구분한다. 추가적인 축은 신경망의 어느 범위까지 이해하는지, 얼마나 넓은 과제 분포를 다루는지, 고정된 모델을 설명하는지 아니면 학습 중 변화를 설명하는지에 관한 것이다.
- 특정 행동을 모니터링할 때는 구성 요소와 입력 중 좁은 범위만 다뤄도 될 수 있다.
- 열거적 안전성은 위험한 메커니즘이 없음을 평가하기 위해 관련 메커니즘을 모두 식별하자고 제안한다. 이 접근법과, 정의된 입력 분포에서 지정된 행동 속성을 수학적으로 증명하는 형식 검증에는 더 넓은 범위의 분석이 필요하다.
3.2 Using mechanistic interpretability for better monitoring and auditing of AI systems for potentially unsafe cognition
White-box 평가는 입출력 테스트가 놓칠 수 있는 우려스러운 패턴을 모델 내부에서 조사한다. 연구 동기에는 평가 중 의도적으로 성능을 낮추는 sandbagging과 사용자의 믿음에 부정직하게 맞춘 응답을 내놓는 sycophancy가 포함된다.
- 상관관계를 보이는 내부 지표는 완전한 인과적 설명이나 전체 신경망에 대한 이해가 없어도 평가자가 우려 사항을 구체화하고 조사하는 데 도움이 될 수 있다.
- 미해결 문제는 학습된 특징이 관련된 우려스러운 추론을 빠짐없이 포착하는지 여부다. 기만을 인식하는 특징과 기만을 생성하는 메커니즘도 구분해야 한다.
배포 중 모니터링은 내부 상태를 지속적으로 조사하거나 모델이 이례적인 이유로 행동할 때 이를 표시할 수 있다. 비전형적 내부 메커니즘을 탐지하려는 mechanistic anomaly detection에는 활성화된 사전 latent를 식별하는 것만으로 얻을 수 있는 수준보다 더 명확한 메커니즘 이해가 필요하다.
- Red-teaming은 실패나 안전하지 않은 출력을 의도적으로 찾는 활동이다. 인용된 연구는 유해한 요청의 거부에 인과적으로 관여하는 활성화 방향인 거부 방향을 사용해 적대적 입력 탐색을 유도한다.
- 리뷰는 이러한 표적 탐색이 전체 모델에 대한 최적화보다 효율적일 수 있다고 제안하지만, 새로 측정한 속도 향상을 보고하지는 않는다.
Activation steering은 추론 중 중간 활성화에 고정 벡터를 더해 행동을 바꾼다. Machine unlearning은 다른 성능을 유지하면서 원치 않는 지식이나 능력을 제거하려 한다. Model editing은 바람직한 일반화 특성을 갖도록 모델을 정밀하게 수정하면서 다른 지식에 미치는 영향을 제한하려 한다.
- 리뷰는 steering에서 어느 정도 성공이 있었다고 보고한다. 다만 가중치를 바꾸지 않고 중간 활성화를 수정하는 unlearning 방법은 인용된 평가에서 경쟁력 있는 결과를 내지 못했다고 지적한다.
- 메커니즘이 겹쳐 있어 정밀한 수정이 어렵고, 인용된 비판들은 기존 위치 식별 방법이 수정해야 할 올바른 구성 요소를 찾는지 의문을 제기한다.
- 기존 모델을 추가 학습하는 finetuning에 관한 연구는 일부 변화가 기존 회로를 얕게 수정하며, 거부 학습은 되돌릴 수 있음을 시사한다. 이러한 결과는 모델 버전 간 내부를 비교하고, 능력이 제거되었는지 아니면 가려졌을 뿐인지 검증할 필요성을 제기한다.
3.3 Using mechanistic interpretability for better predictions about AI systems
메커니즘 분석은 실패 관련 메커니즘이나 사실 지식과 hallucination의 내부 지표를 찾아 낯선 상황의 행동을 예측하는 데 도움이 될 수 있다. Hallucination은 사실적 근거가 없는 모델 출력을 뜻한다. 논문은 이러한 부분적 예측 성공과 위험한 메커니즘이 없음을 입증하는 일을 구분한다.
- 형식 검증은 정의된 분포의 모든 입력에서 지정된 속성이 성립함을 입증한다.
- 인용된 근거에는 합성 과제에서 1개 층을 가진 transformer의 정확도 경계를 증명한 연구와 학습된 단순한 신경망을 프로그램으로 변환한 연구가 포함된다.
- 이러한 결과를 대규모 시스템으로 확장하는 문제는 아직 해결되지 않았다. 특히 행동이 형식적으로 명세하기 어려운 복잡한 환경에 의존할 때 문제가 커진다.
능력 발달을 예측하려면 학습과 finetuning 중 메커니즘이 어떻게 변하는지 이해해야 한다. 리뷰는 단계적 학습의 증거, 합성 데이터에서 나타나는 파라미터 궤적 변화, 새롭게 형성되는 attention 회로와 in-context learning의 상관관계를 연결한다. In-context learning은 현재 입력에 제공된 예시를 활용하는 것이다.
- 이러한 관찰은 추가 연구의 동기가 되지만, 일반적인 능력 예측 방법을 확립하지는 못한다. 리뷰는 규모 증가에 따라 능력이 갑자기 나타나는 듯한 현상을 어떻게 해석할지에 대해서도 의견 차이가 있다고 지적한다.
- 학습 데이터 구성과, 이미 존재하는 능력, 유도해 낼 수 있는 능력, 가려진 능력을 구분하는 일도 미해결 문제다.
- 많은 능력에는 순차적 행동이 포함되지만, 현재 분석은 주로 단일 시점의 예측을 조사한다.
3.4 Using mechanistic interpretability to improve our ability to perform inference, improve training, and make better use of learned mechanisms
구성 요소의 기능을 이해하면 생략할 수 있는 연산을 찾아 추론 속도를 높이고, 모델 간에 학습된 행동이나 정보를 전달하는 distillation을 개선할 수 있다. 그 밖에 학습 데이터 선택, 능력 발달 추적, 과제 관련 파라미터만 갱신하는 활용도 제안된다.
- 이 절은 추론 실패 교정, 모델 파라미터 결합, 표현 전이도 논의한다.
- 이러한 제안은 기존 연구의 사례로 뒷받침되며, 여러 응용에서 효과를 입증한 공통 평가에 근거하지는 않는다.
3.5 Using mechanistic interpretability for ‘microscope AI’
“Microscope AI”는 데이터로 모델을 학습하고 모델이 배운 내용을 해석하여 유용하고 잠재적으로 새로운 예측 요인을 발견하는 접근법이다. 인용된 사례에는 그랜드마스터를 위해 AlphaZero에서 체스 개념을 추출한 연구와 면역 세포의 단백질 발현과 관련된, 이전에 알려지지 않은 형태학적 특징을 찾은 연구가 있다.
- 과학적 가치는 발견한 패턴을 해석하고 검증할 수 있는지에 달려 있다.
- 머신러닝, 해석 가능성, 해당 분야의 전문 지식이 모두 필요하므로 접근성은 여전히 제한적이다.
3.6 Mechanistic interpretability on a broader range of models and model families
리뷰는 연구가 합성곱 연산을 사용하는 이미지 모델인 Convolutional Neural Networks(CNNs)와 BERT 및 GPT 기반 텍스트 모델에 집중되어 왔다고 지적한다. BERT와 GPT는 transformer 언어 모델의 2개 계열이다. 방법과 결론이 다른 구조와 모달리티에도 적용되는지는 미해결 문제다.
- 논문은 변화하는 내부 상태를 사용하는 시퀀스 모델인 state space model로 방법을 전이한 초기 연구를 인용하며, 더 폭넓은 비교를 요구한다.
- 보편성 가설은 서로 다른 신경망이 유사한 특징과 회로를 학습한다고 제안한다. 이를 평가하려면 공유되는 구조와 특정 아키텍처나 모델에만 해당하는 결과를 구분해야 한다.
3.7 Human computer interaction with model internals
모델 내부를 다루는 인터페이스는 엔지니어가 표현을 조사하고, 감사자가 실패를 검토하며, 사용자가 신뢰 수준을 조정하는 데 도움이 될 수 있다. 제안된 대화형 대시보드는 상호작용 중 영향을 미치는 내부 특징을 표시하고 안전 관련 경고를 보여줄 수 있다.
- 제안된 인터페이스가 사용자의 판단을 안정적으로 개선하는지는 아직 입증되지 않았다.
- 내부 특징의 직접 조작과 일반적인 텍스트 상호작용을 어떻게 결합할지도 더 넓은 설계 문제다.
4 Open socio-technical problems in mechanistic interpretability
해석 가능성을 실제로 활용하려면 거버넌스, 제도적 유인, 성공적인 설명의 의미를 검토해야 한다. 기술적 결과는 모델이 개발되고 배포되는 사회적 환경 안에서 평가해야 한다.
4.1 Translating technical progress in mechanistic interpretability into levers for AI policy and governance
가능한 거버넌스 응용에는 더 엄격한 위험 평가, 능력 예측, 사고 조사, 배포 모니터링, 중대한 결정에 대한 설명이 포함된다. 모델이 암기한 저작권 보호 저작물을 탐지하고 제거하는 활용도 제안된다.
- 논의는 인용 문헌에서 제시한 내용을 바탕으로 이러한 가능성을 유럽연합의 AI Act, General Data Protection Regulation, 저작권 문제와 연결한다.
- 저자들은 기술 발전이 효과적인 거버넌스로 어떻게 이어질지 불확실하다고 인정한다.
- 규제나 조약 준수 여부의 검증은 더 추측적인 응용으로 제시된다.
4.2 Social and philosophical problems in mechanistic interpretability
이 분야는 목표, 정의, 성공 기준에 대한 합의가 부족하며, 리뷰는 실제로 선도 시스템을 더 안전하게 만드는 데 사용되는 해석 가능성 도구가 드물다고 지적한다. 따라서 공학적 주장을 하려면 대안적 접근법과 비교해야 한다. 한편 과학적 이해는 별도의 연구 목표로 유지할 수 있다.
- 해석 가능한 방법이 해석 가능성에서 오는 유용한 이점과 함께 비슷한 성능을 제공한다면, 해석 불가능한 베이스라인보다 반드시 높은 성능을 낼 필요는 없다.
- 공정성과 같은 개념의 해석은 개발 및 배포 맥락에 따라 달라진다.
- 선택적 공개, 금전적 이해충돌, 과장된 주장은 부분적 투명성을 잘못된 안도감으로 바꿀 수 있다. 리뷰는 블랙박스 문제가 해결되었다고 잘못 묘사한 로비 주장을 인용한다.
5 Conclusion
결론은 더 탄탄한 분해 기반, 더 견고한 인과적 검증, 메커니즘의 변화와 상호작용에 대한 설명을 우선 과제로 제시한다. 더 나은 벤치마크와 해석 가능성이 필요하지 않은 접근법과의 비교를 바탕으로, 과학적 이해와 실용적 응용을 함께 추구하라고 권장한다.
- 거버넌스와 안전 측면의 잠재적 이점은 기술적 문제를 해결하고 오용과 잘못된 확신을 피할 수 있는지에 달려 있다.
Author Contributions
Lee Sharkey는 프로젝트를 관리하고 기여자들을 조율했으며 기획, 집필, 편집, 관점 종합에 상당히 기여했다. Bilal Chughtai는 논의 틀 구성, 집필, 편집에 상당히 기여했고 모든 그림을 제작했다. 저자 기여 명세는 등재된 저자들이 초안 작성, 편집, 피드백에 기여했다고 명시한다.
- 저자들은 편집을 도운 Fayth Tan과 피드백 및 자금을 제공한 Schmidt Sciences에 감사를 표한다.
- 초록은 Apollo Research가 Schmidt Sciences를 대신해 저자들의 관점을 종합했으며, 본문이 각 저자나 소속 기관의 견해를 반드시 대표하는 것은 아니라고 밝힌다.
부록
- “A Summary of open questions”는 연구 의제를 종합한다. “A.1 Open problems in mechanistic interpretability methods and foundations”의 역공학 질문은 타당한 분해 단위, 선형 표현과 superposition, SDL 오차와 확장, 특징의 기하학, 일반화 이론과의 연결, 성능 손실을 제한하는 해석 가능한 모델 설계를 다룬다. 나머지 방법론 질문은 사람의 기대를 강요하지 않고 낯선 개념을 설명하는 방법, 인과적 효과를 효율적으로 측정하는 방법, 인과 경로와 보상 반응을 구분하는 방법을 묻는다. 또한 참조 신경망, 벤치마크, 여러 분포에 걸친 테스트로 연구자의 직관을 넘어 가설을 검증하는 방법을 다룬다. 개념 기반 probing, circuit discovery, 자동화는 데이터 생성, 일반화, 임의의 과제에 대한 적용 범위, 구성 요소 간 상호작용, 정렬되지 않은 시스템이 자동 해석을 방해할 가능성에 관한 질문을 제기한다. “A.2 Open problems in applications of mechanistic interpretability”는 신뢰할 수 있는 평가와 모니터를 구축하고, 적대적 테스트를 개선하며, steering과 editing을 정밀하게 수행하고, unlearning과 finetuning을 평가하는 방법을 묻는다. 예측 관련 질문은 낯선 입력, 형식 검증, 위험한 메커니즘의 부재, 능력 출현, 학습 데이터의 영향, prompting이나 finetuning으로 드러날 수 있는 능력을 다룬다. 추가 질문은 효율적인 연산, 과학적 발견, 아키텍처 간 전이, 사용하기 쉬운 인터페이스를 다룬다. “A.2.8 Governance”는 실패 메커니즘 식별, 사고 추적, 유해한 과정 탐지, 변경 사항이나 준수 여부 검증을 묻는다. “A.2.9 Open socio-technical problems in mechanistic interpretability”는 이 의제를 능력 평가와 예측, 사고 예방, graphics processing units(GPUs)에서 실행되는 작업 식별, 저작권, 분야의 정의와 성공 기준, 오용을 줄이는 소통으로 확장한다.
짧은 생각
리뷰는 내부 지표, 그럴듯한 구성 요소 설명, 검증된 연산 설명을 유용하게 구분한다. 보고된 재구성 대체 손실과 개입 선택에 따른 circuit 지표의 민감도는, 학습된 특징이나 부분 그래프를 메커니즘 설명으로 받아들이기 전에 예측 주장을 검증해야 할 근거가 된다. 공학적 활용에는 구체적인 기준이 따른다. 지정된 과제에서 관련 대안과 비교하고, 설명이 개입이나 실패를 예측하는지 검증해야 한다. 논문은 단일 실험 절차나 실증적으로 확립된 우선순위 대신 연구 의제를 제시한다. 제안된 응용마다 요구되는 근거가 다르며, 특히 위험한 행동이 없음을 입증하려는 경우에는 이러한 차이가 중요하다.