PaliGemma 2: A Family of Versatile VLMs for Transfer 요약 설명
04 Dec 2024 | Paper Review Vision-Language Models Multimodal Pretraining Supervised Fine-Tuning목차
- 요약
- 1. Introduction
- 2. Related work
- 3. Model
- 4.1. Investigating model size and resolution
- 4.2. Text detection and recognition
- 4.3. Table structure recognition
- 4.4. Molecular structure recognition
- 4.5. Optical music score recognition
- 4.6. Generating long, fine-grained captions
- 4.7. Spatial reasoning
- 4.8. Radiography report generation
- 4.9. CPU inference and quantization
- 5. Conclusion
- 부록
- 짧은 생각
이번 글에서는 PaliGemma 2: A Family of Versatile VLMs for Transfer 논문의 핵심 포인트만 간단히 정리한다.
- 2024년 12월 4일(Arxiv)
- Steiner, Andreas, Pinto, André Susano, Tschannen, Michael, Keysers, Daniel, Wang, Xiao, Bitton, Yonatan, Gritsenko, Alexey, Minderer, Matthias, Sherbondy, Anthony, Long, Shangbang, et al.
- Google DeepMind
- 논문 링크
요약
- 이미지를 처리해 텍스트를 생성하는 비전 언어 모델을 대상 작업에 맞게 추가 학습하려면, 미세 조정 과정에서 이미지의 세부 정보와 언어 모델의 용량에 각각 얼마만큼의 연산을 할당할지 결정해야 한다. 30개가 넘는 학술 벤치마크에서 PaliGemma 2는 모델 크기를 3B로, 해상도를 동일하게 맞춘 PaliGemma보다 평균 작업 점수가 224px²에서 0.65, 448px²에서 0.85 높았다. 더 큰 모델의 추가 향상 폭은 작업에 따라 달랐다. B는 매개변수 10억 개를 뜻한다.
- 이 모델 계열은 이미지를 수치 표현으로 변환하는 이미지 인코더 SigLIP-So400m과 Gemma 2 언어 모델을 결합해 3B, 10B, 28B 모델을 만들고 각각 세 가지 이미지 해상도를 제공한다. 통제된 비교에서 텍스트가 많은 작업은 해상도를 높였을 때 가장 큰 이득을 보는 경우가 많았고, 다국어 작업과 시각적 추론 작업은 언어 모델을 키웠을 때 더 큰 이득을 보는 경우가 많았다. 더 큰 모델은 대체로 더 작은 미세 조정 학습률에 유리했다.
- 논문에 제시된 각 평가 방식에서 작업별 미세 조정은 텍스트 인식, 표 추출, 분자 도식, 악보 전사, 상세 캡션 생성, 흉부 X선 보고서 작성의 보고 결과를 개선했다. 10B에서 28B로 키워도 향상 폭이 작은 경우가 많았다. 보고된 COCO와 DocLayNet 객체 탐지 전이 실험에서는 전문 탐지기보다 성능이 낮았다. 모델 저장에 쓰이는 정밀도를 낮추는 양자화 연구는 5개 작업을 대상으로 했고 작업마다 미세 조정을 한 번 수행했다.
1. Introduction
논문은 PaliGemma의 이미지 인코더와 3단계 학습 방식을 유지하면서 언어 모델 구성 요소인 Gemma를 Gemma 2로 바꾼다. 학습된 매개변수가 공개된 체크포인트는 이미지 캡션 생성, 이미지에 관한 질문에 답하는 시각 질의응답, 짧은 동영상 작업, 텍스트로 설명된 객체의 마스크를 예측하는 참조 분할 등 후속 작업의 미세 조정을 목적으로 한다.
2. Related work
관련 연구에서는 이미지와 텍스트를 각각 인코딩하던 표현 방식에서 사전 학습된 비전 인코더와 언어 모델을 결합하는 시스템으로의 발전을 살펴본다. 이 논문은 같은 미세 조정 방식을 적용한 상태에서 이미지 해상도와 언어 모델 크기를 함께 연구해, 서로 다른 모델 계열을 비교하기 어렵게 만드는 구조와 학습 방식의 차이를 줄인다.
3. Model
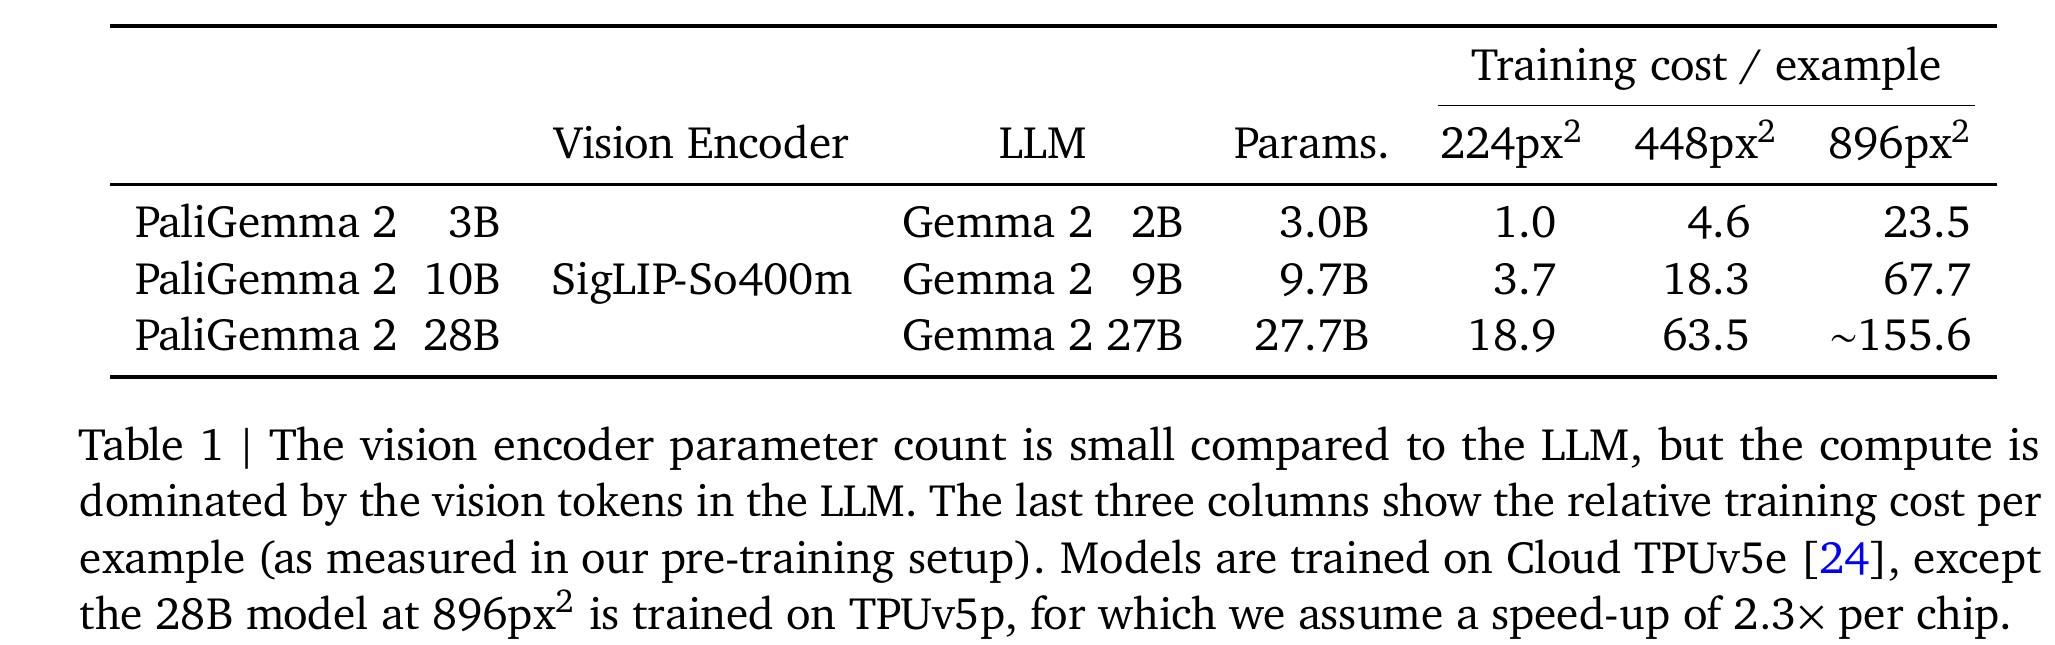
선형 투영은 SigLIP-So400m의 이미지 표현을 Gemma 2의 입력 공간으로 옮긴다. 모델은 앞선 시퀀스를 바탕으로 다음 시퀀스 단위인 답변 토큰을 예측하는 방식으로 답을 자기회귀적으로 생성한다. 패치 크기 14px²를 사용하면 224px², 448px², 896px² 이미지에서 각각 시각 토큰 256개, 1,024개, 4,096개가 나온다. 언어 모델 구성 요소의 크기 2B, 9B, 27B에 따른 전체 매개변수 수는 각각 3.0B, 9.7B, 27.7B다.
Stage 1에서는 224px²의 다중 모달 예제 10억 개로 모든 매개변수를 함께 학습한다. Stage 2에서는 448px² 예제 5,000만 개와 896px² 예제 1,000만 개로 학습을 이어 가며, 시각적 세부 정보가 필요한 작업의 비중을 높이고 더 긴 출력을 허용한다. Stage 3에서는 해당 체크포인트를 목표 작업에 맞게 미세 조정한다. 학습 데이터에는 캡션 생성, 텍스트 읽기, 시각 질의응답, 탐지, 분할이 포함되며, 다수의 레이블은 공개된 전문 모델로 생성했다. 학습에는 적응형 최적화 알고리즘인 Adam을 사용한다. Stages 1 and 2의 학습률은 3B에 10⁻⁵, 10B와 28B에 5 × 10⁻⁶을 적용한다. 어텐션과 출력 점수의 크기를 제한하는 로짓 소프트 캡핑은 일부 전이 결과를 해쳐 Stage 3에서 사용하지 않는다.
각 모델은 같은 이미지 인코더와 언어 모델 연결 방식을 유지한다. 해상도가 높아지면 시각 토큰 시퀀스가 길어지므로 인코더 구조가 같아도 언어 모델의 계산량이 늘어난다.
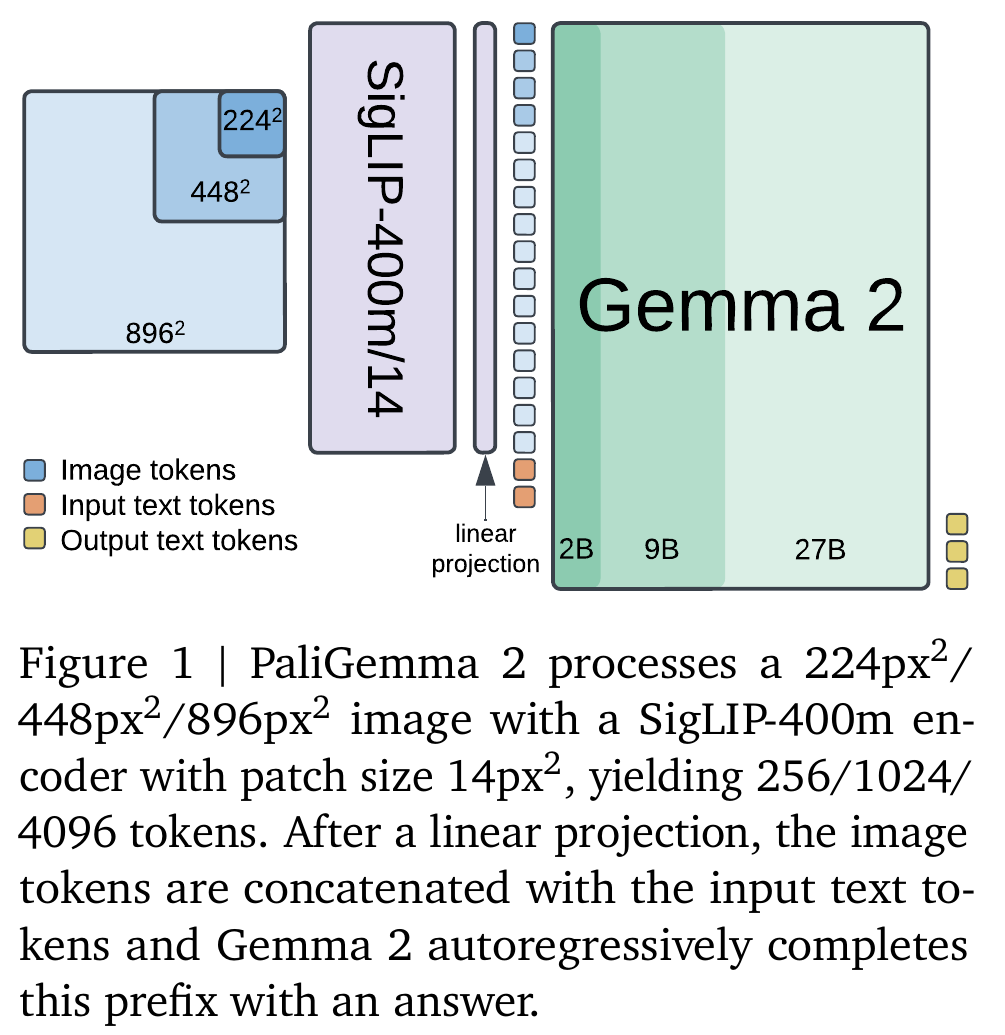
예제당 상대 학습 비용은 3B 모델에서 224px²의 1.0에서 448px²의 4.6, 896px²의 23.5로 증가한다. 28B, 896px²의 약 155.6에는 TPUv5p 칩당 속도가 2.3배 빠르다는 가정이 반영되어 있으므로 같은 하드웨어에서 직접 측정한 값은 아니다.
4.1. Investigating model size and resolution
실험은 기존 PaliGemma 벤치마크에 텍스트와 표 인식, 분자, 악보, 상세 캡션, 공간 추론, 방사선 영상 보고서 작업을 추가한다. 부록 A와 B에는 예제와 전이 세부 사항이 있다. 주요 스케일링 연구는 기존 30개가 넘는 벤치마크에서 작업 설정을 유지하고 3B, 10B, 28B 모델을 224px²와 448px²로 미세 조정하면서 학습률 {0.03, 0.06, 0.1, 0.3, 0.6, 1.0, 3.0} × 10⁻⁵을 탐색한다. 대부분의 작업은 224px²에서 학습률을 탐색해 검증 데이터로 작업과 모델 크기별 학습률을 선택하고, 두 해상도에 같은 값을 적용한다. 표 13은 미세 조정 5회 실행의 평균과 표준편차를 보고한다.
4.1.1. Effect on task performance
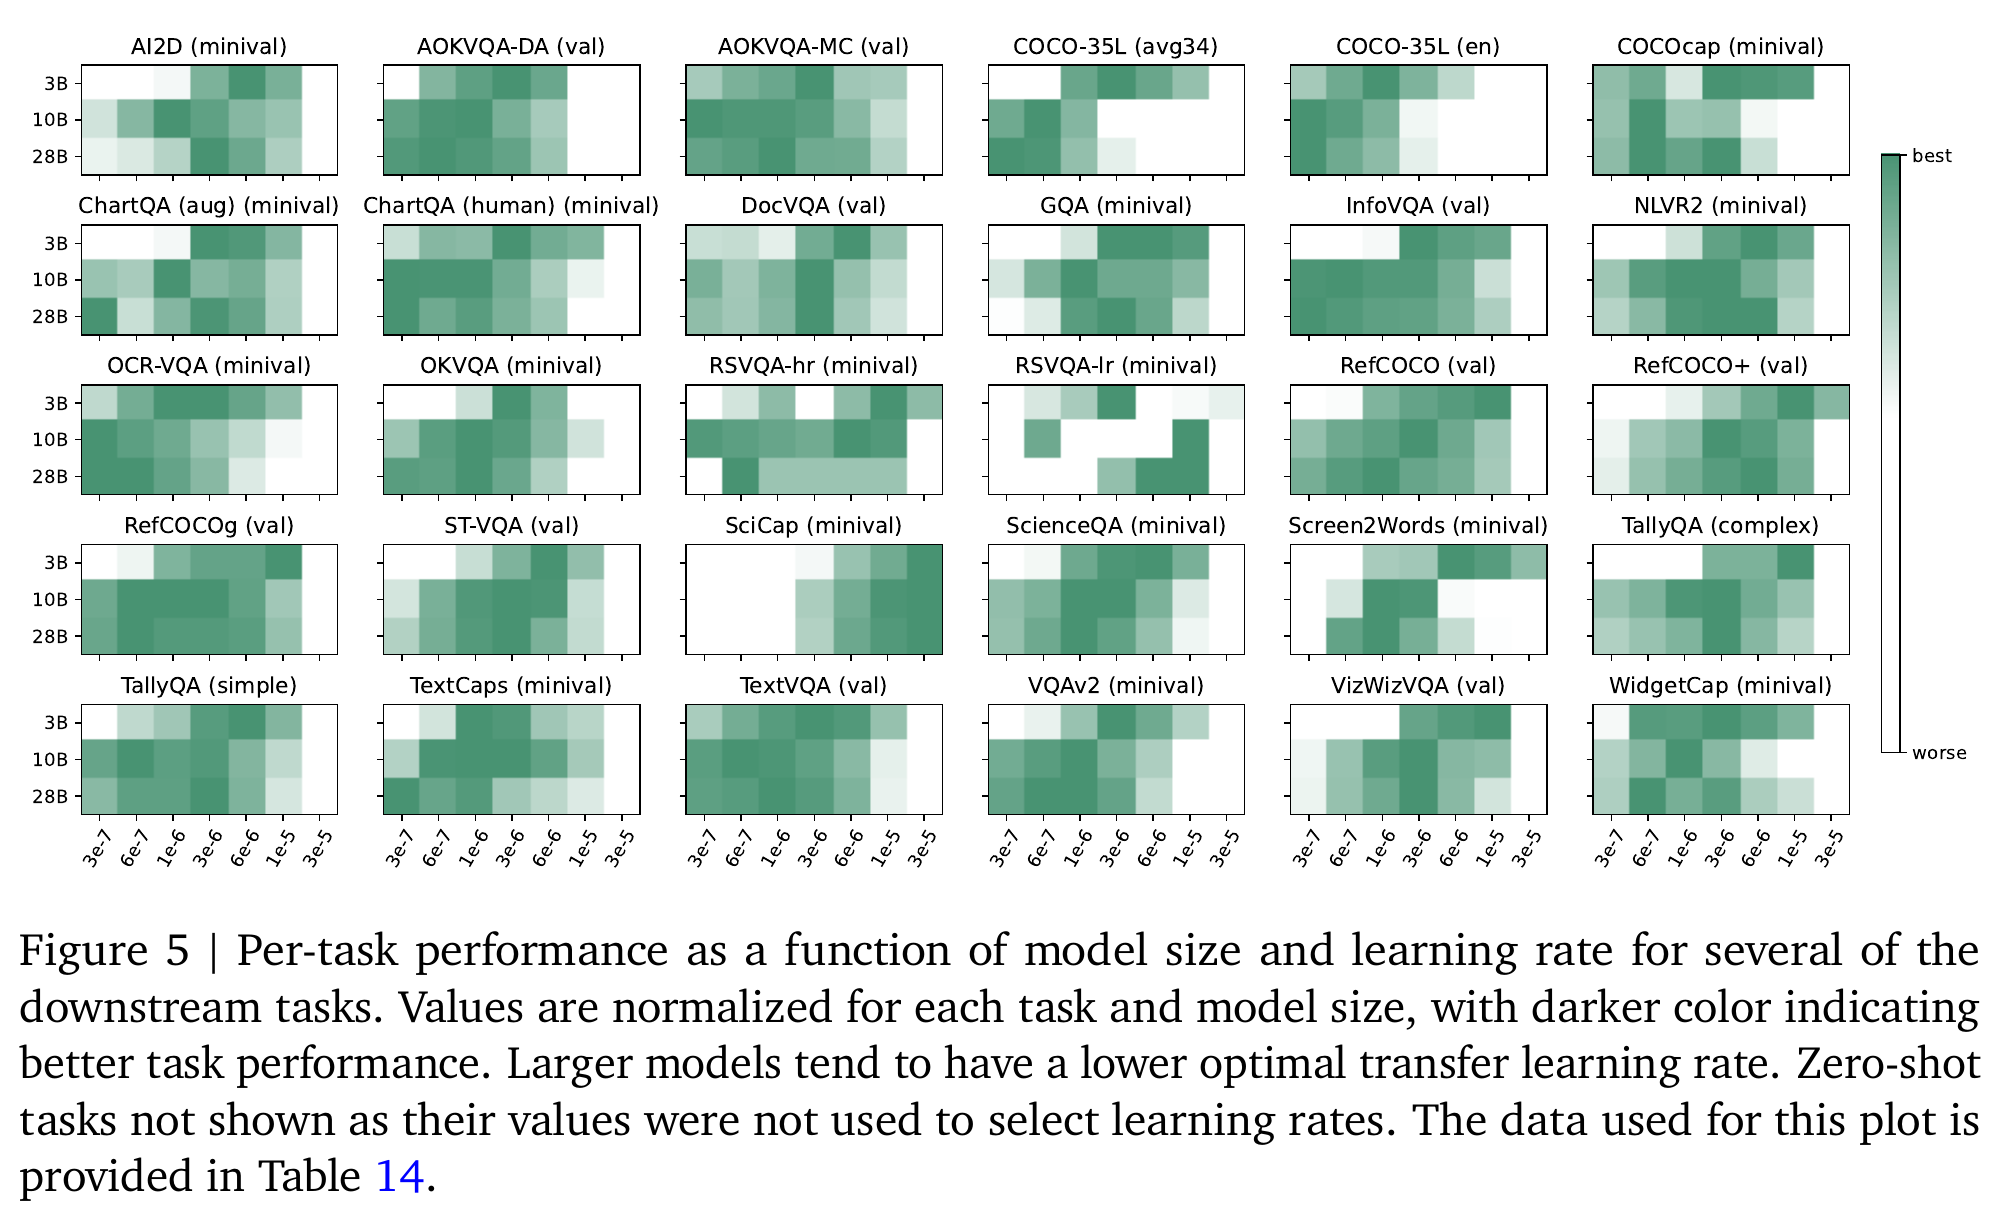
224px²의 3B 모델을 기준으로 모델을 10B로 키우면 부동소수점 연산이 3.7배, 해상도를 448px²로 높이면 4.6배 필요하다. 텍스트, 문서, 화면, 차트 작업은 대체로 높은 해상도에 유리하고, 다국어 캡션 생성과 일부 추론 작업은 더 큰 언어 모델에 유리하다. 28B로 더 키워도 향상이 작거나 정체되거나 성능이 떨어지는 경우가 많다. 저자들은 작은 Gemma 2 모델이 큰 모델의 예측을 이용해 학습하는 증류를 거친 점이 별도로 학습한 27B 모델과의 전이 성능 차이를 설명할 수 있다고 제안하지만, 이 설명을 검증하지는 않았다.
산점도는 더 높은 해상도가 유리한 작업과 더 큰 언어 모델이 유리한 작업을 구분한다. 비교에 쓰인 계산량 증가는 각각 4.6배와 3.7배로 비슷하지만 같지 않으므로 정확히 같은 계산량에서의 성능 향상 비교는 아니다.
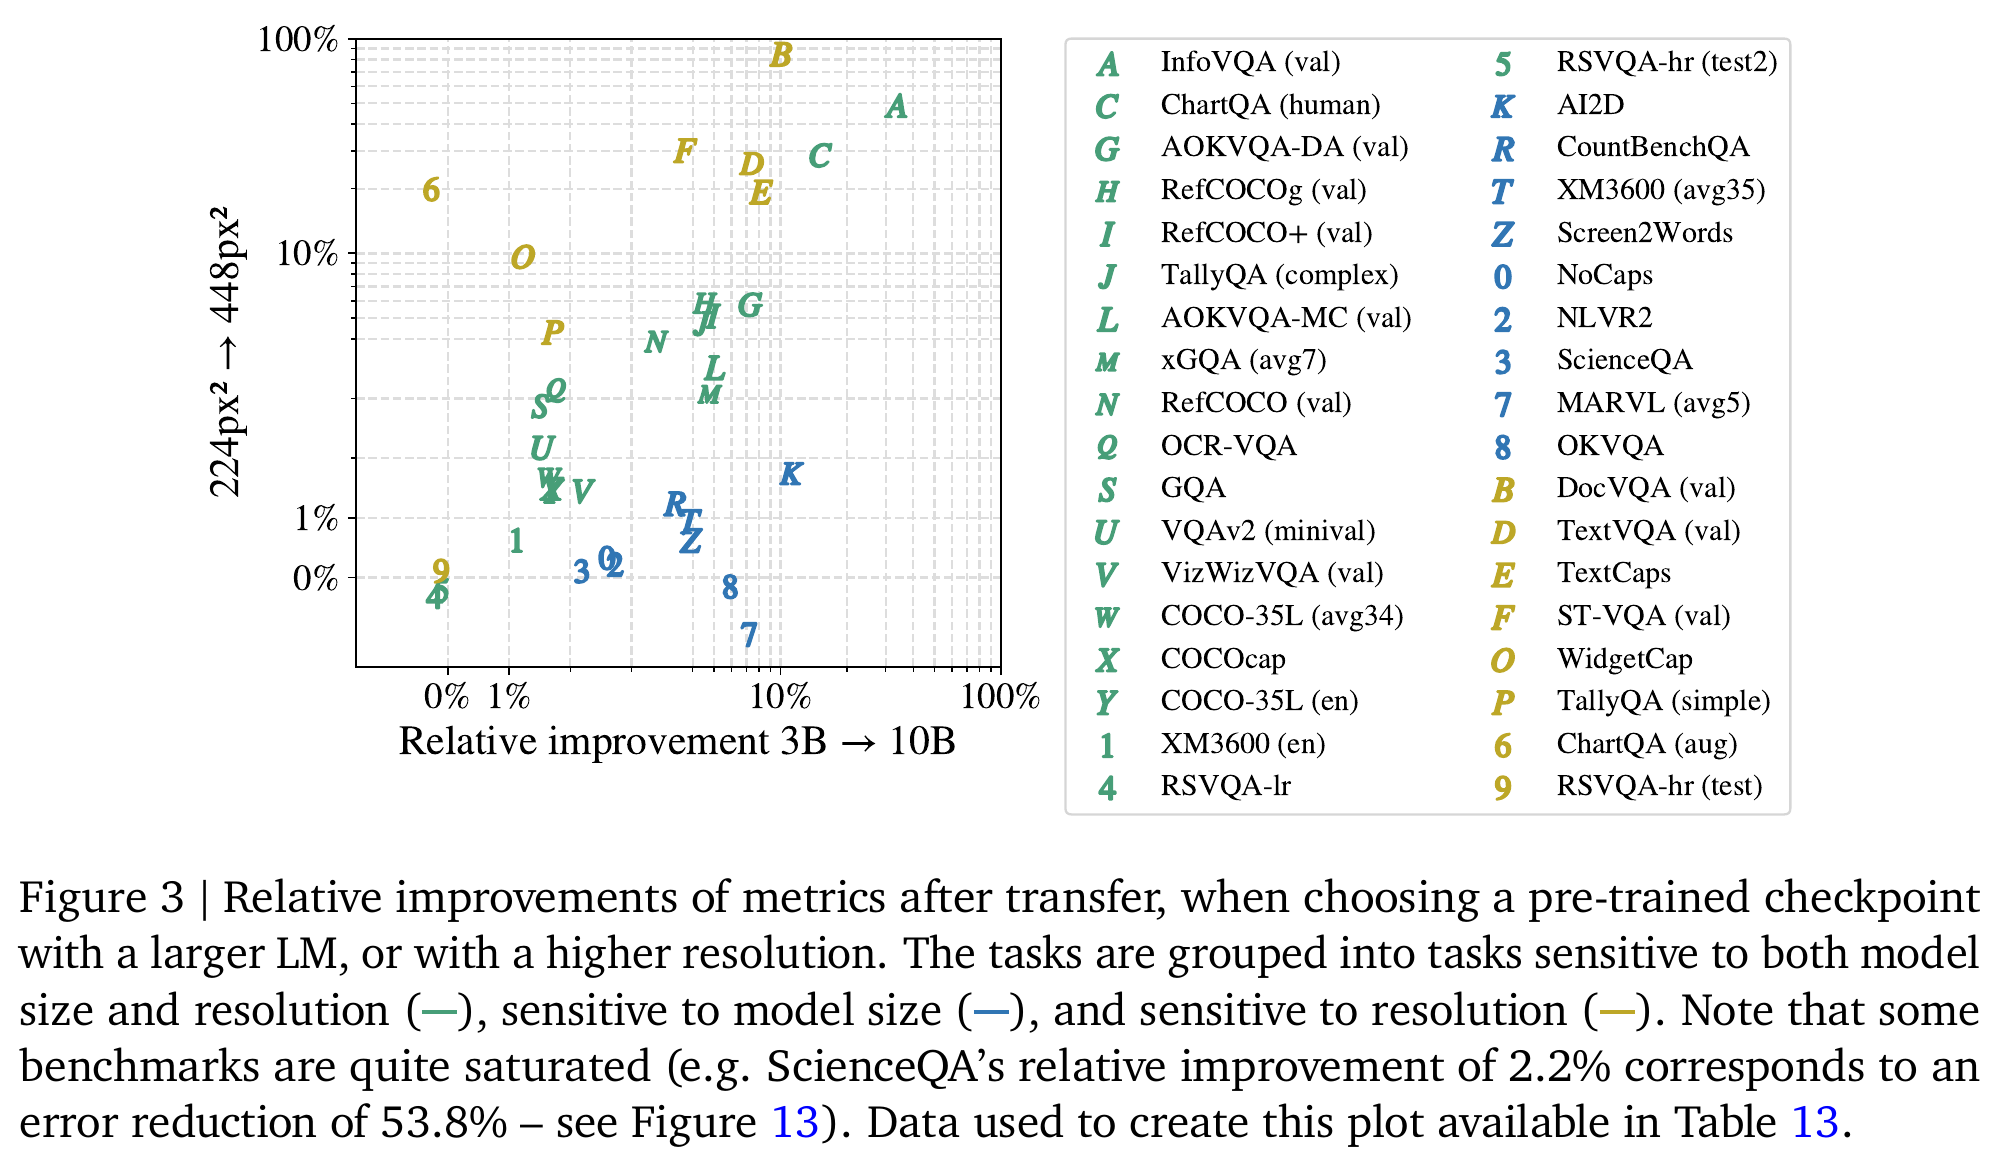
작업별 곡선에는 정체와 성능 하락이 나타난다. 텍스트로 지정한 객체를 찾는 여러 참조 표현 작업은 10B에서 최고점을 보이는 반면, 과학 그림 설명 벤치마크 SciCap의 성능은 모델이 커질수록 감소한다. 해상도가 높아지면 여러 문서 및 텍스트 작업의 성능이 모델 크기 전반에서 크게 오른다. 원문 캡션은 5회 실행의 중앙값과 표준편차 음영을 명시한다.
4.1.2. Model size and transfer learning rate
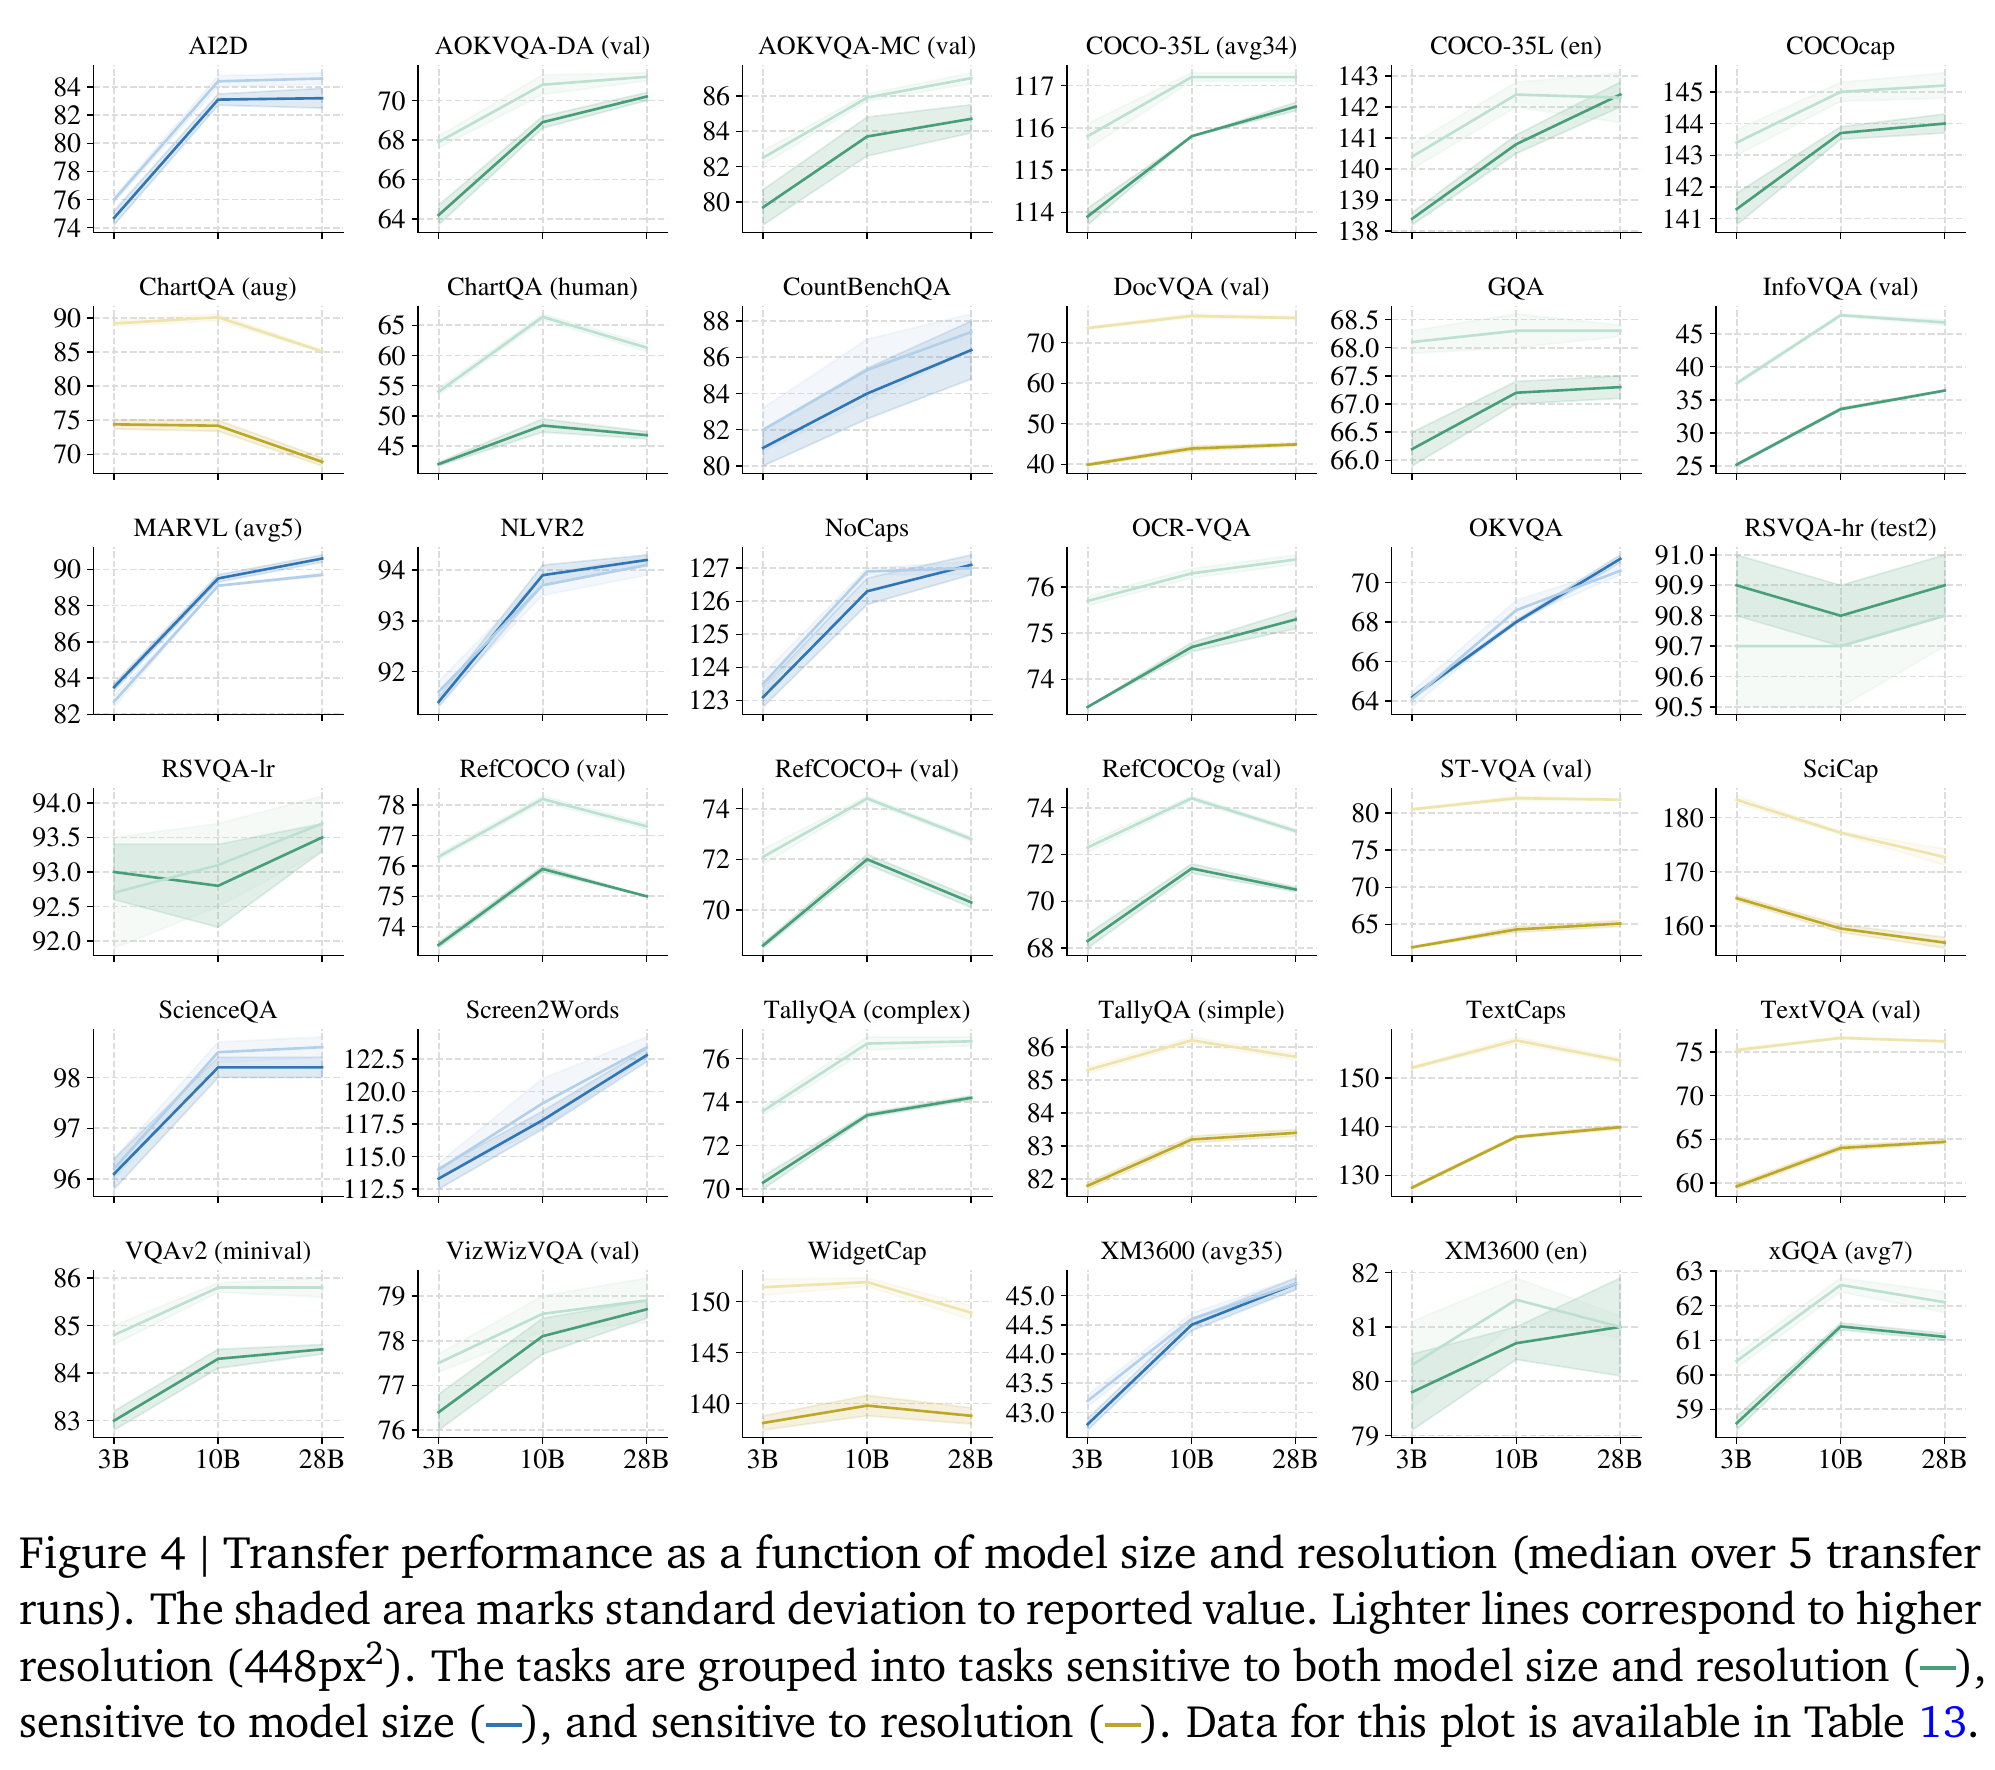
학습률 탐색 결과는 모델 크기가 커질수록 최적 학습률이 대체로 작아지는 경향을 보여 주며, 모델을 확장할 때 더 작은 학습률을 탐색하라는 권고를 뒷받침한다. 경향은 작업별로 다르며 PaliGemma 2 3B도 원래 PaliGemma보다 대체로 작은 학습률을 선호한다.
모델이 커질수록 진한 셀이 더 작은 학습률 쪽으로 이동하는 경우가 많아, 규모를 늘릴 때 학습률을 다시 조정할 근거가 된다. 값은 작업과 모델 크기별로 정규화되어 있으므로 색의 진하기로 모델 크기 간 절대 성능을 비교할 수 없다.
4.1.3. Using Gemma 2 instead of Gemma 1
모델 크기를 3B로, 이미지 해상도를 동일하게 맞춘 비교에서 Gemma를 Gemma 2로 교체하면 평균 벤치마크 점수가 224px²에서 0.65, 448px²에서 0.85 높아진다. 표 15에는 성능 하락 사례도 기록되어 있으며, 모바일 화면 설명 벤치마크 Screen2Words에서는 각각 4.3과 5.6만큼 감소했다.
4.2. Text detection and recognition
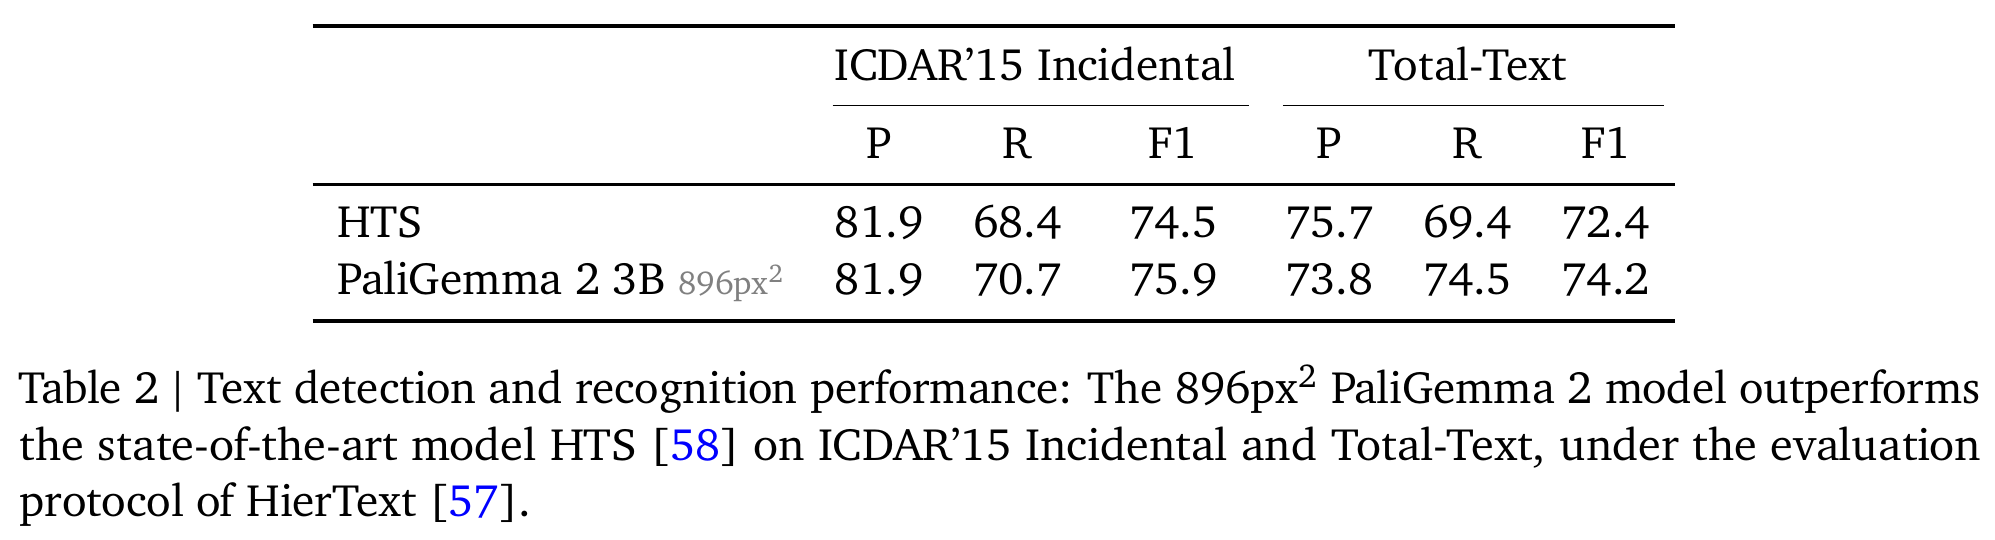
광학 문자 인식(OCR)에서 모델은 일곱 텍스트 인식 데이터셋을 섞어 학습한 뒤 단어 전사와 바운딩 박스를 함께 출력한다. HierText 평가 방식에서는 예측 전사가 정답과 정확히 일치하고 박스의 교집합 면적을 합집합 면적으로 나눈 값이 0.5 이상이어야 한다. 대소문자와 구두점은 정규화하지 않으며 단어 길이에 따른 필터링도 하지 않는다. 896px²의 PaliGemma 2 3B는 정밀도와 재현율의 조화평균인 F1에서 ICDAR’15 Incidental 75.9, Total-Text 74.2를 기록했고, Hierarchical Text Spotter(HTS)는 각각 74.5와 72.4를 기록했다. 해상도를 낮추면 품질이 크게 떨어지는 반면, 모델을 키워도 품질이 개선되지 않았다.
모델의 F1은 두 벤치마크에서 모두 향상되지만 Total-Text의 정밀도는 75.7에서 73.8로 낮아지고 재현율은 69.4에서 74.5로 높아진다. 따라서 F1 향상에는 더 많은 단어를 올바르게 인식하는 것과 예측 중 정답의 비율 사이의 상충관계가 따른다.
4.3. Table structure recognition
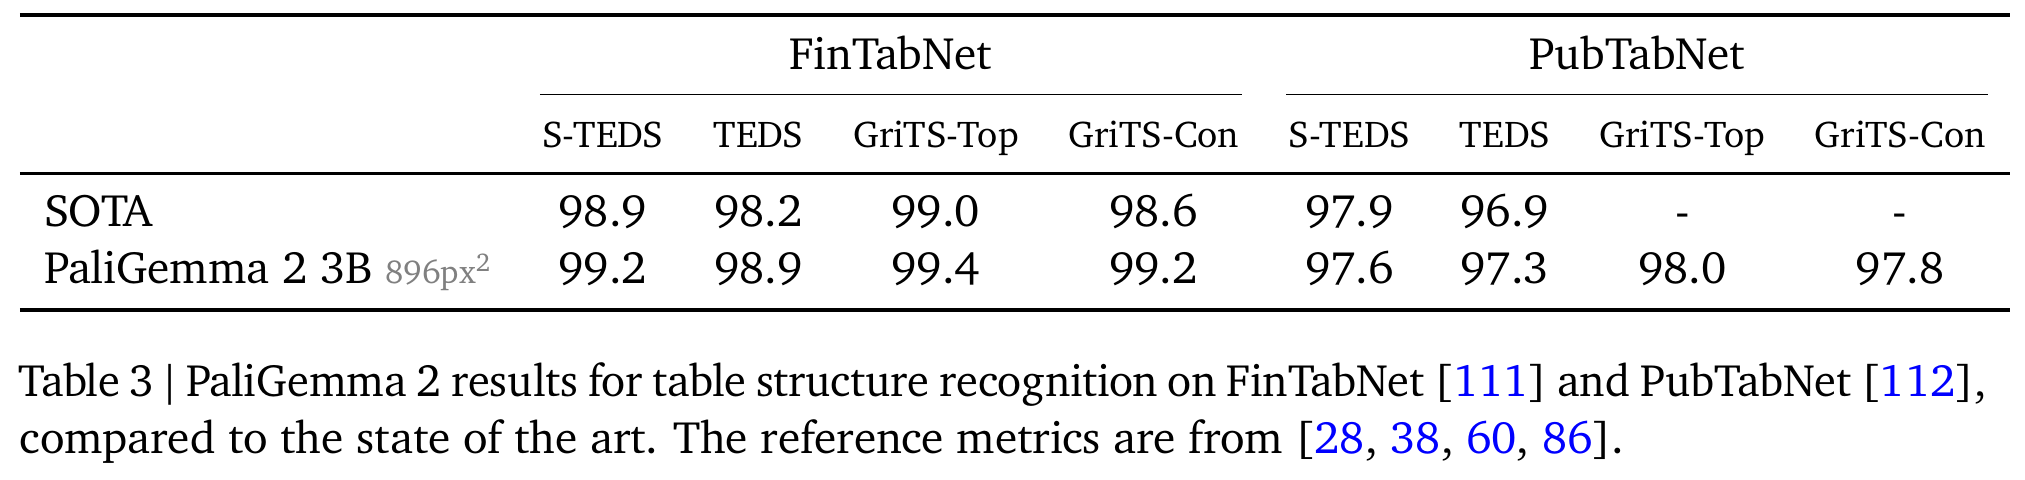
표 구조 인식은 이미지 516k개로 구성된 PubTabNet과 표 113k개로 구성된 FinTabNet의 학습 분할을 사용해 표 텍스트, 셀 좌표, 표 구조를 인코딩하는 마크업인 HTML을 생성한다. 평가는 표 표현을 비교하는 Tree Edit Distance Similarity(TEDS)와 셀 구조 및 내용을 평가하는 Grid Table Similarity(GriTS)를 사용한다. 이전 최고 성능과 비교해 896px²의 3B 모델은 FinTabNet TEDS를 98.2에서 98.9로, PubTabNet TEDS를 96.9에서 97.3으로 높였지만, PubTabNet의 구조 전용 TEDS는 97.9에서 97.6으로 낮아졌다. 더 큰 모델의 추가 이득은 보고되지 않았고, 해상도를 낮추면 품질이 소폭 떨어졌다.
FinTabNet에서는 표시된 네 지표가 모두 향상된다. PubTabNet에서는 전체 TEDS가 향상되지만 구조만 평가한 TEDS는 하락한다. 기존 PubTabNet GriTS 값이 없어 해당 열에서는 직접 비교할 수 없다.
4.4. Molecular structure recognition
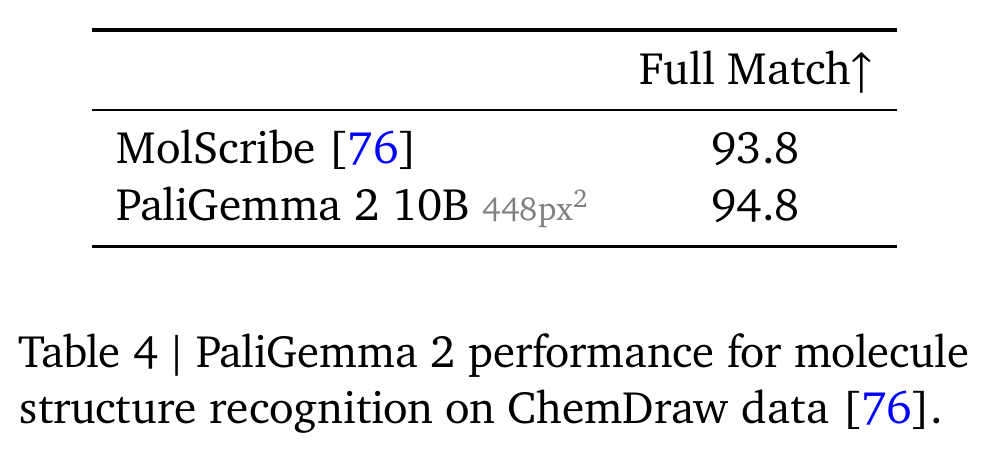
분자 구조 인식은 그림을 분자 그래프의 텍스트 표현인 SMILES 문자열로 변환한다. 학습에는 Indigo 화학 도구로 다양한 스타일로 렌더링한 PubChem 분자 100만 개를 사용했고, 평가는 분자 인식 비교 모델인 MolScribe와 동일한 합성 ChemDraw 이미지 5.7k개를 사용했다. 448px²의 PaliGemma 2 10B는 완전 일치율 94.8%를 기록해 MolScribe의 93.8%를 앞섰으며, 해상도를 더 높여도 추가 이득은 없었다.
448px²의 10B 모델은 공통 ChemDraw 평가에서 MolScribe보다 분자 구조 정확 일치율이 1.0%포인트 높다. 이 결과는 합성 렌더링된 도면에 관한 것이다.
4.5. Optical music score recognition
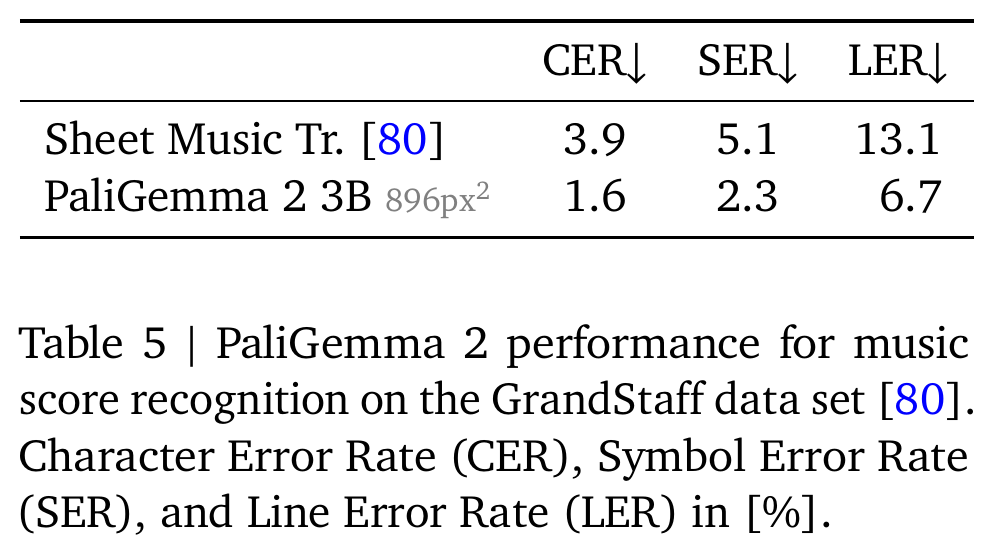
광학 악보 인식은 한 줄로 된 피아노 악보 이미지를 음높이, 길이, 아티큘레이션, 마디선을 인코딩하는 **kern 표현으로 바꾼다. 공식 분할을 사용하는 GrandStaff 이미지 53.7k개 중 학습에는 원본과 합성 증강 이미지를 쓰고 평가에는 왜곡되지 않은 원본을 쓴다. 896px²의 3B 모델은 각각 문자, 기호, 행 단위 편집 거리로 계산한 오류율을 Sheet Music Transformer의 3.9%, 5.1%, 13.1%에서 1.6%, 2.3%, 6.7%로 낮췄다. 10B로 키워도 오류율은 더 낮아지지 않았다.
896px²의 3B 모델에서는 악보 전사 오류 지표 세 가지가 모두 감소한다. 행 단위 편집 오류율 6.7%는 문자 단위 오류율 1.6%보다 높으며, 두 값은 서로 다른 단위의 편집 거리이지 완전히 잘못된 예제의 비율이 아니다.
4.6. Generating long, fine-grained captions
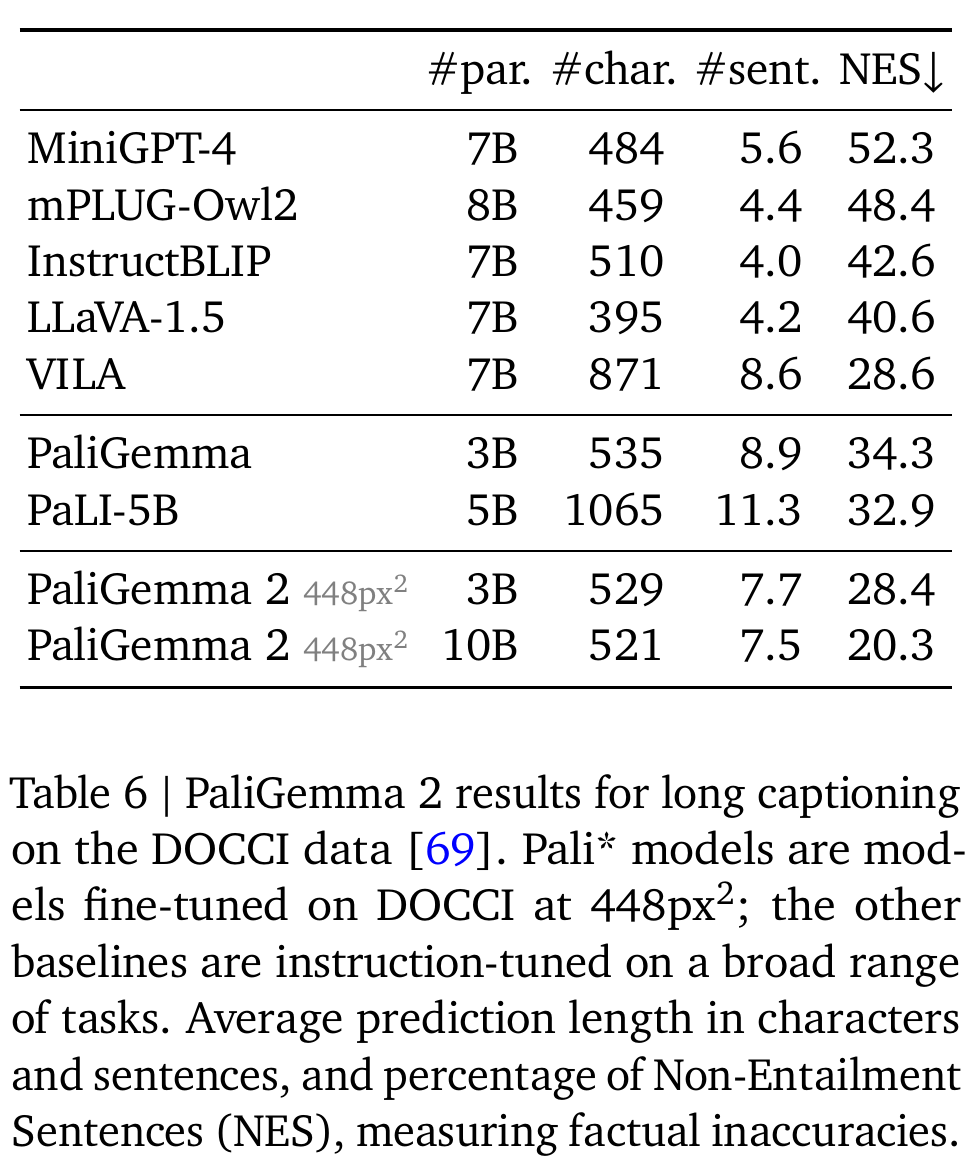
상세 캡션 생성은 사람이 작성한 영어 설명이 평균 7.1문장씩 붙은 이미지 15k개로 구성된 DOCCI(Descriptions of Connected and Contrasting Images)를 사용한다. 448px²에서 10B 모델이 생성한 문장 중 중립 또는 모순으로 평가된 비함의 문장 비율은 20.3%였으며, PaliGemma는 34.3%, PaliGemma 2 3B는 28.4%였다. 이 절차는 모델의 참조 텍스트 예측 능력을 나타내는 테스트 분할 퍼플렉서티로 초기 체크포인트를 고르고, 이미지 100개로 구성된 qual_dev 분할에서 최대 디코딩 길이 192로 사실성을 평가한다. 이후 선택된 설정을 train과 test를 합쳐 재학습하고 qual_dev에서 다시 평가하므로, 최종 사실성 평가에는 모델 선택에 사용한 이미지가 재사용된다.
10B 모델의 비함의율 20.3%에 대응하는 평균 길이는 521자, 7.5문장이다. PaliGemma는 535자, 8.9문장, 비함의율 34.3%다. Pali 계열이 아닌 기준 모델은 여러 작업에 걸친 지시문 조정을 사용하므로 DOCCI 미세 조정 모델과의 비교에서 아키텍처 효과만 분리할 수는 없다.
4.7. Spatial reasoning
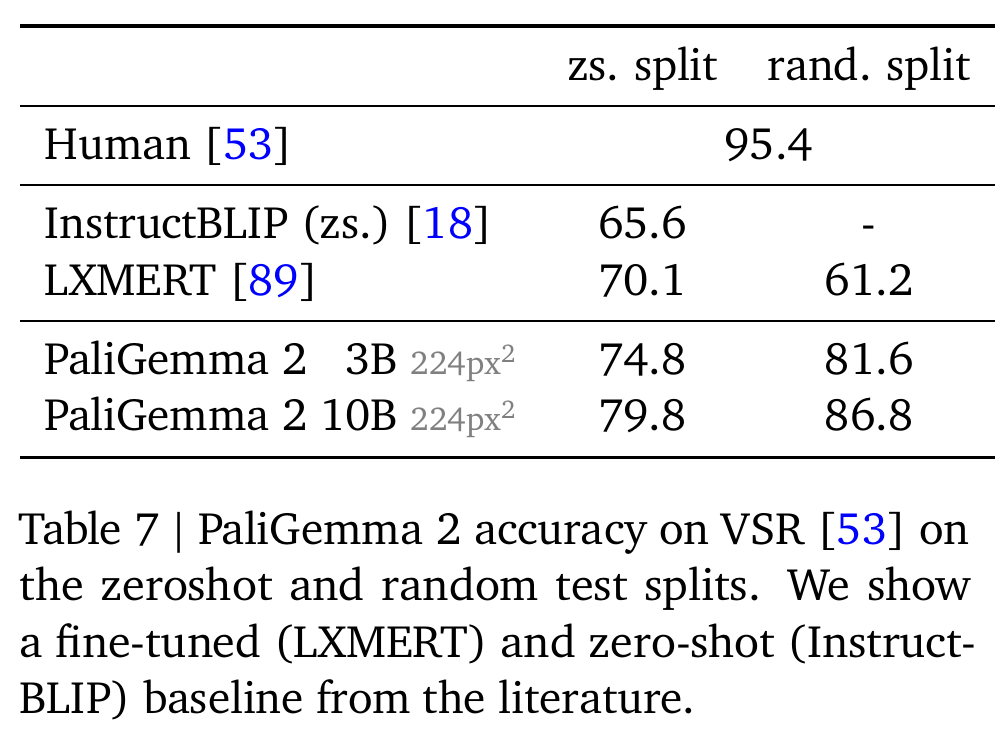
Visual Spatial Reasoning(VSR)은 객체 사이의 관계에 관한 문장이 참인지 거짓인지 평가하며, 일부 위치 파악 벤치마크가 놓치는 부정 표현 등의 실패 사례를 다룬다. 224px²에서 미세 조정한 PaliGemma 2 10B의 정확도는 zero-shot 테스트 분할에서 79.8%, random 테스트 분할에서 86.8%였고, 미세 조정한 교차 모달 인코더 비교 모델 LXMERT는 각각 70.1%와 61.2%였다. 여기서 “zero-shot”은 벤치마크 분할의 이름이며 PaliGemma 2를 미세 조정하지 않고 평가했다는 뜻은 아니다. 모델을 키우면 도움이 되지만 해상도를 224px²보다 높여도 도움이 되지 않았다.
3B에서 10B로 확장하면 VSR 두 분할 모두에서 정확도가 향상되지만 무작위 분할의 86.8%는 보고된 사람의 정확도 95.4%보다 낮다. 표는 작업별 미세 조정 없이 평가한 InstructBLIP과 미세 조정한 시스템들을 구별한다.
4.8. Radiography report generation
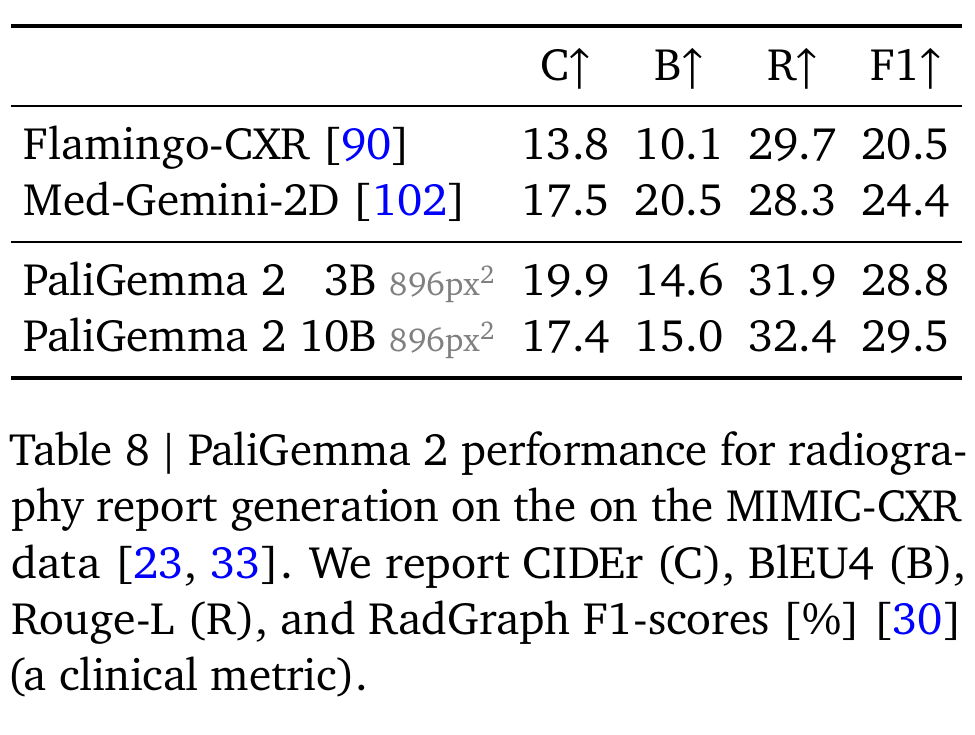
흉부 X선 보고서 생성에는 방사선 검사 228k건의 이미지 377k개가 포함된 MIMIC-CXR을 사용하며, 기존 보고서 생성 시스템 Flamingo-CXR과 같은 데이터 분할을 쓴다. Gemini 1.5 pro는 보고서에서 이용할 수 없는 이전 X선 영상에 관한 언급을 제거한다. 학습과 튜닝에 사용하지 않은 테스트 데이터의 평가에는 생성 보고서와 참조 보고서에서 추출한 임상 개체 및 관계의 일치도를 측정하는 RadGraph F1이 포함된다. 896px²에서 10B 모델의 RadGraph F1은 29.5%로, Med-Gemini-2D의 24.4%와 Flamingo-CXR의 20.5%를 앞섰다. 다만 참조 텍스트와 네 단어 연속열의 중복을 측정하는 BLEU4 점수는 Med-Gemini-2D가 더 높았다.
PaliGemma 2 10B는 열거된 시스템 중 RadGraph F1과 최장 공통 부분수열 기반 참조 중첩 지표 Rouge-L에서 앞선다. 3B 모델은 가중된 단어 시퀀스 중첩 기반 캡션 합의 지표 CIDEr가 가장 높고, Med-Gemini-2D는 BLEU4가 가장 높아 모든 지표에서 앞서는 시스템은 없다.
4.9. CPU inference and quantization
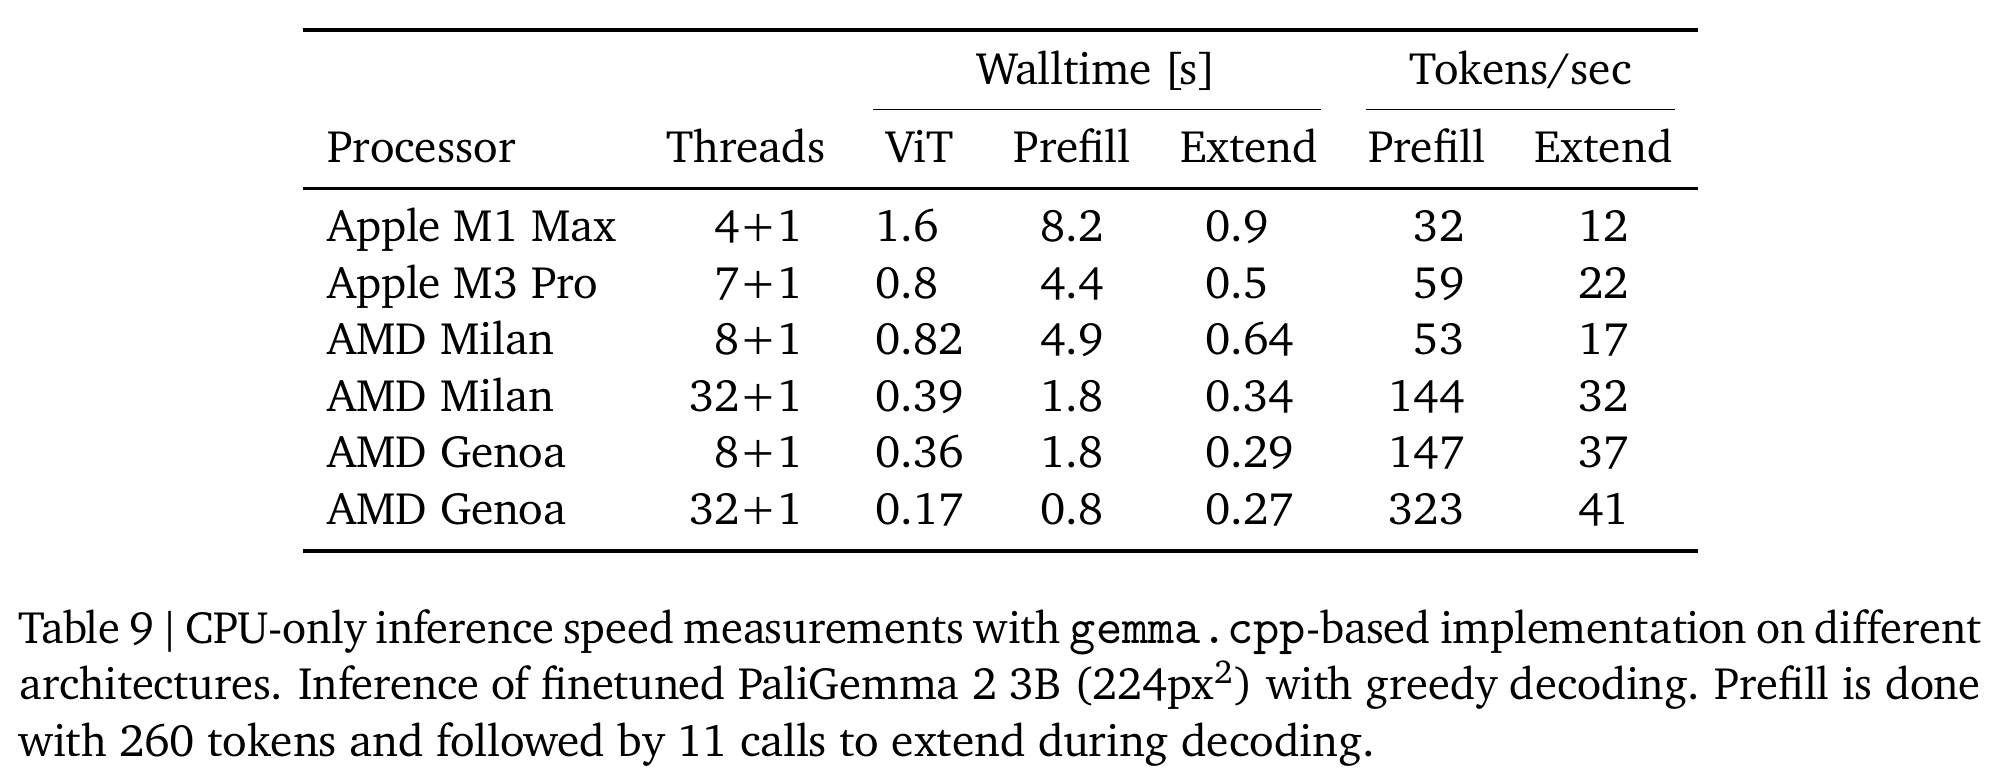
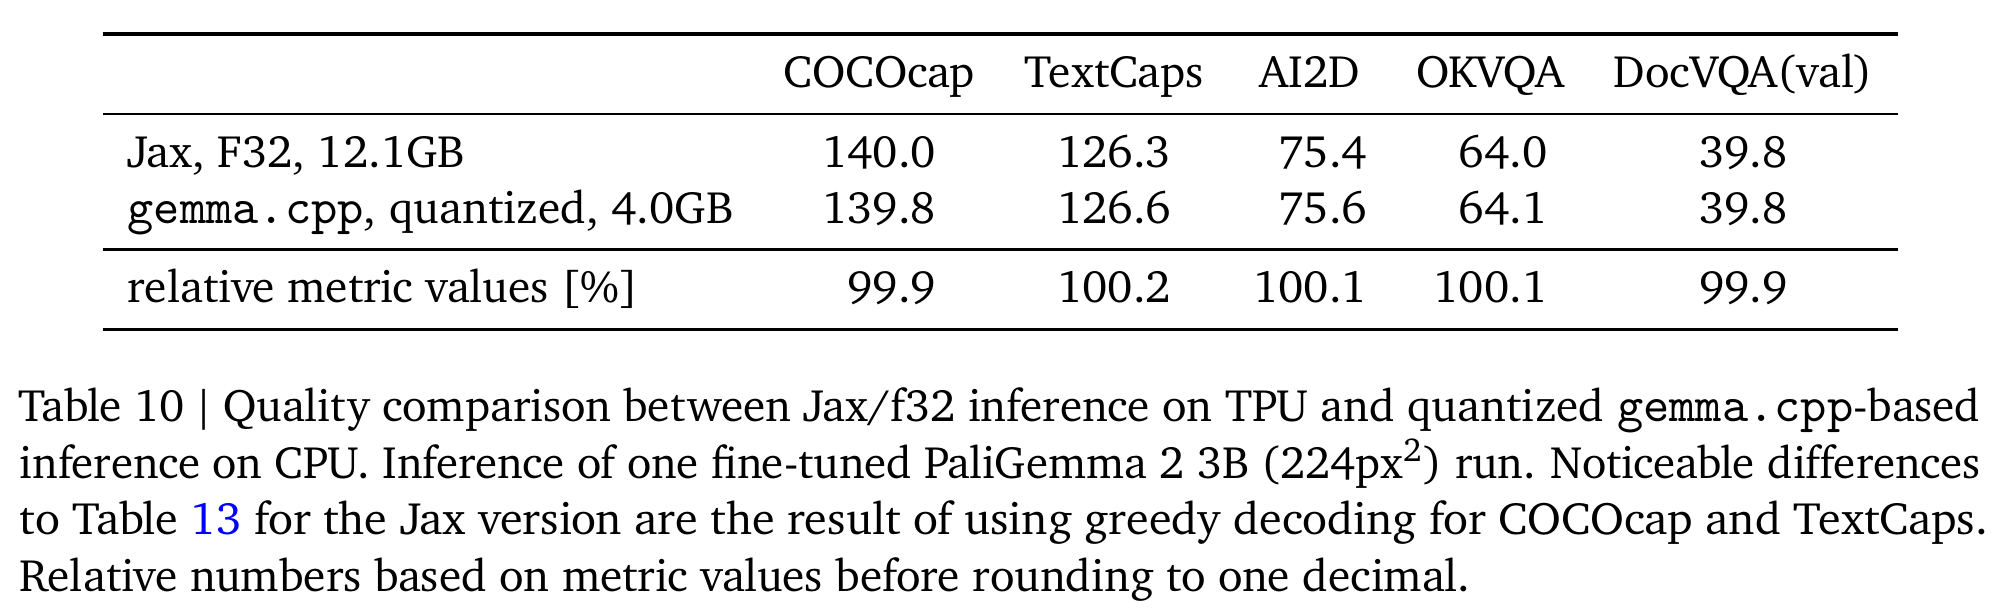
중앙처리장치(CPU) 추론에는 8비트 switched-floating-point 양자화를 지원하는 이식 가능한 C++ 추론 엔진 gemma.cpp를 사용한다. 속도 실험은 224px²의 3B COCOcap 이미지 캡션 체크포인트, 배치 크기 1, 이미지와 텍스트로 구성된 260토큰 접두부의 초기 처리(prefill), 11토큰 출력을 사용한다. 생성 속도는 Apple M1 Max의 초당 12토큰부터 32+1 스레드를 쓰는 AMD Genoa의 초당 41토큰까지였다. 5개 작업에서 양자화는 모델 저장 크기를 12.1GB에서 4.0GB로 줄이고 원래 평가 지표 값의 99.9–100.2%를 유지했다. 이 결과는 작업당 한 번의 미세 조정 실행을 바탕으로 한다.
Apple M3 Pro에서 시각 인코딩은 0.8초, 프리필은 4.4초, 11개 토큰 생성은 0.5초가 걸린다. 따라서 이 예제에서 생성 처리량만으로는 측정된 응답 시간의 대부분을 설명할 수 없다.
양자화 구현은 선택된 5개 작업에서 32비트 부동소수점 점수와 가깝게 일치하면서 모델 저장 공간은 12.1GB에서 4.0GB로 줄인다. 작업당 미세 조정 체크포인트 하나를 사용한 비교이므로 학습 반복 간 변동은 측정하지 않는다.
5. Conclusion
논문은 이 공개 가중치 모델 계열이 캡션 생성, 질의응답, 동영상, 악보, 분자, 의료 영상 작업에 전이된다고 결론짓는다. 추가 연산이 허용될 때 더 큰 모델은 PaliGemma보다 많은 결과를 개선하지만, 향상 폭은 작업, 모델 크기, 해상도에 따라 다르다.
부록
- 부록 A의 Tasks는 텍스트와 표 인식, 분자 그림, 악보 전사, 상세 캡션, 방사선 영상 보고서의 입력과 출력 형식을 보여 준다. 캡션 예제에는 비함의로 판정된 문장이 강조되어 있다.
- 부록 B의 Transfer and evaluation details는 작업별 전이 절차를 설명한다. 표 전처리는 이미지를 패딩하고 크기를 조정하며, 비어 있지 않은 셀의 박스를 위치 토큰으로 인코딩한다. 유효하지 않은 표 구조와 셀 바운딩 박스의 겹침을 이유로 학습 예제를 건너뛰고 FinTabNet 주석을 수정하지만, 보고된 테스트 분할은 필터링하지 않는다. DOCCI에서는 평가자 5명이 문장마다 함의, 중립, 모순, 평가할 내용 없음 중 하나로 분류하고 다수결로 레이블을 정한다. 중립과 모순을 합친 비함의 비율을 모델 선택에 사용한다. 논문이 보고한 전체 이진 일치도 0.8407은 모든 평가자가 함의 범주에 동의한 비율로 설명되어 있다. 부록에는 텍스트, 분자, 악보, 공간 추론, 방사선 영상 작업의 학습과 디코딩 설정도 명시되어 있다. DOCCI의 전이 절차와 하이퍼파라미터는 선행 연구를 따른다.
- 텍스트 인식에서는 TPU-v5e 칩 256개로 배치 크기 256, 최대 시퀀스 길이 2,048, 레이블 스무딩 0.1을 사용해 15,000스텝 미세 조정한다. 저자들은 최적 학습률 10⁻⁵과 896px²에서 가장 좋은 결과를 보고한다. 표 구조 인식은 같은 전이 설정을 사용하되 최대 출력 길이는 4,096이고 레이블 스무딩을 사용하지 않으며, 최적 학습률은 10⁻⁴이다.
- 분자 구조 인식에서는 배치 크기 256, 학습률 10⁻⁴, 레이블 스무딩 0.1로 30,000스텝 미세 조정한다. 이미지는 정사각형이 되도록 패딩한 뒤 크기를 조정한다. 광학 악보 인식은 같은 설정을 따르되 최대 출력 길이를 256 대신 1,024로 사용한다.
- 공간 추론 미세 조정에서는 배치 크기 1,024와 최대 출력 길이 18을 사용하면서 학습률, 가중치 감쇠, 드롭아웃, 에폭 수를 탐색한다. 방사선 영상에서는 검사 지시 사항을 접두부로 입력하고 소견과 판독 결과를 예측한다. 448px²에서 선택한 시작 설정은 8 epochs, 학습률 5 × 10⁻⁶, 그리디 디코딩이며 레이블 스무딩, 드롭아웃, 가중치 감쇠를 사용하지 않는다. 더 높은 해상도와 더 큰 모델에서 학습률을 다시 탐색한다.
- 부록 C의 객체 탐지는 노이즈 박스를 이용한 시퀀스 증강과 클래스 토큰의 우도를 활용한 신뢰도 점수를 사용하고, COCO와 DocLayNet 전이 모델을 각각 50 epochs 학습한다. 보고된 전이 성능은 전문 탐지기보다 낮으며, 탐지 평가 지표와 언어 모델 학습 목표의 불일치가 원인일 수 있다는 설명은 가설로 남아 있다.
- 부록 D의 Ethics and Safety는 아동 안전, 콘텐츠 안전, 대표성 관련 위해 평가를 보고하며 FairFace 이미지의 캡션에 대한 Perspective API 점수도 포함한다. 표 12는 하위 집단의 최댓값과 중앙값을 백분율로 보고하며, 기재된 하위 집단 최댓값 중 가장 큰 값은 Threat의 0.83%다. 본문은 임계값을 > 0.8로, 표 설명은 ≥ 0.8로 표기한다.
- 부록 E의 Detailed results는 상대 점수와 오류 감소율 관점의 결과, 반복 실행 벤치마크 통계, 학습률 탐색, 크기를 맞춘 3B 비교를 제공한다. 표 13은 5회 실행한 평균과 표준편차를 보고한다. 그림 4는 중앙값을, 표 13은 평균을 설명하므로 집계 방식에 관한 기술이 서로 일치하지 않는다.
짧은 생각
언어 모델 용량과 시각 해상도를 통제해 비교한 결과는 체크포인트 선택에 유용하다. 문서 인식은 세부 정보를 유지할 때 이득을 보고, 몇몇 추론 작업은 언어 모델을 키울 때 더 큰 이득을 본다. 검증 데이터 기반 학습률 선택과 반복 벤치마크 실행은 이런 비교를 뒷받침한다. 다만 대부분의 작업에서 224px²에서만 학습률을 선택했으므로, 해당 작업의 448px²에서 다른 학습률이 더 나을지는 검증되지 않았다.
전이 결과는 작업별로 다르게 해석해야 한다. 분자 평가는 합성 그림을 사용하고, 캡션 생성은 모델 선택과 최종 평가에 qual_dev를 재사용하며, 의료 지표는 실제 임상 적용을 시험하지 않고 보고서의 일치도를 측정한다. 객체 탐지의 낮은 성능과 5개 작업의 양자화 연구를 고려하면 체크포인트 선택 시 작업별 검증도 필요하다.