


Phi-4-Mini-Reasoning: Exploring the Limits of Small Reasoning Language Models in Math 요약 설명
30 Apr 2025 | Paper Review Mathematical Reasoning Knowledge Distillation Direct Preference Optimization Reinforcement Learning With Verifiable Rewards목차
이번 글에서는 Phi-4-Mini-Reasoning: Exploring the Limits of Small Reasoning Language Models in Math 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 4월 30일(Arxiv)
- Xu, Haoran, Peng, Baolin, Awadalla, Hany, Chen, Dongdong, Chen, Yen-Chun, Gao, Mei, Kim, Young Jin, Li, Yunsheng, Ren, Liliang, Shen, Yelong, et al.
- Microsoft
- 논문 링크
요약
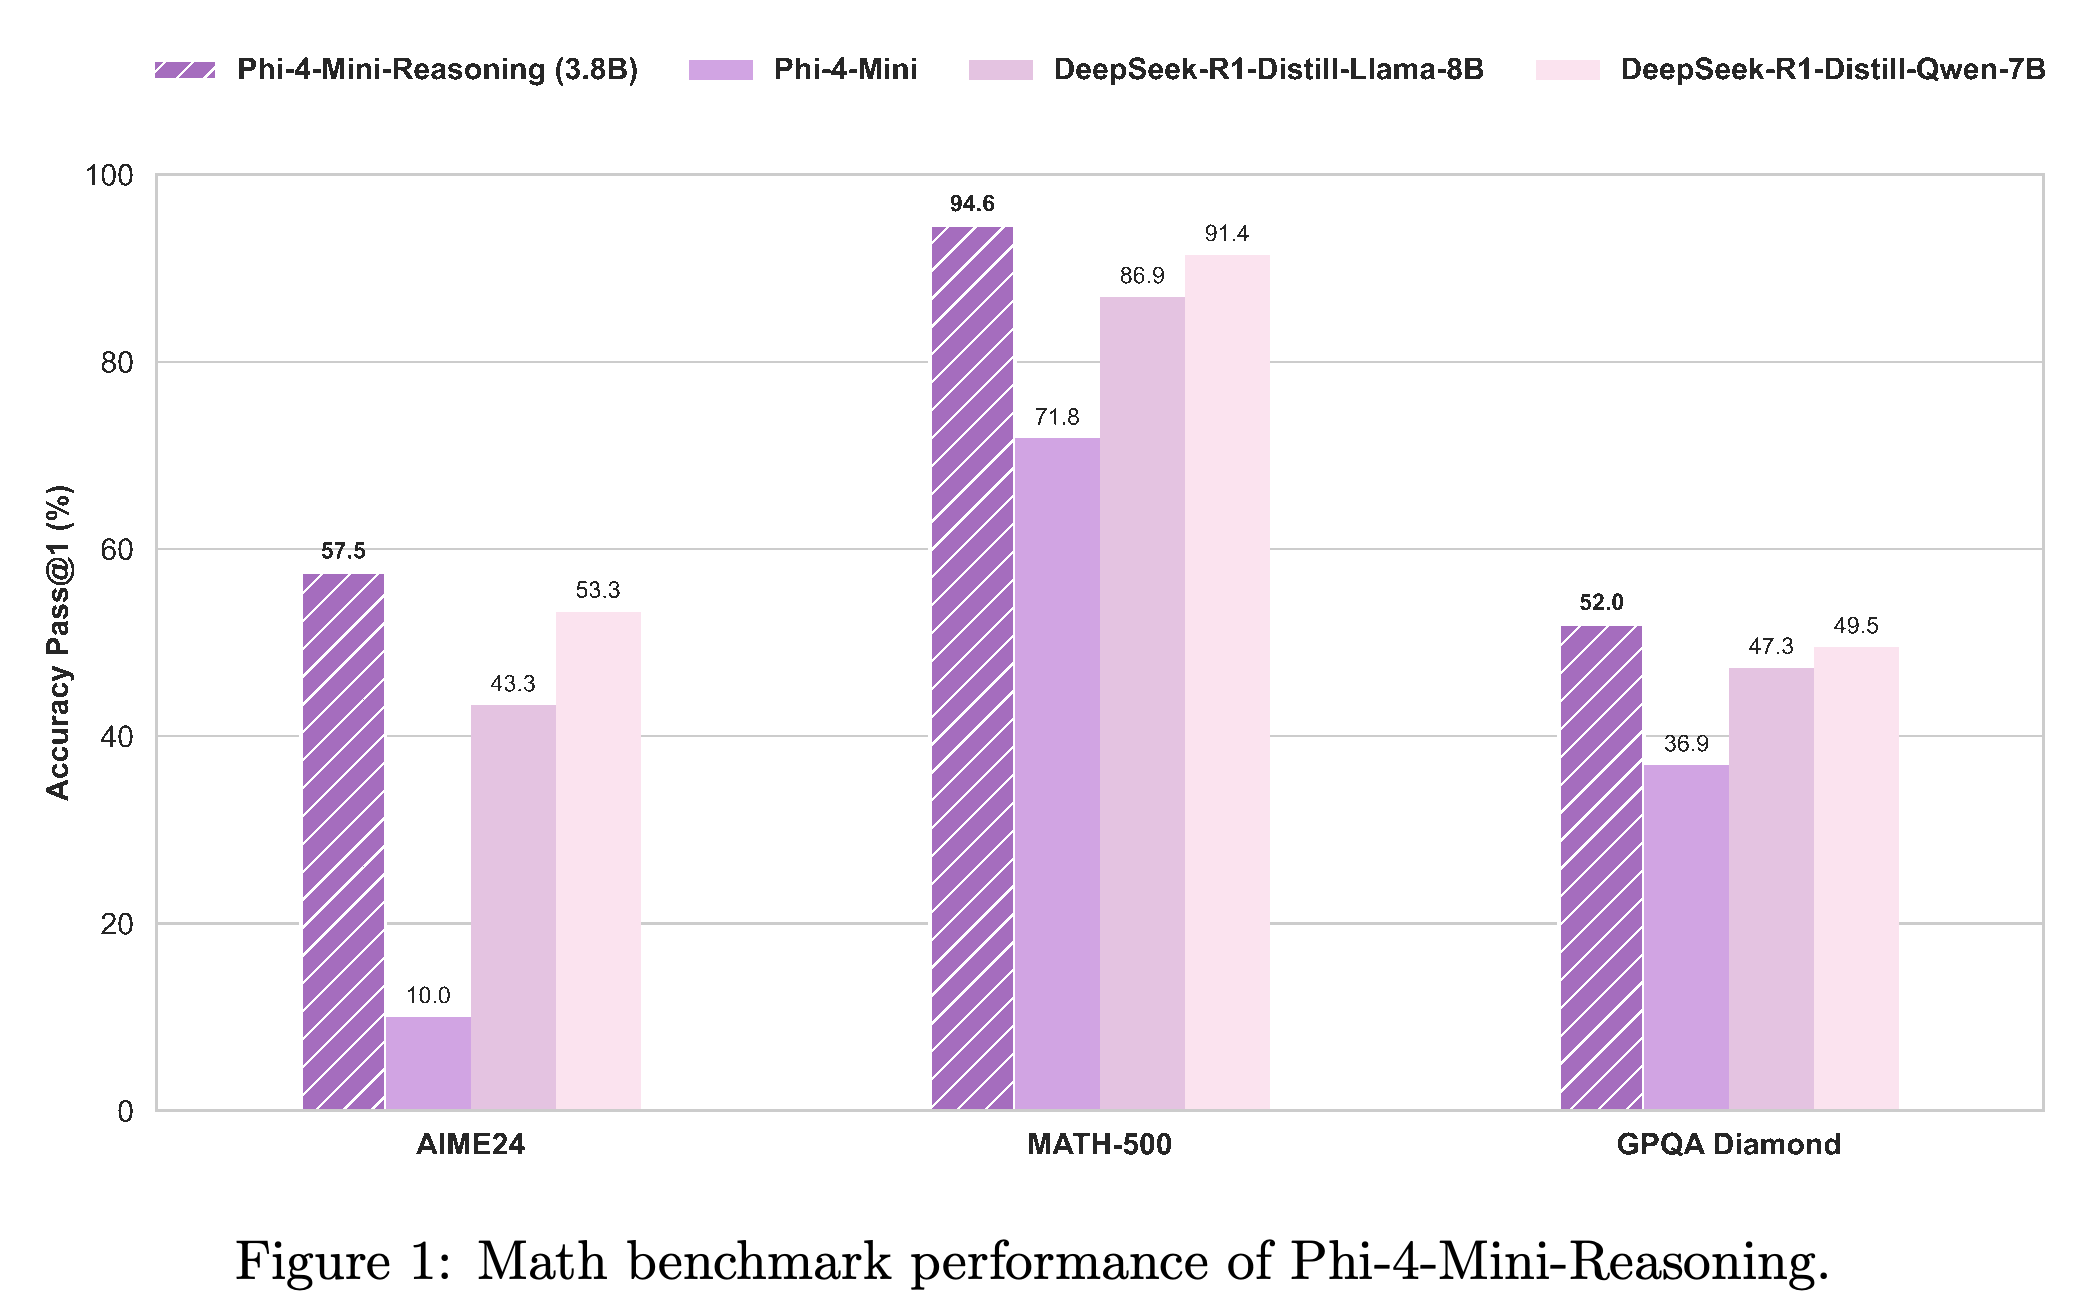
- 소형 언어 모델은 여러 단계의 수학 추론에 필요한 중간 단계를 학습하는 능력이 제한적이다. 논문에서 제안한 3.8B 파라미터 Phi-4-Mini-Reasoning은 단일 답변의 정답 여부를 평가하는 pass@1 기준으로 수학 벤치마크 MATH-500에서 94.6%를 달성한다. 저자들이 재현한 비교 실험에서 DeepSeek-R1-Distill-Qwen-7B는 91.4%, DeepSeek-R1-Distill-Llama-8B는 86.9%를 기록한다.
- 4단계 학습 절차는 더 강력한 모델이 생성한 답변으로 학습하는 증류로 시작하며, 대규모 중간 학습과 선별된 데이터를 이용한 지도 미세 조정을 거친다. 이 단계들은 중간 추론 과정을 명시한 Chain-of-Thought (CoT)를 사용한다. 이후 선호 응답과 비선호 응답 쌍으로 학습하는 Direct Preference Optimization (DPO)를 수행하고, 최종 답변의 정답 여부를 검증한 보상으로 모델을 갱신하는 강화 학습을 진행한다.
- 최종 모델은 수학 시험 벤치마크 AIME 2024에서 57.5%, 대학원 수준의 질의응답 벤치마크 GPQA Diamond에서 52.0%를 기록한다. 학습 단계가 진행될수록 3개 평가 모두에서 성능이 향상된다. 다만 실험은 1개 기반 모델만 다루며, 강화 학습에 적용한 각 수정 사항의 기여를 분리해 검증하지는 않는다.
최종 모델은 3개 벤치마크 모두에서 Phi-4-Mini보다 성능이 높으며, 파라미터 수가 더 적으면서도 제시된 DeepSeek 증류 모델 둘을 능가한다. MATH-500 점수는 94.6% 대 91.4%, 86.9%로, 대표 성과로 제시한 3.2%포인트와 7.7%포인트의 차이를 뒷받침한다.
1 Introduction
서론에서는 중간 추론과 답변 생성 시 추가 연산을 투입하는 test-time scaling을 어려운 다단계 문제의 해결 성능을 높이는 방법으로 소개한다. 이어서 모델 용량이 작아 데이터와 최적화 방식에 민감한 소형 언어 모델에 이러한 이점을 어떻게 전달할 수 있는지 살펴본다.
- 제안한 절차는 2개 증류 단계로 추론 능력을 형성하고, 교사 모델의 오답을 선호 학습에 재사용한 뒤, 강화 학습으로 검증된 답변의 정확도를 최적화한다.
- 이 논문의 기여는 대규모 강화 학습이나 소규모로 엄선한 추론 데이터셋에 중점을 둔 선행 연구를 바탕으로, 여러 학습 단계를 결합한 절차를 제시한 데 있다.
2 Background
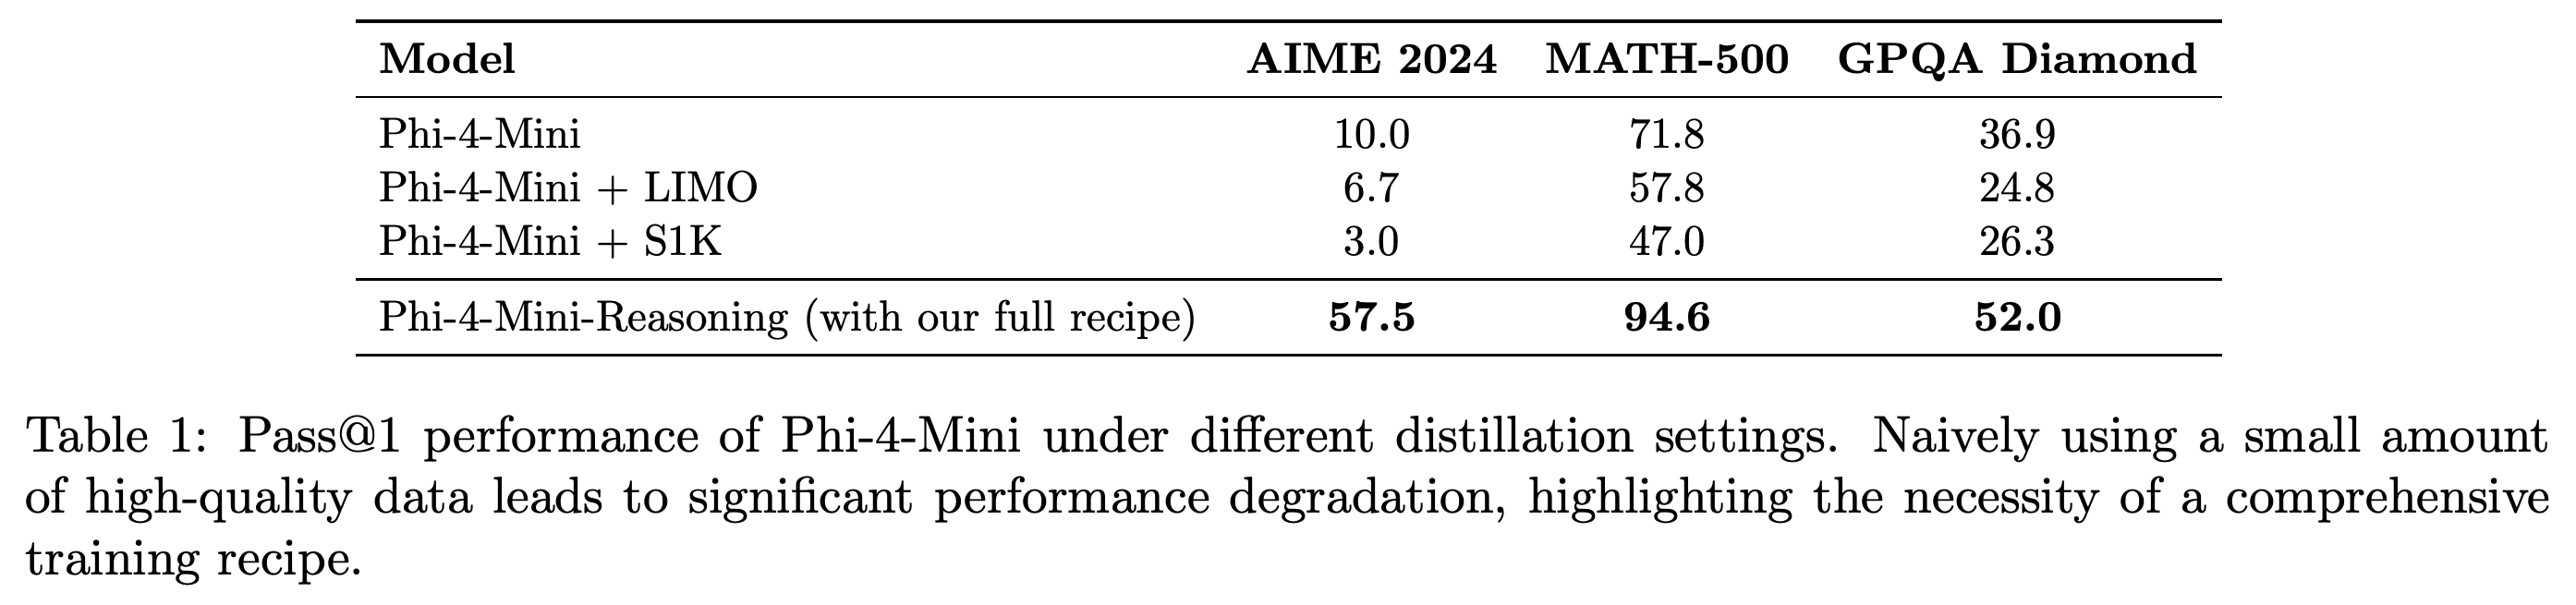
보고된 실험에서 소규모 추론 데이터셋 2개인 LIMO와 S1K로 직접 학습하면 Phi-4-Mini의 정확도가 하락한다. Table 1에서 MATH-500 정확도는 71.8%에서 LIMO 사용 시 57.8%, S1K 사용 시 47.0%로 떨어진다. 전체 학습 절차를 적용하면 94.6%에 도달한다.
- 직접 증류한 두 설정에서는 AIME 2024와 GPQA Diamond의 정확도도 하락한다.
- 이 결과는 선별적 미세 조정 전에 충분한 초기 추론 학습을 수행할 필요성을 뒷받침한다. 다만 모든 소형 모델에 같은 순서가 필요하다는 사실까지 입증하지는 않는다.
소규모 데이터셋으로 직접 증류한 두 설정 모두 보고된 모든 벤치마크에서 정확도가 하락한다. 이는 Phi-4-Mini에 추가적인 사전 학습 준비가 필요하다는 동기를 뒷받침한다. 다만 이 비교로는 전체 절차 중 어떤 부분이 성능 저하를 방지하는지 식별할 수 없다.
3 Multi-Stage Continual Training for Reasoning
제안 방법은 사전 학습된 Phi-4-Mini에서 시작해 중간 학습 형태의 증류, 지도 미세 조정 형태의 증류, rollout 선호 학습, 검증 가능한 보상을 이용한 강화 학습을 4단계로 순차 적용한다. Rollout은 모델에서 샘플링한 응답으로, 추론 과정과 답변을 포함한다.
3.1 Distillation as Mid-Training
중간 학습에서는 분야와 난도가 다양한 합성 추론 예제로 다음 토큰 예측을 수행한다. DeepSeek-R1이 추론 답변을 생성하며, 생성된 응답의 정답 여부를 기준으로 걸러내는 rejection sampling을 통해 통과한 답변만 남긴다.
- Packing은 짧은 예제 여러 개를 하나의 입력 시퀀스에 넣어 학습 효율을 높이는 방식이다.
- 저자들은 검증 성능이 포화될 때까지 대규모 CoT 데이터를 반복해서 사용할 것을 권장한다. 다만 데이터 규모에 따른 정량적 성능 곡선이나 포화 기준은 제시하지 않는다.
3.2 Distillation as Supervised Fine-tuning
선별한 질문과 응답 예제로 학습하는 지도 미세 조정에서는 중간 학습 데이터 중 규모가 작고 대표성이 있으며 품질이 높은 부분집합을 사용한다. 이 부분집합은 다양한 수학 분야를 포함하며, 난도는 ‘대학 수준’을 넘는다. 모델이 생성을 끝낼 지점을 학습하도록 예제를 서로 분리하는 non-packing 방식으로 학습한다.
3.3 Rollout Preference Learning
Rollout 선호 학습은 증류 과정에서 제외한 오답 응답을 재사용한다. GPT-4o-mini가 고등학교 수학 이상으로 분류한 질문에서 응답 쌍을 구성하며, 정답 응답은 선호 응답으로, 오답 응답은 비선호 응답으로 사용한다.
- 저자들은 정답 응답과 미묘한 차이만 있는 오답 응답을 선호 학습에 유용한 후보로 본다.
- DPO는 미리 수집한 데이터셋을 사용해 고정된 참조 모델을 기준으로 오답보다 정답 응답을 선호하도록 모델을 학습한다.
3.4 RL with Verifiable Reward
마지막 단계에서는 증류와 선호 학습을 거친 모델에 새로 샘플링한 응답으로 학습하는 온라인 강화 학습을 적용한다. 논문은 최적화 중 응답 확률의 변화 폭을 제한하는 Proximal Policy Optimization (PPO)과 같은 질문에 대한 응답들을 비교해 각 응답의 advantage를 추정하는 Group-based Relative Policy Optimization (GRPO)를 소개한다. Advantage는 기준값에 비해 해당 응답의 보상이 얼마나 높은지를 나타낸다.
- PPO는 미래 보상을 예측하는 가치 함수의 보상 예측 오차에 할인율을 적용해 결합하는 Generalized Advantage Estimation (GAE)을 사용한다.
- GRPO는 각 응답 그룹 안에서 보상을 표준화하고, 참조 모델의 응답 분포와 얼마나 다른지를 측정하는 Kullback–Leibler (KL) 페널티를 포함한다.
- 검증 가능한 보상은 최종 답변이 정답과의 비교 검증을 통과하면 +1, 그렇지 않으면 −1이다. 이 보상은 중간 추론 과정을 직접 채점하지 않는다.
초기 GRPO 실험에서는 응답 길이의 큰 편차, 동일한 보상 때문에 유용한 상대 보상 신호를 얻지 못하는 그룹, 학습과 평가 간 샘플링 temperature 불일치가 나타난다. Temperature는 샘플링의 무작위성을 조절한다. 같은 프롬프트에 대한 정답 응답도 길이가 약 12k~20k 토큰에 걸쳐 있으며, 어려운 질문에서는 정답 샘플을 1개라도 얻기 위해 응답 배치 크기 128이 필요할 수 있다.
- Prompt Optimization은 샘플링한 응답들의 토큰 길이가 비교적 균일한 후보 프롬프트를 남긴다.
- Reward Rebalancing through Oversampling and Filtering은 정답 응답을 모두 남기고, 같은 수의 오답 응답을 무작위로 추출해 남긴다. 또한 그룹 정확도 기준으로 지나치게 쉬운 프롬프트를 제거하며, 기준값의 예로 50%를 제시한다.
- Temperature Annealing은 전체 학습 스텝의 첫 50% 동안 샘플링 temperature를 1.0에서 0.6으로 선형 감소시킨 뒤, 0.6으로 유지한다.
4 Synthetic CoT Data Generation
데이터셋은 공개 자료와 내부 시드 데이터를 결합하며, 샘플 160만 개에 걸쳐 약 1,000만 rollout을 포함한다. 기존 추론 주석이 있으면 재사용한다. 그렇지 않은 수학 질문에는 671B 파라미터 교사 모델인 DeepSeek-R1 (671B)에서 질문마다 약 8개 응답을 샘플링한다.
- 수학 검증 도구로 답변을 확인하고, 처음에 오답으로 판정된 응답은 GPT-4o-mini가 다시 확인한다. 이를 통해 정답을 오답으로 잘못 제외하는 false negative를 줄인다.
- 주석에는 분야, 난도, 반복 패턴을 기록한다. 분야에는 대수, 기하, 이론, 확률, 미적분이 포함되며, 난도는 초등학교부터 대학원 수준까지 걸쳐 있다.
- 중간 학습에서는 Section 3.1의 정답 필터링을 적용한 전체 데이터셋을 사용하고, 이후 단계에서는 선별한 부분집합을 사용한다. 논문은 각 부분집합의 정확한 크기를 명시하지 않는다.
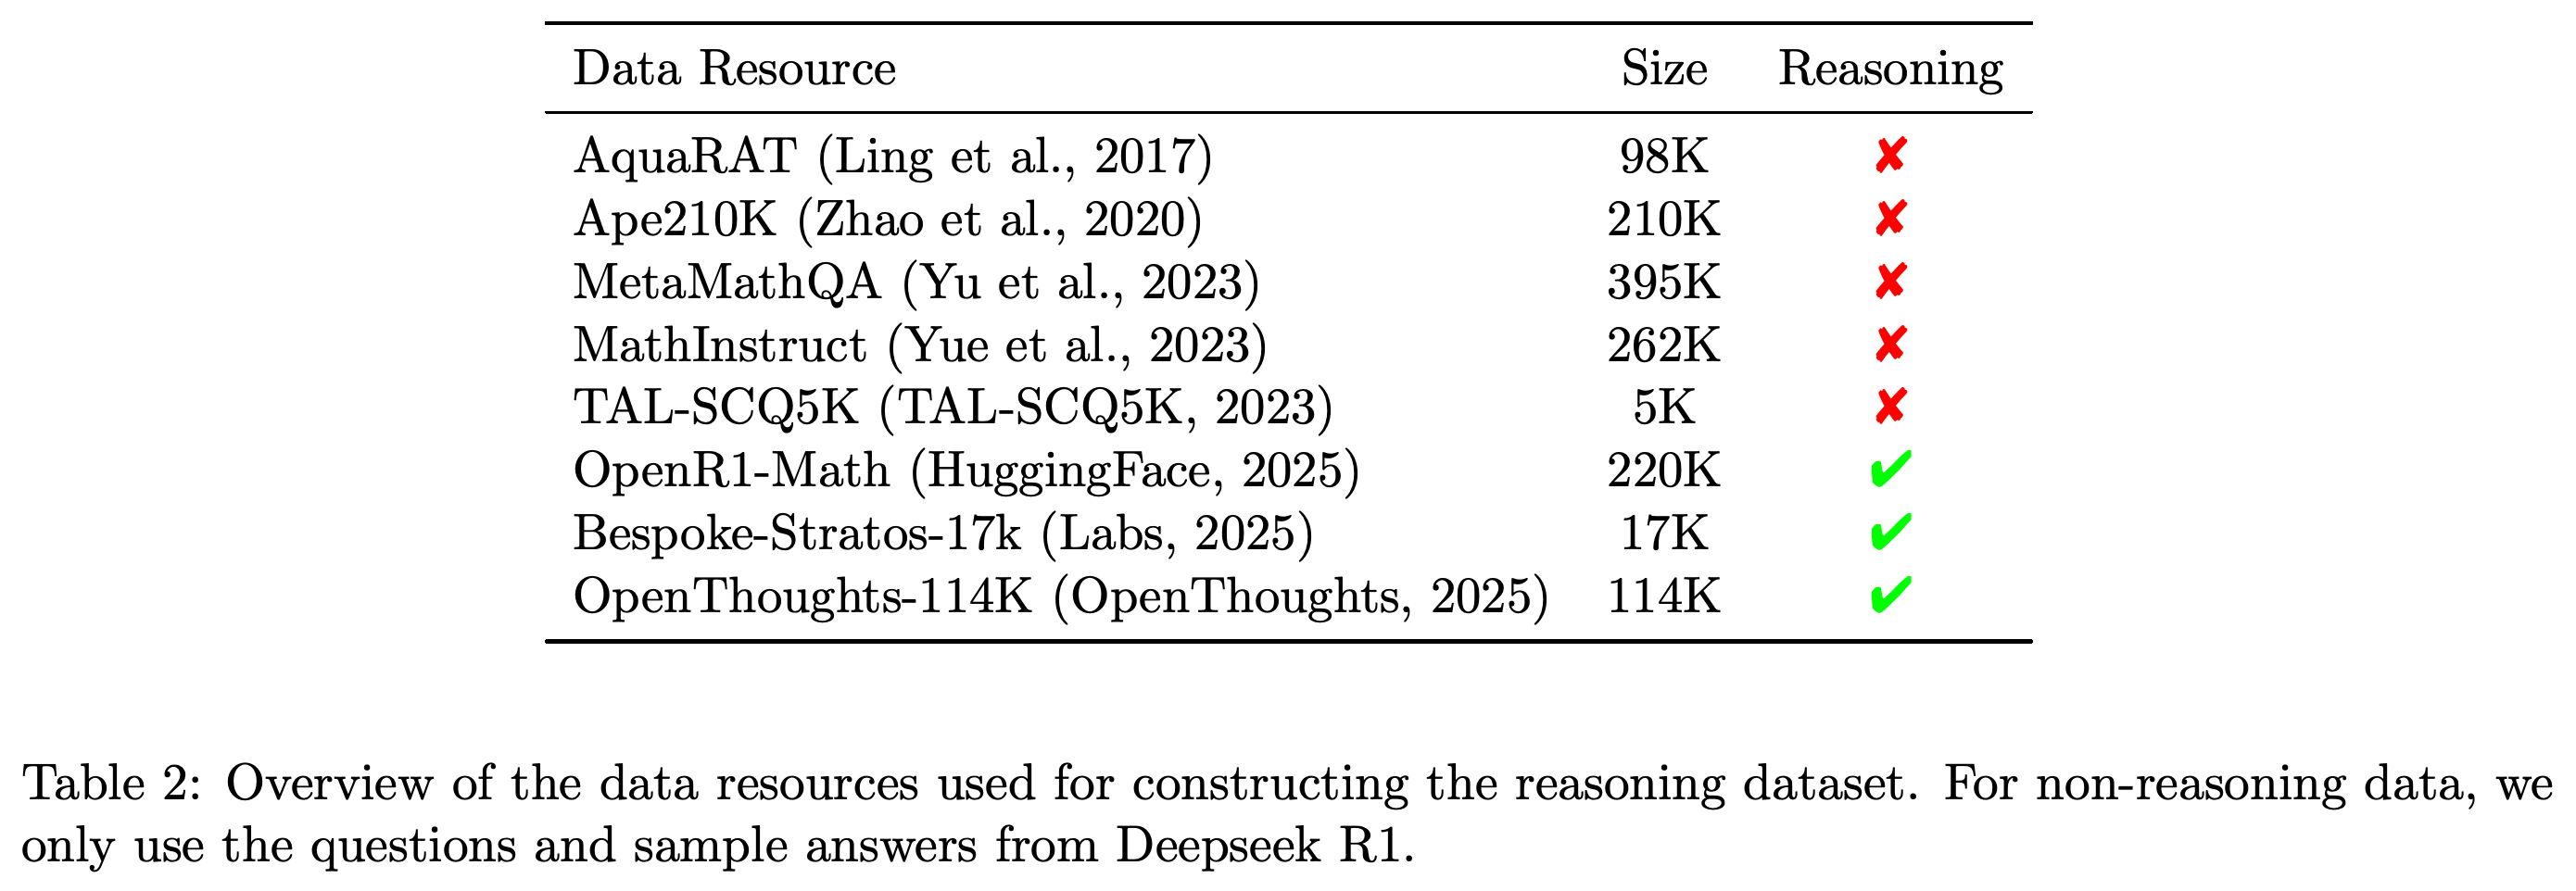
자료 목록은 추론 응답을 새로 샘플링해야 하는 질문 자료와 이미 추론 주석이 포함된 데이터셋을 구분한다. AquaRAT 98K, Ape210K 210K, MetaMathQA 395K, MathInstruct 262K, TAL-SCQ5K 5K, OpenR1-Math 220K, Bespoke-Stratos-17k 17K, OpenThoughts-114K 114K가 제시되어 있으며, 여기에 내부 시드 데이터를 추가한다.
5 Experiment
실험에서는 최종 벤치마크 정확도를 비교하고, 학습 단계별 성능 변화를 추적하며, 여러 응답을 샘플링했을 때 해결할 수 있는 문제의 범위와 강화 학습의 안정성을 살펴본다. 평가에 사용한 기반 모델은 3.8B 파라미터 Phi-4-Mini다.
5.1 Evaluation
평가는 AIME24, MATH-500, GPQA Diamond를 대상으로 하며, temperature 0.6, top_p 0.95, 최대 시퀀스 길이 32K를 사용한다. top_p는 누적 확률이 0.95인 토큰 집합으로 샘플링 범위를 제한하는 설정이다. 보고된 성능은 각 과제를 3회 실행한 평균이다.
- 논문은 평균 정확도를 보고하지만 신뢰구간이나 실행별 산포는 제시하지 않는다.
5.2 Baselines
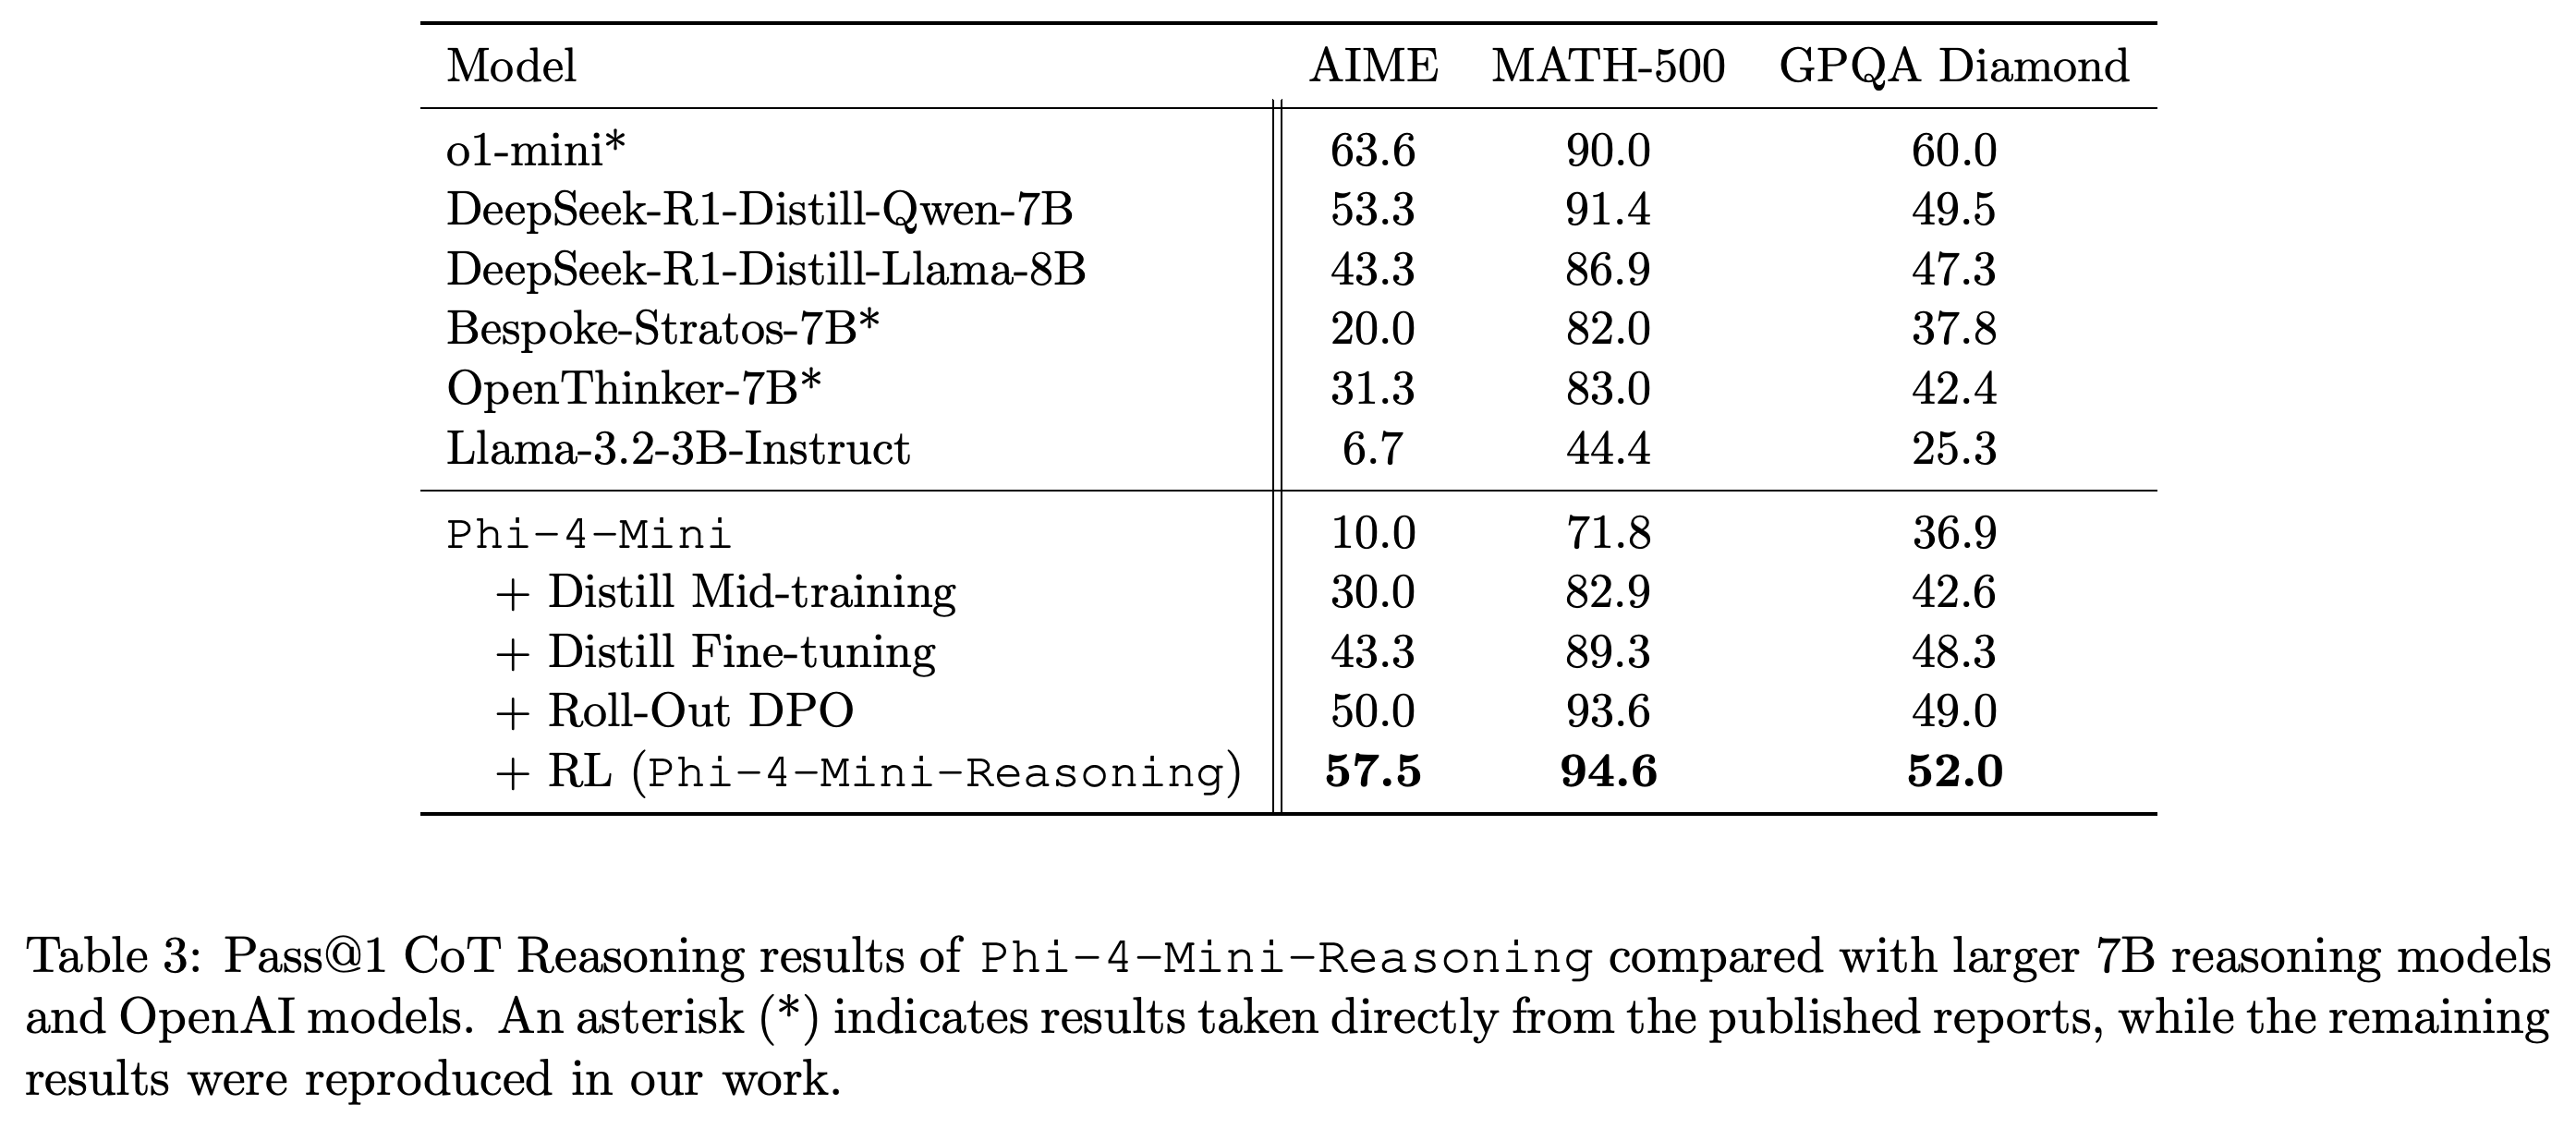
비교 모델에는 o1-mini, DeepSeek-R1-Distill-Qwen-7B, DeepSeek-R1-Distill-Llama-8B, Bespoke-Stratos-7B, OpenThinker-7B, Llama-3.2-3B-Instruct, 원본 Phi-4-Mini가 포함된다.
- Table 3은 o1-mini, Bespoke-Stratos-7B, OpenThinker-7B의 결과를 기존 보고서에서 가져온 값으로 표시한다. 나머지 결과는 저자들이 재현한 값이므로, 표에는 출처가 서로 다른 평가 결과가 함께 제시되어 있다.
5.3 Training Settings
처음 2개 증류 단계에는 배치 크기 128, 학습률 1e-5, 총 5 epoch, warmup 비율 0.1을 사용한다. Warmup 비율은 학습 초기에 학습률을 점차 높이는 구간의 비중이다. 중간 학습에서는 packing과 시퀀스 길이 16K를 사용하고, 지도 미세 조정에서는 packing 없이 시퀀스 길이 20K를 사용한다.
- Rollout DPO에는 학습률 5e-7, 1 epoch, 시퀀스 길이 16K를 사용한다.
- 강화 학습에는 학습률 5e-7과 시퀀스 길이 25k를 사용한다.
5.4 Results
최종 pass@1 점수는 AIME 57.5%, MATH-500 94.6%, GPQA Diamond 52.0%로, Table 3에 제시된 모든 오픈소스 비교 모델을 능가한다. DeepSeek-R1-Distill-Qwen-7B 대비 향상 폭은 각각 4.2, 3.2, 2.5%포인트다.
- Phi-4-Mini의 단계별 체크포인트 점수는 AIME/MATH-500/GPQA Diamond 순으로 초기 10.0/71.8/36.9, 중간 학습 후 30.0/82.9/42.6, 미세 조정 후 43.3/89.3/48.3, Roll-Out DPO 후 50.0/93.6/49.0, 강화 학습 후 57.5/94.6/52.0이다.
- 기존에 보고된 o1-mini 점수와 비교하면 최종 모델은 MATH-500에서 94.6% 대 90.0%로 앞선다. 반면 AIME에서는 57.5% 대 63.6%, GPQA Diamond에서는 52.0% 대 60.0%로 뒤처진다.
학습 단계가 진행될 때마다 보고된 3개 점수가 모두 향상되며, 마지막 강화 학습 단계에서 AIME는 7.5점, MATH-500은 1.0점, GPQA Diamond는 3.0점 상승한다. 이 표는 모델 간 비교의 한계도 보여준다. o1-mini는 여전히 2개 벤치마크에서 앞서며, 별표는 기존 보고서에서 가져온 비교 모델의 결과를 나타낸다.
5.5 Ablations
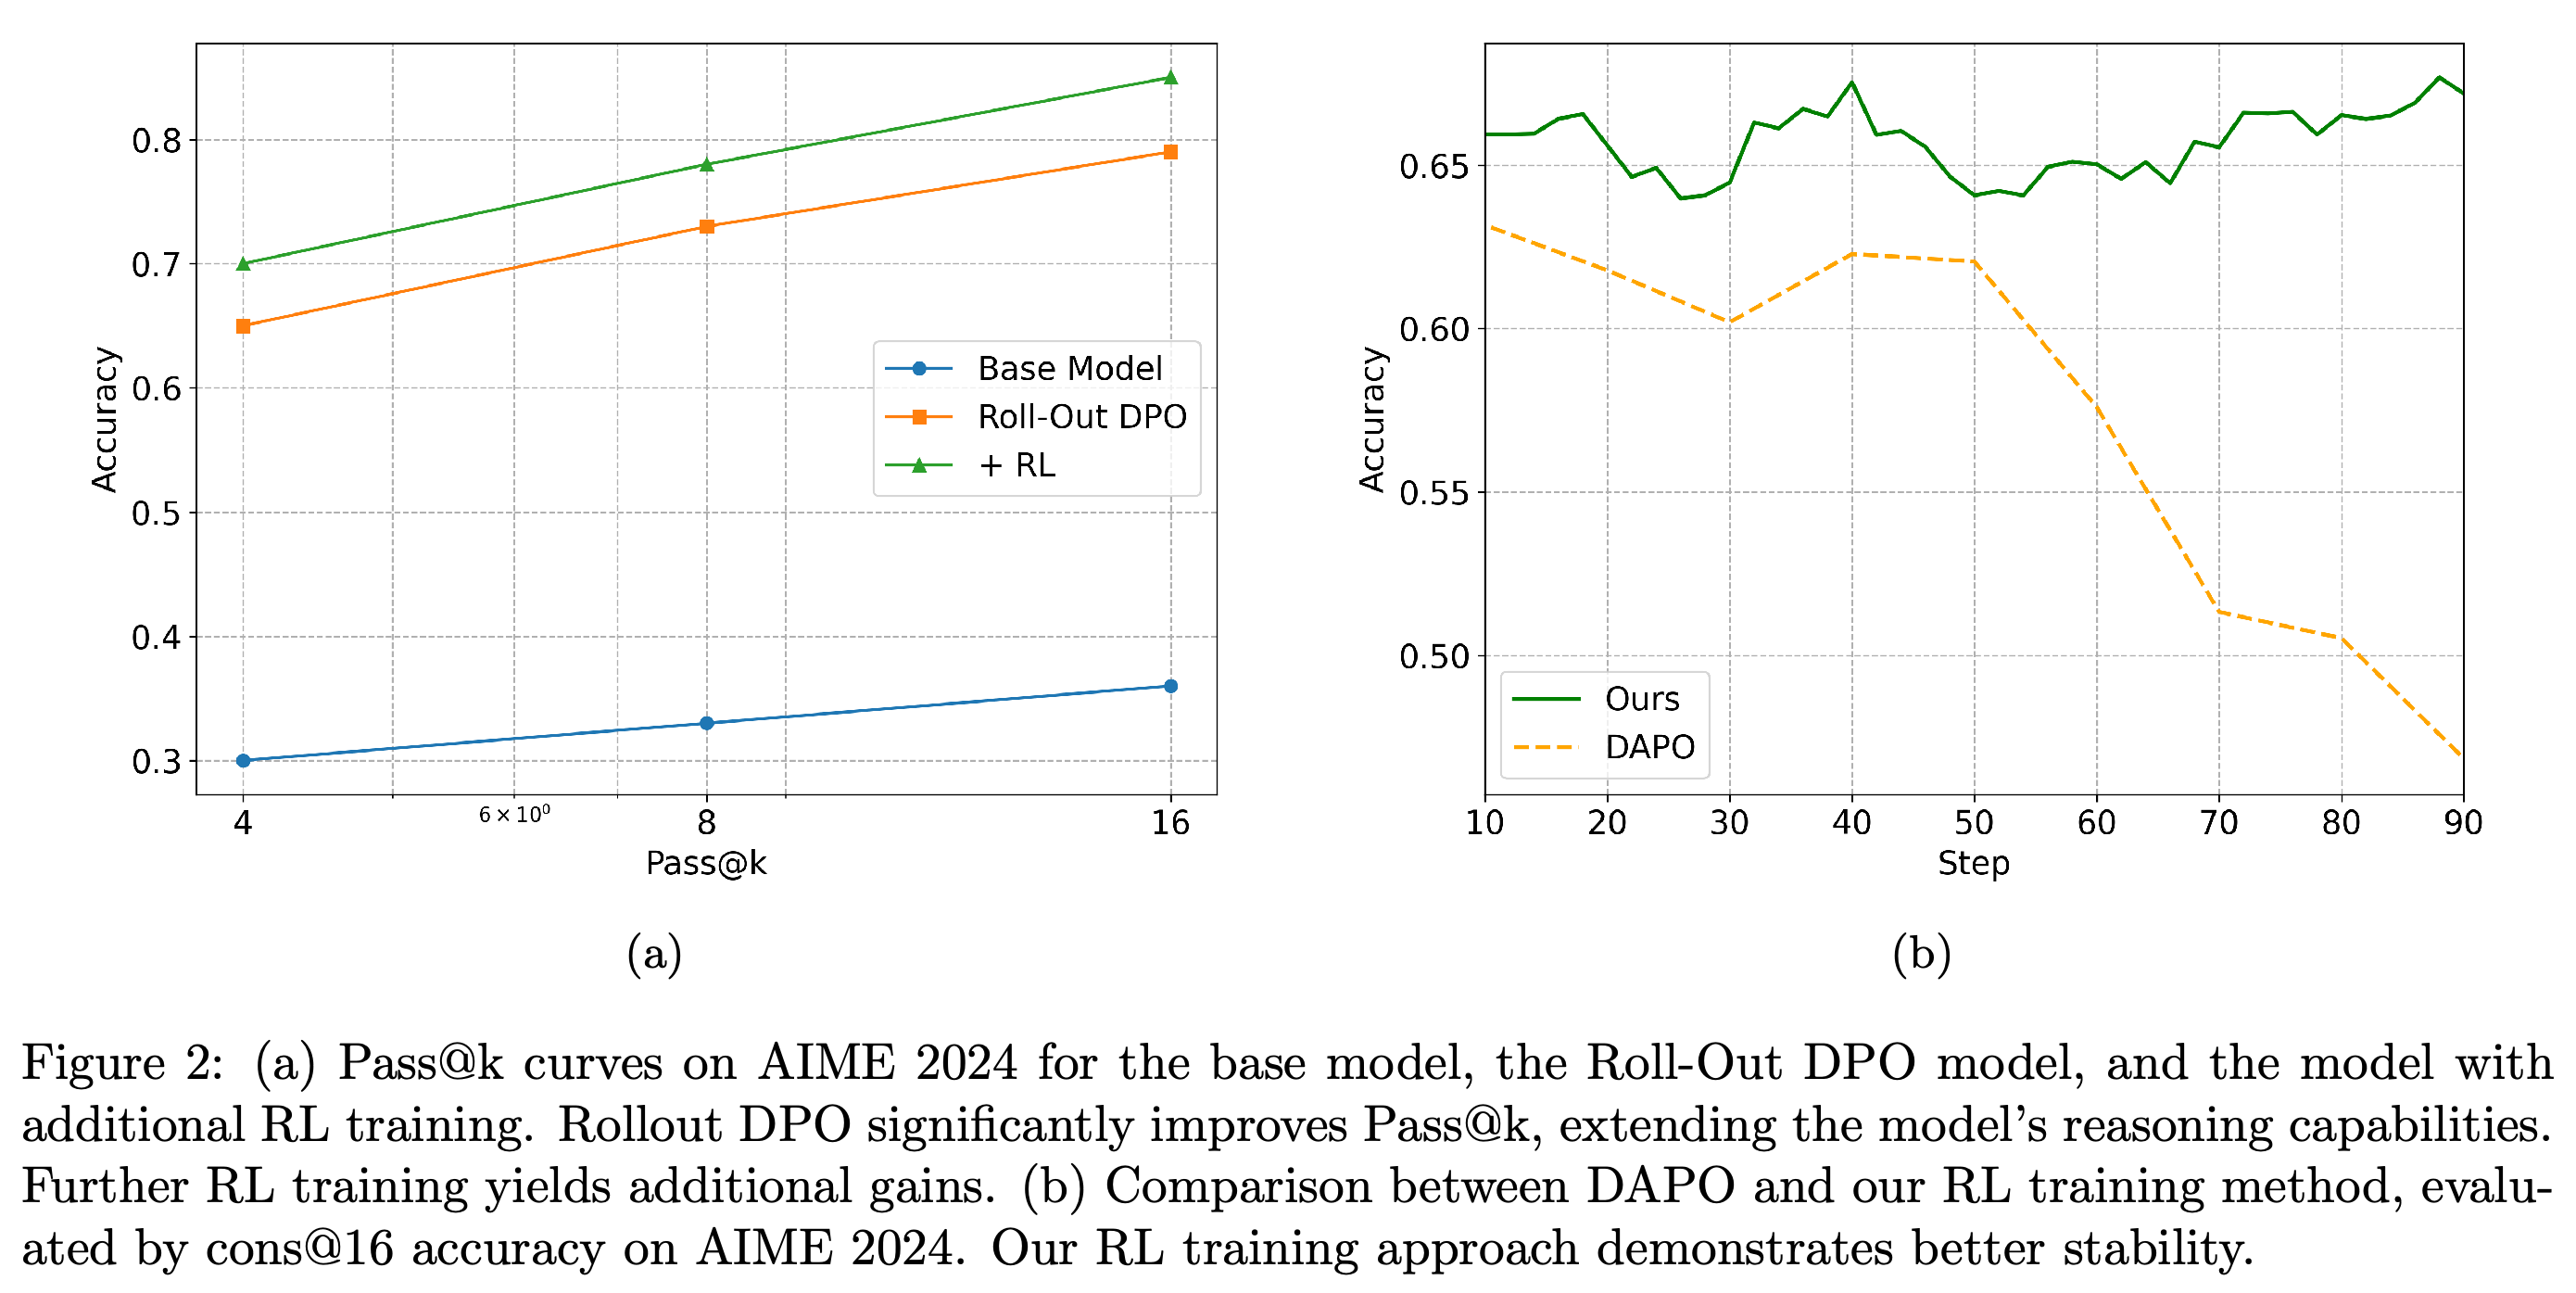
절제 실험에서는 k개 응답 중 검증된 정답이 적어도 1개 있는 문제의 비율인 pass@k로 해결 가능한 문제의 범위를 평가한다. Figure 2a에서는 기반 모델에서 Roll-Out DPO 체크포인트까지 큰 향상이 나타나고, 강화 학습 이후 추가로 향상된다. 저자들은 후자의 향상 폭을 평균 약 7점으로 설명한다.
- Figure 2b는 AIME 2024의 consensus@16 정확도를 사용해 제안한 강화 학습 절차와 기존 강화 학습 시스템 DAPO를 비교한다. 논문은 이 합의 기반 평가 지표의 이름을 제시하지만 응답을 집계하는 절차는 정의하지 않는다. 이 설정에서 제안한 절차는 비교적 안정적으로 유지되는 반면 DAPO의 성능은 하락한다.
- pass@k 그래프는 앞선 학습이 누적된 체크포인트를 비교하므로, DPO의 효과를 이전 증류 단계와 분리하지 못한다. 강화 학습 비교 역시 프롬프트 선택, 보상 균형 조정, temperature annealing을 각각 제거하지 않고 전체 절차를 평가한다.
패널 (a)는 누적된 학습 단계 이후 k = 4, 8, 16에서 AIME 2024 문제 해결 범위가 넓어지고, 강화 학습 이후 추가로 확대됨을 보여준다. 패널 (b)에서 제안한 절차의 consensus@16 정확도는 약 0.64~0.68을 유지하는 반면, DAPO는 90 스텝에 이르러 약 0.47로 하락한다. 두 곡선 모두 단기적인 변동이 있지만, 이 학습 설정에서는 제안한 절차의 안정성이 더 높다는 근거가 된다.
5.6 Safety Statement
저자들은 Microsoft의 책임 있는 AI 원칙에 따라 모델을 개발했다고 밝힌다. 또한 Azure AI Foundry의 Risk and Safety Evaluation 프레임워크로 유해 콘텐츠, 안전장치를 우회하려는 direct jailbreak, 응답이 근거에 기반하는지를 뜻하는 model groundedness를 평가했다고 설명한다. 자세한 내용은 Phi-4-Mini-Reasoning Model Card를 참조하도록 안내하지만, 논문에는 정량적인 안전성 평가 결과를 제시하지 않는다.
6 Conclusion
결론에서는 대규모 증류, rollout 선호 학습, 검증 가능한 보상을 이용한 강화 학습을 결합한 절차가 모델의 추론 성능을 뒷받침한다고 설명한다. 보고된 비교 결과에서 이 3.8B 파라미터 모델은 해당 평가에 제시된 7B 및 8B 오픈소스 비교 모델을 능가한다.
부록
- 제공된 12페이지 논문에는 부록이 없다. 참고문헌은 10~12페이지에 수록되어 있다.
짧은 생각
가장 명확한 근거는 학습 단계가 진행될수록 3개 벤치마크 모두에서 성능이 향상된다는 점과 Table 1에서 LIMO 및 S1K로 직접 학습했을 때 정확도가 하락한다는 점이다. 이 결과는 Phi-4-Mini에 대한 제안 절차의 효과를 뒷받침한다. 다만 순차적으로 학습한 실험 설계만으로는 최적의 단계 순서와 각 구성 요소의 필요성을 판단할 수 없다. 내부 시드 데이터, 명시되지 않은 부분집합 크기, 프롬프트 선택과 필터링에 관한 불완전한 정량 기준 때문에 재현성에 한계가 있다. 파라미터 수가 작다는 사실만으로 총비용이 낮다고 볼 수는 없다. 이 절차는 671B 교사 모델, 약 1,000만 rollout, 긴 생성 시퀀스를 사용하지만, 학습 연산량이나 추론 지연 시간, 비용을 맞춘 비교 결과를 보고하지 않는다. 평가 결과는 보고된 벤치마크에서의 성능 향상을 뒷받침한다. 이 절차를 더 넓은 범위에 적용할 수 있는지 확인하려면 추가 기반 모델 실험과 구성 요소별 독립적인 절제 실험이 필요하다.