


Qwen2.5-VL Technical Report 요약 설명
19 Feb 2025 | Paper Review Vision-Language Models Document Parsing Video Understanding Computer-Use Agents목차
이번 글에서는 Qwen2.5-VL Technical Report 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 2월 19일(Arxiv)
- Bai, Shuai, Chen, Keqin, Liu, Xuejing, Wang, Jialin, Ge, Wenbin, Song, Sibo, Dang, Kai, Wang, Peng, Wang, Shijie, Tang, Jun, et al.
- Alibaba Group
- 논문 링크
- Github
- Project Page
요약
- Qwen2.5-VL은 이미지나 동영상을 텍스트와 함께 처리하는 비전 언어 모델이 하나의 아키텍처에서 세부 정보를 인식하고, 문서의 내용과 구조를 추출하며, 객체의 위치를 찾고, 긴 동영상을 이해하는 방법을 다룬다. 문서 이미지에 관한 질문을 평가하는 보고서의 DocVQA test 비교에서 Qwen2.5-VL-72B는 96.4, Claude-3.5 Sonnet은 95.2, GPT-4o는 91.1을 기록한다. 다른 과제에서는 결과가 엇갈린다.
- 아키텍처는 가변 해상도 이미지 처리, 시각 어텐션 연산 대부분을 국소 영역으로 제한하는 window attention, 경과 시간에 맞춘 동영상 위치 인코딩을 결합한다. 사전 학습은 세 단계에 걸쳐 4.1조 토큰을 사용한다. 토큰은 학습 중 처리하는 시퀀스 단위다. 이후 지시와 응답을 이용한 학습과 선호도 기반 최적화를 수행한다. 모델군은 3B, 7B, 72B로 구성되며, B는 매개변수 규모를 나타내는 단위다.
- 벤치마크 표는 문서 처리, 일부 긴 동영상 과제, 객체 수 세기, 화면 요소 위치 파악에서 성능 향상을 보여준다. 보고서는 개별 변경의 효과를 분리하는 통제된 ablation 실험이나 별도의 지연 시간, 메모리 비교를 제공하지 않는다. 따라서 아키텍처와 데이터가 각각 얼마나 기여했는지는 구분할 수 없다.
1 Introduction
서론은 연산 복잡도, 제한된 문맥 처리, 부족한 세부 시각 정보 인식 능력, 시퀀스 길이에 따른 성능 불안정성을 대형 비전 언어 모델의 한계로 제시한다. 기술적 기여 4가지는 시각 인코더의 window attention, 동적 초당 프레임 수(FPS) 샘플링, 절대 시간에 맞춘 시간 위치 인코딩, 1.2조 토큰에서 4.1조 토큰으로 확대한 정제 학습 데이터다.
- 목표로 하는 능력은 구조화된 문서 파싱, 언어로 설명한 이미지 내용의 위치를 찾는 visual grounding, 긴 동영상의 이벤트 시간 구간 파악, 컴퓨터와 모바일 기기에서 행동을 선택하고 실행하는 에이전트 기능이다.
2.1 Model Architecture
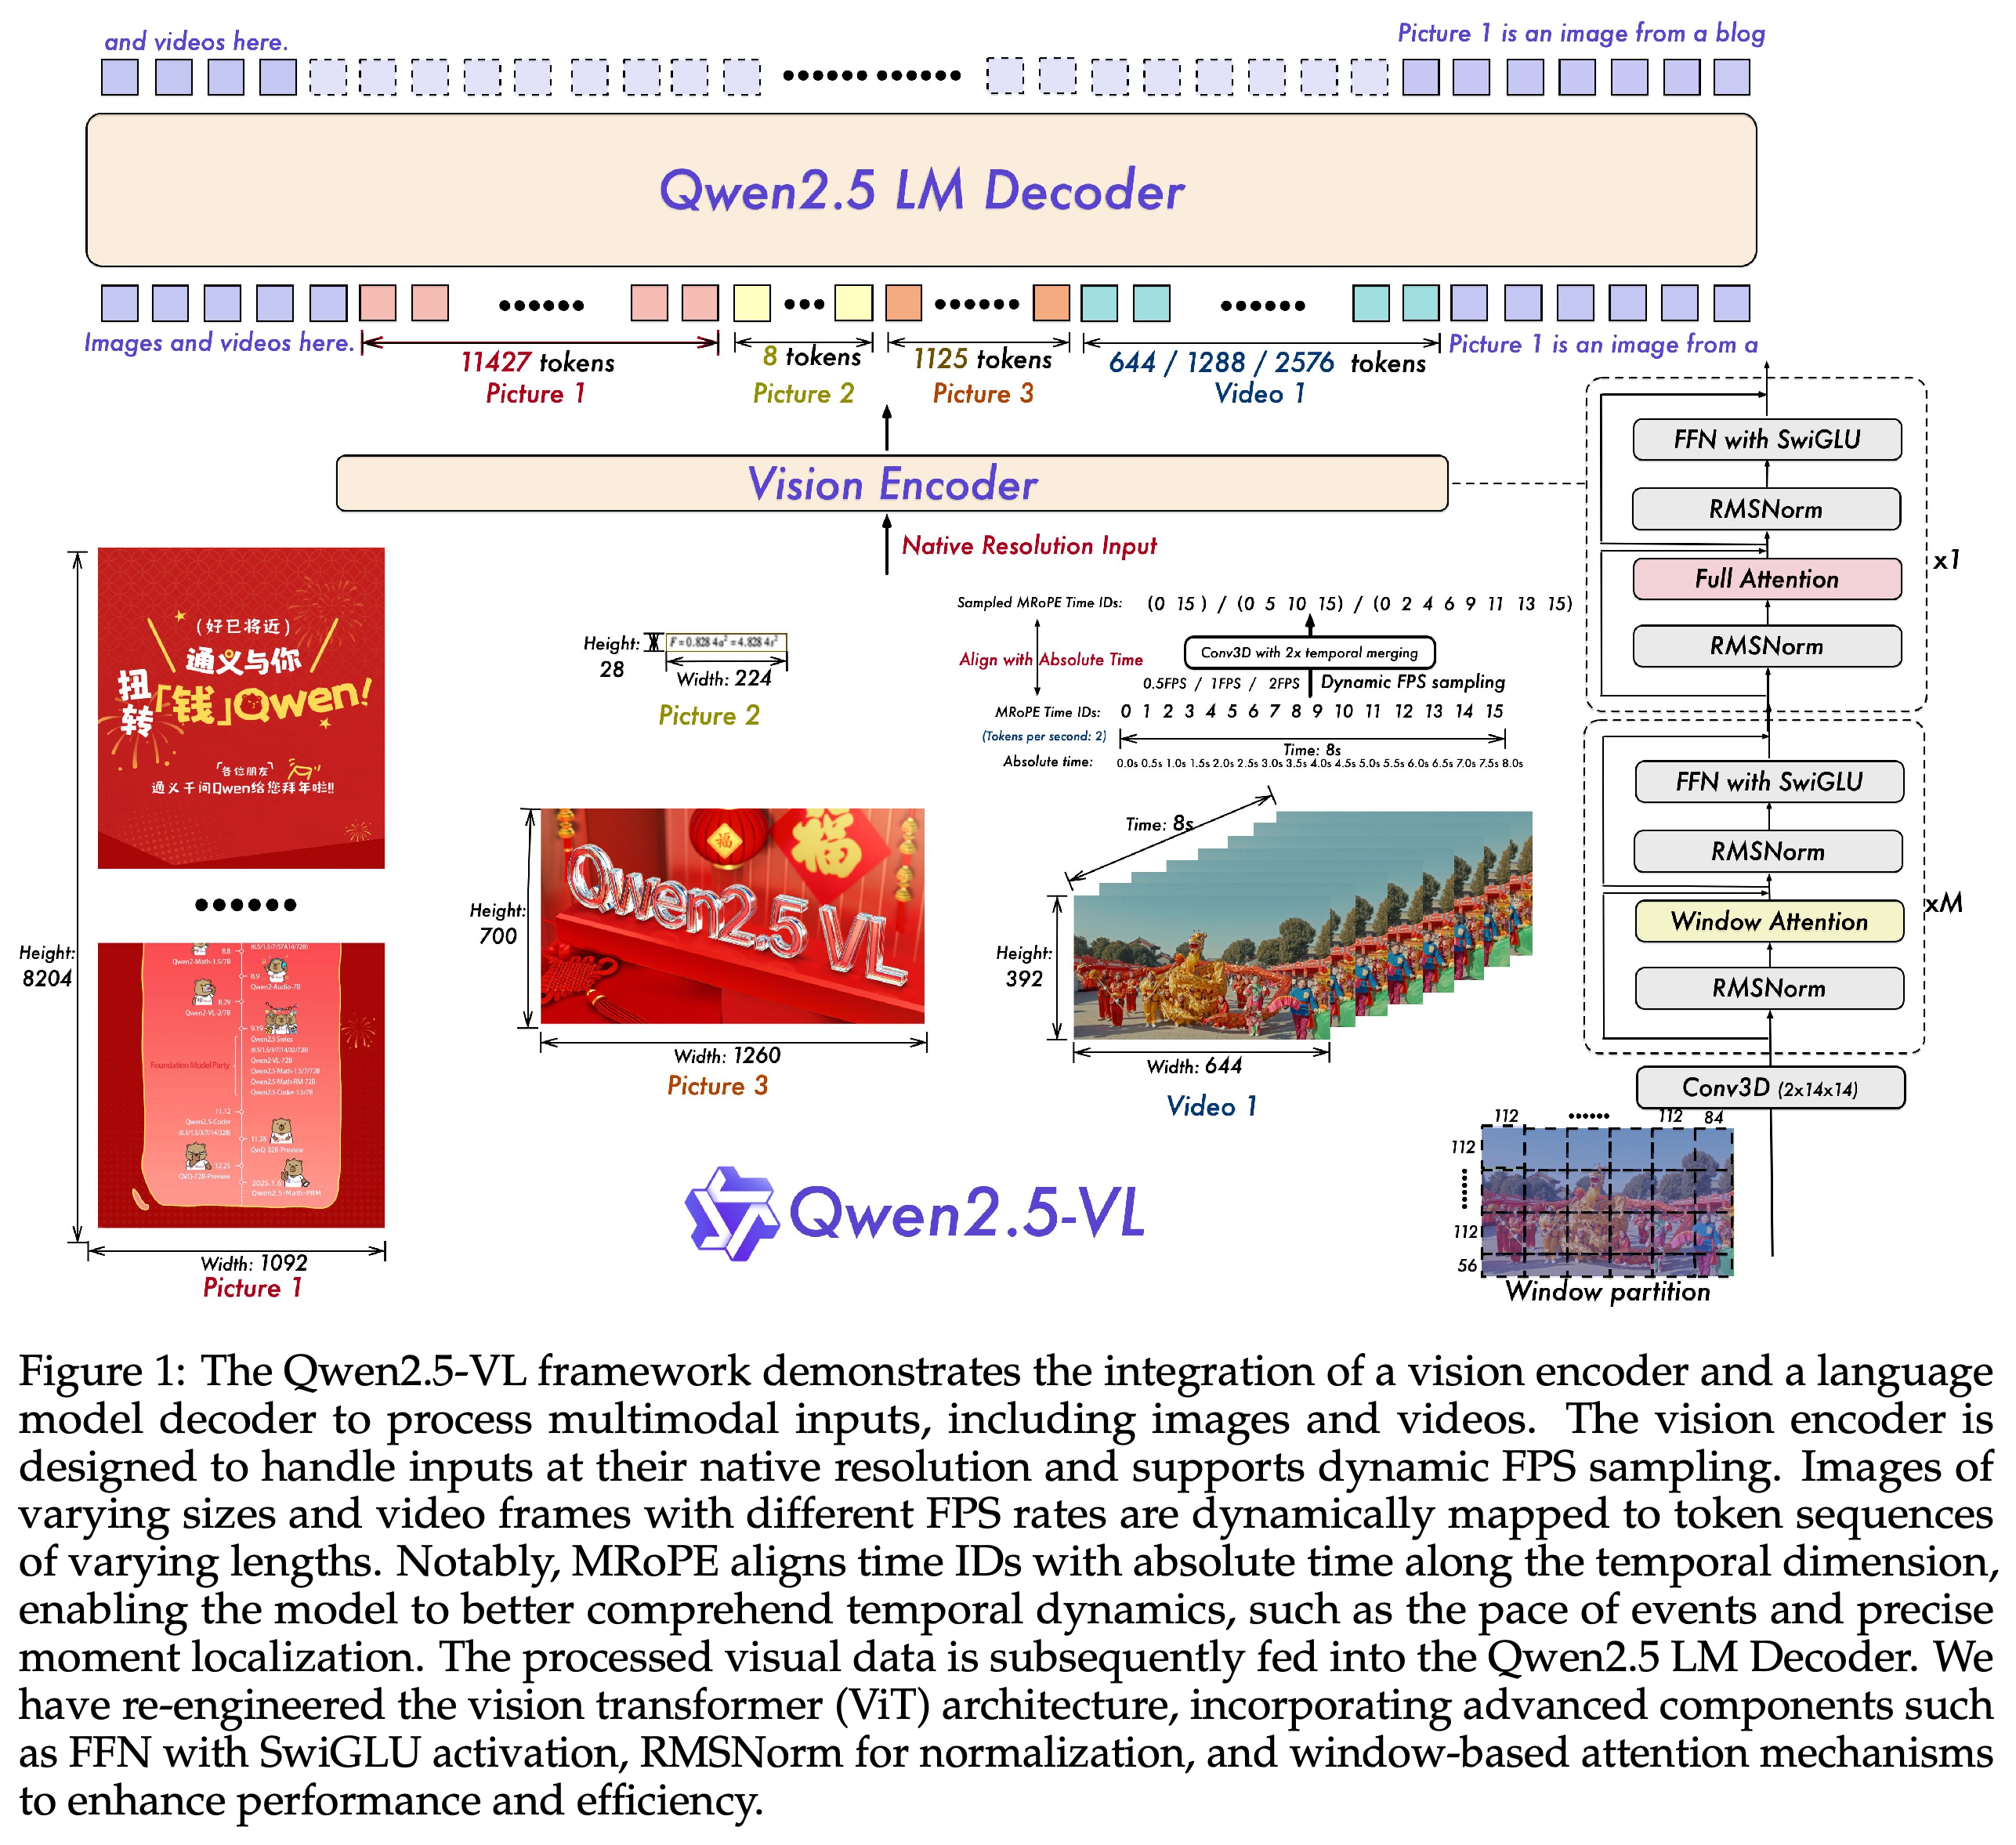
이 접근법은 아키텍처 변경, 데이터 구축, 단계별 학습을 결합한다. 모델의 구성 요소는 3개다. 텍스트를 생성하는 Qwen2.5 대규모 언어 모델(LLM), 이미지 패치를 인코딩하도록 재설계한 Vision Transformer(ViT), 시각 특징을 언어 모델의 임베딩 공간으로 변환하는 순전파 신경망인 2층 multi-layer perceptron(MLP)으로 구성된다. 이미지의 높이와 너비를 28의 배수로 조정하고 패치에는 stride 14를 사용한다. 공간적으로 인접한 패치 특징 4개씩을 이어 붙여 병합한 뒤 언어 모델에 전달한다.
- Figure 1은 이미지 크기와 동영상 샘플링 속도에 따라 시각 시퀀스 길이가 달라지는 관계와, 시각 정보를 Qwen2.5 디코더에서 텍스트와 통합하는 구조를 보여준다.
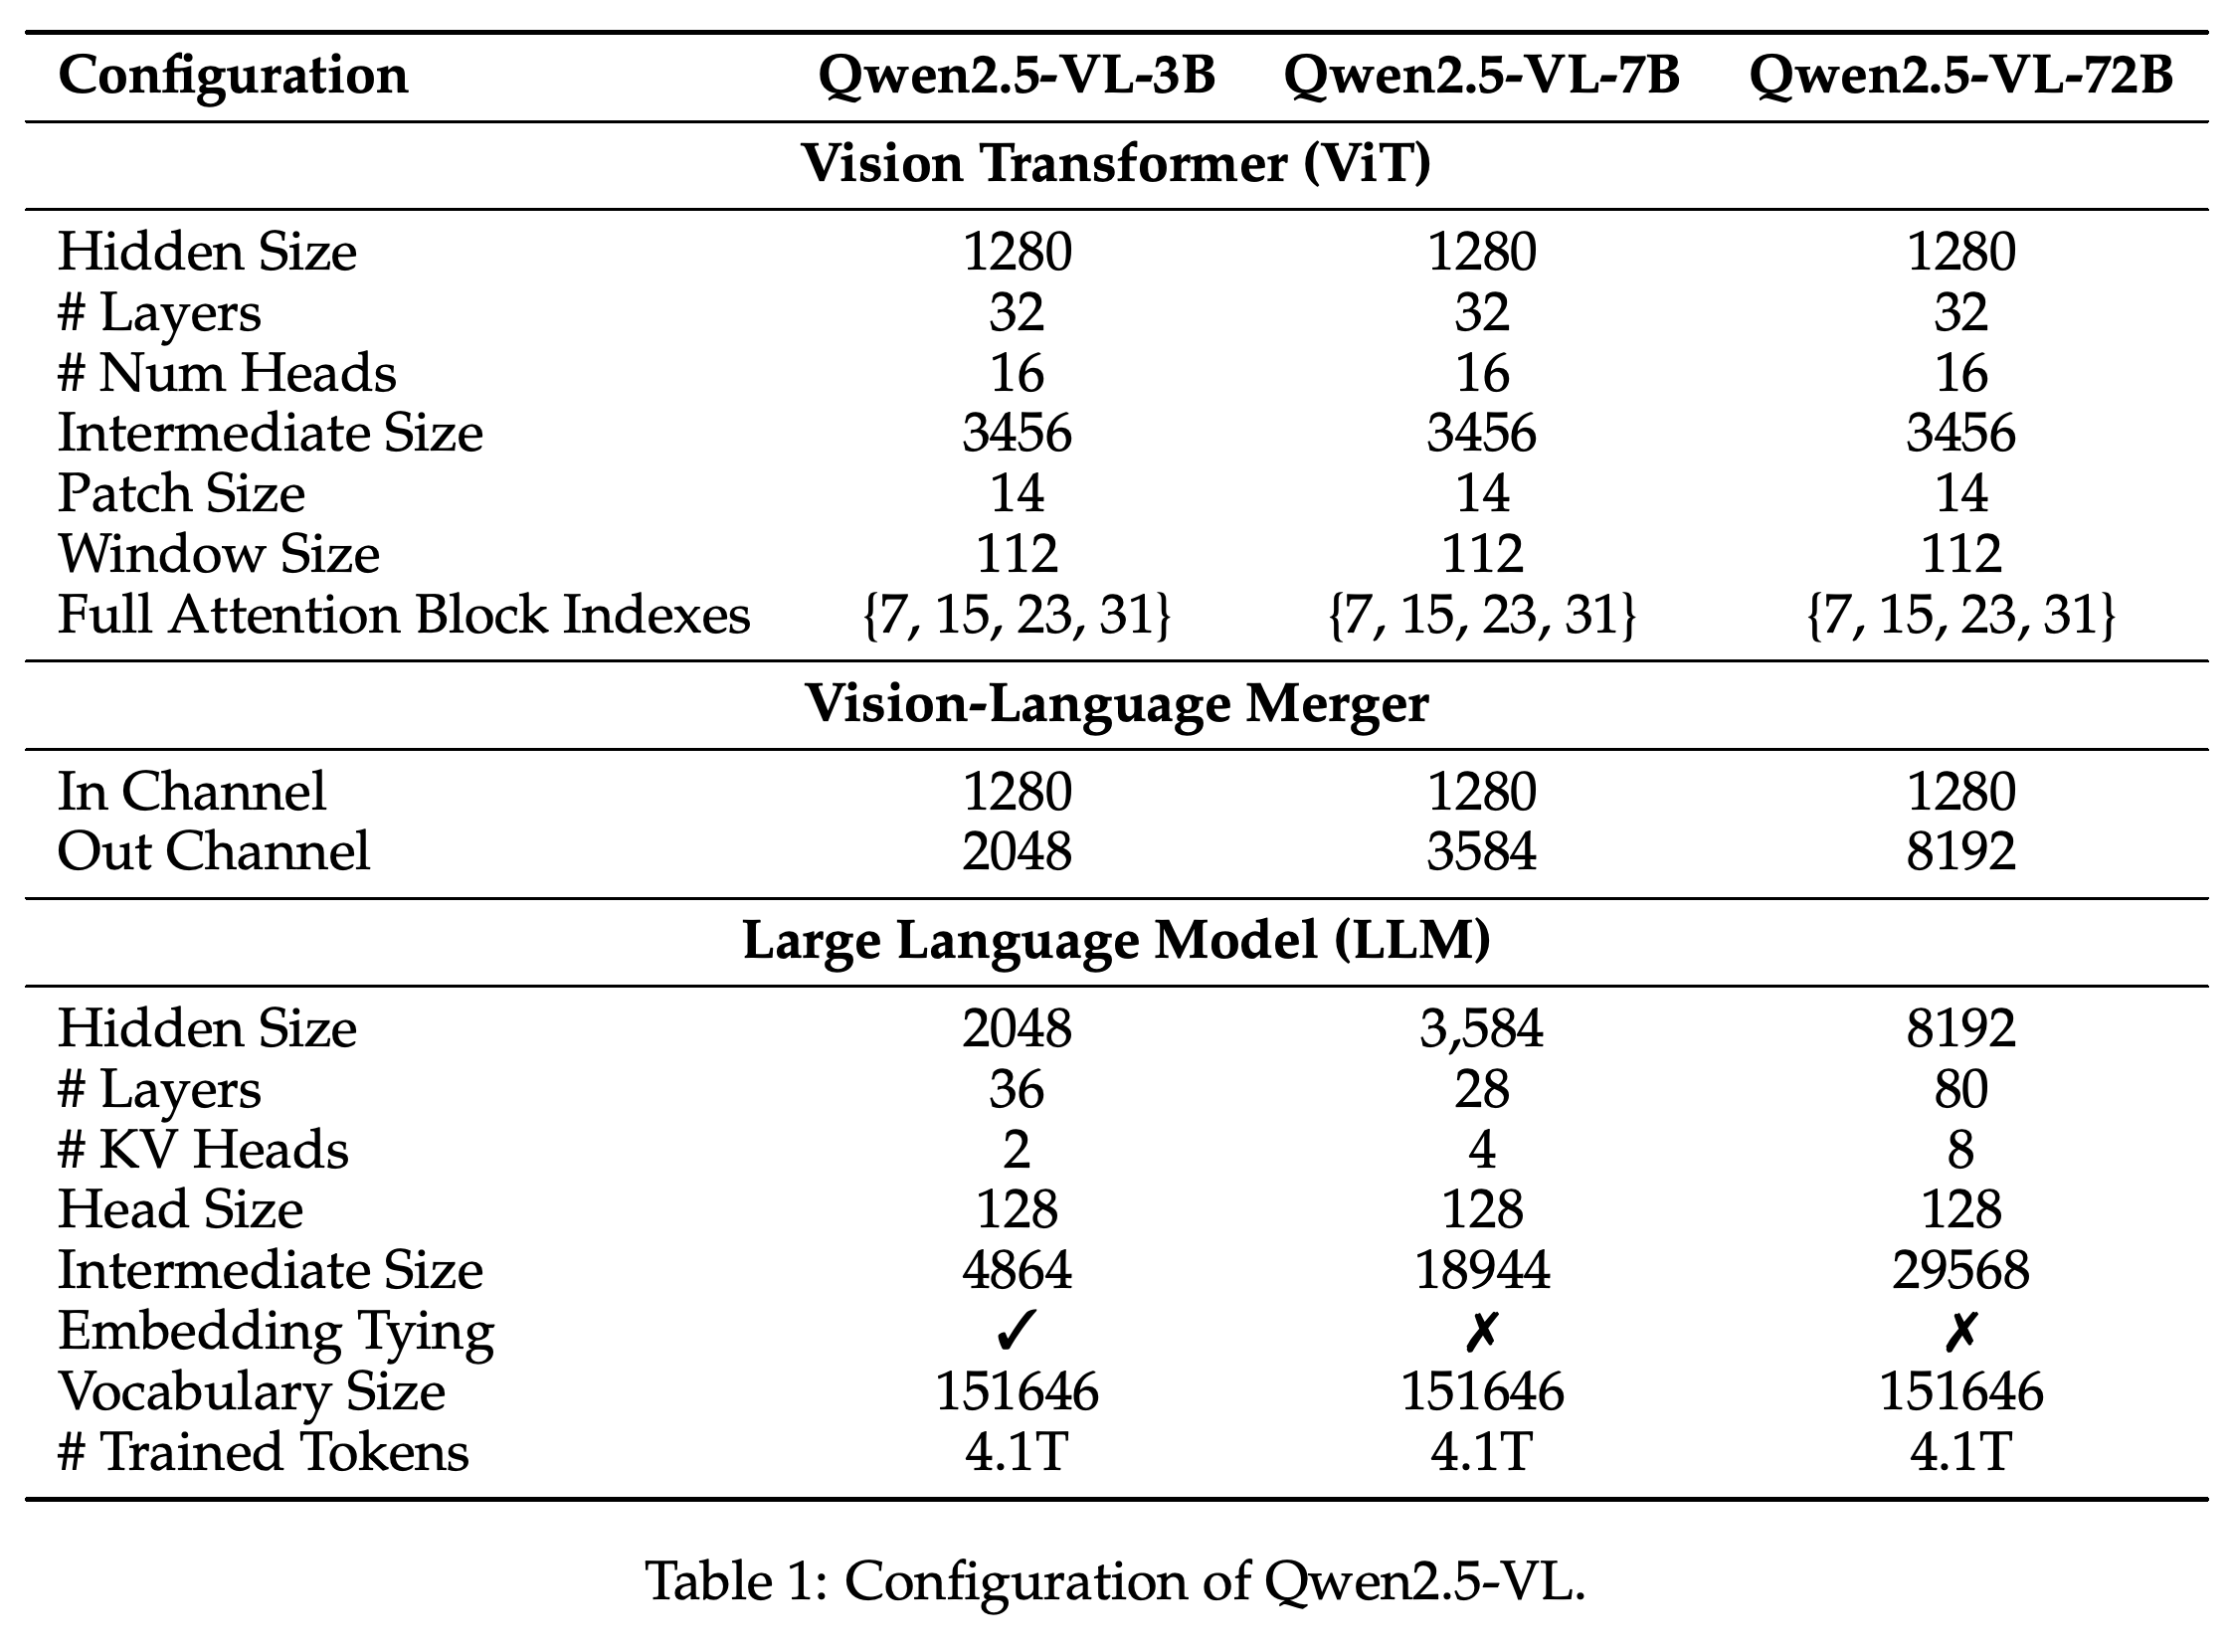
- Table 1은 hidden size 1280, attention head 16개를 갖춘 공통 32층 시각 인코더를 명시한다. 3B, 7B, 72B 디코더의 hidden size는 각각 2048, 3584, 8192이며, 층수는 각각 36, 28, 80이다.
- 모델의 위치 인코딩 방식인 Rotary Position Embedding(RoPE)을 확장해 시각 정보의 공간 위치와 동영상 시간을 표현한다.
예시는 이미지 크기와 동영상 샘플링 속도에 따라 시각 시퀀스 길이가 달라지는 이유를 보여준다. 아키텍처는 국소 윈도우와 간헐적인 전역 어텐션을 결합한 뒤 시각 토큰을 언어 디코더로 전달한다. 시간 위치 간격은 서로 다른 샘플링 속도에서도 경과 시간을 인코딩한다.
3개 모델 모두 동일한 32층 시각 인코더와 full-attention 블록 인덱스를 공유한다. 디코더 차원과 merger 출력 채널은 모델 크기에 따라 달라진다. 이는 공통 시각 구성을 유지하면서 주로 언어 구성 요소를 통해 모델 규모를 확장한다는 점을 보여준다.
2.1.1 Fast and Efficient Vision Encoder
시각 인코더는 블록 인덱스 {7, 15, 23, 31}에서만 모든 패치를 연결하는 full self-attention을 사용한다. 나머지 층은 어텐션 범위를 최대 112×112픽셀, 즉 8×8패치의 윈도우로 제한한다. 고정 크기의 window attention을 사용하는 층에서는 연산량이 패치 수에 선형으로 비례하지만, full attention을 사용하는 4개 층의 어텐션 연산량은 여전히 패치 수의 제곱에 비례한다.
- 윈도우보다 작은 영역은 패딩 없이 처리한다. 이미지에는 14×14패치를 사용하며, 동영상은 연속된 프레임 2개를 하나의 시간 패치로 묶어 처리한다.
- 인코더는 공간 위치에 2D RoPE를 사용하며, 제곱평균제곱근 정규화인 RMSNorm과 활성화 함수 SwiGLU를 사용한다.
- ViT는 이미지와 텍스트의 표현을 학습하는 CLIP 사전 학습, 비전 언어 정렬, 종단 간 미세 조정을 거쳐 처음부터 학습한다. 동적 해상도 샘플링은 원본 종횡비를 유지한다. 보고서는 별도 실험으로 지연 시간이나 메모리 절감량을 정량화하지 않는다. CLIP에 대해서는 CLIP 논문 리뷰(Learning Transferable Visual Models From Natural Language Supervision) 글을 참조하라.
2.1.2 Native Dynamic Resolution and Frame Rate
이미지 크기가 달라지면 그에 맞춰 시각 토큰 시퀀스 길이도 달라지며, 경계 상자와 점은 실제 입력 이미지 크기를 기준으로 한 좌표를 사용한다. 동영상 학습에서는 FPS를 다양하게 설정하고 시간 위치 식별자를 타임스탬프에 맞춘다. 따라서 텍스트 타임스탬프나 별도의 위치 예측 헤드를 추가하지 않아도 위치 식별자 사이의 간격으로 경과 시간을 표현할 수 있다.
2.1.3 Multimodal Rotary Position Embedding Aligned to Absolute Time
Qwen2-VL에서 계승한 위치 표현 방식인 Multimodal Rotary Position Embedding(MRoPE)은 위치를 시간, 높이, 너비 성분으로 나눈다. 텍스트는 3개 성분에 동일한 식별자를 사용하고, 이미지는 시간 성분을 일정하게 유지하며, 동영상은 공간 위치와 시간 식별자를 결합한다.
- Qwen2-VL은 시간 식별자를 프레임 순서에 연결했다. Qwen2.5-VL은 이를 절대 시간에 맞춰, 프레임 샘플링 속도가 달라도 일관된 시간 간격을 표현하도록 한다.
2.2 Pre-Training
사전 학습은 멀티모달 말뭉치 구축과 단계별 학습 일정을 결합한다. 이어지는 하위 절은 이미지, 문서, 동영상, 에이전트 능력을 학습하는 데 사용한 데이터 출처, 품질 관리, 매개변수 갱신, 시퀀스 길이를 설명한다.
2.2.1 Pre-Training Data
사전 학습 말뭉치는 정제한 웹 데이터와 합성 데이터를 결합한다. 데이터는 캡션, 이미지와 텍스트가 섞인 시퀀스, 이미지에서 글자를 읽는 광학 문자 인식(OCR), 시각 지식, 학술 문제, grounding, 문서 파싱, 동영상, 에이전트 상호작용을 다룬다. 이 하위 절에서는 규모를 약 4조 토큰으로 설명하지만, 서론과 학습 표에는 4.1조 토큰으로 명시한다.
- 하나의 시퀀스 안에 이미지와 텍스트를 섞은 데이터에는 일반적인 정제 절차를 적용한다. 내부 모델로 텍스트 품질, 이미지와 텍스트의 관련성, 정보의 상호 보완성, 정보 밀도의 균형도 평가한다.
- Grounding 데이터는 공개 데이터와 자체 보유 데이터의 경계 상자와 점, XML과 JSON을 포함한 구조화 출력 형식, 이미지에 객체를 삽입하는 copy-paste 증강, 모델이 생성한 주석을 결합한다. 탐지 학습은 10,000개가 넘는 객체 범주, 이미지에 없는 범주에 대한 질의, 같은 객체의 여러 개체가 있는 이미지를 포함한다.
- Document Omni-Parsing Data는 문단, 표, 차트, 수식, 삽화, 악보, 화학식을 내용과 배치 좌표를 함께 저장하는 마크업 형식인 HTML로 표현한다. QwenVL HTML Format은 data-bbox 속성으로 요소와 위치를 연결한다.
- OCR 데이터는 한국어를 포함한 여러 언어의 합성 사례, 공개 사례, 내부 수집 사례를 포함한다. 차트 학습에는 합성 샘플 100만 개를 사용하며, 실제 표 샘플 600만 개는 인식 모델로 처리한 뒤 품질을 기준으로 필터링한다.
- 동영상 데이터에는 동적 FPS 샘플링을 사용하고, 반 시간보다 긴 동영상에는 여러 프레임을 설명하는 합성 캡션을 사용한다. 이벤트 위치를 나타내는 타임스탬프는 초 단위와 시-분-초-프레임 형식으로 제공한다.
- 에이전트 데이터는 모바일, 웹, 데스크톱 스크린샷에 캡션과 인터페이스 요소의 위치를 결합한다. 행동에는 공통 함수 호출 형식을 사용한다. 사람과 모델 주석자는 과제, 알려진 행동, 행동 전후의 스크린샷을 바탕으로 단계별 설명을 작성하며, 모델이 품질이 낮은 설명을 걸러낸다.
2.2.2 Training Recipe
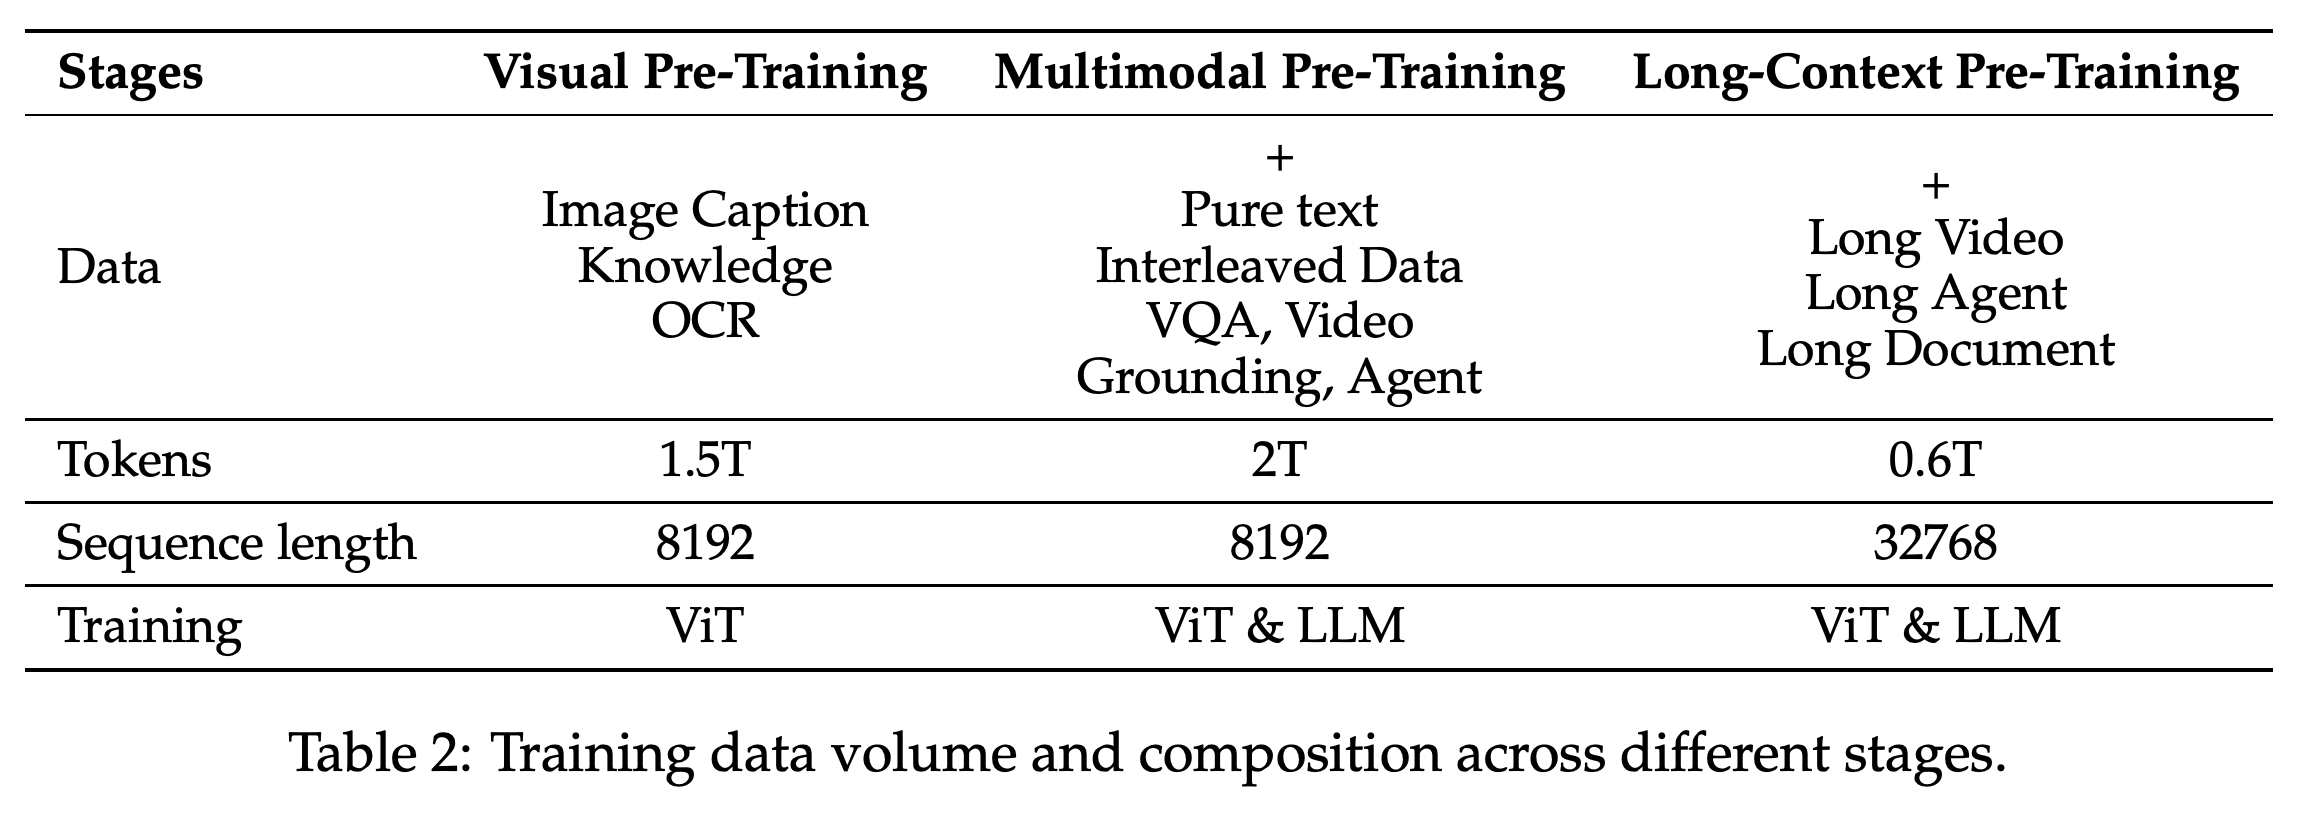
시각 인코더는 이미지와 텍스트 데이터 자원인 DataComp와 내부 데이터셋에서 처음부터 학습해 초기화하며, 언어 구성 요소는 사전 학습된 Qwen2.5 가중치에서 시작한다. Table 2는 시각 사전 학습에 1.5T 토큰, 멀티모달 사전 학습에 2T 토큰, 긴 문맥 사전 학습에 0.6T 토큰을 사용한다고 명시한다. T는 1000000000000을 뜻한다.
- 시각 사전 학습은 시퀀스 길이 8192에서 캡션, 시각 지식, OCR을 사용해 ViT를 갱신한다. 멀티모달 사전 학습은 모든 매개변수를 학습 대상으로 전환하고, 텍스트, 이미지와 텍스트가 섞인 입력, 시각 내용에 관한 질문에 답하는 visual question answering(VQA), 동영상, grounding, 에이전트 데이터를 추가한다. 이 단계의 시퀀스 길이도 8192다.
- 긴 문맥 사전 학습은 긴 동영상, 행동 시퀀스인 에이전트 궤적, 문서를 추가하고 시퀀스 길이를 32768로 늘린다. 그래픽 처리 장치 사이의 연산 부하를 균형 있게 배분하도록 디코더 입력 길이에 따라 샘플을 동적으로 패킹해 학습 시퀀스로 묶는다.
3개 토큰 예산의 합은 4.1T다. 학습 일정은 시퀀스 길이 8192에서 시각 인코더를 학습하는 단계에서 시작해 비전 언어 공동 학습으로 이어진다. 이후 긴 동영상, 에이전트 궤적, 문서를 처리하도록 시퀀스 길이를 32768로 늘린다.
2.3 Post-training
사후 학습은 지시와 응답으로 후속 과제의 동작을 학습하는 Supervised Fine-Tuning(SFT)을 수행한 뒤, 선호도 데이터로 응답을 사람의 판단에 맞추는 Direct Preference Optimization(DPO)을 수행한다. SFT는 역할을 구분하는 대화 형식인 ChatML을 사용하며, 텍스트와 함께 시각 임베딩을 삽입하고 패킹 중에도 모달리티 간 위치 관계를 유지한다.
2.3.1 Instruction Data
지시 데이터셋에는 약 200만 개의 항목이 있으며, 항목 수를 기준으로 순수 텍스트와 멀티모달 사례를 같은 비율로 나눈다. 멀티모달 항목은 더 많은 토큰과 연산을 소비하므로, 항목 수의 50%/50% 분할이 학습 자원의 균등한 배분을 뜻하지는 않는다.
- 데이터셋은 중국어와 영어를 중심으로 다른 언어의 사례를 보충하며, 단일 턴 및 다중 턴 대화, 단일 이미지 및 다중 이미지 입력, 동영상과 텍스트의 조합을 포함한다.
- 출처에는 공개 저장소, 구매한 데이터셋, 온라인 질의가 포함된다. 과제별 데이터는 VQA, 캡션 생성, 수학, 코딩, 보안 관련 질의, 문서 처리, OCR, grounding, 동영상 분석, 에이전트 상호작용을 다룬다.
2.3.2 Data Filtering Pipeline
필터링은 먼저 Qwen2-VL-72B에서 파생한 분류 모델 Qwen2-VL-Instag를 사용해 질문과 답변 쌍을 8개 주요 도메인과 30개 하위 범주로 분류한다. 예시 도메인에는 Coding과 Planning이 있으며, 코딩 식별자에는 Code_Debugging, Code_Generation, Code_Translation, Code_Understanding이 포함된다.
- 도메인별 규칙으로 반복되거나, 불완전하거나, 잘렸거나, 형식이 잘못됐거나, 관련이 없거나, 잠재적으로 유해한 항목을 제거한다.
- 응답 품질에 점수를 매기는 보상 모델은 Qwen2.5-VL 시리즈를 기반으로 학습한다. 질의의 복잡도와 관련성, 답변의 정확성, 완결성, 명확성, 관련성, 유용성을 평가한다. 시각 과제에서는 답변이 이미지 근거를 올바르게 활용하는지도 추가로 확인한다.
2.3.3 Rejection Sampling for Enhanced Reasoning
Rejection sampling은 중간 단계의 Qwen2.5-VL 모델로 응답을 생성하고, 답이 정답과 일치하는 사례를 남긴다. 여러 단계의 추론이 필요한 수학, 코딩, 도메인별 VQA를 대상으로 하며, 중간 추론 단계를 명시한 Chain-of-Thought(CoT) 사례를 만든다.
- 추가 필터는 응답 안에서 언어를 바꾸는 code-switching, 과도한 길이, 반복을 걸러낸다. 규칙과 모델은 중간 단계에서 시각 정보를 올바르게 사용하는지 확인한다.
- 저자들은 추론 단계가 시각적 근거를 무시하거나 잘못 해석할 수 있으며, 추론을 2개 모달리티 모두에 맞추는 일이 여전히 과제라고 인정한다. 보고서는 rejection sampling만의 기여를 정량적으로 측정한 ablation 실험을 제공하지 않는다.
2.3.4 Training Recipe
SFT와 DPO의 2개 단계 모두에서 ViT를 고정한다. SFT는 일반 및 전문 과제의 이미지와 텍스트 쌍, 동영상, 순수 텍스트를 포함한다. DPO는 이미지와 텍스트 및 순수 텍스트 선호도 데이터를 사용하며, 각 샘플을 1회 처리한다.
3.1 Comparison with the SOTA Models
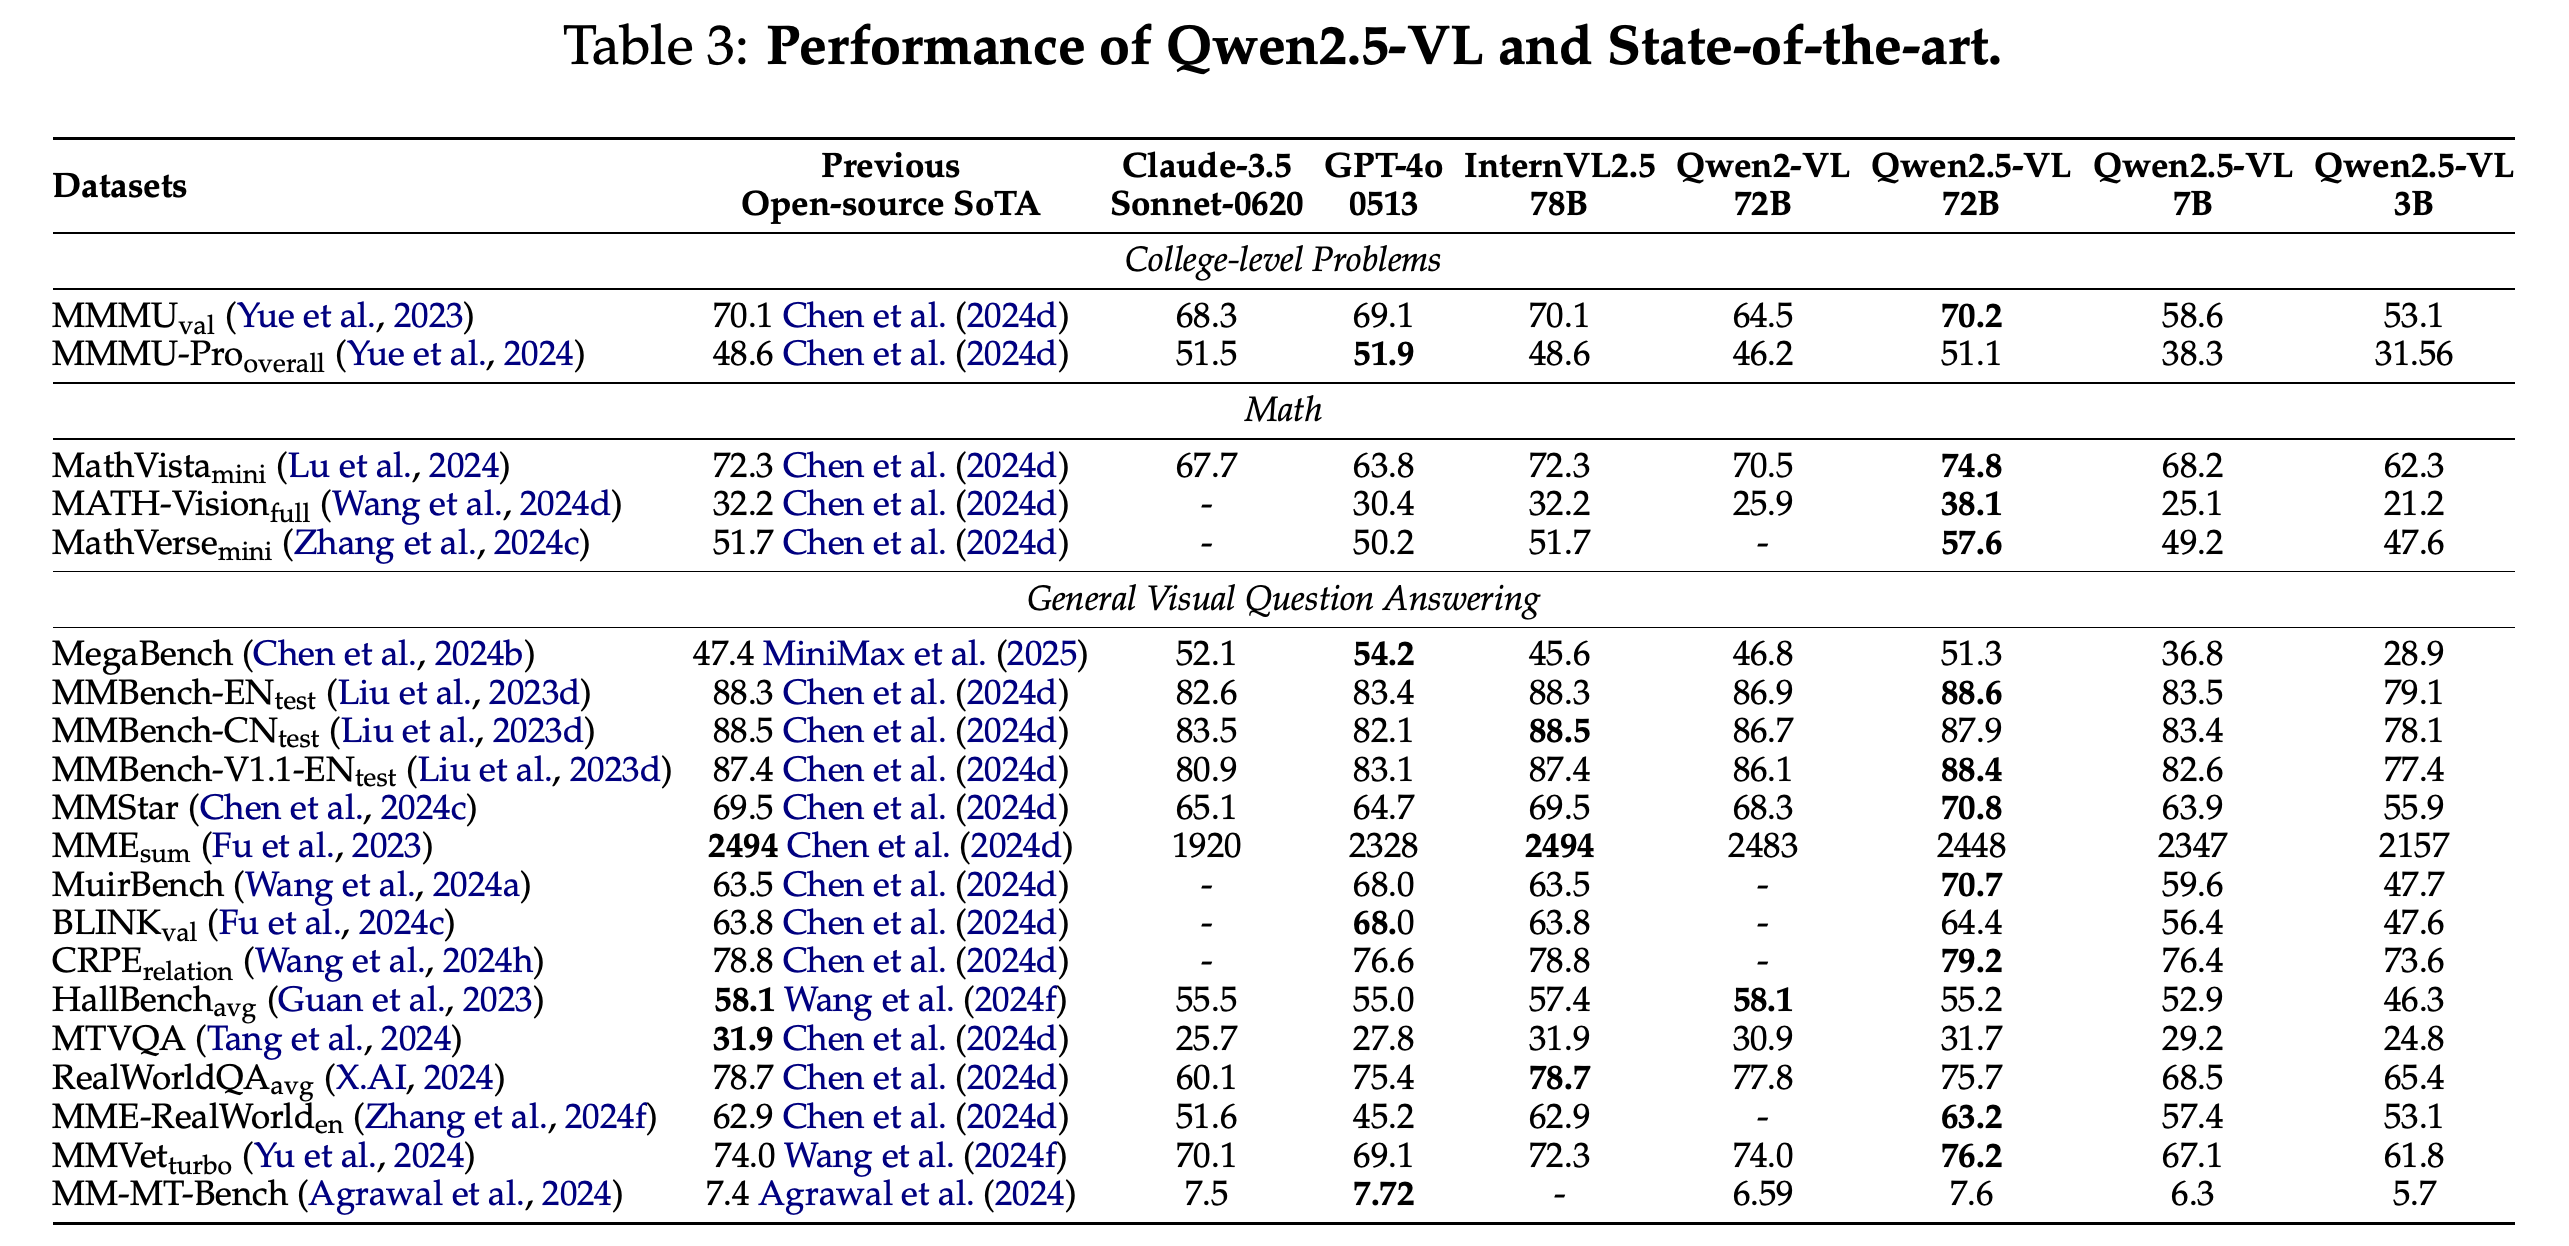
실험은 전체 벤치마크 성능을 비교한 뒤 개별 능력을 살펴본다. Table 3은 Qwen2.5-VL의 3개 크기를 기존 오픈 소스 최고 성능(SOTA) 결과, Claude-3.5-Sonnet-0620, GPT-4o-0513, InternVL2.5-78B, Qwen2-VL-72B와 비교한다. 72B 모델은 대학 수준 멀티모달 벤치마크인 MMMU validation에서 70.2를 기록하며, InternVL2.5-78B는 70.1, GPT-4o-0513은 69.1을 기록한다.
- 평가의 견고성을 높인 대학 수준 멀티모달 평가인 MMMU-Pro overall에서는 51.1로 InternVL2.5-78B의 48.6을 웃돌지만, GPT-4o-0513의 51.9와 Claude-3.5-Sonnet-0620의 51.5에는 못 미친다.
- 시각 수학 벤치마크 MathVista mini, MATH-Vision full, MathVerse mini에서는 각각 74.8, 38.1, 57.6을 기록한다. InternVL2.5-78B의 점수는 각각 72.3, 32.2, 51.7이다.
- 일반 시각 과제에서는 성능이 엇갈린다. 폭넓은 실제 과제를 다루는 MegaBench에서는 51.3으로 GPT-4o-0513의 54.2보다 낮고, 시각 질의응답 벤치마크 RealWorldQA에서는 75.7로 InternVL2.5-78B의 78.7보다 낮다.
72B 모델은 시각 수학과 여러 일반 시각 벤치마크에서 향상되지만, 비교에는 MegaBench, MME, HallBench, RealWorldQA에서 뒤처지는 결과도 포함된다. 작은 모델은 MMMU-Pro와 시각 수학처럼 어려운 과제에서 점수가 더 낮다.
3.2 Performance on Pure Text Tasks
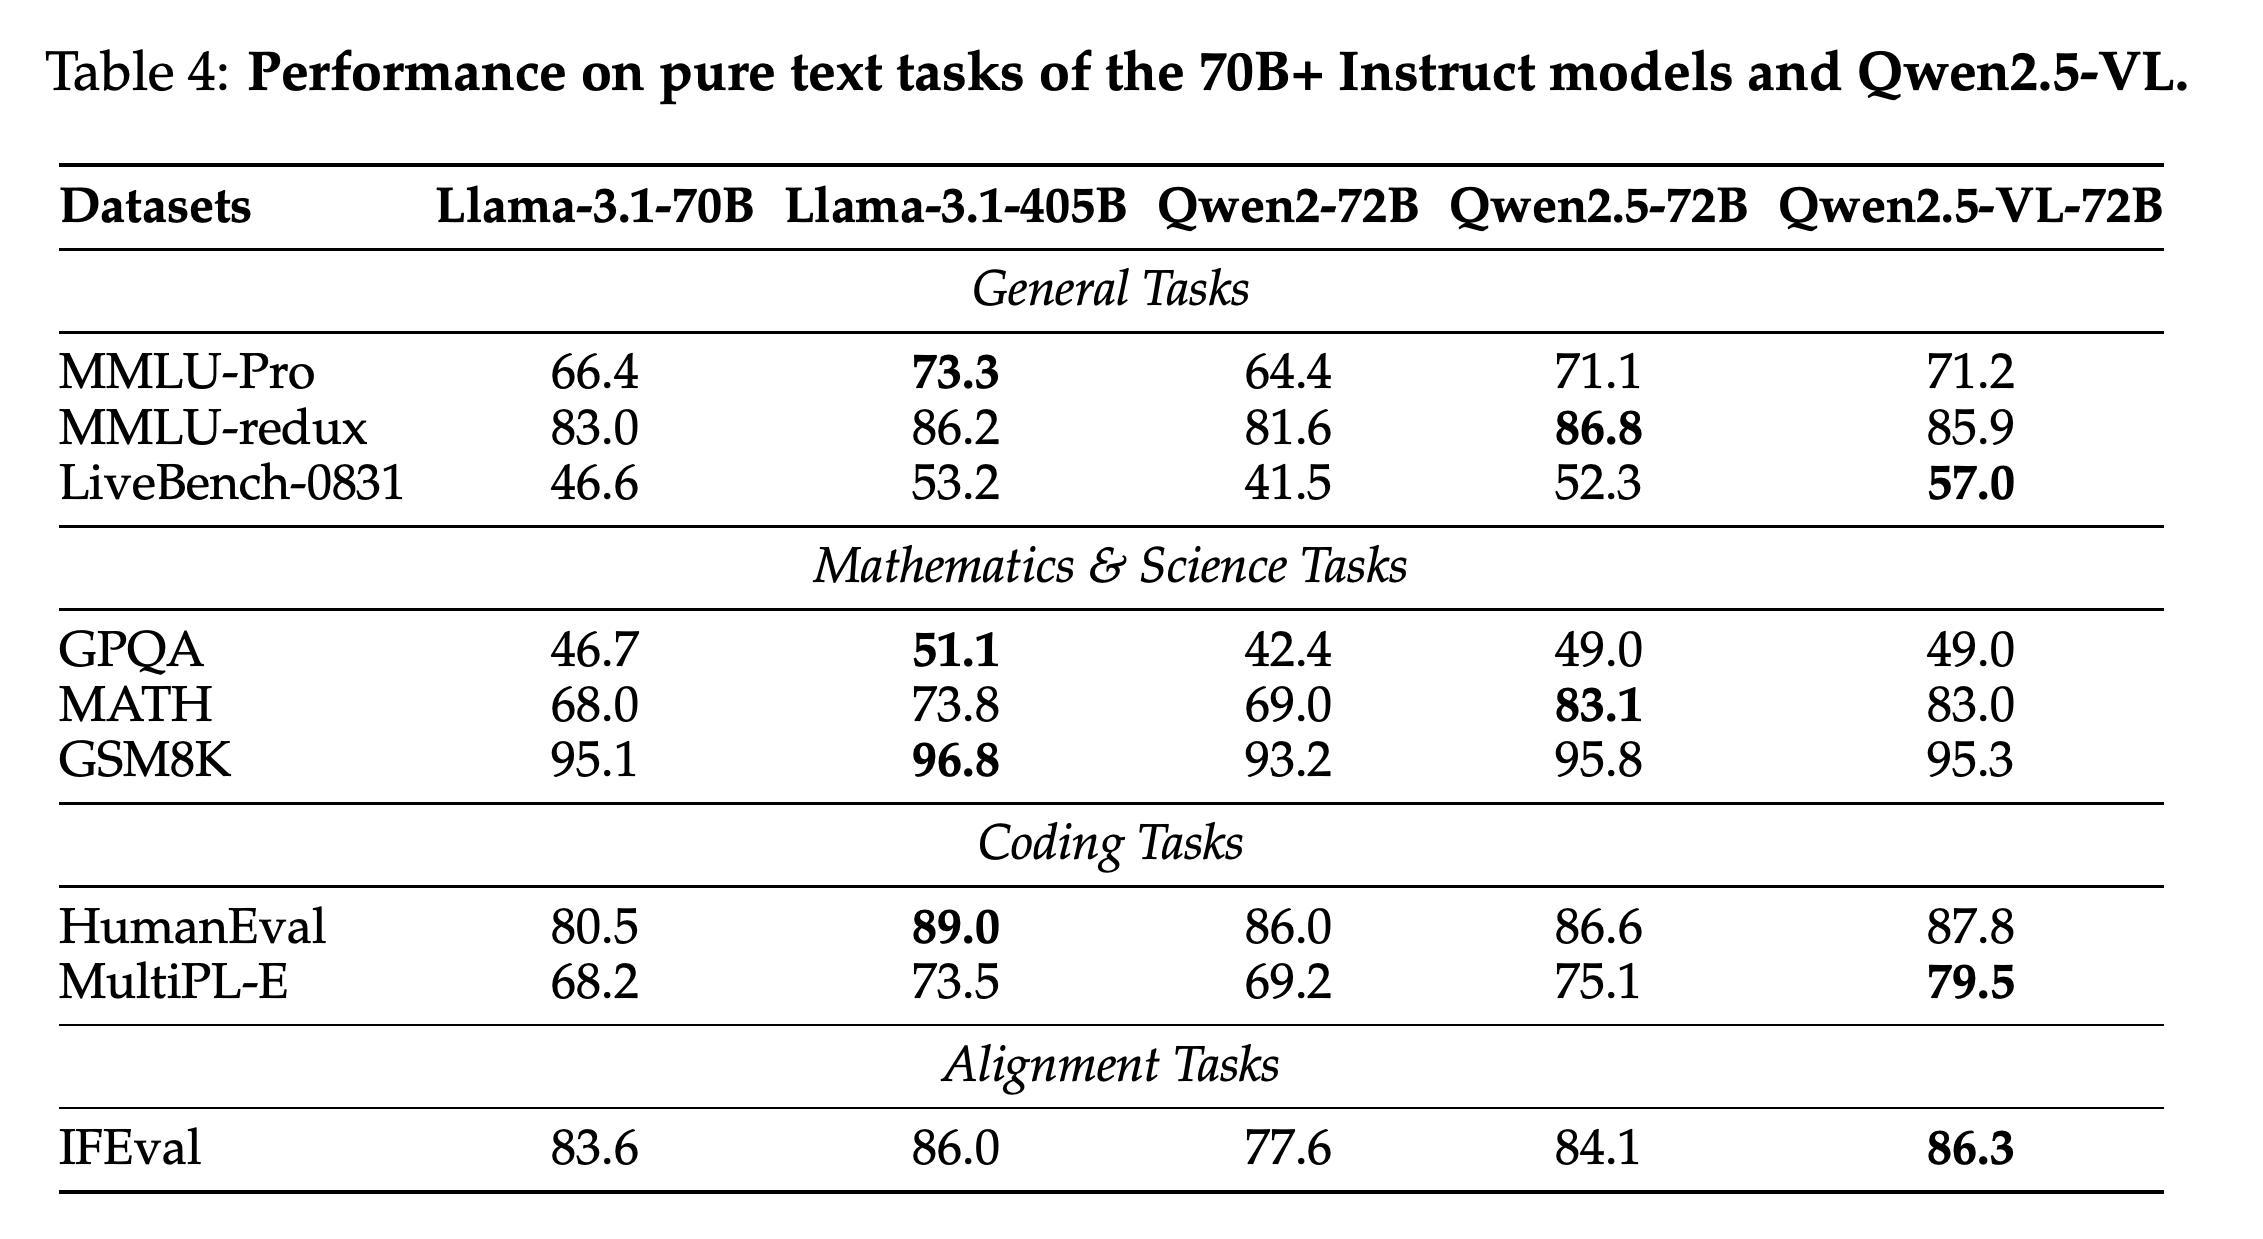
Table 4는 텍스트 전용 일반 지식, 수학과 과학, 코드 생성, 지시 이행 능력을 70B+ 지시 학습 모델과 비교한다. Qwen2.5-VL-72B는 Qwen2.5-72B의 언어 성능을 대체로 유지한다. 일반 지식을 평가하는 MMLU-Pro는 71.2 대 71.1이며, 대학원 수준 질의응답을 평가하는 GPQA는 2개 모델 모두 49.0이다. 수학 문제 해결을 평가하는 MATH는 83.0 대 83.1이다.
- 일반 언어 모델 평가인 LiveBench-0831은 52.3에서 57.0으로, HumanEval 코드 생성은 86.6에서 87.8로, MultiPL-E 다국어 코드 생성은 75.1에서 79.5로, IFEval 지시 이행은 84.1에서 86.3으로 향상된다.
- 일반 지식을 평가하는 MMLU-redux는 85.9 대 86.8, 수학을 평가하는 GSM8K는 95.3 대 95.8로 소폭 하락한다. Llama-3.1-405B는 MMLU-Pro와 HumanEval을 포함한 여러 과제에서 앞선다.
Qwen2.5-72B와의 비교는 멀티모달 학습 이후에도 텍스트 능력이 유지됨을 뒷받침한다. LiveBench-0831, MultiPL-E, IFEval에서는 향상되지만, MMLU-redux, MATH, GSM8K에서는 소폭 하락한다.
3.3 Quantitative Results
정량 평가는 일반 시각 질의응답, 문서 이해와 OCR, 공간 이해, 동영상 이해와 grounding, 에이전트 동작으로 나뉜다. 과제군마다 지표와 평가 설정이 다르므로, 점수는 각 벤치마크의 맥락에서 해석해야 한다.
3.3.1 General Visual Question Answering
Qwen2.5-VL-72B는 시각 이해와 추론 평가 2개인 MMBench-V1.1-EN test에서 88.4, MMStar에서 70.8을 기록한다. 고해상도 실제 이미지를 다루는 MME-RealWorld English에서는 63.2, 다중 이미지 이해를 평가하는 MuirBench에서는 70.7을 기록한다. InternVL2.5-78B의 해당 점수는 각각 87.4, 69.5, 62.9, 63.5다.
- 7B와 3B 모델은 MMStar에서 각각 63.9와 55.9를 기록해 72B 모델보다 낮은 성능을 보인다.
- 비교 표에는 성능이 낮은 결과도 나타난다. 72B 모델은 일반 멀티모달 평가인 MME에서 2448로 InternVL2.5-78B의 2494보다 낮고, 환각과 시각적 착시를 평가하는 HallBench에서는 55.2로 Qwen2-VL-72B의 58.1보다 낮다.
3.3.2 Document Understanding and OCR
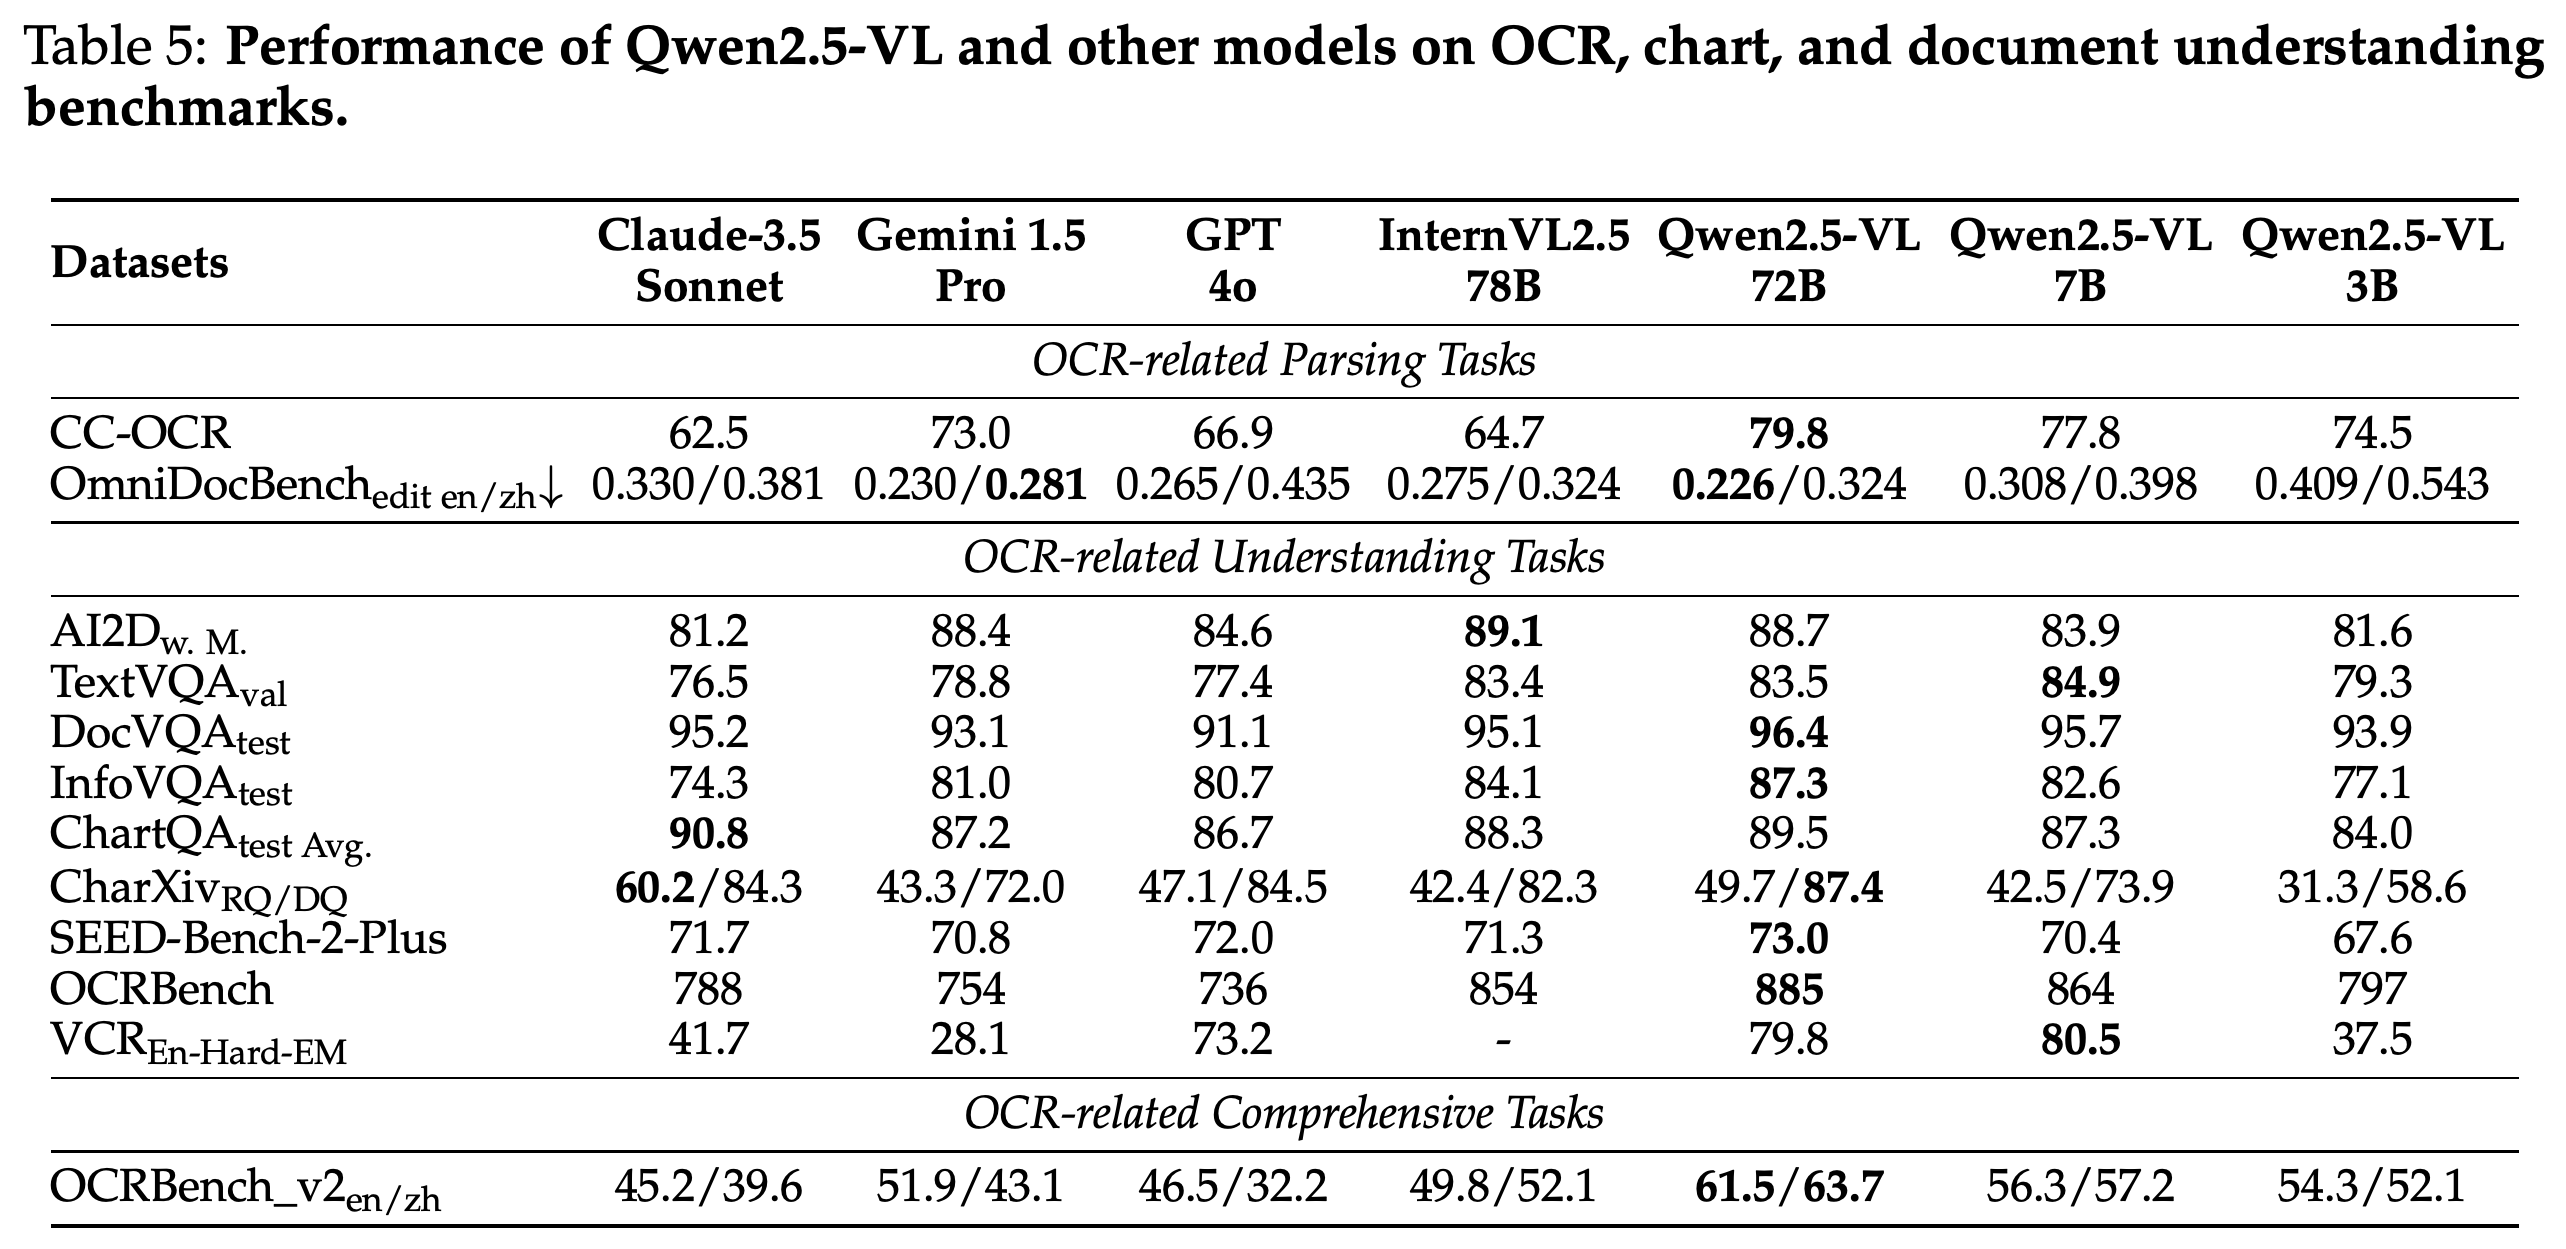
Table 5에서 Qwen2.5-VL-72B는 다국어 텍스트 인식 평가인 CC-OCR에서 79.8, DocVQA test에서 96.4, 인포그래픽에 관한 질문을 평가하는 InfoVQA test에서 87.3, 텍스트 인식과 이해의 종합 평가인 OCRBench에서 885를 기록한다. InternVL2.5-78B의 점수는 각각 64.7, 95.1, 84.1, 854다.
- 텍스트 파싱과 이해를 평가하는 OCRBench_v2에서 영어/중국어 점수는 61.5/63.7로, Gemini 1.5 Pro의 51.9/43.1보다 각각 9.6점과 20.6점 높다.
- OmniDocBench 문서 파싱은 출력 간 차이를 측정하는 편집 거리를 보고하며, 이 값은 낮을수록 좋다. 72B 모델의 영어/중국어 편집 거리는 0.226/0.324이며, Gemini 1.5 Pro는 0.230/0.281이다. 영어 결과는 더 좋지만 중국어 결과는 더 나쁘다.
- 모델이 모든 차트나 도식 과제에서 앞서지는 않는다. 차트 질의응답인 ChartQA는 89.5로 Claude-3.5 Sonnet의 90.8보다 낮고, 도식 이해를 평가하는 AI2D는 88.7로 InternVL2.5-78B의 89.1보다 낮다. 장면 속 텍스트에 관한 질의응답인 TextVQA에서는 7B 모델이 84.9로 72B 모델의 83.5를 웃돈다.
문서 질의응답과 OCR 점수는 여러 베이스라인보다 우수하지만, 지표는 각각 해석해야 한다. 낮을수록 좋은 OmniDocBench 편집 거리에서는 영어의 경우 72B 모델이, 중국어의 경우 Gemini 1.5 Pro가 앞선다. ChartQA에서는 Claude-3.5 Sonnet이 더 높은 점수를 기록한다.
3.3.3 Spatial Understanding
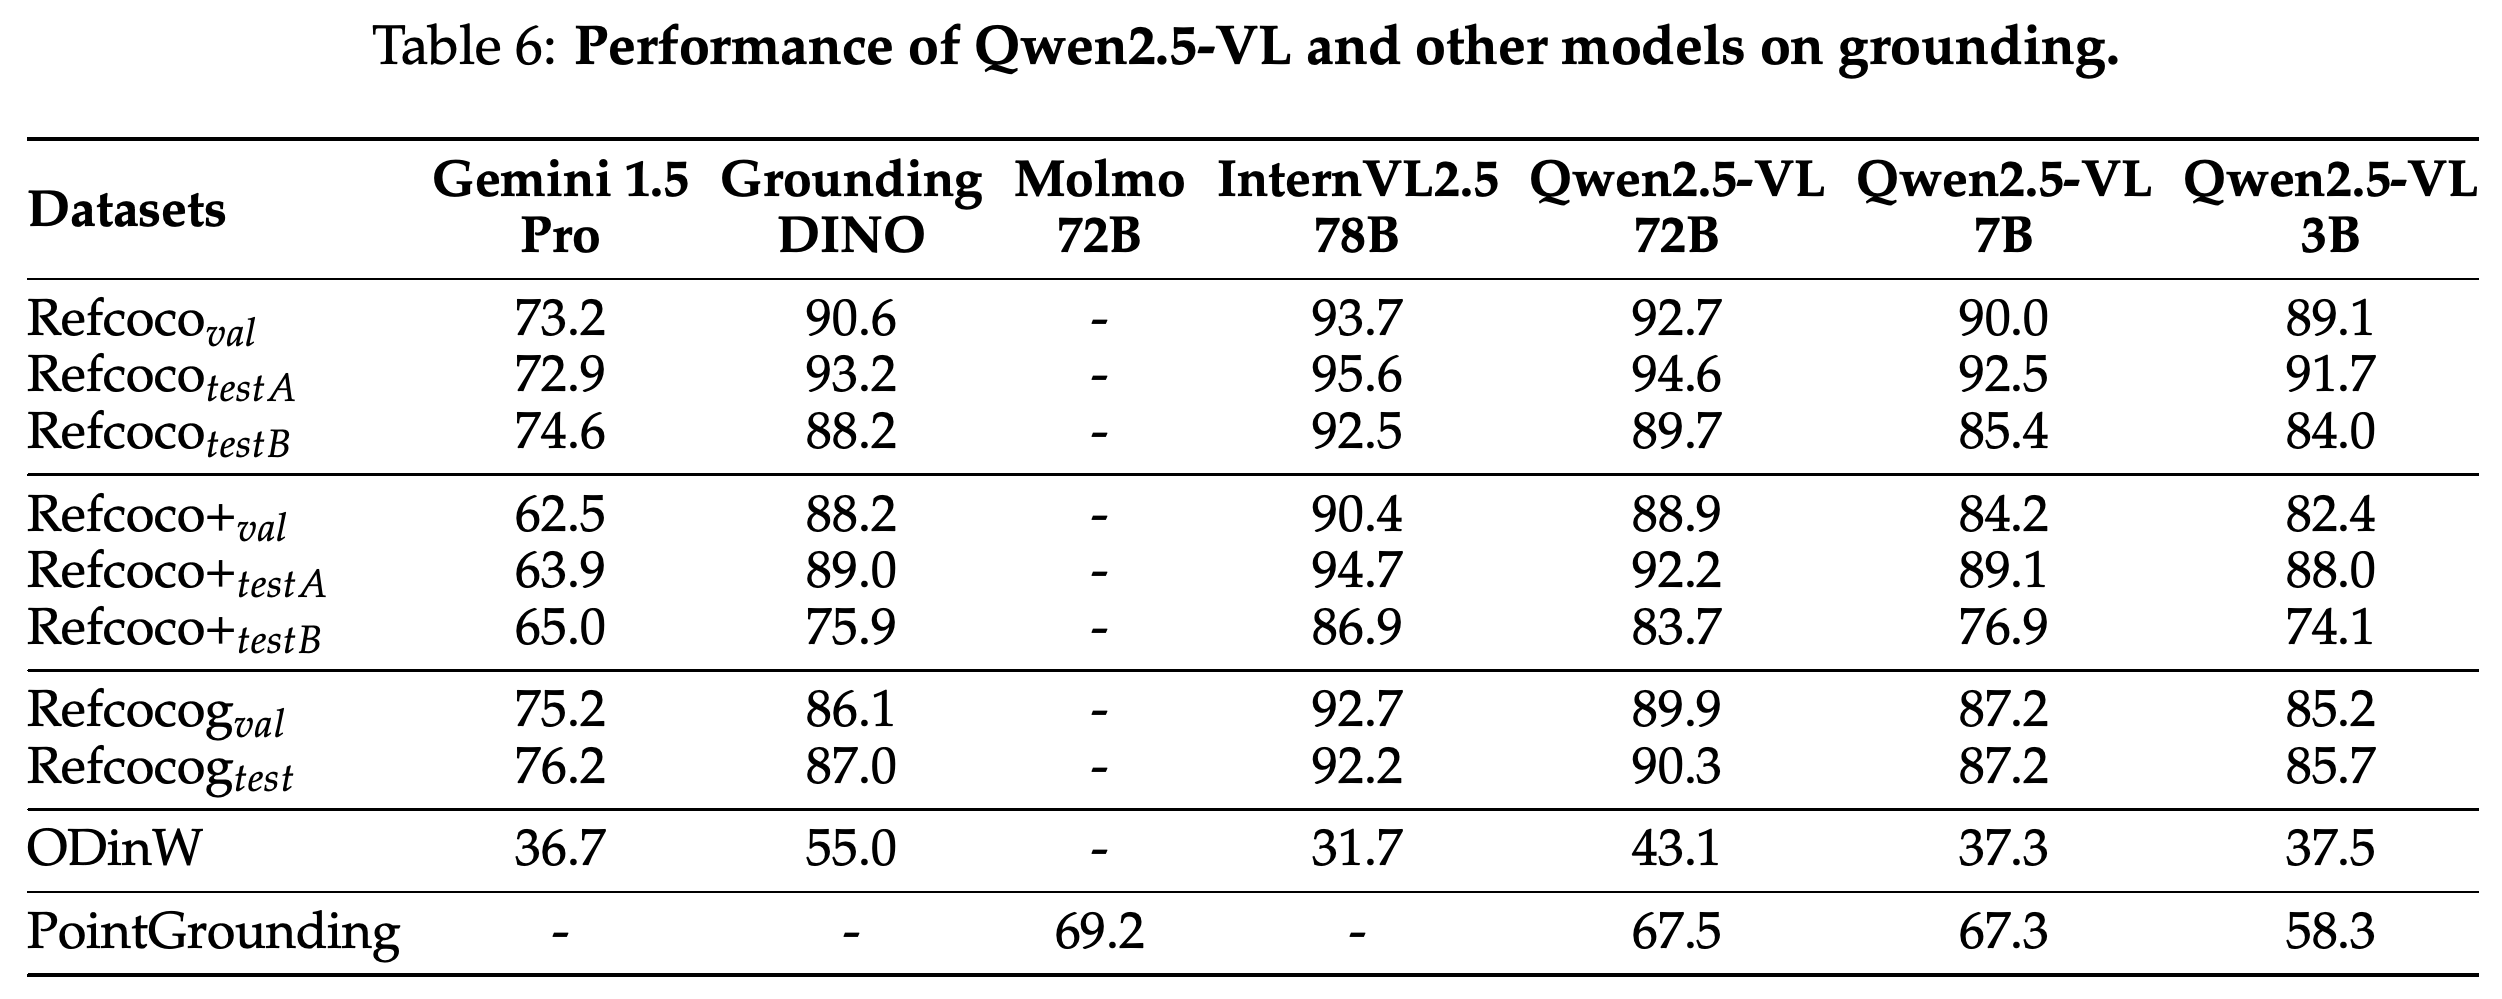
공간 평가는 언어로 설명한 객체를 찾는 지칭 표현 기반 경계 상자 위치 파악, 언어로 지정한 범주를 탐지하는 open-vocabulary detection, 점 위치 파악, 객체 수 세기를 다룬다. Qwen2.5-VL-72B는 ODinW-13의 탐지 지표인 mean average precision에서 43.1을 기록한다. InternVL2.5-78B는 31.7, 전문 탐지 모델 Grounding DINO는 55.0을 기록한다.
- Table 6에서 InternVL2.5-78B는 나열된 Refcoco, Refcoco+, Refcocog의 모든 지칭 표현 평가 분할에서 Qwen2.5-VL-72B보다 높은 점수를 기록한다. 자체 구축한 점 위치 파악 벤치마크 PointGrounding에서 Qwen2.5-VL-72B는 67.5로 Molmo-72B의 69.2보다 낮다.
- Table 7은 객체 수 세기 평가인 CountBench에서 “detect then count” 방식의 프롬프트를 사용해 정확도 93.6을 기록했다고 보고한다. 이는 Molmo-72B의 91.2, Claude-3.5 Sonnet의 89.7, GPT-4o의 87.9를 웃돈다.
모델은 ODinW 탐지에서 InternVL2.5-78B보다 높은 점수를 기록하지만 Grounding DINO에는 못 미친다. 나열된 모든 지칭 표현 평가 분할에서는 InternVL2.5-78B가, 점 grounding 비교에서는 Molmo-72B가 앞선다. 따라서 함께 제시된 전반적인 grounding 성능 우위 주장은 제한적으로 해석해야 한다.
3.3.4 Video Understanding and Grounding
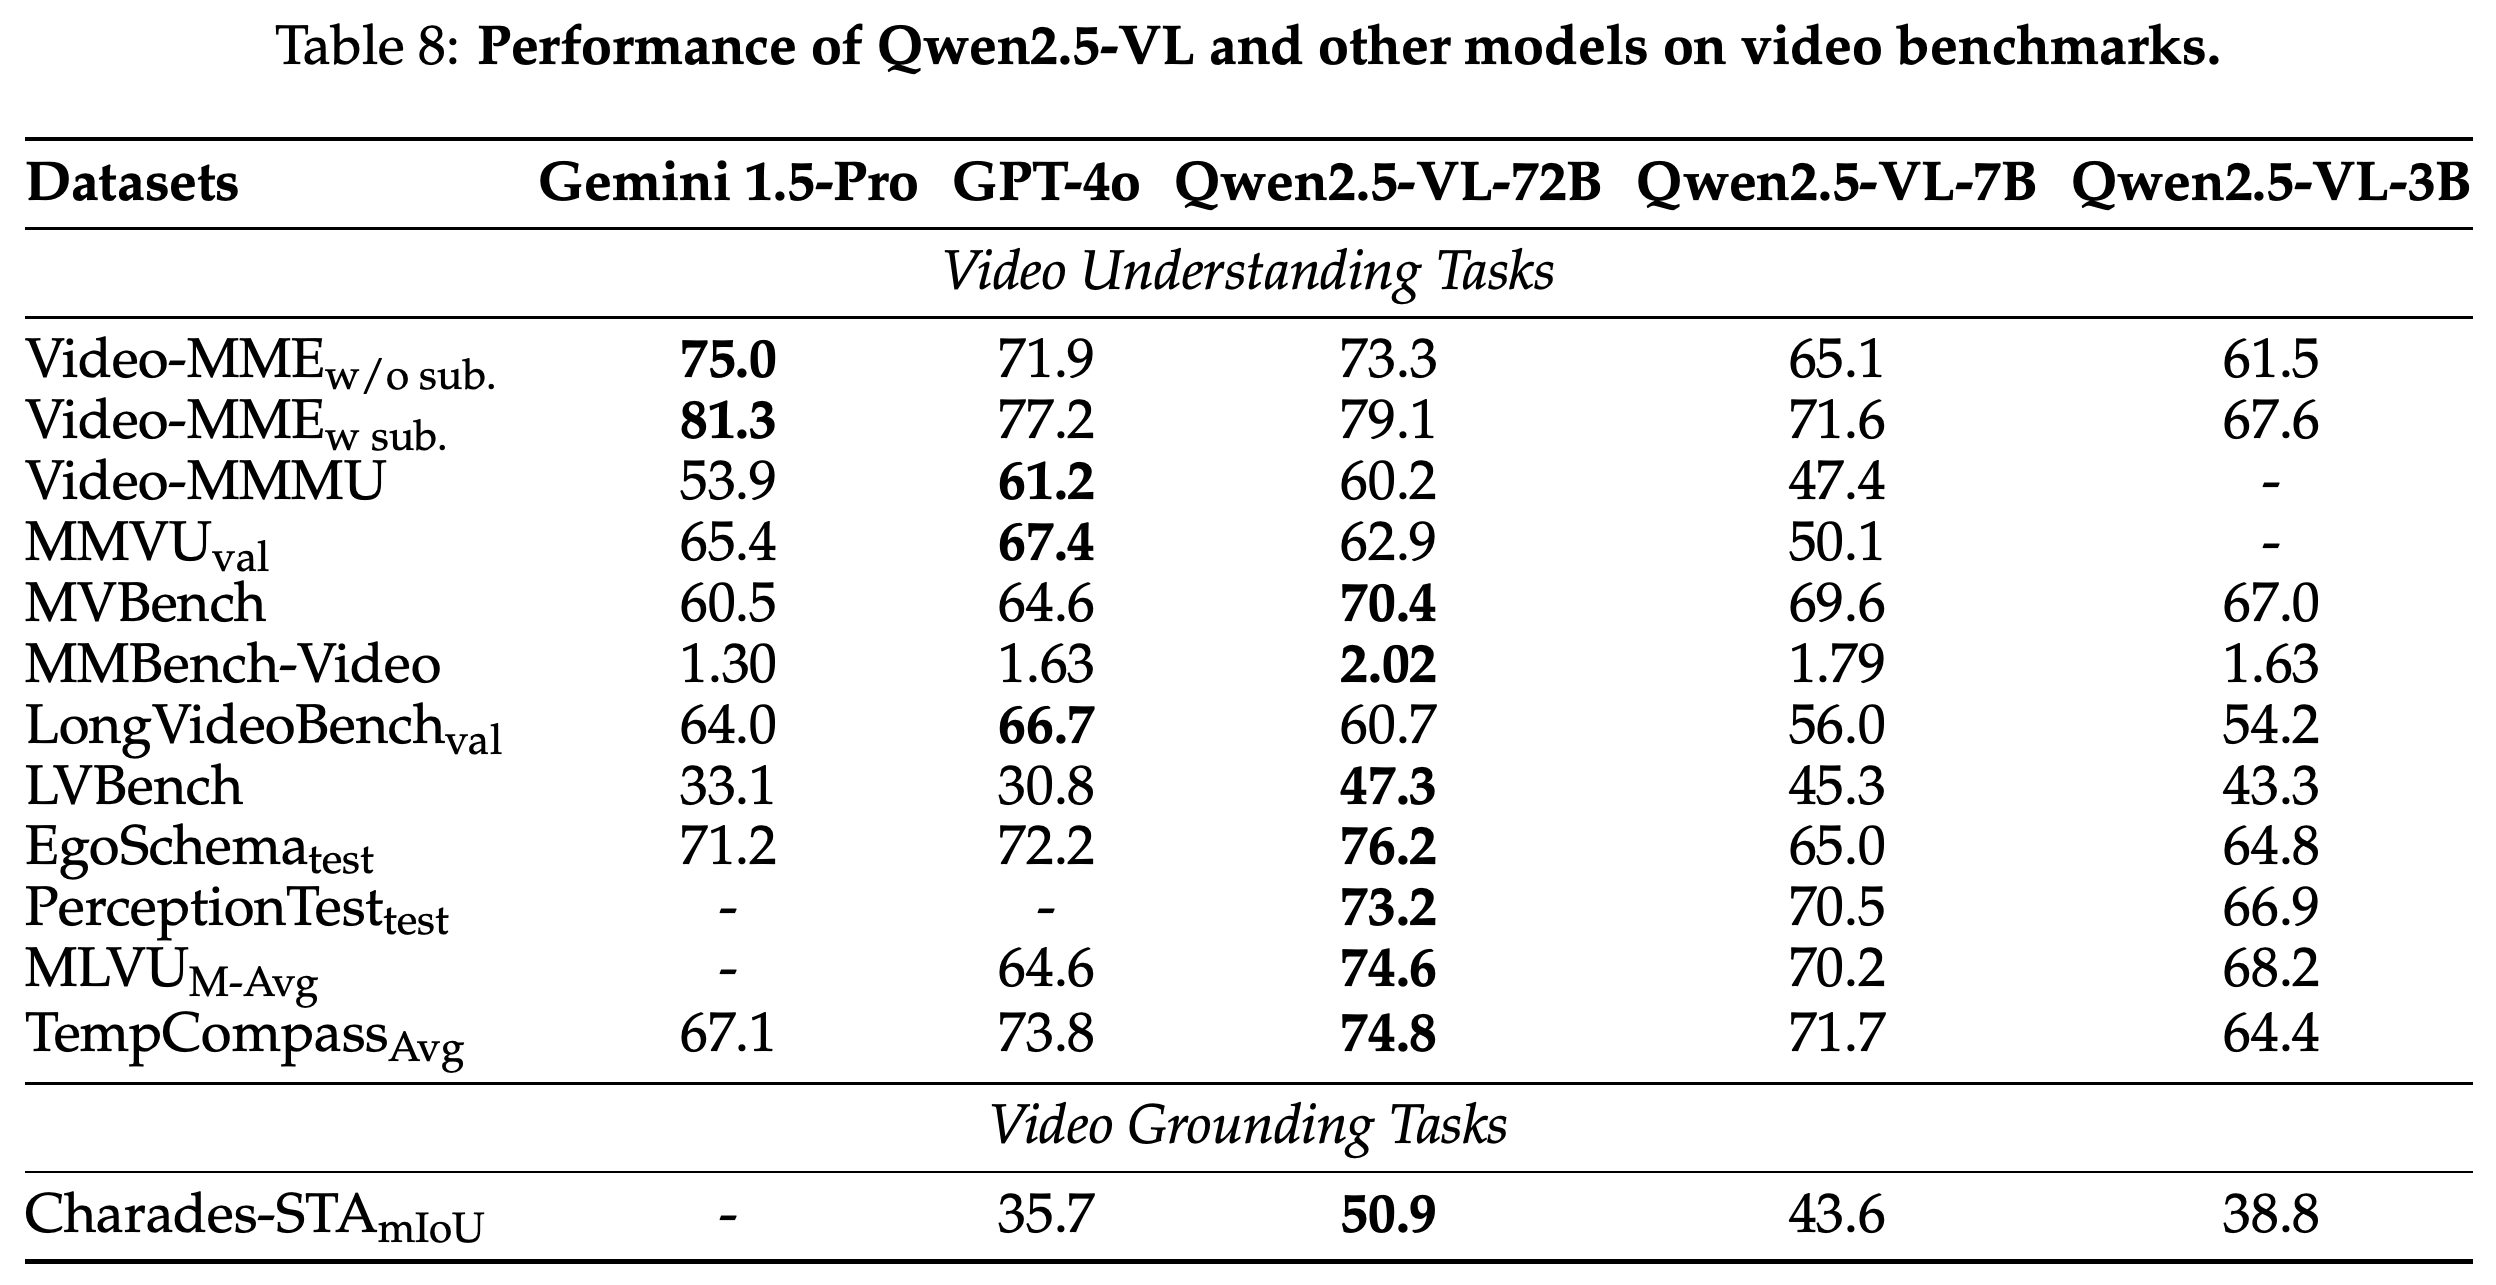
동영상 벤치마크는 수초 길이의 클립부터 수시간 길이의 동영상까지 다룬다. 평가에서는 동영상마다 분석 프레임을 최대 768개, 동영상 토큰을 최대 24,576개로 제한한다. Qwen2.5-VL-72B는 긴 동영상 이해 평가 2개인 LVBench에서 47.3, MLVU M-Avg에서 74.6을 기록하며, GPT-4o는 각각 30.8과 64.6을 기록한다.
- 이벤트의 시간 구간을 찾는 Charades-STA temporal grounding에서 모델은 예측 구간과 정답 구간의 겹침을 측정하는 mean intersection over union 50.9를 기록하며, GPT-4o는 35.7을 기록한다.
- Video-MME 동영상 이해 점수는 자막이 없을 때 73.3, 자막이 있을 때 79.1이다. GPT-4o의 71.9와 77.2보다 높지만, Gemini 1.5 Pro의 75.0과 81.3보다는 낮다.
- 긴 동영상의 성능 향상은 벤치마크마다 다르다. 또 다른 긴 동영상 이해 평가인 LongVideoBench validation에서는 60.7로 GPT-4o의 66.7보다 낮다. 보고서의 수시간 길이 동영상 비교는 토큰과 프레임 제한을 고려해 해석해야 한다.
GPT-4o보다 높은 점수를 기록한 과제에는 LVBench와 Charades-STA가 포함되지만, Video-MME에서는 Gemini 1.5 Pro가, LongVideoBench에서는 GPT-4o가 앞선다. 시간 구간 위치 파악과 일부 긴 동영상 점수는 향상되지만, 다른 동영상 평가에서는 성능이 더 낮다.
3.3.5 Agent
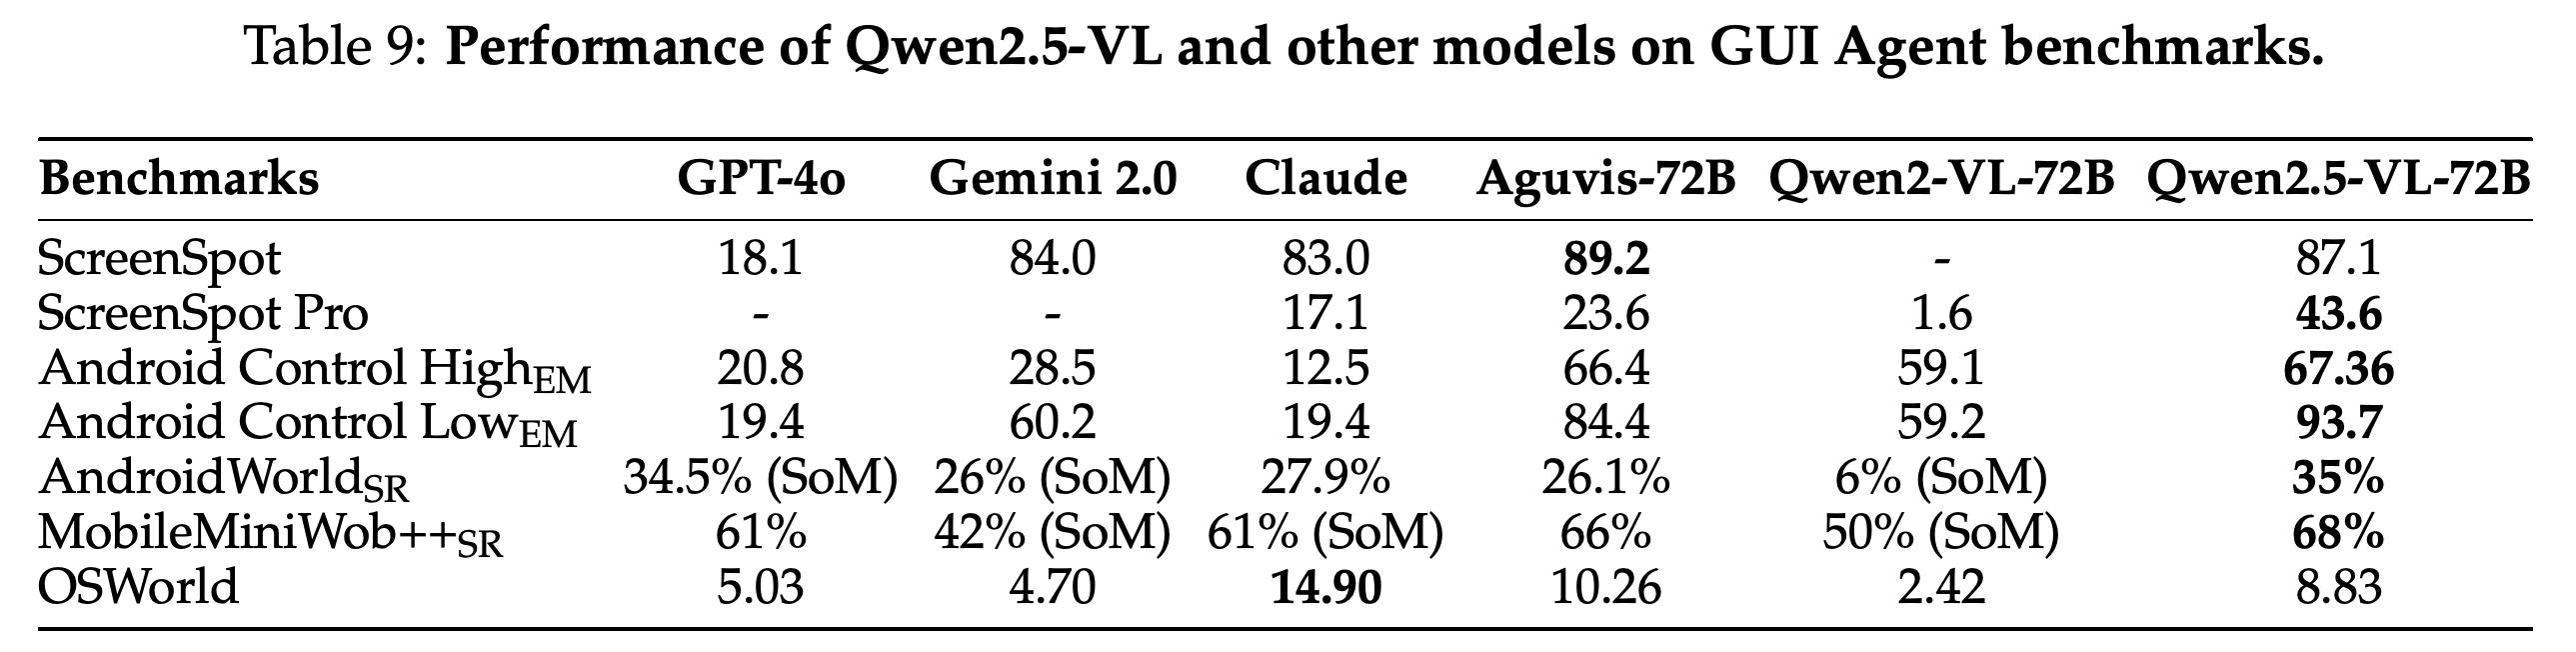
에이전트 평가는 그래픽 사용자 인터페이스(GUI) 요소 위치 파악, 오프라인 행동 예측, 온라인 과제 실행을 구분한다. Qwen2.5-VL-72B는 고해상도 인터페이스 위치 파악 벤치마크 ScreenSpot Pro에서 정확도 43.6%를 기록하며, Aguvis-72B는 23.6%, Qwen2-VL-72B는 1.6%를 기록한다. 일반 ScreenSpot 위치 파악에서는 87.1%로 Aguvis-72B의 89.2%보다 낮다.
- Android Control 오프라인 행동 예측의 High와 Low 완전 일치 점수는 각각 67.36과 93.7이며, Aguvis-72B는 각각 66.4와 84.4를 기록한다.
- 온라인 성공률은 AndroidWorld 모바일 과제에서 35%, MobileMiniWob++ 인터페이스 과제에서 68%다. 일부 비교 시스템은 인터페이스 요소를 식별하는 보조 시각 표식인 Set-of-Mark(SoM)를 입력받지만, Qwen2.5-VL은 이 표식 없이 작동한다.
- OSWorld 컴퓨터 과제 실행 점수는 8.83으로 Claude의 14.90, Aguvis-72B의 10.26보다 낮다. 데스크톱 결과는 모델이 선두를 기록한 모바일 성공률과 ScreenSpot Pro 위치 파악 결과에 비해 경쟁력이 낮다.
ScreenSpot Pro와 Android Control에서는 Qwen2-VL-72B보다 크게 향상되지만, OSWorld에서는 여전히 Claude와 Aguvis-72B보다 낮다. 온라인 비교에는 보조 Set-of-Mark 입력을 사용하는 시스템과 사용하지 않는 시스템이 섞여 있어 성공률을 직접 비교하는 데 제약이 있다.
4 Conclusion
결론은 Qwen2.5-VL을 세부 시각 정보 인식, 문서 파싱, 공간 위치 파악, 동영상 이해, 상호작용 능력을 결합하면서 텍스트 능력을 유지하는 범용 모델군으로 제시한다. 벤치마크 표는 이 가운데 여러 영역의 향상을 뒷받침하지만, 과제별 성능 하락도 보여주므로 결론의 포괄적인 성능 주장은 이를 고려해 해석해야 한다.
5 Authors
보고서에는 저자를 Qwen Team, Alibaba Group으로 표기한다. Authors 절은 Core Contributors와 Contributors를 별도로 나열하며, 후자 목록은 알파벳순임을 명시한다.
부록
- 제공된 23페이지 보고서에는 부록이 없으며, References는 16–23페이지에 실려 있다. 표제 페이지에 기재된 모델 자료 주소는 https://chat.qwenlm.ai, https://huggingface.co/Qwen, https://modelscope.cn/organization/qwen, https://github.com/QwenLM/Qwen2.5-VL이다.
짧은 생각
문서 추출과 인터페이스 위치 파악은 구체적인 벤치마크 향상으로 뒷받침되므로, 응용 테스트를 시작할 만한 영역이다. 중국어 문서 편집 거리, 지칭 표현 기반 위치 파악, LongVideoBench, OSWorld에서는 경쟁 시스템이 더 좋은 성능을 보인다. 아키텍처, 데이터 규모, 필터링, 사후 학습이 함께 바뀐다. 통제된 ablation 실험이 없으므로 보고서만으로는 각 변경의 기여도를 밝힐 수 없다. Window attention은 인코더 대부분의 층에서 어텐션 연산량을 줄이지만, 보고서는 지연 시간, 메모리, 처리량을 별도로 비교하지 않는다. 배포 효율은 벤치마크 정확도보다 직접적인 실증 근거가 부족하다. 에이전트 비교에는 보조 표식 조건이 서로 다른 시스템이 포함되며, 평가 표는 불확실성 추정치나 반복 실행에 따른 변동성을 제공하지 않는다. 따라서 작은 점수 차이는 문서 처리나 위치 파악에서 나타난 큰 격차보다 비교 근거가 약하다.