


Recurrent Looped Transformer 요약 설명
06 Oct 2026 | Paper Review Recurrent Transformers State Tracking Length Generalization이번 글에서는 Recurrent Looped Transformer 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 10월 6일(Arxiv)
- Zhang, Yifan, Feng, Jichen, Qin, Shihan, Kung, Sun-Yuan, Wang, Mengdi.
- Princeton University, University of Pennsylvania
- 논문 링크
- Github
- Project Page
요약
- 알고리즘 상태 추적은 입력마다 누적 상태를 갱신해야 하지만, 표준 Transformer는 시퀀스 길이와 관계없이 각 위치에 고정된 수의 층을 적용한다. Recurrent Looped Transformer(RLT)는 3–40비트 입력으로 학습한 뒤, 켜진 비트의 개수가 홀수인지 짝수인지 판별하는 parity 과제에서 초기화 시드 세 개에 걸쳐 5+3과 7+1 구성으로 256비트 정확도 100±0%를 달성한다. 여덟 층 decoder-only Transformer는 50.07±1.63%를 기록한다. a+b 구성은 인코더 a개 층과 디코더 b개 층을 뜻하며, 보고된 변동은 시드 간 표본 표준편차다.
- RLT는 미래 위치를 참조하지 않으면서 주어진 토큰을 병렬로 처리하는 인과적 인코더와, 피드백 기여도를 조절하는 학습 가능한 게이트를 통해 이전 토큰의 최종 출력을 받는 디코더를 결합한다. 토큰이 이어질수록 계산 경로는 길어지지만, 토큰마다 실행하는 인코더와 디코더 블록 수는 고정된다. 어텐션 연산량은 문맥 길이에 따라 증가한다.
- 항등 순열과 단일 교환을 입력으로 받아 원소 5개의 순열을 합성하는 교환 기반 S₅ 추적에서는, 32개 연산으로 학습한 4+4 분할이 256개 연산에서 최종 상태 정확도 97.30±2.76%를 달성한다. Transformer는 0.85±0.30%를 기록한다. 괄호 없이 5를 법으로 계산하는 flat mod-5 표현식에서는 5,000스텝 학습 후 6+2 분할이 길이 63에서 93.36±5.69%를 달성하며, Transformer는 33.20±2.33%를 기록한다.
- 피드백 빈도에 따른 정확도와 병렬 처리 사이의 절충 관계는 과제마다 다르다. 4+4 분할에서 4토큰마다 피드백을 갱신하면 64비트 parity 정확도는 98.99±1.66%로 유지되지만, 64개 연산의 교환 기반 S₅ 정확도는 100±0%에서 19.60±6.54%로 떨어진다. 피드백을 제거하면 모든 분할에서 과제 2개 모두 길이 64부터 우연 수준에 머문다.
- 실험 근거는 초기화 시드 세 개와 공통 데이터를 사용한 지도학습 합성 과제에서 얻었다. 8개 층으로 구성된 RLT 모델의 파라미터 수는 26.10–28.73M이며, Transformer는 25.31M이다. 덧셈의 길이 외삽 성능은 낮고, 가능한 입력으로 순열 120개를 모두 사용하는 표준 S₅ 추적은 우연 수준에 머문다. 논문은 자연어 모델링이나 보상으로 학습하는 강화학습(RL)을 평가하지 않는다.
1 Introduction
순환 계산은 상태 갱신 결과를 다음 갱신에 직접 전달하므로, 시퀀스가 길어질수록 의존 경로의 깊이가 증가한다. RLT는 병렬 문맥 인코딩과 순차적 상태 갱신을 분리하고, 인코더와 디코더의 깊이 배분 및 피드백 갱신 사이의 토큰 수라는 설계 선택 2가지를 연구한다.
- 임의 길이의 S₅ 합성에 대한 고정 깊이 모델의 한계는 TC⁰ ≠ NC¹을 조건으로 한다. 이는 계산 능력을 규정하는 데 사용하는 회로 복잡도 클래스 사이의 분리 가정이다(Merrill et al., 2024).
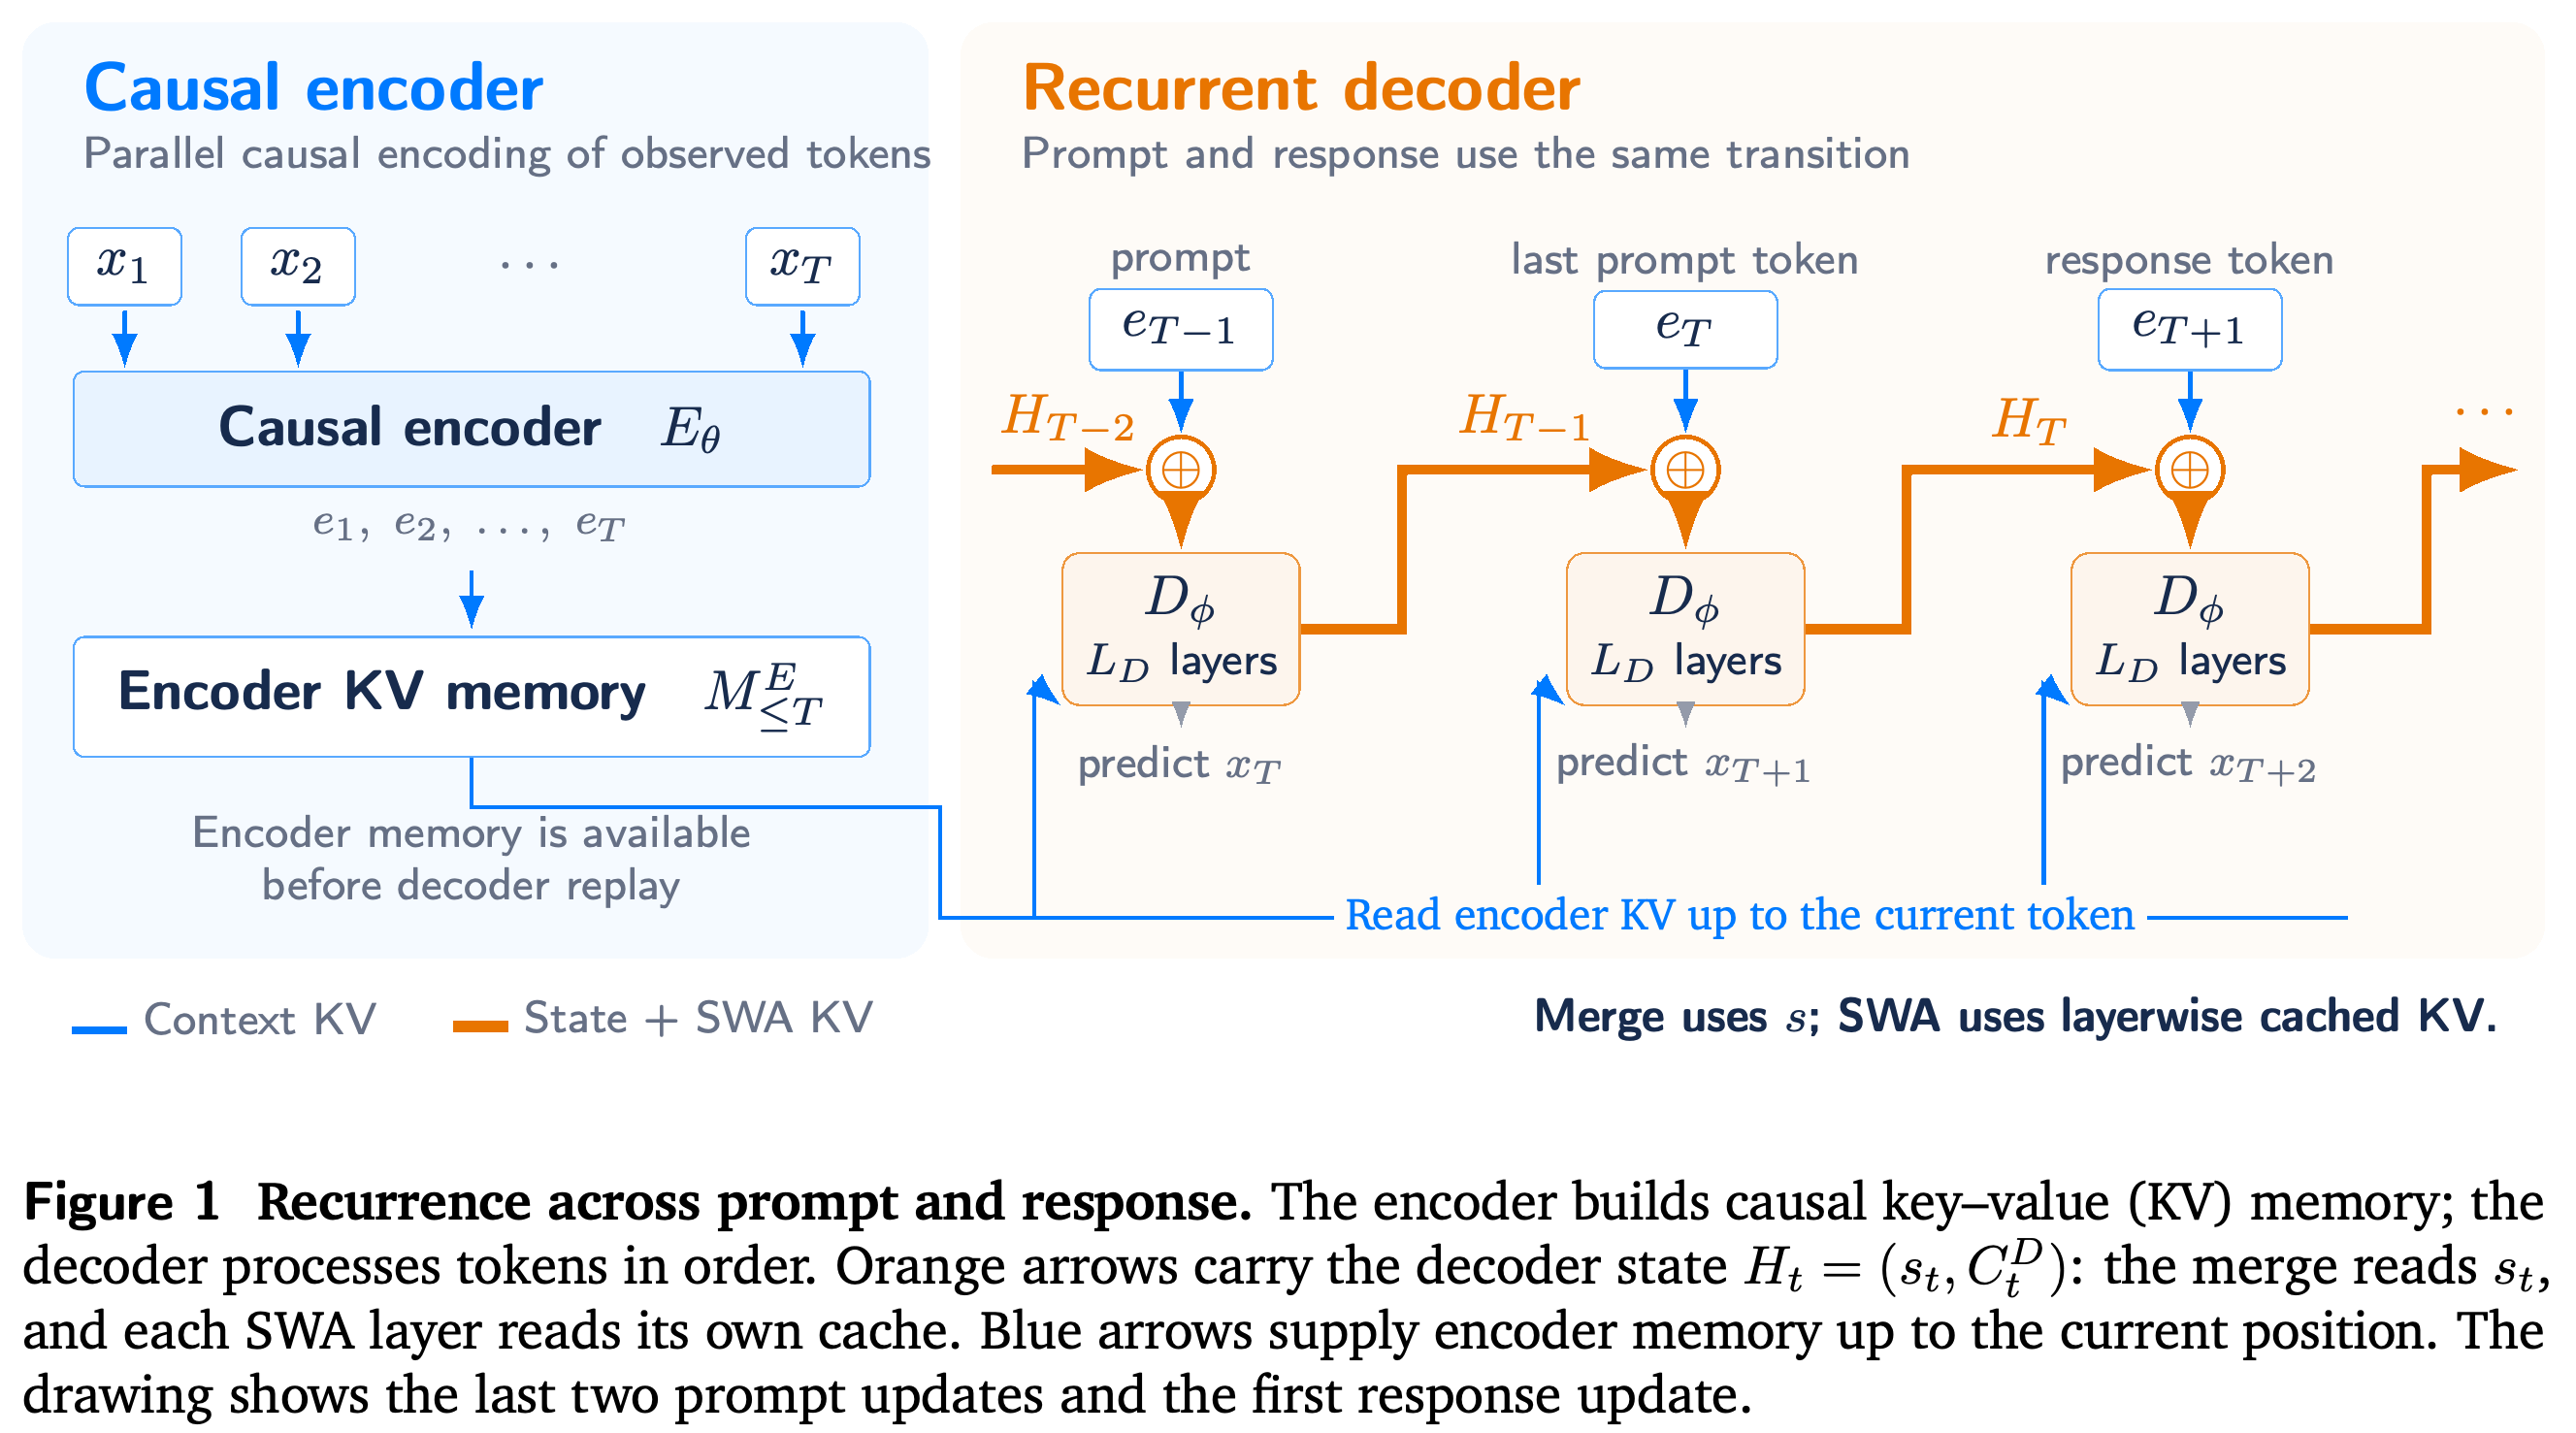
- Figure 1은 프롬프트 토큰과 응답 토큰에 동일한 순환 전이를 적용함을 보여준다. 프롬프트 경계에서도 누적 상태를 초기화하지 않는다.
순환 연결은 프롬프트와 응답의 경계를 넘어 이어지며, 생성 시작 전에 프롬프트 토큰에도 디코더 갱신이 필요한 이유를 보여준다. 인코더 메모리는 디코더 갱신 사이에 전달되는 상태와 별도로 접두 문맥을 제공한다.
2 Method
먼저 토큰마다 피드백을 적용하는 RLT-1을 정의한 뒤, 토큰 청크 안에서 피드백을 공유하는 RLT-2와 최종 출력 피드백을 제거한 RLT-0을 소개한다. 모든 변형은 인과적 인코딩과 현재 사용 가능한 인코더 접두 구간으로 제한된 어텐션을 유지하므로, 피드백 빈도를 연구하기 위한 대조군이 된다.
2.1 Sequence and state
독립된 시퀀스는 시퀀스 시작 토큰 BOS로 시작하며, 학습 가능한 초기 출력 s⋆를 사용한다. 완전한 디코더 상태는 Hₜ = (sₜ, Cₜᴰ)로, 최종 디코더 출력과 층별 key–value(KV) 캐시로 구성된다. KV 캐시는 앞선 위치에서 계산한 어텐션 투영값을 저장한다.
- 최근 디코더 위치로 어텐션을 제한하는 sliding-window attention(SWA)은 현재 토큰을 포함하는 윈도 W ≥ 1을 사용한다. 따라서 각 층은 갱신 후 이전 위치를 최대 W−1개 보관한다.
- 인코더와 디코더의 깊이는 각각 L_E와 L_D이며, 인코더 표현과 순환 출력의 벡터 차원은 모두 d다.
2.2 Causal encoder and memory
인코더는 인과적 마스킹으로 e₁:ₜ = Eθ(x₁:ₜ)를 계산하므로, 각 인코더 층 안에서 주어진 위치들을 함께 처리할 수 있다. 인코더 출력을 정규화하고 투영하여 전역 KV 메모리를 만든다. 디코더 표현이 인코더 메모리를 참조하는 교차 어텐션은 이 메모리에서 현재 위치까지의 정보만 읽는다.
- 메모리 그룹이 1개인 G = 1이면 투영된 인코더 KV를 디코더 층 전체에서 공유한다. G = L_D이면 디코더 층마다 별도의 투영을 사용할 수 있다.
- 전역 인코더 메모리는 접두 구간이 길어질수록 증가하지만, 각 디코더 층은 크기가 제한된 SWA 캐시를 따로 유지한다.
2.3 One transition for every token
관측하거나 샘플링한 모든 토큰은 먼저 인코더 표현을 직전 디코더 출력과 병합하고, 디코더 상태의 구성 요소 2개를 모두 갱신한다. 최종 출력은 정규화와 선형 readout, 출력 점수를 확률로 변환하는 softmax를 거쳐 다음 토큰을 예측한다.
- 핵심 전이는 u_t = Merge(e_t, s_{t−1})를 계산한 다음 H_t = Dφ(u_t; M_{≤t}, C^D_{t−1}, t)를 계산하는 과정이다. 프롬프트 처리도 동일한 전이를 토큰 순서대로 합성한다.
- RLT-1은 전달받은 상태를 반복해서 갱신하는 모델인 recurrent neural network(RNN)로 해석할 수 있으며, 그 셀에는 게이트와 전체 디코더가 포함된다. S4와 Mamba는 층 입력이 고정되면 이전 상태에 대한 갱신이 아핀 형태가 되는 상태 공간 모델이다. RLT-1은 이전 상태에 비선형적으로 의존하므로, 이 모델들의 아핀 병렬 스캔 알고리즘을 직접 적용할 수 없다. Mamba에 대해서는 Hybrid Architectures for Language Models: Systematic Analysis and Design Insights 요약 설명 글을 참조하라.
- 너비, 디코더 깊이, SWA 윈도를 고정하면 디코더 상태의 크기는 제한된다. 전체 모델은 이와 별도로 계속 증가하는 인코더 메모리도 유지한다.
2.4 Prompt prefill and incremental decoding
응답 생성 전에 주어진 프롬프트 토큰을 처리하는 prompt prefill은 먼저 인코더 특징과 메모리를 병렬로 계산한 뒤, 디코더 상태를 순서대로 계산한다. 전체 프롬프트 메모리가 준비되어 있어도 위치 t의 디코더는 인코더 위치 t까지만 읽을 수 있다.
- 생성 중에는 소비한 토큰마다 인코더 캐시를 갱신하고, 인코더 메모리 KV를 추가하며, 디코더 상태와 모든 SWA 캐시를 갱신한다.
- 인코더의 연속 처리용 캐시를 보존하면 주어진 토큰을 청크 단위로 인코딩할 수 있지만, RLT-1은 여전히 토큰마다 디코더를 갱신해야 한다.
2.5 Merge and decoder blocks
병합 연산은 직전 출력을 정규화한 뒤, 현재 인코더 표현과 정규화한 상태로부터 0과 1 사이의 값을 갖는 sigmoid 게이트를 계산한다. 이어서 투영하고 배율을 적용한 피드백 벡터를 인코더 출력에 더한다. 주요 실험은 피드백 배율 α = 0.1을 사용한다.
- 병합 수식은 r_{t−1} = RMSNorm_s(s_{t−1}), g_t = σ(W_g[e_t; r_{t−1}] + b_g), u_t = e_t + αg_t ⊙ W_s r_{t−1}이다. RMSNorm은 상태 정규화 연산자이며, ⊙는 원소별 곱셈을 뜻한다.
- 각 디코더 블록은 인과적 SWA, 인코더 메모리 교차 어텐션, 위치별 변환인 feed-forward network(FFN)를 적용한다. 잔차 연결은 각 하위 층의 입력을 출력에 더한다.
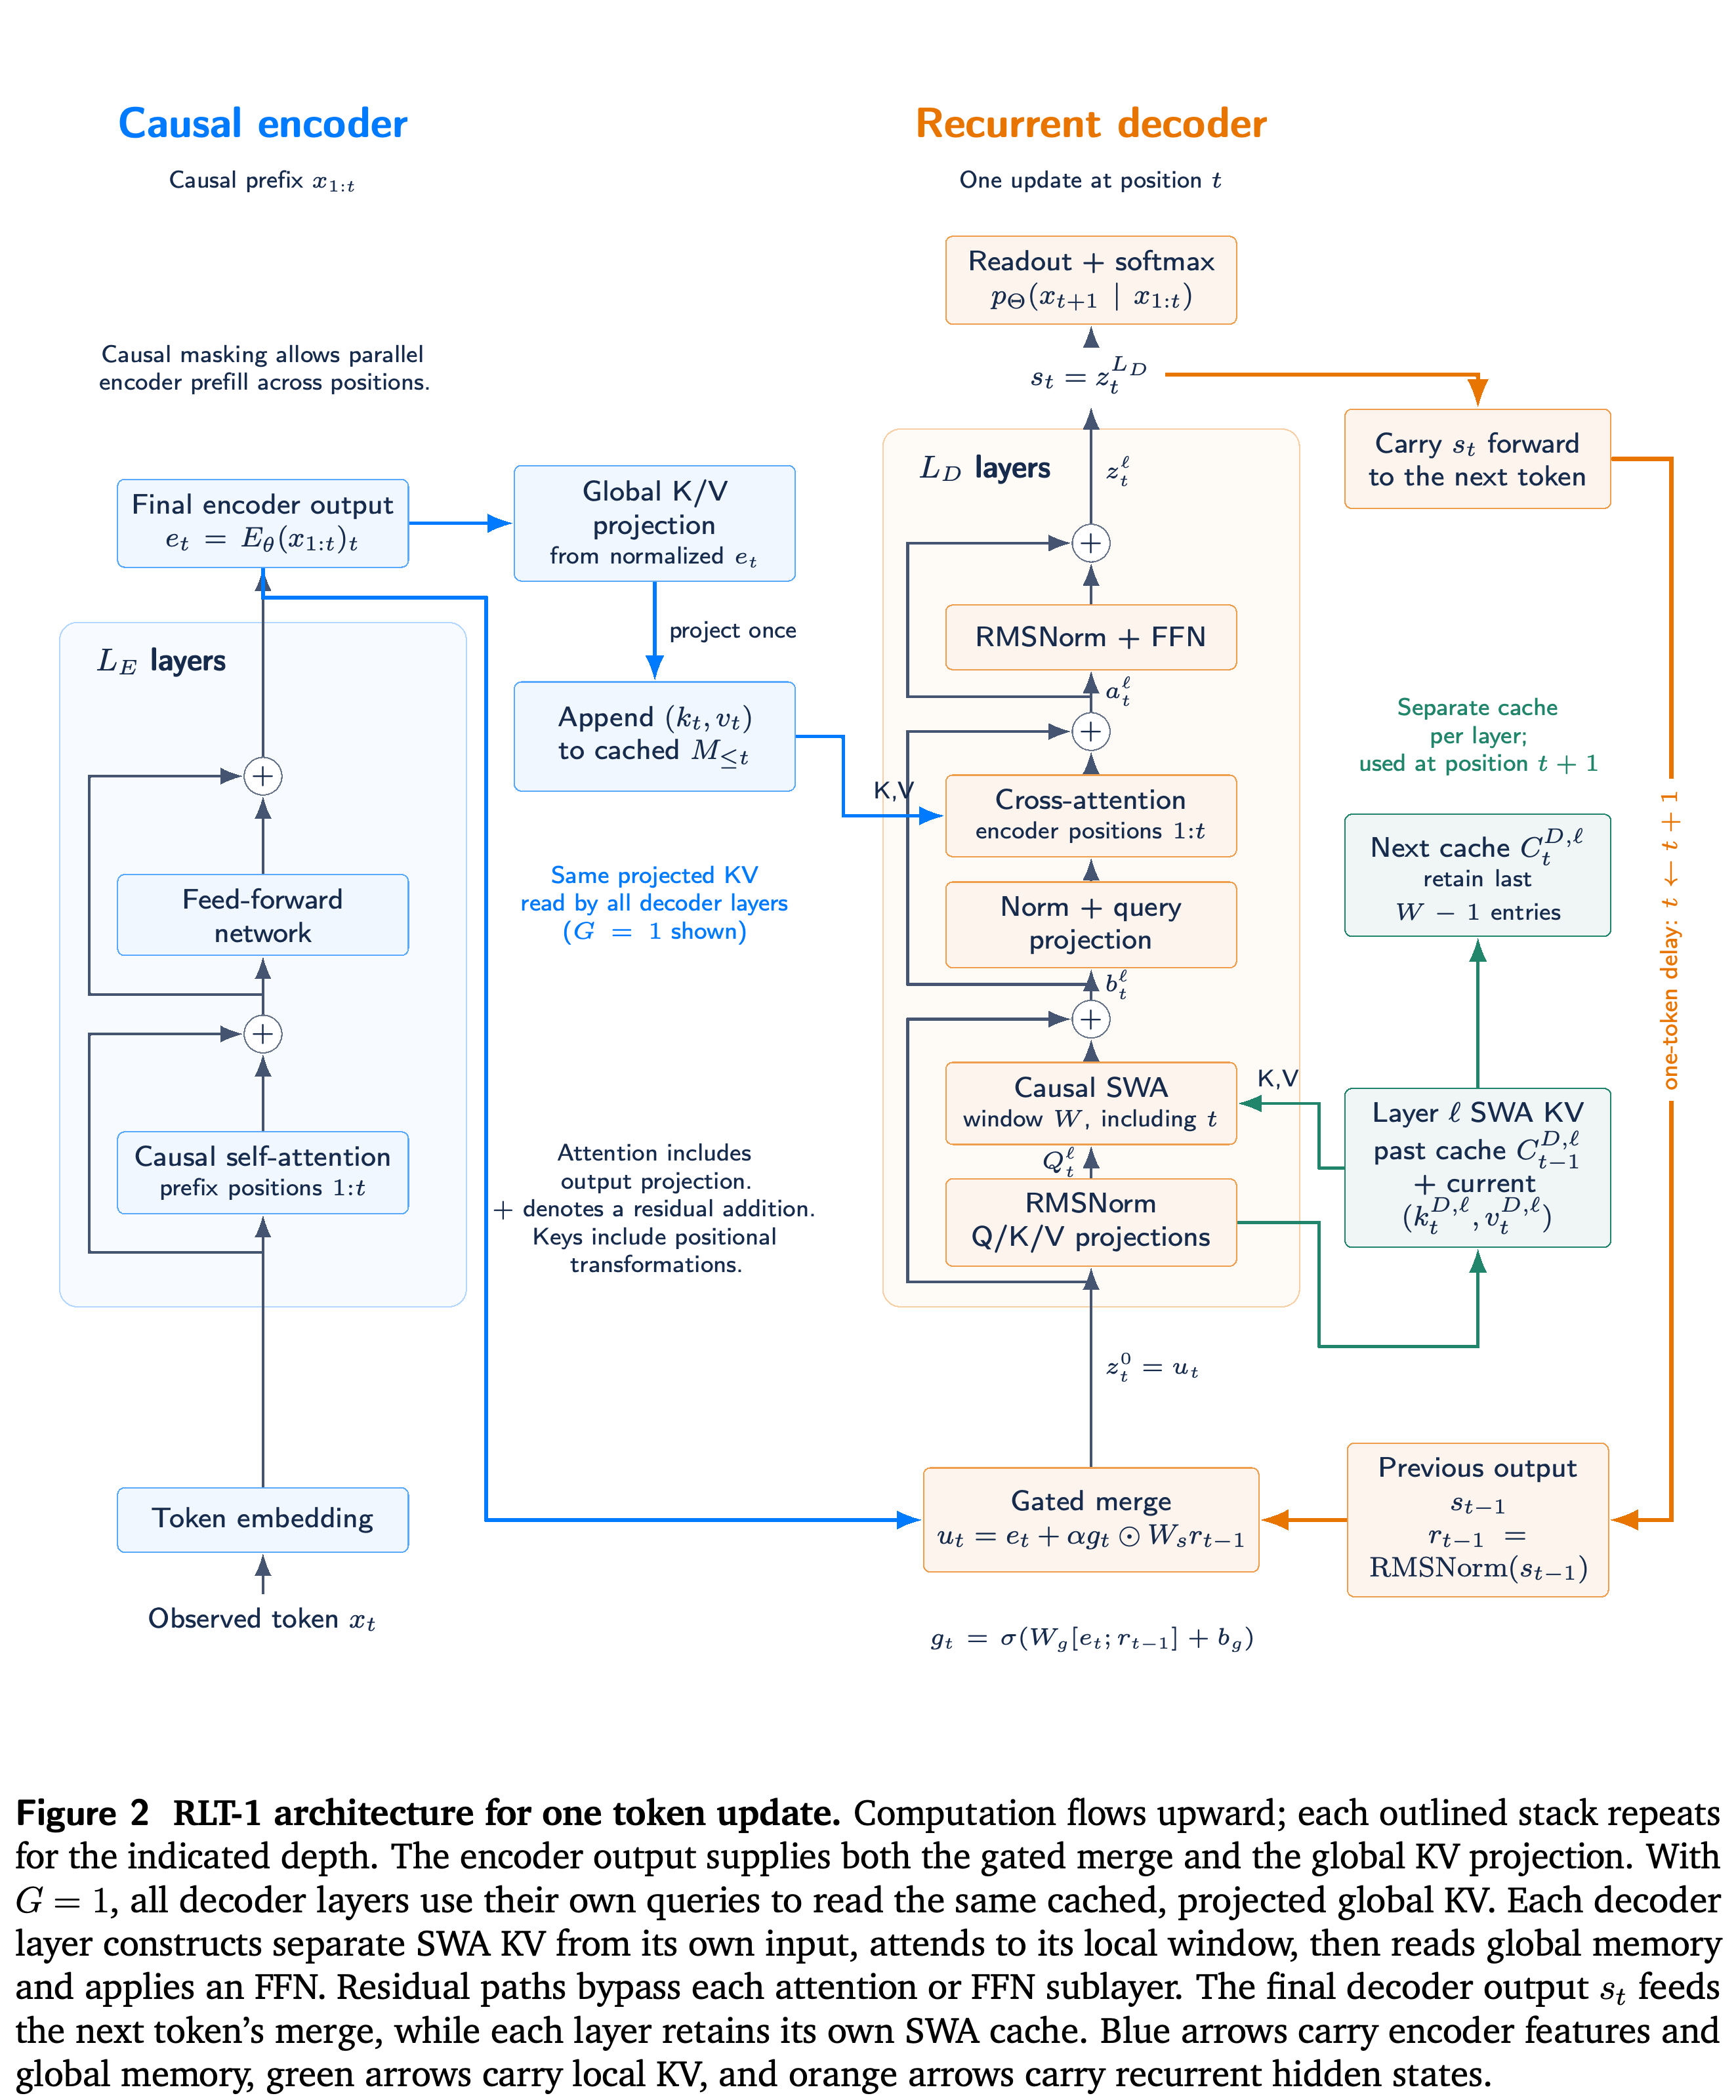
- 현재 위치의 KV는 어텐션 전에 층 입력으로부터 계산하므로 순환 의존성이 발생하지 않는다. Figure 2는 이러한 층별 캐시와 다음 토큰에 전달하는 최종 출력을 구분한다.
그림은 정보 경로 3가지를 구분한다. 인코더 특징과 전역 메모리, 층별 로컬 디코더 KV, 이전 토큰의 최종 디코더 출력이다. 따라서 마지막 은닉 벡터만 저장하면 전체 계산을 재개하는 데 필요한 캐시가 빠진다.
2.6 Recurrent depth and execution cost
T토큰의 프롬프트와 소비한 응답 토큰 n개를 처리한 뒤에는 피드백 경로가 (T+n)L_D개의 디코더 블록을 통과하며, 각 토큰은 L_E+L_D개의 블록을 실행한다. 이는 구조적 의존 경로의 길이를 센 것이다. 앞선 상태가 미치는 영향은 게이트, 투영, 전이 미분값의 곱에도 좌우된다.
- RLT-1은 prefill 중 T번의 순차적 디코더 갱신이 필요하지만, 독립된 시퀀스들의 다음 갱신은 배치로 함께 처리할 수 있다.
- 토큰당 블록 수가 고정되어도 산술 연산 비용이 일정한 것은 아니다. 문맥이 길어질수록 인코더 메모리를 읽는 비용이 증가한다.
2.7 Feedback interval: RLT-1, RLT-2, and RLT-0
RLT-1은 피드백 간격 B = 1을 사용한다. RLT-2는 각 B토큰 청크 안에서 피드백 레지스터를 고정하고, 완전한 청크의 경계에서만 최종 출력으로 교체한다. RLT-0은 학습 가능한 초기 상태, 게이트, 상태 정규화, 피드백 투영을 제거하고 인코더 출력을 디코더에 직접 전달한다.
- 청크 경계는 BOS를 기준으로 정한다. 마지막 청크가 미완성이면 직전 경계의 레지스터를 보존하며, B = 1일 때 RLT-2는 RLT-1과 정확히 같아진다.
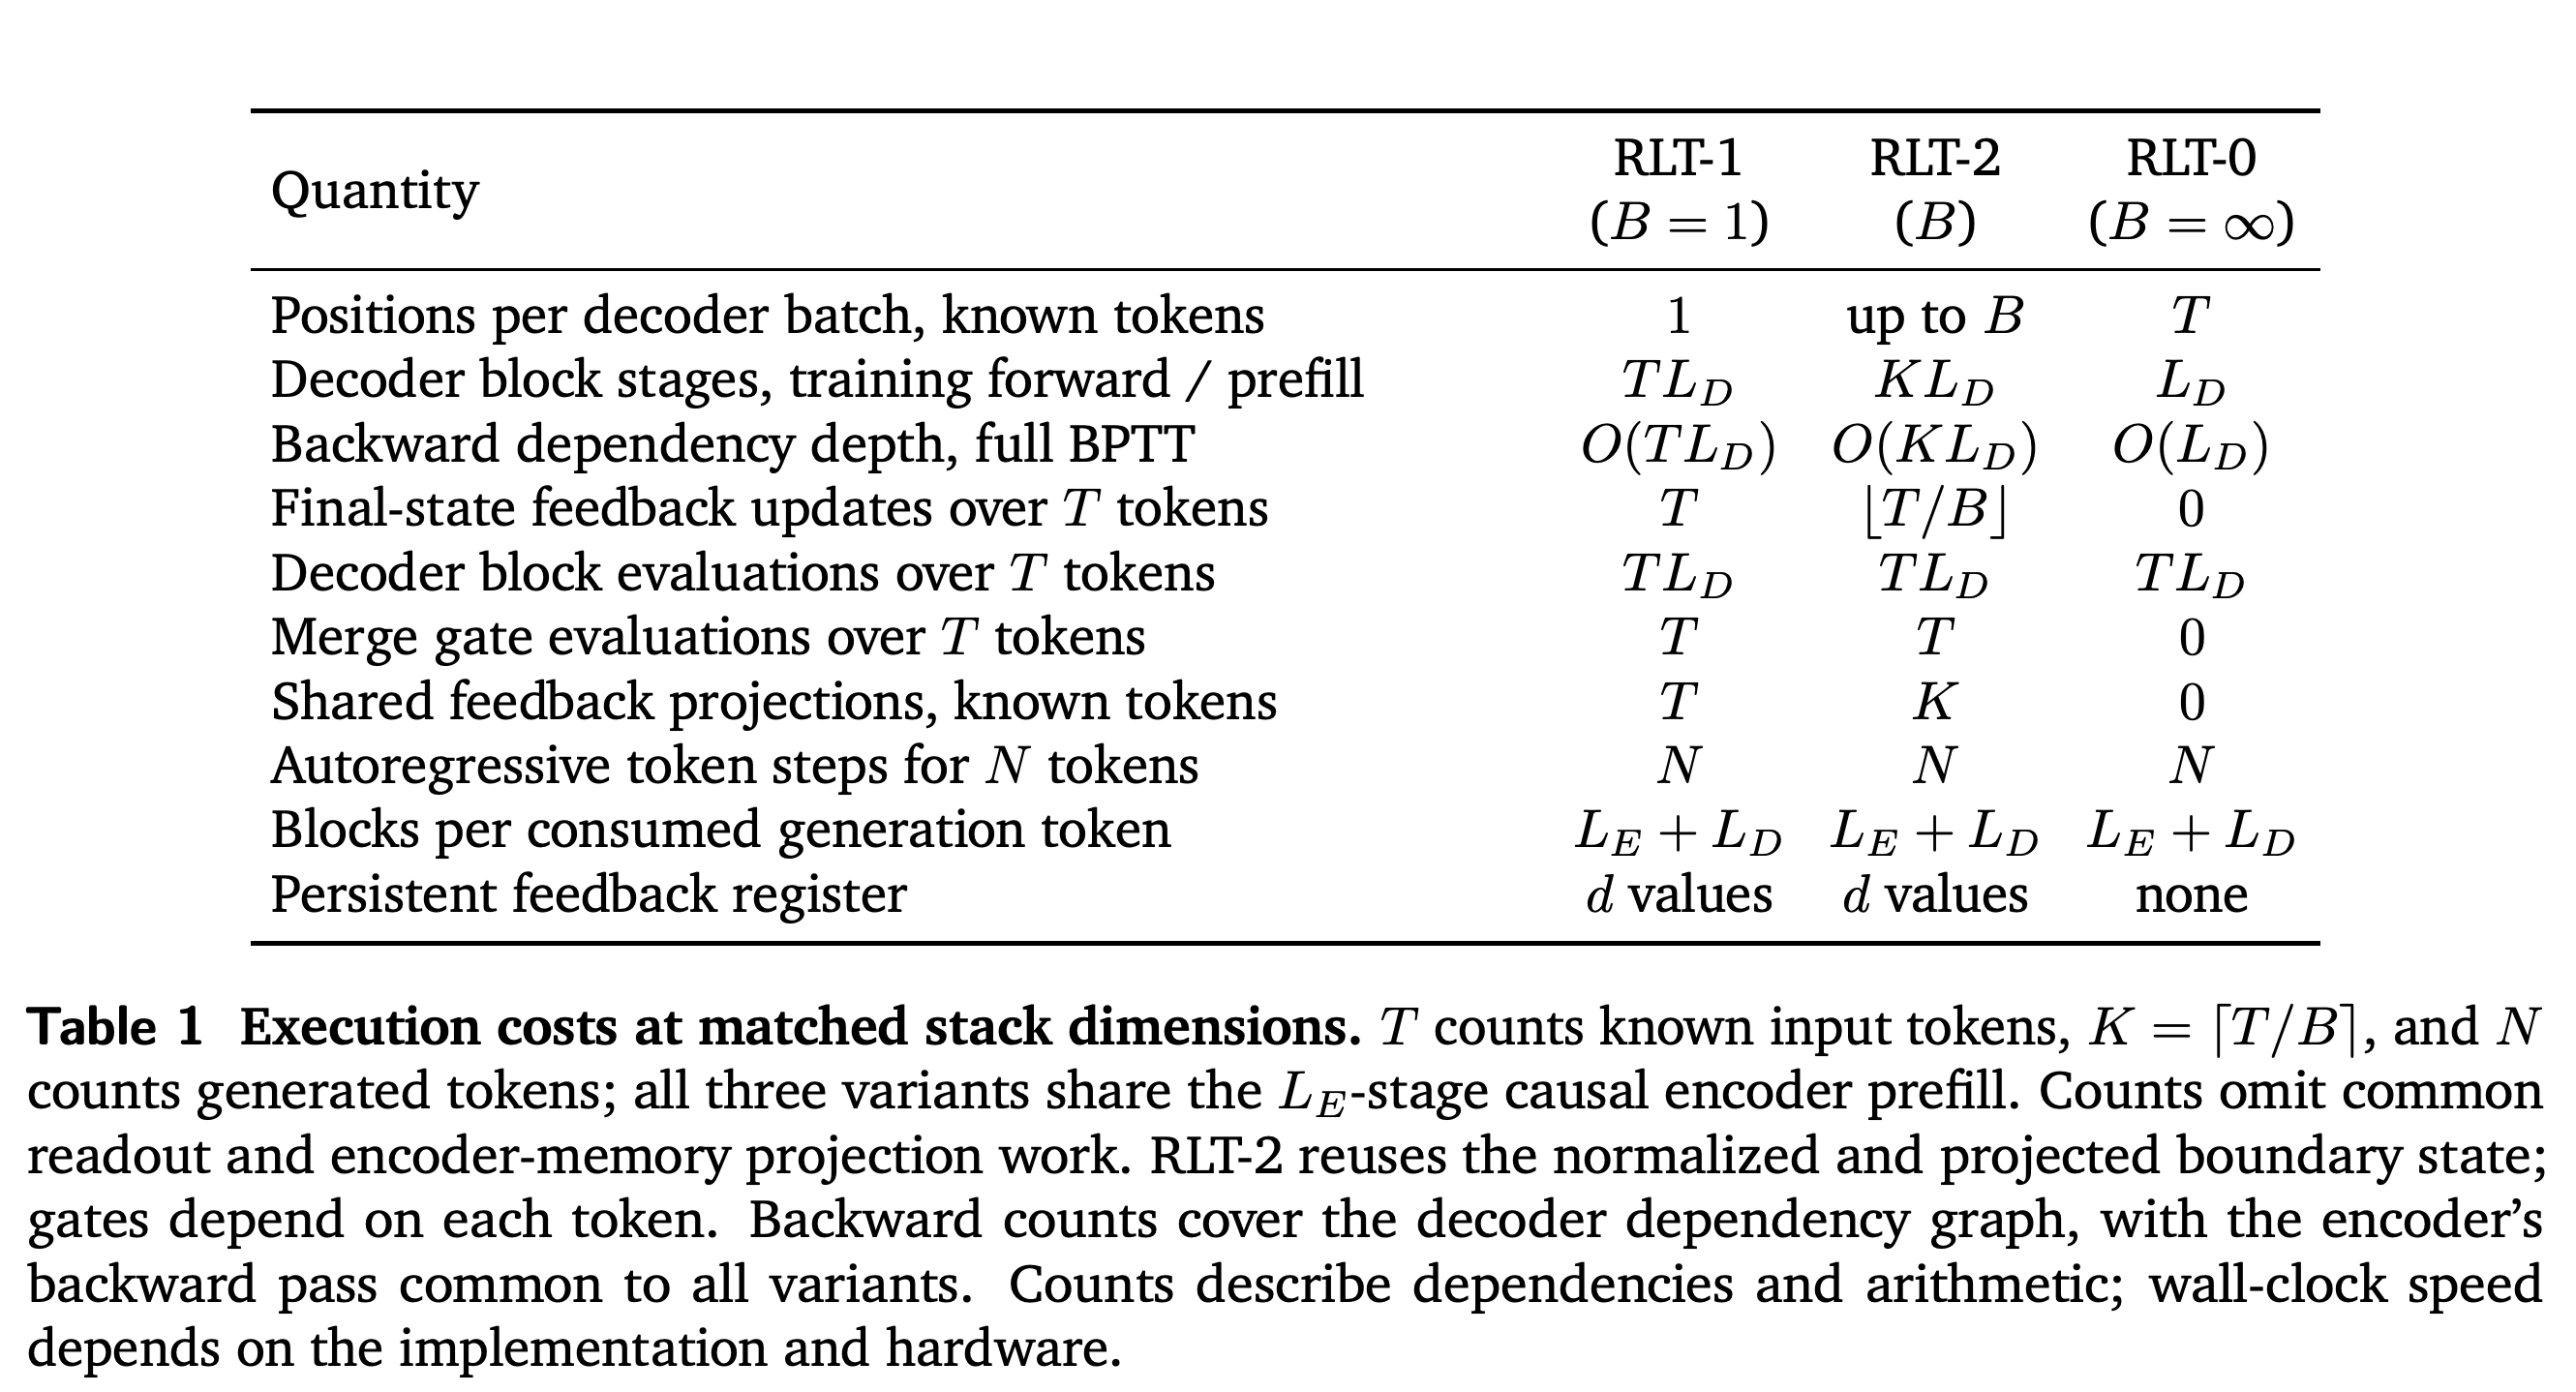
- 주어진 토큰이 T개이고 L_D ≥ 1일 때 순차적 디코더 블록 단계 수는 RLT-1에서 TL_D, RLT-2에서 ⌈T/B⌉L_D, RLT-0에서 L_D다. 전체 디코더 블록 실행 수는 모두 TL_D다. Table 1은 스케줄링 깊이와 산술 연산량을 구분한다.
- RLT-2는 모든 B에 같은 파라미터를 사용한다. 큰 청크로 시작한 뒤 B를 줄이는 학습 스케줄을 제안하지만 검증하지는 않았다. 실험에서는 각 청크 크기마다 처음부터 학습한다.
스택 차원을 맞추면 변형들의 전체 디코더 블록 실행 수는 같지만, 순차적 의존 깊이는 다르다. 청크화는 토큰별 자기회귀 생성을 유지하면서 주어진 위치들을 배치로 함께 처리할 수 있는 범위를 바꾼다. 이 실행 횟수만으로 실제 실행 속도를 알 수는 없다.
2.8 Training and state replay
학습에는 앞선 정답 토큰을 제공하는 teacher forcing과 선택한 다음 토큰 타깃에 대한 교차 엔트로피 손실을 사용한다. 순환 이력을 따라 미분하는 완전한 backpropagation through time(BPTT)은 어떤 토큰의 타깃 손실이 마스킹되어도 순환 출력, 디코더 KV, 인코더 메모리를 따라 역전파한다.
- 파라미터 갱신 후 샘플링된 응답을 현재 모델로 평가하려면, 현재 파라미터로 계산한 동등하고 유효한 상태가 없는 한 이력을 재실행해 상태를 다시 구성해야 한다.
- 부록은 사전학습, 선택한 어시스턴트 타깃에 대한 지도 미세조정, 보상 기반 학습을 위한 정책 경사 재실행을 명시하지만, 실험은 지도학습 알고리즘 과제만 평가한다.
3 Algorithmic Experiments
덧셈, parity, 괄호 없는 모듈러 연산과 괄호 있는 모듈러 연산, 표준 및 교환 기반 S₅ 추적을 포함한 6 tasks로 디코더 배분과 피드백 빈도가 학습 길이를 넘는 성능에 미치는 영향을 평가한다. 최초의 전체 비교는 2,000스텝 학습을 사용하며, 주요 모듈러 연산 결과는 5,000 steps 동안 학습한 실행을 사용한다.
3.1 Models and evaluation
8층 실험에서는 인코더와 디코더 가중치를 별도로 사용하는 비공유 RLT-1의 4+4, 5+3, 6+2, 7+1, 8+0 분할을 논문의 decoder-only Transformer 베이스라인인 GPT Layer 8과 비교한다. 모든 모델은 너비 512, FFN 너비 1,365, 어텐션 헤드 4개를 사용한다. RLT는 SWA 윈도 8, 공유 인코더 메모리 그룹 1개, α = 0.1을 사용한다.
- 초기화 시드 42, 43, 44는 학습 데이터 스트림과 홀드아웃 예제를 공유한다. 전역 배치 크기는 512, 마이크로배치 크기는 32이며, CPU 스레드 4개와 32비트 부동소수점 형식인 FP32로 실행한다.
- AdamW 옵티마이저는 (β₁, β₂) = (0.9, 0.95), 가중치 감쇠 0.1, 노름 1의 그래디언트 클리핑을 사용한다. 학습률은 200 steps에 걸쳐 10⁻⁴까지 워밍업한 뒤, 전체 학습 스텝에 걸친 코사인 스케줄로 5×10⁻⁶까지 낮춘다.
- 학습 범위는 parity가 3–40비트, S₅가 32개 연산, flat mod-5가 홀수 표현식 길이 3–39, 괄호 있는 mod-5가 길이 3–40, 덧셈이 1–8자리 피연산자다. 형식적 과제는 길이마다 공통 테스트 예제 1,024개를 사용하고, 덧셈은 피연산자 자릿수마다 256쌍을 사용한다.
- 각 실행은 학습 길이 분포 안에서 측정한 in-distribution(ID) 검증 예제 손실이 최소인 체크포인트를 선택하며, 정확히 동률이면 더 이른 스텝을 선택한다. 테스트 점수는 체크포인트 선택에 사용하지 않는다. 보고한 평균 ± 표본 표준편차는 고정된 공통 데이터에서 초기화 3회의 결과를 나타낸다. 절단 범위를 128로 설정한 truncated BPTT인 TBPTT128은 여기서 모든 학습 시퀀스를 포함하므로, 그래디언트가 절단되지 않는다.
- 층 수가 같아도 파라미터 수나 계산량이 같지는 않다. 8+0 모델은 디코더 블록이 없어도 순환 게이트 병합을 유지한다.
3.2 Length extrapolation and decoder allocation
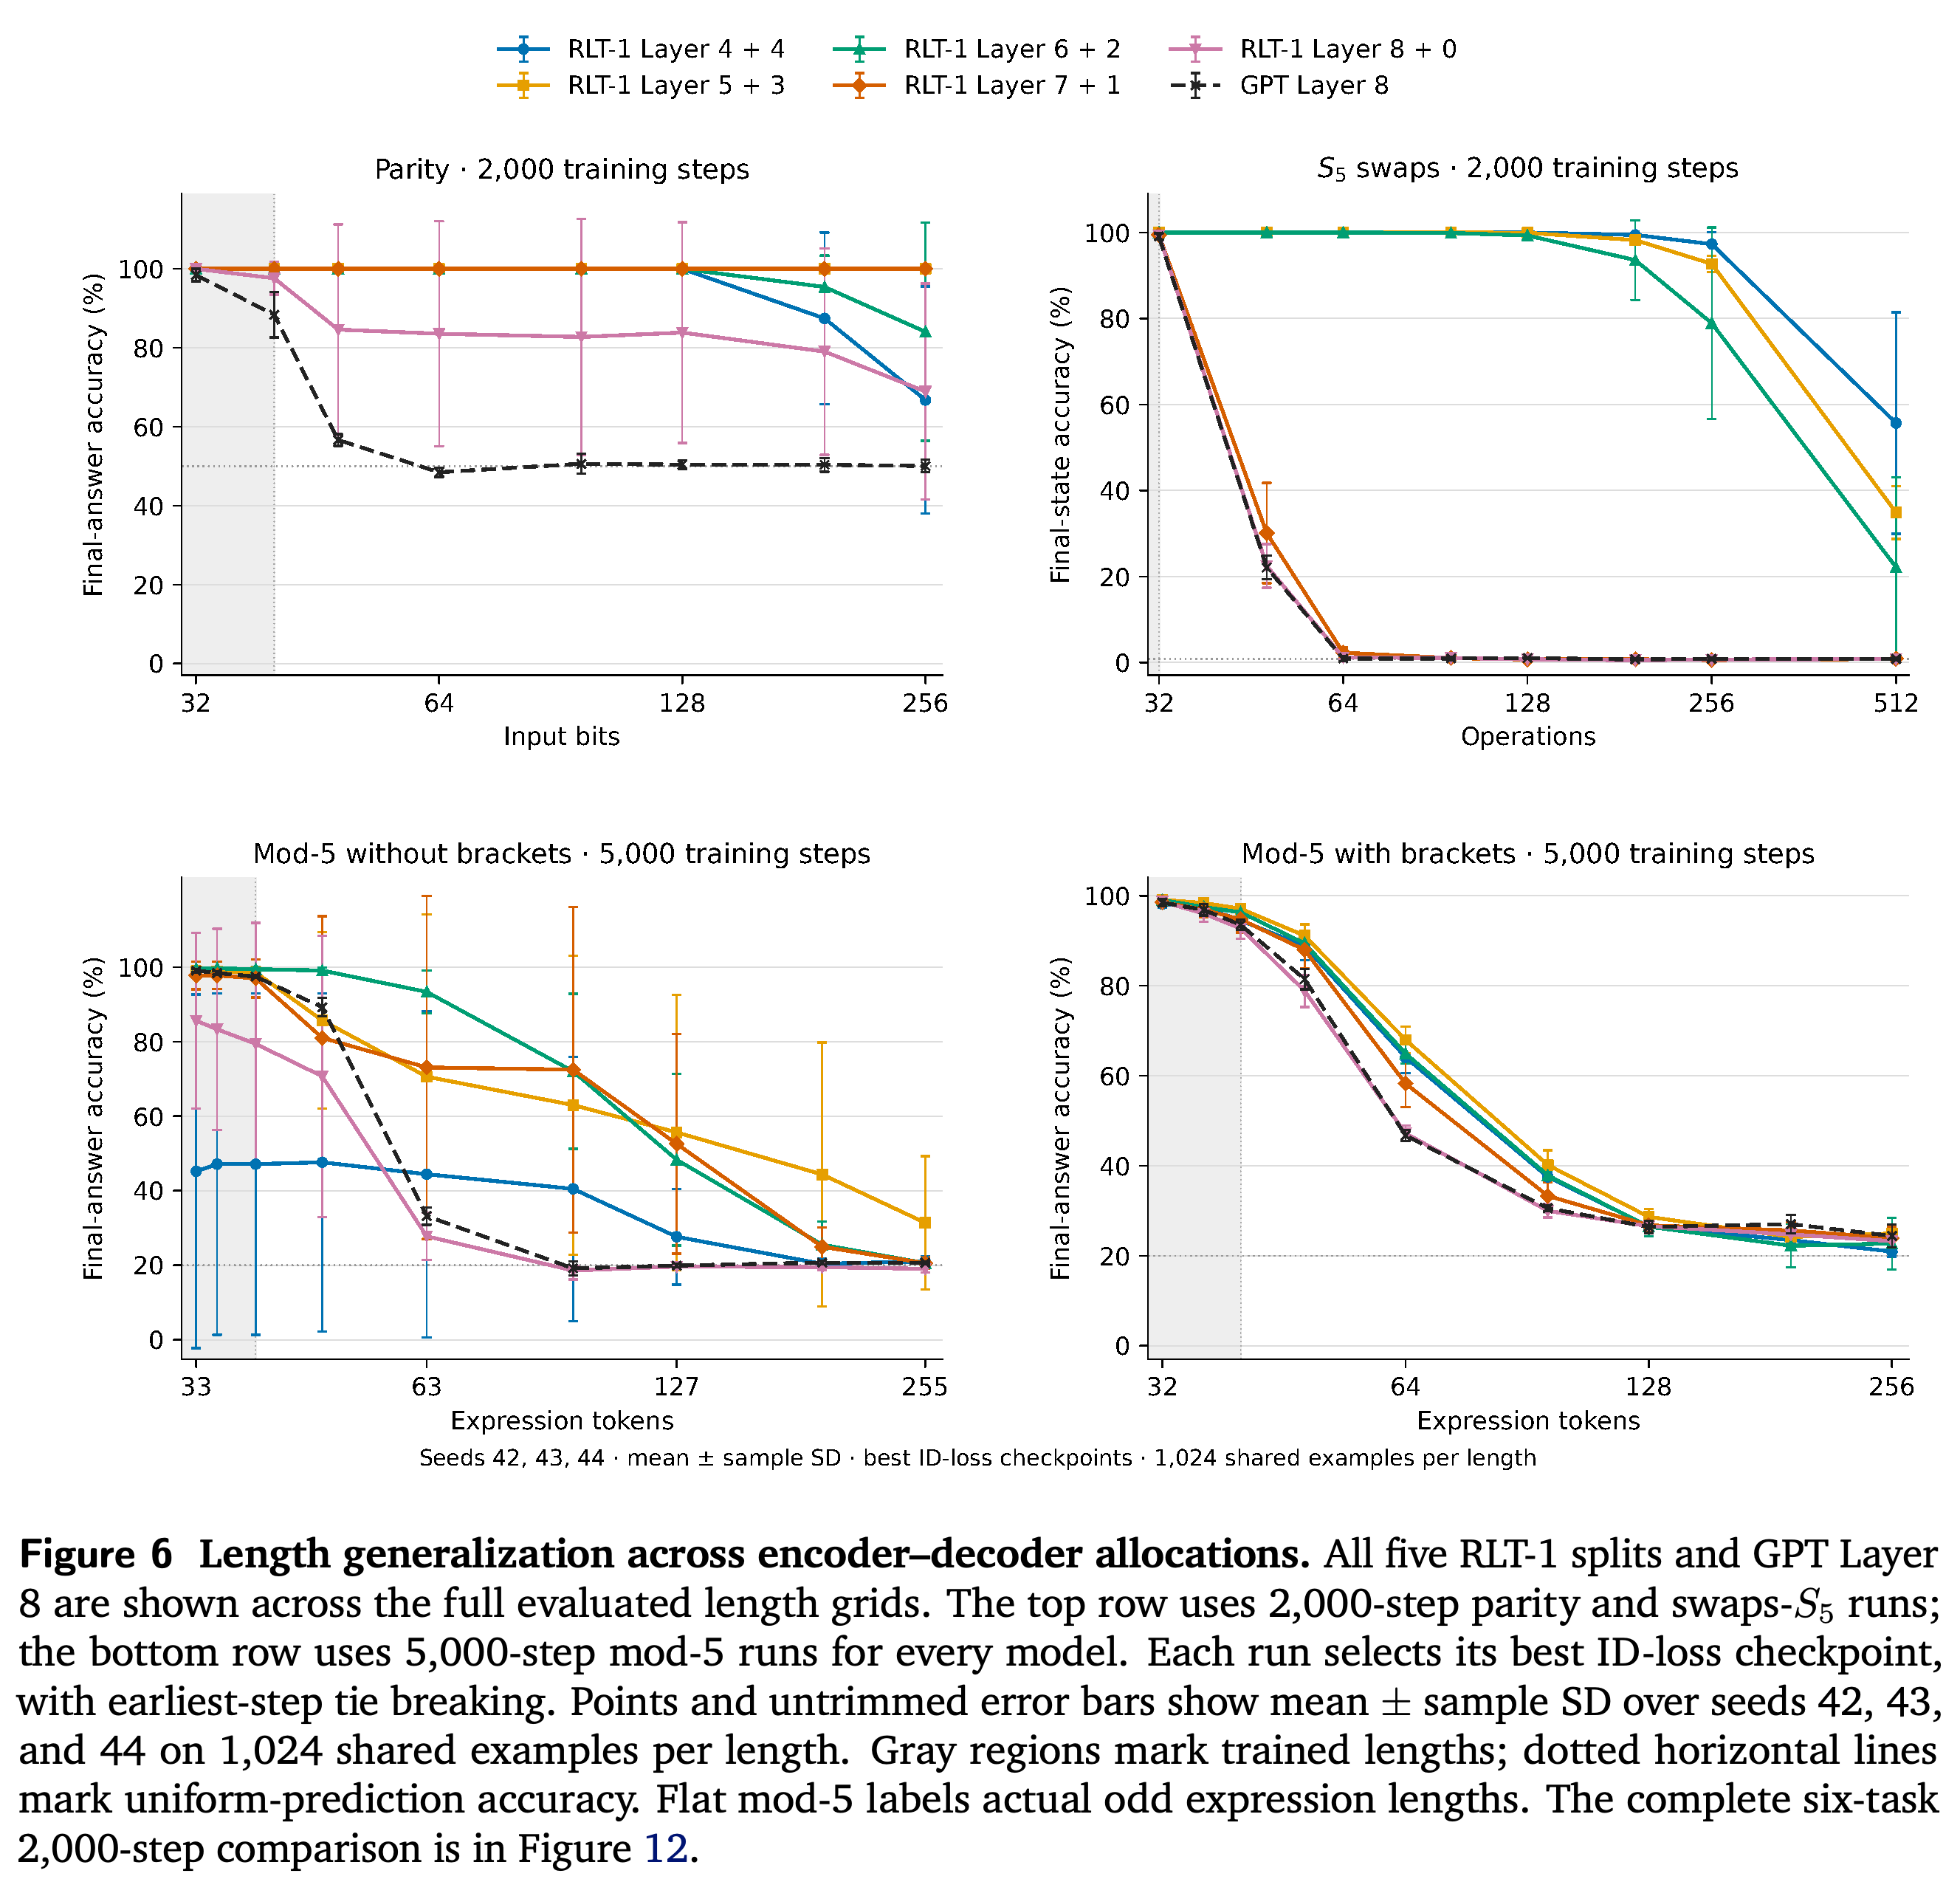
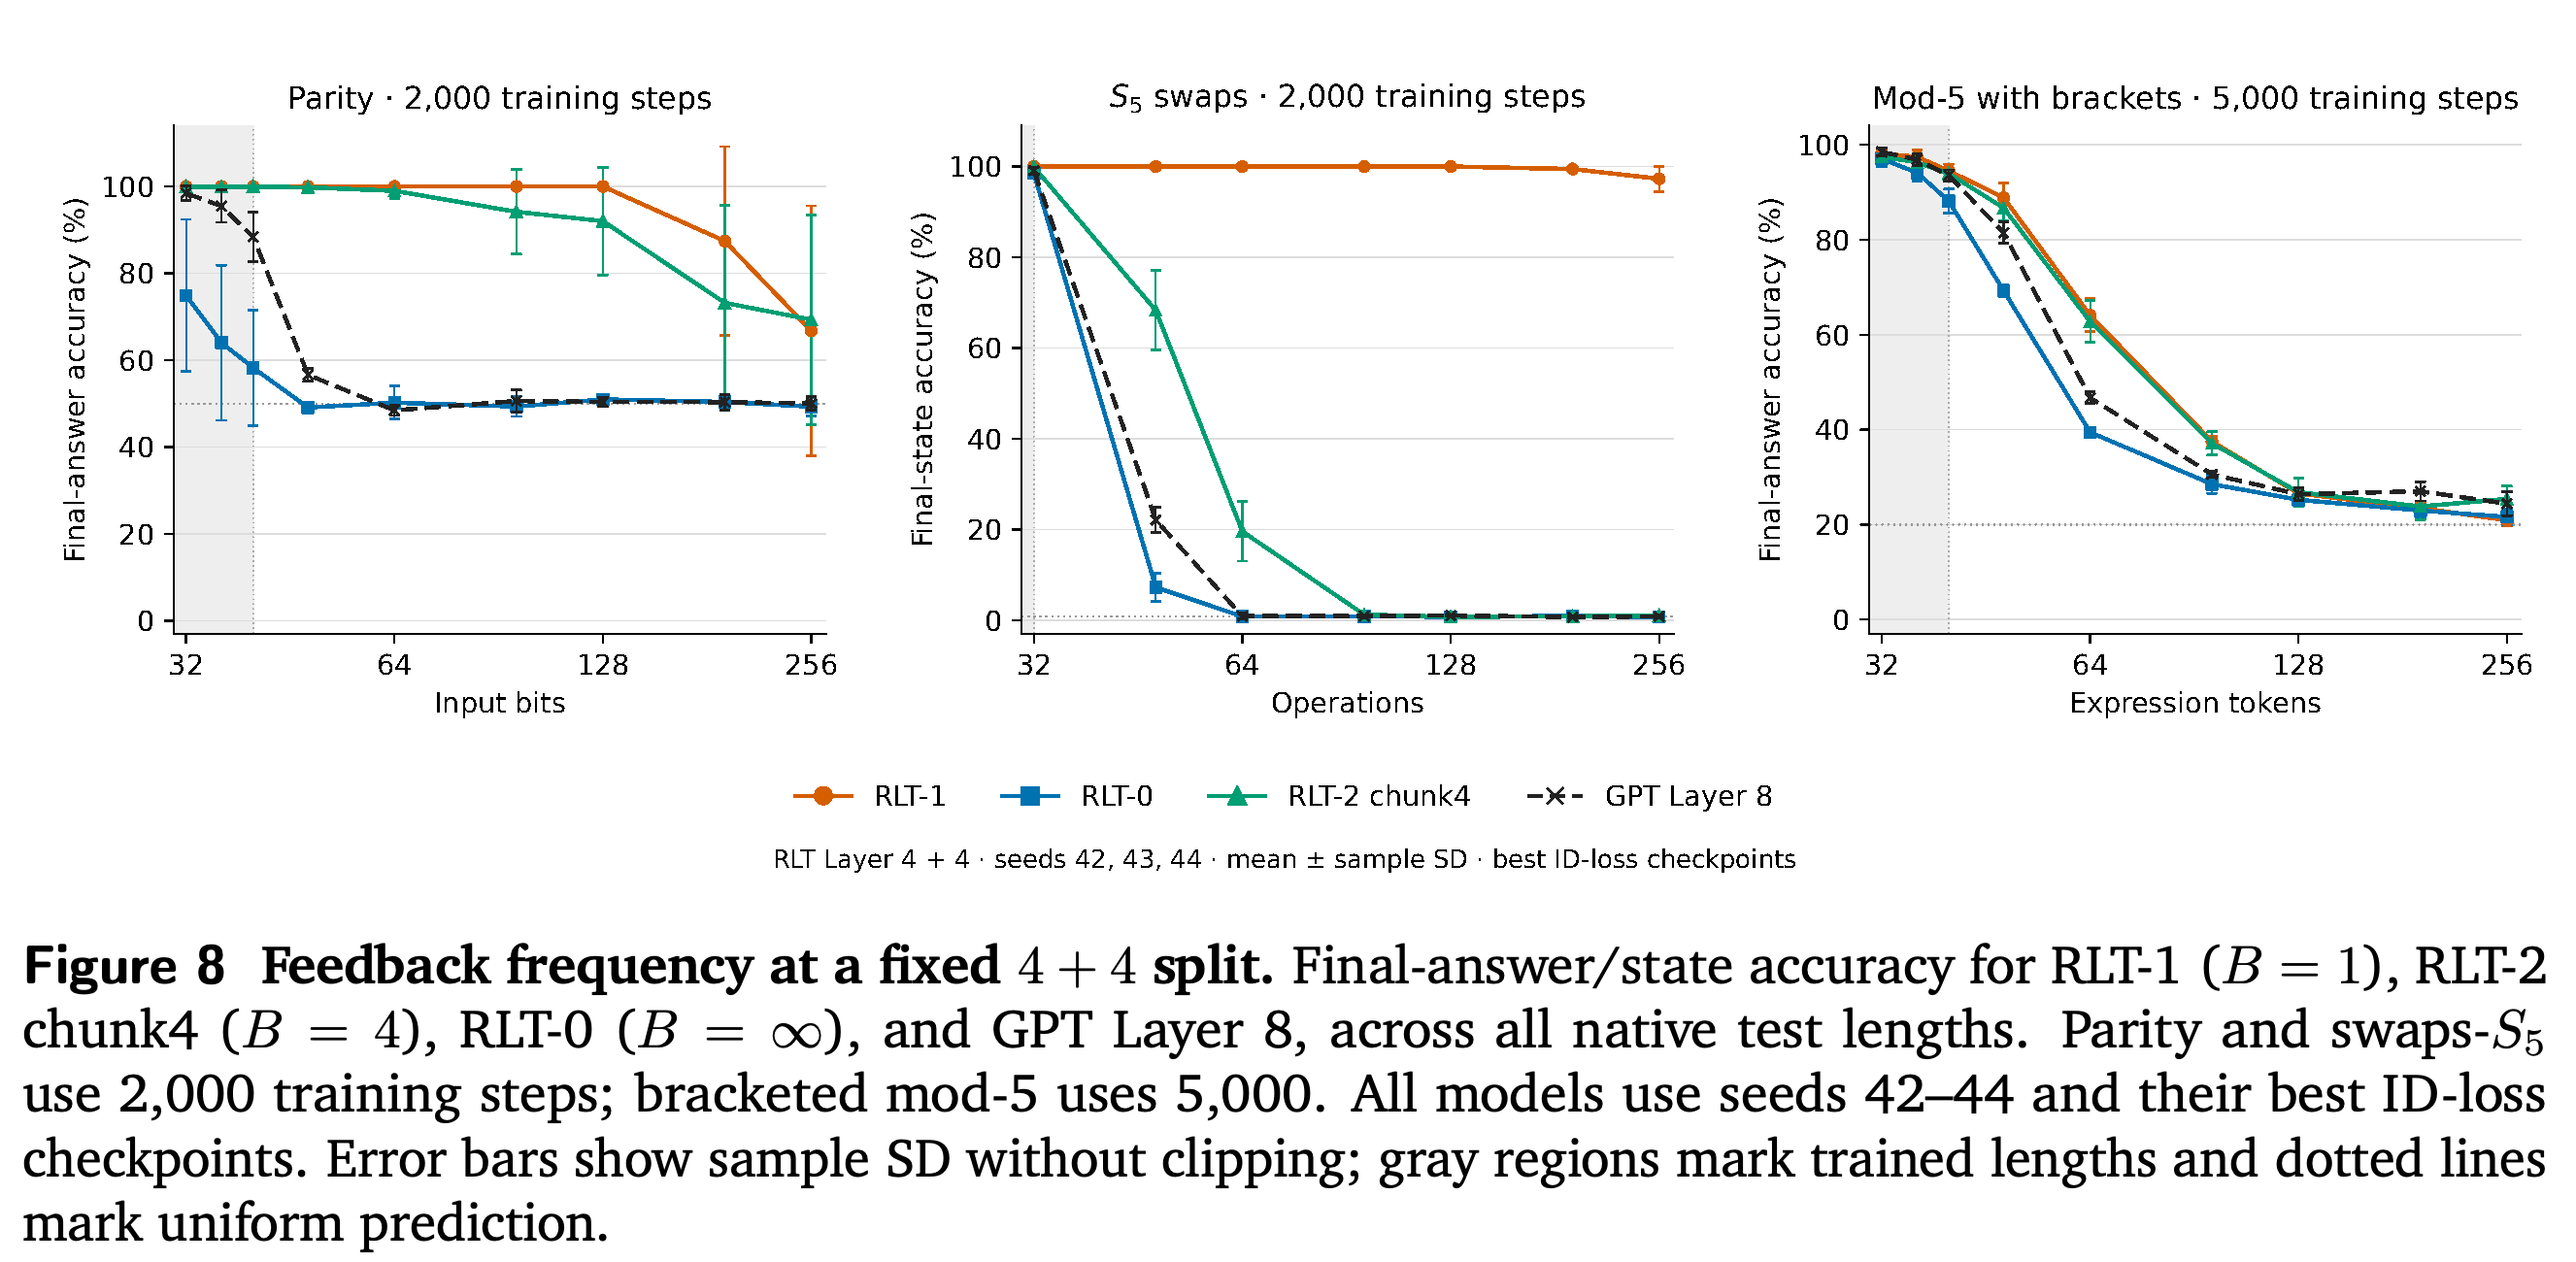
길이 외삽 성능은 과제와 깊이 분할에 따라 달라진다. 5+3과 7+1은 256비트에서 parity 정확도 100±0%를 유지한다. 교환 기반 S₅는 디코더 층이 많을수록 유리하며, 4+4가 256개 연산에서 97.30±2.76%를 달성한다. Figure 6은 모듈러 연산의 이점이 중간 외삽 길이에서 나타나고 더 긴 표현식에서는 줄어듦을 보여준다.
- 교환 연산 512개에서 4+4의 최종 상태 정확도는 55.70±25.78%이며, Transformer는 0.85±0.30%다. 7+1과 8+0은 이미 256개 연산에서 우연 수준에 가깝다.
- 5,000 steps 동안 학습한 뒤 길이 63의 flat mod-5에서 6+2는 93.36±5.69%를 기록하며, Transformer는 33.20±2.33%를 기록한다. 길이 64의 괄호 있는 mod-5에서 5+3은 67.97±2.91%를 기록하며, Transformer는 46.71±1.21%를 기록한다. 여러 flat mod-5 설정에서 초기화에 따른 변동이 크게 나타난다.
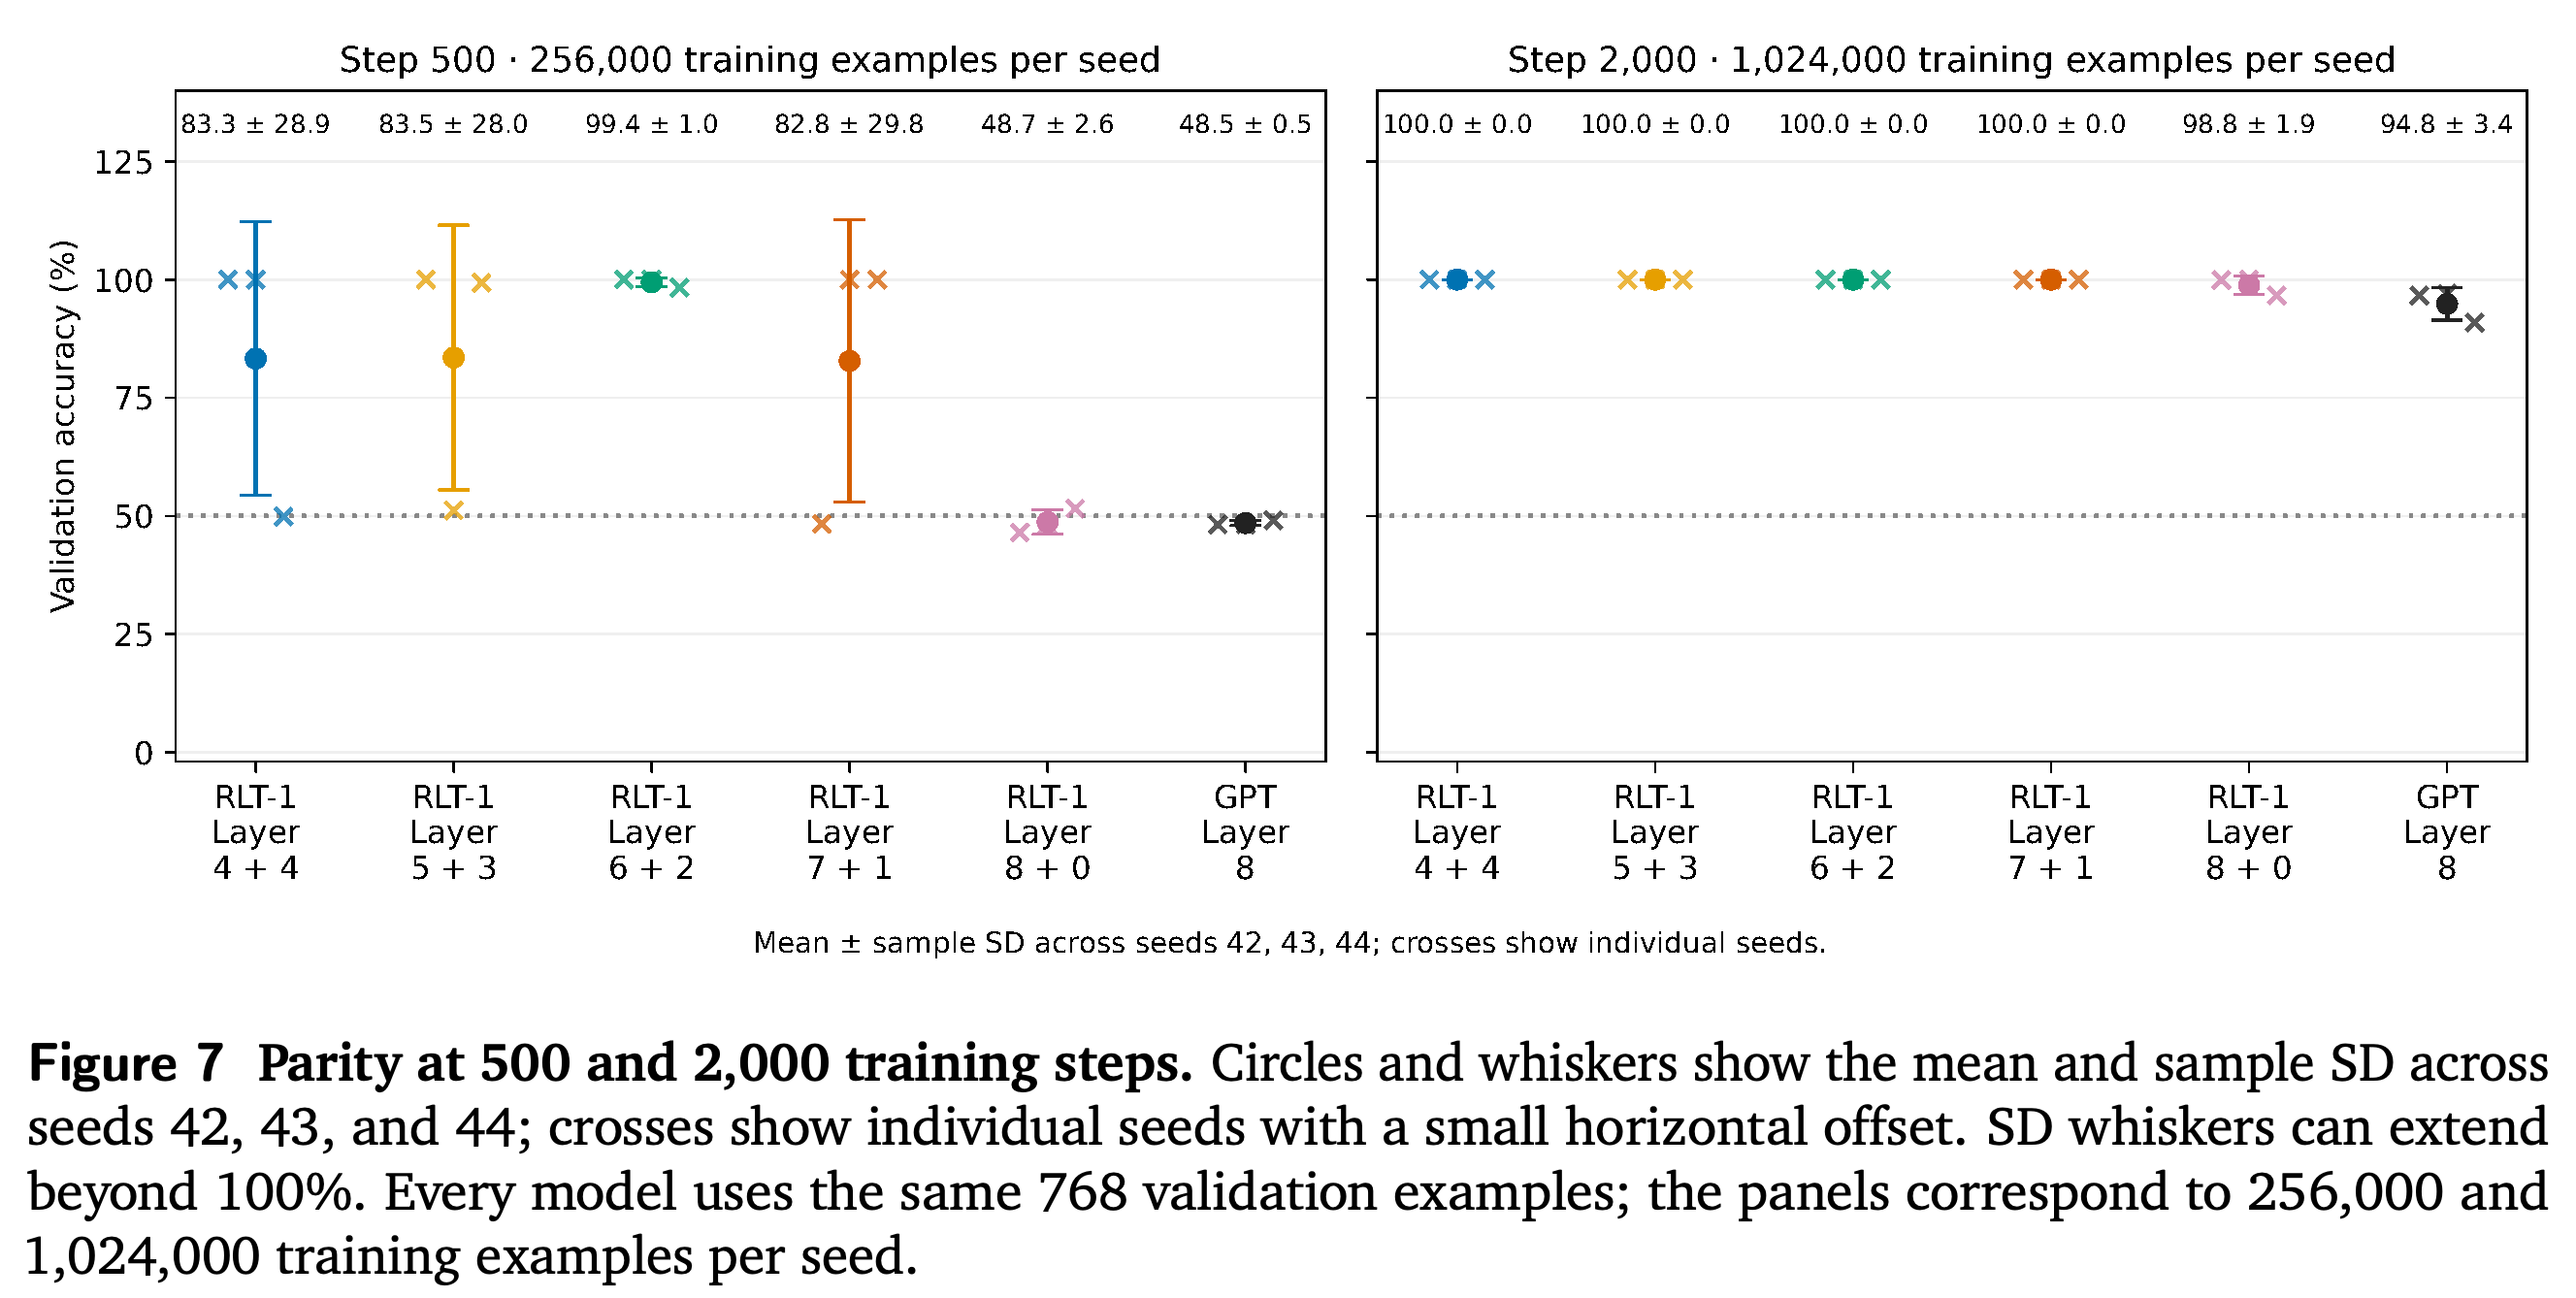
- Figure 7은 초기 parity 학습 결과를 보고한다. 500스텝에서 6+2의 검증 정확도는 99.44±0.98%이며, Transformer는 48.48±0.53%다. 별도의 열여섯 층 실험에서는 여러 분할이 256비트 parity에서 완벽한 정확도를 달성하지만, 사용한 시드는 42뿐이다.
최적의 깊이 분할은 과제마다 다르다. 256비트 parity에서는 5+3과 7+1이 유리하고, 교환 추적에서는 4+4가 유리하다. 모듈러 연산 곡선은 표현식이 길어질수록 균등 예측 기준에 가까워지며, 넓은 오차 막대는 초기화에 따른 변동을 드러낸다.
개별 시드를 나타내는 십자 표시는 6+2의 일관된 초기 학습과 다른 여러 RLT 분할의 더 큰 변동을 구분해 보여준다. 이 비교는 학습 길이 분포 안의 검증 정확도를 측정하므로, 별도의 외삽 결과를 보완한다.
3.3 Feedback frequency and parallelism
Figure 8은 4+4 분할을 고정했을 때 4토큰 피드백 청크가 64비트 parity 성능을 대부분 유지하지만 교환 기반 S₅ 외삽 성능은 크게 낮춤을 보여준다. RLT-1은 64비트 parity와 64개 연산의 교환 과제 모두에서 100±0%를 기록하지만, RLT-2 chunk4는 각각 98.99±1.66%와 19.60±6.54%를 기록한다.
- RLT-0은 64비트 parity에서 50.23±3.80%를 기록하고, 64개 연산의 교환 과제에서는 균등 예측 기준인 1/120 근처에 머문다. 피드백을 제거하면 분할마다 파라미터 787,968개도 제거된다. RLT-2는 RLT-1의 파라미터 수를 유지한다.
- 청크화의 효과는 깊이 배분과도 관련된다. chunk4 4+4는 256비트 parity에서 69.34±24.17%를 기록하지만, chunk4 7+1과 8+0은 이미 64비트에서 우연 수준에 가깝다.
- 교환 연산 64개에서 chunk4 5+3은 50.16±18.77%를 달성하며, chunk4 4+4는 19.60±6.54%를 기록한다. 따라서 피드백 빈도와 디코더 배분은 과제마다 함께 평가해야 한다.
분할을 4+4로 고정하면 4토큰 피드백은 짧은 길이의 parity 외삽에는 효과적이지만, 교환 추적의 이점은 크게 줄어든다. 괄호 있는 연산 패널에서는 중간 길이에서 토큰별 피드백과 청크 피드백의 차이가 더 작게 나타난다.
3.4 Addition, standard S₅, and scope
모든 모델은 학습 범위인 1–8자리 덧셈에서 teacher forcing 정확도 100%를 달성하지만, 32자리에서는 RLT-1과 Transformer의 평균이 14.89–16.84%로 떨어진다. 표준 S₅는 피드백 변형 전반에서 최종 상태 기준인 1/120 근처에 머문다.
- 덧셈 정확도는 앞선 정답 토큰을 제공한 상태에서 정답 토큰을 평가한다. 모델이 스스로 생성한 완전한 답변은 평가하지 않는다.
- 실험은 지도학습 합성 과제의 성능을 측정한다. 강화학습 성능은 평가하지 않았다고 명시한다.
4 Related Work
논문은 RLT를 병렬 인코더와 순환 디코더를 결합하는 모델, 인코더에서 만든 메모리를 재사용하는 모델, 토큰 사이에 은닉 상태를 전달하는 모델과 비교한다. RLT는 별도의 인코더 메모리 저장소와 전체 디코더를 통과하는 최종 출력 피드백을 결합하고, 인코더와 디코더의 깊이 배분을 연구한다.
- Feedback Transformer는 층 표현에서 만든 공유 메모리를 사용하고, Recurrent Transformer는 층별 피드백을 사용한다. RLT는 직전 토큰의 최종 디코더 출력을 다음 디코더 입력에 전달한다.
- Full-bandwidth Transformer, 중간 층에 시간적 순환을 적용하는 Transformer인 T²MLR, Latent Recurrent Transformer도 토큰 사이에 정보를 전달하지만, 피드백 위치나 병렬 학습 근사 방식이 다르다. RLT는 순차적 이력 재실행과 완전한 BPTT를 명시한다.
- 연속 잠재 계산을 사용하는 모델은 토큰 단위 추론 단계에 은닉 상태 계산을 삽입하거나 해당 단계를 대체한다. RLT는 일반 토큰마다 상태를 갱신한다. RLT-2는 블록 단위 순환 아키텍처와 유사하지만, 전용 메모리 토큰 없이 마지막 토큰의 디코더 출력을 경계 상태로 사용한다.
- 깊이 방향으로 반복하는 모델은 한 위치에서 계산을 반복 적용한다. RLT는 토큰을 따라 순환을 진행한다. 인코더와 디코더의 가중치 공유는 선택 사항이다.
5 Conclusion
결론은 알고리즘 실험이 뒷받침하는 아키텍처 선택 2가지로 디코더 배분과 피드백 간격을 제시한다. 토큰별 피드백은 parity와 교환 기반 S₅에서 높은 외삽 성능을 가능하게 한다. 청크화는 주어진 토큰의 병렬 처리를 허용하지만, 과제에 따라 정확도가 낮아진다.
- 큰 청크에서 작은 청크로 전환하는 학습 스케줄은 아직 검증되지 않았다.
- 프로젝트 페이지는 https://github.com/yifanzhang-pro/recurrent-looped-tranformer 이다.
부록
- A Architecture and Execution Details; A.1 Sharing encoder and decoder weights: 가중치 공유 참조 구성은 L_E = L_D = L로 설정하고, 인코더 자기 어텐션과 디코더 SWA 사이에서 호환되는 어텐션 투영과 대응하는 FFN 가중치를 공유한다. 교차 어텐션은 별도의 query/output 투영과 메모리 투영을 사용한다. 인코더와 디코더의 정규화는 분리하며, 병합과 readout도 별도 모듈이다. 가중치를 공유해도 활성값과 캐시는 따로 유지한다. 주요 8층 실험은 가중치를 공유하지 않는다.
- B Computational Properties; B.1 Prompt–response consistency; B.2 Prefill work and sequential depth: 명제 B.1은 파라미터, 토큰, 위치, 초기 상태가 고정되고, 정확한 산술 연산, 동등한 인과적 인코더 실행, 동일한 SWA 윈도와 캐시 갱신, 결정론적 디코더 연산을 사용할 때 프롬프트와 응답의 분할에 대한 불변성을 증명한다. Prefill 연산량은 인코더 연산, 메모리 투영, T번의 디코더 전이를 합한 것이다. 밀집 어텐션에는 시퀀스 길이의 제곱에 비례하는 항이 남으며, 순차적 전이는 하드웨어 활용률을 낮출 수 있다. 추론 저장 공간에는 계속 증가하는 인코더 캐시와 메모리, 크기가 제한된 디코더 SWA 이력, 현재 순환 출력이 포함된다.
- C Hardware Execution; C.1 Batching independent sequences; C.2 Memory traffic and parameter reuse; C.3 Training memory and numerical agreement: 독립된 시퀀스는 상태와 캐시를 따로 유지하면서 다음 디코더 갱신을 배치로 함께 처리할 수 있다. 인코더 메모리를 공유하고 메모리 그룹 수를 줄이면 투영 연산량과 저장 공간이 감소한다. 연산을 하나의 실행 커널로 결합하는 커널 융합과 가중치를 가속기에 상주시키는 방식은 구현 시 적용할 수 있는 최적화다. 활성값 체크포인팅은 중간 활성값 저장량을 줄이는 대신 재계산을 수행한다. 샘플러와 학습기의 수치적 일치를 위해서는 정밀도, 위치 규칙, 캐시 구성, 리덕션, 확률적 동작을 맞춰야 한다.
- D Training Objectives; D.1 Autoregressive pretraining; D.2 Supervised fine-tuning; D.3 Policy gradients and replay: 사전학습은 각 시퀀스 안에서 다음 토큰 손실을 평균한다. 지도 미세조정은 다른 토큰의 상태 갱신을 건너뛰지 않으면서 어시스턴트 타깃을 선택한다. 정책 재실행은 현재 파라미터로 상태를 다시 구성하고, 현재 행동 확률을 행동 샘플링 당시 사용하여 기록한 행동 정책 확률과 비교한다. 샘플링 정책과 목표 정책의 차이를 보정하는 정확한 중요도 샘플링에는 목표 정책이 양의 확률을 부여하는 모든 곳에서 행동 정책 확률도 양수여야 한다. top-k와 top-p 샘플링은 후보 분포를 절단하므로, 절단하지 않은 softmax 목표 정책에 대해 일반적으로 이 조건을 위반한다. 확률비를 토큰별로 클리핑하면 편향이 생길 수 있다.
- E Multi-turn Inference and Cache Reuse: 대화는 사용자 메시지, 도구 결과, 역할 구분자, 어시스턴트 토큰을 포함하는 연속된 토큰 이력이다. 처리를 재개하려면 인코더의 연속 처리용 캐시, 인코더 메모리, 완전한 디코더 상태, 위치, 윈도 규칙, 일치하는 모델 파라미터가 필요하다. 샘플링한 후속 토큰까지 같게 하려면 샘플러의 난수 상태도 필요하다. 이전 토큰을 수정하면 이후 캐시 상태가 무효가 되므로, 그보다 앞선 유효한 체크포인트부터 다시 계산해야 한다.
- F Execution Procedures; F.1 Recurrent prompt prefill; F.2 Generation and new external inputs; F.3 Pretraining and SFT; F.4 Current-policy RL replay: 절차는 병렬 인과적 인코딩 후 순서대로 디코더를 재실행하고, 소비한 토큰마다 갱신하며, 패킹된 시퀀스에서는 문서별 상태를 분리하도록 명시한다. SFT는 지도 미세조정을 뜻하고, EOS는 시퀀스 종료 토큰을 뜻하며 샘플링되면 재실행에 포함한다. 출력했지만 아직 소비하지 않은 마지막 토큰은 기록해 두었다가 후속 처리를 시작하기 전에 1번 소비해야 한다. 전체 BPTT를 정확하게 수행하는 학습 재실행에는 프롬프트 계산을 통한 그래디언트가 필요하며, 가중치를 갱신할 때마다 파라미터에 의존하는 캐시가 무효가 된다.
- G Causality and Gradient Paths; H When Cached States Can Be Reused: 명제 G.1은 결정론적 실행에서 인과적 인코딩, 접두 구간으로 제한한 메모리, 인과적 SWA를 바탕으로 인과성을 증명한다. 그래디언트 분석에는 순환 출력, 디코더 KV, 연속 처리 경계를 넘어 전달되는 인코더 측 텐서를 통한 경로가 포함된다. 이 텐서를 계산 그래프에서 분리하면 순전파 값은 보존하면서 그래디언트 항은 제거할 수 있다. 캐시된 접두 구간은 파라미터, 토큰, 위치, 초기화, 윈도, 실행 설정이 일치할 때만 순전파 재실행을 대체할 수 있다. 완전한 BPTT에는 접두 구간의 계산 그래프를 유지하거나 다시 계산하는 작업도 필요하며, 여기에는 이후에 캐시에서 제거된 SWA 항목을 사용했던 이전 연산도 포함된다.
- I RLT-2: Chunk-Parallel Hidden-State Feedback; I.1 Chunk operator and causal masks; I.2 Training and prefill algorithm; I.3 Incremental generation and partial chunks; I.4 Training and inference efficiency: 청크 경계는 시퀀스 시작을 기준으로 고정하며, BOS를 위치 1로 센다. 경계에서도 위치나 SWA 캐시를 초기화하지 않는다. 주어진 청크 위치들은 각 층 안에서 함께 실행하며, 완전한 청크의 경계에서만 피드백 레지스터를 교체한다. 완전한 BPTT는 경계 상태, 청크를 넘어 전달되는 디코더 KV, 인코더 메모리를 따라 역전파한다. 미완성 청크는 직전 레지스터를 보존한다. B나 경계 기준점을 바꾸면 연속 처리 상태가 무효가 되며, 생성은 계속 토큰 단위로 수행한다. 처리량, 지연 시간, 메모리, 수치적 동등성, 그래디언트를 포괄하는 벤치마크는 제안되었을 뿐, 완료된 결과로 보고하지 않는다.
- J Experimental Details; J.1 Complete six-task study at 2,000 steps; J.1.1 Models, tasks, and evaluation protocol; J.1.2 Parity: learning speed and initialization variability: 최초 연구는 6 architectures에 과제 여섯 개와 초기화 시드 세 개를 적용한 총 108회 실행으로 구성된다. 각 실행은 학습 예제 1,024,000개를 사용하며, 100 steps마다 검증한다. 6+2 parity의 시드 세 개는 모두 600스텝까지 검증 정확도 100%에 도달하지만, 다른 분할은 초기 변동이 더 크다. 이 실행들은 이후의 5,000 steps 모듈러 연산 비교와 별개다.
- J.1.3 Modular arithmetic with and without brackets; J.1.4 Addition and permutation state tracking; J.1.5 Length generalization; J.1.6 Training stability and comparison scope: 2,000 steps에서 flat mod-5 4+4의 검증 점수는 17.58%, 19.53%, 98.96%로, 초기화의 영향이 크다는 점을 보여준다. 반면 괄호 있는 표현식에서는 모델별 평균이 더 비슷하다. 교환 연산 512개에서 4+4는 중간 상태의 정답 여부를 평균한 접두 토큰 정확도 91.16±6.09%를 달성하지만, 최종 상태 정확도는 55.70±25.78%다. 전체 시퀀스 정확도에서는 모든 중간 예측이 맞아야 한다. parity 5+3의 한 시드는 500스텝에서 100%였다가 600스텝에서 일시적으로 48.05%까지 떨어진 후 회복한다. 부록은 Transformer와의 비교에서 어텐션 구조, 파라미터, 계산량, 피드백이 함께 바뀐다는 점을 명시한다.
- J.2 Parameter counts; J.3 Implementation of RLT-0; J.4 Seed aggregation and metric definitions: RLT-1의 파라미터 수는 4+4부터 8+0까지 순서대로 28.73M, 28.20M, 27.68M, 27.15M, 26.10M이며, GPT Layer 8은 25.31M이다. rlt_parallel_tiny 4+4 대조군의 파라미터 수는 27,938,944개이며, nanogptpro-dev PR #164로 병합되었다. 시드 집계는 같은 스텝의 시드 3개 전체에 대해 산술평균과 표본 표준편차를 계산한다. 덧셈 채점에는 정답 숫자, 공백, 괄호, EOS가 포함되며, S₅는 최종 상태 정확도와 접두 토큰 정확도를 구분한다.
- J.5 Reproducing the completed training snapshot; J.6 Length-generalization protocol and supplementary metrics; J.7 Token-accuracy trajectories at lengths 32 and 33: 형식적 과제의 데이터 시드는 학습 20260914, 검증 20260915, 테스트 20260916이며, 최초 덧셈 스냅샷은 데이터 시드 42를 사용한다. 구현 스냅샷은 커밋 d1a4516을 기준으로 하며, 이력은 2026년 9월 17일에 고정했다. data/experiments-depth8/의 manifest.json과 configs.json에 출처 정보가 기록되어 있다. 외삽 연구는 공통 테스트 세트 47개와 모델–시드–길이 평가 846개로 구성되며, 결과와 검증 기록은 data/experiments-depth8-generalization/에 있다. 고정 길이 성능 추이는 괄호 없는 표현식에 길이 33을, 나머지 형식적 과제에 길이 32를 사용한다.
- J.8 Sixteen-layer parity: best and final checkpoints: seed-42 runs 열 개는 전역 배치 1,024와 마이크로배치 32로 2,000번 갱신하며 학습한다. 최저 ID 손실 체크포인트와 최종 체크포인트 사이의 80 model–length comparisons 중 정확도가 같은 경우는 74다. 8+8, 9+7, 11+5, 16+0 구성은 두 평가 모두에서 256비트 정확도 100%를 유지하며, GPT Layer 16은 49.41%를 기록한다. 이 체크포인트 비교는 단일 초기화 시드에 한정된다.
- J.9 Three-seed comparison of feedback variants; J.10 Mod-5 feedback variants at 5,000 steps: 확장 연구는 5,000 steps 동안 학습한 모듈러 연산 실행 96회를 포함하여 총 288회 실행의 학습 종료 시점 검증 결과를 보고한다. RLT-0과 RLT-2의 덧셈 외삽은 평가하지 않는다. 4+4 구성의 길이 64인 괄호 있는 표현식에서 RLT-1은 64.10±3.49%, chunk4는 62.76±4.42%, RLT-0은 39.45±0.61%, GPT Layer 8은 46.71±1.21%를 기록한다. 시드 42로 1,001–2,000스텝의 CPU 시간을 측정하면 chunk4의 학습 스텝 처리 속도는 RLT-1 대비 2.27 times이며, RLT-0은 4.17–4.30 times다. 이 측정은 검증, 체크포인트 저장, 로깅을 제외한다.
- J.11 Addition feedback scale at a fixed learning-rate schedule: 모델 45개 비교에서는 α = 0.1과 GPT 대조군에 더해, 모든 분할에서 α = 0.03을 시험하고 7+1을 제외한 모든 분할에서 α = 0.01을 시험한다. α = 0.1과 조건을 맞춘 비교는 총 63개이며, 평균이 상승한 비교는 37개, 하락한 비교는 26개다. 변화 범위는 −3.86에서 +5.60%p다. 차이가 비교 대상의 표본 표준편차 2개를 모두 넘는 경우는 3개뿐이다. 시험한 피드백 배율 감소 중 어느 것도 어떤 분할에서든 모든 피연산자 자릿수의 성능을 개선하지 못한다. 32자리에서 RLT 평균은 여전히 14.44–15.91%이며, GPT Layer 8은 16.84±1.45%다.
짧은 생각
피드백 대조 실험은 순환 계산의 효과를 뒷받침한다. 최종 출력 피드백을 제거하면 parity와 교환 기반 S₅의 외삽 이점이 사라지며, 파라미터가 동일한 청크화 실험은 갱신 빈도가 과제 2개에 서로 다른 영향을 미침을 보여준다. 공통 데이터, 시드 3개의 결과 보고, 테스트 성능과 독립적인 체크포인트 선택은 이러한 비교를 뒷받침한다. 다만 RLT-0은 병합 파라미터도 제거한다.
실용적인 규모 확장 가능성은 아직 확인되지 않았다. 학습과 prefill 중 순차적 디코더 의존성, 모델 간 계산량과 파라미터 수 차이, 단일 시드 CPU 시간 측정, 낮은 덧셈 외삽 성능, 표준 S₅에서의 실패를 고려하면 근거는 시험한 알고리즘 환경에 한정된다. 대규모 언어 과제 성능과 제안한 청크 크기 학습 스케줄은 아직 평가되지 않았다.