


Scaling Language-Free Visual Representation Learning 요약 설명
01 Apr 2025 | Paper Review Self-Supervised Learning Scaling Laws Visual Question Answering목차
이번 글에서는 Scaling Language-Free Visual Representation Learning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 4월 1일(Arxiv)
- Fan, David, Tong, Shengbang, Zhu, Jiachen, Sinha, Koustuv, Liu, Zhuang, Chen, Xinlei, Rabbat, Michael, Ballas, Nicolas, LeCun, Yann, Bar, Amir, et al.
- FAIR, Meta, New York University, Princeton University
- 논문 링크
- Github
- Project Page
요약
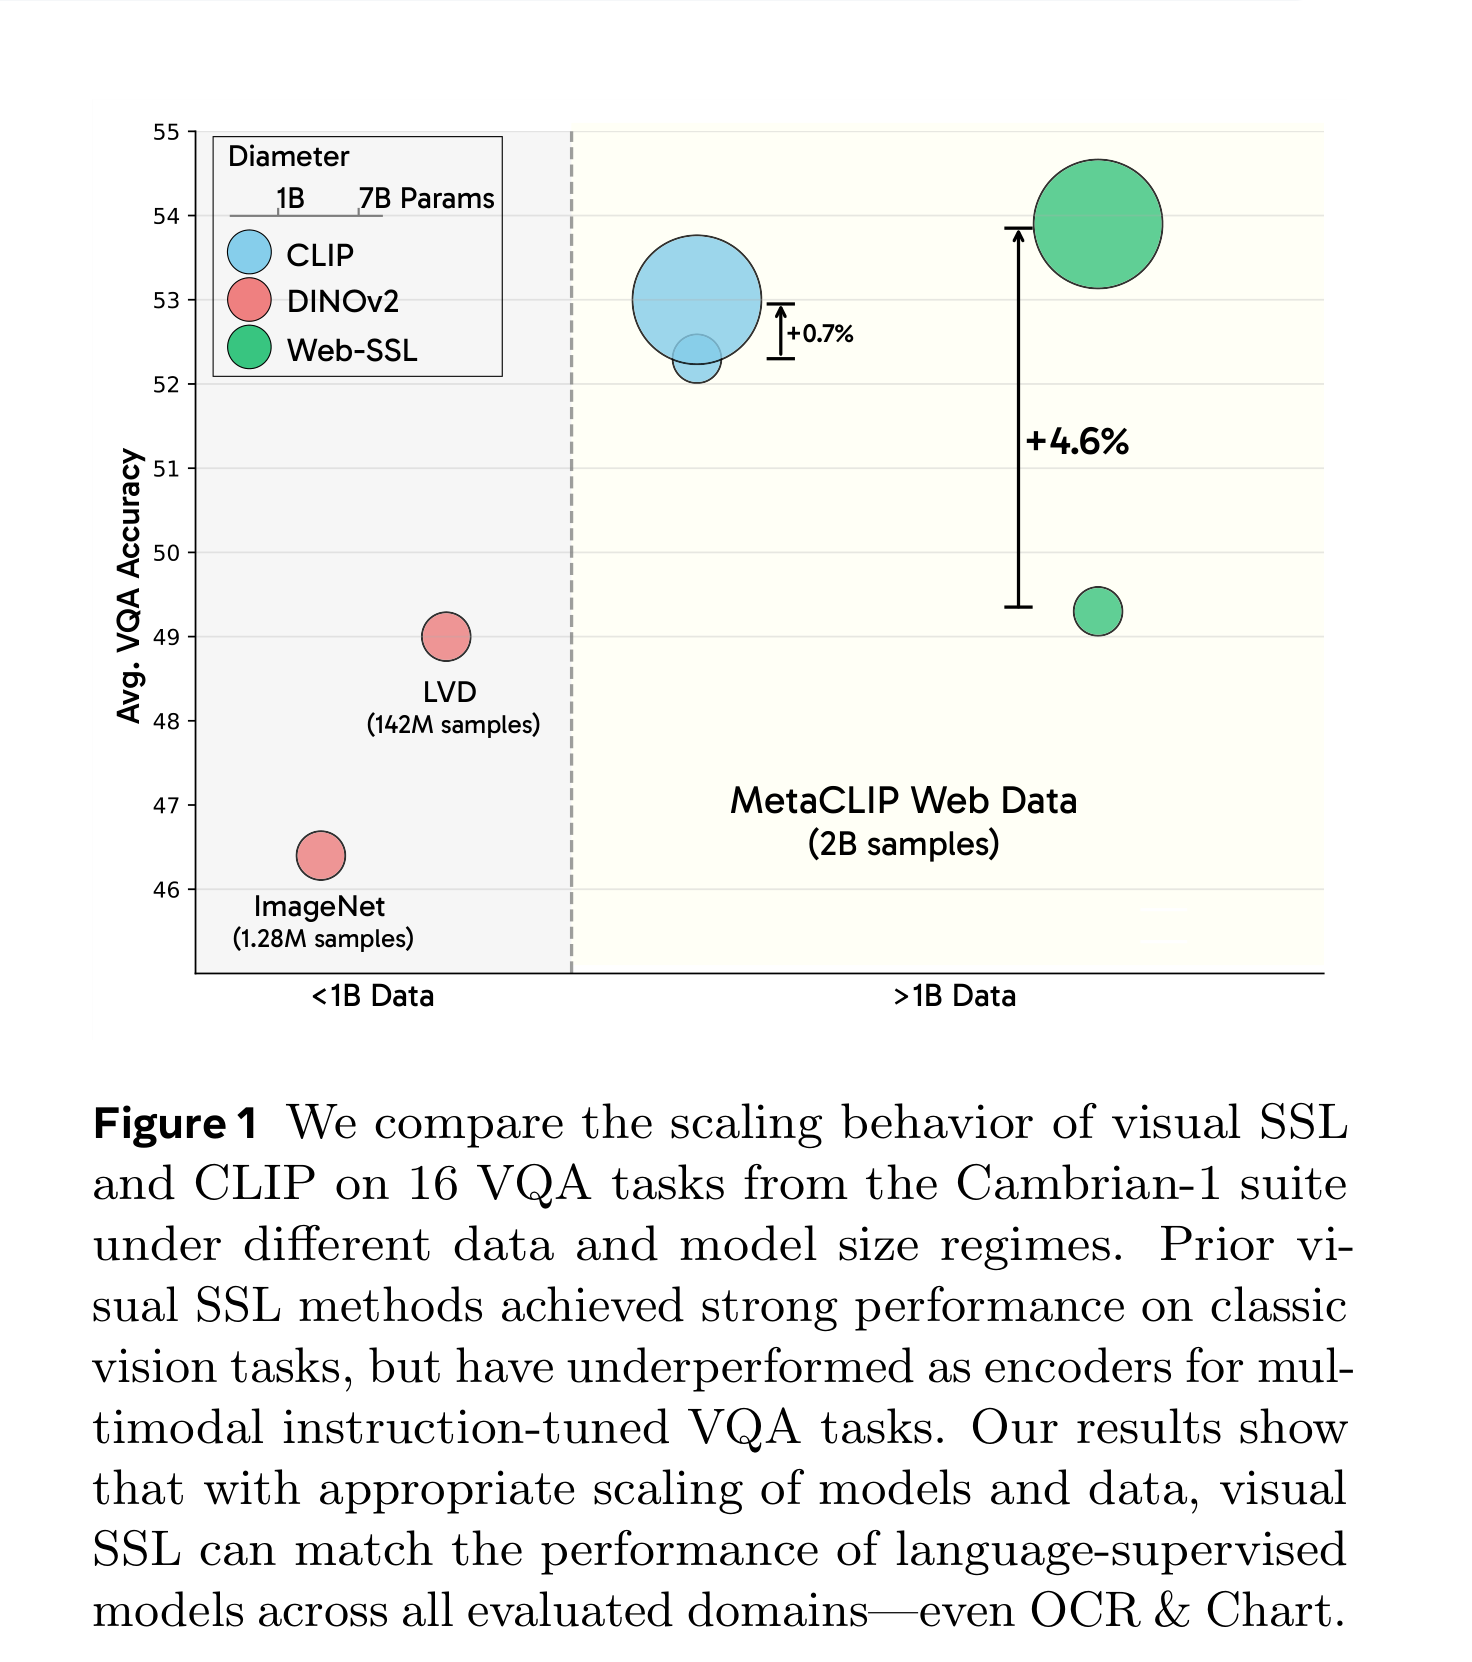
- 이 논문은 텍스트와 짝지어진 데이터 없이 학습한 이미지 특징이 이미지 질문에 답하는 데 한계가 있는지, 아니면 기존 성능 격차가 학습 데이터 차이에서 비롯되었는지 검증한다. 7B-parameter 이미지 인코더를 동일한 MetaCLIP 이미지 20억 장으로 학습하고 동일한 후속 학습 절차로 평가하면, 이미지만으로 학습한 Web-DINO는 평균 visual question answering(VQA) 점수 53.87을 기록한다. 이미지와 텍스트 쌍으로 학습하는 Contrastive Language-Image Pretraining(CLIP)의 점수는 52.97이다.
- 웹 이미지로 학습한 모델 계열인 Web-SSL은 모델 크기와 학습 중 처리하는 이미지 수를 늘려 visual self-supervised learning(SSL)을 확장한다. 이는 언어 감독 없이 이미지 표현을 학습하는 방식이다. Web-DINO는 학습 중 처리한 샘플 수를 2B로 고정하고 파라미터 수를 1B에서 7B로 늘리면 평균 VQA가 49.01에서 53.87로 높아진다. 7B 모델은 2B-image 데이터셋을 반복 사용하여 총 8B 샘플을 처리하면 55.24에 도달한다.
- 데이터 구성은 특히 이미지 속 글자를 읽는 optical character recognition(OCR)과 차트 이해에 영향을 준다. 강하게 필터링한 1.3% 부분집합으로 학습한 2B-parameter 모델은 OCR & Chart에서 40.4를 기록한다. 필터링하지 않은 이미지로 학습한 모델은 26.8, 전체 데이터로 학습한 CLIP은 36.1이며, 비교한 모델 모두 학습 중 2B 샘플을 처리한다. 이 결과는 언어를 사용하지 않는 비전 사전학습에 관한 것이다. 후속 VQA 학습에는 여전히 이미지, 질문, 답변 예제로 학습하는 instruction tuning을 사용하며, 필터링 실험에서는 이미지와 언어를 처리하는 사전학습 모델로 이미지를 선별한다.
1 Introduction
서론은 visual SSL과 CLIP을 비교할 때 학습 데이터가 교란 요인으로 작용한다고 지적한다. 기존 SSL 모델은 이미지 분류 데이터셋인 ImageNet이나 수억 장 규모의 정제된 데이터셋을 주로 사용하지만, CLIP은 대개 수십억 개의 웹 이미지와 텍스트 쌍을 사용한다. 이 논문은 동일한 MetaCLIP 웹 데이터 분포에서 Web-SSL을 학습하고, General, Knowledge, OCR & Chart, Vision-Centric 과제를 포함하는 VQA 평가 모음인 Cambrian-1의 16개 벤치마크로 평가한다.
- Figure 1은 기존 모델과 Web-SSL을 데이터 규모와 모델 규모에 따라 배치하여, 이미지 분포를 고정한 비교가 필요한 이유를 보여준다.
- 프로젝트 페이지는 https://davidfan.io/webssl/ 이다.
이 개요는 학습 데이터 조건을 구분하고 마커 지름으로 모델 크기를 나타낸다. Web-SSL에서 나타나는 더 큰 개선은 조건을 통제한 실험의 동기가 된다. 기존 ImageNet 및 LVD 지점은 공개 모델 간 비교에서 목적함수와 데이터셋의 영향이 뒤섞이는 이유를 보여준다.
2 From Visual SSL 1.0 to 2.0
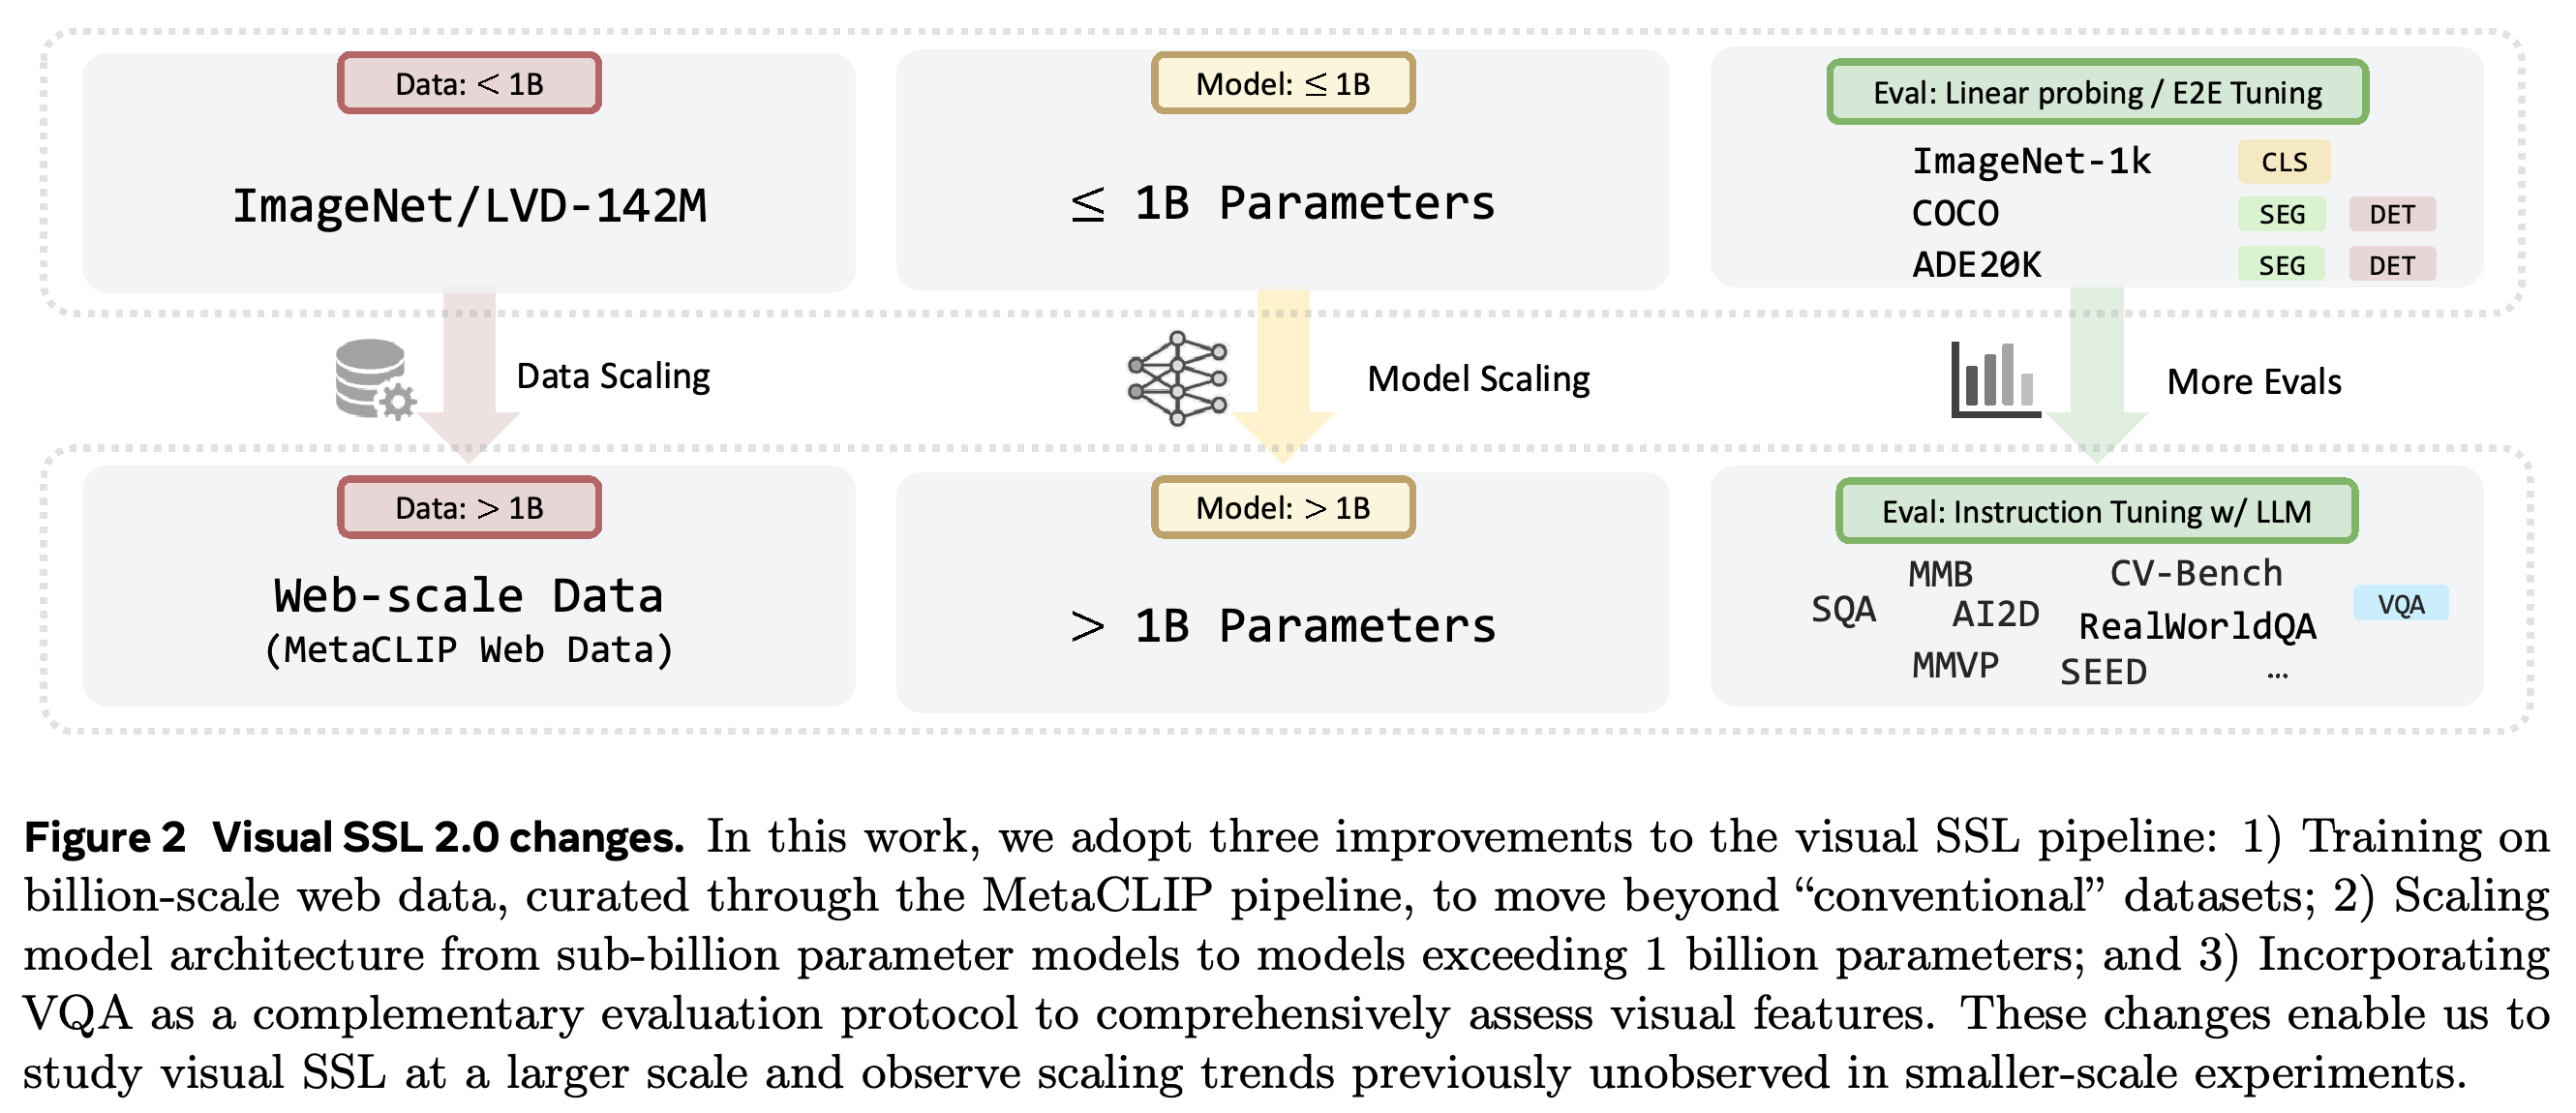
Visual SSL 2.0이라는 실험 체계는 기존 visual SSL에서 데이터, 모델, 평가 방식을 바꾼다. 10억 장 규모의 웹 이미지, 1B 파라미터를 초과하는 비전 인코더, 분류 및 이미지 영역에 클래스를 할당하는 분할 평가와 병행하는 VQA 평가를 도입한다. 이를 통해 작은 데이터셋과 모델에서 얻은 결론이 더 큰 규모에서도 유지되는지 검증한다.
도식은 연구 설계의 3가지 변화로 더 큰 웹 데이터셋, 1B 파라미터를 초과하는 모델, instruction tuning을 적용한 VQA 평가를 제시한다. 기존 자기지도학습 방법의 규모와 평가 범위를 확장한다.
2.1 Beyond ImageNet Pretraining
MC-2B는 이 연구를 위해 MetaCLIP에서 선별한 20억 개 샘플을 뜻한다. SSL 모델에는 이미지만 제공하고, CLIP에는 해당 이미지와 텍스트 쌍을 제공한다. 따라서 사전학습 방식을 비교할 때 기반 이미지 분포와 데이터셋 크기를 통제한다.
2.2 Scaling Up Vision Models to Billion Scale
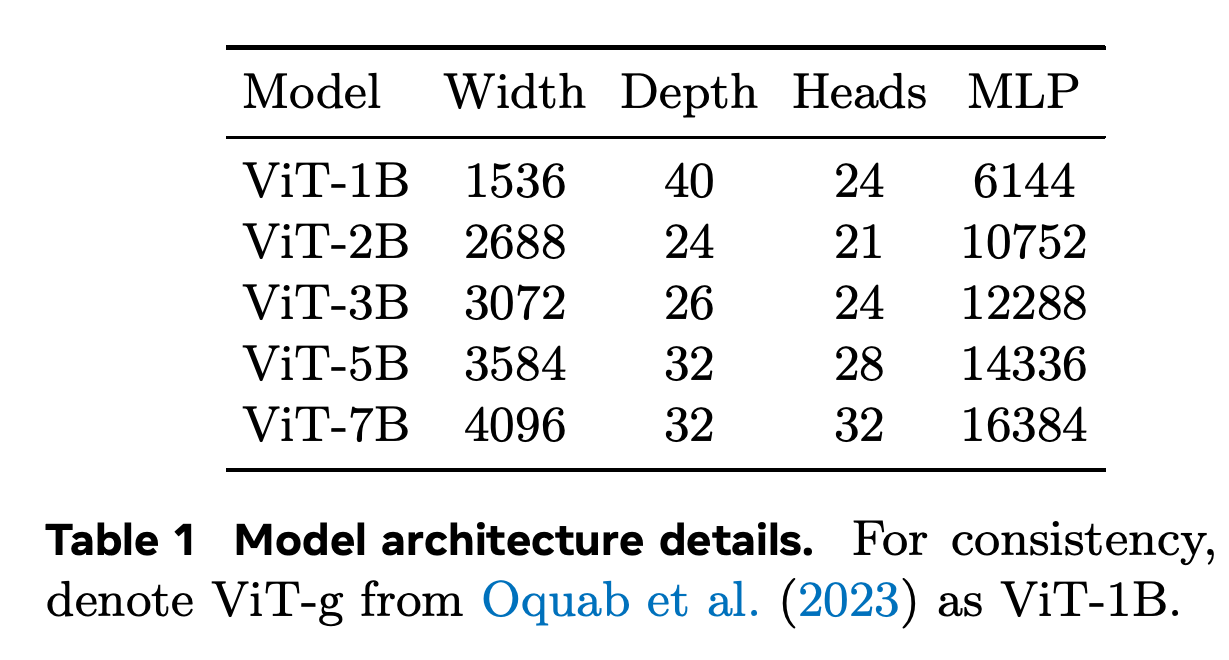
저자들은 명목상 파라미터 수가 1B, 2B, 3B, 5B, 7B인 Vision Transformers(ViTs)를 학습한다. 이는 Transformer 기반 이미지 인코더다. 기존 visual SSL 방법인 DINOv2의 ViT-g를 ViT-1B로 이름을 바꾸고, 더 큰 모델에서는 너비를 늘리면서 깊이와 attention head 수도 조정한다.
- Table 1에 제시된 5개 크기의 너비/깊이/head 수/feed-forward 차원은 각각 1536/40/24/6144, 2688/24/21/10752, 3072/26/24/12288, 3584/32/28/14336, 4096/32/32/16384다.
규모 확장 과정에서는 여러 구조적 차원을 바꾼다. 2B 모델은 1B 모델보다 얕고 넓다. 표에 명시한 너비, 깊이, attention head 수, feed-forward 차원이 비교에 사용한 인코더 계열을 정의한다.
2.3 Multimodal LLMs as an Evaluation Protocol
각 비전 인코더는 답변 생성에 사용하는 large language model(LLM)인 Llama-3 8B Instruct와 함께 동일한 2단계 visual instruction tuning 절차로 평가한다. 먼저 feed-forward 어댑터인 multilayer perceptron(MLP)이 이미지 특징을 언어 모델의 특징 차원으로 투영하도록 학습한다. 이후 어댑터와 LLM을 함께 미세 조정한다. 비전 인코더는 전체 과정에서 파라미터를 고정한다.
- Cambrian-1은 4개 범주마다 4개 벤치마크를 포함한다. 평균 VQA는 4개 범주의 점수에 동일한 가중치를 부여한다.
- 언어 모델과 후속 학습 절차를 고정하면 비전 인코더 간 차이를 구분하는 데 도움이 된다. 결과는 이 평가 설정을 전제로 한다.
3 Scaling Visual SSL
주요 규모 확장 실험에는 동일한 이미지에서 증강한 여러 뷰의 표현을 정렬하는 joint embedding 방법인 DINOv2를 사용하며, 웹 데이터로 학습한 모델을 Web-DINO라고 부른다. 모델 크기 실험에서는 처리한 이미지 수를 2B로 고정한다. 학습량 실험에서는 모델 크기를 7B로 고정하고 처리한 샘플 수를 1B에서 8B까지 늘린다. 각 방법은 모델 크기가 달라져도 기존 학습 설정을 유지한다.
3.1 Scaling Model
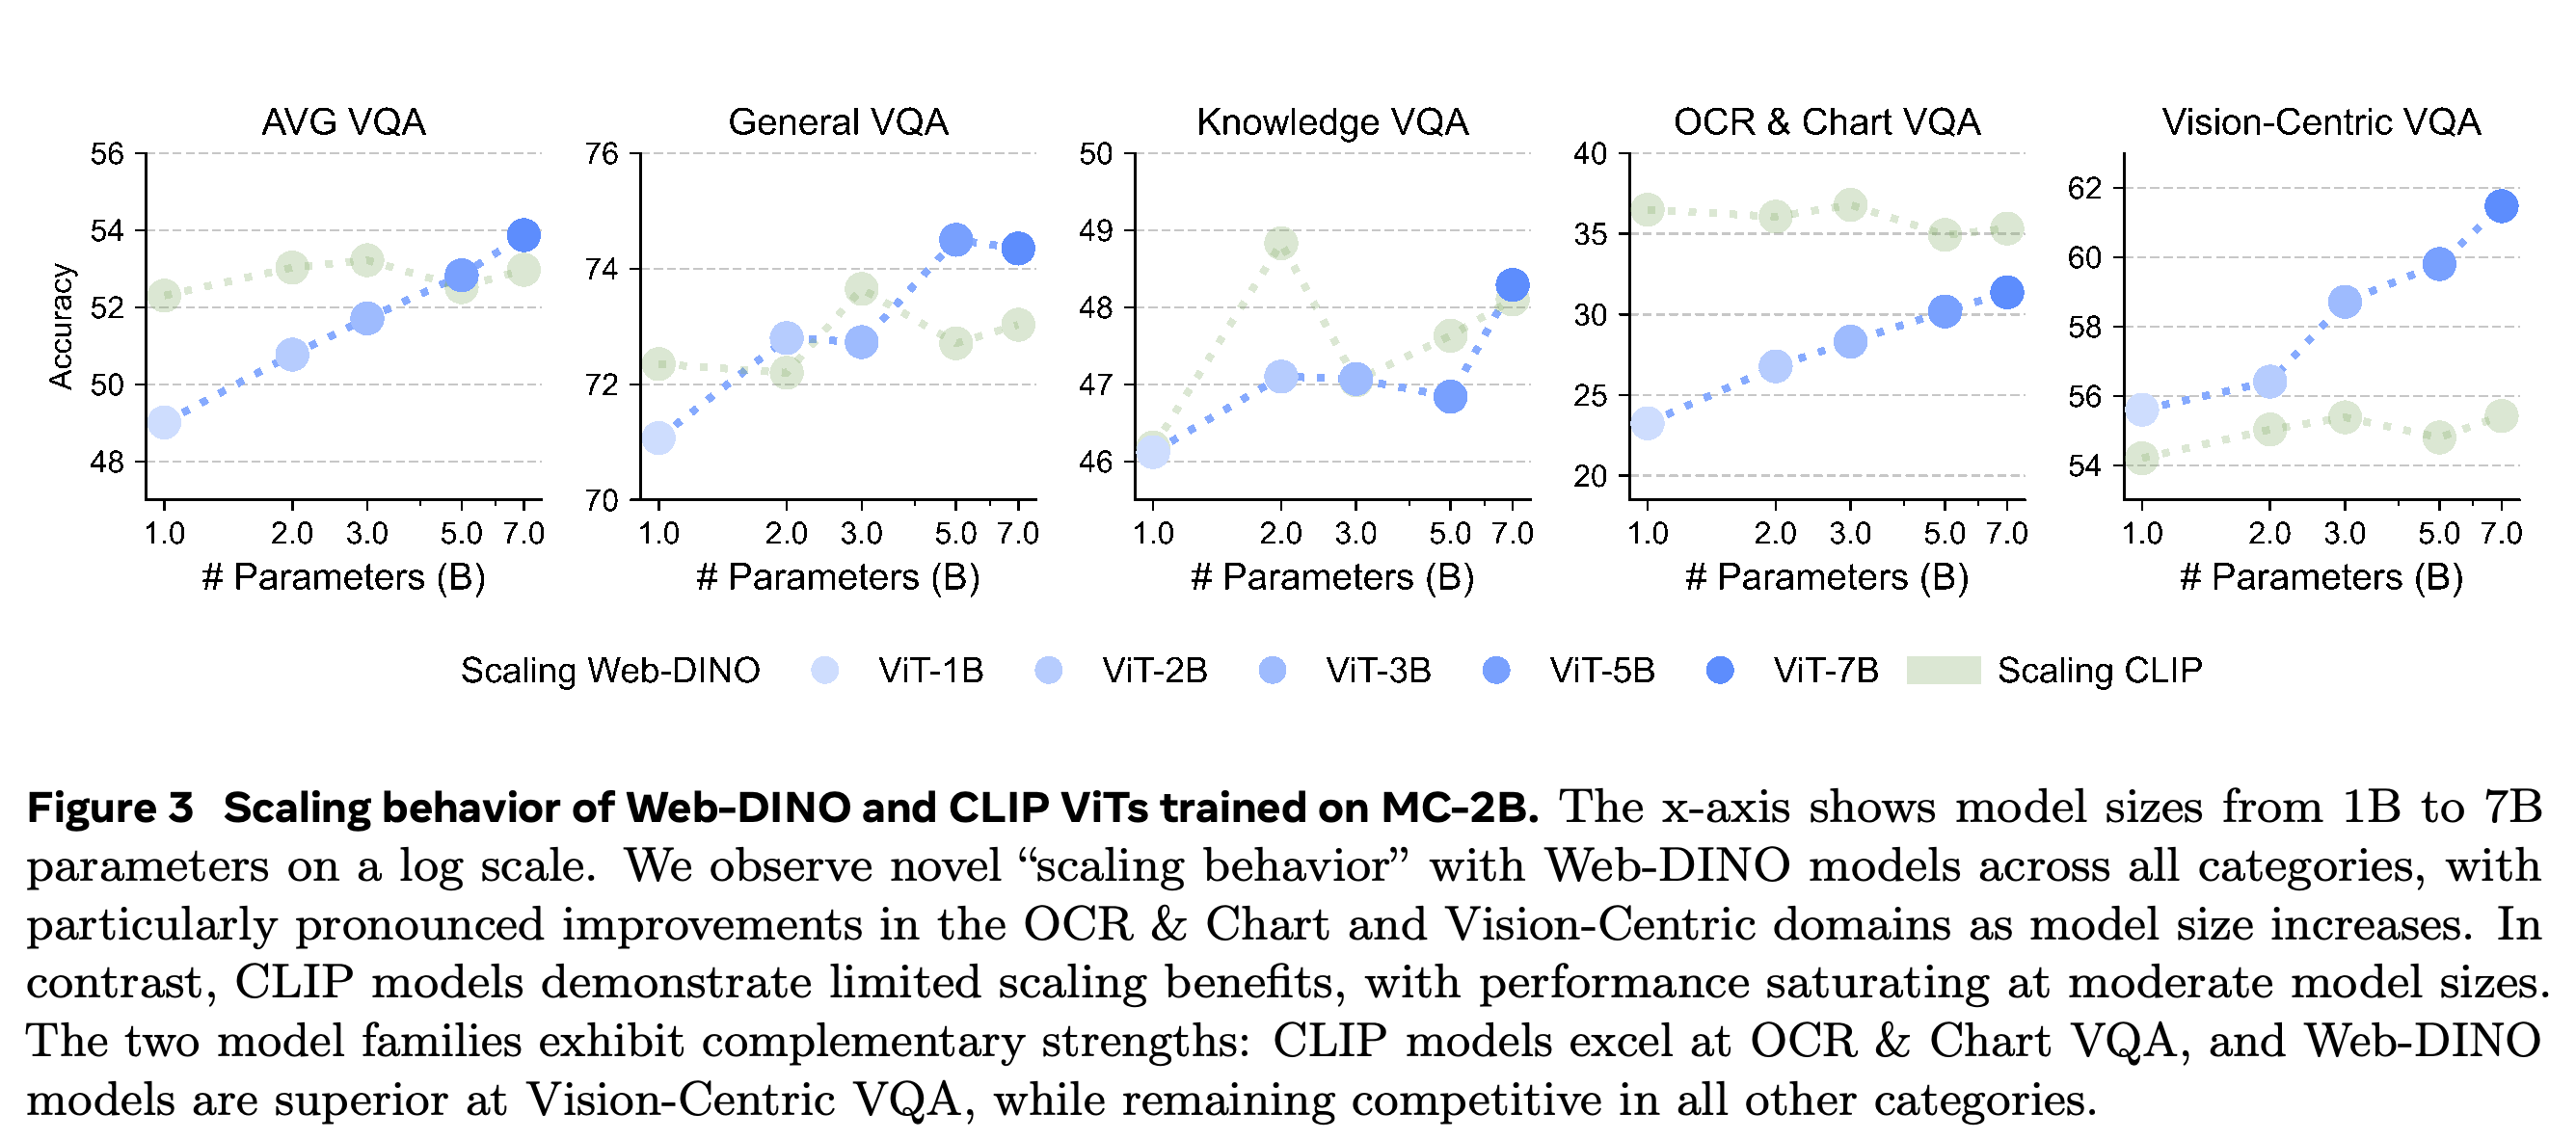
Web-DINO와 CLIP은 MC-2B에서 동일한 모델 크기로 학습한다. 224×224 이미지를 사용하며, 더 큰 이미지 해상도로 추가 학습하는 고해상도 적응은 적용하지 않는다. Web-DINO의 평균 VQA는 1B 파라미터에서 49.01, 7B에서 53.87로 높아진다. 동일한 5개 크기에서 CLIP의 점수는 52.30, 53.03, 53.22, 52.52, 52.97이다. Web-DINO는 5B와 7B 파라미터에서 같은 크기의 CLIP보다 높은 평균 점수를 기록한다.
- Web-DINO의 개선은 OCR & Chart와 Vision-Centric VQA에서 가장 뚜렷하다. General과 Knowledge의 개선 폭은 작으며, 개별 벤치마크 점수는 오르내린다.
- CLIP은 실험한 학습 설정에서 3B 파라미터 이후 대체로 포화된다. 다른 CLIP 학습 설정도 같은 규모에서 포화되는지는 이 실험으로 확인할 수 없다.
이미지와 처리한 샘플 수를 고정하면 Web-DINO의 종합 점수는 계속 높아지는 반면 CLIP의 점수는 정체된다. 범주별 패널은 Web-DINO의 개선이 OCR & Chart와 Vision-Centric에서 가장 크다는 점을 보여준다. 동시에 2B 샘플을 처리한 조건에서는 CLIP이 OCR & Chart 우위를 유지함을 보여준다.
3.2 Scaling Examples Seen
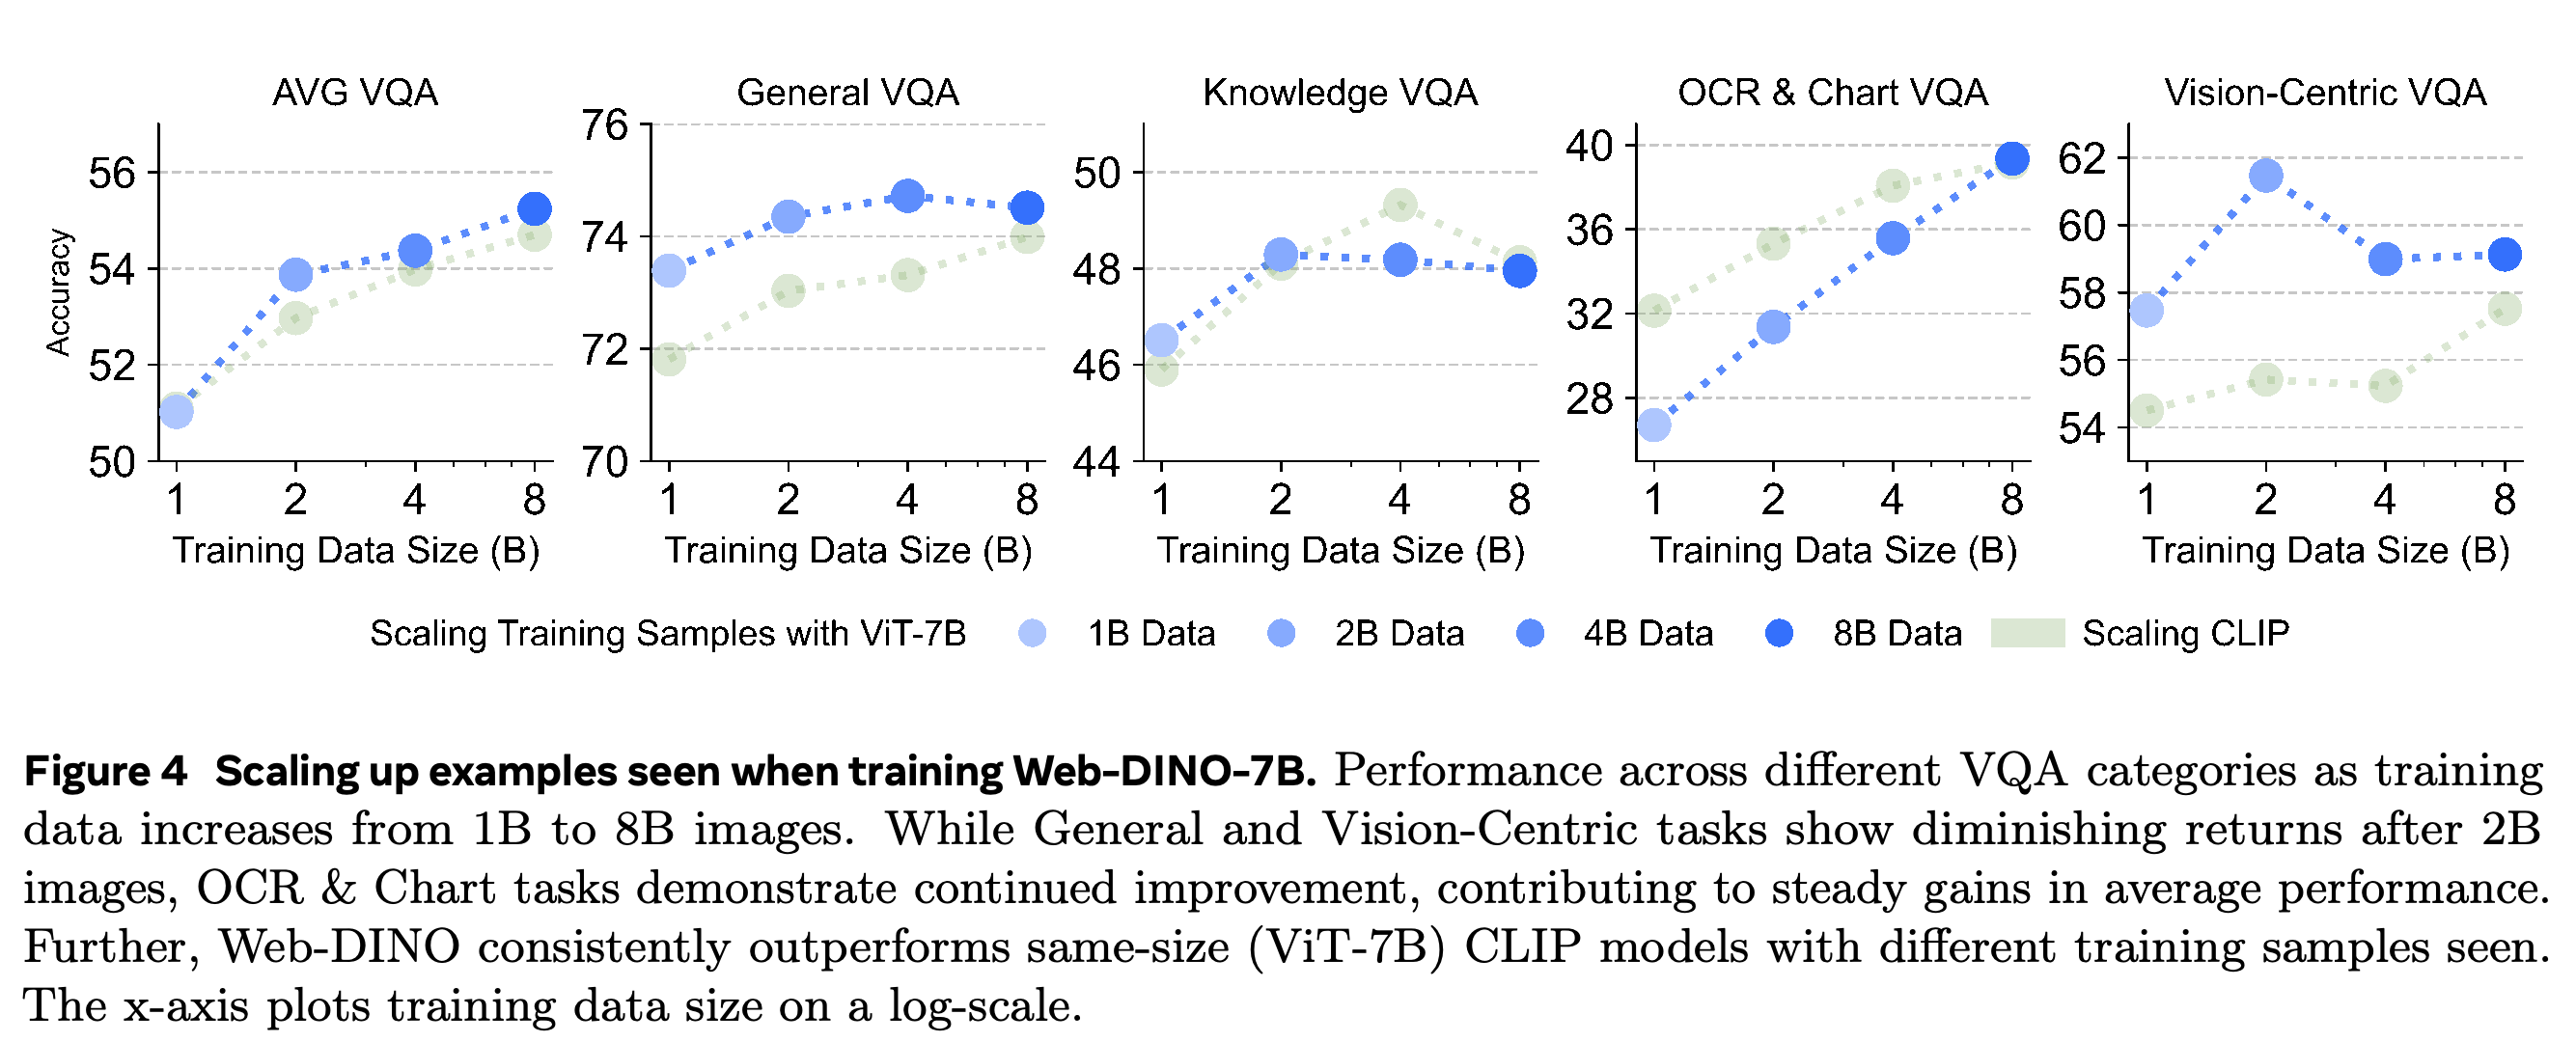
Web-DINO ViT-7B가 학습 중 처리하는 샘플 수를 1B에서 2B, 4B, 8B로 늘리면 평균 VQA가 51.02에서 53.87, 54.37, 55.24로 높아진다. OCR & Chart는 일관되게 개선되지만, General, Knowledge, Vision-Centric은 개선 폭이 줄거나 점수가 오르내린다. Figure 4에서 Web-DINO는 처리한 샘플 수가 같은 모든 비교 지점에서 동일한 크기의 CLIP보다 높은 평균 VQA를 기록한다.
- 2B를 초과하는 학습에서는 MC-2B 이미지를 반복 사용한다. 데이터셋을 서로 다른 이미지 8B장으로 확장하는 것은 아니다.
- Web-DINO는 8B 샘플을 처리했을 때 비교 조건을 맞춘 CLIP과의 OCR & Chart 격차를 해소한다.
처리한 샘플 수를 늘릴수록 종합 점수 개선에서 OCR & Chart가 차지하는 비중이 커지며, 다른 범주의 개선은 작거나 일관되지 않다. 가로축은 반복 사용한 이미지를 포함하여 학습 중 처리한 샘플 수를 나타낸다. 조건을 맞춘 CLIP 곡선은 처리한 샘플 수를 통제한 비교를 제공한다.
4 Scaling Analysis and Findings
분석에서는 5가지 질문을 검증한다. 규모 확장 효과가 DINOv2 이외의 방법에도 나타나는지, ImageNet에서도 나타나는지, 전통적인 비전 과제는 어떻게 반응하는지, 텍스트 관련 과제는 왜 개선되는지, 이미지 표현이 언어 표현과 더 잘 정렬되는지를 살펴본다. 실험을 통해 방법 간 일반성, 사전학습 데이터 의존성, VQA 개선을 설명할 수 있는 요인을 조사한다.
Question 1
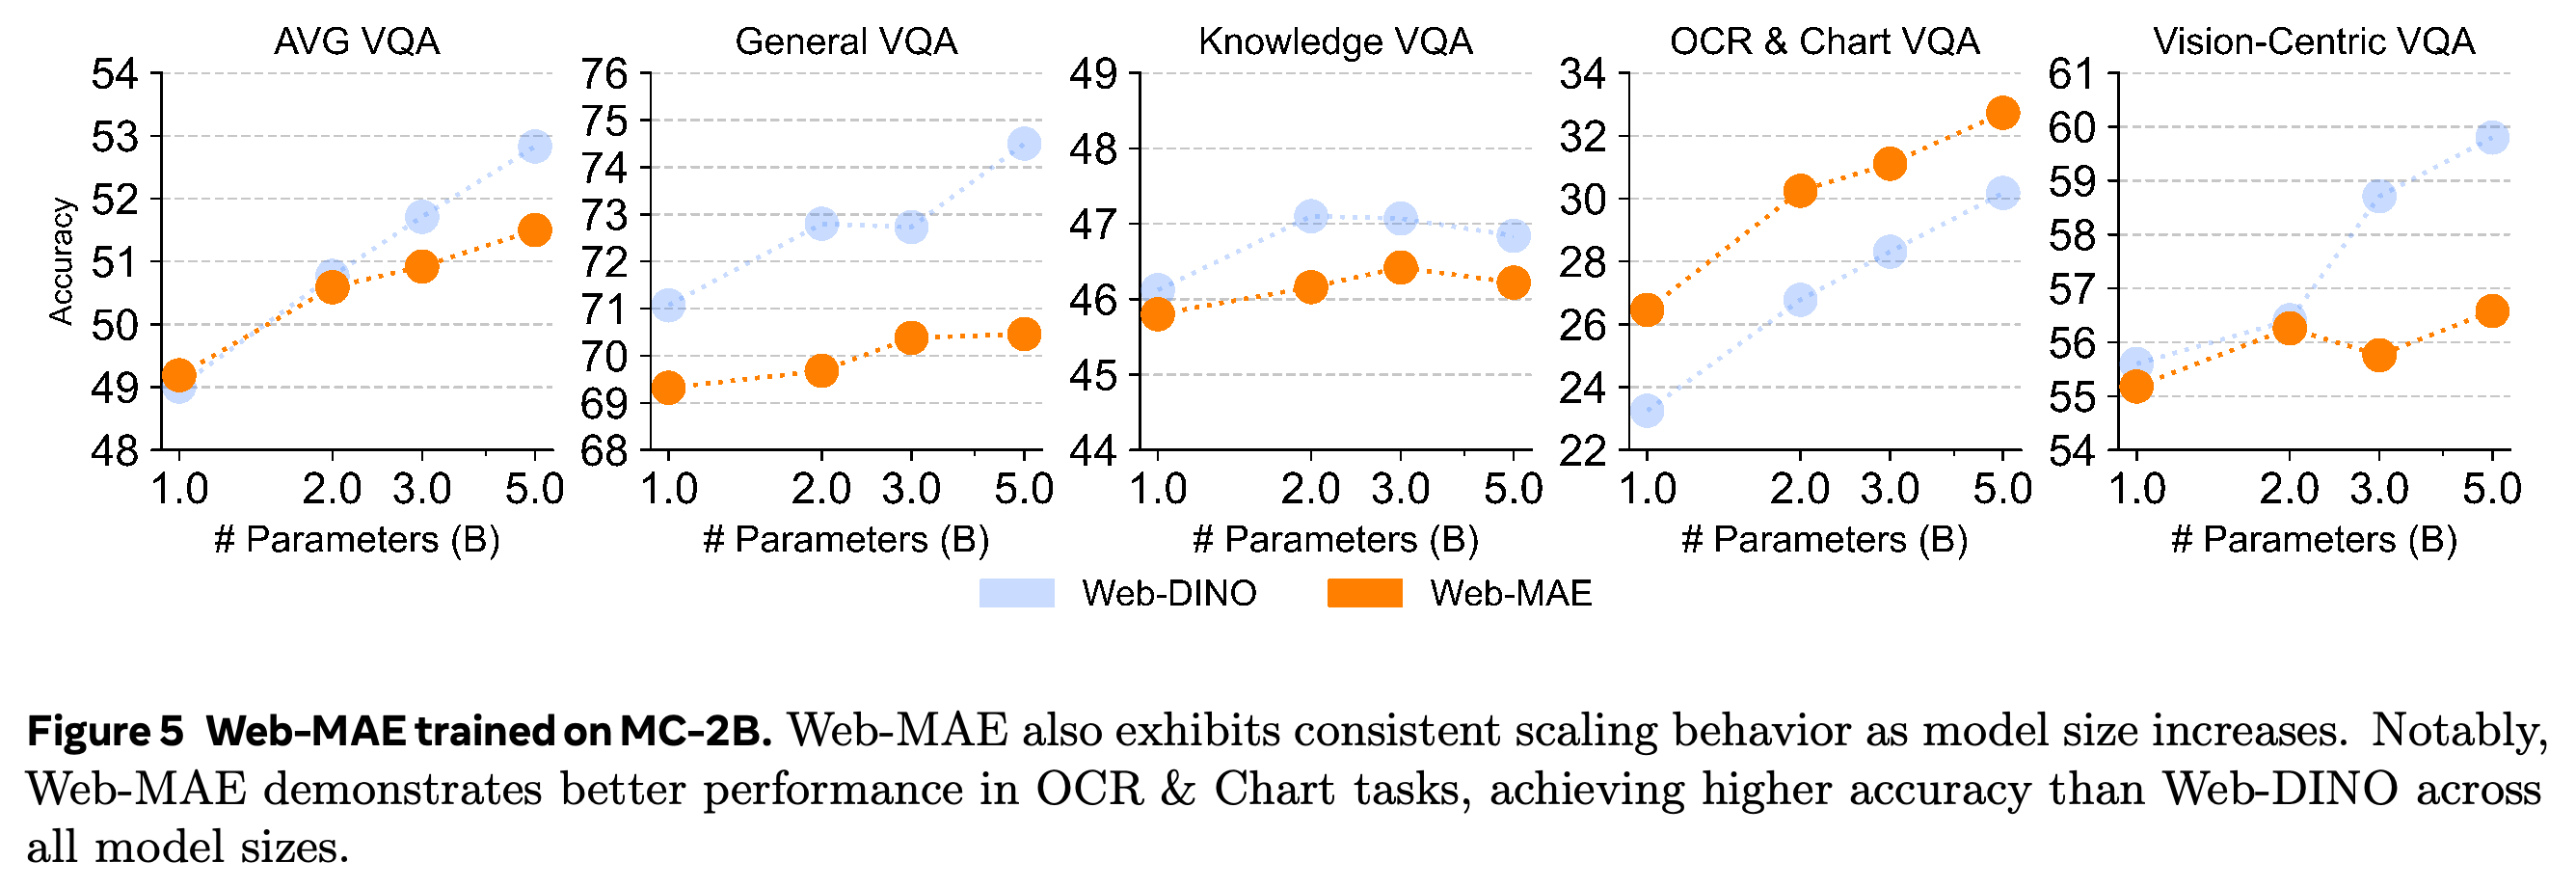
Question 1은 가려진 시각 입력을 예측하며 학습하는 Masked Autoencoder(MAE)를 살펴본다. MC-2B로 학습한 Web-MAE는 파라미터 수를 1B에서 5B로 늘리면 평균 VQA가 49.19에서 51.50으로 높아진다. 비교한 모든 크기에서 OCR & Chart는 Web-DINO보다 높지만, 나머지 범주에서는 대체로 낮다.
- 2번째 방법에서도 규모 확장 효과가 나타나므로, 관찰한 현상이 joint embedding에만 국한되지 않음을 보여준다. 범주별 성능 양상이 다르다는 점은 사전학습 목적함수가 학습한 능력에 영향을 준다는 사실도 보여준다.
Web-MAE의 평균 점수 상승은 2번째 자기지도학습 방법에서도 규모 확장 효과가 나타남을 보여준다. 동일한 원본 데이터셋을 사용해도 OCR & Chart는 더 높고 General은 더 낮다는 점에서 Web-DINO와 다른 능력 구성을 드러낸다.
Question 2
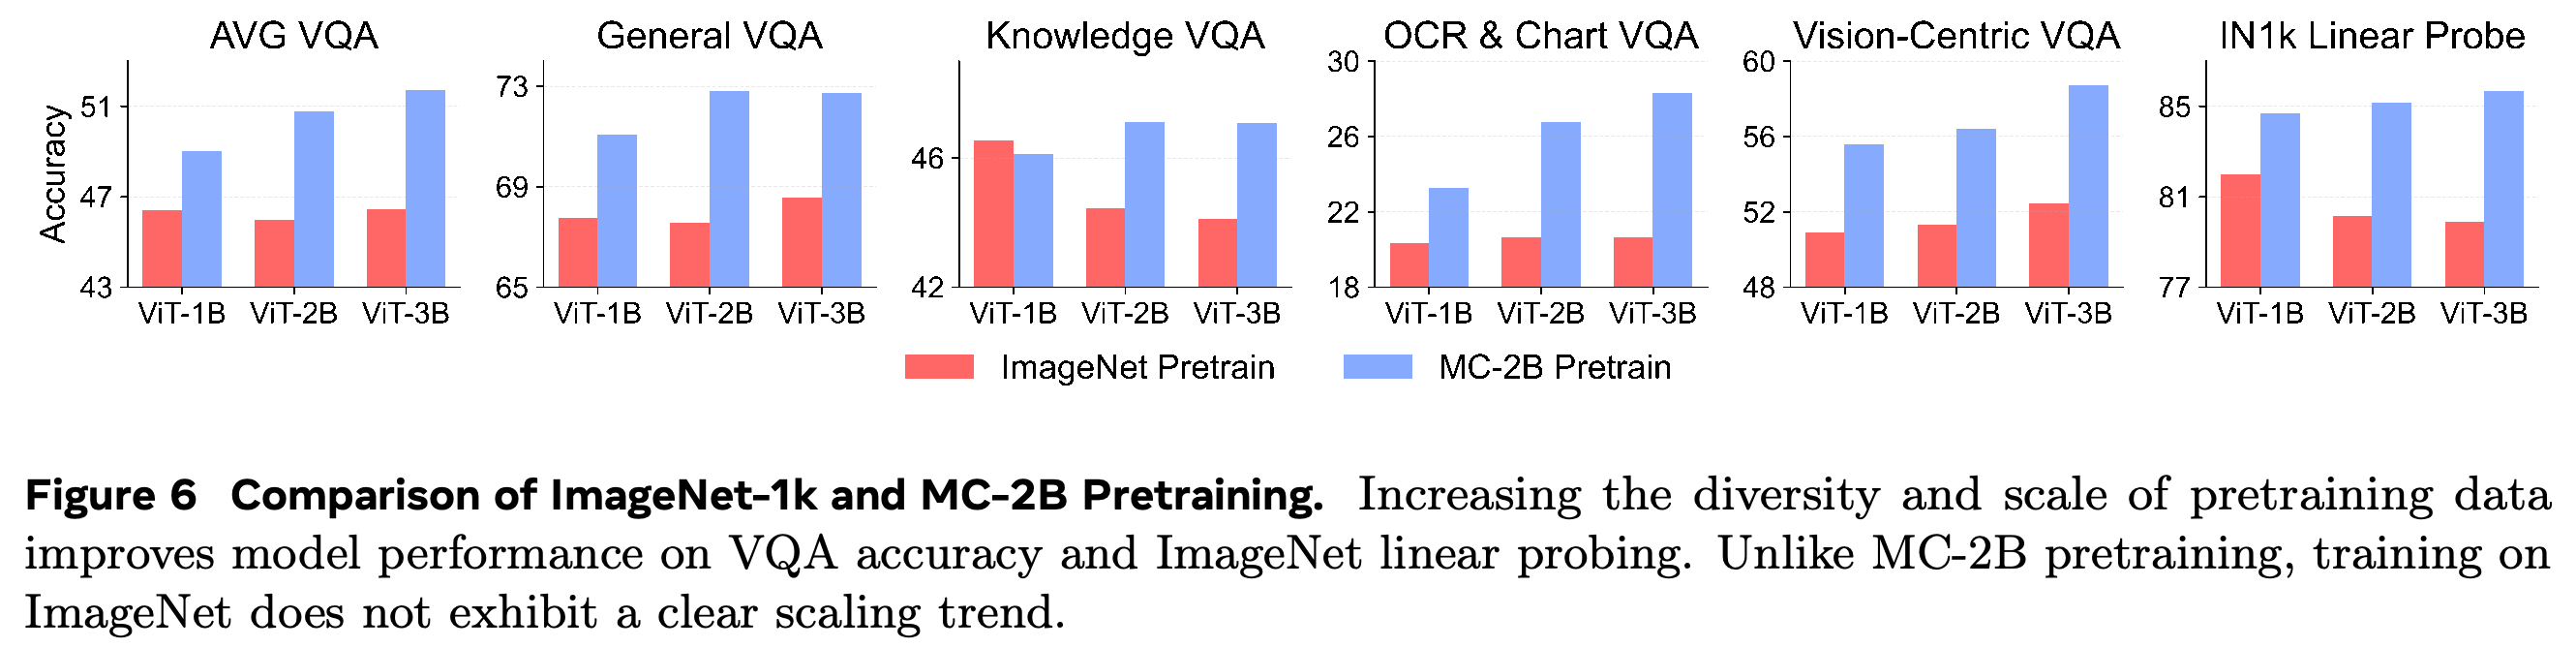
Question 2는 MC-2B 사전학습과 ImageNet-1k에서의 300 epochs 사전학습을 비교한다. Epoch는 학습 데이터셋 전체를 순회하는 단위다. Figure 6은 1B, 2B, 3B 모델을 비교하며, MC-2B를 사용했을 때 전반적인 VQA와 ImageNet linear probe 성능이 더 높음을 보여준다. Linear probing은 고정한 표현 위에서 선형 예측기를 학습하는 평가 방식이다. ImageNet으로 사전학습한 모델은 크기가 커져도 평균 VQA가 뚜렷하게 개선되지 않는다.
- Table 10에는 5B ImageNet 모델도 포함한다. 1B, 2B, 3B, 5B에서 평균 VQA는 각각 46.39, 45.99, 46.43, 46.28이다.
- 데이터셋 크기와 분포가 함께 바뀌므로, 이 비교만으로 각 요인의 기여도를 따로 정량화할 수 없다.
MC-2B에서는 ImageNet 사전학습 모델에 없는 종합 점수 상승 추세가 나타난다. 데이터셋 규모와 구성이 함께 바뀌므로, 이 막대그래프는 사전학습 데이터 조건에 대한 의존성을 보여주지만 각 요인을 분리하지는 못한다. 개별 범주 비교에는 전반적인 우위와 다른 예외도 존재한다.
Question 3
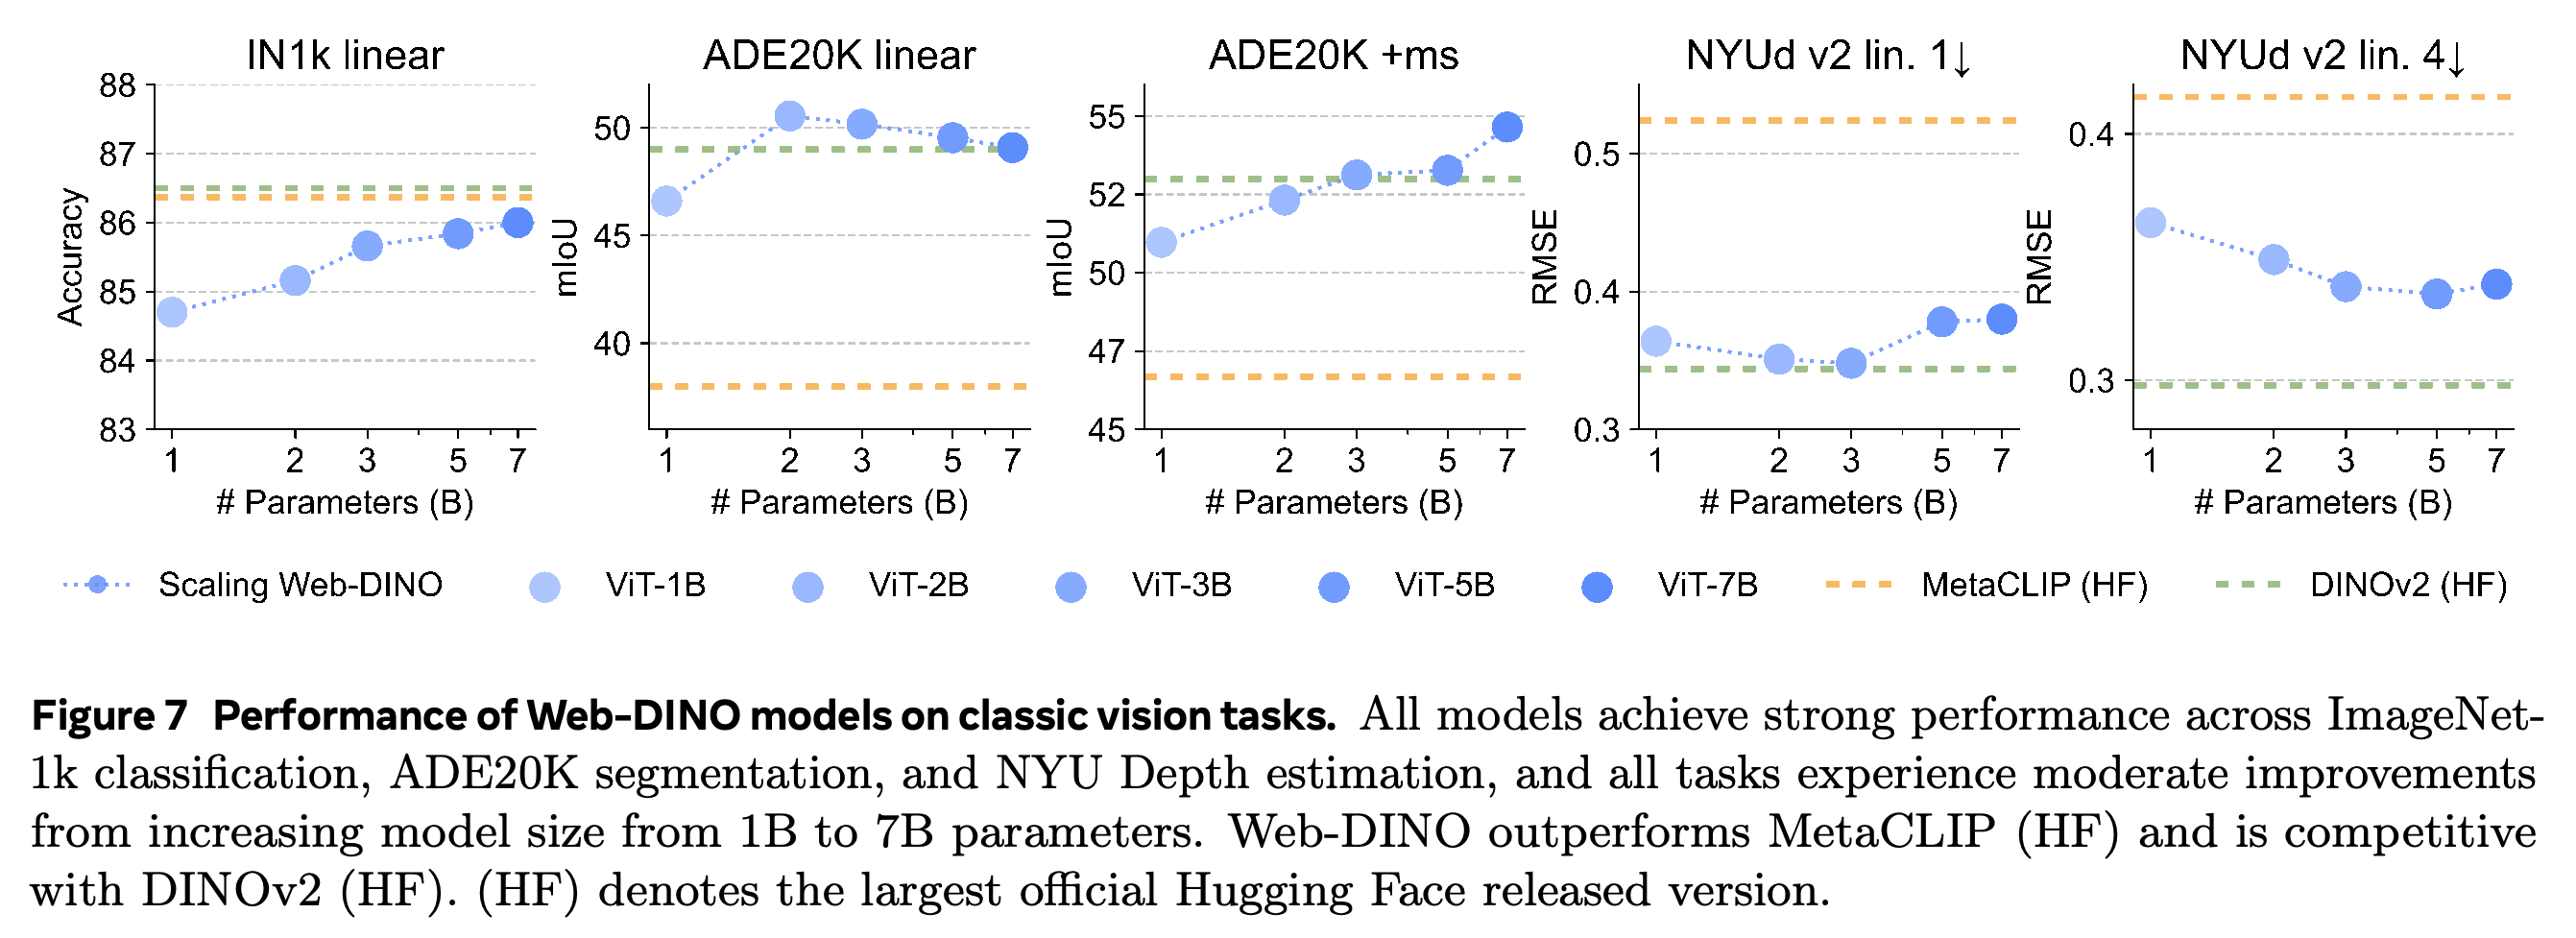
Question 3은 고정한 Web-DINO 인코더를 ImageNet-1k 분류, ADE20K 의미 분할, 이미지에서 거리를 예측하는 NYU Depth v2 깊이 추정으로 평가한다. 모델 크기를 1B에서 7B로 늘리면 ImageNet 정확도가 84.70에서 86.00으로 높아진다. 추가 분할 평가 설정인 ADE20K +ms에서는 분할 예측의 겹침을 측정하는 mean intersection over union이 50.97에서 54.65로 높아진다. 다른 지표는 단조롭게 개선되지 않으므로, 전통적인 비전 과제의 규모 확장 효과는 VQA보다 일관성이 낮다.
- ADE20K linear 성능은 2B에서 50.55로 가장 높고, 7B에서는 49.08로 낮아진다. 낮을수록 좋은 예측 오차 지표인 NYU Depth v2 root mean squared error는 3B 모델 이후 악화된다.
- 공개된 DINOv2와의 비교에는 해당 모델의 고해상도 적응과 더 세심하게 정제된 학습 데이터 분포가 영향을 준다.
ImageNet 정확도와 ADE20K +ms는 모델 크기에 따라 개선되지만, ADE20K linear와 깊이 추정 결과는 단조롭게 개선되지 않는다. 기준선은 Web-DINO가 공개 모델과 경쟁력 있는 지점을 보여주며, 5개 지표 전반에서 일관된 우위를 입증하지는 않는다.
Question 4
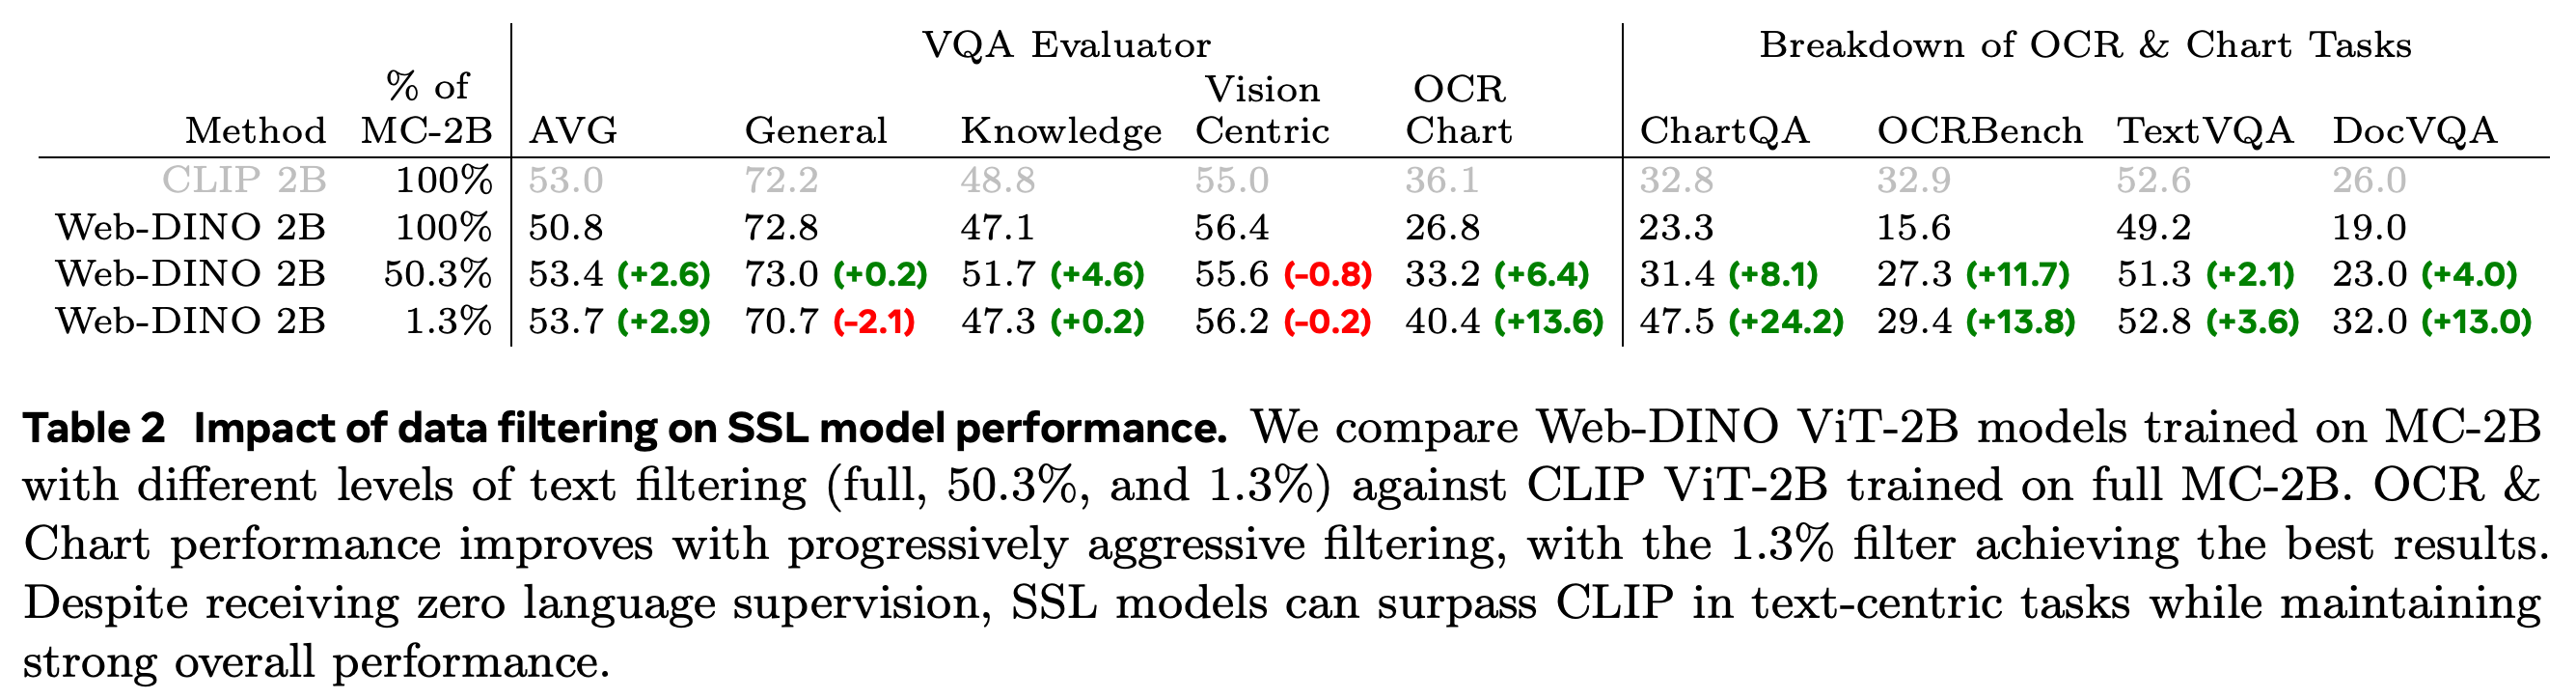
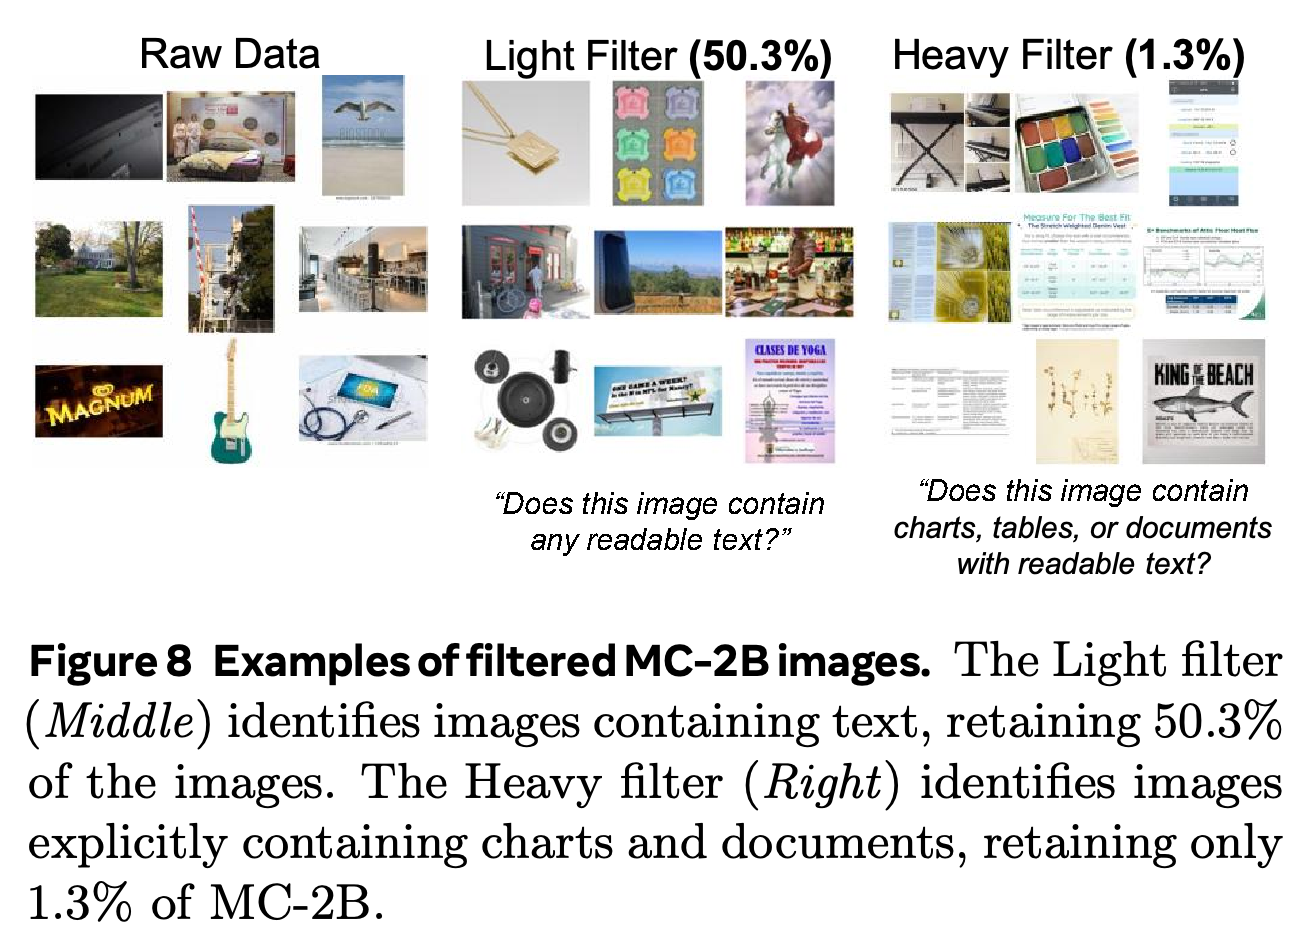
Question 4는 웹 이미지에 이미 포함된 텍스트가 OCR & Chart 성능 향상을 설명하는 데 도움이 되는지 검증한다. 이미지와 언어를 처리하는 사전학습 모델인 SmolVLM2로, 읽을 수 있는 텍스트가 포함된 Light 부분집합과 읽을 수 있는 텍스트가 있는 차트, 표, 문서가 포함된 Heavy 부분집합을 선별한다. 이들은 MC-2B의 50.3%와 1.3%를 각각 유지한다. 모든 Web-DINO ViT-2B 실험은 여전히 2B 샘플을 처리하므로, 필터링한 부분집합을 반복 학습한다.
- Table 2의 OCR & Chart 점수는 필터링하지 않은 Web-DINO가 26.8, Light 필터링이 33.2, Heavy 필터링이 40.4이며, 전체 데이터로 학습한 CLIP은 36.1이다.
- 반올림한 표에서 Heavy 필터링은 평균 VQA를 50.8에서 53.7로 높이지만, General은 72.8에서 70.7로 낮아진다. Table 13에 제시된 반올림 전 평균은 각각 50.77과 53.65다.
- 유지한 1.3%는 서로 다른 원본 이미지 수가 줄었다는 뜻이며, 학습 중 처리하는 샘플 수는 고정한다. 이미지 선별에 언어 모델을 사용하는 과정은 이미지만 사용하는 비전 사전학습 목적함수와 별개다.
학습량을 2B-example로 고정하면 Heavy 필터링은 OCR & Chart를 26.8에서 40.4로 높여 전체 데이터로 학습한 CLIP의 36.1을 넘어선다. General은 72.8에서 70.7로 낮아져 범주 간 상충 관계를 드러낸다. 유지한 1.3%는 서로 다른 원본 데이터의 비율이며, 학습 중 처리하는 샘플 수가 같은 비율로 줄었다는 뜻은 아니다.
예시는 Light 필터링이 텍스트를 포함한 일반 이미지의 비중을 높이고, Heavy 필터링이 차트와 문서를 집중적으로 선별하는 방식을 보여준다. 필터링 정확도를 측정하지는 않지만, Table 2에서 정량 평가한 분포 변화를 구체적으로 보여준다.
Question 5
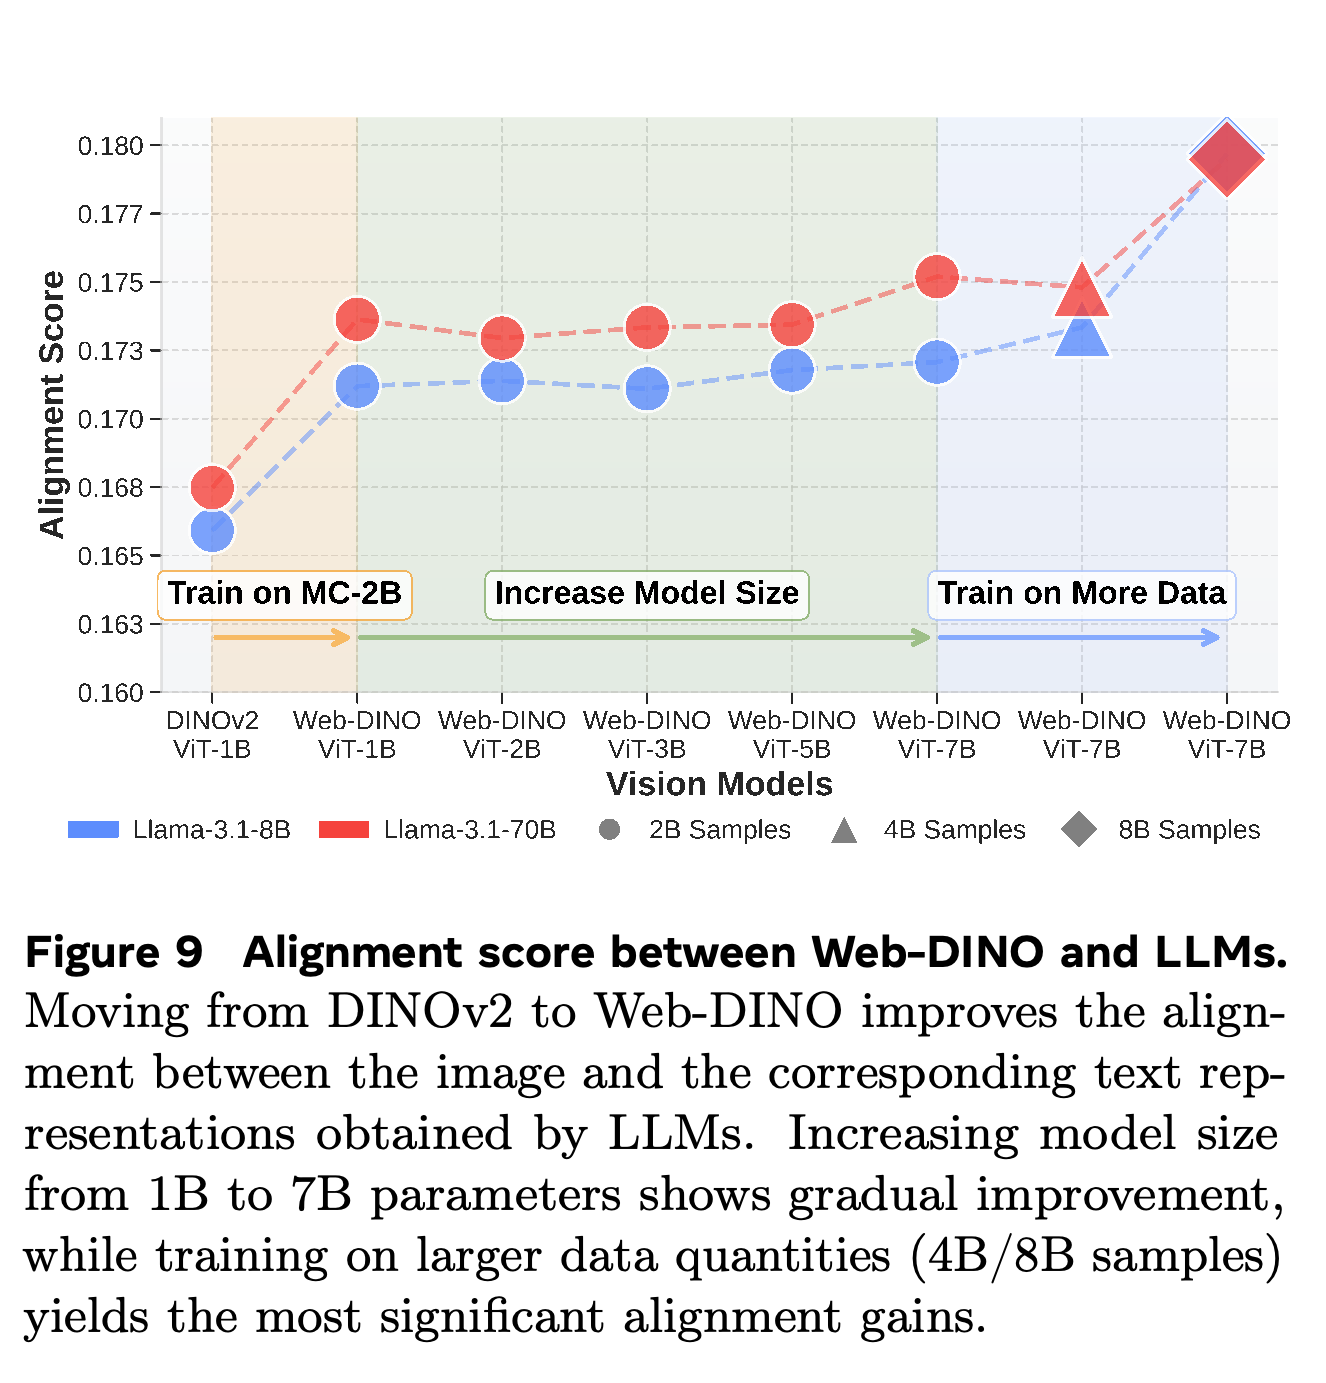
Question 5는 Wikipedia Captions의 이미지와 텍스트 쌍을 사용하여, 이미지 표현과 해당 텍스트 표현 사이의 유사도인 표현 정렬을 측정한다. Huh et al. (2024)을 따라 visual instruction tuning이나 학습한 정렬 절차 없이 DINOv2와 Web-DINO를 Llama-3.1 8B 및 70B와 비교한다. Figure 9에서는 MC-2B로 전환할 때 정렬이 개선되고, 모델 크기에 따른 변화는 크지 않으며, 8B 샘플을 처리했을 때 정렬이 가장 높다.
- 이러한 연관성은 비전 모델의 규모를 확장하면 언어와 더 잘 호환되는 특징이 만들어진다는 가설을 뒷받침한다. 다만 정렬이 후속 VQA 개선의 원인임을 입증하지는 않는다.
공개된 DINOv2를 웹 데이터로 학습한 Web-DINO로 바꾸면 정렬이 개선되며, 비교 기준인 언어 모델 모두에서 8B 샘플을 처리한 뒤 가장 높은 값에 도달한다. 모델 크기에 따라 값이 오르내리므로, 용량에 따른 엄격한 단조 증가보다 처리한 샘플 수의 효과가 더 뚜렷하다.
5 The Web-SSL Model Family
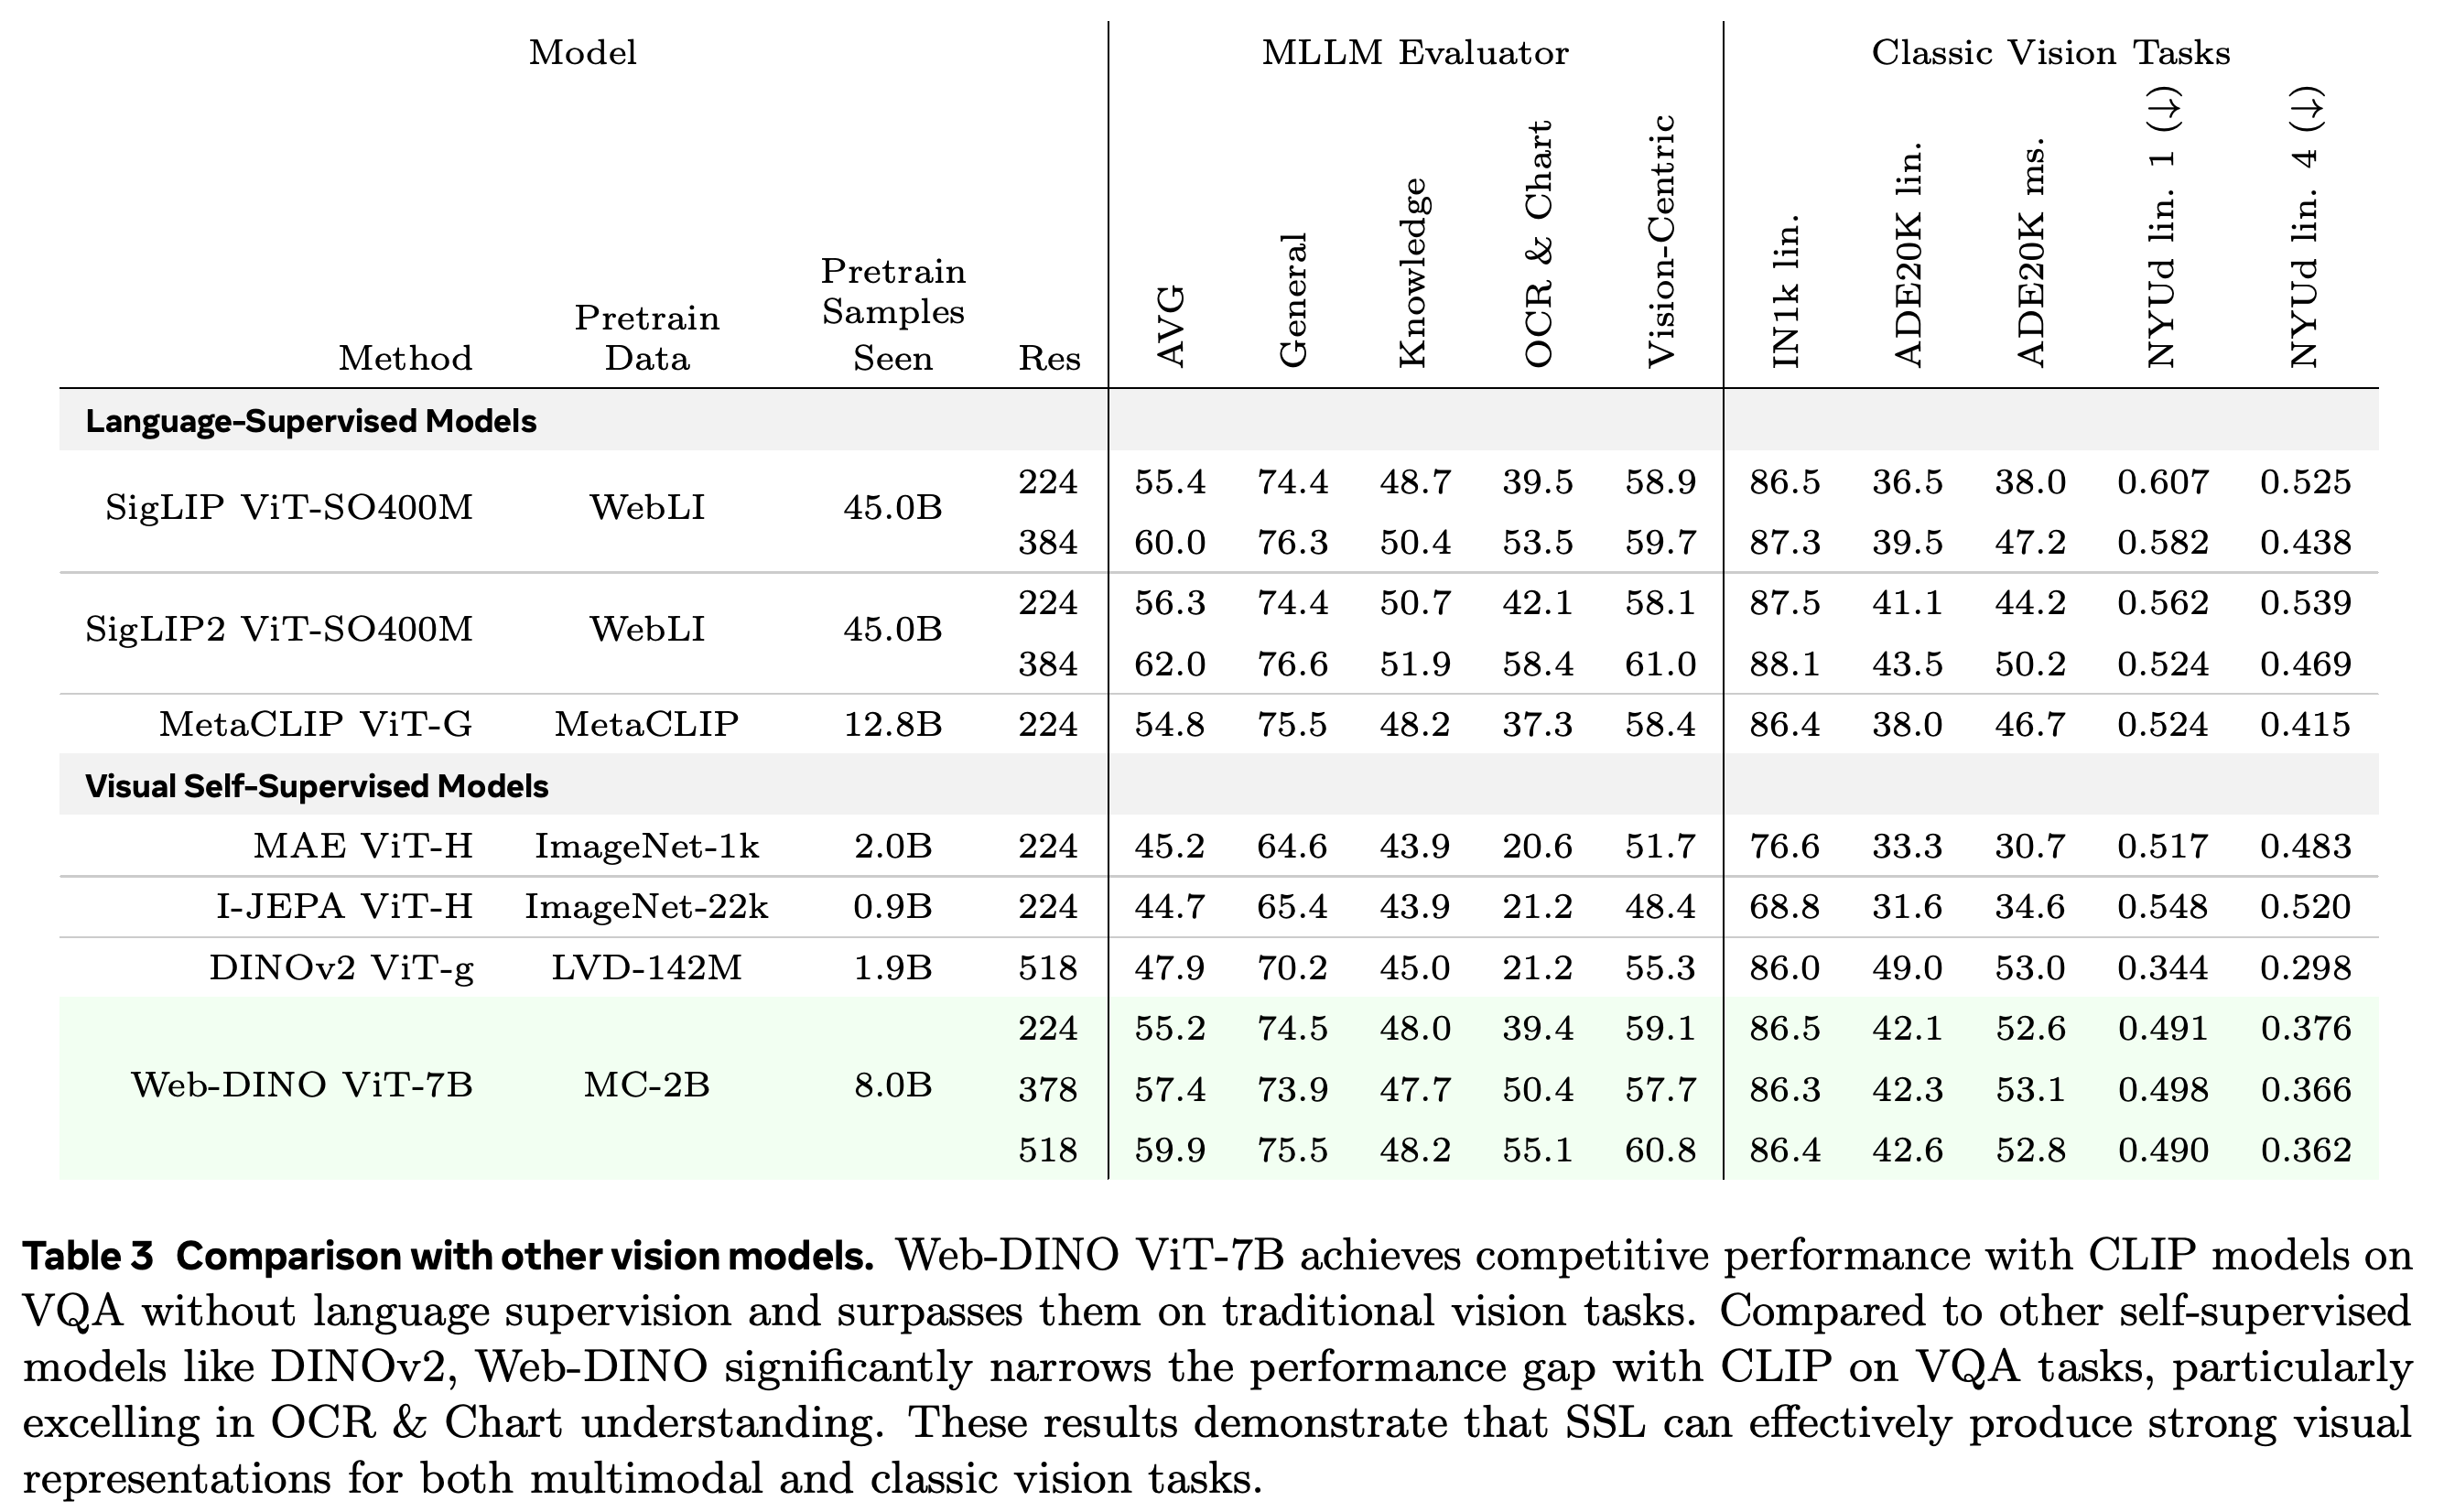
8B 샘플로 학습한 최상위 Web-DINO ViT-7B 모델은 Table 3에서 224픽셀 해상도 기준 평균 VQA 55.2를 기록한다. 공개된 언어 감독 이미지 인코더인 SigLIP과 SigLIP2는 각각 55.4와 56.3이다. 이 기준 모델들은 사전학습 중 45.0B 샘플을 처리하지만 비전 인코더가 훨씬 작으므로, 모델 용량이나 연산량을 맞춘 비교는 아니다. Web-DINO는 이 기준 모델들보다 깊이 추정 결과가 좋고 분할 결과도 대체로 우수하지만, 일부 예외가 있다.
- 고해상도 적응을 적용하면 평균 VQA가 378×378에서 57.43, 518×518에서 59.91로 높아진다. Table 3에서 OCR & Chart는 518픽셀 기준 55.1에 도달한다.
- 384픽셀에서 SigLIP과 SigLIP2의 평균 VQA는 각각 60.0과 62.0이다. 518픽셀 Web-DINO는 SigLIP 점수에 근접하지만 SigLIP2보다 낮으며, 입력 해상도와 모델 크기가 서로 다르다.
- 평가에서는 인코더 비교에 초점을 맞추기 위해 비전 인코더를 고정하고, 이미지를 여러 crop으로 처리하는 image tiling과 추가적인 공간 특징 집계를 생략한다.
이 표는 데이터셋, 처리한 샘플 수, 해상도 정보와 함께 VQA 및 전통적인 비전 결과를 제시한다. Web-DINO의 평균 VQA는 224-pixel language-supervised baselines에 해당하는 언어 감독 기준 모델에 근접하지만, 인코더 크기가 서로 다르다. 더 높은 해상도에서 Web-DINO는 SigLIP에 근접하지만 SigLIP2의 평균보다 낮다.
6 Related Work
관련 연구에서는 Web-SSL을 joint embedding과 masked image modeling, 대규모 비전 사전학습 데이터셋, VQA를 통한 비전 인코더 평가와 연결한다. 이 연구의 기여는 기존 학습 방법을 사용하면서 비교 조건을 통제한 규모 확장 연구다. 실험은 이미지 분포와 학습 목적함수가 모두 후속 평가에서 측정하는 능력에 영향을 준다는 점을 보여준다.
7 Limitations
비전 전용 인코더는 CLIP이 제공하는 이미지와 텍스트 매칭 인터페이스를 통해, 과제별 학습 없이 분류하는 zero-shot 이미지 분류를 직접 수행할 수 없다. VQA 결과는 후속 instruction tuning에 Llama-3 8B Instruct만 사용한 결과다. 다른 언어 모델에서도 비슷한 결과가 나타날지는 가설로 남는다. 더 크거나 정제하지 않은 사전학습 데이터셋도 연구 범위에 포함하지 않는다.
- 핵심 실험은 이미지, 모델 크기, 후속 평가를 맞추지만, 학습 연산량이 같다는 점까지 입증하지는 않는다. 방법마다 목적함수, 배치 크기, 학습 설정이 다르다.
- Tables 7과 9는 VQA가 높아져도 전통적인 비전 지표가 모두 개선되는 것은 아님을 보여준다.
8 Discussion
논의에서는 대규모 비전 인코더가 언어 감독 사전학습 목적함수 없이도 멀티모달 모델에 유용한 특징을 학습할 수 있다고 주장한다. 실험은 검증한 MetaCLIP 분포, 모델 범위, 후속 평가 조건에서 이 결과를 입증한다. 감독을 줄이는 방향을 추구하자는 저자들의 제안은 연구 방향이며, 여러 설정에 걸친 우위를 입증한 결과는 아니다.
부록
- A Implementation Details: 학습에는 공식 DINOv2 및 MAE 저장소와 MetaCLIP 코드베이스를 사용하고, 장치 간에 모델 학습을 분산하는 Fully Sharded Data Parallel을 적용한다. Table 4의 배치 크기/학습률/warmup은 Web-DINO가 3072/3.5e-4/100K, Web-MAE가 4096/1.6e-3/80K, CLIP이 32768/4e-4/2K다. Warmup은 학습 초기에 학습률을 점차 높이는 과정이다. 큰 MAE 모델에서 발생하는 불안정성을 해결하기 위해 학습률을 2.4e-3에서 낮춘다. VQA에는 Cambrian alignment 데이터를 사용한 뒤 Cambrian-7M을 사용하며, 웹 이미지와 텍스트 데이터셋인 LAION의 이미지는 제외한다. 마지막 레이어의 이미지 특징은 어댑터에 전달하는 특징 시퀀스인 576개 토큰으로 보간한다. Table 5는 어댑터와 instruction tuning의 학습률을 각각 1.00e-5와 4.00e-5로, 배치 크기를 512로, 파라미터 정규화 설정인 weight decay를 0으로 지정한다. 부록은 모델 구조, 인코더를 고정한 전통적인 비전 평가, 읽을 수 있는 텍스트나 차트, 표, 문서를 선별하는 텍스트 필터링 프롬프트도 설명한다.
- B Full Results: 부록은 모델 크기, 학습 중 처리한 샘플 수, 사전학습 분포, 텍스트 필터링, 공개 기준 모델 비교의 근거가 되는 벤치마크별 결과를 제공한다. 종합 VQA 점수가 개선되어도 개별 벤치마크나 전통적인 비전 과제의 성능은 낮아질 수 있다.
- B.1 Web-DINO: Tables 6–10은 Web-DINO 모델의 크기 확장, 전통적인 비전 평가, 학습 중 처리한 샘플 수 증가, ImageNet 사전학습 결과를 제시한다. ViT-7B가 처리하는 샘플 수를 2B에서 8B로 늘리면 ImageNet 정확도는 86.00에서 86.52로 높아진다. 반면 ADE20K linear 성능은 49.08에서 42.14로 낮아지고, NYU Depth v2 lin. 1 오차는 0.380에서 0.491로 악화된다. lin. 1과 lin. 4는 논문에서 사용하는 깊이 평가 설정을 가리킨다.
- B.2 Web-MAE: Table 11은 1B, 2B, 3B, 5B의 전체 결과를 제시하며, 평균 VQA는 각각 49.19, 50.59, 50.92, 51.50이다. 차트 질의응답 벤치마크인 ChartQA는 23.60에서 33.80으로, OCR 평가 벤치마크인 OCRBench는 16.40에서 26.50으로 높아진다. 이는 Question 1에서 논의한 텍스트 관련 성능 향상을 뒷받침한다.
- B.3 Scaled CLIP Models: Table 12는 각 모델 크기에서 2B 샘플을 처리하며 학습한 MetaCLIP 결과를 제시한다. 평균 VQA는 ViT-3B에서 53.22로 가장 높고, ViT-7B에서는 52.97이다. 이 학습 설정에서는 종합 점수가 계속 개선되지 않는다.
- B.4 Text Filtered Models: Table 13은 필터링 없음, Light 필터링, Heavy 필터링을 적용한 1B 및 2B Web-DINO 모델을 포함한다. 1B 모델에서 Heavy 필터링은 평균을 49.01에서 49.44로 높이고, Light 필터링은 50.73에 도달한다. 2B 모델에서는 Heavy 필터링의 평균이 53.65로 가장 높다. 따라서 텍스트가 많은 이미지를 더 강하게 선별할 때 얻는 종합 성능 이득은 모델 크기에 따라 달라진다.
- B.5 Baseline Models: Table 14는 공개된 MetaCLIP, SigLIP, SigLIP2, DINOv2, visual SSL 기준 모델인 I-JEPA, MAE 인코더의 개별 VQA 벤치마크 점수를 제공한다. DINOv2의 224, 378, 518픽셀 결과도 제시하며, 평균 점수는 각각 49.25, 47.94, 47.91이다. 입력 해상도만 높인다고 평가한 모든 인코더의 VQA가 개선되지는 않는다.
- C High Resolution Adaption of Web-SSL: 부록은 378×378 및 518×518 적응을 20k iterations 동안 수행하며, 배치 크기는 2048, 학습률은 1.41e-5라고 명시한다. 그러나 같은 문단에서 warmup 비율을 설명할 때는 총 10k iterations를 언급하므로, 학습 일정에 관한 내부적인 모호함이 남는다. Table 15는 해상도별 상세 결과를 제시한다.
- D Evaluation: Table 16은 VQA 벤치마크 16개와 전통적인 비전 데이터셋 3개를 나열한다. General은 GQA, SEED, MME, MMBench로, Knowledge는 AI2D, ScienceQA, MathVista, MMMU로 구성된다. 이들은 평가 모음의 일반 및 지식 질의응답 범주에 배정된 벤치마크 식별자다. OCR & Chart는 이미지 속 텍스트를 평가하는 TextVQA, 문서를 평가하는 DocVQA, ChartQA, OCRBench로 구성된다. Vision-Centric은 시각 지각 벤치마크인 MMVP, RealWorldQA, CVBench-2D, CVBench-3D로 구성된다. 전통적인 비전 평가에는 분류용 ImageNet-1k, 분할용 ADE-20k, 깊이 추정용 NYU Depth v2를 사용한다.
- E Pretraining Dataset Cards: Table 17은 공개된 DINOv2가 학습에 사용한 정제 데이터셋 LVD-142M을 설명한다. 총 142,109,386장의 이미지를 포함하며, 분류, 분할, 깊이, 검색 과제와 관련된 출처에서 데이터를 수집한다. 반면 MetaCLIP은 2021년 1월부터 2023년 1월까지의 CommonCrawl 스냅샷 15개에서 수집한 웹 데이터를 사용한다. 이 차이 때문에 공개된 DINOv2와의 비교로는 사전학습 목적함수의 영향만 분리할 수 없다.
짧은 생각
동일한 이미지를 사용한 비교는 실험한 후속 학습 설정에서 경쟁력 있는 멀티모달 비전 특징을 얻는 데 짝지어진 언어 감독이 필수는 아니라는 가장 명확한 근거를 제공한다. 성능 향상에는 큰 인코더와 상당한 학습량이 사용되며, 부록에서는 처리한 샘플 수가 증가할 때 분할과 깊이 추정 성능에 상충 관계가 나타난다. 텍스트 필터링은 학습하는 능력을 바꿀 수 있는 구체적인 방법이지만, 데이터 선별에는 여전히 언어 모델이 관여한다.