


SmallThinker: A Family of Efficient Large Language Models Natively Trained for Local Deployment 요약 설명
28 Jul 2025 | Paper Review On-Device Inference Mixture-of-Experts Sparse Inference목차
이번 글에서는 SmallThinker: A Family of Efficient Large Language Models Natively Trained for Local Deployment 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 7월 28일(Arxiv)
- Song, Yixin, Xue, Zhenliang, Wei, Dongliang, Chen, Feiyang, Gao, Jianxiang, Liu, Junchen, Liang, Hangyu, Qin, Guangshuo, Tian, Chengrong, Wen, Bo, et al.
- Institute of Parallel and Distributed Systems, Shanghai Jiao Tong University, School of Artificial Intelligence, Shanghai Jiao Tong University, Zenergize AI
- 논문 링크
요약
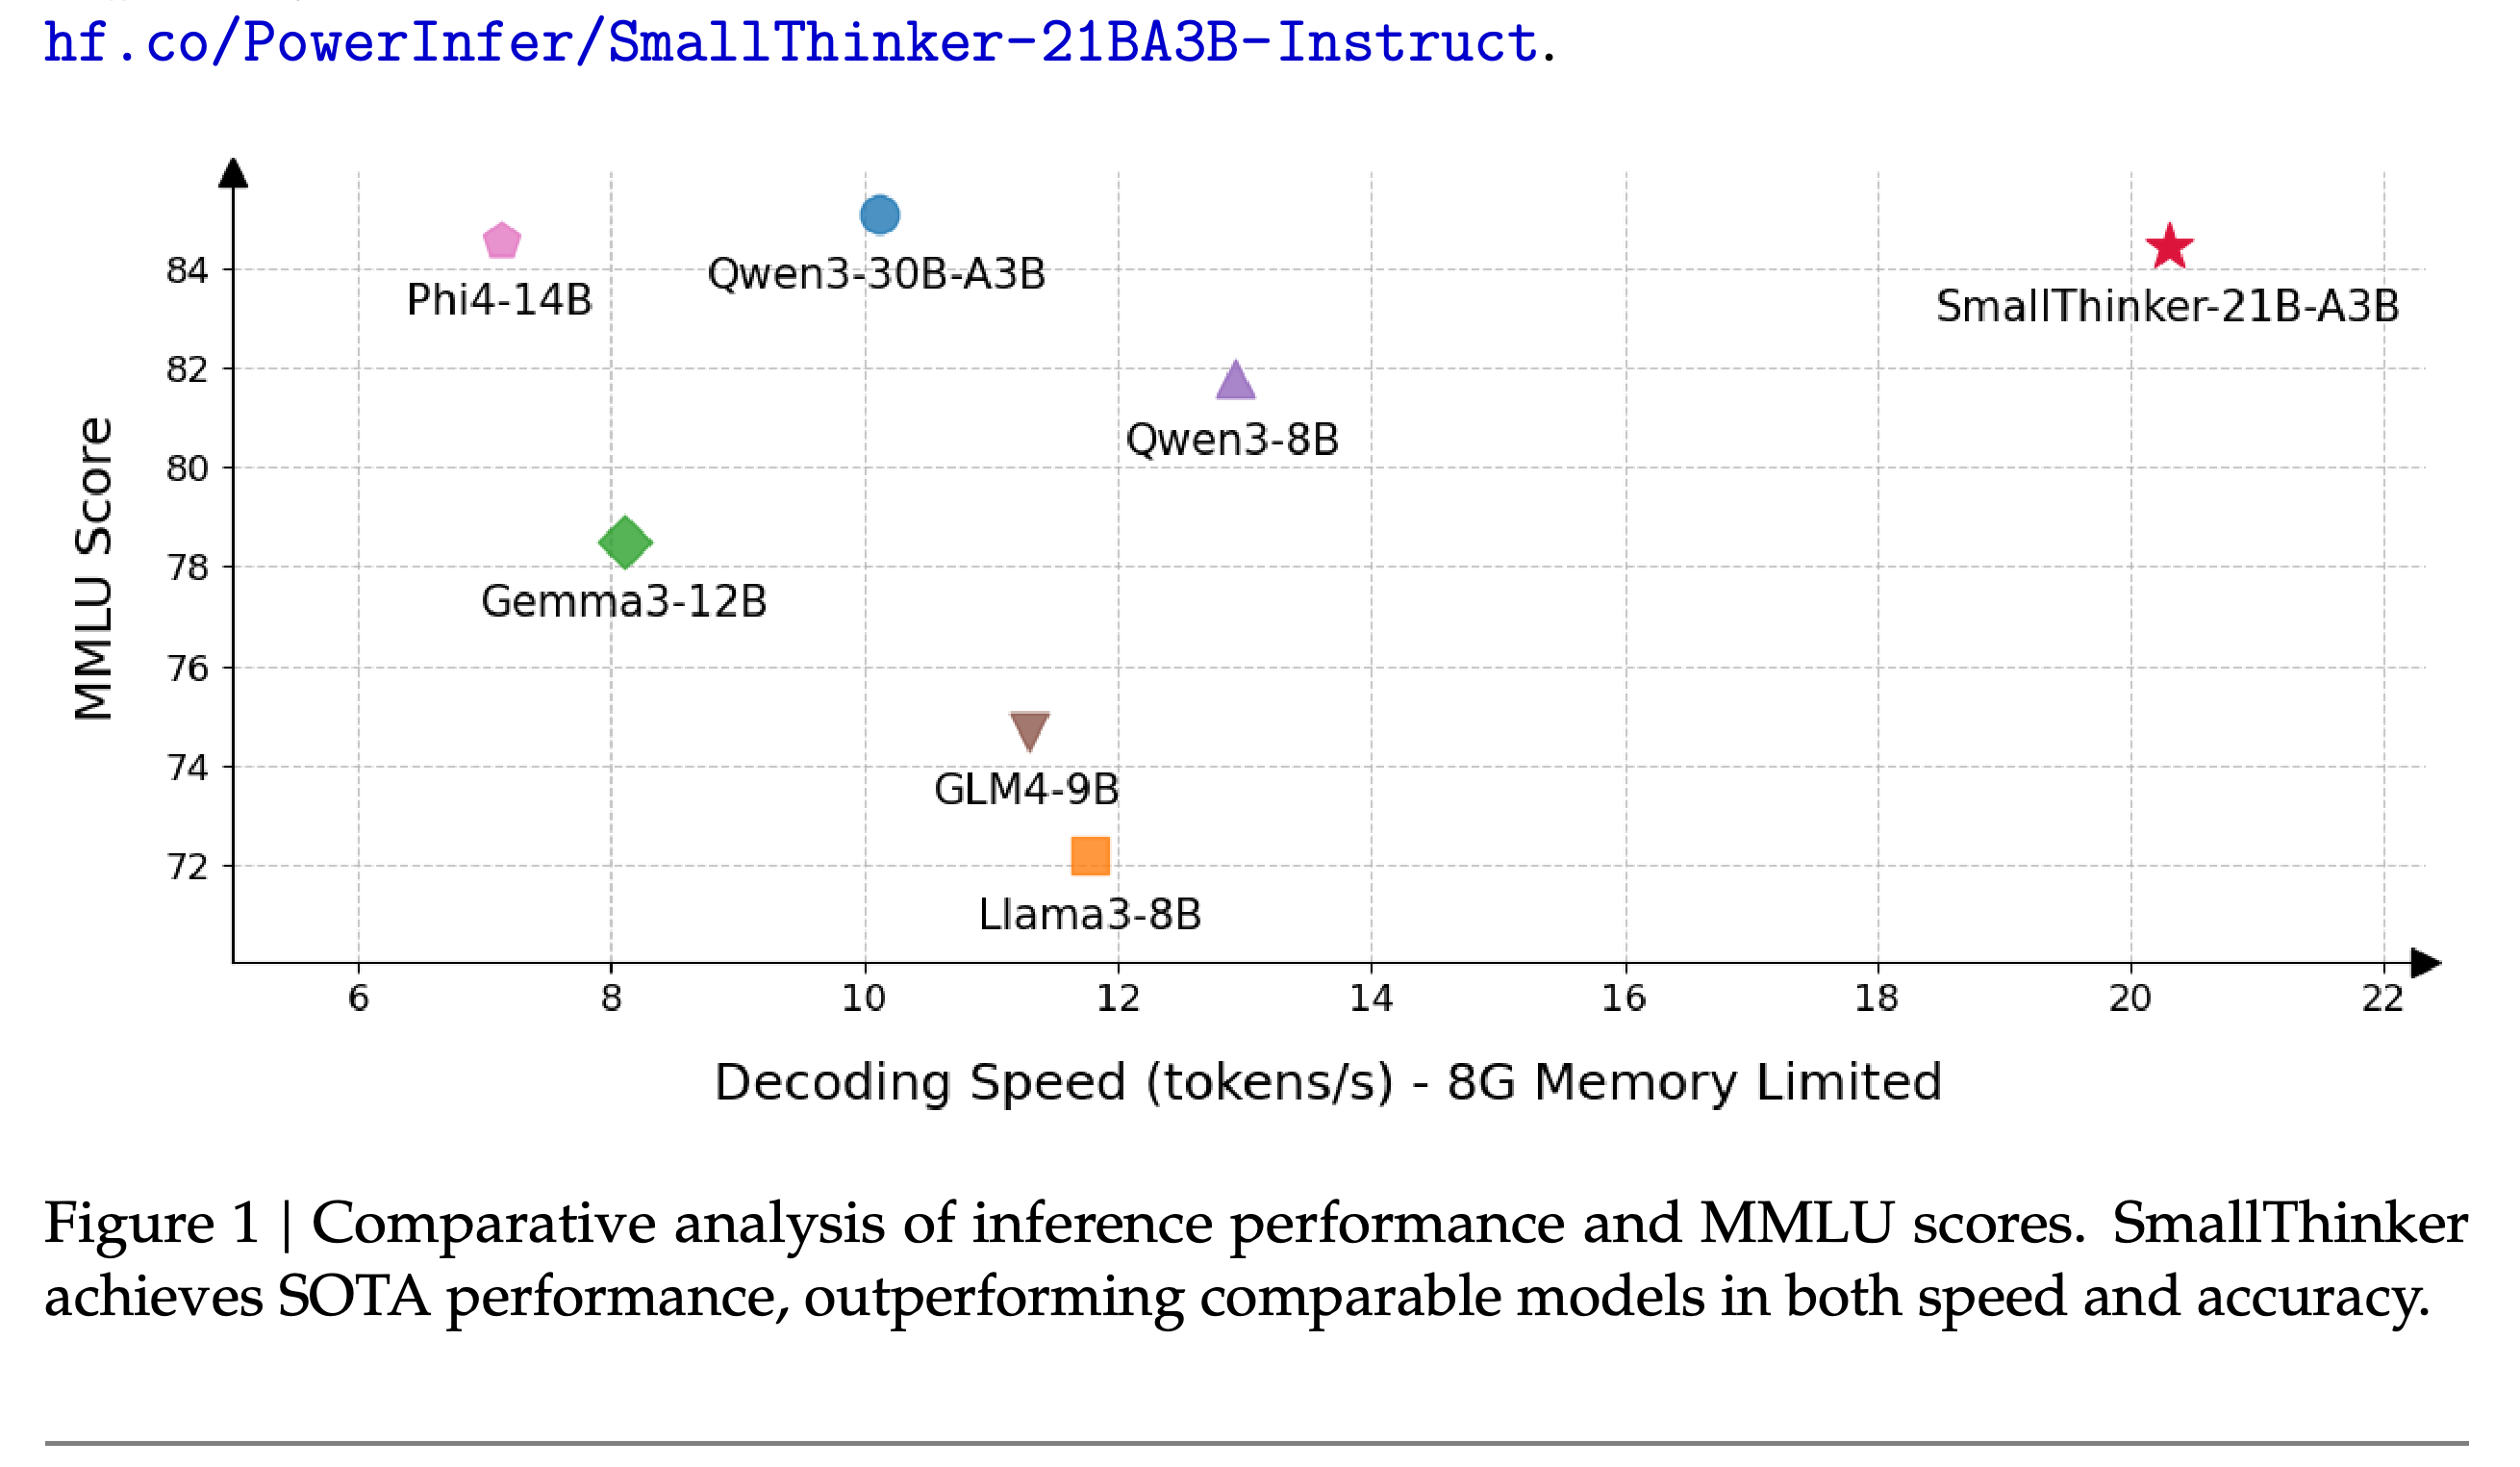
- SmallThinker는 연산 능력, 메모리, 저장장치 대역폭이 제한된 로컬 기기에서 대규모 언어 모델을 실행하는 문제를 다룬다. 실험에서 사용한 저정밀 가중치 형식인 Q4_0 양자화를 적용하면, SmallThinker-21B-A3B는 8 GiB 메모리 제한을 둔 i9 14900K PC에서 20.30 tokens/s의 디코딩 속도를 낸다. Qwen3-30B-A3B는 같은 조건에서 10.11 tokens/s를 기록한다. 일반 지식을 평가하는 MMLU 점수는 각각 84.4와 85.1이다.
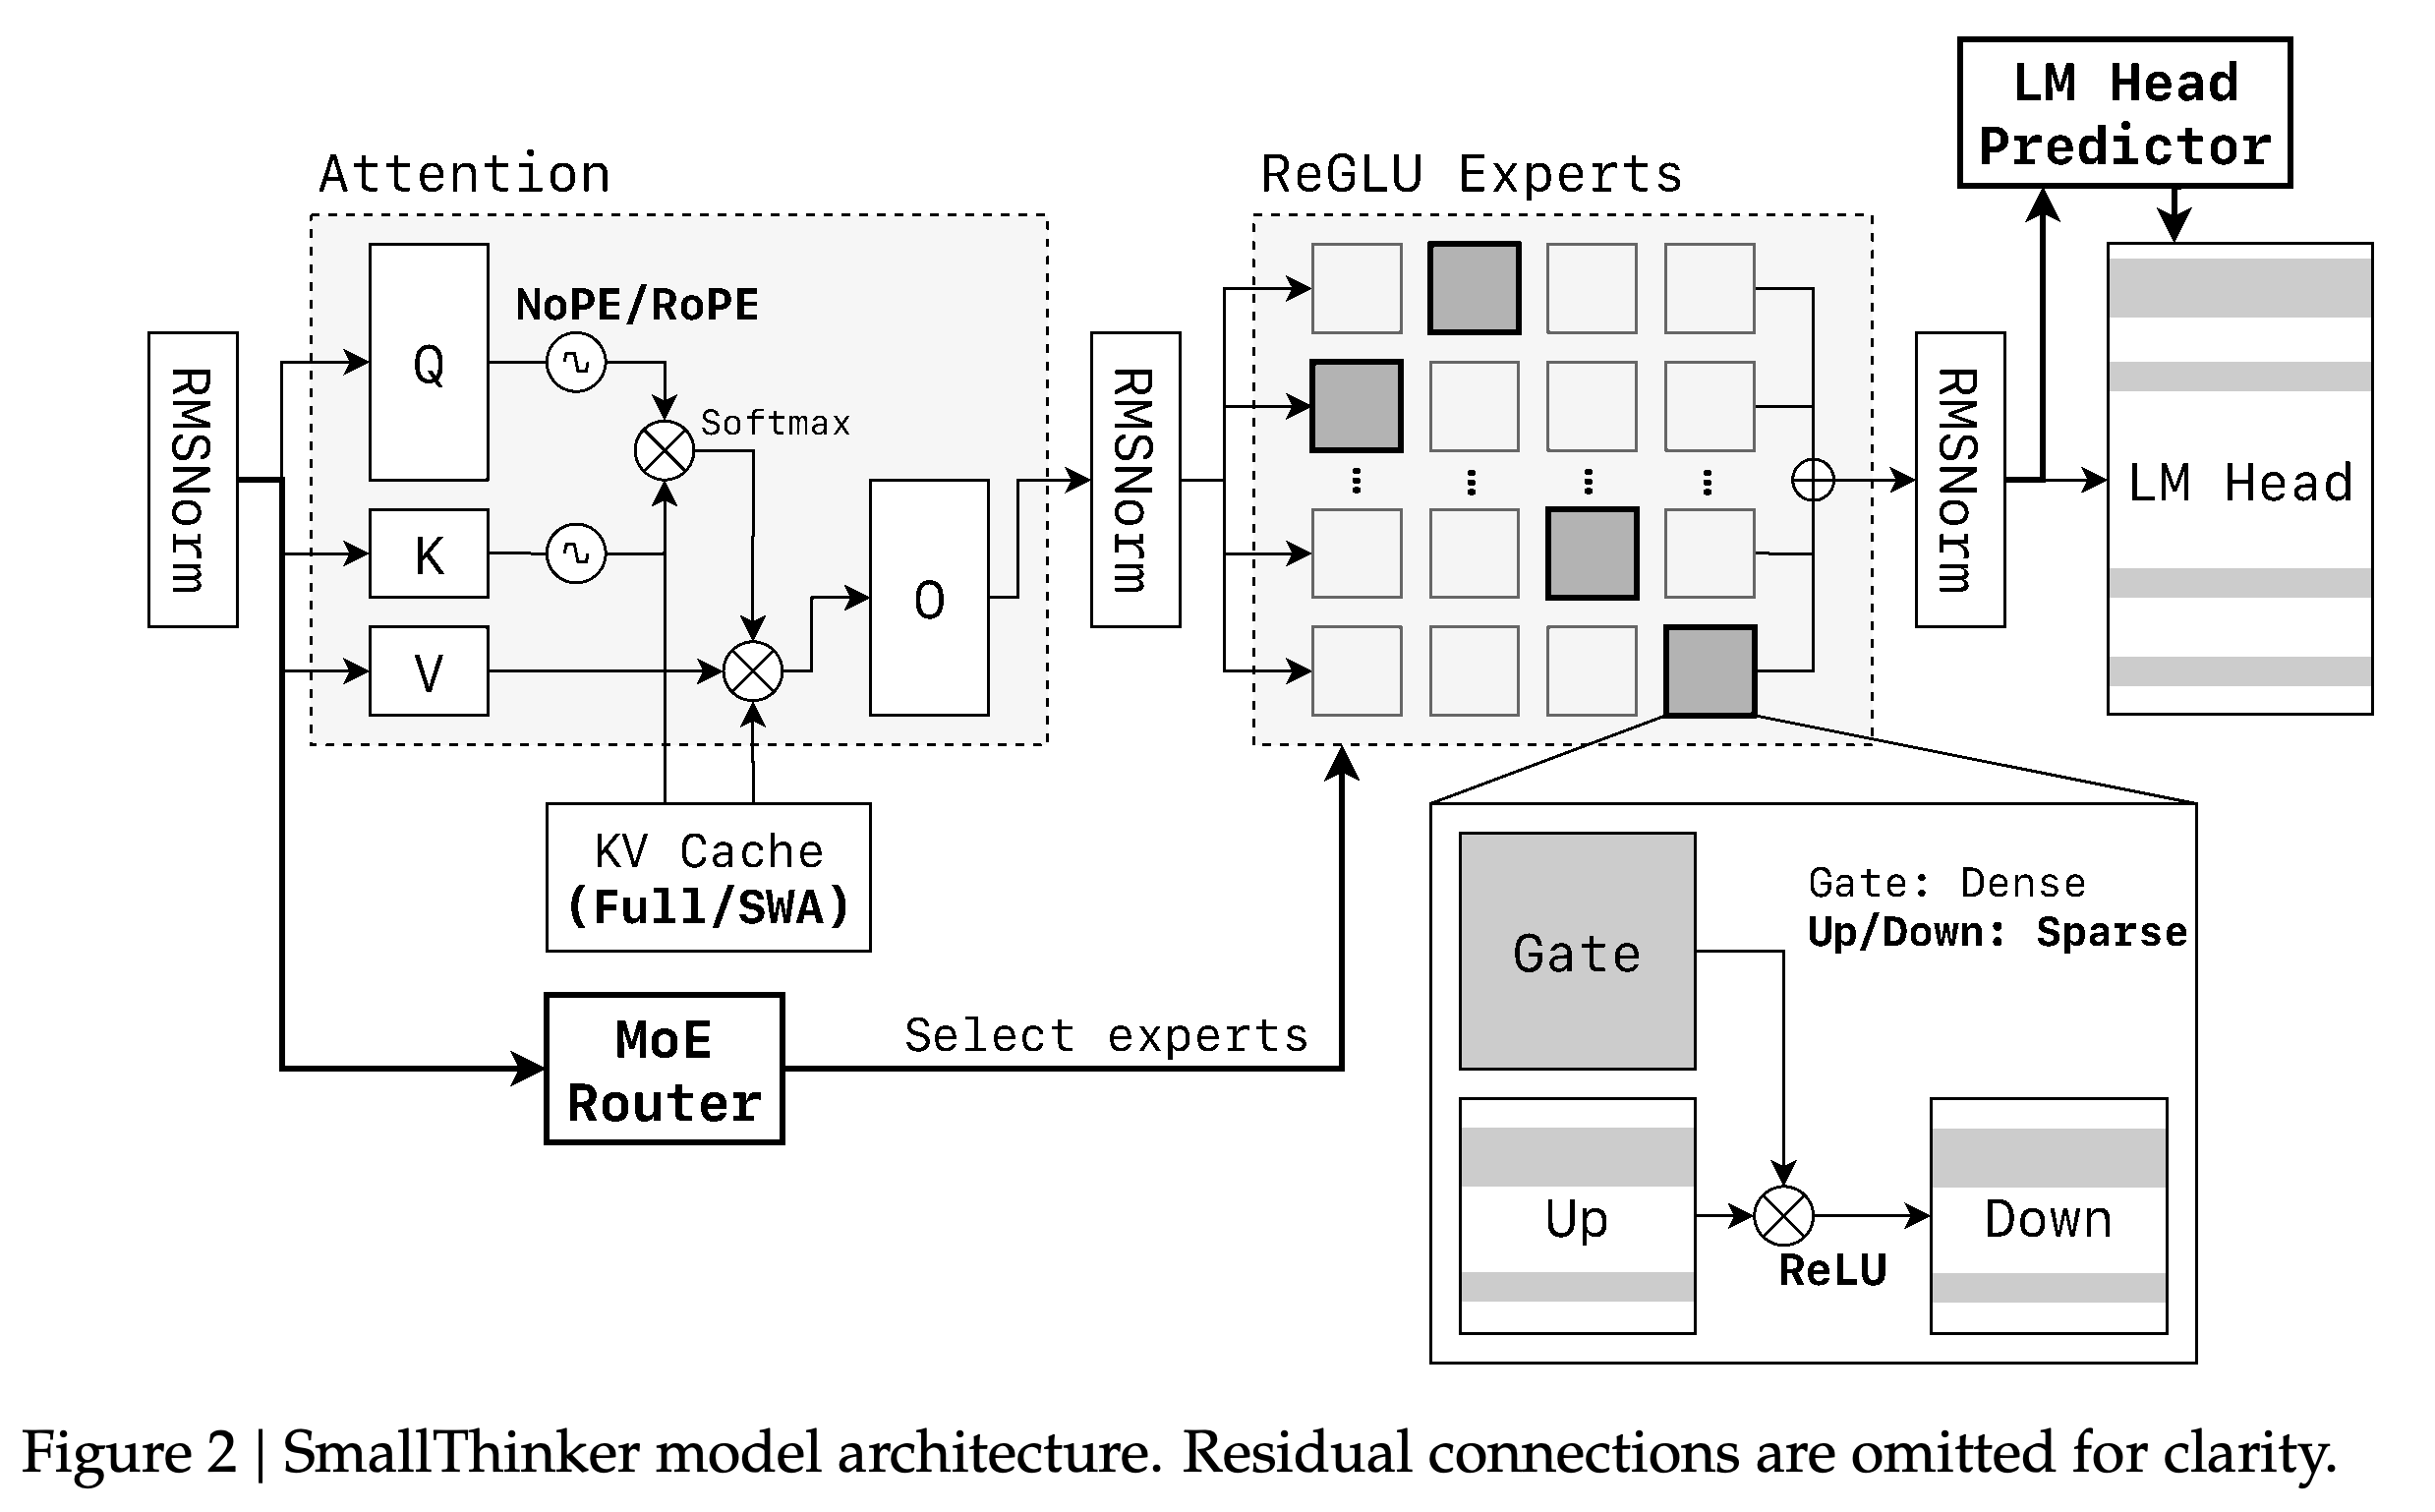
- 이 설계는 토큰마다 일부 expert 네트워크를 선택하는 Mixture-of-Experts (MoE)와 뉴런 수준 희소성을 결합한다. 뉴런 수준 희소성은 선택된 expert 내부에도 비활성 뉴런이 존재한다는 뜻이다. Attention 전에 라우팅을 수행하면 attention을 계산하는 동안 저장장치에서 expert 가중치를 가져올 수 있다. 또한 전역 attention과 지역 attention을 혼합하여 key-value (KV) 캐시를 줄인다. KV 캐시는 생성 중에 사용하는 attention 상태를 저장한다.
- 4B 모델과 21B 모델은 각각 2.5 trillion 토큰과 7.2 trillion 토큰으로 사전 학습한다. 이후 지시와 응답 예시로 학습하는 지도 미세 조정과, 저장된 학습 상태의 가중치를 결합하는 체크포인트 병합을 수행한다. 처리량 향상은 메모리가 제한된 조건에서 가장 크며, 결과는 기기에 따라 달라진다. 논문에는 개별 변경 사항의 효과를 분리하는 구성요소별 ablation 실험과 완전한 디코딩 작업 조건 명세가 없다.
1. Introduction
SmallThinker: A Family of Efficient Large Language Models Natively Trained for Local Deployment는 낮은 프로세서 성능, 제한된 메모리, 느린 저장장치를 모델 학습과 추론 시스템 설계에서 해결할 제약으로 다룬다. 주요 기여는 선택적 연산, 조기 expert 선택, expert 캐싱, attention 상태 저장량 절감을 연결한 데 있다. Figure 1은 메모리가 제한된 조건에서 디코딩 속도와 일반 지식 성능 사이의 절충을 요약한다.
SmallThinker-21B-A3B는 그림의 제한된 메모리 조건에서 MMLU 84.4점과 약 20 tokens/s를 함께 달성한다. Qwen3-30B-A3B는 MMLU 점수가 조금 더 높지만 디코딩 속도는 약 절반이므로, 속도와 품질 사이의 절충을 보여준다.
2. Model Architecture
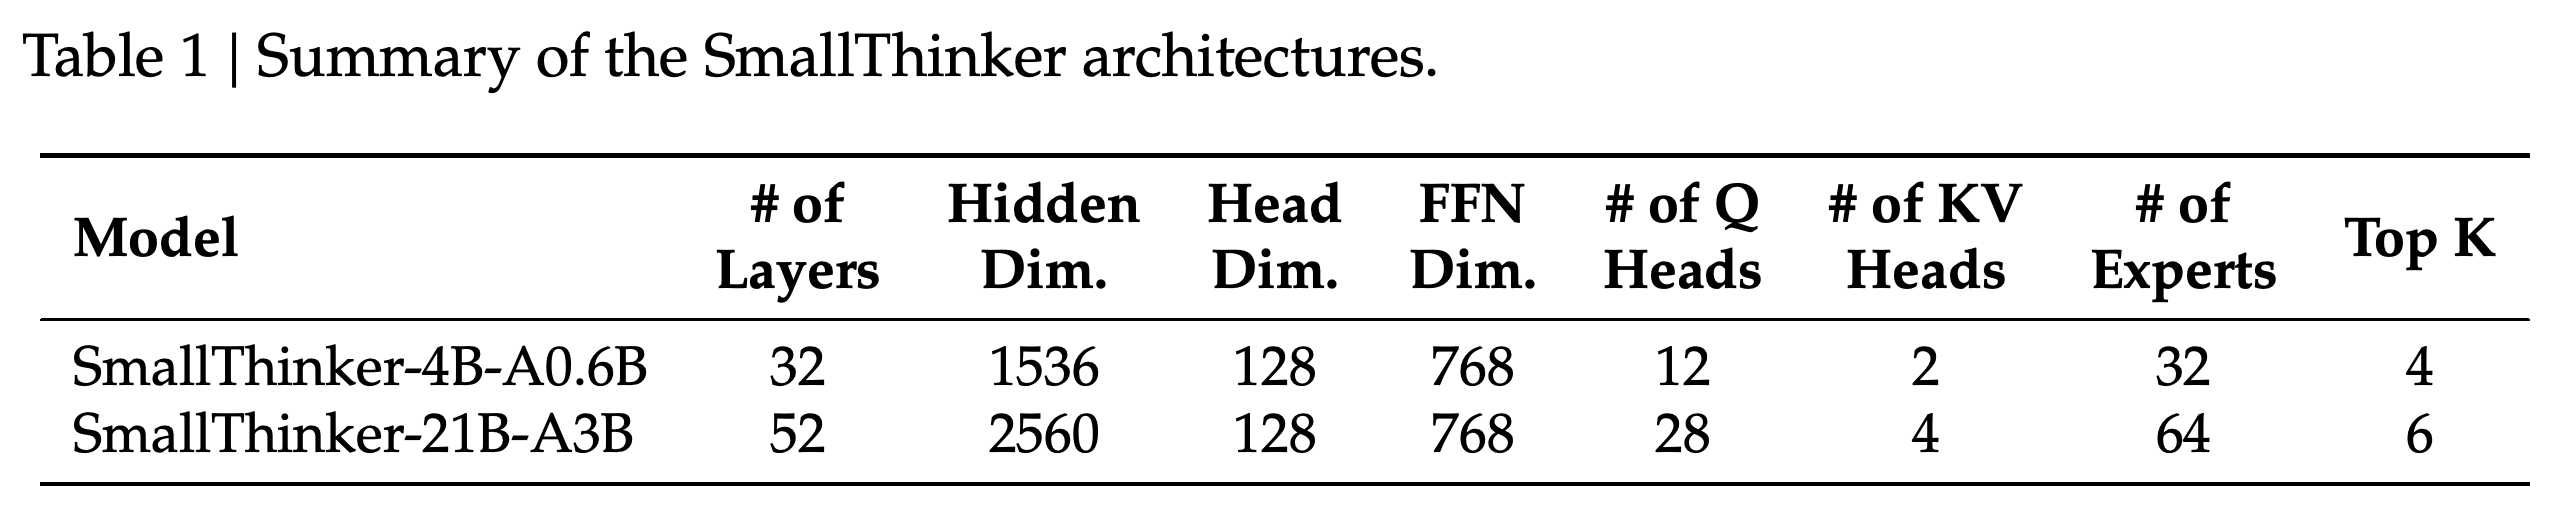
두 모델은 앞선 문맥을 바탕으로 토큰을 생성하는 decoder-only Transformer를 사용한다. SmallThinker-4B-A0.6B는 32개 층, 은닉 차원 1536, query head 12개, key-value head 2개, expert 32개를 사용하며 토큰마다 expert 4개를 선택한다. SmallThinker-21B-A3B는 52개 층, 은닉 차원 2560, query head 28개, key-value head 4개, expert 64개를 사용하며 토큰마다 expert 6개를 선택한다. Attention head는 attention 연산을 병렬로 수행한다. 두 모델 모두 head 차원은 128이고 feed-forward network (FFN) 차원은 768이다. FFN은 expert가 구현하는 토큰별 변환이며, 모델 이름은 전체 매개변수 수와 토큰마다 활성화되는 대략적인 매개변수 수를 구분한다.
큰 모델은 층 수를 32개에서 52개로, expert 수를 32개에서 64개로 늘리며, 토큰마다 선택하는 expert도 4개에서 6개로 늘린다. 두 모델 모두 FFN 차원 768과 head 차원 128을 유지하여 선택적으로 연산하면서 용량을 확장한다.
라우터는 attention 전의 입력에서 분기하므로, 가중치 전송을 attention 연산과 겹칠 수 있을 만큼 일찍 expert를 선택한다. 선택된 expert 내부에서 게이트는 밀집 연산으로, up 및 down projection은 희소 연산으로 처리한다. 별도 예측기는 마지막 language model head에서 계산할 행을 선택한다.
2.1. Fine-Grained Mixture of Experts
세분화된 expert 선택이 첫 번째 수준의 희소성을 제공한다. 각 expert는 ReLU-activated Gated Linear Units (ReGLU)를 사용한다. 이 게이트 활성화 함수에서는 rectified linear unit (ReLU)이 양수가 아닌 게이트 출력을 0으로 만들어 FFN 내부에 두 번째 수준의 희소성을 제공한다.
- Pre-attention router는 attention 블록 전에 expert를 선택하므로, attention을 계산하는 동안 해당 가중치를 가져올 시간을 확보한다.
- DP-Groups Global Load Balance Loss는 분할된 데이터 병렬 그룹 안에서 부하 균형을 맞춘다. 데이터 병렬 그룹은 서로 다른 학습 데이터를 처리하는 그룹이다. 저자들은 균형 조건을 완화하여 expert마다 서로 다른 입력을 처리하도록 전문화를 유도하고, 자주 사용하는 expert를 메모리에 유지하기 쉽게 만들고자 한다.
- 논문은 부하 균형 기법의 개념을 설명하지만, 명시적인 손실 수식이나 그 효과를 분리하는 ablation 실험은 제시하지 않는다.
2.2. NoPE-RoPE Hybrid Sparse Attention
NoPE-RoPE Hybrid Sparse Attention은 1:3 패턴을 반복한다. 위치 임베딩을 생략하는 No Positional Embedding (NoPE) 전역 attention 층 1개 뒤에 Sliding Window Attention (SWA) 층 3개를 배치한다. SWA는 4096토큰 윈도 안에서 attention을 수행하며, 해당 지역 층의 위치 임베딩 기법으로 Rotary Position Embedding (RoPE)을 사용한다. 선행 연구에서 채택한 이 패턴은 전체 문맥의 KV를 저장하는 범위를 네트워크 일부로 제한한다. 논문은 긴 문맥 처리 능력을 대체로 유지한다고 설명하지만, 별도의 긴 문맥 평가나 캐시 감소량 측정 비교는 보고하지 않는다.
3. Pre-Training
SmallThinker-4B-A0.6B-Base와 SmallThinker-21B-A3B-Base는 선별한 오픈소스 코퍼스와 합성 예시를 결합한 영어 중심 데이터로 사전 학습한다. 학습이 진행됨에 따라 데이터 구성을 바꾸고, 마지막 단계에서 문맥 길이를 늘린다.
3.1. Data Construction
수집한 데이터에는 FineWeb-Edu, Nemotron-CC, mga-fineweb-edu, Knowledge Pile에서 가져온 웹 토큰 9 trillion 개와 OpenWebMath, MegaMath, FineMath 등의 출처에서 가져온 수학 토큰 1 trillion 개가 포함된다. 코드 출처에는 StackV2와 OpenCoder가 포함된다. 품질 평가 모델로 품질이 낮은 자료를 걸러내지만, 엄격한 중복 제거는 수행하지 않는다.
- 장르와 독자층에 맞춘 재작성과, 예시 구성에 사용하는 페르소나를 바꾸는 페르소나 기반 증강을 통해 수학 및 코드 토큰 269 billion 개를 추가로 생성한다. 장르와 독자층 프롬프트는 표본 데이터에서 생성한 뒤 수작업으로 선별하고 예시와 무작위로 짝짓는다.
- 마지막 사전 학습 단계에는 오픈소스 데이터 모음의 지시와 응답 데이터, 높은 점수를 받은 웹 텍스트에서 추출한 수백만 개의 질문과 답변 쌍도 포함한다.
- 공개된 합성 데이터셋은 PowerCoding과 PowerMath이며, 주소는 각각 https://huggingface.co/datasets/PowerInfer/PowerCoding 와 https://huggingface.co/datasets/PowerInfer/PowerMath 이다.
3.2. Data Mixture
코퍼스는 6개 범주로 구성된다. General Knowledge, Mathematics, Code, Web-STEM, Chinese, SFT-style data이다. Web-STEM은 과학, 기술, 공학, 수학 분야의 웹 자료이며, SFT-style data는 지도 미세 조정(SFT) 데이터와 유사한 지시와 응답 예시이다. 3단계 커리큘럼은 폭넓은 일반 데이터로 시작하여 고품질 자료와 전문 자료의 비중을 높이고, 마지막에는 품질이 가장 높은 코퍼스와 더 많은 지시 및 응답 예시를 사용한다. 정확한 혼합 비율과 단계별 토큰 배분량은 보고하지 않는다.
3.3. Pretraining Hyperparameter Setting
4B 모델은 2.5 trillion 토큰으로 학습하며, 시퀀스 길이는 4096, 전역 배치 크기는 1536으로 배치당 6,291,456토큰에 해당하고, 최대 학습률은 3e-4이다. 21B 모델은 7.2 trillion 토큰, 시퀀스 길이 4096, 전역 배치 크기 4352, 최대 학습률 4.2e-4를 사용한다.
- 두 모델 모두 학습률을 최댓값의 10%까지 줄이는 코사인 감쇠와 가중치 감쇠 0.1을 사용한다. 학습 옵티마이저는 Adam이며, 이동평균 계수는 β1 = 0.9와 β2 = 0.95이다.
- 보고된 21B 모델의 사전 학습 기간은 20일이다. 논문은 이 기간을 연산 비용 관점에서 해석하는 데 필요한 학습 하드웨어 구성을 명시하지 않는다.
3.4. Long Context Pre-Training
학습은 4096토큰 문맥으로 시작하며, 마지막 단계에서 4B 모델은 32768토큰, 21B 모델은 16384토큰으로 확장한다. 동시에 RoPE 기본 주파수를 1e5에서 1.5e6으로 바꾼다. 이는 학습 문맥 길이이며, 보고된 평가만으로는 해당 전체 길이에서의 정확도를 확인할 수 없다.
4. Post-Training
사후 학습에서는 지식 집약적 예시와 수학 및 코드 예시로 지도 미세 조정을 수행한 뒤 체크포인트 가중치를 보간한다. 이후 인간 선호 피드백을 사용하는 강화 학습 단계는 수행하지 않는다.
4.1. Supervised Fine-Tuning
지식 집약적 미세 조정 데이터는 일반 사전 학습 텍스트 중 점수가 가장 높은 자료에서 질문과 답변 쌍을 추출하여 만든다. 답변을 다듬어 10 million 개가 넘는 샘플을 확보한다. 수학과 코드 문제는 오픈소스 데이터셋에서 표본을 뽑고 페르소나 기반 증강으로 확장한 뒤, Qwen3-32B (thinking)로 상세한 풀이를 생성한다. 생성한 답변은 필터링하여 생성 품질 저하를 줄이고 언어적 일관성을 유지한다. 논문은 완전한 미세 조정 절차나 정량적인 정답성 검증 결과를 제공하지 않는다.
4.2. Model Merging
지도 미세 조정 후에는 서로 다른 학습 단계에서 저장한 체크포인트 가중치를 선형 보간하여 일반 지식과 지시 이행 능력의 균형을 맞춘다. 논문은 보간 계수, 체크포인트 선택 절차, 병합의 기여도를 측정하는 별도 비교를 보고하지 않는다.
5. Model Evaluation
평가는 과제 정확도, expert 활성화 패턴, 뉴런 수준 희소성을 다룬다. 이를 통해 모델 능력, 캐싱과 관련된 expert 재사용 패턴, 선택된 expert 내부에서 연산을 생략할 가능성을 살펴본다.
5.1. Model Performance
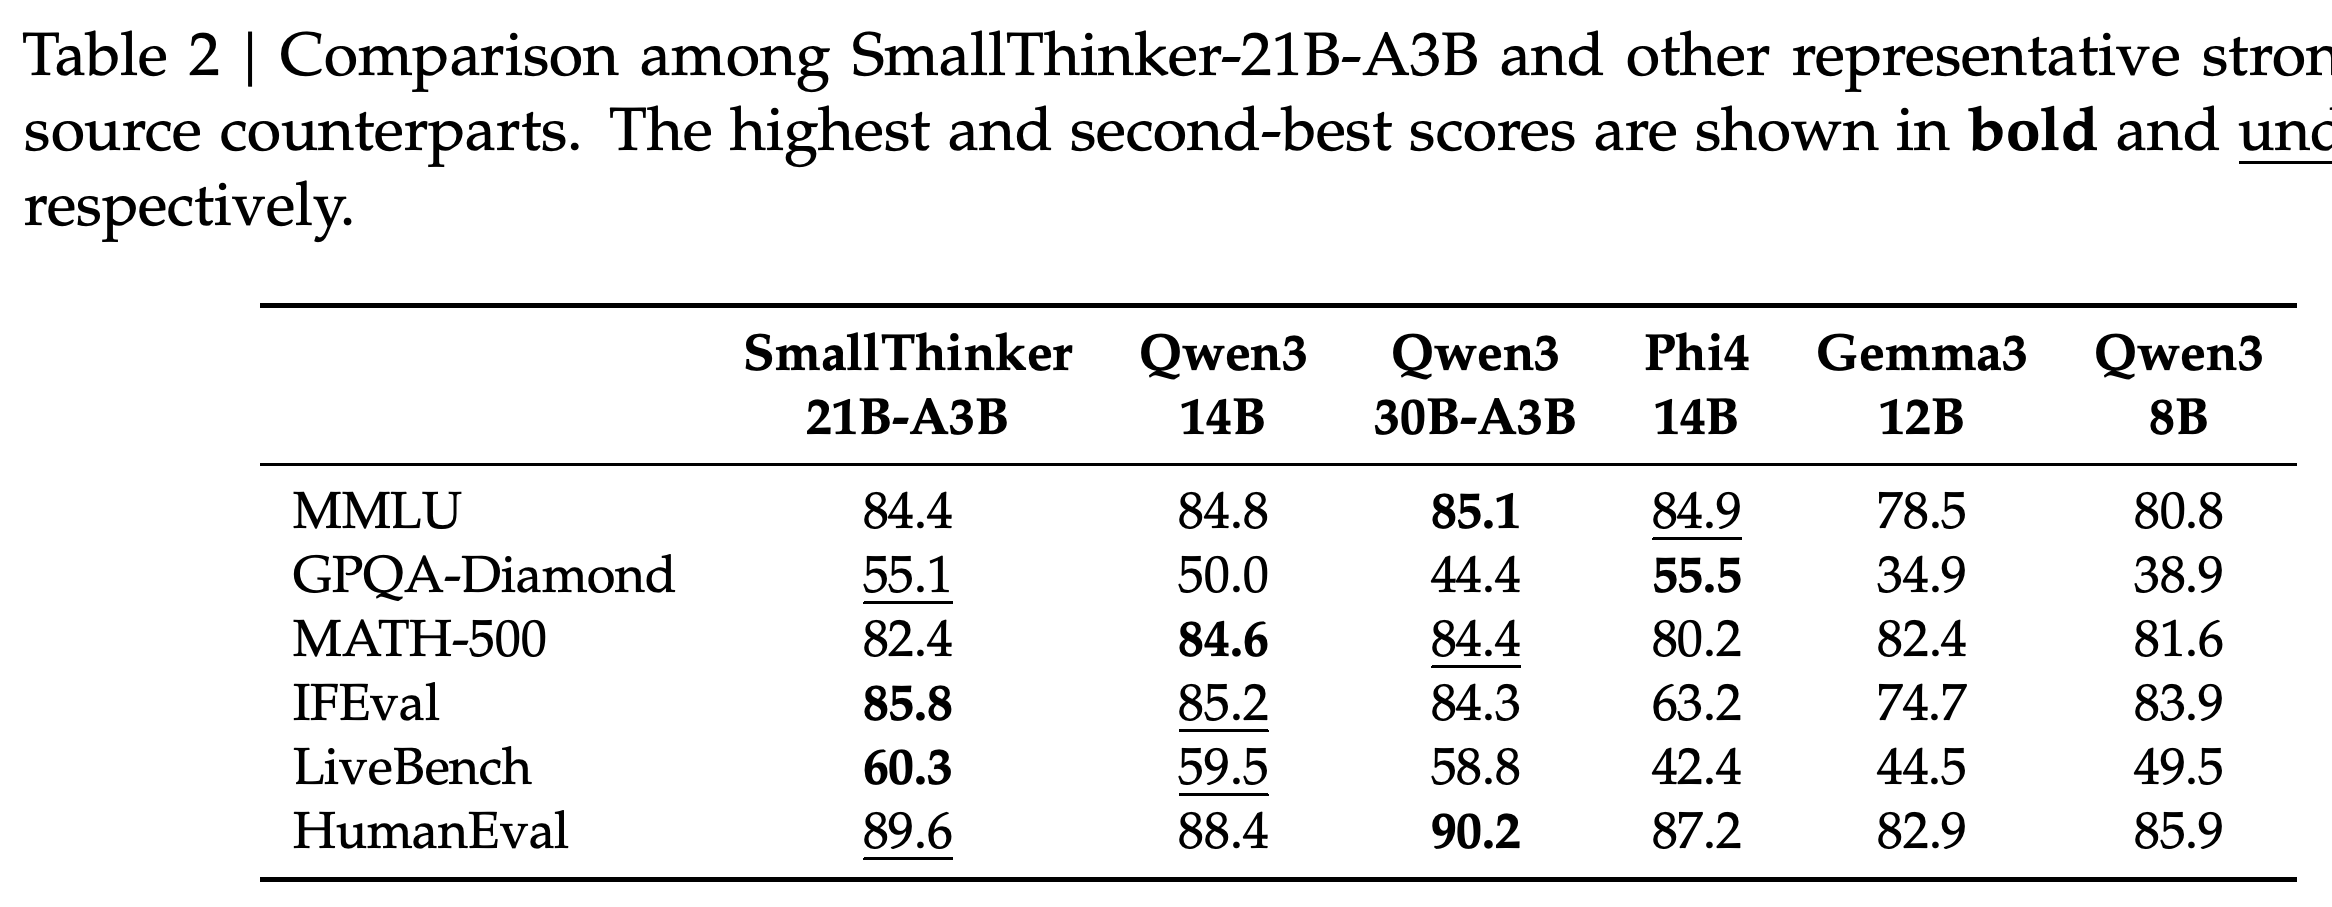
저자들은 내부적으로 수정한 평가 프레임워크 OpenCompass를 사용한다. 기본 모델은 선택지별 perplexity로 후보 답변의 가능도를 비교하여 평가한다. 미세 조정 모델은 시범 예시를 주지 않는 0-shot 방식으로 답변을 생성한 뒤 정답 일치 여부로 평가한다. Table 2는 MMLU와 LiveBench로 일반 과제를, GPQA-Diamond와 MATH-500으로 수학 또는 추론 과제를, IFEval로 지시 이행을, HumanEval로 코딩을 비교한다. SmallThinker-21B-A3B와 Qwen3-30B-A3B의 점수는 각각 MMLU에서 84.4와 85.1, GPQA-Diamond에서 55.1과 44.4, MATH-500에서 82.4와 84.4, IFEval에서 85.8과 84.3, LiveBench에서 60.3과 58.8, HumanEval에서 89.6과 90.2이다.
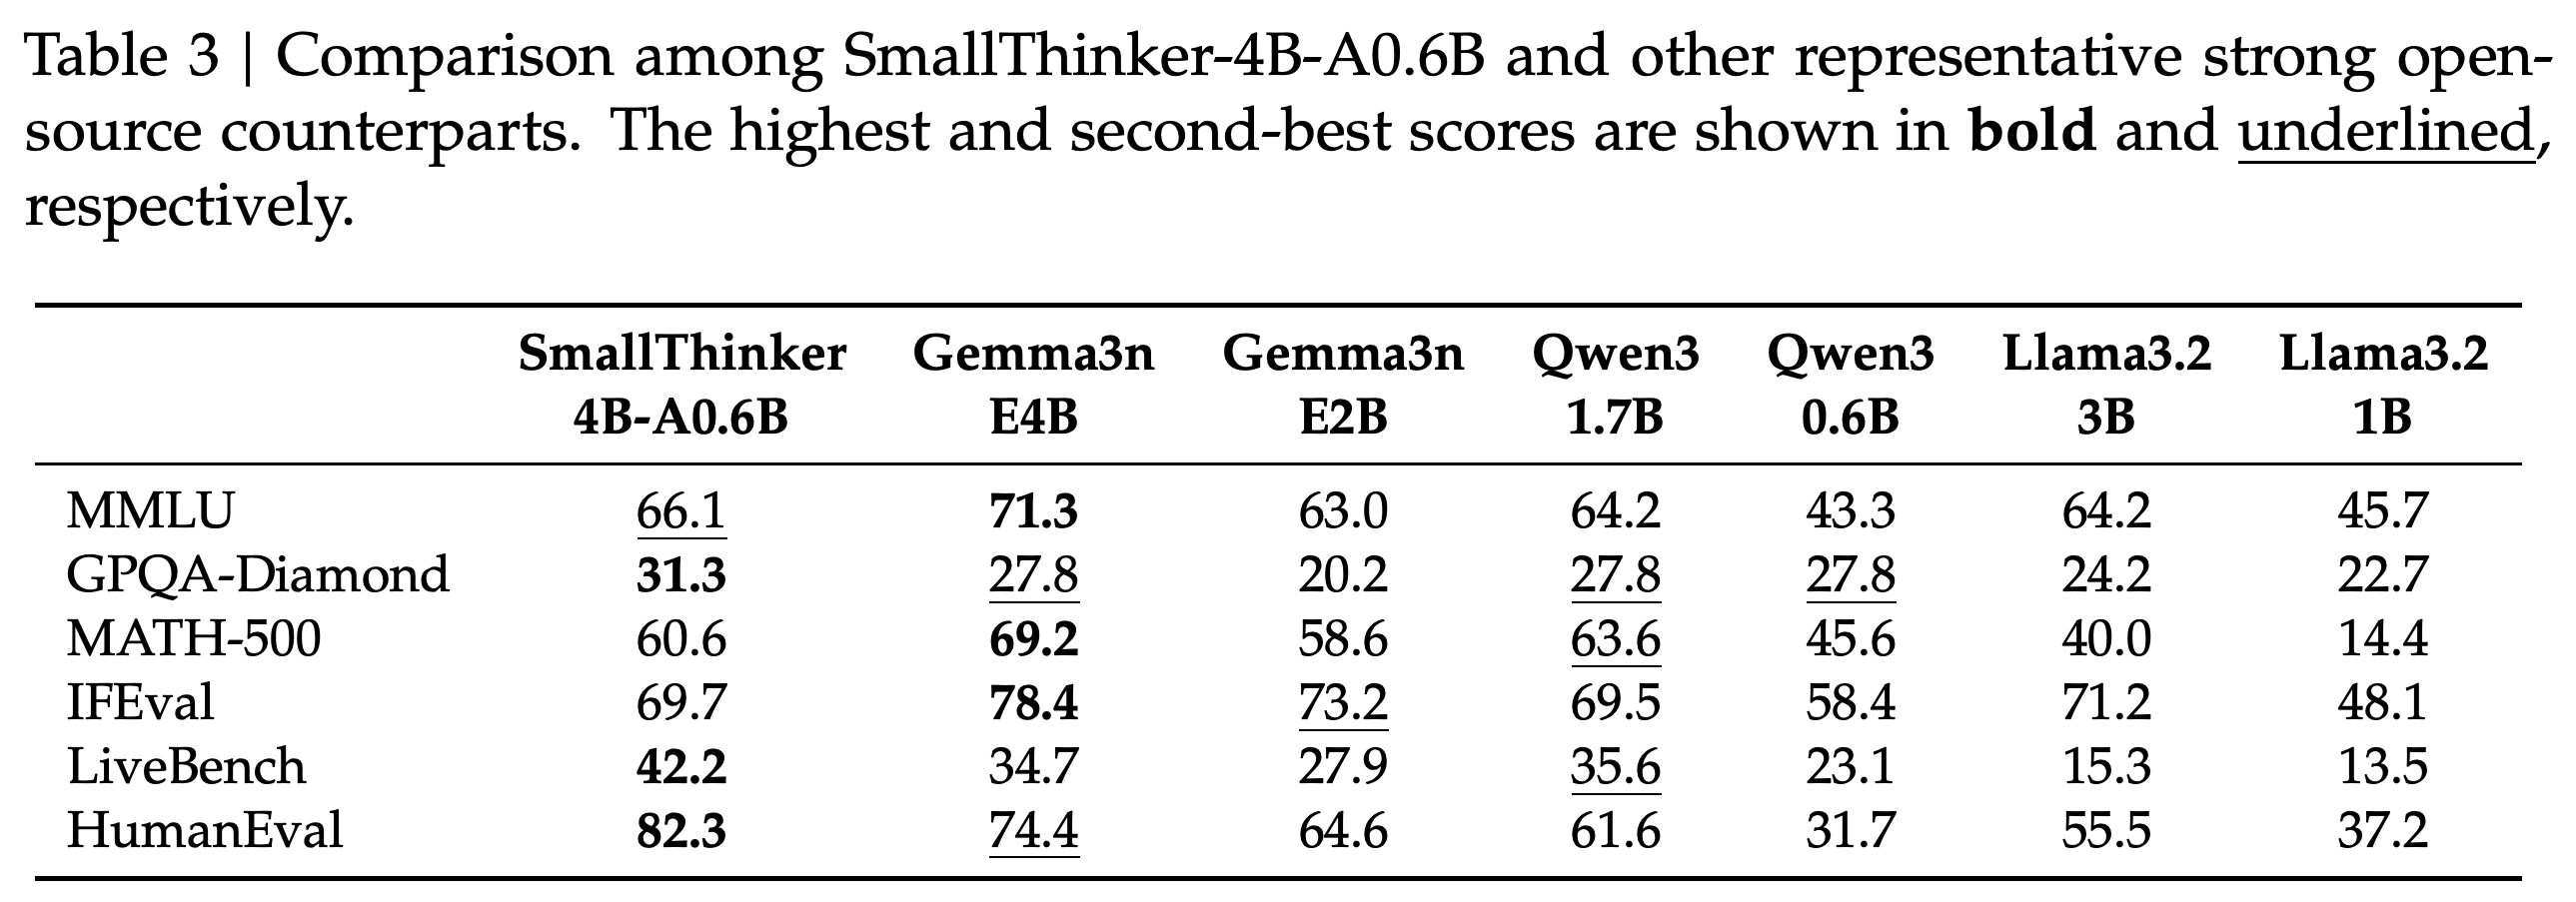
- SmallThinker-4B-A0.6B는 같은 6개 평가에서 순서대로 66.1, 31.3, 60.6, 69.7, 42.2, 82.3을 기록한다. Table 3에서는 GPQA-Diamond, LiveBench, HumanEval에서 가장 높고, Gemma3n-E4B는 MMLU, MATH-500, IFEval에서 가장 높다.
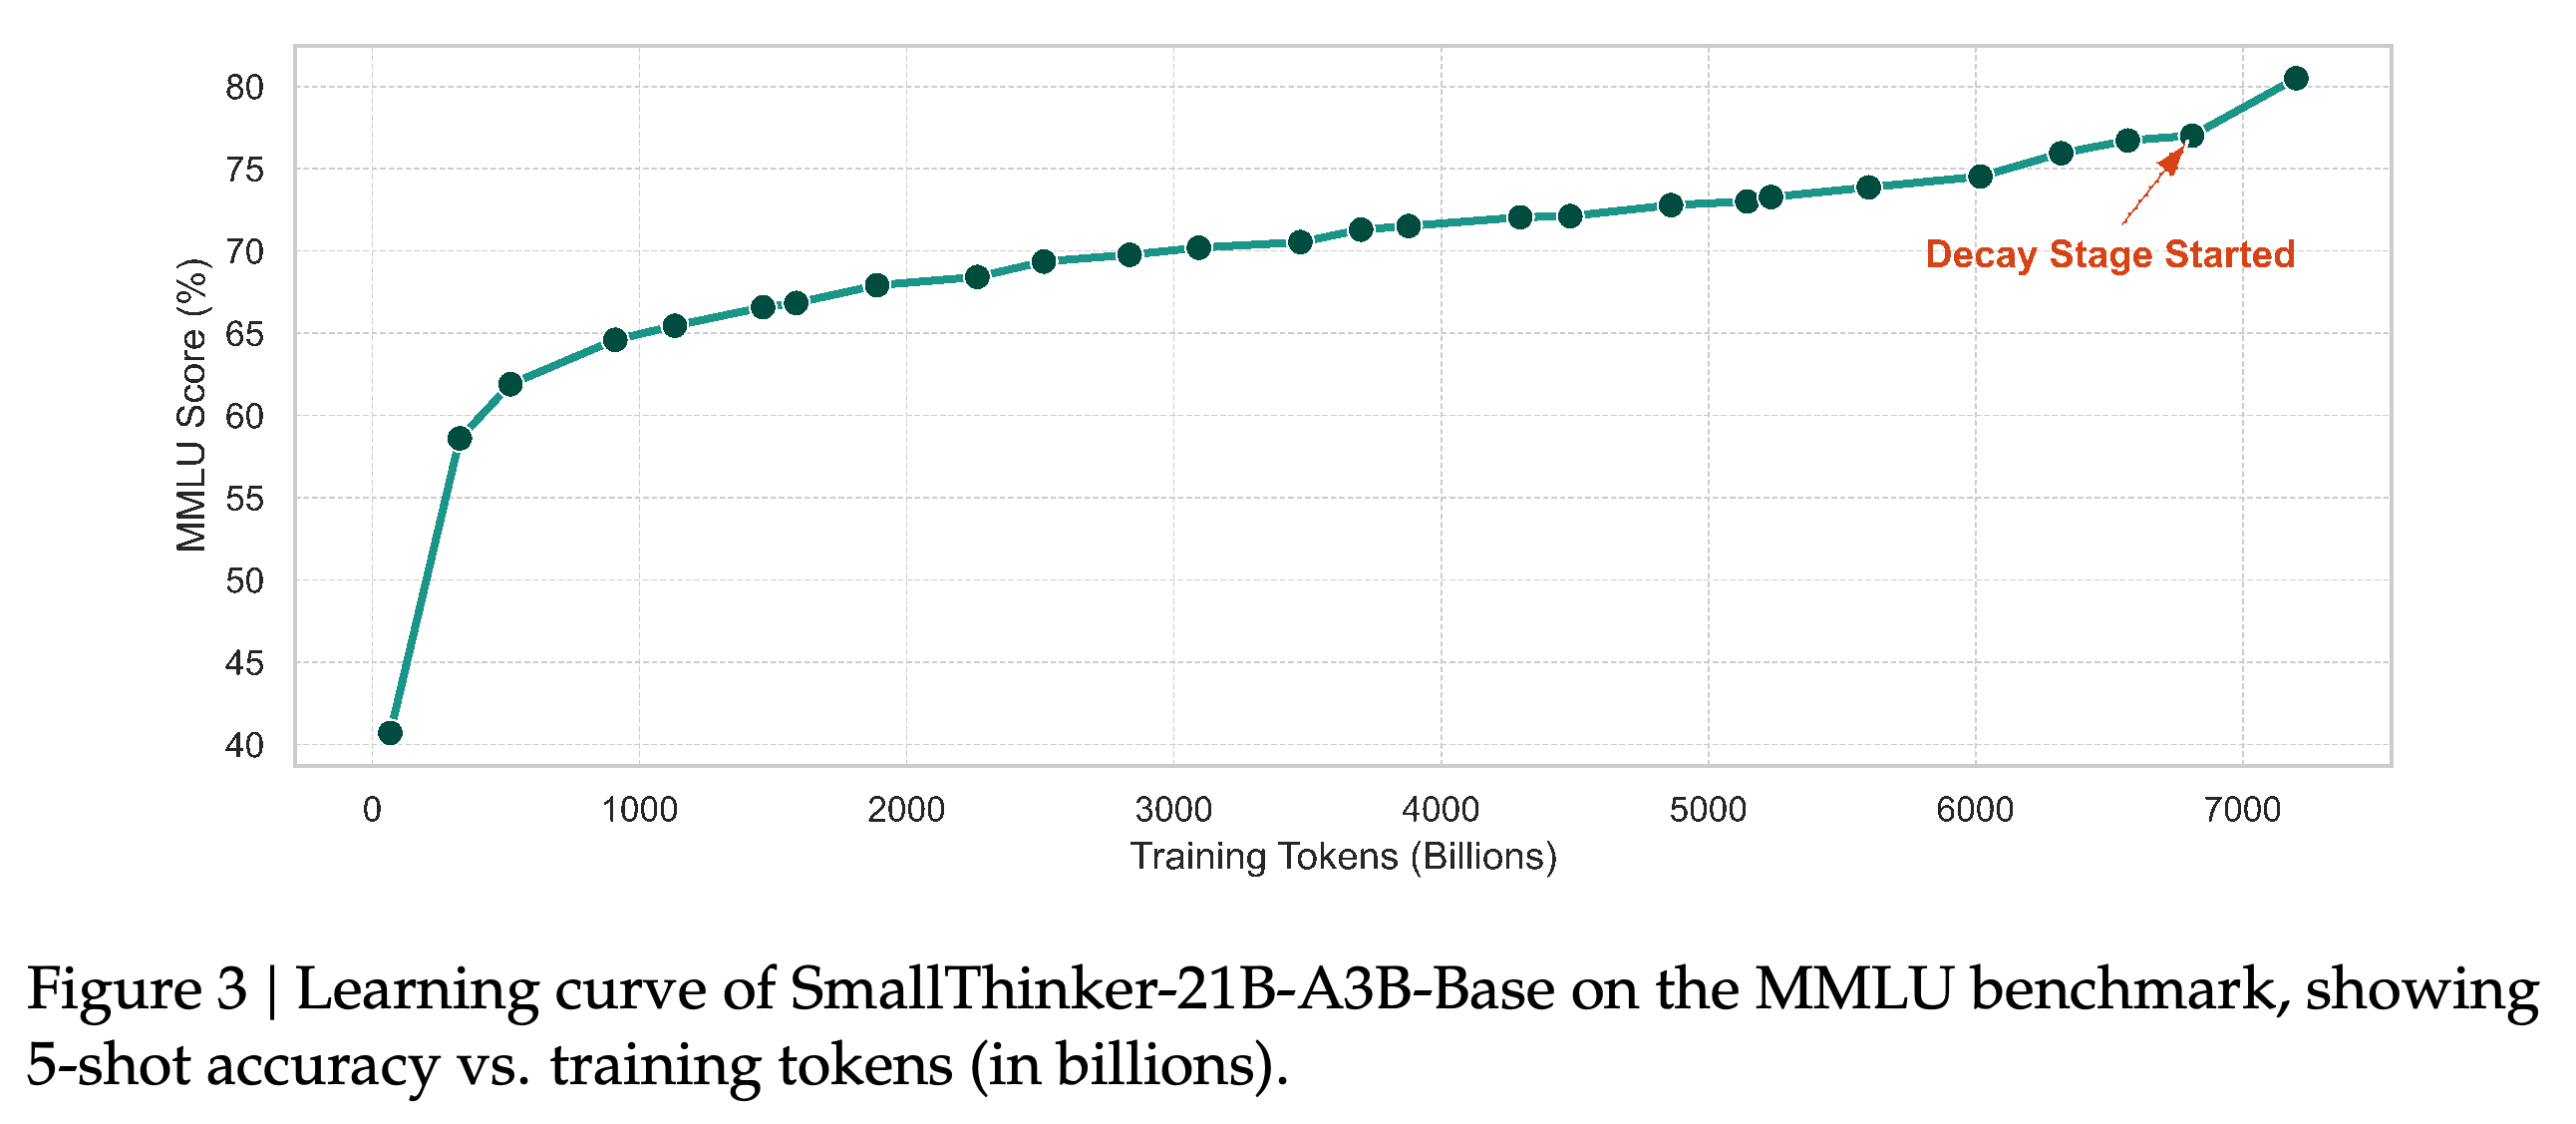
- Figure 3은 SmallThinker-21B-A3B-Base의 5-shot MMLU 정확도를 별도로 추적한다. 평가 문맥에 예시 5개를 제공하는 방식이다. 정확도는 학습 초기에 빠르게 상승하고 이후에는 완만하게 개선되다가, 마지막 학습률 감쇠 단계 부근에서 다시 빠르게 상승한다.
기본 모델의 5-shot MMLU 정확도는 초기에 빠르게 상승하고 사전 학습의 대부분 구간에서는 완만하게 개선되다가, 표시된 감쇠 단계 부근에서 더 가파르게 상승한다. 학습 중 데이터 구성도 달라지므로, 이 곡선만으로 마지막 성능 향상의 원인을 분리할 수 없다.
SmallThinker-21B-A3B는 나열된 모델 중 IFEval에서 85.8, LiveBench에서 60.3으로 가장 높다. Qwen3-30B-A3B보다 GPQA-Diamond 점수는 높지만 MMLU, MATH-500, HumanEval 점수는 낮다. 이는 경쟁력 있는 성능을 보이면서도 과제에 따라 차이가 있음을 보여준다.
SmallThinker-4B-A0.6B는 GPQA-Diamond, LiveBench, HumanEval에서 가장 높다. HumanEval에서는 82.3으로 Gemma3n-E4B의 74.4를 앞선다. Gemma3n-E4B는 MMLU, MATH-500, IFEval에서 더 높으므로, 이 비교가 모든 평가에서의 정확도 우위를 입증하지는 않는다.
5.2. Expert Specialization
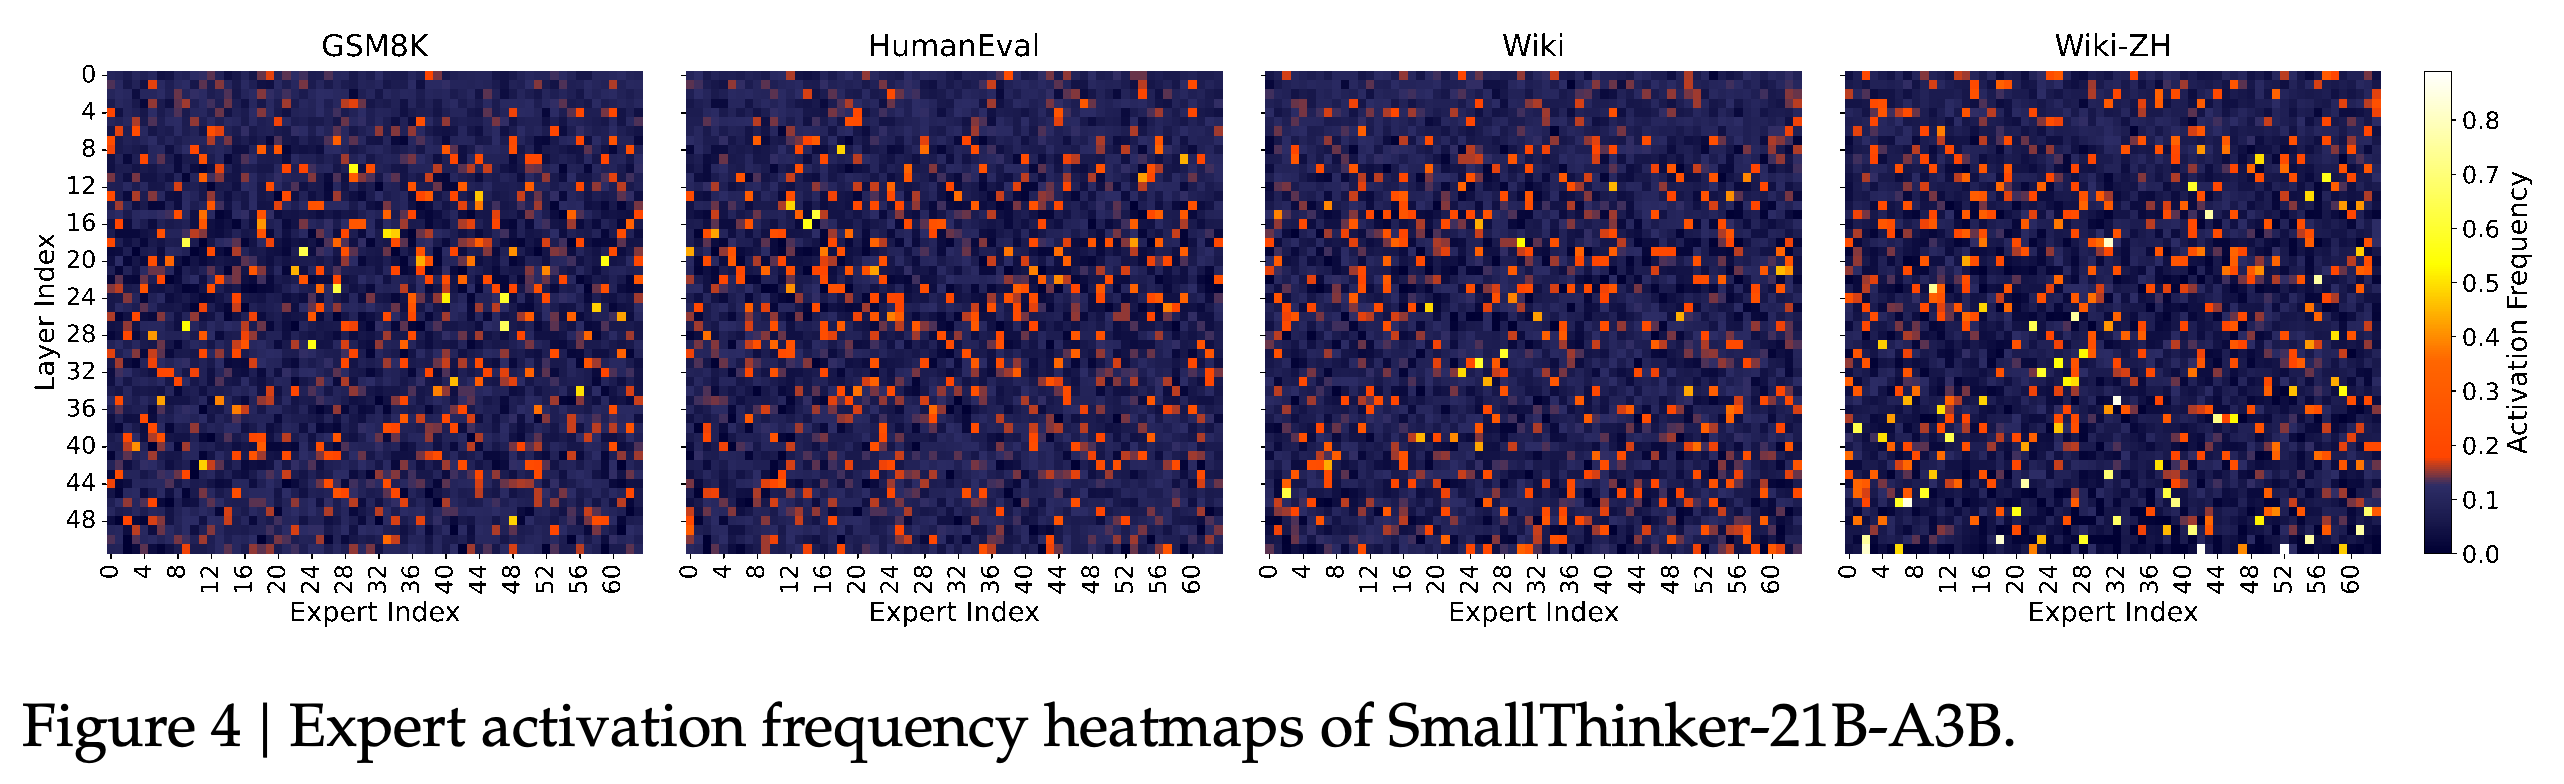
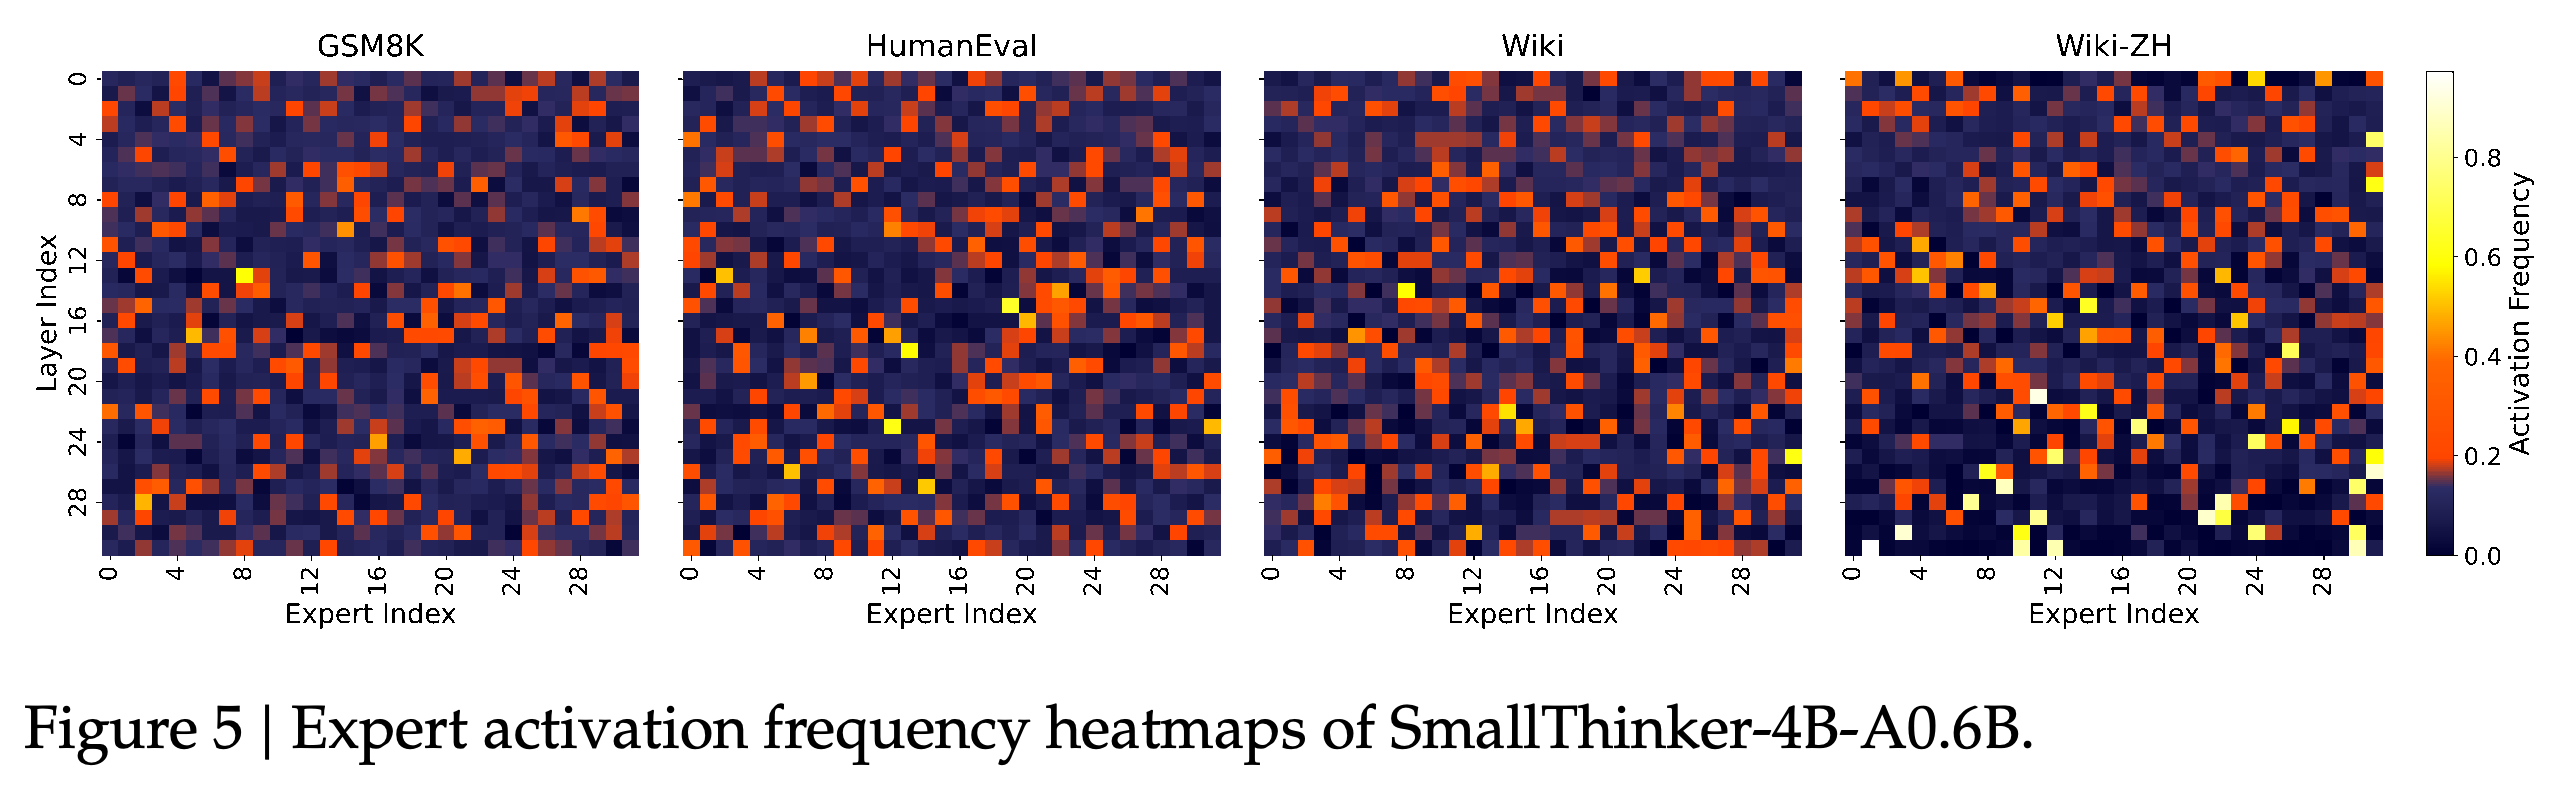
Expert 활성화는 과제와 언어에 따른 라우팅 차이를 살피기 위해 GSM8K, HumanEval, Wiki, Wiki-ZH의 4개 데이터셋에서 분석한다. 저자들은 expert의 70%–80%는 활성화 빈도가 0.14 미만이고, 나머지 20%–30%는 0.4–0.6으로 훨씬 높다고 보고한다. Figure 4와 Figure 5는 활성화가 균일하지 않고 데이터셋에 따라 달라짐을 보여준다. 이는 자주 재사용하는 expert를 캐싱할 근거를 뒷받침하지만, 부하 균형 손실의 효과를 독립적으로 입증하지는 않는다.
21B 모델의 활성화 히트맵에는 빈도가 낮은 expert가 많고, 높은 빈도가 집중된 지점은 더 적으며 데이터셋과 층에 따라 달라진다. 이러한 불균일한 패턴은 자주 사용하는 expert를 메모리에 유지할 근거를 뒷받침하지만, 그림 자체가 캐시의 효과를 측정하지는 않는다.
4B 모델도 과제와 언어에 따라 expert 사용이 균일하지 않다. 이 히트맵은 작은 모델에서도 선택적 캐싱을 적용할 근거를 뒷받침한다. 다만 저자들은 21B 모델에서 전문화가 더 뚜렷하다고 설명한다.
5.3. Neuron-Level Sparsity
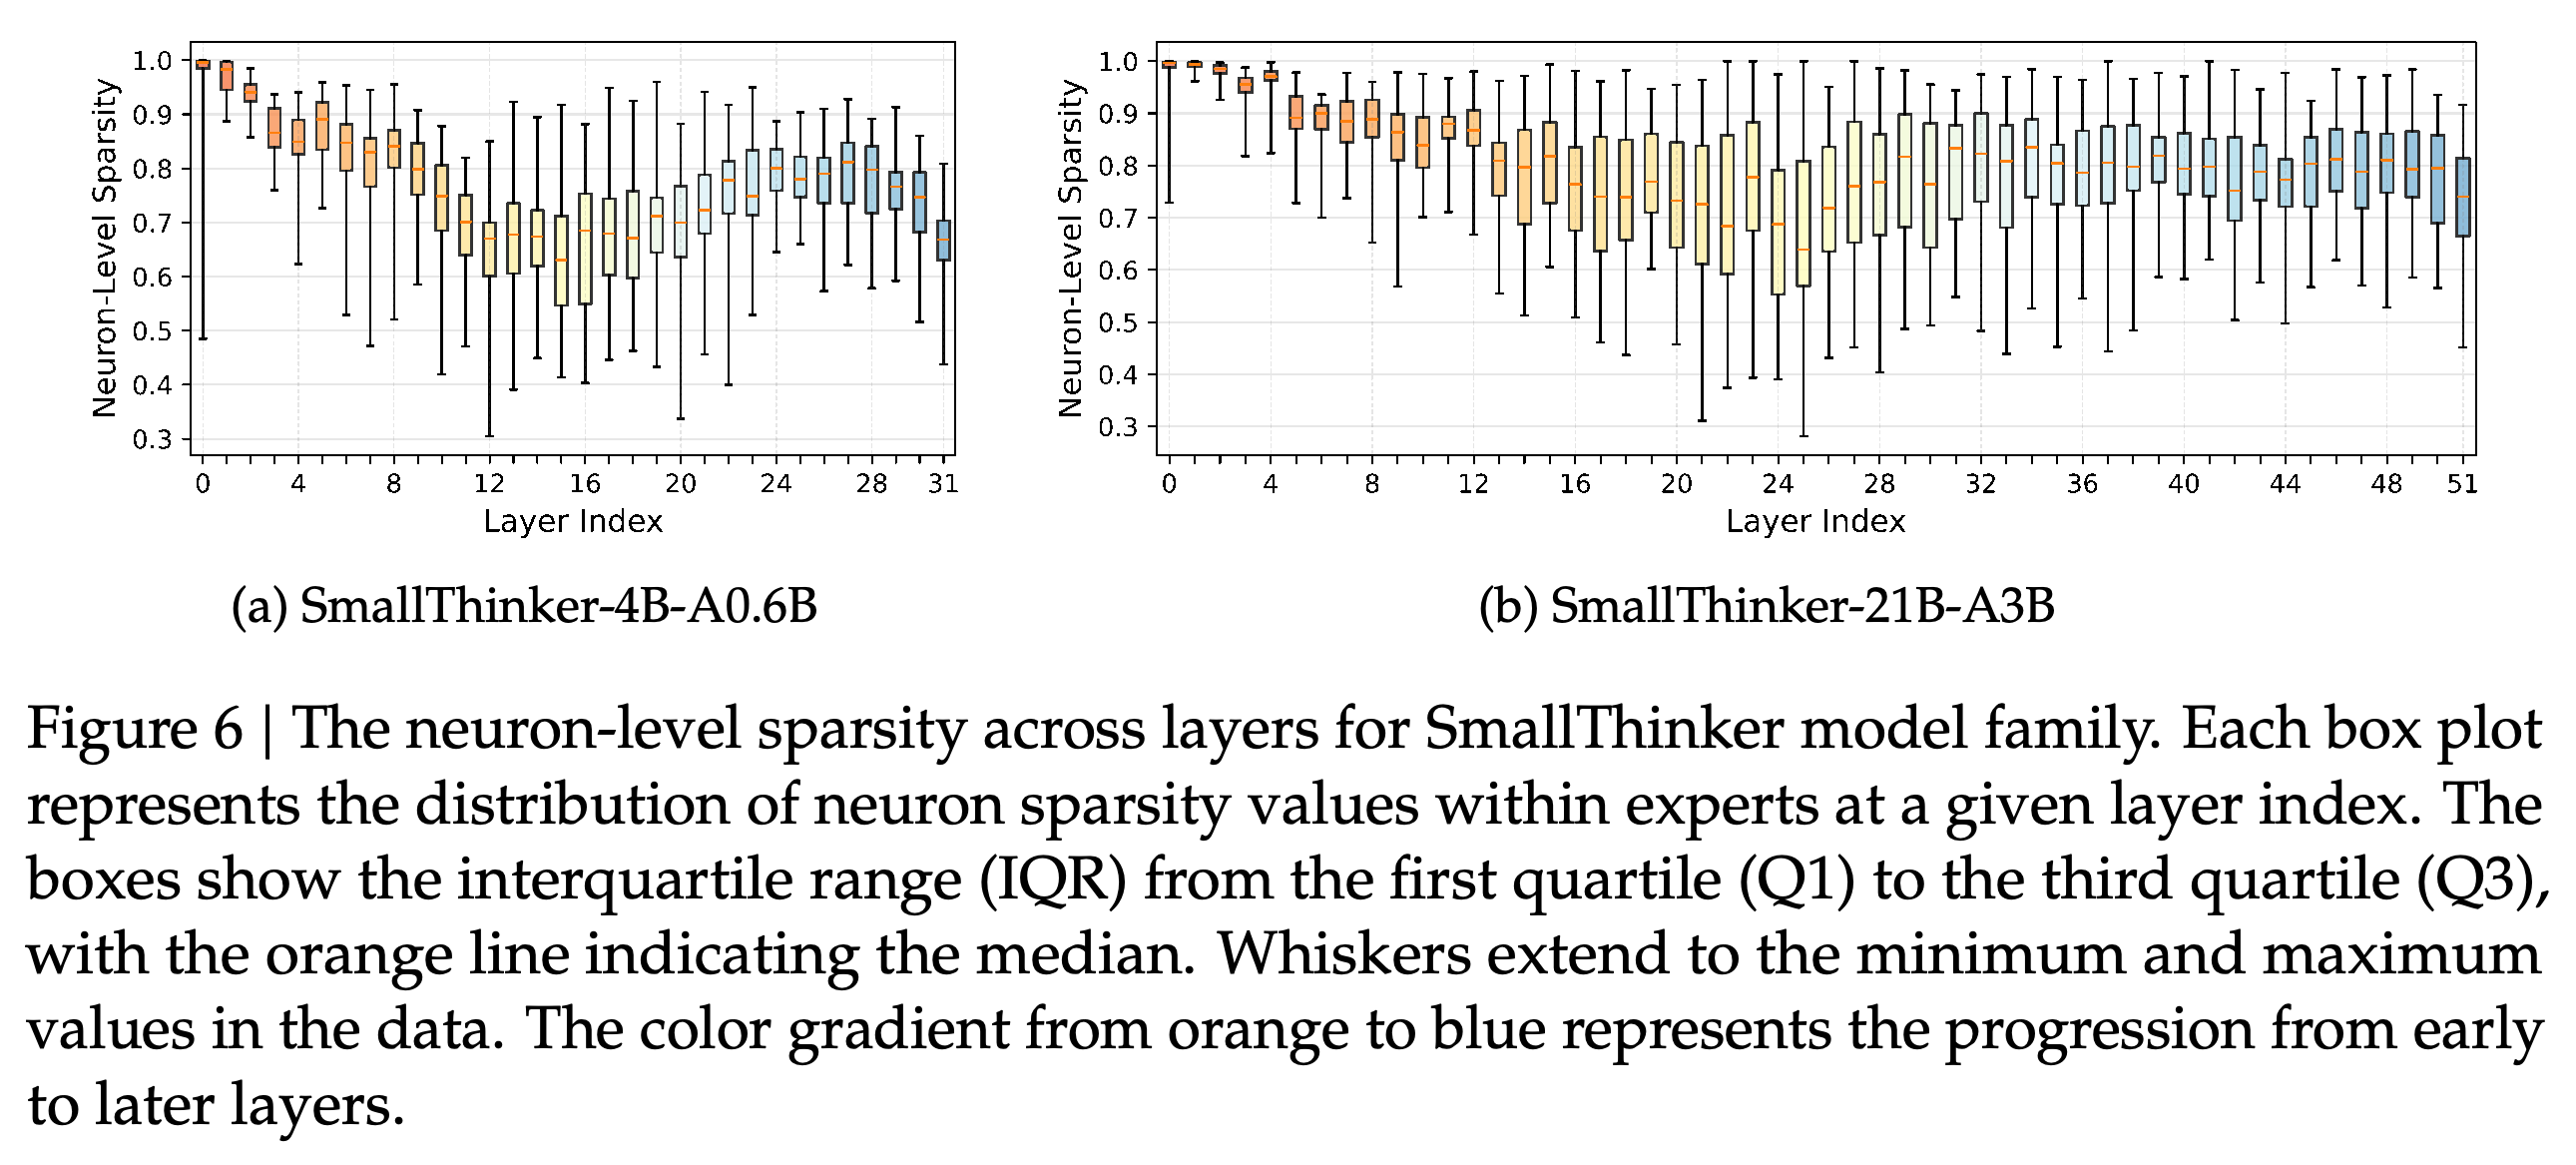
Figure 6은 두 모델의 모든 층에서 expert 내부의 뉴런 수준 희소성을 보여준다. 보고된 희소성 중앙값은 0.6을 넘으며, 초기 층에서는 0.9–1.0에 이른다. 따라서 expert를 선택한 뒤에도 상당한 연산을 생략할 가능성이 있다. 이 분포는 비활성 뉴런을 나타내며, 실제 속도는 이를 활용하는 추론 커널에 달려 있다.
두 모델 모두 네트워크 전반에서 비활성 뉴런 비율의 중앙값이 높다. 초기 층에서 희소성이 가장 높고, 일부 중간 층에서는 expert 사이의 변동 폭이 더 크다. 이는 밀집 게이트 연산 후 up 및 down projection의 일부를 생략할 수 있다는 실증적 근거를 제공한다.
6. Inference Framework for Local Devices
로컬 추론 프레임워크는 일부 expert 가중치를 작업 메모리 밖에 저장하는 expert offloading, 가중치 전송과 연산의 중첩, 희소 실행을 결합한다. 보고된 배포 성능 측정에 사용한 추론 시스템 PowerInfer에 구현되어 있으며, 코드는 https://github.com/SJTU-IPADS/PowerInfer/tree/main/smallthinker 에서 제공한다.
6.1. Memory-Efficient Inference
일부 expert 가중치는 solid-state drive (SSD)에 저장하고, 자주 접근하는 expert는 더 빠른 작업 메모리인 dynamic random-access memory (DRAM)에 유지한다. MoE 층들이 공유하는 캐시는 마지막 접근 시점이 가장 오래된 expert를 내보내는 least recently used (LRU) 교체 정책을 사용한다. Pre-attention 라우팅은 attention을 계산하는 동안 expert 읽기를 시작한다. 추가 파이프라인은 expert 로딩과 FFN 연산을 교차 배치하여 저장장치 대기를 줄인다.
6.2. Sparse Inference
희소 ReGLU 실행은 게이트 행렬을 밀집 연산으로 계산하고, 활성화 함수 전후의 FFN 변환인 up 및 down projection에서는 필요한 부분만 계산한다. 융합 커널은 하나의 연산을 여러 값에 적용하는 프로세서 명령인 Single Instruction, Multiple Data (SIMD)를 사용하여 비활성 뉴런에 해당하는 연산을 줄인다.
- 은닉 상태를 어휘별 점수로 변환하는 마지막 단계인 language model head의 복잡도는 O(HV)이다. H는 은닉 크기이고 V는 어휘 크기이다. 전용 예측기가 계산할 어휘 행을 선택하며, 나머지 logit, 즉 확률 정규화 전의 어휘 점수는 0으로 설정한다.
- 논문은 예측기 구조, 선택 임계값, 이 출력 근사가 정확도에 미치는 독립적인 영향을 명시하지 않는다.
6.3. Inference Performance Evaluation
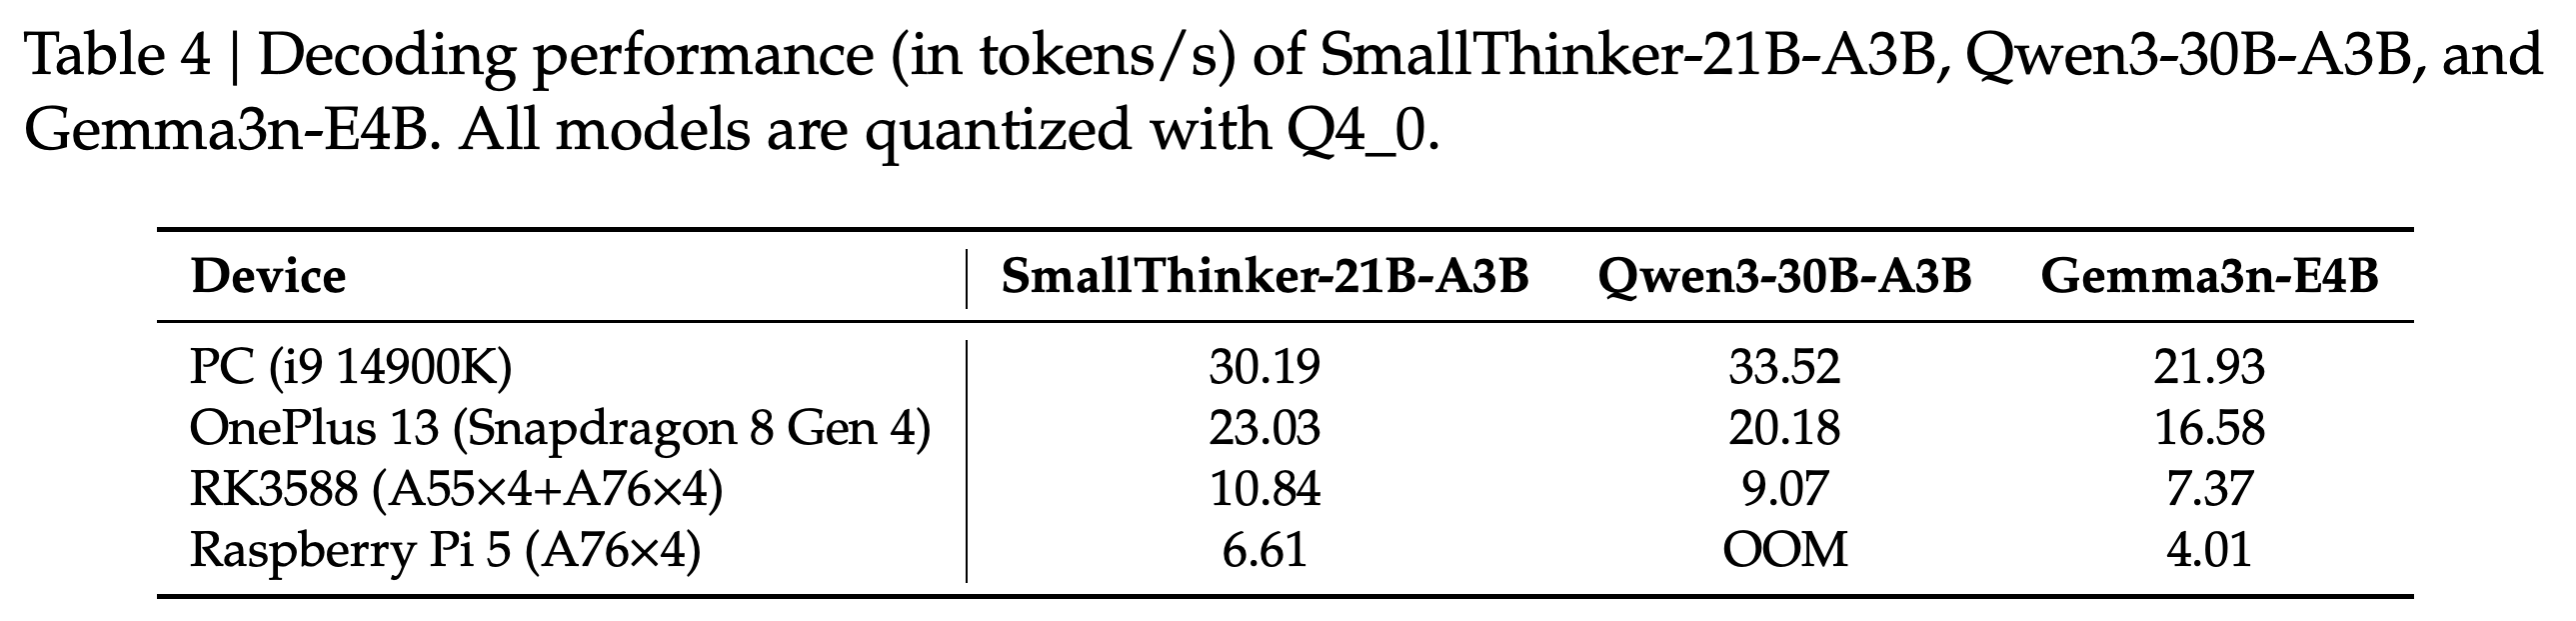
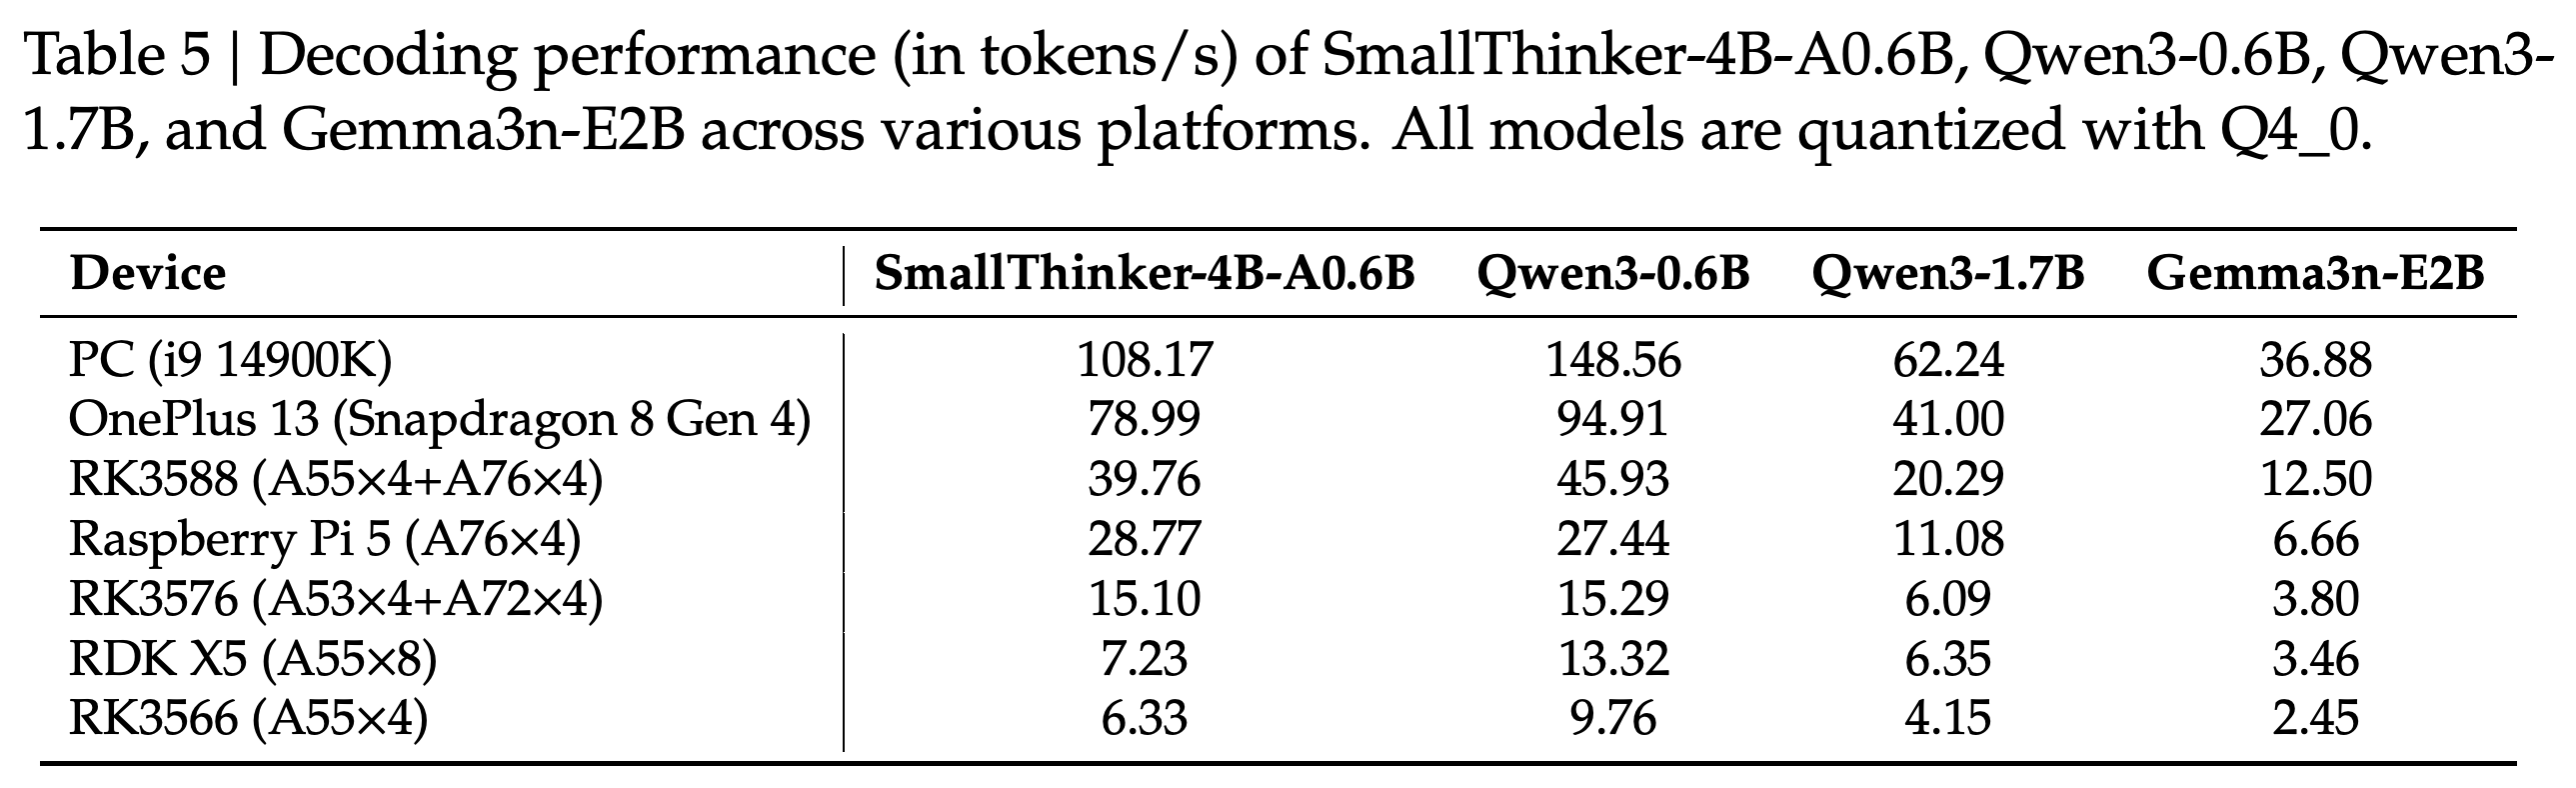
보고된 모든 처리량 비교는 PowerInfer와 Q4_0 양자화를 사용한다. 가중치를 메모리에 모두 올린 조건에서 SmallThinker-21B-A3B는 i9 14900K PC에서 30.19 tokens/s로 Qwen3-30B-A3B의 33.52보다 느리다. 반면 OnePlus 13에서는 23.03 대 20.18, RK3588에서는 10.84 대 9.07로 더 빠르다. SmallThinker-4B-A0.6B는 PC에서 108.17 tokens/s를 기록하며, Qwen3-1.7B는 62.24, Qwen3-0.6B는 148.56을 기록한다.
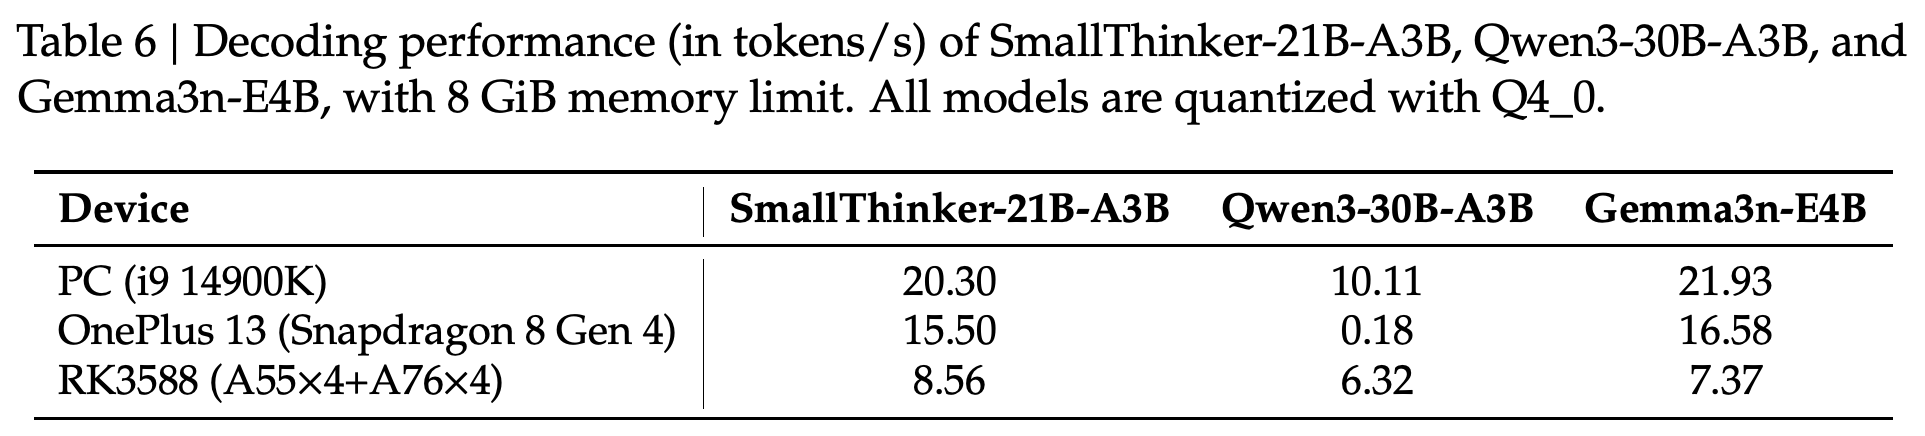
- 8 GiB 메모리 제한에서 21B 모델은 PC, OnePlus 13, RK3588에서 각각 20.30, 15.50, 8.56 tokens/s를 기록한다. Qwen3-30B-A3B는 각각 10.11, 0.18, 6.32를 기록한다. 표에서 가장 큰 속도 비율은 OnePlus 13의 약 86.1배이다. 관련 본문은 최대 향상 폭을 85배 또는 86배로 일관되지 않게 서술한다.
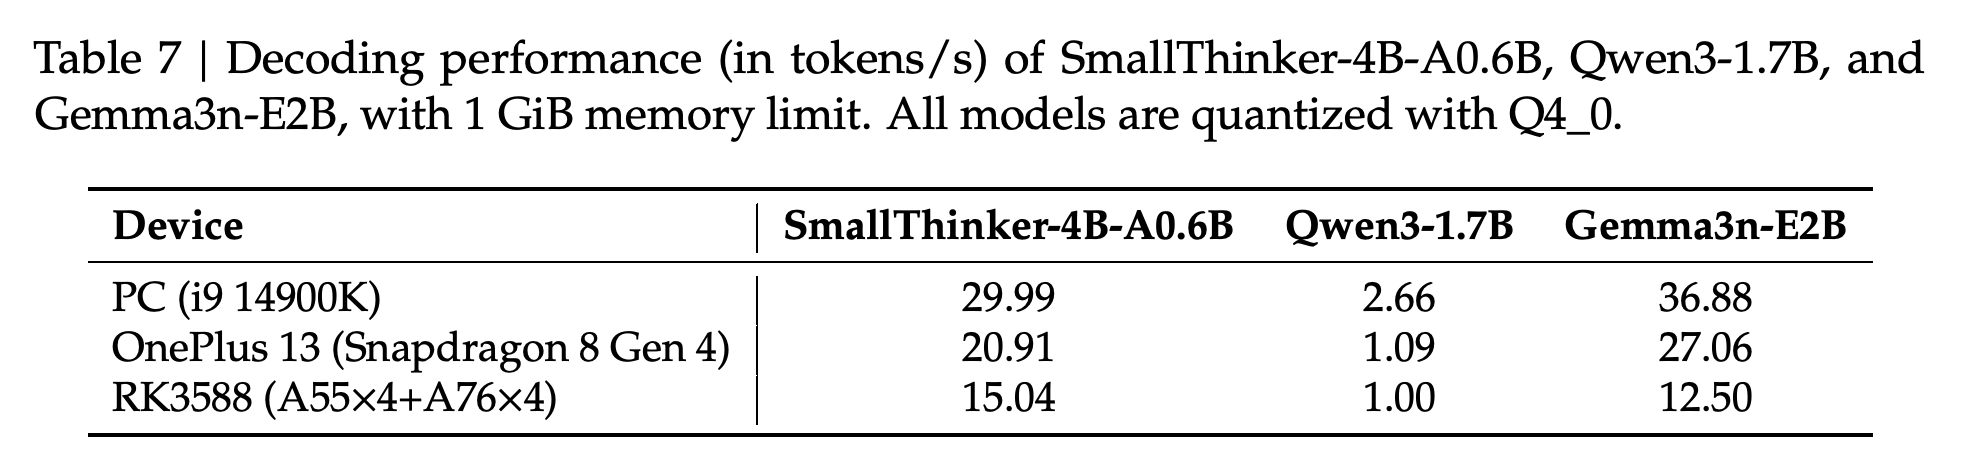
- 1 GiB 메모리 제한에서 4B 모델은 같은 기기에서 각각 29.99, 20.91, 15.04 tokens/s를 기록한다. Qwen3-1.7B는 각각 2.66, 1.09, 1.00을 기록한다. 가장 큰 속도 비율은 OnePlus 13의 약 19.2배이다.
- 가장 큰 향상은 메모리가 제한된 비교에서 나타나며, 저자들은 기준 모델의 속도 저하를 저장장치 데이터 전송 때문으로 설명한다. 프롬프트 길이, 생성 길이, 배치 크기, 스레드 설정, 저장장치 특성, 측정 변동성을 명시하지 않아 재현에 한계가 있다.
메모리에 가중치를 모두 올린 SmallThinker-21B-A3B는 PC에서 30.19 tokens/s로 Qwen3-30B-A3B의 33.52 tokens/s보다 느리지만, OnePlus 13과 RK3588에서는 더 빠르다. Raspberry Pi 5에서는 6.61 tokens/s를 기록하는 반면 Qwen3-30B-A3B는 메모리 부족으로 실행하지 못한다. 따라서 순위는 플랫폼에 따라 달라진다.
SmallThinker-4B-A0.6B는 나열된 모든 기기에서 Qwen3-1.7B와 Gemma3n-E2B보다 처리량이 높다. Qwen3-0.6B는 7개 기기 중 6개에서 더 빠르며, SmallThinker는 Raspberry Pi 5에서 앞선다.
8 GiB 제한에서 Qwen3-30B-A3B 대비 가장 큰 향상은 OnePlus 13에서 나타난다. 처리량은 15.50 대 0.18 tokens/s로 약 86.1배이다. PC에서는 약 2.01배, RK3588에서는 1.35배이다. 반복 기재된 Gemma3n-E4B 수치는 논문에서 가중치를 메모리에 모두 올린 비교 기준으로 사용한다.
명시된 1 GiB 제한에서 SmallThinker-4B-A0.6B는 Qwen3-1.7B보다 PC에서 약 11.3배, OnePlus 13에서 19.2배, RK3588에서 15.0배 빠르다. Gemma3n-E2B 수치는 메모리 상주 측정값을 반복 기재한 것이며, SmallThinker는 RK3588에서만 이 참조값을 넘는다.
7. Limitations and Future Work
저자들은 제한된 사전 학습 데이터 규모가 지식의 범위와 더 폭넓은 과제에서의 성능을 제약할 가능성을 언급한다. 또한 인간 선호 피드백으로 학습하는 Reinforcement Learning from Human Feedback (RLHF)을 수행하지 않았으며, 응답 품질과 사용자 선호 부합도를 개선하기 위한 후속 과제로 제안한다. 논문에는 유용성이나 안전성을 직접 평가한 결과가 없으므로, 벤치마크 결과만으로 이러한 특성을 입증할 수 없다.
8. Authors
기재된 저자는 Yixin Song, Zhenliang Xue, Dongliang Wei, Feiyang Chen, Jianxiang Gao, Junchen Liu, Hangyu Liang, Guangshuo Qin, Chengrong Tian, Bo Wen, Longyu Zhao, Xinrui Zheng, Zeyu Mi, Haibo Chen이다. 표제 페이지에는 Shanghai Jiao Tong University의 Institute of Parallel and Distributed Systems와 School of Artificial Intelligence, 그리고 Zenergize AI가 소속으로 기재되어 있다.
부록
- 제공된 15페이지 논문에는 부록이 없으며, 14–15페이지에는 References가 실려 있다. 공개 모델 주소는 http://hf.co/PowerInfer/SmallThinker-4BA0.6B-Instruct 와 http://hf.co/PowerInfer/SmallThinker-21BA3B-Instruct 이다.
짧은 생각
핵심 기여는 학습 과정에서 형성한 희소성을, 엄격한 메모리 제한에서 이를 활용하는 추론 파이프라인과 연결한 데 있다. Table 4와 Table 6은 비교 조건을 분명히 보여준다. 21B 모델은 가중치를 메모리에 모두 올린 PC 실험에서는 Qwen3-30B-A3B보다 느리지만, 8 GiB 제한에서는 더 빠르다. 구성요소별 ablation 실험, 완전한 추론 작업 조건 명세, 어휘 예측기가 정확도에 미치는 영향이 보고되지 않아 각 최적화의 기여도와 측정된 향상이 다른 환경에서도 유지되는지는 확인되지 않았다.