


LLM in a flash: Efficient Large Language Model Inference with Limited Memory 요약 설명
12 Dec 2023 | Paper Review Efficient Inference Sparse Inference On-Device Inference목차
이번 글에서는 LLM in a flash: Efficient Large Language Model Inference with Limited Memory 논문의 핵심 포인트만 간단히 정리한다.
- 2023년 12월 12일(Arxiv)
- Alizadeh, Keivan, Mirzadeh, Iman, Belenko, Dmitry, Khatamifard, Karen, Cho, Minsik, Del Mundo, Carlo C, Rastegari, Mohammad, Farajtabar, Mehrdad.
- Apple
- 논문 링크
요약
- 대규모 언어 모델(LLM)의 가중치가 기기의 작업 메모리인 DRAM 용량을 초과하면 실행이 어려워진다. 초록에서는 작업 메모리가 모델 크기의 약 절반인 조건에서, 전체 모델을 보관하는 대용량 플래시 저장장치로부터 필요할 때마다 가중치를 읽는 단순한 방식보다 CPU 추론은 최대 4배, GPU 추론은 최대 20배 빨라졌다고 보고한다.
- 이 방법은 FFN에서 중간 뉴런 출력 대부분이 0이 되는 활성화 희소성을 활용한다. FFN은 up projection으로 은닉 표현을 확장하고 down projection으로 다시 축소하는 transformer 구성 요소다. 작은 예측기가 필요한 가중치를 선택하고, windowing은 최근 토큰에서 사용한 가중치를 유지하며, row-column bundling은 대응하는 projection 가중치를 함께 배치해 플래시에서 한 번에 더 크게 읽도록 한다.
- 실험은 Apple M1 Max, Apple M2 Ultra, NVIDIA RTX 4090 systems에서 시퀀스를 하나씩 처리하며, 일반적으로 프롬프트 길이는 128, 생성 길이는 256토큰으로 설정한다. 실험에서 설정한 메모리 제약 아래에서는 지연 시간이 줄지만, 정확도 손실은 모델마다 다르다. 프롬프트 처리, 여러 시퀀스의 동시 처리, 스마트폰 구현, 체계적인 에너지 측정은 후속 과제로 남는다.
1 Introduction
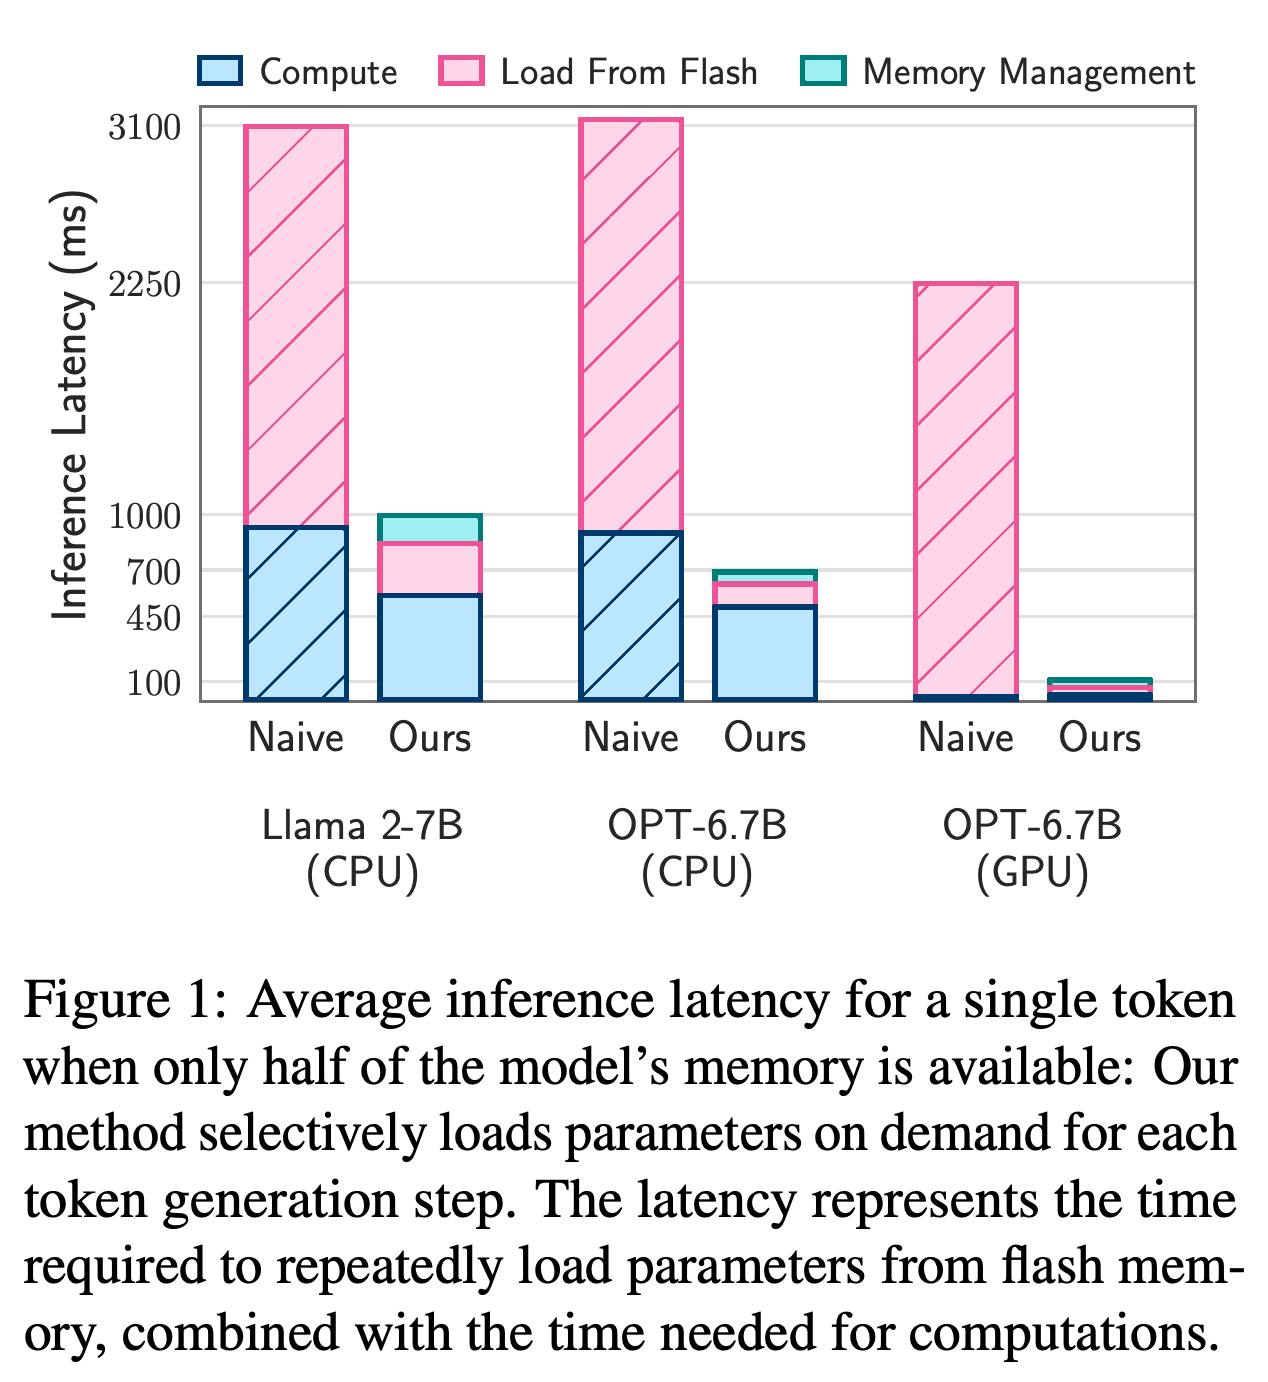
모든 파라미터를 DRAM에 적재하면 기기에서 실행할 수 있는 모델 크기가 제한된다. 서론에 따르면 7B 모델은 반정밀도인 16-bit 부동소수점 가중치만으로도 14GB 넘게 필요하다. 제안 방식은 전체 모델을 플래시에 저장하고 생성 과정에서 필요한 가중치만 DRAM으로 가져온다. Figure 1은 계산, 플래시 로딩, 메모리 관리를 구분해 이 방식이 토큰당 지연 시간을 어디에서 줄이는지 보여준다.
단순 로딩 구성에서는 플래시 로딩이 지연 시간 대부분을 차지하며, 특히 GPU의 OPT-6.7B에서 두드러진다. 선택적 로딩은 메모리 관리 오버헤드를 추가하는 대신 이 비용을 크게 줄여 전체 지연 시간을 낮춘다.
2 Flash Memory & LLM Inference
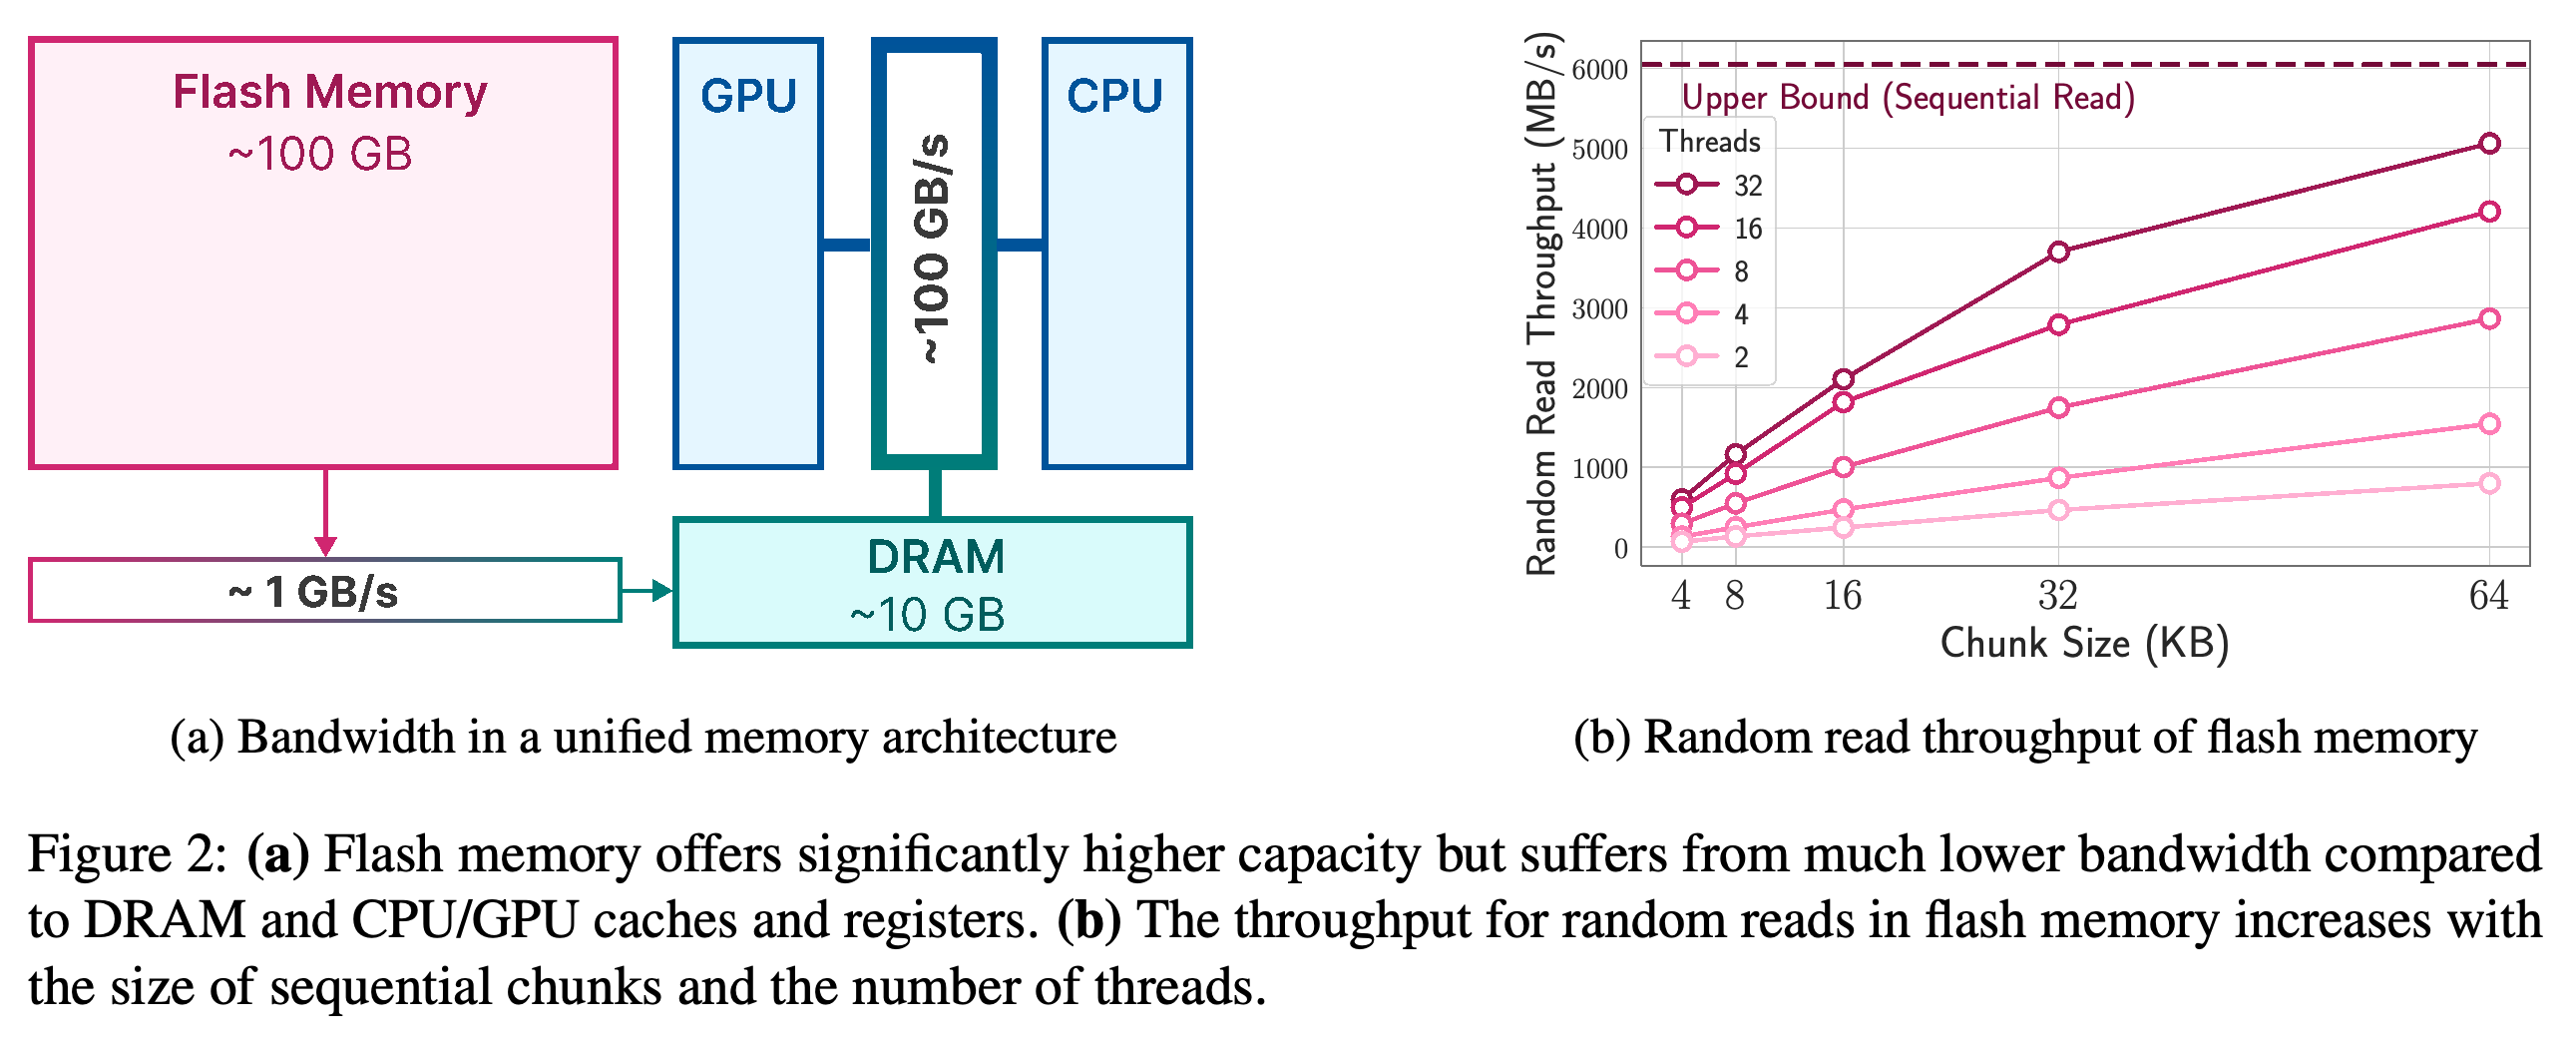
하드웨어 분석에서는 저장 용량, 전송 대역폭, 요청마다 가져오는 데이터의 크기인 읽기 단위를 추론 설계의 제약으로 다룬다. 플래시는 DRAM보다 용량이 훨씬 크지만, 이를 효율적으로 활용하려면 전송량과 각 읽기의 처리량을 함께 조절해야 한다.
2.1 Bandwidth and Energy Constraints
플래시에서 모델을 반복해서 읽으면 순전파마다 수초가 걸릴 수 있으며, DRAM에서 프로세서 메모리로 데이터를 옮길 때보다 에너지를 더 많이 소비한다. 모델 전체가 DRAM에 상주하더라도 최초 로딩에는 시간이 걸린다. 선택적 읽기는 이러한 로딩 비용을 줄이는 데 목적이 있지만, 이 절에서는 에너지를 정량적으로 평가하지 않는다.
2.2 Read Throughput
1TB 플래시 저장장치를 갖춘 Apple MacBook M1 Max에서 캐시되지 않은 파일을 1GiB 연속 읽기하면 처리량이 6GiB/s를 넘는다. 작은 무작위 읽기는 운영체제, 드라이버, 컨트롤러의 지연을 반복해서 부담하므로 처리량이 훨씬 낮다. Figure 2에서는 청크 크기와 스레드 수가 늘어날수록 처리량이 개선된다. 이에 저자들은 큰 연속 읽기와 병렬 요청을 권하며, 여러 스레드에서 32KiB 이상의 무작위 읽기를 수행하면 희소 추론을 지원할 수 있다고 보고한다.
플래시는 용량이 큰 대신 대역폭이 낮다. 읽기 벤치마크에서는 아주 작은 무작위 요청이 저장장치 대역폭을 충분히 활용하지 못하므로, 더 큰 청크와 병렬 읽기가 필요하다는 점을 보여준다.
3 Load From Flash
로딩 전략은 지연 시간을 플래시 입출력(I/O), 메모리 관리, 계산으로 나눈다. 목표는 3가지다. 전송하는 가중치를 줄이고, 각 전송 청크를 키우며, 기존 데이터를 반복해서 재할당하고 복사하지 않으면서 상주 가중치를 갱신한다. 주된 최적화 대상은 가중치의 이동과 관리다.
3.1 Reducing Data Transfer
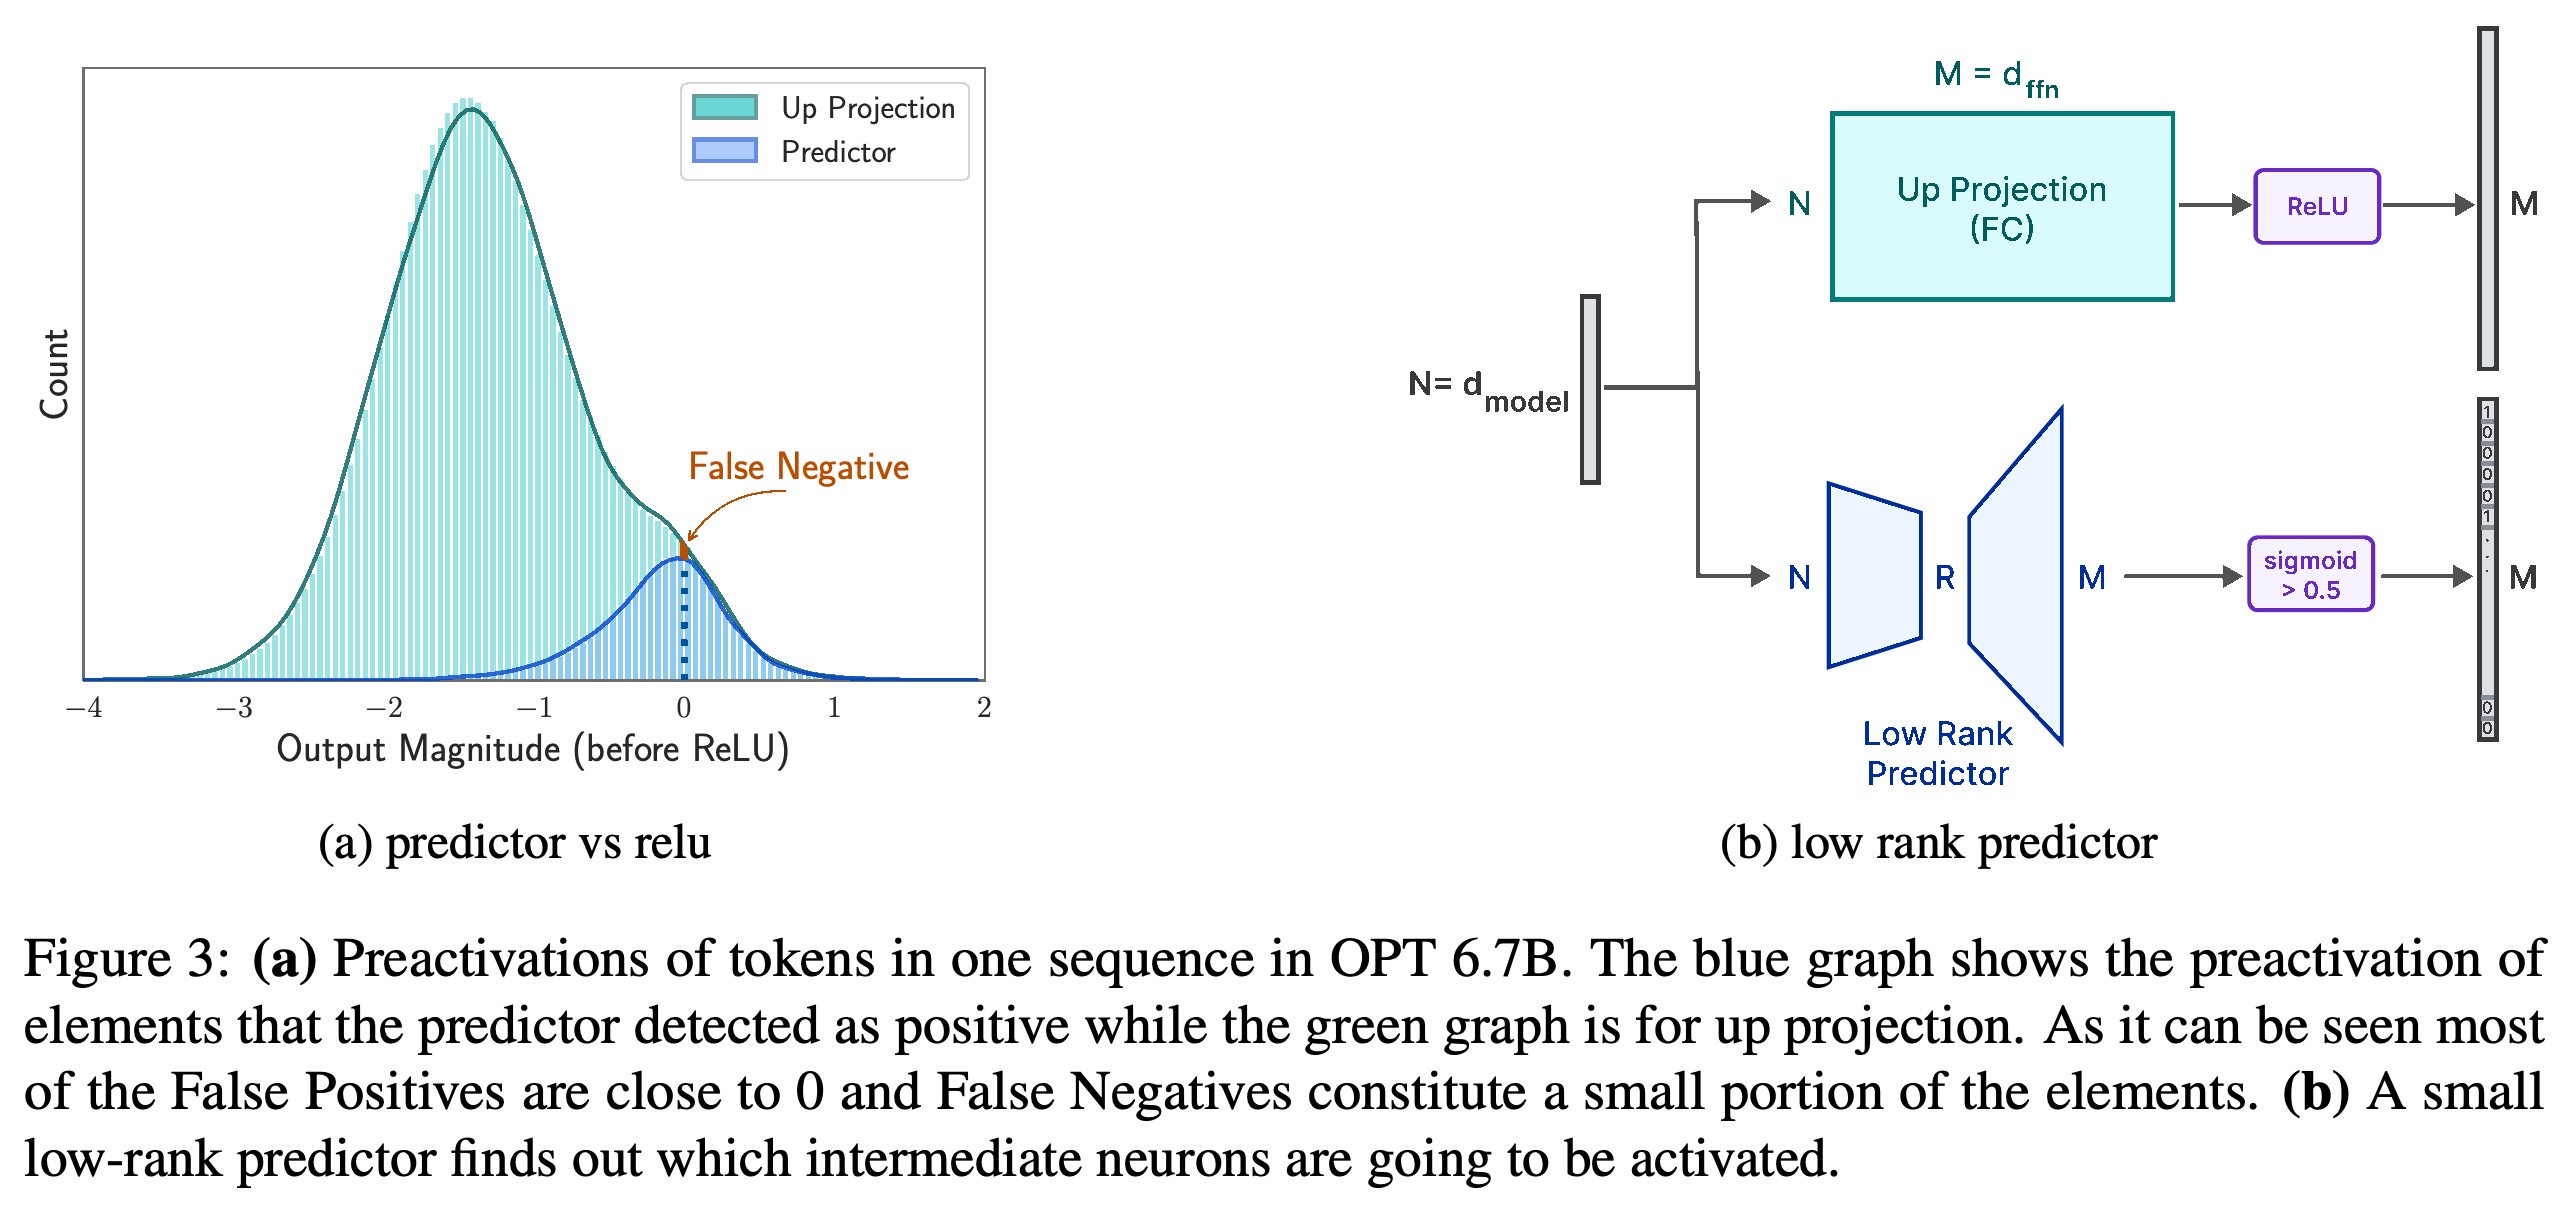
임베딩과 attention 가중치는 DRAM에 유지하고 FFN 가중치는 선택적으로 읽는다. 논문에서 동기를 설명하는 구성에서는 attention 가중치가 모델 크기의 약 3분의 1을 차지한다. 저랭크 예측기는 중간 차원이 입력 및 출력 차원보다 작은 경량 모델이다. 현재 층의 attention 출력을 받아, 양수가 아닌 입력을 영으로 만드는 활성화 함수인 ReLU를 통과해 살아남을 뉴런을 예측한다. 예측기는 양성 및 음성 예제의 균형을 맞추는 손실 함수로 C4 텍스트 데이터셋의 10000개 샘플을 2에포크 학습한다. 논문에서는 예측기마다 A100 GPU에서 4시간이 걸렸다고 보고한다.
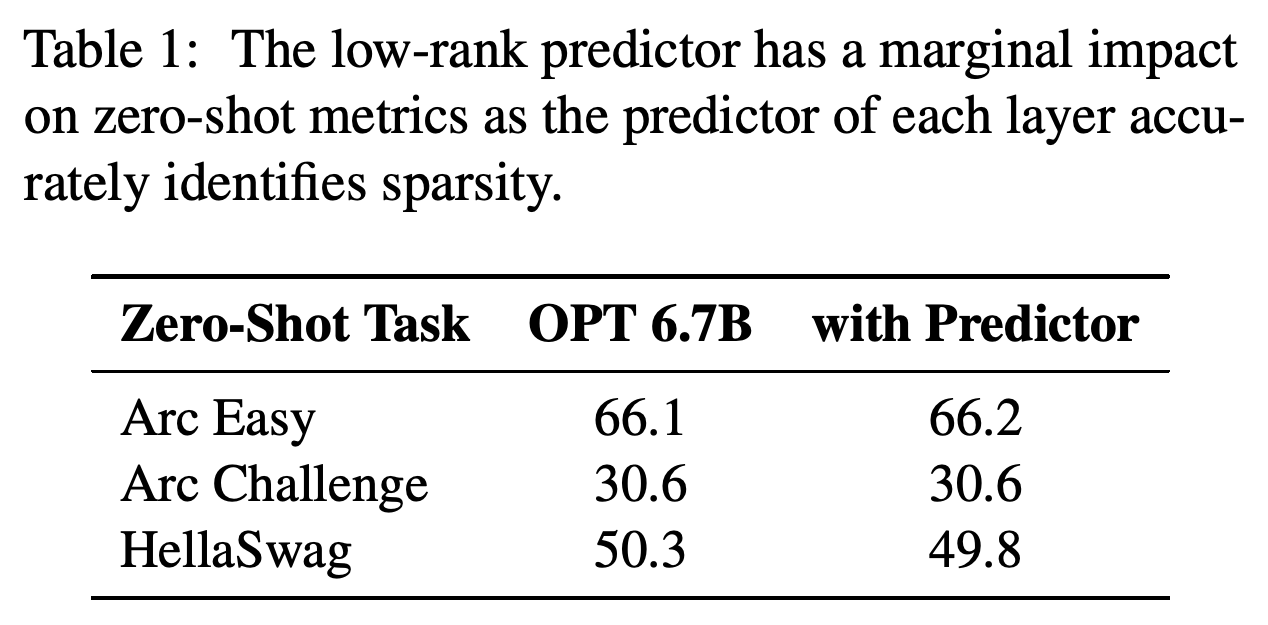
- Figure 3은 활성화 경계 부근의 예측 오류를 보여준다. 거짓 양성은 비활성 뉴런을 선택하고, 거짓 음성은 활성 뉴런을 놓친다. Table 1은 태스크별 예시를 제공하지 않는 zero-shot 평가에서 OPT 6.7B와 예측기를 추가한 모델을 비교한다. 점수는 Arc Easy에서 66.1 대 66.2, Arc Challenge에서 30.6 대 30.6, HellaSwag에서 50.3 대 49.8이다.
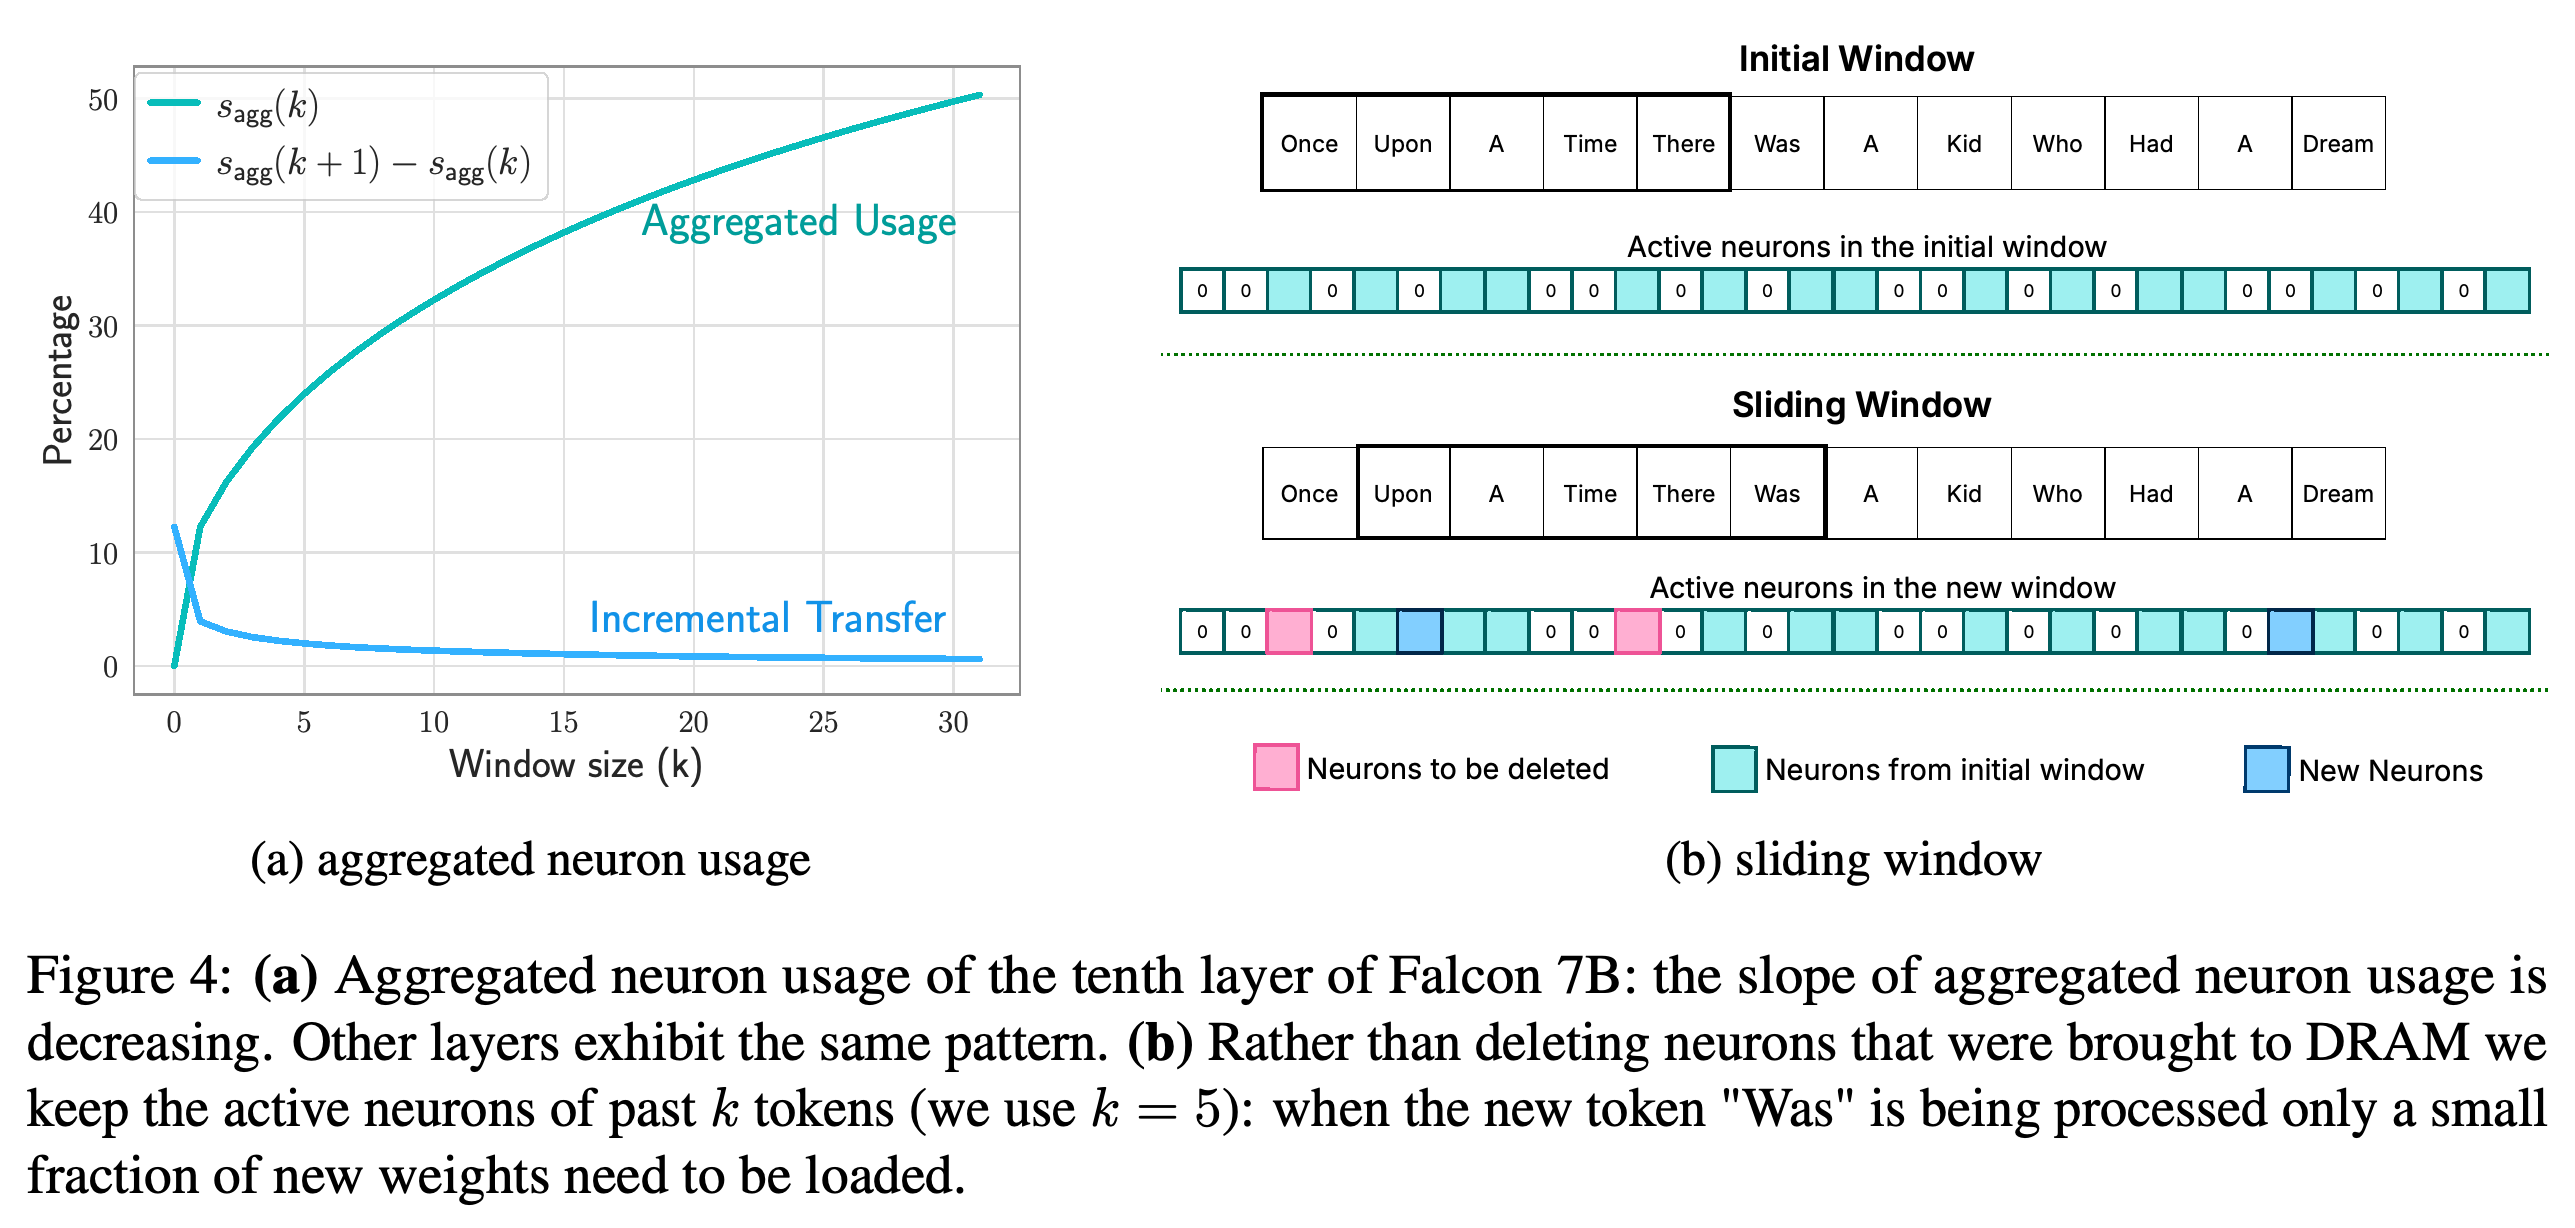
- Windowing은 최근 토큰에서 활성화될 것으로 예측한 가중치를 유지하고, 없는 가중치만 읽는다. s_agg(k)가 k개 토큰에 걸친 누적 뉴런 사용량을 나타낼 때, 논문은 추가 로딩량을 s_agg(k + 1) − s_agg(k)로 표현한다.
- Figure 4에서는 누적 뉴런 사용량이 증가하지만 증가 기울기는 점차 작아진다. 따라서 윈도우를 키우면 DRAM을 더 사용하는 대신 새로 전송할 가중치를 줄일 수 있다.
예측기는 전체 가중치를 읽기 전에 어떤 중간 뉴런이 양수 출력을 낼지 추정한다. 잘못 선택한 비활성 뉴런 중 상당수는 활성화 전 값이 0에 가깝고, 놓친 활성 뉴런은 분포의 작은 부분을 차지한다. 태스크 점수에 미치는 영향은 Table 1에서 별도로 측정한다.
OPT에 예측기를 추가하면 Arc Easy는 +0.1, HellaSwag는 −0.5만큼 변하고 Arc Challenge는 그대로다. 이 평가 3개에서는 OPT의 점수 영향이 작지만, 모든 모델이나 태스크에서 정확도가 유지됨을 입증하지는 않는다.
윈도우에 토큰이 더 많이 들어오면 누적 사용 뉴런의 범위는 늘지만, 다음 토큰에 필요한 추가 범위는 줄어든다. 캐시 갱신 예시는 재사용할 가중치, 만료된 가중치, 새로운 가중치를 구분해 상주량이 늘수록 새 전송량이 줄어드는 원리를 보여준다.
3.2 Increasing Transfer Throughput
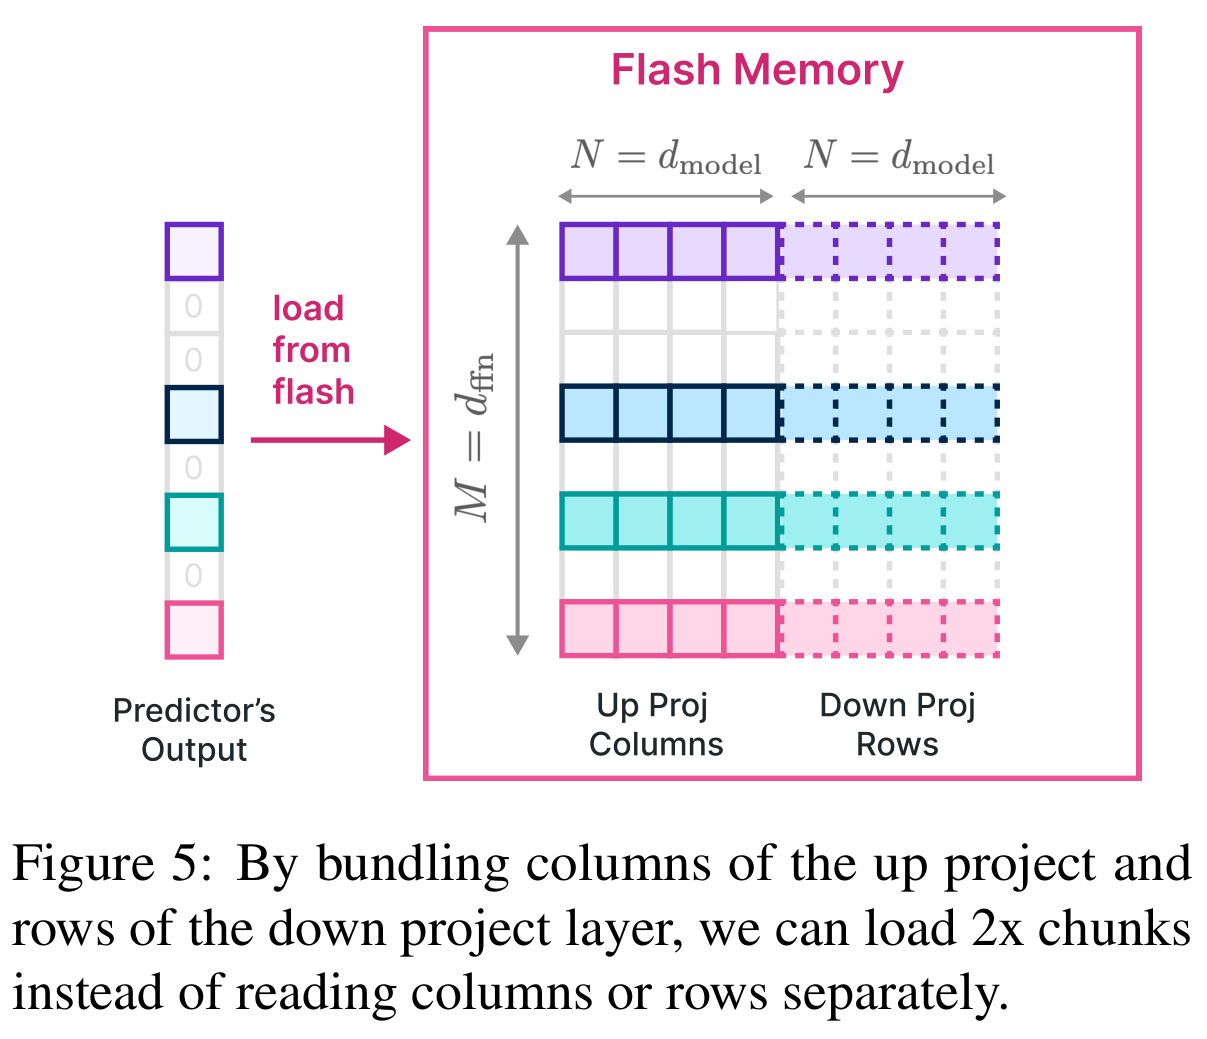
FFN의 중간 뉴런에는 대응하는 up-projection 열과 down-projection 행이 함께 필요하다. Row-column bundling은 이들을 연속해서 저장해 읽기 크기를 d_model × num_bytes에서 2d_model × num_bytes로 늘린다. d_model은 모델의 은닉 차원이고 num_bytes는 가중치 1개를 저장하는 데 필요한 크기다. Figure 5는 이 배치를 보여준다.
- 서로 다른 뉴런이 함께 활성화되는 경향에 따라 묶으려는 별도의 시도는 실패했다. 자주 활성화되는 뉴런이 여러 묶음에 포함되어 반복해서 로딩되었다. 뉴런 쌍의 동시 활성화 경향이 강하더라도 이 저장 배치 방식은 효과적이지 않았다.
선택한 중간 뉴런마다 up projection과 down projection의 가중치가 함께 필요하다. 이 가중치를 함께 배치하면 서로 다른 뉴런이 함께 활성화될지 예측하지 않아도 연속 읽기 크기가 두 배로 늘어난다.
3.3 Optimized Data Management in DRAM
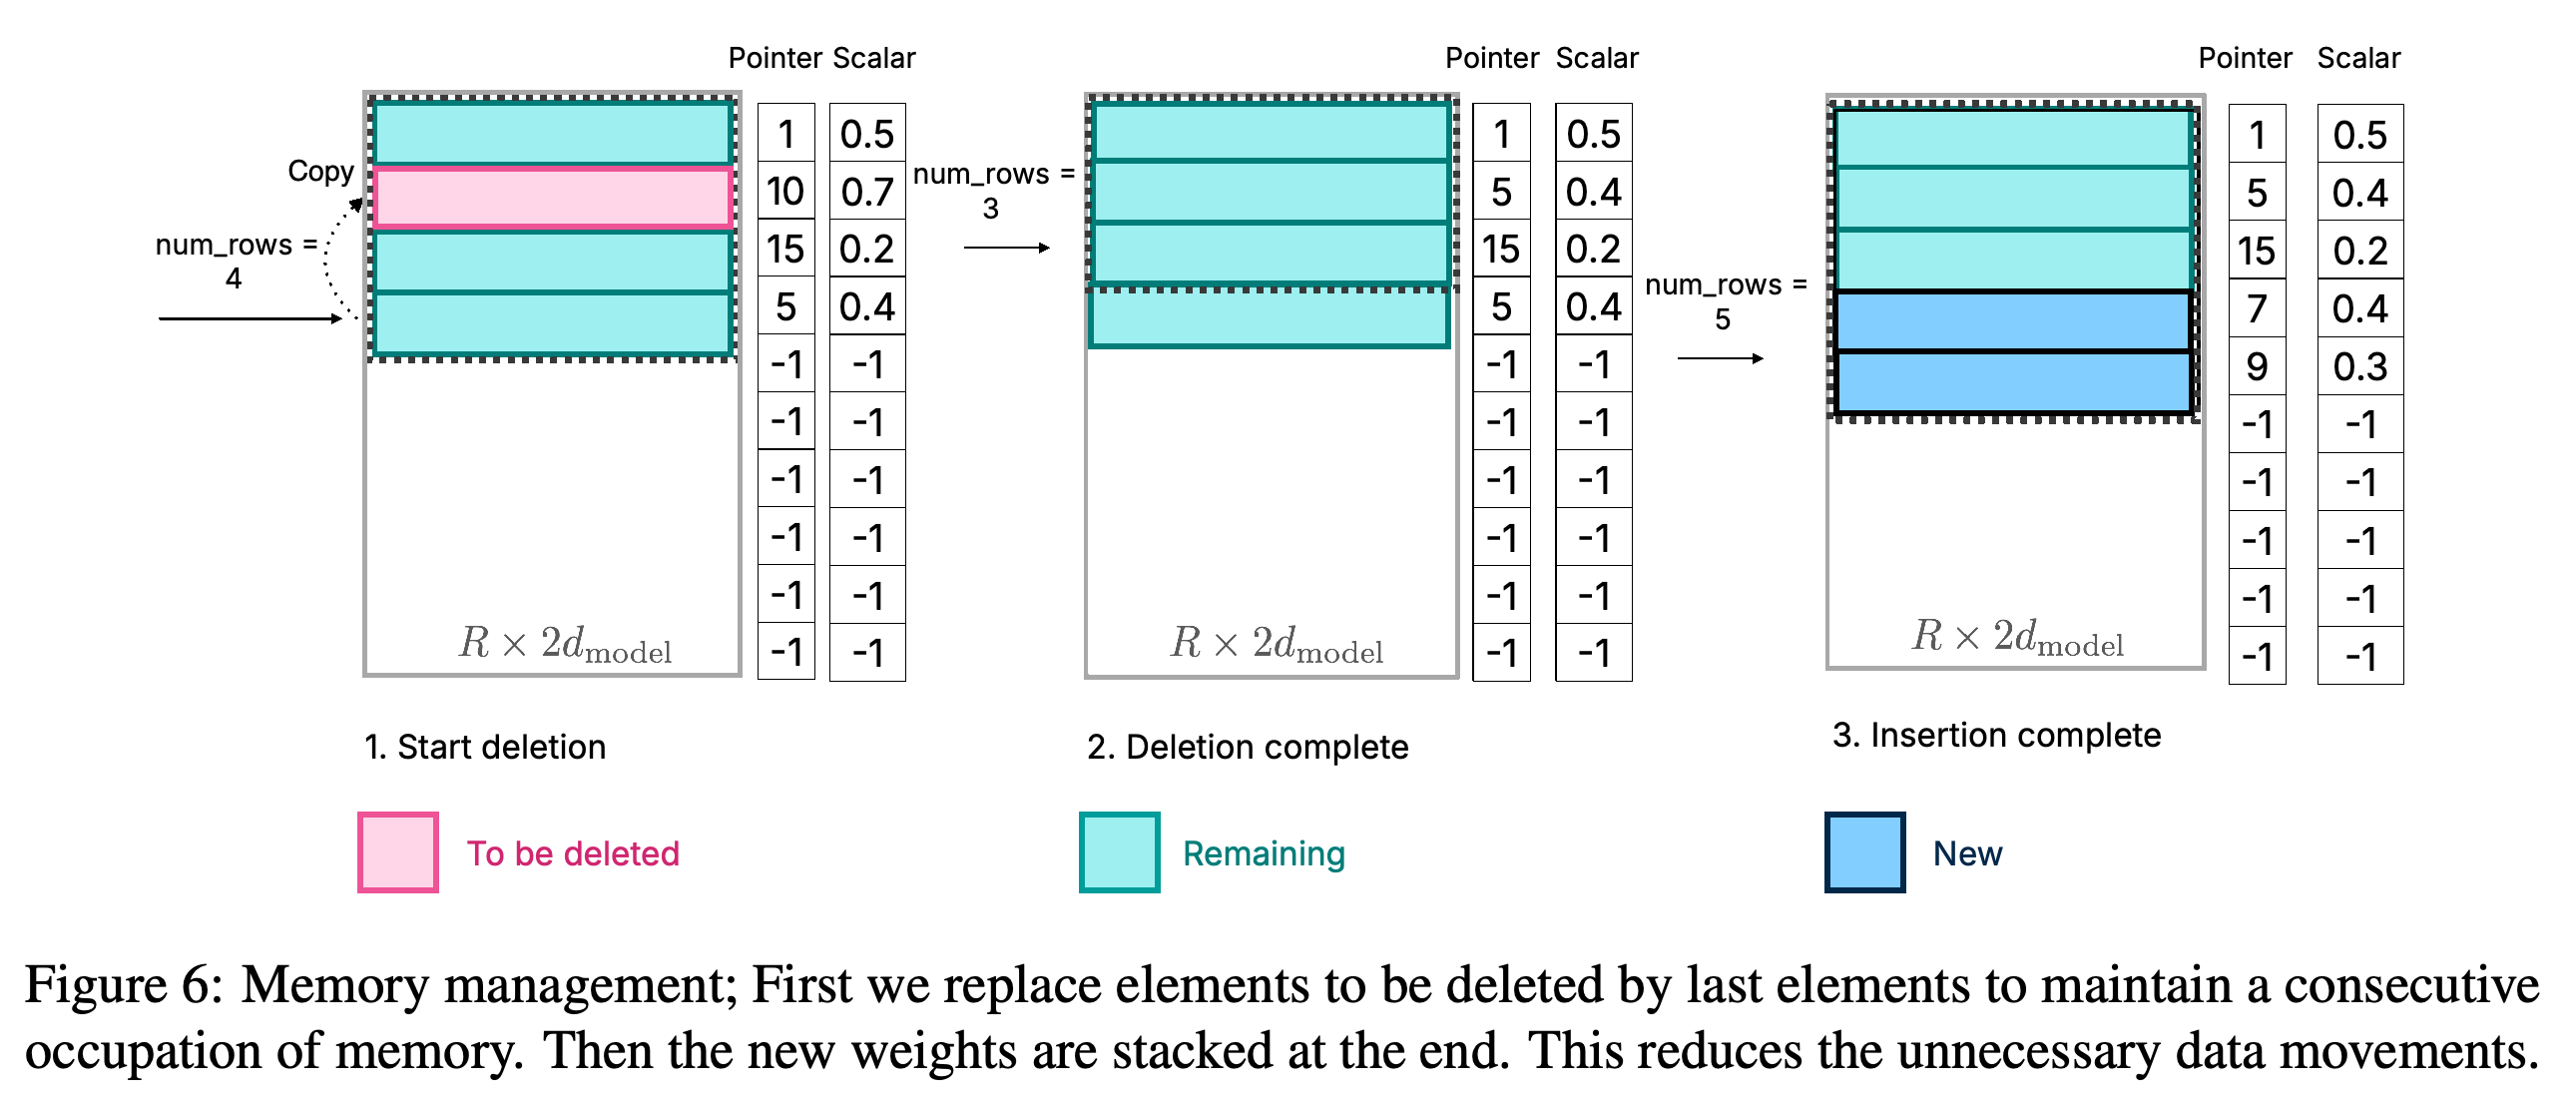
구현에서는 층마다 가중치 행렬을 미리 할당하고 원래 뉴런 인덱스, 편향, 사용 중인 행, 최근 활성 상태를 추적한다. Figure 6처럼 뉴런을 제거할 때는 사용 중인 영역의 마지막 행으로 해당 행을 대체하고, 새로 읽은 가중치는 그 뒤에 추가한다. 이 방식은 캐시 내용이 바뀔 때마다 전체 캐시를 복사하지 않으면서 사용 중인 저장 영역의 연속성을 유지한다.
- 뉴런 c개를 제거할 때 논문에 제시된 재작성 비용은 O(c × d_model)이며, 제거한 뉴런 수와 은닉 차원에 비례한다. 대응하는 up-projection 및 down-projection 가중치를 일관되게 재배열하면 중간 뉴런의 순서를 바꿔도 FFN 출력이 유지된다.
- 추론에서는 up projection에 matrix[:num_rows,:d_model] 뷰를 사용하고, down projection에 matrix[:num_rows,d_model:].transpose() 뷰를 사용한다.
만료된 행을 사용 중인 마지막 행으로 대체하면 활성 영역을 빈틈없이 유지할 수 있다. 이후 행렬을 재할당하거나 유지할 가중치를 모두 복사하지 않고도 새 행을 뒤에 추가할 수 있다.
4 Experiments and Results
실험은 여러 모델과 추론을 실행하는 소프트웨어 및 하드웨어 경로인 실행 백엔드에서 지연 시간을 측정한다. 구성 요소별 로딩 측정, 전체 추론 측정, 메모리와 지연 시간의 절충 관계 분석을 포함한다. 예측기와 구현에 관한 추가 근거는 부록에 제시한다.
4.1 Experimental Setup
구현은 HuggingFace Transformers와 PyTorch를 사용하며, 한 번에 시퀀스 1개를 처리한다. 생성 중에 재사용하는 attention key와 value를 저장하는 Key-Value(KV) 캐시를 위해 메모리를 별도로 확보한다. 지연 시간 측정에는 작은 C4 검증 부분집합을 사용하고, 처음 128토큰을 프롬프트로 입력한 뒤 256토큰을 생성한다. 평가 모델은 OPT 6.7B, 희소화한 Falcon 7B, Phi-2, Persimmon 8B, 희소화한 Llama 2다. 희소화는 활성화 값이 0인 경우가 더 많아지도록 모델을 수정하는 과정이다.
- 하드웨어는 1TB SSD를 탑재한 Apple M1 Max, 2TB SSD를 탑재한 Apple M2 Ultra, 24GB NVIDIA RTX 4090을 탑재한 Linux 머신으로 구성된다. Apple CPU 실행에는 32-bit 부동소수점 형식인 float32를, Apple Metal GPU 실행에는 16-bit 형식인 float16을, RTX 실행에는 또 다른 16-bit 형식인 bfloat16을 사용한다.
- 대부분의 구성은 모델 크기의 약 50%를 상주 가중치에 할당한다. Phi-2는 활성화 희소성이 낮아 65%를 사용한다. 실험은 테스트 머신에서 할당량을 제한하고 KV 캐시 용량은 별도로 확보한다.
- 단순 베이스라인은 순전파마다 필요한 가중치를 읽는다. 하이브리드 베이스라인은 희소성을 활용하지 않고 모델 일부를 유지하면서 나머지를 스트리밍한다. 베이스라인 I/O 시간에는 낙관적인 이론적 전송률을 적용한다. 읽기에는 스레드 32개를 사용하며, 저장장치 벤치마크에서는 운영체제 캐싱을 비활성화한다.
4.2 Faster Load From Flash
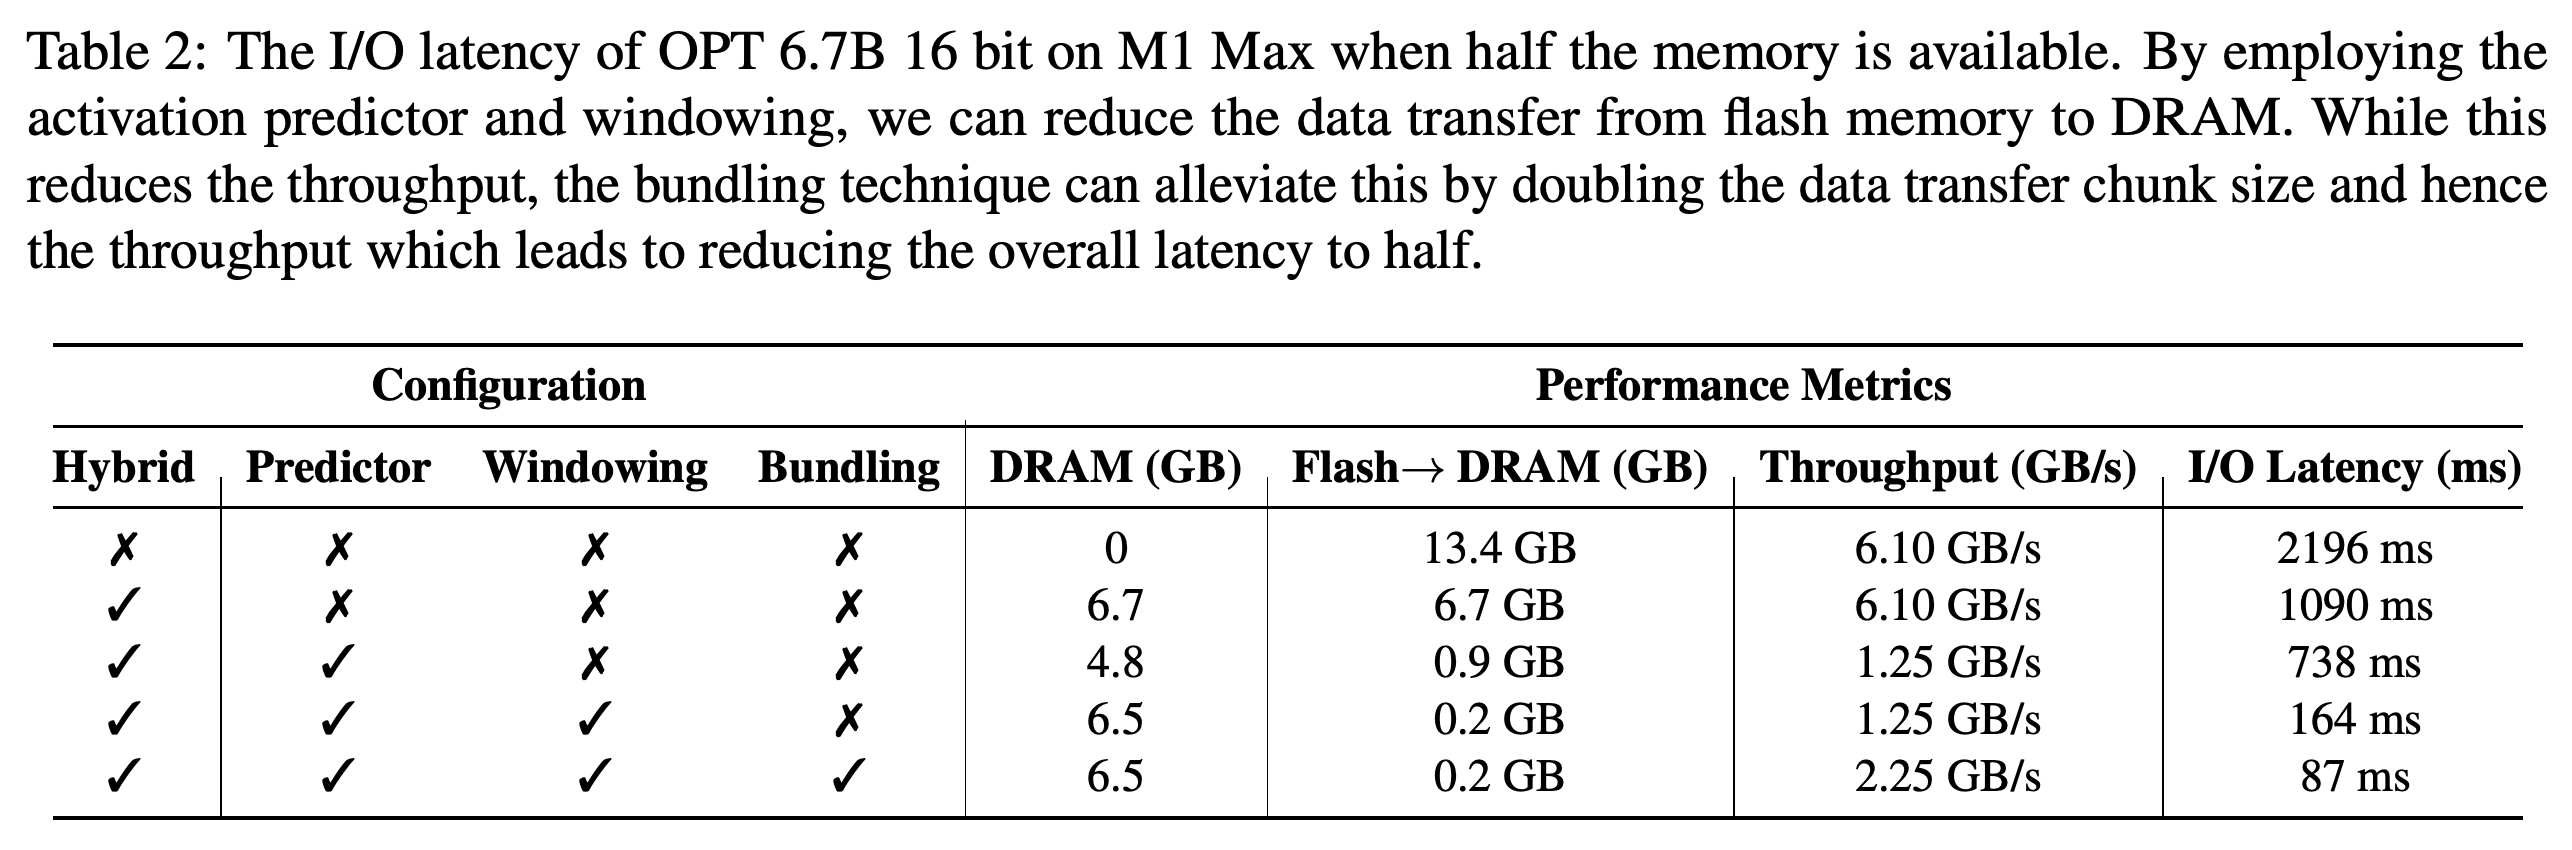
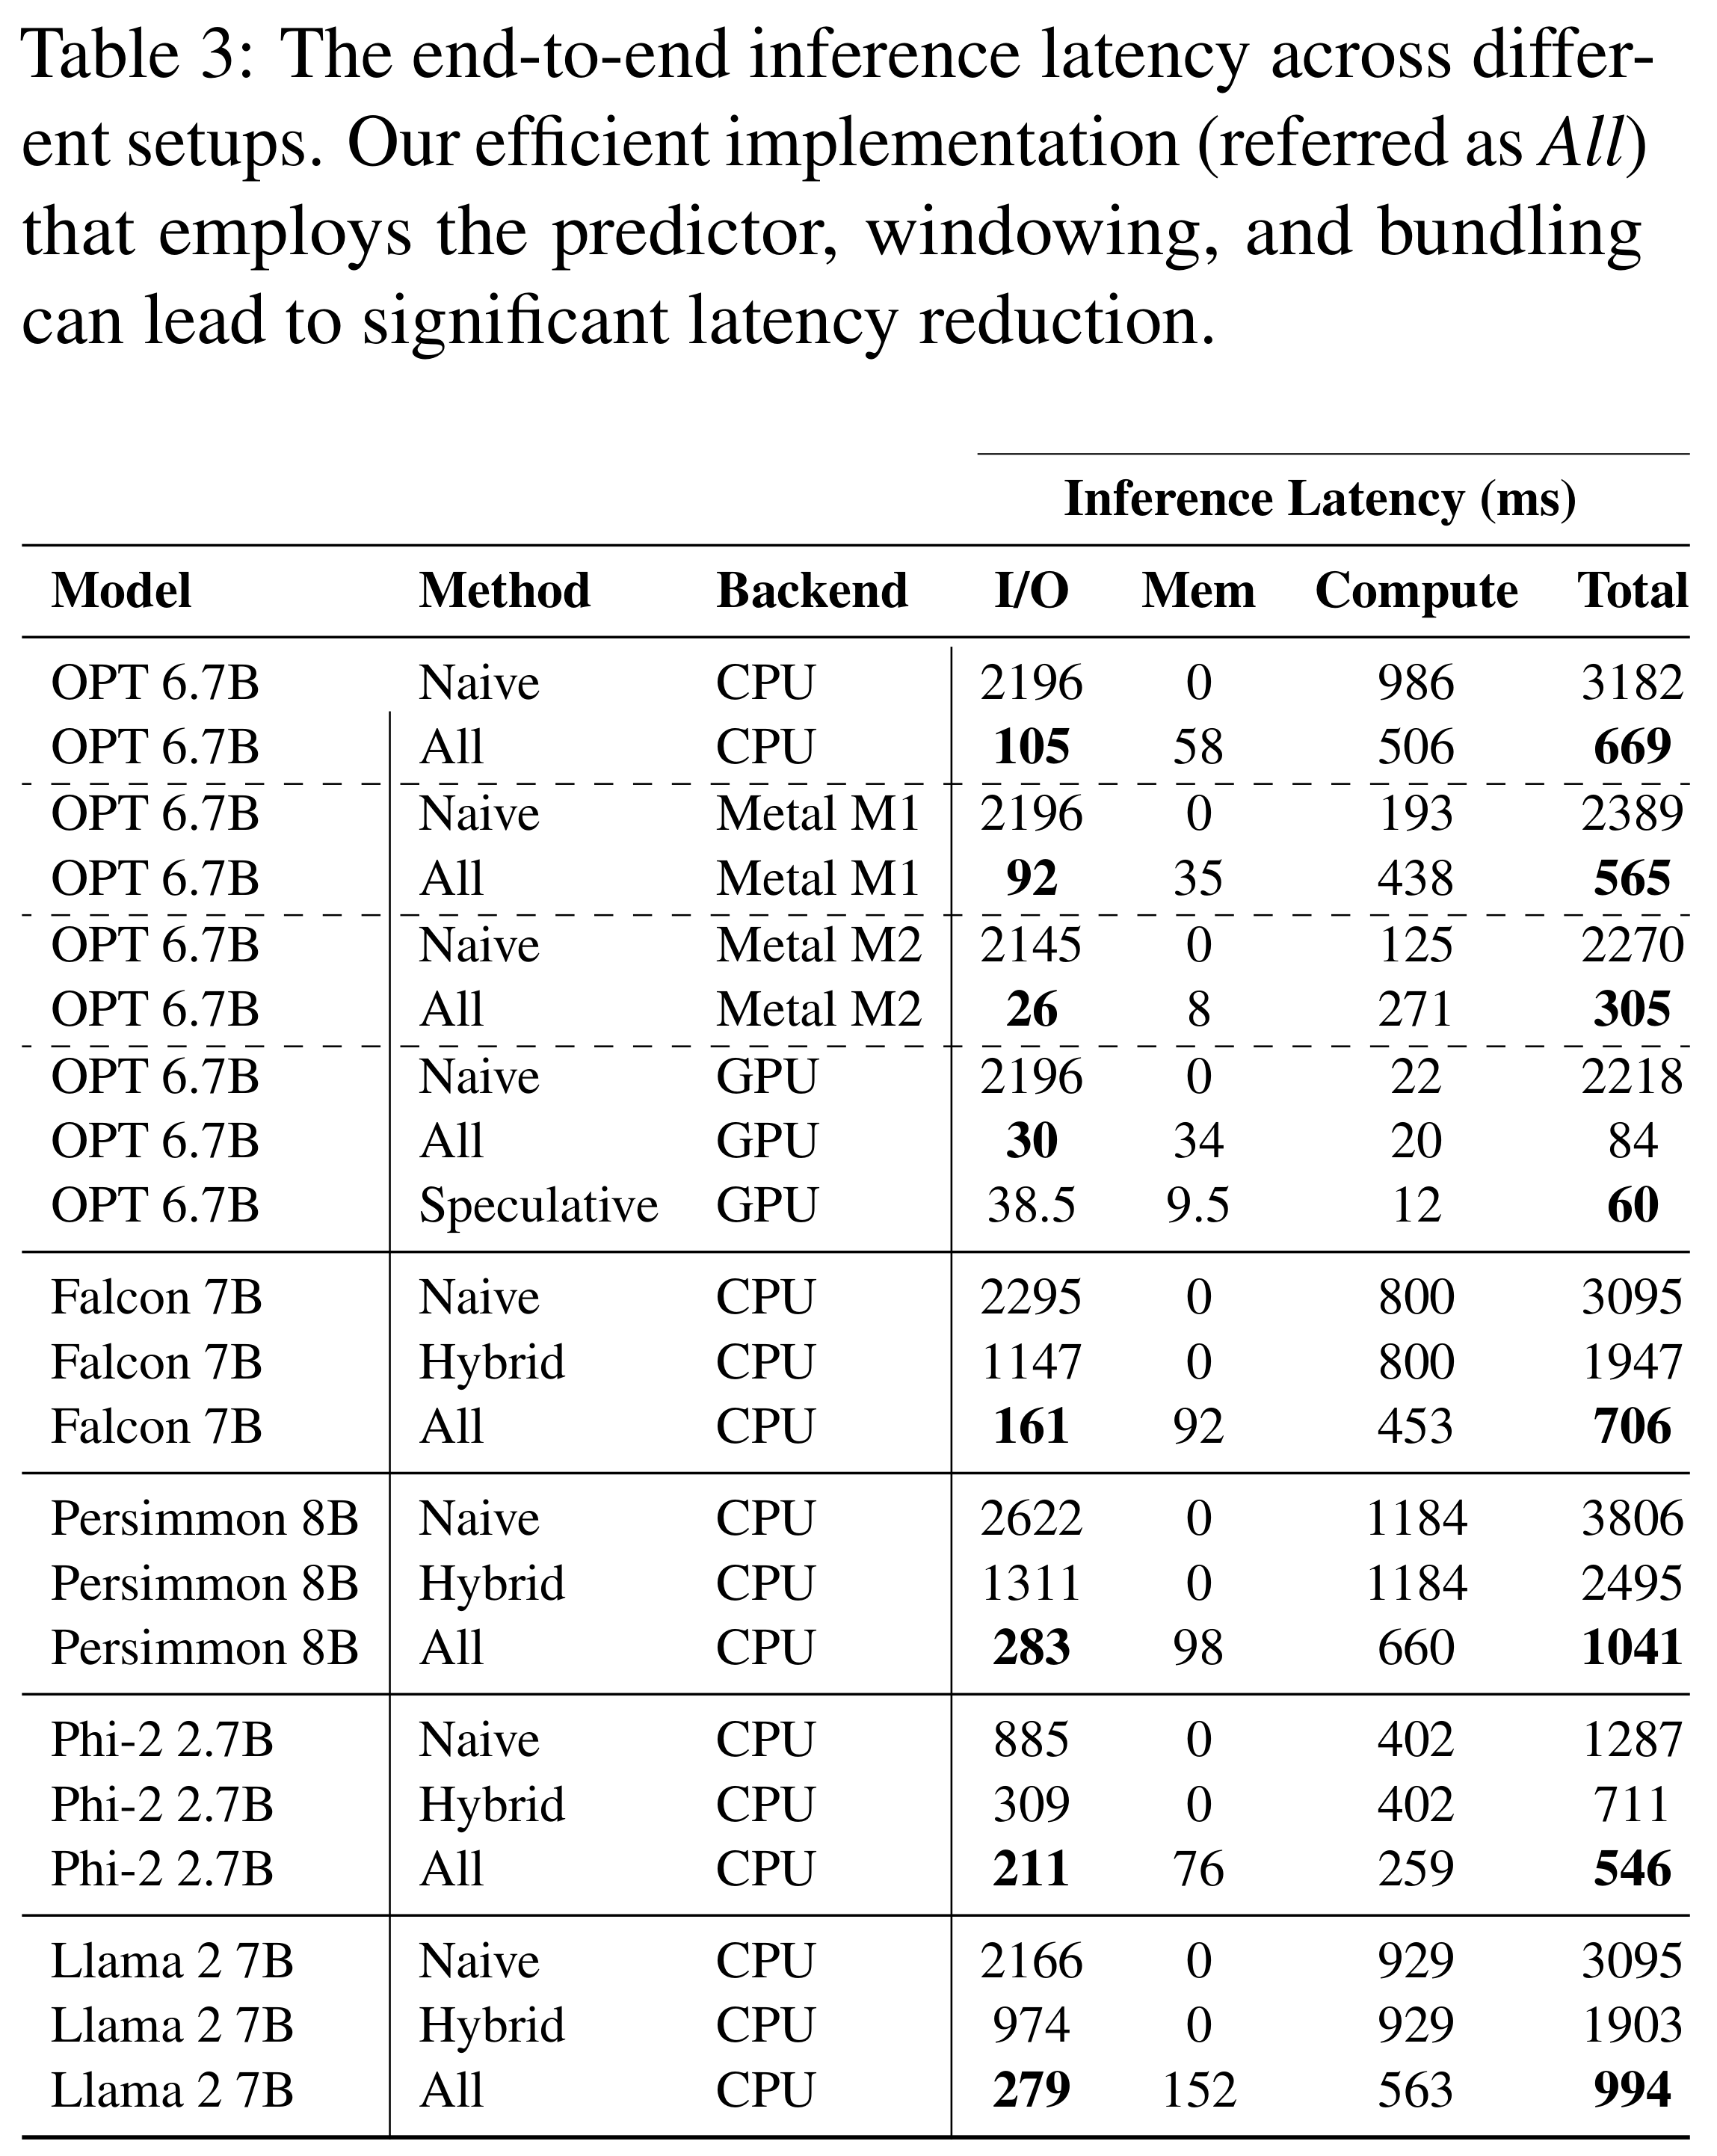
Table 2는 M1 Max에서 16-bit OPT 6.7B를 실행할 때 각 로딩 기법의 효과를 구분한다. 예측과 windowing은 전송량을 줄이고, bundling은 남은 희소 읽기의 처리량을 높인다. Table 3에서 OPT 6.7B의 전체 지연 시간은 CPU에서 3182 → 669ms, Metal M1에서 2389 → 565ms, Metal M2에서 2270 → 305ms, NVIDIA GPU에서 2218 → 84ms로 줄어든다.
- Table 2에서 하이브리드 로딩은 6.7GB를 전송하며 1090ms가 걸린다. 예측을 추가하면 전송량은 0.9GB, 시간은 738ms로 줄어든다. Windowing을 적용하면 0.2GB와 164ms로 줄고, bundling은 처리량을 1.25 → 2.25GB/s로 높여 I/O 지연 시간을 87ms로 줄인다.
- 전체 제안 방식을 적용한 CPU 추론 지연 시간은 Falcon 7B에서 706ms, Persimmon 8B에서 1041ms, Phi-2 2.7B에서 546ms, Llama 2 7B에서 994ms다. 각 모델의 하이브리드 베이스라인은 같은 순서로 1947, 2495, 711, 1903ms다.
- 희소 실행은 계산 오버헤드를 유발할 수 있다. Metal M1에서 OPT 6.7B의 계산 시간은 193 → 438ms로 늘지만 전체 지연 시간은 줄어든다. 이 구성에서는 로딩 시간 절감이 추가 계산 비용보다 크다.
절제 실험은 전송량과 처리량의 효과를 구분한다. 예측과 windowing은 바이트 수를 줄이고, bundling은 보고된 전송량 0.2GB를 그대로 유지하면서 처리량을 1.25 → 2.25GB/s로 높인다. 이에 따라 I/O 지연 시간이 164 → 87ms로 줄어든다.
나열된 모델 전반에서 전체 추론 성능이 개선되지만 개선 폭은 크게 다르다. 세부 내역에서는 Metal 백엔드의 계산 시간이 증가하고, speculative decoding을 적용하면 GPU 시간이 84 → 60ms로 더 줄어드는 점도 드러난다.
4.3 The Memory-Latency Tradeoff
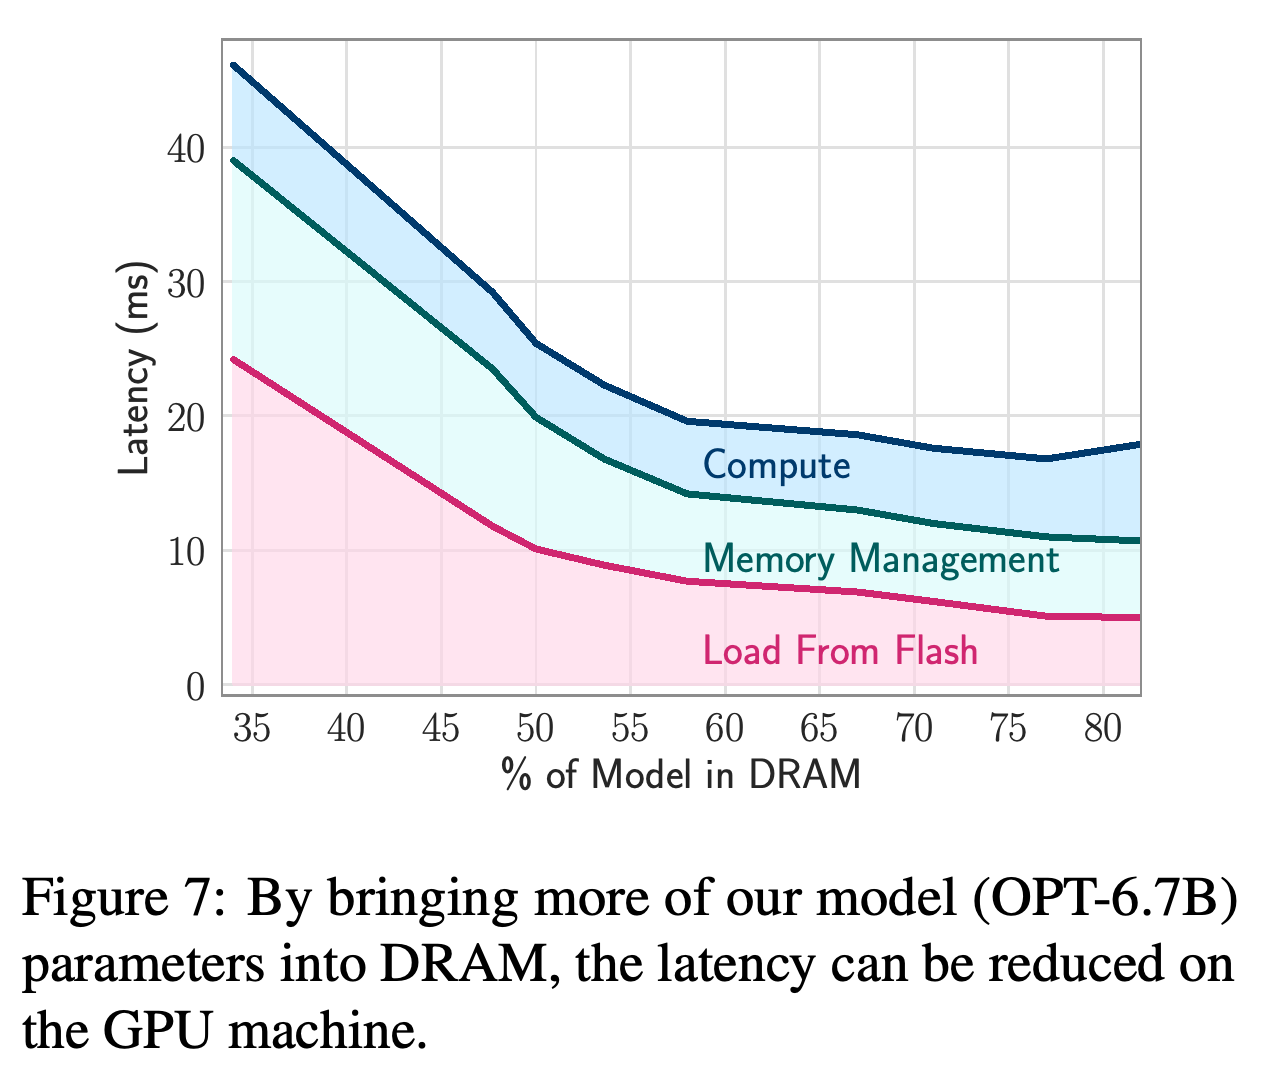
윈도우를 키우면 DRAM에 더 많은 가중치를 유지하므로 이후 토큰을 위해 읽어야 하는 가중치가 줄어든다. Figure 7은 GPU 머신에서 OPT-6.7B의 이러한 절충 관계를 보여주며, 그래프 범위 대부분에서 상주 비율이 높아질수록 전체 지연 시간이 낮아진다. 모델의 약 절반을 상주시키는 설정은 실험에서 선택한 운영 조건이며 고정된 요구 사항은 아니다.
OPT-6.7B의 상주 가중치 비율을 높이면 대부분의 범위에서 플래시 로딩과 메모리 관리 지연 시간이 줄어든다. 전체 지연 시간 곡선은 개선 폭이 점차 작아지다가 가장 높은 상주 비율에서 조금 상승하므로, 측정된 관계가 엄밀하게 단조롭지는 않다.
5 Ablation analysis
절제 실험은 생성 길이를 늘리는 경우와 speculative decoding을 추가하는 경우를 평가한다. Speculative decoding은 초안 모델이 제안한 토큰을 더 큰 모델이 검증하는 방식이다. 별도의 전력 논의에서는 순간 전력과 생성 과정에서 소비한 총에너지를 구분한다.
5.1 The Impact of Longer Generation
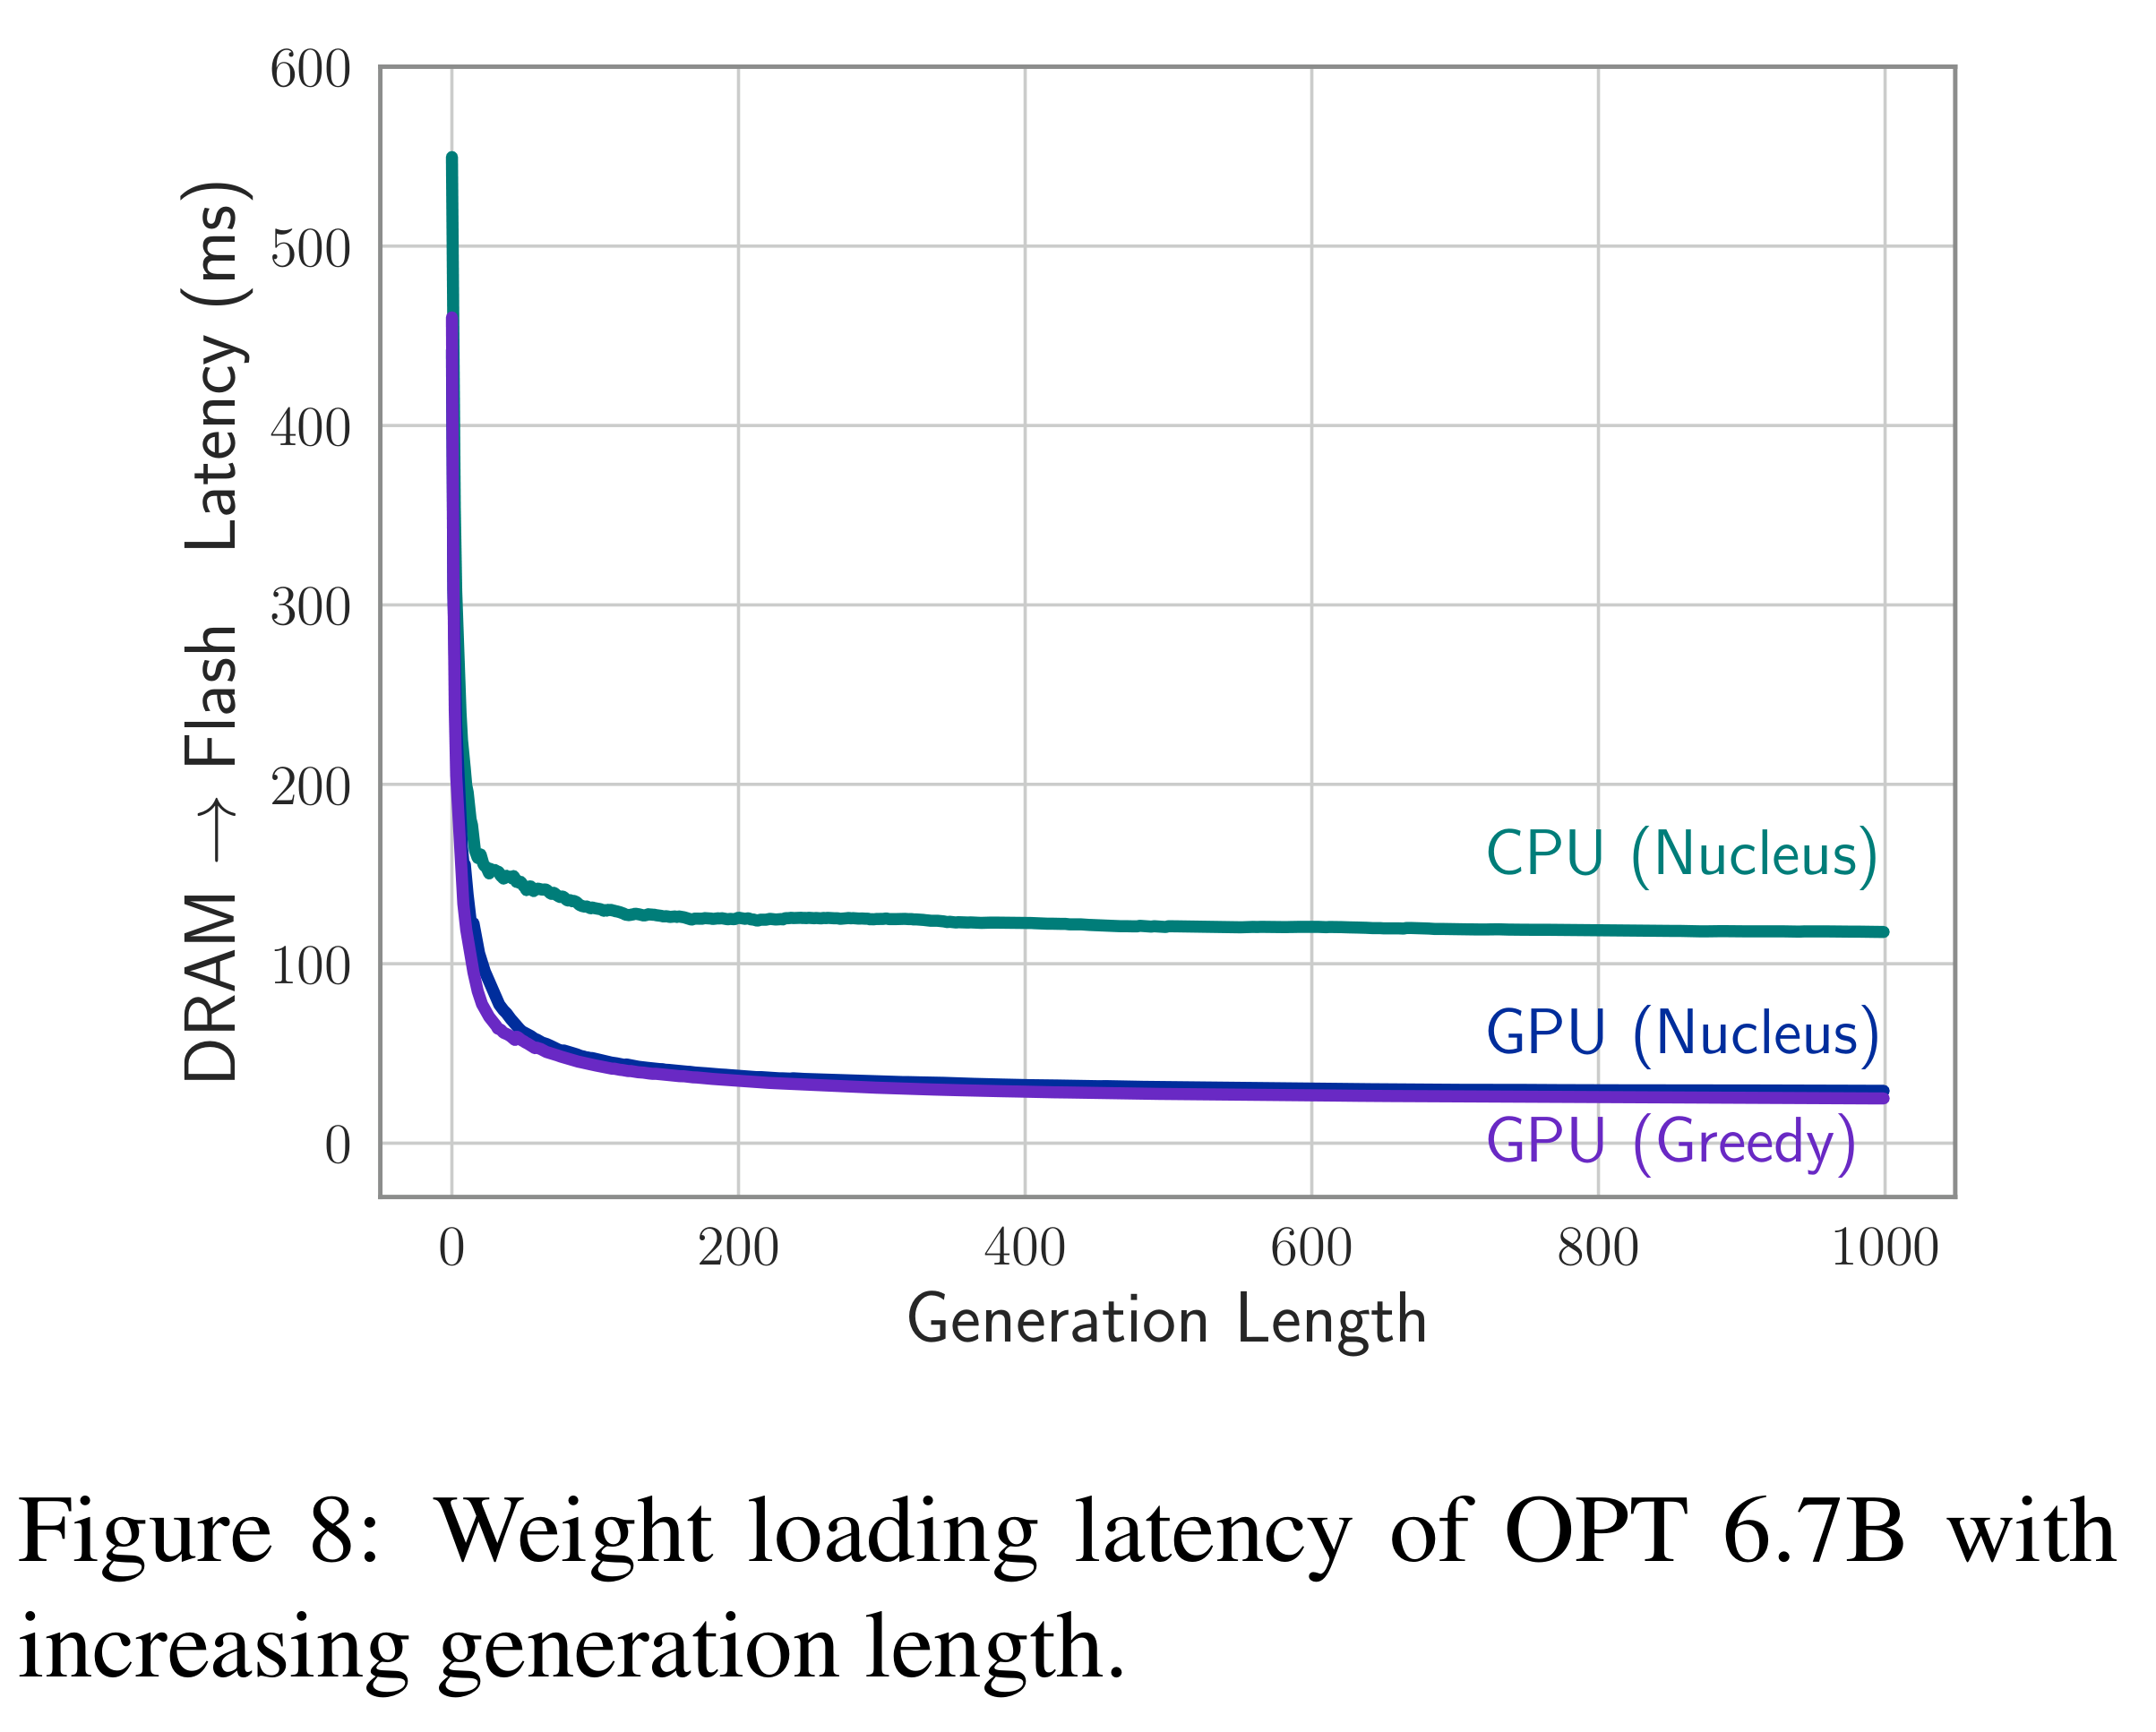
저자들은 OPT 6.7B의 생성 길이를 256토큰에서 1000토큰으로 늘려도 해당 구간에서 평균 플래시 로딩 지연 시간이 증가하지 않는다고 보고한다. Figure 8에서는 초기 로딩 비용이 크지만, 가중치 캐시가 채워지면서 평균 지연 시간이 줄어든 뒤 대체로 안정된다. 탐욕적 선택을 사용하지 않는 토큰 선택 방식인 nucleus sampling에서도 CPU와 GPU의 로딩 성능이 유지된다.
평균 로딩 지연 시간은 초기 캐시 충전 후 급격히 낮아지고, 생성 길이 1000토큰까지 대체로 안정적으로 유지된다. 이는 측정 구간에서 로딩 성능이 지속됨을 뒷받침하지만, 그림에 직접적인 온도 측정값은 없다.
5.2 Speculative Decoding
Speculative decoding에서는 제안한 토큰의 수락 여부를 알기 전에 어떤 토큰의 뉴런을 유지할지 결정해야 한다. 그렇지 않으면 거부된 제안이 다음 단계에 기여하지 못하면서 캐시 공간을 차지할 수 있다. 초안 토큰 수를 \(\lambda=4\)로 설정했을 때 논문은 디코딩이 추가로 1.4배 빨라졌다고 보고한다. Table 5에서 전체 GPU 제안 방식은 84.64 ± 6.16ms, speculative decoding을 추가한 방식은 60.16 ± 13.4ms이며, ±는 표준편차를 나타낸다.
- 제안한 캐시 규칙은 \(\alpha(\lambda+1)\)번째 토큰에서 끝나는 k개 토큰을 유지하며, α는 수락 비율이다. 저자들은 이 규칙의 최적성을 추측으로 제시한다.
5.3 A Note on Power Consumption
저자들의 비교에서 희소 방식은 활성화 희소성을 활용하지 않는 비슷한 크기의 밀집 모델보다 순간 전력이 낮지만, 토큰 생성 시간이 길어 총에너지 소비는 더 크다. 논문은 수치로 된 전력 추이를 제공하지 않으며, 체계적인 정량 평가는 후속 과제로 남긴다. 따라서 플래시 로딩 베이스라인보다 지연 시간이 줄었다는 결과만으로 밀집 실행보다 에너지를 절감한다고 볼 수는 없다.
6 Related Works
논문은 플래시 로딩을 효율화하는 접근을 압축 및 선택적 계산과 함께 설명한다. Deja vu는 활성화 희소성을 예측해 GPU 메모리에서 가중치를 선택하고, FlexGen은 GPU 메모리, DRAM, 플래시 사이에서 가중치와 KV 캐시를 이동한다. 이 연구는 전체 모델을 가용 작업 메모리에 유지할 수 없어 반복적인 플래시 접근이 주요 비용이 되는 경우에 집중한다.
7 Discussion
논의에서는 최근 토큰 간 가중치 재사용, 대응하는 가중치의 연속 읽기, 상주 가중치의 효율적인 관리를 결합한 것이 성능 향상의 원인이라고 설명한다. 기존 로딩 방식과 비교한 OPT의 가속률은 CPU에서 약 4–5배, GPU에서 약 20–25배로 보고하며, Table 3에는 백엔드별 측정값을 제시한다. 개선된 bundling, 자료 구조, 하드웨어별 실행 최적화는 후속 과제로 제시한다.
8 Limitations
실험 근거는 단일 시퀀스 추론에 한정되며, speculative decoding 결과는 예비 수준이고 메모리 할당량은 주로 모델 크기의 절반이다. 프롬프트 처리, 여러 시퀀스의 동시 실행, 더 다양한 메모리 예산, 체계적인 발열 특성 분석, 정량적인 에너지 평가에는 추가 연구가 필요하다. 입증된 방법은 희소하거나 희소화한 네트워크에 의존하며, 비희소 모델에 개념을 적용하는 방안은 향후 방향으로 제안한다.
부록
- A Appendix Overview는 보충 근거의 구성을 안내한다. B는 예측기의 정확도와 효율성, C는 구현과 모델별 결과, D는 실패한 동시 활성화 기반 bundling 실험, E는 확장된 관련 연구, F는 소형 기기에 대한 시사점, G는 생성 텍스트 비교를 다룬다.
- B Low-Rank Activation Predictor: Additional Results는 예측기가 정확도, 가중치 전송량, 추론 오버헤드에 미치는 영향을 평가한다. 활성 뉴런을 놓치지 않으려면 뉴런을 더 많이 선택해야 하므로 불필요한 플래시 읽기가 추가된다.
- B.1 Sparsity patterns of predictors는 무작위로 뽑은 C4 검증 샘플 100개를 사용한다. 예측기는 OPT와 Persimmon에서 실제 활성 뉴런 수의 약 3배를, Phi-2에서는 약 2배를 선택한다. 활성 뉴런을 놓치는 경우를 줄이기 위해 중복 로딩을 감수하는 방식이다. OPT와 Persimmon은 후반 층에서, Phi-2는 중간 층에서 활성도가 더 높다.
- B.2 Accuracy of models using predictors는 정확도 유지 여부가 예측기의 랭크와 임계값에 따라 달라진다는 점을 보여준다. 여러 태스크의 정확도를 평가하는 Massive Multitask Language Understanding(MMLU)에서, Persimmon의 마지막 4개 층에 더 큰 예측기를 배치하면 모든 층에 rank-256 예측기를 사용할 때보다 성능을 더 잘 유지한다. Phi-2는 증류를 적용한 ReLU 변환 후 54.3이던 점수가 예측기를 추가하면 52로 낮아진다. Table 4에서도 모델마다 zero-shot 점수 변화가 다르게 나타난다.
- B.3 Overhead of predictors에 따르면 OPT-6.7B 예측기의 평균 랭크는 240이며, 예측기는 임베딩을 제외한 가중치와 부동소수점 연산 수(FLOPs)의 2.4% 미만을 차지한다. 측정한 추론 시간 비중은 OPT의 M1 Max CPU에서 2.75%, RTX GPU에서 4.8%이고, Persimmon의 CPU에서 2.85%다. Llama 2는 CPU에서 3.92%다. Falcon 예측기는 모델 크기와 CPU 계산량의 4%를 차지한다.
- C Extended Results는 형태가 달라지는 희소 가중치를 효율적으로 처리하기 위한 구현 변경을 설명한다. macOS 14.3에서는 Apple의 MLX 프레임워크에서 가져온 GPU 계산 루틴인 맞춤형 Metal 커널이 바이너리 확장 안에서 동적 형태를 처리한다. MTLStorageModeShared는 CPU와 GPU가 공유 버퍼에 접근할 수 있게 한다. 저장장치 측정에서는 macOS와 iOS의 fcntl()을 통한 F_NOCACHE, Linux의 DirectIO로 파일시스템 캐싱을 비활성화한다. macOS 벤치마크에서는 purge로 메모리에 남은 버퍼도 비운다.
- C.1 Results for OPT 6.7B Model은 처음 28개 층에 rank-128 예측기를, 마지막 4개 층에 rank-1024 예측기를 사용하며, 평균 거짓 음성률과 거짓 양성률을 각각 5%와 7%로 보고한다. 상주 가중치의 구성은 예측기 1.25%, 임베딩 3%, attention 32.3%, 캐시된 FFN 가중치 15.5%로, 합계는 모델 크기의 52.1%다. 본문에서는 k = 4라고 설명하면서 최근 5토큰도 언급하므로 윈도우의 토큰 수를 세는 기준이 모호하다. Table 5의 CPU 지연 시간은 토큰당 669.20 ± 39.74ms다.
- C.2 Results for Falcon 7B Model은 ReLU로 변환하고 미세 조정한 모델을 사용한다. 예측기 랭크는 처음 28개 층에서 256, 마지막 4개 층에서 1152다. 4토큰 윈도우는 FFN 가중치의 33%를 유지하며, 전체 상주 비율은 모델 크기의 52.93%다. 플래시 로딩 약 161ms와 메모리 관리 90ms는 메모리 관련 비용을 나타낸다. Table 3의 전체 시간 706ms에는 계산도 포함된다.
- C.3 Persimmon 8B는 추가 미세 조정 없이 기존 squared-ReLU 활성화를 사용한다. 이 함수는 ReLU의 양수 출력을 제곱한다. 예측기 랭크는 처음 32개 층에서 256, 마지막 4개 층에서 1152이며 임계값은 0.7이다. 기본 4토큰 윈도우는 캐시된 가중치가 FFN 크기의 25%를 넘으면 줄어든다. Table 5의 전체 CPU 지연 시간은 1090.08 ± 79.08ms로 Table 3의 1041ms와 다르지만, 이 차이를 명시적으로 설명하지는 않는다.
- C.4 Phi-2는 먼저 모델을 ReLU로 변환하고, 모델 품질 회복을 위한 학습 항인 증류 손실을 사용해 refined-web 데이터로 미세 조정한다. MMLU는 이 변환 후 57에서 54.3으로, 예측기를 통합한 후 52로 낮아진다. 구현에서는 희소성이 낮은 중간 층에 더 큰 예측기를 배치하고, 메모리 예산 65%에 맞춰 윈도우를 조절한다. 단순 로딩 대비 가속률은 약 2.35배로 보고한다.
- C.5 Llama 2는 게이트 값이 충분히 큰 뉴런을 유지하는 임계값 기반 활성화 함수 FATReLU로 희소화한 모델을 평가한다. 2토큰 윈도우를 사용하고, 중간 4개 층에는 rank-1024 예측기를, 나머지 층에는 rank-256 예측기를 배치한다. 상주 가중치가 모델 크기의 55%를 넘으면 추가 캐싱을 중단한다. 보고된 MMLU 점수는 원본 모델 41.8, 희소화 모델 38.96, 예측기를 추가한 모델 38.63이다. 희소 활성화를 결정하는 gate projection을 직접 유지하는 방식은 윈도우가 1이어도 상주 비율 65%가 필요하다.
- D Bundling Based on Co-activation은 자주 함께 활성화되는 뉴런을 같은 저장 묶음에 배치하는 방안을 검토한다. 각 뉴런은 가장 자주 함께 활성화되는 상대와 강한 동시 활성화 관계를 보이지만, 여러 뉴런이 같은 상대를 공유한다. 따라서 이들을 묶으면 자주 쓰이는 뉴런을 반복해서 읽게 된다. 이 실험은 해당 배치 방식에 대한 부정적 결과를 제시한다.
- E Extended Related Works는 압축, 선택적 로딩, 하드웨어 최적화, 투기적 실행, Mixture of Experts와의 비교를 확장한다. Mixture of Experts는 별도의 FFN 구성 요소 중에서 사용할 요소를 선택하는 아키텍처다. 저자들은 이러한 접근이 플래시 전송량을 줄이고 효율적인 플래시 읽기를 위해 가중치를 배치하는 방법과 상호 보완적이라고 설명한다.
- F Small Device Implications는 수치 정밀도를 낮춰 가중치를 저장하는 양자화와 제안 방식을 결합하는 방안을 제시한다. 4-bit 가중치를 사용하면 7B 모델의 상주 메모리를 3.5GB dense baseline에서 2GB 미만으로 줄일 수 있다는 제안이다. 시퀀스 100개에서 보고한 평균 활성 뉴런 비율은 OPT 6.7B가 3.30%, 양자화 버전이 3.27%로, 이 비교에서는 희소성이 비슷하게 유지된다. 전용 4-bit 커널을 사용하는 스마트폰 실행은 구현 범위에 포함되지 않으므로, 이 메모리 추정치는 기기에서 전체 추론을 시연한 결과가 아니다.
- G Qualitative Evaluations는 “Once upon a time there was a”와 C4 지문에 이어 원본 모델과 예측기를 추가한 모델이 생성한 텍스트를 비교한다. Tables 7–9의 출력은 읽을 수 있지만 서로 다르며, 반복과 미완성된 이어쓰기도 나타난다. 선택된 예시는 동작 양상을 보여주지만, 생성 품질이나 실패 빈도를 체계적으로 추정하는 근거는 제공하지 않는다.
짧은 생각
성능 향상의 원인은 구성 요소별 절제 실험에서 가장 명확하게 드러난다. 예측과 windowing은 전송 바이트 수를 줄이고, bundling은 읽기 처리량을 높이며, 사전 할당은 캐시 복사 오버헤드를 제한한다. 가장 큰 대표 가속률은 단순 로딩과 비교한 값이고 일부 모델은 희소화와 예측 과정에서 정확도를 잃으므로, 실용적인 비교에는 하이브리드 베이스라인과 모델별 정확도 결과를 포함해야 한다. 실험은 제한된 메모리 할당 조건에서 용량과 지연 시간의 절충 관계를 입증한다. 스마트폰 성능과 에너지 효율은 직접 평가가 더 필요하다.