


The CoT Encyclopedia: Analyzing, Predicting, and Controlling how a Reasoning Model will Think 요약 설명
15 May 2025 | Paper Review Reasoning LLM Evaluation Model Merging목차
이번 글에서는 The CoT Encyclopedia: Analyzing, Predicting, and Controlling how a Reasoning Model will Think 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 5월 15일(Arxiv)
- Lee, Seongyun, Kim, Seungone, Seo, Minju, Jo, Yongrae, Go, Dongyoung, Hwang, Hyeonbin, Park, Jinho, Yue, Xiang, Welleck, Sean, Neubig, Graham, et al.
- KAIST AI, Carnegie Mellon University, LG AI Research, NAVER Search US, Cornell University
- 논문 링크
요약
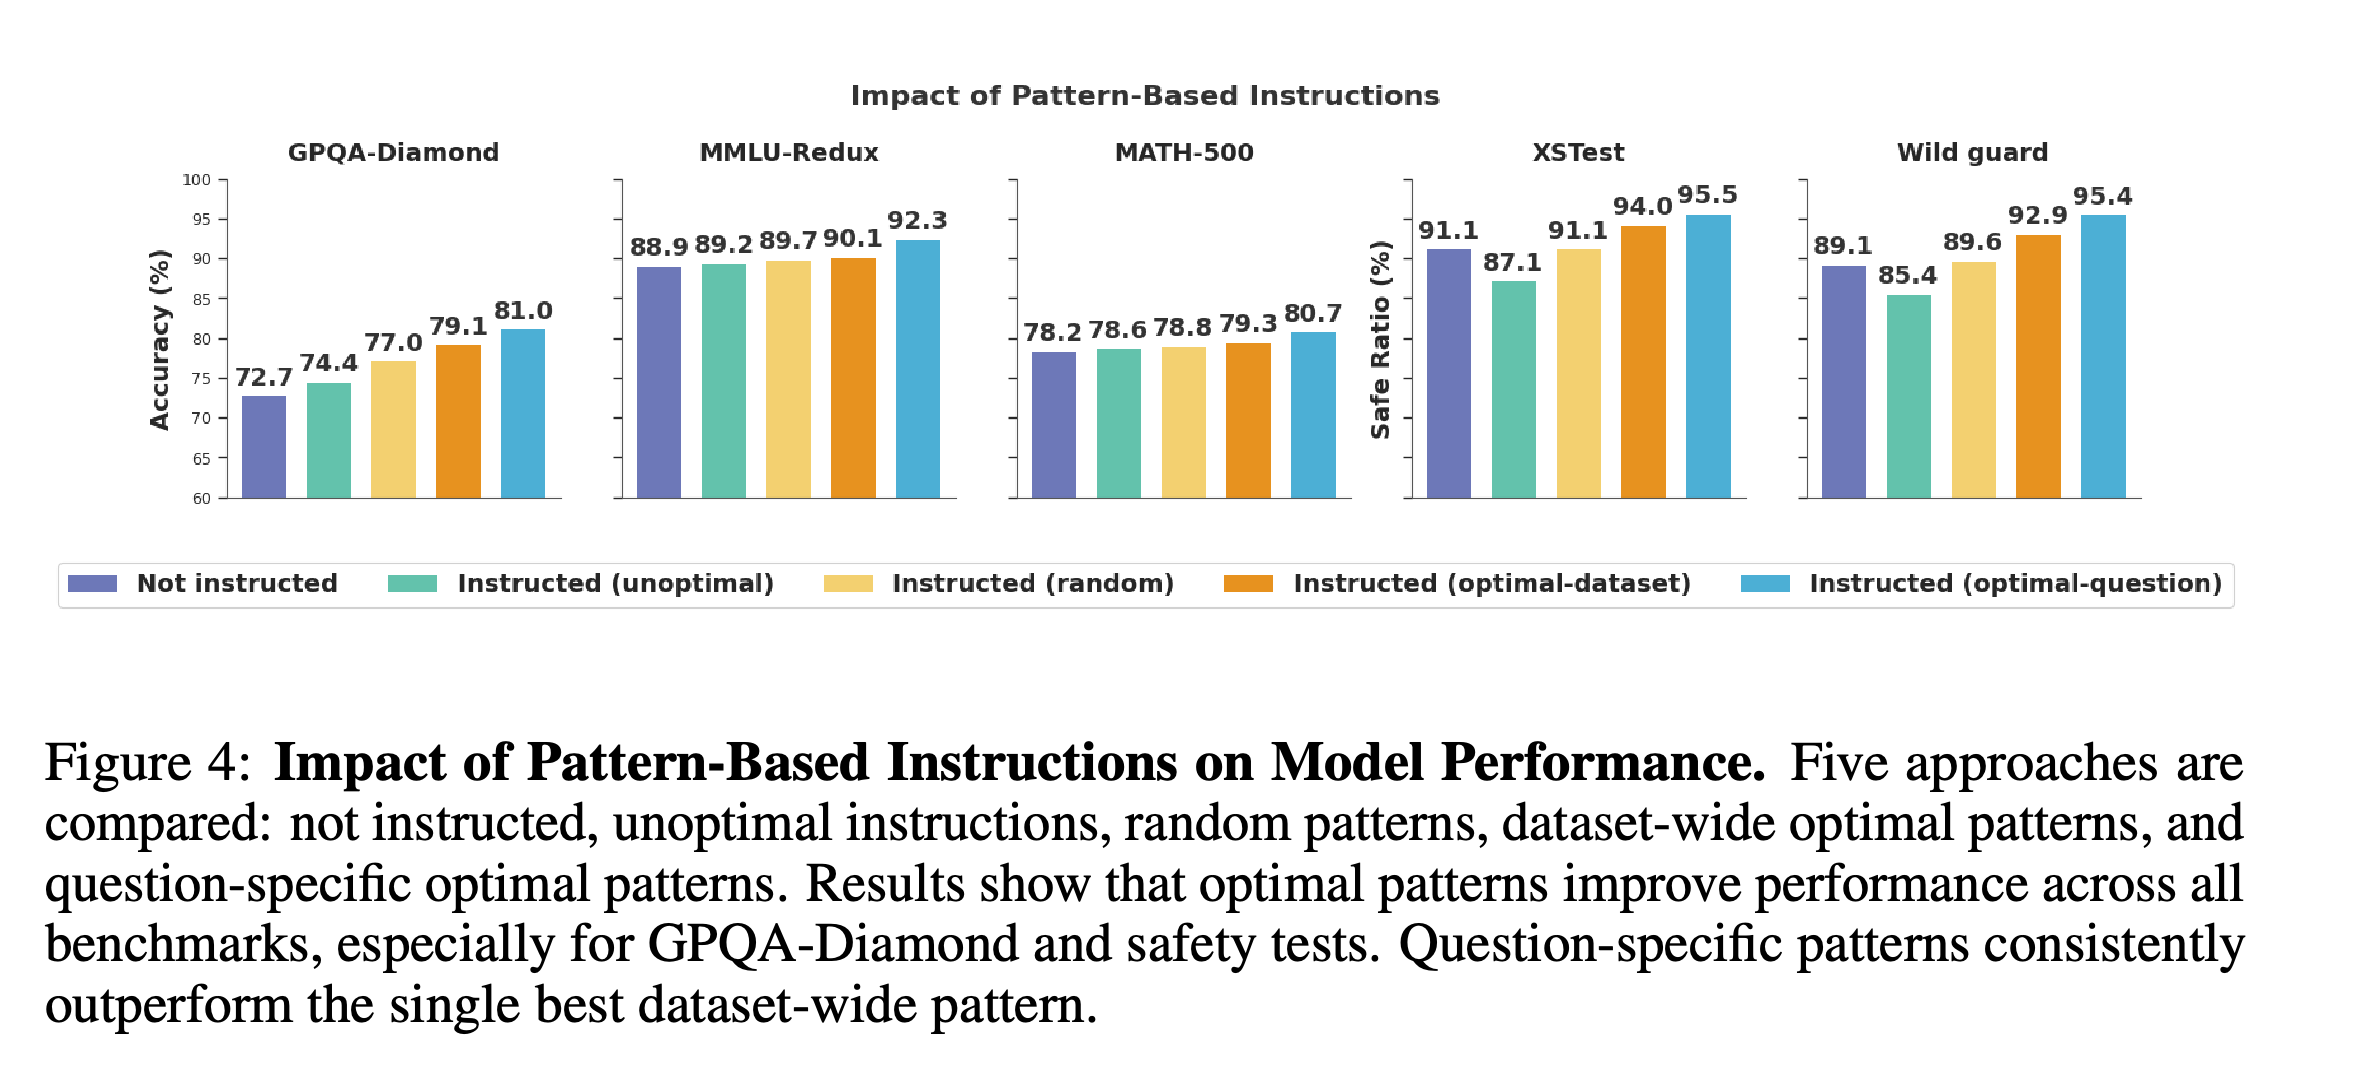
- 이 논문은 모델이 최종 답변 전에 생성하는 중간 추론 단계인 chain-of-thought(CoT)에 나타나는 전략을 기술하고, 예측하고, 제어하는 방법을 연구한다. 추론 벤치마크인 GPQA-Diamond에서 질문별 전략 지시를 적용하면 보고된 전체 정확도가 전략 지시가 없을 때의 72.7%에서 81.0%로 높아진다. 이 평가는 처음에 틀린 응답을 수정 대상으로 삼고, 기존 정답 응답도 전체 집계에 포함한다.
- CoT Encyclopedia는 모델 출력에서 서로 대립하는 전략 설명을 추출하고, 이를 의미를 수치로 표현한 임베딩으로 변환한 뒤 비슷한 설명을 군집화한다. 이어서 대립하는 전략을 구분하는 설명인 루브릭을 생성하고, 이를 사용해 응답을 분류한다. 사람 평가자는 이 방법의 종합 분석을 92%의 사례에서 타당하다고 평가했으며, 사전에 정의한 인지 행동을 사용한 분석에서는 그 비율이 51%였다.
- 성공한 응답에서 관찰한 전략으로 학습한 분류기는 처음에 실패한 질문에 적용할 지시를 선택한다. 질문별 지시는 문제 해결 벤치마크 3개와 안전성 벤치마크 2개에서 데이터셋 공통 지시보다 높은 성능을 보인다. 다만 이 실험은 모든 질문에 지시를 적용하는 대신, 실패한 응답을 선택적으로 수정하는 방식을 평가한다.
- 통제된 학습 실험은 답변 선택지를 제공하는 객관식(MC) 질문과 선택지 없이 답을 작성하는 자유 형식(FF) 질문을 비교한다. 주요 분석에서 형식 변경에 따른 전략 변화는 도메인 변경에 따른 변화보다 크게 측정된다. 학습된 모델 가중치를 선형 보간하는 모델 병합도 추가 학습 없이 전략 분포를 바꾼다.
- 이 연구의 근거는 자동 평가자인 GPT-4o와 응답 100개의 분석이 얼마나 타당해 보이는지 평가한 사람 평가에 의존한다. 도메인 효과 표의 불일치와 정성적 예시의 내용 불일치 때문에 학습 형식과 분석 품질에 관한 가장 강한 주장은 주의해서 해석해야 한다.
1 Introduction
The CoT Encyclopedia: Analyzing, Predicting, and Controlling how a Reasoning Model will Think는 추론 모델이 어떤 전략을 드러내는지, 그 전략이 과제와 모델에 따라 어떻게 달라지는지, 지시로 결과를 개선할 수 있는지 연구한다. 기존 분석은 이전 결정을 다시 검토하는 backtracking이나 문제를 중간 목표로 나누는 subgoal setting처럼 고정된 행동을 탐지하는 경우가 많다. 논문은 이러한 범주가 새로운 전략의 발견을 제한한다고 주장한다.
- 논문은 대안으로 생성된 응답에서 범주를 도출하고, 그 결과로 얻은 프로필을 정답 여부, 안전성, 학습 데이터, 모델 가중치 보간과 연결한다.
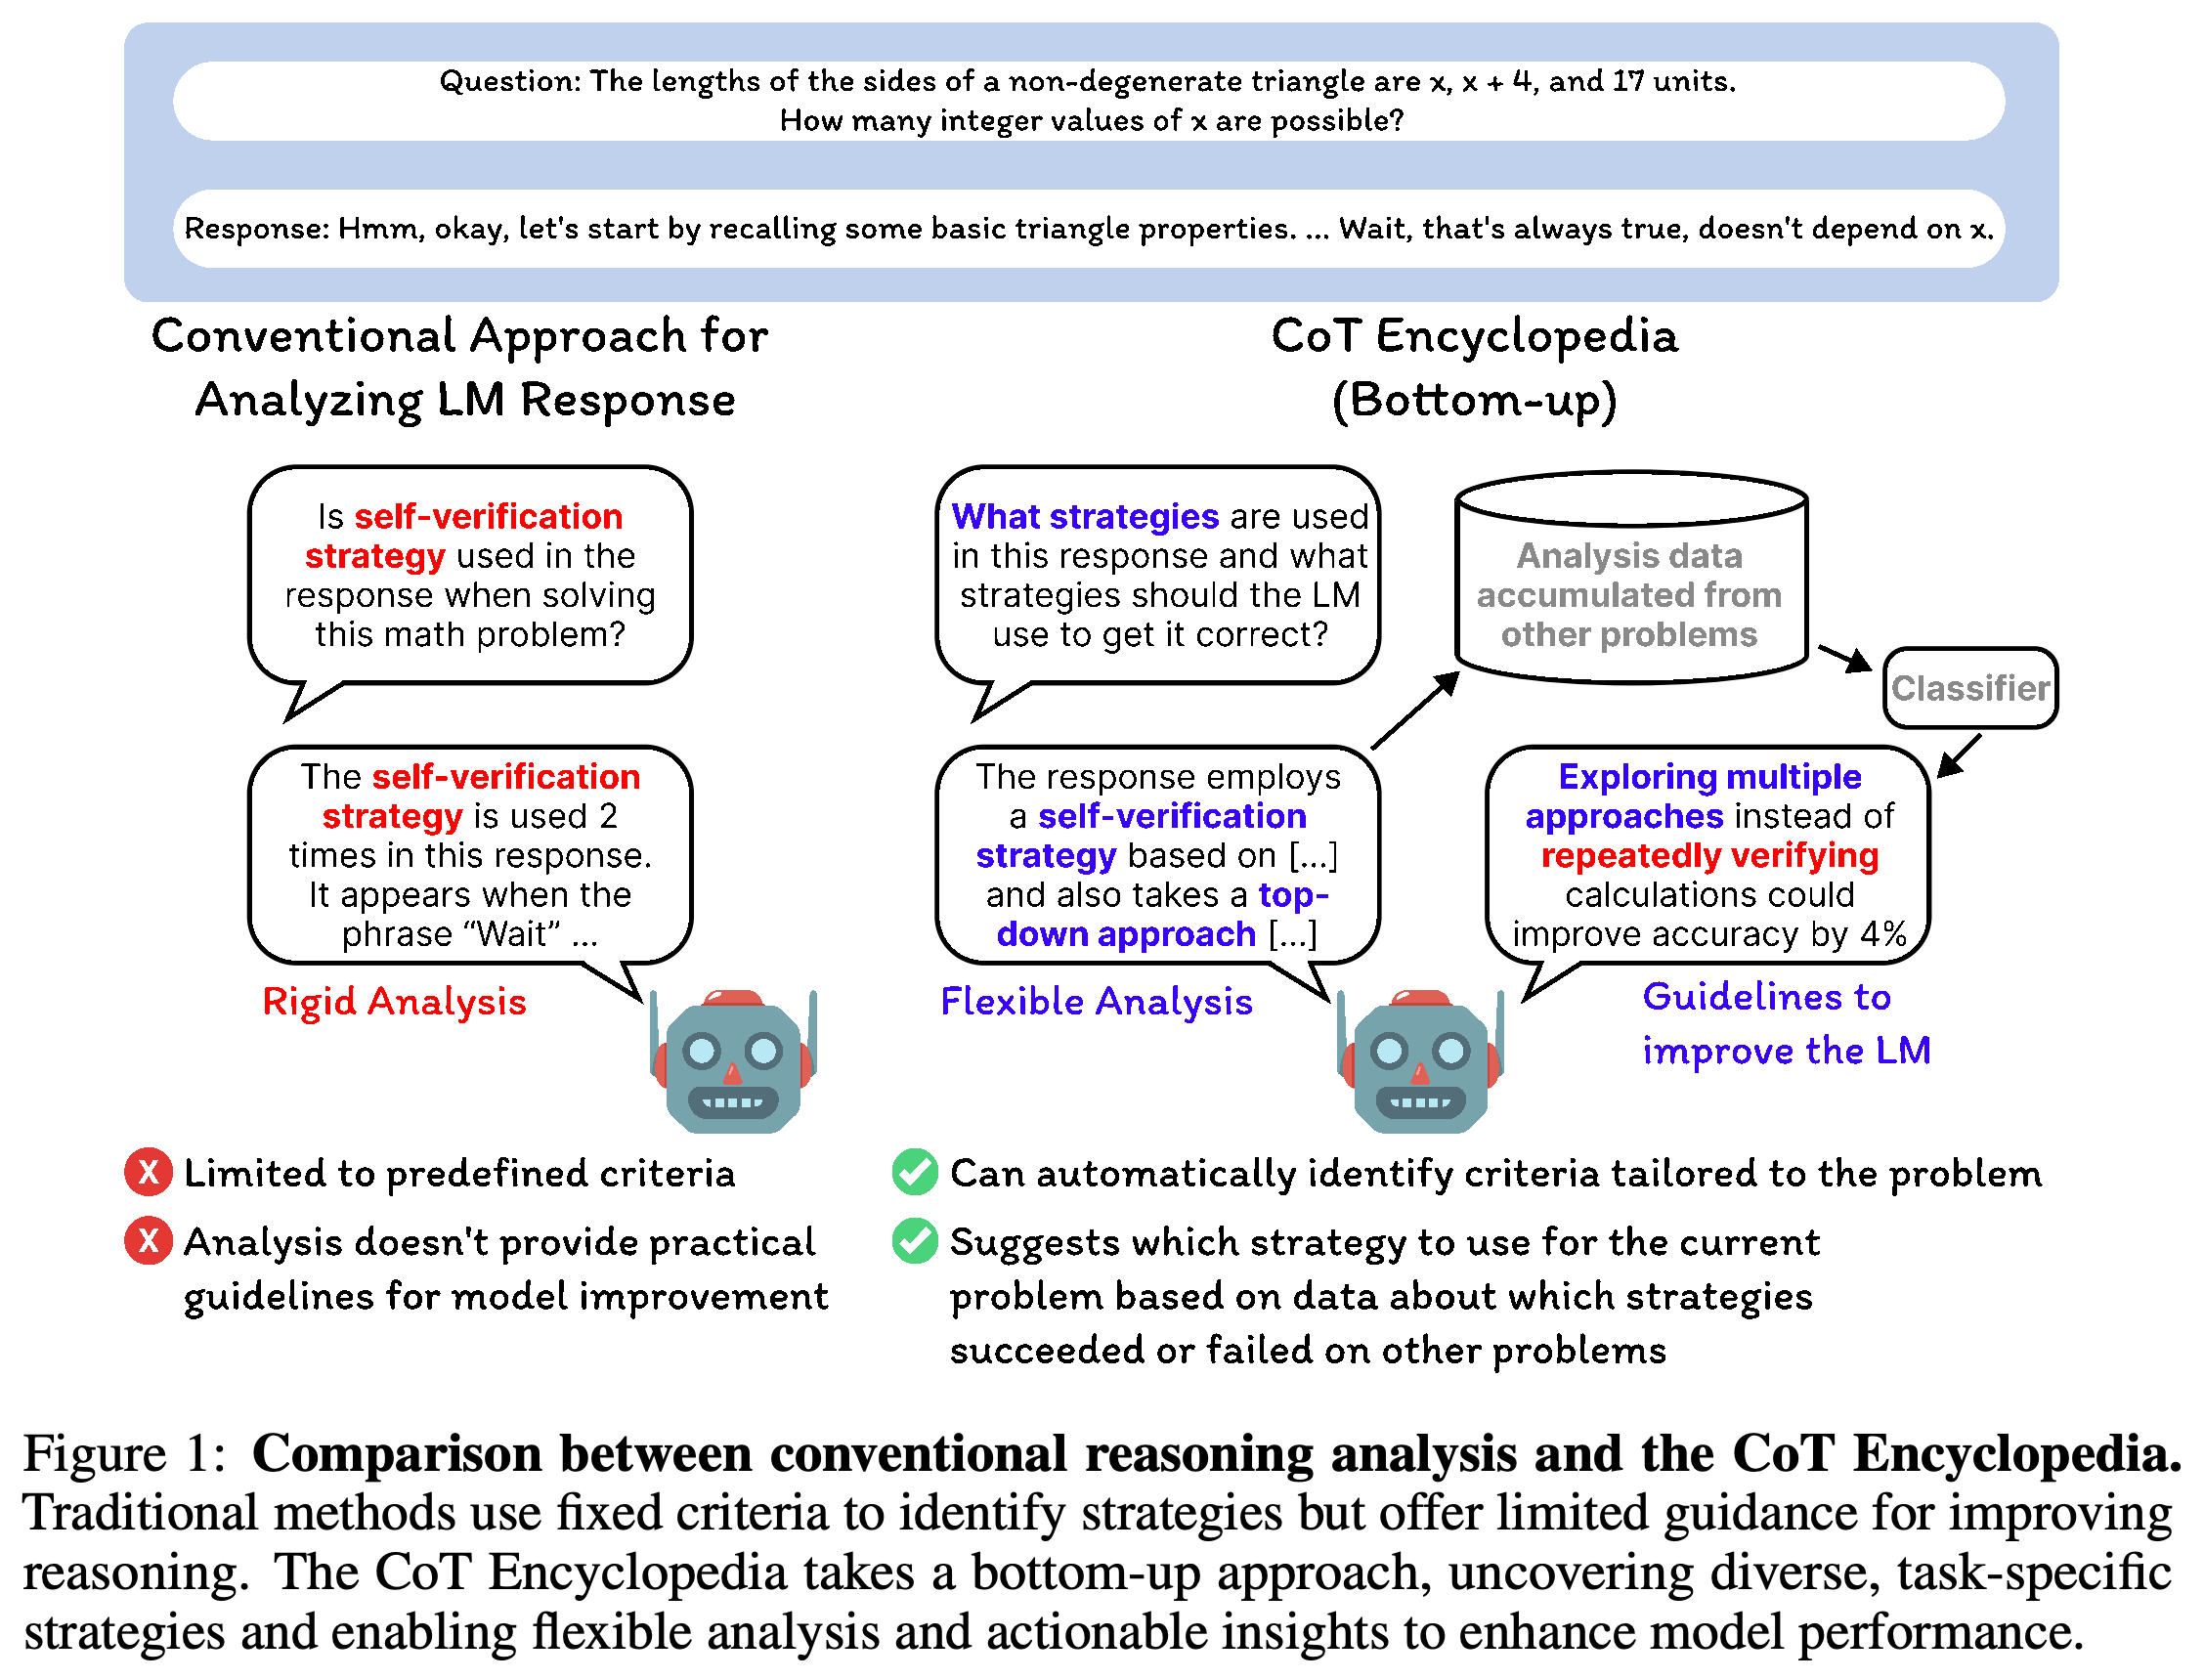
- Figure 1은 사전에 정의한 행동을 탐지하는 방식에서 다른 질문의 결과를 축적해 전략을 추천하는 방식으로 전환하는 모습을 보여준다. 그림에 표시된 4% 개선은 개념을 설명하기 위한 예시다.
이 도식은 사전에 정의한 행동의 횟수를 세는 방식과 여러 전략을 추출한 뒤 축적된 결과로 대안을 추천하는 방식을 대비한다. 4% 개선은 설명을 위한 예시이므로 측정된 결과로 해석하면 안 된다.
2 Related Work
관련 연구는 추론 시점의 계산량을 늘리는 방법과 생성된 응답에 나타난 전략을 분석하는 방법으로 나뉜다. CoT Encyclopedia는 전략 분석을 명시적 지시 및 통제된 학습 비교와 연결한다.
2.1 Scaling test-time compute through long chain-of-thought generation
기존 방법은 어려운 질문에 추론 단계를 더 배정하거나, 여러 차례에 걸쳐 답변을 개선하거나, 해답 탐색을 구조화한다. 논문은 다양한 추론 경로를 사용하는 self-consistency sampling, 추론을 트리로 구성하는 Tree-of-Thoughts, 과제를 더 간단한 문제로 분해하는 least-to-most prompting을 다룬다. Tree-of-Thoughts에 대해서는 Tree of Thoughts - Deliberate Problem Solving with Large Language Models (ToT) 요약 설명 글을 참조하라.
2.2 Analyzing reasoning strategies of models
기존 분석은 반복되는 사고 패턴, 사전에 정의한 인지 행동, 갑작스러운 통찰, 추론 텍스트를 명시적으로 표시하는 구조화된 <think> 메커니즘을 살펴본다. 논문은 전략 분석을 예시 선택 및 특정 문제를 겨냥한 데이터 생성과도 연결하며, 응답에서 대조적인 범주를 직접 발견하는 점을 기여로 제시한다.
3 The CoT Encyclopedia
CoT Encyclopedia는 긴 추론 응답을 전략 범주를 체계적으로 정리한 분류 체계로 변환한 뒤, 구조화된 프로필과 자연어 보고서를 생성한다. 범주는 분석 대상 응답에서 도출하므로 과제가 달라지면 분류 체계도 달라질 수 있다.
3.1 A framework for taxonomizing reasoning strategies
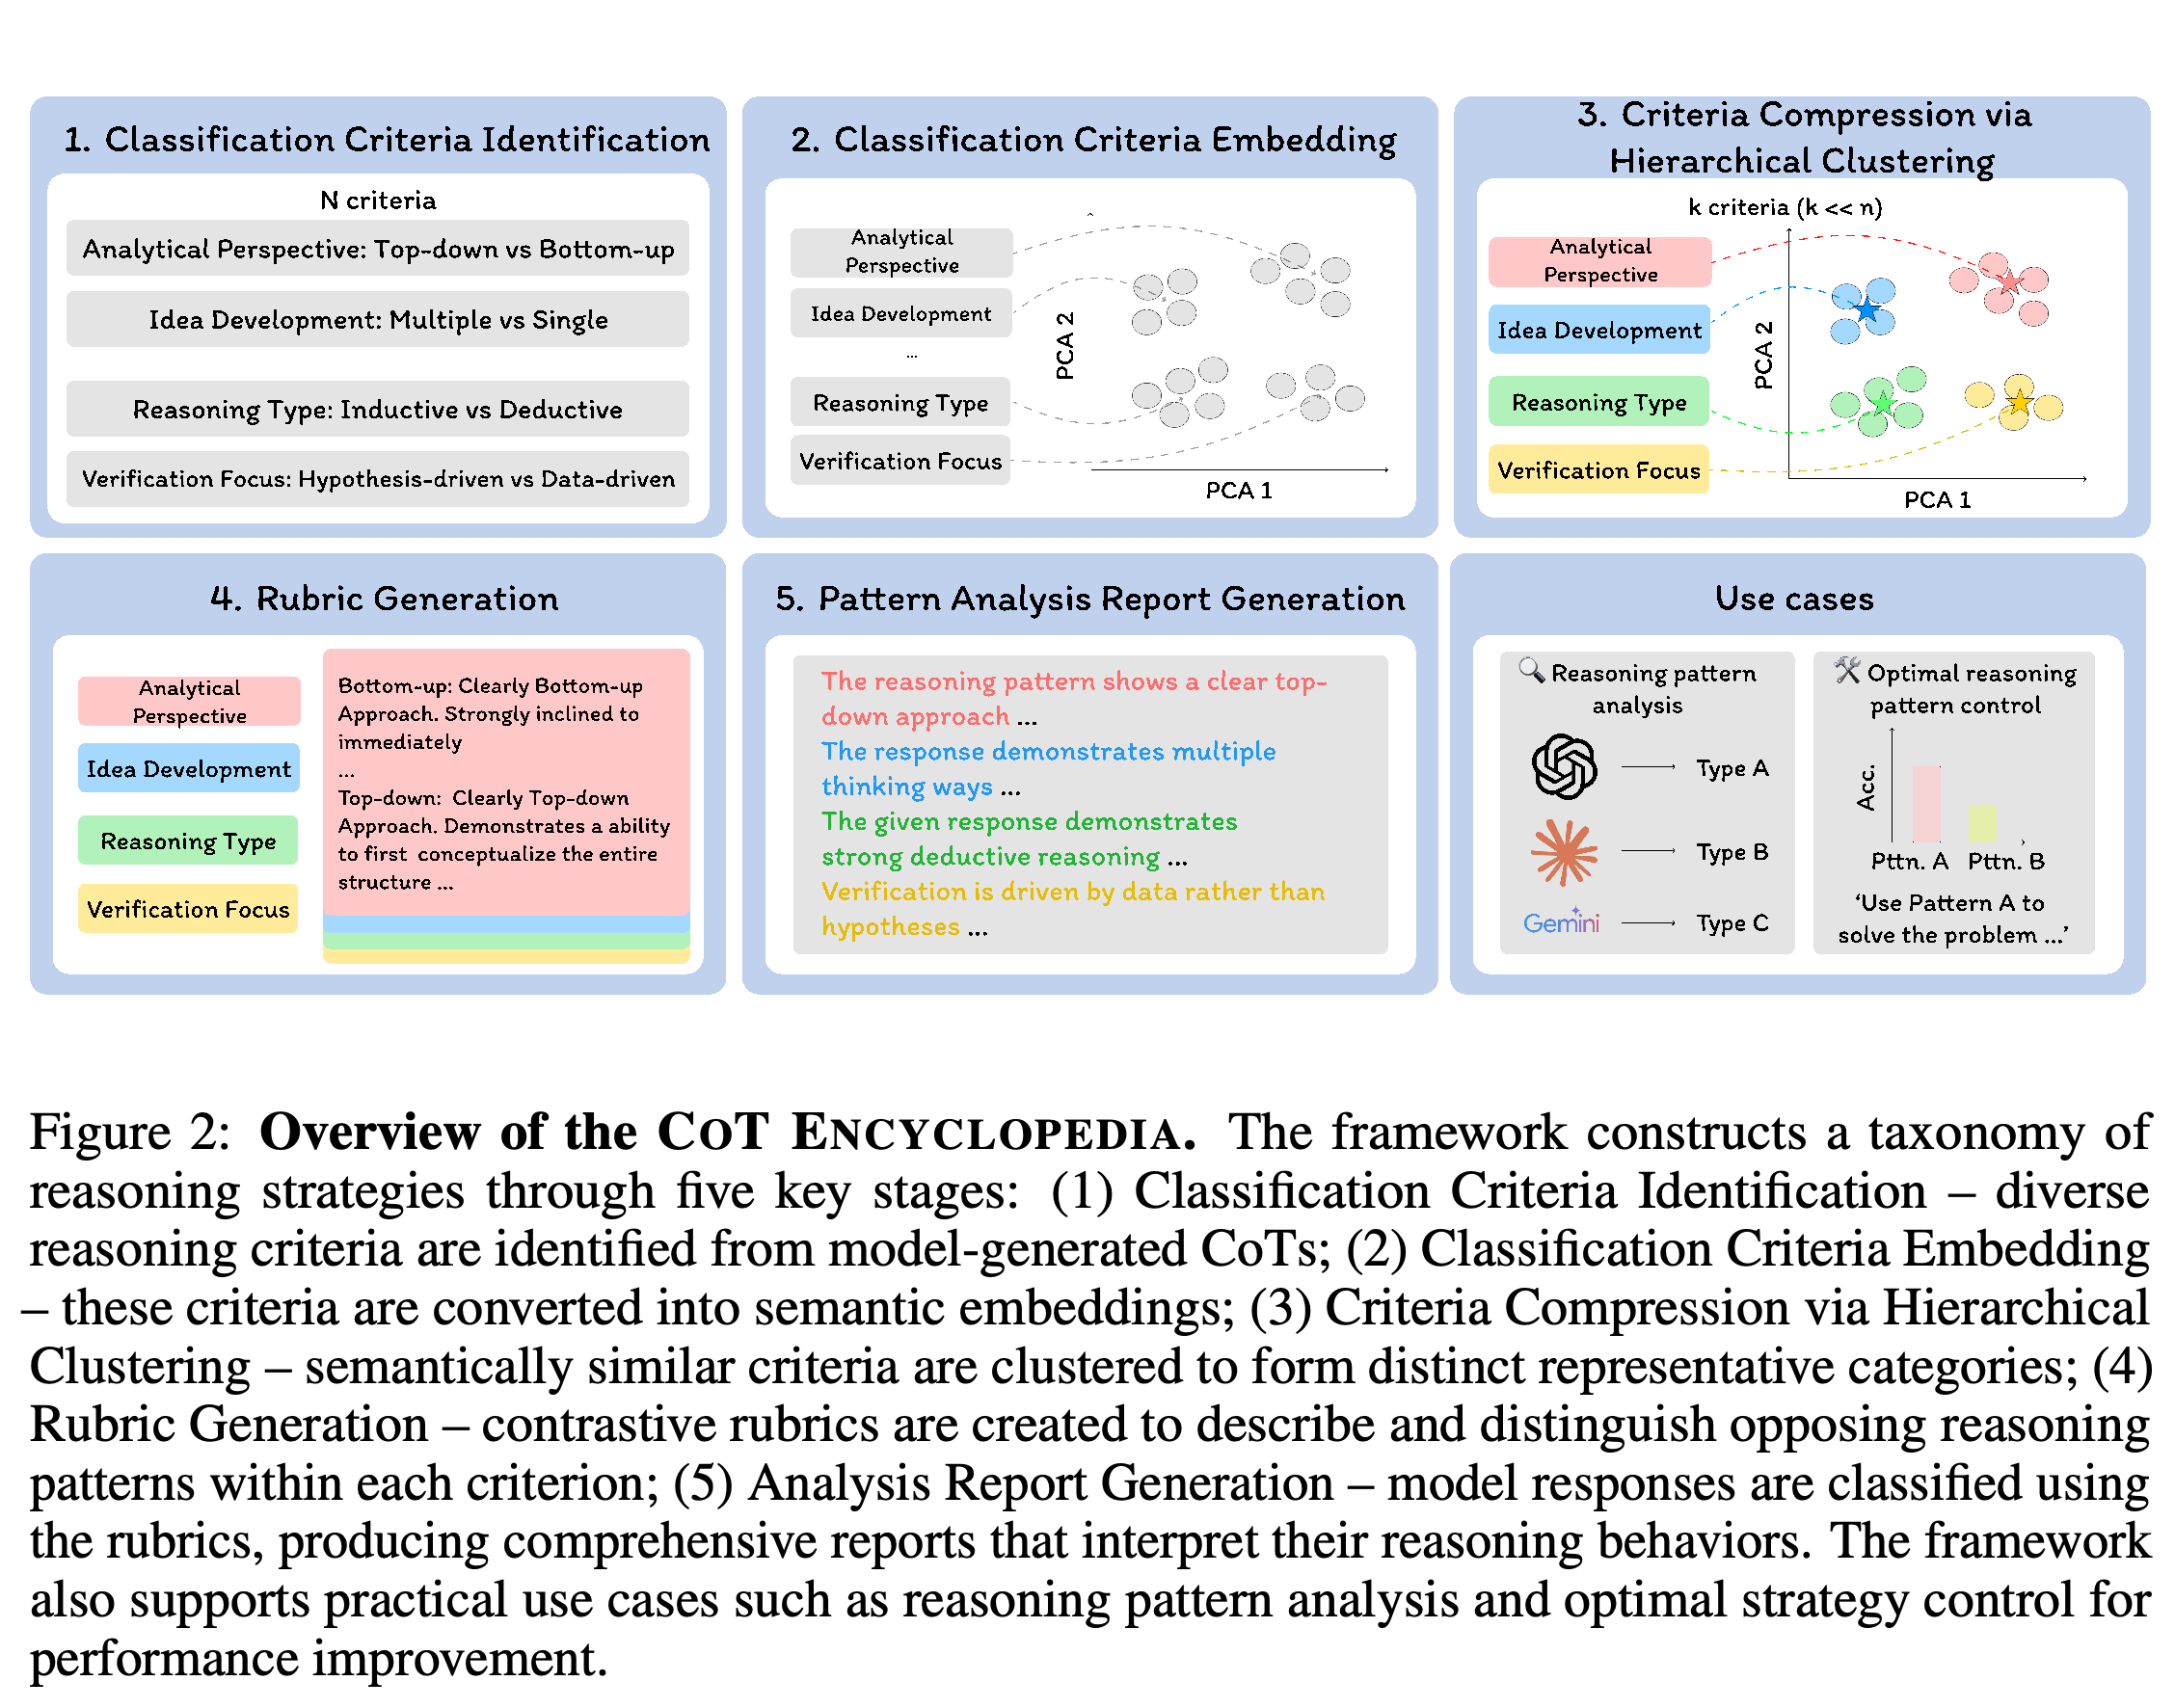
이 파이프라인은 5단계로 구성된다. 서로 대립하는 전략 설명을 담은 기준을 식별하고, 각 기준과 설명을 임베딩하며, 군집화로 중복 기준을 압축하고, 대조적 루브릭을 생성한 뒤, 그 루브릭으로 응답을 분류한다. 유지된 각 기준은 추론 패턴 2개 사이의 구분 1개를 기술한다.
- 비슷한 기준을 점진적으로 묶는 계층적 응집 군집화는 임베딩 벡터의 방향 차이를 측정하는 코사인 거리를 사용한다. 각 군집은 실제 기준 중에서 대표로 선택한 메도이드로 표현하므로, 사람이 읽을 수 있는 설명을 유지한다.
- 각 응답에는 유지된 모든 기준에 따라 이진 레이블을 부여한다. 이렇게 만든 전략 프로필을 언어 모델이 분석 보고서 작성에 사용한다.
- Appendix A는 전략 식별과 루브릭 생성에 GPT-4o를, 임베딩에 text-embedding-3-large를 사용한다고 명시한다. 군집 수는 군집 간 분리 정도를 측정하는 실루엣 점수로 선택한다.
이 파이프라인은 추출한 다수의 설명을 사람이 읽을 수 있는 소수의 기준으로 줄인 뒤, 루브릭과 응답 프로필로 변환하는 과정을 보여준다. 이렇게 만든 표현을 서술적 분석과 전략 지시에 활용한다.
3.2 CoT Encyclopedia enables sharper reasoning strategy classification
분석에는 GPQA-Diamond, 지식 벤치마크인 MMLU-Redux, 수학 벤치마크인 MATH-500에서 생성한 DeepSeek-R1-Distill-Qwen-32B, s1.1-32B, QwQ-32B의 응답을 사용한다. 세부 기준 4,057개를 Analytical Perspective, Scope of Approach, Reasoning Type, Idea Development, Verification Focus, Clarification Approach의 6개 차원으로 압축한다.
- 베이스라인은 추론을 점검하는 verification, backtracking, subgoal setting, 원하는 결과에서 거꾸로 추론하는 backward chaining을 탐지한다. 카이제곱 검정으로 범주형 분포를 비교하고, Cohen’s d로 분포 차이의 크기를 측정한다.
- 발견한 기준은 여러 모델 쌍을 베이스라인보다 더 뚜렷하게 구분한다. 예를 들어 Table 4의 MATH-500 Clarification Approach 차이는 Cohen’s d = 0.44이며, 베이스라인 행동의 차이는 대체로 훨씬 작다.
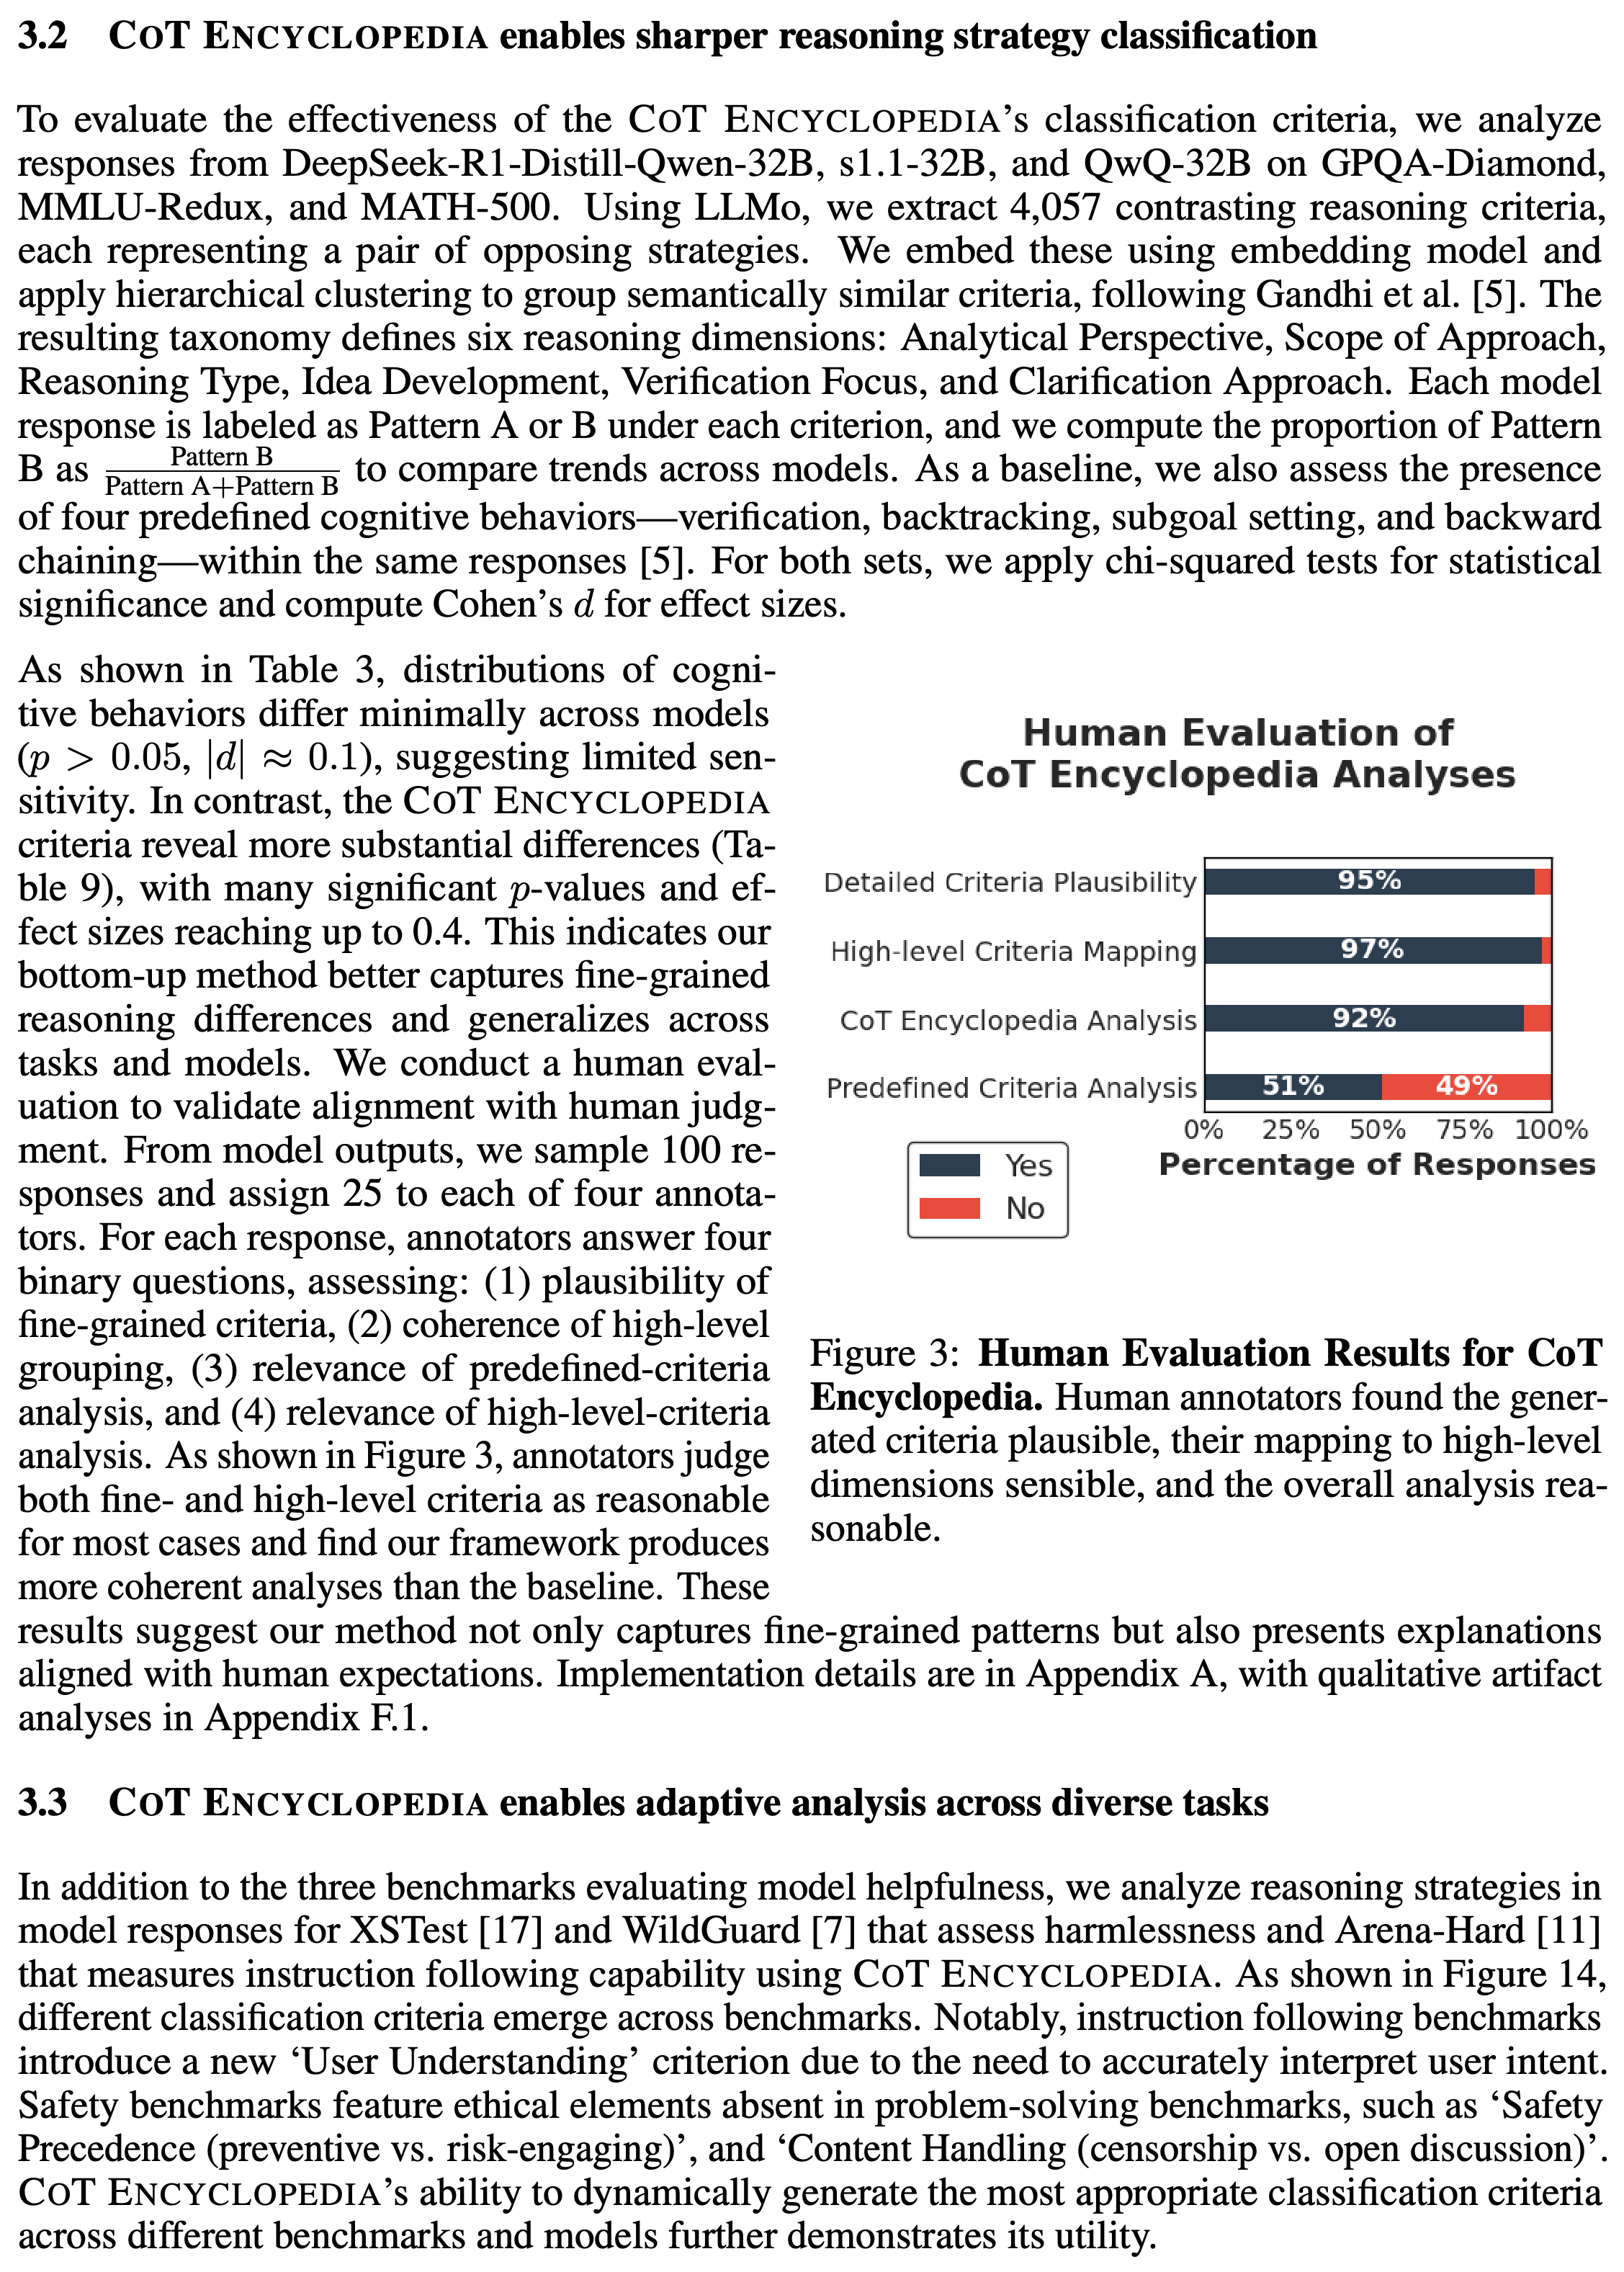
- 평가자 4명이 응답 100개를 평가하며, 각 평가자에게 25개를 배정한다. 긍정 평가 비율은 세부 기준의 개연성이 95%, 상위 범주 매핑이 97%, CoT Encyclopedia 분석이 92%, 사전 정의 기준을 사용한 분석이 51%다. 이 수치는 평가자가 느끼는 타당성을 측정한다.
긍정 평가 비율은 세부 기준이 95%, 범주 매핑이 97%, 프레임워크 분석이 92%이며, 사전 정의 기준을 사용한 분석은 51%다. 이는 응답 100개에 대한 개연성과 관련성 판단이며, 모델 내부 계산 과정을 검증한 결과는 아니다.
3.3 CoT Encyclopedia enables adaptive analysis across diverse tasks
프레임워크를 논문의 안전성 벤치마크인 XSTest와 WildGuard, 지시 이행 벤치마크인 Arena-Hard에 적용하면 과제별 기준이 생성된다. Arena-Hard에서는 응답이 사용자 의도를 해석하는지 나타내는 User Understanding이 도입된다. 안전성 분석에서는 예방적 행동과 위험을 감수하는 행동, 검열과 개방적 토론 등의 구분이 도입된다.
- Figure 14의 벤치마크별 군집은 과제에 따라 추출한 분류 체계가 어떻게 달라지는지 보여준다. 이 결과가 해당 기준들이 관련된 모든 추론 행동을 포괄한다는 점까지 입증하지는 않는다.
4 Enhancing model helpfulness and safety via optimal reasoning control
제어 실험은 정답 또는 안전한 응답과 연관된 전략으로 이후 생성을 유도할 수 있는지 살펴본다. 먼저 데이터셋 수준에서 유망한 패턴을 찾고, 이어서 개별 질문에 맞는 패턴을 예측한다.
4.1 Exploring optimal reasoning strategies for helpfulness and harmlessness
저자들은 모델 3개의 결과를 평균하여 각 전략을 조건으로 한 정답 또는 안전한 응답의 확률을 추정한다. 문제 해결 기준 6개와 안전성 기준 7개를 사용한다. 처음에 틀리거나 안전하지 않았던 응답을 대상으로 지시 없음, 비최적 지시, 무작위 지시, 데이터셋 공통 최적 지시 조건을 비교한다.
- 데이터셋 공통 최적 지시는 보고된 전체 GPQA-Diamond 정확도를 72.7%에서 79.1%로, XSTest의 안전한 응답 비율을 91.1%에서 94.0%로, WildGuard의 안전한 응답 비율을 89.1%에서 92.9%로 높인다. 이 집계에는 기존에 성공한 응답과 수정에 성공한 응답이 포함된다.
- 지시가 없는 조건을 베이스라인으로 삼고, 무작위 지시와 비최적 지시를 통해 전략 선택이 중요한지 평가한다. Figure 11은 처음에 실패한 응답에 초점을 맞춘 결과를 별도로 보고한다.
- 안전성은 자동 응답 평가자인 LLaMA-Guard-3 8B가 안전하다고 분류한 비율이다. 이 지표만으로는 무해한 요청에 유용한 답변을 제공하는지 별도로 확인할 수 없다.
4.2 Similar inputs, Similar thoughts: How models approach related problems
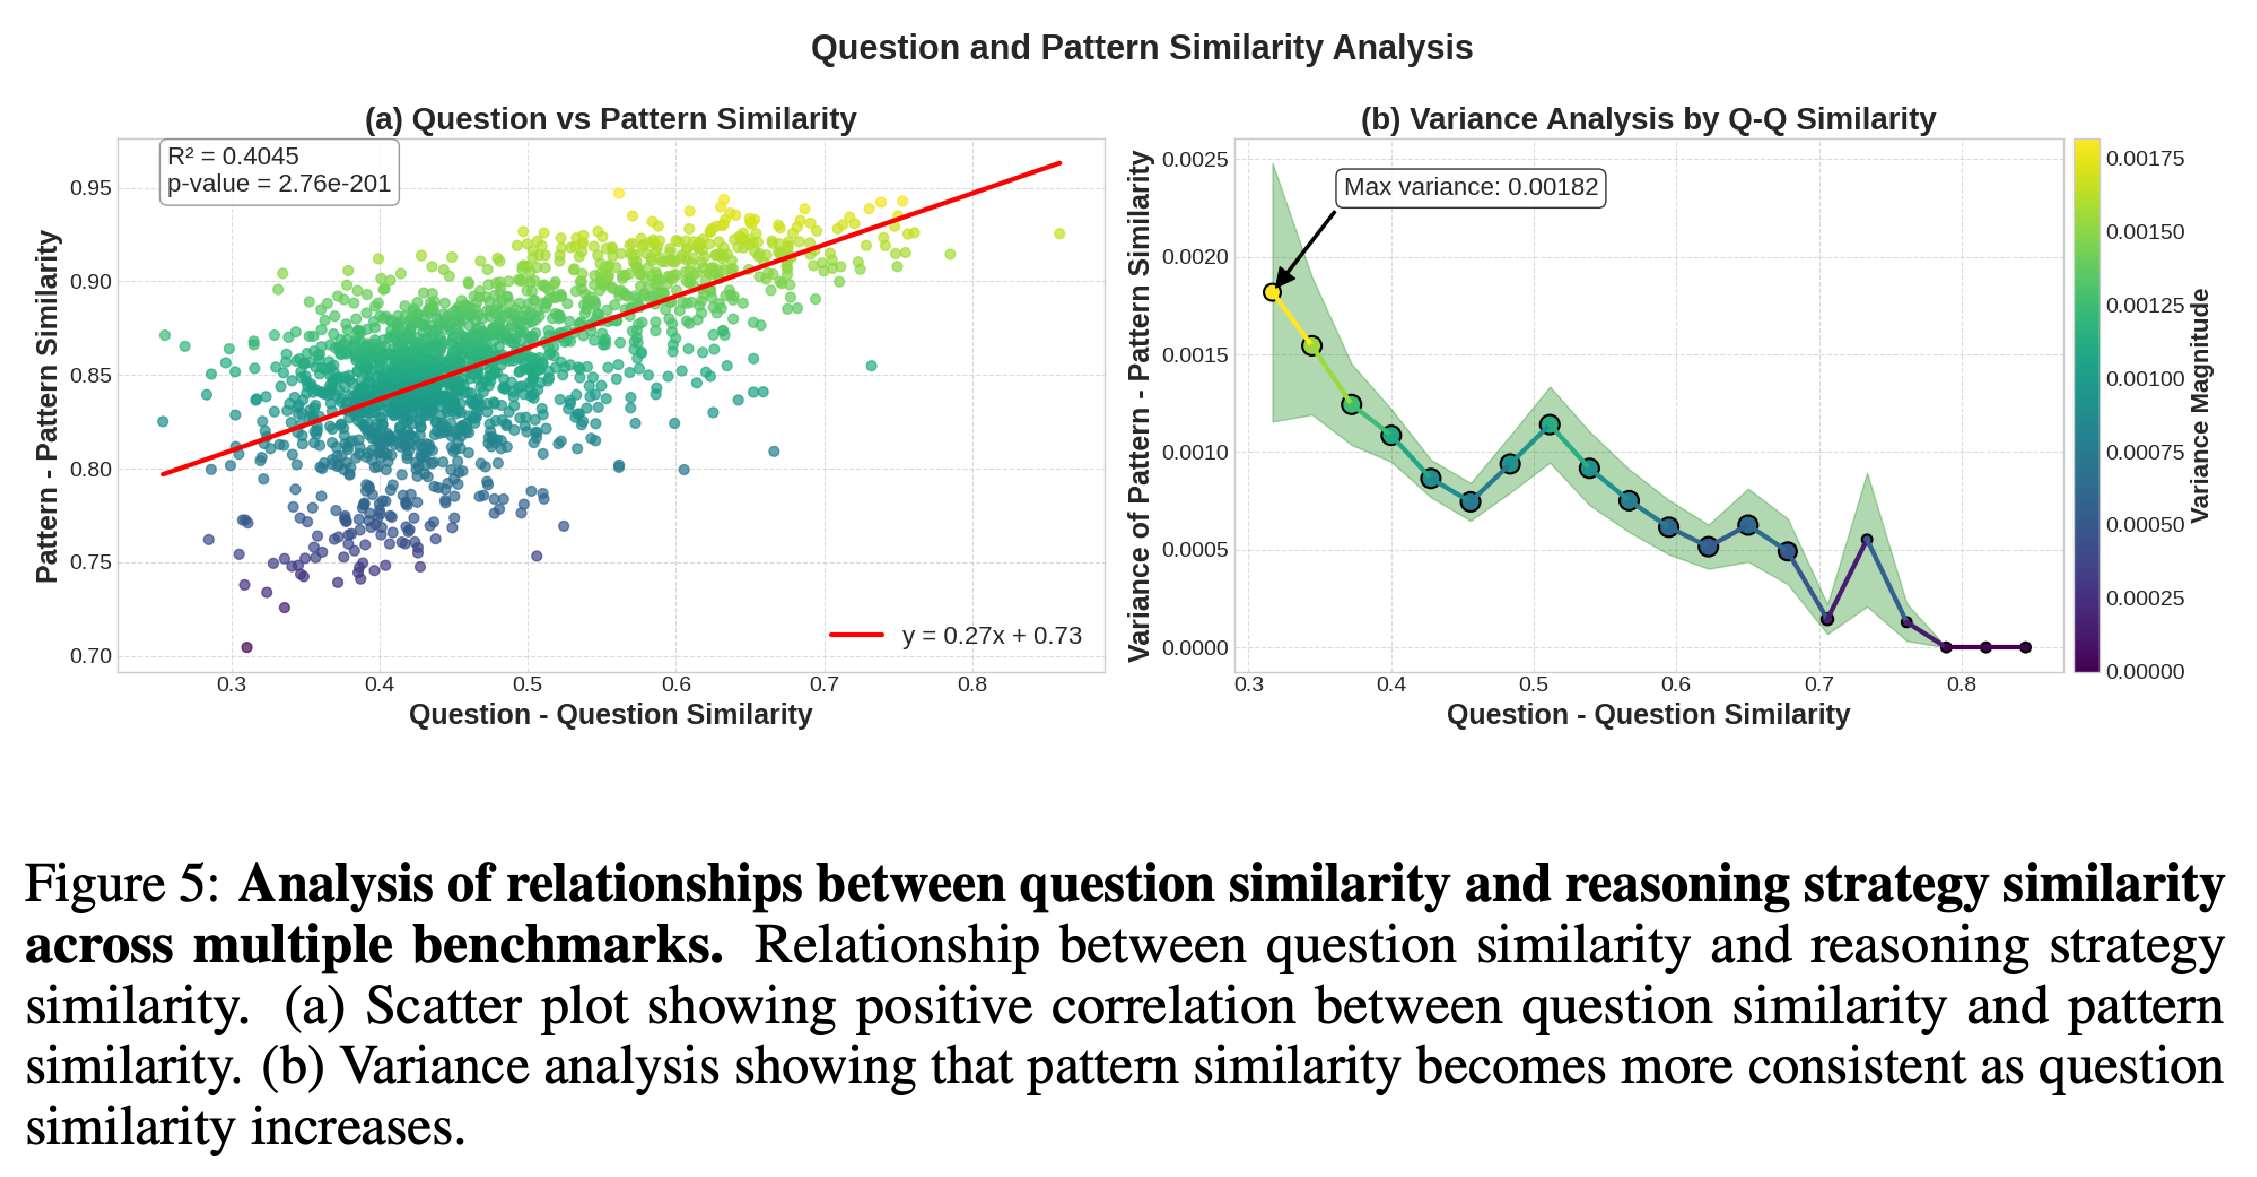
논문은 문제 해결 벤치마크 3개에서 모델 3개가 생성한 정답 응답을 사용해, 임베딩 공간의 질문 유사성을 독립변수로, 전략 유사성을 종속변수로 회귀분석을 수행한다. Figure 5는 적합된 관계가 설명하는 변동의 비율인 \(R^2 = 0.4045\)를 보고한다. 질문 유사성이 높아질수록 전략 유사성의 변동은 줄어든다.
- 이 연관성은 질문으로부터 전략을 예측하는 근거가 된다. 다만 관찰된 전략 때문에 원래 답변이 정답이 되었다는 인과관계를 입증하지는 않는다.
4.3 Predicting question-specific optimal reasoning strategies
기준마다 이진 분류기 1개를 학습하며, 처음에 정답을 낸 질문에서 학습한 뒤 처음에 틀린 질문에 적용할 전략 지시를 예측한다. 논문은 같은 벤치마크에서 학습하고 평가하는 도메인 내 평가와, 벤치마크 2개에서 학습하고 3번째 벤치마크에서 평가하는 도메인 간 평가를 다룬다.
- 질문별 지시를 적용한 전체 정확도는 GPQA-Diamond, MMLU-Redux, MATH-500에서 각각 81.0%, 92.3%, 80.7%다. 지시가 없을 때는 각각 72.7%, 88.9%, 78.2%이며, 상승 폭은 8.3, 3.4, 2.5%포인트다.
- XSTest와 WildGuard의 안전한 응답 비율은 95.5%와 95.4%에 도달한다. 전략 지시가 없을 때는 각각 91.1%와 89.1%다.
- Figure 13은 학습한 분류기가 예시를 0개 제공하는 GPT-4o zero-shot prompting이나 예시를 4개 제공하는 four-shot prompting보다 높은 점수를 기록했다고 보고한다. 다만 질문에서 패턴을 예측하는 실험으로 설명하면서 안전성 패널에는 Safe Response Ratio라는 레이블을 붙여, 지표의 해석이 모호하다.
질문별 지시는 벤치마크 5개 모두에서 보고된 전체 점수가 가장 높다. GPQA-Diamond 정확도는 72.7%에서 81.0%로 상승한다. 이 집계에는 기존에 성공한 응답과 처음에 실패했다가 수정된 응답이 포함된다.
양의 관계를 보이는 회귀모형의 설명력은 R² = 0.4045이며, 다른 패널은 질문이 비슷해질수록 전략 유사성의 분산이 줄어드는 모습을 보여준다. 이는 질문으로부터 전략을 예측하는 근거가 되지만, 연관된 전략이 성공을 유발한다는 인과관계를 입증하지는 않는다.
5 Analyzing pathways to reasoning strategies: Data selection and interpolation
학습 실험은 데이터의 제시 형식과 주제가 학습 후 응답에 나타나는 전략에 어떤 영향을 주는지 조사한다. 별도 실험에서는 서로 다른 형식으로 학습한 모델의 가중치를 선형 결합하여 전략 분포를 보간할 수 있는지 확인한다.
5.1 Format matters more than domain in shaping reasoning strategies
저자들은 정답 여부를 검증할 수 있는 답변에 보상을 주는 Reinforcement Learning with Verifiable Rewards(RLVR)로 7B DeepSeek-R1-Distill 모델을 학습한다. 형식 비교에는 수학 데이터셋인 NuminaMath의 원래 자유 형식 버전과 합성한 5지선다 버전을 사용한다. 도메인 비교에서는 객관식 제시 형식을 고정한 채 수학 데이터와 지식 및 상식 데이터를 비교한다.
- 모든 학습 데이터셋은 예시 100k개를 포함한다. 지식 및 상식 데이터 출처에는 OpenBookQA, QASC, SciQ, CommonsenseQA, ARC-Challenge, MCQA 68k가 포함된다.
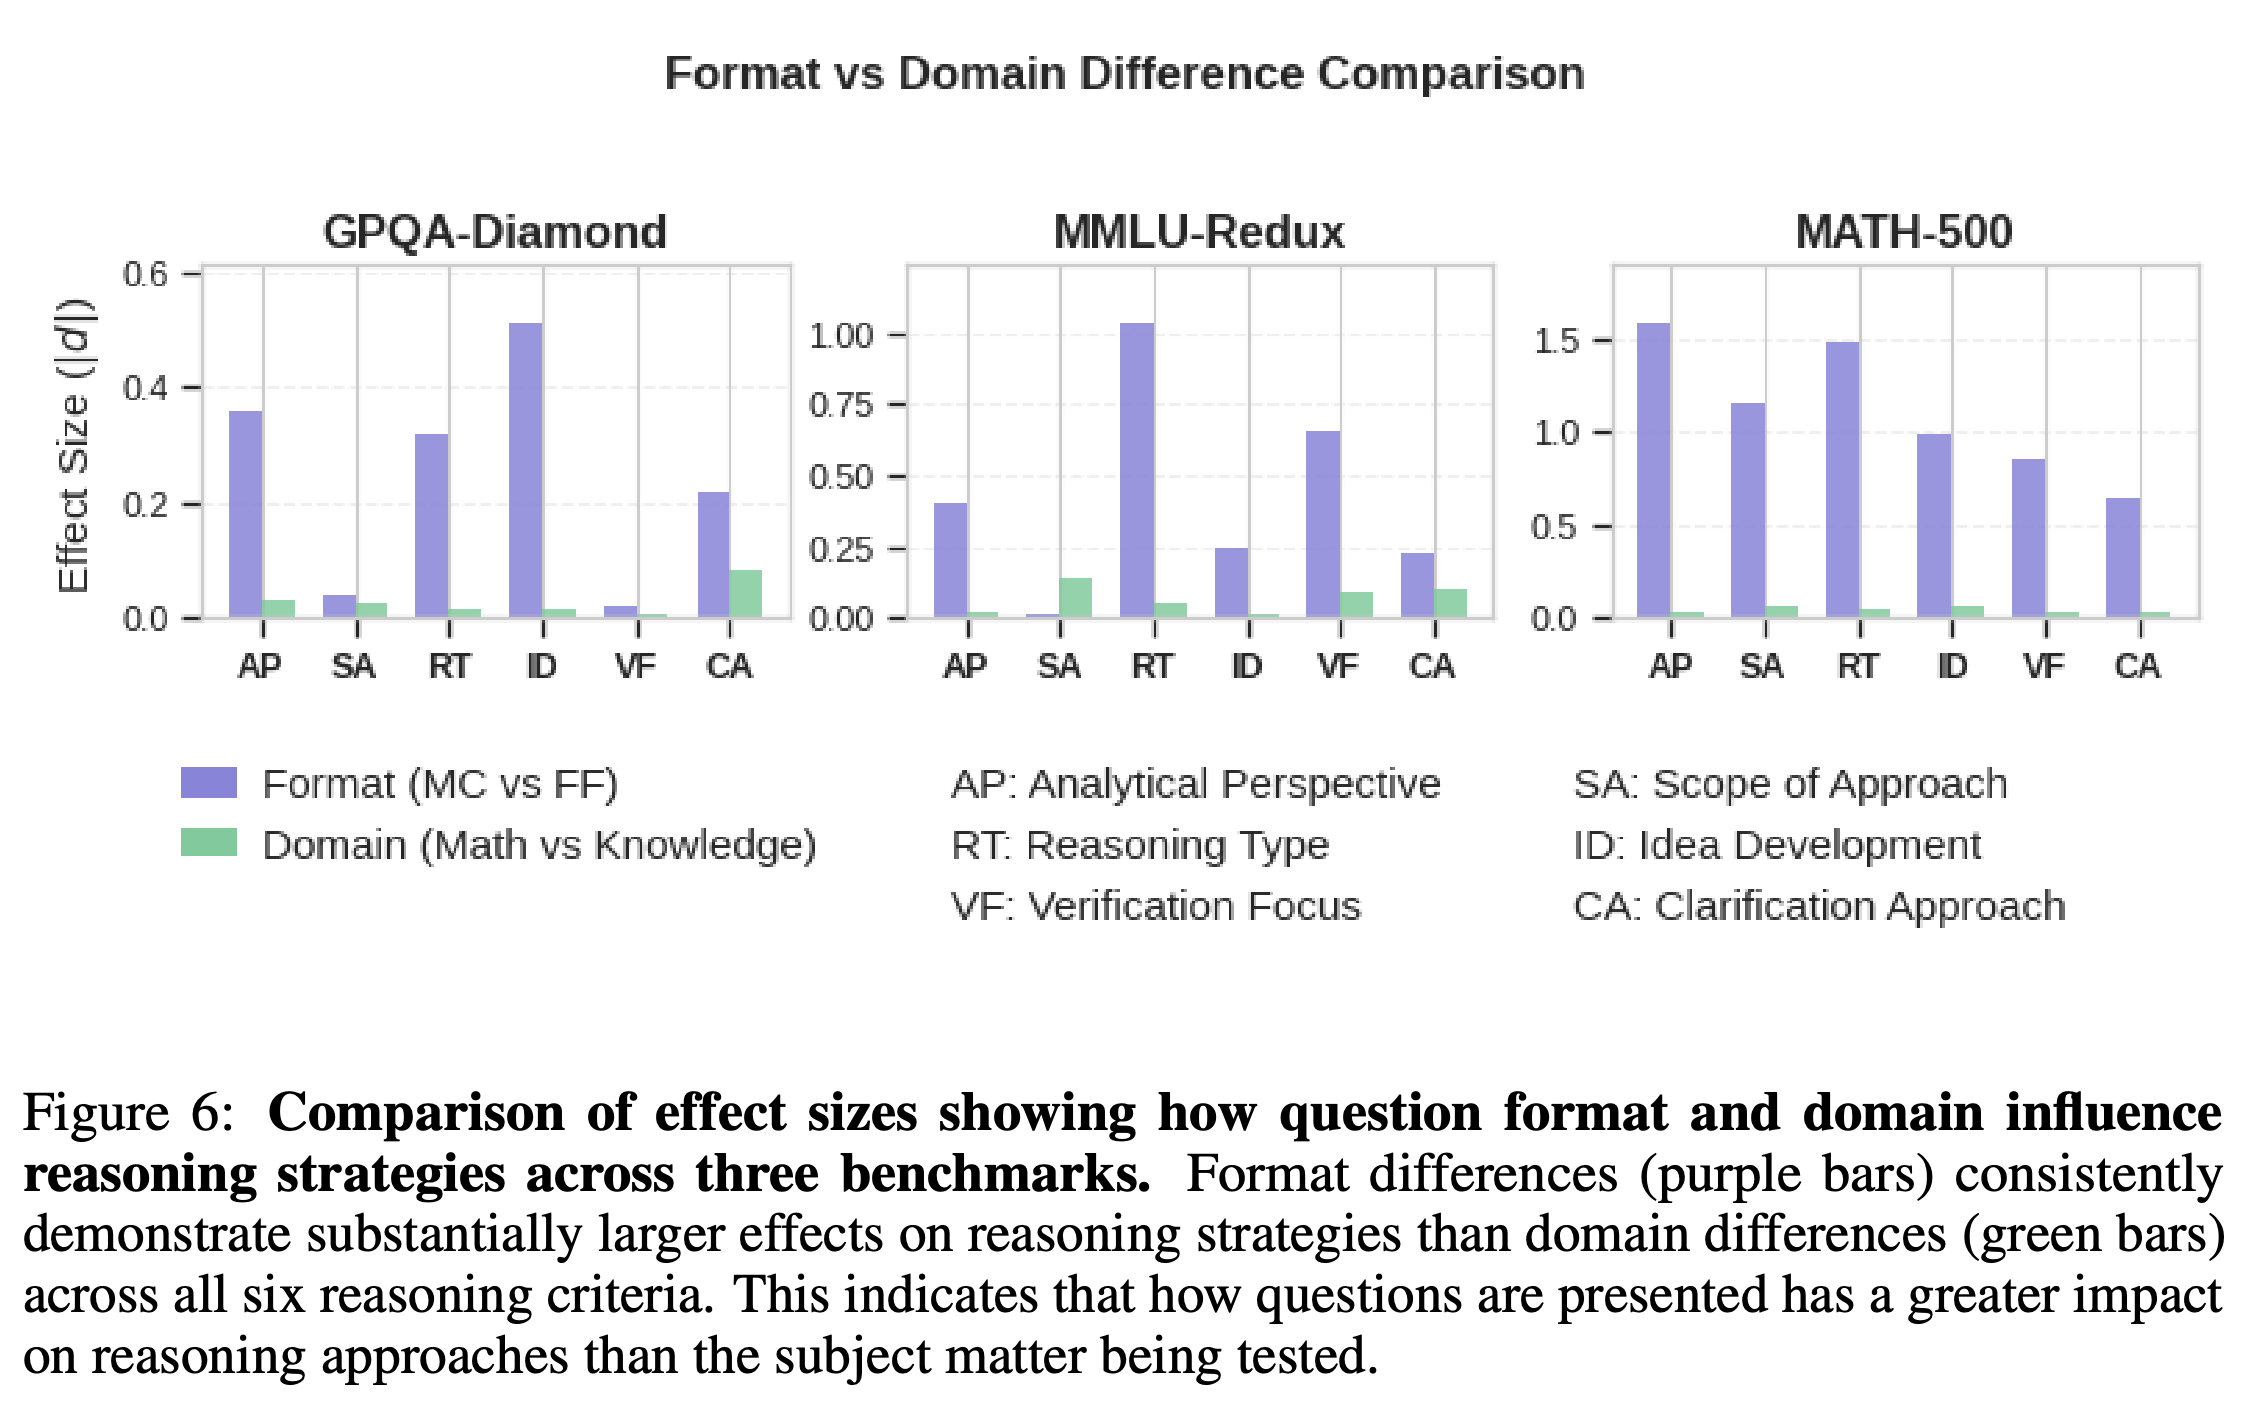
- Figure 6에서는 대체로 형식 효과가 도메인 효과보다 크게 나타난다. Table 10은 MATH-500 Analytical Perspective에서 최대 형식 효과인 Cohen’s d = 1.58을 보고한다.
- 도메인 효과가 일관되게 0.2 미만이라는 주장은 MATH-500의 효과를 0.37과 0.44로 제시한 Table 11과 충돌한다. 또한 이 표는 비교 5개를 유의하다고 표시하지만 캡션은 18개 중 4개라고 기술한다. 도메인 효과 결과의 불일치를 해소해야 한다.
그래프에서 형식 효과는 대체로 도메인 효과보다 크며, 특히 MATH-500에서 차이가 두드러진다. 그러나 Table 11은 도메인 효과를 0.37과 0.44로 보고한다. 이는 작게 표시된 도메인 효과 막대 및 모든 도메인 효과가 0.2 미만이라는 주장과 충돌한다.
5.2 Impact of training data format on model reasoning behavior
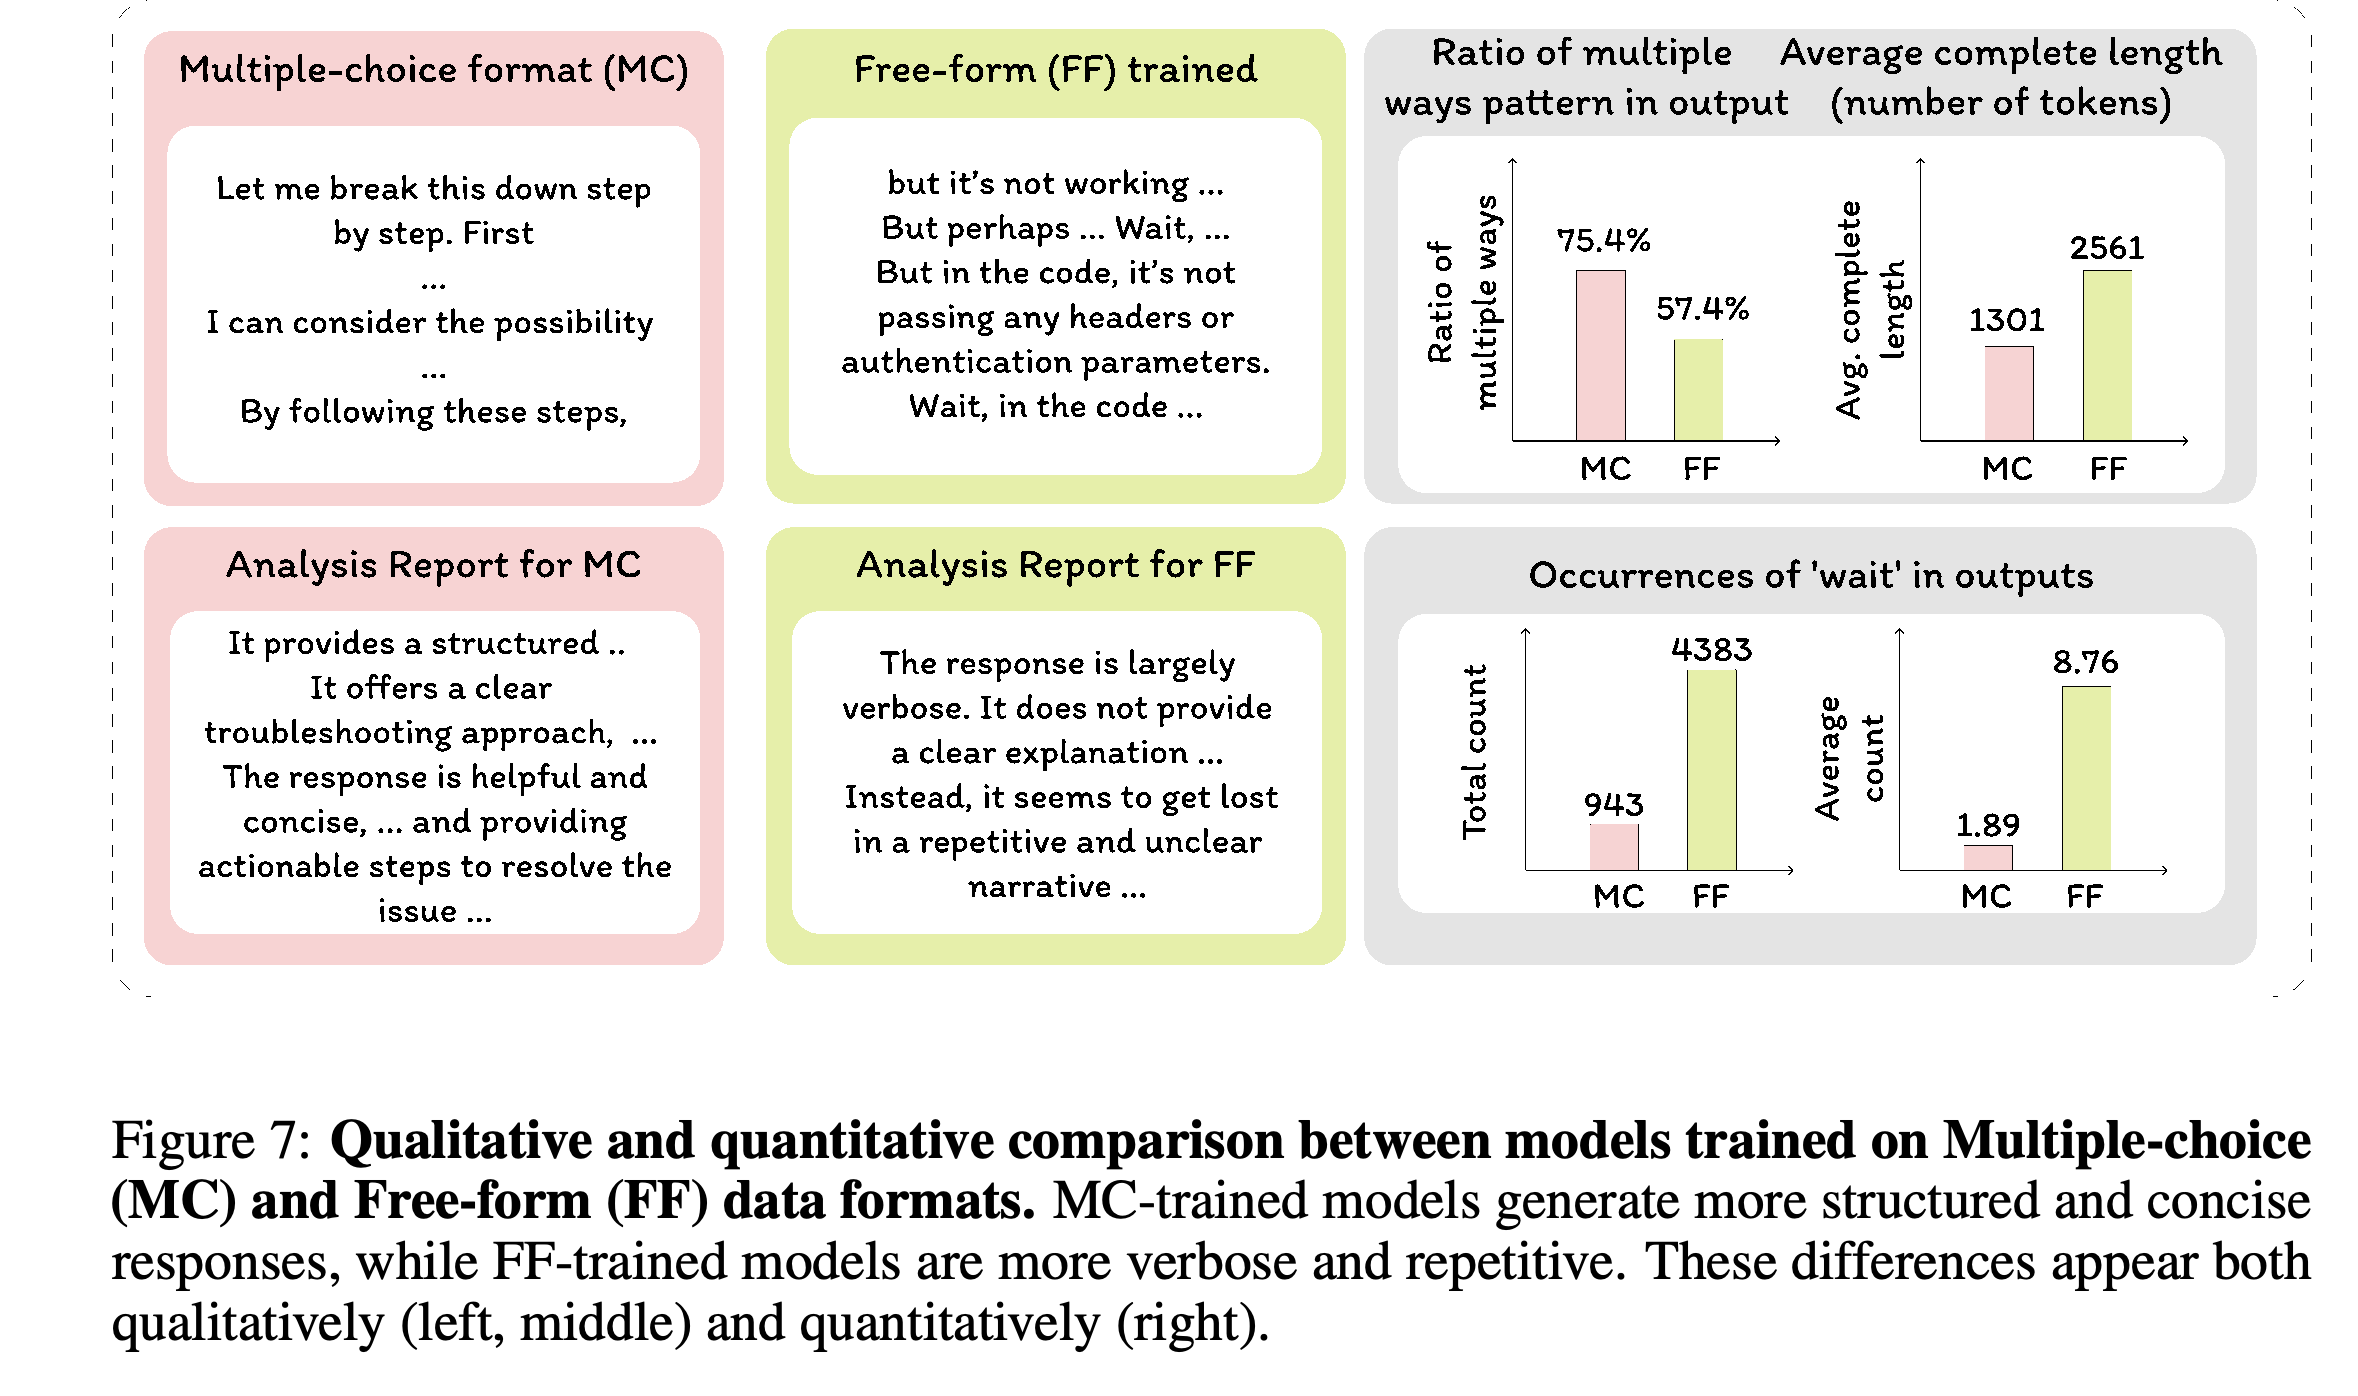
Arena-Hard에서 MC로 학습한 모델은 더 짧게 응답하고 여러 접근법을 더 자주 탐색한다. FF로 학습한 모델은 추론 경로 1개 안에서 검증을 더 자주 반복한다. 논문은 이를 초반에 여러 경로를 고려하는 너비 우선 탐색과, 반복 점검하며 경로 1개를 따라가는 깊이 우선 탐색에 비유한다.
- Figure 7에서 여러 접근법을 사용하는 비율은 MC가 75.4%, FF가 57.4%다. 평균 생성 길이는 1301토큰과 2561토큰이며, ‘wait’의 평균 출현 횟수는 1.89회와 8.76회다.
- 이 측정치는 출력 구조와 반복 양상의 차이를 뒷받침한다. 답변 단서가 이러한 스타일을 유도한다는 설명은 형식 비교에 대한 해석이며, 별도로 검증한 메커니즘은 아니다.
- 정성적 보고서는 MC 모델의 구조를 높이 평가하지만, 이러한 문체 평가는 답변의 정답 여부를 입증하지 않는다.
MC 모델의 평균 생성 길이는 1301토큰이고 'wait'의 평균 출현 횟수는 1.89회다. FF 모델은 각각 2561토큰과 8.76회다. 여러 접근법을 사용하는 비율인 75.4%와 57.4%도 측정된 출력 차이를 보여주며, 함께 제시한 보고서는 정성적 판단을 덧붙인다.
5.3 Interpolating desired reasoning strategies through model merging
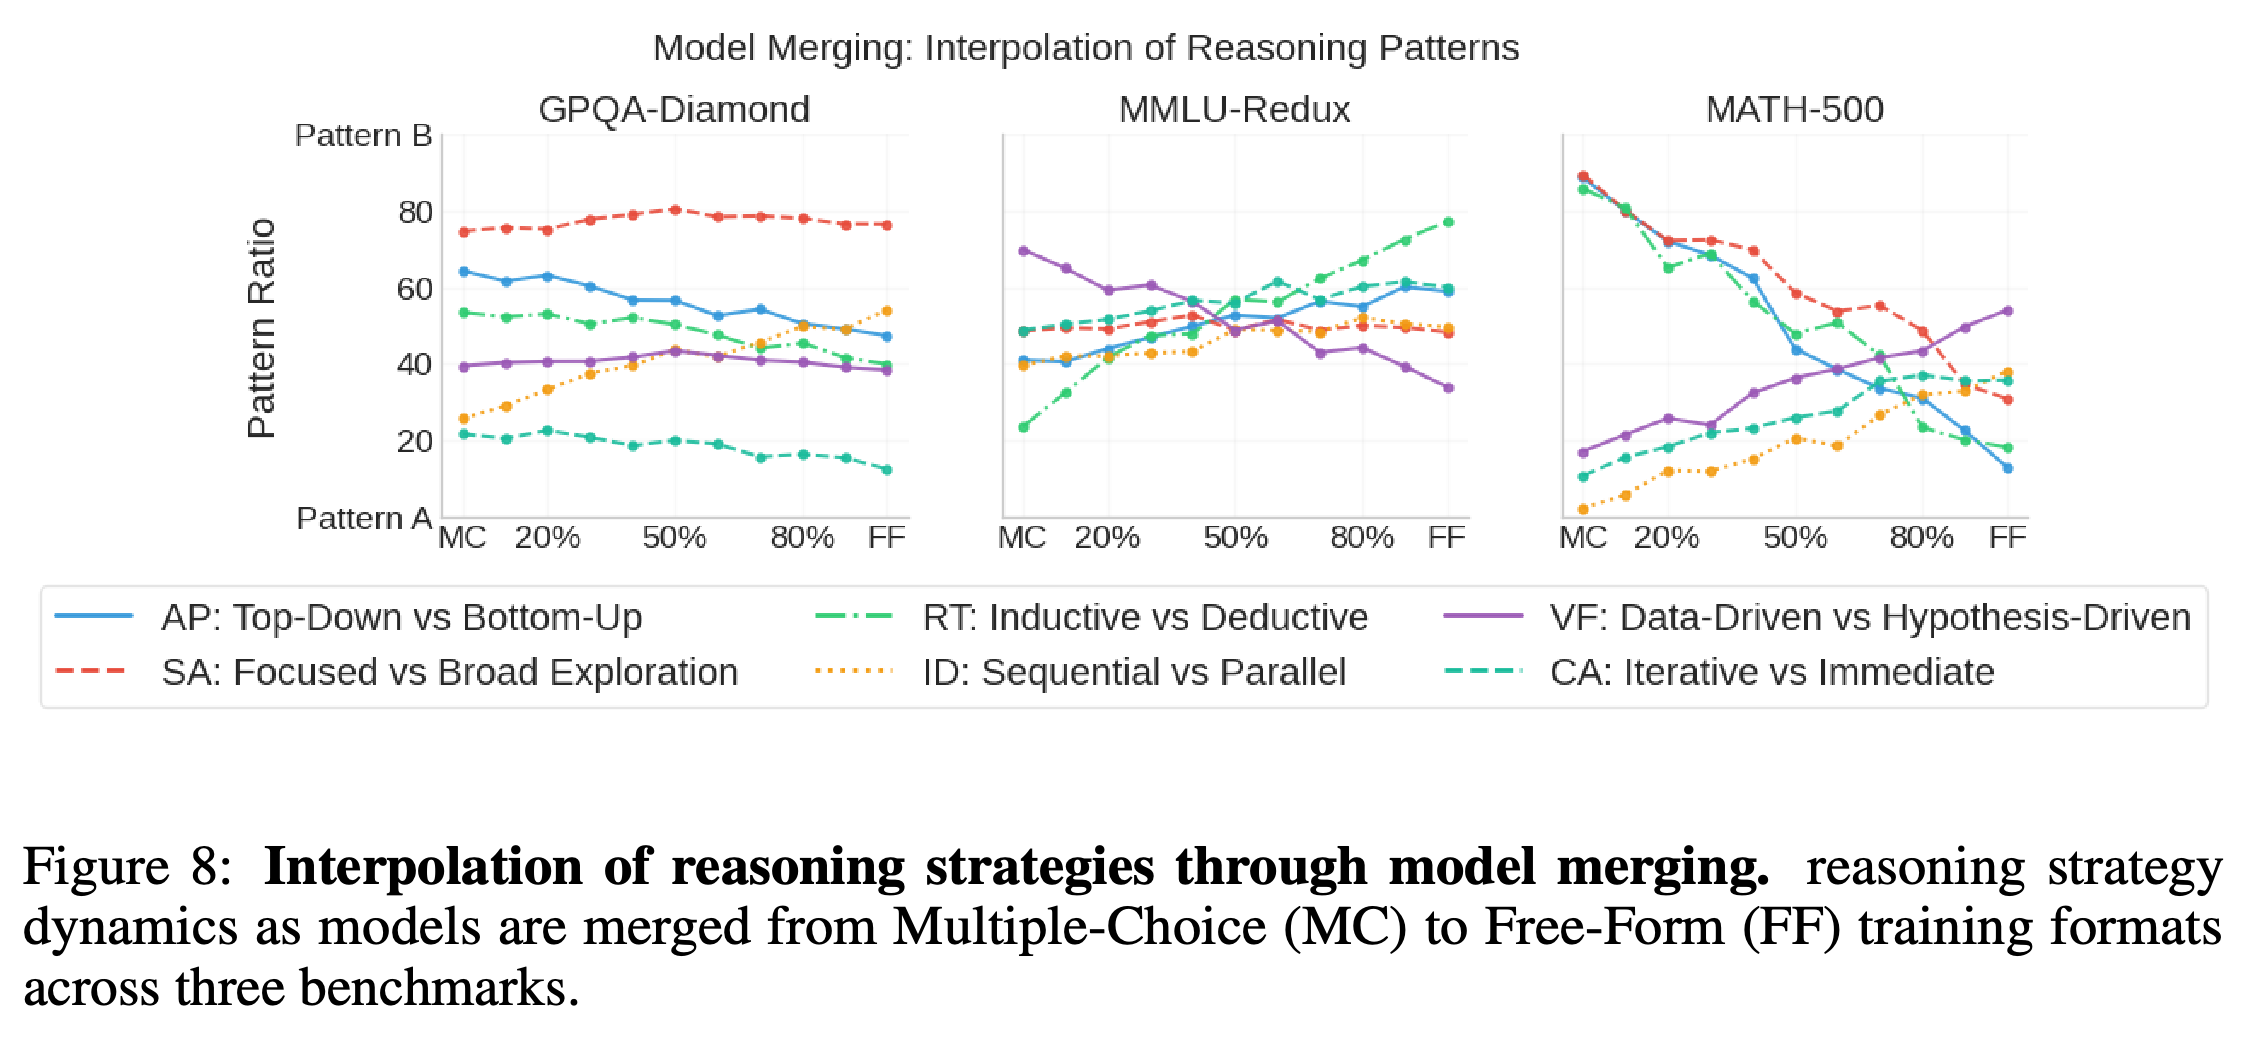
선형 모델 병합에서 혼합 비중이 MC 모델에서 FF 모델 쪽으로 이동하면 전략별 비율이 달라진다. GPQA-Diamond의 변화는 비교적 완만하고, MMLU-Redux에서는 병합 비율 50% 부근에서 여러 전략의 비율이 교차하며, MATH-500에서는 가장 큰 변화가 나타난다.
- 논문은 MATH-500에서 보간에 따라 Bottom-Up Analytical Perspective의 비율이 거의 85%에서 약 15%로 감소한다고 기술한다. 이 기준은 세부 사항에서 시작하는 방식과 전체 구조에서 시작하는 방식을 대비한다.
- Figure 8은 추가 학습 없이 측정된 전략 분포가 달라짐을 보여준다. 중간 혼합 모델의 정확도나 안전성이 개선되었다는 결과는 보고하지 않으며, 여러 변화 곡선은 단조 증가하거나 단조 감소하지 않는다.
가중치 혼합 비중을 바꾸면 여러 전략의 비율이 달라진다. MATH-500에서 가장 큰 변화가 나타나고, MMLU-Redux에서는 더 복잡한 변화 양상이 나타난다. 이 그림은 행동 프로필을 측정하며, 병합 모델의 정확도나 안전성이 개선되었다는 결과는 보고하지 않는다.
6 Conclusion
논문은 생성된 응답에서 도출한 분류 체계가 전략 분석, 지시를 통한 선택적 수정, 학습 데이터의 영향 조사에 활용될 수 있다고 결론짓는다. 실험은 모델 가중치 보간으로 측정된 전략 프로필을 바꿀 수 있음도 보여준다. 다만 이 벤치마크 조건을 넘어 실제 배포에서 얻을 이점은 검증하지 않았다.
부록
- A Implementation details, A.1 CoT Encyclopedia details에서는 GPT-4o로 기준을 추출하고 루브릭을 생성하며, text-embedding-3-large로 임베딩한다. 기준은 GPQA-Diamond, MMLU-Redux, MATH-500의 테스트 세트 응답에서 도출한다. 실루엣 점수로 군집 수를 선택하여 메도이드로 대표되는 군집 6개를 얻는다.
- A.2 Statistical test details, A.3 Human evaluation details에서는 유의수준 0.05의 카이제곱 검정으로 분포를 비교하고 Cohen’s d로 효과 크기를 측정한다. 평가자 4명은 데이터 주석 플랫폼인 Argilla에서 기준과 보고서에 관한 이진 질문 4개에 답한다. 각 평가자에게 응답 25개를 배정하며, 공통 예시에 대한 평가자 간 일치도는 보고하지 않는다.
- A.4 Benchmark evaluation details에서는 추론 라이브러리인 vLLM을 사용하며, 생성 설정은 temperature 0.6, top p 0.95, 최대 32768토큰이다. Temperature와 top p는 샘플링의 변동성과 후보 토큰이 차지하는 누적 확률을 조절한다. 생성된 추론에서 답을 파싱한 뒤 정답 검증 라이브러리인 Math-Verify로 확인한다. LLaMA-Guard-3 8B는 응답을 안전 또는 비안전으로 분류하며, 안전하다고 분류한 비율을 보고한다.
- A.5 Training details에서는 같은 입력에 대한 여러 출력의 보상을 비교하는 알고리즘인 GRPO를 Open-R1 학습 라이브러리로 실행한다. 목적함수는 클리핑한 정책 업데이트와 참조 모델에서 벗어난 정도를 측정하는 KL 발산 페널티를 결합한다. 보상은 정답이면 1, 그렇지 않으면 0이며, 별도의 형식 보상은 없다. 설정은 최대 생성 길이 2048, 생성 수 3, 배치 크기 72, bfloat16 수치 정밀도, 어텐션 구현인 flash attention 2, 1 epoch, 워밍업 비율 0.1을 포함한다. 학습률은 2.0e05로 인쇄되어 있어 의도한 값이 불확실하다.
- A.6 Computing resources에서는 샘플 100,000개로 7B 모델을 학습하는 데 NVIDIA H100 80GB GPU 8개와 576 GPU시간을 사용한다. 샘플 3,698개의 추론에는 NVIDIA A100 40GB GPU 16개와 384 GPU시간을 사용한다. CPU는 AMD EPYC 7763 64-Core Processor다.
- B Further Analyses, B.1 Fine-grained benchmark-specific criteria analysis에서는 벤치마크별로 군집화하여 서로 연관된 문제 해결 범주와 User Understanding을 포함한 별도의 지시 이행 범주를 얻는다. B.2 Ablation study on representative embedding selection에서는 메도이드, 빈도, 밀도, 실루엣 기반 대표 선택을 비교한다. 대부분의 범주는 유사하게 유지되며, 대안 2개에서는 Clarification Approach가 Computation Style 또는 Clarity on Steps로 바뀐다.
- B.3 Consistency of reasoning strategies across model sizes within the same family에서는 Distill-R1 1.5B, 7B, 32B가 문제 해결 벤치마크 3개에서 비슷한 전략 분포를 보인다. 쌍별 Cohen’s d 절댓값은 대부분 0.1 미만이다. B.4 Extending reasoning strategy analysis to non-reasoning models에서는 Qwen-2.5-Instruct-32B와 Qwen-2.5-Math-Instruct-32B에 프레임워크를 적용하여 관련된 기준과 여러 분포 차이를 발견한다. 다만 Table 13은 모델을 QwQ와 s1.1로 표기하여 이 확장 실험과 어떤 관계인지 모호하다.
- C Broader Impact는 모델 디버깅, 학습 커리큘럼, 상호작용형 설명에 활용하는 방안을 제안하고 데이터셋의 구조적 다양성이 필요하다고 주장한다. 이는 잠재적 활용 방안이며, 논문에서 언급한 교육, 의료, 과학적 발견 환경의 실제 배포를 평가하지는 않는다.
- D Limitations는 GPT-4o 평가자의 편향 가능성, 제한된 과제와 모델 범위, 모델이 문체 지시를 따르는 능력에 대한 의존성을 인정한다. 사람 평가는 분석이 타당해 보이는지 판단하므로, 그 분석이 모델 내부의 계산 과정과 일치하는지는 검증하지 않는다.
- E Prompts는 대립하는 기준 추출, 루브릭 생성, 응답 발췌문을 근거로 한 보고서 작성, 객관식 답변 평가, 전략 지시를 위한 템플릿을 제공한다. 보고서 템플릿은 패턴 2개 모두의 근거를 제시하고 혼재된 신호를 인정하도록 요구하지만, 최종 표현은 여전히 기준마다 패턴 1개를 선택한다.
- F Qualitative Analyses, F.1 Comparative Analysis of CoT Encyclopedia Outputs and Pre-defined Criteria는 프레임워크의 서술형 보고서와 backtracking 레이블을 비교한다. Table 14는 움직이는 매질에 관한 물리 응답을 분석한다. 반면 Table 15는 limonene 합성 질문에 관련 없는 분광학 문제를 논하는 응답을 연결한다. 이 불일치로 인해 후자 예시의 증거로서의 가치는 제한된다.
- F.2 Divergent reasoning strategies from Multiple-Choice vs. Free-Form Training Data는 장난감 배분의 공정성과 보안 원격 로그인 서버가 출력한 메시지인 sshd 오류에 관한 Arena-Hard 응답을 비교한다. 보고서는 MC 모델의 구조를 높이 평가하지만, 이 모델의 오류 진단 응답은 질문에 없는 blockchain 주장을 추가한다. FF 응답은 코드와 인증 세부 사항을 지어낸다. 이 예시는 정답 여부나 신뢰할 수 있는 진단보다 문체 차이를 더 직접적으로 보여준다.
짧은 생각
가장 강한 실용적 근거는 응답 행동에서 자동으로 도출한 설명을 선택적 수정의 성과를 높이는 지시와 연결한 결과다. 무작위 지시 및 지시가 없는 조건과의 비교는 개입 효과를 평가하는 데 도움이 된다. 실제 배포를 평가하려면 들어오는 모든 질문에 전략 선택을 적용하고, 지시가 없었으면 맞혔을 답변을 지시가 훼손하는지 측정해야 한다.
학습 형식 실험은 추론 스타일을 진단할 때 주제와 함께 데이터 제시 형식도 살펴볼 구체적인 근거를 제공한다. 정량적으로 해석하려면 Figure 6과 Table 11의 불일치를 해소해야 한다. 정성적 예시의 불일치는 읽기 쉬운 분석 보고서에도 관련성과 사실 정확성에 대한 독립적인 검증이 필요함을 보여준다.