


The Design Space of Tri-Modal Masked Diffusion Models 요약 설명
25 Feb 2026 | Paper Review Unified Multimodal Models Masked Diffusion Models Scaling Laws Multimodal Pretraining목차
이번 글에서는 The Design Space of Tri-Modal Masked Diffusion Models 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 2월 25일(Arxiv)
- Bethune, Louis, Turrisi, Victor, Mlodozeniec, Bruno Kacper, Lopez, Pau Rodriguez, Boominathan, Lokesh, Bhendawade, Nikhil, Shidani, Amitis, Pelemans, Joris, Olausson, Theo X., Hjelm, Devon, et al.
- Apple, Google Deepmind, University of Cambridge, MIT
- 논문 링크
요약
- The Design Space of Tri-Modal Masked Diffusion Models는 하나의 양방향 transformer와 통합 이산 어휘를 사용해 text-only, image-text, audio-text 데이터로 처음부터 사전학습하는 방법을 연구한다. 핵심 기여는 최적화 설정 전이, 연산량 배분, 모달리티 혼합 비율, 마스킹 스케줄, 추론 설정을 통제된 실험으로 분석한 데 있다.
- CompleteP와 확률미분방정식(SDE) 스케일링을 결합하면 임계값 아래에서 물리적 배치 크기가 달라져도 최종 손실이 거의 일정하게 유지된다. 이를 통해 하드웨어에 맞춘 배치 설정과 최적화 동작을 분리한다. 학습 기간 스케일링 실험에서는 기존 연구에서 사용한 양 끝점보다 중간 수준의 drift–horizon 배분인 γ* ≈ 0.44가 유리했다.
- 262개의 tri-modal 모델을 5 × 10^18부터 1 × 10^22까지의 24개 isoFLOP 예산에서 학습한 결과, Kaplan 방식의 스케일링 법칙은 R² = 99.3%와 평균 상대 오차 0.5%를 달성했다. 보고된 토큰 최적 경계는 D★(N) = 7754 · N^0.84다. 점근적으로는 파라미터당 최적 토큰 수가 감소하지만, 3B 규모에서 추정한 필요량은 약 480B 토큰으로 Chinchilla 기준인 약 60B보다 많다.
- 보고된 학습량인 6.4T 토큰으로 사전학습만 수행한 3B 모델은 텍스트, 이미지, 음성을 생성한다. CC12M FID-Inception은 10.06, GenEval overall은 48.89, MMLU는 41.57이며, LibriSpeech-PC FAD는 0.368, WER은 0.164다. 한계로는 낮은 공간적 구성 능력, 평가 지표에 따라 달라지는 최적 샘플링 설정, 실험한 작은 규모에서 관찰되지 않은 모달리티 혼합 시너지, 정답 길이를 제공하는 음성 평가가 있다.
1 Introduction
논문은 서로 다른 위치와 모달리티에 조건 정보가 존재하는 생성 문제에서, masked diffusion을 생성 순서에 구애받지 않는 반복적 정제 방법으로 제시한다. 공동 denoising은 작업마다 별도의 인과적 분해를 정의하지 않고도 infilling과 유연한 조건부 생성을 지원한다.
- 이 연구는 LLaDA로 초기화하거나 autoregressive backbone을 재활용하지 않고 처음부터 사전학습하는 방법을 다룬다. 따라서 비교에서는 총 학습 토큰 수를 집계하는 일이 중요하다.
- 저자들은 단순한 MDM 구현이 여전히 autoregressive 모델보다 샘플링 지연 시간이 상당히 크다고 인정한다. 양방향 구조만으로 추론 효율이 더 높다고 볼 수는 없다.
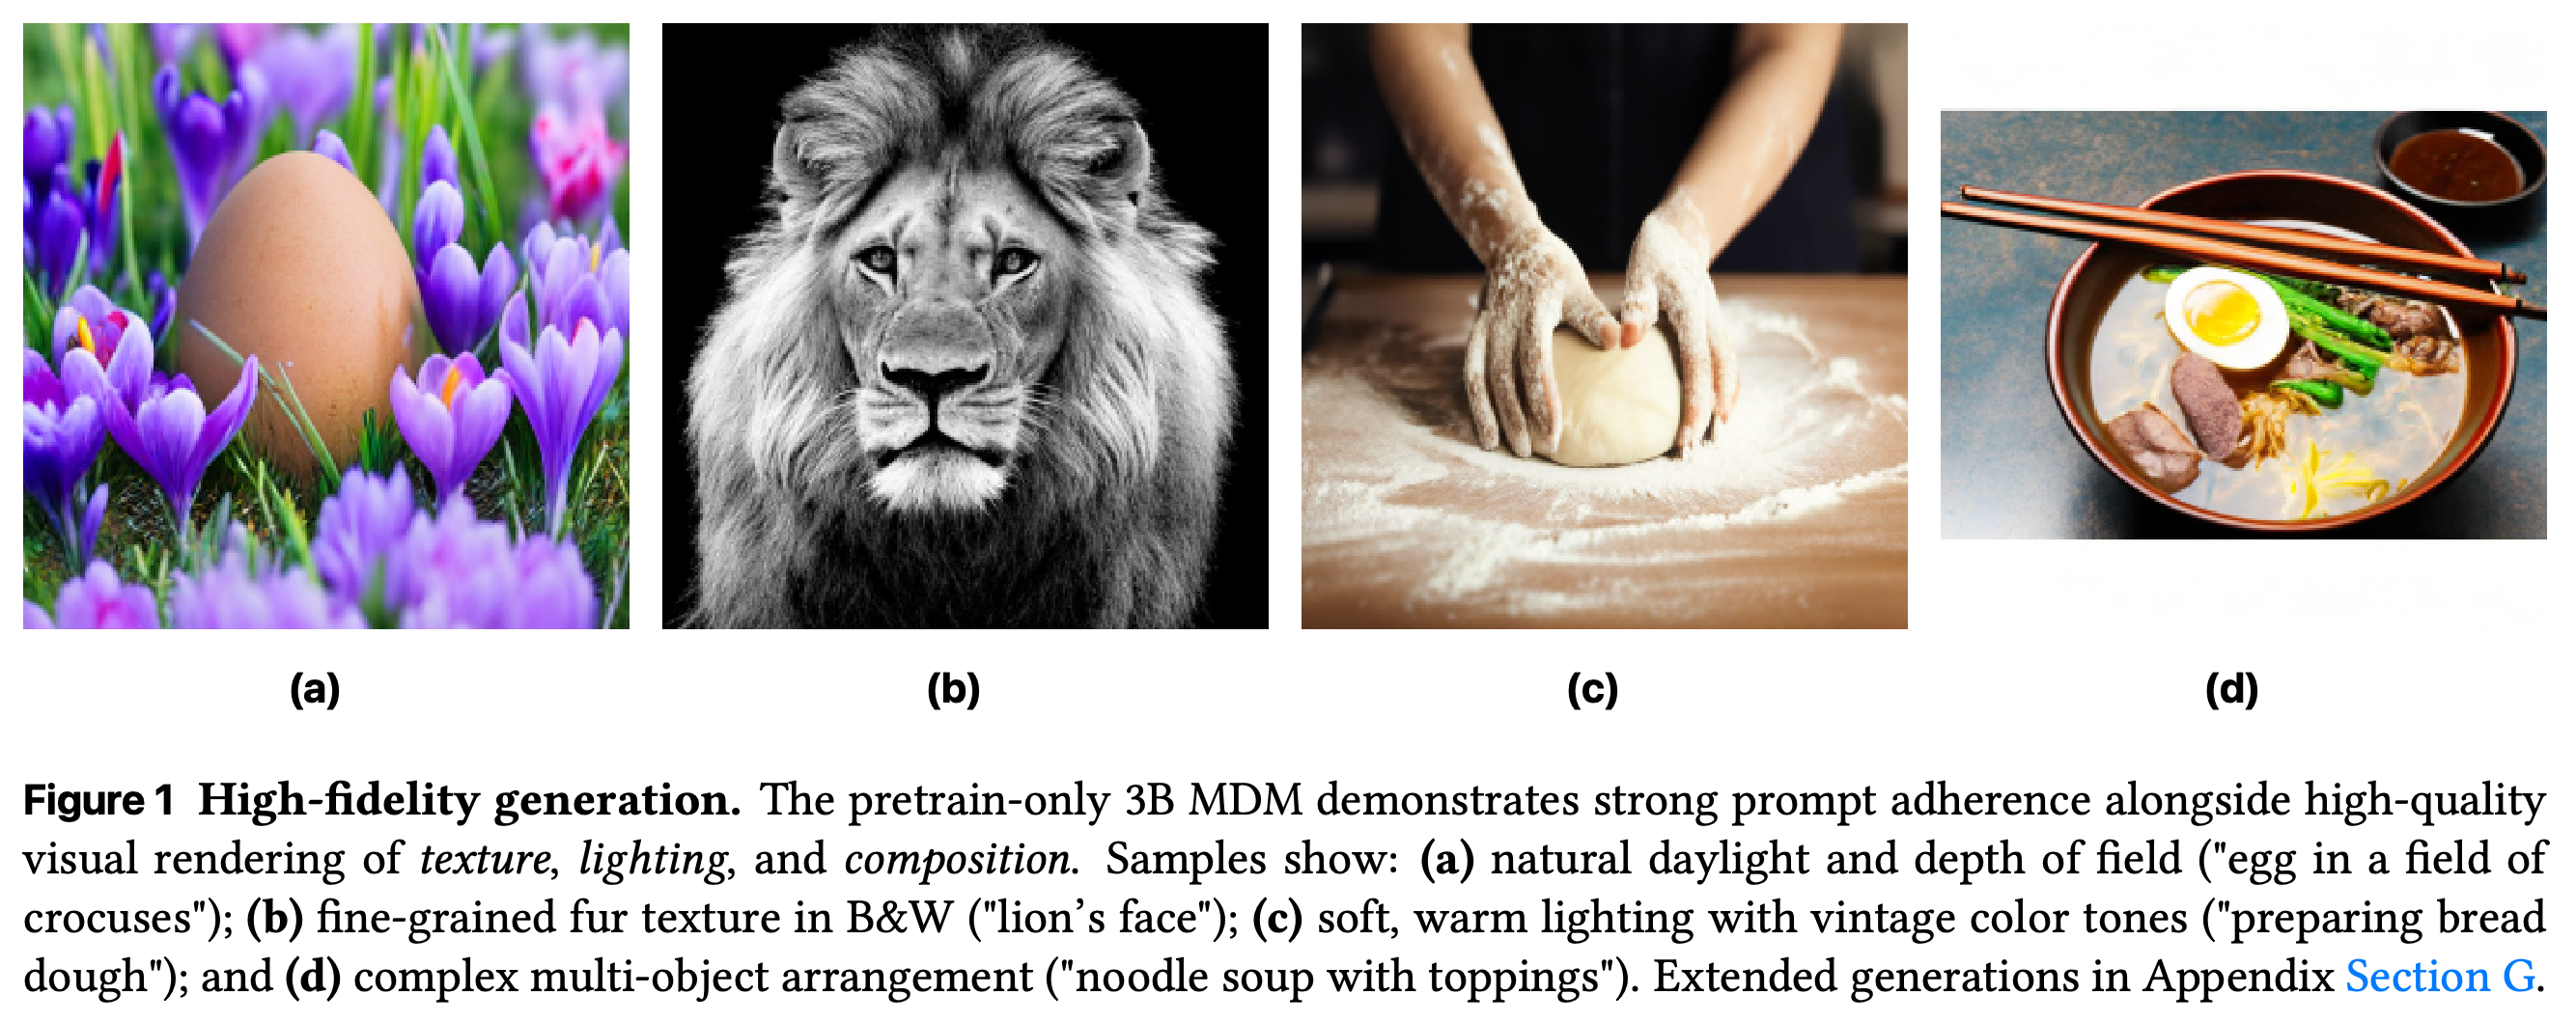
- Figure 1은 선별된 이미지 생성 사례를 보여준다. 그러나 정성적 예시만으로 일반적인 프롬프트 준수율이나 비교 우위를 입증할 수는 없다.
4개의 예시는 사전학습만 수행한 3B 모델의 질감, 조명, 여러 객체의 렌더링 능력을 보여준다. 이는 생성 능력의 정성적 근거이며, 측정된 성공률이나 다른 모델과의 비교 결과는 아니다.
2 Background and Related Work
관련 연구에서는 텍스트, 이미지, 오디오 각각의 masked diffusion과 통합 멀티모달 모델을 구분한다. 다른 모달리티를 조건으로 하나의 모달리티를 생성하는 것과, 여러 모달리티를 생성할 수 있는 공유 토큰 수준 모델을 학습하는 것도 구분한다.
2.1 Masked Diffusion Models
MDM은 이산 토큰을 점진적으로 [MASK]로 대체하고 이를 복원하는 역과정을 학습한다. 생성은 모든 토큰이 마스킹된 시퀀스에서 시작한다. 연속 시간 정식화는 고정 시간 단계의 틀을 확장하며, 샘플링한 손상 수준에서 학습할 수 있게 한다.
- LLaDA와 Dream은 변분 우도 경계와 관련된 마스킹 복원 목적함수를 사용한다. 손실은 마스킹된 위치에서 계산하며 시간에 따른 가중치를 적용한다.
- 이미지 tokenizer는 픽셀을 이산 공간 코드로 압축한다. 이를 통해 픽셀을 직접 범주형으로 모델링할 때 필요한 긴 시퀀스를 피한다.
- 오디오 분야에서 인용한 방법들은 이산 diffusion 또는 반복적인 마스킹과 마스킹 해제를 neural audio codec과 결합한다.
2.2 Multimodal Masked Diffusion Models
기존의 통합 text–image MDM에는 MMaDA, UniDisc, 그리고 이전의 동시 vision-language diffusion 모델들이 있다. 이 연구는 오디오를 추가하고 모든 모달리티를 처음부터 공동 사전학습한다. 또한 비교할 때 모델 크기와 총 학습 토큰 수라는 2가지 정보를 모두 보고할 것을 권고한다.
- 학습 데이터는 text-only, image-text, audio-text로 나뉜다. 데이터 설명에는 직접 짝지어진 image-audio 예시가 없다.
- 정식화는 여러 방향의 조건부 생성을 지원하지만, 주요 정량 결과는 언어 benchmark, text-to-image 생성, text-to-speech 생성을 다룬다.
3 Method
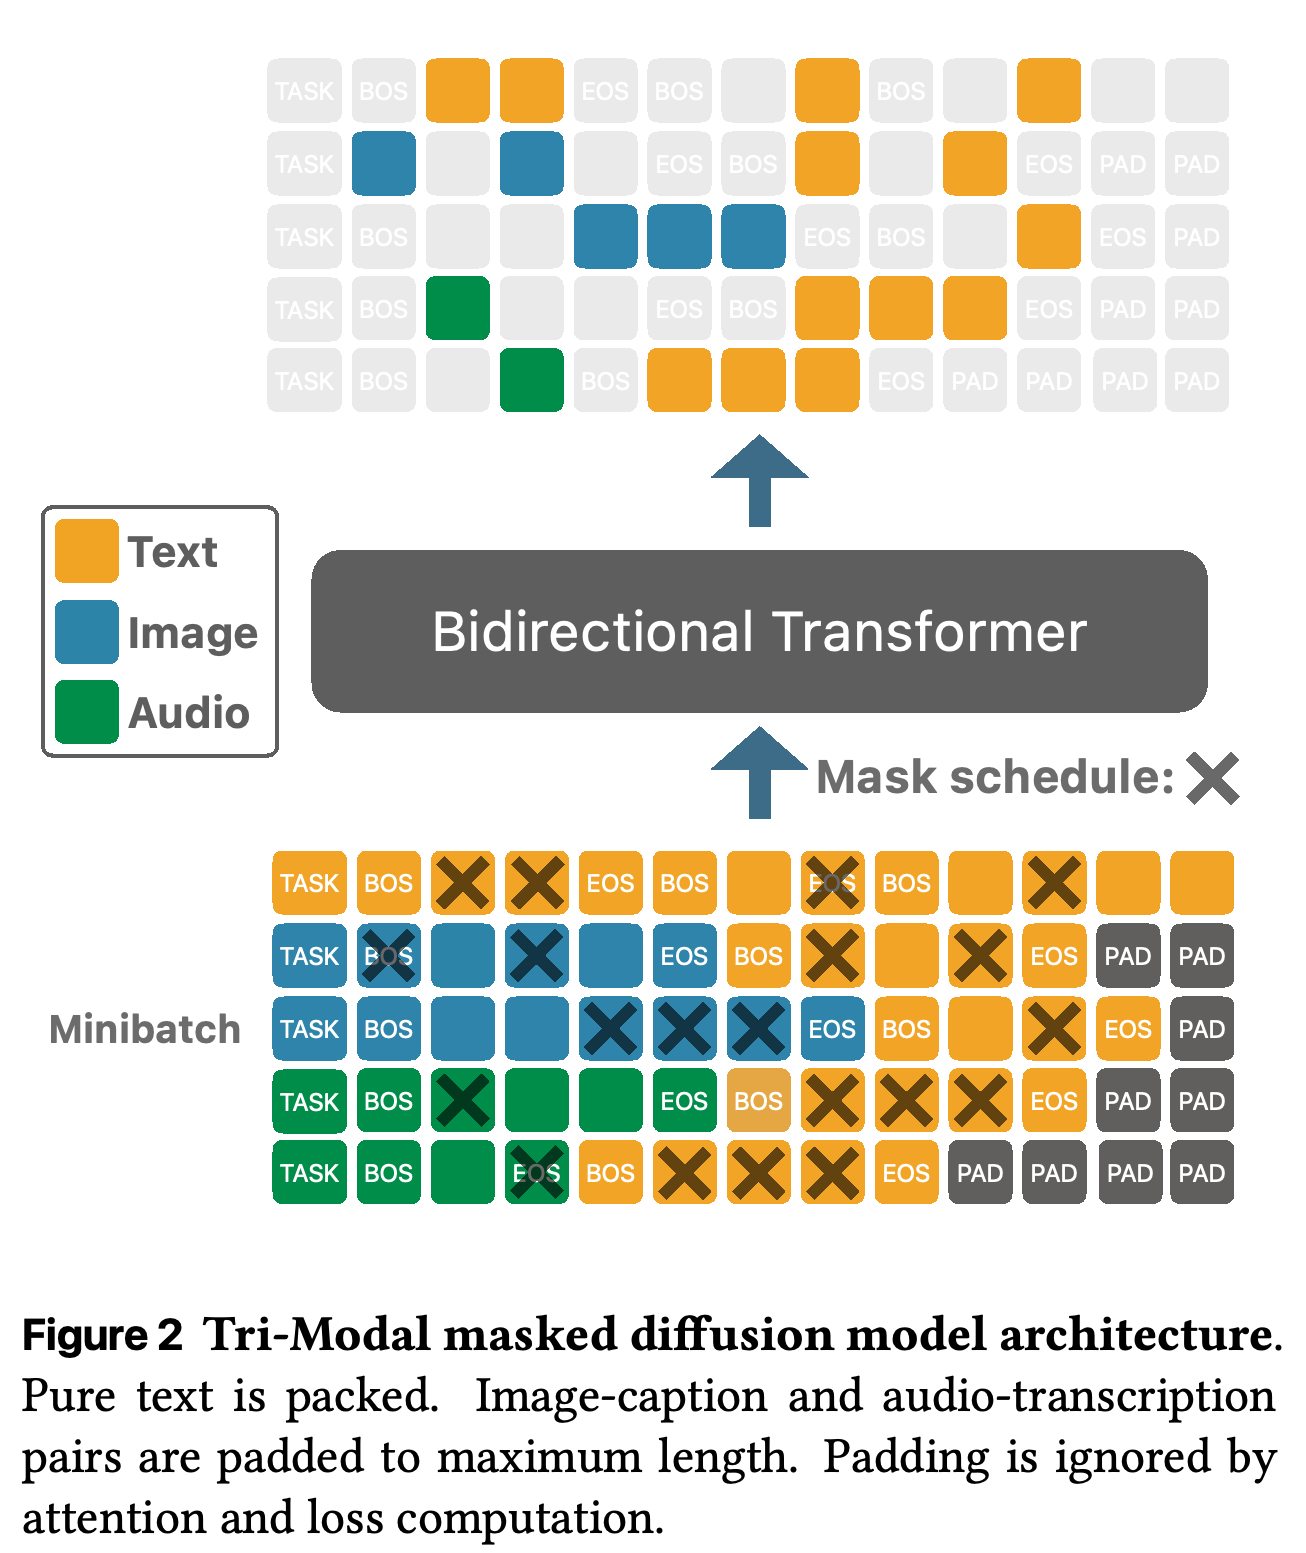
모델은 서로 겹치지 않는 텍스트, 오디오, 이미지 어휘에 모달리티별 BOS, EOS, MASK 토큰, 3개의 task 토큰, padding 토큰을 결합한다. 텍스트 시퀀스는 packing한 뒤 잘라내며, image-text와 audio-text 시퀀스는 EOStext 뒤를 오른쪽으로 padding한다. Task 토큰은 마스킹하지 않는다.
- 각 위치를 독립적으로 마스킹해 손상된 시퀀스를 만들고, 공유 denoiser가 통합 어휘에 대한 logits를 예측한다.
- 제시된 목적함수는 마스킹된 위치 중 padding이 아닌 위치의 복원 손실을 평균하고, w(t) = 1/t를 적용한 뒤 z-loss 정규화 항을 더한다. Cut-cross-entropy를 사용해 큰 어휘 전체의 확률 tensor를 직접 생성하지 않는다.
- 생성은 마스킹된 목표 토큰과 관측된 프롬프트에서 시작한다. 이후 모달리티에 맞게 제한한 분포와 미리 정한 선형 unmasking 스케줄에 따라 샘플링한 토큰을 점진적으로 드러낸다.
하나의 denoiser가 packing한 텍스트와 padding한 image-text 또는 audio-text 시퀀스를 처리한다. 모달리티별 mask는 토큰 유형을 유지하며, padding은 attention과 손실에서 제외한다.
3.1 Architecture
Backbone은 pre-normalization RMSNorm, SwiGLU MLP, RoPE, QK-norm을 사용하는 양방향 transformer다. 3B 모델은 배치 크기 3072, 시퀀스 길이 3256으로 1,000,000 step 동안 처음부터 학습한다. 이미지에는 SBER-MoVQGAN, 오디오에는 Higgs Audio v2, 텍스트에는 Tiktoken을 사용한다.
- 최종 설정은 24개 block, 너비 3072, 24개 attention head로 구성되며, 특수 토큰을 포함한 전체 어휘 크기는 117,698 토큰이다.
- 이미지는 256×256 해상도로 학습하며, 오디오는 4개의 codec codebook을 사용하고 최대 길이는 30초다.
- 모달리티별 생성 head를 따로 추가하지 않고 transformer backbone과 어휘 수준 예측 방식을 공유한다.
4 Hyperparameter Transfer
하이퍼파라미터 전이는 작은 모델과 짧은 토큰 학습 기간에서 탐색해, 실행하기 어려운 대규모 튜닝을 대신한다. 이 연구는 CompleteP 기반의 너비·깊이 전이와 SDE 스케일링을 함께 사용한다. Appendix D에서는 예비 확장으로 모듈별 AdamW 튜닝을 검토한다.
- 대부분의 통제된 ablation은 전역 하이퍼파라미터 튜닝 결과를 출발점으로 삼는다.
- 모듈별 튜닝은 모듈 유형과 깊이 그룹에 따라 학습률, weight decay, momentum, 수치적 damping, 초기화를 달리한다. 작은 규모에서 얻은 결과만으로 3B 규모에서도 같은 개선을 기대할 수는 없다.
4.1 Eliminating 𝐵opt with SDE Parametrization
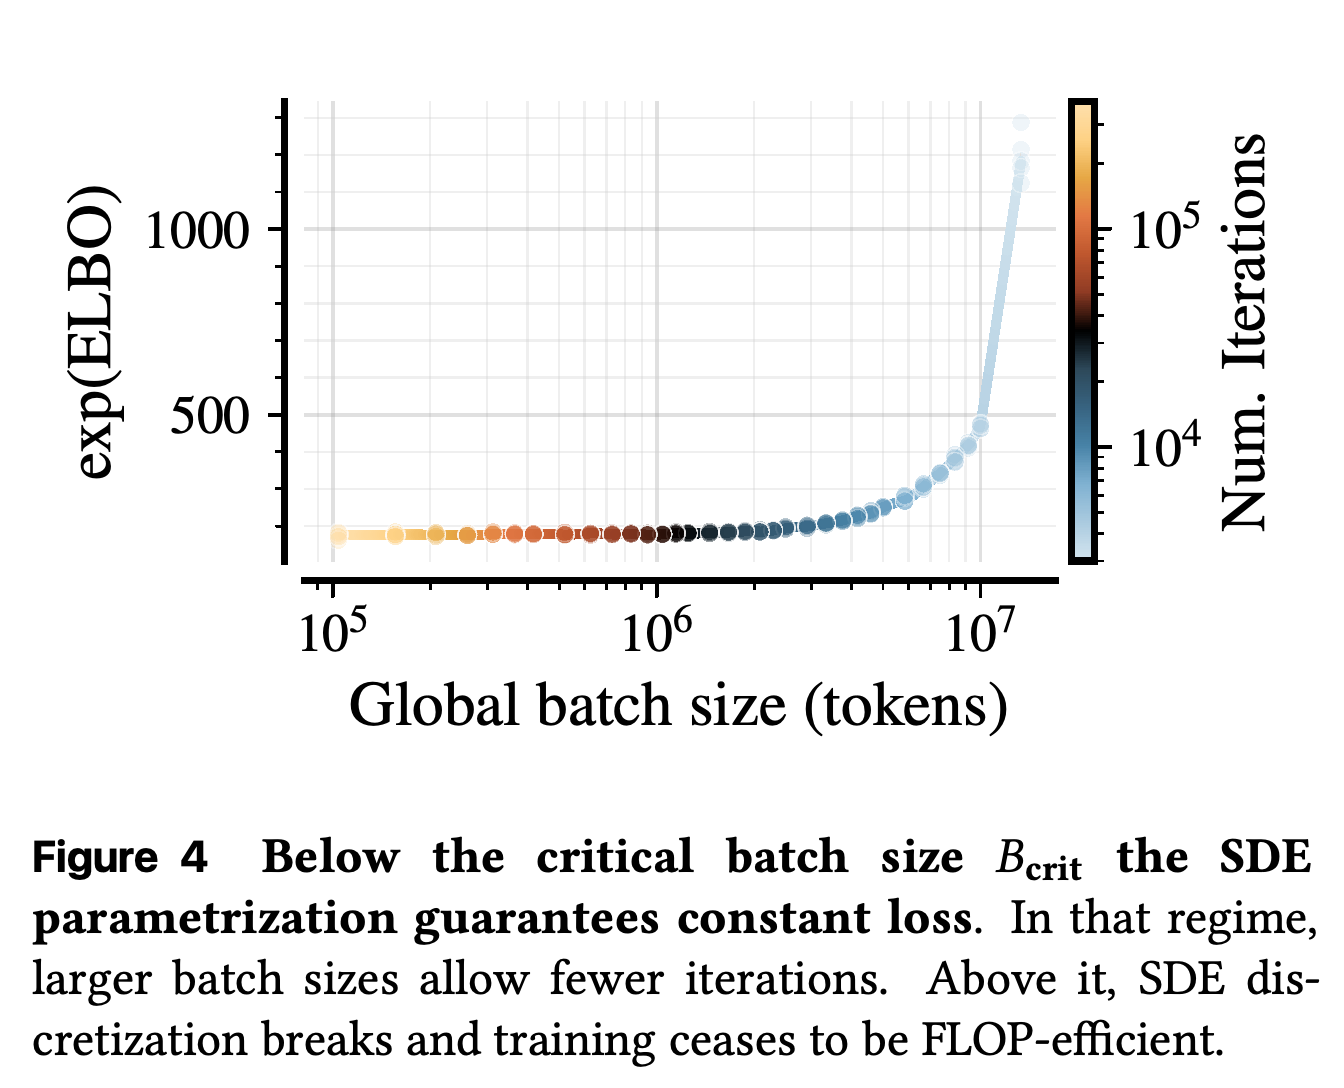
AdamW 하이퍼파라미터와 배치 크기는 SDE로 근사하는 연속 최적화 동역학을 함께 결정한다. 물리적 배치 크기를 바꿀 때 optimizer를 재스케일링하면 Bcrit 아래에서 최종 손실을 거의 동일하게 유지할 수 있다. 따라서 이 구간에서는 유일한 물리적 Bopt를 찾을 필요가 없다.
- Figure 4는 넓은 손실 평탄 구간과 큰 배치에서의 성능 저하를 보여준다. 배치가 커지면 적분 step이 너무 적어져 SDE 근사가 깨진다.
- 이 결과는 B ≤ Bcrit, 동일한 토큰 예산, 지정된 optimizer 재스케일링을 전제로 한다. 임의의 배치 크기나 optimizer 설정을 서로 바꿔 써도 된다는 뜻은 아니다.
SDE 재스케일링을 적용하면 일정 범위의 물리적 배치 크기에서 최종 손실이 거의 일정하게 유지된다. 이후 배치가 커져 optimizer step이 너무 적어지면 손실이 증가한다. 이 평탄 구간은 임계 구간 안에서 물리적 Bopt 튜닝을 생략할 근거가 된다.
4.2 Isonoise and Isohorizon Scaling Rules
학습 기간 전이 규칙은 κ = (Dbase/D)^γ(B/Bbase)를 사용해 γ = 0의 isonoise 스케일링과 γ = 1의 isohorizon 스케일링 사이를 보간한다. AdamW는 lr = lrbase√κ, β1 = (β1base)^κ, β2 = (β2base)^κ, ε = εbase/√κ로 재스케일링한다.
- 주변 실험에서 D는 학습 토큰 수를 뜻하지만, Equation (4.1) 뒤의 설명 문장은 이를 모델 크기라고 부른다.
- 기준 탐색은 240M embedding 파라미터를 포함한 320M-parameter 모델로 약 3k회의 실행을 수행한다. Dbase = 13B 토큰이고 Bbase = 256 시퀀스다.
- γ를 바꾸면 추가 토큰을 가상 최적화 경로의 연장과 gradient noise 변동의 감소에 나누어 배분한다.
5 Scaling Behavior of MDM under the SDE Transfer Rule
스케일링 실험은 CompleteP + SDE 전이와 cosine 학습률 스케줄을 사용한다. 선형 warmup은 1k step이며 전체 반복 횟수의 25%를 넘지 않도록 제한한다. 일관된 하이퍼파라미터 전이를 위해 demb/nlayers = 128을 고정하고 깊이에 맞춰 너비를 늘린다.
5.1 Scaling Rules for Critical Batch Size
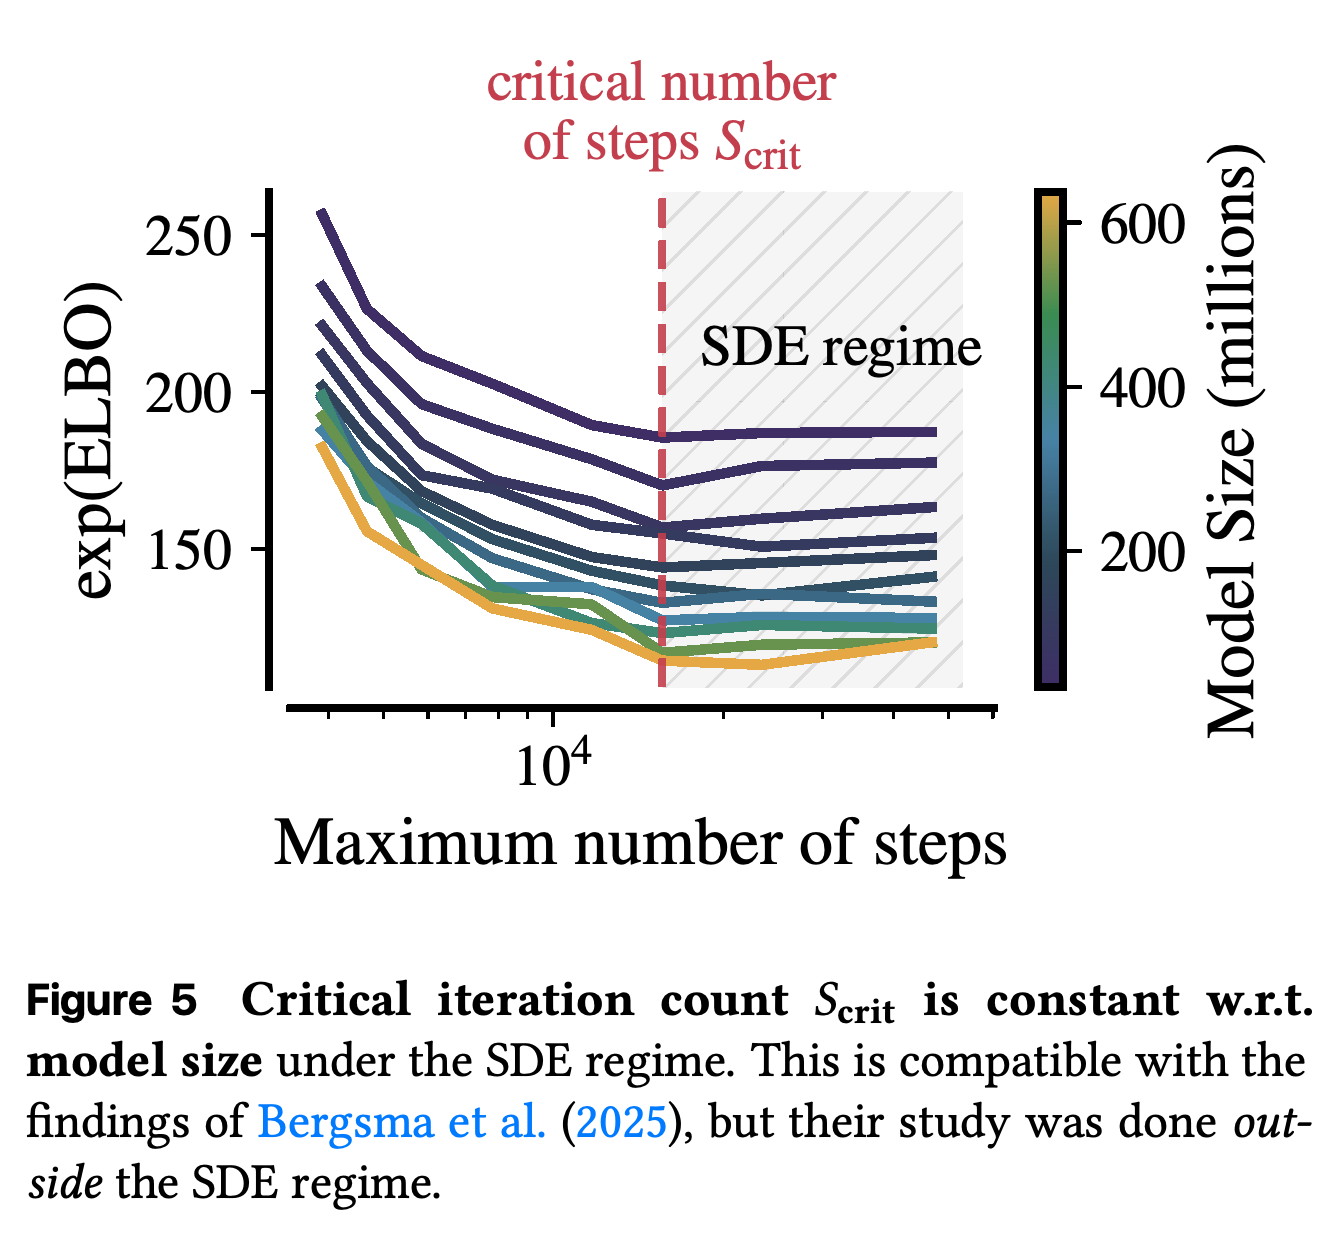
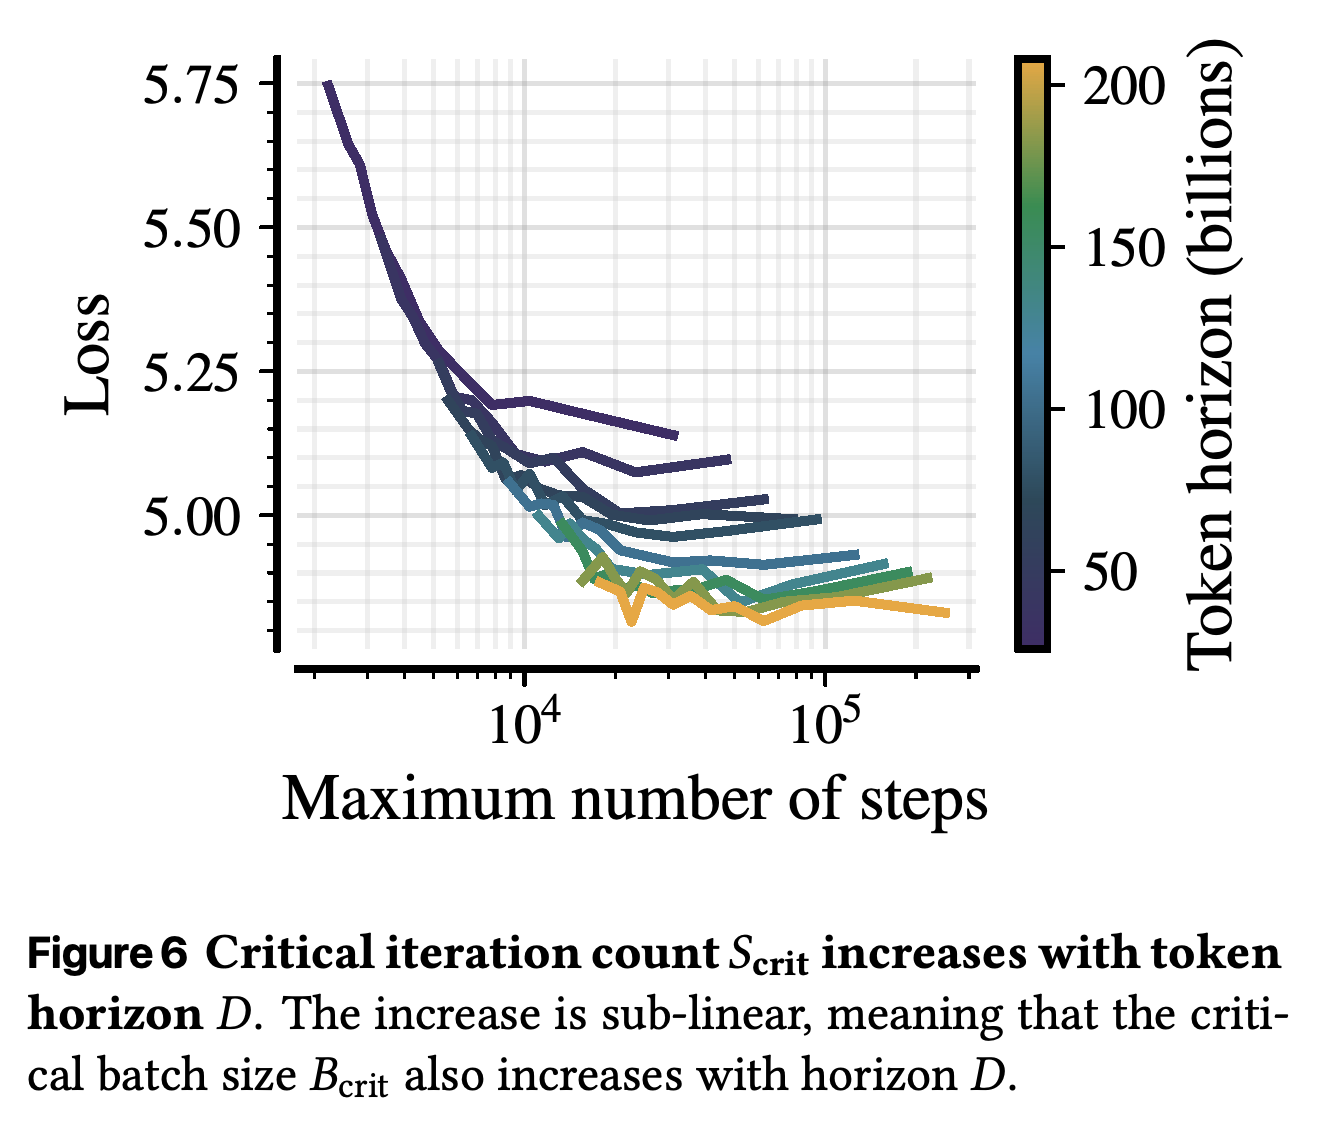
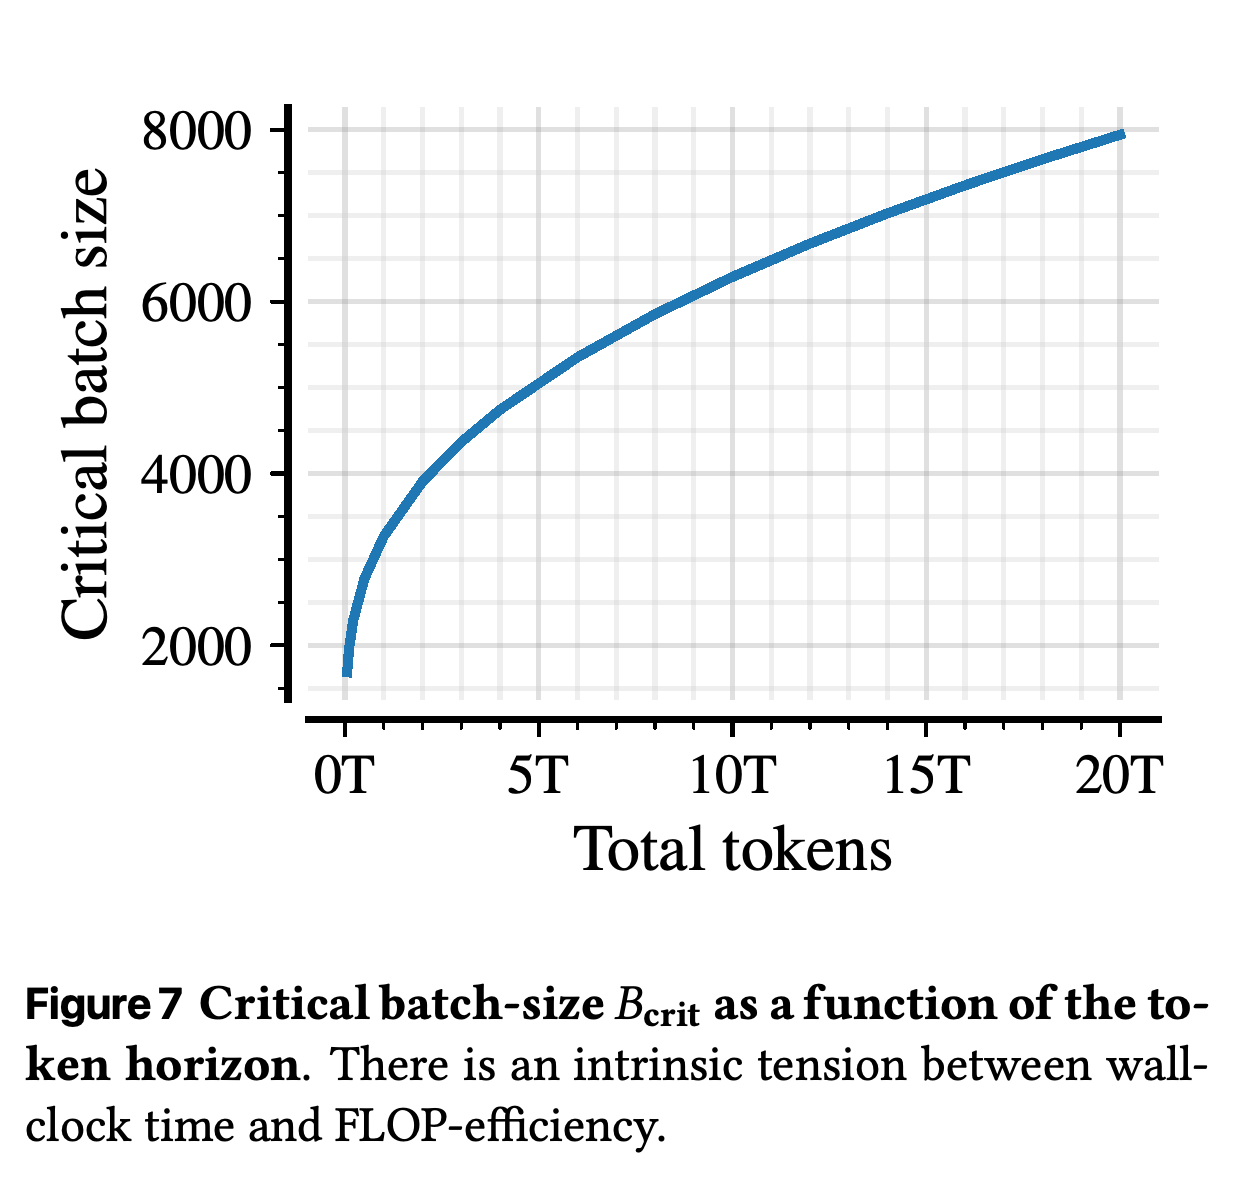
임계 반복 횟수 Scrit은 FLOP 효율적인 학습을 유지하는 데 필요한 최소 optimizer step 수다. 배치 크기를 시퀀스 단위로 측정하면 Bcrit = D/(L Scrit)다. 13B 토큰으로 고정한 학습 기간에서 Scrit은 모델 크기와 거의 무관하다. 보고된 실험에서는 학습 토큰 수를 늘리면 임계 step 수와 허용 가능한 임계 배치 크기가 모두 선형보다 느리게 증가한다.
- Figures 5–7은 실측 임계값 아래에서 하드웨어를 충분히 활용하도록 물리적 배치 크기를 선택할 수 있음을 뒷받침한다.
- Bcrit를 넘어서 배치를 더 크게 만들면 토큰 효율이 낮아진다. 따라서 토큰 효율을 유지하면서 GPU 수를 토큰 예산에 비례해 계속 늘릴 수는 없다.
- Section 5.1의 일부 문장은 step 수의 부등호 방향을 뒤집어 설명한다. 정의와 그림에 따르면 손실을 유지하는 구간은 S ≥ Scrit, 즉 B ≤ Bcrit다.
토큰 예산을 고정하면 크기가 다른 모델들이 대략 같은 반복 횟수의 임계값에서 각자의 손실 평탄 구간에 도달한다. 이는 실험한 모델 크기 사이에서 임계 배치 크기 제약을 전이할 수 있음을 뒷받침한다.
학습 토큰 수가 많을수록 손실이 평탄 구간에 도달하기까지 더 많은 최적화 step이 필요하다. 따라서 임계 반복 횟수는 학습 기간에 따라 달라진다.
임계 배치 크기는 총 토큰 수에 대해 선형보다 느리게 증가한다. 따라서 토큰 효율을 낮추지 않고 병렬성을 늘려 장기 학습 시간을 단축할 수 있는 범위에는 한계가 있다.
5.2 Optimal Drift–horizon Tradeoffs
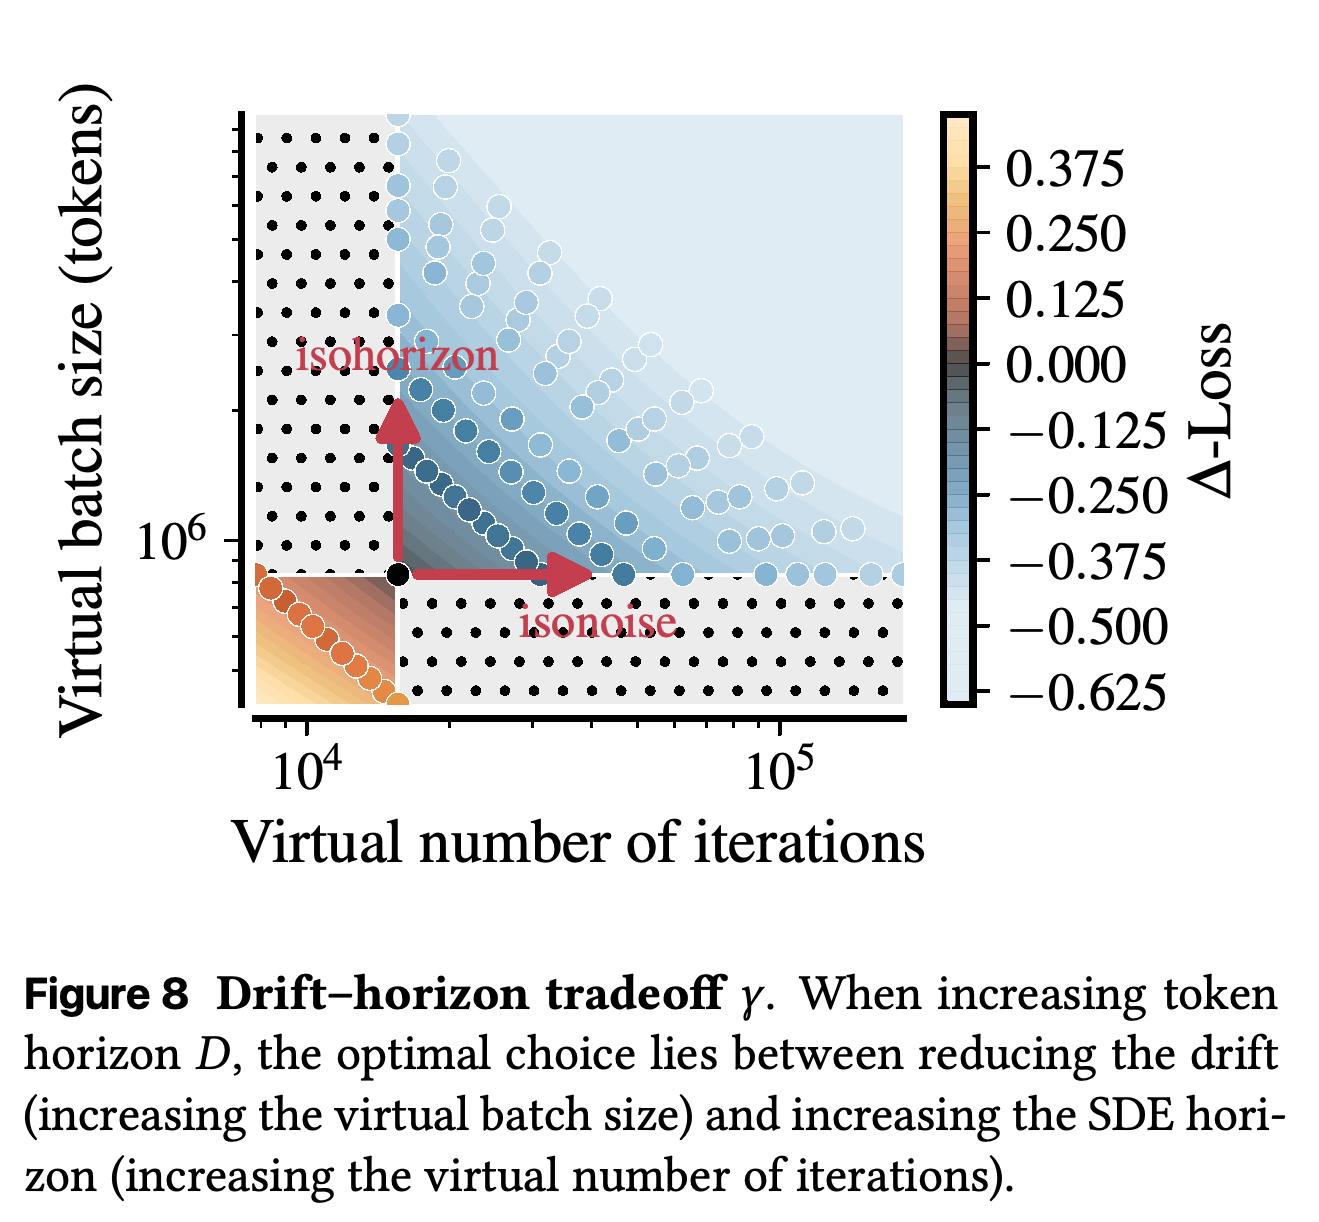
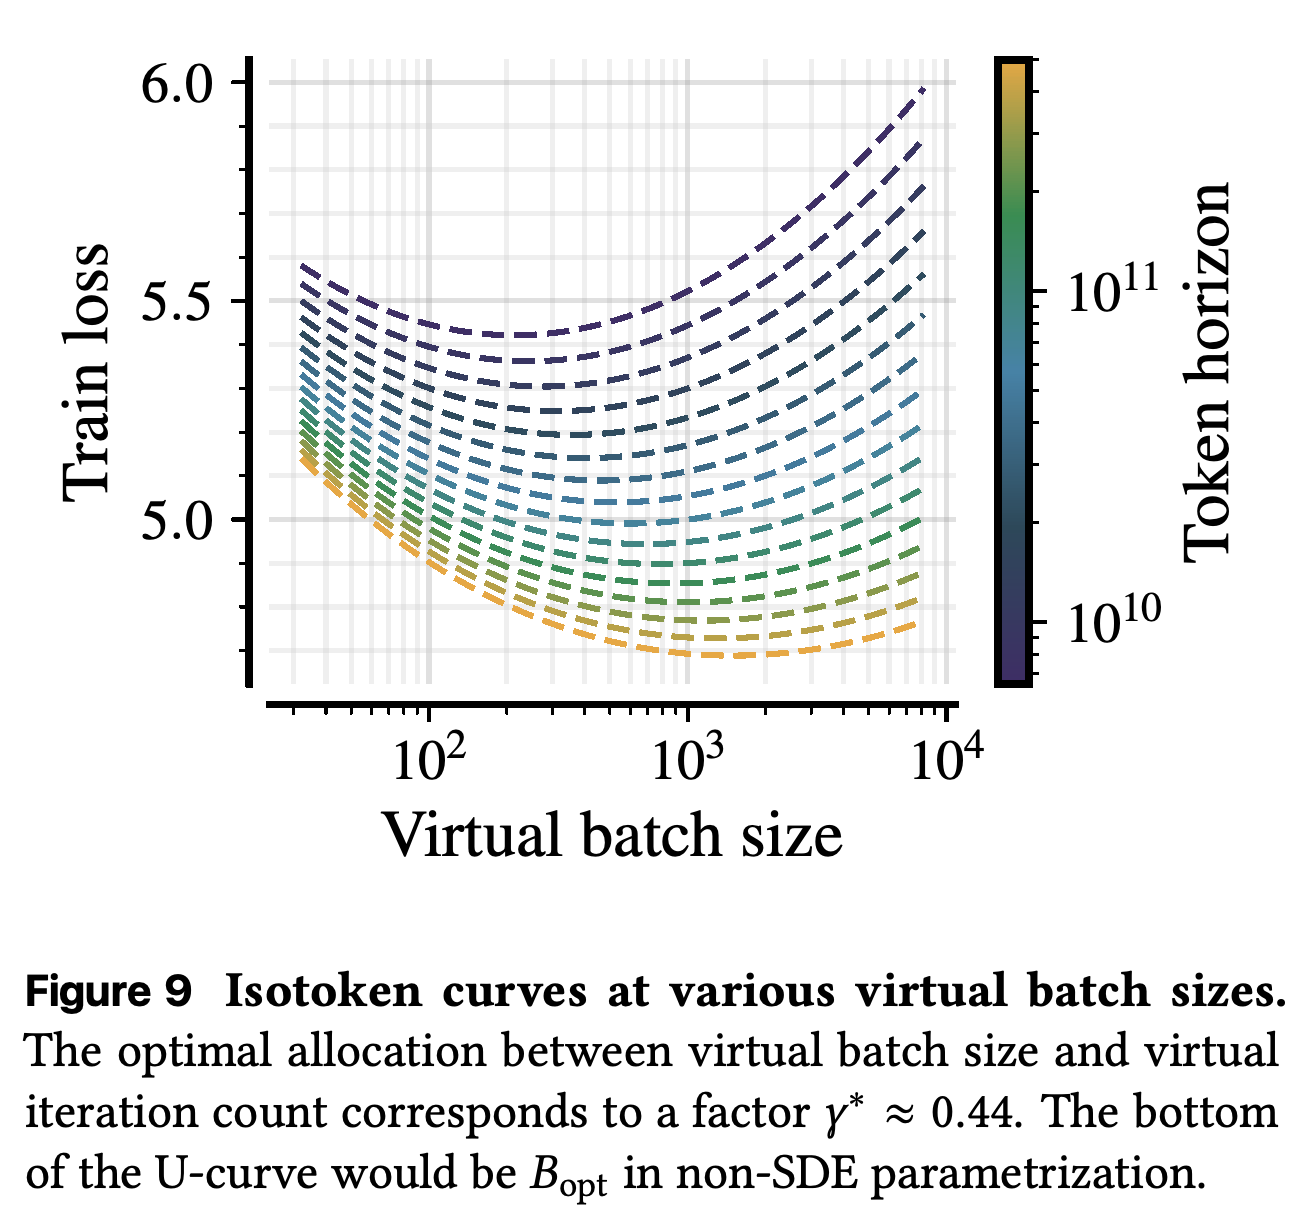
물리적 배치와 별개로 가상 배치 크기와 가상 반복 횟수를 정의하며, 이들은 D = B̃S̃L을 만족한다. γ를 바꾸는 실험은 추가 토큰을 B̃ 증가와 S̃ 증가에 배분한다. E + A S̃^−α + B B̃^−β를 fitting한 결과 α = 0.18, β = 0.23, γ* ≈ 0.44를 얻었다.
- Figures 8과 9는 실험한 설정에서 순수 isonoise와 순수 isohorizon 스케일링 모두 손실을 최소화하지 못함을 보여준다.
- 이 최적값은 논리적인 최적화 동작에 관한 값이며, 하드웨어 배치 크기를 다시 탐색한 결과가 아니다.
- 저자들은 warmup-stable-decay처럼 다른 학습률 스케줄을 사용하면 γ*가 달라질 수 있다고 언급한다.
손실 지형은 양 끝점 중 한 방향만 따르기보다 가상 반복 횟수와 가상 배치 크기를 함께 늘리는 편이 유리함을 보여준다. 이 가상 값들은 하드웨어 배치가 아니라 학습 기간의 배분을 나타낸다.
각 학습 토큰 수에서 fitting한 U자 곡선은 중간 수준의 논리적 배치 크기가 최적임을 보여준다. 최저점이 이동하는 양상은 가상 배치와 반복 횟수를 함께 스케일링하는 γ* ≈ 0.44의 근거가 된다.
5.3 Scaling Laws for Tri-modal MDM
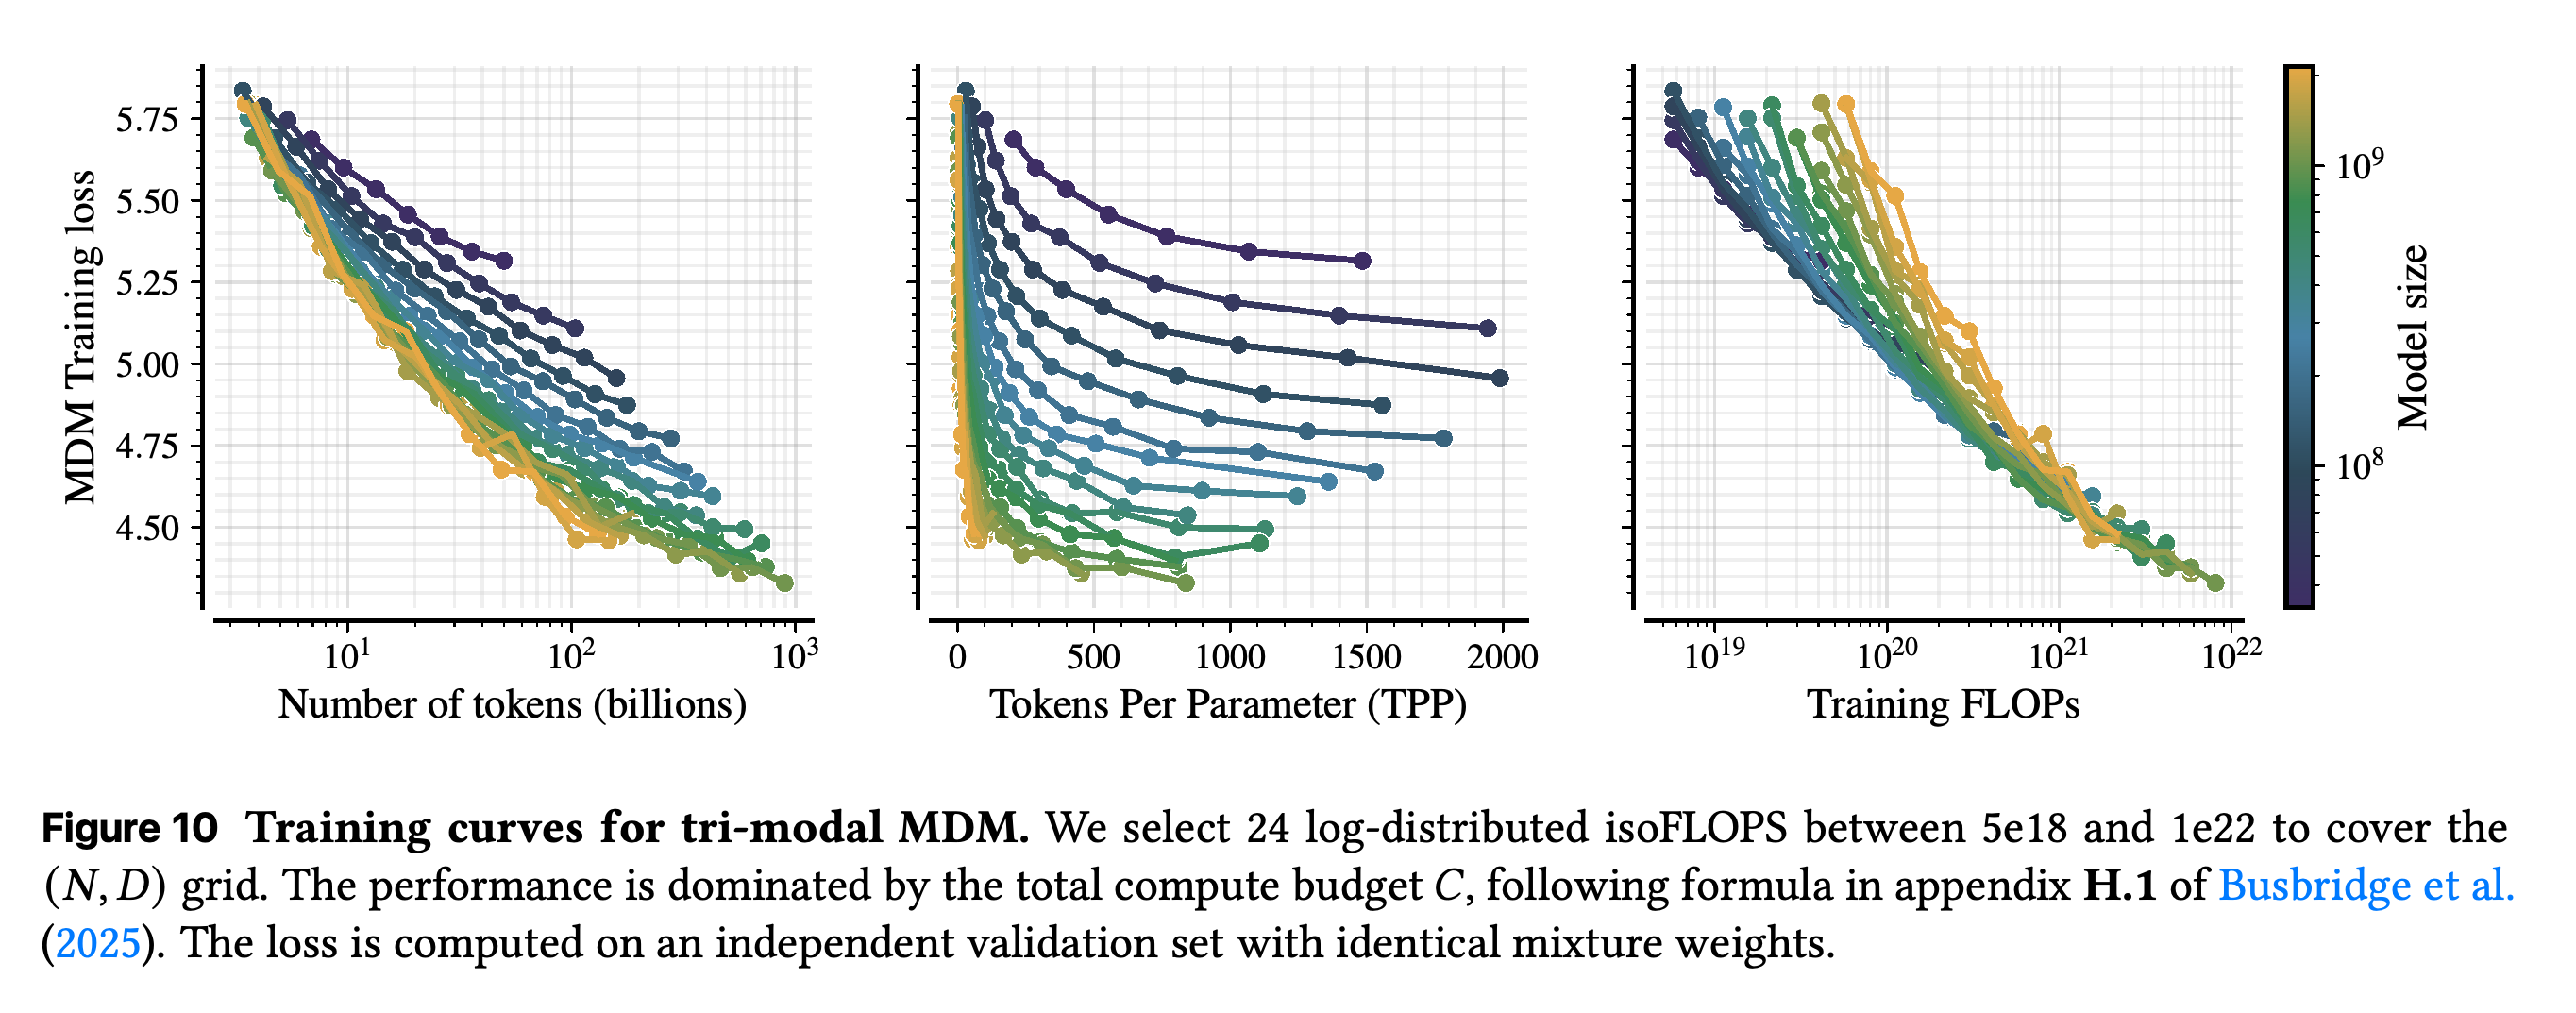
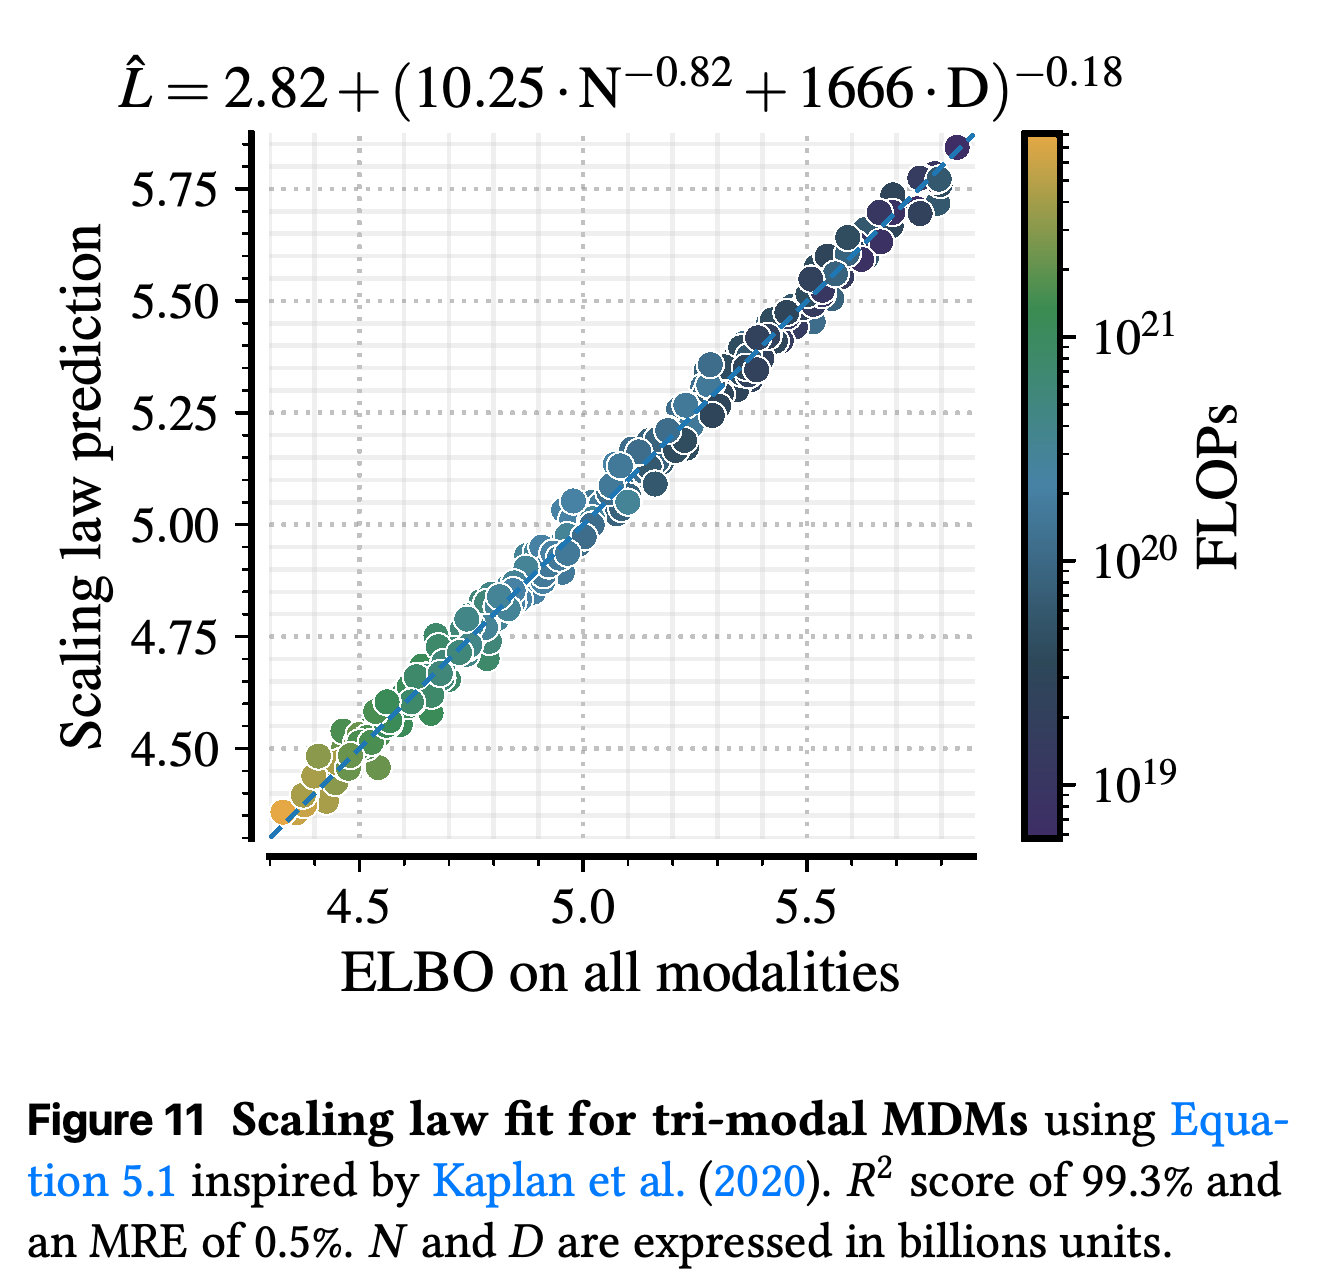
스케일링 법칙 연구는 5 × 10^18부터 1 × 10^22까지 로그 간격으로 배치한 24개 isoFLOP 예산에서, 파라미터당 토큰 비율이 1부터 2000인 262개의 tri-modal MDM을 학습한다. Basin hopping과 LBFGS, 20개 bootstrap 표본, 90%–10% 교차 검증으로 L(N,D) = E + (A N^−a/b + B D^−1)^b를 fitting한 결과 a ≈ 0.14, b ≈ 0.17, R² = 99.3%, 평균 상대 오차 0.5%를 얻었다.
- Fitting한 손실 법칙의 N은 embedding 파라미터를 제외한다. 반면 학습 FLOPs에는 embedding 연산을 포함하고 모달리티 tokenizer는 제외한다.
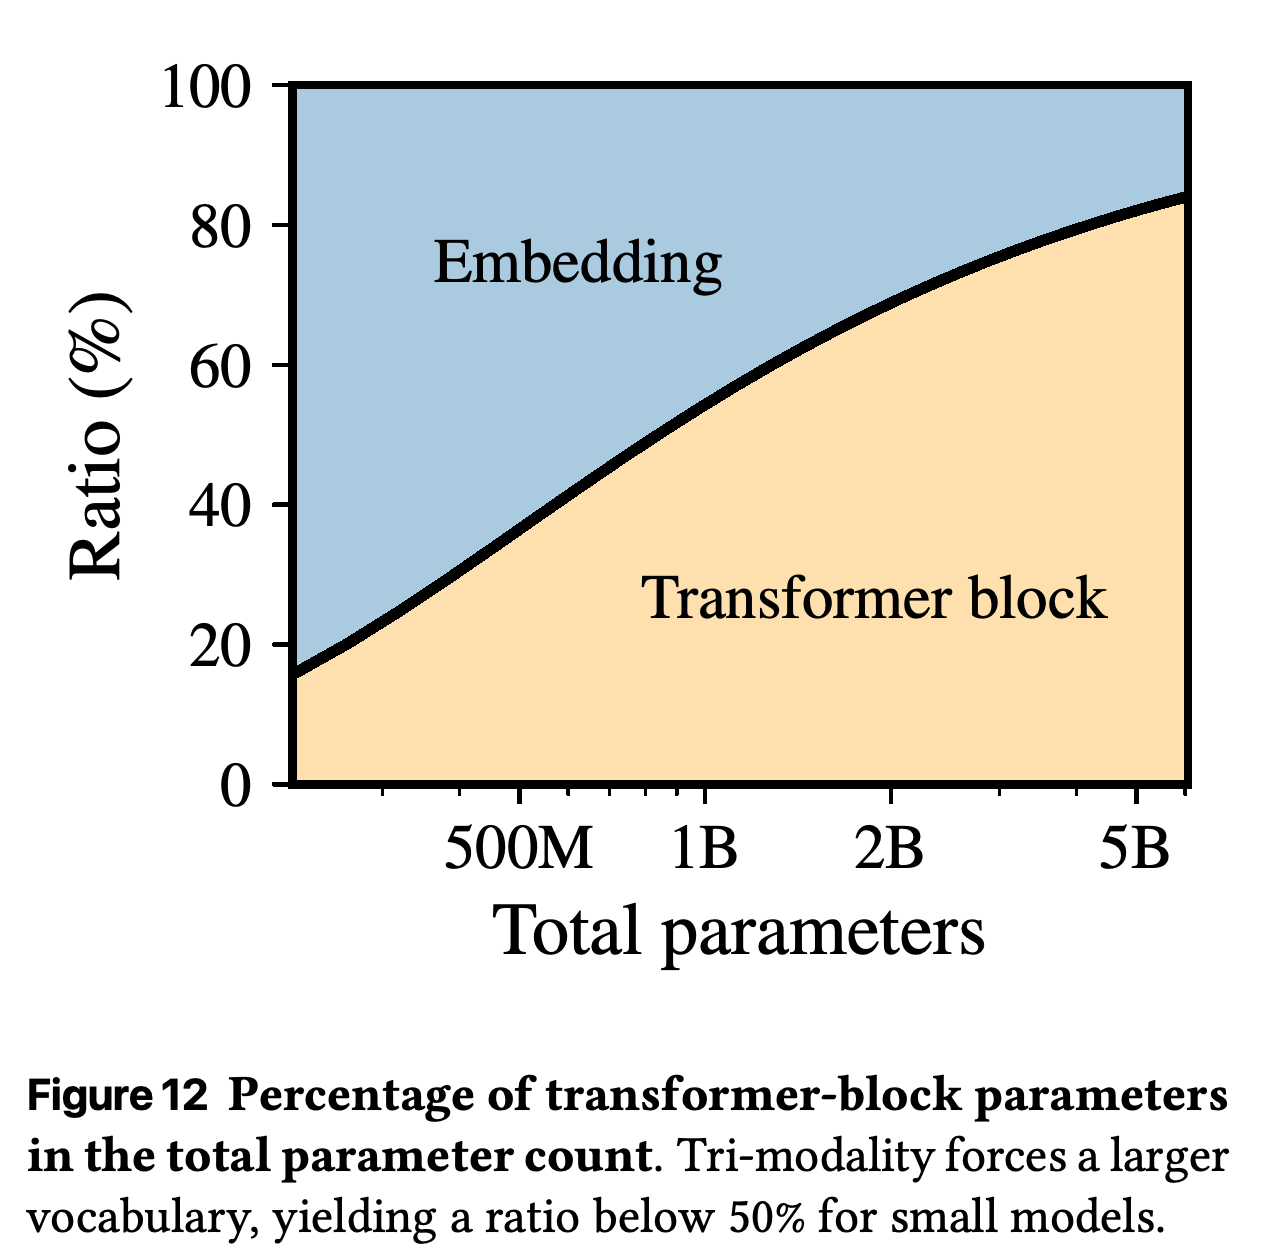
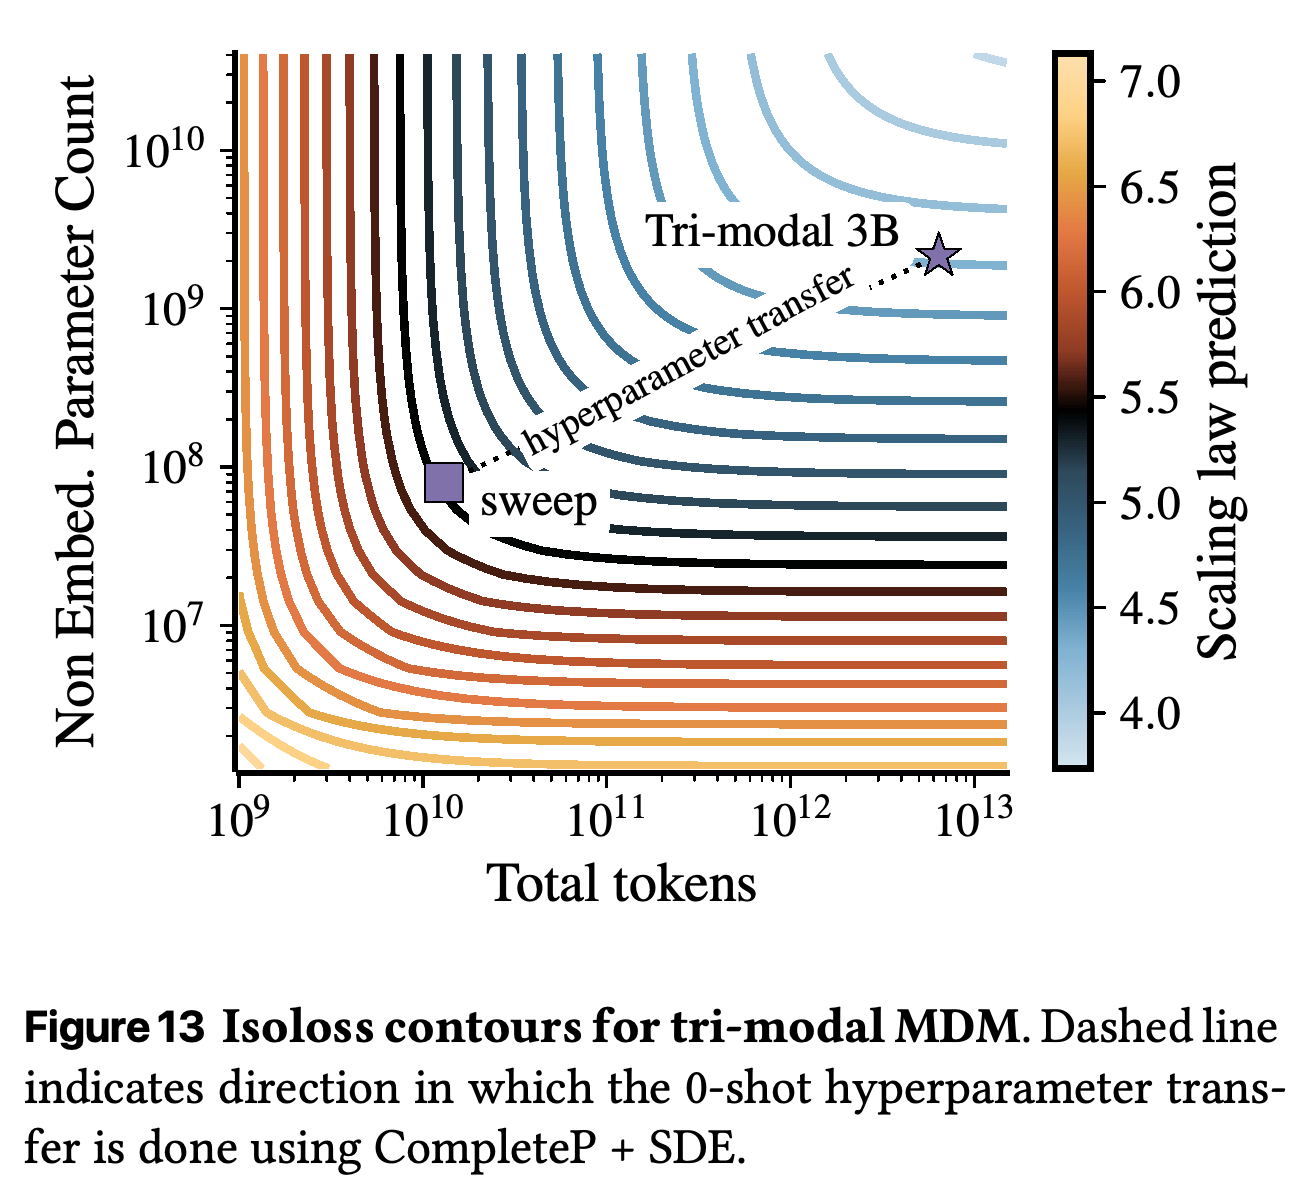
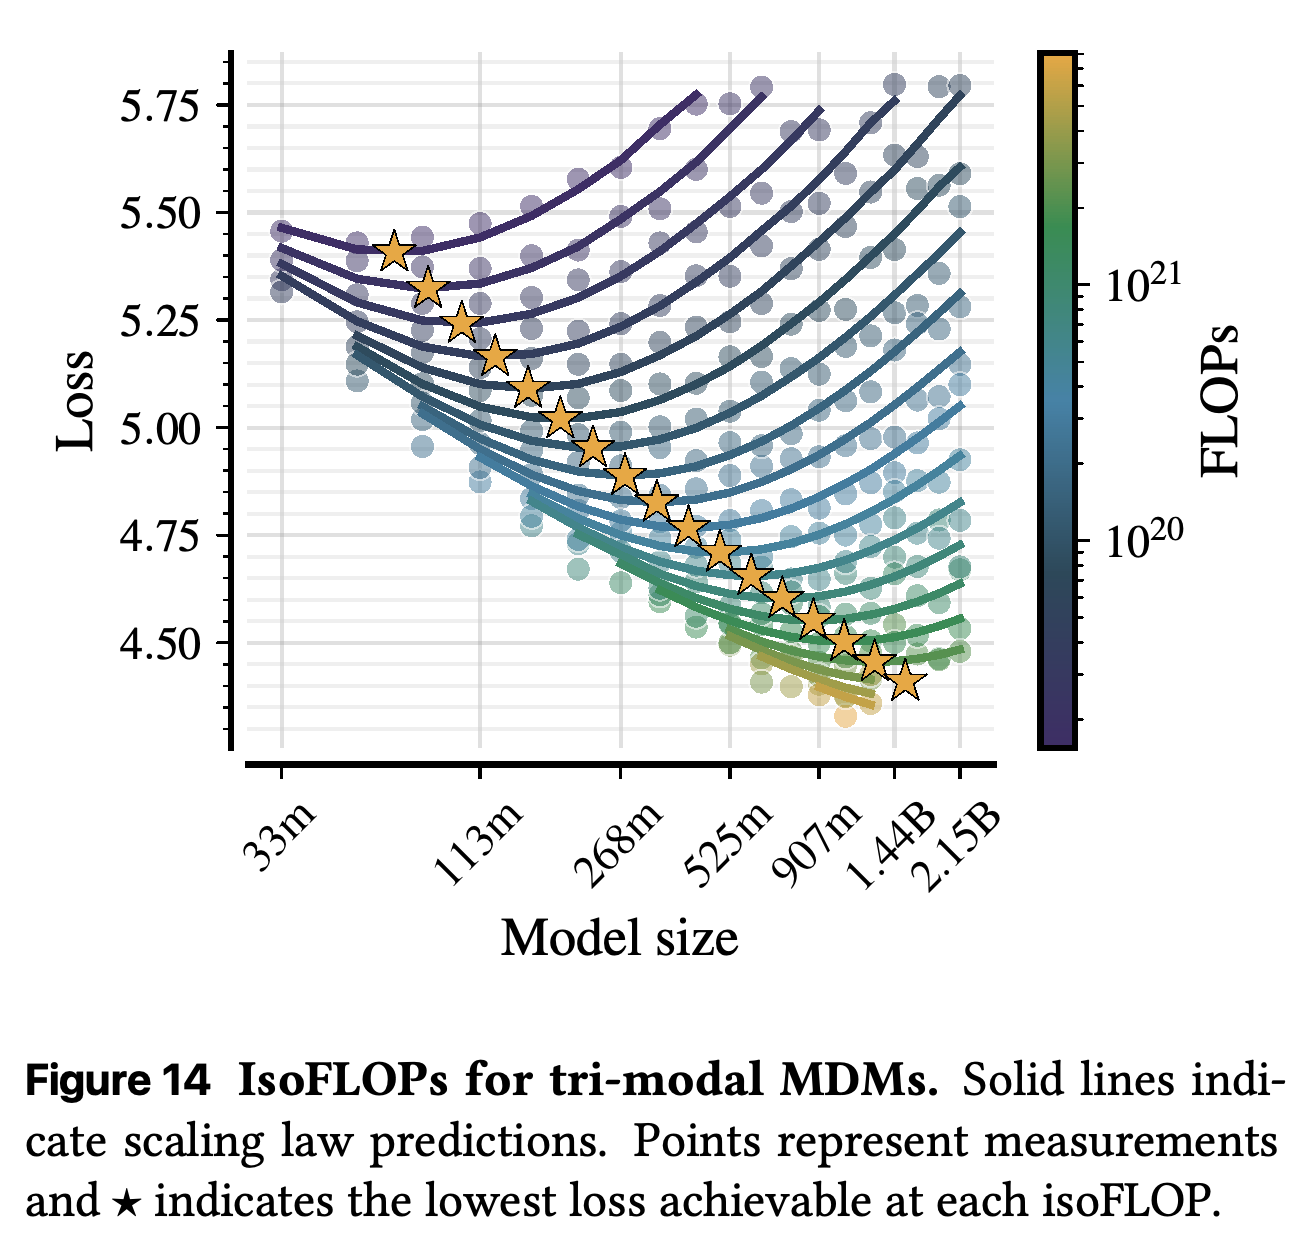
- Figures 10–14는 검증 손실 측정값, 예측과 측정의 일치도, embedding 오버헤드, 등손실 곡선, 각 연산 예산에서 손실을 최소화하는 모델 크기를 보여준다.
- 보고된 경계 D★(N) = 7754 · N^0.84에 따르면 파라미터당 최적 토큰 수는 N^−0.16에 비례하며, 연산량 배분은 대략 N★(C) ∝ C^0.55와 D★(C) ∝ C^0.45를 따른다.
262개 모델의 측정값은 토큰 수나 파라미터당 토큰 수보다 FLOPs를 기준으로 볼 때 더 잘 정렬된다. Panel에는 학습 손실이라고 표기했지만, caption은 같은 혼합 가중치를 적용한 독립 검증 집합을 사용했다고 명시한다.
예측 손실과 측정 손실이 대각선에 가깝게 분포하며, 이는 보고된 R² 99.3%와 평균 상대 오차 0.5%에 부합한다. 그래프 위에 인쇄된 수식은 Equation (5.1)과 다르다. 따라서 이 일치도 그래프만으로는 재현에 어느 식을 사용해야 하는지 알 수 없다.
통합 어휘가 크기 때문에 작은 모델에서는 embedding 파라미터가 대부분을 차지한다. 따라서 스케일링 법칙 fitting이나 연산량 집계에서 전체 파라미터 수와 non-embedding backbone 크기를 같은 값으로 취급할 수 없다.
등고선은 같은 손실을 달성할 것으로 예측한 모델 크기와 데이터 양의 조합을 나타낸다. 전이 경로는 작은 튜닝 모델과 더 오래 학습한 3B 시연 모델을 연결해 외삽 범위를 명확히 보여준다.
각 고정 연산량 곡선에는 손실을 최소화하는 모델 크기가 있으며 별표로 표시한다. 측정값과 예측값은 고정 예산을 지나치게 작거나 큰 backbone에 배분할 때 발생하는 손실 증가를 보여준다.
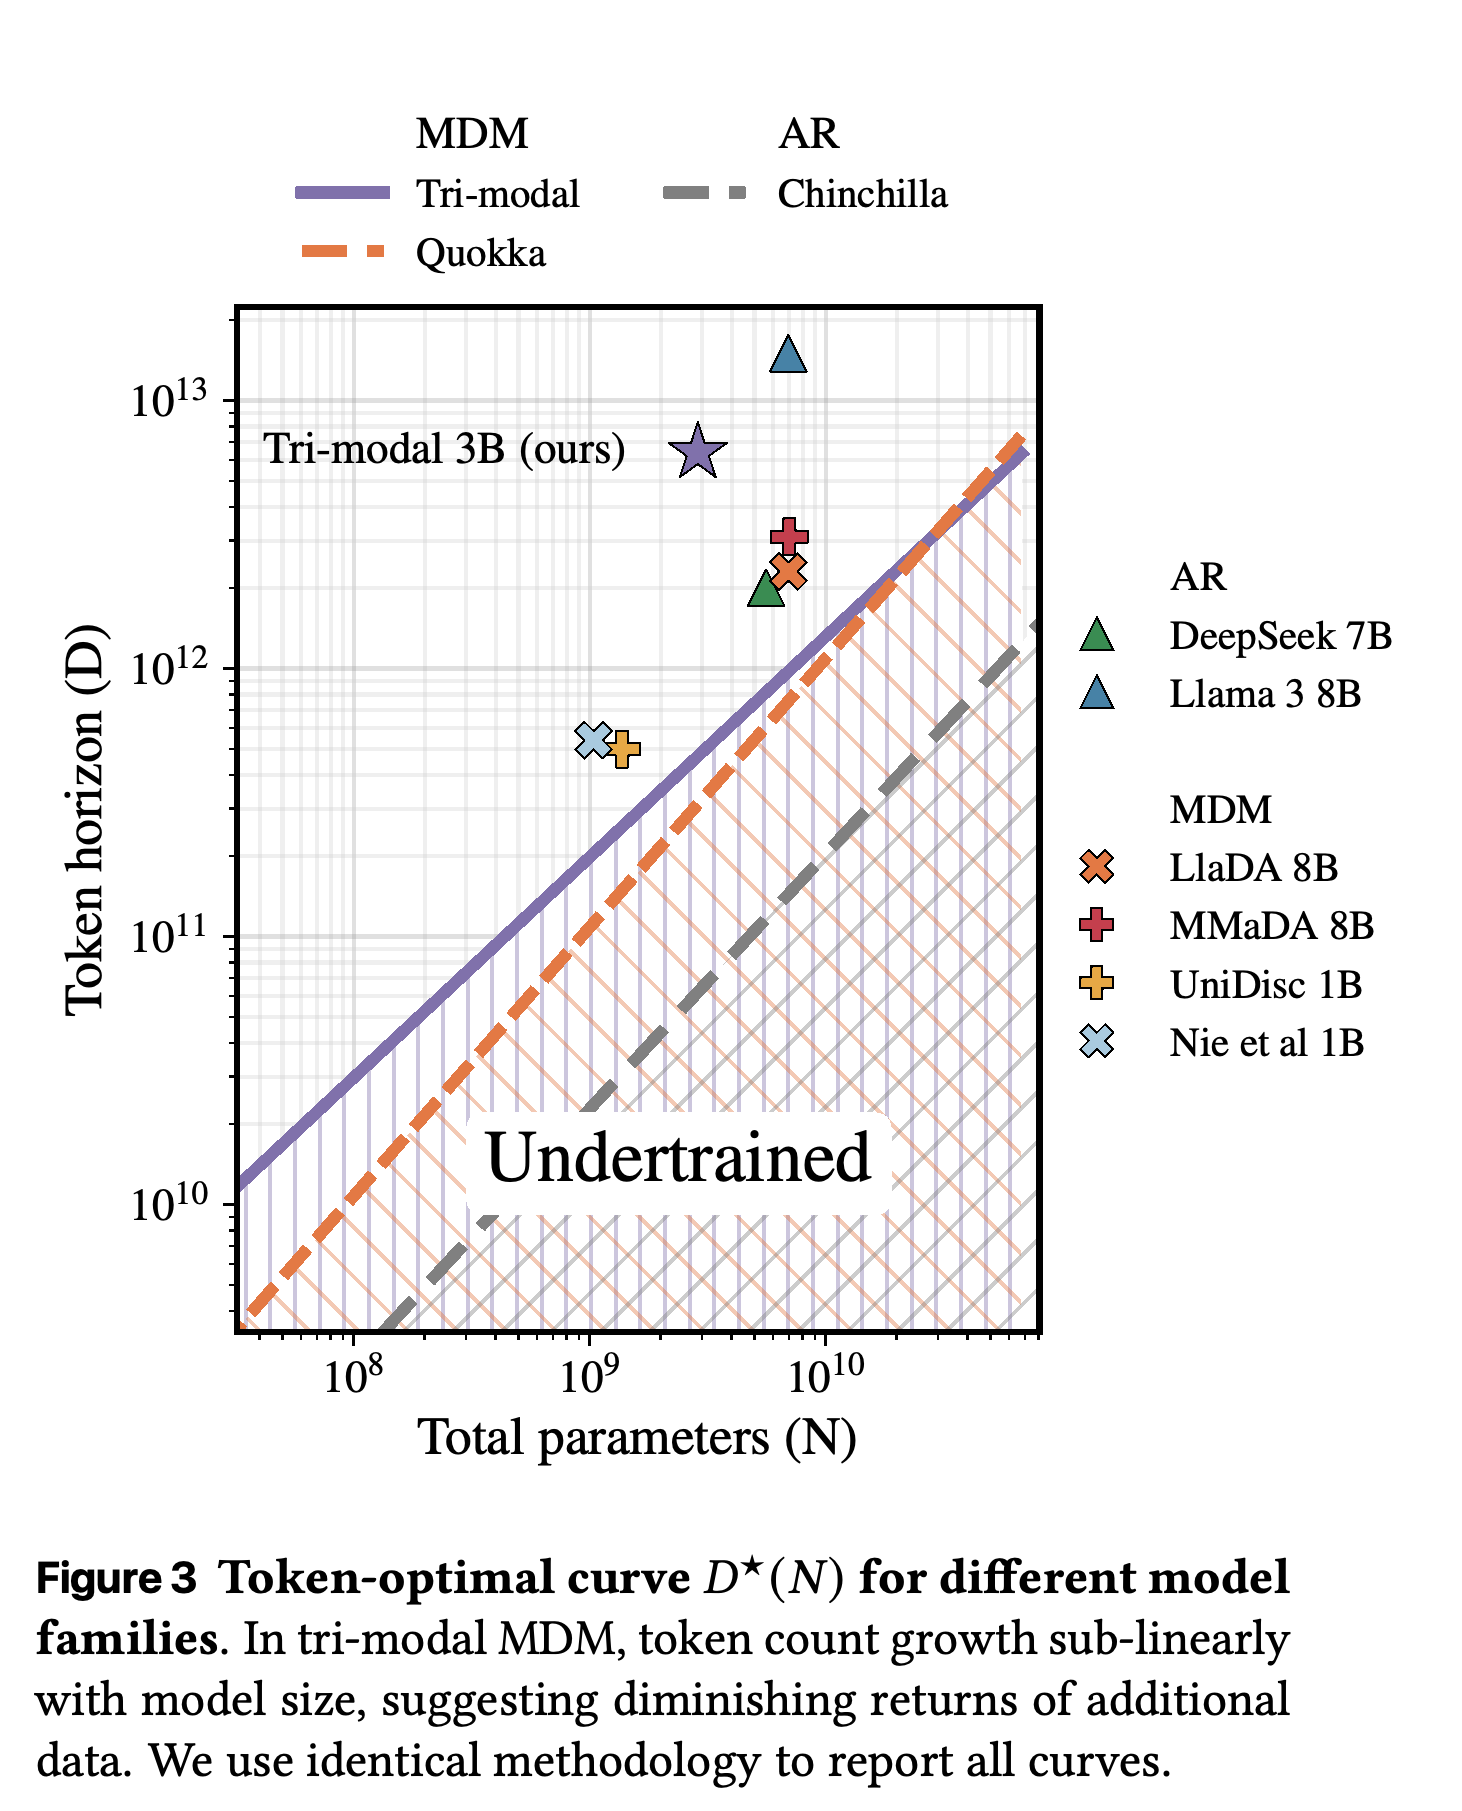
점근적 추세만으로 autoregressive 언어 모델보다 실용적인 데이터 효율이 높다고 볼 수는 없다. 논문은 3B 모델에 약 480B 토큰이 필요하다고 추정하며, 인용한 Chinchilla 규칙에서는 약 60B가 필요하다. Quokka diffusion 언어 모델의 경계와 교차하는 지점은 약 20B 파라미터와 약 2T 토큰으로 제시한다.
- Figure 3은 전체 파라미터 수와 공통 최적화 방법을 사용해 경계를 비교한다. 대표 사례인 3B 모델은 추정한 연산 최적 토큰 수보다 많이 학습했다.
- 스케일링 지수는 같은 모델 계열 안에서의 상대적 이득을 나타내며, 계열 간 절대적 능력이나 우위를 나타내지 않는다.
- 줄일 수 없는 손실, 모델 계열의 편향, forward process에 따라 달라지는 ELBO 경계, 데이터 구성, 반복 학습 때문에 계열 간 비교가 복잡해진다.
Tri-modal 경계는 선형보다 느리게 증가하지만, 실용적인 모델 크기에서는 제시된 Chinchilla 기준보다 더 많은 토큰이 필요하다. 대표 사례인 3B 모델은 추정된 연산 최적 경계보다 많은 토큰으로 학습했다. Quokka는 autoregressive 기준 모델이 아니라 다른 MDM 계열로 제시한다.
6 Data
혼합 비율 ablation을 제외하면 기본 tri-modal 샘플링 가중치는 text-only 33%, image-text 33%, audio-text 33%로 거의 같다. Section 6은 총 데이터셋 크기보다 적은 학습 토큰 수를 사용하며, 선별한 소규모 고품질 데이터는 최대 4회 반복한다고 설명한다. Anti-masking 비교에서는 별도로 2 epoch의 기준 설정을 사용한다.
- 텍스트는 Nemotron-CC, DCLM, 선별한 The Pile 하위 집합, 라이선스를 확보한 StackOverflow, Qwen-32B reasoning-trace 합성 데이터, 기타 라이선스 corpus를 결합한다. 개인정보와 라이선스 관련 필터링도 추가로 적용한다.
- 오디오는 Whisper로 전사한 2M시간의 웹 오디오로 구성한다. 개인정보, 음성 활동, 대화, 제작 품질, 제작 복잡성을 기준으로 필터링한다.
- Image-text 데이터는 CC3M, CC12M, COYO, recaptioning한 데이터, Manzano에서 사용한 기타 라이선스 데이터셋을 결합한다. 검증 손실은 같은 혼합 비율을 적용한 별도 split에서 측정한다.
7 Results
결과에서는 통합 3B 모델을 평가하고 모달리티 혼합, 추론 하이퍼파라미터, anti-masking을 각각 독립적으로 ablation한다. 마스킹 스케줄 비교는 Appendix F에 있다. Ablation은 모든 변경 사항을 누적해서 적용하지 않고 같은 설정에서 출발한다.
7.1 Unified 3B Tri-modal MDM
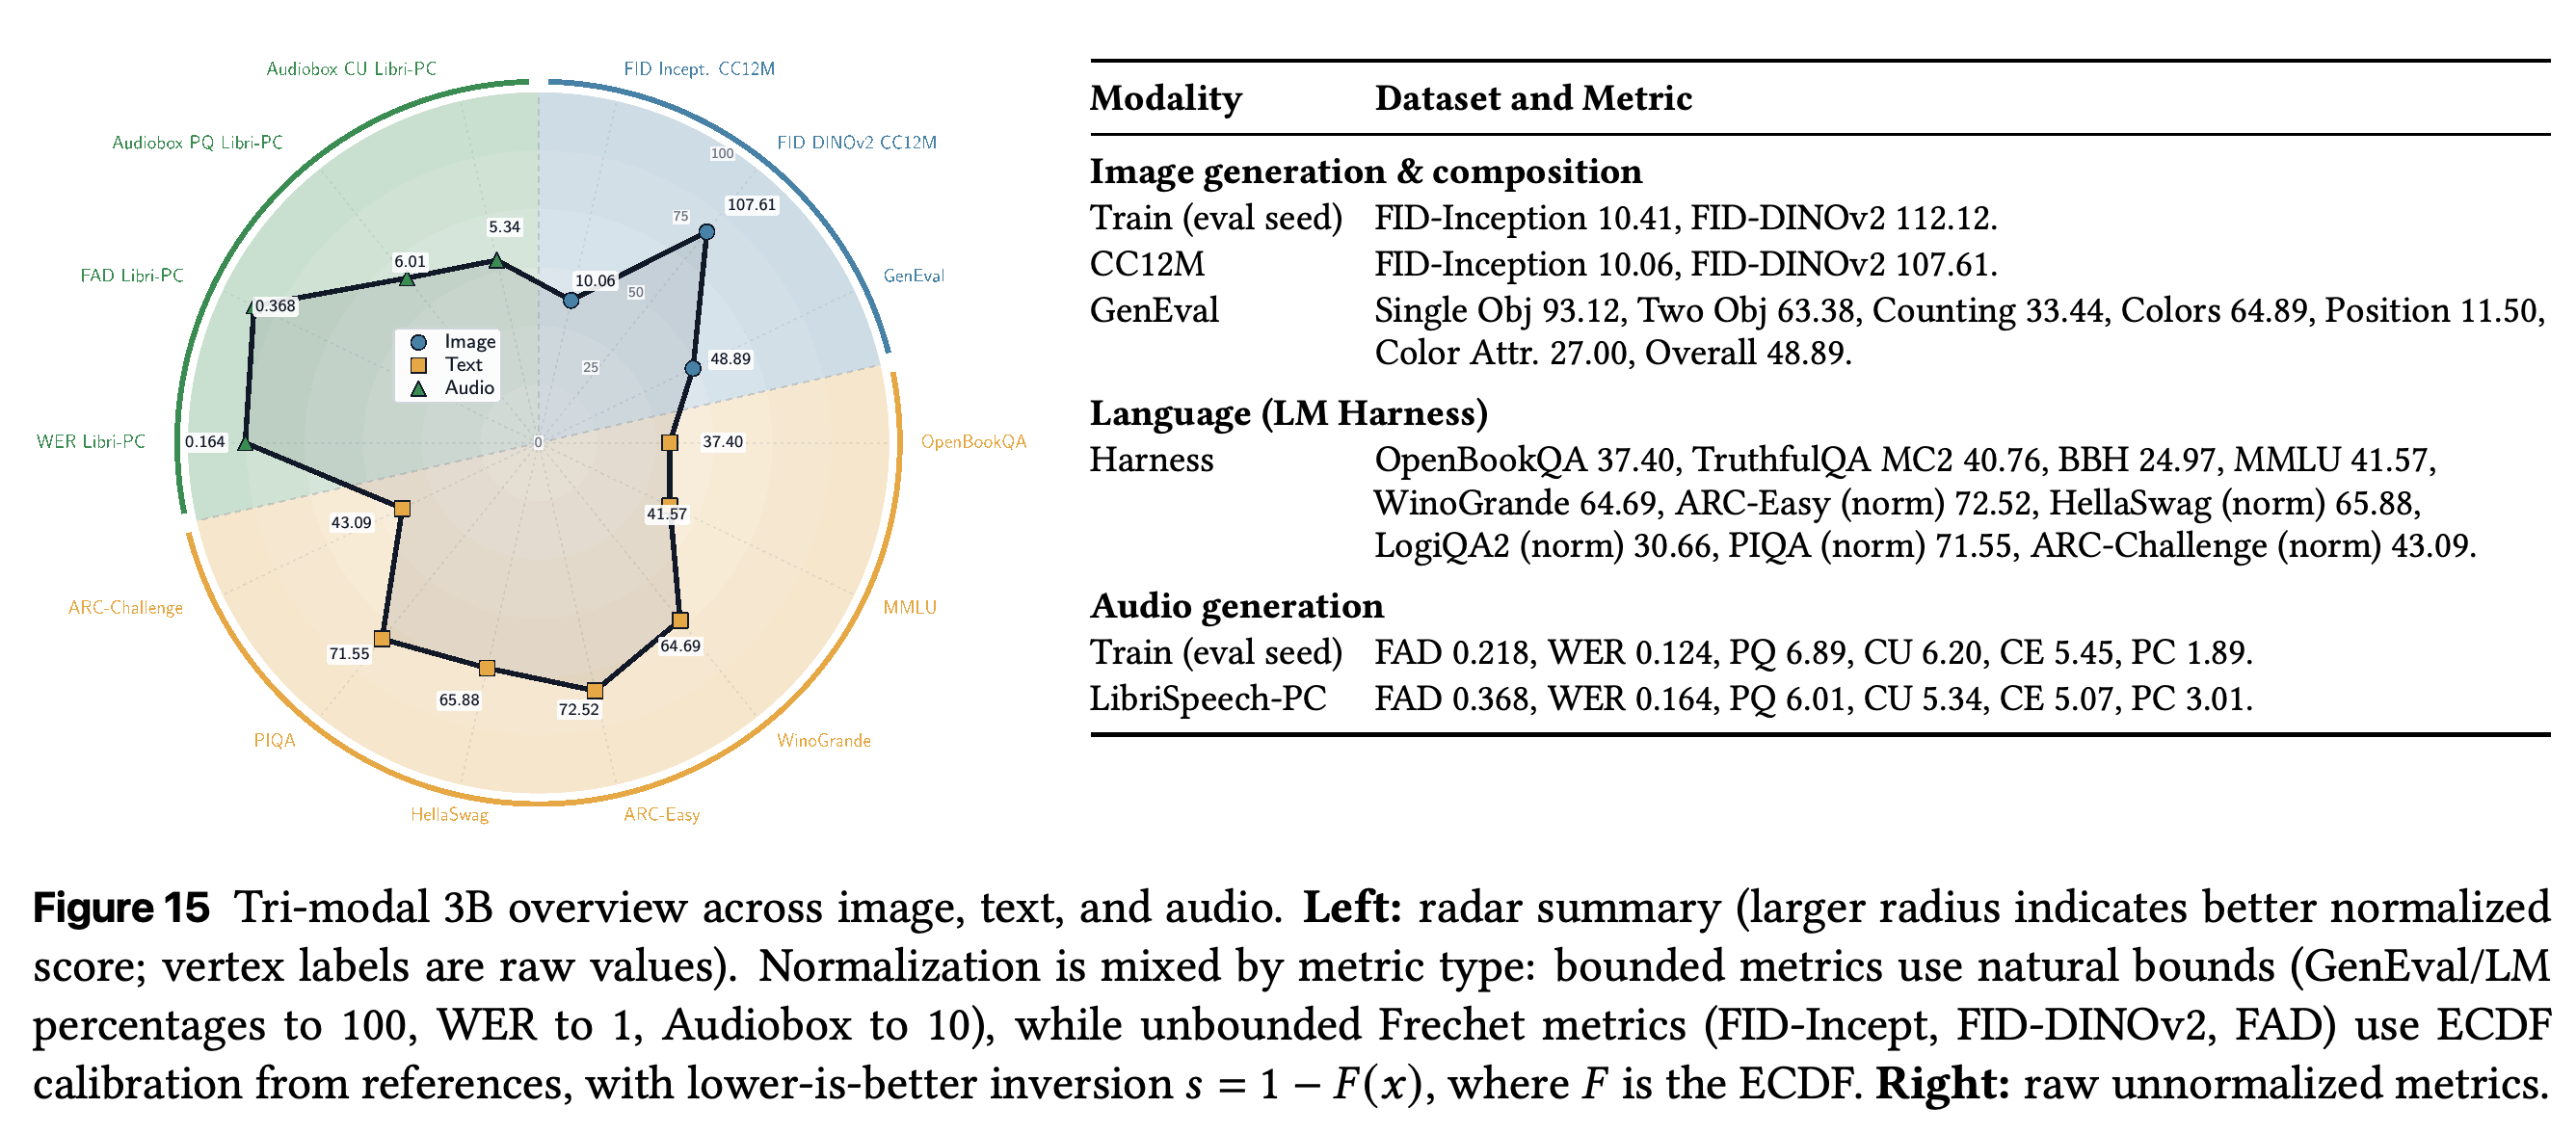
사전학습만 수행한 3B 모델은 LM evaluation harness, Inception-v3와 DINOv2-L 특징을 사용하는 이미지 FID, GenEval, 음성 FAD와 WER, Audiobox Aesthetics로 평가한다. Figure 15는 CC12M FID-Inception 10.06, FID-DINOv2 107.61, GenEval overall 48.89, MMLU 41.57, LibriSpeech-PC FAD 0.368, WER 0.164를 보고한다.
- GenEval single-object 성능은 93.12지만 counting은 33.44, position은 11.50, color attributes는 27.00이다. 이는 구성적 생성 성능이 고르지 않음을 보여준다.
- 언어 점수는 ARC-Easy normalized 72.52, HellaSwag normalized 65.88, PIQA normalized 71.55, BBH 24.97을 포함한다. 성능 개요에는 조건을 맞춘 autoregressive 기준 모델이 없다.
- 음성 생성에는 기준 텍스트와 정답 길이를 제공한다. 따라서 이 결과는 모델이 자체적으로 길이를 예측하는 능력을 평가하지 않는다.
- Radar chart는 지표의 자연적 경계에 따른 정규화와, 경계가 없는 거리 지표의 ECDF 보정을 함께 사용한다. 따라서 반지름을 원래 측정값처럼 직접 비교할 수는 없다.
원래 지표 값은 tri-modal 생성이 가능하지만 성능이 고르지 않으며, 특히 이미지 구성 능력이 약함을 보여준다. Radar chart는 지표 유형마다 다른 정규화 방식을 사용하므로, 도형의 형태만 보지 말고 수치 결과를 확인해야 한다.
7.2 Modality Mixing Ratios
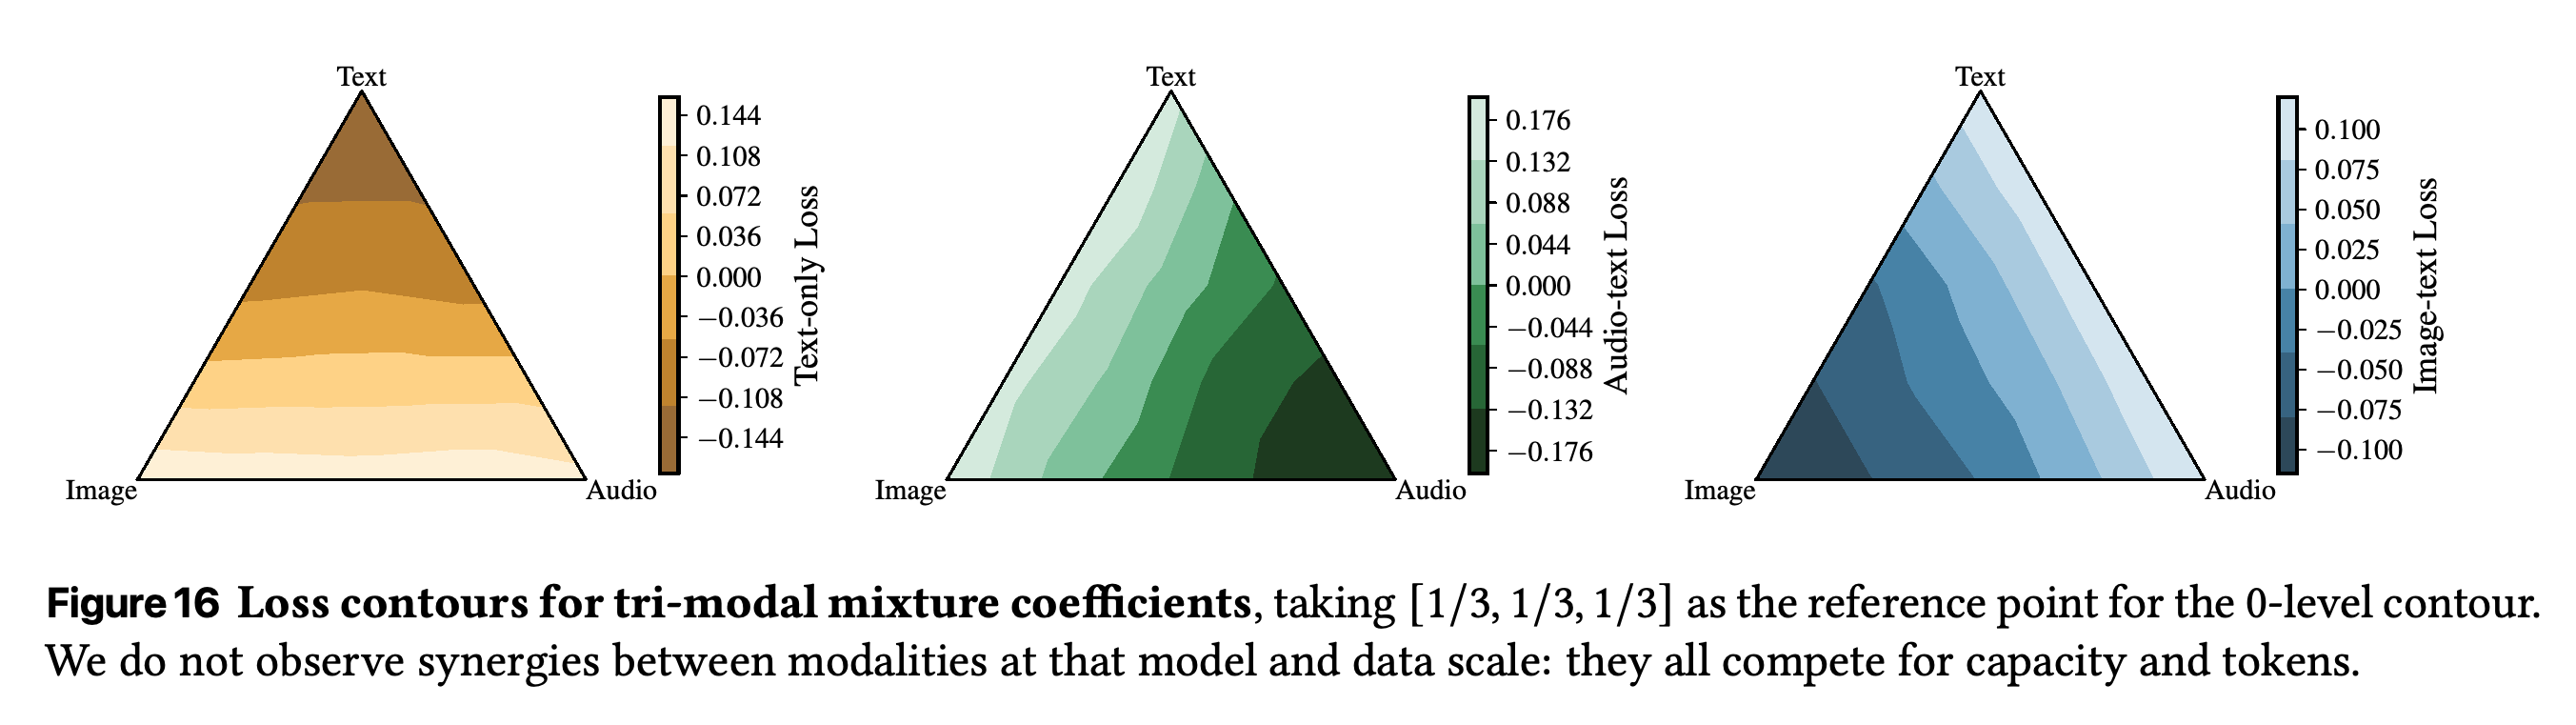
15개의 혼합 비율 실험은 non-embedding 파라미터 80M을 포함한 320M-parameter 모델을 13B 토큰으로 학습하며, 각 모달리티에 최소 20%의 비율을 배정한다. 모달리티 자체의 비중을 늘리면 해당 손실이 감소하지만, 나머지 2개 모달리티의 상대 비중을 바꿔도 이 규모에서는 관찰 가능한 시너지가 없다.
- Figure 16은 [1/3, 1/3, 1/3]을 기준으로 손실 차이를 나타낸다. 이는 동일 가중치가 균형 잡힌 기본값임을 뒷받침하지만, 모든 상황에서 최적인 혼합 비율이라는 뜻은 아니다.
- 이 결과는 작은 규모에서의 모달리티별 검증 손실에 관한 것이다. 더 큰 규모에서의 전이 이득이나 작업 수준의 시너지까지 배제하지는 않는다.
각 모달리티의 손실은 주로 해당 모달리티의 비중이 커지는 꼭짓점 방향으로 개선된다. 손실 차이는 동일 가중치를 기준으로 나타낸다. 320M 파라미터와 13B 토큰에서는 나머지 2개 모달리티 사이에 비중을 재배분해도 등고선 구조상 관찰 가능한 손실 시너지가 없다.
7.3 Best Generation Hyperparameters
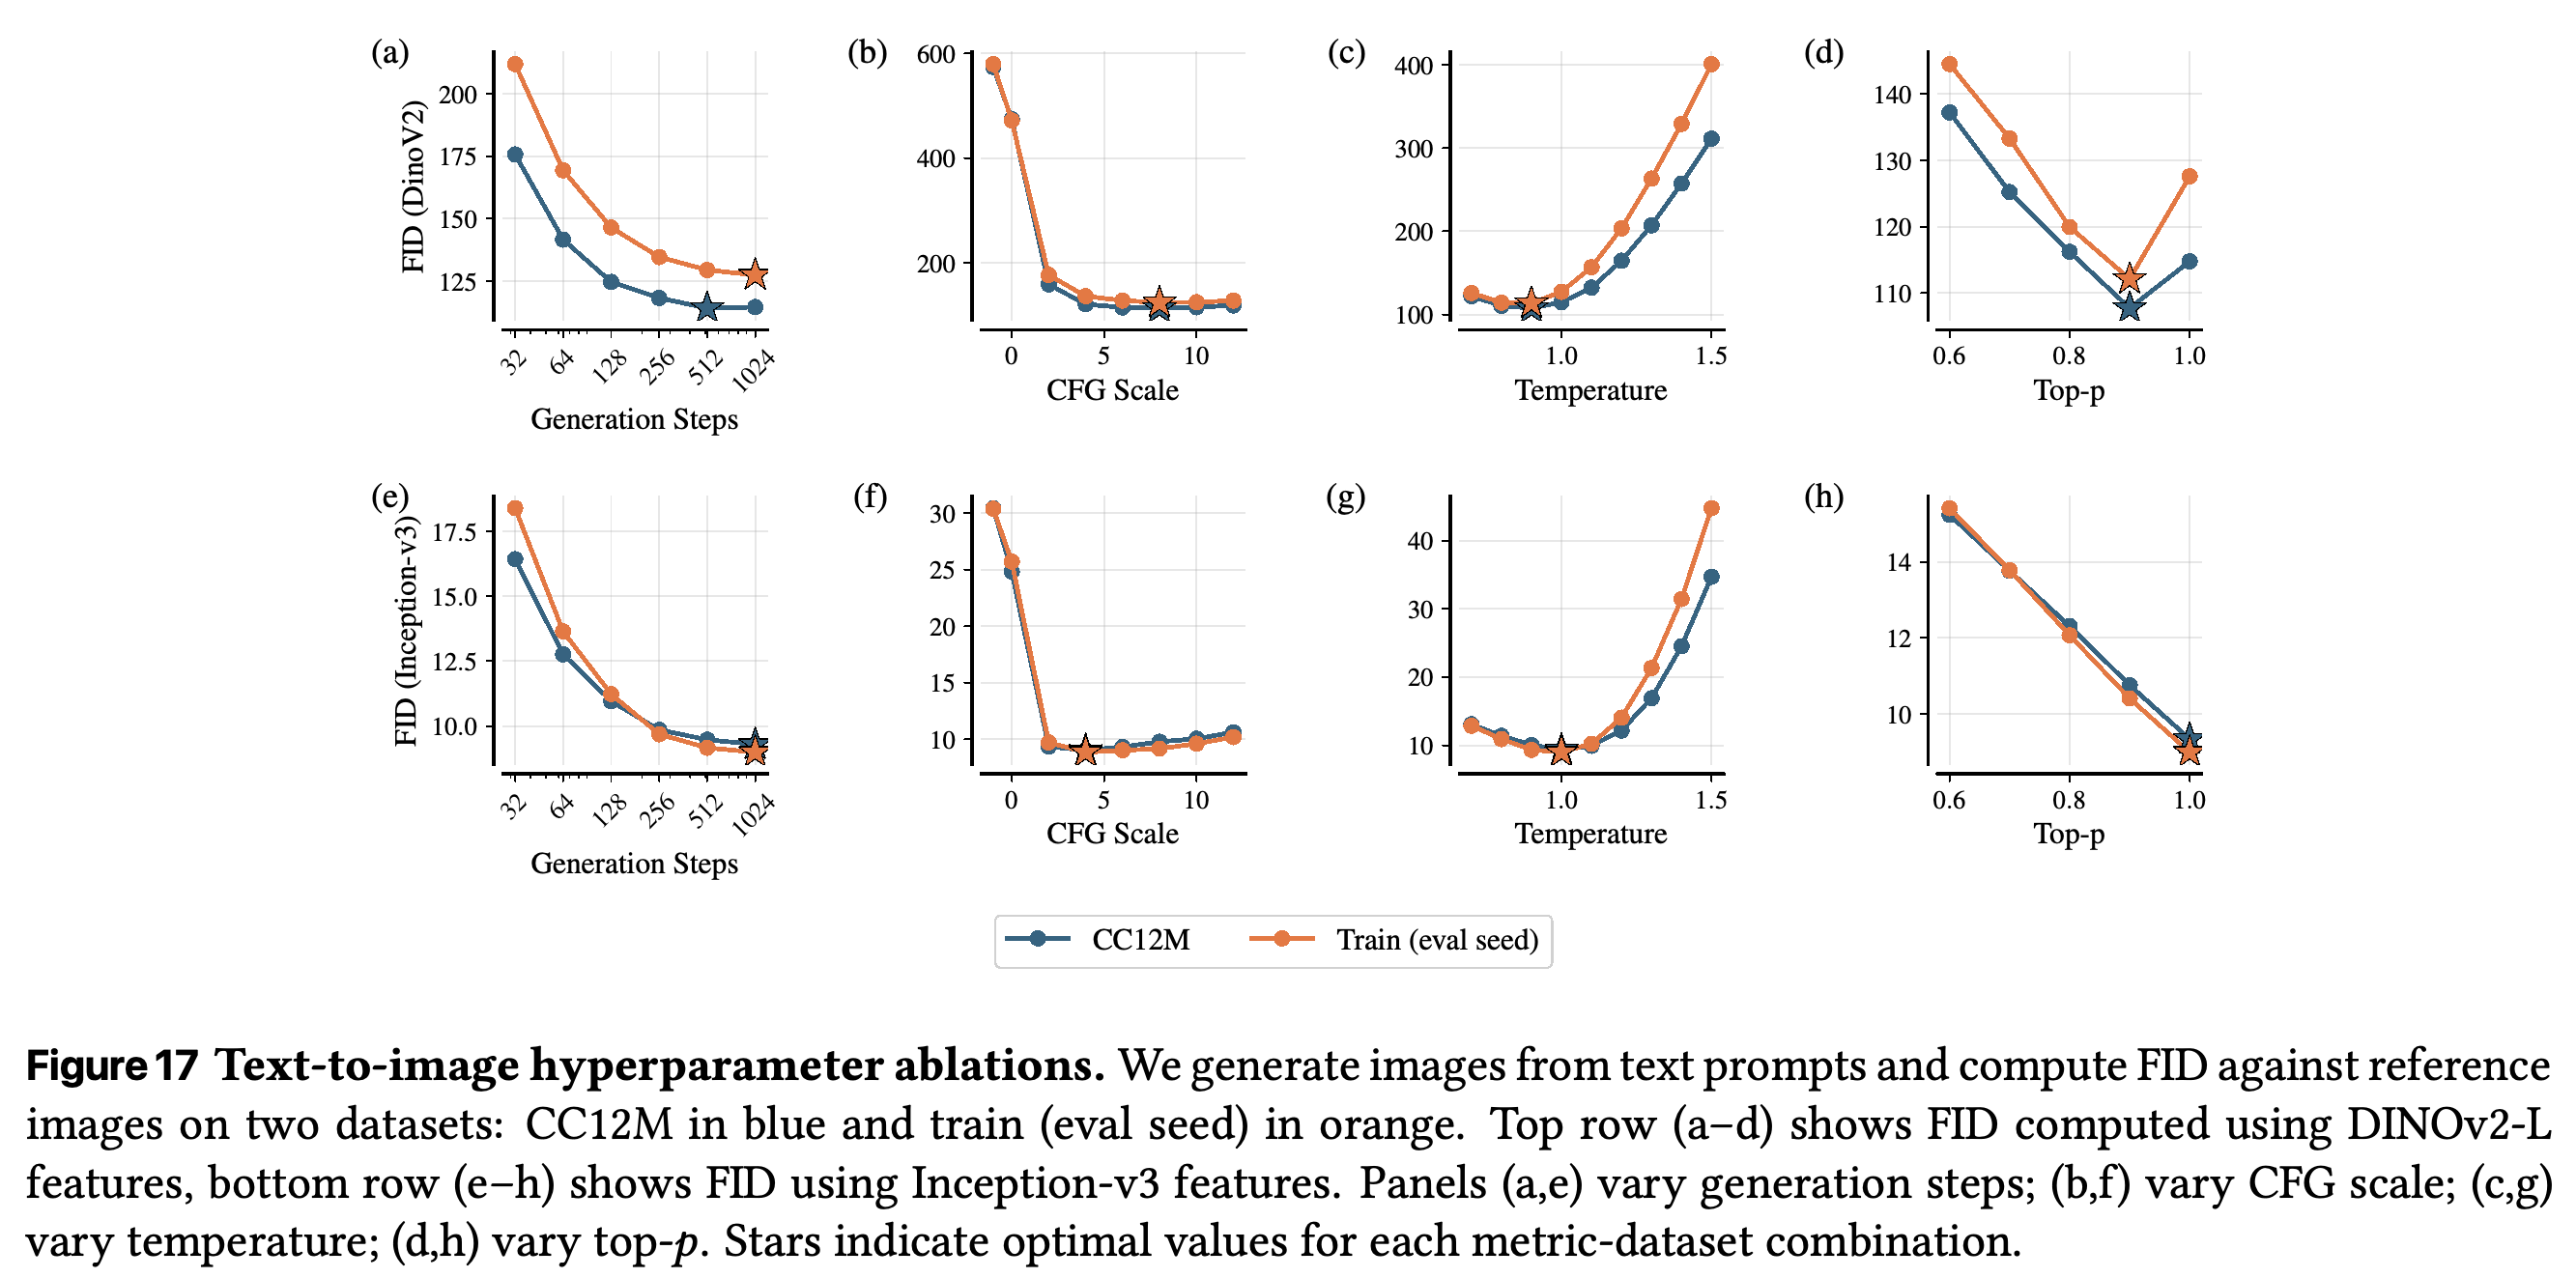
Text-to-image 추론 실험은 CC12M과 train (eval seed) 프롬프트를 조건으로 생성한 10,000개의 이미지를 사용한다. CFG, temperature, top-p, 생성 step 수를 한 번에 하나씩 바꾼다. 기준 설정은 CFG = 6.0, temperature = 1.0, top-p = 1.0, 생성 step 수 1024다.
- Figure 17은 step 수가 늘어날수록 FID 개선 폭이 줄어듦을 보여준다.
- Guidance와 temperature의 최적값은 실험 범위의 내부에 있다. 제시된 실험에서 DINOv2-L FID는 top-p 약 0.9를, Inception-v3 FID는 1.0을 선호한다.
- CFG는 텍스트 프롬프트를 완전히 마스킹해 무조건부 예측을 얻는다. 이 실험들은 서로 영향을 주는 샘플링 파라미터를 공동 최적화하지 않는다.
Denoising step을 늘리면 이미지 FID가 개선되지만 개선 폭은 줄어든다. Guidance와 temperature의 최적값은 실험 범위의 내부에 있다. DINOv2-L과 Inception-v3가 선호하는 top-p 값은 서로 다르며, 이는 선호 설정이 feature extractor에 따라 달라짐을 보여준다.
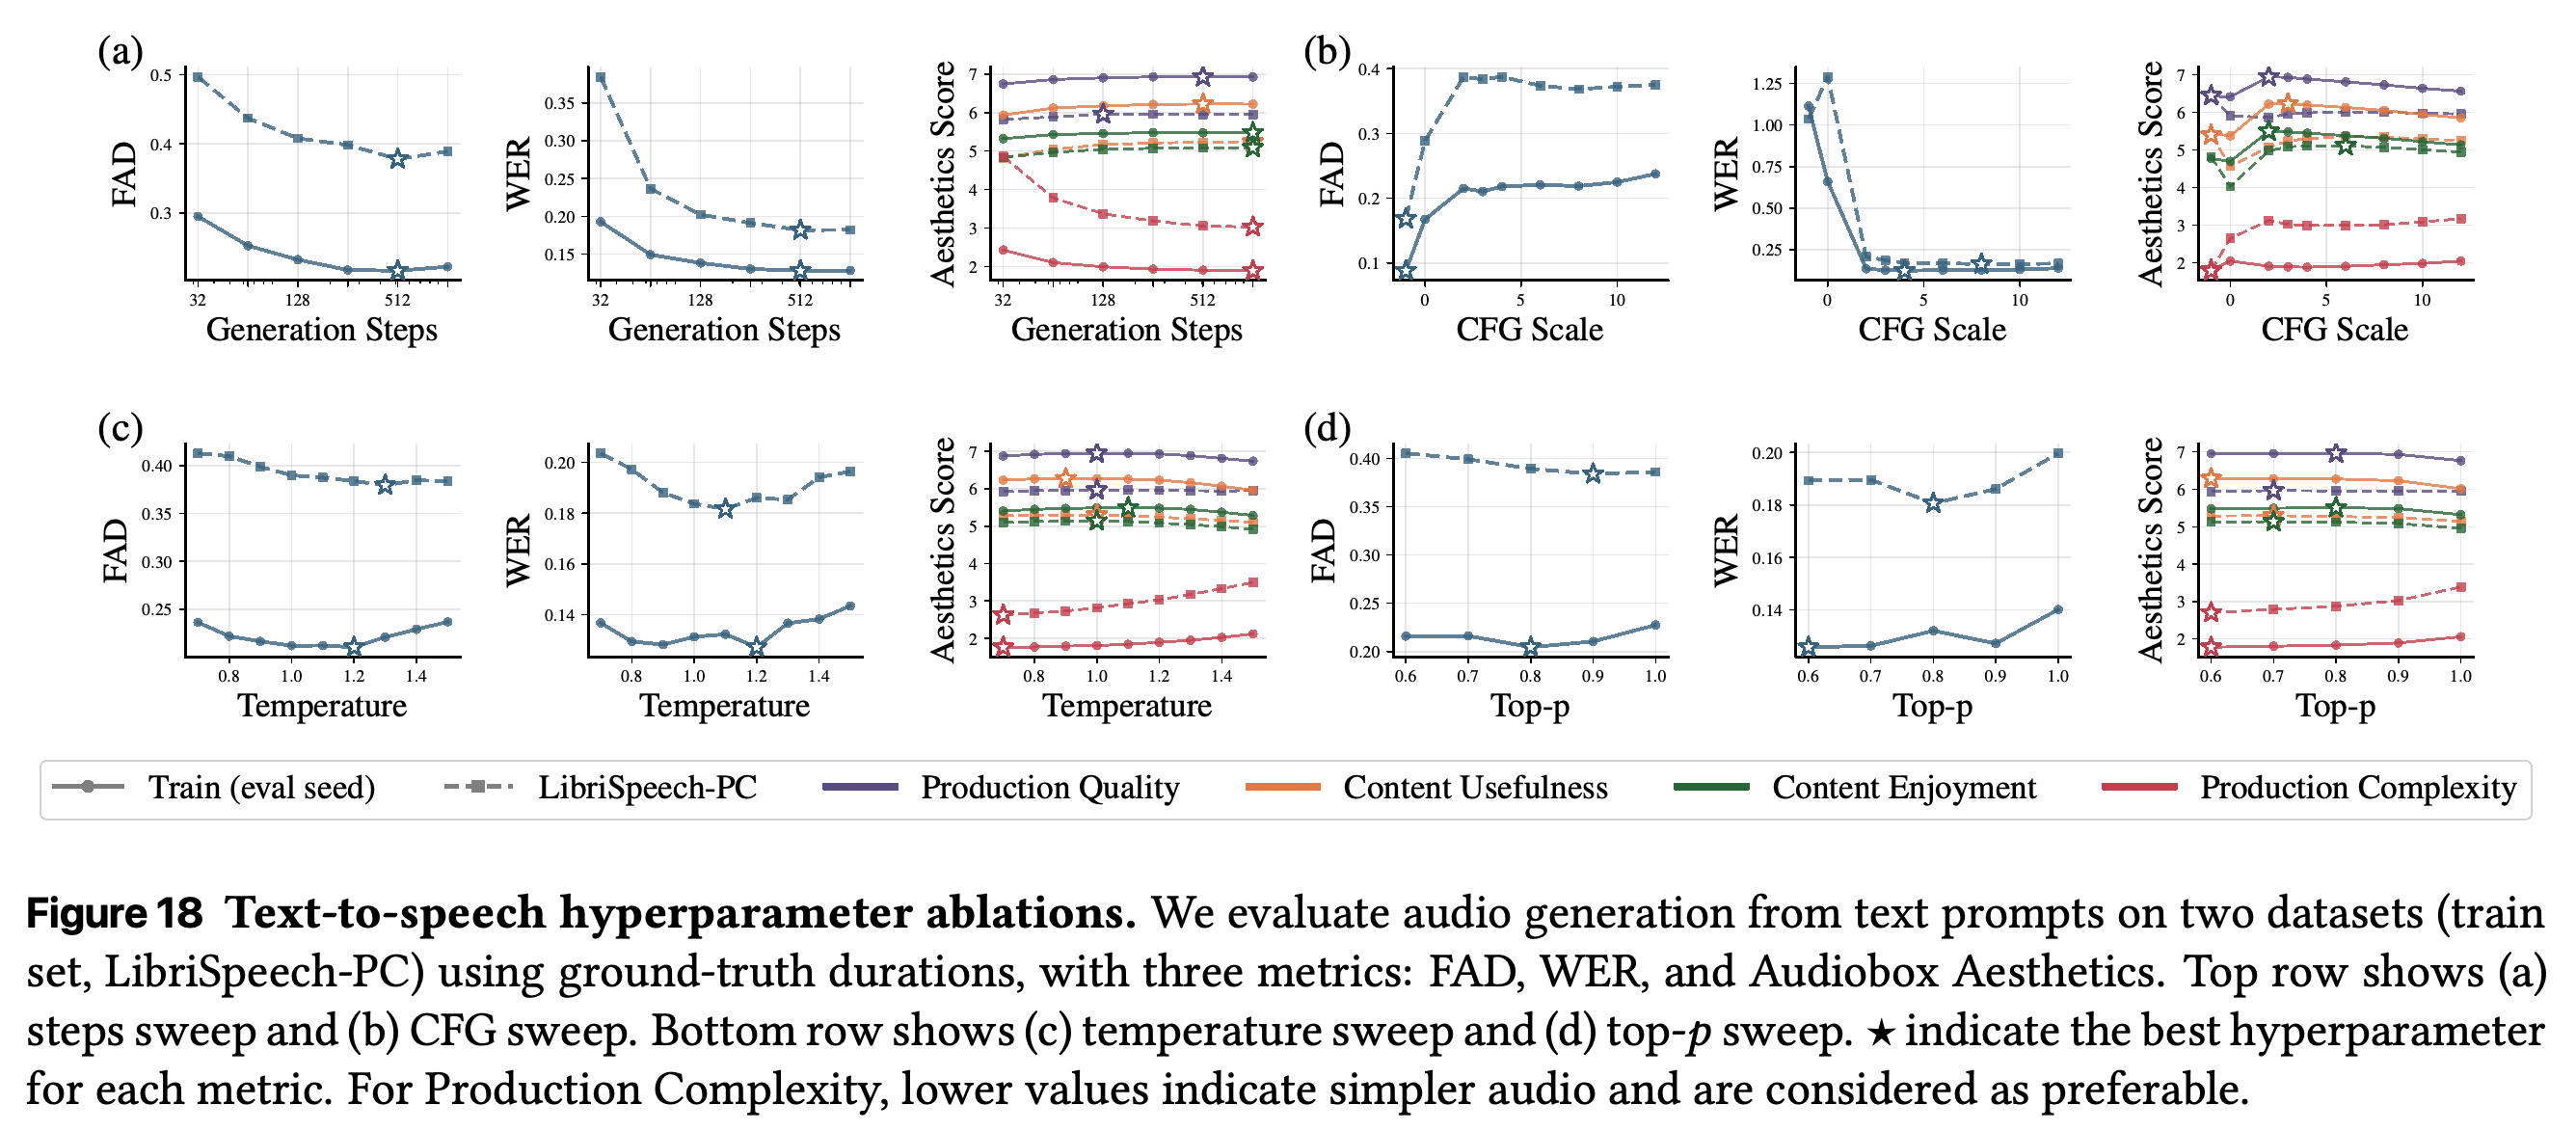
Text-to-speech 실험은 train (eval seed)와 LibriSpeech-PC 각각에서 10,000개 표본으로 시작한다. 길이 ≤ 30초인 표본만 남기고, 생성 시 정답 길이를 제공한다. 각 데이터셋에서 약 70%와 99%의 표본이 남는다. 기준 설정은 CFG = 3.0, temperature = 1.2, top-p = 0.9, 생성 step 수 1000이다.
- Figure 18은 step을 추가할수록 개선 폭이 줄어들며 guidance에 상충 관계가 있음을 보여준다. 조건을 더 강하게 적용하면 WER은 개선되지만 FAD는 악화된다.
- Temperature, top-p, CFG의 최적값은 충실도, 전사 정확도, 미적 평가 항목에 따라 다르다. 이 평가에서는 Production Complexity가 낮을수록 좋다고 본다.
- LibriSpeech-PC에서도 비슷한 추세가 나타난다. 이는 기준 길이를 제공하는 평가 절차 안에서 관찰한 민감도가 외부 데이터셋에도 이어짐을 뒷받침한다.
Guidance는 전사 정확도를 높이지만 오디오 분포의 충실도를 악화시키며, 미적 평가 항목마다 최적 샘플링 설정이 다르다. 2개 데이터셋에서 나타난 전반적인 추세는 기준 길이를 제공한 조건에서 측정한 결과다. Production Complexity는 낮을수록 좋다고 본다.
7.4 Anti-Masking
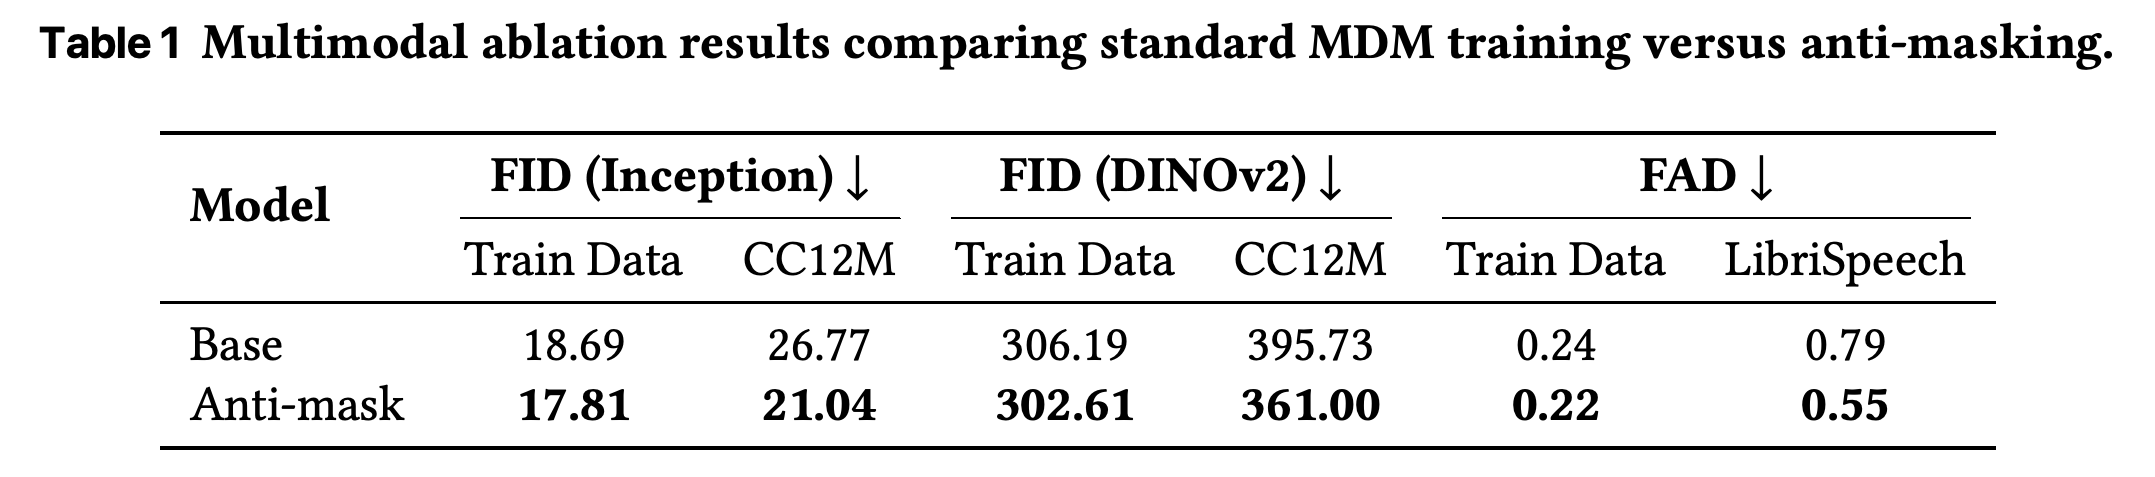
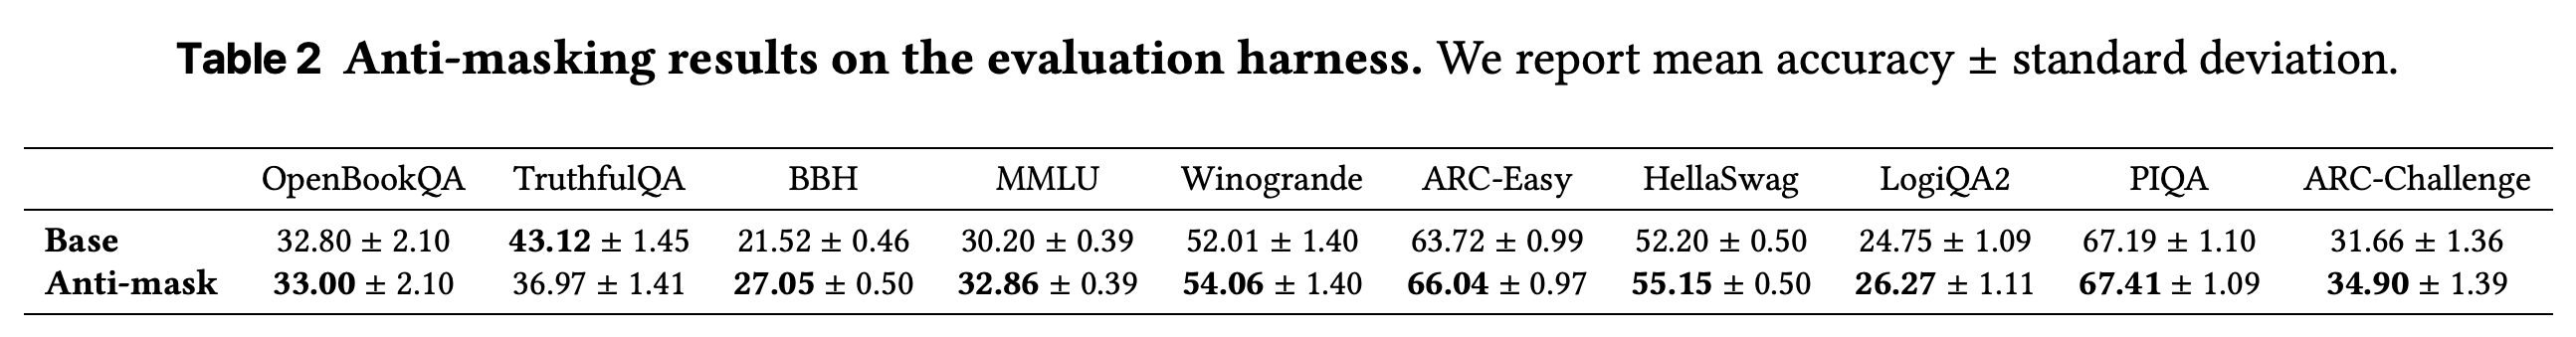
Anti-masking은 학습 분산을 줄이기 위해 각 입력에서 상보적으로 마스킹한 2개의 버전을 만든다. 연산량을 맞추기 위해 짝지어진 anti-masked 예시로 학습하는 1 epoch과 일반 마스킹으로 학습하는 2 epoch을 비교한다. 약 7B 텍스트 모델은 파라미터당 고유 토큰 100개를 사용하며, 약 1.3B multimodal models는 파라미터당 고유 토큰 50개를 사용한다.
- Table 1에서 보고한 이미지와 오디오 거리 값은 모두 낮아진다. CC12M FID-Inception은 26.77에서 21.04로, LibriSpeech FAD는 0.79에서 0.55로 감소한다.
- Table 2에서는 대부분의 언어 작업 평균이 개선된다. BBH는 21.52 ± 0.46에서 27.05 ± 0.50으로, MMLU는 30.20 ± 0.39에서 32.86 ± 0.39로 높아진다.
- TruthfulQA는 43.12 ± 1.45에서 36.97 ± 1.41로 낮아진다. 따라서 benchmark 전반에서 효과가 일관되게 긍정적인 것은 아니다.
- 연산량이 늘지 않는다는 설명은 반복되는 일반 예시를 이 방식으로 대체하는 경우에 해당한다. Anti-masking도 고유 표본마다 손상된 인스턴스 2개를 처리한다.
연산량을 맞춘 비교에서 anti-masking은 보고된 모든 이미지 FID와 오디오 FAD를 낮춘다. LibriSpeech FAD는 0.79에서 0.55로, 학습 데이터 FAD는 0.24에서 0.22로 변한다.
대부분의 언어 작업 평균이 개선되며, BBH와 ARC-Challenge에서 변화가 크지만 TruthfulQA는 낮아진다. 보고된 평균 정확도와 표준편차는 benchmark 효과가 대체로 긍정적이지만 모든 경우에 그렇지는 않음을 뒷받침한다.
8 Conclusion
결론은 공유 이산 tri-modal 구조와 최적화 설정 전이, 연산 최적 배분, 모달리티별 샘플링에 관한 실험적 지침을 종합한다. 실험은 구현 가능성과 학습 설정의 효과를 입증하지만, 경쟁 생성 모델 계열보다 우수함을 입증하지는 않는다.
- SDE 전이는 임계 구간 안에서 물리적 배치 크기를 튜닝할 필요를 줄인다.
- Anti-masking은 연산량을 맞춘 반복 학습 설정에서 대부분의 평가 결과를 개선한다. 추론 설정은 모달리티와 평가 지표 모두에 따라 달라진다.
부록
- A General formulation of weighting and the masking process, A.1 Connection of Loss Weighting and Cumulative Corruption, A.2 Unbiasedness of the Importance Weighting은 absorbing-mask 전이 과정, 누적 생존 확률, 역방향 posterior, 시간에 따른 손실 가중치를 전개한다. 유도 과정에서는 posterior rate의 −ᾱ′t/(1 − ᾱt)가 제시된 손실 가중치의 ᾱ′t/(1 − ᾱt)로 바뀌어 부호 불일치가 발생한다. 1/t subsampling 논증도 손상된 문맥에 따라 달라지는 복원 손실을 고정값으로 취급하며, 이 논증이 Section 3 에 제시된 마스킹 위치 정규화와 어떻게 일치하는지 설명하지 않는다.
- B Tokenizer Ablations와 B.1 Audio Tokenizer Ablations는 3256 토큰 문맥과 30초 오디오 제약 아래에서 사전학습된 DAC, 사전학습된 Higgs Audio v2, 재학습한 DAC 방식 codec을 비교한다. 4개 codebook으로 디코딩하는 Higgs Audio v2를 rate–distortion 절충에 따라 선택하며, LibriTTS-clean 복원 PESQ는 2.544다. Codebook을 늘리면 복원 품질은 개선되지만 시퀀스가 길어진다.
- B.2 Image Tokenizer Ablations는 CC12M과 ImageNet의 reconstruction FID로 Cosmos, IBQ, OpenMagVIT, UniTok, MoVQGAN을 비교한다. ImageNet은 256과 512 해상도를 포함한다. 복원 품질, 압축률, 어휘 크기의 균형을 고려해 MoVQGAN을 선택한다. 이미지당 1024 토큰과 어휘 크기 16,384를 사용하며 CC12M rFID는 0.50이다.
- C Training details는 C.1 Optimal Global Hyper-Parameter Search, C.2 Runtime as Function of Batch Size, C.3 Hyperparameters for the Unified 3B Tri-modal MDM을 포함한다. 전역 탐색은 본문에 명시된 전체 파라미터 320M과 13B 토큰으로 2900회 수행하지만, Figure 19의 caption에는 350M이라고 적혀 있다. 실행 시간 측정은 GPU 활용도가 포화되는 과정과 노드 수 확장에 따른 통신 오버헤드를 구분한다. 최종 학습 설정은 기본 학습률 9e−4, AdamW ε = 1e−8, β1 = 0.9, β2 = 0.95, weight decay 0.1, warmup 2,000 step, z-loss 가중치 1e−5다.
- D MDM with Per-module Hyperparameters는 8개 block으로 구성한 width-1024 모델을 13B 멀티모달 토큰으로 학습하며, 모듈과 깊이에 따른 optimizer 및 초기화 배수를 탐색한다. 기준 규모에서 같은 손실에 도달하는 데 필요한 토큰 수가 1.81× 감소했다고 보고한다. 텍스트 embedding과 unembedding에는 더 큰 학습률을, 뒤쪽 block에는 더 강한 수치적 damping을 사용한다. Figure 21의 caption은 모델을 350M으로 표기하지만 주변 본문은 320M이라고 설명한다.
- E Extended Scaling Laws Results는 embedding 오버헤드가 큰 소규모 모델에서 non-embedding 파라미터 수를 C = 6ND에 직접 대입할 수 없는 이유를 설명한다. 연산 최적 곡선은 토큰당 전체 FLOPs 계산을 사용한다. 별도의 text-only 연구는 SDE 스케일링 없이 CompleteP를 사용하며, 시퀀스 길이는 4,096이고 GPU 활용도를 높이기 위해 모델마다 배치를 달리한다. Fitting한 식은 L̂ = 1.88 + 0.28 · N^−0.48 + 0.75 · D^−0.21이다.
- F Masking Schedules for Image and Audio Generation은 다른 설정을 고정한 채 1B 모델을 100k step 학습해 linear, cosine, polynomial, geometric 스케줄을 비교한다. 이미지 평가는 8,192개 표본, 256×256 해상도, diffusion 1024 step, temperature 0.9, top-p 0.9를 사용한다. 오디오 평가는 10,000개 표본, 기준 길이, 512 step, temperature 1.0, top-p 0.9를 사용한다. Polynomial 마스킹이 전반적으로 가장 좋은 결과를 보이며, 선호 CFG 범위는 이미지 7–9, 오디오 1–3으로 보고한다. 다만 제시된 Production Complexity 점수에서는 모든 guidance 수준에서 polynomial이 일관되게 우수하지는 않다.
- G Extended generations는 이미지 표본과 전체 synthetic-caption 프롬프트를 제공한다. 예시는 더 큰 생성 표본 집합에서 품질 필터링과 다양성을 고려해 선별했다. 따라서 갤러리는 일반적인 성공률이 아니라 생성 능력을 보여준다. H Contributions는 코드, 실험, 데이터 준비, 인프라, 이론 정식화, 프로젝트 총괄의 담당 역할을 기록한다.
짧은 생각
가장 분명한 실용적 기여는 물리적 배치 크기와 논리적 최적화 동역학을 분리한 데 있다. 측정한 손실 평탄 구간과 이를 벗어나는 임계값은 정해진 구간 안에서 하드웨어를 고려해 배치를 설정할 근거를 제공한다. 체계적인 스케일링 연구도 유용한 배분 추정치를 제공하지만, 이 추정치는 실험한 tokenizer, 데이터 혼합, 구조, 전이 규칙에 한정된다. 실제 배포를 뒷받침하는 근거는 제한적이다. 샘플링에 많은 step이 필요하고, 조건을 맞춘 추론 지연 시간 비교는 보고하지 않으며, 음성 생성에는 기준 길이를 제공한다. 3B 결과는 3개 모달리티의 생성 가능성을 보여준다. 다만 GenEval position과 counting 점수가 낮아 구성적 이해 능력에 관한 주장은 제한된다. 학습 설정을 재현하기 전에 수식 표기, step 수 부등호, 탐색 모델 크기의 불일치를 해결해야 한다.