


The GAN is dead; long live the GAN! A Modern GAN Baseline 요약 설명
09 Jan 2025 | Paper Review GAN Loss Functions Residual Architectures목차
이번 글에서는 The GAN is dead; long live the GAN! A Modern GAN Baseline 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 1월 9일(Arxiv), 38th Conference on Neural Information Processing Systems (NeurIPS 2024)
- Huang, Yiwen, Gokaslan, Aaron, Kuleshov, Volodymyr, Tompkin, James.
- Brown University, Cornell University
- 논문 링크
- Github
요약
- 생성적 적대 신경망(GAN)은 실제 이미지와 생성 이미지에 점수를 매기는 판별기와 경쟁하며 이미지 생성기를 학습한다. 이 과정에서 학습이 불안정하거나 표본 다양성이 부족할 수 있다. 네트워크 용량이 비슷한 조건에서 R3GAN은 클래스 레이블 없이 256 × 256 얼굴 이미지를 생성하는 무조건부 FFHQ-256 생성에서 Fréchet Inception Distance(FID) 2.75를 달성하며, StyleGAN2의 3.78보다 낮다. FID는 이미지 분포를 비교하는 지표로, 낮을수록 좋다. 생성적 적대 신경망(GAN)에 대해서는 GAN(Generative Adversarial Networks), GAN 논문 설명 글을 참조하라.
- 이 방법은 생성 표본과 실제 표본의 판별기 점수를 비교하는 relativistic pairing GAN(RpGAN)에 R₁과 R₂를 결합한다. R₁과 R₂는 각각 실제 데이터와 생성 데이터에 대한 판별기 입력 기울기에 페널티를 부과한다. 명시된 가정과 충분히 작은 학습률 아래에서 이 목적 함수는 국소 수렴을 보장한다. 국소 수렴은 평형점에 충분히 가까운 상태에서 학습을 시작하면 수렴한다는 뜻이다. 이러한 안정성을 바탕으로 항등 연결에 학습한 변환을 더하는 잔차 블록을 사용해 더 단순한 아키텍처를 구성한다.
- R3GAN은 손글씨 숫자를 쌓아 만든 서로 다른 조합인 StackedMNIST 모드 1000개를 모두 복원한다. 또한 이미지마다 네트워크를 1회 평가하여 소형 이미지 벤치마크 CIFAR-10에서 FID 1.96, ImageNet 이미지 데이터셋을 64 × 64로 축소한 ImageNet-64에서 2.09를 달성한다. 논문은 이 조건에서 경쟁력 있는 베이스라인을 제시한다. 전역 수렴, 더 높은 해상도의 ImageNet으로의 확장, 텍스트 설명을 통한 대규모 생성은 아직 검증되지 않았다.
1 Introduction
논문은 불안정한 적대적 목적 함수를 보완하기 위해 GAN 아키텍처에 특수 장치가 누적되어 왔다고 본다. 목적 함수를 안정화하고 불필요한 StyleGAN2 기능을 제거한 뒤, 용량을 대략 비슷하게 유지하면서 생성기와 판별기를 현대화한다. PDF에 적힌 제목은 “The GAN is dead; long live the GAN! A Modern Baseline GAN”이며, 코드 URL은 https://www.github.com/brownvc/R3GAN 이다.
2 Serving Two Masters: Stability and Diversity with RpGAN + R₁ + R₂
학습이 안정적이어도 생성기가 데이터 분포의 일부를 누락할 수 있다. 저자들은 다양성을 고려한 RpGAN 목적 함수에 판별기 입력 기울기를 0으로 유도하는 영점 중심 기울기 페널티를 결합해 안정성과 다양성을 함께 다룬다.
2.1 Traditional GAN
전통적인 목적 함수는 L(θ,ψ) = E_z[f(Dψ(Gθ(z)))] + E_x[f(−Dψ(x))]이다. 여기서 θ와 ψ는 생성기와 판별기의 매개변수이고, z는 샘플링한 잡음, x는 실제 데이터, E는 기댓값이다. 생성기 Gθ는 L을 최소화하고 판별기 Dψ는 이를 최대화하며, 논문은 f(t) = −log(1 + e^(−t))를 사용한다. 분포를 직접 최적화할 때는 유리한 성질이 있지만, 실제 매개변수 갱신은 판별기의 결정 경계를 기준으로 생성 표본을 이동시킨다. 이 과정에서 학습 분포의 일부를 누락하는 모드 누락이나 비수렴이 발생할 수 있다.
2.2 Relativistic f-GAN
RpGAN은 실제 표본과 생성 표본의 점수를 독립적으로 사용하는 대신 L(θ,ψ) = E_z,x[f(Dψ(Gθ(z)) − Dψ(x))]를 사용해 각 생성 표본을 실제 표본과 비교한다. 논문은 후보 해에 따라 목적 함수가 어떻게 변하는지를 다룬 기존 손실 지형 연구를 인용한다. 해당 연구는 자체 가정 아래에서 모드 누락을 일으키는 국소 최솟값을 배제한다. 다만 이러한 손실 지형이 기울기 기반 학습의 최적점 도달까지 보장하지는 않는다.
2.3 Training Dynamics of RpGAN
저자들은 규제를 적용하지 않은 RpGAN이 수렴하지 않을 수 있음을 보이고, 기존 수렴 분석을 R₁ 또는 R₂를 적용한 RpGAN으로 확장한다. 페널티는 R₁ = (γ/2)E_real[‖∇xDψ(x)‖²]와 R₂ = (γ/2)E_generated[‖∇xDψ(x)‖²]이며, ∇x는 입력에 대한 미분이고 γ는 규제 강도를 조절한다. 국소 수렴 결과는 실제 분포를 재현할 수 있는 생성기, 실제 데이터 지지집합 근처에서 상숫값을 출력하는 판별기, 평형점 근처의 정칙성과 민감도 조건, 충분히 작은 학습률을 요구한다. 임의의 초기화에서 수렴한다는 보장은 없다.
2.4 A Practical Demonstration
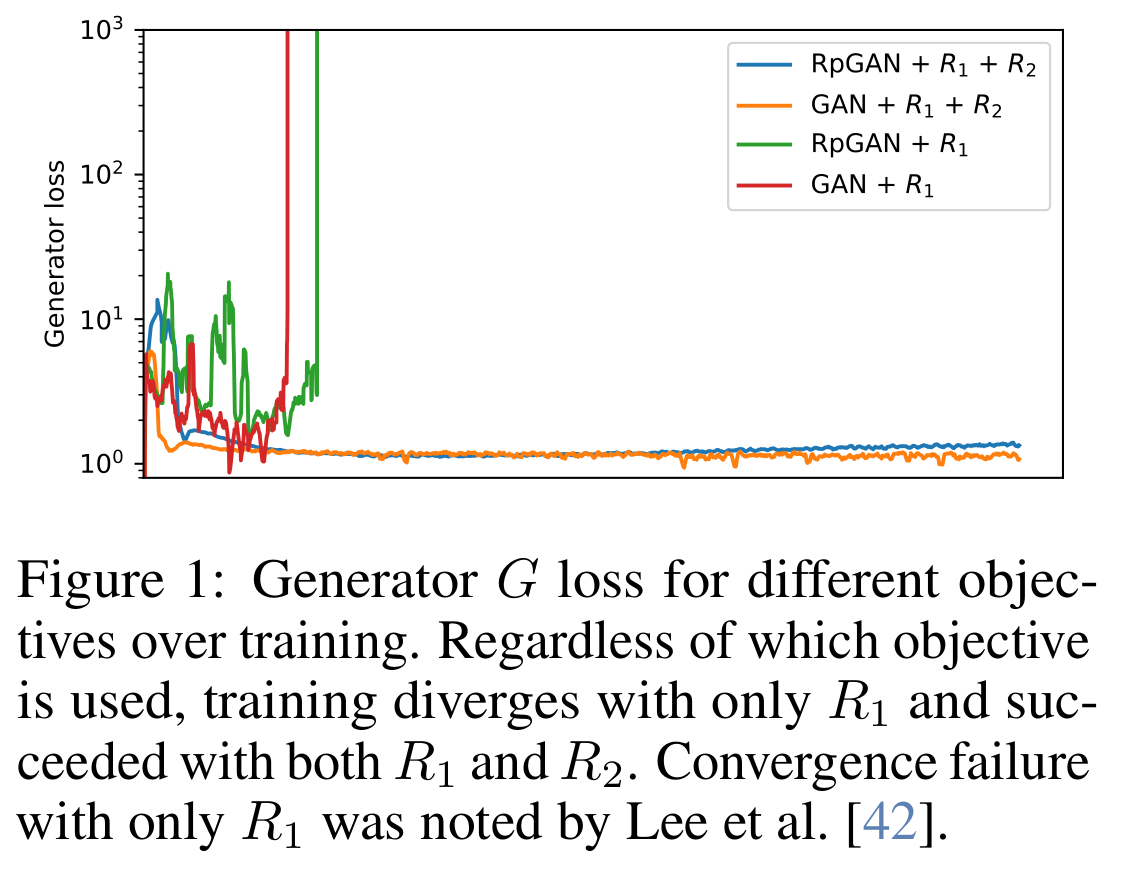
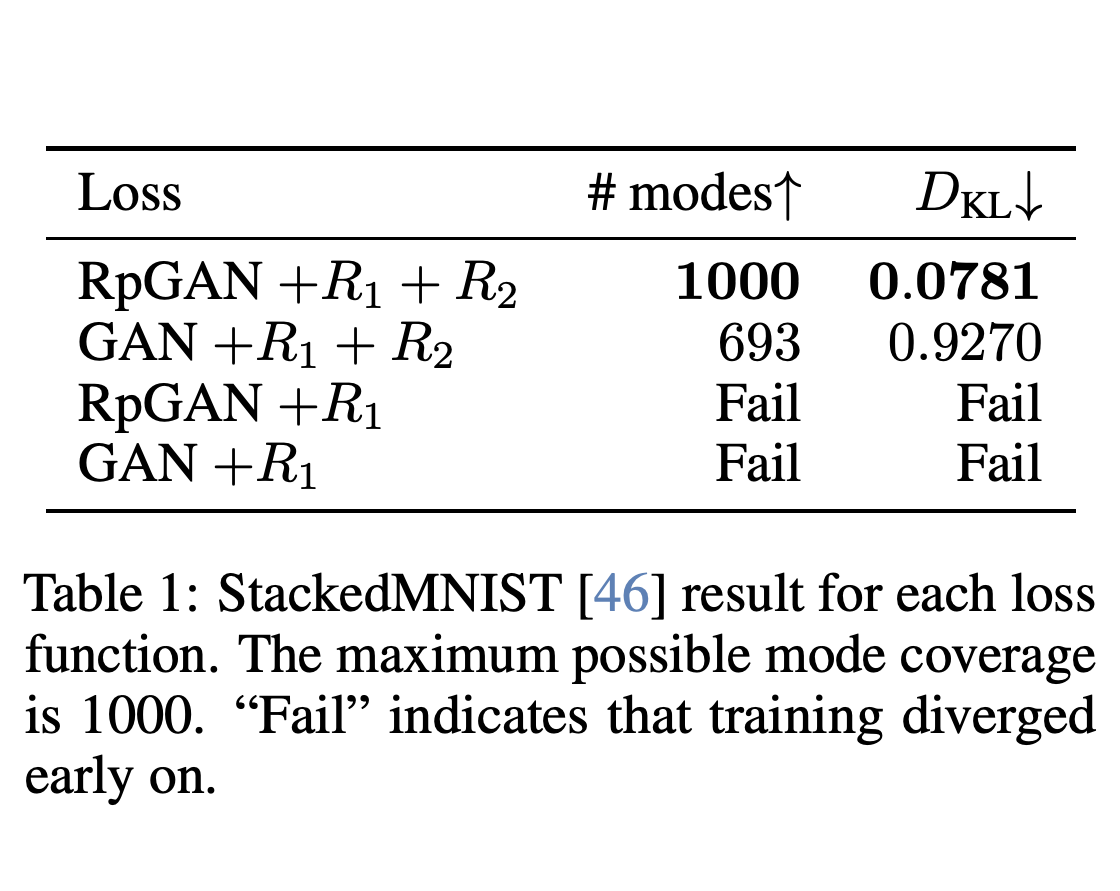
중간 활성값을 표준화하는 정규화 계층 없이 소형 잔차 네트워크를 StackedMNIST에서 시험한다. 사전 학습한 숫자 분류기로 모드 포괄률과 역방향 Kullback–Leibler(KL) 발산을 측정하며, 이 발산은 생성 모드 빈도와 균등한 목표 분포 사이의 차이를 나타낸다. Figure 1에서는 어느 목적 함수든 R₁만 적용하면 초기에 발산하지만, R₂를 추가하면 안정화된다. Table 1에서는 다양성 차이가 나타난다. RpGAN은 모드 1000개와 발산 0.0781을 기록하지만, 전통적인 목적 함수는 모드 693개와 0.9270을 기록한다. γ를 0.1에서 100까지 바꾸어도 R1-only 조건은 안정화되지 않았다. 이는 이 실험에서 실제 분포와 생성 분포 모두에 페널티를 적용할 근거가 된다.
R1-only 조건의 2회 실행은 모두 초기에 발산하지만, R₂를 추가하면 어느 목적 함수에서든 표시된 생성기 손실 궤적이 유계로 유지된다. 이는 이 실험에서 생성 데이터와 실제 데이터에 모두 규제를 적용할 근거가 된다. 다양성은 별도로 측정해야 한다.
페널티 2개를 모두 적용하면 RpGAN은 모드 1000개를 포괄하고 역방향 KL 발산 0.0781을 기록한다. 전통적인 목적 함수는 모드 693개와 0.9270을 기록한다. 따라서 학습이 안정적이라는 사실만으로 모든 모드의 복원을 보장할 수는 없다.
3 A Roadmap to a New Baseline — R3GAN
로드맵은 256 × 256 FFHQ에서 구성 A–E를 비교한다. 각 구성은 판별기가 실제 이미지 5 M장을 볼 때까지 학습하며, 용량은 대략 비슷하게 유지한다. 제거한 기능은 잠재 제어값을 변환하고 삽입하는 style mapping과 injection, 이 제어값으로 합성곱 가중치를 조정하는 weight modulation/demodulation, noise injection, 스타일 조합과 잠재값 변화에 대한 민감도를 제한하는 mixing 및 path-length regularization, latent normalization, 배치 다양성 통계를 제공하는 minibatch standard deviation, 연산 중 가중치를 재조정하는 equalized learning rate, 페널티를 간헐적으로 적용하는 lazy regularization이다.
- 기능을 제거한 베이스라인은 잠재 차원을 64로 줄이고 학습률을 2.5 × 10⁻³에서 5 × 10⁻⁵로 낮춘다. 유지한 설정은 1차 모멘트의 모멘텀 계수가 β₁ = 0인 Adam 옵티마이저, 활성값 정규화를 사용하지 않는 방식, 이미지 해상도를 바꾸는 bilinear resampling, 음수 입력에서도 기울기가 0이 아닌 활성 함수 leaky ReLU이다. leaky ReLU에 대해서는 DCGAN(Deep Convolutional GAN, DCGAN 논문 설명) 글을 참조하라.
- 현대화한 아키텍처는 해상도 전환 계층을 별도로 두고 해상도마다 잔차 블록 두 개를 사용한다. 각 블록은 1 × 1, 3 × 3, 1 × 1 합성곱을 사용하며 마지막 합성곱에는 편향을 두지 않는다. fix-up 초기화는 마지막 계층을 영으로 초기화하고 나머지 두 계층의 초기값에 L⁻⁰·²⁵를 곱한다. 여기서 L은 잔차 블록 수이며, 이 방식은 정규화 없이 활성값 분산을 제어한다.
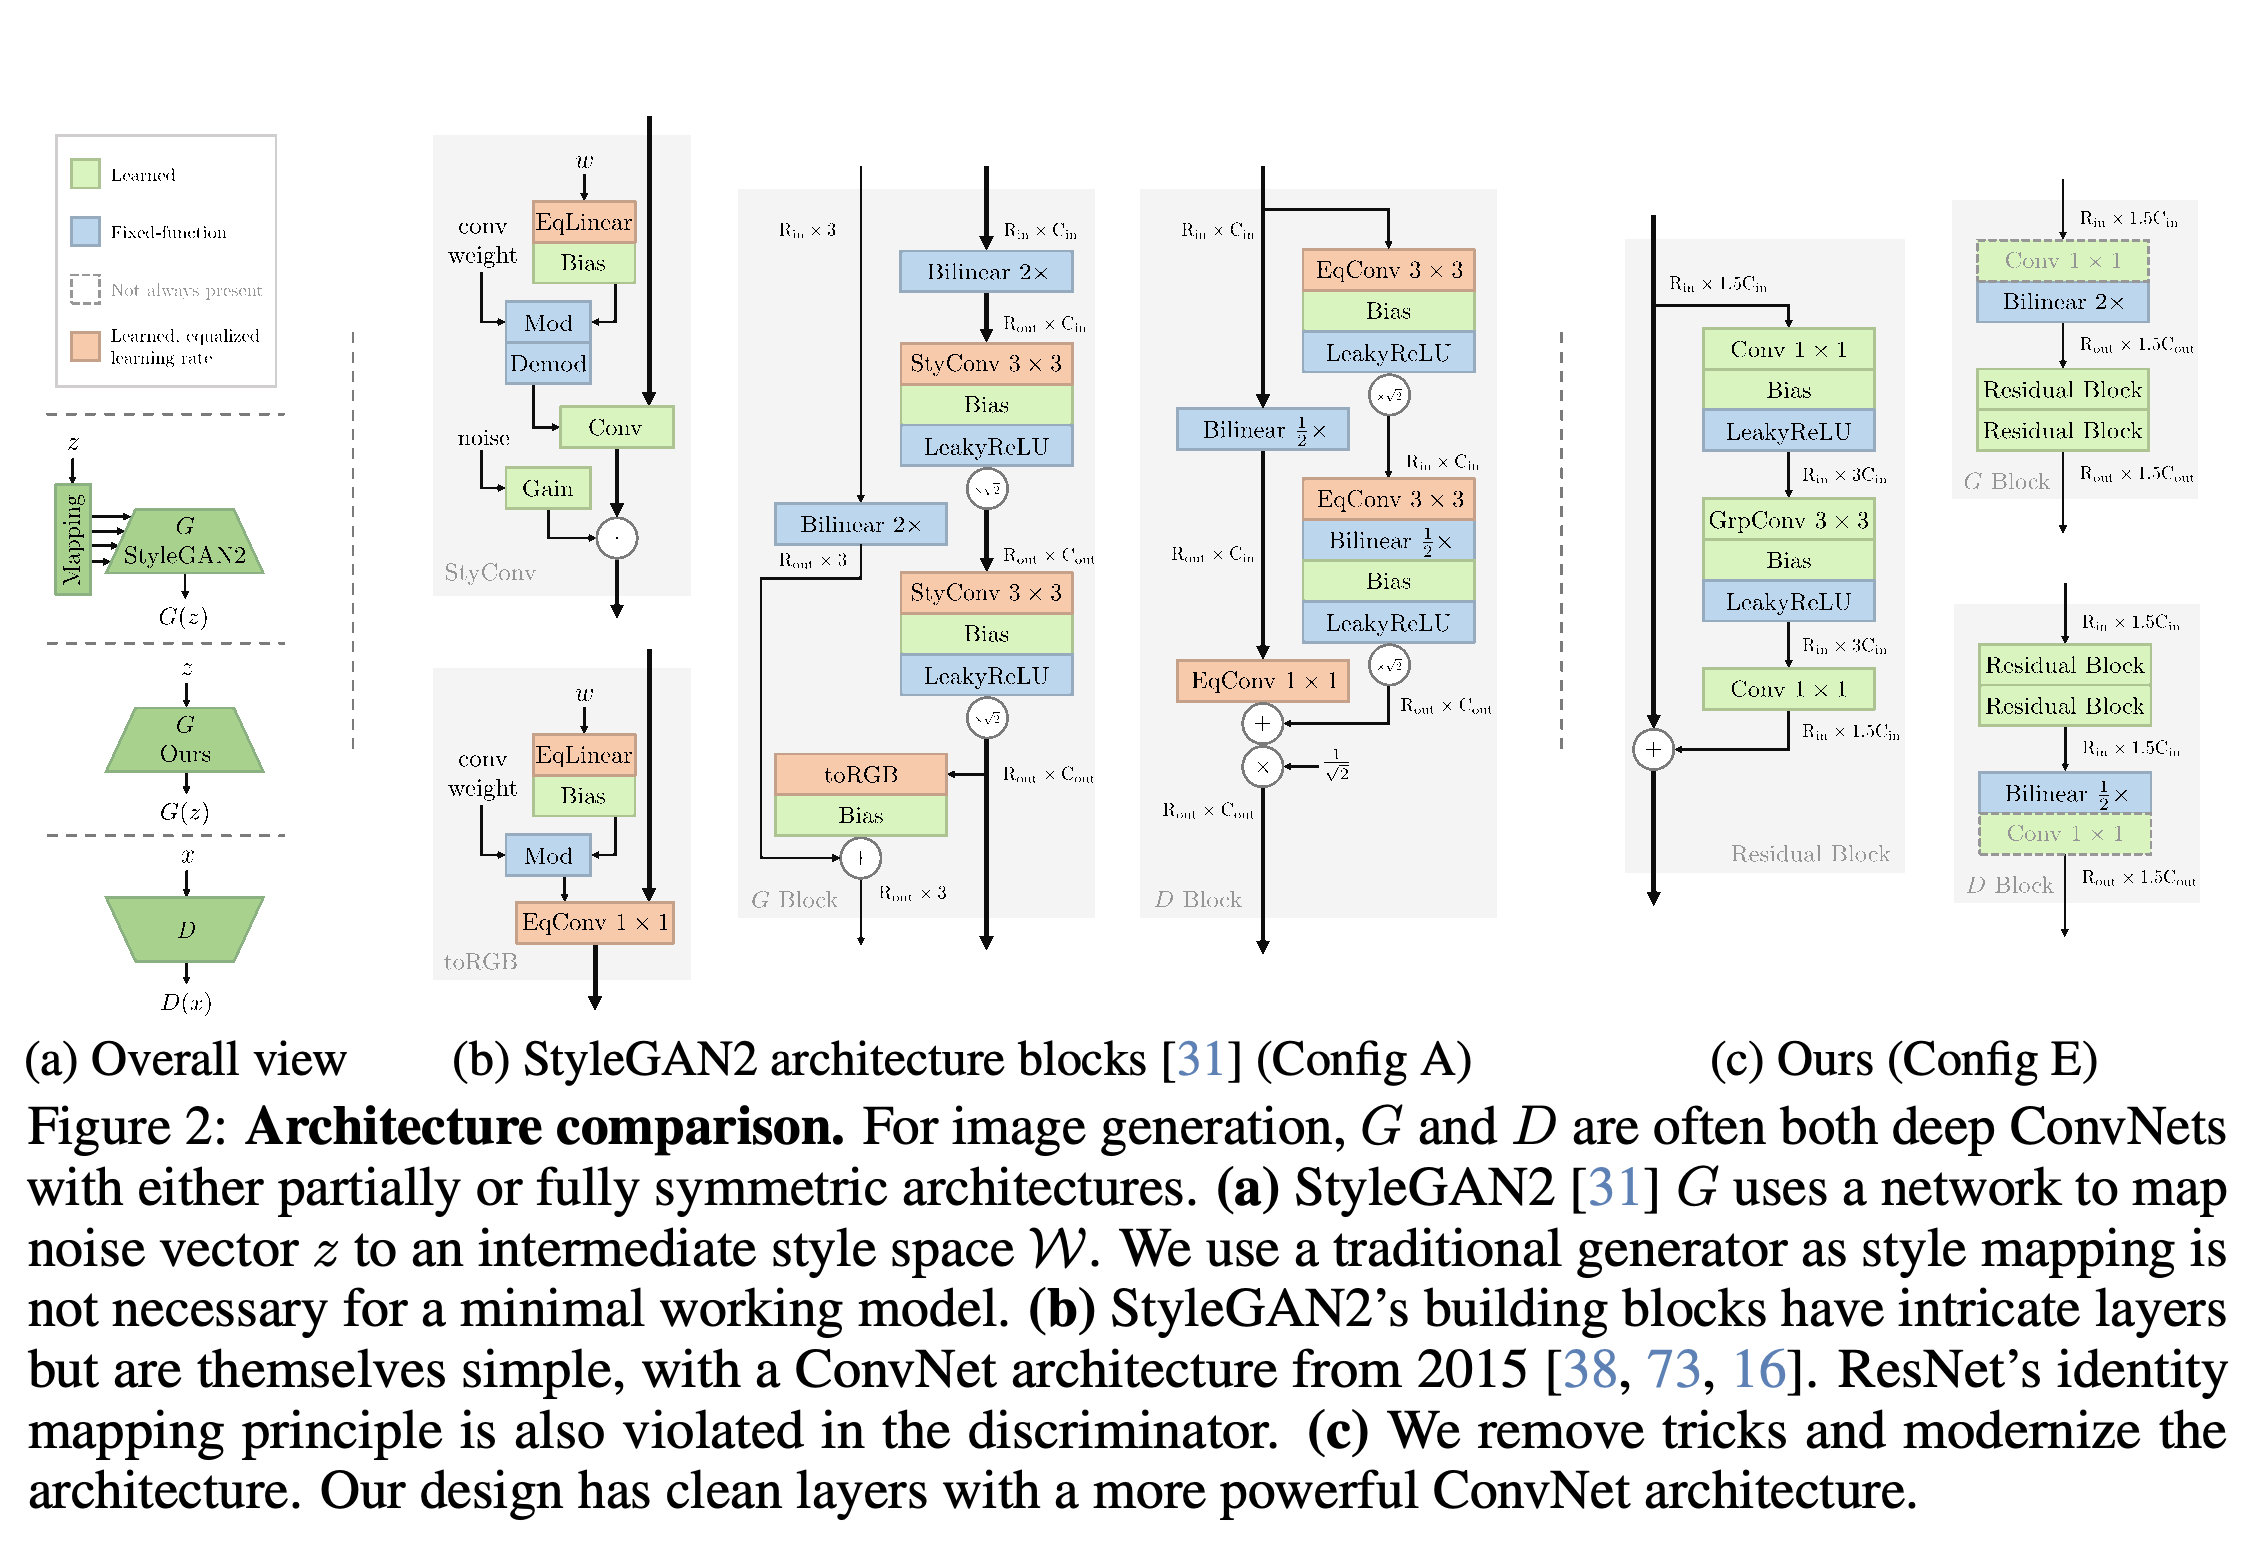
- 최종 설계는 채널을 그룹별로 처리하는 3 × 3 grouped convolution을 그룹 크기 16으로 사용한다. inverted bottleneck은 넓은 채널 차원과 좁은 채널 차원을 맞바꿔 모델 크기를 늘리지 않으면서 grouped convolution의 용량을 높인다. Figure 2는 이 설계를 StyleGAN2와 비교한다. inverted bottleneck에 대해서는 MobileNetV2 논문 설명(MobileNetsV2 - Inverted Residuals and Linear Bottlenecks 리뷰) 글을 참조하라.
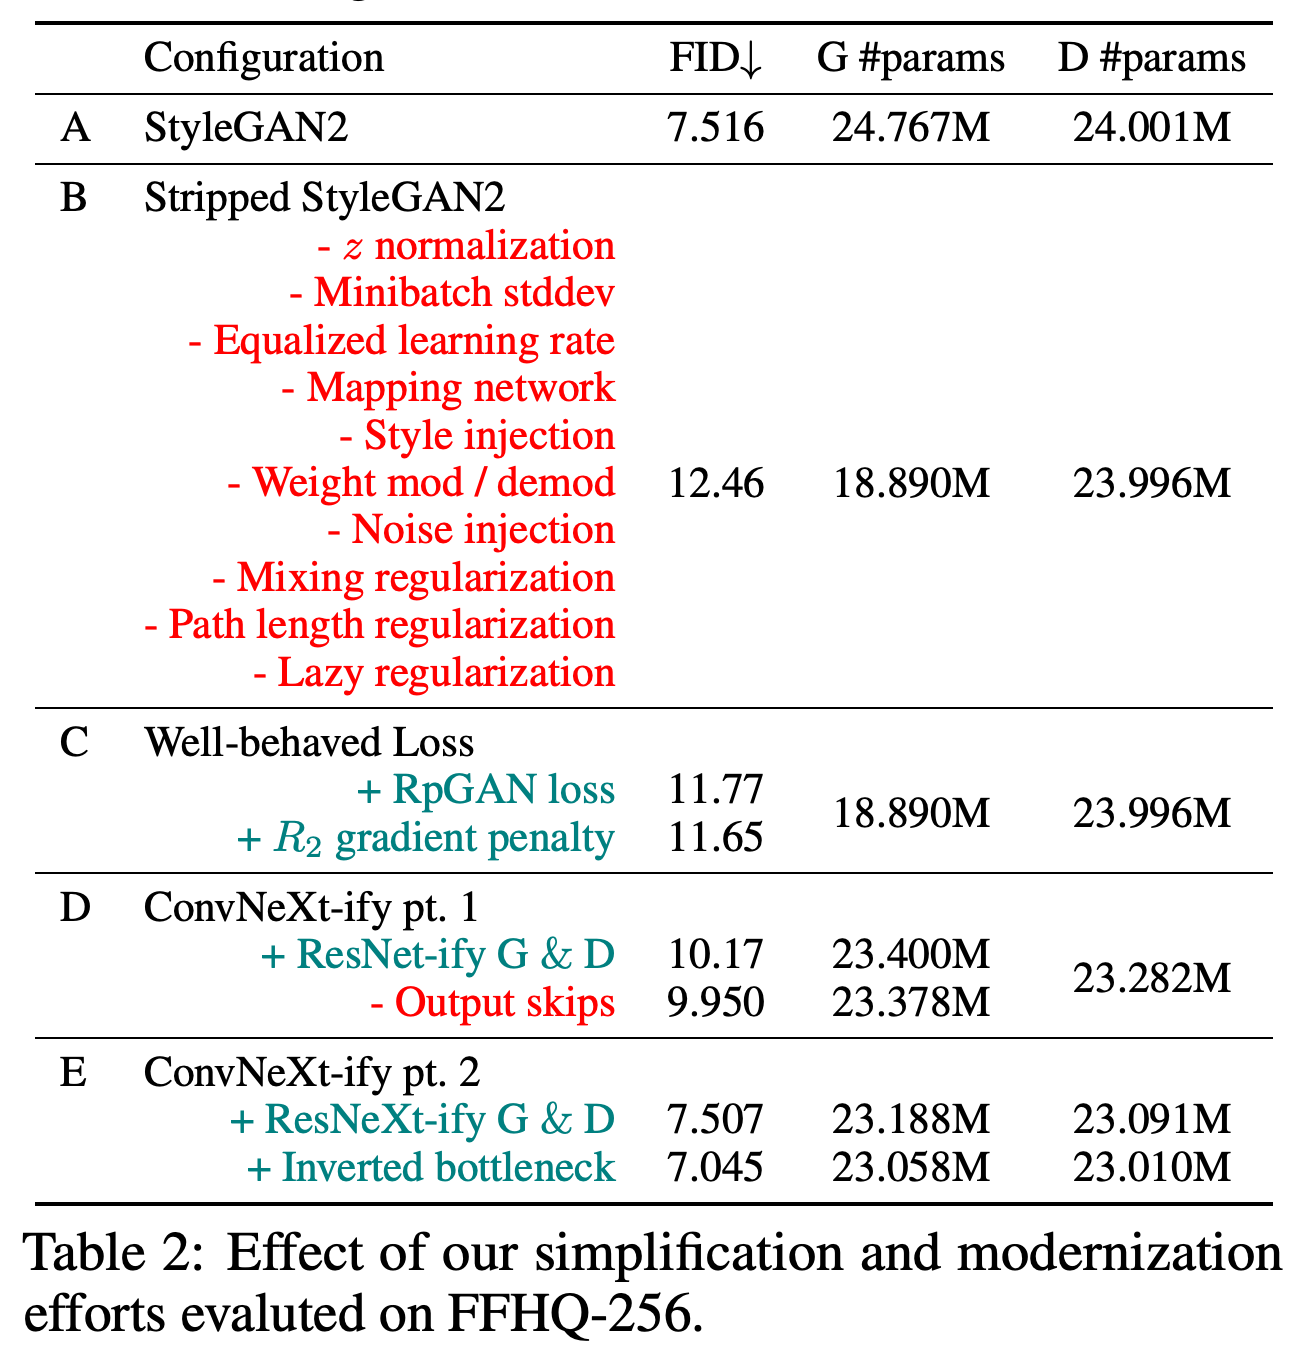
StyleGAN2 기능을 제거하면 FID가 7.516에서 12.46으로 악화된다. 규제를 적용한 손실을 사용하면 11.65로 개선되고, 이후 아키텍처를 차례로 변경하면 동일하게 실제 이미지 5 M장을 판별기에 제시한 학습에서 7.045까지 낮아진다. 이 비교는 다른 목적 함수에서도 아키텍처 개선 효과가 나타나는지 분리해 검증하지 않는다.
최종 모델은 중간 style-mapping 경로를 제거하고 resampling을 잔차 처리와 분리한다. 단순해진 블록은 생성기와 판별기의 대칭 구조를 유지하면서 합성곱 아키텍처를 바꾼다.
4 Experiments Details
실험은 짧은 학습으로 아키텍처를 비교하는 로드맵과, 하이퍼파라미터 및 스케줄을 최적화해 수렴할 때까지 학습한 최종 모델을 구분한다. 평가 대상은 무조건부 얼굴 및 StackedMNIST 생성과, 클래스 레이블로 샘플링을 유도하는 클래스 조건부 CIFAR-10 및 축소된 ImageNet 생성이다. 평가지표로 FID, 모드 포괄률, 표본 다양성을 측정하는 recall, 표본 생성에 필요한 네트워크 평가 횟수인 number of function evaluations(NFE)를 사용한다. 클래스 조건부에 대해서는 CGAN(Conditional GAN), C-GAN 논문 설명 글을 참조하라.
4.1 Roadmap Insights on FFHQ-256 [29]
Table 2의 FID는 StyleGAN2에서 7.516, 기능 제거 후 12.46, RpGAN 도입 후 11.77, R₂ 추가 후 11.65이다. 잔차 구조를 현대화하고 서로 다른 해상도의 생성기 출력을 결합하는 output skip 연결을 제거하면 9.950에 도달한다. grouped convolution을 적용하면 7.507, inverted bottleneck을 적용하면 7.045에 도달한다. 이 짧은 학습 비교에서는 기능을 제거한 베이스라인의 성능 회복 대부분이 아키텍처 변경에서 나온다. 다만 이 실험은 아키텍처 개선 효과를 얻는 데 새로운 목적 함수가 반드시 필요한지까지 입증하지는 않는다.
4.2 Mode Recovery — StackedMNIST [53]
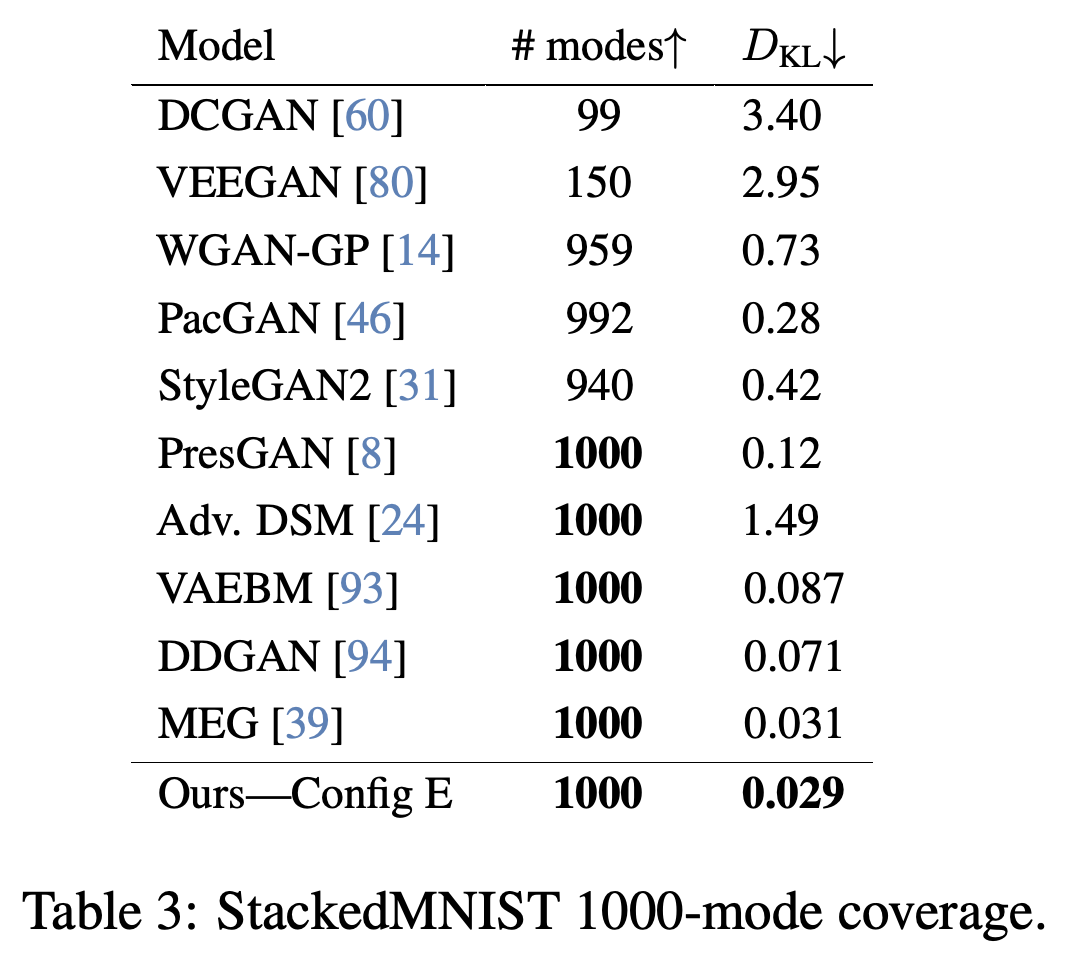
최종 아키텍처를 사용한 R3GAN은 StackedMNIST 모드 1000개를 모두 복원하고 KL 발산 0.029를 달성한다. Table 3에서 StyleGAN2는 모드 940개와 0.42를 기록한다. 다른 방법 중에도 모든 모드를 복원한 사례가 있지만 발산은 더 높다. denoising diffusion GAN인 DDGAN은 0.071, 최대 엔트로피 생성기인 MEG는 0.031을 기록한다. 모든 모드를 포괄하는 것과 모드 빈도가 균등 분포에 가까운 것은 서로 다른 결과다.
여러 방법이 모드 1000개를 모두 복원하지만, R3GAN의 KL 발산 0.029가 표에서 가장 낮다. 이는 모든 모드를 복원하는 것과 균등한 모드 빈도를 재현하는 것을 구분한다.
4.3 FID — FFHQ-256 [29] (Optimized)
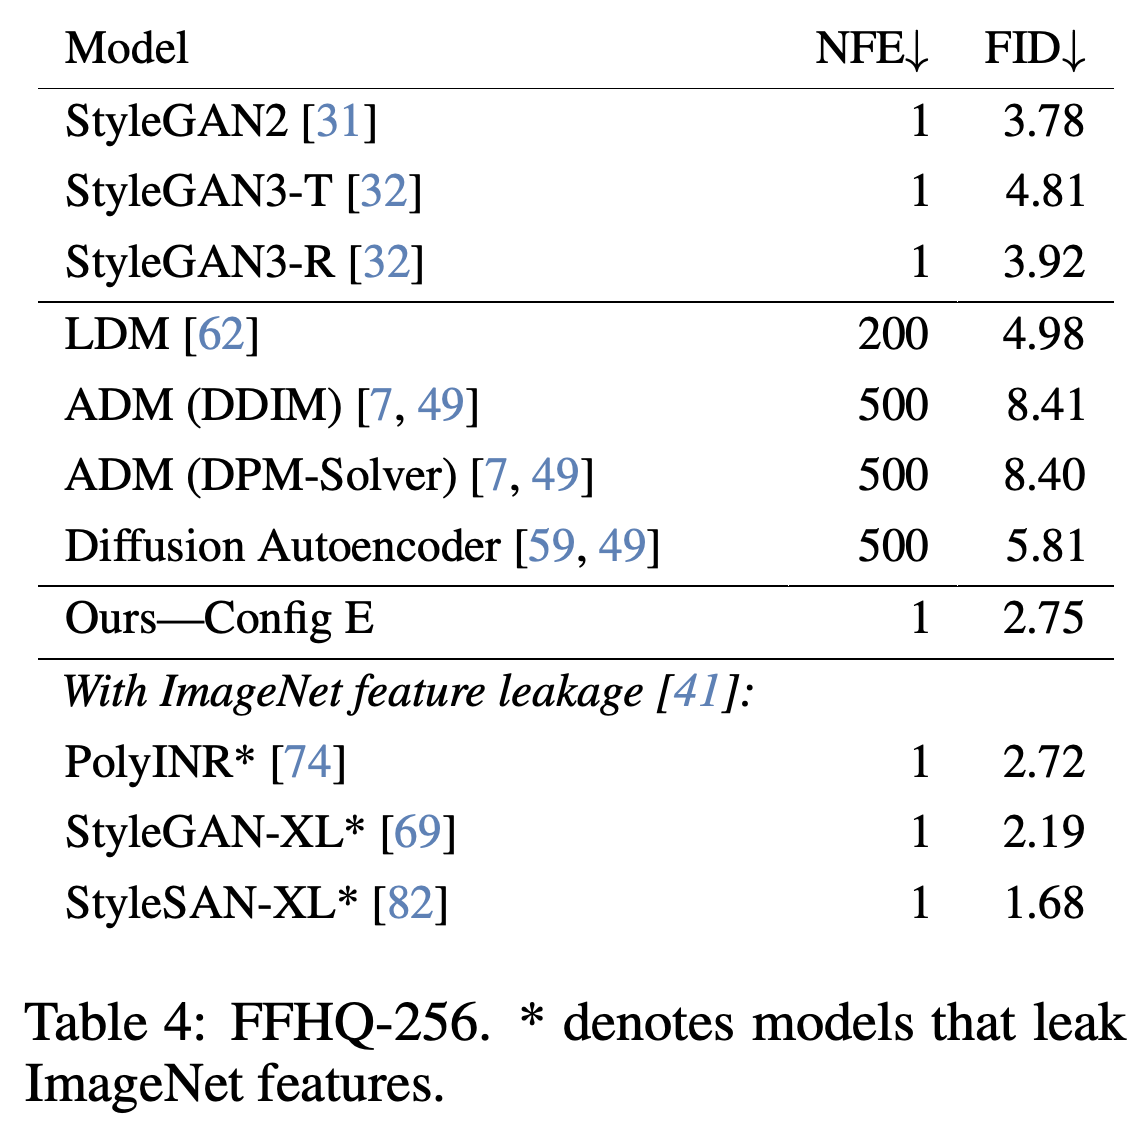
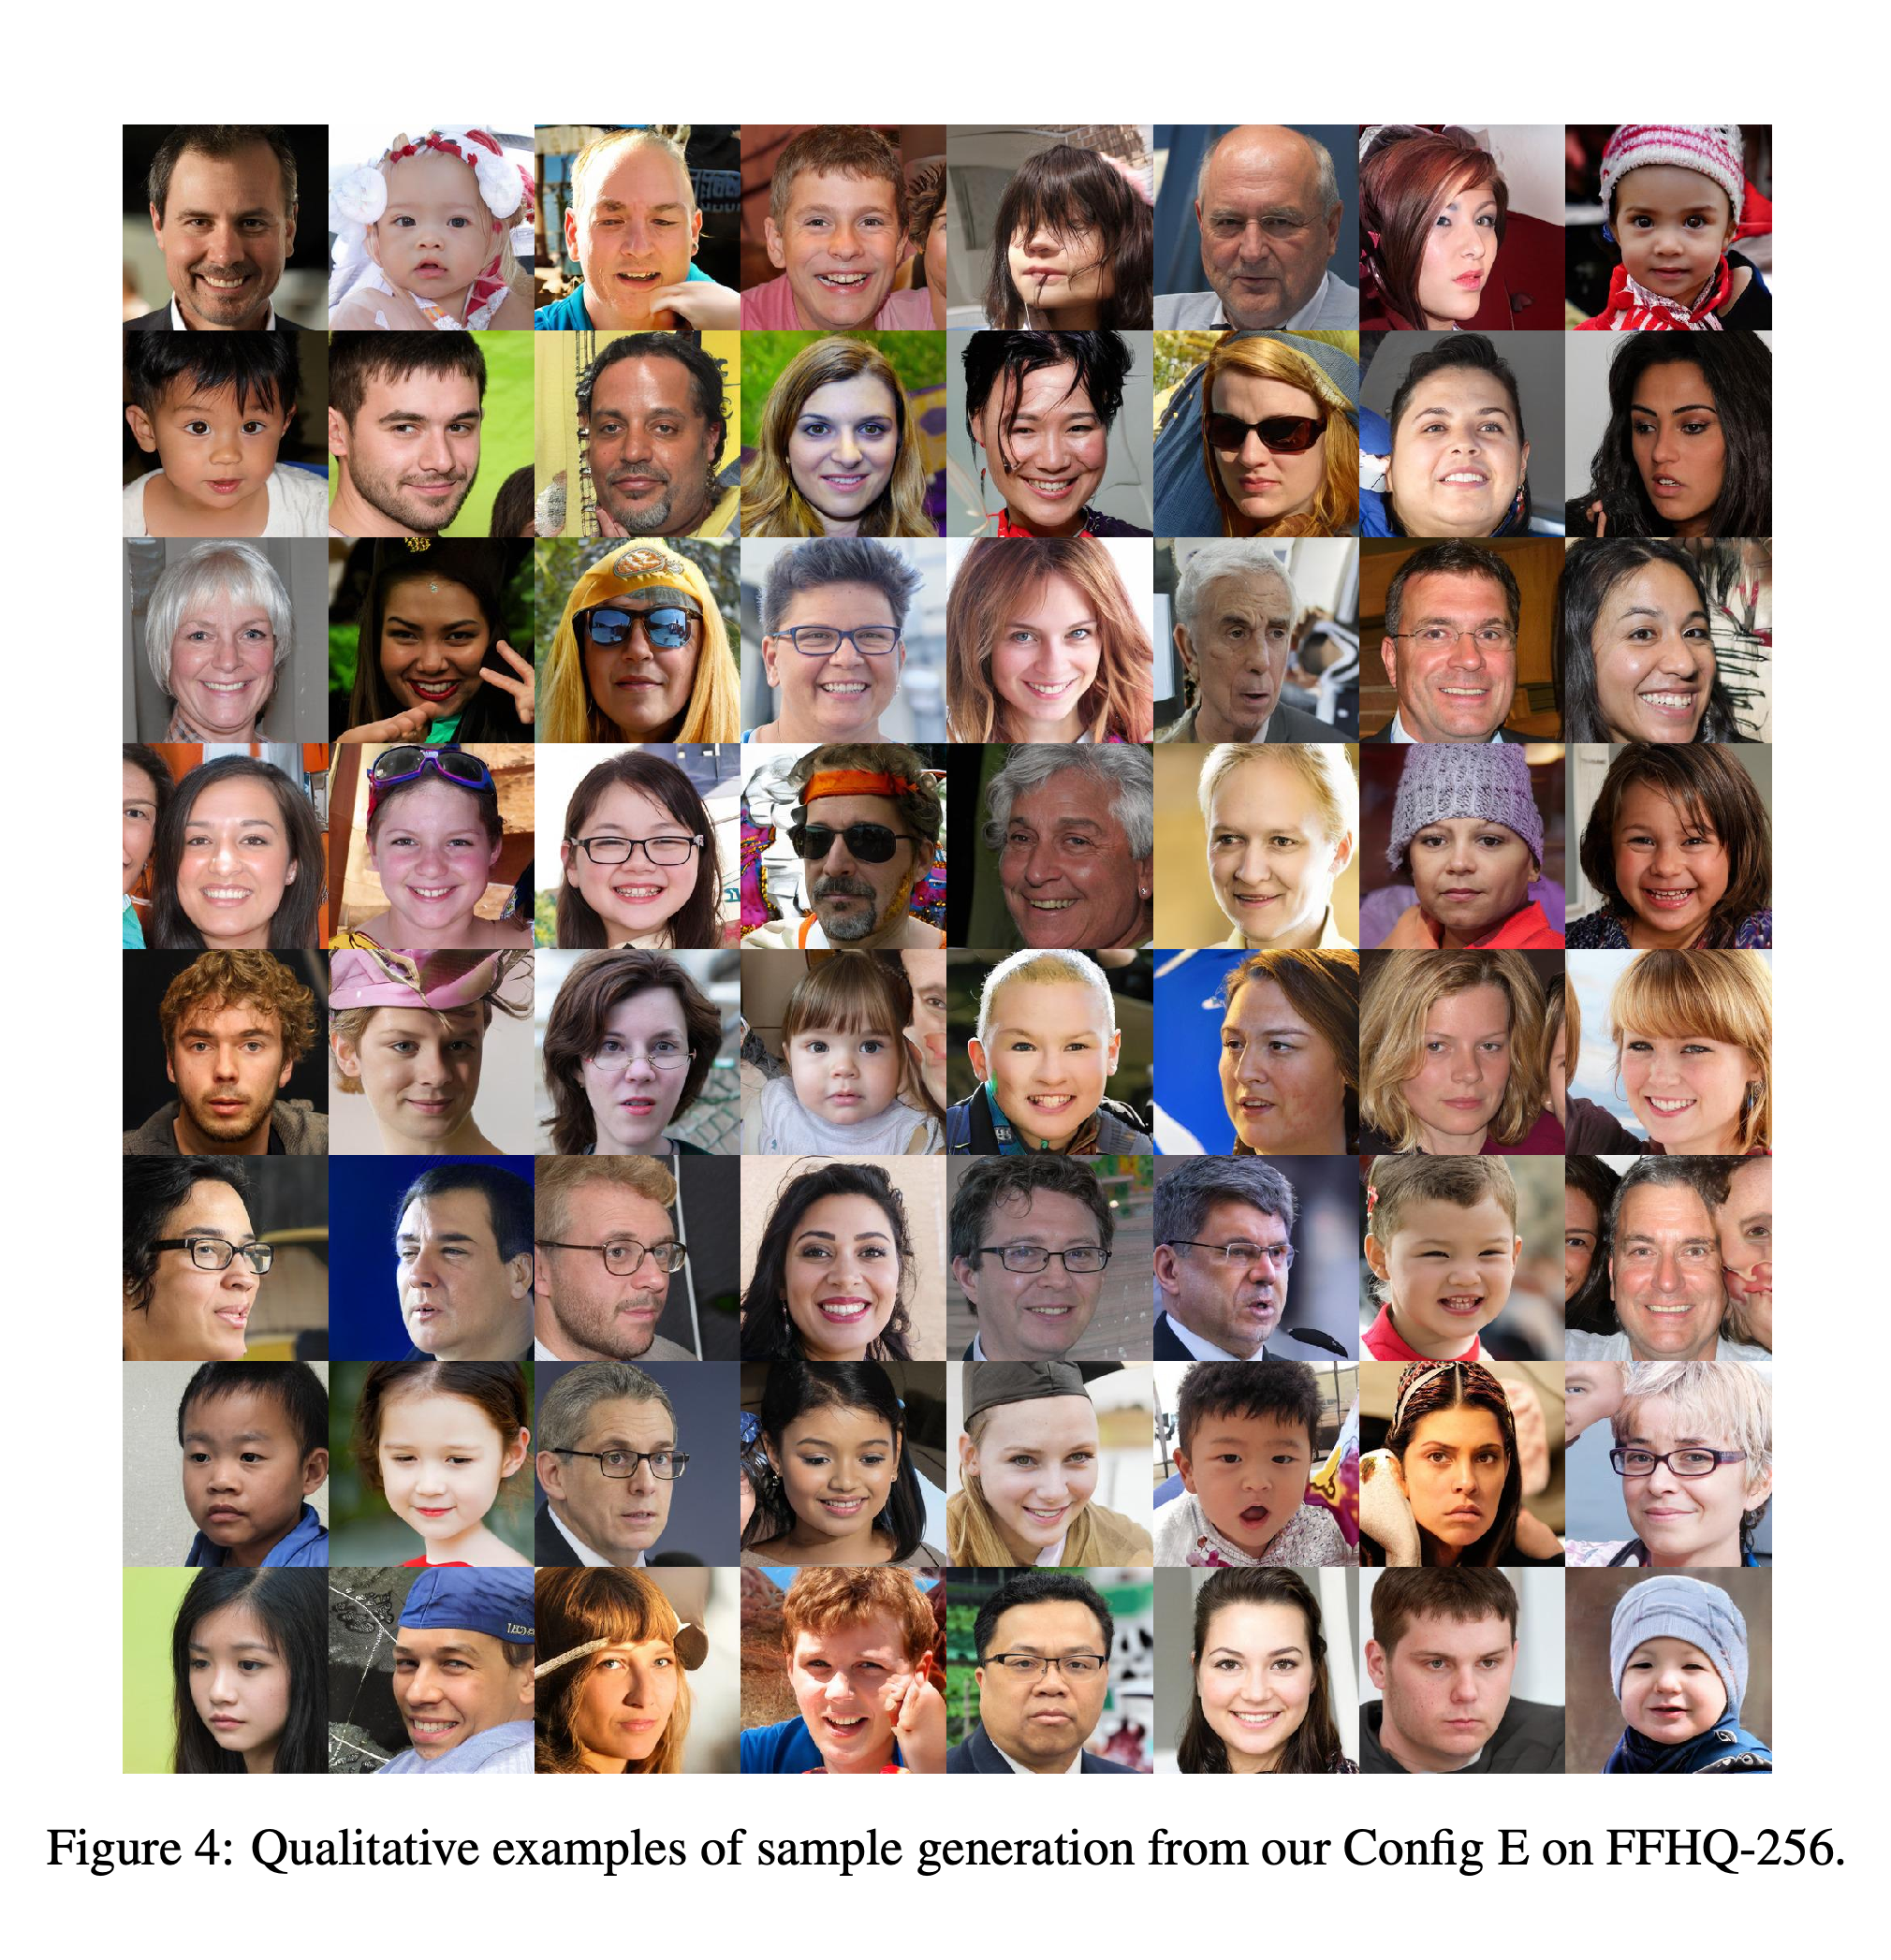
최적화한 설정으로 수렴할 때까지 학습하면 무조건부 FFHQ-256 생성에서 NFE 1로 FID 2.75를 달성한다. StyleGAN2는 3.78이며, 반복적인 잡음 제거로 이미지를 생성하는 표의 확산 기반 방법들은 200–500회 평가에서 4.98–8.41을 기록한다. Table 4는 FID 평가에 영향을 줄 수 있는 사전 학습된 ImageNet 특징을 사용하는 모델을 별도로 표시한다. 이 중에는 StyleSAN-XL의 1.68처럼 더 낮은 점수도 있다. Figure 4는 얼굴 생성 표본을 제시한다. R3GAN은 이 절에서 논의한 추가 consistency regularization을 사용하지 않는다. 이는 이미지 변환 전후에 판별기가 일관되게 동작하도록 유도하는 제약이다.
R3GAN은 1회 평가로 표에 나열된 StyleGAN2/3 및 확산 결과보다 나은 성능을 보인다. 별도로 표시한 ImageNet 특징 사용 모델에는 더 낮은 FID도 있으므로, 이 조건을 고려해 비교해야 한다.
4.4 FID — FFHQ-64 [33]
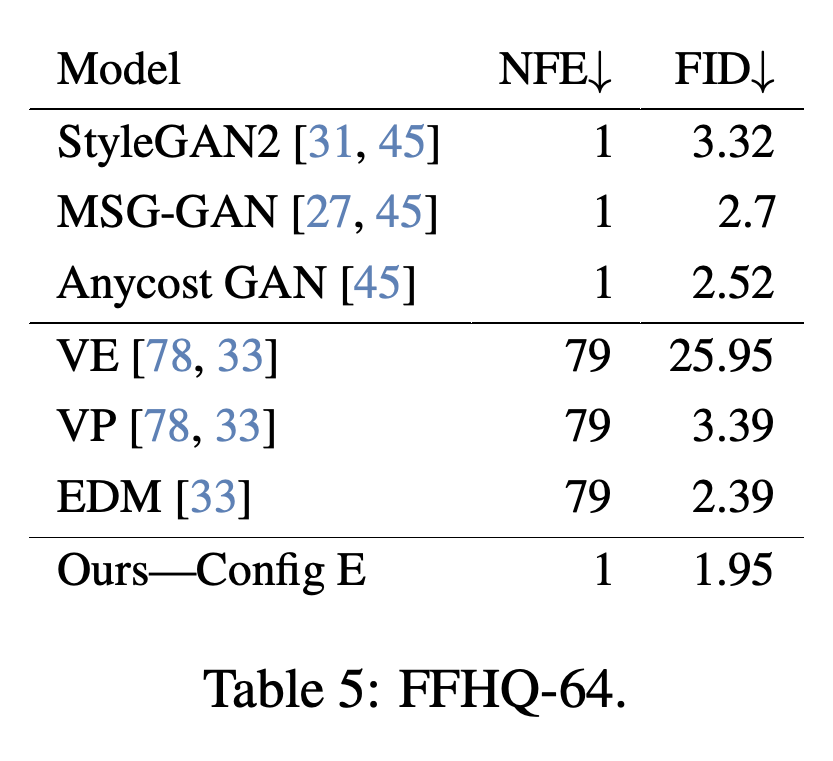
FFHQ-64에서는 FFHQ-256 아키텍처에서 해상도가 가장 높은 2개 단계를 제거한다. Table 5는 1회 평가로 FID 1.95를 기록한 결과를 제시한다. “Elucidating the Design Space of Diffusion-Based Generative Models”의 확산 베이스라인 EDM은 79회 평가로 2.39를 기록한다. 이렇게 구성한 생성기의 매개변수 수는 EDM의 절반 미만이다.
R3GAN은 1회 평가로 FID 1.95를 달성하며, EDM은 79회 평가로 2.39를 기록한다. 이 수치는 분포 오차와 평가 횟수를 비교하며, 하드웨어 지연 시간을 직접 측정하지는 않는다.
4.5 FID — CIFAR-10 [37]
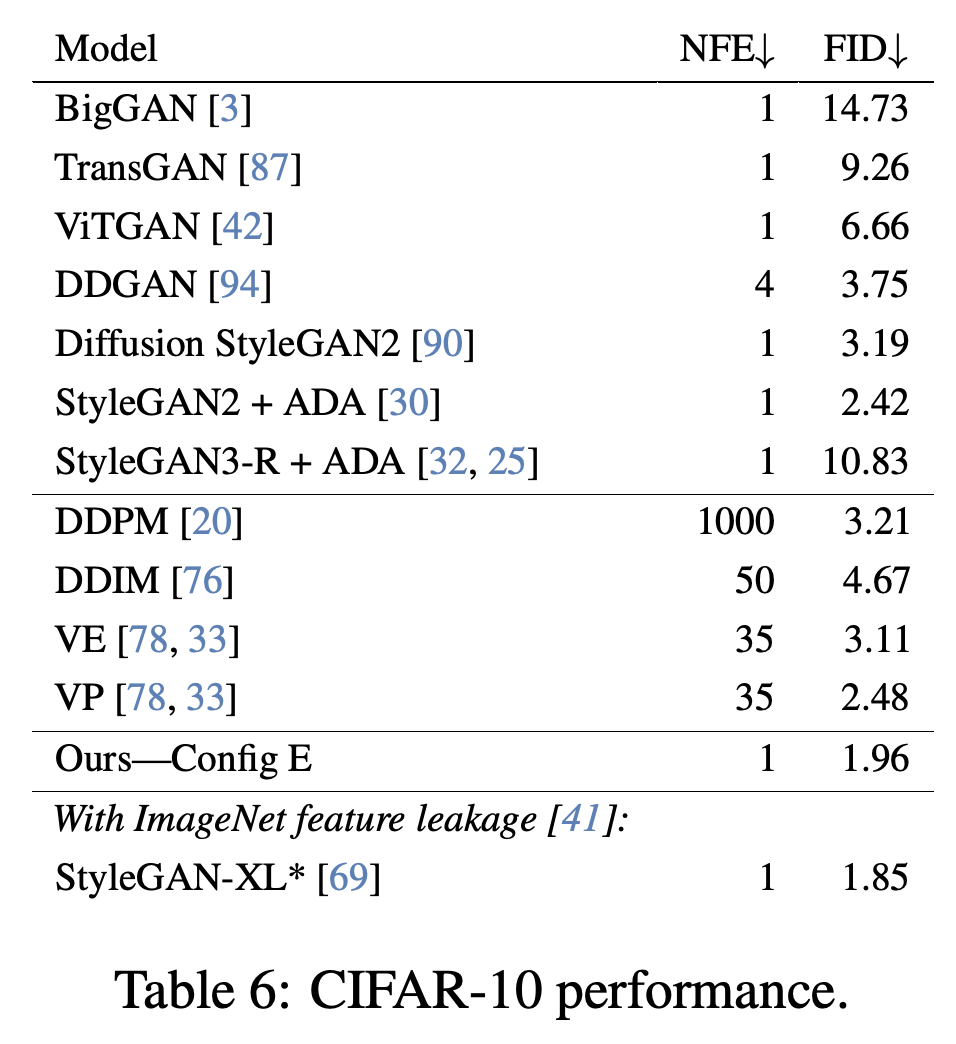
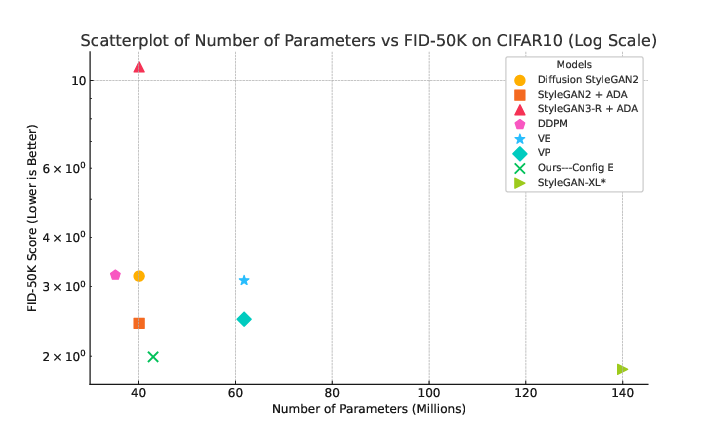
클래스 조건부 CIFAR-10에서 R3GAN은 1회 평가로 FID 1.96을 달성한다. adaptive discriminator augmentation을 적용한 StyleGAN2 + ADA는 2.42, 표에 나열된 확산 베이스라인은 2.48–4.67을 기록한다. Figure 3은 FID와 매개변수 수를 비교하며, Table 9는 생성기 매개변수를 20.78 M개, 판별기 매개변수를 21.28 M개로 명시한다. StyleGAN-XL은 1.85를 기록하지만, 논문은 사전 학습된 ImageNet 판별기 특징을 사용한 이 결과를 별도로 구분한다. FID도 ImageNet으로 학습한 특징 추출기에 의존하기 때문이다.
R3GAN의 FID 1.96은 별도로 표시한 ImageNet 특징 사용 행을 제외한 표의 베이스라인보다 낮다. StyleGAN-XL은 다른 특징 사전 학습 조건에서 1.85를 달성한다.
R3GAN은 StyleGAN-XL보다 전체 매개변수가 상당히 적으면서도 낮은 FID를 달성한다. 매개변수 수로 용량을 비교할 수 있지만, 학습 비용이나 평가당 속도까지 판단할 수는 없다.
4.6 FID — ImageNet-32 [6]
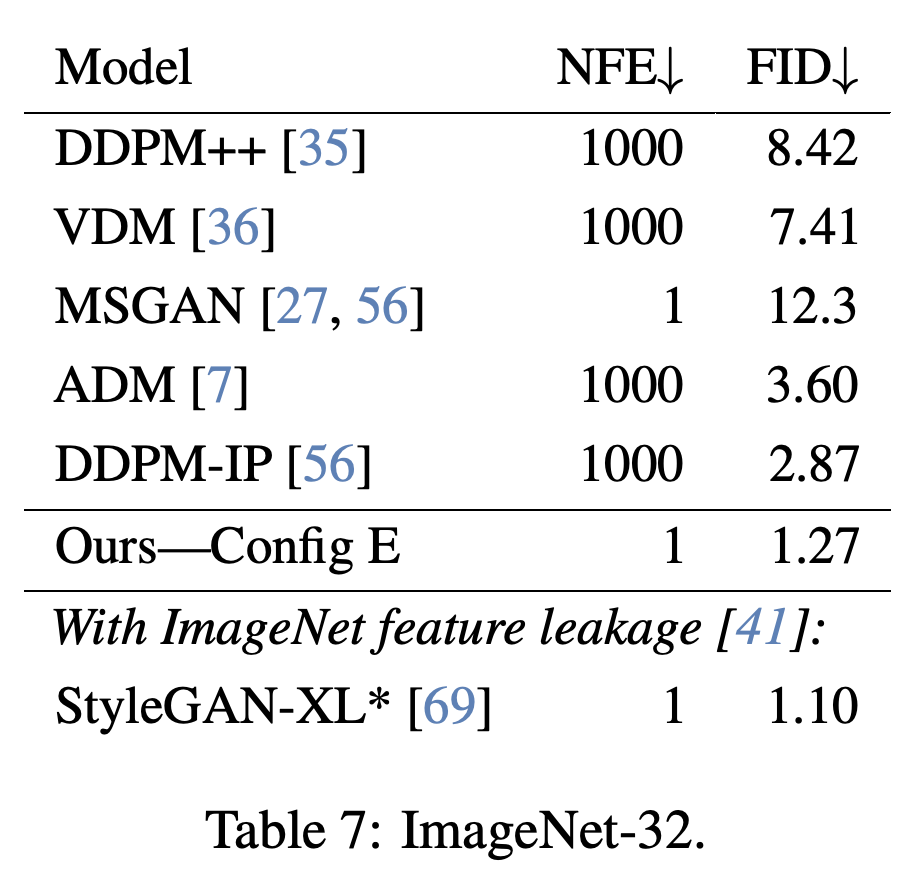
클래스 조건부 ImageNet-32에서는 생성기 매개변수가 84 M개인 StyleGAN-XL과 대략 맞추도록 모델의 폭을 넓힌다. Table 9에 명시된 R3GAN 생성기 크기는 82.91 M개다. R3GAN은 1회 평가로 FID 1.27을 달성한다. 입력 섭동을 사용해 학습한 denoising diffusion 모델 DDPM-IP는 1000회 평가로 2.87을 기록하며, 별도로 표시한 ImageNet 특징 사용 비교에서 StyleGAN-XL은 1.10을 기록한다. 저자들은 판별기가 StyleGAN-XL보다 60% 작고 사전 학습된 ImageNet 분류기를 사용하지 않는다고 보고한다.
R3GAN은 1회 평가로 FID 1.27을 달성하며, 이는 표에 나열된 확산 방법들이 각자 보고한 샘플링 설정에서 얻은 결과보다 낮다. 별도로 표시한 StyleGAN-XL의 1.10은 이보다 더 낮다.
4.7 FID — ImageNet-64 [6]
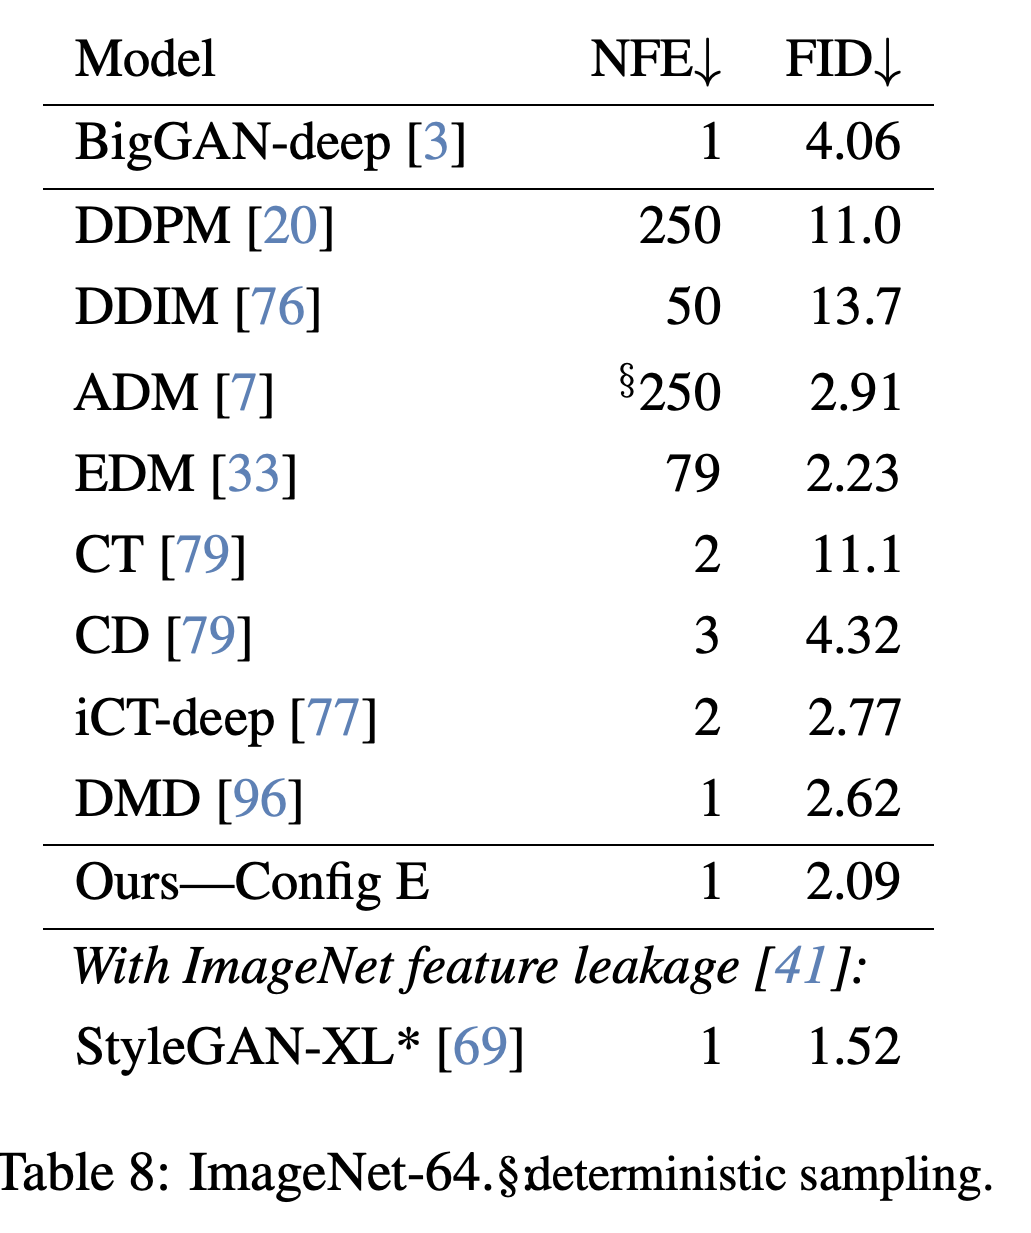
해상도 단계 1개를 추가하면 ImageNet-64 생성기의 매개변수 수는 103.57 M개가 되며, 본문은 이를 약 104 M개로 표기한다. 비교 대상으로 인용한 확산 백본의 매개변수 수는 약 300 M개다. Table 8은 1회 평가로 FID 2.09를 기록한 결과를 제시한다. EDM은 79회 평가로 2.23을 기록하며, distribution matching distillation로 학습해 1단계 생성을 수행하는 DMD는 1회 평가로 2.62를 기록한다. 별도로 표시한 ImageNet 특징 사용 비교에서 StyleGAN-XL은 1.52를 달성한다.
R3GAN의 FID 2.09는 EDM의 2.23과 DMD의 2.62보다 낮으며, DMD와는 1회 평가 조건에서도 비교한다. 별도로 표시한 StyleGAN-XL 결과는 1.52이며, ADM의 평가 횟수에는 결정론적 샘플링이라는 조건이 붙는다.
4.8 Recall
CIFAR-10에서 recall의 최댓값은 0.57로, StyleGAN-XL의 0.47보다 높다. R3GAN은 FFHQ-64에서 0.53, FFHQ-256에서 0.49를 기록하며, StyleGAN2는 FFHQ-256에서 0.43을 기록한다. ImageNet-32 recall은 0.63으로, “Diffusion Models Beat GANs on Image Synthesis”의 확산 베이스라인 ADM과 비슷하다. ImageNet-64 recall은 0.59이며, 여러 확산 모델은 약 0.63, BigGAN-deep은 0.48을 기록한다. 따라서 FID가 낮다고 해서 모든 비교에서 다양성이 더 높은 것은 아니다.
5 Discussion and Limitations
저자들은 최소한의 생성 베이스라인을 우선하며 이미지 편집, 이미지를 잠재 입력으로 되돌리는 inversion, 제어 가능한 합성에 유용한 기능을 제거한다. 잠재 입력으로 정규화를 조절하는 latent-conditioned adaptive normalization과 공간 위치 간 정보를 결합하는 attention도 사용하지 않는다. 더 높은 해상도의 ImageNet과 대규모 text-to-image로의 확장은 아직 검증되지 않았다. 또한 인물 위조 이미지를 통한 오용 가능성을 인정하며, Appendix D에는 며칠 또는 몇 주가 걸리는 학습 비용을 기록한다.
얼굴 격자는 256 × 256 해상도에서 외모, 자세, 표정, 배경의 변화를 보여준다. 정량적 결과와 함께 제시되지만, 통제된 인간 평가나 독립적인 포괄률 추정치를 제공하지는 않는다.
6 Conclusion
결론은 R3GAN을 단순화한 GAN 베이스라인으로 제시한다. 규제를 적용한 relativistic 목적 함수는 명시된 조건 아래에서 국소 수렴을 보장하며 현대적인 아키텍처 설계를 가능하게 한다. 보고된 실험에서는 평가한 데이터셋에서 비슷한 매개변수 규모의 모델과 경쟁력 있는 성능을 보인다.
부록
부록은 수렴 분석, 구현 세부 사항, 성과가 없었던 설계 선택, 표본 격자, 학습 추이를 제공한다.
- A Local convergence는 갱신의 국소적 변화를 나타내는 행렬인 갱신 Jacobian의 고윳값을 사용해 학습을 동역학계로 분석한다.
- B DiracRpGAN: A demonstration of non-convergence는 점질량 생성기와 선형 판별기를 다룬다. 규제를 적용하지 않은 연속 시간 궤적에서는 θ(t)² + ψ(t)²가 일정하게 유지되어 평형점 밖의 궤적이 평형점에 접근하지 못한다. 반면 양의 기울기 페널티를 적용하면 충분히 작은 학습률에서 국소 수렴한다.
- C General Convergence Results는 Mescheder et al.의 분석을 적용한다. C.1 Assumptions는 실제 분포를 재현할 수 있는 생성기, 실제 데이터 지지집합 근처에서 상숫값을 출력하는 판별기, f′(0) ≠ 0 및 f″(0) < 0, 정칙 평형 다양체를 요구한다. 평형 다양체는 동등한 매개변수화의 집합이며, 판별기는 분포 이탈에 충분히 민감해야 한다. C.2 Convergence는 R₁ 또는 R₂를 적용하고 학습률이 충분히 작으면 이 집합으로 적어도 선형 속도로 국소 수렴함을 증명한다. 또한 이 결과가 페널티 2개를 함께 적용하는 경우에도 확장된다고 명시한다.
- D Hyperparameters, training configurations, and compute는 공식 StyleGAN3 코드 기반 구현을 설명한다. 생성기 가중치의 이력을 평활화하는 exponential moving average(EMA), 데이터 증강, 평가 기능을 재사용한다. Table 9는 StackedMNIST, CIFAR-10, FFHQ-256, FFHQ-64, ImageNet-32, ImageNet-64의 학습량을 각각 10, 250, 200, 100, 1000, 1000 Mimg로 제시하며, Mimg는 millions of images를 뜻한다. 목표 설정으로 부드럽게 전환하는 초기 cosine burn-in 스케줄로 학습률, 페널티 강도, Adam의 2차 모멘트 평균 계수 β₂, EMA 반감기, 데이터 증강 확률을 조정한다. 여러 수치 형식을 함께 사용하는 혼합 정밀도 연산에서는 16비트 부동소수점 FP16이 학습을 저해하여 BFloat16을 사용한다.
- E Negative Results and Future Work는 매끄러운 활성 함수 대안인 GELU(Gaussian error linear units), Swish, SMU(smoothing maximum units)를 사용했을 때 FID가 악화되었다고 보고한다. 특징 채널을 그룹별로 표준화하는 group normalization은 개선 효과가 없었고, 채널과 공간 위치를 재배열하는 Pixel-Shuffle/Unshuffle은 저역 통과 필터링 없이 사용하면 아티팩트를 만들었다. 낮은 해상도에서 용량을 늘리면 대체로 과적합이 빨라졌고, Adam β₂ = 0.999는 ImageNet에서 안정성 문제를 일으켰다. R₁과 R₂를 미니배치 8개마다 1회만 적용하면 StackedMNIST와 여러 간단한 실험용 데이터셋에서 수렴에 실패했다. attention과 attention 기반 처리를 사용하는 transformer 아키텍처는 실험으로 평가하지 않았다.
- F Qualitative Results는 Figures 5–10에서 Stacked-MNIST, FFHQ-256, FFHQ-64, CIFAR-10, ImageNet-32, ImageNet-64의 생성 예시를 제공한다. 이 격자는 생성 표본을 보여주지만 분포 포괄률이나 상대적인 지각 품질을 독립적으로 입증하지는 않는다.
- G Training Curves는 Figures 11–15에서 CIFAR-10, FFHQ-64, FFHQ-256, ImageNet-32, ImageNet-64의 판별기 및 생성기 손실, R₁과 R₂ 측정값, 실제 경과 시간에 따른 FID를 제시한다. 표시된 실행에서는 FID가 감소하지만, 독립적인 실행 간 변동성은 측정하지 않는다.
- NeurIPS Paper Checklist는 반복 학습 비용이 너무 커서 오차 막대를 생략했으며, 초록에 URL이 있어도 제출 당시에는 코드를 공개하지 않았다고 밝힌다. Appendix D는 8 × NVIDIA L40에서 StackedMNIST 학습에 7시간, CIFAR-10에 4일이 걸리고, 8 × NVIDIA A6000에서 FFHQ에 약 3주가 걸린다고 보고한다. ImageNet 연산량 설명에는 “H100 32개에서 1일”과 “약 5000 H100시간”이 함께 나오지만, 이 수치들은 산술적으로 일치하지 않는다. Table 9는 별도로 ImageNet-32에 GPU 32개, ImageNet-64에 64개를 명시한다.
짧은 생각
가장 명확한 근거는 학습 안정성, 다양성, 아키텍처 용량을 구분해서 보여준다. Figure 1과 Table 1은 안정적인 학습과 모드 포괄률을 구분하고, Table 2는 짧은 학습에서 FID 회복의 대부분이 아키텍처 변경에서 비롯됨을 보여준다. 정리는 명시적인 가정 아래에서 국소 동작을 규명하며, 초기화부터 학습이 안정적으로 진행된다는 근거는 보고된 실험에 의존한다. 실행 간 불확실성이 보고되지 않은 점, 상당한 학습 비용, 검증하지 않은 고해상도 조건은 벤치마크 비교의 적용 범위를 제한한다.