


The Leaderboard Illusion 요약 설명
29 Apr 2025 | Paper Review LLM Evaluation Evaluation Metrics Selection Bias목차
- 요약
- 1 Introduction
- 2 Overview of Methodology
- 3 Results: Impact of Private Testing and Selective Retraction on Arena Scores
- 4 Results: Impact of Data Access Asymmetries on Arena Scores
- 5 Results: Impact of Model Deprecation on Arena Scores
- 6 Recommendations and Guidelines for Improving Leaderboards
- 7 Limitations
- 8 Related Work
- 9 Conclusion
- 부록
- 짧은 생각
이번 글에서는 The Leaderboard Illusion 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 4월 29일(Arxiv)
- Singh, Shivalika, Nan, Yiyang, Wang, Alex, D’Souza, Daniel, Kapoor, Sayash, Üstün, Ahmet, Koyejo, Sanmi, Deng, Yuntian, Longpre, Shayne, Smith, Noah A., et al.
- Cohere Labs, Cohere, Princeton University, Stanford University, University of Waterloo, Massachusetts Institute of Technology, Allen Institute for Artificial Intelligence, University of Washington
- 논문 링크
요약
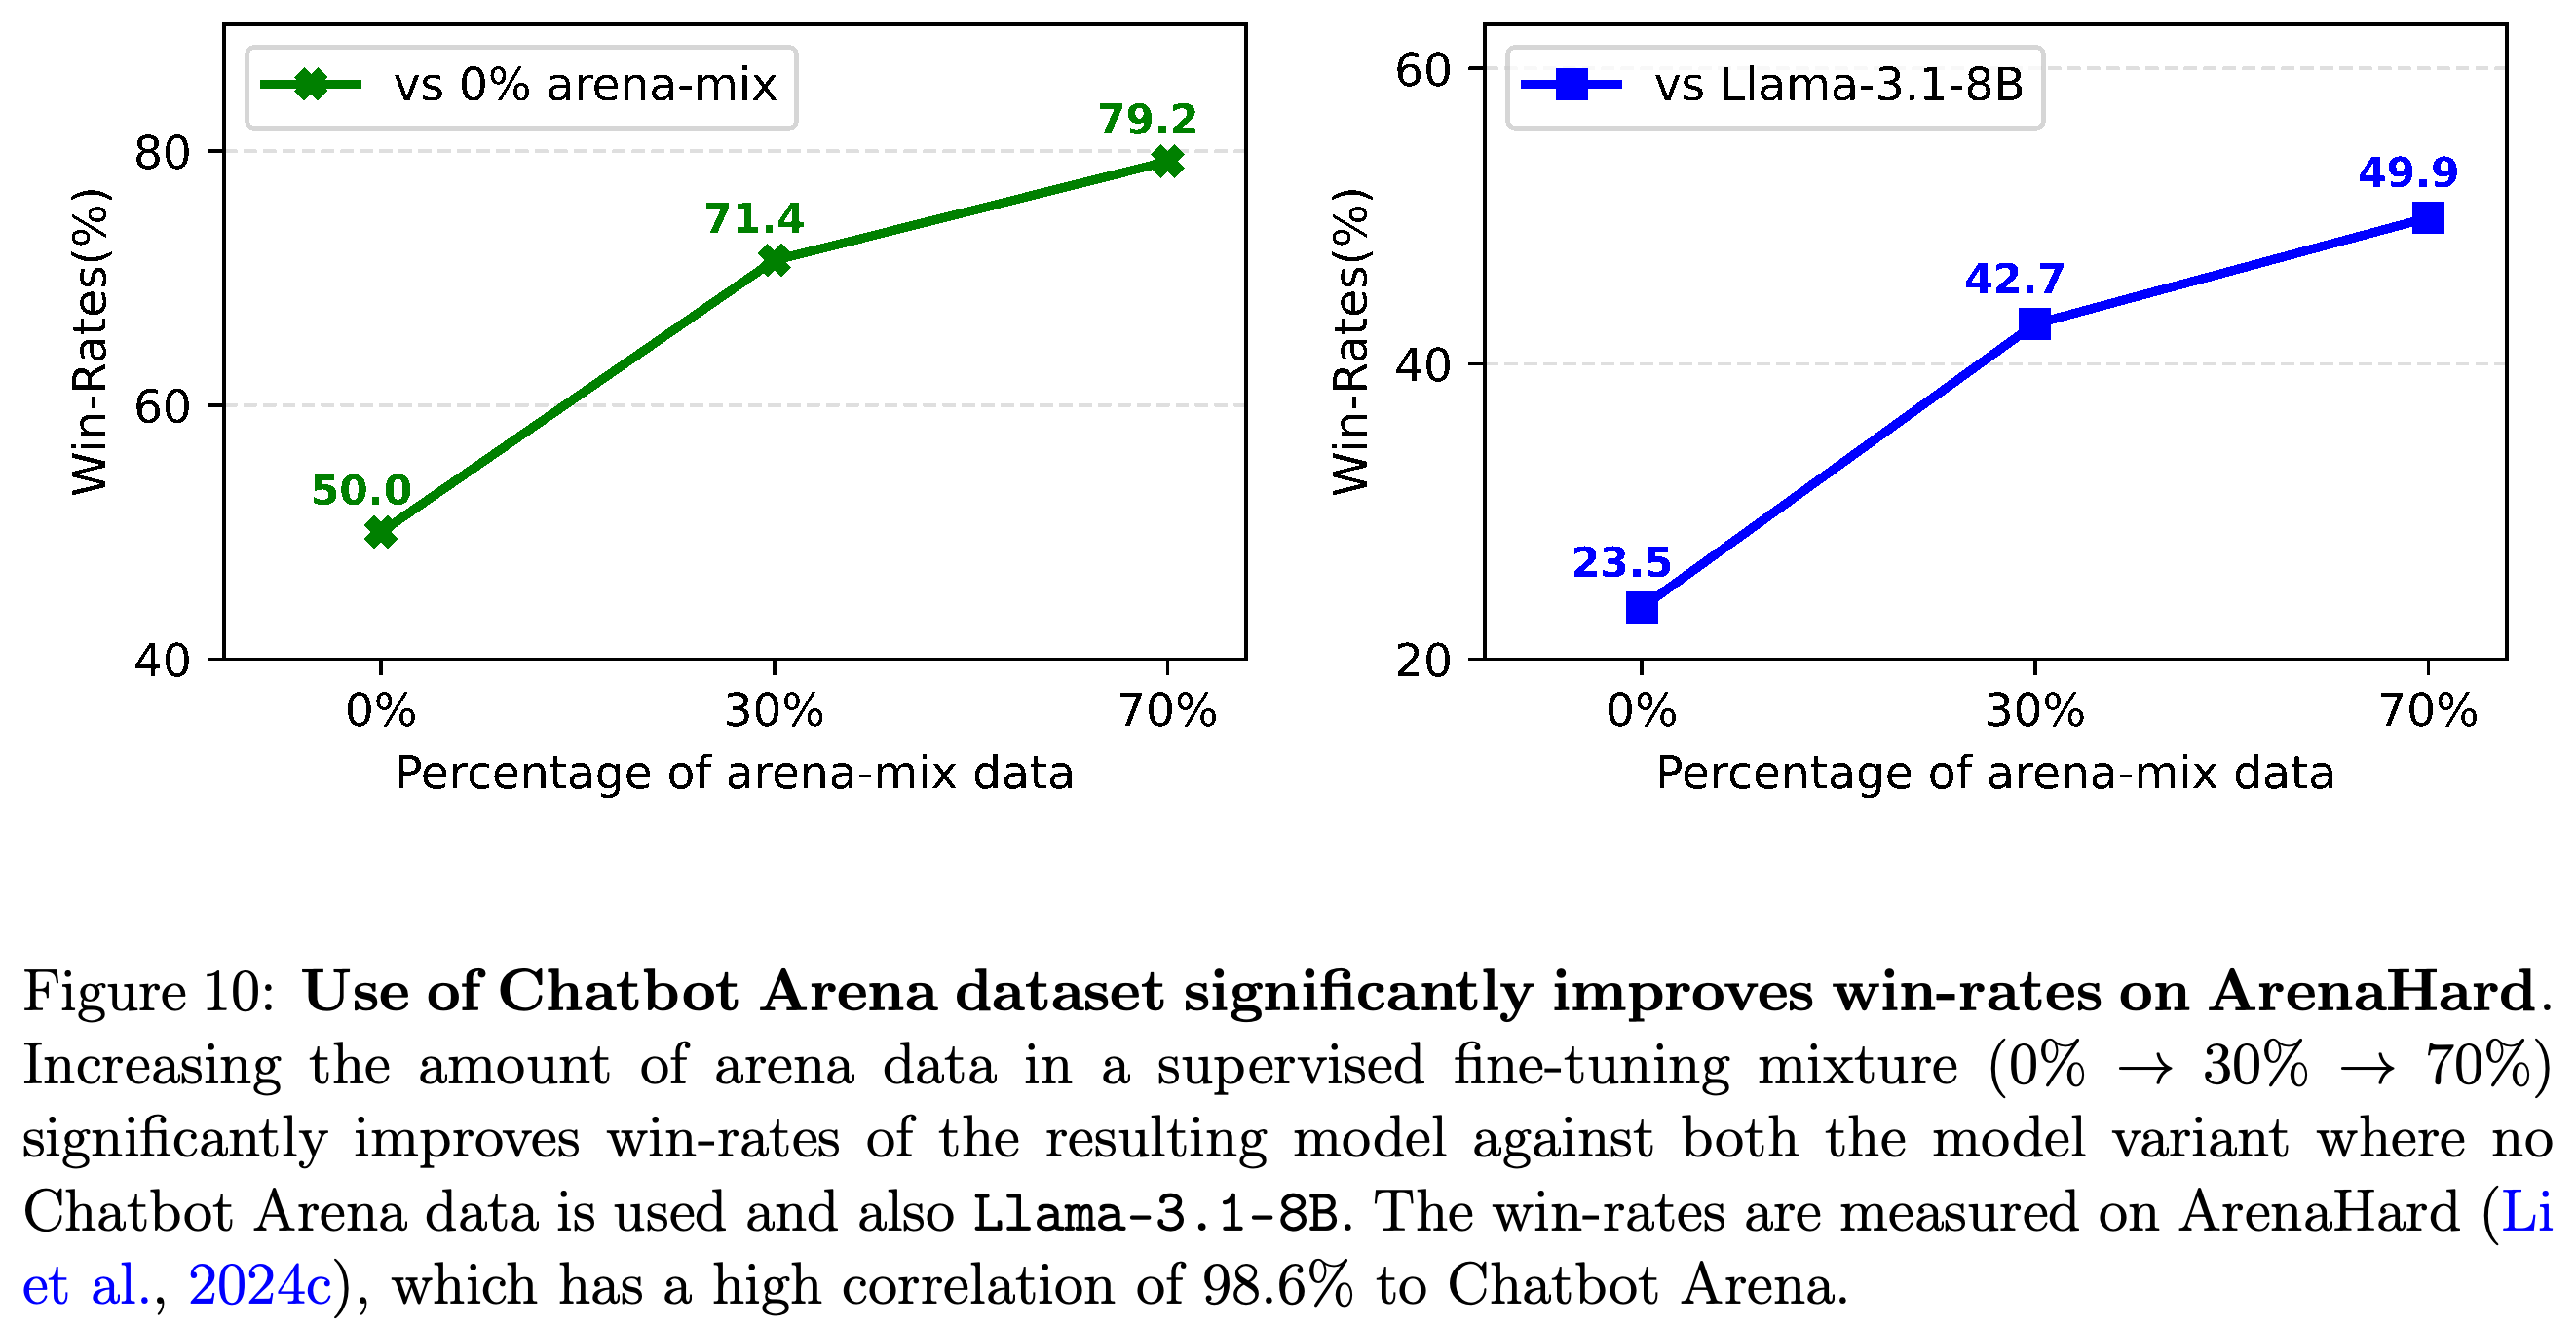
- The Leaderboard Illusion은 사용자가 익명 모델의 응답을 비교해 선호하는 쪽을 고르는 Chatbot Arena가 제공자마다 테스트 기회와 평가 데이터 접근권이 다른 상황에서도 모델 품질을 신뢰할 만하게 측정하는지 살펴본다. 학습 예산을 고정한 상태에서 Arena 학습 데이터 비중을 0%에서 70%로 늘리자, ArenaHard에서 Llama-3.1-8B-Instruct를 상대로 한 승률이 23.5%에서 49.9%로 올랐다. ArenaHard는 Arena에서 추출한 영어 프롬프트 500개를 자동 모델 평가자가 채점하는 테스트다. 반면 별도의 지식 벤치마크에서는 정확도가 개선되지 않았다. Chatbot Arena에 대해서는 Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (LLM-as-a-Judge) 요약 설명 글을 참조하라.
- 이 감사 연구는 제공자 42곳의 모델 243개를 다룬 약 2M건의 배틀, 즉 모델 간 쌍대 비교 기록을 시뮬레이션 및 실제 제출 실험과 결합한다. 연구는 모델 정체를 공개하기 전에 평가하는 비공개 테스트 기회의 불균형, 점수의 선택적 공개, 모델 노출량 차이, 광범위한 비활성 상태가 순위와 사용자 프롬프트 접근에 영향을 줄 수 있다고 지적한다.
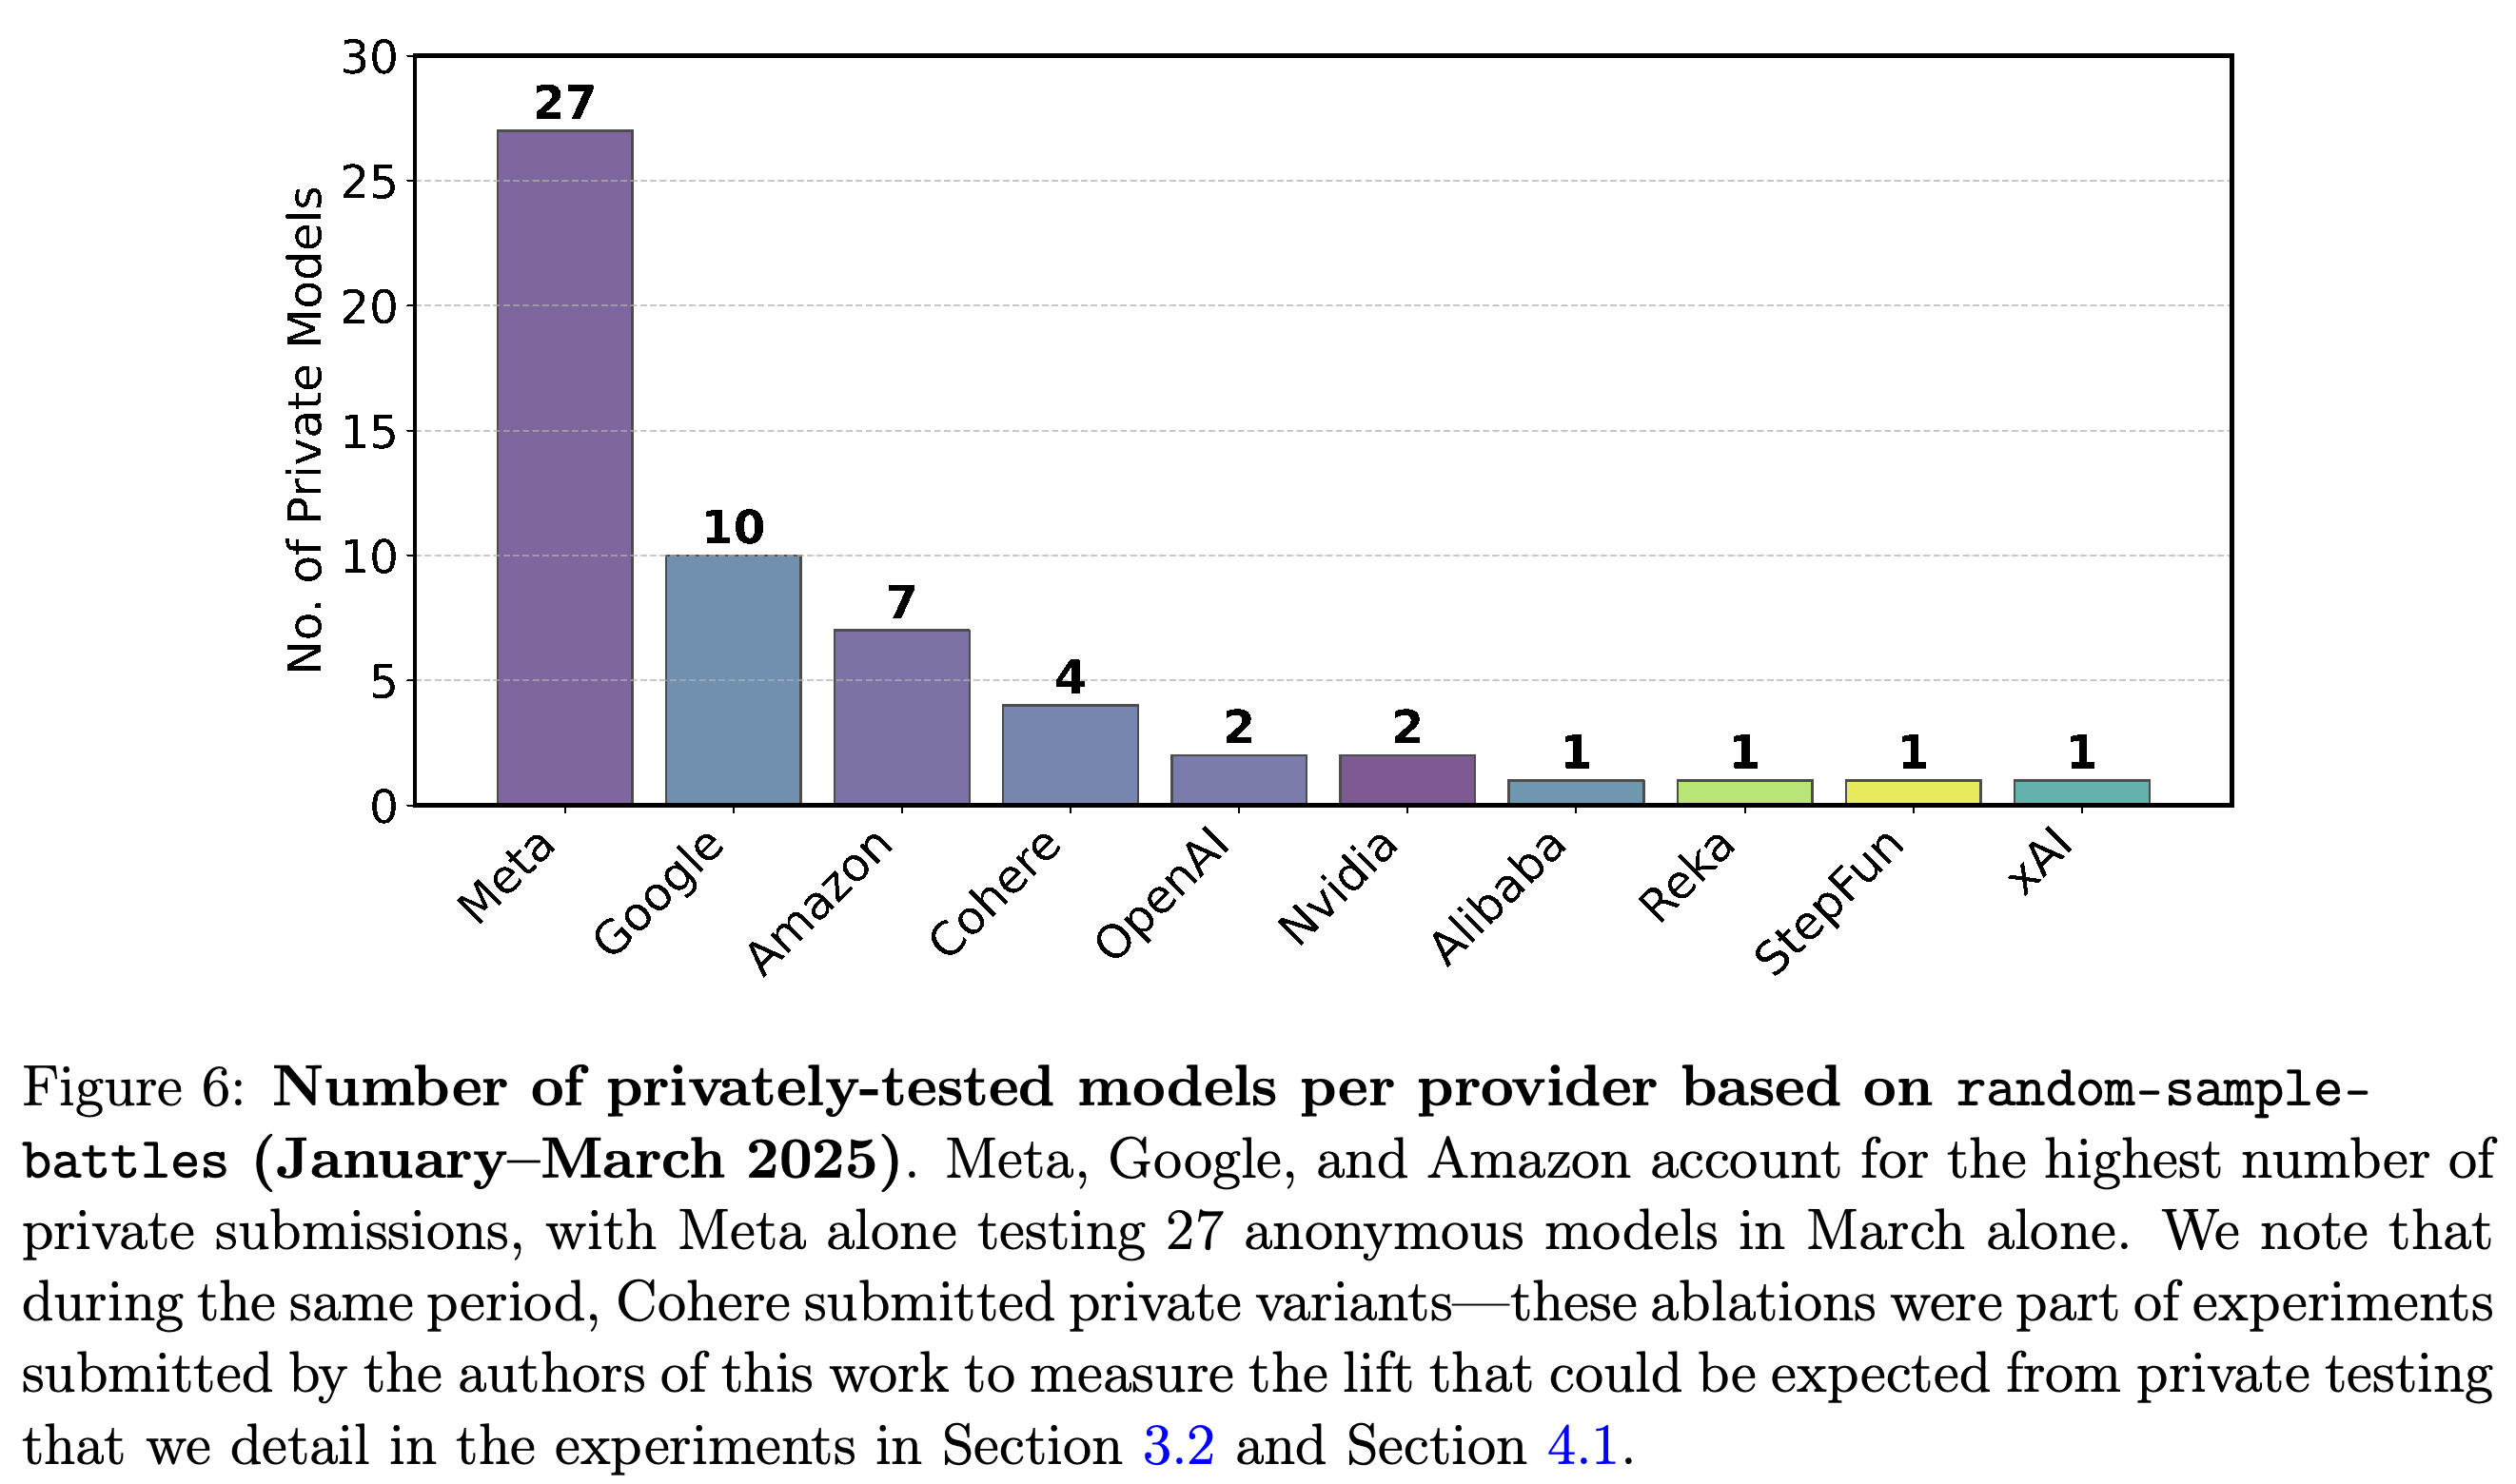
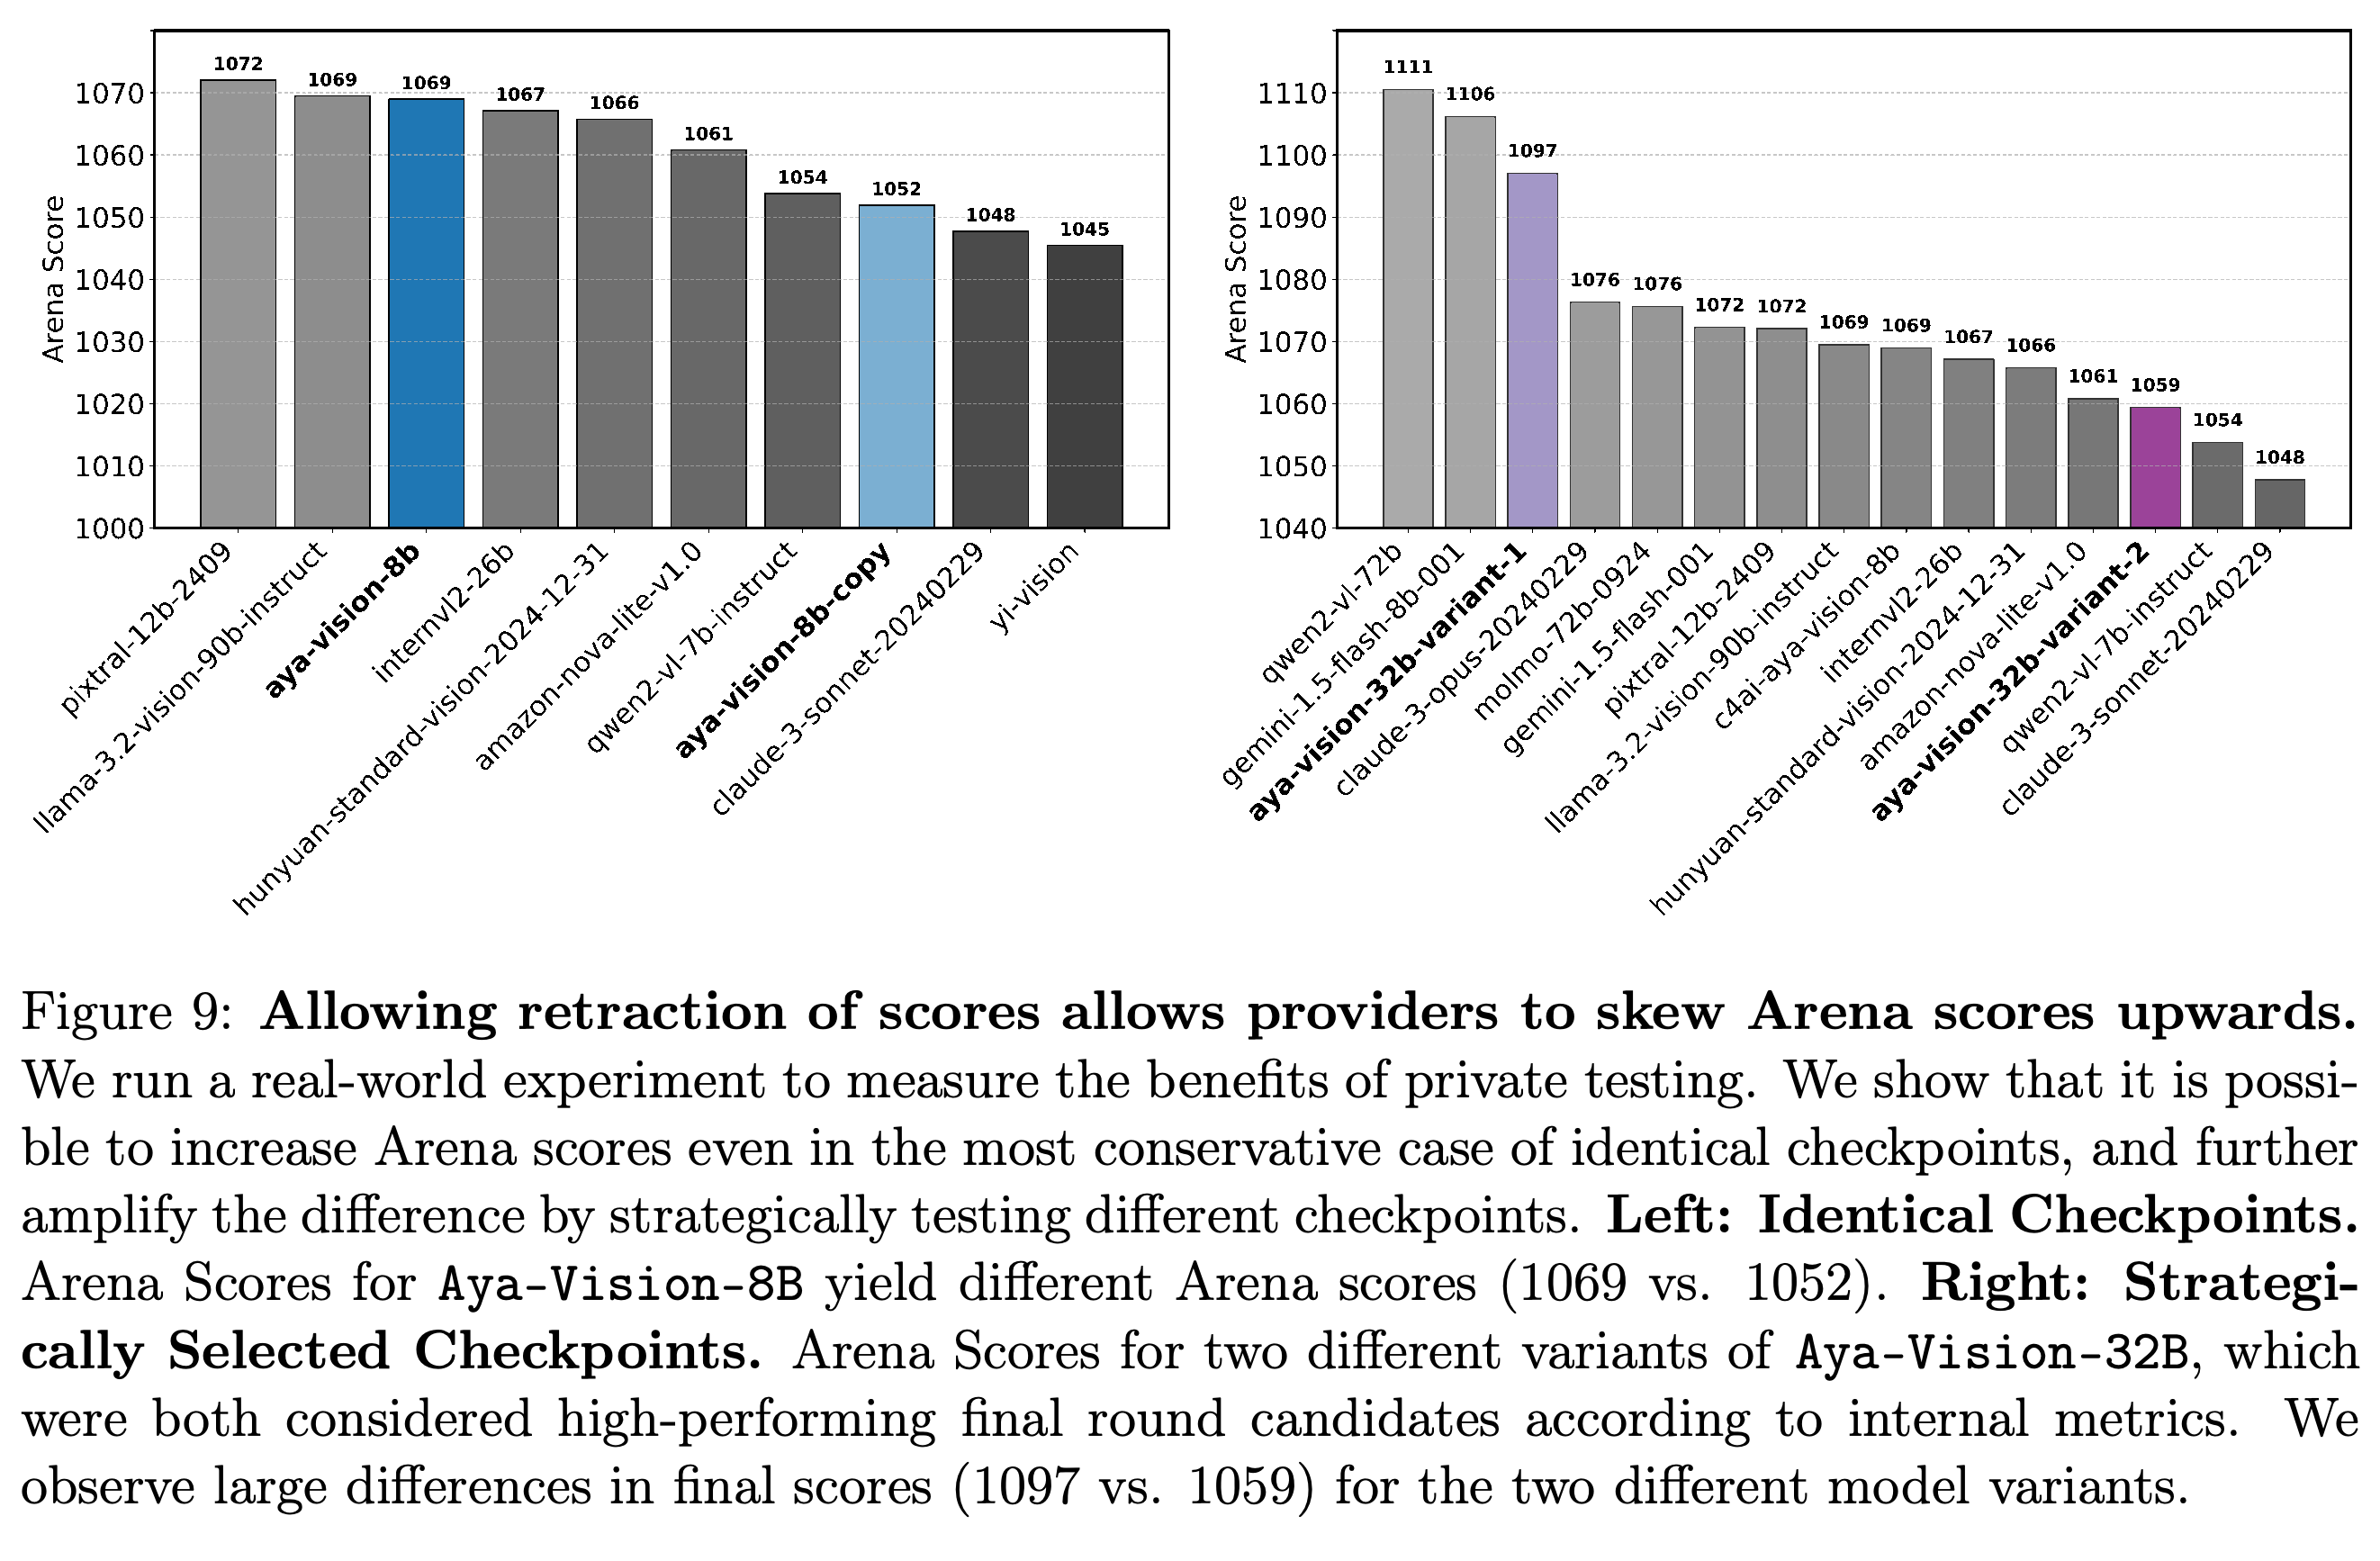
- 저자들은 2025년 1월부터 3월까지 메인 리더보드에서 관찰한 비공개 변형 중 27개를 Meta, 10개를 Google, 7개를 Amazon의 모델로 추정했다. 실제 제출 실험에서는 동일한 Aya-Vision-8B 체크포인트 2개가 각각 1052와 1069를 받았다. 체크포인트는 저장된 모델 가중치다. 이는 모델을 바꾸지 않아도 관측 점수가 높은 결과만 공개하면 이점을 얻을 수 있음을 보여준다.
- 실험은 리더보드 결과가 달라질 수 있는 메커니즘을 입증하지만, 각 메커니즘이 개별 제공자의 공개 점수에 얼마나 기여했는지는 정량화하지 않는다. 제공자 추정은 모델의 자기소개 응답에 의존하며, 비공개 테스트 관찰 기간도 제한적이다. 저자들은 완전한 Arena 원시 기록과 다른 제공자의 비공개 점수에도 접근하지 못했다.
1 Introduction
Chatbot Arena는 평가의 공백을 메운다. 개방형 응답에 대한 사람의 판단은 고정된 객관식 테스트가 놓치는 동작을 포착할 수 있다. 논문은 관심이 특정 리더보드에 집중되면 그 플랫폼의 사용자, 프롬프트, 보고 규칙에 맞춘 최적화도 촉진된다고 주장한다.
- 서론은 비공개 후보 선택, 불균등한 프롬프트 접근, Arena 분포에 대한 적응, 모델 평가 중단이라는 4가지 메커니즘을 연결한다. 여기서 모델 평가 중단은 모델을 평가 대상에서 제외하거나 이후 비교에 거의 참여시키지 않는 것을 뜻한다.
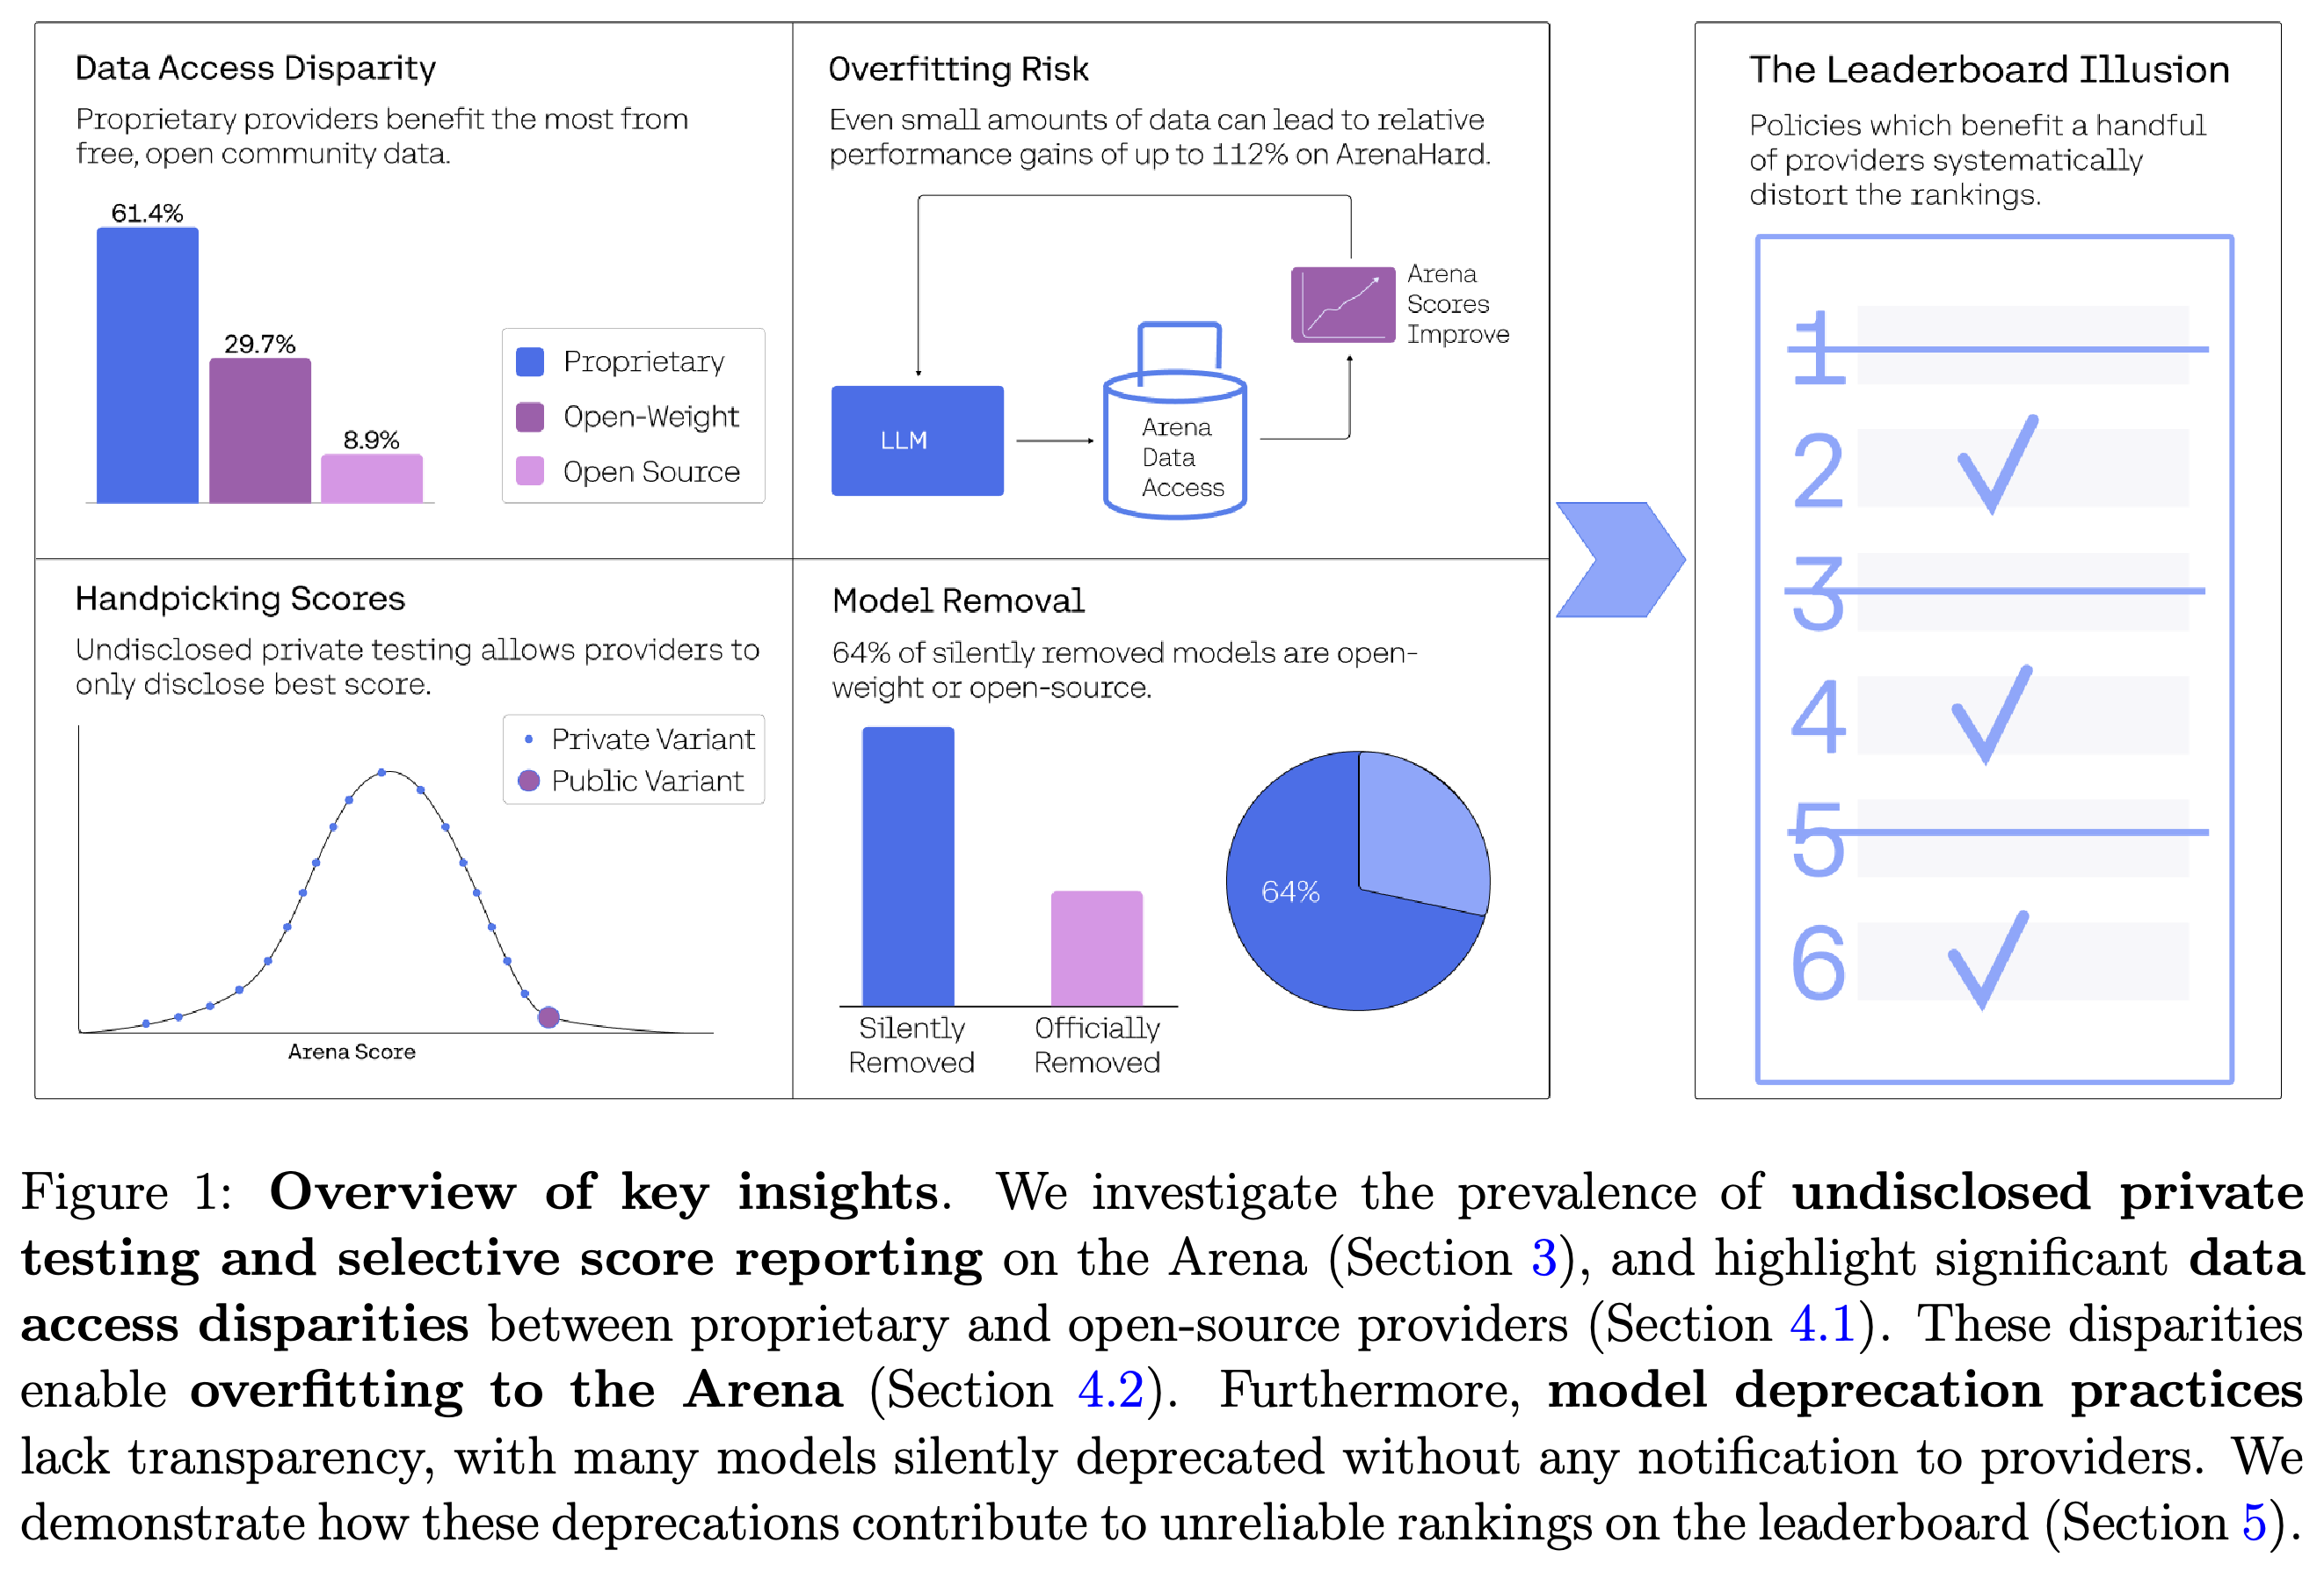
- 추정 데이터 비중은 가중치를 공개하지 않는 독점 모델이 61.4%, 공개 가중치에 Appendix F에서 분류한 라이선스를 적용하는 open-weight 모델이 29.7%, 해당 부록의 라이선스 분류에 따라 open source로 구분한 모델이 8.9%다.
- 여러 저자가 Cohere 모델 제출을 통해 Arena에 참여한다. 저자들은 샘플링에 대한 우려로 연구를 시작했으며, 이후 비공개로 제출한 모델은 연구 실험용이었다고 밝힌다.
이 도식은 선택적 점수 공개, 불균등한 데이터 노출, 평가 중단 관행을 순위에 영향을 주는 메커니즘으로 연결한다. 수치 패널은 뒤에서 전개할 결과를 요약하며, 각 메커니즘의 인과적 기여도를 추정하지는 않는다.
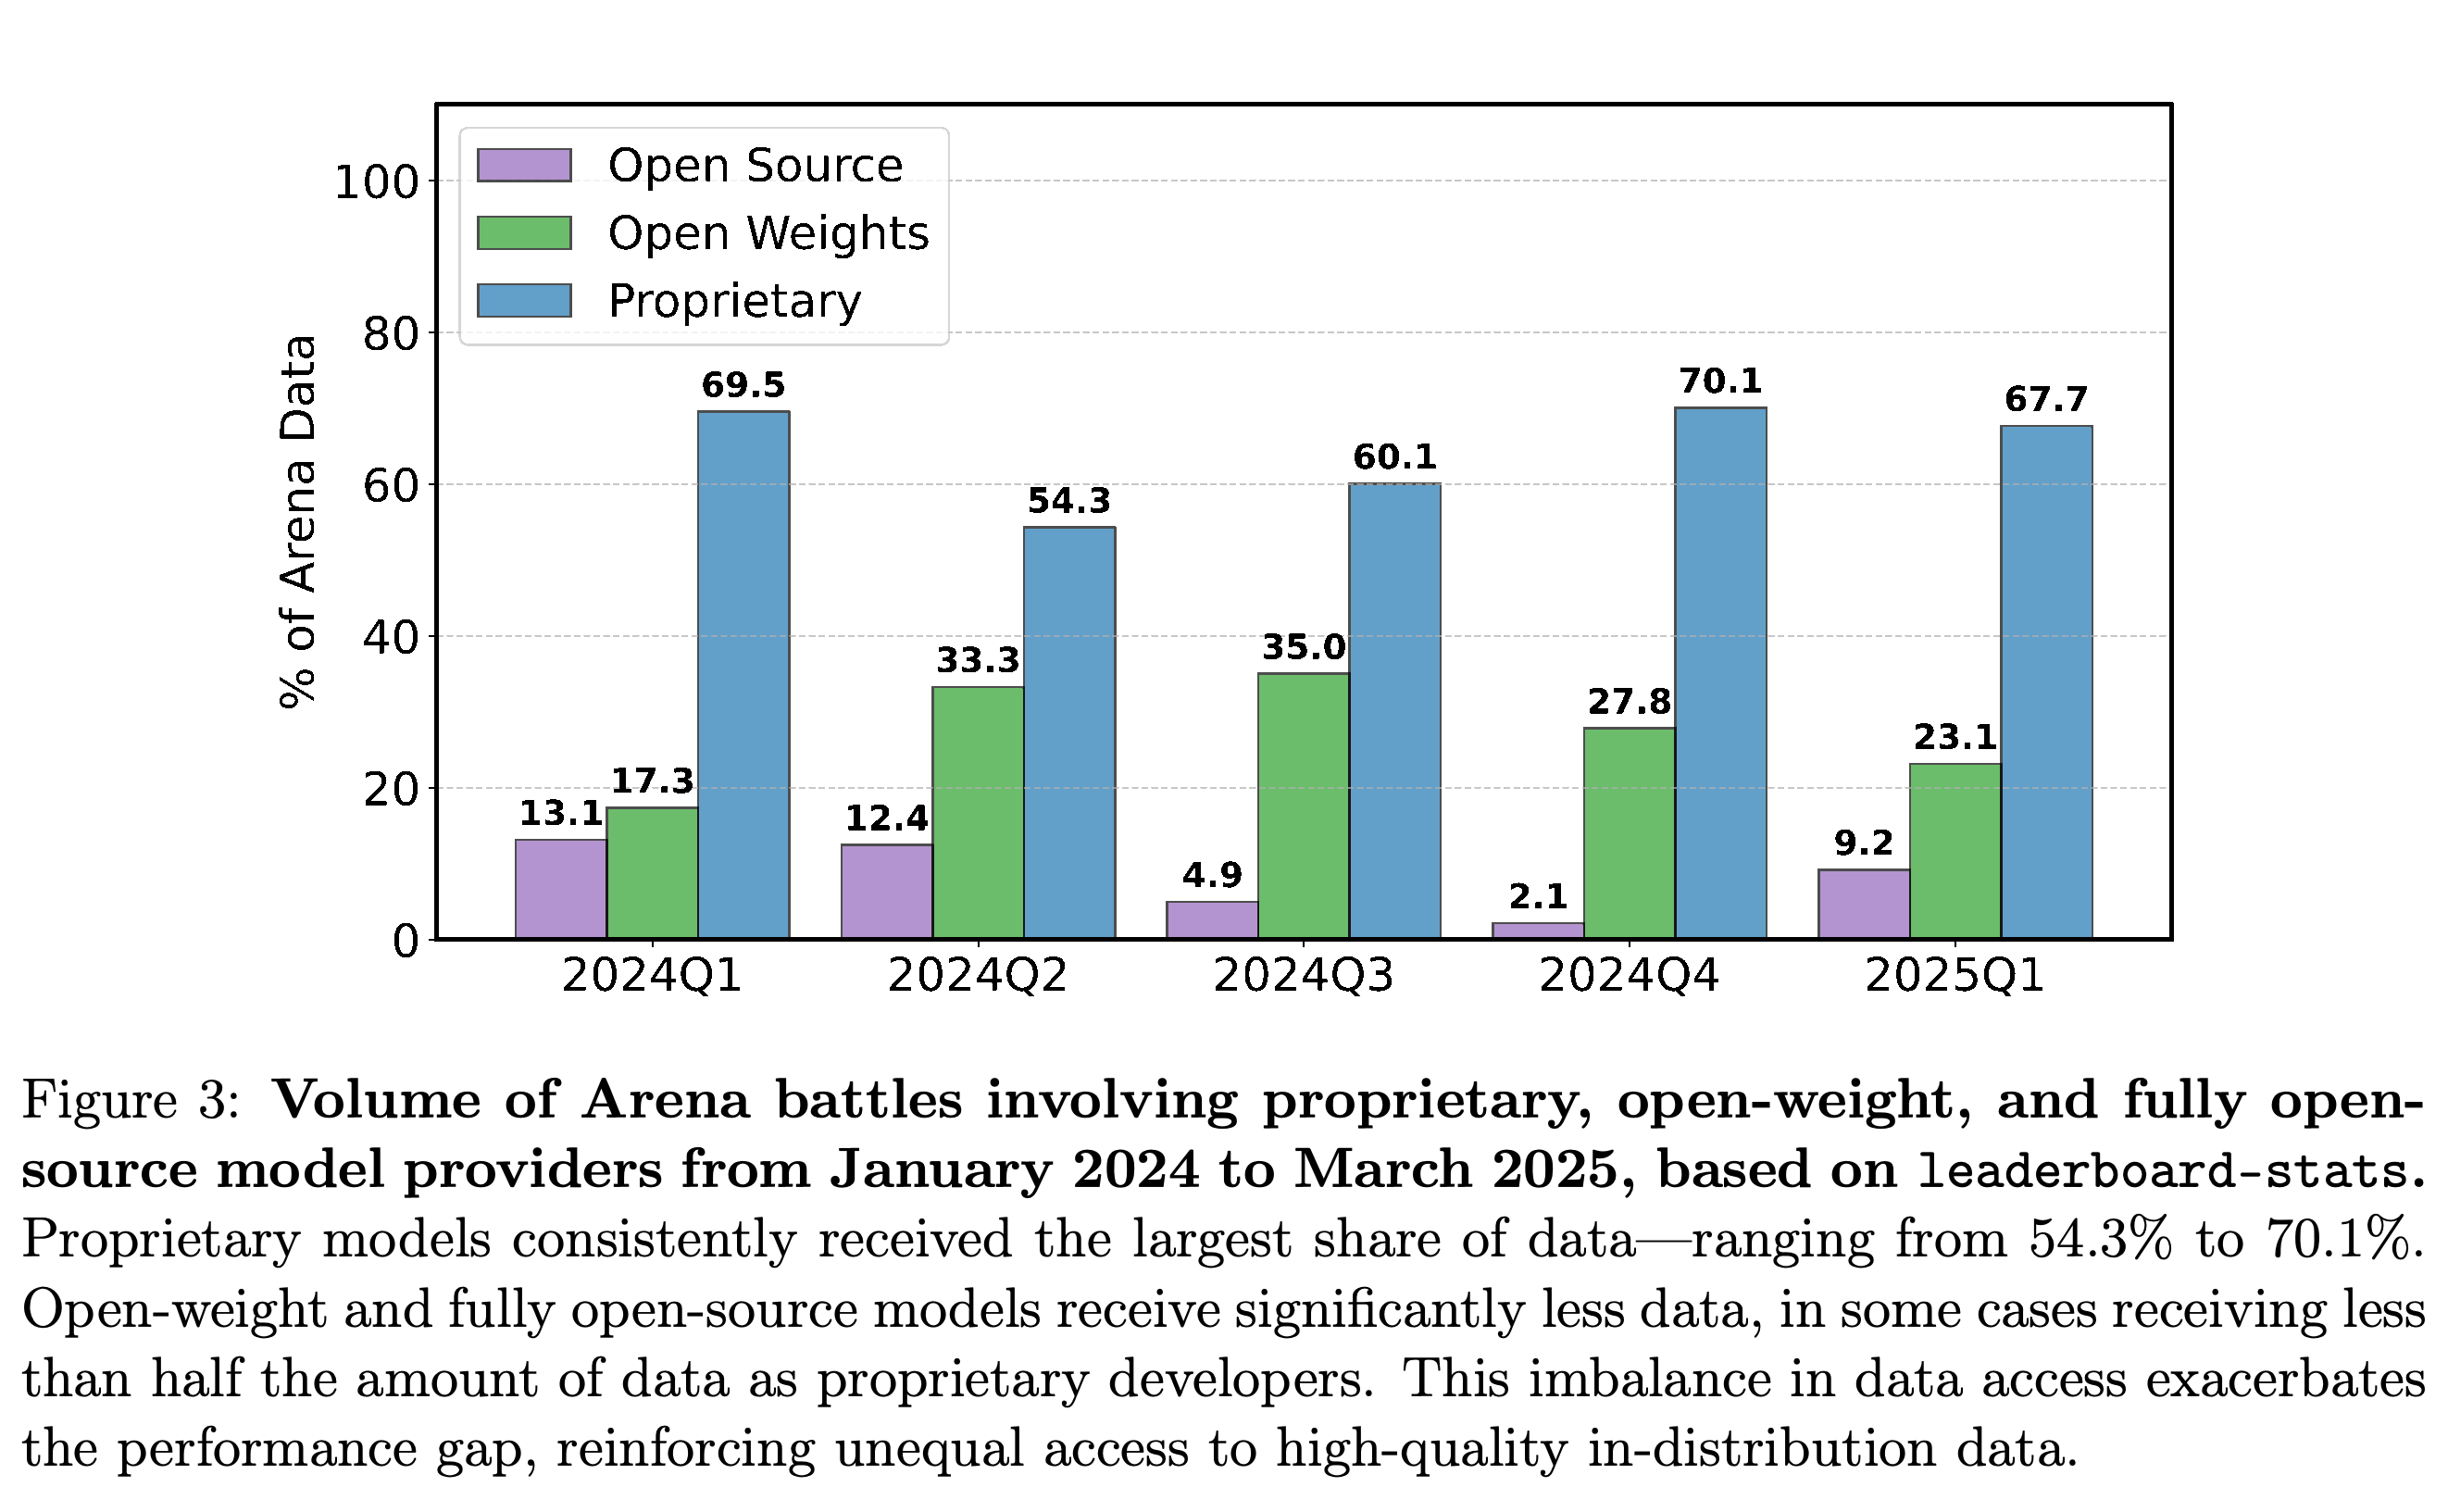
표시된 기간에 독점 모델은 분기별 노출량의 54.3%–70.1%를 차지한다. 지속적인 차이는 라이선스 집단별 누적 접근량이 불균등함을 뒷받침하지만, 노출만으로 이후 학습에 사용했음을 입증하지는 않는다.
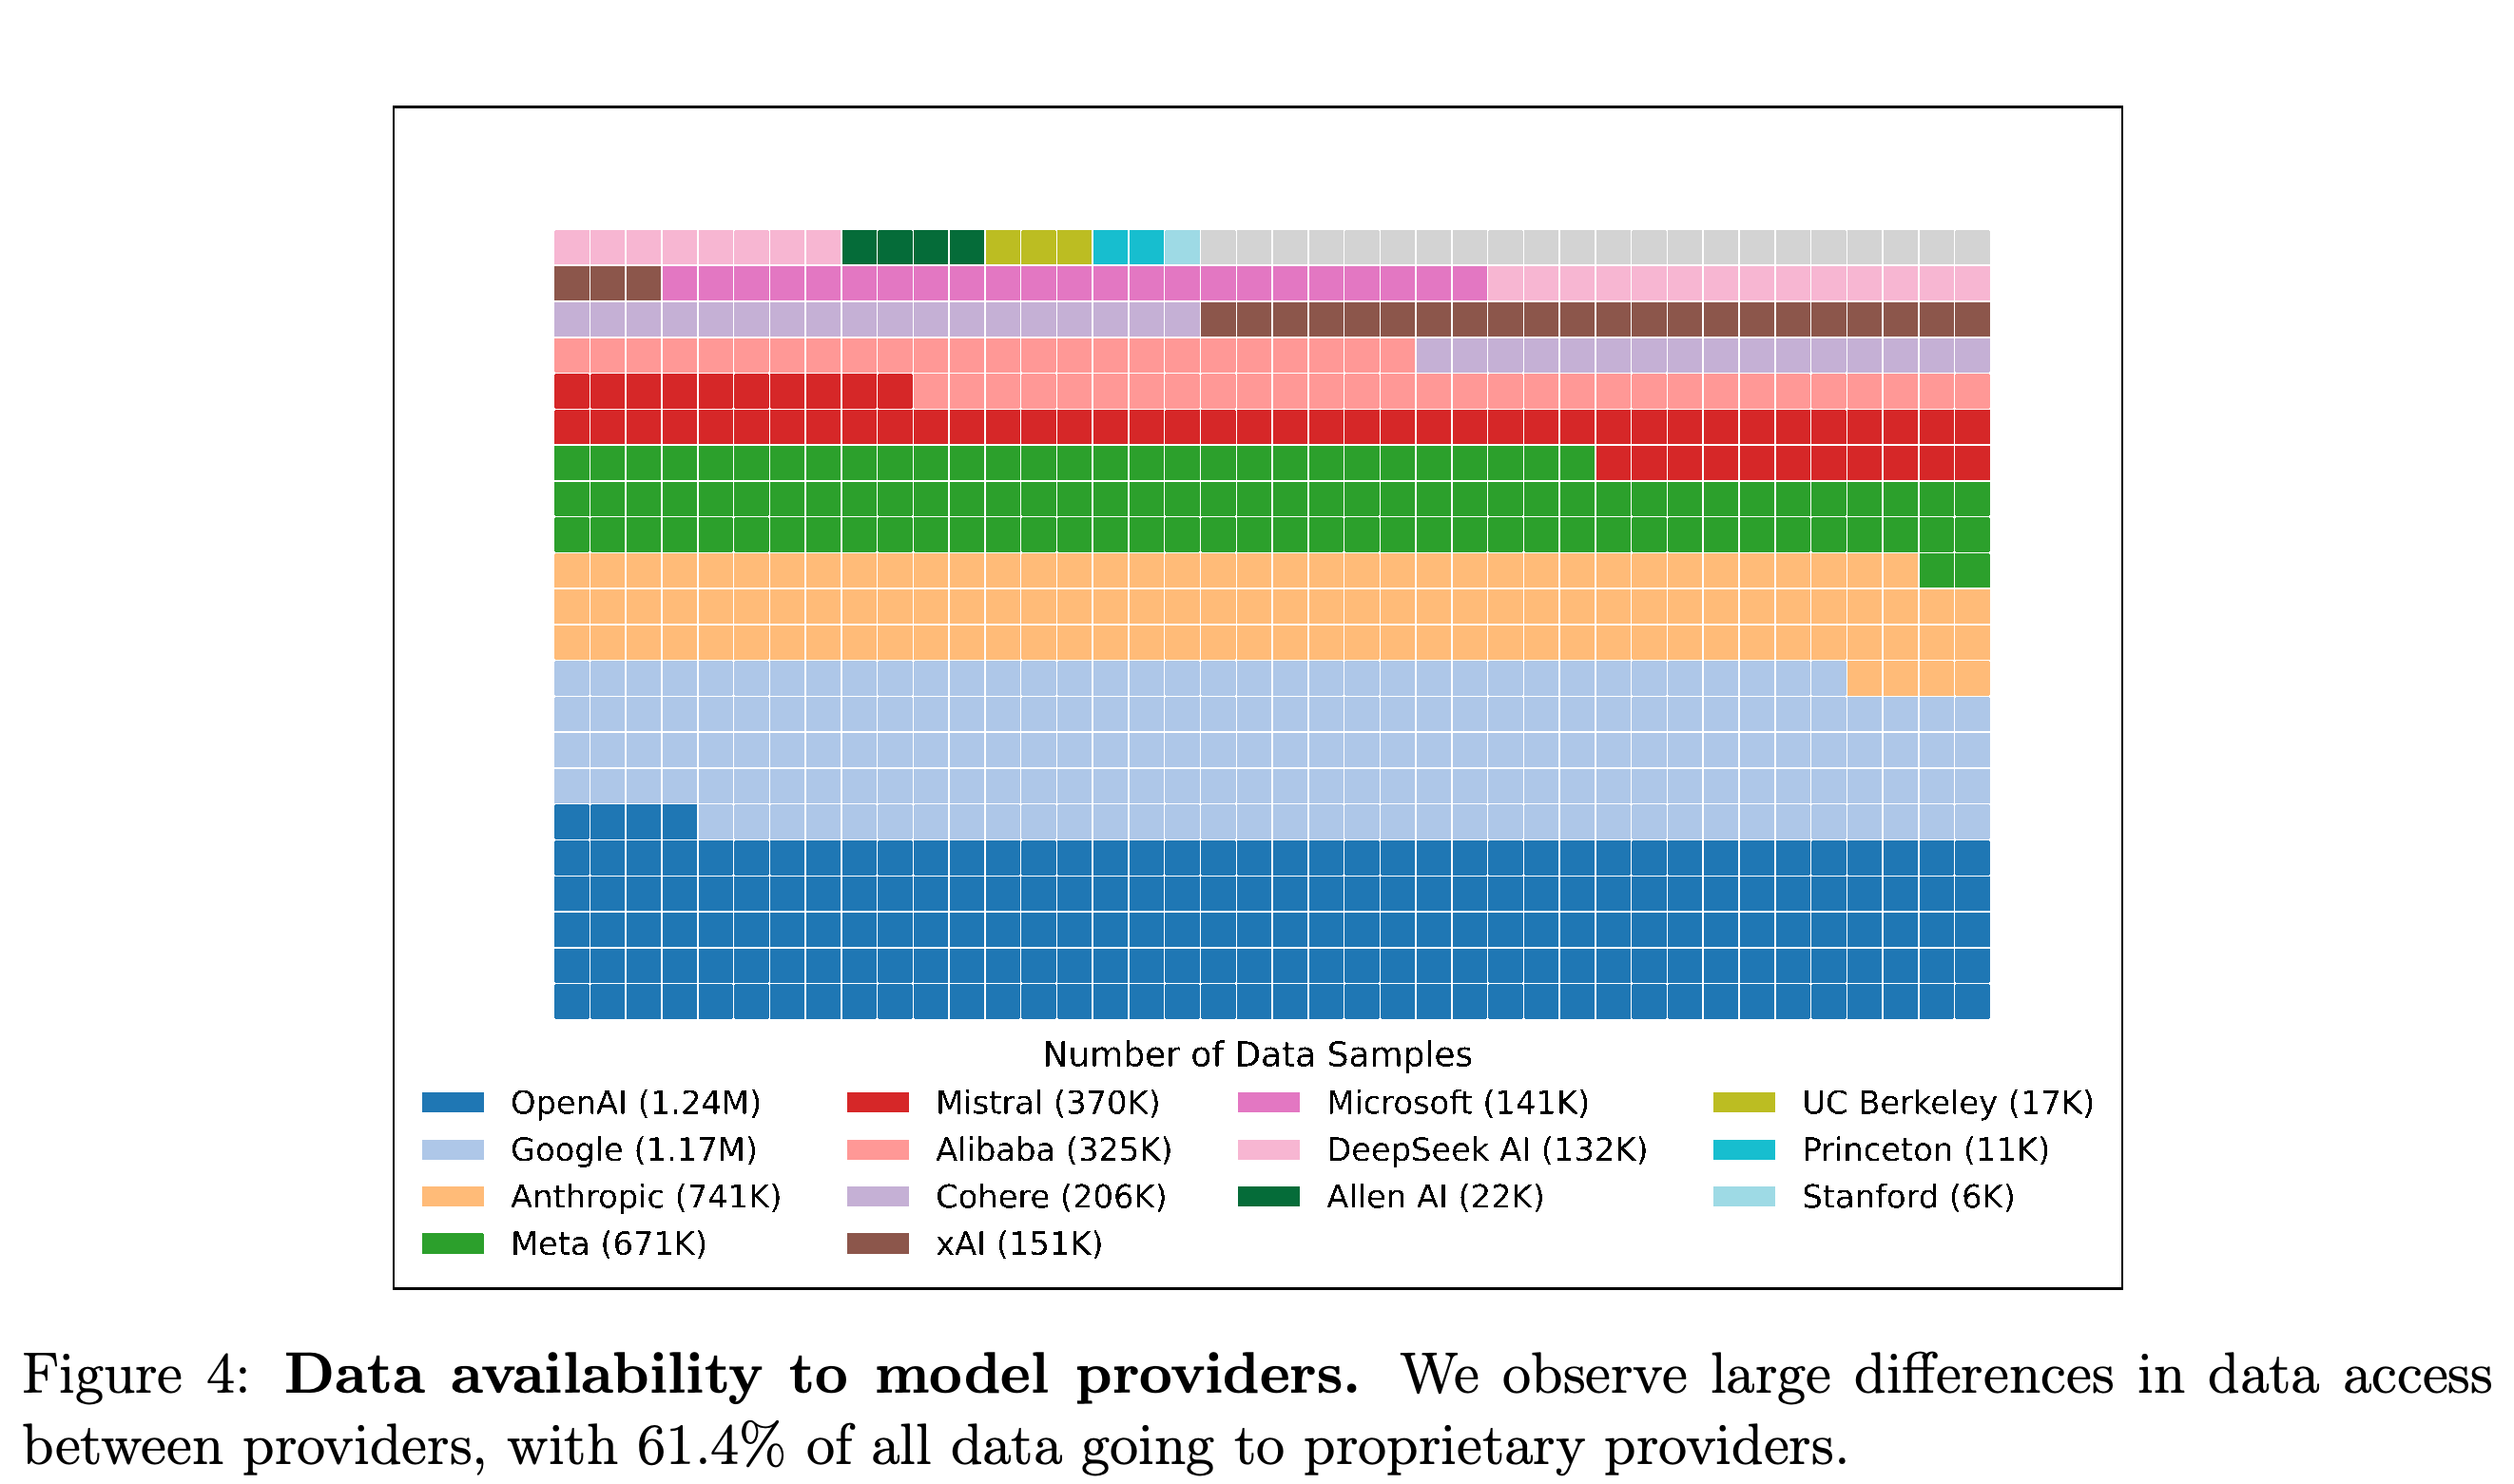
추정 표본 수는 OpenAI 1.24M개, Google 1.17M개인 반면 Allen AI 22K개, UC Berkeley 17K개, Princeton 11K개, Stanford 6K개다. Appendix G는 이를 API 호출 노출량 추정치로 설명하므로, 서로 겹치지 않는 고유 프롬프트 수로 해석하면 안 된다.
2 Overview of Methodology
방법론은 비공개 테스트와 선택적 공개가 점수에 미치는 영향, 제공자별 Arena 데이터 확보량이 달라지는 경로, 해당 데이터가 Arena에 특화된 성능을 높이는지 여부, 평가 중단이 순위의 신뢰성에 미치는 영향이라는 4가지 질문을 구분한다. 이를 위해 과거 배틀 기록, 크롤링으로 수집한 관찰 자료, 제공자 측 애플리케이션 프로그래밍 인터페이스(API) 프롬프트, 과거 리더보드 스냅샷을 결합한다.
- 리더보드 분석은 2024년 1월 9일부터 2025년 4월 23일까지를 다루며, 고유 모델 243개의 기록 14.3K개를 포함한다.
- 다른 자료의 범위는 서로 다르다. 과거 배틀 기록은 2023년 4월까지 거슬러 올라가고, 메인 리더보드에서 수집한 관찰 자료는 2025년 1월부터 3월까지다. 프롬프트 분석은 2024년 11월부터 2025년 4월까지의 자료를 사용한다.
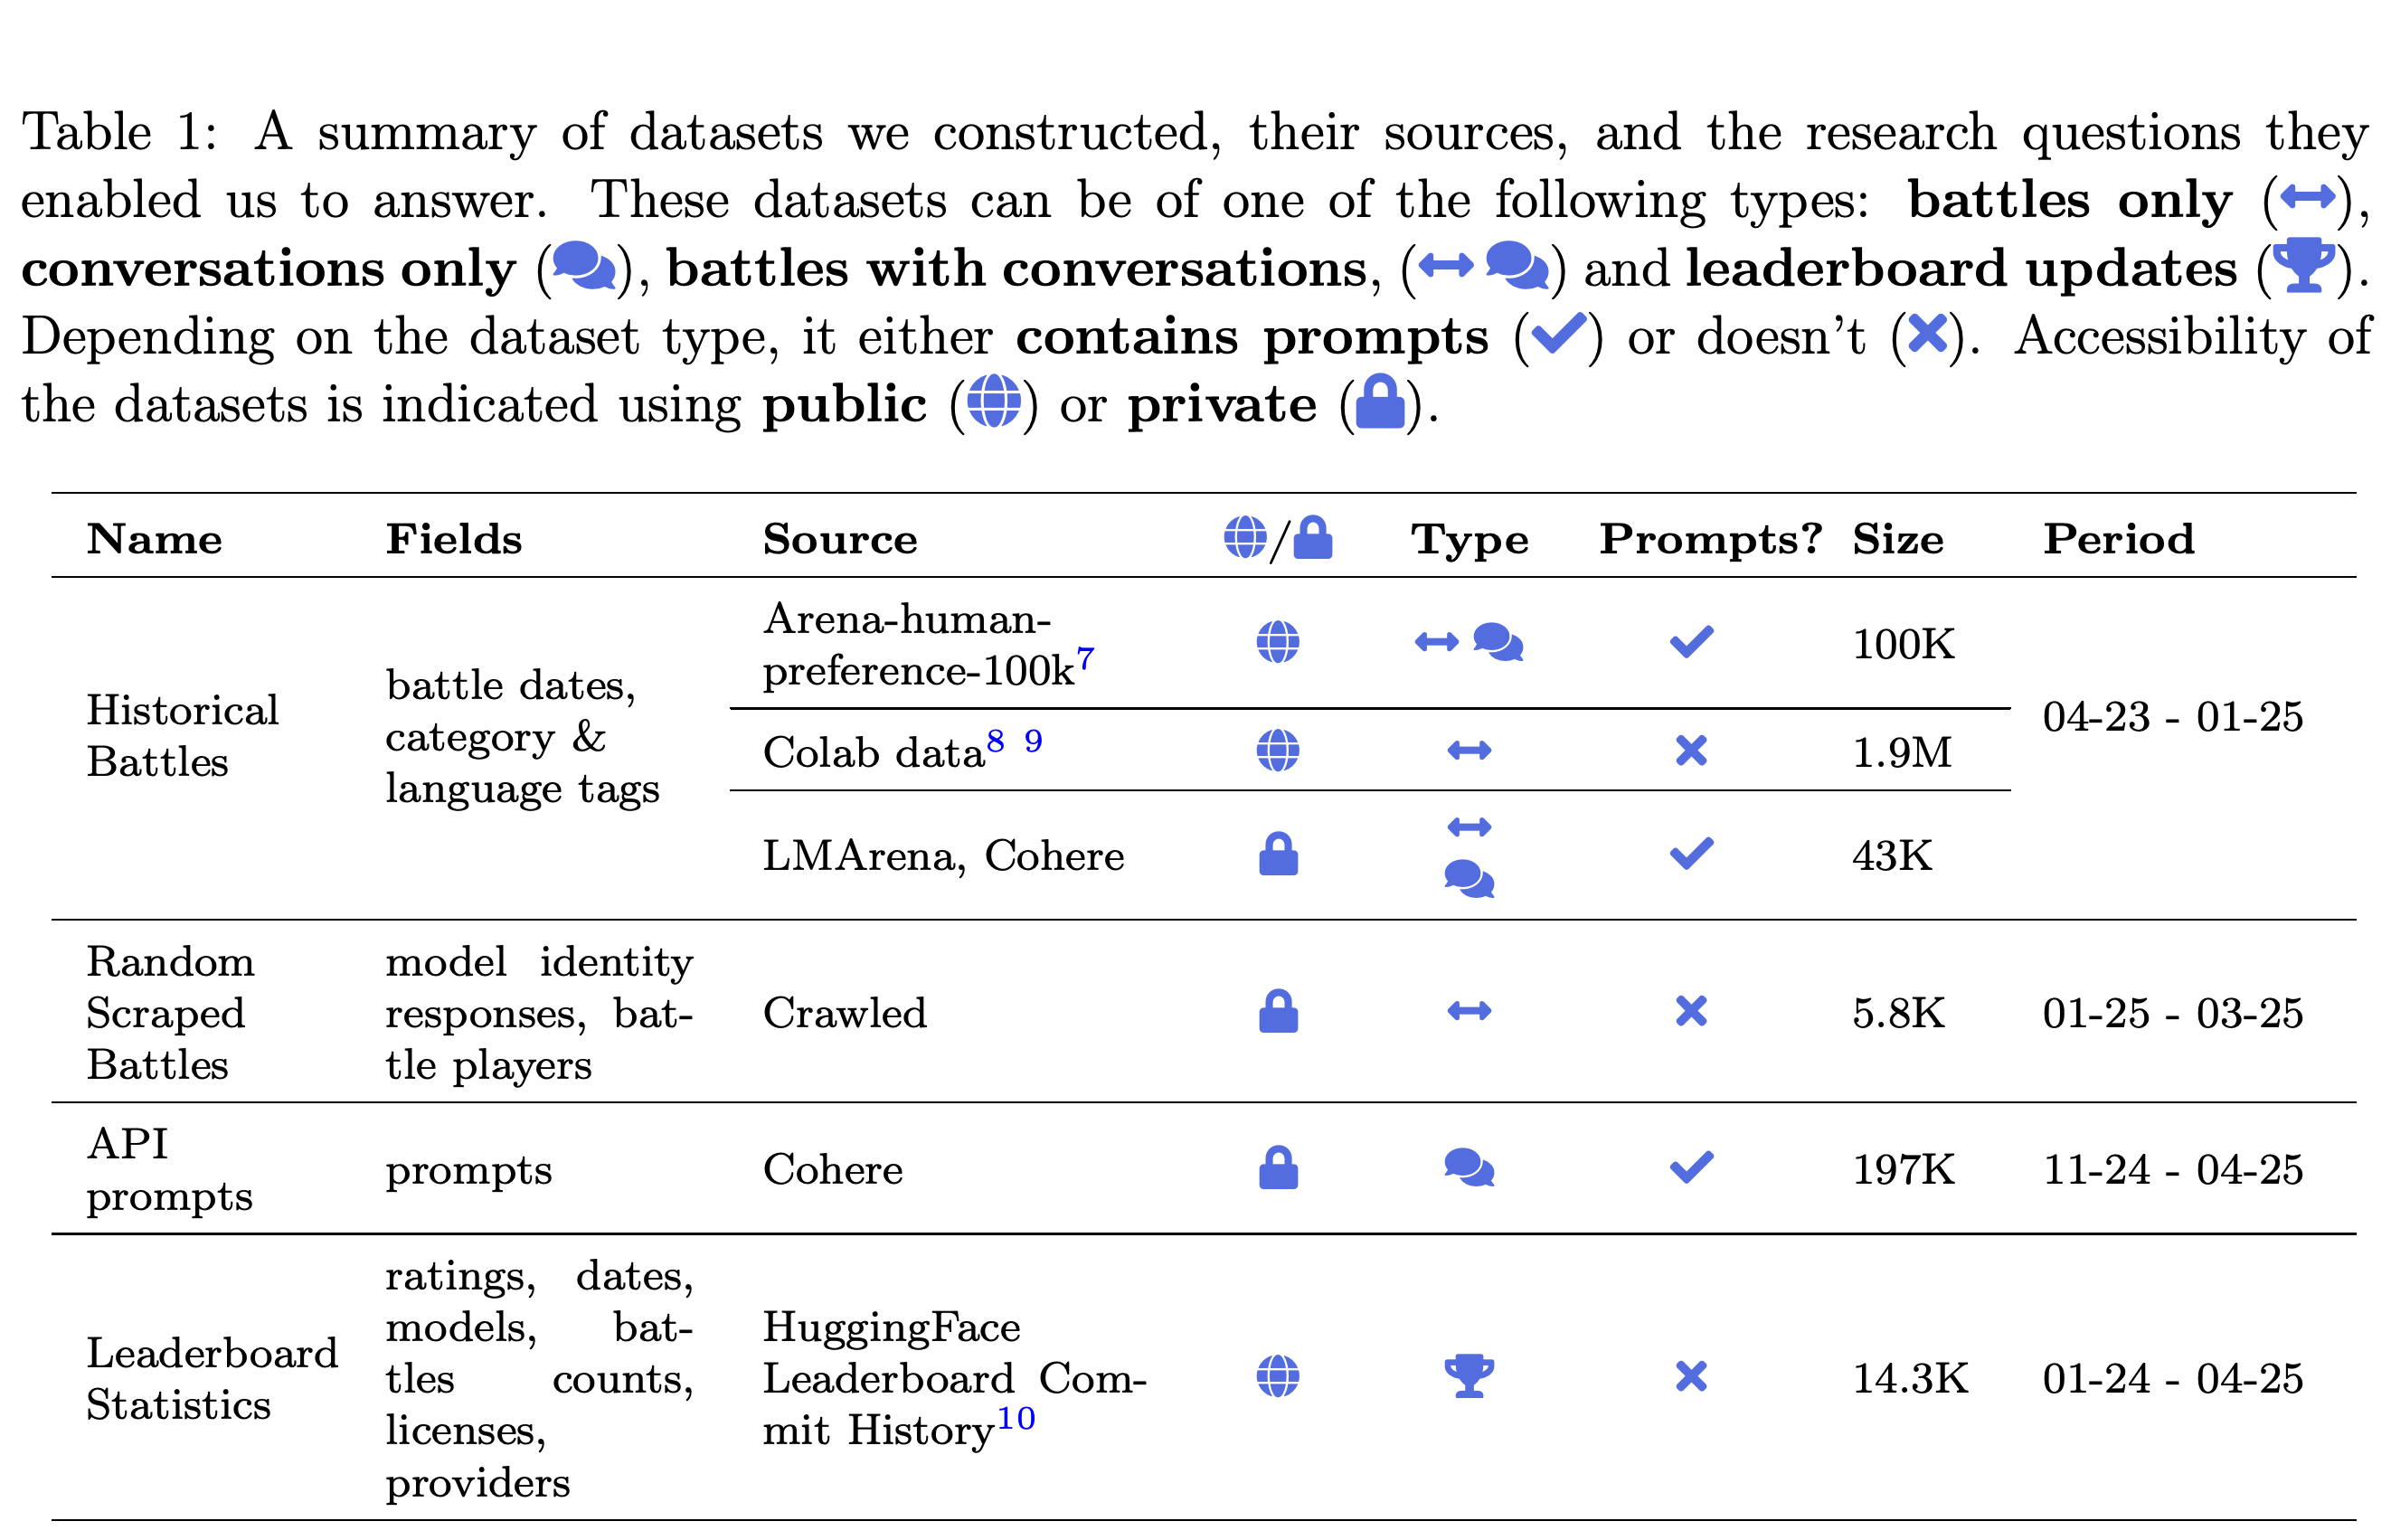
- Table 1은 프롬프트와 전체 대화를 포함하는 기록과 상대 모델, 결과, 언어 태그 또는 리더보드 통계만 포함하는 기록을 구분한다.
이 표는 감사에서 관찰할 수 있는 범위의 한계를 명시한다. 가장 큰 과거 자료에는 프롬프트가 없으며, 프롬프트 수준의 반복 분석은 더 작은 제공자 측 수집 자료에 의존한다. 관찰 기간도 달라서 비공개 테스트 수와 누적 리더보드 통계의 범위가 다르다.
2.1 Introduction to the Arena Score
Arena Score는 쌍대 비교 결과로 상대적 실력을 추정하는 확률 모델인 Bradley-Terry(BT) 모델의 매개변수를 환산한 점수다. 단순 평균 승률과 달리 상대의 실력을 고려하며, 직접 맞붙은 적이 없는 모델 사이에서도 간접 비교를 지원한다.
- 논문은 대표성 있는 관측, 안정적인 평가 조건, 공통 비교를 통한 모델 간 충분한 연결을 강조한다.
- 추이성은 공통된 잠재 실력 순서가 간접 비교를 뒷받침한다는 뜻이다. 과제 구성이 달라지면 과거 비교가 현재 성능과 일치하지 않을 수 있다.
- Appendix B는 Arena 순위가 추정 점수의 불확실성을 나타내는 신뢰구간도 고려한다고 설명한다. 점추정치 차이만으로는 순서가 통계적으로 구분된다고 볼 수 없다.
3 Results: Impact of Private Testing and Selective Retraction on Arena Scores
비공개 테스트에 점수 철회 선택권, 즉 테스트 결과를 공개하지 않을 선택권이 결합되면 제공자는 여러 후보를 평가한 뒤 원하는 결과만 공개할 수 있다. 논문은 관찰된 비공개 별칭, 선택 편향에 대한 논증, 모의 배틀, 실제 제출을 통해 이를 연구한다.
- 실제로 더 강한 후보를 선택하는 이점과 측정 잡음 덕분에 높아진 점수를 선택하는 이점이라는 2가지 요인은 구분해서 해석해야 한다.
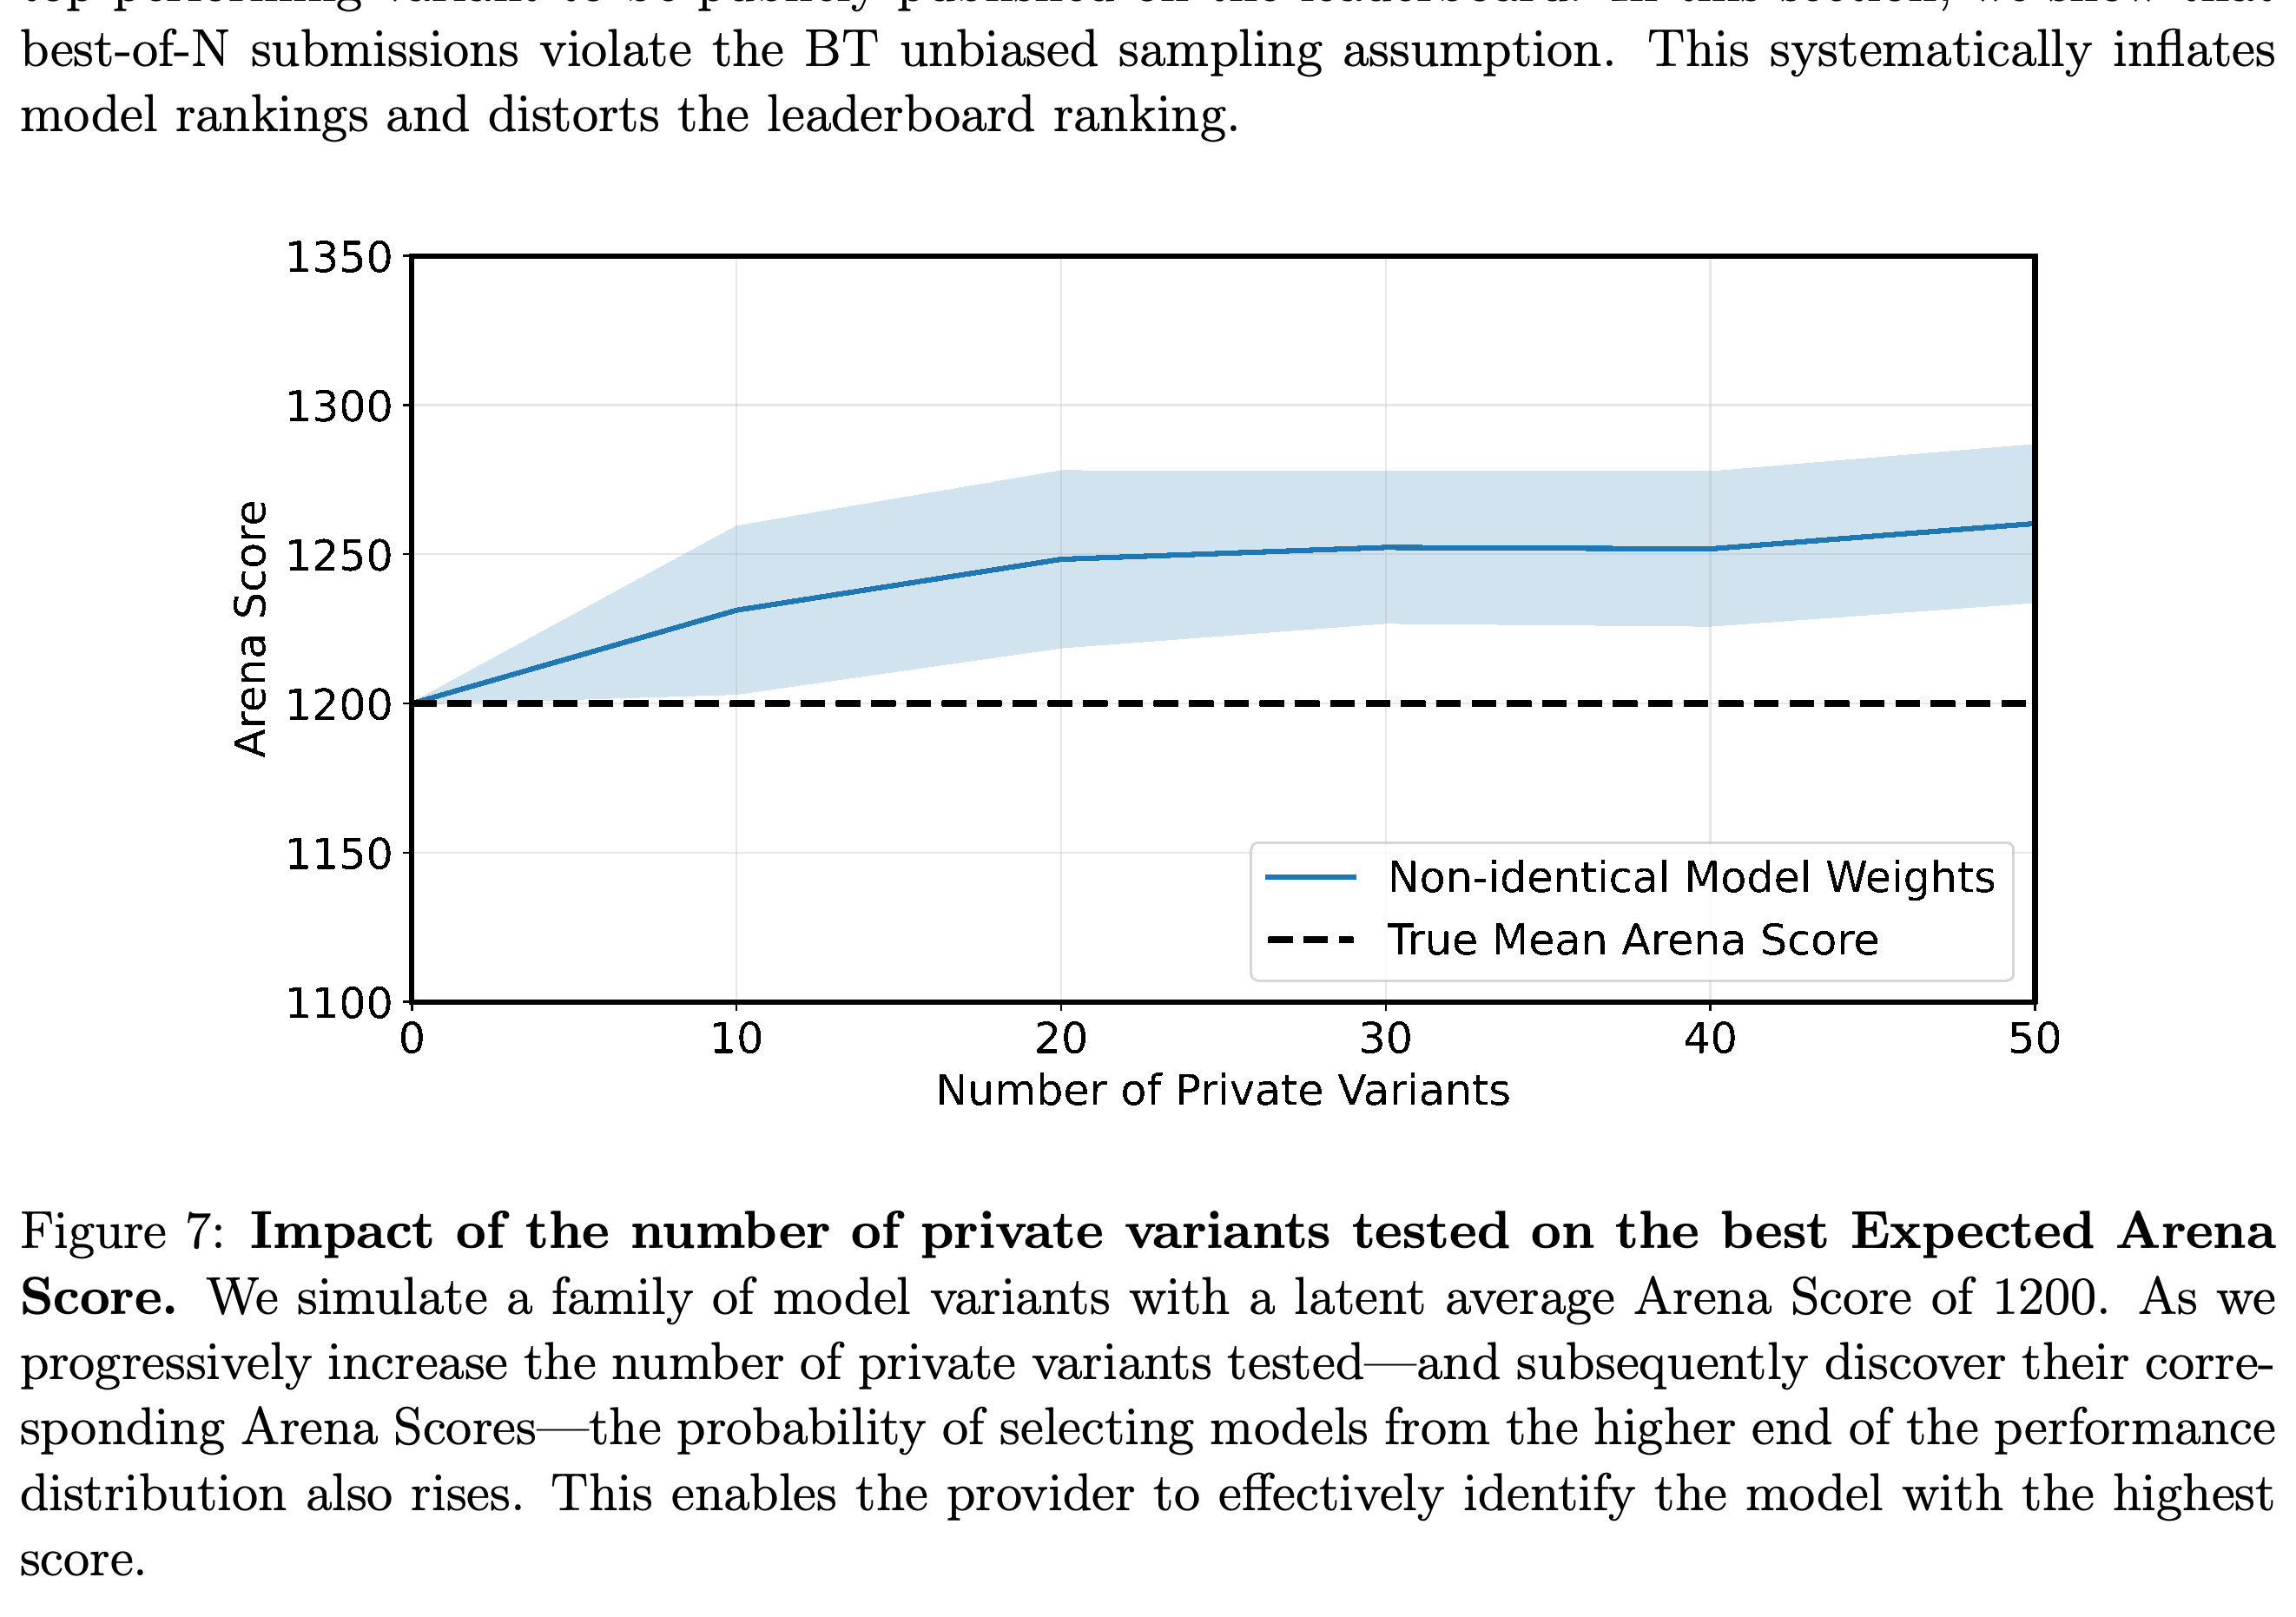
- 이 절의 주요 결과 상자는 변형 10개로 약 100점의 상승을 얻는다고 서술하지만, 상세 논의와 Figure 7은 서로 다른 변형 20개로 약 50점을 얻는다고 보고한다. 제시된 시뮬레이션은 후자를 뒷받침한다.
3.1 Preferred Providers Frequently Use Private Testing
2025년 1월부터 3월까지 수집한 자료에서는 메인 리더보드의 비공개 변형 수가 제공자별로 크게 달랐다. 추정된 수는 Meta 27개, Google 10개, Amazon 7개, Cohere 4개, OpenAI 2개, Nvidia 2개이며, Alibaba, Reka, StepFun, xAI는 각각 1개다. 추가 vision 변형 16개를 포함하면 Meta로 추정된 총수는 43개다.
- 이 관찰 기간에는 학술 연구실 소유로 추정된 비공개 모델이 없었다.
- Google로 추정된 비공개 모델은 대부분 Gemini 계열이었으며, 한 모델은 Gemma의 버전 3으로 추정됐다.
- 저자들은 공개 발표에서 선두 모델이 빠르게 바뀐 현상을 여러 후보의 병렬 테스트와 부합하는 것으로 해석한다. 발표 시점만으로는 변화의 원인을 확정할 수 없다.
메인 리더보드에서 관찰한 비공개 변형 수는 Meta, Google, Amazon에 집중된다. Cohere의 제출 4개는 연구 실험으로 명시되며, 제공자 배정은 공식 확인이 아니라 모델 응답에 의존한다.
3.2 Simulated Experiments on Private Testing and Retraction
best-of-N 전략은 테스트한 후보 N개 중 가장 높은 점수만 공개하는 방식이며, 일반적인 제출보다 선택된 점수의 기댓값을 높인다. Appendix C는 기댓값이 유한하고 분산이 0이 아니며 N ≥ 2인 독립 동일 분포 추정치에 대해 이 최댓값 선택 결과를 증명한다.
- 시뮬레이션은 비공개 후보 수를 0개에서 50개까지 바꾸면서 배틀을 생성하고 BT로 점수를 추정한다. 불확실성은 관측 결과에서 반복적으로 표본을 뽑는 부트스트랩 재표본추출로 추정한다.
- 평균 Arena Score가 1200인 모델군에서 서로 다른 변형 20개를 테스트하면 발견된 최고 점수의 평균이 약 50점 증가한다.
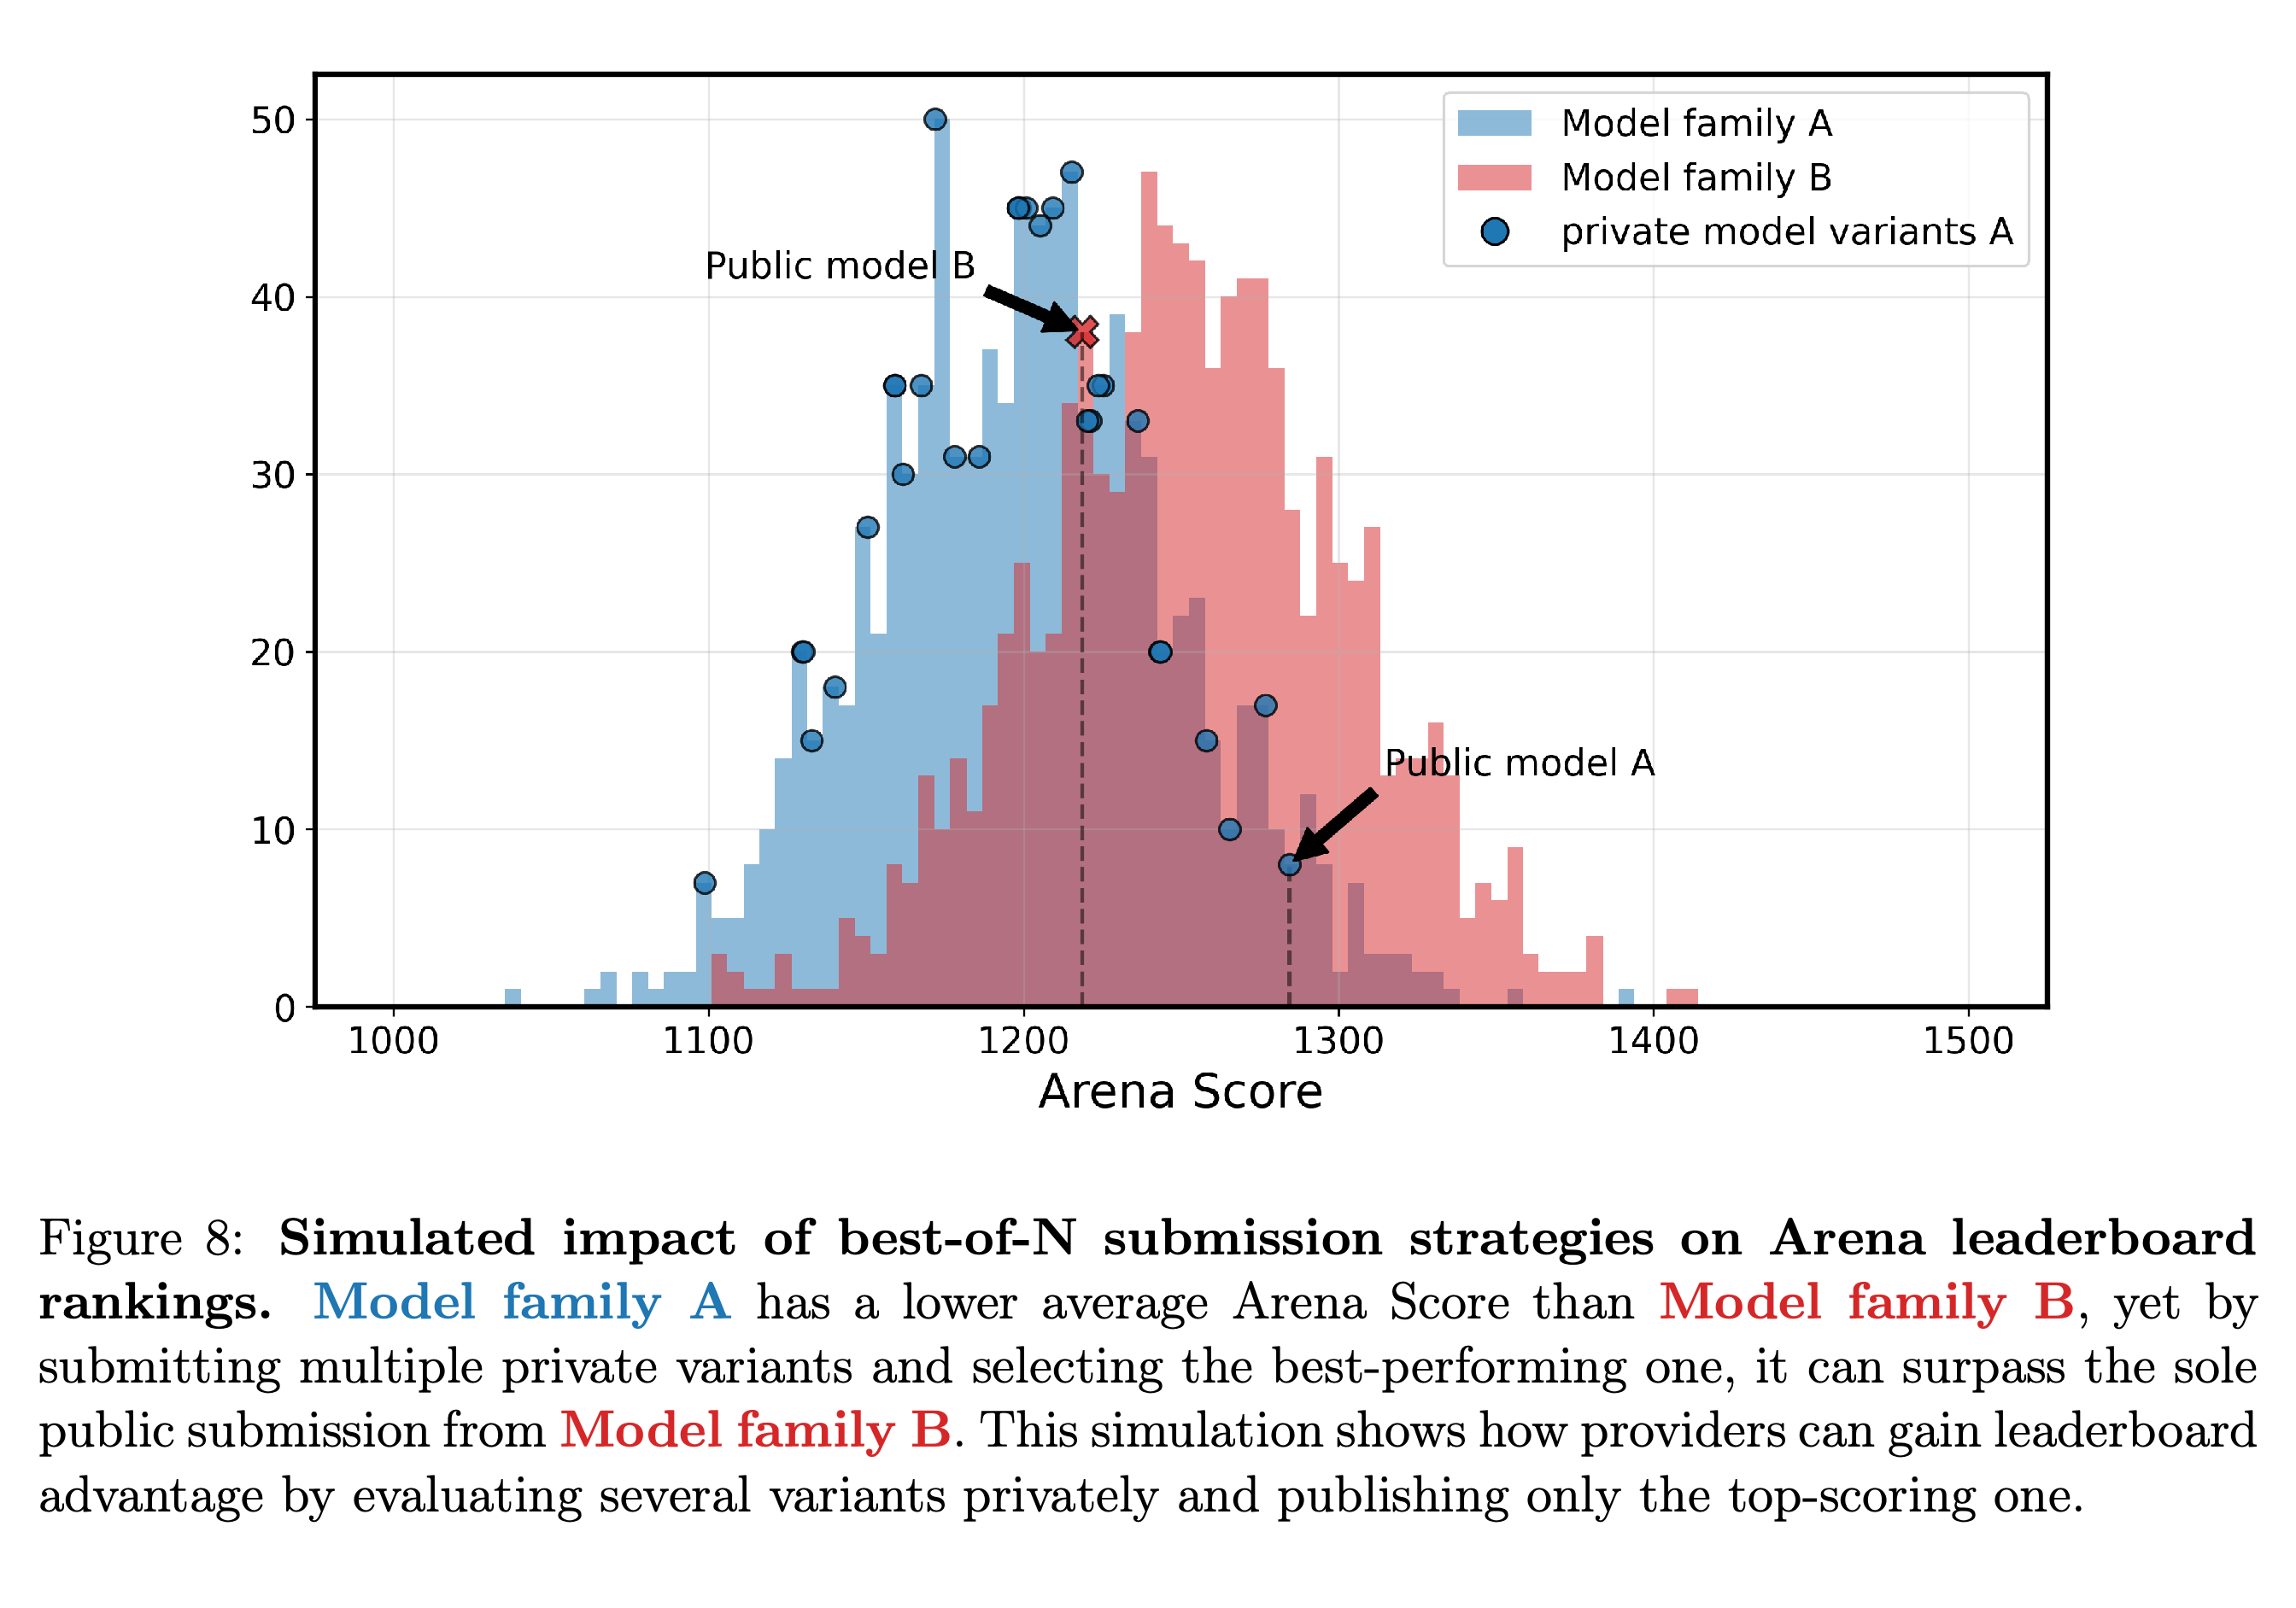
- 추가 예시는 평균 성능이 낮은 모델군만 여러 비공개 테스트 후보 중에서 선택할 수 있을 때, 평균 성능이 높은 모델군의 단일 제출을 앞서는 상황을 보여준다.
중심 점수가 1200인 후보 모델군에서 서로 다른 변형 20개를 사용하면 선택된 최댓값이 약 1250으로 오른다. 이는 상세 시뮬레이션 논의를 뒷받침하며, 앞선 주요 결과 상자의 변형 10개로 약 100점이라는 주장과 충돌한다.
평균이 낮은 모델군에서 선택된 후보가 더 강한 모델군의 단일 공개 후보를 앞선다. 이 예시는 불균등한 모델 선택 기회를 보여주며, 선택된 결과에는 평가 잡음과 실제 후보 변동이 함께 반영된다.
3.3 Real-world Chatbot Arena Experiment
2025년 3월에 동일한 Aya-Vision-8B 체크포인트 2개는 Arena Score 1052(±21/22)와 1069(±19/23)를 받았으며, 점추정치 사이에 모델 4개가 있었다. 서로 다른 Aya-Vision-32B 최종 후보 2개는 1097(±29/25)과 1059(±18/23)를 받았으며, 그 사이에 모델 9개가 있었다.
- 동일 체크포인트 비교는 가중치가 바뀌지 않아도 관측 점수가 달라짐을 보여준다. 저자들은 중복 제출 사실을 Arena에 알리지 않았다.
- 서로 다른 체크포인트는 내부 벤치마크 일부에서 성능이 다소 달랐다. 따라서 점수 차이에는 평가 변동과 함께 후보 품질 차이도 포함된다.
- 보고된 불확실성 구간은 서로 겹친다. 이 예시들은 유리한 점추정치를 선택할 기회가 있음을 보여주지만, 동일한 제출 모델의 능력이 통계적으로 구분된다는 근거는 아니다.
동일한 Aya-Vision-8B 제출 모델의 점수 차이는 17점이며, 서로 다른 Aya-Vision-32B 후보의 차이는 38점이다. 그 사이에 위치한 리더보드 항목들은 유리한 점추정치를 선택할 여지를 드러낸다. 다만 보고된 불확실성 구간이 겹치므로 차이가 통계적으로 구분된다는 주장은 제한된다.
4 Results: Impact of Data Access Asymmetries on Arena Scores
데이터 접근량은 제출한 변형 수, 샘플링 빈도, 활동 기간, 모델 요청을 호스팅하는 주체에 따라 달라진다. 논문은 OpenAI, Google, Meta, Anthropic이 합쳐서 Arena 데이터 노출량의 62.8%를 차지한다고 추정한다. 이는 Allen AI, Stanford, Princeton, UC Berkeley의 합산 비중의 약 68배다.
- 통제된 학습 실험은 학습 예산이 고정된 조건에서 이 평가 분포에 접근하면 점수가 높아지는지 검증한다.
- 이 노출량 추정치는 데이터를 받을 기회를 측정한다. 다른 제공자가 해당 프롬프트를 보관하거나 학습에 사용했는지는 보여주지 않는다.
4.1 Disparity in access to Chatbot Arena Data
모델의 샘플링 비율은 하루 배틀 중 해당 모델이 등장한 비율이다. 제공자별 최대치는 조건을 충족하는 날짜에 해당 제공자의 모델 중 어느 모델에서든 관측된 가장 높은 비율이다. 2025년 1월부터 3월까지 수집한 자료에서 Google과 OpenAI는 약 34%에 도달했으며, Reka는 3.3%였다.
- 저자들의 실험에서 보고된 프롬프트 비중은 변형 1개일 때 5.9%에서 변형 3개일 때 19.4%로 증가했다.
- 자체 API를 제공하는 제공자는 자사 모델로 전달된 모든 프롬프트를 받을 수 있다. 반면 제3자 호스팅에 의존하는 제공자는 공개 데이터나 자사 모델이 참여한 기록의 20%를 요청할 수 있는 Arena 정책에 의존한다.
- Google과 OpenAI의 추정 비중은 각각 19.2%와 20.4%다. 배틀마다 모델 2개가 참여하므로 프롬프트가 제공자 2곳에 전달될 수 있다. 따라서 이 비중은 서로 겹치지 않는 고유 사용자 질문 집합을 뜻하지 않는다.
- 평가 중단은 향후 데이터 접근을 제한한다. 논문은 활동량이 매우 낮다고 분류한 모델 205개와 공식 평가 중단 목록의 47개를 대조한다. 이 수치를 서로 겹치지 않는 집단으로 보고 합산하면 안 된다.
4.2 Risk of Potential Overfitting
여기서 과적합은 평가 분포의 특성을 학습해 익숙한 과제에서는 성능이 좋아지지만 다른 영역에서는 그에 상응하는 개선이 나타나지 않는 현상을 뜻한다. 논문은 프롬프트 구성 변화와 반복 프롬프트를 조사해, 실시간 벤치마크가 변화하면서도 적응에 활용할 수 있는 규칙성을 유지할 수 있음을 보여준다.
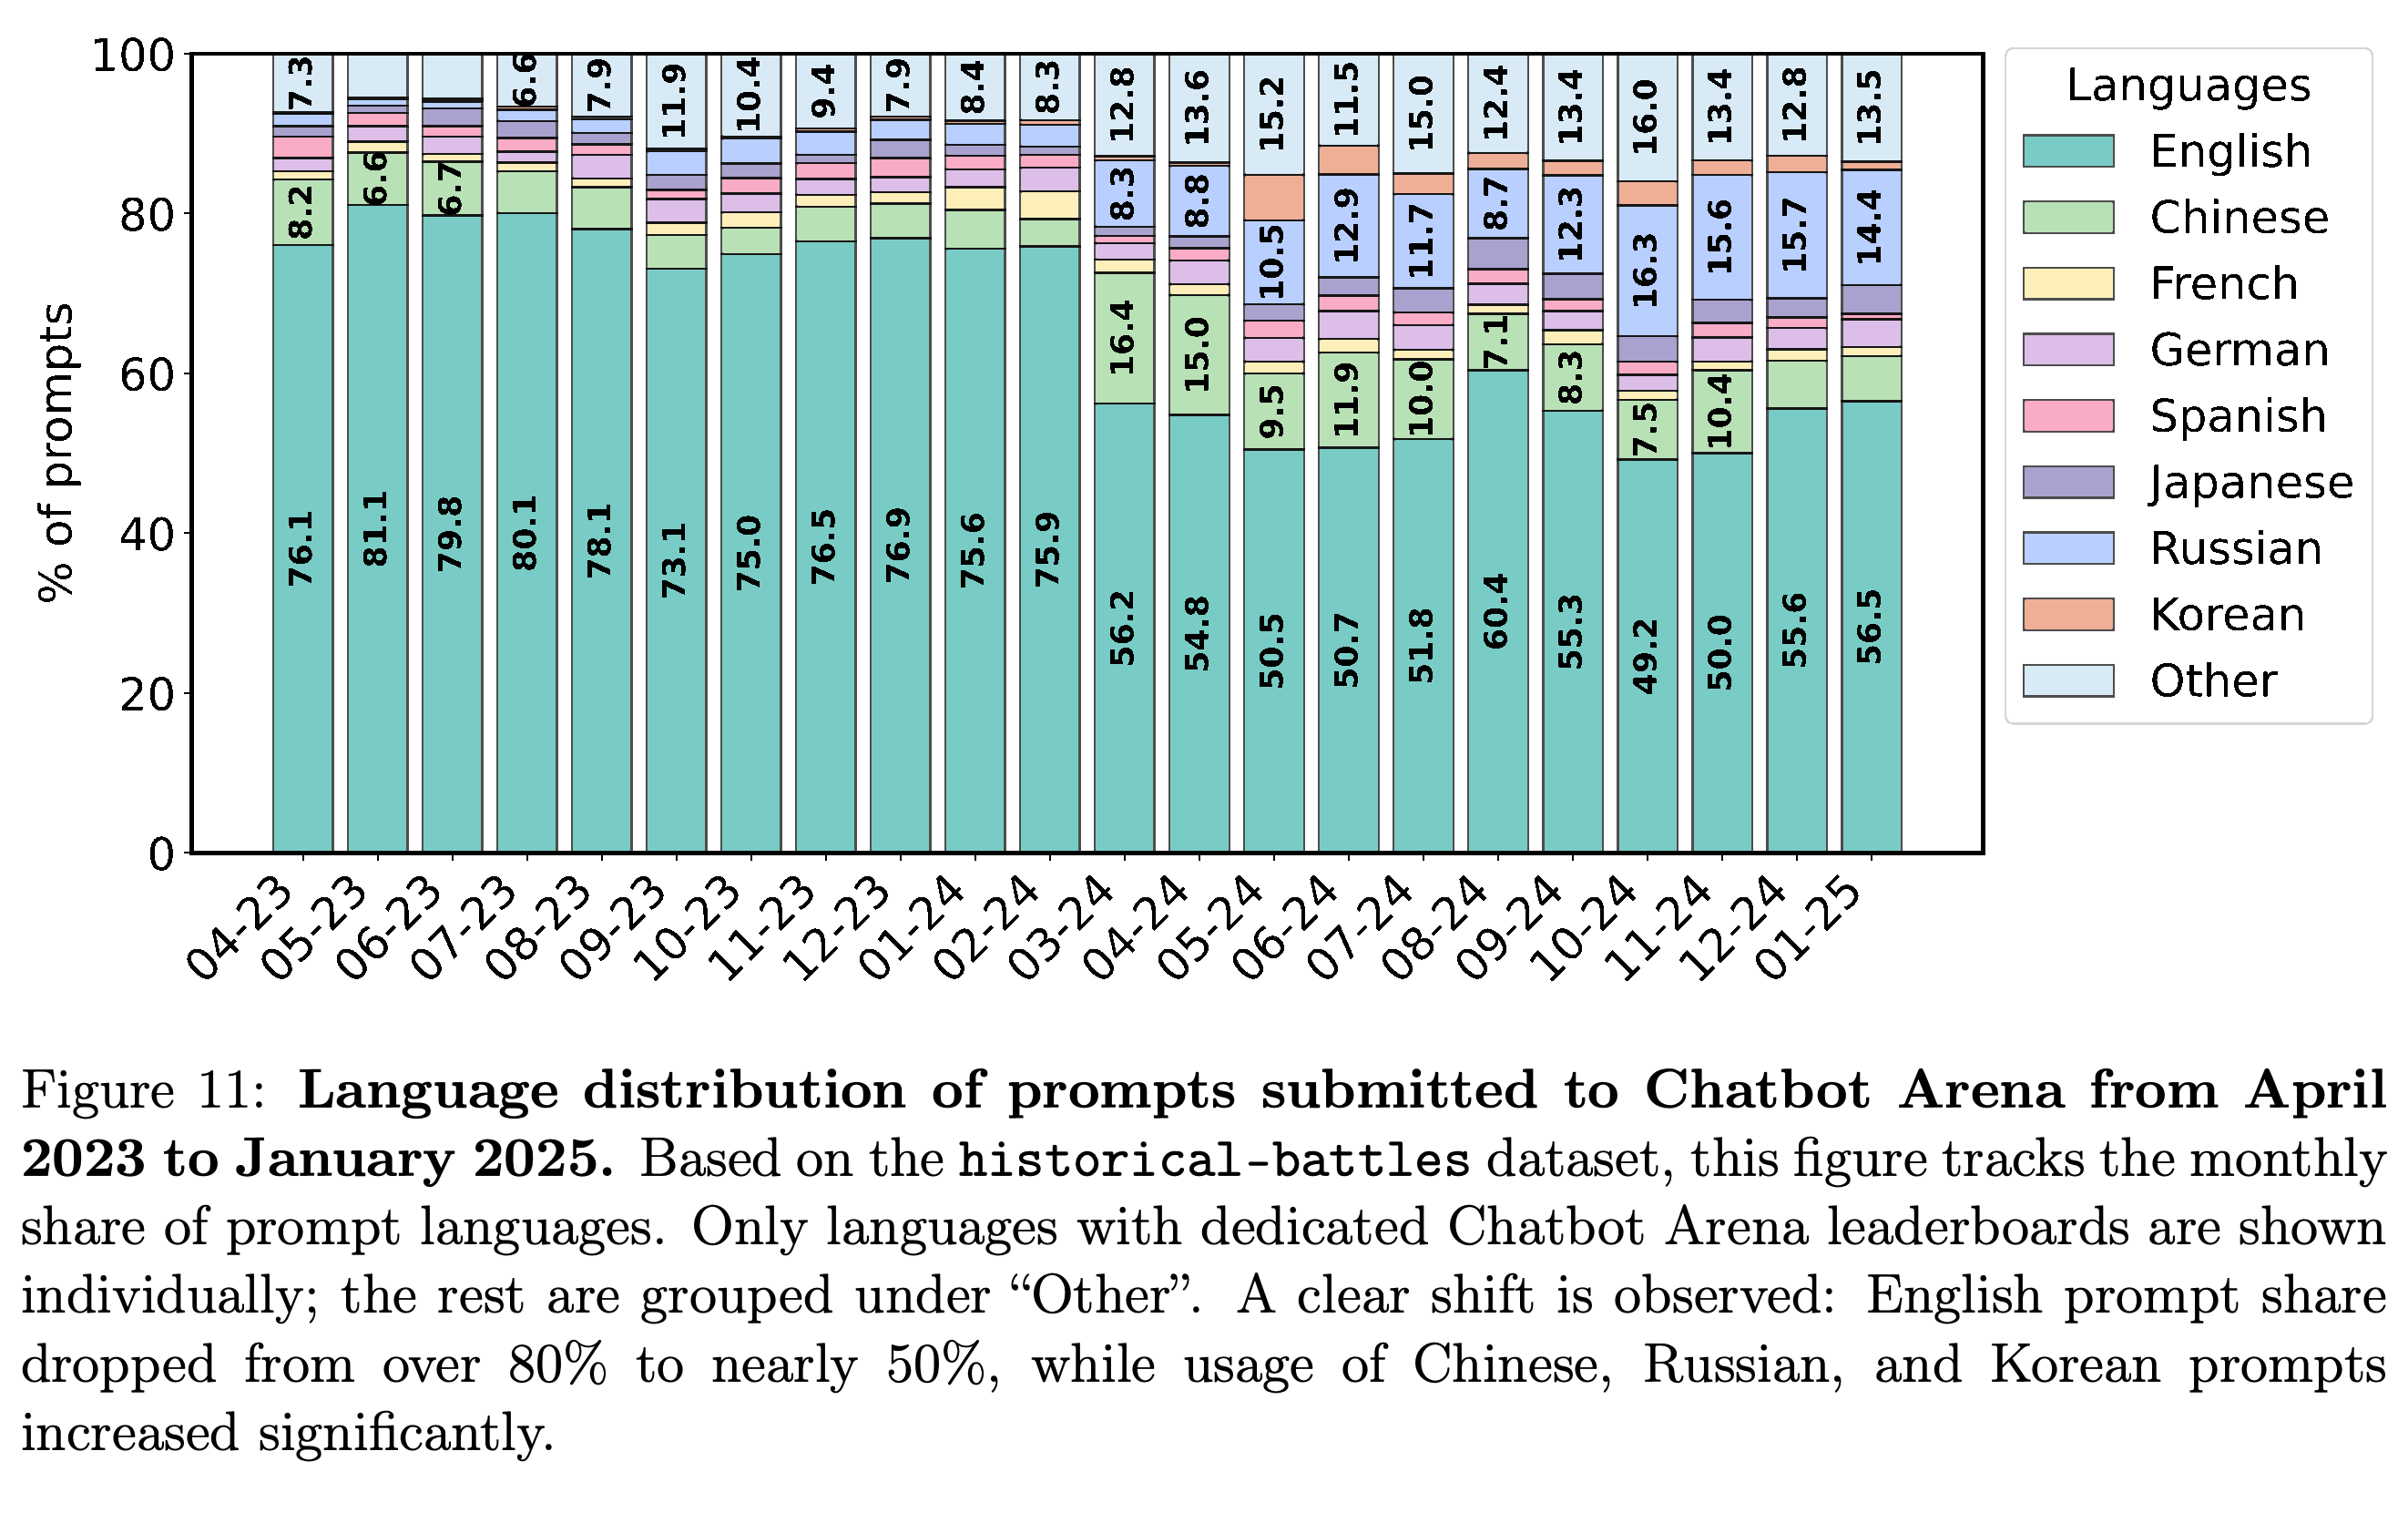
- 장기적으로 프롬프트 분포가 변한다. 비영어 프롬프트 비중은 2023년 4월 23.9%에서 2025년 1월 43.5%로 증가했다. 러시아어 프롬프트는 2024년 12월 15.7%에 도달했다. 중국어 프롬프트는 2024년 3월 16.4%로 정점을 기록한 뒤 2025년 1월 6.2%로 감소했다.
- 모델의 상대적 강점은 언어와 과제 구성에 따라 달라질 수 있으므로 이러한 변화가 중요하다.
- 분석은 공개 기록과 Cohere 관련 비공개 배틀 기록을 결합한다. 플랫폼 전체의 추세를 해석할 때는 이러한 표본 구성을 고려해야 한다.
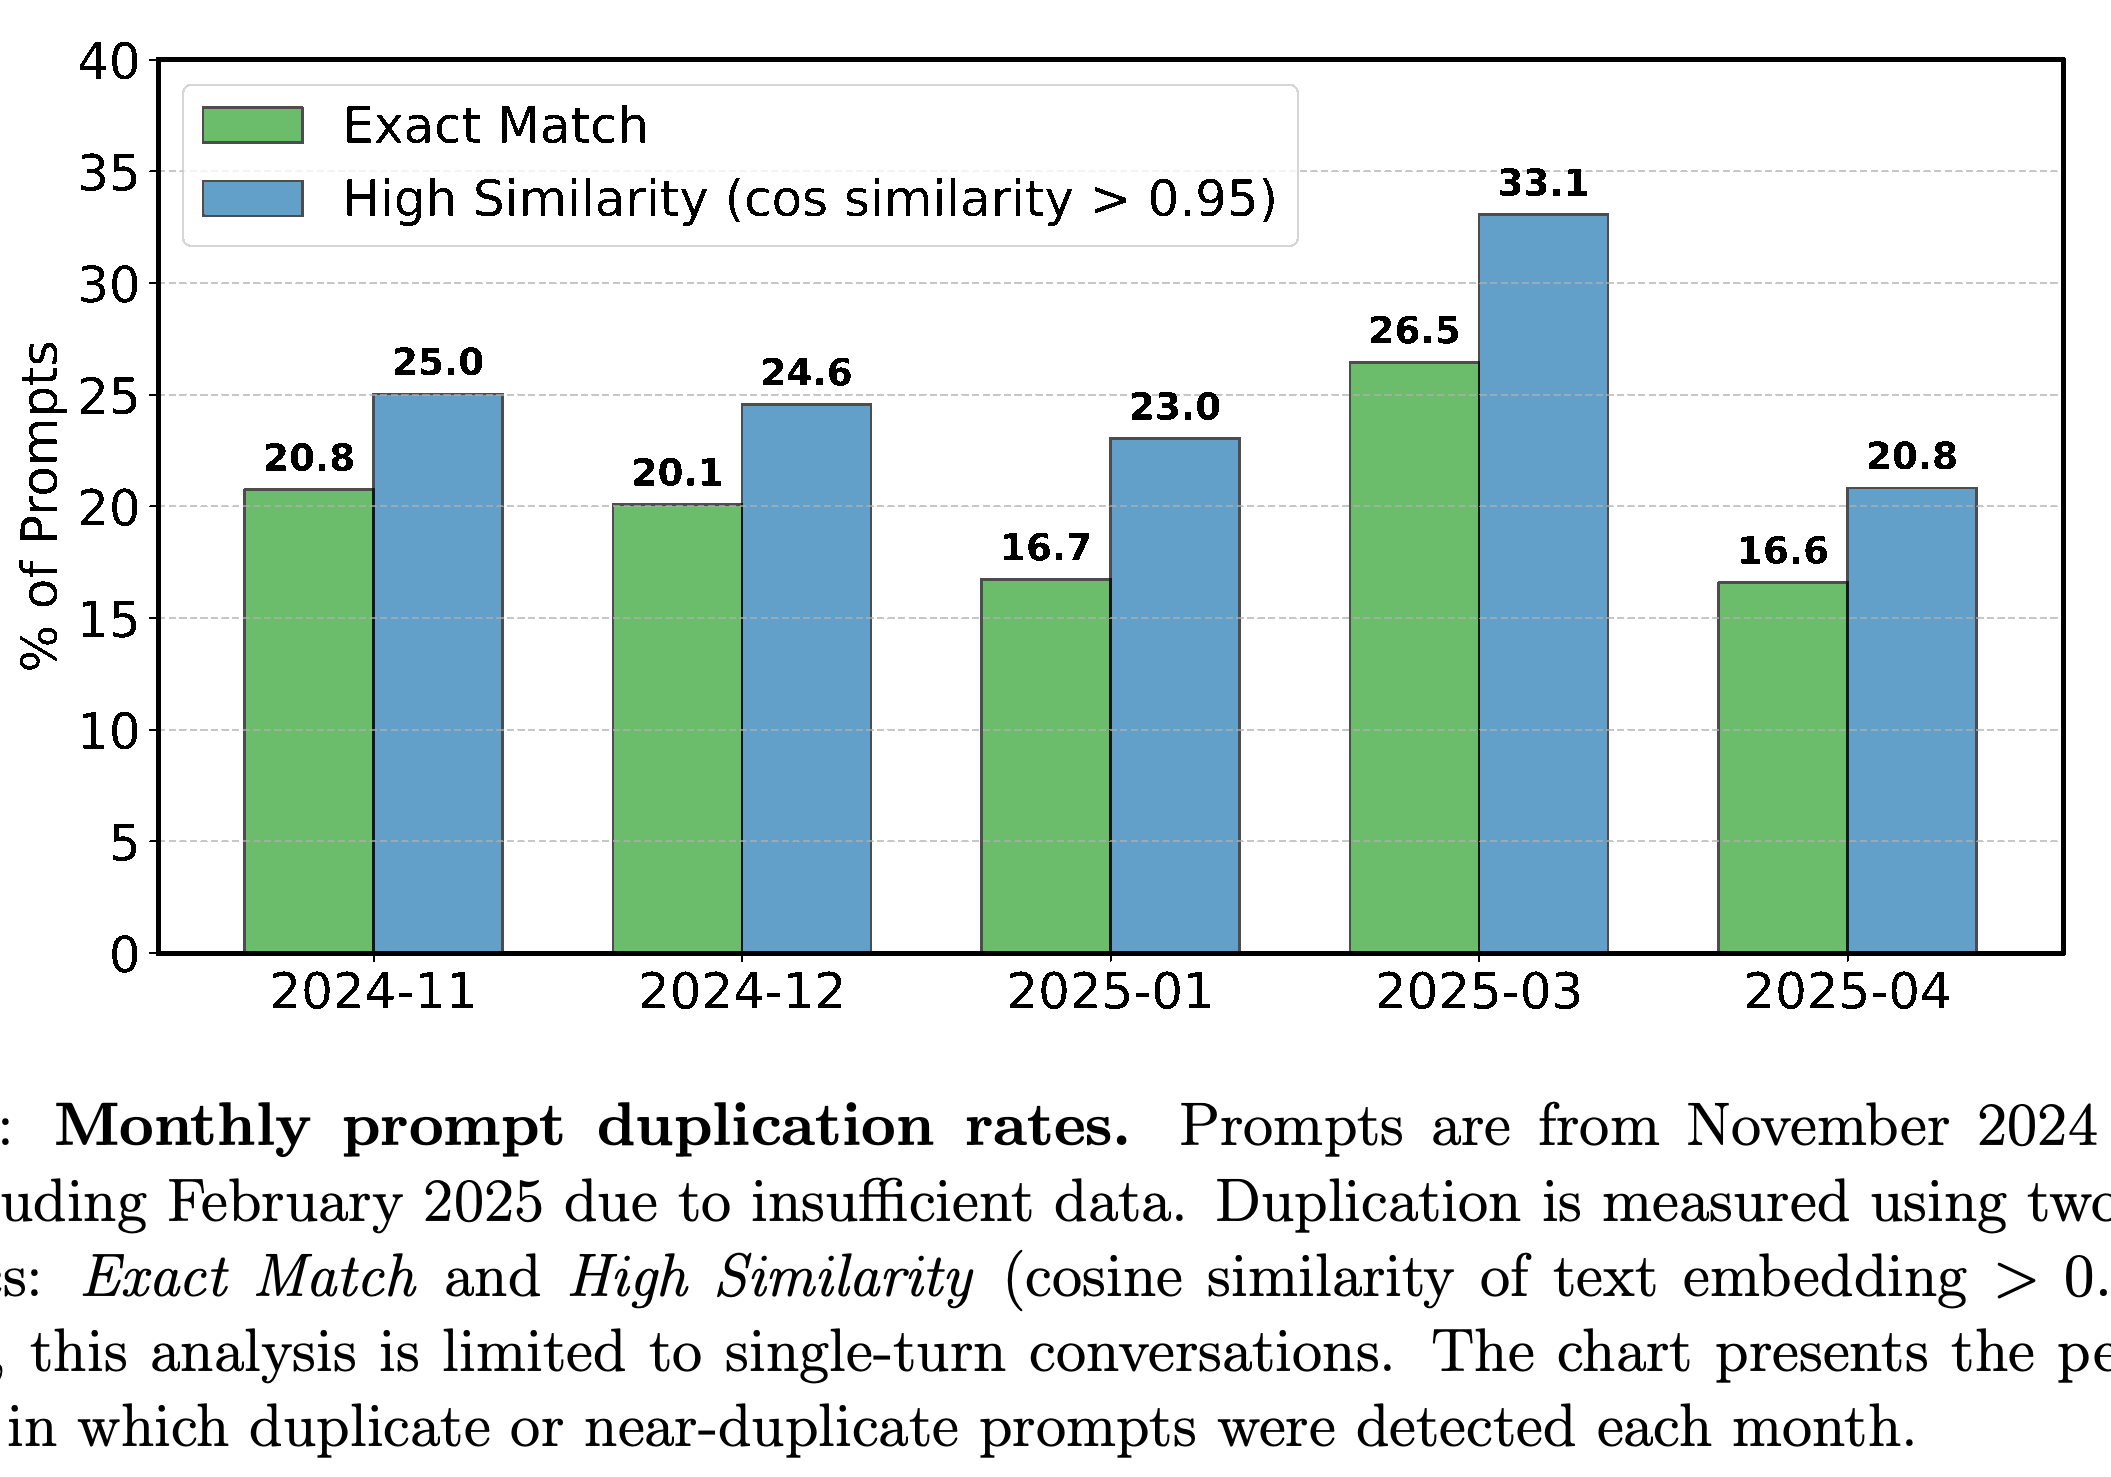
- 프롬프트의 반복과 중복이 나타난다. 단일 턴 API 대화 197,217개에서 월평균 완전 중복 제거율은 20.14%였으며, 2025년 3월에 최고 26.5%를 기록했다. 유사 중복 탐지에는 텍스트를 수치로 표현하는 embed-multilingual-v3.0 텍스트 임베딩을 사용한다. 표현 간 유사성 기준은 cosine similarity > 0.95이며, 이 기준에 따른 월별 비율은 33.1%에 도달했다. 텍스트 임베딩에 대해서는 Gemini Embedding: Generalizable Embeddings from Gemini 요약 설명 글을 참조하라.
- 2025년 2월은 가용 데이터가 부족해 제외했다.
- 논문은 2024년 12월과 2025년 1월을 비교했을 때 완전 일치 중복이 7.3%, 의미적으로 유사한 중복이 약 9%였다고 보고한다.
- 저자들은 프롬프트 길이 제한이 12000자라는 보고도 확인했으며, 개발자 중심의 사용자층이 Arena에 나타나는 주제를 편향시킬 수 있다고 제안한다.
학습 실험은 Cohere Command 계열에 사용하는 7B, 즉 매개변수 규모가 7B인 기반 모델을 미세 조정한다. arena-mix 데이터 비중은 0%, 30%, 70%로 설정하고, 나머지는 지시 이행, 다국어, 수학, 코드 예제로 구성된 독점 데이터 모음인 other-sft-mix로 채운다. 모든 변형은 제공된 응답 예제로 학습하는 지도 미세 조정을 배치 크기 128로 1.3K스텝 수행한다.
- 평가에는 영어 ArenaHard 프롬프트 500개를 사용하며, 비교 모델은 Llama-3.1-8B-Instruct, 자동 응답 평가자는 gpt-4o-2024-11-20이다.
- 0_arena, 30_arena, 70_arena의 승률은 각각 23.5%, 42.7%, 49.9%다. 논문은 0_arena 대비 상대적 개선율을 81.7%와 112.3%로 보고한다.
- 0_arena 자체를 상대로는 30%와 70% 혼합 모델이 각각 71.4%와 79.2%의 승률을 기록한다.
- 별도의 평가 분포로 사용하는 Massive Multitask Language Understanding 벤치마크인 MMLU에서 정확도는 각각 66.5%, 64.4%, 65.9%다. 이 결과는 추가 벤치마크에서 개선이 없었음을 보여주지만, 일반 능력을 포괄적으로 설명하지는 않는다.
학습 스텝과 배치 크기를 고정했을 때 Arena 데이터 비중을 늘리면 비교 대상 2개인 0_arena와 Llama-3.1-8B-Instruct 모두에 대한 승률이 오른다. 후자를 상대로 한 승률은 23.5%에서 42.7%를 거쳐 49.9%로 높아지며, 실험에서 조작한 요인은 학습 데이터 혼합 구성이다.
언어 비중의 변화는 서로 다른 시점에 평가된 모델이 다른 프롬프트 구성을 접한다는 점을 보여준다. 이는 상대적 강점이 언어에 따라 달라지는 오래된 모델을 계속 평가할 필요성을 뒷받침한다. 다만 공개 자료와 제공자별 자료를 결합한 표본이므로 플랫폼 전체로 해석하는 데는 한계가 있다.
표시된 월별 완전 중복률은 16.6%에서 26.5%, 높은 유사도 비율은 20.8%에서 33.1%다. 이 제공자 측 표본의 반복은 벤치마크에 새로운 사용자 제출이 들어오더라도 분포에 특화된 적응이 가능함을 뒷받침한다.
5 Results: Impact of Model Deprecation on Arena Scores
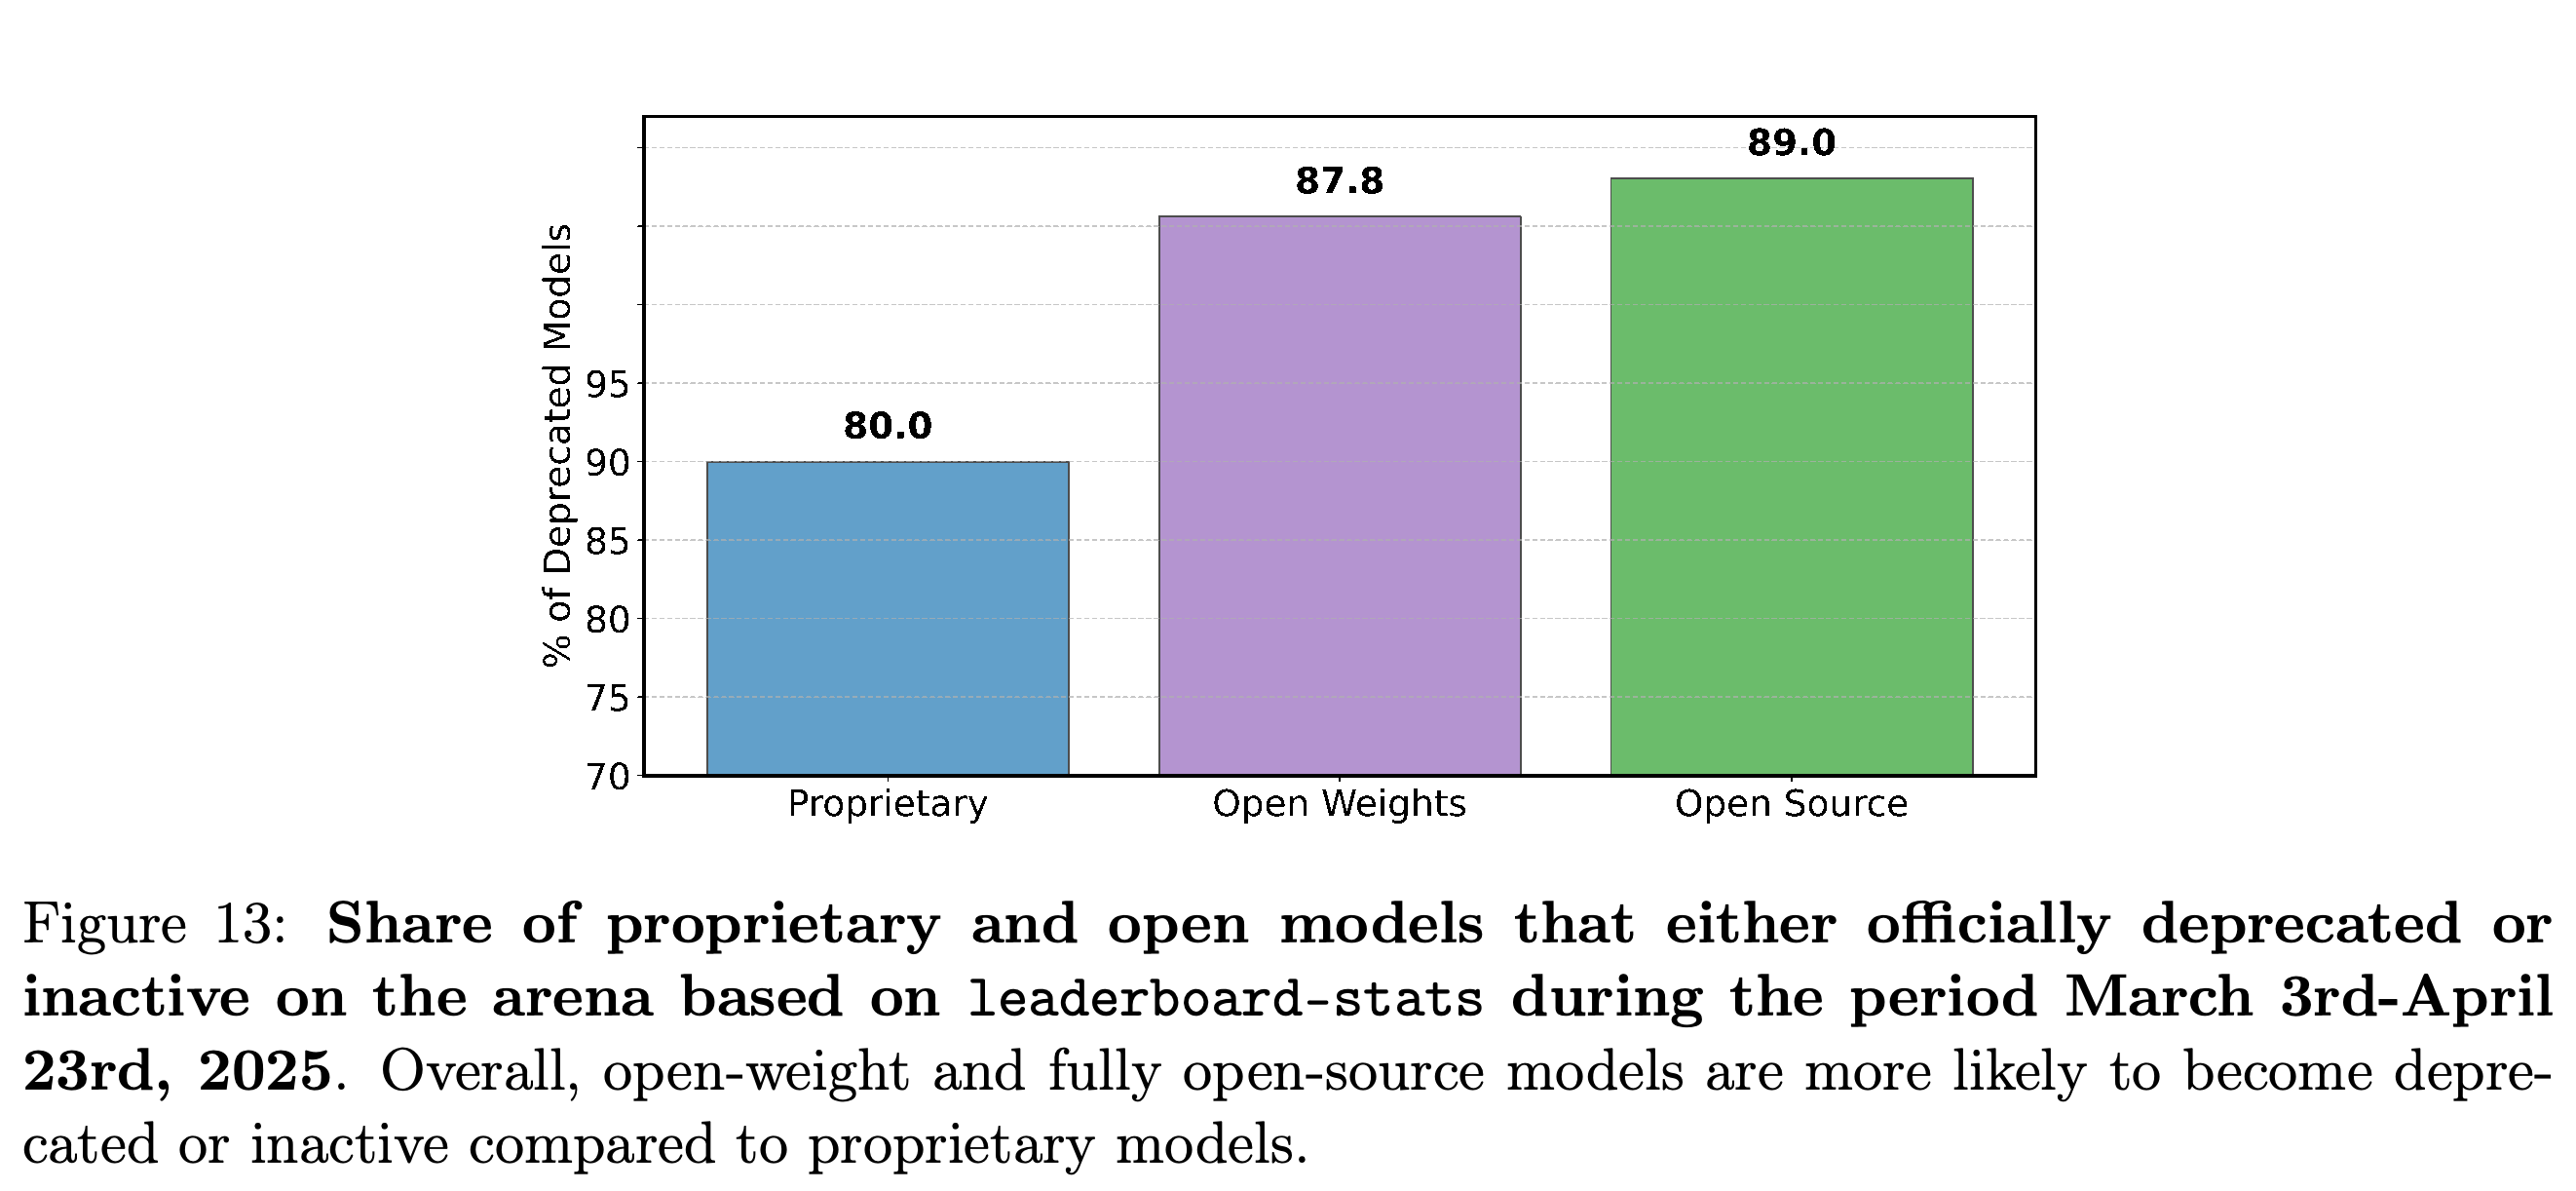
논문은 2025년 3월 3일부터 4월 23일까지 독점 모델의 80%, open-weight 모델의 87.8%, open-source 모델의 89%가 공식적으로 평가가 중단됐거나 비활성 상태였다고 보고한다. 이어서 과제가 변한 뒤에도 남아 있는 오래된 비교와 모델 집단 사이의 부족한 연결이라는 2가지 잠재적 순위 문제를 분석한다.
- 비활성 상태는 내부 평가 중단 결정에 직접 접근해 확인한 것이 아니라 배틀 수의 변화로 추론한다.
- 실험은 가능한 실패 메커니즘을 보여준다. 실제 Arena 순위에서 발생한 오차를 측정하지는 않는다.
표시된 평가 중단 또는 비활성 비율은 독점 모델 80.0%, open-weight 모델 87.8%, open-source 모델 89.0%다. 이는 각 범주 내부의 비율이며, 통보 없이 제거된 모델 중 공개 모델이 64%를 차지한다는 별도 주장과는 다르다.
5.1 Transitivity Under Changing Evaluation Conditions
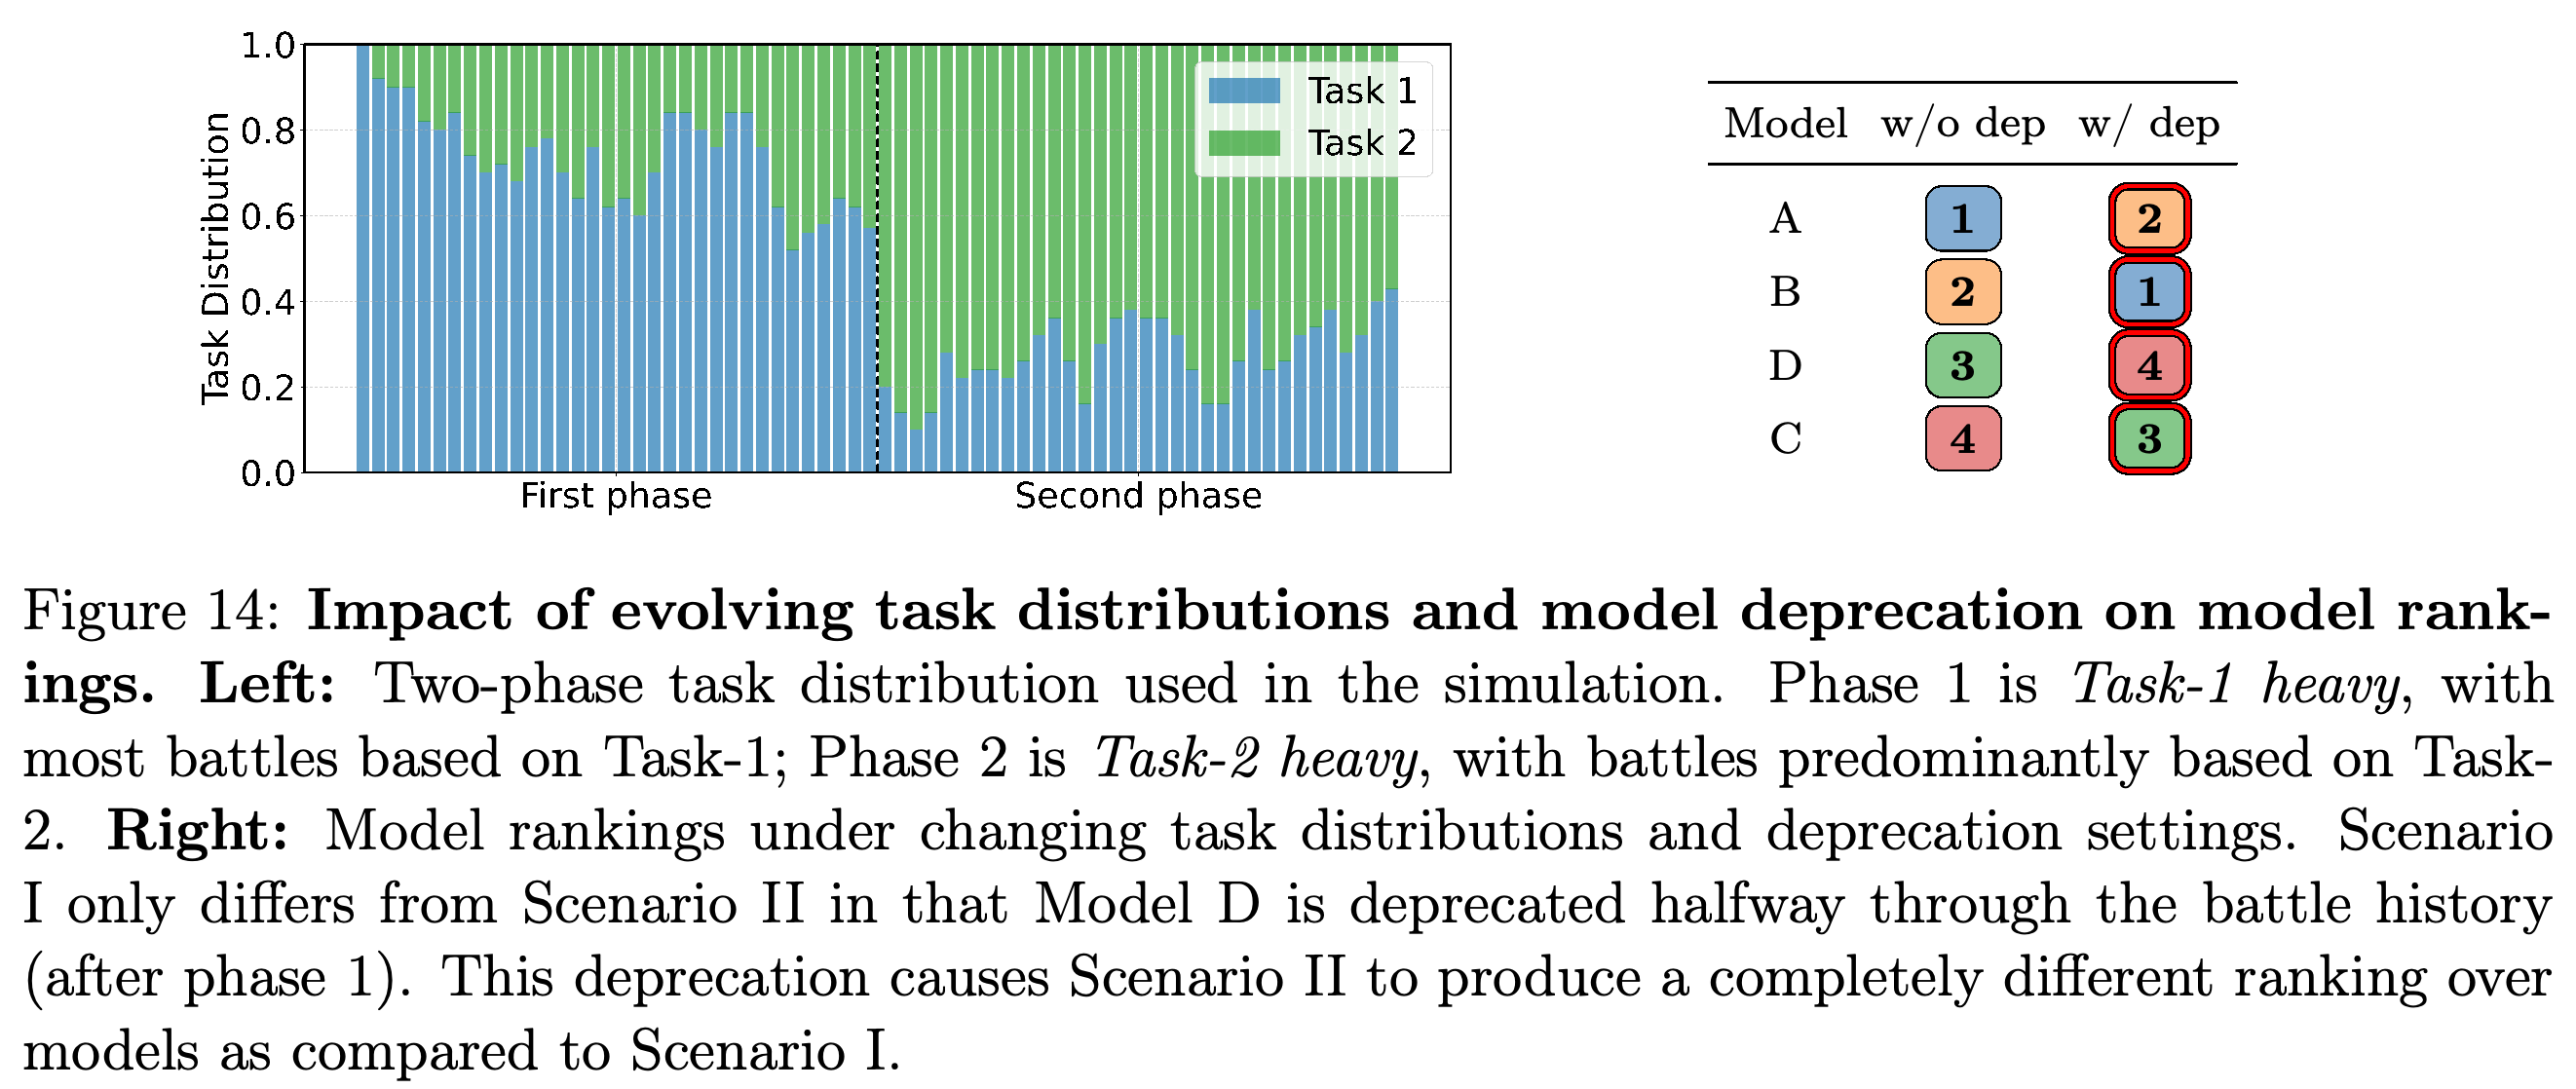
모델 4개를 사용한 시뮬레이션은 2단계에 걸쳐 과제 구성을 바꾸고, 모델 D가 계속 참여하는 경우와 1단계 후 평가가 중단되는 경우를 비교한다. 실험은 모의 배틀 2000건과 Arena의 FastChat 점수 계산 구현을 사용한다.
- 과제별 강점은 크게 다르다. 모델 B가 D를 이길 확률은 Task-1에서 0.9, Task-2에서 0.2다.
- 평가 중단이 없으면 표시된 순서는 A, B, D, C다. D의 평가를 중단하면 B, A, C, D로 바뀐다.
- 이 결과는 모델 1개가 주로 과거 조건에서 평가된 상태로 남으면 계속 활동하는 모델들의 추정 순서도 달라질 수 있음을 보여준다.
과제 구성이 다른 2단계 사이에서 D를 제거하면 표시된 모든 순위가 바뀐다. A와 D는 내려가고 B와 C는 올라간다. 이 시뮬레이션은 평가 중단이 공유된 비교 이력을 통해 계속 활동하는 모델에도 영향을 줄 수 있음을 보여준다.
5.2 Sparse Battle History Risks
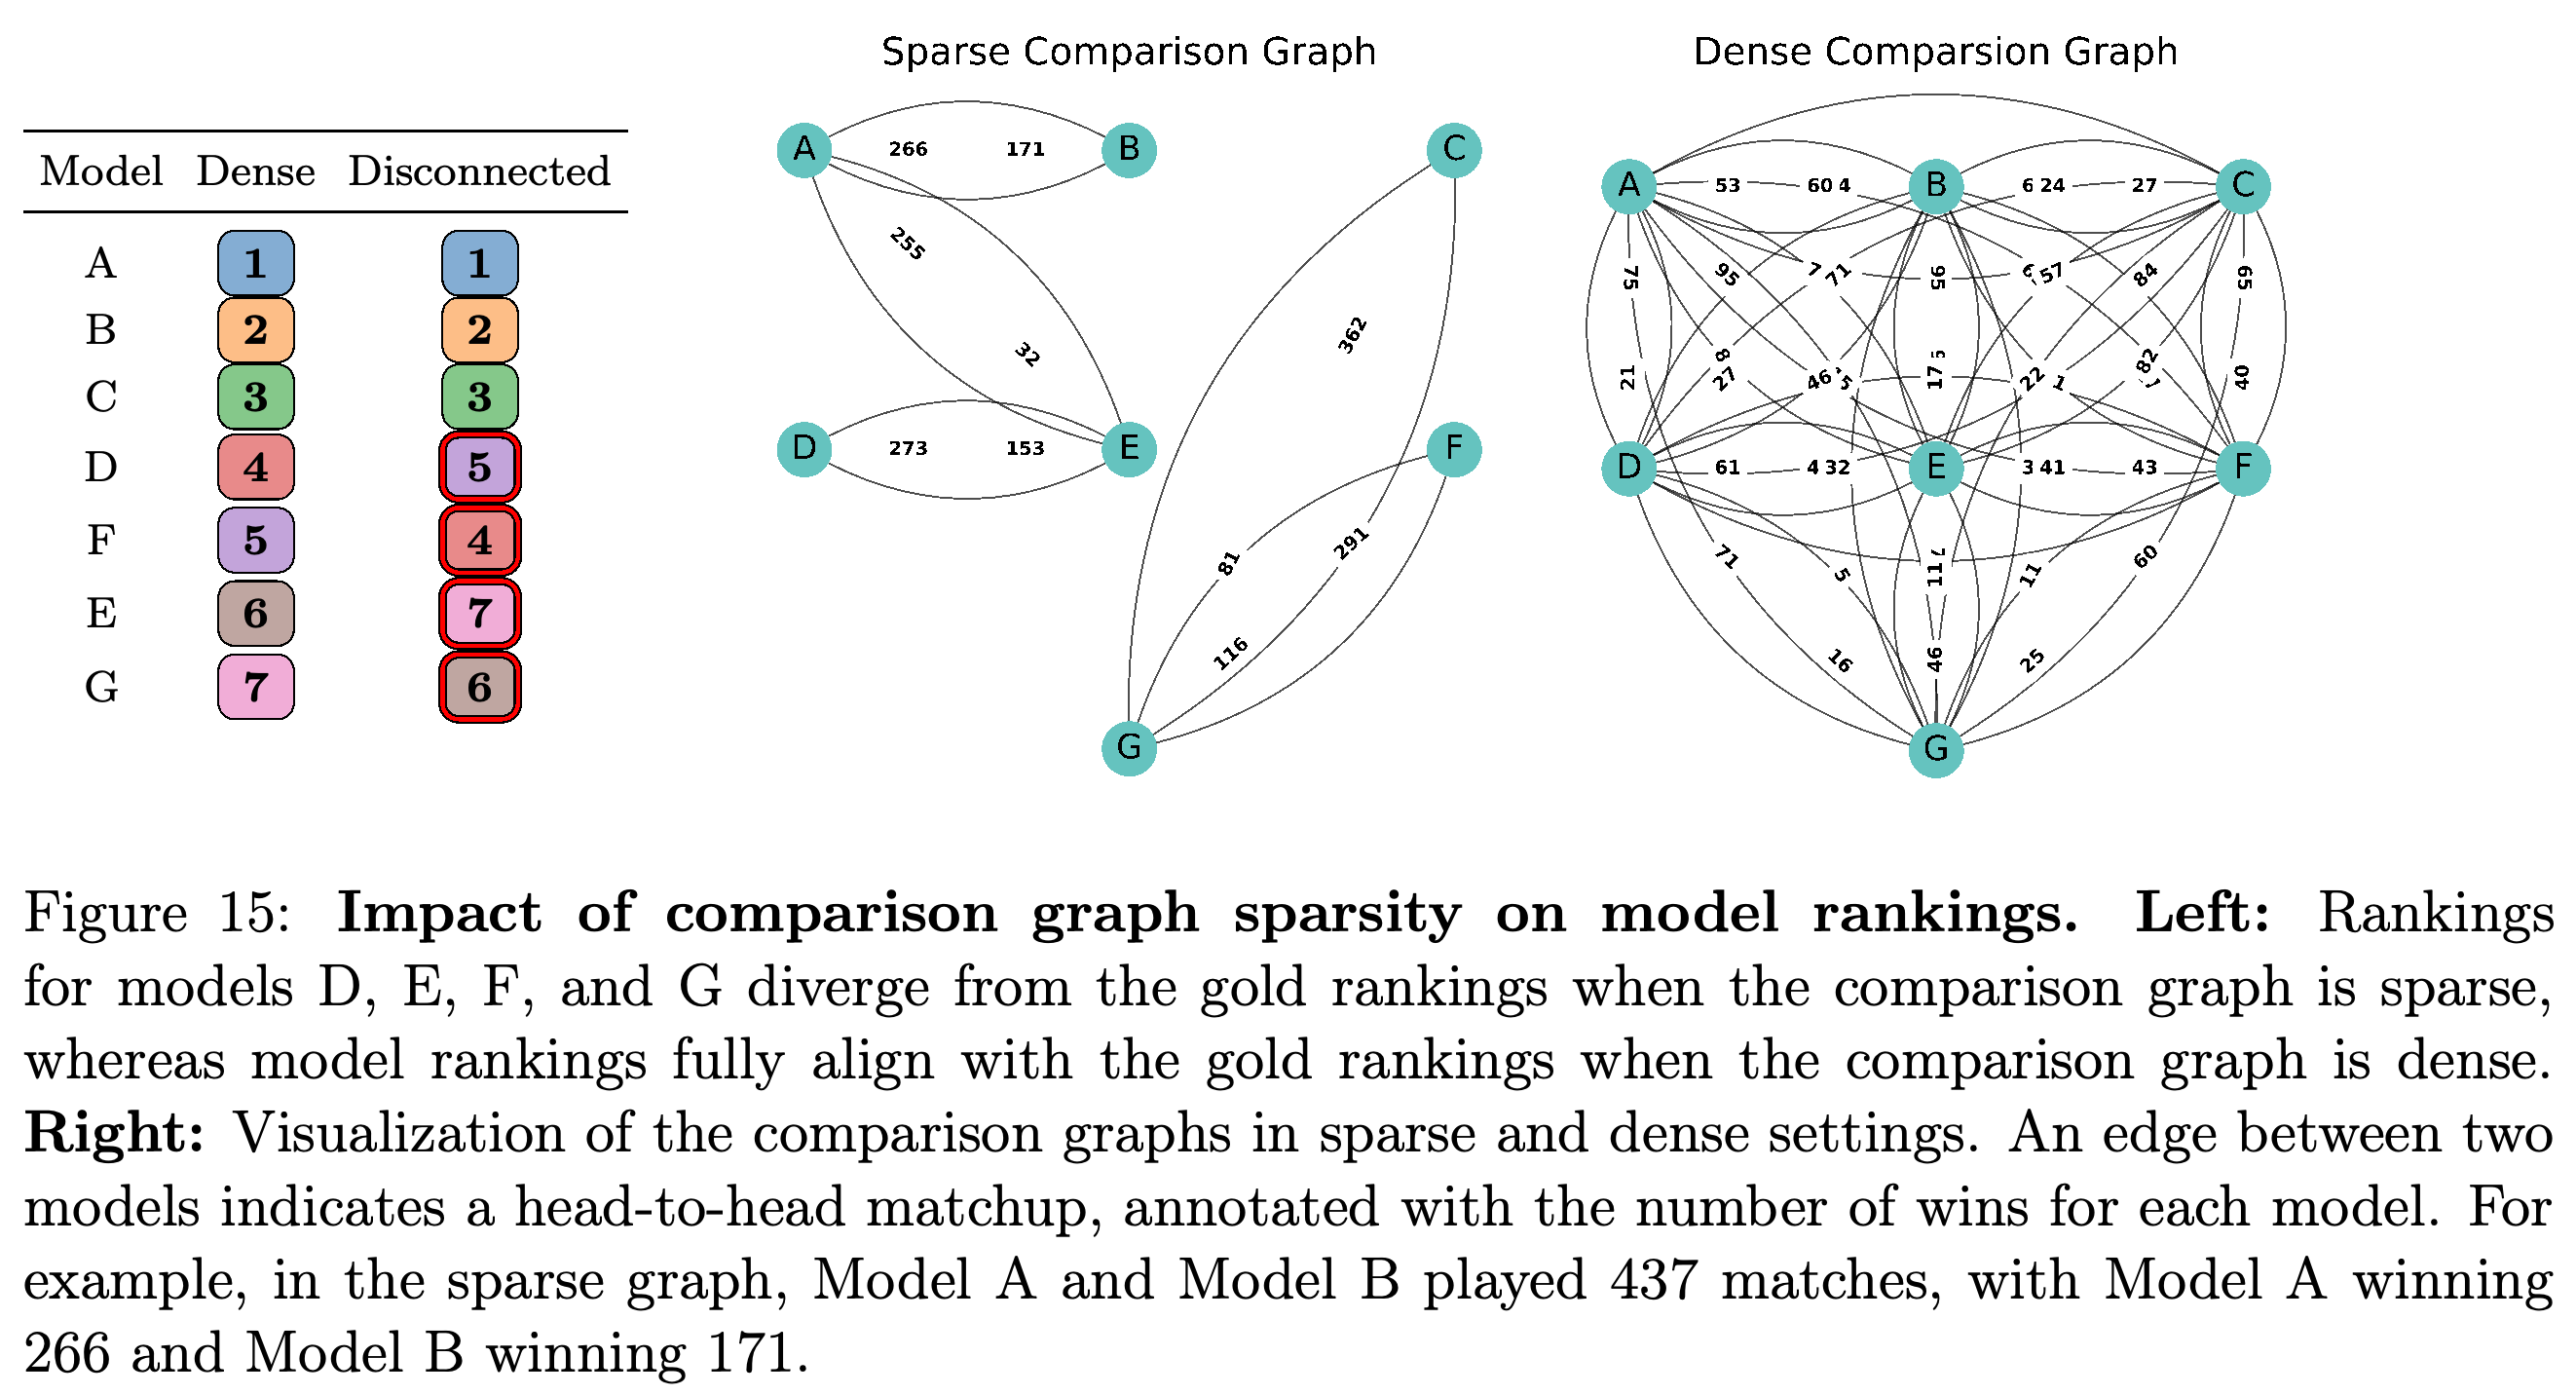
희소한 비교 이력 실험은 모델을 노드로, 기록된 쌍대 비교 결과를 연결로 나타낸 그래프에서 조밀한 경우와 단절된 경우를 비교한다. 설정 2개 모두 모델 7개 사이의 배틀 2000건을 포함하며 무승부는 없다. A부터 G까지 부여한 실력은 1450, 1390, 1250, 1200, 1101, 1150, 1000이다.
- 조밀한 비교는 제시된 실력 순서를 복원하지만, 단절된 비교에서는 D, E, F, G의 위치가 바뀐다.
- 관측 결과에 실력을 적합하는 BT 최대우도 해가 유일하고 유한하려면 더 강한 연결 조건이 필요하다고 논문은 설명한다. 모든 분할에서 각 방향으로 경계를 넘는 관측 승리가 최소 1건씩 있어야 한다. 쌍대 비교 결과만으로는 실력의 절대 척도를 식별할 수 없으므로 공통 정규화도 필요하다.
- 연결이 없으면 신뢰할 만한 전체 비교가 어려울 수 있다. 논문은 실제 과거 Arena 그래프가 시뮬레이션과 같은 단절 구조를 가진다고 보여주지는 않는다.
전체 배틀 수를 2000건으로 고정해도 맞붙을 수 있는 쌍을 제한하면 조밀한 설정에 비해 하위 순위 4곳이 달라진다. 이 예시는 단절된 집단 내부에서 수집한 결과만으로 신뢰할 만한 전체 순서를 식별할 수 없는 이유를 보여준다.
6 Recommendations and Guidelines for Improving Leaderboards
권고안은 감사에서 확인한 메커니즘에 대응한다. 제출된 모든 점수를 영구 공개하고, 비공개 변형 수를 공개하고 제한하며, 감사 가능한 평가 중단 규칙을 정의하고, 순위 불확실성을 줄이도록 샘플링하며, 테스트 및 활동 기록을 공개할 것을 제안한다.
- 서론의 권고안은 제공자별 동시 비공개 변형의 상한을 3개로 제시하지만, 이는 실험으로 최적화한 한도가 아니라 예시다.
- 평가 중단 제안은 순위가 수렴한 뒤 가용성과 성능을 고려해 라이선스 범주별 30번째 백분위수 미만의 모델을 제거한다. 효과는 실험으로 평가하지 않았다.
- 제안된 능동 샘플링 규칙은 예상 정보 이득에 따라 비교 대상을 선택한다. 승률 신뢰구간의 감소량을 추정해 평가가 부족하고 불확실성이 높은 모델 쌍을 우선한다.
- 투명성 방안으로 테스트한 변형, 상대 모델, 샘플링 빈도, 더 이상 정기적으로 샘플링하지 않는 모델을 분기별 등의 주기로 보고할 것을 제안한다.
7 Limitations
저자들은 포괄적인 Arena 원시 데이터에 접근하지 못하며, 공개된 일부 기록은 이미 중복 제거 또는 의심스러운 투표 필터링을 거쳤다. 제공자 측 기록도 트래픽 일부만 포함하므로, 순위 조작을 목적으로 의도적으로 투표하는 적대적 투표는 조사하지 않는다.
- 비공개 모델 관찰은 Llama 4 출시를 앞둔 시기와 겹치는 2025년 1월부터 3월까지다. 출시 일정이 다른 제공자의 모델 수는 과소 집계됐을 수 있다.
- 익명 모델의 소유자는 자기소개 응답으로 추정하므로 틀리거나 모호할 수 있다.
- 저자들은 일부 제공자가 더 많은 데이터를 보유할 수 있다는 점에서 학습 실험을 보수적이라고 설명한다. 추가 데이터로 더 큰 이득을 얻을 수 있다는 것은 가능성이며 측정된 결과는 아니다.
8 Related Work
관련 연구 논의는 이 감사를 벤치마크 타당성과 인간 선호 평가 연구의 맥락에서 설명한다. 실시간 사용자 판단의 유용성과 인센티브, 데이터 품질, 재현성, 조작에 대한 우려를 구분한다.
8.1 Meta-studies on the Rigor of Benchmarking in AI
논문은 벤치마크가 연구 인센티브를 형성하며 여러 문제를 겪을 수 있다는 근거를 검토한다. 여기에는 학습 중 평가 예제에 노출되는 학습 데이터 오염, 일관되지 않은 과제 정의, 라벨 오류, 점수가 높아져 추가 진전을 구분할 여지가 줄어드는 포화가 포함된다. 이 논문의 기여는 사용자가 계속 새 프롬프트를 제공하더라도 실시간 리더보드의 운영 정책이 유사한 문제를 일으킬 수 있는 경로를 살펴본 데 있다.
- 벤치마크 과제가 관련 환경이나 능력을 빠뜨리면 높은 점수가 실제 배포 환경의 유용성을 나타내지 않을 수 있다는 점도 강조한다.
8.2 Human Voting-based Benchmarks
사람의 투표는 응답의 논리적 일관성, 가독성, 무해성에 대한 선호를 포착하고 모델 학습에 유용한 피드백을 제공한다. 실시간 플랫폼은 변화하는 사용 방식에 적응할 수 있으며, 자동 평가자에는 고유한 강건성 및 편향 문제가 따른다.
- 논문은 의심스러운 사용자 탐지, 봇 방어, 투표 제한, 중복 제거 등 Arena의 보호 장치를 인정한다.
- 표적 투표 공격에 관한 선행 연구가 배경을 제공하지만, 이 논문이 살펴보는 대상은 제공자의 테스트와 운영 정책이며 적대적 투표에 대한 감사는 수행하지 않는다.
9 Conclusion
결론은 신뢰할 만한 공개 비교를 위해 통계적 점수 모델과 함께 후보 선택, 데이터 노출, 샘플링, 평가 중단에 대한 투명성이 필요하다고 주장한다. 커뮤니티 자원을 구축한 운영진의 노력을 인정하면서, 참여의 이익이 소수 제공자에게 집중되지 않도록 정책을 바꿀 것을 촉구한다.
부록
- A Chatbot Arena Background는 플랫폼을 만든 연구 협력체 LMSYS 아래에서 2023년 5월 서비스를 출시한 과정, 이후 LMArena로 발전한 과정, 사용자 선호로 평점을 계산하는 방식을 설명한다. B Bradley-Terry Rating Model은 로지스틱 쌍대 선호 공식, 예측 확률과 관측 결과를 비교하는 손실인 이진 교차 엔트로피를 통한 최대우도 적합, 점수 척도 변환, 순위에서 불확실성이 하는 역할을 제시한다.
- C Unbiased Sampling: Why Selecting the Maximum Introduces Bias?는 독립 동일 분포 표본에서 최댓값이 x를 넘지 않을 확률인 누적분포를 F(x)^N으로 유도한다. 분포의 기댓값이 유한하고 분산이 0이 아니며 N ≥ 2이면 최댓값의 기댓값이 표본 1개의 기댓값보다 크다는 것을 증명한다. 이는 일반적인 표본에 비해 유리한 결과를 선택하게 됨을 보인다. 서로 다른 체크포인트에서는 상승분 전체를 추정 오차로 해석하면 실제 후보 차이와 측정 잡음을 혼동하게 된다.
- D Data sources와 D.1 Public and Private Battles는 historical-battles, API prompts, leaderboard-stats, scraped-random-sample을 상세히 설명한다. API 수집 자료는 필터링 전 567,319개 항목이며, 필터링 후 단일 턴 대화 197,217개가 남는다. 비공개 과거 기록 하위 집합에는 Command와 Aya 모델이 참여한 배틀 43,729건이 있고, 메인 수집 자료에는 배틀 5864건이 있다.
- E Our Scraping Methodology of LMArena Statistics와 E.1 De-anonymizing Model Identities는 Chrome 드라이버와 함께 사용하는 브라우저 자동화 라이브러리 Selenium, 정체를 묻는 질문, 무승부를 유도하기 위한 후속 질문을 설명한다. 2025년 3월 9일부터 28일까지 vision 관찰 자료 약 500건도 추가로 수집했다. 자기소개 응답은 제공자 추정을 뒷받침하지만 체크포인트 소유자를 독립적으로 검증하지는 않는다.
- E.2 Encountered Private Models in Scraping은 전체 및 vision 리더보드의 비공개 별칭을 나열하며, Meta의 전체 리더보드 변형 27개와 추가 vision 변형 16개를 포함한다. E.3 Encountered Public Models in Scraping은 관찰된 공개 모델을 나열하고 Google 15개, OpenAI 9개를 보고한다. 이 관측 활성 모델 수는 누적 공개 리더보드 모델 수와 집계 범위가 다르다.
- E.4 Assignment of Private Variants to Providers는 정체를 드러낸 응답 수와 예시를 기록하며, 소수 응답만으로 추정한 변형도 포함한다. p2l 및 experimental-router 접두사가 붙은 모델은 응답에서 원래 모델 제공자를 언급하더라도 LMArena의 모델 라우팅 연구 프로젝트인 Prompt-to-Leaderboard에 배정한다. E.5 Sampling Rates는 수집 표본이 최소 100개인 날짜로 일별 최대치 계산을 제한하며, Google의 enigma는 34.21%, gpt-4.5-preview-2025-02-27은 34.0%로 기록한다.
- F License Categories는 보고된 라이선스 라벨을 Proprietary, Open-Weights, Open-Source로 분류한다. G Data Access Estimation for Different Providers는 배틀마다 모델 2개를 사용하므로 약 3M표를 약 6M건의 모델 API 호출로 환산한다. Figure 4에서 선택된 제공자들은 약 5M건의 호출을 차지하며, 각 정사각형은 대략 5K건의 호출을 나타낸다.
- H Analysis of Prompt Repetitions in Arena Data는 완전 일치와 임베딩 유사도에 대한 월내 및 월간 행렬을 제공한다. 2025년 3월 대각선 값은 완전 일치에서 0.265, 높은 유사도에서 0.331에 도달한다. 이는 제공자 측 표본 내부의 반복을 보여주며, 월간 중복은 더 낮지만 0은 아니다.
- I Simulation for Expected Lift from Private Testing과 I.1 Background는 적합으로 구한 로그 실력 매개변수를 Arena Score = 1000 + (400/ln 10)β̂로 변환한다. 여기서 β̂는 추정 로그 실력이며 ln은 자연로그다. 부록은 실력이 같은 모델의 독립 비교에서 표본 변동성을 추정하는 표준오차가 n표에 대해 Arena 척도상 약 347.4/√n이라고 구하고, 동일한 후보 모델과 서로 다른 후보 모델을 구분한다.
- I.2 Identical Variants (σtrue = 0), I.2.1 Extreme-value uplift, Asymptotics는 선택된 점수의 상승분을 전부 측정 잡음으로 설명하며, 이 잡음은 투표 수가 늘수록 감소한다. 여기서 σtrue는 실제 체크포인트 실력의 산포를 나타낸다. 수치 예시는 n = 3000과 후보 50개를 사용해 약 17.7 Arena점을 보고한다. 제시된 σnoise√(2 ln N) 식에서 σnoise는 측정 잡음의 표준편차다. 이 식은 극값의 선도항 근사이지만 Equation (6)은 이를 등식으로 제시한다.
- I.3 Heterogeneous Variants (σtrue > 0), I.3.1 Extreme-value uplift, Key consequences.는 측정 잡음에 실제 체크포인트 간 변동을 더한다. 부록은 σtrue = 20, N = 50, n = 3000에서 약 56점을 보고하며, n이 증가해도 선택 이점이 남는다고 설명한다. 남는 이점은 후보 모델군 평균에 대한 이점이며 실제로 더 강한 체크포인트를 고르는 효과를 포함한다. J A. Fisher Information for a Single BT Match는 실력이 같은 모델 간 비교에서 결과 1개가 상대적 실력에 제공하는 정보량을 0.25로 유도한다.
- K Silent Model Deprecation: Additional Details는 2025년 3월 3일부터 4월 23일까지의 분석 기간에 평균 배틀 수가 10건 이하인 모델을 활동량이 낮은 모델로 식별하며, 243개 중 205개가 이에 해당한다고 보고한다. 부록의 그림은 공식 평가 중단과 통보 없는 평가 중단을 구분하지만, 본문의 여러 구절은 205개 전체를 통보 없이 평가가 중단된 모델로 부른다. 따라서 범주별 집계 설명은 일관되지 않다.
- L Transitivity Under Changing Evaluation Conditions: Additional Details는 Task-1과 Task-2의 쌍대 승리 확률을 제공한다. 여기에는 Task-1의 A 대 B 무승부율 0.1과 Task-2의 A 대 B 및 A 대 C 무승부율 0.2가 포함된다. M Overfitting Experiments: Additional Evaluations는 0_arena, 30_arena, 70_arena의 MMLU 정확도를 각각 66.5%, 64.4%, 65.9%로 보고한다.
짧은 생각
논문의 가장 명확한 근거는 통제된 비교에서 나온다. 중복된 실제 제출은 유리한 점수를 선택하는 데 활용할 수 있는 변동을 드러내며, 고정 예산 학습은 평가 분포에 대한 민감성을 보여준다. 관찰 기반 감사는 더 검증하기 쉬운 절차의 필요성을 뒷받침한다. 다만 불완전한 기록과 근사적인 소유자 추정 때문에 개별 제공자의 의도나 실제 순위 왜곡 규모에 대한 주장은 제한된다. 서로 다른 후보들에서 선택한 최댓값의 기댓값이 높아지는 데에는 실제로 더 강한 후보를 선택하는 이득도 포함된다. 공정성 문제는 그 선택 과정에 대한 접근 기회가 불균등하고 테스트 이력이 공개되지 않는다는 점이다. 평가 중단 시뮬레이션은 가능한 실패 양상을 입증하지만, 제안된 30번째 백분위수 규칙은 실험으로 검증되지 않았으며 실제 리더보드의 연결성도 측정하지 않았다. 비공개 테스트의 주요 수치 간 충돌, 평가 중단 집계, 유한한 N에서 극값 근사를 등식으로 제시한 부분 때문에 정확한 수치 주장을 재사용할 때는 주의가 필요하다.