


TinyGSM: achieving >80% on GSM8k with small language models 요약 설명
14 Dec 2023 | Paper Review Mathematical Reasoning Synthetic Training Data Reward Modeling목차
이번 글에서는 TinyGSM: achieving >80% on GSM8k with small language models 논문의 핵심 포인트만 간단히 정리한다.
- 2023년 12월 14일(Arxiv)
- Liu, Bingbin, Bubeck, Sebastien, Eldan, Ronen, Kulkarni, Janardhan, Li, Yuanzhi, Nguyen, Anh, Ward, Rachel, Zhang, Yi.
- Carnegie Mellon University, Microsoft Research
- 논문 링크
요약
- 이 논문은 소형 언어 모델이 수학적 추론과 언어 이해를 평가하는 GSM8K에서 여러 추론 단계가 필요한 초등 수학 문장제를 풀 수 있는지 살펴본다. 1.3B 파라미터의 생성기에 같은 크기의 별도 검증기를 결합하면, 문제당 Python 풀이 48개 중에서 답을 선택해 정확도 81.5%를 달성한다. 검증기는 후보 풀이가 정답인지 점수를 매기는 모델이다. 문제당 단일 Python 풀이를 생성할 때 생성기 단독 정확도는 68.2%, GPT-3.5-0613의 정확도는 77.4%다.
- TinyGSM은 합성 질문–Python 풀이 쌍 12.3M개로 구성되며, 총 1.8B 토큰을 포함한다. 토큰은 언어 모델이 처리하는 텍스트 단위이며, M과 B는 각각 million과 billion을 뜻한다. GPT-3.5-turbo는 GSM8K 훈련 질문과 무관한 정보를 포함한 변형 질문을 바탕으로 이 데이터를 생성한다. 기존 모델을 과제별 예제로 추가 훈련하는 미세 조정을 거치면 1.3B Phi-1.5 생성기의 정확도가 44.6%에서 68.2%로 높아진다. 이후 검증기는 생성된 풀이를 원래 GSM8K 훈련 정답과 비교해 부여한 레이블로 훈련한다.
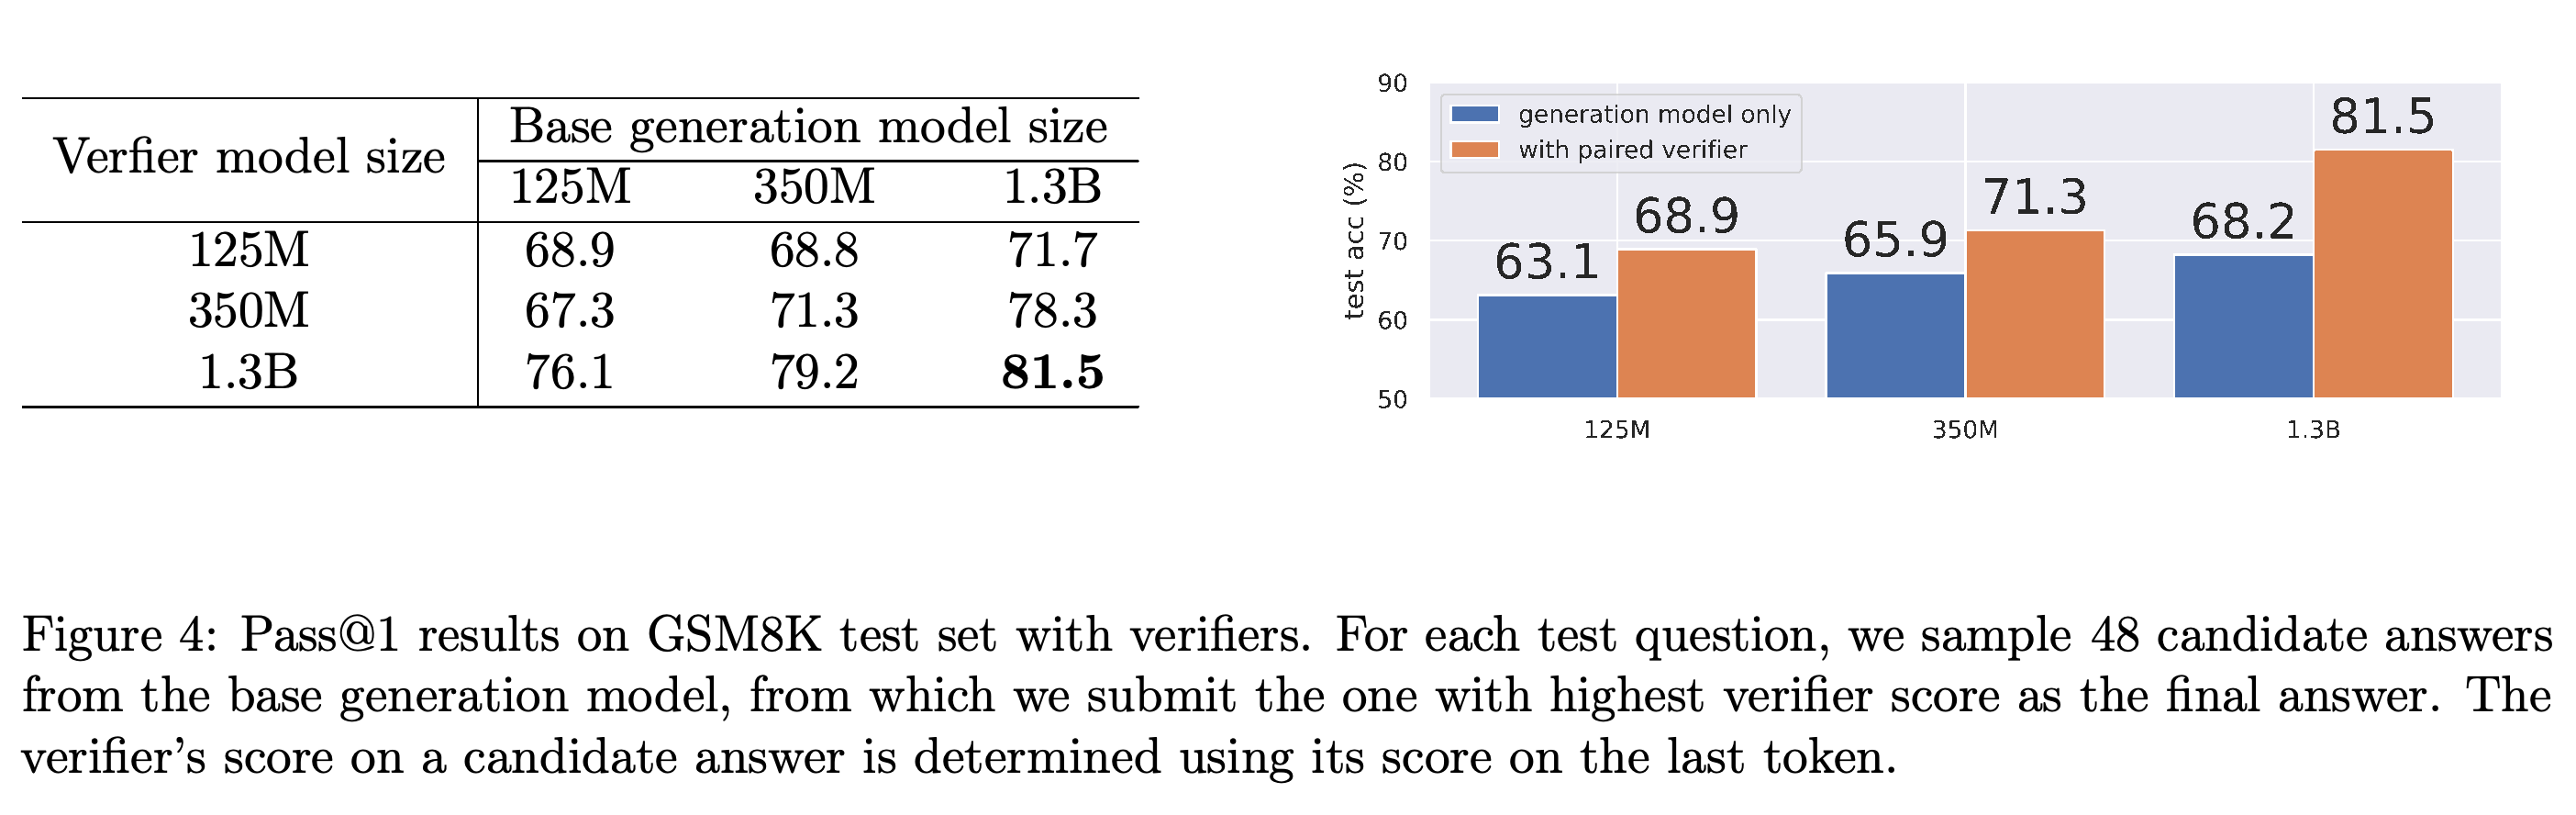
- 125M 생성기와 1.3B 검증기를 결합하면 정확도가 76.1%지만, 구성 요소의 크기를 서로 바꾸면 71.7%다. 서로 다른 훈련 단계에서 저장한 모델 상태인 체크포인트를 활용해 검증기 훈련 데이터를 다양화하면 정확도가 78.9%에서 81.5%로 높아진다. 이 결과는 실험 조건에서 검증에 더 많은 파라미터를 배분하는 방식을 뒷받침한다. 다만 대표 성능 비교에서 후보 풀이 수가 서로 다르고, 합성 풀이의 수학적 정확성을 검사하지 않았으며, 오염 검사로는 표현을 바꾼 테스트 데이터의 중복을 배제할 수 없다.
1 Introduction
서론에서는 수학적 추론에 큰 모델이 필요한지, 더 나은 훈련 데이터와 답 선택 방법으로 작은 생성기의 한계를 보완할 수 있는지 묻는다. GSM8K는 2~11단계의 추론이 필요한 문장제 8.8K개로 구성되며, 기초 수학과 자연어 해석 능력 2가지를 평가한다.
- 교사–학생 구성에서는 큰 모델이 생성한 예제로 작은 모델을 훈련해 원래 훈련 데이터보다 더 많은 데이터를 확보한다.
- 검증기는 GSM8K와 함께 제안된 방법을 따른다. 이 논문은 검증기에 대규모 합성 훈련 데이터를 결합하고, 검증기 크기와 훈련 데이터의 다양성을 살펴본다.
검증기를 추가하면 Phi-GSM 구성은 비교적 적은 파라미터 수를 유지하면서 정확도가 높아진다. 파라미터 축에는 여러 후보를 생성하고 점수를 매기는 비용이 반영되지 않으므로, 이 그래프만으로 추론 비용을 맞춘 조건에서 우위가 있다고 볼 수는 없다.
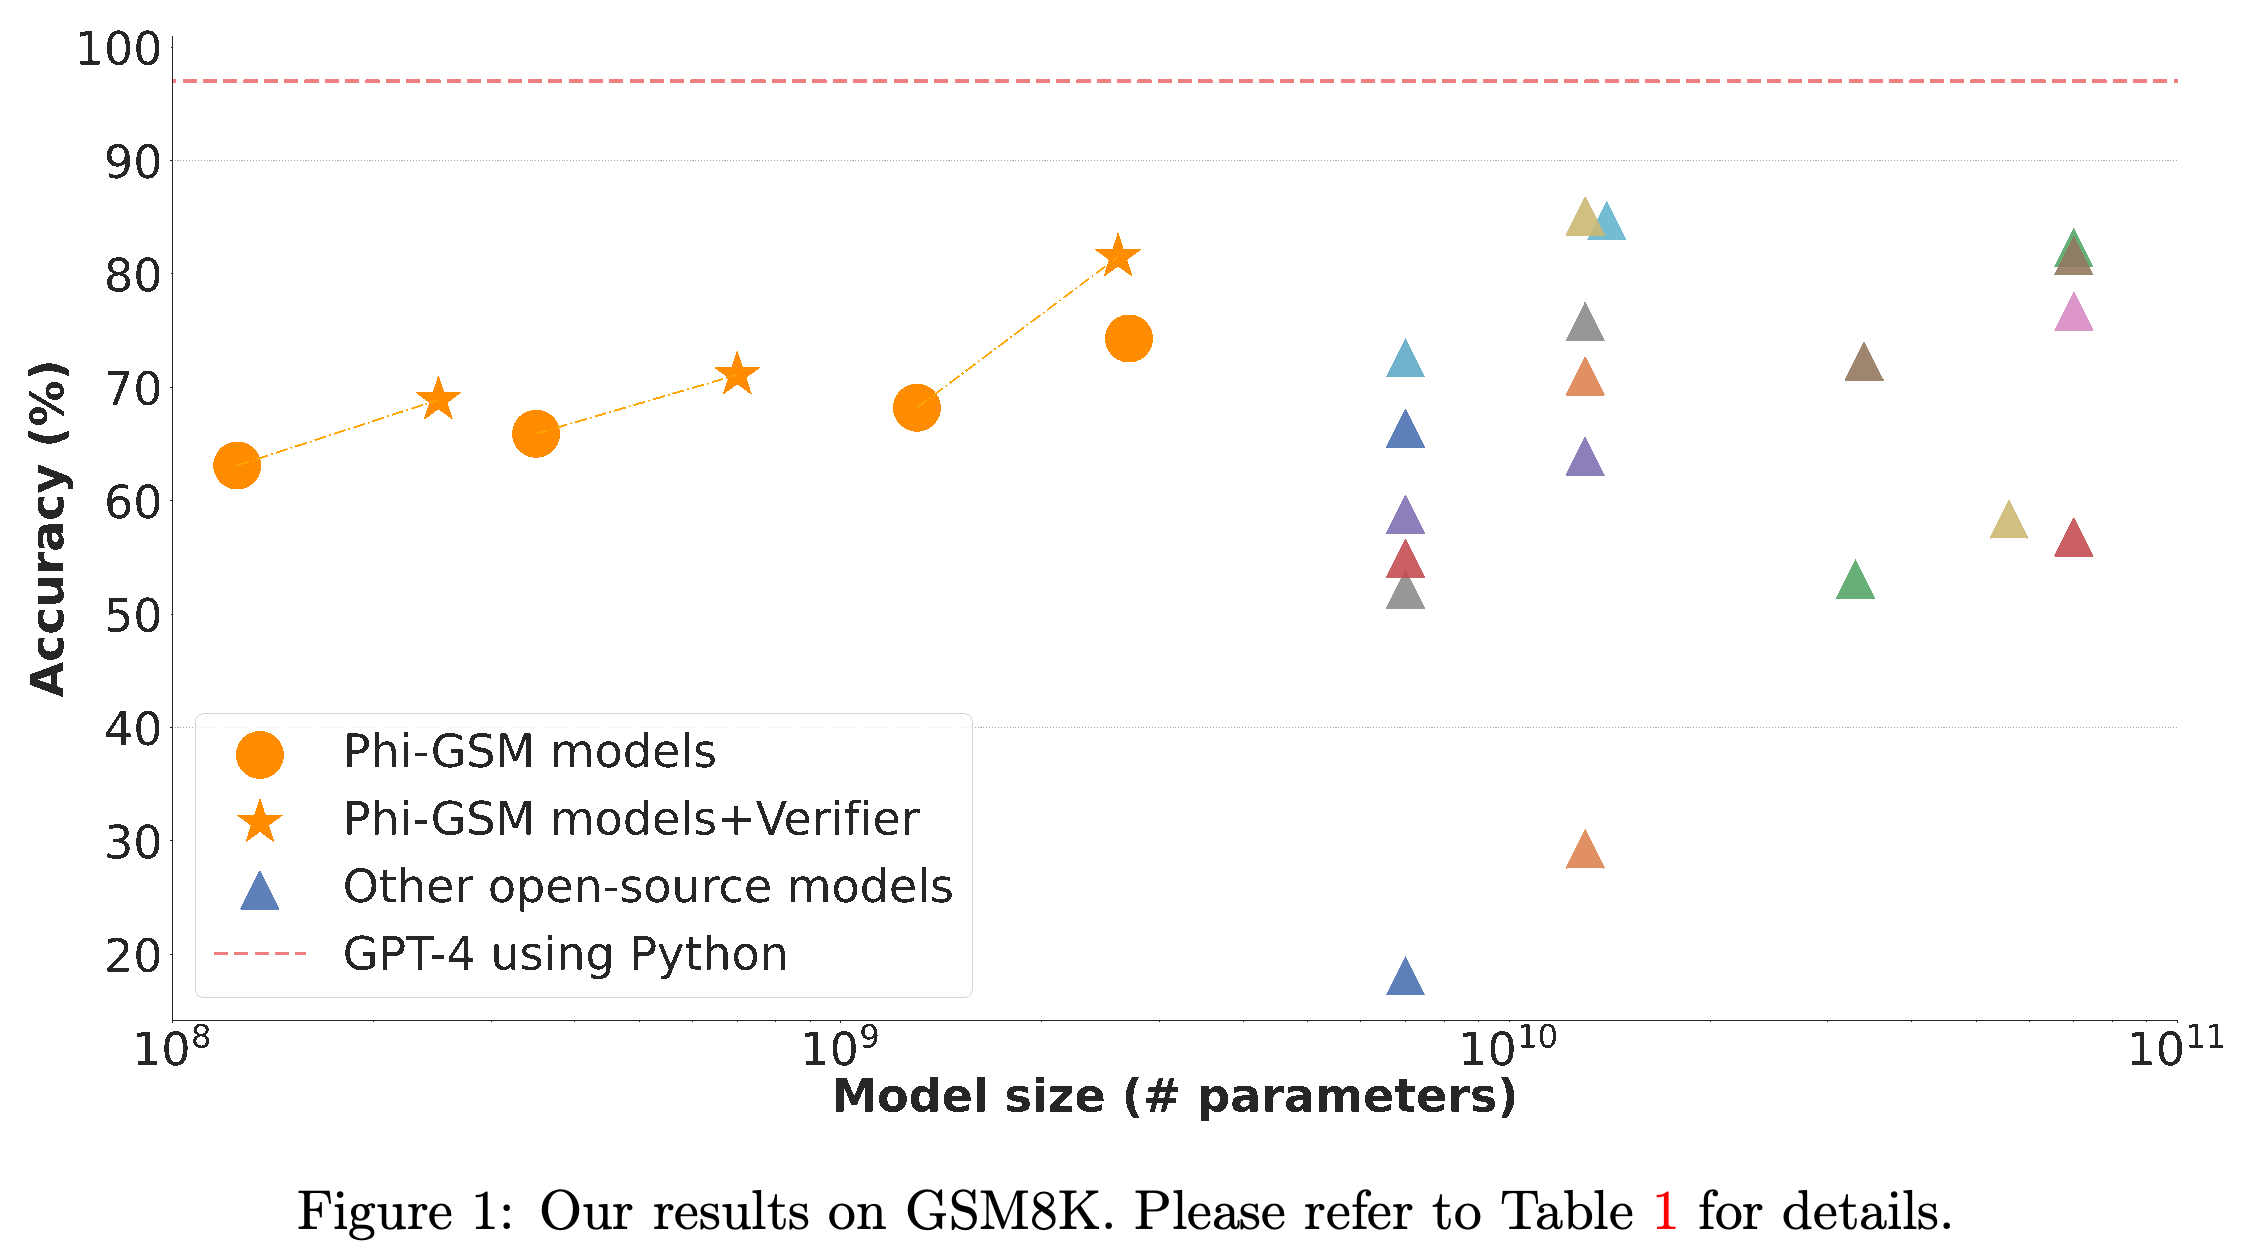
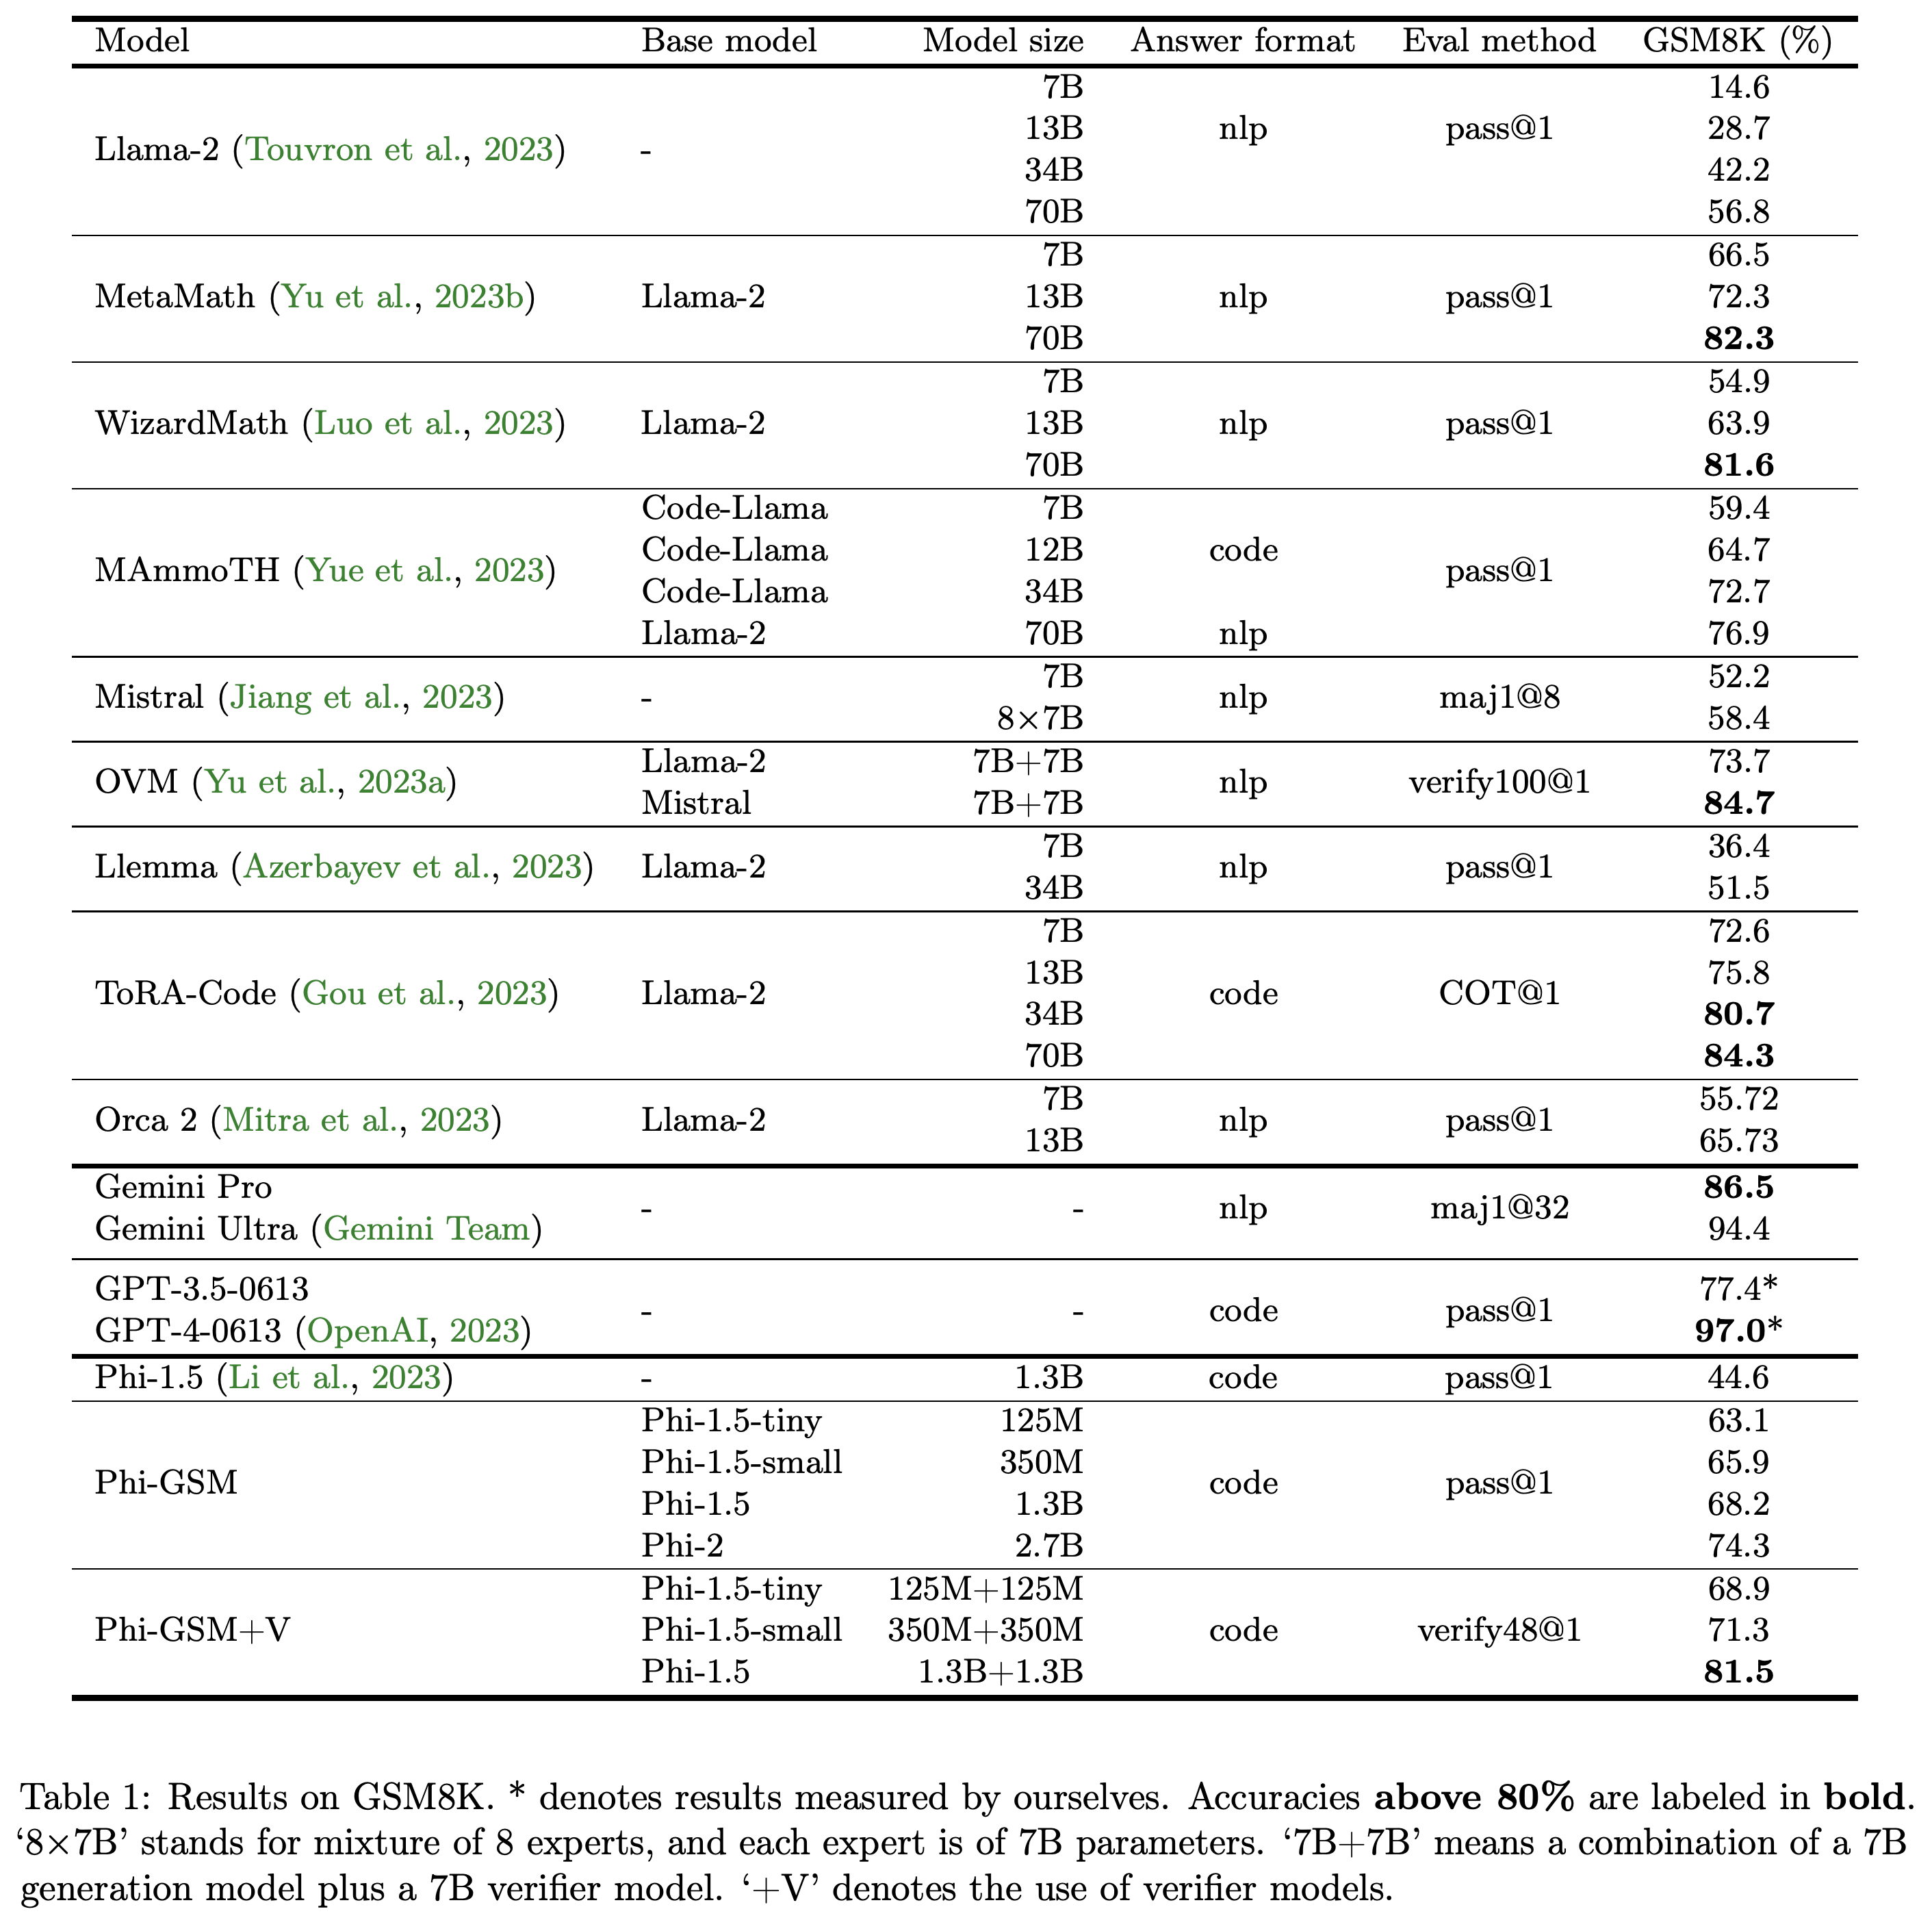
Phi-GSM+V는 1.3B 생성기와 1.3B 검증기를 사용해 verify48@1에서 81.5%를 달성하며, 생성기 단독으로는 pass@1에서 68.2%를 달성한다. GPT-3.5-0613은 코드 풀이를 사용해 pass@1에서 77.4%를 달성한다. 표의 각 행은 답 형식과 후보 선택 방법이 다르므로 비교할 때 주의가 필요하다.
2 Related works
관련 연구에서는 합성 데이터 훈련, 수학 문장제 데이터셋, 여러 생성 결과 중에서 답을 선택하는 방법, 다양한 감독 방식을 연결해 살펴본다. Self-consistency는 후보 중 가장 자주 나온 답을 선택한다. 확신이 높거나 반복해서 나온 답도 틀릴 수 있으므로, 학습된 검증기와 비교할 필요가 있다.
- 결과 감독은 최종 답을 기준으로 풀이에 레이블을 부여하고, 과정 감독은 중간 추론 단계에 레이블을 부여한다. 이 연구는 중간 단계를 검사하지 않고 실행 결과에 따라 전체 프로그램에 레이블을 부여한다.
- 저자들은 별도로 전체 미세 조정한 검증기와, 생성기에게 자신의 답을 비평하고 수정하도록 요청하는 방법을 구분한다.
- GSM-IC는 GSM8K 질문에 무관한 맥락을 추가하며, TinyGSM 일부를 생성하는 시드로 쓰인다. 이는 불필요한 정보가 없는 문제만으로 평가할 때 드러나지 않는 약점을 다룬다.
- 이 절에서는 프롬프트에 제공된 예제로 과제를 수행하는 in-context learning과 중간 추론 단계를 요청하는 chain-of-thought prompting도 다룬다. 저자들은 이러한 프롬프팅 방법이 주로 큰 모델에서 효과적이라고 설명하며 소형 모델 훈련의 필요성을 제시한다.
3 The TinyGSM dataset
TinyGSM은 풀이를 제외한 원래 질문을 조건으로 GPT-3.5-turbo가 데이터를 생성하게 해 GSM8K 훈련 문제 7473개를 확장한다. 생성된 예제는 새로운 문장제와 Python 풀이를 짝지어, 인터프리터가 수치 계산을 수행할 수 있게 한다. 데이터셋의 약 3분의 1은 무관한 정보가 포함된 GSM-IC 변형에서 생성한다.
- 생성의 무작위성을 조절하는 temperature sampling과 다양한 표현, 여러 논리 단계를 요청하는 프롬프트로 다양성을 유도한다. 각 시드에 사용하는 프롬프트는 호출 간에 동일하게 유지한다.
- 대부분의 예제는 질문과 풀이를 함께 생성한다. GSM-IC-derived 데이터 전체를 포함한 나머지 예제는 질문 생성과 풀이 생성을 별도 단계로 수행한다.
- 데이터셋에는 질문–풀이 쌍 12.3M개와 1.8B 토큰이 포함된다. 논문은 당시 적용한 상용 요금 기준으로 생성 비용을 약 $3600으로 추산한다.
질문은 Python 함수 안에 포함된 텍스트인 함수 docstring에 들어가며, 함수 본문은 계산을 코드로 표현한다. 이 표현 방식에서는 모델이 문장제를 연산으로 변환한 뒤 인터프리터가 산술 계산을 수행한다.
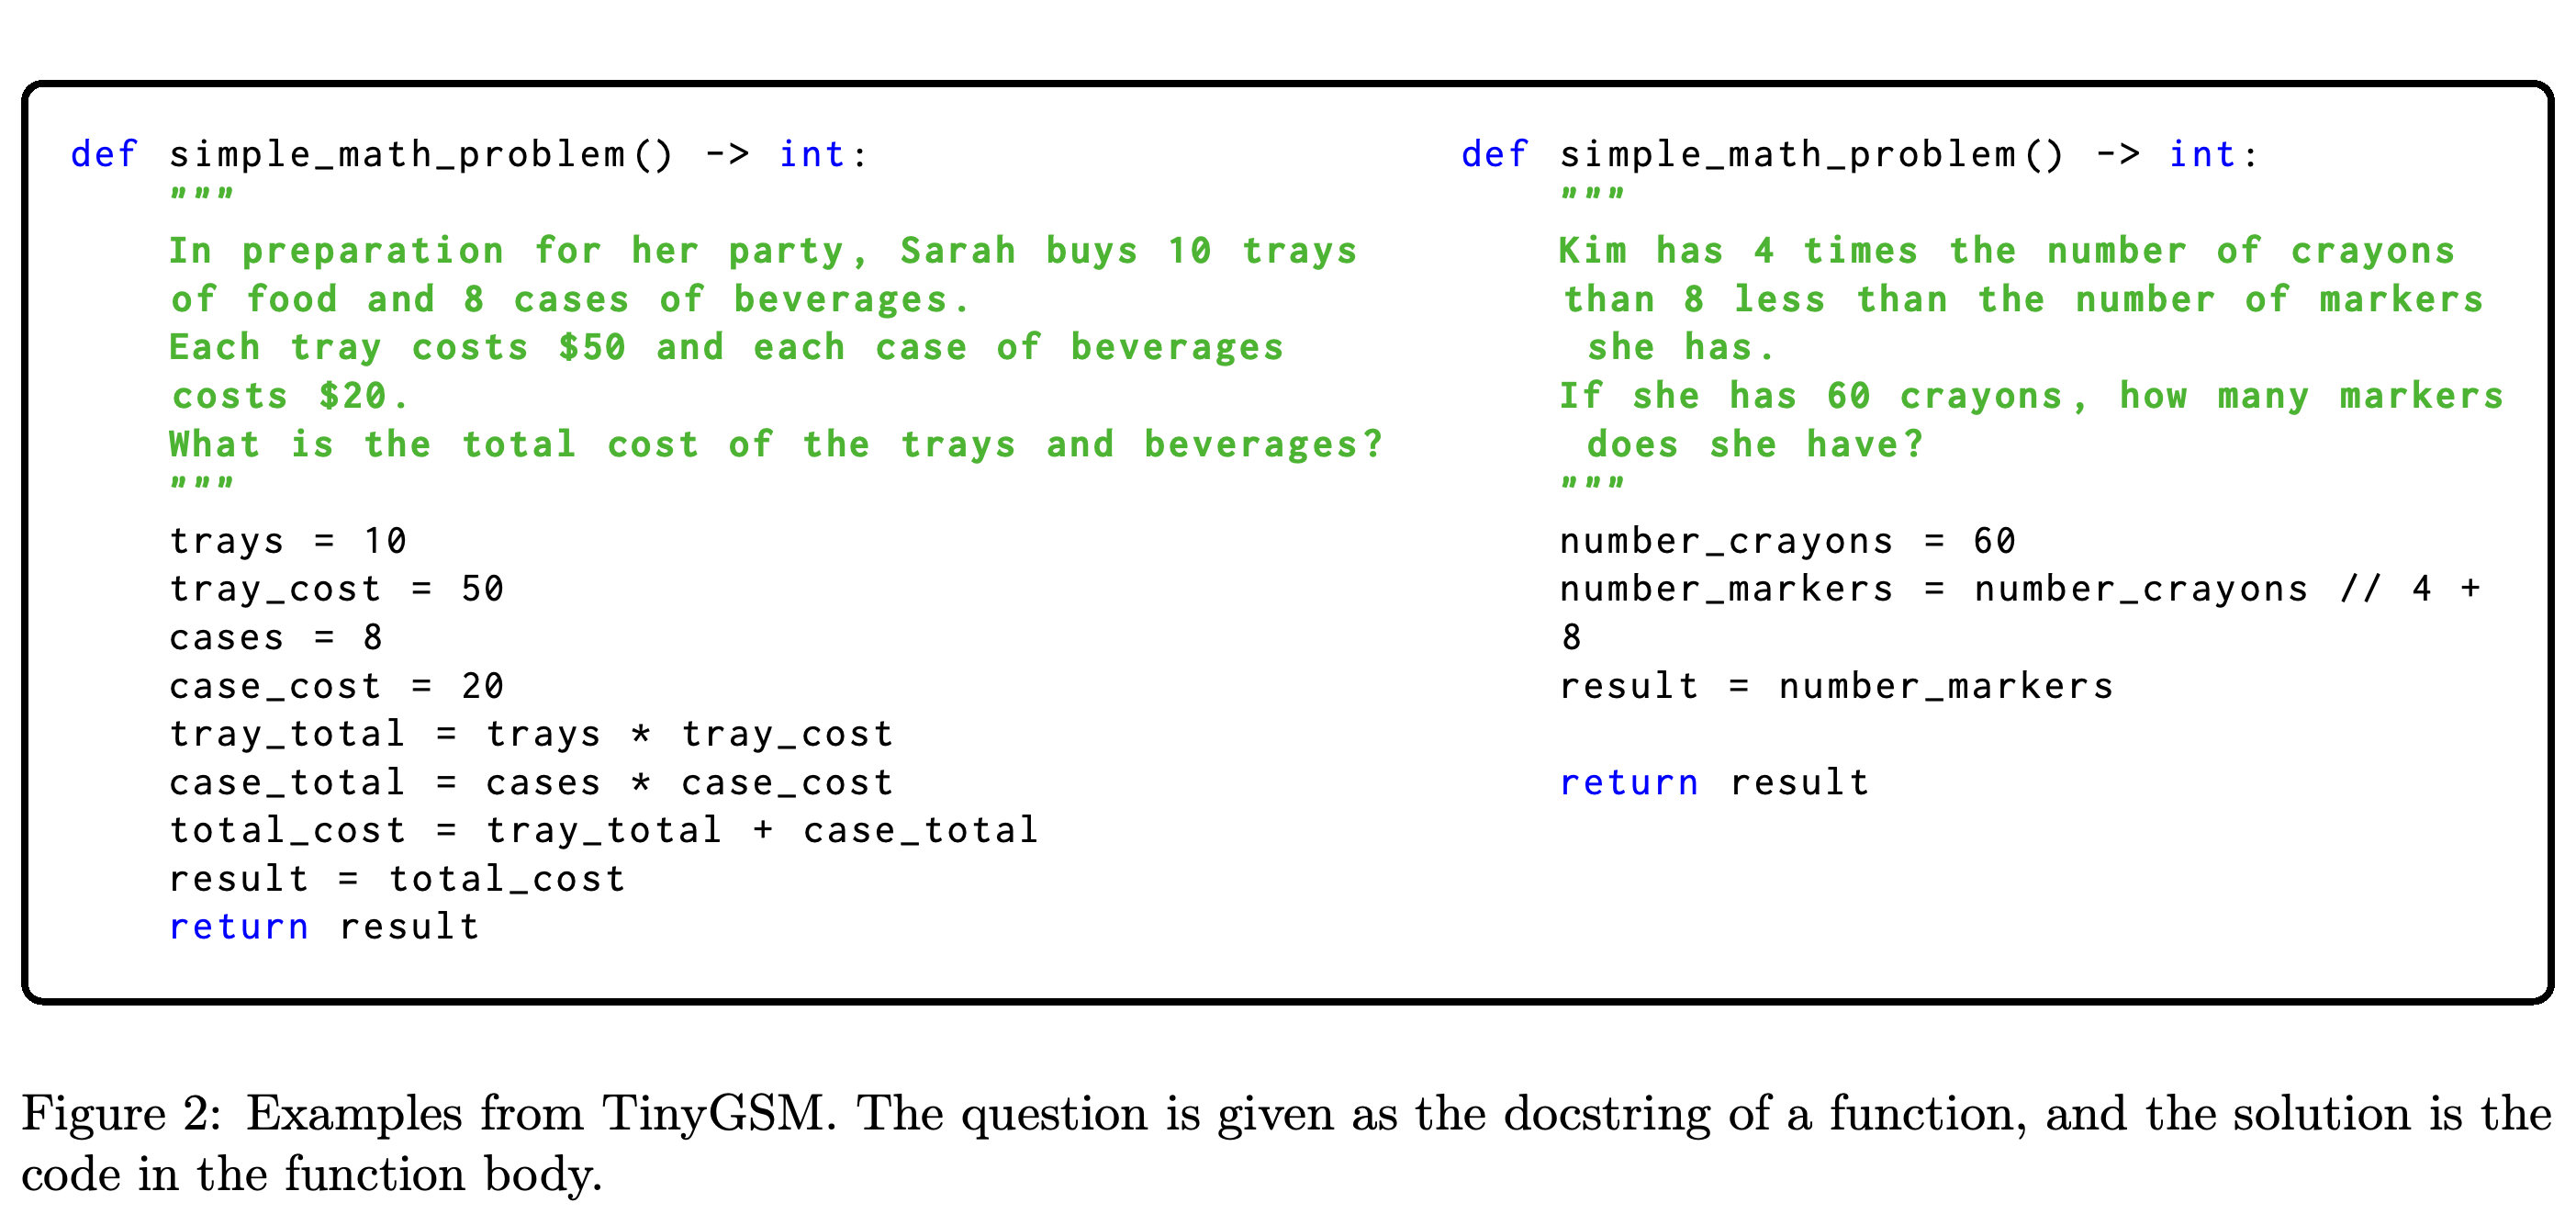
필터링 과정에서는 너무 짧거나 숫자가 없는 질문과 코드가 실행되지 않는 풀이를 제거한다. 수학적 정확성은 검증하지 않으며, 저자들은 생성된 문제가 수학적으로 타당하더라도 상식에 어긋날 수 있다고 인정한다.
- 저자들은 답의 다수결 일치를 기준으로 필터링하지 않는다. 답의 일치가 쉬운 질문에 집중되어 있어 유용한 어려운 예제가 제거될 수 있기 때문이다.
- 초기 350M 모델은 GSM8K에서 약 50%의 정확도를 보이지만, 답이 일치하는 합성 질문에서는 87%를 넘는다. 이는 답의 일치로 필터링하면 지나치게 쉬운 훈련 데이터가 선택될 수 있다는 우려를 뒷받침한다.
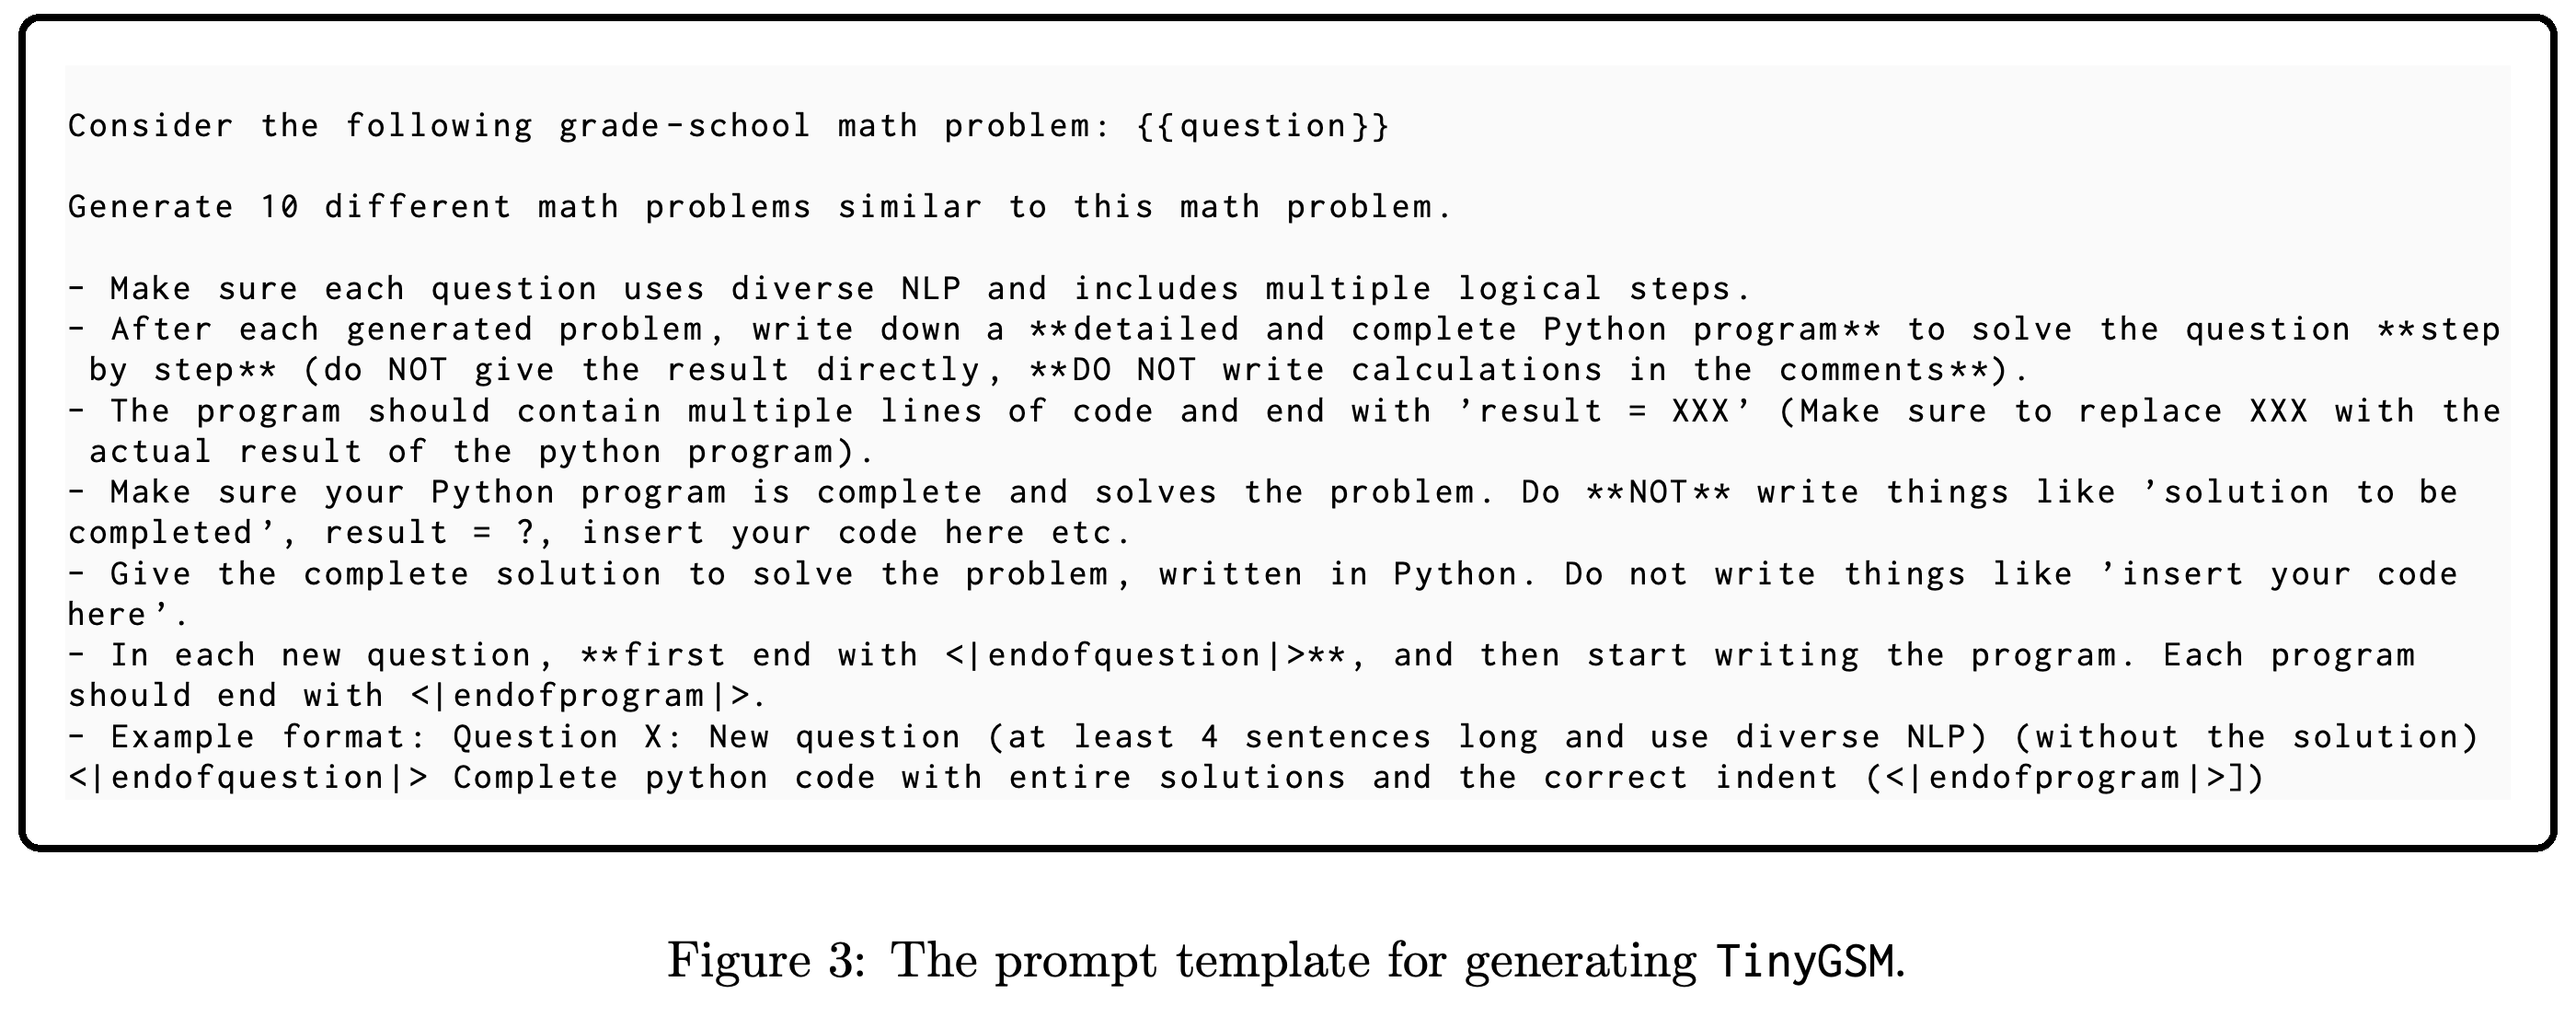
공동 생성 템플릿은 시드 질문의 변형 10개, 다양한 표현, 여러 논리 단계, 완전한 Python 프로그램을 요청한다. 명시적인 질문 및 프로그램 구분자로 생성된 쌍의 구조를 정하지만, 이러한 형식 요건이 수학적 정확성을 검증하지는 않는다.
4 Solving grade school math with small language models
풀이 파이프라인은 학습된 구성 요소 2개로 이루어진다. 생성기는 TinyGSM으로 미세 조정하고, 검증기는 생성된 풀이의 정오를 구분하도록 훈련한다. 추론 시 생성기가 여러 Python 프로그램을 생성하면 검증기는 마지막 토큰의 점수가 가장 높은 후보를 선택한다.
4.1 Learning from synthetic data
저자들은 125M, 350M, 1.3B 파라미터의 사전 훈련된 Phi-1.5 변형을 최적화 알고리즘 Adam과 16비트 부동소수점 훈련 방식인 FP16으로 미세 조정한다. 훈련 초기에는 학습률을 선형으로 점차 높이는 warm-up을 적용한다. 최대 학습률은 1e-4, 모델 가중치를 정규화하는 weight decay는 0.01, 업데이트당 유효 배치 크기는 예제 1024개이며, 최대 20k단계까지 훈련한다.
- GSM8K에서 단일 풀이를 생성할 때 정확도는 각각 63.1%, 65.9%, 68.2%다. Table 1은 파라미터 규모가 2.7B 인 Phi-2-based 생성기가 달성한 정확도 74.3%도 보고한다.
- 이전 1.3B 모델은 pass@32에서 94%를 달성한다. 이는 생성 결과 32개 중 정답이 적어도 1개 있는 질문의 비율이다. 정답 후보가 존재하는지를 측정하며, 정답을 모르는 상태에서 답을 1개 선택해야 하는 방법의 정확도를 뜻하지는 않는다.
4.2 Improving small models with a verifier
검증은 후보 집합 어딘가에 정답을 생성하는 능력과 그 정답을 안정적으로 선택하는 능력 사이의 격차를 다룬다. 논문은 TinyGSM의 마지막 3분의 1을 추가했을 때 성능 향상이 줄어든다고 보고한다. 생성기 크기나 합성 데이터 양을 늘리는 방법 외의 추가 수단으로 별도의 정답 예측기를 연구한다.
- 추론 시 질문마다 후보 48개를 샘플링하고, 점수가 가장 높은 후보를 최종 답 1개로 제출한다.
- 81.5% 결과는 후보 48개에서 답 1개를 선택하는 verify48@1을 사용한다. 비교 대상으로 보고한 GPT-3.5-0613의 77.4%는 생성된 풀이 1개를 평가하는 pass@1을 사용한다.
검증기 훈련에서는 GSM8K 훈련 질문마다 생성 결과 48개를 샘플링하고, 실행으로 얻은 수치 답을 알려진 정답과 비교해 이진 레이블을 부여한다. 검증기는 생성기 가중치로 초기화하고, 토큰 위치 전체에서 공유하는 출력층인 예측 헤드를 추가한 뒤 네트워크의 모든 파라미터를 업데이트한다.
- 전체 프로그램의 정오를 나타내는 동일한 레이블로 모든 토큰을 감독하며, 중간 계산에는 별도의 정오 레이블을 부여하지 않는다.
- 저자들은 이 훈련 목적이 전체 시퀀스에 대해 레이블 1개를 예측하는 방식보다 일관되게 성능이 높다고 보고한다. 전체 미세 조정은 예측 헤드만 업데이트하거나 검증기를 처음부터 훈련하는 방식보다도 성능이 높다.
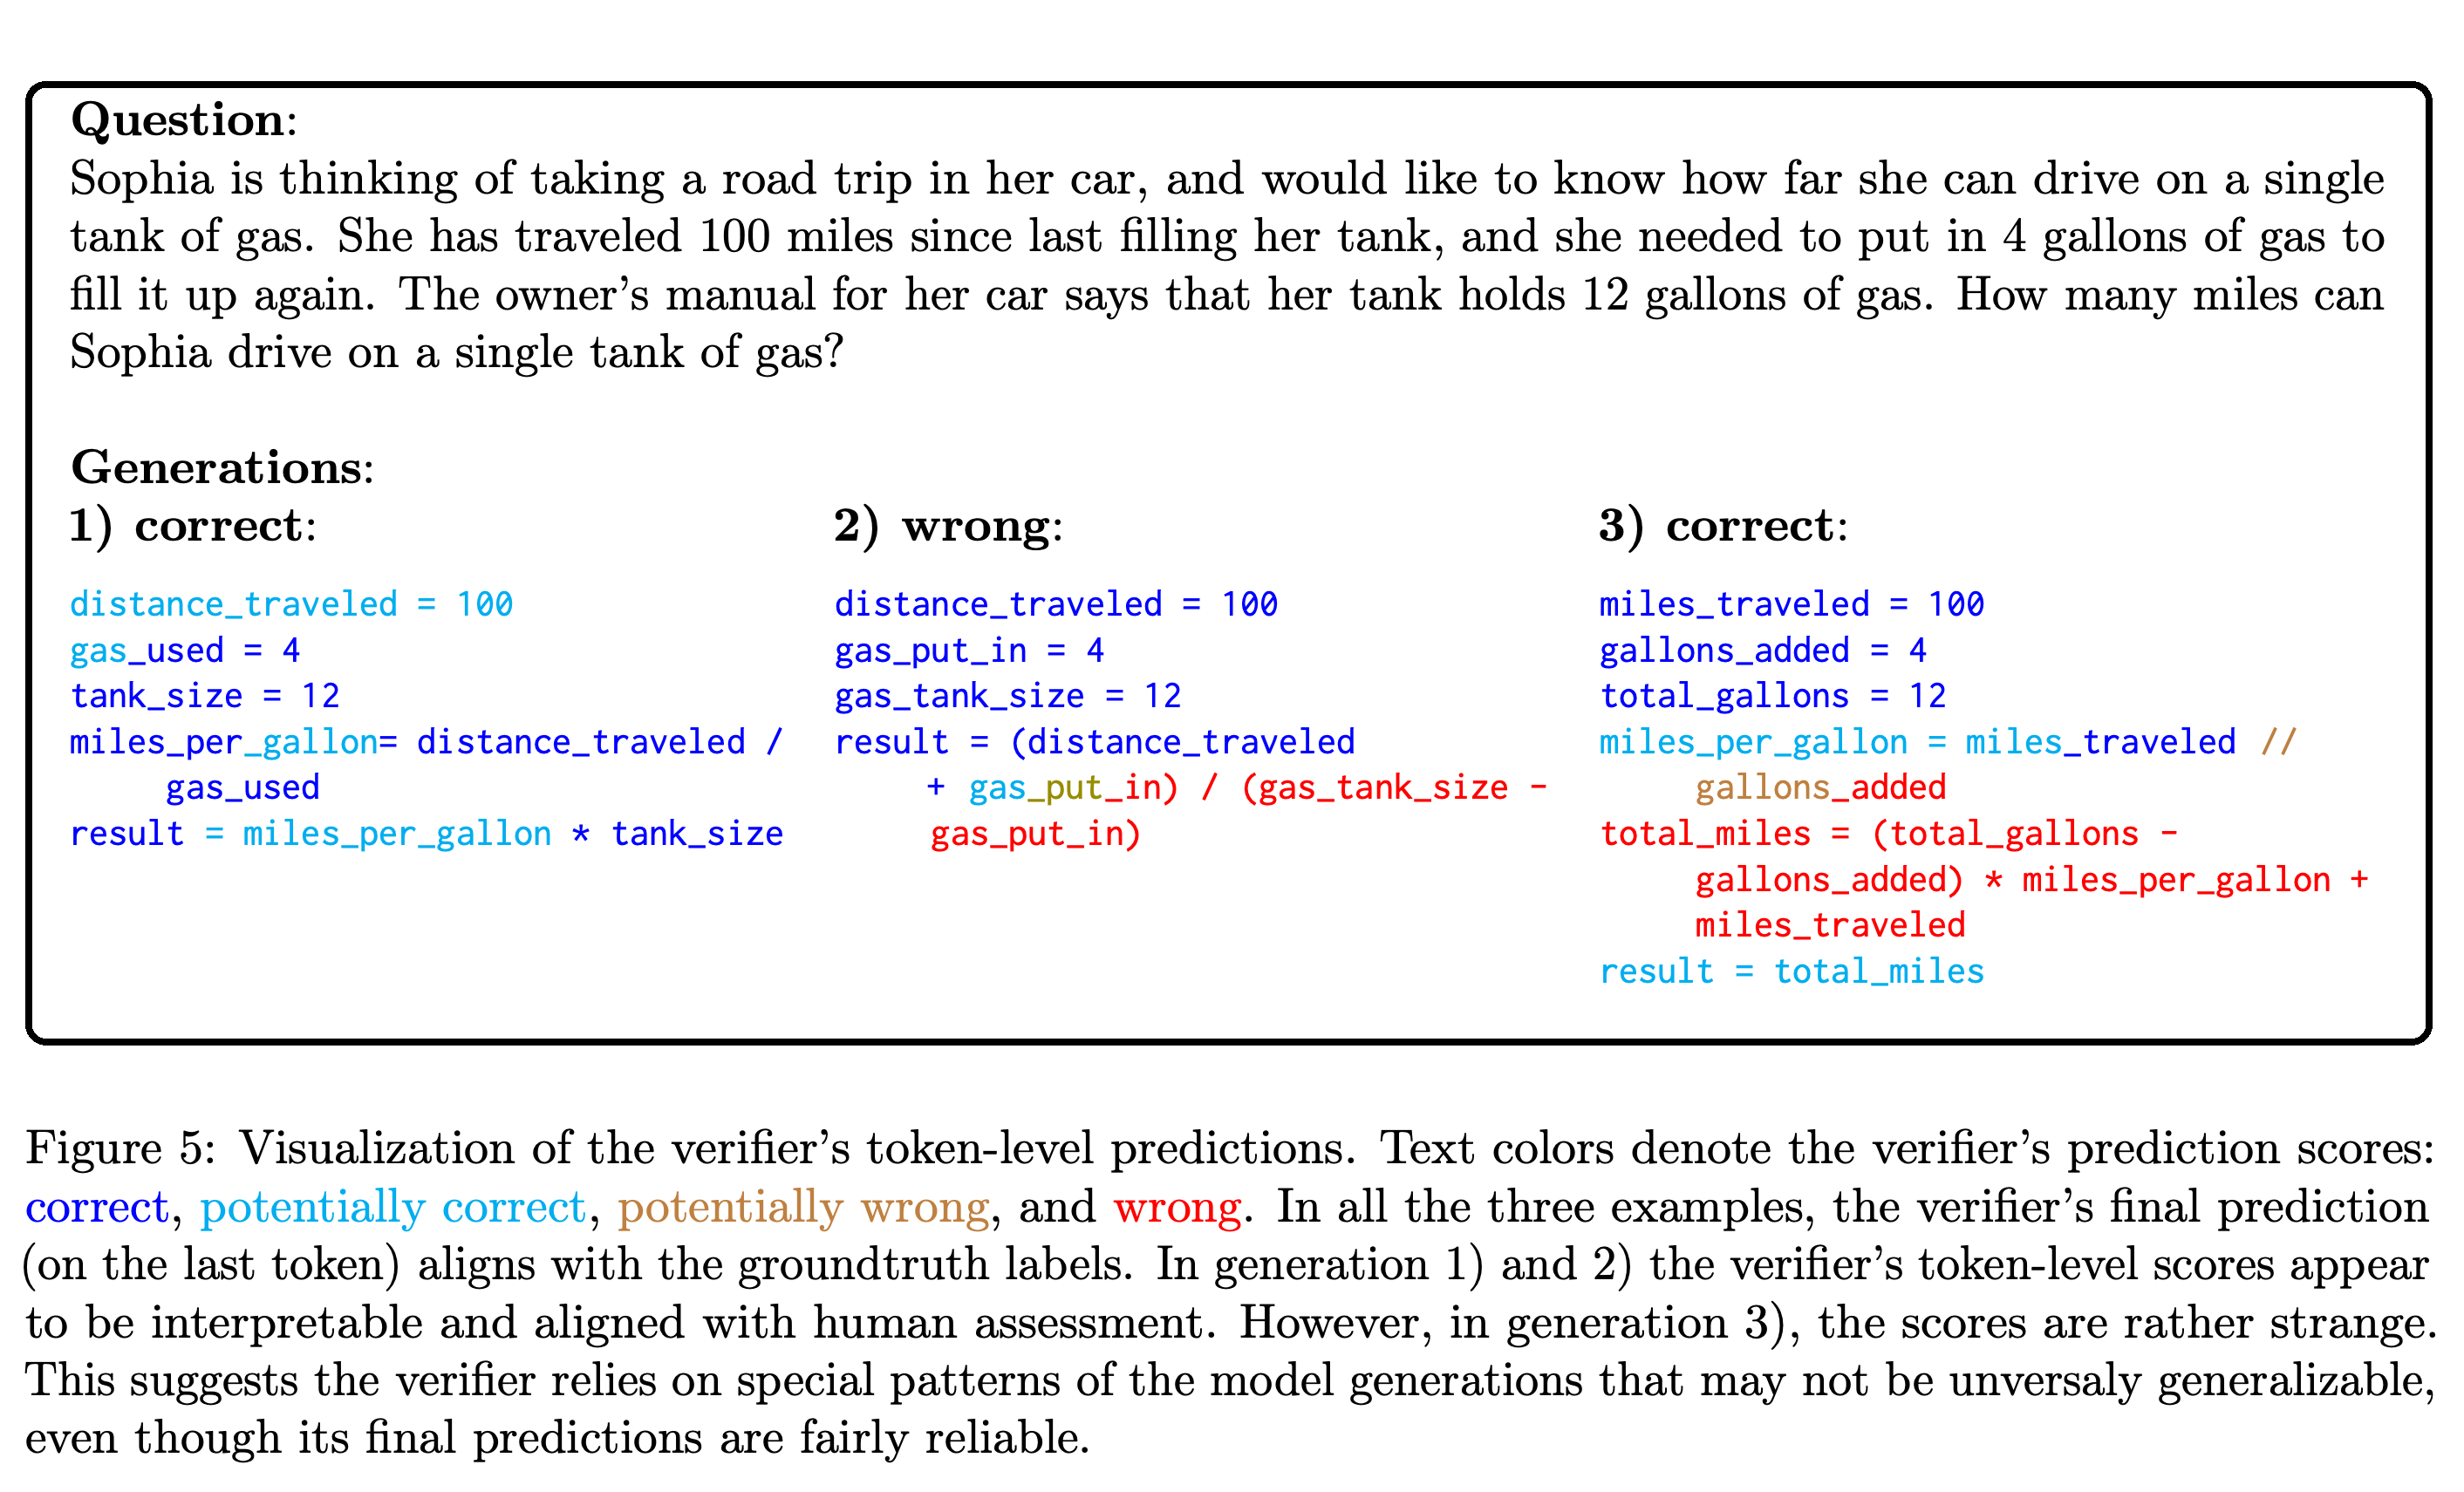
- 추론 점수는 마지막 토큰에서 얻는다. Figure 5는 앞선 토큰의 점수를 개별 추론 단계에 대한 타당한 평가로 바로 해석하면 안 되는 이유를 보여준다.
검증기 훈련에는 1k, 6k, 12k단계의 체크포인트가 생성한 예제가 도움이 된다. 훈련 후보와 테스트 후보 2가지 모두 temperature 0.5와 0.7을 혼합한다. 여러 체크포인트를 사용하면 정확도가 78.9%에서 81.5%로 높아진다. 일부 체크포인트의 정확도가 낮더라도 생성 결과의 다양성이 유용함을 뒷받침한다.
- 논문은 가장 확률이 높은 다음 토큰을 선택하는 temperature 0에 비해, temperature 1에서 생성 정확도가 10% 넘게 낮아질 수 있다고 보고한다.
- 검증기는 어느 정도 다른 생성기에도 적용할 수 있다. 350M 생성기의 출력으로 훈련한 350M 검증기를 사용하면 1.3B 생성기의 정확도가 78.1%에 도달한다.
생성기와 검증기의 크기 조합별 결과에서 가장 좋은 구성은 각 구성 요소에 1.3B 파라미터를 사용하며, 정확도 81.5%를 달성한다. 합산 파라미터 수가 같을 때 125M-generator/1.3B-verifier 구성의 정확도는 76.1%이며, 파라미터 규모가 1.3B 인 생성기와 125M 검증기를 결합한 구성의 정확도는 71.7%다.
- 각 생성기에 같은 크기의 검증기를 결합하면 정확도가 125M에서 63.1%에서 68.9%로, 350M에서 65.9%에서 71.3%로, 1.3B에서 68.2%에서 81.5%로 높아진다.
- 이 비교는 실험에 사용한 샘플링 조건에서 더 큰 검증기를 사용하는 방식을 뒷받침한다. 논문은 추론 지연 시간이나 총 연산량을 맞춘 구성 간 비교를 제공하지 않는다.
조합별 결과에서 125M 생성기와 1.3B 검증기의 정확도는 76.1%이며, 크기를 서로 바꾸면 71.7%다. 막대그래프는 생성기 3개 모두에 같은 크기의 검증기를 결합했을 때 성능이 높아짐을 보여준다. 1.3B에서는 68.2%에서 81.5%로 높아진다. 검증기를 사용하는 각 결과는 후보 48개에서 답 1개를 선택한다.
제시된 프로그램 3개는 모두 최종 정오 분류가 맞지만, 정답 프로그램 1개에는 낮은 점수를 받은 중간 토큰이 포함된다. 이 예시는 전체 프로그램의 결과 레이블로 학습한 점수가 중간 계산의 정확성과 일치하지 않을 수 있음을 보여준다.
5 Robustness and decontamination
강건성 분석에서는 GPT가 생성한 훈련 데이터에 GSM8K 테스트 데이터의 중복이 유입되었을 가능성과 다른 산술 문장제 벤치마크로의 전이를 살펴본다. 이를 통해 훈련 데이터의 중복과 GSM8K 이외의 성능을 평가한다.
5.1 Contamination test
오염 검사는 문장부호와 숫자를 제거한 뒤, 연속된 단어 n개인 n-gram을 GSM8K 테스트 질문과 비교한다. 중복을 제외한 합성 질문 11.0M개 중 22개에서 0이 아닌 13-gram 일치가 나타나며, 약 0.35%인 38k개에서 0이 아닌 8-gram 일치가 나타난다.
- 논문은 13-gram 일치를 오염 제거 절차로 설명하며, 정확히 일치하는 문자열을 찾는 방법으로는 표현을 바꾼 데이터의 오염을 막을 수 없다고 명시한다.
- 2단계 생성 절차에서 일부 질문에 여러 풀이를 생성하므로, 중복을 제외한 질문 수는 질문–풀이 쌍의 수보다 적다.
- 논문은 일치한 예제를 제거한 뒤 대표 정확도가 얼마나 달라지는지 보고하지 않는다.
5.2 Evaluation on SVAMP
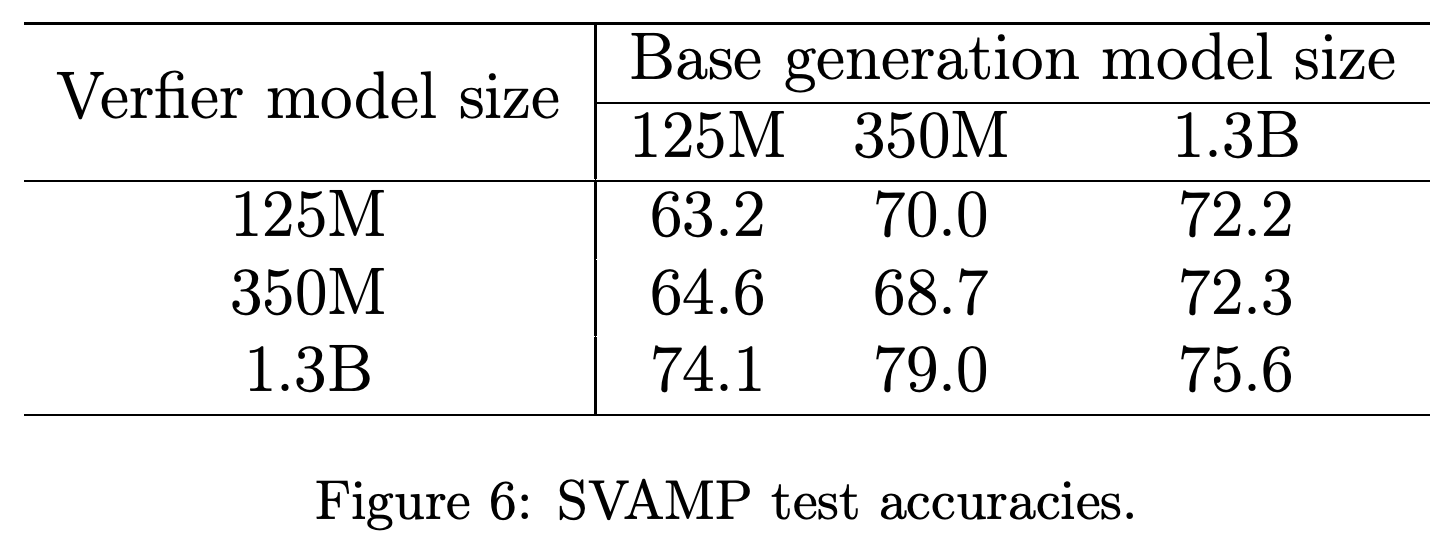
SVAMP는 Simple Variations on Arithmetic Math word Problems의 약자로, 기본 질문을 변형해 만든 산술 문장제 1000개로 구성된다. 1.3B 생성기와 1.3B 검증기를 결합하면 추가 미세 조정 없이 75.6%를 달성한다. 이는 GSM8K 이외의 데이터로도 성능이 전이된다는 근거를 제공한다.
- Figure 6의 최고 성능은 350M 생성기와 1.3B 검증기를 사용한 79.0%다. 따라서 이 조합별 비교에서 가장 큰 생성기가 최상의 전이 성능을 보이지는 않는다.
- 생성기 크기 3가지 모두 1.3B 검증기를 사용할 때 보고된 SVAMP 정확도가 가장 높다. 125M, 350M, 1.3B 생성기의 정확도는 각각 74.1%, 79.0%, 75.6%다.
모든 생성기 크기에서 1.3B 검증기가 가장 좋은 결과를 낸다. 최고 정확도는 350M 생성기를 사용한 79.0%로, 생성기와 검증기가 모두 1.3B 파라미터를 가진 구성의 75.6%보다 높다. 따라서 전이 성능은 생성기 크기에 따라 단조롭게 증가하지 않는다.
6 Discussions
논의에서는 풀이 형식과 검증기 크기를 후속 연구 방향으로 제시한다. Python 실행은 일부 계산 오류를 피하게 해 주지만, 저자들은 방정식을 풀어야 하는 질문에서 성능이 낮아지는 현상을 관찰하고 코드와 자연어 풀이를 결합하는 방법을 제안한다.
- 크기 조합별 결과는 고정된 파라미터 예산을 생성과 검증에 어떻게 배분해야 하는지 연구할 필요성을 제시한다.
- 풀이 형식의 결합은 향후 연구로 제안하며, 논문은 형식을 결합한 시스템의 평가 결과를 보고하지 않는다.
- 저자들은 TinyGSM을 공개할 계획이라고 밝힌다. PDF에서는 공개가 완료되었는지 확인할 수 없다.
부록
- A.1 Other prompts를 포함한 A Additional details on TinyGSM은 2단계 생성 절차를 설명한다. Figures 7과 8은 각각 GSM8K와 GSM8K-IC 시드에서 새로운 질문 변형을 요청한다. Figure 9는 완전한 Python 풀이를 요청하며, 출력 형식, sympy.solve()를 이용한 기호 방정식 풀이, math.ceil()을 이용한 정수 올림을 지정한다.
- A.2 Contamination check: 13-gram collisions는 중복을 제외한 질문 11.0M개 중 22개가 해당 비교 절차에서 테스트 질문과 겹친다는 결과를 다시 설명한다. Figure 10은 이러한 일치 사례를 보여주지만, 인쇄된 캡션은 실제 내용을 설명하는 대신 코드 풀이 프롬프트의 설명을 반복한다.
- B Pretrained vs Random Init는 무작위 가중치에서 TinyGSM 훈련을 시작하는 경우와 사전 훈련된 가중치에서 시작하는 경우를 비교한다. Table 2에서 파라미터 규모가 각각 125M, 350M, 1.3B 인 모델의 무작위 초기화 정확도는 53.1%, 55.5%, 57.3%이며, 사전 훈련을 사용한 정확도는 각각 63.3%, 65.9%, 68.2%다. 이 표의 125M 사전 훈련 결과는 Table 1에 보고된 63.1%와 다르다.
짧은 생각
생성기와 검증기의 크기 조합별 결과는 합산 파라미터 수가 같은 조건에서 유용한 비교를 제공한다. 구성 요소의 크기를 서로 바꾸면 GSM8K 정확도가 71.7%에서 76.1%로 달라진다. 체크포인트 다양화로 정확도가 78.9%에서 81.5%로 높아진 결과와 함께, 검증기 용량과 훈련 예제의 분포 2가지를 연구할 필요성을 뒷받침한다.
대표 결과는 모델 2개로 구성된 시스템이 후보 48개와 Python 실행을 사용하는 조건에서 측정했다. PDF는 추론 비용을 맞춘 비교, TinyGSM의 수학적 정확성 점검, 표현을 바꾼 중복까지 배제하는 오염 검사를 제공하지 않는다. Figure 5 역시 결과 감독으로 학습한 토큰 점수를 개별 추론 단계의 설명으로 해석하는 데 주의가 필요함을 보여준다.