


Dynamic Scaling of Unit Tests for Code Reward Modeling 요약 설명
02 Jan 2025 | Paper Review Code Generation Reward Modeling Test-Time Scaling Synthetic Training Data목차
이번 글에서는 Dynamic Scaling of Unit Tests for Code Reward Modeling 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 1월 2일(Arxiv)
- Ma, Zeyao, Zhang, Xiaokang, Zhang, Jing, Yu, Jifan, Luo, Sijia, Tang, Jie.
- School of Information, Renmin University of China, Tsinghua University, Key Laboratory of Data Engineering and Knowledge Engineering, Beijing, China
- 논문 링크
- Github
- Project Page
요약
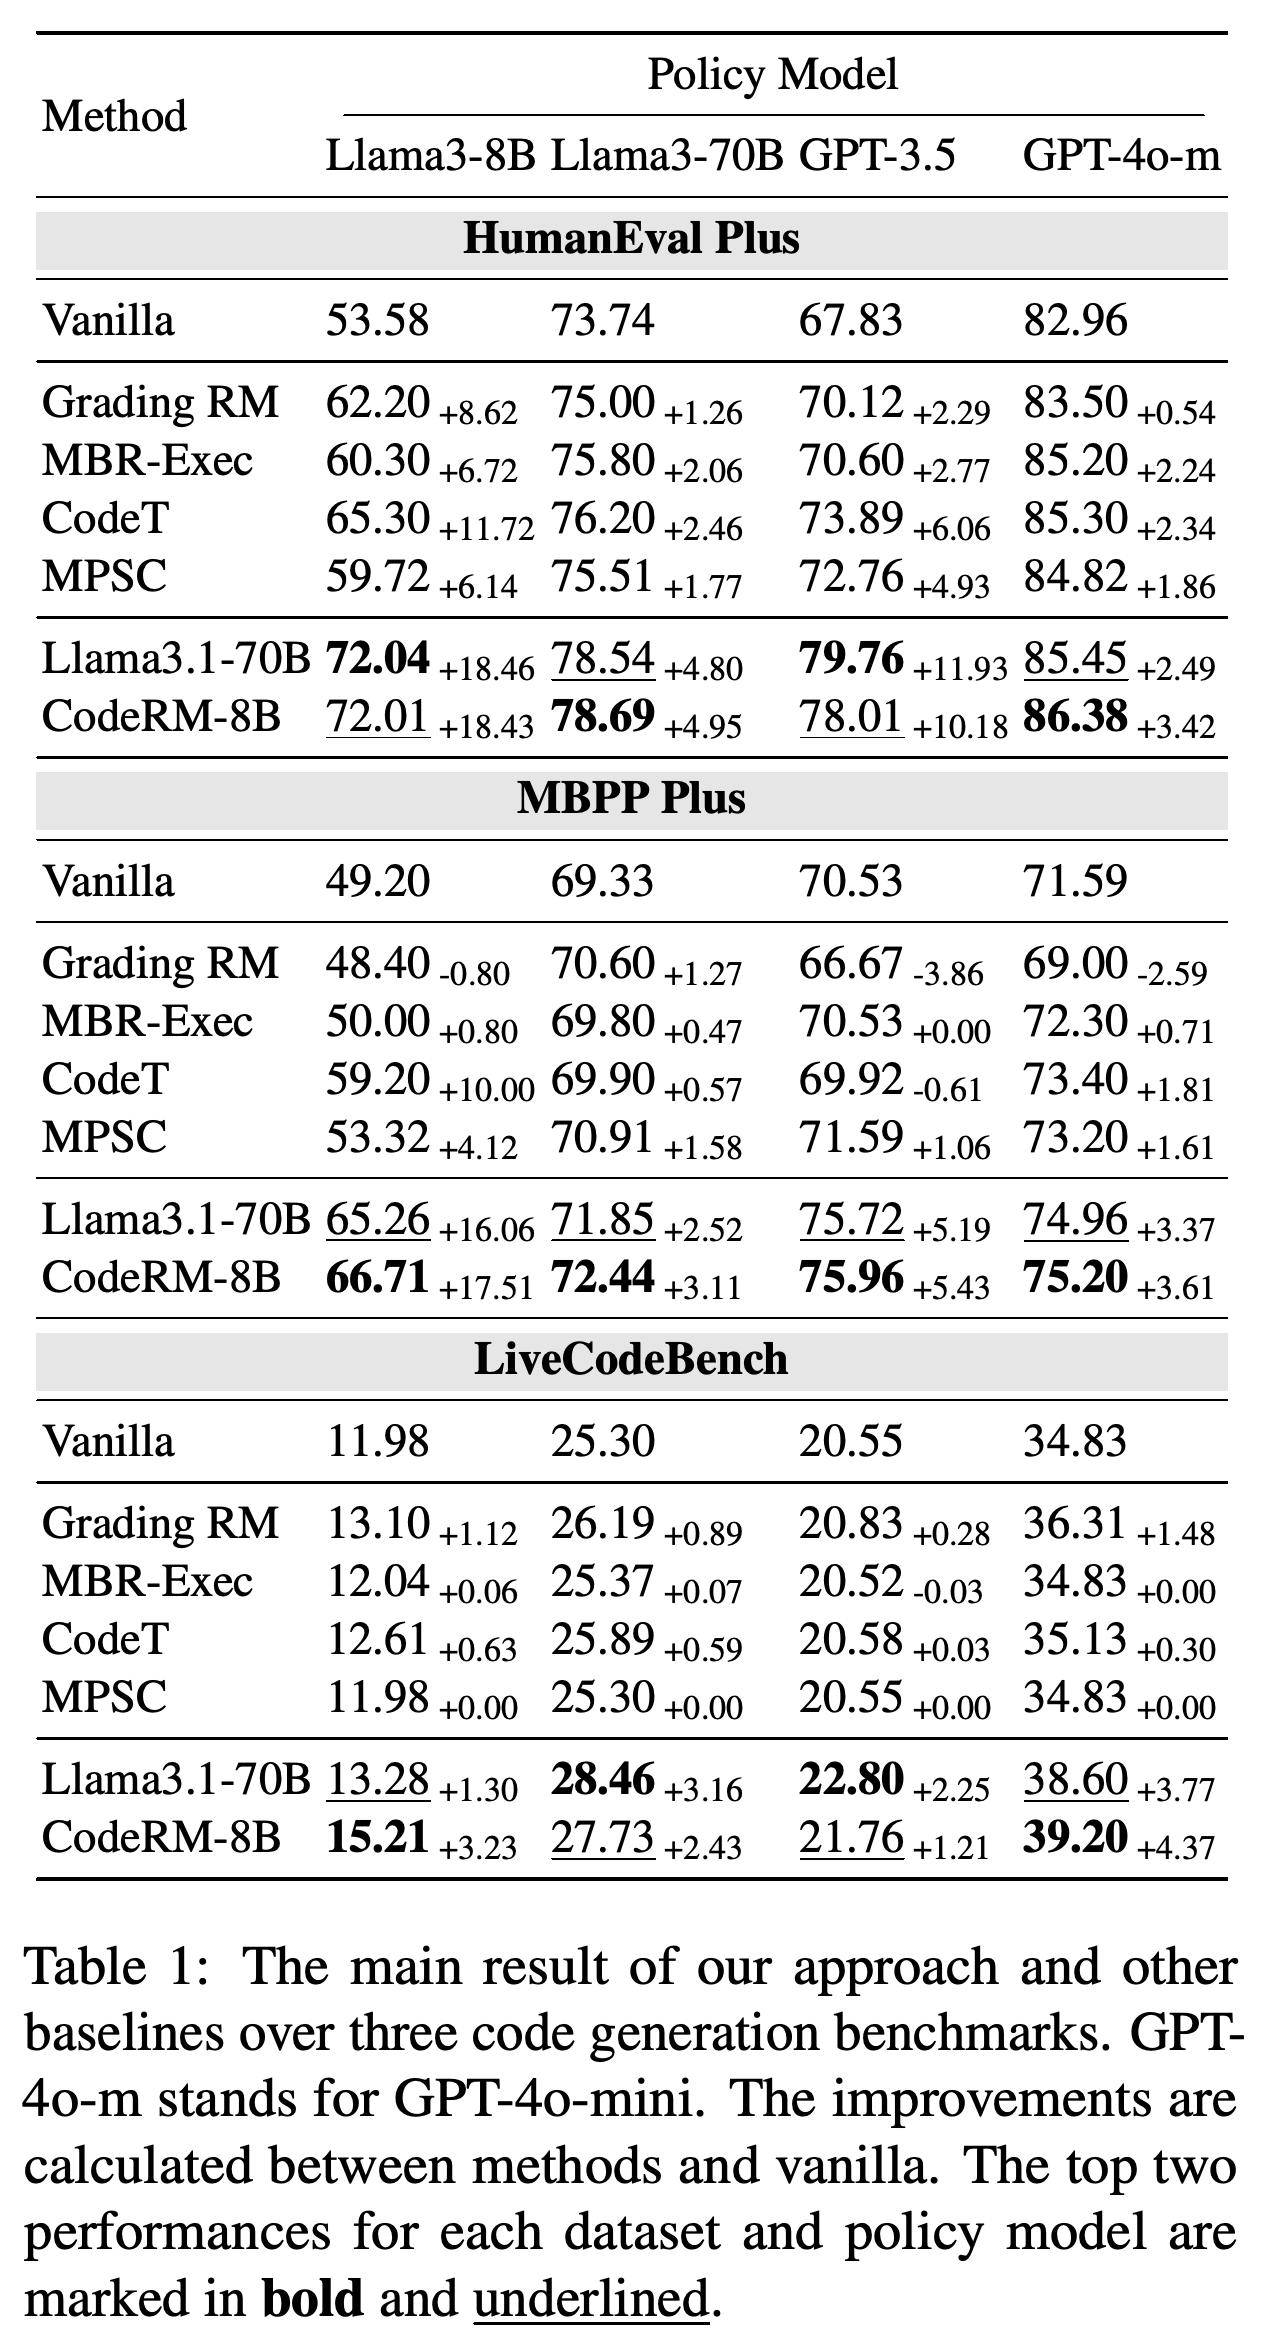
- 생성된 코드에 정답이 있어도 자동 선택 과정에서 이를 놓칠 수 있다. 입력과 기대 출력을 짝지어 검사하는 생성 단위 테스트가 부정확하기 때문이다. 정답 검증 테스트를 확장한 Python 프로그래밍 벤치마크 HumanEval Plus에서 8B-parameter 테스트 생성기 CodeRM-8B로 후보 풀이 100개 중 하나를 선택하면, Llama3-8B 성능이 무작위 선택의 53.58%에서 72.01%로 18.43퍼센트포인트 높아진다.
- CodeRM-8B는 문제와 풀이를 입력으로, 검증된 테스트를 출력으로 삼아 Llama3.1-8B를 지도 미세 조정한 모델이다. 합성 학습 데이터 파이프라인은 실행 피드백으로 테스트를 수정하고, 오답 풀이를 통과시키는 테스트를 걸러낸다. 생성한 테스트를 많이 결합하면 Llama3.1-70B와 대체로 비슷한 풀이 선택 성능을 얻는다.
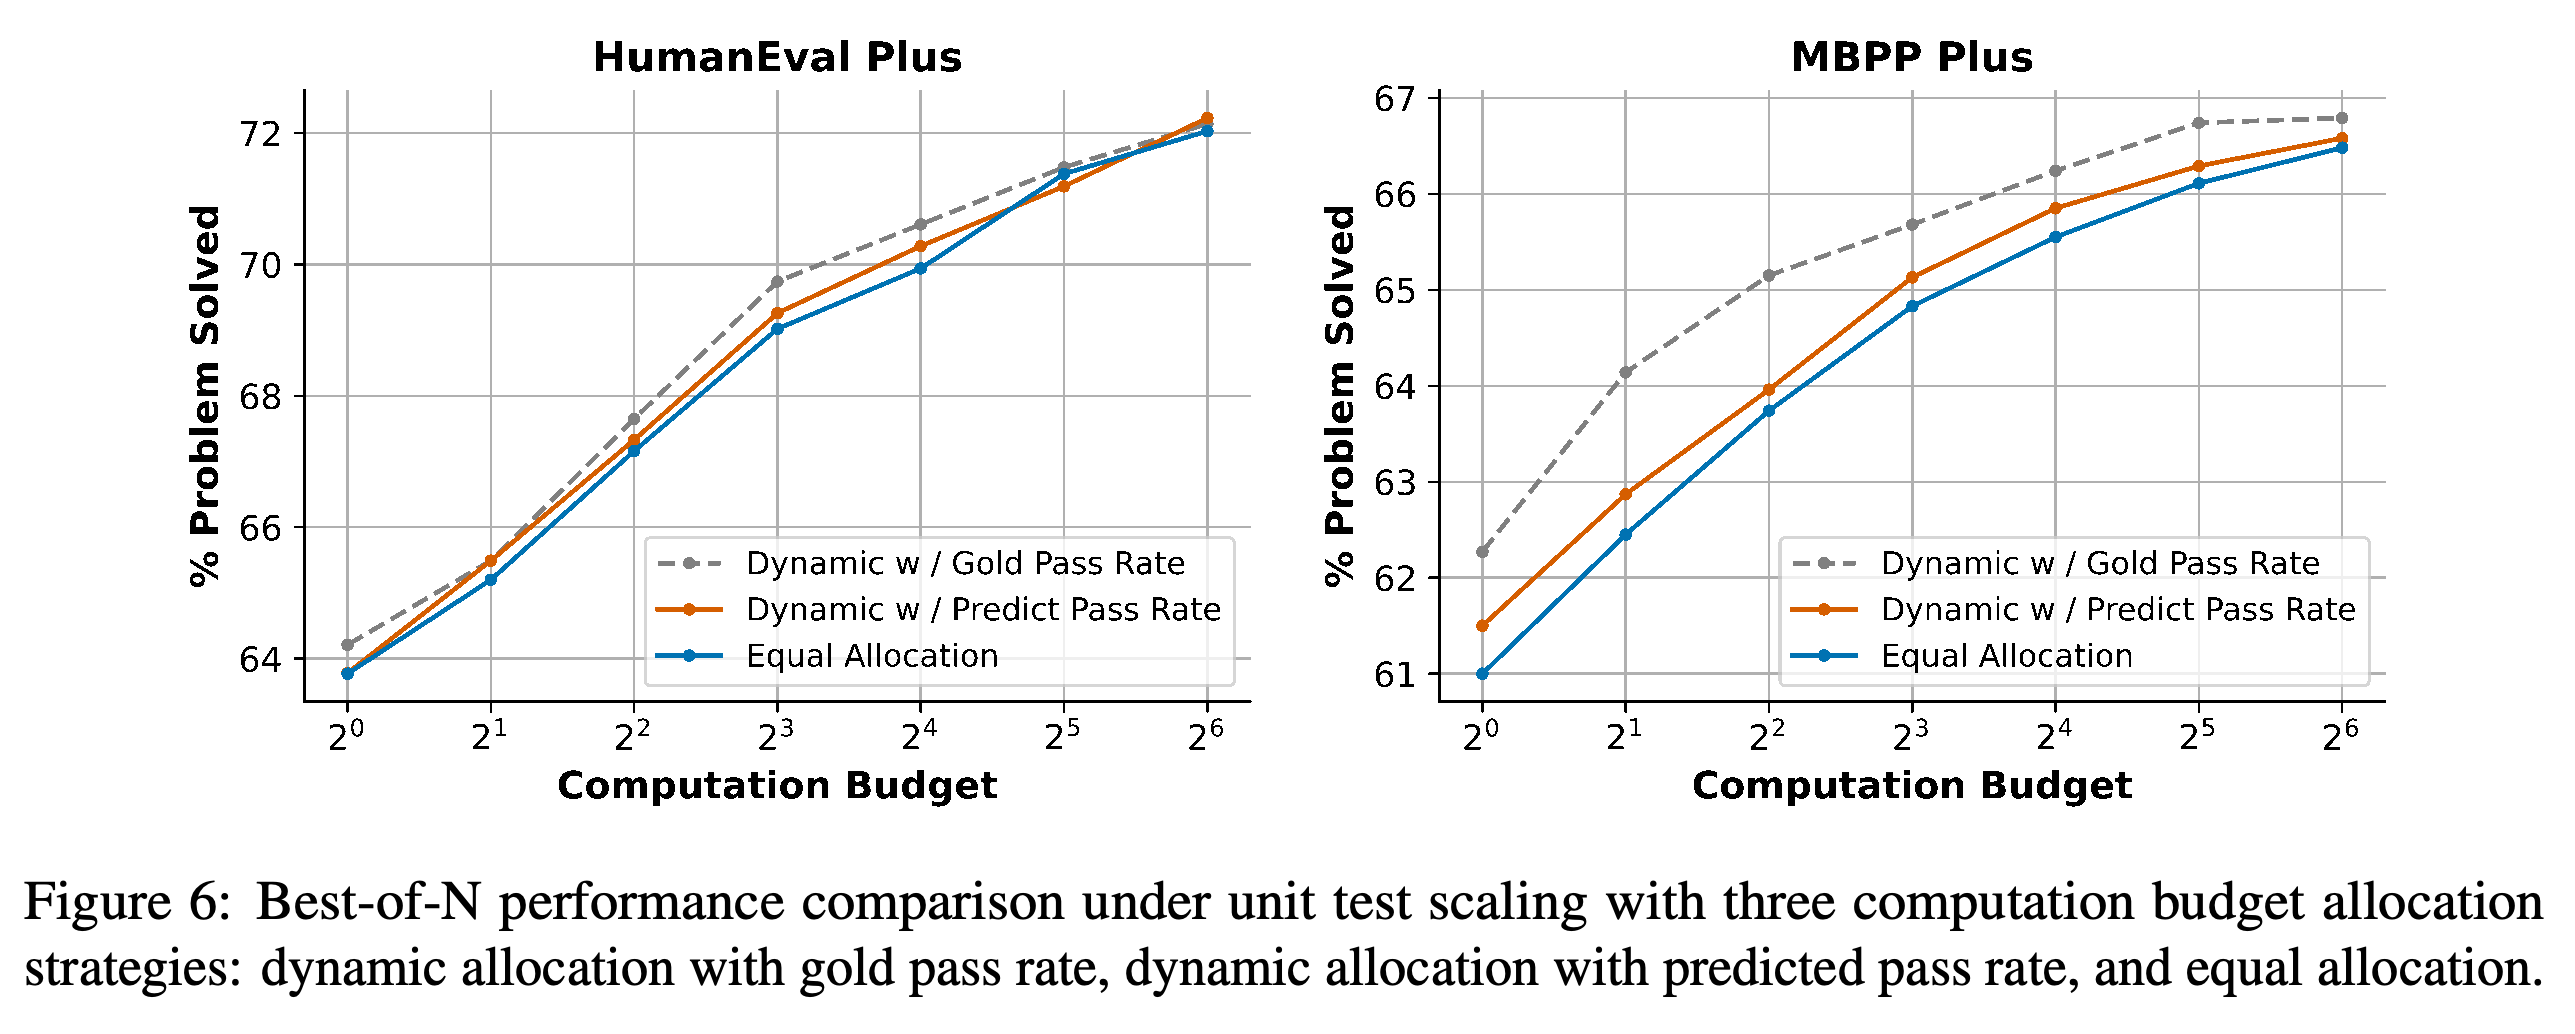
- 테스트 수를 늘리면 대체로 풀이 선택 성능이 높아진다. 샘플링한 후보에 정답이 있는 문제만 분석했을 때는 어려운 문제에서 개선 폭이 더 컸다. 예측한 문제 난도에 따라 테스트 예산을 다르게 배분하는 동적 할당은, 테스트를 확장한 프로그래밍 벤치마크 MBPP Plus에서 고정 예산을 균등하게 배분할 때보다 성능을 최대 약 0.5%p 높인다. 이 할당 규칙은 풀이 샘플링에 쓰이던 규칙을 적용한 것이며, HumanEval Plus에서는 개선 폭이 작다.
1 Introduction
Dynamic Scaling of Unit Tests for Code Reward Modeling은 추론 시 검증에 더 많은 연산을 사용하면 코드 선택 성능이 높아지는지 연구한다. 여기서 대규모 언어 모델(LLM)은 코드나 테스트를 생성하는 모델이다. LLM은 여러 후보 풀이를 생성할 수 있지만, 부정확한 테스트는 후보 순위를 정하는 실행 결과인 보상 신호를 왜곡할 수 있다.
- 논문은 풀이를 생성하는 정책 모델과 실행 가능한 테스트를 생성하는 보상 모델을 구분한다.
- 주요 기여는 테스트 수 확장 연구, 학습된 8B-parameter 테스트 생성기, 난도에 따른 테스트 생성 예산 할당이다.
- PDF에 제시된 프로젝트 URL은 https://code-reward-model.github.io 이다.
2 Pioneer Experiment
Pioneer Experiment는 테스트 수가 실행 기반 풀이 순위의 품질에 어떤 영향을 주는지 살펴본다. 풀이 수, 테스트 생성기, 정책 모델을 바꿔 실험하고, 관찰된 개선 효과가 문제 난도에 따라 달라지는지 분석한다.
2.1 Methodology
이 방법은 best-of-N 선택을 따른다. 후보 풀이 N개를 생성한 뒤, 생성된 테스트 스위트를 가장 많이 통과한 후보를 반환한다. 각 스위트는 입력과 출력을 검사하는 테스트의 모음이다. 논문의 다수결 방식에서 각 스위트는 이진 투표 1표를 제공하며, 풀이가 스위트 안의 모든 테스트 케이스를 통과해야 해당 스위트를 통과한 것으로 본다.
- 식 (1)은 C_opt = argmax over C_i of the sum of r_i,j for j = 1,…,M에 따라 풀이를 선택한다. 후보 C_i가 스위트 T_j의 모든 케이스를 통과하면 r_i,j는 1이고, 그렇지 않으면 0이다.
- HumanEval Plus 탐색 실험에서는 문제마다 풀이 N = 200개와 테스트 스위트 M = 100개를 생성하고, 선택한 풀이를 벤치마크의 정답 테스트로 평가한다.
- 더 적은 풀이 수와 테스트 수의 결과는 생성된 집합에서 반복 추출하는 부트스트랩 재표집으로 추정한다. 부트스트랩 표본 100개로 평균과 신뢰구간을 구한다. 부트스트랩에 대해서는 Bootstrap, Bagging, Boosting 글을 참조하라.
2.2 Observations
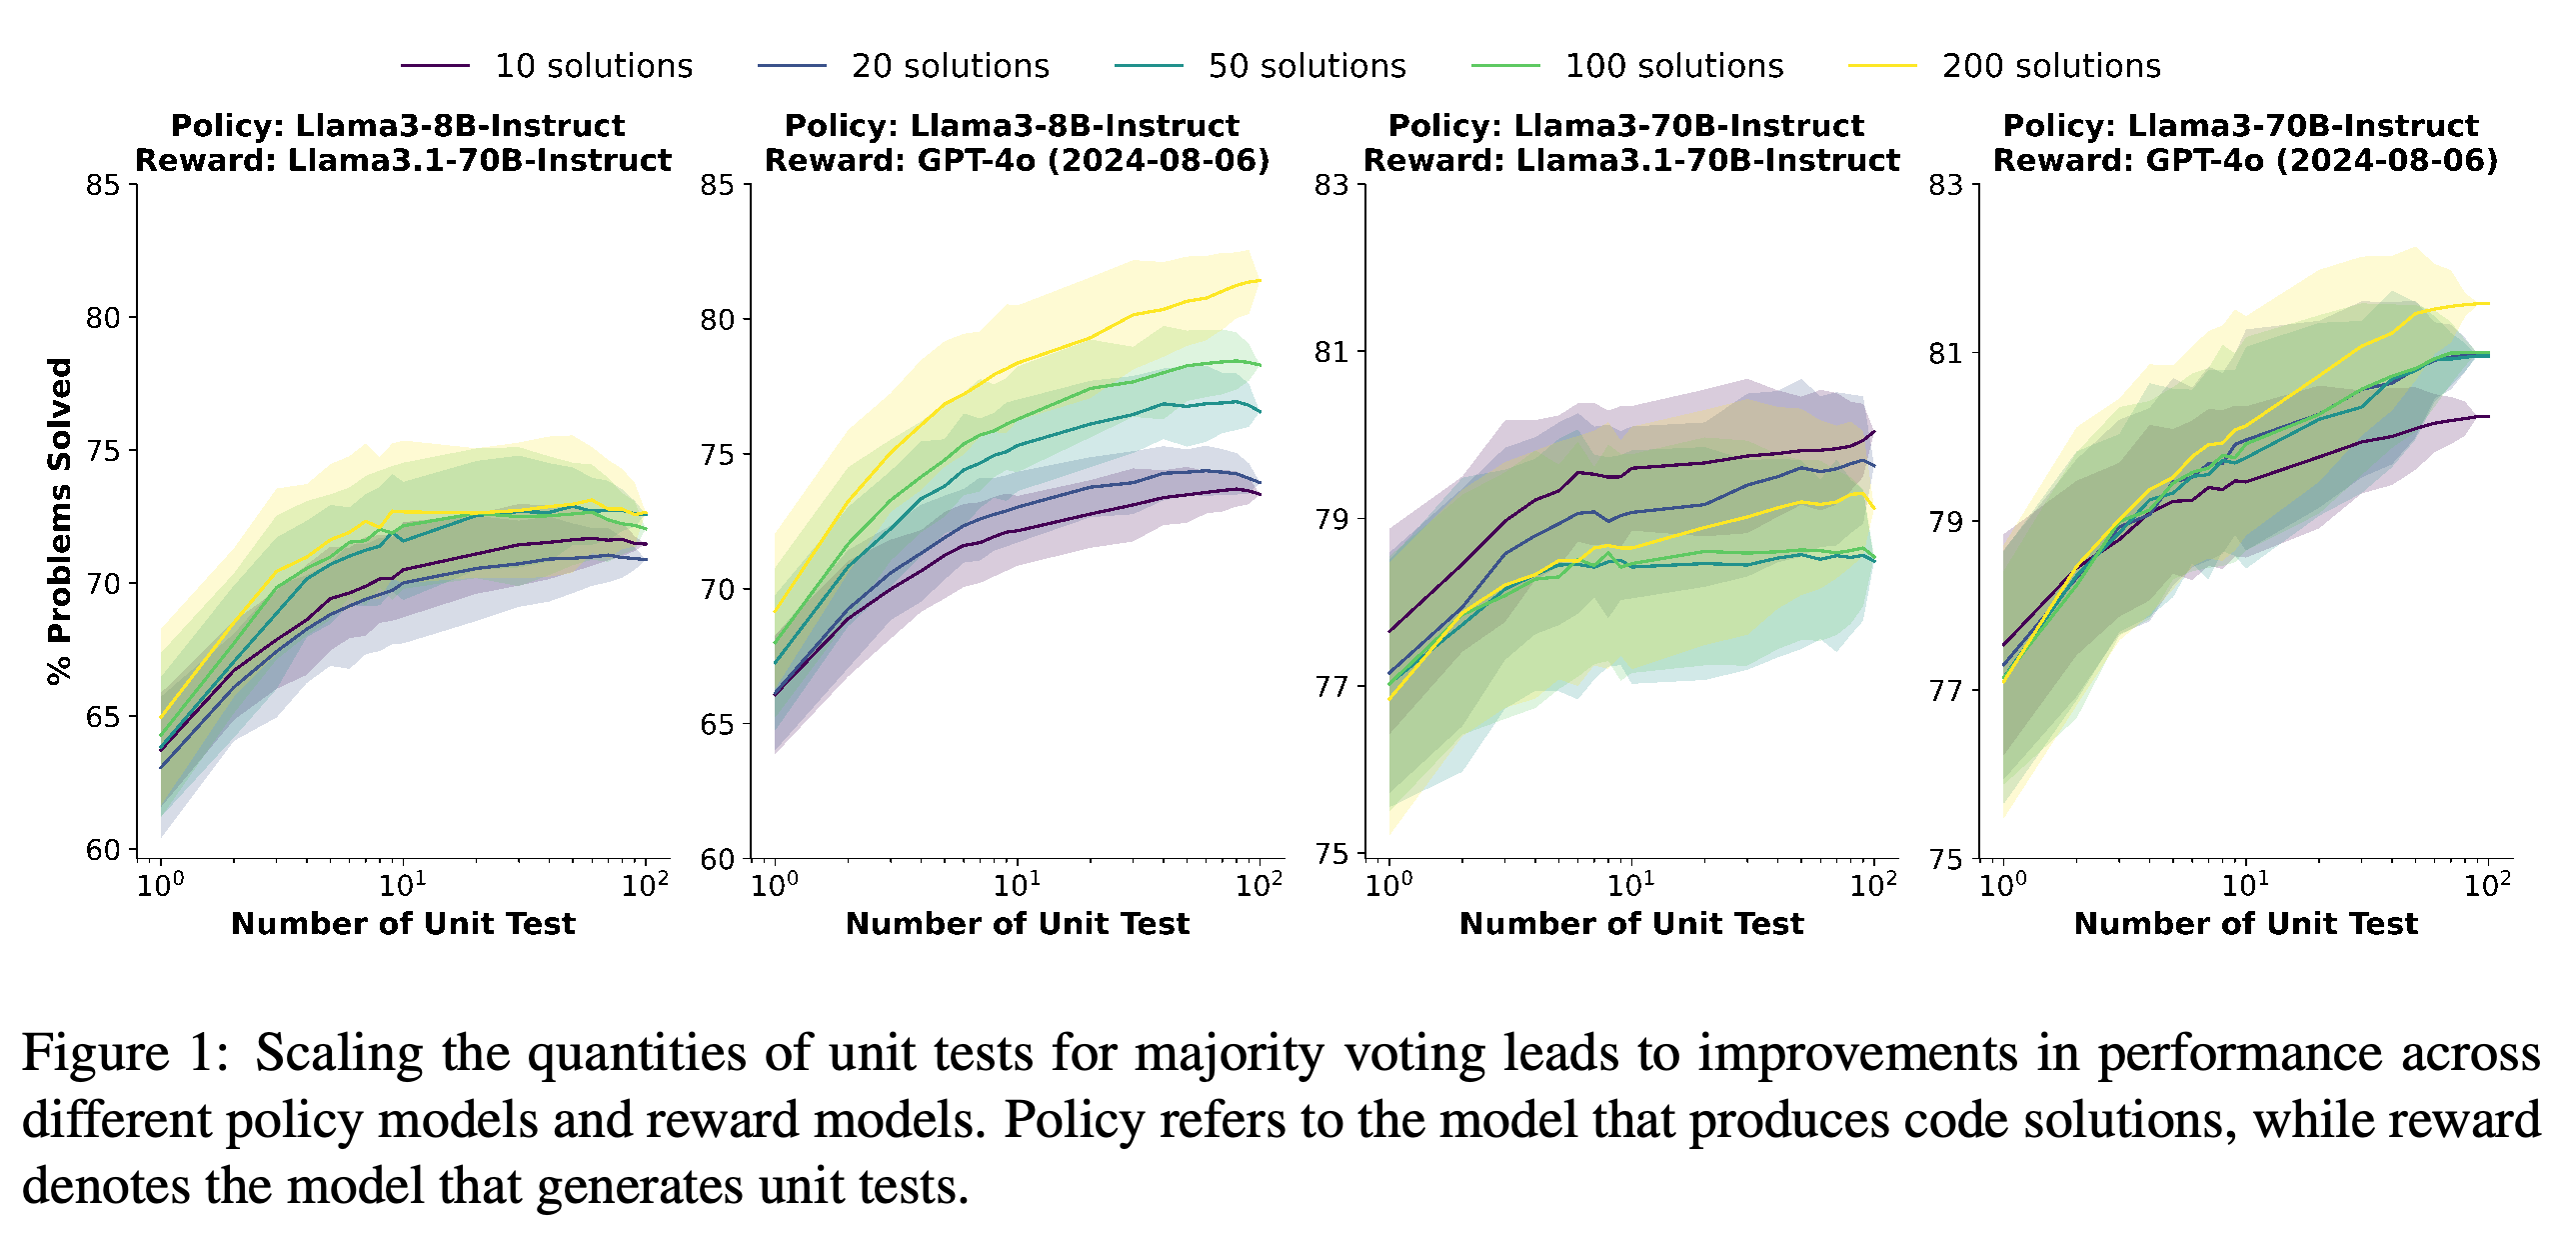
생성 테스트를 늘리면 대체로 선택 성능이 높아지며, 특히 약한 정책 모델과 어려운 문제에서 효과가 크다. GPT-4o로 테스트를 생성했을 때, 논문은 테스트 수 증가에 따라 Llama3-8B에서 약 11%p, Llama3-70B에서 약 5%p의 개선을 보고한다.
- Figure 1에서는 Llama3-70B 풀이를 Llama3.1-70B로 검증할 때 후보 수를 늘리면 성능이 떨어질 수도 있다. 추가 샘플링이 더 나은 선택을 보장하지는 않는다.
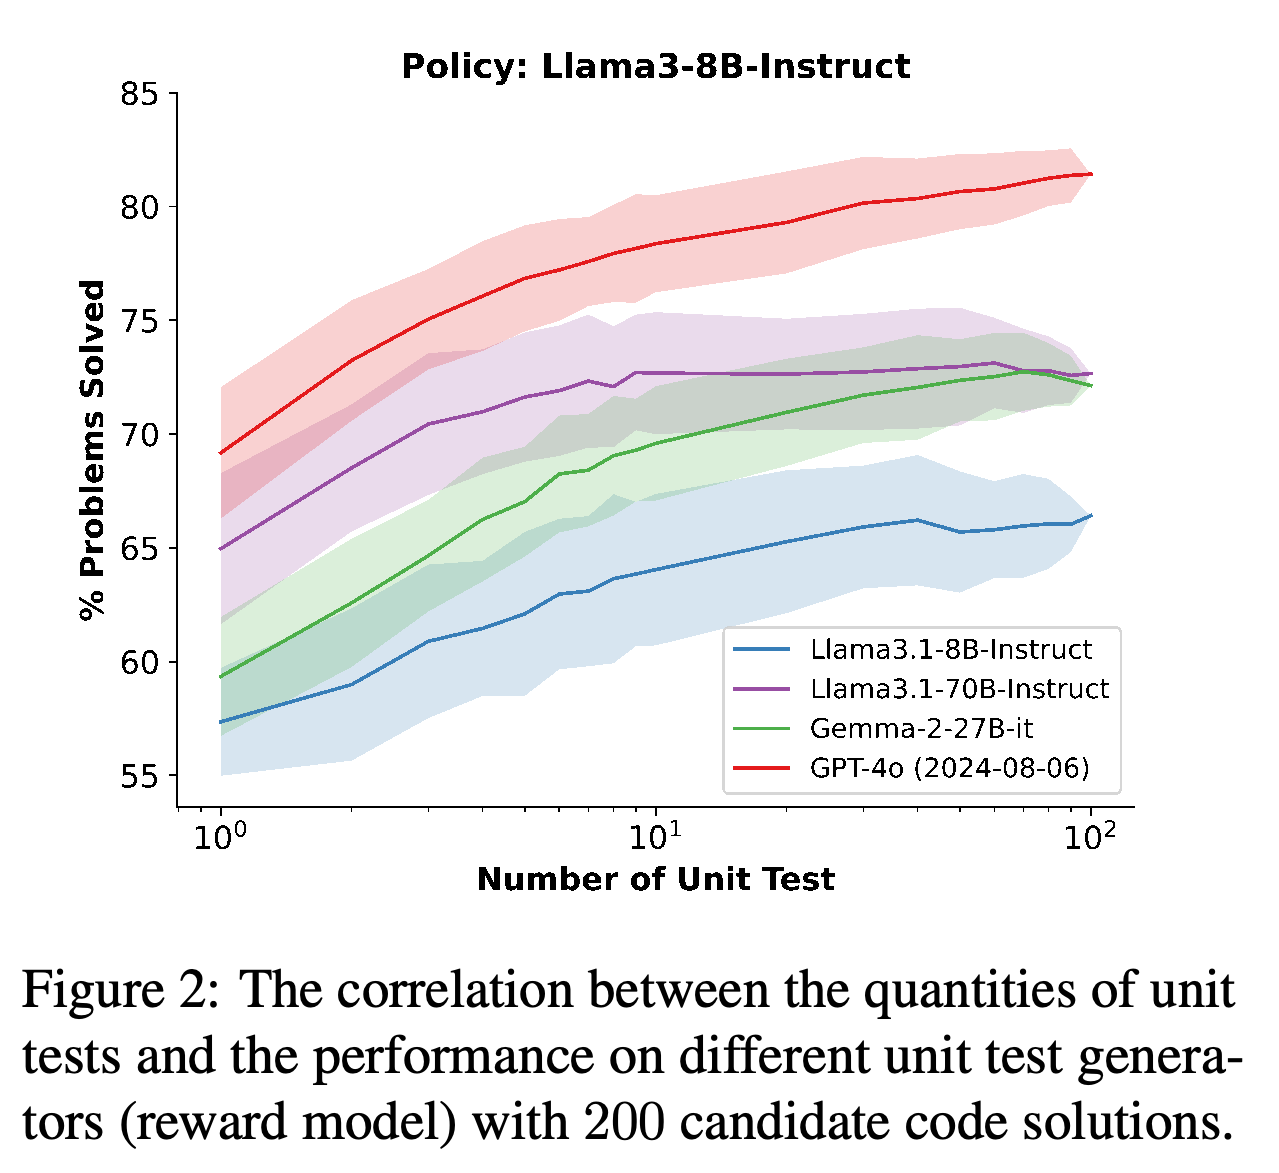
- Gemma-2-27B-it는 테스트가 1개일 때 Llama3.1-70B보다 성능이 낮지만, 100개에서는 비슷해진다. 다양성이나 커버리지 증가가 가능한 설명으로 제시되지만 직접 측정되지는 않았다.
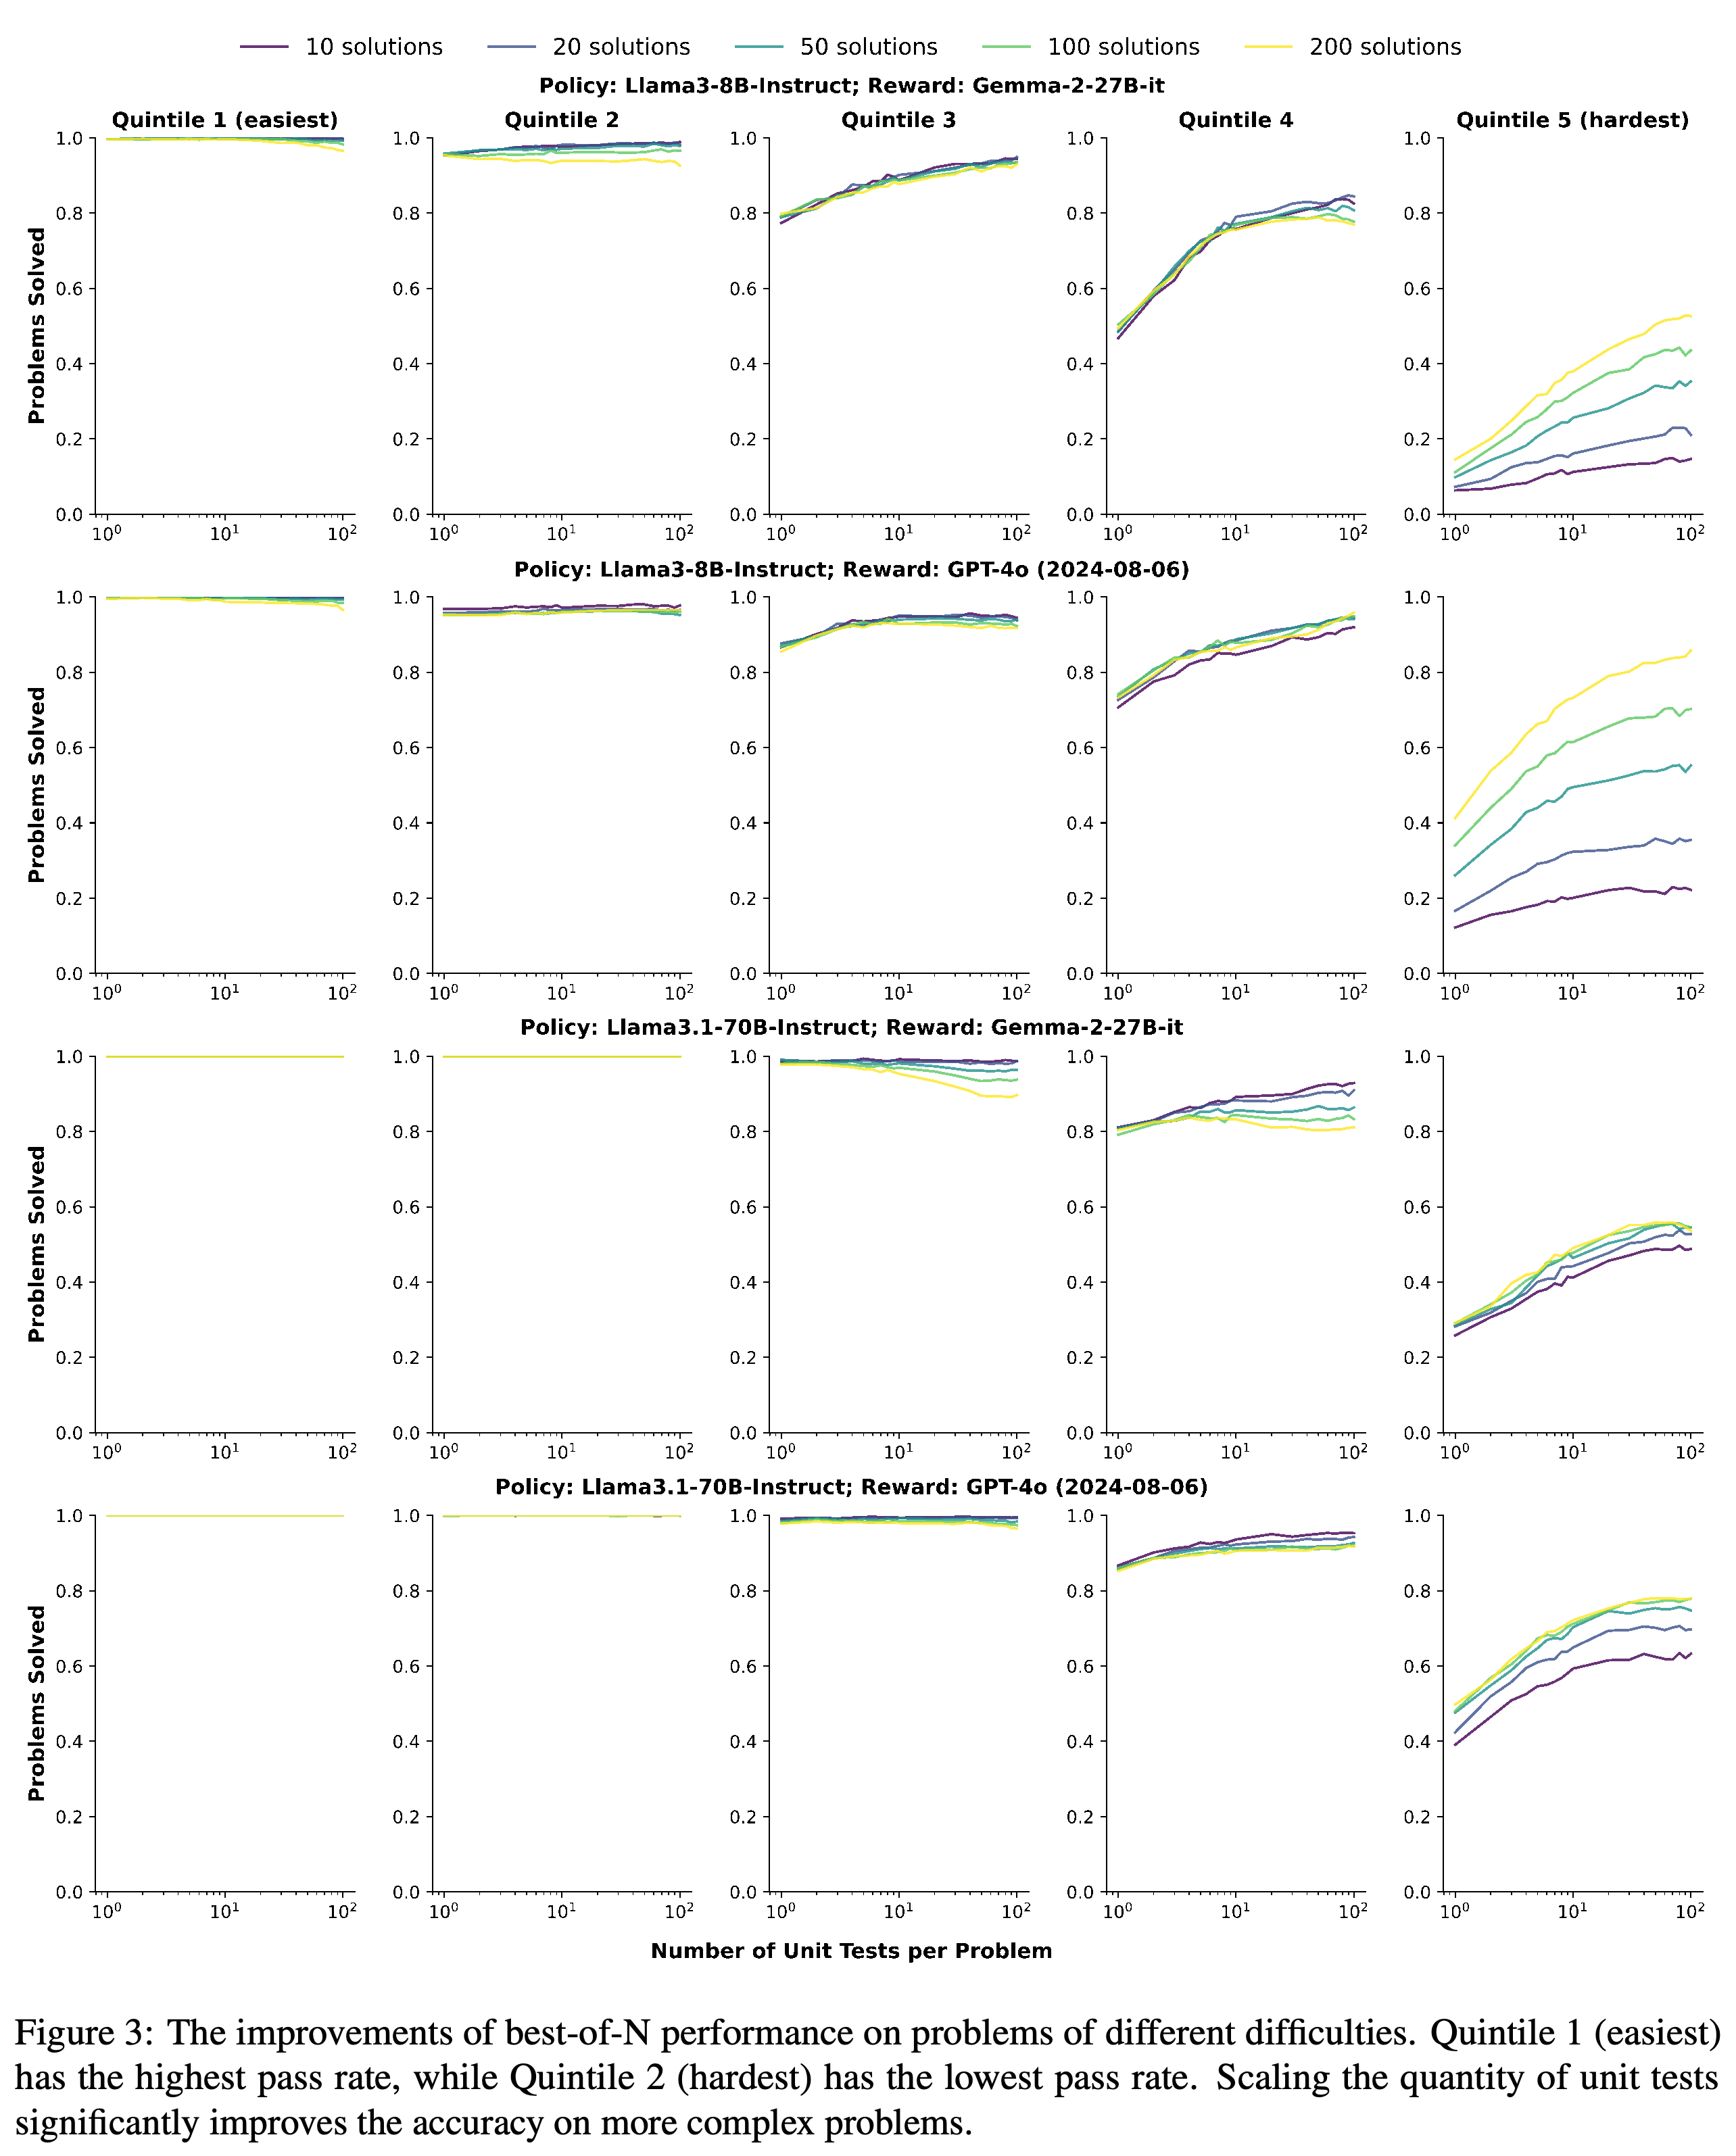
- 난도 분석에서는 샘플링한 풀이에 정답이 없는 문제를 제외하고, 나머지를 관측된 풀이 통과율에 따라 크기가 같은 5개 집단으로 나눈다. Figure 3은 Quintile 5를 가장 어렵다고 표시하지만, 캡션에서는 Quintile 2를 가장 어렵다고 잘못 설명한다.
더 많은 테스트 스위트가 후보의 정답 여부에 투표할수록 곡선은 대체로 상승한다. 다만 Llama3-70B 정책 모델을 Llama3.1-70B로 검증하는 경우에는 후보 집합을 키우면 선택 성능이 떨어질 수도 있다. 음영으로 표시한 부트스트랩 구간은 추정 성능의 불확실성을 보여준다.
후보를 200개로 고정하면, Gemma-2-27B-it는 초기 성능이 낮아도 테스트 수가 100개에 도달할 때 Llama3.1-70B에 가까워진다. GPT-4o는 여전히 더 높은 성능을 보인다. 테스트 확장은 도움이 되지만 생성기 품질 차이를 없애지는 않는다.
가장 쉬운 집단은 이미 거의 완벽한 선택 성능에 도달하지만, 가장 어려운 집단은 테스트와 후보를 추가해 개선할 여지가 훨씬 크다. 패널은 Quintile 5를 가장 어렵다고 표시하므로, Quintile 2를 가장 어렵다고 설명한 캡션과 일치하지 않는다. 샘플링한 풀이에 정답이 없는 문제는 제외했다.
3 Towards Efficient and High-Quality Unit Test Scaling
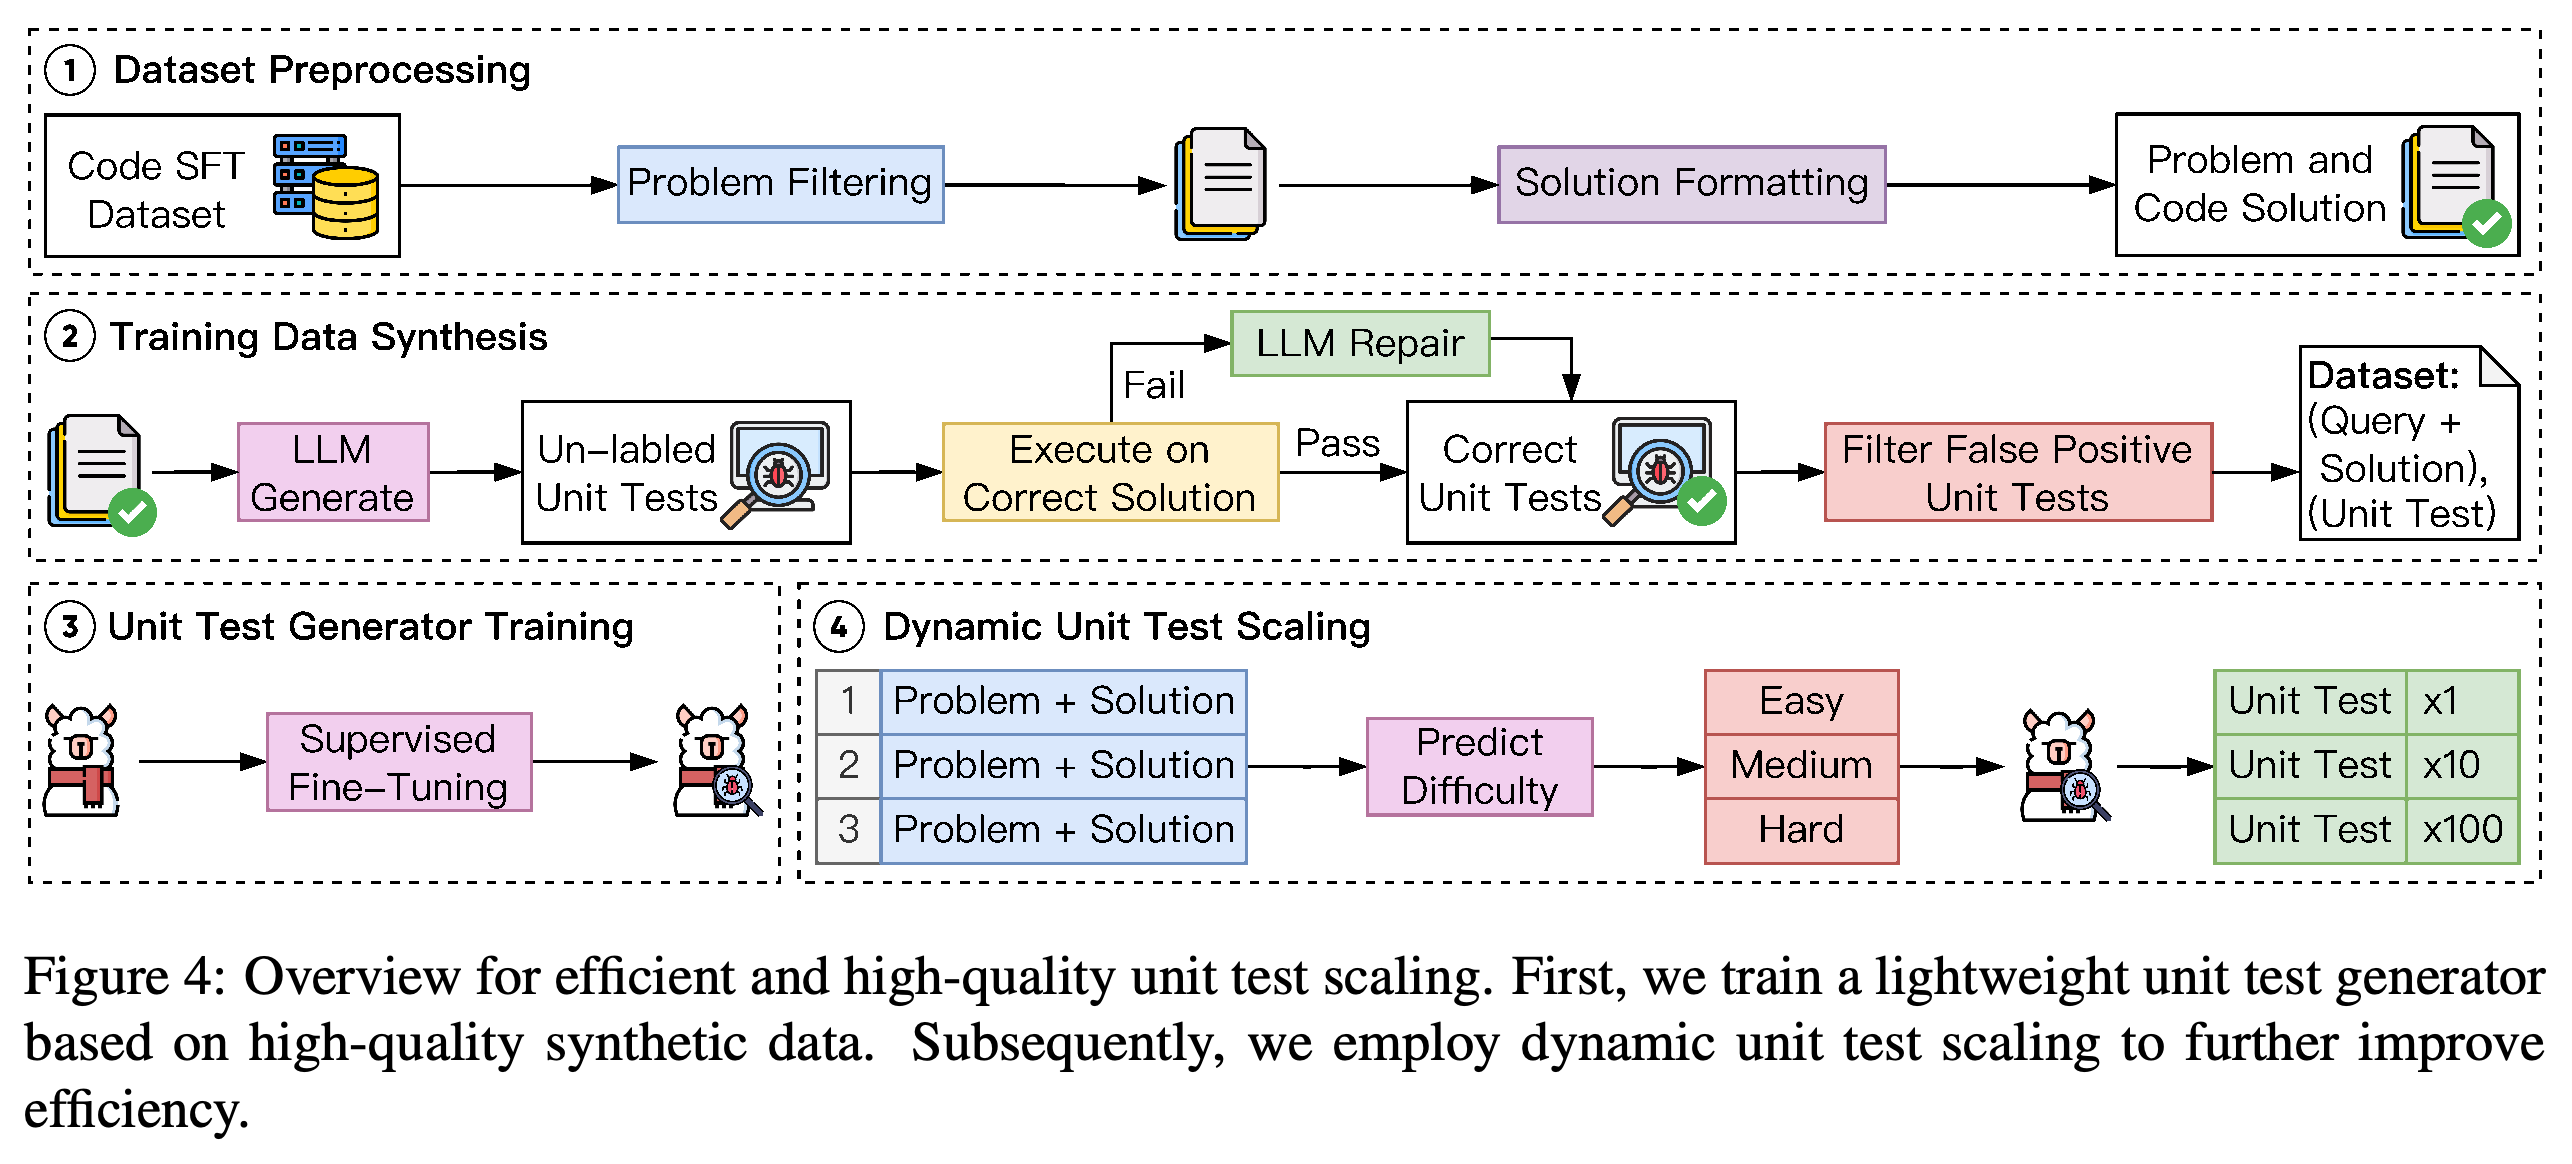
제안 시스템은 학습된 소형 생성기와 적응형 테스트 예산이라는 2개 구성 요소로 테스트 생성 비용 문제에 대응한다. CodeRM-8B가 테스트를 제공하고, 학습된 난도 추정기에 따라 탐욕적 할당 절차가 문제별 연산 예산을 점진적으로 배분한다.
3.1 Unit Test Generator
학습 데이터는 코드 생성 지시문 모음인 CodeFeedback-Filtered-Instruction과 알고리즘 프로그래밍 문제 데이터셋 TACO의 학습 세트에서 가져온다. 파이프라인은 Llama3.1-70B로 일반적인 단위 테스트에 부적합한 문제를 걸러내고, 풀이를 함수 형태로 준비한다. 이어 Llama3.1-70B로 테스트 스위트를 생성하고 Python 실행 피드백을 사용해 실패한 스위트를 수정한다.
- 먼저 기준 풀이가 통과하는 스위트를 채택한다. 추가 품질 관리에서는 성능이 낮은 모델이 생성한 오답 풀이를 걸러내지 못하는 테스트를 제거한다.
- 지도 미세 조정에서는 프로그래밍 문제와 코드 풀이를 입력으로, 선별한 테스트 스위트를 목표 출력으로 사용한다. 이를 통해 Llama3.1-8B에서 CodeRM-8B를 학습한다.
- 원본 데이터셋 링크는 https://huggingface.co/datasets/m-a-p/CodeFeedback-Filtered-Instruction 및 https://huggingface.co/datasets/BAAI/TACO 이다.
3.2 Dynamic Unit Test Scaling
난도는 정책 모델이 생성한 풀이의 추정 통과율로 표현한다. 모델의 중간 표현으로 학습한 소형 예측기인 2층 피드포워드 프로브가 이 통과율을 예측한다. 입력으로는 코드 생성 중 이미 계산된 내부 표현인 은닉 상태를 사용한다.
- 학습 목표는 반복 샘플링한 풀이를 미리 수집한 유효 테스트로 검사해 얻은 평균 성공률이다.
- Damani et al. (2024)을 따라, 할당 규칙은 q(x,b) = 1 − (1 − λ)^b를 사용해 탐욕적으로 예산을 배분한다. 이는 통과 확률이 λ일 때 b번 시도에서 정답을 1개 이상 얻을 확률이다.
- 이 확률은 추가 검증 테스트의 효과가 아니라 풀이 샘플링을 설명한다. 논문은 이 불일치를 한계로 명시한다.
기준 풀이를 실행해 생성 스위트가 올바른 코드를 통과시키는지 확인하고, 별도의 필터링 단계에서 오답 코드를 거부하는지 확인한다. 이 2개 기준을 반영한 데이터로 생성기를 학습한 뒤, 난도 예측에 따라 문제별 생성 테스트 수를 조절한다.
4 Experiments
실험에서는 풀이 선택 성능, 생성된 검증 신호의 품질, 합성 데이터 구성의 효과를 평가한다. 또한 고정된 테스트 생성 예산에서 난도 기반 할당과 균등 할당을 비교한다.
4.1 Experimental Setup
평가에는 HumanEval Plus, MBPP Plus와 LiveCodeBench에서 함수 형태의 풀이를 갖춘 문제 168개를 사용한다. LiveCodeBench는 새로운 프로그래밍 문제를 지속적으로 수집하는 벤치마크다. 사용한 부분집합의 기간은 2024-01부터 2024-09까지다. 보고 지표인 Pass@1은 선택 후 반환한 풀이 1개로 해결한 문제의 비율이다.
- 주요 비교에서는 Llama3-8B-Instruct, Llama3-70B-Instruct, GPT-3.5-turbo 또는 GPT-4o-mini로 문제마다 후보 풀이 100개를 생성한다.
- 베이스라인은 무작위 선택, ArmoRM-Llama3-8B-v0.1을 이용한 스칼라 점수 평가, 실행 결과에 기반한 minimum Bayes risk decoding으로 후보 순위를 정하는 MBR-Exec, 풀이와 생성 테스트 사이의 일치를 이용하는 CodeT, 풀이, 명세, 테스트의 일관성을 결합하는 multi-perspective self-consistency인 MPSC다.
- 실행 기반 베이스라인은 Llama3.1-70B로 테스트를 생성하며, 명시된 추론 예산은 모두 100회다. 이는 생성 호출 수를 맞춘 것이며, 보고된 비교만으로 생성기와 출력 형식 사이의 실행 시간이나 토큰 비용이 같다고 볼 수는 없다.
4.2 Main Results
CodeRM-8B는 벤치마크 3개 모두에서 정책 모델 4개 전부의 성능을 무작위 선택보다 높인다. HumanEval Plus에서 Llama3-8B는 53.58%에서 72.01%로, Llama3-70B는 73.74%에서 78.69%로, GPT-4o-mini는 82.96%에서 86.38%로 높아진다.
- MBPP Plus에서 CodeRM-8B는 Llama3-8B, Llama3-70B, GPT-3.5-turbo, GPT-4o-mini에 대해 각각 66.71%, 72.44%, 75.96%, 75.20%를 기록한다. LiveCodeBench에서는 각각 15.21%, 27.73%, 21.76%, 39.20%를 기록한다.
- Llama3.1-70B와의 비교 결과는 엇갈린다. CodeRM-8B는 MBPP Plus의 비교 4개에서 모두 앞서지만, HumanEval Plus의 Llama3-8B와 GPT-3.5, LiveCodeBench의 Llama3-70B와 GPT-3.5에서는 뒤처진다.
- Figure 6에서는 고정 예산에서 예측 난도에 따른 할당이 균등 할당보다 소폭 개선되며, MBPP Plus의 개선 폭은 최대 약 0.5%p다. 예측 성공률 대신 관측 성공률인 gold pass rates를 사용해 측정된 난도로 할당한 결과도 비교한다.
CodeRM-8B는 정책 모델과 벤치마크의 조합 12개 모두에서 무작위 선택보다 성능이 높다. MBPP Plus의 모든 열에서 Llama3.1-70B 검증기를 앞서지만, HumanEval Plus와 LiveCodeBench에서는 결과가 엇갈린다. 따라서 대체로 비슷한 성능을 보인다는 해석을 뒷받침한다.
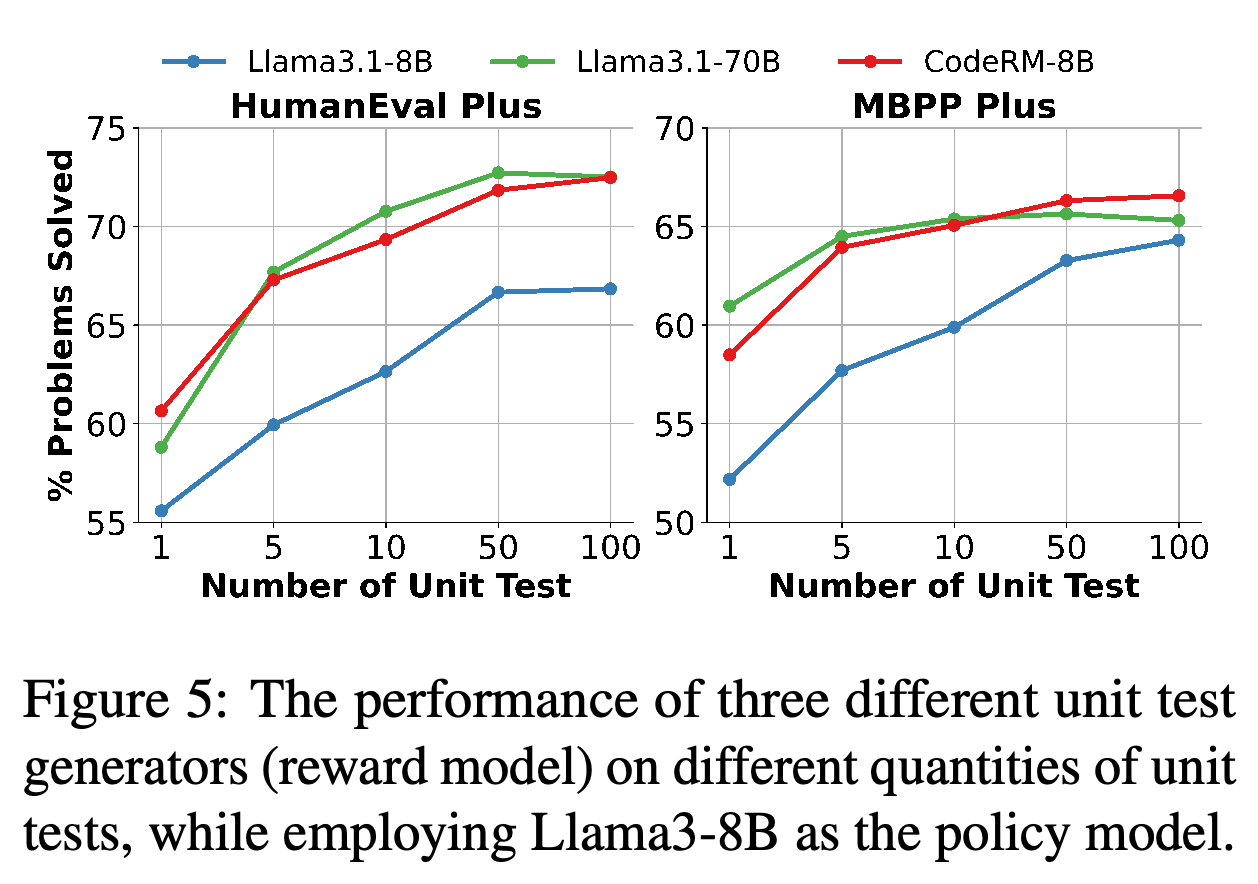
테스트 수가 늘어날수록 미세 조정한 8B 생성기는 원래 모델보다 훨씬 높은 성능을 보인다. CodeRM-8B는 HumanEval Plus에서 Llama3.1-70B에 가까워지고, MBPP Plus에서는 테스트 수가 많을 때 이를 앞선다.
예측 통과율에 따른 할당은 같은 예산의 균등 할당보다 성능이 소폭 높으며, MBPP Plus에서 차이가 더 뚜렷하다. 관측 통과율로 할당한 결과와의 차이는 예측을 측정된 난도로 대체하는 효과를 보여준다. 이 경우에도 HumanEval Plus의 개선 폭은 작다.
4.3 Quality of Generated Unit Tests
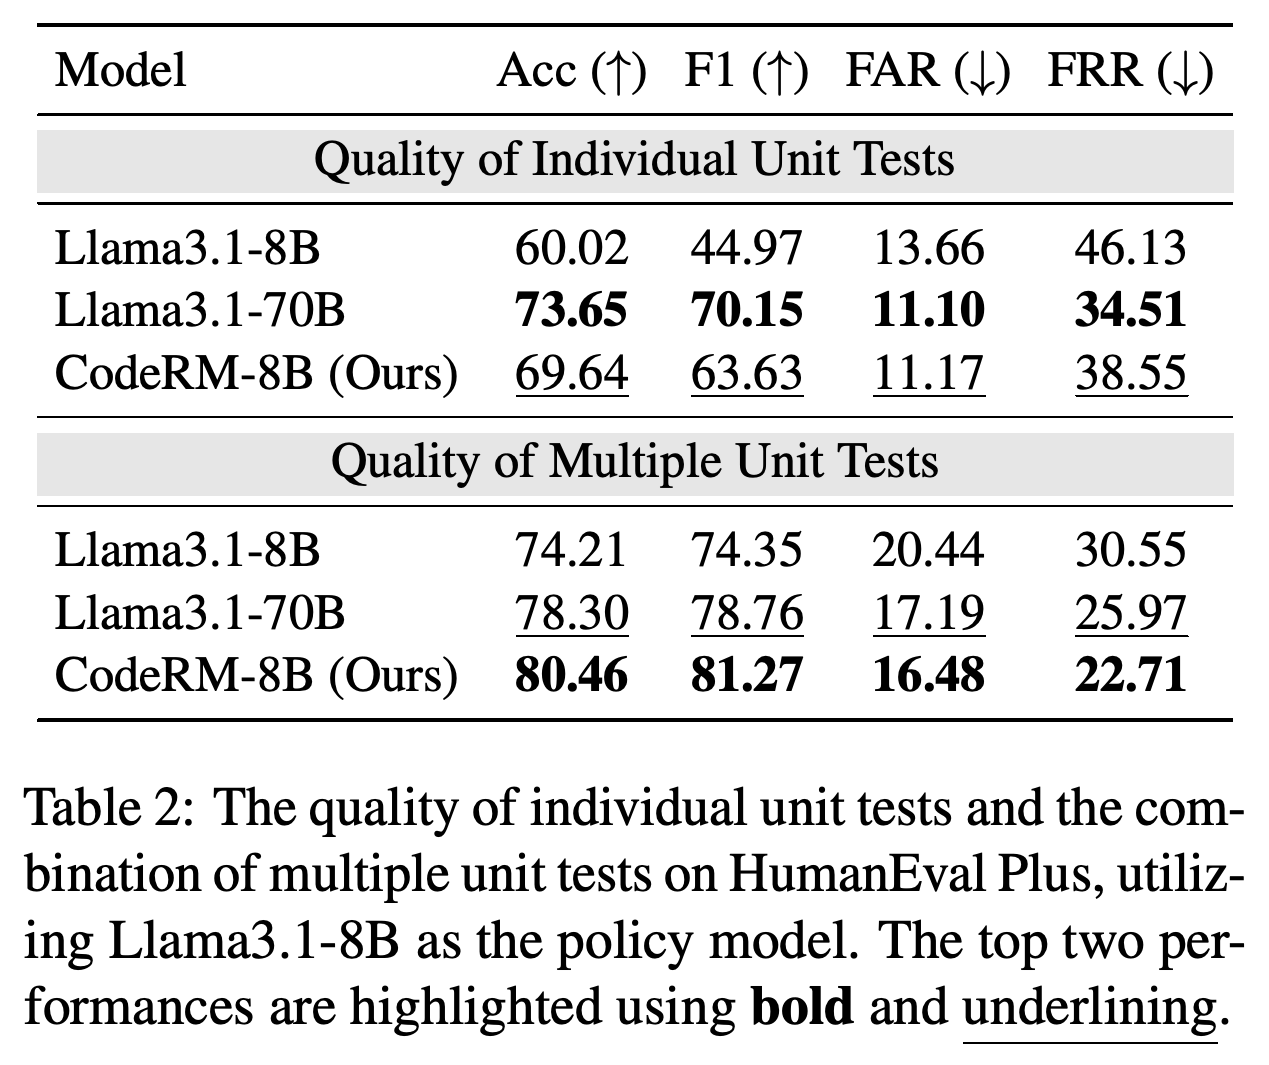
논문은 테스트를 풀이의 정답 여부를 판별하는 분류기로 보고 정확도와 F1을 보고한다. F1은 정밀도와 재현율의 조화평균이다. 정밀도는 통과시킨 풀이 중 정답의 비율이고, 재현율은 정답 풀이 중 통과시킨 비율이다. 오답 풀이를 통과시키는 False Acceptance Rate(FAR)와 정답 풀이를 거부하는 False Rejection Rate(FRR)도 보고하지만, 부록에 제시된 수식의 분모는 이러한 설명과 다르다.
- HumanEval Plus에서 Llama3.1-8B를 정책 모델로 사용하면, CodeRM-8B의 개별 테스트는 정확도 69.64%, F1 63.63을 기록한다. 이는 Llama3.1-70B의 73.65%, 70.15보다 낮다.
- 테스트 100개를 결합하면 비교 결과가 뒤집힌다. CodeRM-8B는 정확도 80.46%, F1 81.27을 기록하고, Llama3.1-70B는 78.30%, 78.76을 기록한다.
- 이 역전은 개별 테스트와 결합된 검증기를 따로 평가할 필요성을 뒷받침한다. 유용한 테스트 다양성이 작용했을 가능성과 부합하지만, 다양성이 개선의 원인임을 직접 입증하지는 않는다.
CodeRM-8B의 개별 테스트는 정확도가 69.64%로 Llama3.1-70B의 73.65%보다 낮지만, 테스트 100개를 결합하면 각각 80.46%와 78.30%로 순위가 뒤집힌다. 이는 테스트를 결합한 검증의 이점을 입증하지만, 그 원인으로 제안한 다양성을 직접 측정한 결과는 아니다.
4.4 Ablation Study of Synthetic Data
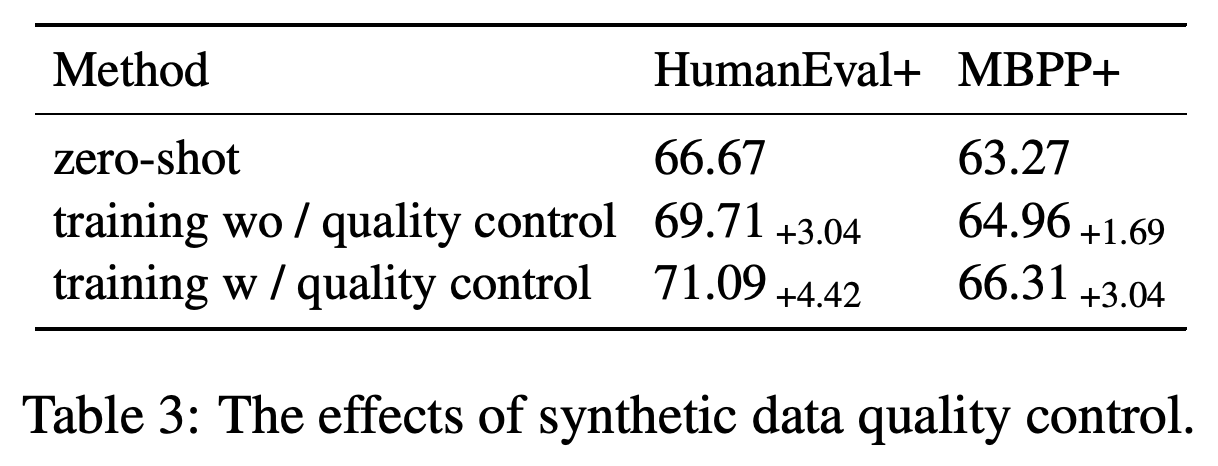
오답 풀이를 통과시키는 테스트를 걸러내면, 이러한 품질 관리 없이 미세 조정했을 때보다 학습된 생성기의 성능이 높아진다. HumanEval Plus는 69.71%에서 71.09%로, MBPP Plus는 64.96%에서 66.31%로 높아진다.
- 과제별 미세 조정 없이 평가한 zero-shot 생성기의 성능은 66.67%, 63.27%다. 이를 기준으로 품질 관리를 적용한 학습의 개선 폭은 각각 4.42와 3.04%p이며, 필터링 없는 학습에서는 각각 3.04와 1.69다.
- 본문에서 언급한 약 45%와 80%의 상대적 개선은 최종 벤치마크 정확도의 상대 증가율이 아니라, zero-shot 대비 개선 폭의 증가율이다.
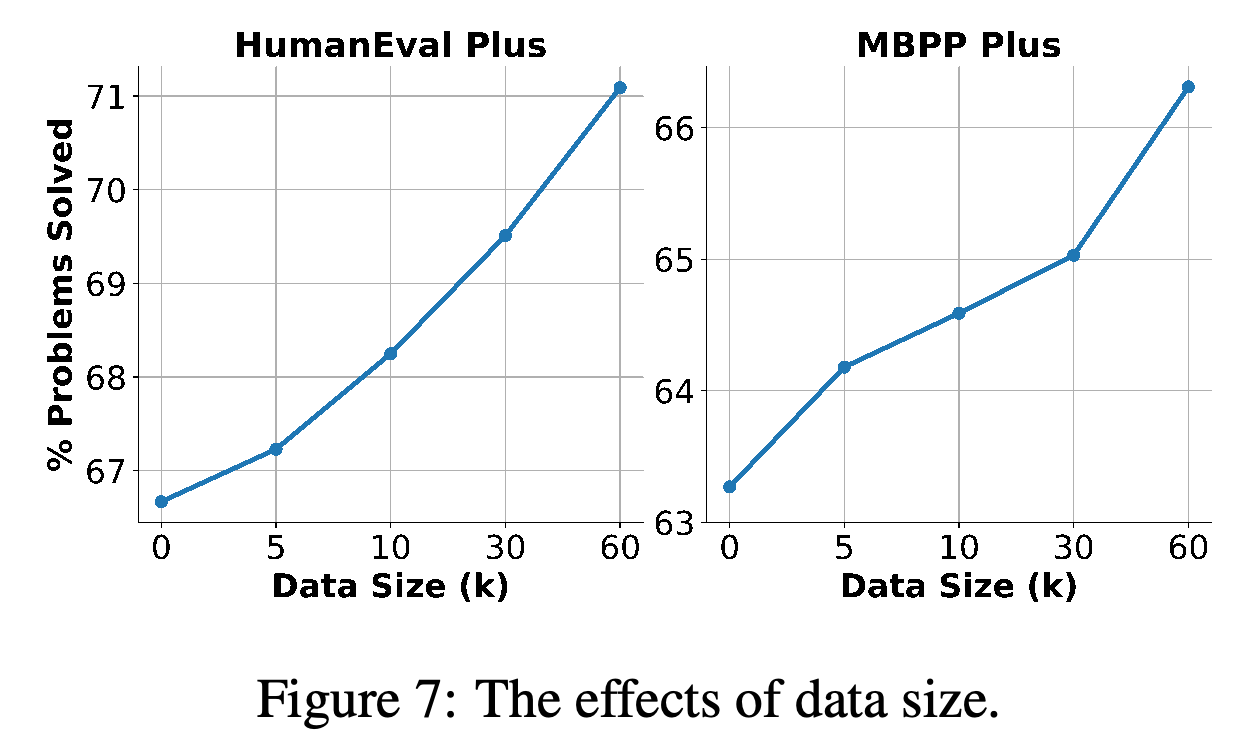
- Figure 7에서는 학습 예제 수가 0, 5k, 10k, 30k, 60k로 늘어날수록 성능이 높아지며, HumanEval Plus에서 약 71.1%, MBPP Plus에서 약 66.3%에 도달한다.
품질 관리가 필터링 없는 학습에 더하는 개선 폭은 HumanEval Plus에서 1.38%p이고 MBPP Plus에서 1.35다. 본문의 약 45%와 80%는 최종 정확도가 아니라 zero-shot 대비 개선 폭의 증가율을 뜻한다.
벤치마크 2개의 곡선은 평가한 학습 데이터 규모가 60k개에 이르기까지 모두 상승한다. 이 결과는 실험 범위 안에서 선별된 합성 학습 데이터를 늘리는 것이 유용함을 뒷받침한다.
5 Related Work
관련 연구는 테스트로 후보의 동작을 확인하는 실행 기반 재순위화와, 후보를 실행하지 않고 점수를 매기는 학습된 재순위화 모델을 구분한다. 단위 테스트 생성 연구로는 후보 테스트를 탐색하는 검색 기반 방법, 프로그램 조건에서 테스트를 도출하는 제약 기반 방법, 확률 기반 방법, LLM 기반 접근을 다룬다. 이 논문은 실행 기반 설정에서 확장 분석과 합성 데이터로 학습한 생성기를 제시한다.
6 Conclusion
결론에서는 생성 테스트 수와 코드 보상 품질 사이에 양의 관계가 있으며, 어려운 문제에서 개선 효과가 더 크다고 보고한다. CodeRM-8B는 더 큰 테스트 생성기와 대체로 비슷한 풀이 선택 성능을 달성한다. 동적 할당은 고정 예산에서 추가 개선을 제공하지만 그 폭은 더 작다.
7 Limitations
저자들은 풀이 생성을 위해 개발된 할당 규칙이 검증기 생성에는 잘 맞지 않을 수 있음을 인정한다. 실제 통과율로 할당해도 HumanEval Plus의 개선 폭은 비교적 작다.
- 다양성과 커버리지가 개선을 설명한다는 가설은 미해결 과제로 남는다. 테스트 수가 늘어날 때 어느 쪽도 직접 정량화하지 않았다.
- 난도별 탐색 결과는 샘플링한 후보에 정답이 없는 문제를 제외한다. 따라서 정답을 선택할 가능성이 있는 후보 집합에서의 선택 성능을 보여준다.
- 전처리에서는 무작위성이나 외부 자원 의존성처럼 테스트하기 어려운 여러 동작을 제외한다. 따라서 실험 근거가 다루는 범위는 일반적인 소프트웨어 테스트보다 좁다.
부록
- A License는 CodeFeedback-Filtered-Instruction과 TACO가 Apache 2.0을 사용한다고 명시하고, 논문이 채택되면 CodeRM-8B와 합성 학습 데이터를 Apache 2.0으로 공개할 계획이라고 밝힌다. 이 PDF는 공개 의향을 기록하며, 실제 공개가 이루어졌다는 근거를 제공하지는 않는다.
- B More Results of Unit Test Scaling은 정책 모델과 보상 모델 조합별 난도를 더 세밀하게 분석한 Figure 8을 제공한다. 히트맵은 대체로 어려운 문제에서 테스트 추가 효과가 더 크다는 결과를 뒷받침하지만, 모델 조합과 난도 구간에 따라 차이가 있다.
- C Experiment Settings and Baselines는 문제당 후보 풀이 100개, temperature 0.8, Top P 0.95를 명시한다. Temperature와 Top P는 샘플링의 무작위성과 선택 가능한 토큰의 누적 확률을 조절한다. Frequency penalty는 0, presence penalty는 0으로 설정해 해당 반복 페널티를 비활성화한다. NVIDIA A800 그래픽 처리 장치(GPU) 8개를 사용했다고 보고한다. MBR-Exec와 CodeT에는 각각 테스트 생성 추론 100회를 제공하며, 추론마다 테스트 케이스 10개를 요청한다. MPSC에는 명시된 공통 예산 안에서 테스트 케이스 50개와 명세 50개를 제공한다.
- D Metrics for Assessing Unit Test Quality는 true positives(TP, 통과시킨 정답 풀이), true negatives(TN, 거부한 오답 풀이), false positives(FP, 통과시킨 오답 풀이), false negatives(FN, 거부한 정답 풀이)를 사용해 정확도, 정밀도, 재현율, F1을 정의한다. 수식은 \(\mathrm{FAR}=\frac{FP}{FP+TP}\)와 \(\mathrm{FRR}=\frac{FN}{FN+TN}\)이며, 각각 통과 예측과 거부 예측을 조건으로 삼는다. 이는 실제 풀이의 정답 여부를 조건으로 확률을 설명한 본문과 다르다. 테스트가 여러 개일 때는 통과 횟수가 가장 많은 후보를 정답으로, 나머지 후보를 오답으로 분류한다.
- E Prompt for Data Synthetic Pipeline은 문제 필터링, 테스트 수정, 함수 인터페이스 추출, TACO 풀이 생성, 코드와 테스트 생성, 문제와 풀이 형식 변환을 위한 템플릿을 제공한다. 필터링 대상은 무작위성, 시간 의존성, 외부 자원, 동시성, 하드웨어, 사용자 인터페이스, 부수 효과, 암호화, 적응형 학습, 복잡한 수학 또는 시뮬레이션 동작이다. Figure 9는 문제와 풀이를 입력으로 받고 Python 단위 테스트 라이브러리 unittest를 사용한 출력을 생성하는 예시다. 양수 반환 케이스와 0 case라고 표시된 테스트의 실제 계산 결과는 각각 −45와 −36으로, 표시와 다르다.
짧은 생각
가장 강한 근거는 테스트를 결합한 검증에 있다. CodeRM-8B의 개별 테스트는 70B 생성기보다 성능이 낮지만, 테스트 100개를 결합하면 정답 여부 분류 성능이 높아지고 풀이 선택 성능도 대체로 비슷해진다. 동적 할당기의 목적함수는 검증 품질이 아닌 풀이 샘플링을 모델링하며, 측정된 개선 폭도 작아 근거가 상대적으로 약하다. 실용적인 효율성을 평가하려면 파라미터 수와 동일한 추론 횟수의 비교에 더해 실행 시간과 토큰 비용을 직접 측정해야 한다.