


Transformer Memory as a Differentiable Search Index 요약 설명
14 Feb 2022 | Paper Review Information Retrieval Generative Indexing Multi-Task Learning목차
이번 글에서는 Transformer Memory as a Differentiable Search Index 논문의 핵심 포인트만 간단히 정리한다.
- 2022년 2월 14일(Arxiv), 36th Conference on Neural Information Processing Systems (NeurIPS 2022)
- Tay, Yi, Tran, Vinh Q., Dehghani, Mostafa, Ni, Jianmo, Bahri, Dara, Mehta, Harsh, Qin, Zhen, Hui, Kai, Zhao, Zhe, Gupta, Jai, et al.
- Google Research
- 논문 링크 (v3, 2022년 10월 21일 수정)
요약
- 이 논문은 검색 인덱스를 Transformer의 파라미터에 저장해 관련 문서를 검색하는 방법을 연구한다. 질문과 Wikipedia 문서를 짝지은 Natural Questions 데이터셋인 NQ320K에서 문서 군집으로 만든 식별자를 사용하는 11B-parameter Differentiable Search Index(DSI)는 Hits@1 40.4%를 달성했다. Hits@1은 정답 문서가 1위에 오른 질의의 비율이다. 질의와 문서를 각각 인코딩해 검색하는 11B-parameter T5 dual encoder의 성능은 24.3%였다.
- DSI는 문서 텍스트와 문서 식별자를 연결하고, 질의에서 식별자를 생성하도록 학습한다. 성능은 식별자 설계, 인덱싱 전략, 모델 크기, 인덱싱과 검색 학습의 균형에 따라 달라진다.
- 평가에는 질의응답 검색 데이터셋 1개와 중간 규모의 코퍼스를 사용한다. 부록에서는 인덱싱한 문서를 망각하면서 성능이 크게 변동한다고 보고하므로, 검증 체크포인트 선택이 결과에 영향을 미친다.
1 Introduction
정보 검색은 질의를 관련 문서에 연결하며, 보통 검색과 순위 결정 단계를 별도로 거친다. DSI는 입력 시퀀스에서 출력 시퀀스를 생성하는 sequence-to-sequence 모델을 사용해 질의를 문서 식별자(docid)에 직접 연결한다. sequence-to-sequence 모델에 대해서는 BART 논문 설명(BART - Denoising Sequence-to-Sequence Pre-training for Natural Language Generation, Translation, and Comprehension) 글을 참조하라.
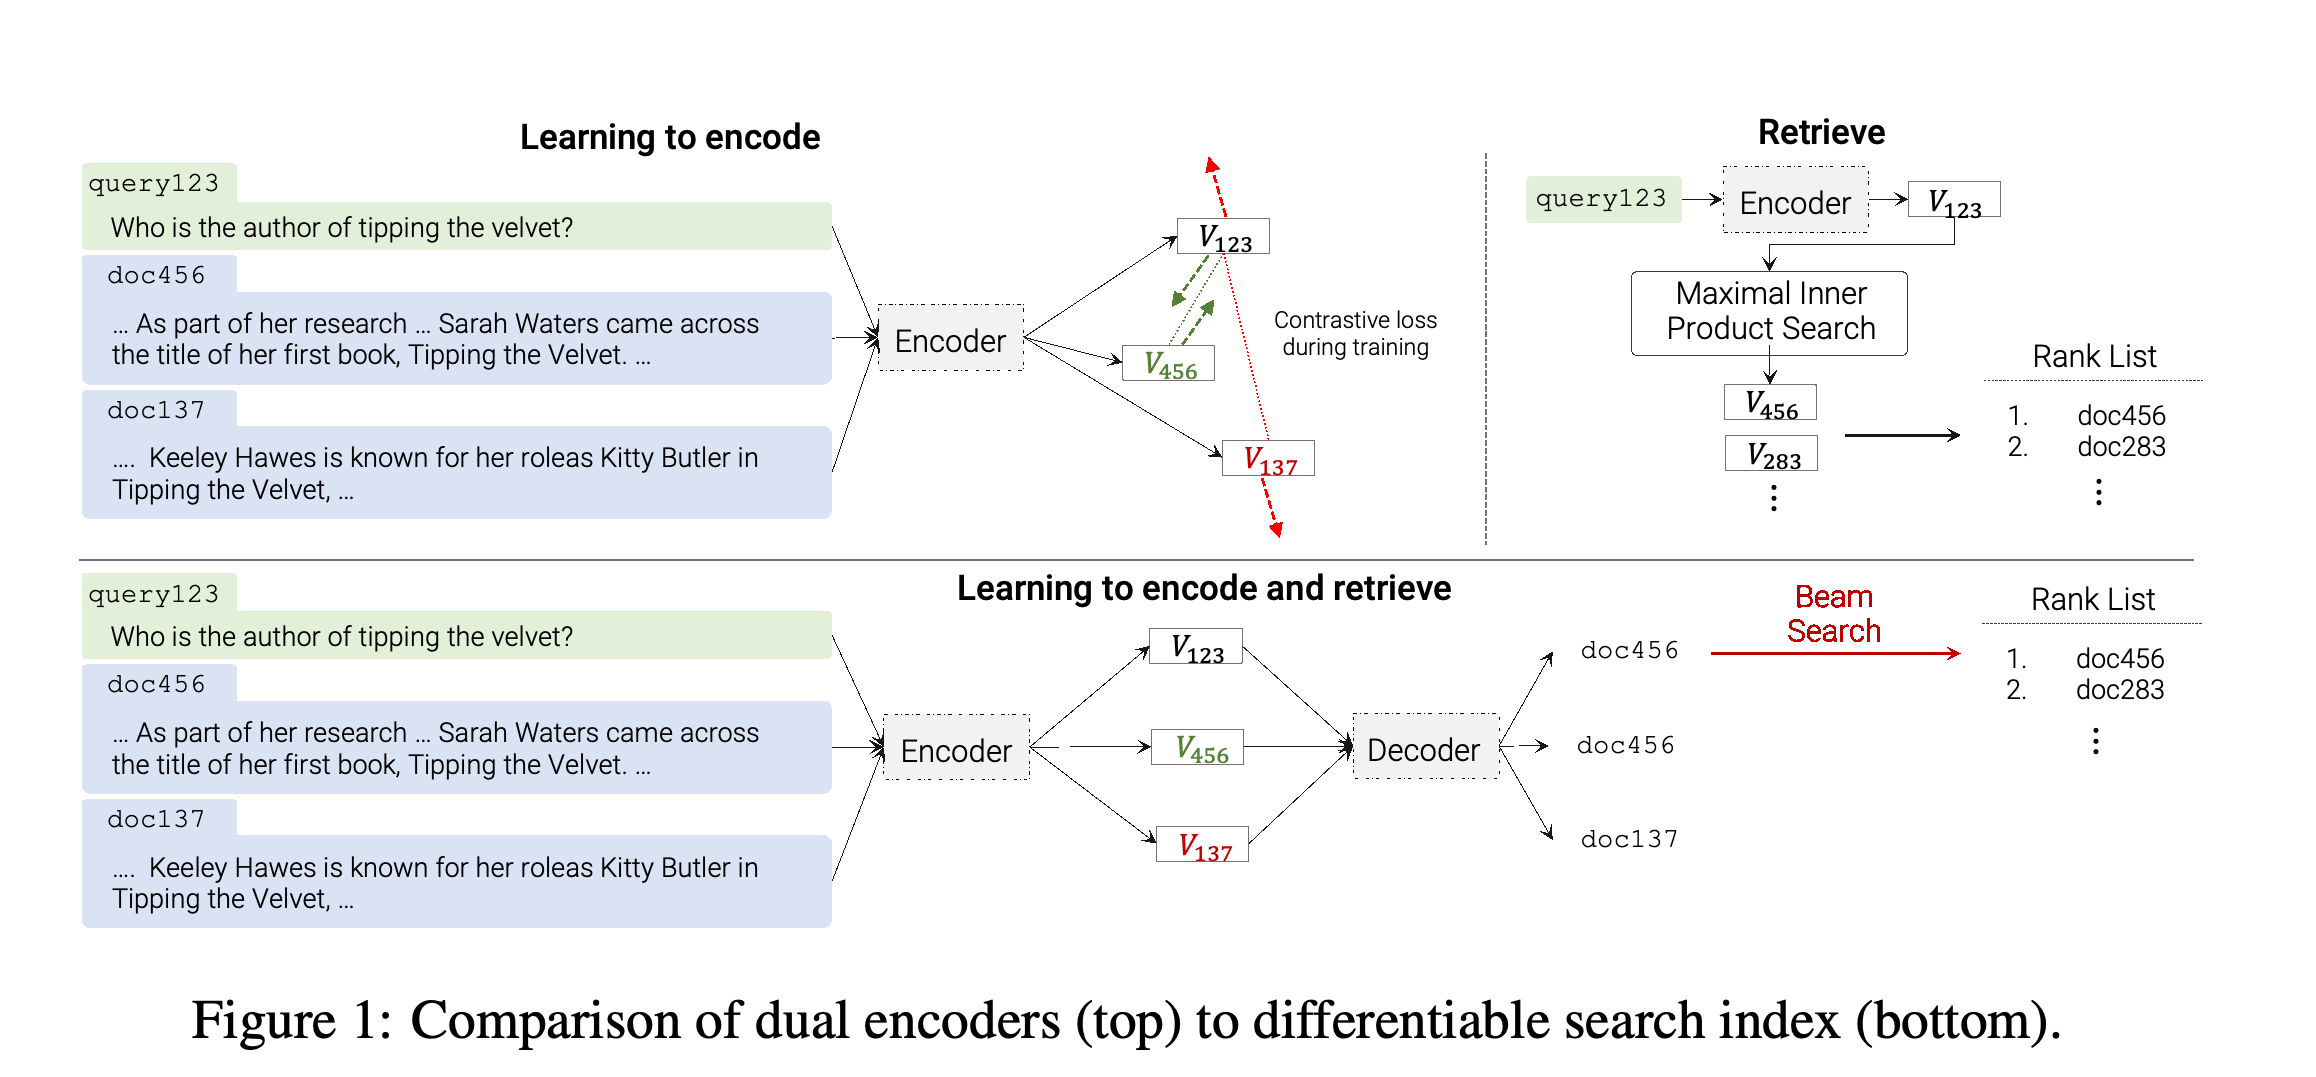
위쪽 경로는 질의와 문서를 임베딩한 뒤 별도로 유사도 검색을 수행한다. 아래쪽 경로는 문서 식별자를 출력하도록 encoder-decoder를 학습하고 beam search로 순위를 만든다.
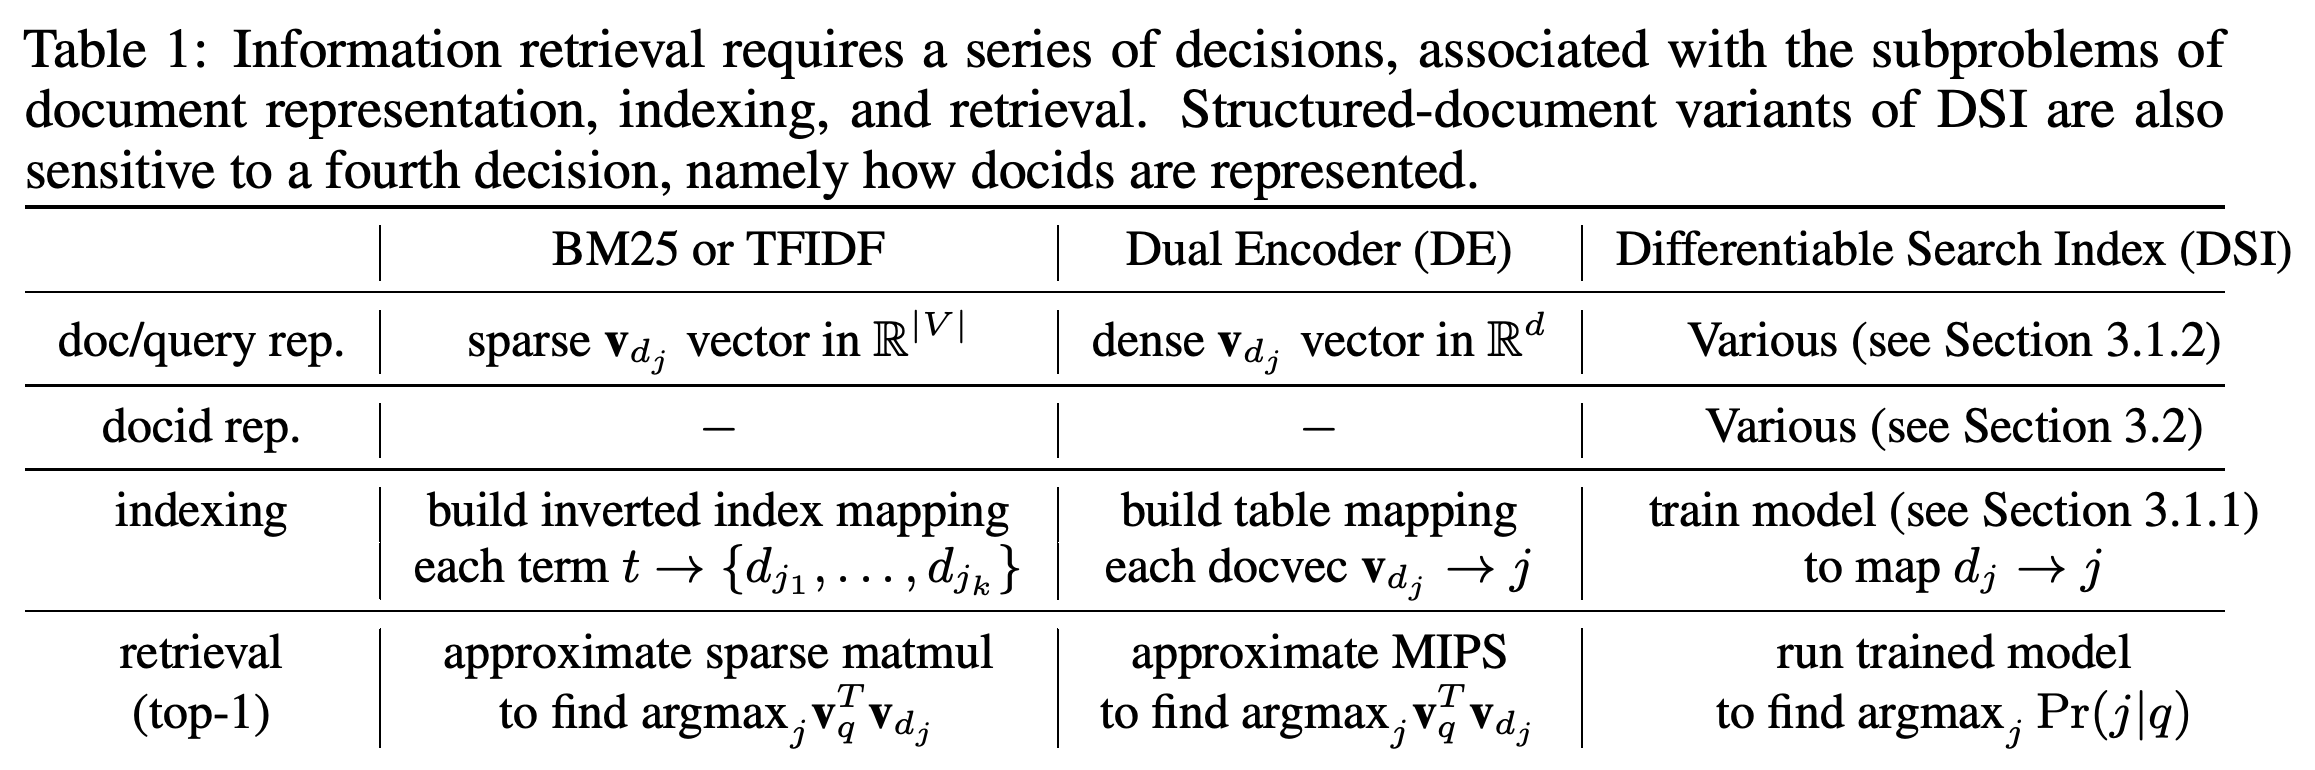
표는 인덱싱과 검색에서 달라진 구조를 보여준다. DSI는 문서와 식별자의 대응 관계를 학습하고 식별자 확률을 예측한다. Dual encoder는 문서 벡터를 저장하고 유사도로 검색한다.
2 Related Work
Autoregressive entity linking은 의미 있는 엔티티 이름을 생성하지만, DSI는 답을 포함한 문서에 임의의 식별자를 생성할 수 있다. 논문은 문서를 검색해 언어 모델의 텍스트 생성을 돕는 retrieval-augmented generation, 모델 파라미터에서 답을 생성하는 closed-book question answering과도 DSI를 구분한다.
3 Differentiable Search Index
DSI에는 연산 2개가 있다. 인덱싱은 각 문서의 내용을 docid와 연결하고, 검색은 질의에서 후보 docid를 생성한다. 디코딩 중 여러 출력 시퀀스 후보를 유지하는 beam search로 순위 목록을 만들 수 있다.
3.1 Indexing Strategies
최종 인덱싱 방법인 Inputs2Targets는 doc_tokens → docid를 학습한다. 다른 방법은 docid에서 문서 토큰을 생성하거나, 양방향을 결합하거나, 텍스트 구간을 가리고 복원하는 span corruption을 사용한다. Direct indexing은 문서의 첫 L개 토큰을 순서대로 사용한다. Set indexing은 반복된 용어와 흔한 불용어를 제거하고, inverted-index 변형은 연속된 토큰 구간을 표본 추출한다.
3.2 Representing Docids for Retrieval
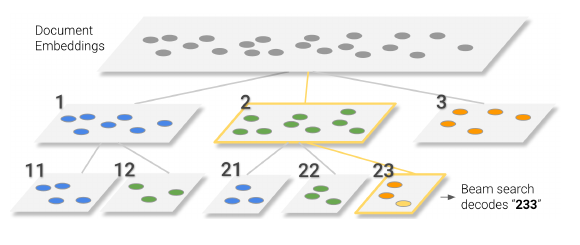
Atomic identifier는 각 문서에 서로 다른 출력 토큰을 할당한다. Naive string identifier는 임의의 정수를 토큰화하고 순차적으로 디코딩한다. Semantic string identifier는 계층적 군집화를 사용해 유사한 문서가 접두사를 공유하도록 한다. 저자들은 8개 층으로 구성된 BERT 모델의 문서 임베딩을 재귀적으로 10개 그룹으로 군집화하고, 각 군집에 문서가 최대 100개 남으면 재귀를 멈춘다.
각 군집 선택은 식별자의 연속된 자릿수가 되므로, 같은 분기에 속한 문서는 접두사를 공유한다. 디코딩은 이 계층을 따라 진행할 수 있다.
3.3 Training and Optimization
모델은 sequence-to-sequence cross-entropy와 teacher forcing을 사용한다. Teacher forcing은 학습할 때 이전 정답 토큰을 디코더에 제공한다. 작업 프롬프트를 사용해 인덱싱과 검색을 함께 학습하는 방식이 인덱싱 후 검색을 fine-tuning하는 방식보다 성능이 좋아 저자들은 multi-task training을 채택했다.
4 Experiments
Natural Questions(NQ)는 자연어 질문과 Wikipedia 문서를 제공한다. NQ10K, NQ100K, NQ320K는 합쳐진 질의-문서 쌍 집합의 크기를 나타낸다. 저자들은 Hits@1과 Hits@10을 보고하고, Base부터 XXL까지 사전 학습된 T5 모델을 사용한다. 학습은 batch size 128로 최대 1M 스텝 동안 진행하며, 주요 설정에서는 L = 32인 direct indexing을 사용한다.
4.1 Baselines
베이스라인에는 용어 기반 검색 방법인 BM25와 NQ 쌍으로 대조 학습한 T5 dual encoder가 포함된다. 레이블이 있는 질의-docid 학습 쌍을 제공하지 않는 zero-shot 실험에서는 SentenceT5와 가공하지 않은 T5 임베딩도 비교한다.
4.2 Experimental Results
NQ10K의 지도 학습에서 11B semantic-string DSI는 Hits@1 48.5%를 달성했고, 11B dual encoder는 22.1%를 기록했다. NQ320K에서는 DSI의 Hits@1과 Hits@10이 각각 40.4%와 70.3%였고, 해당 베이스라인은 각각 24.3%와 67.3%였다.
NQ320K에서 가장 좋은 지도 학습 결과는 11B semantic-string DSI가 기록했다. 식별자 선택에 따라 성능 차이가 크며, 같은 데이터셋에서 11B naive-string 변형은 Hits@1 23.8%를 기록했다.
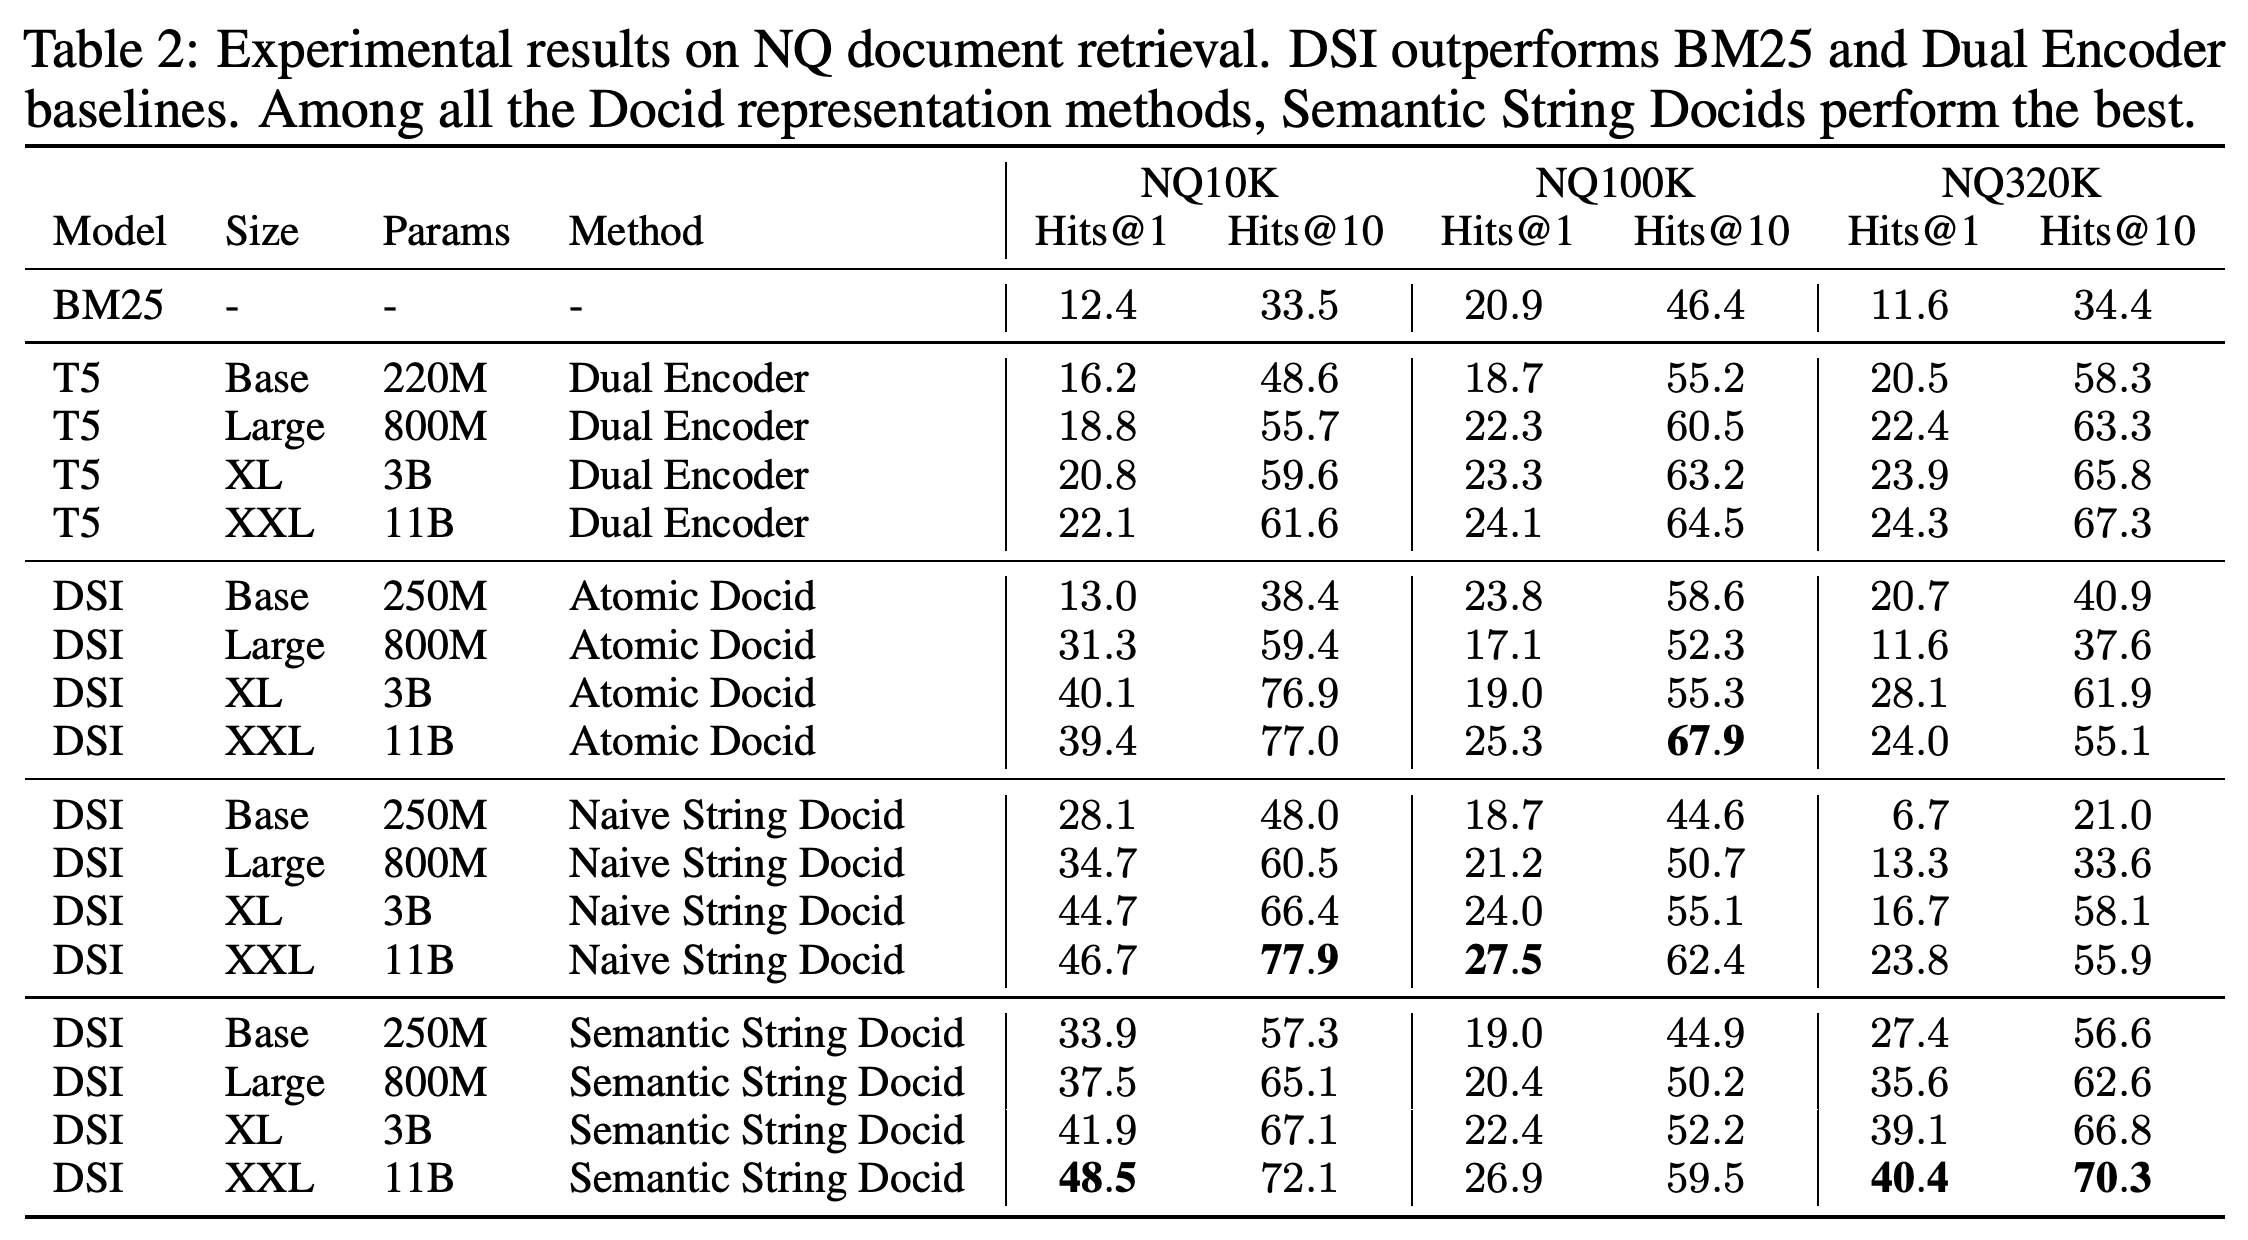
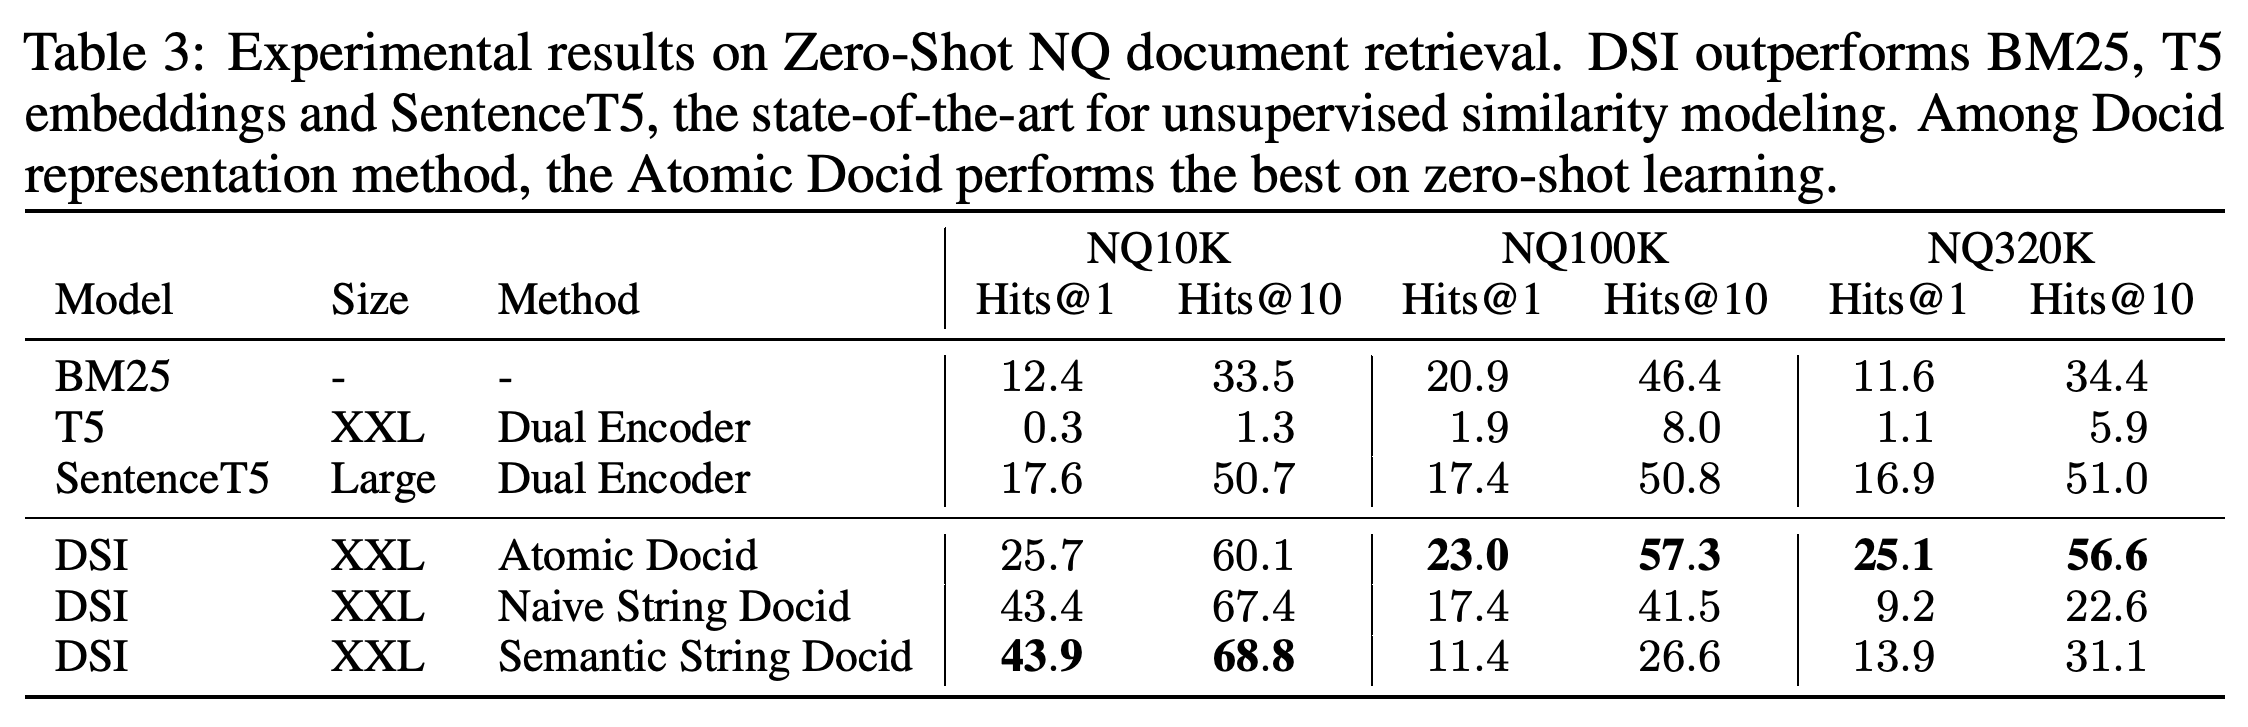
NQ320K의 zero-shot 검색에서 11B atomic-docid DSI는 Hits@1 25.1%를 기록했고, BM25는 11.6%, SentenceT5는 16.9%를 기록했다. 이 설정에서는 NQ100K와 NQ320K에서 atomic identifier가 가장 좋은 성능을 보였지만, 지도 학습 결과는 변동이 있었고 저자들은 간헐적인 최적화 실패를 보고했다.
가장 좋은 식별자 유형은 데이터셋 크기에 따라 달라진다. NQ10K에서는 semantic string이 앞서고, NQ100K와 NQ320K에서는 atomic identifier가 앞선다.
Naive docid를 사용한 NQ100K에서 Inputs2Targets와 양방향 인덱싱은 각각 Hits@1 13.5와 13.2를 기록한 반면, Targets2Inputs와 span corruption은 0%를 기록했다. NQ320K에서는 문서 표현 방식 중 direct indexing이 가장 좋은 성능을 보였다. 보고된 공동 학습 연구에서는 인덱싱과 검색 예제의 비율을 32로 설정했을 때 대체로 좋은 결과가 나왔다.
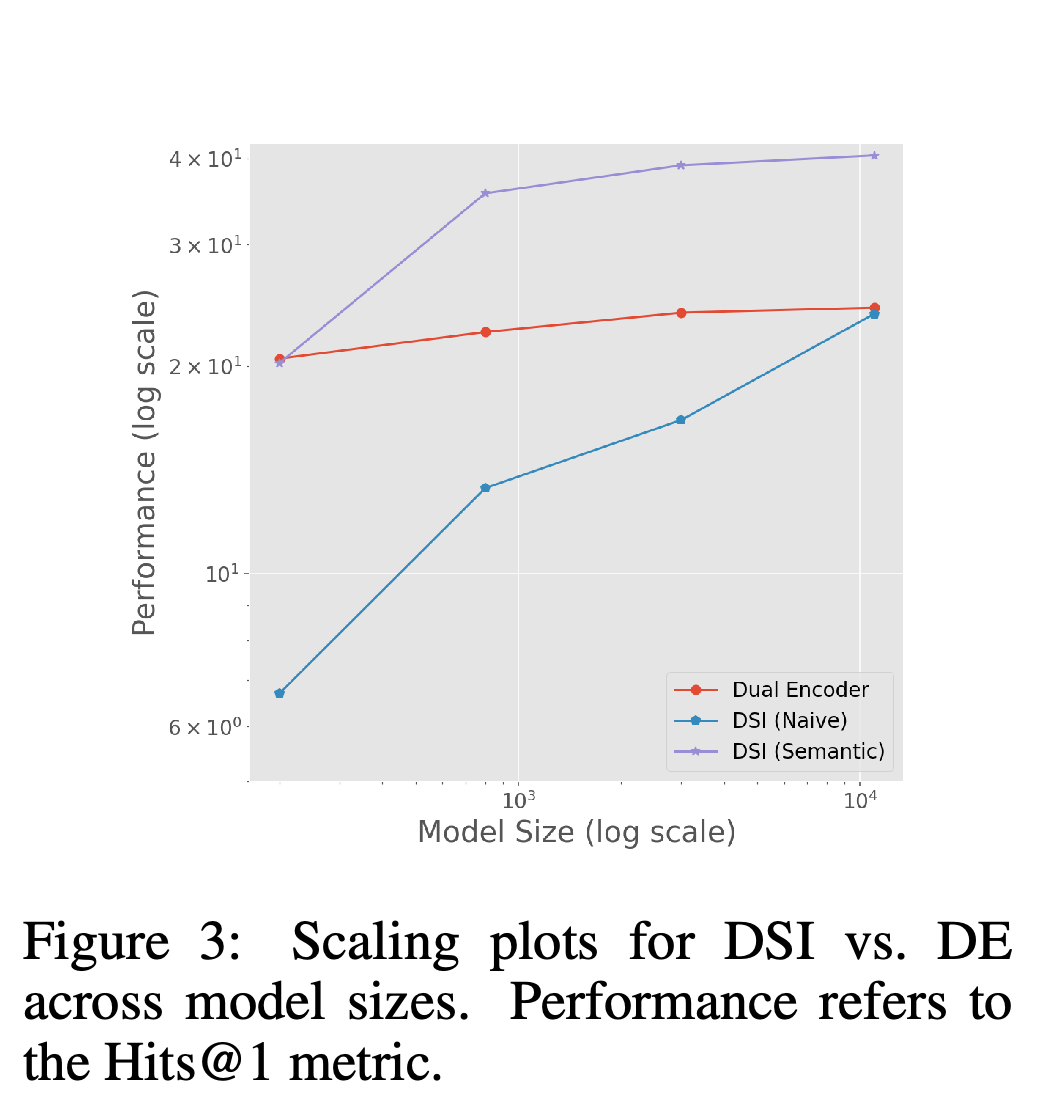
NQ320K에서 모델 크기가 증가할 때 semantic-string DSI의 Hits@1 상승 폭은 dual encoder보다 크다. Naive-string DSI는 훨씬 낮은 성능에서 시작해 모델 크기에 따라 향상된다.
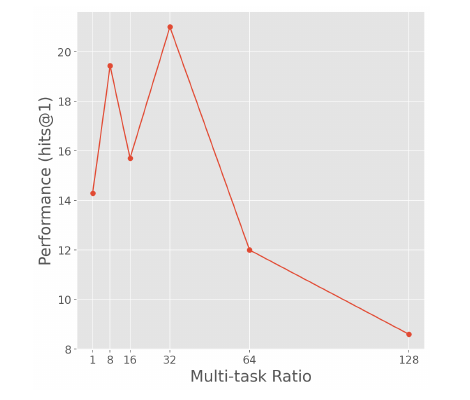
그래프의 검색 점수는 인덱싱과 검색 예제 비율이 32일 때 최고점에 도달하고, 비율이 더 높아지면 하락한다. 이는 학습 데이터 혼합 비율에 따라 성능이 달라짐을 보여준다.
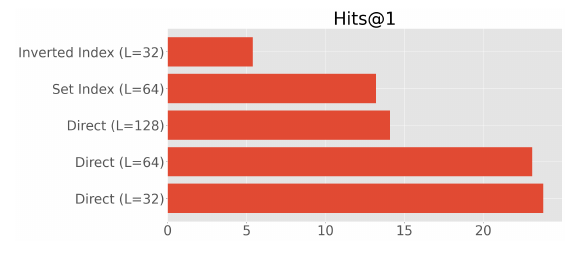
토큰 32개 또는 64개를 사용하는 direct indexing은 그래프에 표시된 set 및 inverted-index 방식보다 성능이 좋다. 토큰 128개를 사용하는 direct indexing도 더 짧은 direct 입력보다 성능이 낮다.
5 Conclusion
저자들은 더 큰 코퍼스, 다른 문서 및 식별자 표현 방식, 동적으로 변하는 문서 집합의 갱신을 향후 연구 방향으로 제시한다. 실험은 여러 검색 작업을 폭넓게 비교하기보다 NQ에서 개념의 실현 가능성을 입증한다.
부록
- Dataset Statistics: NQ10K, NQ100K, NQ320K에는 각각 중복을 제외한 문서가 10K, 86K, 228K개 있고, 학습/검증 쌍은 각각 8K/2K, 80K/20K, 307K/8K개 있다. Extended Results에서는 나열된 모델과 식별자 설정의 인덱싱 Hits@1이 76.3%에서 92.7% 사이라고 보고한다.
- Discussion of DSI Training Dynamics: 인덱싱에는 학습과 검증 분할의 문서를 모두 사용하지만, 검색 학습에는 학습 질의만 사용한다. 검증 문서는 학습 문서 뒤에 이어 붙인 다음 5,000개 예제 버퍼로 섞었다. 망각으로 인해 검증 성능에 고점과 저점이 발생하므로, 최고 체크포인트를 선택하면 망각이 가장 적은 시점이 유리해졌다. NQ320K에서 11B semantic docid의 Hits@1은 망각이 최소일 때 40.4%, 최대일 때 12.2%였고, 보고된 평균은 26.3%였다.
짧은 생각
비슷한 크기의 T5 dual encoder와 비교한 결과는 제안된 검색 방식을 뒷받침한다. 다만 체크포인트에 따른 성능 차이를 고려하면 주요 결과를 제한적으로 해석해야 한다. 보고된 11B semantic DSI의 평균 Hits@1은 26.3%이고, 11B dual encoder는 24.3%다. DSI 평균은 검증 문서가 인덱싱 과정에 균등하게 분포한다고 가정한 값이며, dual encoder 수치는 본문 표의 결과다. 이 논문은 더 크거나 변화하는 코퍼스에서 성능을 검증하지 않았으며, 실험에서 1B 파라미터를 초과하는 모델을 학습할 때 TPUv4 칩 128–256개를 사용했다.