


Regression Language Models for Code 요약 설명
30 Sep 2025 | Paper Review Code-to-Metric Regression Neural Architecture Search Multi-task Regression목차
이번 글에서는 Regression Language Models for Code 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 30일(Arxiv), 43rd International Conference on Machine Learning, PMLR 306, 2026
- Akhauri, Yash, Song, Xingyou, Wongpanich, Arissa, Lewandowski, Bryan, Abdelfattah, Mohamed S..
- Cornell University, Google DeepMind, Google Cloud
- 논문 링크
- Github
요약
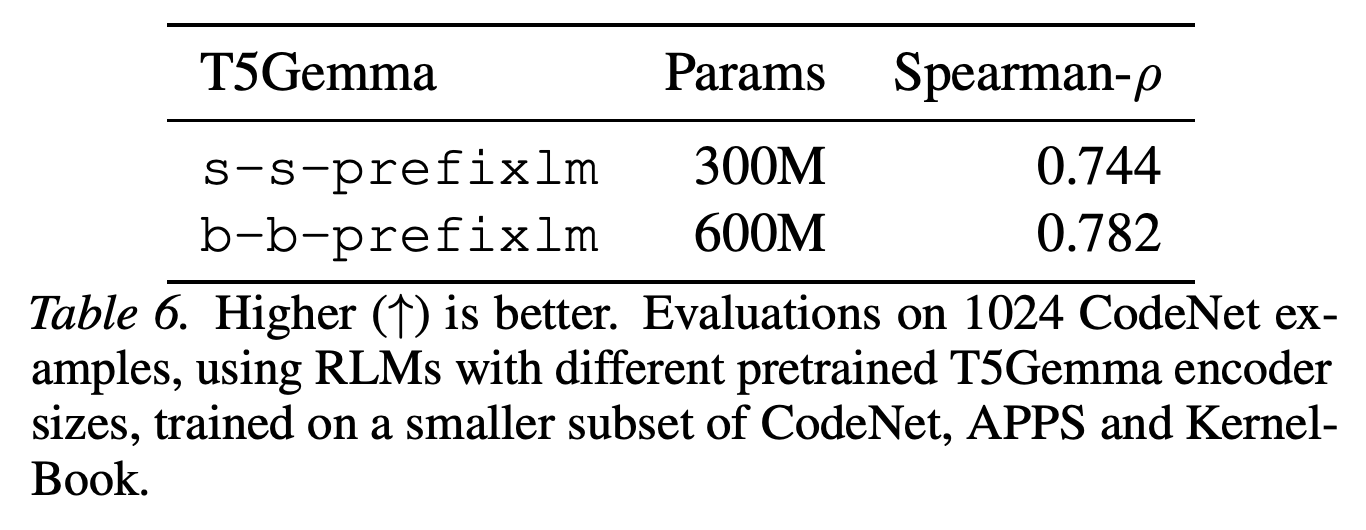
- 코드에서 실행 메모리, 지연 시간, 학습된 네트워크의 정확도를 예측하려면 보통 프로그램이나 그래프 표현에 맞춘 특징이 필요하다. 텍스트를 읽고 수치 목표값을 생성하는 Regression Language Model(RLM)은 후보 네트워크 설계 집합인 5개 신경망 아키텍처 탐색(NAS) 공간에서 평균 Kendall τ 0.461을 달성한다. Kendall τ는 순위 일치도를 나타낸다. 보고된 목표 공간 샘플링 조건에서 기존 최고 성능 아키텍처 예측기인 FLAN의 평균은 0.459다.
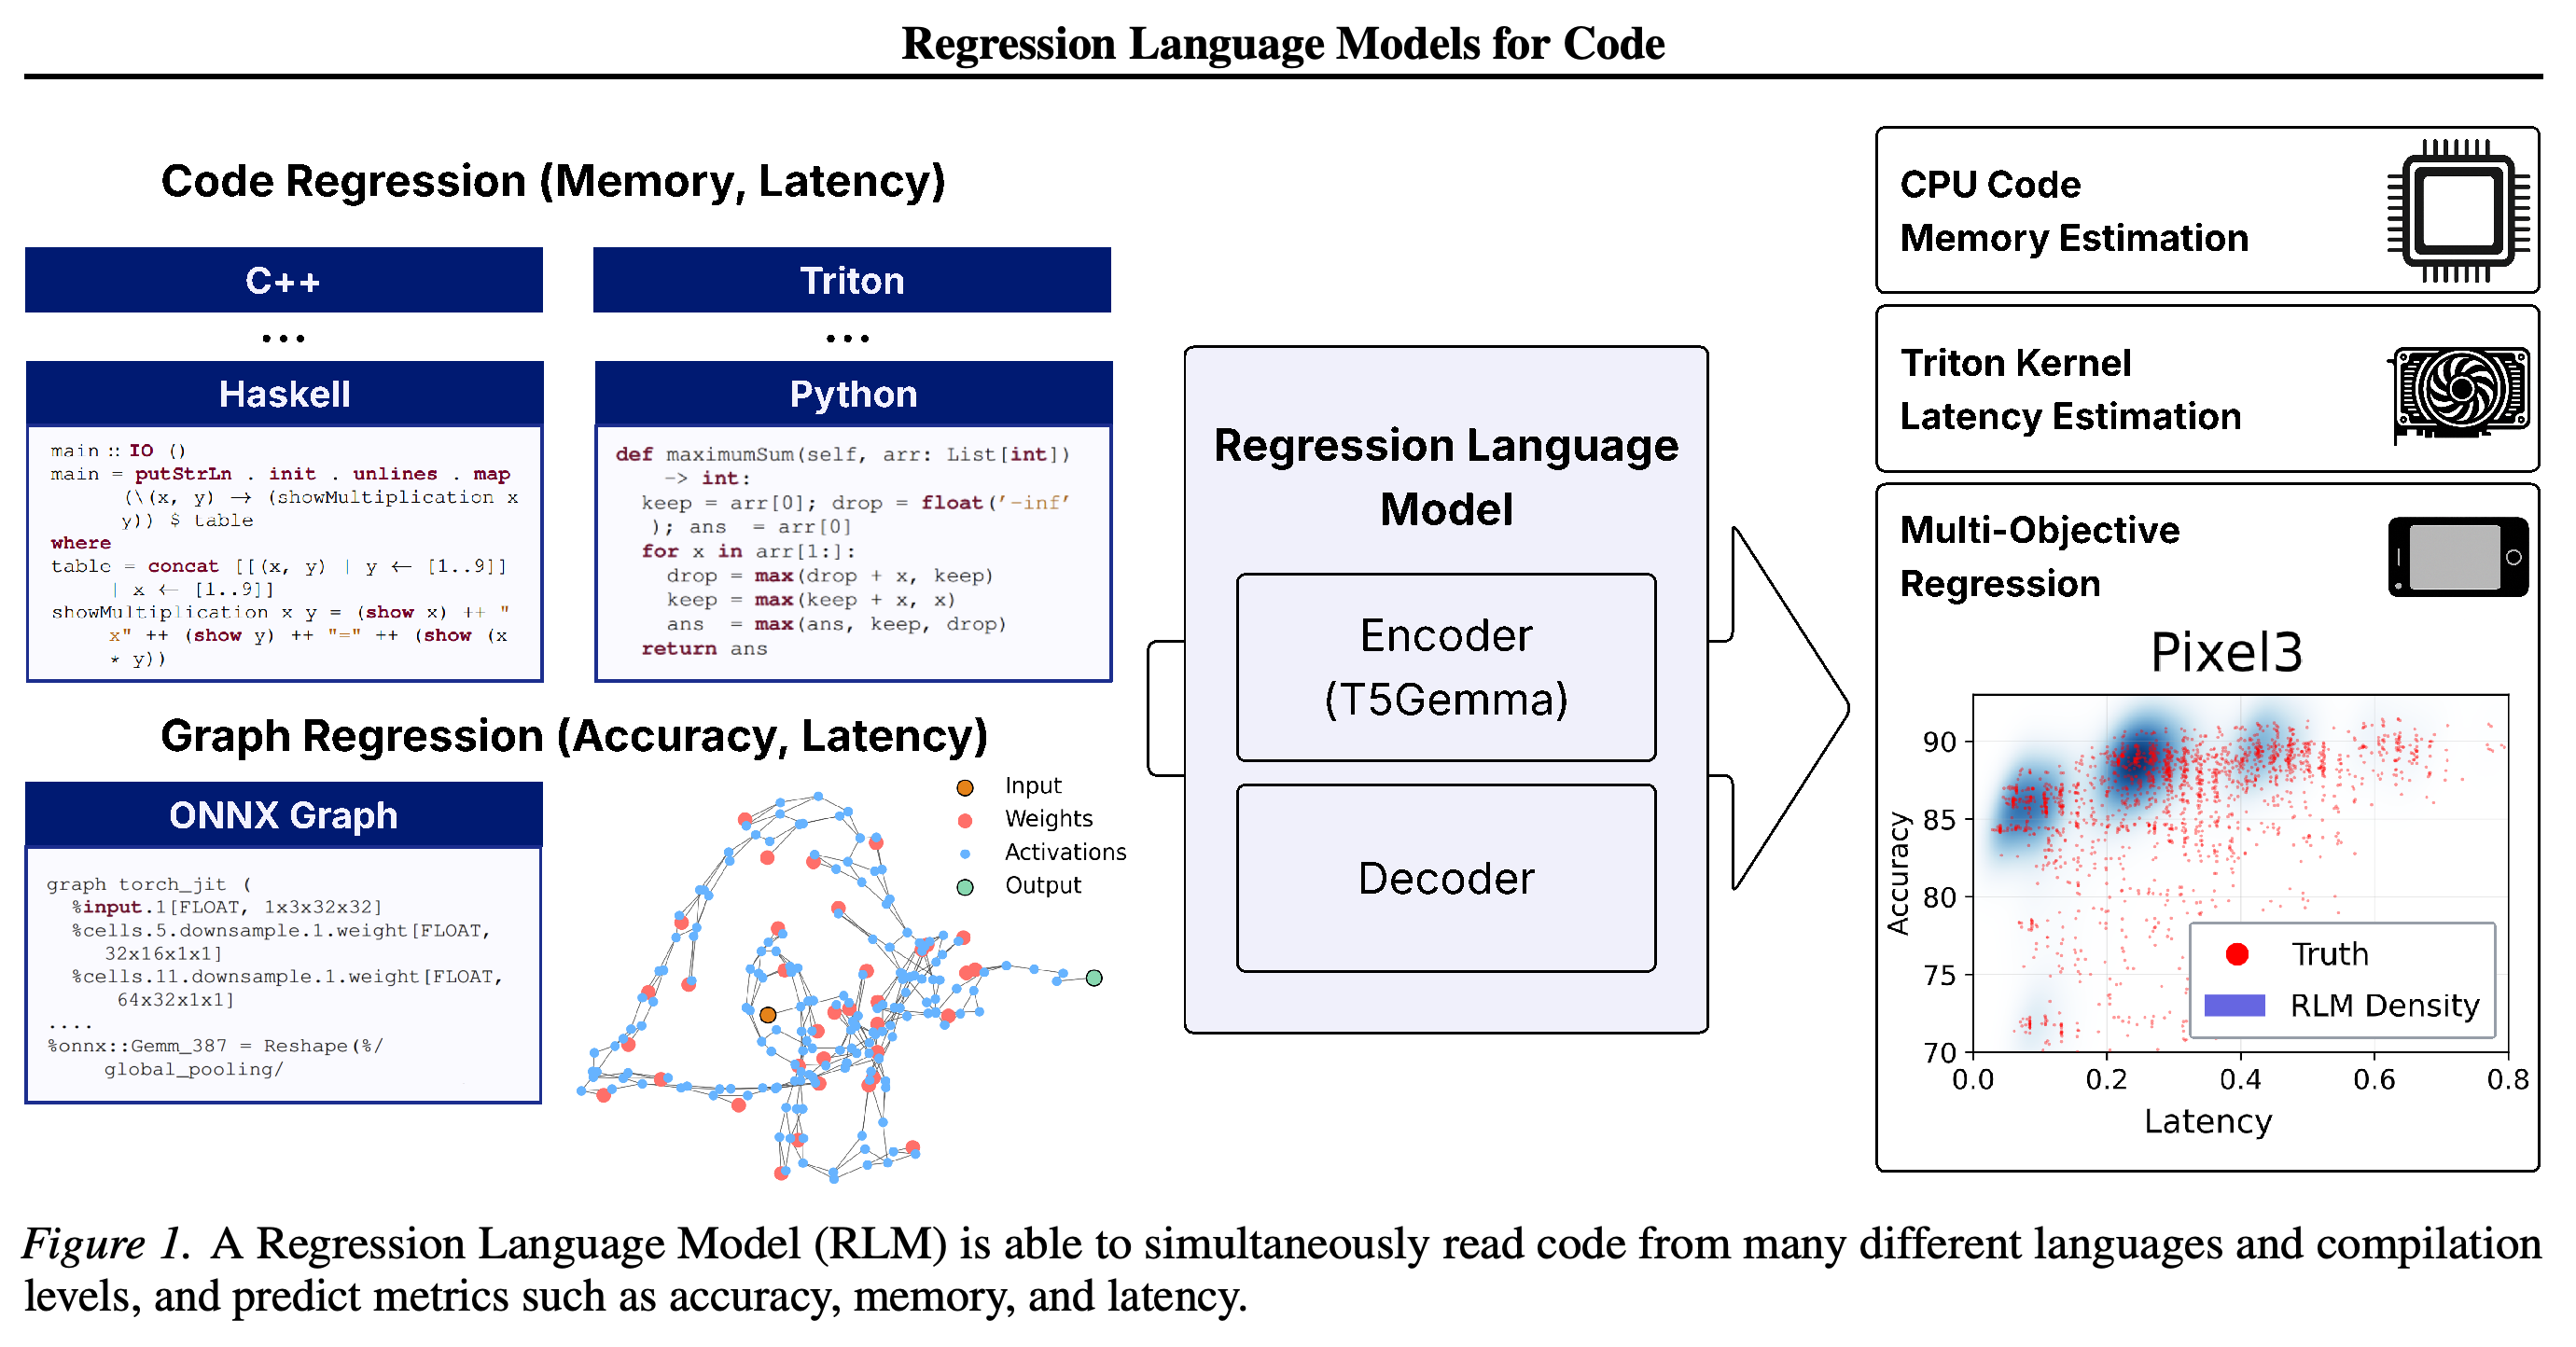
- 약 300M 파라미터 모델은 입력 텍스트를 표현하는 사전 학습 언어 모델 구성 요소인 T5Gemma 인코더를 고정하고 숫자를 자릿수별로 생성하도록 디코더를 학습한다. 제약 디코딩은 유효한 숫자만 생성하도록 제한한다. 공동 학습에는 고수준 프로그램, 그래픽 프로세서에서 실행하도록 컴파일된 프로그램인 Triton GPU 커널, 신경망 연산 그래프의 Open Neural Network Exchange(ONNX) 텍스트 표현을 사용한다.
- 통합 모델은 프로그래밍 문제 데이터셋인 APPS의 Python 최대 메모리 사용량에서 Spearman ρ 0.930을, Triton 커널 지연 시간에서 0.516을 달성한다. Spearman ρ는 예측 순위와 관측 순위 사이의 상관관계다. 다국어 제출 코드 데이터셋인 CodeNet의 24개 언어에서는 평균 ρ가 0.5를 넘는다. 평가한 4개 과제 모두에서 GPT-5-Thinking의 in-context learning보다 높은 성능을 보인다. In-context learning은 모델 가중치를 갱신하지 않고 프롬프트에 제공된 라벨 예제로 예측하는 방식이다.
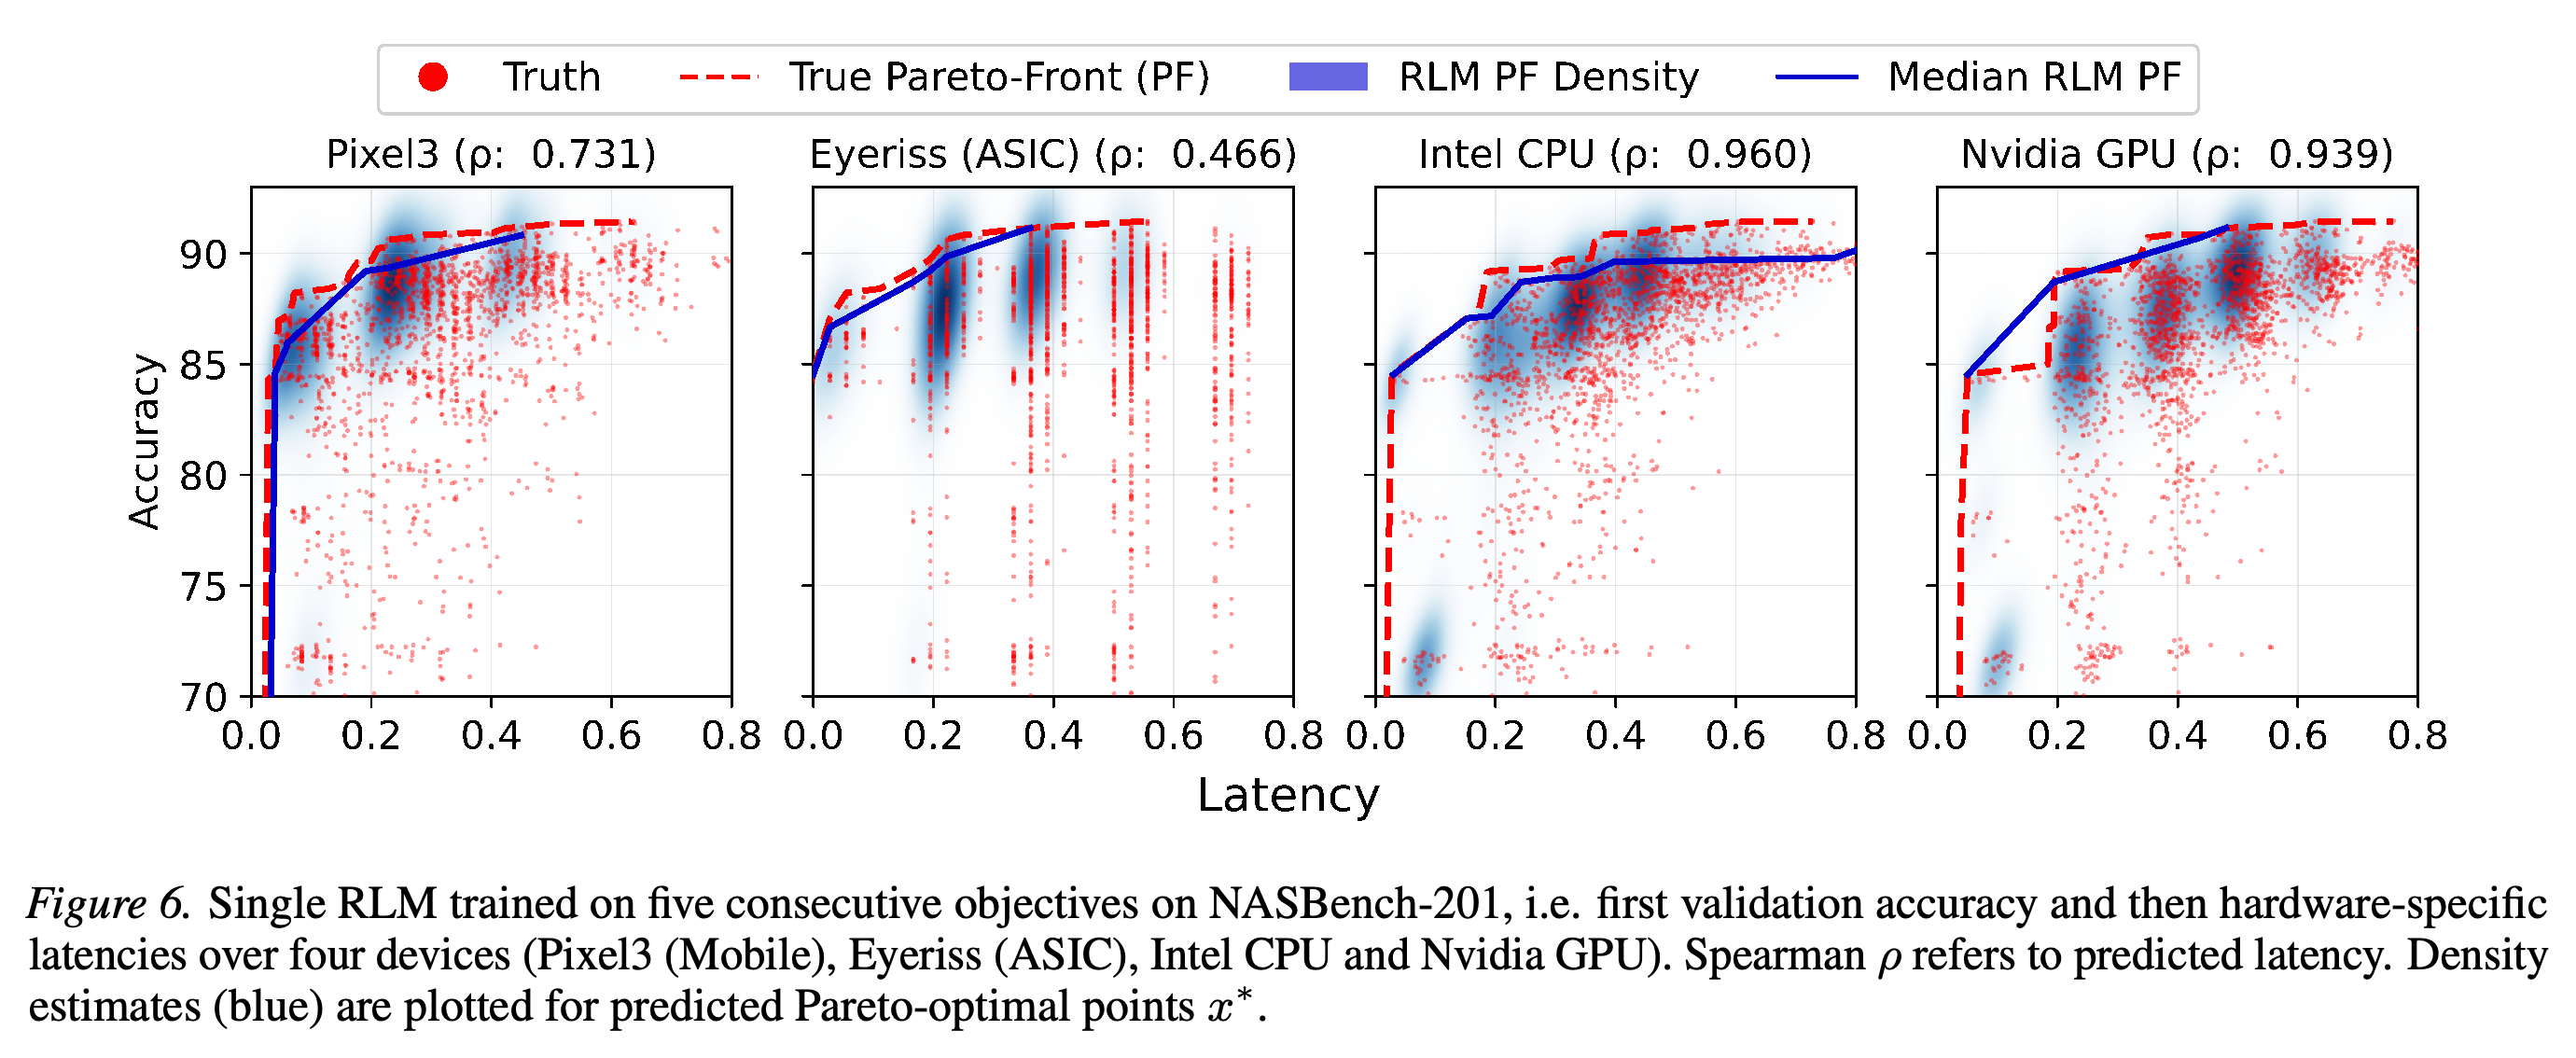
- 출력 방식 비교에서 수치 디코딩은 ρ = 0.800을 달성한다. 스칼라를 직접 예측하는 회귀 헤드는 목표값을 정규화하면 0.717, 정규화하지 않으면 0.478을 달성한다. 이 비교는 전체 레이어 수를 맞추지만 인코딩과 디코딩에 레이어를 다르게 배분한다. 평가 결과는 데이터 수집과 분할 조건에 따라 해석해야 한다. CodeNet의 학습 및 테스트 데이터는 문제를 공유하고 지연 시간은 지정된 하드웨어에서 측정한다. 언어 다양성을 높이거나 목표 과제에서 추가 학습하는 fine-tuning을 적용해도 이미 학습 데이터에 충분히 포함된 코드 과제의 성능이 일관되게 개선되지는 않는다.
1. Introduction
논문은 code-to-metric regression을 프로그램이나 연산 그래프의 메모리 사용량, 실행 지연 시간, 학습 후 정확도와 같은 수치 속성을 예측하는 문제로 정의한다. 공통 텍스트 기반 예측기가 과제별 특징 설계 작업을 줄이면서 그래프 연결 관계를 학습하는 그래프 신경망(GNN)과 경쟁할 수 있는지 살펴본다.
- 회귀 문제를 수치 출력에 대한 다음 토큰 예측 문제로 바꾼다.
- 서론은 고정된 언어 인코더, 합성 회귀 데이터 사전 학습, 수치 토큰화, 인코더 문맥 길이를 주요 설계 선택으로 제시한다.
고수준 소스 코드와 직렬화된 신경망 그래프를 동일한 인코더와 디코더에 입력해 서로 다른 수치 지표를 출력한다. 밀도 그림은 의도한 공동 출력 인터페이스를 보여주며, 별도의 벤치마크 결과는 아니다.
2. Related Work and Motivation
기존 접근법은 명령 수, 프로그램 통계, 구문 트리, 그래프 경로, 하드웨어 특징을 요약한 뒤 특화된 예측기를 적용한다. 이러한 표현은 고정된 연산 어휘나 그래프 형식에 의존할 수 있어 프로그램, 커널, 목표 지표가 바뀌면 추가 작업이 필요하다.
- 논문은 수치 생성 방식을 사전 학습된 대규모 언어 모델(LLM)에 스칼라 회귀 헤드를 붙이는 방식과 구분한다.
- 연구의 동기는 표현의 유연성이며 실험에서는 이 유연성이 순위 예측 성능을 유지하는지 검증한다.
3. Method
인코더는 입력 문자열 x를 읽고, 디코더는 해당 수치 목표값 y를 생성하도록 학습한다. Akhauri et al. (2025)과 Song et al. (2024)의 RLM 접근법에 따라 사전 학습된 T5Gemma 인코더를 고정하면 역전파를 디코더로 제한해 학습 비용을 줄일 수 있다.
- 부호, 지수, 가수를 나타내는 특수 토큰으로 출력을 자릿수별로 인코딩한다. 가수는 숫자의 유효 자릿수를 나타내며, <+><-><1><7><2><5>는 +10⁻¹ × 725 = 72.5를 나타낸다.
- 제약 디코딩은 유효한 수치 샘플을 생성한다. 샘플의 평균이나 중앙값을 점 추정값으로 사용하고 샘플 분포로 목표값 정규화 없이 밀도를 추정할 수 있다.
3.1. Multi-task Regression
공통 텍스트 입력과 수치 출력 형식을 사용하면 1개 모델을 여러 회귀 과제에 학습할 수 있다. 실제 또는 합성 회귀 데이터로 먼저 학습한 뒤 fine-tuning으로 적응시킬 수 있다.
- 저자들은 범용 문자열 기반 모델이 특화된 그래프 모델보다 더 많은 사전 학습 데이터를 필요로 할 수 있다고 주장한다. 특화된 그래프 모델은 그래프 관계를 우선하도록 설계된 강한 구조적 귀납 편향을 갖춘다.
3.2. Multi-Objective Modeling
각 출력이 앞선 출력에 의존하는 자기회귀 생성에서는 p(y′ | y, x)를 통해 뒤의 지표가 앞의 지표에 의존하도록 할 수 있다. 따라서 인코더 표현이 주어졌을 때 출력들이 서로 독립이라고 가정하는 대신, 아키텍처 지연 시간과 분류 정확도를 공동으로 모델링할 수 있다.
- 일반적인 조건부 형식은 k > 1에 대해 p(y⁽ᵏ⁾ | y⁽ᵏ⁻¹⁾, …, y⁽¹⁾, x)다.
- 실험에서는 검증 정확도를 생성한 뒤 4개 하드웨어 플랫폼의 지연 시간을 생성한다.
4. Data
데이터셋은 실행 가능한 고수준 코드와 텍스트로 직렬화한 신경망 그래프를 결합한다. 라벨에는 측정한 실행 속성, 데이터셋에서 제공하는 메모리 값, 아키텍처 벤치마크 지표가 포함된다. 사용 가능한 입력과 학습에 제공되는 정답 정보는 데이터셋마다 다르다.
4.1. High-Level Programming Datasets
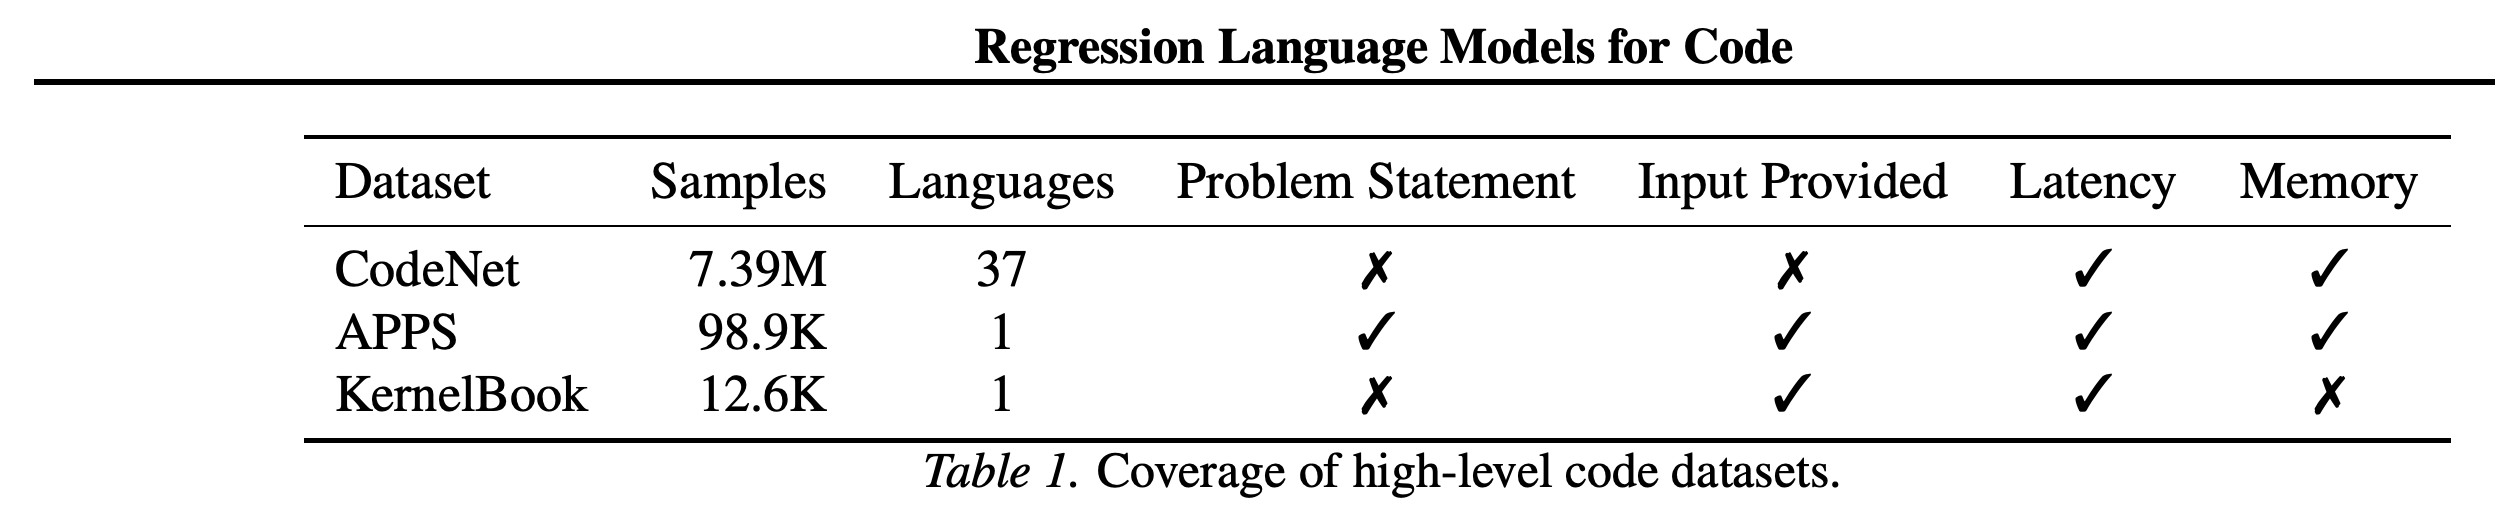
APPS에는 Python 문제 10K개, 풀이 232.4K개, 131.7K test cases가 있으며 약 99K개 풀이가 프로파일링을 위해 정상 실행된다. PyTorch 프로그램과 컴파일된 Triton 커널을 짝지은 데이터셋인 KernelBook에서는 18.2K개 문제 중 정상 실행된 커널 12,652개를 제공하며 단일 NVIDIA A6000에서 프로파일링한다.
- CodeNet에는 37개 언어로 작성된 제출 코드 약 14M개가 있다. 정답으로 인정된 풀이만 남기면 약 7.3M개이며 Table 1에는 7.39M개로 기재되어 있다. 예측 목표는 기존 memory 열이다.
- CodeNet에는 구체적인 프로그램 입력이 없다. 학습 및 테스트 분할이 문제를 공유하므로, 평가는 이전에 관측한 문제에 대한 새 제출 코드를 다룬다. 새 문제에 대한 zero-shot 예측은 평가하지 않는다. 여기서 zero-shot 예측은 목표 문제의 예제 없이 예측하는 방식이다.
- Triton 커널은 대응하는 PyTorch 프로그램에 사용되는 컴파일러인 TorchInductor로 생성한다. 실행 실패는 대부분 커널 자체의 오류가 아니라 자동화된 인자 매칭 도구에서 발생한다.
입력의 제공 여부가 평가 조건을 결정한다. CodeNet은 문제 설명과 구체적인 입력을 모두 제공하지 않고, APPS는 모두 제공하며 KernelBook은 입력을 제공하지만 메모리 라벨은 제공하지 않는다. 나열된 지표는 데이터셋이 제공하는 범위를 나타내며, 동일하게 통제된 예측 과제를 뜻하지는 않는다.
4.2. NAS Datasets
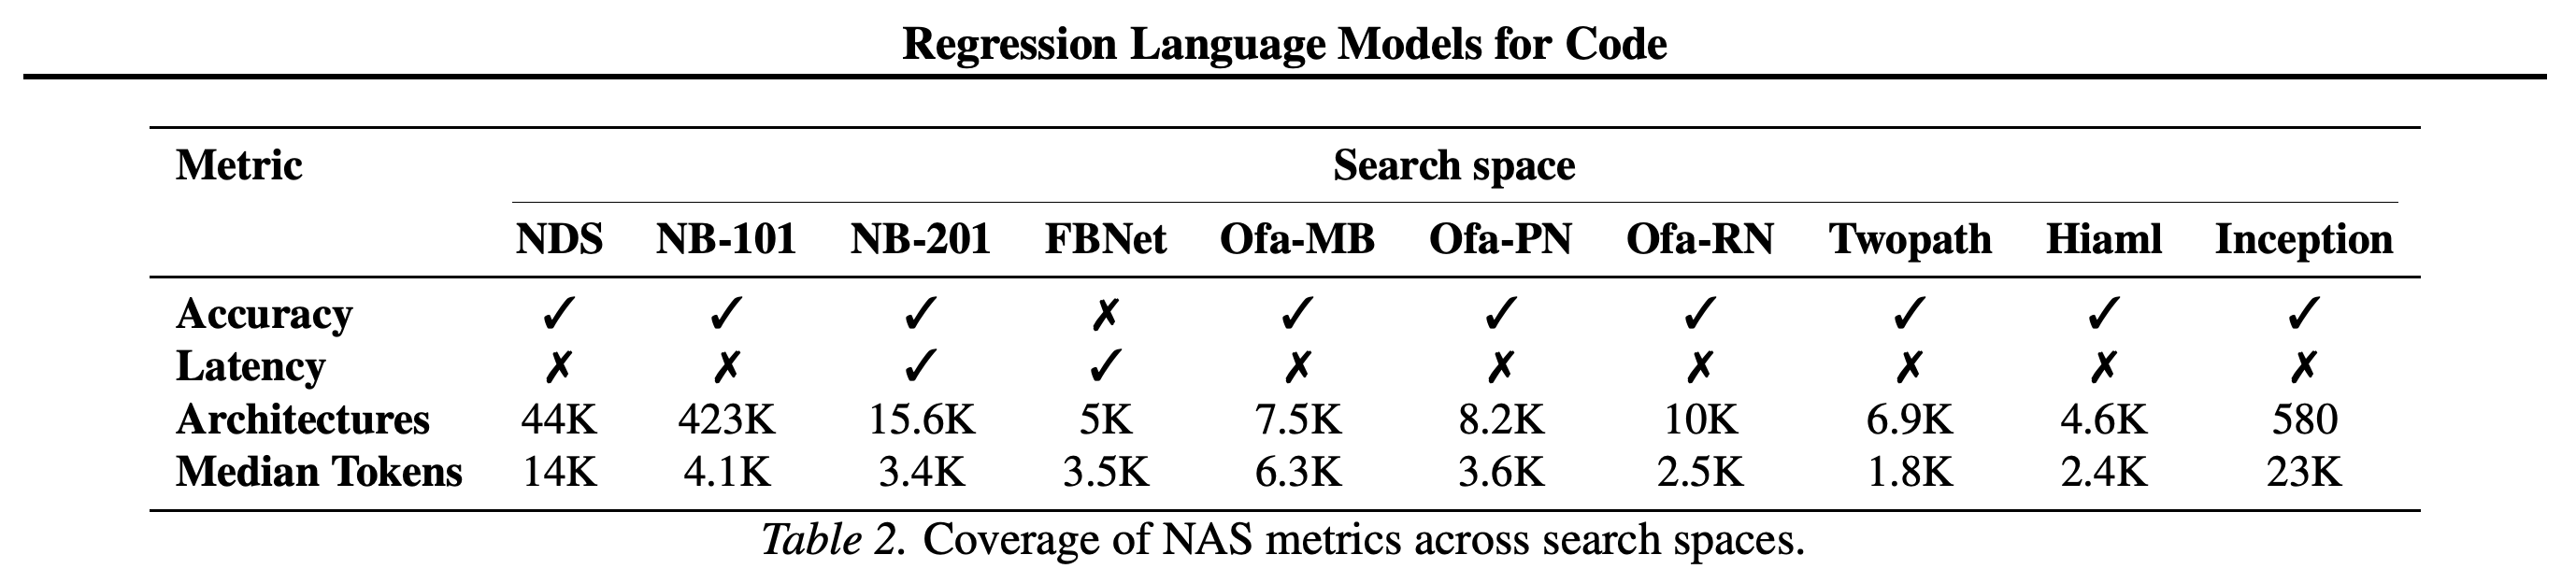
NAS 예측은 고정된 하이퍼파라미터로 학습한 아키텍처의 정확도를 추정한다. 저자들은 아키텍처를 연산과 연결 관계를 기술하는 ONNX 중간 표현(IR)으로 내보낸다. 나열된 벤치마크 공간 전체에서 약 520K개의 고유 아키텍처를 얻는다.
- 수집 데이터에는 NASBench-101, NASBench-201, FBNet, Once-for-all 변형, Twopath, Hiaml, Inception, Network Design Spaces(NDS)가 포함된다.
- 저자들이 추가로 만든 NAS 공간인 SNAS에는 이미지 분류 데이터셋 CIFAR-10에서 32 steps 동안 학습한 아키텍처 85.5K개가 있다.
- 직렬화된 입력 길이의 중앙값은 Twopath의 1.8K토큰부터 Inception의 23K토큰까지 분포하므로 입력 잘림을 고려해야 한다.
아키텍처 공간마다 크기, 사용 가능한 라벨, 직렬화 길이가 다르다. Inception의 토큰 길이 중앙값 23K와 NDS의 14K는 기본 인코더 한도인 2048토큰을 넘는다. 따라서 데이터셋이 제공하는 범위를 입력 잘림 및 토크나이저 설계와 함께 고려해야 한다.
5. Experiments
주요 모델은 코드 및 아키텍처 데이터셋의 학습 분할로 공동 학습한다. 실험에서는 in-context 회귀, 고수준 코드 예측, 아키텍처 순위 예측, 다목적 예측을 평가한다.
- Appendix A.3은 코드만 사용한 학습과 코드 및 그래프를 함께 사용한 학습을 비교하며 Appendix C는 기본 학습 및 추론 설정을 제시한다.
5.1. In-context Regression with LLMs
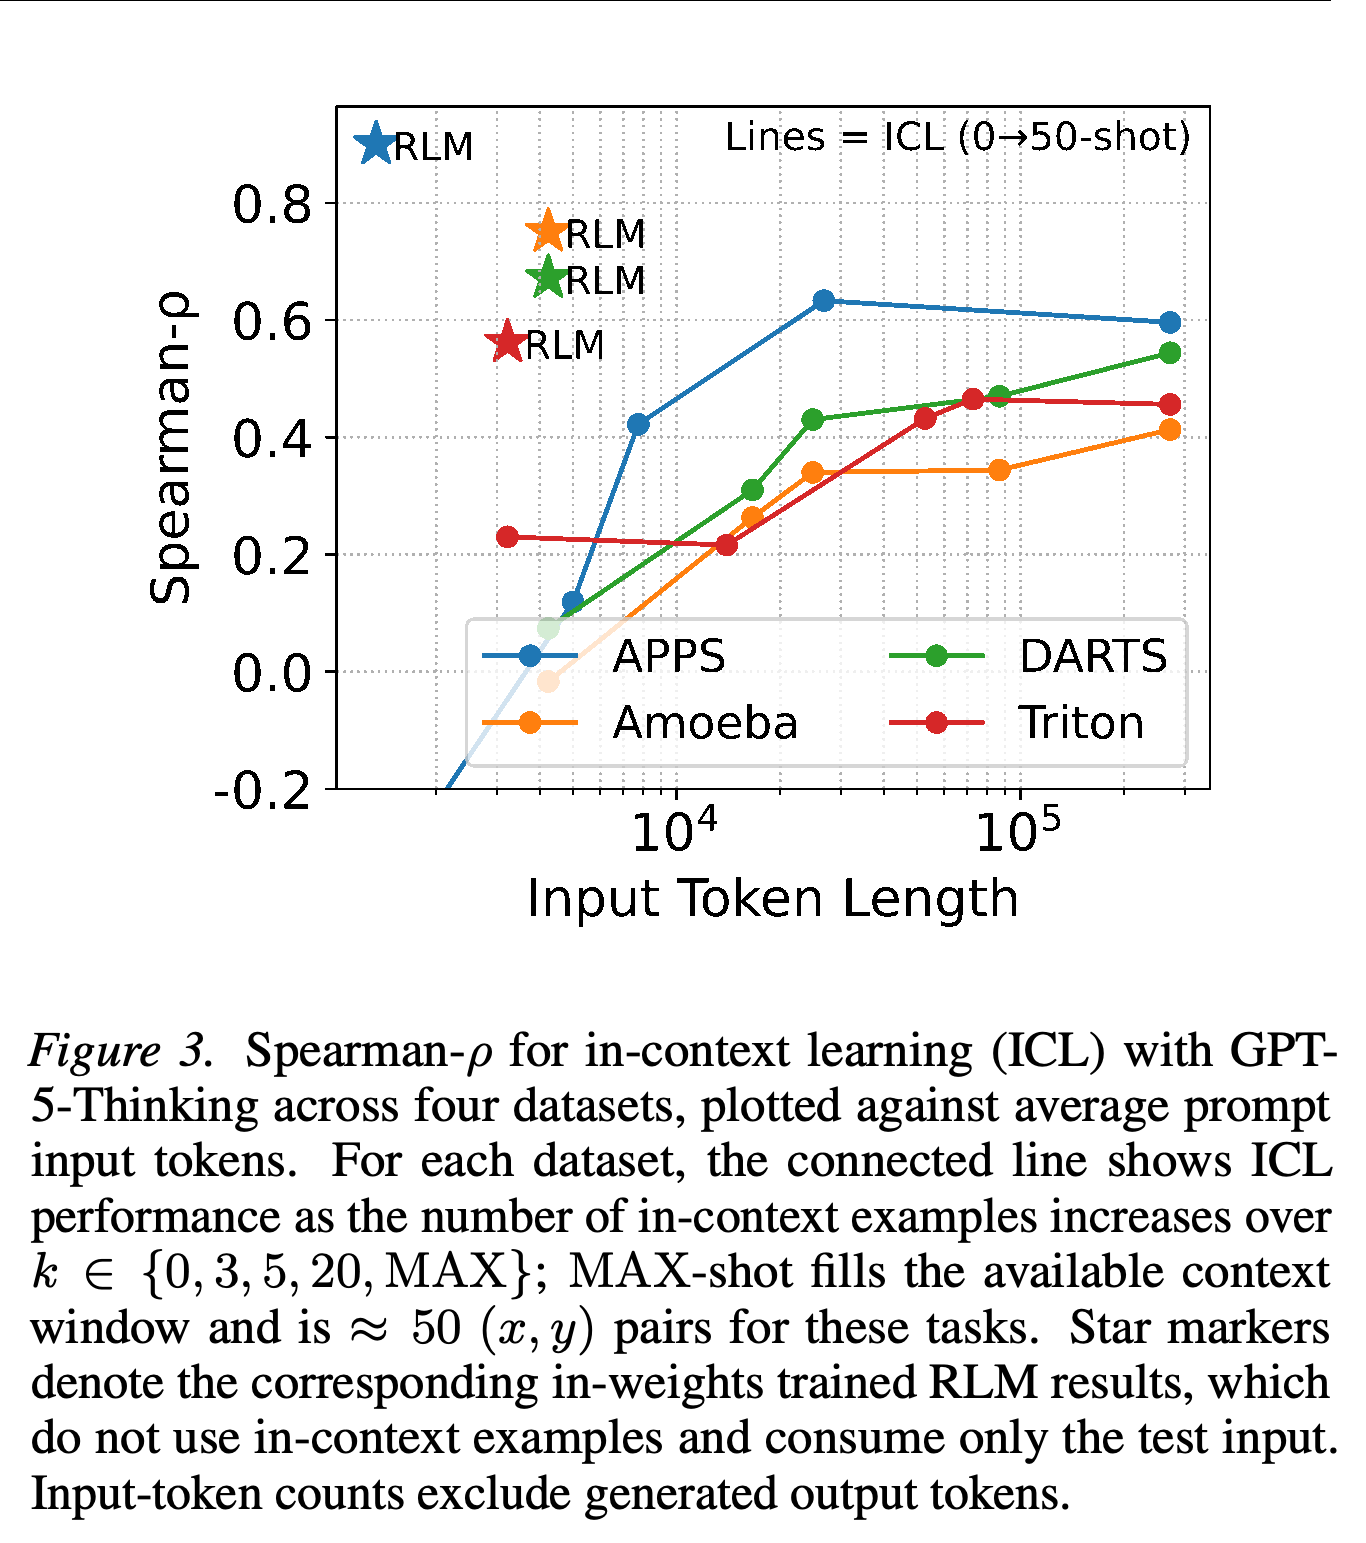
GPT-5-Thinking에는 무작위로 추출한 라벨 예제 뒤에 테스트 입력을 제공하며 k ∈ {0, 3, 5, 20, MAX}를 사용한다. MAX는 약 50개 예제로 문맥 창을 채운다. APPS, Amoeba, DARTS, Triton에서 예제를 추가하면 대체로 in-context 회귀 성능이 개선되지만 보고된 모든 설정의 성능은 학습된 RLM보다 낮다.
- MAX-shot 프롬프트는 질의당 약 2.7 × 10⁵개의 입력 토큰이 필요하다. 이 비교에서 RLM의 원본 테스트 입력은 보통 10³–10⁴토큰이며 생성된 출력 토큰은 제외한다. Appendix C는 별도로 기본 인코더 한도를 2048토큰으로 지정한다.
- 논문은 thinking과 출력 비용을 제외한 MAX-shot 질의당 비용을 약 $0.3125로 추산하며 임대한 A6000에서 초당 RLM 질의 12.5개를 처리한다고 보고한다. 비용 비교는 명시된 가격과 배포 가정에 따라 달라진다.
- 모델에 제공되는 정답 예제의 양은 다르다. RLM은 학습 예제로 학습하지만 GPT-5-Thinking은 프롬프트에 들어가는 예제만 제공받는다.
프롬프트 예제를 추가하면 대체로 GPT-5-Thinking의 순위 상관계수가 높아지고 입력 토큰 사용량도 늘어난다. 학습된 RLM의 표시점은 4개 과제에서 표시된 모든 프롬프트 기반 설정보다 높다. 다만 모델에 제공되는 학습 및 추론 시점의 정답 예제는 다르다.
5.2. High-Level Programming Languages
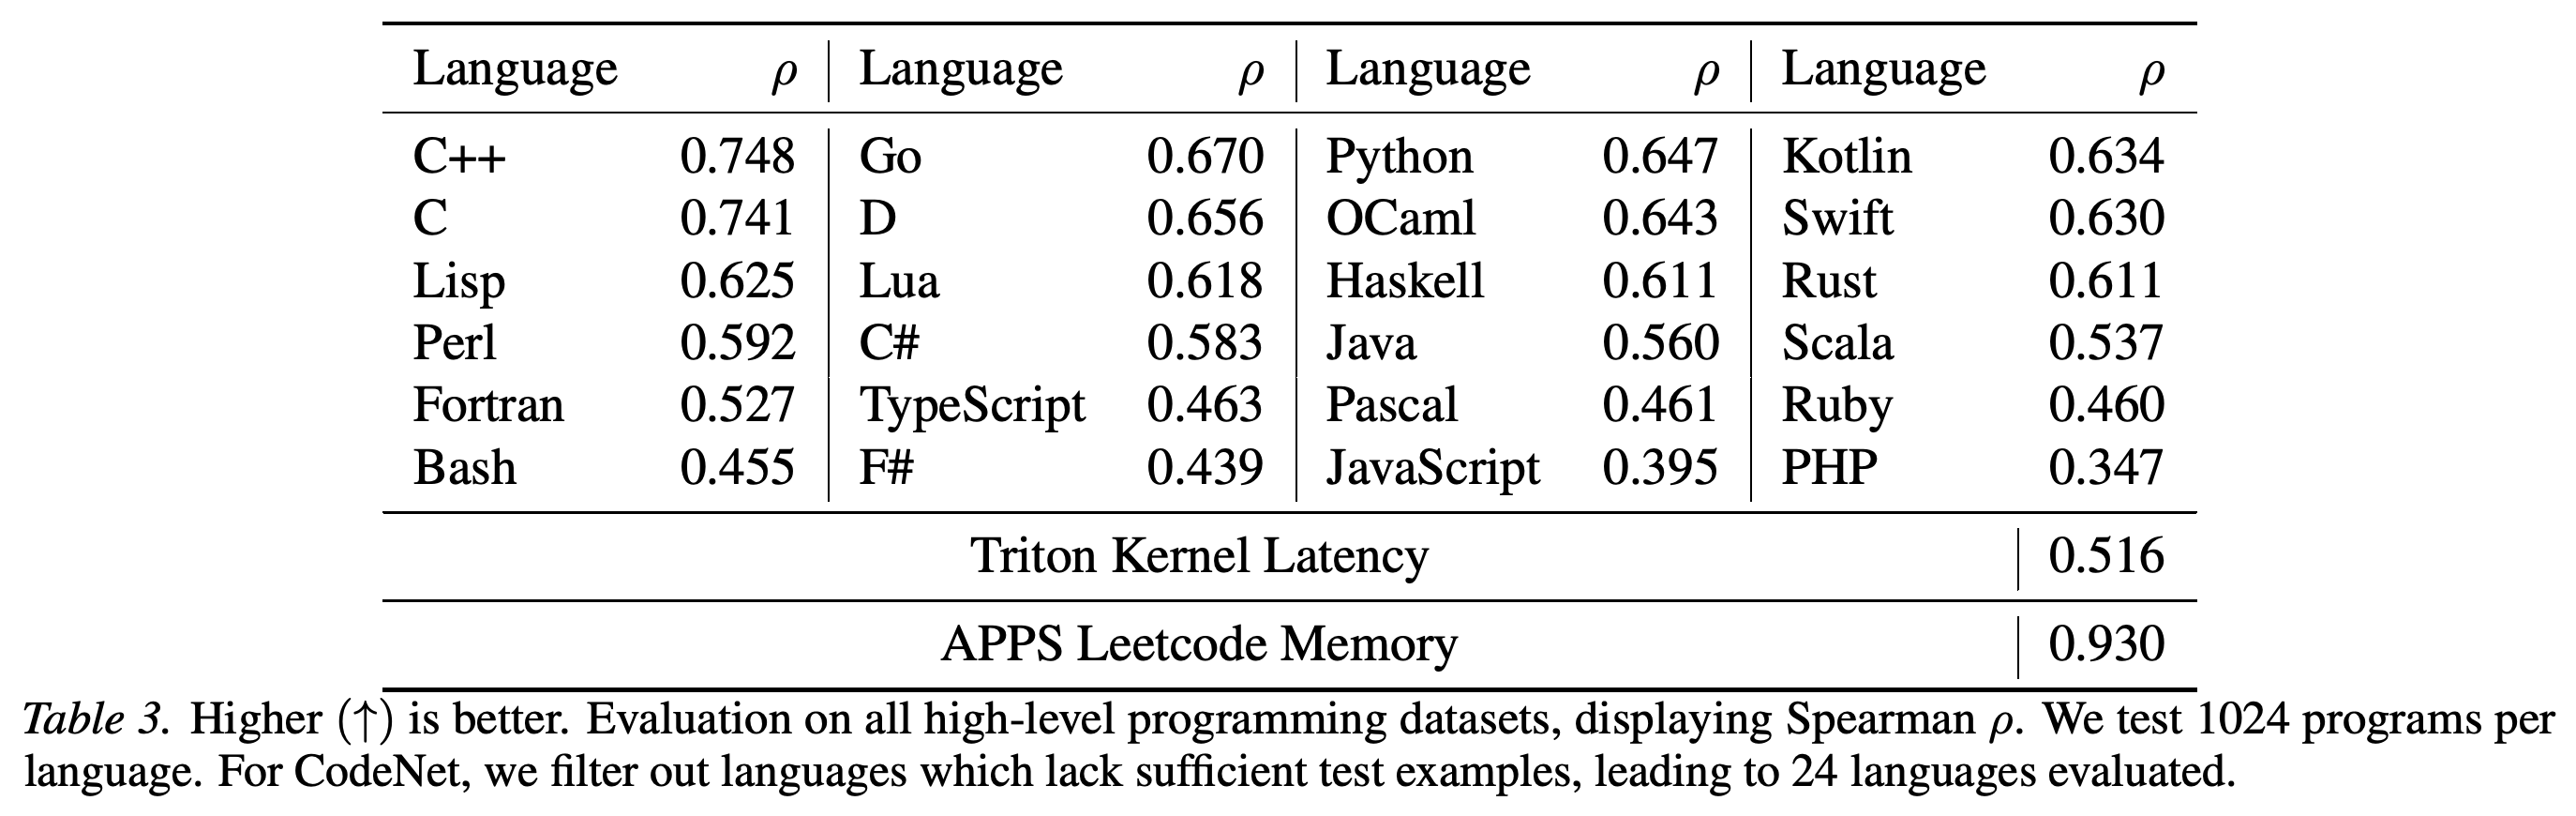
Table 3은 언어당 프로그램 1024개를 평가하며 테스트 예제가 충분한 CodeNet 언어 24개를 포함한다. 상관계수는 C++의 ρ = 0.748부터 PHP의 0.347까지 분포한다. APPS 최대 메모리 사용량은 0.930, Triton 지연 시간은 0.516을 달성한다.
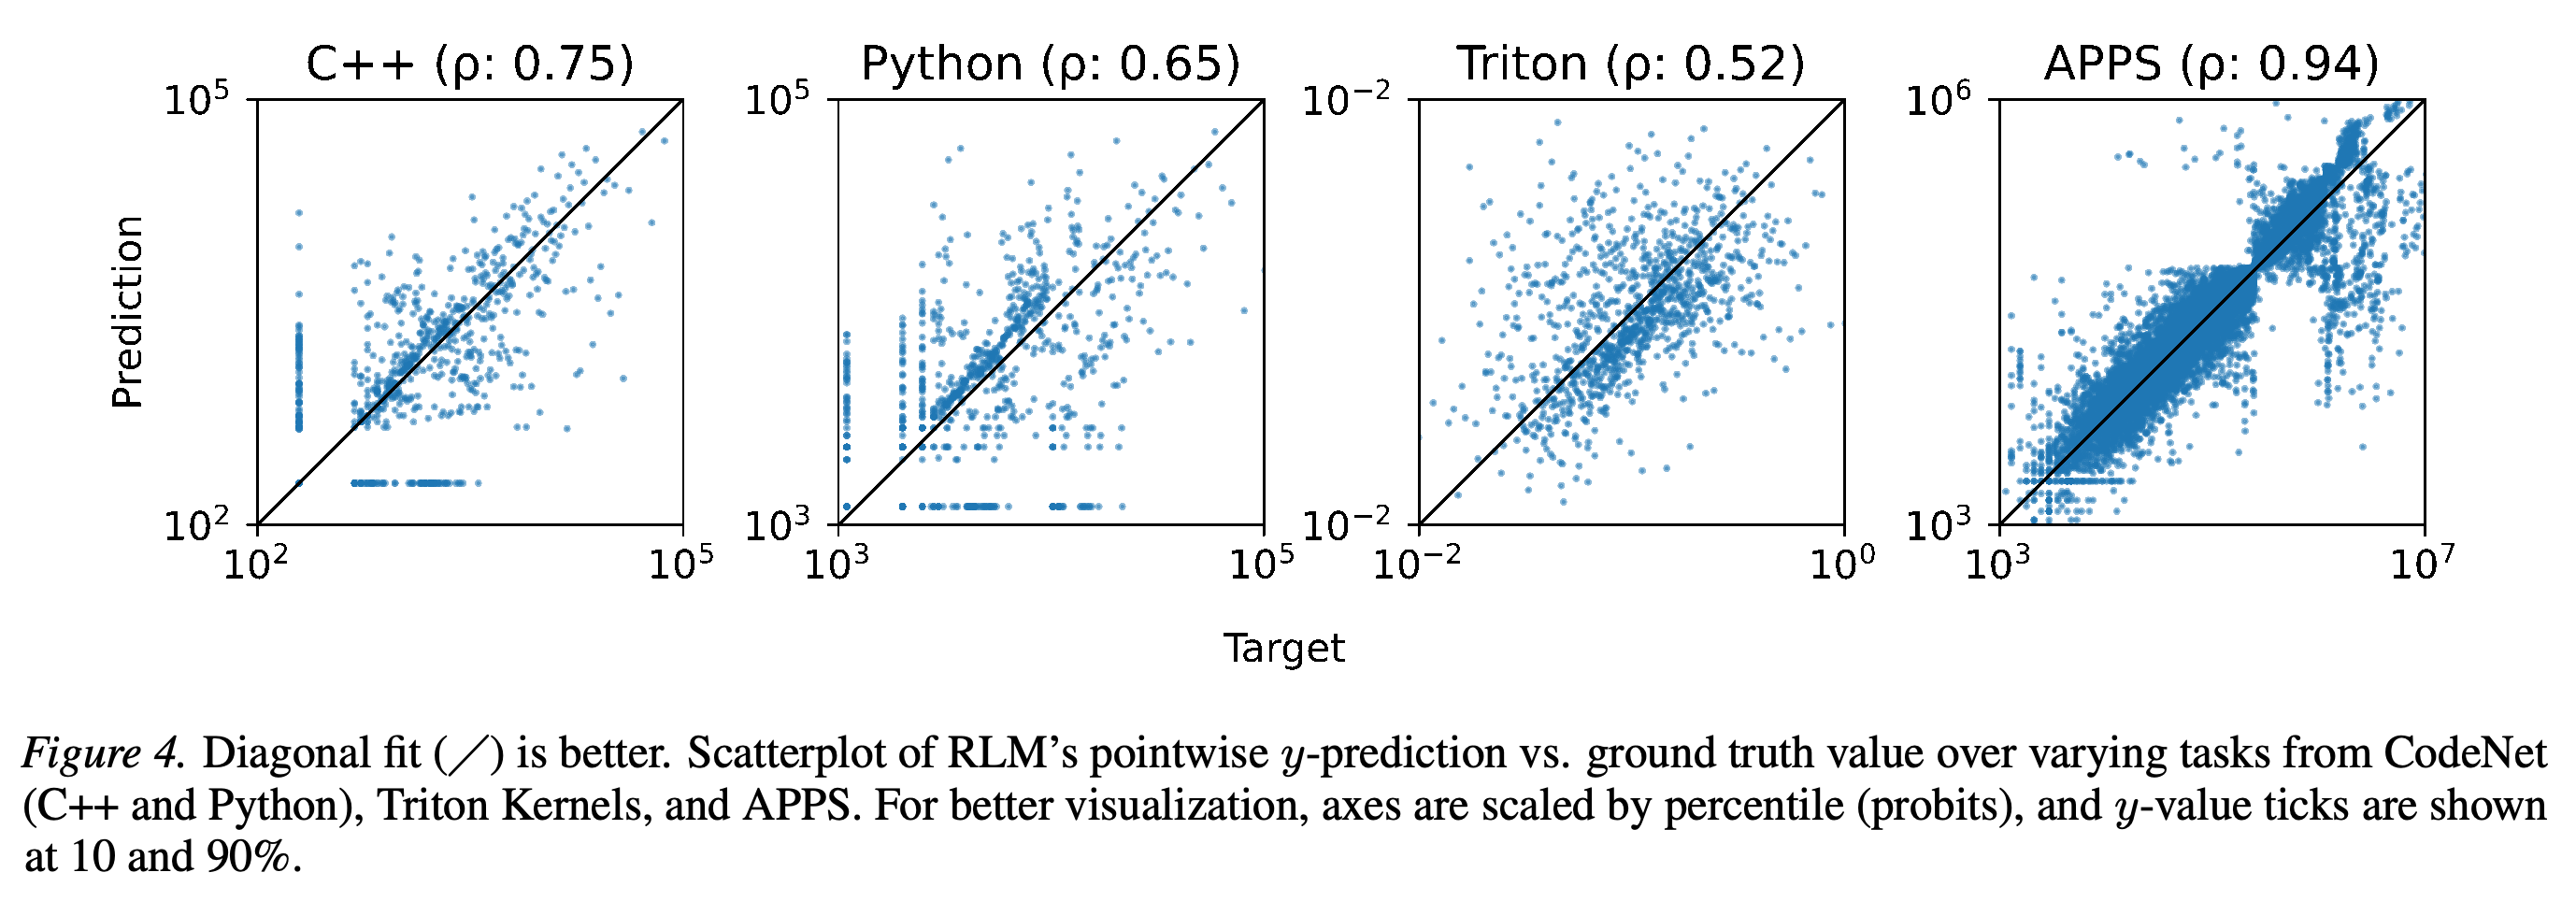
- 점 예측 그래프의 목표값 척도는 크게 다르지만 순위 상관계수는 절대 예측 오차를 측정하지 않는다.
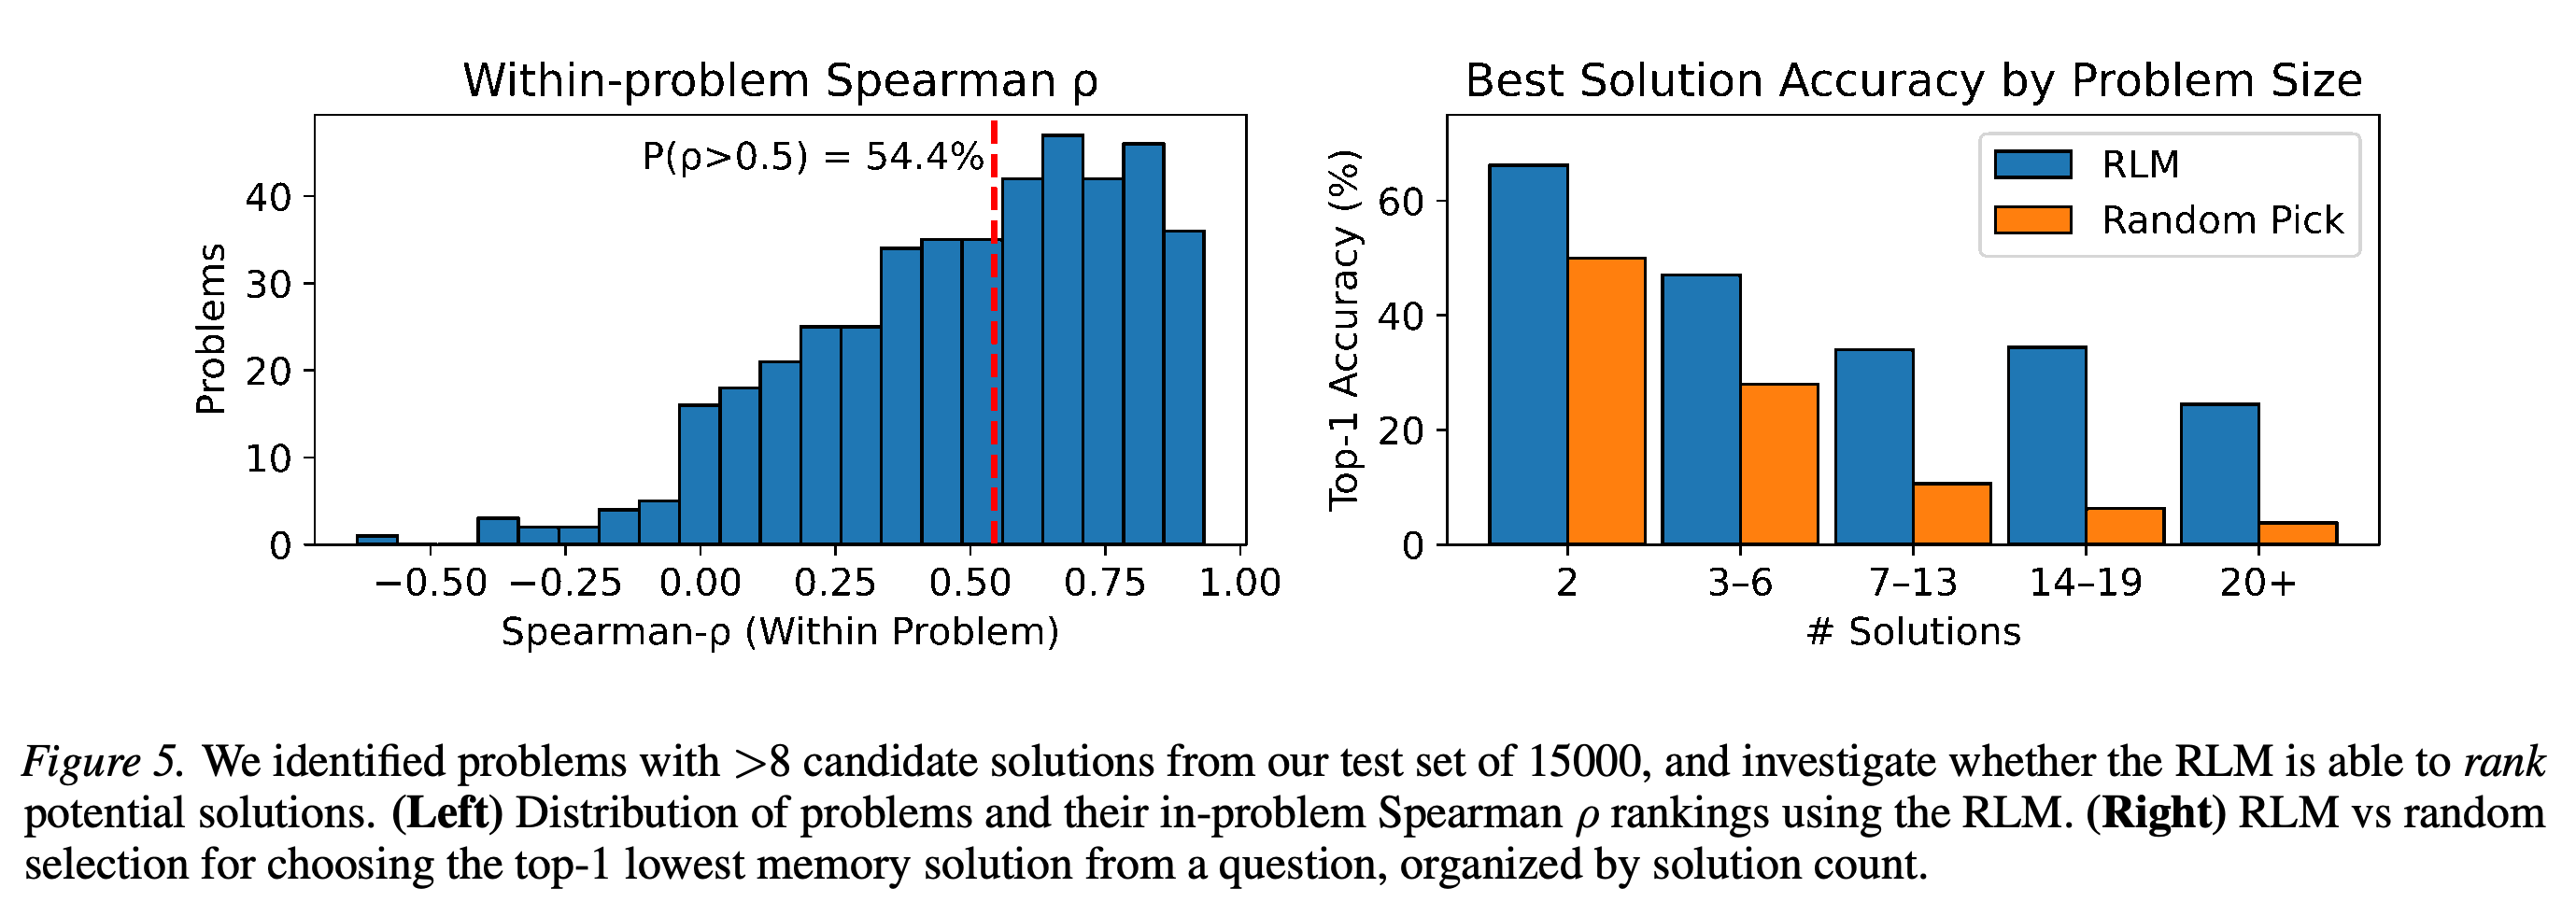
- Figure 5의 히스토그램은 표시된 문제 중 54.4%에서 문제 내 ρ > 0.5라고 보고한다. 예측 메모리가 가장 낮은 제출 코드를 선택하면 표시된 풀이 개수별 그룹에서 무작위 선택보다 좋은 결과를 얻는다.
- APPS에서 순위 예측이 가장 나쁜 5개 문제의 변동계수 중앙값은 약 0.0056이며, 가장 좋은 5개 문제에서는 0.037이다. 변동계수는 목표값의 표준편차를 평균으로 나눈 값이다. 이 결과는 목표값이 거의 같은 경우 순위 예측이 더 나빠지는 경향을 보여준다.
24개 언어의 결과는 C++의 0.748부터 PHP의 0.347까지 순위 예측 성능이 고르지 않음을 보여준다. APPS 메모리의 0.930은 Triton 지연 시간의 0.516보다 상당히 높다. 따라서 공통 인터페이스가 동일한 수준의 성능을 뜻하지는 않는다.
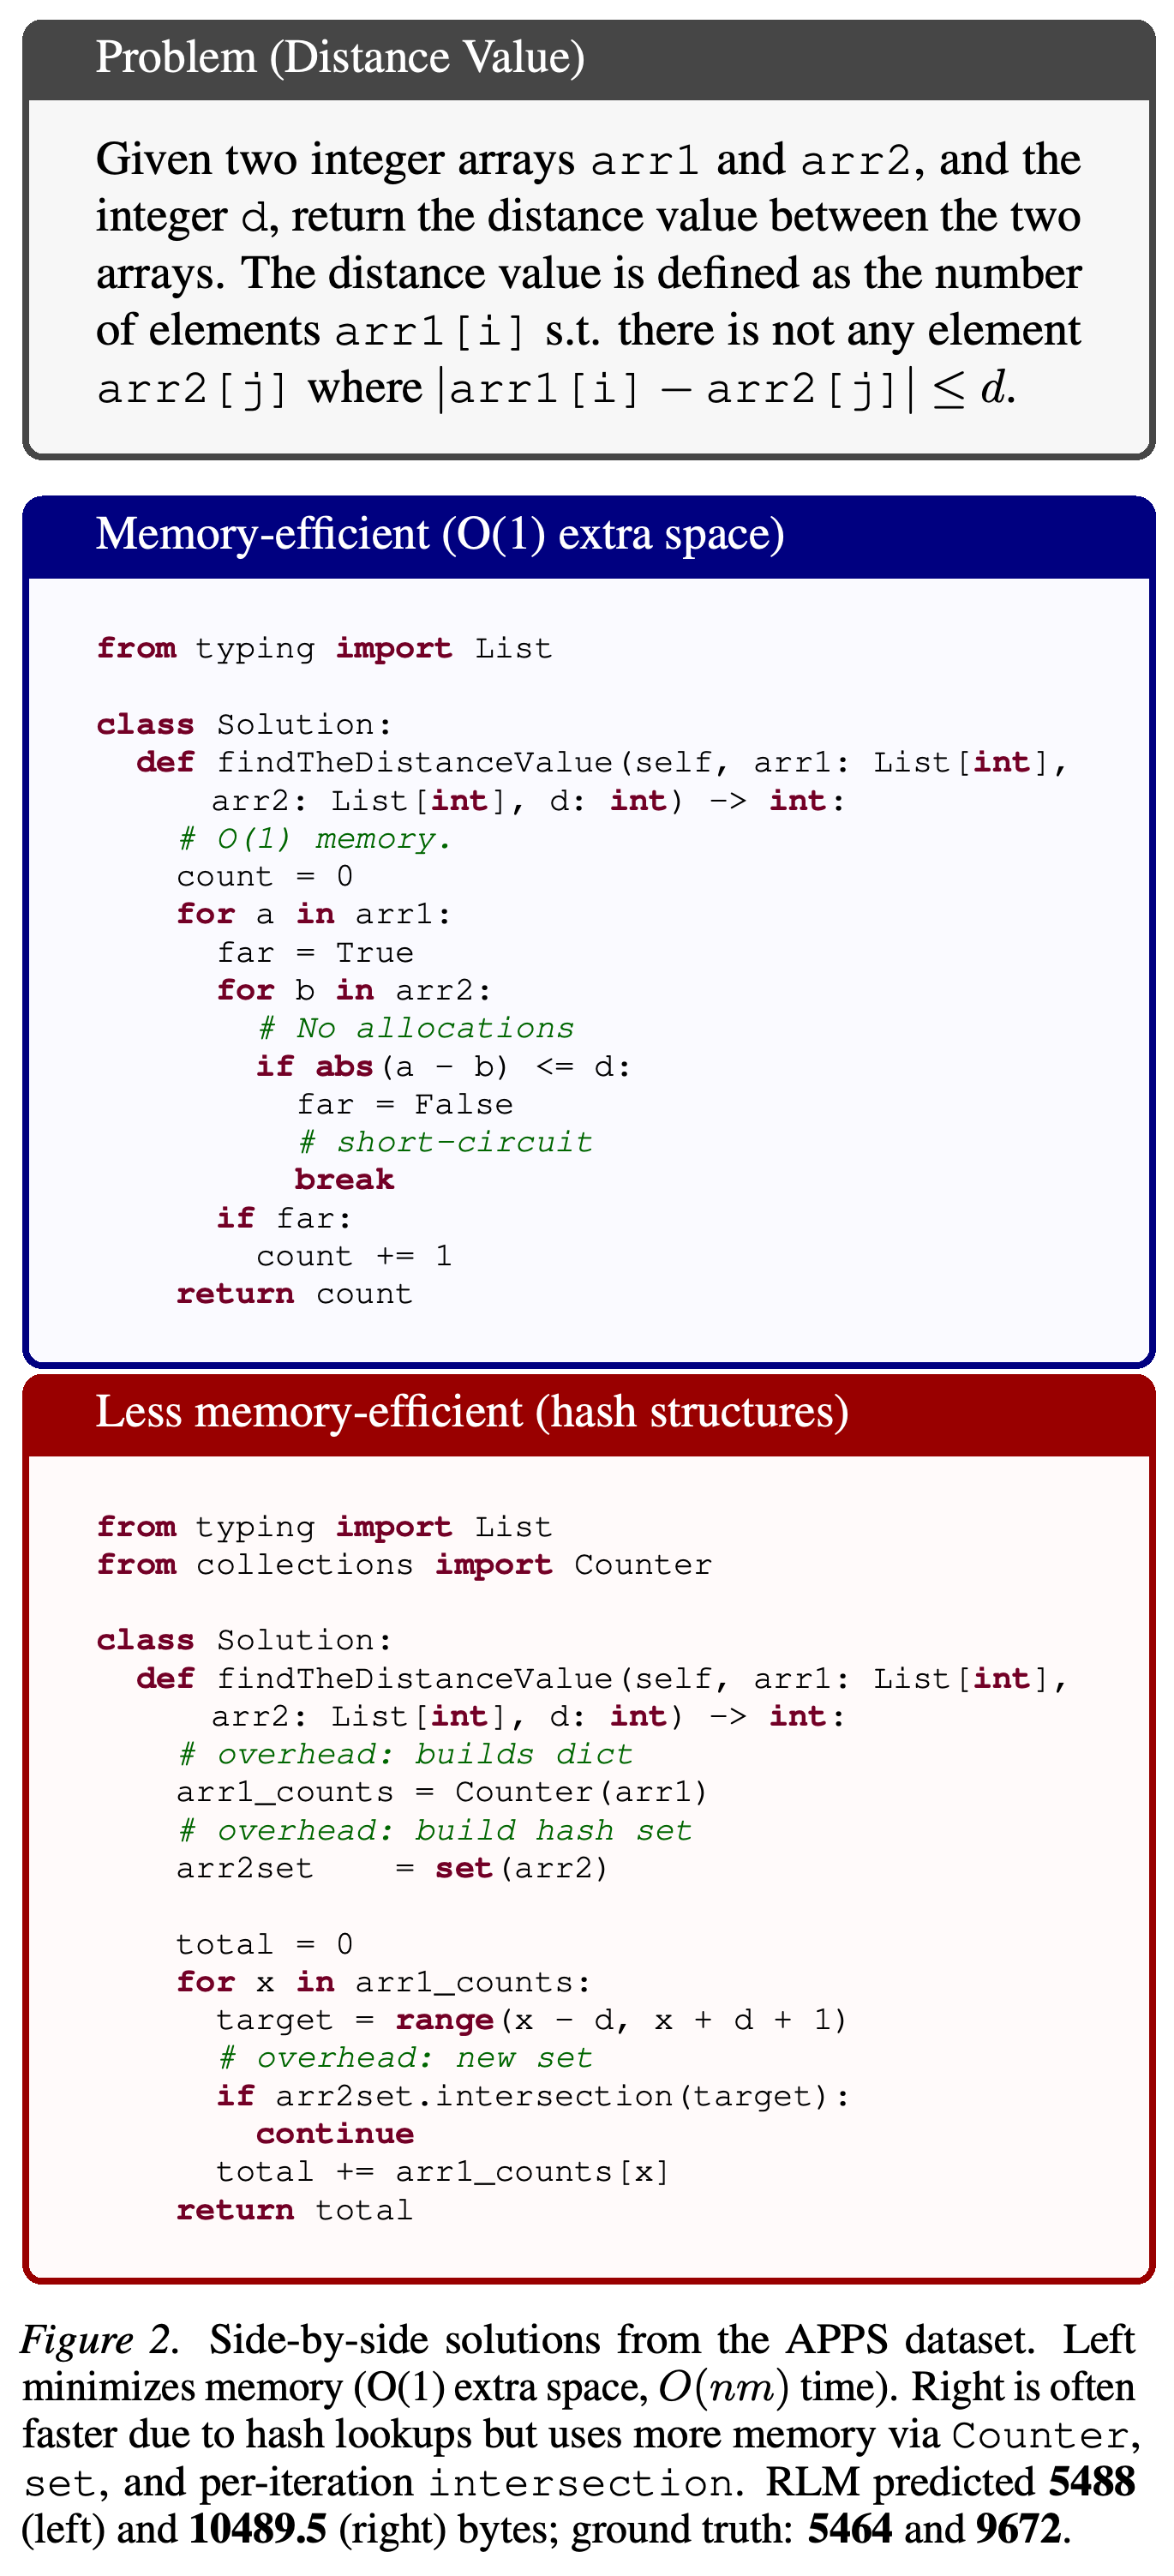
예측기는 중첩 반복문 구현과 Counter, set, intersection에 메모리를 할당하는 구현을 구분한다. 예측값 5488과 10489.5 bytes는 측정 메모리 5464와 9672 bytes의 순서를 유지하지만 2개 구현의 수치 오차는 다르다.
APPS에서는 표시된 다른 과제보다 예측값이 목표값을 더 가깝게 따른다. 축에는 백분위수를 정규분포 척도로 변환하는 백분위 기반 probit 스케일을 사용하므로, 절대 오차를 직접 보여주지는 않는다. APPS 패널은 0.94를 보고해 Table 3의 0.930과 다르지만 원문은 이 차이를 설명하지 않는다.
히스토그램은 문제의 54.4%에서 문제 내 ρ가 0.5를 넘는다고 보고한다. 막대그래프에서는 예측 메모리가 가장 낮은 풀이를 선택하는 방식이 표시된 모든 후보 수 그룹에서 무작위 선택보다 좋은 결과를 보인다. 캡션의 후보가 8개보다 많다는 조건은 오른쪽 패널에 표시된 모든 그룹을 설명하지 못한다.
5.3. NAS Results
NASNet, Amoeba, PNAS, ENAS, DARTS에서 RLM의 평균 Kendall τ는 0.461이며, FLAN은 0.459, GNN 기준 모델은 0.429다. RLM은 NASNet과 Amoeba에서 가장 높은 성능을 보이며 나머지 공간에서는 다른 방법이 앞선다.
- Table 4는 FLAN 설정에 맞춰 NASNet, Amoeba, PNAS의 목표 공간 샘플 수를 16개로, DARTS는 100개로 지정한다. 캡션에는 ENAS 샘플 수가 명시되어 있지 않다.
- RLM은 FLAN의 추가 zero-cost proxy 없이 ONNX 텍스트를 사용한다. Zero-cost proxy는 전체 학습 없이 저렴하게 계산하는 아키텍처 신호다(Akhauri & Abdelfattah, 2024b; Abdelfattah et al., 2021).
- 단일 NASBench-201 모델은 정확도와 4개 장치의 지연 시간을 생성한다. 지연 시간 상관계수는 Pixel3에서 0.731, 특화 하드웨어 가속기 Eyeriss에서 0.466, Intel CPU에서 0.960, Nvidia GPU에서 0.939다. 예측한 Pareto front는 관측된 front를 대체로 따른다. Pareto front는 어떤 목적을 개선하려면 다른 목적을 악화시켜야 하는 절충 관계를 나타낸다.
RLM의 평균 Kendall τ 0.461은 FLAN의 0.459보다 조금 높다. NASNet과 Amoeba에서는 가장 높은 성능을 보이지만 PNAS, ENAS, DARTS에서는 최고 성능 방법보다 낮다. 종합 성능 차이에 대한 불확실성 추정치는 제공되지 않는다.
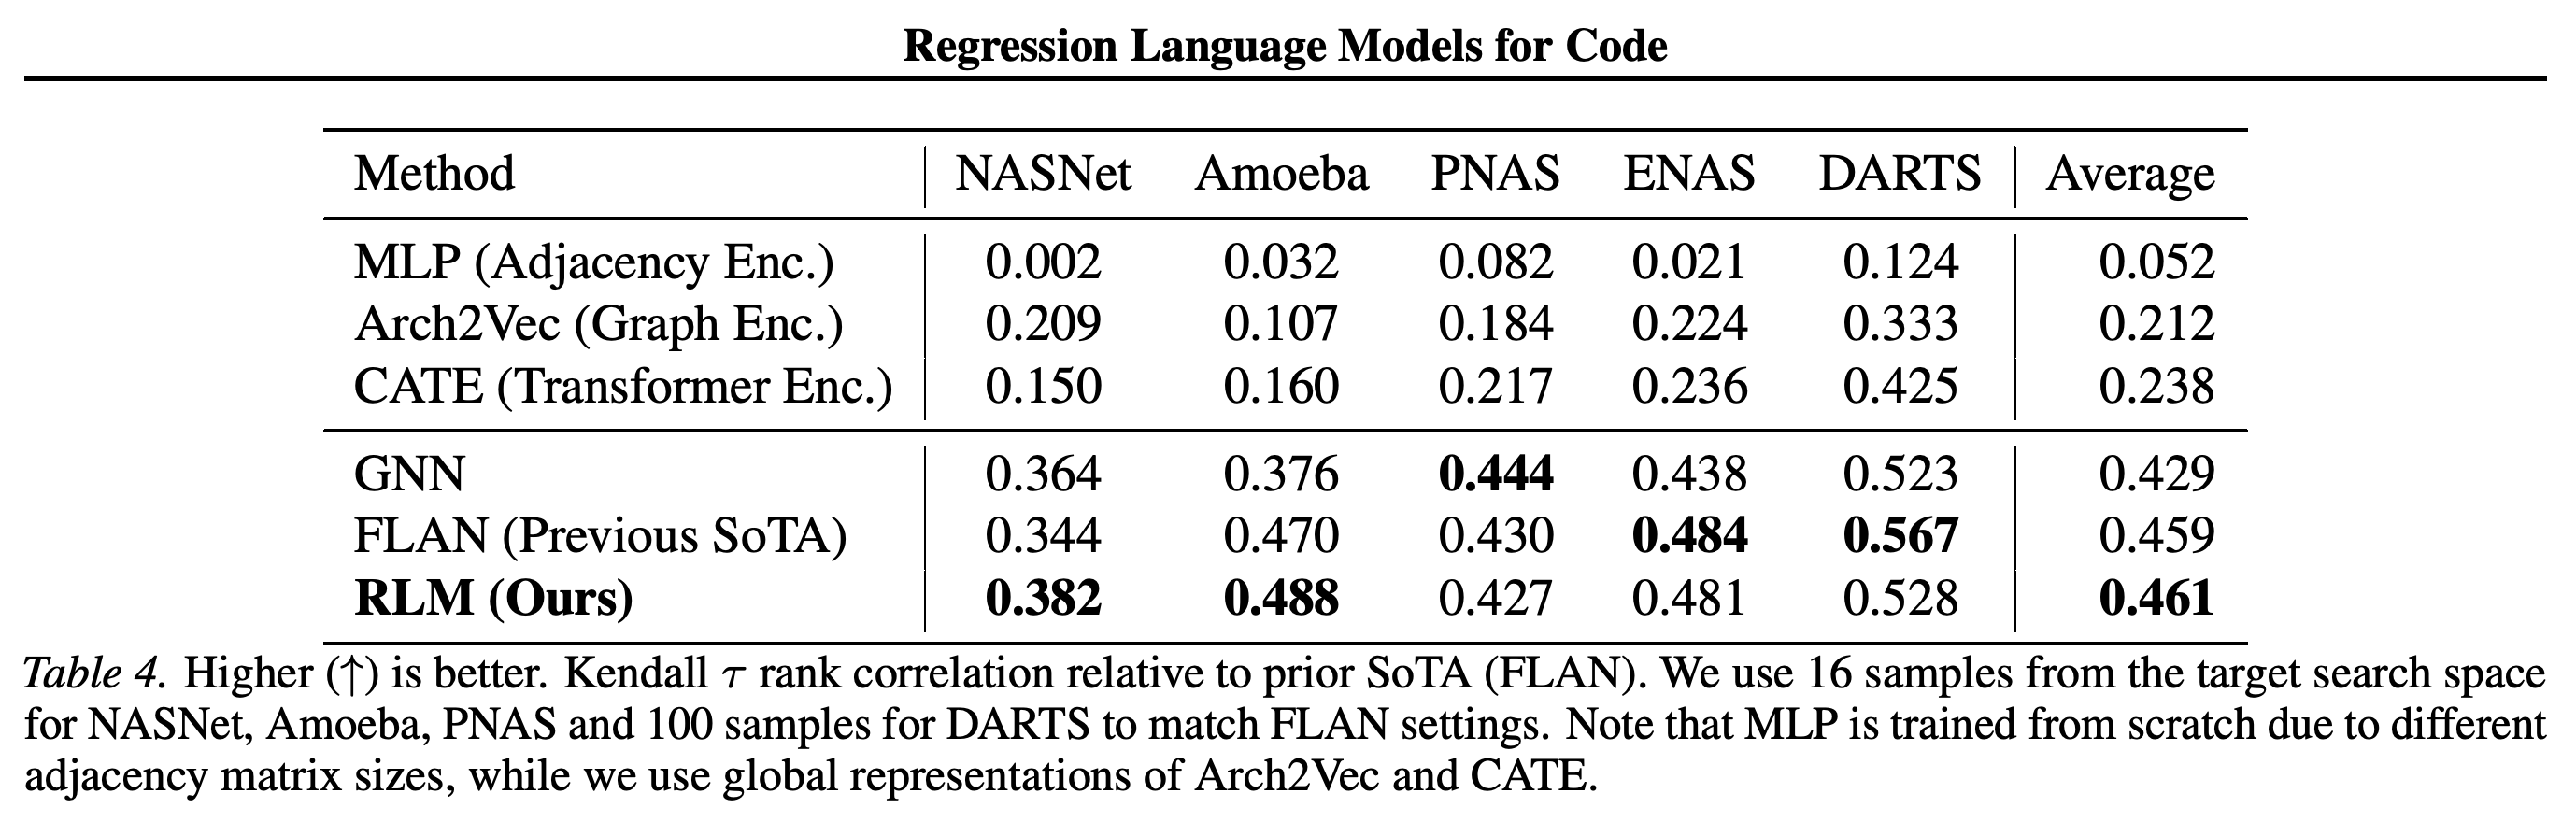
예측한 정확도와 지연 시간의 Pareto front는 측정된 절충 관계를 대체로 따르며, 밀도 등고선은 생성된 지표 사이의 의존성을 보여준다. 지연 시간 순위 성능은 Eyeriss의 0.466부터 Intel CPU의 0.960까지 장치에 따라 다르다. 이 그래프들은 불확실성 보정을 정량화하지 않는다.
6. Experiments: Ablations
주요 ablation 실험은 설계 선택을 통제해 비교하며 수치 출력 생성, 인코더 크기, 토큰화를 살펴본다. 실험마다 데이터 부분집합과 학습 조건이 다르므로 각 결과는 해당 비교 조건에 적용된다.
6.1. Comparing with Regression Heads
출력 헤드 비교는 전체 깊이를 4개 레이어로 고정한다. 2개 레이어 인코더와 2개 레이어 디코더를 예측 토큰 확률에 대한 손실인 교차 엔트로피로 학습하는 방식과, 4개 레이어 인코더에 수치 오차의 제곱을 손실로 사용하는 평균 제곱 오차(MSE) 회귀 헤드를 붙이는 방식을 비교한다. NASBench-101 테스트 예제 512개에서 수치 디코딩은 ρ = 0.800을 달성한다. 회귀 헤드는 데이터셋별로 목표값을 [0, 1]로 정규화하면 0.717, 정규화하지 않으면 0.478을 달성한다.
- 학습 데이터에는 목표값 척도가 크게 다른 NASBench-101, SNAS, Once-for-all 변형이 포함된다.
- 결과는 실험한 디코더 설계를 뒷받침하지만 출력 표현의 효과와 인코딩 및 디코딩 사이의 레이어 배분 효과를 분리하지는 못한다.
목표값 정규화는 회귀 헤드의 상관계수를 0.478에서 0.717로 높인다. 전체 깊이를 맞춘 비교에서 수치 디코딩은 0.800을 달성한다. 이 비교에서는 인코딩과 디코딩 사이의 레이어 배분도 바뀐다.
6.2. Scaling Regression Language Models
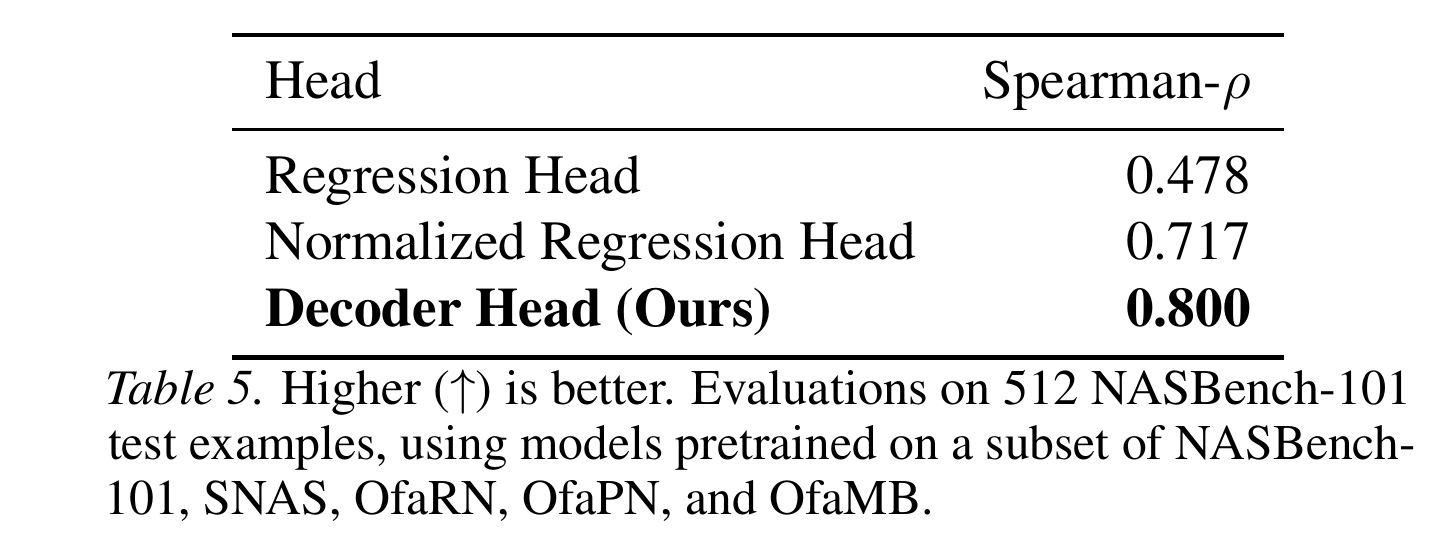
작은 고정 인코더를 t5gemma-b-b-prefixlm으로 교체하면 모델 파라미터 수가 300M에서 600M으로 늘어난다. 더 작은 혼합 코드 학습 부분집합과 CodeNet 예제 1024개를 사용한 평가에서 Spearman ρ는 0.744에서 0.782로 개선된다.
- 저자들은 더 큰 T5Gemma 모델에 광범위한 하이퍼파라미터 조정이 필요해 주어진 계산 예산으로 비교를 확장하지 못했다.
보고된 부분집합 실험에서 600M 모델은 300M 모델보다 상관계수가 0.038 높다. 2개 크기의 비교는 해당 조건에서의 개선을 보여주지만 더 넓은 범위의 스케일링 관계를 입증하지는 않는다.
6.3. Encoder-Decoder Settings
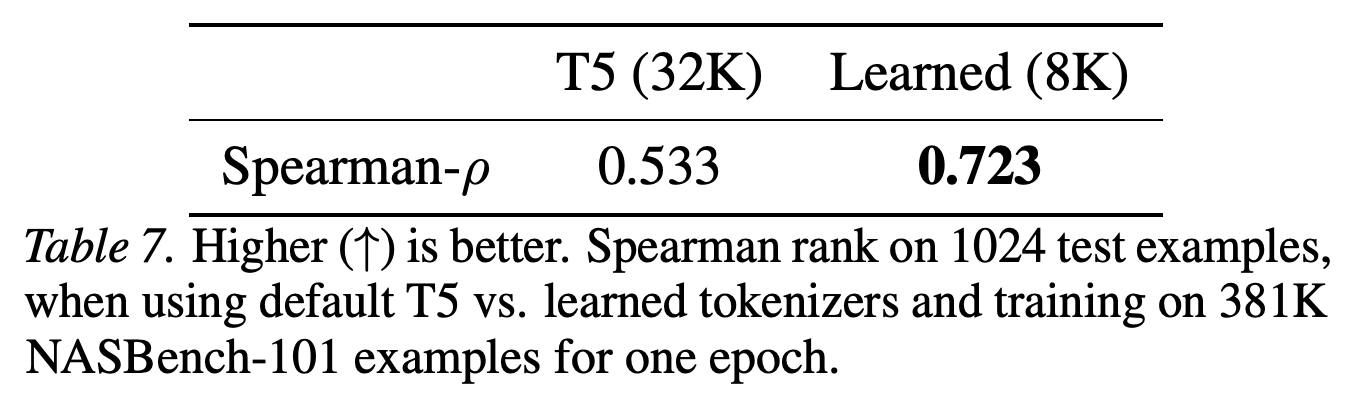
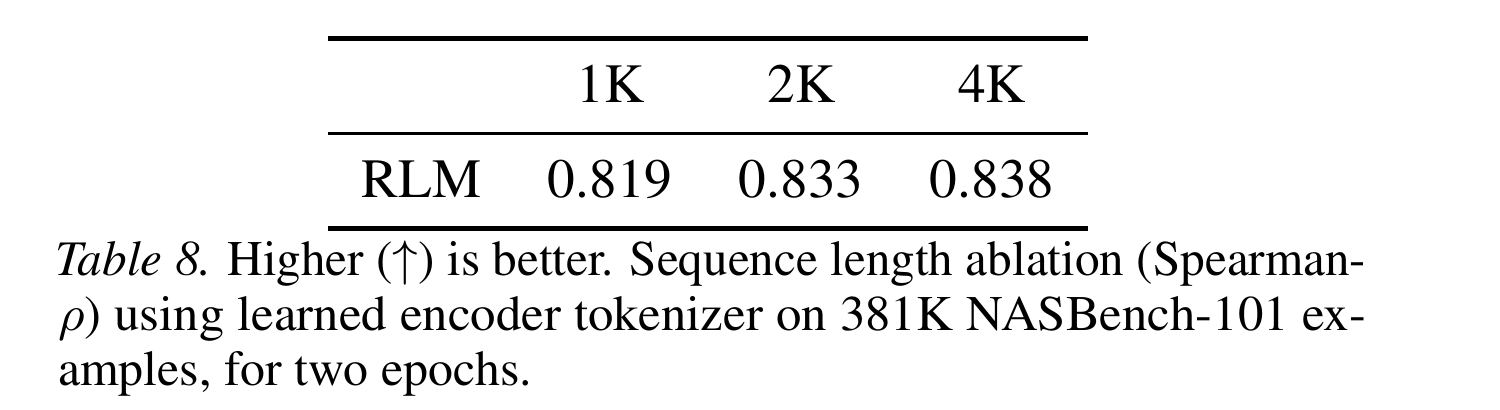
처음부터 학습하는 모델에서 ONNX 구조를 고려한 SentencePiece 토크나이저는 학습된 텍스트 분할 어휘 8K토큰을 사용한다. NASBench-101 예제 381K개로 1 epoch 학습하면 기본 32K-token T5 어휘의 ρ 0.533보다 높은 0.723을 달성한다. 학습된 토크나이저로 2 epochs 학습할 때 문맥 길이를 1K에서 2K, 4K로 늘리면 ρ는 0.819에서 0.833, 0.838로 높아진다.
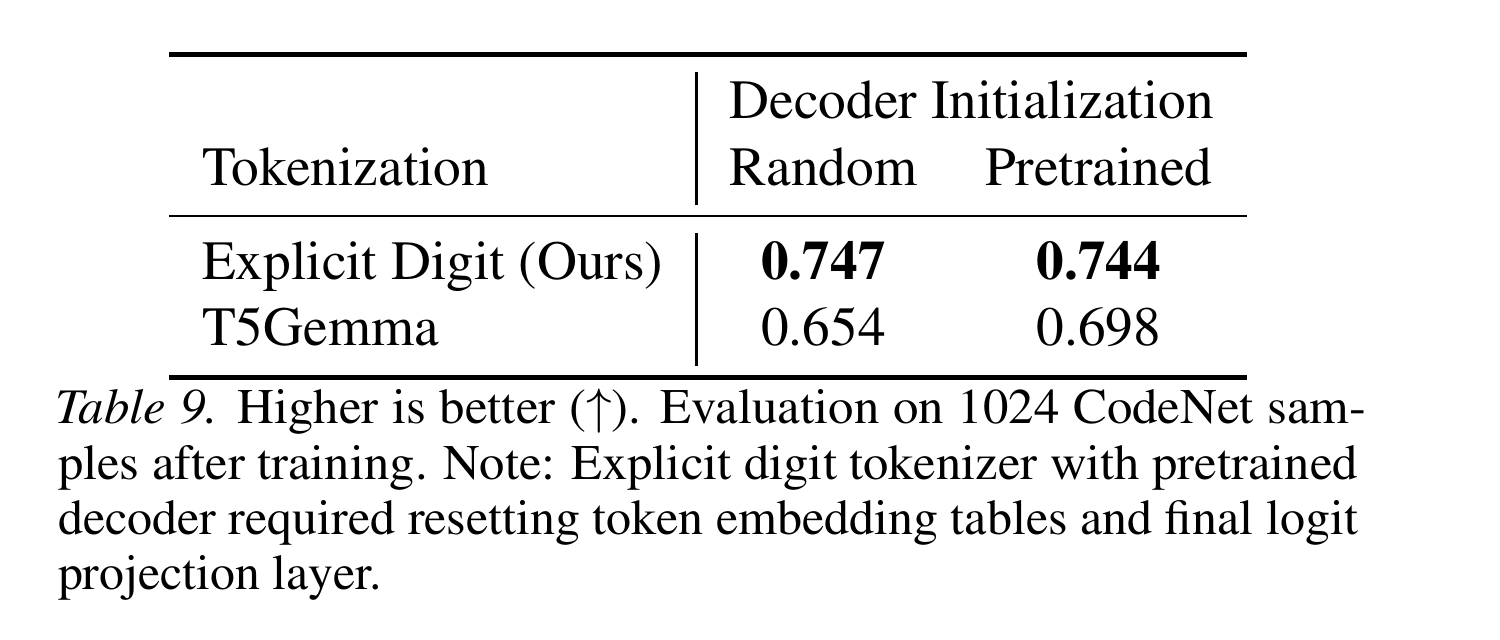
- 명시적 수치 토큰은 디코더를 무작위로 초기화하면 0.747, 사전 학습 가중치로 초기화하면 0.744를 달성한다. 표준 T5Gemma 토크나이저는 각각 0.654와 0.698을 달성한다.
- 특화된 수치 어휘에서는 디코더 사전 학습의 이점이 거의 관측되지 않지만 표준 텍스트 어휘에서는 사전 학습된 디코더 가중치가 도움이 된다.
- 사전 학습된 디코더에 명시적 수치 토큰을 사용하려면 토큰 임베딩과 최종 출력 투영을 재초기화해야 한다.
ONNX 텍스트에서 학습한 8K 어휘는 1 epoch 후 0.723을 달성하며 기본 32K T5 어휘는 0.533을 달성한다. 이 결과는 처음부터 학습할 때 텍스트 분할을 그래프 구문에 맞추는 방식을 뒷받침한다.
문맥을 늘리면 상관계수는 1K에서 0.819, 4K에서 0.838로 개선되며, 개선의 대부분은 2K까지 늘릴 때 나타난다. 이 비교는 해당 토크나이저와 데이터셋에서 2 epochs 학습할 때 입력 잘림과 관련된 효과가 크지 않음을 보여준다.
명시적 수치 토큰은 디코더를 무작위로 초기화하거나 사전 학습 가중치로 초기화할 때 비슷한 성능을 보인다. 표준 토크나이저는 사전 학습 가중치로 초기화하면 성능이 개선된다. 명시적 토큰을 위한 임베딩과 최종 투영의 재초기화도 비교 조건에 포함된다.
7. Conclusion
논문은 수치 생성이 여러 프로그래밍 언어와 연산 그래프 표현에 공통 회귀 인터페이스를 제공할 수 있다고 결론짓는다. 프로그램 탐색, 하드웨어 및 소프트웨어 공동 설계, 컴파일러 최적화에 적용할 수 있다고 제안한다. 원본 코드에서 전체 실험의 결과를 예측하는 문제는 열린 연구 과제로 남아 있다.
Impact Statement
저자들은 이 연구가 머신러닝 발전을 목표로 하며, 별도로 논의할 필요가 있는 특정한 사회적 영향은 없다고 밝힌다. 이 진술에는 후속 영향에 대한 추가 실증 분석이 포함되지 않는다.
부록
- A. Unified Model Ablations의 A.1. Decoder-only Regressors: Qwen and Llama는 기본 텍스트 토크나이저를 사용하는 Qwen3-0.6B와 Llama-3.2-1B를 비교한다. 이 모델들은 단일 디코더로 입력을 처리하고 출력을 생성한다. 학습에는 CodeNet 예제 128K개, APPS 예제 80K개, KernelBook 예제 10K개와 1024토큰 문맥을 사용하며 디코더 레이어의 약 절반을 고정한다. 파싱한 생성 결과 128개의 중앙값을 사용해도 APPS 메모리 상관계수는 각각 약 0.15와 0.17로, 전용 수치 어휘 P10을 사용한 T5Gemma RLM의 약 0.90보다 낮다. 숫자가 아닌 출력이 자주 발생하므로 수치 제약을 사용할 이유가 되지만 이 비교에서는 기반 모델, 토크나이저, 문맥 조건도 함께 바뀐다.
- A.2. Value of Pretraining은 언어 학습을 통한 초기화와 회귀 과제에 대한 선행 학습을 구분한다. T5Gemma 초기화는 Triton 상관계수를 0.504에서 0.532로 개선한다. 부동소수점 연산량을 나타내는 합성 아키텍처 지표 FLOPs로 사전 학습하면 테스트 아키텍처 1024개에서 ρ = 0.999를 달성하며 이후 정확도 예측 성능은 약 0.83에서 0.85로 개선된다. 검증 곡선은 언어 사전 학습과 회귀 사전 학습 모두에서 수렴이 더 빠름을 보여준다.
- A.3. Training on Code and NAS는 언어당 예제 1024개에서 코드만 사용한 학습과 코드 및 그래프를 혼합한 학습을 비교한다. 평균 상관계수는 0.701에서 0.706으로 바뀌며, 개별 과제의 성능은 높아지기도 하고 낮아지기도 한다. KernelBook 학습 곡선은 비슷하게 유지된다. 이 결과는 실험한 혼합 조건에서 큰 평균 성능 손실 없이 공동 학습할 수 있음을 뒷받침한다.
- A.4. Pretraining Diversity and Impact on Language는 전체 예제 수를 482K개로 고정하고 Go, Haskell, Rust 예제를 각각 15K개씩 포함한다. 나머지 437K개 예제를 1개, 2개, 4개 또는 6개 언어에 배분한다. Table 11의 평균은 각각 0.45, 0.45, 0.37, 0.43으로, 언어 다양성이 높아질수록 성능이 일관되게 개선되지는 않는다. Go, Haskell, Rust는 학습에 포함되며, 표에서는 회귀 학습 데이터에 없는 언어도 별도로 평가한다. 문제의 다양성이 구문 다양성보다 중요하다는 설명은 저자들의 가설이다.
- A.5. Fine-tuning은 언어별 예제 1024개로 추가 학습하면 표시된 코드 과제 10개 모두에서 상관계수가 낮아진다고 보고한다. C++은 0.730에서 0.595로, Python은 0.637에서 0.448로 낮아진다. 목표 NAS 예제 약 1K개로 추가 학습하면 NASBench201은 0.681에서 0.738로, NASBench101은 0.646에서 0.734로, ENAS는 0.165에서 0.516으로, Amoeba는 0.045에서 0.501로 개선된다. 저자들은 코드 결과의 원인으로 추가 학습 중 기존 능력이 저하되는 catastrophic forgetting을 가설로 제시하지만 해당 메커니즘을 직접 검증하지는 않는다.
- B. Additional Experiments의 B.1. Limited Information Scenario는 문제와 코드를 함께 입력할 때 0.93이던 상관계수가 코드만 입력하면 0.85로 낮아진다고 보고한다. B.2. Ranking은 풀이가 8개보다 많은 문제에서 예측상 최선인 제출 코드가 실제 상위 p%에 포함되는지 측정하며 해당 곡선은 무작위 선택보다 높다. Appendix B는 이 실험들을 지연 시간 용어로 설명하지만 Figure 5와 주요 APPS 분석은 메모리를 강조한다. 따라서 원문 내부에서 목표 지표에 대한 해석이 일치하지 않는다.
- C. Experimental Settings는 https://github.com/google-deepmind/regress-lm과 학습 옵티마이저 Adafactor를 사용한다. 기본 학습률은 사전 학습에서 1 × 10⁻³, fine-tuning에서 5 × 10⁻⁵이며, 전역 노름 2.0에서 gradient clipping을 적용하고 10% 선형 warmup과 cosine decay를 사용한다. 지정된 T5Gemma 디코더에 맞추는 경우를 제외하면 모델은 은닉 크기 2048, attention head 8개인 디코더 레이어 2개를 사용한다. 점 추정값은 디코더 샘플 64개의 중앙값이며 기본 인코더는 2048토큰을 넘는 입력을 자른다. 저자들은 ONNX 그래프에서만 입력 잘림이 발생했다고 보고한다.
- D. Data: Extended의 D.1. y-Value Distributions는 메모리와 지연 시간 목표값이 이질적이어서 정규화 없는 수치 디코딩을 사용할 이유가 됨을 보여준다. D.2. Extra Leetcode Data for APPS는 프로그래밍 문제와 제출 코드를 모은 또 다른 데이터셋인 EffiBench의 예제 600개를 추가하고 generate_test_case()가 제공한 케이스에서 실제 경과 실행 시간을 반복 측정한다. D.3. Generating the SNAS Dataset는 합성곱 연산으로 구성된 경량 이미지 모델인 합성곱 신경망을 샘플링하고 모멘텀을 적용한 확률적 경사 하강법, 코사인 학습률 스케줄, FP16/BF16 형식으로 연산하는 혼합 정밀도를 사용해 CIFAR-10에서 짧게 학습한다. 각 아키텍처는 정확도, 학습 정보, 아키텍처 메타데이터와 함께 기록한다.
- D.4. Hardware Profiling의 D.4.1. APPS는 AMD EPYC 7702, 503 GiB RAM, Ubuntu 22.04, Linux 6.8.0-45-generic을 사용한다. 매 실행은 -I -S -B 옵션을 지정한 새 Python 프로세스에서 수행한다. 기본 시간 측정 프로토콜은 warmup 3회를 제외하고 11회 반복 측정하며 10 s 시간 제한을 적용한다. 주요 메모리 목표값은 Python 메모리 할당 추적기 tracemalloc으로 별도의 시간 측정 없는 실행에서 수집한 dyn_peak_alloc_bytes다. 이 값은 전체 프로세스 메모리가 아니라 Python 힙 사용량을 측정한다.
- D.4.2. KERNELBOOK은 48 GiB 메모리의 단일 NVIDIA RTX A6000, 드라이버 530.30.02, CUDA 12.1과 Intel Xeon Gold 6448Y 프로세서를 사용한다. Just-in-time 컴파일 warmup 후 20회 반복으로 시간 측정을 시작하고 측정 구간을 최소 1 s까지 늘려 5회 시행한다. 라벨은 ms 단위 지연 시간의 중앙값이다. 자동화된 인자 순서 및 텐서 형태 검사로 프로파일링 가능한 커널을 결정하며 실패한 커널은 건너뛴다.
- D.5. Triton Code Sample (KernelBook)은 지연 시간이 0.0152 ms인 커널 #4949와 DiceLossNew 래퍼를 제시한다. D.6. ONNX Graph Code Sample은 정확도가 60.93%인 SNAS 아키텍처 #10을 제시하며 텐서 형태, 합성곱, 정규화, 풀링, 연결 관계를 포함한다. 이 예제들은 예측기에 제공하는 구조화된 텍스트를 보여준다.
- D.7. Example Code Submissions는 메모리 할당 패턴이 다른 구현 쌍 3개를 제시한다. Maximum Subarray Sum with One Deletion의 예측값은 5549와 6228 bytes이며, 측정값은 5608과 7136이다. Maximum Sum Circular Subarray의 예측값은 5634와 6430이며, 측정값은 5508과 6528이다. Array of Doubled Pairs의 예측값은 6518과 10197이며, 측정값은 6178과 10588이다. 선택된 3개 쌍 모두 측정된 메모리 순서를 유지하지만 수치 오차는 서로 다르다.
짧은 생각
실험은 코드 회귀를 위한 공통 텍스트 인터페이스와 특화된 수치 디코더를 뒷받침한다. FLAN 대비 평균 Kendall τ 차이는 0.002이며, Table 4는 불확실성 추정치를 제공하지 않는다. 따라서 이 근거는 종합적인 순위 예측 성능이 경쟁력 있음을 보여주지만 작은 차이의 신뢰성을 판단하기에는 부족하다. 실제 활용에서는 프로파일링 목표와 하드웨어 조건을 유지해야 한다. Python 힙 메모리와 A6000 커널 지연 시간은 특정 조건의 측정량이다. 문제를 공유하는 CodeNet 분할은 새 문제에 대한 예측 능력을 입증하지 않는다. 공동 밀도 그래프도 예측 불확실성과 관측 오차의 일치도를 나타내는 불확실성 보정을 측정하지 않는다.