


Zetta $\zeta$: An Efficient Closed-Loop Embodied Harness for Self-Evolving Physical Intelligence 요약 설명
17 Aug 2026 | Paper Review Embodied AI Self-Evolving Agents Vision-Language-Action목차
- 요약
- 2. Enabling Deployment-Time Evolution of Embodied Agents
- 3. Z-Infra: Embodied Agent Rollout Infrastructure
- 4. Experiments
- 부록
- 짧은 생각
- 관련 글
이번 글에서는 Zetta $\zeta$: An Efficient Closed-Loop Embodied Harness for Self-Evolving Physical Intelligence 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 17일(Arxiv), arXiv
- Ding, Xin, Mi, Liang, Huang, Mingzhe, Wang, Zixuan, Zhang, Chao, Hao, Zixu, Chen, Fu, Li, Xiangyu, Zheng, Yikai, Guo, Yaoyu, et al.
- Institute for AI Industry Research (AIR), Tsinghua University, Z-Trans AI
- 논문 링크
- Github
- Project Page
요약
- Zetta는 고정된 VLA 또는 WAM 정책이 물리 실행 중 변화하는 상태를 고빈도로 교정하기 어렵고, 기존 embodied harness가 대체로 episode 종료 뒤에만 반성한다는 문제를 다룬다. 정책 가중치와 Orchestrator Agent는 고정하고, code-based runtime critic, recovery playbook, toolset으로 이루어진 Harness $H=\{C,R,T\}$를 rollout 경험으로 갱신한다.
- 제안한 세 loop는 action 단계의 Critic-Governed Action Loop, 실패 rollout을 cluster화하고 patch를 제안하는 Rollout-Batch Candidate Optimization Loop, held-out 검증을 통과한 skill만 채택하는 Validation-Gated Skill Update Loop다. Z-Infra는 agent logic을 환경 실행과 모델 추론 자원에서 분리해 이 과정의 병렬 rollout을 지원한다.
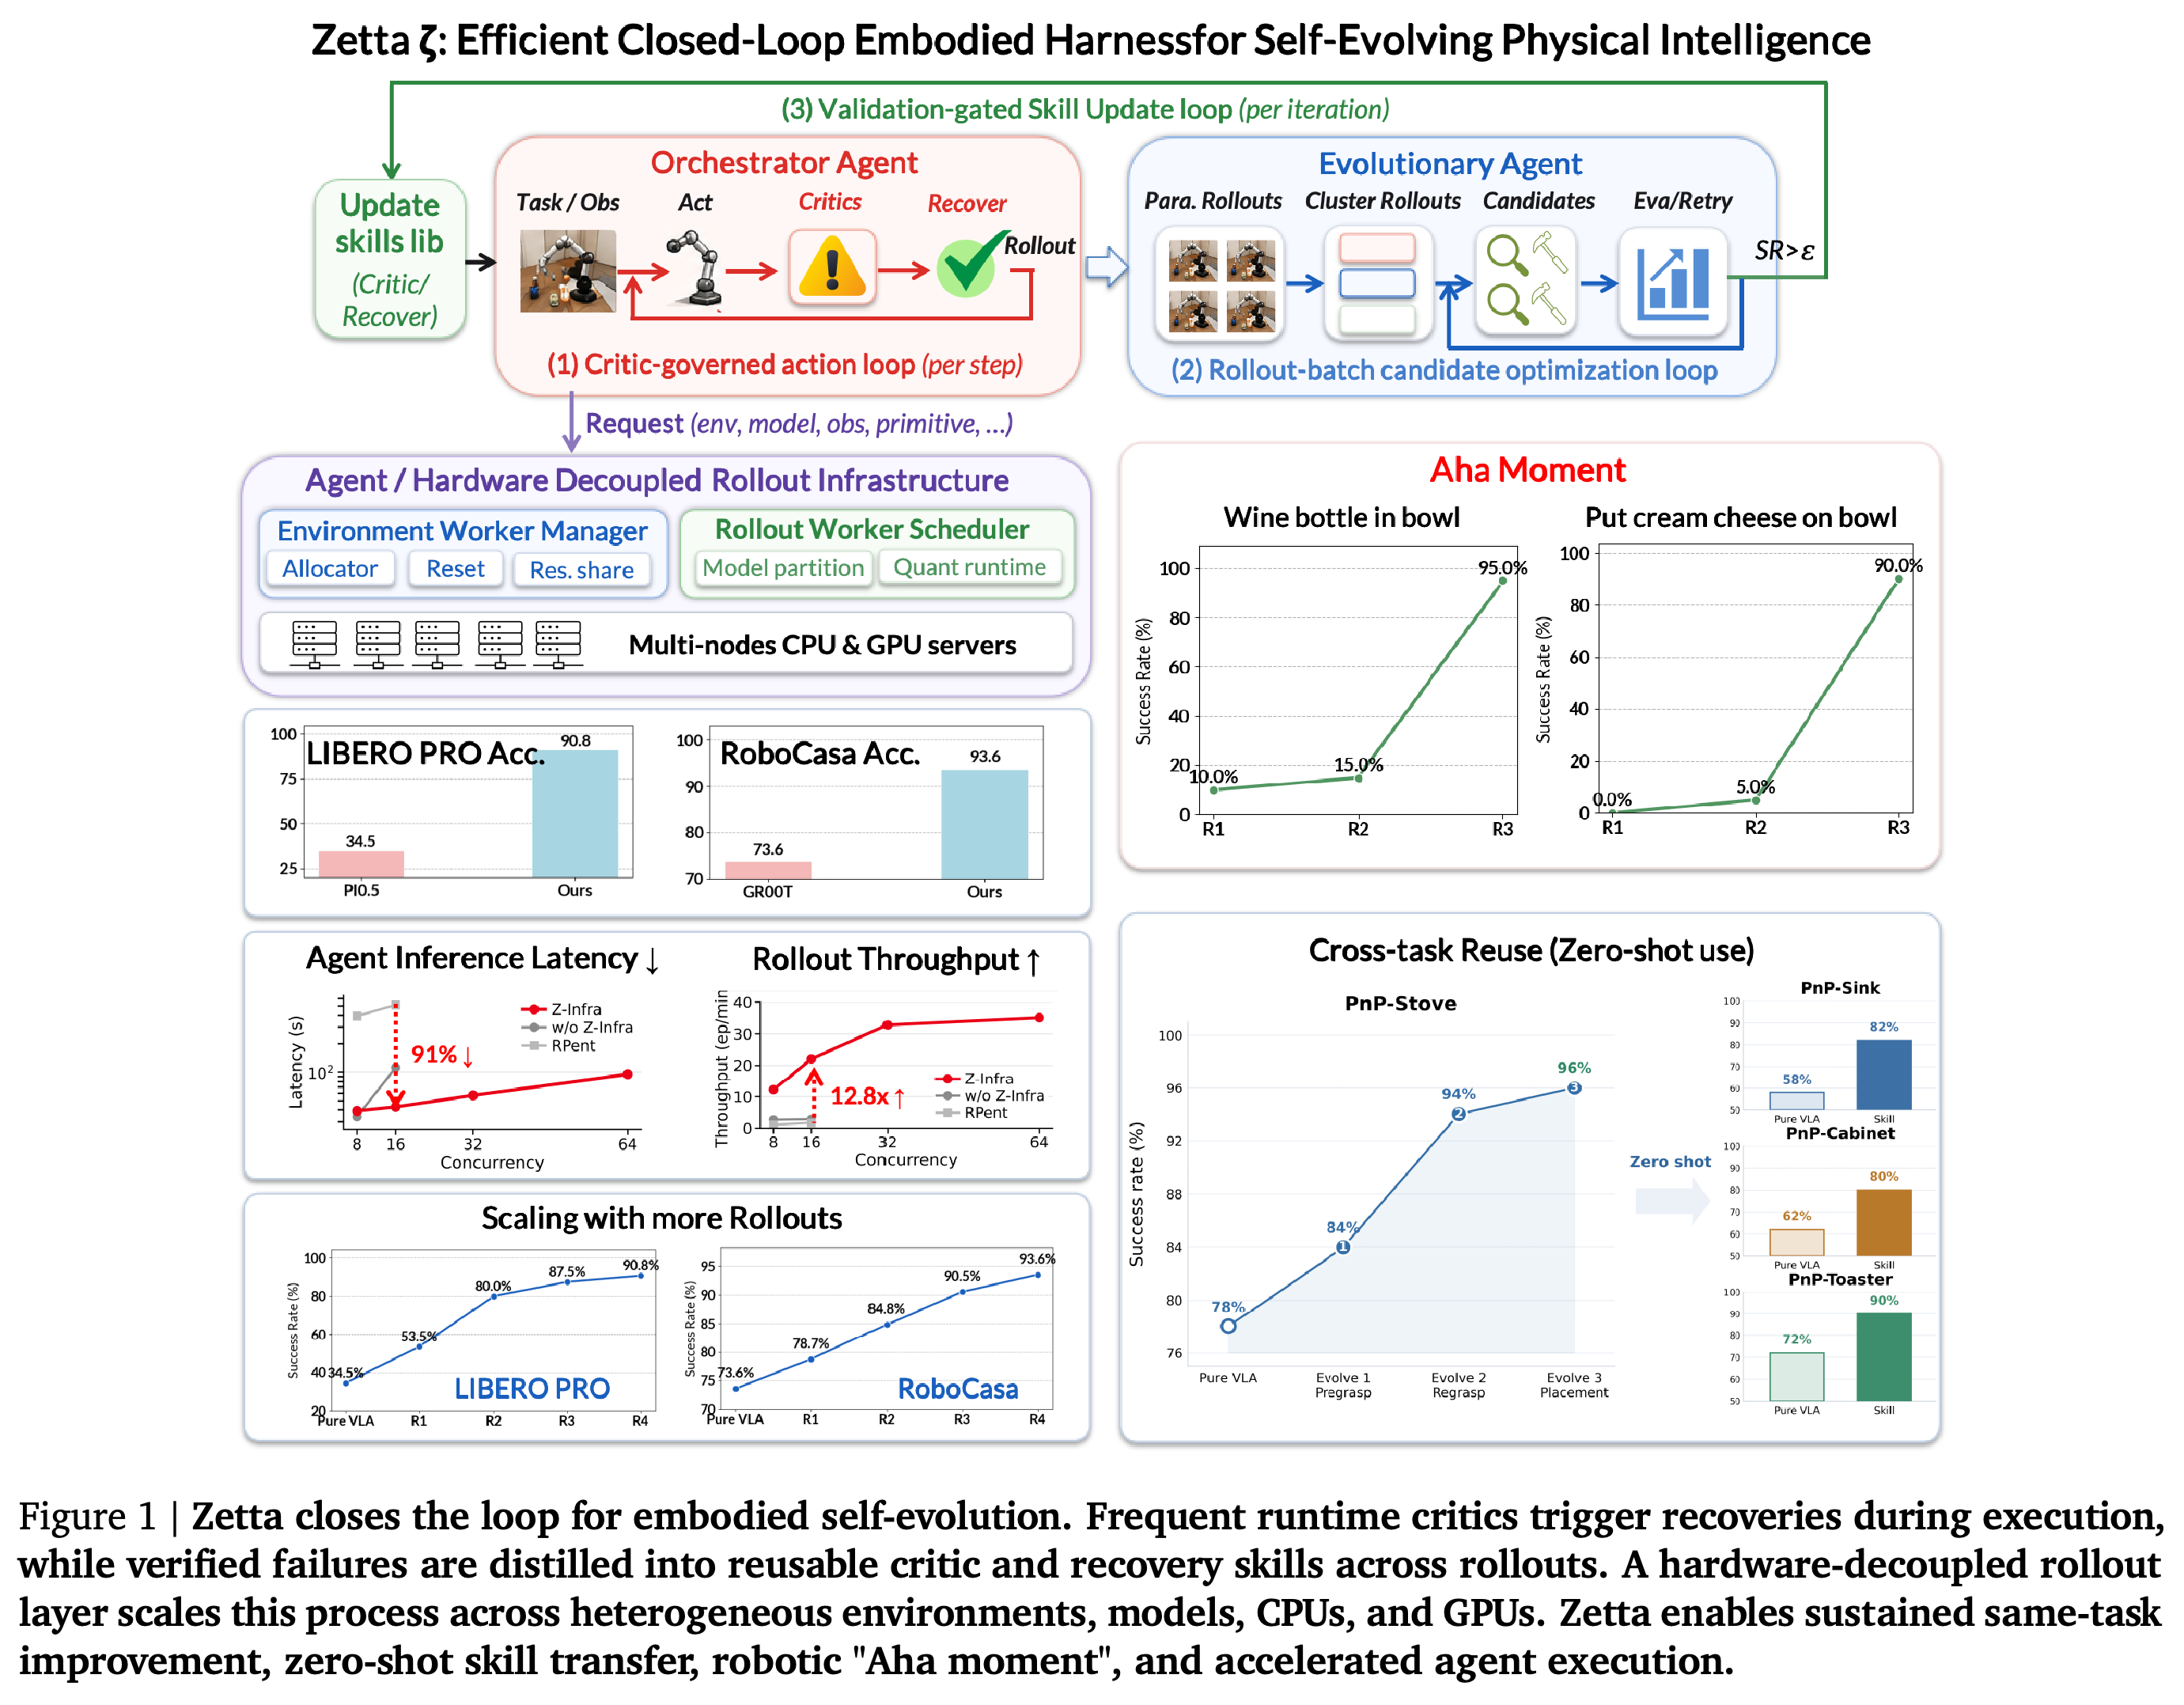
- 저자들은 현재 rollout budget에서 LIBERO-Pro 90.8%, RoboCasa 93.6%, 11.1× inference speedup을 주장한다. Figure 6의 Goal-T와 Goal-S 10-task 평균을 다시 평균하면 34.5%에서 90.75%로 변해 90.8% 반올림과 범위가 맞지만, Table 3의 Goal 및 LIBERO-10 네 setting을 함께 평균한 값은 32.00%에서 71.13%다. Table 2와 Table 3에는 다른 SOTA 방법의 결과가 없으므로 SOTA 비교 대상 전체와 조건은 확인할 수 없다.
Zetta는 실행 중 runtime critic이 recovery를 제안하고 Orchestrator Agent가 mode 전환을 승인하는 action loop, 실패 rollout을 분석해 후보를 만드는 evolution loop, 검증한 skill을 갱신하는 loop를 배치한다. 하단의 LIBERO-Pro 90.8%는 Goal-T와 Goal-S 평균을 다시 평균한 반올림 값이며, Table 3의 네 setting 전체 macro-average와 집계 범위가 다르다.
2. Enabling Deployment-Time Evolution of Embodied Agents
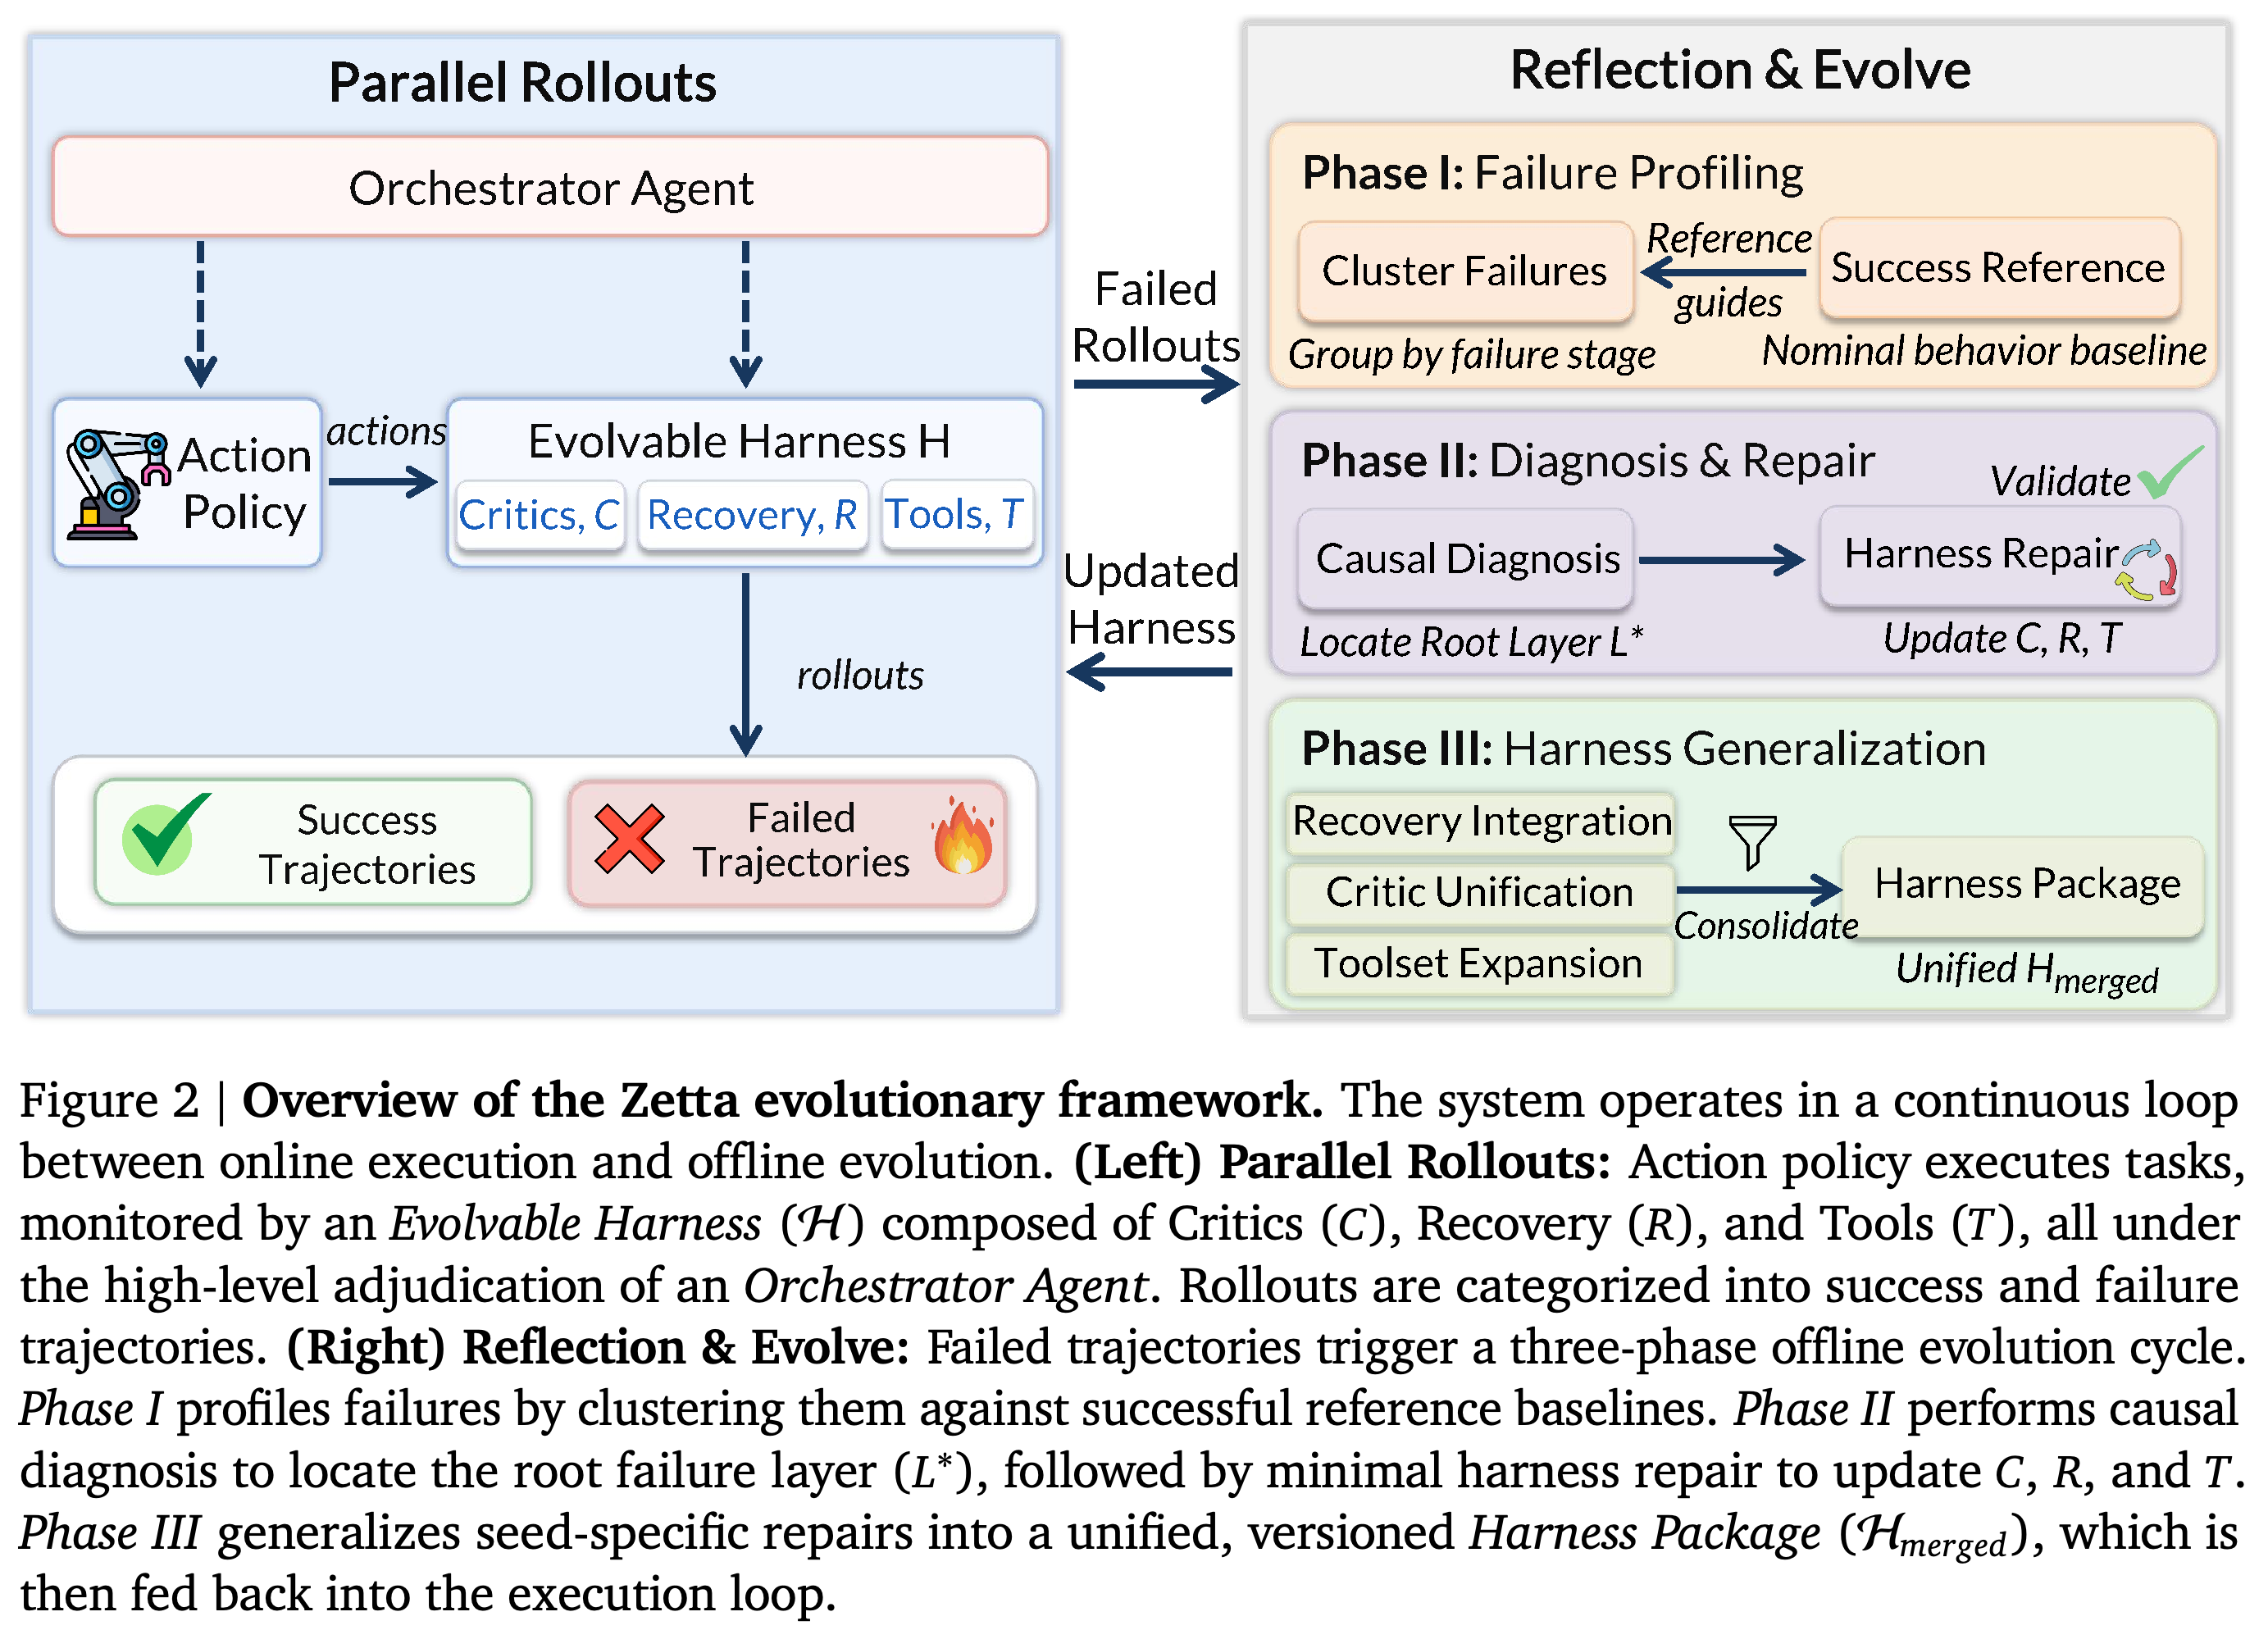
Phase I는 development seed에서 governance 개입 없이 base policy를 실행해 성공 기준 궤적과 실패 증거를 수집한다. 중앙 스케줄러는 동일한 container, simulator version, hardware configuration에서 rollout을 배치하며, 인프라 오류는 원래 logical seed로 재실행해 policy failure와 분리한다. 유효 궤적은 상태, 행동, milestone 완료 상태, 충돌과 접촉력 같은 물리 보조 신호를 append-only 방식으로 보존한다.
왼쪽은 Action Policy가 Critics, Recovery, Tools로 구성된 Harness의 감시 아래 병렬 rollout을 수행하고 성공 및 실패 궤적으로 분류되는 흐름을 보인다. 오른쪽은 실패 cluster화, causal diagnosis, 최소 Harness repair, 검증, versioned Harness Package 통합의 세 phase를 실행 loop에 되돌린다.
2.1. Problem Formulation: Dual-Agent Governance and Evolutionary Architecture
장기 manipulation은 $\pi$와 $A_{\mathrm{orch}}$를 고정한 채 Harness $H$를 갱신하여 기대 task success rate $J$를 최대화하는 문제로 정식화한다. Action Policy는 관측과 goal에서 저수준 action을 생성하며 $\nabla_\theta=0$이고, Orchestrator Agent는 critic이 낸 실패 증거와 제안 mode, task knowledge, recovery 및 tool을 근거로 VLA 실행 또는 전문 tool 전환을 승인한다. Evolutionary Agent는 실패 rollout을 분석해 Harness의 sensing과 action 공간을 갱신한다.
2.4. Phase II Stage 1: Failure Clustering and Causal Diagnosis
Phase II Stage 1은 First Missing Milestone과 Earliest Observable Divergence를 사용해 최종 결과가 아닌 가장 이른 상태 이탈, 상대 pose, 활성 tool ID가 유사한 failure seed를 묶고 cluster별 medoid seed를 선택한다. 진단은 end-effector, 목표 물체, 핵심 접촉면이 보이는 primary view를 고정하며, 증거가 부족하면 simulator state, sensor trajectory, 물리 신호로 교차 검증한다. Evaluation, Critic, State Representation, Planning/Control, Recovery, Parameter 순서로 가장 높은 우선순위의 원인 계층을 찾고, cluster 구성원 전체에서 해당 mechanism의 일관성을 확인한다.
2.5. Phase II Stage 2: Critic-Guided Harness Repair and Validation
Repair Agent는 진단된 root layer에 맞춰 critic, recovery, tool을 최소 수정하고 base Action Policy의 무결성을 유지한다. base VLA로 제어를 돌려주려면 원래 failure evidence가 해소되고 contact torque 진동과 grasp force로 측정한 안정성이 임계값 $\gamma$를 넘어야 한다. patch는 medoid seed에서 critic이 이탈 시점을 다시 탐지하는지 확인한 뒤 새 closed-loop rollout이 goal milestone에 도달하고 모든 intervention이 Orchestrator 승인을 받았을 때 검증된다.
2.6. Phase III: Harness Consolidation, Packaging and Generalization
Generalization Agent는 같은 failure cluster의 seed별 patch를 critic trigger 조건의 논리 OR, 일반화한 recovery sequence, 확장한 toolset으로 통합한다. 결과물은 $\texttt{SKILL.md}$, $\texttt{tools/}$, $\texttt{plans/}$, $\texttt{params/}$로 구성한 versioned Harness Package다. 채택에는 원래 cluster의 모든 failed rollout을 해결하는 historical regression과 엄격히 분리한 held-out seed에서 base VLA 대비 success-rate increment를 보이는 조건이 필요하며, held-out에서 새 failure mechanism을 발견하면 그 seed를 development set으로 편입하고 새 held-out set을 구성한다.
3. Z-Infra: Embodied Agent Rollout Infrastructure
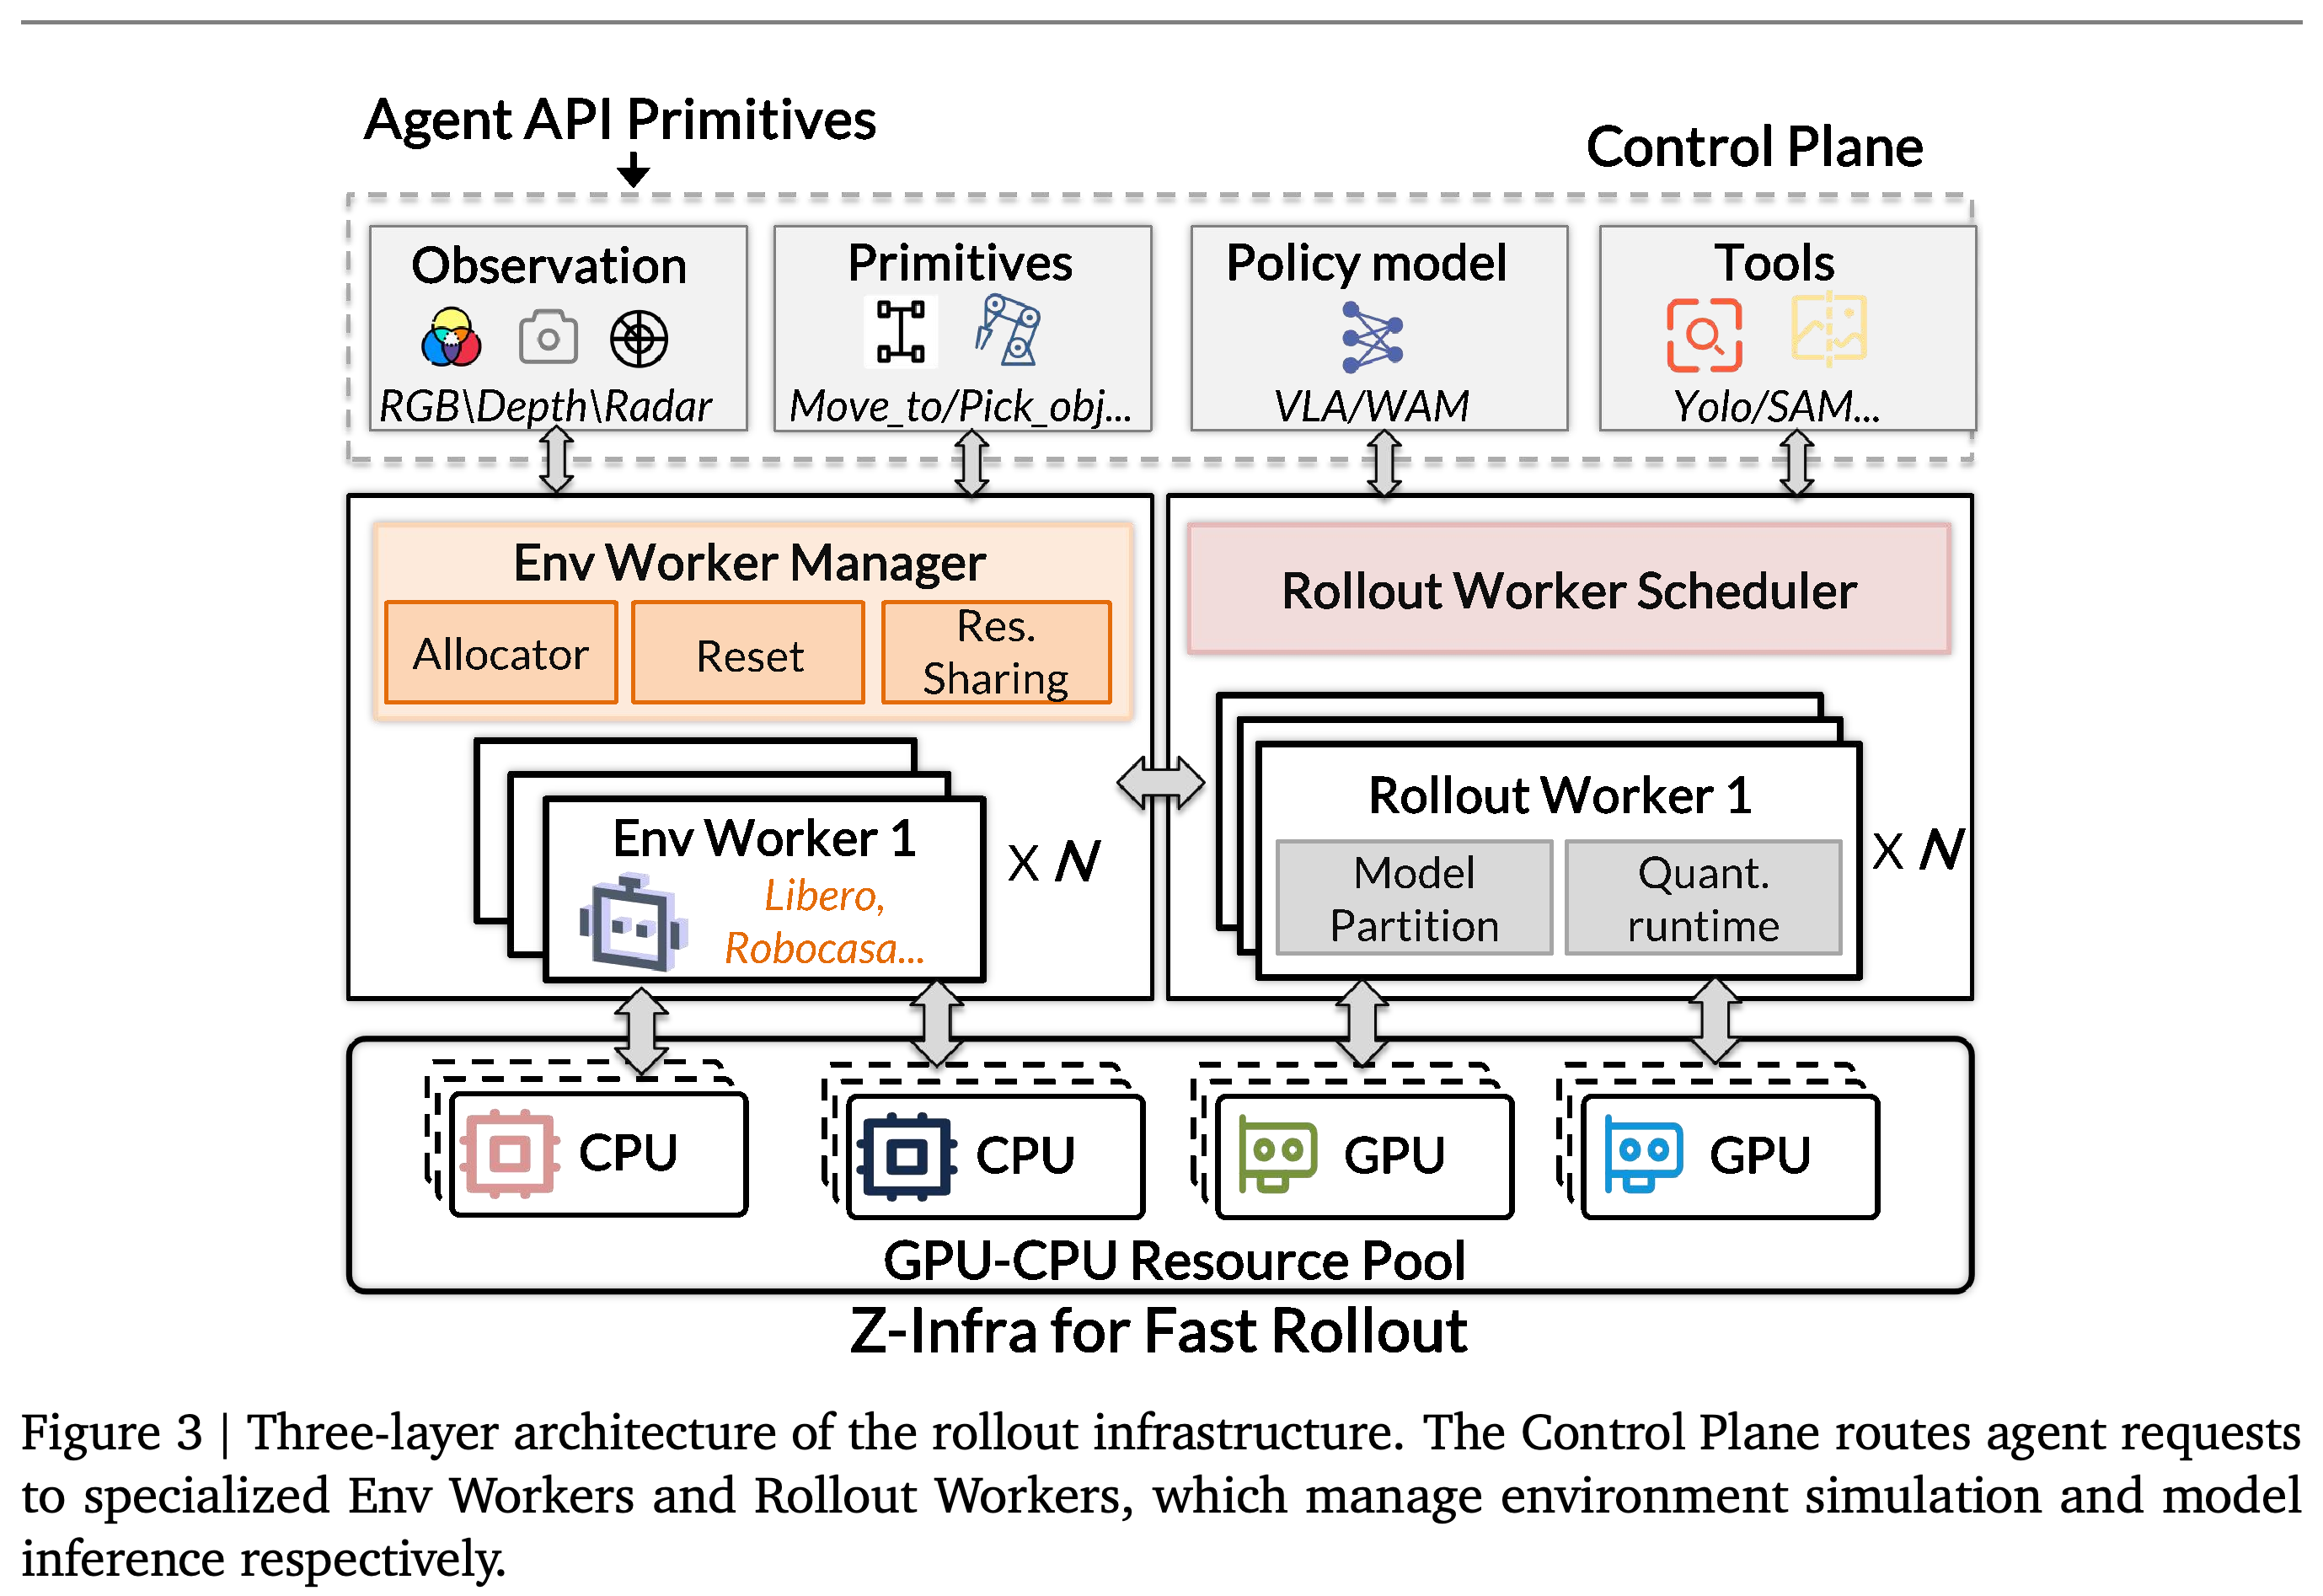
Z-Infra는 session 생성, reset, observation, policy_step, 종료로 이어지는 통합 rollout interface를 제공한다. agent는 실행할 environment, model, operation만 지정하고, 인프라는 이질적인 CPU, GPU, simulator, policy, perception model, primitive workload의 worker 배치, 요청 routing, batch 형성, 자원 매핑을 맡는다. 논문은 주로 CPU 중심 MuJoCo와 robosuite를 평가했지만, interface는 MJX, MJLab, SAPIEN, ManiSkill, Isaac Sim, Isaac Lab 같은 backend를 수용하도록 설계했다.
3.3. System Architecture
아키텍처는 요청 유형과 자원 요구로 worker pool에 routing하고 heartbeat로 health를 감시하는 Control Plane, environment slot과 session lifecycle을 관리하는 Environment Worker, 동적 batch inference를 수행하는 GPU Rollout Worker로 구성한다. Env Worker는 공유 가능한 MuJoCo $\textit{mjModel}$ template과 session별 mutable $\textit{mjData}$를 분리하고, Rollout Worker는 호환되는 model, modality, tensor shape 요청만 batch로 묶는다. $\pi0.5$에서는 VLM과 Action Expert를 분리해 CUDA IPC로 activation을 전달하며, RTX 4090에서 prefix MLP만 W8A8로 양자화하고 나머지는 BF16으로 유지해 success rate 저하 없이 1.18×부터 1.32× inference speedup을 보고한다.
Control Plane은 agent API 요청을 environment simulation 담당 Env Worker와 model inference 담당 Rollout Worker에 routing한다. Env Worker는 session과 environment state를 관리하고, Rollout Worker는 model partition과 quantization runtime을 포함해 동적 batch inference를 수행한다.
4. Experiments
실험은 8×RTX 4090 cluster에서 수행했으며, LIBERO-Pro의 frozen base policy는 $\pi0.5$, RoboCasa의 frozen base policy는 GR00T N1.5다. 두 모델의 가중치는 fine-tuning하지 않았다. RoboCasa는 task별 development seed 50개와 분리된 test seed 50개를 사용하고, LIBERO-Pro는 parent seed에서 뽑은 development seed 50개로 evolution한 뒤 seed 1부터 20까지를 최종 held-out 평가에 사용한다.
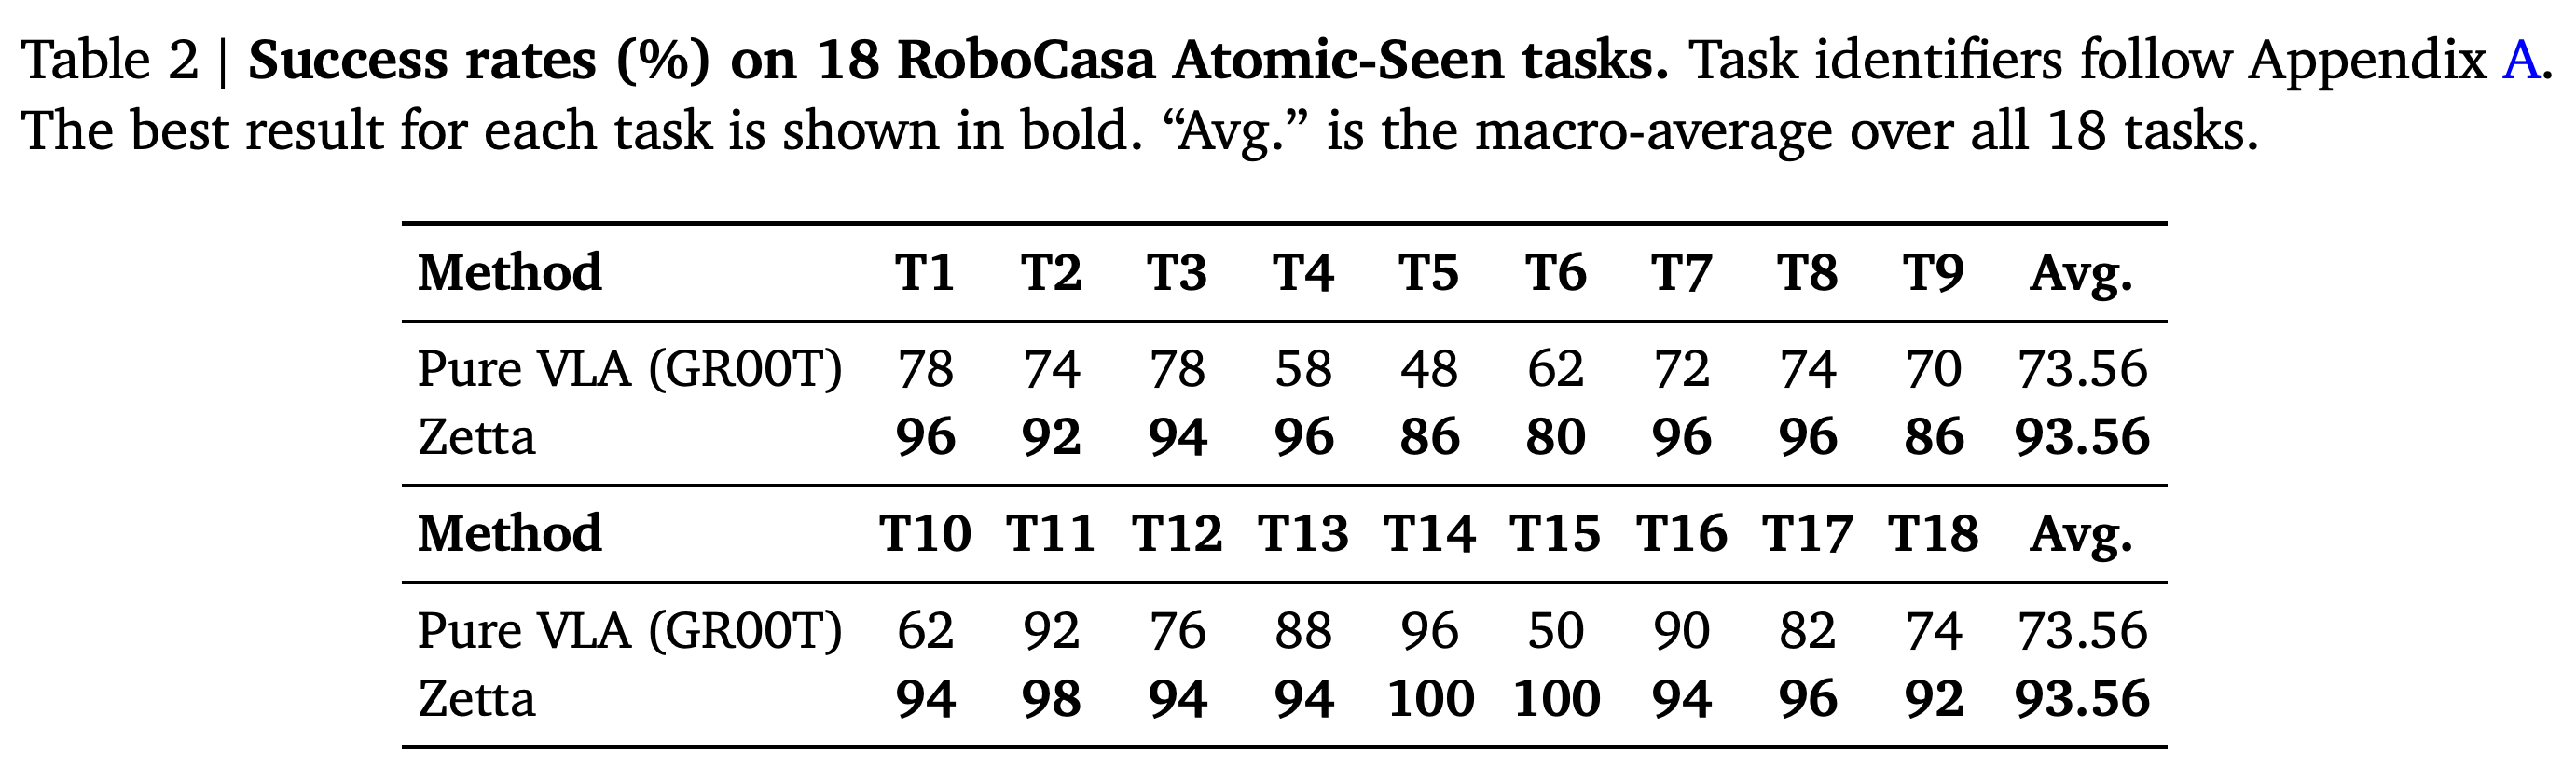
Table 2에서 RoboCasa Atomic-Seen 18개 task의 macro-average success rate는 Pure VLA (GR00T) 73.56%, Zetta 93.56%로, $93.56-73.56=20.00$%p 증가한다. Table 3에서 Goal (T), Goal (S), LIBERO-10 (T), LIBERO-10 (S)의 평균을 다시 평균한 LIBERO-Pro 전체 macro-average는 $32.00\%$에서 $71.13\%$로 $39.13$%p 증가한다. Goal (T)는 31.0%에서 92.5%, Goal (S)는 38.0%에서 89.0%로 변하며, Table 3은 32개 task-setting pair에서 baseline보다 높고 8개에서 같은 값을 보인다.
18개 RoboCasa Atomic-Seen task에서 Pure VLA (GR00T)와 Zetta의 success rate를 비교한다. macro-average는 73.56%와 93.56%이며, 절대 차이는 20.00%p다. 모든 task 열에서 Zetta 값이 Pure VLA 값보다 높다.
Goal (T), Goal (S), LIBERO-10 (T), LIBERO-10 (S)의 task별 success rate를 frozen $\pi0.5$와 Zetta로 비교한다. setting별 평균은 차례로 31.0%와 92.5%, 38.0%와 89.0%, 50.0%와 63.0%, 9.0%와 40.0%다.
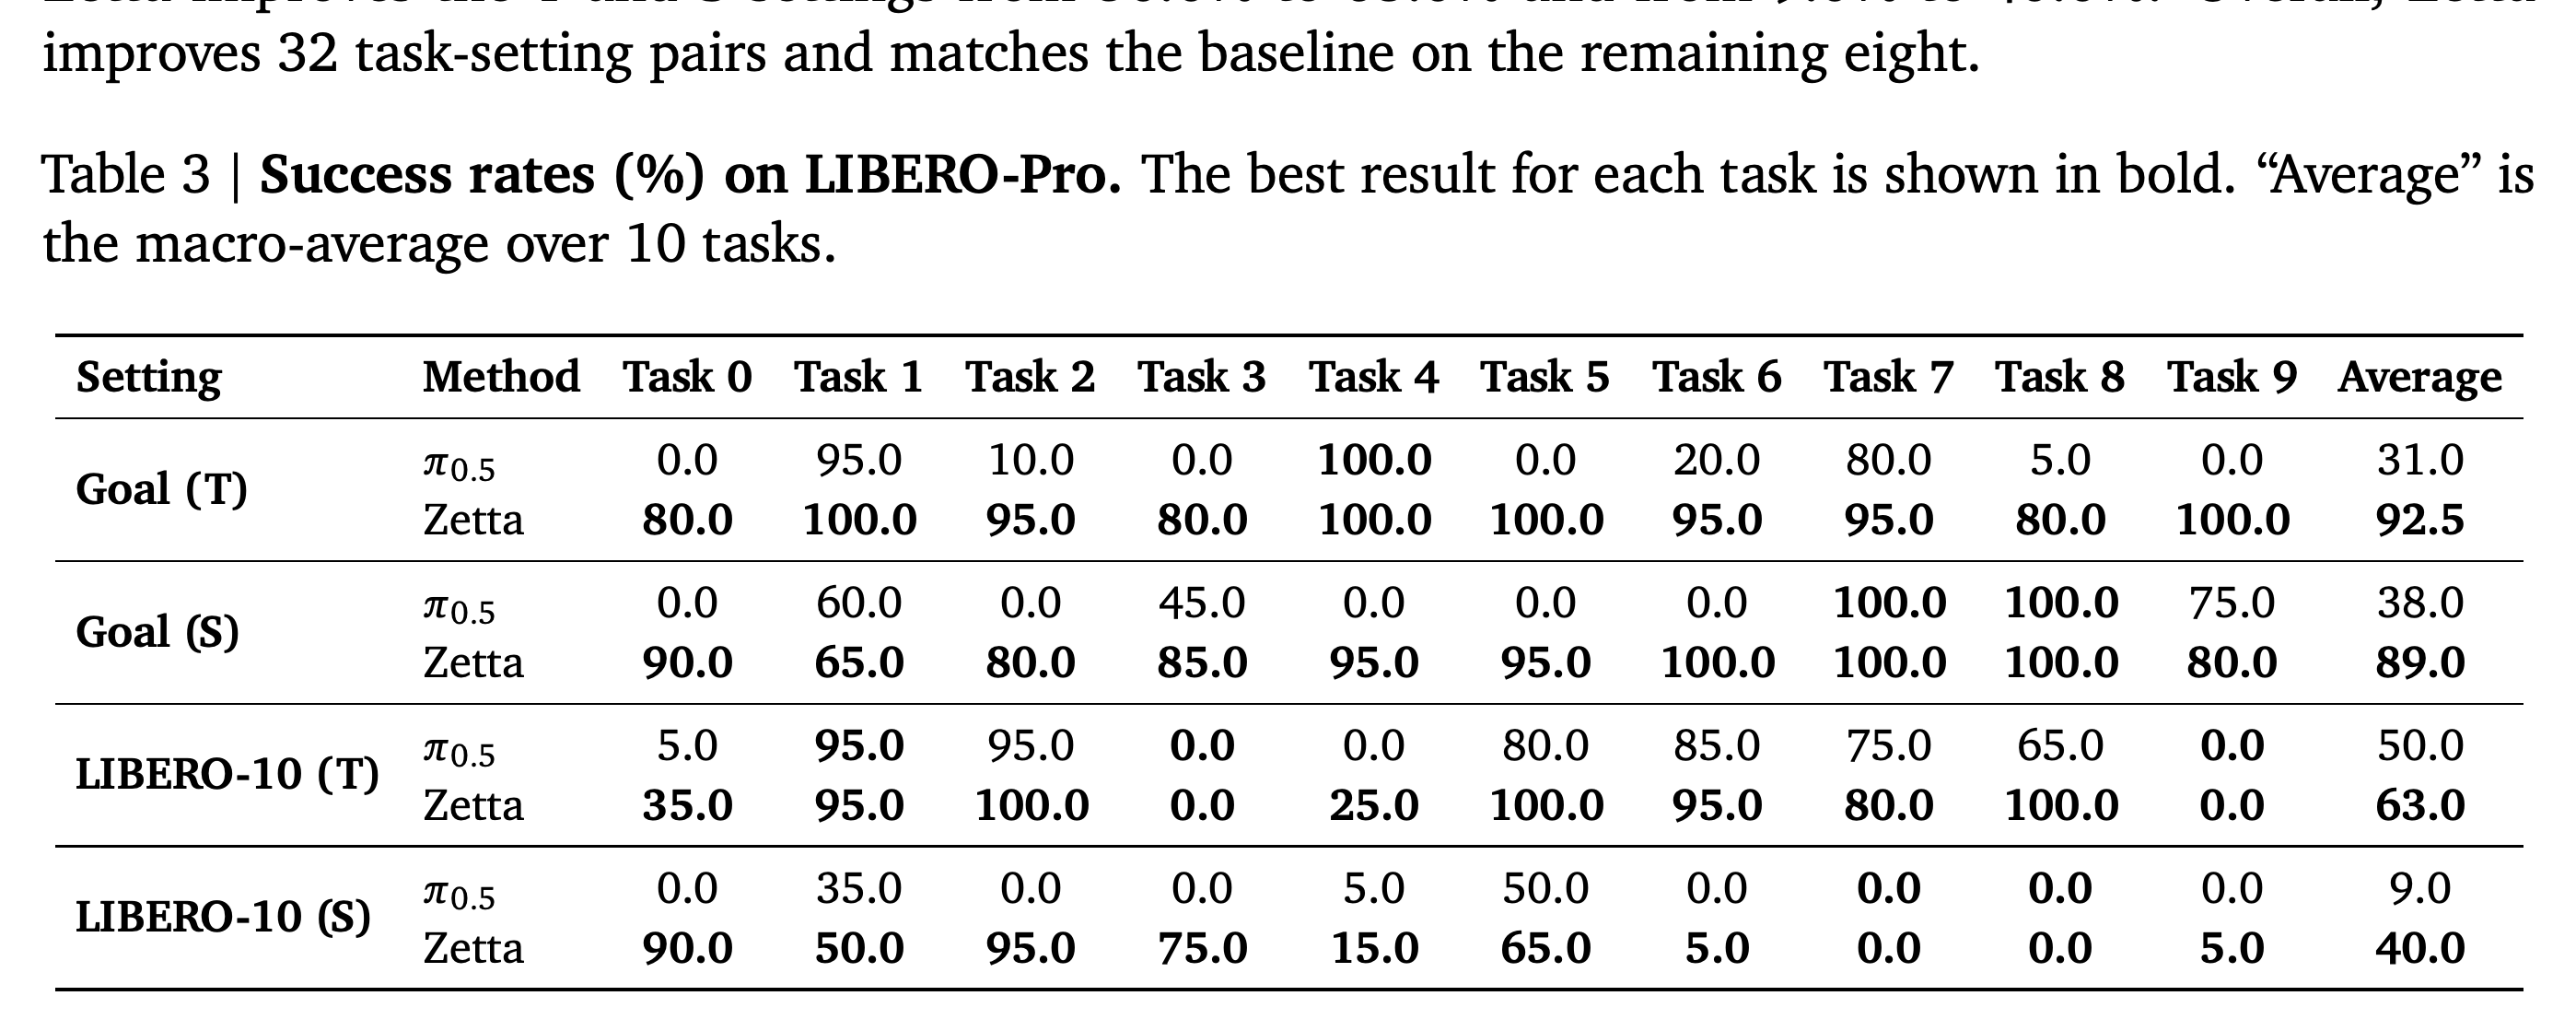
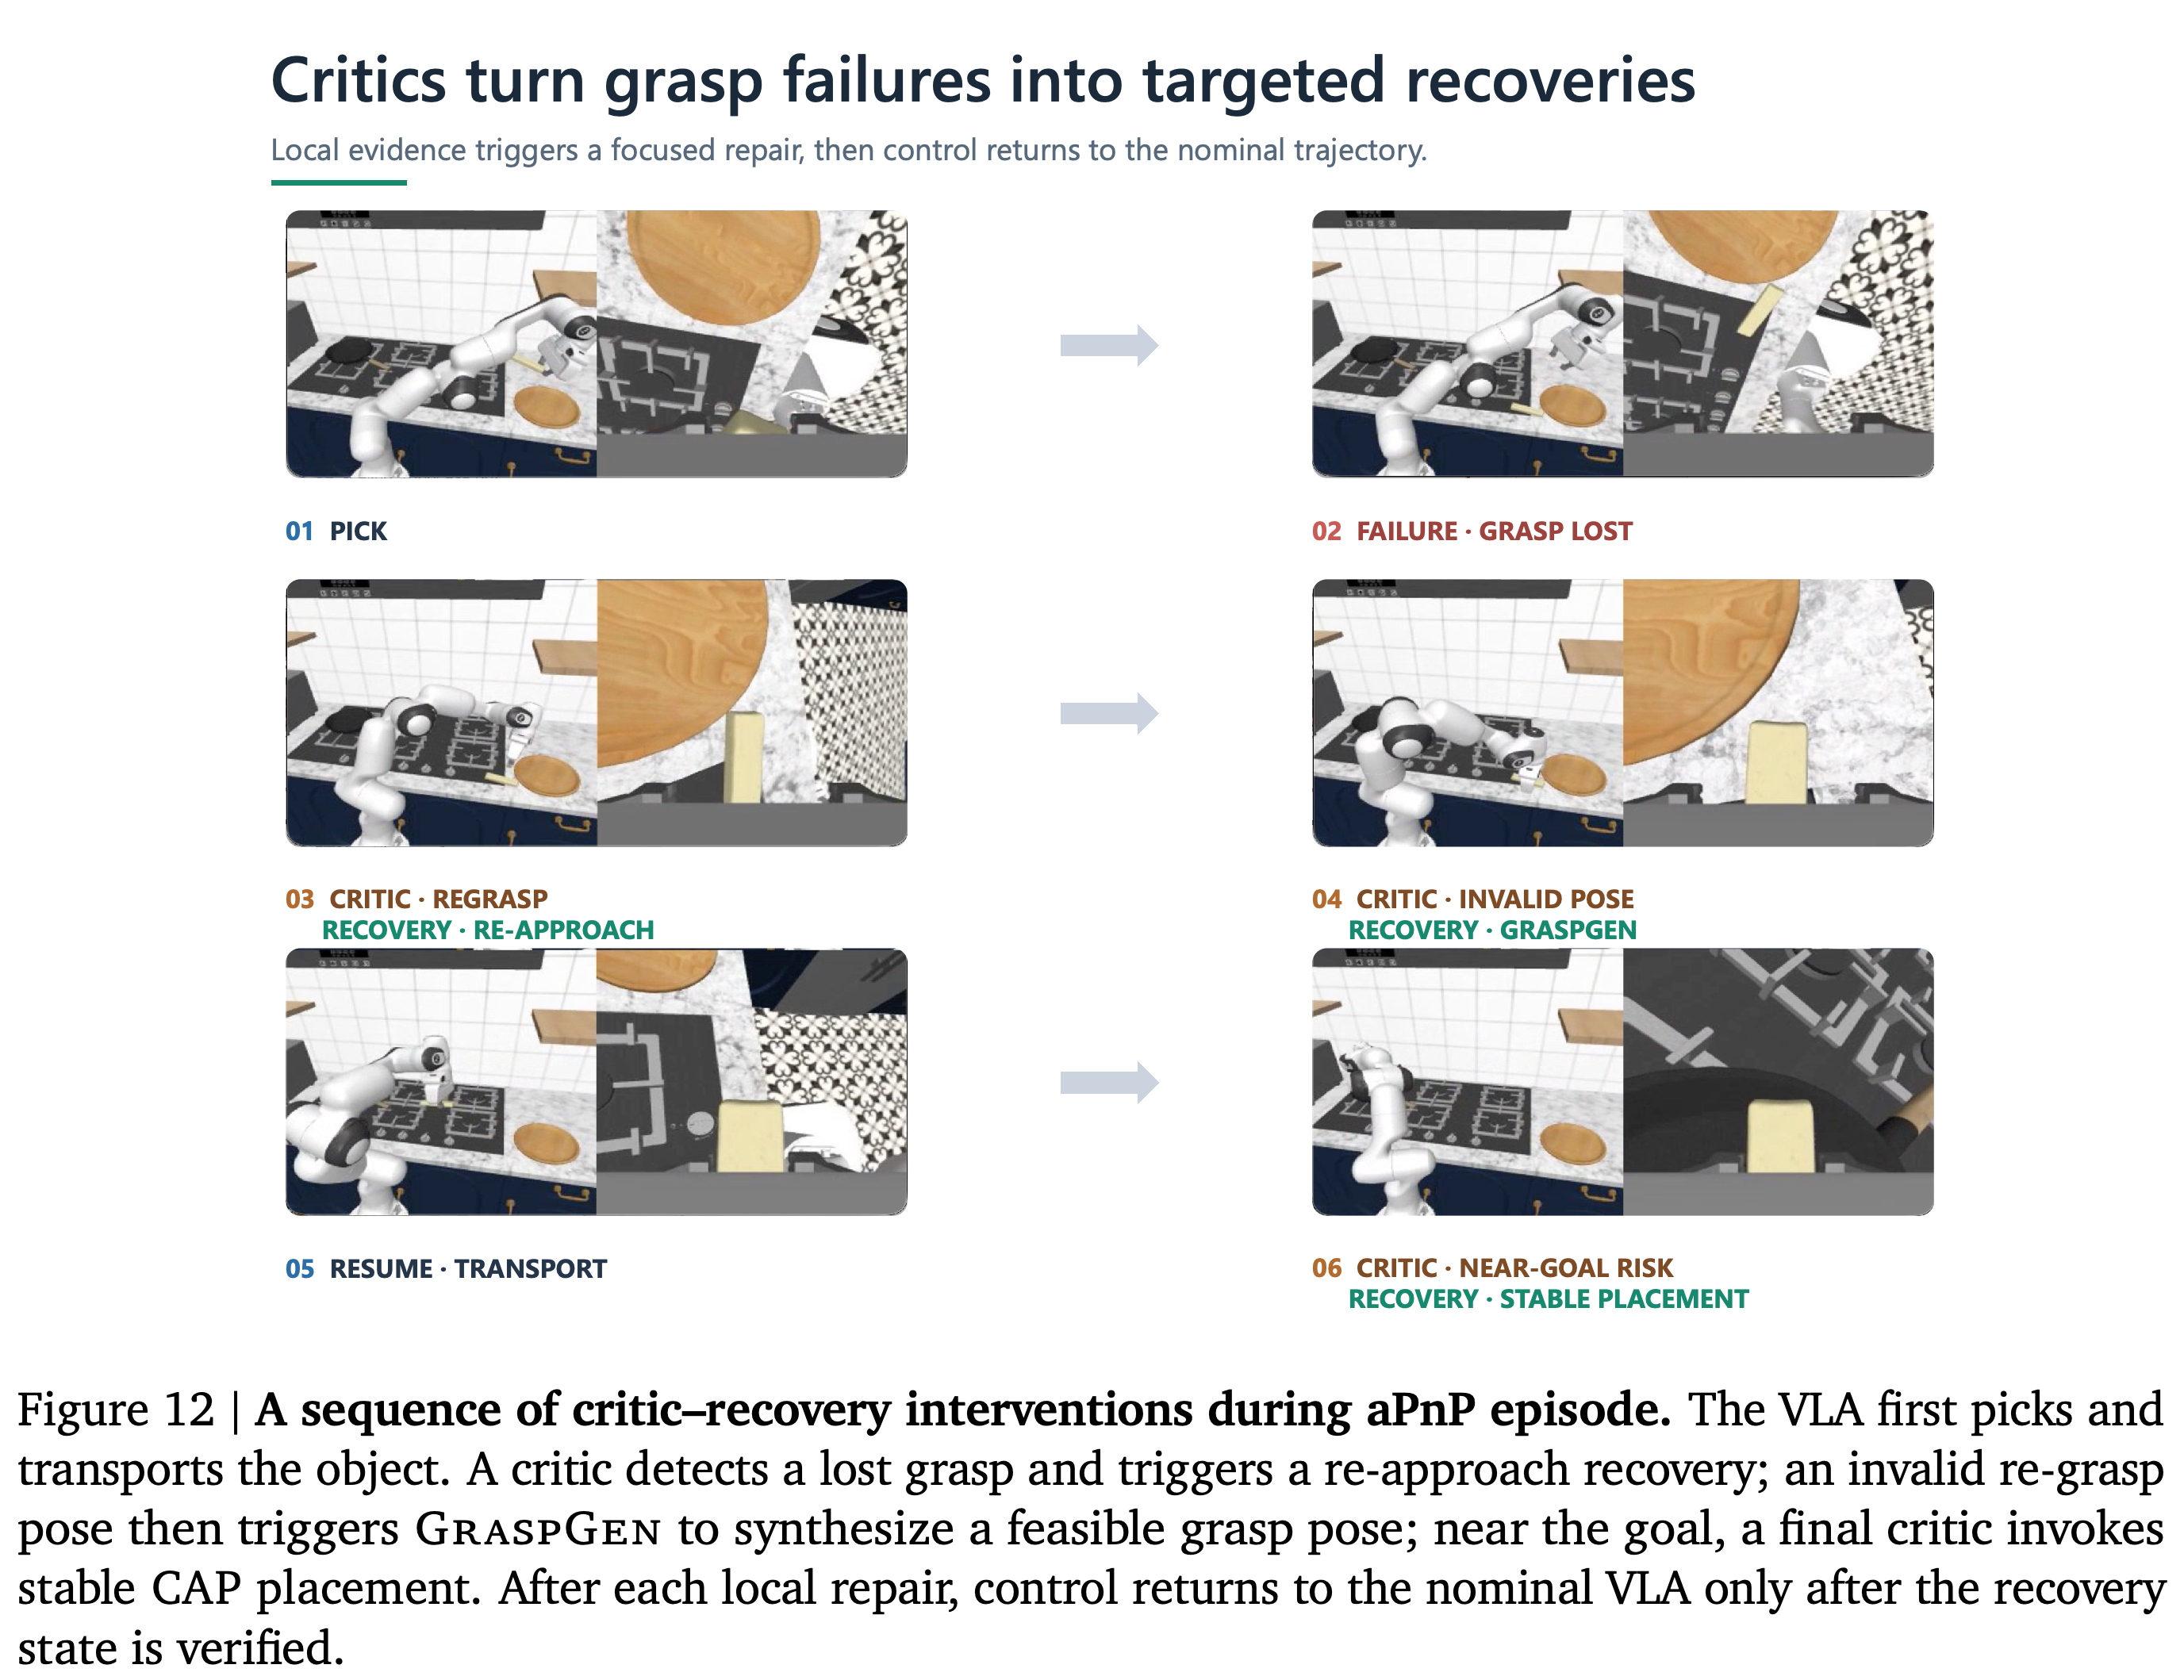
Figure 12는 RoboCasa Pick-and-Place episode에서 grasp loss, infeasible re-grasp pose, near-goal placement risk를 각각 re-approach, GraspGen, CAP 기반 stable placement로 처리하고, 검증 뒤 VLA 제어를 재개하는 사례다. Figure 13은 LIBERO-Pro Goal-S5에서 promotion round별로 retention-gated handoff, contact-gated grasp, bounded re-grasp retry를 더해 가장 이른 미해결 failure가 뒤 단계로 이동하는 과정을 보인다. Round 2와 Round 3은 같은 environment seed와 policy RNG를 사용한다.
Pick-and-Place episode에서 grasp loss가 발생하면 critic이 re-approach recovery를 호출한다. 이어 infeasible re-grasp pose에는 GraspGen, goal 근처 placement risk에는 CAP 기반 stable placement가 호출되며, recovery state를 검증한 뒤 VLA 제어가 재개된다.
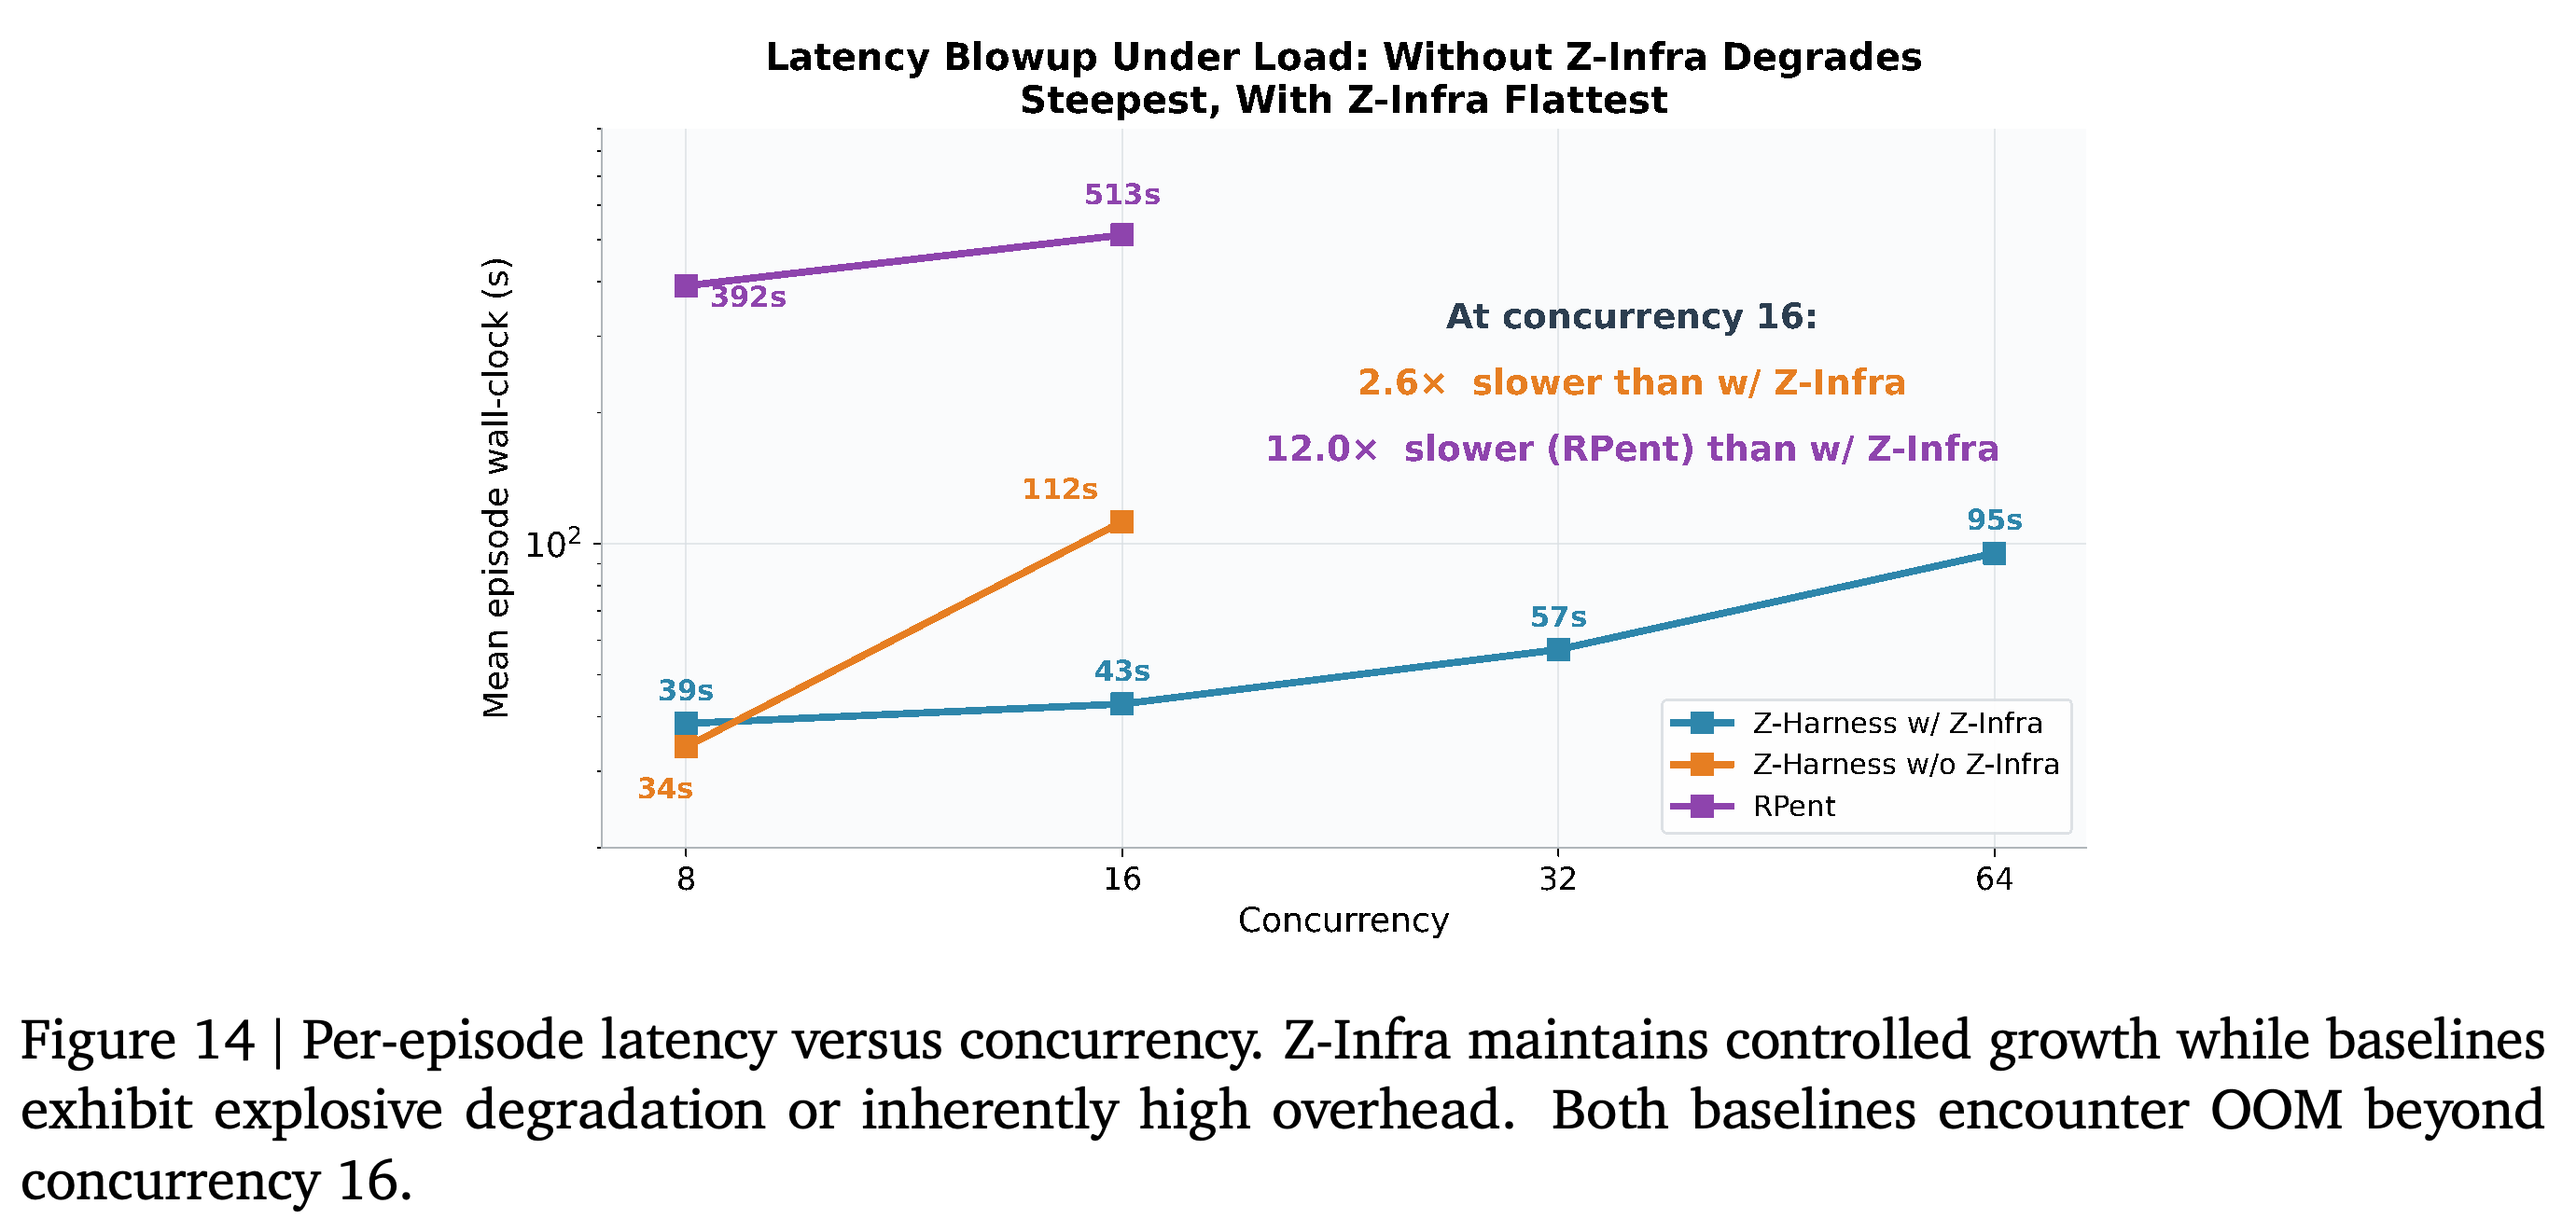
concurrency 8, 16, 32, 64에서 per-episode wall-clock latency를 Z-Harness w/ Z-Infra, w/o Z-Infra, RPent로 비교한다. Z-Infra 구성은 39s, 43s, 57s, 95s이며, 두 기준선은 concurrency 16 이후 OOM으로 결과가 없다. concurrency 16에서는 Z-Infra 43s, w/o Z-Infra 112s, RPent 513s다.
concurrency에 따른 rollout throughput을 비교한다. Z-Infra 구성은 concurrency 8에서 12.18 ep/min, 16에서 22.09 ep/min, 32에서 32.8 ep/min, 64에서 35.1 ep/min을 기록한다. concurrency 16에서 w/o Z-Infra는 2.88 ep/min, RPent는 1.72 ep/min이고, 두 기준선은 그 이후 OOM으로 실패한다.
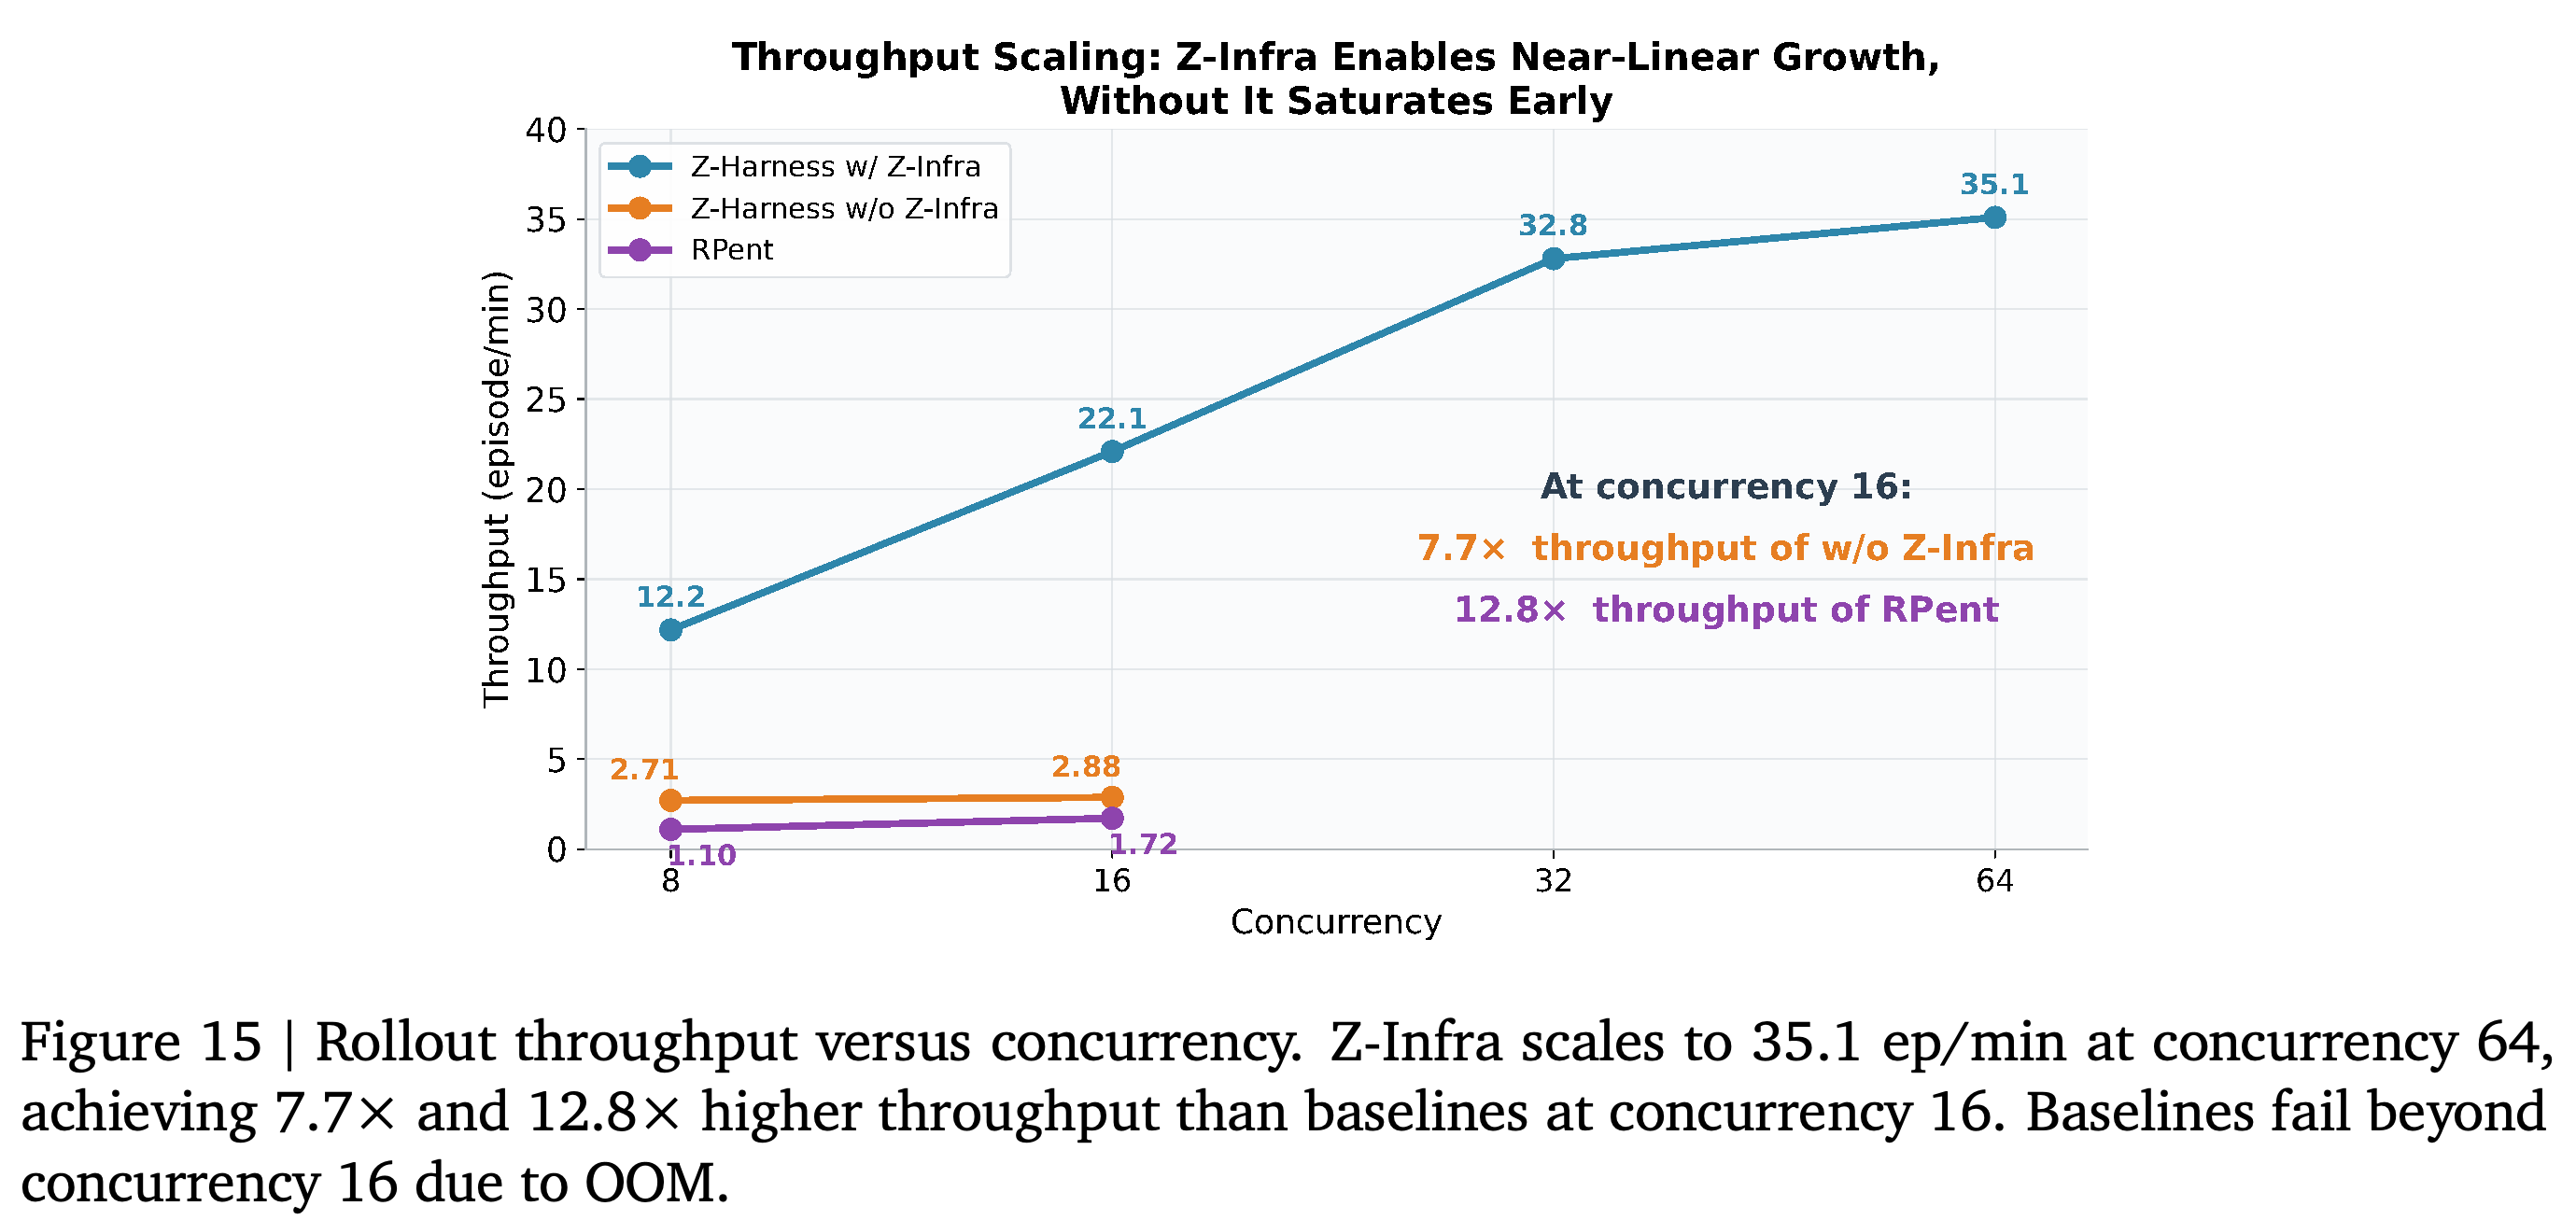
Z-Infra 평가는 LIBERO Goal에서 동일 checkpoint와 action budget으로 8×A100 GPU를 사용해 concurrency 1, 8, 16, 32, 64를 비교한다. Figure 15에서 concurrency 16의 throughput은 Z-Harness w/ Z-Infra 22.09 ep/min, w/o Z-Infra 2.88 ep/min, RPent 1.72 ep/min이므로 각각 $22.09/2.88=7.67\times$, $22.09/1.72=12.84\times$다. Figure 14에서 concurrency 16의 per-episode latency는 43s와 513s로 $513/43=11.93\times$이며, 초록의 11.1× inference speedup은 별도 측정 조건이 제시되지 않아 직접 대조할 수 없다.
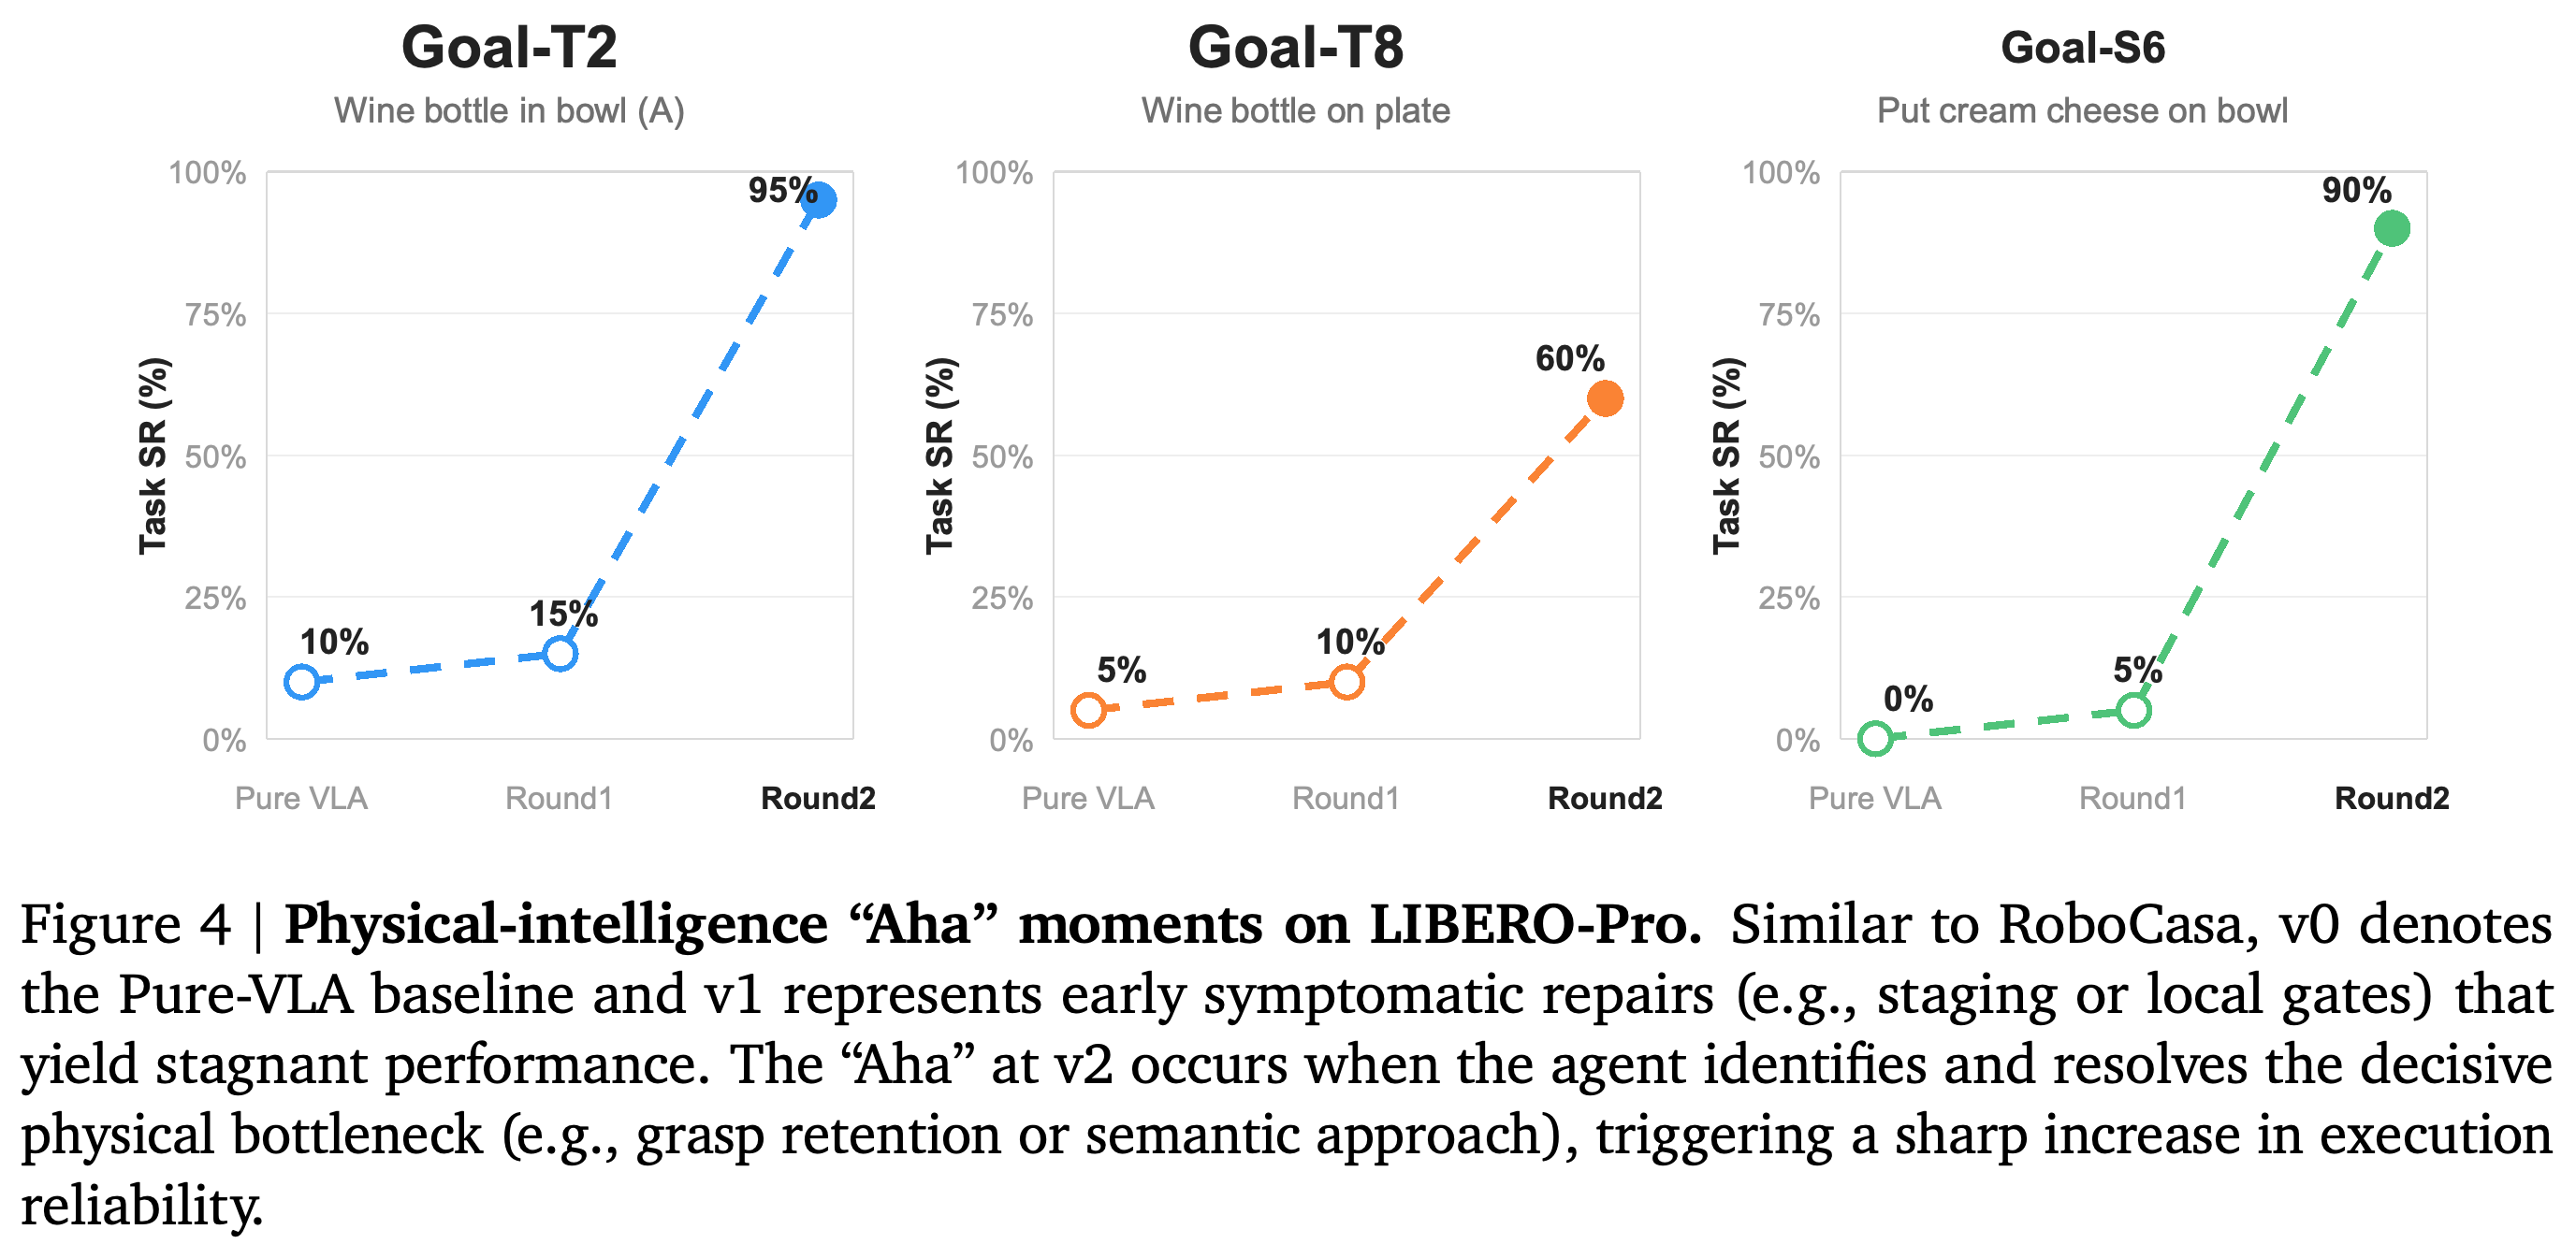
LIBERO-Pro Goal-T2, Goal-T8, Goal-S6에서 Pure VLA, Round 1, Round 2 내부 checkpoint의 task success rate를 표시한다. 세 패널은 각각 10%에서 15%에서 95%, 5%에서 10%에서 60%, 0%에서 5%에서 90%로 변하며, 초기 patch 뒤 정체와 뒤이은 상승을 보인다.
4.2. Physical Intelligence “Aha” Moments
저자들이 정의한 physical intelligence “Aha” moment는 단일 failure cluster에서 초기 증상 수준 patch가 정체된 뒤 핵심 물리 상태 변수를 찾아 success rate가 불연속적으로 상승하는 선택된 내부 version의 변화다. Figure 4에서 Goal-T2는 Pure VLA 10%, Round 1 15%, Round 2 95%이며, Goal-T8은 5%, 10%, 60%, Goal-S6은 0%, 5%, 90%다. 저자들은 각각 grasp retention, contact-grasp-retention sequence, 접근 단계의 semantic progress를 decisive bottleneck으로 해석한다.
RoboCasa Figure 5는 Loop-2 Stage-2 안에서 고른 세 checkpoint를 비교한다. TurnOnElectricKettle은 88%, 88%, 94%, SlideDishwasherRack은 76%, 76%, 94%, CloseToasterOvenDoor는 82%, 82%, 96%이며, 저자들은 EEF re-alignment와 centered contact의 식별을 상승 원인으로 설명한다. 이 수치는 전체 evolution round의 aggregate 결과가 아니라 각 task의 내부 repair version success rate다.
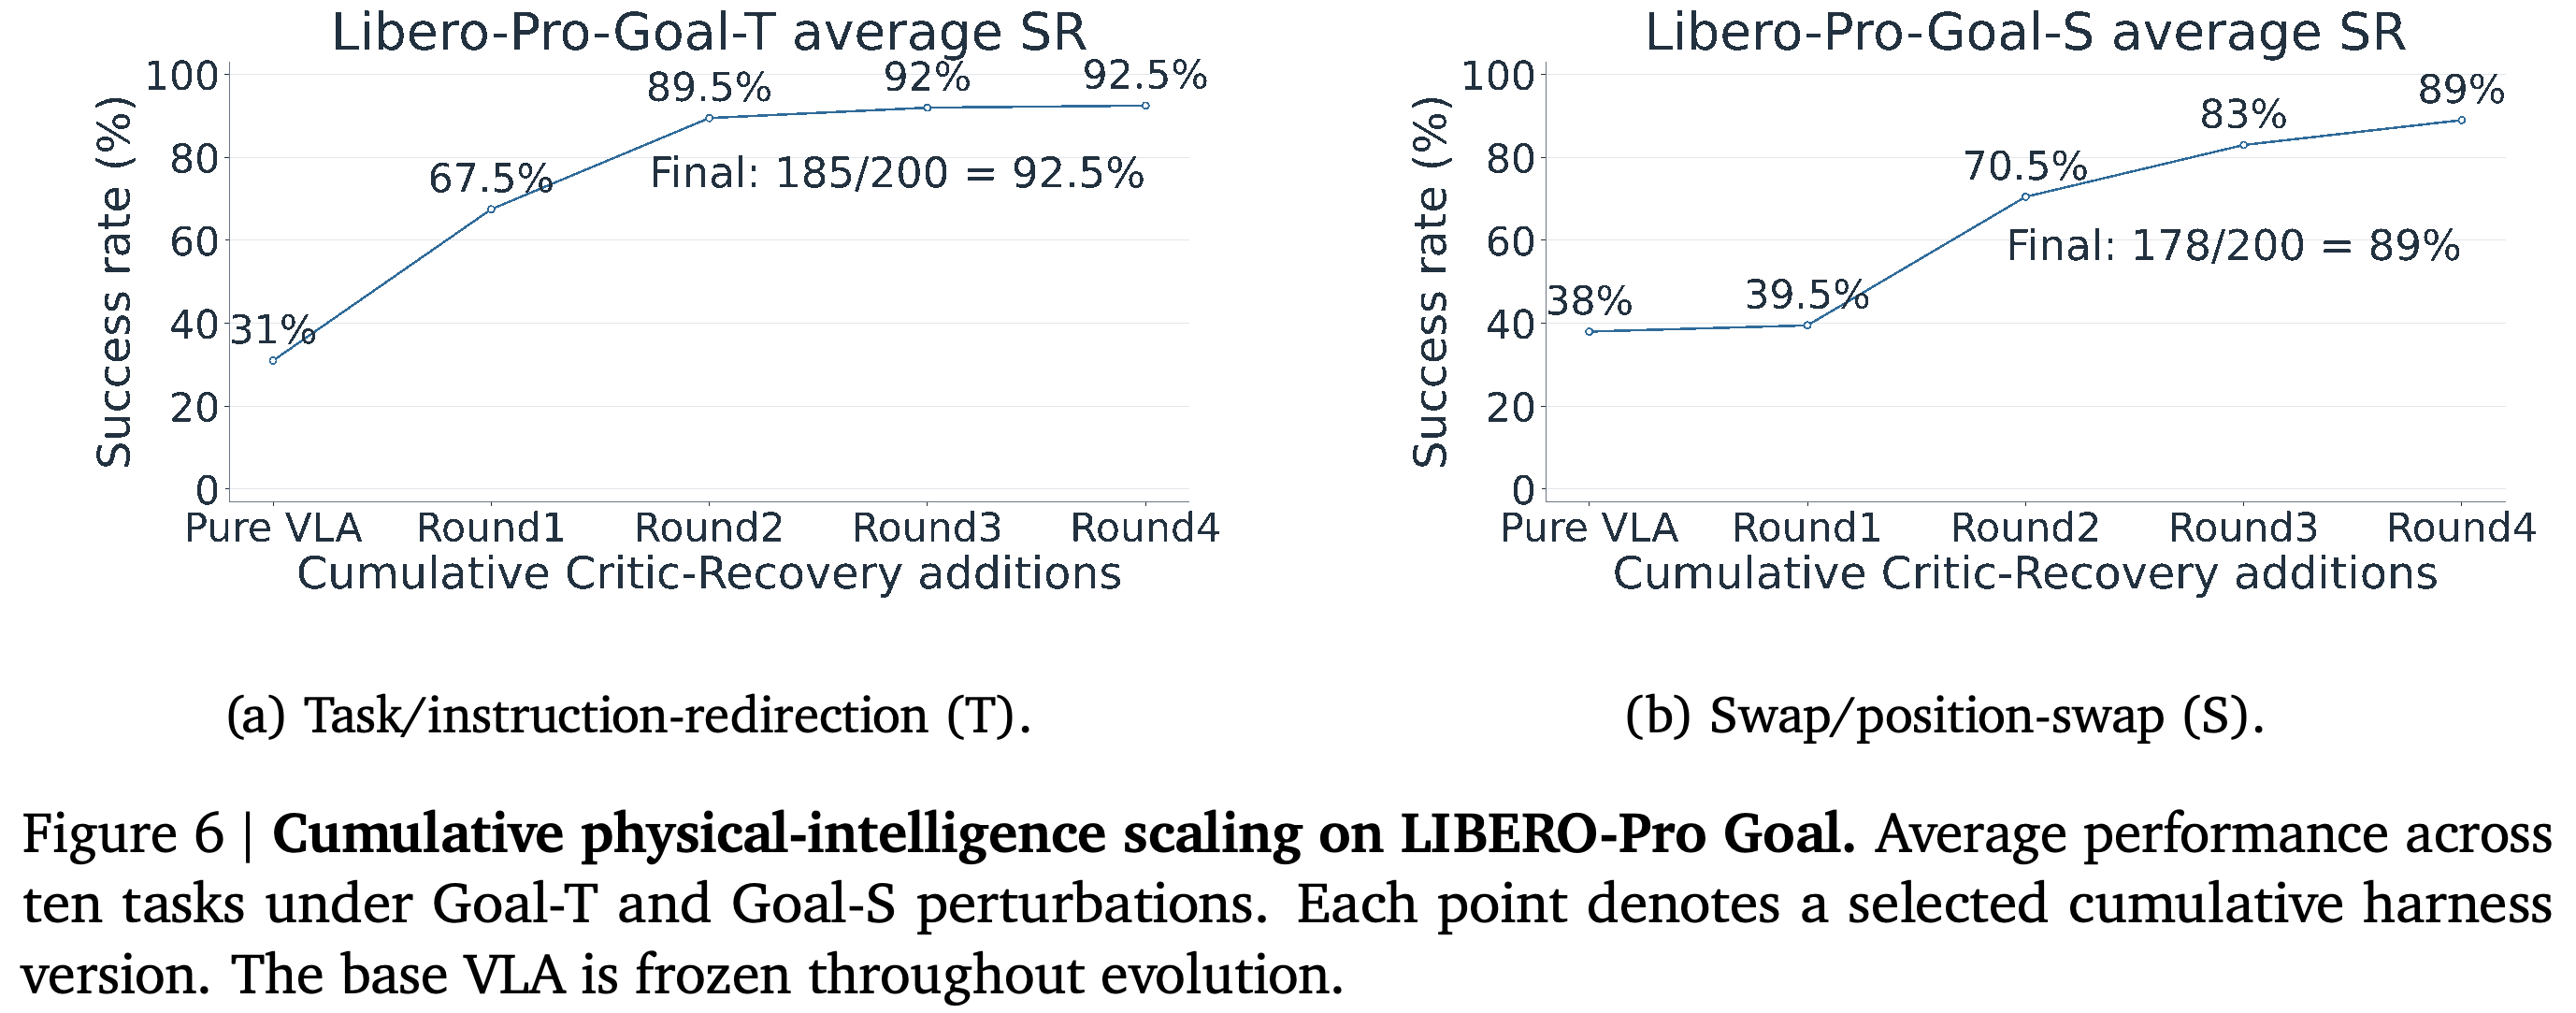
고정된 base VLA에 누적 Critic-Recovery mechanism을 추가할 때 Goal-T와 Goal-S의 10-task 평균 success rate 변화를 나타낸다. Goal-T는 31.0%에서 92.5%, Goal-S는 38.0%에서 89.0%로 변하며, 각 점은 선택된 누적 Harness version이다.
4.3. Physical Intelligence Scaling and Zero-shot Capability
Figure 6에서 frozen base VLA에 누적 Critic-Recovery mechanism을 더한 LIBERO-Pro 10-task 평균은 Goal-T에서 31.0%, 67.5%, 89.5%, 92.0%, 92.5%, Goal-S에서 38.0%, 39.5%, 70.5%, 83.0%, 89.0%다. Goal-T8에서 얻은 pre-grasp staging, grasp-retention critic, failure-gated retry는 target별 evolution 없이 Goal-T2, Goal-T6, Goal-S3로 전이되며, Figure 7의 Goal-S3은 9/20에서 20/20으로 변한다.
Figure 9에서 RoboCasa 18-task macro-average는 frozen parent 73.56%에서 CR-1 78.71%, CR-2 84.85%, CR-3 90.54%, CR-4 93.56%로 증가한다. PnP-Stove에서 얻은 pre-grasp alignment, re-grasp, stable placement stack을 PnP-Sink, PnP-Cabinet, PnP-Toaster에 zero-shot 적용한 세 target task macro-average는 64%에서 84%로 +20%p 변한다. TurnOffStove에서 얻은 articulated-interaction stack을 세 target task에 적용한 macro-average는 64%에서 80%로 +16%p 변한다.
부록
- 부록 A. RoboCasa Atomic Task Mapping은 Table 2의 T1부터 T18까지를 RoboCasa 1.0.1 Atomic-Seen의 공식 task 이름에 대응한다.
- 부록 B. LIBERO-Pro Task Mapping은 Goal과 LIBERO-10의 task index 및 기본 instruction을 제시하고, T를 task/instruction-redirection, S를 swap/position-swap perturbation으로 정의한다.
- 부록 C. Case Study: Critic-Guided Recovery for PnP-Stove는 frozen VLA와 Orchestrator 아래에서 object-relative pregrasp, bounded regrasp, placement recovery를 수행하는 critic-guided skill과 의사코드를 설명한다.
- 부록 D. Case Study: Critic-Guided Recovery for Libero-Pro Goal-T2는 bottle의 접근, 획득, grasp retention, bowl 안 placement를 감시하고 재접근, 재획득, 안정된 placement를 수행하는 critic-guided recovery loop를 제시한다.
짧은 생각
가중치 fine-tuning 없이 성능을 높였다는 결과와 함께, held-out 실패를 development seed로 편입하면 반드시 새 held-out set을 요구하는 전환 규칙이 중요하다. 반복적인 code patching에서는 평가 자료가 점차 진단 자료로 바뀌기 쉬운데, 이 규칙은 평가 누수를 관리할 절차를 명시한다. 다만 핵심 성능 평가는 simulation에 한정되므로 실제 로봇의 지연, sensing noise, 안전 제약 아래에서도 같은 일반화 규칙이 유지되는지 확인해야 한다.