


PAST-Bench: Benchmarking the Foundations of Recursive Self-Improvement in Personal Agents 요약 설명
04 Aug 2026 | Paper Review Self-Evolving Agents LLM Evaluation Agent's Memory목차
이번 글에서는 PAST-Bench: Benchmarking the Foundations of Recursive Self-Improvement in Personal Agents 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 4일(Arxiv), arXiv
- Xue, Shuhan, Ding, Zixin, Shen, Yichen, Wang, Yinjie, Yin, Zhenfei, Wu, Yingcheng, Chen, Yuxin, Wang, Mengdi, Yang, Ling.
- 논문 링크
- Github
요약
- PAST-Bench는 개인 AI agent가 세션 간에 보존한 경험을 이후 과제 성능 향상으로 전환하는지를 측정하는 performance-attribution benchmark다. 같은 task family에서 persistence-on과 persistence-off를 짝지어 실행하고, 이후 과제의 점수 차이와 저장, 검색, 갱신 경로의 artifact 및 runtime telemetry 근거를 함께 보고한다.
- Benchmark는 Memory, Procedural Reuse, Information Gathering, Update에 걸친 26개 scenario와 204개 episode로 구성된다. 저자들은 모델 재학습, prompt optimization, long-context adaptation 없이 과거 상호작용의 경험을 재사용해 미래 행동을 바꾸는 능력을 online self-evolution으로 정의하고, 이를 완전한 recursive self-improvement의 운영상 기반으로 둔다.
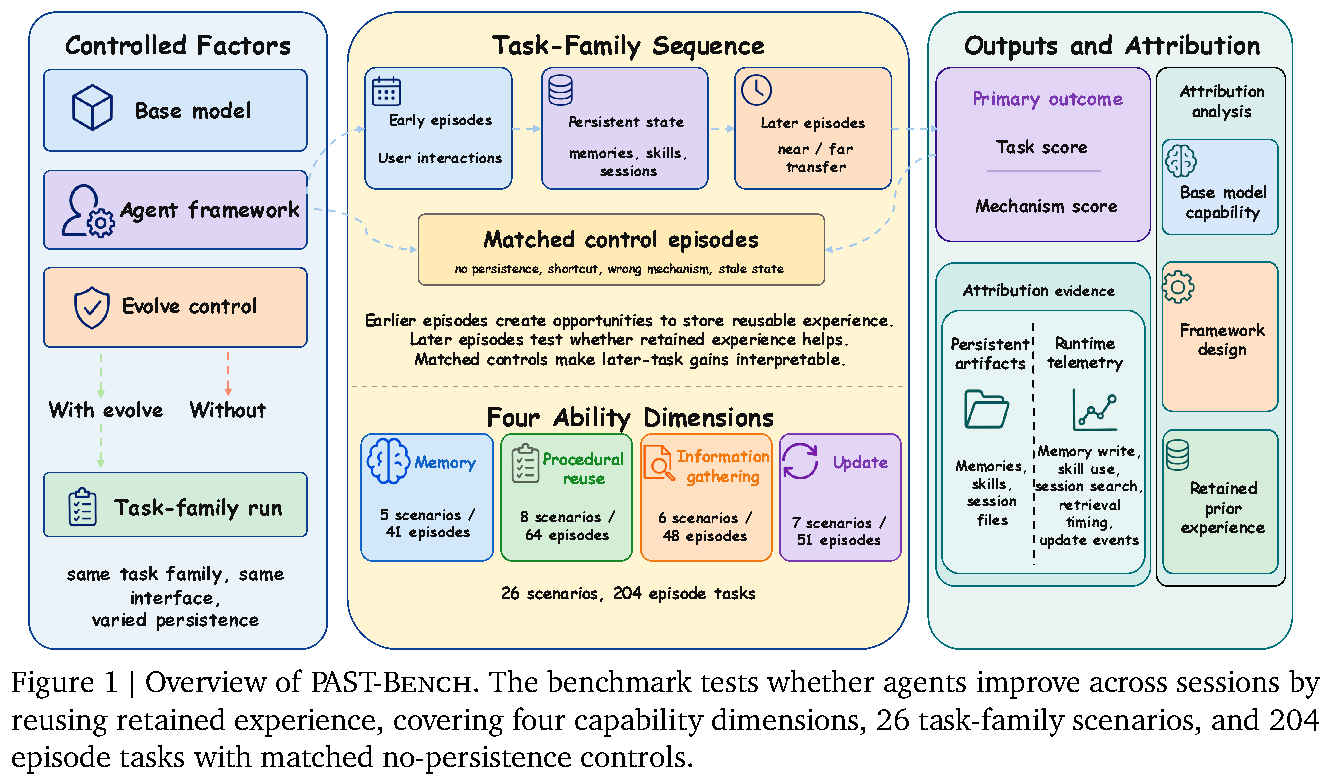
이 그림은 base model, agent framework, evolve control을 통제한 task-family 실행에서 earlier episode의 persistent state가 later episode 성능에 미치는 영향을 persistence-on과 persistence-off로 대조하는 흐름을 보여 준다. Memory, Procedural Reuse, Information Gathering, Update의 네 능력과 task score, mechanism score, artifact 및 runtime telemetry 기반 attribution 출력을 배치한다.
- MiniMax-M2.7 고정 조건에서 Hermes+는 Hermes의 다섯 runtime 단계에 개입해 보고된 평균 Overall Δ를 +0.13에서 +0.15로, Mech를 0.64에서 0.73으로 높였다. Overall Δ의 절대 차이 +0.02는 세 실행의 변동보다 작고, 가장 뚜렷한 평균 변화는 Update에서 관찰되며 capability와 base model에 따른 결과 차이가 남는다.
1. Introduction
강한 형태의 recursive self-improvement는 모델 파라미터, 학습 알고리즘, agent architecture를 수정할 수 있지만, 이 논문은 persistent state를 통해 경험을 재사용하는 운영 계층을 다룬다. 기존 interactive benchmark는 대체로 fresh session의 단발 과제 점수를 보고하고, memory와 skill benchmark는 persistence의 개별 요소를 다루므로 이후 성능 향상에서 retained experience의 기여를 분리하기 어렵다고 저자들은 설명한다.
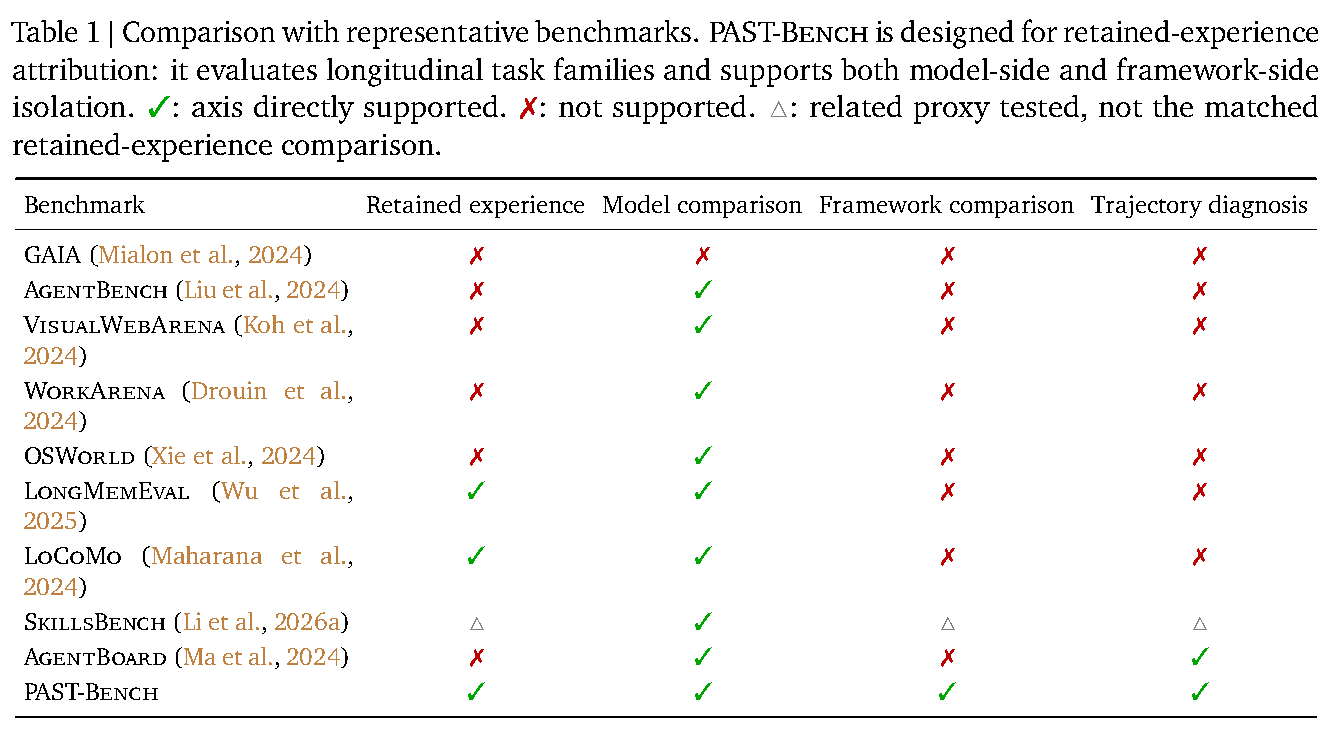
PAST-Bench는 이전 episode가 재사용 가능한 상태를 만들고 이후 fresh-session episode가 이를 쓰는 task family를 평가 단위로 삼는다. Table 1은 retained experience, model comparison, framework comparison, trajectory diagnosis의 네 축을 직접 지원하는 benchmark로 PAST-Bench를 제시하며, 기존 benchmark는 해당 축들의 일부 또는 관련 proxy만 제공한다고 분류한다.
이 표는 대표 benchmark가 retained experience, model comparison, framework comparison, trajectory diagnosis를 직접 지원하는지를 대조한다. 표의 표기 기준에서 PAST-Bench만 네 축 모두에 체크되어 있고, SkillsBench의 일부 축은 matched retained-experience 비교가 아닌 관련 proxy로 표시된다.
재현 설정에서 각 persistence-on/off 쌍은 model, agent, prompt, tools, context window, output limit, agent limit, compaction policy를 고정하고 retained state 접근만 변경한다. 시스템 간 절대 점수에는 native memory rendering, truncation, context policy 차이가 남으며, Agent-Zero에는 recursive sub-agent 실행을 위해 Hermes와 Hermes+의 과제당 300초보다 긴 1,200초 wall-clock 예산을 적용했다.
3. PAST-Bench
PAST-Bench는 순서 있는 fresh-session episode들로 구성된 task family를 평가한다. episode 사이에 volatile context를 비우므로 이후 episode의 향상은 residual prompt context가 아니라 memory store, skill file, playbook, 편집된 rule 같은 persistent substrate를 통해 전달되어야 한다.
3.1. Benchmark Construction
Memory는 사용자 선호, 제약, 예외 같은 선언적 절을 검색하고 적용하는 능력을, Procedural Reuse는 SOP와 playbook의 순서 및 tool 조합을 다시 실행하는 능력을 평가한다. Information Gathering은 persistence layer에 미리 넣은 근거를 noisy context에서 적시에 능동적으로 검색하는지를, Update는 권위 있는 두 번째 write가 오래된 사실, rule, SOP를 대체하는지를 검사한다.
각 family에는 이전 상태를 제거하는 no-retention control, 관련 없어 보이는 정보를 주입하는 distractor control, 오래된 memory를 노출하는 stale control, 잘못된 skill 또는 근거원을 제공하는 wrong-mechanism control이 포함된다. Appendix A에 따르면 26개 family와 204개 episode는 모두 synthetic이며, Codex와 GPT-5.4, Claude Code와 Claude Opus 4.6 조합이 task, prompt, grader, expected artifact 생성에 사용됐고 세 저자가 품질 조건을 점검했다.
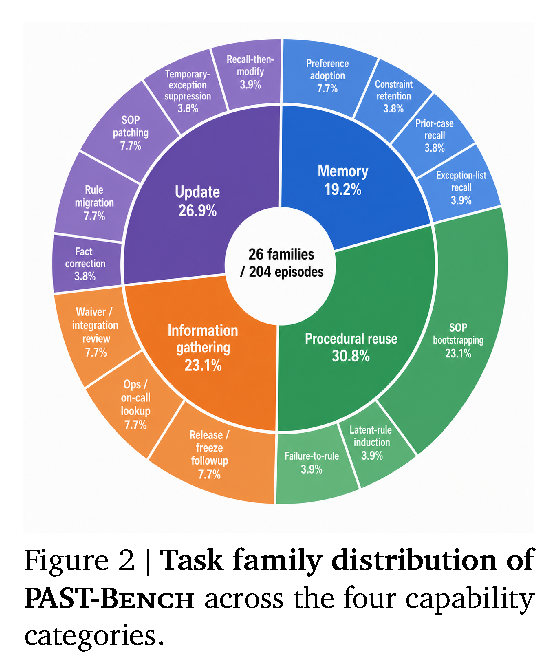
이 도넛 차트는 26개 family와 204개 episode의 네 capability별 구성을 보여 준다. Procedural Reuse는 64개 episode, Update는 51개, Information Gathering은 48개, Memory는 41개 episode이며, 바깥 고리는 각 sub-family의 비중을 나타낸다.
3.2. Evaluation Pipeline
Cold episode는 persistence가 존재하기 전의 첫 접촉 성능을 측정하고, Learn episode와 Update family의 Update episode는 목표 상태를 저장한다. Evaluation episode는 결정 규칙을 다시 말하지 않은 이후 fresh session에서 상태 재사용을 검사하며, persistence-off는 family가 만든 상태 접근을 막고 persistence-on은 이를 허용한다.
주 결과인 family별 self-evolution gap Δ는 persistence-on 평가 점수에서 matched persistence-off 평가 점수를 뺀 값이며, cold score는 calibration과 headroom 분석용일 뿐 이 기준선이 아니다. episode task score는 completion 0.80과 tool error recovery 기반 robustness 0.20의 가중합에 safety gate를 곱해 산출하며, Mech는 올바른 artifact write, 기대 retrieval 신호를 쓴 recall, update correctness, 먼 transfer에서의 retention, artifact pollution을 결합해 의도한 persistence 경로와의 정합성을 측정한다.
4. Experiments
실험은 Hermes framework를 고정하고 일곱 base model을 비교하는 설정과 MiniMax-M2.7을 고정하고 framework를 비교하는 설정으로 model 효과와 runtime 효과를 구분한다. 각 episode는 세 독립 trial로 실행하며 crash, timeout, missing trial은 0.0점으로 처리한다.
4.1. Experimental Setup
Model 비교에서는 Hermes, task, grader, benchmark limit을 유지하지만 provider의 context window와 context policy는 native 차이로 남는다. Agent 비교에서는 MiniMax-M2.7, task, grader를 고정하고 각 framework의 memory rendering, compaction, truncation 정책을 유지하므로, framework 간 절대 점수는 단일 architecture 요인만 분리한 비교가 아니다.
Open-ended task는 temperature 0, 최대 출력 8,192 tokens의 MiniMax-M2.7 LLM judge가 채점한다. 48개 blinded sample에서 인간 채점자 간 exact agreement는 83.3%, 0.25 이내 agreement는 97.9%였고, judge와 인간 평균 간 0.25 이내 및 0.5 이내 agreement는 각각 68.8%, 91.7%였다. LLM judge에 대해서는 이 글을 참조하라.
4.2. Main Results
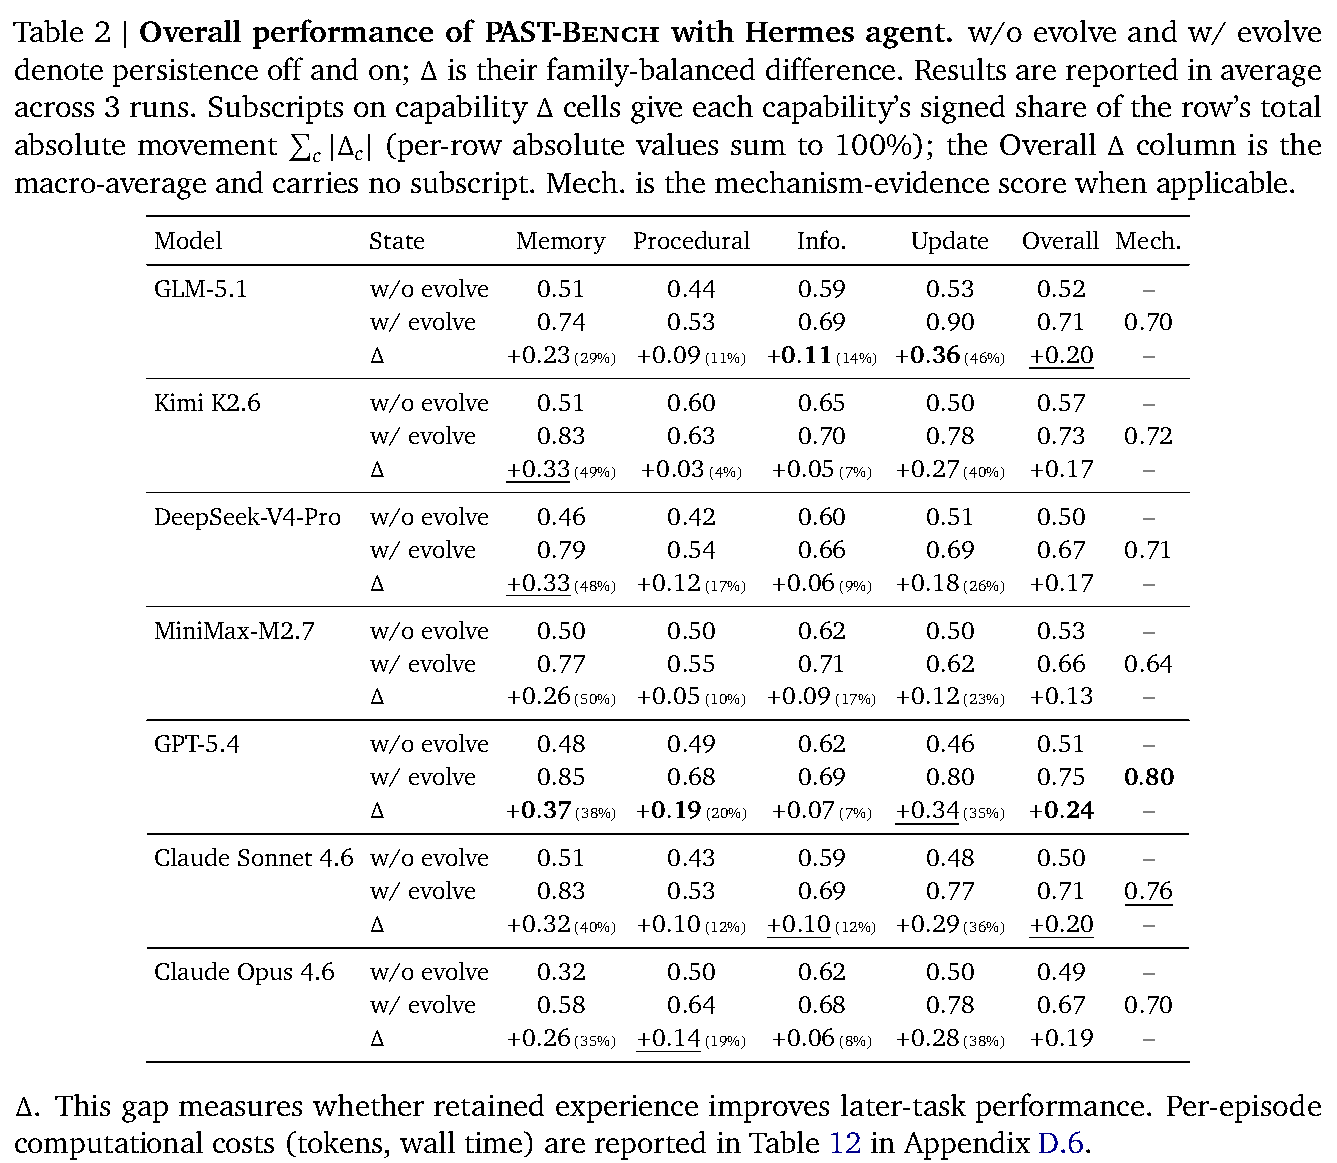
Table 2에서 Hermes를 고정한 일곱 model은 모두 retained experience에 대해 양의 Overall Δ를 보이며, MiniMax-M2.7은 +0.13, GPT-5.4는 +0.24를 기록한다. 이 범위는 해당 Hermes 고정, family-balanced 조건의 비교 결과이며, capability별 이동 비중은 GPT-5.4에서 Memory 38%, Update 35%, GLM-5.1에서 Update 46%, Kimi K2.6에서 Memory 49%로 달랐다.
이 표는 Hermes framework를 고정한 일곱 base model의 persistence-off 점수, persistence-on 점수, capability별 Δ, Overall Δ, Mech를 비교한다. 모든 model의 Overall Δ는 양수이지만 capability Δ 행의 괄호 안 비율은 각 행의 절대 이동량 가운데 capability가 차지하는 비율이어서 이득 집중 영역은 model마다 다르다.
MiniMax-M2.7을 고정한 Table 3에서 Hermes+는 보고된 framework 중 Overall Δ +0.15와 Mech 0.73을 기록한다. Hermes와 nanobot은 모두 Overall Δ +0.13이지만 Mech는 각각 0.64와 0.57이며, 저자들은 nanobot의 이득이 Update에 집중되고 일관된 write-then-read trace가 부족한 사례로 해석한다.
이 표는 MiniMax-M2.7을 고정하고 nanobot, ZeroClaw, Agent-Zero, Hermes, Hermes+의 capability별 persistence gap, Overall Δ, Mech를 비교한다. Hermes와 nanobot은 같은 Overall Δ +0.13이지만 Mech는 각각 0.64와 0.57이며, Hermes+는 Overall Δ +0.15와 Mech 0.73을 기록한다.
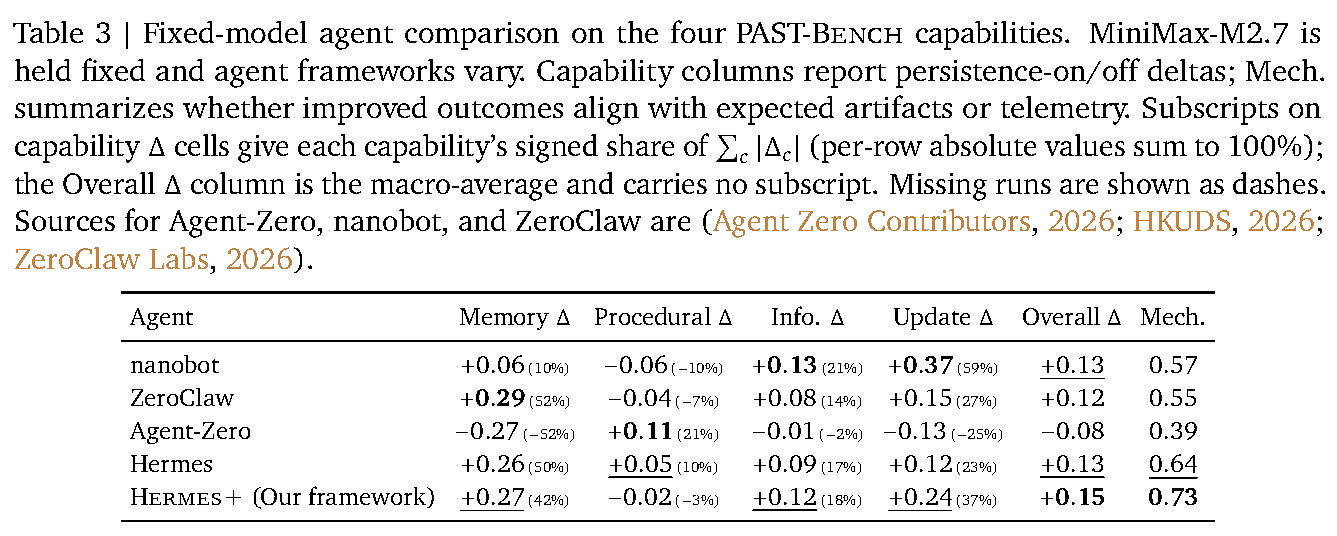
Agent-Zero는 Overall Δ −0.08, Mech 0.39을 기록했고, ZeroClaw는 Overall Δ +0.12, Mech 0.55를 기록했다. Appendix C의 Codex CLI와 Claude Code 일반 목적 agent 평가에서도 MiniMax-M2.7 고정 시 네 capability 모두 양의 matched gap이 보고됐으며, Overall 값은 각각 persistence-on score 0.63과 Δ +0.10, 0.70과 Δ +0.16이다.
4.3. Diagnosis-Driven Design: Hermes+
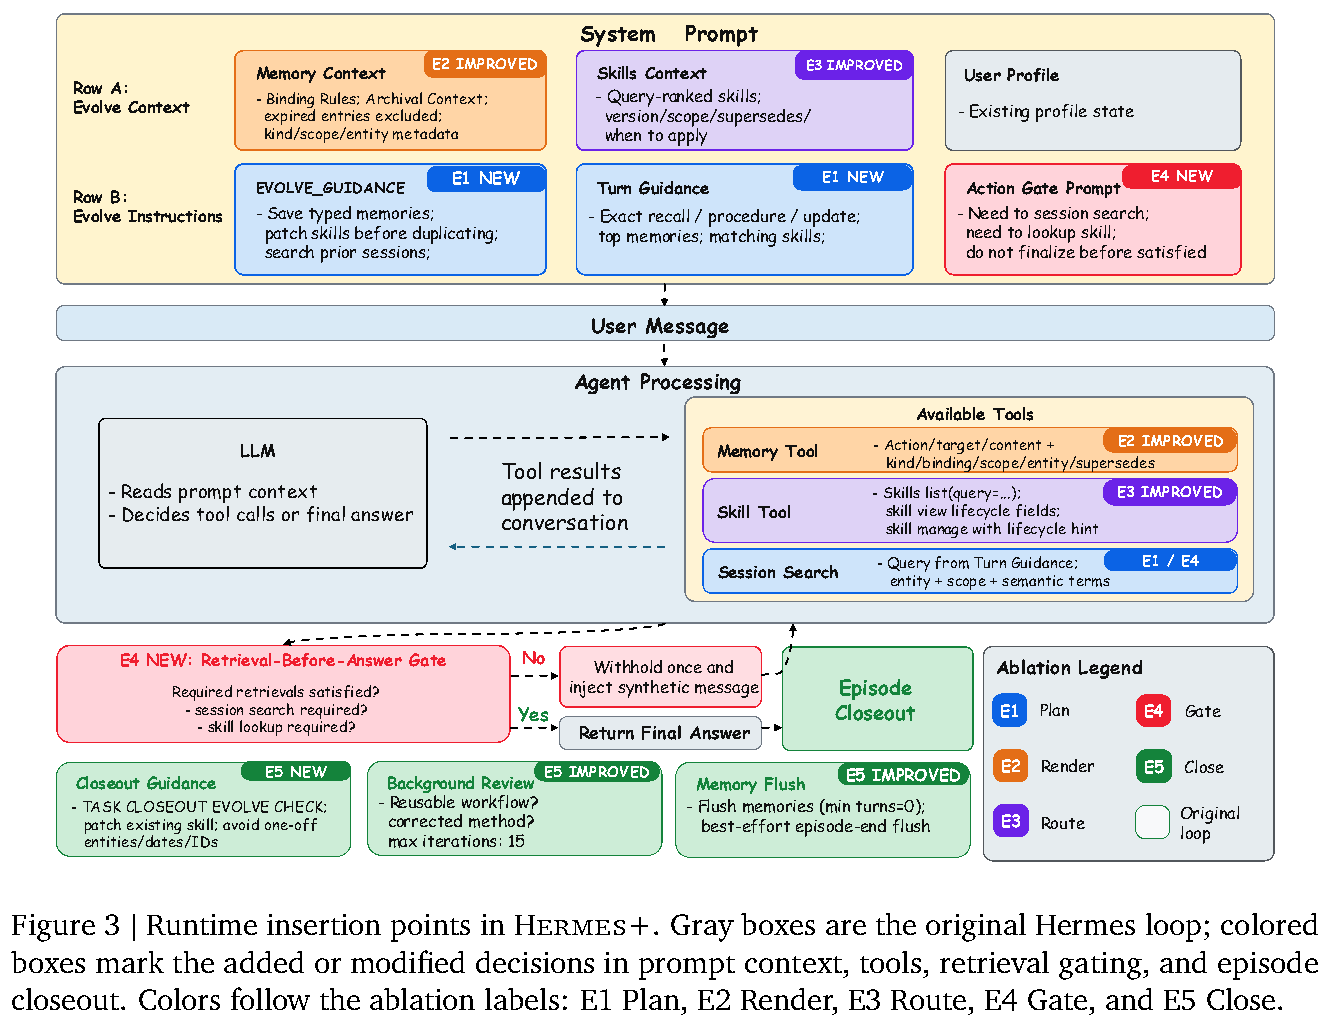
Hermes+는 trace에서 찾은 다섯 실패 지점에 독립 개입을 대응한다. E1 Plan은 위험하거나 recall 의존적인 행동을 계획하기 전에 저장 상태를 확인하고, E2 Render는 type, scope, entity, 현재값, superseded value, expiry를 갖는 typed binding에서 현재 유효한 memory만 보이게 하며, E3 Route는 적용 조건과 순서가 있는 query-ranked skill을 저장하고 patch한다.
E4 Gate는 이전 상태에 의존하는 답변이나 비가역 행동 전에 필요한 retrieval이 없으면 초안을 보류하고 관련 채널 검색을 요구한다. E5 Close는 episode 종료 때 최종 binding 또는 갱신 rule을 권위 있는 artifact로 동기 flush해 다음 fresh session에 전달하며, Figure 3은 이 개입들이 prompt context, tool, retrieval gate, closeout에 삽입되는 위치와 순서를 보여 준다.
이 그림은 원래 Hermes loop에 E1 Plan, E2 Render, E3 Route, E4 Gate, E5 Close를 삽입한 위치와 처리 순서를 나타낸다. prompt context와 available tools를 거친 뒤 E4가 필요한 retrieval 충족 여부를 검사하고, 최종 답변 뒤 E5 closeout과 memory flush가 persistent state를 다음 episode로 넘긴다.
4.4. Mechanism Evidence and Generalization
Table 4의 MiniMax-M2.7, 고정 task set 및 grader 조건 단일 개입 절제에서 E2의 Memory persistence-on score는 0.80으로 가장 높다. E3는 단일 개입 가운데 Procedural Δ +0.10, E4는 Info. Δ +0.17, E5는 Update Δ +0.16으로 각 대상 capability에서 가장 큰 Δ를 보이며, 모든 개입을 켠 Hermes+는 Update score 0.74와 Update Δ +0.24, Procedural Δ −0.02를 기록한다.
MiniMax-M2.7의 세 실행에서 Hermes와 Hermes+의 Overall Δ는 각각 0.13 ± 0.04, 0.15 ± 0.06이다. 저자들은 평균 차이 +0.02가 실행 간 변동보다 작으므로 안정적인 종합 이득으로 해석하지 않으며, Update Δ는 +0.12에서 +0.24로 이동했지만 그 표준편차도 0.01에서 0.09로 증가했다고 보고한다.
이 표는 MiniMax-M2.7, 고정 task set, 고정 grader 조건에서 Base Hermes에 E1부터 E5를 각각 하나씩 더한 비누적 절제와 모든 개입을 켠 Hermes+를 비교한다. E3, E4, E5는 각각 Procedural, Info., Update에서 단일 개입 가운데 가장 큰 Δ를 보이며, 전체 Hermes+ 행은 Update Δ +0.24와 Procedural Δ −0.02를 함께 기록한다.
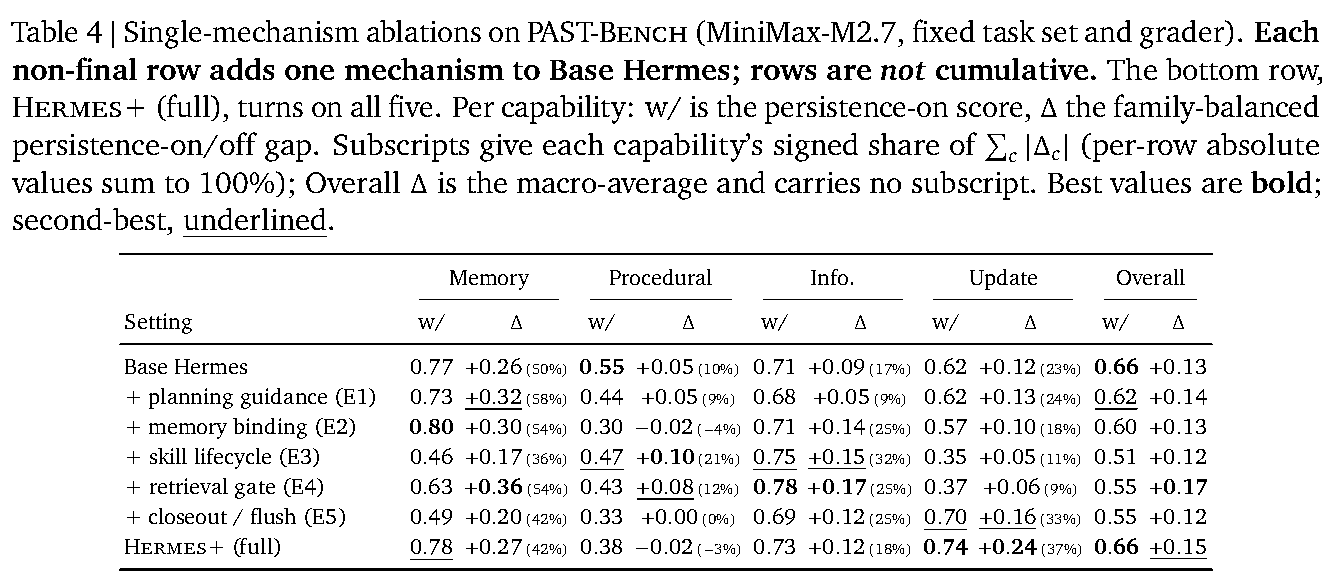
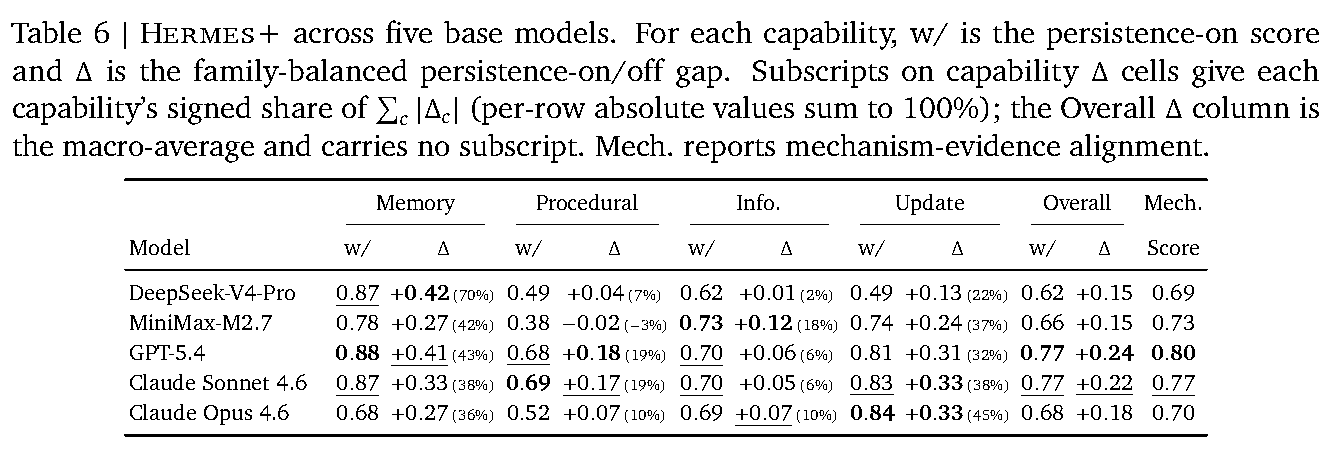
Table 6의 transfer에서 Hermes+는 MiniMax-M2.7에서 +0.15, Claude Sonnet 4.6에서 +0.22를 기록해 각 Hermes 기준 +0.13, +0.20보다 높고, GPT-5.4에서는 Hermes와 같은 +0.24를 기록한다. DeepSeek-V4-Pro는 Hermes의 +0.17에서 Hermes+의 +0.15로, Claude Opus 4.6은 +0.19에서 +0.18로 낮아져, 저자들은 전이 효과가 균일하지 않다고 결론짓는다.
6. Future Work
향후 연구로는 synthetic이고 독립적으로 평가된 현재 family를 사람 작성 또는 실제 상호작용 유래 scenario, 더 긴 sequence, family 간 transfer로 확장하는 과제가 제시된다. 저자들은 artifact 삭제, 교체, 손상 같은 counterfactual intervention을 통해 경로 근거를 인과적 필요성에 가깝게 검증하고, memory, skill, structured artifact, revised policy처럼 서로 다른 유효 경로를 인정하는 평가가 필요하다고 제안한다.
이 표는 MiniMax-M2.7에서 조정한 Hermes+를 다섯 base model에 적용했을 때 capability별 persistence-on score, matched Δ, Mech를 제시한다. GPT-5.4 조합은 Overall Δ +0.24와 Mech 0.80을 기록하며, model별 Δ의 크기와 capability 분포가 달라 Hermes+의 전이 효과가 균일하지 않음을 보여 준다.
후속 benchmark는 tool-use strategy 획득, 장기 계획 수정, multi-agent 경험 조정, 저장과 검색과 검증과 갱신 mechanism 자체의 개선까지 capability 범위를 넓힐 수 있다. 저자들은 structured memory rendering과 procedural skill routing의 상호작용을 바탕으로, 어떤 경험을 어느 persistence surface에 둘지 동적으로 선택하는 mechanism을 accuracy, latency, token cost 제약 아래 연구할 필요가 있다고 본다.
부록
- 부록 A. PAST-Bench Benchmark Details는 네 capability의 family taxonomy, synthetic task 생성과 품질 관리 절차, trace 기반 mechanism 사례를 설명한다.
- 부록 B. Metric Definitions and Aggregation은 episode task score, family 및 capability 집계, Mechanism-Evidence Score의 구성 요소, LLM judge 인간 검증과 민감도 분석을 정의한다.
- 부록 C. Agent Scope and Framework Details는 개인 agent framework adapter의 범위와 제약, 일반 목적 agent 평가, 서로 다른 persistence interface에서의 protocol 적용 조건을 다룬다.
- 부록 D. Additional Experimental Results는 mechanism ablation heatmap, procedural routing trace, agent-level attribution frontier, family별 paired result, 실행 분산, 계산 비용을 제시한다.
- 부록 E. Reproducibility Details는 fresh-session context와 persistence 처리, model inference 설정, agent별 종료 한계와 retry policy를 기록한다.
- 부록 F. Extended Related Work는 within-task trajectory diagnosis와 cross-episode persistence attribution의 차이, memory, skill, architecture 평가와 PAST-Bench의 평가 범위를 비교한다.
짧은 생각
이 논문의 설득력은 persistence-on 점수 상승을 곧바로 self-improvement로 귀속하지 않고, matched ablation과 artifact, telemetry 기반 Mech를 병렬로 둔 데 있다. Hermes와 nanobot이 MiniMax-M2.7 고정 조건에서 같은 Overall Δ +0.13을 보이면서 Mech가 0.64와 0.57로 갈리는 관찰은 endpoint 성능만으로 저장과 검색의 질을 판단하기 어렵다는 점을 구체화한다.
다만 Mech는 기대한 경로와의 정합성을 측정하며 인과적 필요성을 증명하지는 않는다. 실제 agent 환경에서 의미상 같은 경험을 memory와 skill 중 어디에 저장해도 성공할 수 있으므로, artifact를 삭제하거나 교체한 뒤 행동 변화를 측정하고 그때도 Mech 순위와 Hermes+의 Update 결과가 유지되는지 확인해야 이 진단 체계의 강도를 더 분명히 판단할 수 있다.